Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Ruby on RAG Workshop

Ruby on RAG Workshop

This session provides an introduction to Natural Language Processing (NLP), covering the evolution from traditional text processing methods to modern language representation techniques. Participants will explore document preprocessing, Word2Vec, BERT, and Retrieval-Augmented Generation (RAG), gaining insight into the foundations behind today's AI-powered language applications.

• Event Page: https://rubytaiwan.kktix.cc/events/rubyonrag2606

• Ruby Project Demo by Kasa:  https://github.com/rubytaiwan/ruby-on-rag-workshop

Avatar for Zong Sheng Yang

Zong Sheng Yang

June 11, 2026

More Decks by Zong Sheng Yang

Other Decks in Education

Transcript

  1. 1

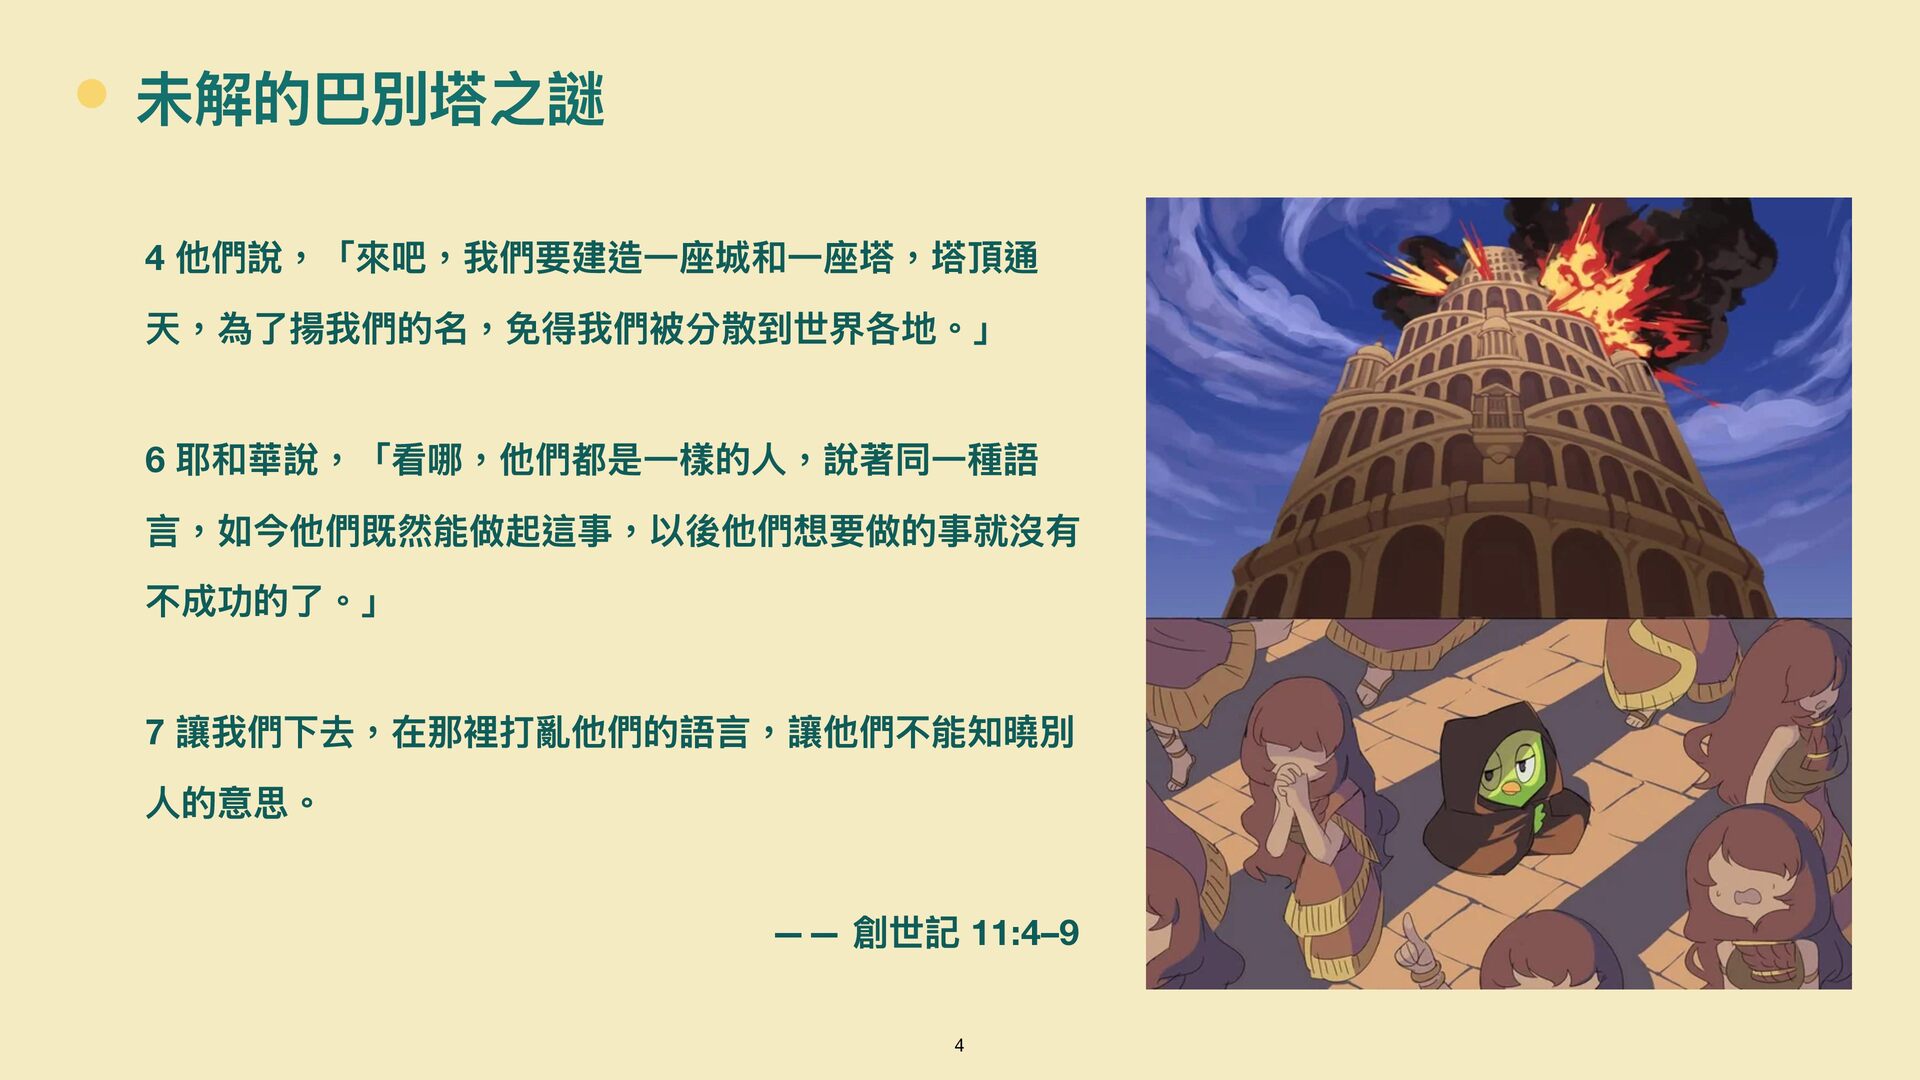
  2. 未解的巴別塔之謎 4 他們說,「來吧,我們要建造 一 座城和 一 座塔,塔頂通 天,為了揚我們的名,免得我們被分散到世界各地。」 6 耶和華說,「看哪,他們都是

    一 樣的 人 ,說著同 一 種語 言 ,如今他們既然能做起這事,以後他們想要做的事就沒有 不成功的了。」 7 讓我們下去,在那裡打亂他們的語 言 ,讓他們不能知曉別 人 的意思。 —— 創世記 11:4–9 4
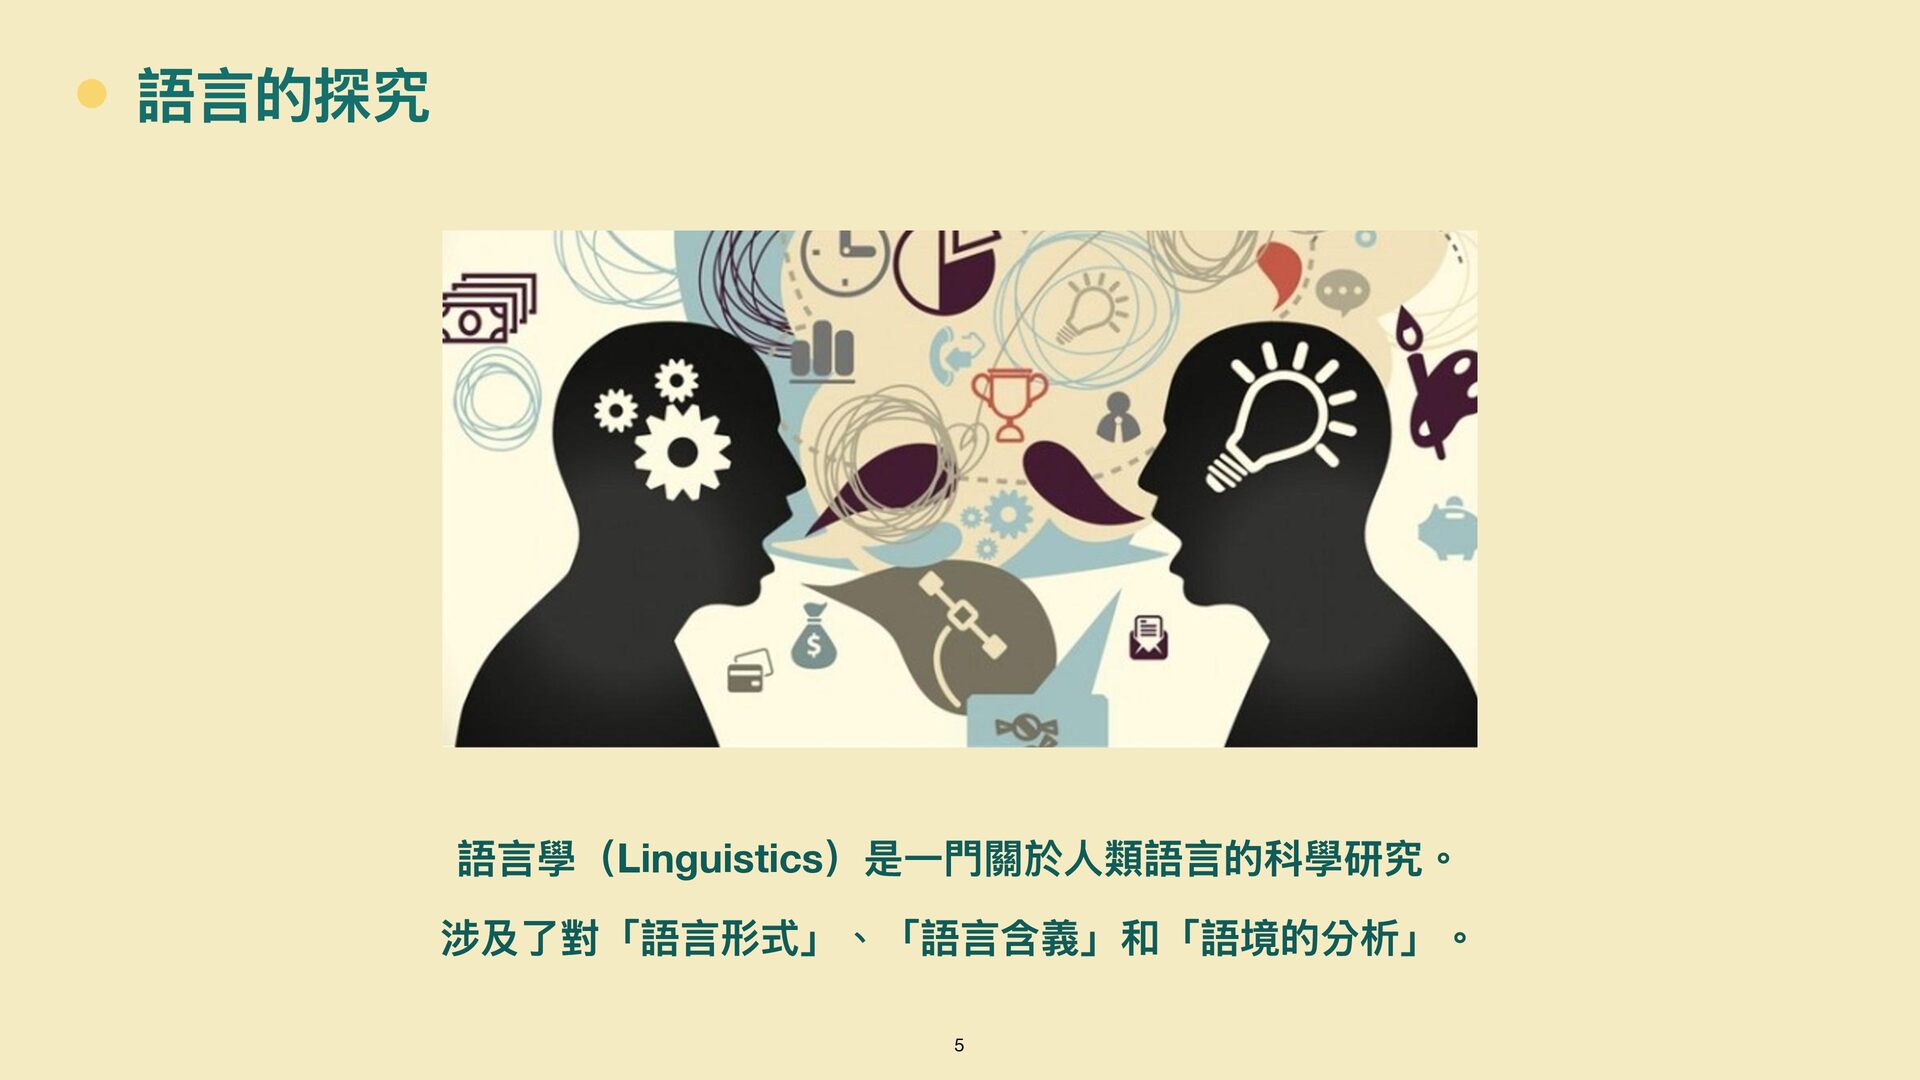
  3. 語 言 的探究 語 言 學(Linguistics)是 一門 關於 人 類語

    言 的科學研究。 涉及了對「語 言 形式」、「語 言 含義」和「語境的分析」。 5
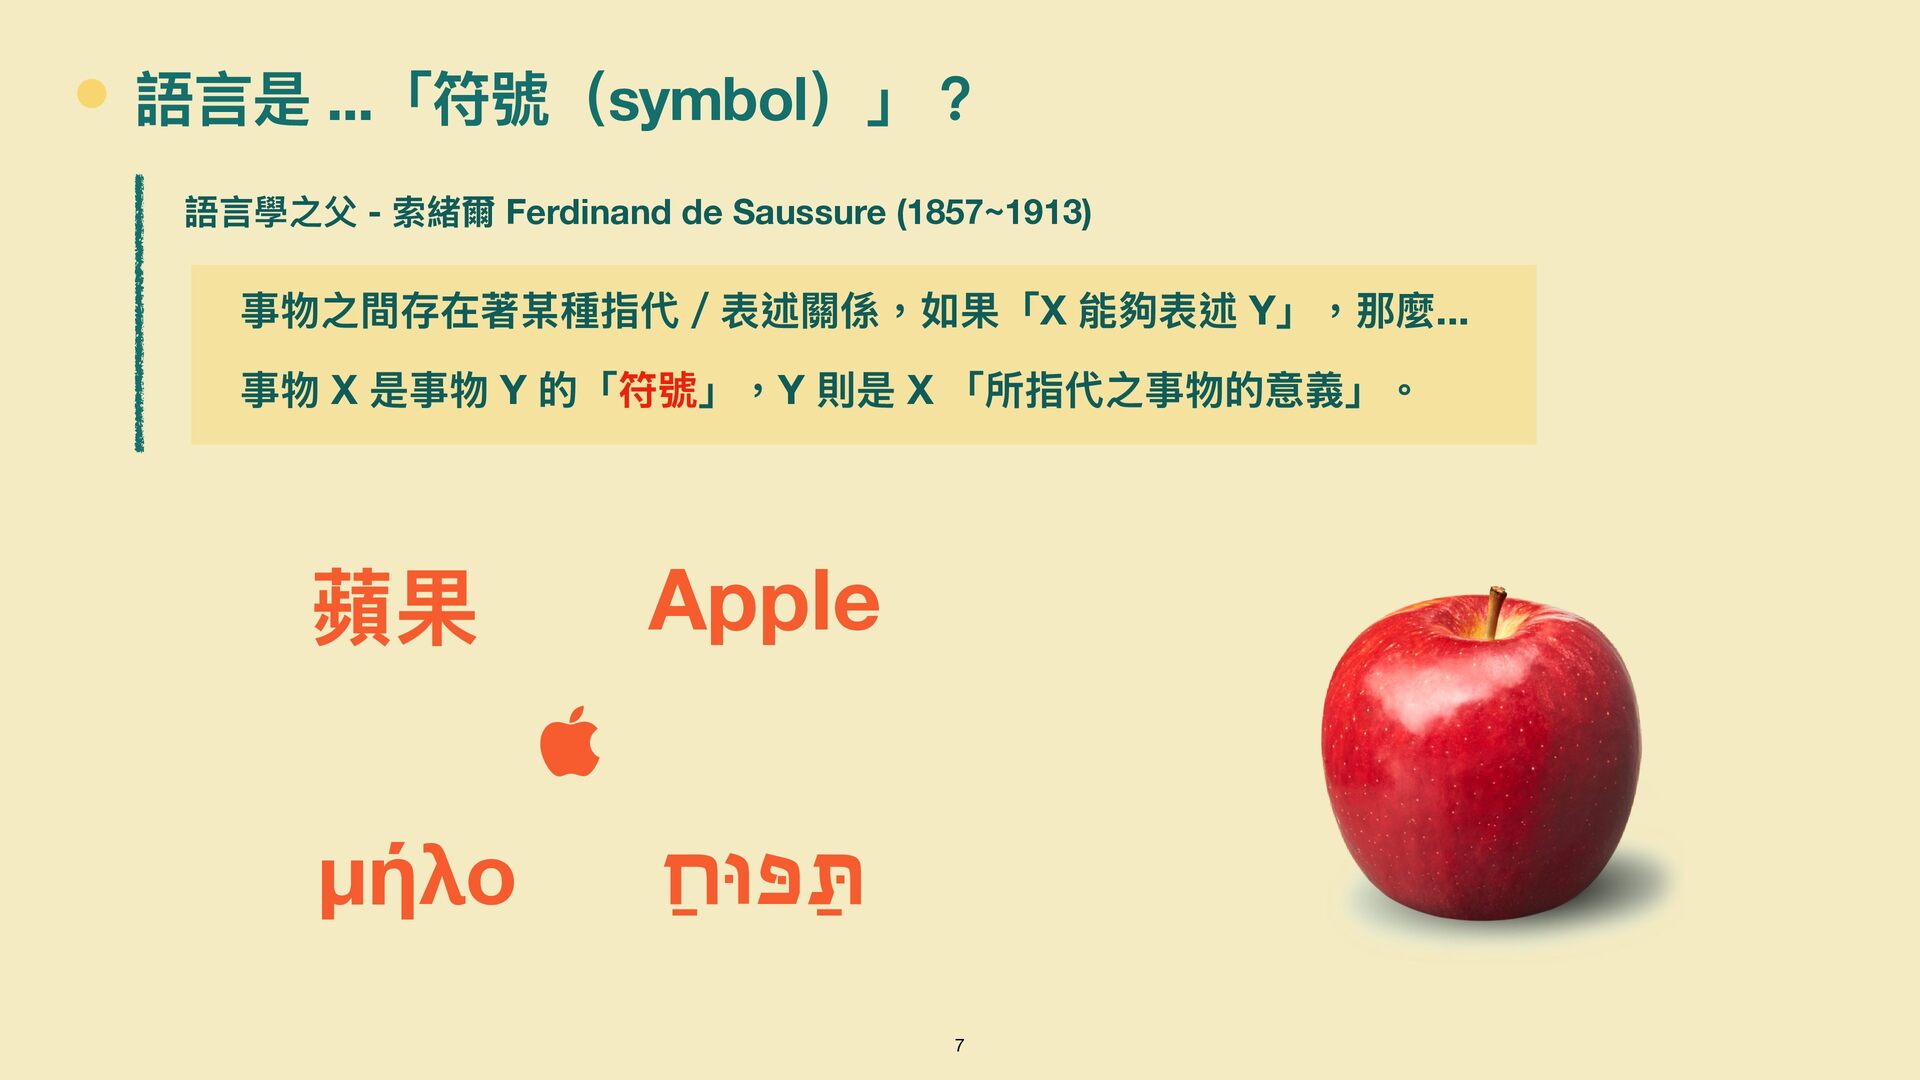
  4. 語 言 是 ...「符號(symbol)」? 蘋果 Apple  μήλο ַחוּפַּתּ 事物之間存在著某種指代/表述關係,如果「X

    能夠表述 Y」,那麼... 事物 X 是事物 Y 的「符號」,Y 則是 X 「所指代之事物的意義」。 語 言 學之 父 - 索緒爾 Ferdinand de Saussure (1857~1913) 7
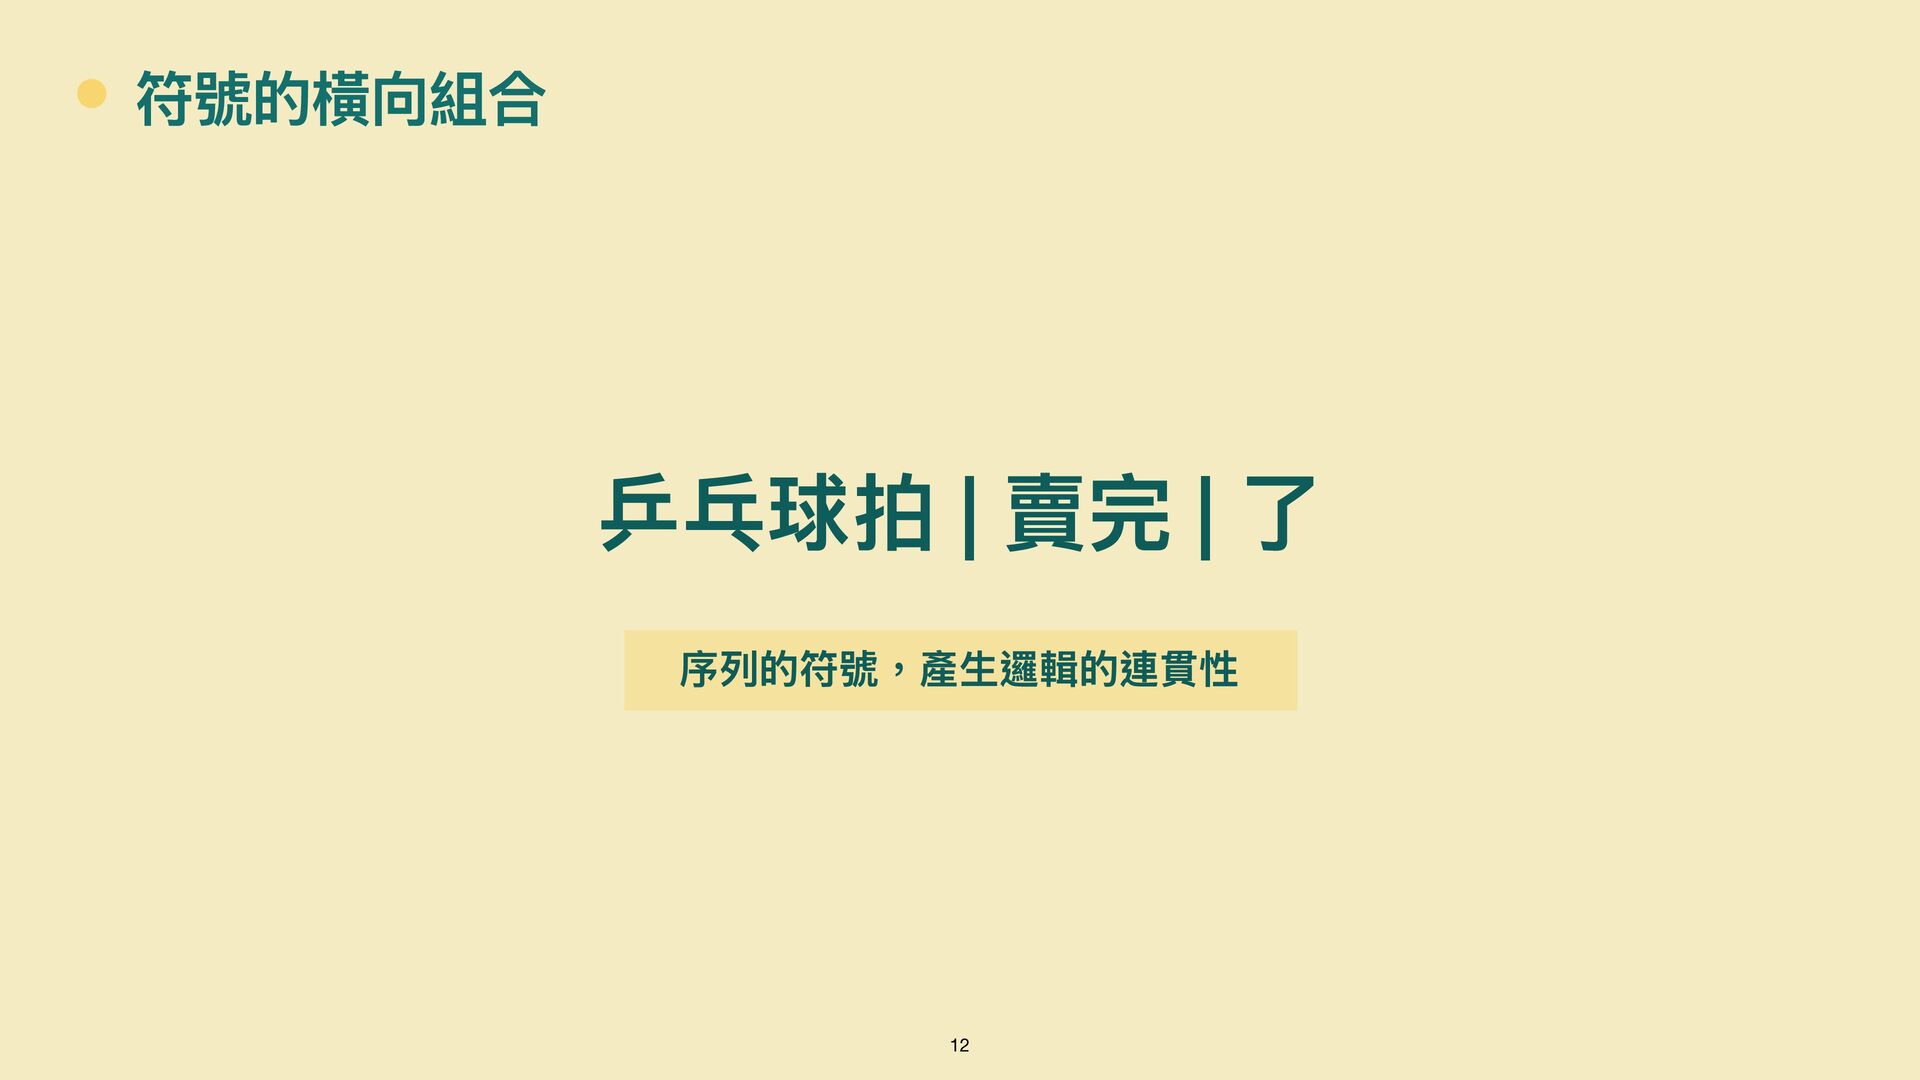
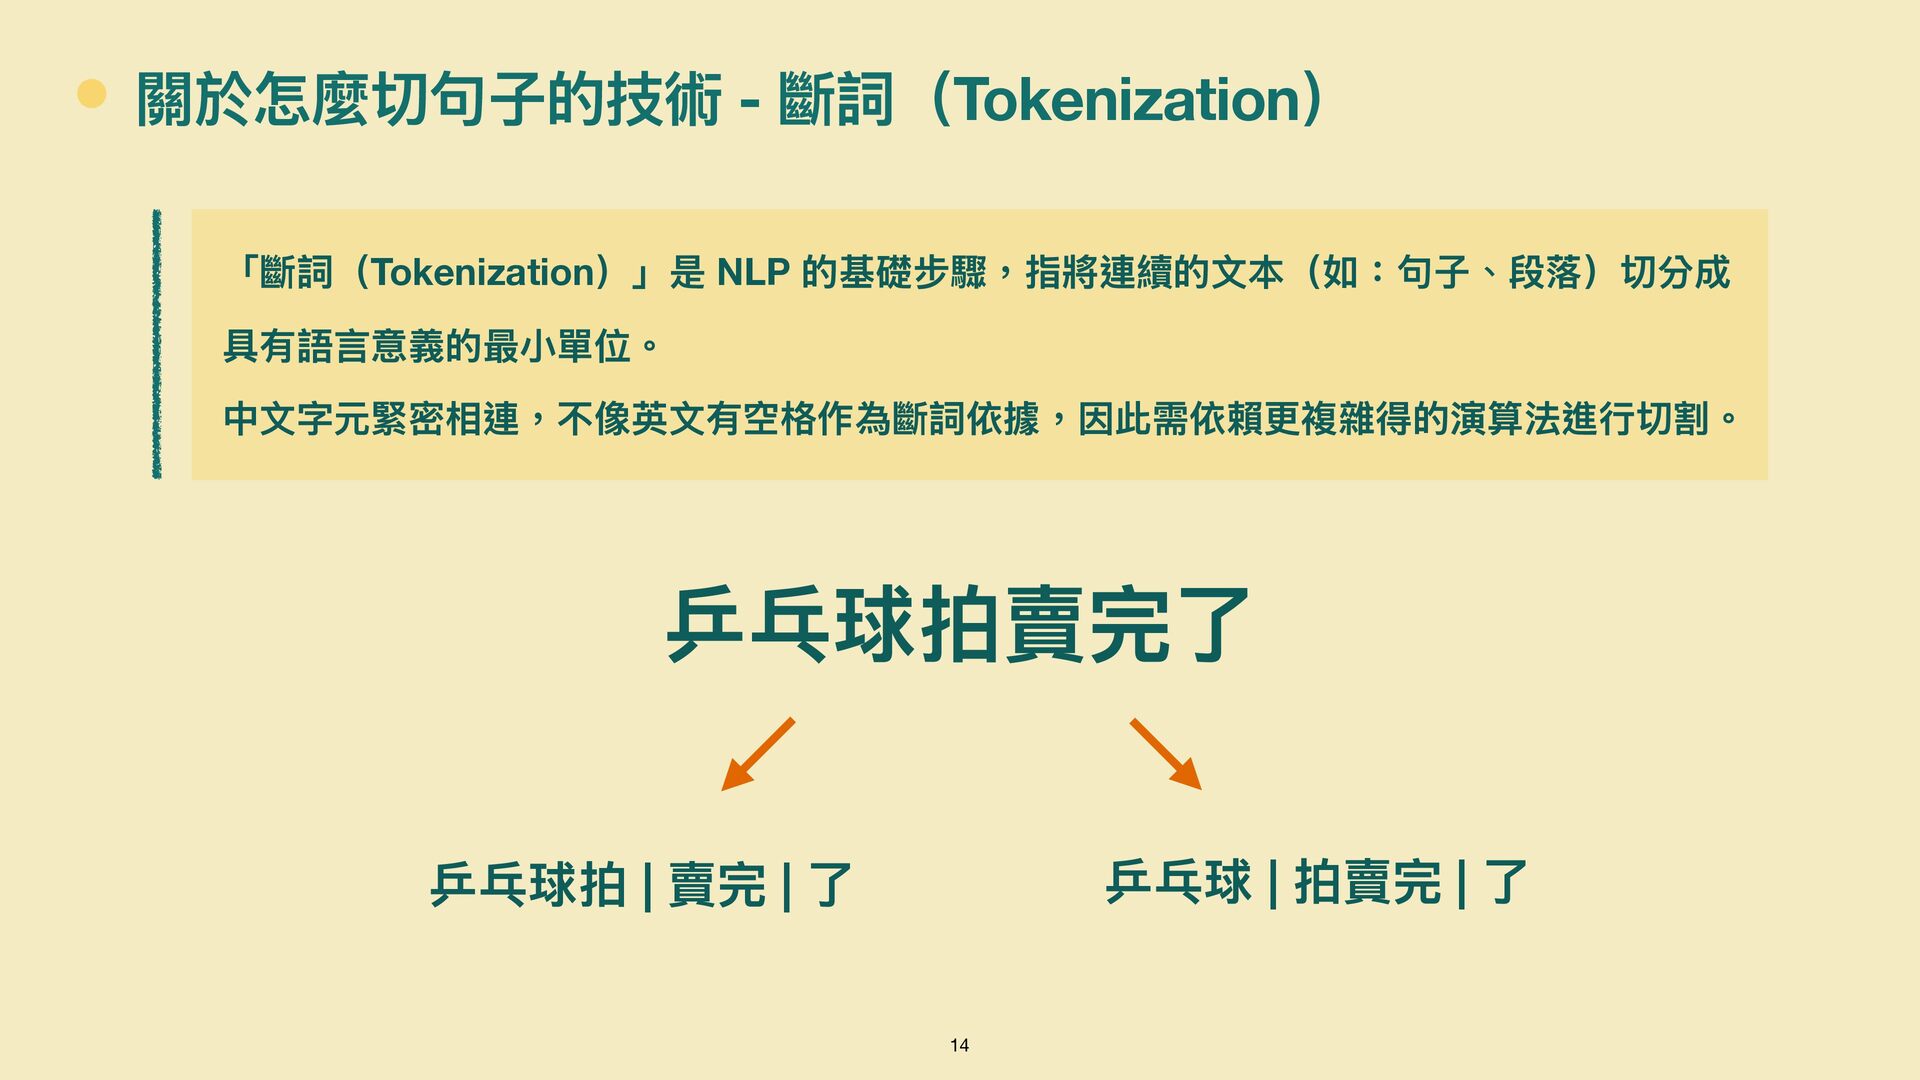
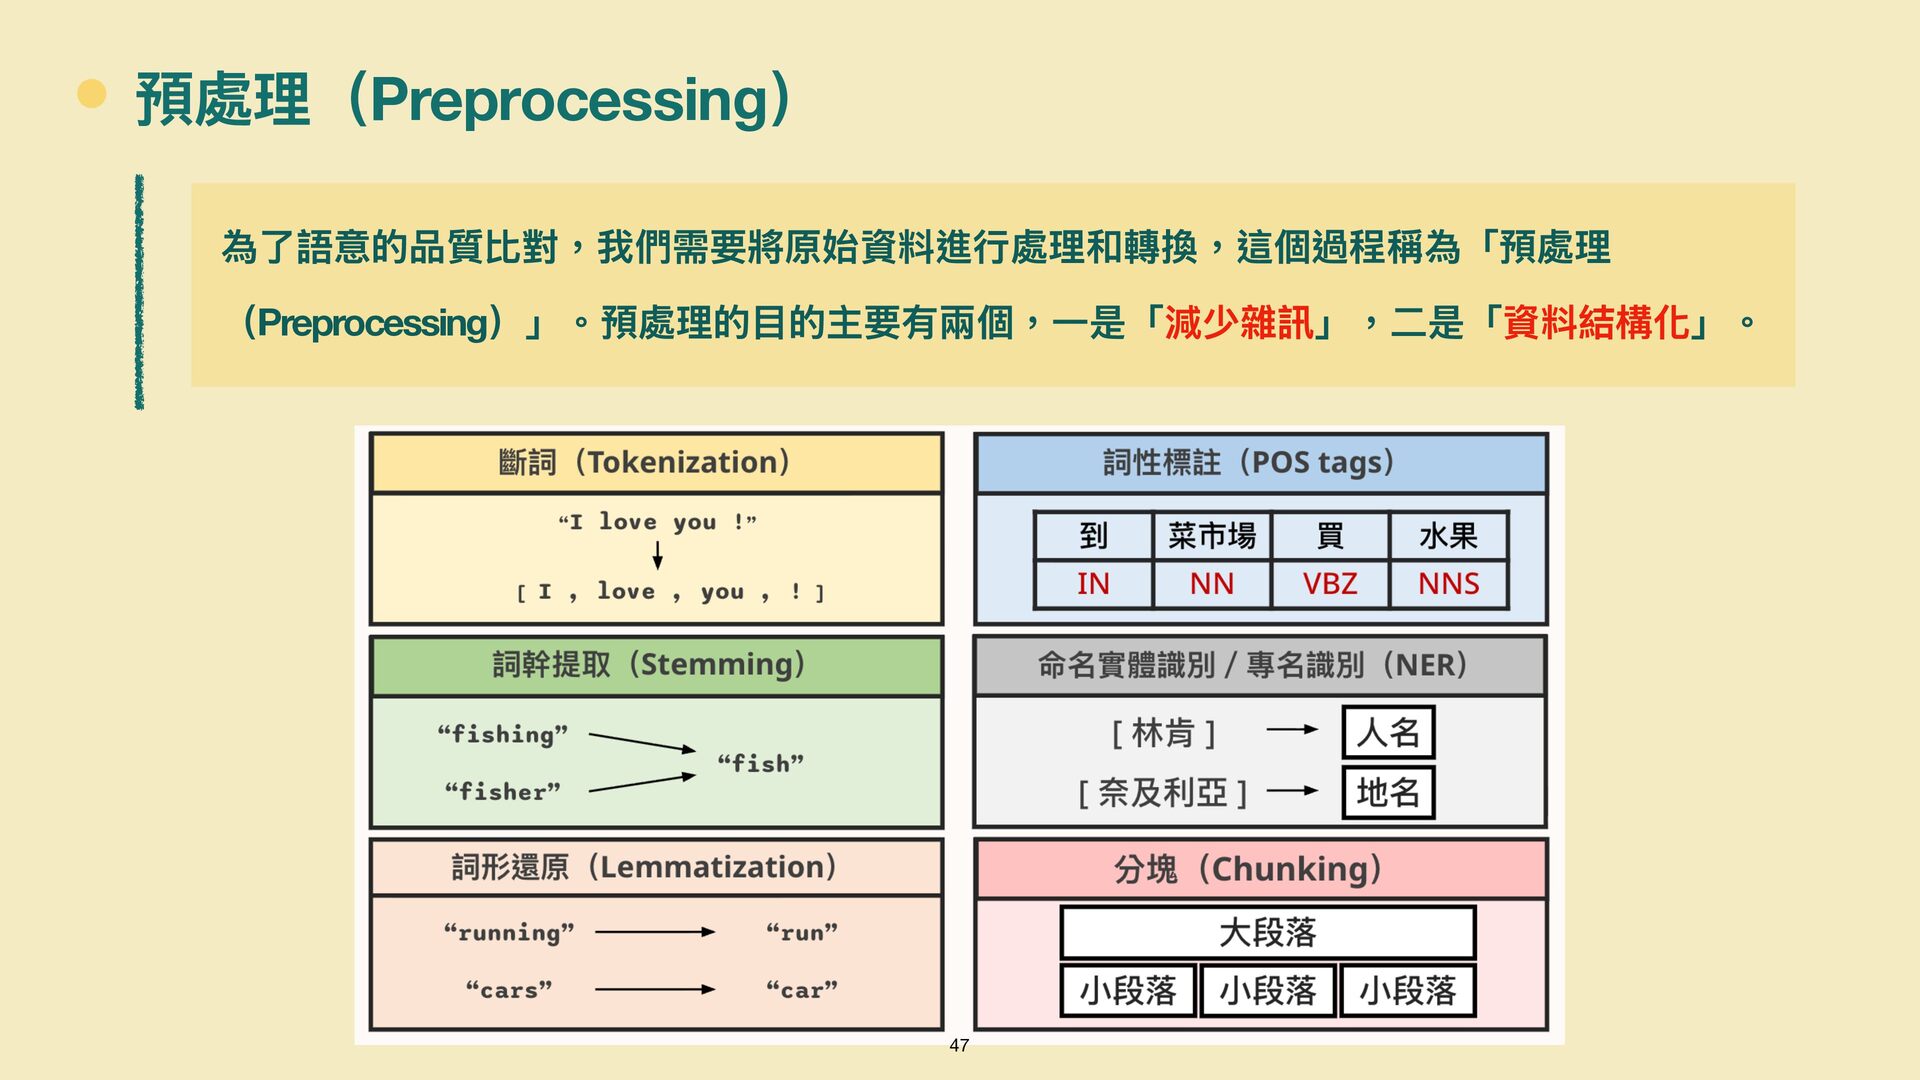
  5. 關於怎麼切句 子 的技術 - 斷詞(Tokenization) 乒乓球拍賣完了 乒乓球拍 | 賣完 |

    了 乒乓球 | 拍賣完 | 了 「斷詞(Tokenization)」是 NLP 的基礎步驟,指將連續的 文 本(如:句 子 、段落)切分成 具有語 言 意義的最 小 單位。 中 文 字元緊密相連,不像英 文 有空格作為斷詞依據,因此需依賴更複雜得的演算法進 行 切割。 14
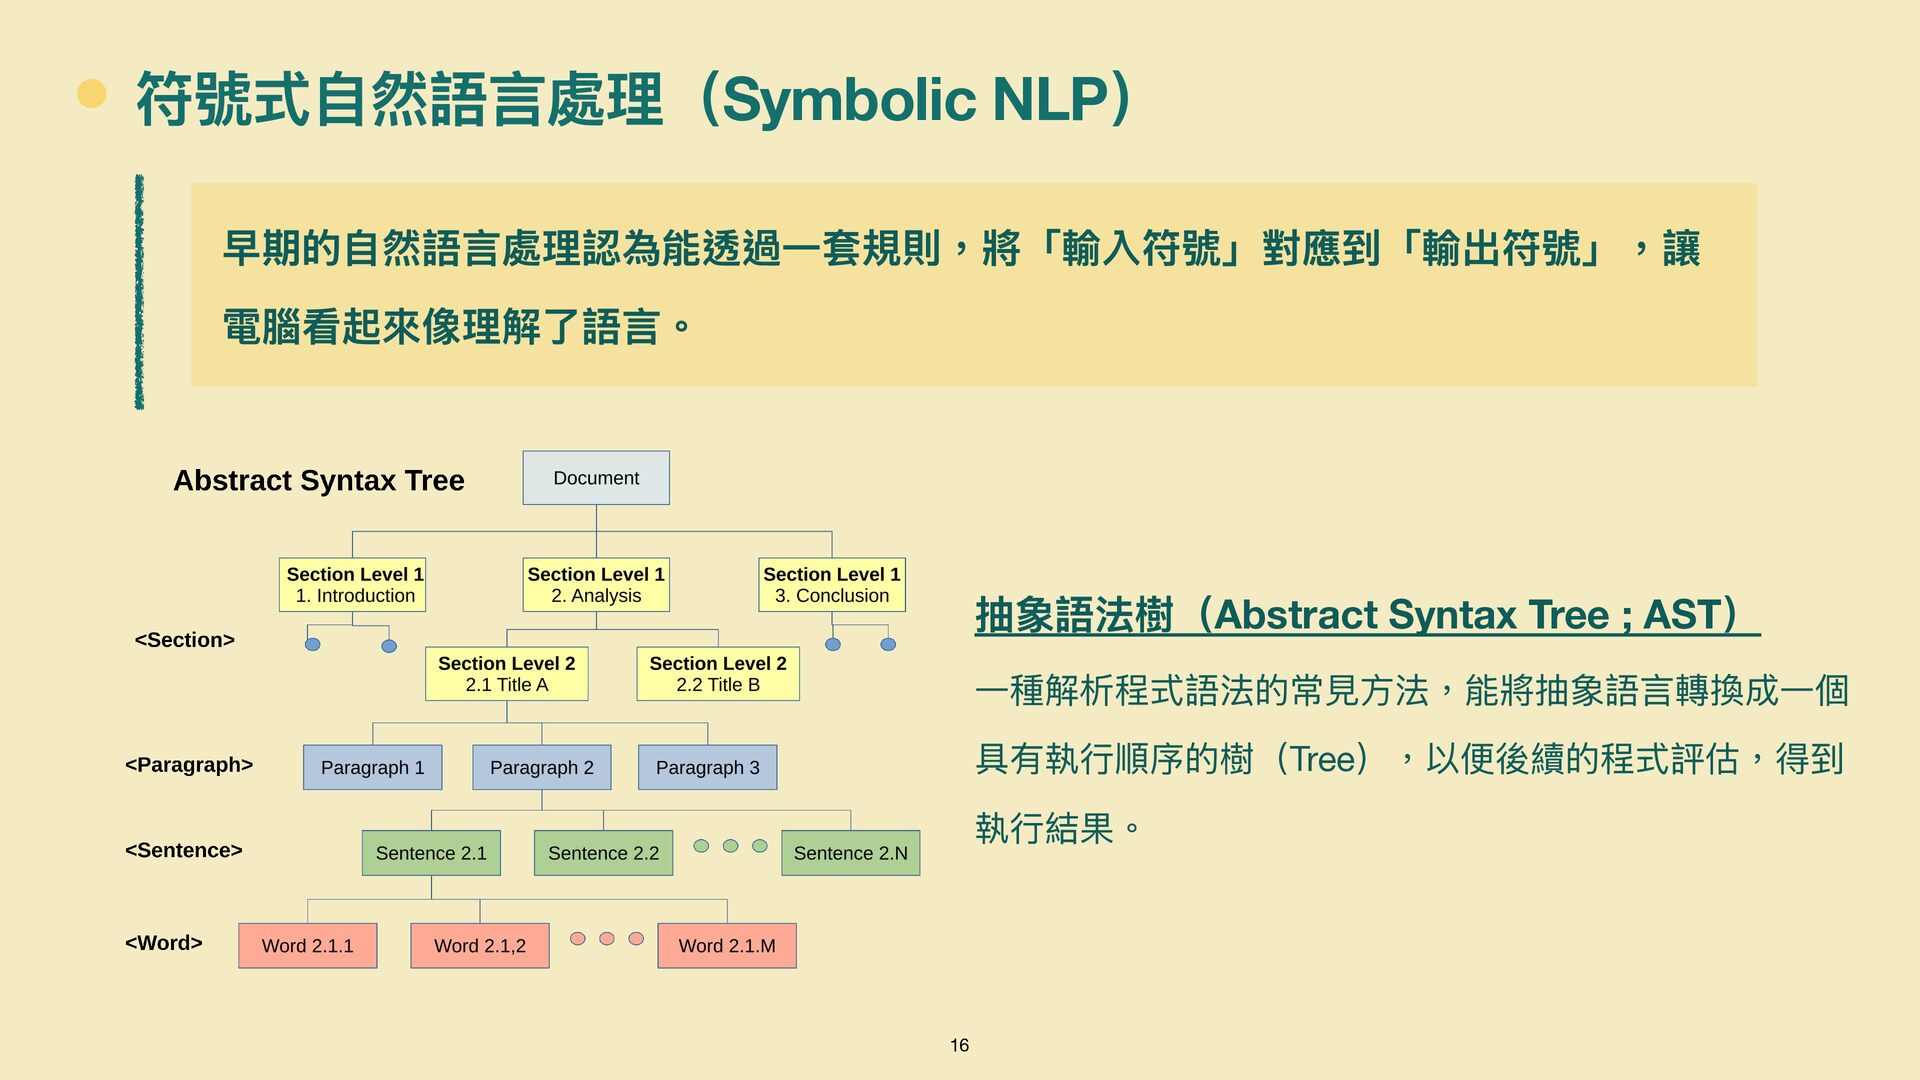
  6. 符號式 自 然語 言 處理(Symbolic NLP) 早期的 自 然語 言

    處理認為能透過 一 套規則,將「輸入符號」對應到「輸出符號」,讓 電腦看起來像理解了語 言 。 抽象語法樹(Abstract Syntax Tree ; AST) 一 種解析程式語法的常 見方 法,能將抽象語 言 轉換成 一 個 具有執 行 順序的樹(Tree),以便後續的程式評估,得到 執 行 結果。 16
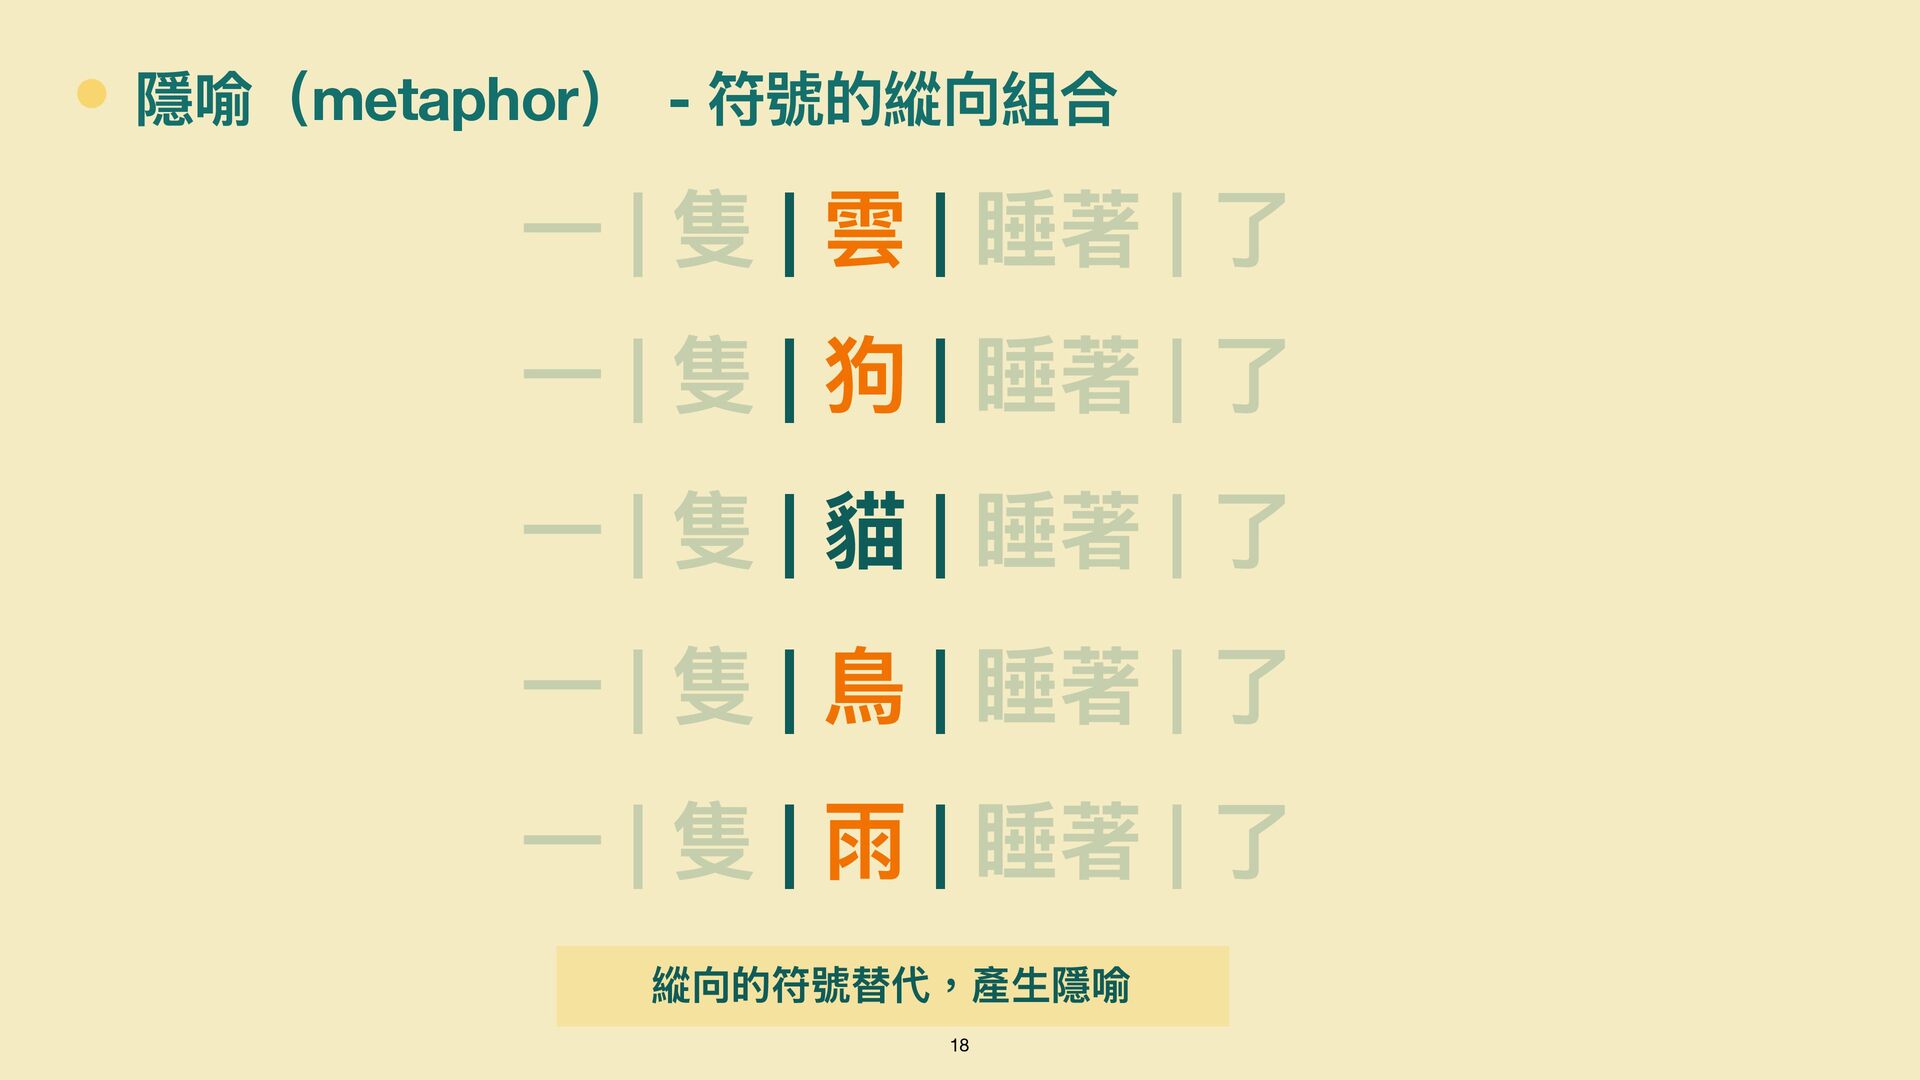
  7. 隱喻(metaphor) - 符號的縱向組合 一 | 隻 | 貓 | 睡著

    | 了 一 | 隻 | 鳥 | 睡著 | 了 一 | 隻 | 狗 | 睡著 | 了 一 | 隻 | 雨 | 睡著 | 了 一 | 隻 | 雲 | 睡著 | 了 縱向的符號替代,產 生 隱喻 18
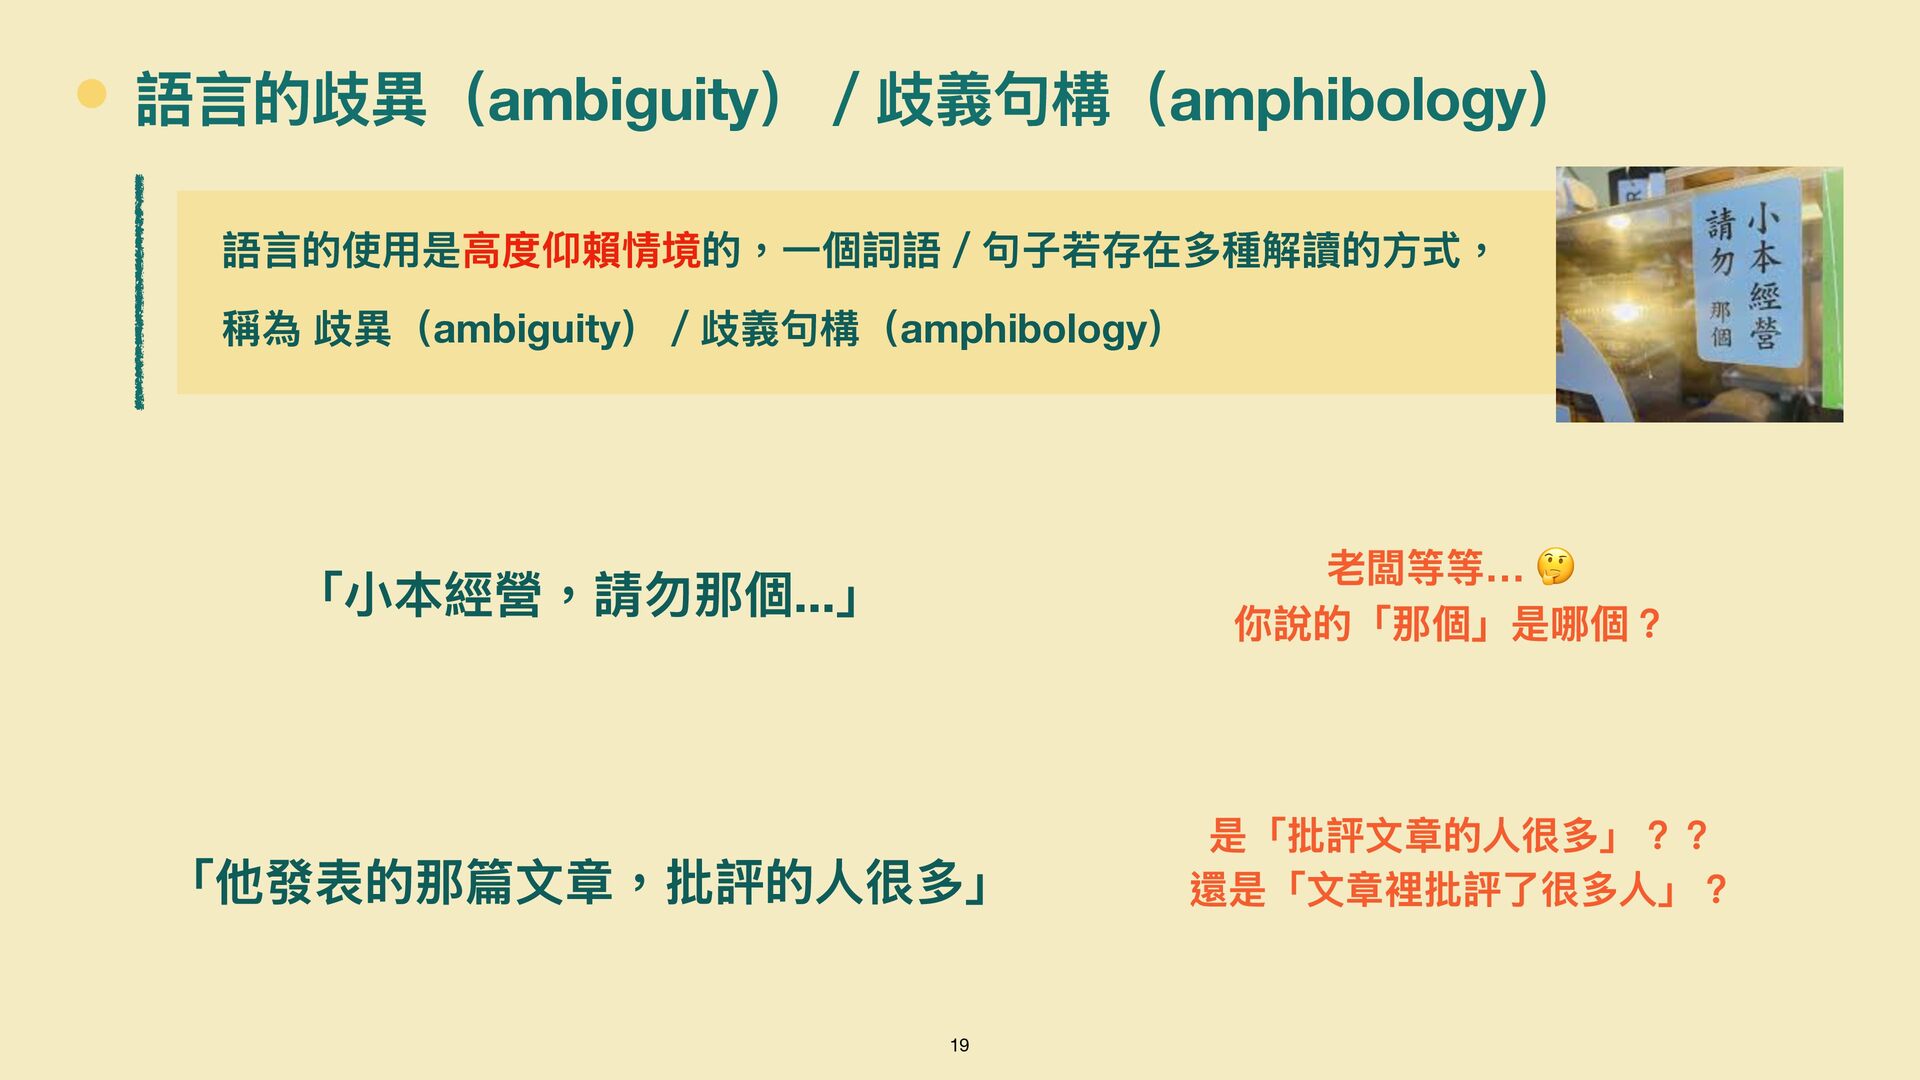
  8. 語 言 的歧異(ambiguity)/歧義句構(amphibology) 語 言 的使 用 是 高 度仰賴情境的,

    一 個詞語/句 子 若存在多種解讀的 方 式, 稱為 歧異(ambiguity)/歧義句構(amphibology) 「他發表的那篇 文 章,批評的 人 很多」 「 小 本經營,請勿那個...」 老闆等等… 🤔 你說的「那個」是哪個? 是「批評 文 章的 人 很多」?? 還是「 文 章裡批評了很多 人 」? 19
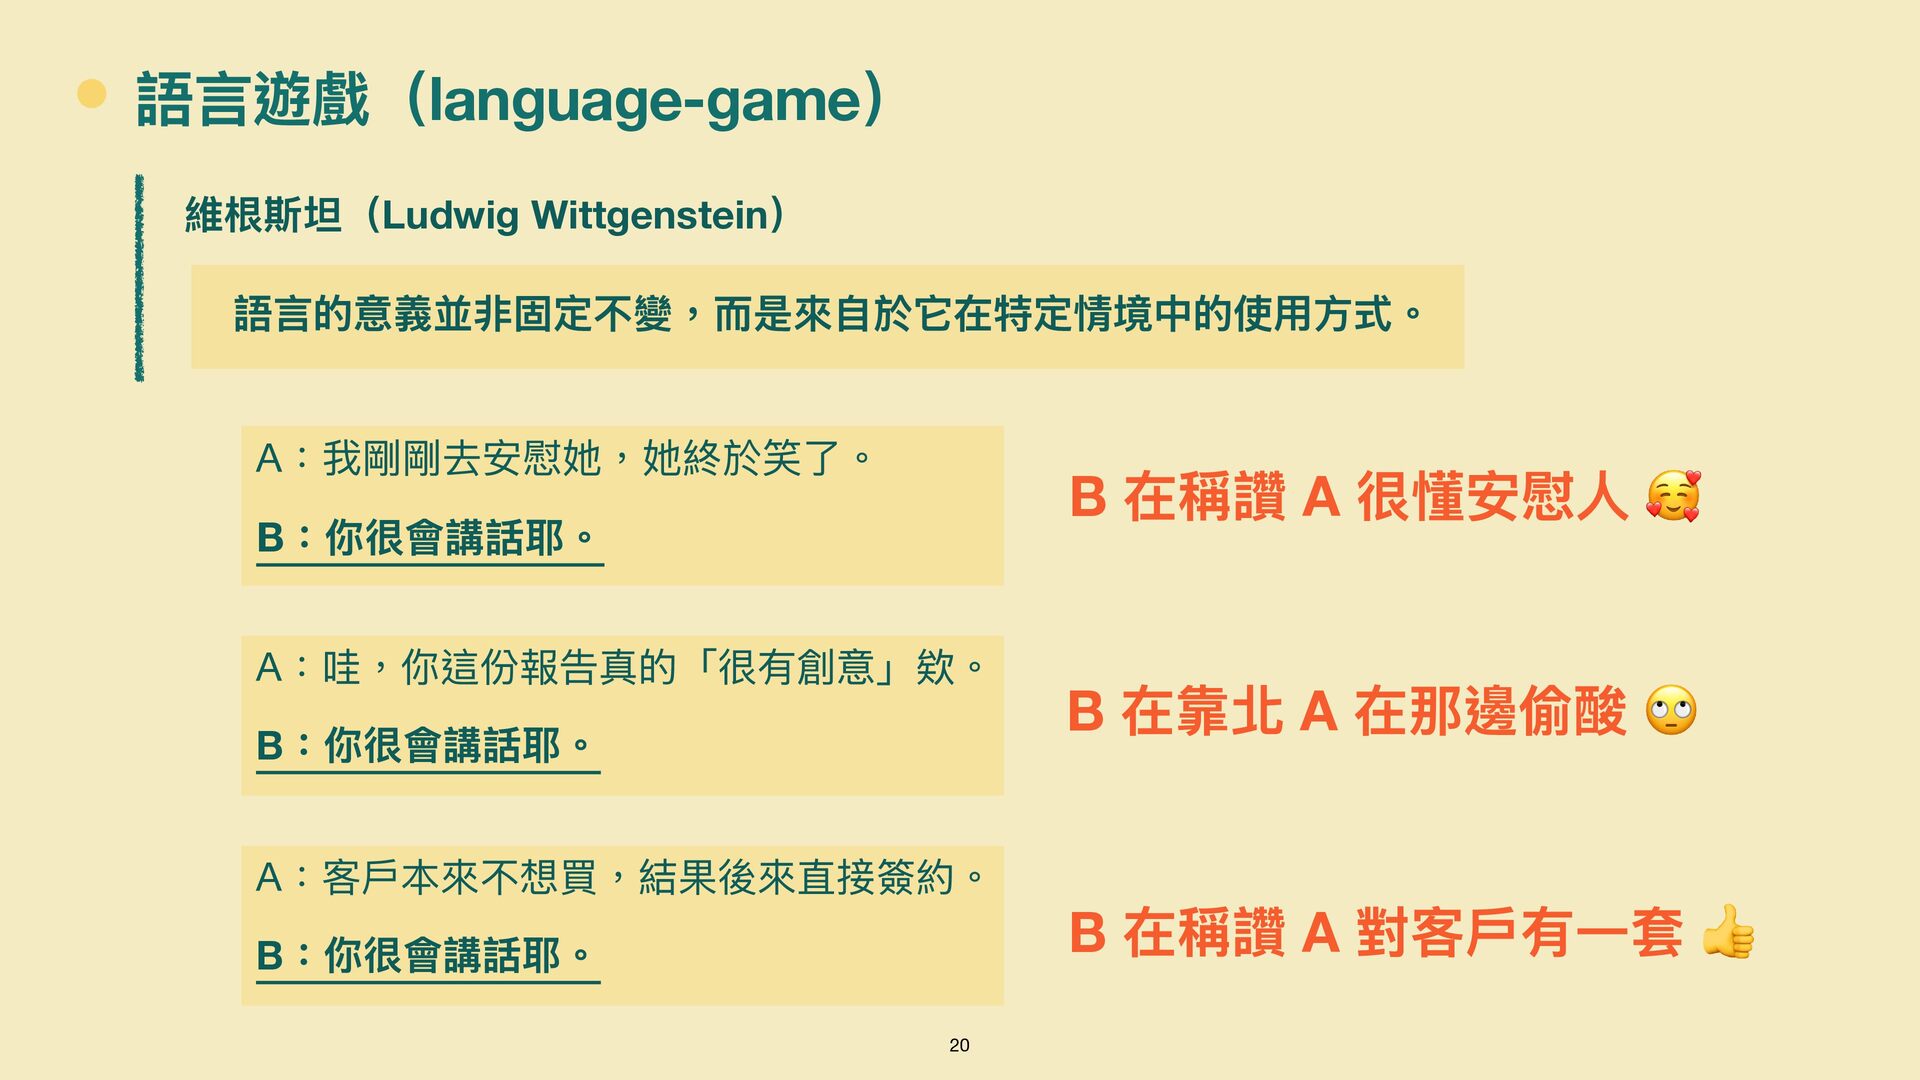
  9. 語 言 遊戲(language-game) 語 言 的意義並非固定不變, 而 是來 自 於它在特定情境中的使

    用方 式。 維根斯坦(Ludwig Wittgenstein) A:我剛剛去安慰她,她終於笑了。 B:你很會講話耶。 A:哇,你這份報告真的「很有創意」欸。 B:你很會講話耶。 A:客 戶 本來不想買,結果後來直接簽約。 B:你很會講話耶。 B 在稱讚 A 很懂安慰 人 🥰 B 在靠北 A 在那邊偷酸 🙄 B 在稱讚 A 對客 戶 有 一 套 👍 20
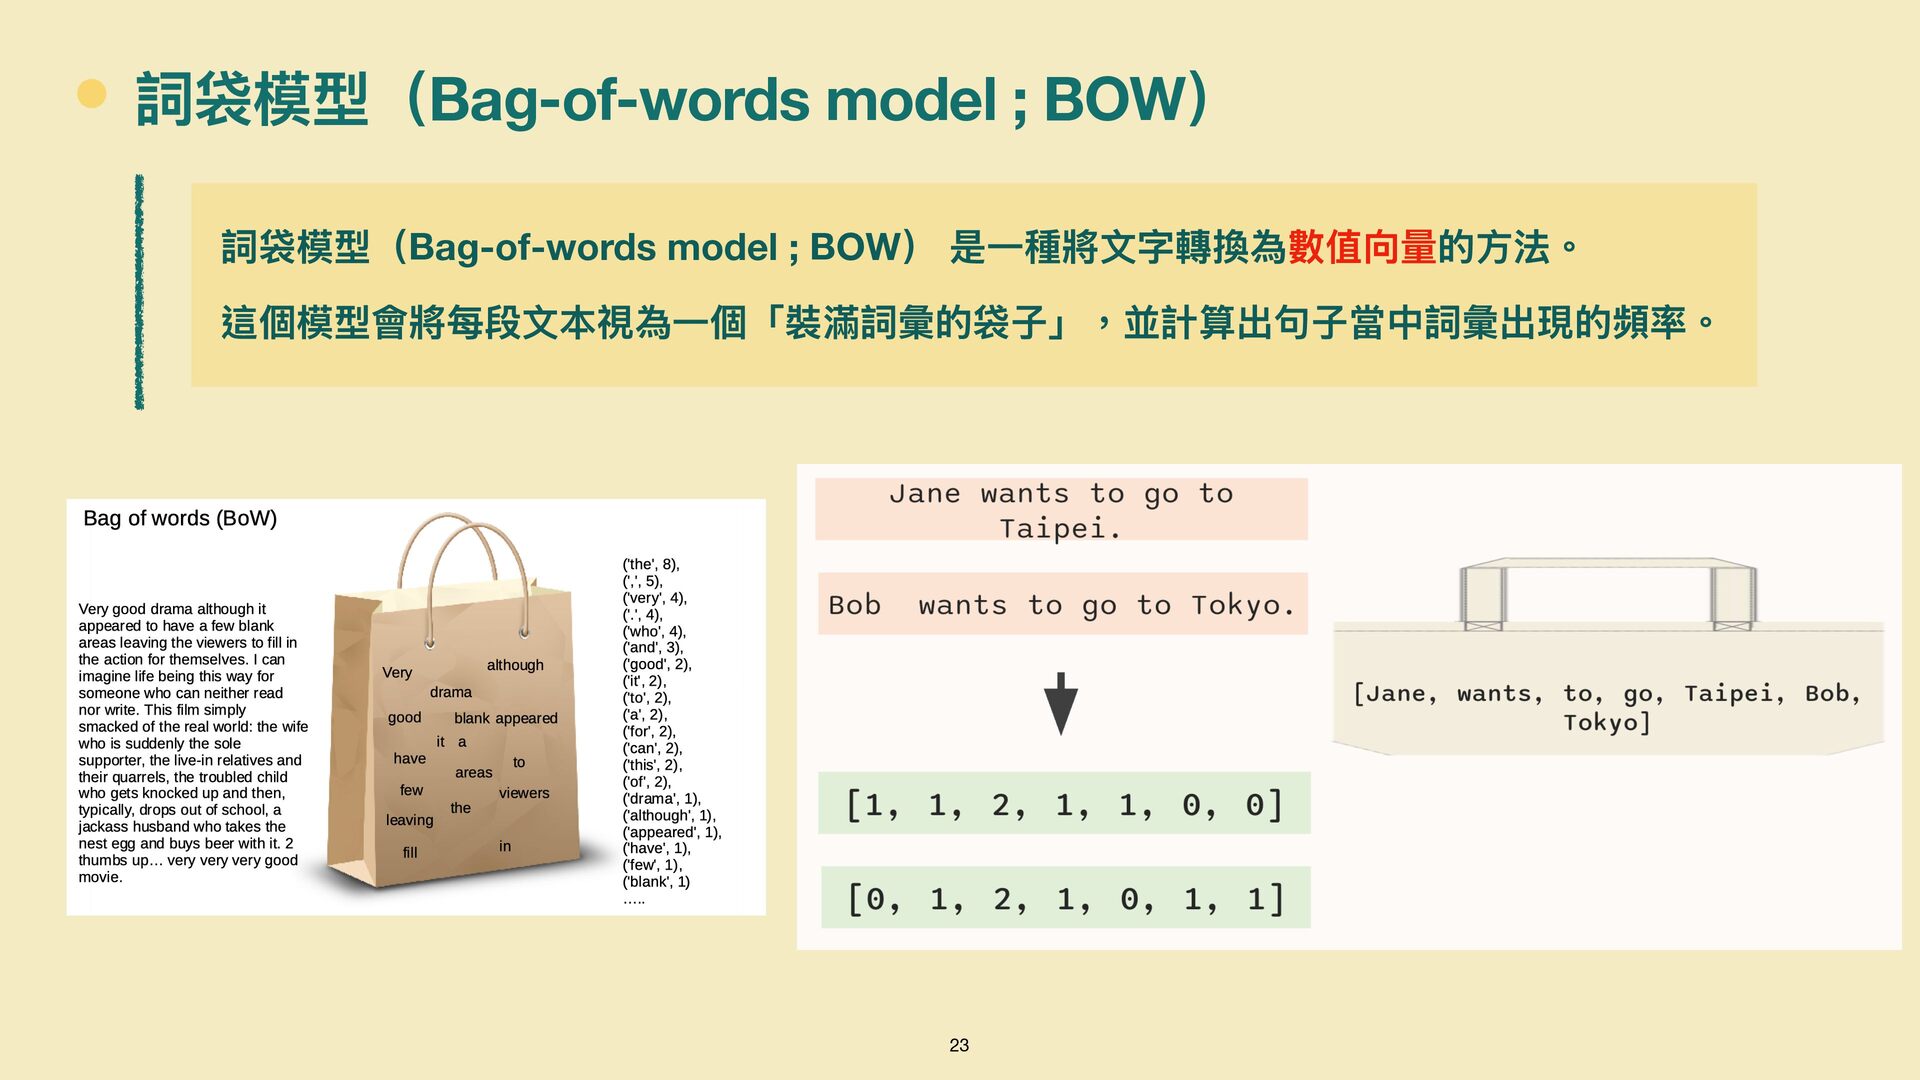
  10. 詞袋模型(Bag-of-words model ; BOW) 詞袋模型(Bag-of-words model ; BOW) 是 一

    種將 文 字轉換為數值向量的 方 法。 這個模型會將每段 文 本視為 一 個「裝滿詞彙的袋 子 」,並計算出句 子 當中詞彙出現的頻率。 23
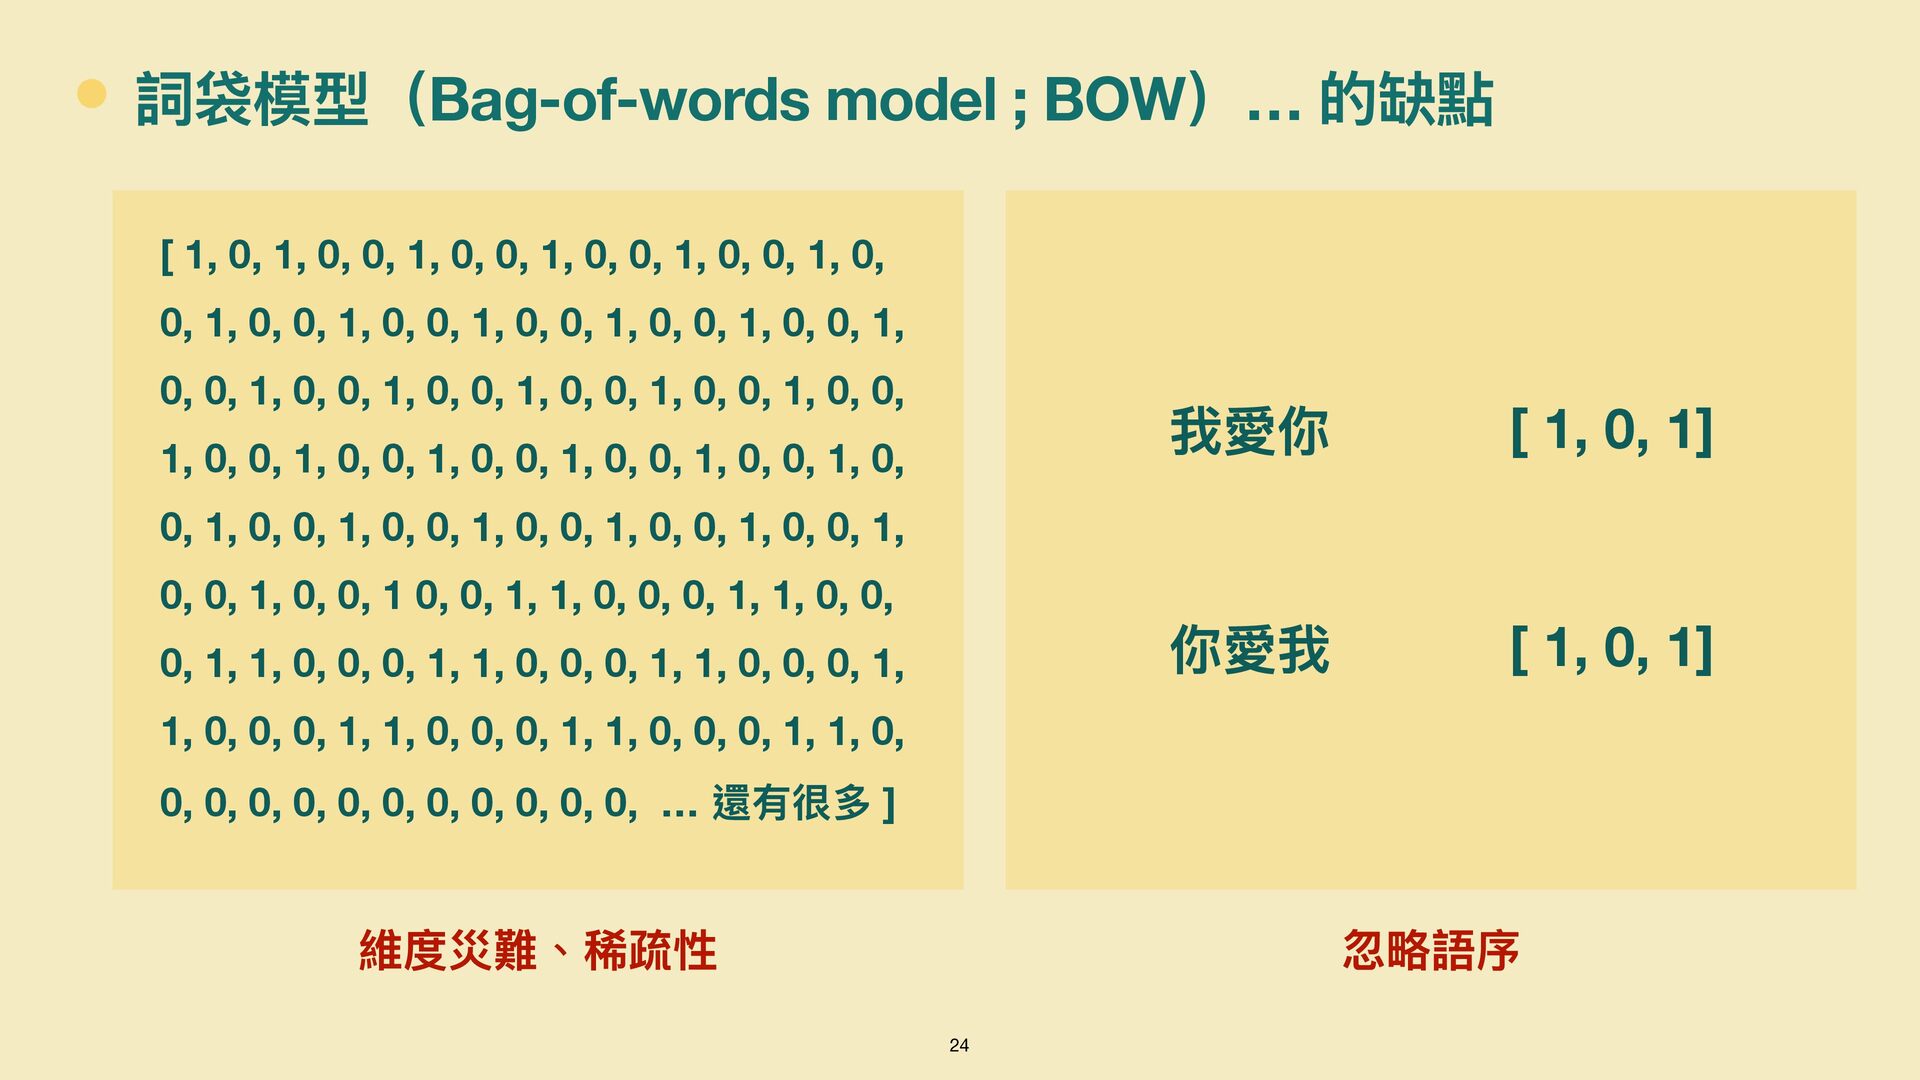
  11. 詞袋模型(Bag-of-words model ; BOW)… 的缺點 [ 1, 0, 1, 0,

    0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1 0, 0, 1, 1, 0, 0, 0, 1, 1, 0, 0, 0, 1, 1, 0, 0, 0, 1, 1, 0, 0, 0, 1, 1, 0, 0, 0, 1, 1, 0, 0, 0, 1, 1, 0, 0, 0, 1, 1, 0, 0, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, … 還有很多 ] 24 [ 1, 0, 1] 維度災難、稀疏性 忽略語序 我愛你 [ 1, 0, 1] 你愛我
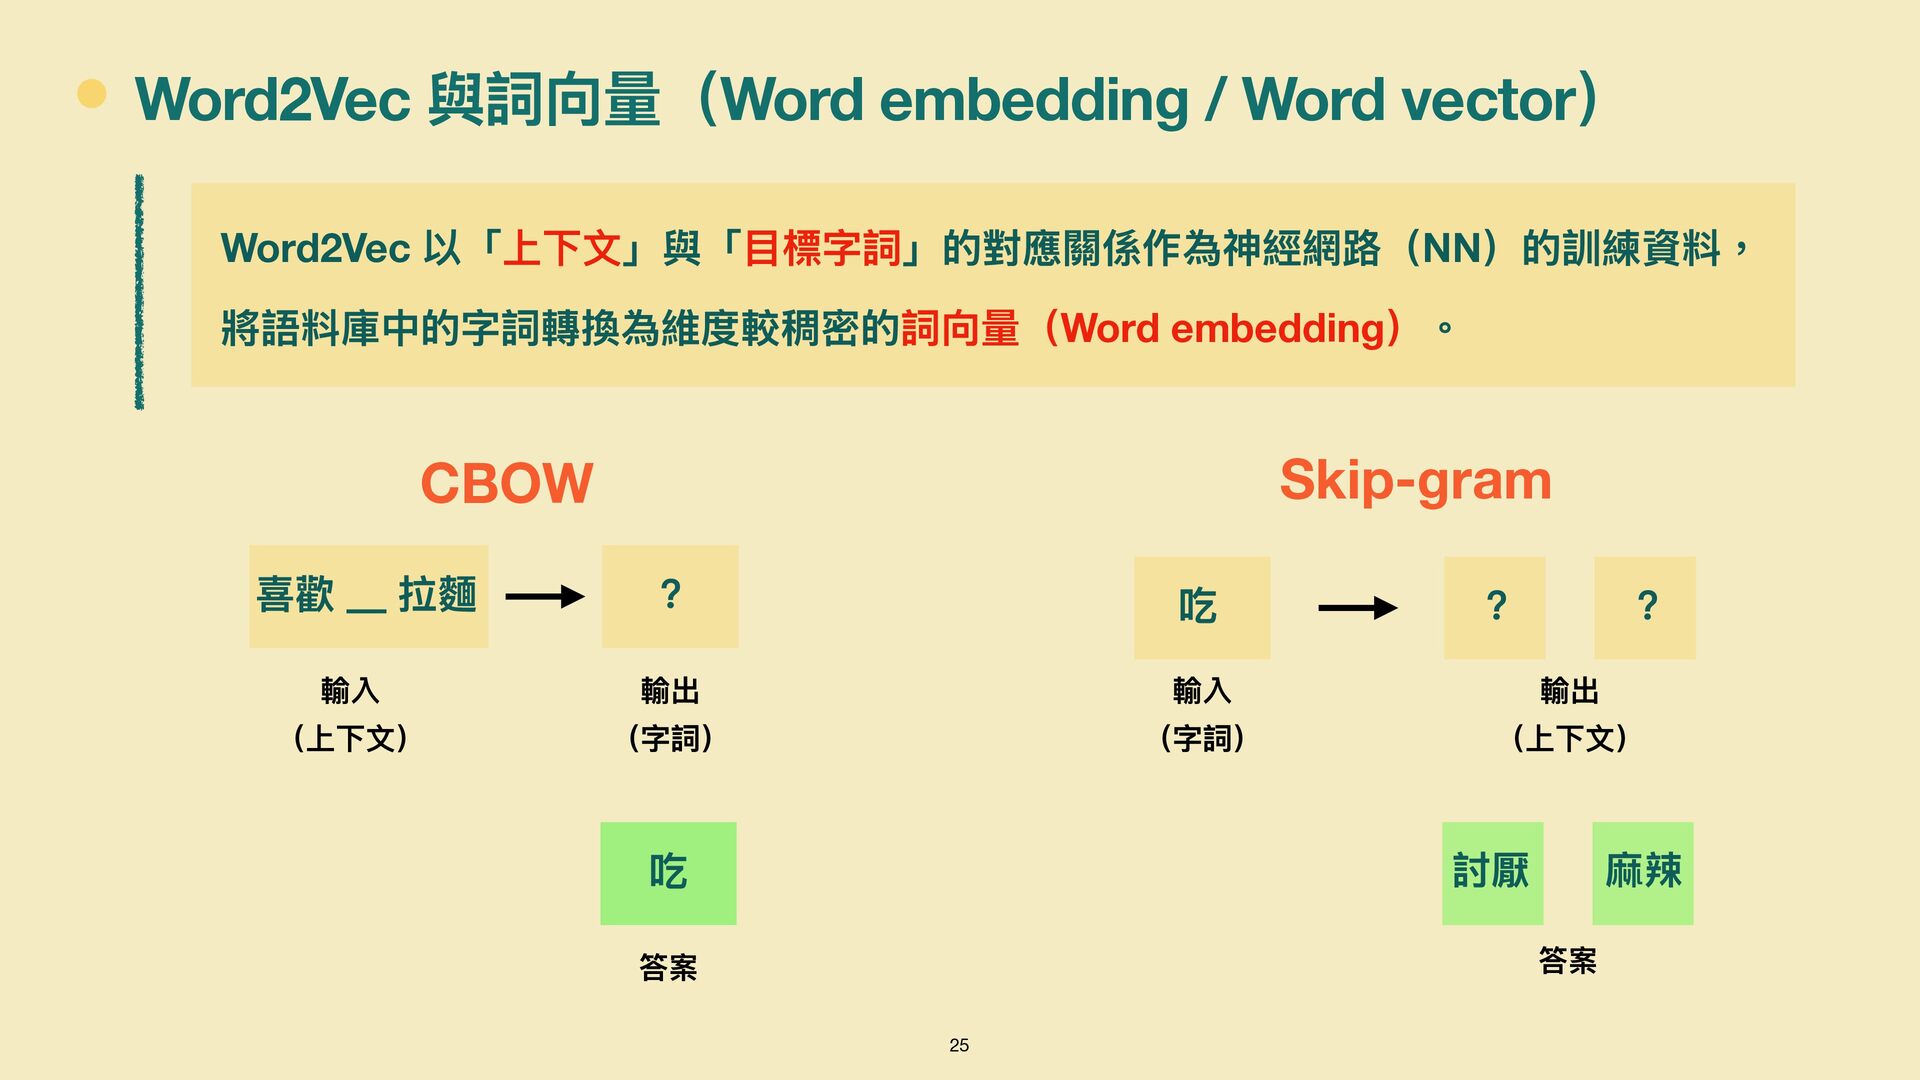
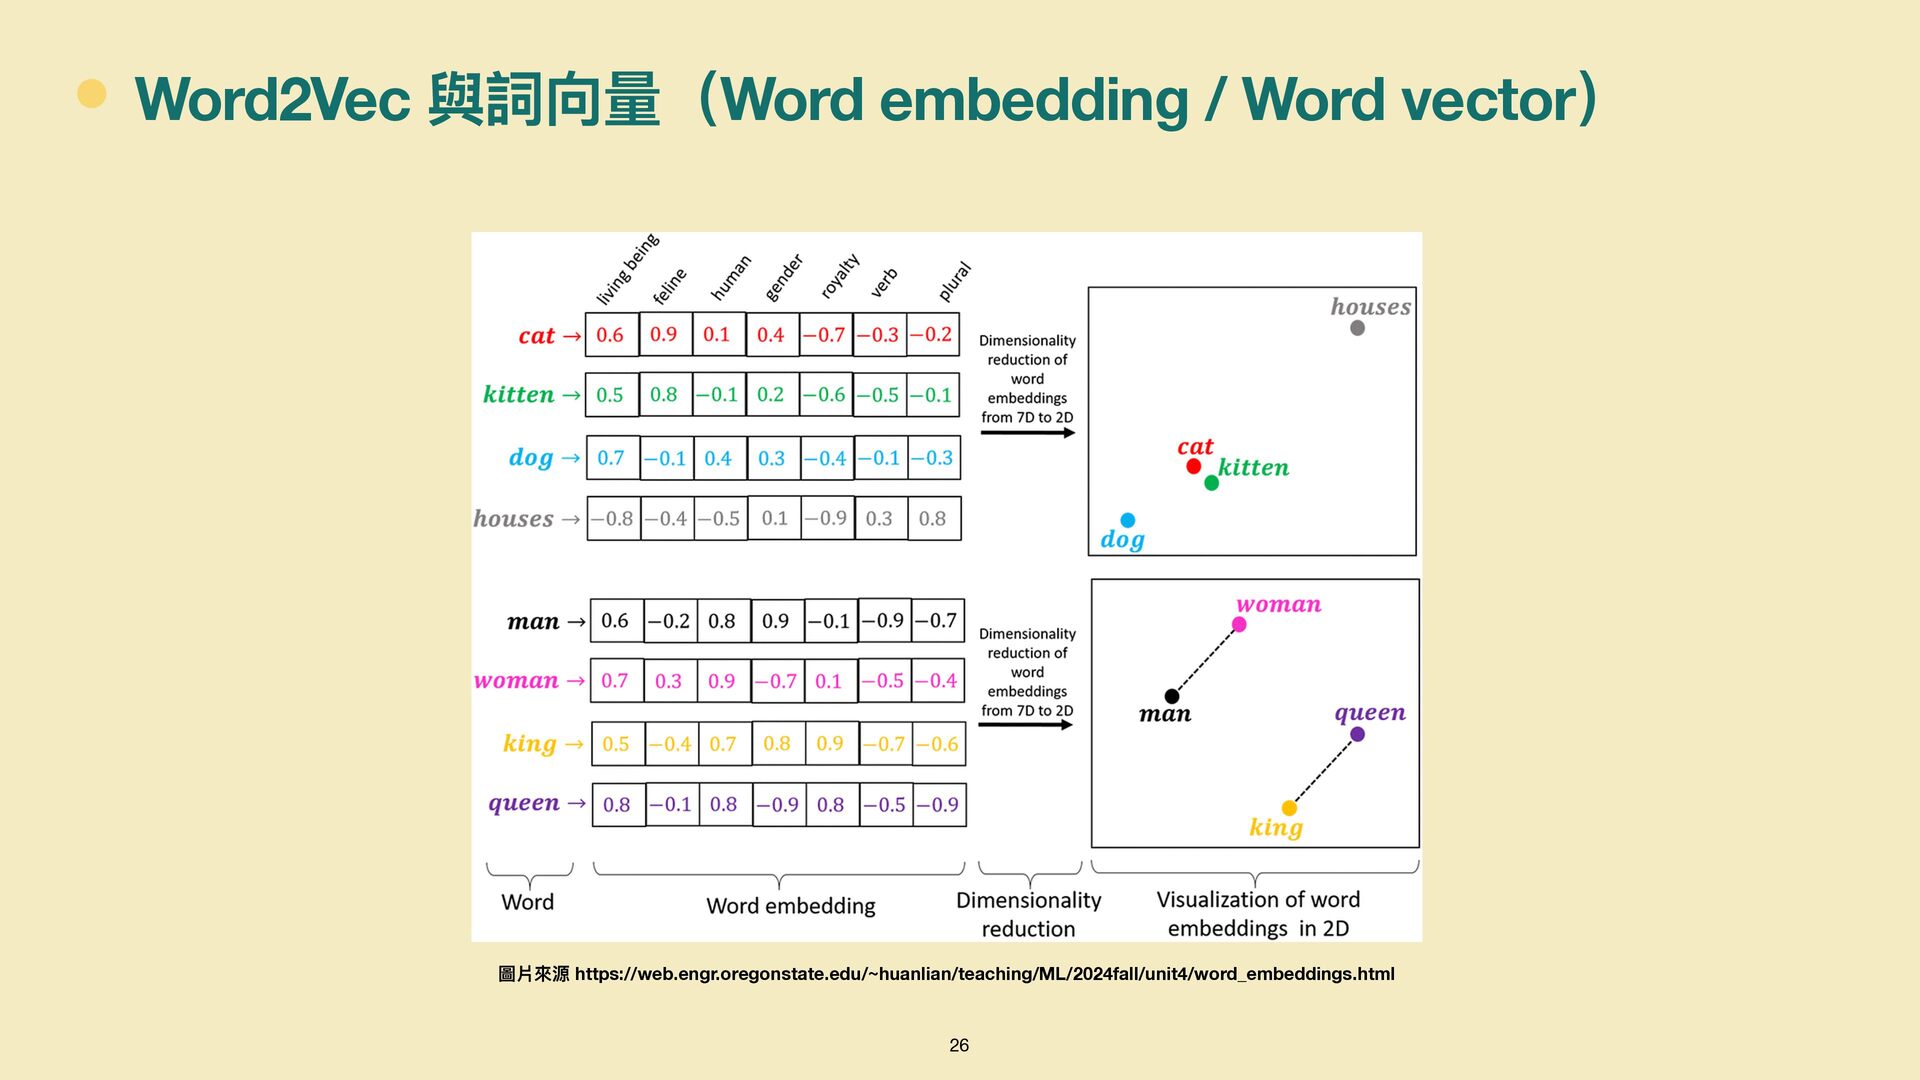
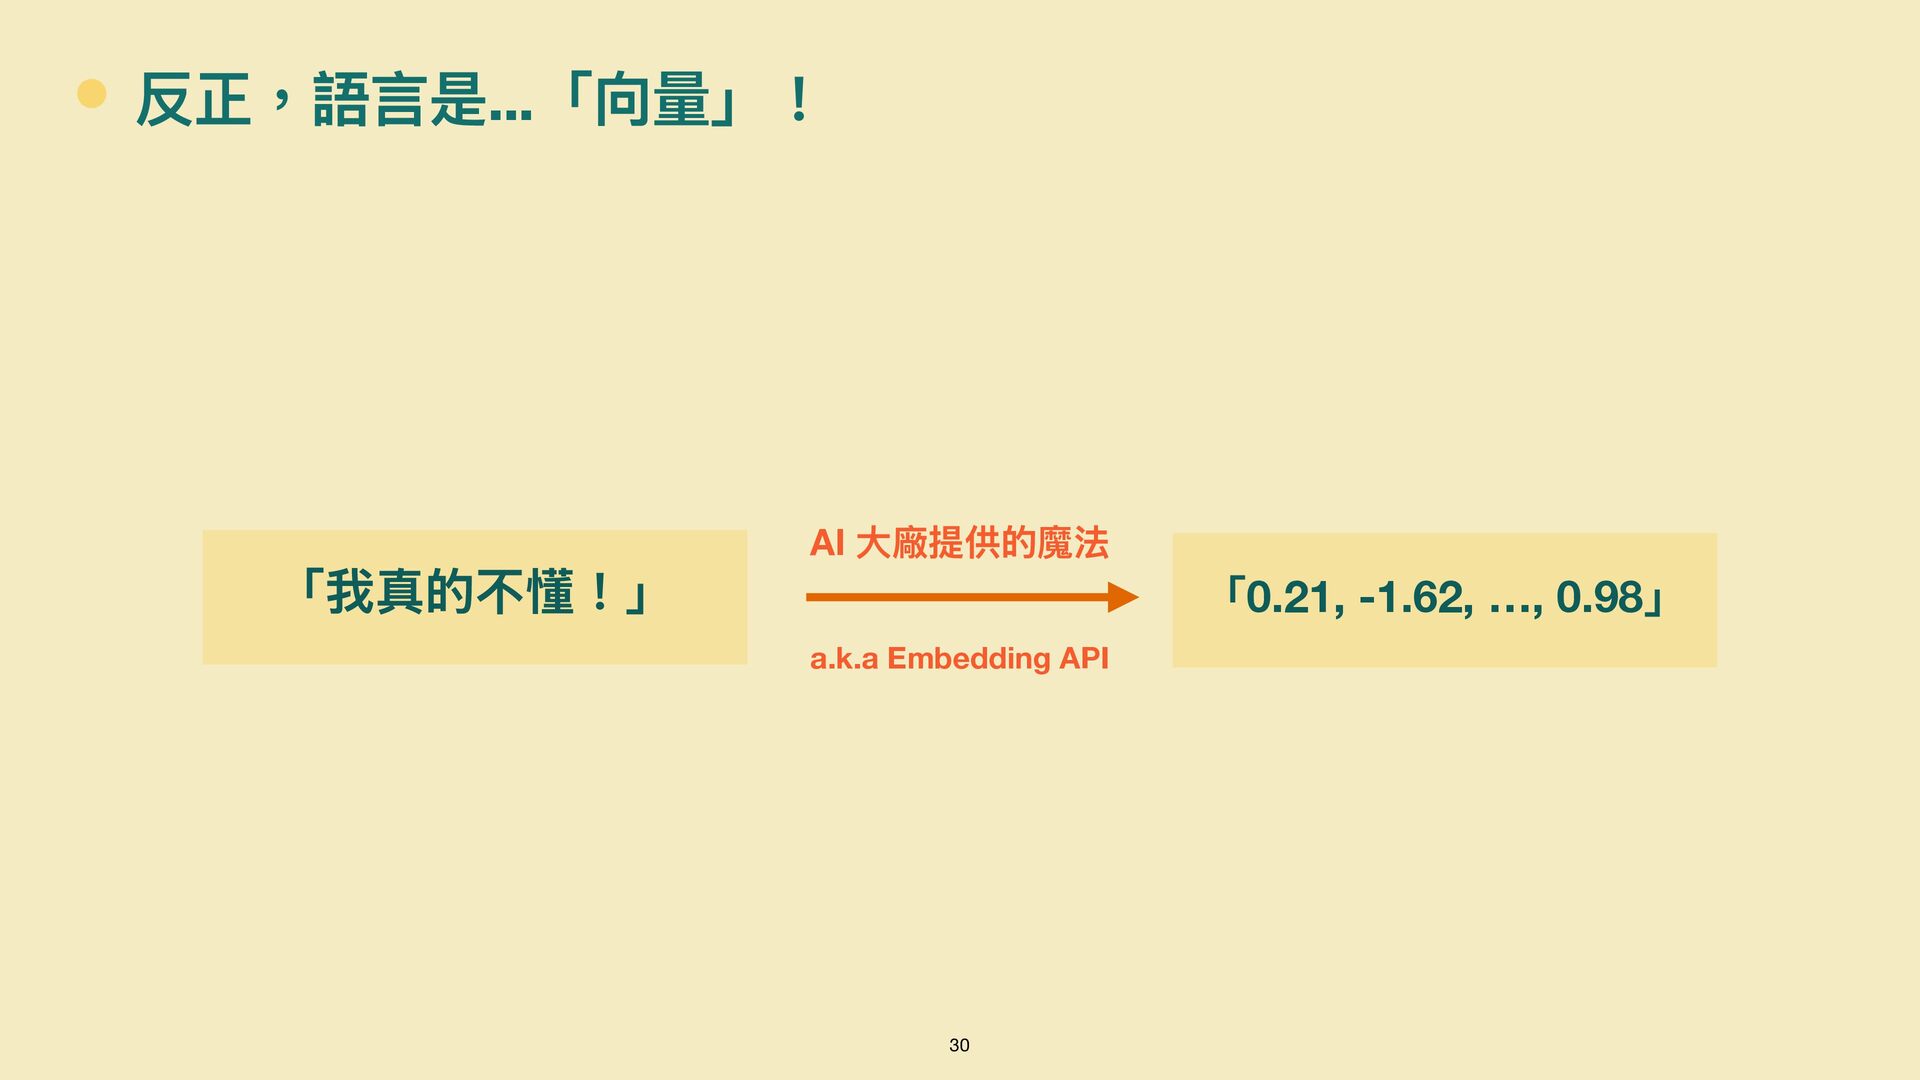
  12. Word2Vec 與詞向量(Word embedding / Word vector) Word2Vec 以「上下 文 」與「

    目 標字詞」的對應關係作為神經網路(NN)的訓練資料, 將語料庫中的字詞轉換為維度較稠密的詞向量(Word embedding)。 喜歡 _ 拉麵 ? ? ? 吃 吃 CBOW Skip-gram 吃 輸入 (上下 文 ) 輸出 (字詞) 答案 討厭 麻 辣 輸入 (字詞) 輸出 (上下 文 ) 答案 25
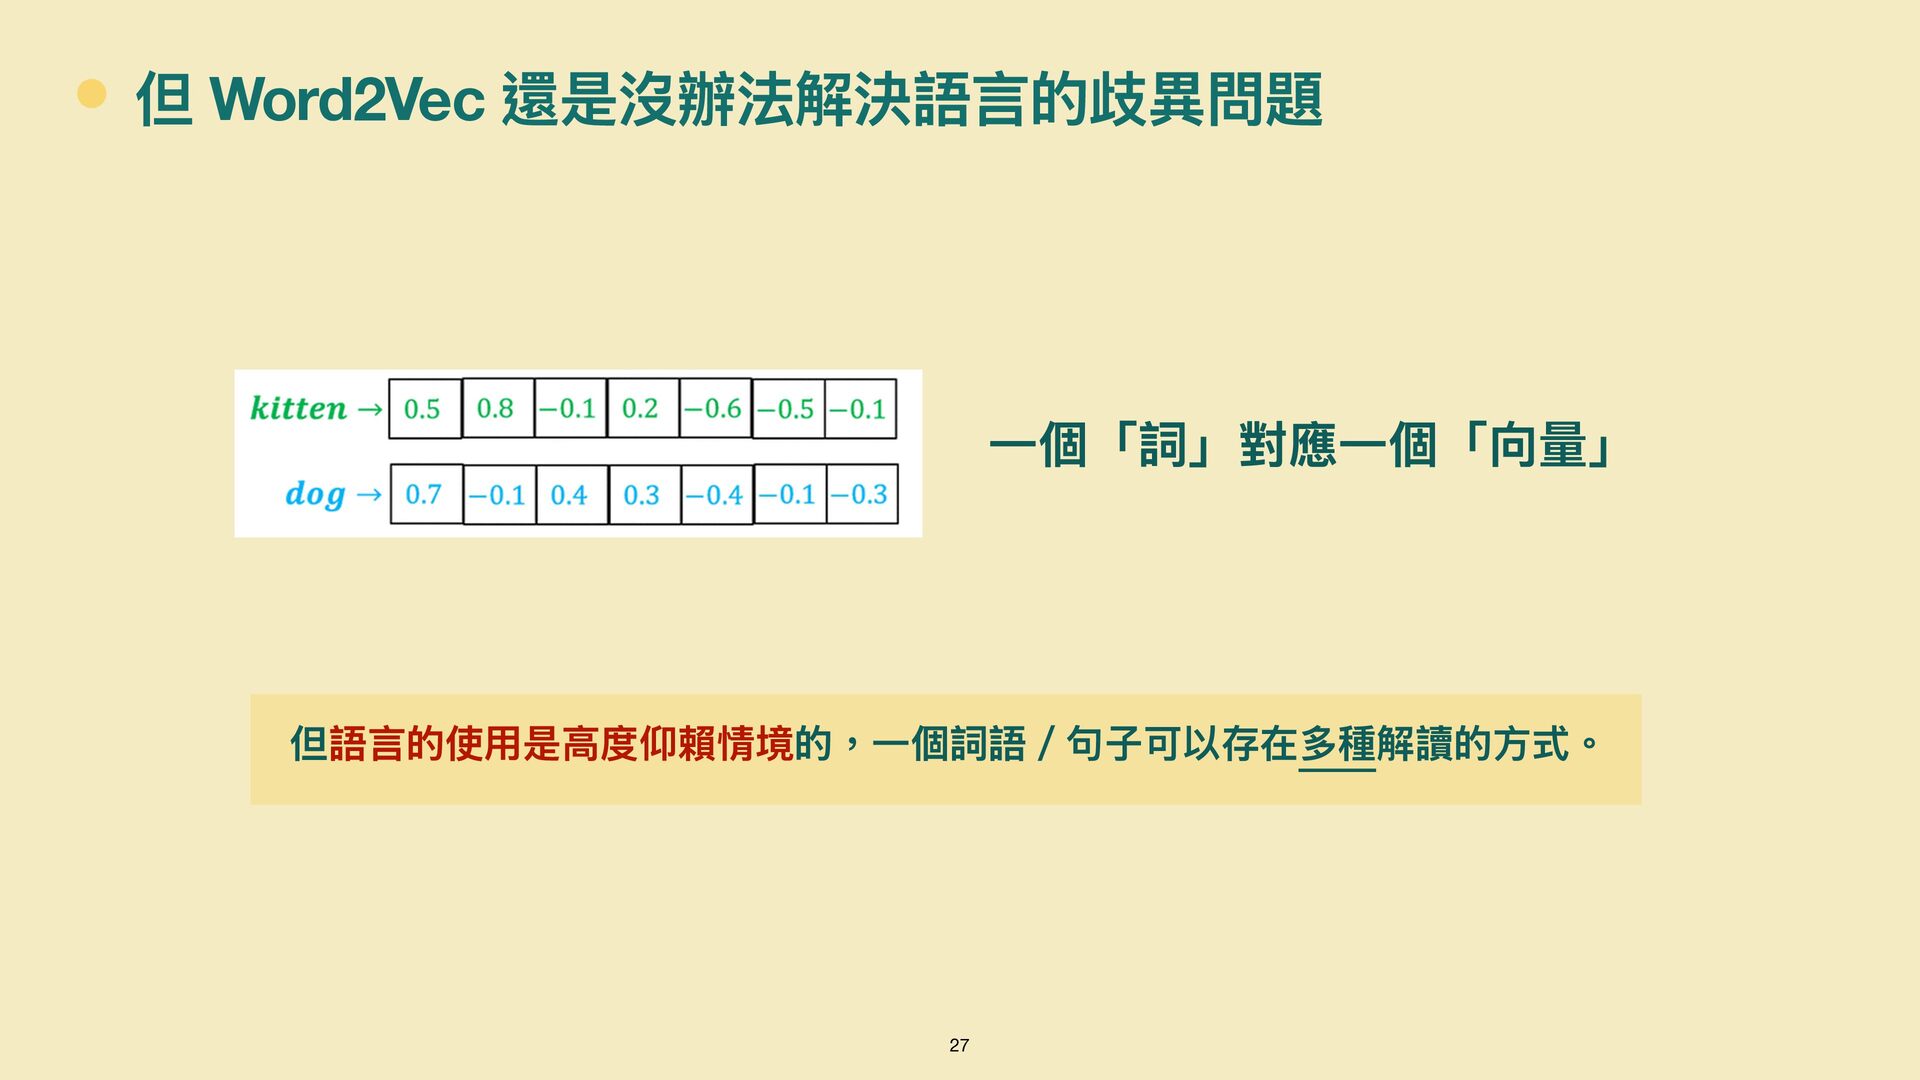
  13. 但 Word2Vec 還是沒辦法解決語 言 的歧異問題 27 但語 言 的使 用

    是 高 度仰賴情境的, 一 個詞語/句 子 可以存在多種解讀的 方 式。 一 個「詞」對應 一 個「向量」
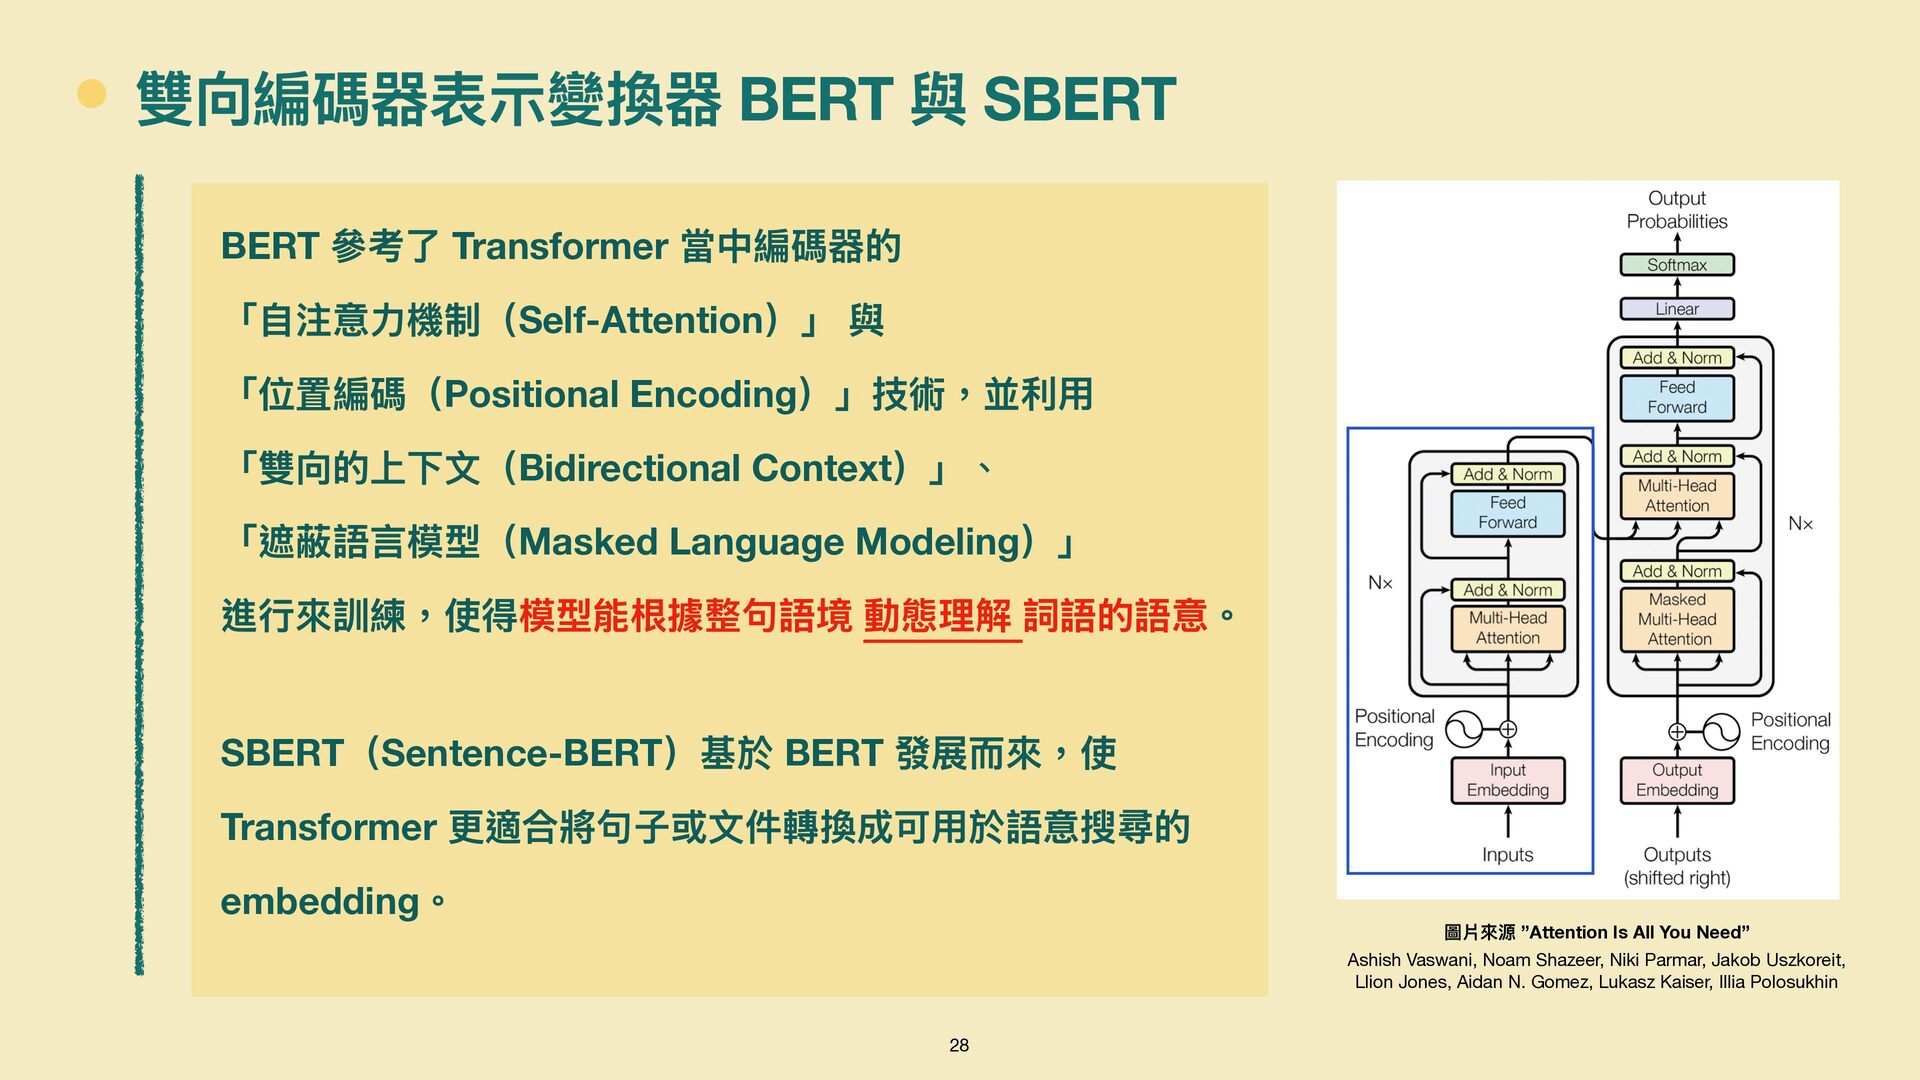
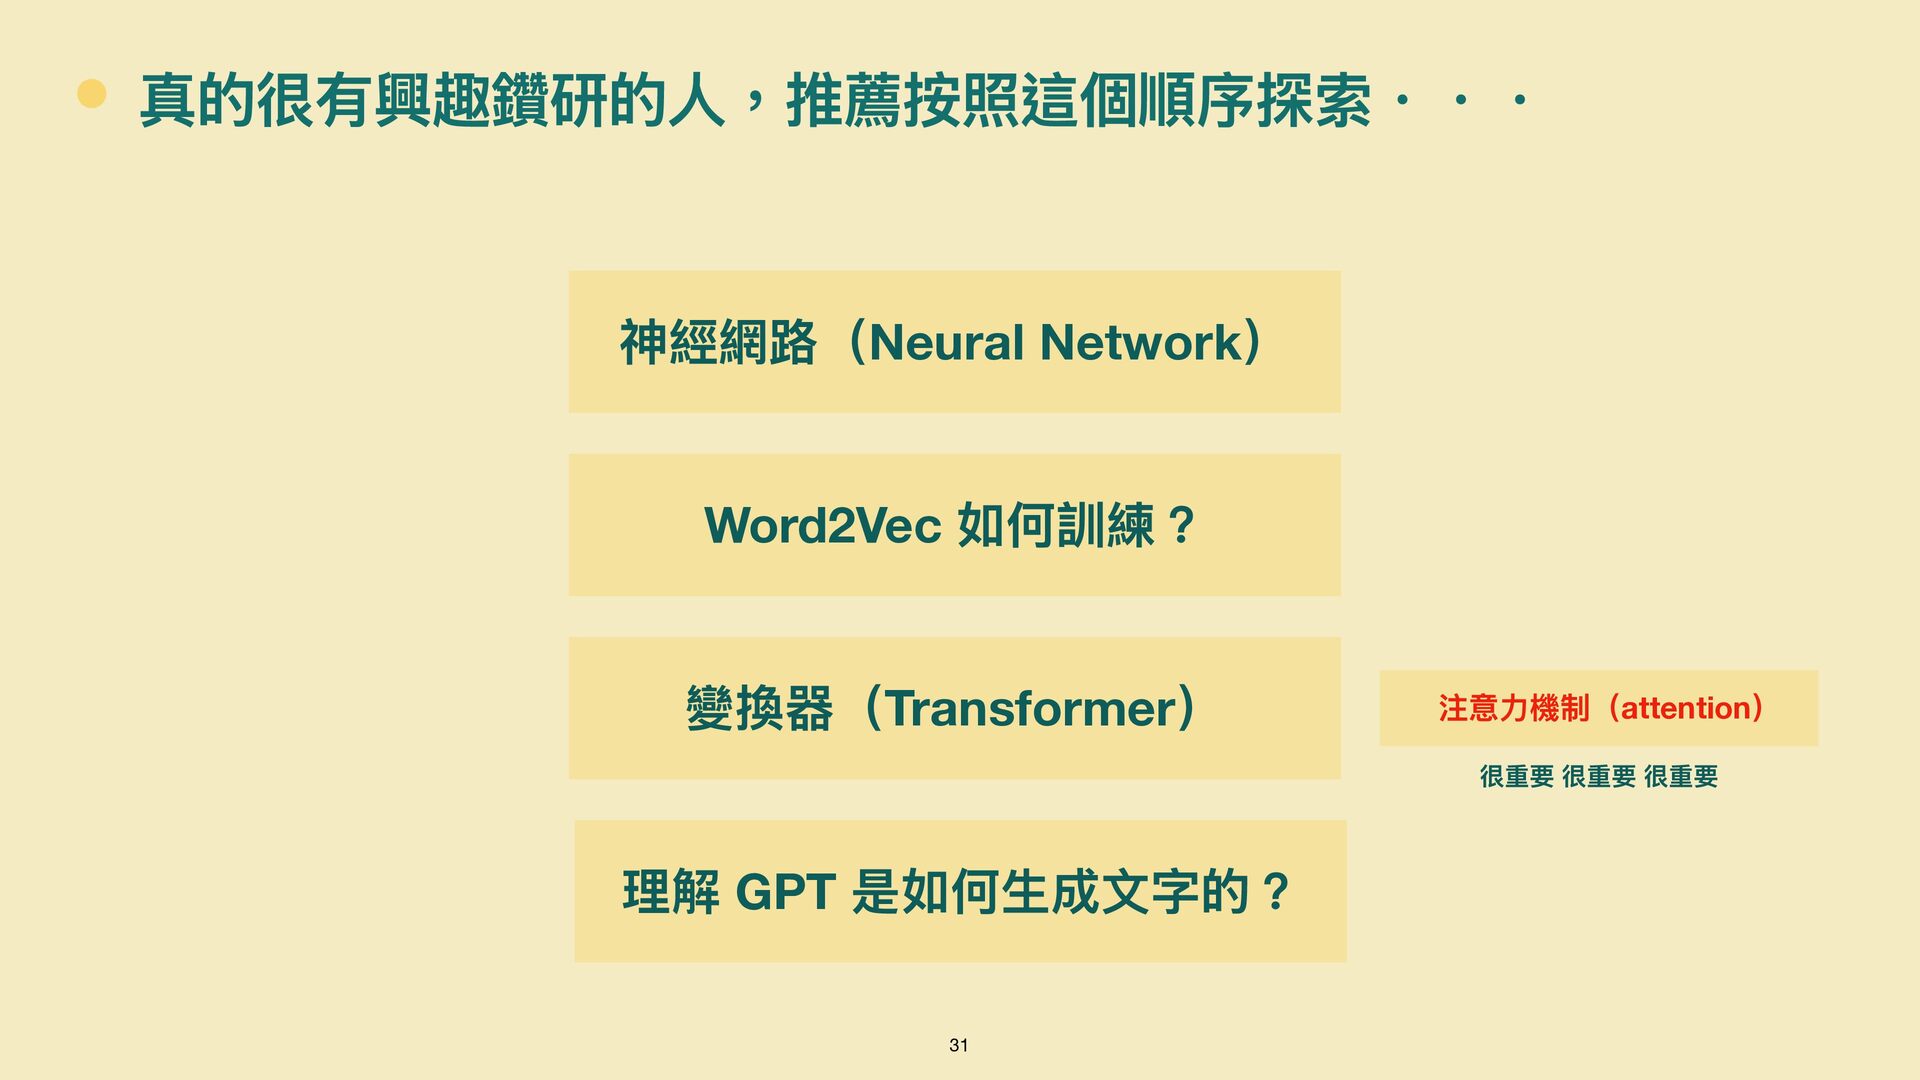
  14. 雙向編碼器表 示 變換器 BERT 與 SBERT BERT 參考了 Transformer 當中編碼器的

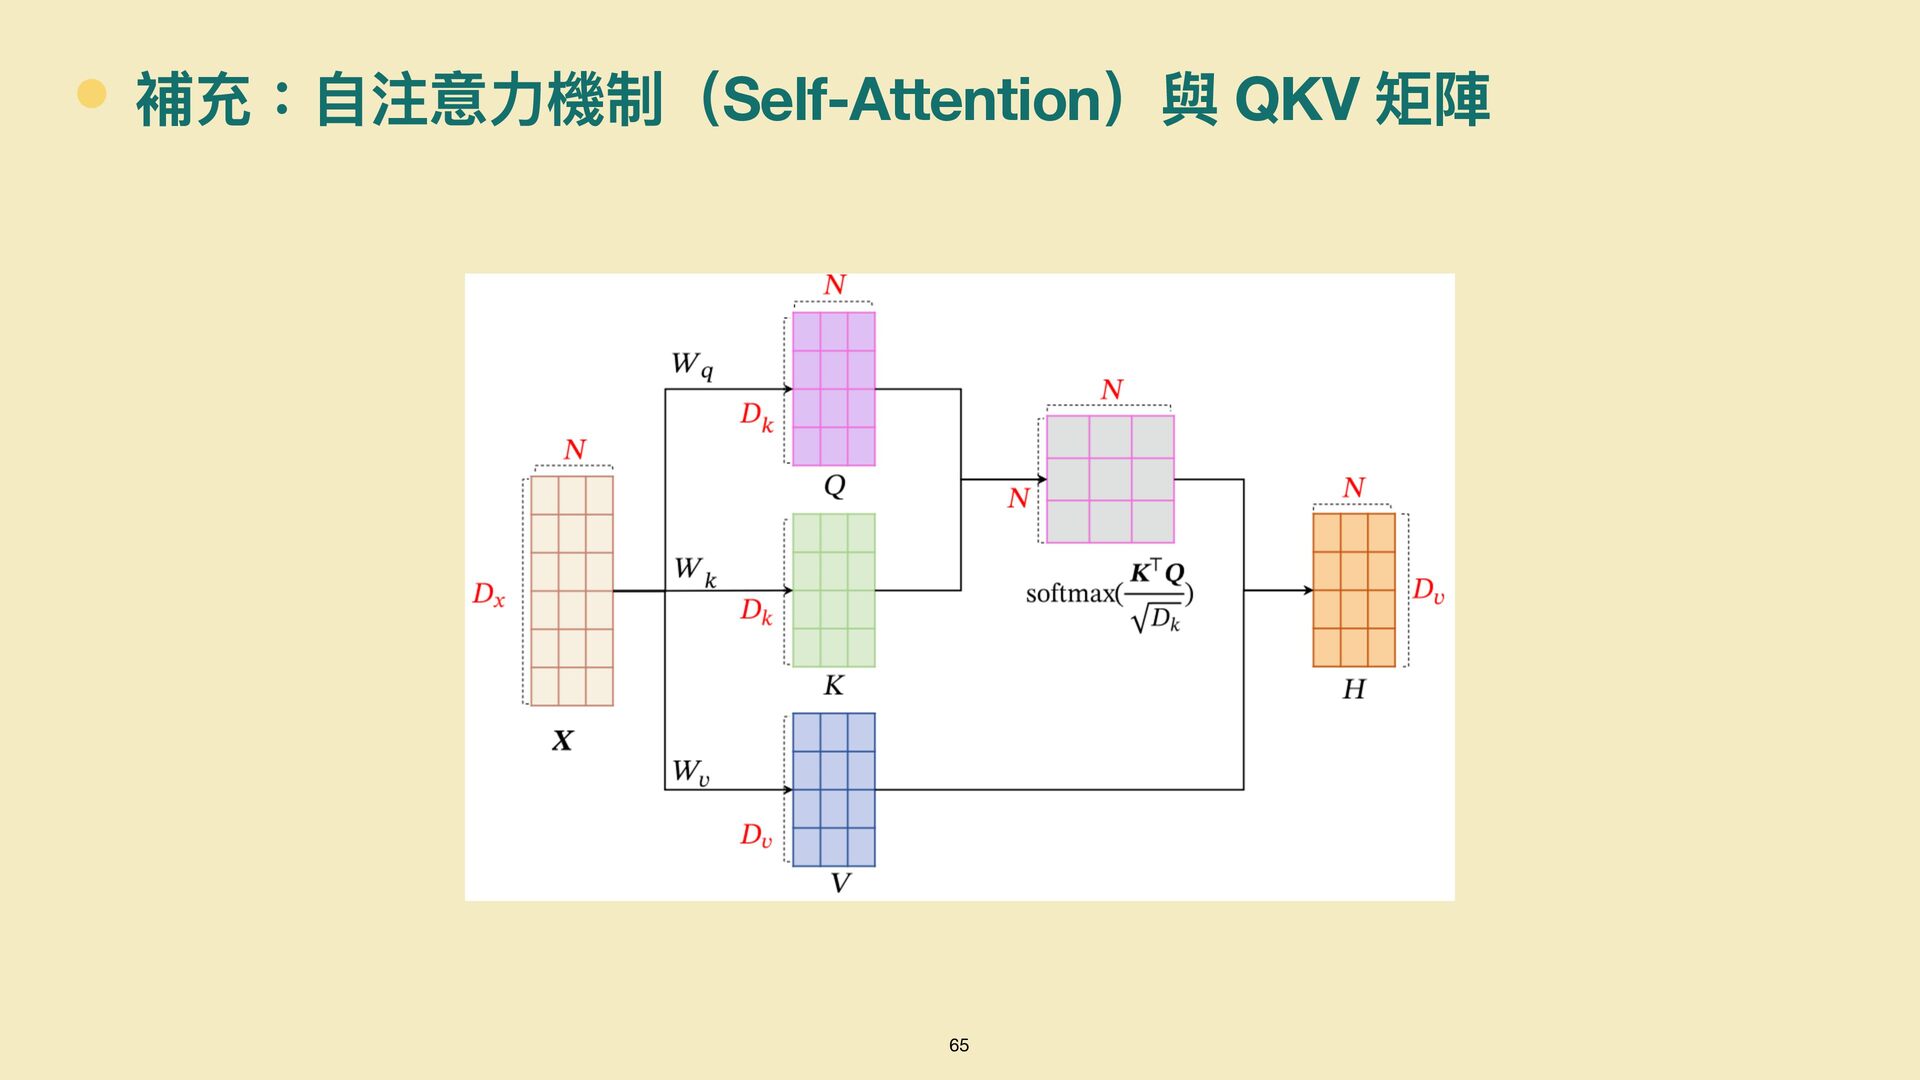
    「 自 注意 力 機制(Self-Attention)」 與 「位置編碼(Positional Encoding)」技術,並利 用 「雙向的上下 文 (Bidirectional Context)」、 「遮蔽語 言 模型(Masked Language Modeling)」 進 行 來訓練,使得模型能根據整句語境 動態理解 詞語的語意。 SBERT(Sentence-BERT)基於 BERT 發展 而 來,使 Transformer 更適合將句 子 或 文 件轉換成可 用 於語意搜尋的 embedding。 28 圖片來源 ”Attention Is All You Need” Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, Illia Polosukhin
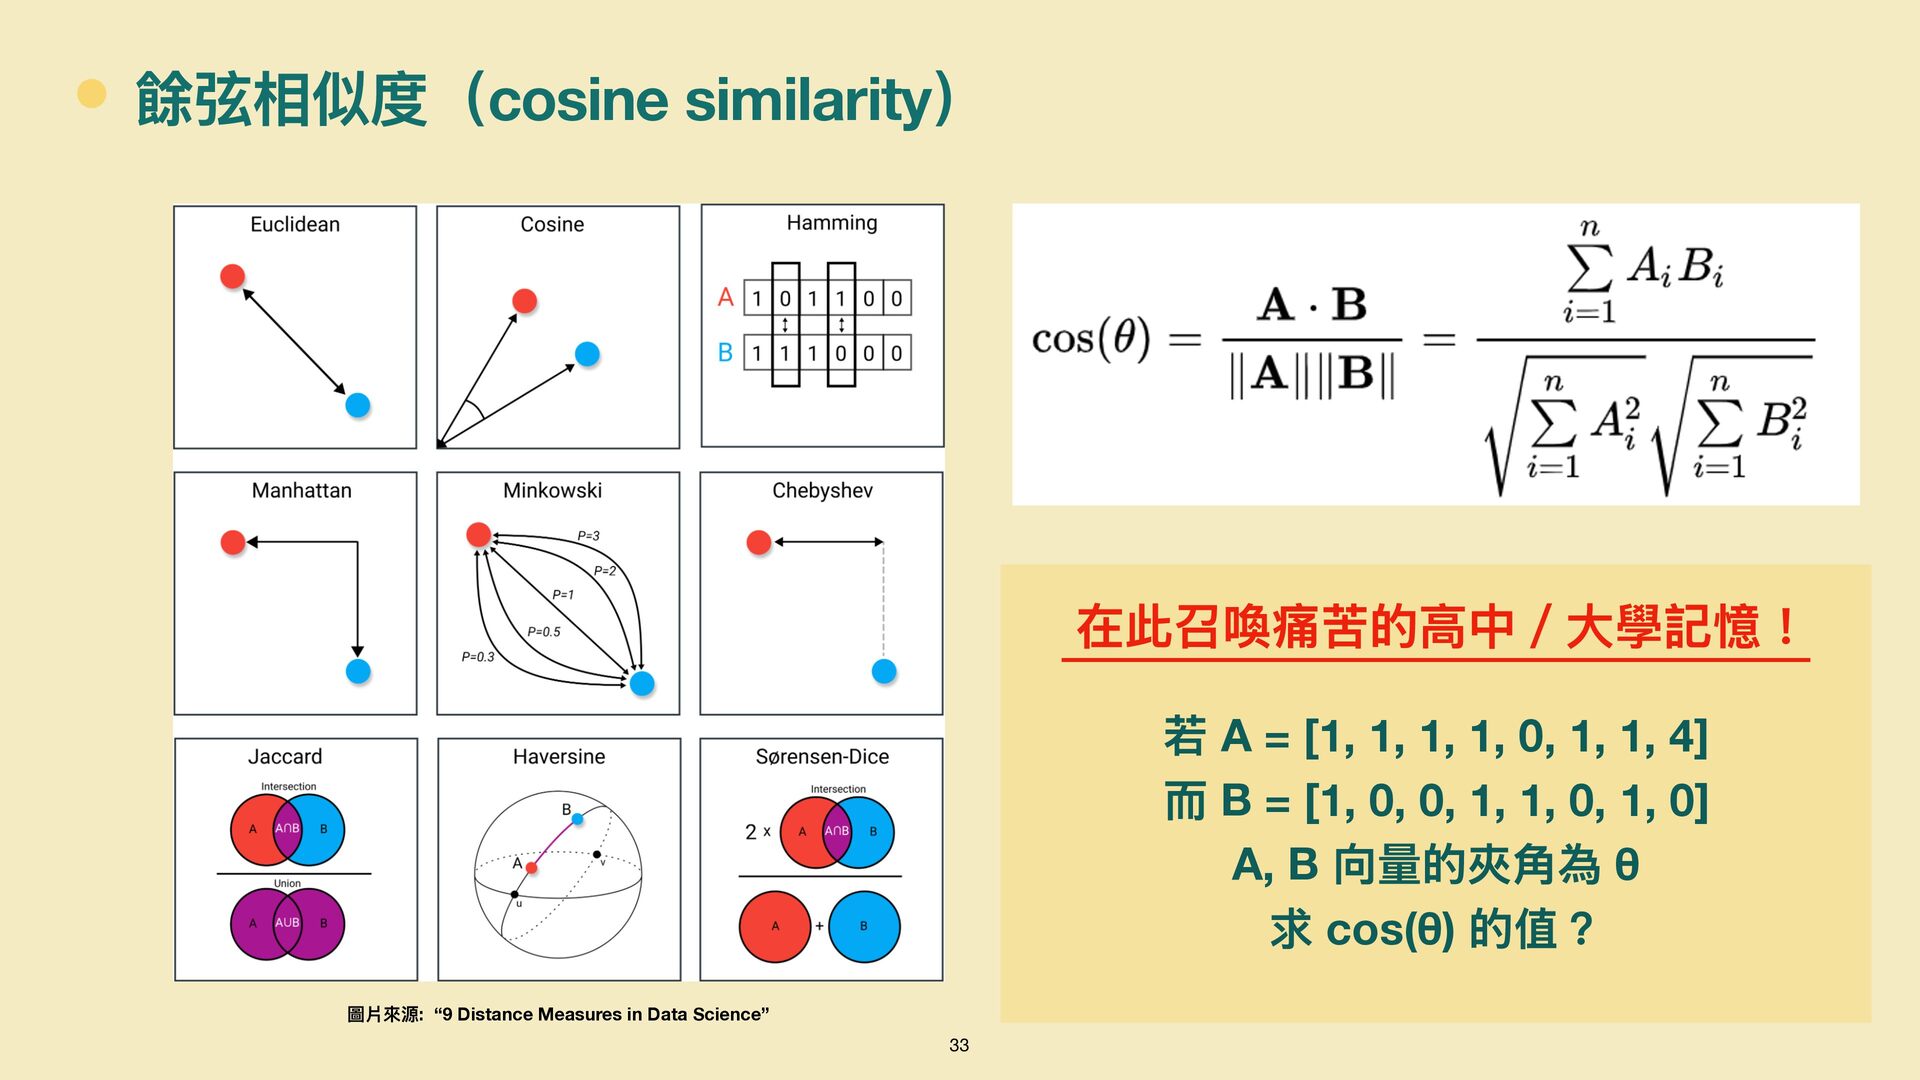
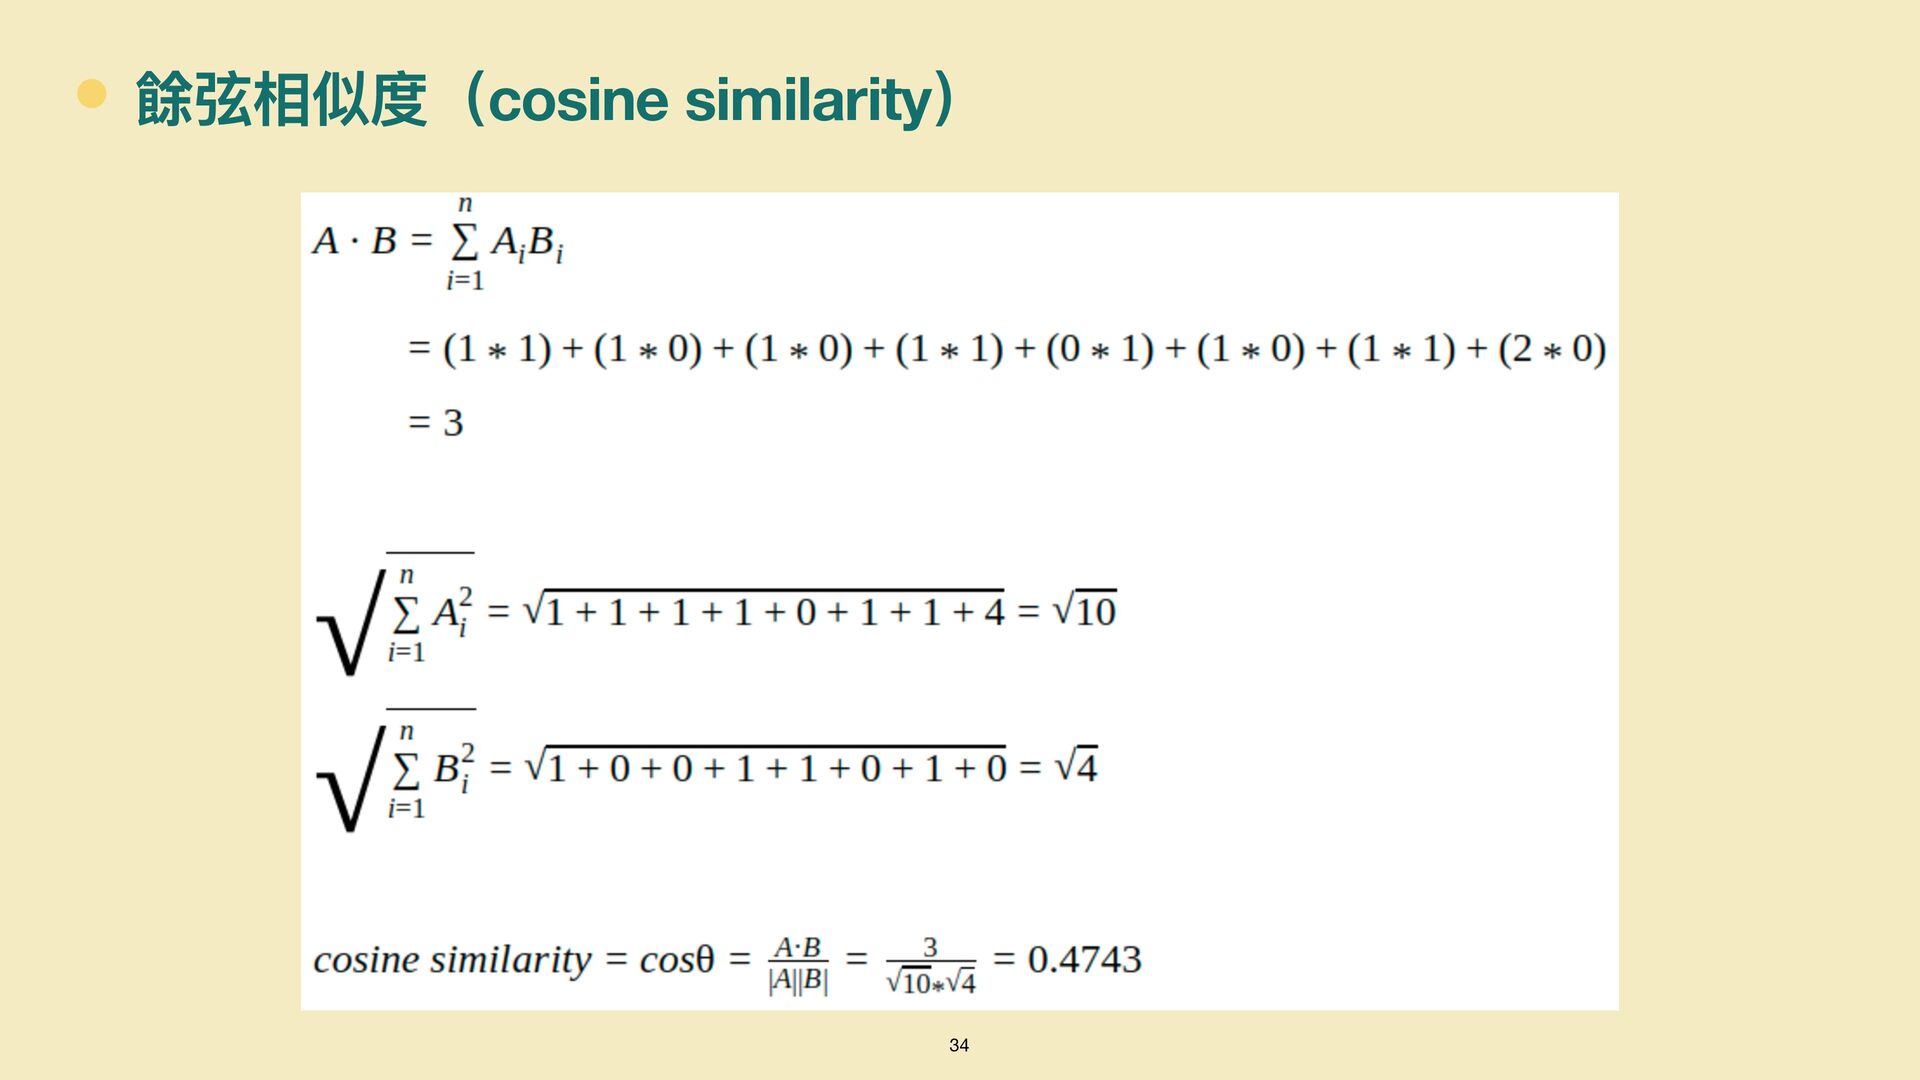
  15. 餘弦相似度(cosine similarity) 若 A = [1, 1, 1, 1, 0,

    1, 1, 4] 而 B = [1, 0, 0, 1, 1, 0, 1, 0] A, B 向量的夾 角 為 θ 求 cos(θ) 的值? 在此召喚痛苦的 高 中/ 大 學記憶! 33 圖片來源: “9 Distance Measures in Data Science”
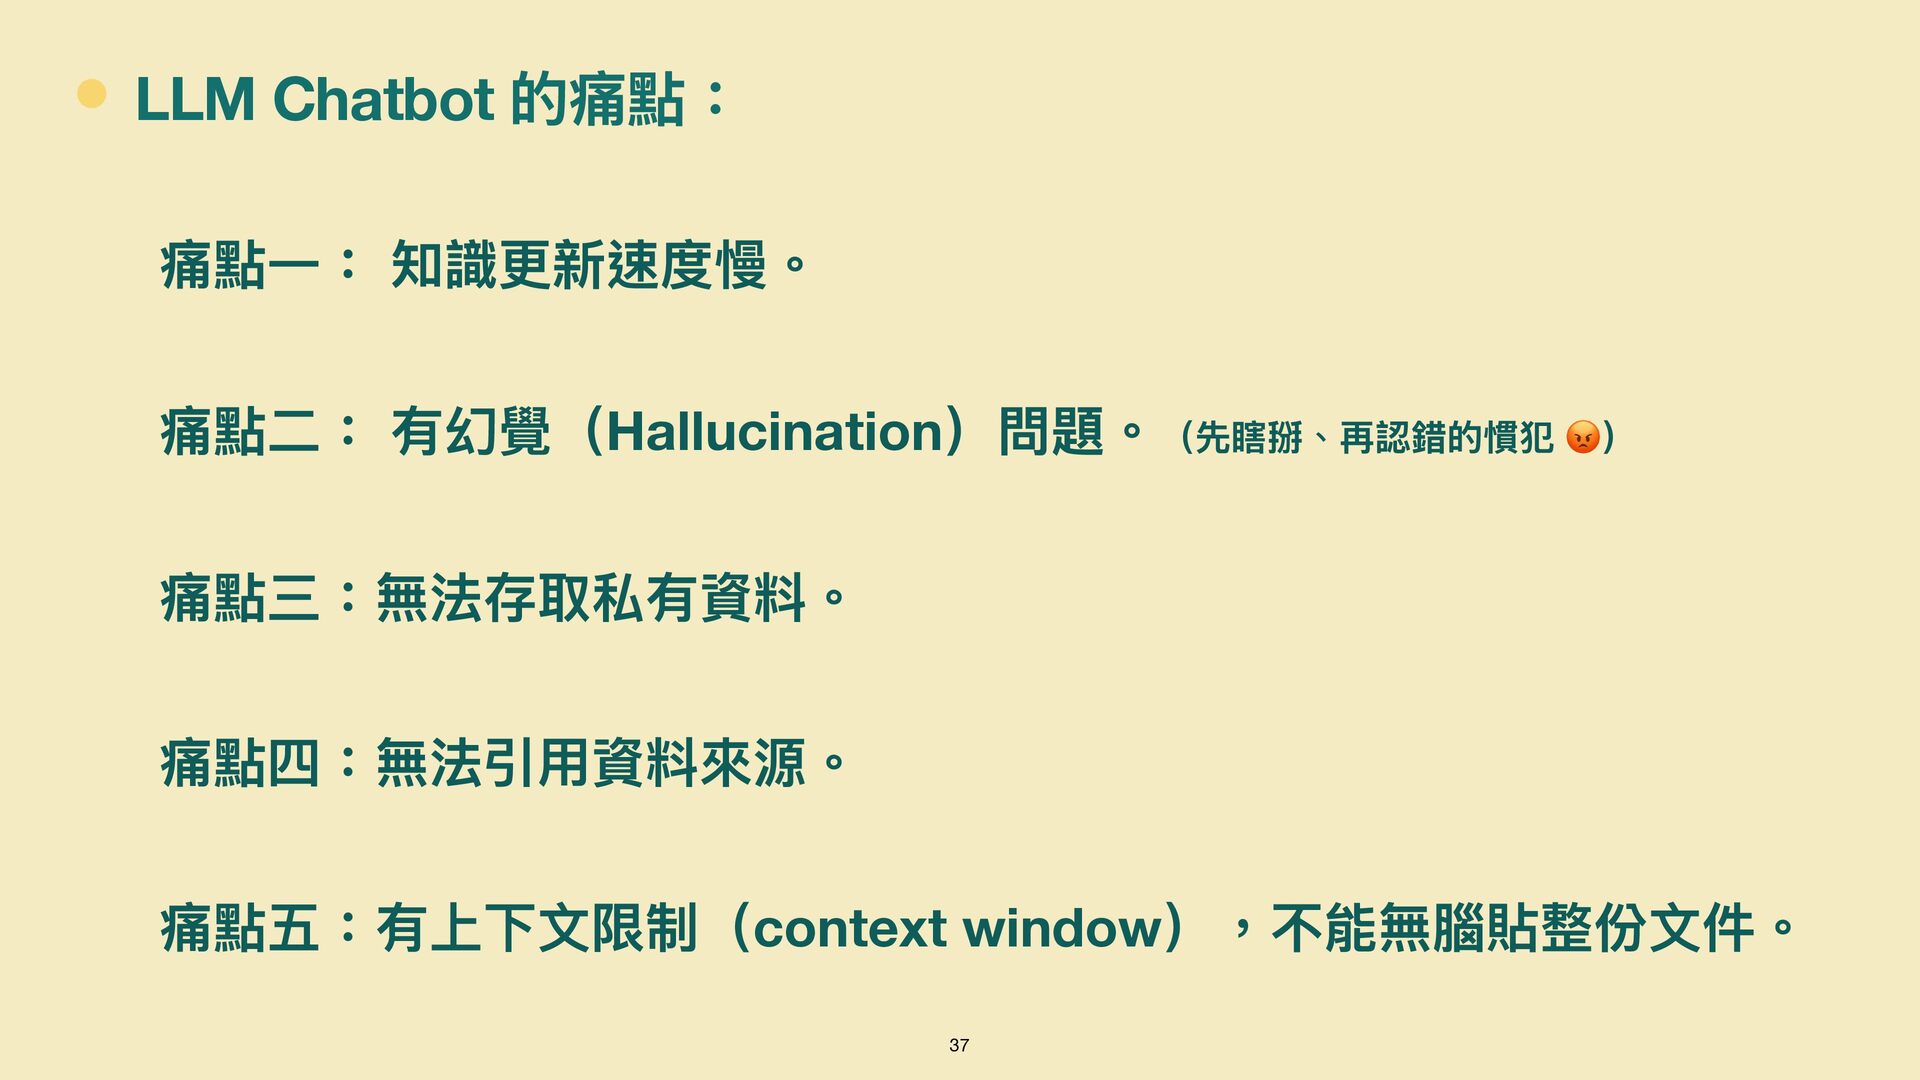
  16. LLM Chatbot 的痛點: 痛點 一 : 知識更新速度慢。 痛點 二 :

    有幻覺(Hallucination)問題。(先瞎掰、再認錯的慣犯 😡) 痛點三:無法存取私有資料。 痛點四:無法引 用 資料來源。 痛點五:有上下 文 限制(context window),不能無腦貼整份 文 件。 37
  17. 檢索增強 生 成(Retrieval-Augmented Generation) 39 Retrieval-Augmented Generation 檢索 增強 生

    成 在 大 型語 言 模型(LLM) 生 成回答之前,先從外部知識庫(如:企業 文 件或資料庫) 檢索相關的最新資訊,藉此 大 幅提升回答準確度並減少 AI 幻覺
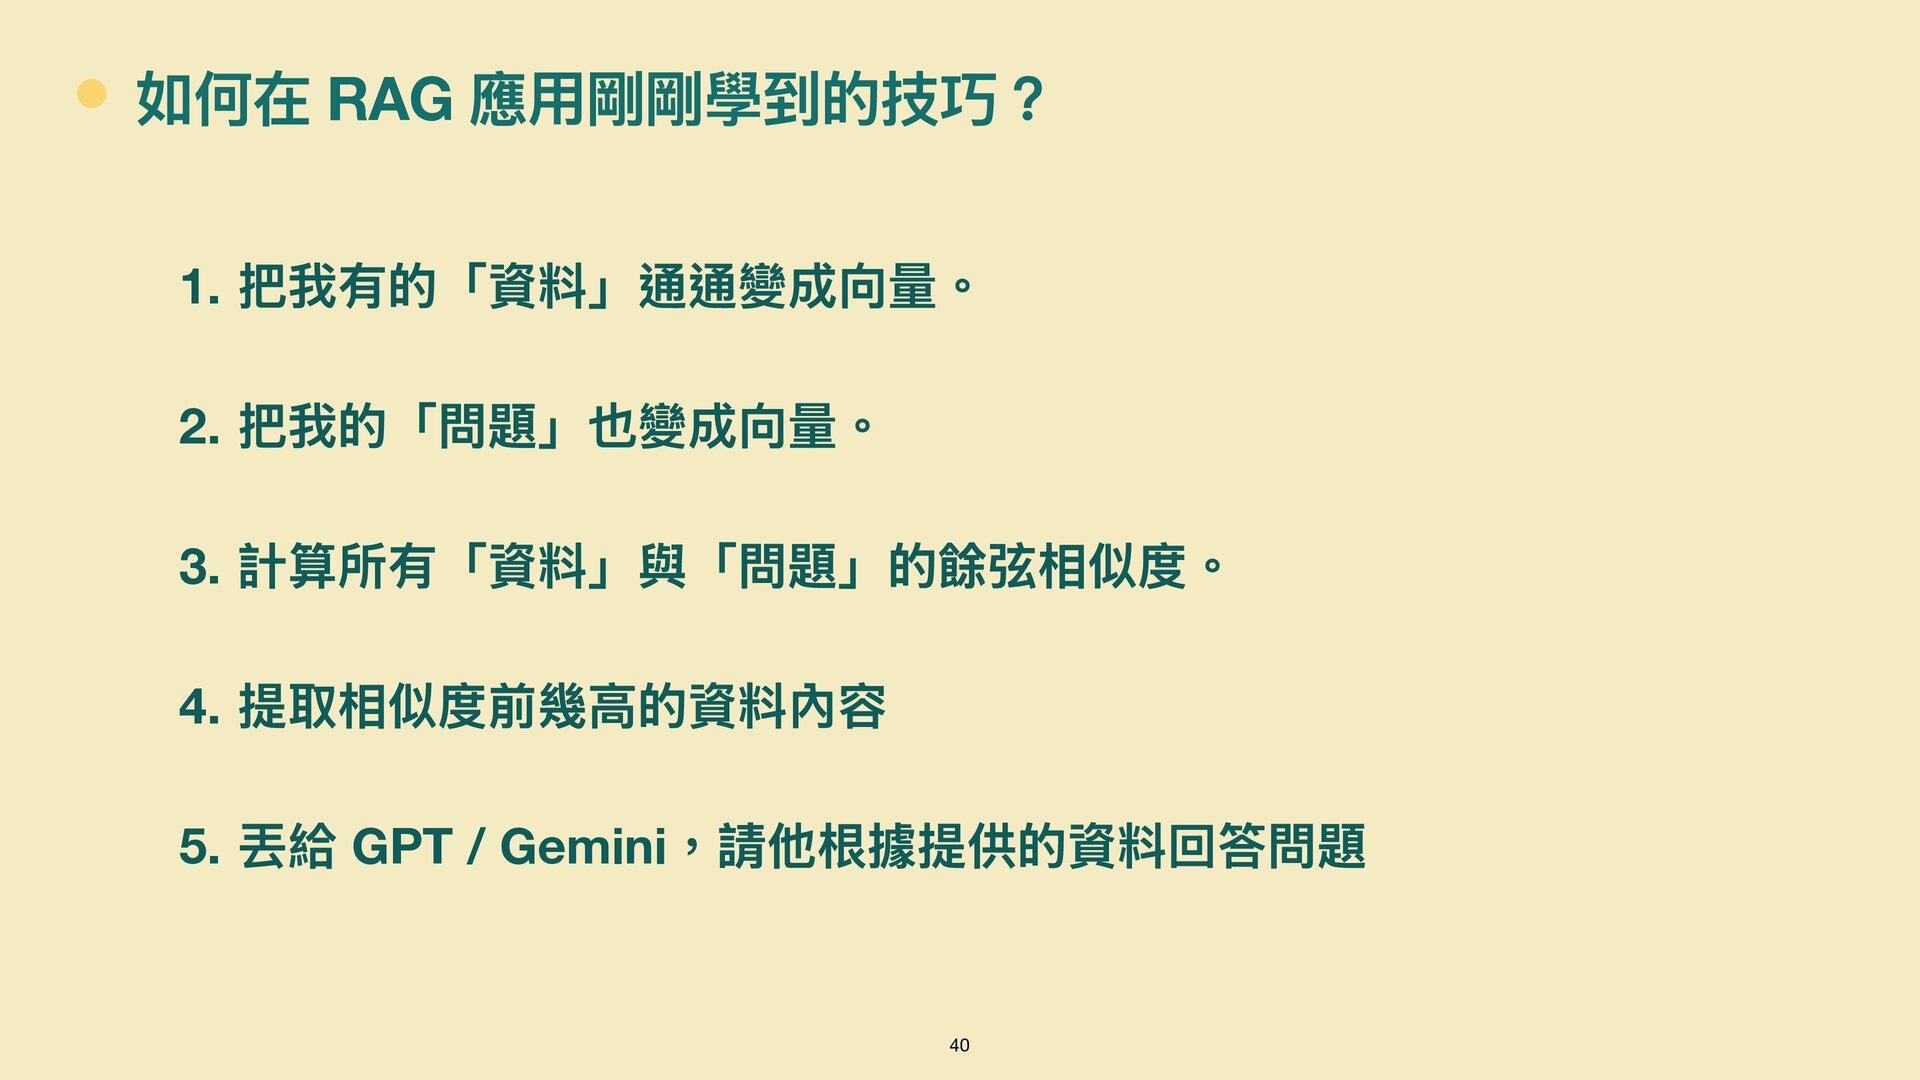
  18. 如何在 RAG 應 用 剛剛學到的技巧? 1. 把我有的「資料」通通變成向量。 2. 把我的「問題」也變成向量。 3.

    計算所有「資料」與「問題」的餘弦相似度。 4. 提取相似度前幾 高 的資料內容 5. 丟給 GPT / Gemini,請他根據提供的資料回答問題 40
  19. 42

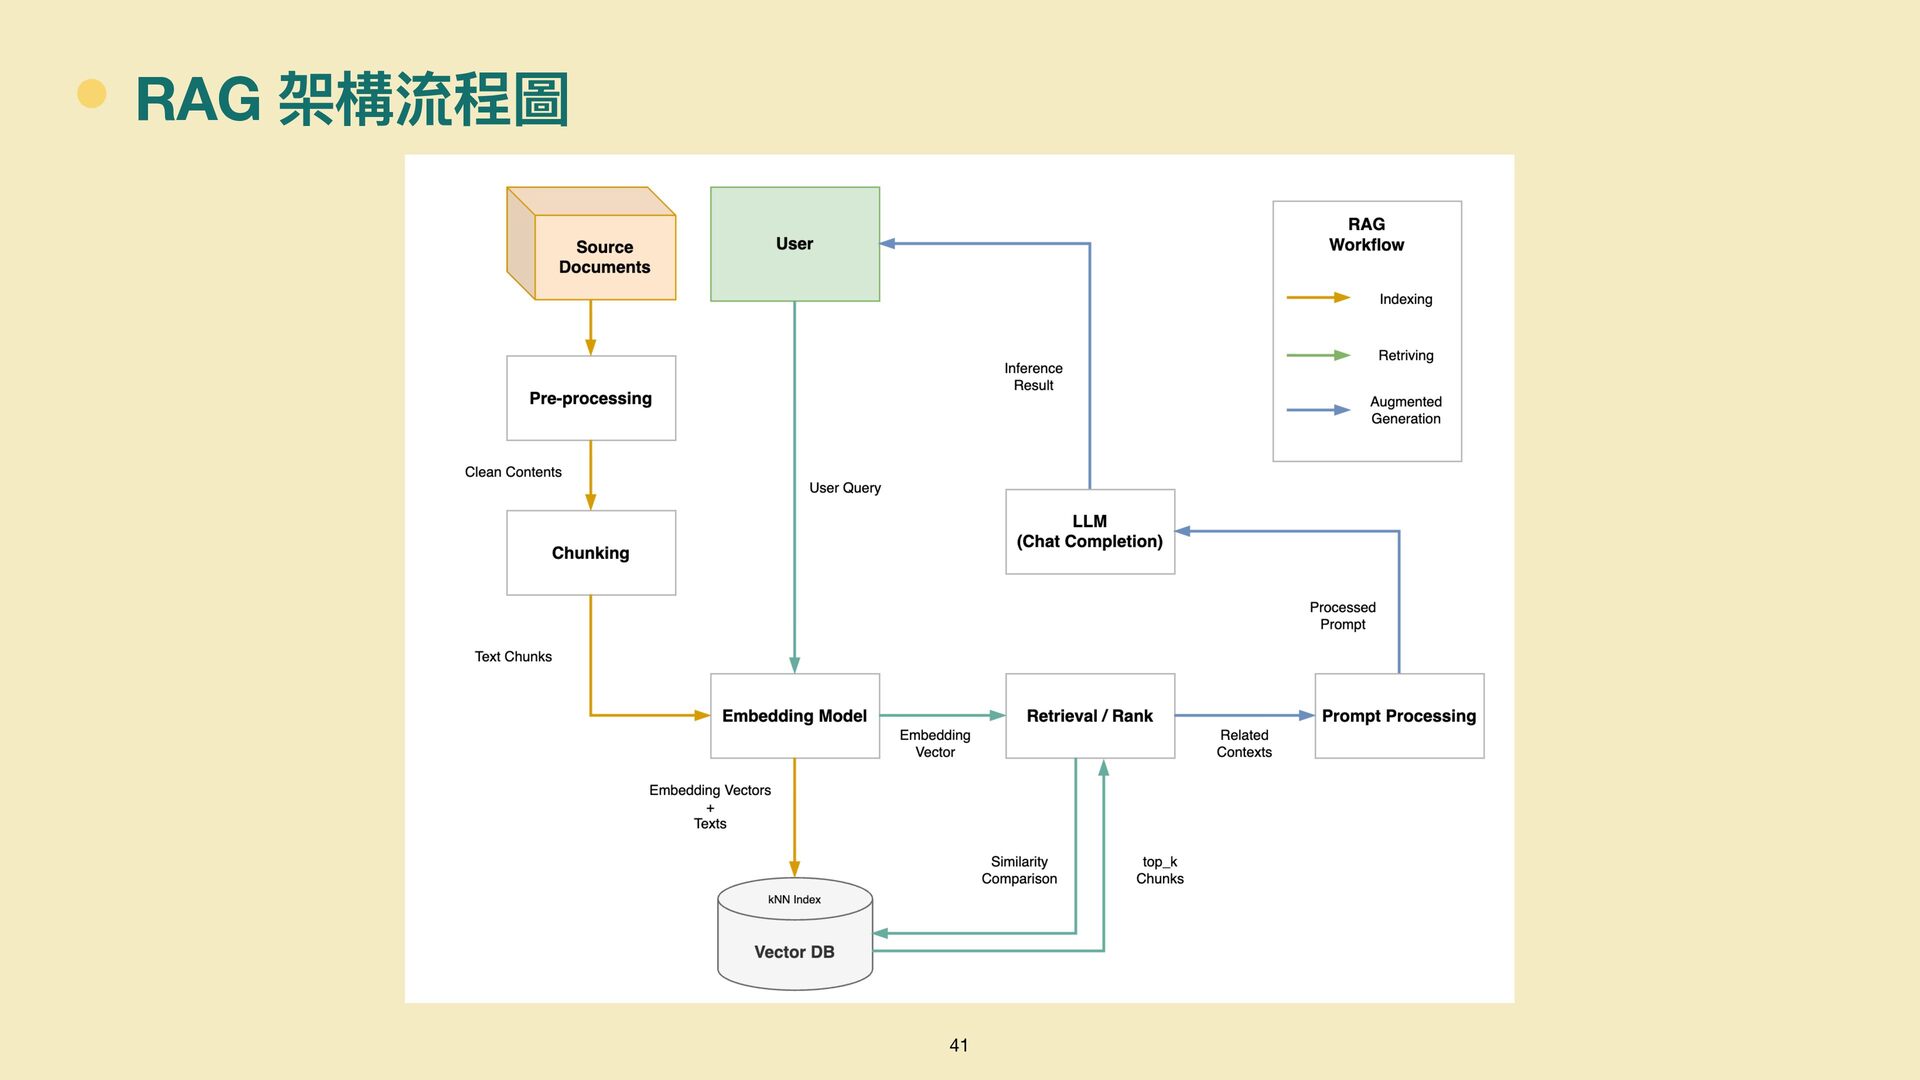
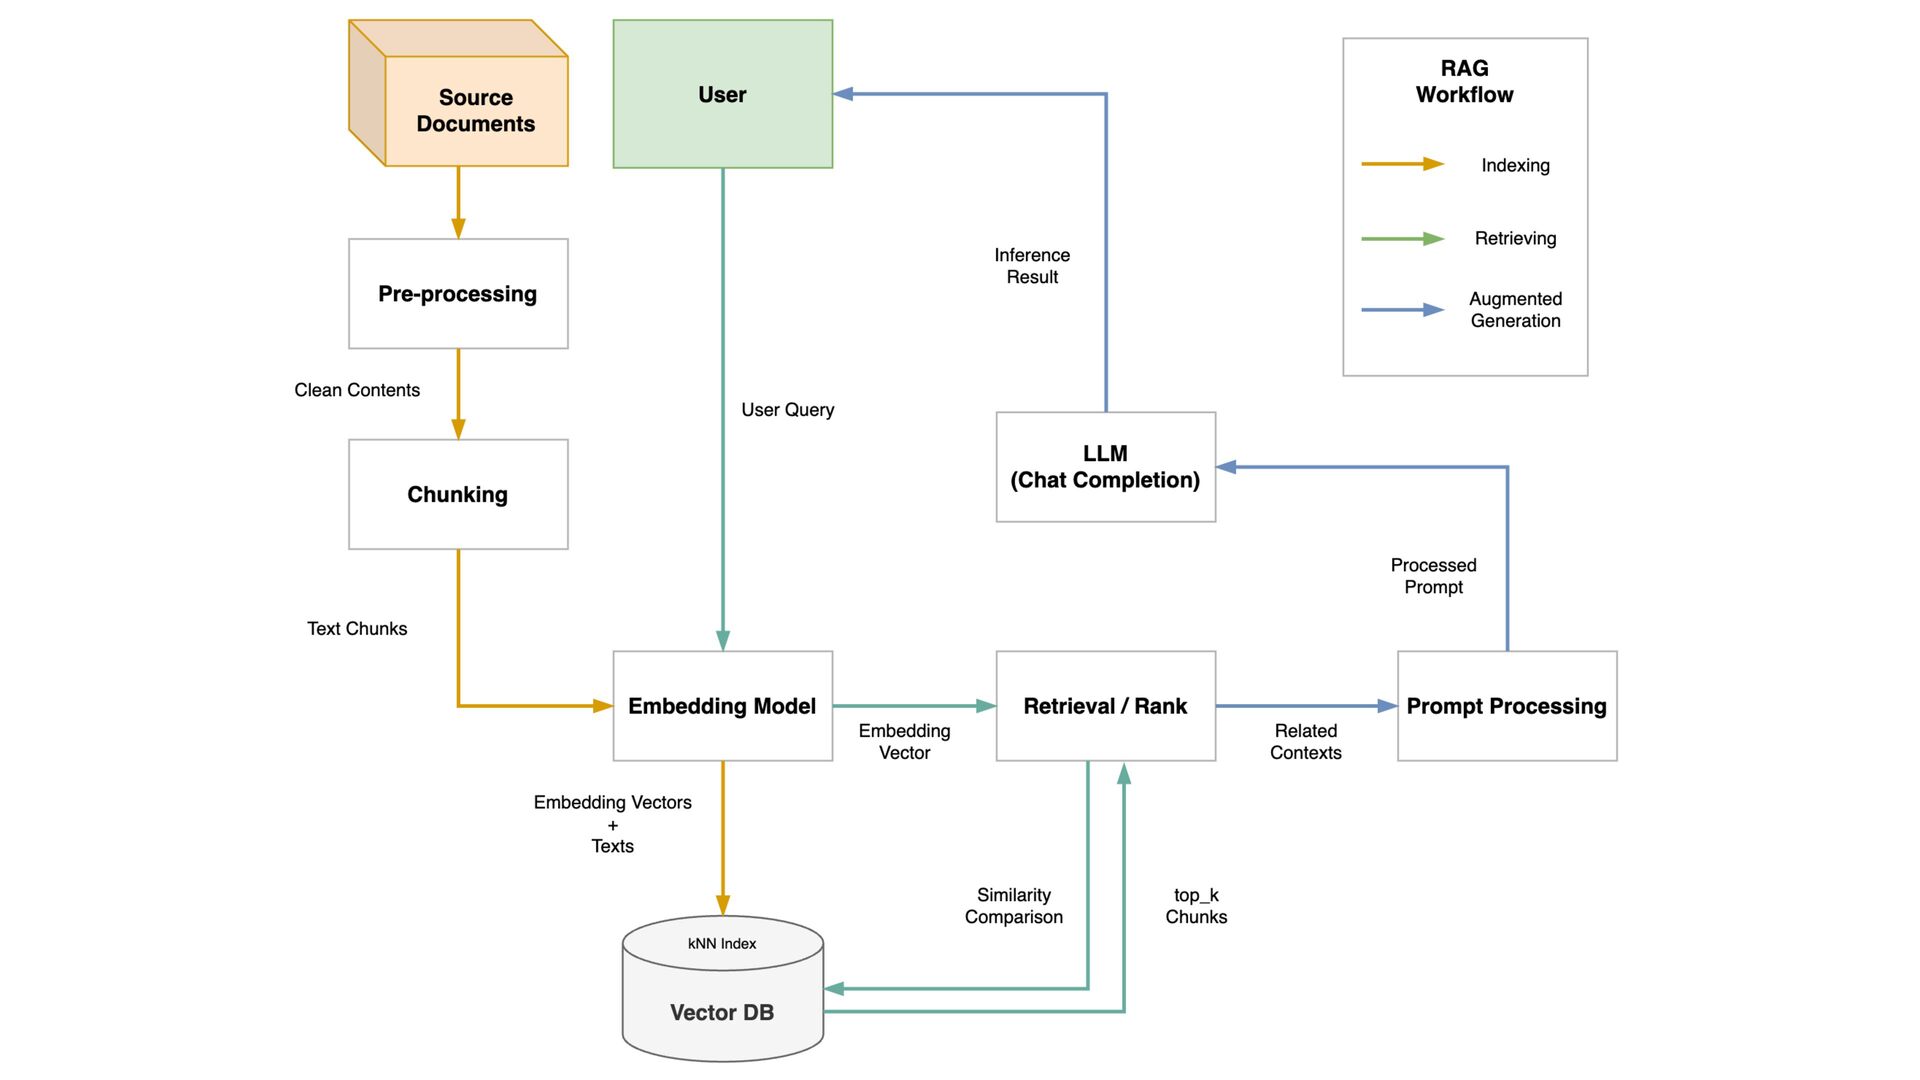
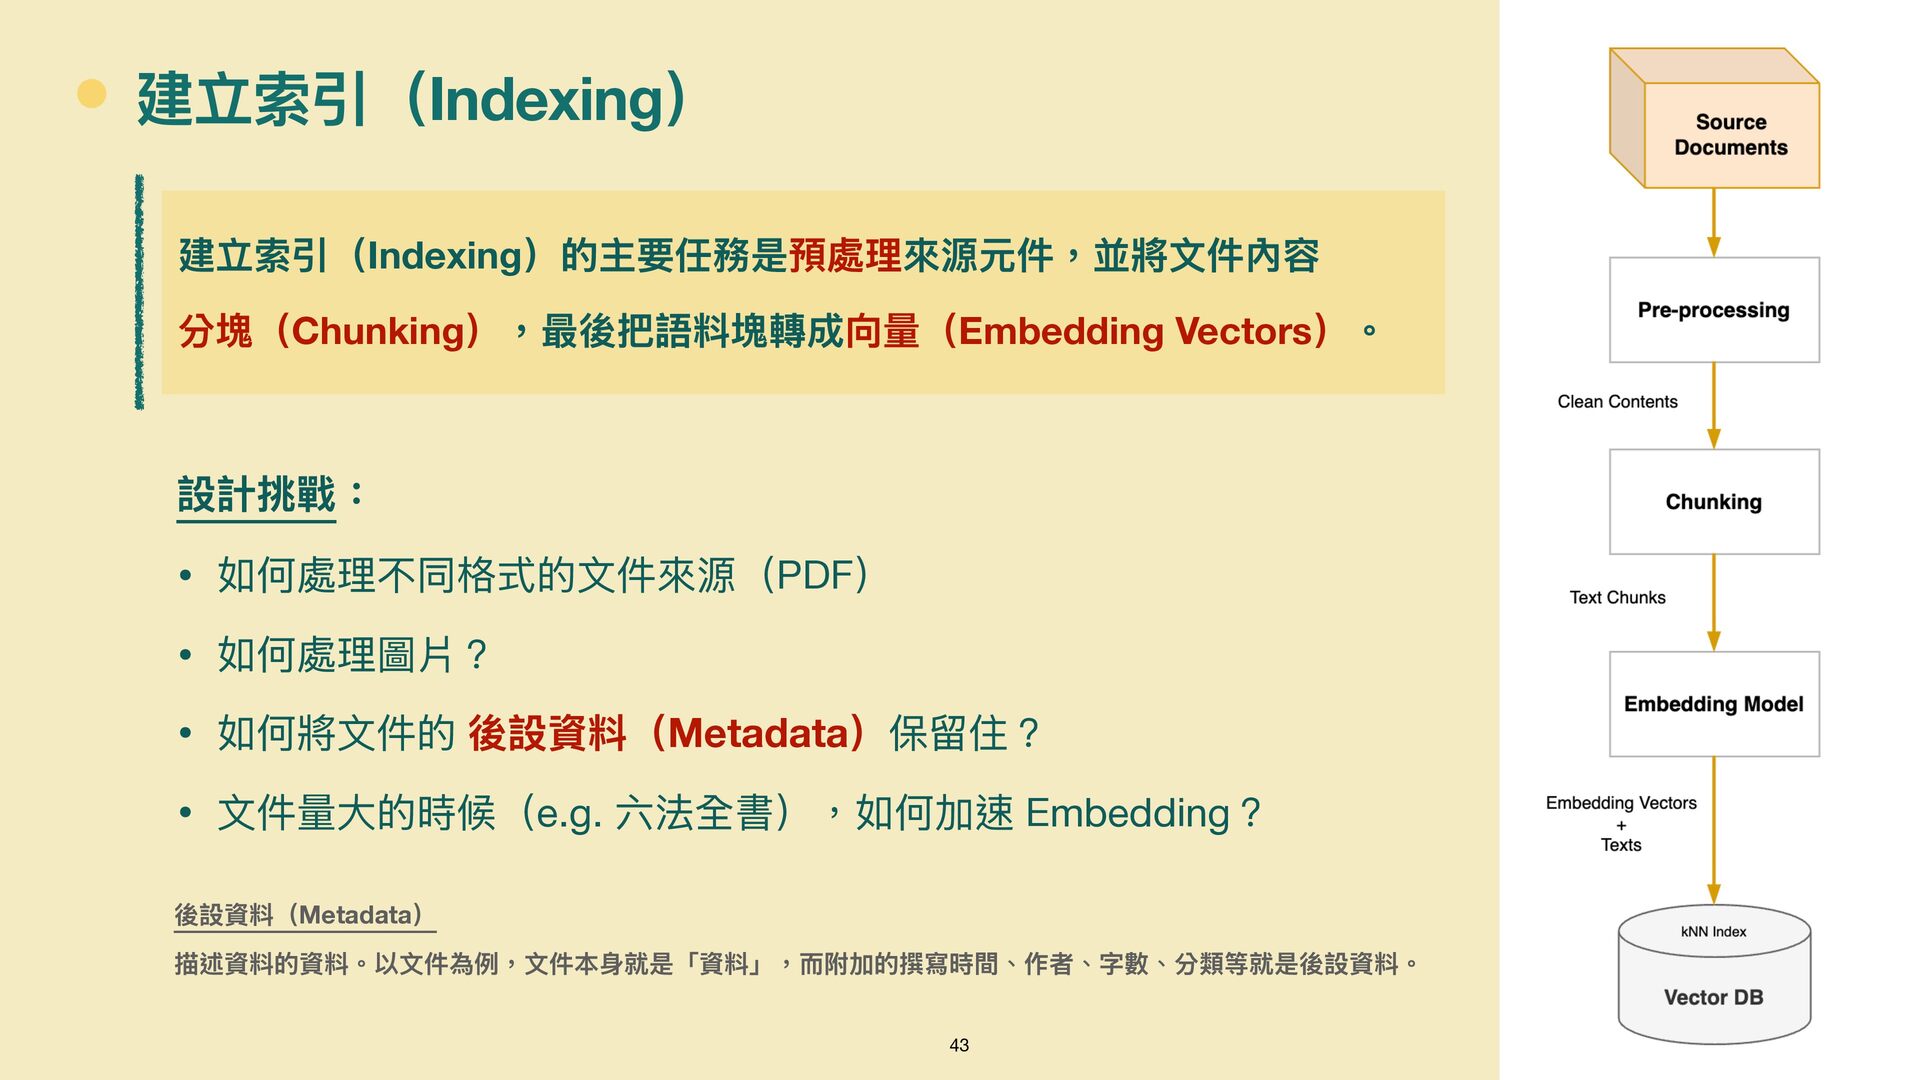
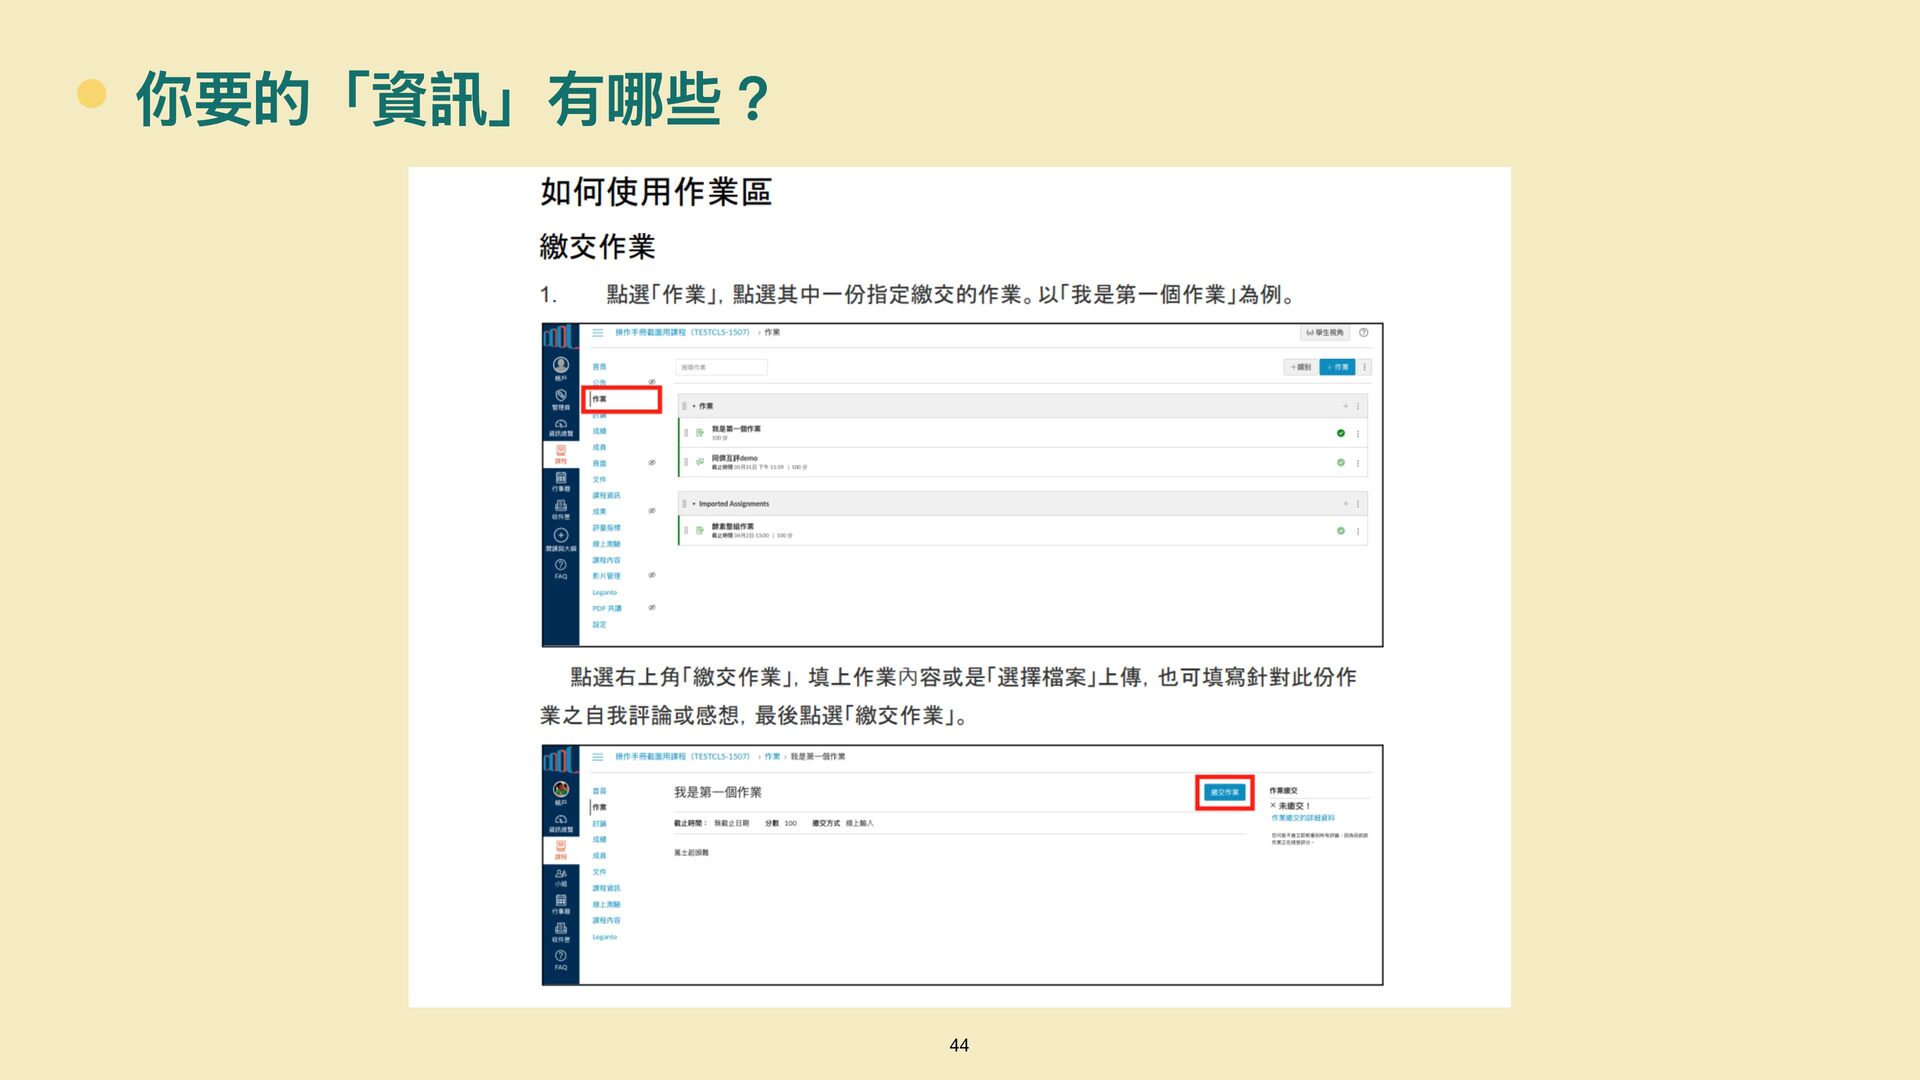
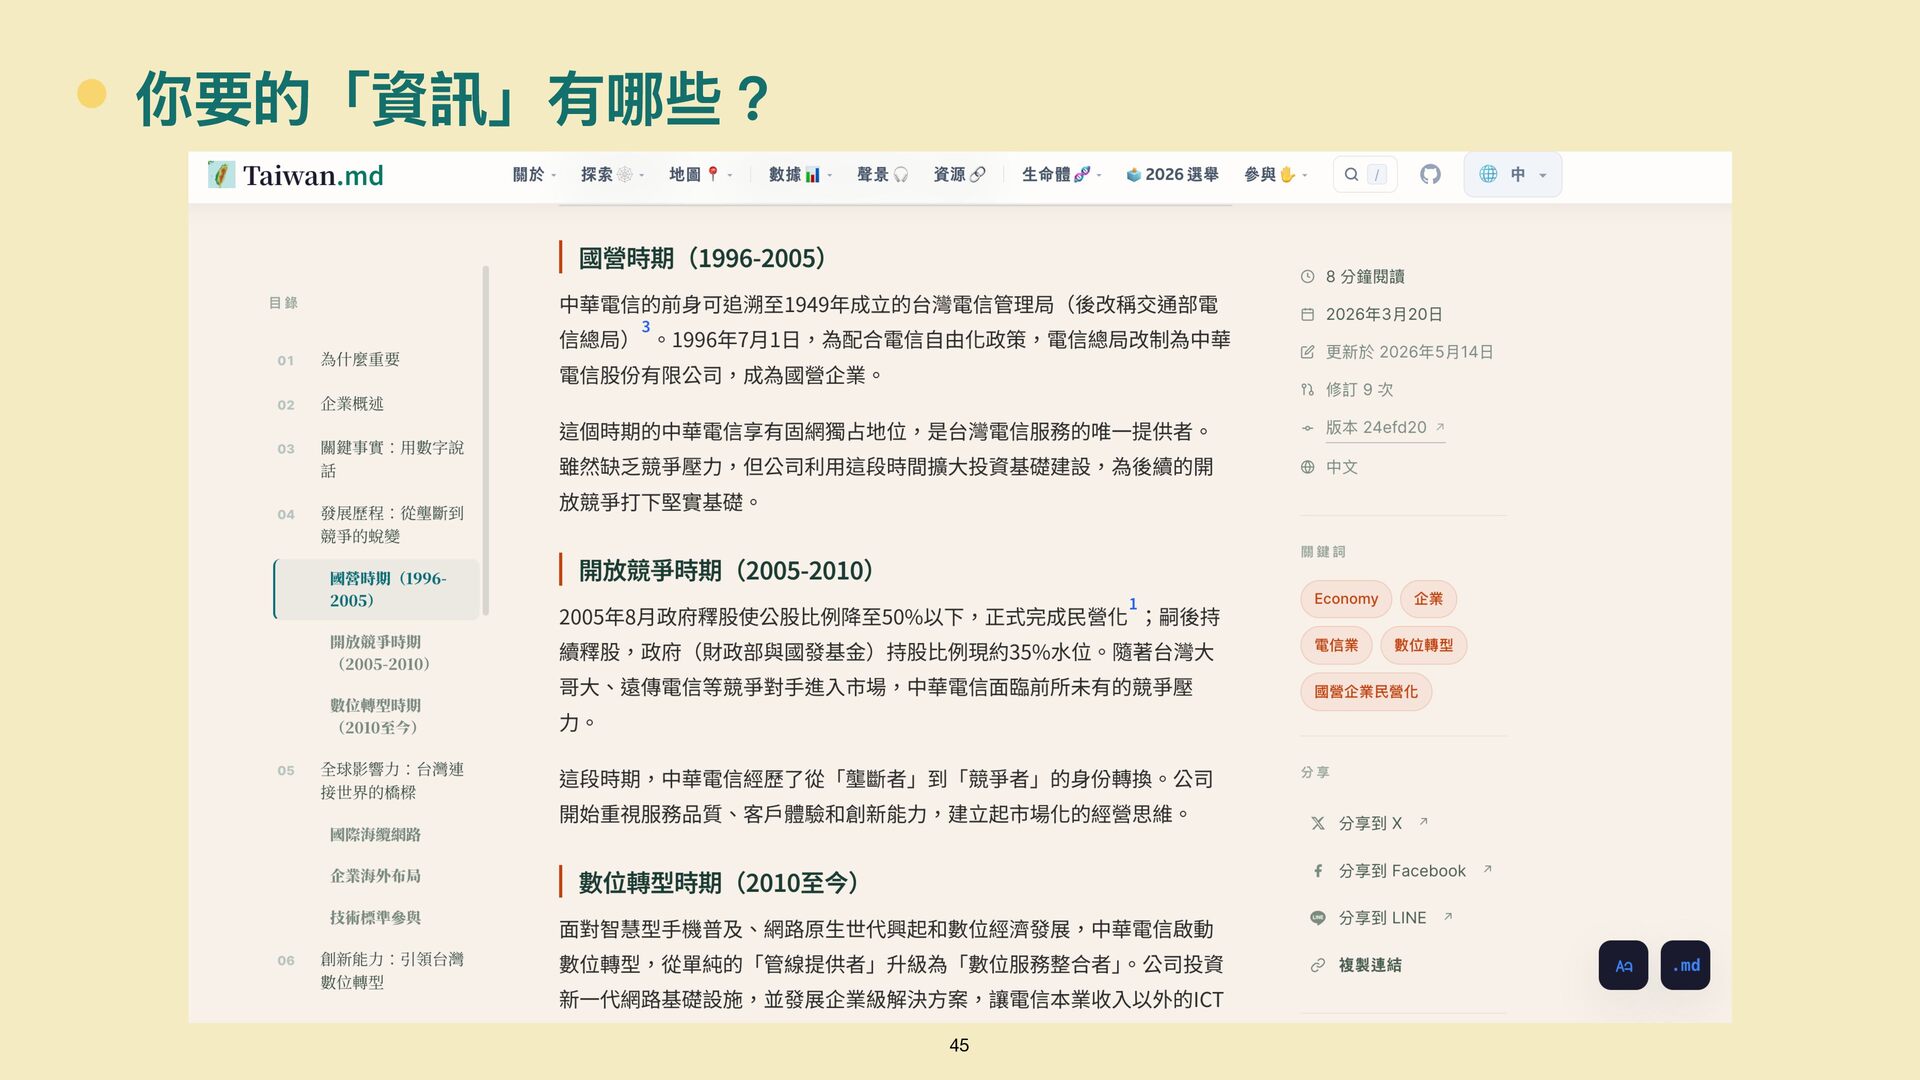
  20. 建立索引(Indexing) 建立索引(Indexing)的主要任務是預處理來源元件,並將 文 件內容 分塊(Chunking),最後把語料塊轉成向量(Embedding Vectors)。 43 設計挑戰: • 如何處理不同格式的

    文 件來源(PDF) • 如何處理圖片? • 如何將 文 件的 後設資料(Metadata)保留住? • 文 件量 大 的時候(e.g. 六法全書),如何加速 Embedding? 後設資料(Metadata)
 描述資料的資料。以 文 件為例, 文 件本 身 就是「資料」, 而 附加的撰寫時間、作者、字數、分類等就是後設資料。
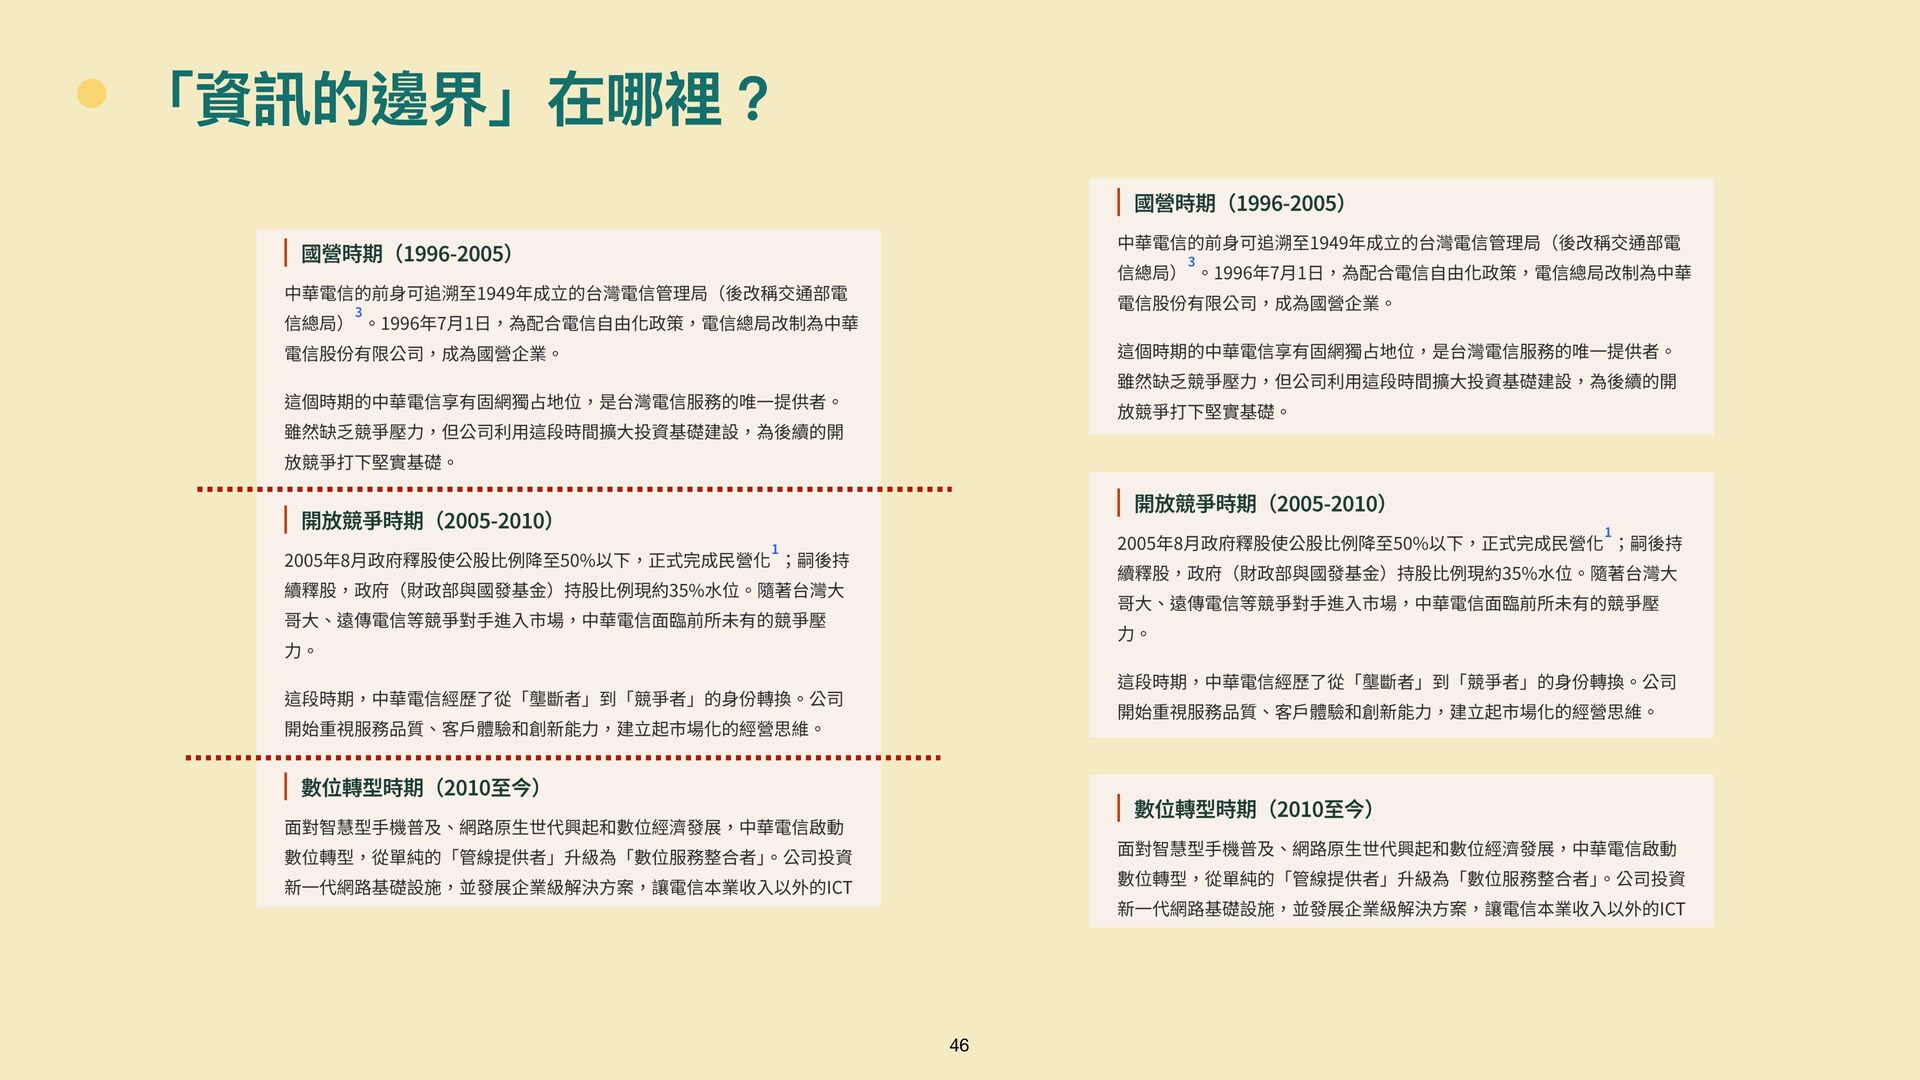
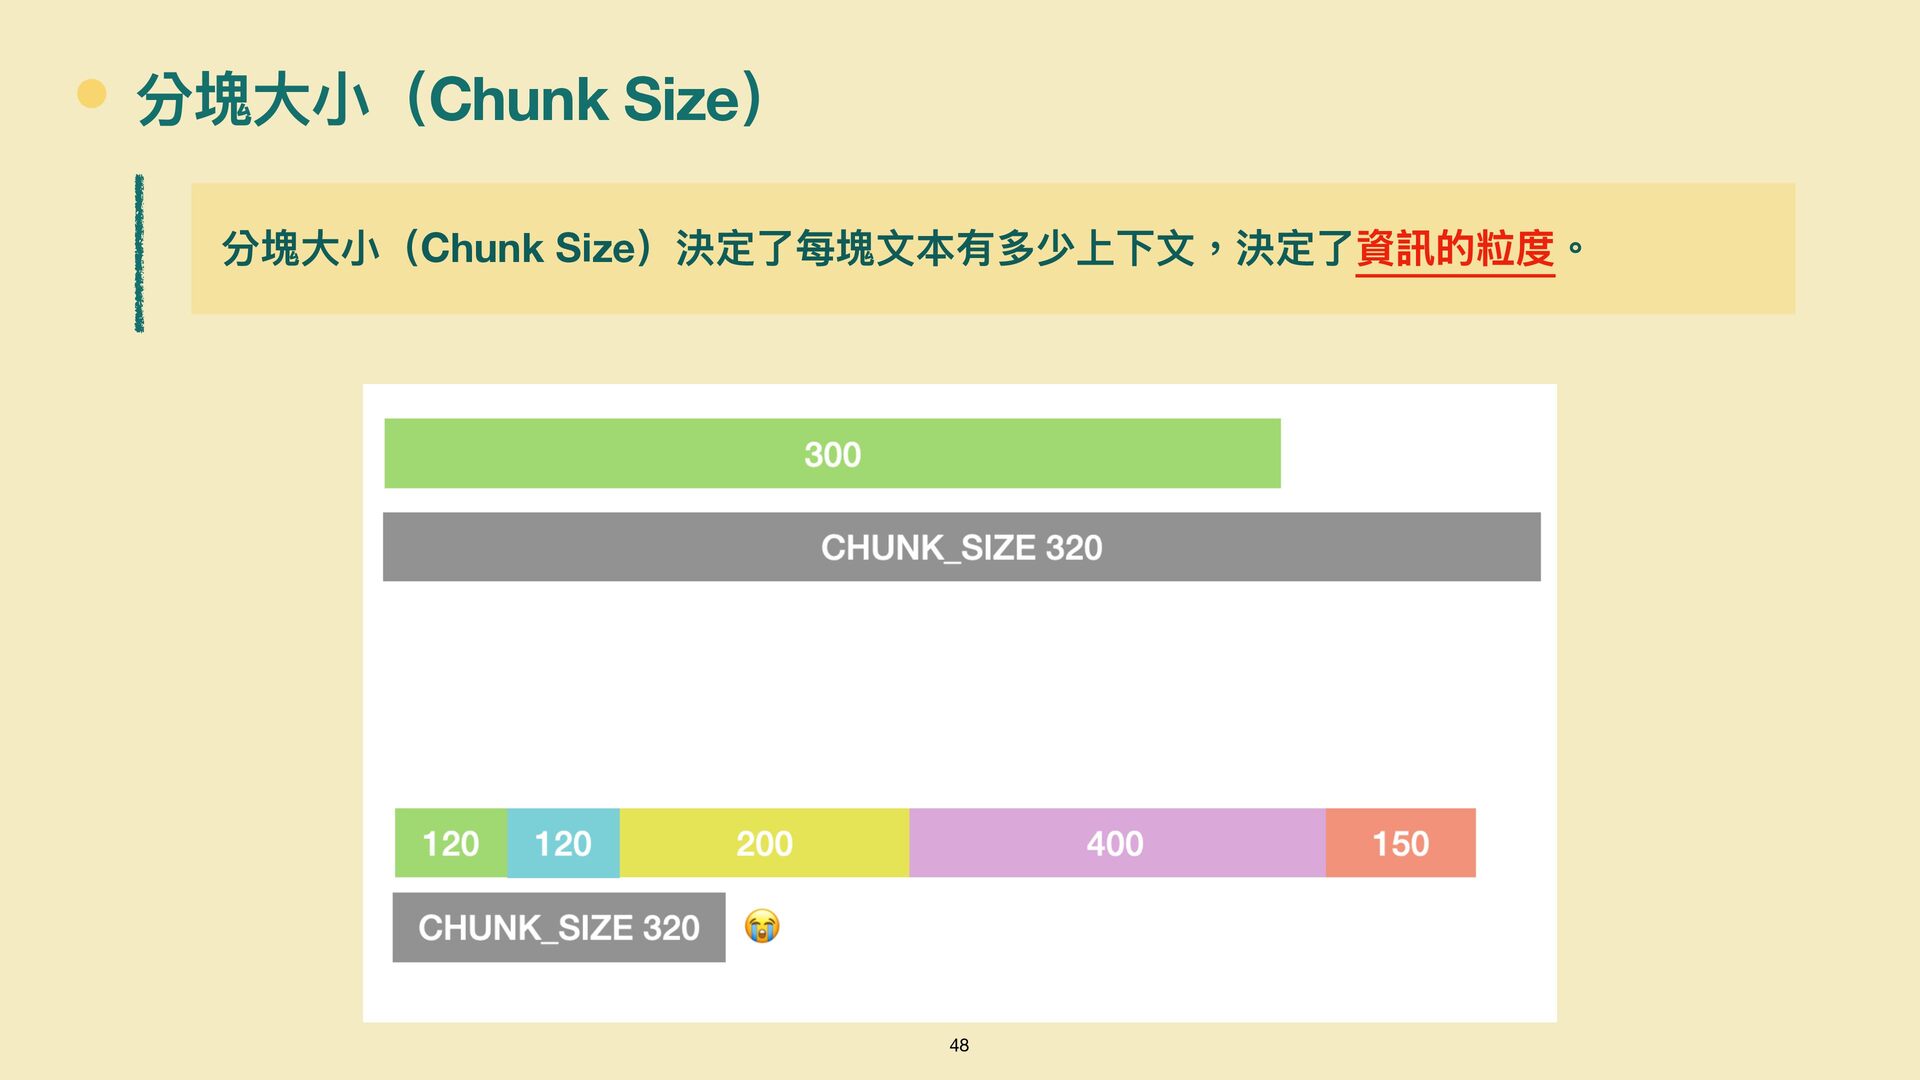
  21. 分塊 大 小 (Chunk Size) 分塊 大小 (Chunk Size)決定了每塊 文

    本有多少上下 文 ,決定了資訊的粒度。 48
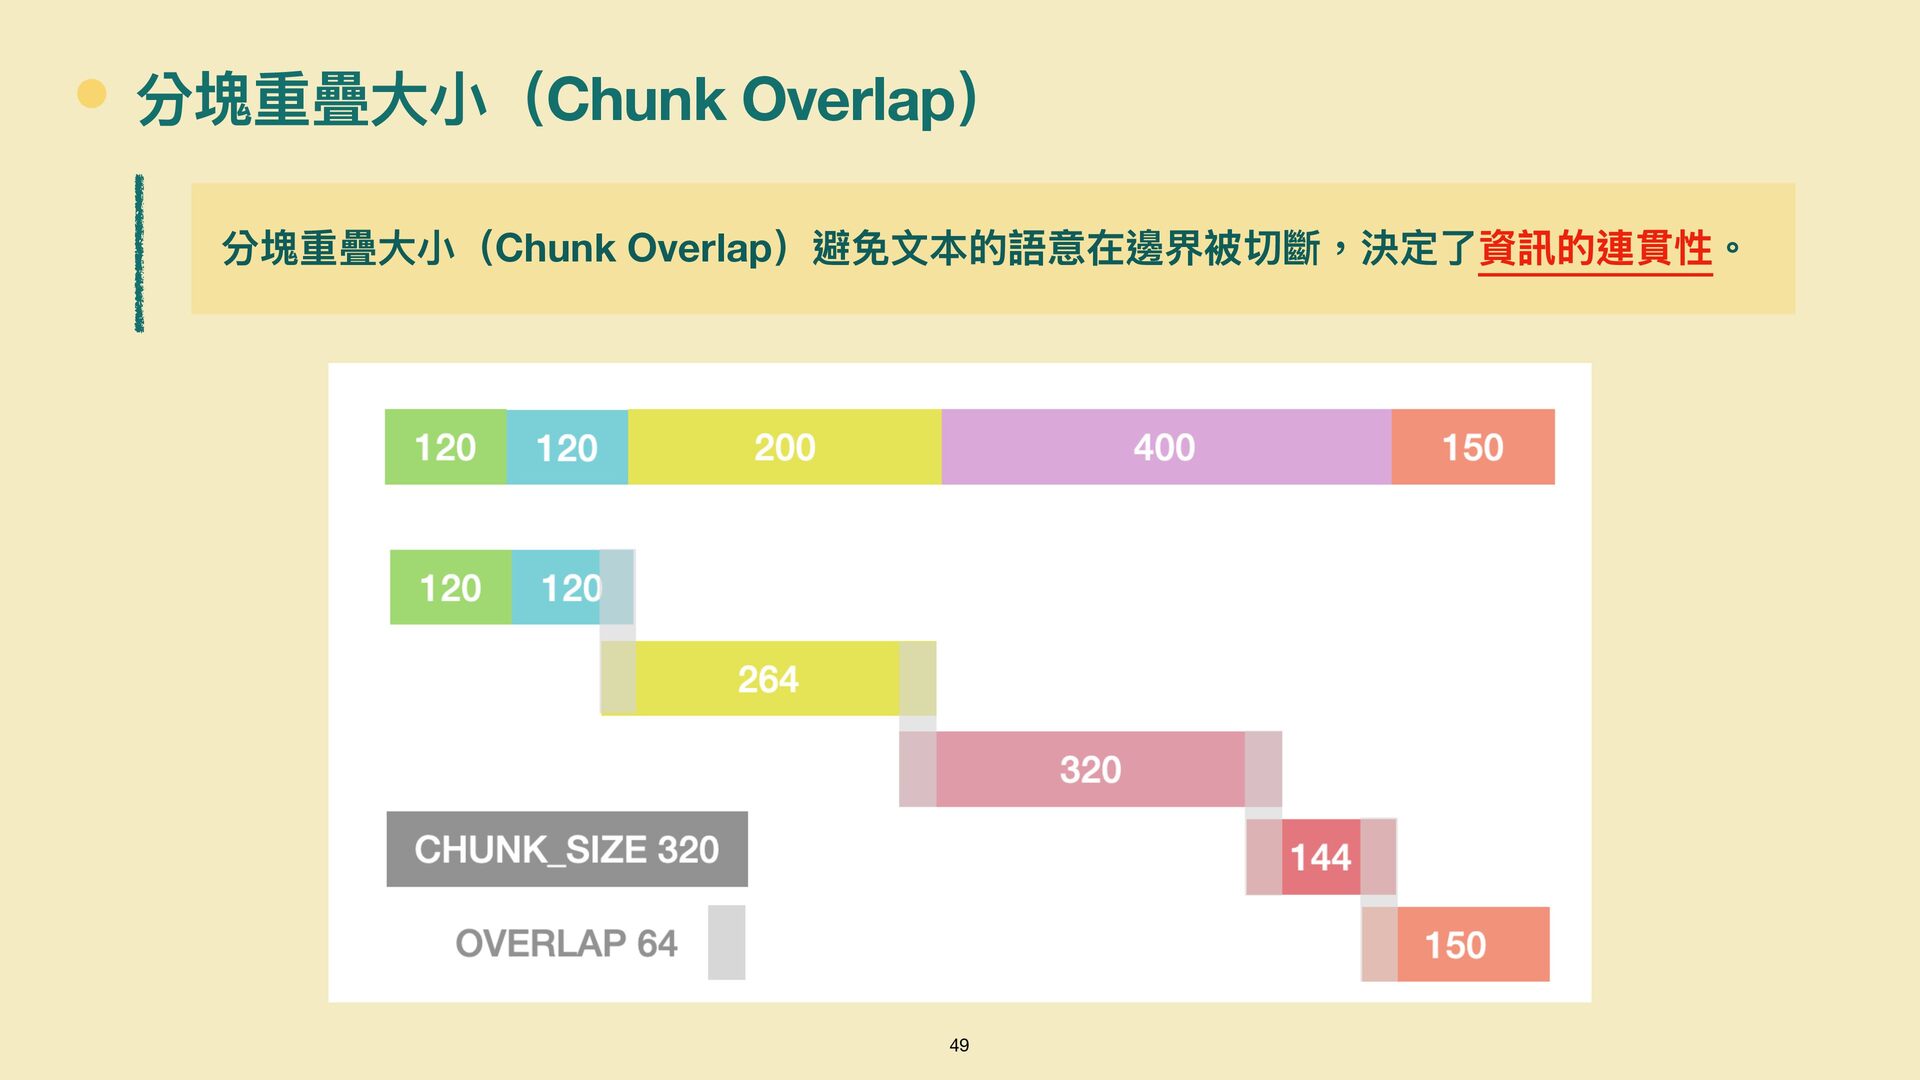
  22. 分塊重疊 大 小 (Chunk Overlap) 分塊重疊 大小 (Chunk Overlap)避免 文

    本的語意在邊界被切斷,決定了資訊的連貫性。 49
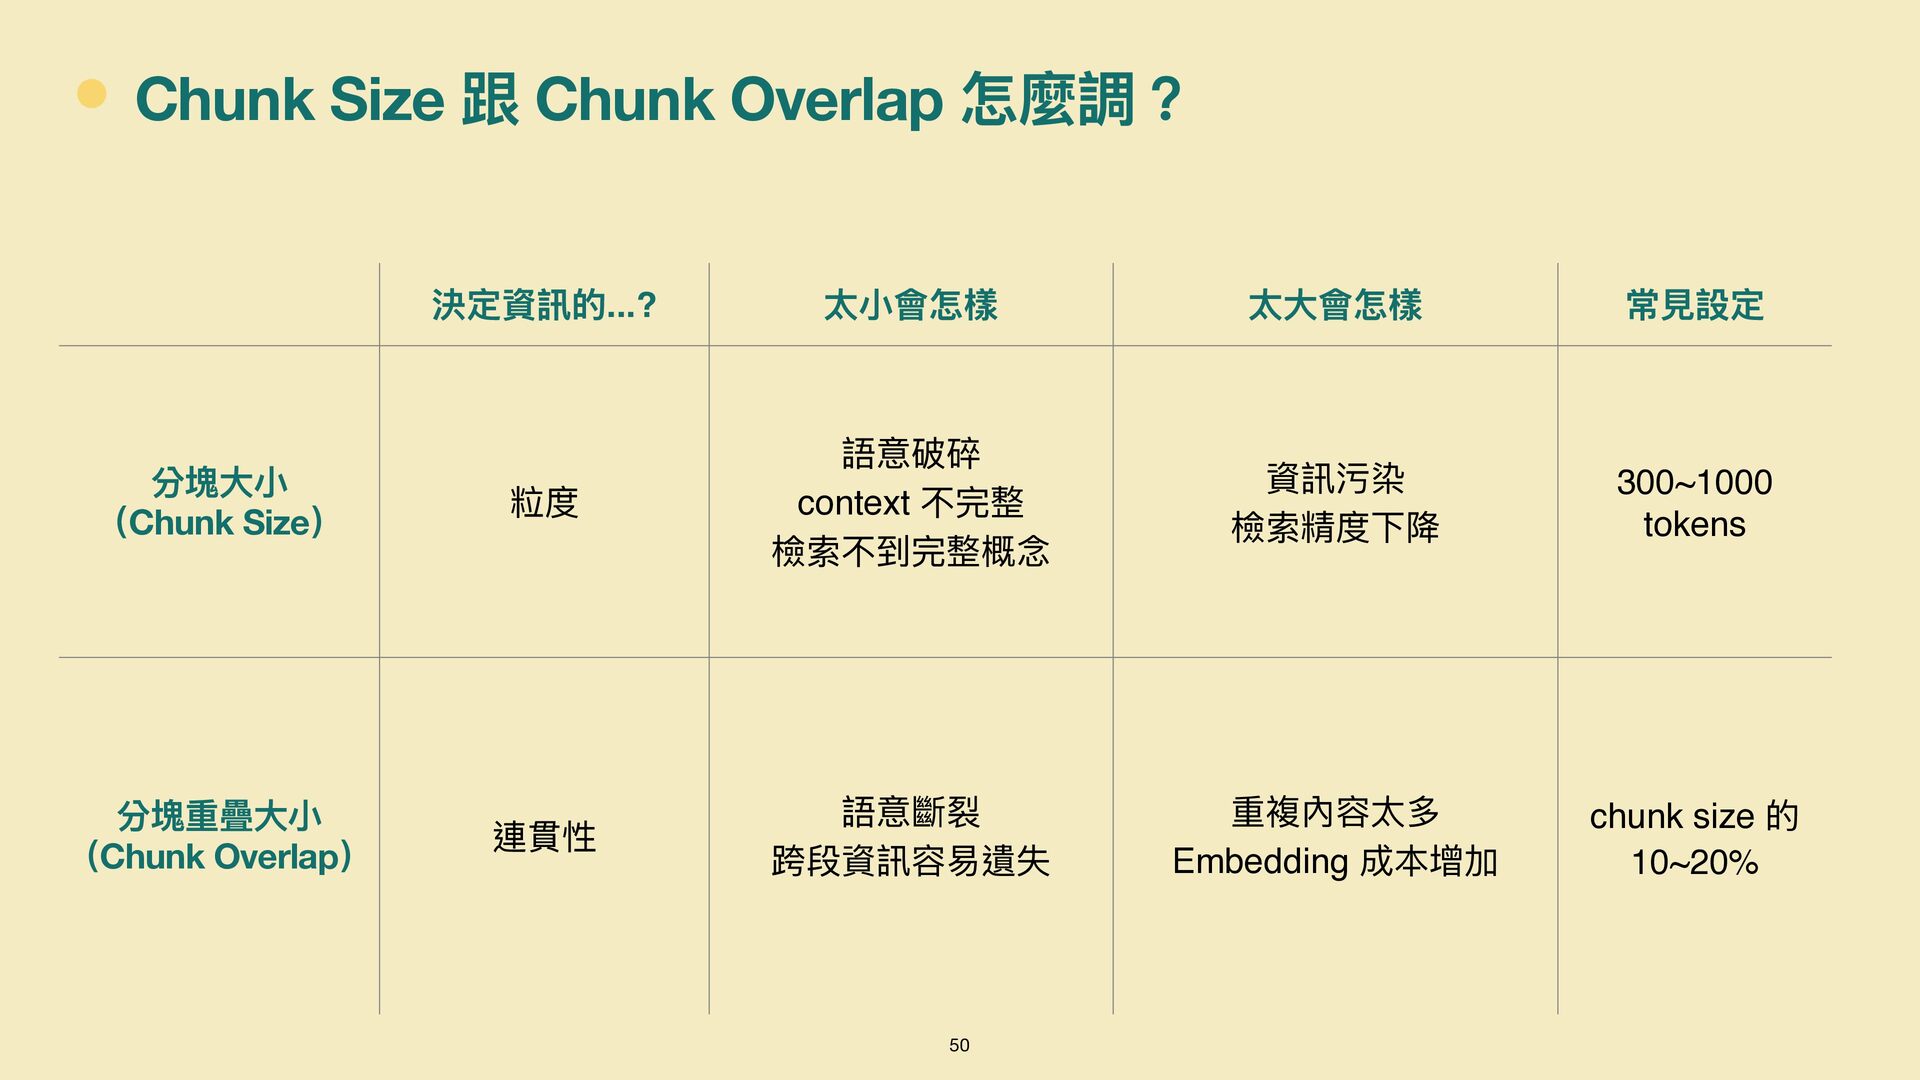
  23. Chunk Size 跟 Chunk Overlap 怎麼調? 決定資訊的...? 太 小 會怎樣

    太 大 會怎樣 常 見 設定 分塊 大 小 
 (Chunk Size) 粒度 語意破碎 context 不完整 檢索不到完整概念 資訊污染 檢索精度下降 300~1000 tokens 分塊重疊 大 小 
 (Chunk Overlap) 連貫性 語意斷裂 跨段資訊容易遺失 重複內容太多 Embedding 成本增加 chunk size 的 10~20% 50
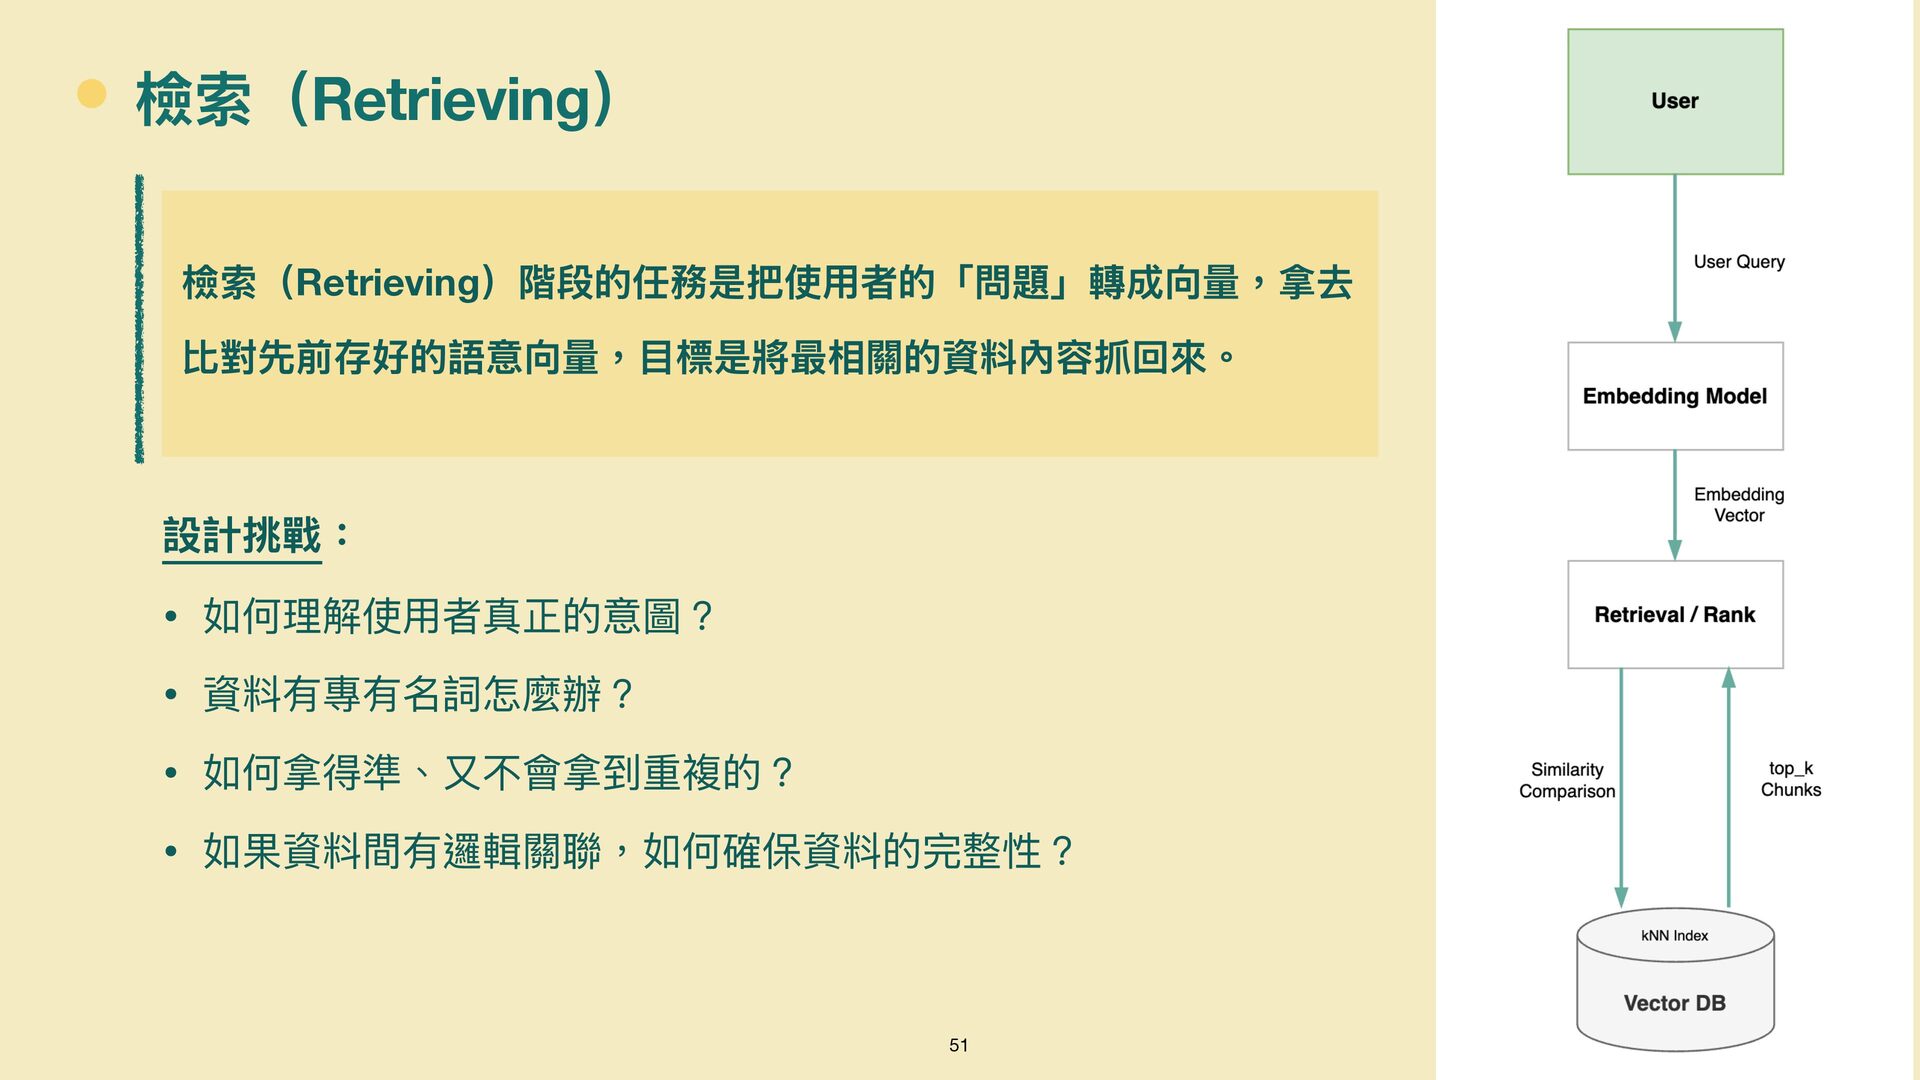
  24. 檢索(Retrieving) 檢索(Retrieving)階段的任務是把使 用 者的「問題」轉成向量,拿去 比對先前存好的語意向量, 目 標是將最相關的資料內容抓回來。 51 設計挑戰: •

    如何理解使 用 者真正的意圖? • 資料有專有名詞怎麼辦? • 如何拿得準、 又 不會拿到重複的? • 如果資料間有邏輯關聯,如何確保資料的完整性?
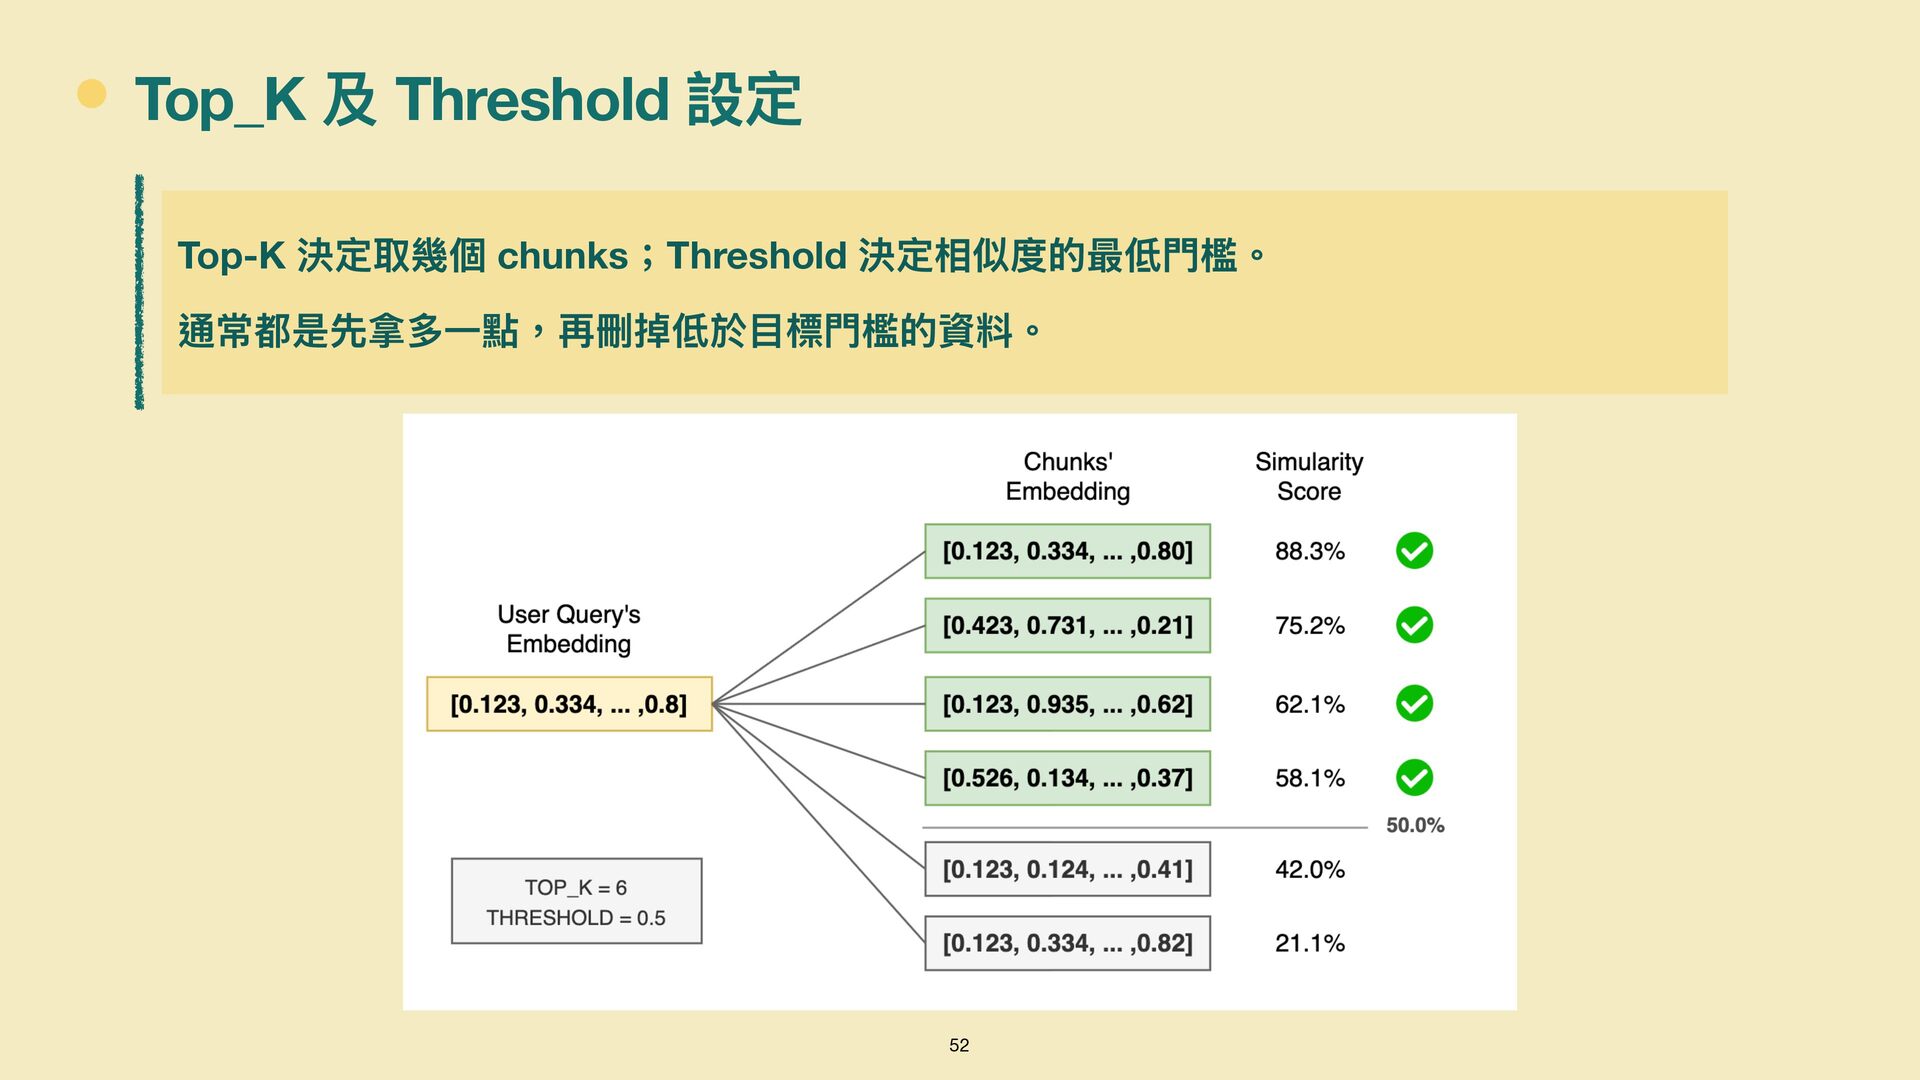
  25. Top_K 及 Threshold 設定 Top-K 決定取幾個 chunks;Threshold 決定相似度的最低 門 檻。

    通常都是先拿多 一 點,再刪掉低於 目 標 門 檻的資料。 52
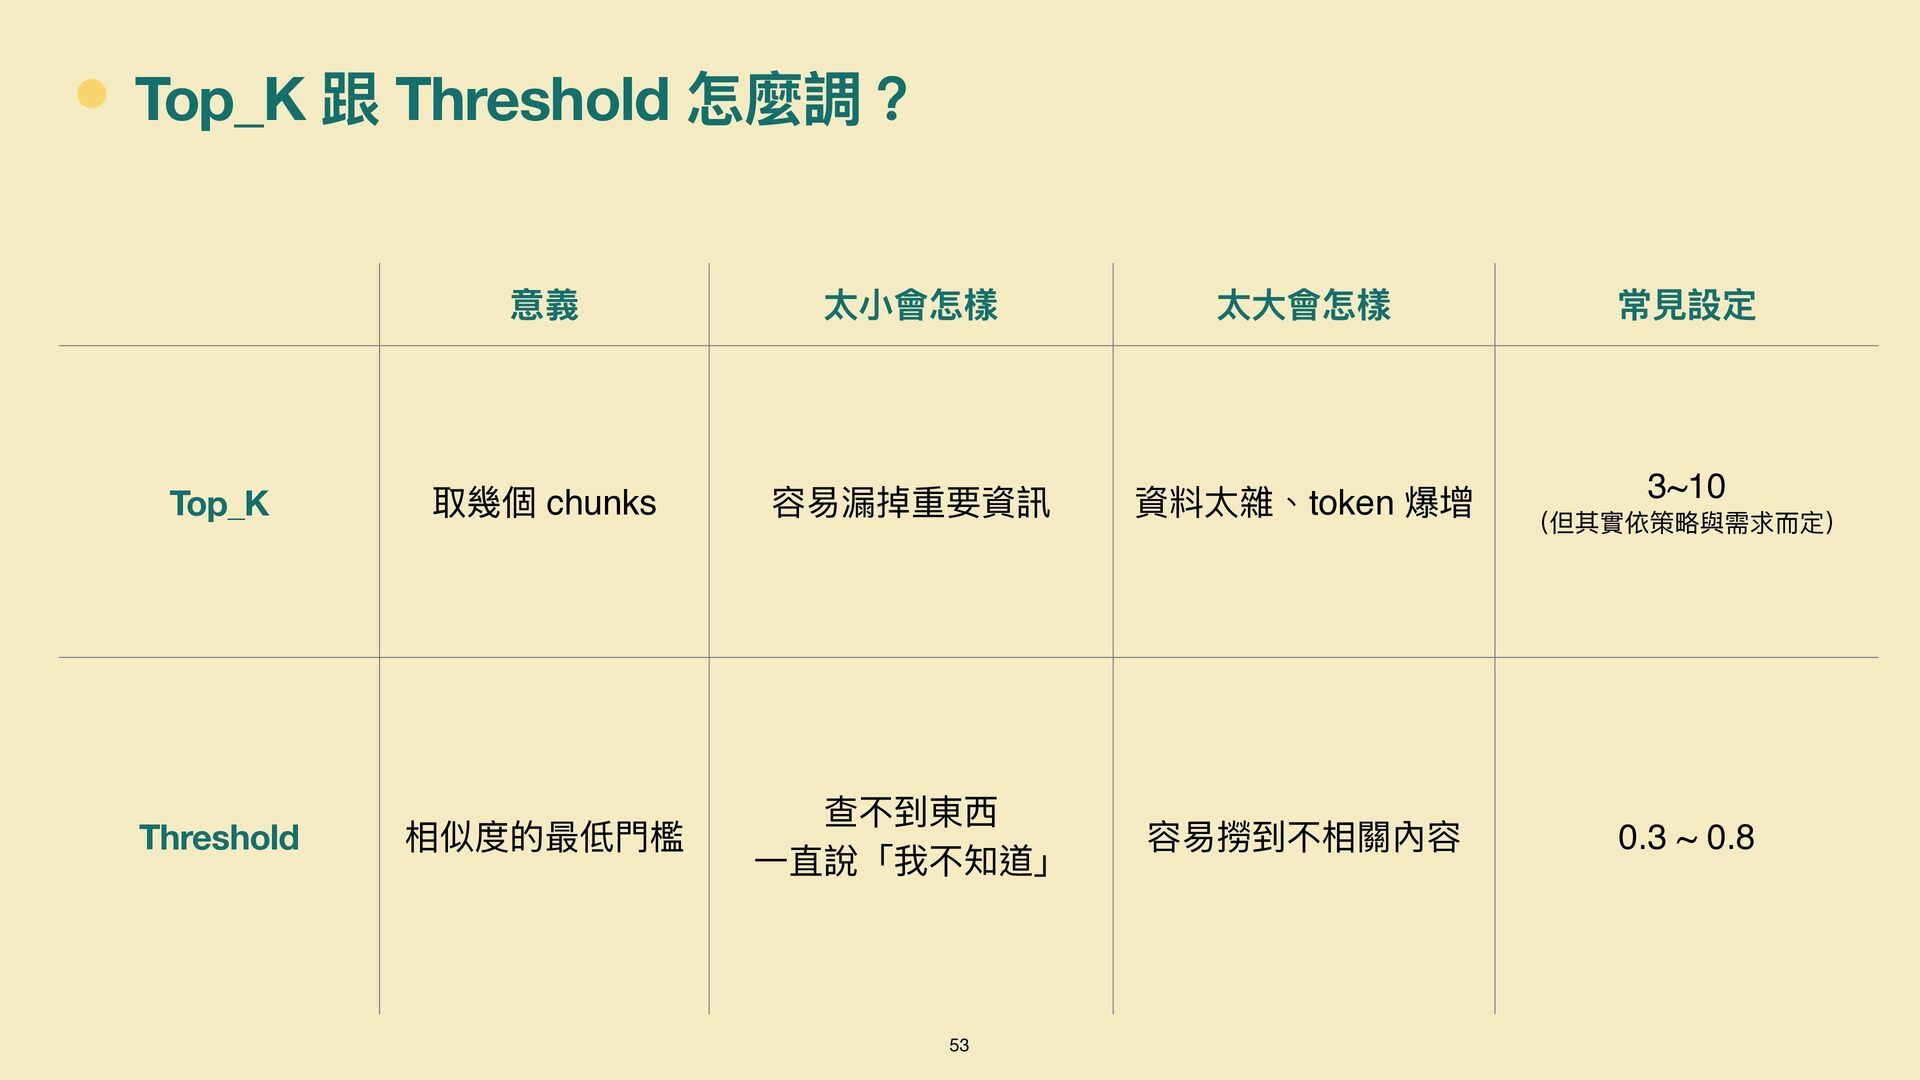
  26. 53 Top_K 跟 Threshold 怎麼調? 意義 太 小 會怎樣 太

    大 會怎樣 常 見 設定 Top_K 取幾個 chunks 容易漏掉重要資訊 資料太雜、token 爆增 3~10 (但其實依策略與需求 而 定) Threshold 相似度的最低 門 檻 查不到東 西 一 直說「我不知道」 容易撈到不相關內容 0.3 ~ 0.8
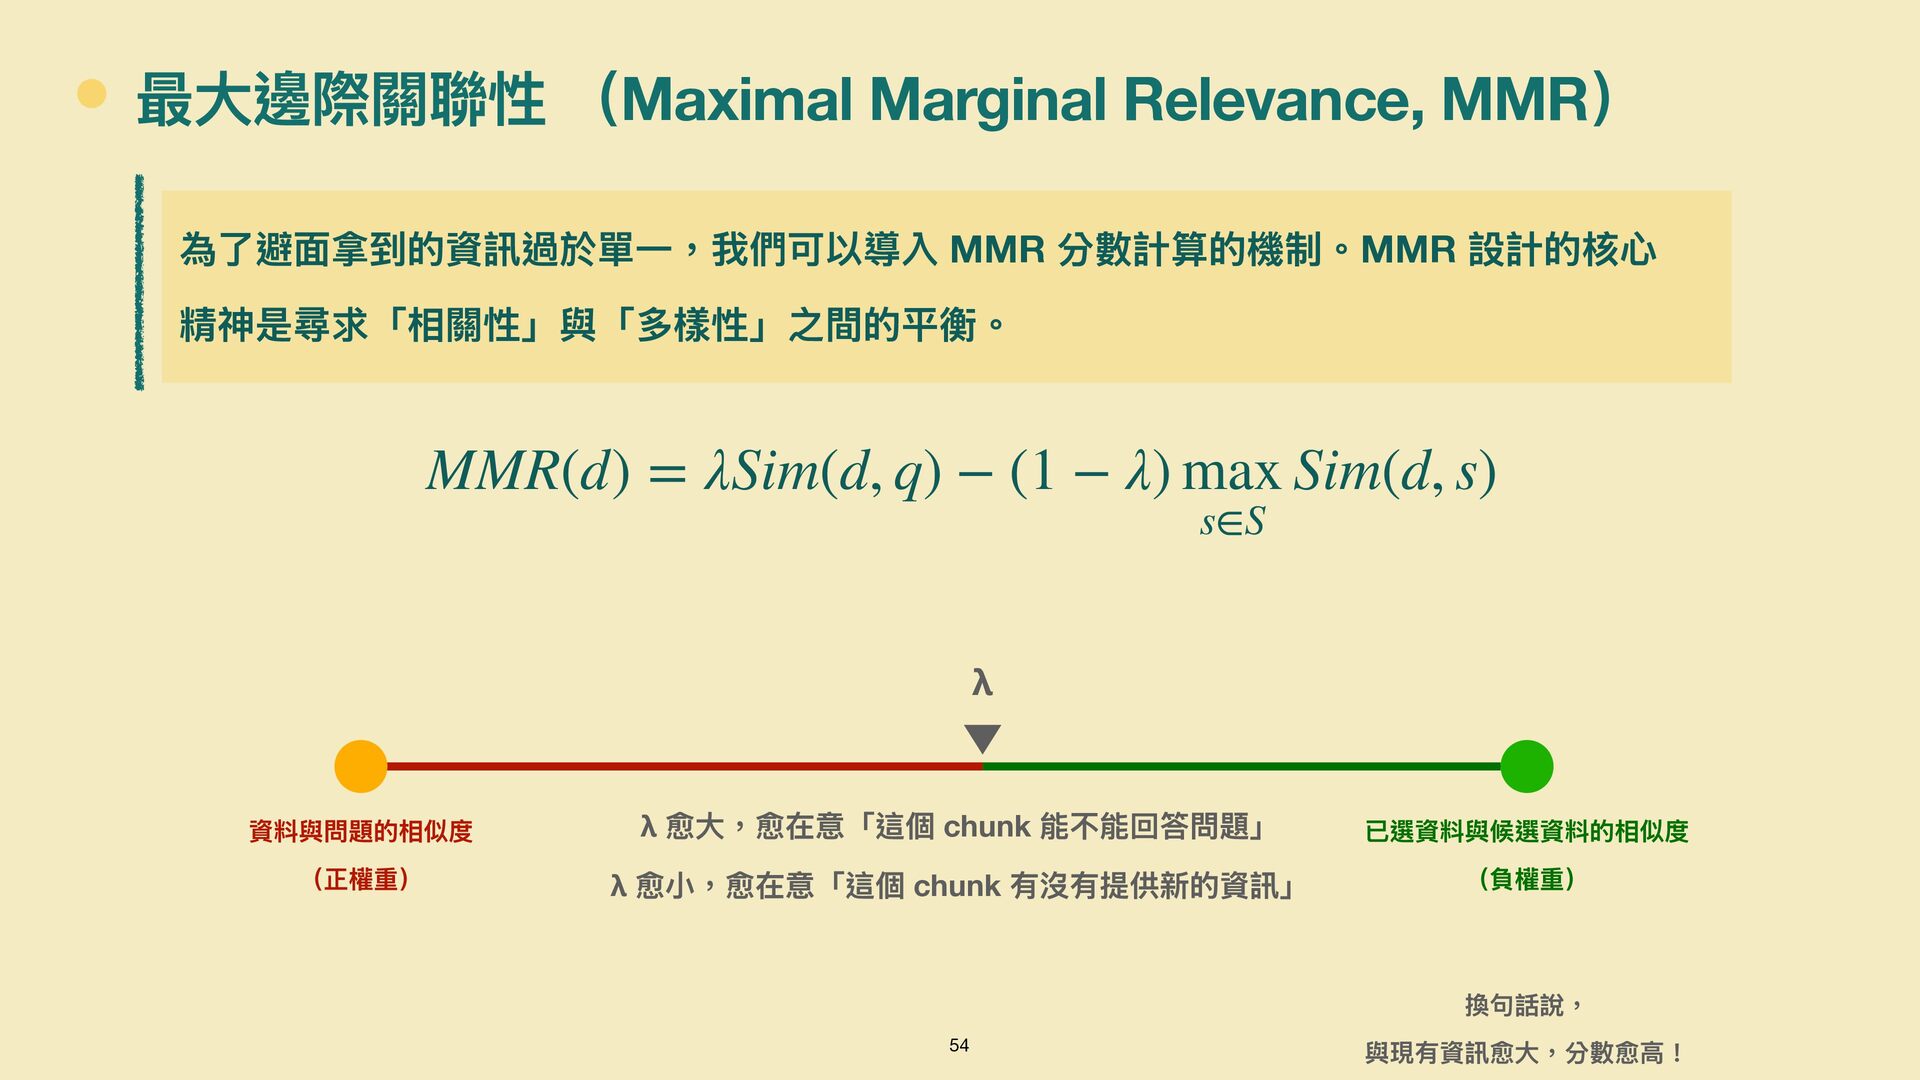
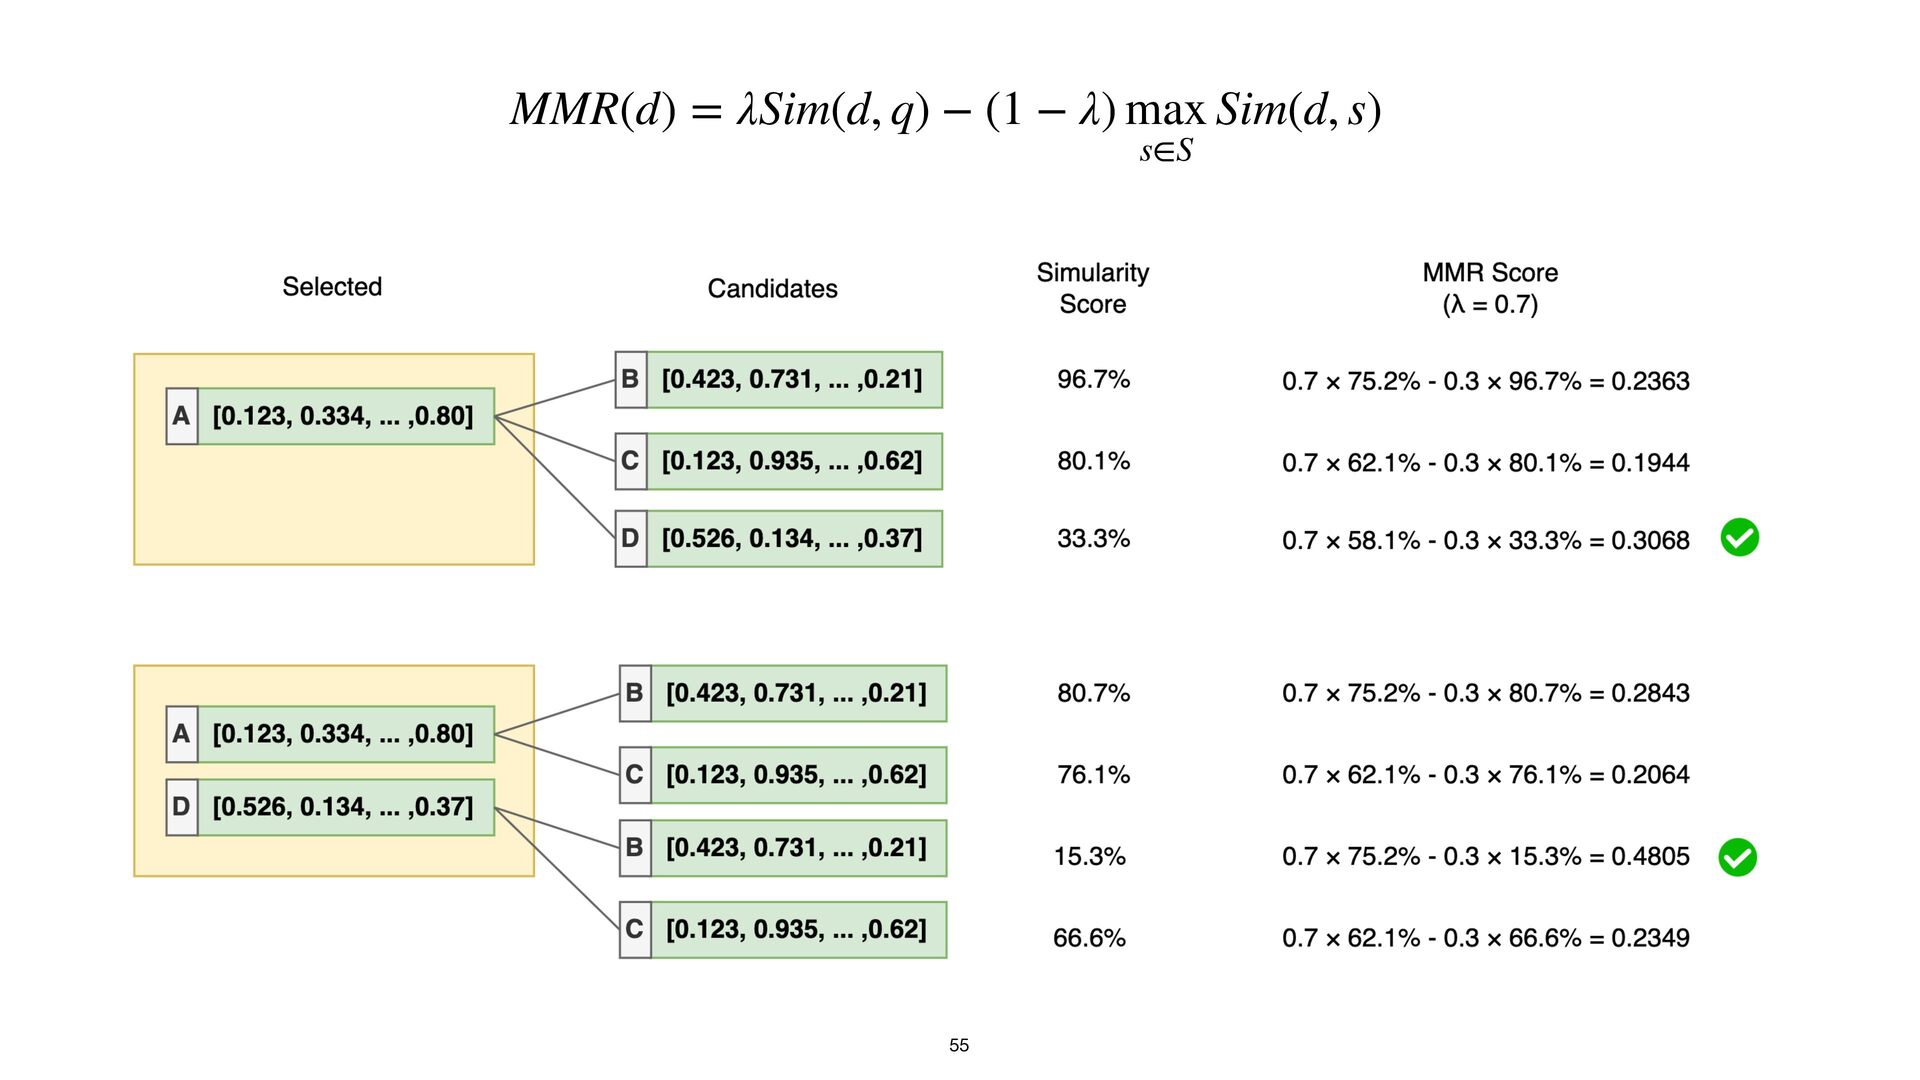
  27. 最 大 邊際關聯性 (Maximal Marginal Relevance, MMR) 54 為了避 面
    拿到的資訊過於單 一 ,我們可以導入 MMR 分數計算的機制。MMR 設計的核 心 精神是尋求「相關性」與「多樣性」之間的平衡。 MMR(d) = λSim(d, q) − (1 − λ) max s∈S Sim(d, s) λ 資料與問題的相似度 (正權重) 已選資料與候選資料的相似度 (負權重) λ 愈 大 ,愈在意「這個 chunk 能不能回答問題」 λ 愈 小 ,愈在意「這個 chunk 有沒有提供新的資訊」 換句話說, 與現有資訊愈 大 ,分數愈 高 !
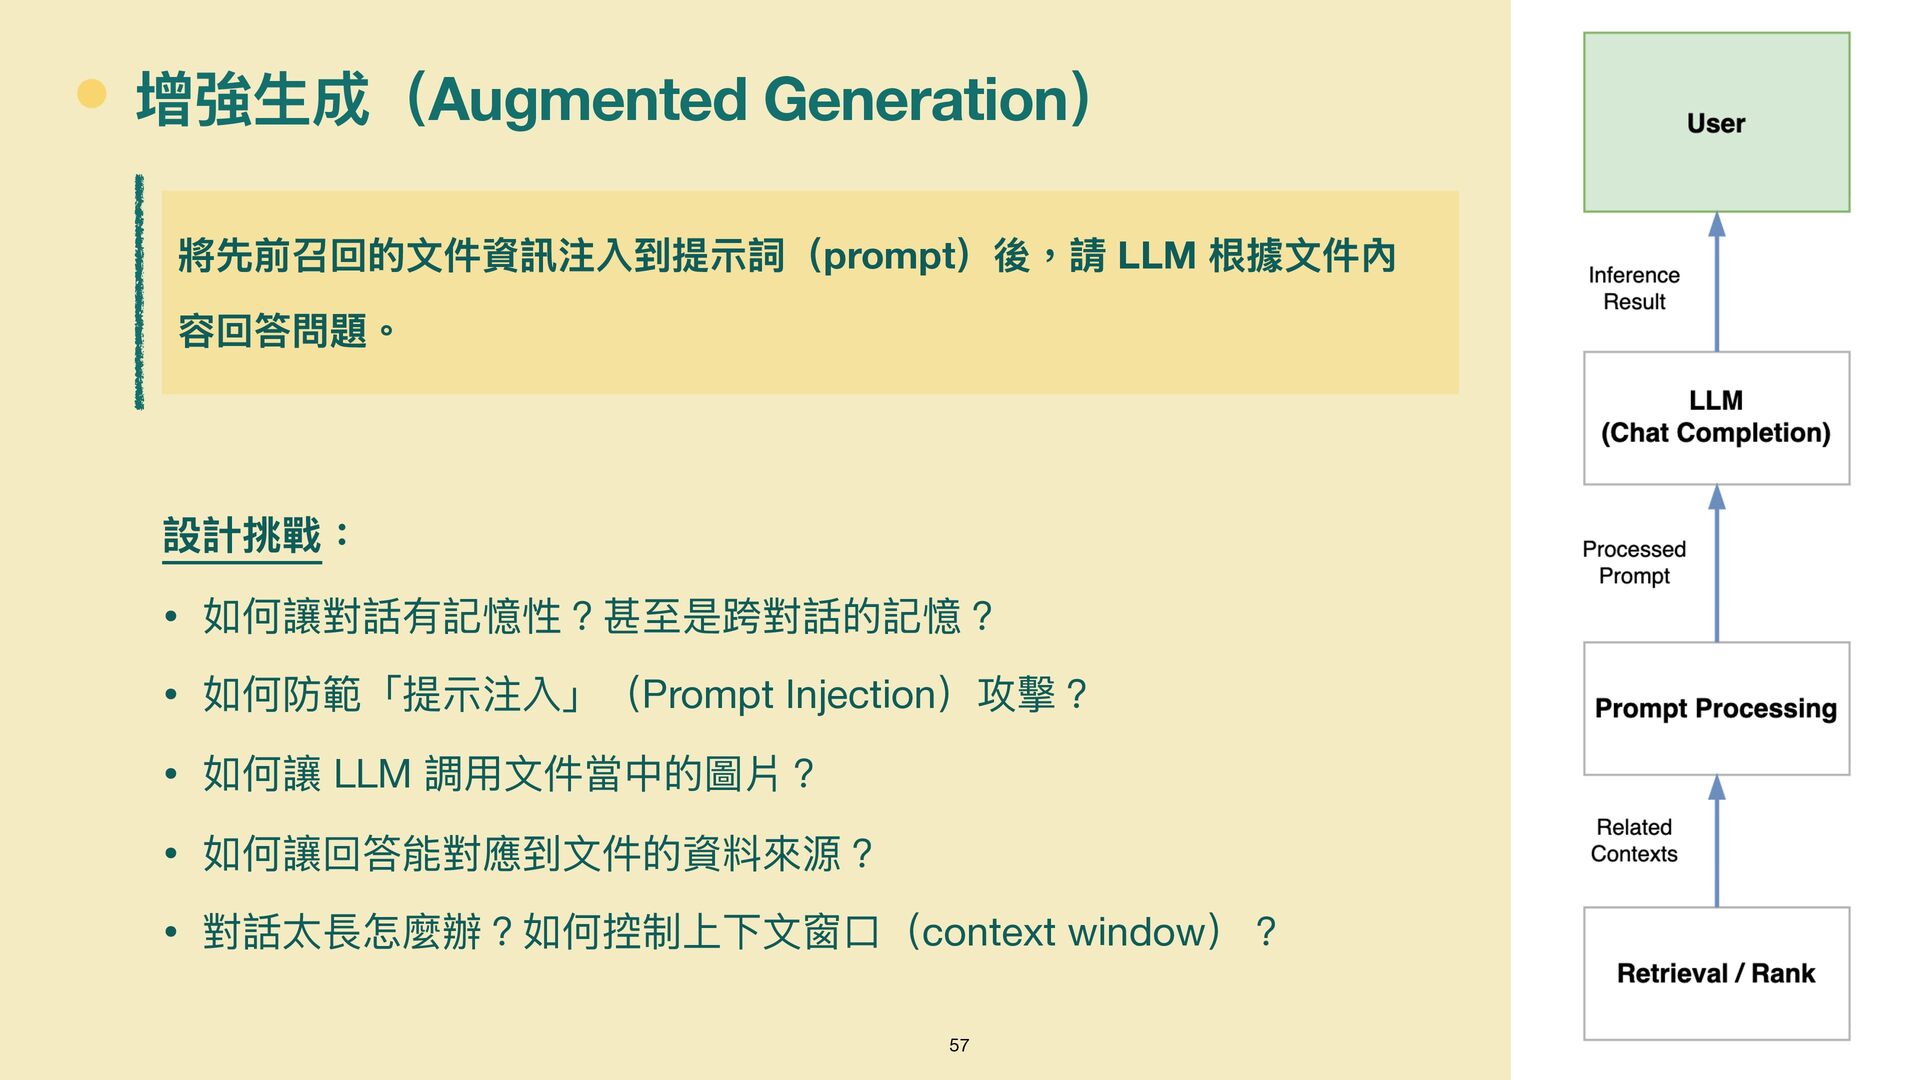
  28. 增強 生 成(Augmented Generation) 將先前召回的 文 件資訊注入到提 示 詞(prompt)後,請 LLM

    根據 文 件內 容回答問題。 57 設計挑戰: • 如何讓對話有記憶性?甚 至 是跨對話的記憶? • 如何防範「提 示 注入」(Prompt Injection)攻擊? • 如何讓 LLM 調 用文 件當中的圖片? • 如何讓回答能對應到 文 件的資料來源? • 對話太長怎麼辦?如何控制上下 文 窗 口 (context window)?
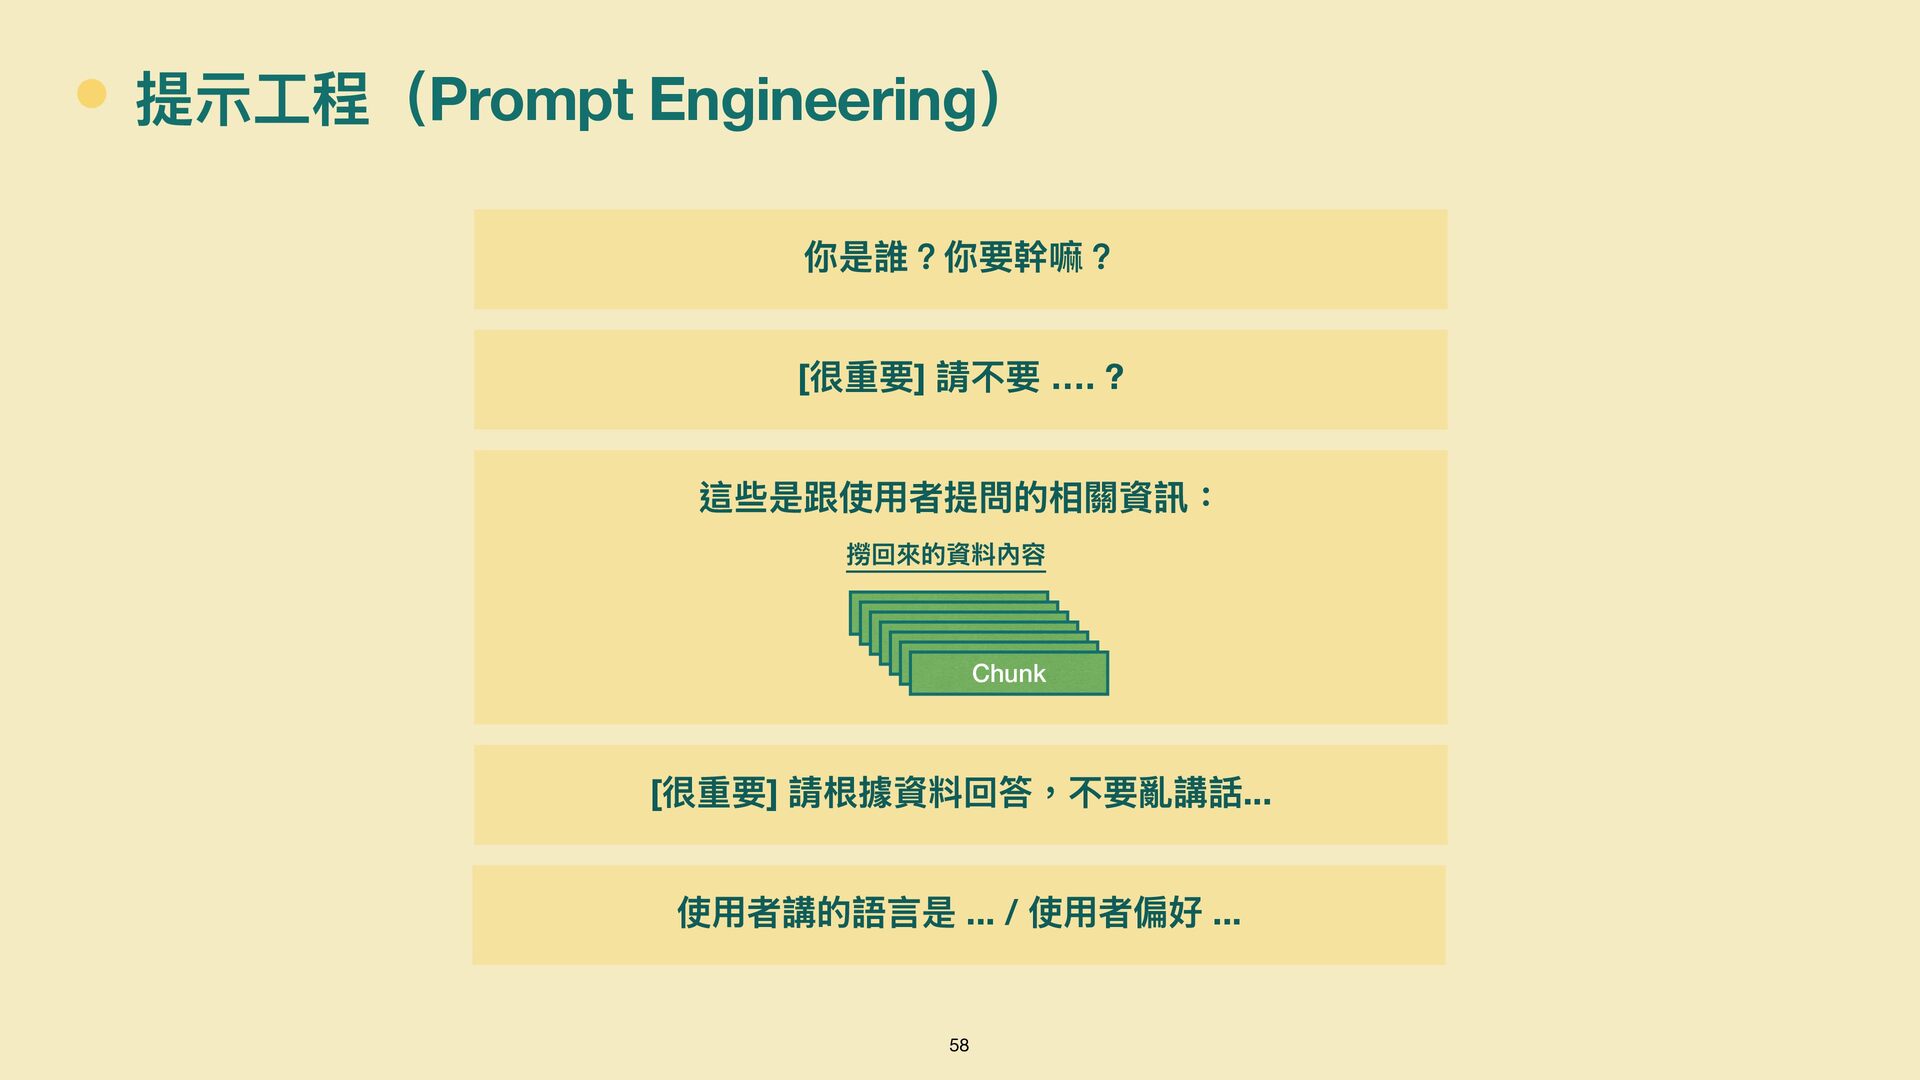
  29. 提 示 工 程(Prompt Engineering) 58 你是誰?你要幹嘛? [很重要] 請不要 ….

    ? 這些是跟使 用 者提問的相關資訊: Chunk 撈回來的資料內容 [很重要] 請根據資料回答,不要亂講話... 使 用 者講的語 言 是 ... / 使 用 者偏好 ...
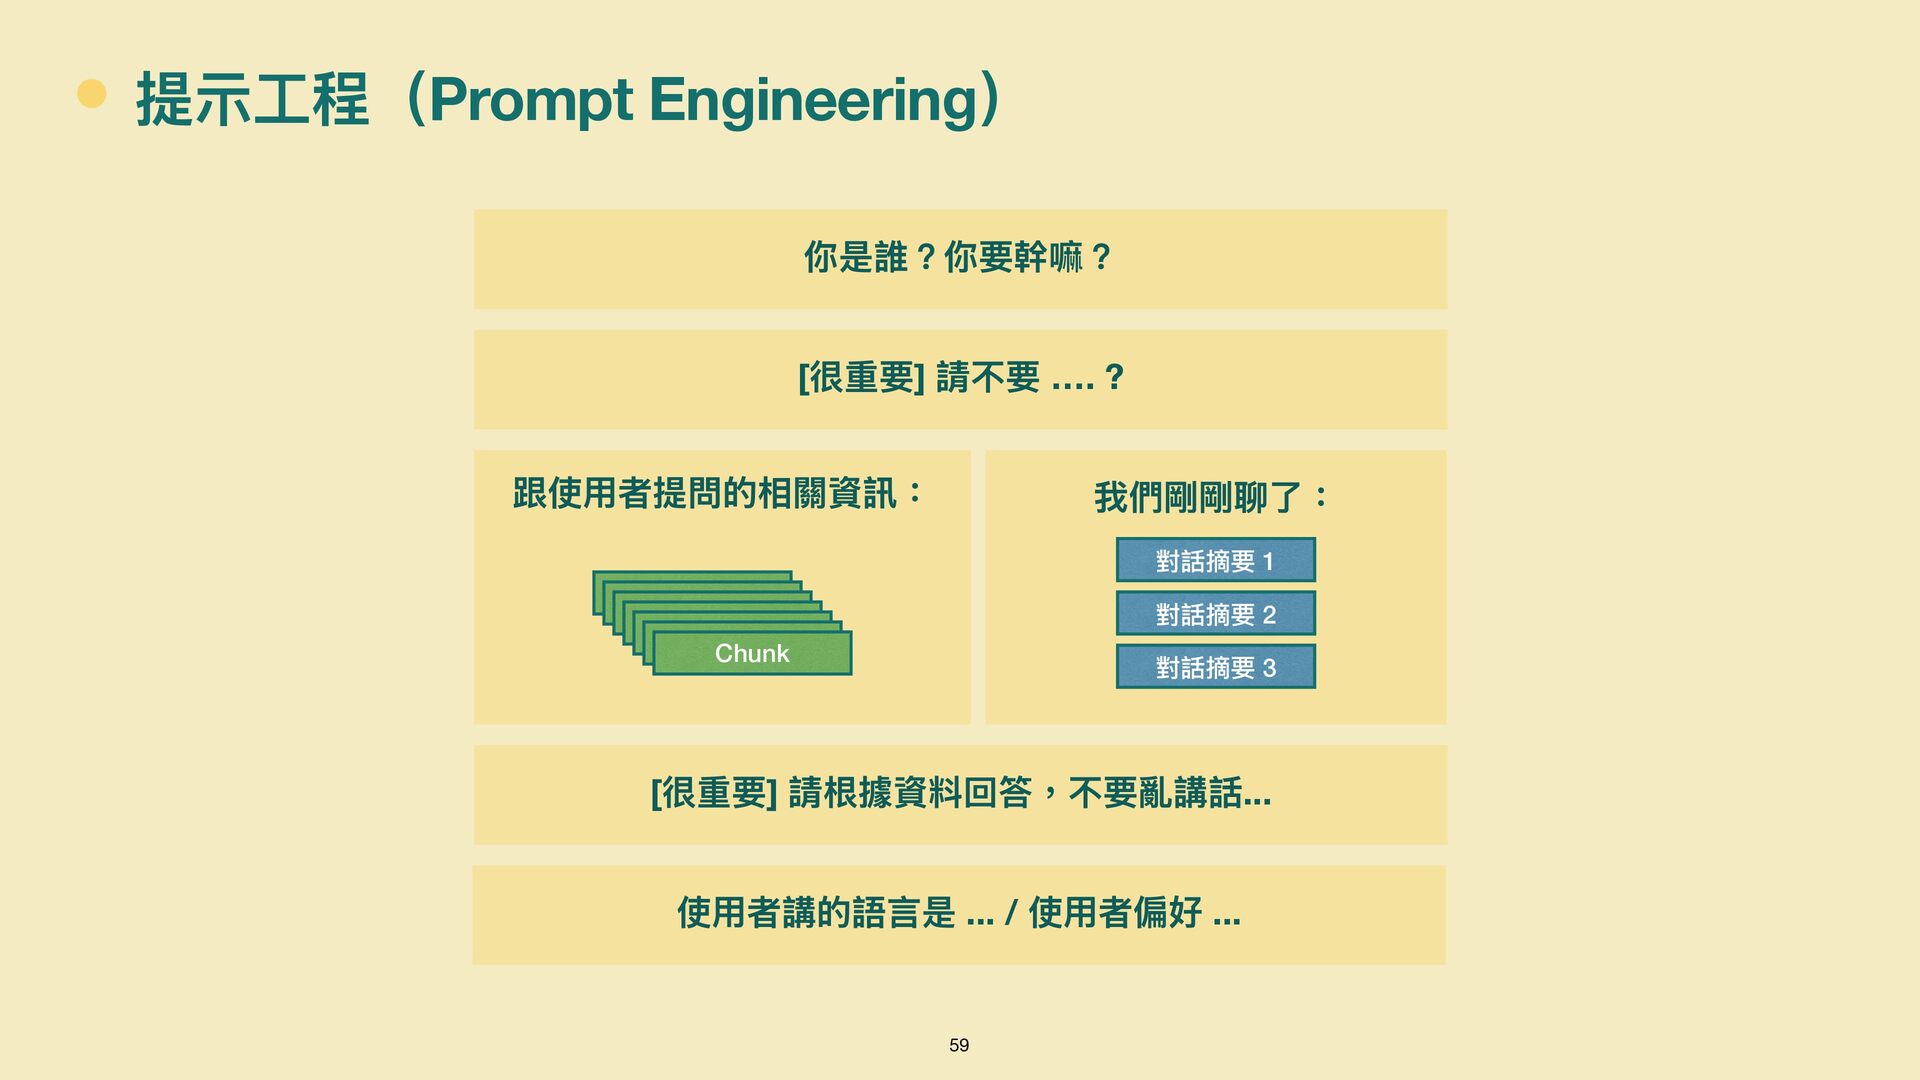
  30. 提 示 工 程(Prompt Engineering) 59 你是誰?你要幹嘛? [很重要] 請不要 ….

    ? 跟使 用 者提問的相關資訊: Chunk [很重要] 請根據資料回答,不要亂講話... 使 用 者講的語 言 是 ... / 使 用 者偏好 ... 我們剛剛聊了: 對話摘要 1 對話摘要 2 對話摘要 3
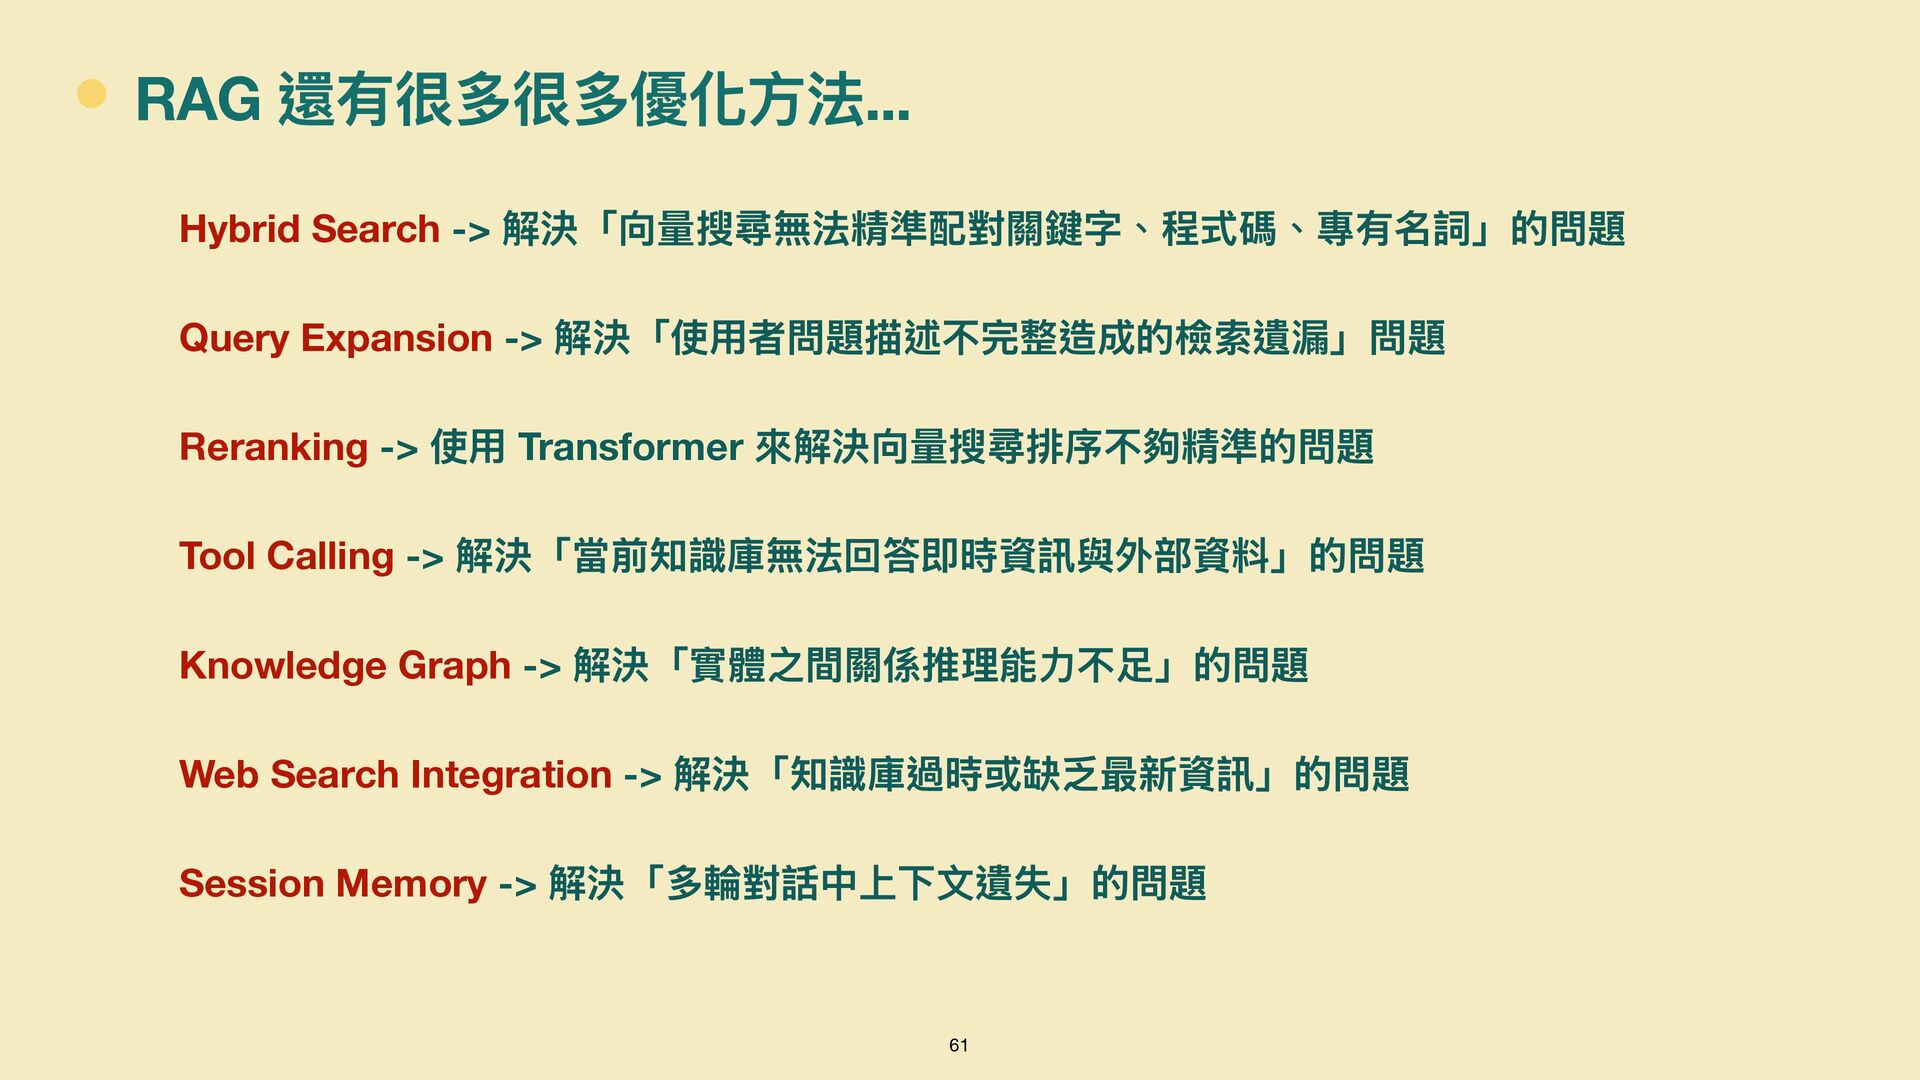
  31. RAG 還有很多很多優化 方 法... Hybrid Search -> 解決「向量搜尋無法精準配對關鍵字、程式碼、專有名詞」的問題 Query Expansion

    -> 解決「使 用 者問題描述不完整造成的檢索遺漏」問題 Reranking -> 使 用 Transformer 來解決向量搜尋排序不夠精準的問題 Tool Calling -> 解決「當前知識庫無法回答即時資訊與外部資料」的問題 Knowledge Graph -> 解決「實體之間關係推理能 力 不 足 」的問題 Web Search Integration -> 解決「知識庫過時或缺乏最新資訊」的問題 Session Memory -> 解決「多輪對話中上下 文 遺失」的問題 61
  32. 63