Share
Embed
Transcript
85 slides
-
3 KYOTO UNIVERSITY 推論の高速化に集中する ◼ 高速化には二種類あります。 ⚫ 訓練の高速化 ⚫ 推論の高速化
★ ◼ このサーベイでは、推論の高速化に焦点を当てます。 ◼ 理由 1: 推論の高速化の方が単純なのでまずはこちらから 入ると分かりやすい。 ◼ 理由 2: 推論の高速化のいくつかは、そのまま、あるいは 多少の変形で訓練の高速化にも用いることができる。 -
4 KYOTO UNIVERSITY CPU と GPU の両方を考える ◼ 主に二種類の実行方式があります。 ⚫
GPU 上での推論 ★ ⚫ CPU 上での推論 ★ ◼ このサーベイでは両方の方式を扱います。 ◼ どちらを用いるかでアプローチが大きく異なる場合があります。 ◼ 訓練は GPU 上で行われることが大半ですが、 推論は CPU 上で行うことも一般的であることに注意。 GPU 上での推論も一般的で、実用上どちらもありえます。 -
6 KYOTO UNIVERSITY 量子化は浮動小数点数を整数に丸める 3.25 1.98 −2.11 2.15 0.11 3.01
−0.25 1.55 1.33 3 2 −2 2 0 3 0 2 1 量子化 float32 int8 -
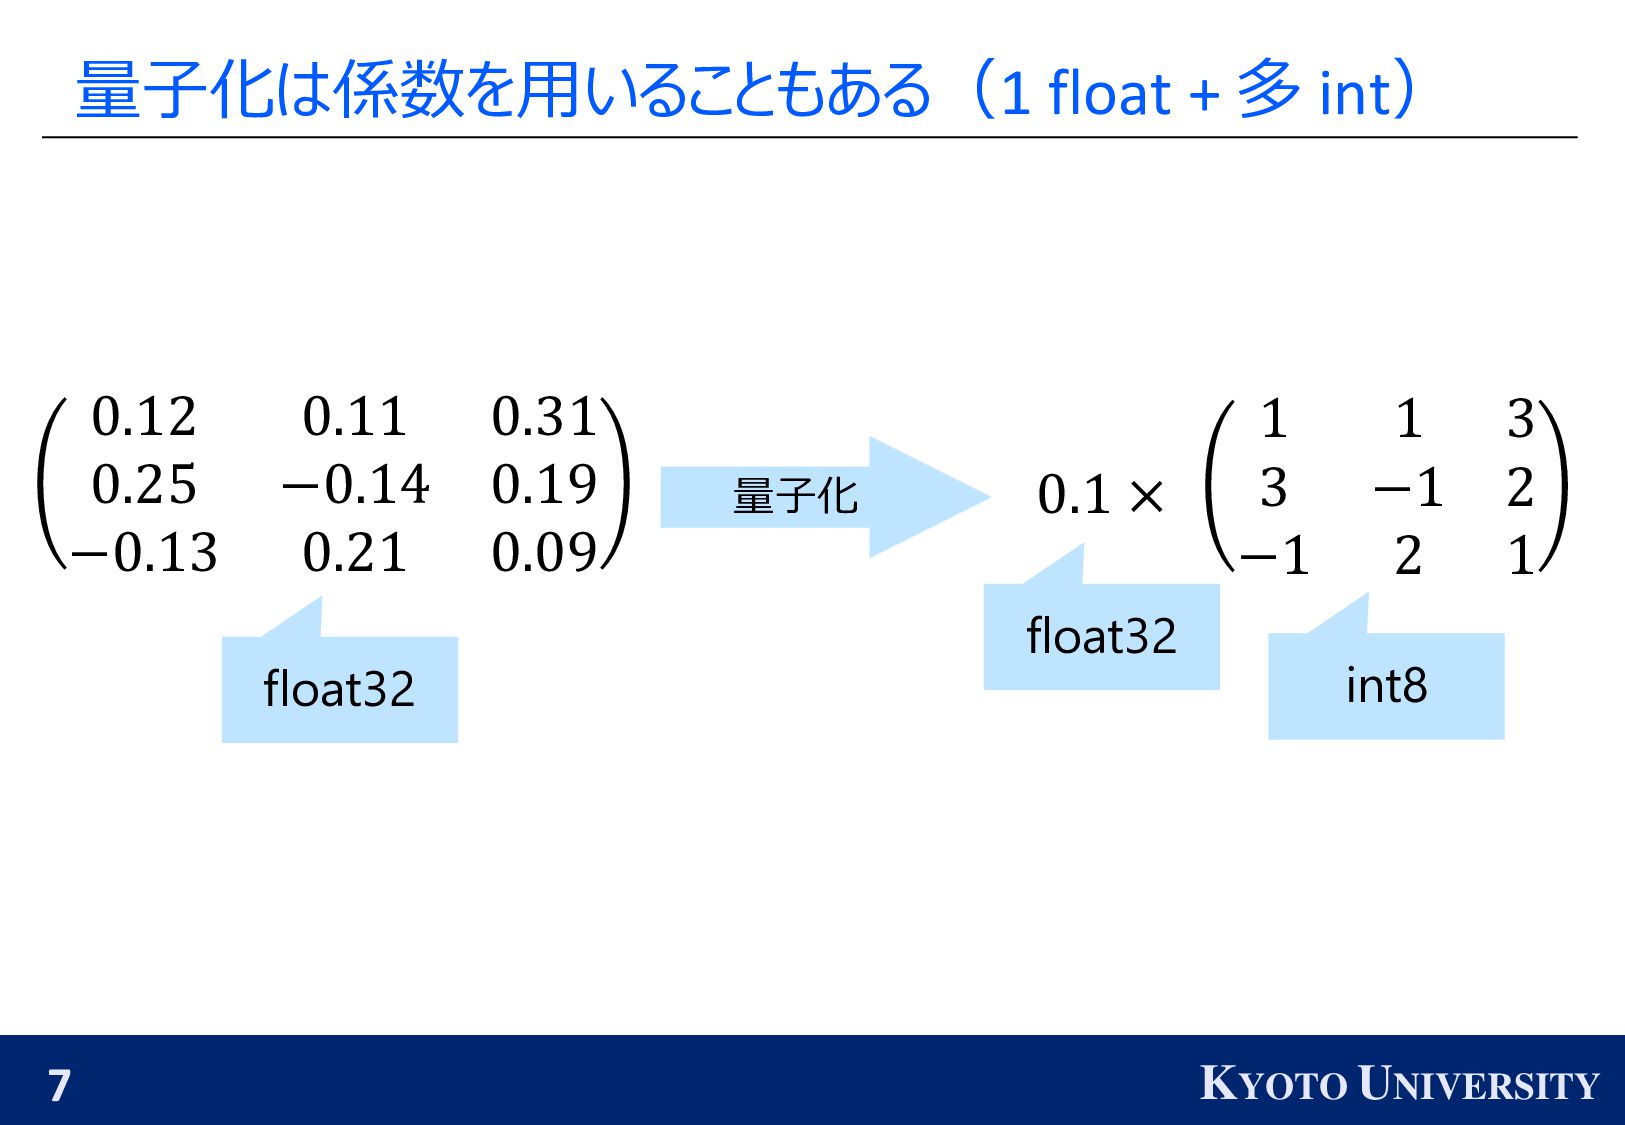
7 KYOTO UNIVERSITY 量子化は係数を用いることもある(1 float + 多 int) 0.12 0.11
0.31 0.25 −0.14 0.19 −0.13 0.21 0.09 1 1 3 3 −1 2 −1 2 1 量子化 float32 int8 0.1 × float32 -
8 KYOTO UNIVERSITY なぜ量子化により高速化されるのか? ◼ なぜ量子化を行うと高速化されるのでしょうか? ◼ 計算の型が変わるだけで、掛け算や足し算など 演算の回数と種類は量子化をしたとて同じです。 ◼
理由をきちんと理解することは実際に高速化を チューニングする上で大切です。 -
9 KYOTO UNIVERSITY 量子化は様々な側面から高速化を達成する ◼ なぜ量子化を行うと高速化されるのでしょうか? 演算の回数と種類は量子化をしたとて同じです。 ⚫ 量子化によりメモリ消費量が下がる →
バッチサイズを大きくできるようになる → スループットが大きくなる ⚫ (CPU 上で)SIMD をより活用できるようになる ⚫ (GPU 上で)Tensor コアをより活用できるようになる ⚫ 通信コストが減少する。 ⚫ キャッシュ効率が向上する。 -
10 KYOTO UNIVERSITY 量子化は様々な側面から高速化を達成する ◼ なぜ量子化を行うと高速化されるのでしょうか? 演算の回数と種類は量子化をしたとて同じです。 ⚫ 量子化によりメモリ消費量が下がる →
バッチサイズを大きくできるようになる → スループットが大きくなる ⚫ (CPU 上で)SIMD をより活用できるようになる ⚫ (GPU 上で)Tensor コアをより活用できるようになる ⚫ 通信コストが減少する。 ⚫ キャッシュ効率が向上する。 -
11 KYOTO UNIVERSITY バッチサイズの向上はスループットの向上につながる GPU 上のモデル x y GPU 上のモデル
x y 10.0 msec x y 10.1 msec 並列計算が飽和していない限り ほとんど同じ時間でできる → スループットは倍増 -
12 KYOTO UNIVERSITY 量子化によりメモリ削減 → バッチサイズを大きくできる ◼ メモリ制限のために、いくらでもバッチサイズを大きくできるというこ とはありません。 ◼
量子化により、必要なメモリが小さくなるため、 バッチサイズの限界を向上させることができます。 -
13 KYOTO UNIVERSITY バッチサイズを上げてもレイテンシは良くならない ◼ スループット(単位時間に処理できるデータの個数)は向上 するが、レイテンシ(1 つのデータの処理をはじめてから処理が 終わるまでの時間)は向上しないことに注意してください。 ◼
バッチサイズを上げるとむしろレイテンシは悪くなります。 ◼ 処理すべきデータがたくさん控えているとき、例えばデータベース のすべてのデータにモデルを適用するときや、ユーザーからすごい 勢いでクエリが到着するとき、にはスループットの向上は嬉しい。 ◼ スループットとレイテンシのどちらを向上させるべきかは、 チューニングにおいて意識するべきです。 -
14 KYOTO UNIVERSITY バッチサイズを上げると訓練も早くなる ◼ バッチサイズを増やすと訓練も早くなります。 ◼ モデルの精度は、モデルが訓練中に見たサンプル数でおおむね 決まります。もちろん、様々な要因にもよります。 例えば
tuning playbook が参考になります。 https://github.com/google-research/tuning_playbook ◼ バッチサイズを倍増させると、半分の時間で同じサンプル数を見 せることができます。 ◼ FP32 の代わりに FP16 を用いたり、混合精度 (FP16 + FP32) で訓練することは一般的な戦略です。 -
15 KYOTO UNIVERSITY 量子化は様々な側面から高速化を達成する ◼ なぜ量子化を行うと高速化されるのでしょうか? 演算の回数と種類は量子化をしたとて同じです。 ⚫ 量子化によりメモリ消費量が下がる →
バッチサイズを大きくできるようになる → スループットが大きくなる ⚫ (CPU 上で)SIMD をより活用できるようになる ⚫ (GPU 上で)Tensor コアをより活用できるようになる ⚫ 通信コストが減少する。 ⚫ キャッシュ効率が向上する。 -
16 KYOTO UNIVERSITY 通常の 64 bit int の足し算 0000101110100010100000111111000011101100001111100111110000010011 0000010011001001010101111010000000010101011111010000000010010100
0001000001101011110110111001000100000001101110110111110010100111 + 64 bit Arithmetic Logic Unit (ALU) int64 int64 int64 -
17 KYOTO UNIVERSITY 64 bit 演算器で 8 個の int8 の足し算が同時にできる
0000101110100010100000111111000011101100001111100111110000010011 0000010011001001010101111010000000010101011111010000000010010100 0001000001101011110110101001000000000001101110110111110010100111 + 64 bit Arithmetic Logic Unit (ALU) int8 int8 int8 int8 int8 int8 int8 int8 繰り上げ を切る -
18 KYOTO UNIVERSITY SIMD は低精度の演算を同時にこなす ◼ 現代の CPU は 256
~ 512 bit のレジスタと ALU を持って います。 ◼ 現代の CPU はそれらを使って、低精度の演算を同時に複数 こなすことができます。例)AVX2 ◼ この種の命令のことを SIMD (Single Instruction / Multiple Data) と言います。 ◼ 例えば、 AVX2 は 32 個の int8 演算を一度にできます。 -
19 KYOTO UNIVERSITY 量子化は様々な側面から高速化を達成する ◼ なぜ量子化を行うと高速化されるのでしょうか? 演算の回数と種類は量子化をしたとて同じです。 ⚫ 量子化によりメモリ消費量が下がる →
バッチサイズを大きくできるようになる → スループットが大きくなる ⚫ (CPU 上で)SIMD をより活用できるようになる ⚫ (GPU 上で)Tensor コアをより活用できるようになる ⚫ 通信コストが減少する。 ⚫ キャッシュ効率が向上する。 -
20 KYOTO UNIVERSITY Tensor コア は行列積を行う装置 ◼ NVIDIA GPU は
CUDA コア と Tensor コア からなります。 ◼ Tensor コアは行列積に特化した装置です。 ▲ A100 GPU のホワイトペーパーより -
21 KYOTO UNIVERSITY Tensor コアは int8 演算をより多くできる ◼ Tensor コアは
float 演算より int8 演算をより多くできます。 理由は CPU の SIMD で述べたことと基本的には同じです。 ▲ A100 GPU のホワイトペーパーより -
22 KYOTO UNIVERSITY QAT と後処理の二種類の量子化がある ◼ いつ量子化を行うかについて二種類の選択があります。 ⚫ 量子化を意識した訓練 (QAT)
⚫ 後処理による量子化 ◼ 後処理よりも QAT の方が効果的です。 ◼ しかし、すでにモデルを訓練し終わっている場合もあります。 この時には後処理の方を選択する必要があります。 -
23 KYOTO UNIVERSITY 高速化を意識した訓練 vs 後処理による高速化 ◼ 推論の高速化を意識した訓練 vs 後処理による高速化
という構図は、量子化に限らず、様々な高速化のアプローチで 出てきます。 ◼ ただし、いくつかのアプローチでは、後処理には対応できず、 訓練時から採用する必要が生じます。 -
24 KYOTO UNIVERSITY STE が QAT のための基本的な道具 ◼ QAT の基本的なアプローチ:
Straight-Through Estimator (STE) [Bengio+ 2013] w = 2.14 q = 2 量子化 x = 1.4 h = 2.8 Forward: w を生パラメータとして持つ (float) 乗算 -
25 KYOTO UNIVERSITY STE が QAT のための基本的な道具 ◼ QAT の基本的なアプローチ:
Straight-Through Estimator (STE) [Bengio+ 2013] w = 2.14 q = 2 量子化 x = 1.4 h = 2.8 Forward: 乗算 w = 2.14 q = 2 x = 1.4 h = 2.8 Backward: 勾配なし 𝜕𝐿 𝜕ℎ = 2.1 𝜕𝐿 𝜕𝑤 = 1.5 𝜕𝐿 𝜕𝑞 = 1.5 コピー STE w を生パラメータとして持つ (float) -
26 KYOTO UNIVERSITY STE により連続的にパラメータを更新できる ◼ 直感的には、q (量子化後のパラメータ) を上げるべきならば、 w(量子化前のパラメータ)も上げるべきだろうという考え
◼ 生パラメータを float として持ち、STE を使うことで、連続的に 最適化ができます。 w = 2.14 q = 2 x = 1.4 h = 2.8 𝜕𝐿 𝜕ℎ = 2.1 𝜕𝐿 𝜕𝑤 = 1.5 𝜕𝐿 𝜕𝑞 = 1.5 コピー q を (lr *1.5) だけ減らすべきことを示唆し ているが、(lr * 1.5) < 0.5 は小数である -
27 KYOTO UNIVERSITY STE により連続的にパラメータを更新できる ◼ 直感的には、q (量子化後のパラメータ) を上げるべきならば、 w(量子化前のパラメータ)も上げるべきだろうという考え
◼ 生パラメータを float として持ち、STE を使うことで、連続的に 最適化ができます。 w = 2.14 q = 2 x = 1.4 h = 2.8 𝜕𝐿 𝜕ℎ = 2.1 𝜕𝐿 𝜕𝑤 = 1.5 𝜕𝐿 𝜕𝑞 = 1.5 コピー q を (lr *1.5) だけ減らすべきことを示唆し ているが、(lr * 1.5) < 0.5 は小数である この量だけ w を減ら す。 これにより q は変わ らないかもしれない。 しかし、勾配が正で ある傾向が続けば、 変化が積み重なって 最終的に q が下が ることになる。 -
28 KYOTO UNIVERSITY 重みのみ量子化するか、活性化も量子化するかの選択 ◼ どこを量子化するかについて二種類の選択があります。 ⚫ 重みのみの量子化 ⚫ 重みと活性化値の量子化
◼ 重みのみの量子化では、モデルサイズは小さくなるが、計算は float で行います。 → モデルのロード時間は短縮されるが、計算時間はさほど 変わらない モデルによっては、小さいデバイスに乗らないことがあります。 モデルサイズの削減はエッジでの推論では有用です。 -
29 KYOTO UNIVERSITY どれだけ量子化するかについてはいくつも選択肢がある ◼ どれだけ量子化するかについていくつかの選択肢があります。 ⚫ FP16, BP16 (16bit
float フォーマット) ⚫ Int8 ⚫ 二値化 ◼ Update: H100 GPU は FP8 もサポートしました。 ◼ Int4 など、これ以外で量子化することもしばしばあります。 ◼ 上記の 3 つの精度について詳しく見ていきます。 正確にいえば量子化ではなく低精度計算 -
30 KYOTO UNIVERSITY FP16 は簡単に使えるのでまず最初の一歩におすすめ ◼ FP16, BP16 (16bit float)
32bit のモデルはナイーブに FP16 や BP16 にキャストしても 大丈夫なことが多いです。 低精度計算をする上ではまずこれを試すのがおすすめです。 ◼ 約 1.5 倍の高速化が期待できます。 ◼ Tensor コアは Volta アーキテクチャ(V100など)から FP16 と BP16 をサポートしました。 Tensor コアがうまく活用できる計算環境・モデルであればさら に高速化される場合があります。 model = model.half() -
31 KYOTO UNIVERSITY Int8 は効率がよく精度の低下もほとんどない ◼ Int8 int8 モデルに変換するのはやや込み入った操作が必要でし。 ただし、慎重に変換すると、精度の低下は無視できる程度です。
[Jacob+ CVPR 2018] ◼ 2 ~ 4 倍の高速化が期待できます。 ◼ Tensor コアは Turing アーキテクチャ (RTX20xx など) から int8 をサポートしました。 [Jacob+ CVPR 2018] Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. -
32 KYOTO UNIVERSITY 二値化は究極的に高速だが精度は低下する ◼ 二値化 (1bit) 掛け算をビット演算で実行でき、非常に高速です。 洗練された方法で変換しても精度低下は免れません。 ◼
CPU では 30 ~ 60 倍の高速化が期待できます。 [Rastegari+ ECCV 2016]. ◼ GPU では 2 ~ 7 倍の高速化が期待できます。 [Courbariaux+ NeurIPS 2016]. ◼ どうしても速度が欲しいときにおすすめです。 [Rastegari+ ECCV 2016] XNOR-Net: ImageNet Classification Using Binary Convolutional Neural Networks. [Courbariaux+ NeurIPS 2016] Binarized Neural Networks. -
33 KYOTO UNIVERSITY 二冪の量子化によりさらに早くなる ◼ 量子化方法によっては、重みやバッチ正則化の係数を 2 冪に 量子化することがあります (…,
1/4, 1/2, 1, 2, 4, …)。 [Courbariaux+ NeurIPS 2016] ◼ このとき、掛け算はビットシフトでできるようになるので、さらに計 算が早くなります。 [Courbariaux+ NeurIPS 2016] Binarized Neural Networks. -
34 KYOTO UNIVERSITY Reference ◼ 有名論文紹介: ◼ [Jacob+ CVPR 2018]
Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. Pytorch と TensorFlow の量子化実装はこの論文に基づきます。 -
35 KYOTO UNIVERSITY Reference ◼ [Courbariaux+ NeurIPS 2015] BinaryConnect: Training
Deep Neural Networks with binary weights during propagations. 重みのみの二値化を提案しました。 ◼ [Courbariaux+ NeurIPS 2016] Binarized Neural Networks. 重みと活性化の二値化を提案し GPU を扱っています。 ◼ [Rastegari+ ECCV 2016] XNOR-Net: ImageNet Classification Using Binary Convolutional Neural Networks. 重みと活性化の二値化を提案し CPU を扱っています。 -
38 KYOTO UNIVERSITY 知識蒸留は 2 ステップからなる ◼ 知識蒸留は 2 ステップからなります:
1. 大きなモデルを訓練する。 2. 大きなモデルの出力をターゲットに小さなモデルを訓練する。 -
40 KYOTO UNIVERSITY 知識蒸留は回りくどいがノイズのために必要 ◼ 知識蒸留は回りくどいことをしているように見えます。 なぜ最初から小さいモデルを訓練しないのでしょうか? [Ba+ NeurIPS 2014]
Do Deep Nets Really Need to be Deep? 訓練データ (確率的) 教師モデルの 出力 (決定的) 小さいモデルはノイジーなデータに 当てはまるのに苦労します。 小さいモデルにとっては、決定的な信号に 当てはまる方が簡単です。 -
42 KYOTO UNIVERSITY 枝刈りは重みを疎にする 3.25 0.19 −2.11 2.15 0.11 3.01
−0.25 1.55 0.12 枝刈り 3.25 0 −2.11 2.15 0 3.01 0 1.55 0 -
43 KYOTO UNIVERSITY 枝刈りは 3 ステップからなる。ファインチューニングが重要 ◼ 枝刈りは 3 ステップからなります:
1. モデルを訓練する 2. いくつかの重みを削除する 3. モデルをファインチューニングする ファインチューニングの最中では、削除された重みは 0 に 固定される ◼ ファインチューニングが精度のために重要です。 -
44 KYOTO UNIVERSITY 強度枝刈りが最もスタンダードな方法 ◼ 枝刈りの基準はさまざまなものが提案されています。 ◼ 最も基本的なものは強度枝刈りです。 絶対値の小さな重みを枝刈ります。 つまり、|w|
< ε なら w を枝刈ります。 ◼ Lasso 的な L1 正則化などを用いて、訓練中に動的に パラメータを枝刈りすることもよくやられます。 -
46 KYOTO UNIVERSITY 畳み込み層は F x C x 3 x
3 のパラメータを持つ ◼ 3x3 畳み込み層の復習: K C x H x W F x C x 3 x 3 ∗ F x H x W チャンネル数 フィルタ数 各フィルタはチャンネルごとに重 みをもっている convolution -
47 KYOTO UNIVERSITY フィルタ枝刈りは K[f, :, :, :] をグループとする ◼
フィルタ枝刈りは K[f, :, :, :] という形のグループを用いて 疎性を作ります。 K F x C x 3 x 3 K- F- x C x 3 x 3 フィルタ枝刈り [Wen+ NeurIPS 2016] Learning Structured Sparsity in Deep Neural Networks. -
48 KYOTO UNIVERSITY チャンネル枝刈りは K[:, c, :, :] をグループとする ◼
チャンネル枝刈りは K[:, c, :, :] という形のグループを 用いて疎性を作ります。 K F x C x 3 x 3 K- F x C- x 3 x 3 チャンネル枝刈り [Wen+ NeurIPS 2016] Learning Structured Sparsity in Deep Neural Networks. -
49 KYOTO UNIVERSITY 位置枝刈りは K[:, c, h, w] をグループとする ◼
位置枝刈りは K[:, c, h, w] という形のグループを用いて 疎性を作ります。 K F x (C x 3 x 3) K- F x D 位置枝刈り [Wen+ NeurIPS 2016] Learning Structured Sparsity in Deep Neural Networks. -
51 KYOTO UNIVERSITY 畳み込み層は行列積により実現する ◼ 畳み込み層の詳細な流れ: K C x H
x W F x C x 3 x 3 F x HW X 各位置について パッチを抽出 X’ (H x W) x (C x 3 x 3) = HW x 9C flatten K’ F x (C x 3 x 3) = F x 9C 行列積 Y’ unflatten F x H x W Y -
52 KYOTO UNIVERSITY 位置枝刈りにより列の数を削減することができる ◼ 位置枝刈りにより列の数を削除することができます。 C x H x
W F x HW X X’ (H x W) x (C x 3 x 3) = HW x 9C K- F x D Y’ unflatten F x H x W Y X’’HW x D 列を削除 各位置について パッチを抽出 行列積 -
54 KYOTO UNIVERSITY 非構造枝刈りは主に CPU 向け ◼ 非構造化枝刈り 細かい単位でパラメータを削り取ることで、積み重なって より高い疎性を達成することができます。
GPU 計算には向いていません。 Tensor コアではどうせ密形式で計算するので、 ところどころ 0 になったところで速度に影響しません。 主に CPU 向けの技術です。 -
55 KYOTO UNIVERSITY 構造枝刈りは GPU 向きだがあまり効果的ではない ◼ 構造枝刈り 行列のサイズが小さくなるので GPU
計算でも効きます。 もちろん CPU 計算でも効きます。 精度を守ろうと思うとほとんど枝刈りすることができません。 あるいは、フィルタやチャンネル単位で削除すると 精度は大きく下がる可能性があります。 -
56 KYOTO UNIVERSITY Ampere アーキテクチャから疎行列が採用 ◼ 朗報:今では GPU でも疎行列計算ができるようになりました ◼
疎行列積は Ampere アーキテクチャ (A100 など) からサポートされています。 ◼ ただし、最大 50% の疎性までで、 効果は限定的です。 ▲ A100 GPU のホワイトペーパーより -
58 KYOTO UNIVERSITY 枝刈りは回りくどいが過パラメータのために必要 ◼ 枝刈りは周りくどいように見えます。 なぜ最初から小さいモデルを使わないのでしょうか? ◼ 深層モデルはパラメータ過多です。 ◼
パラメータ過多であることが、最適化の容易さや汎化にとって 重要であることが知られています。 宝くじ仮説や二重降下現象を参照。 ◼ 良いモデルを得るために最初の訓練ではパラメータ過多である 必要があるのですが、一度手に入るとあとは余分なパラメータを 枝刈りによって削除することができます。 -
59 KYOTO UNIVERSITY 構造枝刈りは意味がないという批判がある ◼ 構造枝刈りついての批判: ◼ 後でフィルタを消すくらいなら最初からフィルタ数をその分小さく しておいた方がよい場合もあるようなので、気を付けましょう。 [Liu+
ICLR 2019] Rethinking the Value of Network Pruning. For all state-of-the-art structured pruning algorithms we examined, fine-tuning a pruned model only gives comparable or worse performance than training that model with randomly initialized weights [Liu+ ICLR 2019]. Zhuang Liu -
61 KYOTO UNIVERSITY 行列 W を細長い行列 A と B で近似する
W 低ランク近似 A B × -
62 KYOTO UNIVERSITY CNN のフィルタは低ランク構造を持っている ◼ CNN の第一層の重みは連続的で、多様性もそこまで大きくな いことが知られています (cf.
Gabor filter) ◼ ゆえに、重みをまとめたテンソルは比較的低ランクでかなり精度 よく近似できます [Denton+ NeurIPS 2014, Denil+ NeurIPS 2013] [Denil+ NeurIPS 2013] Predicting Parameters in Deep Learning. [Denton+ NeurIPS 2014] Exploiting Linear Structure within Convolutional Networks for Efficient Evaluation. ▲ from AlexNet paper ImageNet Classification with Deep Convolutional Neural Networks. マスクされた値を 推測できる → パラメータは 冗長である -
64 KYOTO UNIVERSITY アテンション行列 A の計算に時間がかかる ◼ 続いて、アテンションの高速化を考えます。 ◼ アテンション行列
A (n x n 行列)の計算に時間がかかります。 Y Softmax Q KT V = A -
65 KYOTO UNIVERSITY アテンション行列 A はグラム行列のようだ ◼ 続いて、アテンションの高速化を考えます。 ◼ A
ij はクエリ Q i とキー K j の類似度を表しています。 A はほぼグラム行列とみなすことができます。 一旦、 A はガウスカーネルのグラム行列とみなしましょう。 Y Softmax Q KT V = A -
66 KYOTO UNIVERSITY グラム行列は効率よく近似することができる ◼ 続いて、アテンションの高速化を考えます。 ◼ グラム行列はランダム特徴量 [Rahimi+ NeurIPS
2008] や Nystrom 近似 [Williams+ NeurIPS 2000] などで高速に近似で きます。 Y Softmax Q KT V ≈ Q’ [Rahimi+ NeurIPS 2008] Random Features for Large-Scale Kernel Machines. [Williams+ NeurIPS 2000] Using the Nyström Method to Speed Up Kernel Machines. K’T Q のランダム特徴量 K のランダム特徴量 -
67 KYOTO UNIVERSITY ランダム特徴量はアテンション行列にも適用できる ◼ アテンション行列はガウスカーネルのグラム行列ではありません。 ◼ しかし、ほぼ同じテクニックがアテンション行列に適用することがで きます。 ⚫
FAVOR+ and Performers [Choromanski+ ICLR 2021] ⚫ Random Feature Attention [Peng+ ICLR 2021] [Choromanski+ ICLR 2021] Rethinking Attention with Performers. [Peng+ ICLR 2021] Random Feature Attention. -
68 KYOTO UNIVERSITY ランダム特徴量によるアテンションは線形時間 ◼ Y = Attention(Q, K, V)
の近似 1. ランダム特徴量を計算する 2. 細長い行列を掛け算する 計算量: O(n d’ (d + d’)) → n について線形 Q′ = 𝜓 𝑄 ∈ ℝ𝑛×𝑑′ 𝐾′ = 𝜓 𝐾 ∈ ℝ𝑛×𝑑′ 𝑌 = 𝑄′𝐾′⊤𝑉 -
69 KYOTO UNIVERSITY アテンションのランダム特徴量の導出 ◼ をガウスカーネルのランダム特徴量とします。 以下のように定義します。 すると、 𝜙 𝑥
∈ ℝ𝑑 𝜙 𝑞 𝑇𝜙 𝑘 ≈ exp − q − 𝑘 2 𝜓 𝑥 = exp 𝑥 2 𝜙 𝑥 𝜓 𝑞 𝑇𝜓 𝑣 ≈ exp 𝑞𝑇𝑣 正規化されていない アテンション -
70 KYOTO UNIVERSITY 正規化定数は線形時間で計算できる ◼ 正規化定数は Z = 𝑖
exp 𝑞𝑇𝑘𝑖 ≈ 𝑖 𝜓 𝑞 𝑇𝜓 𝑘𝑖 = 𝜓 𝑞 𝑇 𝑖 𝜓(𝑘𝑖 ) ランダム特徴量近似 この和の計算には線形 時間かかるが、すべての クエリ q で使いまわせる → 全体で線形時間 -
72 KYOTO UNIVERSITY 従来の畳み込み層フィルタはチャンネルごとに重みをもつ ◼ 3x3 畳み込み層の復習: K C x
H x W F x C x 3 x 3 ∗ F x H x W チャンネル数 フィルタ数 各フィルタはチャンネルごとに重 みをもっている convolution -
73 KYOTO UNIVERSITY Mobilenets は空間方向とチャンネル方向に分ける ◼ MobileNets: K1 C x
H x W C x 3 x 3 ∗ F x H x W d C x H x W 深さごとの 畳み込み K2 F x C x 1 x 1 ∗ 標準の 畳み込み 1/F の削減 1/9 の削減 -
74 KYOTO UNIVERSITY NAS により良いアーキテクチャを見つけることができる [Tan+ ICML 2019] EfficientNet: Rethinking
Model Scaling for Convolutional Neural Networks. ◼ 精度が高く、かつ高速に実行できるアーキテクチャは、 ニューラルアーキテクチャ探索 (NAS) で自動で見つけることが しばしばあります [Tan+ ICML 2019] -
75 KYOTO UNIVERSITY FLOPs は良い評価指標ではない Irwan Bello [Bello+ NeurIPS 2021]
Revisiting ResNets: Improved Training and Scaling Strategies. [Dehghani+ ICLR 2022] The Efficiency Misnomer. FLOPs is not a good indicator of latency on modern hardware. [Bello+ NeurIPS 2021] ◼ アーキテクチャの効率はしばしば FLOPs で評価されます。 ◼ 批判: -
76 KYOTO UNIVERSITY FLOPs ではなく実時間で測るべき ◼ Tensor コアは密行列積を非常に速い時間で処理することが できます。 ◼
複雑な近似手法は、密行列積を Tensor コアに送るナイーブ な計算よりも遅い場合がしばしばあります。 ◼ FLOPs ではなく実時間で速度は評価するべきです。 -
78 KYOTO UNIVERSITY 異なるテクニックは組み合わせることができる ◼ 高速化の種々のテクニックは組み合わせることができます。 ◼ Deep Compression [Han+
ICLR 2016] は枝刈りと量子化を 組み合わせて高い圧縮率を達成します。 [Han+ ICLR 2016] Deep Compression: Compressing Deep Neural Networks with Pruning, Trained Quantization and Huffman Coding. -
79 KYOTO UNIVERSITY 組み合わせにより効果が逓減することがある ◼ 効果が逓減する場合があることには注意が必要です。 ResNet はそもそも冗長なので、精度低下なしにある程度 圧縮するのは簡単です。 MobileNets
は圧縮するのは難しいです [Jacob+ CVPR 2018]。 ◼ 「精度低下なしに〇倍圧縮しました」という主張は、元が何で あるかを吟味するのが重要です。 [Jacob+ CVPR 2018] Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. -
81 KYOTO UNIVERSITY 量子化は浮動小数点数を整数に変換 0.12 0.11 0.31 0.25 −0.14 0.19
−0.13 0.21 0.09 1 1 3 3 −1 2 −1 2 1 量子化 float32 int8 0.1 × float32 -
85 KYOTO UNIVERSITY ゴールに合わせた手法を用いましょう ◼ 高速化のテクニックにはさまざまなものがあります。 ◼ FP16 が簡単なのでまずはこれを試すのがおすすめです。 ◼
まだモデルを訓練していないのであれば、効率的なモデル (MobileNets, Performers, MoE など) は検討してもよい かもしれません。 ◼ チューニングの前に速度のゴールを設定しましょう。 ◼ 速度を FLOPs ではなく実時間で測るのは非常に重要なので 忘れないようにしましょう。