Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Journal club] GRES: Generalized Referring Expr...
Search
Semantic Machine Intelligence Lab., Keio Univ.
PRO
June 23, 2023
Technology
150
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Journal club] GRES: Generalized Referring Expression Segmentation
Semantic Machine Intelligence Lab., Keio Univ.
PRO
June 23, 2023
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
200
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
160
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
220
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
230
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
190
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
230
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
55
[MIRU26] To What Extent Does MLLM-as-a-Judge Exhibit Cross-Model Preference Bias?
keio_smilab
PRO
0
310
[Journal club] FlashVID: Efficient Video Large Language Models via Training-free Tree-based Spatiotemporal Token Merging
keio_smilab
PRO
0
47
Other Decks in Technology
See All in Technology
あなたの知らないAmazon VPC Route Server/Amazon VPC Route Server you don't know about
masakiokuda
1
180
営業オントロジーの作り方と、エージェントからの辿り方 ── ナレッジワークの現場から
kworkdev
PRO
1
210
AI駆動開発で仕様はどこまで書くべきか? ― 人とAIの責務境界から考える開発プロセスの実践
takahiromatsui
1
260
Harness Engineering on Rails
joelq
0
770
10年欲しかった音楽管理アプリを、AIと一緒に作りはじめた
judau
1
190
IR Today: Theory, Practice, and Agents
dtunkelang
0
290
BedrockとLambdaで作る リアルタイム進行型推理ゲーム
kawametho
0
130
Incremental HTTP
kazuho
4
1.7k
なぜAI任せのゲームは面白くならないのか?
hirohasuyoutube
0
350
Claude起点の仕様駆動開発
tanakaseiya
0
240
【ゲームメーカーズスクランブル2026】『Shadowverse: Worlds Beyond』UIとアニメーションで実現する最高のユーザー体験を叶えるプロトタイピング
cygames
PRO
1
710
OpenClawでAzure DevOpsのWiki更新を自動化する - クラウドAIだけでは届かない場所へ
yutakaosada
0
130
Featured
See All Featured
Large-scale JavaScript Application Architecture
addyosmani
515
110k
The Straight Up "How To Draw Better" Workshop
denniskardys
239
140k
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
How to Get Subject Matter Experts Bought In and Actively Contributing to SEO & PR Initiatives.
livdayseo
0
200
Hiding What from Whom? A Critical Review of the History of Programming languages for Music
tomoyanonymous
3
1.3k
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.6k
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
430
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
290
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
350
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1k
Utilizing Notion as your number one productivity tool
mfonobong
4
600
Transcript
GRES: Generalized Referring Expression Segmentation 杉浦孔明研究室 九曜克之 Chang Liu† Henghui
Ding† Xudong Jiang Nanyang Technological University, Singapore CVPR2023 highlight Liu, Chang et al. "GRES: Generalized Referring Expression Segmentation." CVPR. 2023.
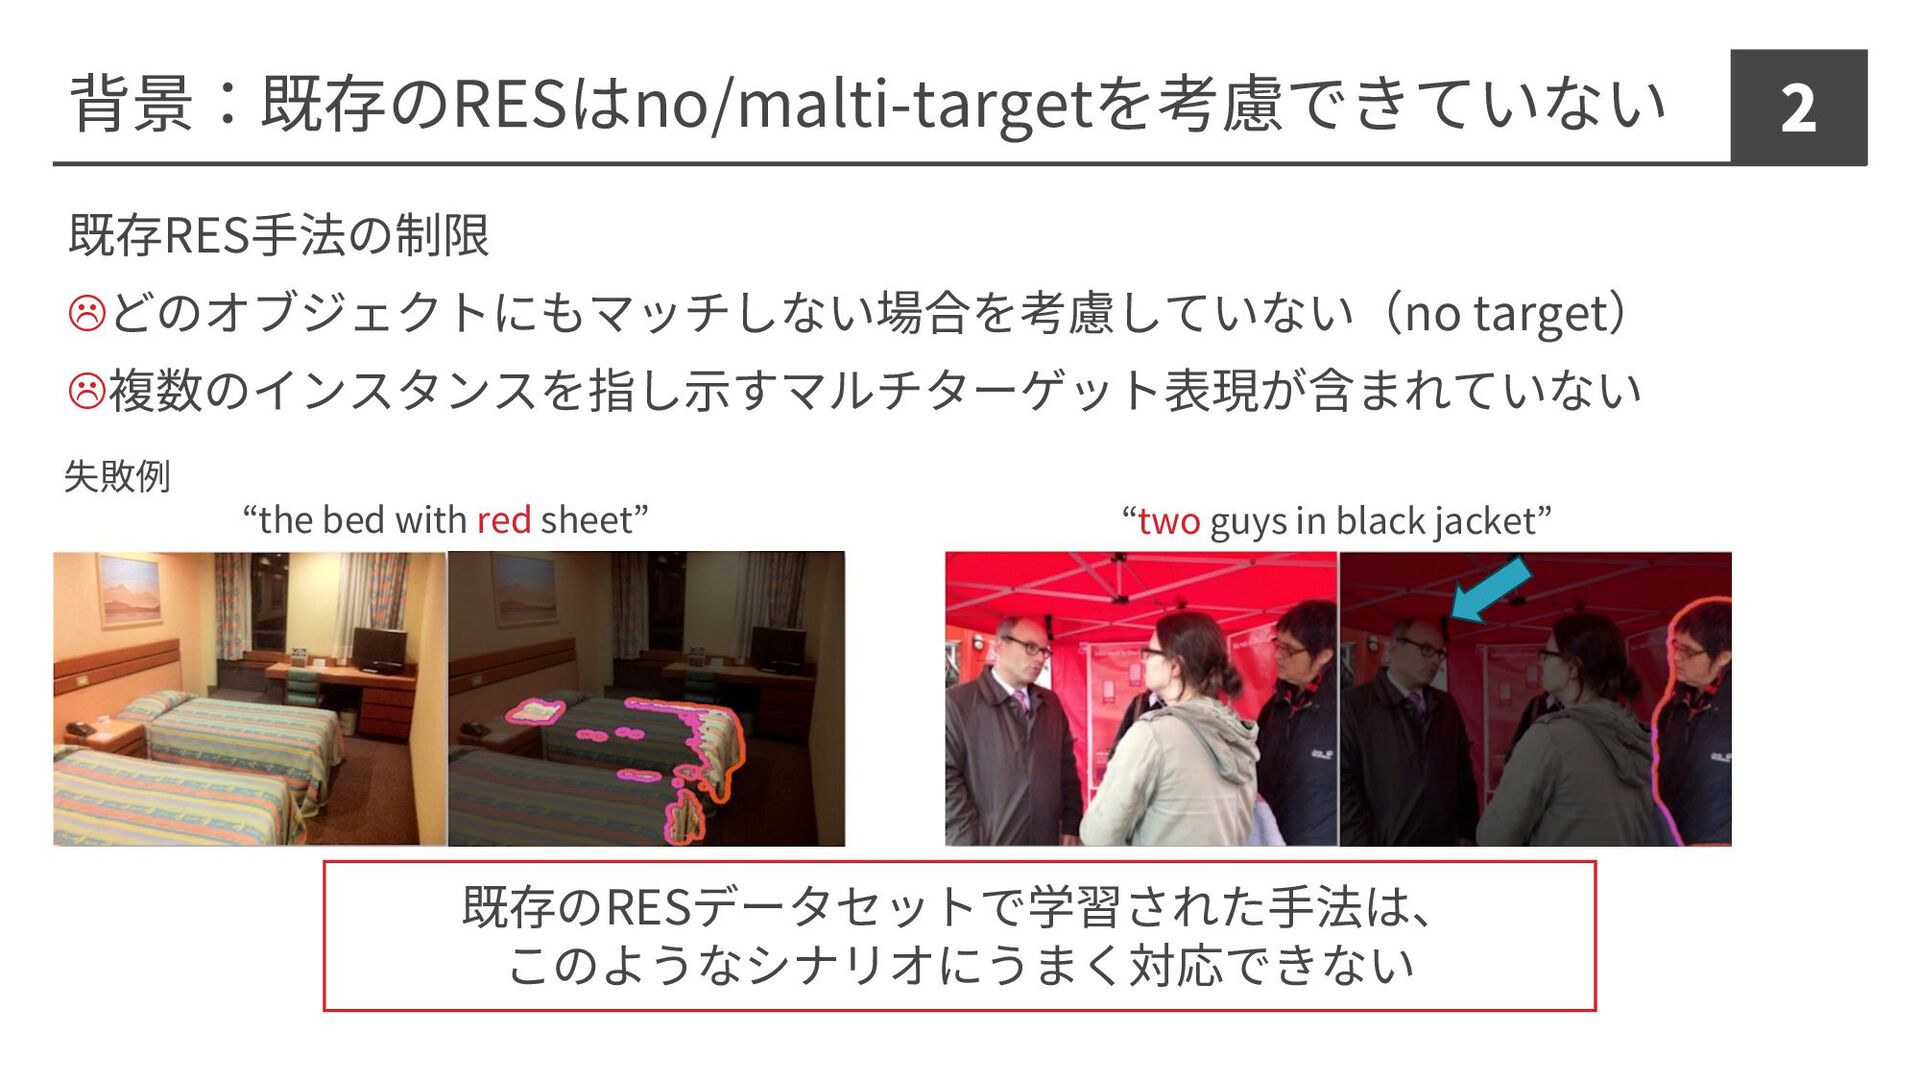
背景:既存のRESはno/malti-targetを考慮できていない 2 既存RES⼿法の制限 Lどのオブジェクトにもマッチしない場合を考慮していない(no target) L複数のインスタンスを指し⽰すマルチターゲット表現が含まれていない 既存のRESデータセットで学習された⼿法は、 このようなシナリオにうまく対応できない “two guys
in black jacket” “the bed with red sheet” 失敗例
関連研究:no-/multi-target設定に対しては不⼗分 3 PhraseCutにはmulti-target表現があるが,対象物が⼀意に定まらない場合にのみ使⽤ データセット no-target multi-target 形式 ReferIt [Kazemzadeh+, EMNLP14]
× × ⾃由 RefCOCOg [Mao+, CVPR16] × × ⾃由 PhraseCut [Wu+, CVPR20] × △ テンプレート
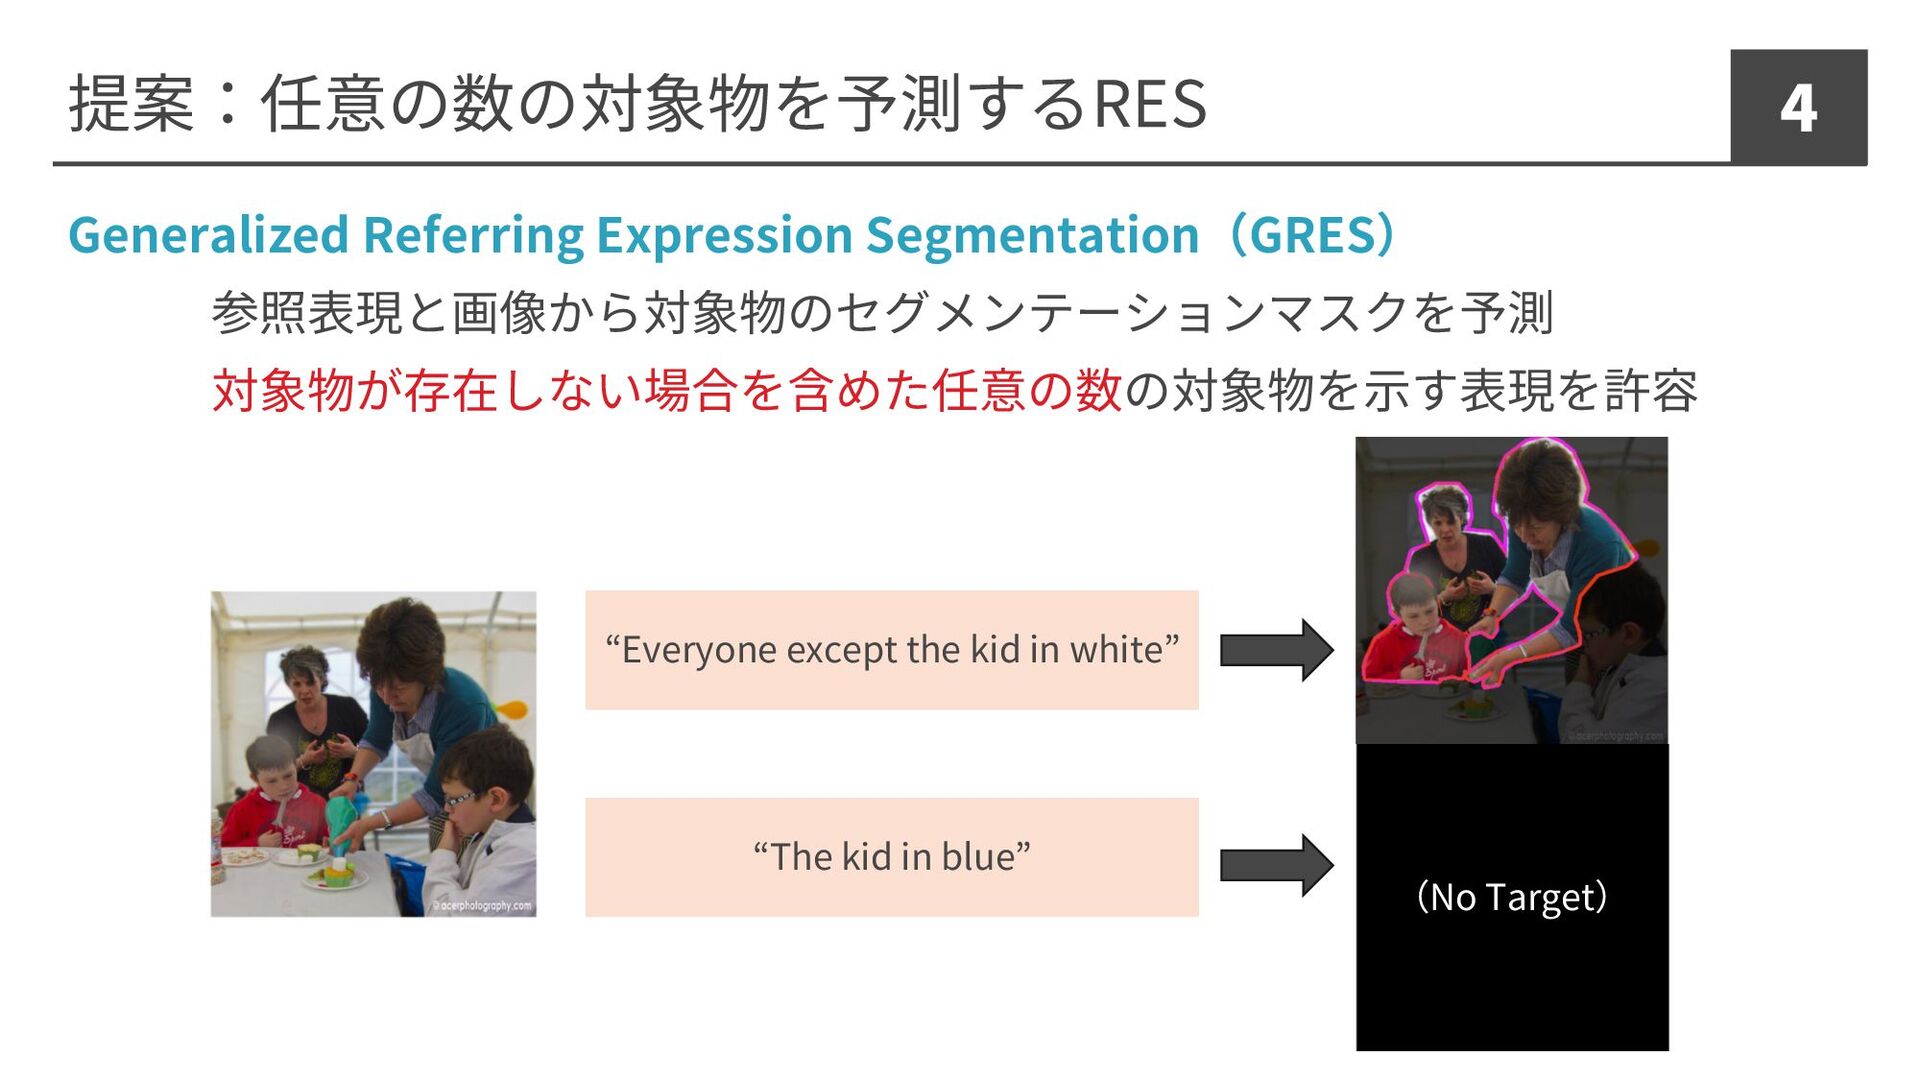
提案:任意の数の対象物を予測するRES 4 Generalized Referring Expression Segmentation(GRES) 参照表現と画像から対象物のセグメンテーションマスクを予測 対象物が存在しない場合を含めた任意の数の対象物を⽰す表現を許容 “Everyone except
the kid in white” “The kid in blue” (No Target)
データセット: RefCOCOを基にGRES⽤に新たに構築 5 gRefCOCO • RefCOCO [Kazemzadeh+, EMNLP14]を⽤いて構築 • 参照表現,対応する画像,対象物のマスク画像およびno-targetを⽰すラベル
画像数 インスタンス数 参照表現数 multi-target no-target 19,994 60,287 278,232 80,022 32,202 “horse on center and its rider” “the guy standing in back”(no target)
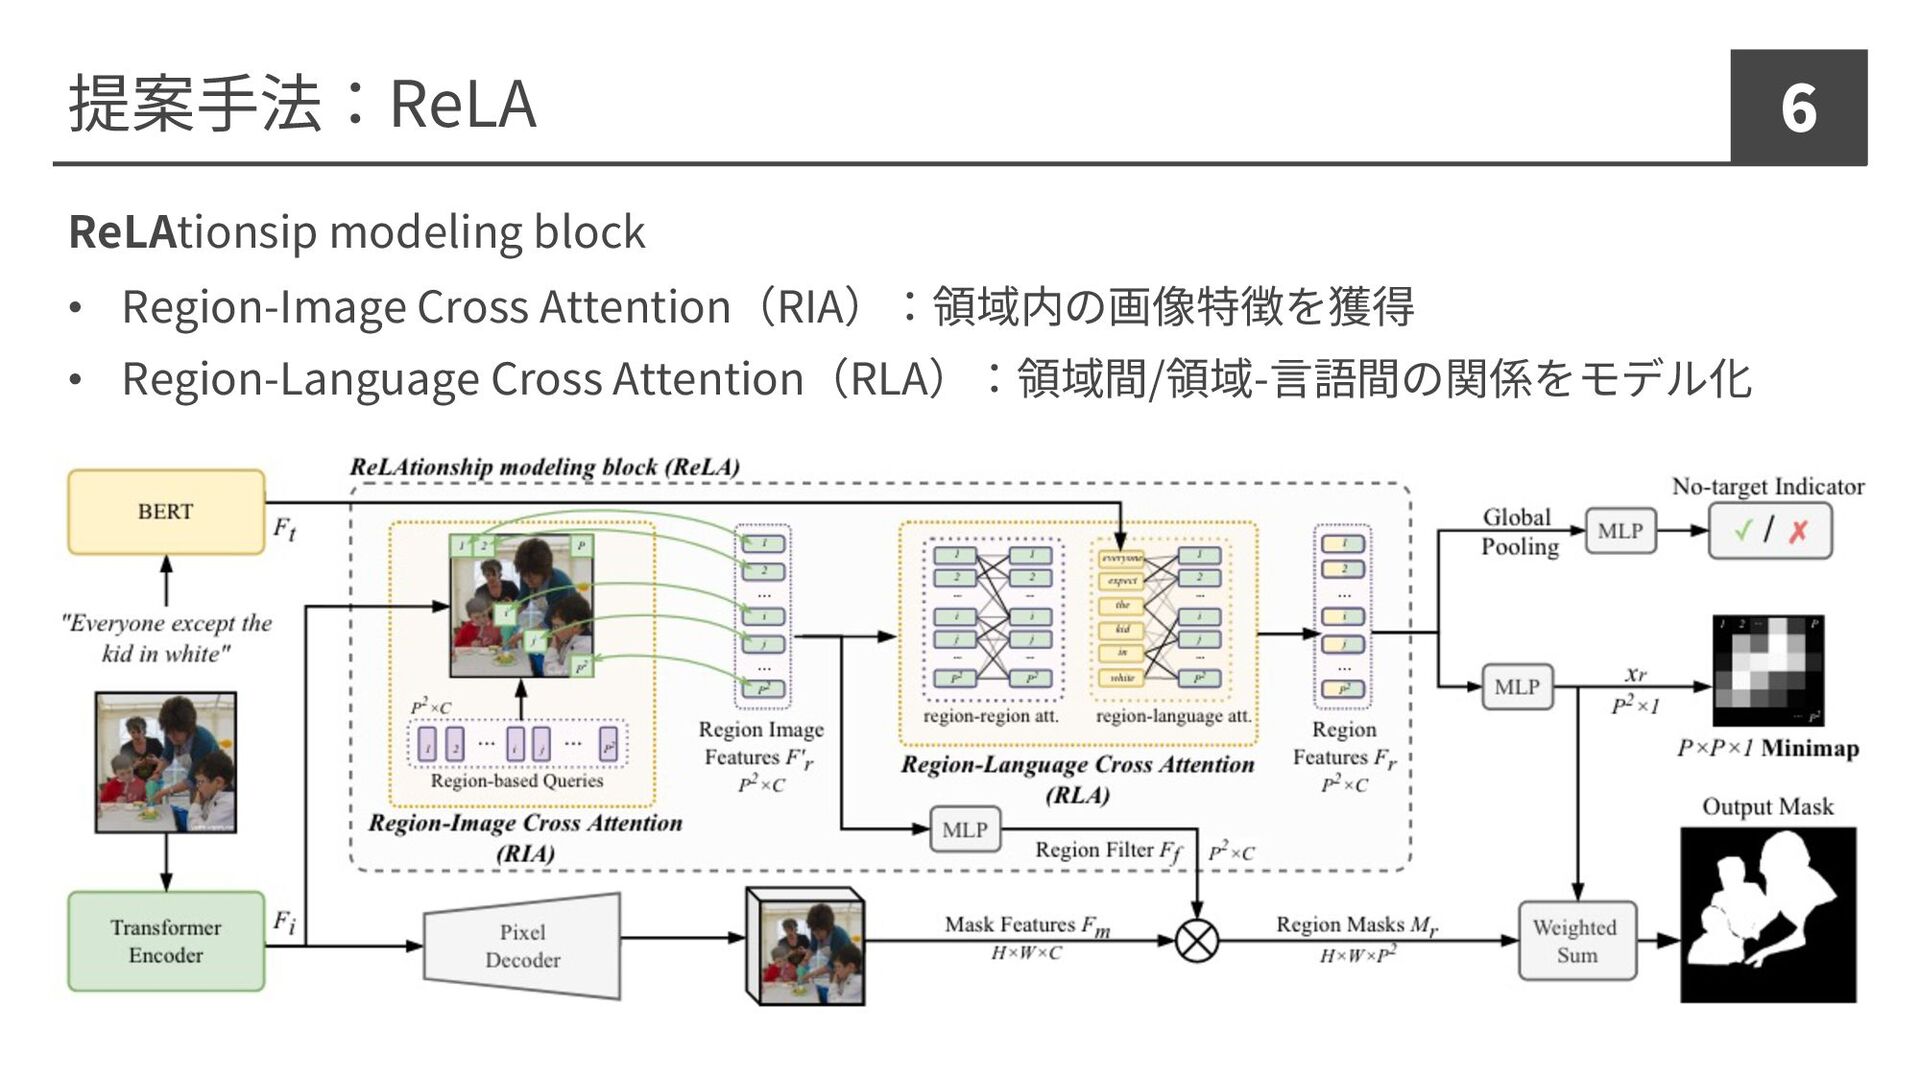
提案⼿法:ReLA 6 ReLAtionsip modeling block • Region-Image Cross Attention(RIA):領域内の画像特徴を獲得 •
Region-Language Cross Attention(RLA):領域間/領域-⾔語間の関係をモデル化
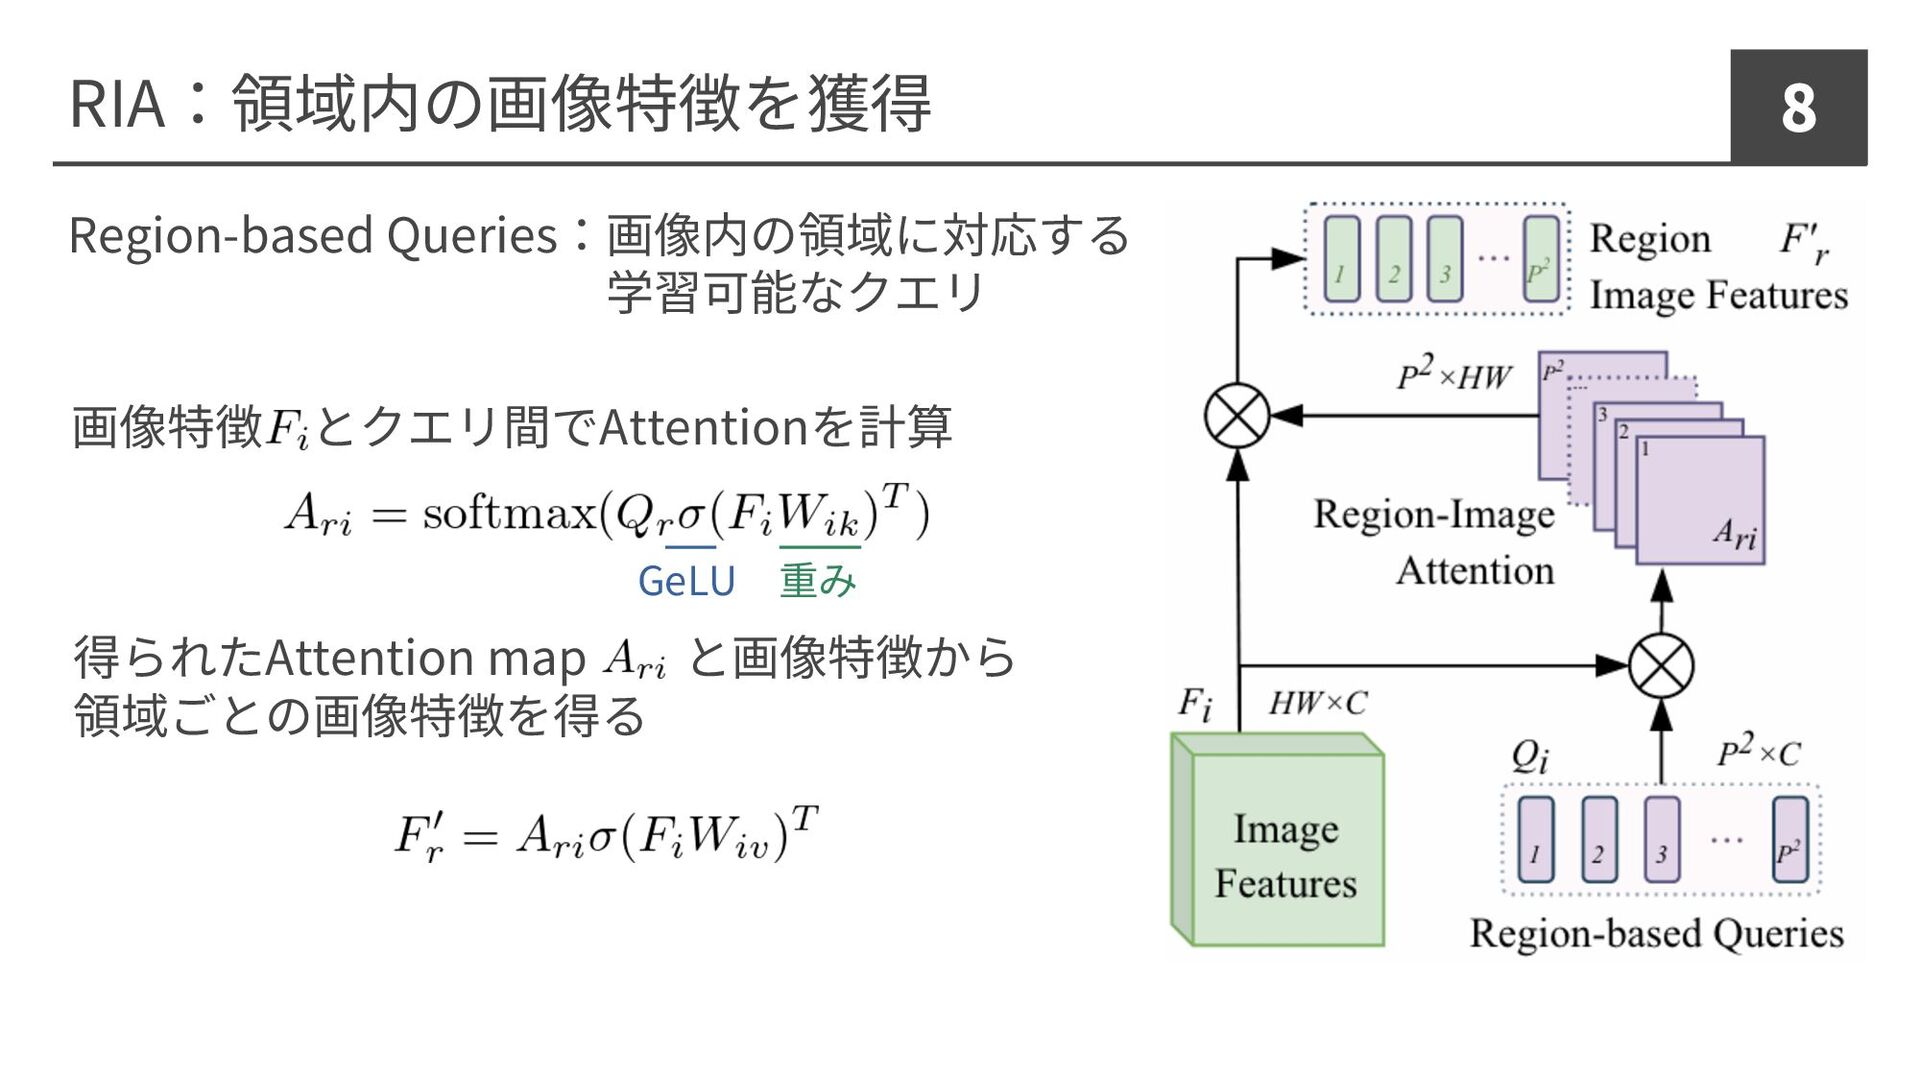
RIA:領域内の画像特徴を獲得 8 Region-based Queries:画像内の領域に対応する 学習可能なクエリ 画像特徴 とクエリ間でAttentionを計算 得られたAttention map と画像特徴から
領域ごとの画像特徴を得る GeLU 重み
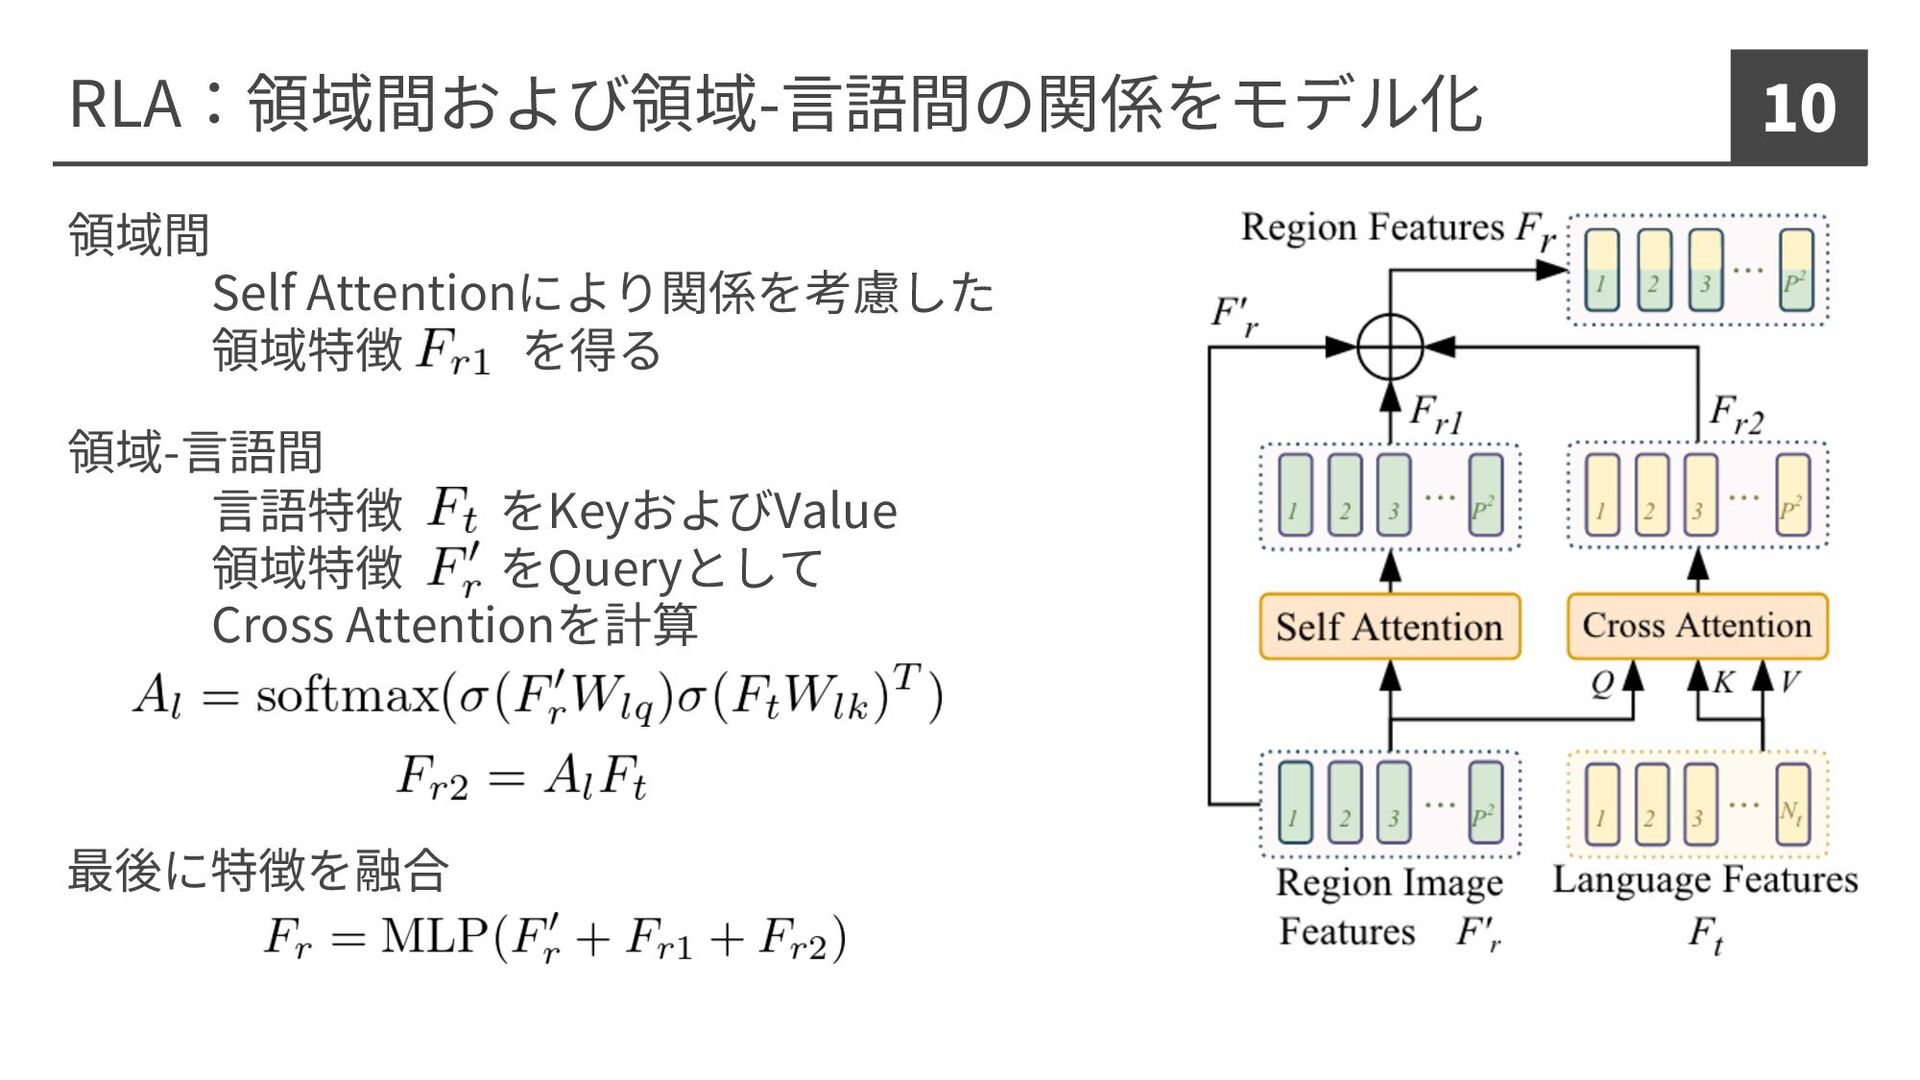
RLA:領域間および領域-⾔語間の関係をモデル化 10 領域間 Self Attentionにより関係を考慮した 領域特徴 を得る 領域-⾔語間 ⾔語特徴 をKeyおよびValue
領域特徴 をQueryとして Cross Attentionを計算 最後に特徴を融合
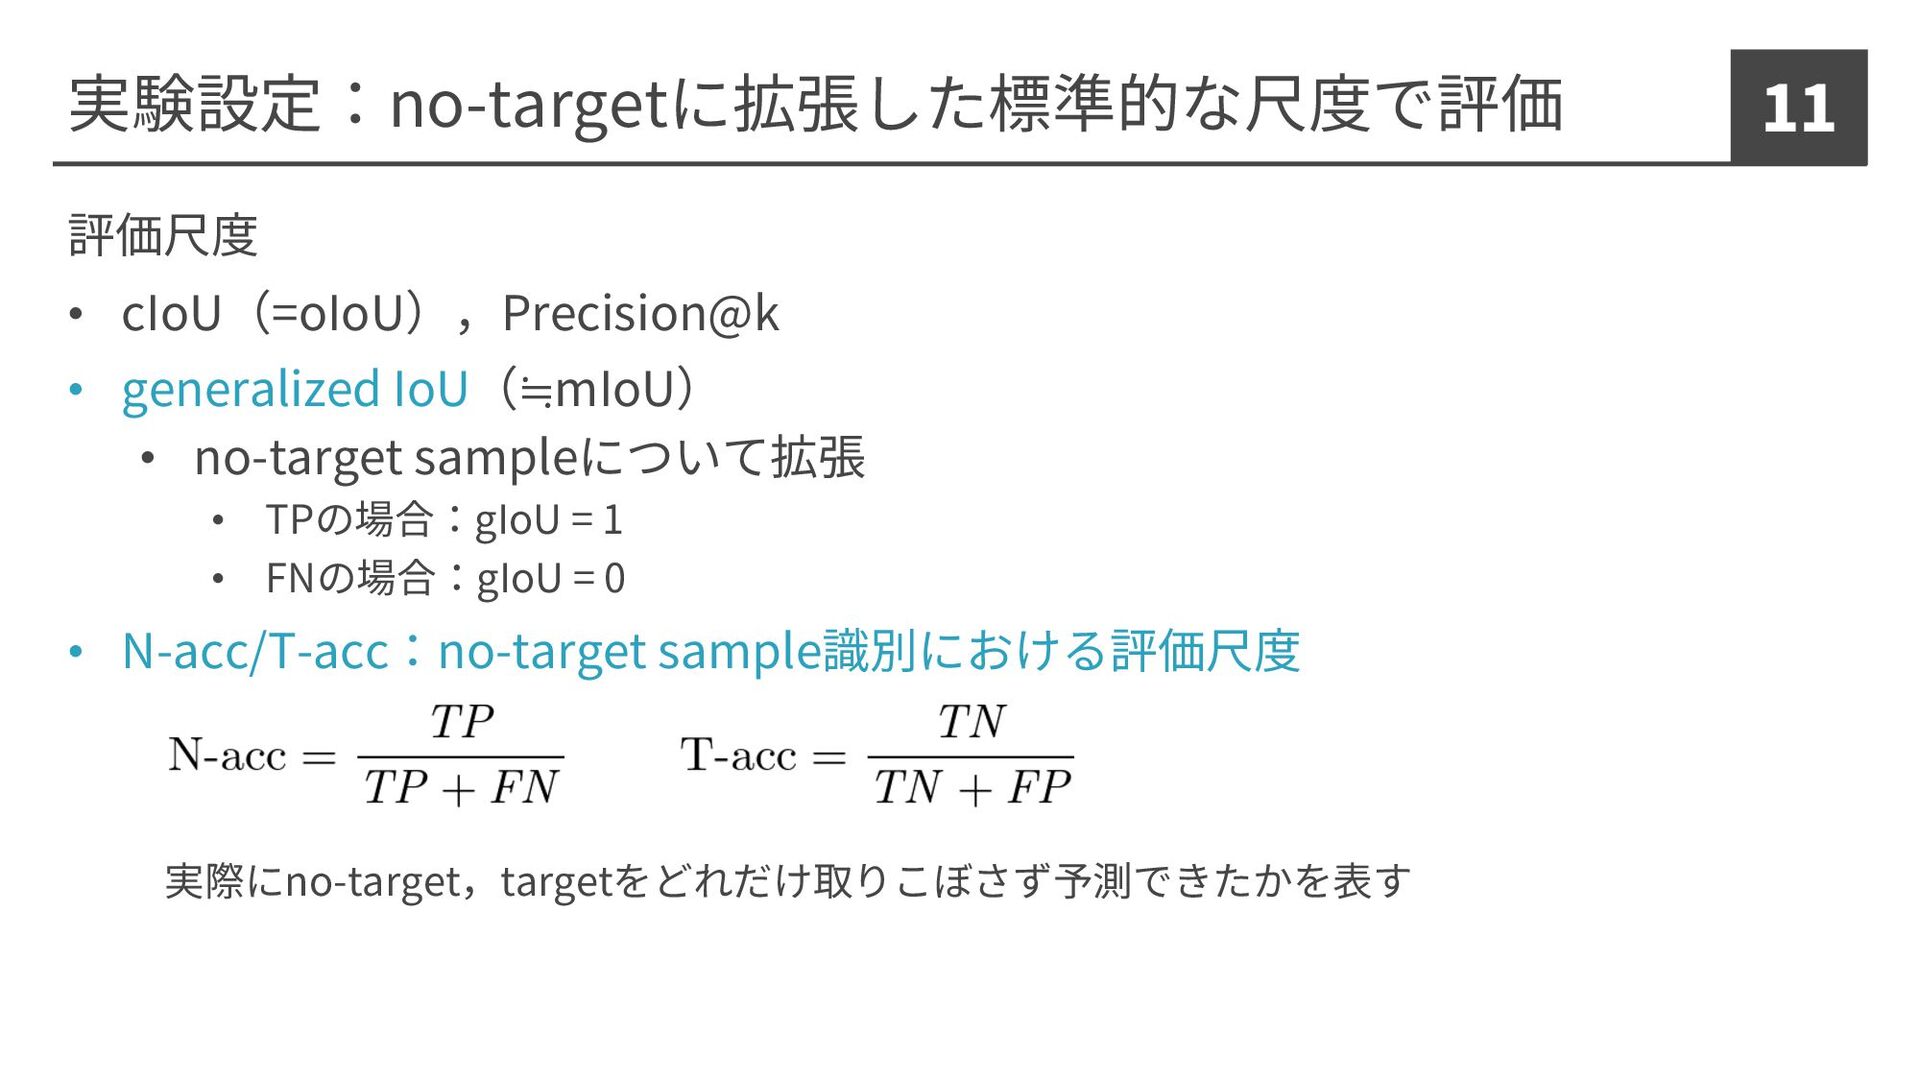
実験設定:no-targetに拡張した標準的な尺度で評価 11 評価尺度 • cIoU(=oIoU),Precision@k • generalized IoU(≒mIoU) • no-target
sampleについて拡張 • TPの場合:gIoU = 1 • FNの場合:gIoU = 0 • N-acc/T-acc:no-target sample識別における評価尺度 実際にno-target,targetをどれだけ取りこぼさず予測できたかを表す
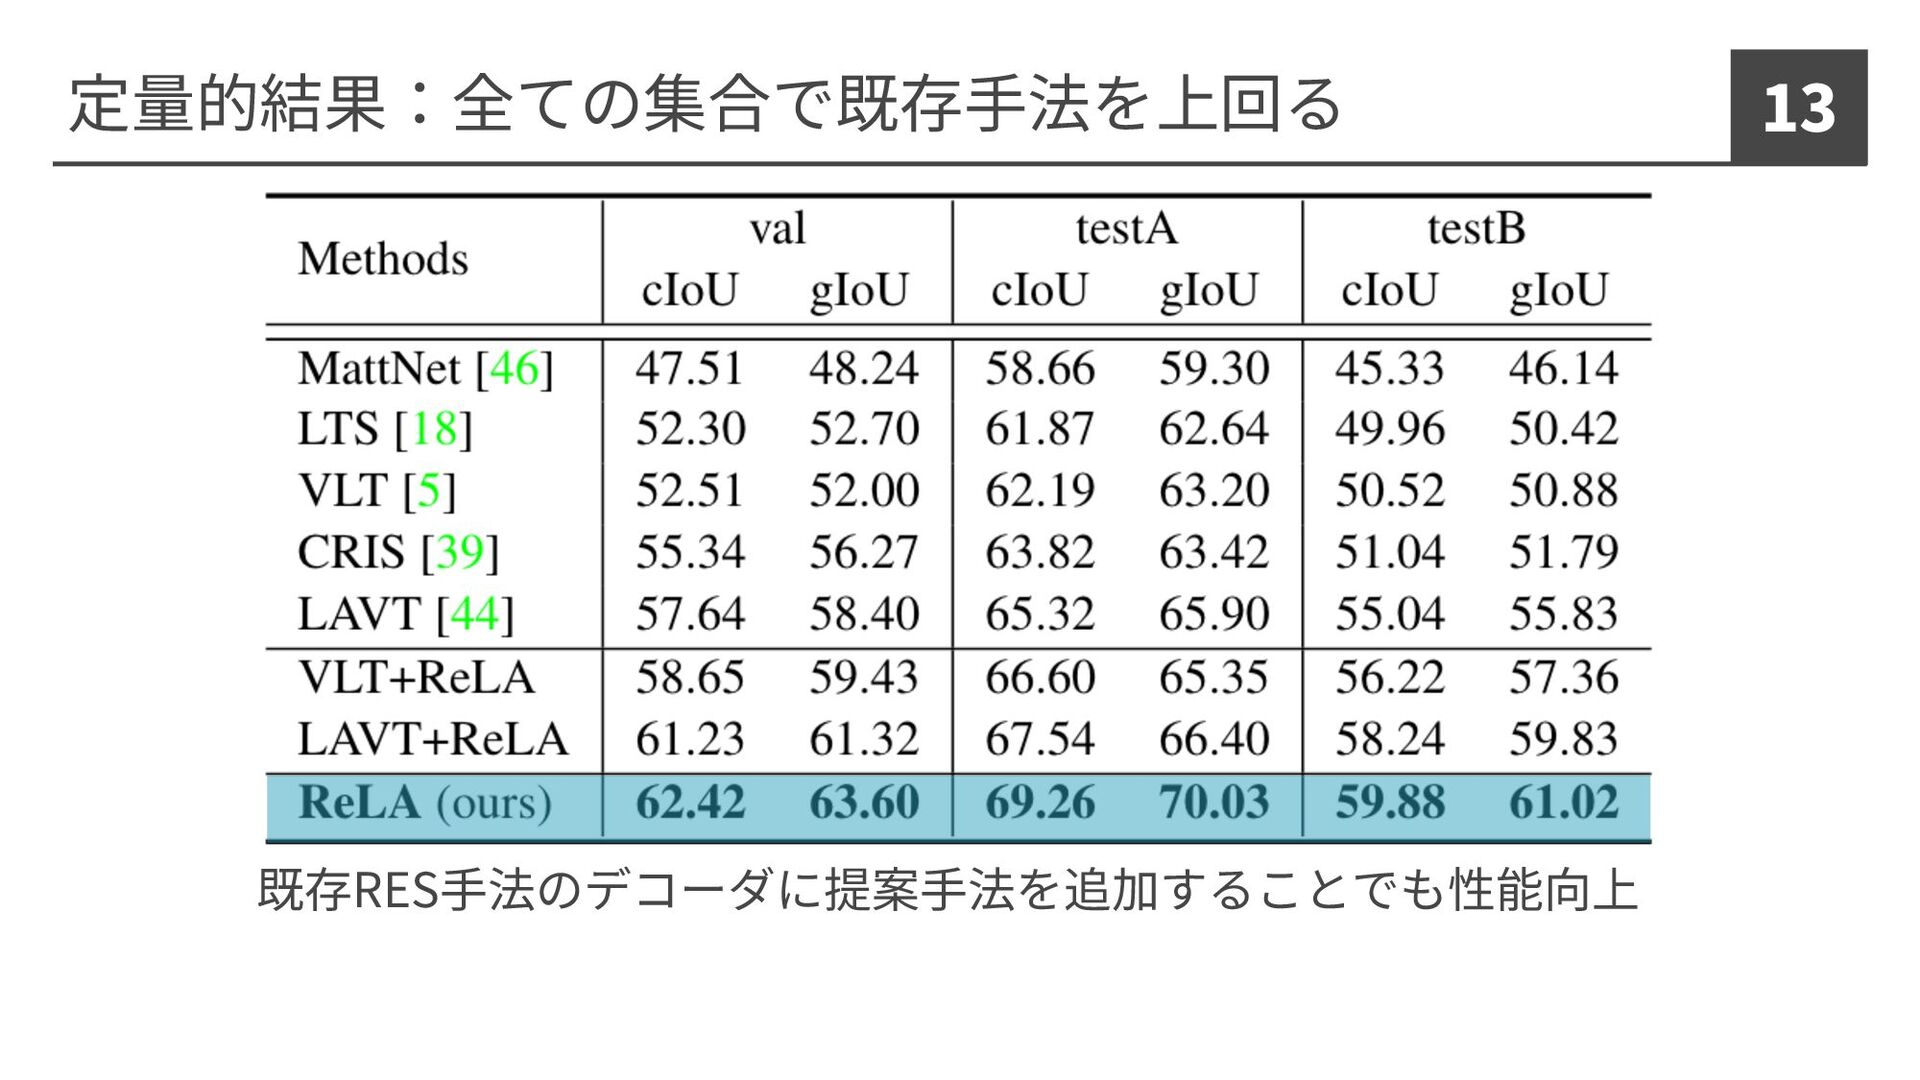
定量的結果:全ての集合で既存⼿法を上回る 13 既存RES⼿法のデコーダに提案⼿法を追加することでも性能向上
既存RESデータセットでも提案⼿法が⾼い性能 14 ほとんどの集合でLAVT [Yang+, CVPR22]よりも⾼い性能 J提案⼿法が既存RES⼿法にも有効
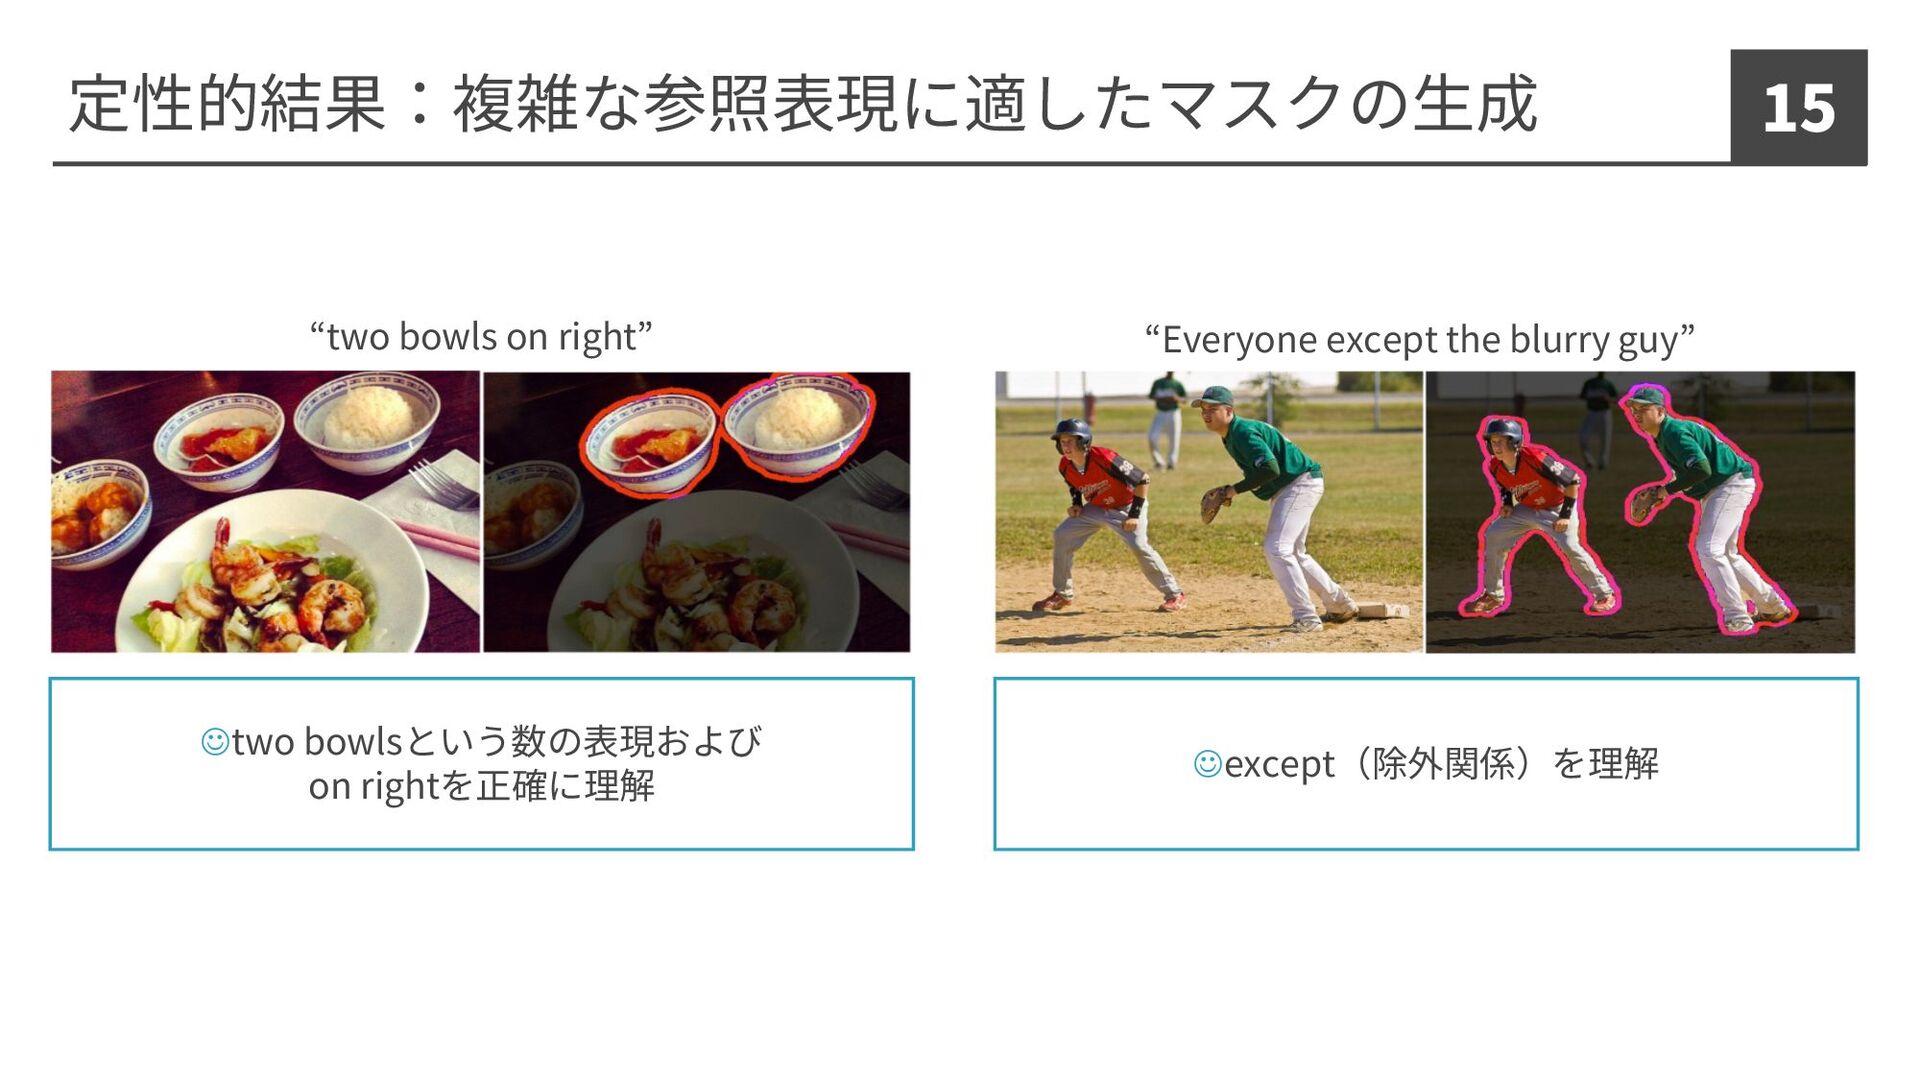
定性的結果:複雑な参照表現に適したマスクの⽣成 15 “two bowls on right” “Everyone except the blurry
guy” Jtwo bowlsという数の表現および on rightを正確に理解 Jexcept(除外関係)を理解
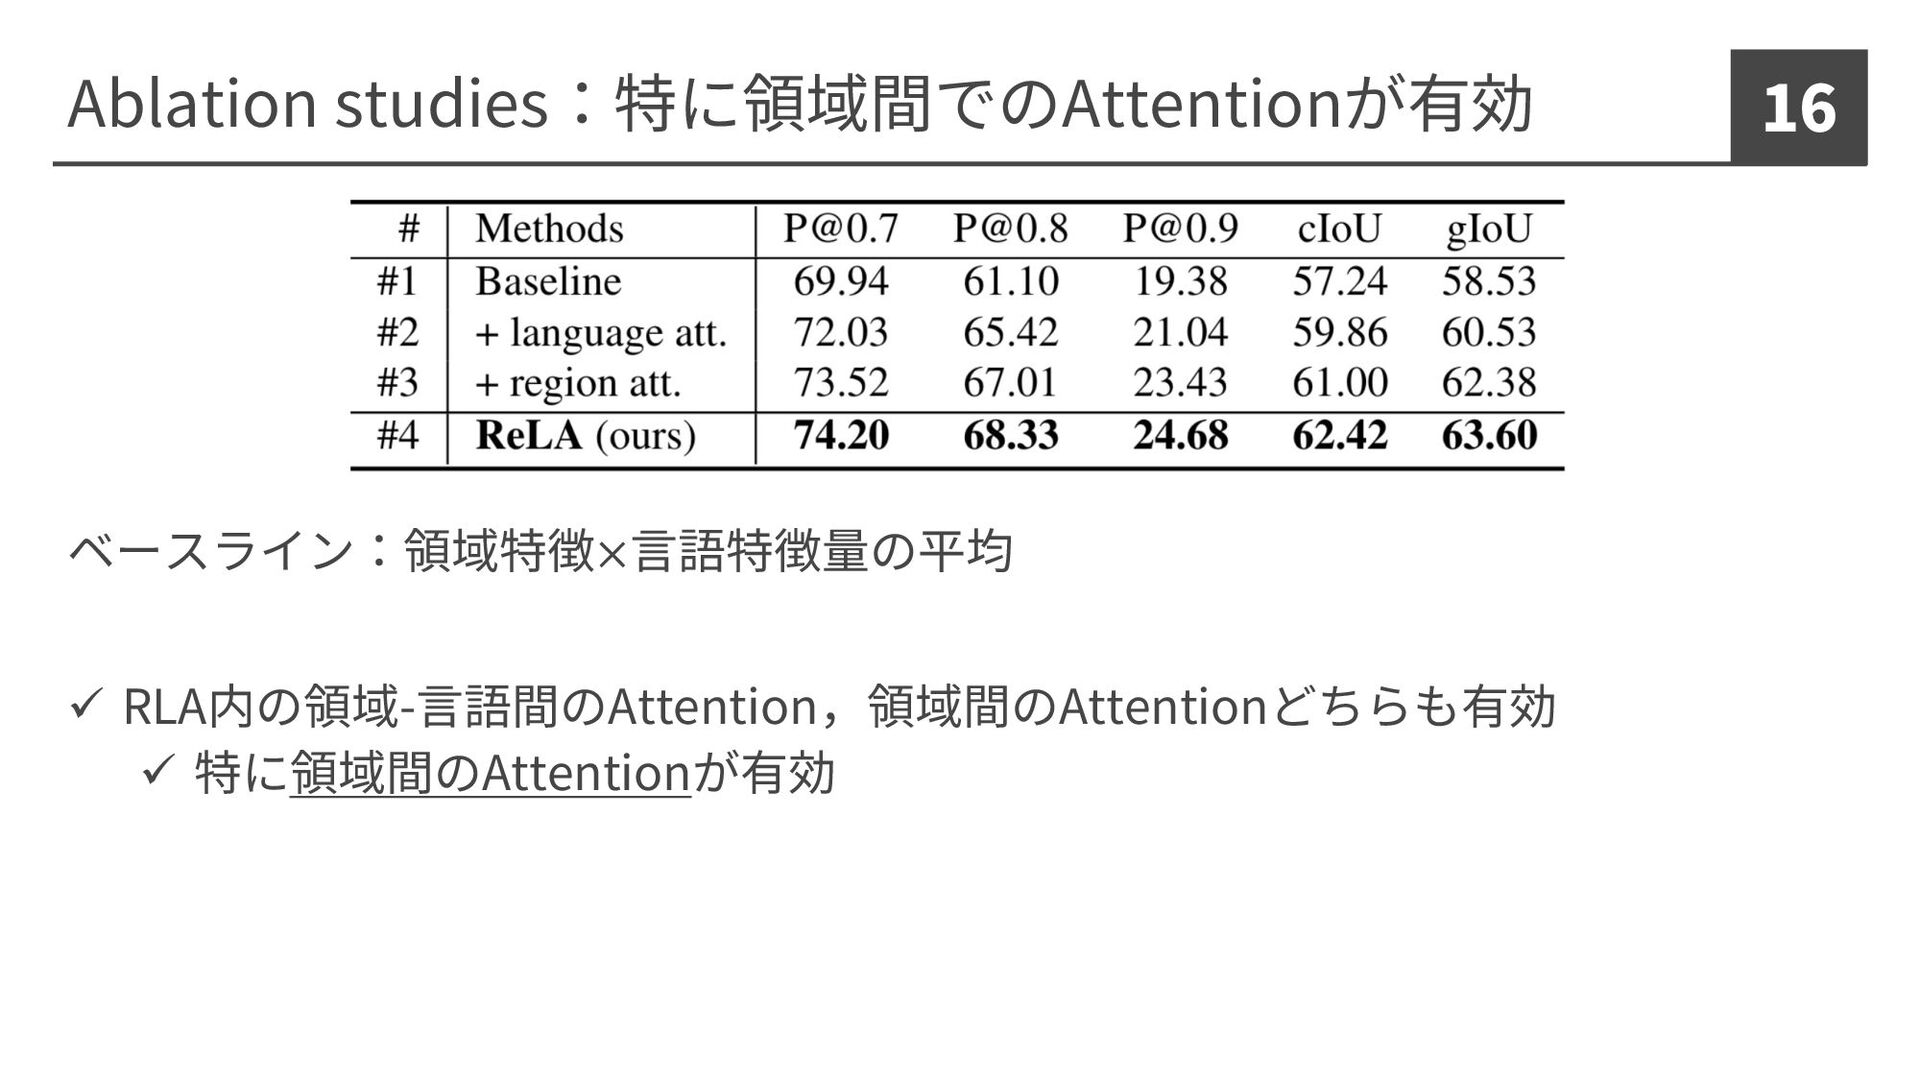
Ablation studies:特に領域間でのAttentionが有効 16 ベースライン:領域特徴×⾔語特徴量の平均 ü RLA内の領域-⾔語間のAttention,領域間のAttentionどちらも有効 ü 特に領域間のAttentionが有効
所感 17 Strengths • データセットと⼿法両⽅ • 標準データセットでも実験し性能向上している • ReLAは既存モデルと組み合わせても有⽤ Weaknesses
• no targetサンプルとして許容する/しないの基準が曖昧 • 画像に無いものを表現するとなると個⼈間のばらつきが⼤きそう Others • 改善するならRegion-based QueriesにSAMのマスクを導⼊ • 命名はどうにかならなかったのか…(gRefCOCO vs G-Ref)
まとめ 18 背景 既存のRESはno/malti-targetを考慮できていない 提案 no/malti-targetを許容したRESタスクGRES GRESタスクのためのデータセットgRefCOCO ベースラインモデルReLA 結果 gRefCOCOにおいて全ての評価尺度で既存RES⼿法を上回る
RESの標準データセットにおいて既存RES⼿法と同等以上の性能
Appendix
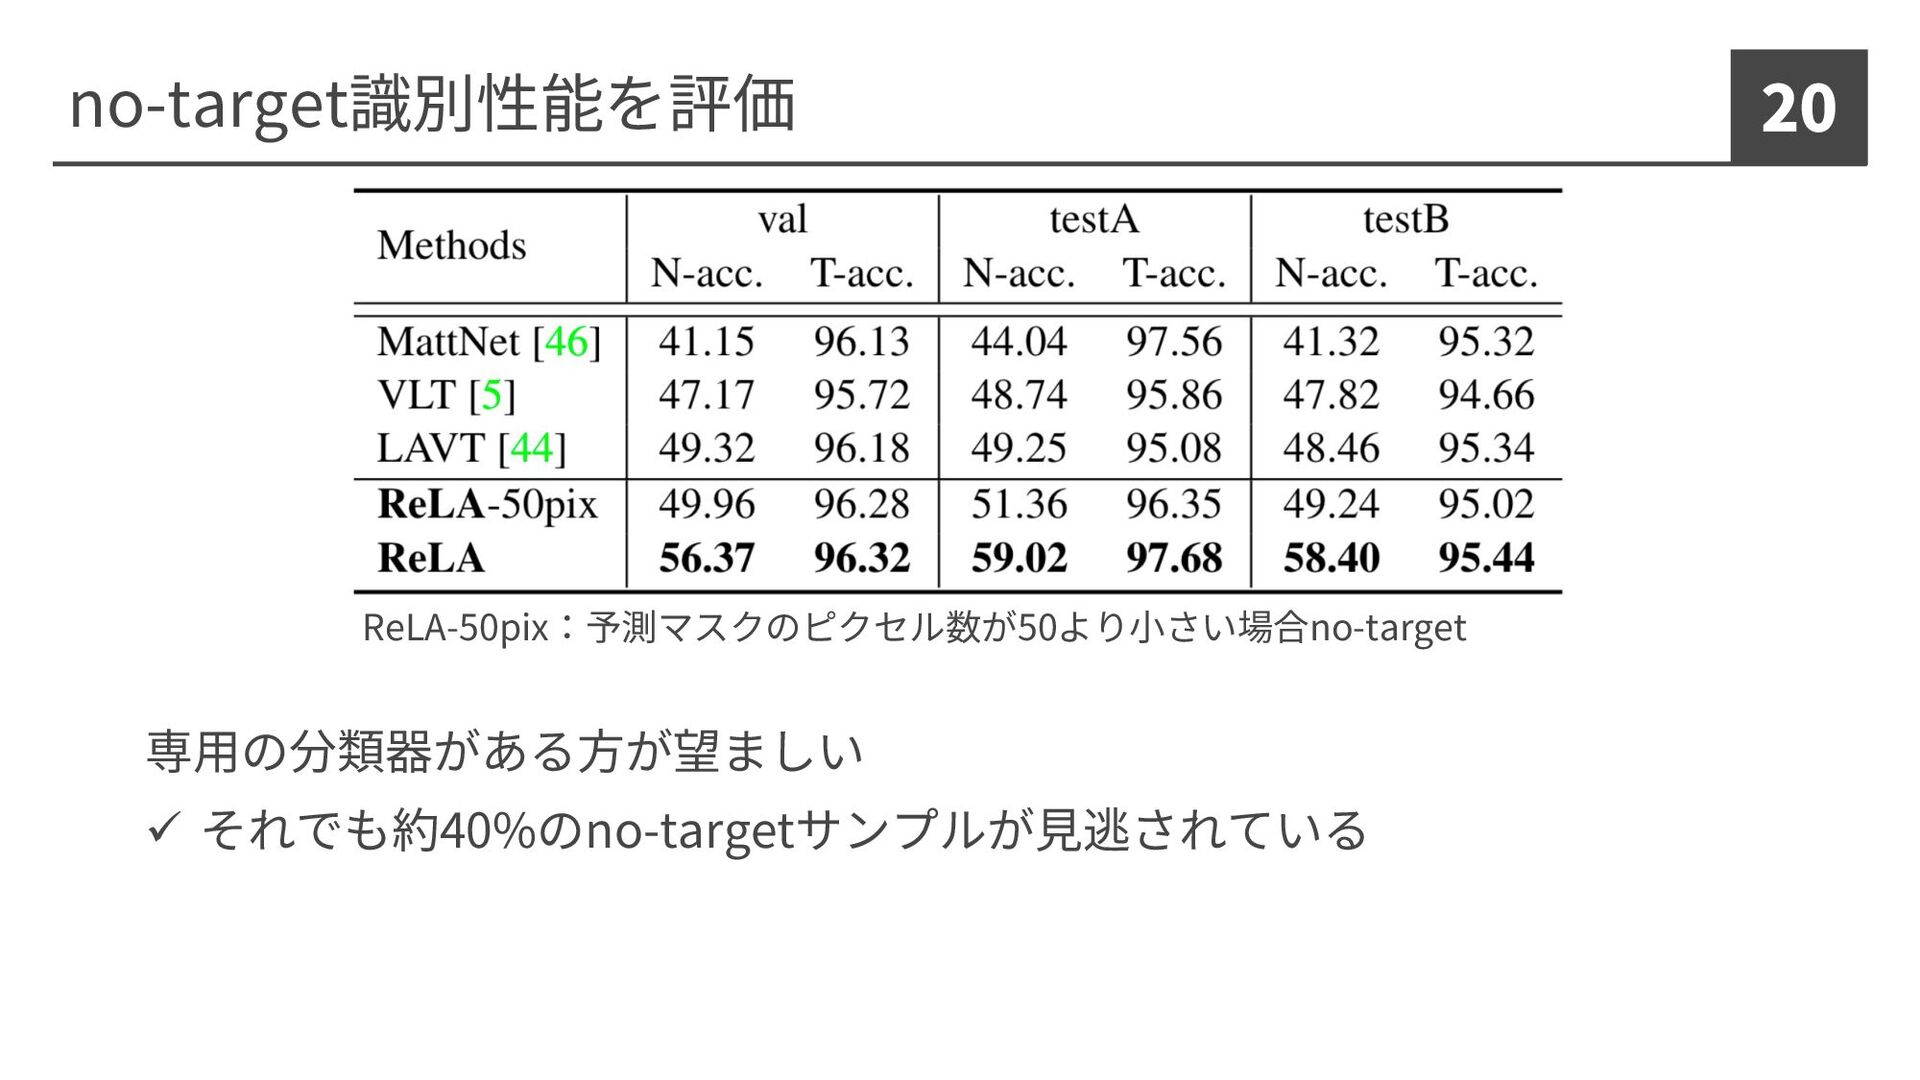
no-target識別性能を評価 20 専⽤の分類器がある⽅が望ましい ü それでも約40%のno-targetサンプルが⾒逃されている ReLA-50pix:予測マスクのピクセル数が50より⼩さい場合no-target
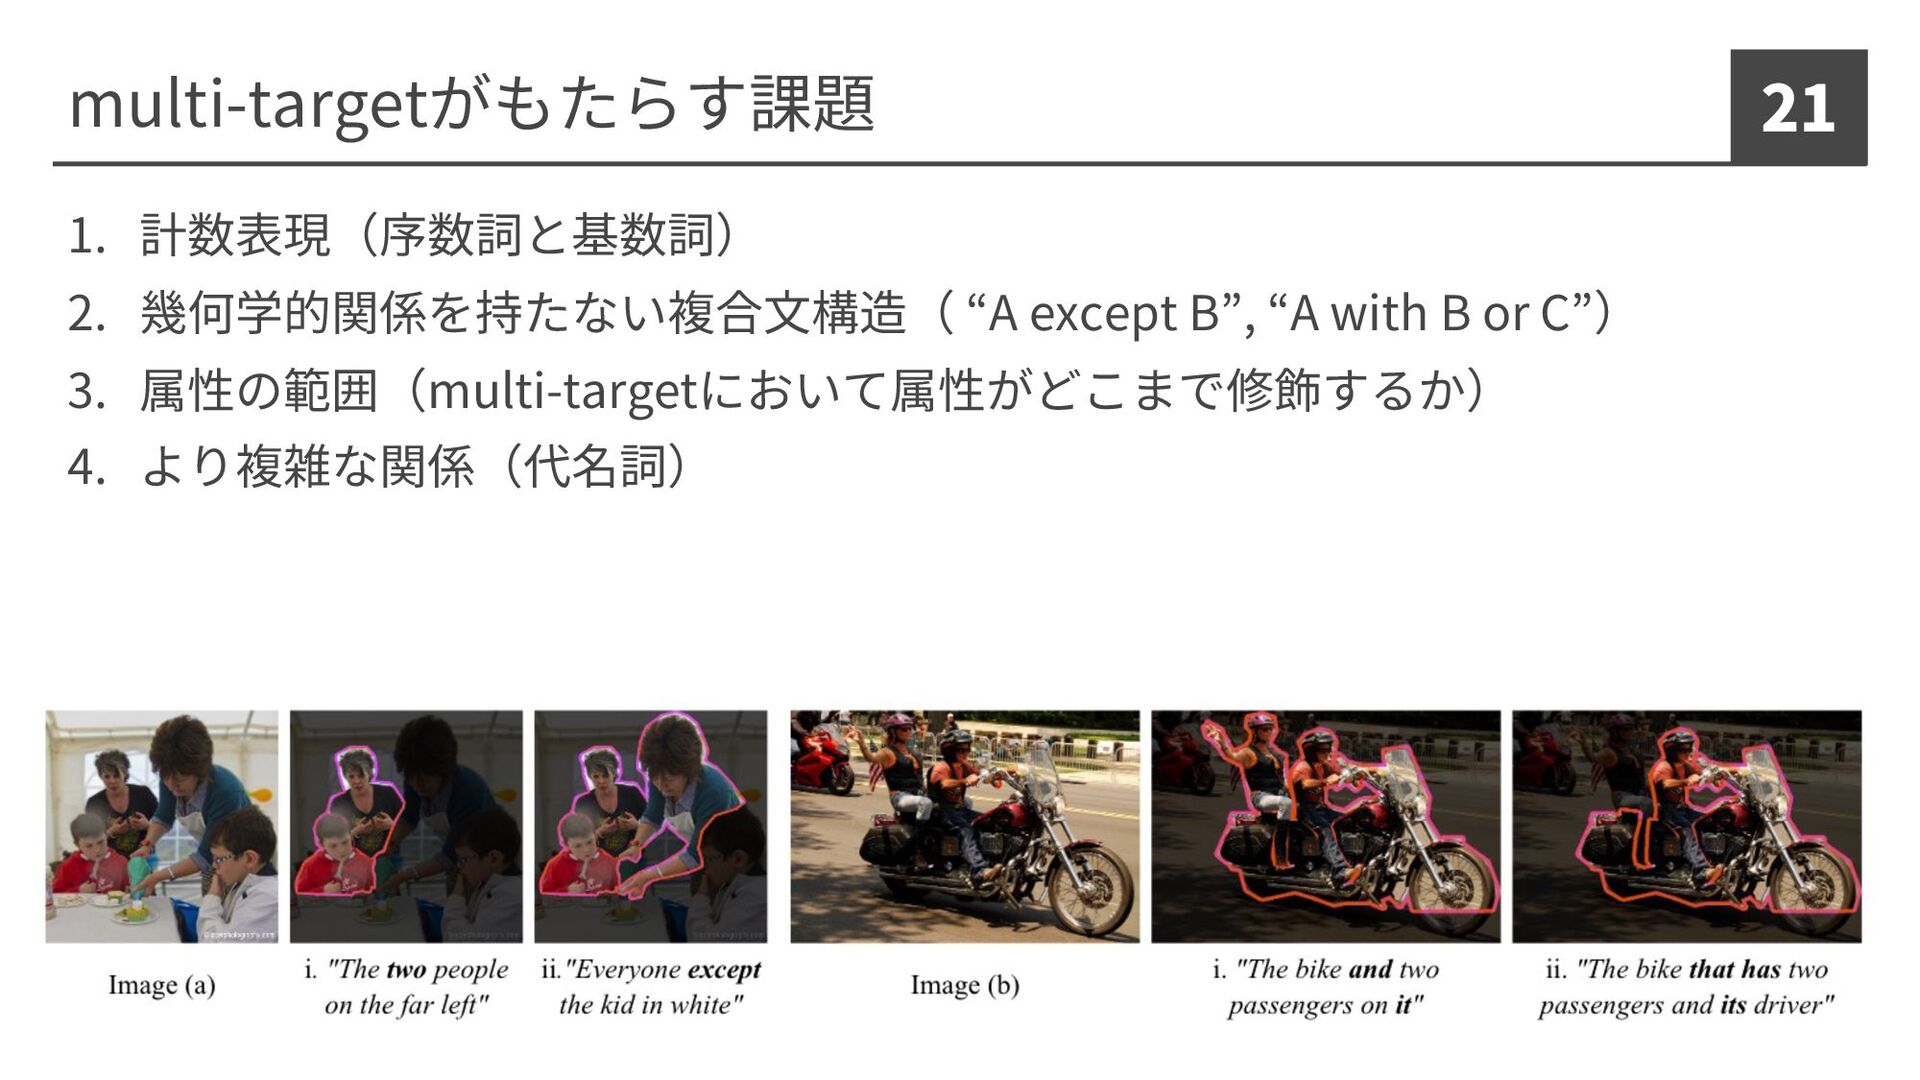
multi-targetがもたらす課題 21 1. 計数表現(序数詞と基数詞) 2. 幾何学的関係を持たない複合⽂構造( “A except B”, “A
with B or C”) 3. 属性の範囲(multi-targetにおいて属性がどこまで修飾するか) 4. より複雑な関係(代名詞)
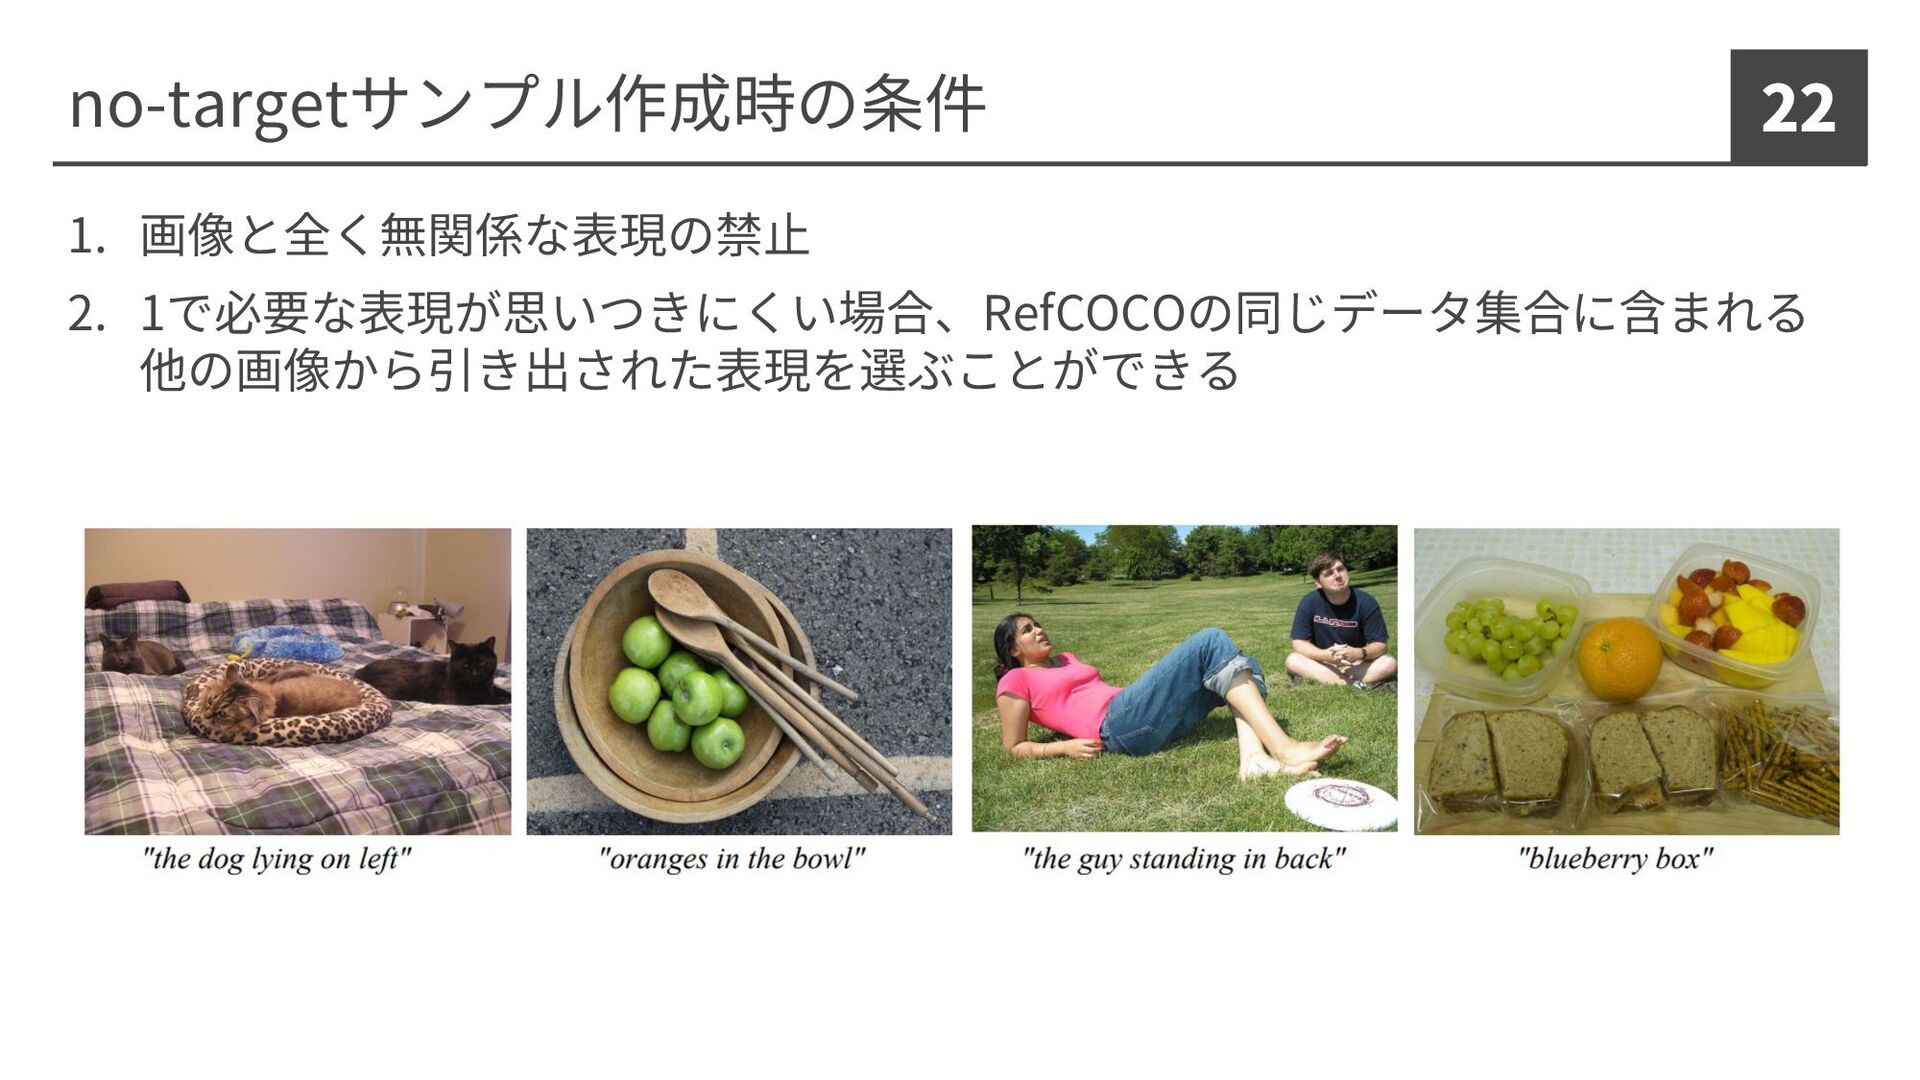
no-targetサンプル作成時の条件 22 1. 画像と全く無関係な表現の禁⽌ 2. 1で必要な表現が思いつきにくい場合、RefCOCOの同じデータ集合に含まれる 他の画像から引き出された表現を選ぶことができる
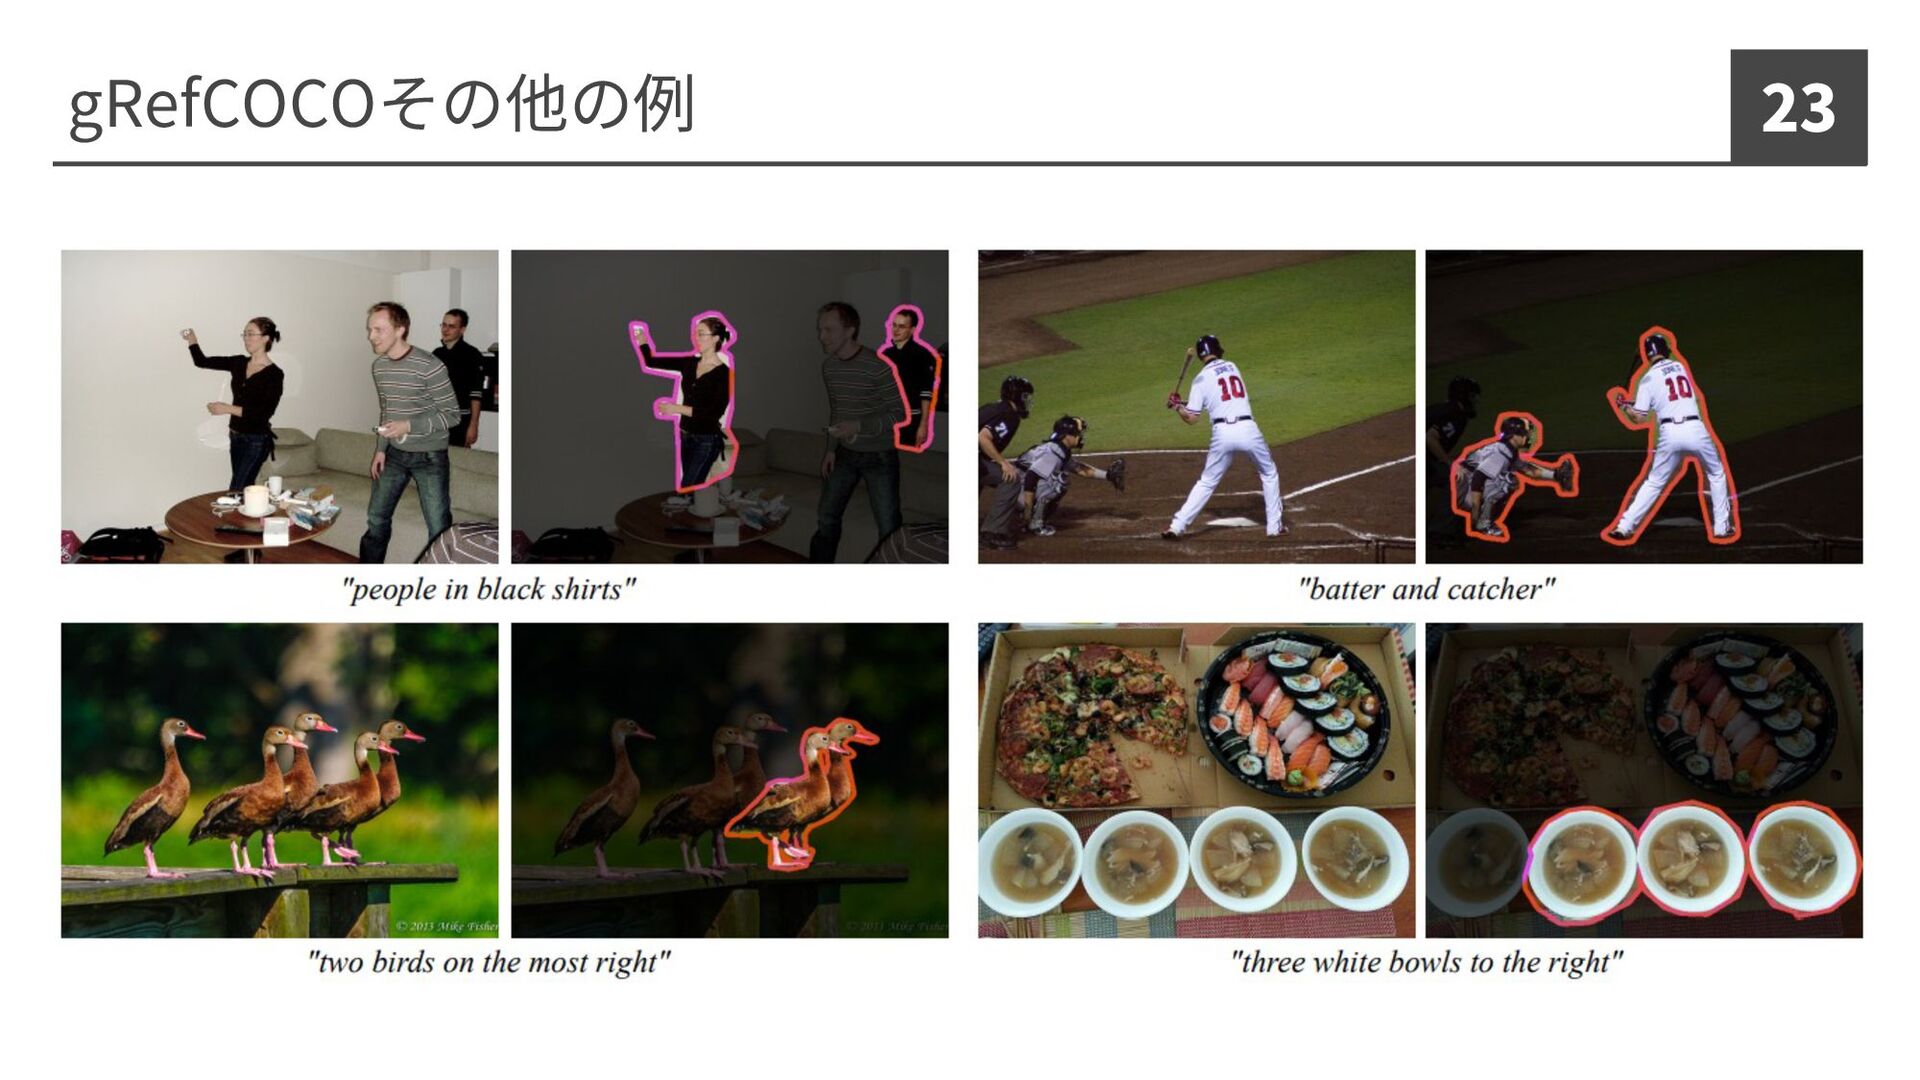
gRefCOCOその他の例 23
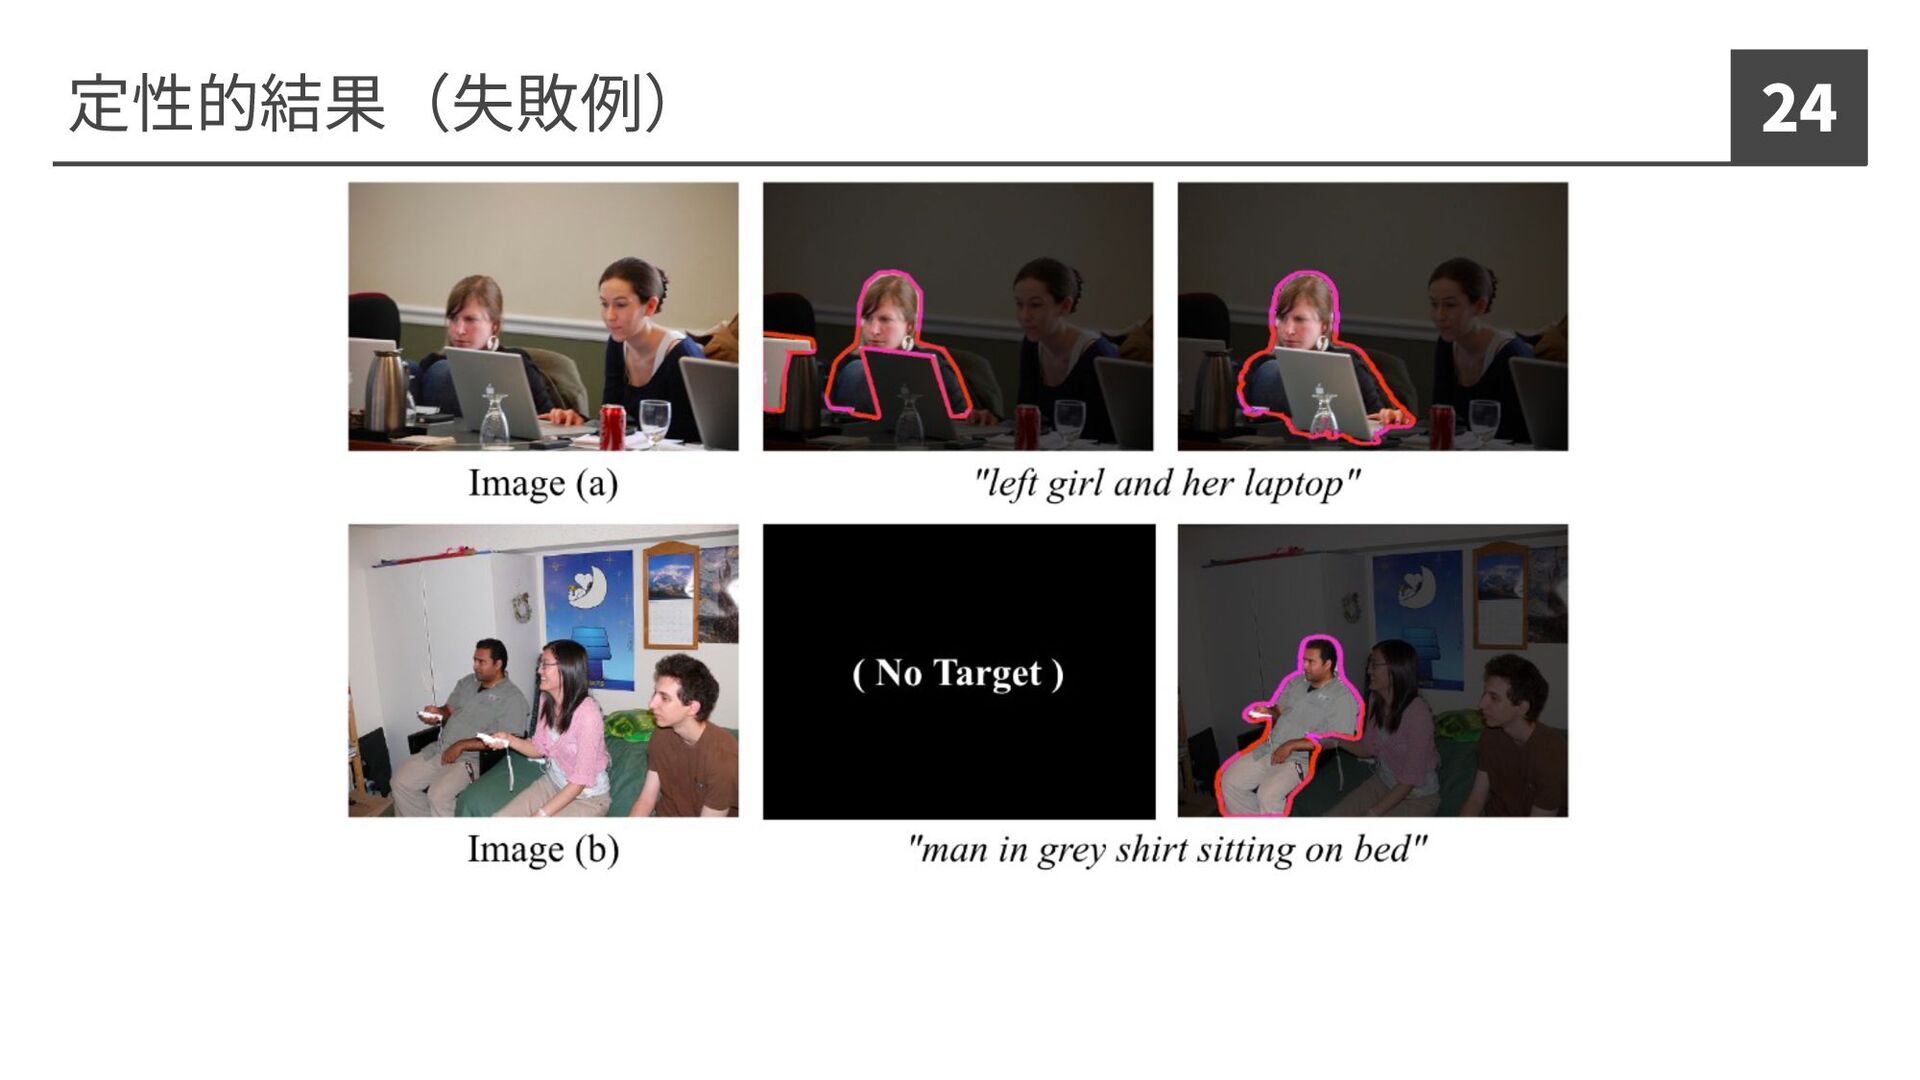
定性的結果(失敗例) 24
学習設定 25 学習時間:記載なし デバイス:4 × V100 GPUs


 keio_smilab
 masakiokuda
 kworkdev
 takahiromatsui
 joelq
 judau
 dtunkelang
 kawametho
 kazuho
 hirohasuyoutube
 tanakaseiya
 cygames
 yutakaosada
 addyosmani
 denniskardys
 bermonpainter
 livdayseo
 tomoyanonymous
 aleyda
 uxyall
 tamaranovitovic
 stephenakadiri
 jdejongh
 tammyeverts
 mfonobong