Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Semantic Machine Intelligence for Vision, Langu...

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

Semantic Machine Intelligence for Vision, Language, and Actions

cvpaper.challenge Conference summer 2025資料
2025年7月19日

More Decks by Semantic Machine Intelligence Lab., Keio Univ.

Other Decks in Technology

Transcript

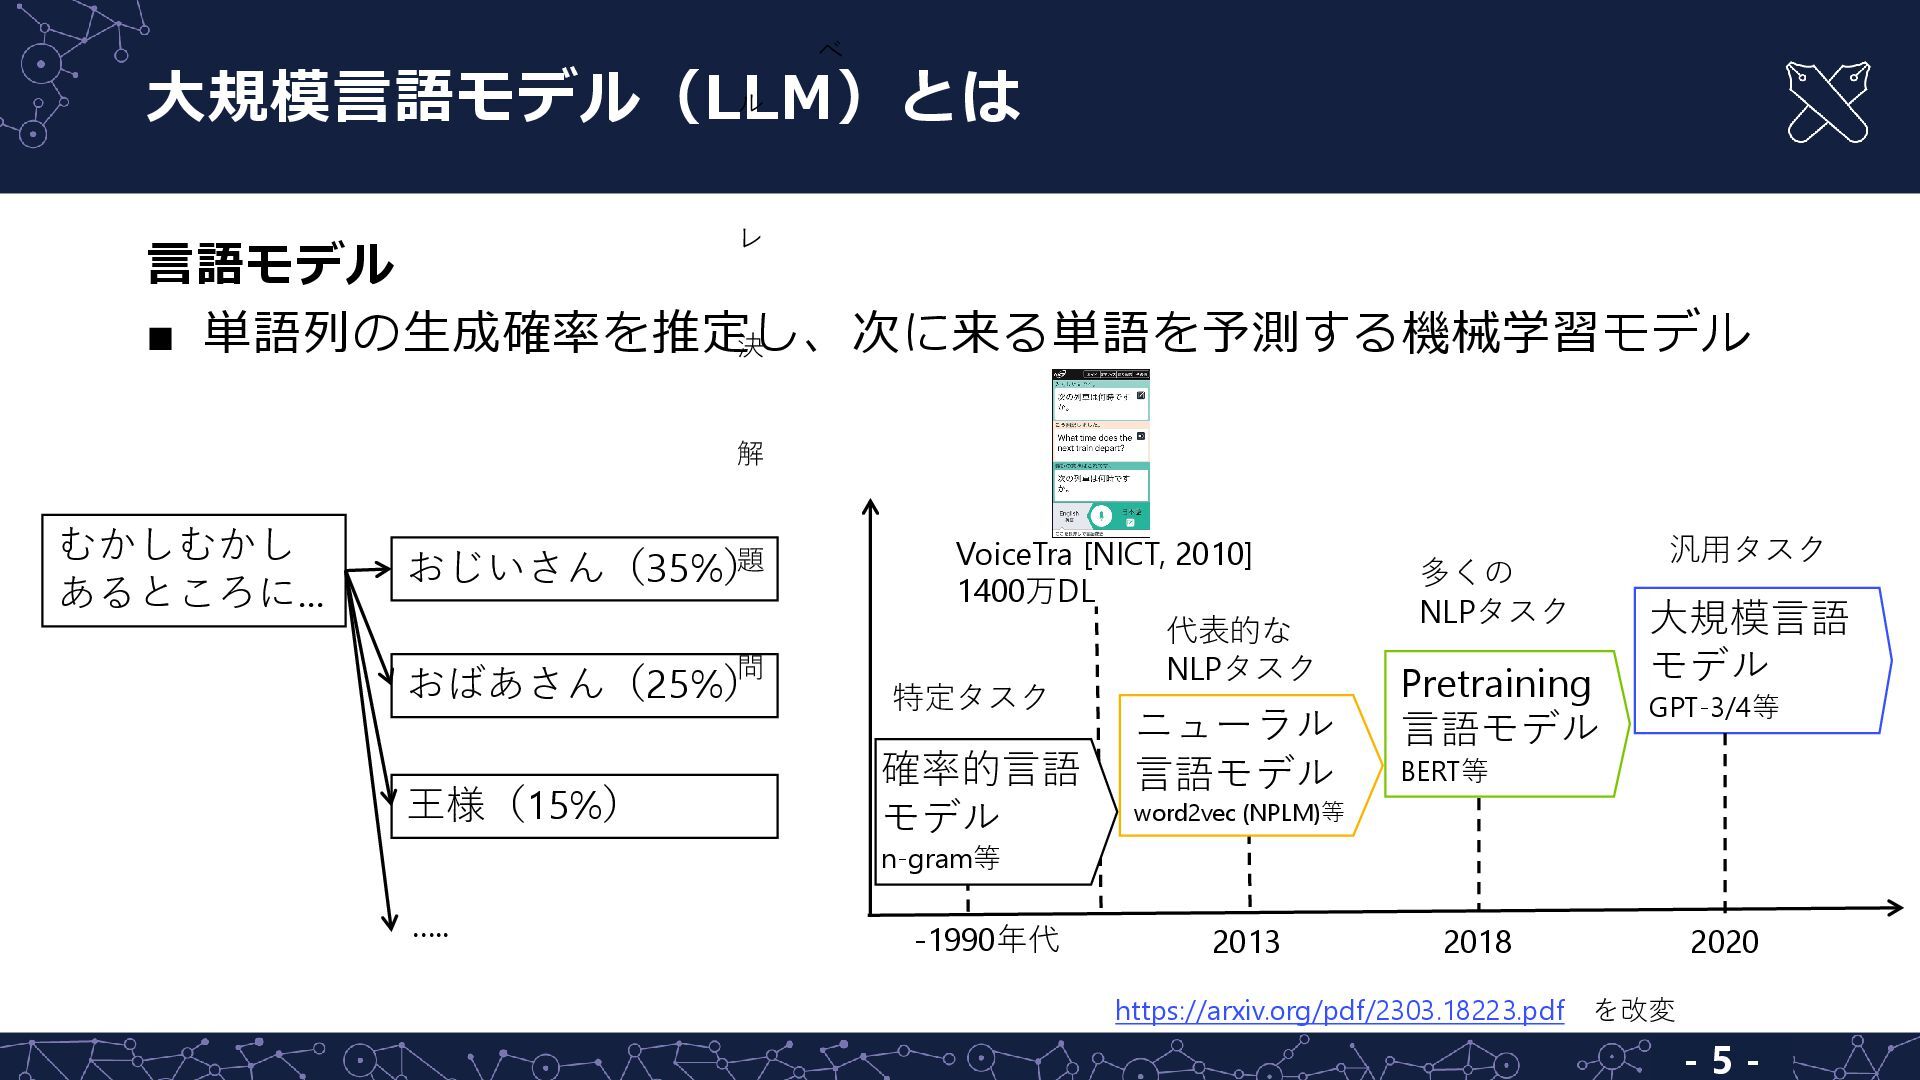
  1. 大規模言語モデル(LLM)とは - - 5 言語モデル ▪ 単語列の生成確率を推定し、次に来る単語を予測する機械学習モデル むかしむかし あるところに… おじいさん(35%)

    おばあさん(25%) 王様(15%) https://arxiv.org/pdf/2303.18223.pdf を改変 -1990年代 2013 2018 2020 大規模言語 モデル GPT-3/4等 Pretraining 言語モデル BERT等 ….. 問 題 解 決 レ ベ ル 特定タスク 代表的な NLPタスク 汎用タスク 多くの NLPタスク ニューラル 言語モデル word2vec (NPLM)等 VoiceTra [NICT, 2010] 1400万DL 確率的言語 モデル n-gram等
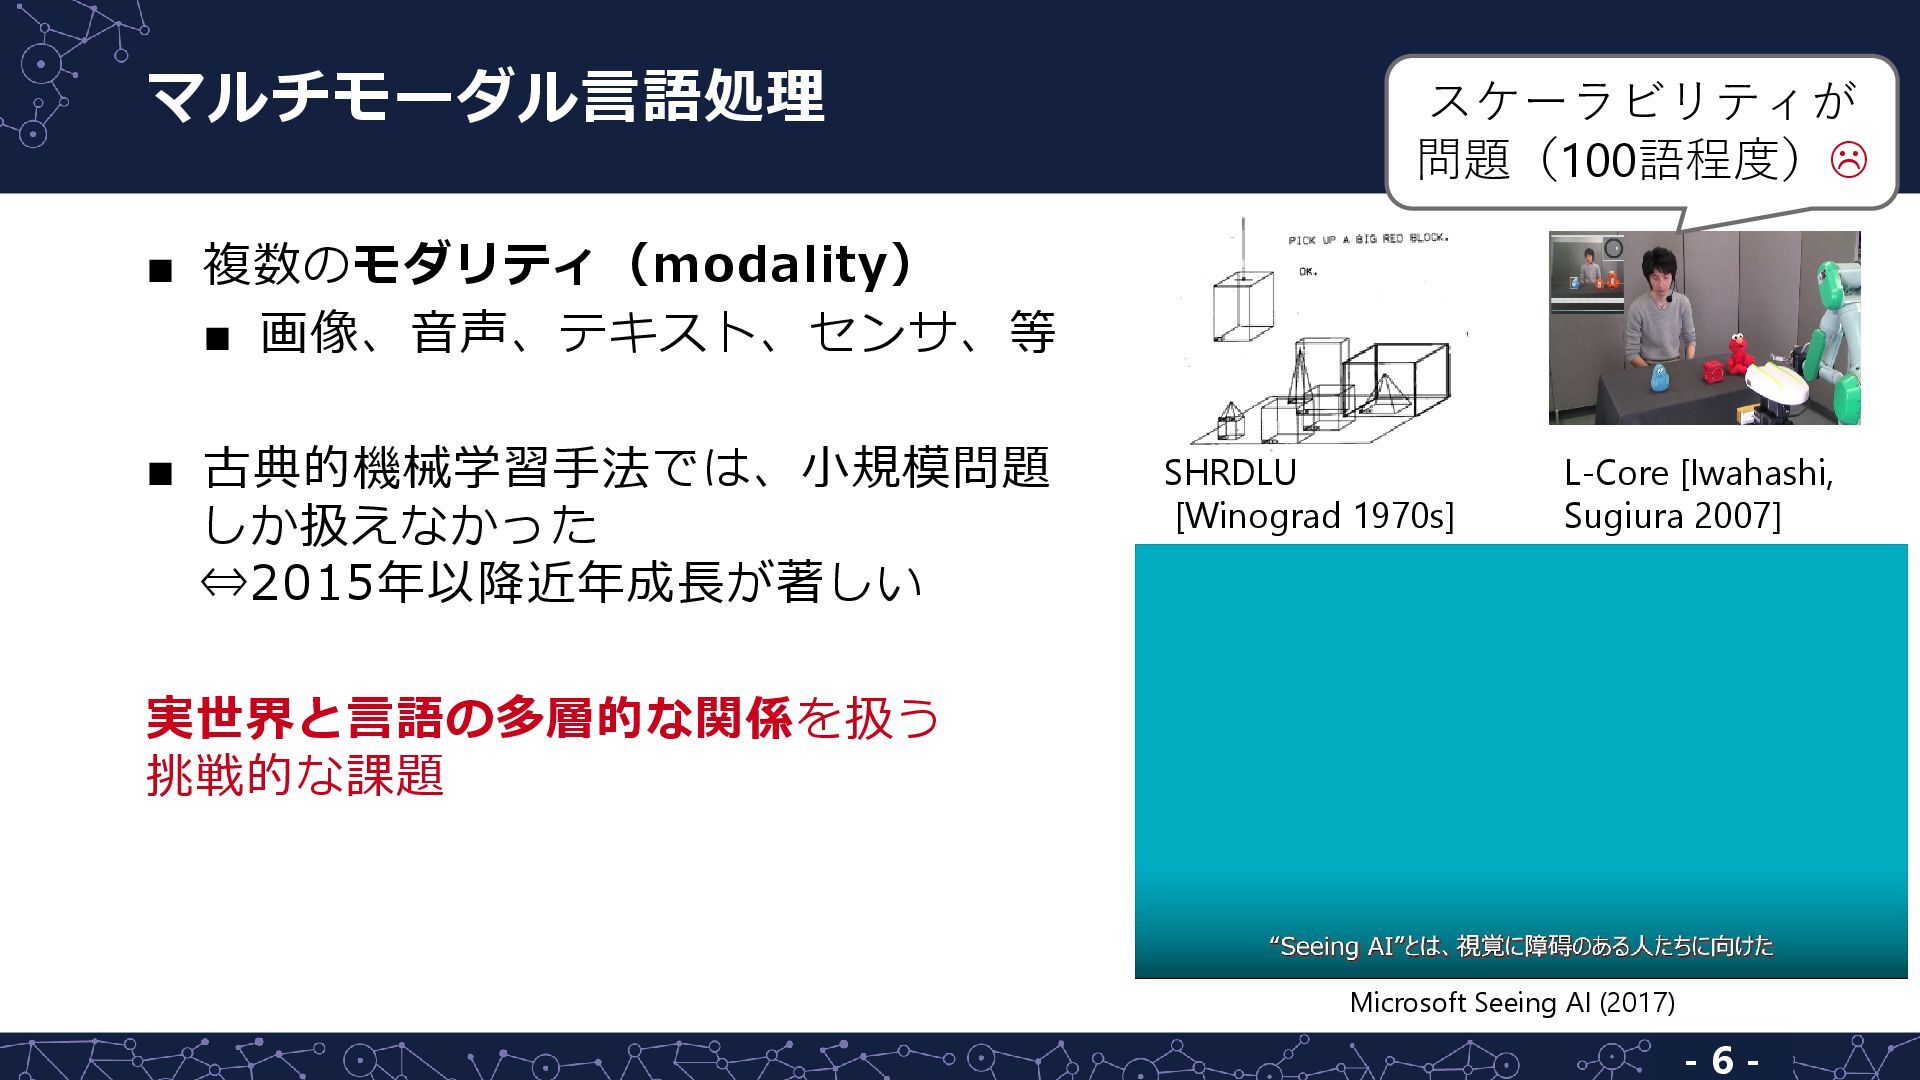
  2. マルチモーダル言語処理 - - 6 ▪ 複数のモダリティ(modality) ▪ 画像、音声、テキスト、センサ、等 ▪ 古典的機械学習手法では、小規模問題

    しか扱えなかった ⇔2015年以降近年成長が著しい 実世界と言語の多層的な関係を扱う 挑戦的な課題 SHRDLU [Winograd 1970s] Microsoft Seeing AI (2017) L-Core [Iwahashi, Sugiura 2007] スケーラビリティが 問題(100語程度)
  3. 視覚言語基盤モデルの代表例:CLIP [Radford+ 2021] - - 7 ▪ 学習: 画像とテキストの組(4億組)の特徴量同士を近付ける ▪

    画像エンコーダ: ViT-B/32, ResNet等 ▪ テキストエンコーダ: トランスフォーマ等 ▪ 推論: 新規の画像(or テキスト)を入力して特徴量に変換 ▪ 多数の応用(DALL·E 2 [Aditya+ 2022]等) a photo of a beer bottle satellite imagery of roundabout a photo of a marimba a meme テキスト エンコーダ 画像 エンコーダ
  4. CLIPを物体操作・探索に利用 - - 8 物体操作 CLIPort [Shridhar+ CoRL21], PerAct [Shridhar+

    CoRL22] • Transporter Networks[Zeng+ CoRL20] を拡張してCLIP の言語/画像特徴量を導入 • 「どの位置にグリッパを移動させるか」を予測 KITE [Sundaresan+ CoRL23] 「物体のどの部分を掴むか(キーポイント)」を予測 物体検索 CLIP-Fields [Shafiullah+ RSS23] Detic, BERT, CLIPの組み合わせで物体の探索を行う OpenScene [Peng+ CVPR23] Open-vocabularyの3D Scene understanding
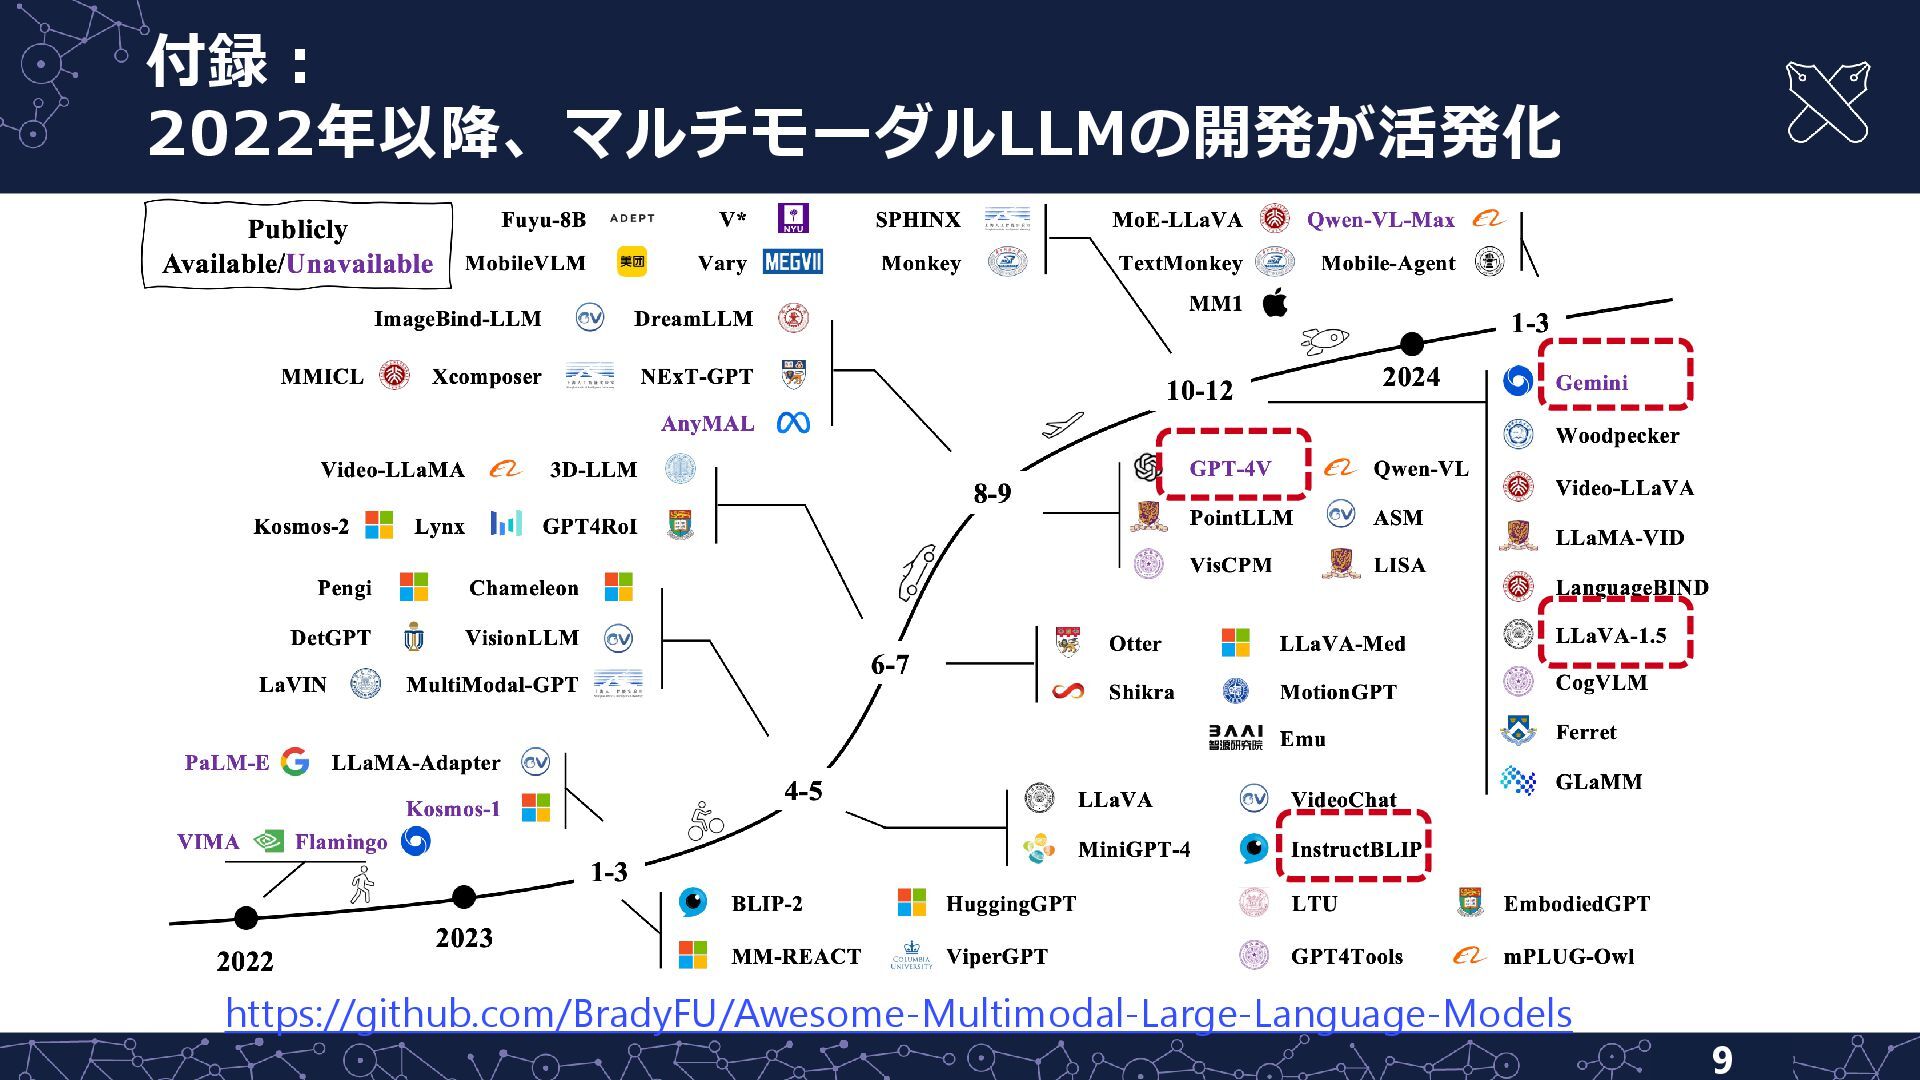
  5. マルチモーダルLLM(MLLM)の代表的構成 BLIP-2 [Li+ 2023], LLaVA[Liu+ NeurIPS23]等 11 ▪ 非言語モダリティを、テキスト側の表現空間に変換 https://arxiv.org/abs/2306.13549

    画像・動画・ 軌道・音声等 各モダリティ用の 特徴抽出(CLIP, SigLIP等) テキスト側の表現と整合 (MLP, Q-Former等)
  6. マルチモーダルLLM(MLLM)の代表的構成 BLIP-2 [Li+ 2023], LLaVA[Liu+ NeurIPS23]等 12 ▪ Modality EncoderとGeneratorを設計すれば他モダリティに適用可

    ▪ 例: 視覚言語行動モデル→軌道を出力 https://arxiv.org/abs/2306.13549 画像・動画・ 軌道・音声等 画像・動画・ 軌道・音声等 各モダリティ用の 特徴抽出(CLIP, SigLIP等) テキスト側の表現と整合 (MLP, Q-Former等)
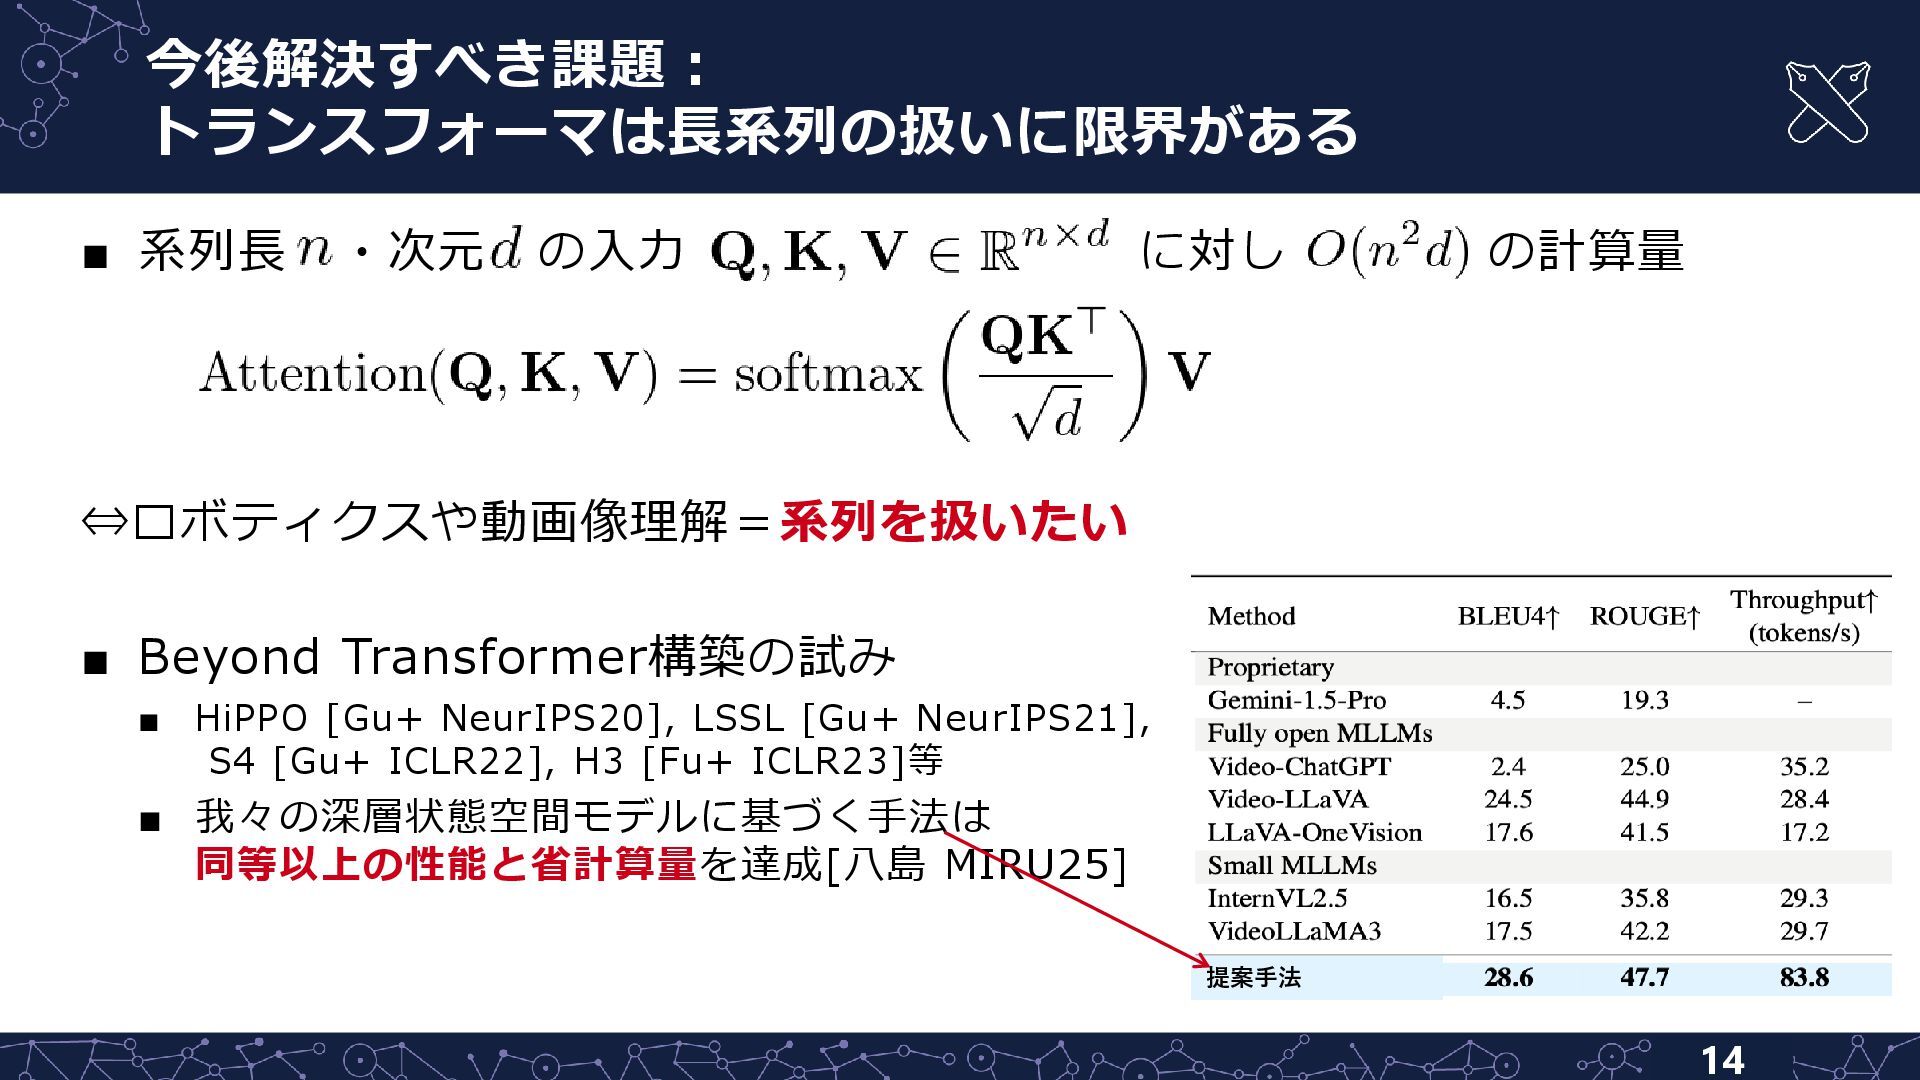
  7. 今後解決すべき課題: トランスフォーマは長系列の扱いに限界がある 14 ▪ 系列長 ・次元 の入力 に対し の計算量 ⇔ロボティクスや動画像理解=系列を扱いたい

    ▪ Beyond Transformer構築の試み ▪ HiPPO [Gu+ NeurIPS20], LSSL [Gu+ NeurIPS21], S4 [Gu+ ICLR22], H3 [Fu+ ICLR23]等 ▪ 我々の深層状態空間モデルに基づく手法は 同等以上の性能と省計算量を達成[八島 MIRU25] 提案手法
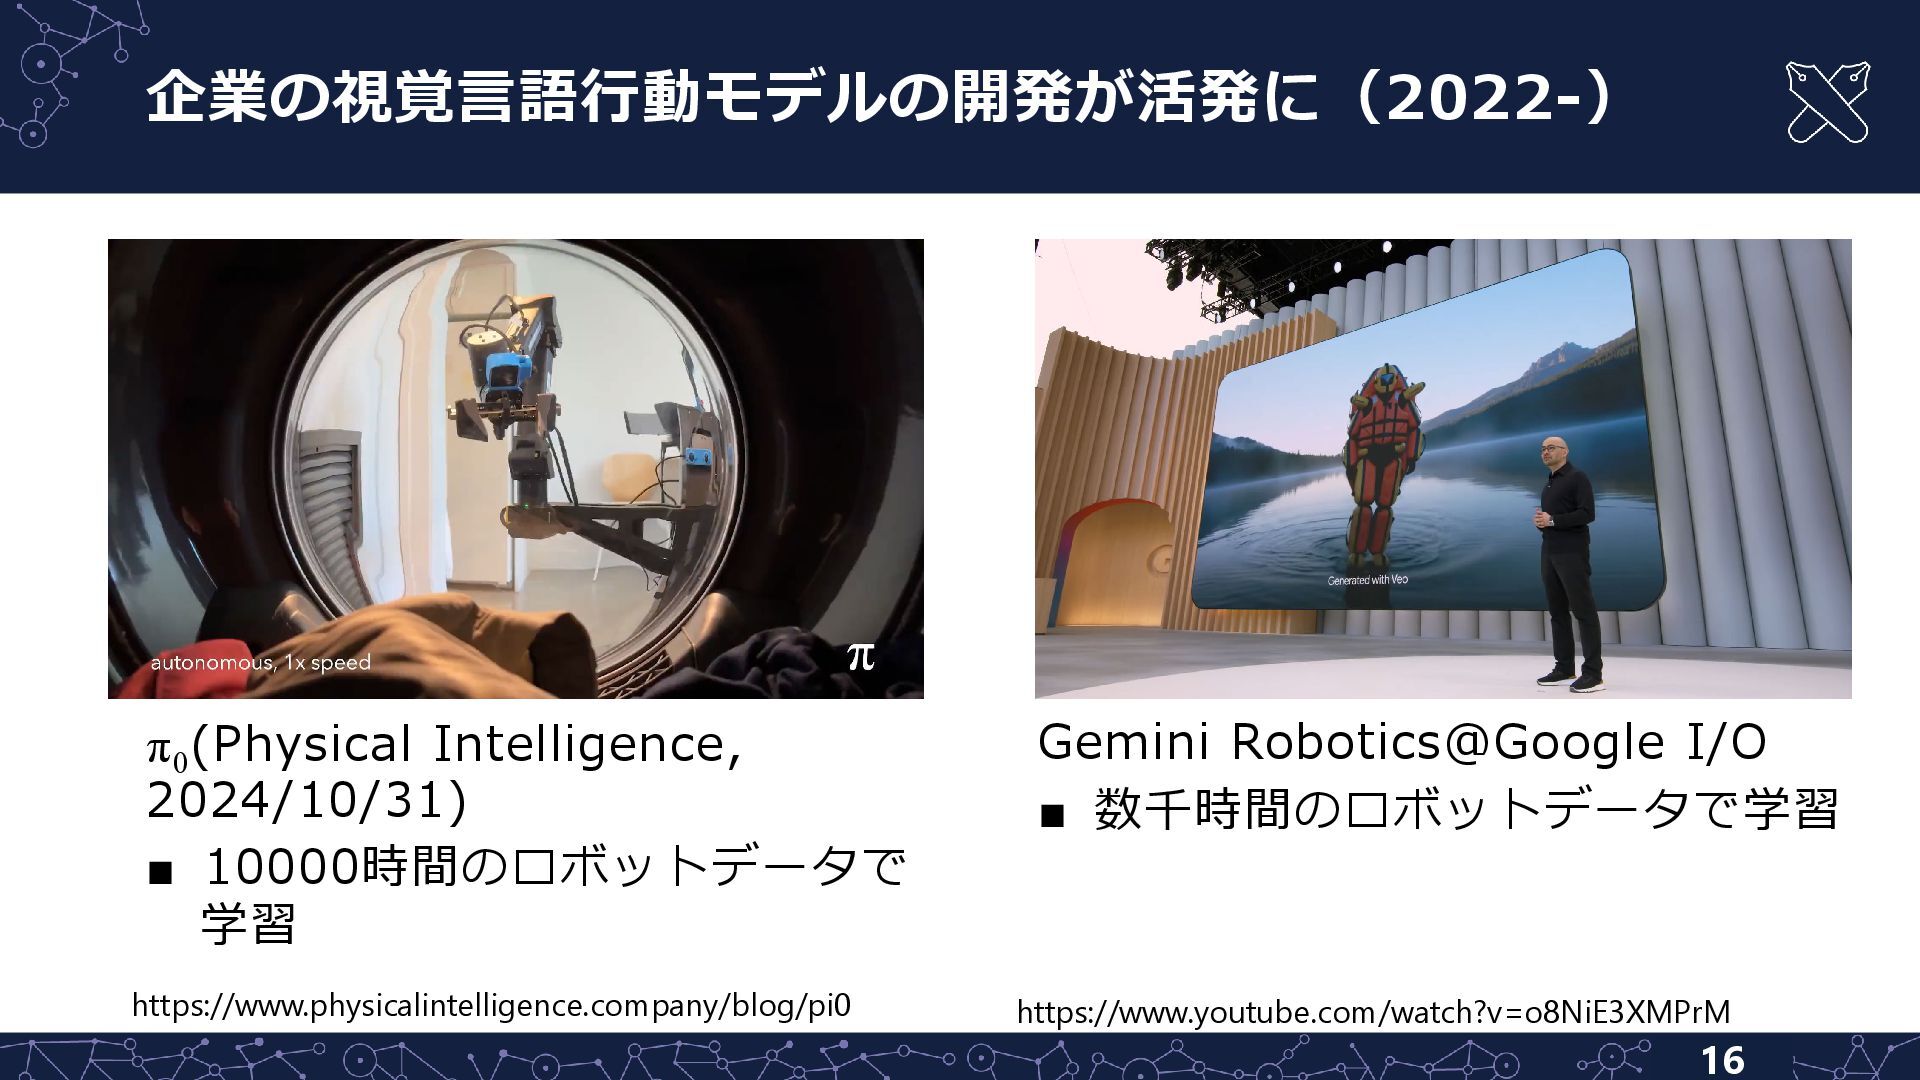
  8. 企業の視覚言語行動モデルの開発が活発に(2022-) 16 π0 (Physical Intelligence, 2024/10/31) ▪ 10000時間のロボットデータで 学習 Gemini

    Robotics@Google I/O ▪ 数千時間のロボットデータで学習 https://www.physicalintelligence.company/blog/pi0 https://www.youtube.com/watch?v=o8NiE3XMPrM
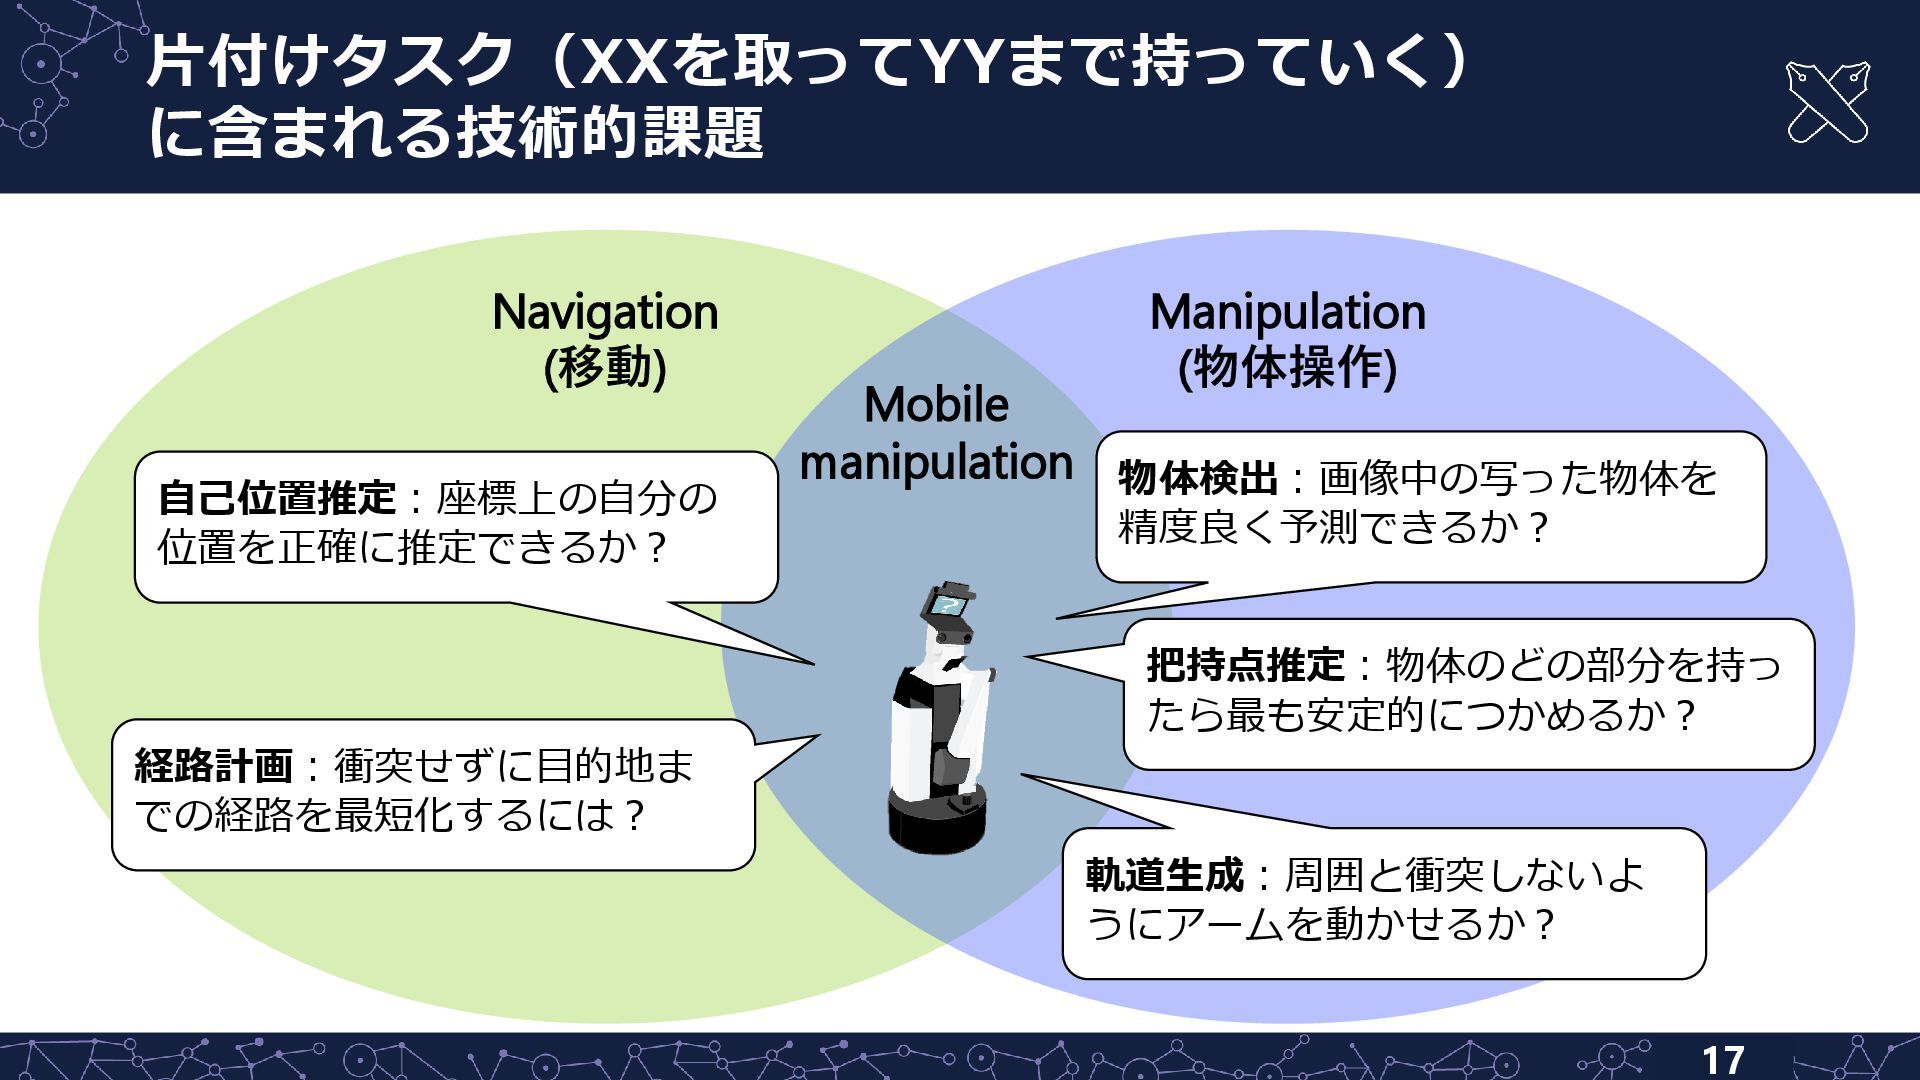
  9. 片付けタスク(XXを取ってYYまで持っていく) に含まれる技術的課題 17 Navigation (移動) Manipulation (物体操作) 自己位置推定:座標上の自分の 位置を正確に推定できるか? 経路計画:衝突せずに目的地ま

    での経路を最短化するには? 把持点推定:物体のどの部分を持っ たら最も安定的につかめるか? 物体検出:画像中の写った物体を 精度良く予測できるか? 軌道生成:周囲と衝突しないよ うにアームを動かせるか? Mobile manipulation
  10. Q. これまでのロボティクスのパラダイムの話が聞きたい 1960-1980 • 産業用ロボットの最初の会社Unimation社設立(1962) 1980-2000 • 【基礎】コンフィギュレーション空間 [Lozano-Perez 1983]、

    ポテンシャルフィールドによる移動[Khatib 1985]、サブサンプ ション・アーキテクチャ [Brooks 1986]、RRT [LaValle 1998] • 【学習ベース】Cart poleタスクへの初期の強化学習の適用、自 動運転車等へのニューラルネットの適用[Pomerleau 1988] https://www.youtube.com/watch?v=VdolSBpyCaU https://en.wikipedia.org/wiki/Rapidly_exploring_random_tree https://www.youtube.com/watch?v=2KMAAmkz9go Unimate (1968) ALVINN(1988)
  11. 2000年以降の学習ベースのパラダイム 2000-2015 • Dynamic Motion Primitives (DMP) [Ijspeert+ 2002] 制御ベースの点推定手法

    • 確率モデルによる模倣学習 by ガウス過程 [Lawrence+ 2004]、by 隠れマルコフモデル(HMM) [Ogawara+ 2002]、RPD-HMM[Sugiura+ 2007] 2015- • 深層強化学習[Levine+ 2016]、参照表現理解ベース[Hatori+ 2018] • Vision-and-Language Navigation (VLN) [Anderson+ 2018] 模倣学習 [Sugiura+ 2009] VLN (2018) [Hatori+ 2018]
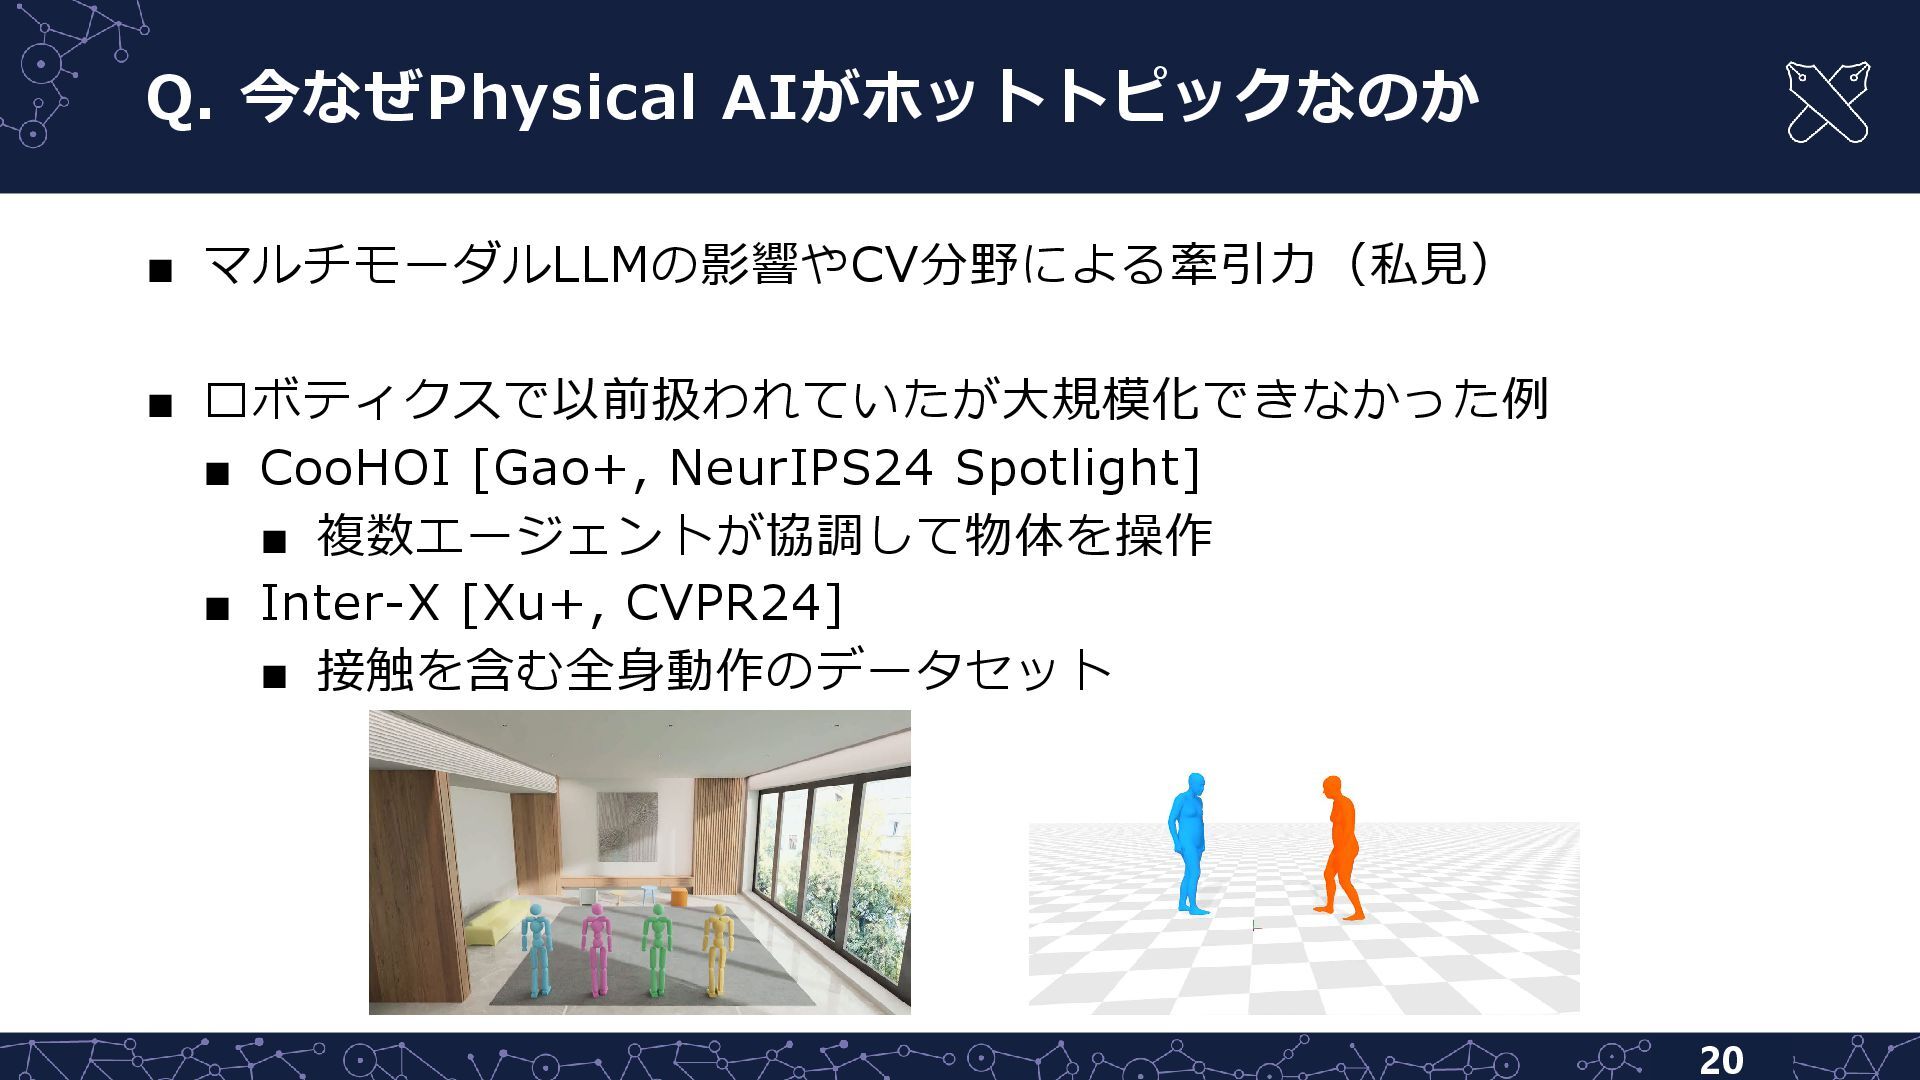
  12. Q. 今なぜPhysical AIがホットトピックなのか 20 ▪ マルチモーダルLLMの影響やCV分野による牽引力(私見) ▪ ロボティクスで以前扱われていたが大規模化できなかった例 ▪ CooHOI

    [Gao+, NeurIPS24 Spotlight] ▪ 複数エージェントが協調して物体を操作 ▪ Inter-X [Xu+, CVPR24] ▪ 接触を含む全身動作のデータセット
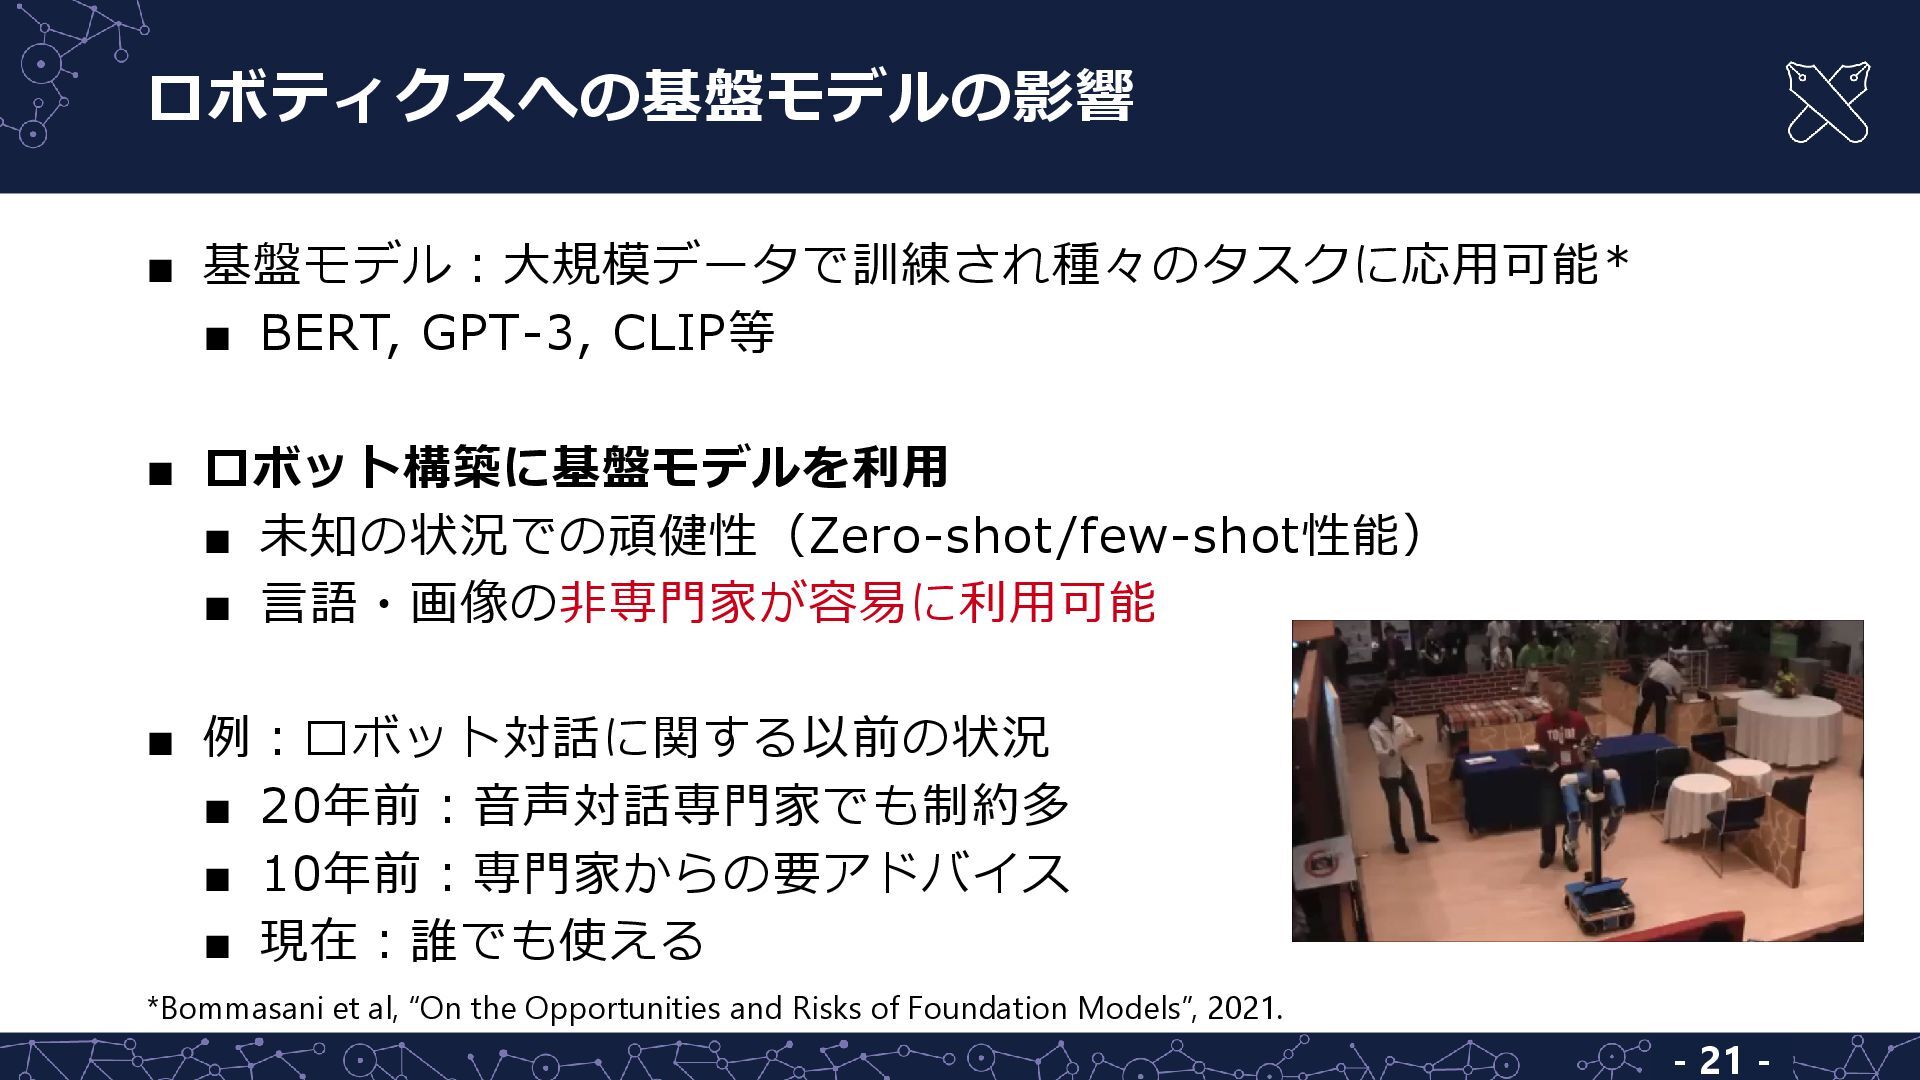
  13. ロボティクスへの基盤モデルの影響 - - 21 ▪ 基盤モデル:大規模データで訓練され種々のタスクに応用可能* ▪ BERT, GPT-3, CLIP等

    ▪ ロボット構築に基盤モデルを利用 ▪ 未知の状況での頑健性(Zero-shot/few-shot性能) ▪ 言語・画像の非専門家が容易に利用可能 ▪ 例:ロボット対話に関する以前の状況 ▪ 20年前:音声対話専門家でも制約多 ▪ 10年前:専門家からの要アドバイス ▪ 現在:誰でも使える *Bommasani et al, “On the Opportunities and Risks of Foundation Models”, 2021.
  14. 視覚言語行動モデル - - 23 手法 概要 PaLM SayCan [Ahn+ 2022]

    言語スコア(Say):LLMで生成した動詞+目的語の生成確率 動作スコア(Can):その状況での動作成功確率 PaLM-E [Driess (Google)+ 2023] 画像と言語を入力とするMLLMを用いたタスク分解と実行 RT-1/2/X [Brohan+ 23]等 LLMを複数利用して「位置と角度の差分」を予測 OpenVLA [Kim+ CoRL24] Llama 2ベース。OpenVLA-OFT[Kim+ RSS25]で高速化された https://palm-e.github.io/
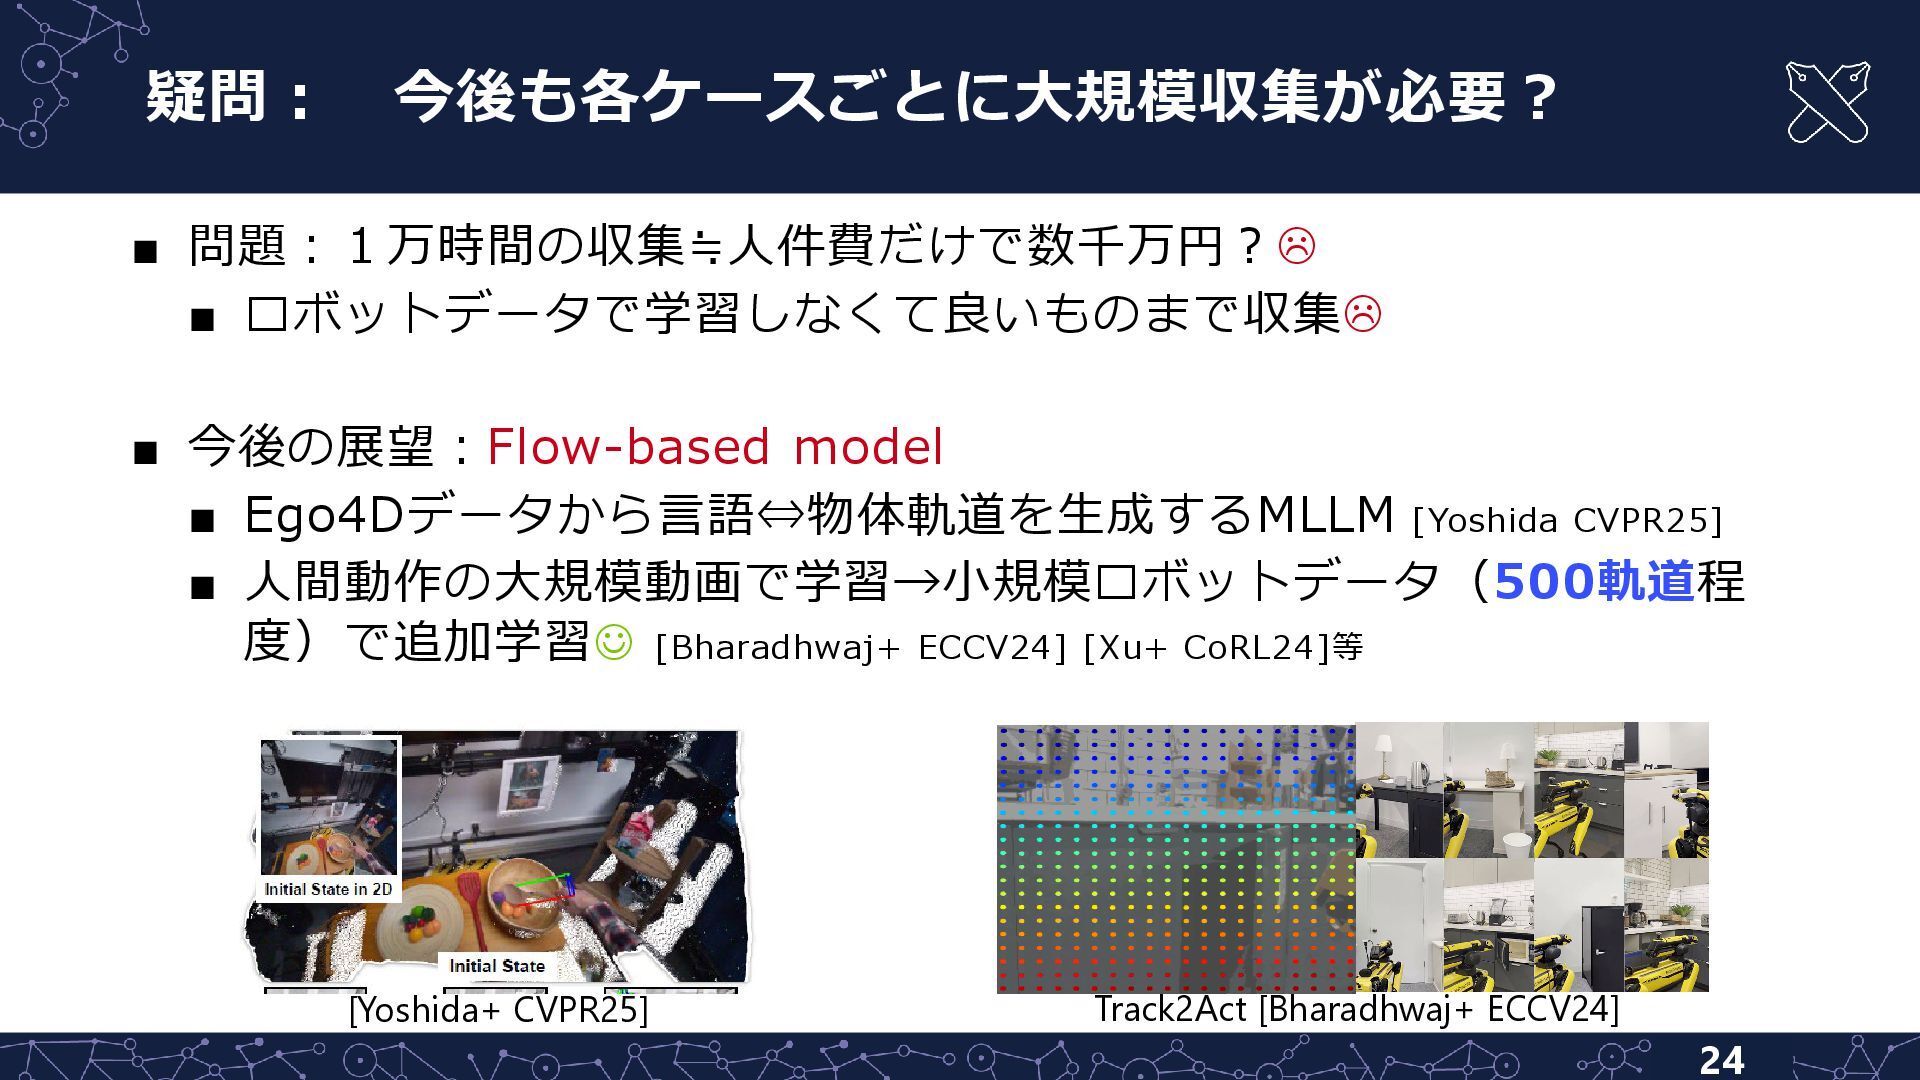
  15. 疑問: 今後も各ケースごとに大規模収集が必要? 24 ▪ 問題:1万時間の収集≒人件費だけで数千万円? ▪ ロボットデータで学習しなくて良いものまで収集 ▪ 今後の展望:Flow-based model

    ▪ Ego4Dデータから言語⇔物体軌道を生成するMLLM [Yoshida CVPR25] ▪ 人間動作の大規模動画で学習→小規模ロボットデータ(500軌道程 度)で追加学習 [Bharadhwaj+ ECCV24] [Xu+ CoRL24]等 Track2Act [Bharadhwaj+ ECCV24] [Yoshida+ CVPR25]
  16. Flow-based VLA with language [神原+ RSJ25] 25 ▪ 背景 ▪

    End2EndのVLAはsample-efficientではない(≒物体検出は embodied dataで学習しなくて良い) ▪ 技術ポイント ▪ Flow-based modelとして視覚+言語→行動を初めて可能とした
  17. Robotics x MLの最高峰会議: CoRL (Conference on Robot Learning) ※コールと発音 26

    ▪ 2017年開始の新しい会議 ▪ 内容 ▪ Robot learning, 強化学習, autonomous driving, Robot x Language等 ▪ トップ研究室では、博士課程学 生がCoRL/RSS採択を目指す流 れが進む CoRL 2025 Sponsors
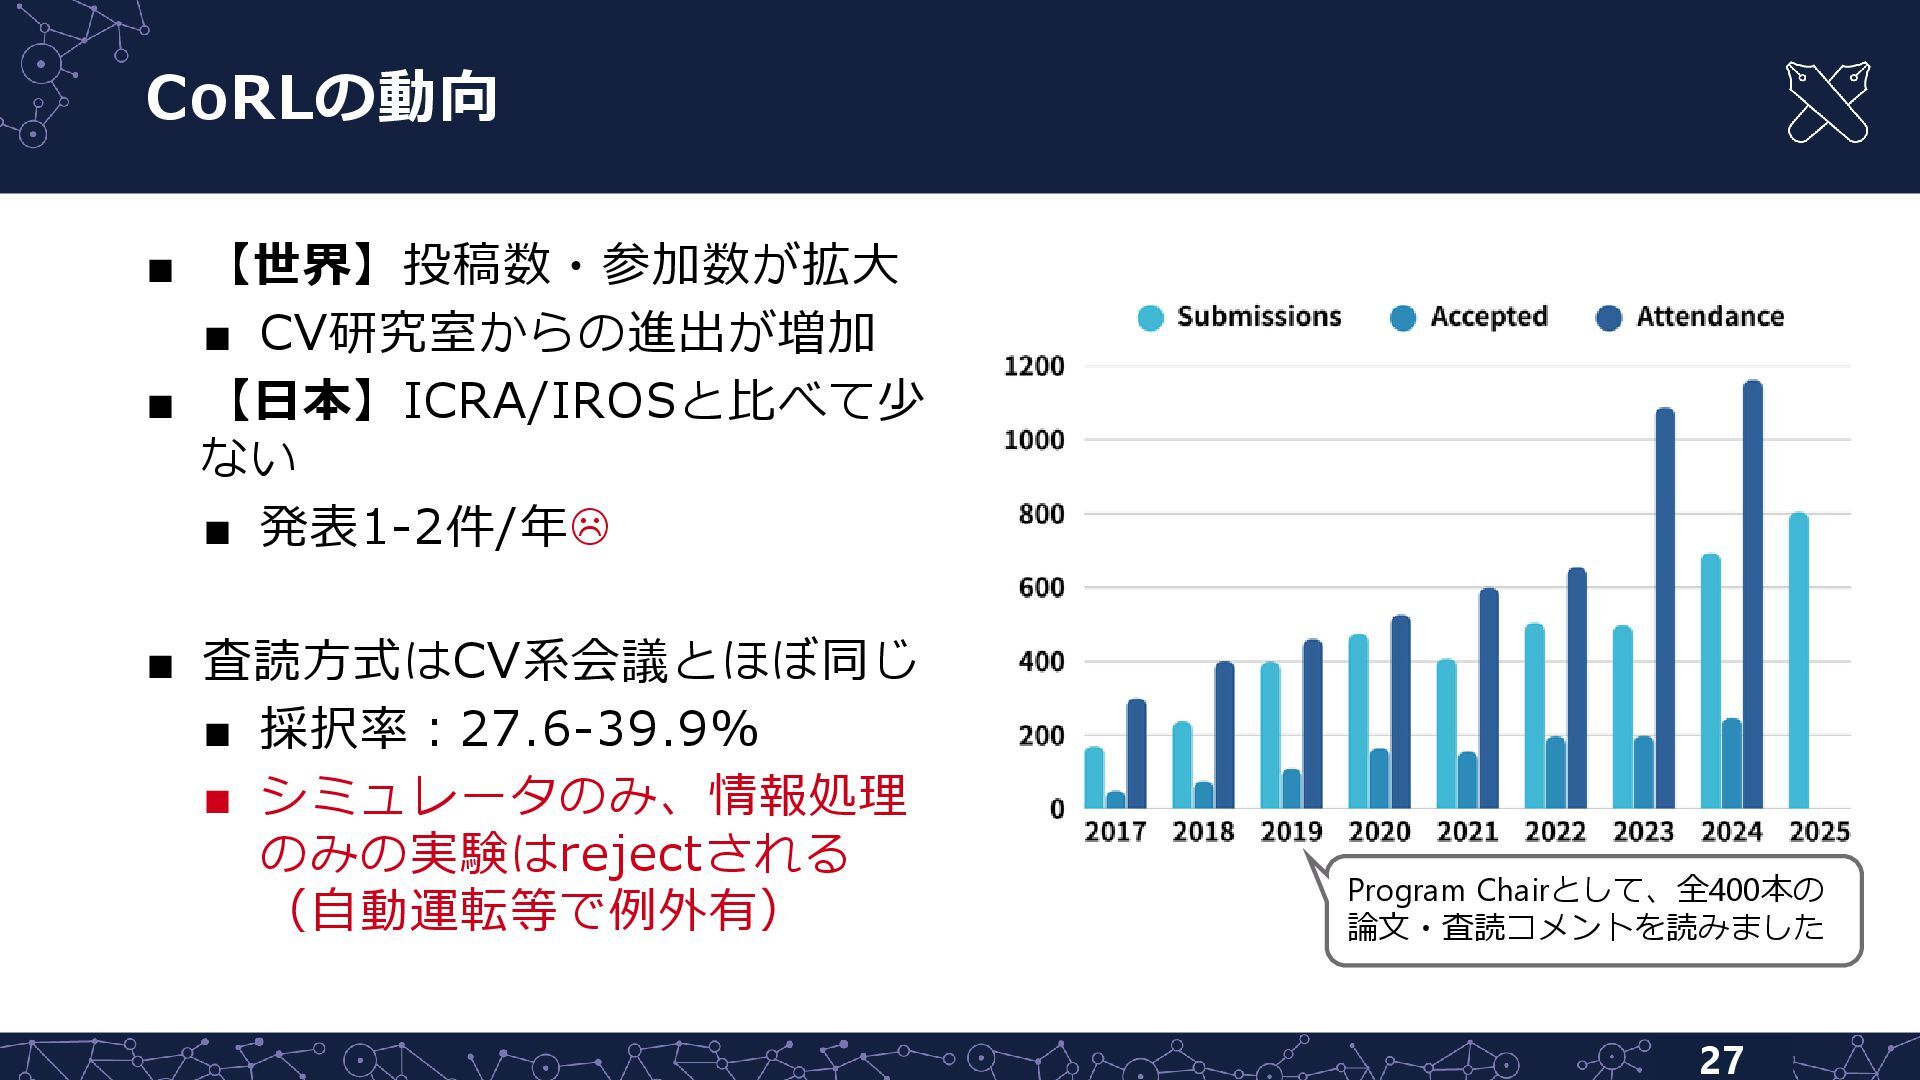
  18. CoRLの動向 27 ▪ 【世界】投稿数・参加数が拡大 ▪ CV研究室からの進出が増加 ▪ 【日本】ICRA/IROSと比べて少 ない ▪

    発表1-2件/年 ▪ 査読方式はCV系会議とほぼ同じ ▪ 採択率:27.6-39.9% ▪ シミュレータのみ、情報処理 のみの実験はrejectされる (自動運転等で例外有) Program Chairとして、全400本の 論文・査読コメントを読みました
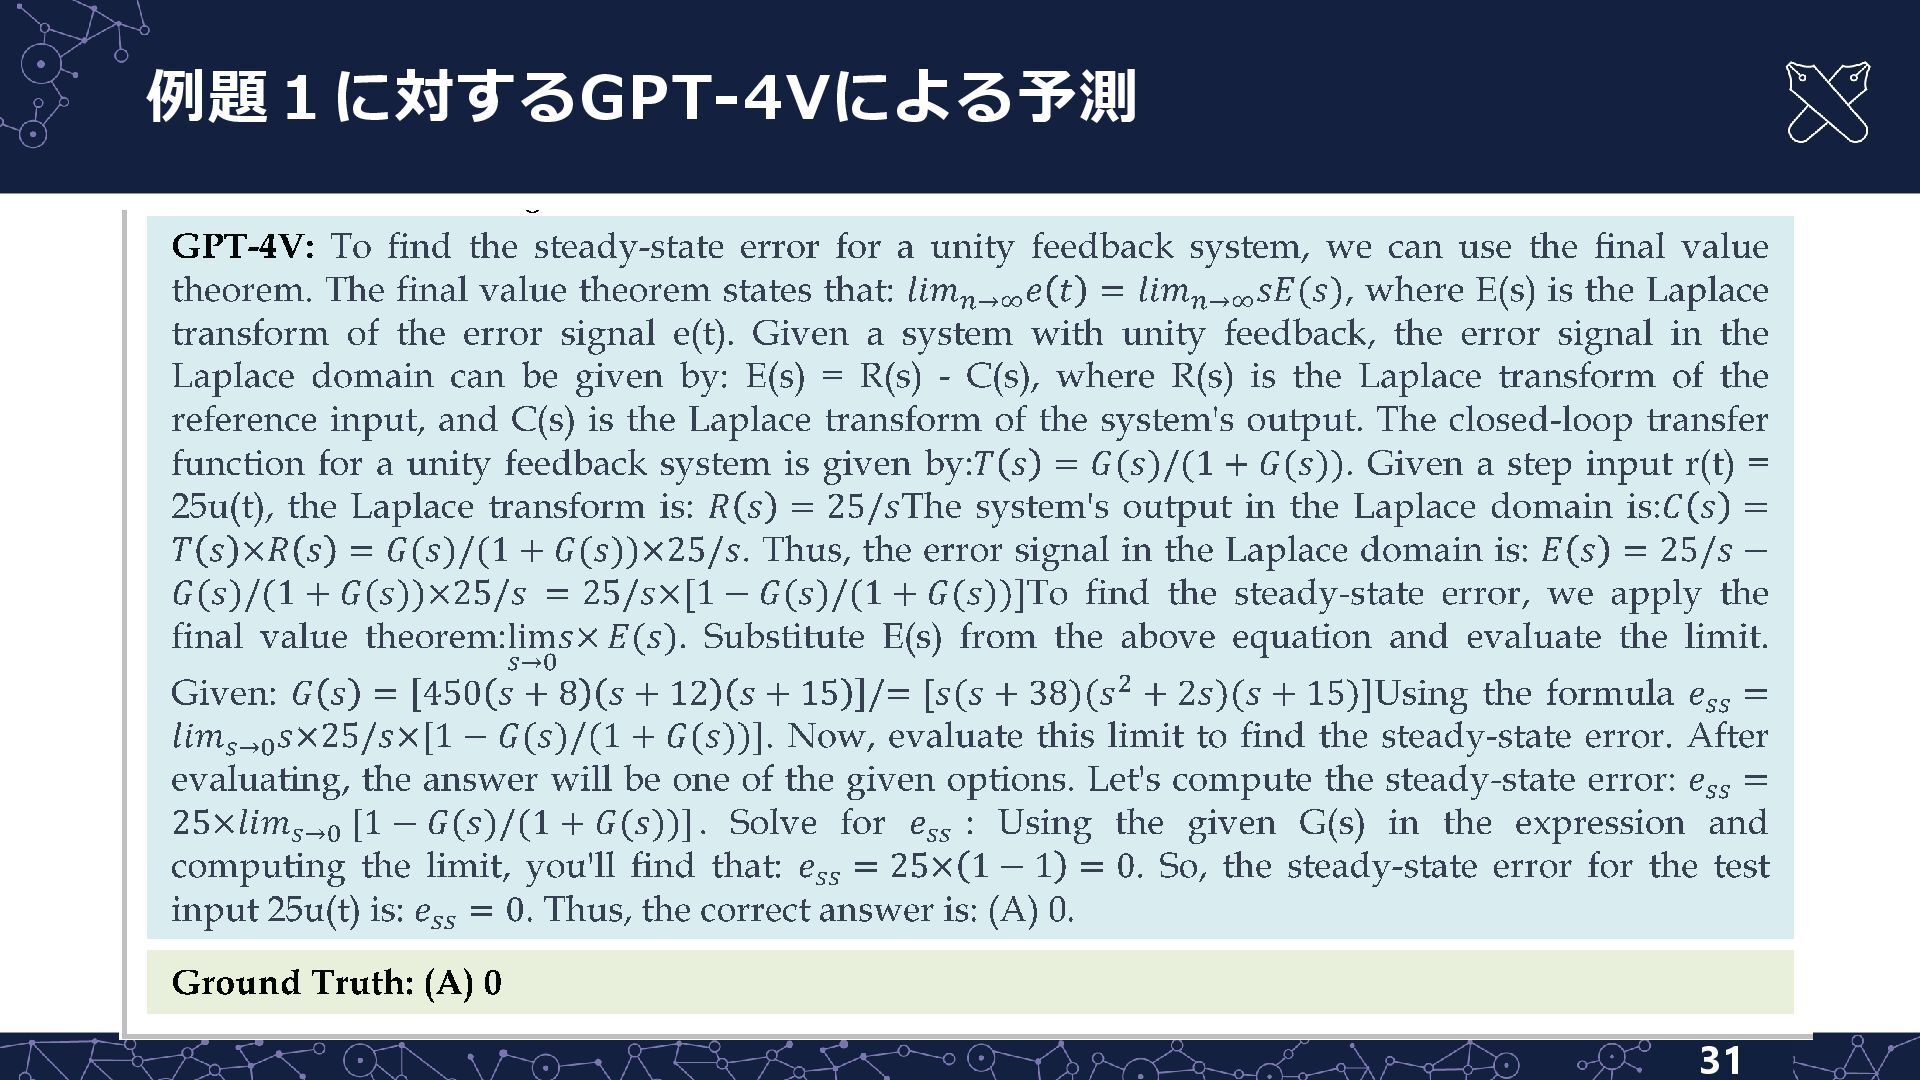
  19. 画像ベンチマーク:MMMU, MMMU-Pro Massive Multi-discipline Multimodal Understanding [Yue+ CVPR24][Yue+ 2024] 29

    ▪ 専門知識の理解と推論のベンチマーク ▪ 一言でいうと「学部生の小テストに 近い」 ▪ 教科書や試験等から収集 ▪ 30科目(工学・音楽・政治等) 11500問 ▪ オープンソースモデルが1年前の GPT-4oより高性能 ▪ ということは、N年後はどうなる? ▪ https://mmmu-benchmark.github.io/ 2025/6/6時点
  20. 画像説明生成の評価[Wada+ CoNLL23][Wada+ CVPR24][Matsuda+ ACCV24] デモ→https://huggingface.co/spaces/yuwd/Polos-Demo 32 背景: 画像説明生成モデル開発の標準尺度は人手評価との相関が0.3しかない 技術ポイント: ▪

    世界最高性能の自動評価尺度を構築・公開 [Wada+ CVPR24 (採択率23.8%) highlight11,532投稿中 上位3.6%] [Wada+ CoNLL23 (採択率28%)] ▪ 550人から13万の人手評価を収集・公開 (世界最大データセットの約10倍) ▪ 企業への成果展開(Apple社等) 人手評価同士の相関 =0.6-0.7 人通りの少なくなった道路で,青いズ ボンを着た男の子がオレンジ色のヘル メットを被りスケートボードに乗って いる
  21. LLM-as-a-Judgeの改良と限界 33 LLM-Hybrid-as-a-Judge [松田, MIRU25] ▪ 長文の画像キャプショニング評 価尺度は未確立 ▪ Superhuman性能、LLM-as-a-

    Judgeより5倍高速 MLLMは自己を選好する [小山, MIRU25] Evaluator Generator 「対角成分が赤い」=自身による 生成文を不当に高く評価
  22. エージェントベンチマーク: 移動指示・物体探索指示理解 実世界 ▪ R2R [Anderson+ CVPR18], REVERIE[Qi+ CVPR20] ▪

    Honorable Mention Award@REVERIE Challenge 2022 シミュレーション ▪ ALFRED [Shridhar+ CVPR20] ▪ CVPR 2023 DialFRED Challenge優勝[Kaneda+ 23] VLN-BERT 「壁に縞模様がある寝室の横の蛇口 から水が出ていないか確認して」 Matterport3D (90種類の家屋)
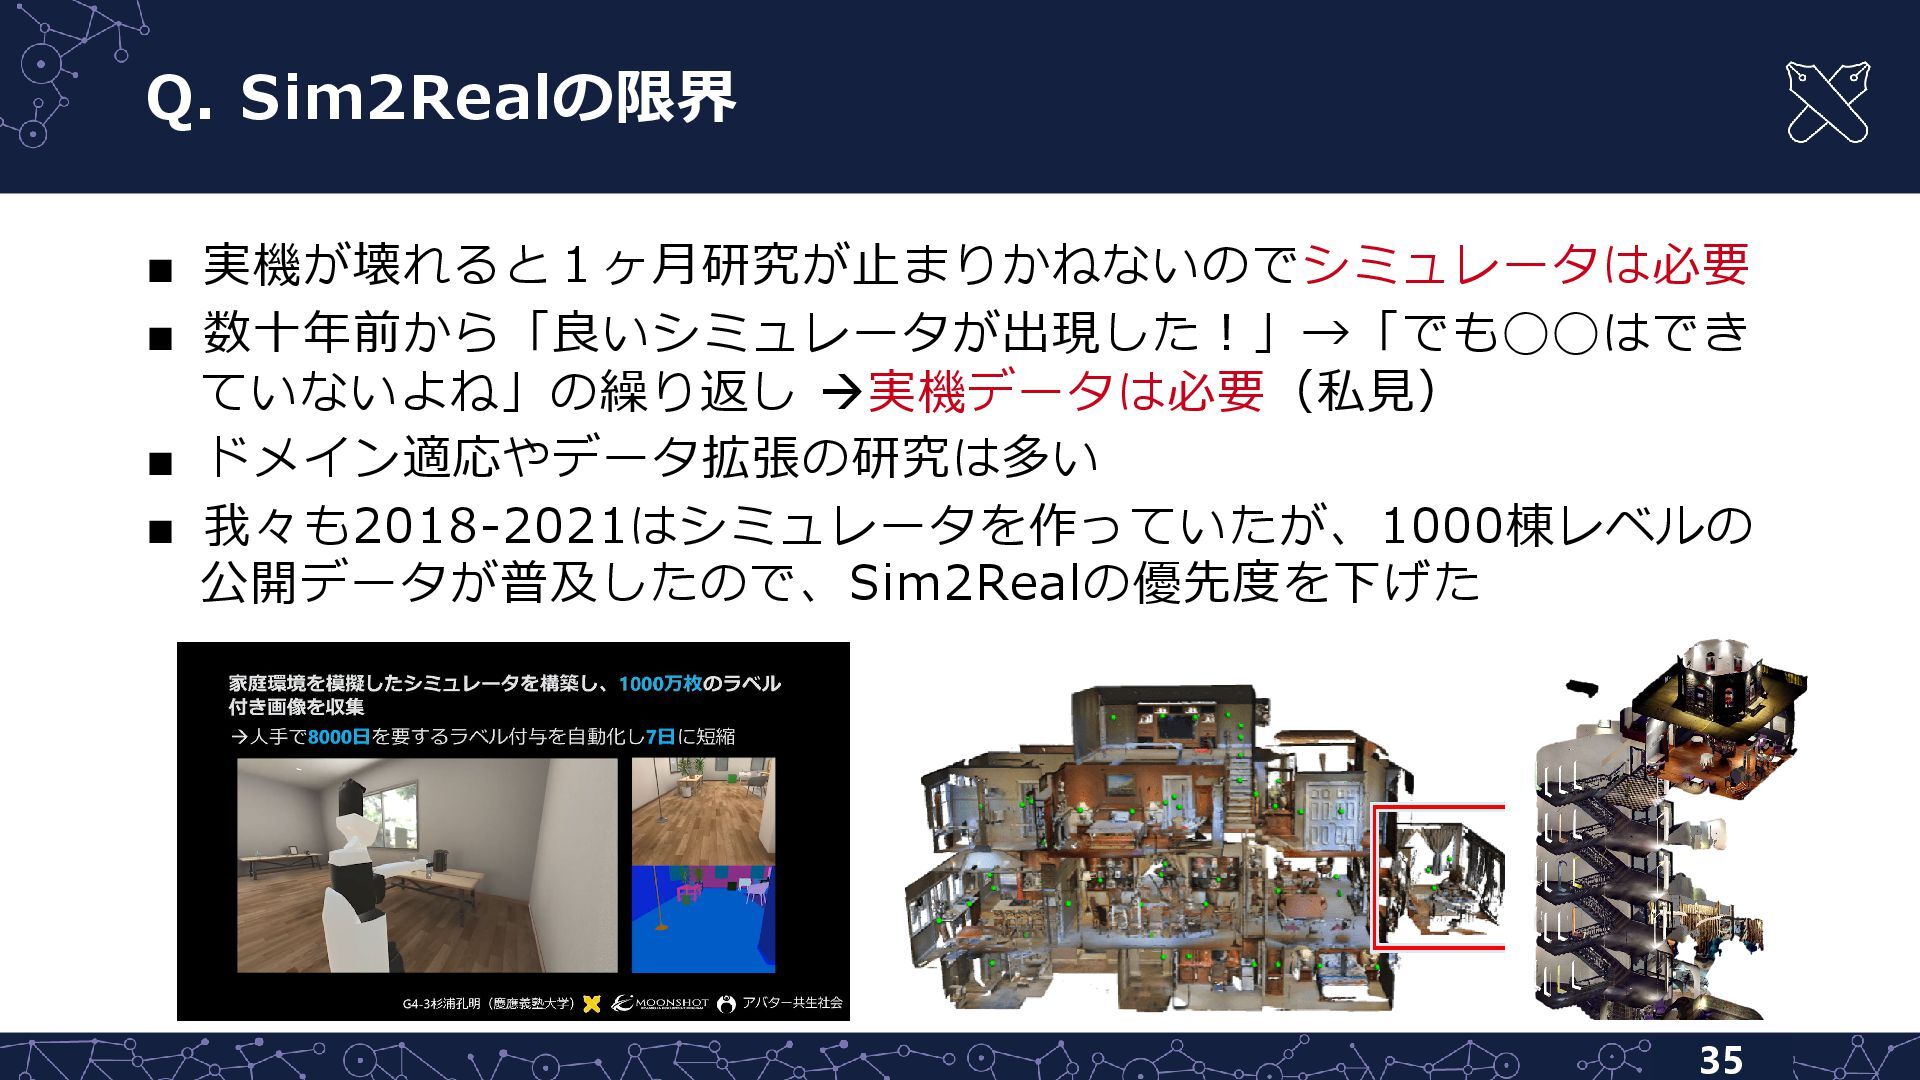
  23. Q. Sim2Realの限界 35 ▪ 実機が壊れると1ヶ月研究が止まりかねないのでシミュレータは必要 ▪ 数十年前から「良いシミュレータが出現した!」→「でも◯◯はでき ていないよね」の繰り返し 実機データは必要(私見) ▪

    ドメイン適応やデータ拡張の研究は多い ▪ 我々も2018-2021はシミュレータを作っていたが、1000棟レベルの 公開データが普及したので、Sim2Realの優先度を下げた
  24. 語彙の制約がない物体操作の統合デモ [Yashima+ RAL25] [Kaneda+ RAL24] [Nishimura+ IROS24] [Korekata+ IROS23] 社会課題

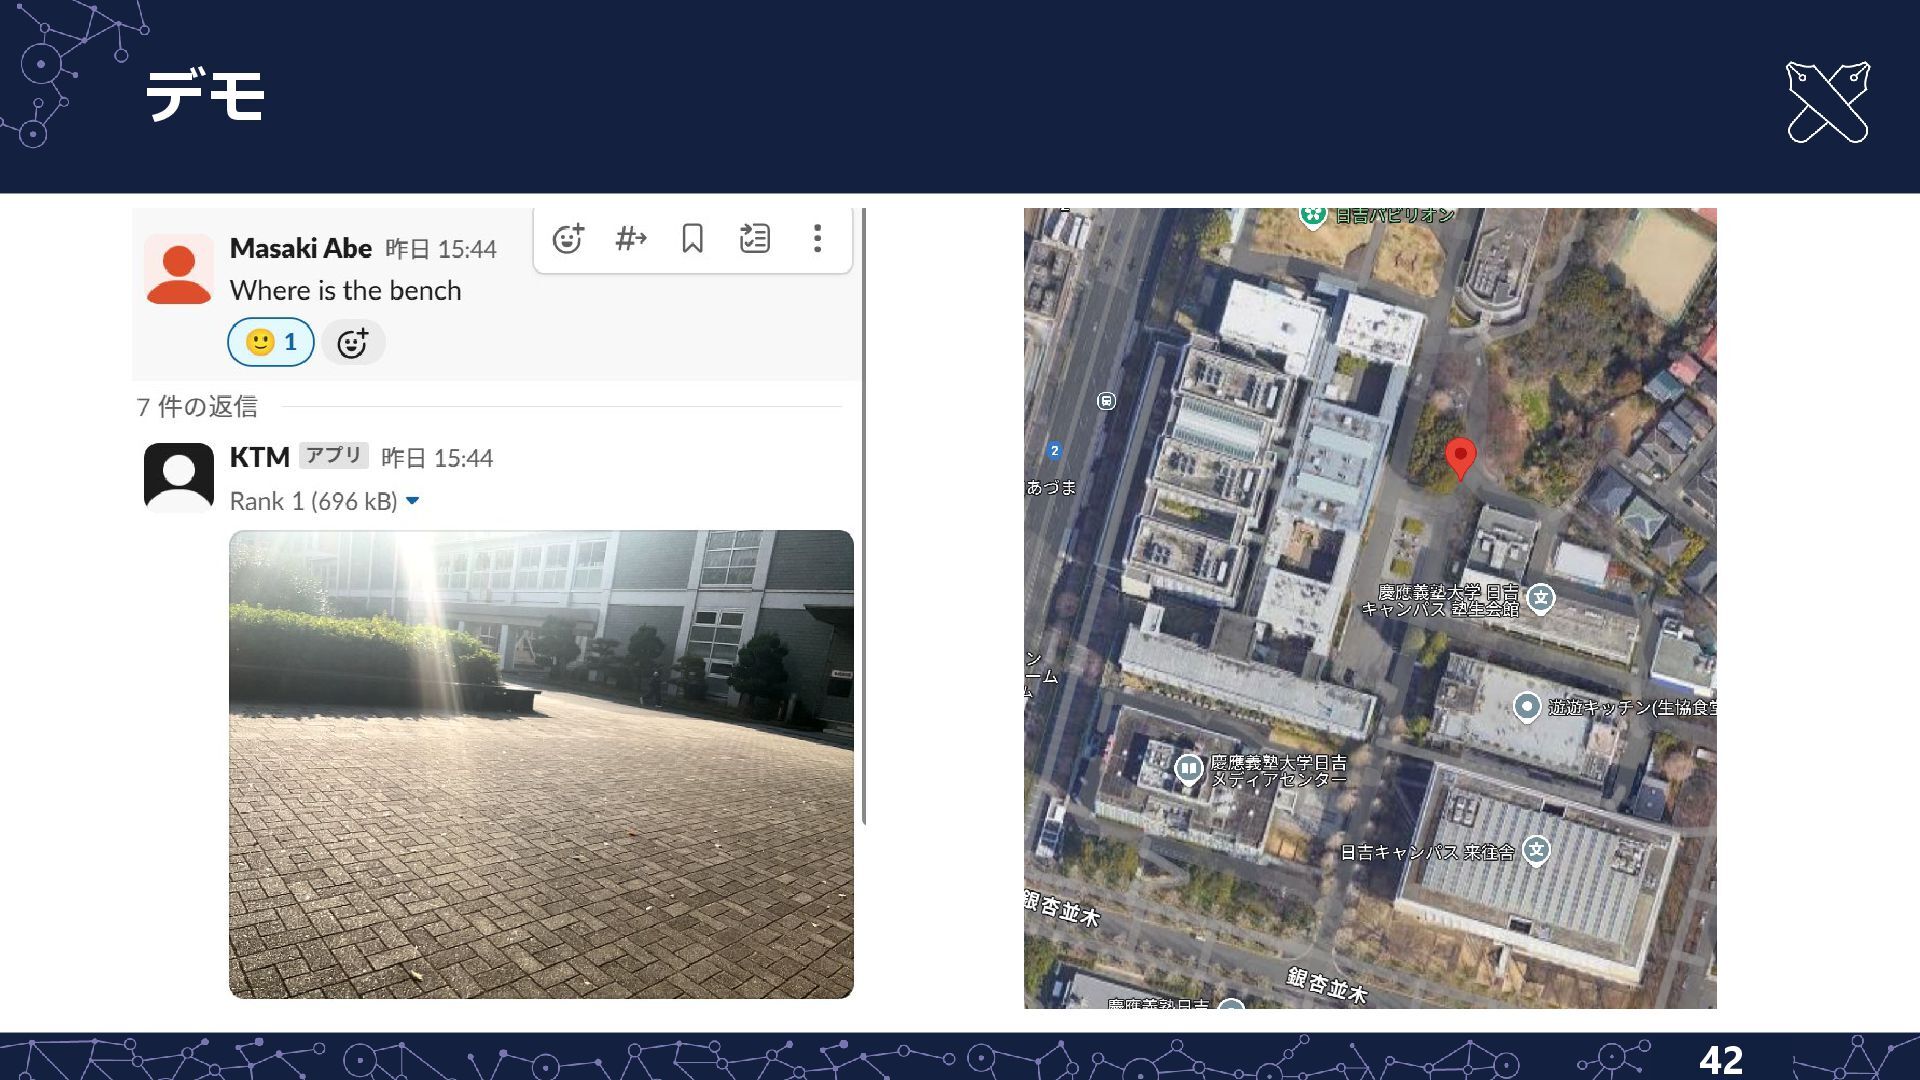
    • 要支援者を物理的・経済的に支える 生産年齢人口の減少 • ポテンシャルユーザのなかで介助犬 (育成に2年300万円)の利用者≒0.5% 家族の世話で仕事 辞めないと… 介助犬を世話 できない ドライバーの隣にあるサインペン を持ってきて 介助犬タスクの96%は 物体操作と開閉 https://www.toyota.com/usa/toyota-effect/romy-robot.html
  25. 言語指示に基づく物体操作までの流れ - - 38 ① 探索位置・姿勢の最適化 ② 実世界検索 [Kaneda+ RAL24][Yashima+

    RAL25] ③ 参照表現理解 [Nishimura+ IROS24] ④ タスク成否判定 [Goko+ CoRL24] place a red can on the front right pick up the tissue box next to the sink 「ものを置ける」「通 路ではない」等の言語 で3Dモデルから決定 x4 x16 最大3万枚の画像 を検索可能 →操作者が場所を 記憶しなくて良い
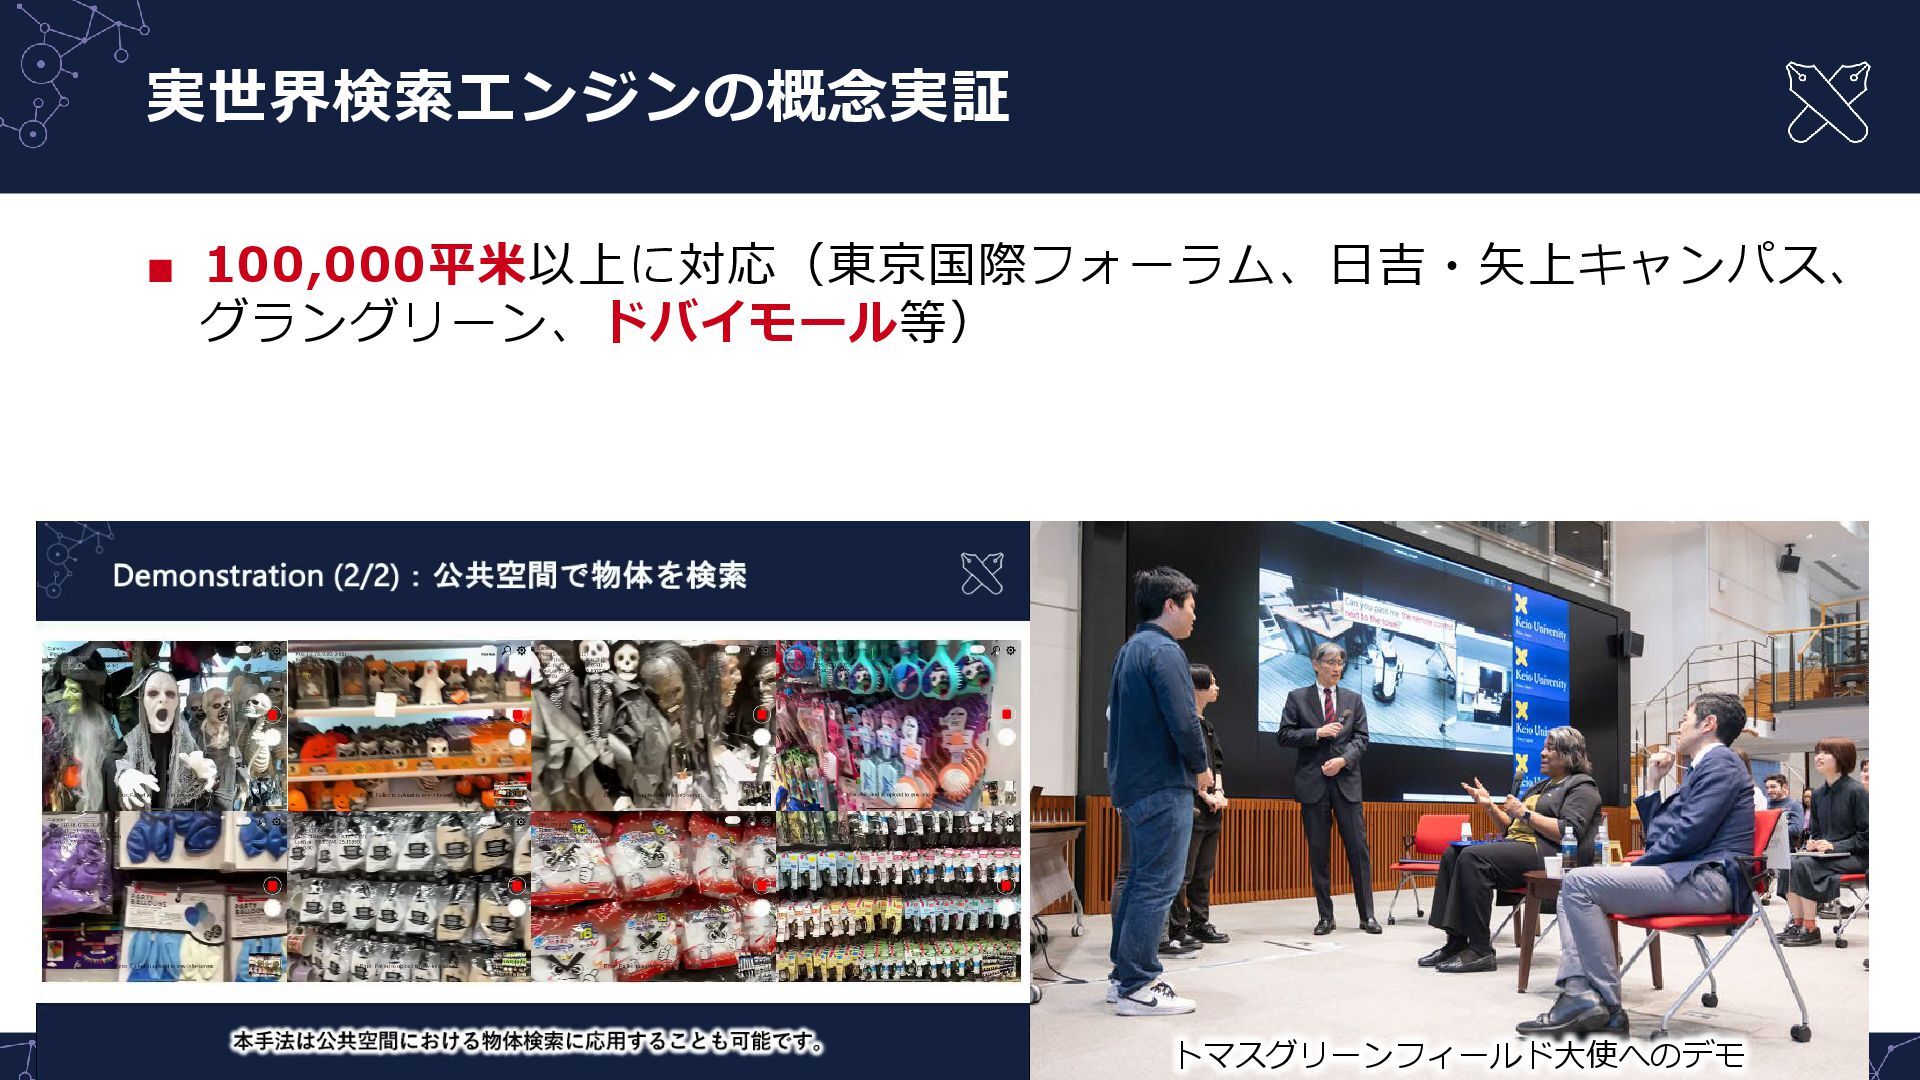
  26. 実世界検索エンジン [Kaneda+ IEEE RAL24] [Yashima+ IEEE RAL25] 39 背景 ▪

    クエリにマッチするUnlabeled Positive を人手でラベリングするのは困難 ▪ 1万ペアのラベリングに20万時間以上 技術ポイント ▪ 基盤モデルによる疑似ラベル付与 ▪ 正例以外を負例とみなすInfoNCEの代わりに、 二重緩和損失を導入 「壁にかかっている絵」
  27. モビリティ向け移動指示理解 [Hosomi+ IEEE RAL24] [Hosomi+ IEEE RAL25] [勝又 MIRU25] 【タスク】

    「バイクが止まっている所の横に 停めて」等の移動指示言語理解 【技術ポイント】 ▪ 夜間画像のセグメンテーション マスク信頼度を推定 ▪ [Rufus+ IROS21]を超える性能 Mean IoU [Rufus+, IROS2021] 32.71±4.59 TNRSM (提案手法) 37.61±2.73 - 43 -
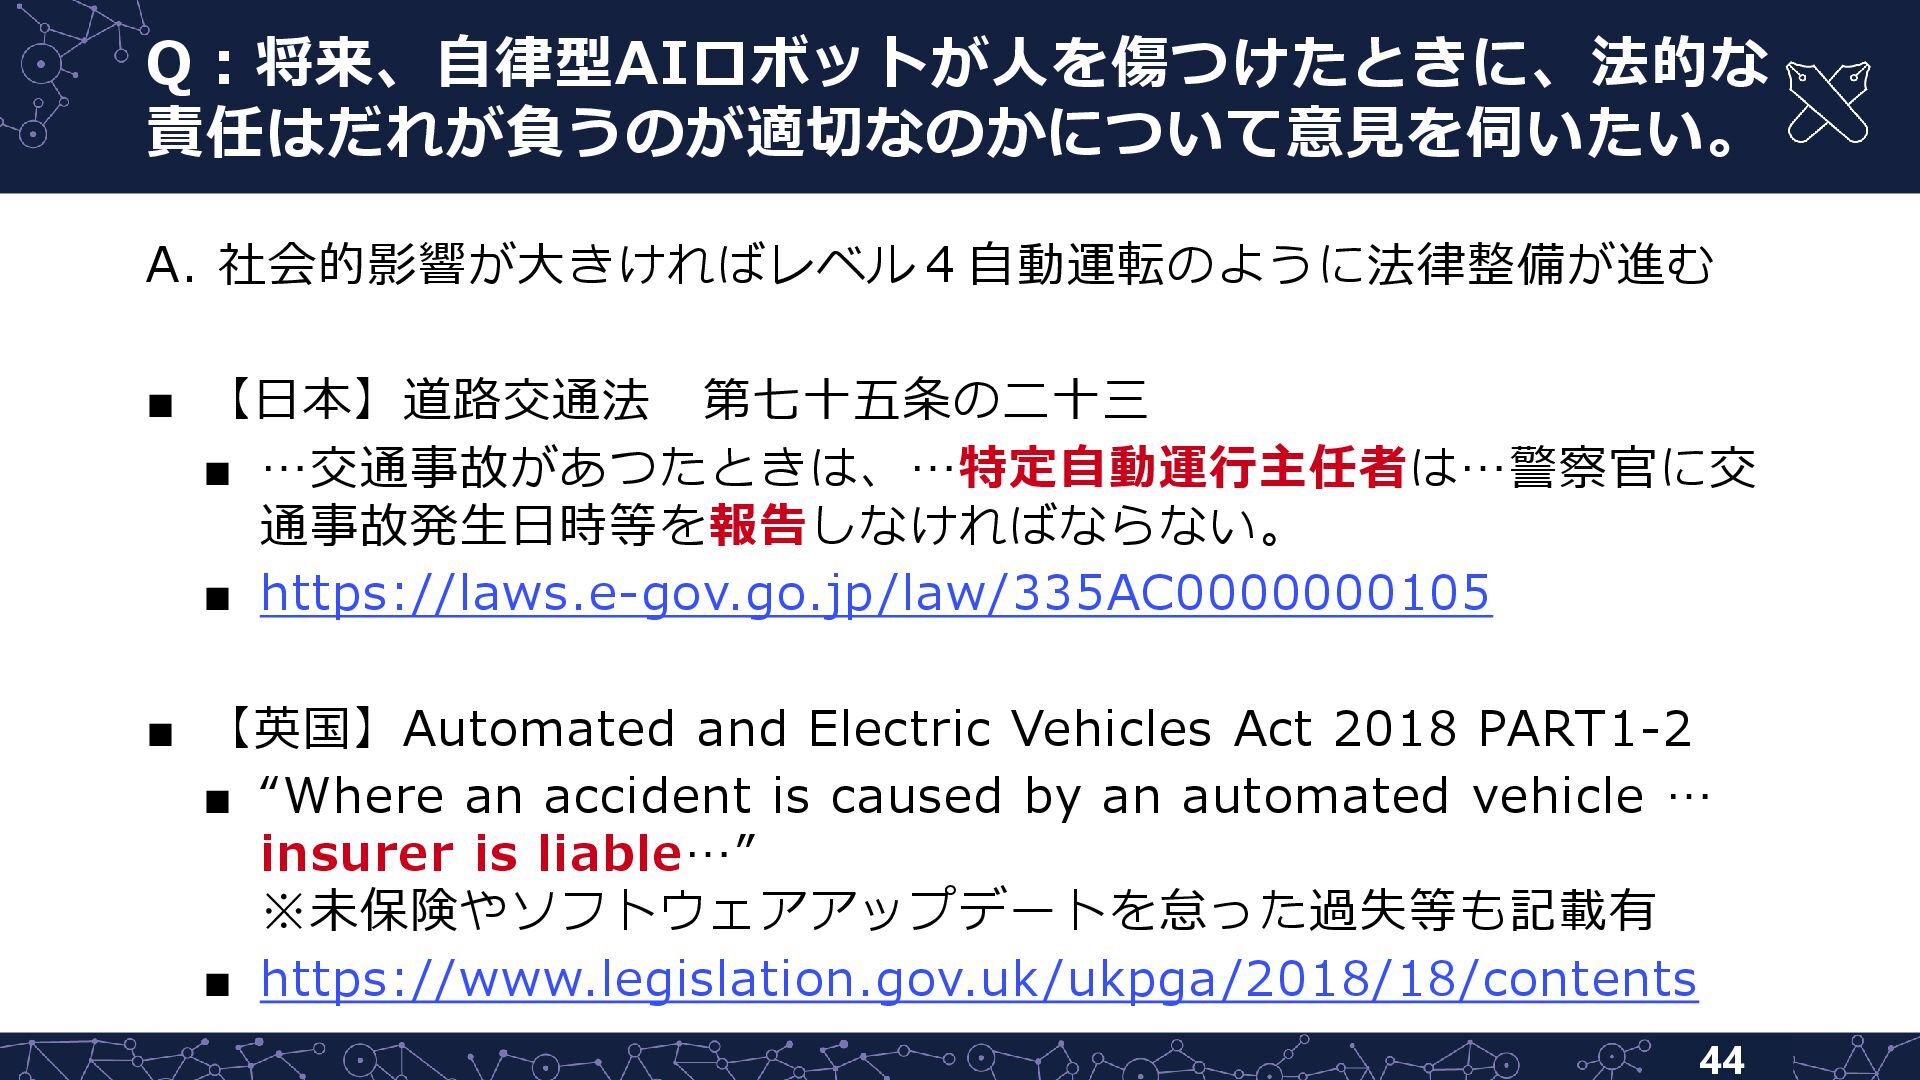
  28. Q:将来、自律型AIロボットが人を傷つけたときに、法的な 責任はだれが負うのが適切なのかについて意見を伺いたい。 44 A. 社会的影響が大きければレベル4自動運転のように法律整備が進む ▪ 【日本】道路交通法 第七十五条の二十三 ▪ …交通事故があつたときは、…特定自動運行主任者は…警察官に交

    通事故発生日時等を報告しなければならない。 ▪ https://laws.e-gov.go.jp/law/335AC0000000105 ▪ 【英国】Automated and Electric Vehicles Act 2018 PART1-2 ▪ “Where an accident is caused by an automated vehicle … insurer is liable…” ※未保険やソフトウェアアップデートを怠った過失等も記載有 ▪ https://www.legislation.gov.uk/ukpga/2018/18/contents
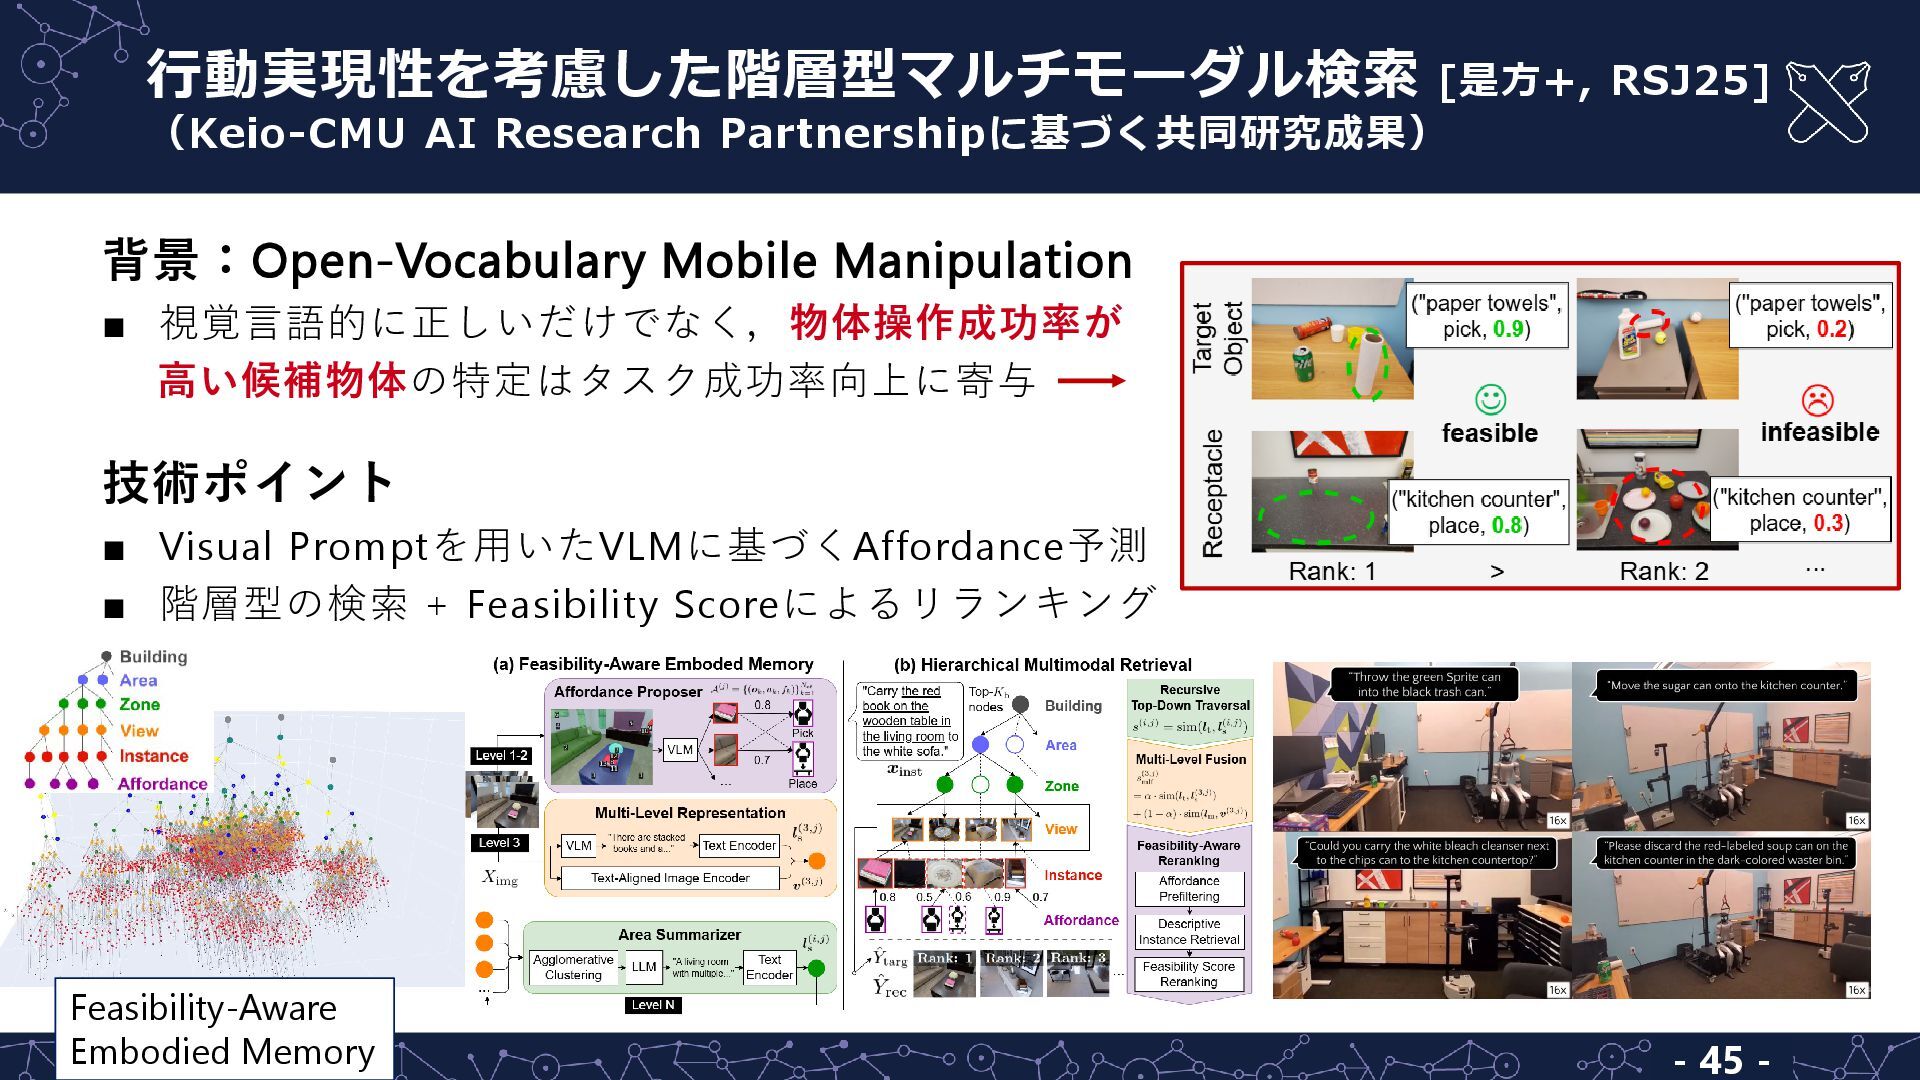
  29. 背景:Open-Vocabulary Mobile Manipulation ▪ 視覚言語的に正しいだけでなく,物体操作成功率が 高い候補物体の特定はタスク成功率向上に寄与 技術ポイント ▪ Visual Promptを用いたVLMに基づくAffordance予測

    ▪ 階層型の検索 + Feasibility Scoreによるリランキング 行動実現性を考慮した階層型マルチモーダル検索 [是方+, RSJ25] (Keio-CMU AI Research Partnershipに基づく共同研究成果) - - 45 Feasibility-Aware Embodied Memory
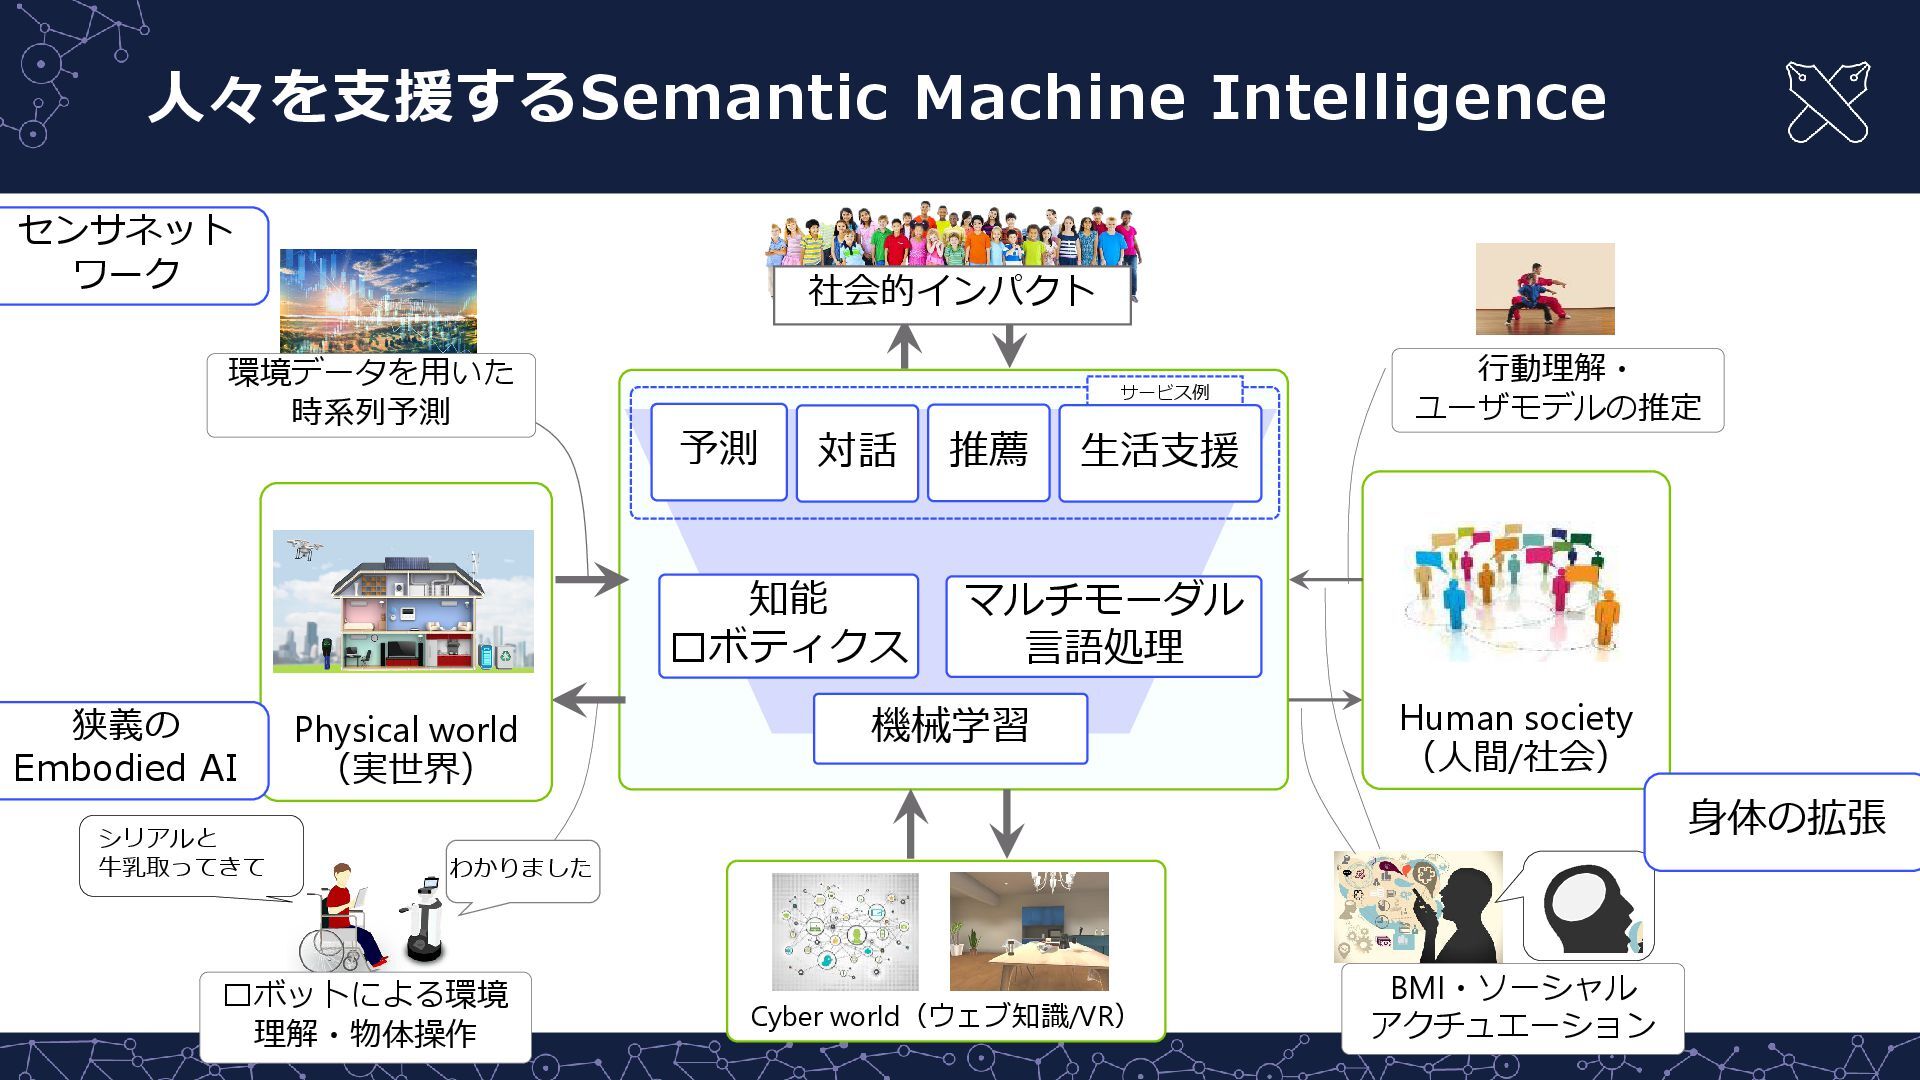
  30. 人々を支援するSemantic Machine Intelligence Cyber world(ウェブ知識/VR) 推薦 予測 対話 Physical world

    (実世界) サービス例 Human society (人間/社会) 生活支援 知能 ロボティクス 社会的インパクト 環境データを用いた 時系列予測 マルチモーダル 言語処理 行動理解・ ユーザモデルの推定 BMI・ソーシャル アクチュエーション シリアルと 牛乳取ってきて わかりました 機械学習 ロボットによる環境 理解・物体操作 狭義の Embodied AI 身体の拡張 センサネット ワーク
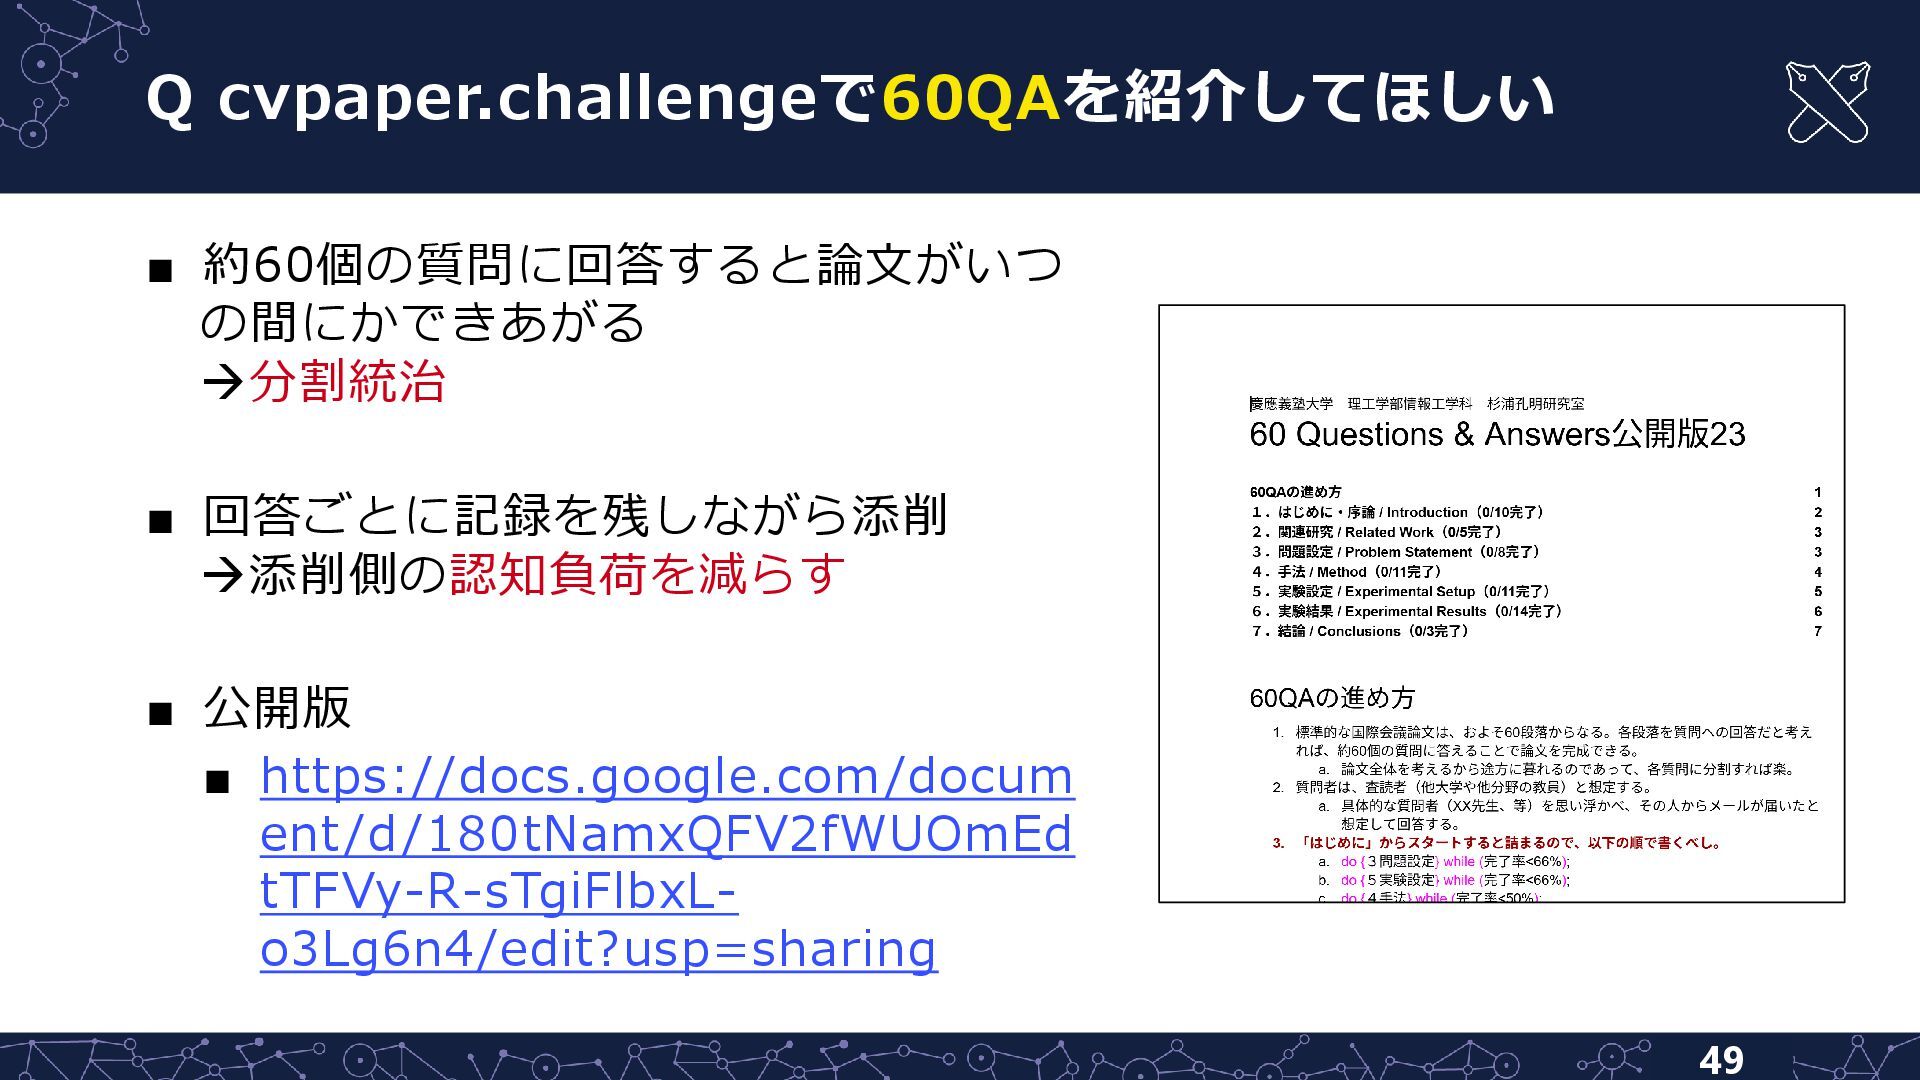
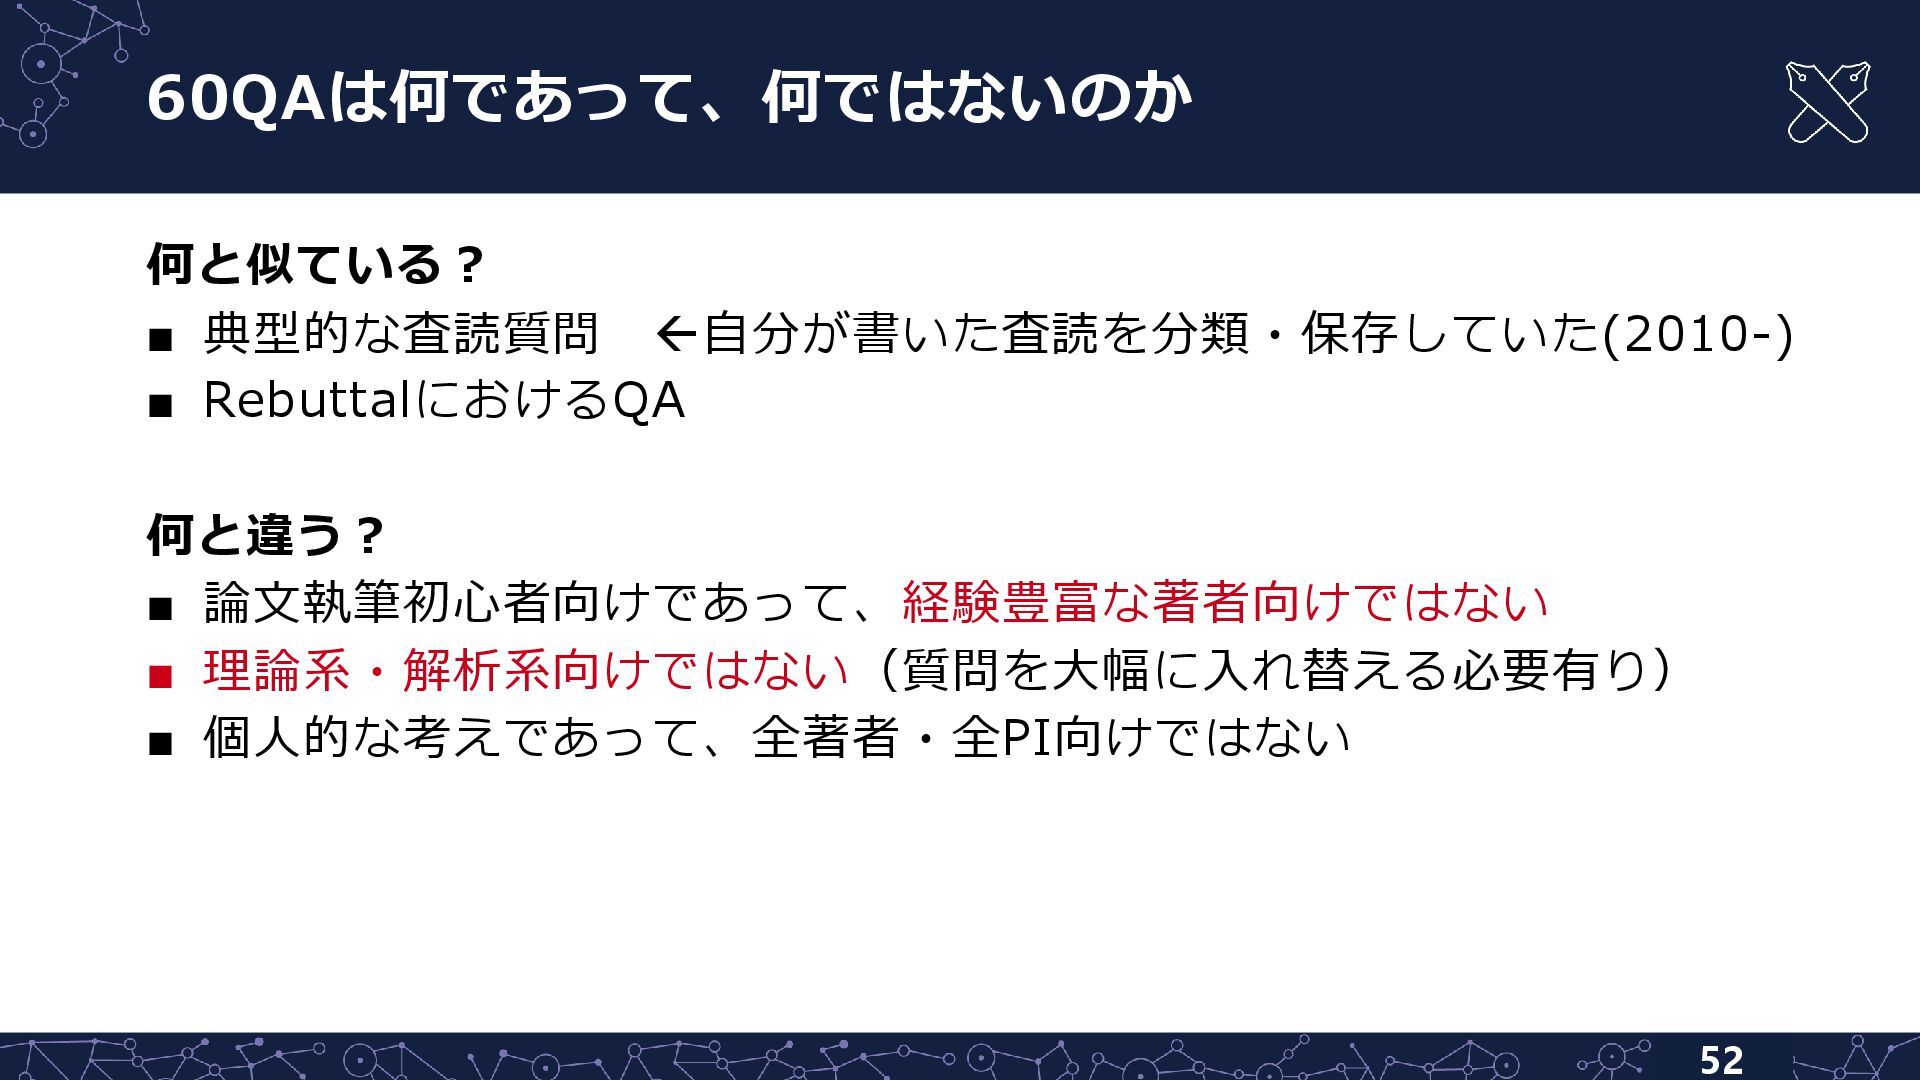
  31. 60QAは何であって、何ではないのか 52 何と似ている? ▪ 典型的な査読質問 自分が書いた査読を分類・保存していた(2010-) ▪ RebuttalにおけるQA 何と違う? ▪

    論文執筆初心者向けであって、経験豊富な著者向けではない ▪ 理論系・解析系向けではない(質問を大幅に入れ替える必要有り) ▪ 個人的な考えであって、全著者・全PI向けではない
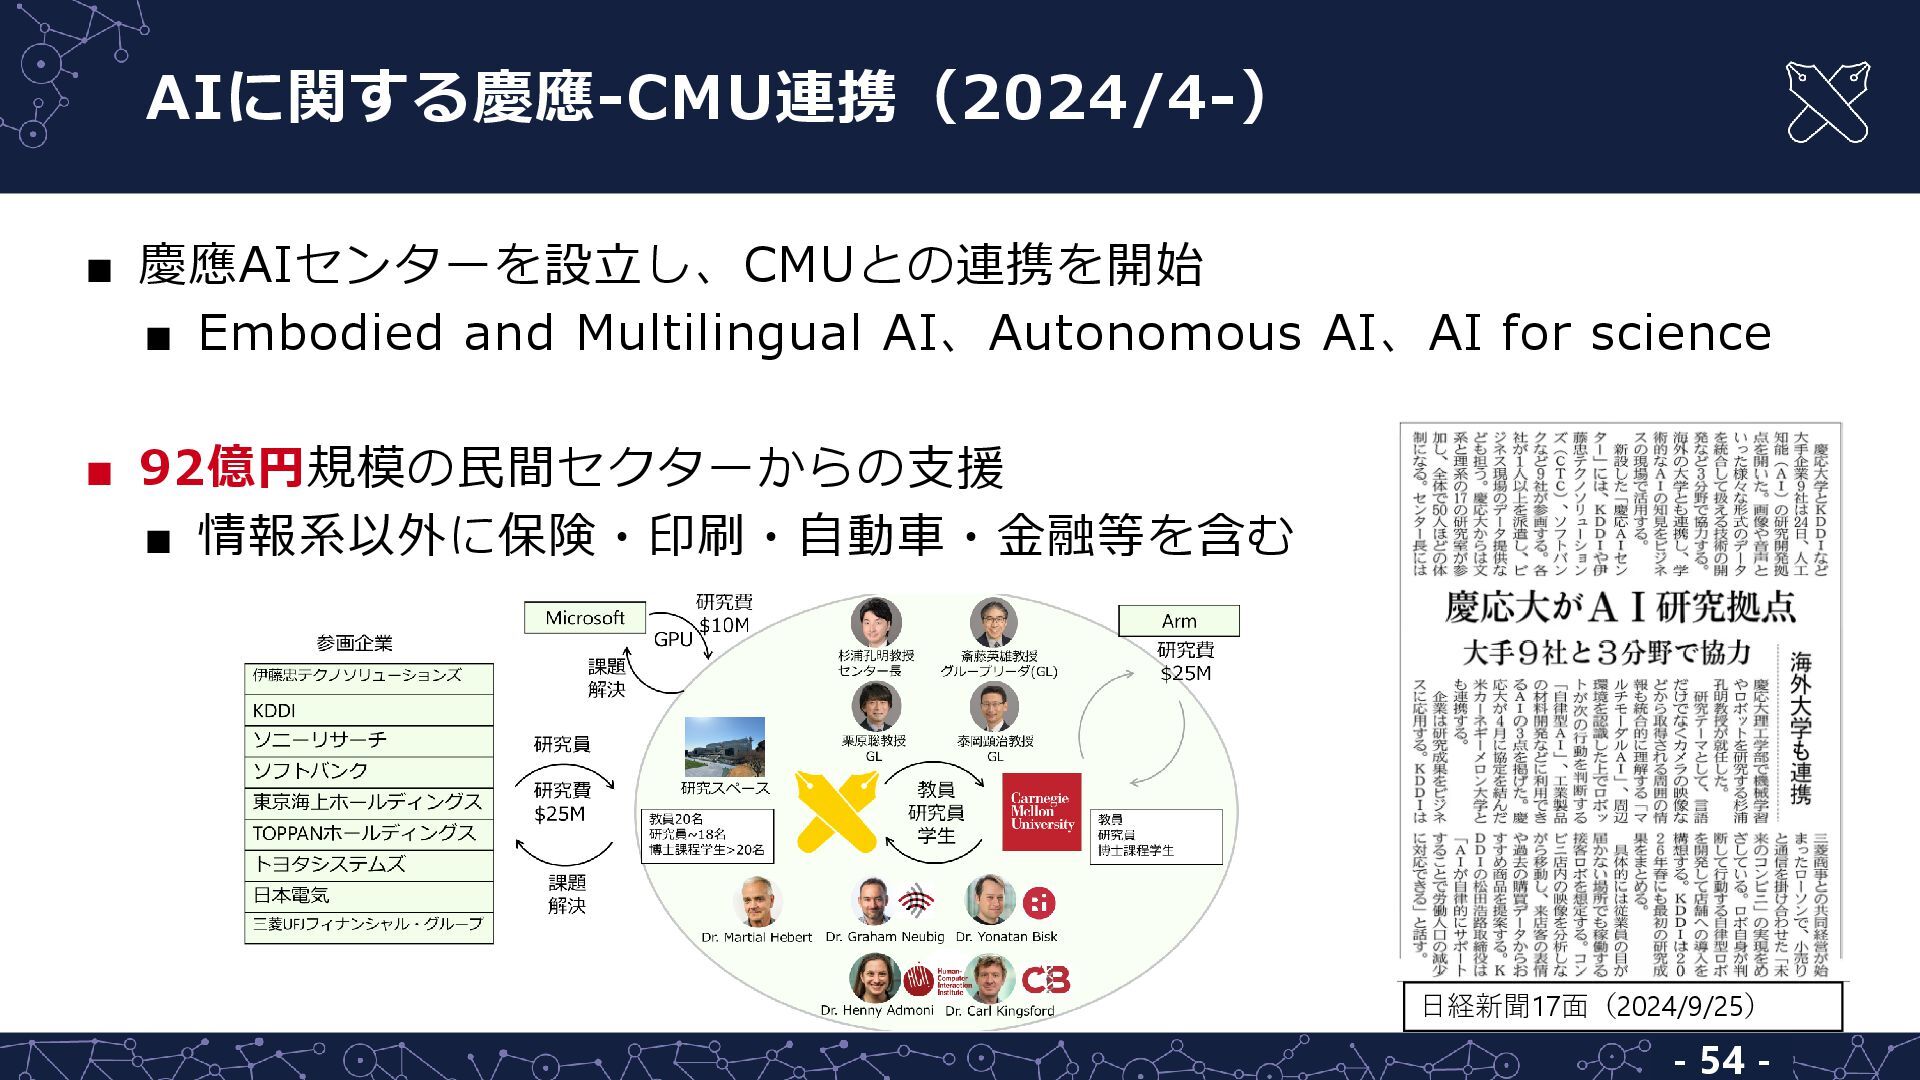
  32. AIに関する慶應-CMU連携(2024/4-) - - 54 ▪ 慶應AIセンターを設立し、CMUとの連携を開始 ▪ Embodied and Multilingual

    AI、Autonomous AI、AI for science ▪ 92億円規模の民間セクターからの支援 ▪ 情報系以外に保険・印刷・自動車・金融等を含む 日経新聞17面(2024/9/25)
  33. まとめ - - 55 1. マルチモーダルLLMの基礎 2. Embodied AIと視覚言語行動モデル 3.

    取り組み事例:Embodied AI 4. MLLMの評価 5. 論文執筆 ※JSPS・JST CREST・JSTムーンショット・NEDO・SCOPE・Apple・トヨタ 自動車・NICT・本田技研・大阪大学・中部大学・本学共同研究者・研究室 の学生・スタッフに感謝申し上げます。 本資料はD3神原君・D1是方君と 共同作成しました