Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Sparkが社内で流行ってきた話
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Okada Haruki
October 08, 2016
Technology
980
4
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Sparkが社内で流行ってきた話
Scala関西 Summit 2016での発表資料
Okada Haruki
October 08, 2016
More Decks by Okada Haruki
See All by Okada Haruki
HyperLogLog feature of ClickHouse
ocadaruma
0
1.6k
HyperLogLog is interesting
ocadaruma
3
910
A Redis compatible HLL implementation in Java
ocadaruma
0
360
sbt-uglifier
ocadaruma
0
1.3k
Other Decks in Technology
See All in Technology
AIに書かせて、プラットフォームで縛る ― EKSプラットフォームで実践した責任境界と権限設計
elmodev09
0
230
Oracle Cloud Infrastructure(OCI):Onboarding Session(はじめてのOCI/Oracle Supportご利⽤ガイド)
oracle4engineer
PRO
2
20k
CLIライブラリ開発を支える技術
htnabe
0
150
AIエージェントの一手は 誰も見ていない - Falco拡張OSS「Prempti」とeBPFで サーバーレス実行基盤を二層防御する
keitah
0
540
C#コードの結合を可視化する Roslyn解析による設計改善と リファクタリング判断
dora56
0
560
人間はどの意思決定を手放せるのか
kawasima
15
8.1k
Lambda MicroVMsは常駐サーバーの代わりに なるか? Kiro Crew を動かして検証してみた / Kiro Crew on Lambda MicroVMs
k_adachi_01
2
150
AI coding 整合正規方法
philipz
0
530
なぜ「決定性」が 決定的に重要なのか? Durable Execution 基盤の数理的理解 #serverlessjp / ServerlessDays Tokyo 2026
ytaka23
3
1.2k
あけおめLINE 傾向とその対策
nasa9084
0
310
ボードゲームの遊び相手をFoundation Modelsで作る / iOSDC Japan 2026
genda
0
140
その Lambda、8分で 管理者権限まで奪われます
k1nakayama
7
3.6k
Featured
See All Featured
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
Context Engineering - Making Every Token Count
addyosmani
9
1.2k
How to train your dragon (web standard)
notwaldorf
97
6.8k
The Art of Programming - Codeland 2020
erikaheidi
57
14k
Information Architects: The Missing Link in Design Systems
soysaucechin
1
1.2k
Taking LLMs out of the black box: A practical guide to human-in-the-loop distillation
inesmontani
PRO
3
2.4k
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
340
Building Adaptive Systems
keathley
44
3.2k
The Limits of Empathy - UXLibs8
cassininazir
1
690
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
410
Building an army of robots
kneath
307
46k
Transcript
Sparkが社内で 流行ってきた話 株式会社オプト 岡田遥来
目次 • Sparkとは • オプトでのSpark採用の経緯 • Spark採用プロダクトが増えてきた話
自己紹介 • 岡田 遥来 (@ocadaruma) • 株式会社 Demand Side Science
(2015-03~2015-12) • 株式会社 オプト (2016-01~) • おもにログ計測/集計等バックエンド • Spark (on EMR) • DynamoDB • Redshift • Github: sbt-youtube, chronoscala
Sparkとは • オープンソースの大規模データ処理フレームワーク • Scalaで実装されている • オンメモリ主体の高速な処理 • Scala, Java,
Python, R用のインターフェースがある
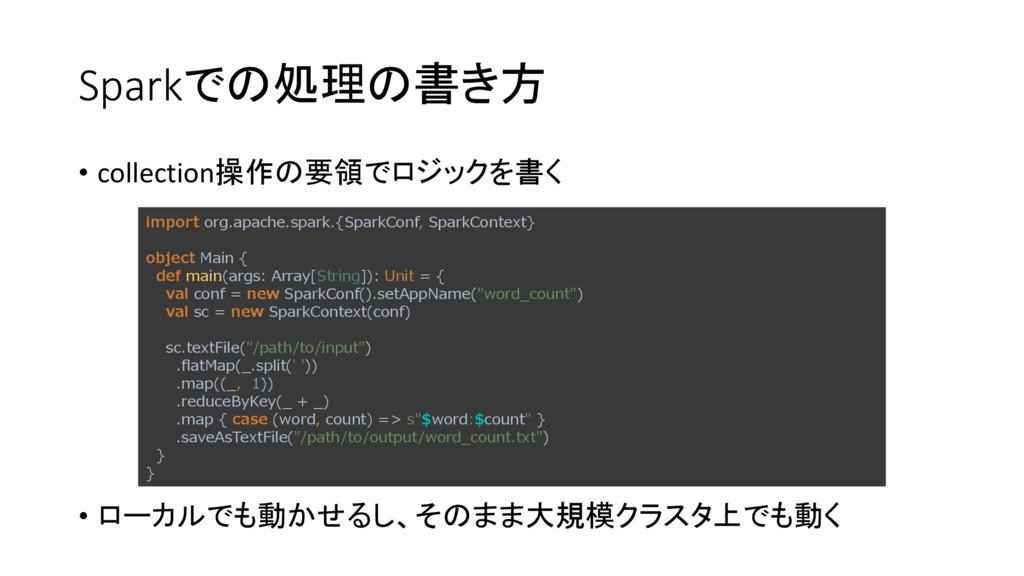
Sparkでの処理の書き方 • collection操作の要領でロジックを書く • ローカルでも動かせるし、そのまま大規模クラスタ上でも動く import org.apache.spark.{SparkConf, SparkContext} object Main
{ def main(args: Array[String]): Unit = { val conf = new SparkConf().setAppName("word_count") val sc = new SparkContext(conf) sc.textFile("/path/to/input") .flatMap(_.split(' ')) .map((_, 1)) .reduceByKey(_ + _) .map { case (word, count) => s"$word:$count" } .saveAsTextFile("/path/to/output/word_count.txt") } }
Sparkで扱える入力 • ローカルファイル • Scalaのコレクション • HDFS • S3 •
etc,…
オプトでのSpark採用の経緯 • 広告効果計測システムの新バージョン開発 • 開発言語: Scala • インフラ: AWS •
データ規模: 6,000,000 req / h • Sparkが候補に -> 採用
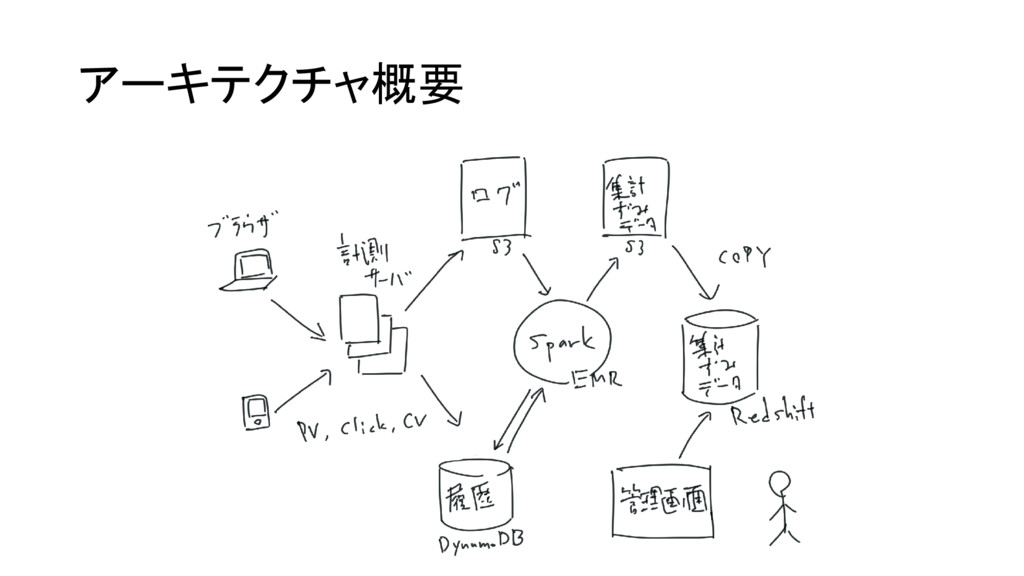
アーキテクチャ概要
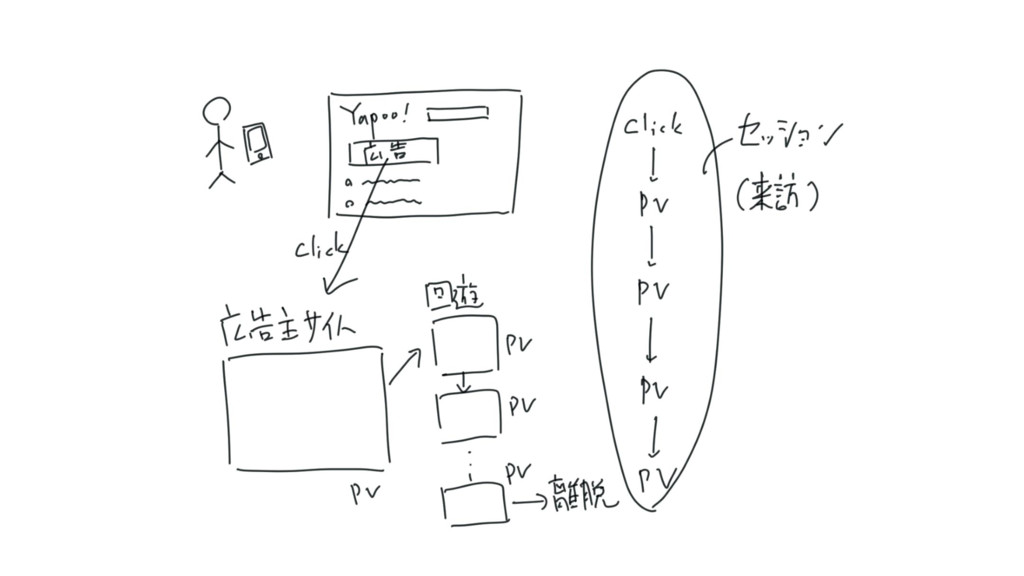
広告効果計測で行う処理の例 • セッション化 • アクセス解析 / 広告効果解析では、サイトへの来訪を表す「セッション」単位 での分析を行う • 一定間隔空かないPVの集合を「セッション」にまとめる
None
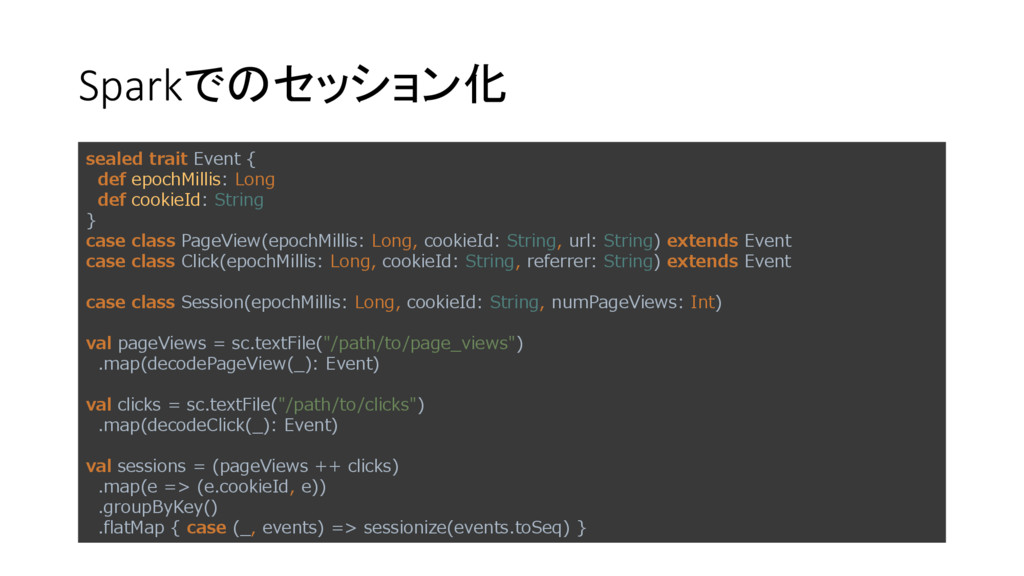
Sparkでのセッション化 sealed trait Event { def epochMillis: Long def cookieId:
String } case class PageView(epochMillis: Long, cookieId: String, url: String) extends Event case class Click(epochMillis: Long, cookieId: String, referrer: String) extends Event case class Session(epochMillis: Long, cookieId: String, numPageViews: Int) val pageViews = sc.textFile("/path/to/page_views") .map(decodePageView(_): Event) val clicks = sc.textFile("/path/to/clicks") .map(decodeClick(_): Event) val sessions = (pageViews ++ clicks) .map(e => (e.cookieId, e)) .groupByKey() .flatMap { case (_, events) => sessionize(events.toSeq) }
広告効果計測で行う処理の例 • ラストクリックの突合せ • 広告効果解析では、コンバージョン(購入等)に至るまでにクリックされた広 告のうち、最後のもの(ラストクリック)を重視する • (最近は、ラストクリック以外を評価する様々な考え方も出てきているが) • CVログに対して、過去のクリック履歴を参照し、ラストクリックを突き合わせる
処理
None
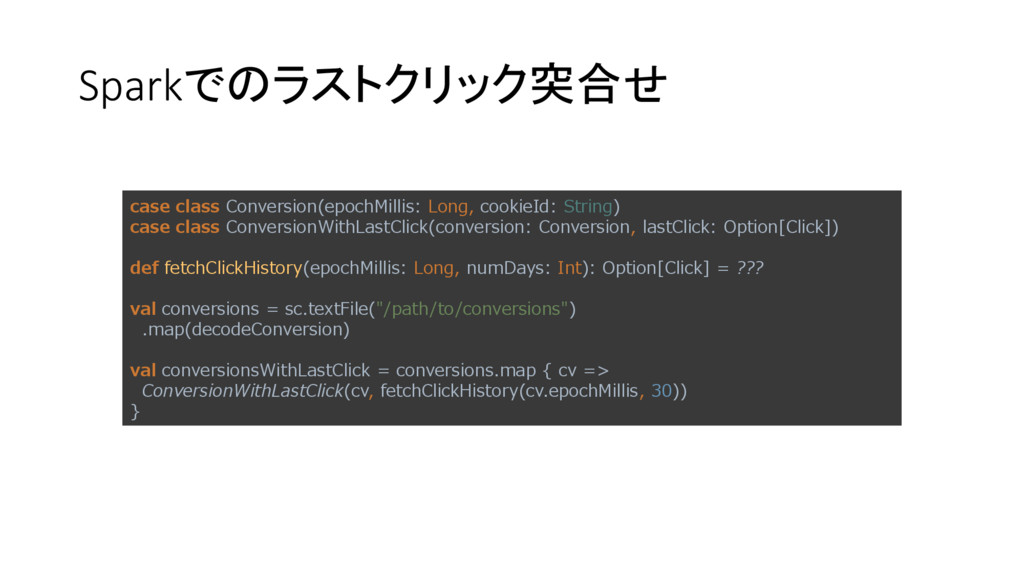
Sparkでのラストクリック突合せ case class Conversion(epochMillis: Long, cookieId: String) case class ConversionWithLastClick(conversion:
Conversion, lastClick: Option[Click]) def fetchClickHistory(epochMillis: Long, numDays: Int): Option[Click] = ??? val conversions = sc.textFile("/path/to/conversions") .map(decodeConversion) val conversionsWithLastClick = conversions.map { cv => ConversionWithLastClick(cv, fetchClickHistory(cv.epochMillis, 30)) }
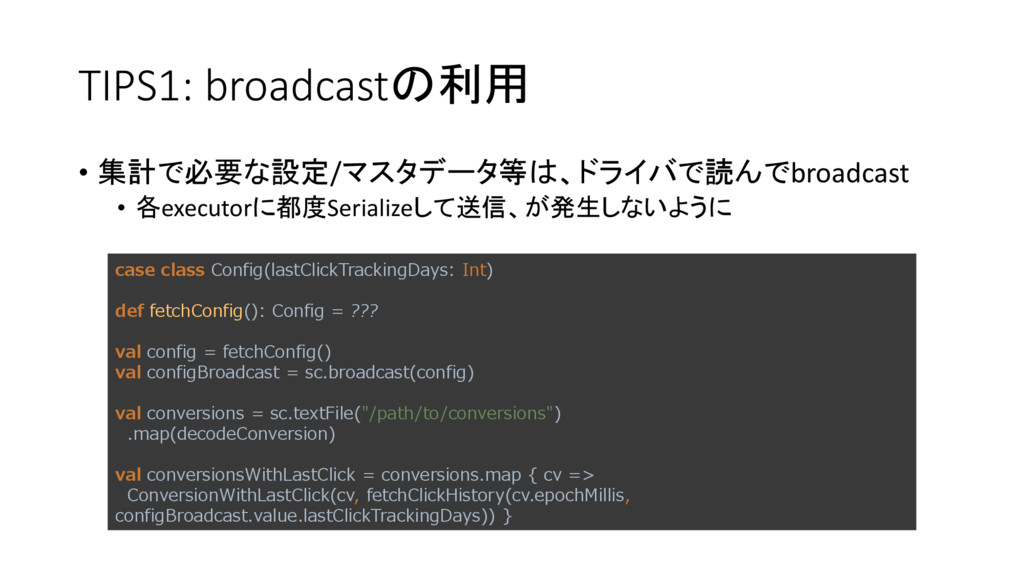
TIPS1: broadcastの利用 • 集計で必要な設定/マスタデータ等は、ドライバで読んでbroadcast • 各executorに都度Serializeして送信、が発生しないように case class Config(lastClickTrackingDays: Int)
def fetchConfig(): Config = ??? val config = fetchConfig() val configBroadcast = sc.broadcast(config) val conversions = sc.textFile("/path/to/conversions") .map(decodeConversion) val conversionsWithLastClick = conversions.map { cv => ConversionWithLastClick(cv, fetchClickHistory(cv.epochMillis, configBroadcast.value.lastClickTrackingDays)) }
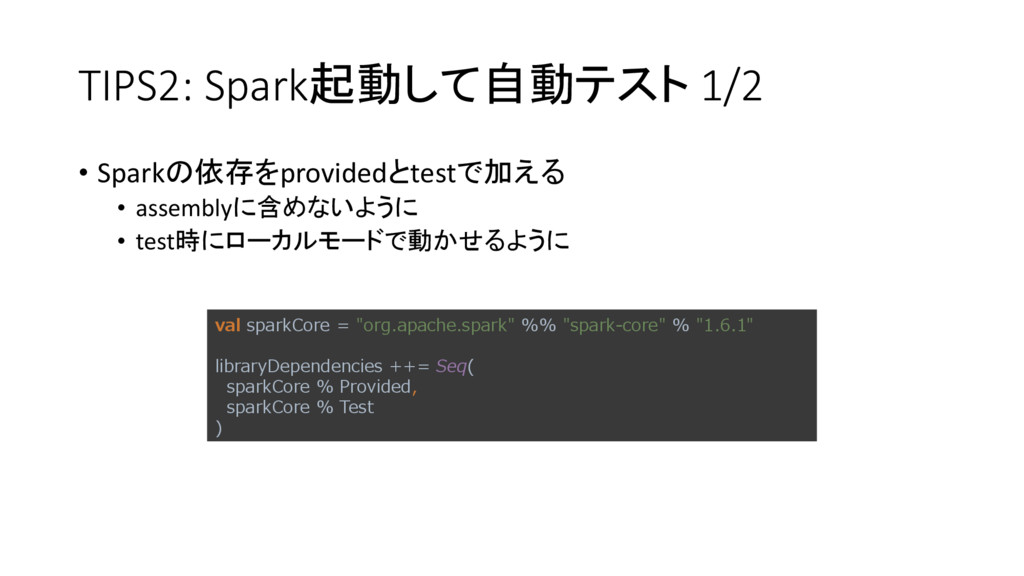
TIPS2: Spark起動して自動テスト 1/2 • Sparkの依存をprovidedとtestで加える • assemblyに含めないように • test時にローカルモードで動かせるように val
sparkCore = "org.apache.spark" %% "spark-core" % "1.6.1" libraryDependencies ++= Seq( sparkCore % Provided, sparkCore % Test )
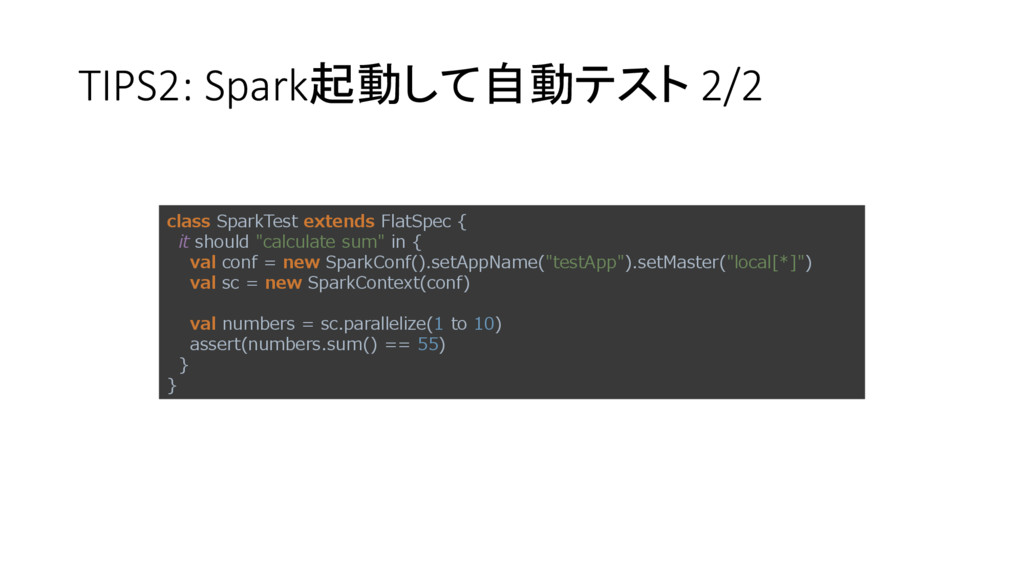
TIPS2: Spark起動して自動テスト 2/2 class SparkTest extends FlatSpec { it should
"calculate sum" in { val conf = new SparkConf().setAppName("testApp").setMaster("local[*]") val sc = new SparkContext(conf) val numbers = sc.parallelize(1 to 10) assert(numbers.sum() == 55) } }
Sparkを導入して分かったこと • RDDの枠組みの上でロジックを書けば、ちゃんとスケールする • localモードを使って、Sparkを起動するユニットテストも書ける • EMRのSparkバイナリがScala 2.10ビルドだった • Scala
2.11アプリを動かすには、ひと工夫必要 • 自前でビルドしたものをS3に配置、実行時にspark-yarn-jarを指定 • EMR 5.0.0ではSpark 2.0.0になり、Scala 2.11ビルドになった • DynamoDBがボトルネックに • せっかくのSparkの高速性を活かせない • できるだけI/Oは減らし、Sparkで完結する作りにするべき
Spark採用プロダクトが増えてきた話 • Sparkの知見が得られ、社内に詳しい人がいる状態になった • 他プロダクトでも採用 • 商品リスト広告(PLA)のレコメンドエンジン開発 • データフィード管理システム開発
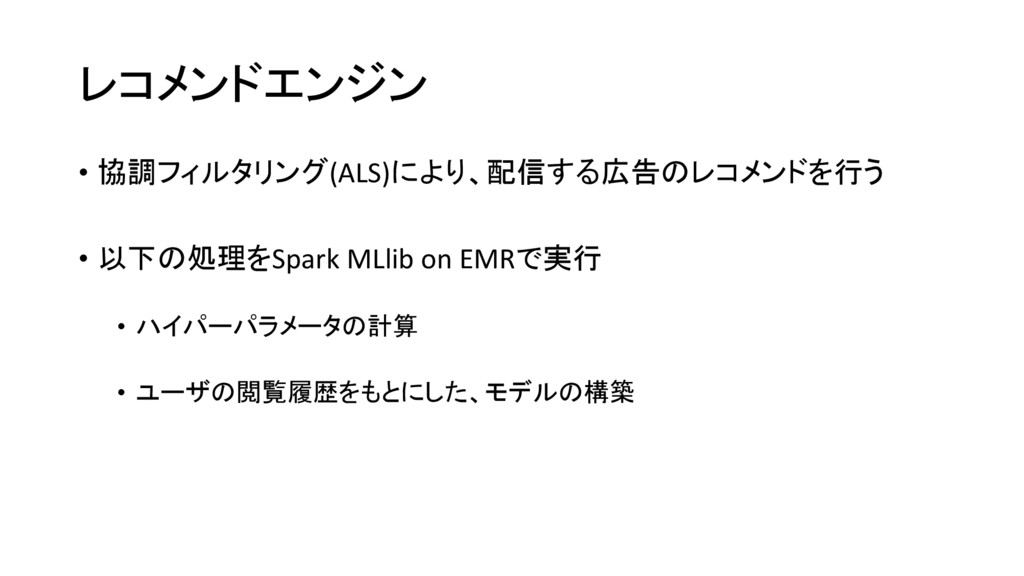
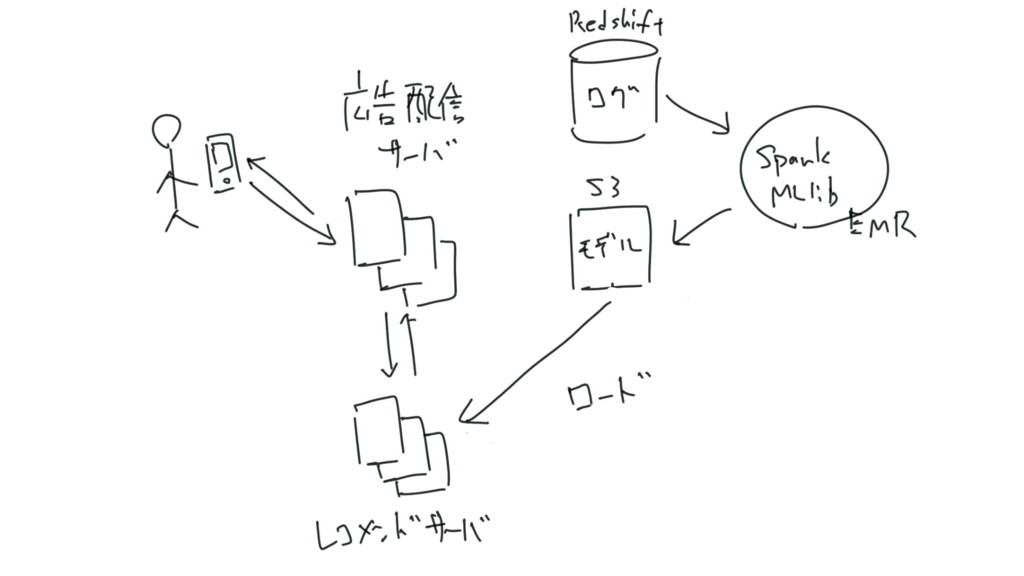
レコメンドエンジン • 協調フィルタリング(ALS)により、配信する広告のレコメンドを行う • 以下の処理をSpark MLlib on EMRで実行 • ハイパーパラメータの計算
• ユーザの閲覧履歴をもとにした、モデルの構築
None
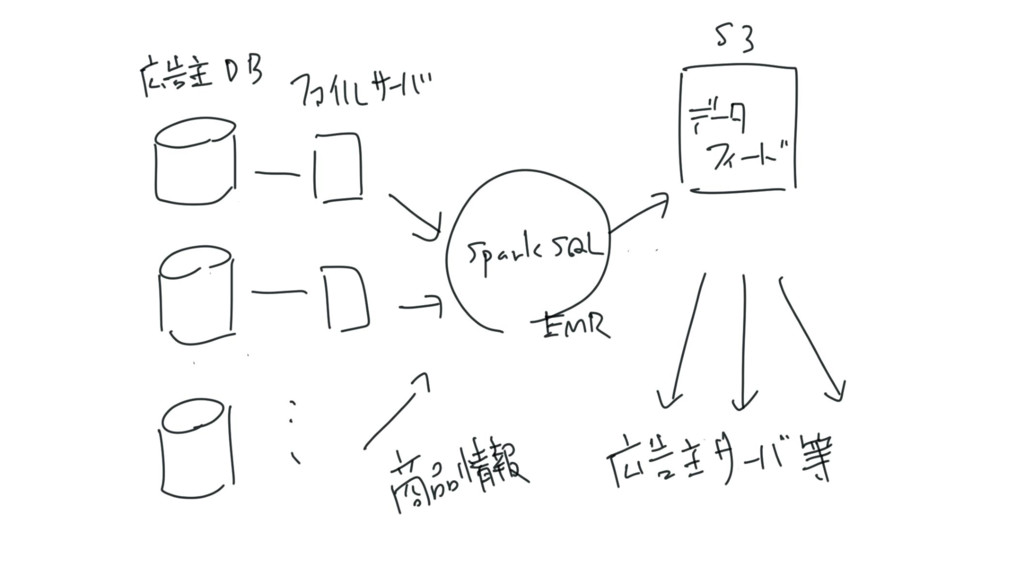
データフィード管理システム • 広告主のもつ様々な商品情報を結合・加工し、データフィード広告の ためのフィードを生成する • 商品情報のフィルタ / 結合 / 加工に、Spark
SQL on EMRを利用
None
まとめ • 社内で、分散並列処理を行う際の有力候補として定着してきた • マネージドクラスタが用意されていて楽 • AWS -> EMR •
GCP -> Cloud Dataproc(試してない) • Scalaで書けるのがよい
株式会社オプトでは Scalaエンジニアを募集しています! • https://www.opt.ne.jp/opttechnologies/


 ocadaruma
 elmodev09
 oracle4engineer
 htnabe
 keitah
 dora56
 kawasima
 k_adachi_01
 philipz
 ytaka23
 nasa9084
 genda
 k1nakayama
 mongodb
 addyosmani
 notwaldorf
 erikaheidi
 soysaucechin
 inesmontani
 dugsong
 keathley
 cassininazir
 caitiem20
 uxyall
 kneath