Share
Embed
Transcript
119 slides
-
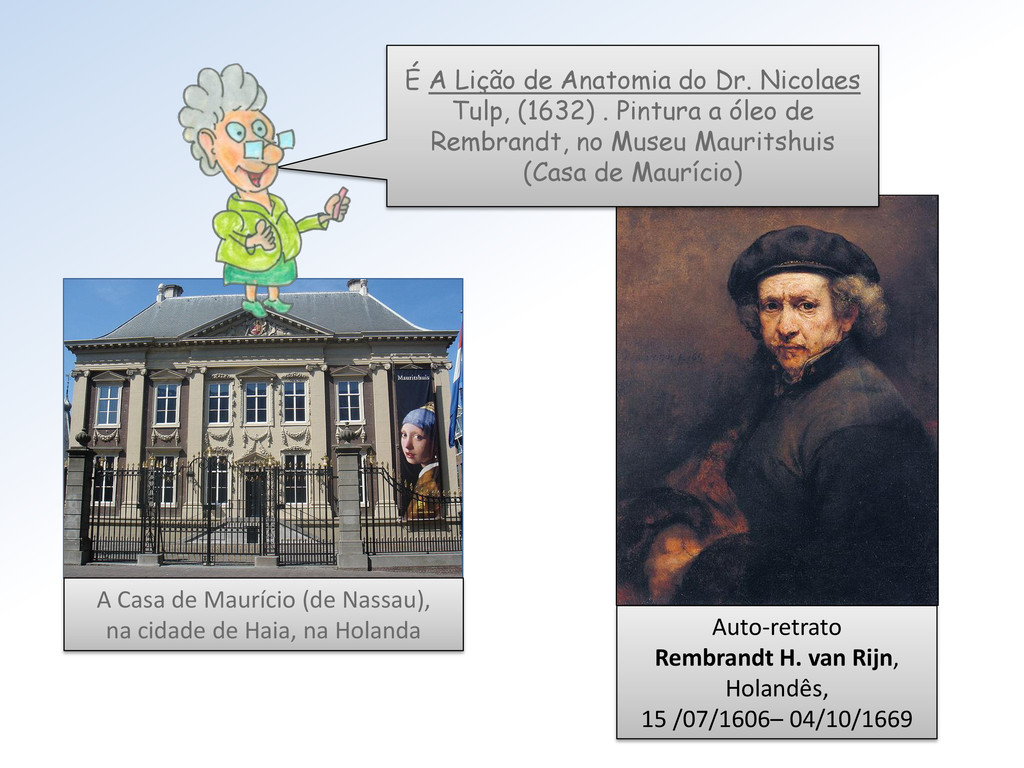
Auto-retrato Rembrandt H. van Rijn, Holandês, 15 /07/1606– 04/10/1669 A
Casa de Maurício (de Nassau), na cidade de Haia, na Holanda É A Lição de Anatomia do Dr. Nicolaes Tulp, (1632) . Pintura a óleo de Rembrandt, no Museu Mauritshuis (Casa de Maurício) -
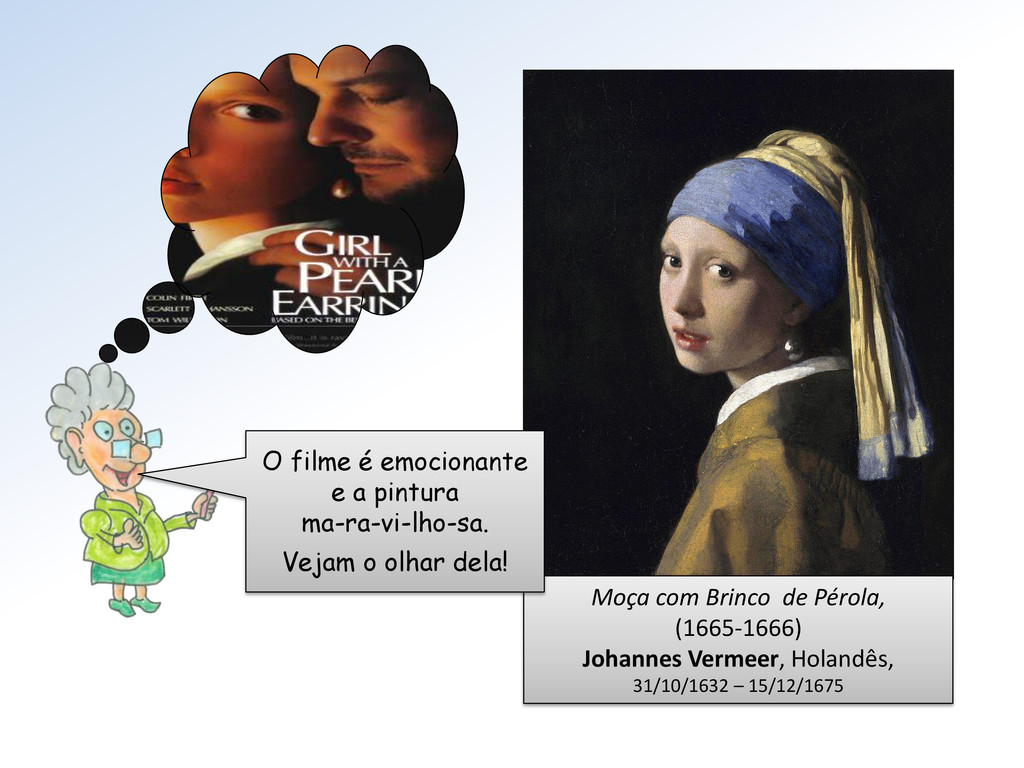
Moça com Brinco de Pérola, (1665-1666) Johannes Vermeer, Holandês, 31/10/1632
– 15/12/1675 O filme é emocionante e a pintura ma-ra-vi-lho-sa. Vejam o olhar dela! -
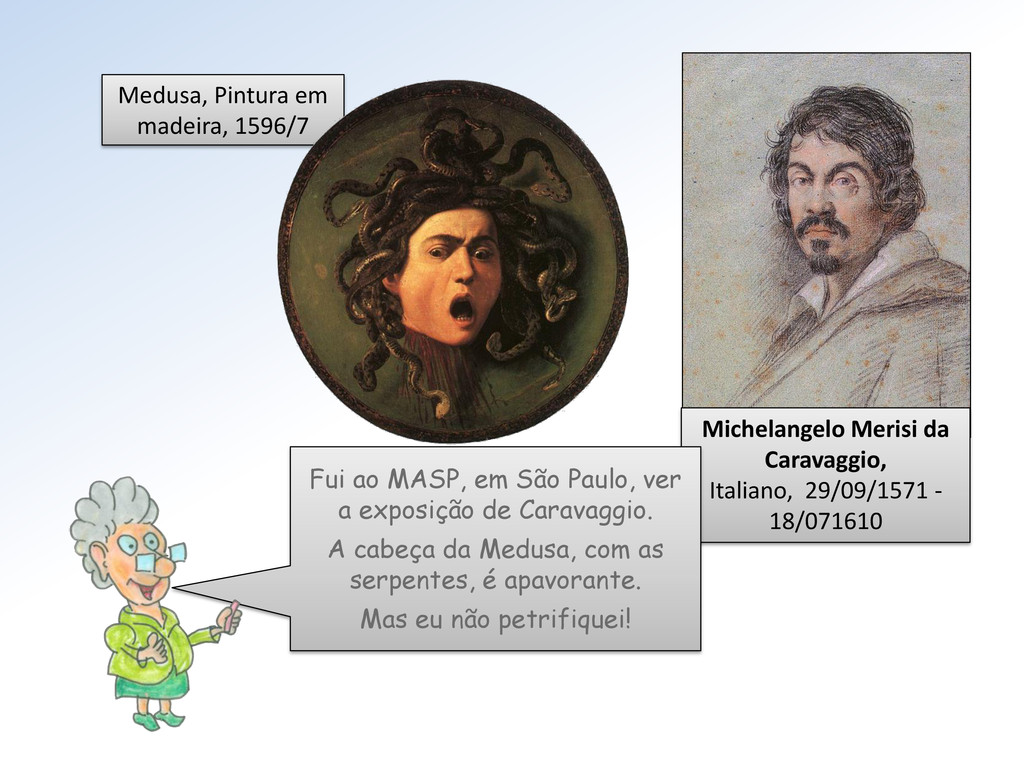
Michelangelo Merisi da Caravaggio, Italiano, 29/09/1571 - 18/071610 Medusa, Pintura
em madeira, 1596/7 Fui ao MASP, em São Paulo, ver a exposição de Caravaggio. A cabeça da Medusa, com as serpentes, é apavorante. Mas eu não petrifiquei! -
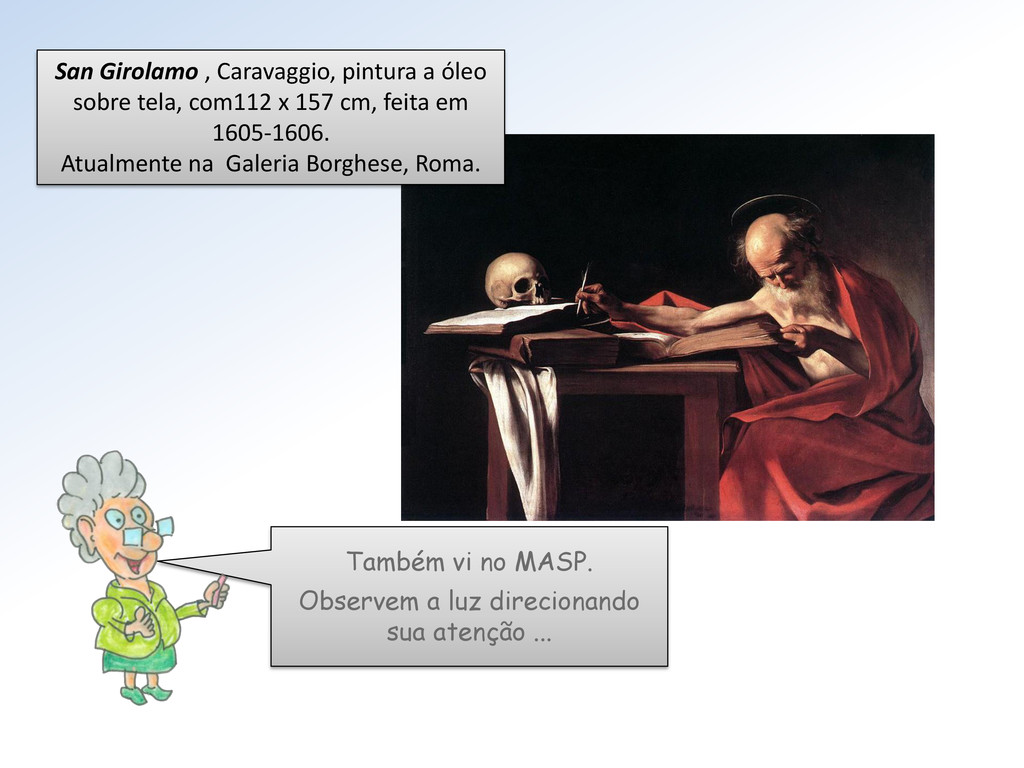
San Girolamo , Caravaggio, pintura a óleo sobre tela, com112
x 157 cm, feita em 1605-1606. Atualmente na Galeria Borghese, Roma. Também vi no MASP. Observem a luz direcionando sua atenção ... -
http://masp.art.br/masp2010/ Na ida a São Paulo além do MASP, passeiem
pela Av. Paulista e procurem as Livrarias. Ouçam a OSESP na Sala São Paulo, apreciem a arquitetura da Catedral da Sé. Almocem no Mercado Municipal, ... -
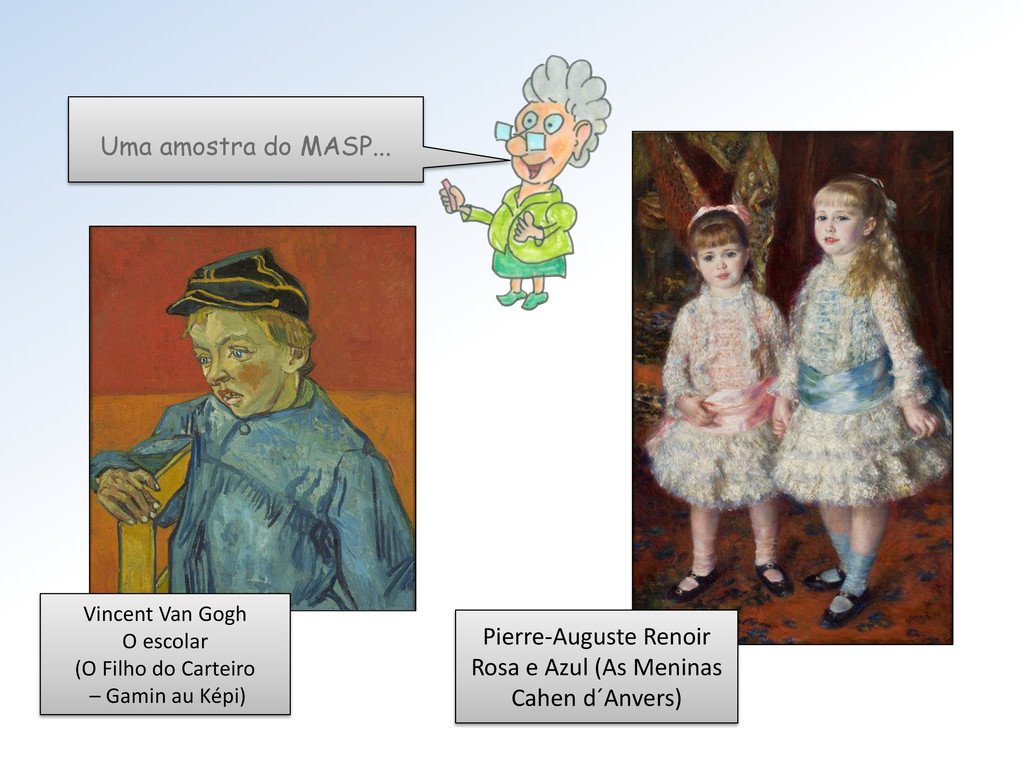
Vincent Van Gogh O escolar (O Filho do Carteiro –
Gamin au Képi) Pierre-Auguste Renoir Rosa e Azul (As Meninas Cahen d´Anvers) Uma amostra do MASP... -
A escolha da pintura A Lição de Anatomia do Dr.
Nicolaes Tulp para abertura desta lição não é por acaso. É uma indicação artística de que, agora, passaremos a dissecar a representação IEEE 754/2008 em Python/NumPy. -
Bem, meus jovens, vamos retornar aos números. Vamos construir um
sistema numérico de brinquedo, fiel ao padrão IEEE 754/2008. Fala sério, Mestre! -
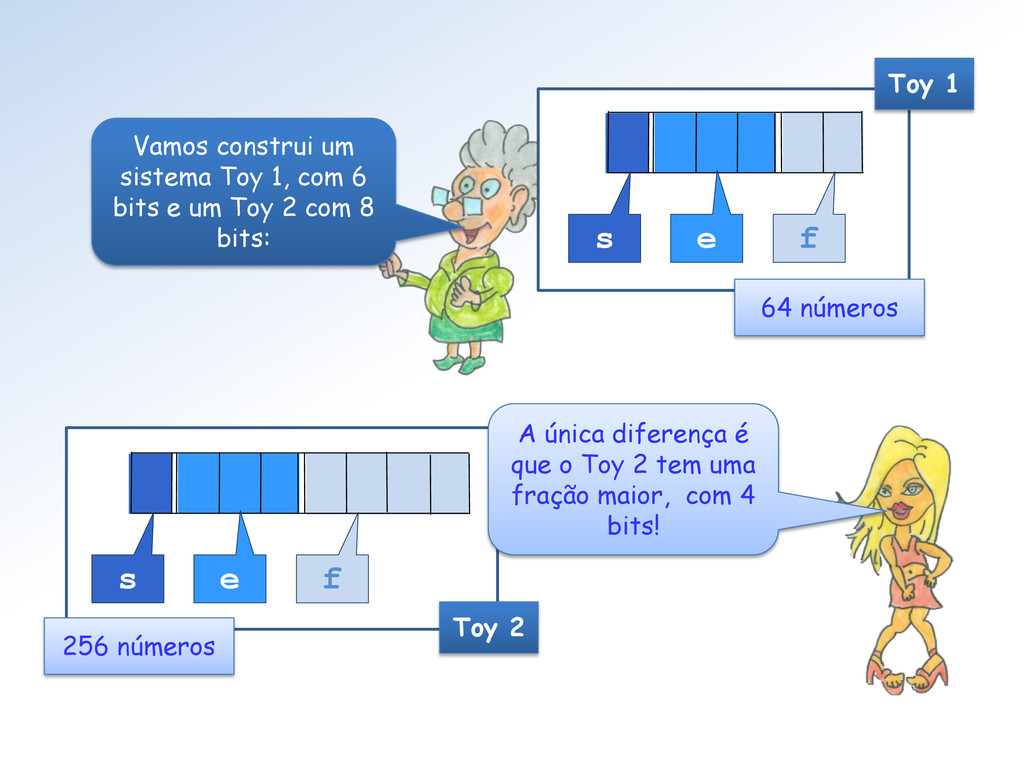
Vamos construi um sistema Toy 1, com 6 bits e
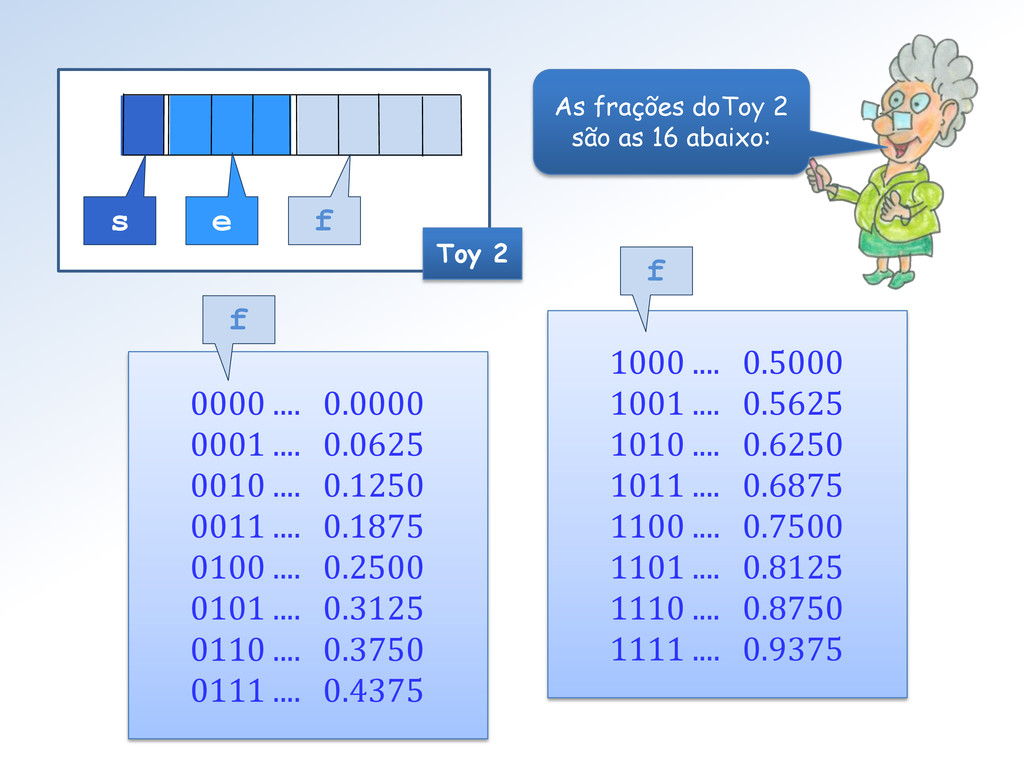
um Toy 2 com 8 bits: s e f Toy 1 64 números Toy 2 s e f 256 números A única diferença é que o Toy 2 tem uma fração maior, com 4 bits! -
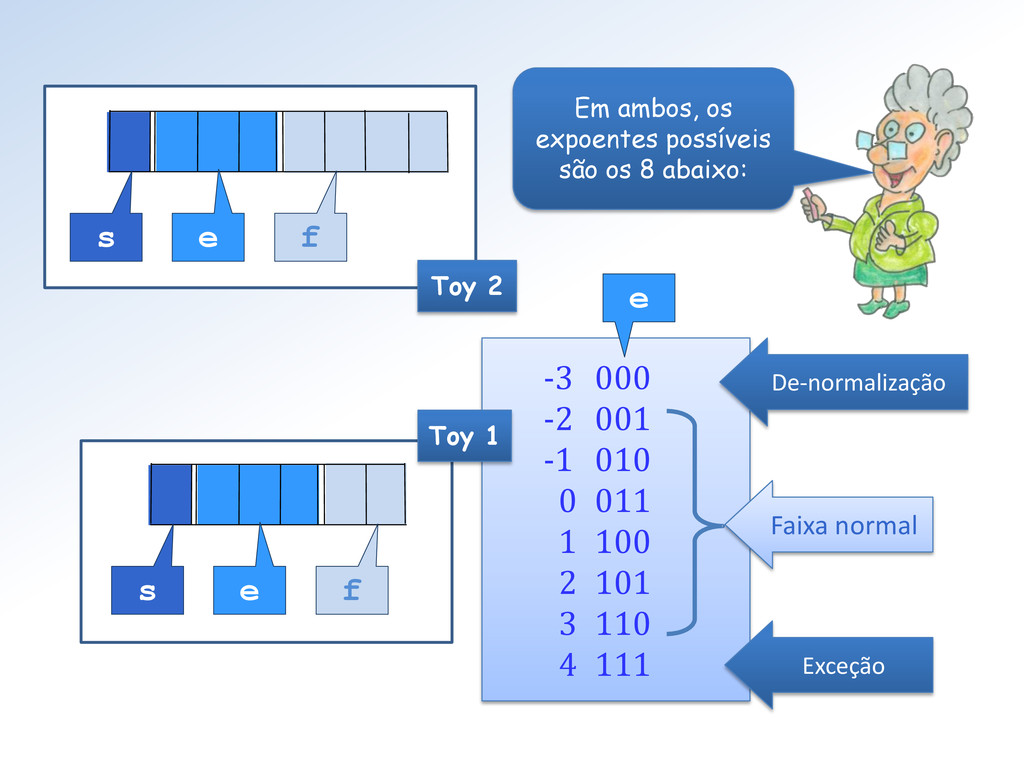
Em ambos, os expoentes possíveis são os 8 abaixo: -3
000 -2 001 -1 010 0 011 1 100 2 101 3 110 4 111 Faixa normal Exceção De-normalização e Toy 2 s e f s e f Toy 1 -
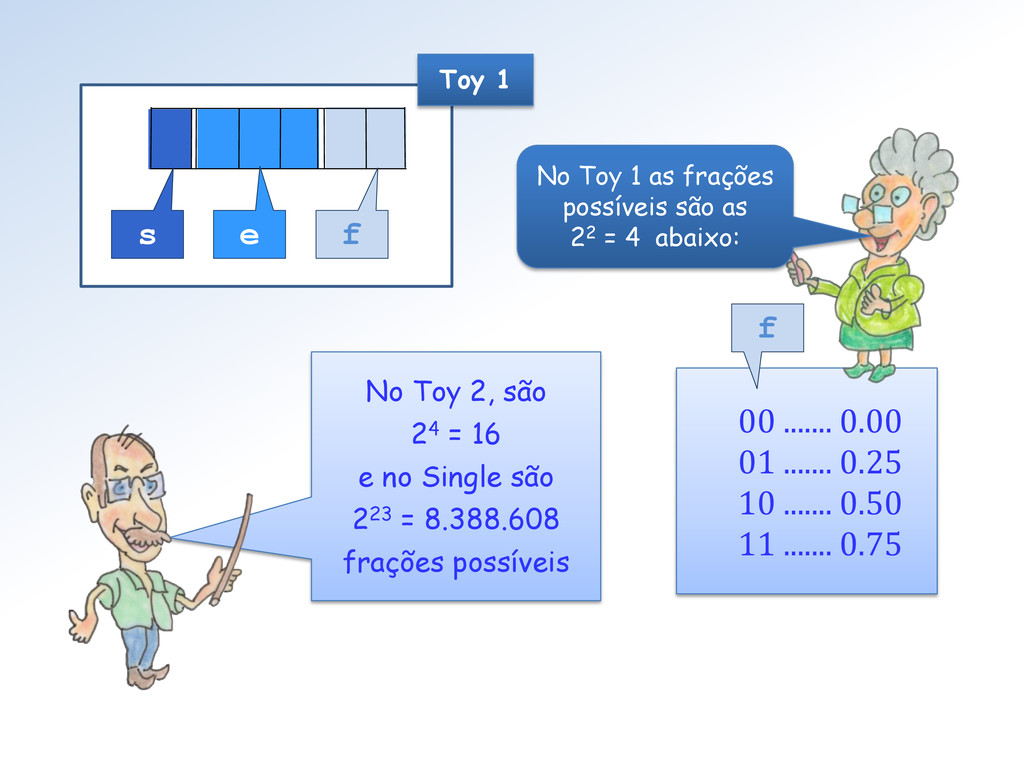
s e f Toy 1 00 ....... 0.00 01 .......
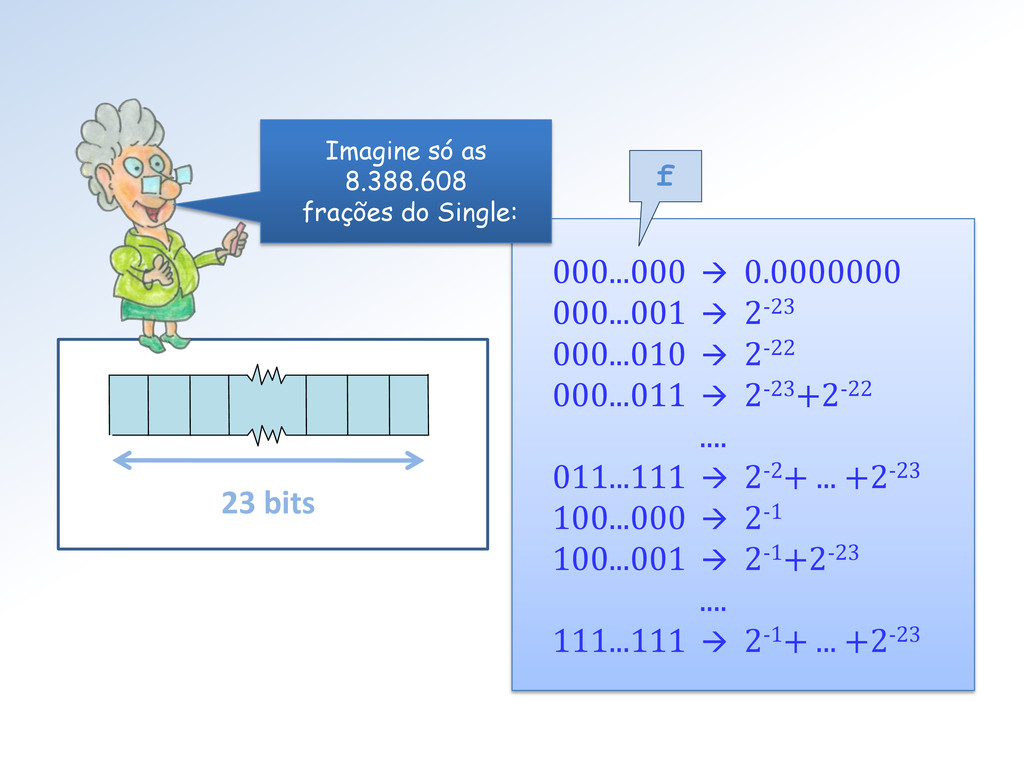
0.25 10 ....... 0.50 11 ....... 0.75 f No Toy 1 as frações possíveis são as 22 = 4 abaixo: No Toy 2, são 24 = 16 e no Single são 223 = 8.388.608 frações possíveis -
0000 .... 0.0000 0001 .... 0.0625 0010 .... 0.1250 0011
.... 0.1875 0100 .... 0.2500 0101 .... 0.3125 0110 .... 0.3750 0111 .... 0.4375 f As frações doToy 2 são as 16 abaixo: Toy 2 s e f 1000 .... 0.5000 1001 .... 0.5625 1010 .... 0.6250 1011 .... 0.6875 1100 .... 0.7500 1101 .... 0.8125 1110 .... 0.8750 1111 .... 0.9375 f -
000...000 0.0000000 000...001 2-23 000...010 2-22 000...011
2-23+2-22 .... 011...111 2-2+ ... +2-23 100...000 2-1 100...001 2-1+2-23 .... 111...111 2-1+ ... +2-23 f 23 bits Imagine só as 8.388.608 frações do Single: -
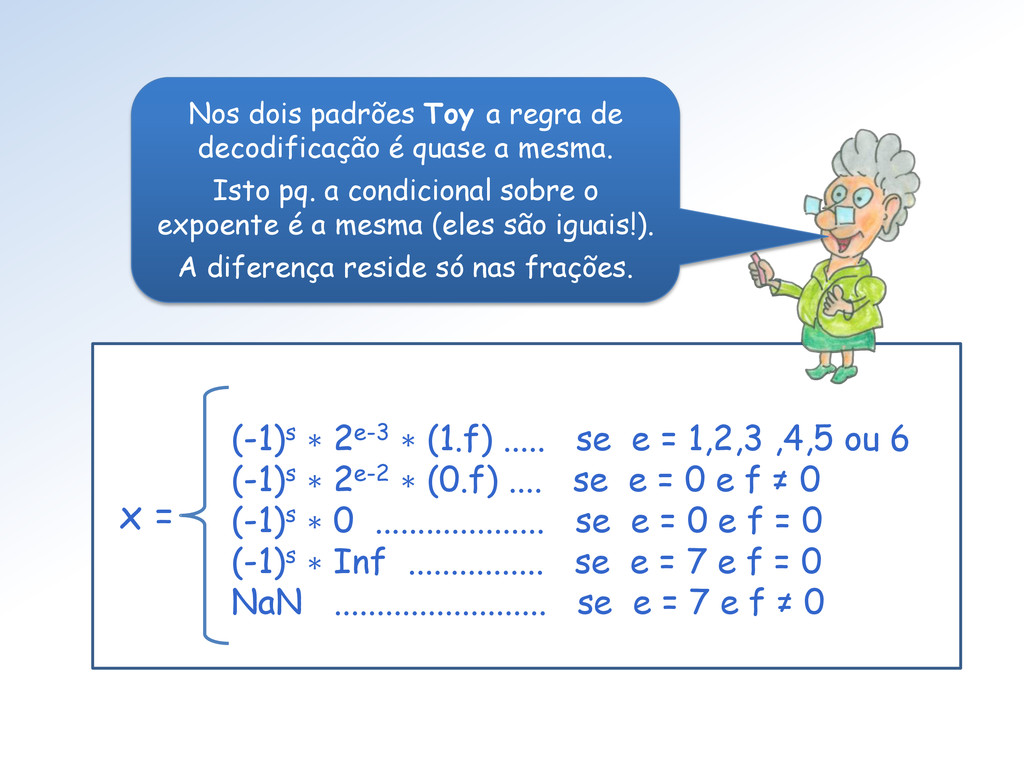
(-1)s ∗ 2e-3 ∗ (1.f) ..... se e = 1,2,3
,4,5 ou 6 (-1)s ∗ 2e-2 ∗ (0.f) .... se e = 0 e f ≠ 0 (-1)s ∗ 0 .................... se e = 0 e f = 0 (-1)s ∗ Inf ................ se e = 7 e f = 0 NaN ......................... se e = 7 e f ≠ 0 x = Nos dois padrões Toy a regra de decodificação é quase a mesma. Isto pq. a condicional sobre o expoente é a mesma (eles são iguais!). A diferença reside só nas frações. -
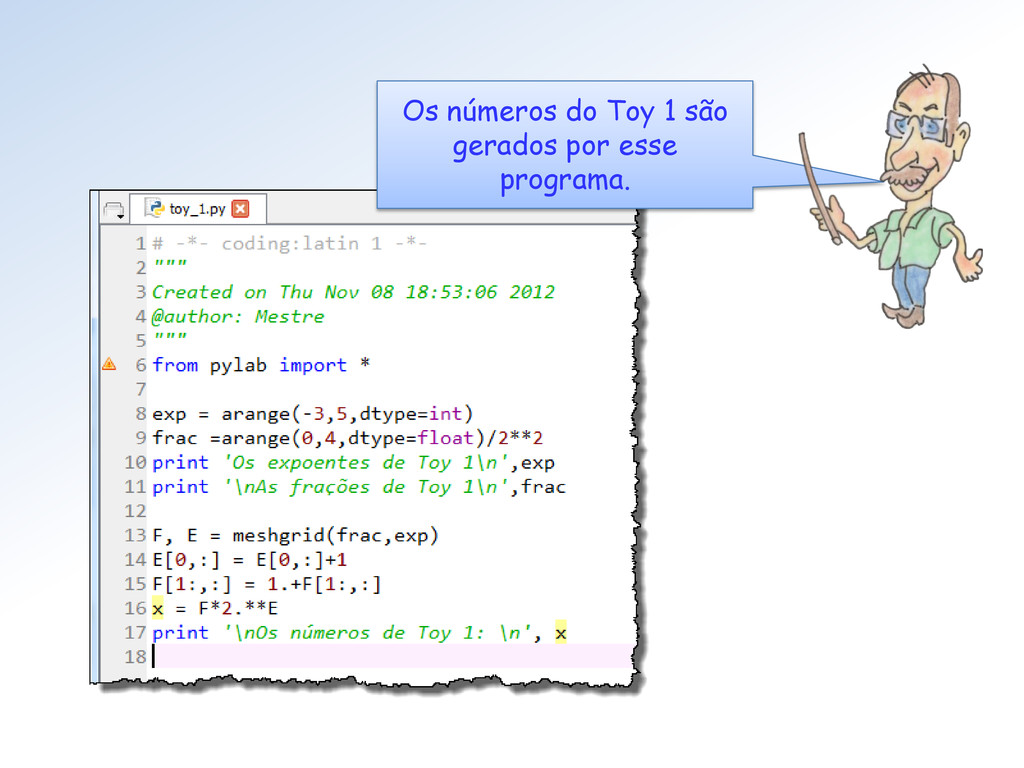
Fiz um programa para mostrar os números do Toy 1.
O Toy 2 ficará por conta de vocês. Vou fazer, Mestre! -
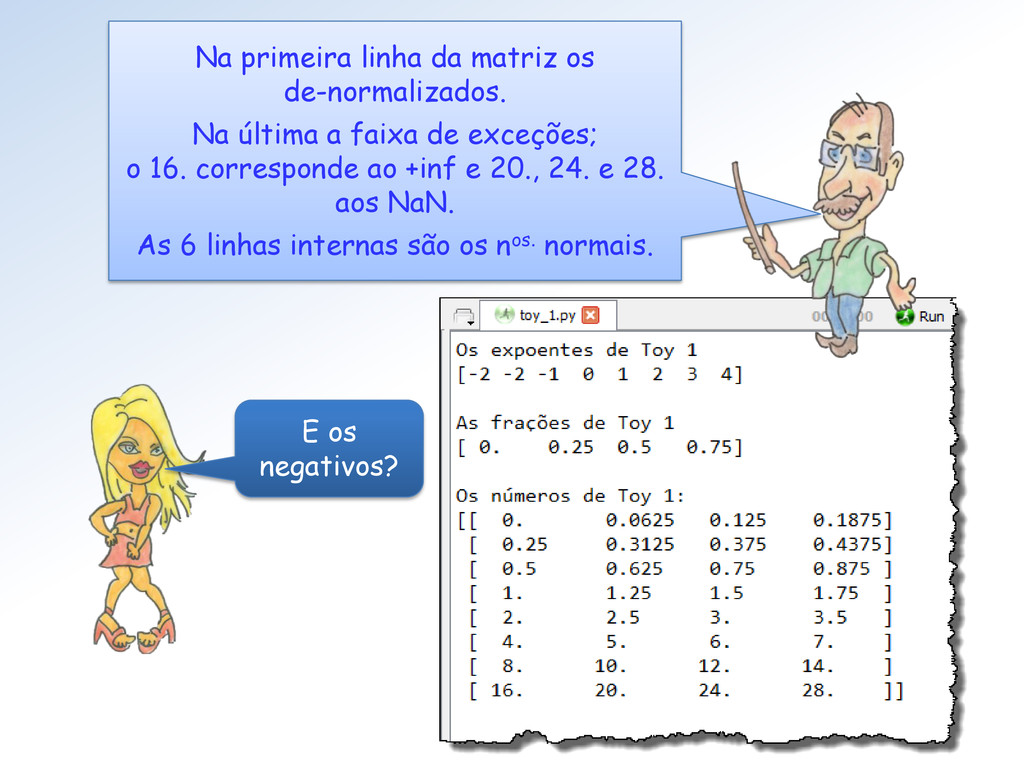
Na primeira linha da matriz os de-normalizados. Na última a
faixa de exceções; o 16. corresponde ao +inf e 20., 24. e 28. aos NaN. As 6 linhas internas são os nos. normais. E os negativos? -
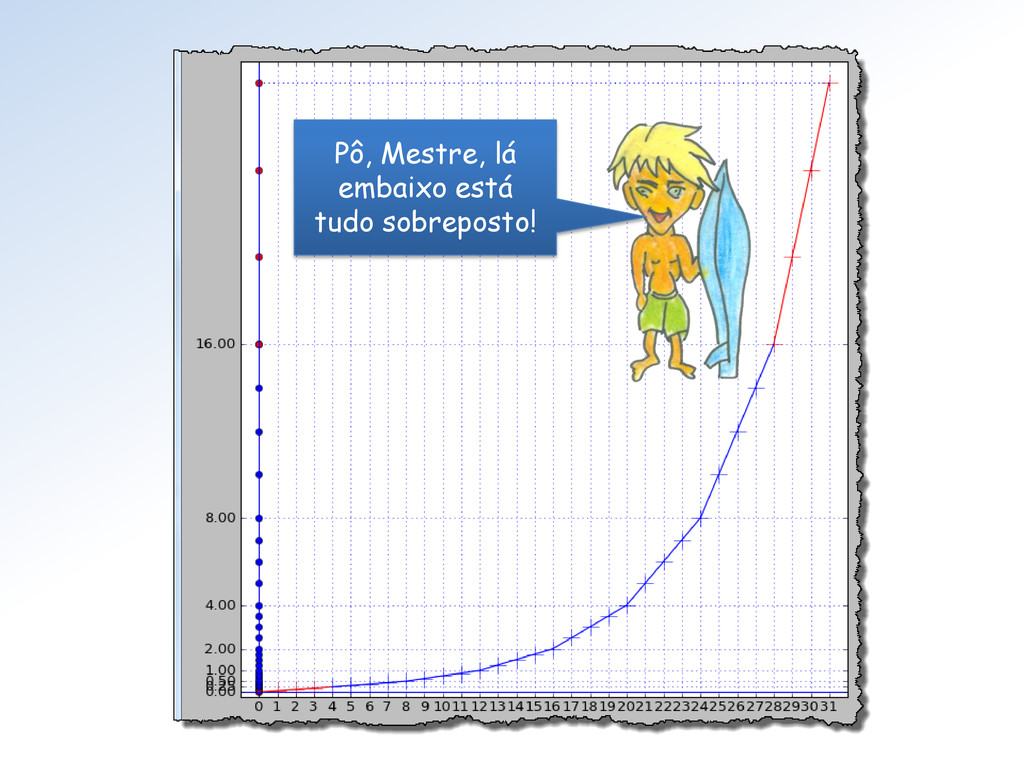
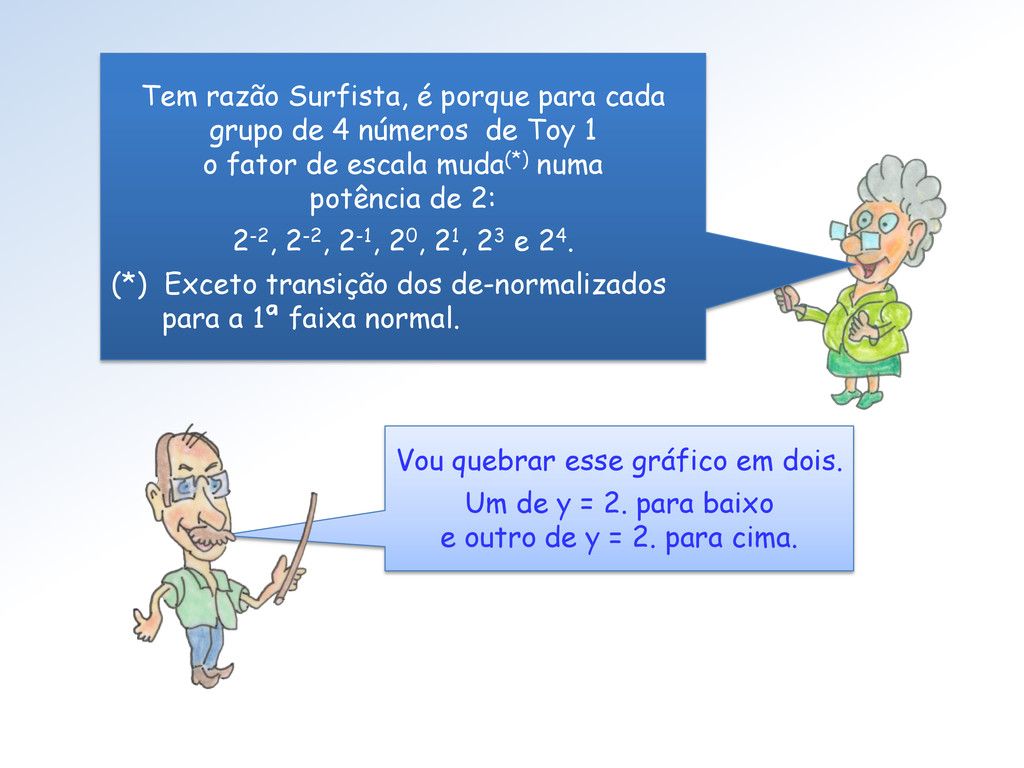
Vou quebrar esse gráfico em dois. Um de y =
2. para baixo e outro de y = 2. para cima. Tem razão Surfista, é porque para cada grupo de 4 números de Toy 1 o fator de escala muda(*) numa potência de 2: 2-2, 2-2, 2-1, 20, 21, 23 e 24. (*) Exceto transição dos de-normalizados para a 1ª faixa normal. -
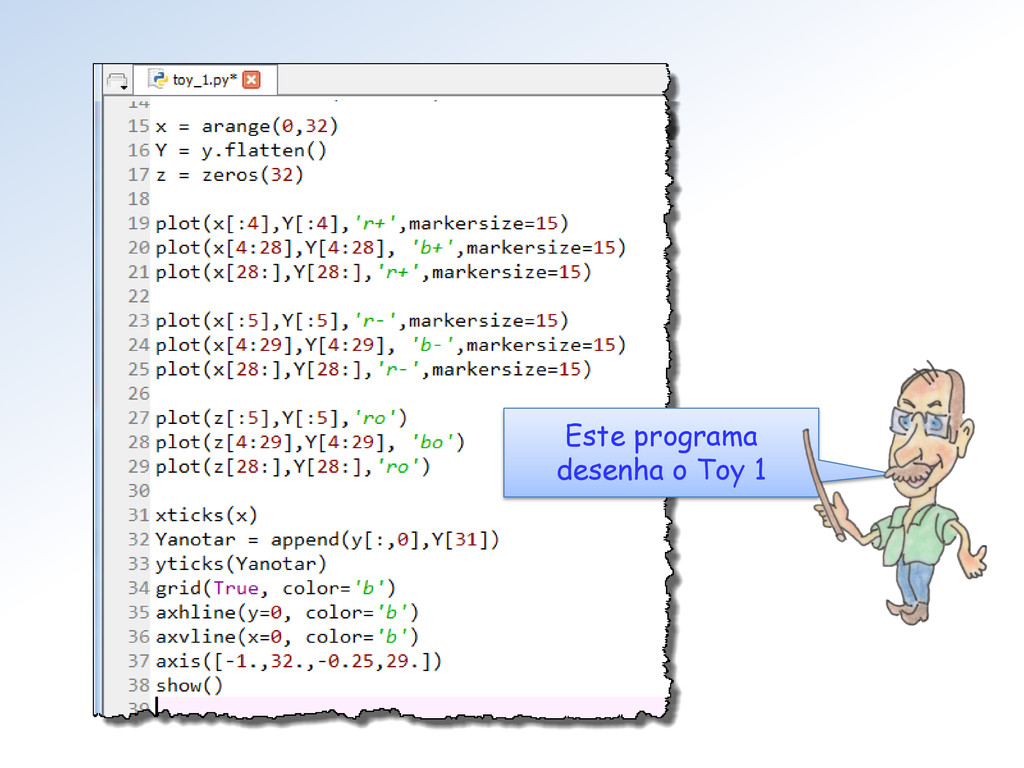
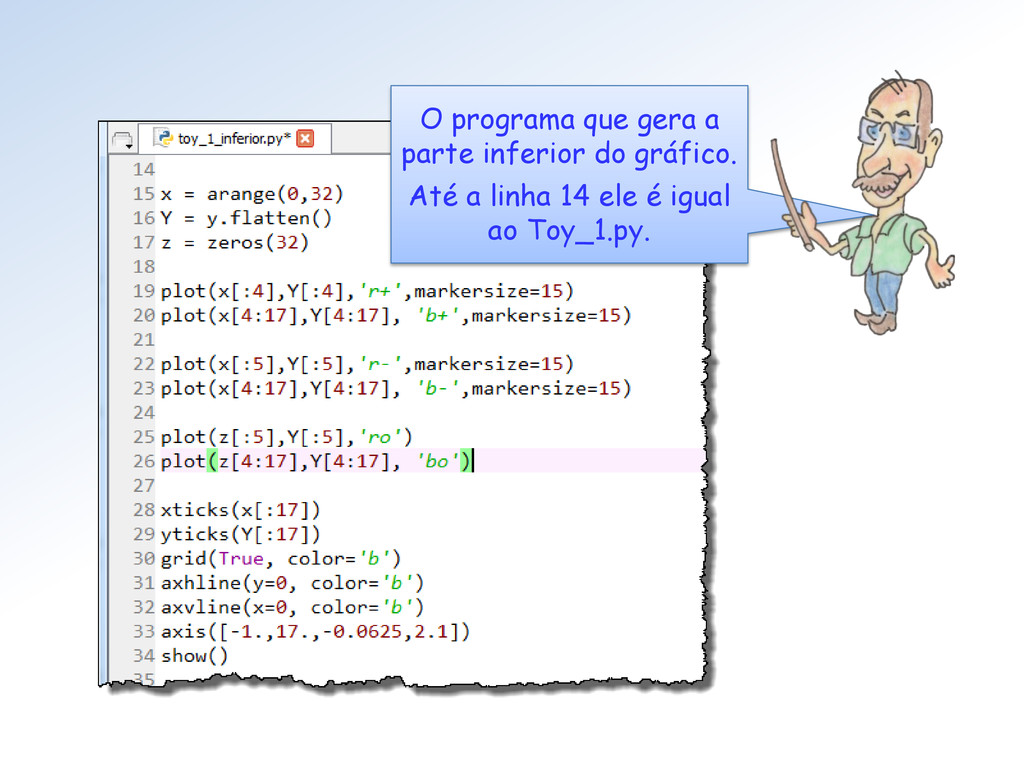
O programa que gera a parte inferior do gráfico. Até
a linha 14 ele é igual ao Toy_1.py. -
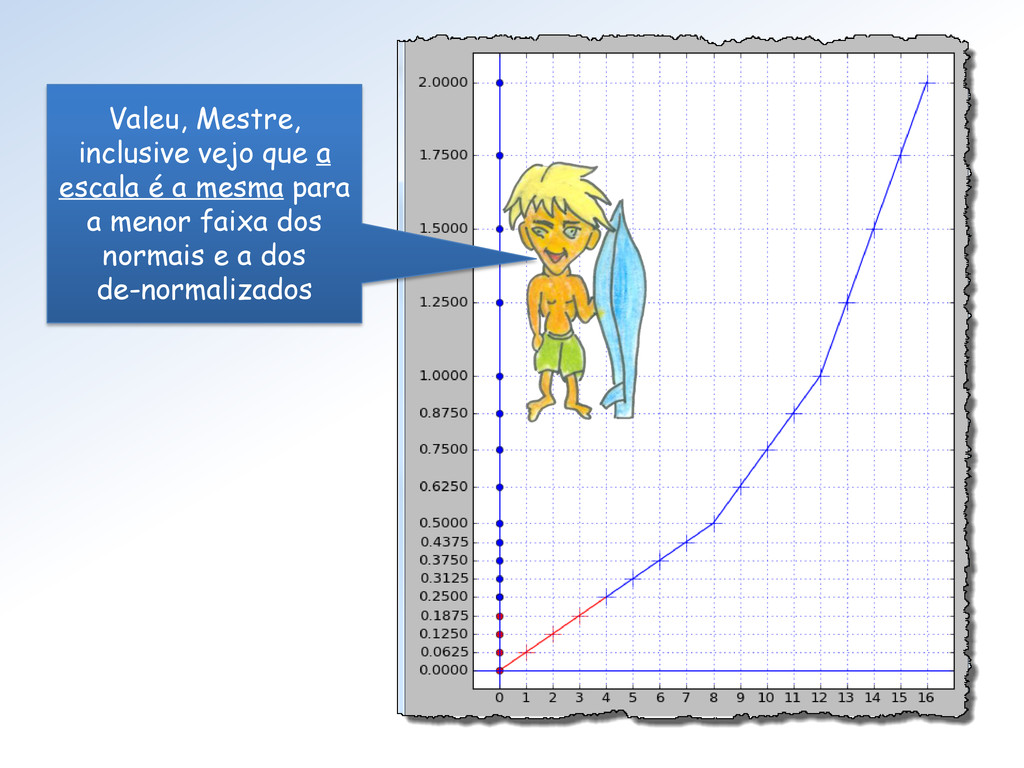
Valeu, Mestre, inclusive vejo que a escala é a mesma
para a menor faixa dos normais e a dos de-normalizados -
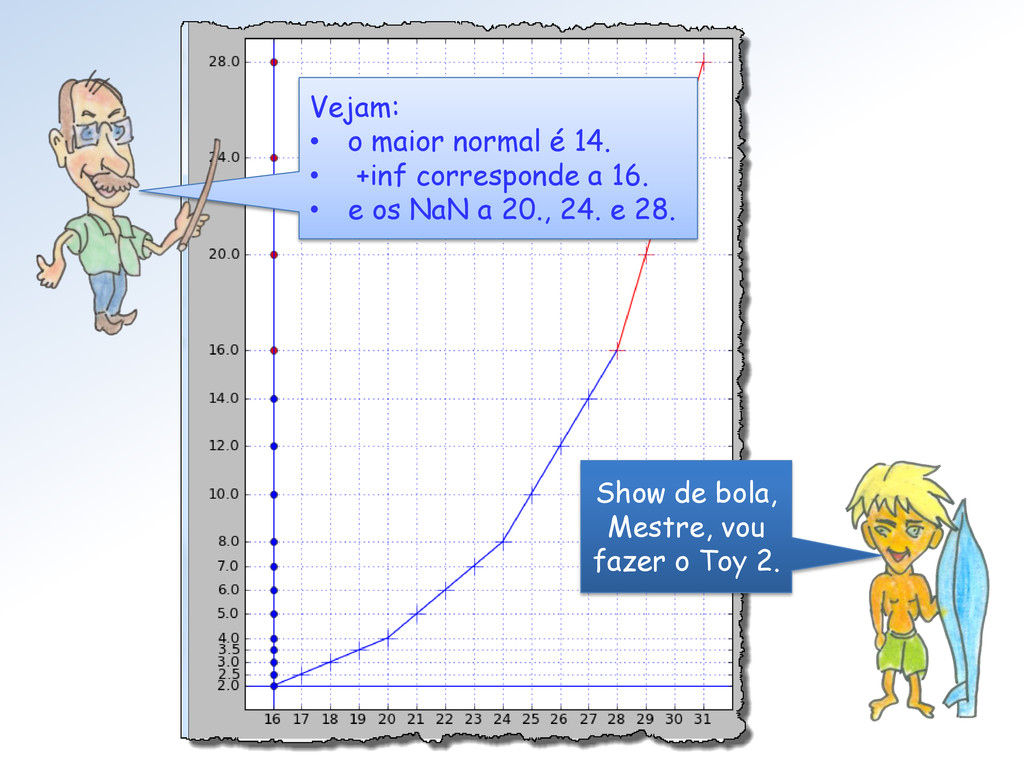
Vejam: • o maior normal é 14. • +inf corresponde
a 16. • e os NaN a 20., 24. e 28. Show de bola, Mestre, vou fazer o Toy 2. -
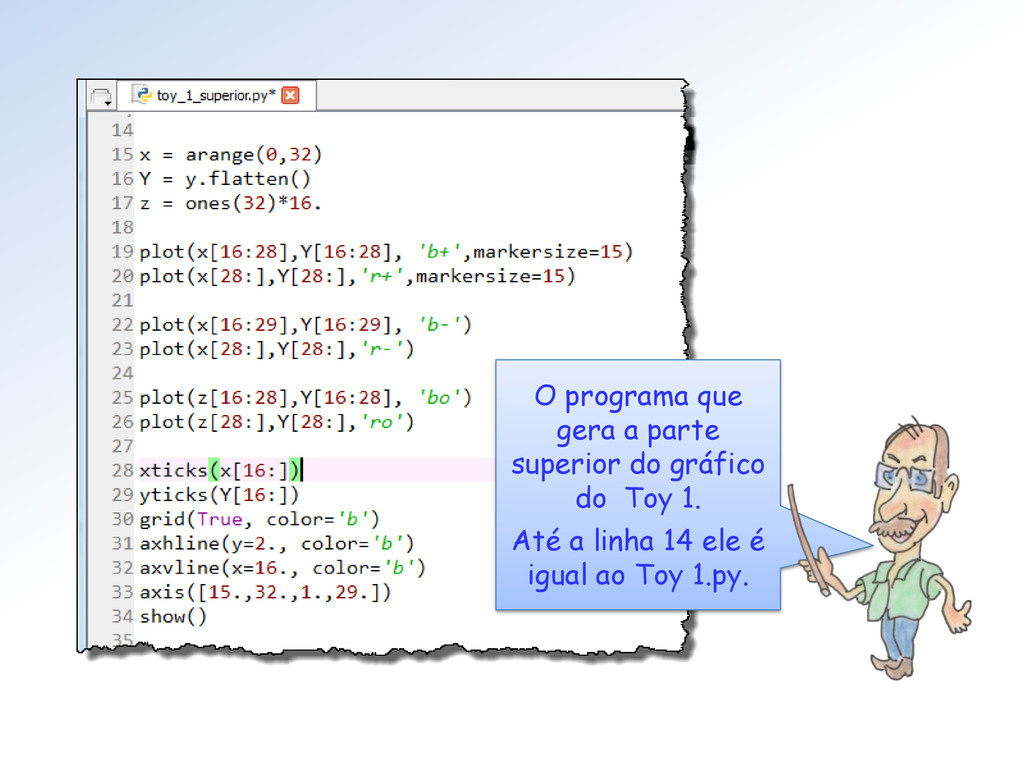
O programa que gera a parte superior do gráfico do
Toy 1. Até a linha 14 ele é igual ao Toy 1.py. -
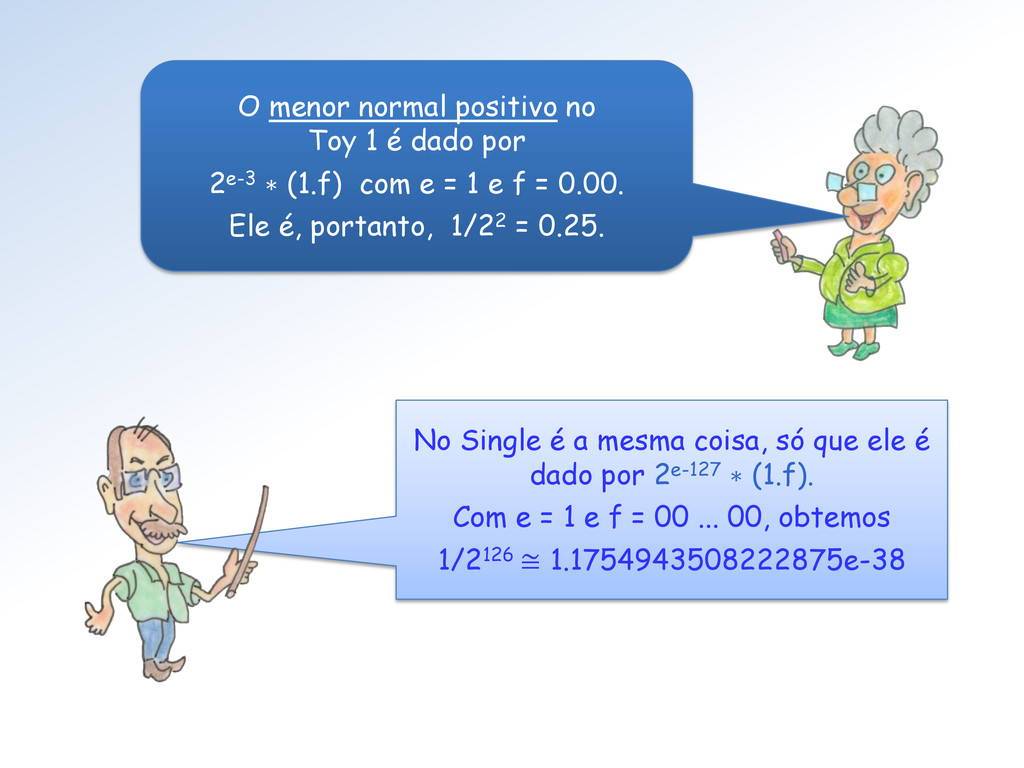
O menor normal positivo no Toy 1 é dado por
2e-3 ∗ (1.f) com e = 1 e f = 0.00. Ele é, portanto, 1/22 = 0.25. No Single é a mesma coisa, só que ele é dado por 2e-127 ∗ (1.f). Com e = 1 e f = 00 ... 00, obtemos 1/2126 ≅ 1.1754943508222875e-38 -
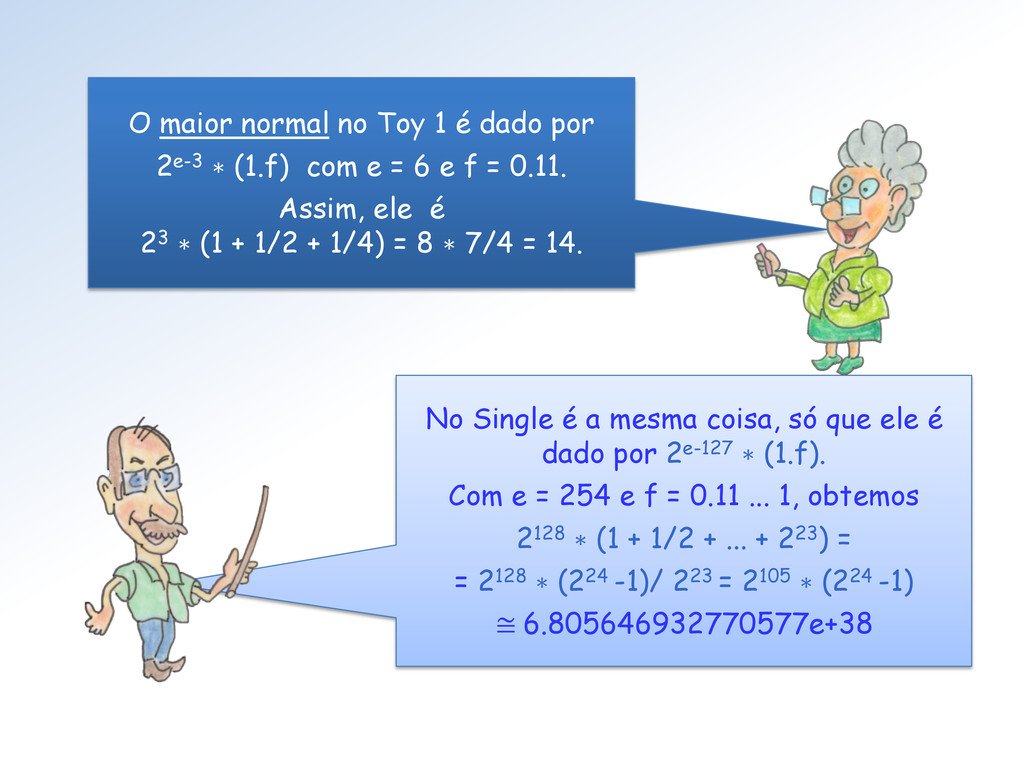
No Single é a mesma coisa, só que ele é
dado por 2e-127 ∗ (1.f). Com e = 254 e f = 0.11 ... 1, obtemos 2128 ∗ (1 + 1/2 + ... + 223) = = 2128 ∗ (224 -1)/ 223 = 2105 ∗ (224 -1) ≅ 6.805646932770577e+38 O maior normal no Toy 1 é dado por 2e-3 ∗ (1.f) com e = 6 e f = 0.11. Assim, ele é 23 ∗ (1 + 1/2 + 1/4) = 8 ∗ 7/4 = 14. -
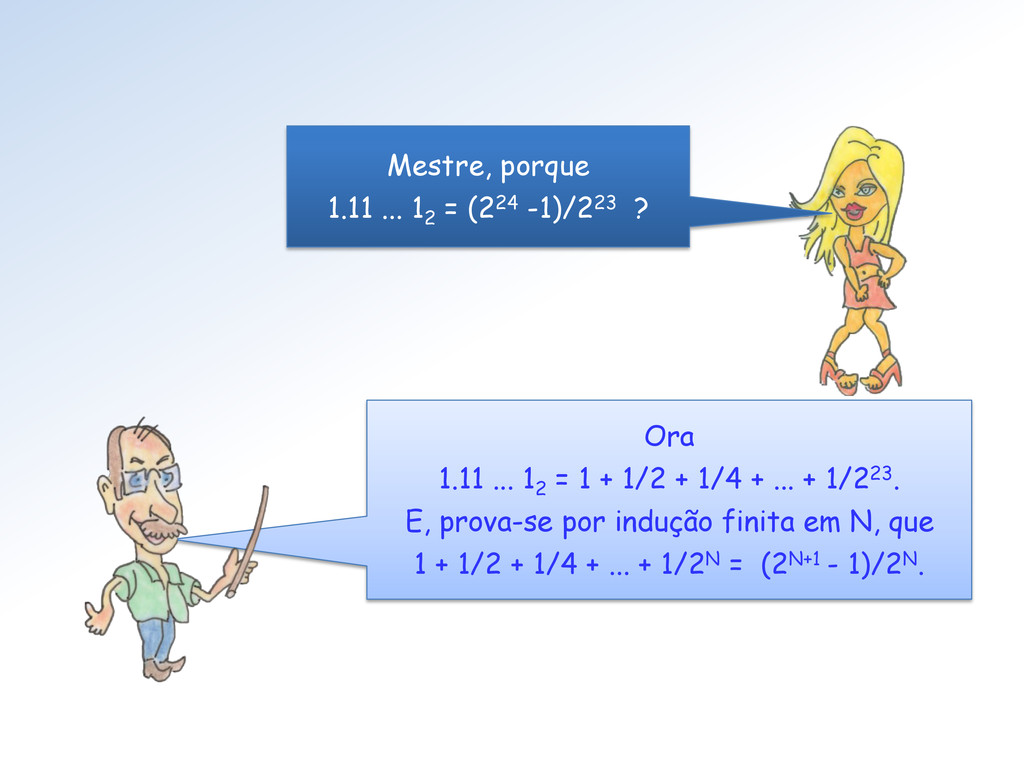
Ora 1.11 ... 1 2 = 1 + 1/2 +
1/4 + ... + 1/223. E, prova-se por indução finita em N, que 1 + 1/2 + 1/4 + ... + 1/2N = (2N+1 - 1)/2N. Mestre, porque 1.11 ... 1 2 = (224 -1)/223 ? -
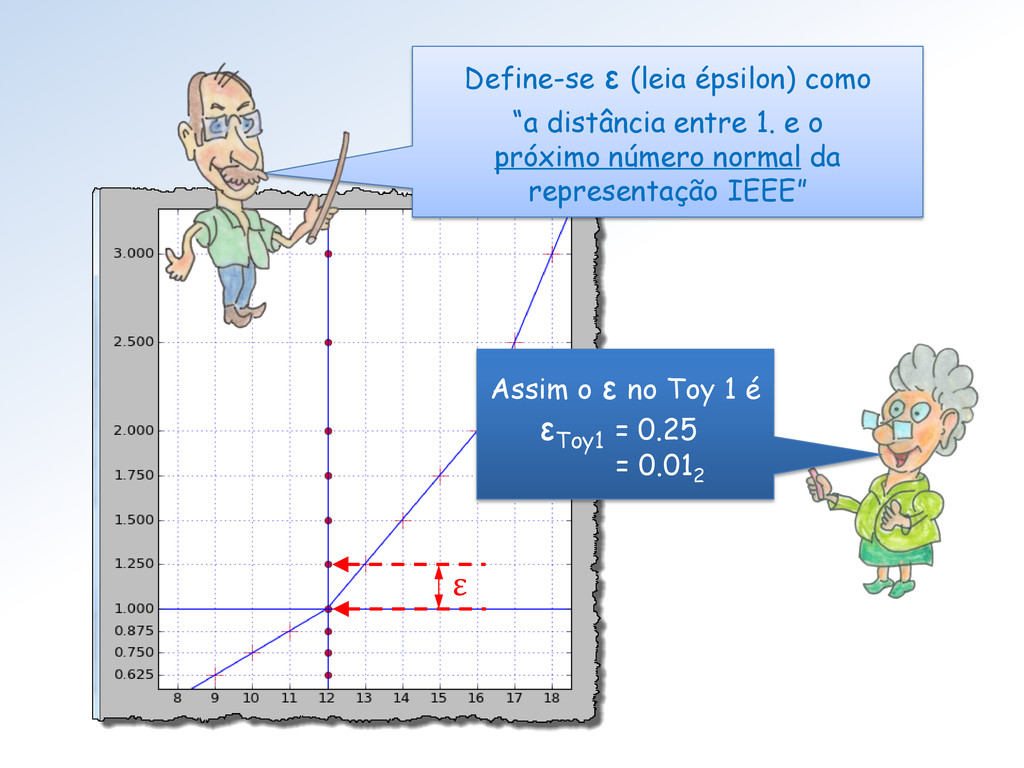
ε Assim o ε no Toy 1 é ε Toy1
= 0.25 = 0.01 2 Define-se ε (leia épsilon) como “a distância entre 1. e o próximo número normal da representação IEEE” -
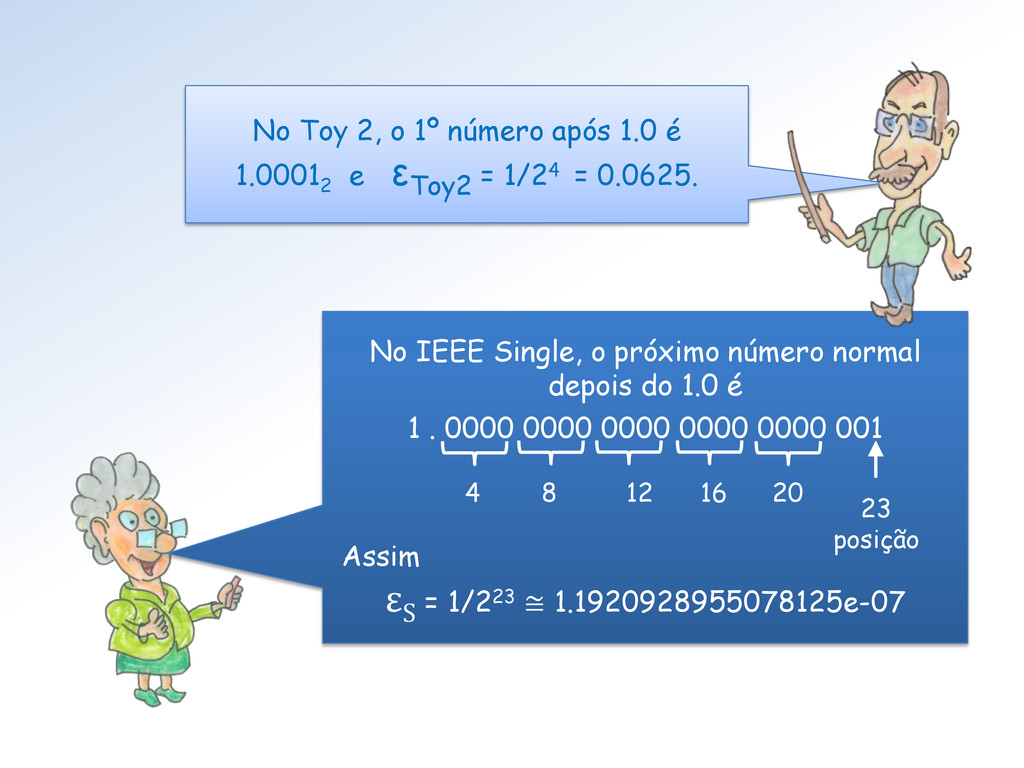
No IEEE Single, o próximo número normal depois do 1.0
é 1 . 0000 0000 0000 0000 0000 001 Assim ε S = 1/223 ≅ 1.1920928955078125e-07 4 8 12 16 20 23 posição No Toy 2, o 1º número após 1.0 é 1.0001 2 e ε Toy2 = 1/24 = 0.0625. -
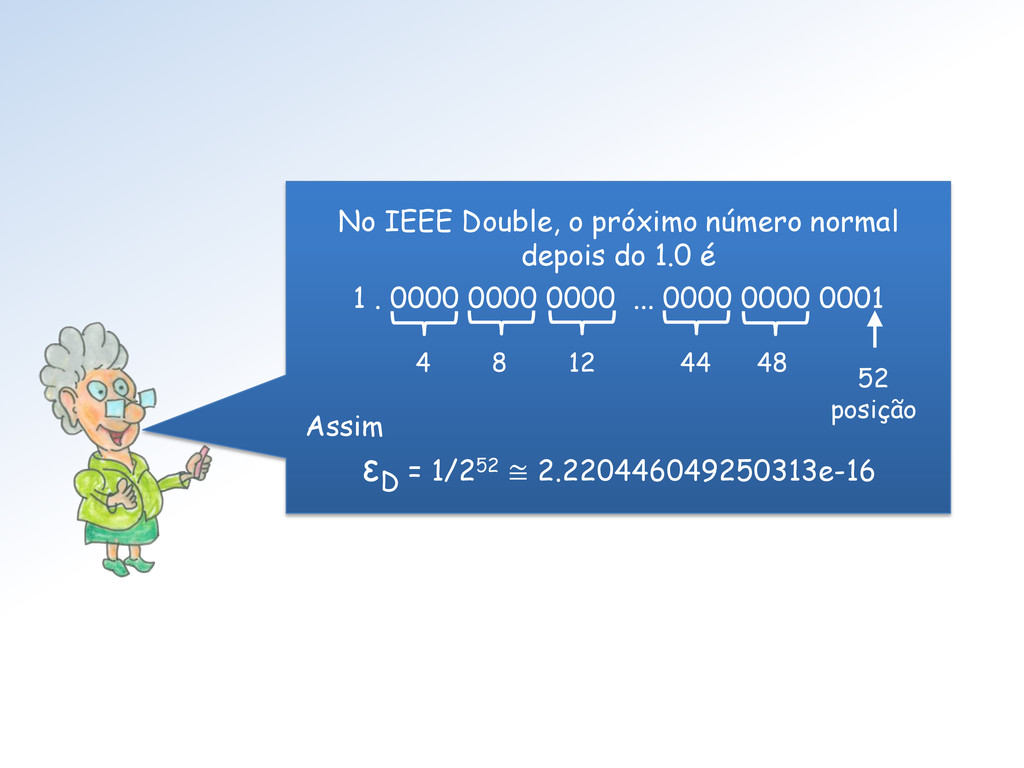
No IEEE Double, o próximo número normal depois do 1.0
é 1 . 0000 0000 0000 ... 0000 0000 0001 Assim ε D = 1/252 ≅ 2.220446049250313e-16 4 8 12 44 48 52 posição -
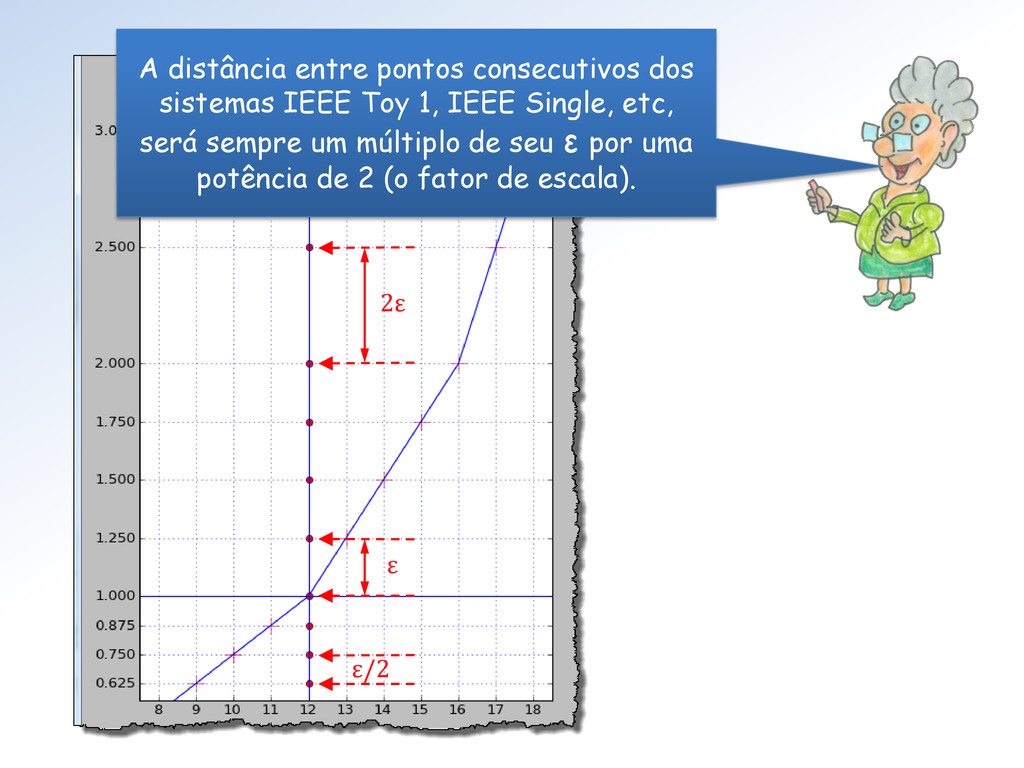
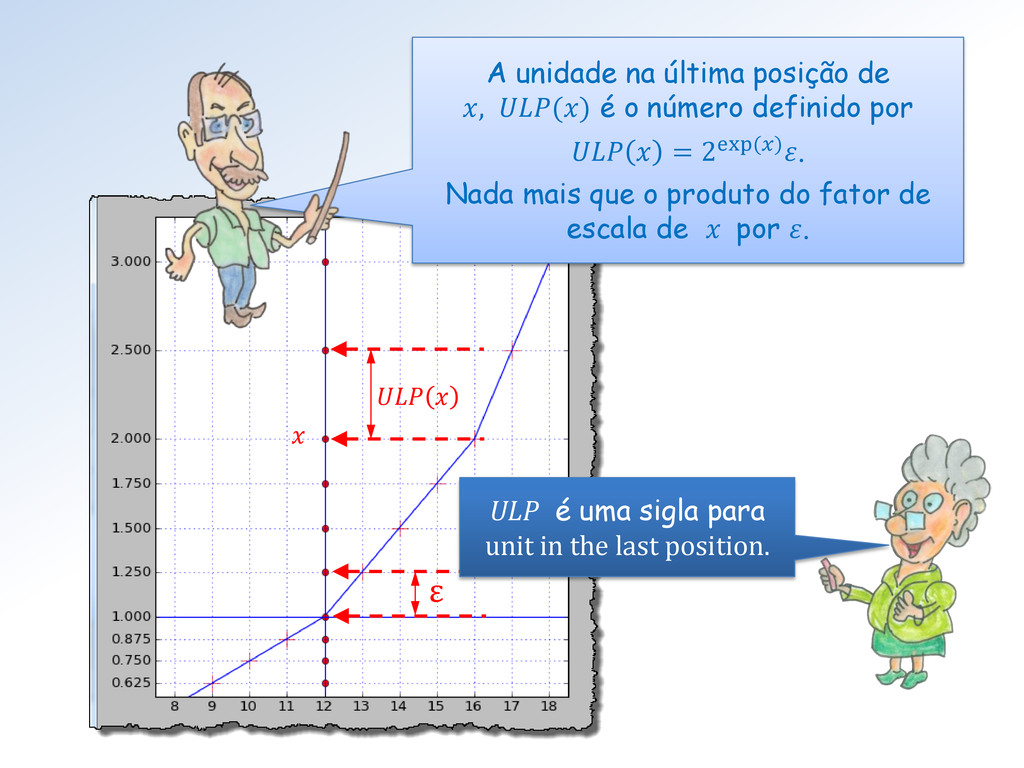
A distância entre pontos consecutivos dos sistemas IEEE Toy 1,
IEEE Single, etc, será sempre um múltiplo de seu ε por uma potência de 2 (o fator de escala). 2ε ε ε/2 -
ε ULP é uma sigla para unit in the last
position. A unidade na última posição de , () é o número definido por = 2exp (). Nada mais que o produto do fator de escala de por . -
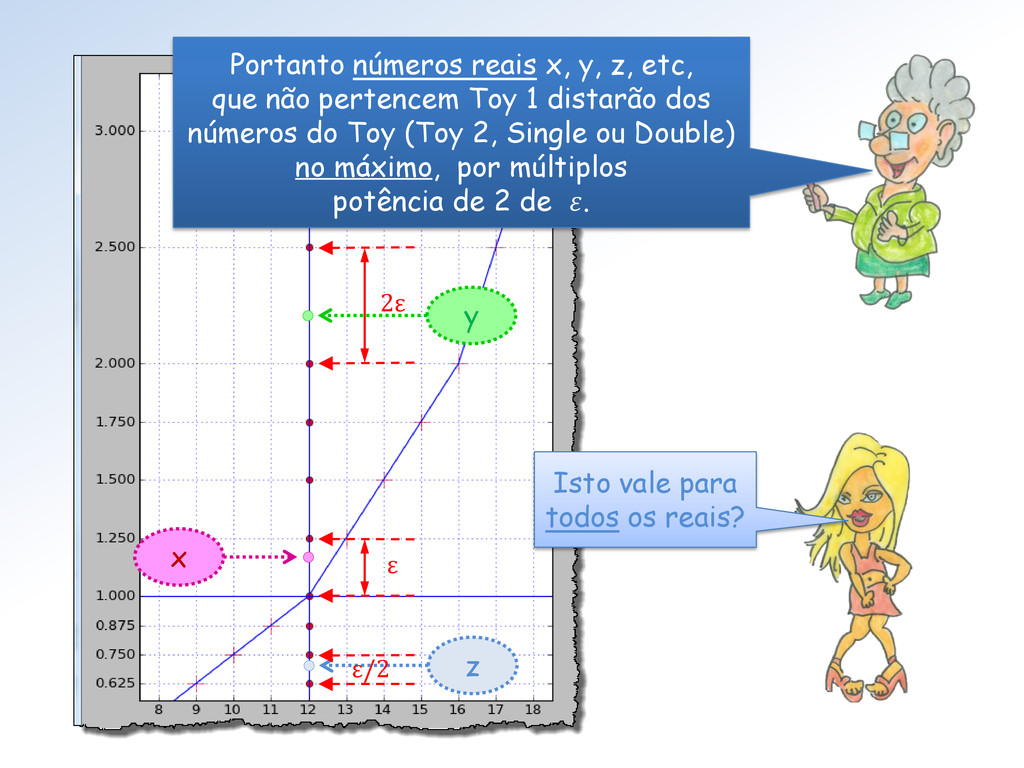
x y Portanto números reais x, y, z, etc, que
não pertencem Toy 1 distarão dos números do Toy (Toy 2, Single ou Double) no máximo, por múltiplos potência de 2 de . ε z Isto vale para todos os reais? 2ε ε/2 -
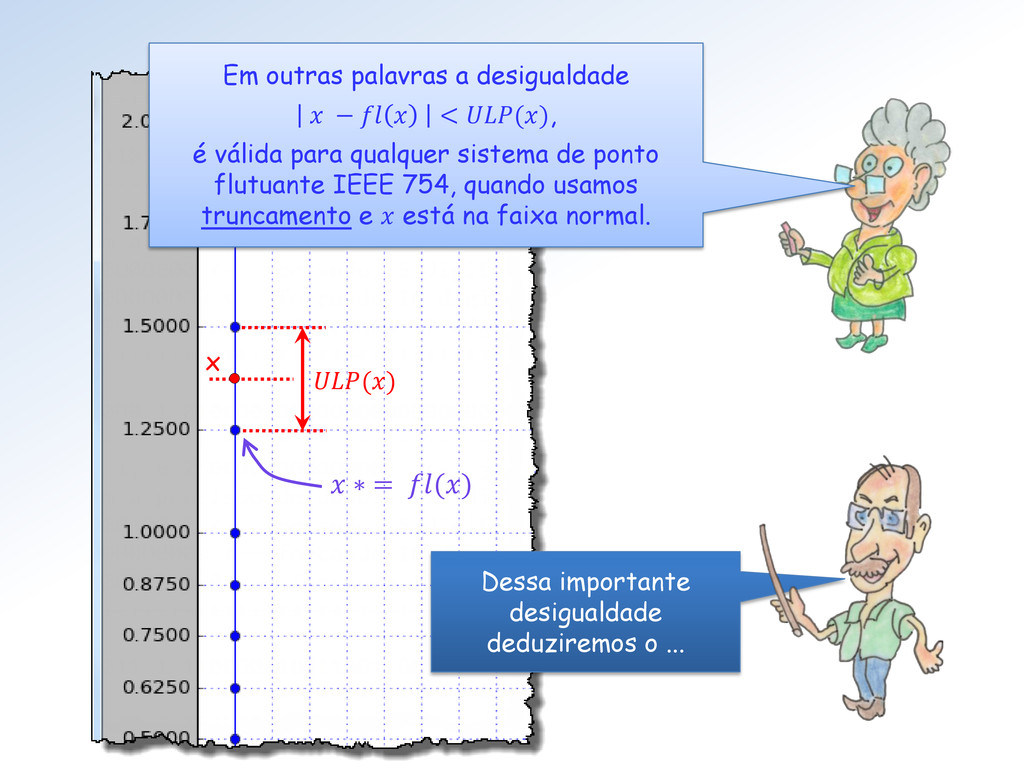
() x ∗= () Dessa importante desigualdade deduziremos o ...
Em outras palavras a desigualdade − < (), é válida para qualquer sistema de ponto flutuante IEEE 754, quando usamos truncamento e está na faixa normal. -
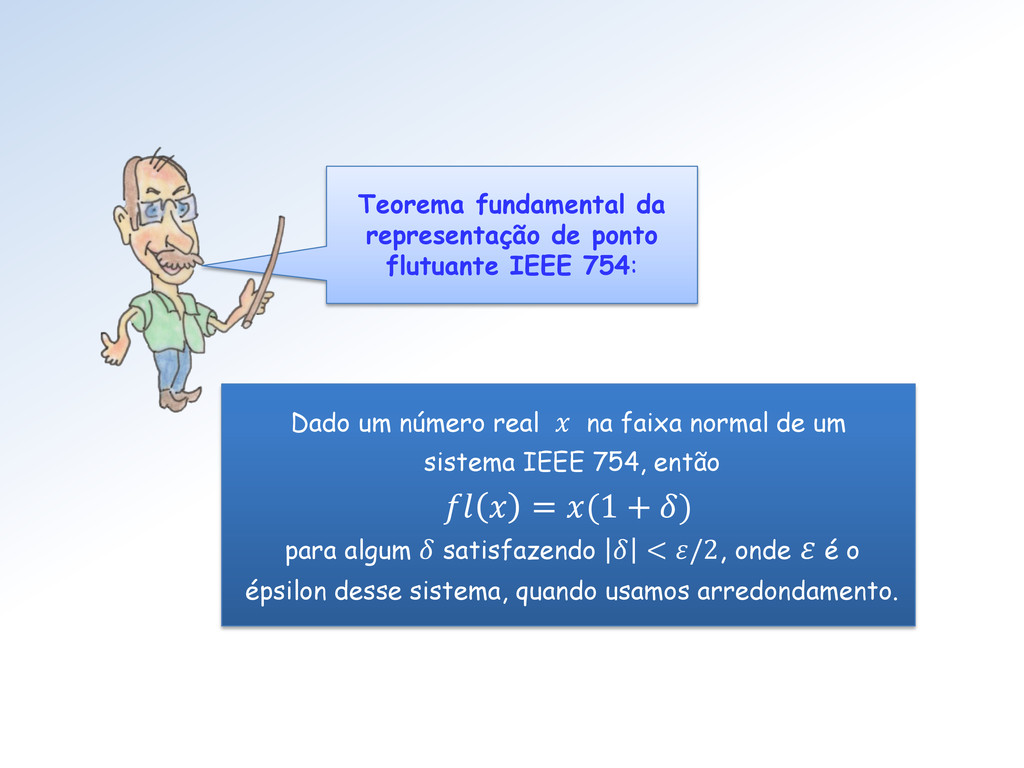
Dado um número real na faixa normal de um sistema
IEEE 754, então = (1 + ) para algum satisfazendo < /2, onde é o épsilon desse sistema, quando usamos arredondamento. Teorema fundamental da representação de ponto flutuante IEEE 754: -
Para prová-lo, basta dividir a desigualdade − < ()/2 por
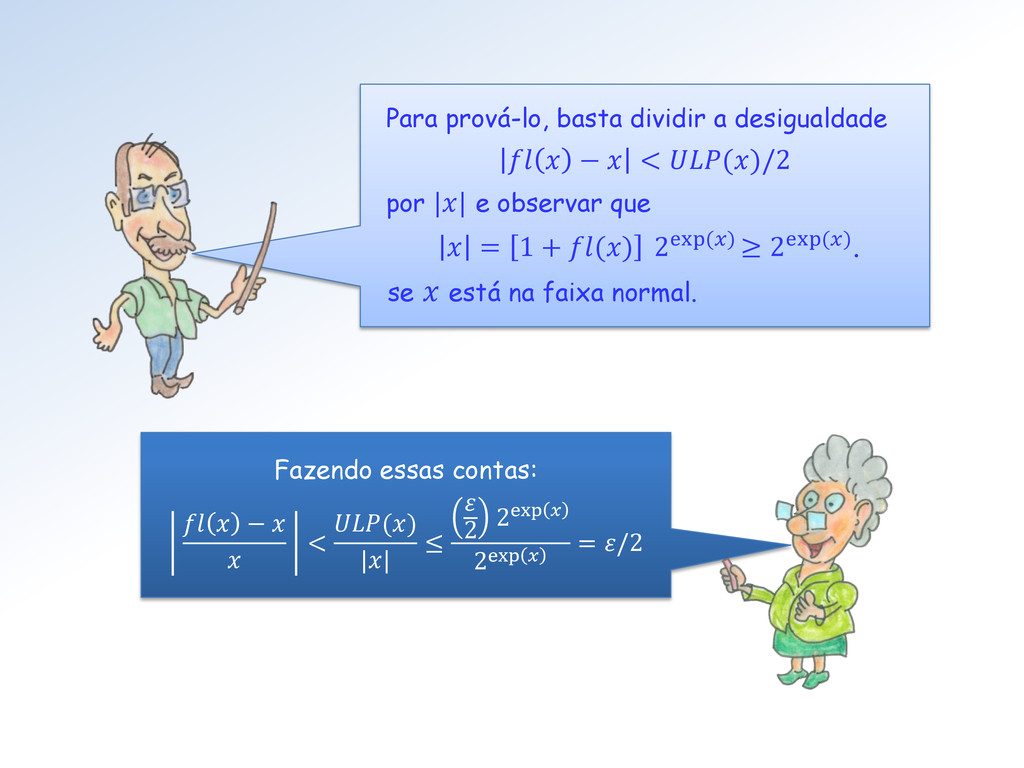
|| e observar que = 1 + () 2exp () ≥ 2exp (). se está na faixa normal. Fazendo essas contas: − < () || ≤ 2 2exp 2exp = /2 -
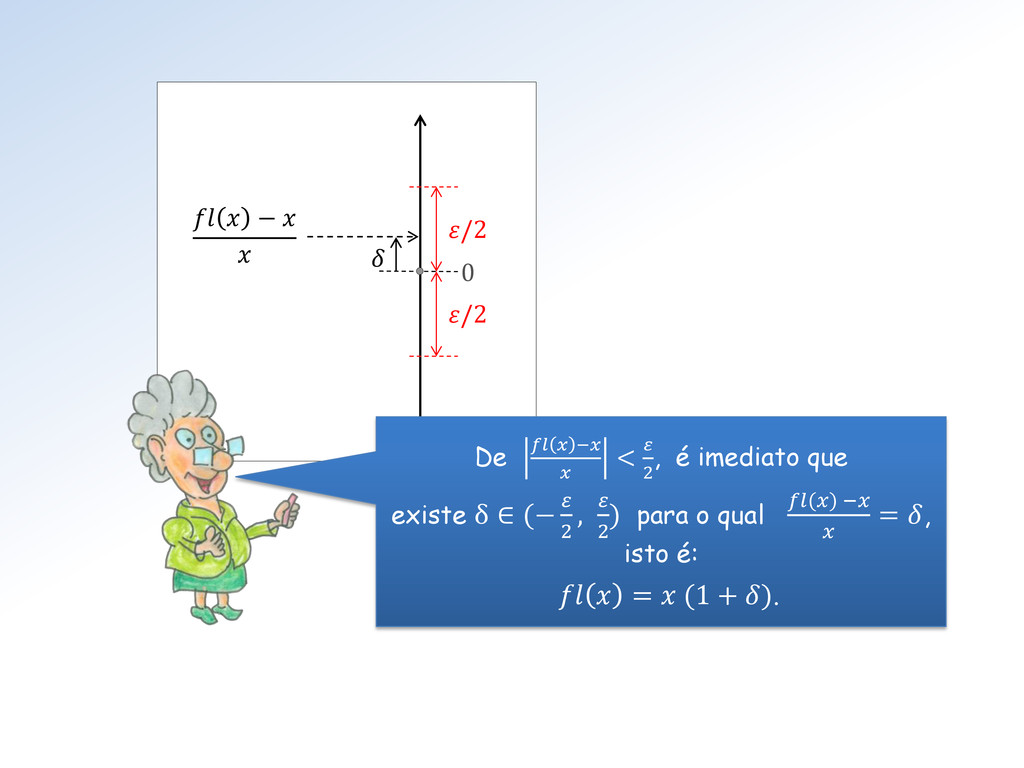
/2 /2 0 − De − < 2 , é
imediato que existe δ ∈ (− 2 , 2 ) para o qual ()− = , isto é: = (1 + ). -
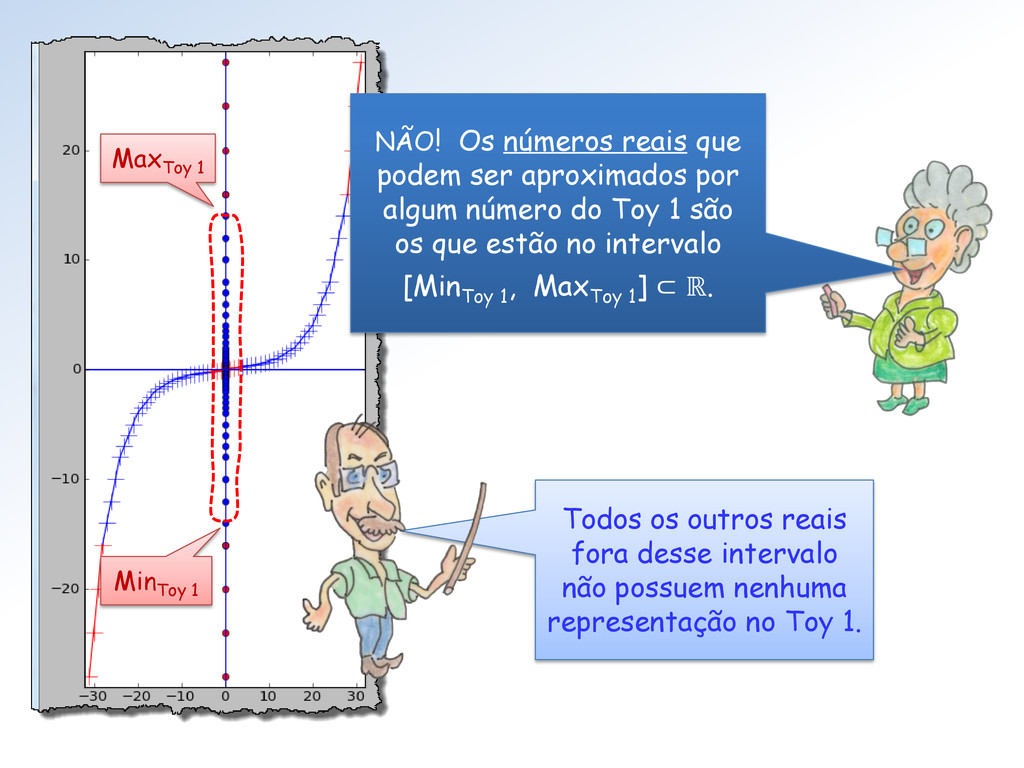
NÃO! Os números reais que podem ser aproximados por algum
número do Toy 1 são os que estão no intervalo [Min Toy 1 , Max Toy 1 ] ⊂ ℝ. Max Toy 1 Min Toy 1 Todos os outros reais fora desse intervalo não possuem nenhuma representação no Toy 1. -
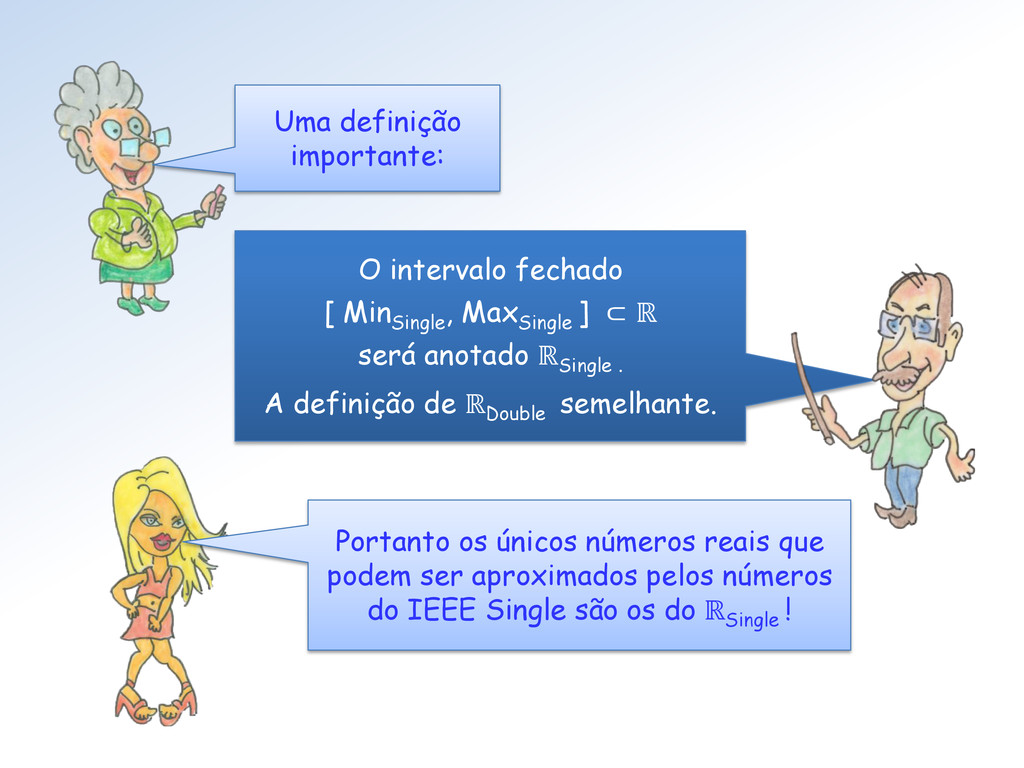
Portanto os únicos números reais que podem ser aproximados pelos
números do IEEE Single são os do ℝSingle ! O intervalo fechado [ Min Single , Max Single ] ⊂ ℝ será anotado ℝSingle . A definição de ℝDouble semelhante. Uma definição importante: -
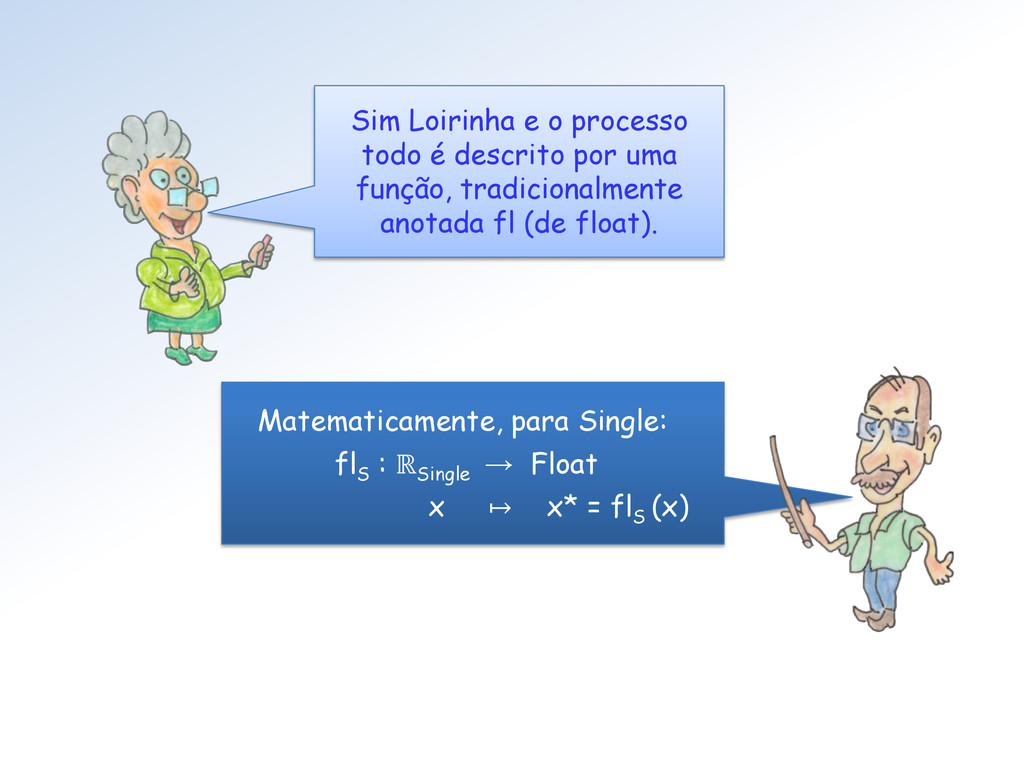
Matematicamente, para Single: fl S : ℝSingle → Float x
↦ x* = fl S (x) Sim Loirinha e o processo todo é descrito por uma função, tradicionalmente anotada fl (de float). -
Para Double temos outra função: fl D : ℝDouble →
Double x ↦ x* = fl D (x) Mais que isso, Mestre , para truncamento teremos uma e se usarmos arredondamento teremos outra. -
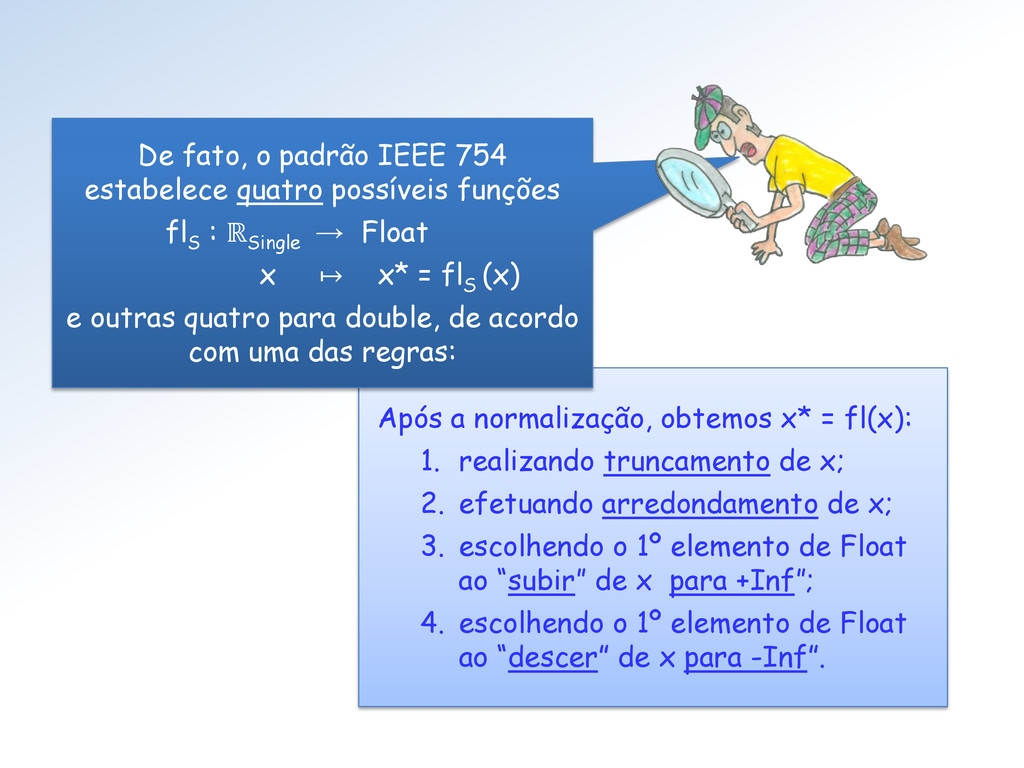
Após a normalização, obtemos x* = fl(x): 1. realizando truncamento
de x; 2. efetuando arredondamento de x; 3. escolhendo o 1º elemento de Float ao “subir” de x para +Inf”; 4. escolhendo o 1º elemento de Float ao “descer” de x para -Inf”. De fato, o padrão IEEE 754 estabelece quatro possíveis funções fl S : ℝSingle → Float x ↦ x* = fl S (x) e outras quatro para double, de acordo com uma das regras: -
Não Loirinha, no truncamento você sempre “perde” um dígito. Por
exemplo, truncando -2.38 obtemos -2,3 e truncando 2.38 obtemos 2.3, ambos mais próximo de zero. Assim, ao truncar, você sempre “caminha” em direção ao zero. Mas no truncamento não “descemos” sempre para -Inf? -
Bem Loirinha, primeiro você precisa passá-lo de sua representação de
base 10 para sua representação de base 2. Fizemos isto na aula passada! Mestre, mas como eu obtenho, de fato, a representação IEEE Single de um número decimal no ℝSingle ? -
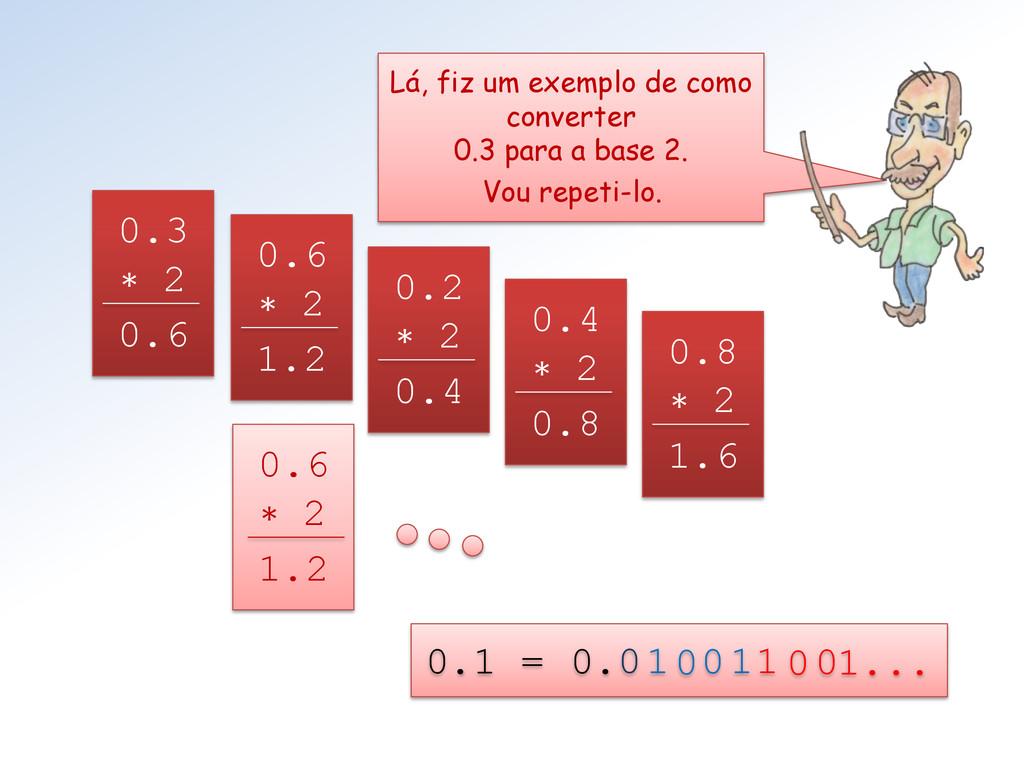
0.1 = 0. 0.3 ∗ 2 0.6 0 0.6 ∗
2 1.2 1 0.2 ∗ 2 0.4 0 0.4 ∗ 2 0.8 0 0.8 ∗ 2 1.6 1 0.6 ∗ 2 1.2 1 1... 0 0 Lá, fiz um exemplo de como converter 0.3 para a base 2. Vou repeti-lo. -
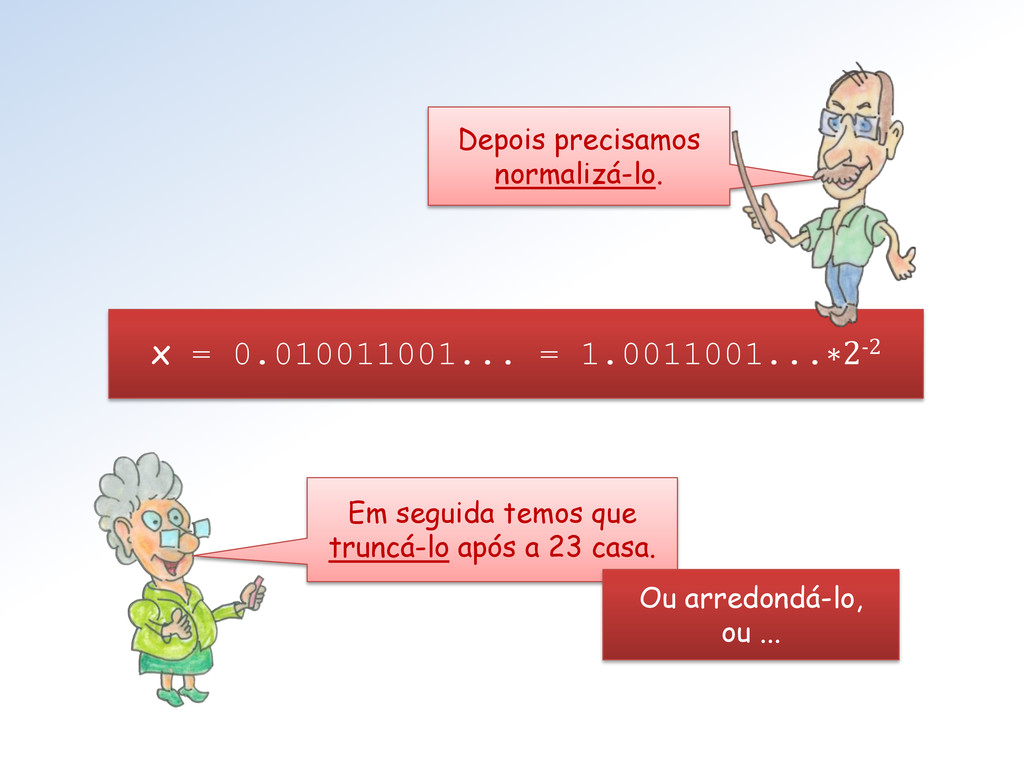
x = 0.010011001... = 1.0011001...∗2-2 Depois precisamos normalizá-lo. Em seguida
temos que truncá-lo após a 23 casa. Ou arredondá-lo, ou ... -
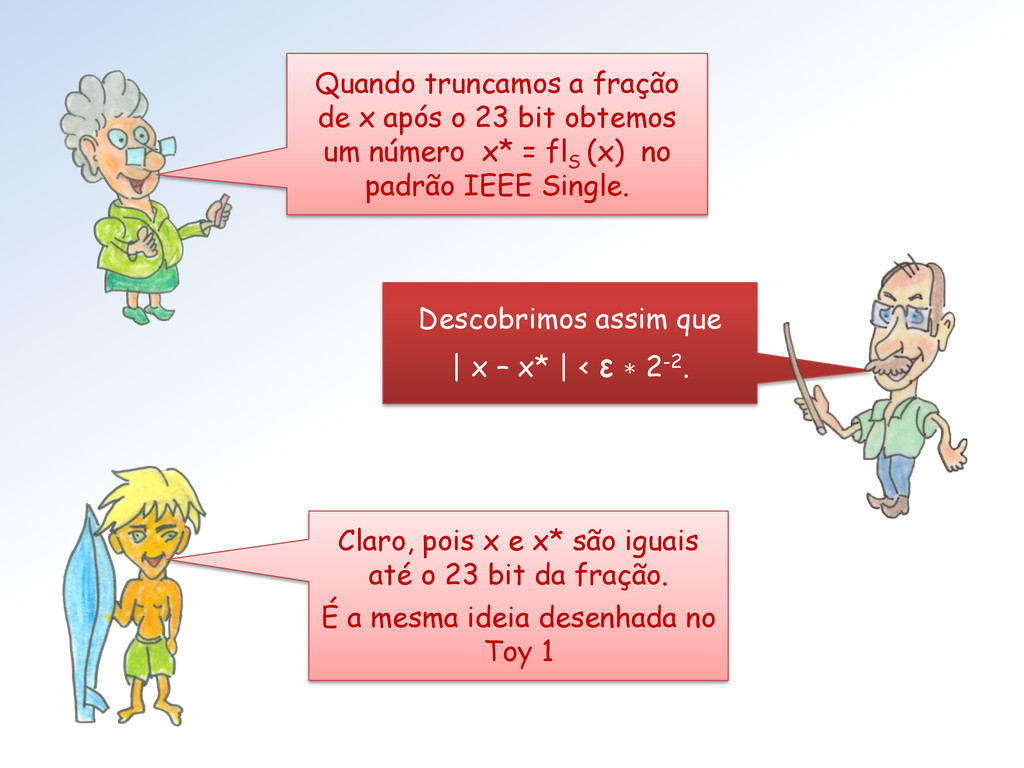
Quando truncamos a fração de x após o 23 bit
obtemos um número x* = fl S (x) no padrão IEEE Single. Descobrimos assim que | x – x* | < ε ∗ 2-2. Claro, pois x e x* são iguais até o 23 bit da fração. É a mesma ideia desenhada no Toy 1 -
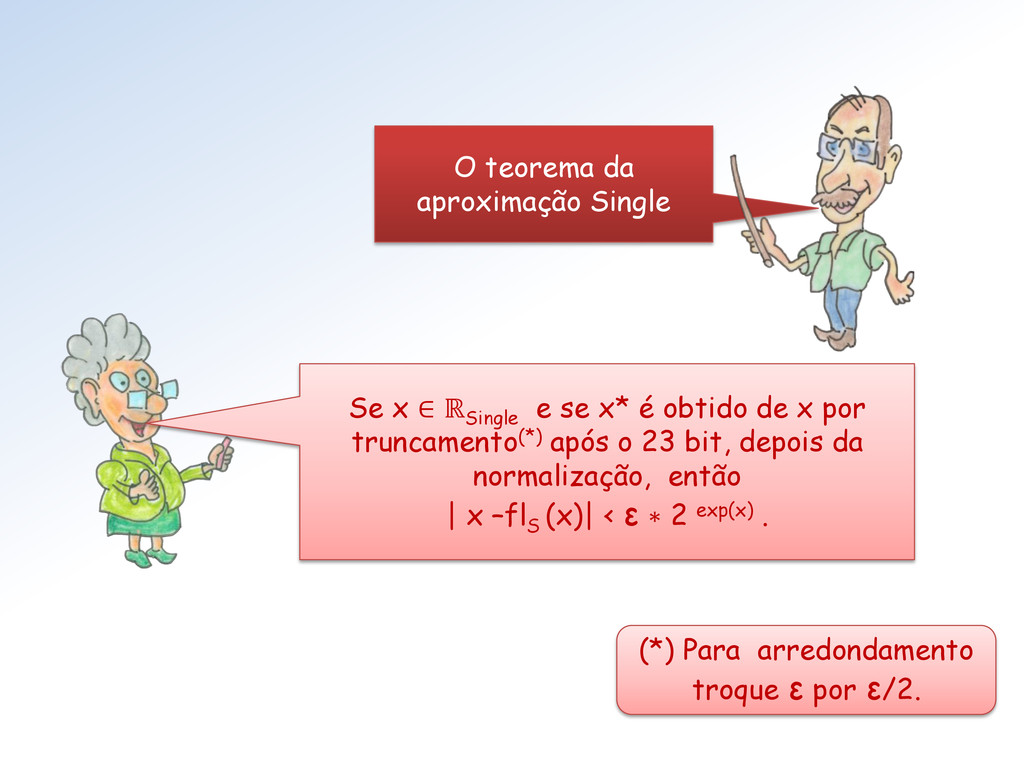
O teorema da aproximação Single Se x ∈ ℝSingle e
se x* é obtido de x por truncamento(*) após o 23 bit, depois da normalização, então | x –fl S (x)| < ε ∗ 2 exp(x) . (*) Para arredondamento troque ε por ε/2. -
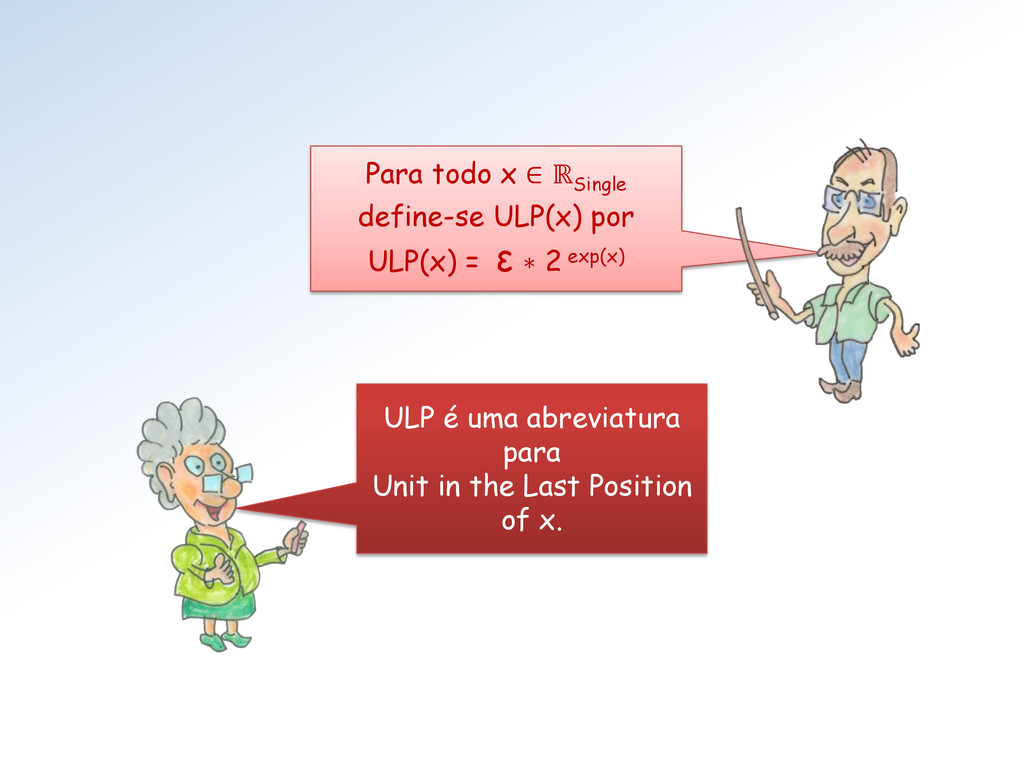
Para todo x ∈ ℝSingle define-se ULP(x) por ULP(x) =
ε ∗ 2 exp(x) ULP é uma abreviatura para Unit in the Last Position of x. -
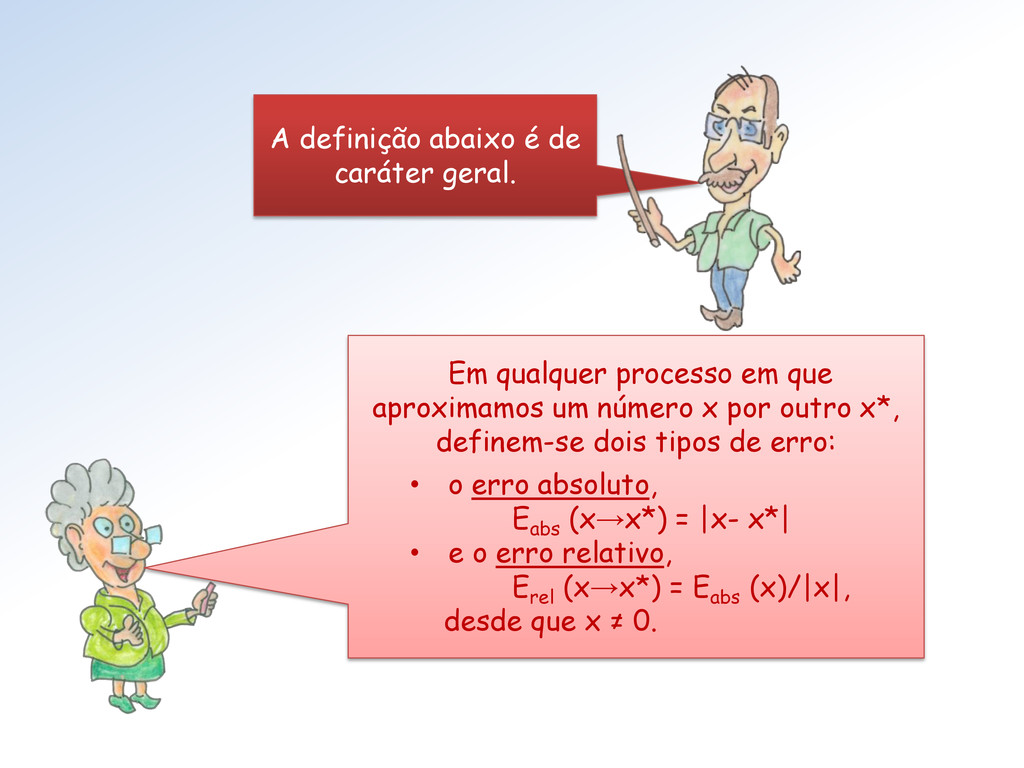
Em qualquer processo em que aproximamos um número x por
outro x*, definem-se dois tipos de erro: • o erro absoluto, E abs (x→x*) = |x- x*| • e o erro relativo, E rel (x→x*) = E abs (x)/|x|, desde que x ≠ 0. A definição abaixo é de caráter geral. -
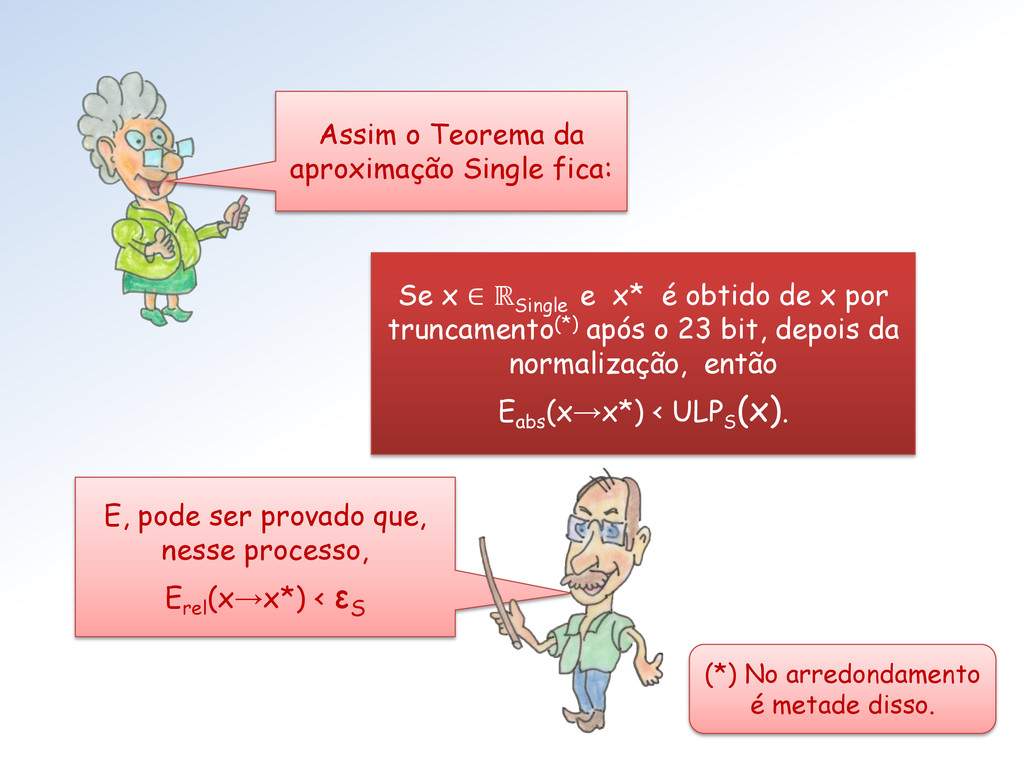
Se x ∈ ℝSingle e x* é obtido de x
por truncamento(*) após o 23 bit, depois da normalização, então E abs (x→x*) < ULP S (x). Assim o Teorema da aproximação Single fica: E, pode ser provado que, nesse processo, E rel (x→x*) < ε S (*) No arredondamento é metade disso. -
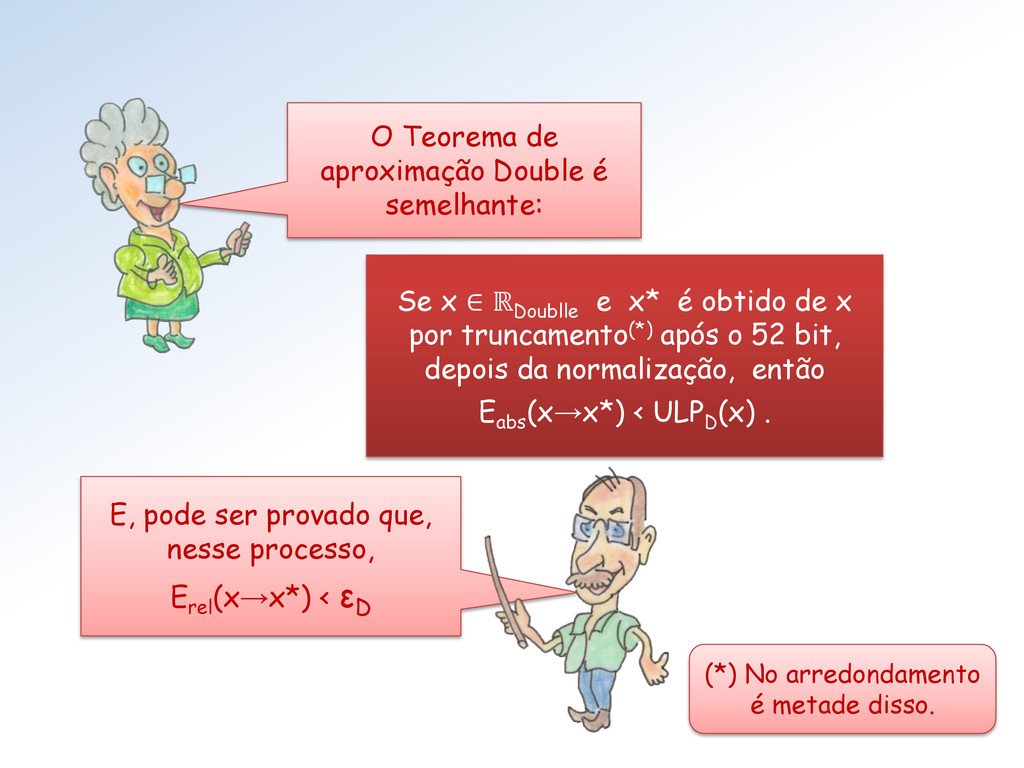
Se x ∈ ℝDoublle e x* é obtido de x
por truncamento(*) após o 52 bit, depois da normalização, então E abs (x→x*) < ULP D (x) . O Teorema de aproximação Double é semelhante: E, pode ser provado que, nesse processo, E rel (x→x*) < ε D (*) No arredondamento é metade disso. -
A limitação para o erro relativo só depende do sistema
IEEE: • Para o Single é ε S • Para o Double é ε D Pois é Sherlock, já a limitação para o erro absoluto também depende do número: • Para o Single é ULPS (x) • Para o Double é ULPD (x) -
Mestres, na prática, como esses conceitos sobre floats aparecem em
Python? Vamos pedir ajuda ao Manoel, Loirinha. -
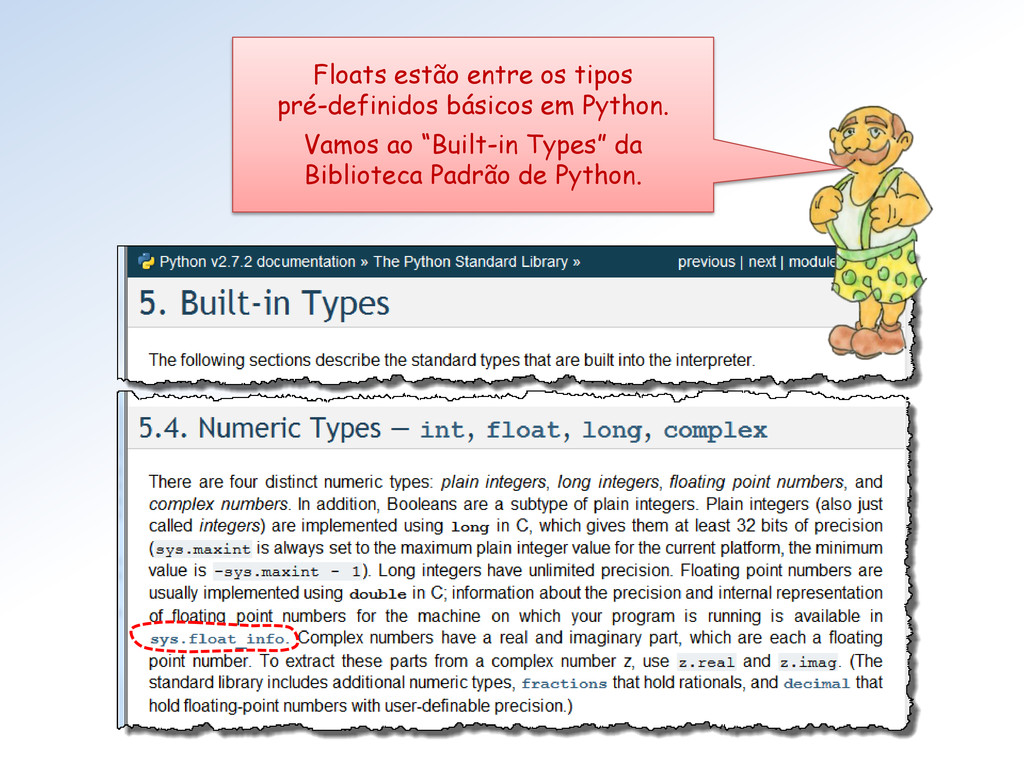
Floats estão entre os tipos pré-definidos básicos em Python. Vamos
ao “Built-in Types” da Biblioteca Padrão de Python. -
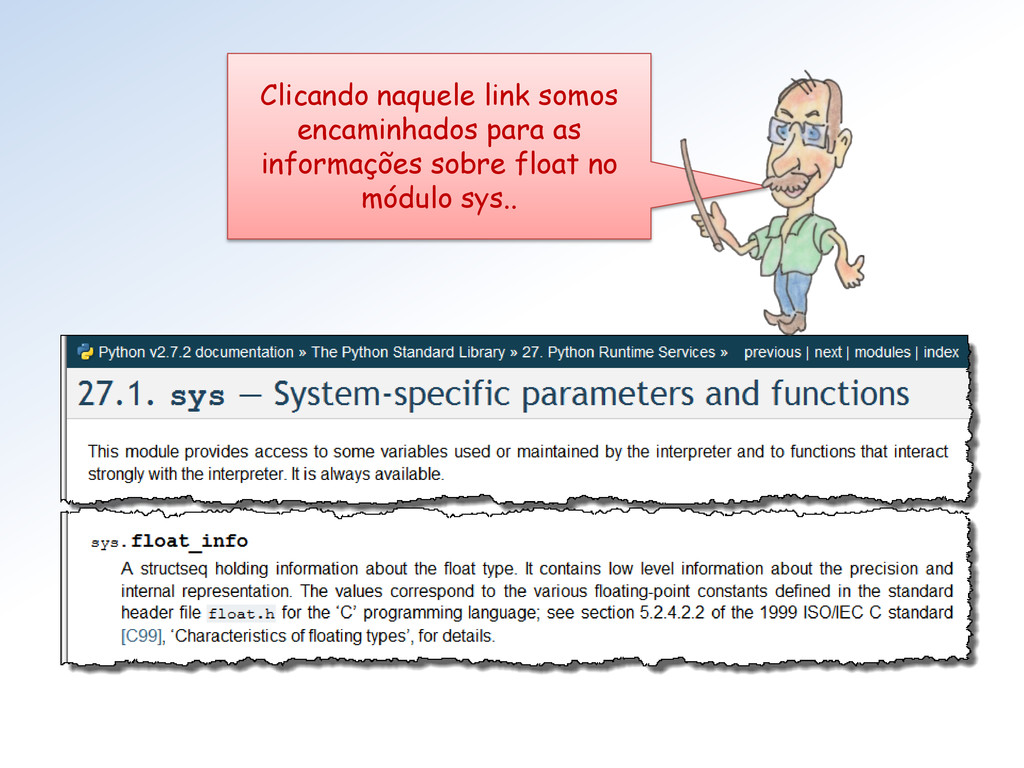
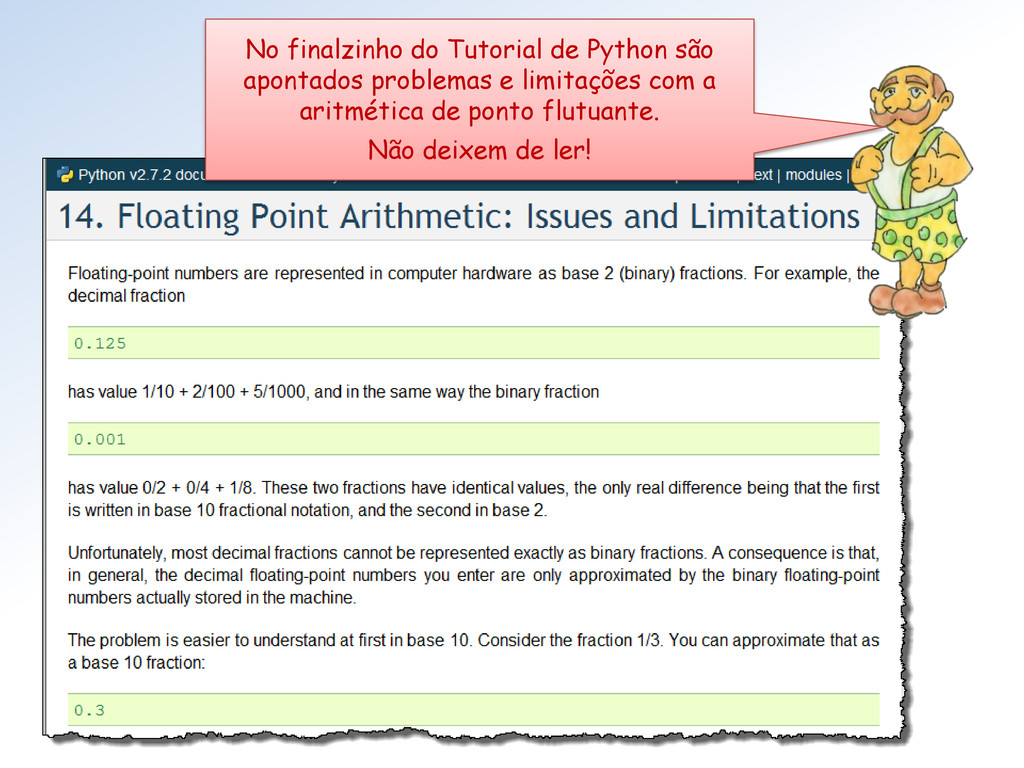
No finalzinho do Tutorial de Python são apontados problemas e
limitações com a aritmética de ponto flutuante. Não deixem de ler! -
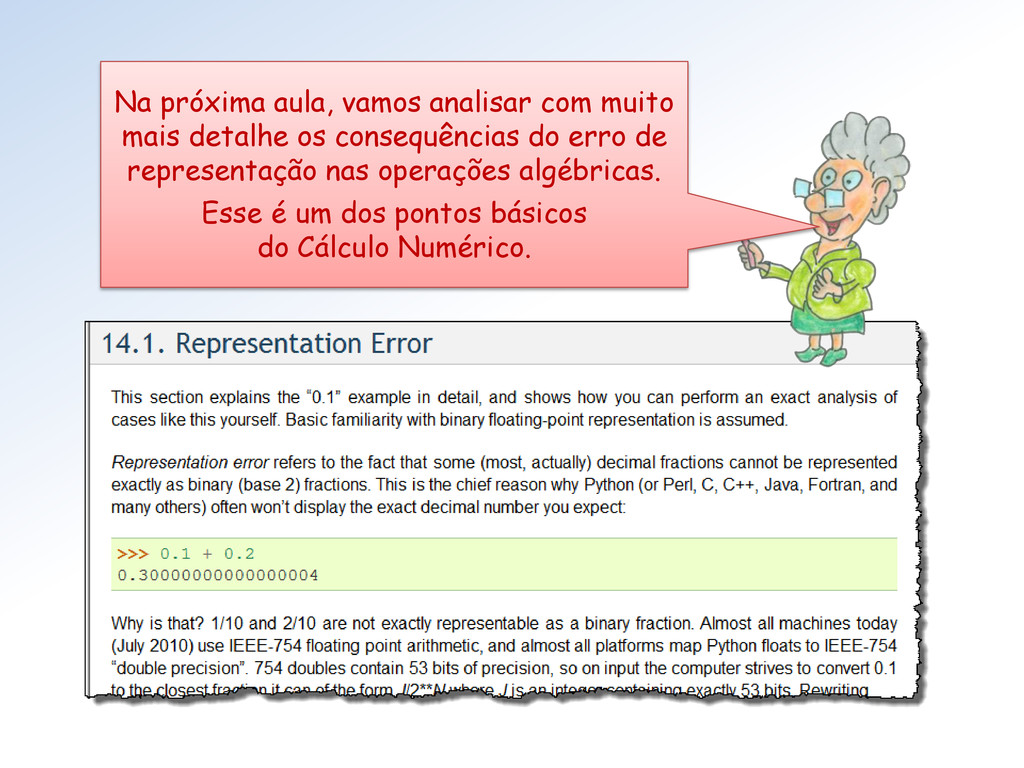
Na próxima aula, vamos analisar com muito mais detalhe os
consequências do erro de representação nas operações algébricas. Esse é um dos pontos básicos do Cálculo Numérico. -
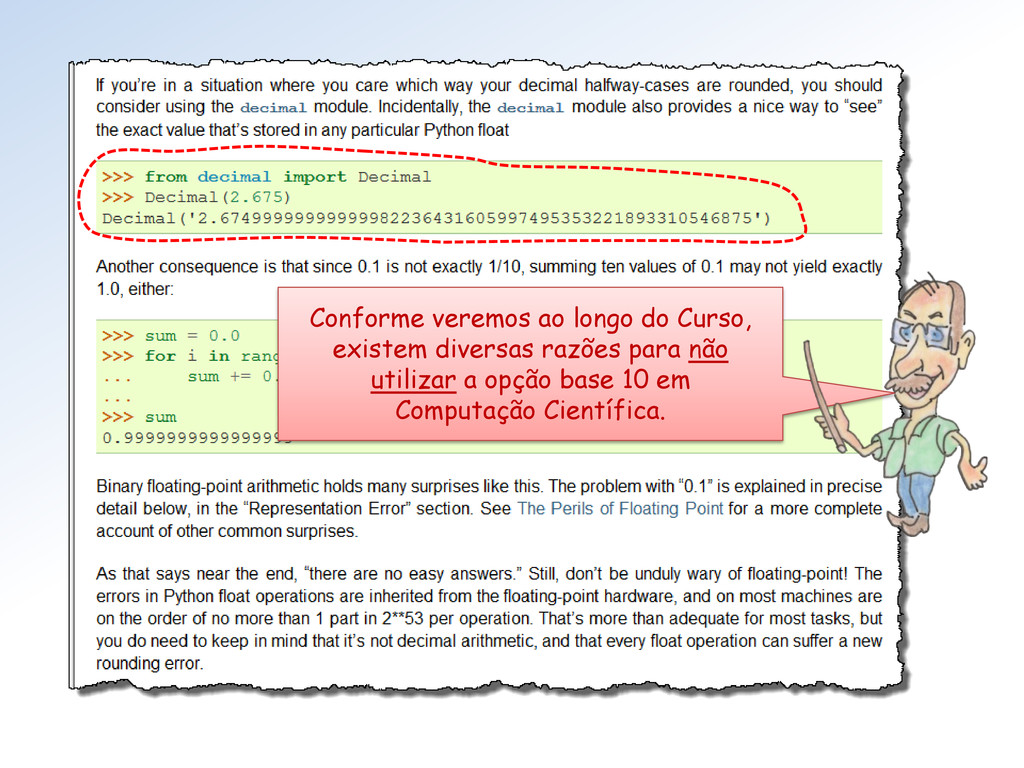
Conforme veremos ao longo do Curso, existem diversas razões para
não utilizar a opção base 10 em Computação Científica. -
Mestres, me sinto perdida! Como faço para buscar informação sobre
esses assuntos no Numpy? Bem, Loirinha, vou pedir à Professora para te ajudar. Ela tem mais paciência! -
O tratamento de números realizado por NumPy está em“Scalars”. É
o que passaremos a examinar. -
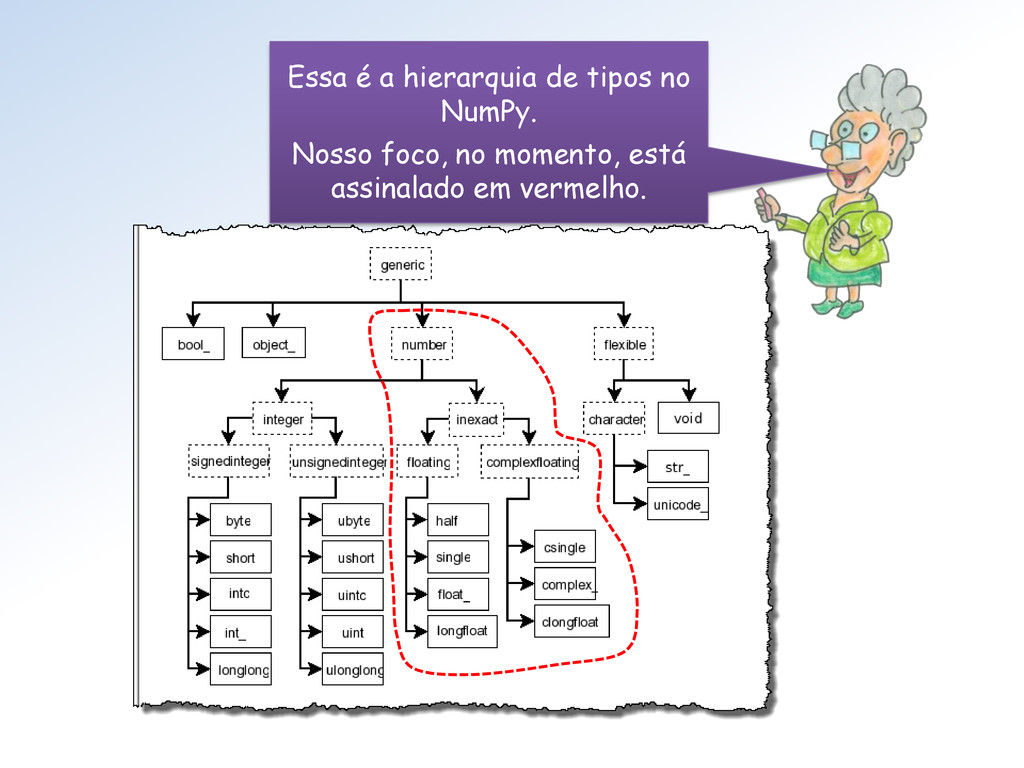
Essa é a hierarquia de tipos no NumPy. Nosso foco,
no momento, está assinalado em vermelho. -
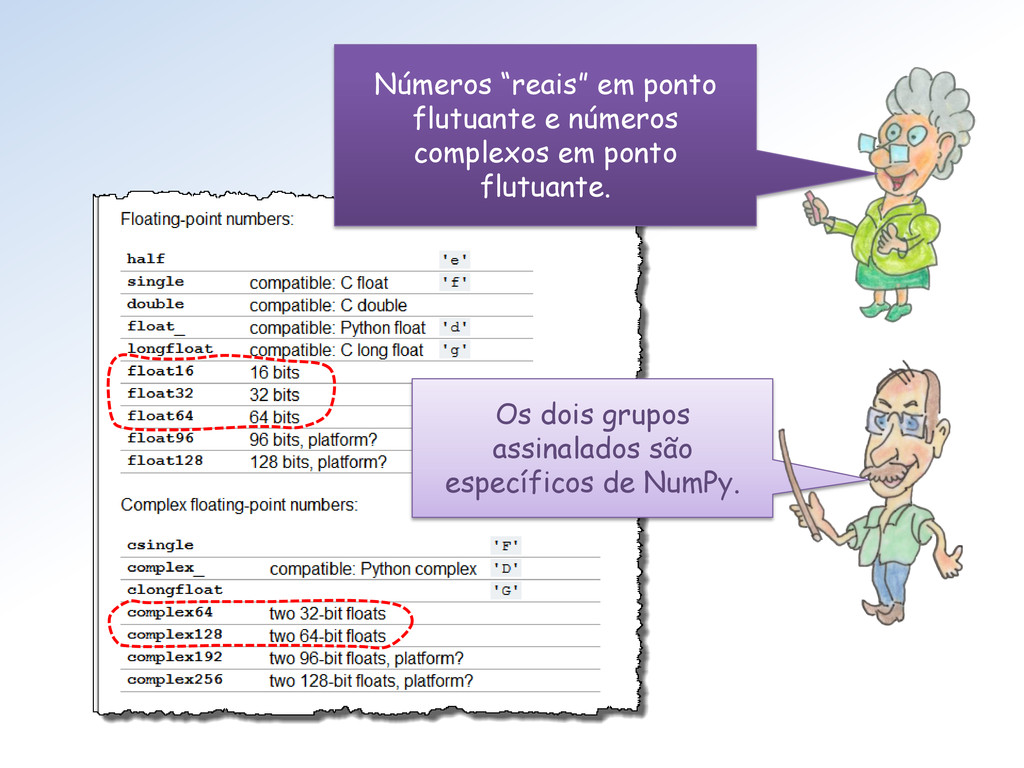
Números “reais” em ponto flutuante e números complexos em ponto
flutuante. Os dois grupos assinalados são específicos de NumPy. -
O programinha a seguir recebe um decimal, via teclado e
devolve suas representações binárias IEEE 754/2008 em: • Half (via numpy.float16) • Single (via numpy.float32) • Double (via nump.float64) Na formatação de saída forçamos 16 dígitos após a vírgula para exibir os erros inerentes ao processo. -
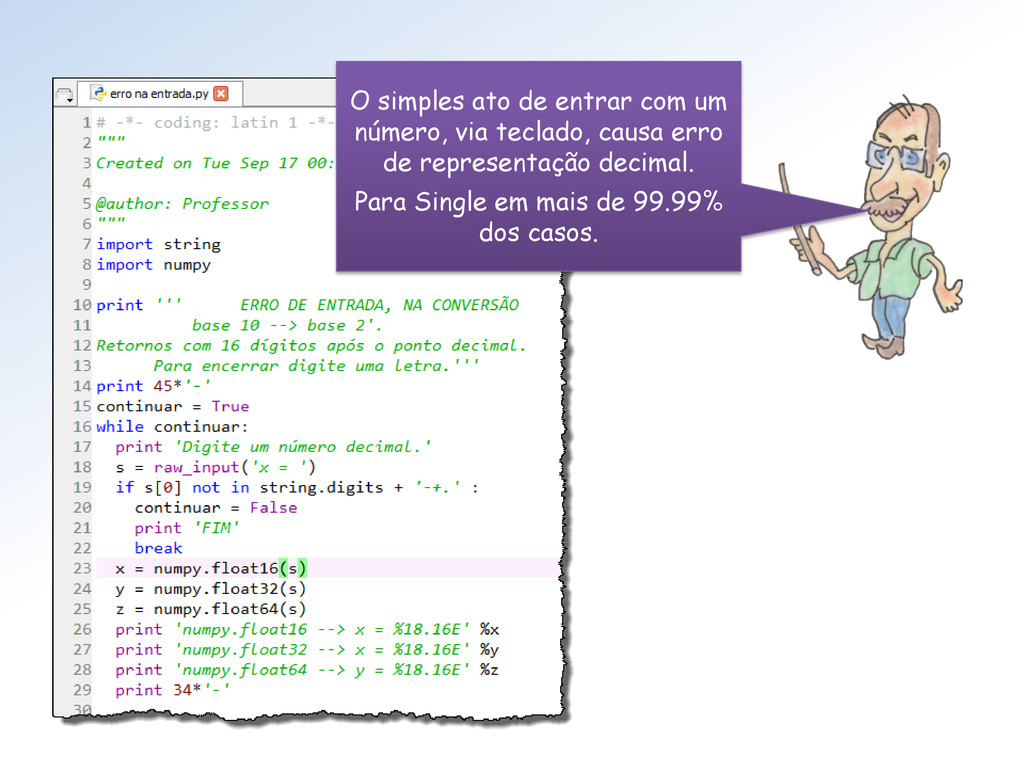
O simples ato de entrar com um número, via teclado,
causa erro de representação decimal. Para Single em mais de 99.99% dos casos. -
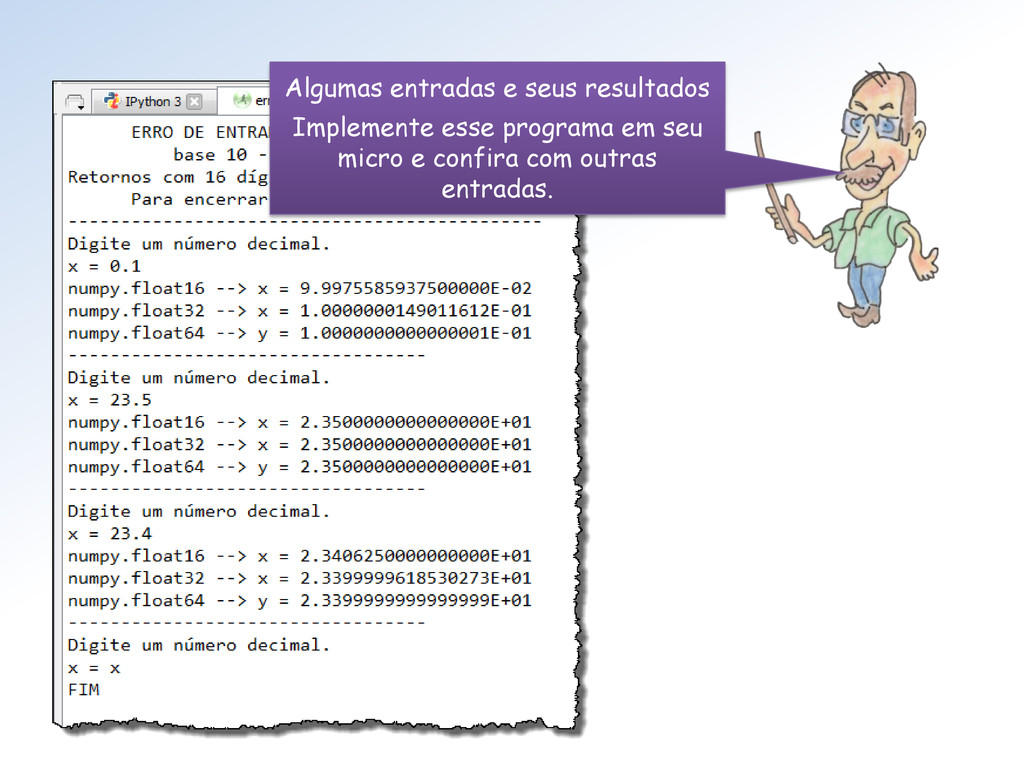
Algumas entradas e seus resultados Implemente esse programa em seu
micro e confira com outras entradas. -
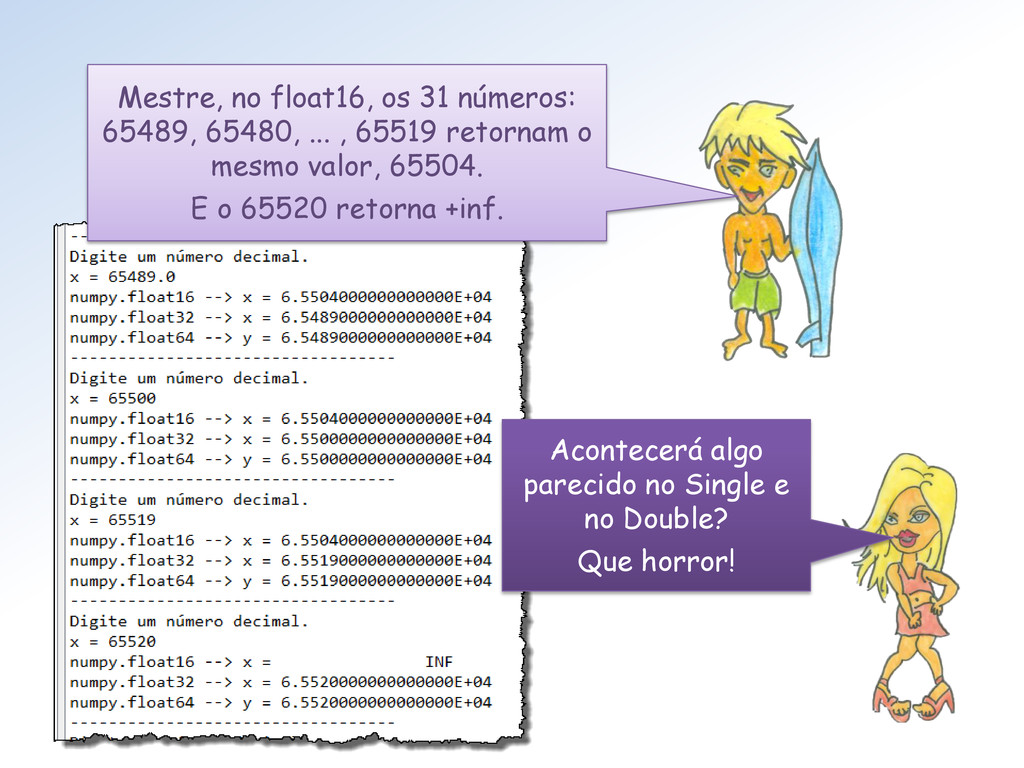
Acontecerá algo parecido no Single e no Double? Que horror!
Mestre, no float16, os 31 números: 65489, 65480, ... , 65519 retornam o mesmo valor, 65504. E o 65520 retorna +inf. -
Usaremos o float16 para evidenciar, de forma gritante, a propagação
do erro no cálculo de funções. Aguardem! Vou voltar no tempo, lá para a Magna Grécia, nos 400 AC. Desisto de apoiar os cursos desse Professor. Lá usamos ábacos – são mais confiáveis que esses computadores. -
Mestres, continuo angustiada! Existe alguma outra forma de buscar informação
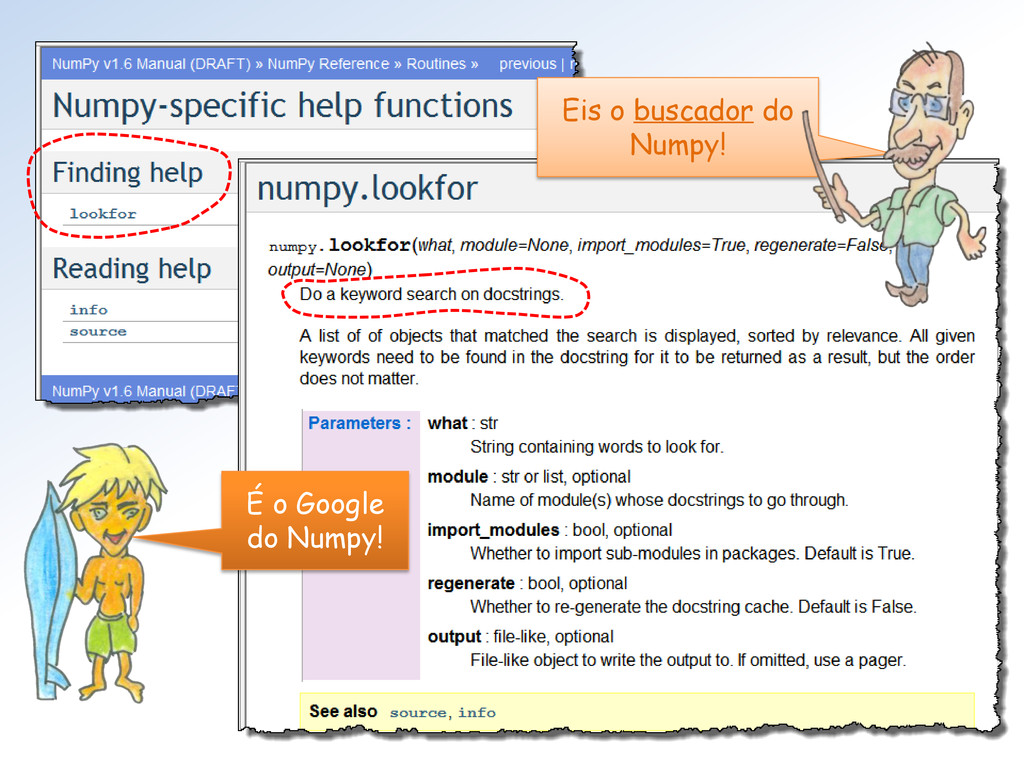
sobre esses assuntos no Numpy sem ter que que olhar o Manuel todinho – da 1ª à última página??? Bem Loirinha, resolva sua angústia com seu Psicanalista. Aqui usaremos o Google! -
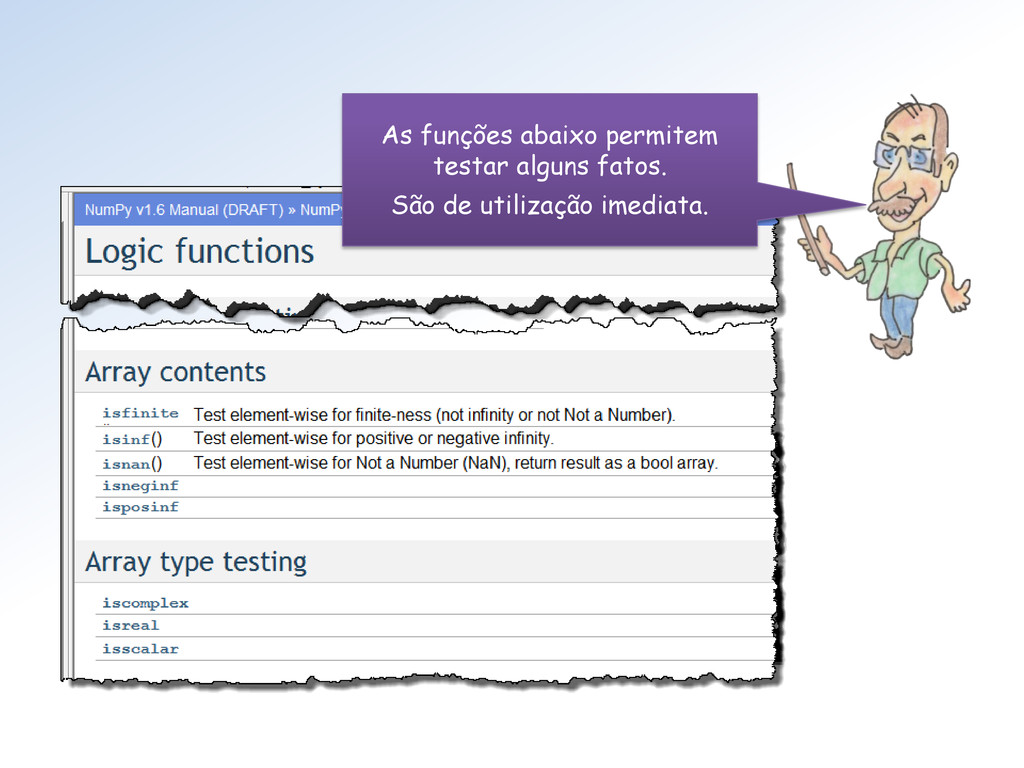
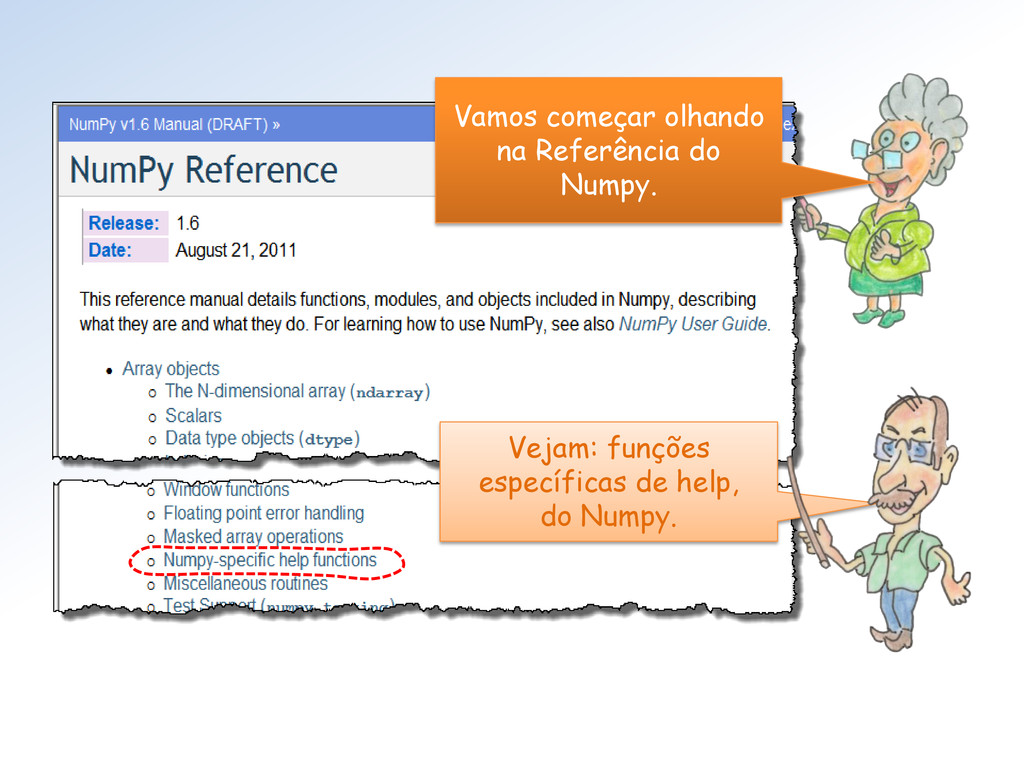
Vamos começar olhando na Referência do Numpy. Vejam: funções específicas
de help, do Numpy. -
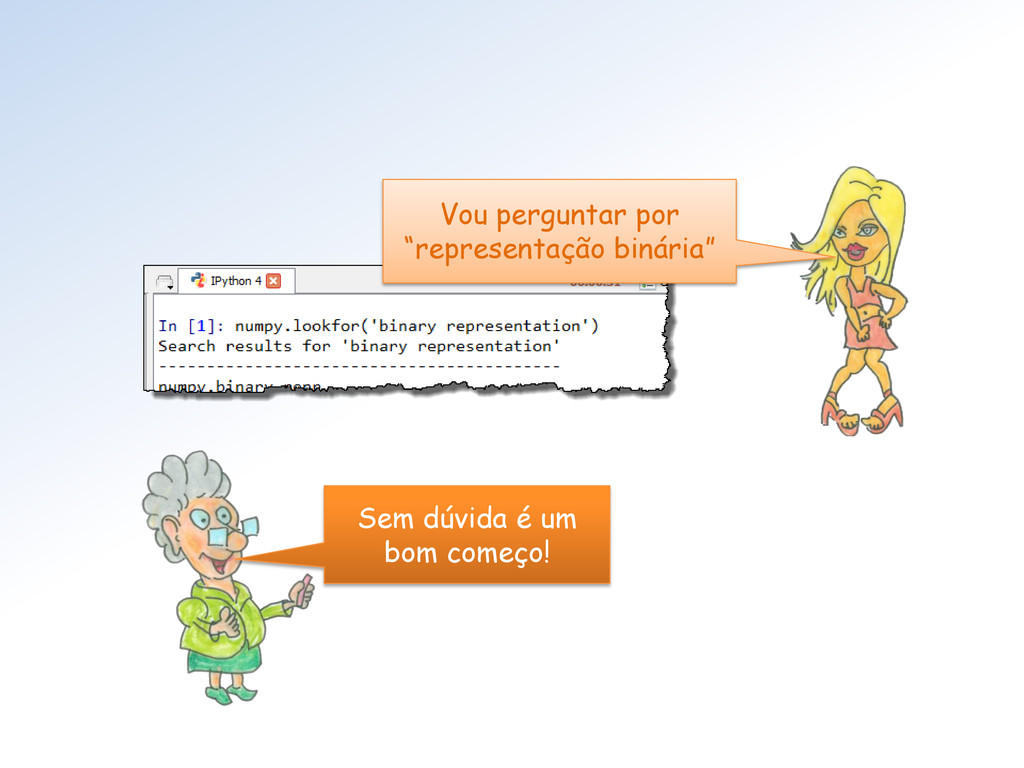
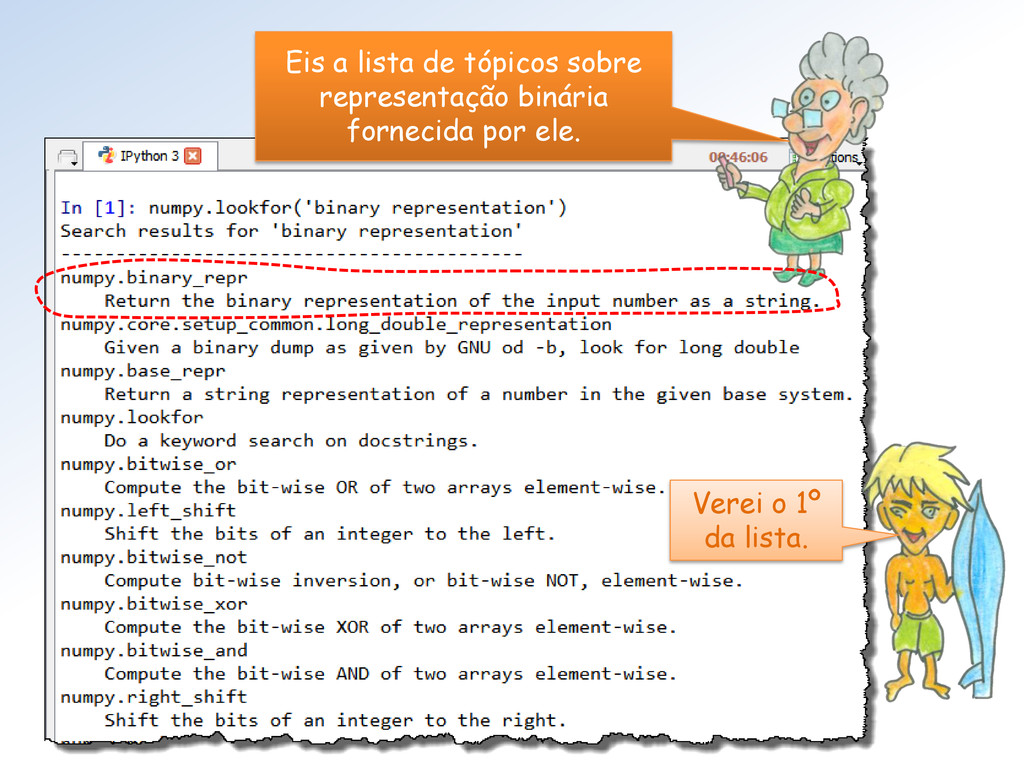
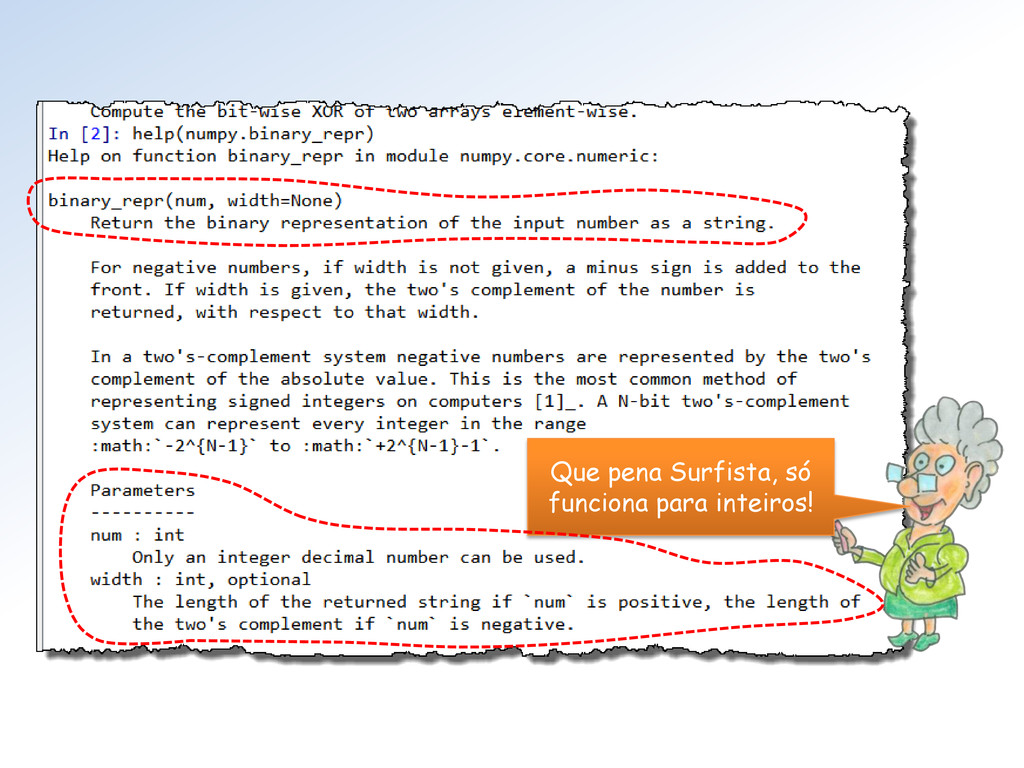
Eis a lista de tópicos sobre representação binária fornecida por
ele. Verei o 1º da lista. -
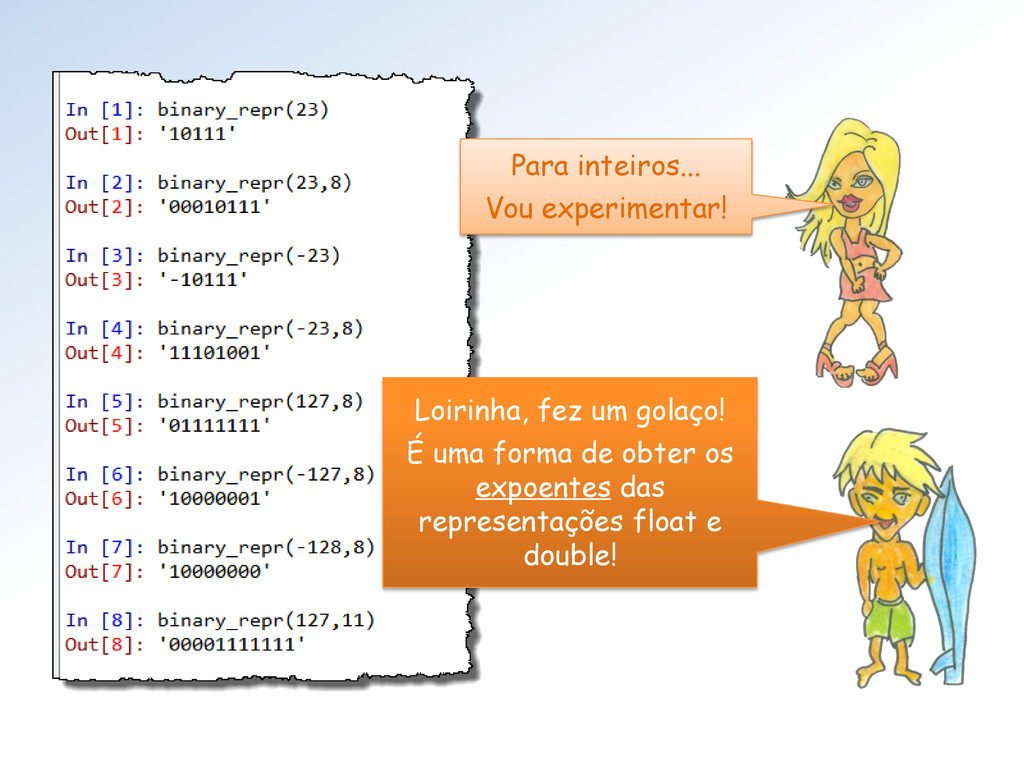
Para inteiros... Vou experimentar! Loirinha, fez um golaço! É uma
forma de obter os expoentes das representações float e double! -
Bem, Loirinha, vamos buscar informações sobre “floating point”. E agora
Mestra? Em “binary representation” não havia nada! -
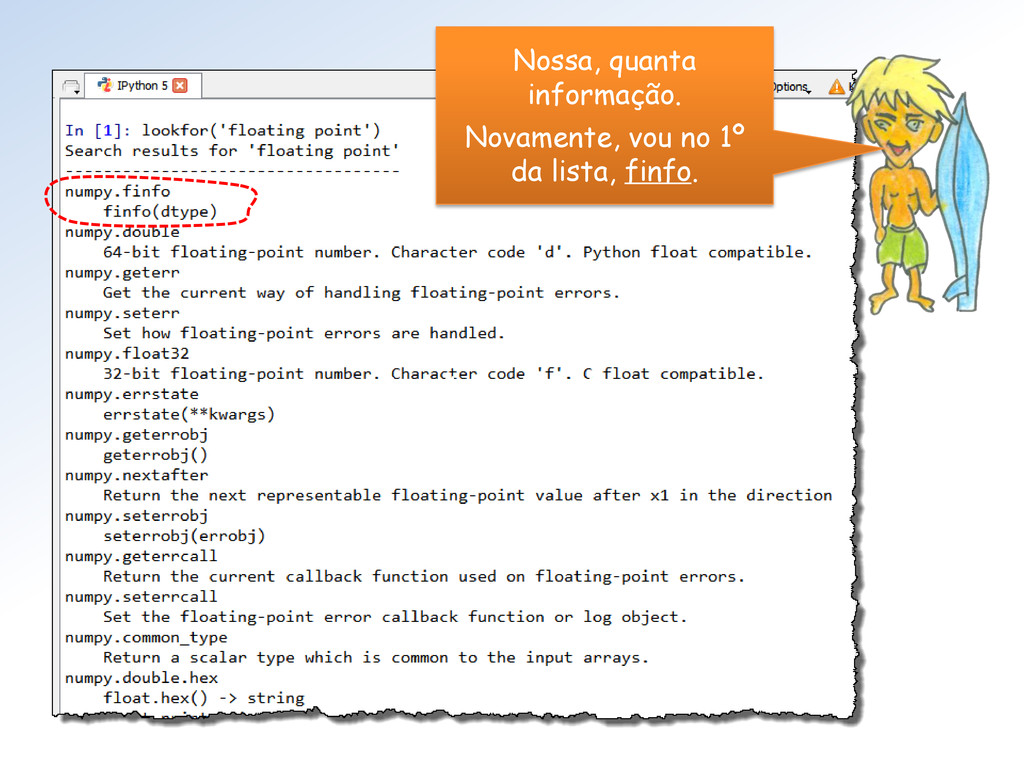
Nossa, quanta informação. Novamente, vou no 1º da lista, finfo.
Nossa, quanta informação. Vou olhar a 1ª da lista, a finfo -
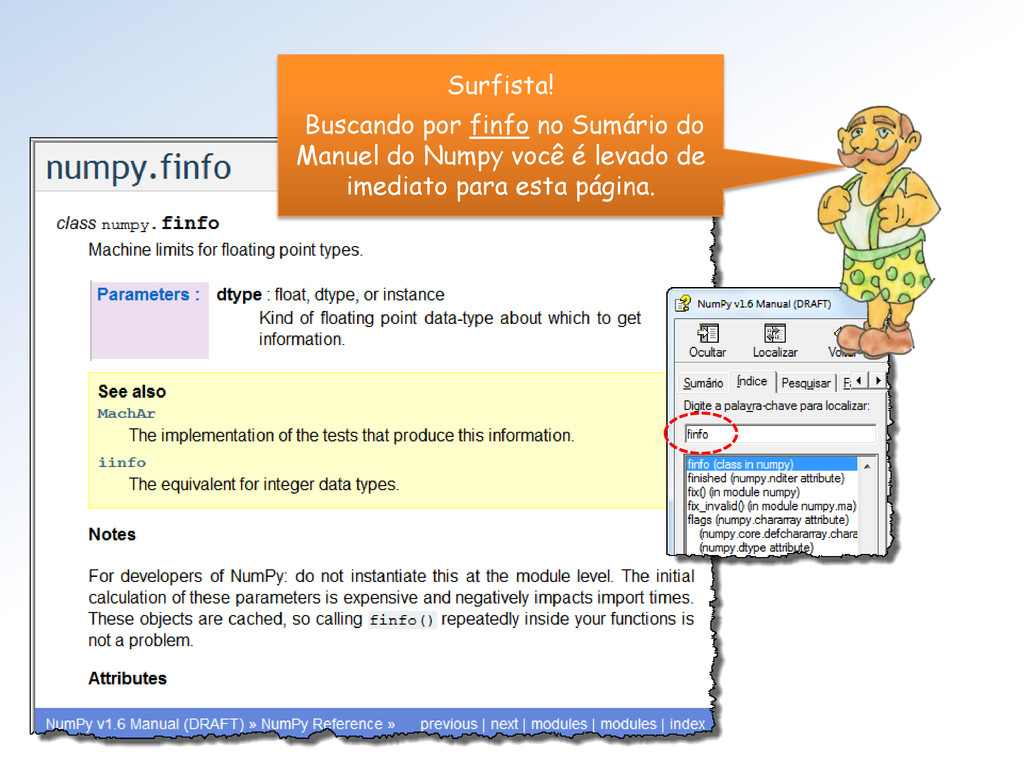
Surfista! Buscando por finfo no Sumário do Manuel do Numpy
você é levado de imediato para esta página. -
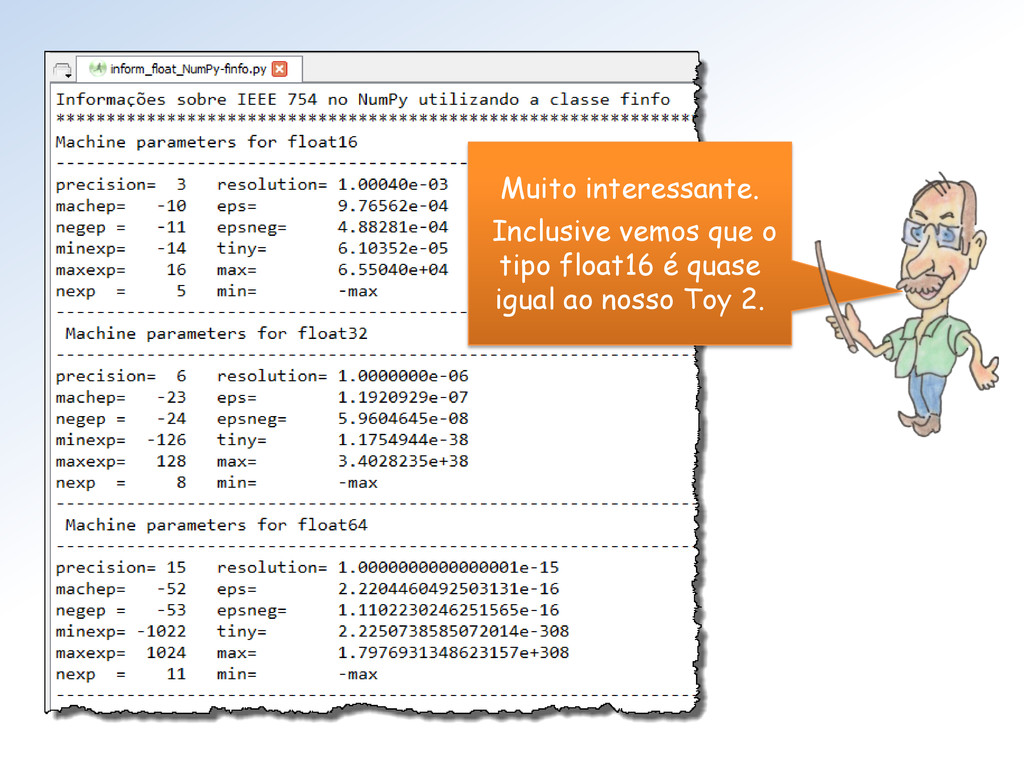
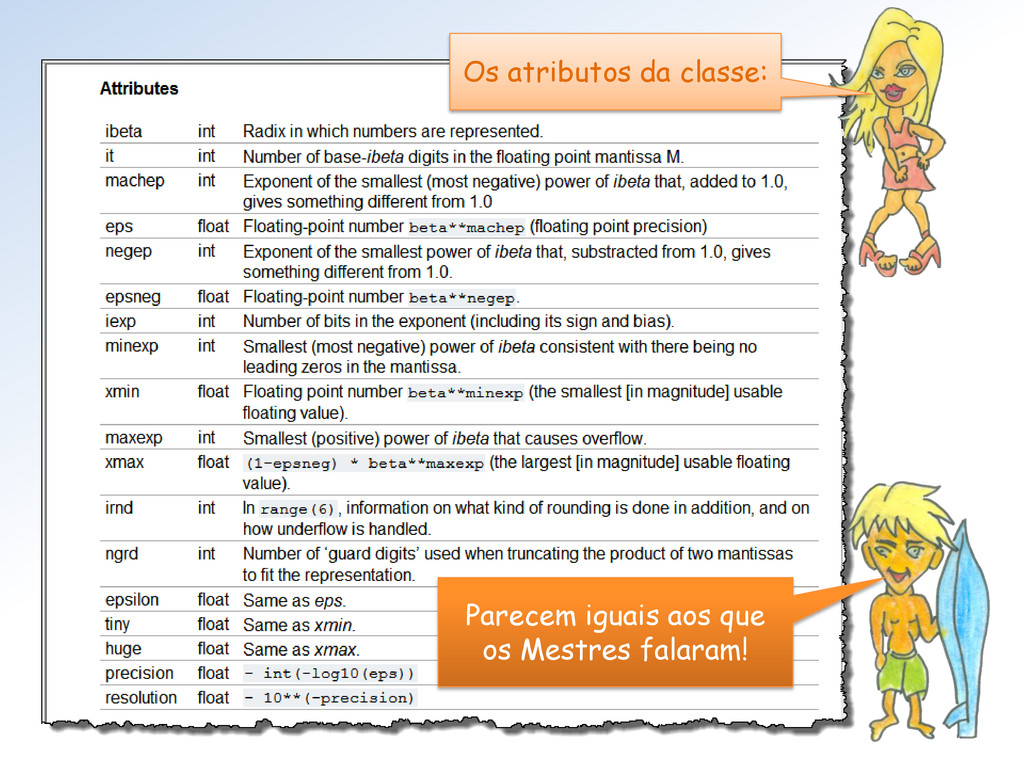
Obrigado Manoel. Vemos que a classe finfo fornece informações sobre
tipos float do Numpy (seus limites). Mestra não vejo como proceder para utilizar essa classe. Além disso, parece que faltam informações (Atributos = ??). -
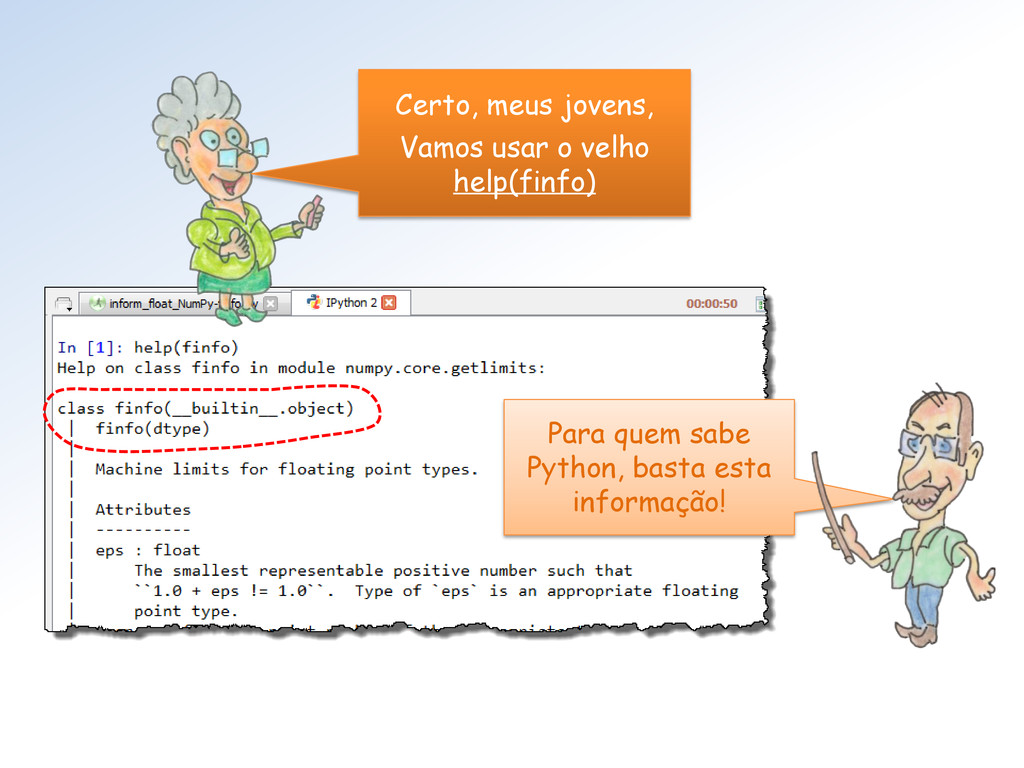
Certo, meus jovens, Vamos usar o velho help(finfo) Para quem
sabe Python, basta esta informação! -
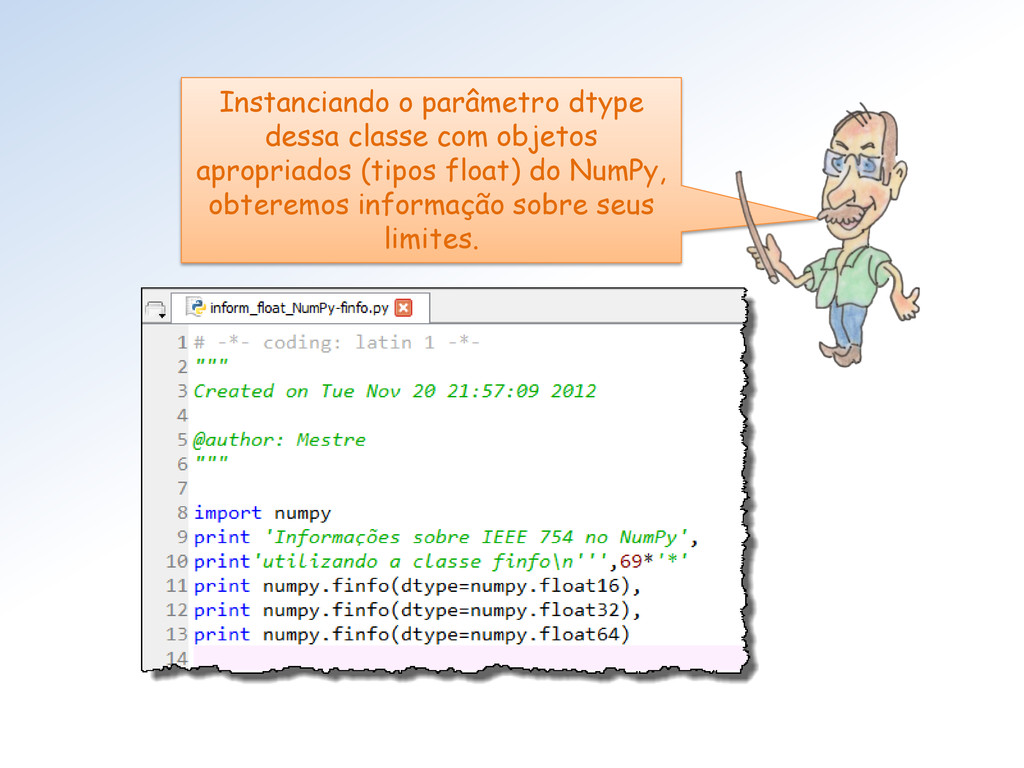
Instanciando o parâmetro dtype dessa classe com objetos apropriados (tipos
float) do NumPy, obteremos informação sobre seus limites. -
Muito interessante. Inclusive vemos que o tipo float16 é quase
igual ao nosso Toy 2. -
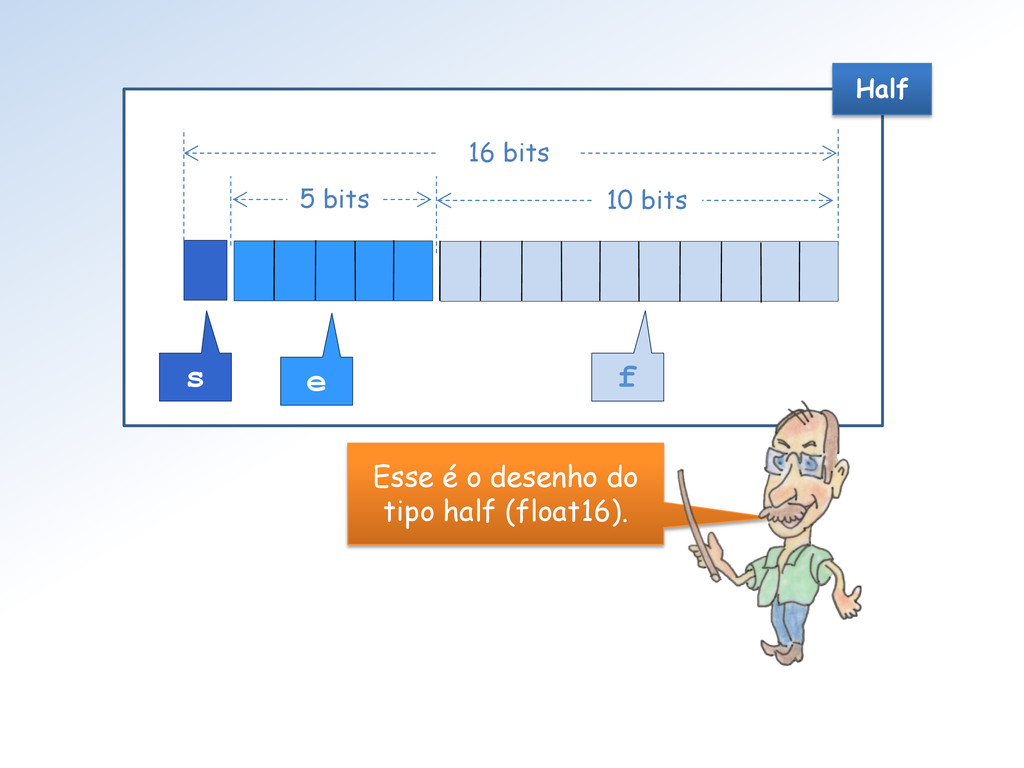
Half s e f 16 bits 10 bits 5 bits
Esse é o desenho do tipo half (float16). -
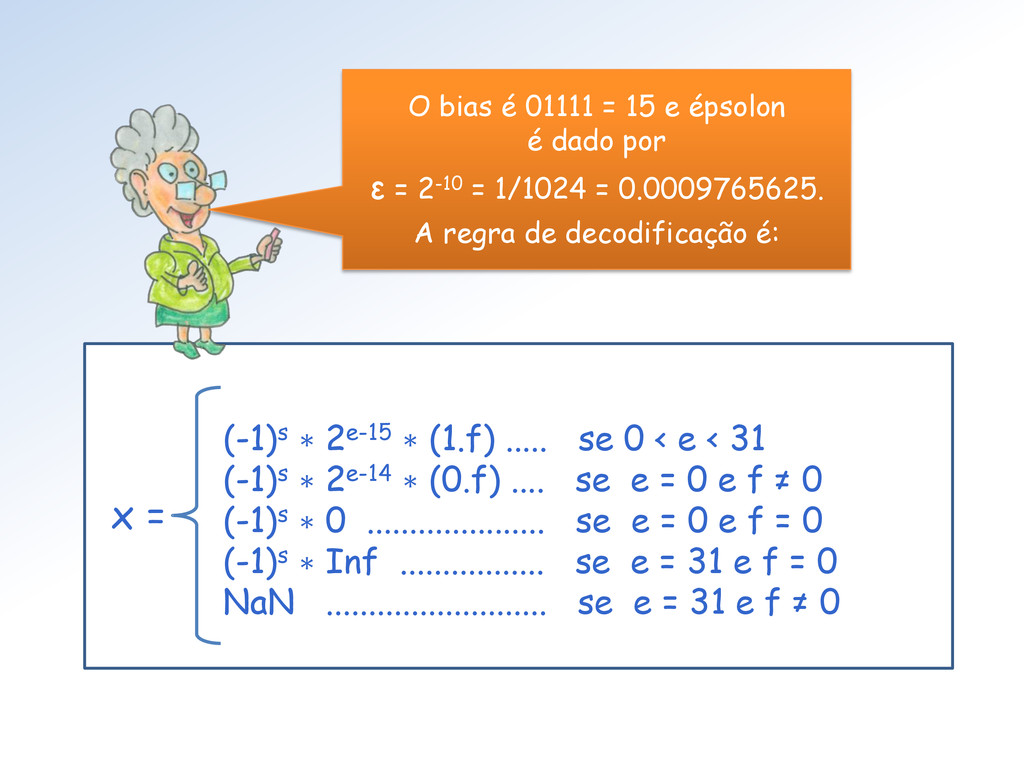
(-1)s ∗ 2e-15 ∗ (1.f) ..... se 0 < e
< 31 (-1)s ∗ 2e-14 ∗ (0.f) .... se e = 0 e f ≠ 0 (-1)s ∗ 0 ..................... se e = 0 e f = 0 (-1)s ∗ Inf ................. se e = 31 e f = 0 NaN .......................... se e = 31 e f ≠ 0 x = O bias é 01111 = 15 e épsolon é dado por ε = 2-10 = 1/1024 = 0.0009765625. A regra de decodificação é: -
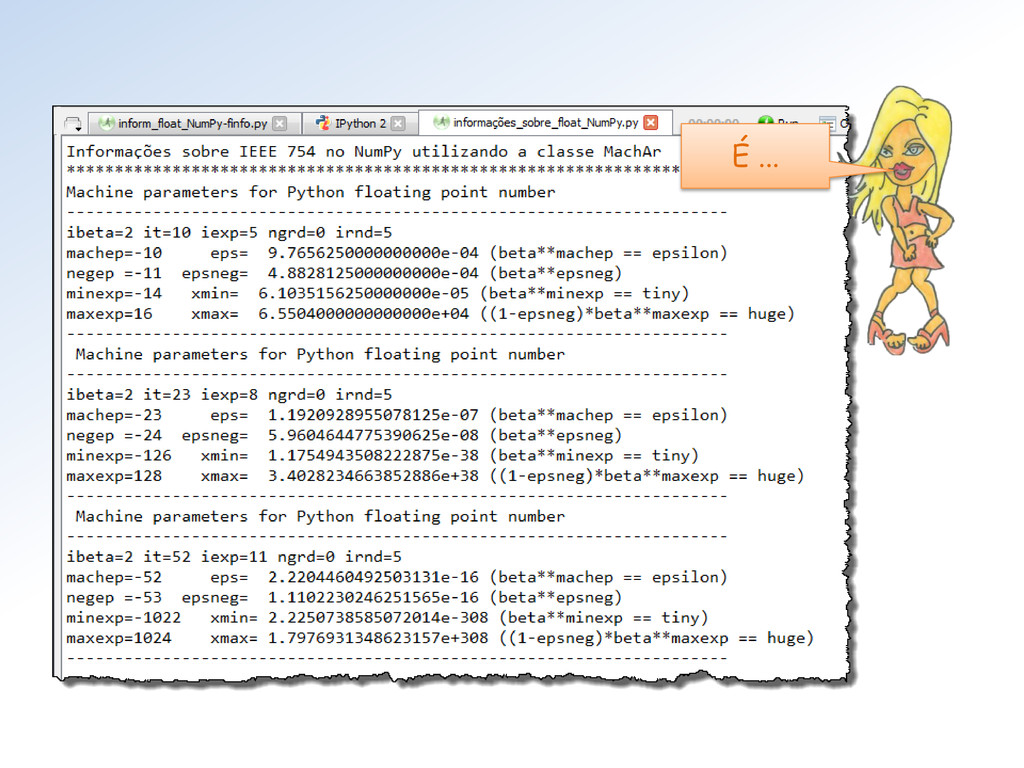
Loirinha, os Mestres já falaram sobre quase tudo isso! É...
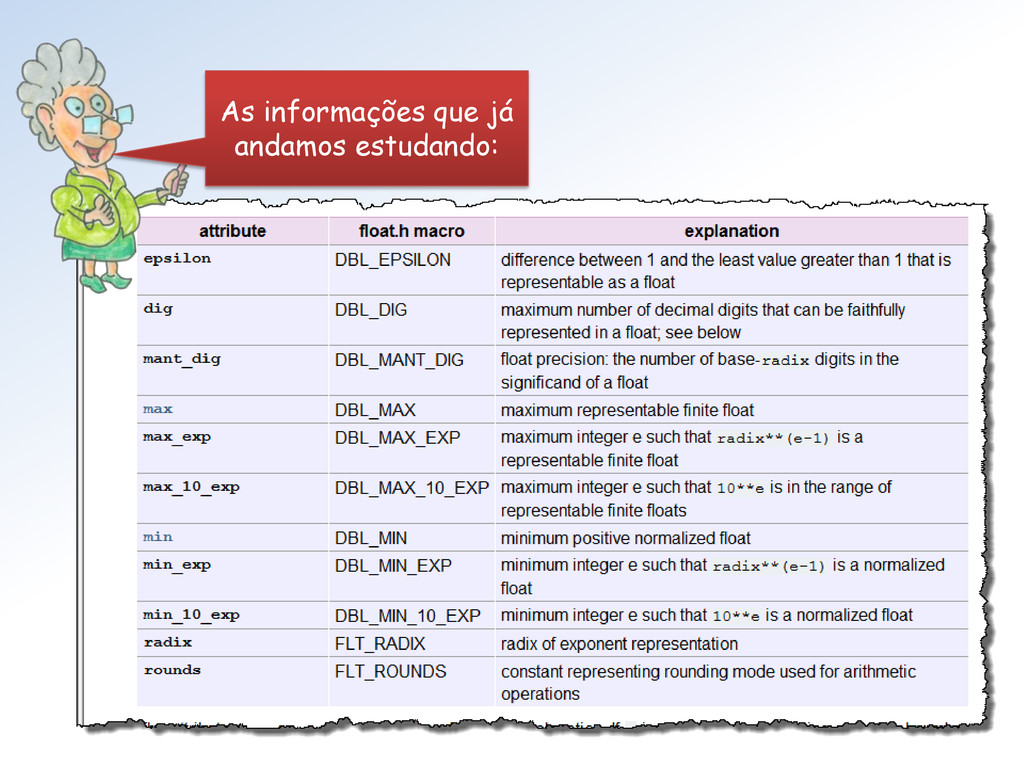
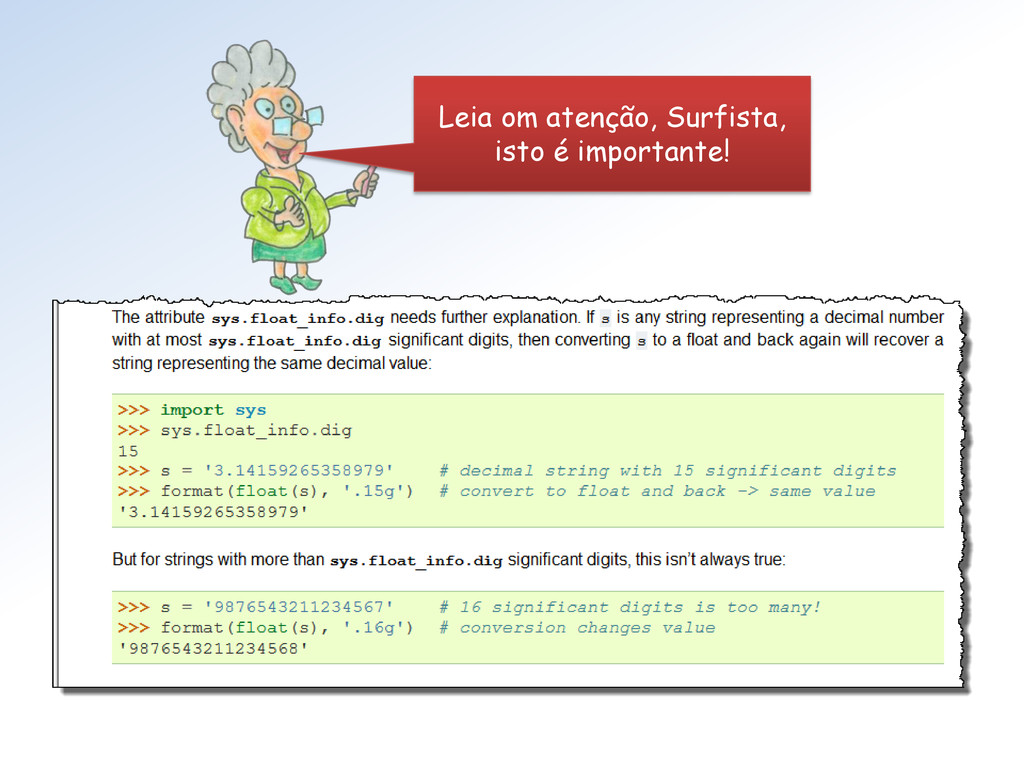
Mas estou curiosa para ver o que mais tem no MachAr. -
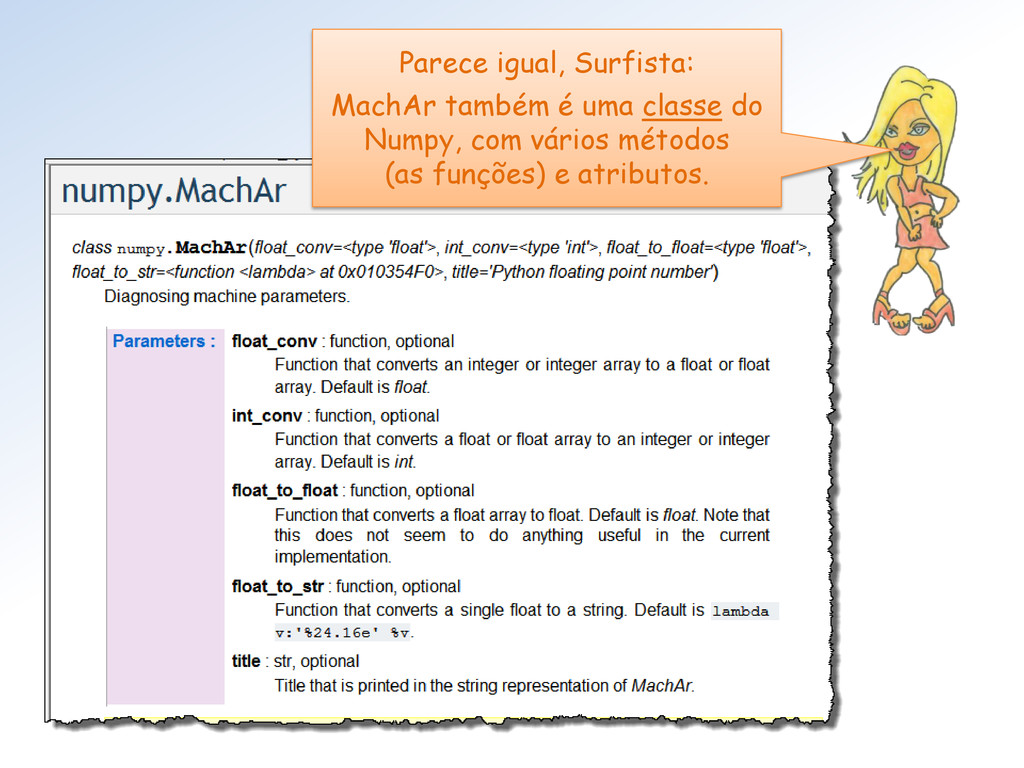
Parece igual, Surfista: MachAr também é uma classe do Numpy,
com vários métodos (as funções) e atributos. -
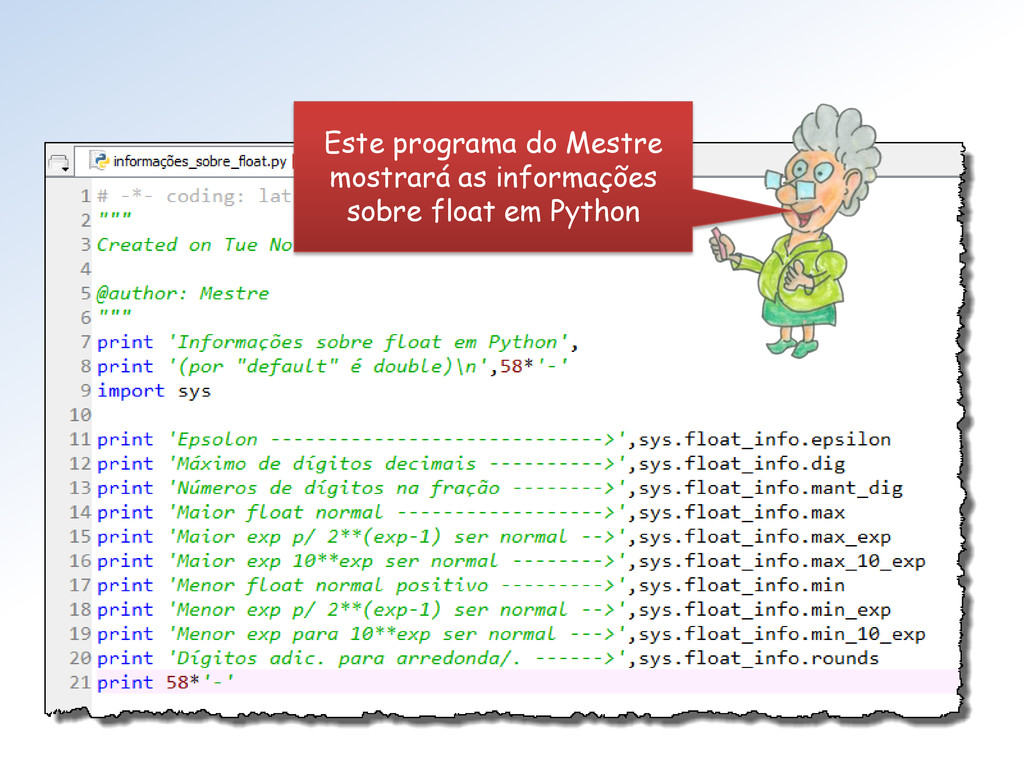
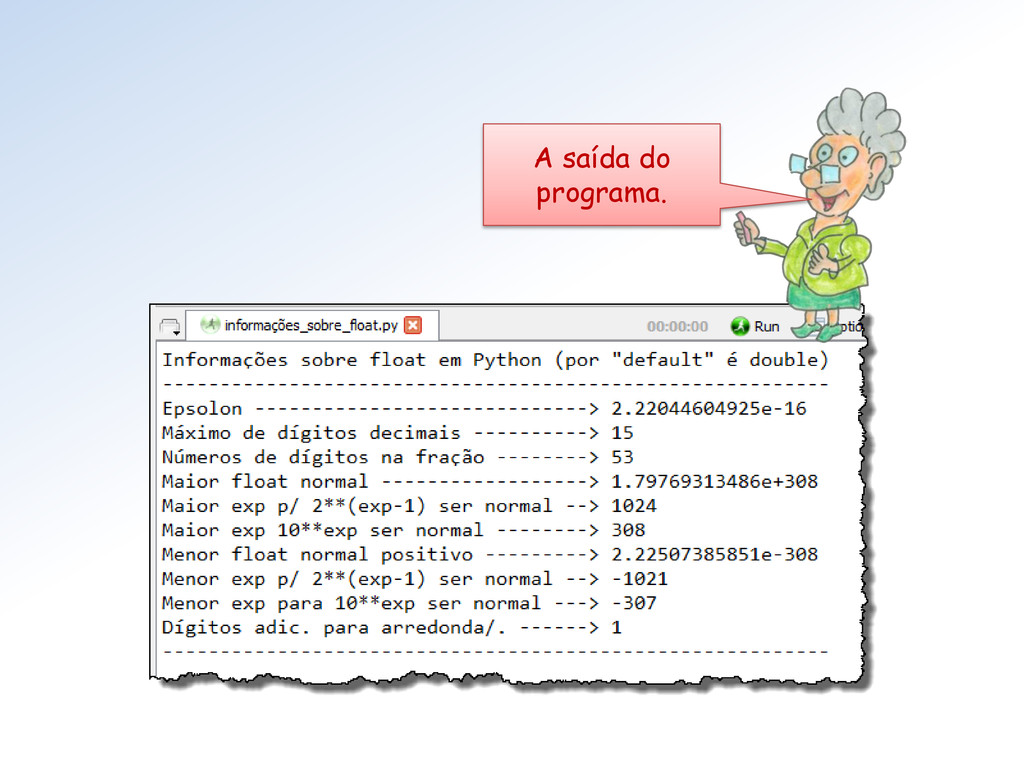
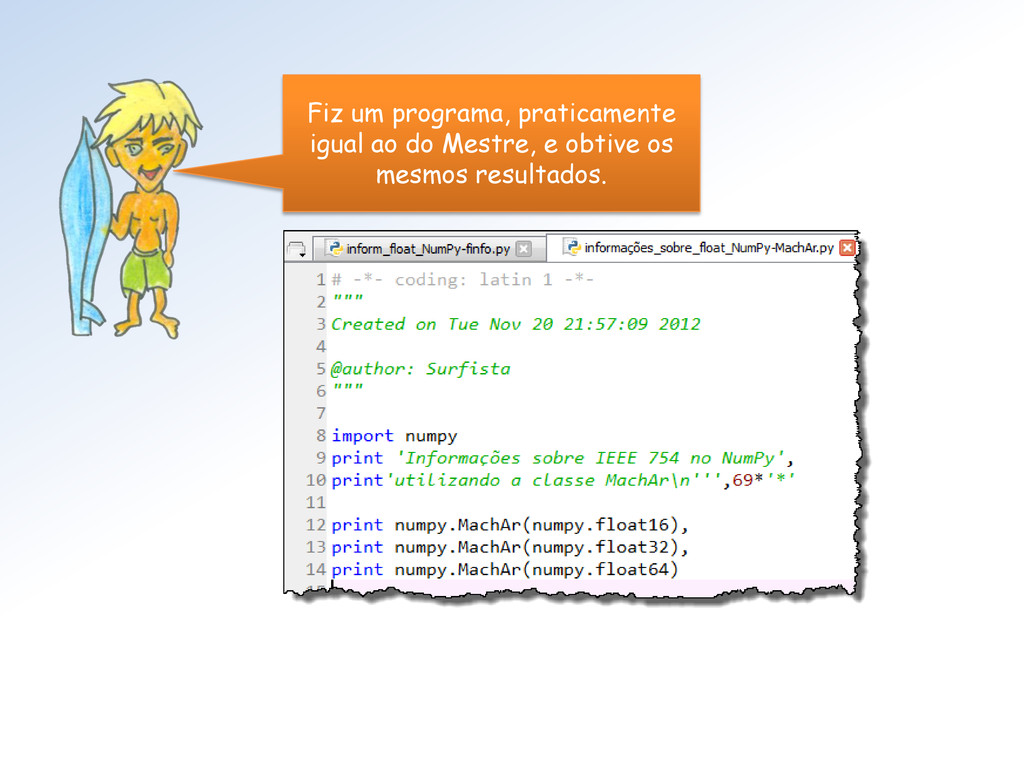
Fiz um programa, praticamente igual ao do Mestre, e obtive
os mesmos resultados. -
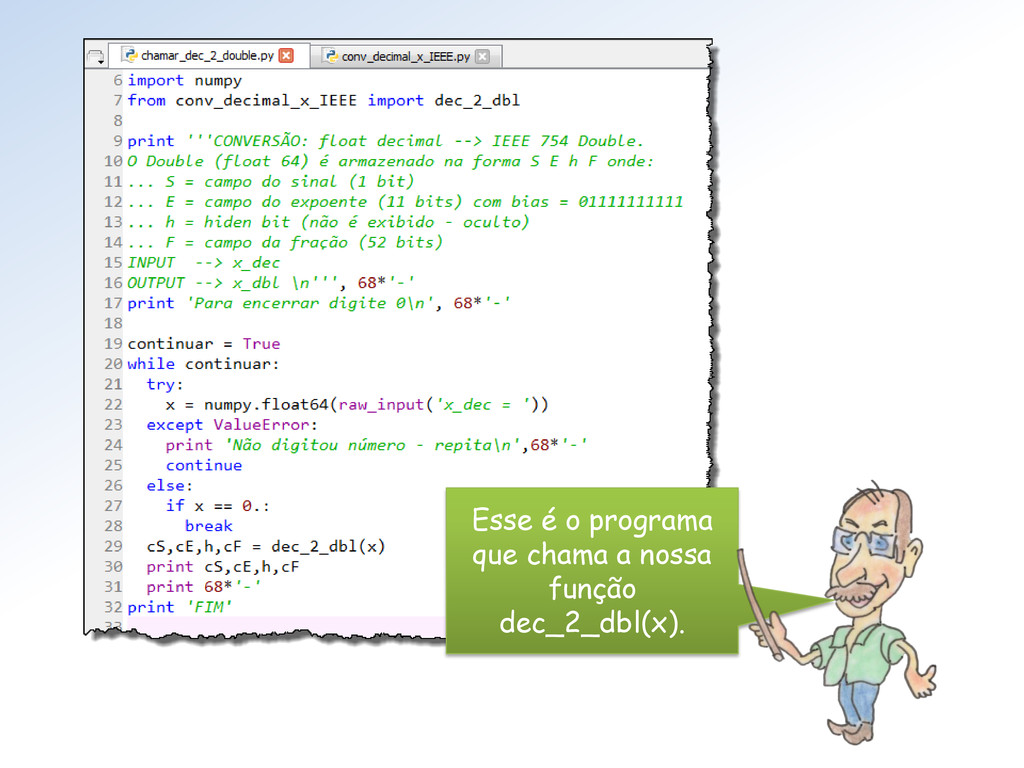
Vamos fechar esta aula construindo a função dec_dbl(x) do módulo
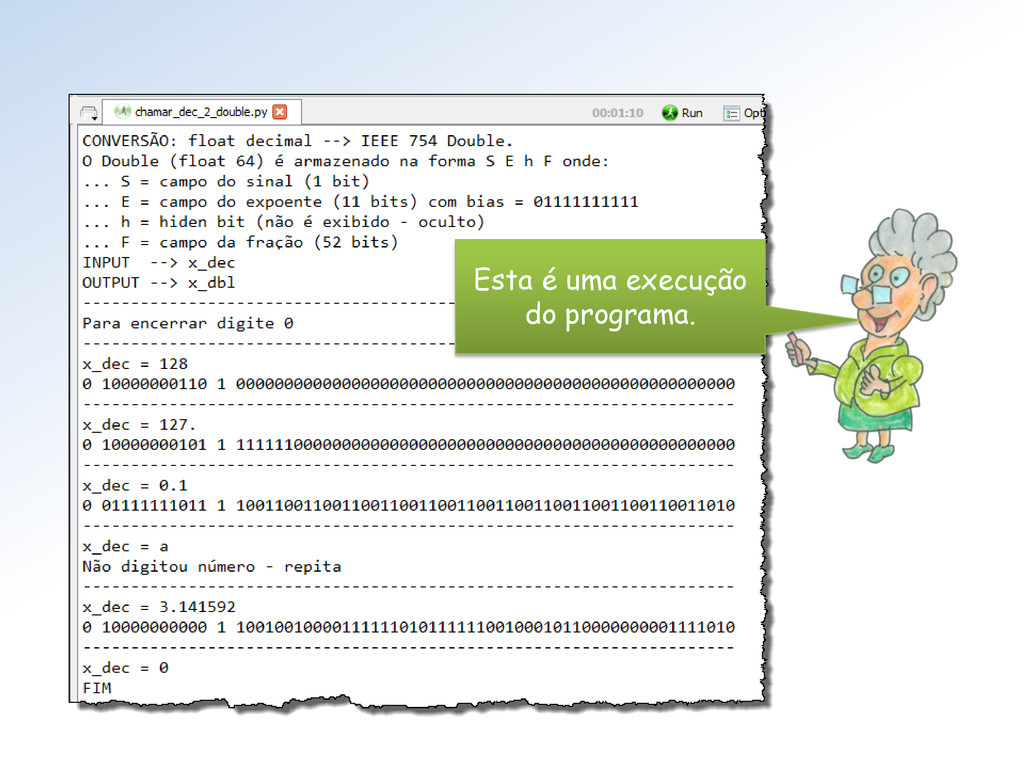
conv_dec_x_IEEE.py. Ela: • recebe um número decimal em ponto flutuante • e retorna sua representação binária em double do padrão IEEE 754/2008 Na próxima aula, mostraremos outras funções desse módulo. -
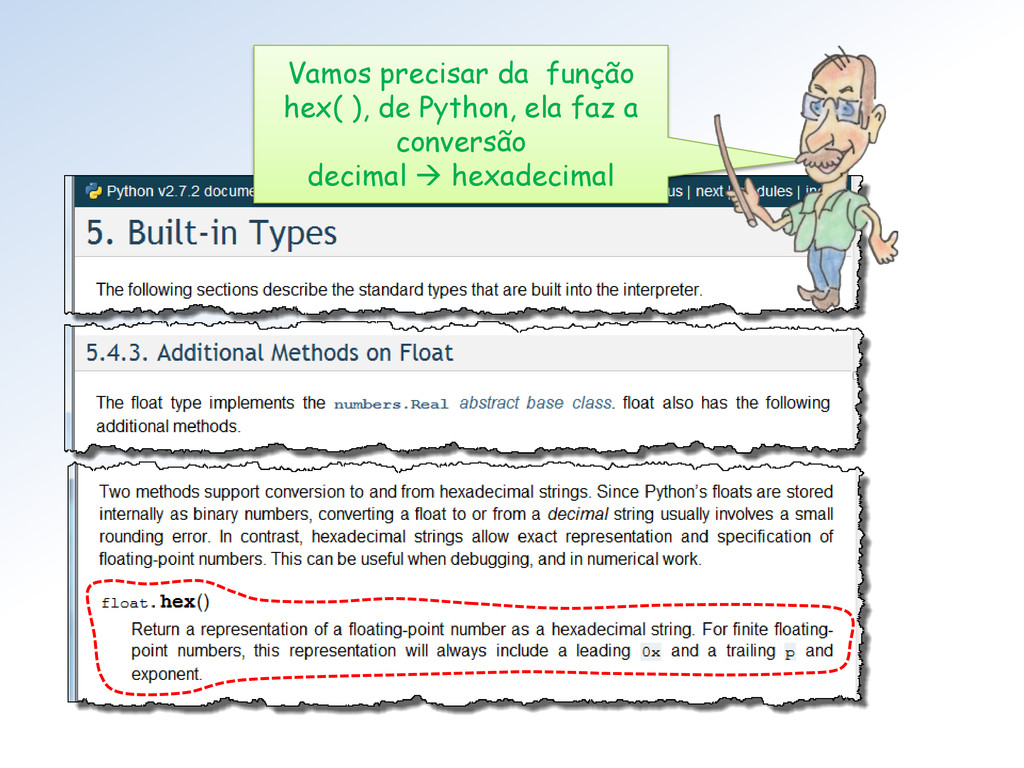
Vamos precisar da função hex( ), de Python, ela faz
a conversão decimal hexadecimal -
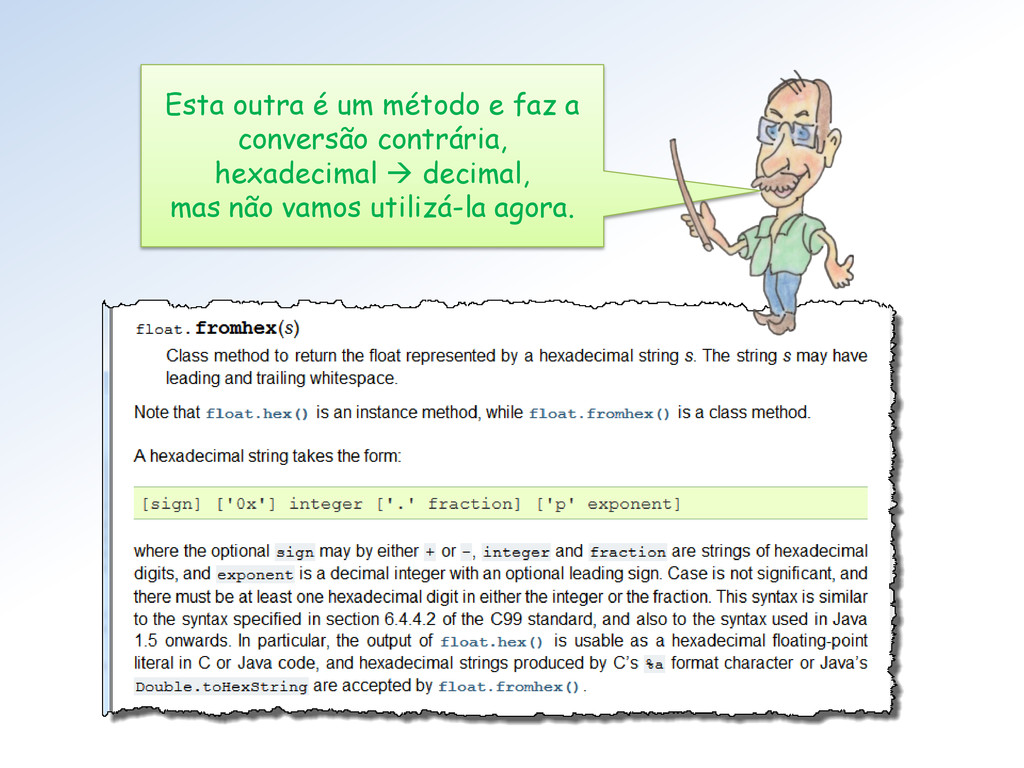
Esta outra é um método e faz a conversão contrária,
hexadecimal decimal, mas não vamos utilizá-la agora. -
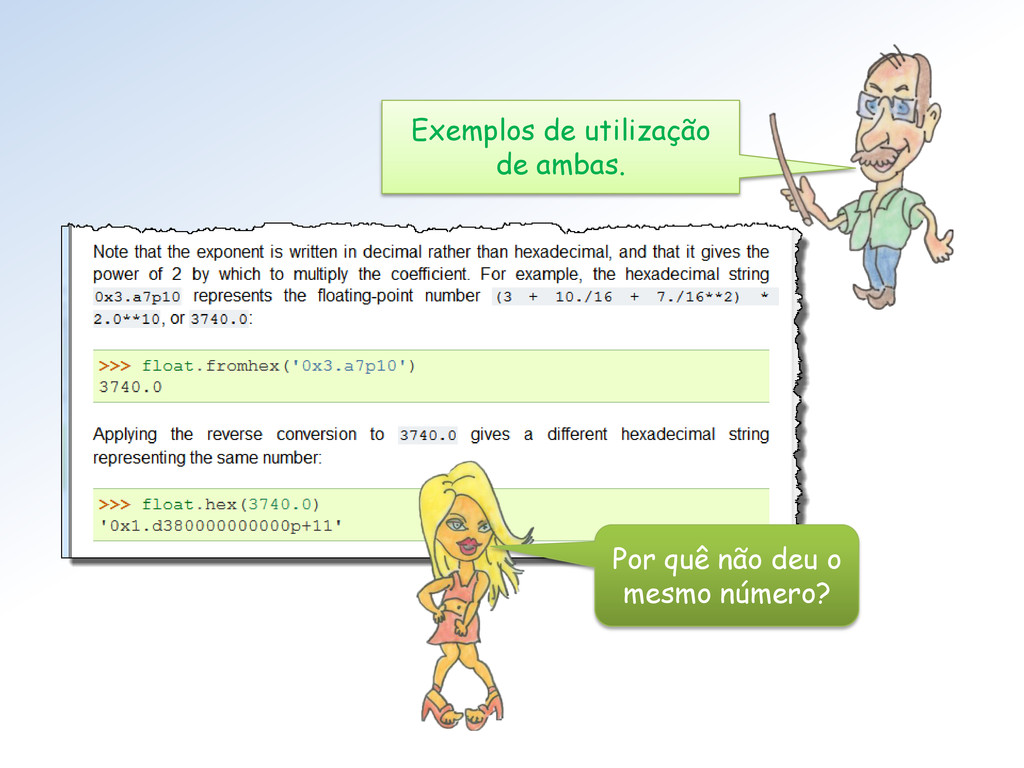
Exemplos de utilização de ambas. Por quê não deu o
mesmo número? -
Nosso programa receberá (enquanto o usuário quiser) um numeral decimal
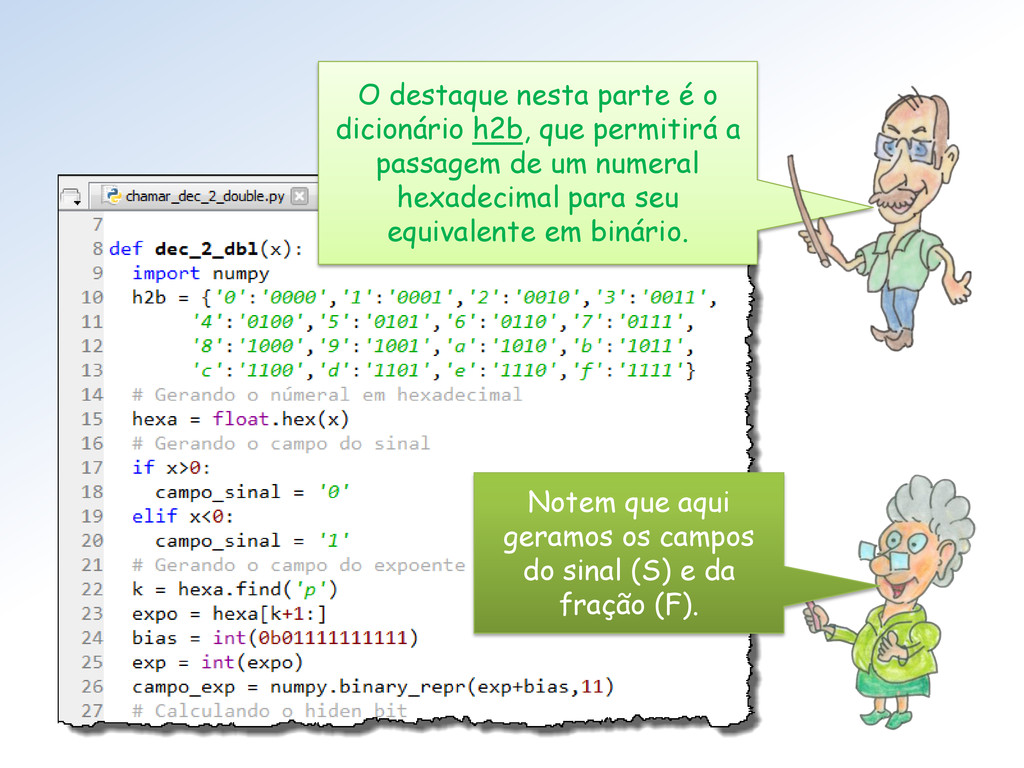
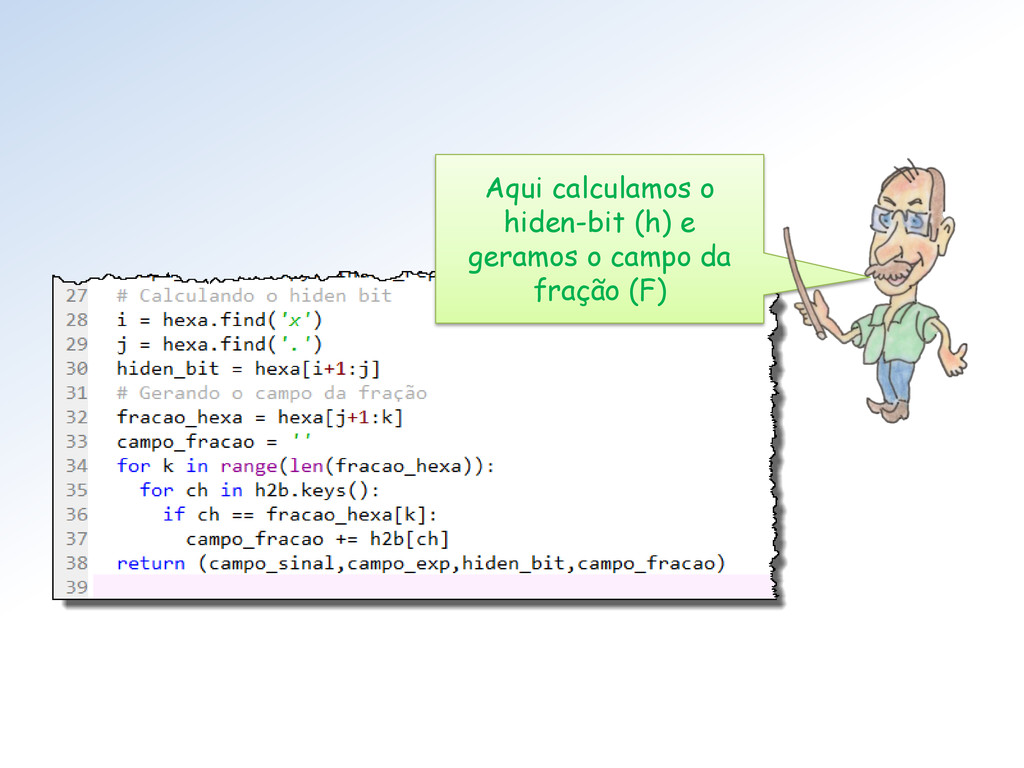
x que será convertido um float f (decimal). Em seguida f será convertido em numa string hexadecimal: hexa = float. hex( f). Depois, cada parte dessa string hexa será utilizada para gerar os campos • S (do sinal), • E (do expoente), • h (o hiden-bit), • F (da fração) da representação IEEE 754 Double do número. -
O destaque nesta parte é o dicionário h2b, que permitirá
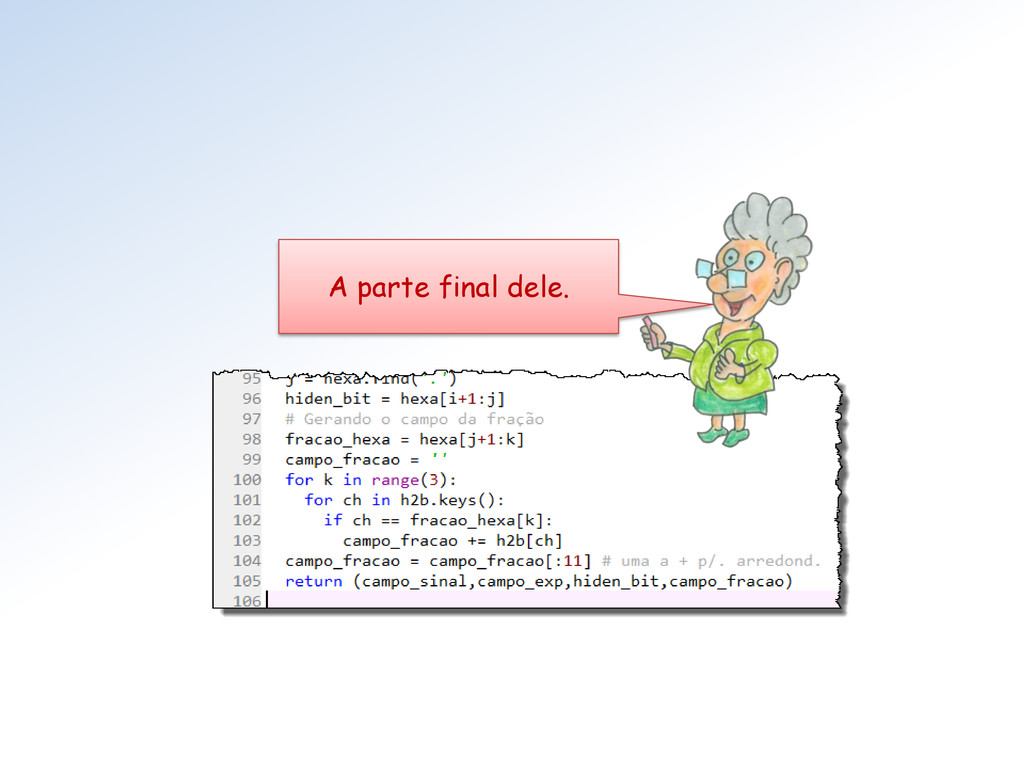
a passagem de um numeral hexadecimal para seu equivalente em binário. Notem que aqui geramos os campos do sinal (S) e da fração (F). -
Na aula passada, mostramos a ida: Decimal → IEEE 754
Double A volta, IEEE 754 Double → Decimal, é mais simples. Vejam: -
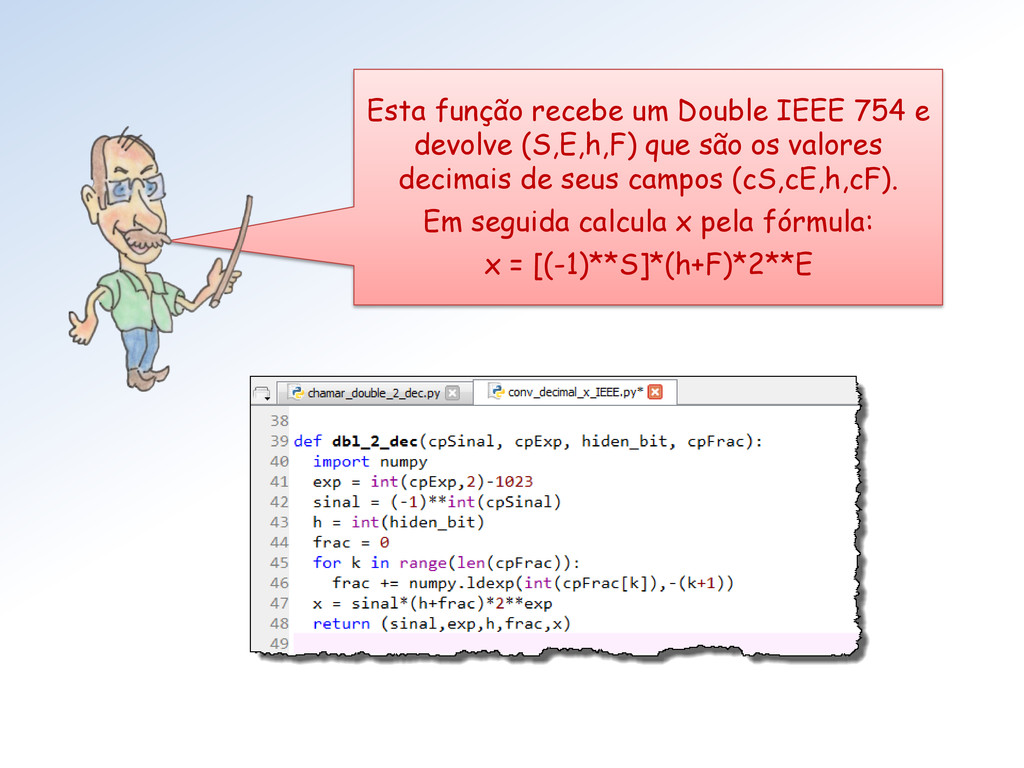
Esta função recebe um Double IEEE 754 e devolve (S,E,h,F)
que são os valores decimais de seus campos (cS,cE,h,cF). Em seguida calcula x pela fórmula: x = [(-1)**S]*(h+F)*2**E -
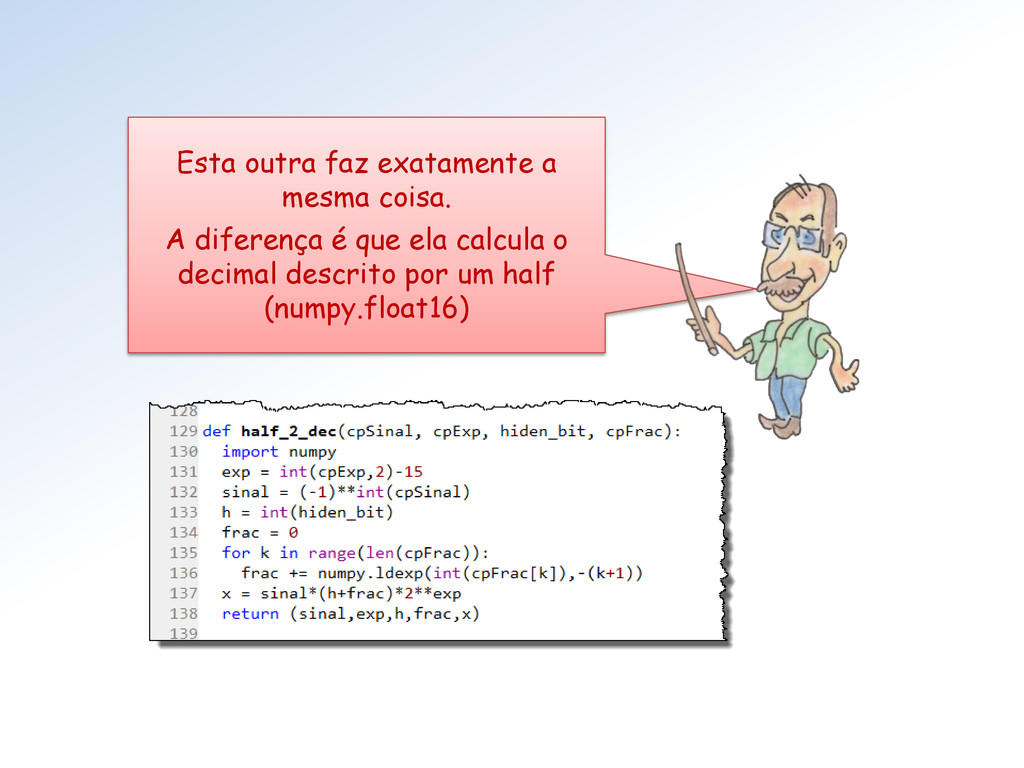
Esta outra faz exatamente a mesma coisa. A diferença é
que ela calcula o decimal descrito por um half (numpy.float16) -
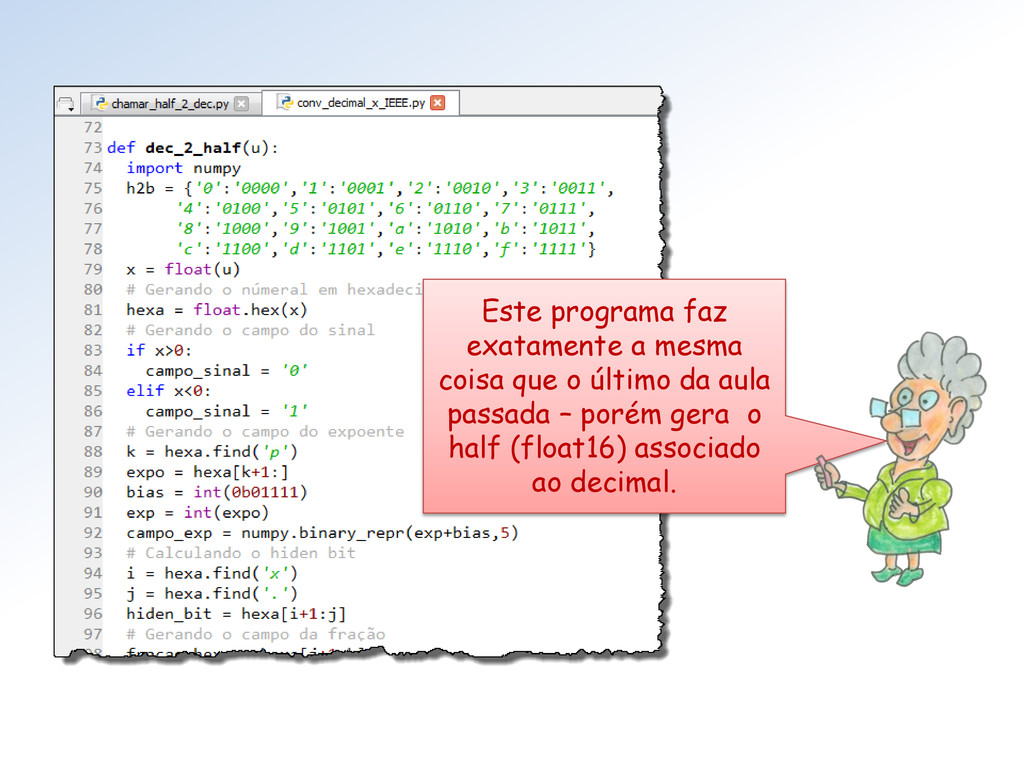
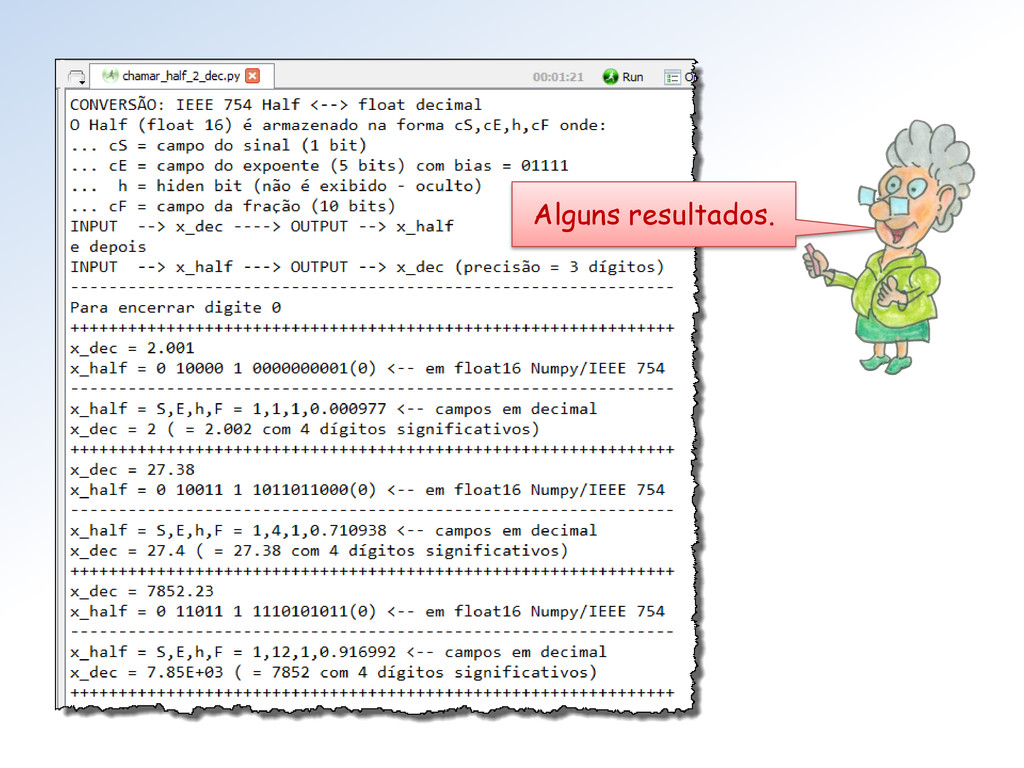
Este programa faz exatamente a mesma coisa que o último
da aula passada – porém gera o half (float16) associado ao decimal. -
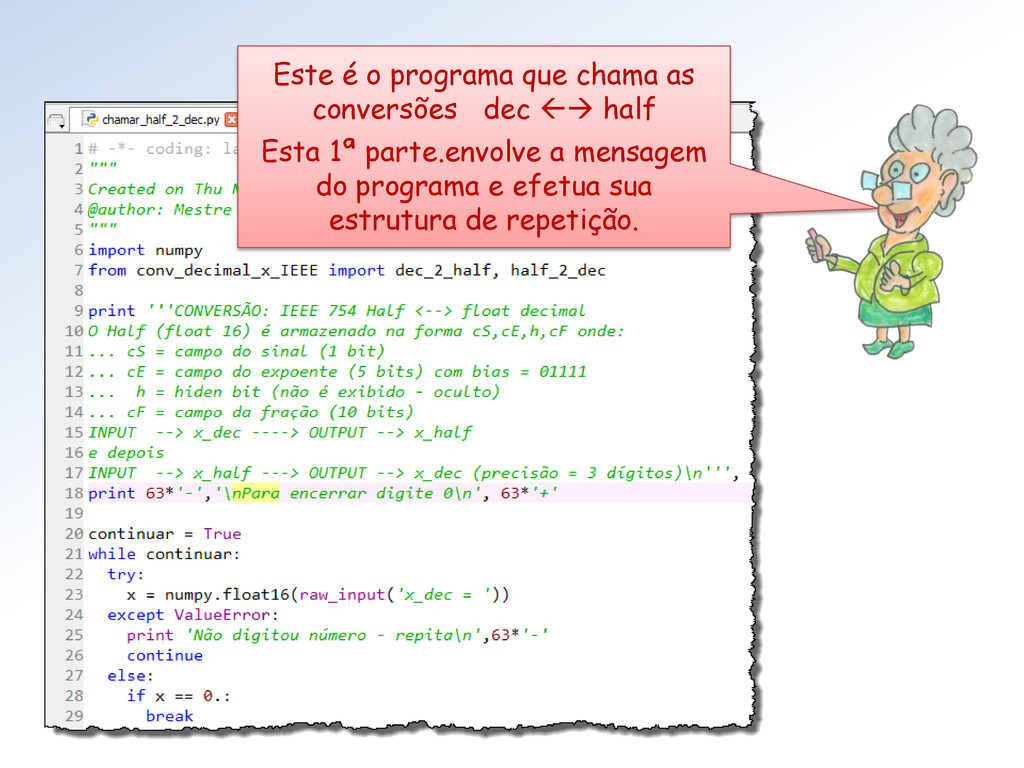
Este é o programa que chama as conversões dec
half Esta 1ª parte.envolve a mensagem do programa e efetua sua estrutura de repetição. -
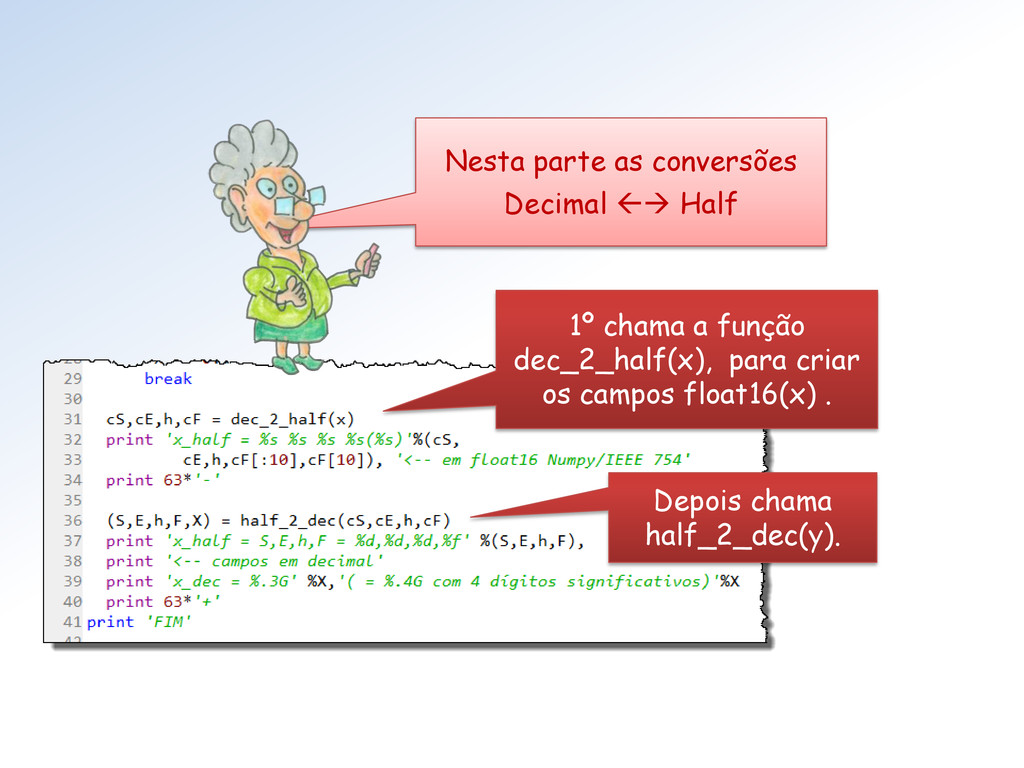
Nesta parte as conversões Decimal Half 1º chama a
função dec_2_half(x), para criar os campos float16(x) . Depois chama half_2_dec(y).