Share
Embed
Sistemas lineares, métodos iterativos estacionários
Veja a apresentação no site do Professor Bordoni!
Paulo Bordoni
June 23, 2016
Transcript
89 slides
-
Começaremos entendo o que é uma norma matricial. O conceito
será fundamental para o estudo da convergência dos métodos iterativos. -
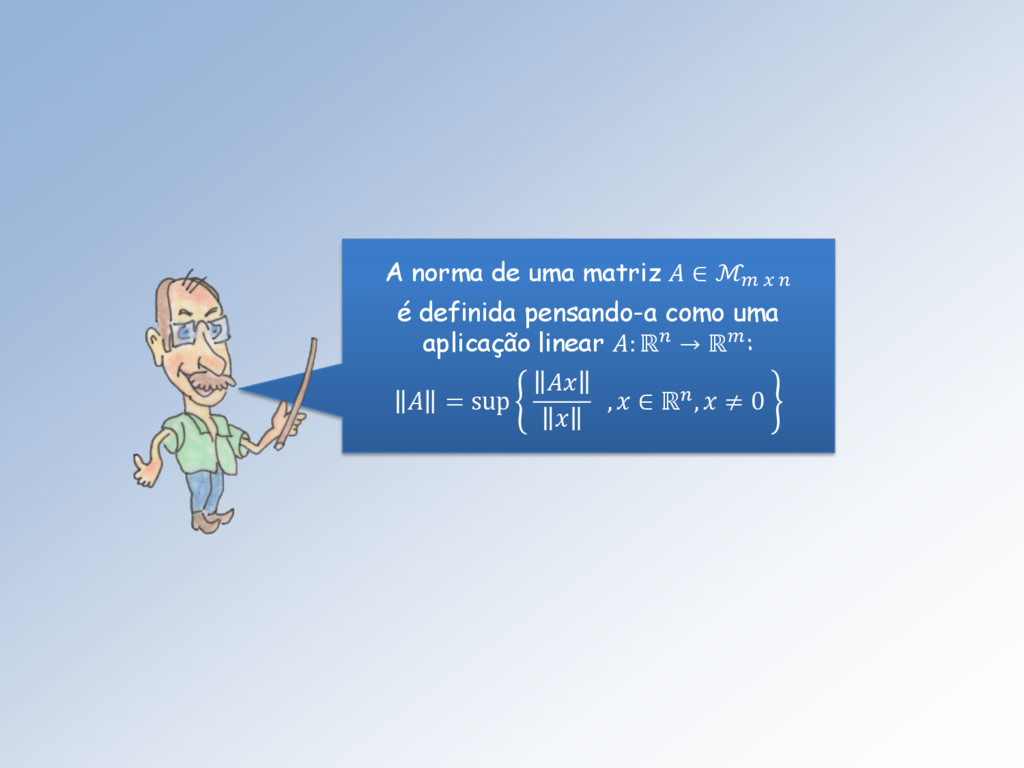
A norma de uma matriz ∈ ℳ é definida pensando-a
como uma aplicação linear : ℝ → ℝ: = sup , ∈ ℝ, ≠ 0 -
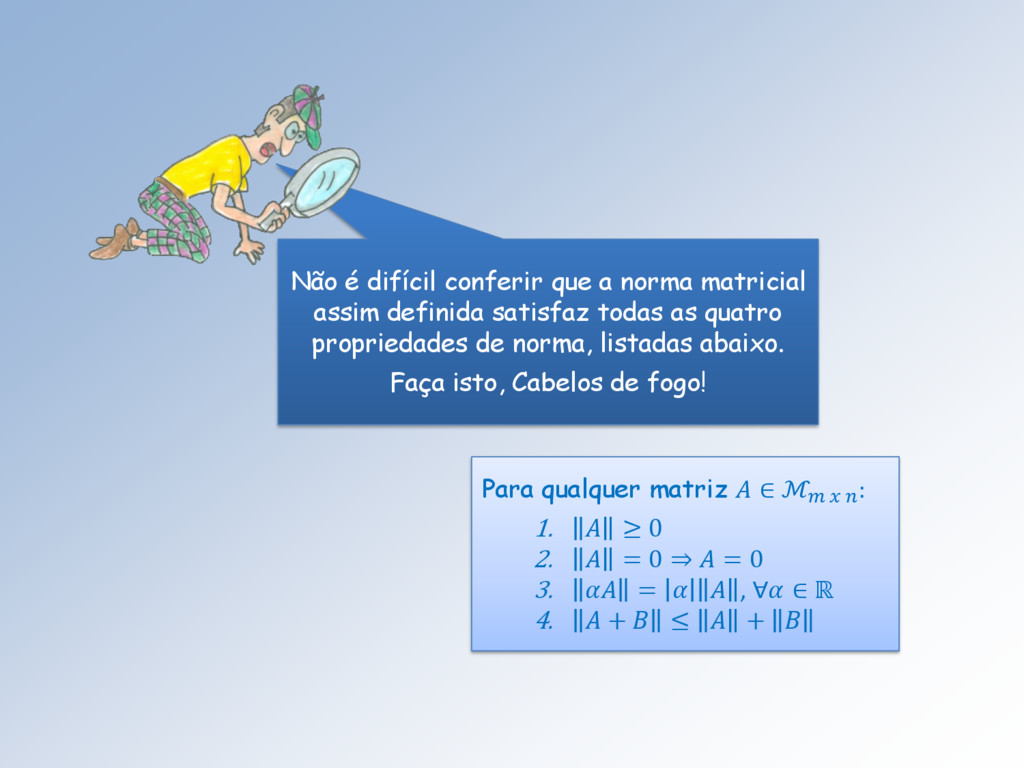
Não é difícil conferir que a norma matricial assim definida
satisfaz todas as quatro propriedades de norma, listadas abaixo. Faça isto, Cabelos de fogo! Para qualquer matriz ∈ ℳ : 1. ≥ 0 2. = 0 ⇒ = 0 3. = , ∀ ∈ ℝ 4. + ≤ + -
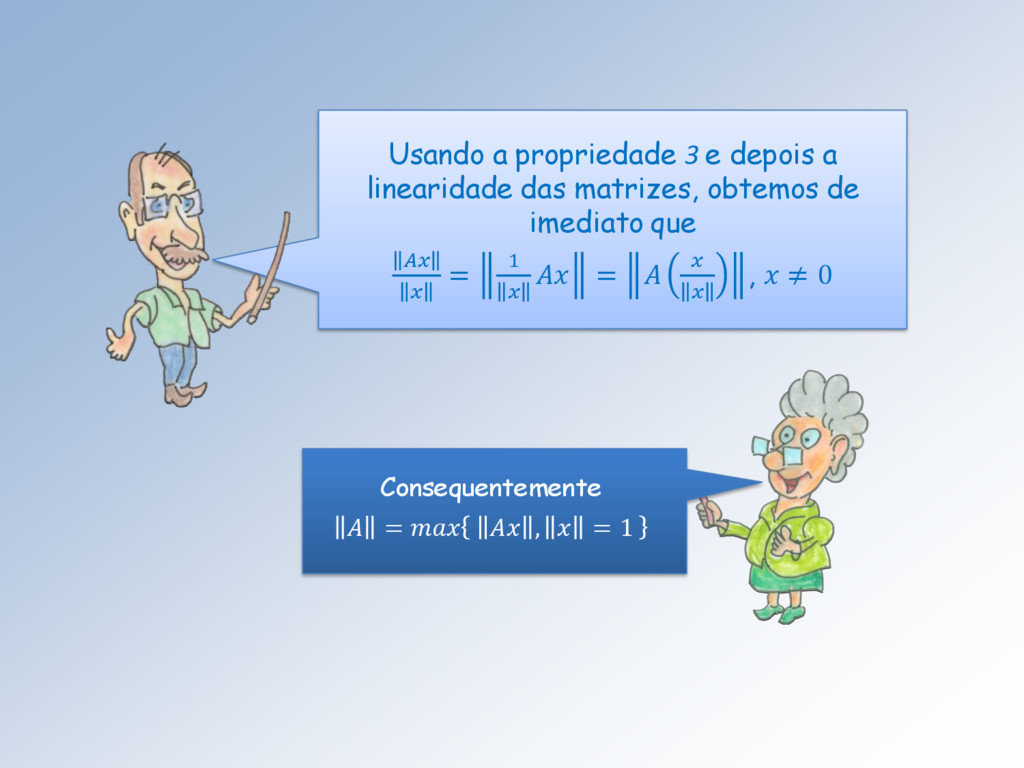
Consequentemente = , = 1 Usando a propriedade 3 e
depois a linearidade das matrizes, obtemos de imediato que = 1 = , ≠ 0 -
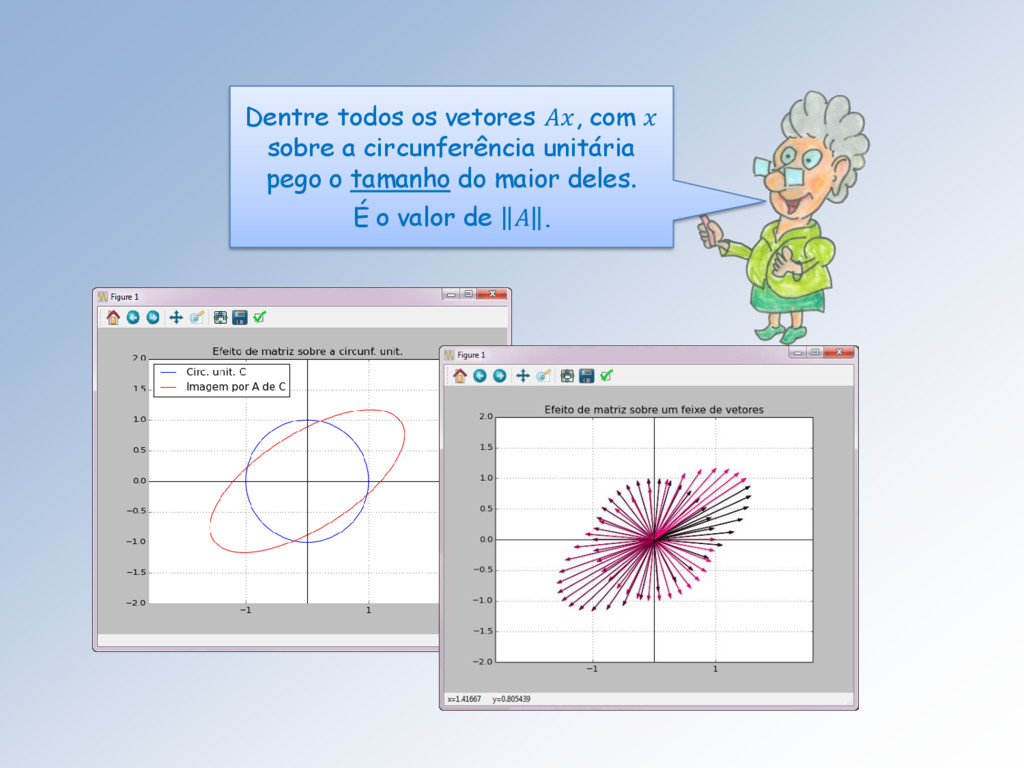
Dentre todos os vetores , com sobre a circunferência unitária
pego o tamanho do maior deles. É o valor de . -
Claro coleguinha! Em outras palavras mede a deformação máxima que
matriz A causa na circunferência unitária. -
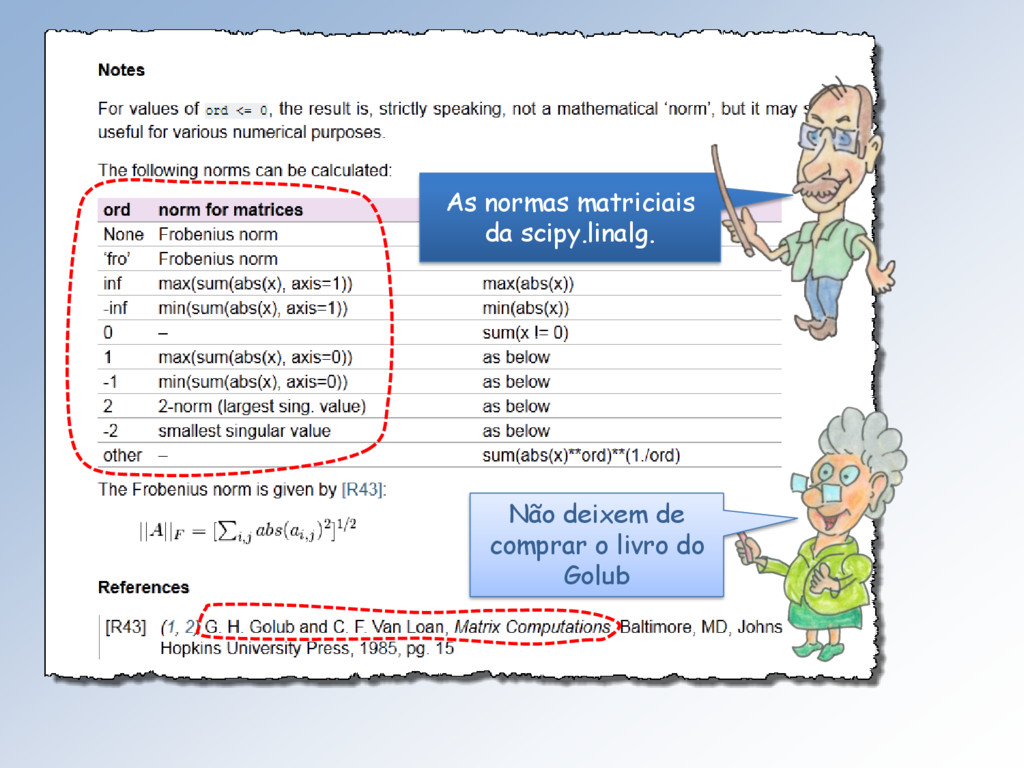
Meu rapaz, lá na scipy.linalg, vimos a função norma, tanto
para matrizes como para vetores. Esqueceu? Na prática, como eu calculo a 2 de uma matriz A? -
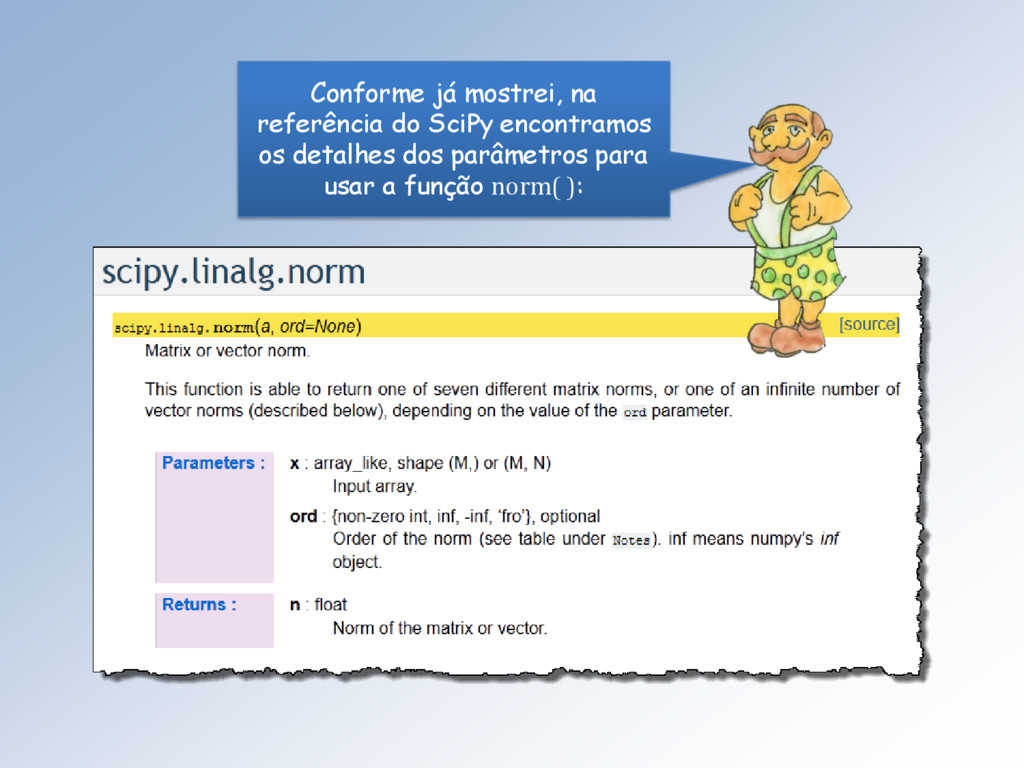
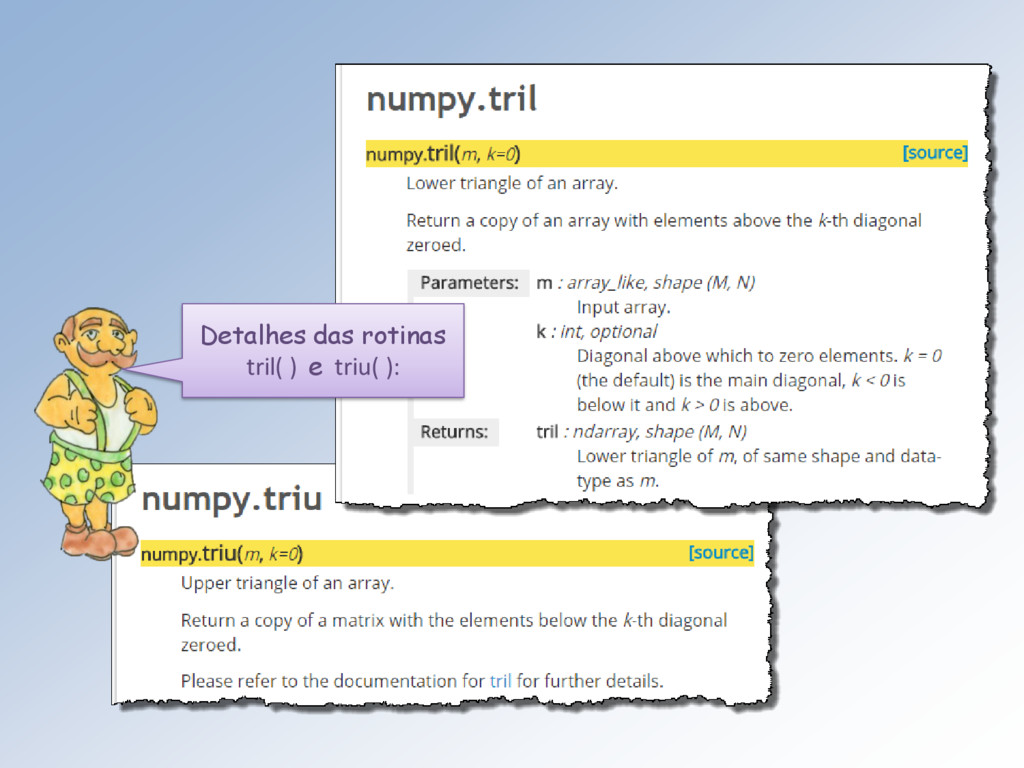
Conforme já mostrei, na referência do SciPy encontramos os detalhes
dos parâmetros para usar a função norm( ): -
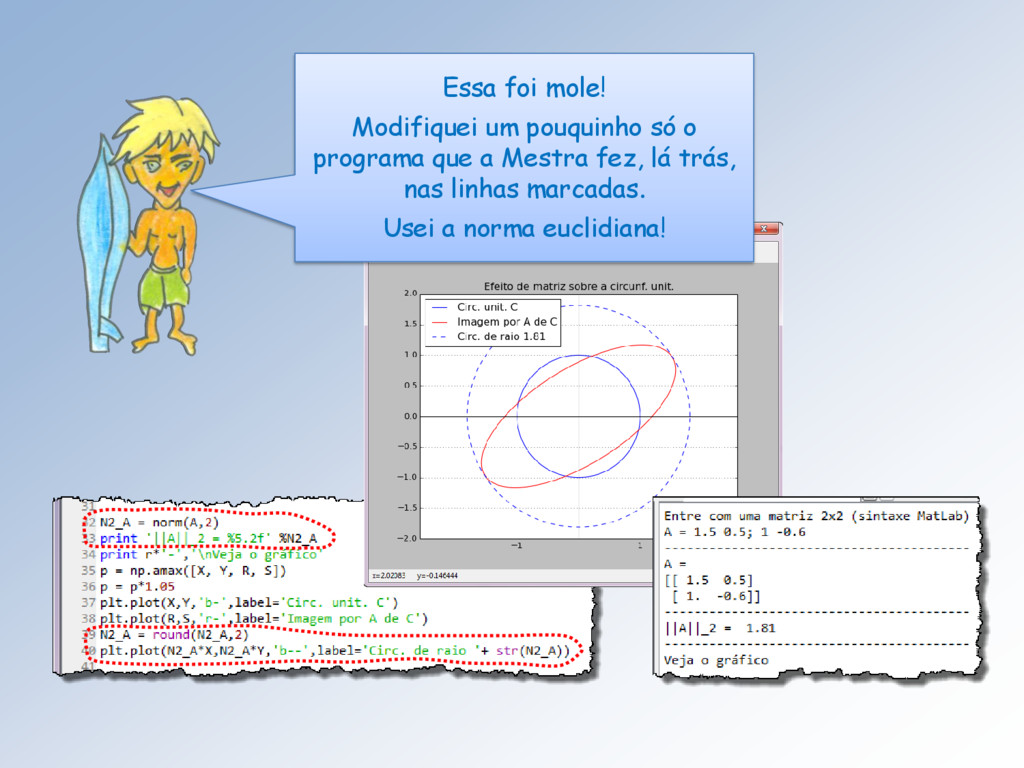
Essa foi mole! Modifiquei um pouquinho só o programa que
a Mestra fez, lá trás, nas linhas marcadas. Usei a norma euclidiana! -
Já vimos métodos diretos para resolução de sistemas lineares e
métodos iterativos para resolução de equações. Passaremos aos métodos iterativos para resolução de sistemas de equações. -
Agora vamos esses conceitos à resolução de sistemas lineares. Surfista,
acabamos de ver espaços métricos e também o conceito de ponto-fixo. Subimos nos ombros de gigantes pensando no futuro. -
Construiremos três métodos iterativos de ponto-fixo para resolver o sistema
linear = , conhecidos na literatura como métodos estacionários. Como desejamos achar uma “raiz” da equação vetorial () = 0, onde = − , procuraremos por pontos-fixo de alguma função linear = + obtida através de manipulação algébrica de (). -
Para tudo funcionar, precisaremos garantir que a () seja uma
contração. E como podemos garantir que essa : ℝ → ℝ é uma contração, Mestra? -
Para responder tua pergunta, Loirinha apresentaremos antes resultados importantes sobre
normas vetoriais e matriciais e limites de sequências em ℝ geradas por funções : ℝ → ℝ do tipo = + . -
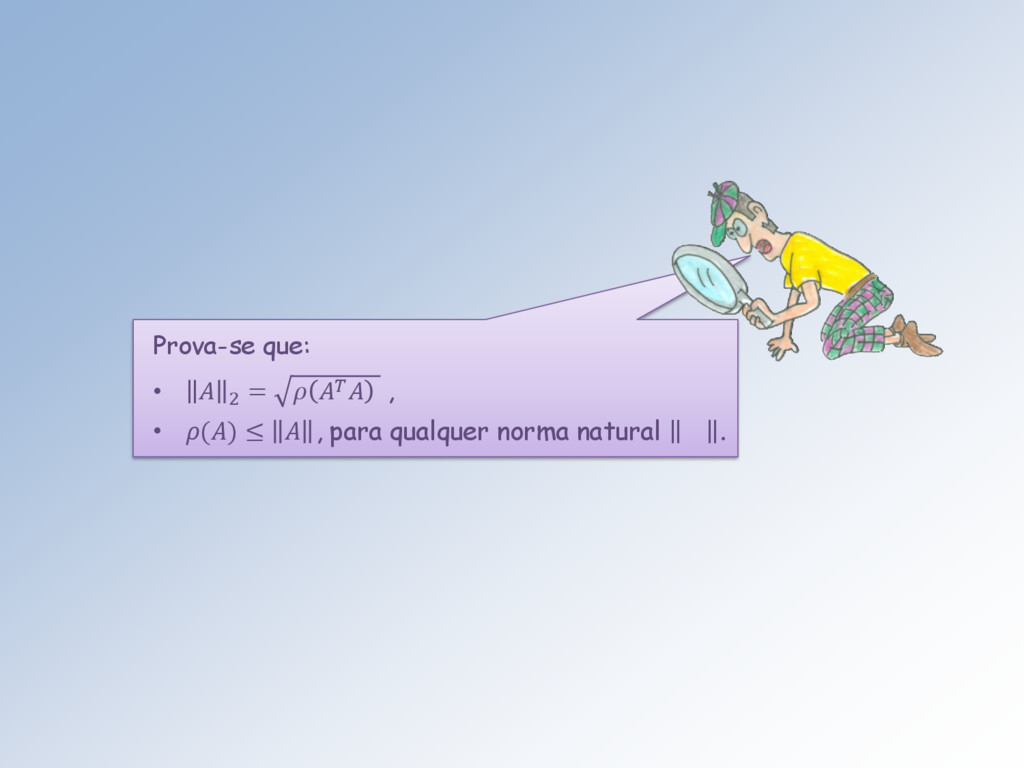
Prova-se que: • 2 = , • () ≤ ,
para qualquer norma natural . -
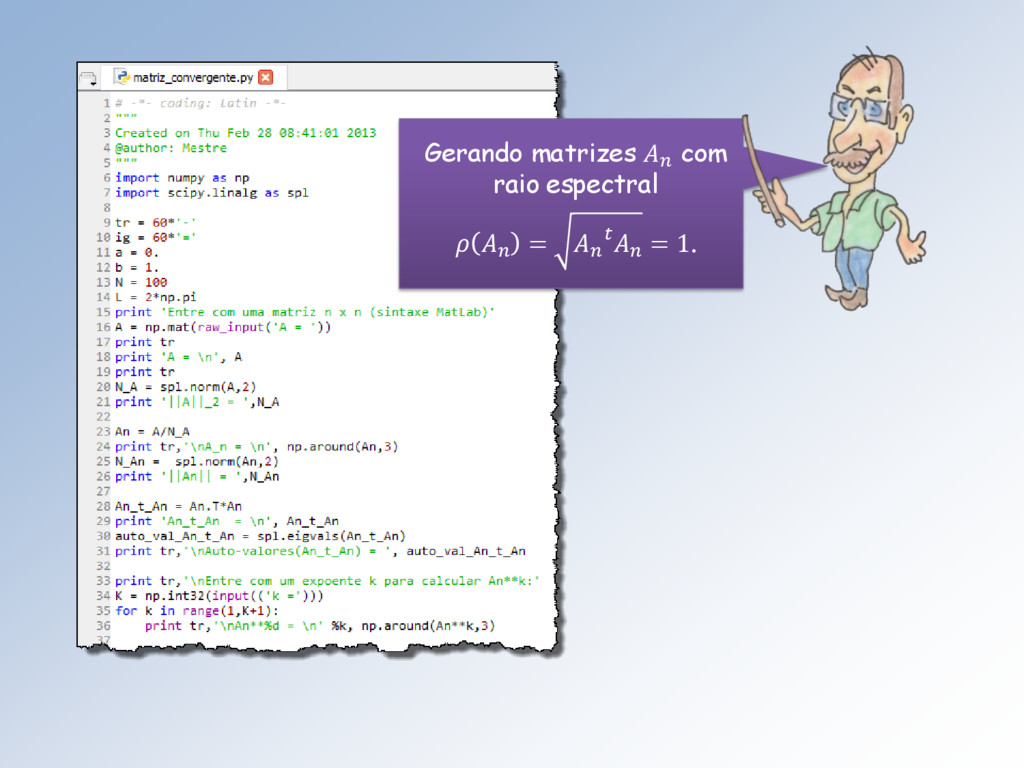
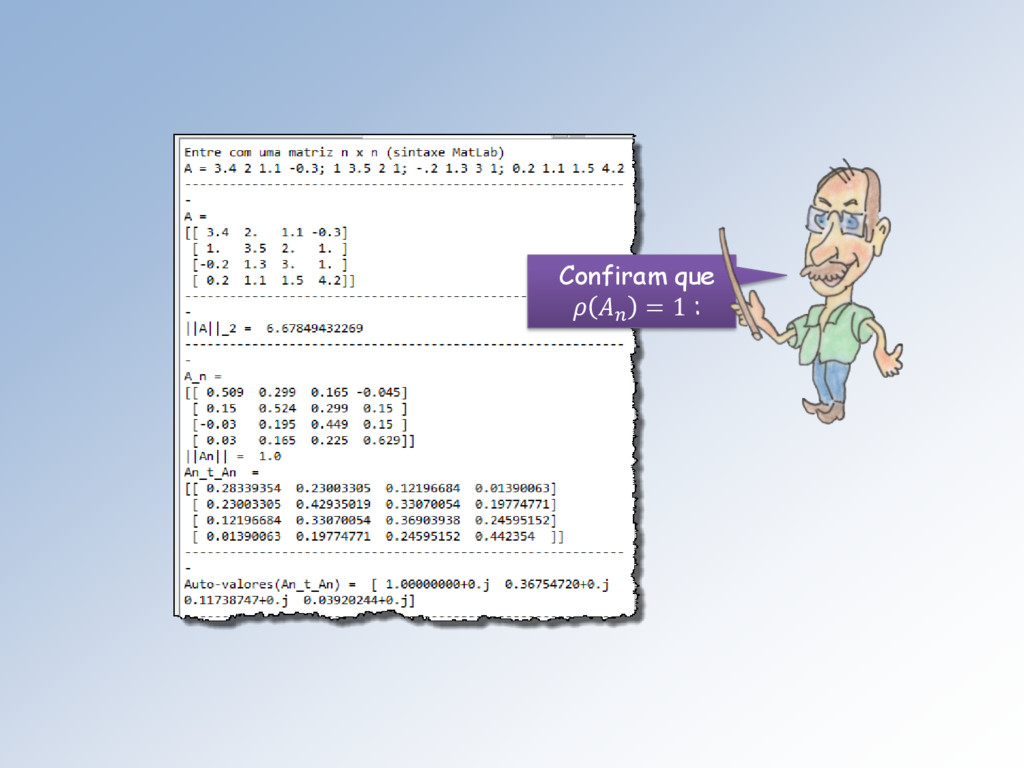
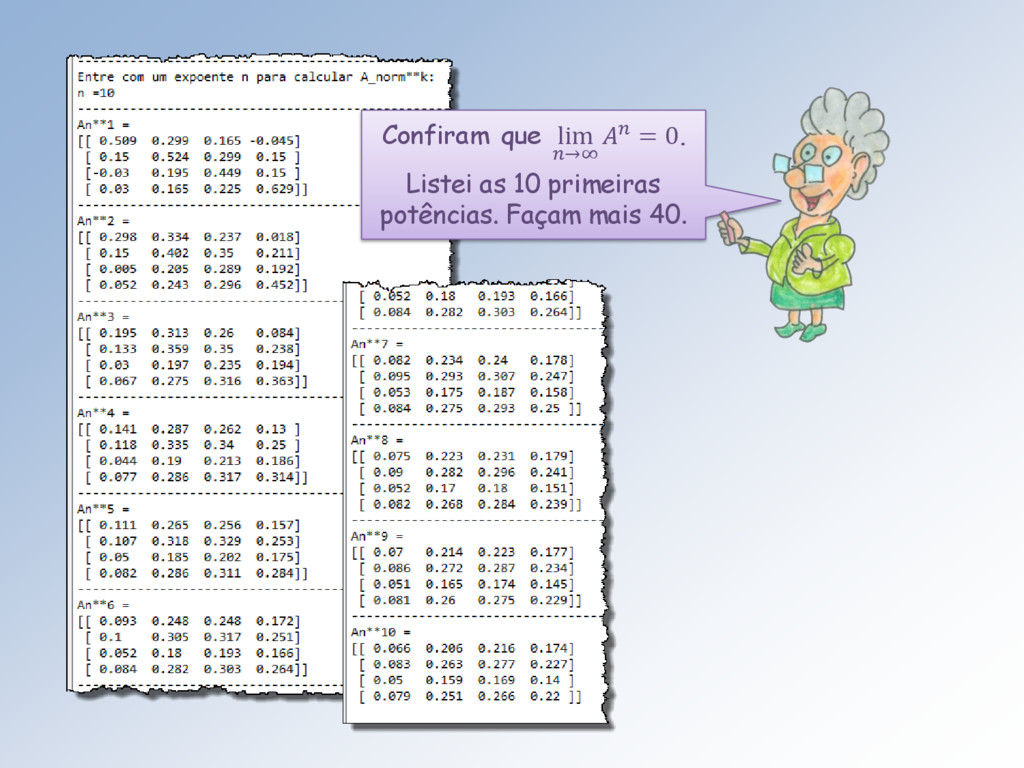
Confiram que lim →∞ = 0. Listei as 10 primeiras
potências. Façam mais 40. -
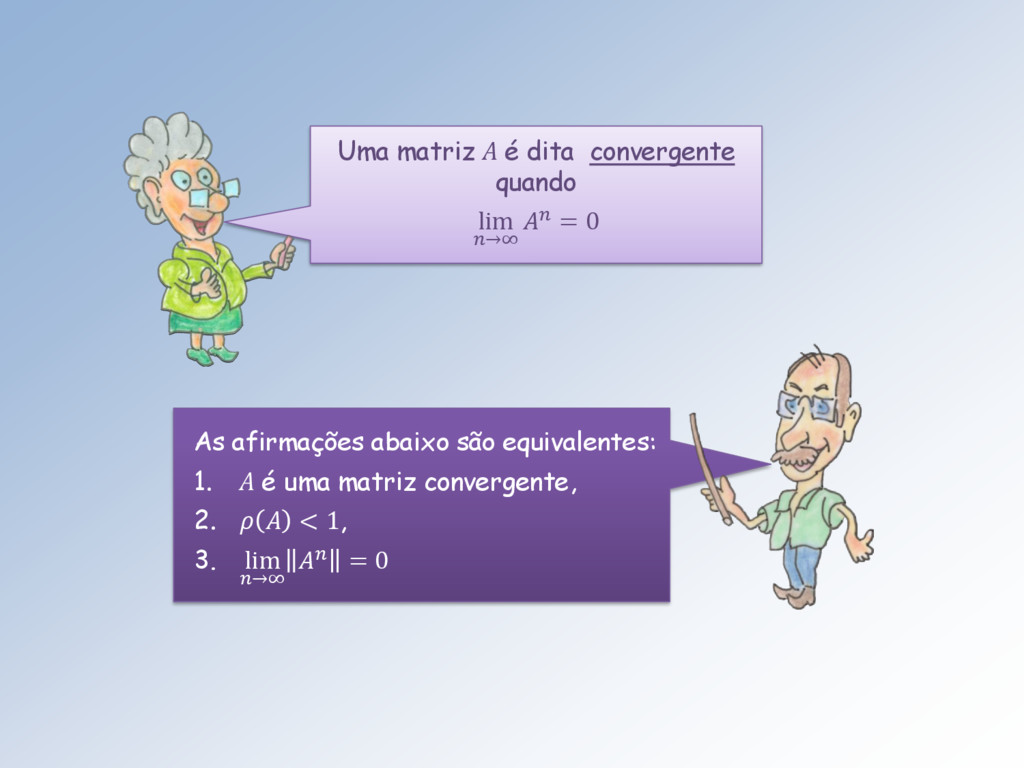
Uma matriz A é dita convergente quando lim →∞ =
0 As afirmações abaixo são equivalentes: 1. A é uma matriz convergente, 2. < 1, 3. lim →∞ = 0 -
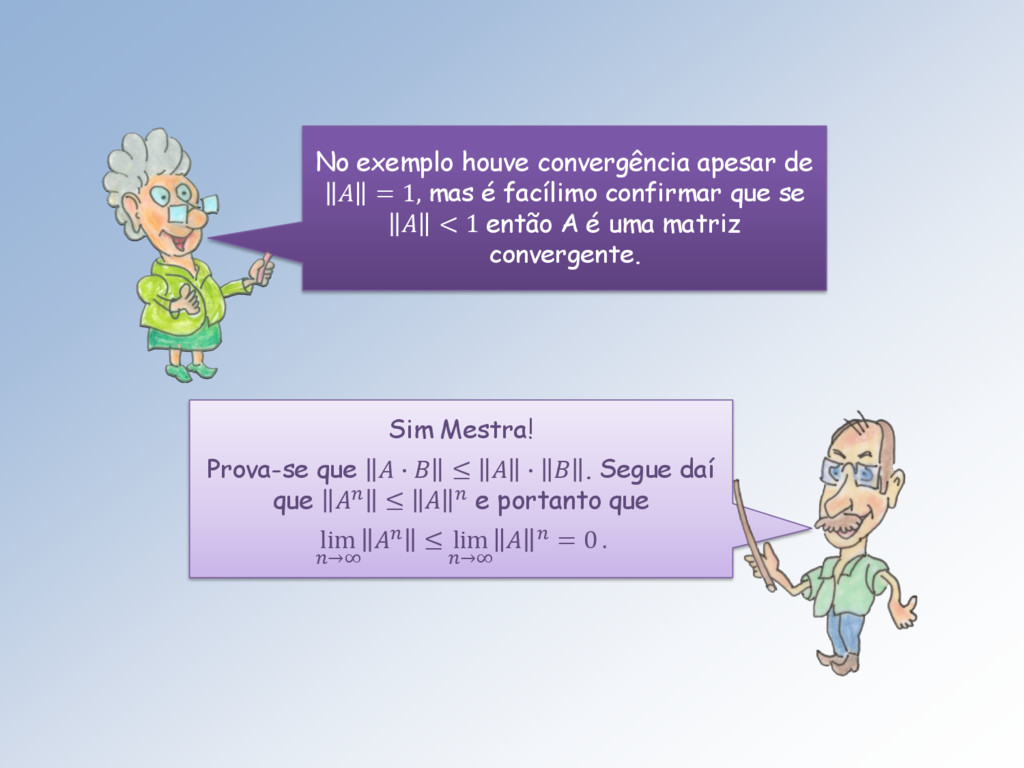
No exemplo houve convergência apesar de = 1, mas é
facílimo confirmar que se < 1 então A é uma matriz convergente. Sim Mestra! Prova-se que ∙ ≤ ∙ . Segue daí que ≤ e portanto que lim →∞ ≤ lim →∞ = 0 . -
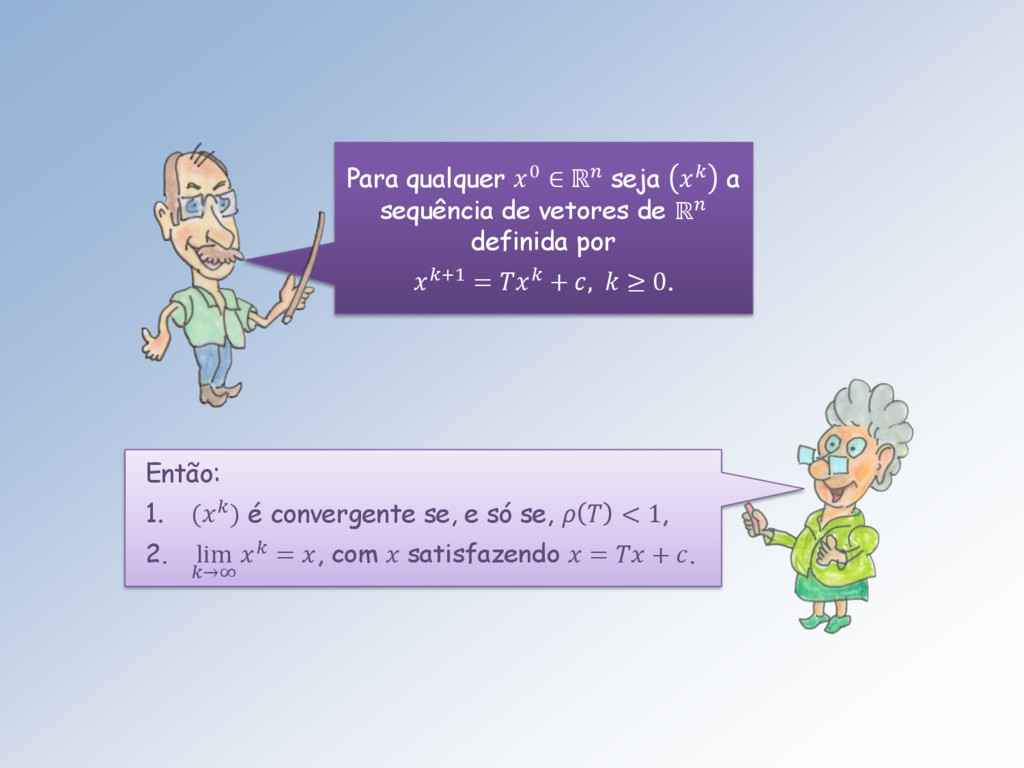
Para qualquer 0 ∈ ℝ seja a sequência de vetores
de ℝ definida por +1 = + , ≥ 0. Então: 1. () é convergente se, e só se, < 1, 2. lim →∞ = , com satisfazendo = + . -
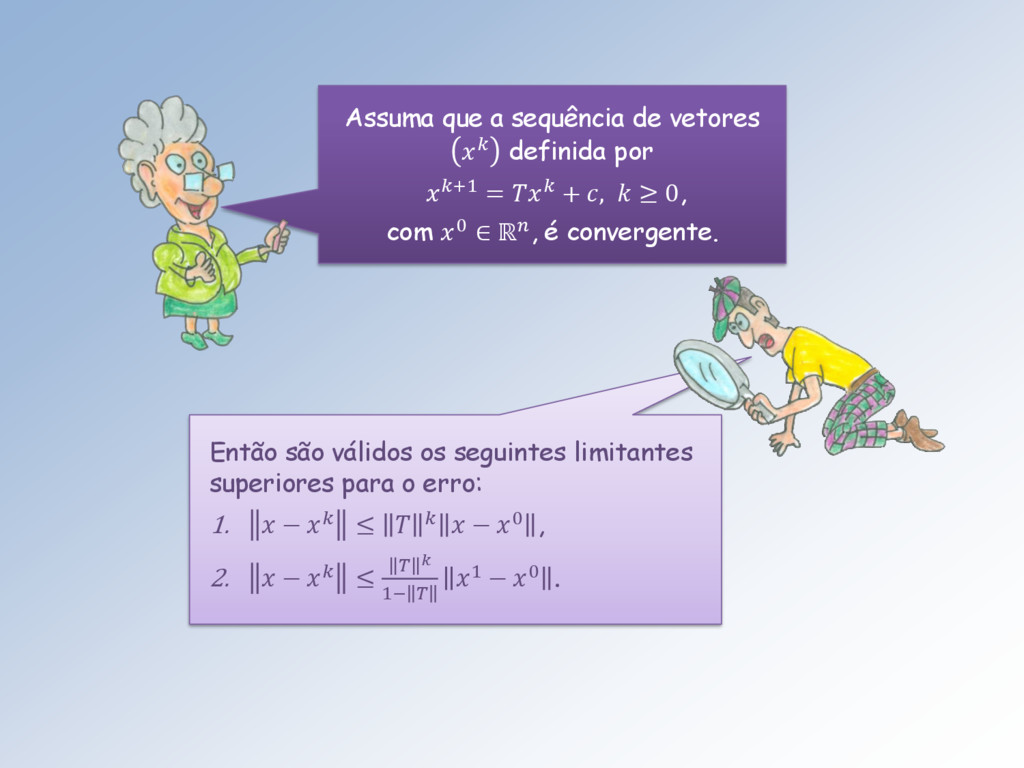
Então são válidos os seguintes limitantes superiores para o erro:
1. − ≤ − 0 , 2. − ≤ 1− 1 − 0 . Assuma que a sequência de vetores definida por +1 = + , ≥ 0, com 0 ∈ ℝ, é convergente. -
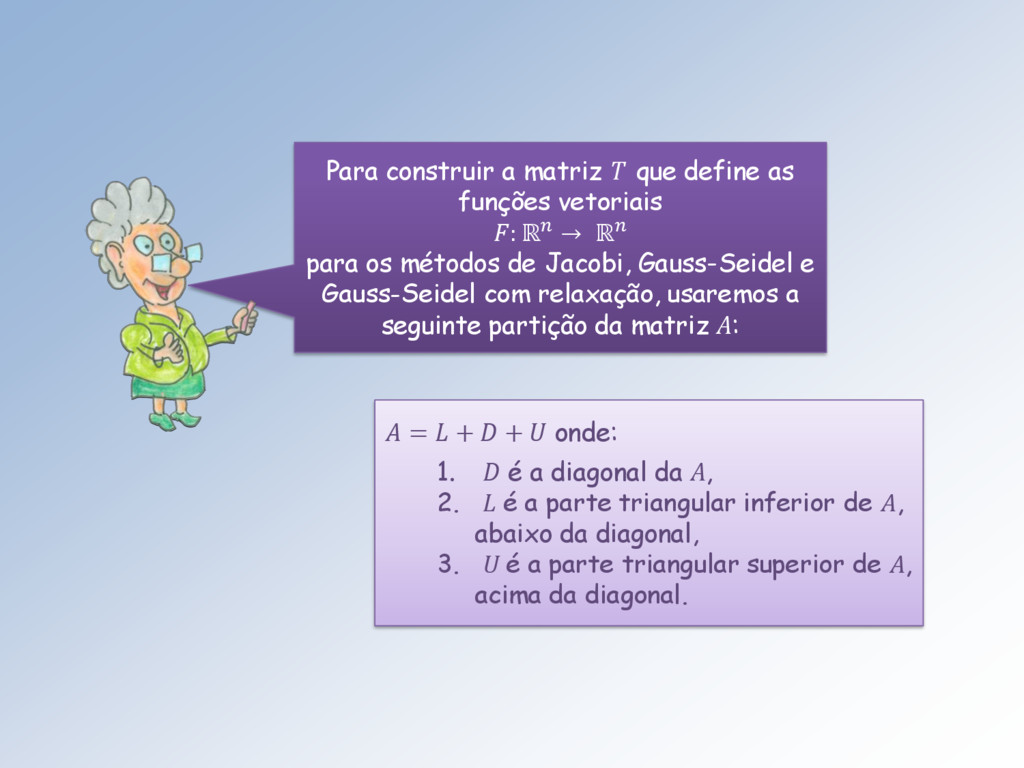
Para construir a matriz T que define as funções vetoriais
: ℝ → ℝ para os métodos de Jacobi, Gauss-Seidel e Gauss-Seidel com relaxação, usaremos a seguinte partição da matriz A: = + + onde: 1. é a diagonal da A, 2. L é a parte triangular inferior de A, abaixo da diagonal, 3. U é a parte triangular superior de A, acima da diagonal. -
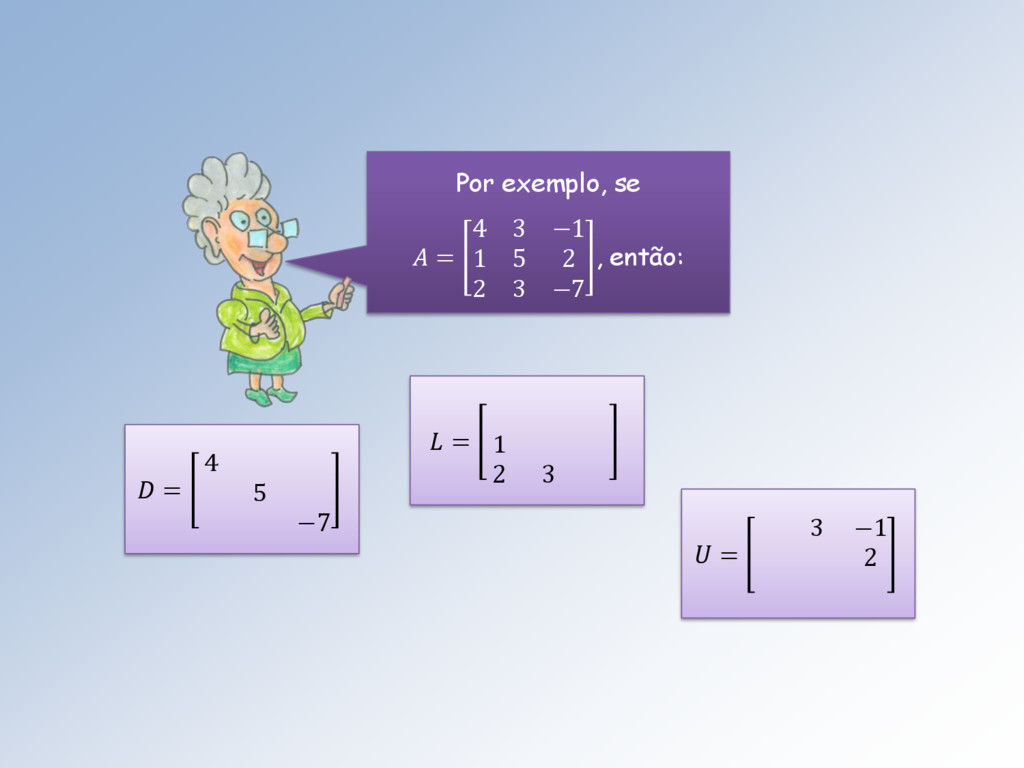
Por exemplo, se = 4 3 −1 1 5 2
2 3 −7 , então: = 4 5 −7 = 1 2 3 = 3 −1 2 -
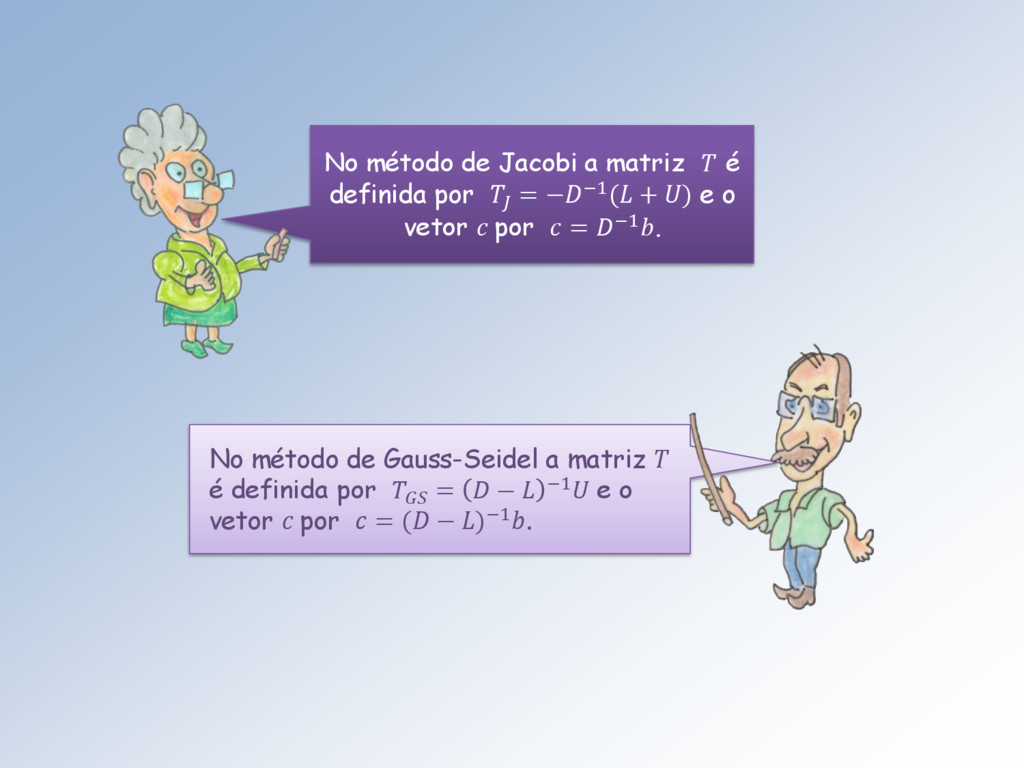
No método de Jacobi a matriz T é definida por
= −−1( + ) e o vetor c por = −1. No método de Gauss-Seidel a matriz T é definida por = − −1 e o vetor c por = ( − )−1. -
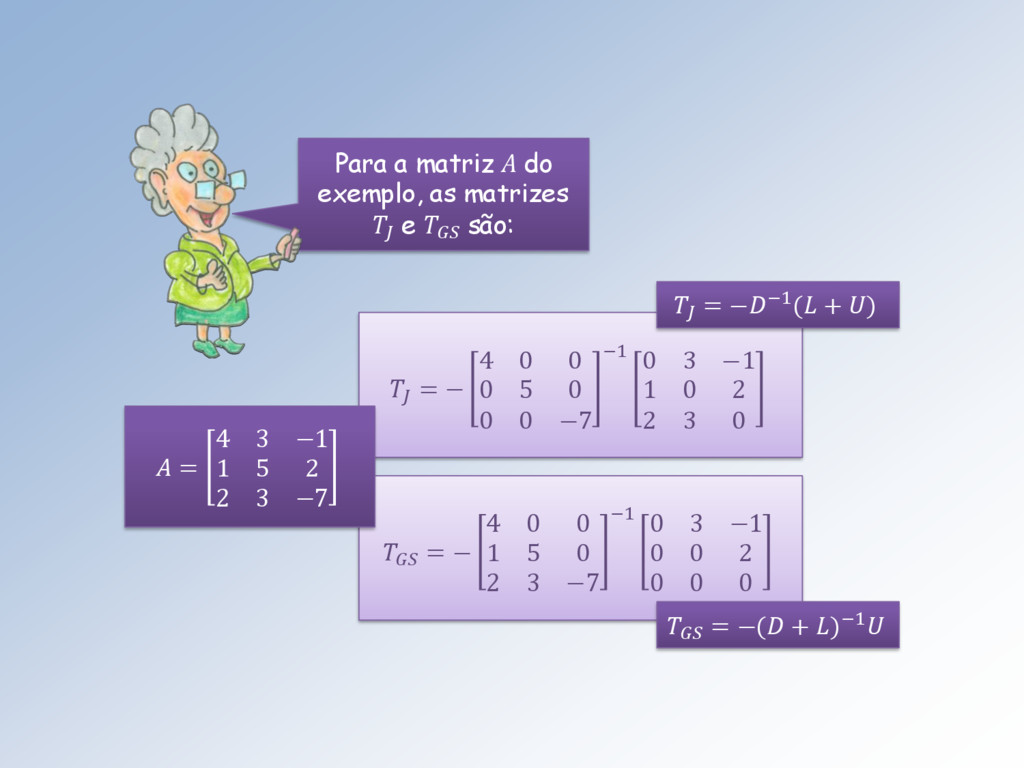
Para a matriz A do exemplo, as matrizes e são:
= − 4 0 0 0 5 0 0 0 −7 −1 0 3 −1 1 0 2 2 3 0 = − 4 0 0 1 5 0 2 3 −7 −1 0 3 −1 0 0 2 0 0 0 = 4 3 −1 1 5 2 2 3 −7 = −−1( + ) = −( + )−1 -
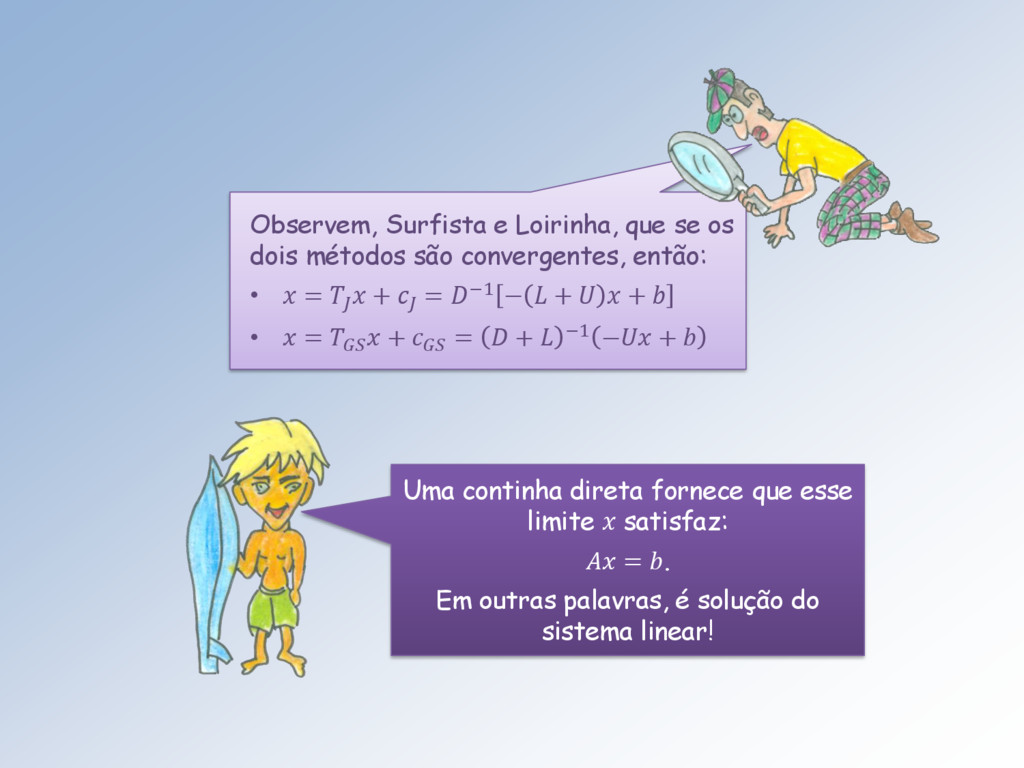
Observem, Surfista e Loirinha, que se os dois métodos são
convergentes, então: • = + = −1 − + + • = + = + −1 − + Uma continha direta fornece que esse limite satisfaz: = . Em outras palavras, é solução do sistema linear! -
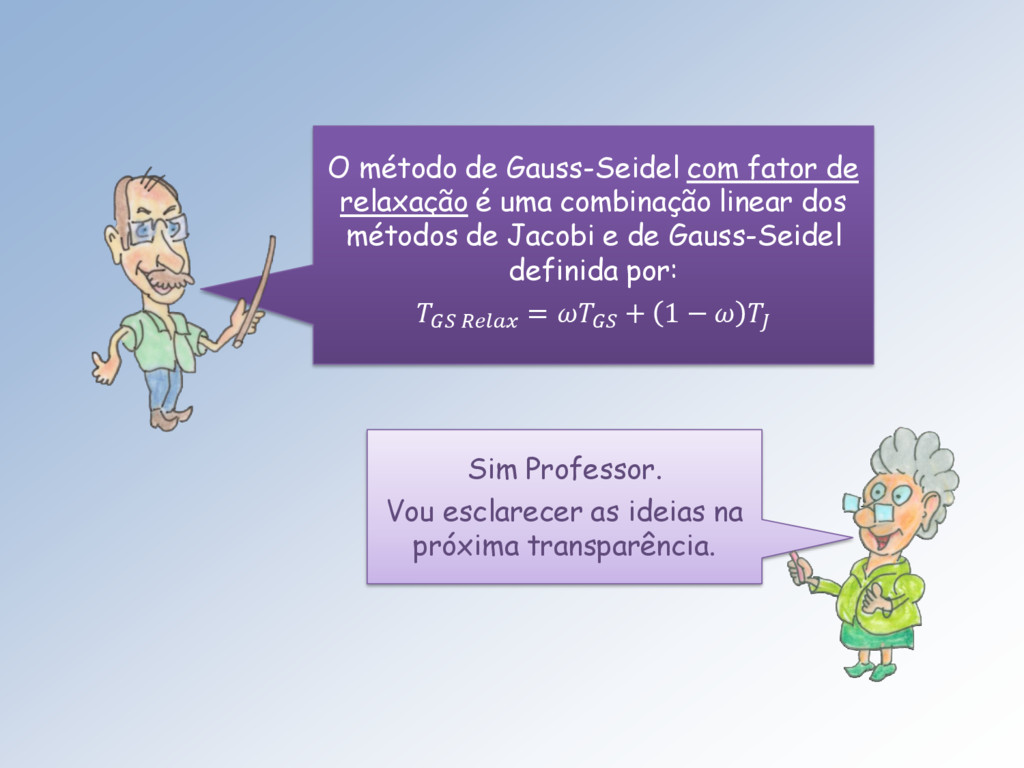
Sim Professor. Vou esclarecer as ideias na próxima transparência. O
método de Gauss-Seidel com fator de relaxação é uma combinação linear dos métodos de Jacobi e de Gauss-Seidel definida por: = + 1 − -
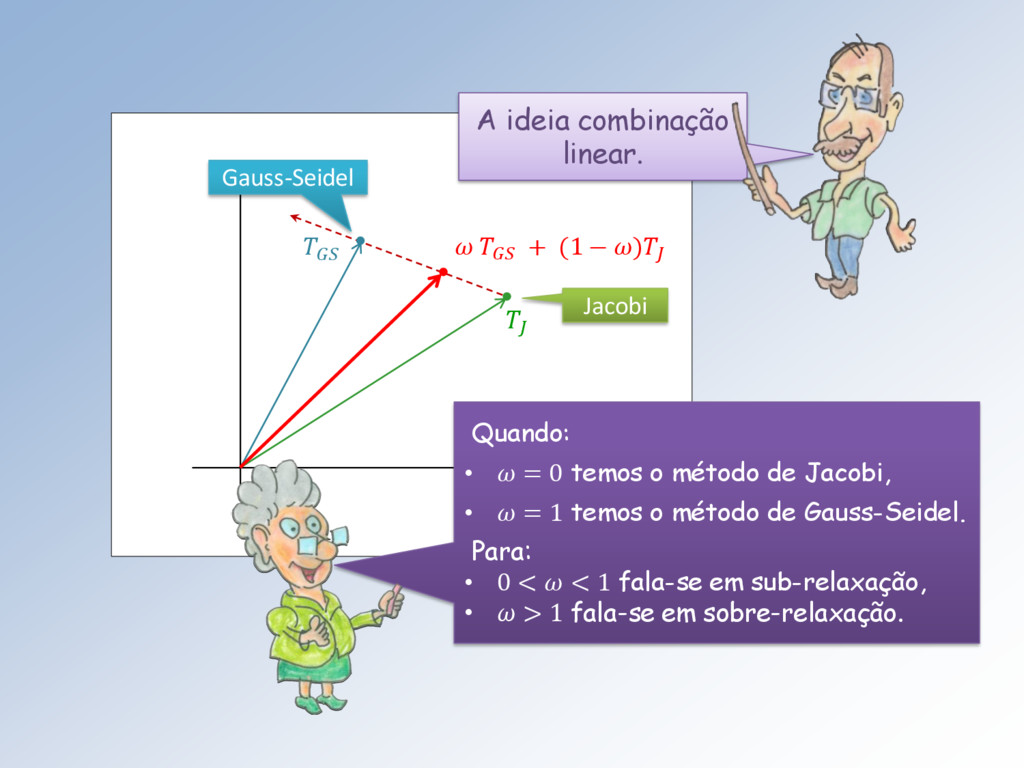
+ (1 − ) A ideia combinação linear. Quando: •
= 0 temos o método de Jacobi, • = 1 temos o método de Gauss-Seidel. Para: • 0 < < 1 fala-se em sub-relaxação, • > 1 fala-se em sobre-relaxação. Jacobi Gauss-Seidel -
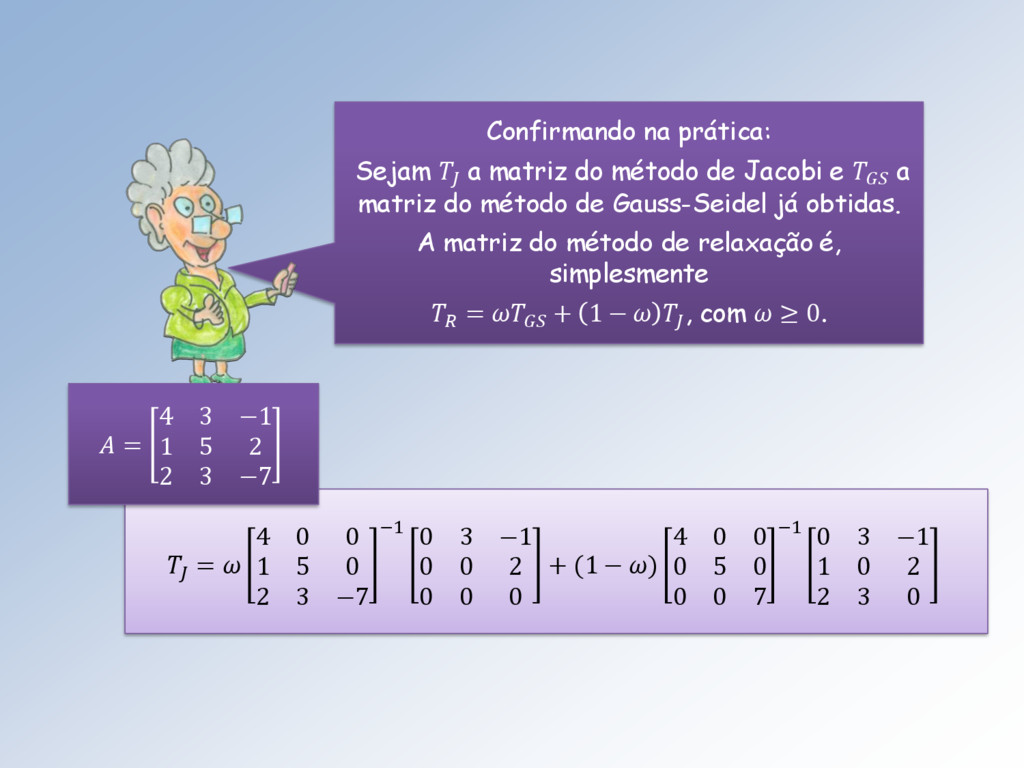
= 4 0 0 1 5 0 2 3 −7
−1 0 3 −1 0 0 2 0 0 0 + (1 − ) 4 0 0 0 5 0 0 0 7 −1 0 3 −1 1 0 2 2 3 0 Confirmando na prática: Sejam a matriz do método de Jacobi e a matriz do método de Gauss-Seidel já obtidas. A matriz do método de relaxação é, simplesmente = + 1 − , com ≥ 0. = 4 3 −1 1 5 2 2 3 −7 -
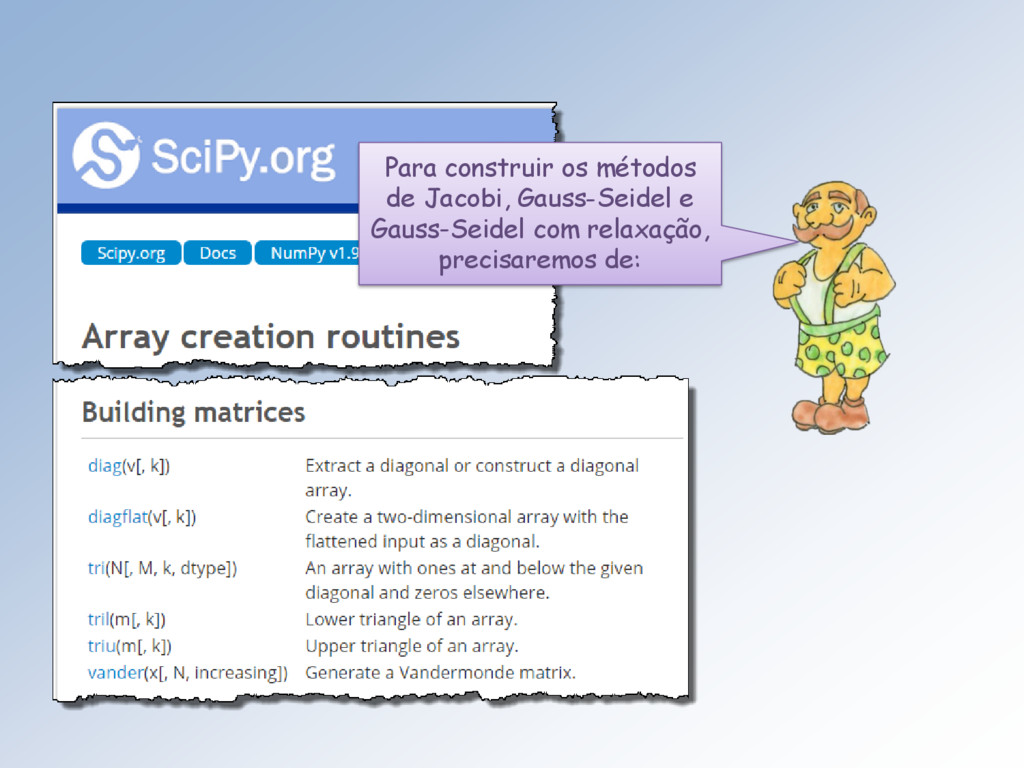
Para construir os métodos de Jacobi, Gauss-Seidel e Gauss-Seidel com
relaxação, precisaremos de: -
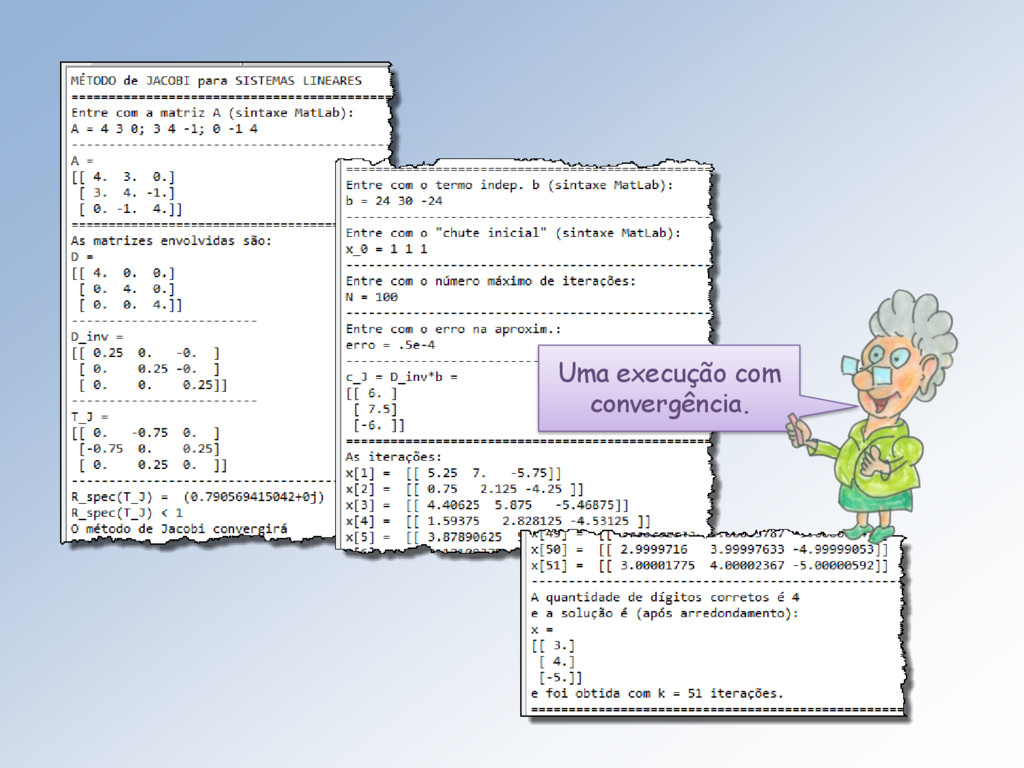
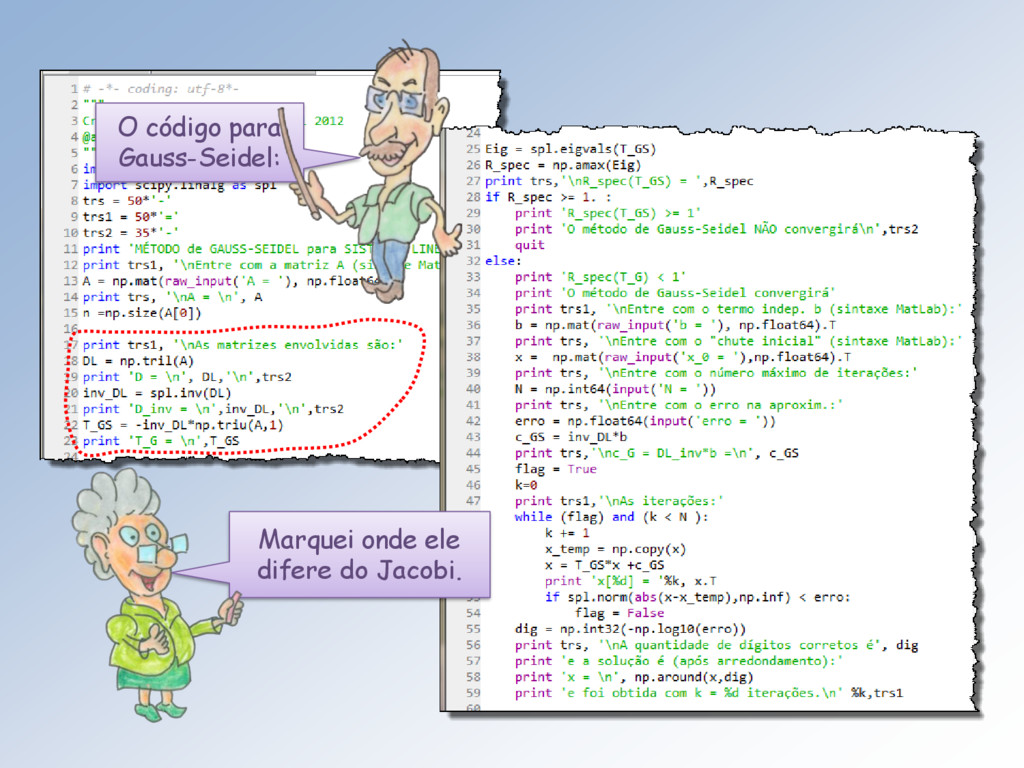
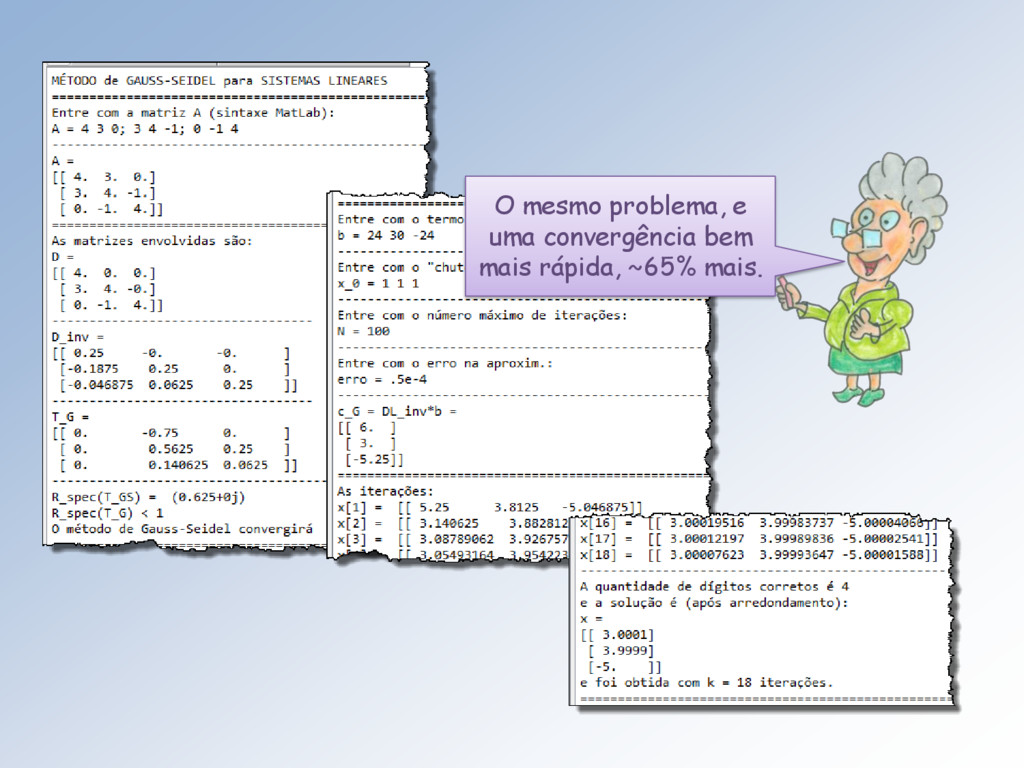
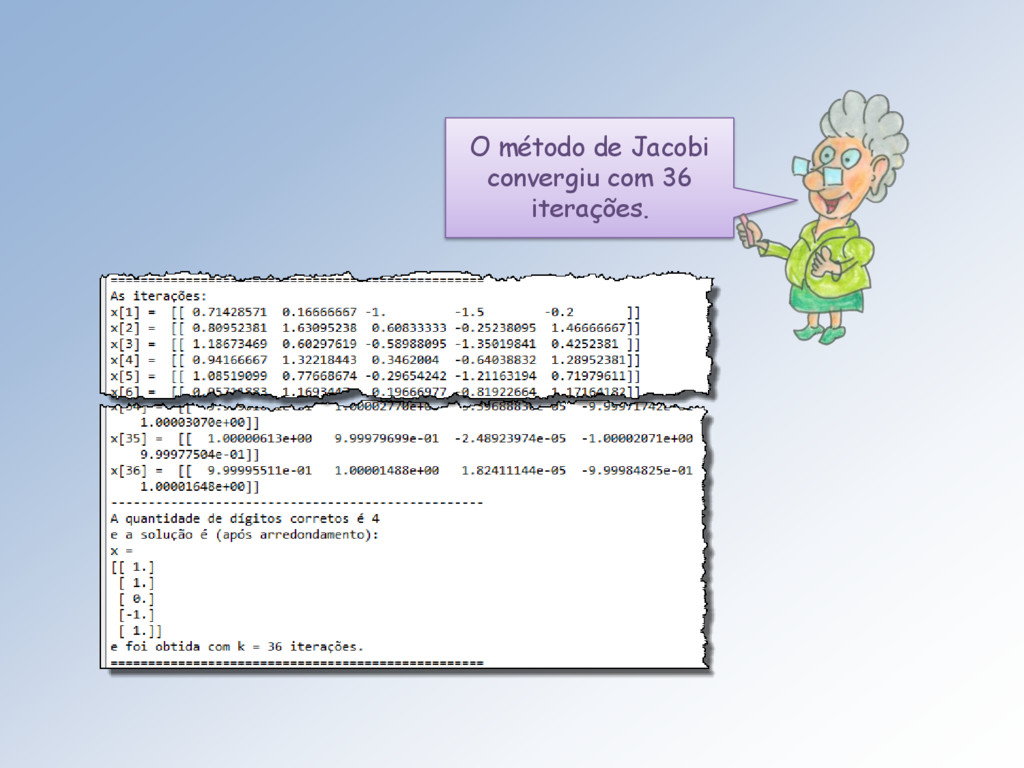
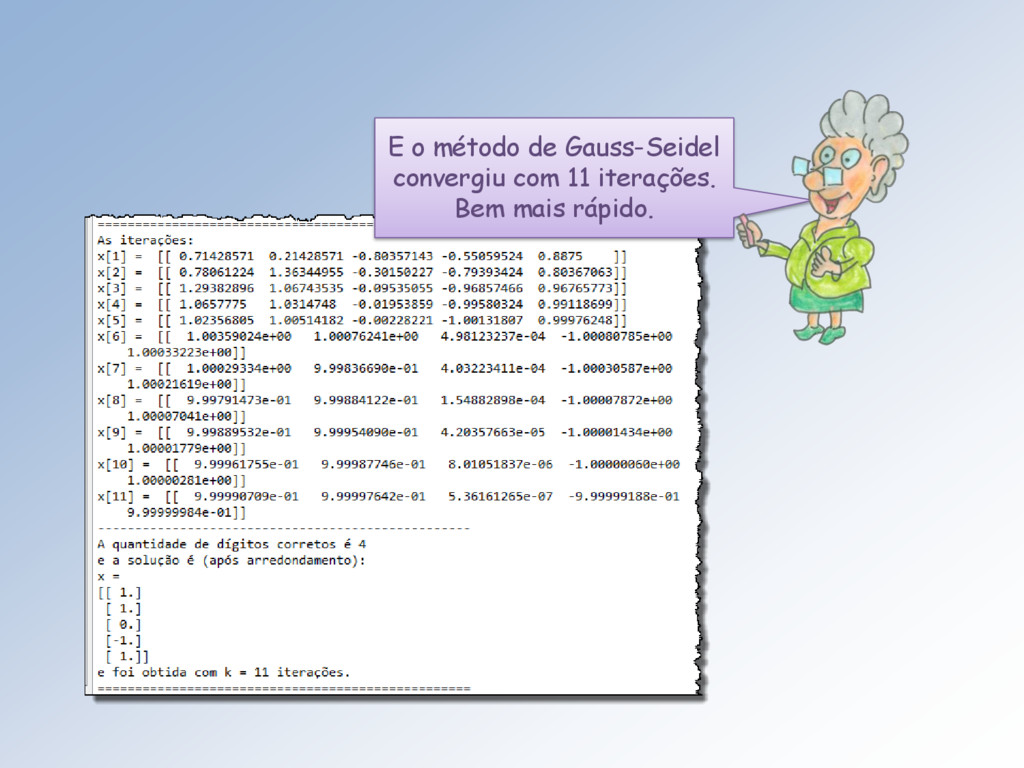
Apresentarei agora programas para o: • Método de Jacobi, •
Método de Gauss-Seidel, • Método de Gauss-Seidel com relaxação, e exemplos de execução. -
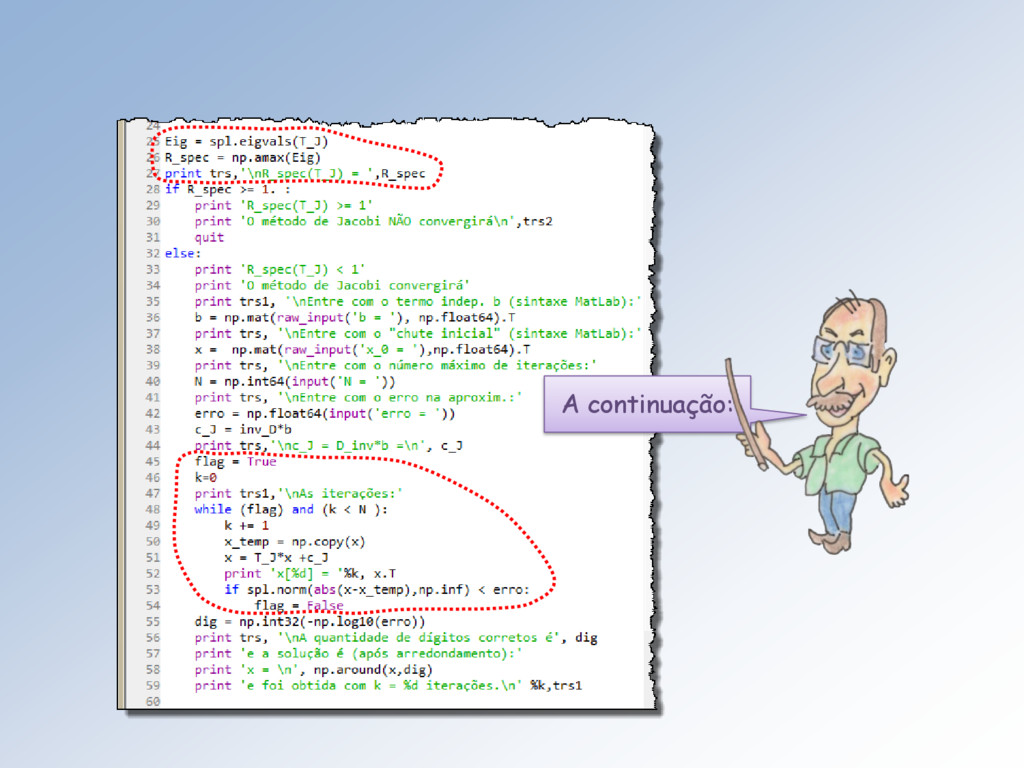
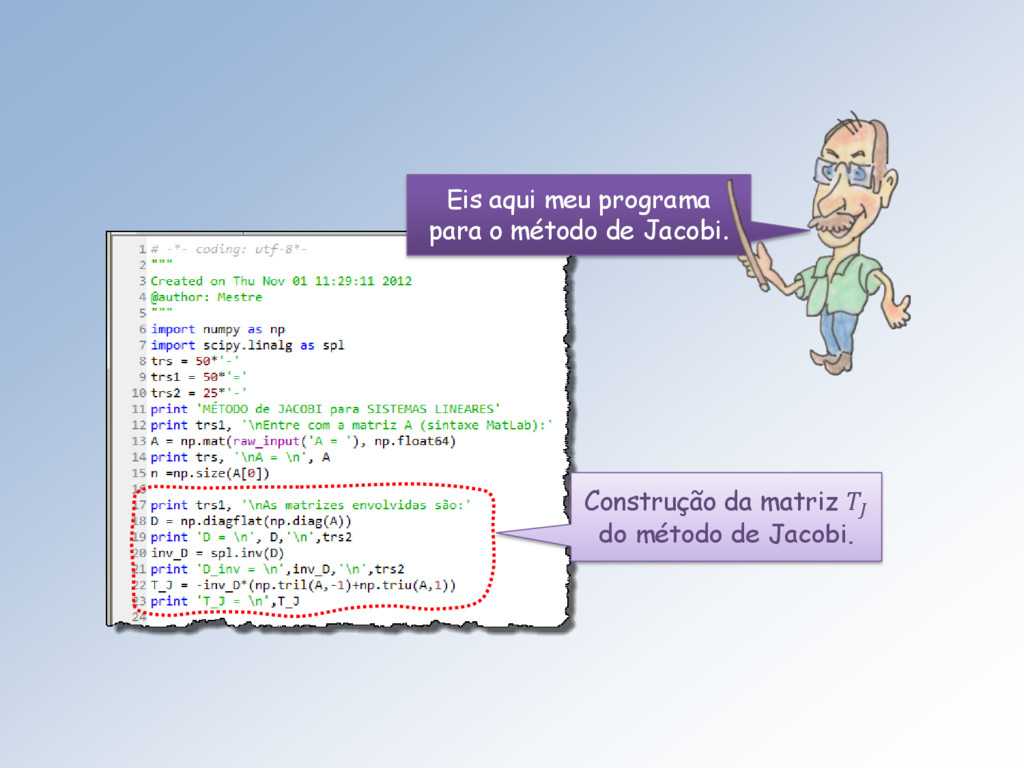
Eis aqui meu programa para o método de Jacobi. Construção
da matriz do método de Jacobi. -
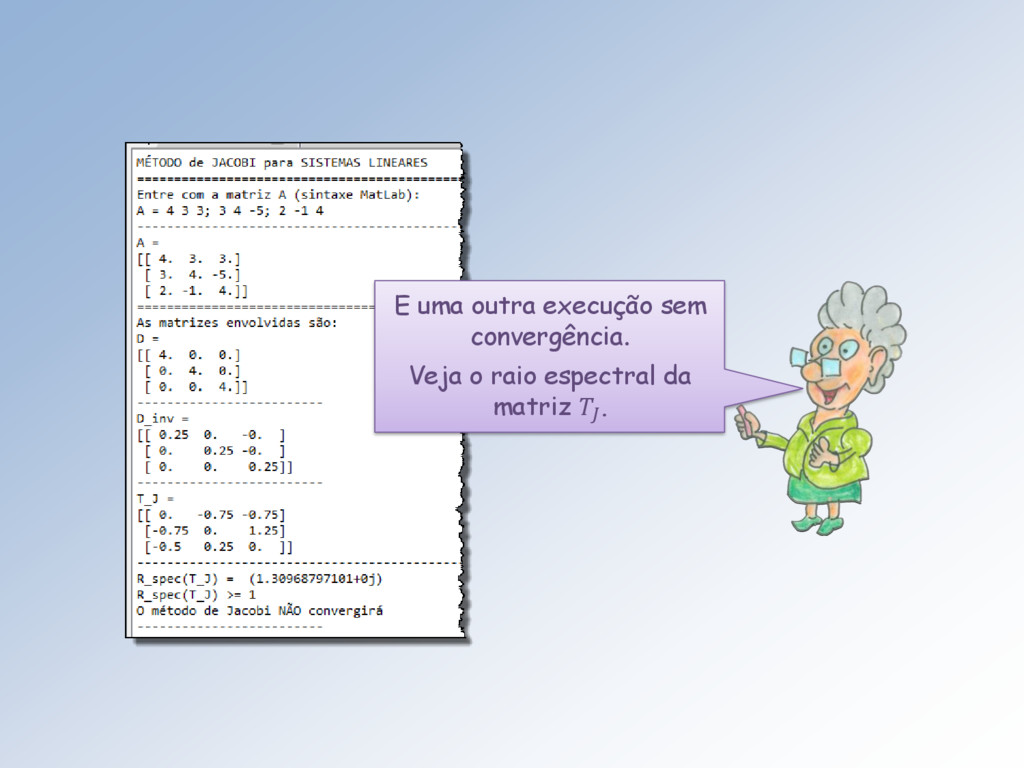
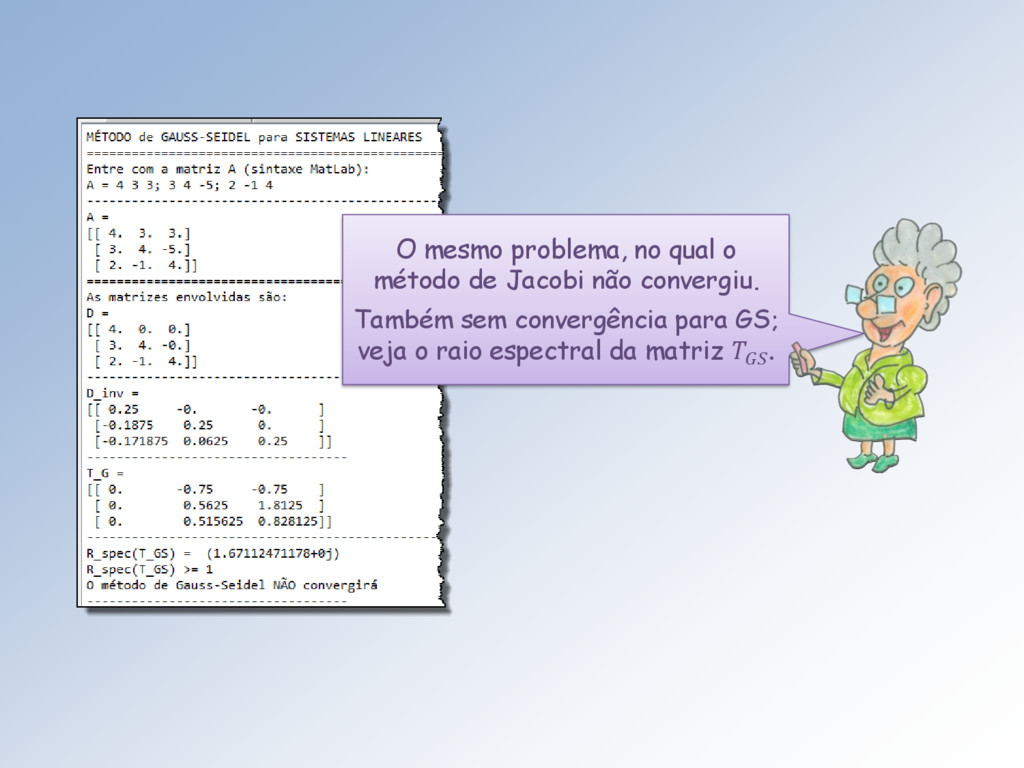
O mesmo problema, no qual o método de Jacobi não
convergiu. Também sem convergência para GS; veja o raio espectral da matriz . -
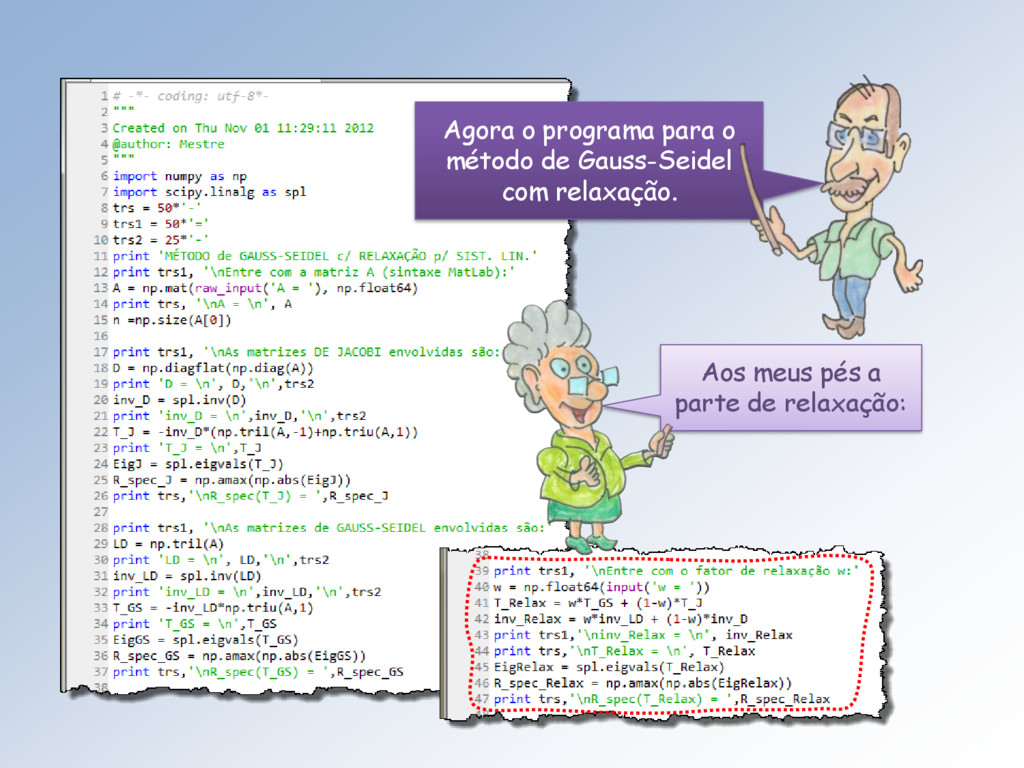
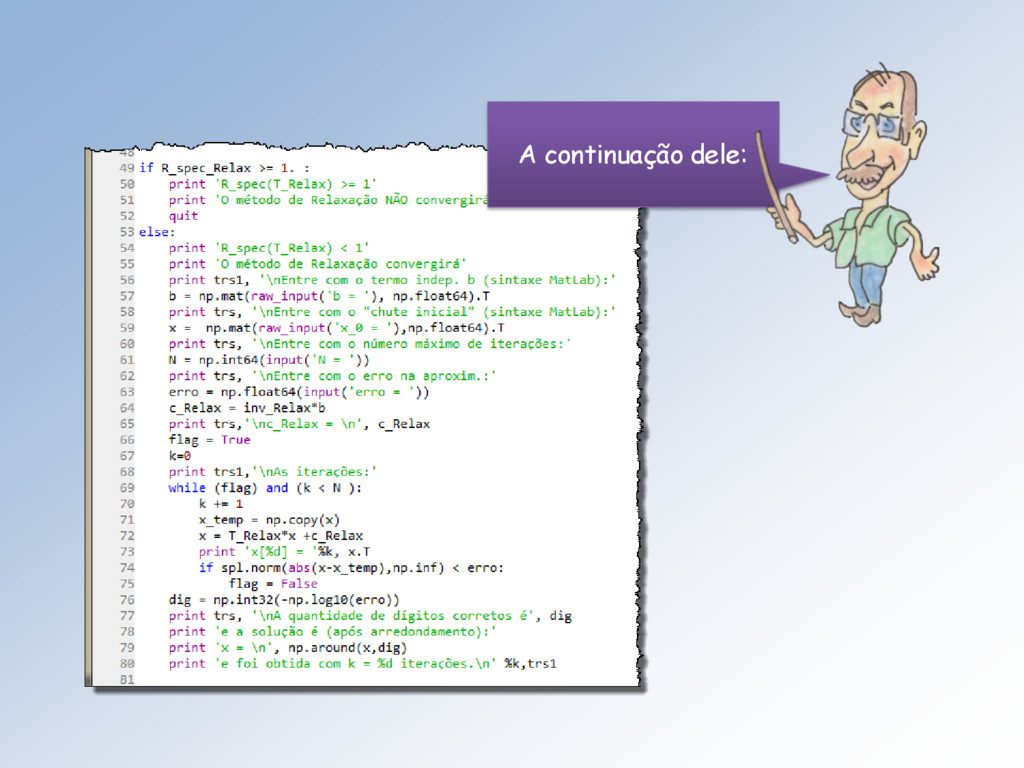
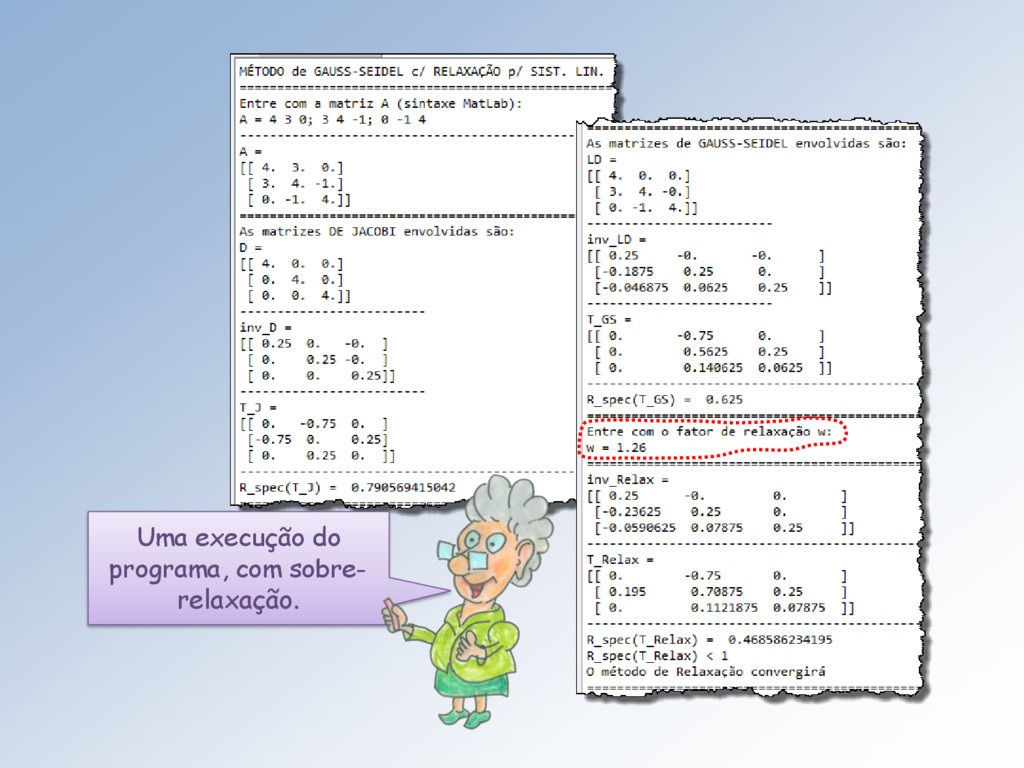
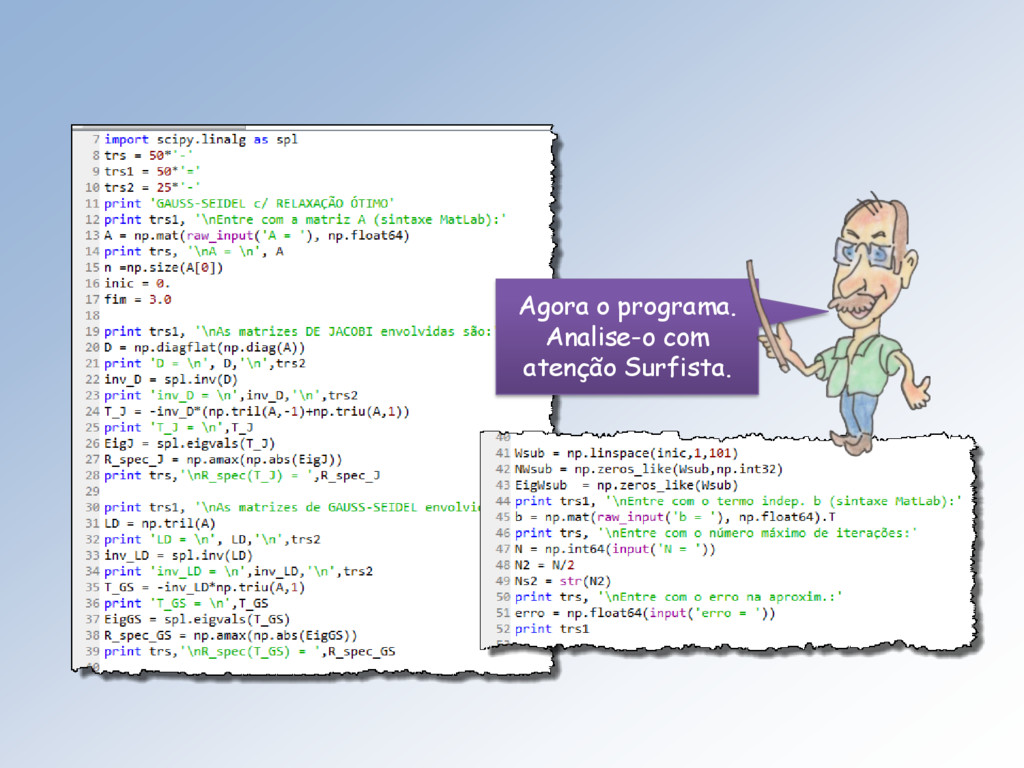
Agora o programa para o método de Gauss-Seidel com relaxação.
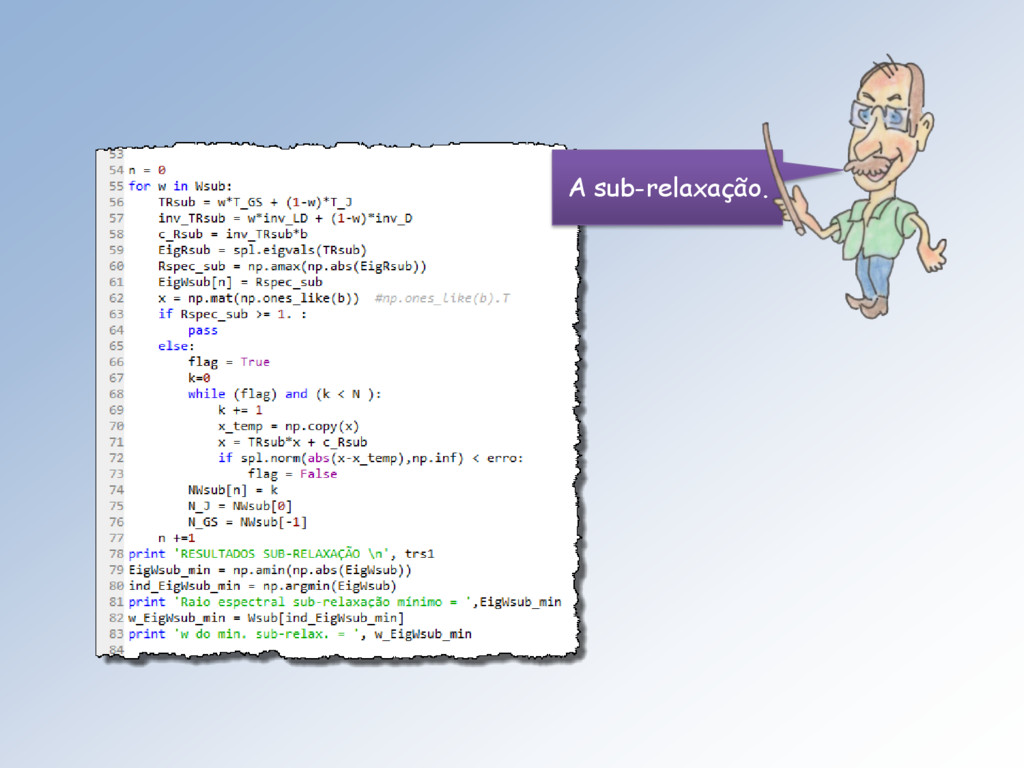
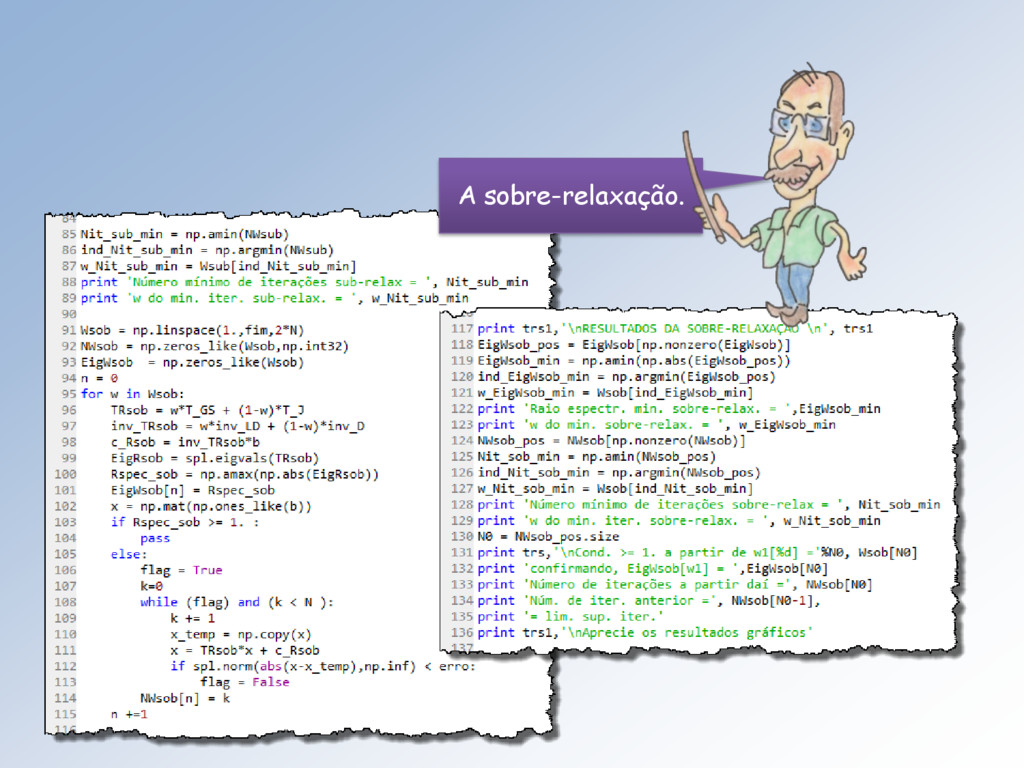
Aos meus pés a parte de relaxação: -
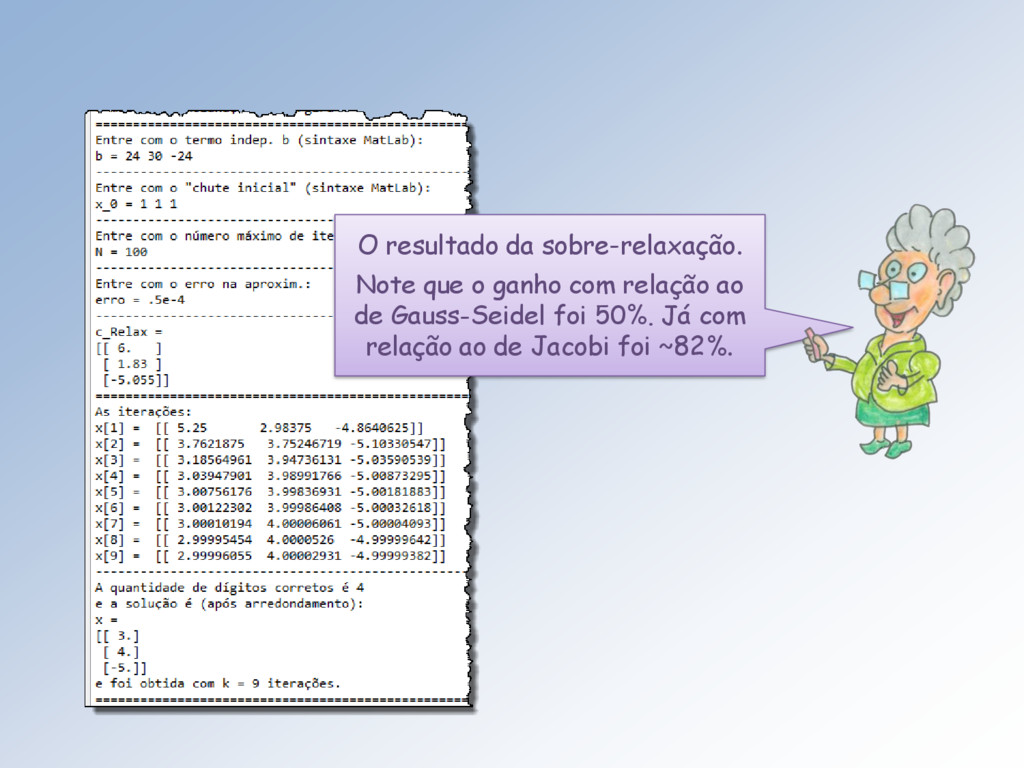
O resultado da sobre-relaxação. Note que o ganho com relação
ao de Gauss-Seidel foi 50%. Já com relação ao de Jacobi foi ~82%. -
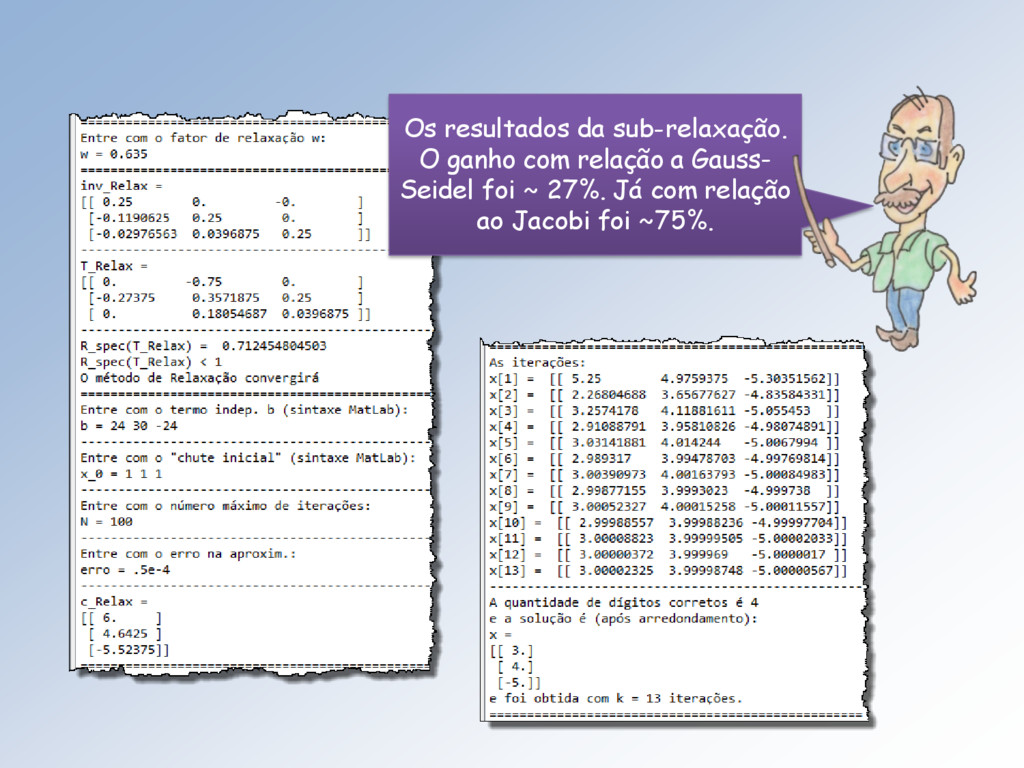
Os resultados da sub-relaxação. O ganho com relação a Gauss-
Seidel foi ~ 27%. Já com relação ao Jacobi foi ~75%. -
Mestre, e como você conseguiu esses valores de ? Ganhou
na loteria? Não Loirinha! Usei o programa que eu e a Mestra passaremos a analisar -
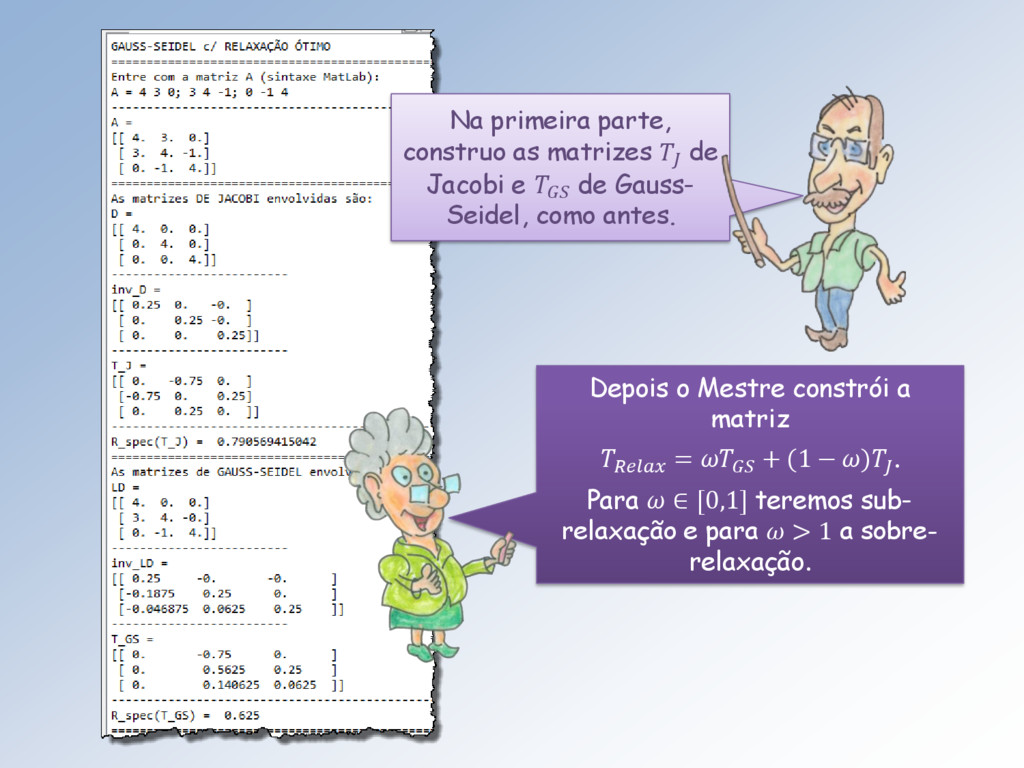
Na primeira parte, construo as matrizes de Jacobi e de
Gauss- Seidel, como antes. Depois o Mestre constrói a matriz = + (1 − ) . Para ∈ [0,1] teremos sub- relaxação e para > 1 a sobre- relaxação. -
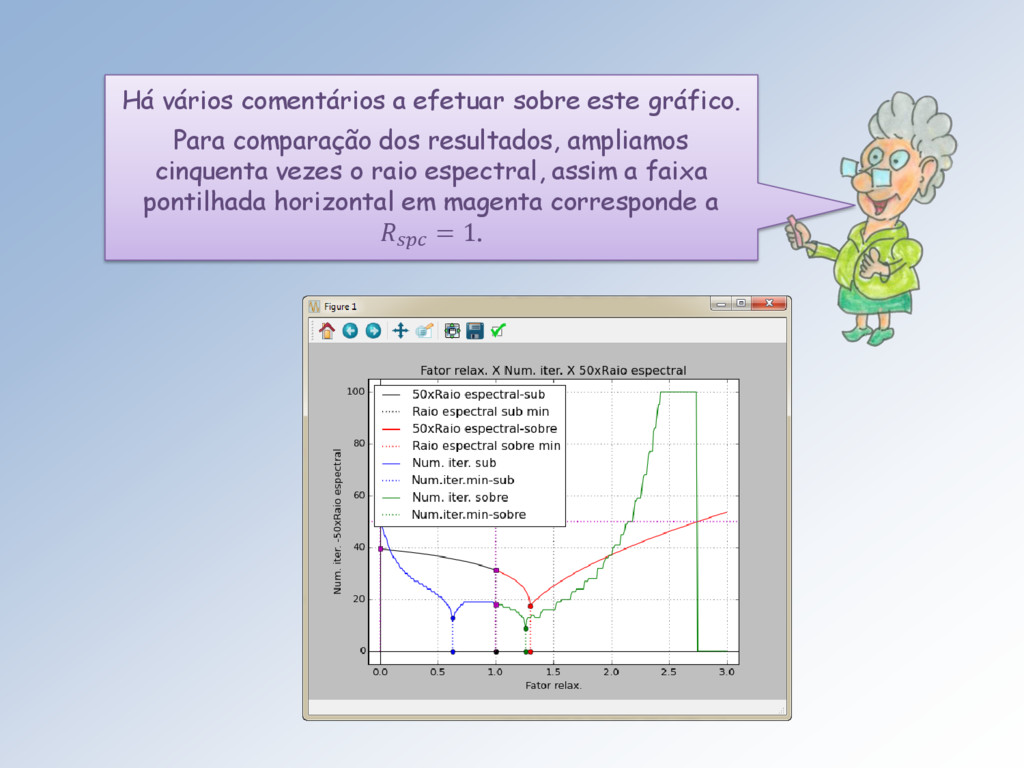
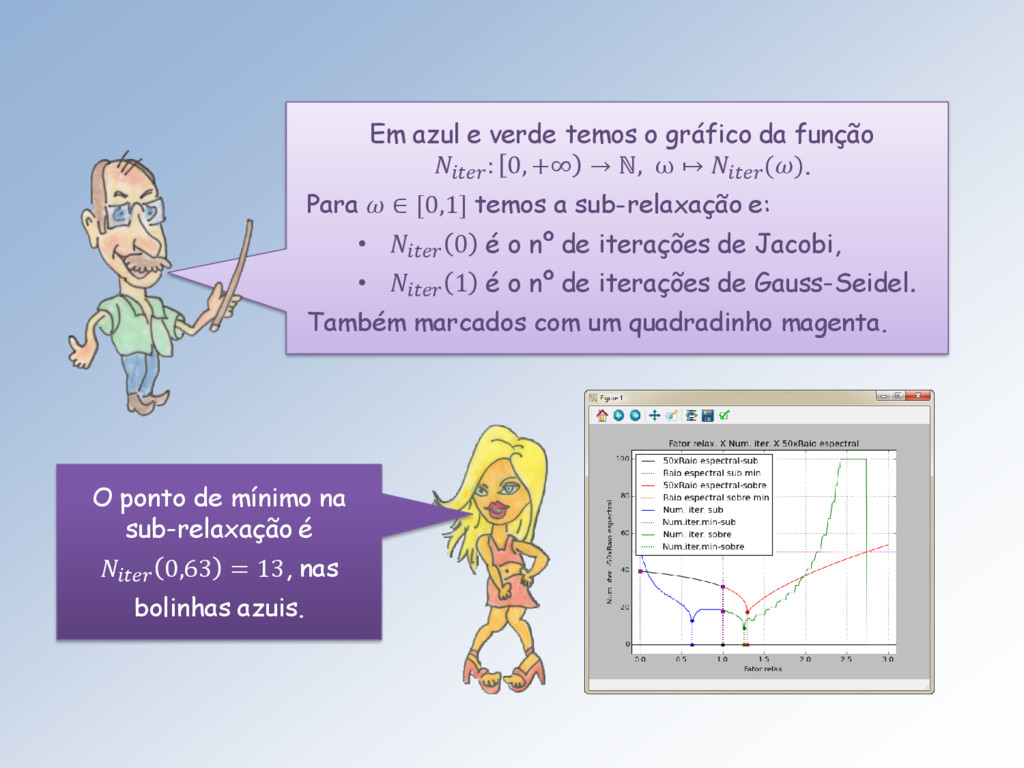
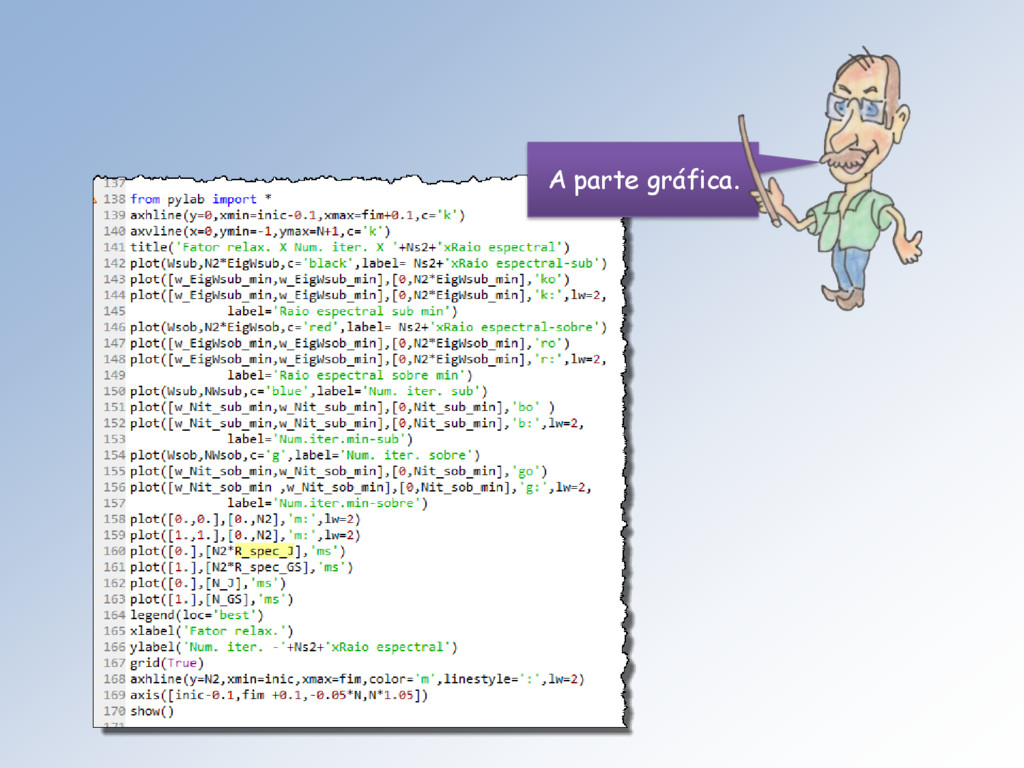
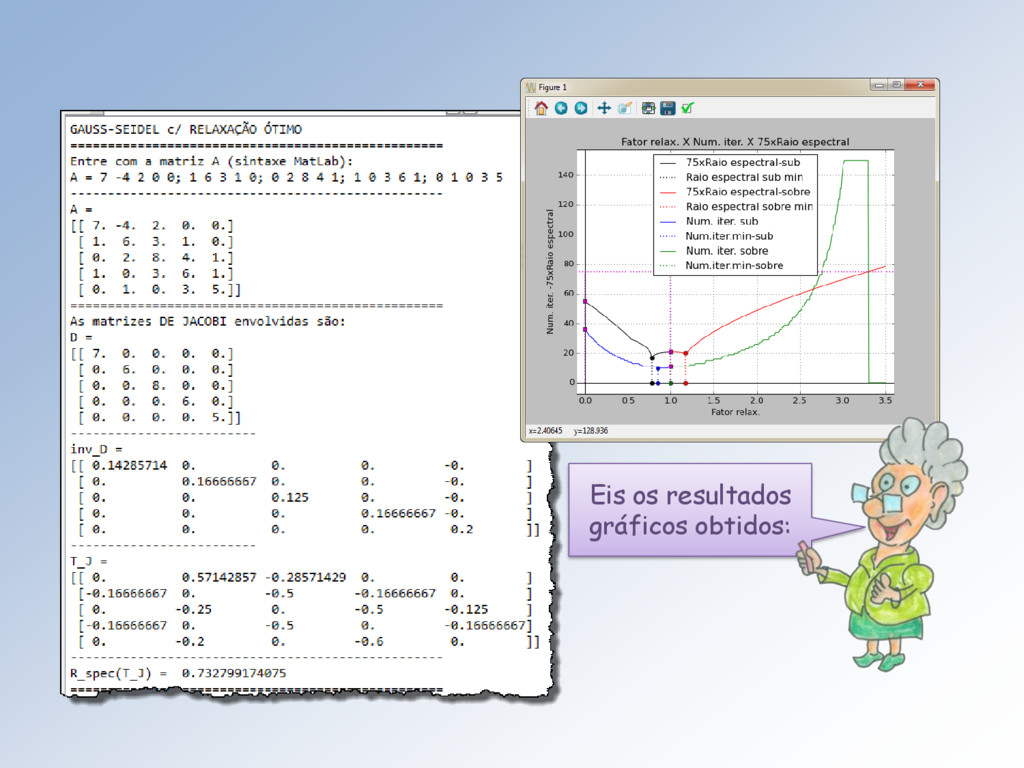
Há vários comentários a efetuar sobre este gráfico. Para comparação
dos resultados, ampliamos cinquenta vezes o raio espectral, assim a faixa pontilhada horizontal em magenta corresponde a = 1. -
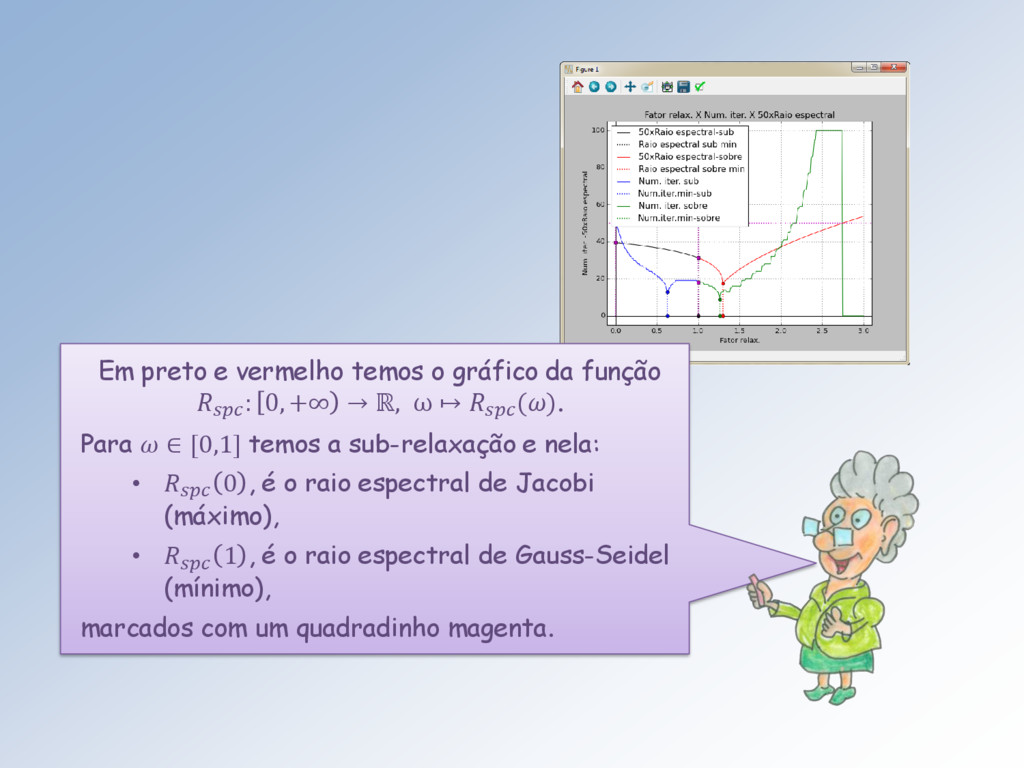
Em preto e vermelho temos o gráfico da função :
0, +∞ → ℝ, ω ↦ (). Para ∈ [0,1] temos a sub-relaxação e nela: • 0 , é o raio espectral de Jacobi (máximo), • 1 , é o raio espectral de Gauss-Seidel (mínimo), marcados com um quadradinho magenta. -
Em azul e verde temos o gráfico da função :
0, +∞ → ℕ, ω ↦ (). Para ∈ [0,1] temos a sub-relaxação e: • 0 é o nº de iterações de Jacobi, • 1 é o nº de iterações de Gauss-Seidel. Também marcados com um quadradinho magenta. O ponto de mínimo na sub-relaxação é 0,63 = 13, nas bolinhas azuis. -
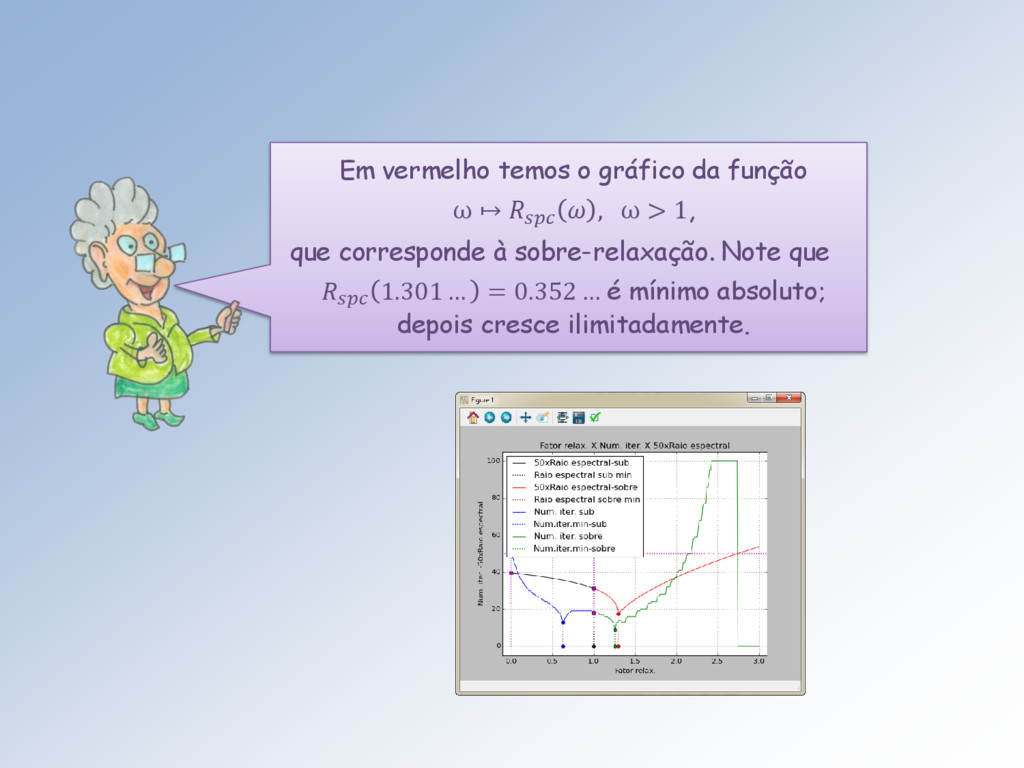
Em vermelho temos o gráfico da função ω ↦ ,
ω > 1, que corresponde à sobre-relaxação. Note que 1.301… = 0.352 … é mínimo absoluto; depois cresce ilimitadamente. -
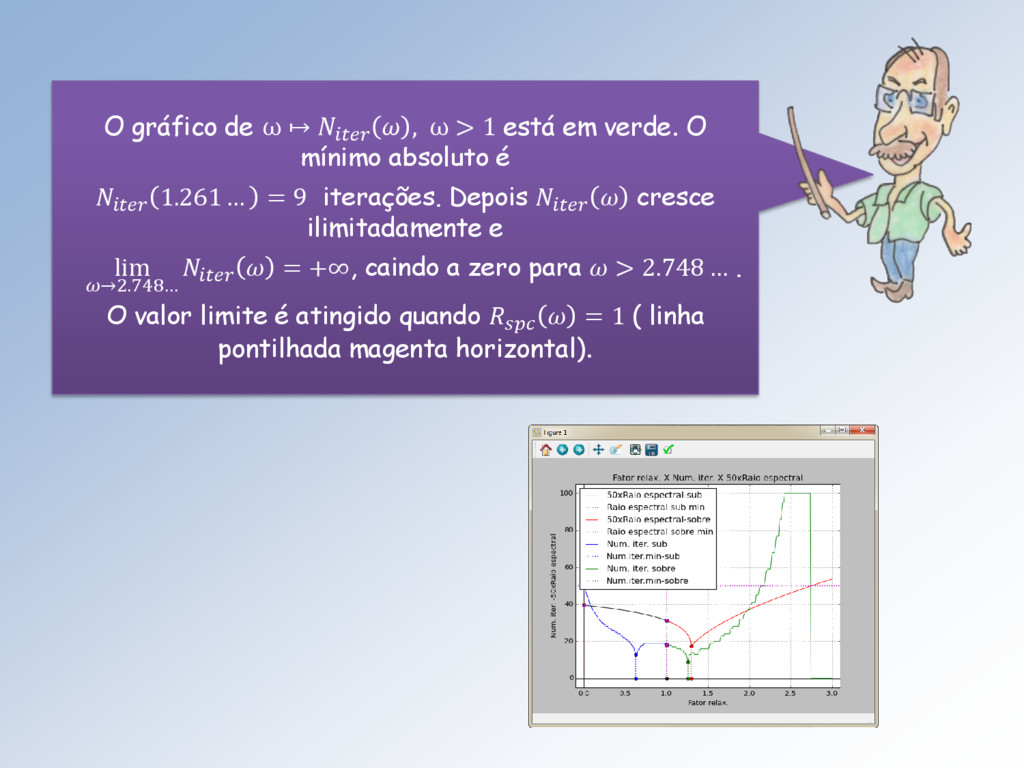
O gráfico de ω ↦ , ω > 1 está
em verde. O mínimo absoluto é 1.261… = 9 iterações. Depois cresce ilimitadamente e lim →2.748… = +∞, caindo a zero para > 2.748 … . O valor limite é atingido quando = 1 ( linha pontilhada magenta horizontal). -
Faremos mais um exemplo para ver o que se repete.
Mestres, os resultados do exemplo anterior se repetem sempre? -
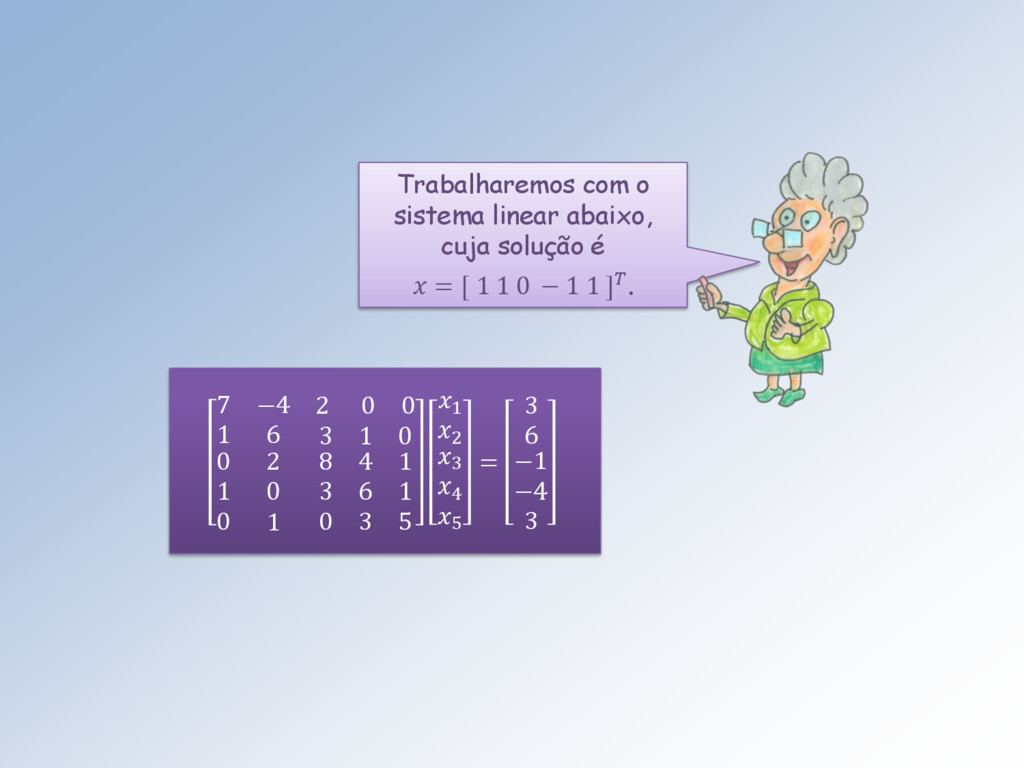
Trabalharemos com o sistema linear abaixo, cuja solução é =
[ 1 1 0 − 1 1 ]. 7 −4 2 0 0 1 6 3 1 0 0 1 0 2 0 1 8 3 0 4 6 3 1 1 5 1 2 3 4 5 = 3 6 −1 −4 3 -
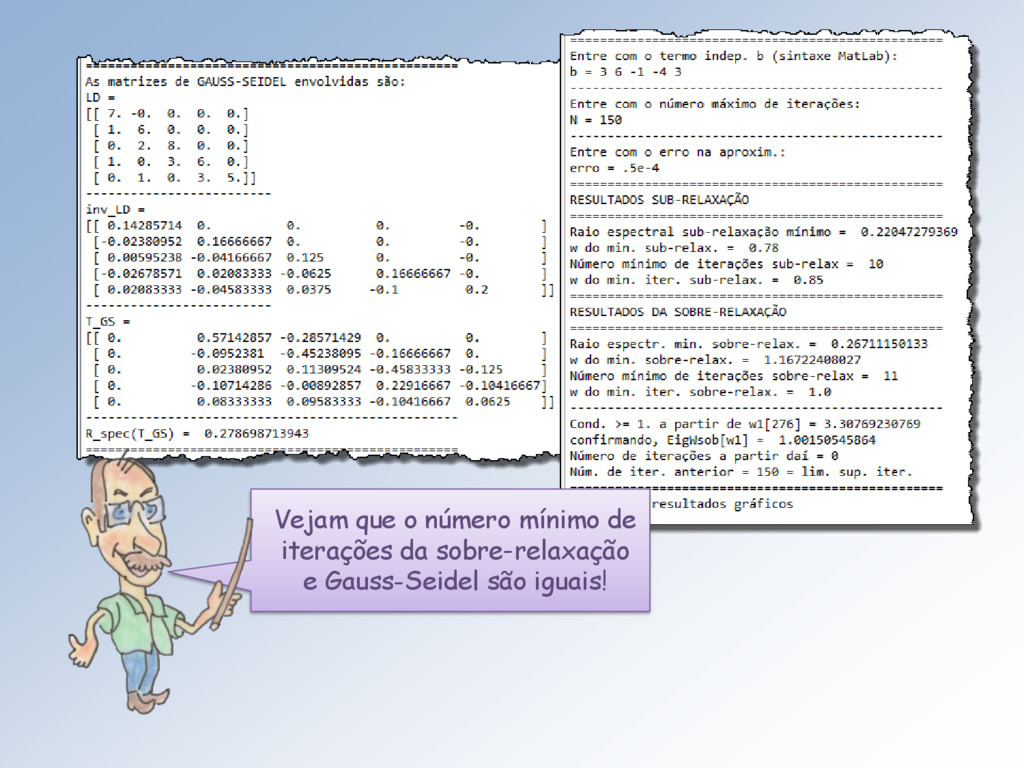
Vejam que o número mínimo de iterações da sobre-relaxação e
Gauss-Seidel são iguais! -
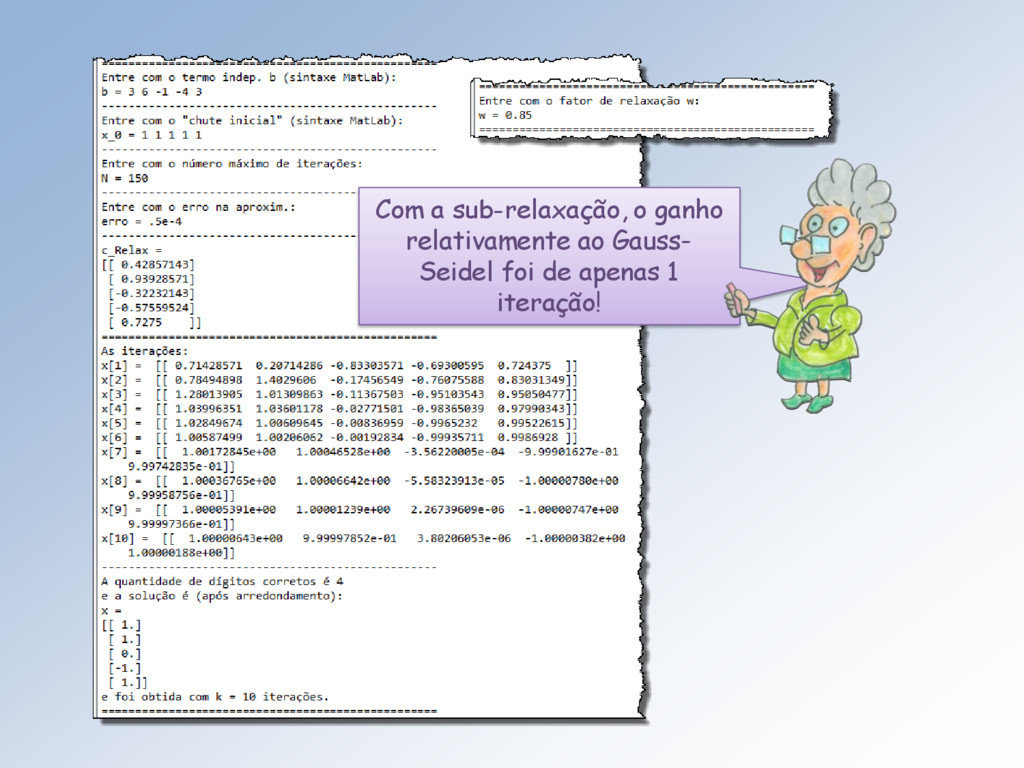
Com a sub-relaxação, o ganho relativamente ao Gauss- Seidel foi
de apenas 1 iteração! -
Agora vou apresentar uma outra forma de implementar os três
métodos, trabalhando diretamente com as equações. -
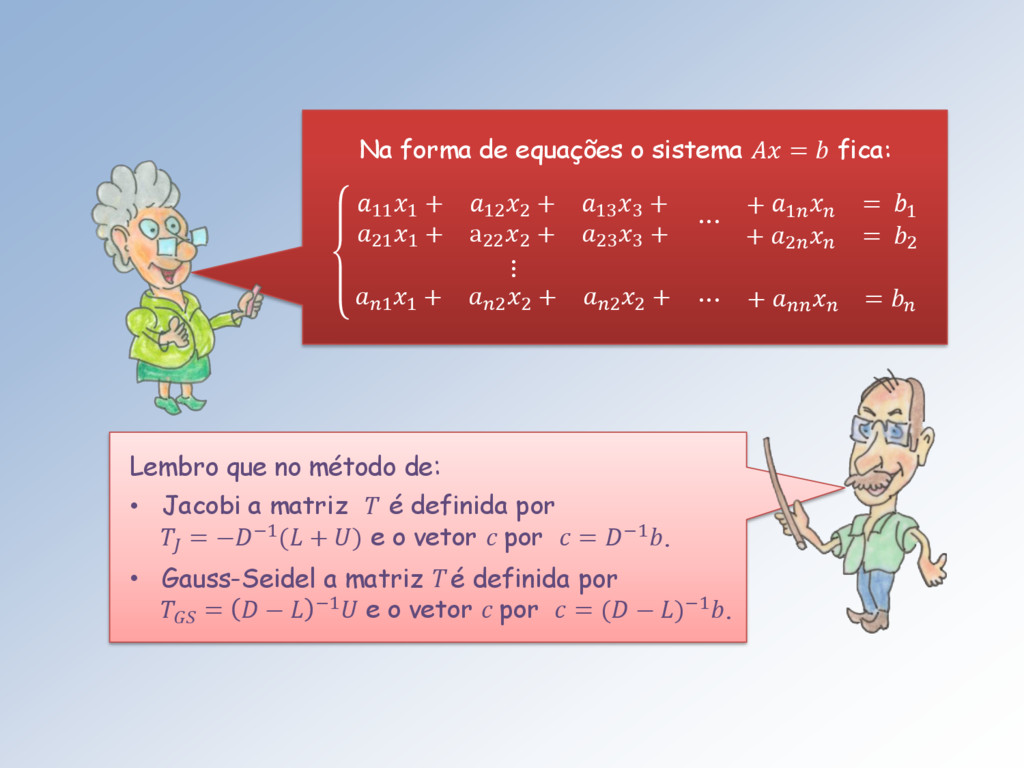
Na forma de equações o sistema = fica: 11 1
+ 21 1 + 12 2 + a22 2 + 13 3 + 23 3 + ⋯ + 1 = 1 + 2 = 2 ⋮ 1 1 + 2 2 + 2 2 + ⋯ + = Lembro que no método de: • Jacobi a matriz T é definida por = −−1( + ) e o vetor c por = −1. • Gauss-Seidel a matriz T é definida por = − −1 e o vetor c por = ( − )−1. -
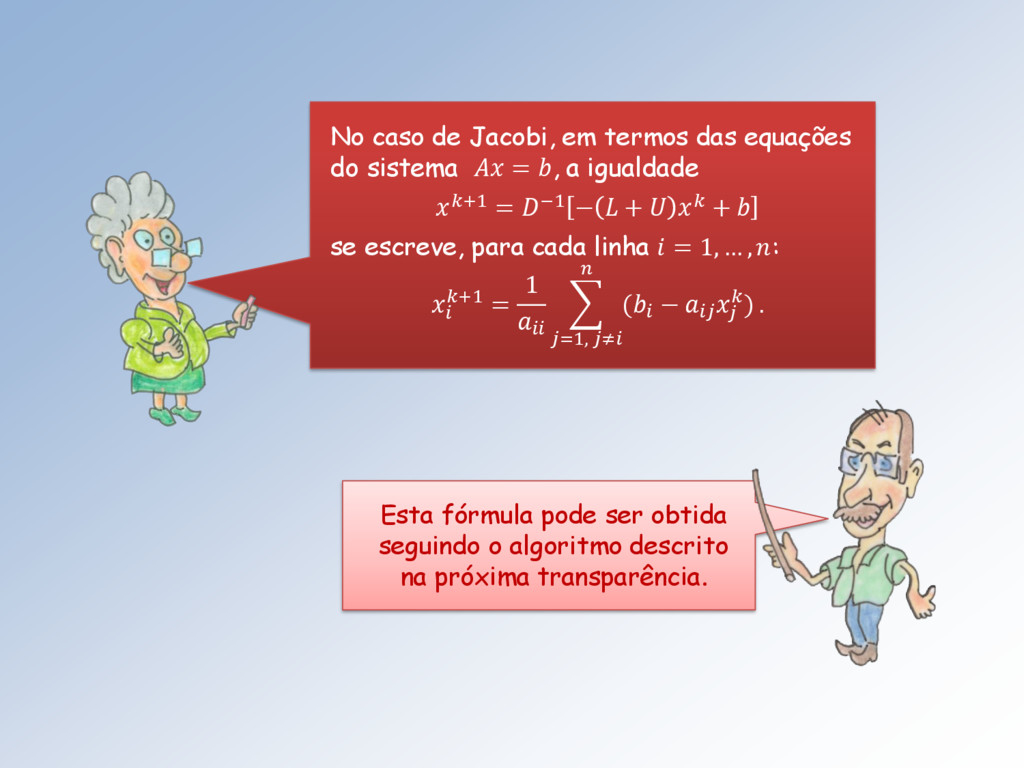
No caso de Jacobi, em termos das equações do sistema
= , a igualdade +1 = −1 − + + se escreve, para cada linha = 1, … , : +1 = 1 =1, ≠ ( − ) . Esta fórmula pode ser obtida seguindo o algoritmo descrito na próxima transparência. -
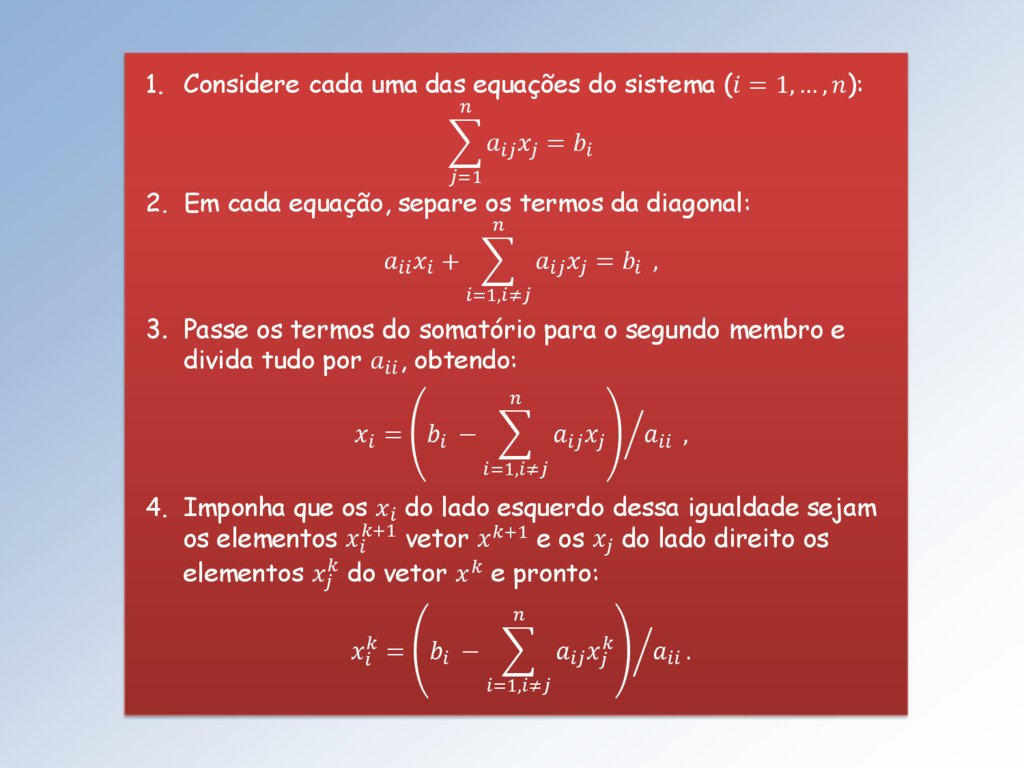
1. Considere cada uma das equações do sistema ( =
1, … , ): =1 = 2. Em cada equação, separe os termos da diagonal: + =1,≠ = , 3. Passe os termos do somatório para o segundo membro e divida tudo por , obtendo: = ൘ − =1,≠ , 4. Imponha que os do lado esquerdo dessa igualdade sejam os elementos +1 vetor +1 e os do lado direito os elementos do vetor e pronto: = ൘ − =1,≠ . -
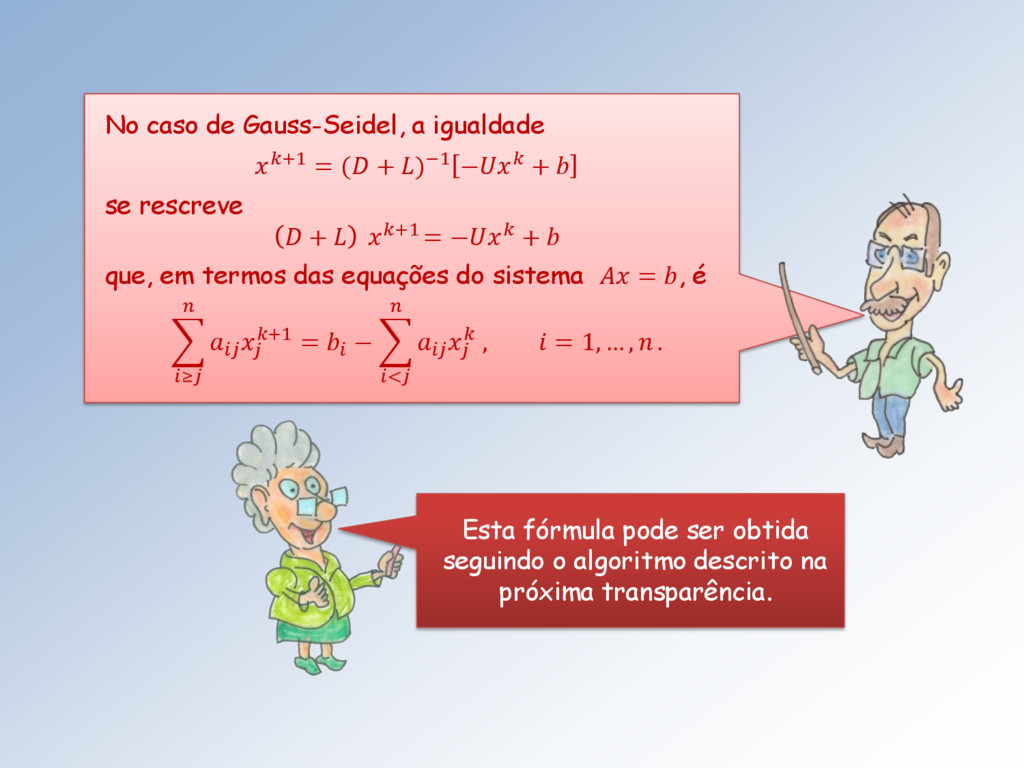
No caso de Gauss-Seidel, a igualdade +1 = ( +
)−1 − + se rescreve + +1 = − + que, em termos das equações do sistema = , é ≥ +1 = − < , = 1, … , . Esta fórmula pode ser obtida seguindo o algoritmo descrito na próxima transparência. -
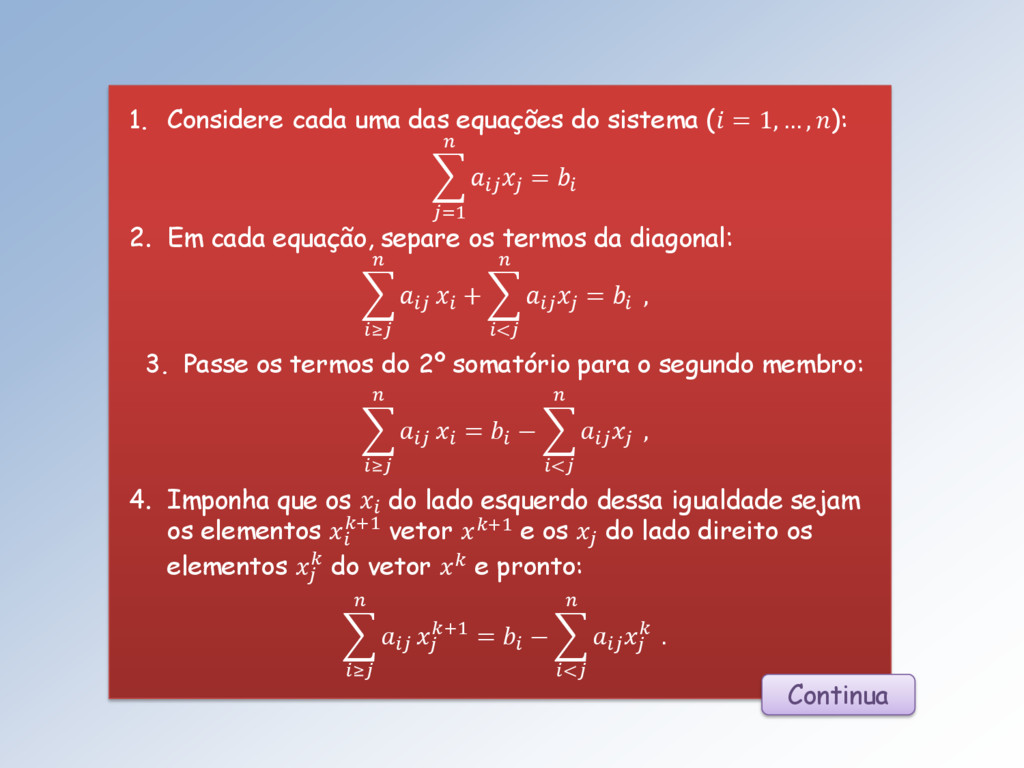
1. Considere cada uma das equações do sistema ( =
1, … , ): =1 = 2. Em cada equação, separe os termos da diagonal: ≥ + < = , 3. Passe os termos do 2º somatório para o segundo membro: ≥ = − < , 4. Imponha que os do lado esquerdo dessa igualdade sejam os elementos +1 vetor +1 e os do lado direito os elementos do vetor e pronto: ≥ +1 = − < . Continua -
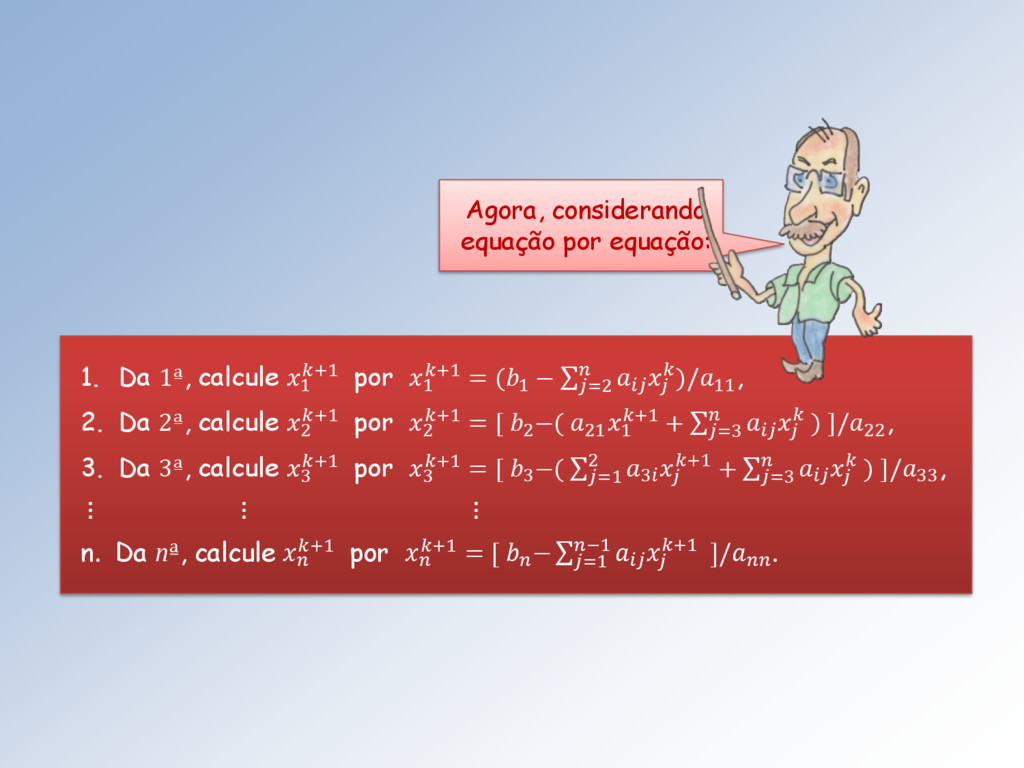
1. Da 1ª, calcule 1 +1 por 1 +1 =
(1 − σ =2 )/11 , 2. Da 2ª, calcule 2 +1 por 2 +1 = [ 2 −( 21 1 +1 + σ =3 ) ]/22 , 3. Da 3ª, calcule 3 +1 por 3 +1 = [ 3 −( σ =1 2 3 +1 + σ =3 ) ]/33 , ⋮ ⋮ ⋮ n. Da nª, calcule +1 por +1 = [ − σ =1 −1 +1 ]/ . Agora, considerando equação por equação: -
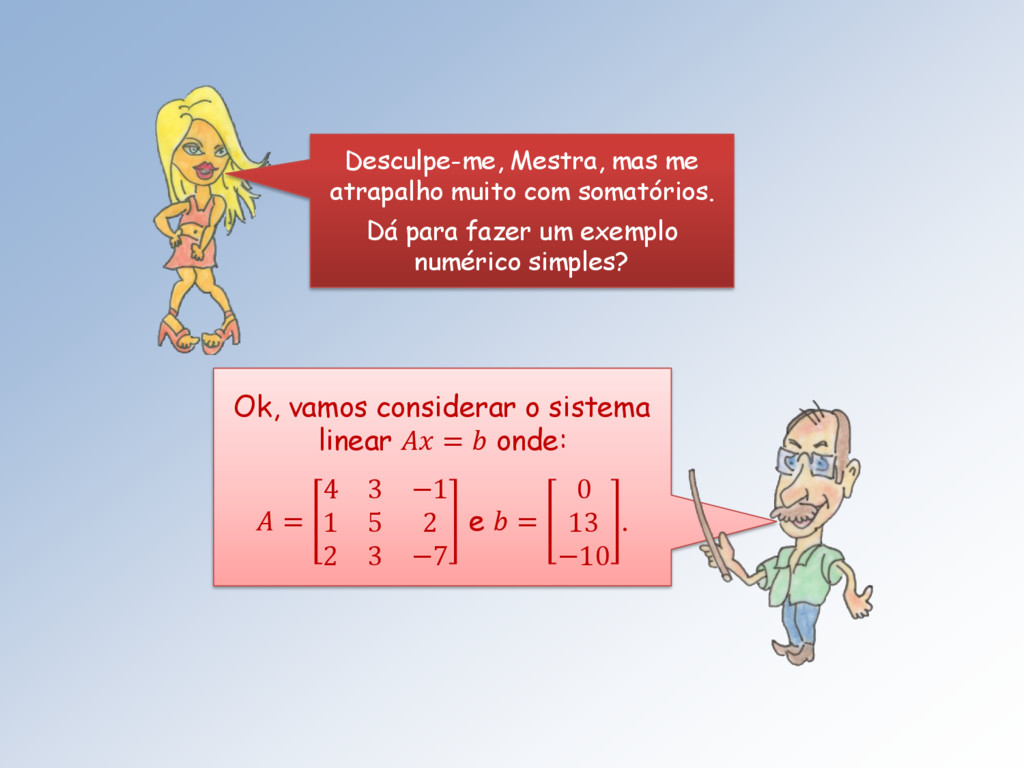
Desculpe-me, Mestra, mas me atrapalho muito com somatórios. Dá para
fazer um exemplo numérico simples? Ok, vamos considerar o sistema linear = onde: = 4 3 −1 1 5 2 2 3 −7 e = 0 13 −10 . -
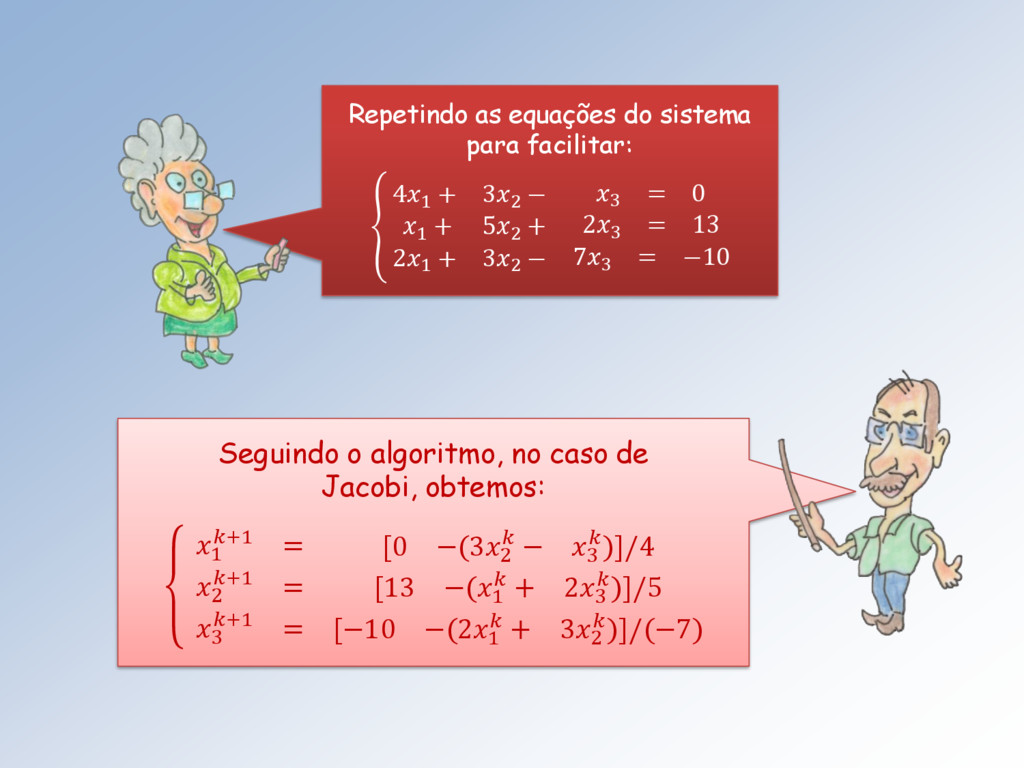
Repetindo as equações do sistema para facilitar: ൞ 41 +
32 − 3 = 0 1 + 52 + 23 = 13 21 + 32 − 73 = −10 Seguindo o algoritmo, no caso de Jacobi, obtemos: 1 +1 = [0 −(32 − 3 )]/4 2 +1 = [13 −(1 + 23 )]/5 3 +1 = [−10 −(21 + 32 )]/(−7) -
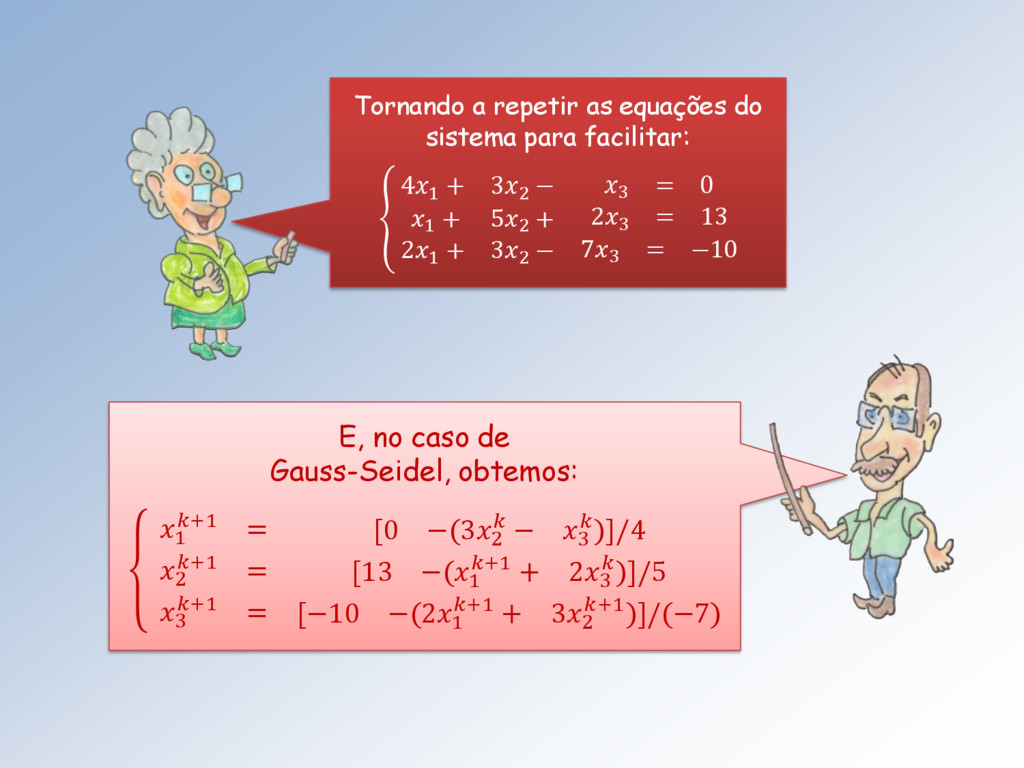
Tornando a repetir as equações do sistema para facilitar: ൞
41 + 32 − 3 = 0 1 + 52 + 23 = 13 21 + 32 − 73 = −10 E, no caso de Gauss-Seidel, obtemos: 1 +1 = [0 −(32 − 3 )]/4 2 +1 = [13 −(1 +1 + 23 )]/5 3 +1 = [−10 −(21 +1 + 32 +1)]/(−7) -
Implemente computacionalmente estes outros algoritmos, Surfista. Não vejo porquê, Mestra!
Basta usar os programas do Mestre. -
É importantíssimo. O motivo fundamental é que assim, apenas os
coeficientes não-nulos da matriz A são utilizados. É aqui que eu compareço. Veja como nas próximas transparências. -
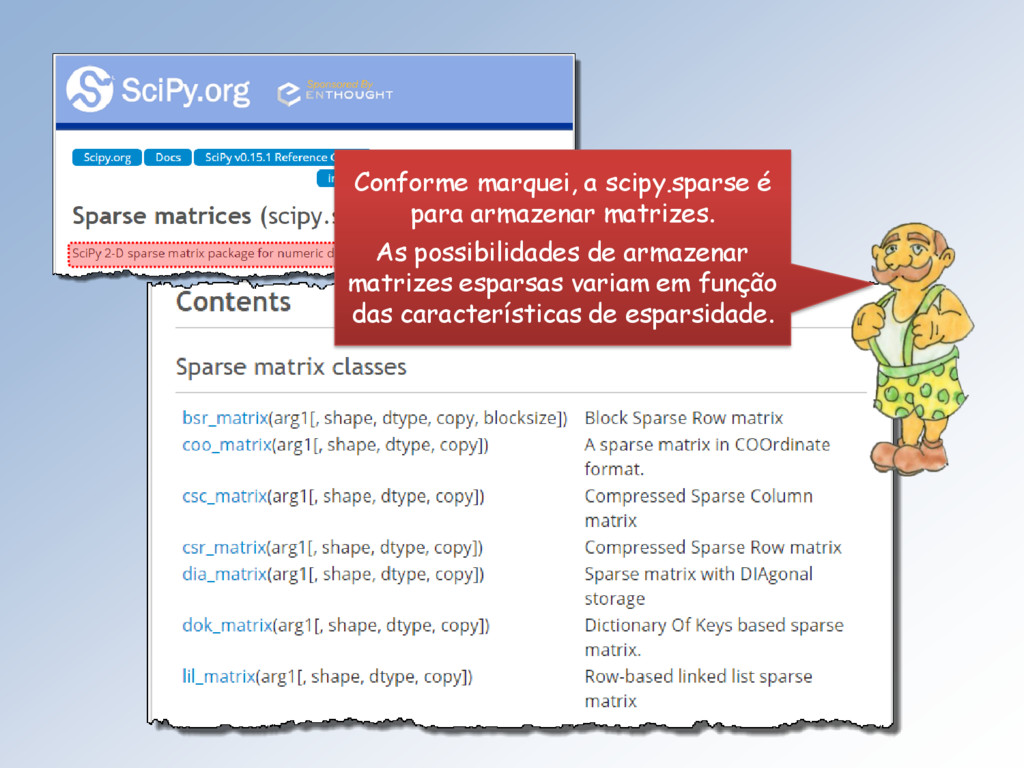
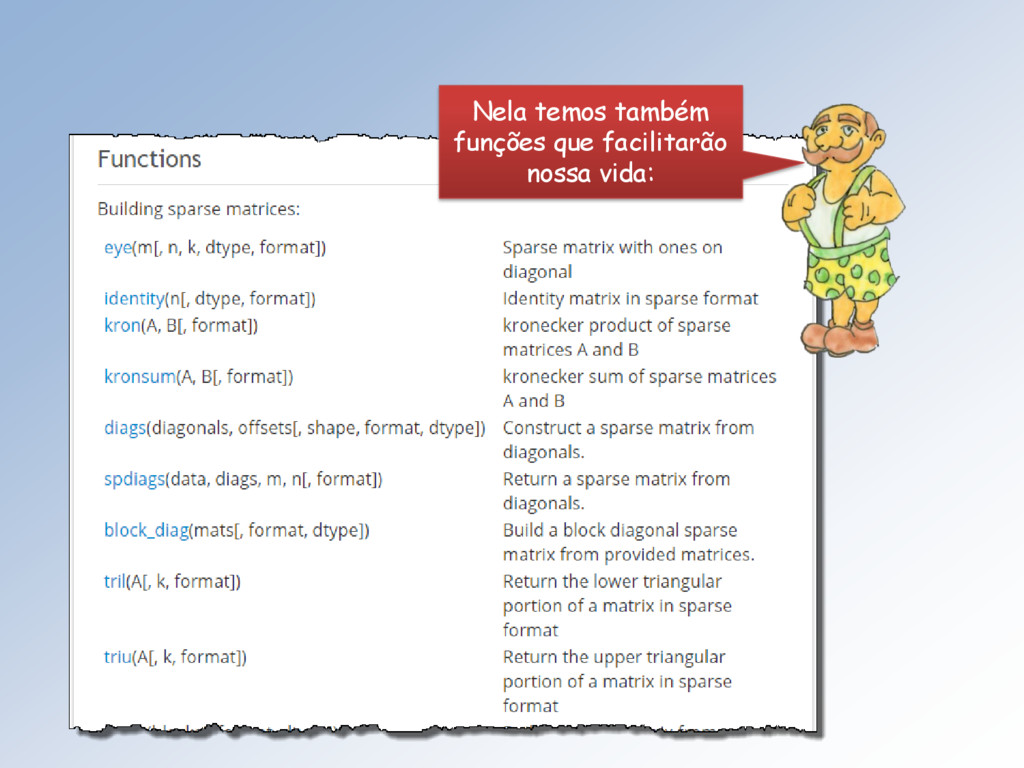
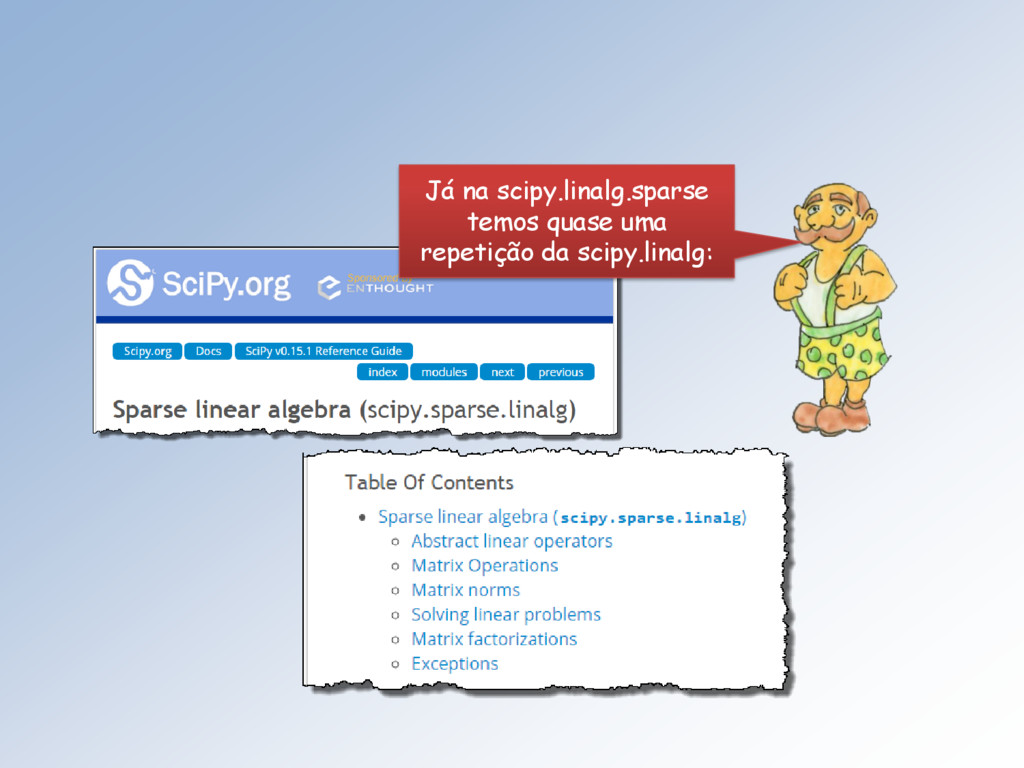
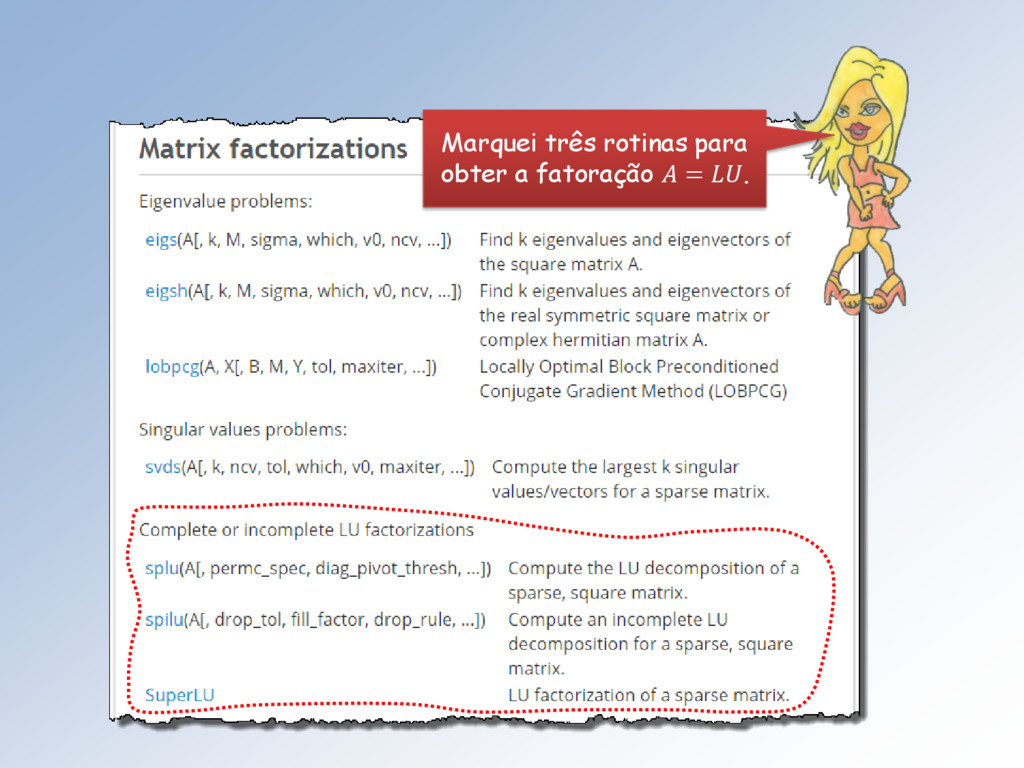
Apenas mostrarei o que há na sicpy.linalg sobre matrizes esparsas.
Divirta-se Cabelos de fogo! -
Conforme marquei, a scipy.sparse é para armazenar matrizes. As possibilidades
de armazenar matrizes esparsas variam em função das características de esparsidade. -
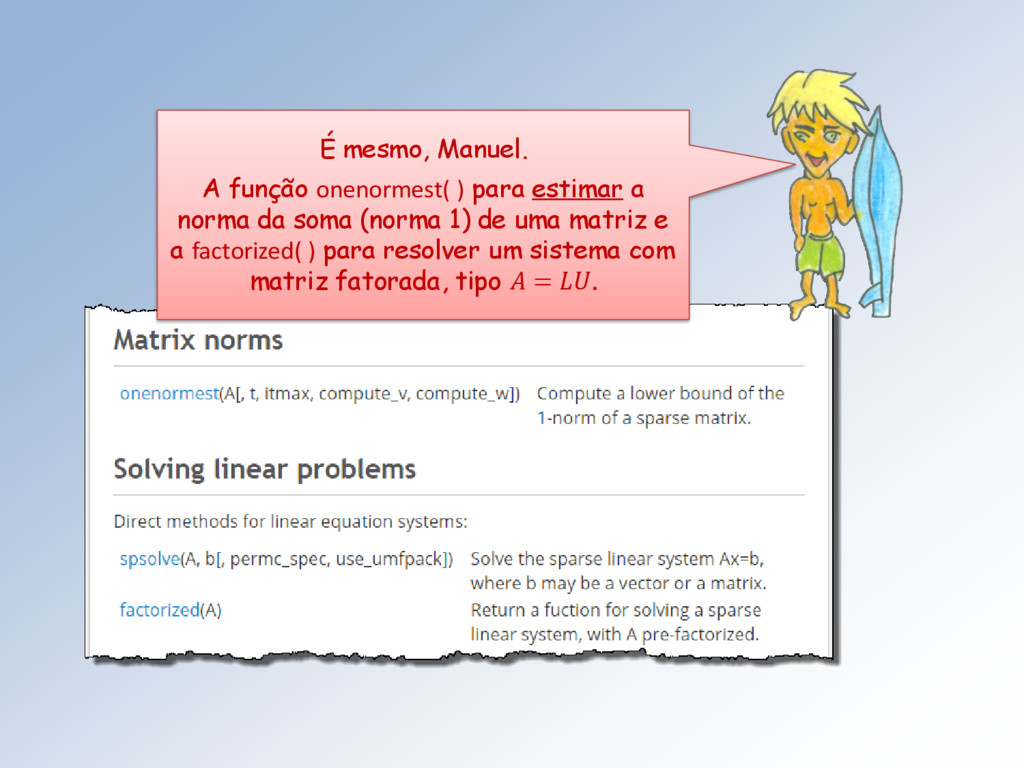
É mesmo, Manuel. A função onenormest( ) para estimar a
norma da soma (norma 1) de uma matriz e a factorized( ) para resolver um sistema com matriz fatorada, tipo = . -
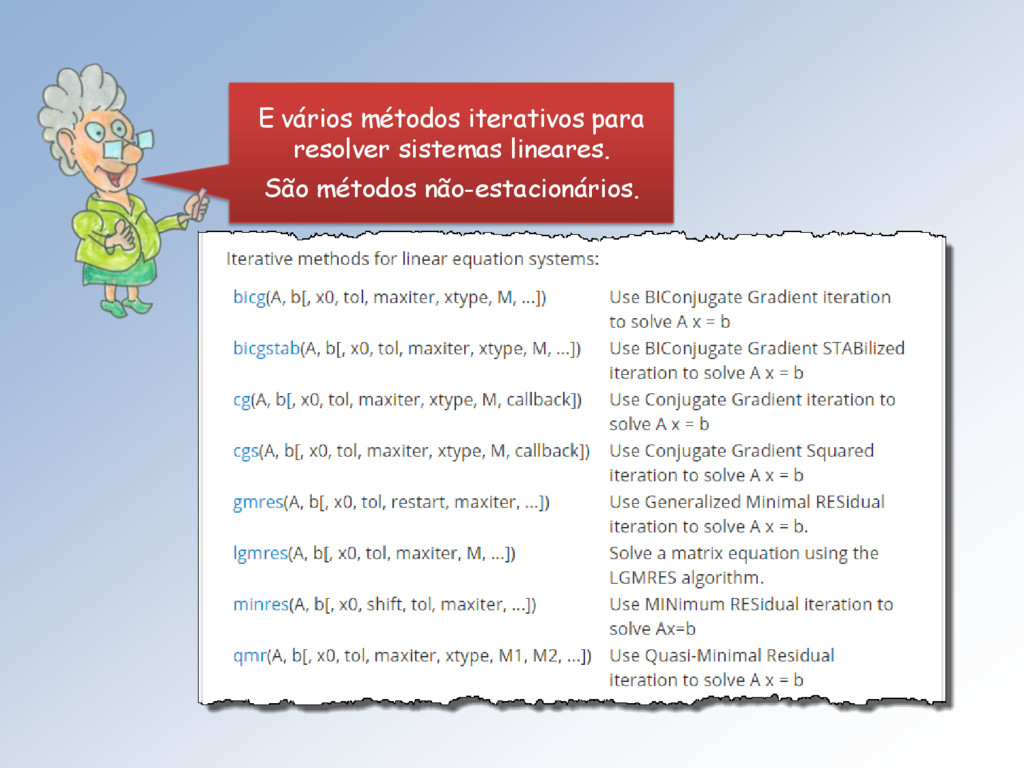
E vários métodos iterativos para resolver sistemas lineares. São métodos
não-estacionários.