Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Unified Language Model Pre-training for Natural...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Scatter Lab Inc.
April 10, 2020
Research
2.3k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Unified Language Model Pre-training for Natural Language Understanding and Generation
Scatter Lab Inc.
April 10, 2020
Transcript
20 slides
Unified Language Model Pre-training for Natural Language Understanding and Generation
Li Dong et al., NeurIPS 2019 (Microsoft) ࢲ࢚ (ML Research Scientist, Pingpong)
ݾର ݾର 1. Pre-training Language Model ѐਃ 2. Unified Language
Model 1. Method 2. Pre-training step 3. Fine-tuning step 3. Experiments 1. NLG Task 2. NLU Task
Pre-training Language Model ѐਃ Pre-training Language Model ѐਃ
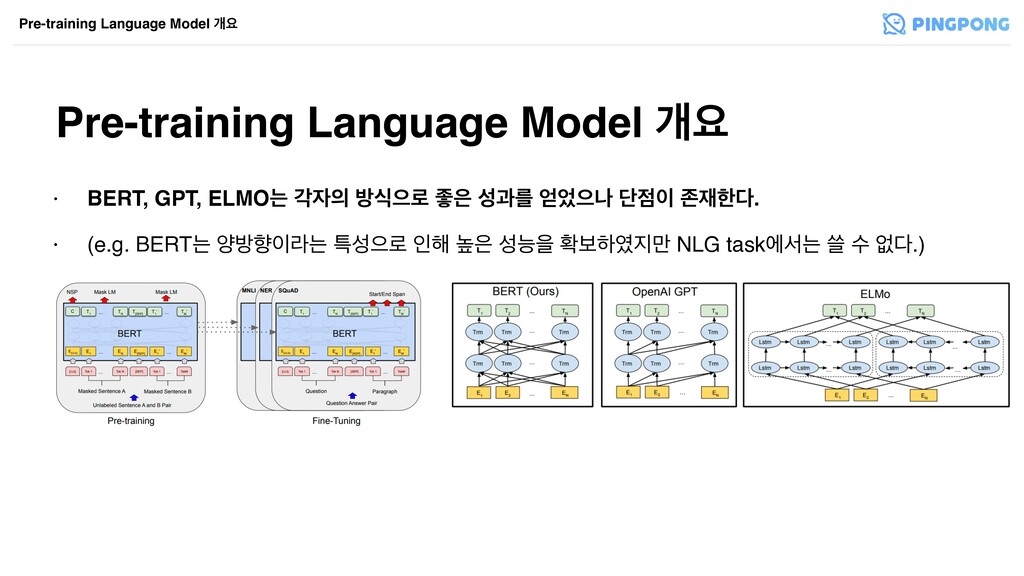
Pre-training Language Model ѐਃ Pre-training Language Model ѐਃ • BERT,
GPT, ELMOח п ߑधਵ۽ જ ࢿҗܳ ਵա ױ ઓೠ. • (e.g. BERTח নߑೱۄח ౠࢿਵ۽ ੋ೧ ֫ ࢿמਸ ഛࠁೞ݅ NLG taskীࢲח ॶ ࣻ হ.)
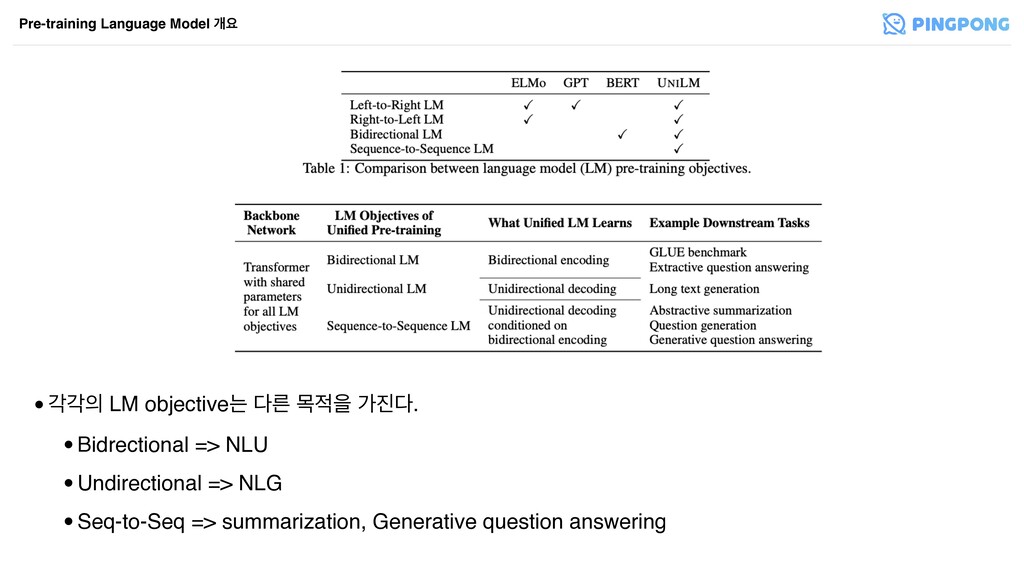
•пп LM objectiveח ܲ ݾਸ о. •Bidrectional => NLU •Undirectional
=> NLG •Seq-to-Seq => summarization, Generative question answering Pre-training Language Model ѐਃ
Unified Language Model Pre-training Language Model ѐਃ
Unified Language Model Unified Language Model •unified pre-training ৈ۞ ఋੑ
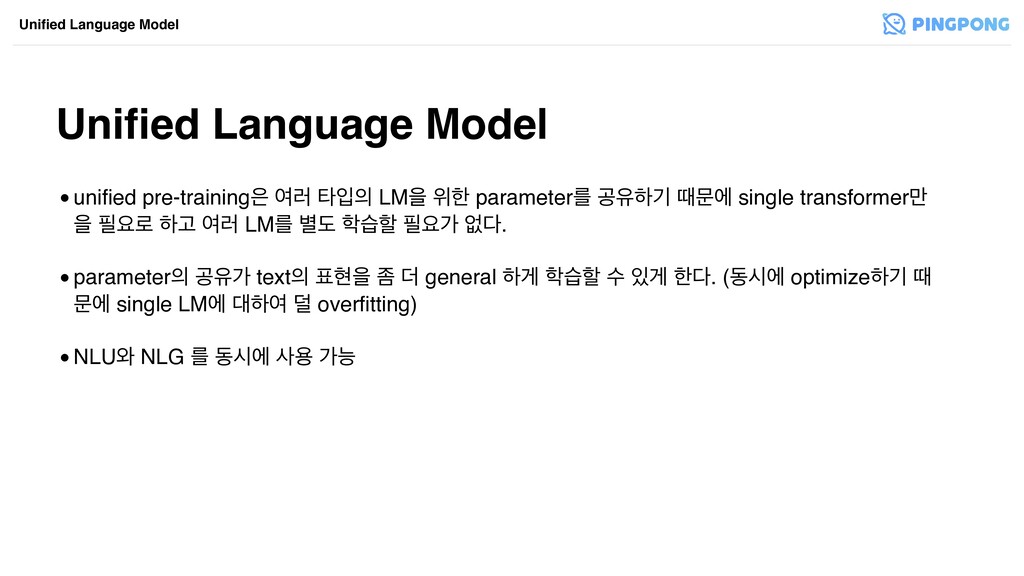
LMਸ ਤೠ parameterܳ ҕਬೞӝ ٸޙী single transformer݅ ਸ ਃ۽ ೞҊ ৈ۞ LMܳ ߹ب णೡ ਃо হ. •parameter ҕਬо text അਸ ખ ؊ general ೞѱ णೡ ࣻ ѱ ೠ. (زदী optimizeೞӝ ٸ ޙী single LMী ೞৈ ؏ overfitting) •NLU৬ NLG ܳ زदী ࢎਊ оמ
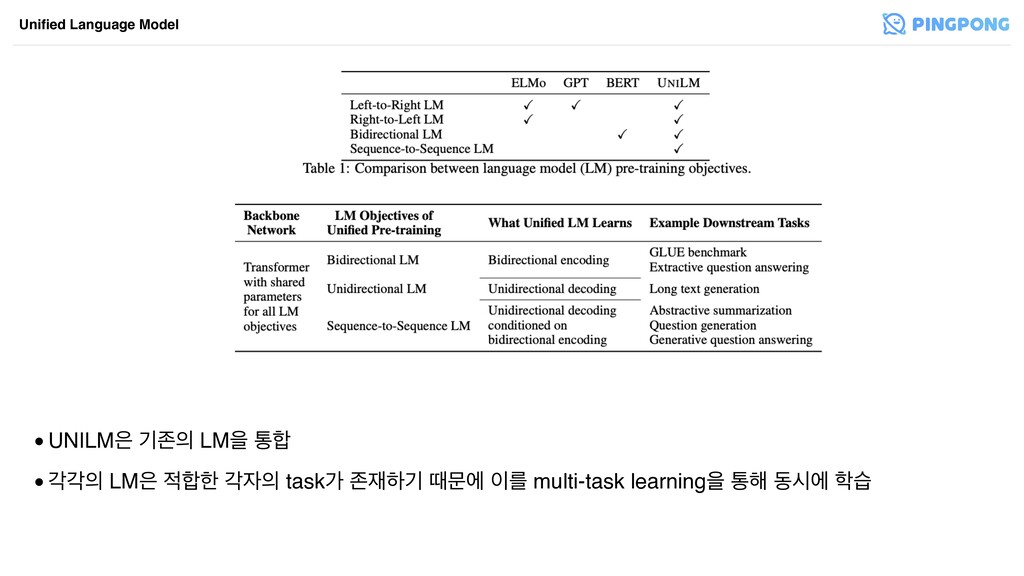
•UNILM ӝઓ LMਸ ా •пп LM ೠ п taskо ઓೞӝ
ٸޙী ܳ multi-task learningਸ ా೧ زदী ण Unified Language Model
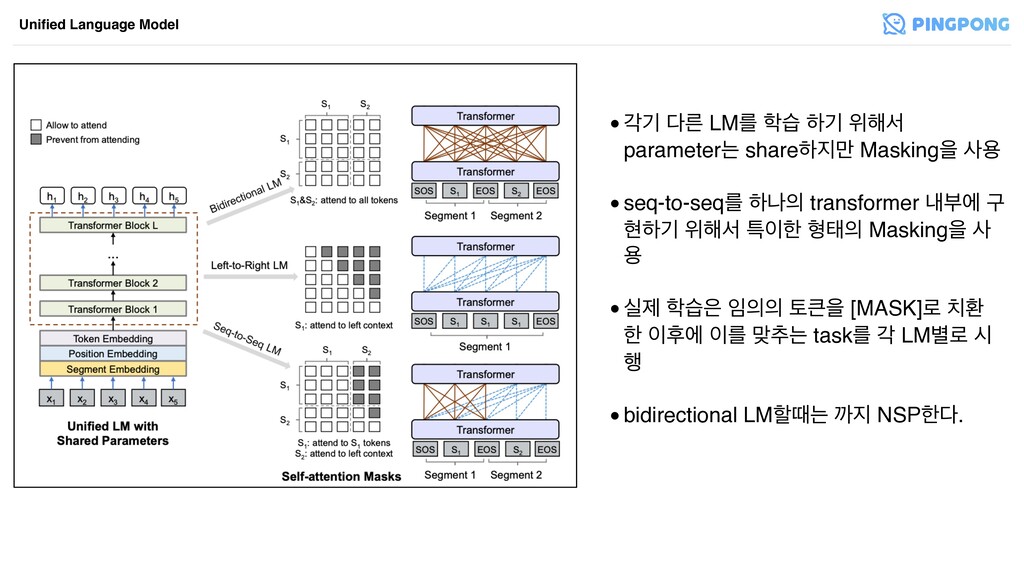
•пӝ ܲ LMܳ ण ೞӝ ਤ೧ࢲ parameterח shareೞ݅ Maskingਸ ࢎਊ
•seq-to-seqܳ ೞա transformer ղࠗী ҳ അೞӝ ਤ೧ࢲ ౠೠ ഋక Maskingਸ ࢎ ਊ •पઁ ण షਸ [MASK]۽ ജ ೠ റী ܳ ݏ୶ח taskܳ п LM߹۽ द ೯ •bidirectional LMೡٸח ө NSPೠ. Unified Language Model
•[SOS]ח scpecial start-of-sequence •[EOS]ח NLU task ޙ ҃҅ scpecial end-of-sequence
•Embedding BERTܳ ٮܰݴ textח WordPieceܳ ా೧ tokenize •пп LM task߹۽ ܲ segment embedding ࢎਊػ. Unified Language Model
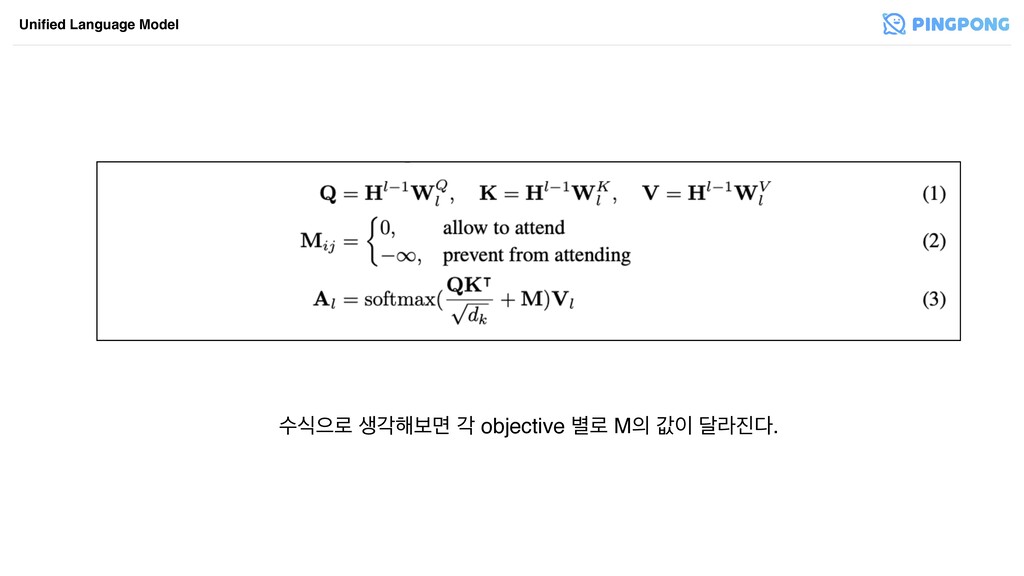
ࣻधਵ۽ ࢤп೧ࠁݶ п objective ߹۽ M ч ׳ۄ. Unified Language
Model
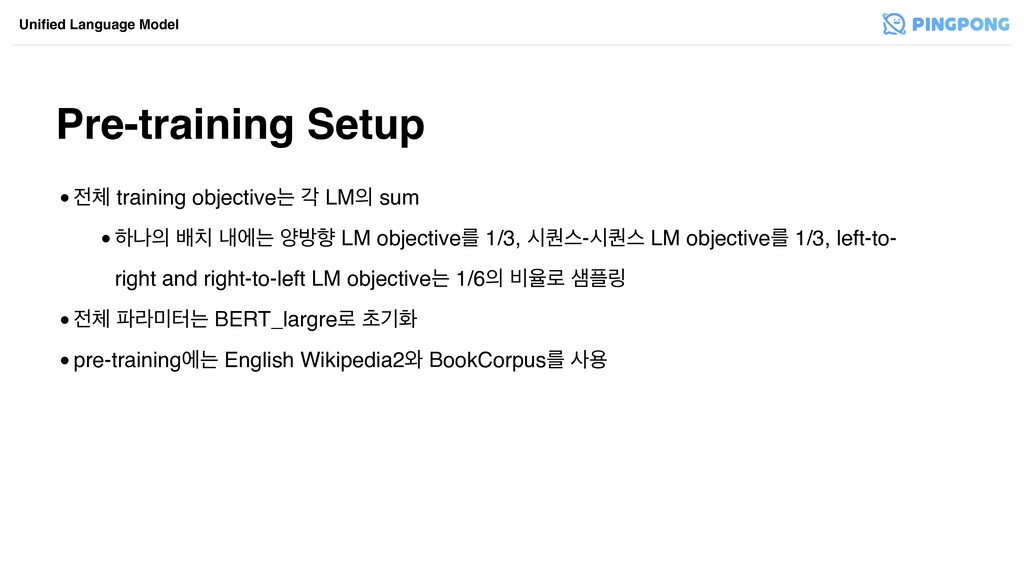
Pre-training Setup Unified Language Model • training objectiveח п LM
sum •ೞա ߓ ղীח নߑೱ LM objectiveܳ 1/3, द௫झ-द௫झ LM objectiveܳ 1/3, left-to- right and right-to-left LM objectiveח 1/6 ࠺ਯ۽ ࢠ݂ • ۄఠח BERT_largre۽ ୡӝച •pre-trainingীח English Wikipedia2৬ BookCorpusܳ ࢎਊ
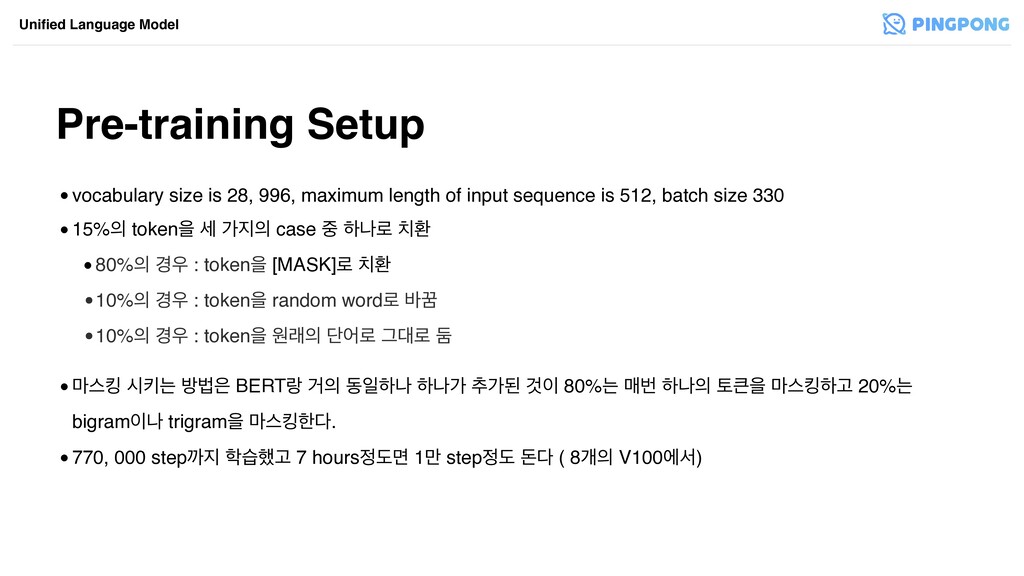
Pre-training Setup Unified Language Model •vocabulary size is 28, 996,
maximum length of input sequence is 512, batch size 330 •15% tokenਸ ࣁ о case ೞա۽ ജ • 80% ҃ : tokenਸ [MASK]۽ ജ •10% ҃ : tokenਸ random word۽ ߄Է •10% ҃ : tokenਸ ਗې ױয۽ Ӓ۽ م •݃झఊ दఃח ߑߨ BERTی Ѣ زੌೞա ೞաо ୶оػ Ѫ 80%ח ݒߣ ೞա షਸ ݃झఊೞҊ 20%ח bigramա trigramਸ ݃झఊೠ. •770, 000 stepө ण೮Ҋ 7 hoursبݶ 1݅ stepب ت ( 8ѐ V100ীࢲ)
Fine-tuning on Downstream NLU and NLG Tasks Unified Language Model
•NLUীࢲ fine-tuning दীח [SOS] షਸ representationਵ۽ ࢎਊ ( BERT [CLS] ৬ زੌ ) •NLGܳ fine-tuning दীח target sequenceী ೠ maskingਸ ೞҊ ݏ୶ח taskܳ ೯ೠ. • җীࢲ [EOS] ژೠ ਕ ࣻ ӝ ٸޙী ݽ؛ ઁ [EOS]ܳ ஏ೧ঠ ೞחب ߓ ࣻ Ҋ ೠ.
Experiments Experiments
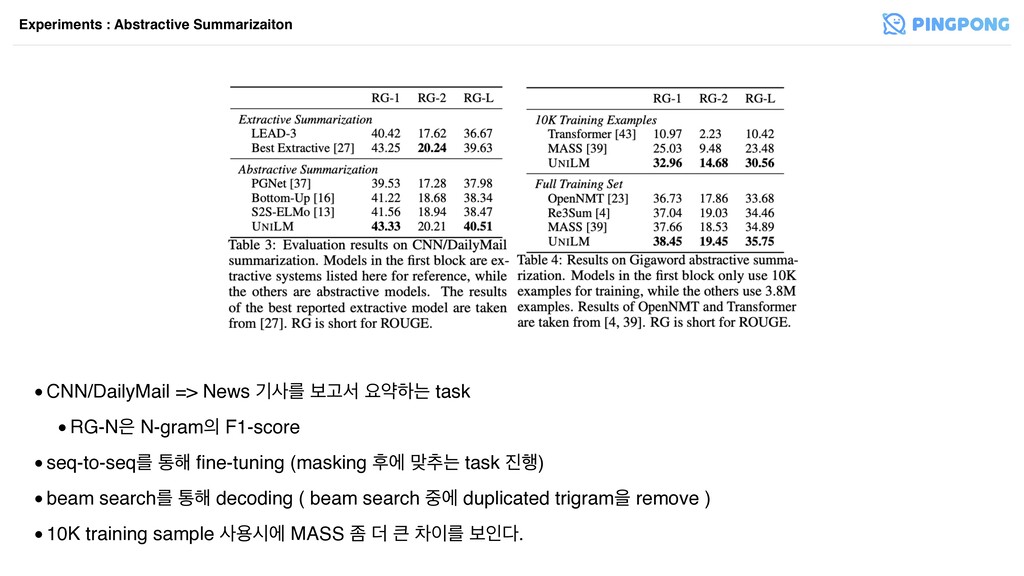
•CNN/DailyMail => News ӝࢎܳ ࠁҊࢲ ਃডೞח task •RG-N N-gram F1-score
•seq-to-seqܳ ా೧ fine-tuning (masking റী ݏ୶ח task ೯) •beam searchܳ ా೧ decoding ( beam search ী duplicated trigramਸ remove ) •10K training sample ࢎਊदী MASS ખ ؊ ରܳ ࠁੋ. Experiments : Abstractive Summarizaiton
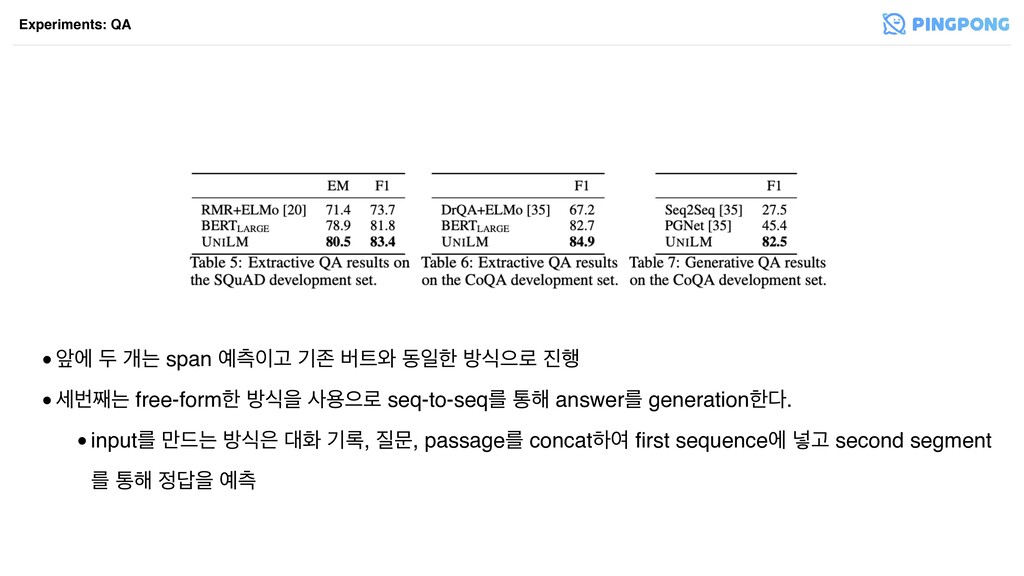
•খী ف ѐח span ஏҊ ӝઓ ߡ৬ زੌೠ ߑधਵ۽ ೯
•ࣁߣ૩ח free-formೠ ߑधਸ ࢎਊਵ۽ seq-to-seqܳ ా೧ answerܳ generationೠ. •inputܳ ݅٘ח ߑध ച ӝ۾, ޙ, passageܳ concatೞৈ first sequenceী ֍Ҋ second segment ܳ ా೧ ਸ ஏ Experiments: QA
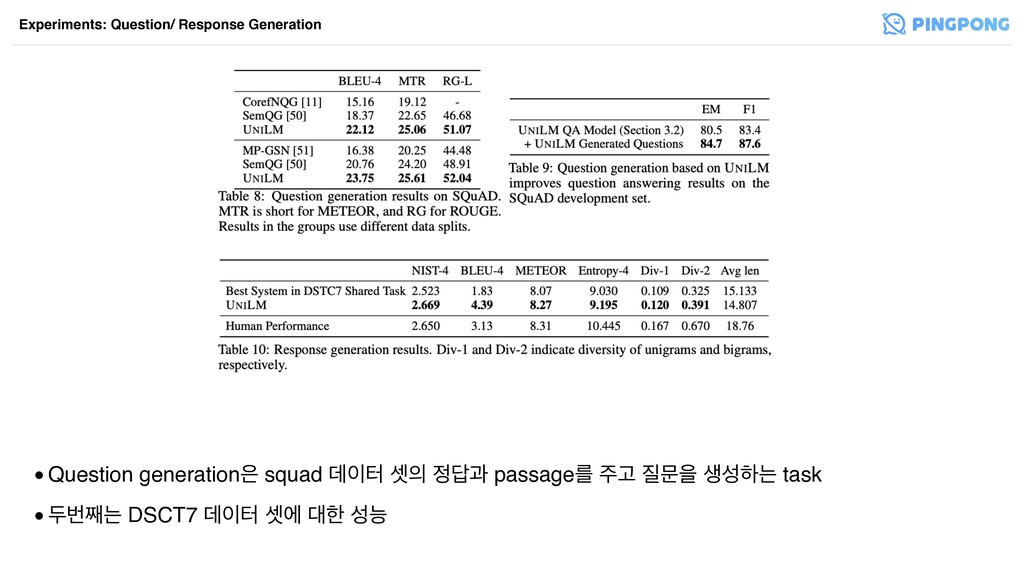
•Question generation squad ؘఠ ࣇ җ passageܳ Ҋ ޙਸ ࢤࢿೞח
task •فߣ૩ח DSCT7 ؘఠ ࣇী ೠ ࢿמ Experiments: Question/ Response Generation
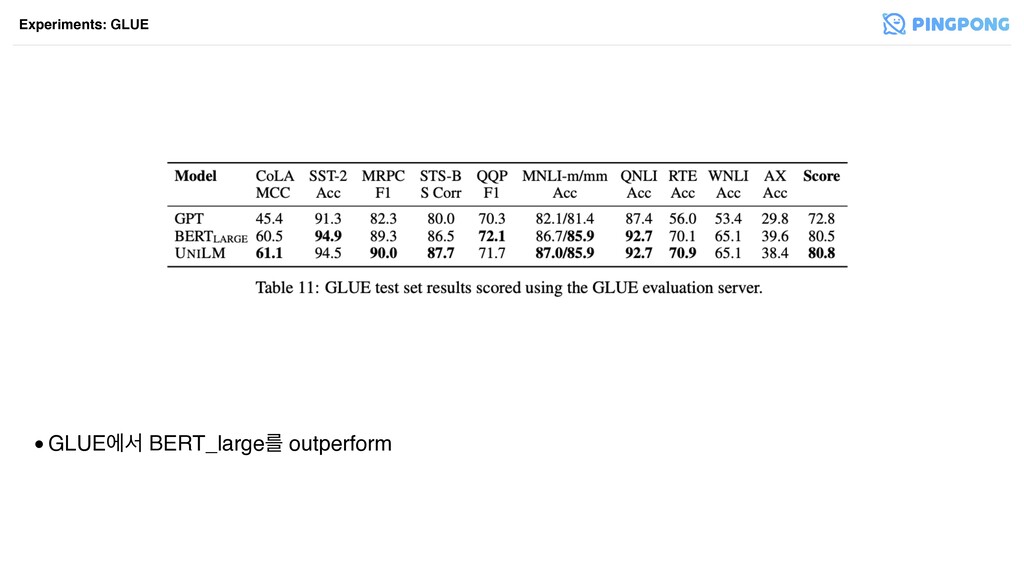
•GLUEীࢲ BERT_largeܳ outperform Experiments: GLUE
хࢎפ✌ ୶о ޙ ژח ҾӘೠ ݶ ઁٚ ইې োۅ۽
োۅ ࣁਃ! ࢲ࢚ (ML Research Scientist, Pingpong)
[email protected]
More Decks by Scatter Lab Inc.
See All by Scatter Lab Inc.
zeta introduction
scatterlab
0
2.2k
SimCLR: A Simple Framework for Contrastive Learning of Visual Representations
scatterlab
0
4.6k
Adversarial Filters of Dataset Biases
scatterlab
0
2.3k
Sparse, Dense, and Attentional Representations for Text Retrieval
scatterlab
0
2.4k
Weight Poisoning Attacks on Pre-trained Models
scatterlab
0
2.2k
Approximate Nearest Neighbor Negative Contrastive Learning for Dense Text Retrieval
scatterlab
0
2.6k
Beyond Accuracy: Behavioral Testing of NLP Models with CheckList
scatterlab
0
2.4k
Open-Retrieval Conversational Question Answering
scatterlab
0
2.4k
What Can Neural Networks Reason About?
scatterlab
0
2.4k
Other Decks in Research
See All in Research
幾何学的深層学習入門 ~3次元構造と対称性を学習するニューラルネットワーク~
taniai
3
1.1k
AI対話に何を挟むか ― 高回転対話・デジタル摘録・手書き記録による創造体験の違い|日本創造学会2026
ishiirikie
0
210
PHTalks Bengaluru - SSRF When All Else Fails
dk999
0
1.2k
XDPerf: A High-Performance Traffic Generator Built with WASM and eBPF
takehaya
1
400
マニアックセッション 〜次世代のメールプロトコルの斜め読み(2026年版)
hirachan
0
520
【令和7年度版】内航船 VS 外航船 早見表
anikisencyo
0
220
VLMの推論を高速化する視覚トークン削減の仕組み
tattaka
2
440
J-STAGEの現況と全文XML登載必須化について
xspa2012
0
410
HAKARI-Bench - 実運用視点での情報検索モデル評価ベンチマーク
hotchpotch
1
870
Top 4セキュリティ会議に一通り論文が採択されるまでの道のりと展望 / Top 4 Security Grand Slam
takaomurakami
0
1.1k
ハードウェア研究で国際トップ会議を目指す!IROS 2027での論文採択を目指して
ayatokanada
7
4.2k
SAM3を用いたコマ・吹き出しの 領域検出と分割構造からの読み順推定
kzmssk
0
230
Featured
See All Featured
Bridging the Design Gap: How Collaborative Modelling removes blockers to flow between stakeholders and teams @FastFlow conf
baasie
0
770
Embracing the Ebb and Flow
colly
88
5.2k
Technical Leadership for Architectural Decision Making
baasie
4
650
Jess Joyce - The Pitfalls of Following Frameworks
techseoconnect
PRO
1
480
What's in a price? How to price your products and services
michaelherold
247
13k
The Straight Up "How To Draw Better" Workshop
denniskardys
239
140k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
290
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
620
Why You Should Never Use an ORM
jnunemaker
PRO
61
10k
個人開発の失敗を避けるイケてる考え方 / tips for indie hackers
panda_program
123
22k
Utilizing Notion as your number one productivity tool
mfonobong
4
640
Code Reviewing Like a Champion
maltzj
529
40k


 scatterlab
 taniai
 ishiirikie
 dk999
 takehaya
 hirachan
 anikisencyo
 tattaka
 xspa2012
 hotchpotch
 takaomurakami
 ayatokanada
 kzmssk
 baasie
 colly
 techseoconnect
 michaelherold
 denniskardys
 stuffmc
 katarinadahlin
 jnunemaker
 panda_program
 mfonobong
 maltzj