Share
Embed
Erwan Raffin - Déploiement d'applications multimédia sur architecture reconfigurable à gros grain

SCEE Team
June 16, 2011
Transcript
79 slides
-
Déploiement d’applications multimédia sur architecture reconfigurable à gros grain :
modélisation avec la programmation par contraintes Séminaire SCEE, Supélec 16 juin 2011 Rennes - France Erwan RAFFIN sous la supervision de Christophe WOLINSKI & François CHAROT -
2 Plan I. Introduction et motivations II. Présentation de la
Programmation par Contraintes III. Fusion d’unités fonctionnelles reconfigurables sous contraintes architecturales et technologiques IV. Déploiement d’applications sur architecture reconfigurable à gros grain V. Conclusion et perspectives -
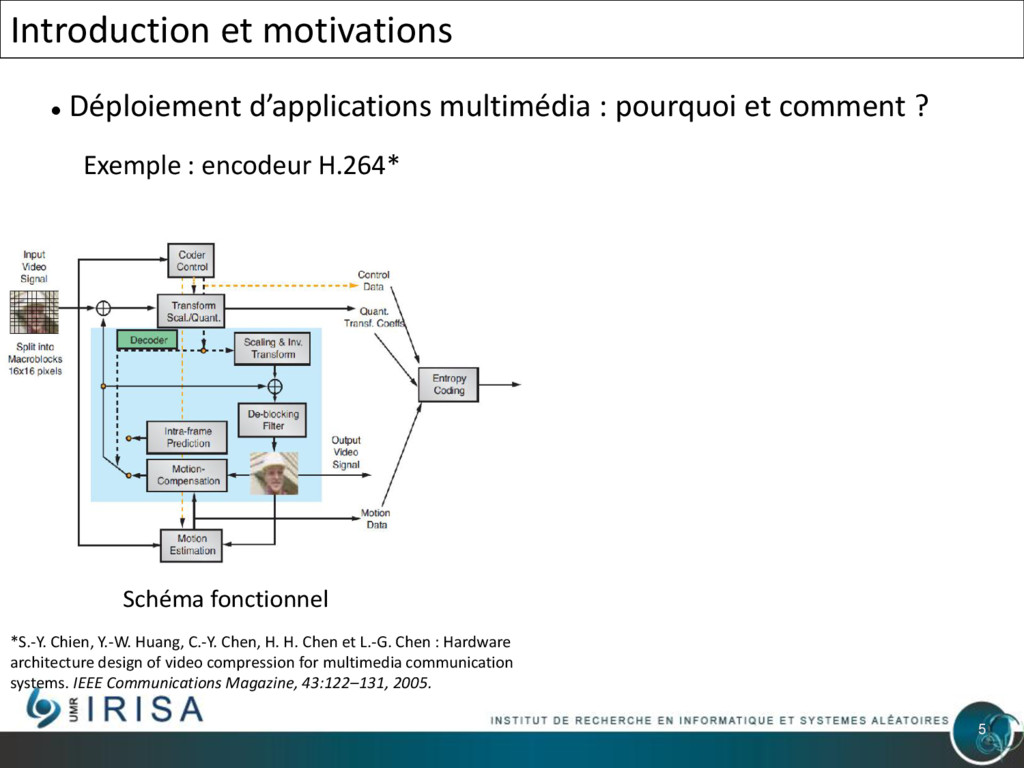
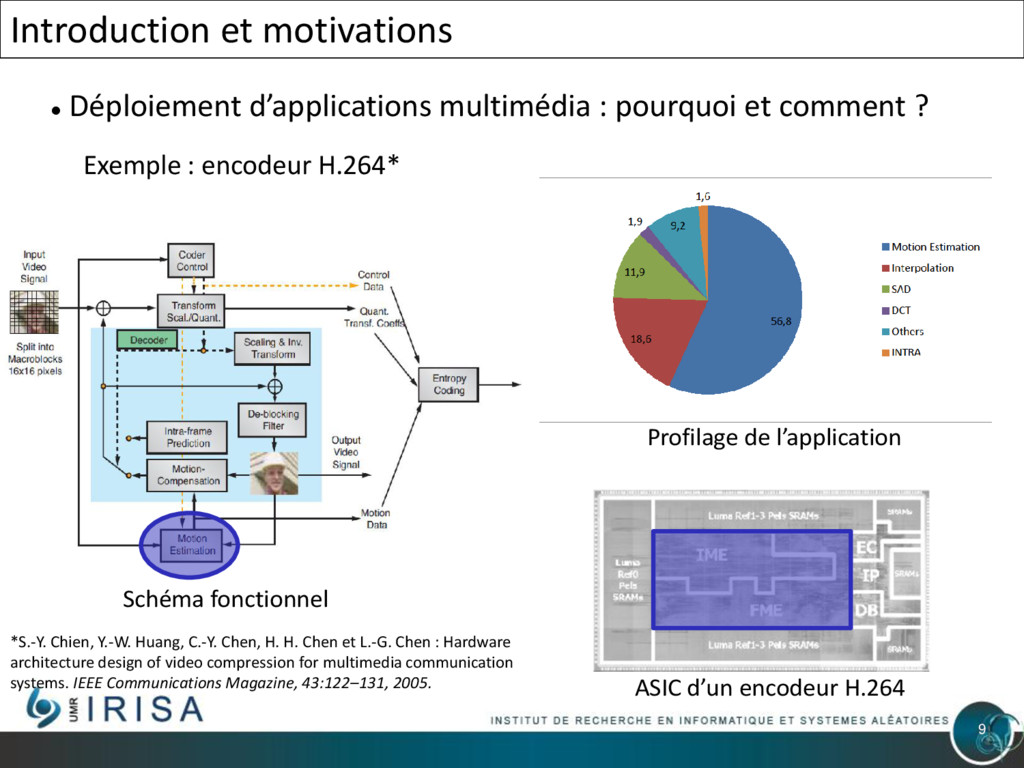
5 Introduction et motivations Déploiement d’applications multimédia : pourquoi
et comment ? Exemple : encodeur H.264* Schéma fonctionnel *S.-Y. Chien, Y.-W. Huang, C.-Y. Chen, H. H. Chen et L.-G. Chen : Hardware architecture design of video compression for multimedia communication systems. IEEE Communications Magazine, 43:122–131, 2005. -
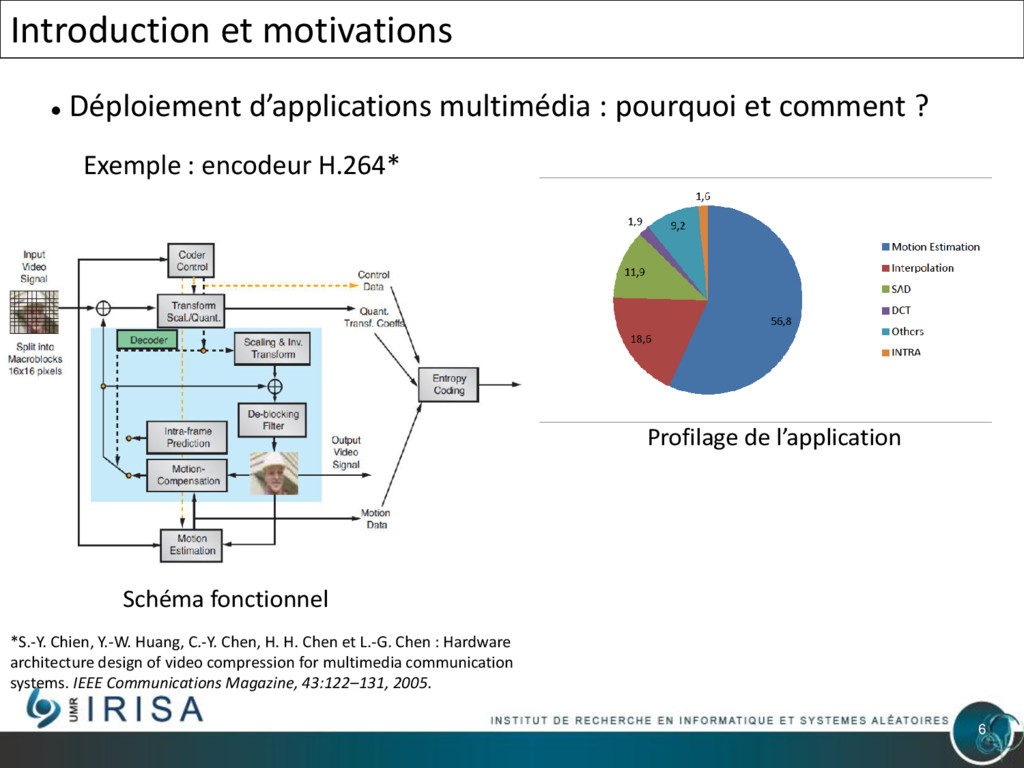
6 Introduction et motivations Déploiement d’applications multimédia : pourquoi
et comment ? Exemple : encodeur H.264* Profilage de l’application Schéma fonctionnel *S.-Y. Chien, Y.-W. Huang, C.-Y. Chen, H. H. Chen et L.-G. Chen : Hardware architecture design of video compression for multimedia communication systems. IEEE Communications Magazine, 43:122–131, 2005. -
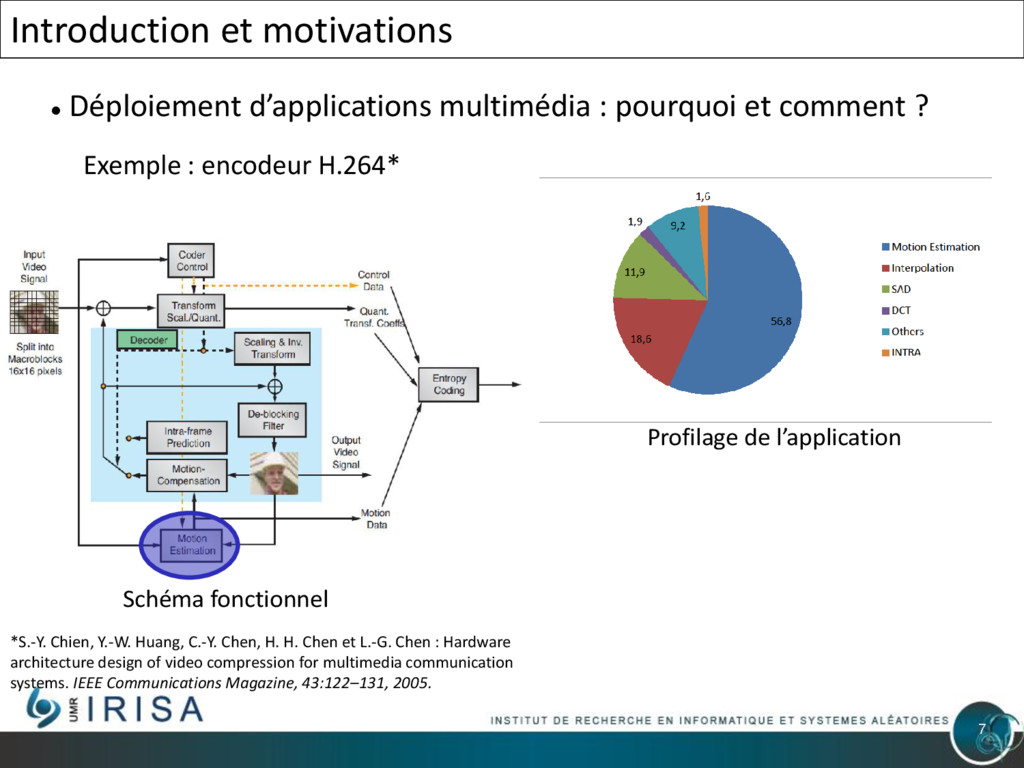
7 Introduction et motivations Déploiement d’applications multimédia : pourquoi
et comment ? Exemple : encodeur H.264* Profilage de l’application Schéma fonctionnel *S.-Y. Chien, Y.-W. Huang, C.-Y. Chen, H. H. Chen et L.-G. Chen : Hardware architecture design of video compression for multimedia communication systems. IEEE Communications Magazine, 43:122–131, 2005. -
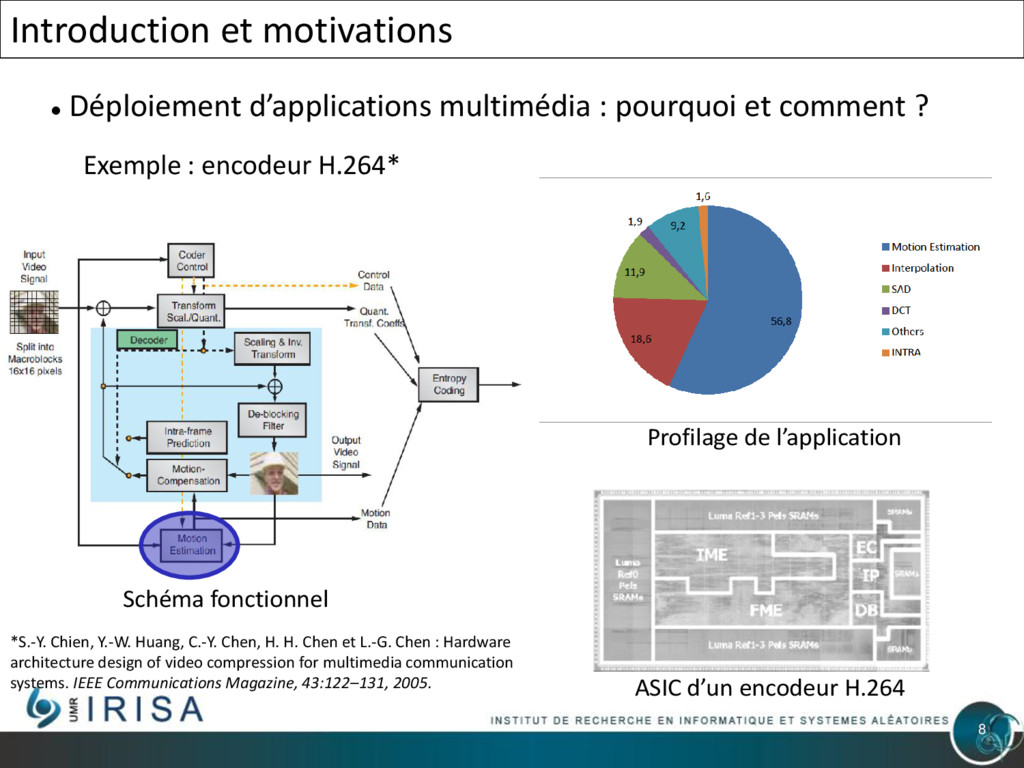
8 Introduction et motivations Déploiement d’applications multimédia : pourquoi
et comment ? Exemple : encodeur H.264* Profilage de l’application Schéma fonctionnel *S.-Y. Chien, Y.-W. Huang, C.-Y. Chen, H. H. Chen et L.-G. Chen : Hardware architecture design of video compression for multimedia communication systems. IEEE Communications Magazine, 43:122–131, 2005. ASIC d’un encodeur H.264 -
9 Introduction et motivations Déploiement d’applications multimédia : pourquoi
et comment ? Exemple : encodeur H.264* Profilage de l’application Schéma fonctionnel *S.-Y. Chien, Y.-W. Huang, C.-Y. Chen, H. H. Chen et L.-G. Chen : Hardware architecture design of video compression for multimedia communication systems. IEEE Communications Magazine, 43:122–131, 2005. ASIC d’un encodeur H.264 -
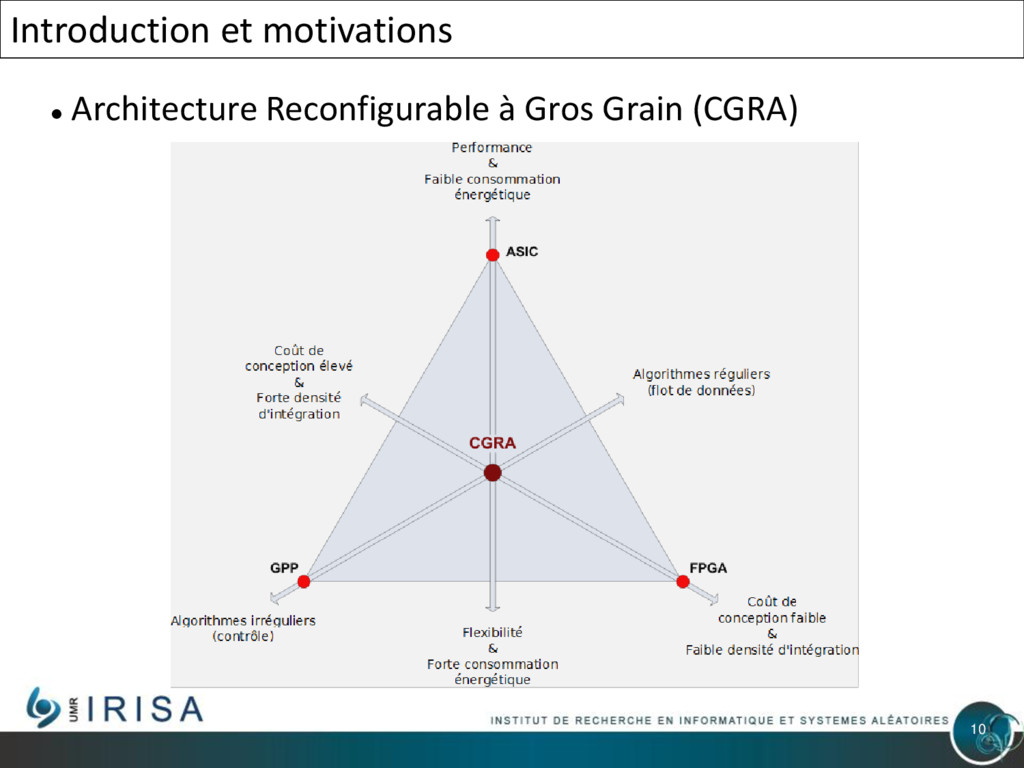
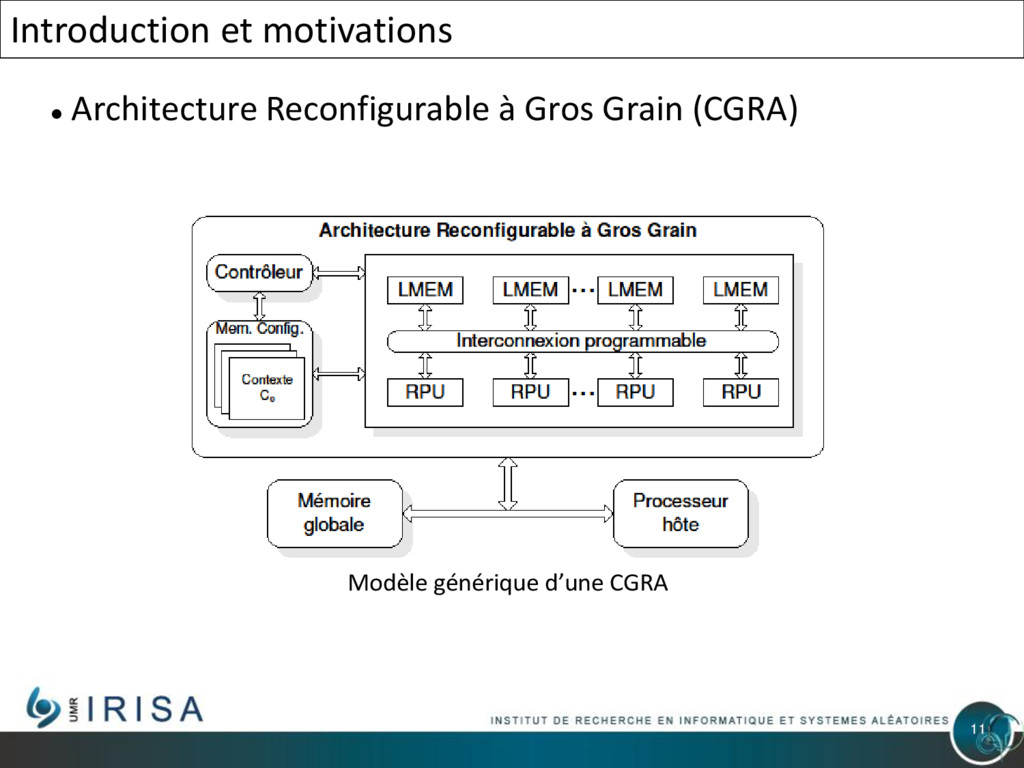
11 Introduction et motivations Architecture Reconfigurable à Gros Grain
(CGRA) Modèle générique d’une CGRA -
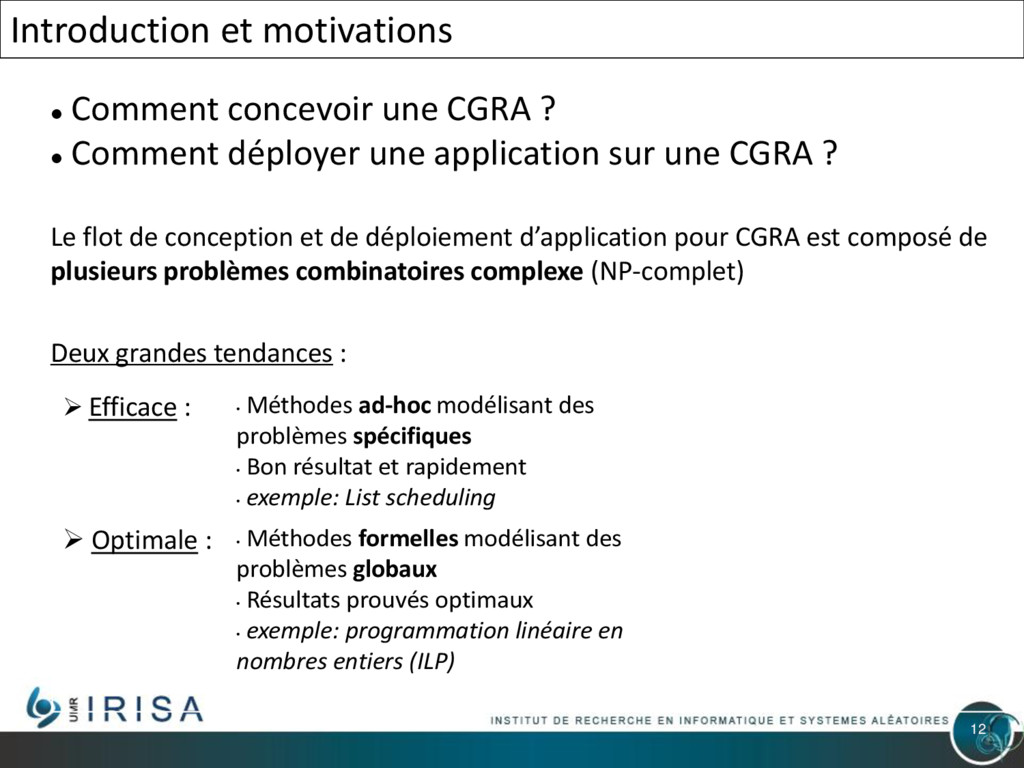
12 Introduction et motivations Comment concevoir une CGRA ?
Comment déployer une application sur une CGRA ? Le flot de conception et de déploiement d’application pour CGRA est composé de plusieurs problèmes combinatoires complexe (NP-complet) Deux grandes tendances : Efficace : • Méthodes ad-hoc modélisant des problèmes spécifiques • Bon résultat et rapidement • exemple: List scheduling Optimale : • Méthodes formelles modélisant des problèmes globaux • Résultats prouvés optimaux • exemple: programmation linéaire en nombres entiers (ILP) -
13 Introduction et motivations Comment concevoir une CGRA ?
Comment déployer une application sur une CGRA ? Le flot de conception et de déploiement d’application pour CGRA est composé de plusieurs problèmes combinatoires complexe (NP-complet) Deux grandes tendances : Efficace : • Méthodes ad-hoc modélisant des problèmes spécifiques • Bon résultat et rapidement • exemple: List scheduling Solutions spécifiques basées sur des heuristiques Optimale : • Méthodes formelles modélisant des problèmes globaux • Résultats prouvés optimaux • exemple: programmation linéaire en nombres entiers (ILP) Pas de contraintes globales Méthodes lentes -
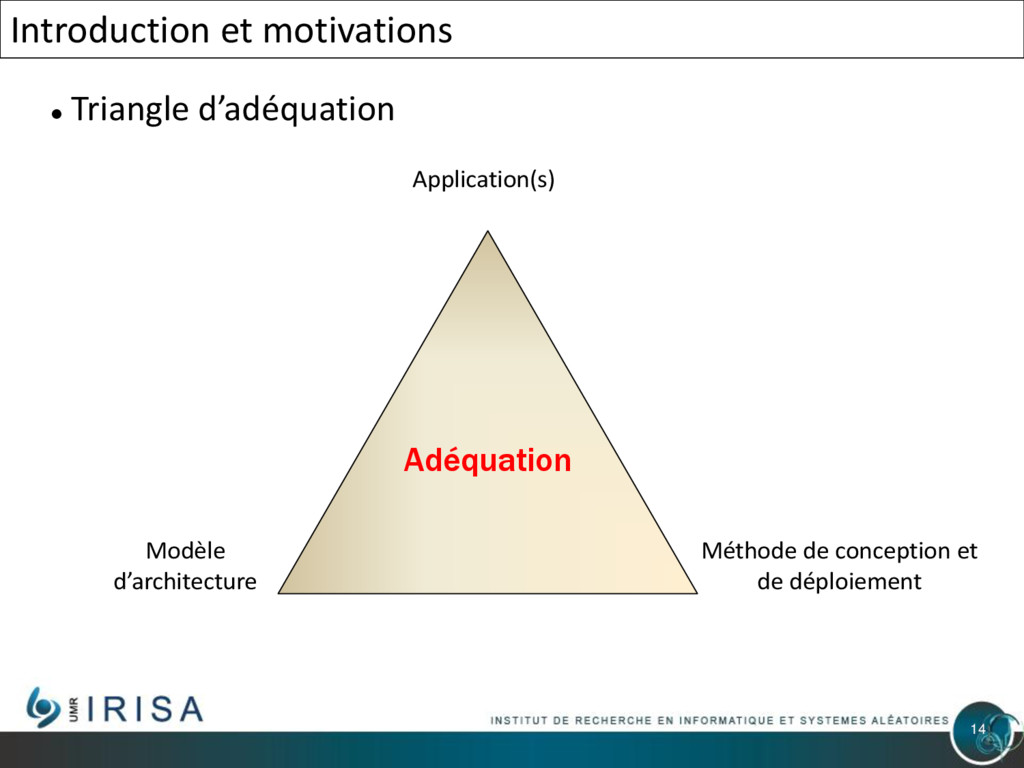
14 Introduction et motivations Triangle d’adéquation Application(s) Modèle d’architecture
Adéquation Méthode de conception et de déploiement -
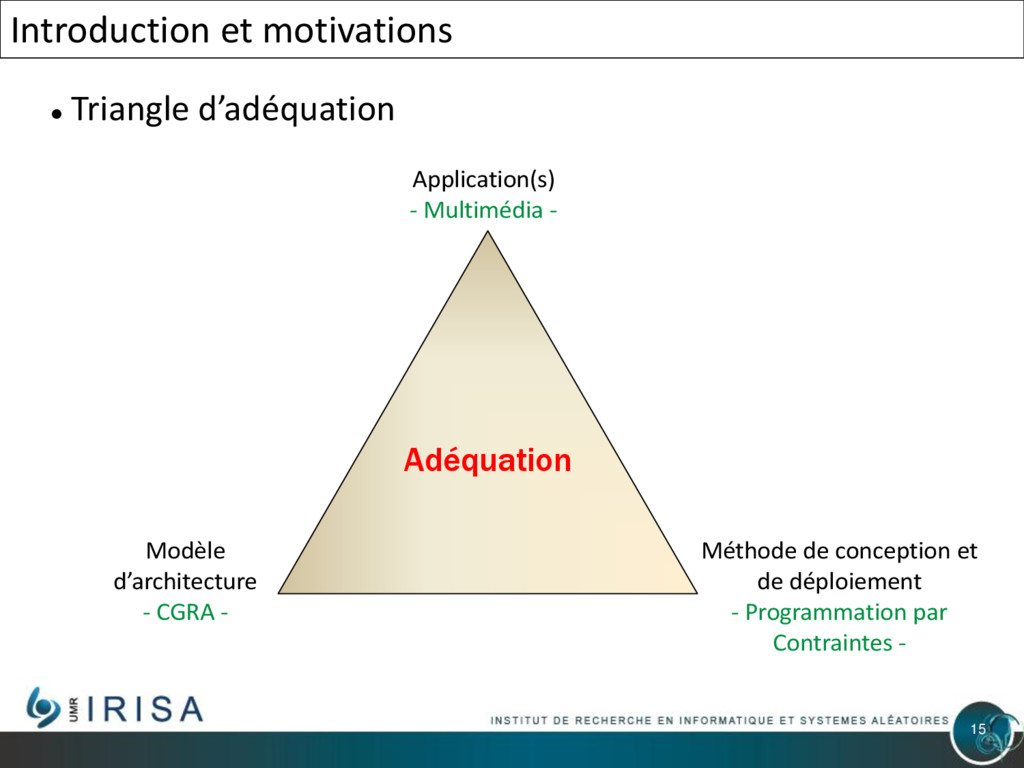
15 Introduction et motivations Triangle d’adéquation Application(s) - Multimédia
- Modèle d’architecture - CGRA - Méthode de conception et de déploiement - Programmation par Contraintes - Adéquation -
16 Présentation de la Programmation par Contraintes (CP) En
bref : « Constraint programming represents one of the closest approaches computer science has yet made to the Holy Grail of programming : the user states the problem, the computer solves it. » E. C. Freuder -
17 Présentation de la Programmation par Contraintes (CP) Un
problème de satisfaction de contraintes, ou CSP pour Constraint Satisfaction Problem, est défini par un triplet (X, D, C) représentant un ensemble de : variables V = {x1, ..., xn}, domaines finis D = {D(x1), ...,D(xn)}, contraintes C = {C1, ...,Ck)}. Une solution à un CSP correspond à l’affectation, pour toutes les variables, d’une valeur de son domaine, satisfaisant toutes les contraintes. Environnement de programmation par contraintes JaCoP (open source) • Solveur fournissant des techniques évoluée de réduction des domaines des variables - techniques de consistances • Optimalité prouvée par recherche exhaustive -
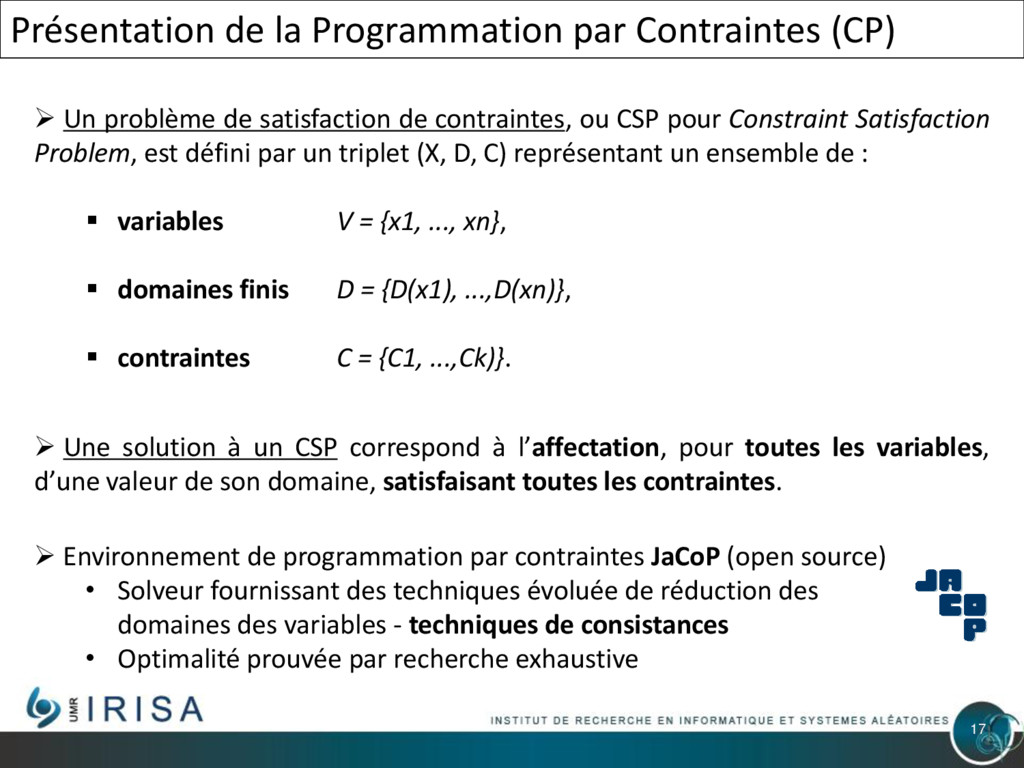
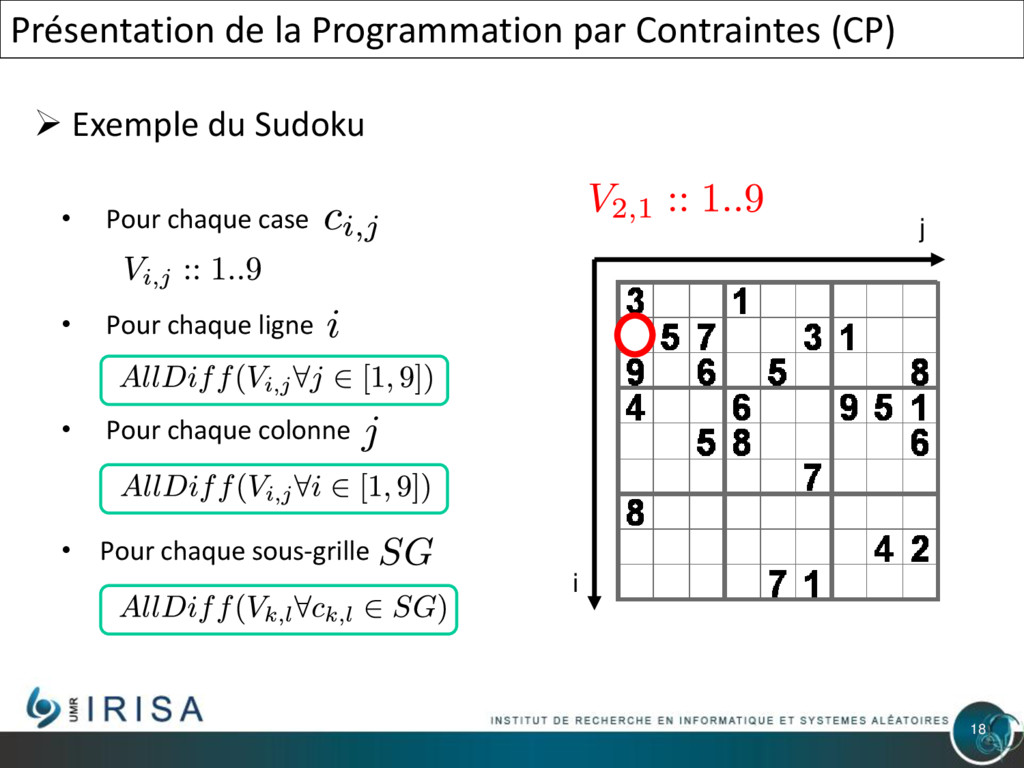
18 Présentation de la Programmation par Contraintes (CP) Exemple
du Sudoku • Pour chaque case • Pour chaque ligne • Pour chaque colonne • Pour chaque sous-grille j i j i -
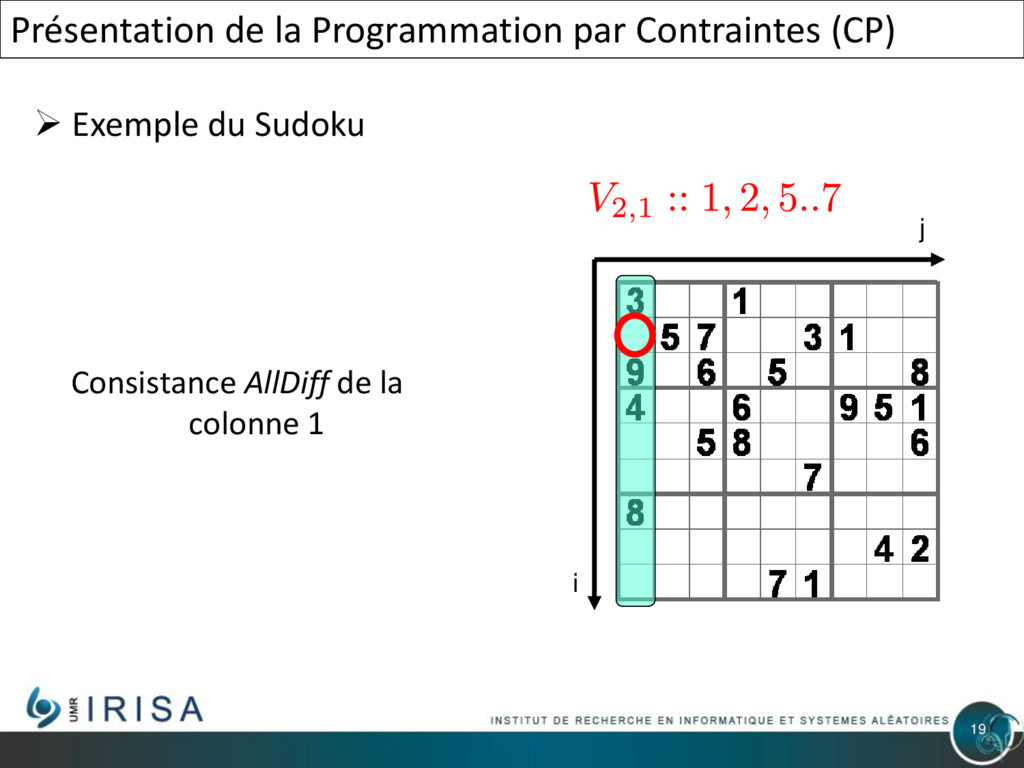
19 Présentation de la Programmation par Contraintes (CP) Exemple
du Sudoku Consistance AllDiff de la colonne 1 j i j i -
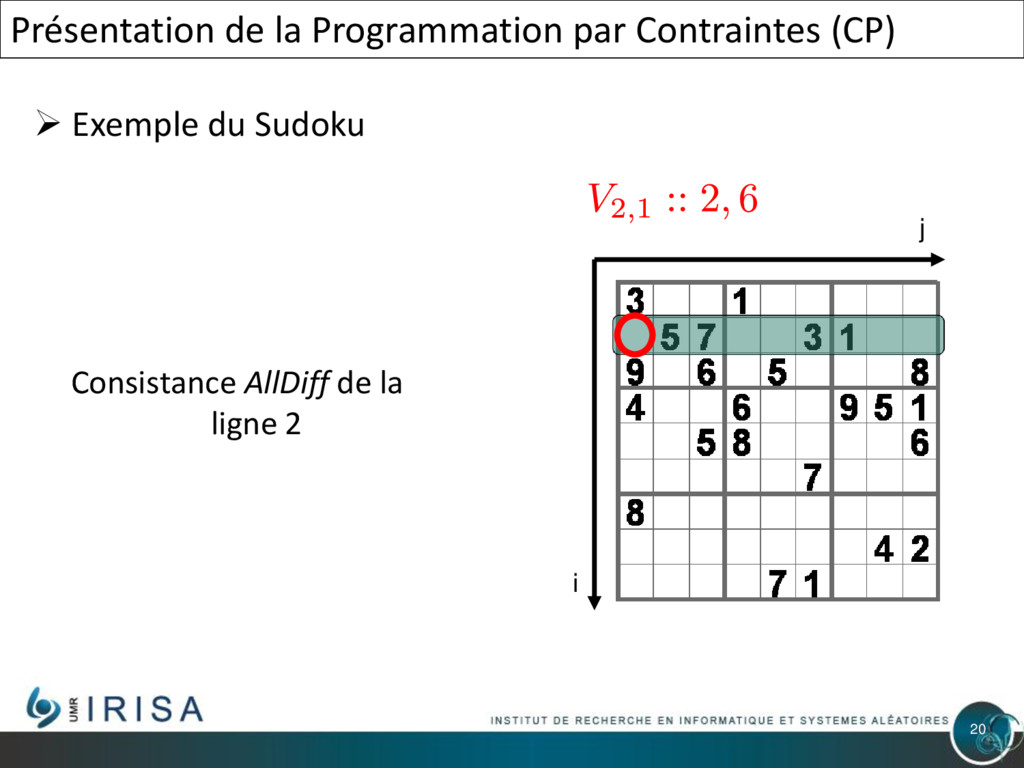
20 Présentation de la Programmation par Contraintes (CP) Exemple
du Sudoku j i j i Consistance AllDiff de la ligne 2 -
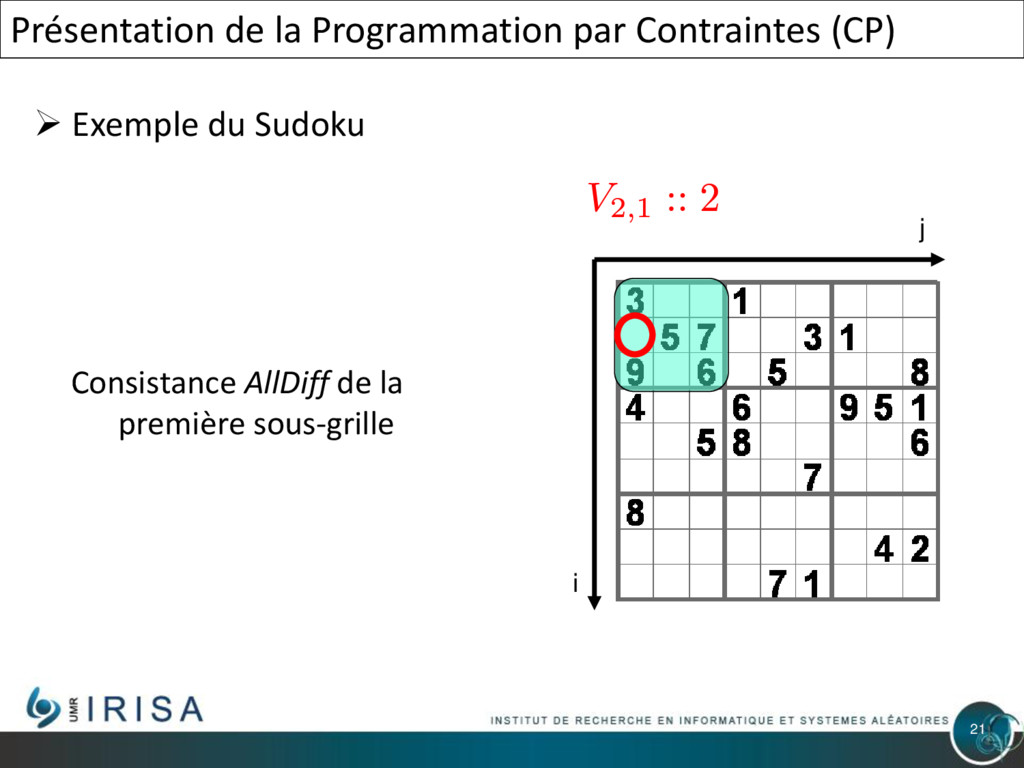
21 Présentation de la Programmation par Contraintes (CP) Exemple
du Sudoku j i j i Consistance AllDiff de la première sous-grille -
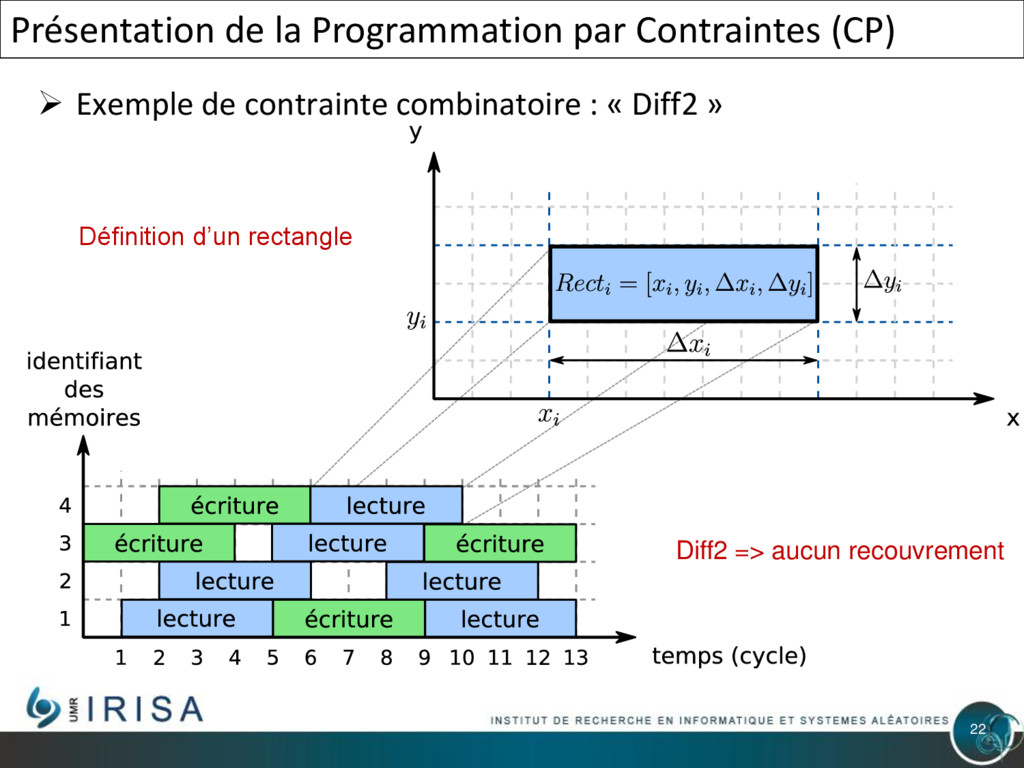
22 Exemple de contrainte combinatoire : « Diff2 »
Présentation de la Programmation par Contraintes (CP) Définition d’un rectangle Diff2 => aucun recouvrement -
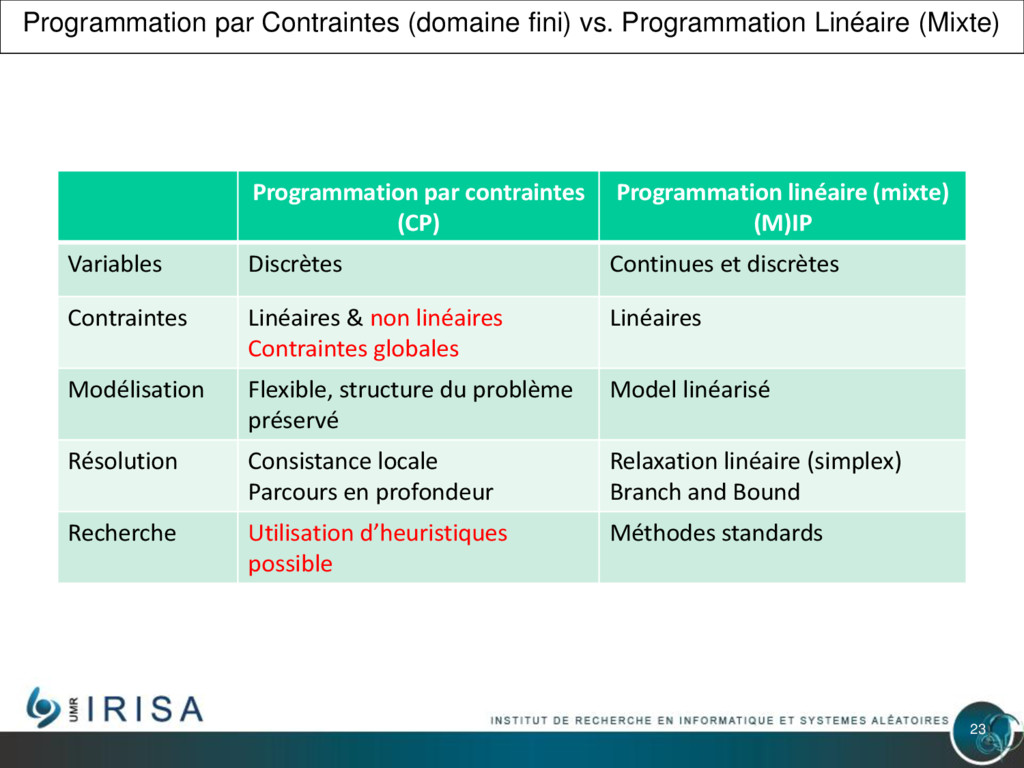
23 Programmation par Contraintes (domaine fini) vs. Programmation Linéaire (Mixte)
Programmation par contraintes (CP) Programmation linéaire (mixte) (M)IP Variables Discrètes Continues et discrètes Contraintes Linéaires & non linéaires Contraintes globales Linéaires Modélisation Flexible, structure du problème préservé Model linéarisé Résolution Consistance locale Parcours en profondeur Relaxation linéaire (simplex) Branch and Bound Recherche Utilisation d’heuristiques possible Méthodes standards -
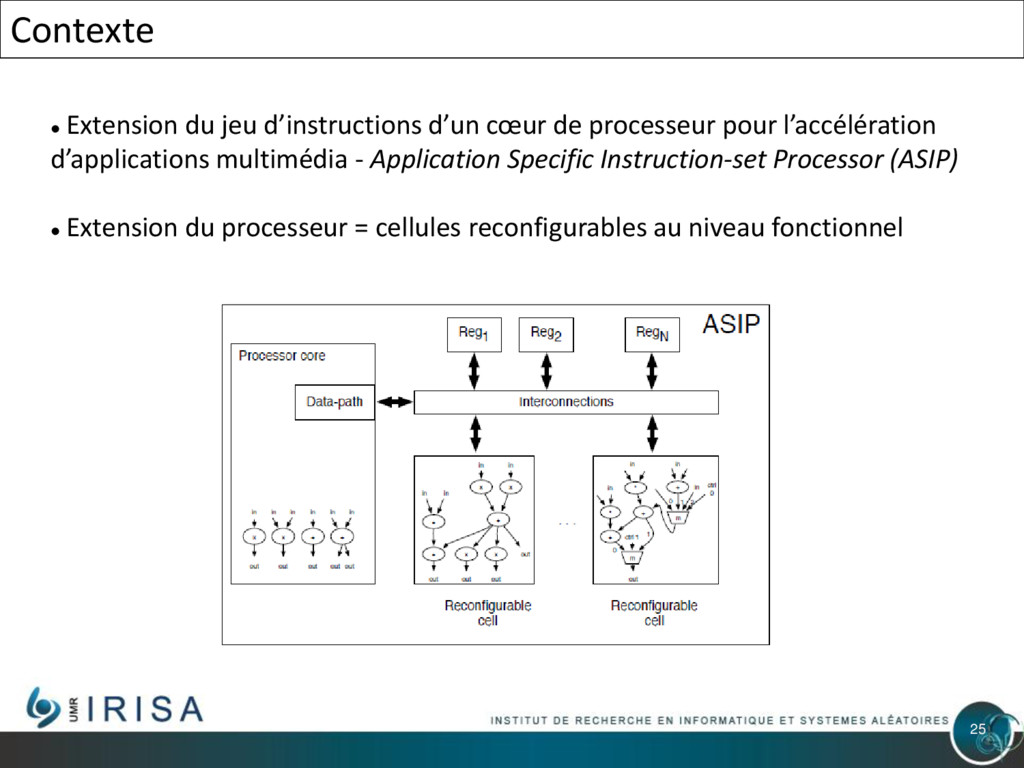
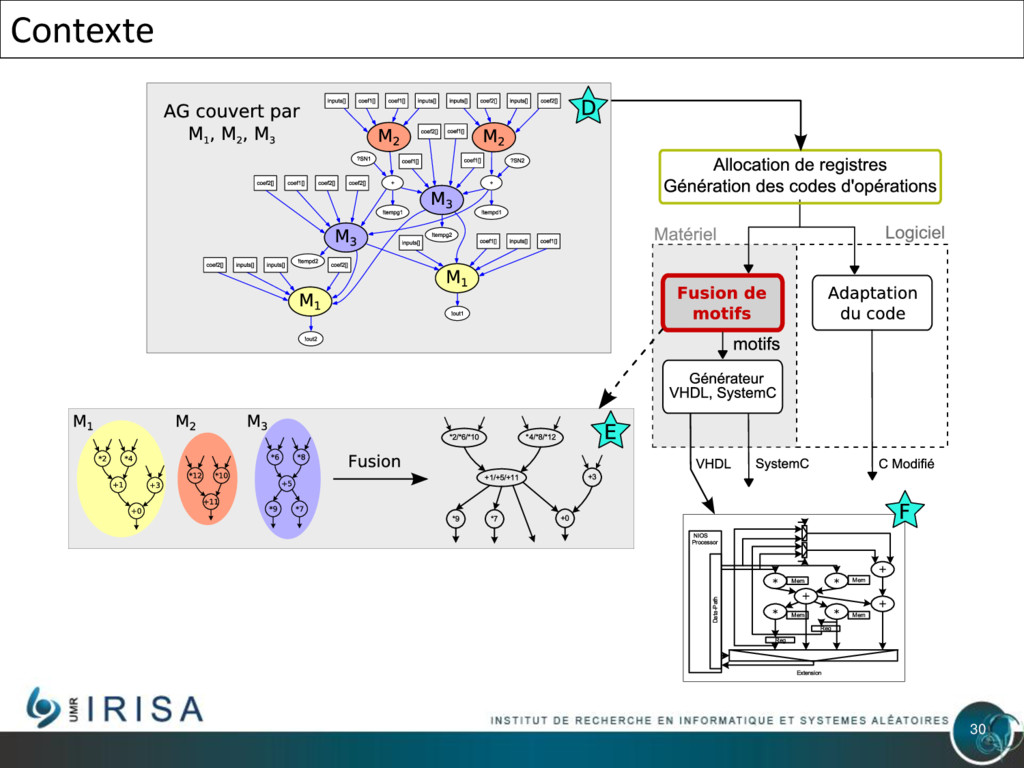
25 Contexte Extension du jeu d’instructions d’un cœur de
processeur pour l’accélération d’applications multimédia - Application Specific Instruction-set Processor (ASIP) Extension du processeur = cellules reconfigurables au niveau fonctionnel -
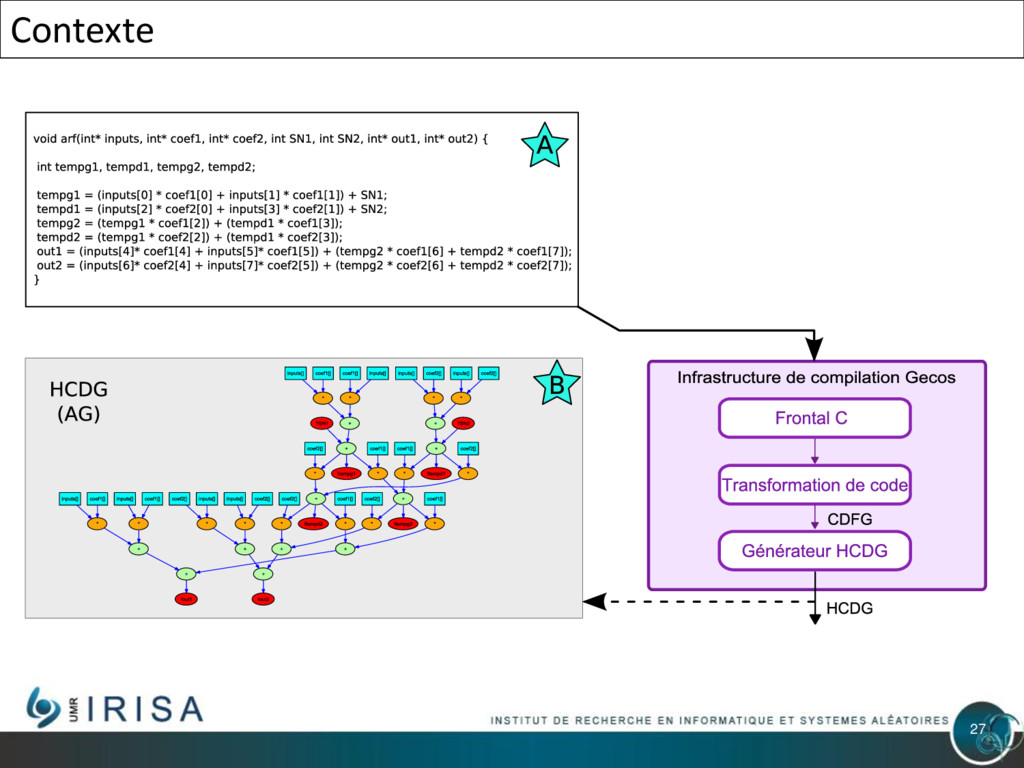
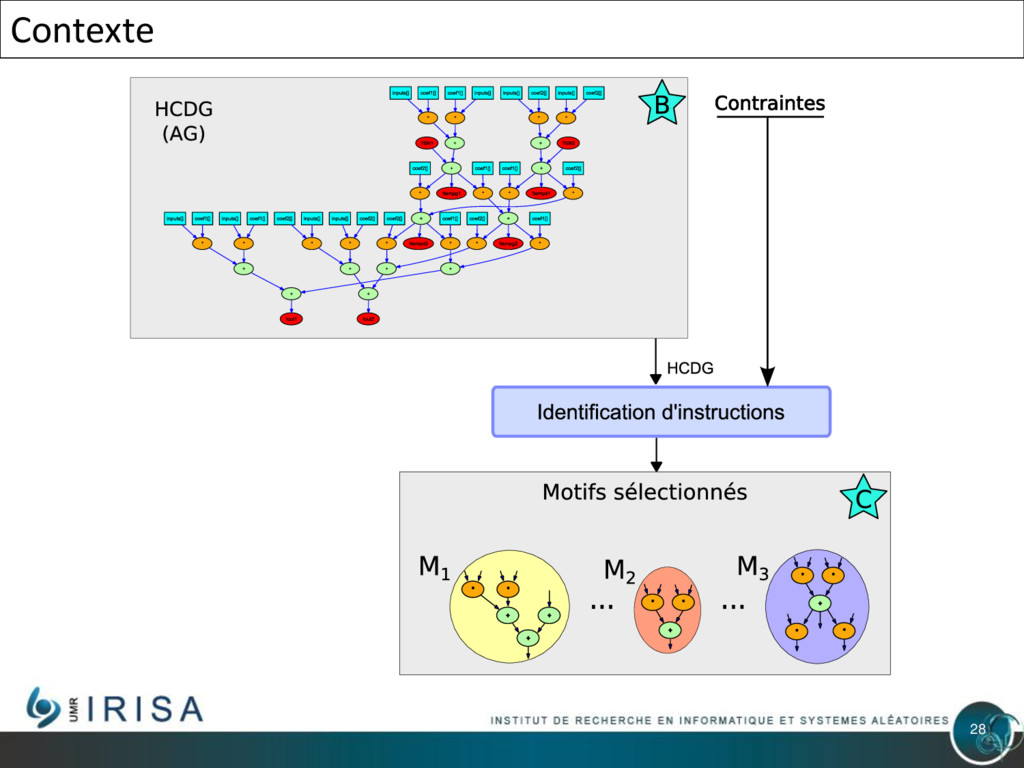
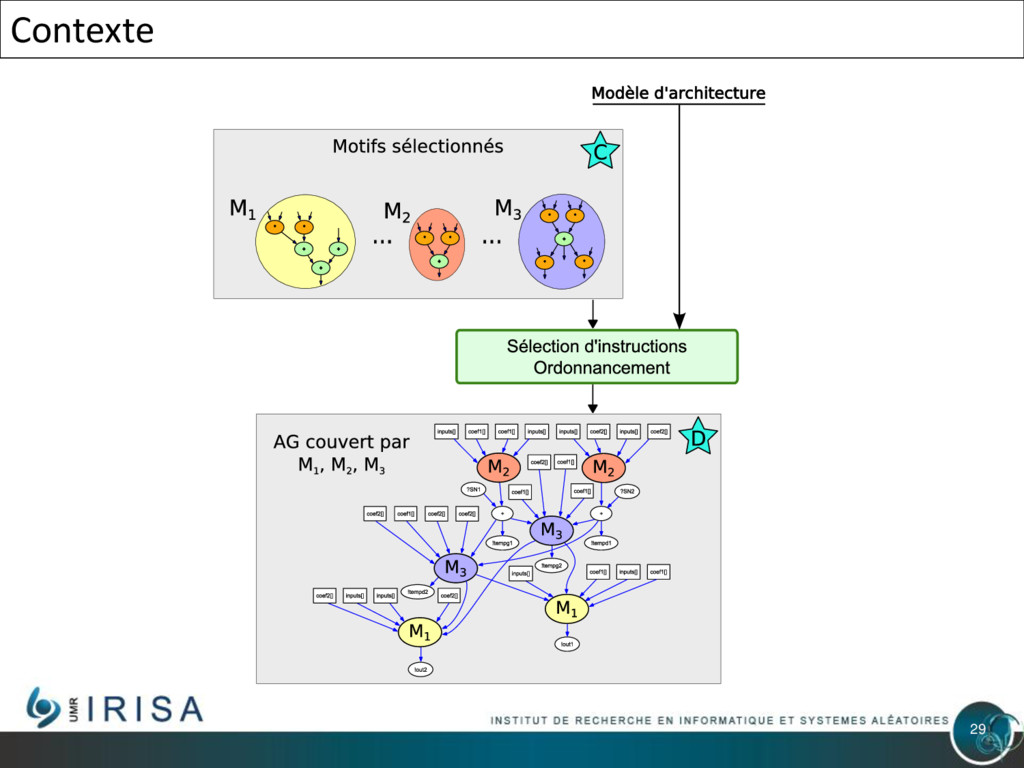
26 Contexte DURASE [Martin10] : Generic Environment for Design and
Utilization of Reconfigurable Application- Specific Processors Extensions Le flot de conception est basé sur la Programmation par Contraintes -
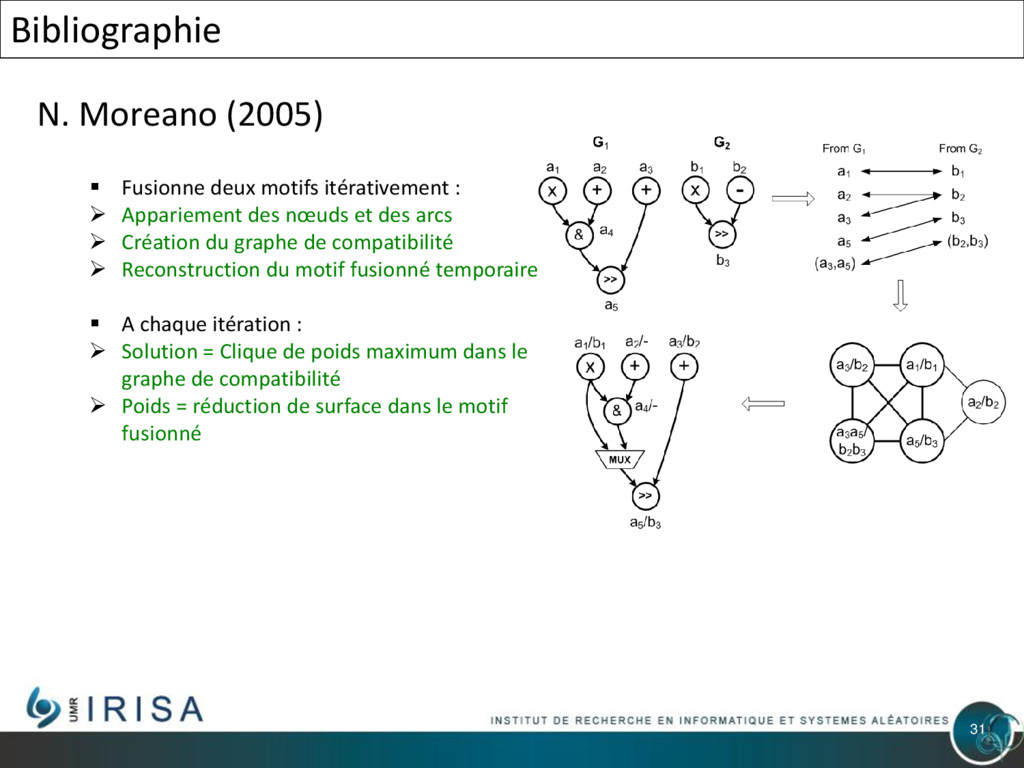
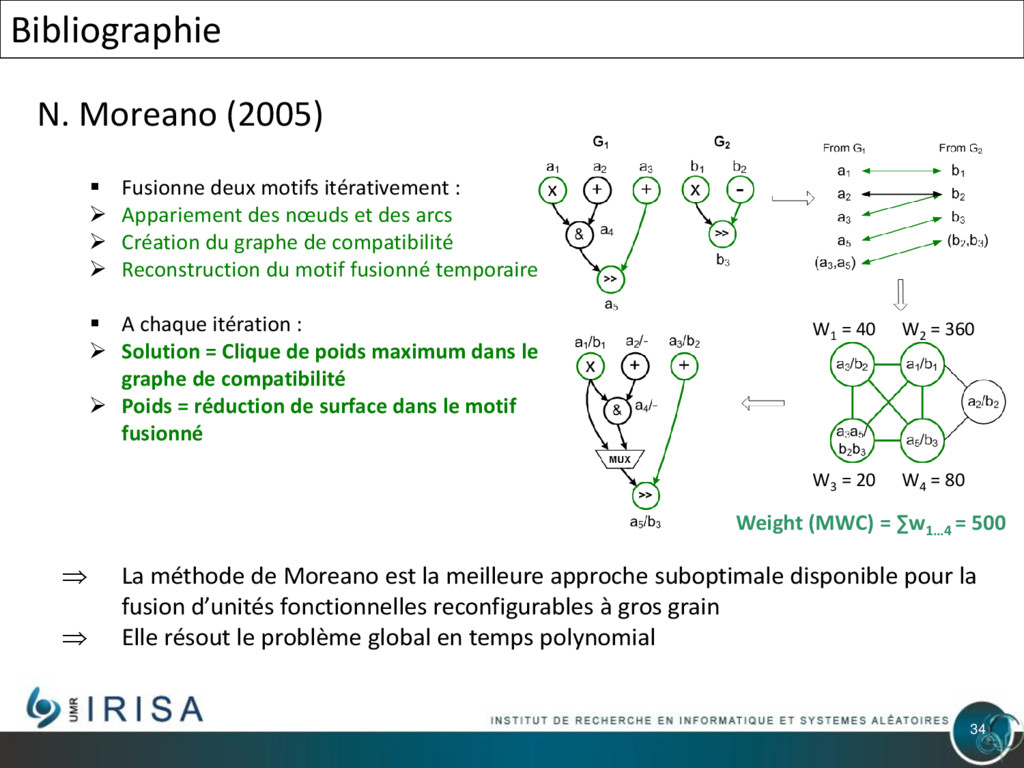
31 Bibliographie N. Moreano (2005) Fusionne deux motifs itérativement
: Appariement des nœuds et des arcs Création du graphe de compatibilité Reconstruction du motif fusionné temporaire A chaque itération : Solution = Clique de poids maximum dans le graphe de compatibilité Poids = réduction de surface dans le motif fusionné -
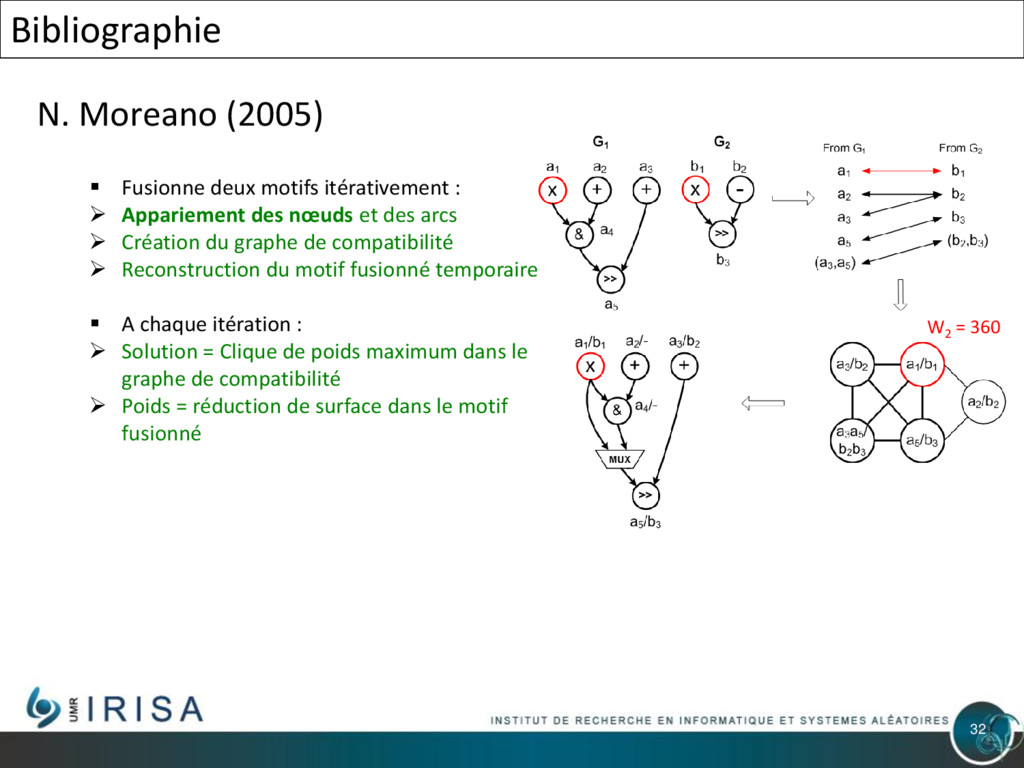
32 Bibliographie N. Moreano (2005) W2 = 360 Fusionne
deux motifs itérativement : Appariement des nœuds et des arcs Création du graphe de compatibilité Reconstruction du motif fusionné temporaire A chaque itération : Solution = Clique de poids maximum dans le graphe de compatibilité Poids = réduction de surface dans le motif fusionné -
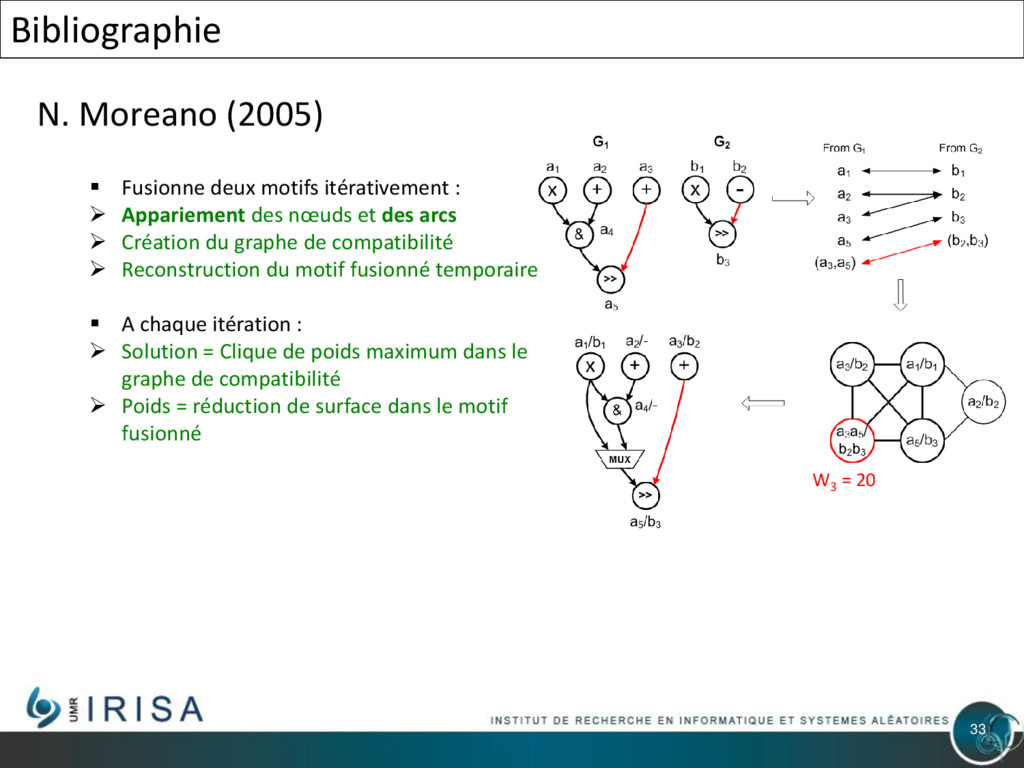
33 Bibliographie N. Moreano (2005) W3 = 20 Fusionne
deux motifs itérativement : Appariement des nœuds et des arcs Création du graphe de compatibilité Reconstruction du motif fusionné temporaire A chaque itération : Solution = Clique de poids maximum dans le graphe de compatibilité Poids = réduction de surface dans le motif fusionné -
34 Bibliographie N. Moreano (2005) La méthode de Moreano
est la meilleure approche suboptimale disponible pour la fusion d’unités fonctionnelles reconfigurables à gros grain Elle résout le problème global en temps polynomial Weight (MWC) = ∑w1…4 = 500 W1 = 40 W2 = 360 W3 = 20 W4 = 80 Fusionne deux motifs itérativement : Appariement des nœuds et des arcs Création du graphe de compatibilité Reconstruction du motif fusionné temporaire A chaque itération : Solution = Clique de poids maximum dans le graphe de compatibilité Poids = réduction de surface dans le motif fusionné -
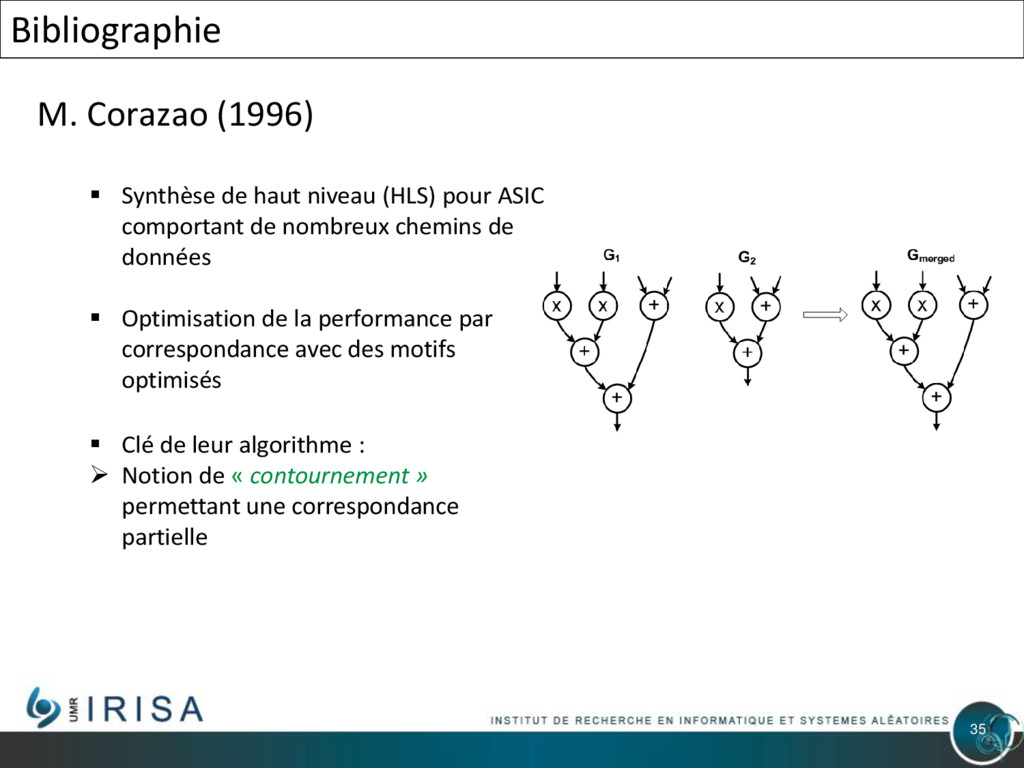
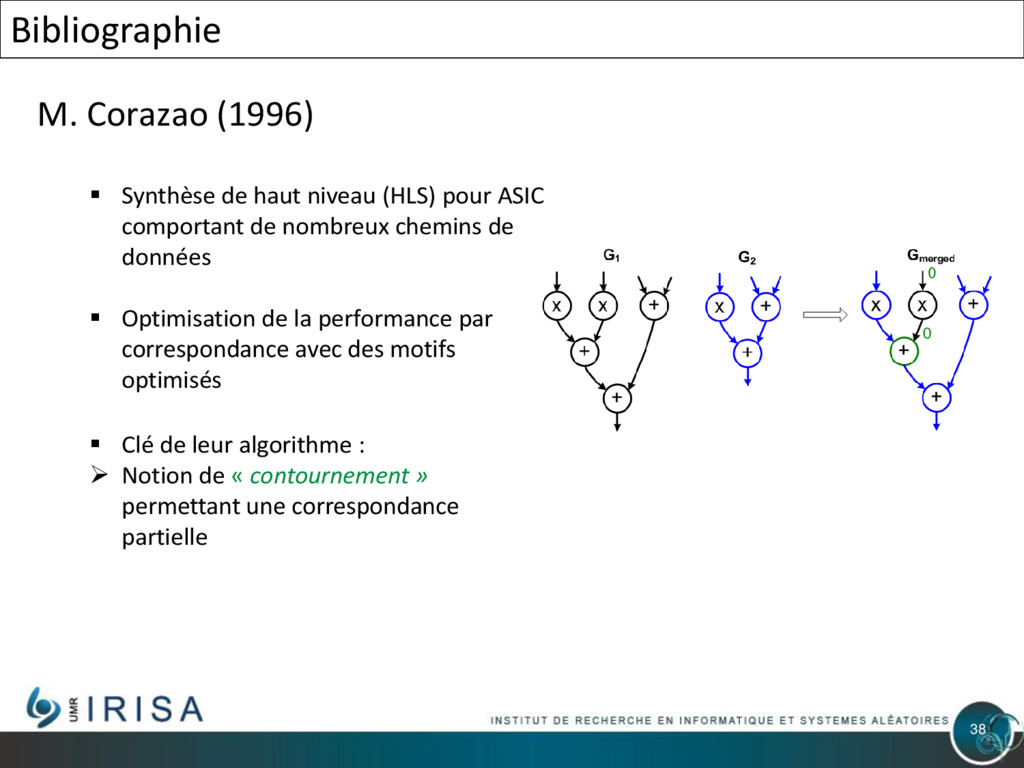
35 M. Corazao (1996) Synthèse de haut niveau (HLS)
pour ASIC comportant de nombreux chemins de données Optimisation de la performance par correspondance avec des motifs optimisés Clé de leur algorithme : Notion de « contournement » permettant une correspondance partielle Bibliographie -
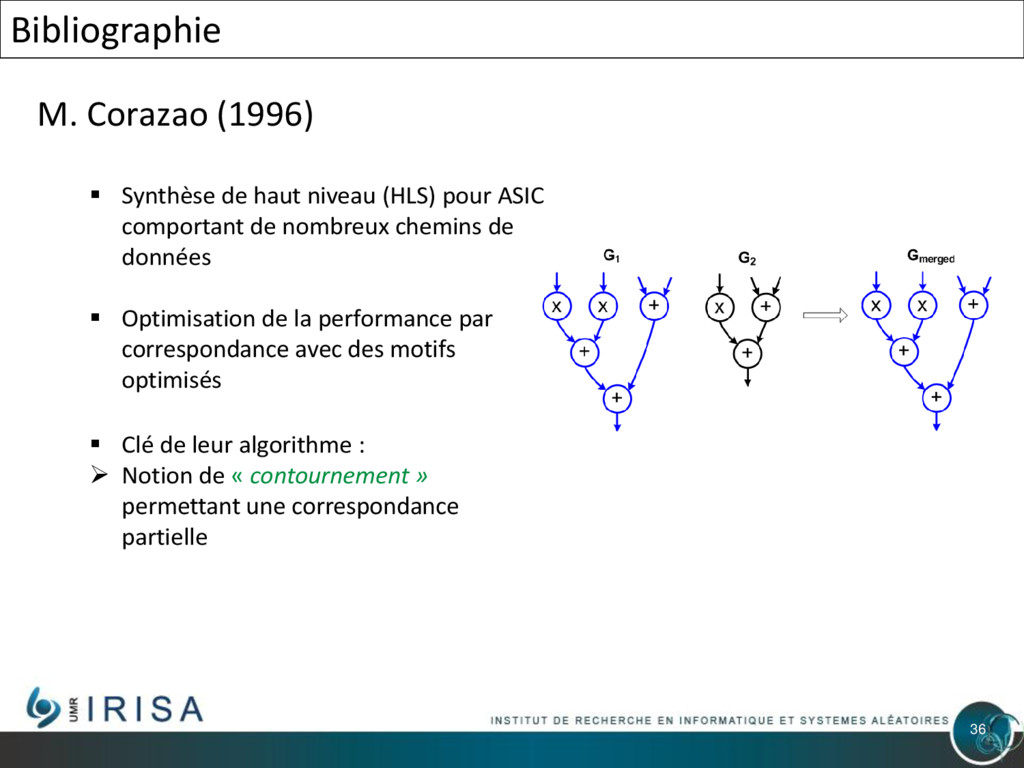
36 M. Corazao (1996) Bibliographie Synthèse de haut niveau
(HLS) pour ASIC comportant de nombreux chemins de données Optimisation de la performance par correspondance avec des motifs optimisés Clé de leur algorithme : Notion de « contournement » permettant une correspondance partielle -
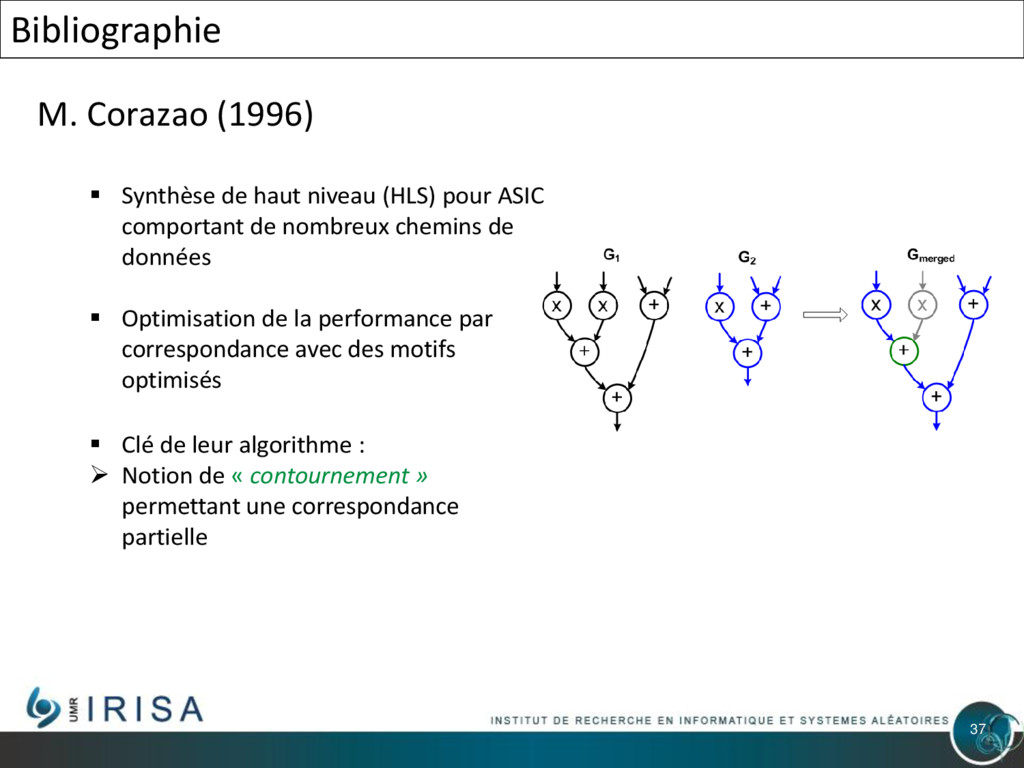
37 M. Corazao (1996) Bibliographie Synthèse de haut niveau
(HLS) pour ASIC comportant de nombreux chemins de données Optimisation de la performance par correspondance avec des motifs optimisés Clé de leur algorithme : Notion de « contournement » permettant une correspondance partielle -
38 M. Corazao (1996) Bibliographie Synthèse de haut niveau
(HLS) pour ASIC comportant de nombreux chemins de données Optimisation de la performance par correspondance avec des motifs optimisés Clé de leur algorithme : Notion de « contournement » permettant une correspondance partielle -
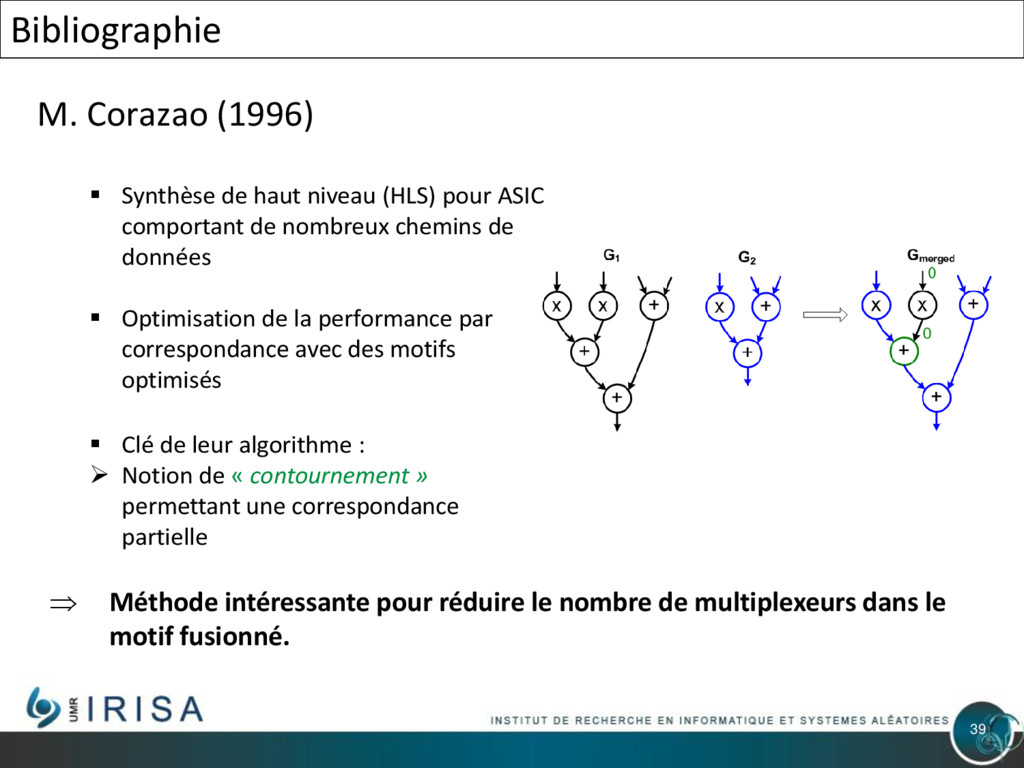
39 M. Corazao (1996) Méthode intéressante pour réduire le
nombre de multiplexeurs dans le motif fusionné. Bibliographie Synthèse de haut niveau (HLS) pour ASIC comportant de nombreux chemins de données Optimisation de la performance par correspondance avec des motifs optimisés Clé de leur algorithme : Notion de « contournement » permettant une correspondance partielle -
40 Inconvénients dans l’approche de Moreano La performance de
l’unité fonctionnelle issue de la fusion n’est pas prise en considération Pas de contournement permettant une correspondance partielle sans ajout de multiplexeur Nous proposons un système basé sur la programmation par contraintes pour la fusion de chemins de données Fusion optimale en termes de surface Restrictions sur l’allongement du chemin Intégration du contournement Bibliographie -
41 Contribution Fusion de chemins de données avec/sans allongement
du chemin critique sous différentes conditions : • Nombre maximum de multiplexeurs sur le chemin critique • Nombre maximum de nœuds contournés sur un chemin (généralisation du la notion de contournement) • Pas d’allongement du chemin critique par contournement d’opérateur Combinaison des contraintes modélisant ces conditions et résolution du problème global de minimisation de la surface de l’unité fonctionnelle reconfigurable issue de la fusion. Modélisation du problème par la programmation par contraintes et résolution par le solveur JaCoP. Tous les détails sur ce modèle de contraintes sont disponibles dans [DSD09], [TODAES10]. -
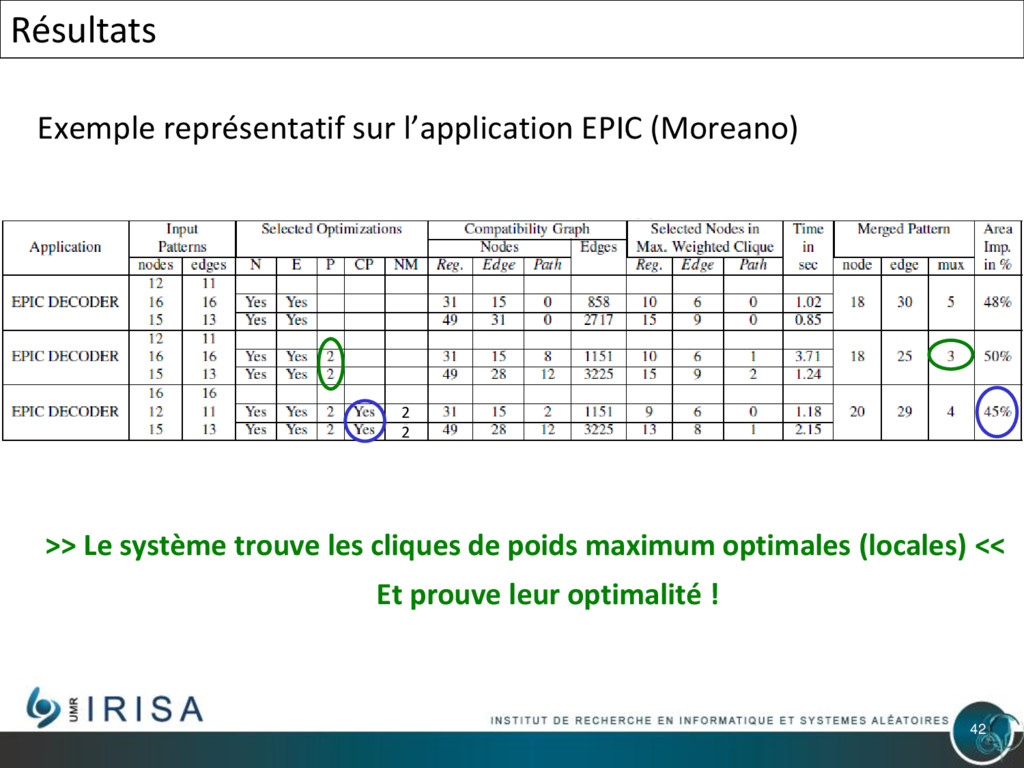
42 Exemple représentatif sur l’application EPIC (Moreano) >> Le système
trouve les cliques de poids maximum optimales (locales) << Et prouve leur optimalité ! Résultats 2 2 -
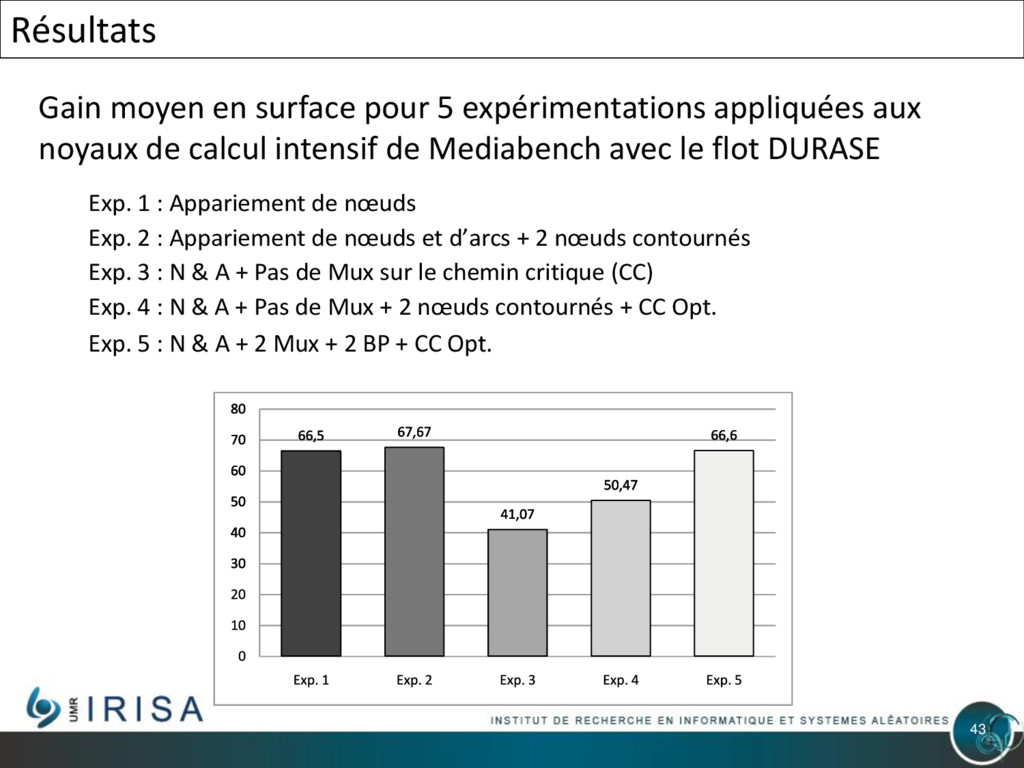
43 Exp. 1 : Appariement de nœuds Exp. 2 :
Appariement de nœuds et d’arcs + 2 nœuds contournés Exp. 3 : N & A + Pas de Mux sur le chemin critique (CC) Exp. 4 : N & A + Pas de Mux + 2 nœuds contournés + CC Opt. Exp. 5 : N & A + 2 Mux + 2 BP + CC Opt. Résultats Gain moyen en surface pour 5 expérimentations appliquées aux noyaux de calcul intensif de Mediabench avec le flot DURASE -
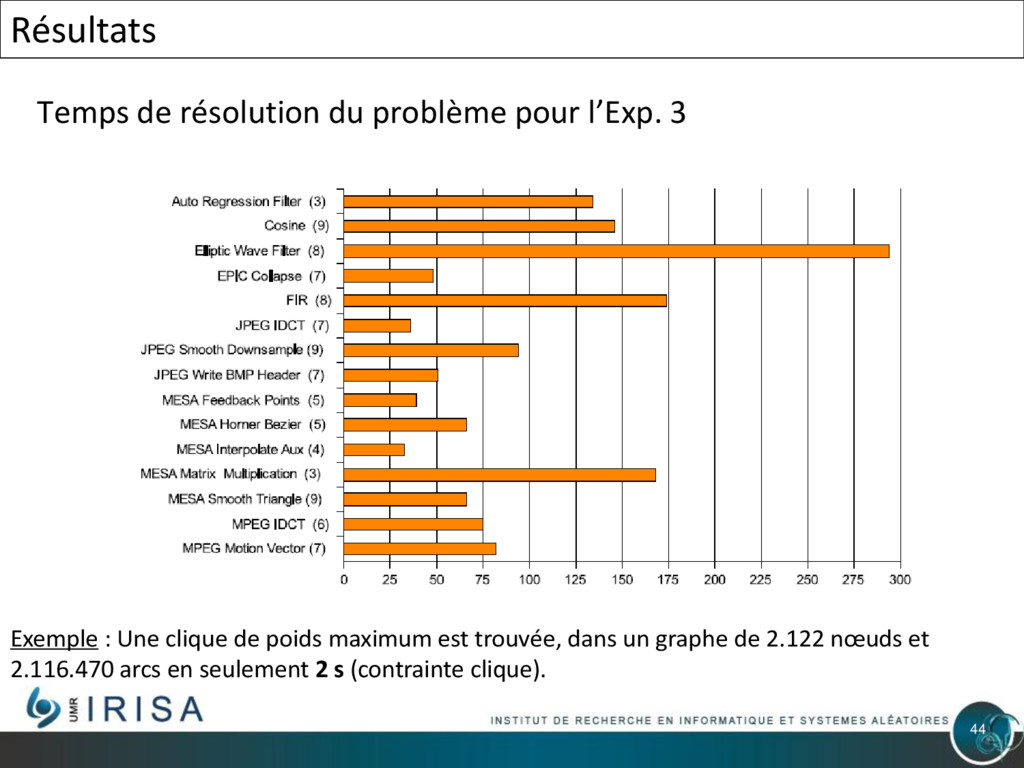
44 Résultats Temps de résolution du problème pour l’Exp. 3
ms Exemple : Une clique de poids maximum est trouvée, dans un graphe de 2.122 nœuds et 2.116.470 arcs en seulement 2 s (contrainte clique). -
46 Contexte ROMA – Reconfigurable Operators for Multimedia Applications •
Principaux objectifs : Développer à la fois une méthodologie de conception et un processeur reconfigurable efficace en termes de surface et de consommation de puissance dédié à l’accélération d’applications multimédia. • Partenaires : Université de Rennes 1- IRISA/INRIA CEA-LIST CNRS-LIRMM Technicolor R&I (Thomson R&D France) • Planning et financement : Début en janvier 2007 pour une durée de 45 mois. Financé par le programme Architecture du Futur de l’ANR (ANR-06-ARFU-004) et labélisé par le pôle de compétitivité Images et Réseaux. -
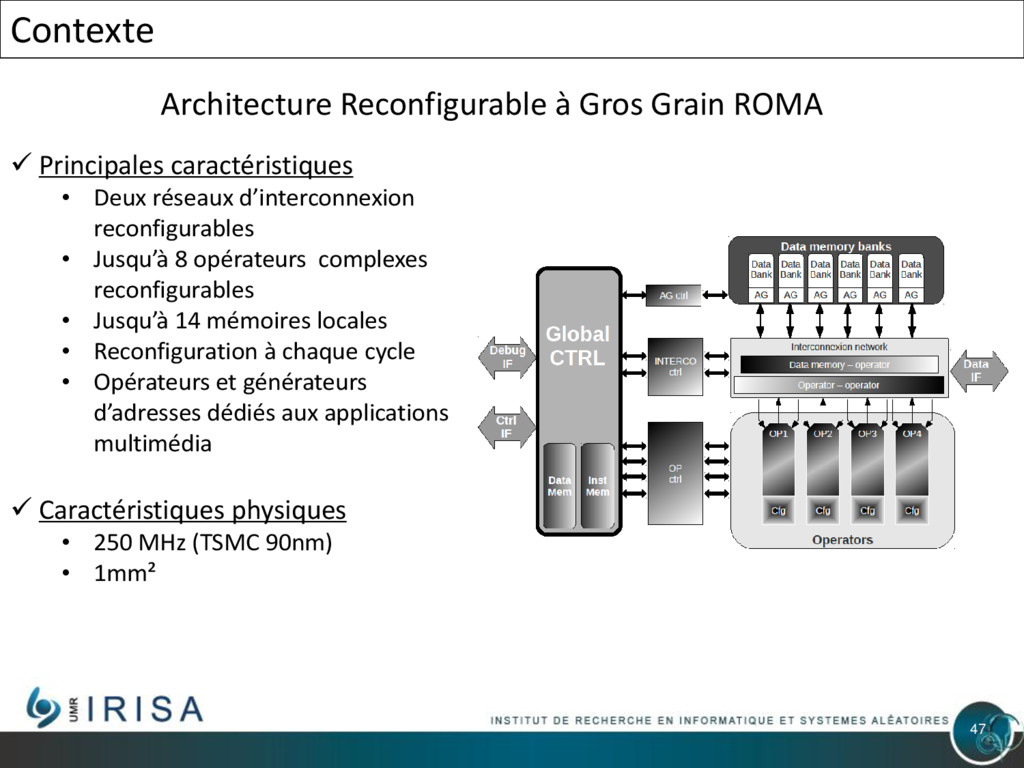
47 Contexte Principales caractéristiques • Deux réseaux d’interconnexion reconfigurables
• Jusqu’à 8 opérateurs complexes reconfigurables • Jusqu’à 14 mémoires locales • Reconfiguration à chaque cycle • Opérateurs et générateurs d’adresses dédiés aux applications multimédia Caractéristiques physiques • 250 MHz (TSMC 90nm) • 1mm² Architecture Reconfigurable à Gros Grain ROMA -
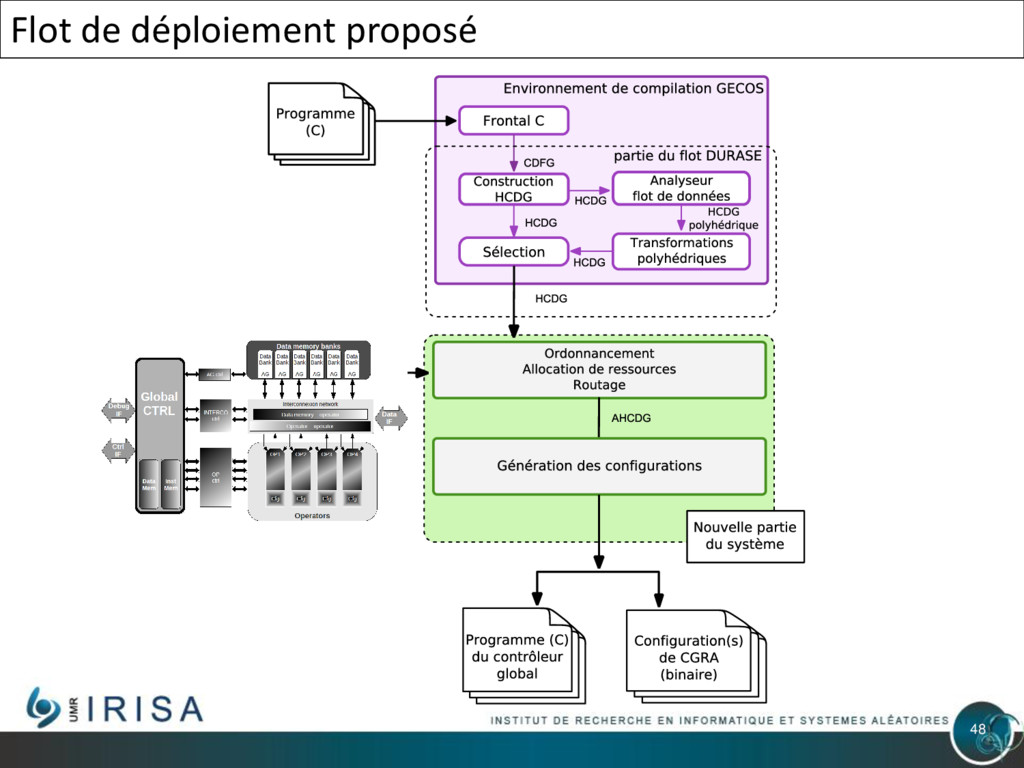
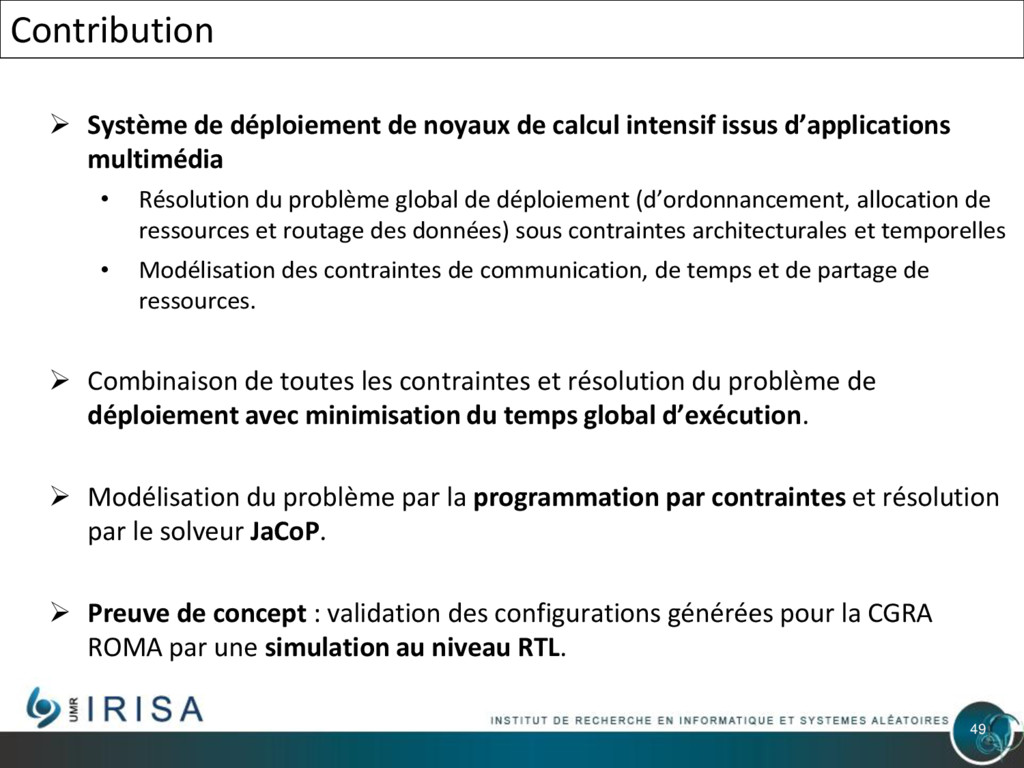
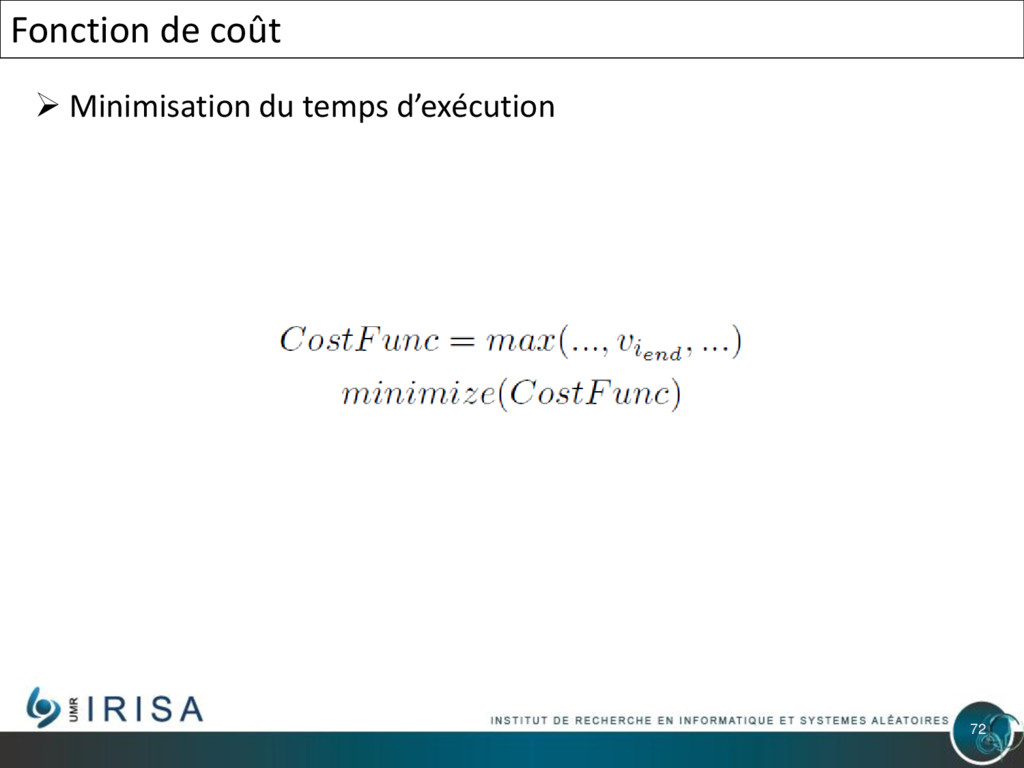
49 Contribution Système de déploiement de noyaux de calcul
intensif issus d’applications multimédia • Résolution du problème global de déploiement (d’ordonnancement, allocation de ressources et routage des données) sous contraintes architecturales et temporelles • Modélisation des contraintes de communication, de temps et de partage de ressources. Combinaison de toutes les contraintes et résolution du problème de déploiement avec minimisation du temps global d’exécution. Modélisation du problème par la programmation par contraintes et résolution par le solveur JaCoP. Preuve de concept : validation des configurations générées pour la CGRA ROMA par une simulation au niveau RTL. -
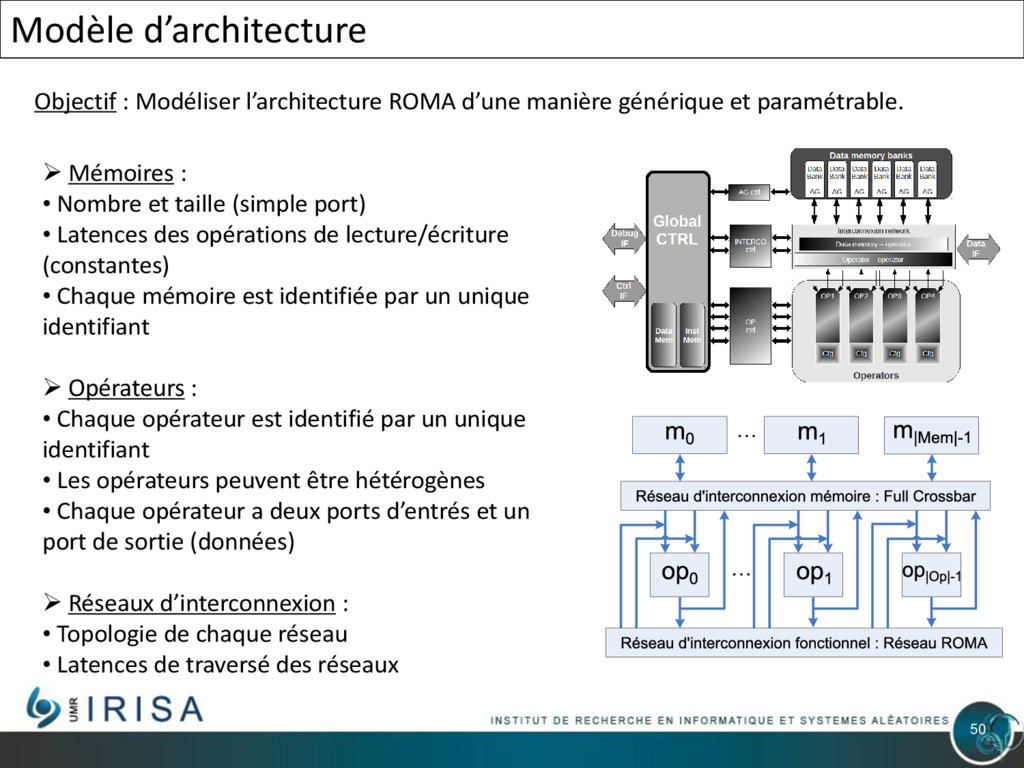
50 Modèle d’architecture Objectif : Modéliser l’architecture ROMA d’une manière
générique et paramétrable. Mémoires : • Nombre et taille (simple port) • Latences des opérations de lecture/écriture (constantes) • Chaque mémoire est identifiée par un unique identifiant Opérateurs : • Chaque opérateur est identifié par un unique identifiant • Les opérateurs peuvent être hétérogènes • Chaque opérateur a deux ports d’entrés et un port de sortie (données) Réseaux d’interconnexion : • Topologie de chaque réseau • Latences de traversé des réseaux -
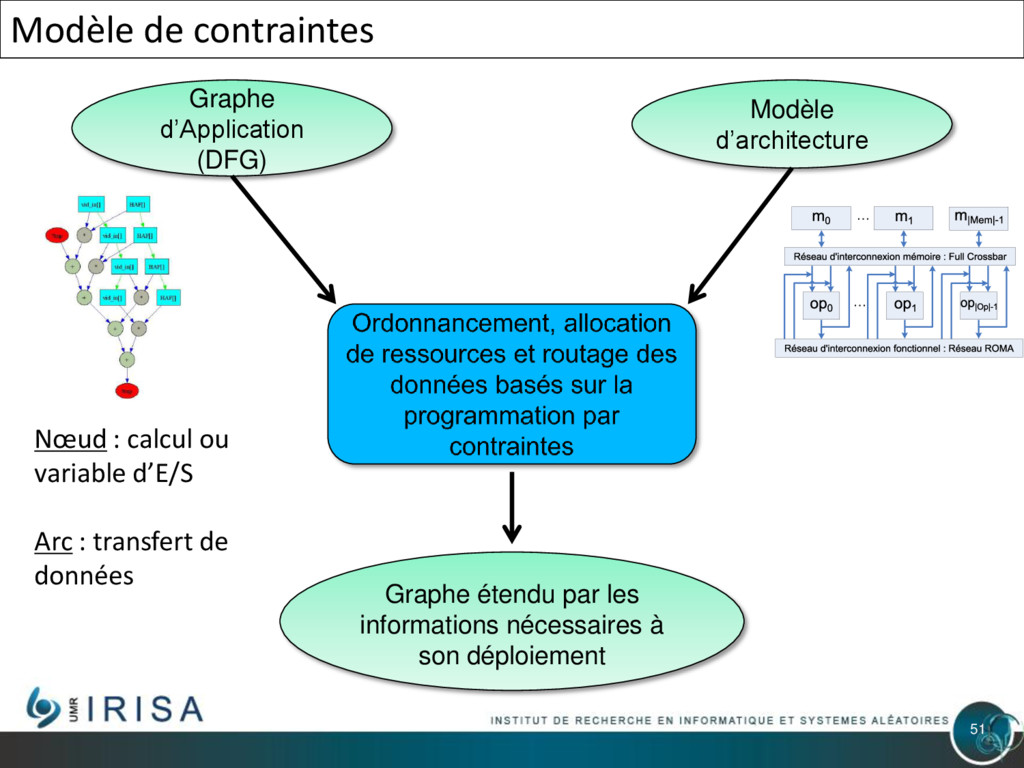
51 Modèle de contraintes Graphe d’Application (DFG) Modèle d’architecture Graphe
étendu par les informations nécessaires à son déploiement Nœud : calcul ou variable d’E/S Arc : transfert de données -
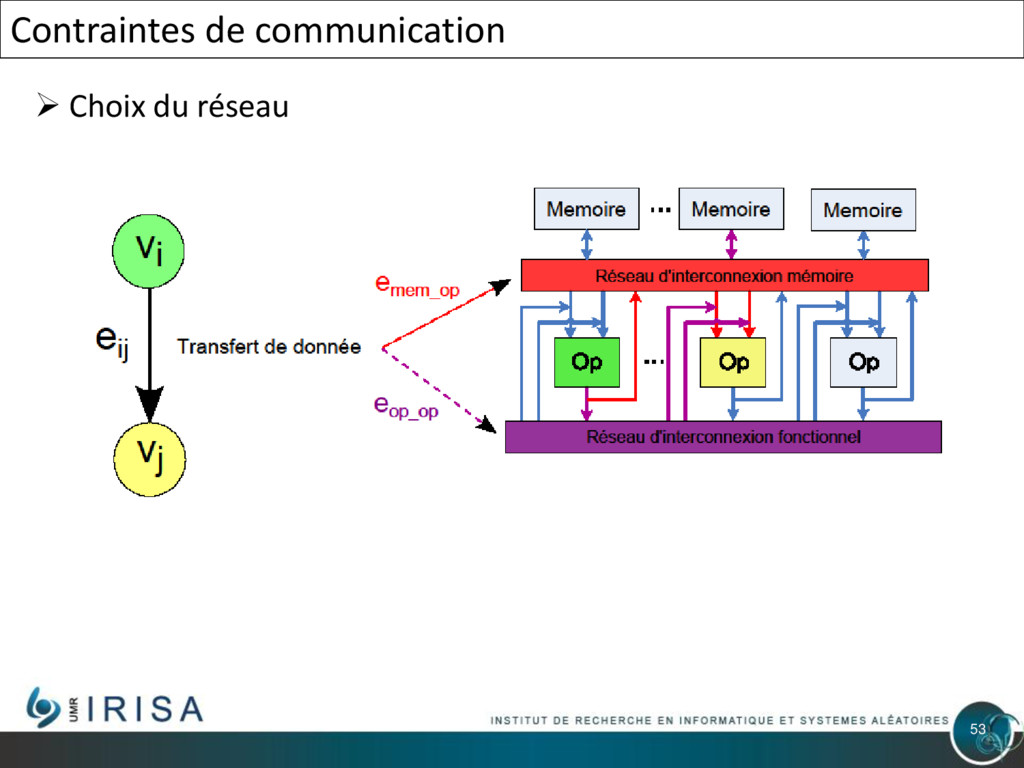
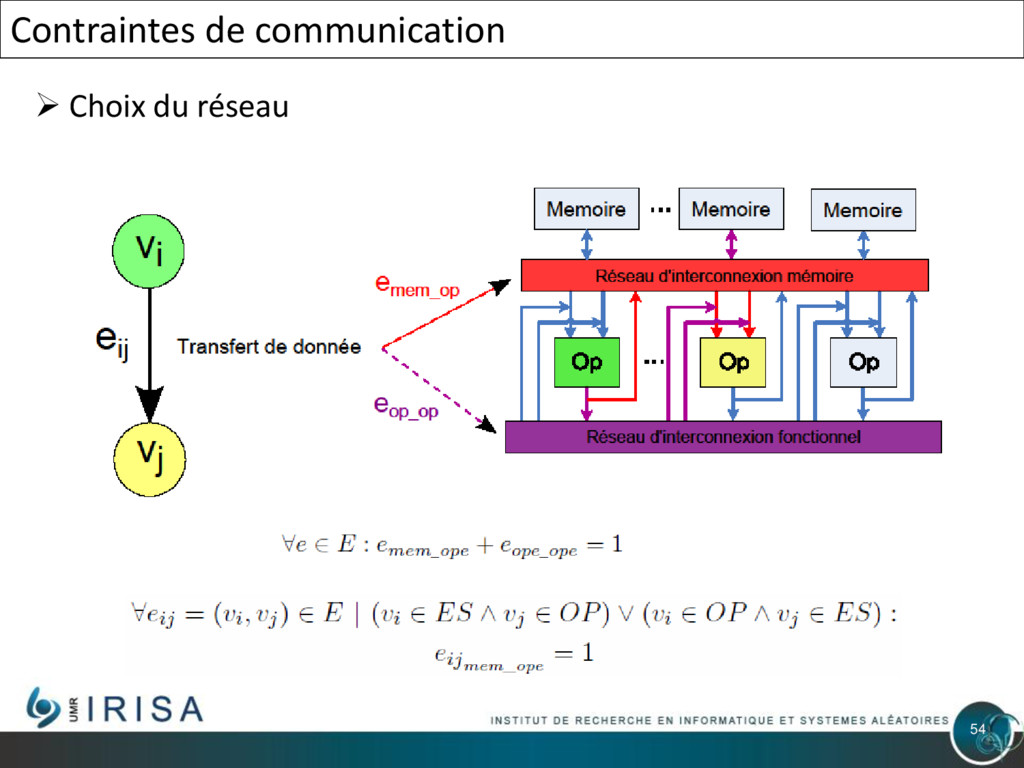
52 Modèle de contraintes Contraintes de communication Quel
réseau d’interconnexion utiliser pour un transfert de données ? Comment contraindre l’utilisation d’un réseau par sa topologie ? -
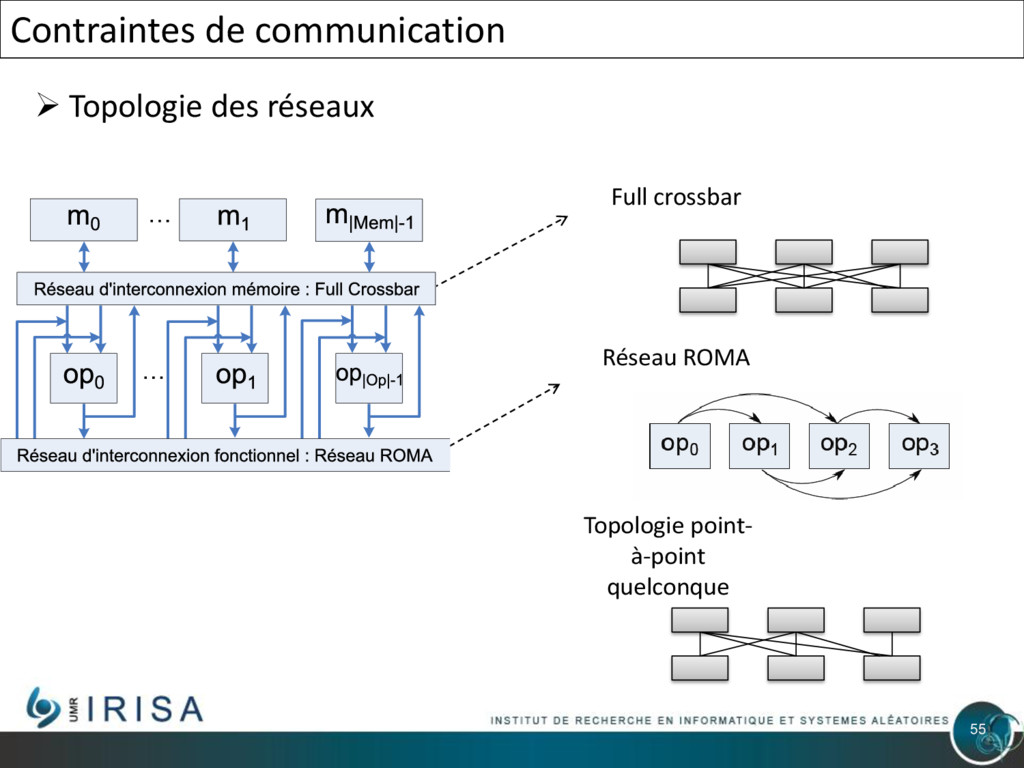
55 Contraintes de communication Topologie des réseaux Full crossbar
Réseau ROMA Topologie point- à-point quelconque -
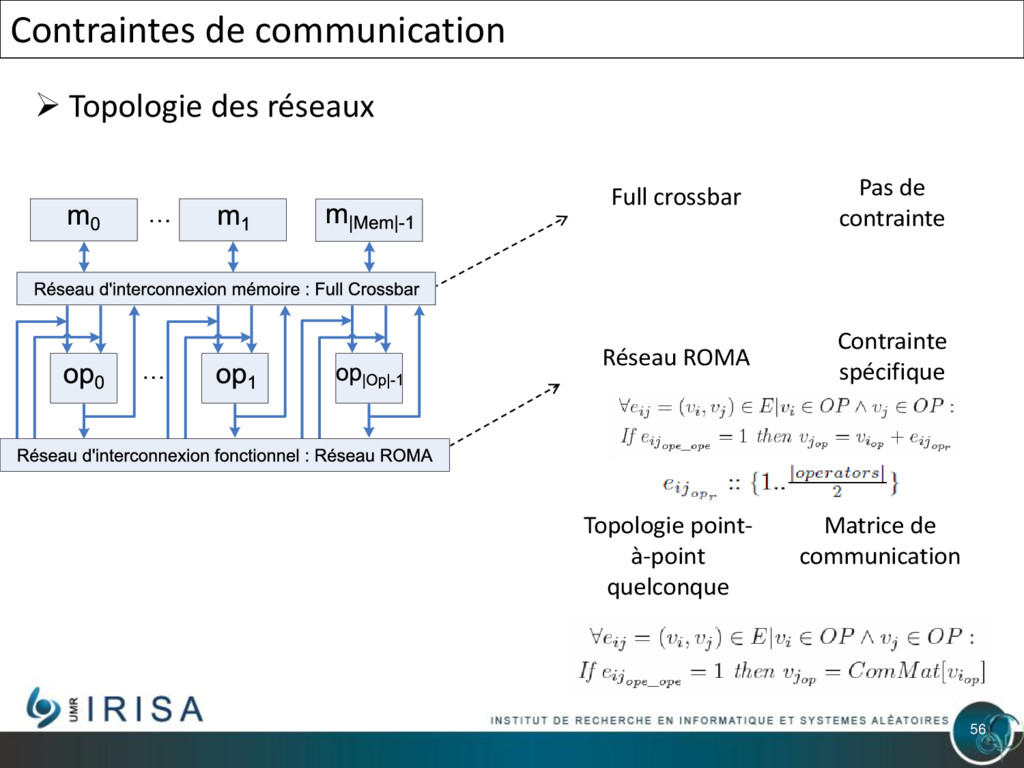
56 Contraintes de communication Topologie des réseaux Pas de
contrainte Matrice de communication Contrainte spécifique Full crossbar Réseau ROMA Topologie point- à-point quelconque -
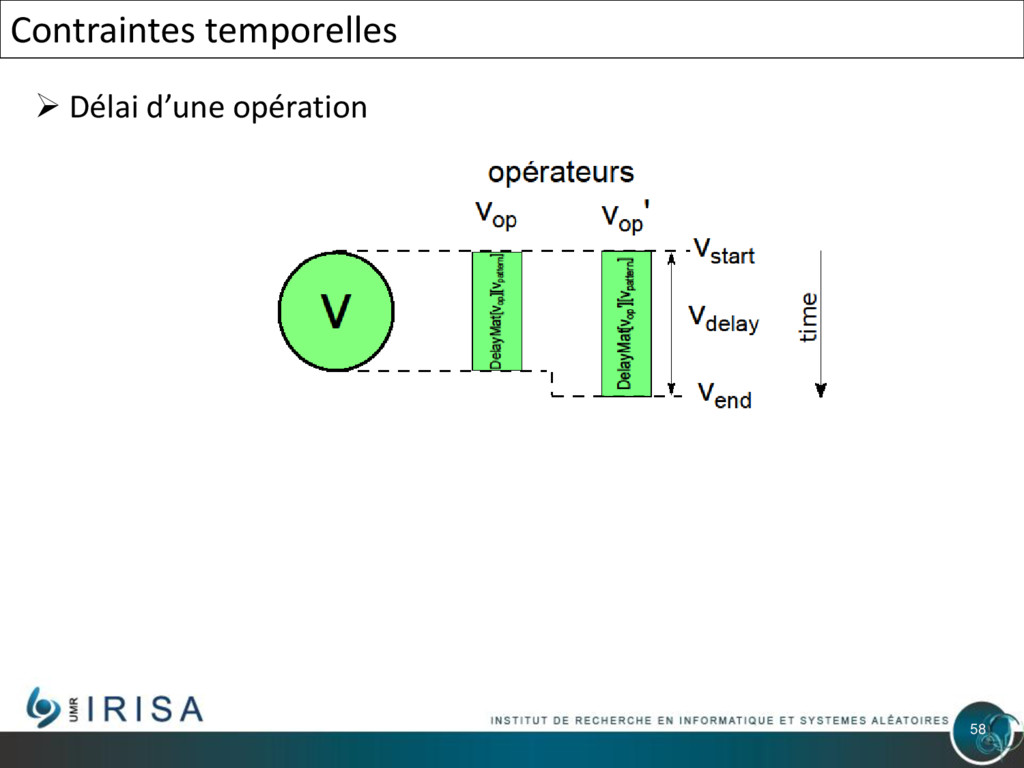
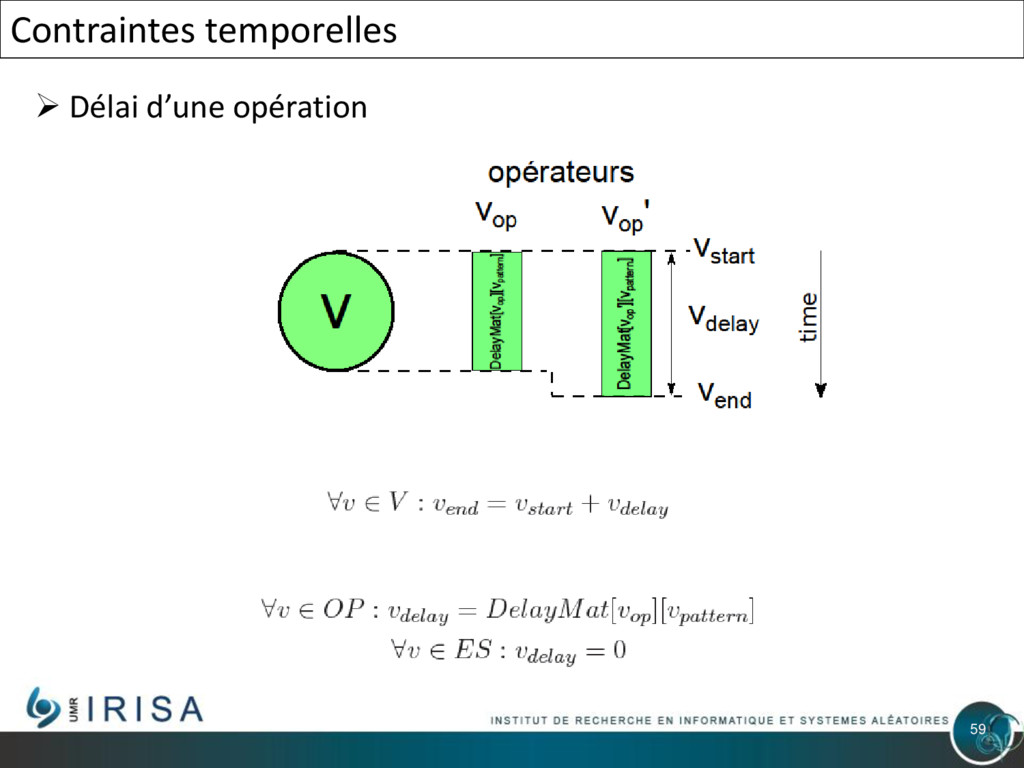
57 Modèle de contraintes Contraintes temporelles Comment assurer
les contraintes de précédences imposées par le graphe d’application (ordre partiel) ? Comment adapter les contraintes de précédences en fonction du réseau emprunté ? -
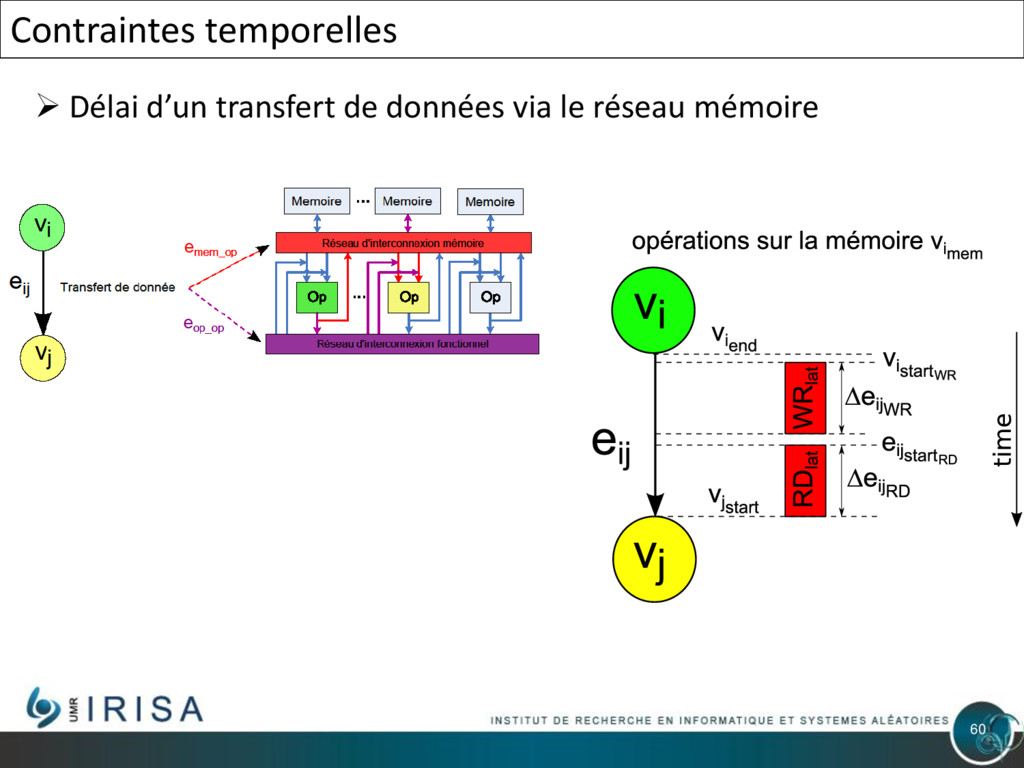
60 Contraintes temporelles Délai d’un transfert de données via
le réseau mémoire -
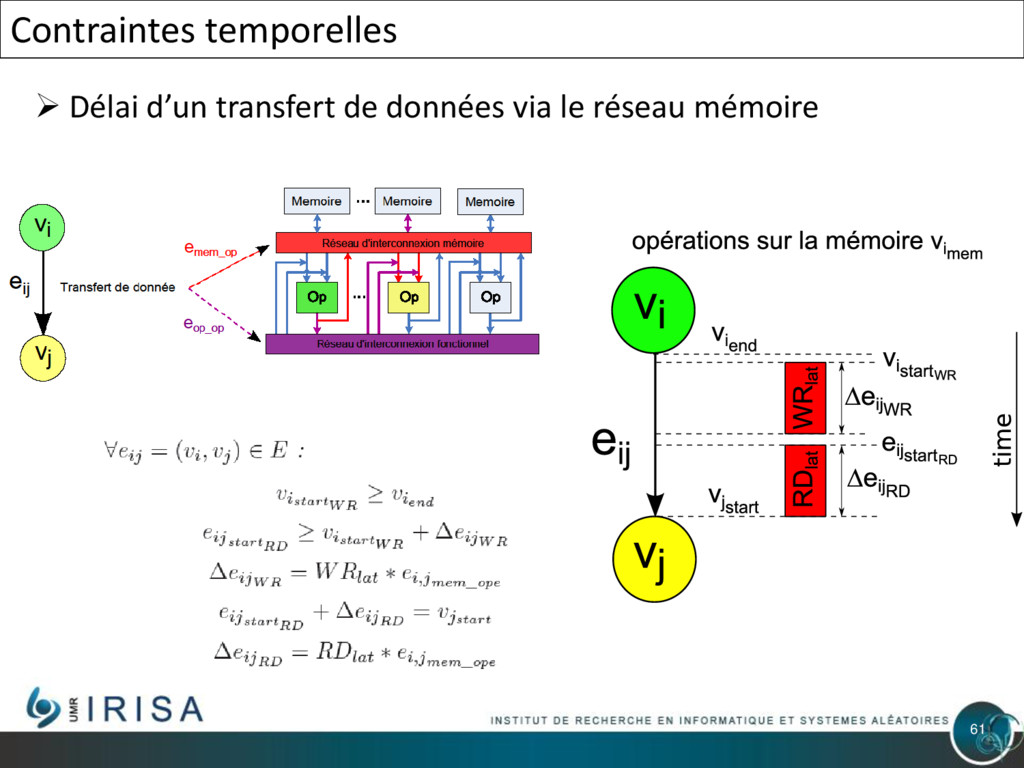
61 Contraintes temporelles Délai d’un transfert de données via
le réseau mémoire -
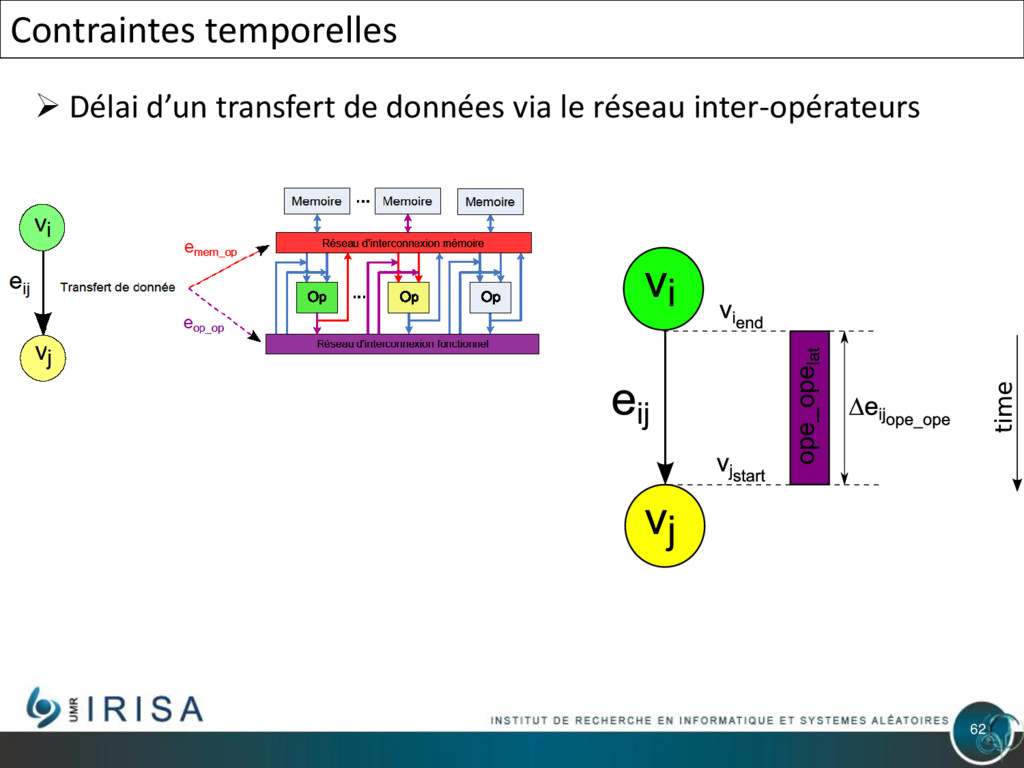
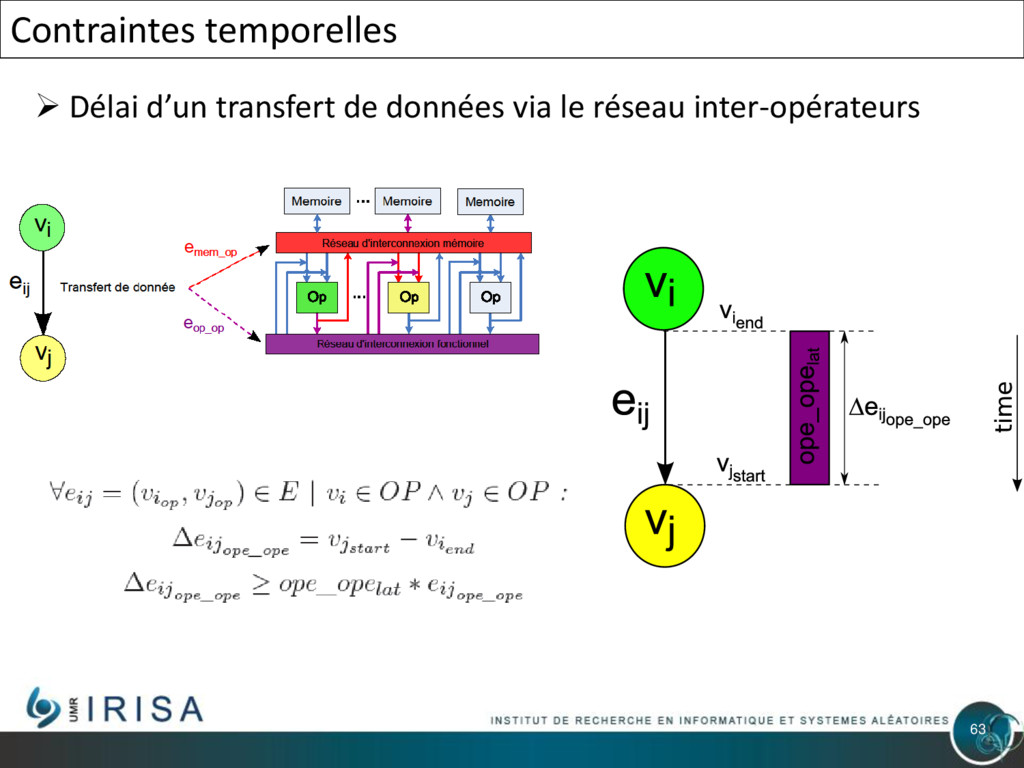
62 Contraintes temporelles Délai d’un transfert de données via
le réseau inter-opérateurs -
63 Contraintes temporelles Délai d’un transfert de données via
le réseau inter-opérateurs -
64 Modèle de contraintes Contraintes de partage de ressources
Comment assurer que les ressources de calcul/mémoire ne sont pas utilisés au même moment ? Comment assurer que la capacité des mémoires n’est jamais dépassée ? -
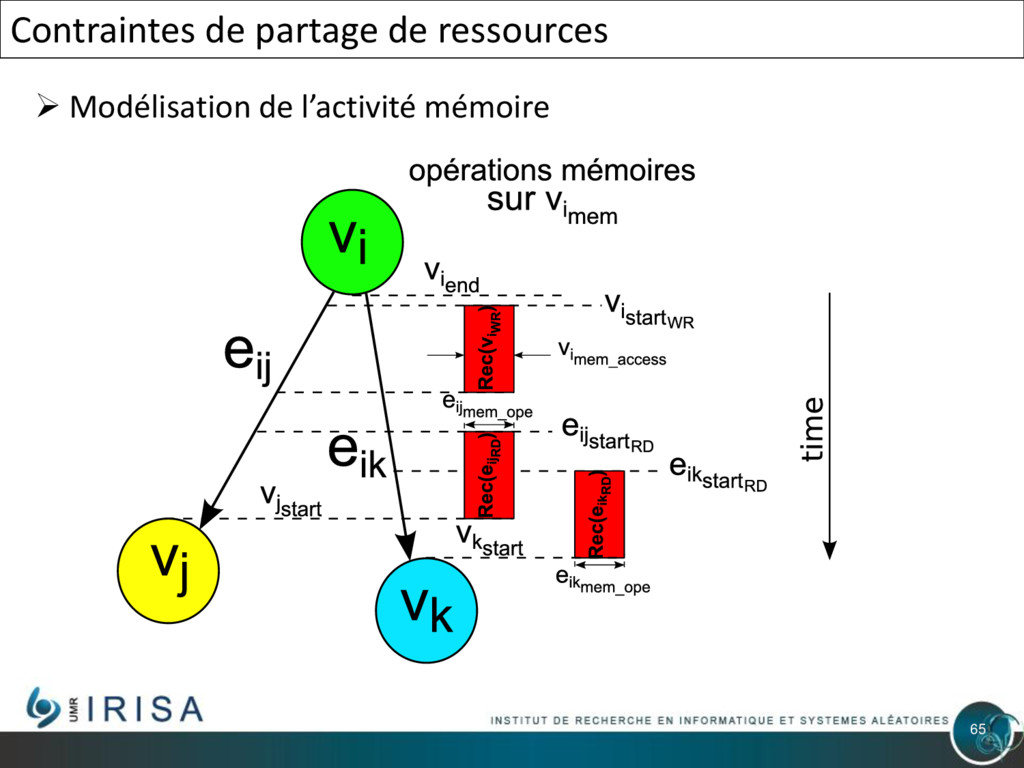
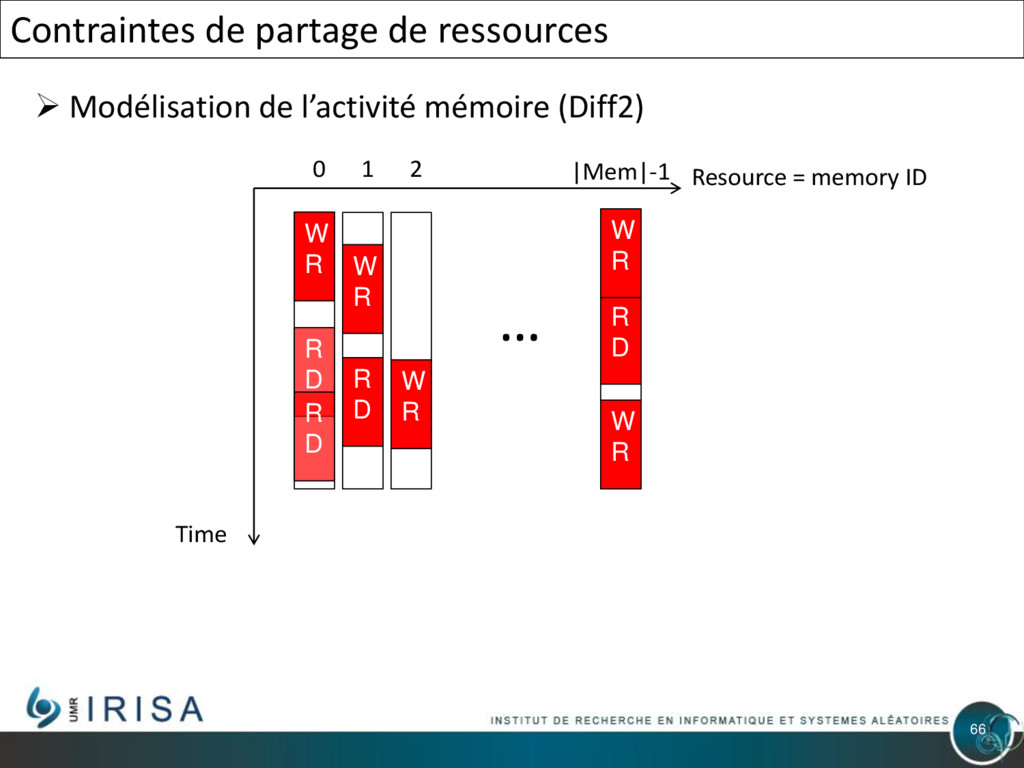
66 Contraintes de partage de ressources Modélisation de l’activité
mémoire (Diff2) … Resource = memory ID Time W R R D 1 0 2 W R W R R D R D R D W R W R |Mem|-1 -
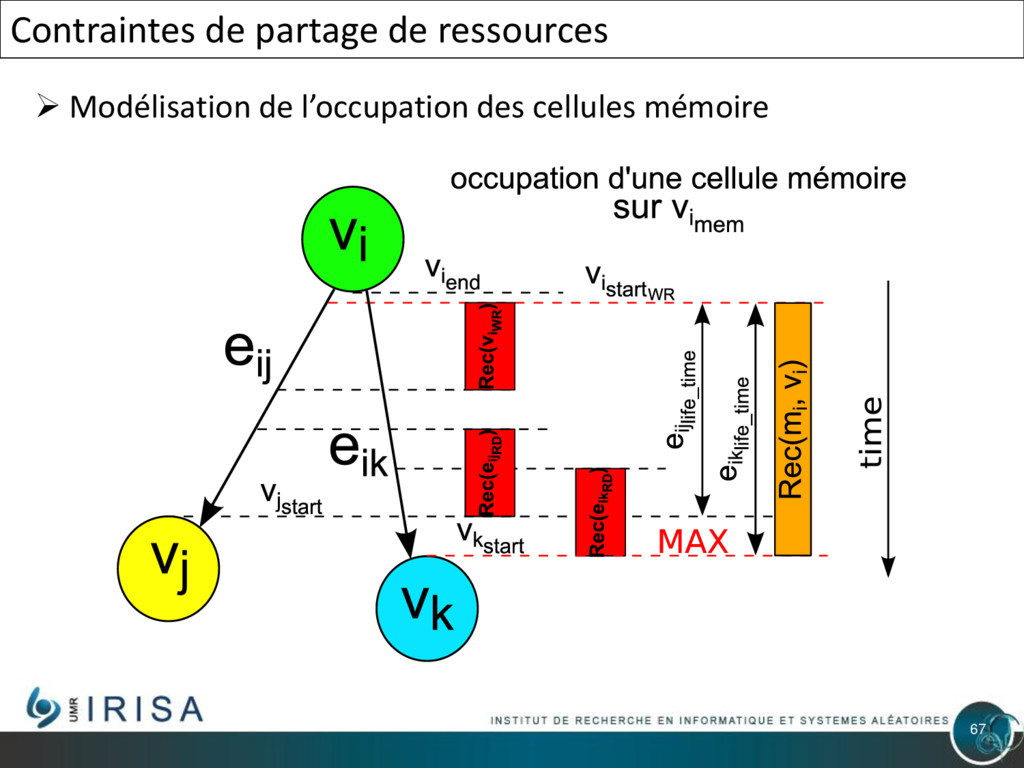
67 Contraintes de partage de ressources Modélisation de l’occupation
des cellules mémoire -
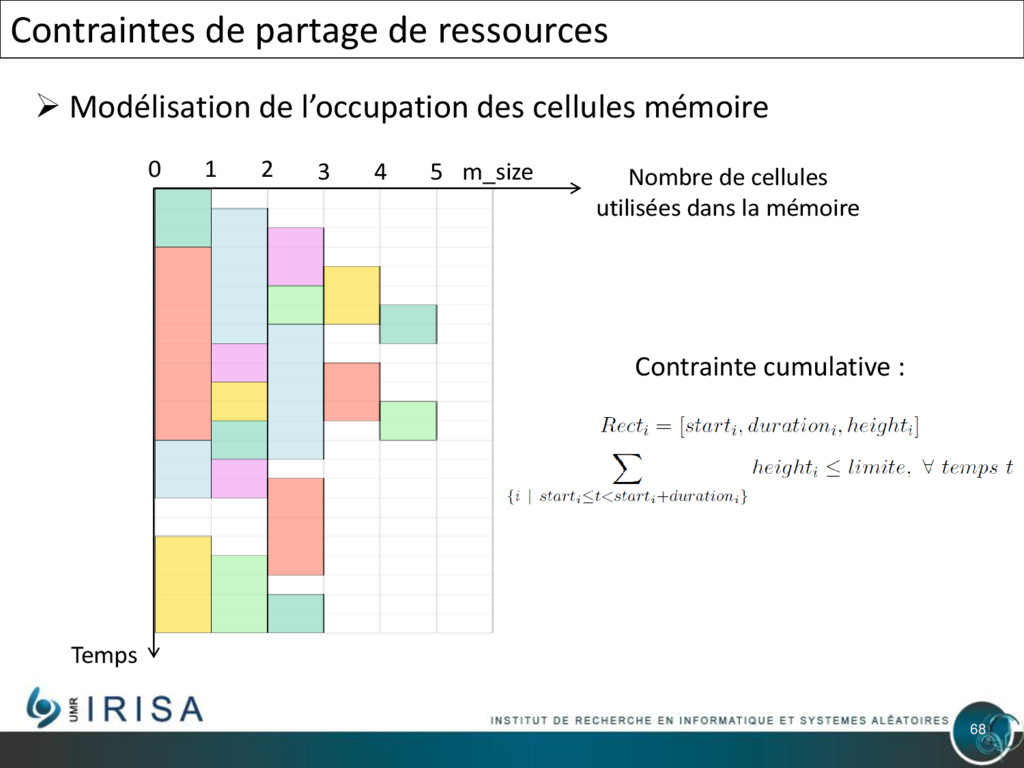
68 Contraintes de partage de ressources Modélisation de l’occupation
des cellules mémoire Nombre de cellules utilisées dans la mémoire Temps 1 0 2 m_size 4 3 5 Contrainte cumulative : -
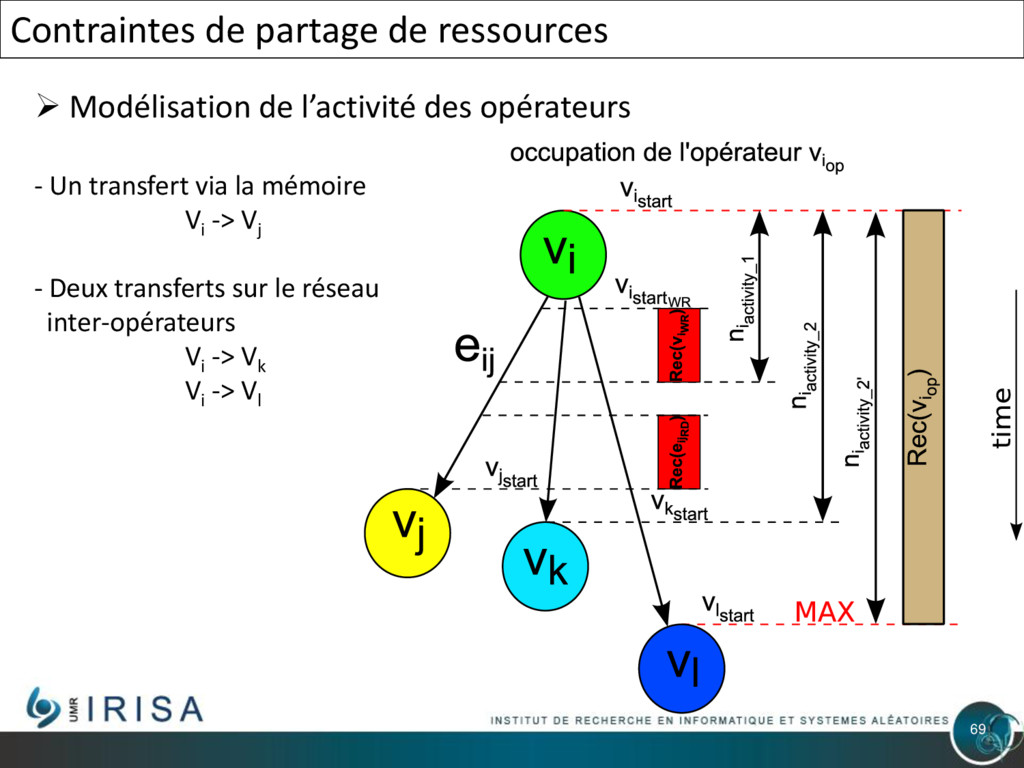
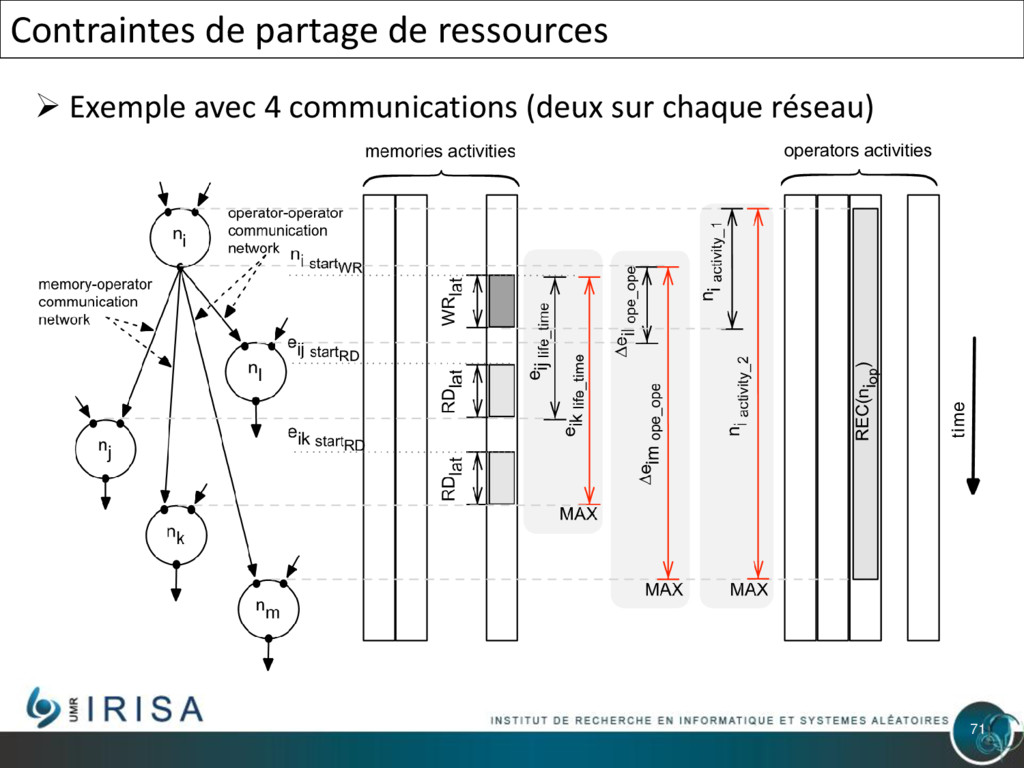
69 Contraintes de partage de ressources Modélisation de l’activité
des opérateurs - Un transfert via la mémoire Vi -> Vj - Deux transferts sur le réseau inter-opérateurs Vi -> Vk Vi -> Vl -
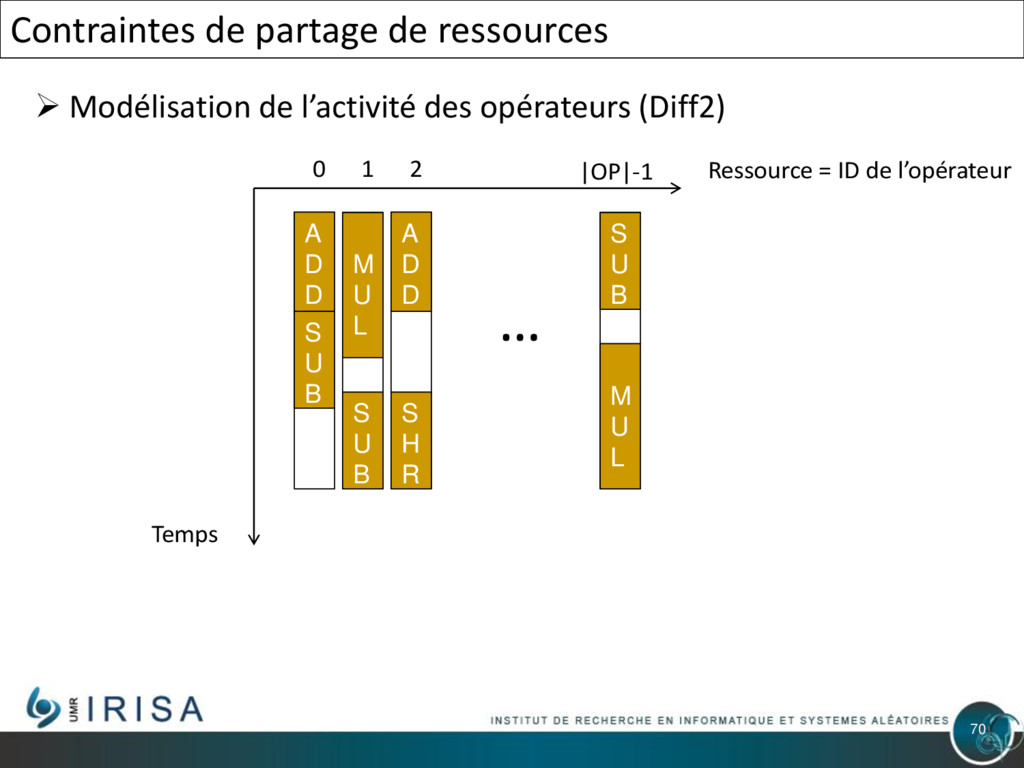
70 Contraintes de partage de ressources Modélisation de l’activité
des opérateurs (Diff2) … Ressource = ID de l’opérateur Temps M U L 1 0 2 A D D S U B S U B S H R |OP|-1 S U B A D D M U L -
71 Contraintes de partage de ressources Exemple avec 4
communications (deux sur chaque réseau) -
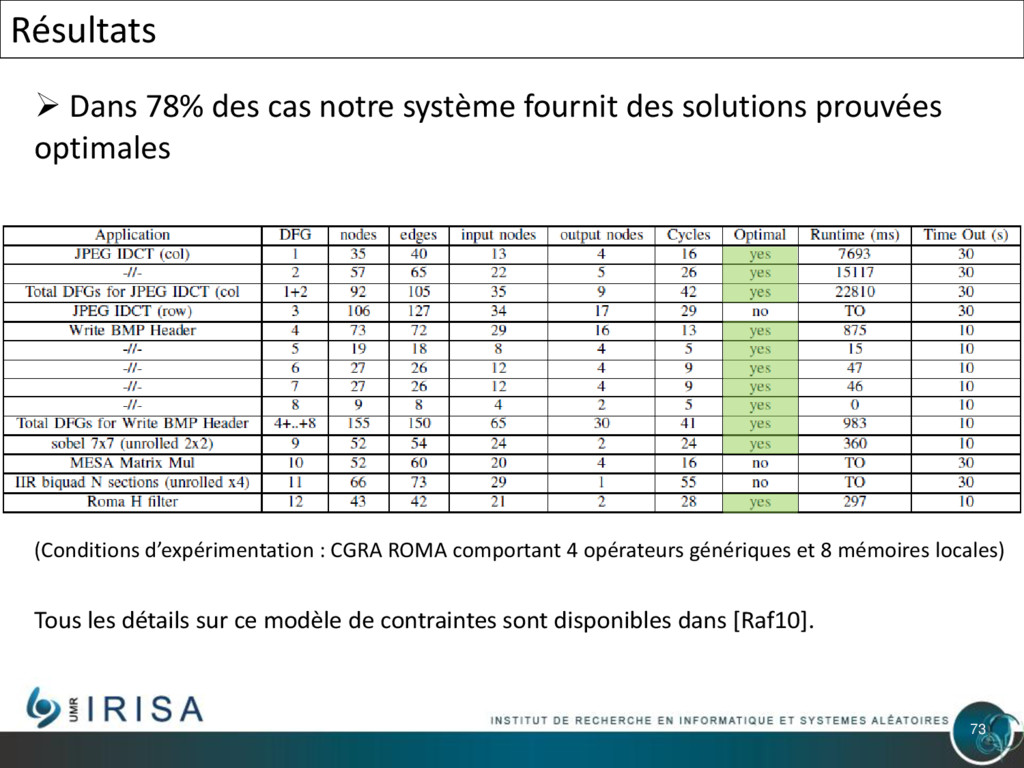
73 Résultats Dans 78% des cas notre système fournit
des solutions prouvées optimales (Conditions d’expérimentation : CGRA ROMA comportant 4 opérateurs génériques et 8 mémoires locales) Tous les détails sur ce modèle de contraintes sont disponibles dans [Raf10]. -
74 Conclusion et perspectives Conclusion Nous avons présenté deux
modèles de contraintes pour la résolution de problèmes d’optimisation complexes : 1. Fusion d’unités fonctionnelles reconfigurables améliorée dans le flot DURASE • Minimisation de la surface de l’unité fonctionnelle reconfigurable • Restriction sur le nombre de multiplexeurs sur le chemin critique • Restriction sur l’utilisation du contournement d’opérateur 2. Déploiement (ordonnancement, allocation de ressources et routage) de noyaux de calcul intensif sur CGRA ROMA • Minimisation du temps d’exécution • Contraintes de communication, temporelles et de partage de ressources -
75 Conclusion et perspectives Conclusion Les travaux de la
thèse qui n’ont pas pu être présentés : Exploration de l’espace de conception d’une CGRA • Modèle de contraintes pour le déploiement simplifié • Définition des opérateurs (nombre, type d’opération, etc.) • Dimensionnement de l’espace mémoire (nombre de mémoires locales, taille et type, etc.) Déploiement de noyaux de calcul intensif sur un modèle de CGRA pipelinée • Modèle d’architecture pipelinée • Identification dans le graphe d’application des motifs de calcul (bibliothèque) • Couverture du graphe d’application par ces motifs • Dimensionnement de l’architecture -
76 Conclusion et perspectives Perspectives sur la fusion d’unités
fonctionnelles reconfigurables Court terme • Simplification du graphe de compatibilité => Traitement de plus grands problèmes ou plus contraints • Appariement des nœuds d’entrée/sortie => Augmentation de l’impact du concept de contournement Long terme • Fusion en plusieurs unités (VLIW) + multi-objectifs • Contraintes sur la largeur des données, pipeline, SWP, etc. -
77 Conclusion et perspectives Perspectives sur le déploiement d’applications
sur CGRA Court terme • Ajout d ’heuristiques de recherche de solution (clustering, fenêtre glissante, ordre de sélection des variables évaluées, etc.) => Meilleur passage à l’échelle • Ajout de variables temporaires sur des dépendances complexes => Résolution du problème pour des graphes d’application à dépendances complexes Long terme • Approche multi-objectifs pour l’exploration de l’espace de conception (énergie, performance, etc.) • Prise en compte des différents niveaux de parallélisme des applications (des transferts au niveau applicatif jusqu’à la génération d’adresses) -
78 Principales références - Moreano (2005) : N. Moreano, E.
Borin, C. de Souza et G. Araujo : Efficient datapath merging for partially reconfigurable architectures. IEEE Transactions on Computer-Aided Design of Integrated Circuits and Systems, 24(7):969–980, 2005. - Corazao (1996) : M. R. Corazao, M. A. Khalaf, L. M. Guerra, M. Potkonjak et J. M. Rabaey : Performance optimization using template mapping for datapath-intensive high-level synthesis. IEEE Transactions on Computer- Aided Design of Integrated Circuits and Systems, 15:877–888, 1996. [Martin10] : K. Martin : Génération automatique d’extensions de jeux d’instructions de processeurs. Thèse de doctorat, Université de Rennes 1, 2010. - [DSD09] : C. Wolinski, K. Kuchcinski, E. Raffin et F. Charot : Architecture-driven synthesis of reconfigurable cells. In Proceedings of the 12th EUROMICRO Conference on Digital System Design Architectures, Methods and Tools (DSD ’09), 2009. - [TODAES10] : C. Wolinski, K. Kuchcinski et E. Raffin : Automatic design of application specific reconfigurable processor extensions with UPaK synthesis kernel. ACM Transactions on Design Automation of Electronic Systems (TODAES), 15:1–36, 2009. - [Raf10] : E. Raffin, C.Wolinki, F. Charot, K. Kuchcinski, S. Guyetant, S. Chevobbe et E. Casseau : Scheduling, binding and routing system for a run-time reconfigurable operator based multimedia architecture. In Proceedings of IEEE Conference on Design and Architectures for Signal and Image Processing (DASIP), October 2010.
 scee_team
 gkazunii
 institutdelelevage
 pomcho555
 resolutionfoundation
 tattaka
 tomonom
 yumaichikawa
 kzmssk
 youten622
 hirachan
 mza
 nwiizo
 eileencodes
 marktimemedia
 tammyeverts
 427marketing
 skipperchong
 eitanlees
 cassininazir
 ivargrimstad
 mongodb