Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Points-to-3D: Structure-Aware 3D Generation wit...

Points-to-3D: Structure-Aware 3D Generation with Point Cloud Priors

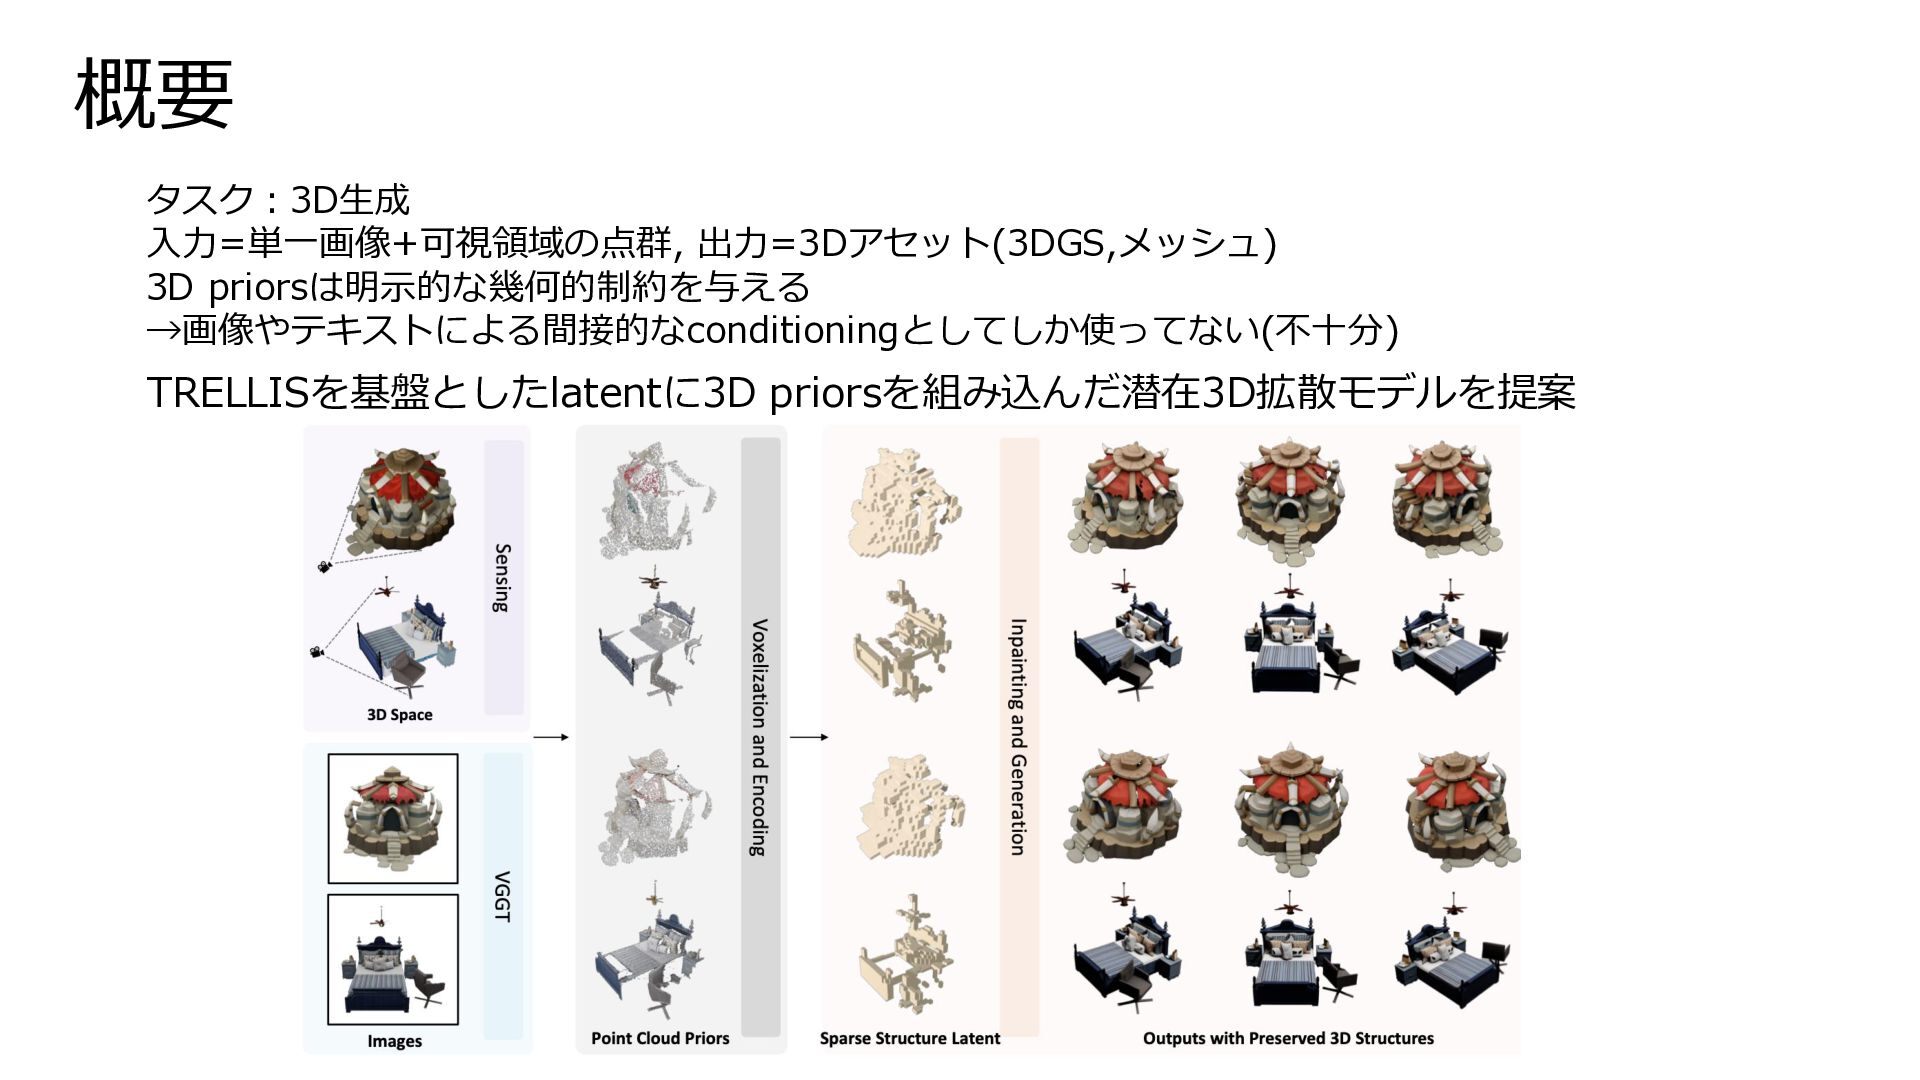
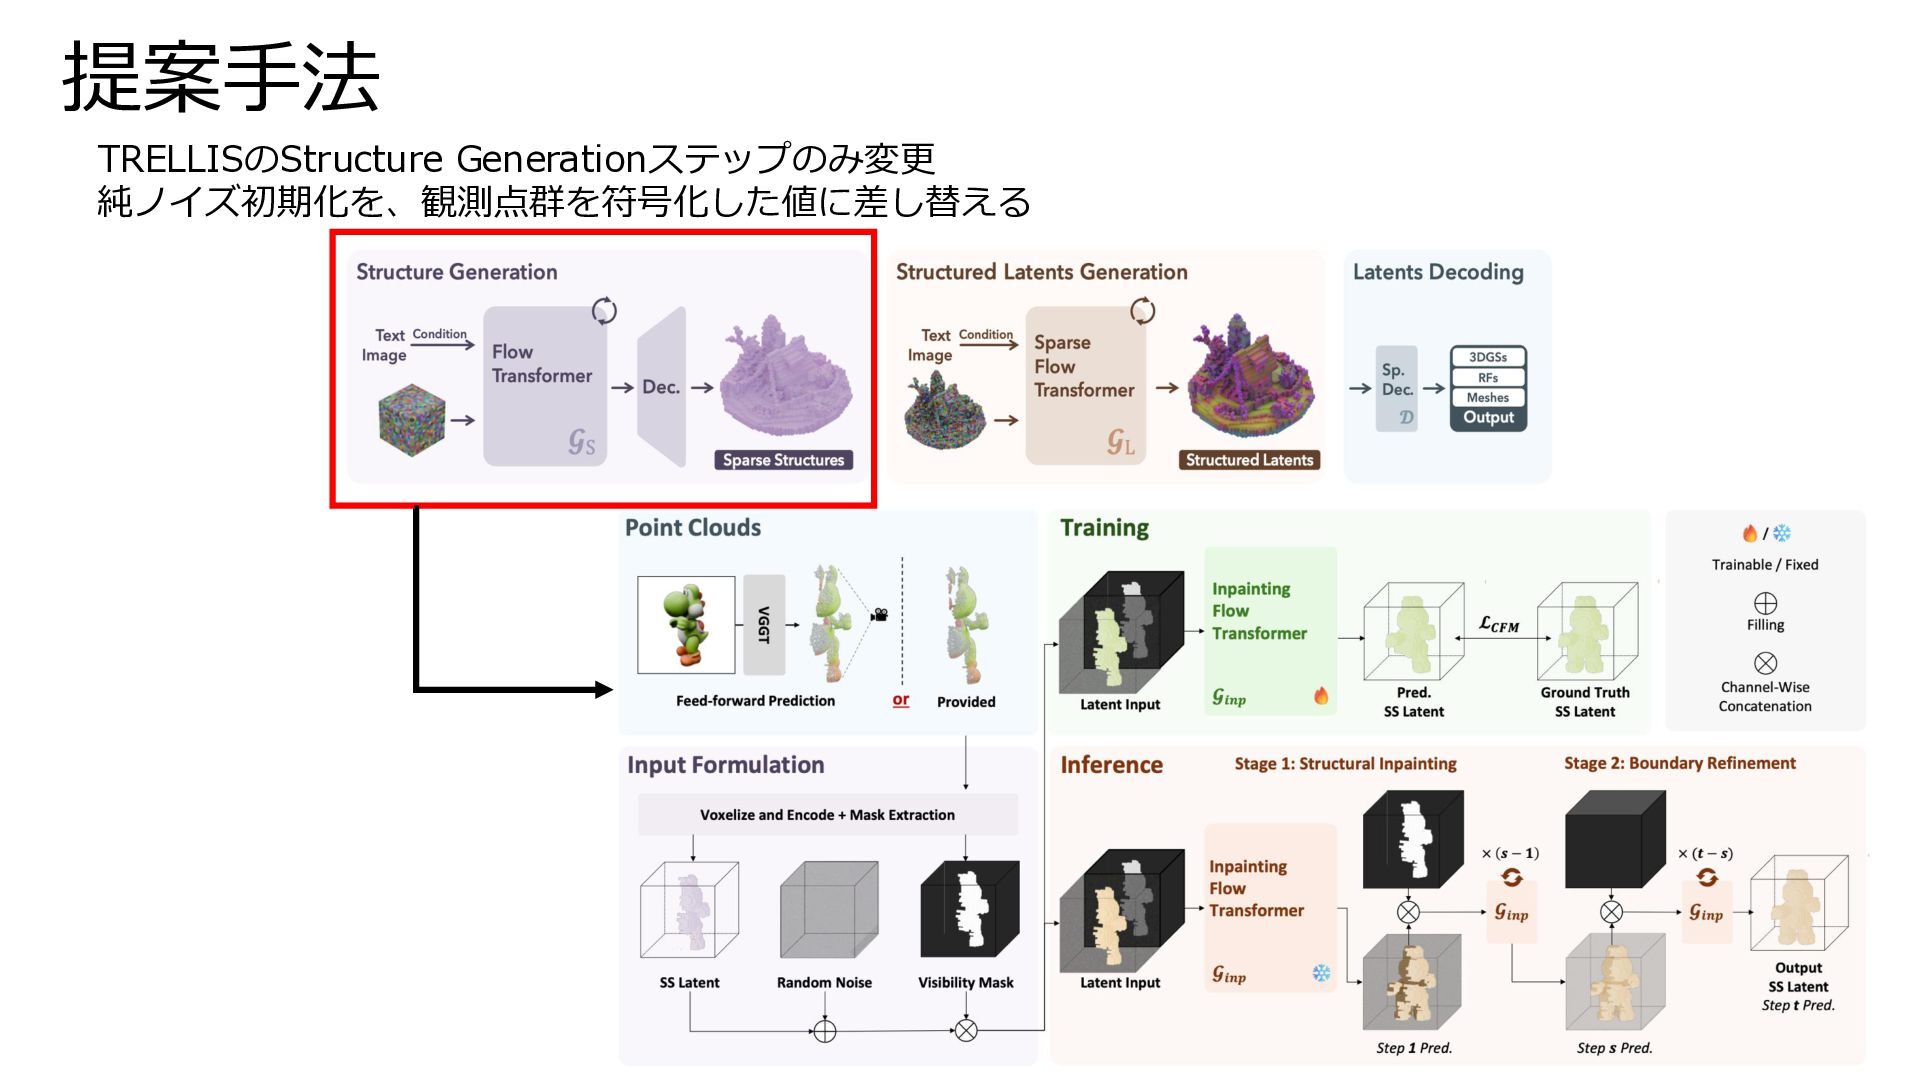
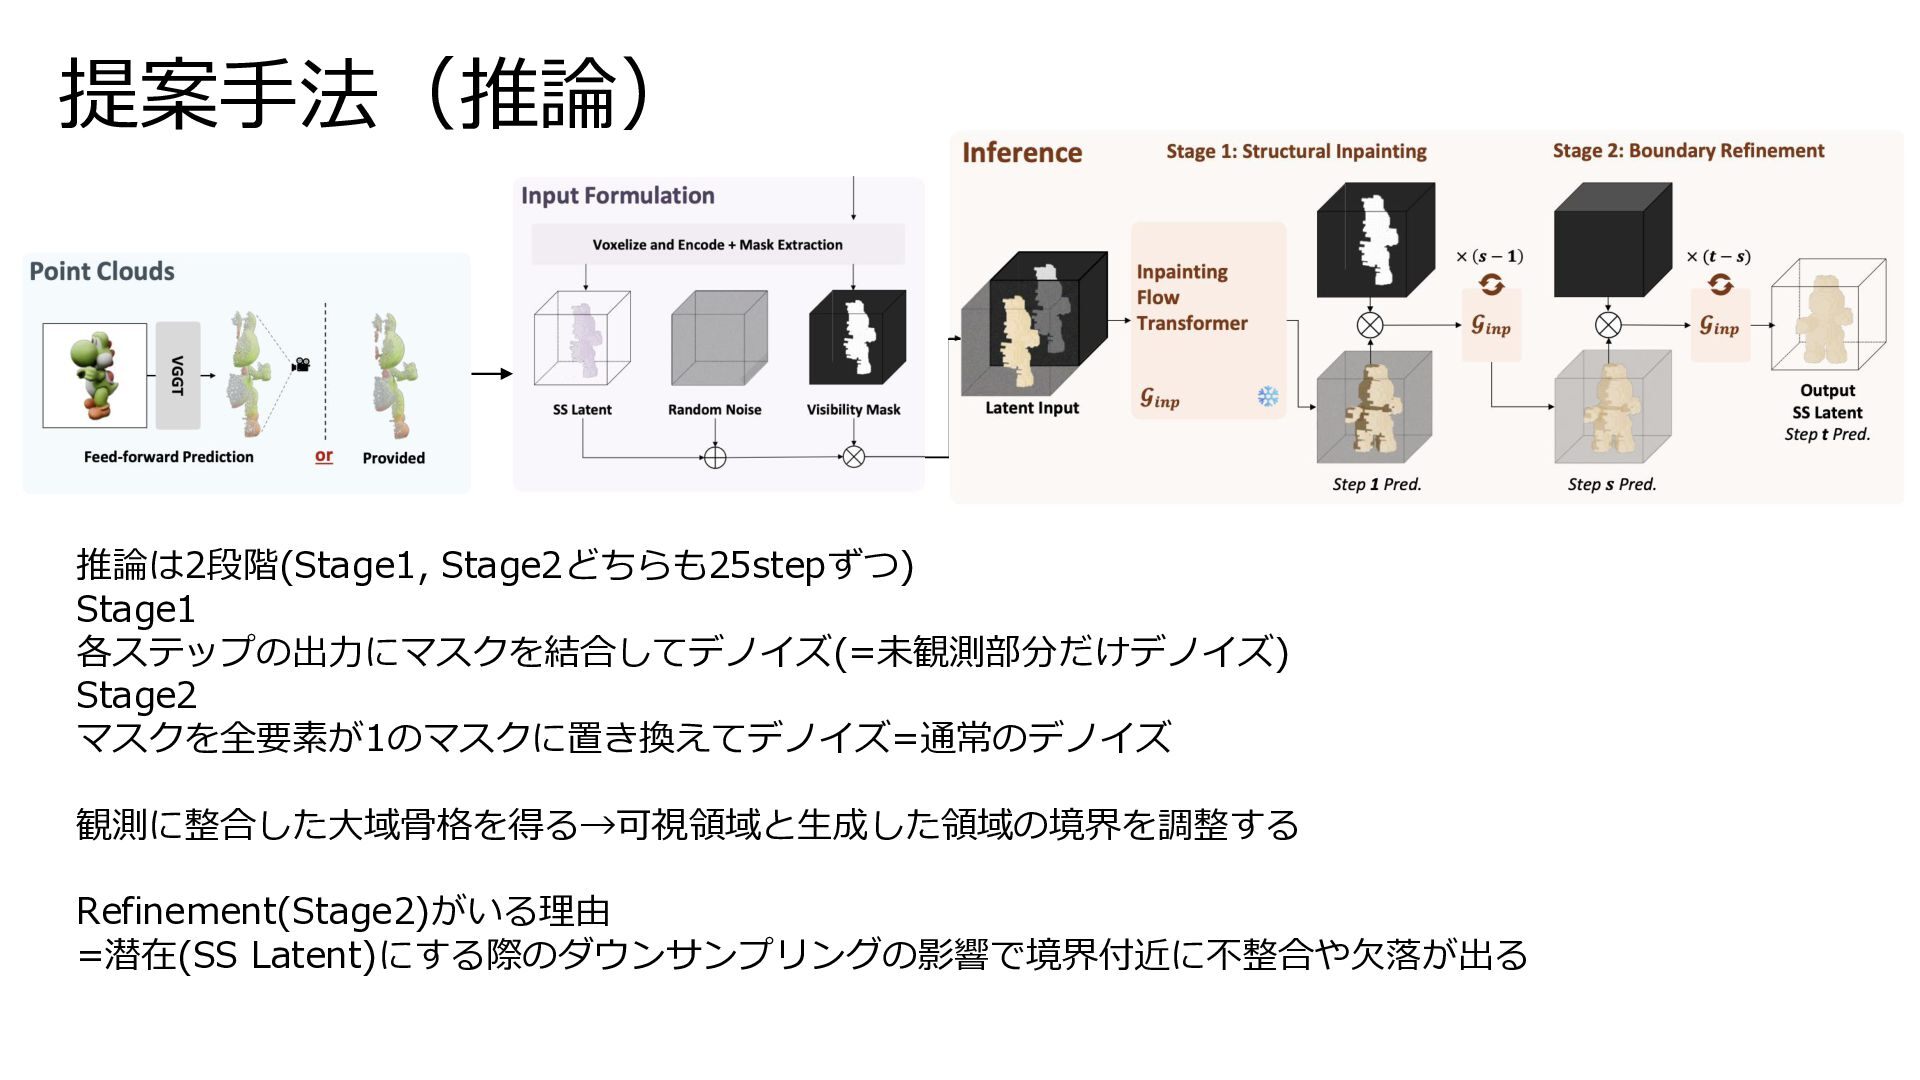
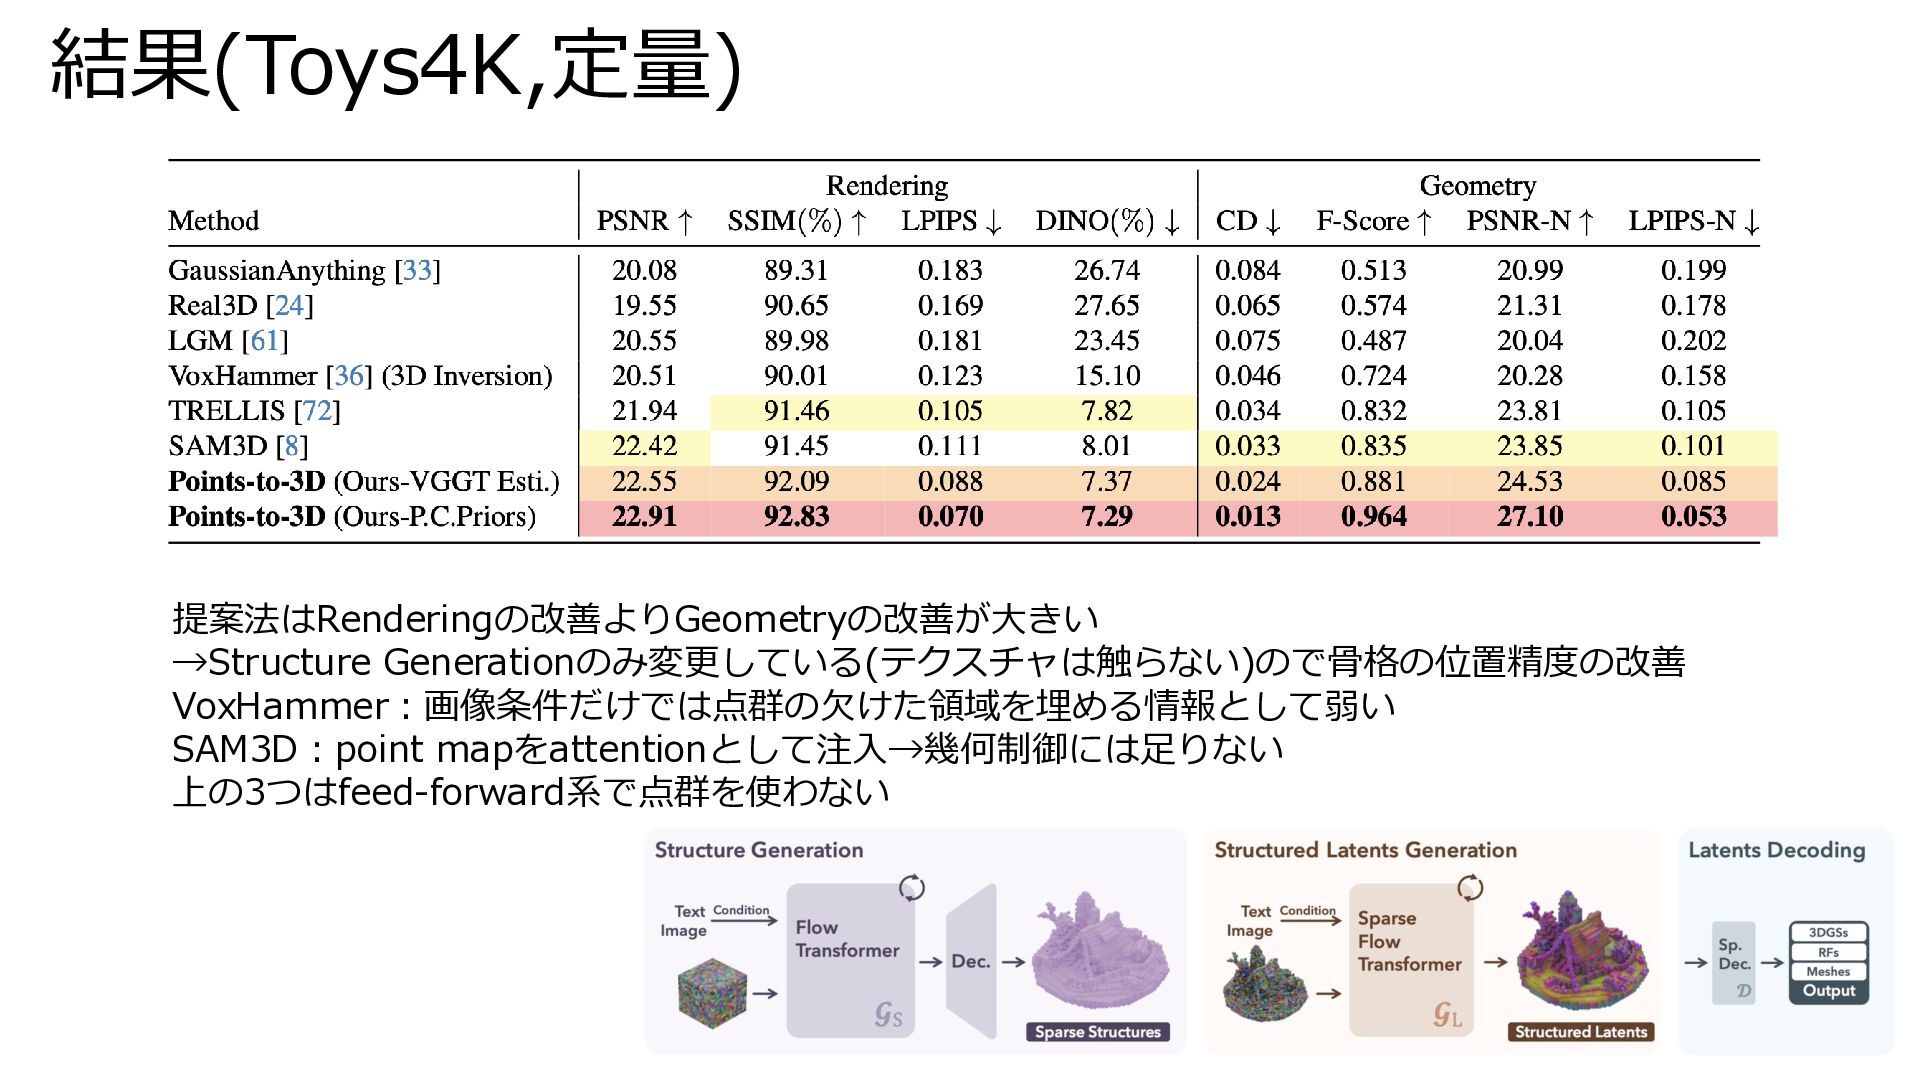
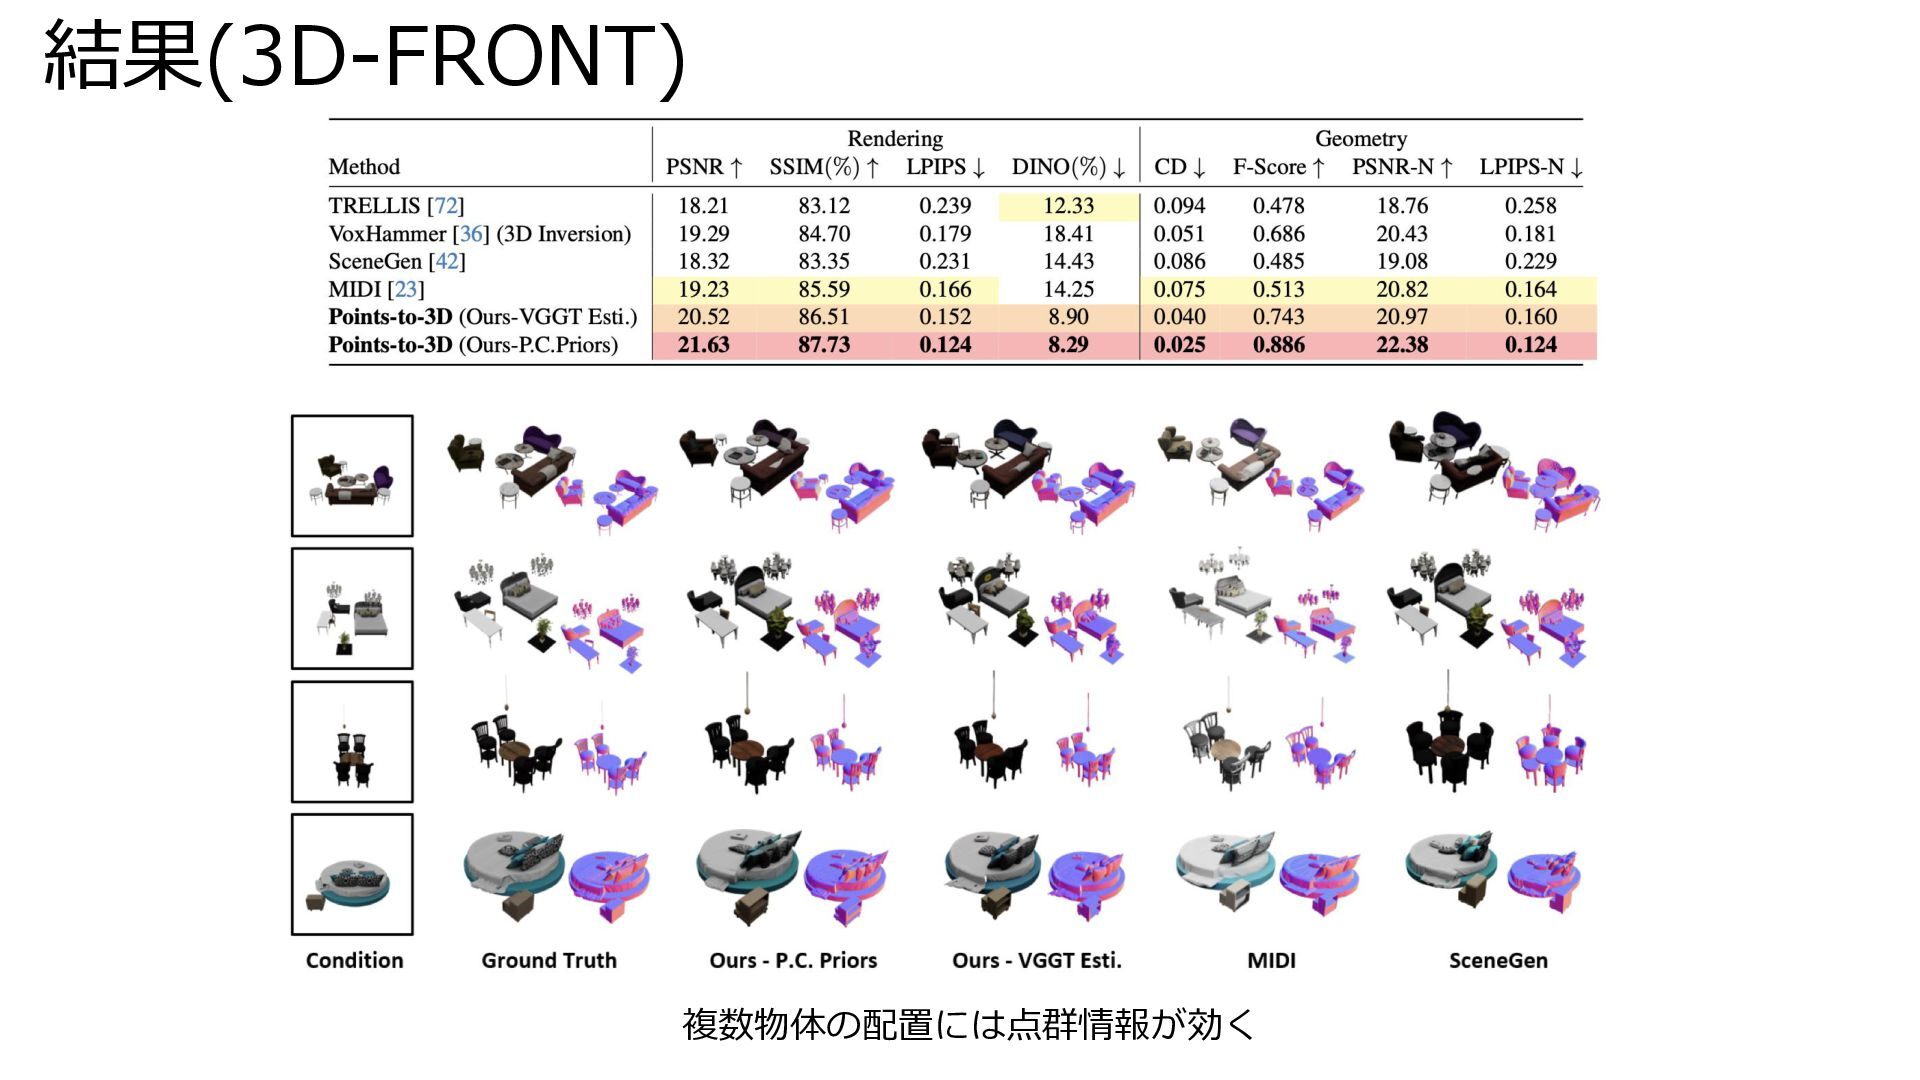
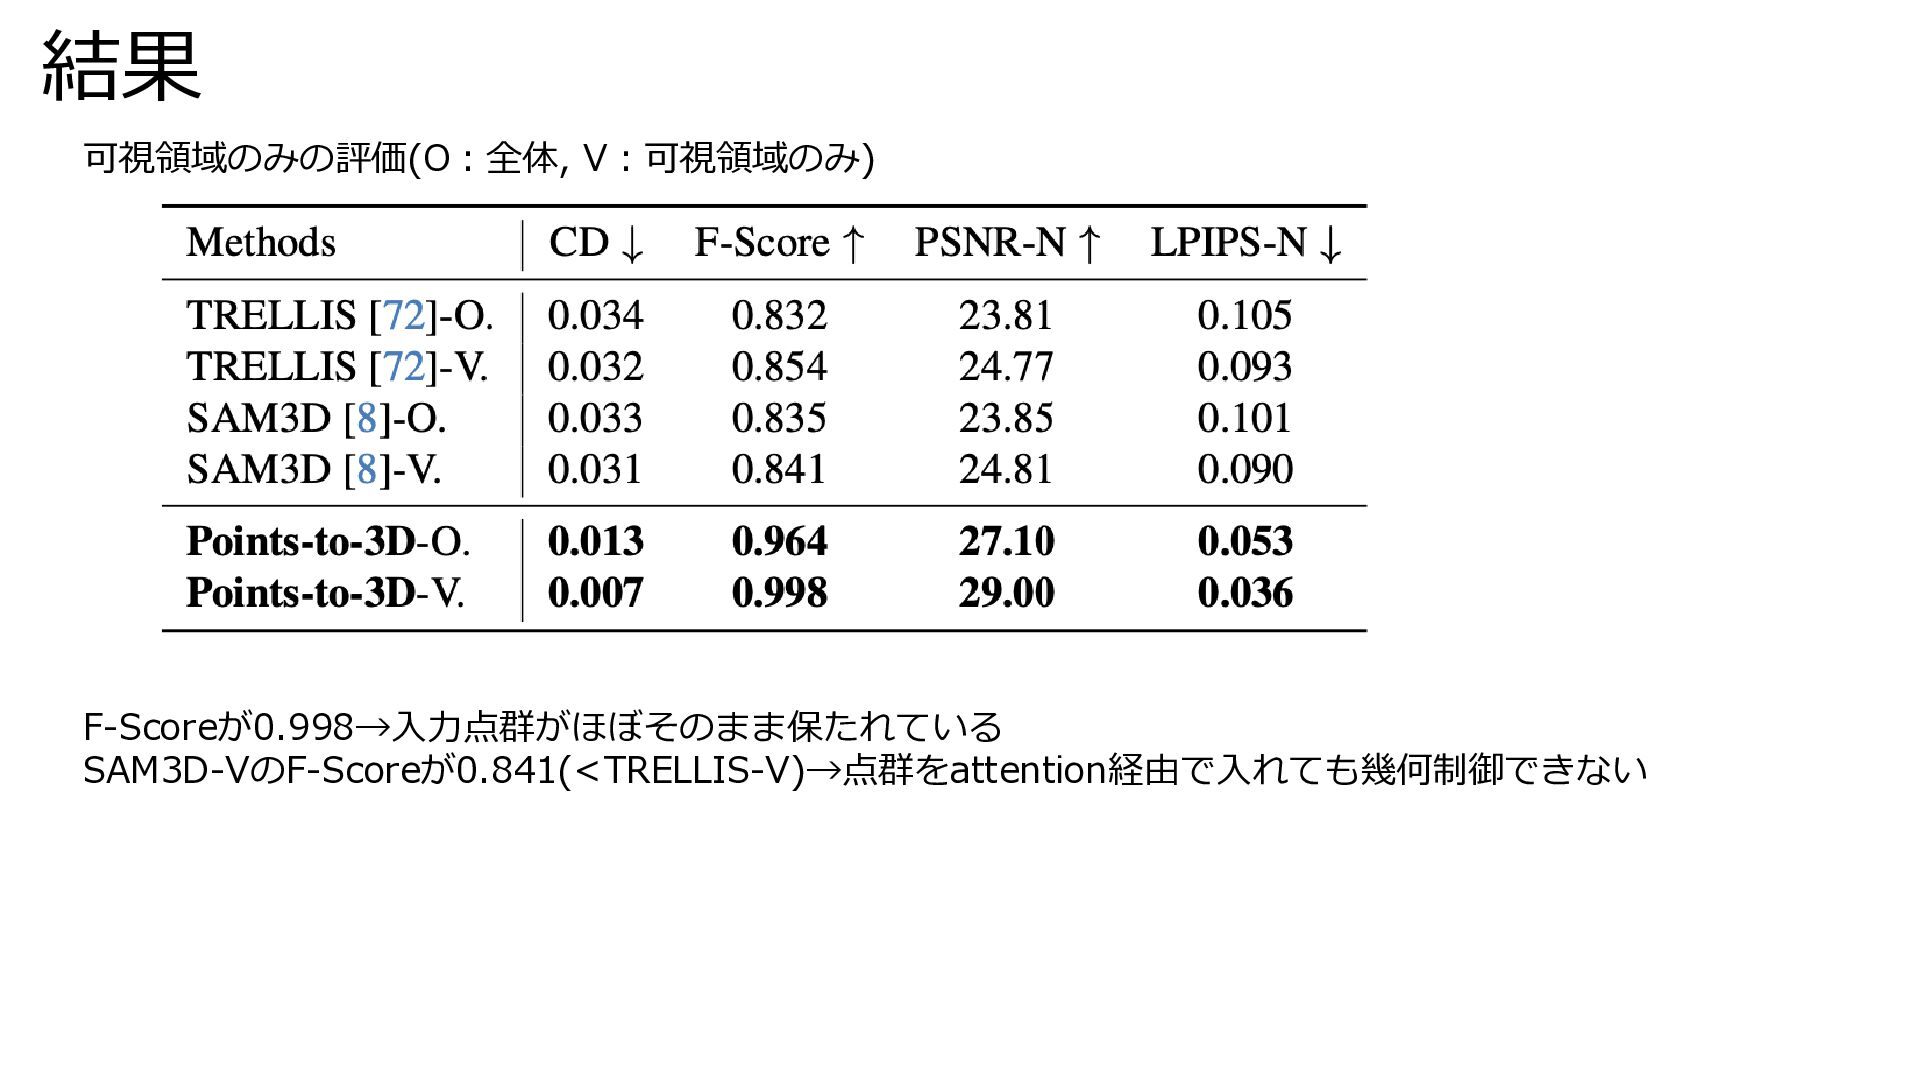
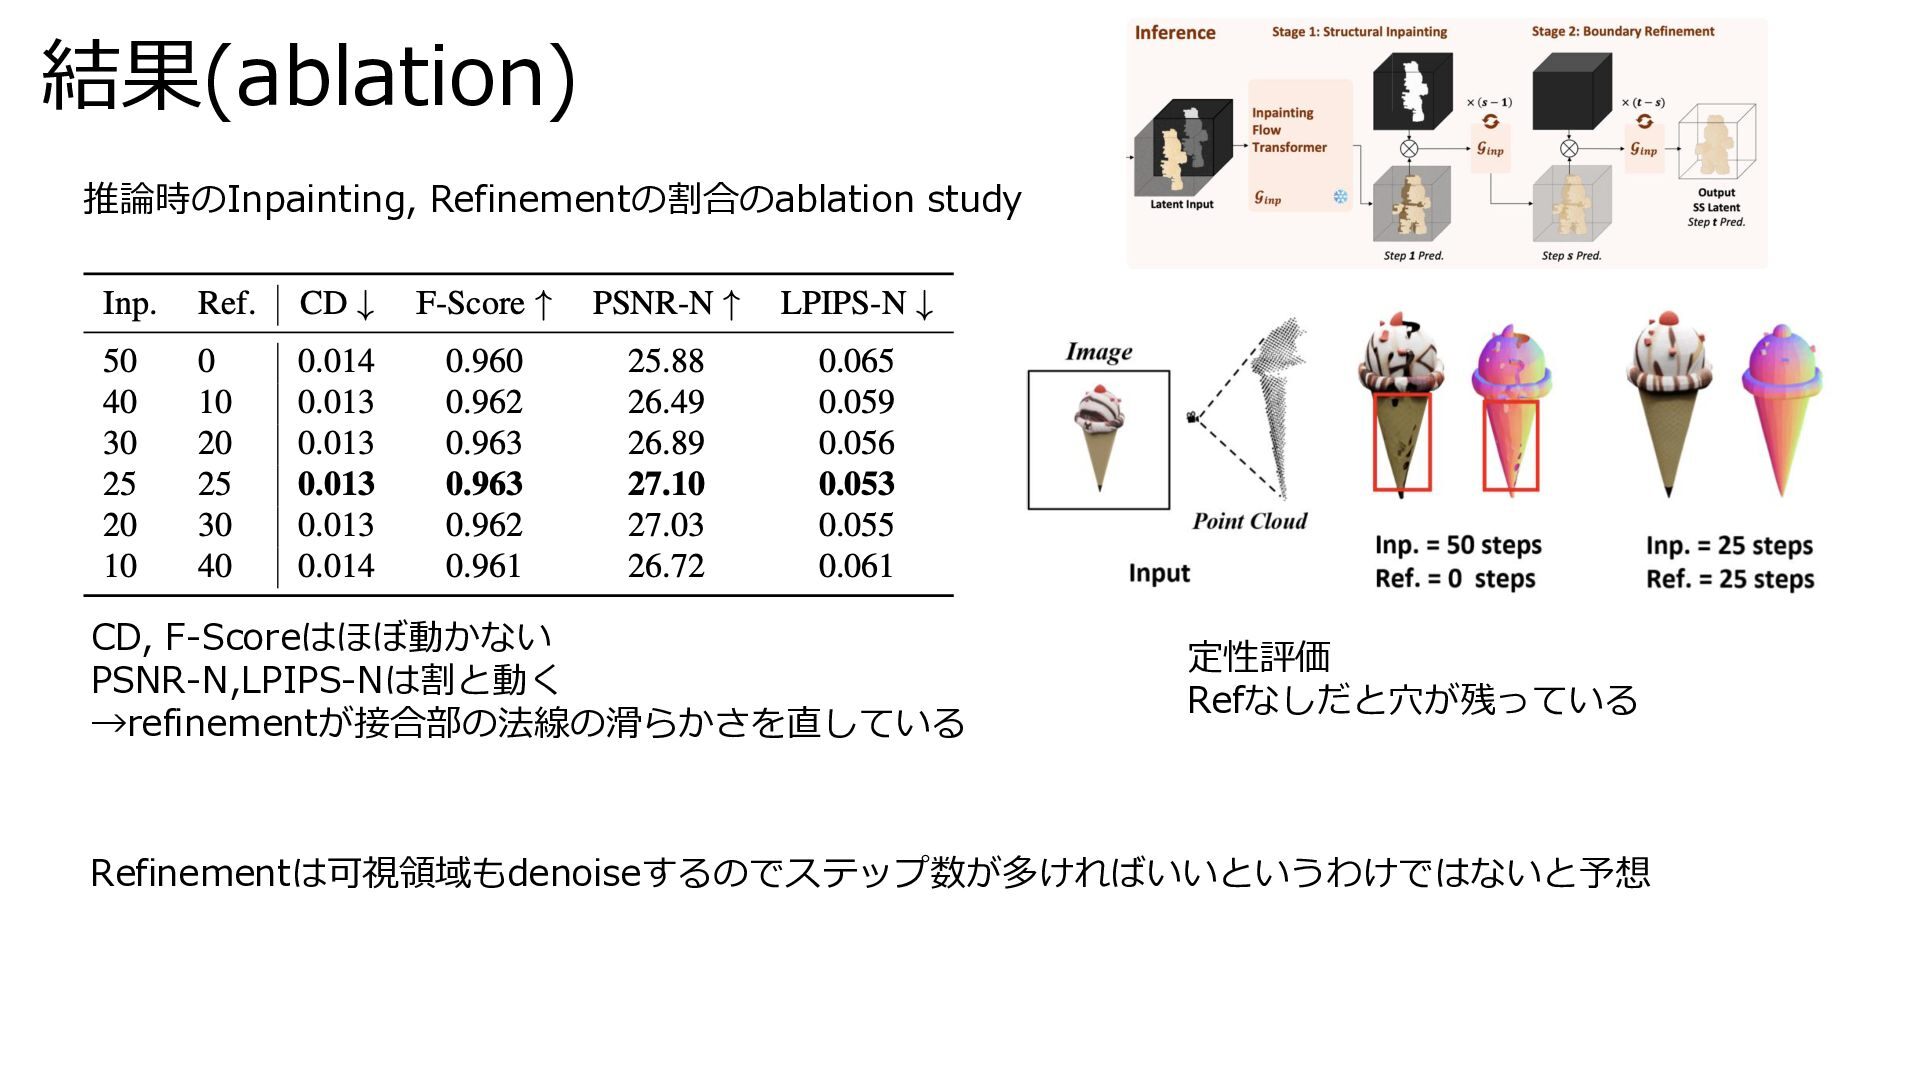
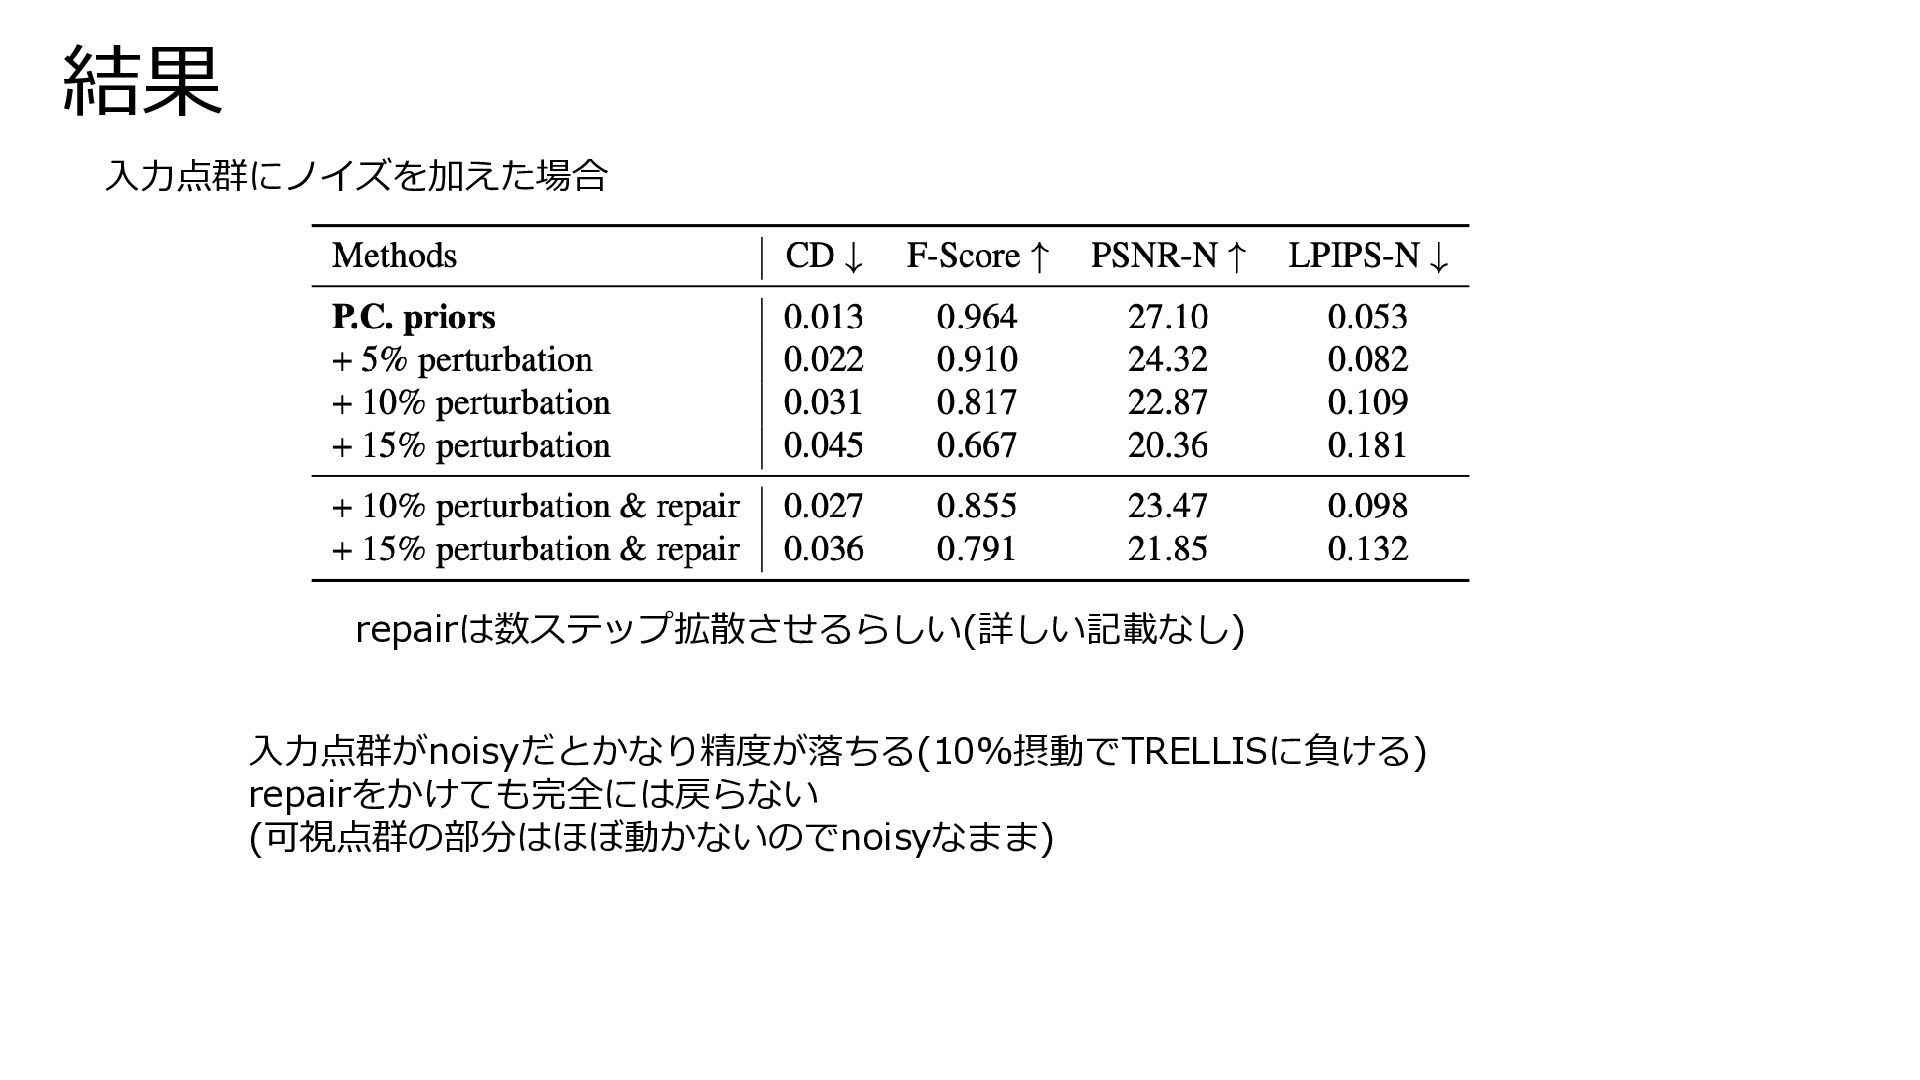
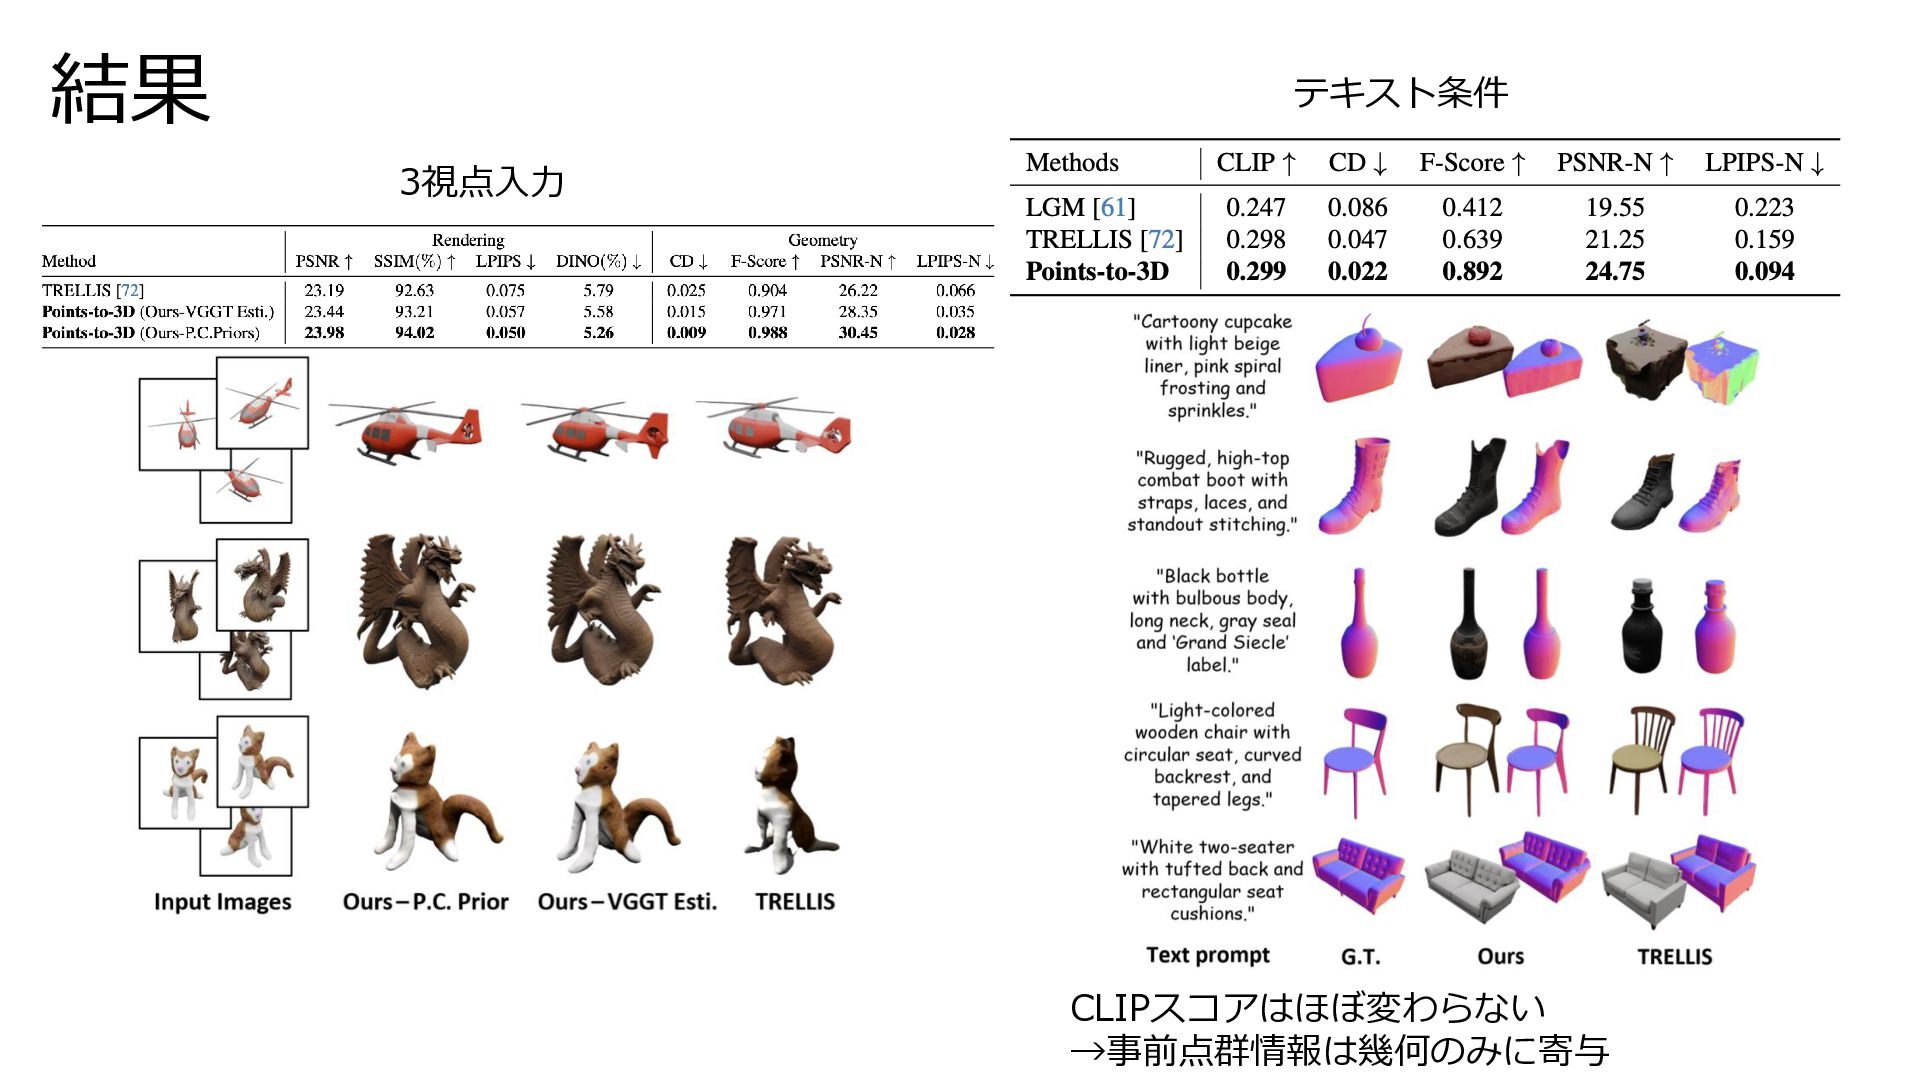
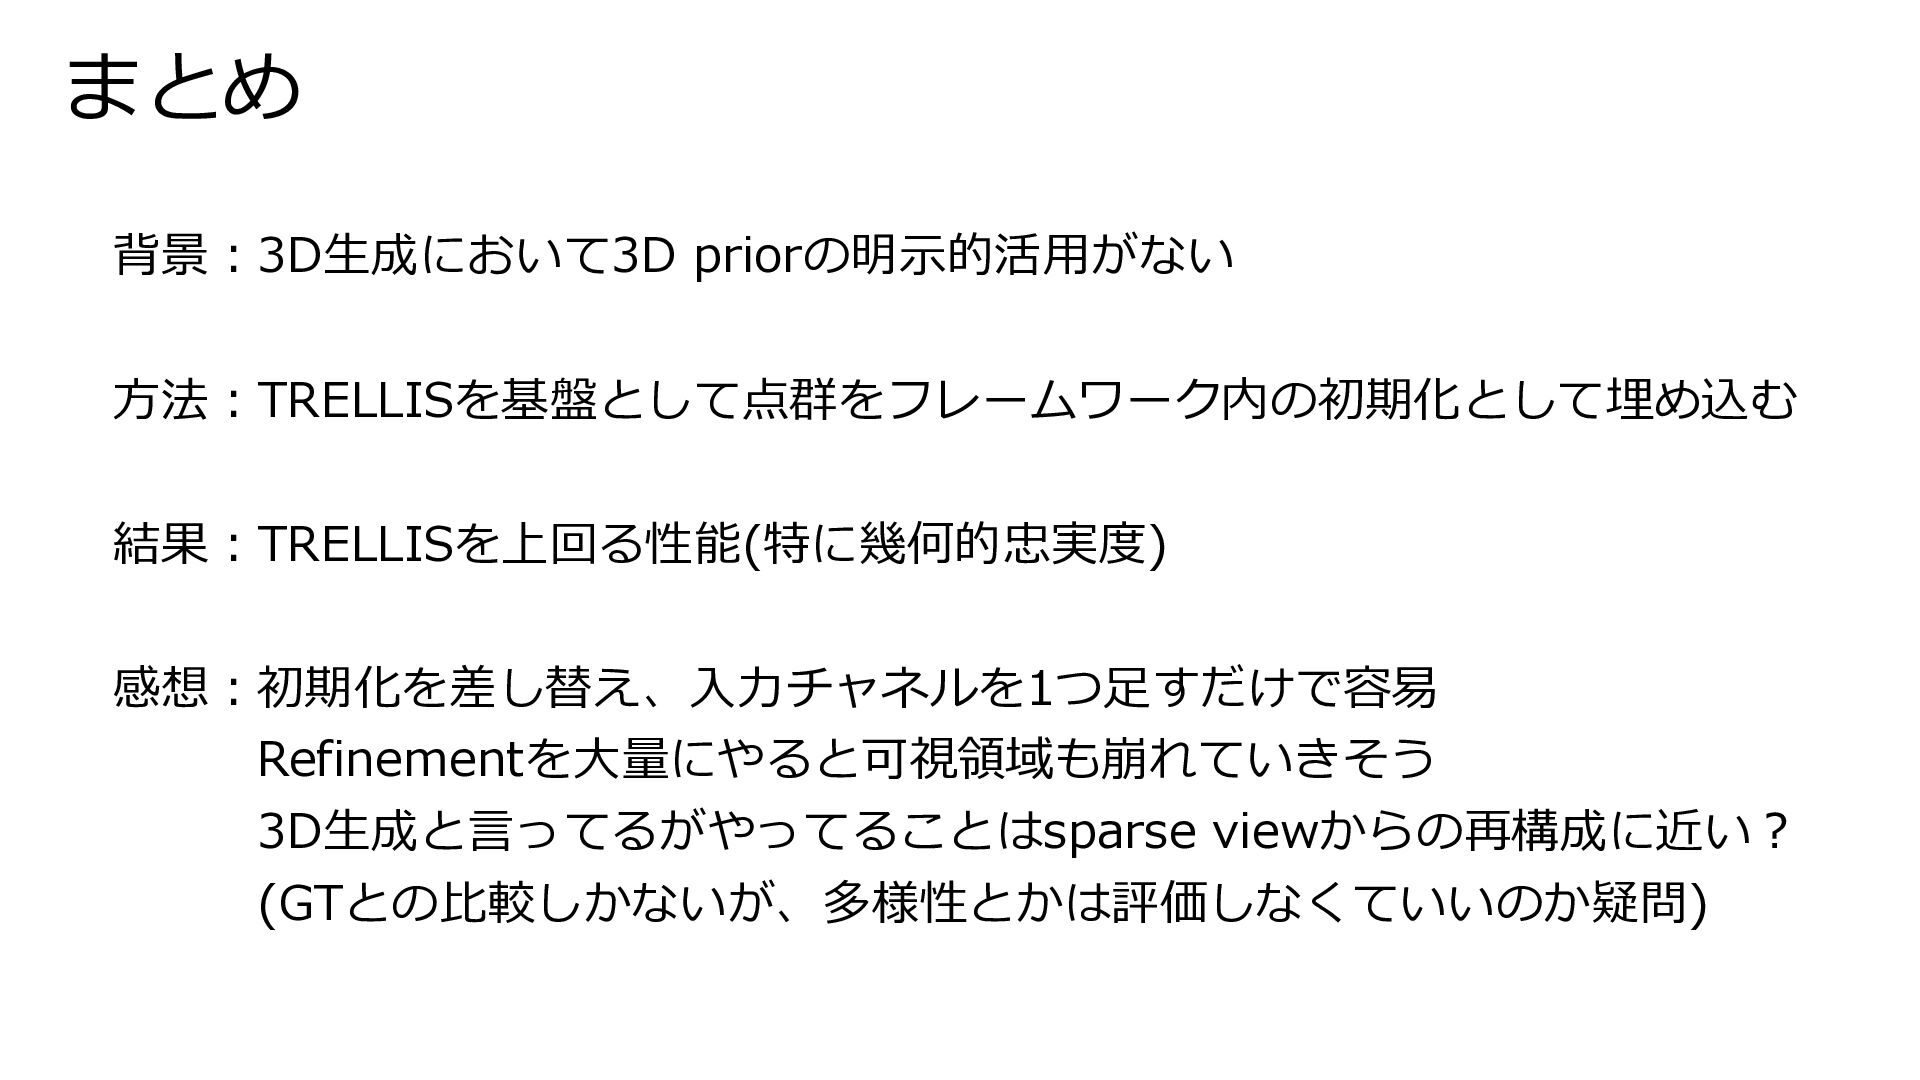
Points-to-3D は、潜在3D拡散モデル TRELLIS の Structure Generation の初期値を、純ガウスノイズから観測点群をボクセル化して符号化した値に差し替える手法である。観測点群が覆う潜在セルを示す占有マスクを入力チャネルに連結し、生成を inpainting として解き直す。推論は前半で観測を保ったまま骨格を作り、後半でマスクを外して境界をならす。基盤である TRELLIS を含む既存手法を、幾何忠実度とレンダリング品質の双方で上回る。

Spatial AI Network

October 06, 2026

Transcript

22 slides
  1. Spatial AI Network 勉強会(08/25) Points-to-3D: Structure-Aware 3D Generation with Point

    Cloud Priors(CVPR2026) Jiatong Xia, Zicheng Duan, Anton van den Hengel, Lingqiao Liu 発表者:堀岡柚太(大阪大学 浦西研究室 M2)
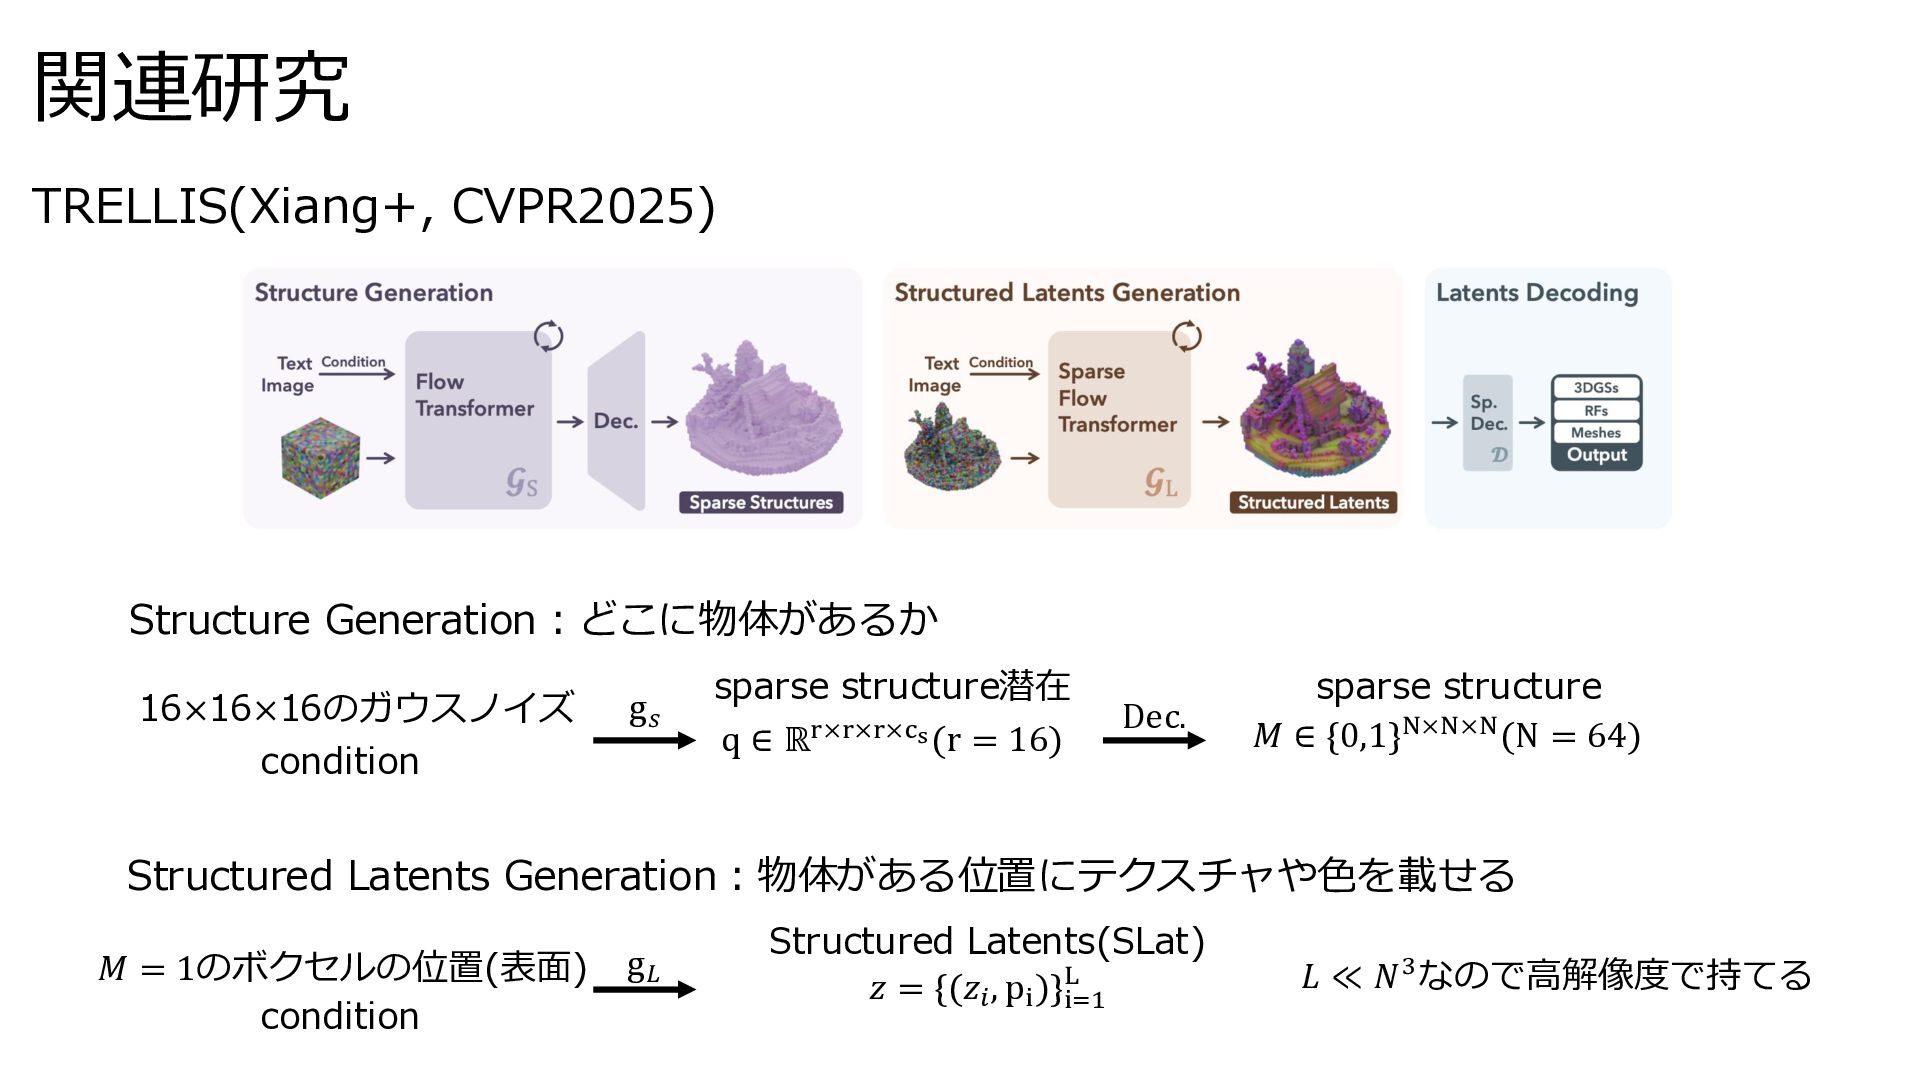
  2. 関連研究 TRELLIS(Xiang+, CVPR2025) Structure Generation:どこに物体があるか 16×16×16のガウスノイズ condition g𝑠 sparse structure潜在

    q ∈ ℝr×r×r×cs (r = 16) Dec. sparse structure 𝑀 ∈ {0,1}N×N×N (N = 64) Structured Latents Generation:物体がある位置にテクスチャや色を載せる 𝑀 = 1のボクセルの位置(表面) condition g𝐿 Structured Latents(SLat) 𝑧 = {(𝑧𝑖 , pi )}Li=1 𝐿 ≪ 𝑁 3 なので高解像度で持てる
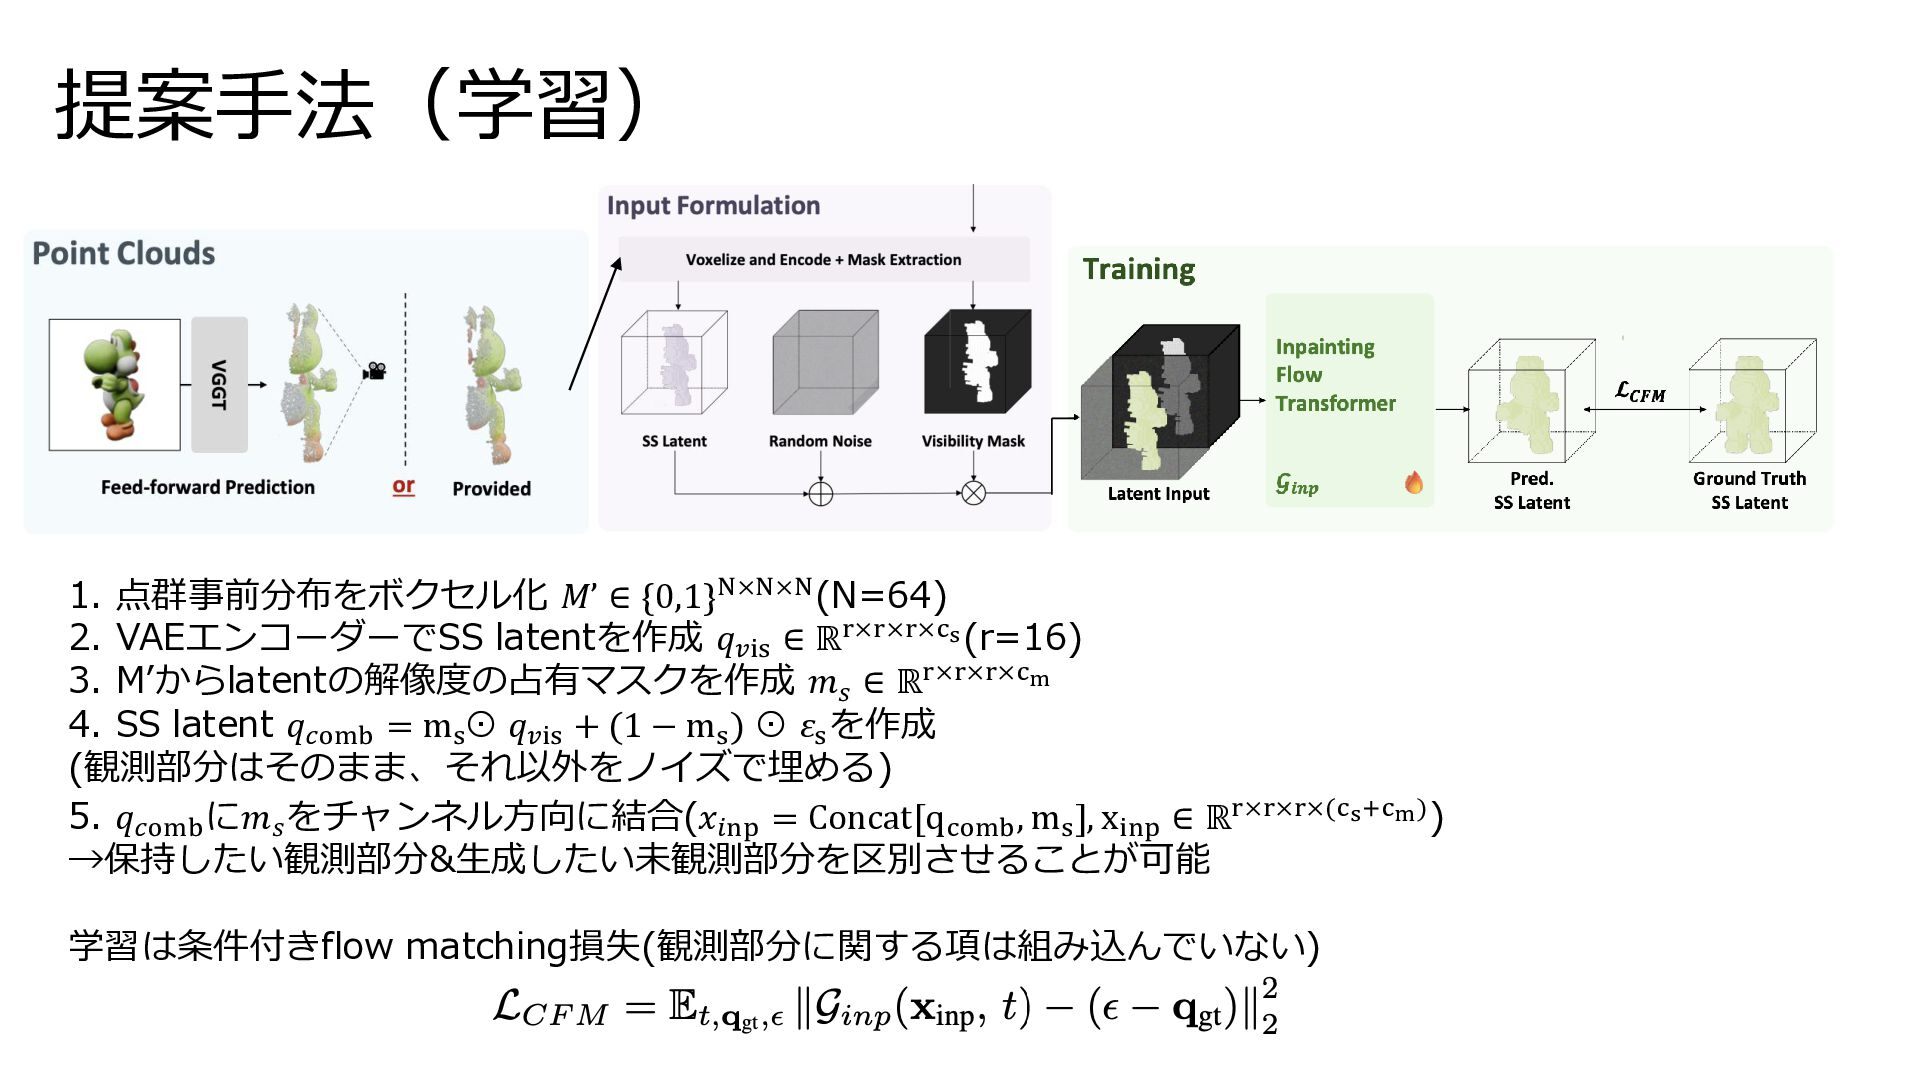
  3. 提案手法(学習) 1. 点群事前分布をボクセル化 𝑀’ ∈ {0,1}N×N×N (N=64) 2. VAEエンコーダーでSS latentを作成

    𝑞𝑣is ∈ ℝr×r×r×cs (r=16) 3. M’からlatentの解像度の占有マスクを作成 𝑚𝑠 ∈ ℝr×r×r×cm 4. SS latent 𝑞𝑐omb = ms ⊙ 𝑞𝑣is + (1 − ms ) ⊙ 𝜀s を作成 (観測部分はそのまま、それ以外をノイズで埋める) 5. 𝑞𝑐omb に𝑚𝑠 をチャンネル方向に結合(𝑥𝑖np = Concat[qcomb , ms ], xinp ∈ ℝr×r×r×(cs+cm) ) →保持したい観測部分&生成したい未観測部分を区別させることが可能 学習は条件付きflow matching損失(観測部分に関する項は組み込んでいない)
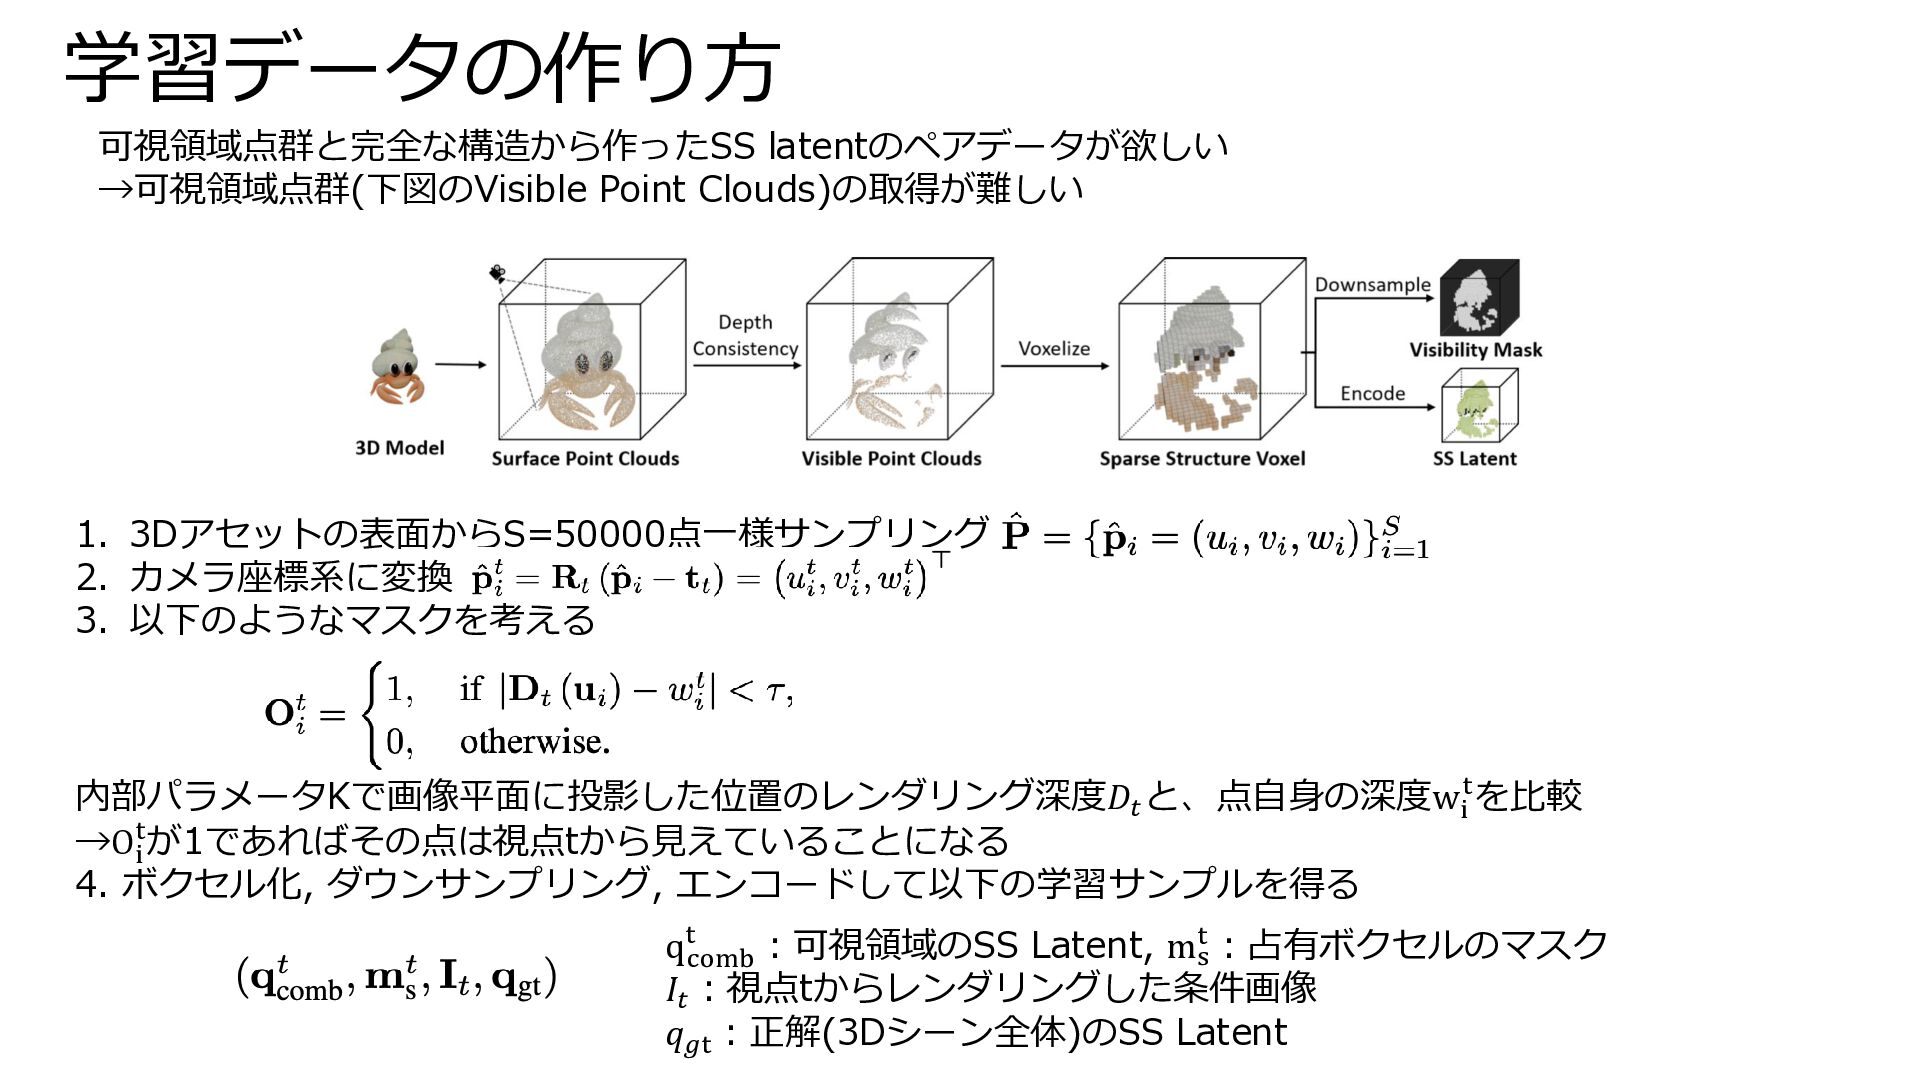
  4. 学習データの作り方 可視領域点群と完全な構造から作ったSS latentのペアデータが欲しい →可視領域点群(下図のVisible Point Clouds)の取得が難しい 1. 3Dアセットの表面からS=50000点一様サンプリング 2. カメラ座標系に変換

    3. 以下のようなマスクを考える 内部パラメータKで画像平面に投影した位置のレンダリング深度𝐷𝑡 と、点自身の深度wit を比較 →Oti が1であればその点は視点tから見えていることになる 4. ボクセル化, ダウンサンプリング, エンコードして以下の学習サンプルを得る qtcomb :可視領域のSS Latent, mts :占有ボクセルのマスク 𝐼𝑡 :視点tからレンダリングした条件画像 𝑞𝑔t :正解(3Dシーン全体)のSS Latent
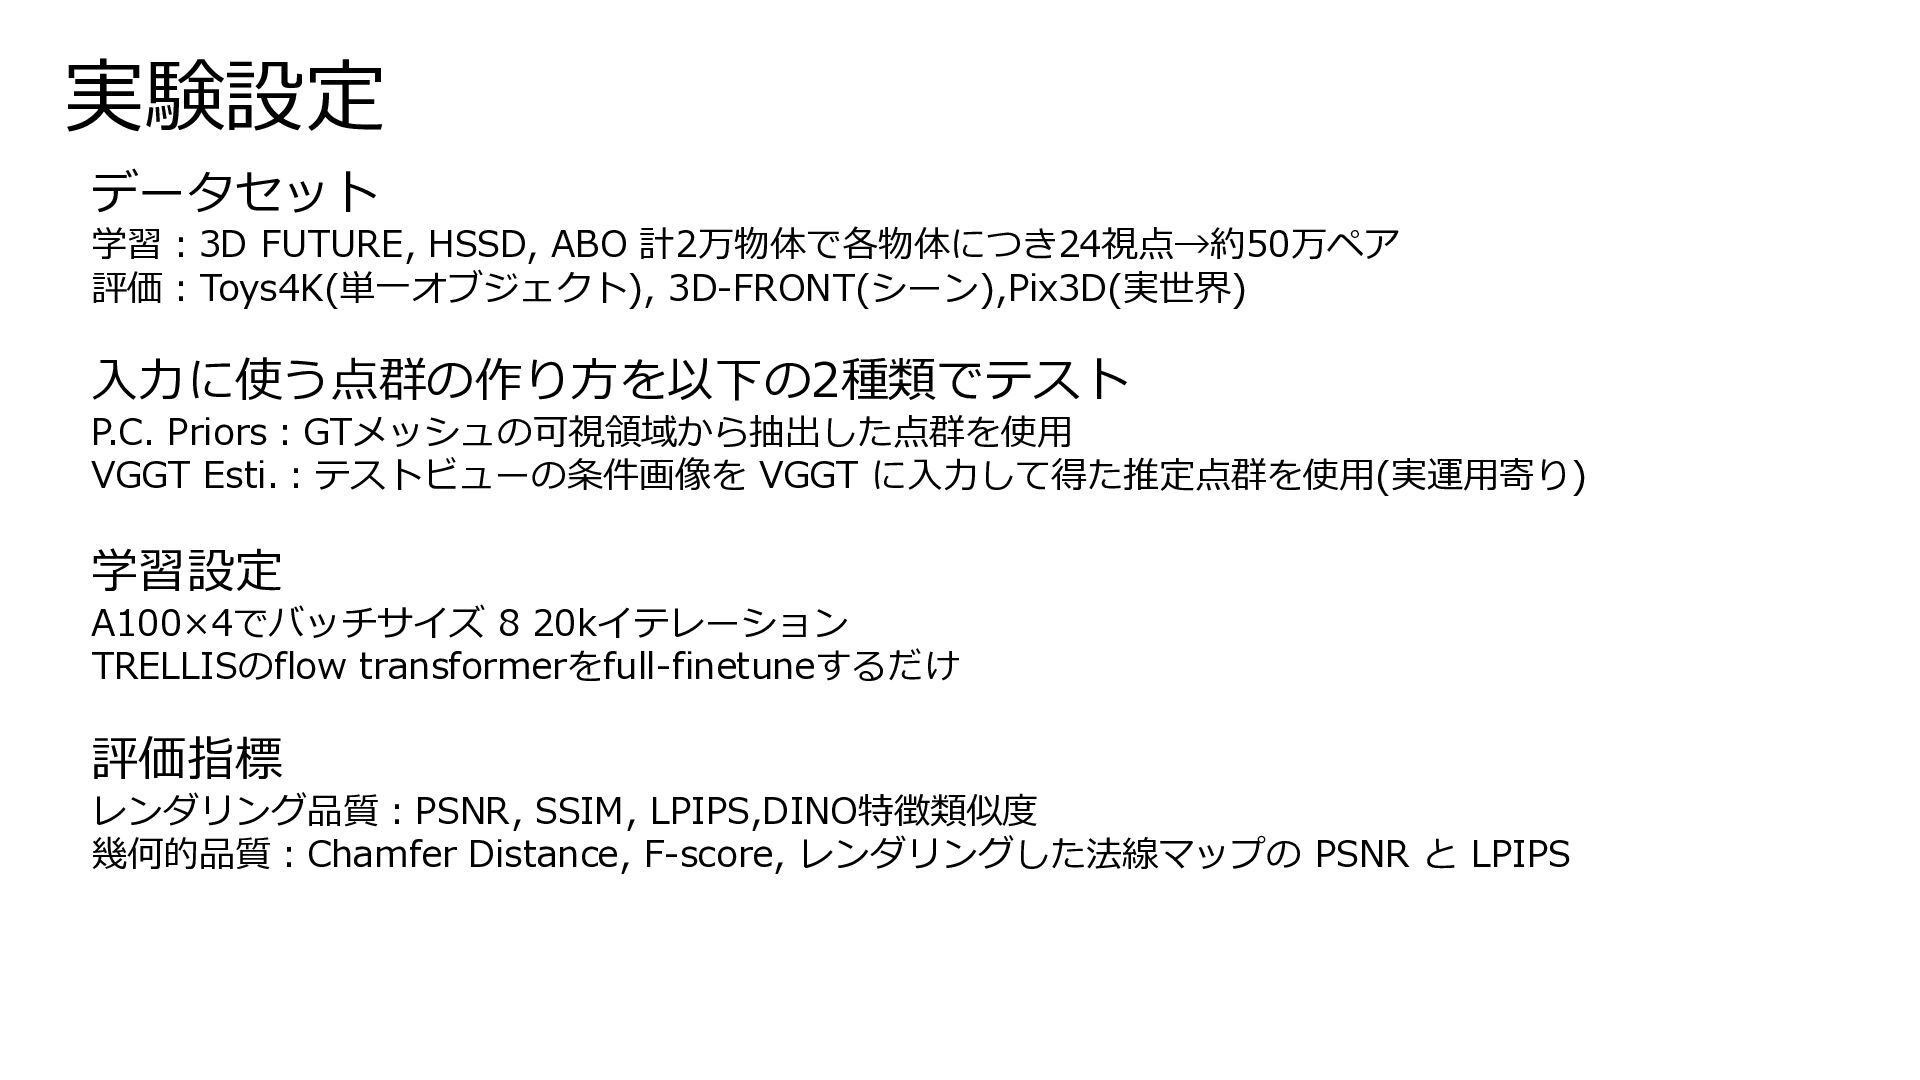
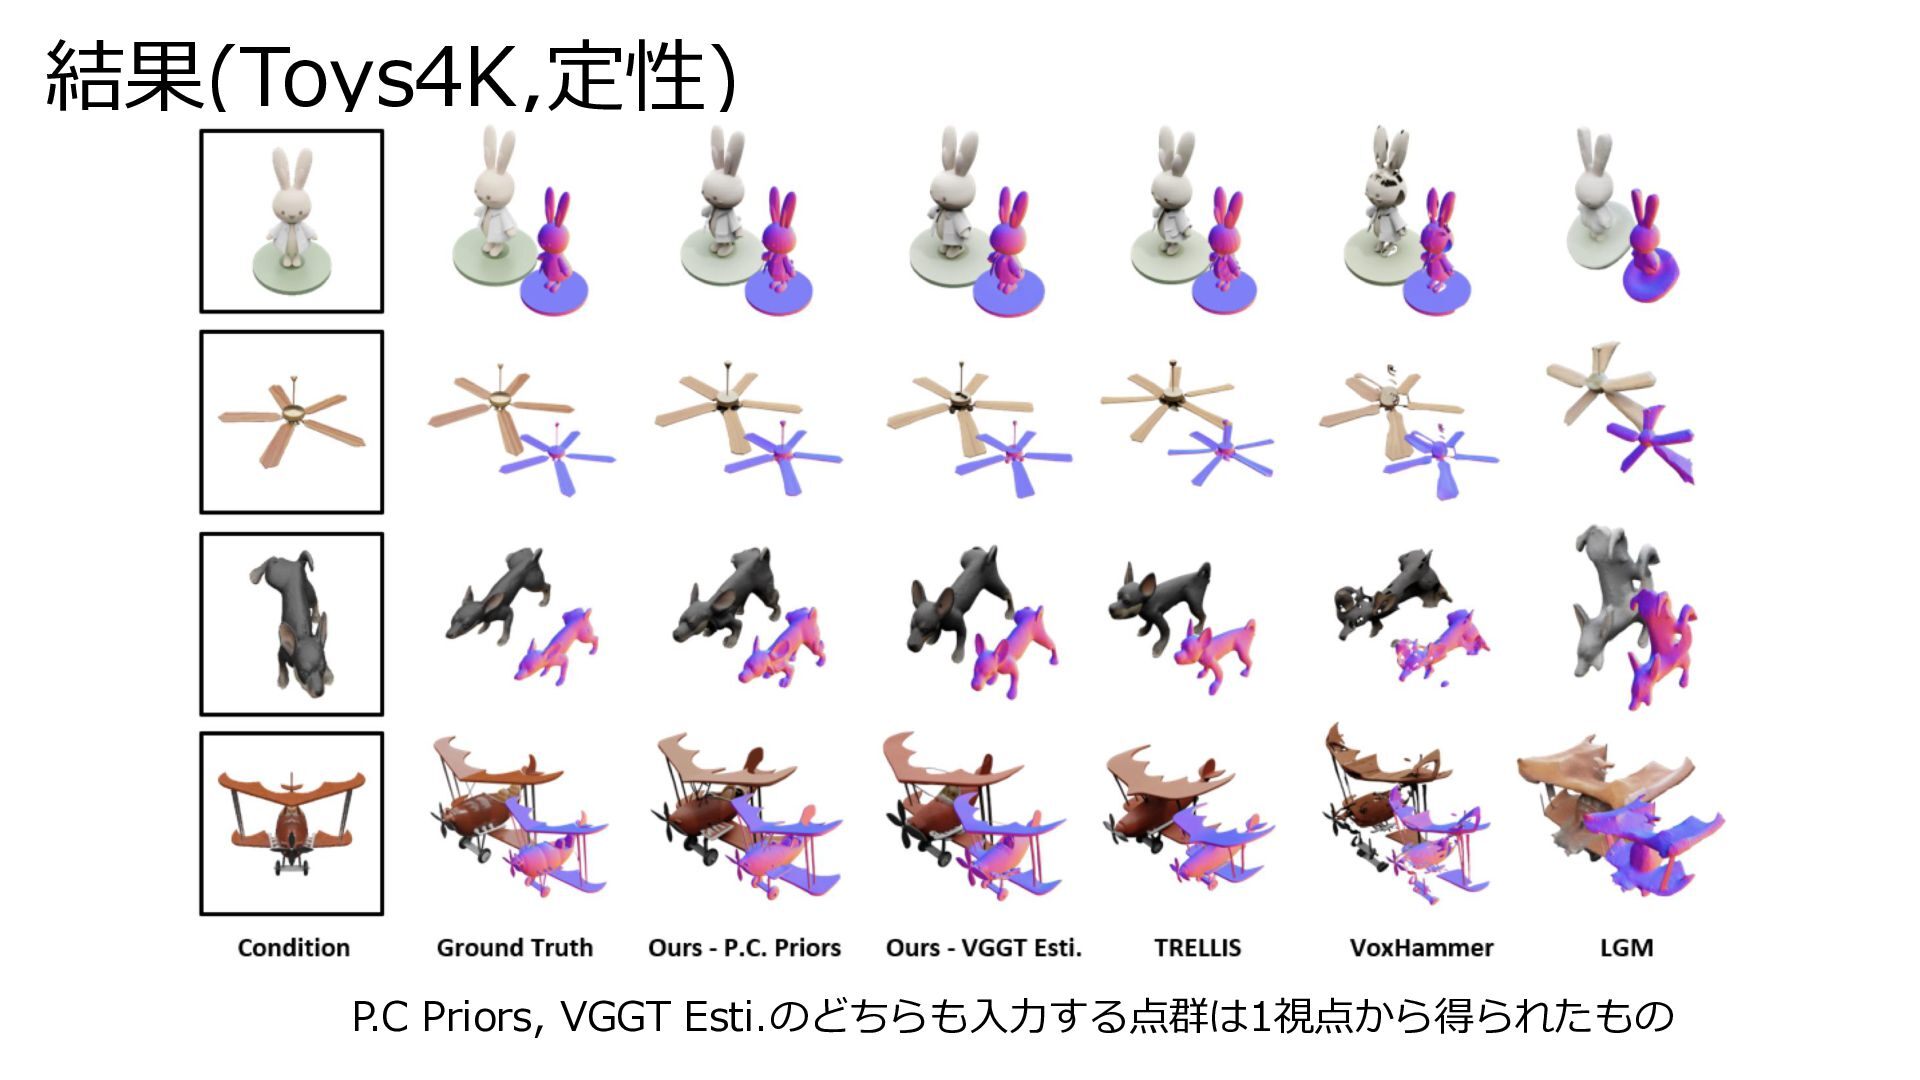
  5. 実験設定 データセット 学習:3D FUTURE, HSSD, ABO 計2万物体で各物体につき24視点→約50万ペア 評価:Toys4K(単一オブジェクト), 3D-FRONT(シーン),Pix3D(実世界) 入力に使う点群の作り方を以下の2種類でテスト

    P.C. Priors:GTメッシュの可視領域から抽出した点群を使用 VGGT Esti.:テストビューの条件画像を VGGT に入力して得た推定点群を使用(実運用寄り) 学習設定 A100×4でバッチサイズ 8 20kイテレーション TRELLISのflow transformerをfull-finetuneするだけ 評価指標 レンダリング品質:PSNR, SSIM, LPIPS,DINO特徴類似度 幾何的品質:Chamfer Distance, F-score, レンダリングした法線マップの PSNR と LPIPS
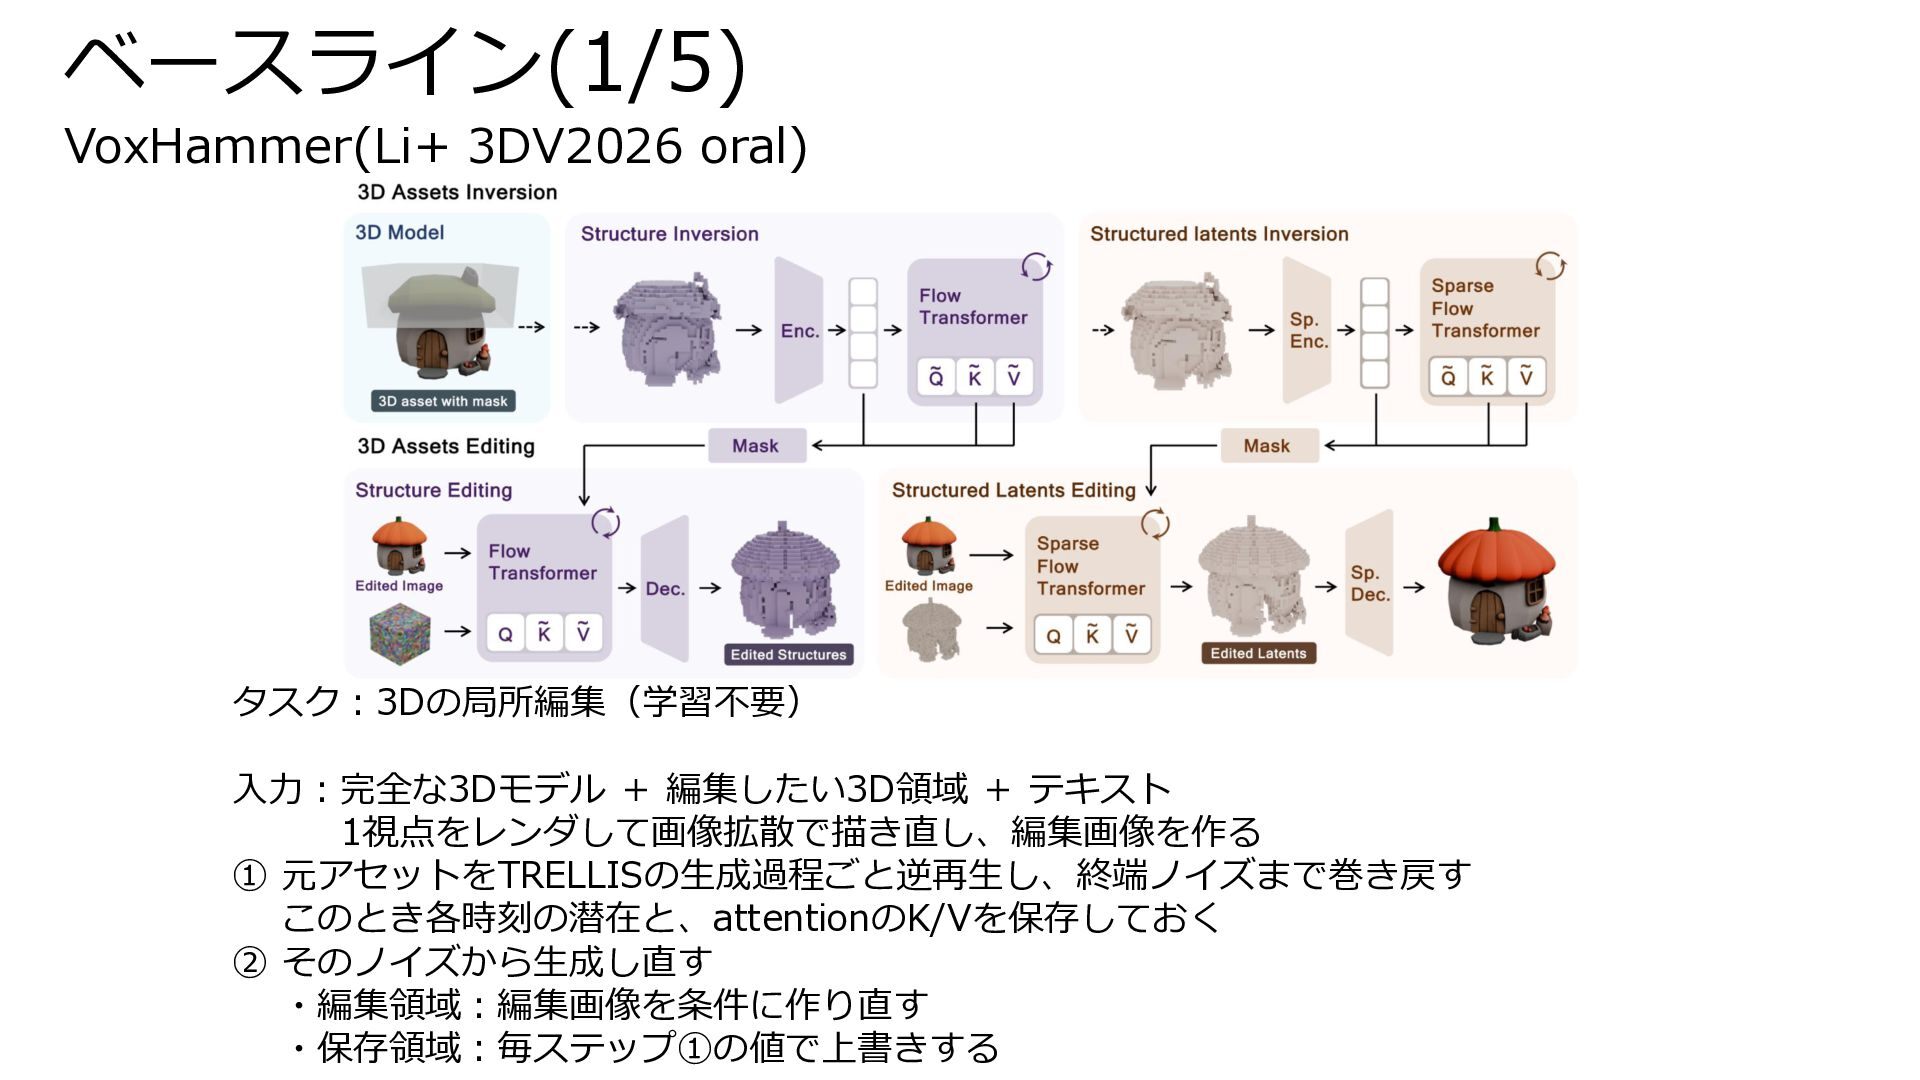
  6. ベースライン(1/5) VoxHammer(Li+ 3DV2026 oral) タスク:3Dの局所編集(学習不要) 入力:完全な3Dモデル + 編集したい3D領域 + テキスト

    1視点をレンダして画像拡散で描き直し、編集画像を作る ① 元アセットをTRELLISの生成過程ごと逆再生し、終端ノイズまで巻き戻す このとき各時刻の潜在と、attentionのK/Vを保存しておく ② そのノイズから生成し直す ・編集領域:編集画像を条件に作り直す ・保存領域:毎ステップ①の値で上書きする
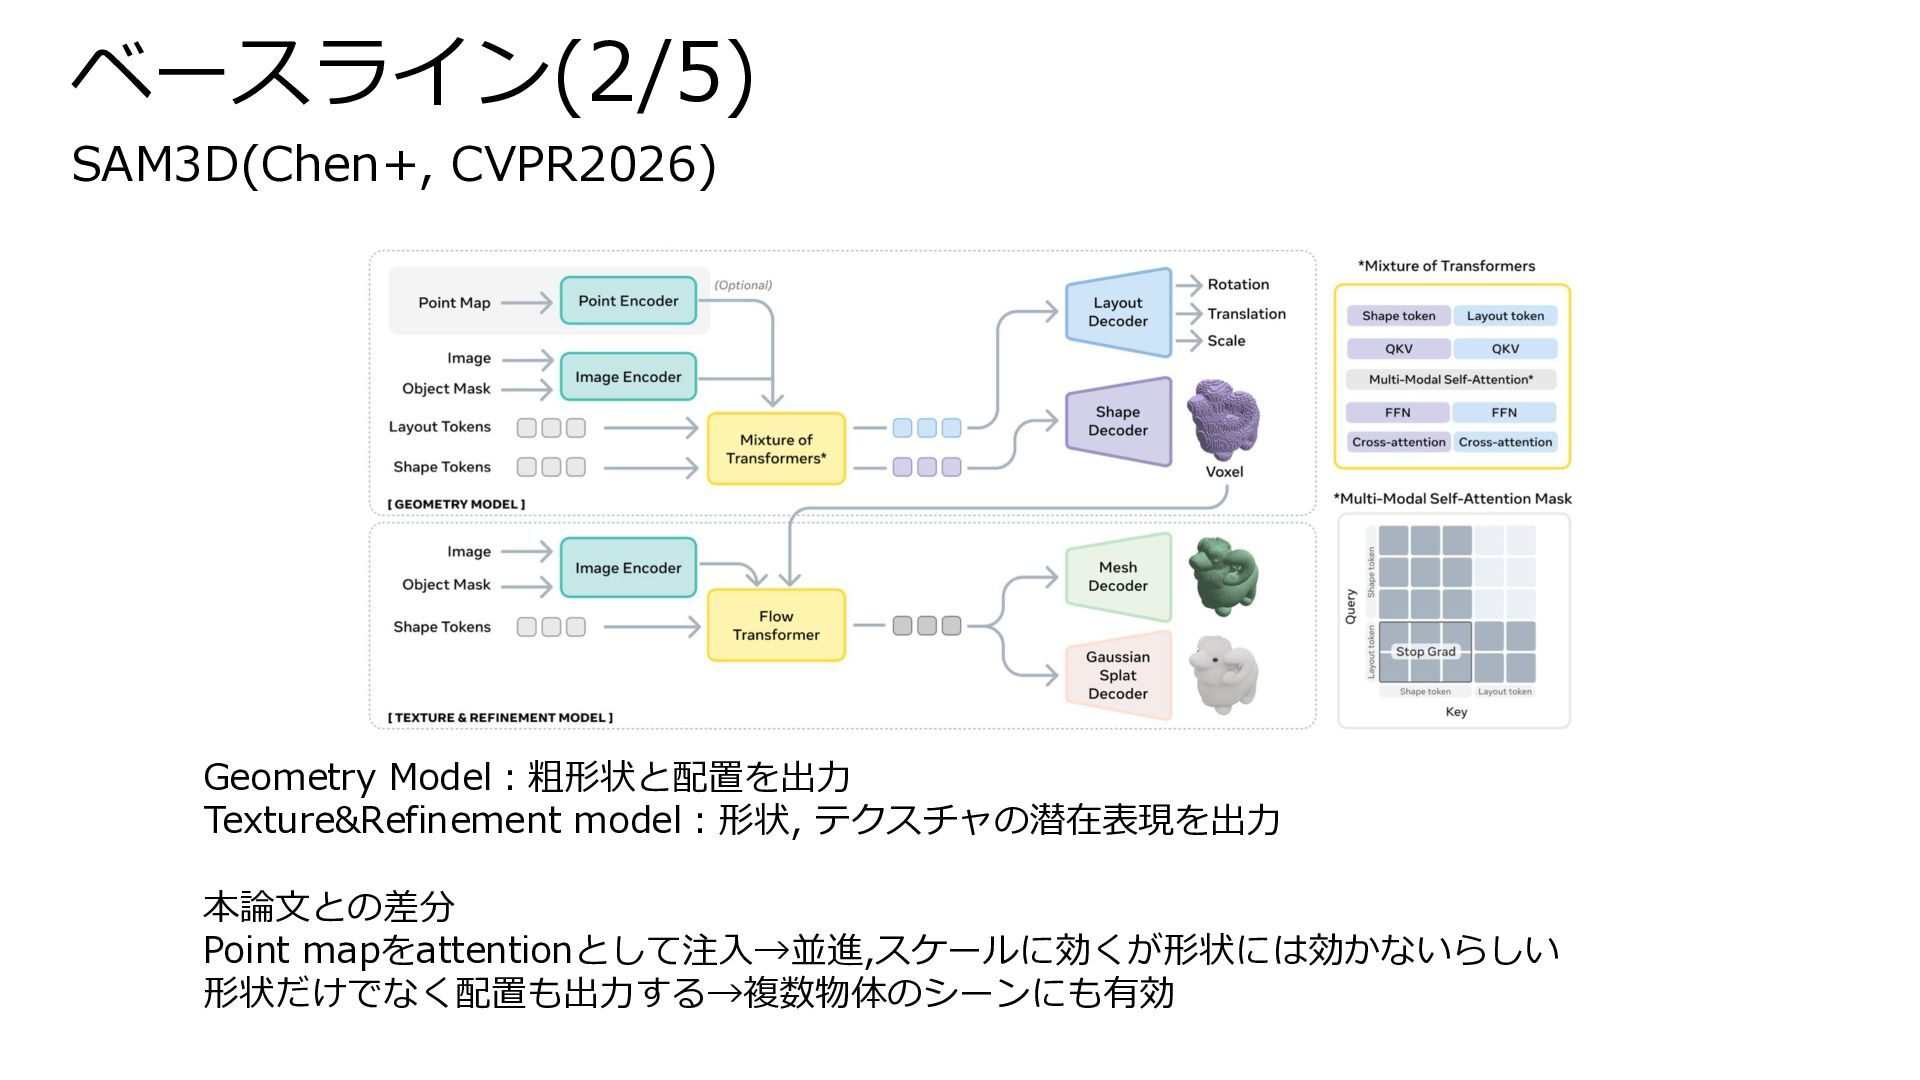
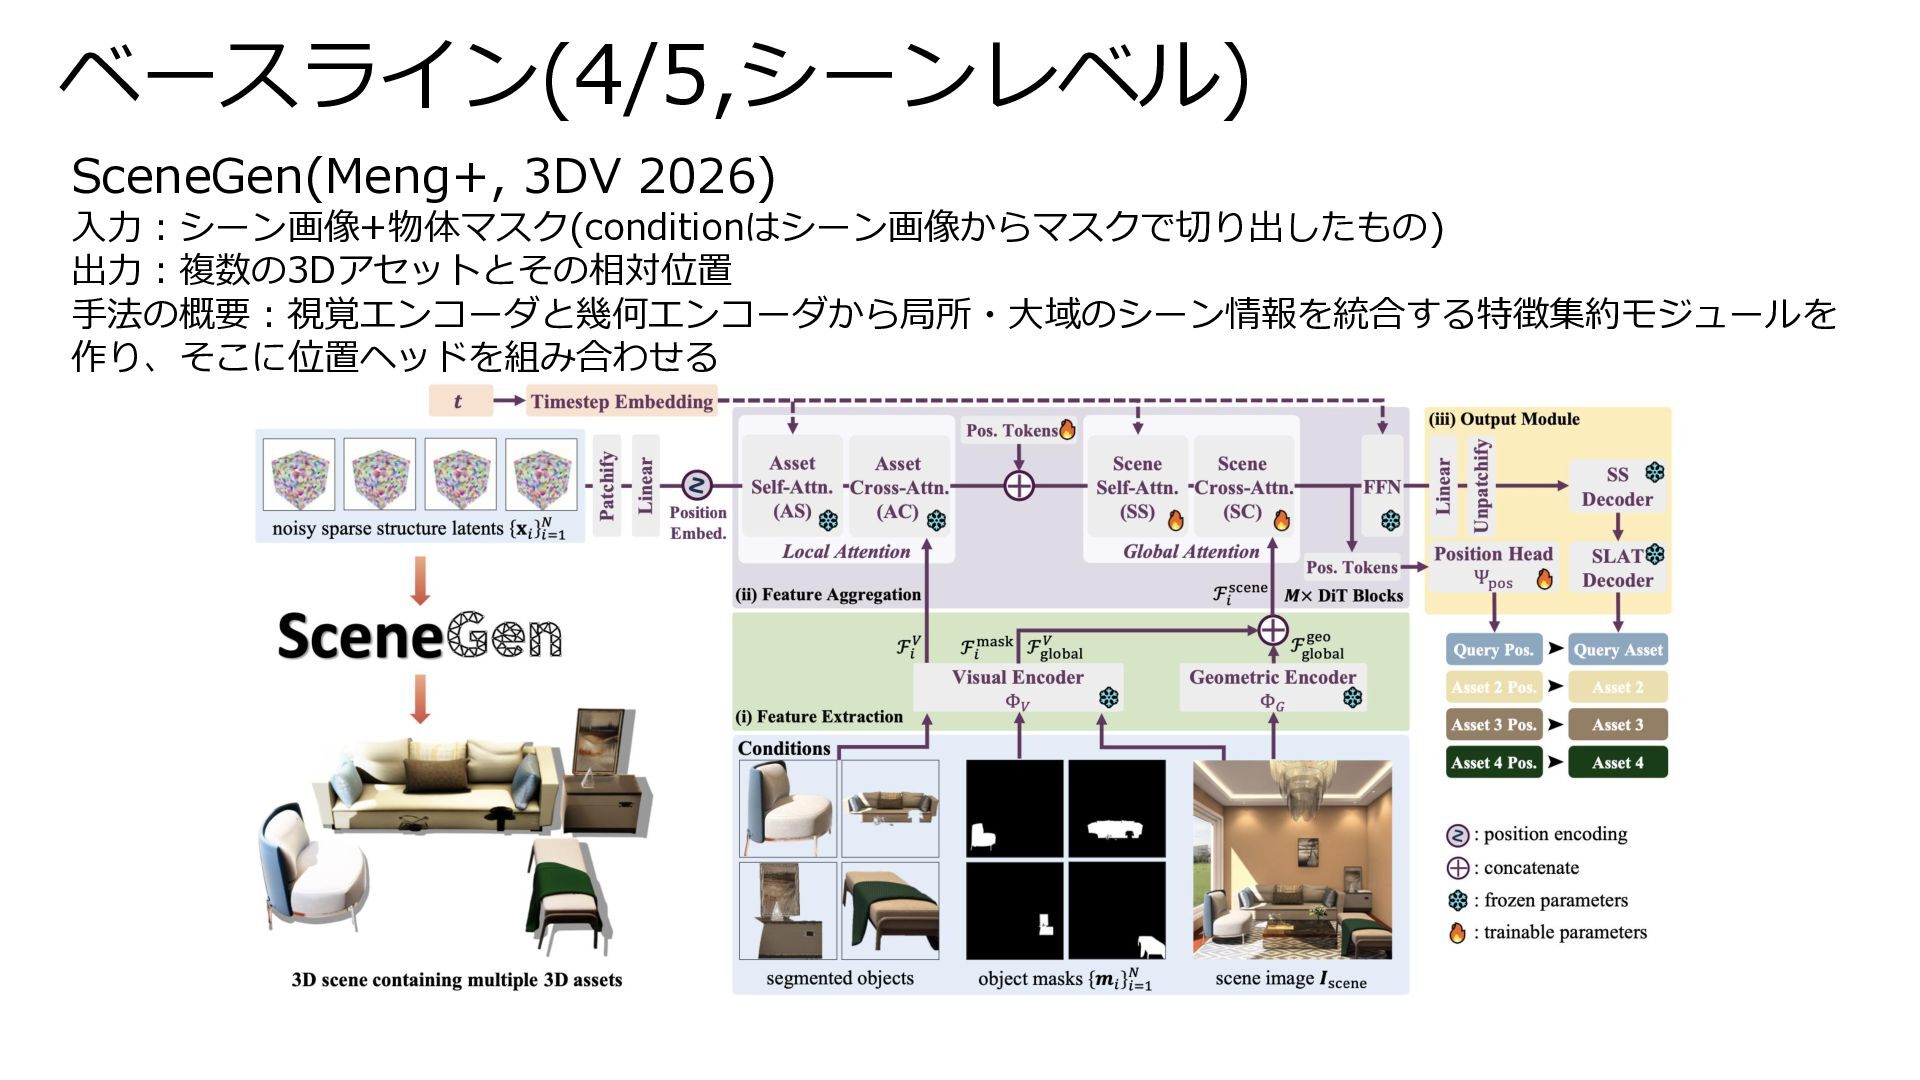
  7. ベースライン(2/5) SAM3D(Chen+, CVPR2026) Geometry Model:粗形状と配置を出力 Texture&Refinement model:形状, テクスチャの潜在表現を出力 本論文との差分 Point

    mapをattentionとして注入→並進,スケールに効くが形状には効かないらしい 形状だけでなく配置も出力する→複数物体のシーンにも有効
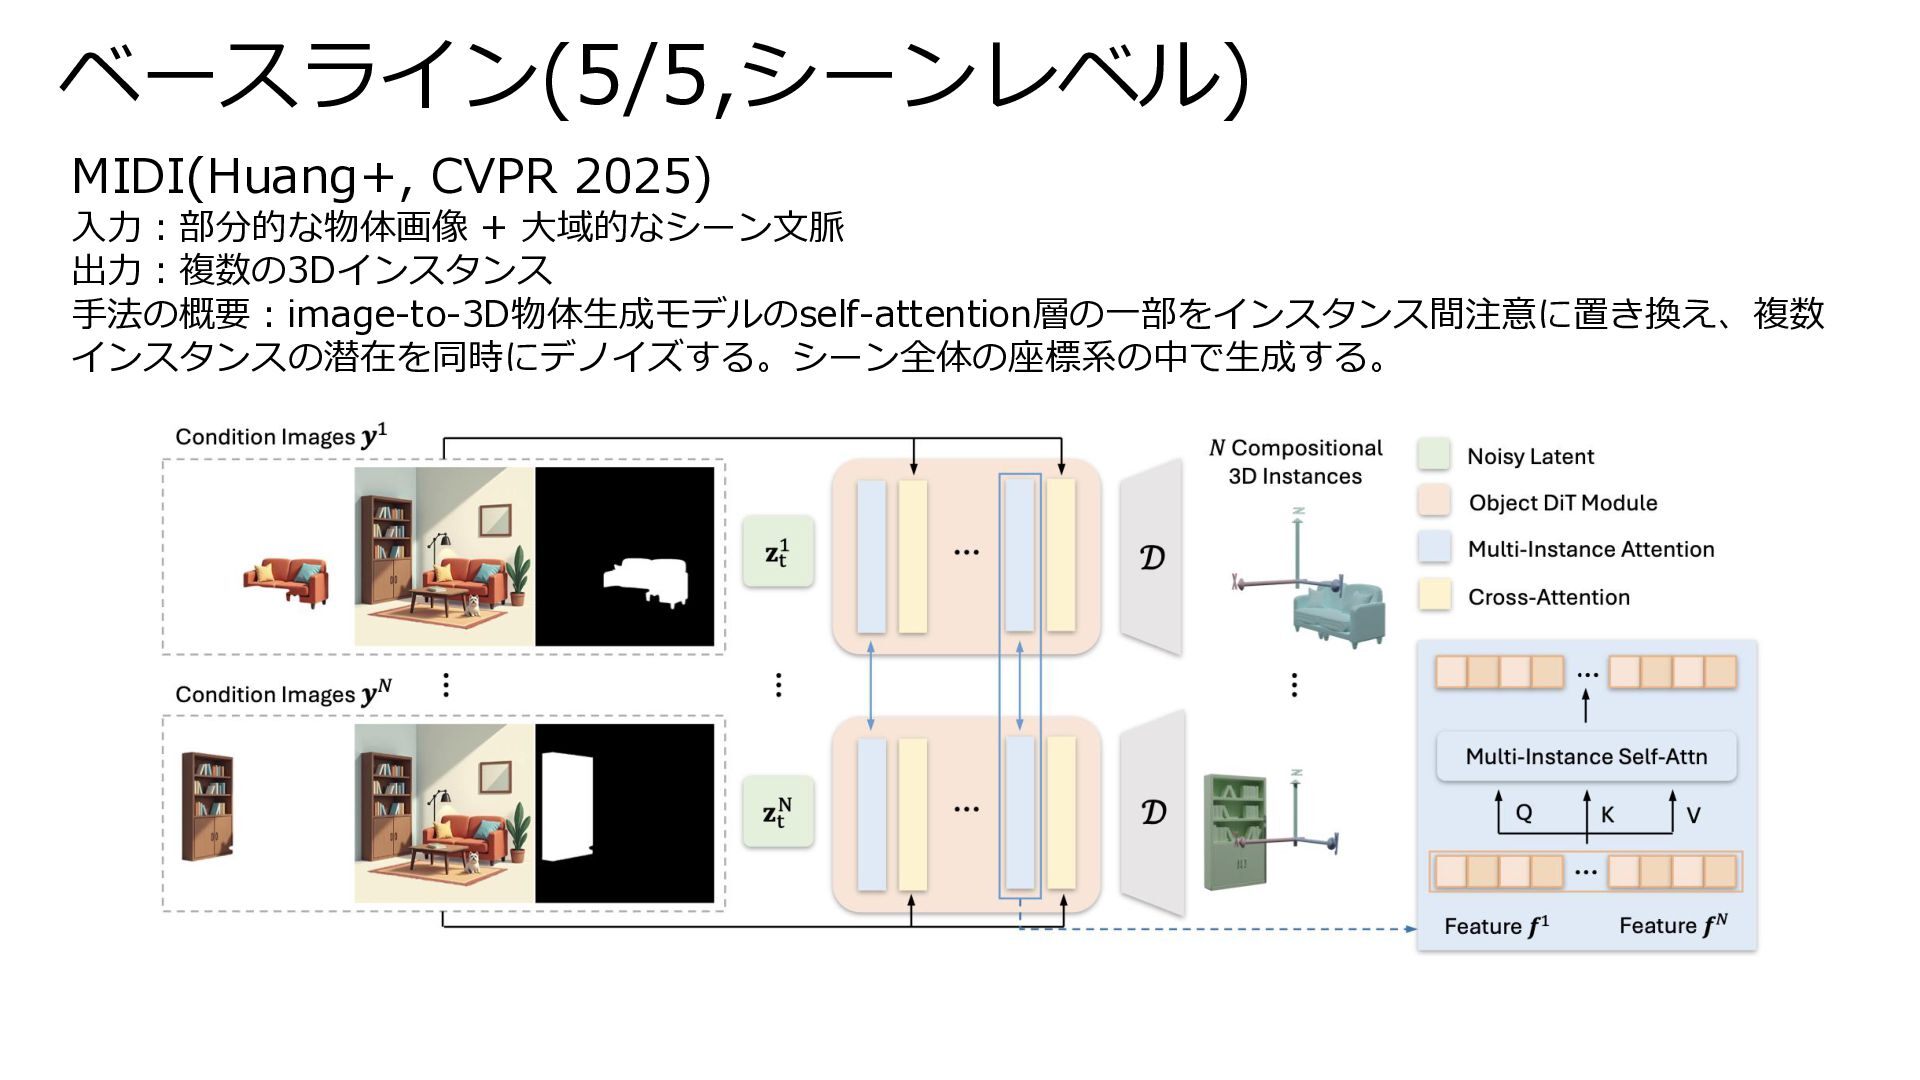
  8. ベースライン(3/5,物体レベル) LGM(ECCV 2024) テキストか単一画像を多視点拡散モデルに通して4枚のビューを作り、 それを非対称U-Netで処理して各視点ごとのガウス特徴を出し、融合して3D Gaussianにする。 GaussianAnything(ICLR 2025) 多視点の姿勢つきRGB-D-NormalをVAEに入れて点群構造の潜在空間を作り、 その上でカスケードした潜在フローマッチングを回す。

    点群構造なので3D形状の情報が保たれ、形状とテクスチャの分離と3D-aware編集が自然にできる。 Real3D(ICCV 2025) 単一視点のLarge Reconstruction Modelを、 合成3Dアセットではなく実世界の単一視点画像で学習できるようにした自己学習の枠組み。 →これら全て3D事前情報を使わない

More Decks by Spatial AI Network

Other Decks in Research