Upgrade to Pro — share decks privately, control downloads, hide ads and more …

DeWorldSG: Depth-Aware 3D Semantic Scene Graph ...

DeWorldSG: Depth-Aware 3D Semantic Scene Graph Generation via World-Model Priors

RGB-Dシーケンスから3Dセマンティックシーングラフを生成する手法DeWorldSGを提案した論文。DeWorldSGは、深度情報に基づく3Dガウス表現により物体の幾何構造を安定して推定するとともに、世界モデルV-JEPA 2を用いて複数フレームの情報を集約し、物体間関係を高精度化する。3DSSGおよびReplicaSSGで既存手法を上回る性能を示している。

Avatar for Spatial AI Network

Spatial AI Network

October 06, 2026

More Decks by Spatial AI Network

Other Decks in Research

Transcript

  1. DeWorldSG: Depth-Aware 3D Semantic Scene Graph Generation via World-Model Priors

    [ECCV 2026] 伊東 聖矢(NICT) Spatial AI Network 勉強会 2026.9.1
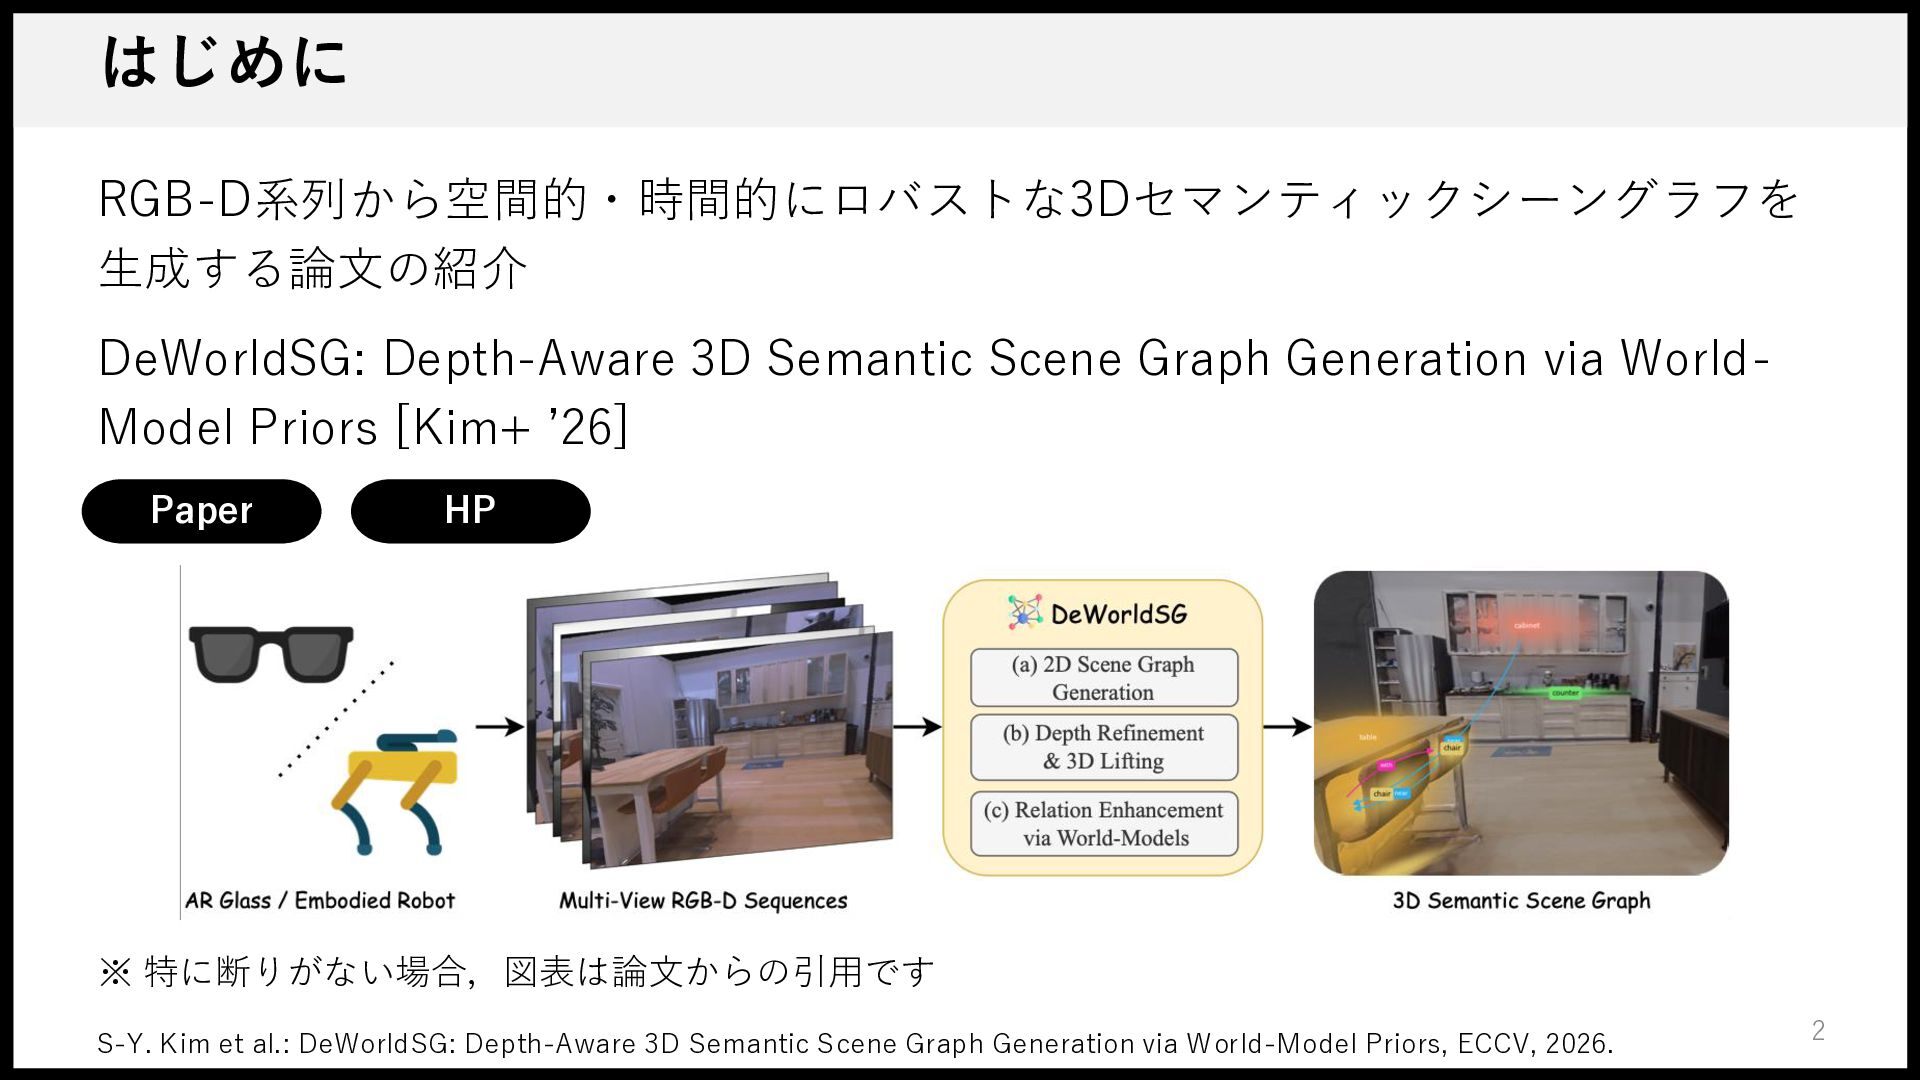
  2. はじめに RGB-D系列から空間的・時間的にロバストな3Dセマンティックシーングラフを 生成する論文の紹介 DeWorldSG: Depth-Aware 3D Semantic Scene Graph Generation

    via WorldModel Priors [Kim+ ’26] Paper Paper HP HP ※ 特に断りがない場合,図表は論文からの引用です S-Y. Kim et al.: DeWorldSG: Depth-Aware 3D Semantic Scene Graph Generation via World-Model Priors, ECCV, 2026. 2
  3. 背景 3D Semantic Scene Graph (3D SSG) • 3D環境を物体ノード+物体間関係エッジとしてコンパクトに表現 •

    幾何情報と意味情報を統合し、ロボット・ARにおける行動計画・3Dコンテンツ生成・ 仮想物体配置などに活用 近年のアプローチ RGB(-D)系列 → 2D Scene Graph → 逐次3D化・統合 → Global 3D SSG 課題 1. 深度の不安定性:物体境界付近のノイズ・異なる物体の誤統合と同一物体の分断 2. 単一フレームでの関係推論:オクルージョン・低解像度で関係を見落とす 共通:フレーム単位の独立推論そのものが問題 3
  4. 予備知識:3D Semantic Scene Graph (SSG) 物体をノード、物体間の関係をエッジとする有向グラフ 𝐺 = (𝑉, 𝐸)

    ノード 𝑣𝑖 ∈ 𝑉:3D幾何パラメータと意味カテゴリラベルで定義 → 位置・スケール・空間的不確実性 エッジ 𝑒𝑖→𝑗 ∈ 𝐸:事前に定義された関係集合 𝑅 から選択 → attached to, under, ... DeWorldSG は RGB-D 系列から 3D SSG を構築 4
  5. 予備知識:3Dガウス分布による物体表現 3D SSGにおける物体表現:3D BBox・点群・メッシュ・確率分布… 3𝐷 3𝐷 DeWorldSG は 3Dガウス分布 𝒩(𝜇𝑖,𝑡

    , Σ𝑖,𝑡 ) を採用 • 確率的な表現により、物体の位置と広がりを低次元のパラメータで表現可能 • 平均と共分散を逐次更新することにより、複数視点から得られた観測を簡潔に統合可能 DeWorldSG は深度からインスタンス単位の3Dガウス分布を直接推定 5
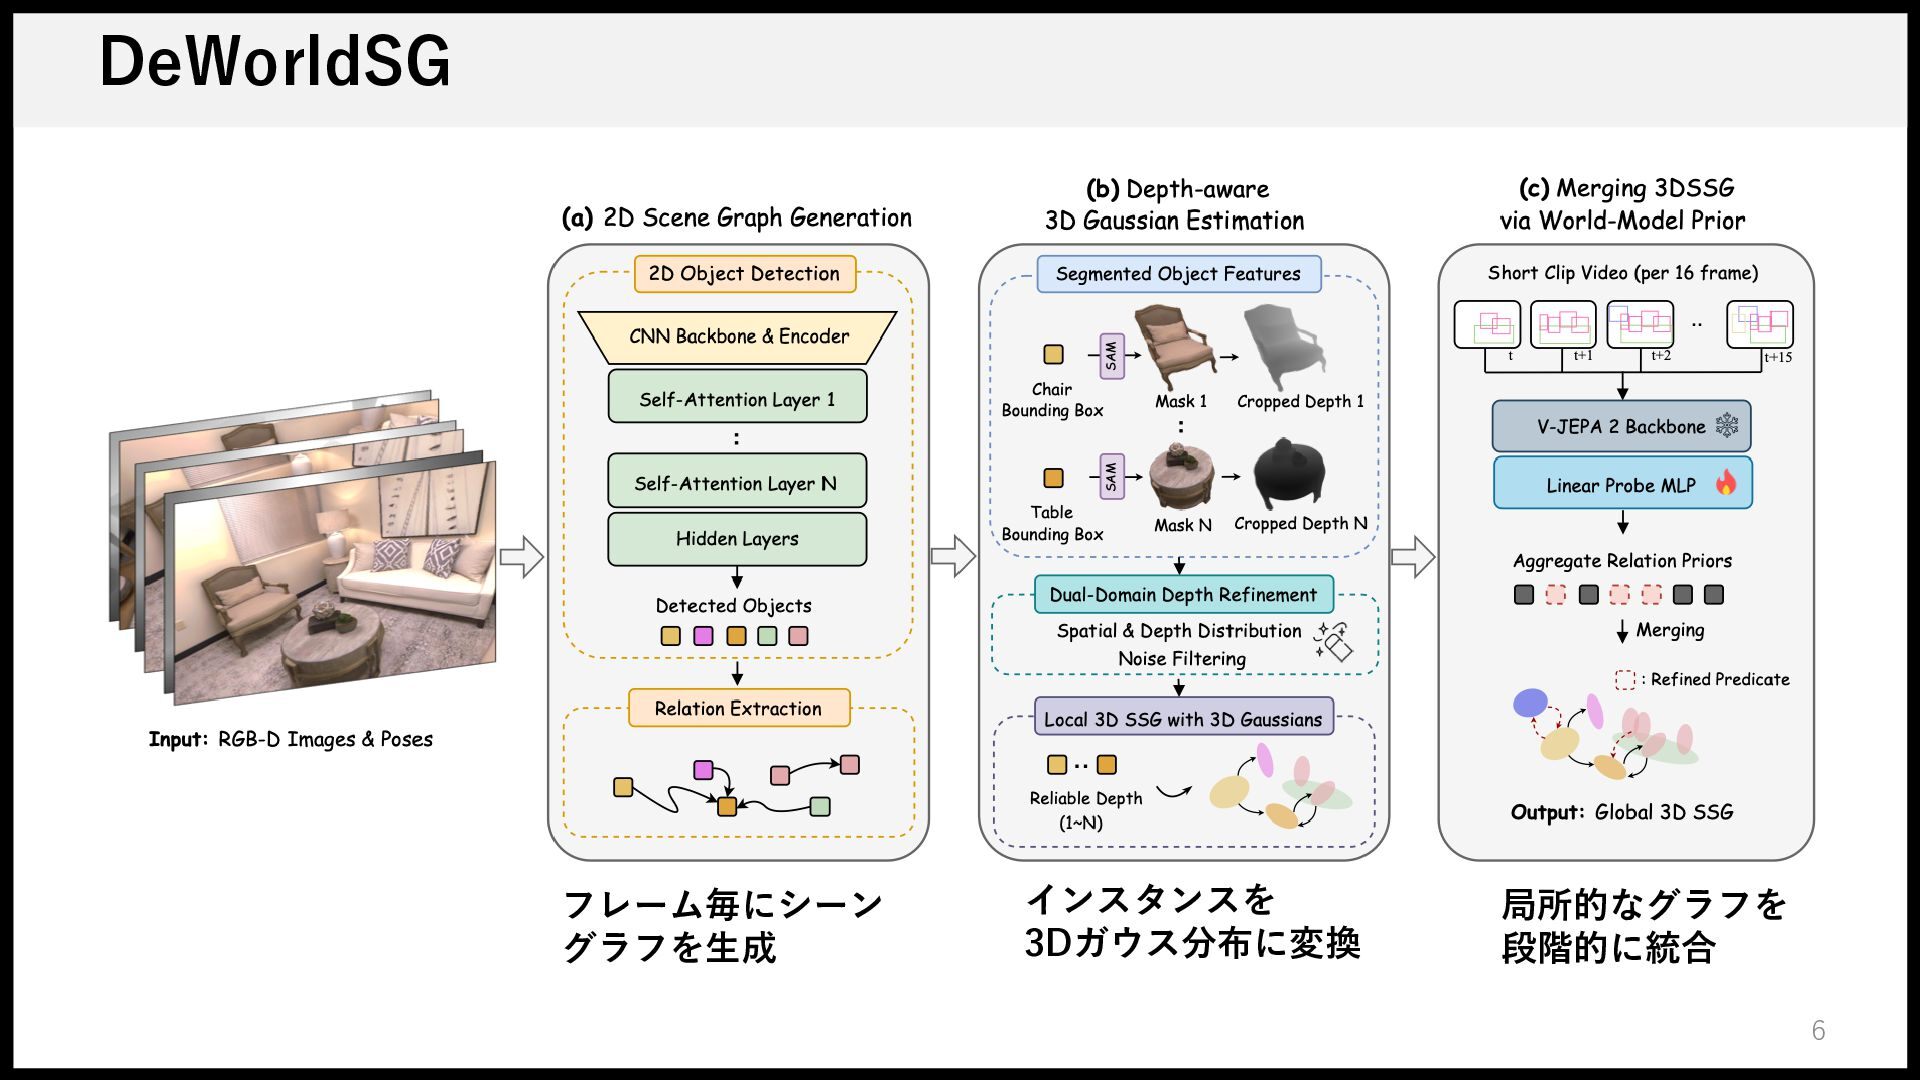
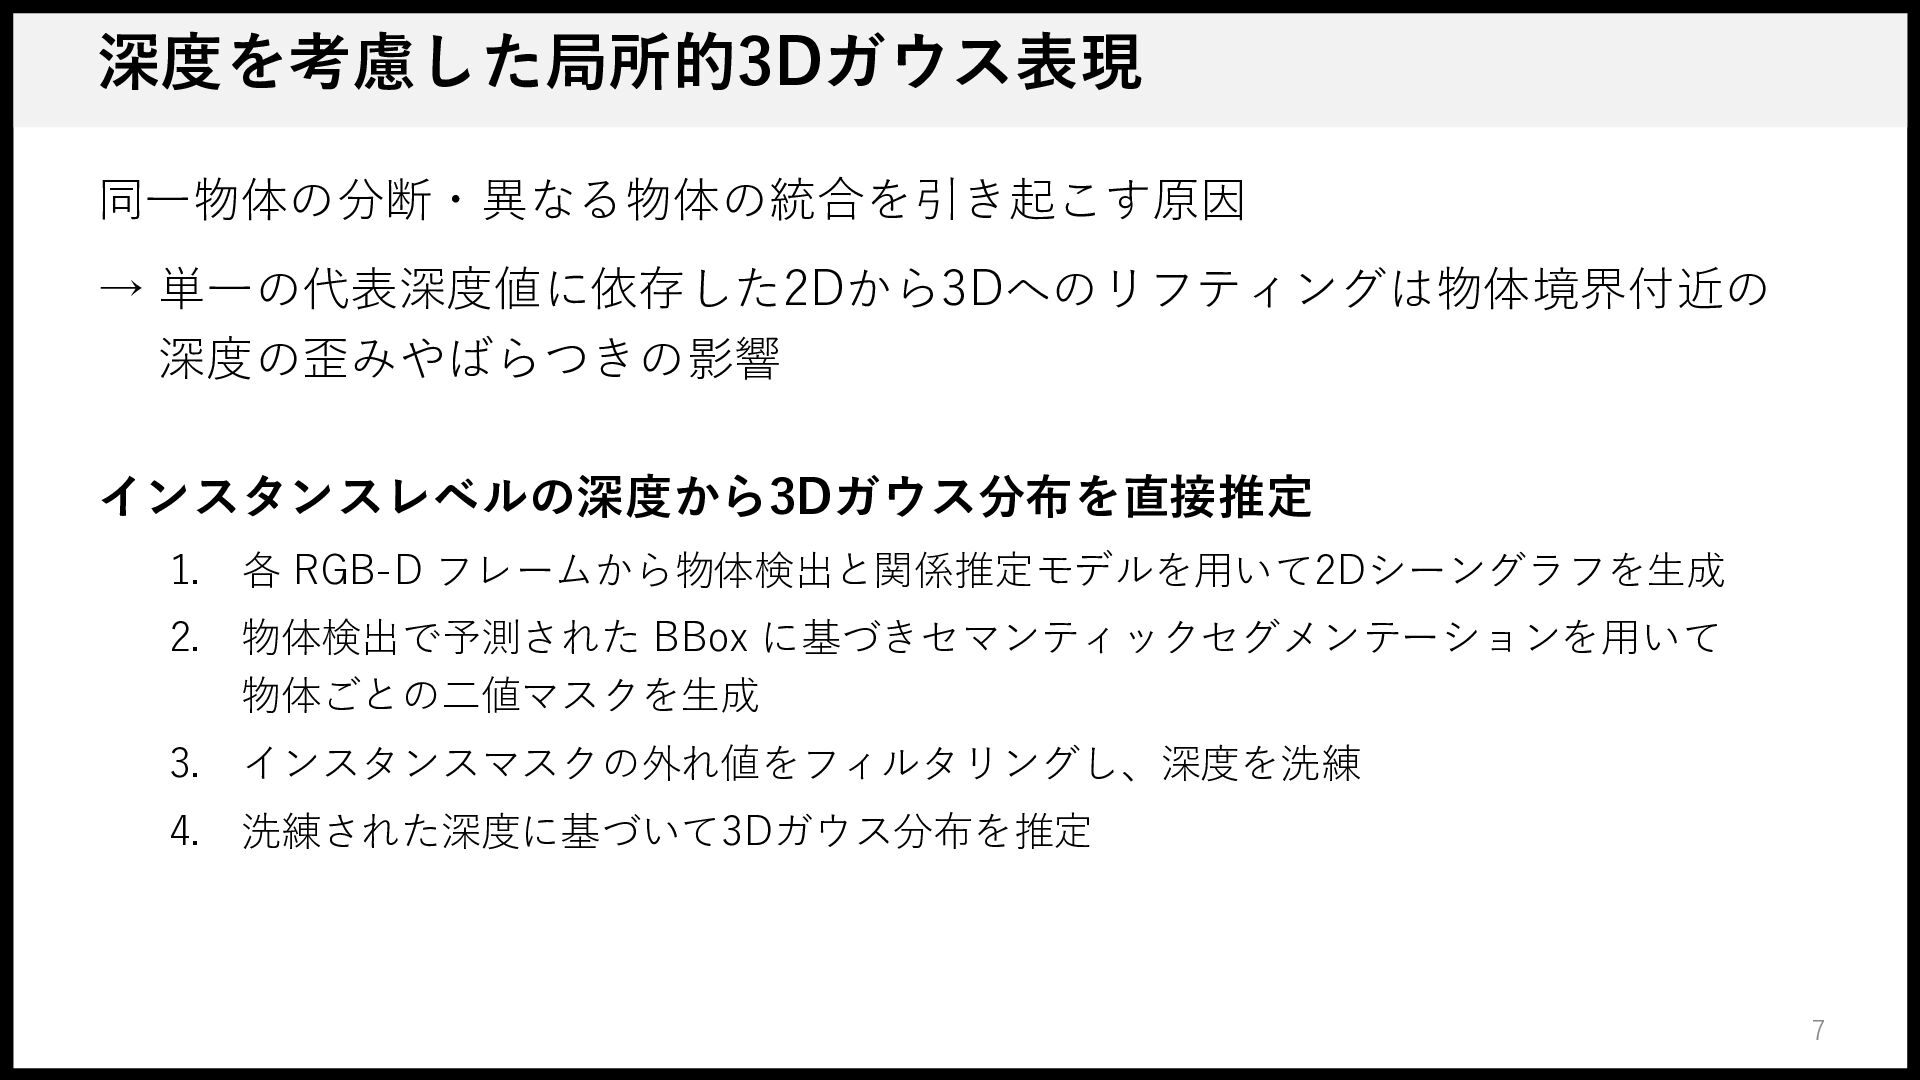
  6. 深度を考慮した局所的3Dガウス表現 同一物体の分断・異なる物体の統合を引き起こす原因 → 単一の代表深度値に依存した2Dから3Dへのリフティングは物体境界付近の 深度の歪みやばらつきの影響 インスタンスレベルの深度から3Dガウス分布を直接推定 1. 各 RGB-D フレームから物体検出と関係推定モデルを用いて2Dシーングラフを生成

    2. 物体検出で予測された BBox に基づきセマンティックセグメンテーションを用いて 物体ごとの二値マスクを生成 3. インスタンスマスクの外れ値をフィルタリングし、深度を洗練 4. 洗練された深度に基づいて3Dガウス分布を推定 7
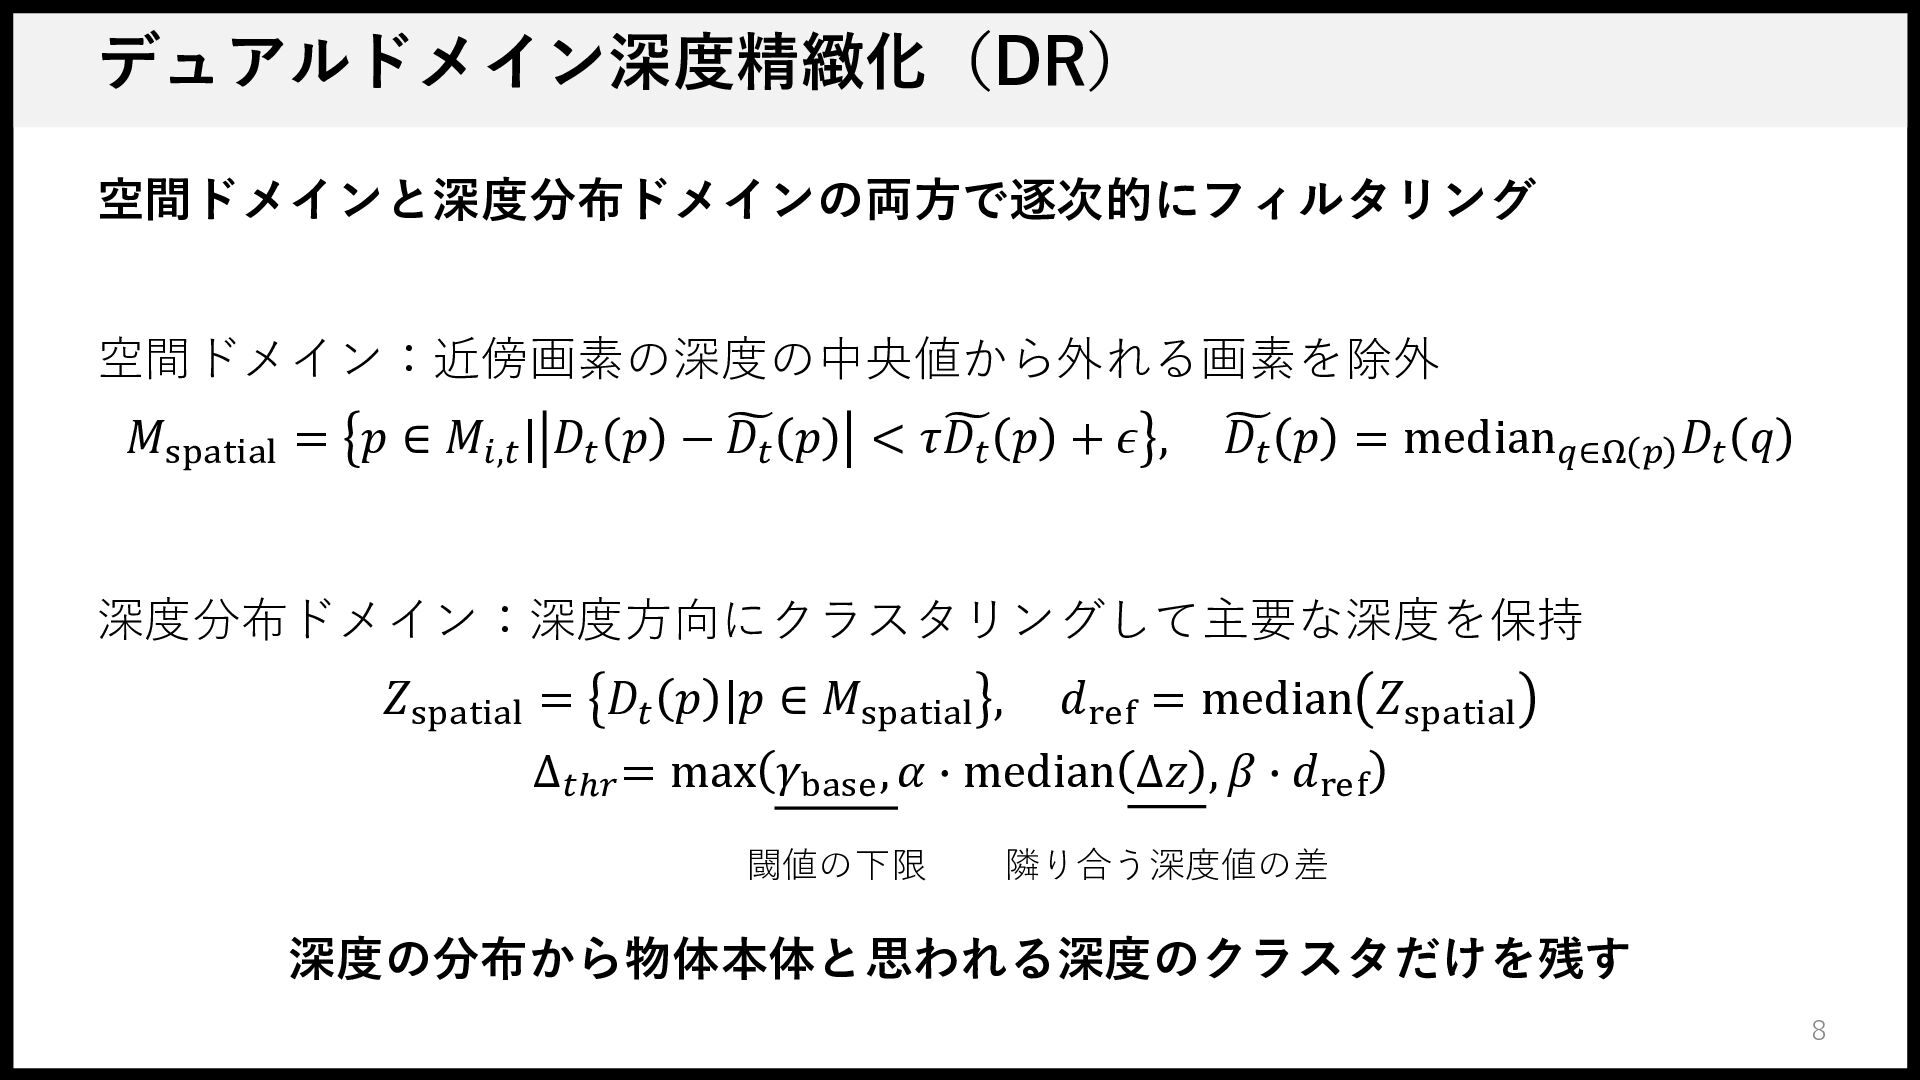
  7. デュアルドメイン深度精緻化(DR) 空間ドメインと深度分布ドメインの両方で逐次的にフィルタリング 空間ドメイン:近傍画素の深度の中央値から外れる画素を除外 ෪𝑡 𝑝 < 𝜏𝐷 ෪𝑡 𝑝 +

    𝜖 , 𝐷 ෪𝑡 𝑝 = median𝑞∈Ω 𝑝 𝐷𝑡 𝑞 𝑀spatial = 𝑝 ∈ 𝑀𝑖,𝑡 | 𝐷𝑡 𝑝 − 𝐷 深度分布ドメイン:深度方向にクラスタリングして主要な深度を保持 𝑍spatial = 𝐷𝑡 𝑝 |𝑝 ∈ 𝑀spatial , 𝑑ref = median 𝑍spatial ∆𝑡ℎ𝑟 = max 𝛾base , 𝛼 ∙ median ∆𝑧 , 𝛽 ∙ 𝑑ref 閾値の下限 隣り合う深度値の差 深度の分布から物体本体と思われる深度のクラスタだけを残す 8
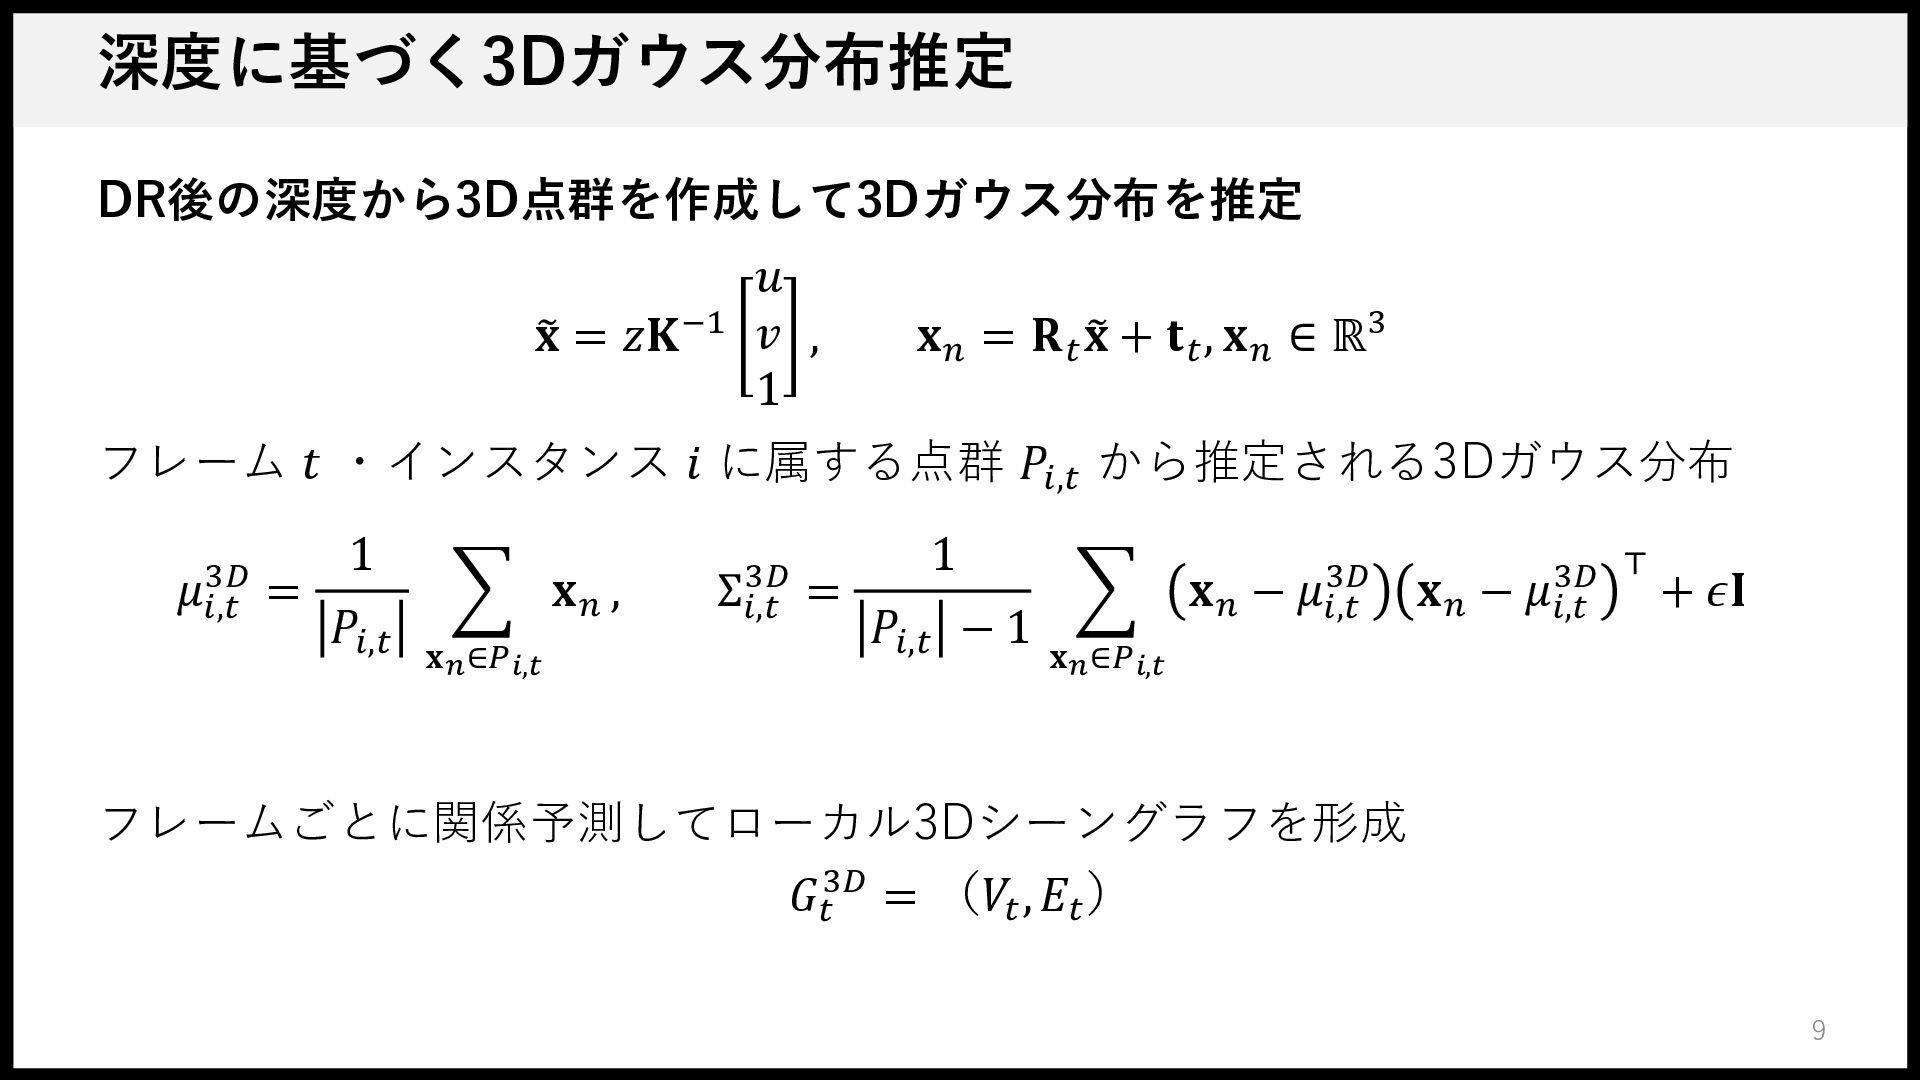
  8. 深度に基づく3Dガウス分布推定 DR後の深度から3D点群を作成して3Dガウス分布を推定 𝑢 𝐱෤ = 𝑧𝐊 −1 𝑣 , 1

    𝐱 𝑛 = 𝐑 𝑡 𝐱෤ + 𝐭 𝑡 , 𝐱 𝑛 ∈ ℝ3 フレーム 𝑡 ・インスタンス 𝑖 に属する点群 𝑃𝑖,𝑡 から推定される3Dガウス分布 3​𝐷 𝜇𝑖,𝑡 = 1 𝑃𝑖,𝑡 ෍ 𝐱𝑛 , 𝐱 𝑛 ∈𝑃𝑖,𝑡 3​𝐷 Σ𝑖,𝑡 = 1 𝑃𝑖,𝑡 − 1 ෍ 3​𝐷 𝐱 𝑛 − 𝜇𝑖,𝑡 3​𝐷 ⊤ 𝐱 𝑛 − 𝜇𝑖,𝑡 + 𝜖𝐈 𝐱 𝑛 ∈𝑃𝑖,𝑡 フレームごとに関係予測してローカル3Dシーングラフを形成 𝐺𝑡3​𝐷 = (𝑉𝑡 , 𝐸𝑡 ) 9
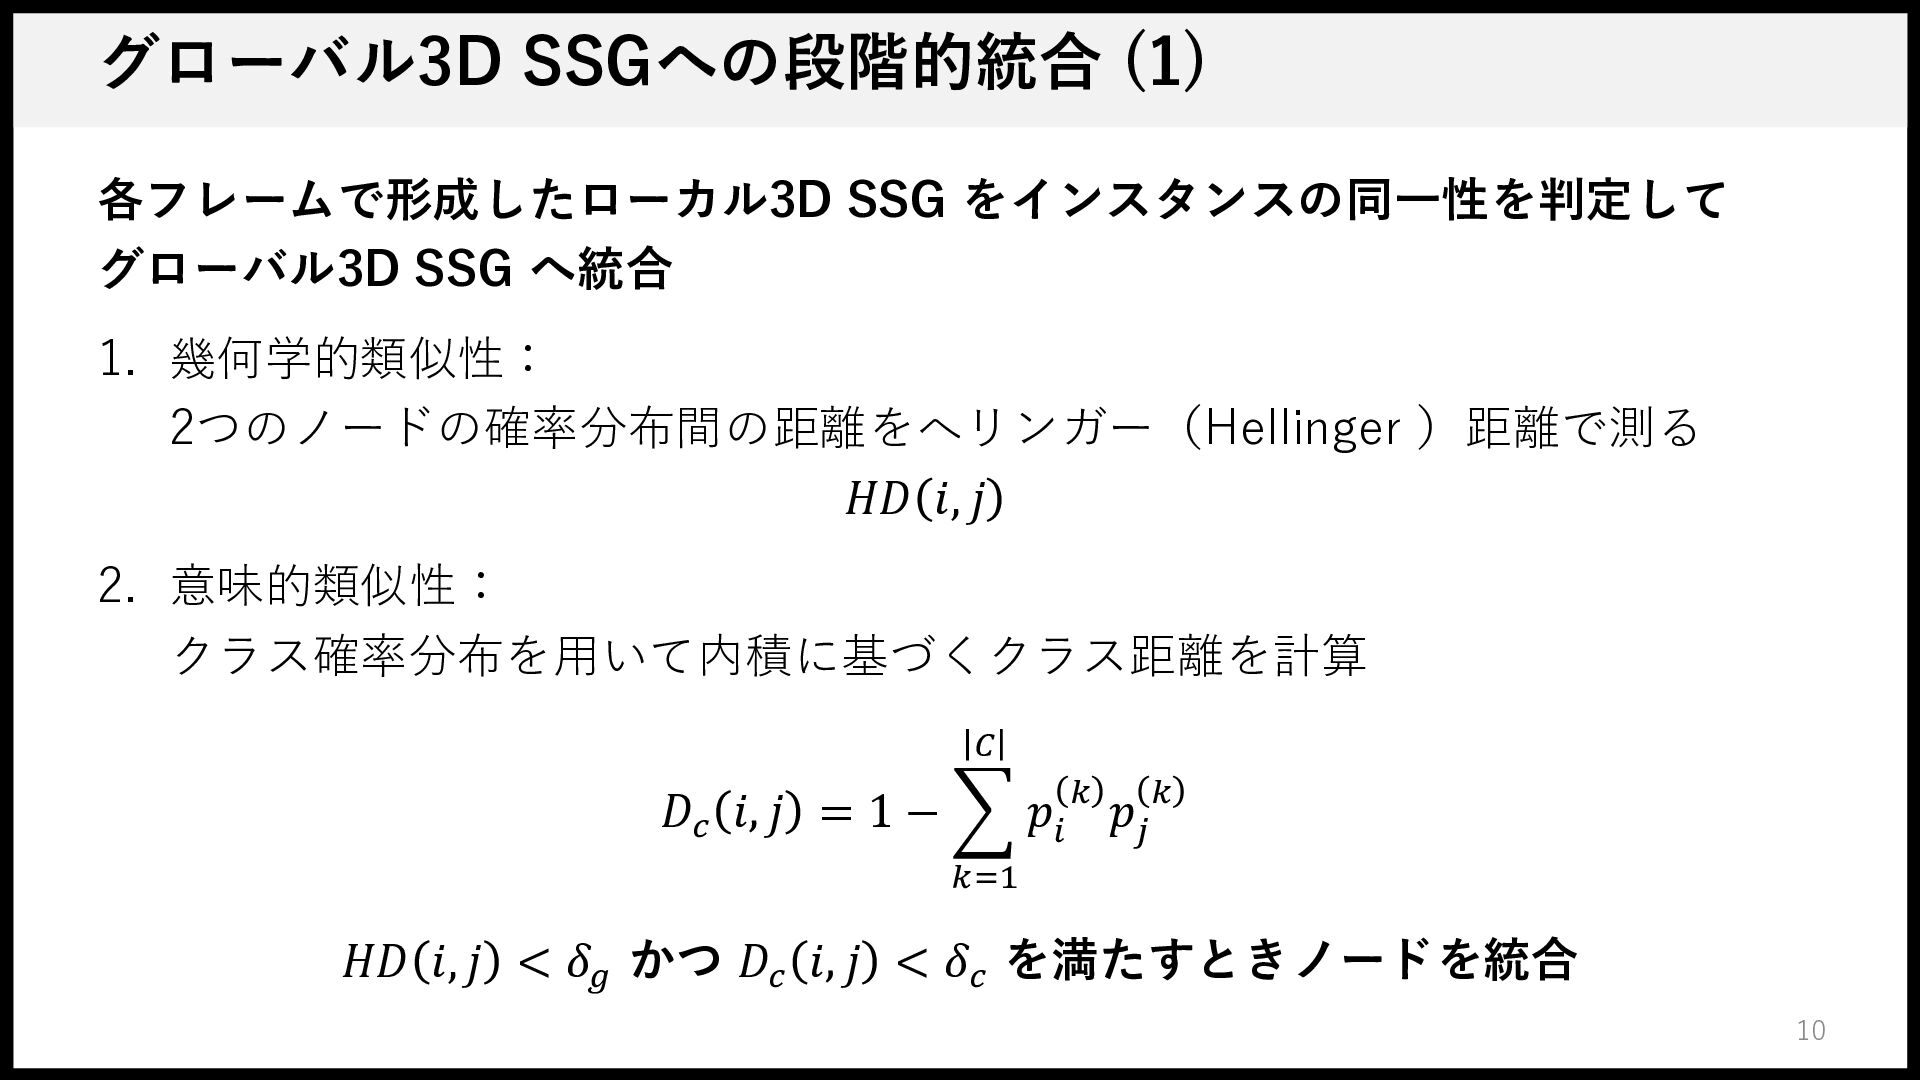
  9. グローバル3D SSGへの段階的統合 (1) 各フレームで形成したローカル3D SSG をインスタンスの同一性を判定して グローバル3D SSG へ統合 1.

    幾何学的類似性: 2つのノードの確率分布間の距離をへリンガー(Hellinger )距離で測る 𝐻𝐷 𝑖, 𝑗 2. 意味的類似性: クラス確率分布を用いて内積に基づくクラス距離を計算 𝐶 𝑘 𝐷𝑐 𝑖 𝑗 = 1 − ෍ 𝑝𝑖 𝑝𝑗 𝑘 𝑘=1 𝐻𝐷 𝑖, 𝑗 < 𝛿𝑔 かつ 𝐷𝑐 𝑖 𝑗 < 𝛿𝑐 を満たすときノードを統合 10
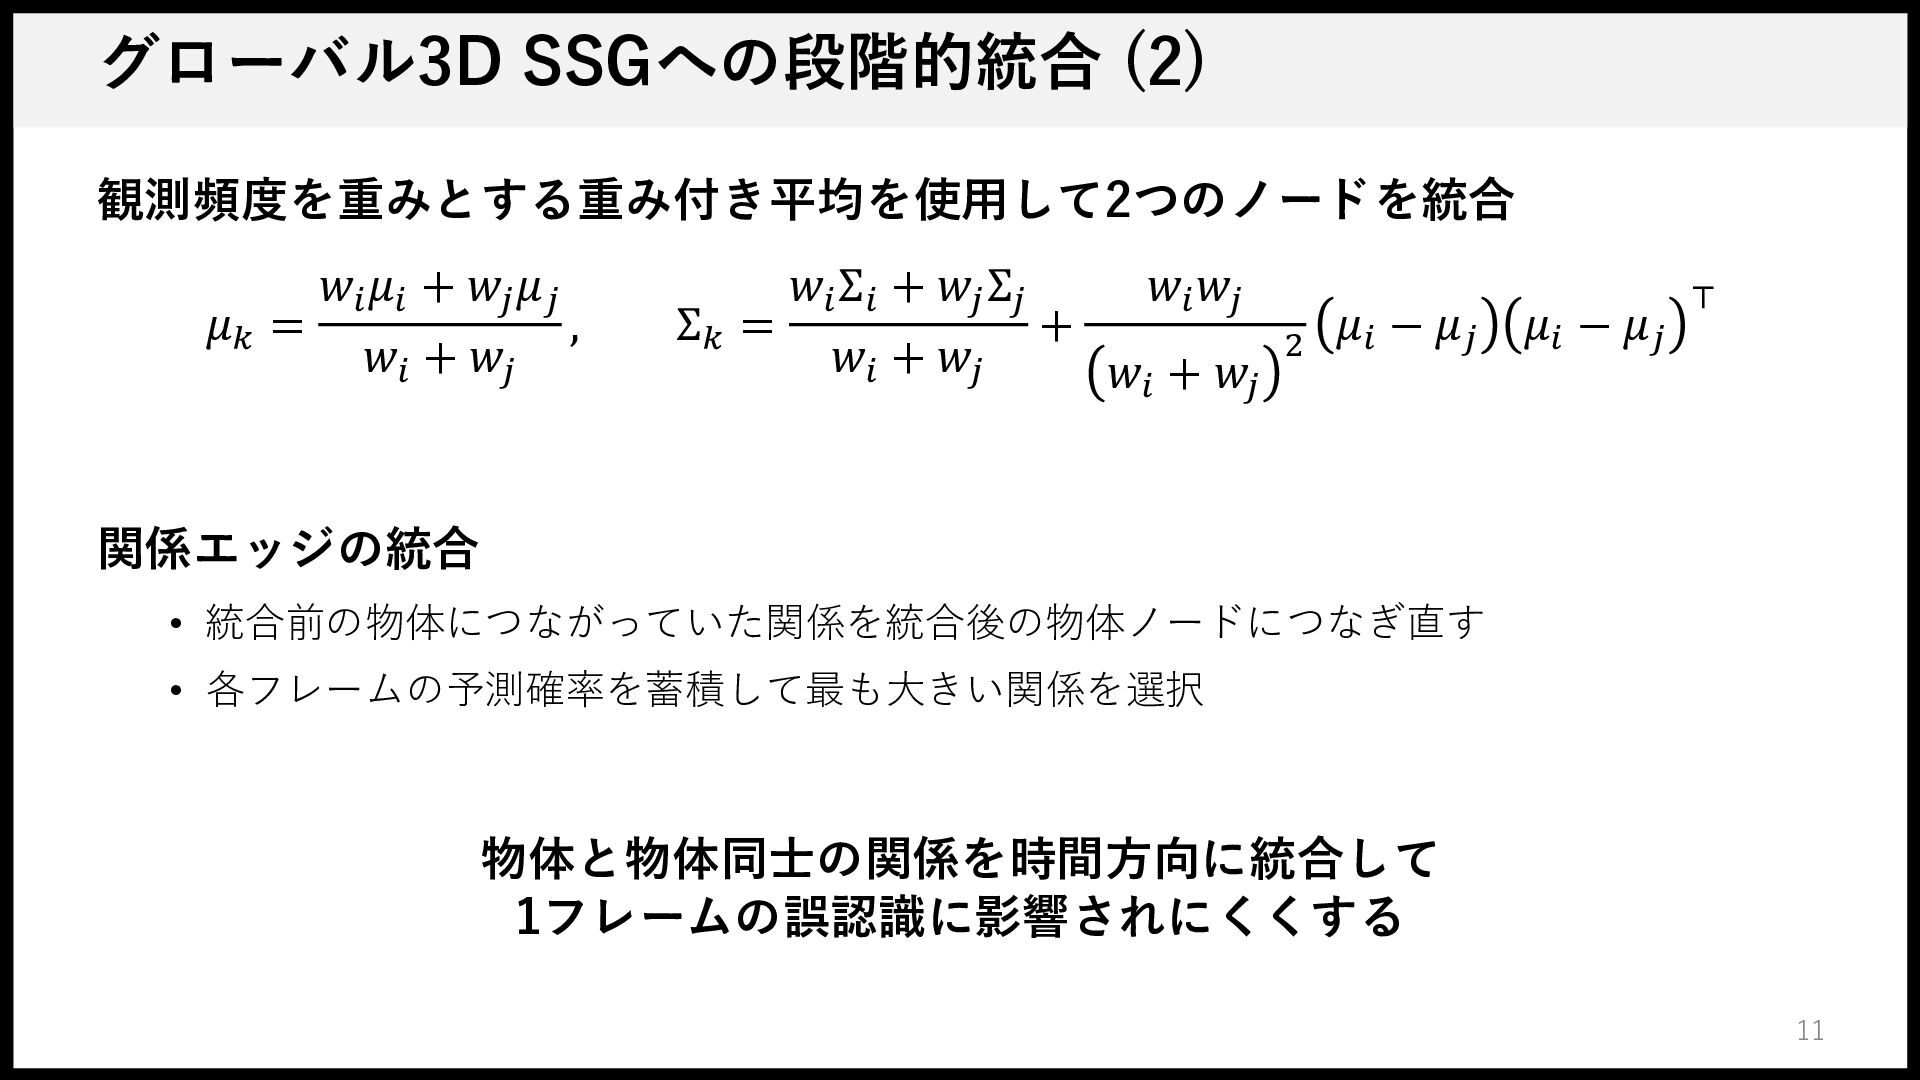
  10. グローバル3D SSGへの段階的統合 (2) 観測頻度を重みとする重み付き平均を使用して2つのノードを統合 𝑤𝑖 𝜇𝑖 + 𝑤𝑗 𝜇𝑗 𝜇𝑘

    = , 𝑤𝑖 + 𝑤𝑗 𝑤𝑖 Σ𝑖 + 𝑤𝑗 Σ𝑗 𝑤𝑖 𝑤𝑗 Σ𝑘 = + 𝑤𝑖 + 𝑤𝑗 𝑤 +𝑤 𝑖 2 𝜇𝑖 − 𝜇𝑗 𝜇𝑖 − 𝜇𝑗 ⊤ 𝑗 関係エッジの統合 • 統合前の物体につながっていた関係を統合後の物体ノードにつなぎ直す • 各フレームの予測確率を蓄積して最も大きい関係を選択 物体と物体同士の関係を時間方向に統合して 1フレームの誤認識に影響されにくくする 11
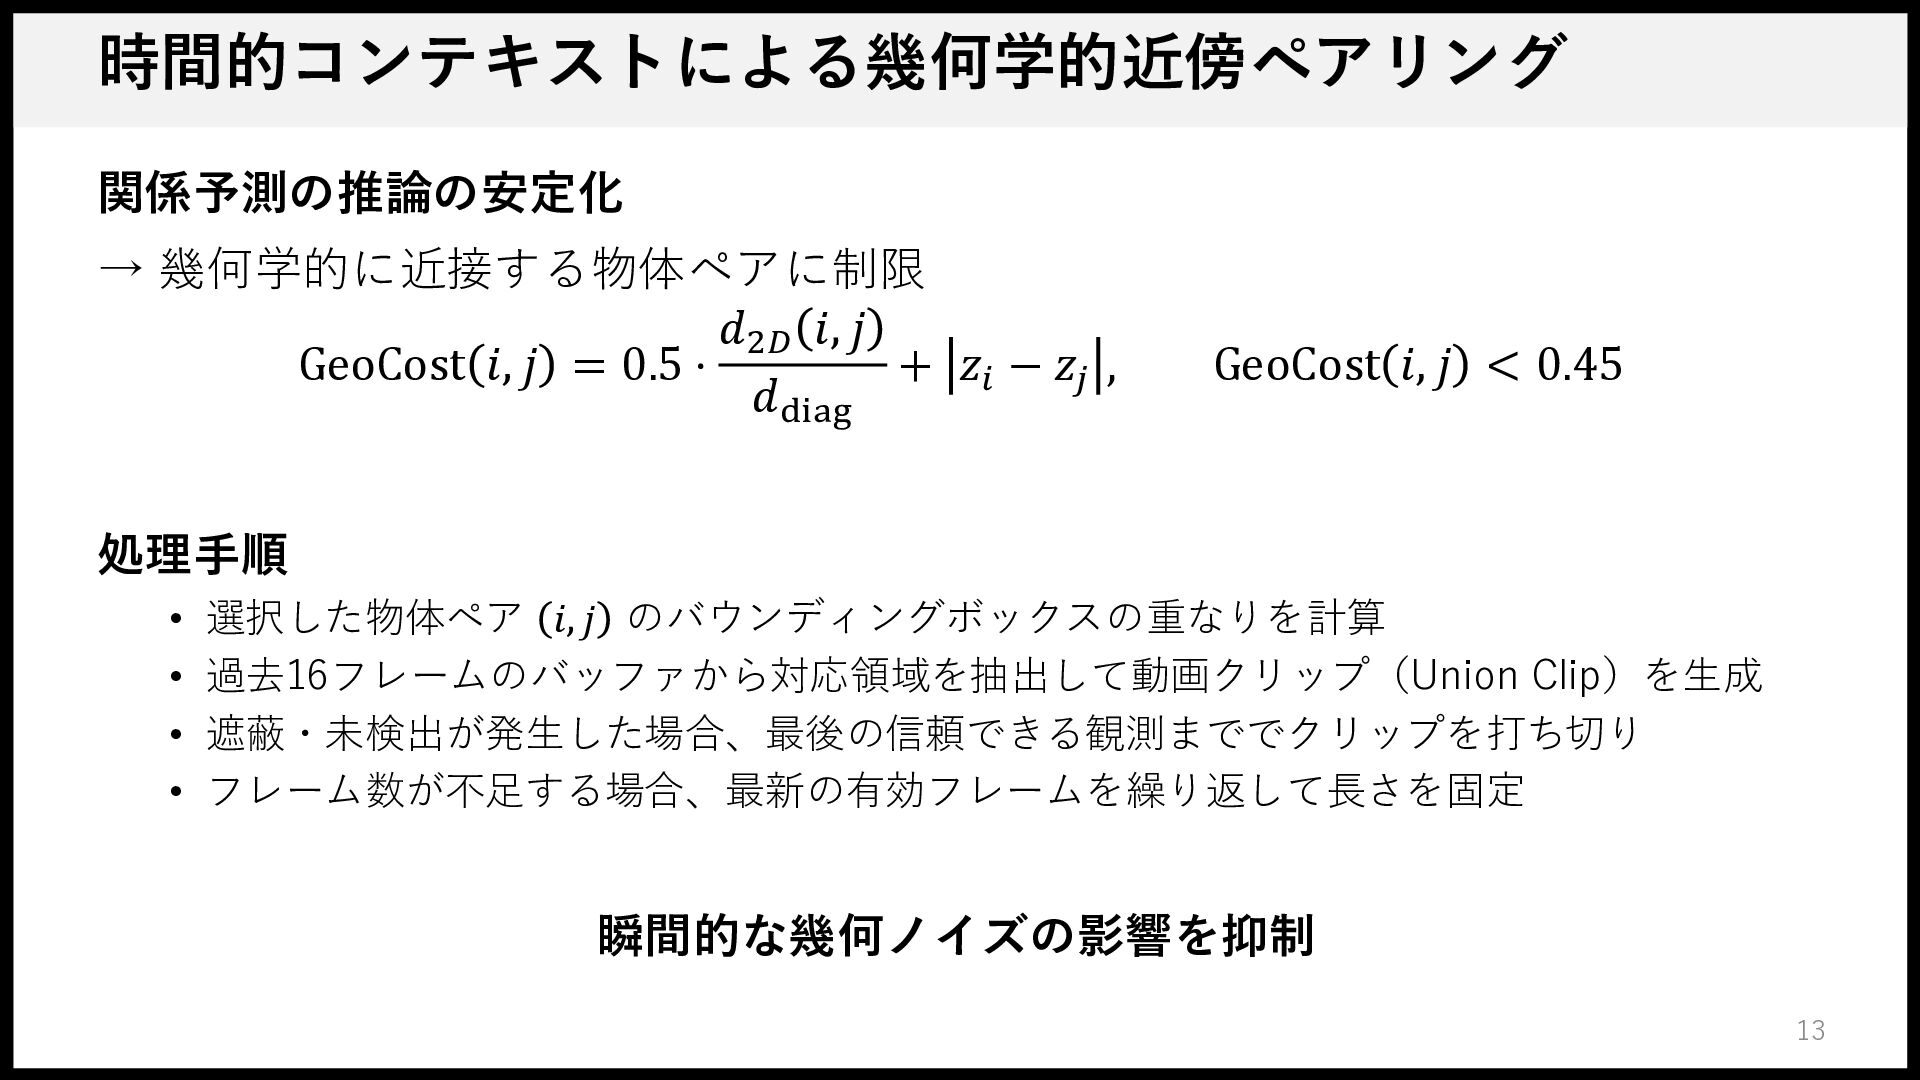
  11. 時間的コンテキストによる幾何学的近傍ペアリング 関係予測の推論の安定化 → 幾何学的に近接する物体ペアに制限 𝑑2​𝐷 𝑖 𝑗 GeoCost 𝑖 𝑗

    = 0.5 ⋅ + 𝑧𝑖 − 𝑧𝑗 , 𝑑diag GeoCost 𝑖 𝑗 < 0.45 処理手順 • 選択した物体ペア 𝑖 𝑗 のバウンディングボックスの重なりを計算 • 過去16フレームのバッファから対応領域を抽出して動画クリップ(Union Clip)を生成 • 遮蔽・未検出が発生した場合、最後の信頼できる観測まででクリップを打ち切り • フレーム数が不足する場合、最新の有効フレームを繰り返して長さを固定 瞬間的な幾何ノイズの影響を抑制 13
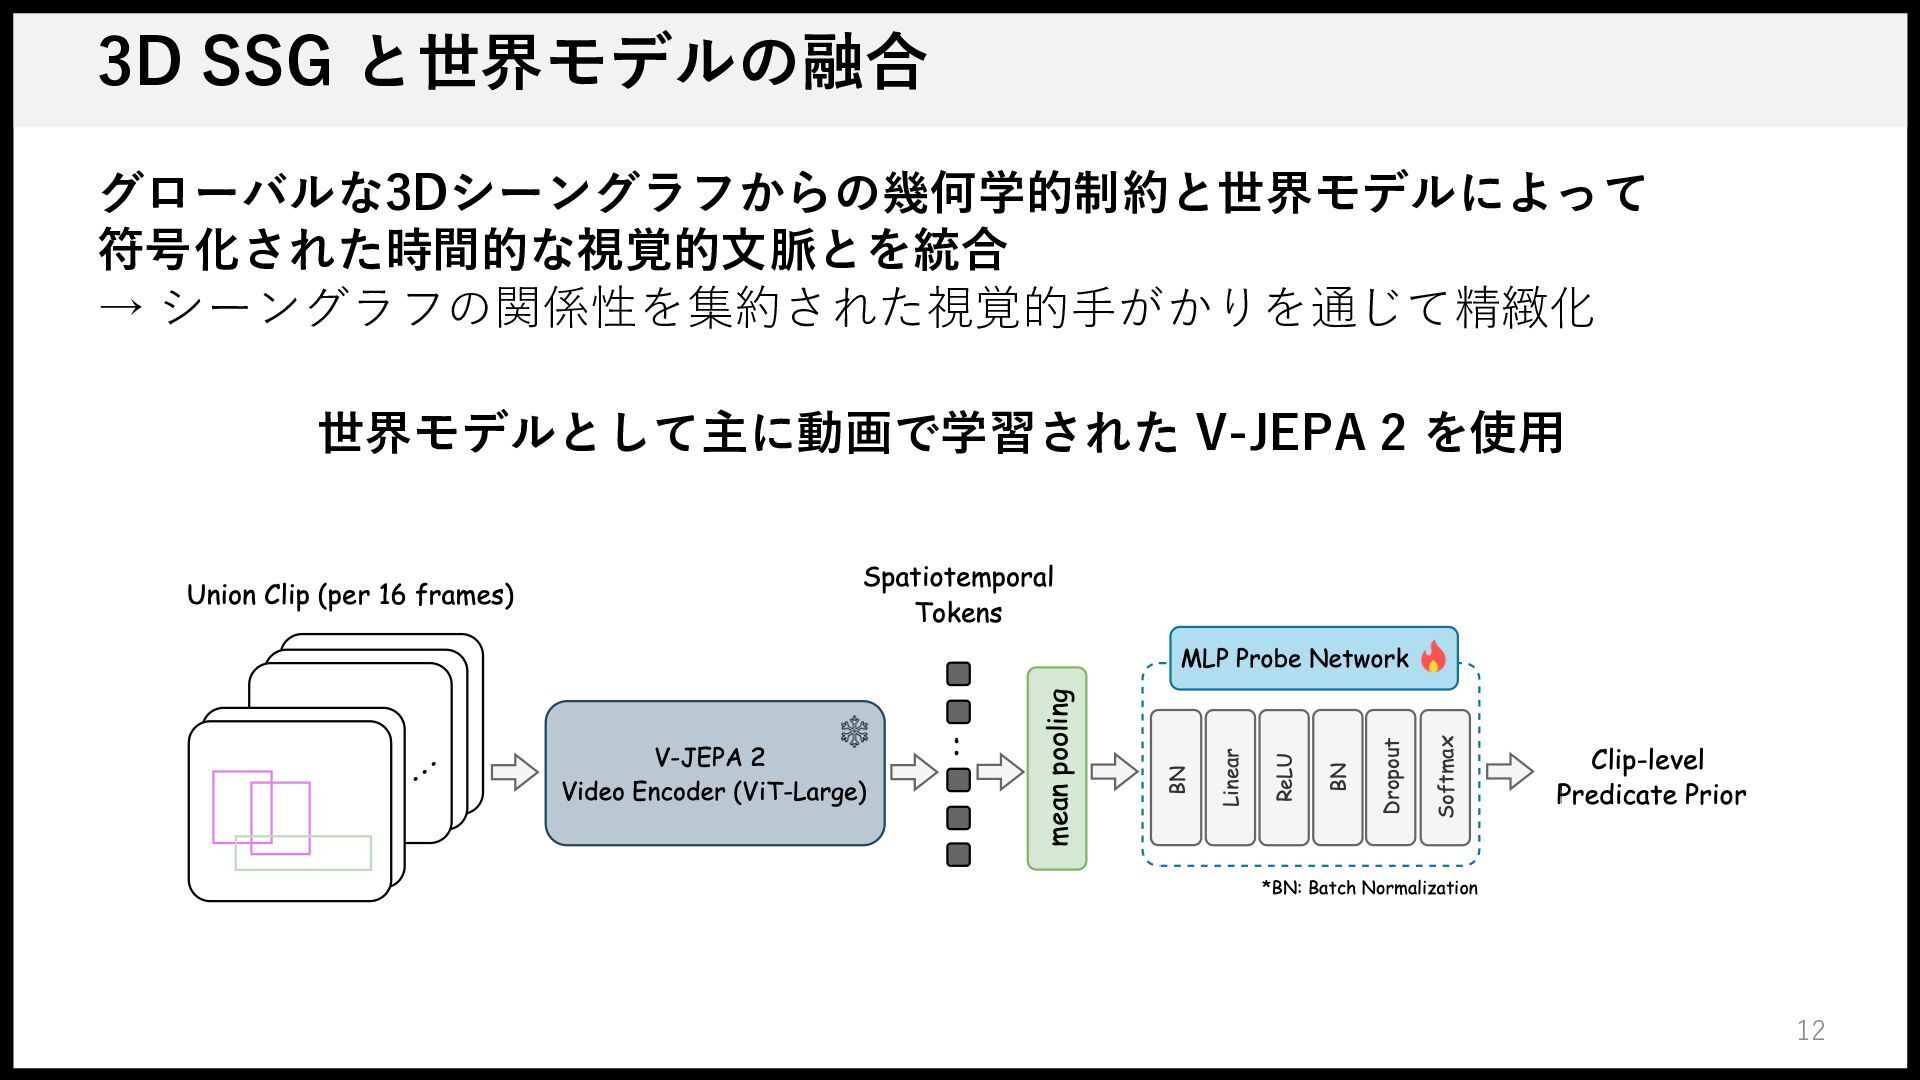
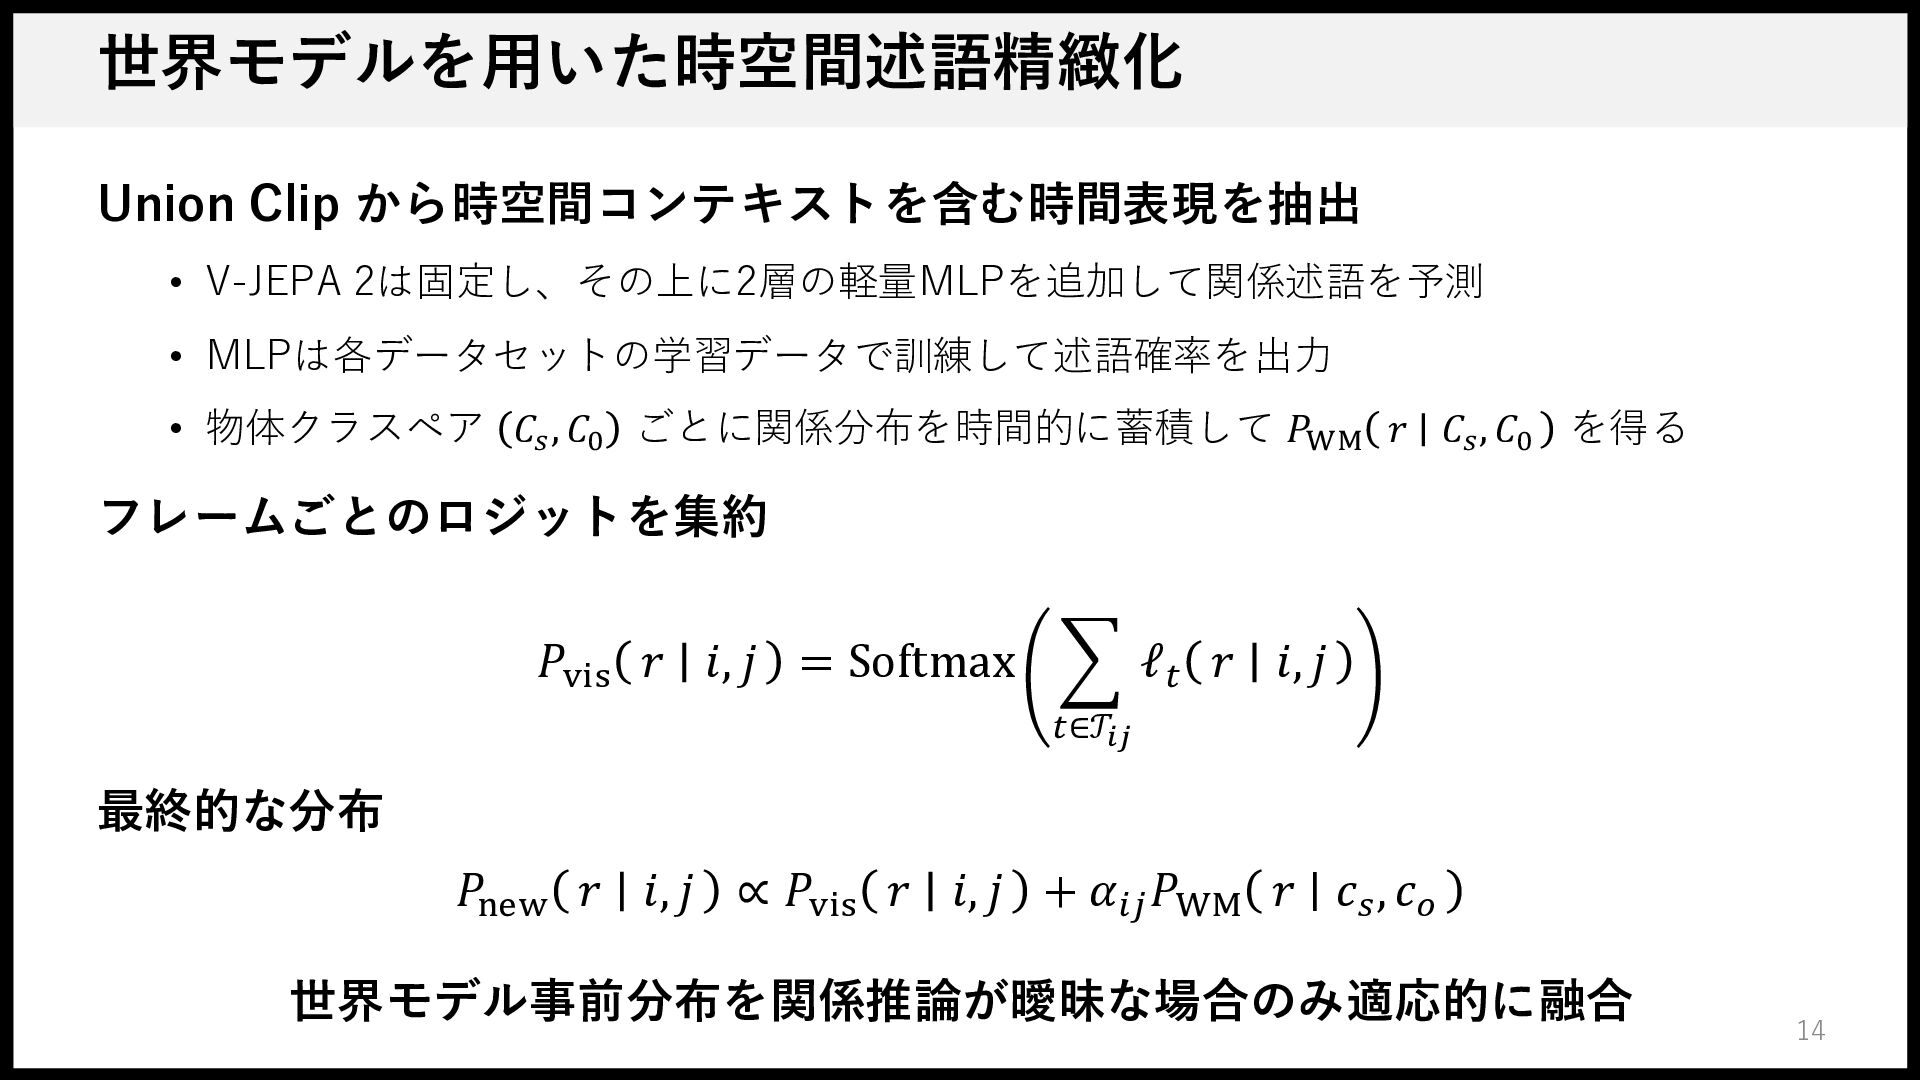
  12. 世界モデルを用いた時空間述語精緻化 Union Clip から時空間コンテキストを含む時間表現を抽出 • V-JEPA 2は固定し、その上に2層の軽量MLPを追加して関係述語を予測 • MLPは各データセットの学習データで訓練して述語確率を出力 •

    物体クラスペア 𝐶𝑠 , 𝐶0 ごとに関係分布を時間的に蓄積して 𝑃WM 𝑟 𝐶𝑠 , 𝐶0 を得る フレームごとのロジットを集約 𝑃vis 𝑟 𝑖, 𝑗 = Softmax ෍ ℓ𝑡 𝑟 𝑖, 𝑗 𝑡∈𝒯𝑖𝑗 最終的な分布 𝑃new 𝑟 𝑖, 𝑗 ∝ 𝑃vis 𝑟 𝑖, 𝑗 + 𝛼𝑖𝑗 𝑃WM 𝑟 𝑐𝑠 , 𝑐𝑜 世界モデル事前分布を関係推論が曖昧な場合のみ適応的に融合 14
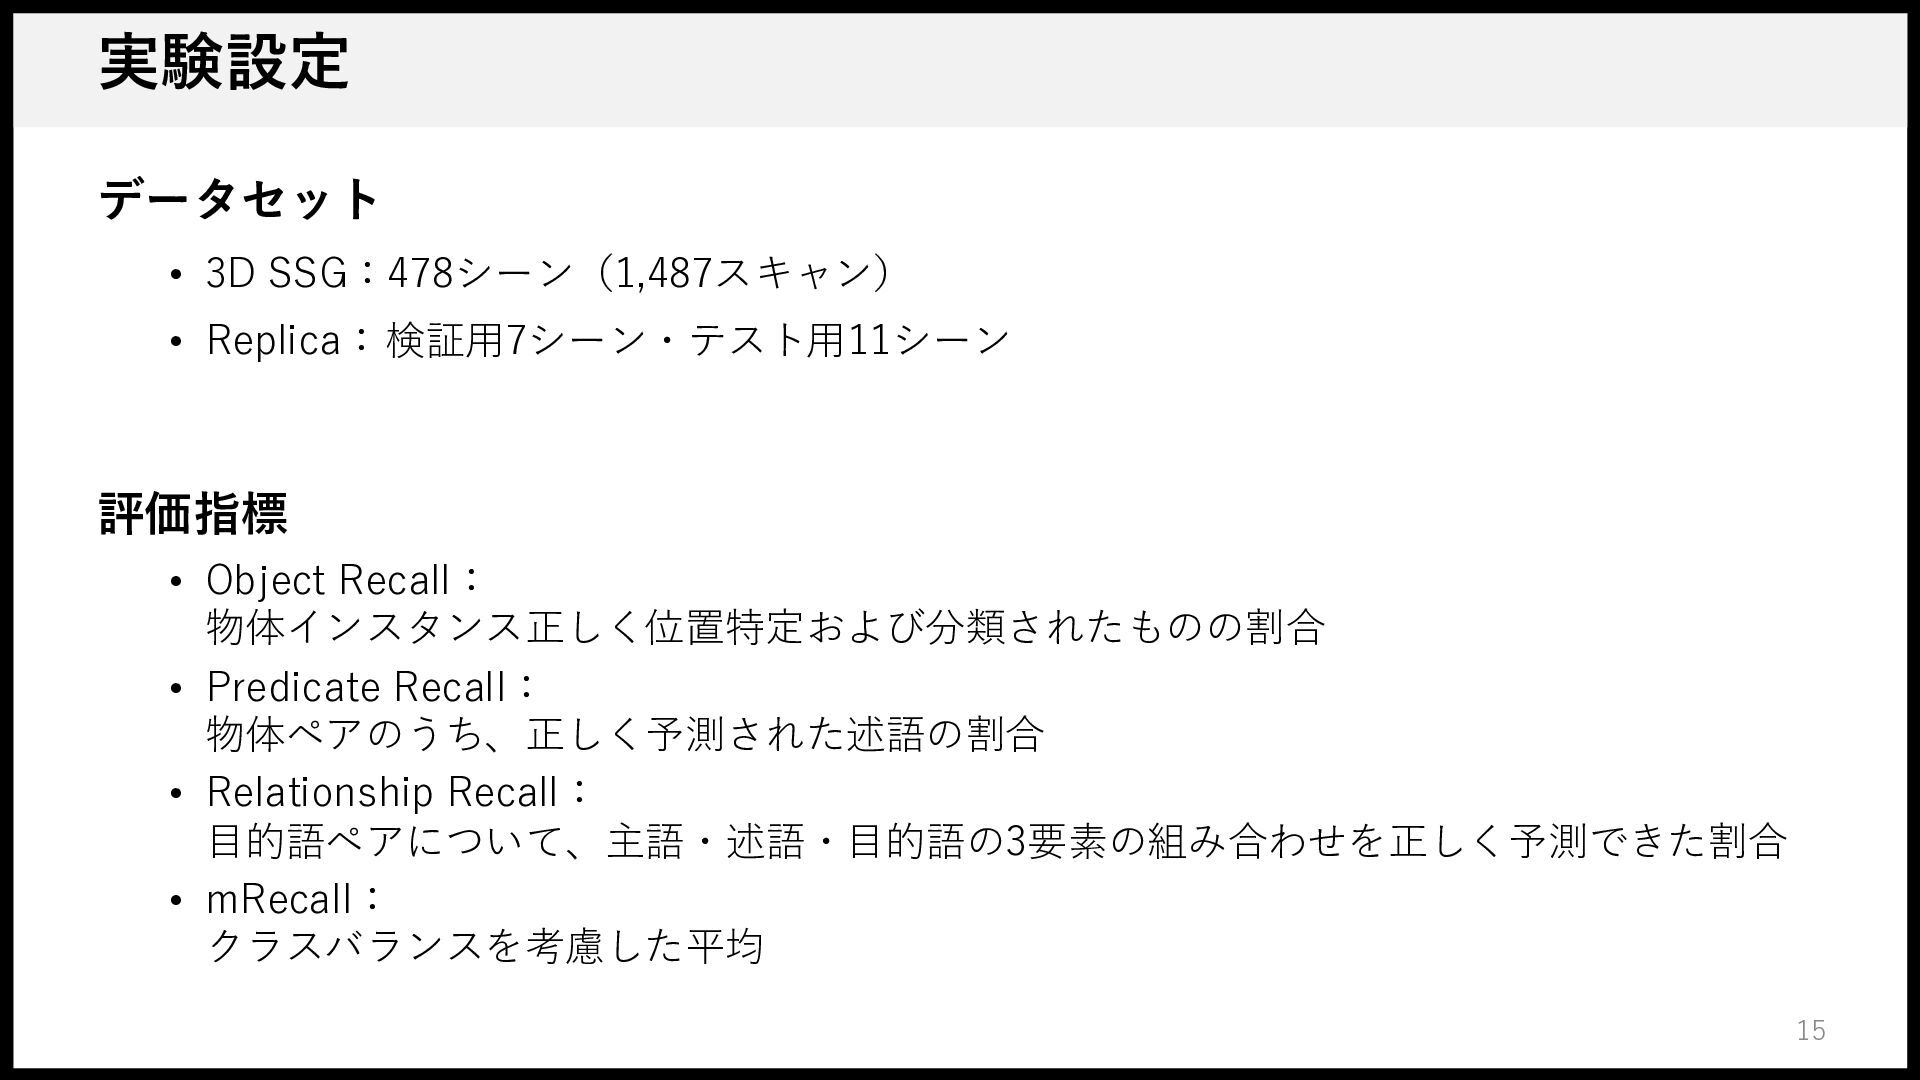
  13. 実験設定 データセット • 3D SSG:478シーン(1,487スキャン) • Replica: 検証用7シーン・テスト用11シーン 評価指標 •

    Object Recall: 物体インスタンス正しく位置特定および分類されたものの割合 • Predicate Recall: 物体ペアのうち、正しく予測された述語の割合 • Relationship Recall: 目的語ペアについて、主語・述語・目的語の3要素の組み合わせを正しく予測できた割合 • mRecall: クラスバランスを考慮した平均 15
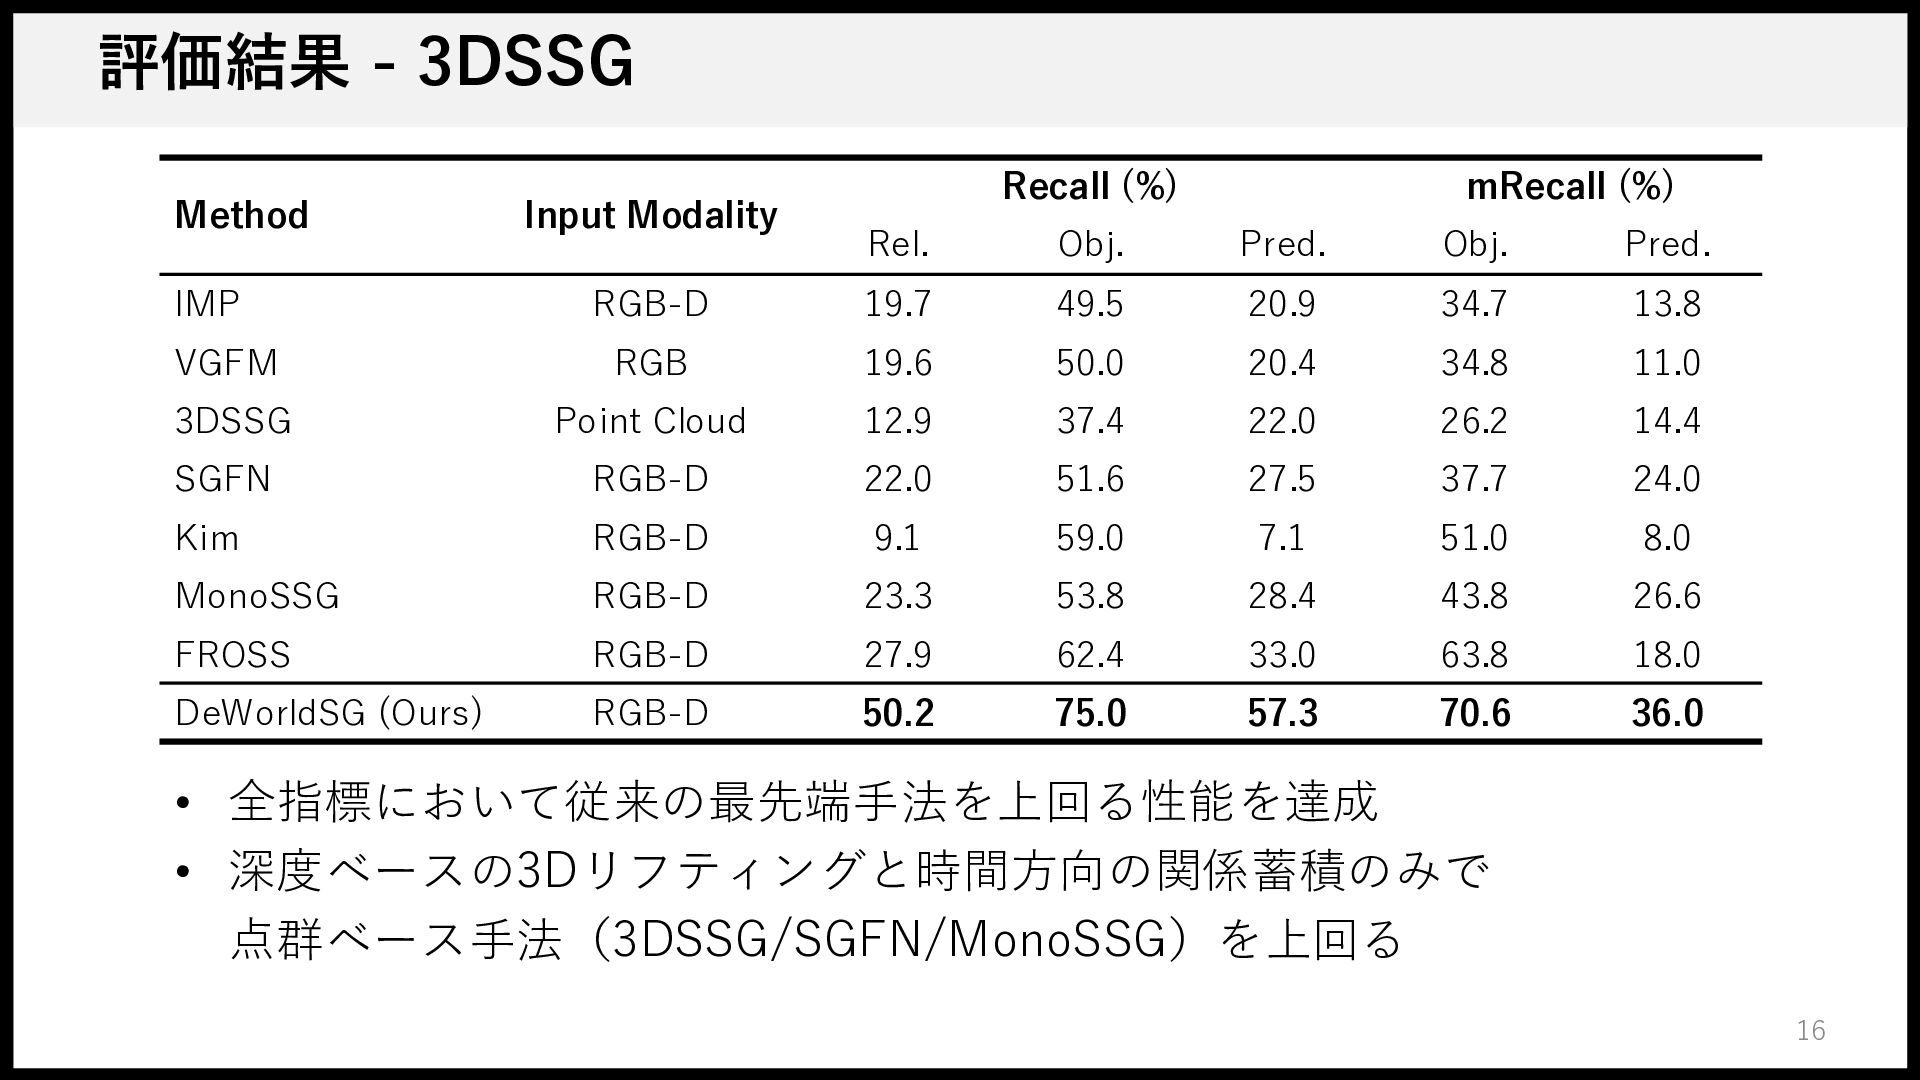
  14. 評価結果 - 3DSSG Method Input Modality Recall (%) mRecall (%)

    Rel. Obj. Pred. Obj. Pred. IMP RGB-D 19.7 49.5 20.9 34.7 13.8 VGFM RGB 19.6 50.0 20.4 34.8 11.0 3DSSG Point Cloud 12.9 37.4 22.0 26.2 14.4 SGFN RGB-D 22.0 51.6 27.5 37.7 24.0 Kim RGB-D 9.1 59.0 7.1 51.0 8.0 MonoSSG RGB-D 23.3 53.8 28.4 43.8 26.6 FROSS RGB-D 27.9 62.4 33.0 63.8 18.0 DeWorldSG (Ours) RGB-D 50.2 75.0 57.3 70.6 36.0 • 全指標において従来の最先端手法を上回る性能を達成 • 深度ベースの3Dリフティングと時間方向の関係蓄積のみで 点群ベース手法(3DSSG/SGFN/MonoSSG)を上回る 16
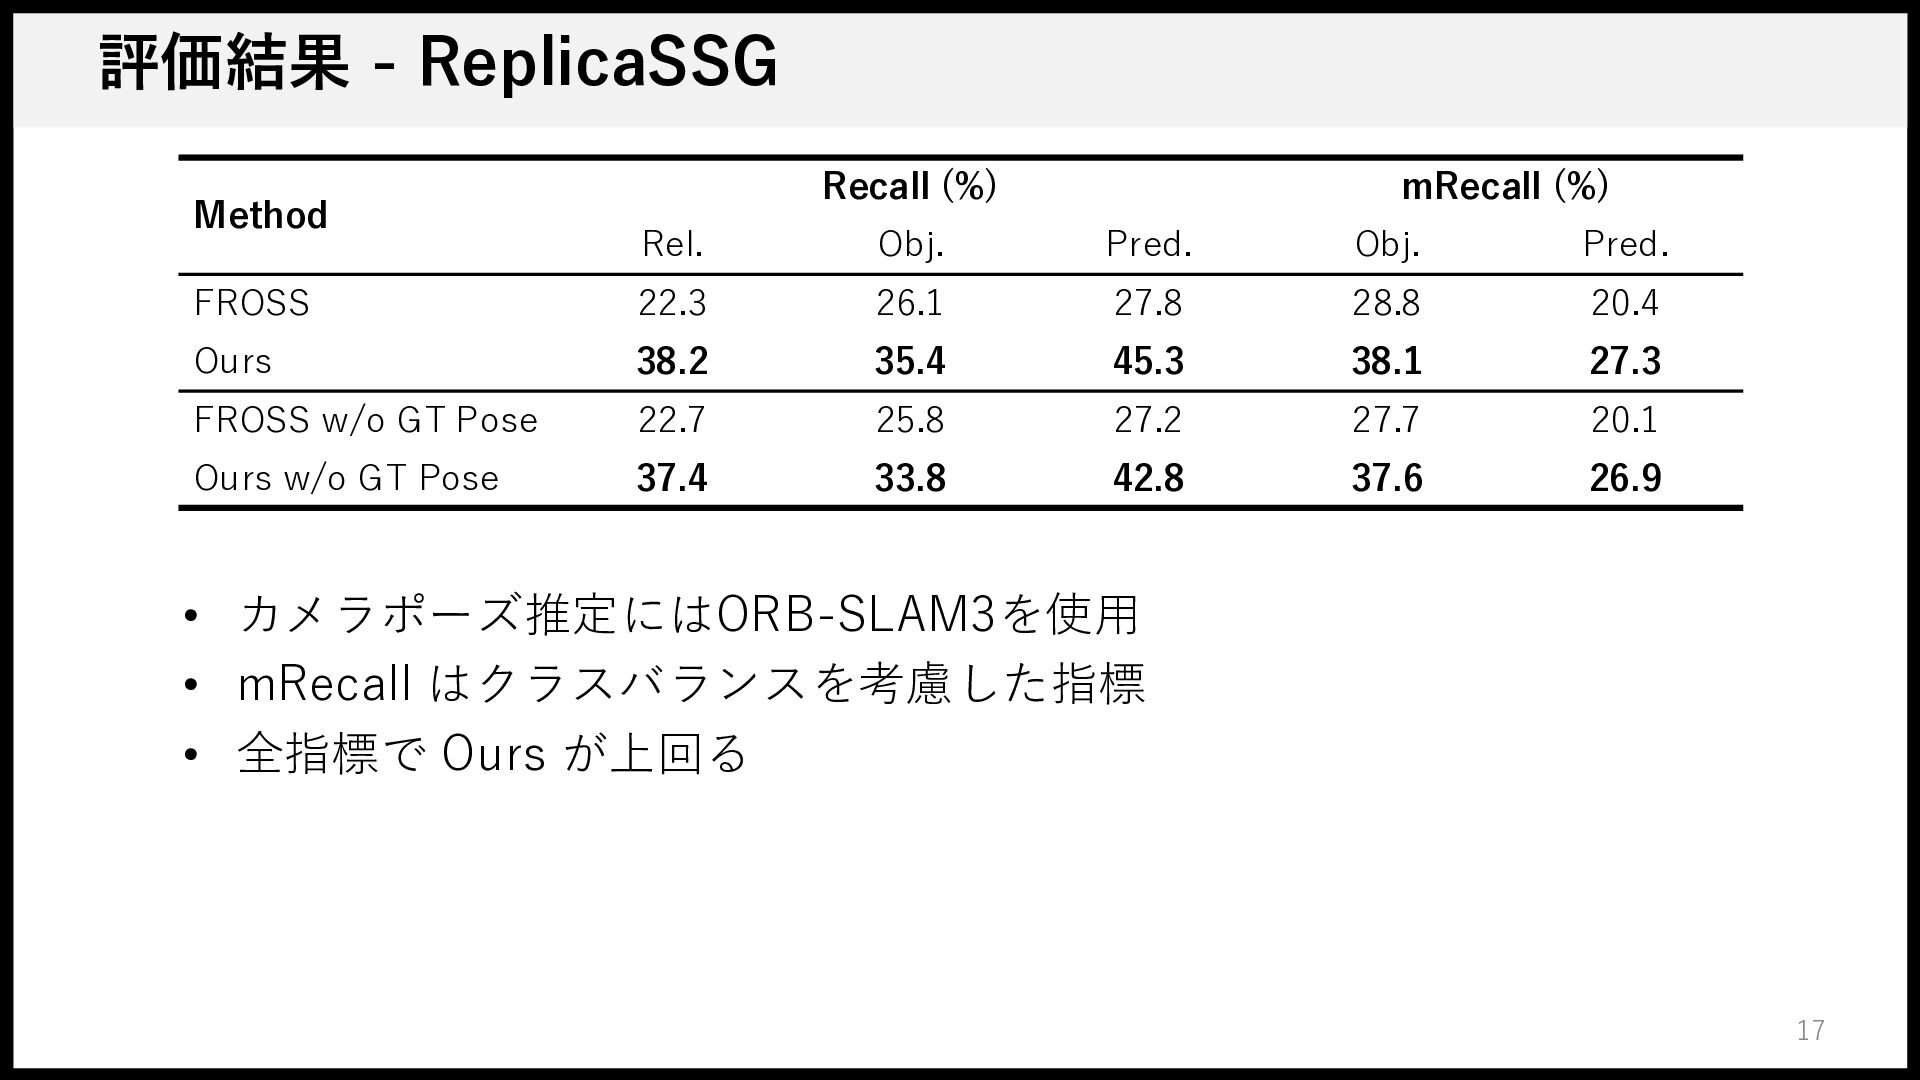
  15. 評価結果 - ReplicaSSG Method Recall (%) mRecall (%) Rel. Obj.

    Pred. Obj. Pred. FROSS 22.3 26.1 27.8 28.8 20.4 Ours 38.2 35.4 45.3 38.1 27.3 FROSS w/o GT Pose 22.7 25.8 27.2 27.7 20.1 Ours w/o GT Pose 37.4 33.8 42.8 37.6 26.9 • カメラポーズ推定にはORB-SLAM3を使用 • mRecall はクラスバランスを考慮した指標 • 全指標で Ours が上回る 17
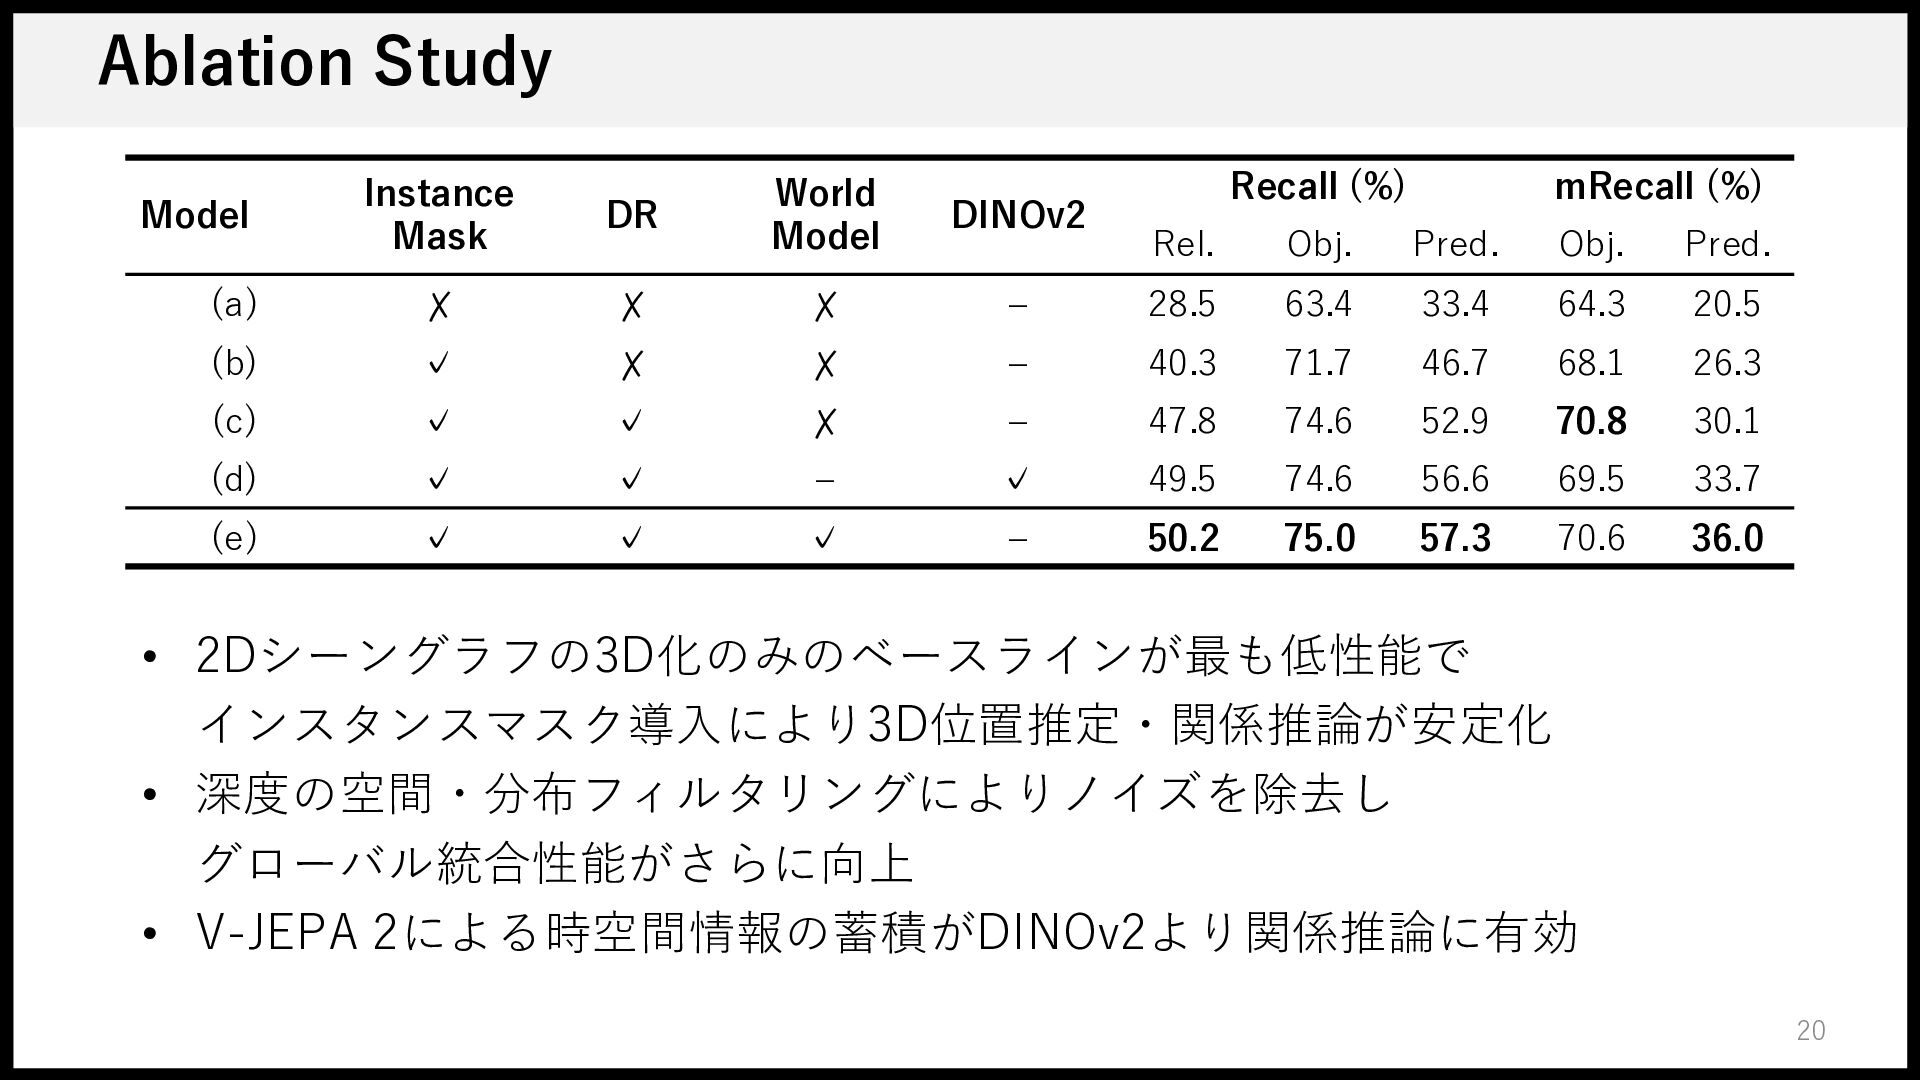
  16. Ablation Study Instance Mask DR World Model DINOv2 (a) ✗

    ✗ ✗ (b) ✓ ✗ (c) ✓ (d) (e) Model Recall (%) mRecall (%) Rel. Obj. Pred. Obj. Pred. – 28.5 63.4 33.4 64.3 20.5 ✗ – 40.3 71.7 46.7 68.1 26.3 ✓ ✗ – 47.8 74.6 52.9 70.8 30.1 ✓ ✓ – ✓ 49.5 74.6 56.6 69.5 33.7 ✓ ✓ ✓ – 50.2 75.0 57.3 70.6 36.0 • 2Dシーングラフの3D化のみのベースラインが最も低性能で インスタンスマスク導入により3D位置推定・関係推論が安定化 • 深度の空間・分布フィルタリングによりノイズを除去し グローバル統合性能がさらに向上 • V-JEPA 2による時空間情報の蓄積がDINOv2より関係推論に有効 20
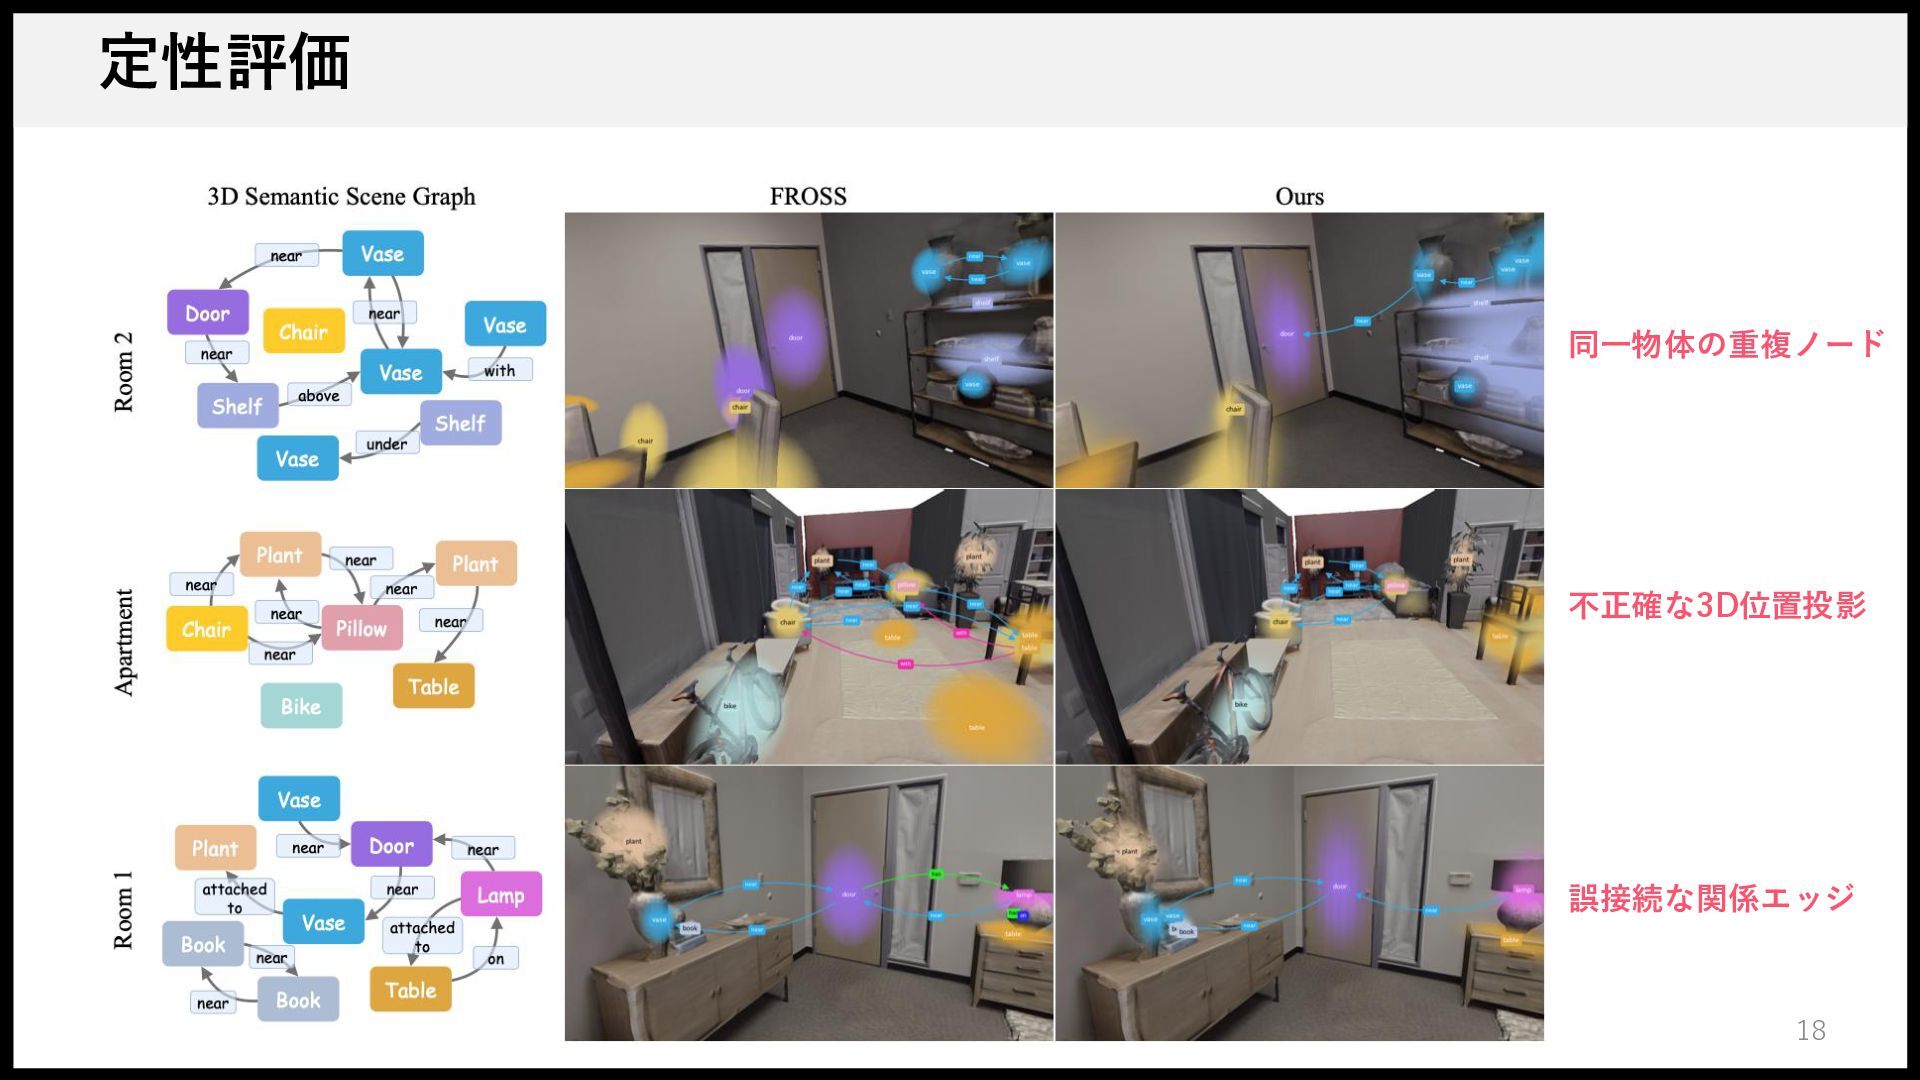
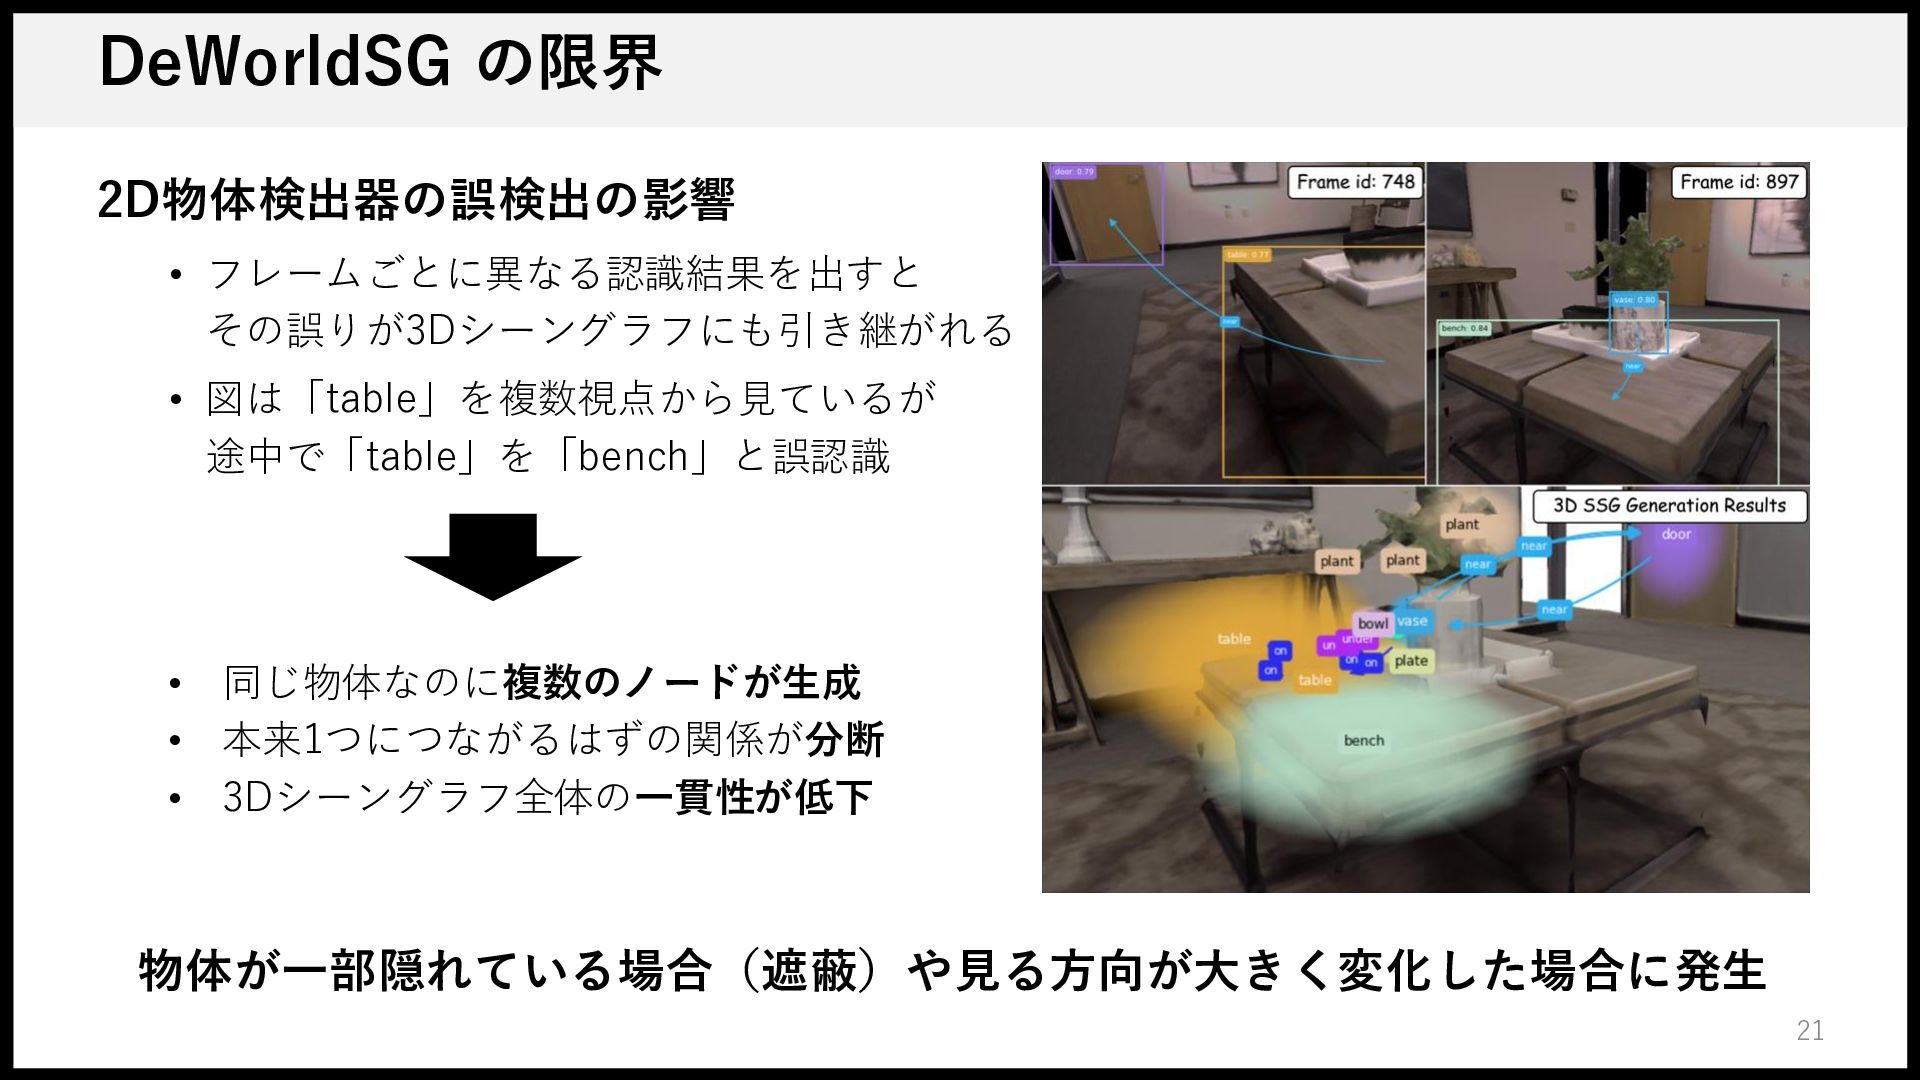
  17. DeWorldSG の限界 2D物体検出器の誤検出の影響 • フレームごとに異なる認識結果を出すと その誤りが3Dシーングラフにも引き継がれる • 図は「table」を複数視点から見ているが 途中で「table」を「bench」と誤認識 •

    同じ物体なのに複数のノードが生成 • 本来1つにつながるはずの関係が分断 • 3Dシーングラフ全体の一貫性が低下 物体が一部隠れている場合(遮蔽)や見る方向が大きく変化した場合に発生 21
  18. まとめ RGB-D 系列から 3D SSG を生成する DeWorldSG を提案 • 深度を考慮した

    3D SSG 生成:マスク内の深度情報から各物体を3Dガウス分布で表現 • デュアルドメイン深度精緻化:空間・深度分布の両面からノイズを除去し、 安定した3D物体推定とグラフ統合を実現 • 時空間的関係推論:複数フレームの関係情報と世界モデルの事前知識を統合し、 関係の完全性・一貫性を向上 所感・疑問 • 精度が大幅に向上したが、ダウンストリームタスク(ロボット・AR)に 対してどれくらい影響があるのか? • 世界モデルを活用して関係予測の精度を向上できたが、具体的にどういった場面で 関係予測精度が向上できたのか? • 2D物体検出器を限界として挙げているが、本質的な課題はそこだけなのか? 22