Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ReSplat: Learning Recurrent Gaussian Splatting

ReSplat: Learning Recurrent Gaussian Splatting

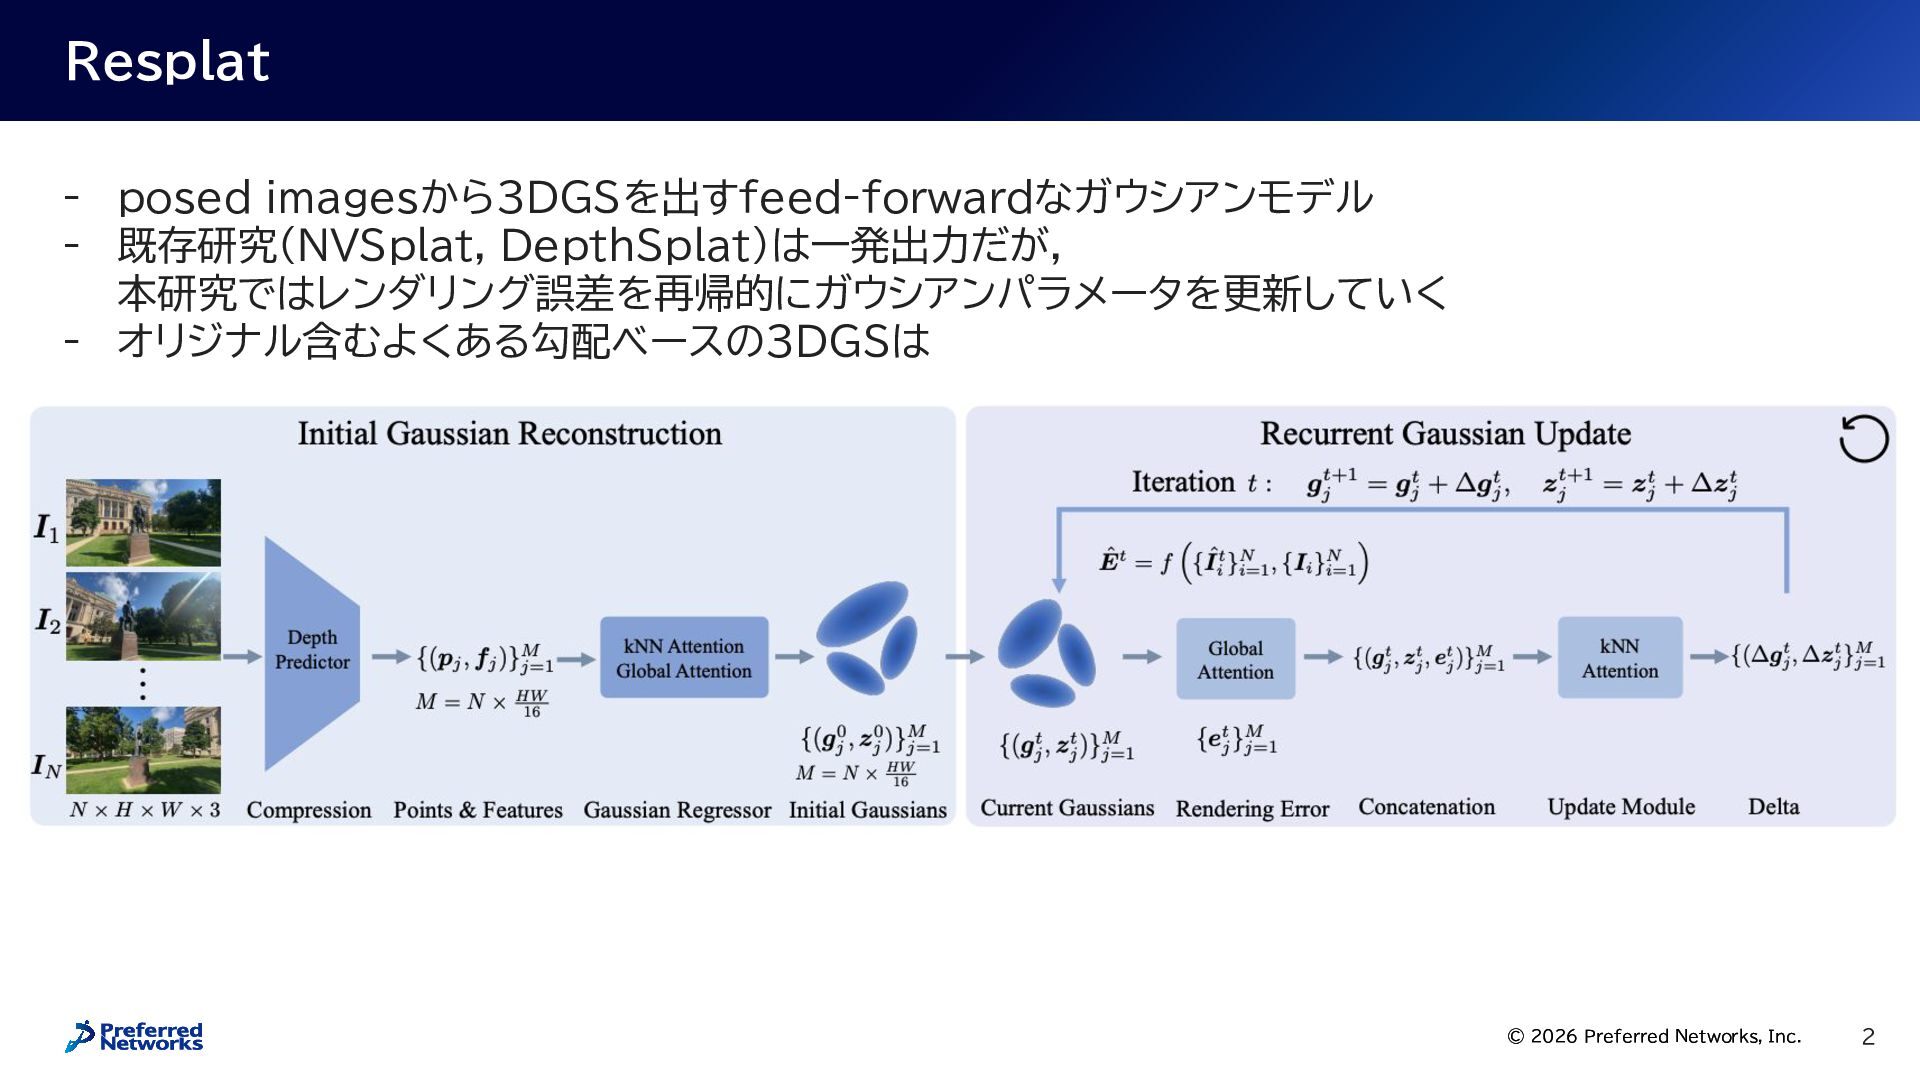
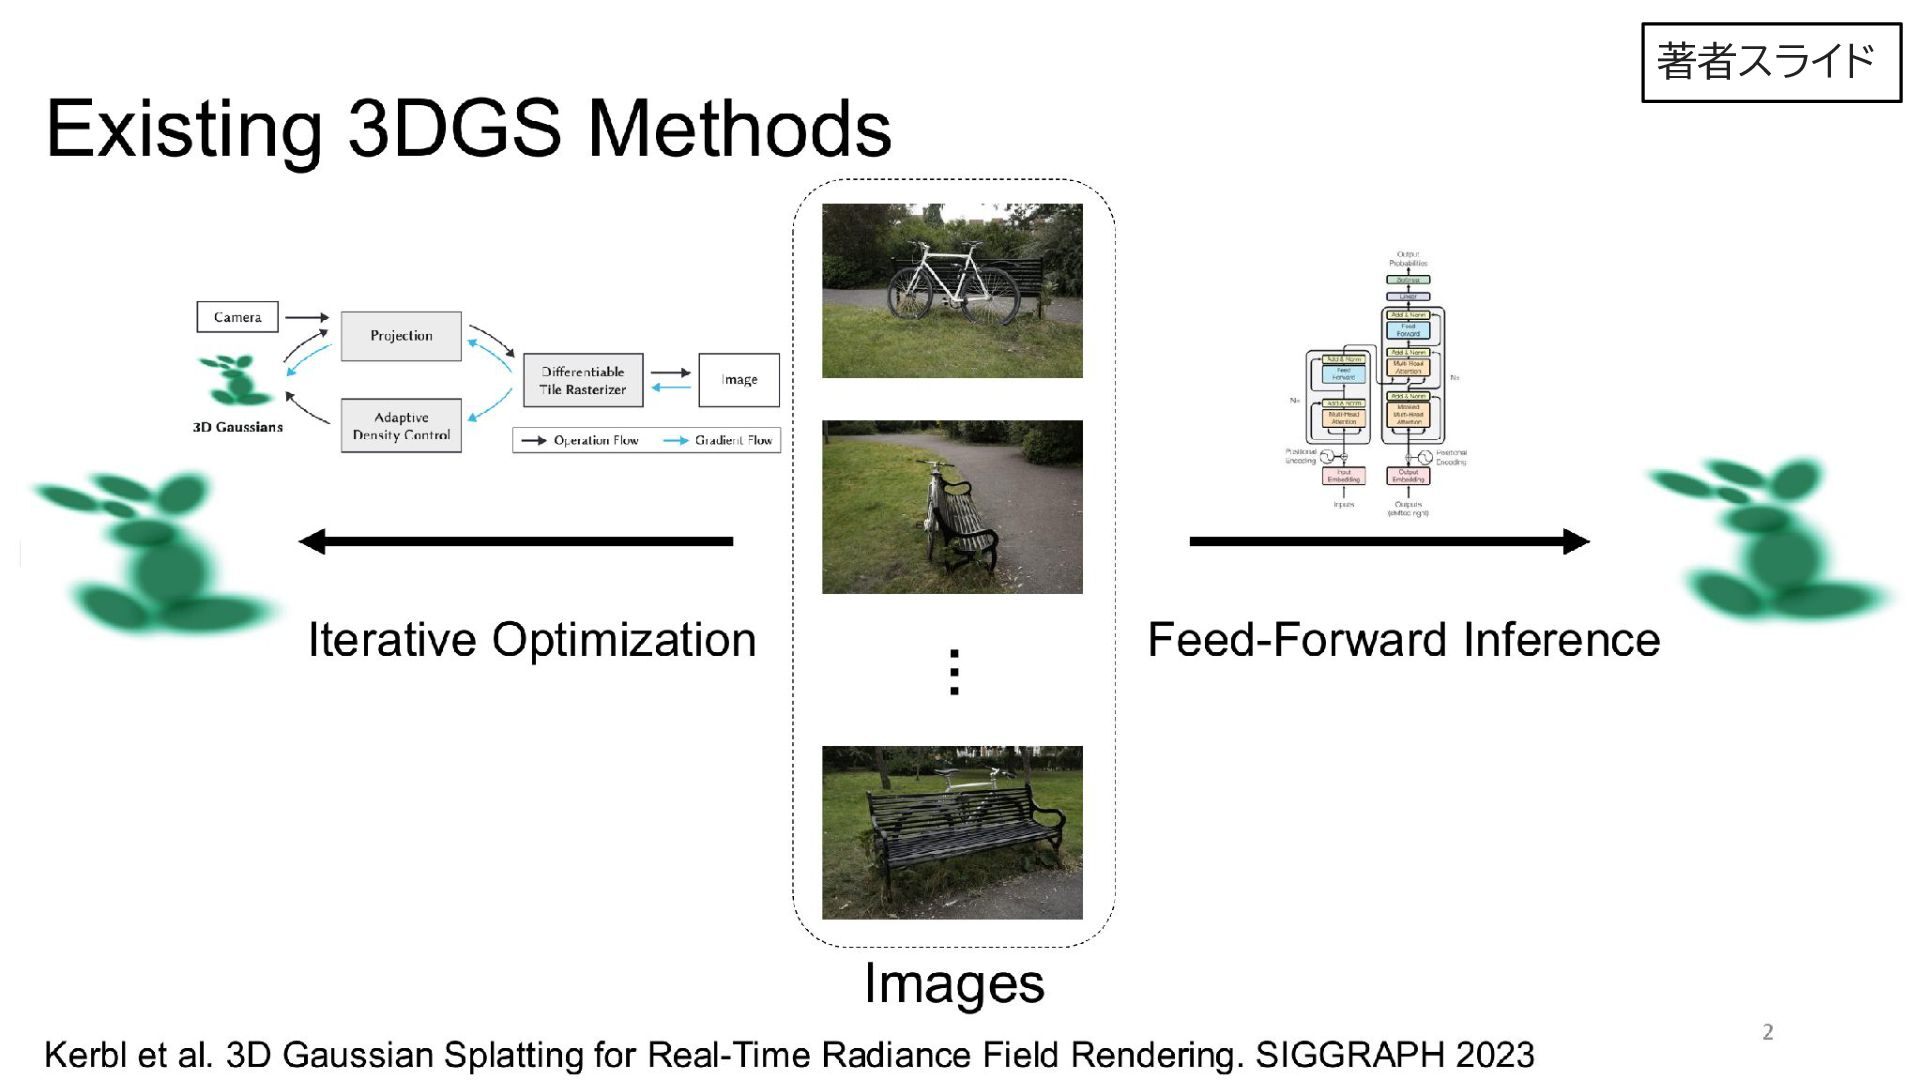
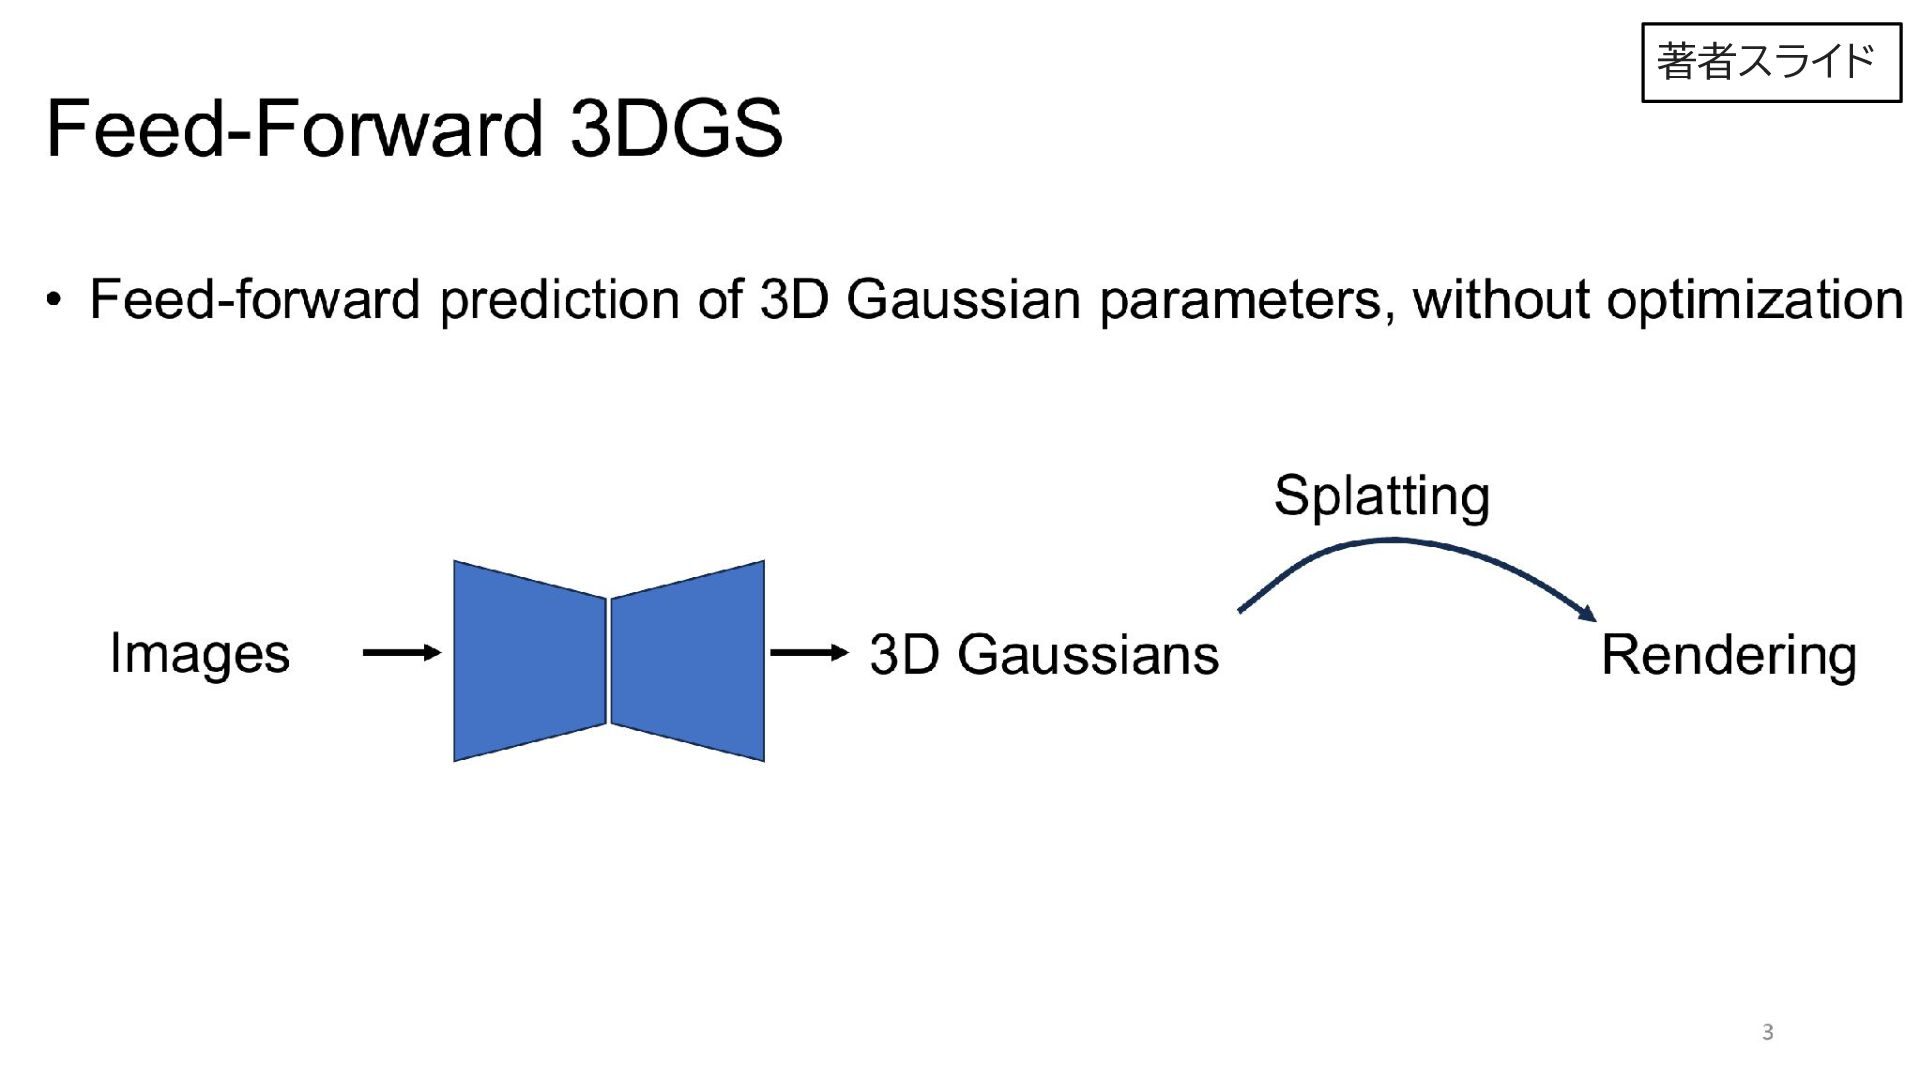
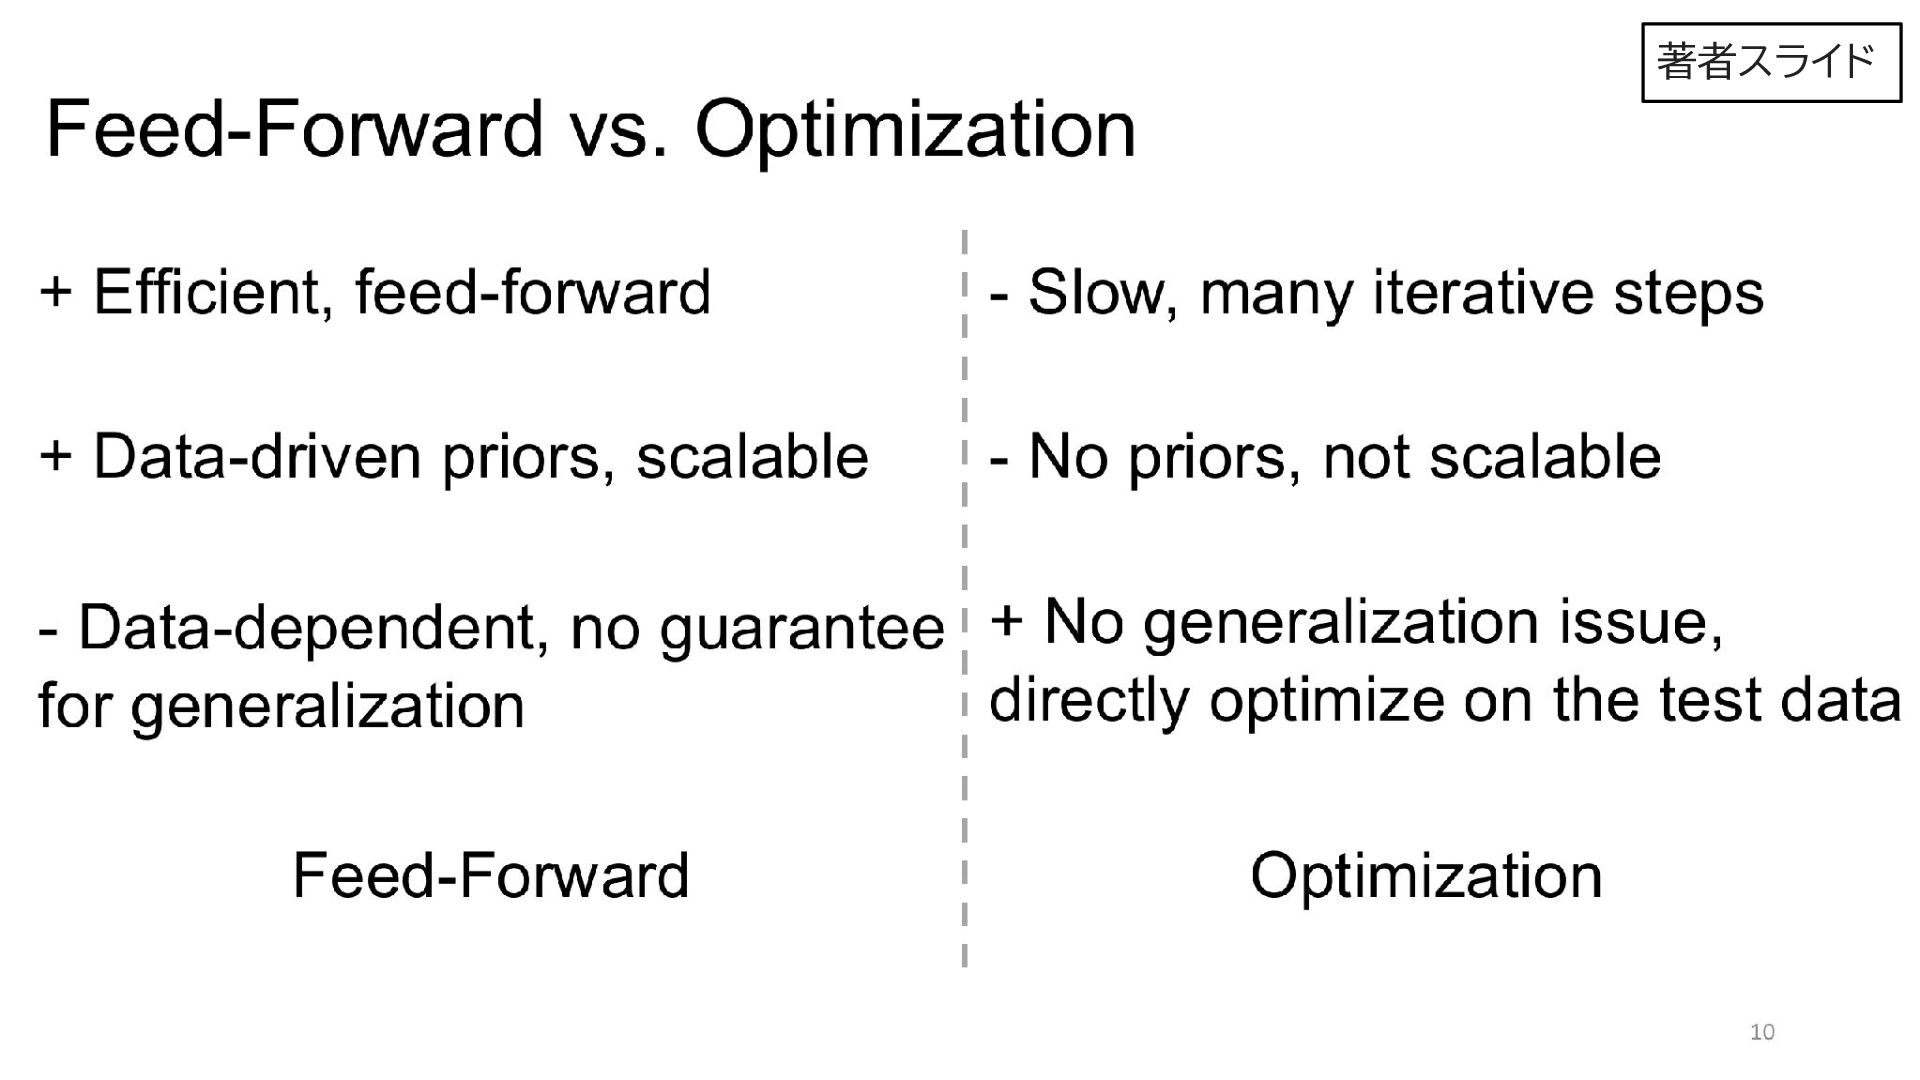
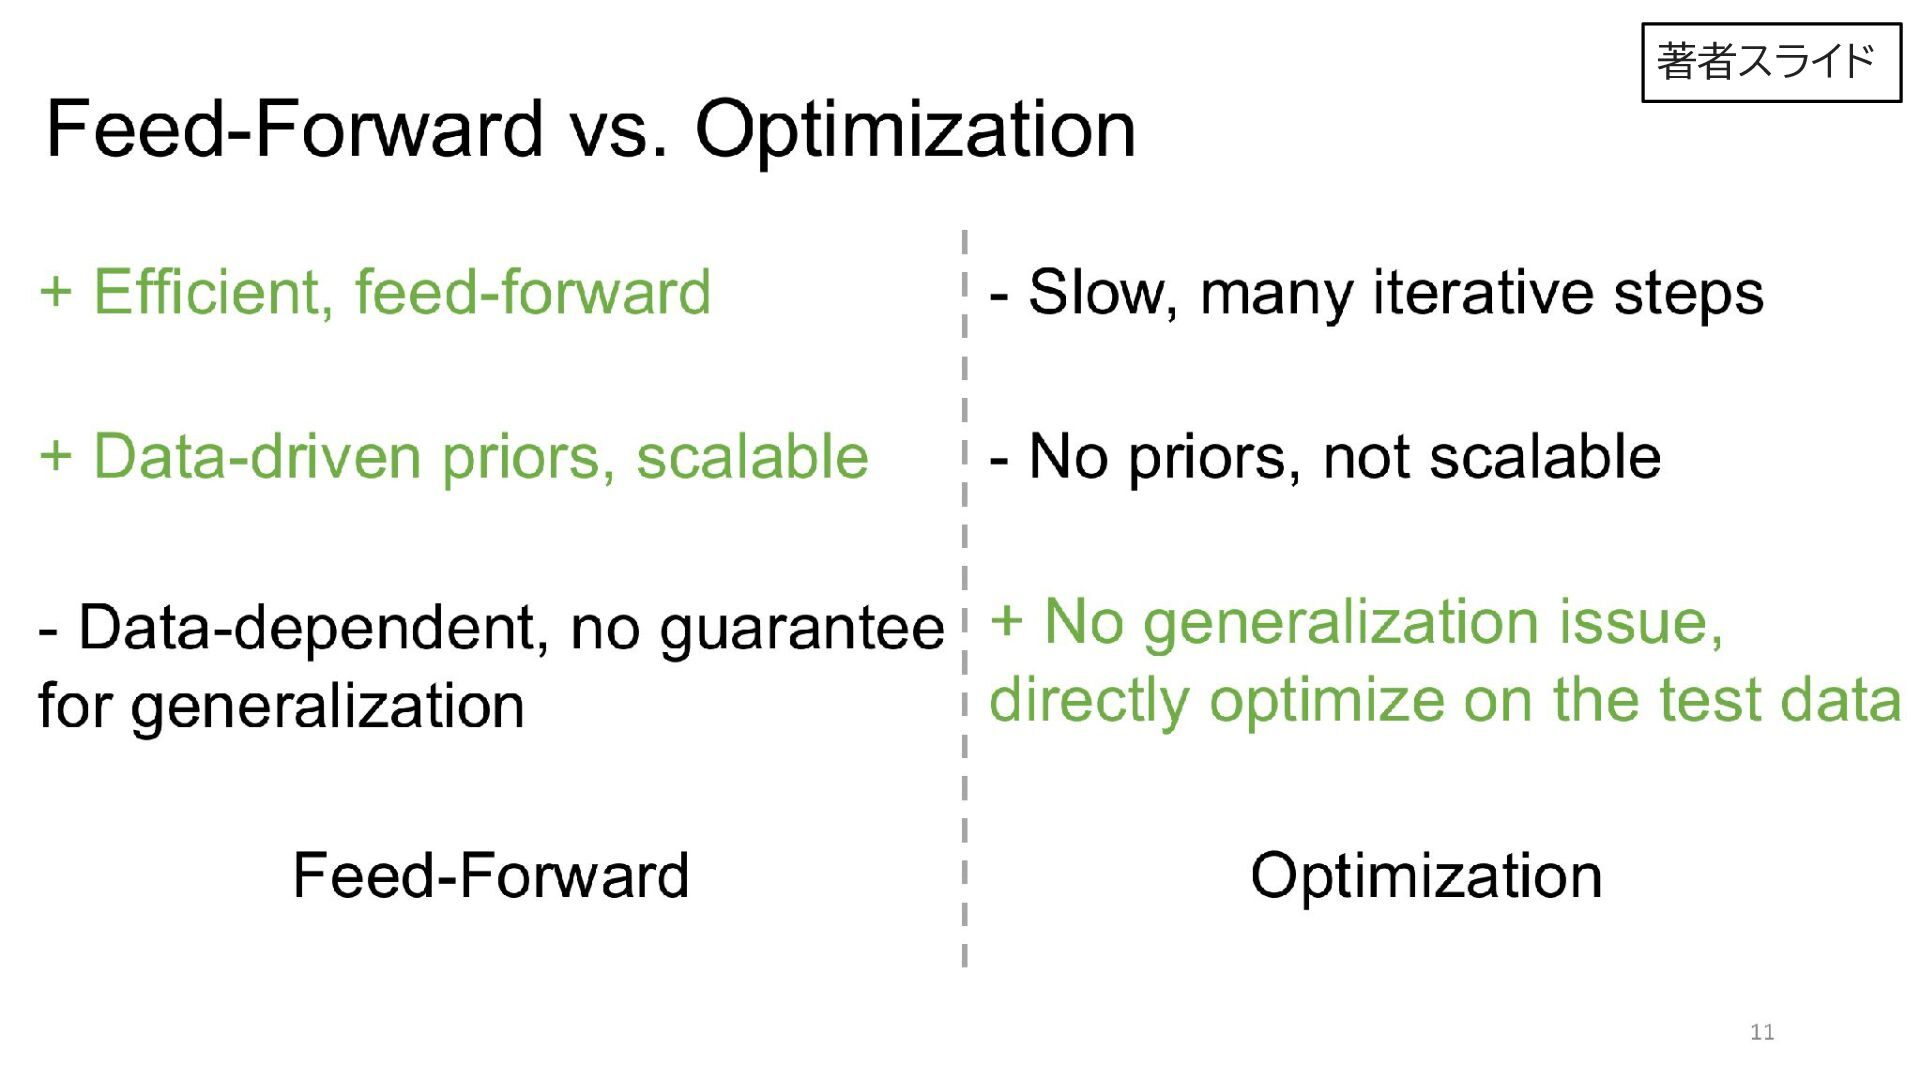
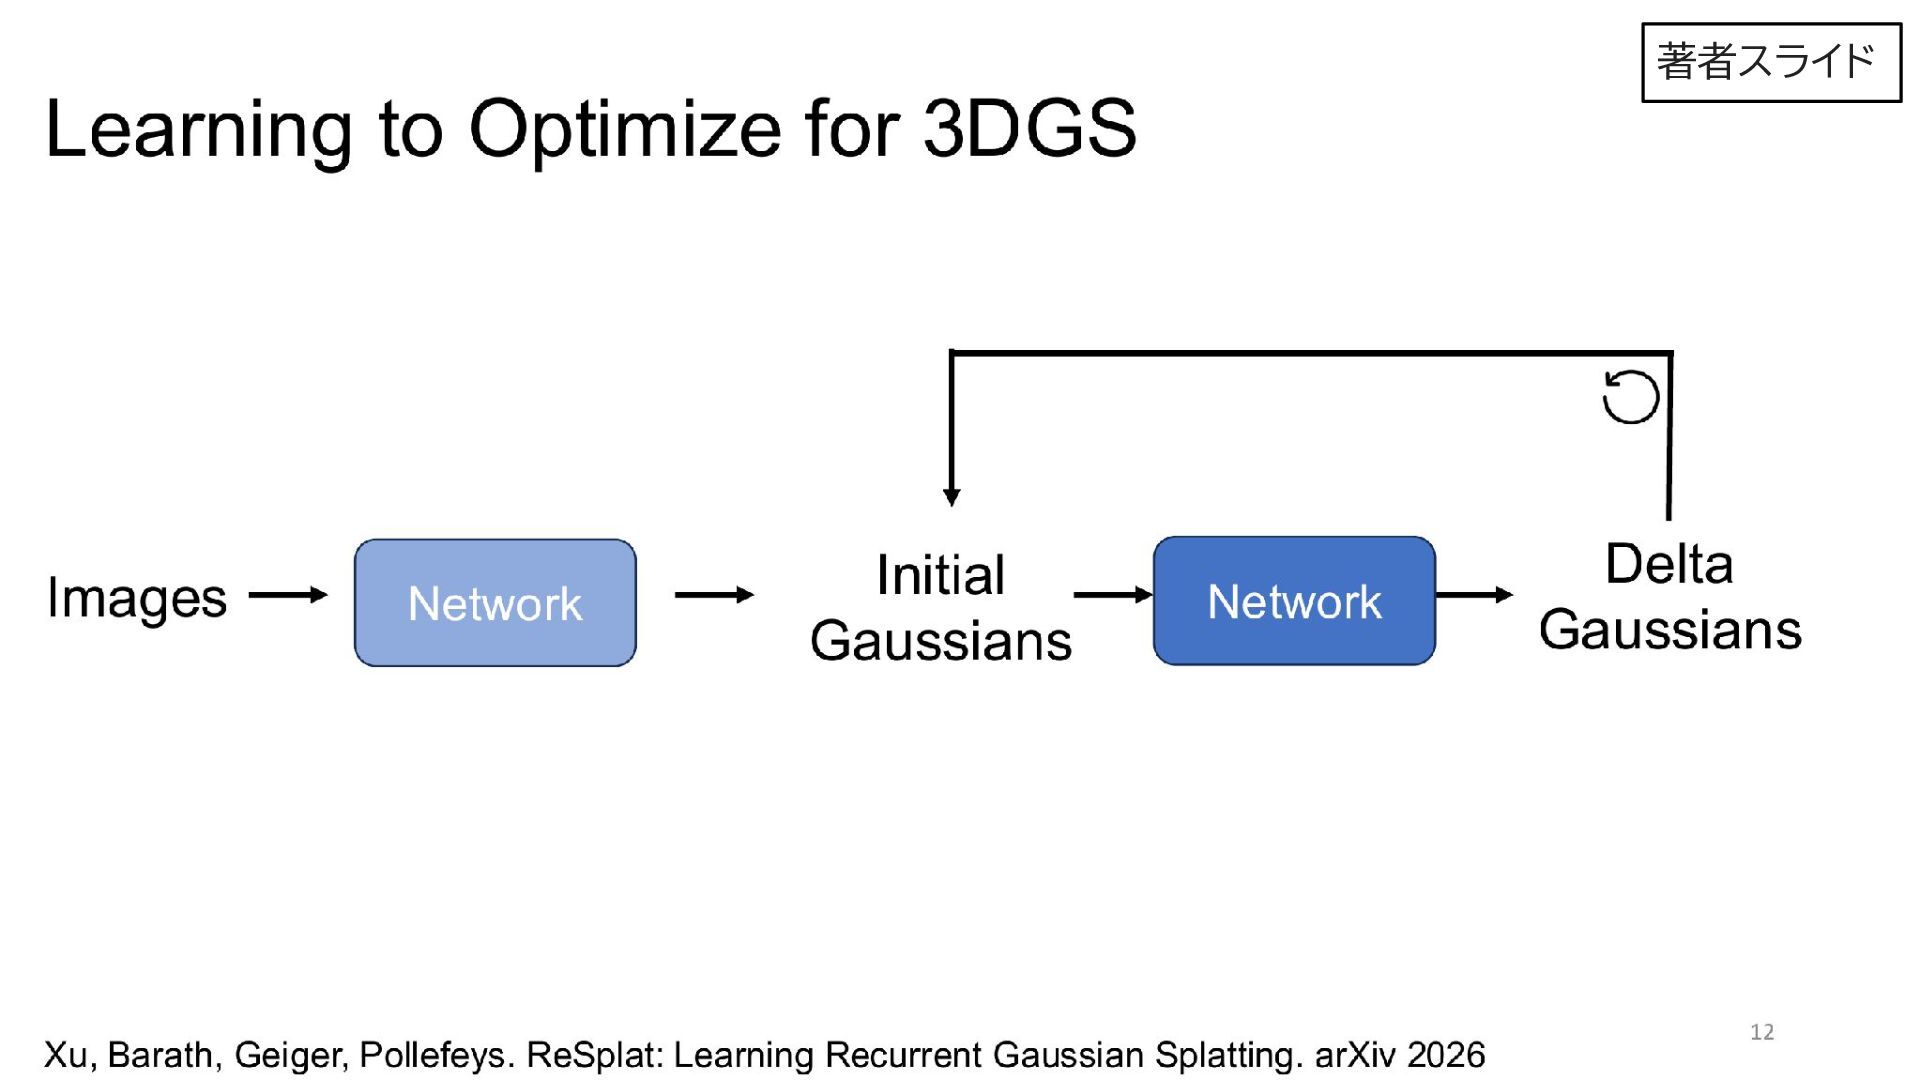
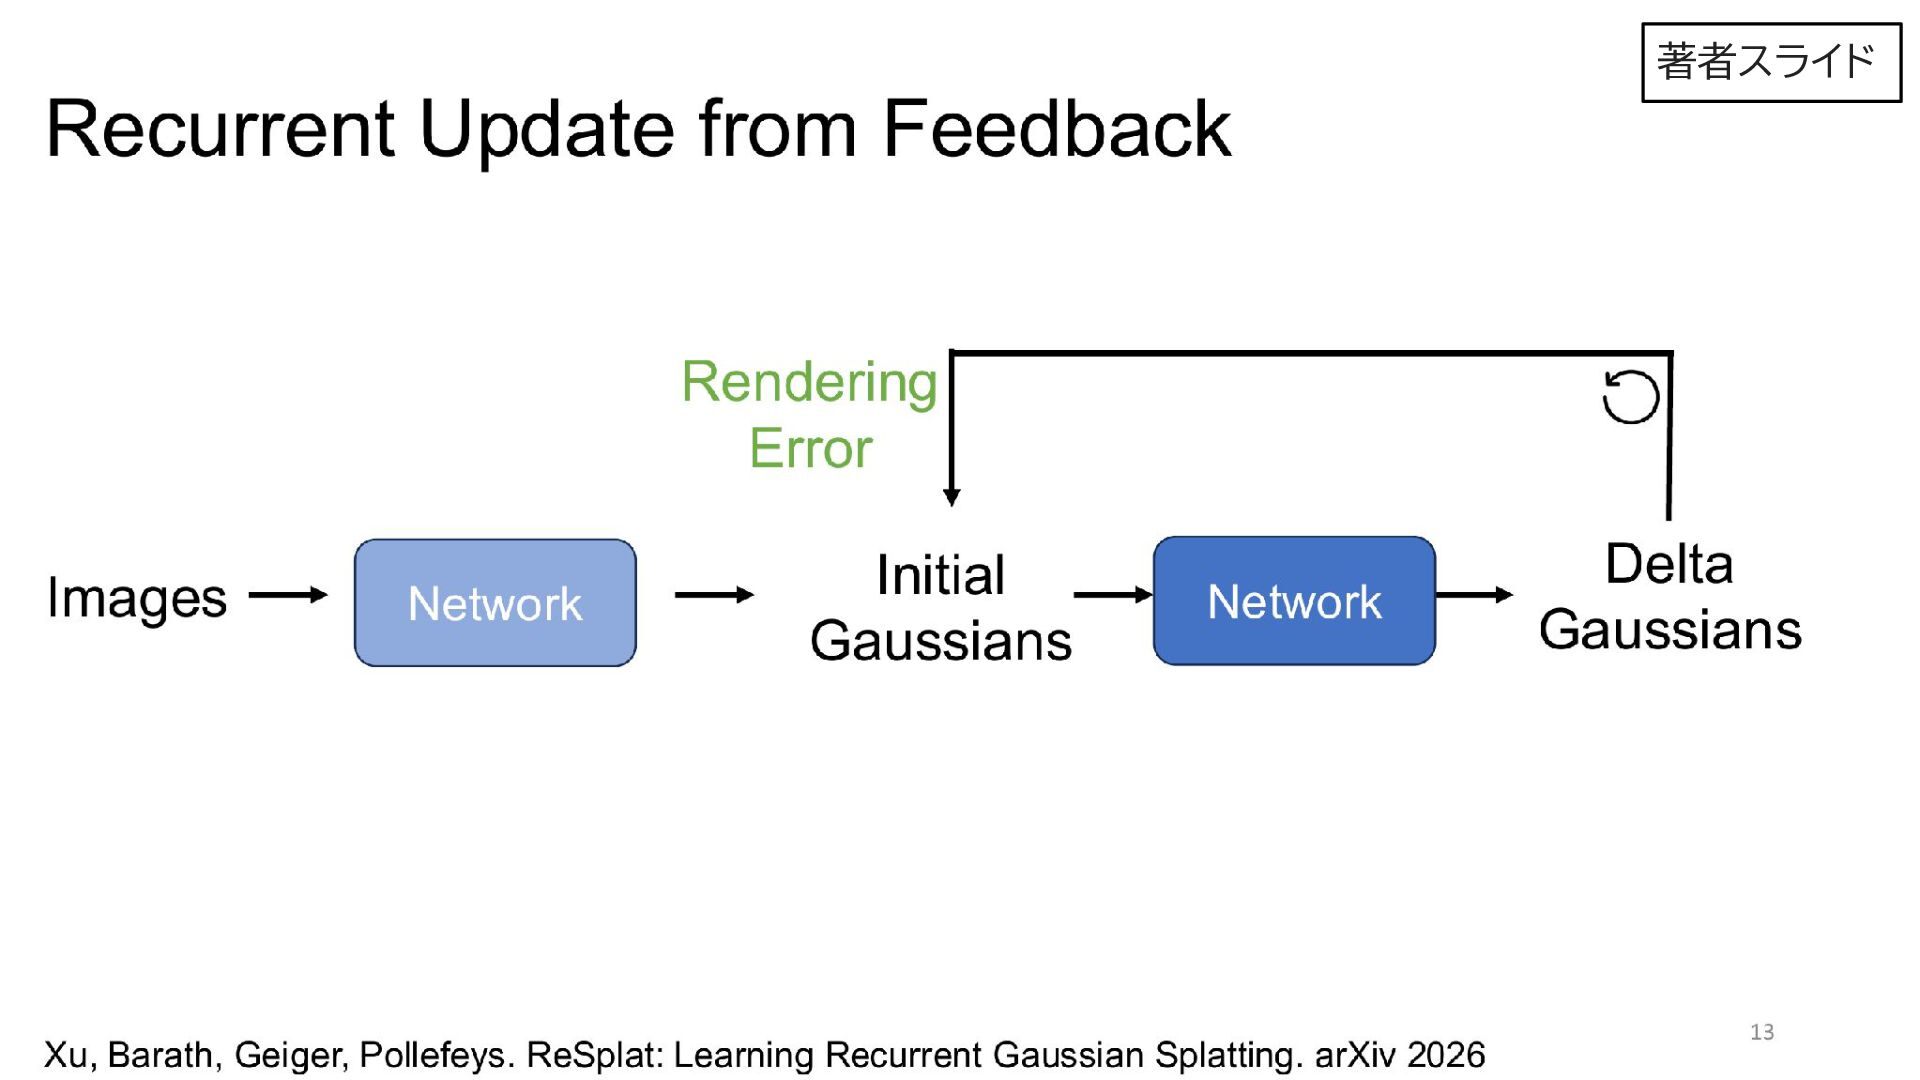
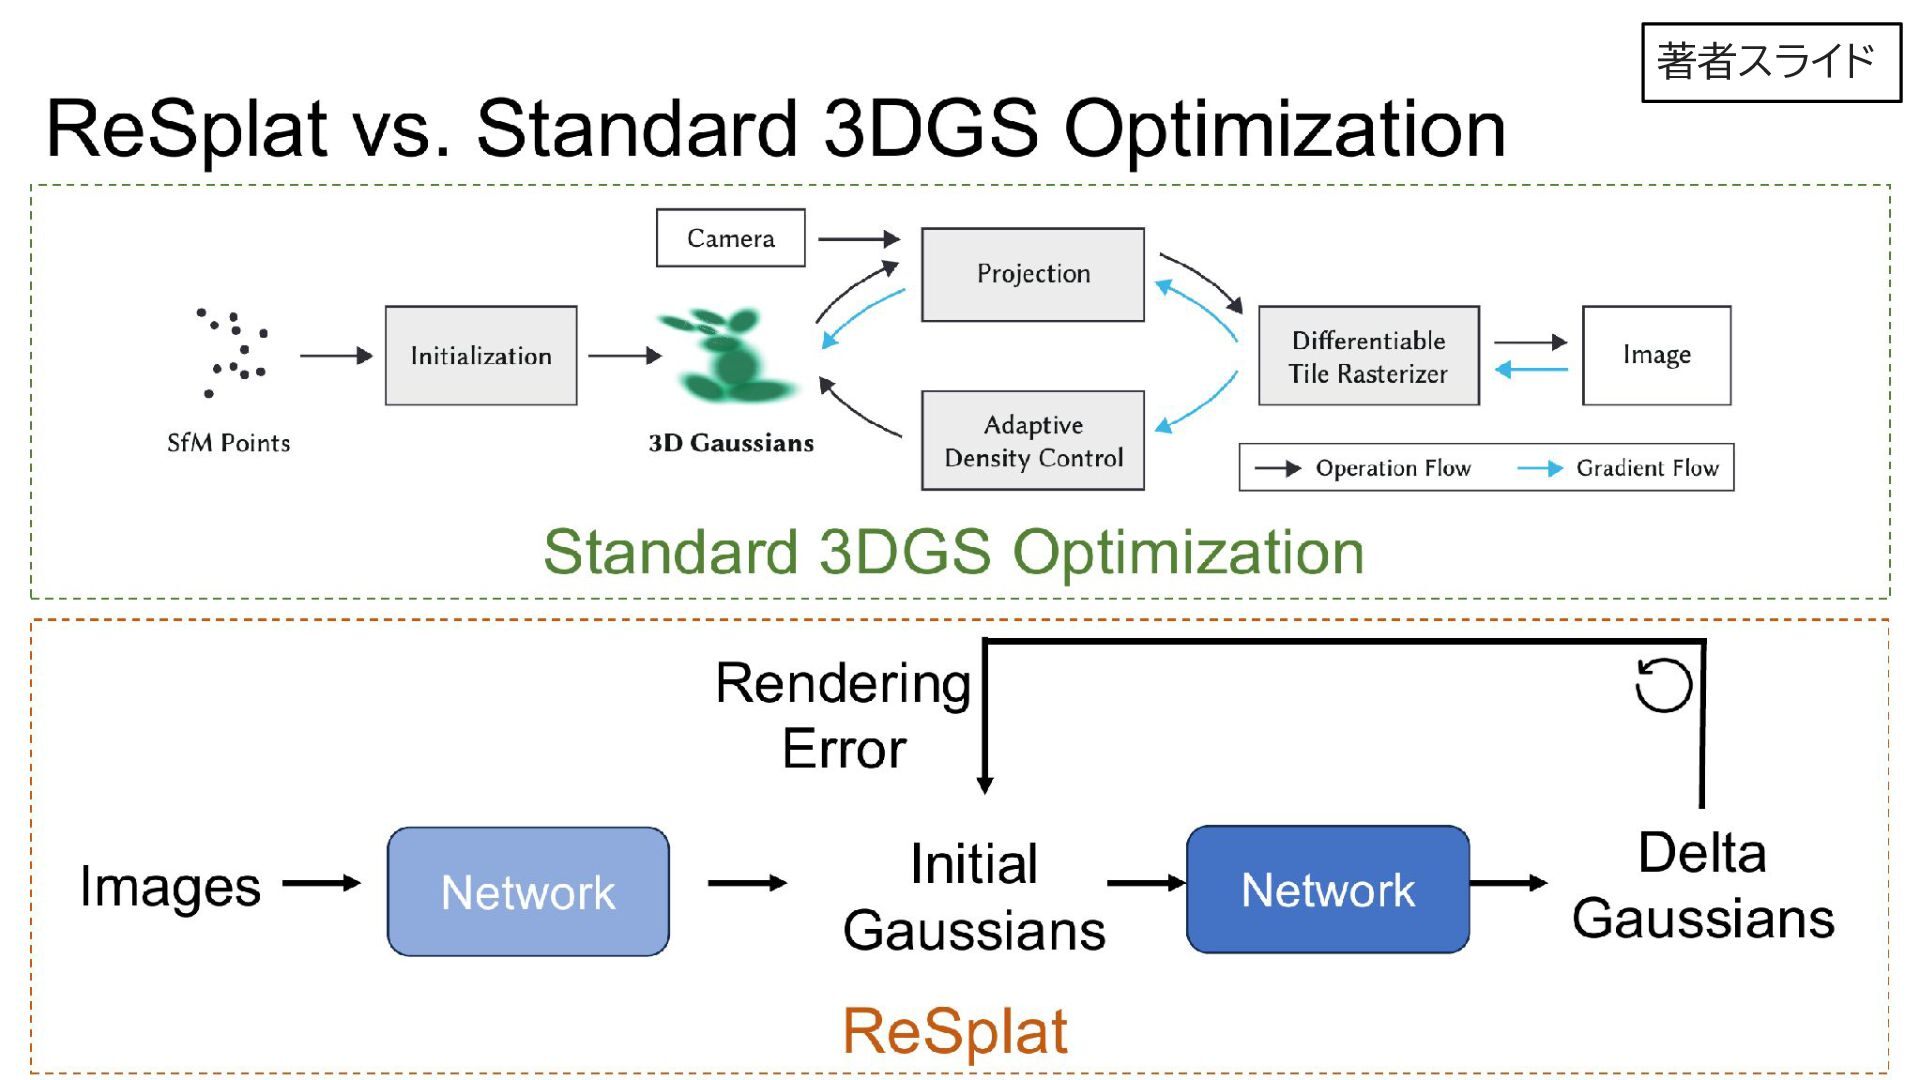
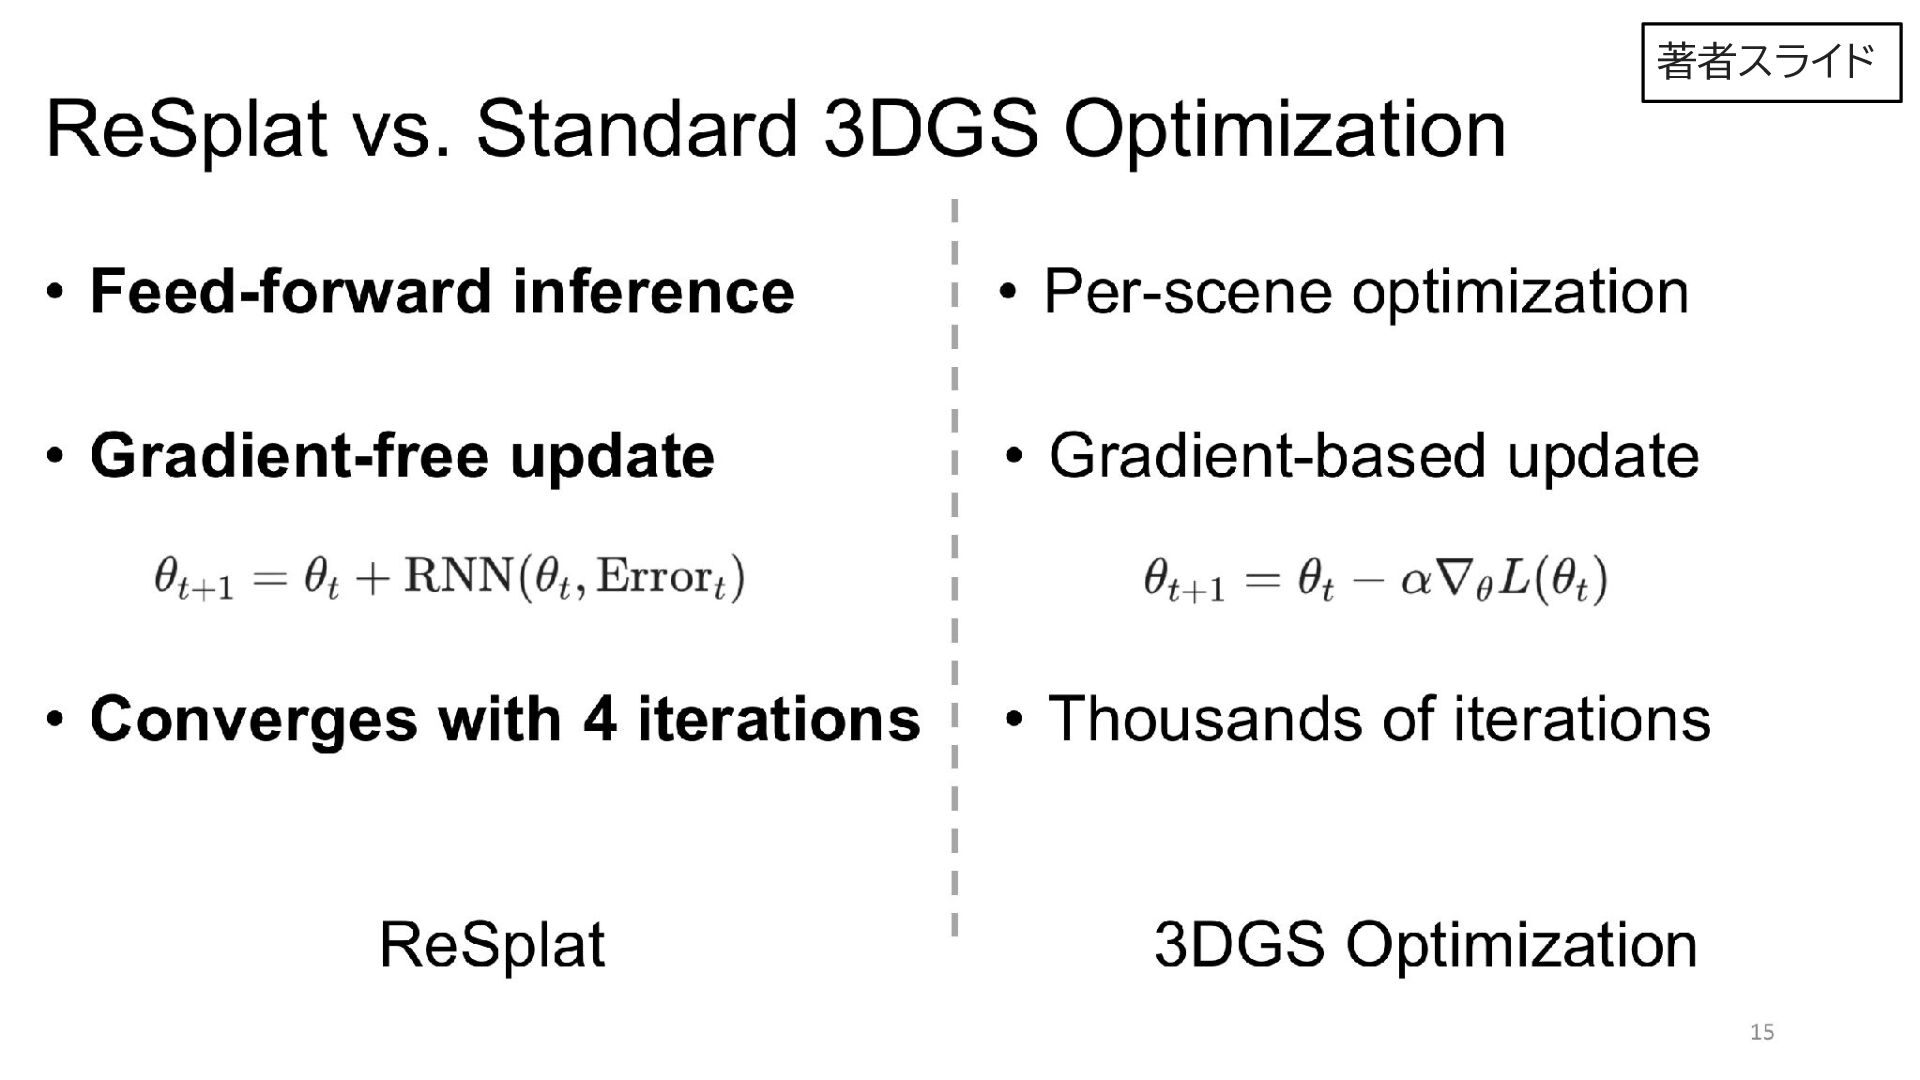
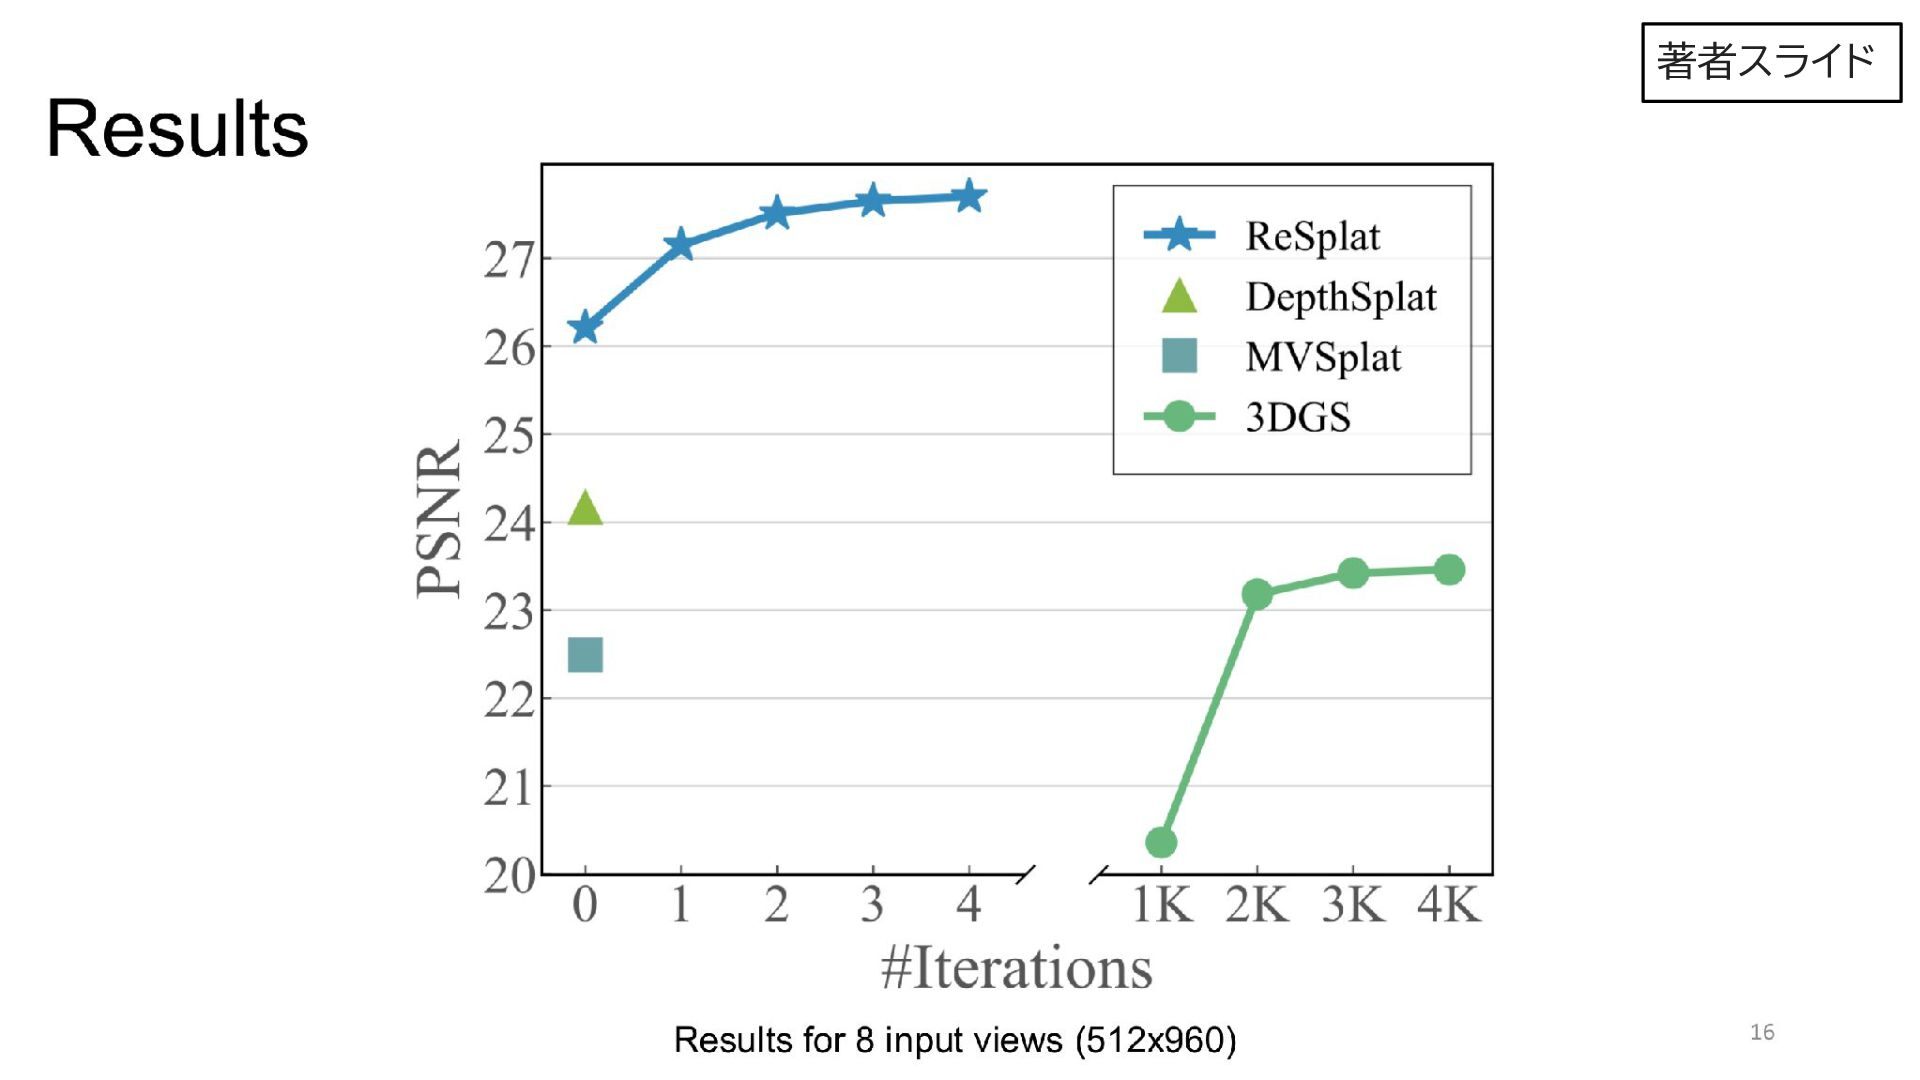
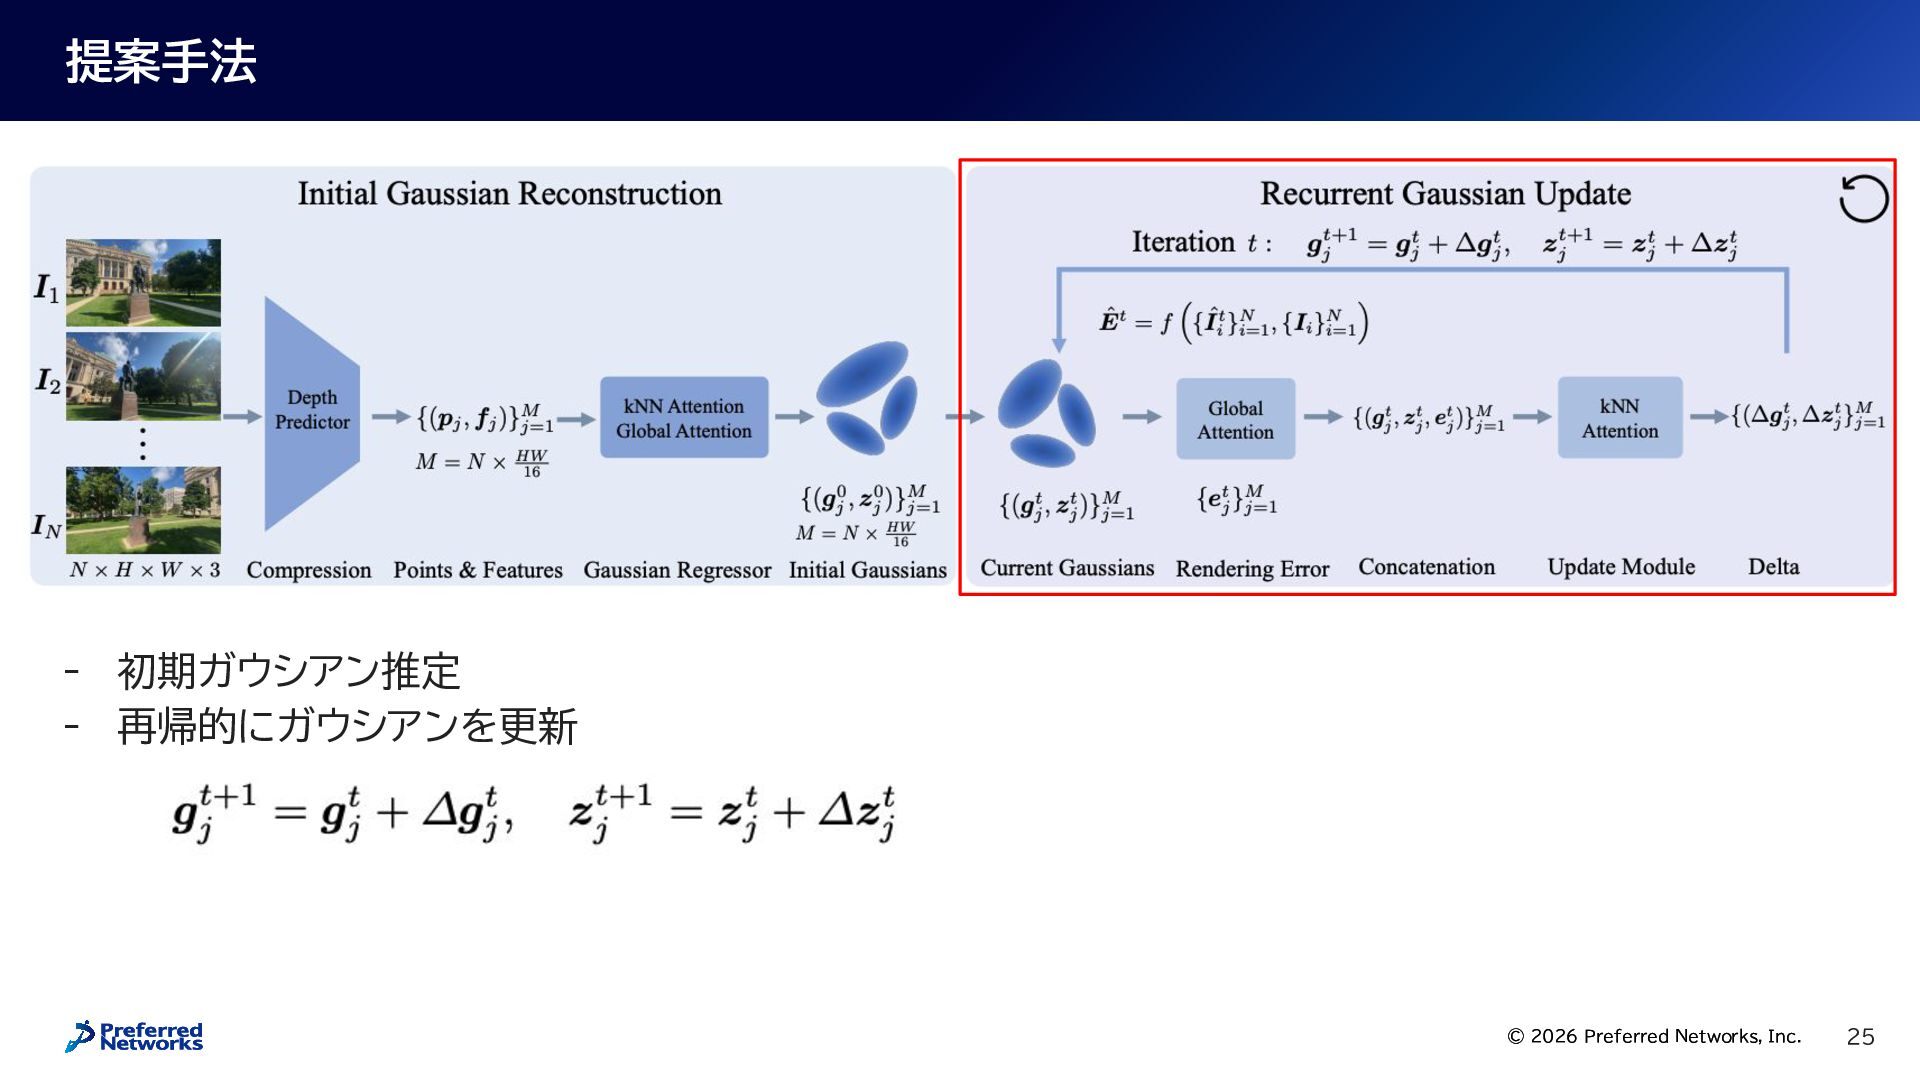
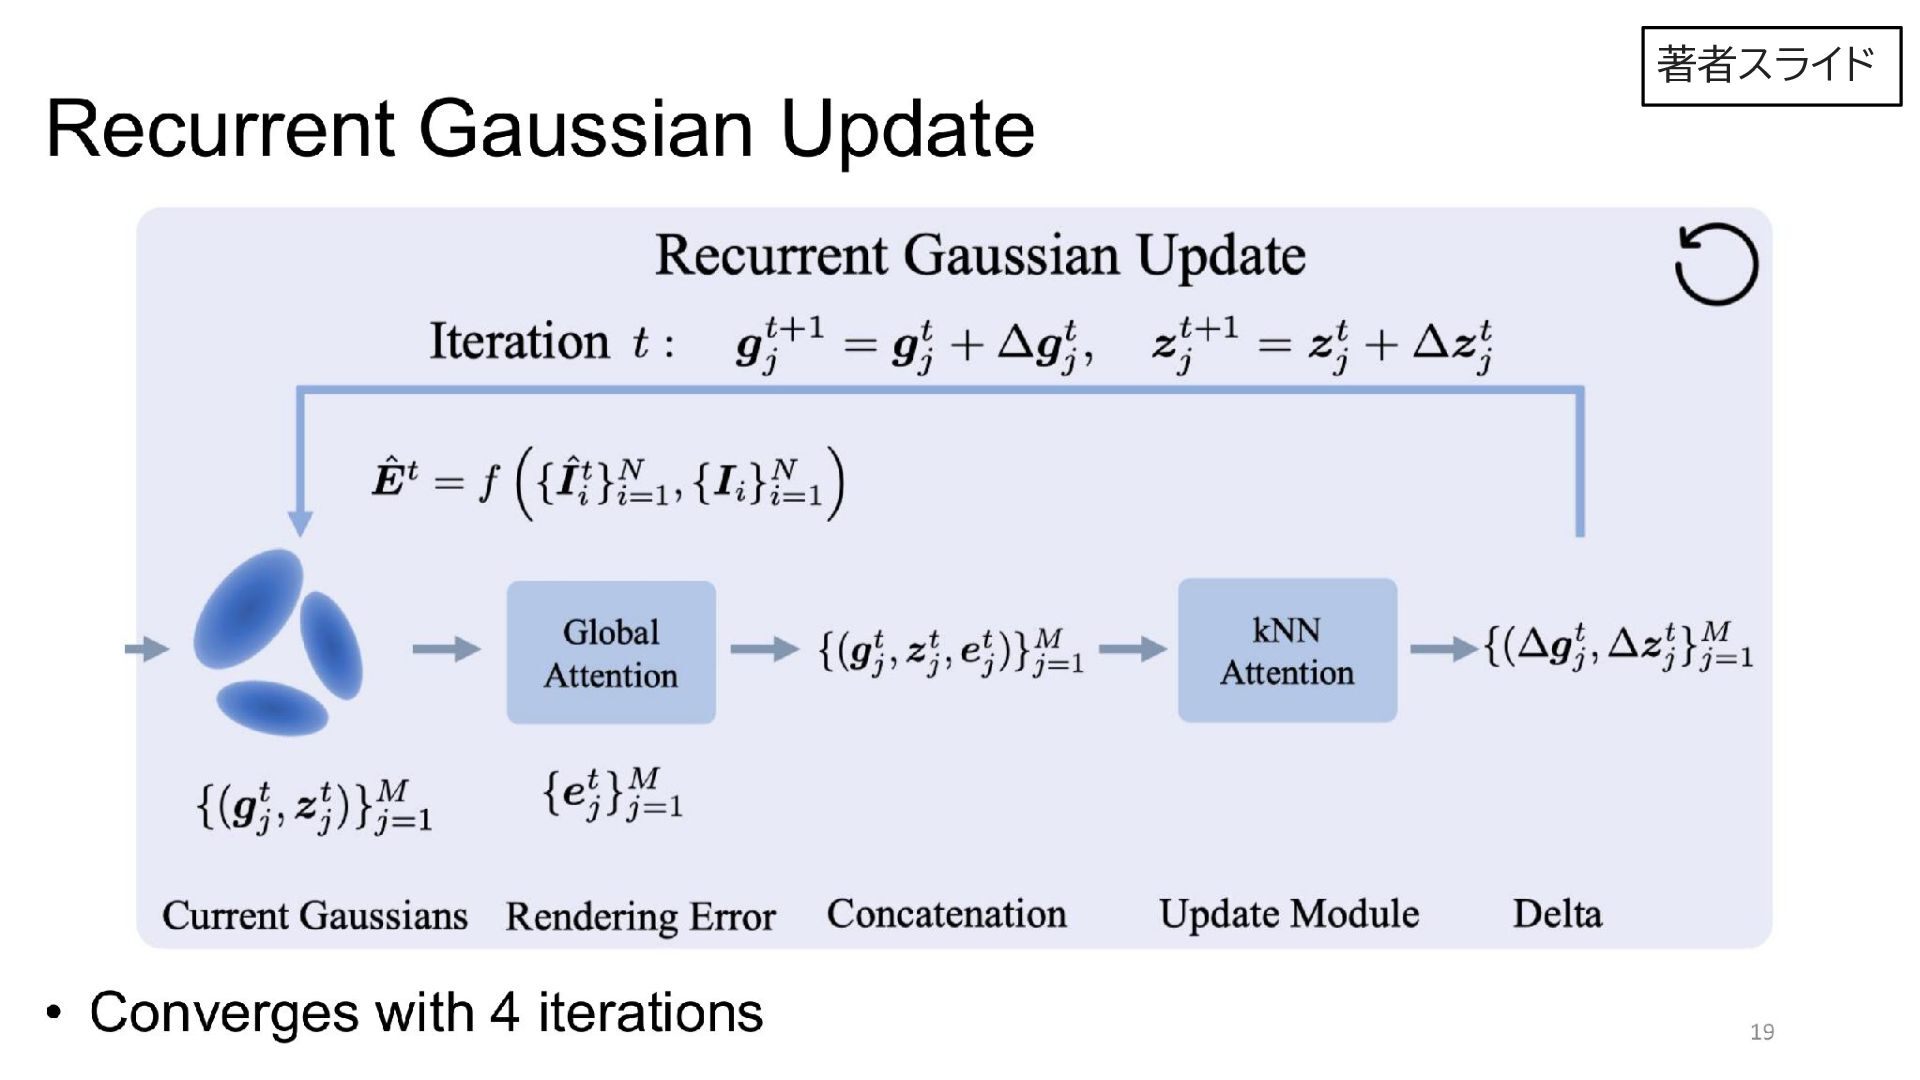
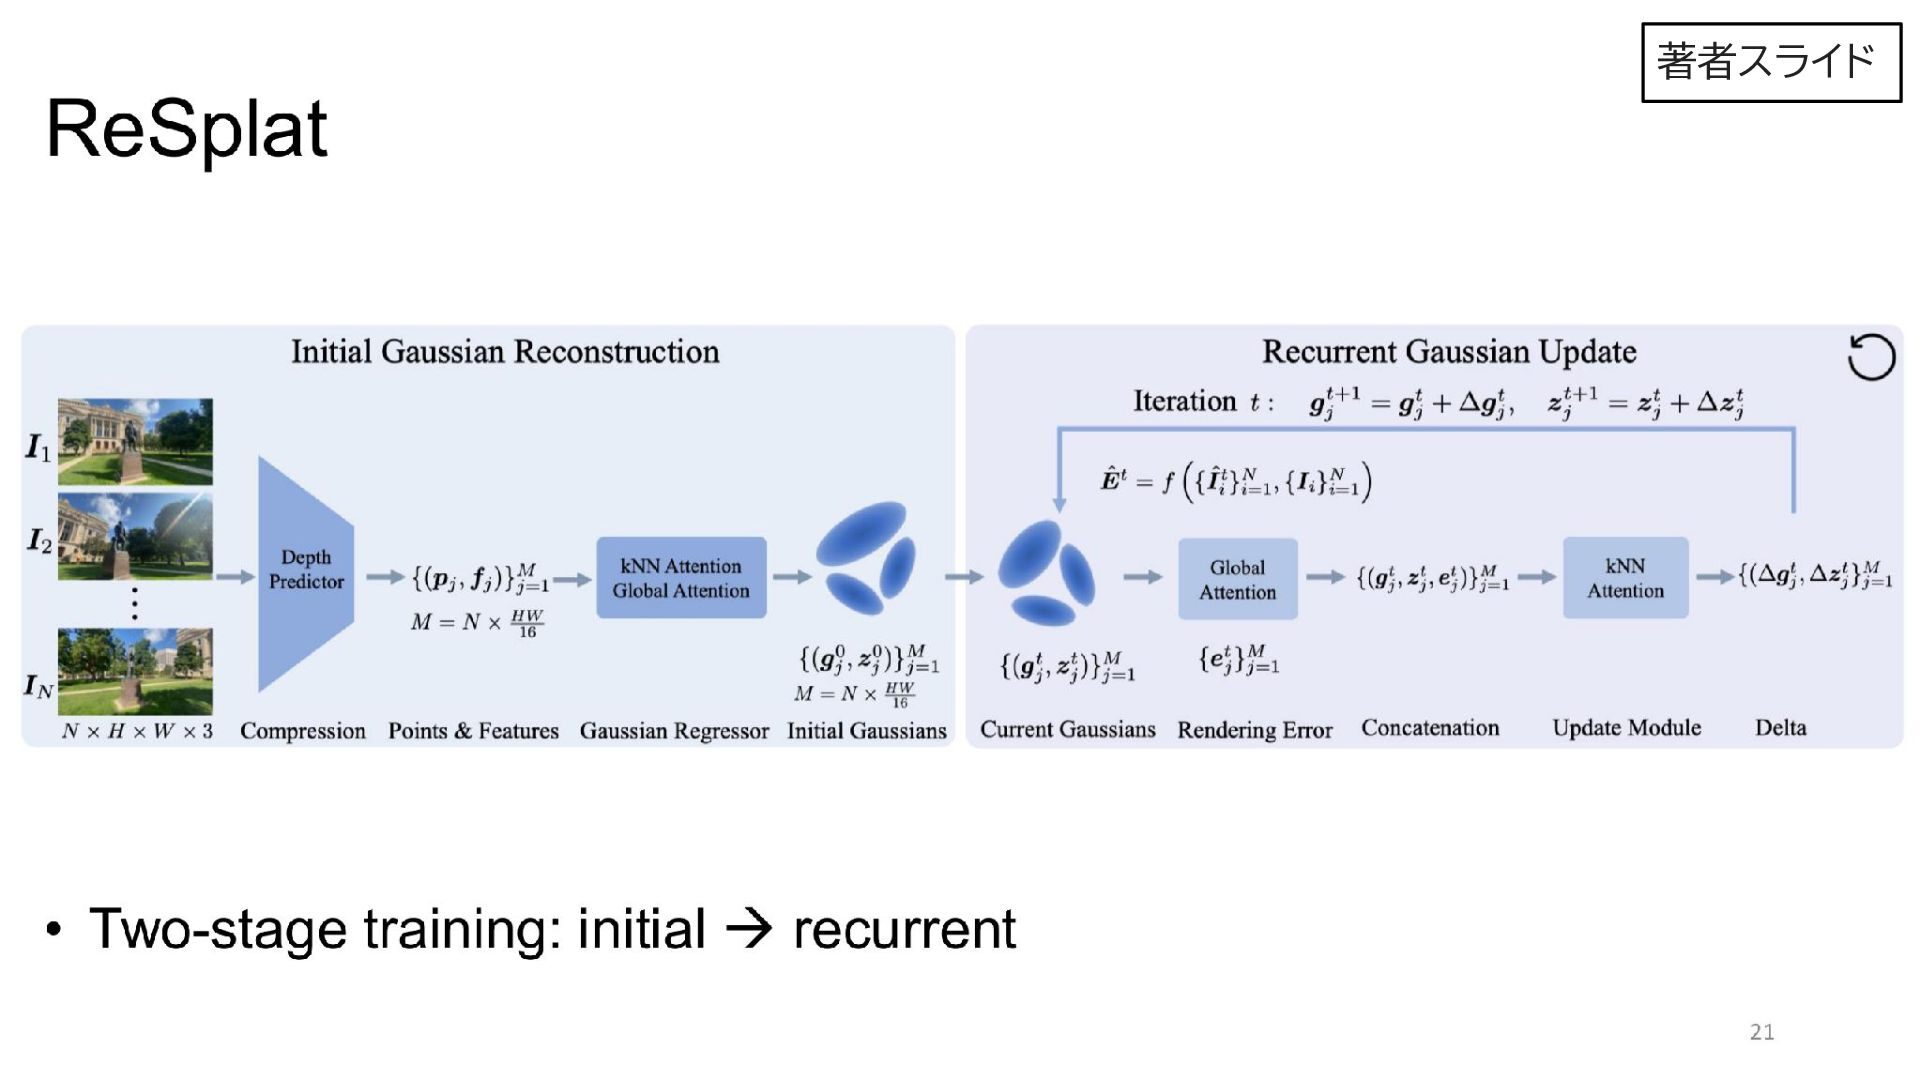
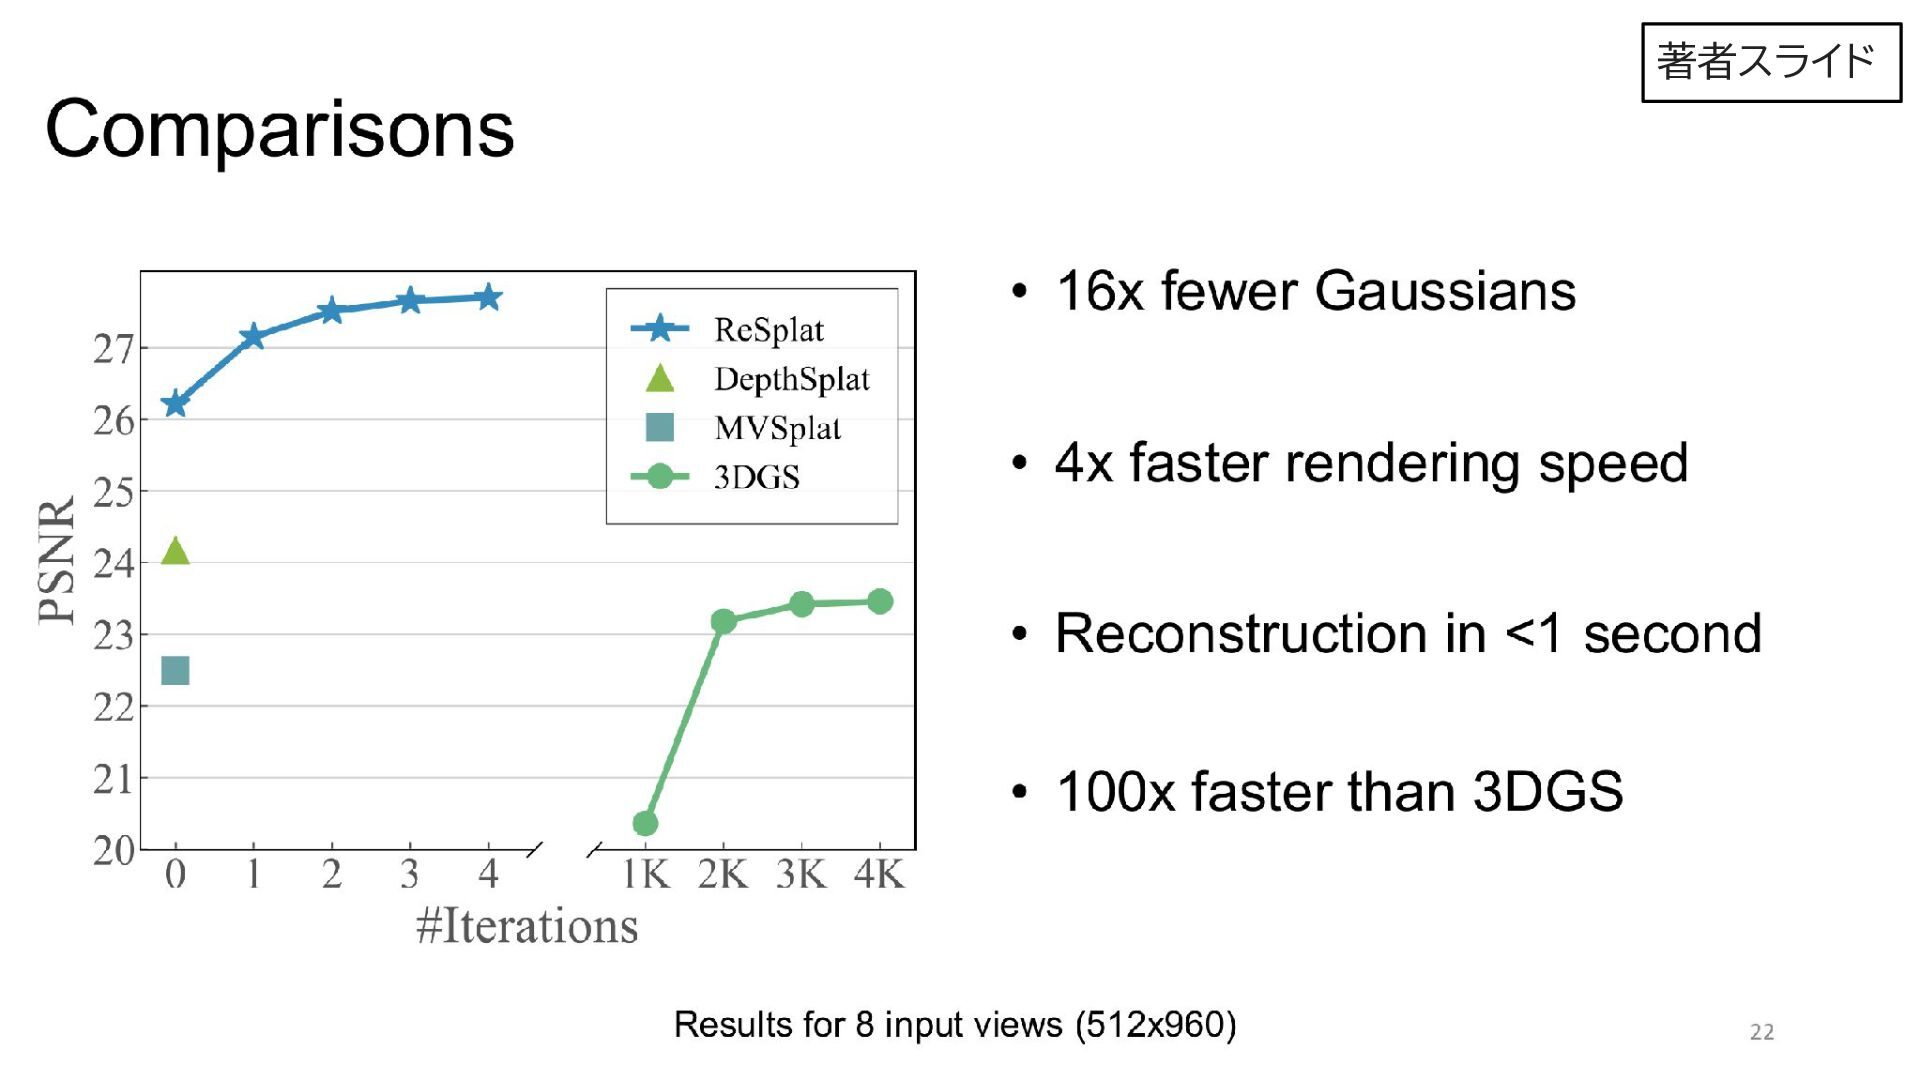
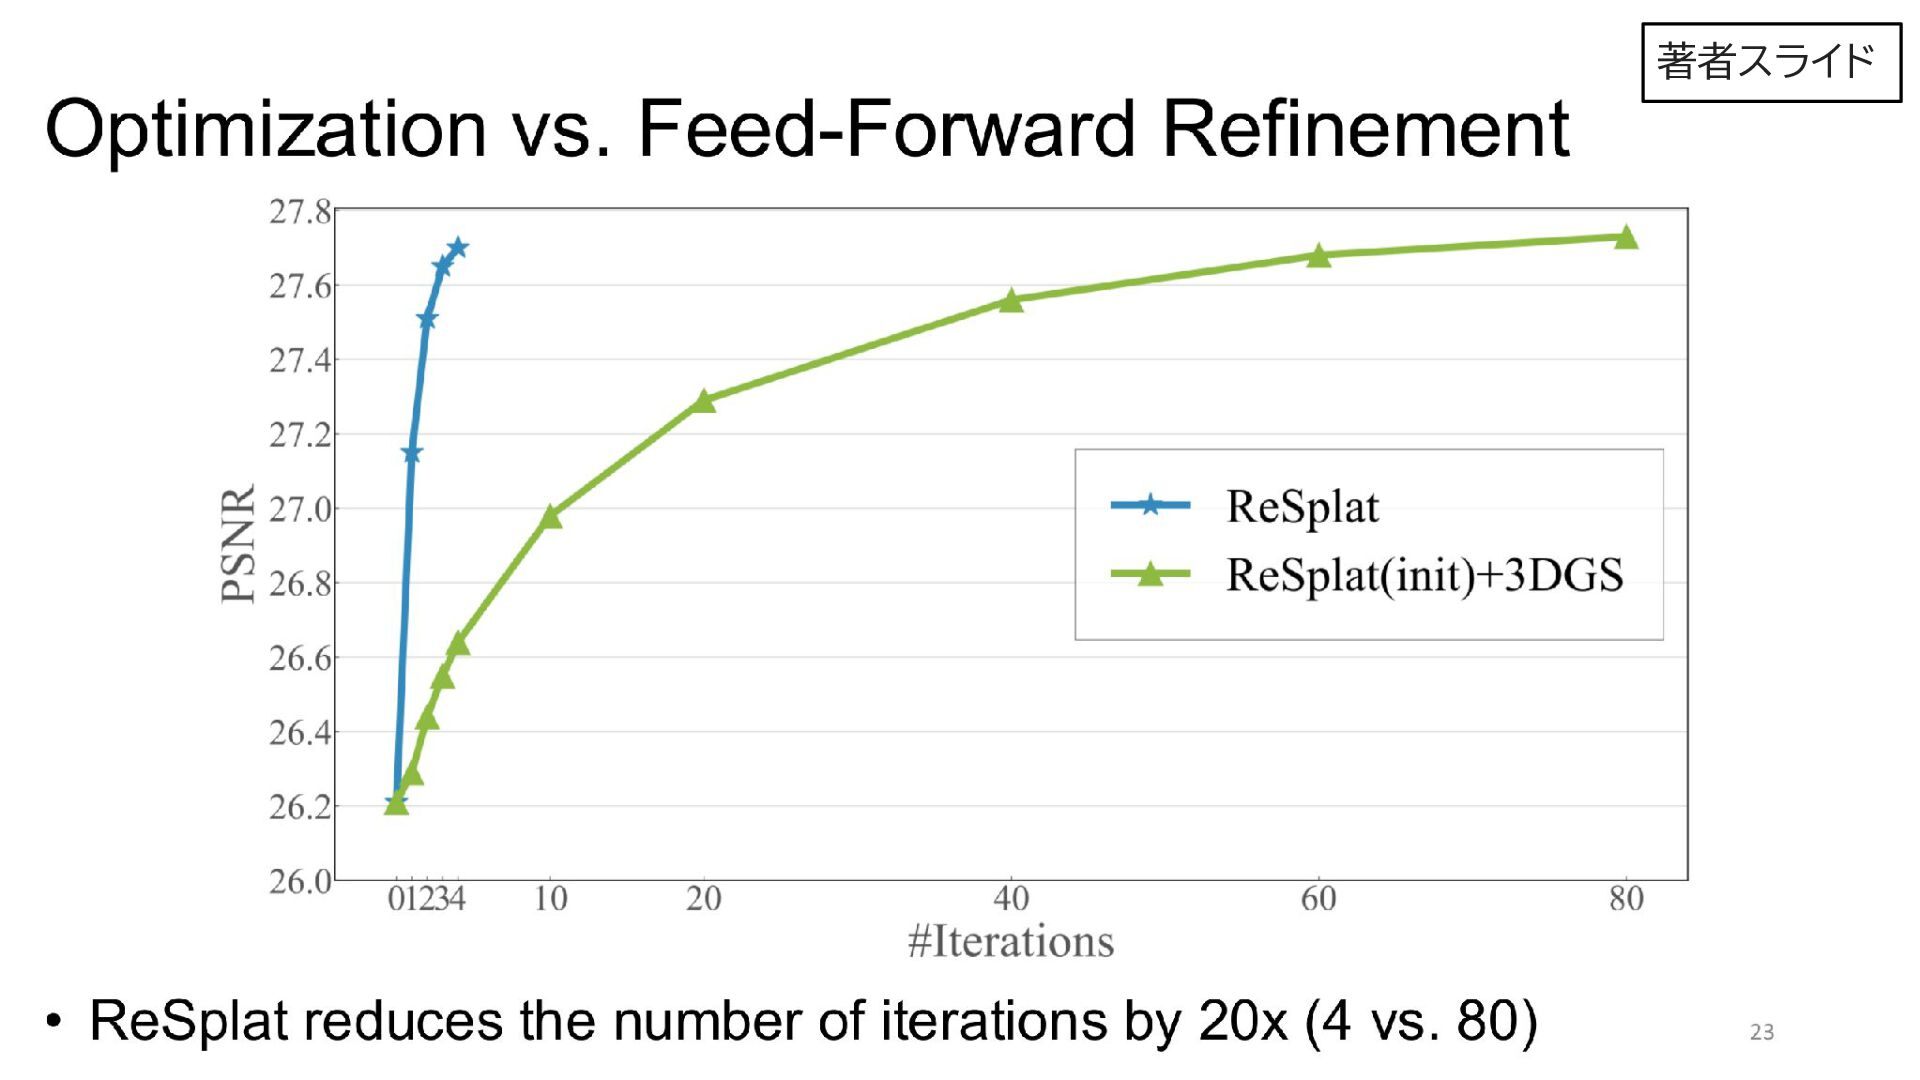
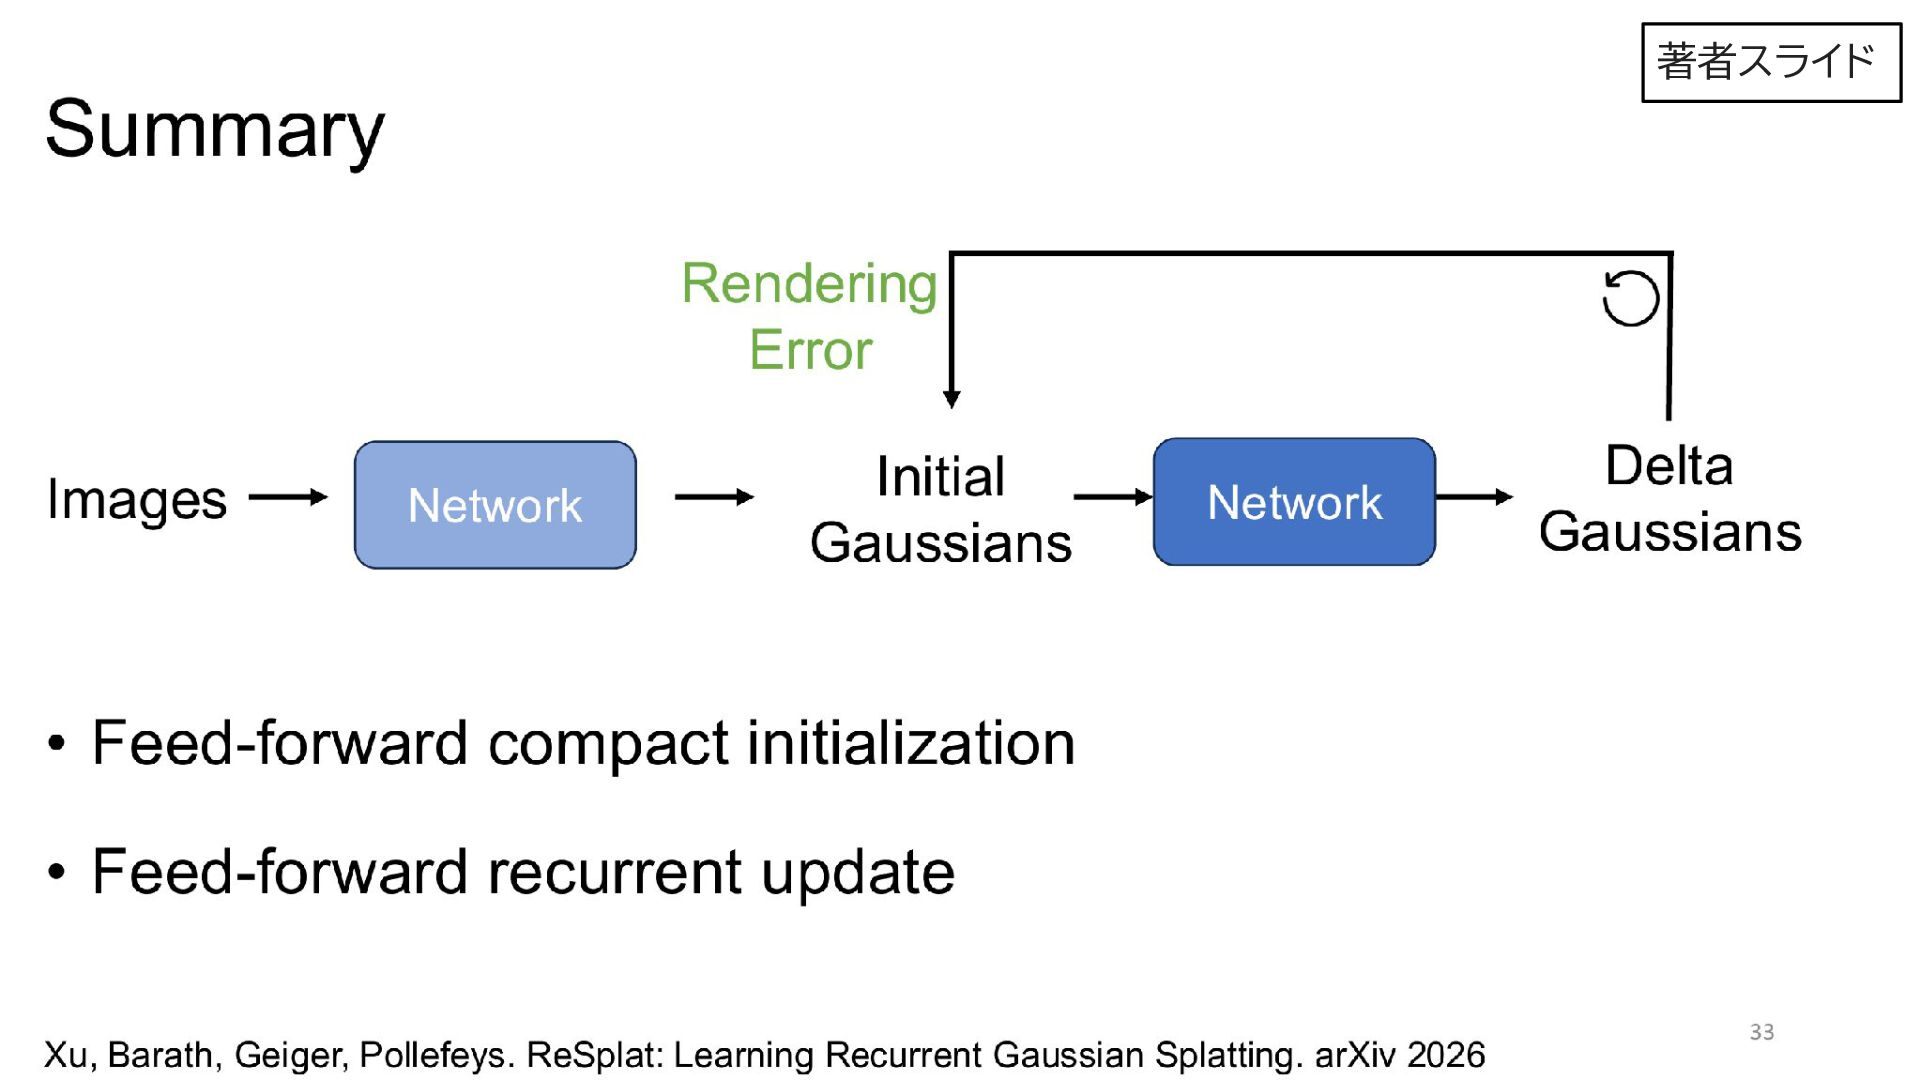
ECCV 2026 Spotlight.カメラパラメータ既知の複数画像から3DGSを生成するfeed-forward手法.一発推定を行う従来のfeed-forwardモデルに対し,ReSplatではレンダリング誤差からガウシアンパラメータの更新量を予測するネットワークを学習する.これを少数回反復適用することで,推論時の勾配計算なしに新規視点の描画品質を向上させる.

Avatar for Spatial AI Network

Spatial AI Network

October 06, 2026

More Decks by Spatial AI Network

Other Decks in Research
Transcript

  1. 2026/09/07 Spatial AI Network 勉強会 ReSplat: Learning Recurrent Gaussian Splatting

    Haofei Xu, Daniel Barath, Andreas Geiger, Marc Pollefeys ECCV 2026 Spotlight https://haofeixu.github.io/resplat/ 読む人: 菊池悠太 © 2026 Preferred Networks, Inc.
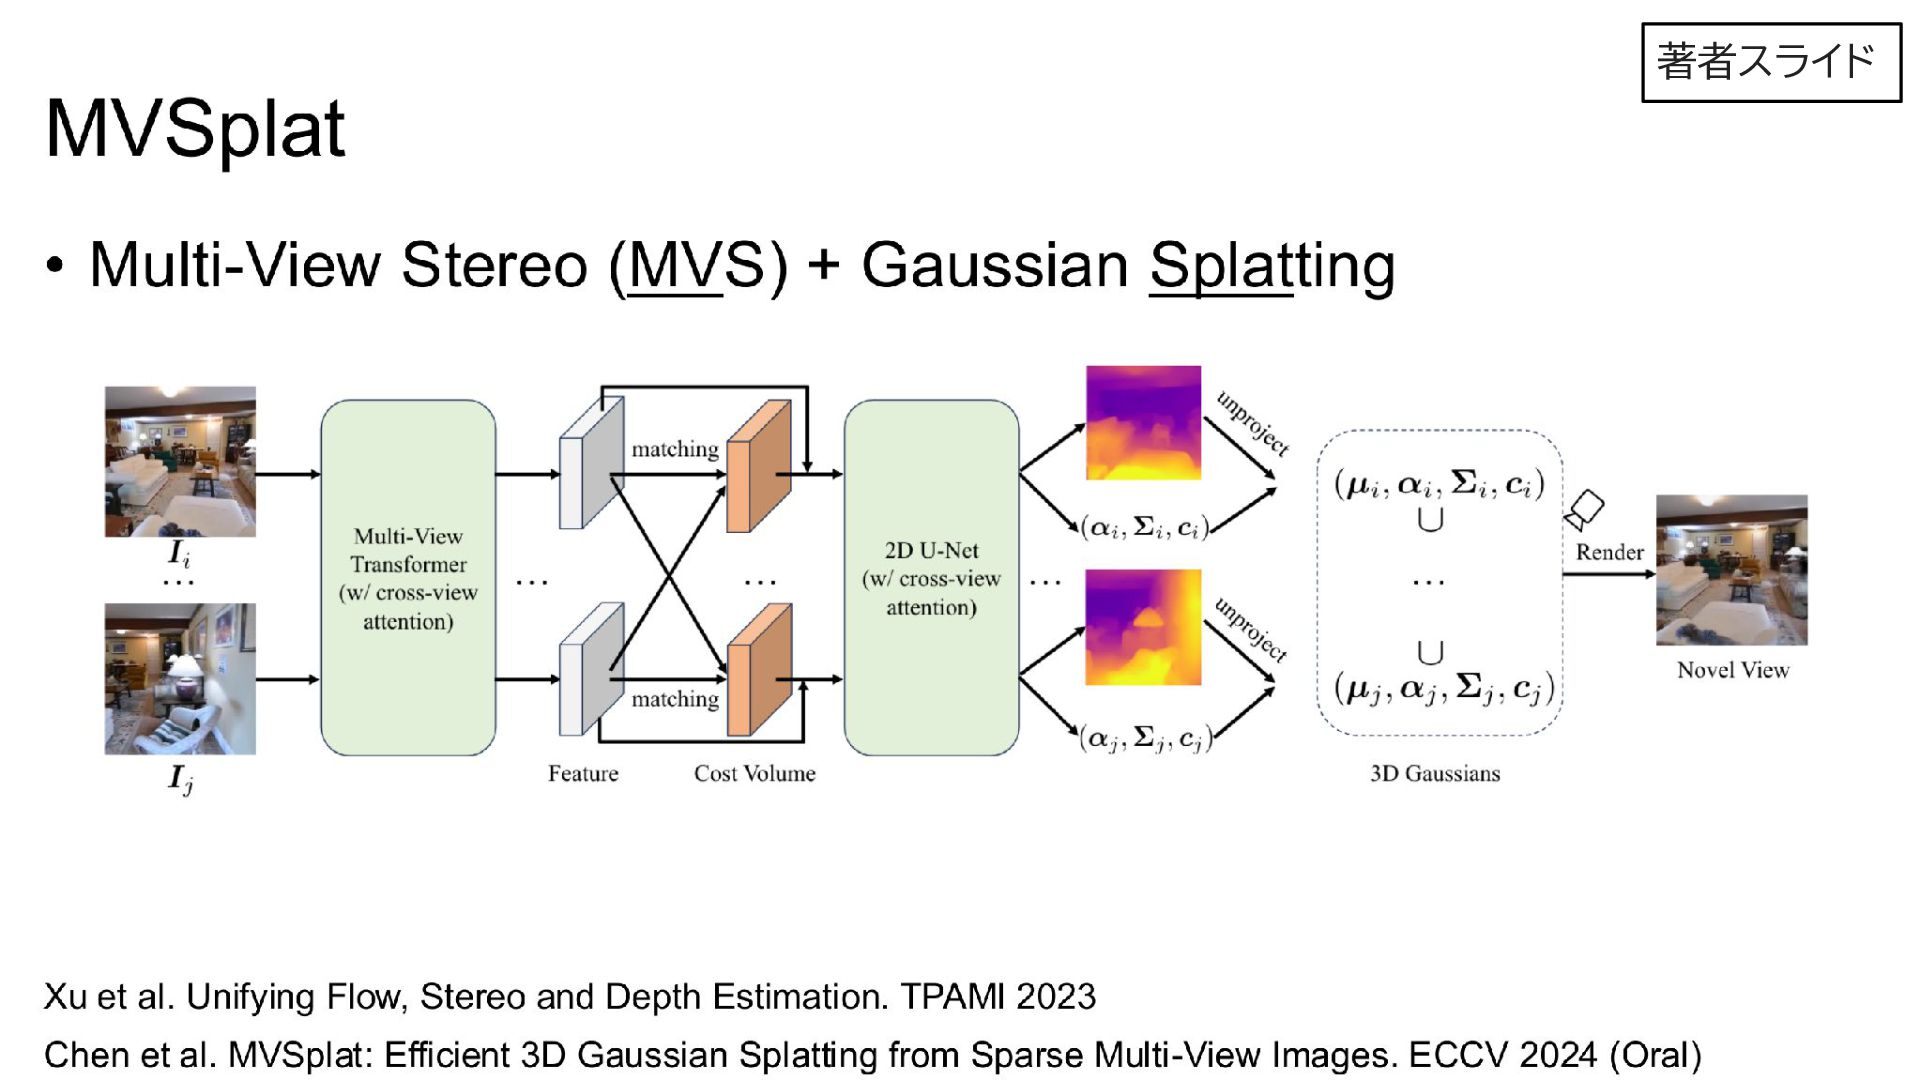
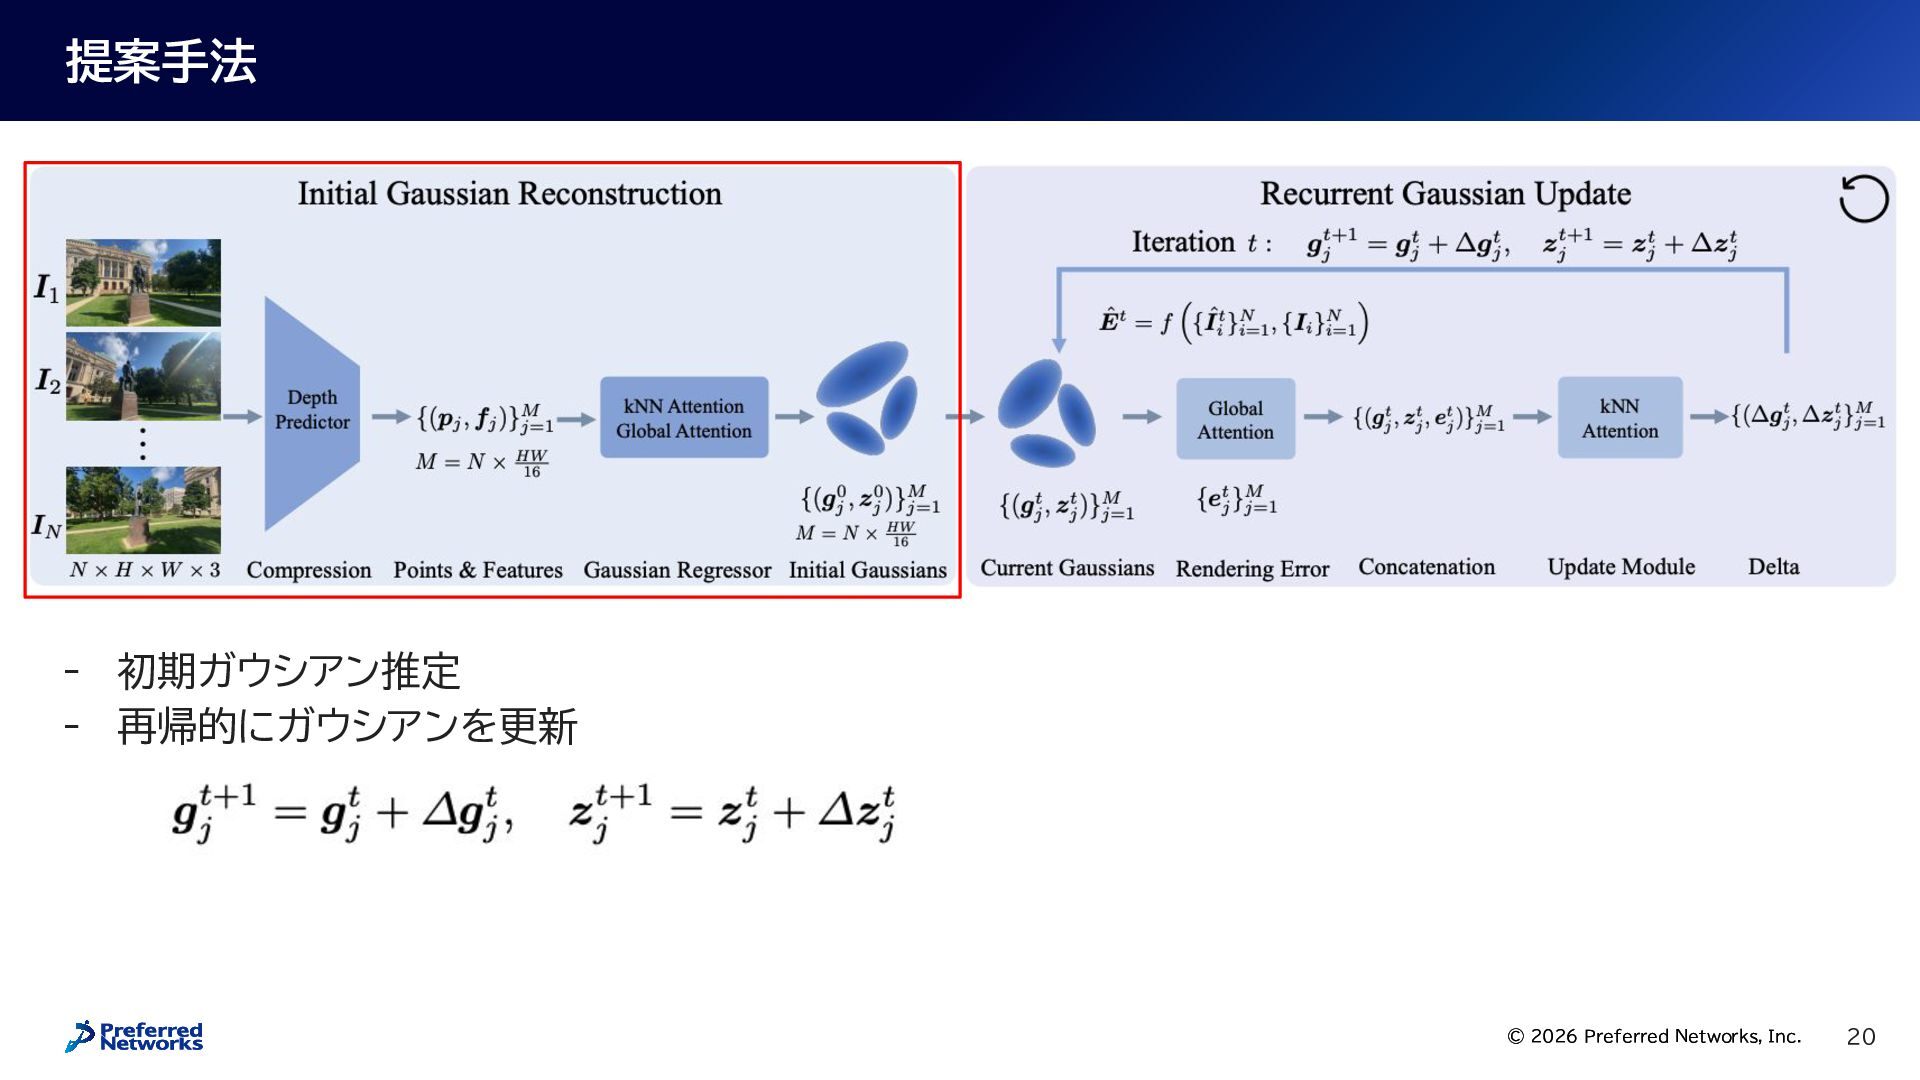
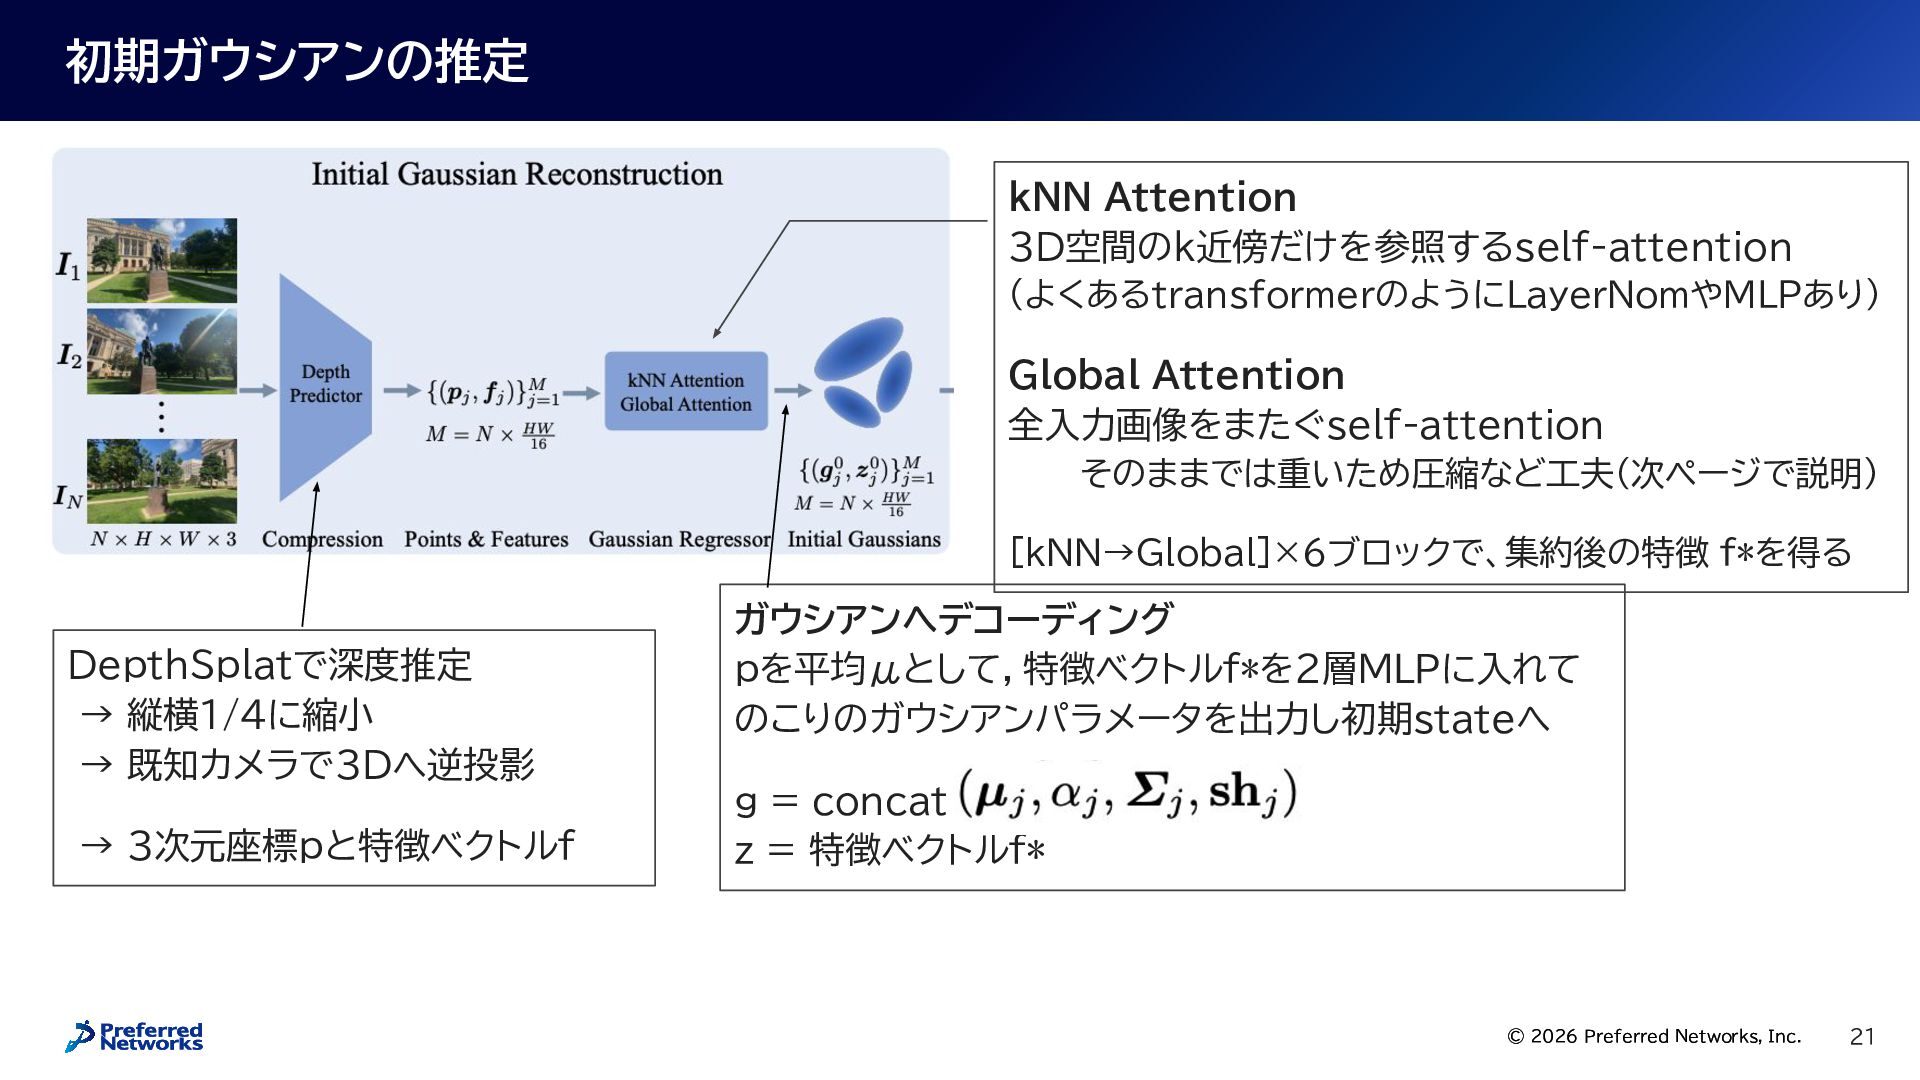
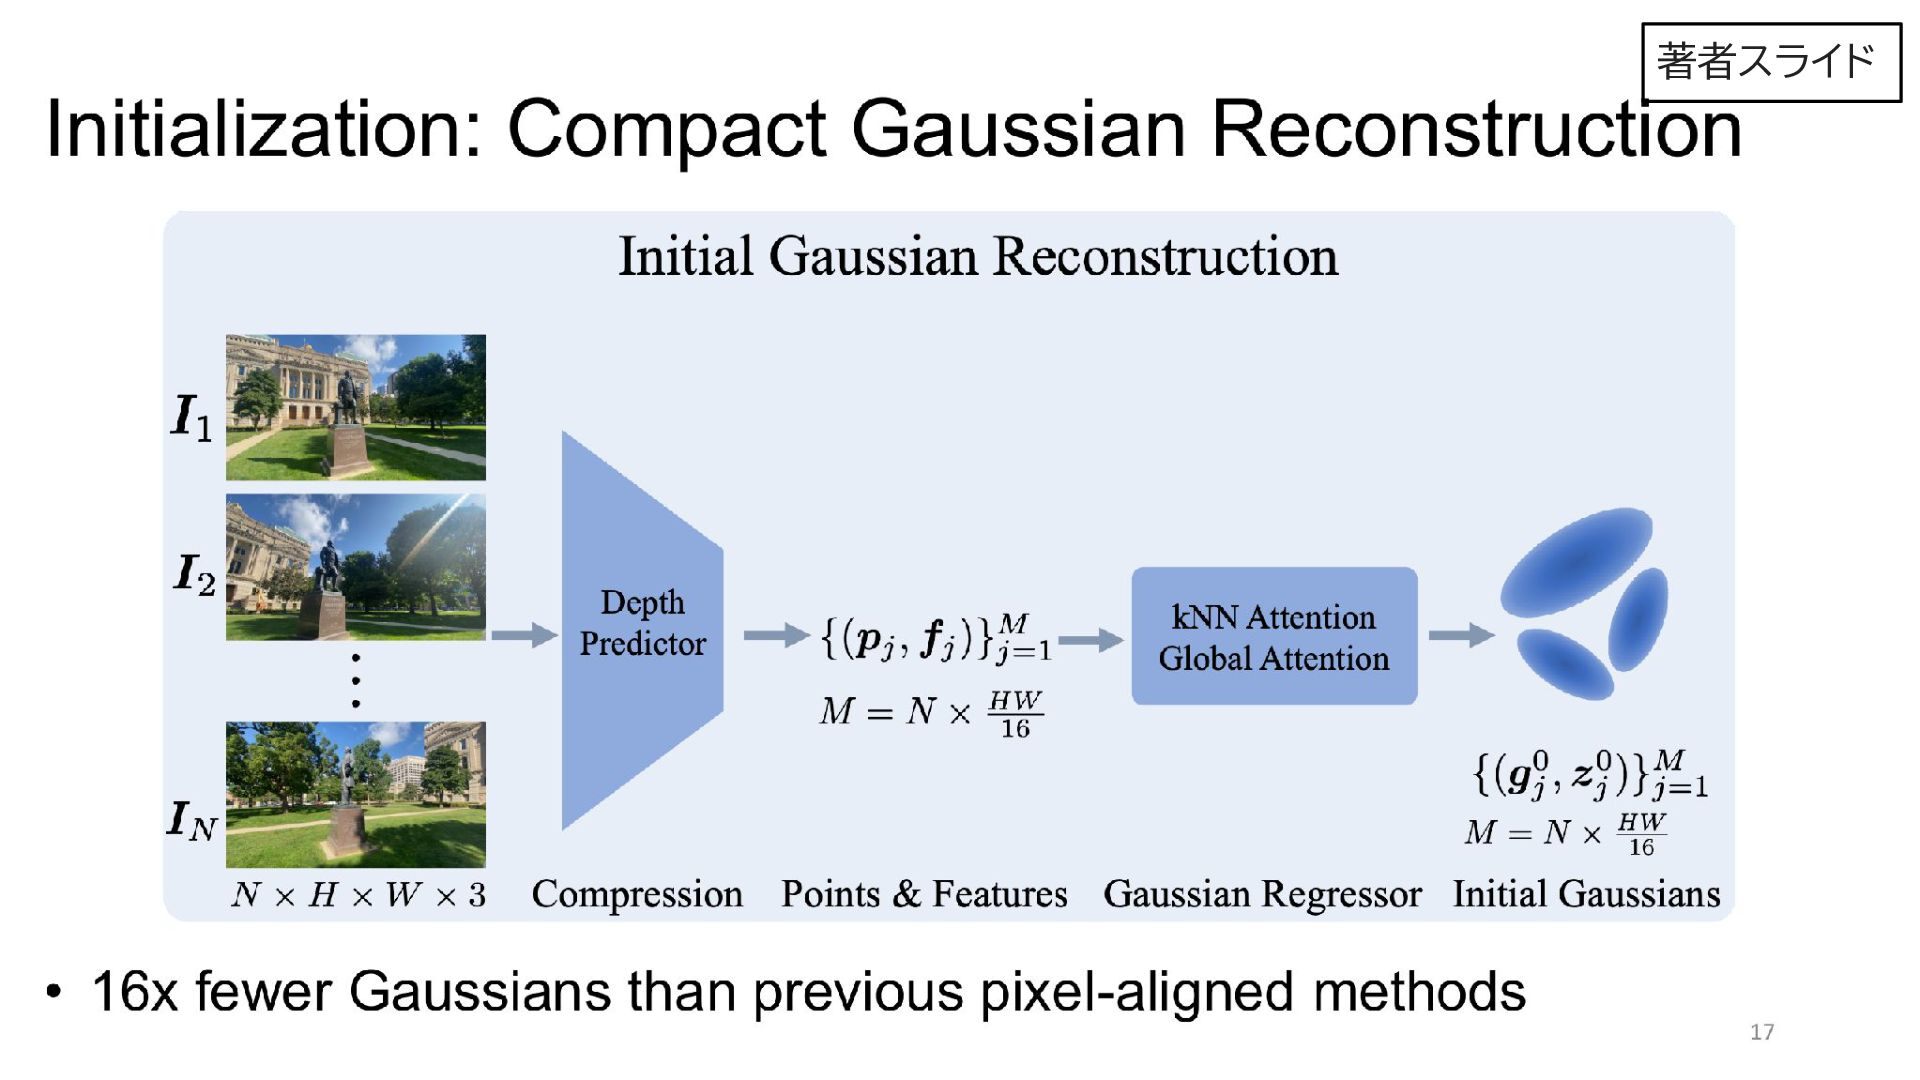
  2. 初期ガウシアンの推定 kNN Attention 3D空間のk近傍だけを参照するself-attention (よくあるtransformerのようにLayerNomやMLPあり) Global Attention 全入力画像をまたぐself-attention そのままでは重いため圧縮など工夫(次ページで説明) [kNN→Global]×6ブロックで、集約後の特徴

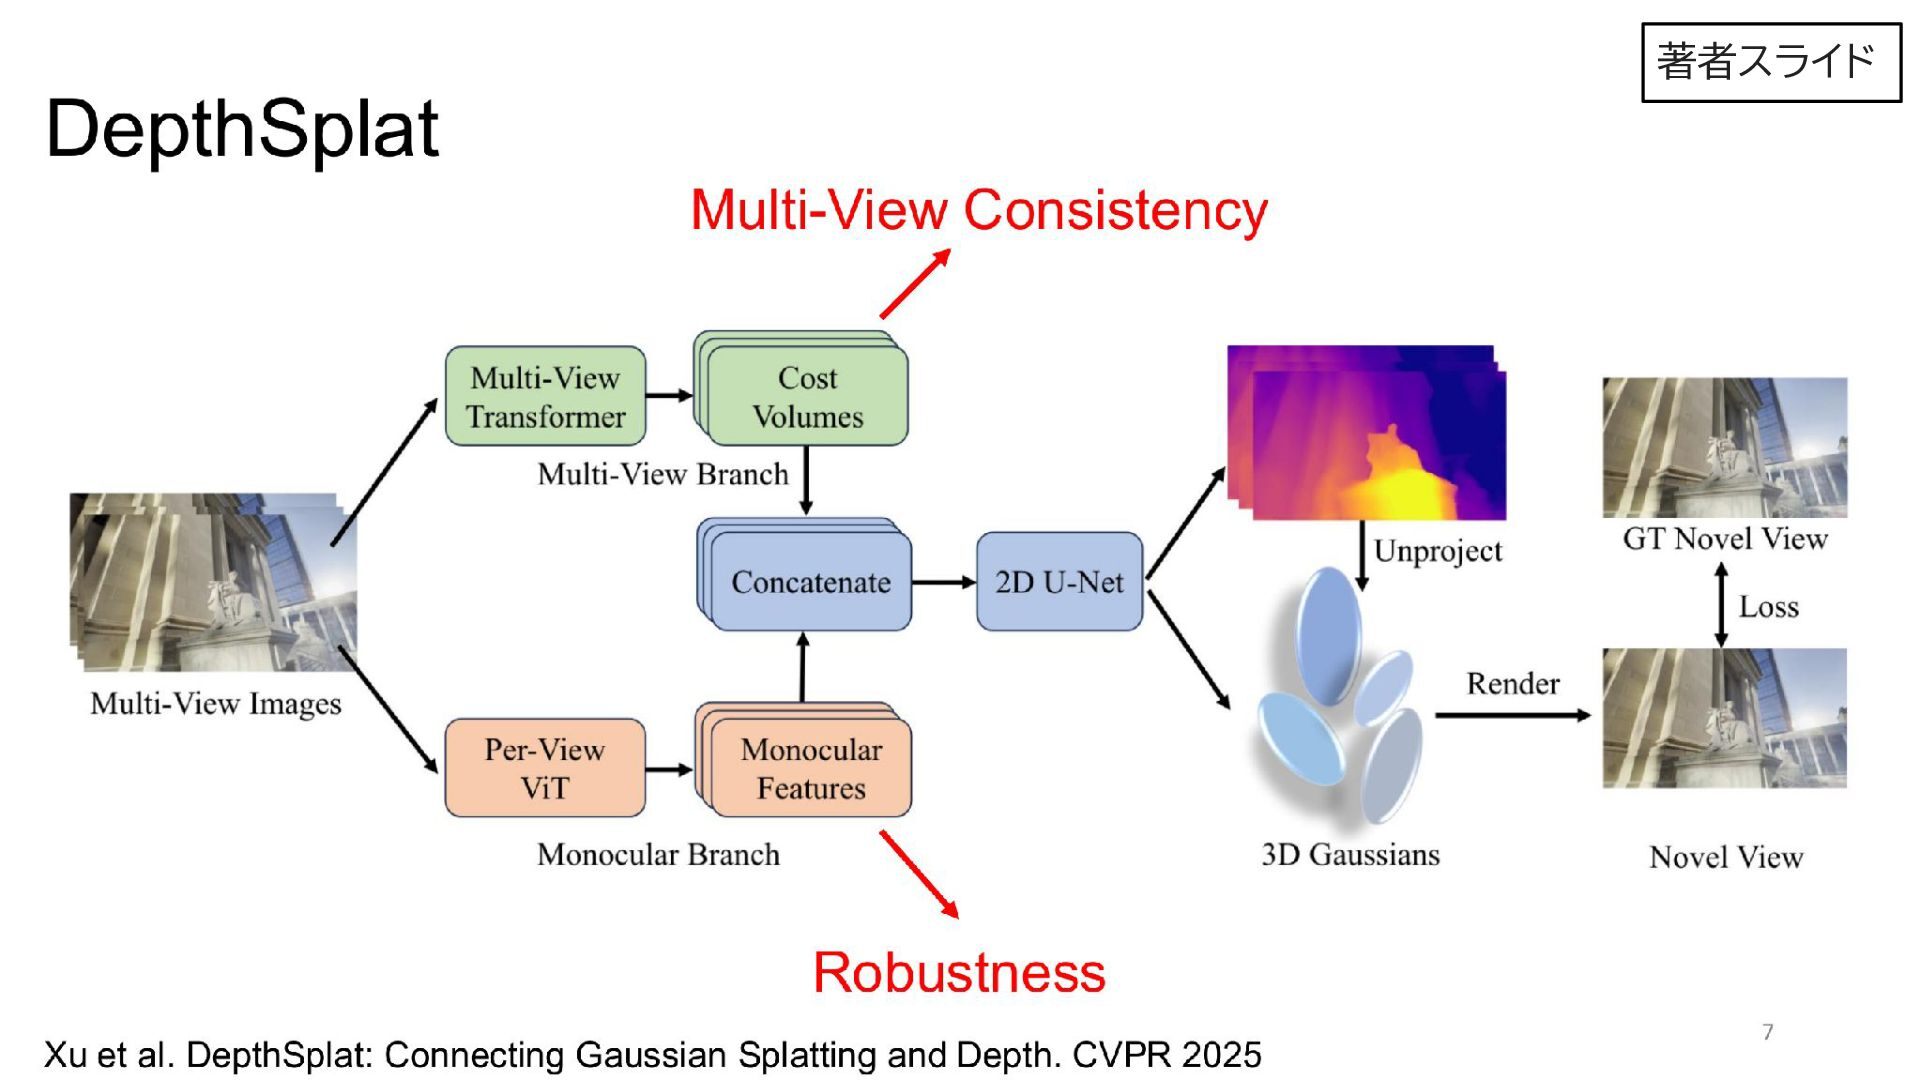
    f*を得る DepthSplatで深度推定 → 縦横1/4に縮小 → 既知カメラで3Dへ逆投影 → 3次元座標pと特徴ベクトルf ガウシアンへデコーディング pを平均μとして,特徴ベクトルf*を2層MLPに入れて のこりのガウシアンパラメータを出力し初期stateへ g = concat z = 特徴ベクトルf* © 2026 Preferred Networks, Inc. 21
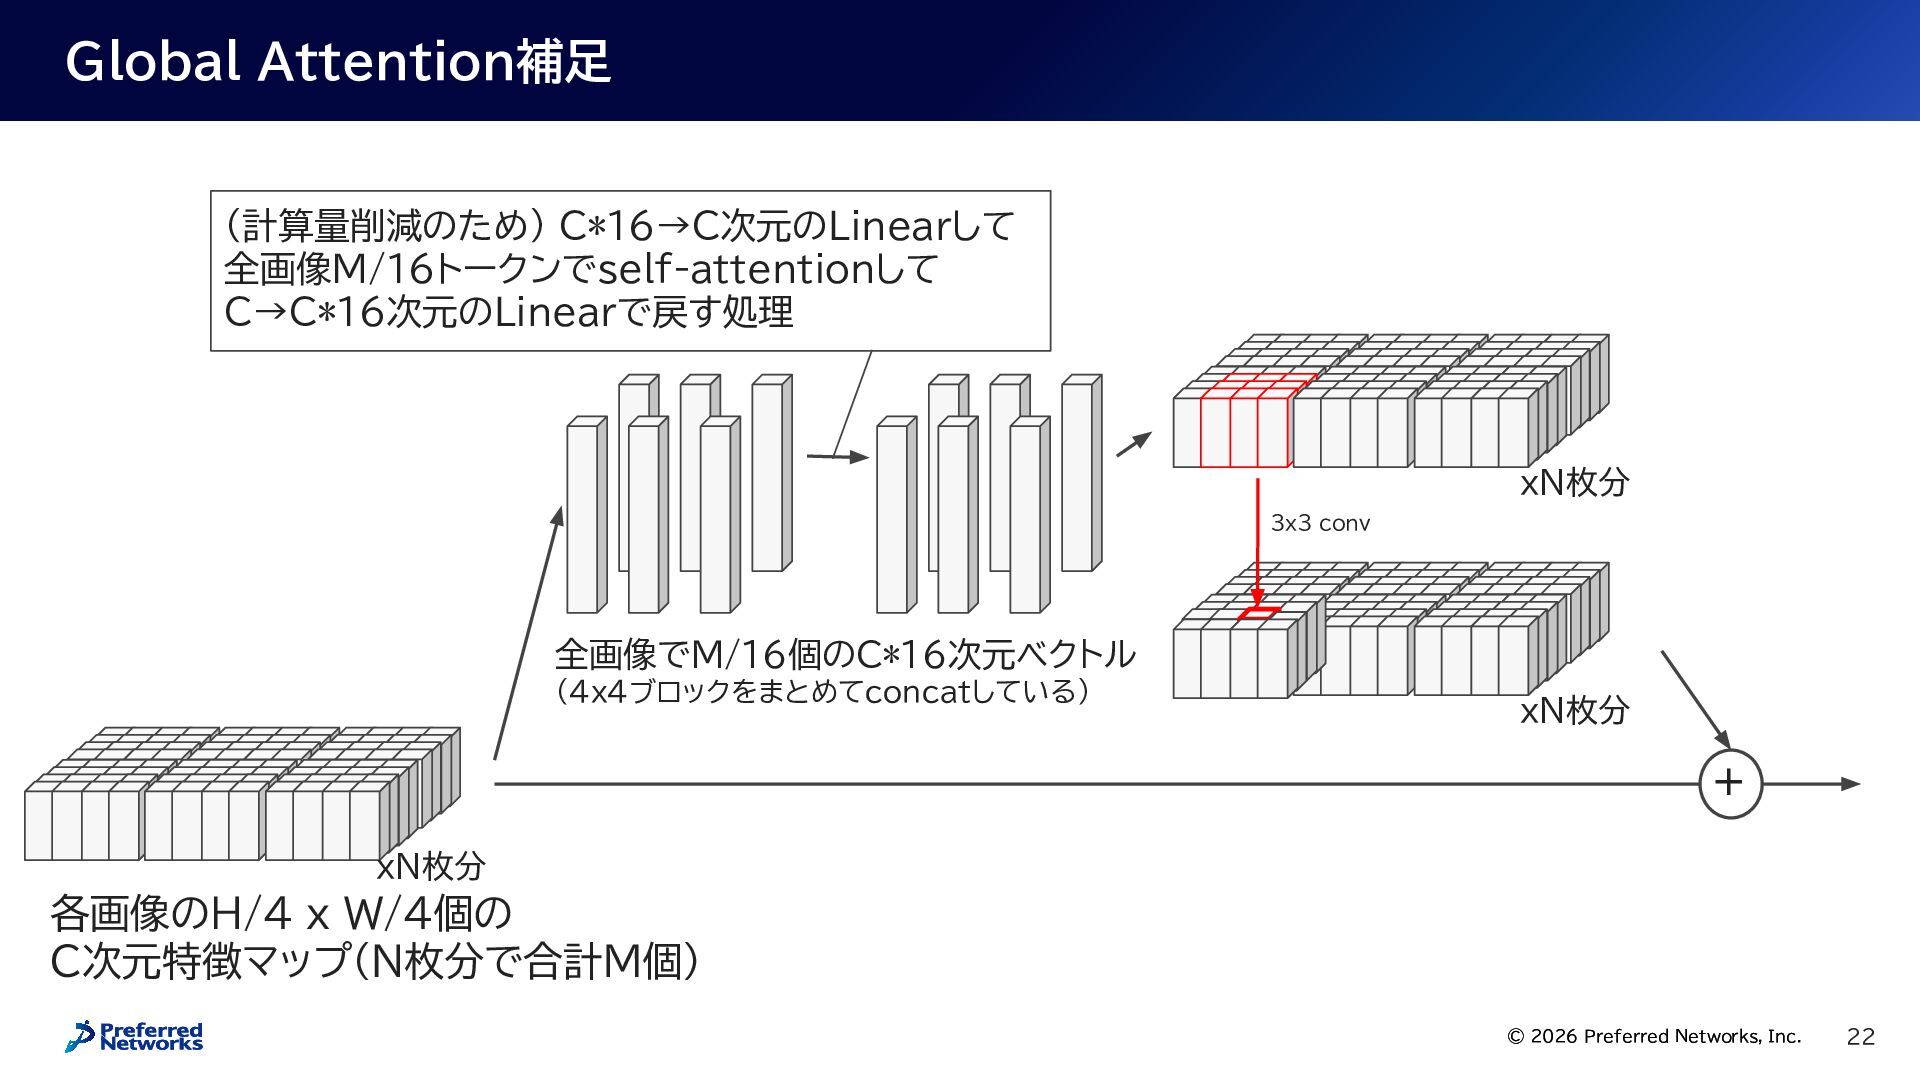
  3. Global Attention補足 (計算量削減のため) C*16→C次元のLinearして 全画像M/16トークンでself-attentionして C→C*16次元のLinearで戻す処理 xN枚分 3x3 conv 全画像でM/16個のC*16次元ベクトル

    (4x4ブロックをまとめてconcatしている) xN枚分 + xN枚分 各画像のH/4 x W/4個の C次元特徴マップ(N枚分で合計M個) © 2026 Preferred Networks, Inc. 22
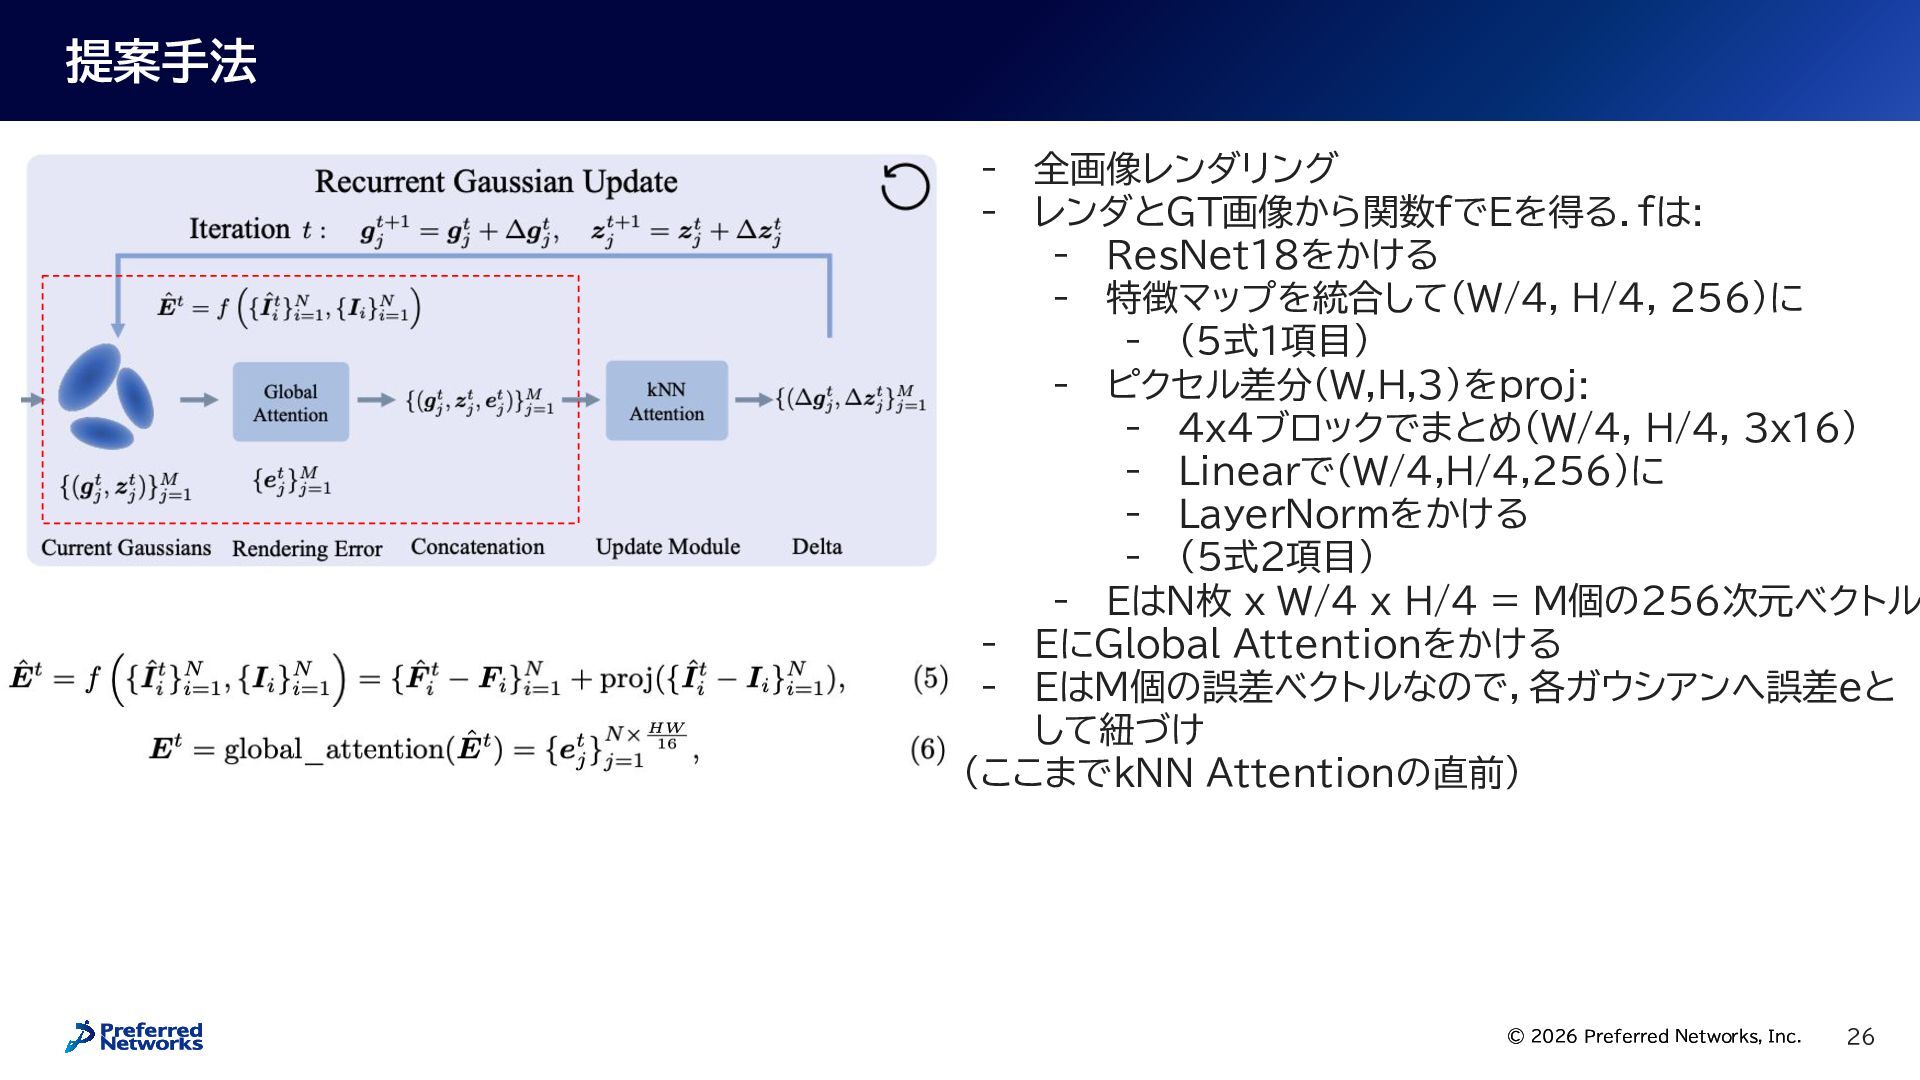
  4. 提案手法 - 全画像レンダリング レンダとGT画像から関数fでEを得る.fは: - ResNet18をかける - 特徴マップを統合して(W/4, H/4, 256)に

    - (5式1項目) - ピクセル差分(W,H,3)をproj: - 4x4ブロックでまとめ(W/4, H/4, 3x16) - Linearで(W/4,H/4,256)に - LayerNormをかける - (5式2項目) - EはN枚 x W/4 x H/4 = M個の256次元ベクトル - EにGlobal Attentionをかける - EはM個の誤差ベクトルなので,各ガウシアンへ誤差eと して紐づけ (ここまでkNN Attentionの直前) © 2026 Preferred Networks, Inc. 26
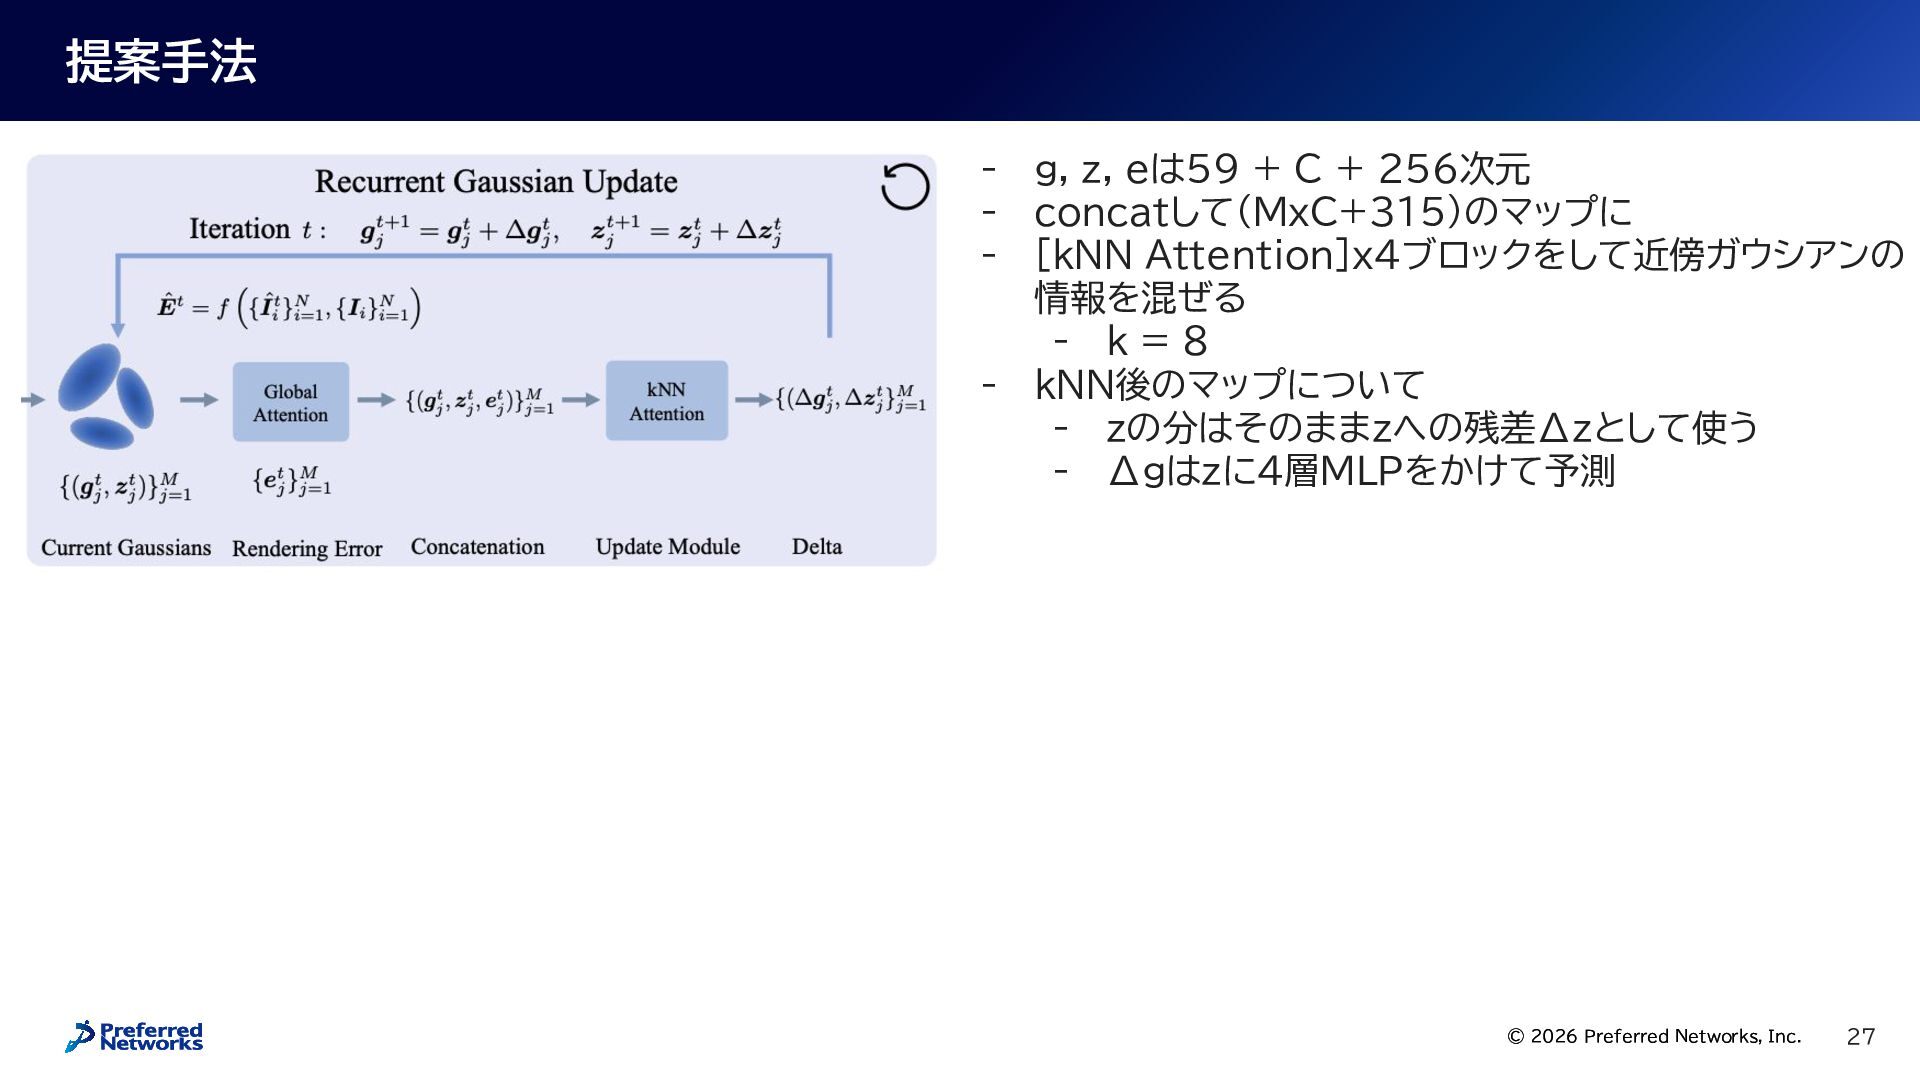
  5. 提案手法 - - g, z, eは59 + C + 256次元

    concatして(MxC+315)のマップに [kNN Attention]x4ブロックをして近傍ガウシアンの 情報を混ぜる - k=8 kNN後のマップについて - zの分はそのままzへの残差Δzとして使う - Δgはzに4層MLPをかけて予測 © 2026 Preferred Networks, Inc. 27
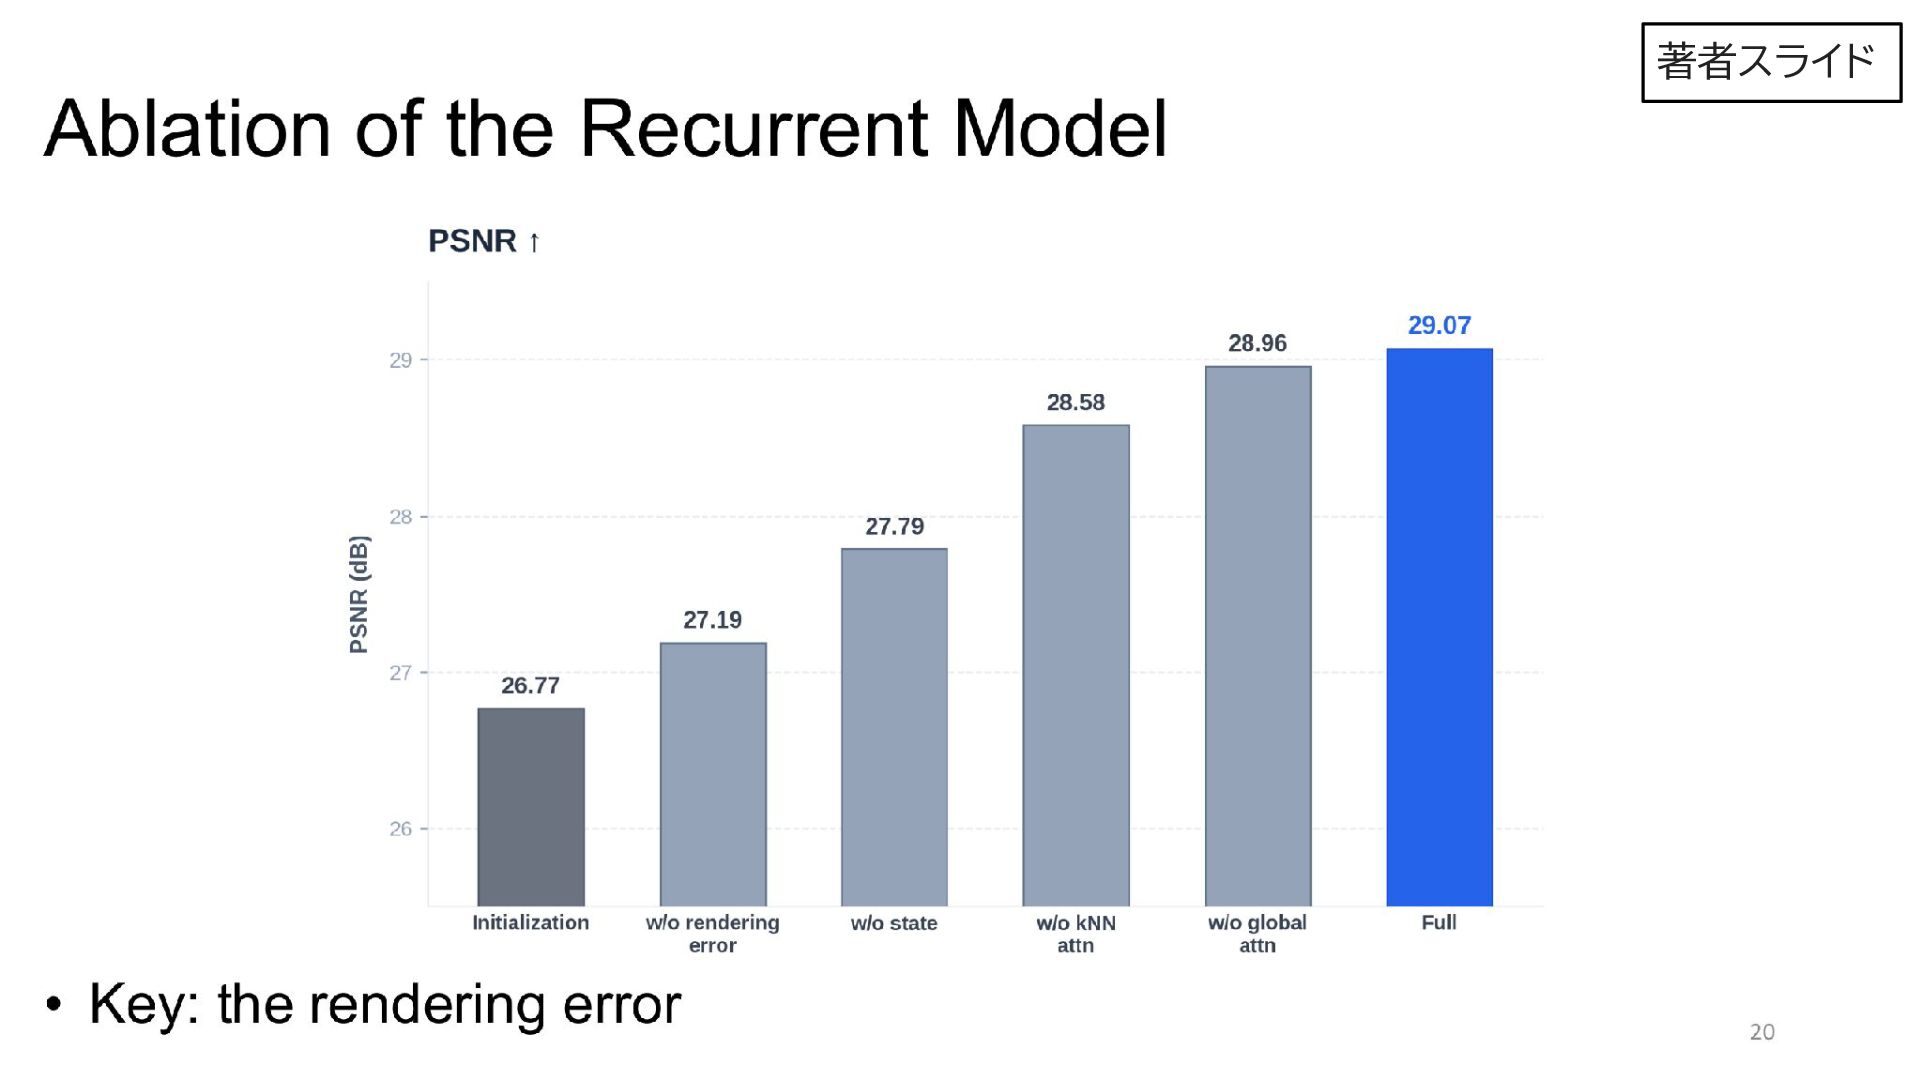
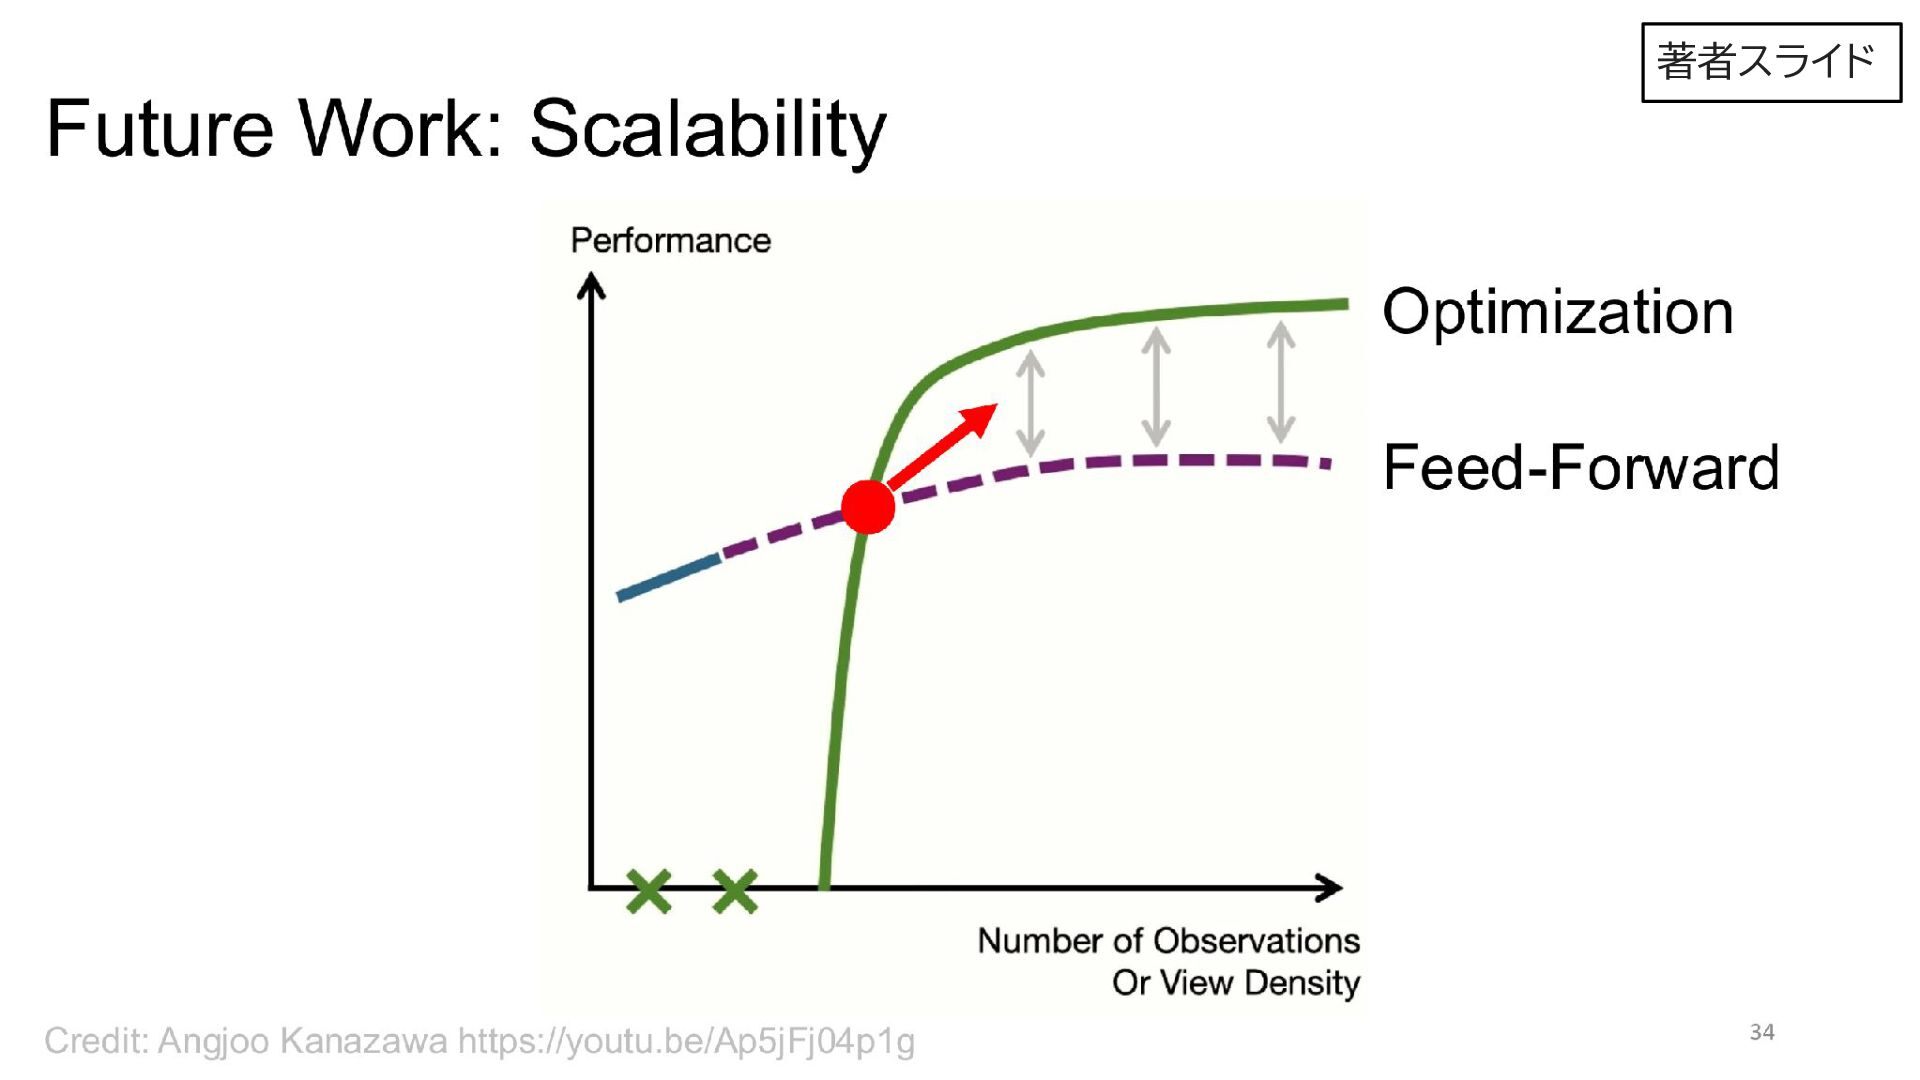
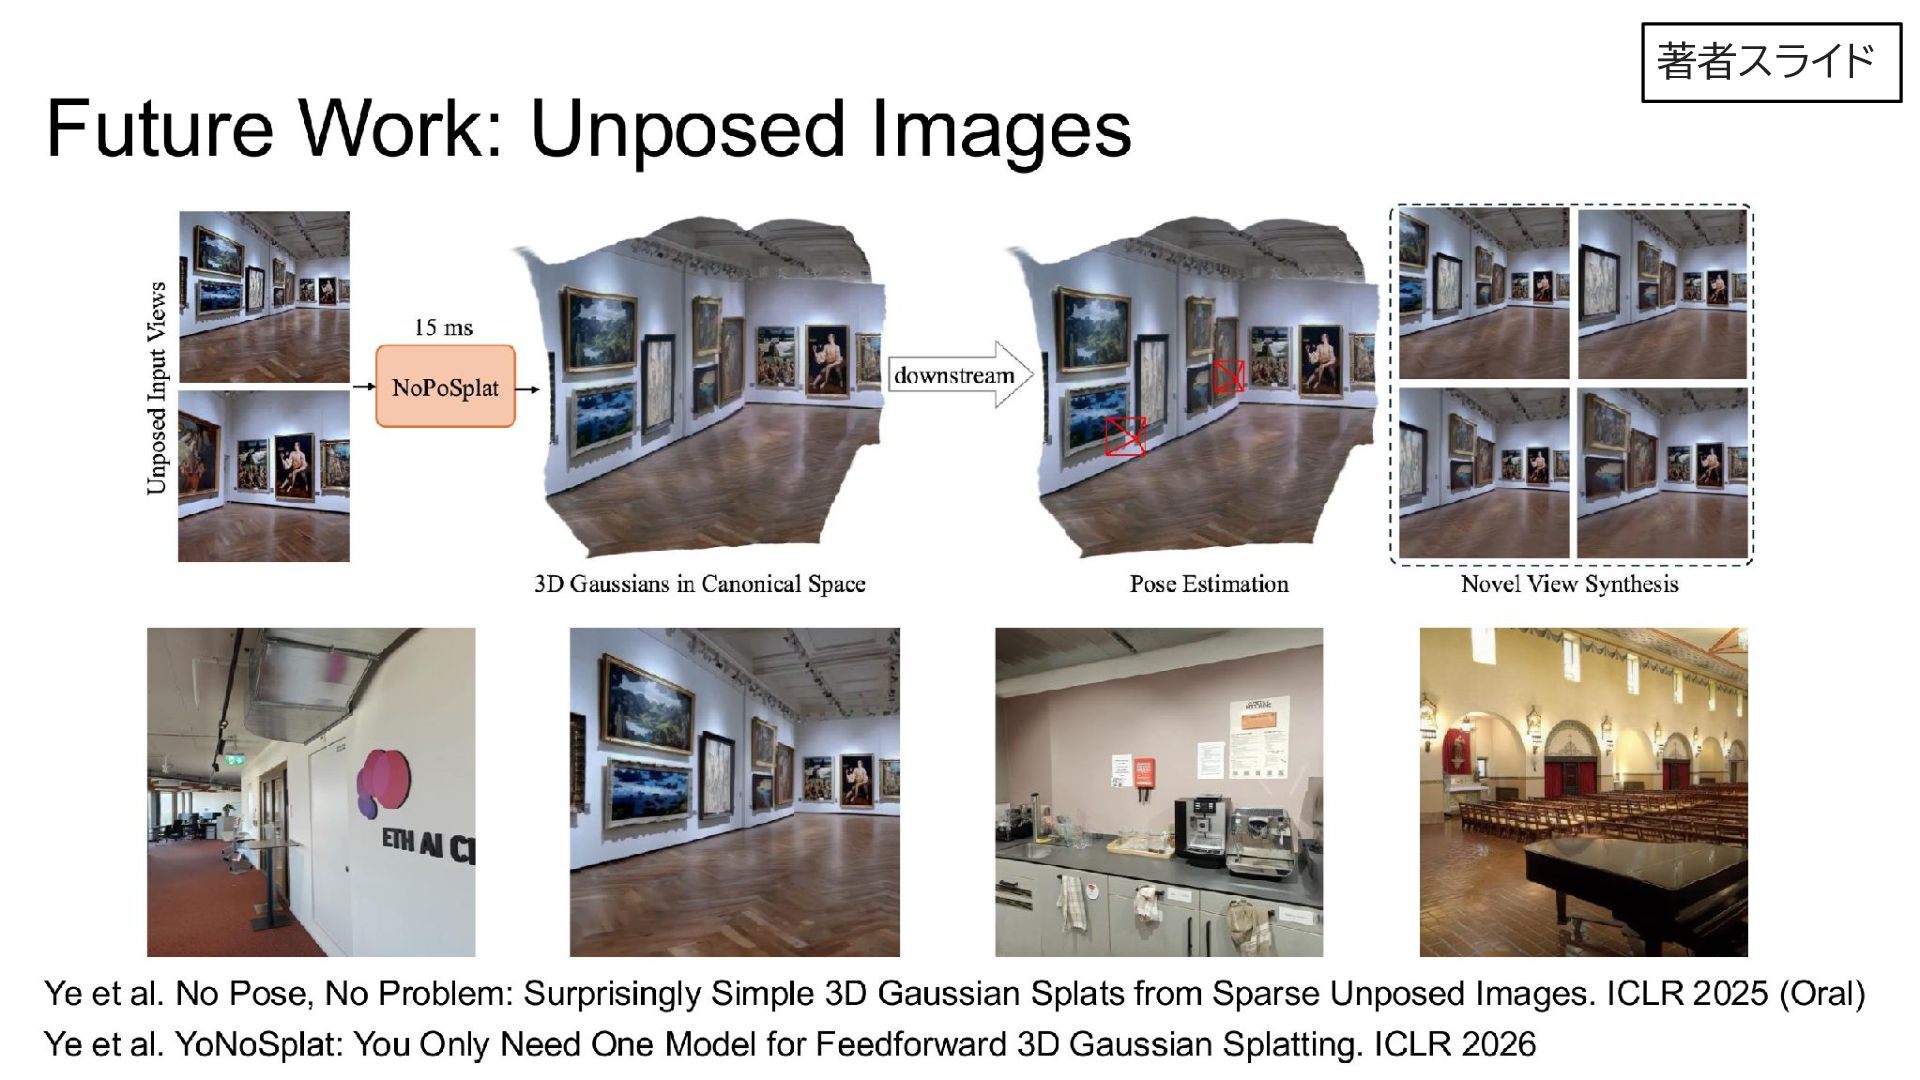
  6. まとめ - 一発推定でなく,レンダリング誤差を見ながら反復的にrefineしていけるのは面白い - 同じ更新ネットワークを共有し,勾配計算なしの少数回の推論で品質を詰める - 一方カメラパラメータが分かっている前提で,実用的にはここが結構ネック - 少数画像から3DGSを作れることと、少数画像だけでpose推定まで完結することは別 -

    ただし,poseが十分正確でも少数画像からの復元は難しく、学習済みの知識で後段の復元・描 画品質を改善する意義はある - 既存PLYを直せる汎用refiner化や、poseも同時に更新する拡張に期待 - 特に、VGGT系の不完全なposeから、カメラとGaussianを一緒に詰められると嬉しい © 2026 Preferred Networks, Inc. 47