VGGT: Visual Geometry Grounded Transformer

VGGT: Visual Geometry Grounded Transformer
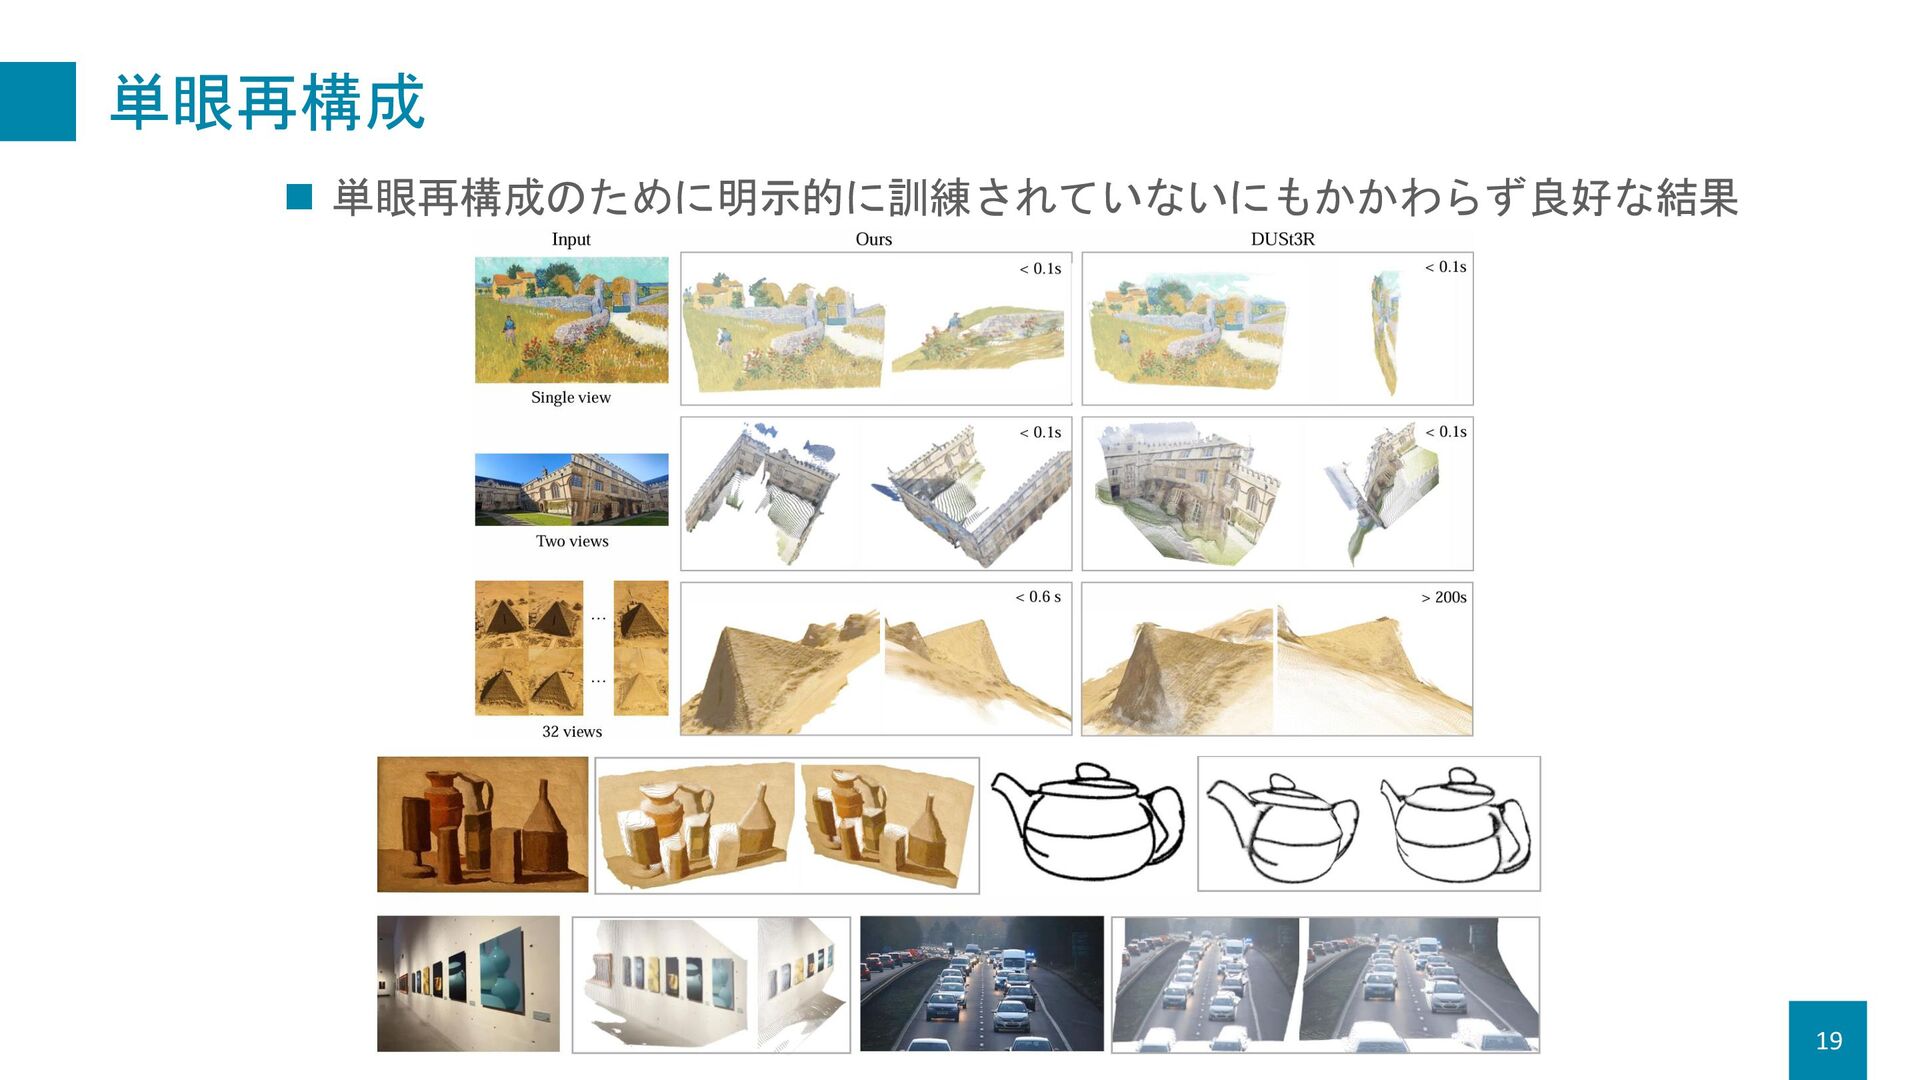
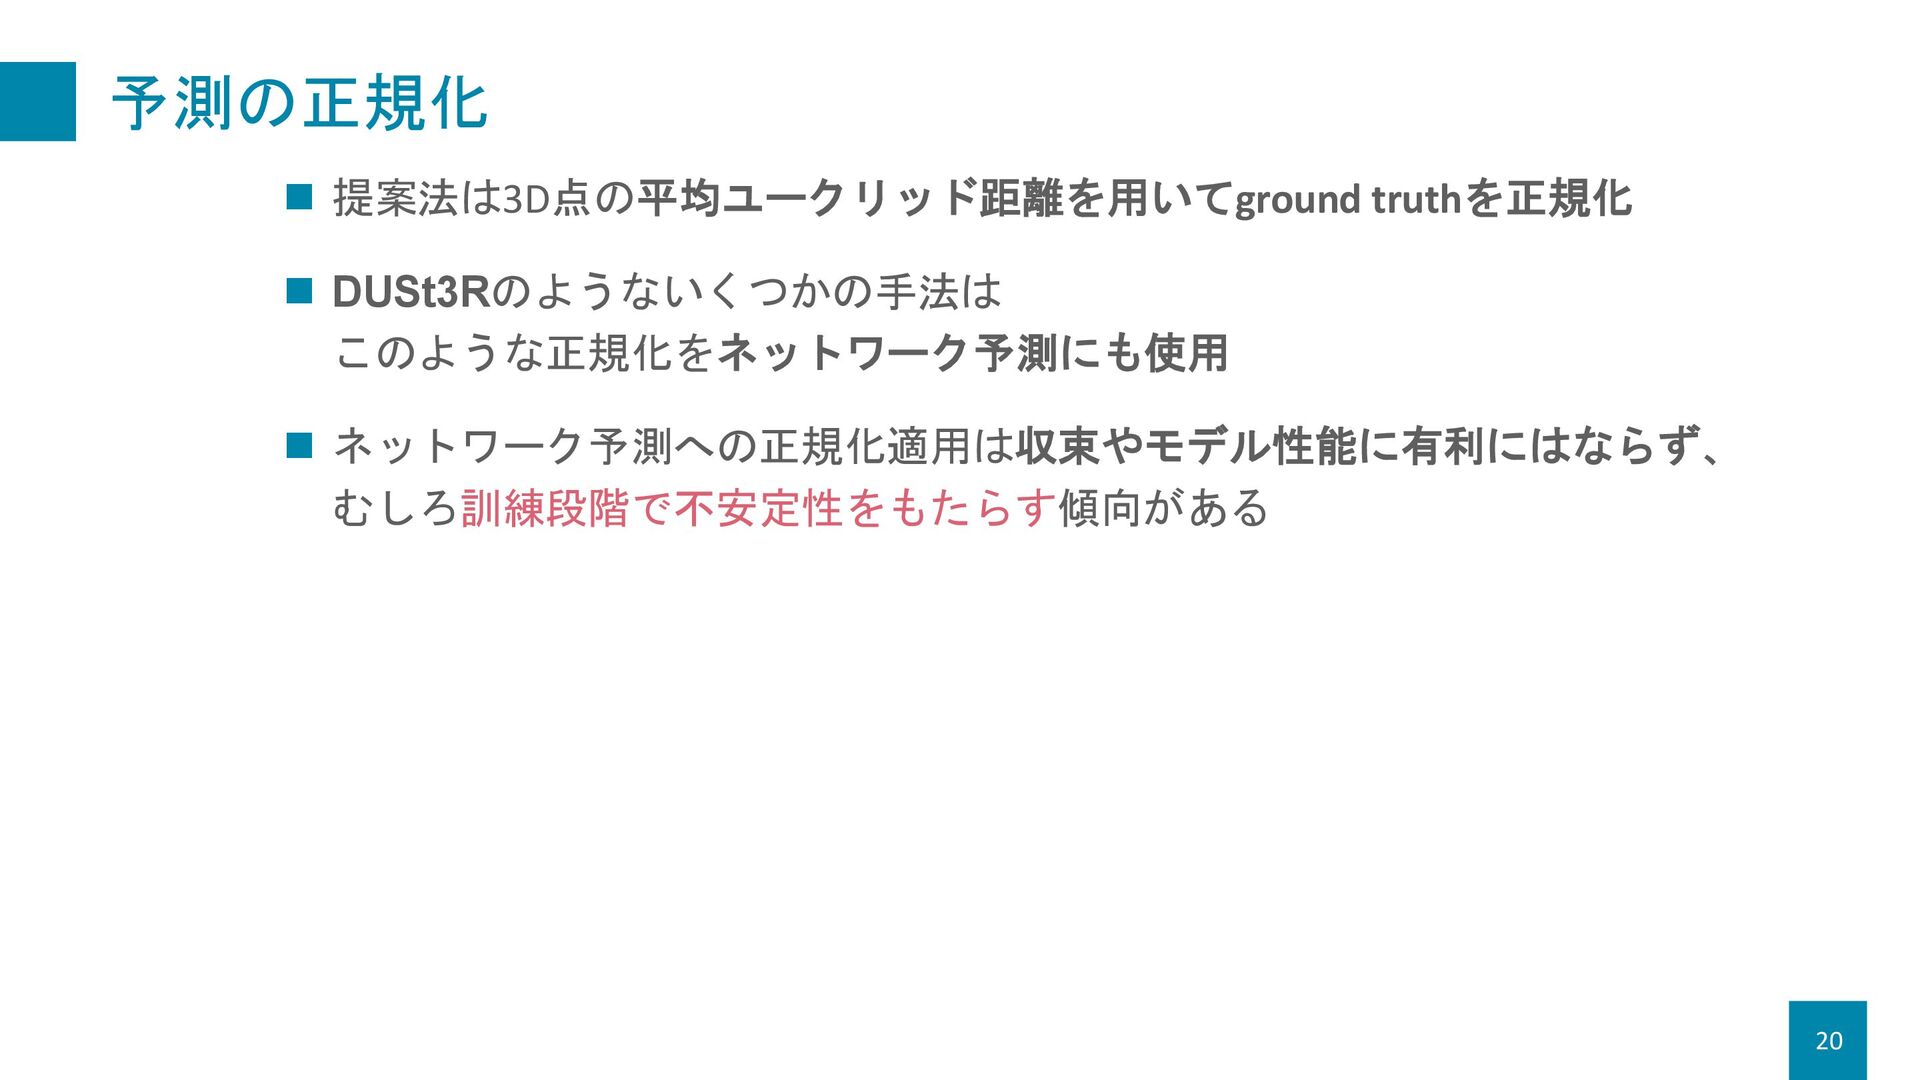
CVPR 2025で発表が予定されている"VGGT: Visual Geometry Grounded Transformer"の論文の内容をまとめたスライドです。
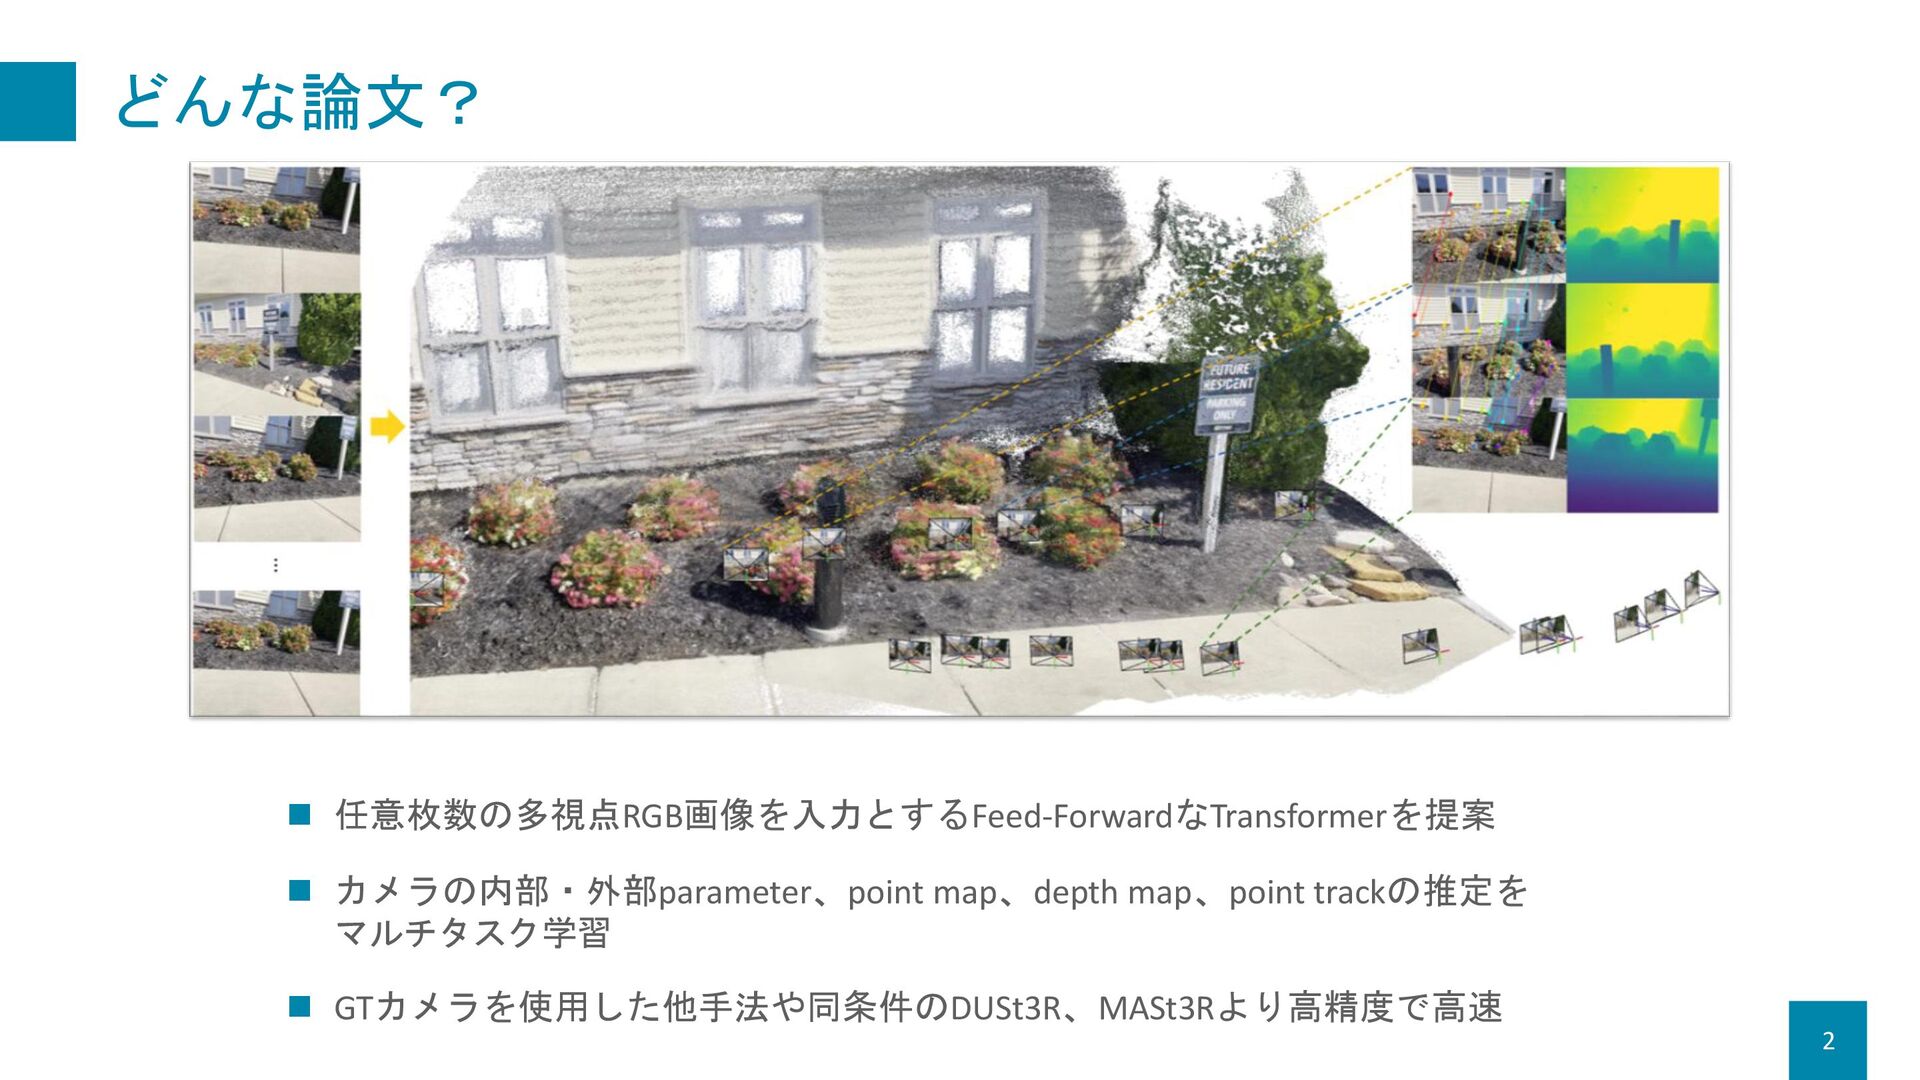
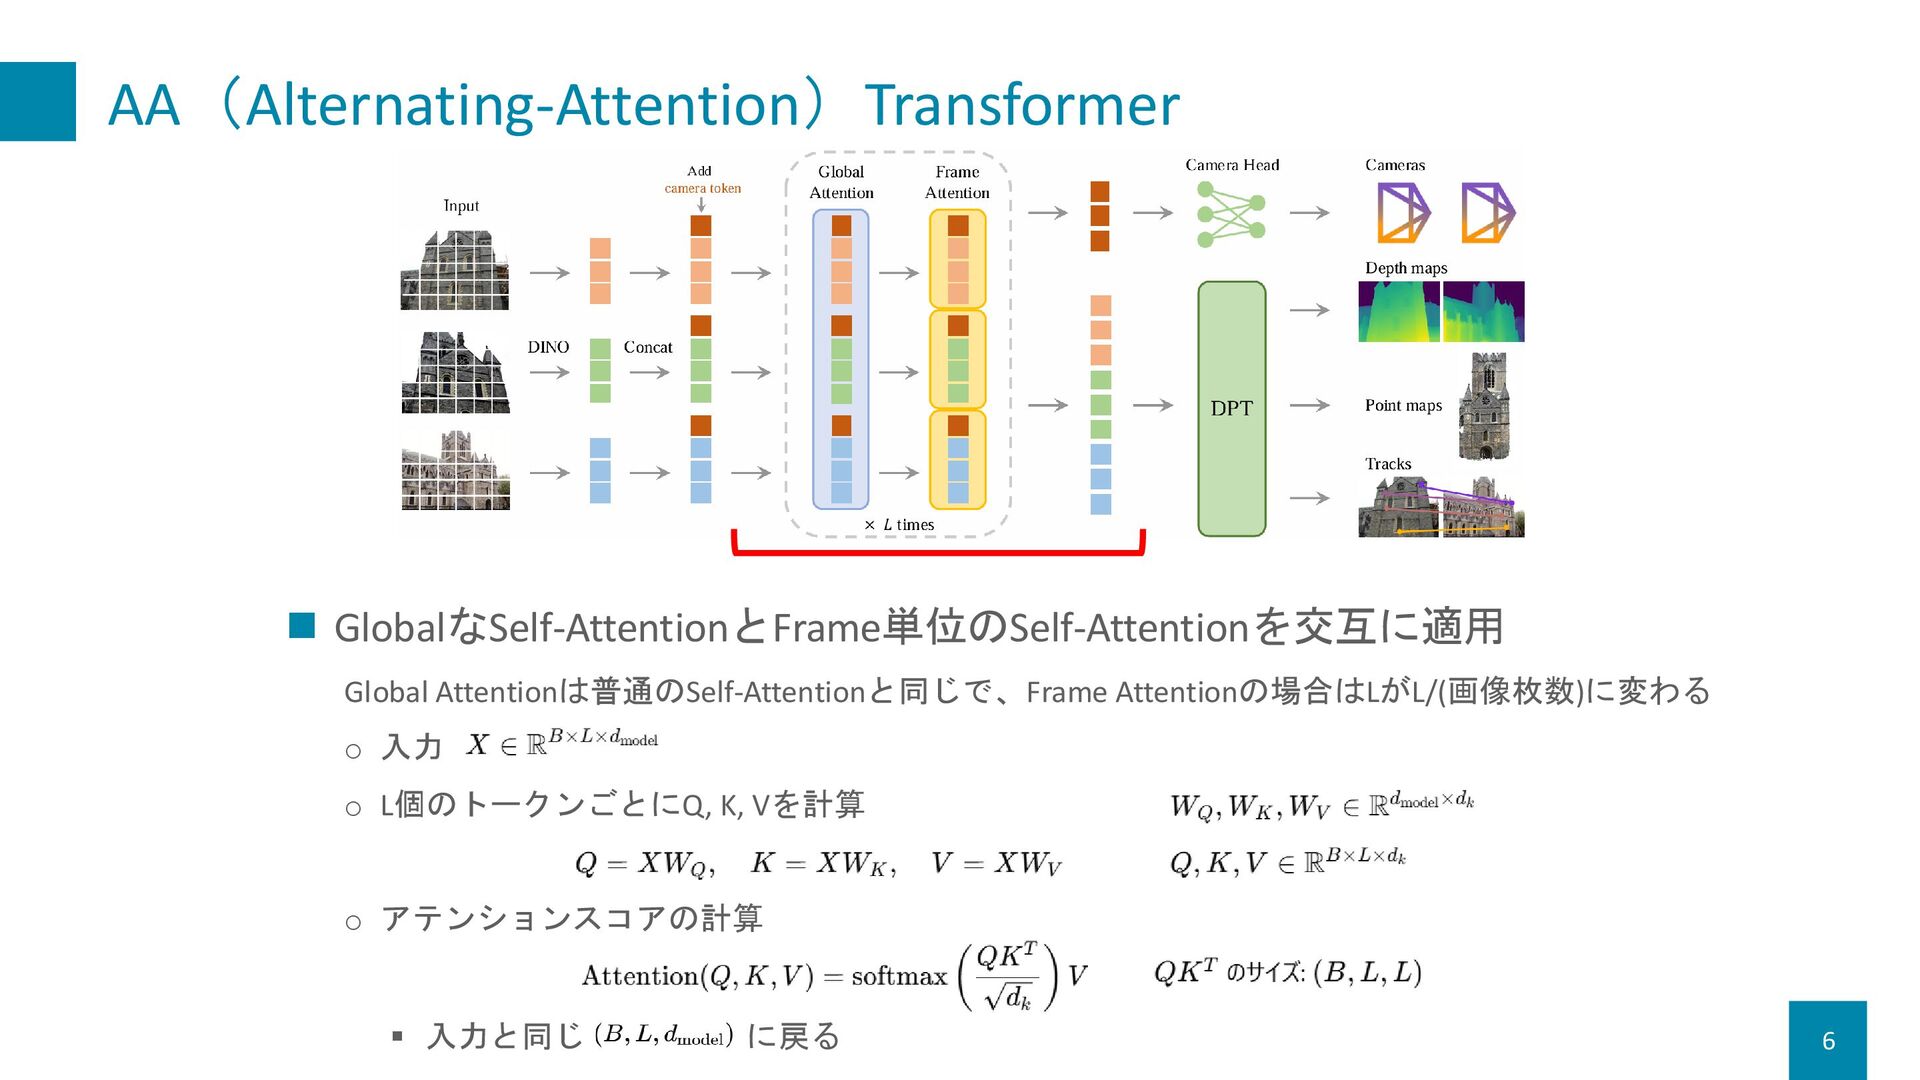
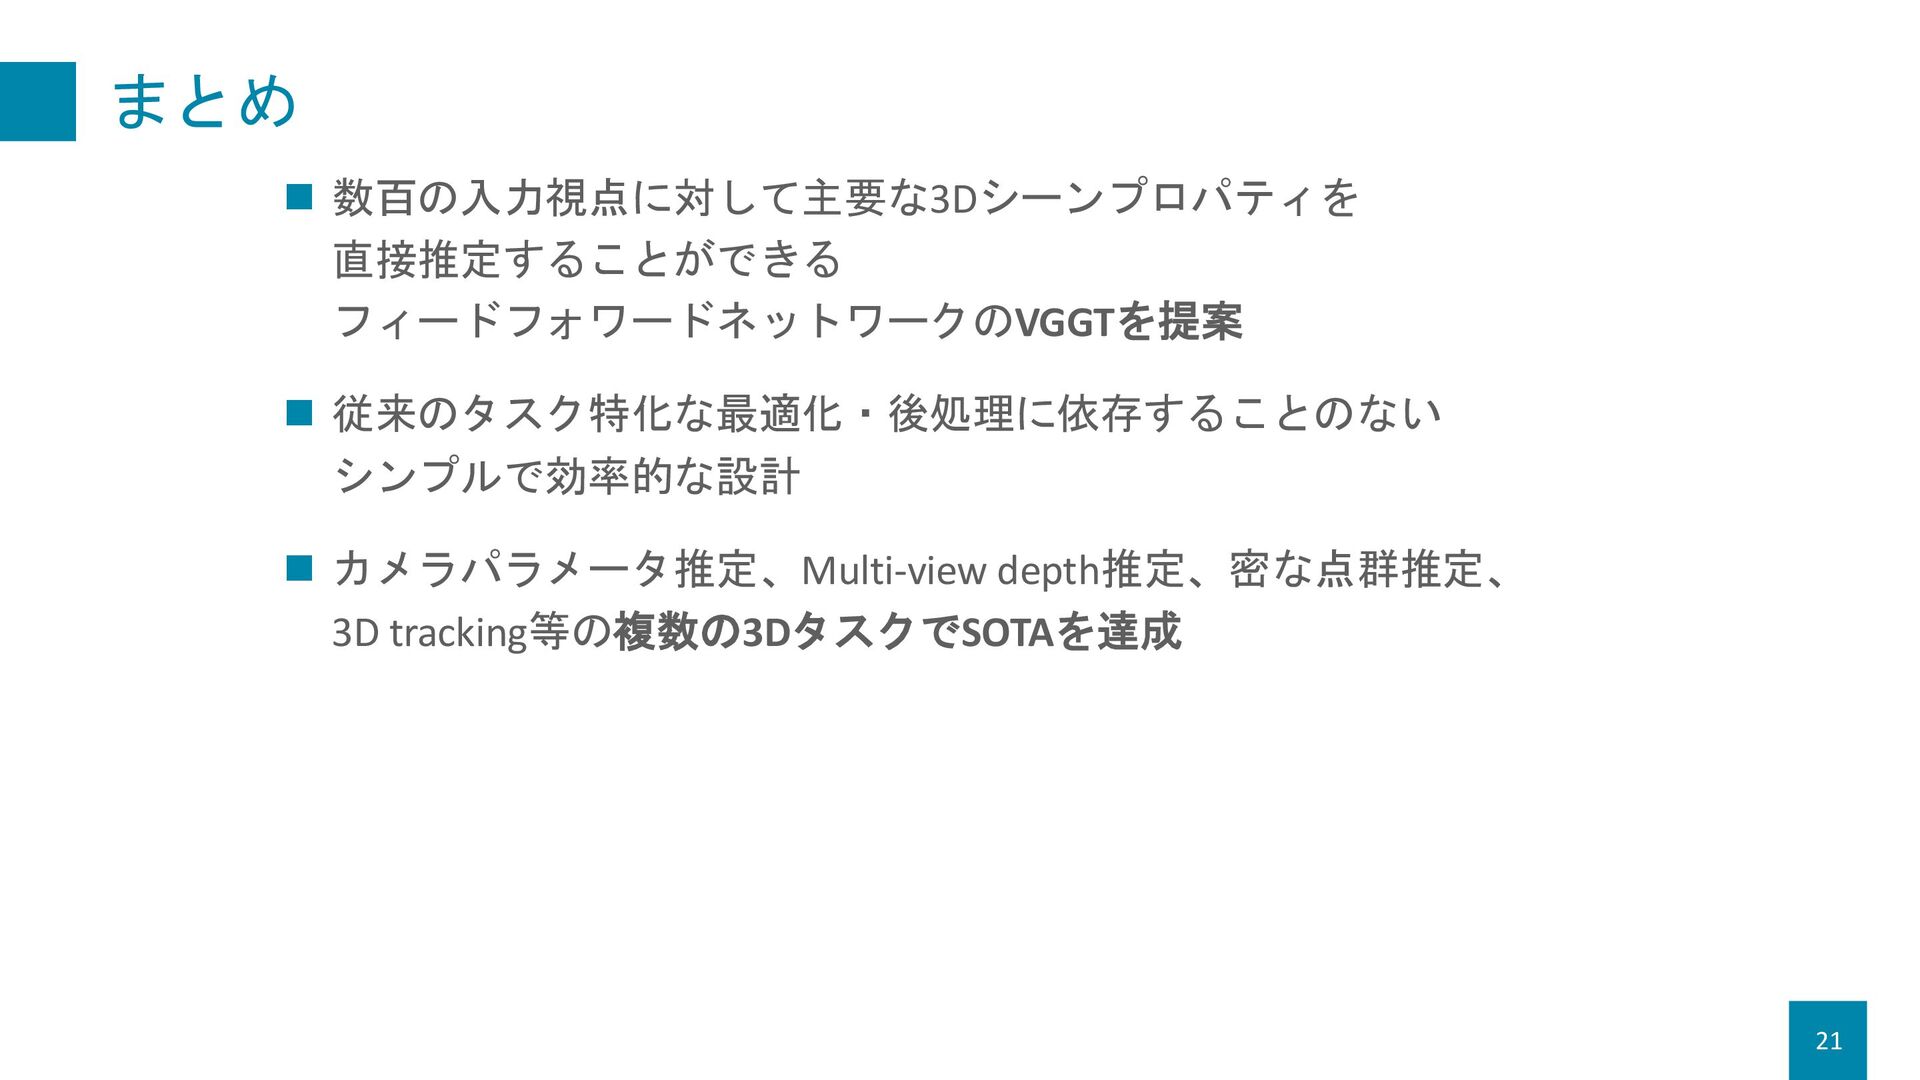
- 任意枚数の多視点RGB画像を入力とするFeed-ForwardなTransformerを提案
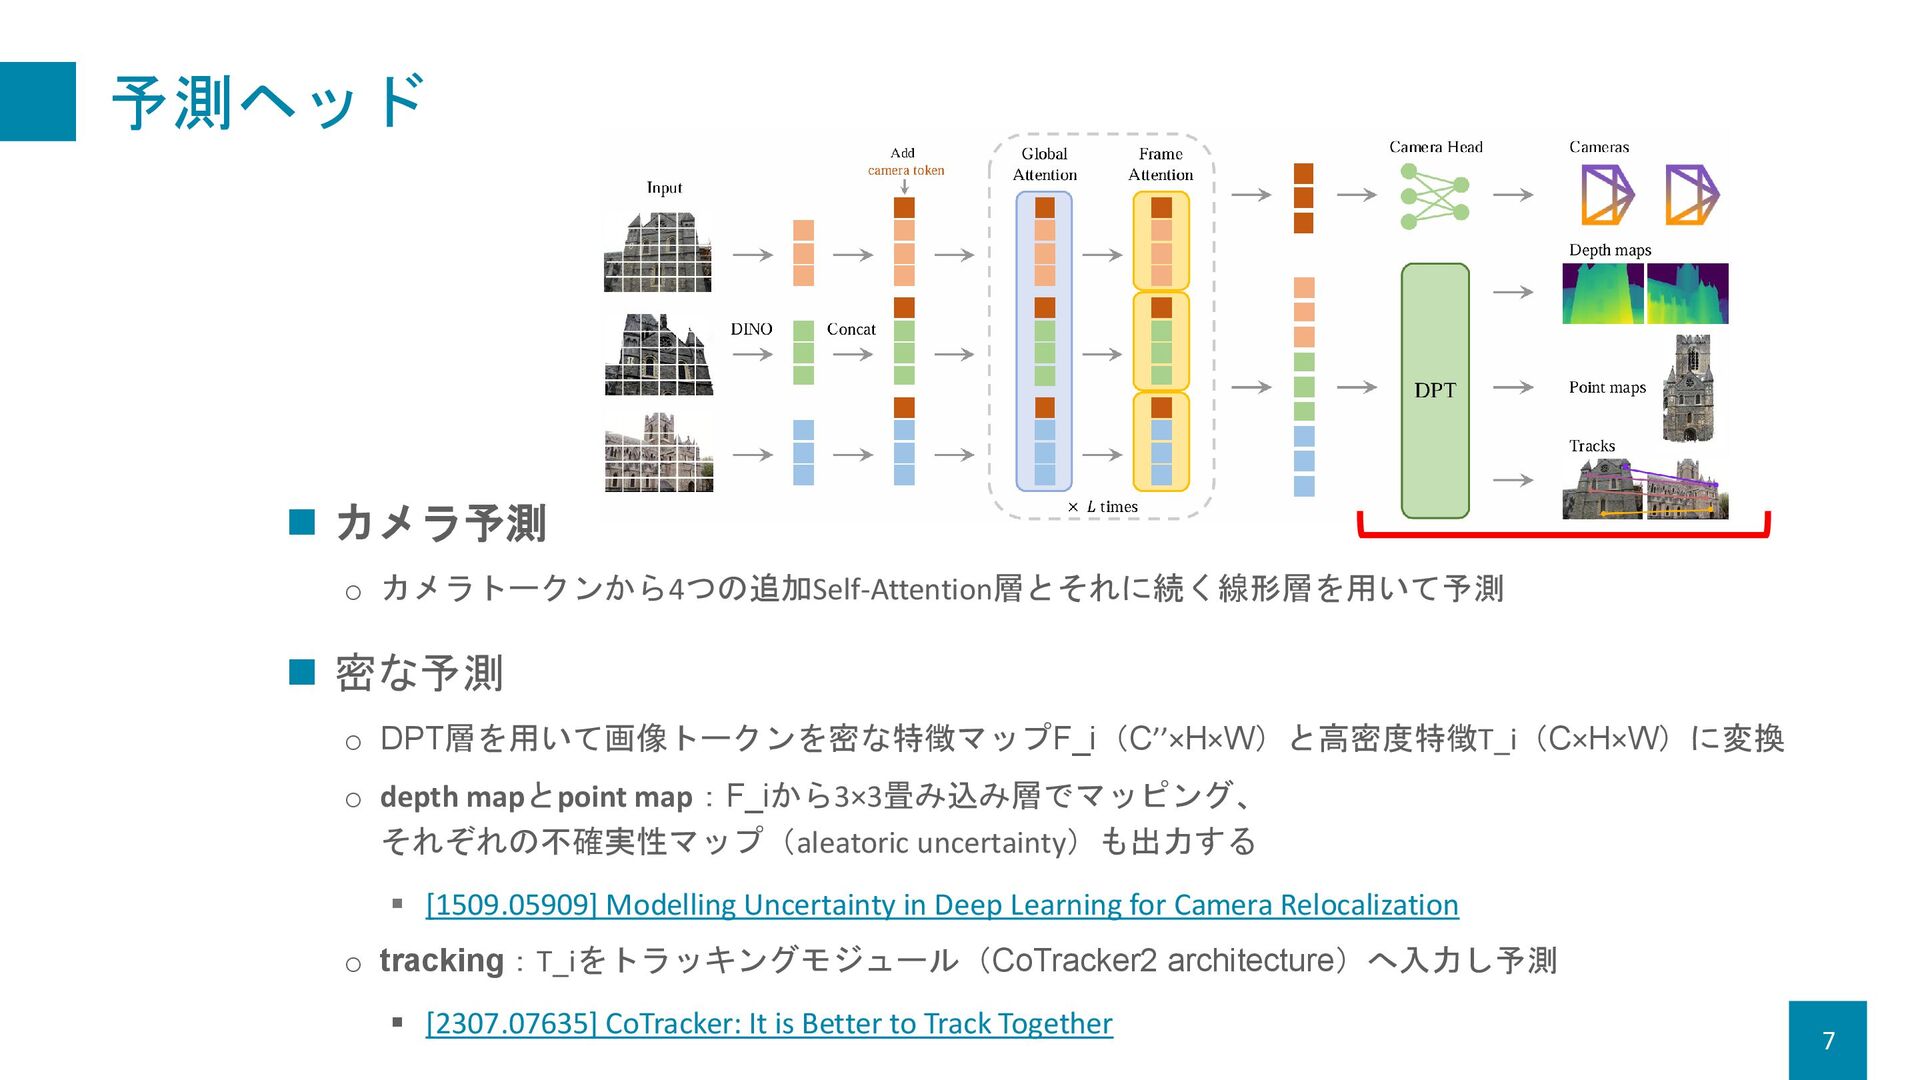
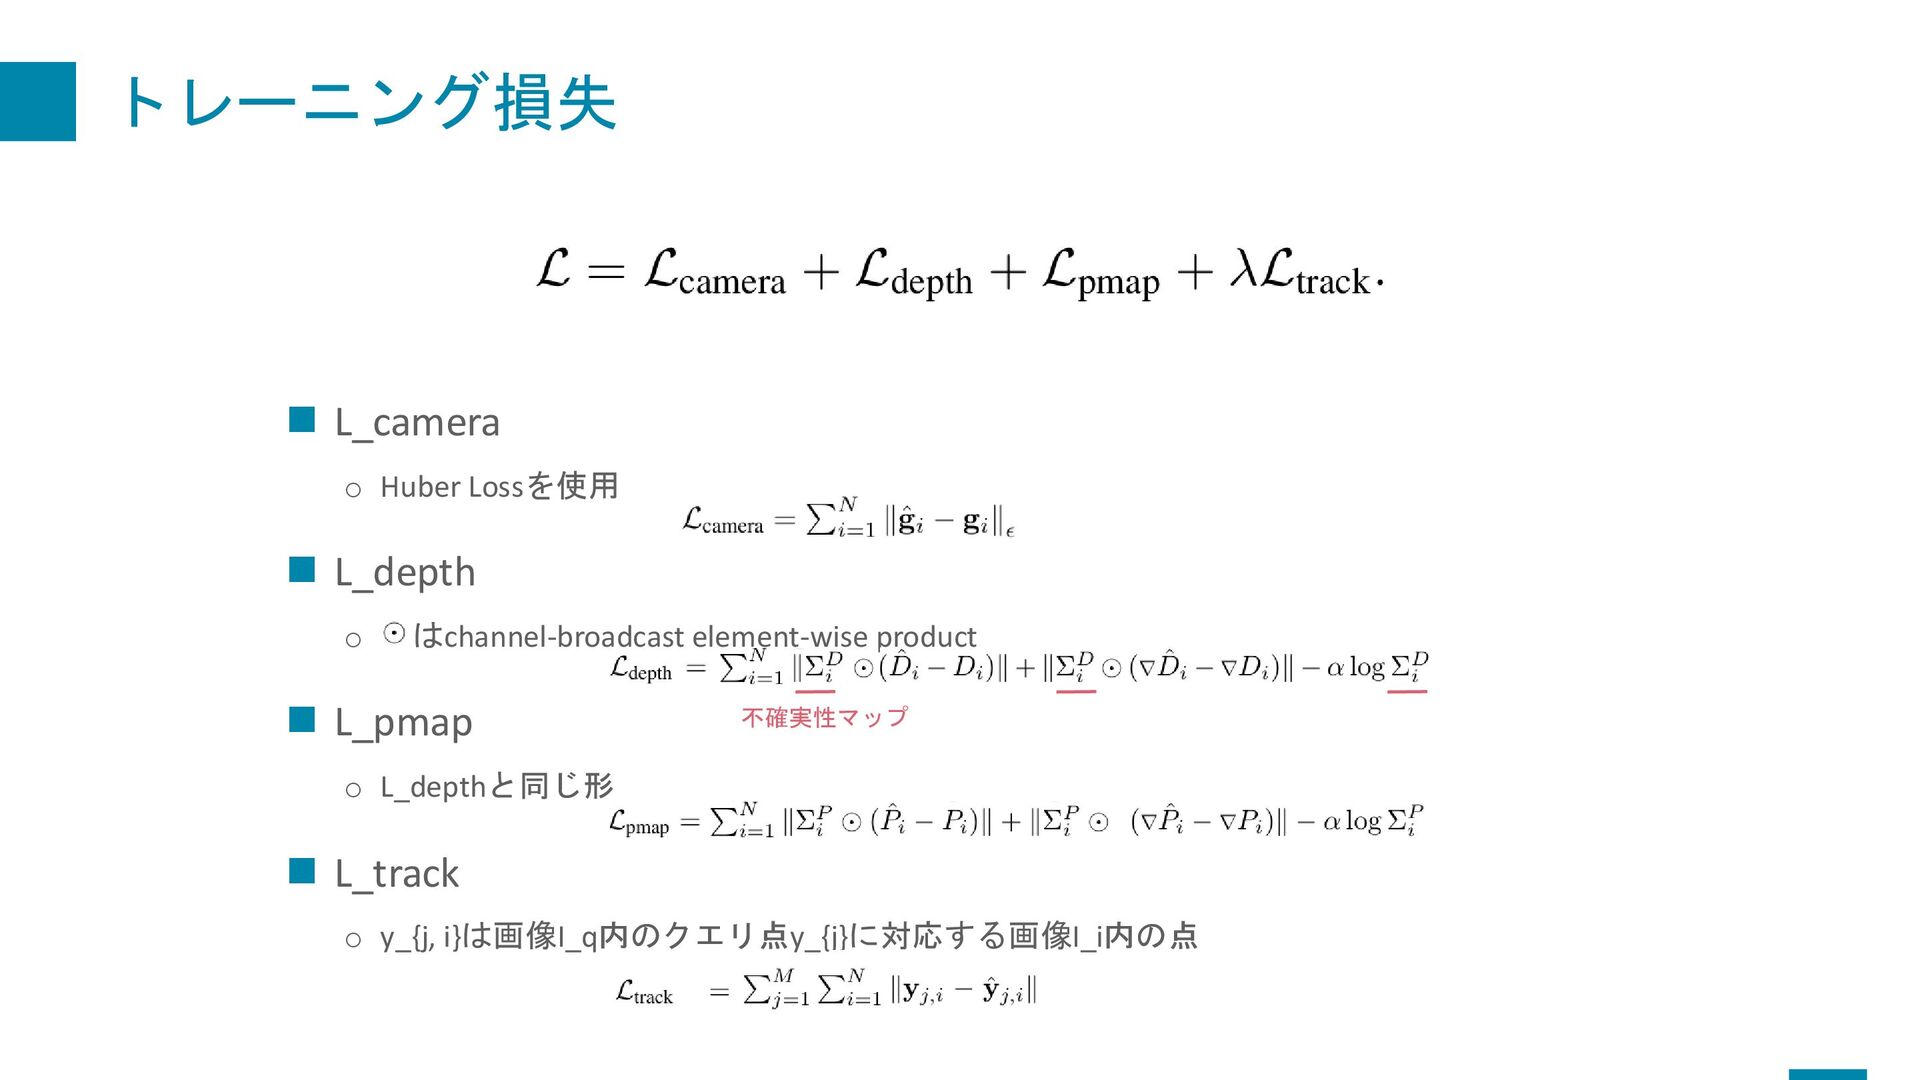
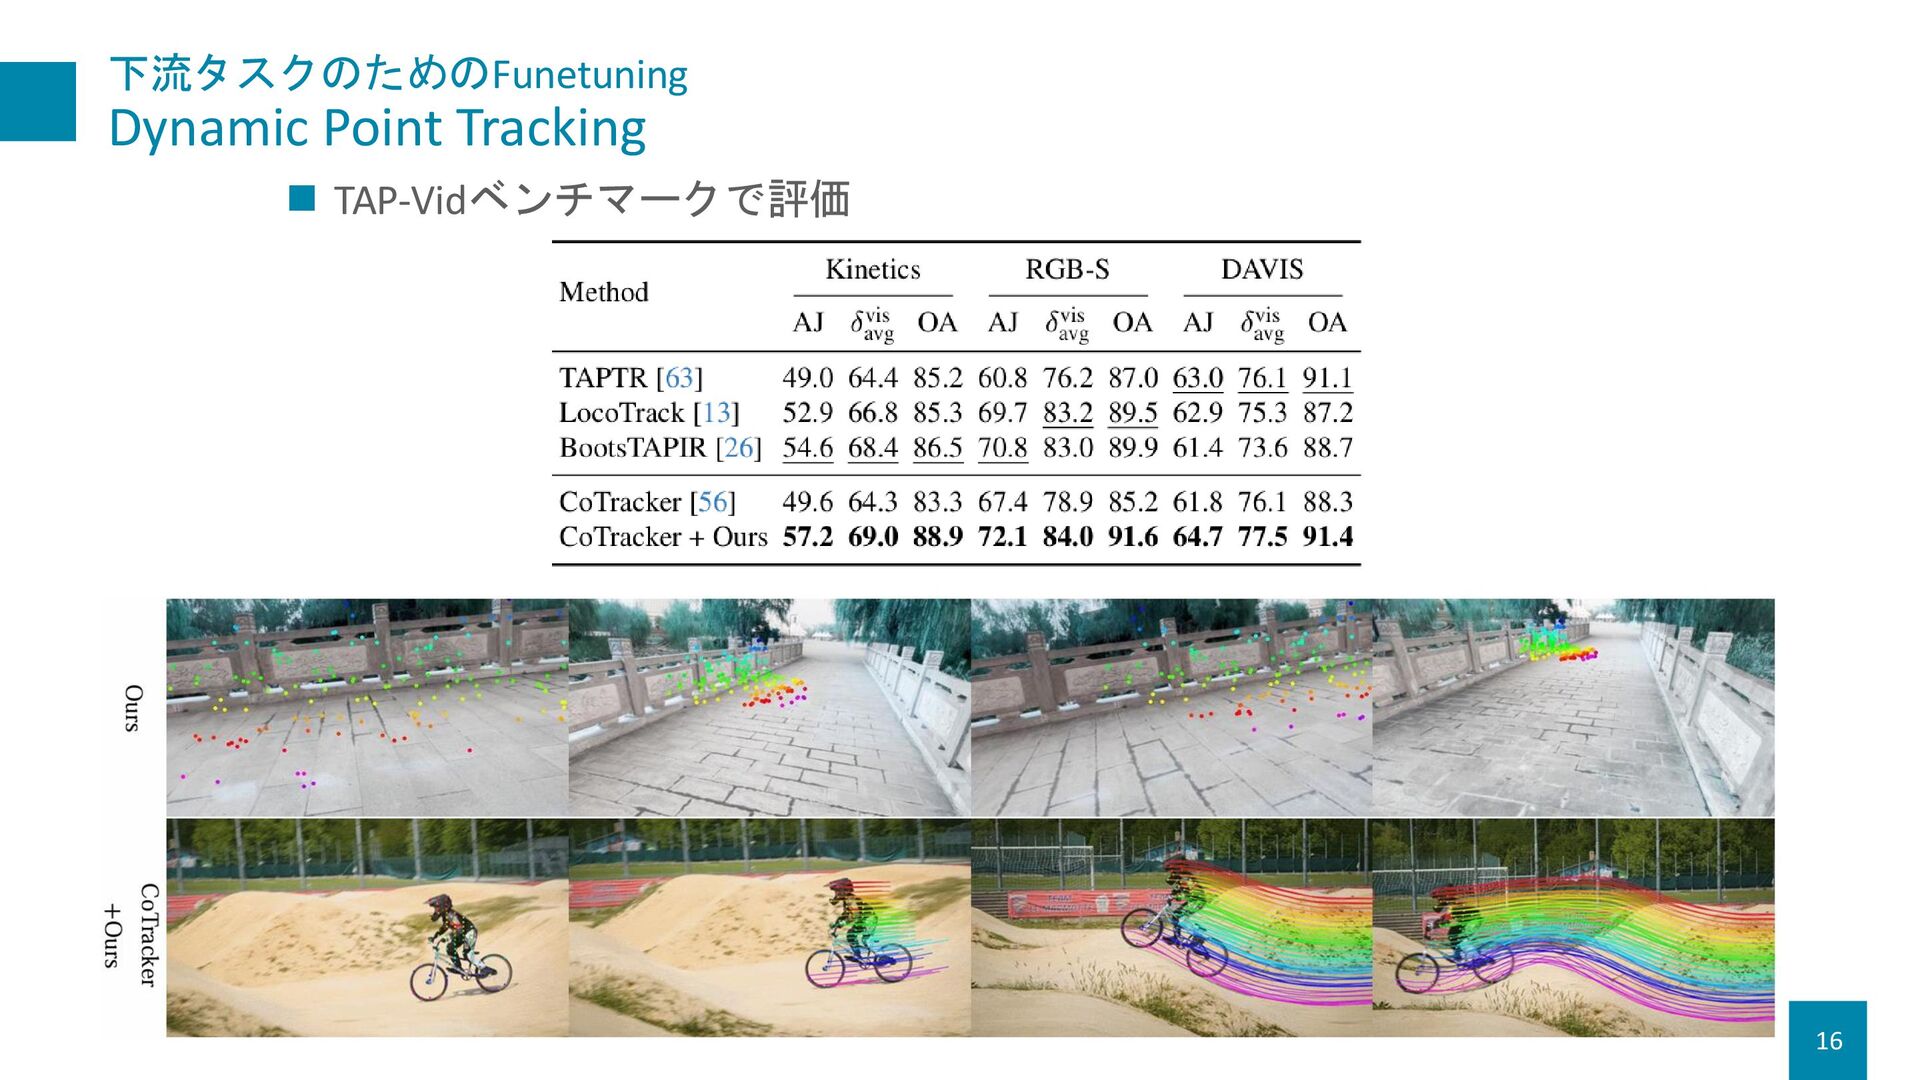
- カメラの内部・外部parameter、point map、depth map、point trackの推定をマルチタスク学習
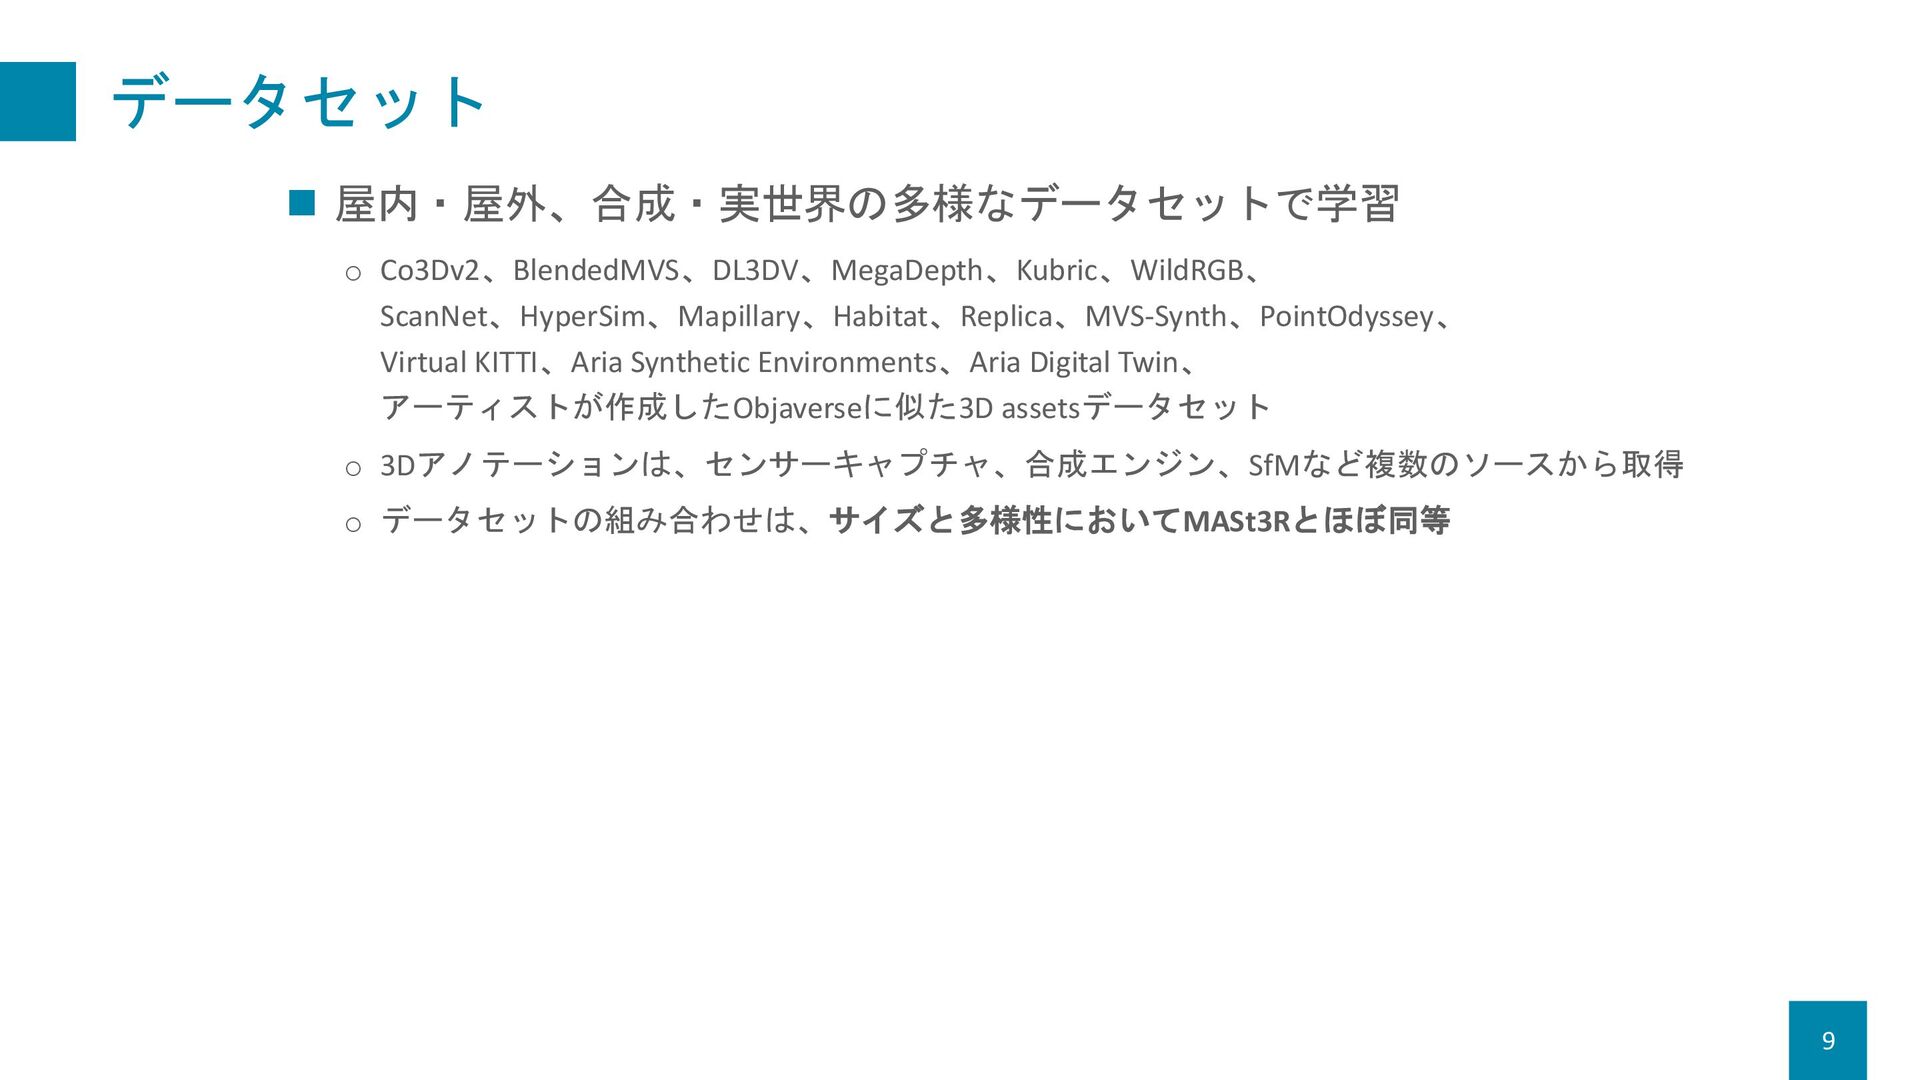
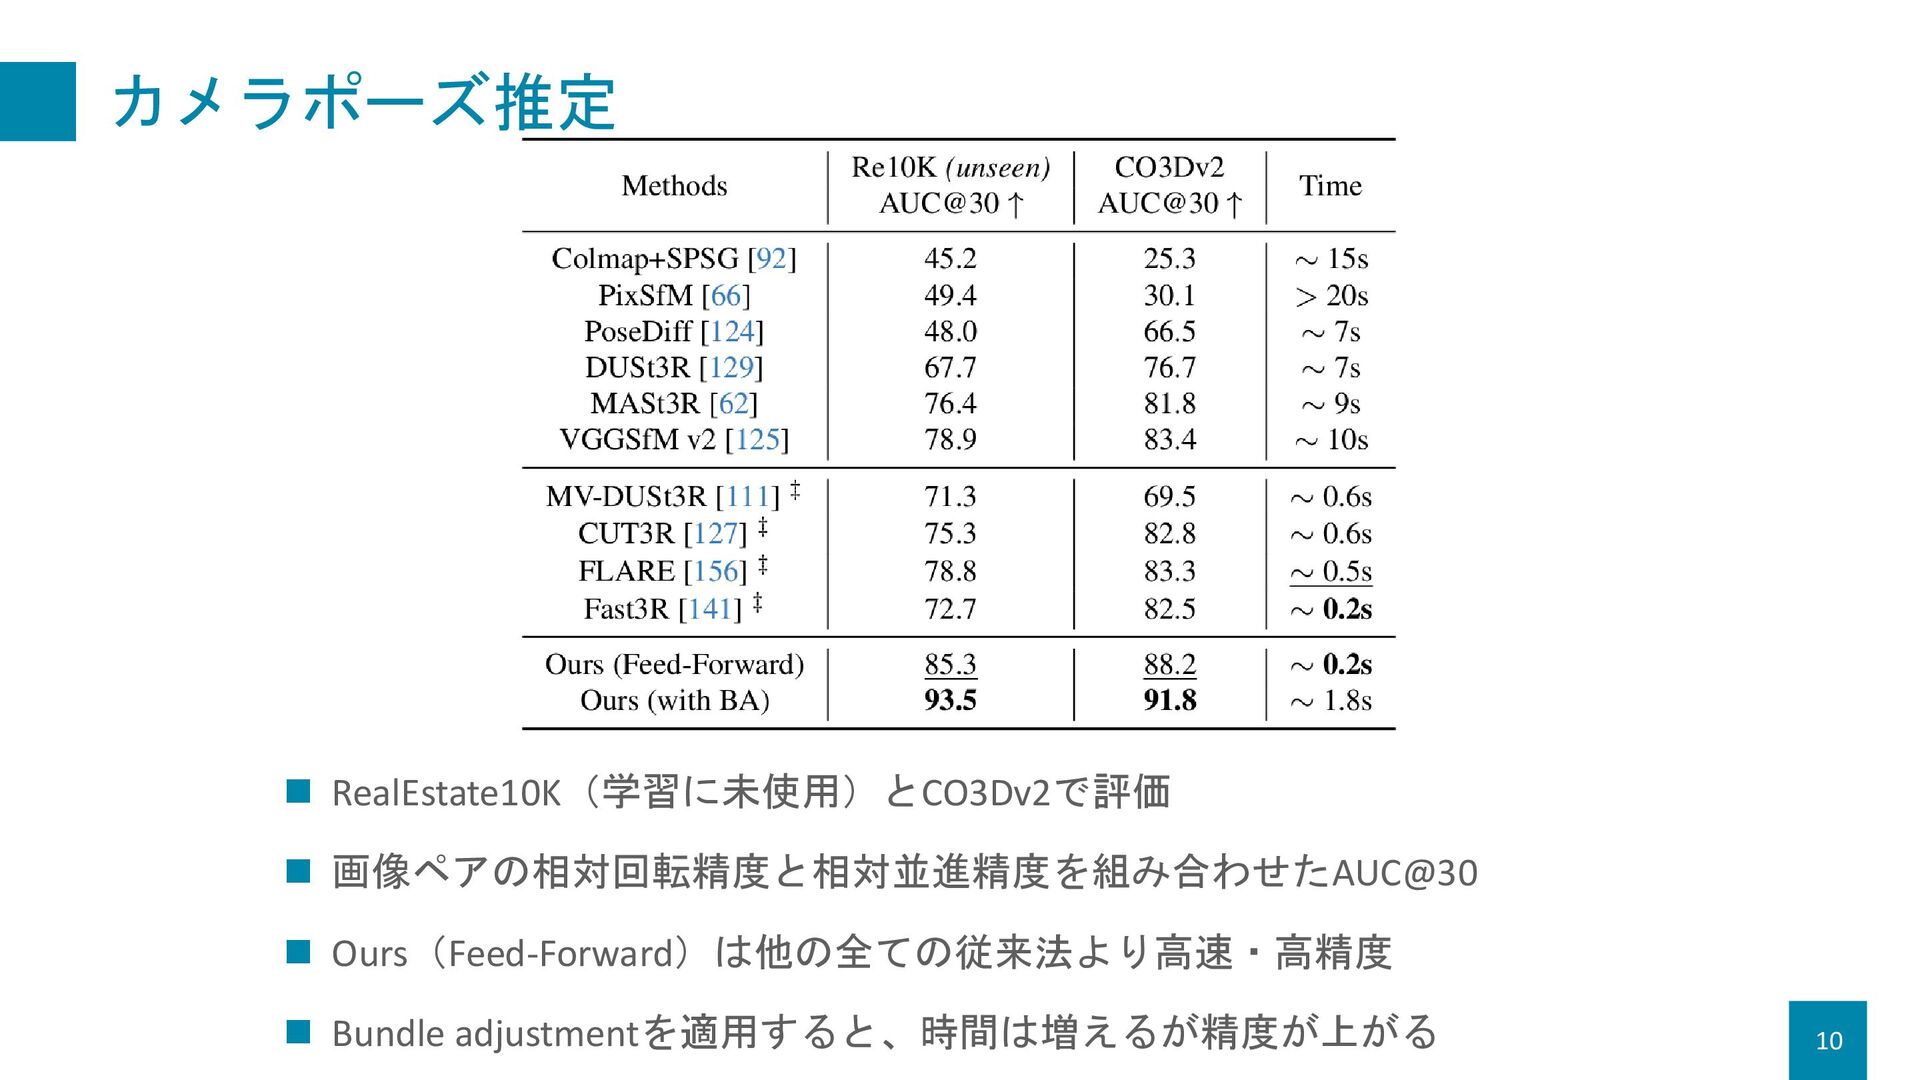
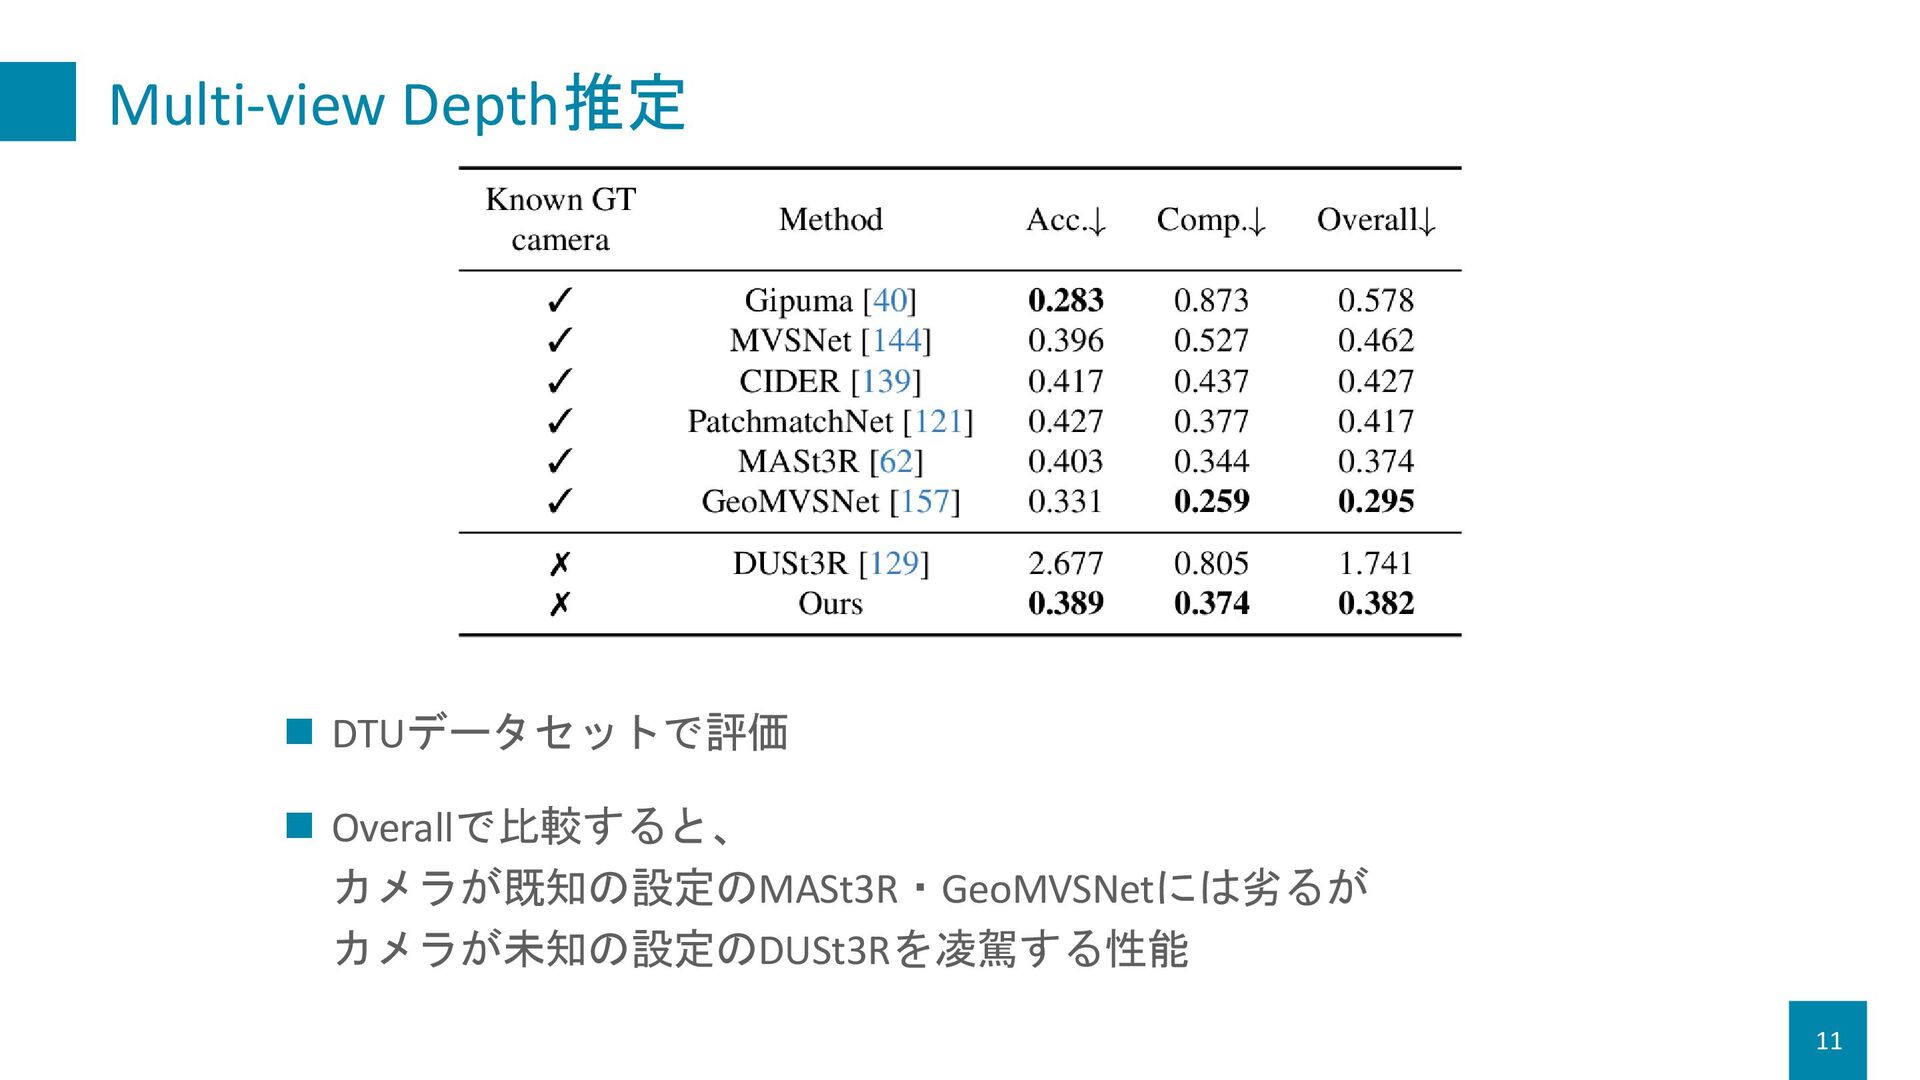
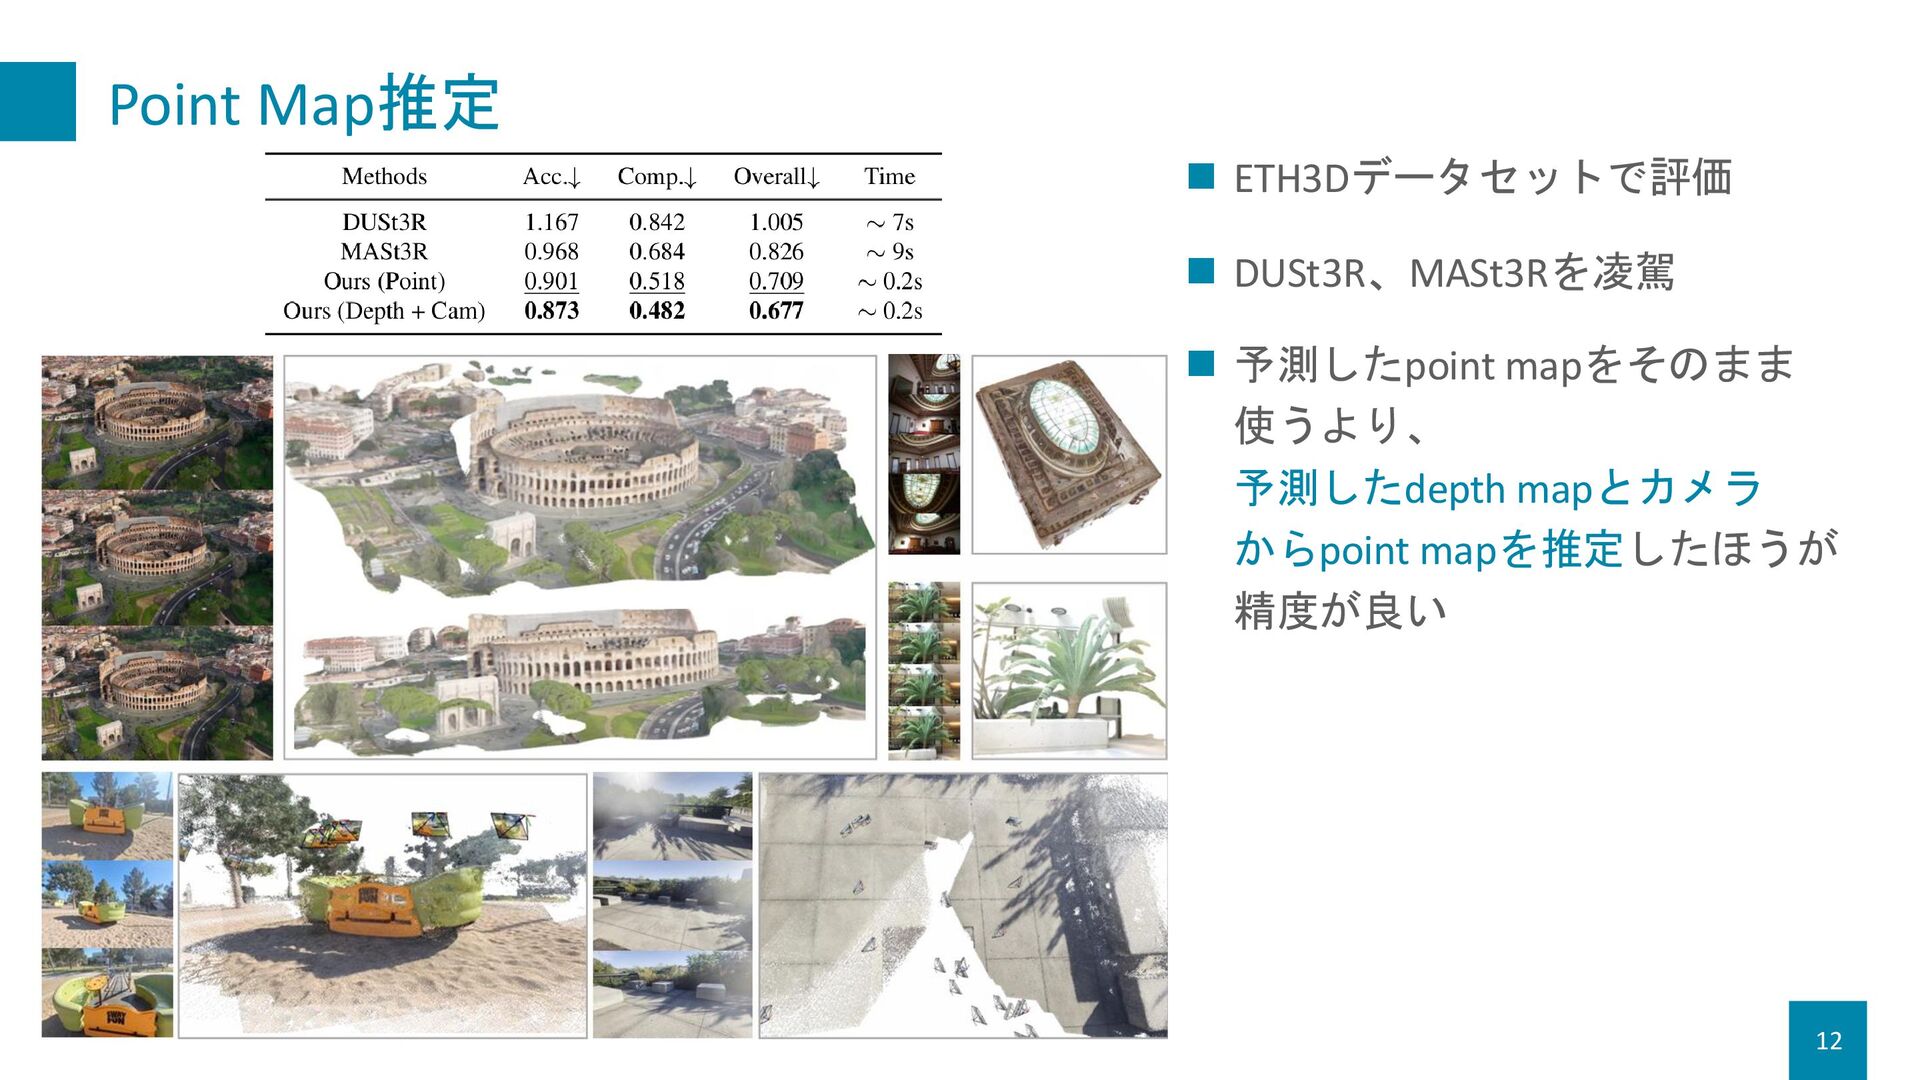
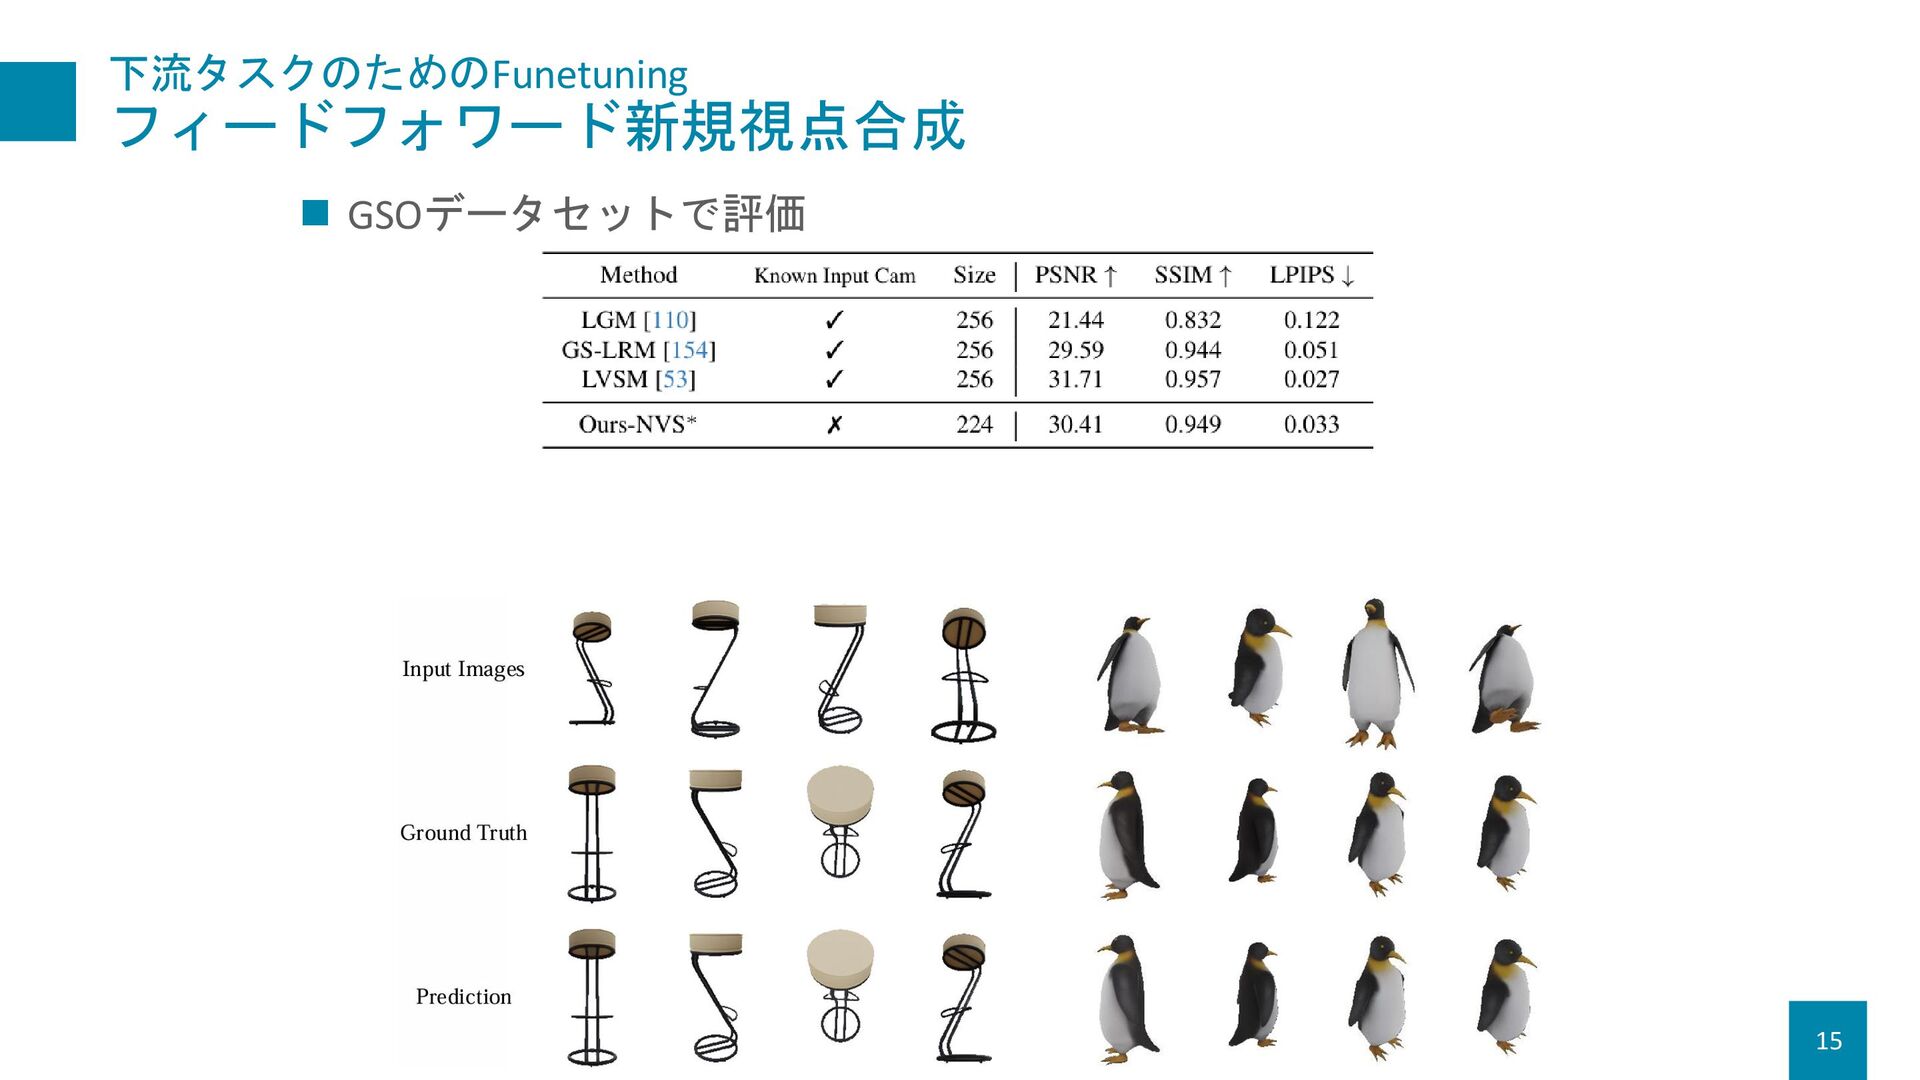
- GTカメラを使用した他手法や同条件のDUSt3R、MASt3Rより高精度で高速

Spatial AI Network
May 15, 2025
 spatial_ai_network
 carta_engineering
 keitah
 z63d
 sioncojp
 okiyuki99
 kota2and3kan
 iwamot
 inariku
 munenick
 harutiro
 kazzpapa3
 say_no_w
 addyosmani
 kristinabergwall1
 helenjbeal
 morganepeng
 jct
 twada
 emna__ayadi
 tmiket
 tammyeverts
 tamaranovitovic
 sabderemane
 mayatellez