Share
サイバーエージェントにおけるMLOpsに関する取り組み | CA BASE NEXT
□ 登壇者
芝田 将
□ 発表について
サイバーエージェントには、機械学習を活用したプロダクトが多数存在します。
しかし、機械学習システムの開発や運用は、機械学習の知識とシステム開発・運用の知識の両方が求められるなど技術的に難しい点も多く存在します。
機械学習のコミュニティにおいてもMLOpsという単語とともにその方法論や設計プラクティスが議論・共有されてきました。
サイバーエージェントにおいてもMLOpsに関する様々な取り組みが行われています。
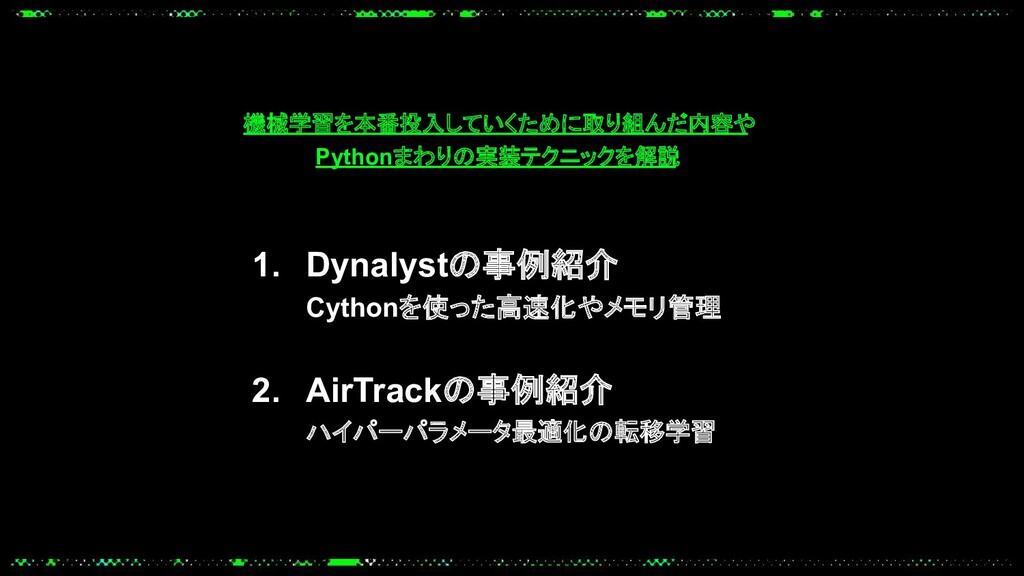
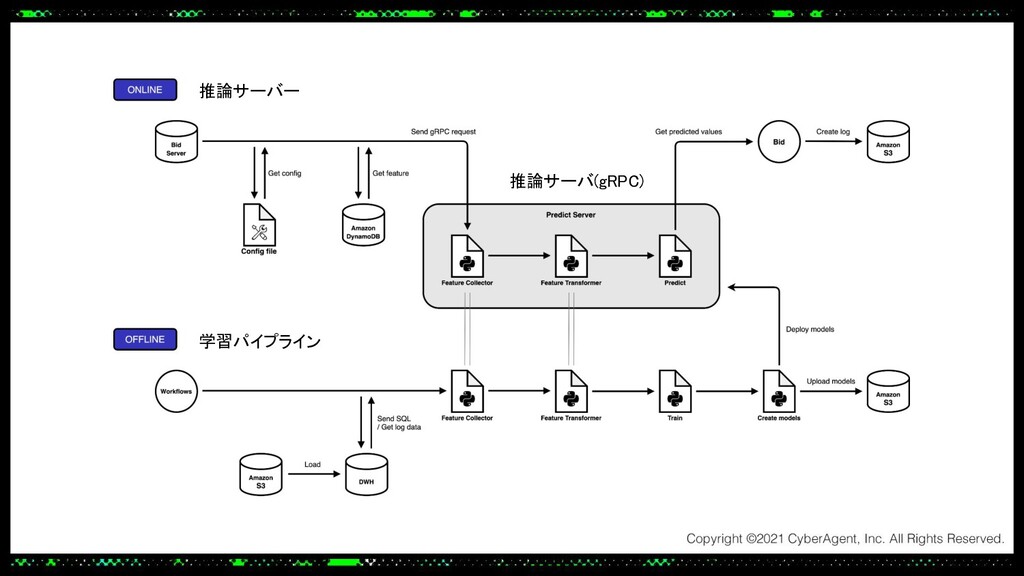
あるプロダクトでは大規模なトラフィックにも耐えられる推論サーバーをPythonで実装する必要があり、Cythonを使って機械学習モデルの推論処理を高速化し、低レイテンシーかつ高スループットを実現しました。
またあるプロダクトでは、継続的に最適なハイパーパラメータの探索を行う上で、より効率的に探索を行うためOptunaとMLflowを用いたハイパーパラメータ最適化の転移学習を実装しました。
本発表を通してこういった社内の事例を共有します。
□ CA BASE NEXT (CyberAgent Developer Conference by Next Generations) とは
20代のエンジニア・クリエイターが中心となって創り上げるサイバーエージェントの技術カンファレンスです。
当日はセッション・LT・パネルディスカッション・インタビューセッションを含む約50のコンテンツをYouTube Liveを通じて配信します。
イベントページ
□ 採用情報
サイバーエージェントに少しでも興味を持っていただきましたら、お気軽にマイページ登録やエントリーをおねがいします!
◆新卒エンジニア採用
エントリー・マイページ登録はこちら
採用関連情報のまとめはこちら
◆新卒クリエイター採用
エントリー・マイページ登録はこちら
◆中途採用
採用情報はこちら
CyberAgent PRO
Transcript
43 slides
-
芝田 将 画像 ・Optunaコミッター ・Kubeflow/Katibレビュアー ・go-prompt、 kube-prompt開発者 ・エキスパートPython プログラミング改訂2版 @c-bata
@c_bata_ 2017年度 新卒入社 AI Lab HPOチーム -
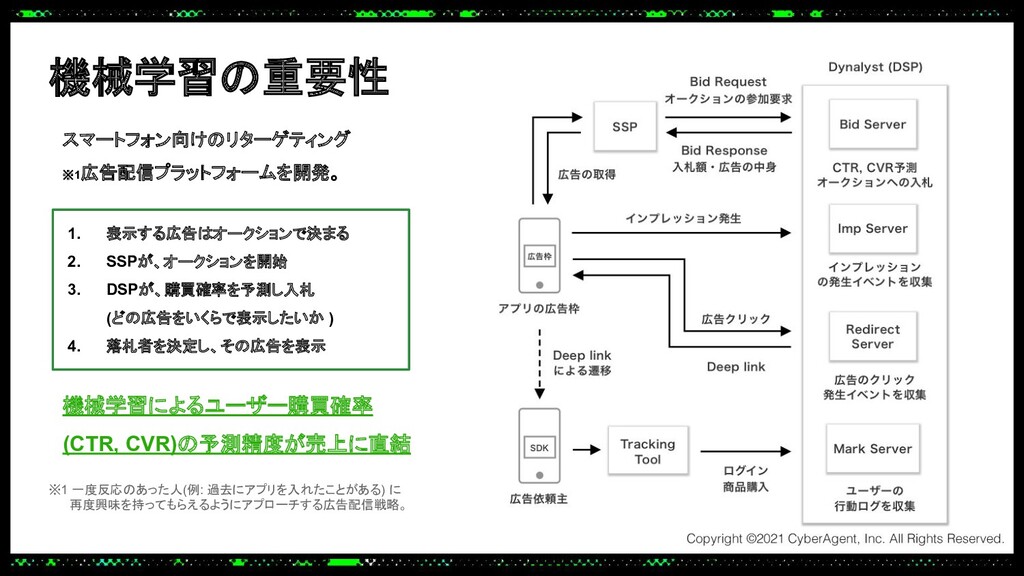
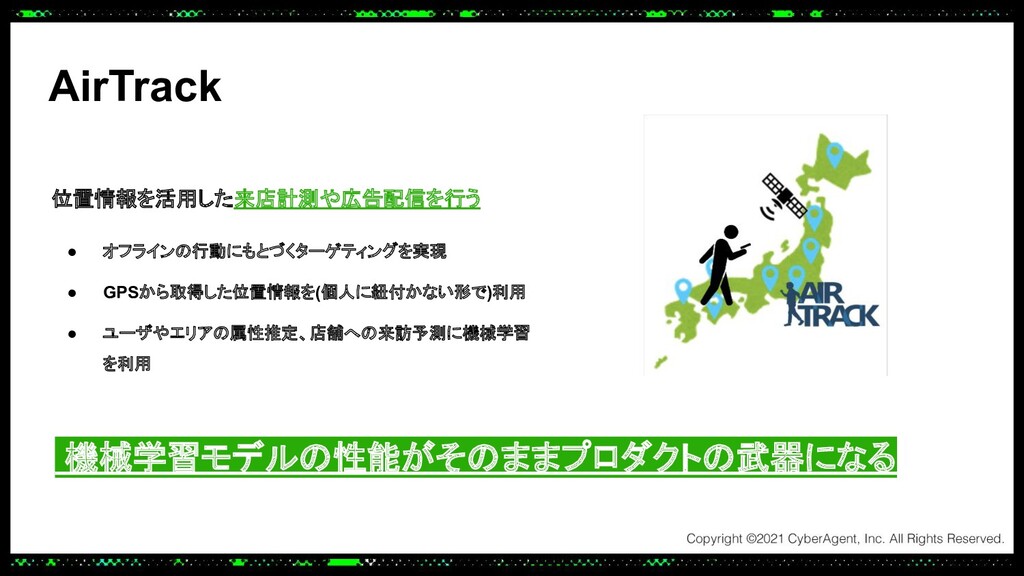
機械学習の重要性 スマートフォン向けのリターゲティング ※1広告配信プラットフォームを開発。 ※1 一度反応のあった人(例: 過去にアプリを入れたことがある) に 再度興味を持ってもらえるようにアプローチする広告配信戦略。 機械学習によるユーザー購買確率 (CTR,
CVR)の予測精度が売上に直結 1. 表示する広告はオークションで決まる 2. SSPが、オークションを開始 3. DSPが、購買確率を予測し入札 (どの広告をいくらで表示したいか ) 4. 落札者を決定し、その広告を表示 -
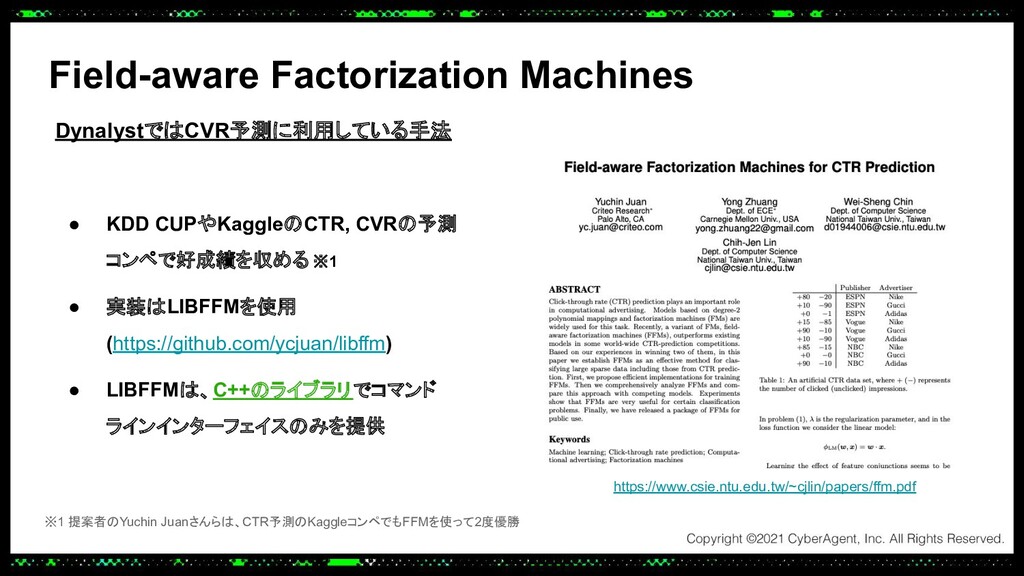
Field-aware Factorization Machines https://www.csie.ntu.edu.tw/~cjlin/papers/ffm.pdf • KDD CUPやKaggleのCTR, CVRの予測 コンペで好成績を収める ※1
• 実装はLIBFFMを使用 (https://github.com/ycjuan/libffm) • LIBFFMは、C++のライブラリでコマンド ラインインターフェイスのみを提供 ※1 提案者のYuchin Juanさんらは、CTR予測のKaggleコンペでもFFMを使って2度優勝 DynalystではCVR予測に利用している手法 -
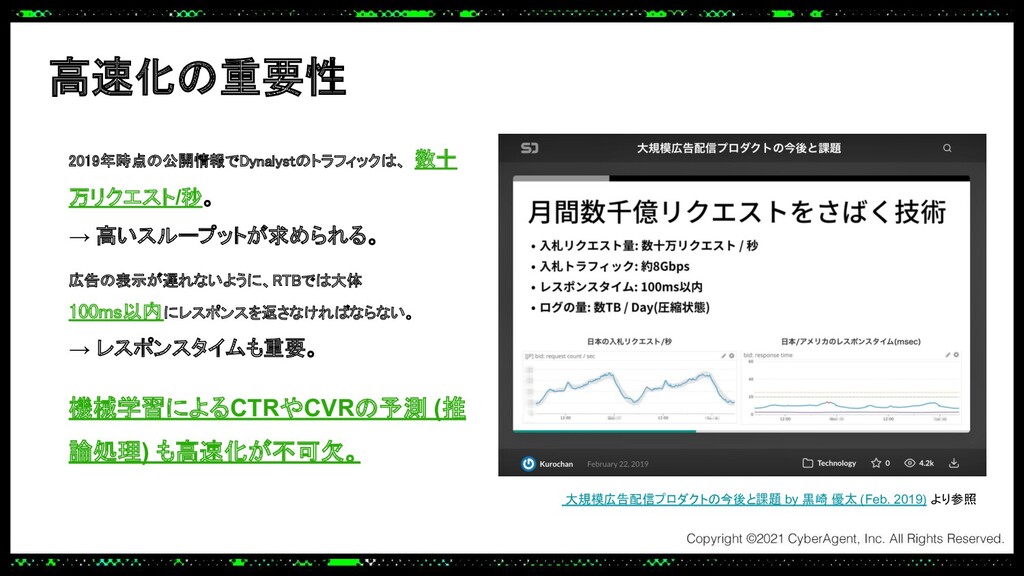
高速化の重要性 2019年時点の公開情報でDynalystのトラフィックは、 数十 万リクエスト/秒。 → 高いスループットが求められる。 大規模広告配信プロダクトの今後と課題 by 黒崎 優太
(Feb. 2019) より参照 広告の表示が遅れないように、RTBでは大体 100ms以内にレスポンスを返さなければならない。 → レスポンスタイムも重要。 機械学習によるCTRやCVRの予測 (推 論処理) も高速化が不可欠。 -
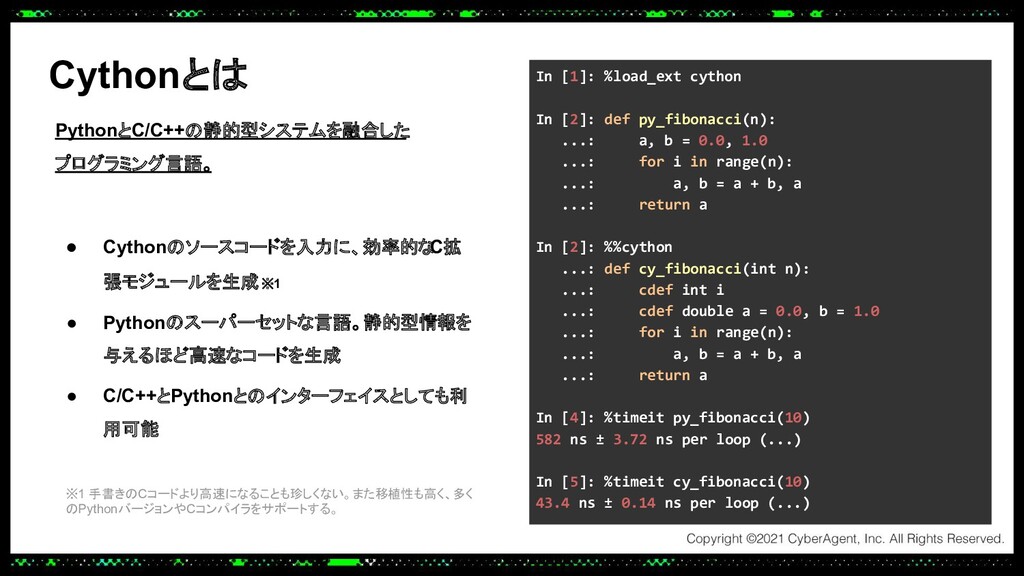
Cythonとは • Cythonのソースコードを入力に、効率的な C拡 張モジュールを生成 ※1 • Pythonのスーパーセットな言語。静的型情報を 与えるほど高速なコードを生成 •
C/C++とPythonとのインターフェイスとしても利 用可能 In [1]: %load_ext cython In [2]: def py_fibonacci(n): ...: a, b = 0.0, 1.0 ...: for i in range(n): ...: a, b = a + b, a ...: return a In [2]: %%cython ...: def cy_fibonacci(int n): ...: cdef int i ...: cdef double a = 0.0, b = 1.0 ...: for i in range(n): ...: a, b = a + b, a ...: return a In [4]: %timeit py_fibonacci(10) 582 ns ± 3.72 ns per loop (...) In [5]: %timeit cy_fibonacci(10) 43.4 ns ± 0.14 ns per loop (...) ※1 手書きのCコードより高速になることも珍しくない。また移植性も高く、多く のPythonバージョンやCコンパイラをサポートする。 PythonとC/C++の静的型システムを融合した プログラミング言語。 -
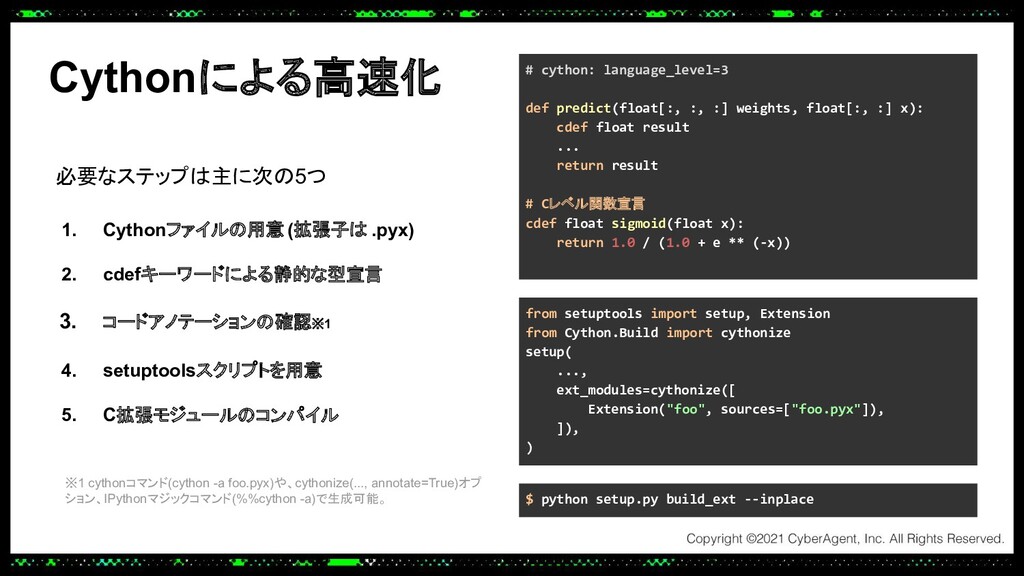
Cythonによる高速化 1. Cythonファイルの用意 (拡張子は .pyx) 2. cdefキーワードによる静的な型宣言 3. コードアノテーションの確認 ※1
4. setuptoolsスクリプトを用意 5. C拡張モジュールのコンパイル from setuptools import setup, Extension from Cython.Build import cythonize setup( ..., ext_modules=cythonize([ Extension("foo", sources=["foo.pyx"]), ]), ) ※1 cythonコマンド(cython -a foo.pyx)や、cythonize(..., annotate=True)オプ ション、IPythonマジックコマンド(%%cython -a)で生成可能。 # cython: language_level=3 def predict(float[:, :, :] weights, float[:, :] x): cdef float result ... return result # Cレベル関数宣言 cdef float sigmoid(float x): return 1.0 / (1.0 + e ** (-x)) $ python setup.py build_ext --inplace 必要なステップは主に次の5つ -
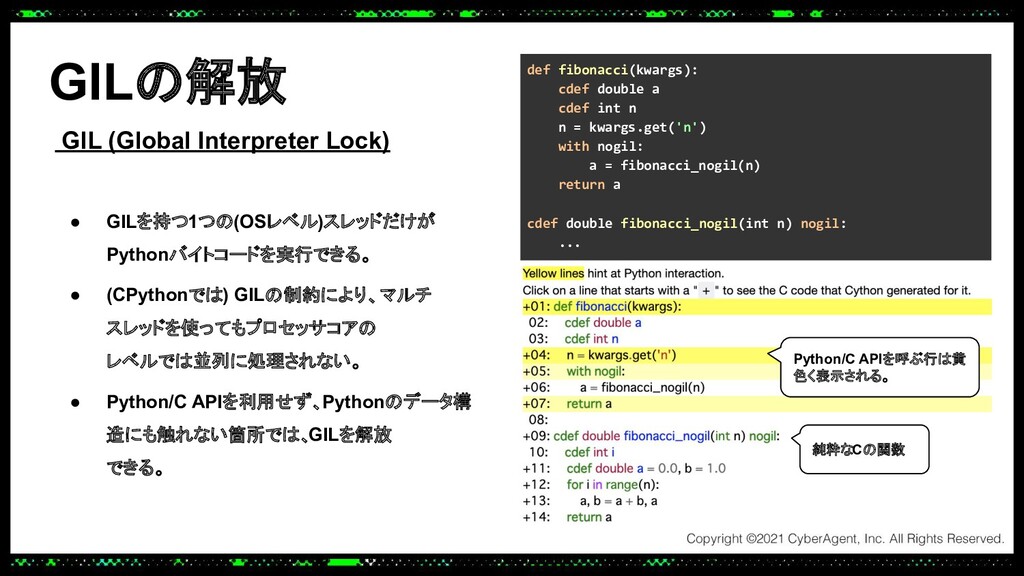
GILの解放 • GILを持つ1つの(OSレベル)スレッドだけが Pythonバイトコードを実行できる。 • (CPythonでは) GILの制約により、マルチ スレッドを使ってもプロセッサコアの レベルでは並列に処理されない。 •
Python/C APIを利用せず、Pythonのデータ構 造にも触れない箇所では、 GILを解放 できる。 def fibonacci(kwargs): cdef double a cdef int n n = kwargs.get('n') with nogil: a = fibonacci_nogil(n) return a cdef double fibonacci_nogil(int n) nogil: ... GIL (Global Interpreter Lock) Python/C APIを呼ぶ行は黄 色く表示される。 純粋なCの関数 -
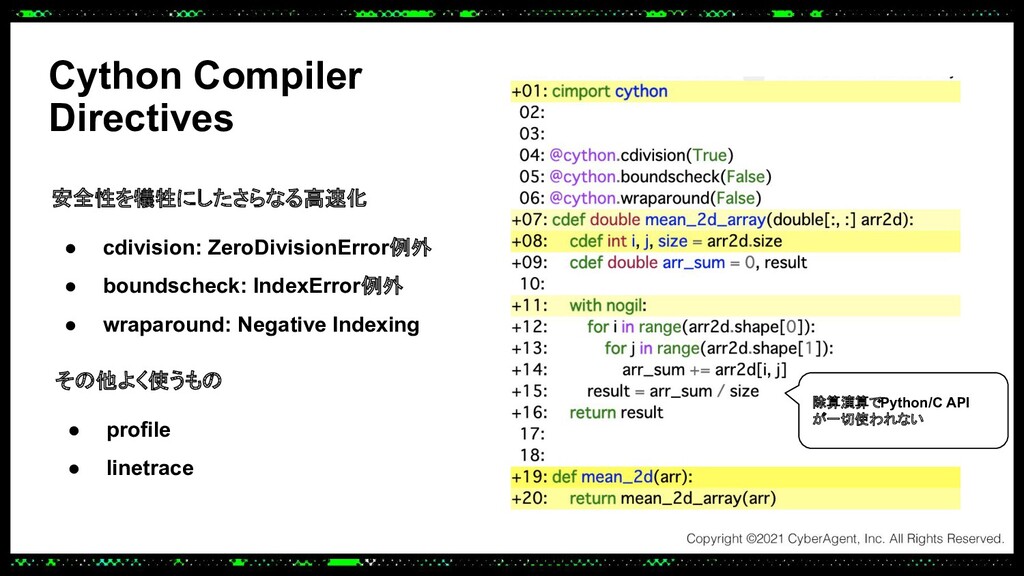
Cython Compiler Directives 安全性を犠牲にしたさらなる高速化 • cdivision: ZeroDivisionError例外 • boundscheck: IndexError例外
• wraparound: Negative Indexing 除算演算でPython/C API が一切使われない その他よく使うもの • profile • linetrace -
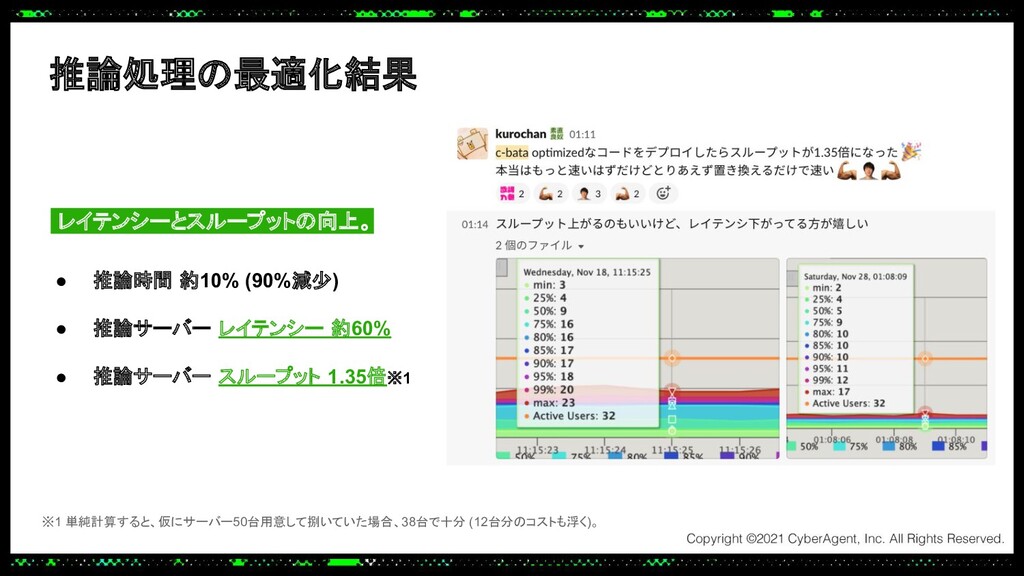
推論処理の最適化結果 • 推論時間 約10% (90%減少) • 推論サーバー レイテンシー 約60% •
推論サーバー スループット 1.35倍※1 ※1 単純計算すると、仮にサーバー50台用意して捌いていた場合、38台で十分 (12台分のコストも浮く)。 レイテンシーとスループットの向上。 -
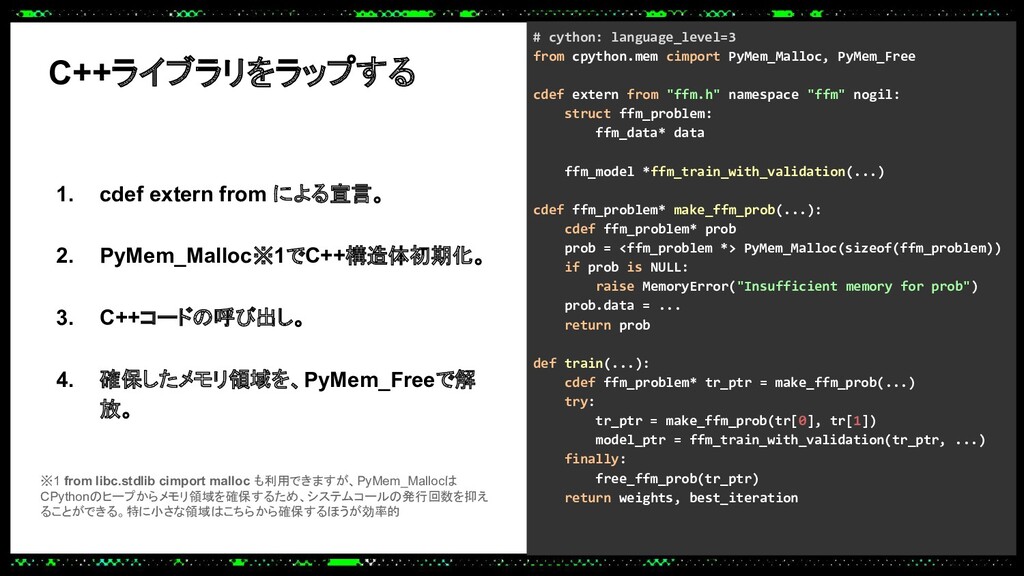
C++ライブラリをラップする 1. cdef extern from による宣言。 2. PyMem_Malloc※1でC++構造体初期化。 3. C++コードの呼び出し。
4. 確保したメモリ領域を、PyMem_Freeで解 放。 # cython: language_level=3 from cpython.mem cimport PyMem_Malloc, PyMem_Free cdef extern from "ffm.h" namespace "ffm" nogil: struct ffm_problem: ffm_data* data ffm_model *ffm_train_with_validation(...) cdef ffm_problem* make_ffm_prob(...): cdef ffm_problem* prob prob = <ffm_problem *> PyMem_Malloc(sizeof(ffm_problem)) if prob is NULL: raise MemoryError("Insufficient memory for prob") prob.data = ... return prob def train(...): cdef ffm_problem* tr_ptr = make_ffm_prob(...) try: tr_ptr = make_ffm_prob(tr[0], tr[1]) model_ptr = ffm_train_with_validation(tr_ptr, ...) finally: free_ffm_prob(tr_ptr) return weights, best_iteration ※1 from libc.stdlib cimport malloc も利用できますが、PyMem_Mallocは CPythonのヒープからメモリ領域を確保するため、システムコールの発行回数を抑え ることができる。特に小さな領域はこちらから確保するほうが効率的 -
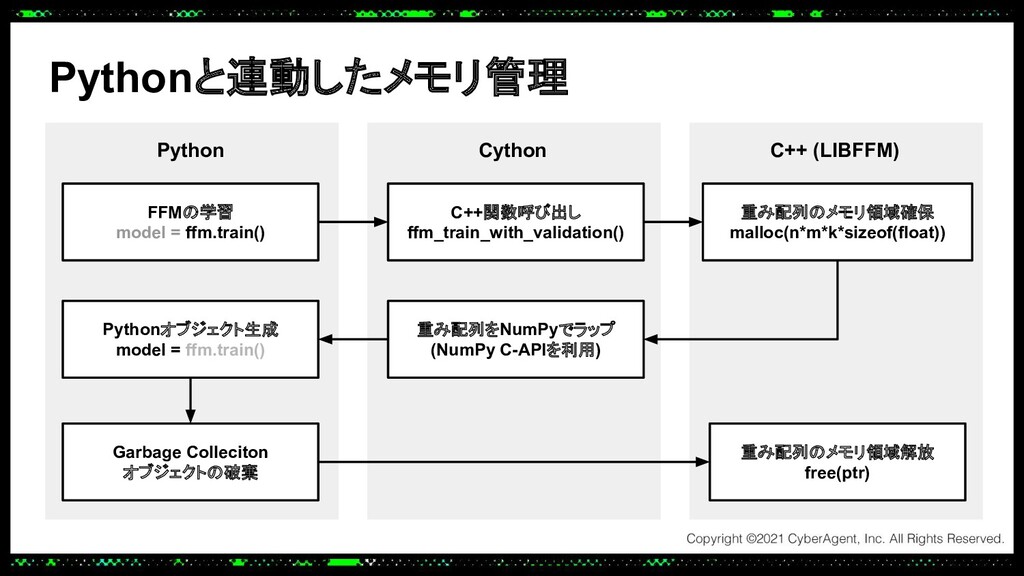
Pythonと連動したメモリ管理 C++ (LIBFFM) Cython 重み配列のメモリ領域確保 malloc(n*m*k*sizeof(float)) FFMの学習 model = ffm.train()
C++関数呼び出し ffm_train_with_validation() Python 重み配列のメモリ領域解放 free(ptr) Garbage Colleciton オブジェクトの破棄 重み配列をNumPyでラップ (NumPy C-APIを利用) Pythonオブジェクト生成 model = ffm.train() -
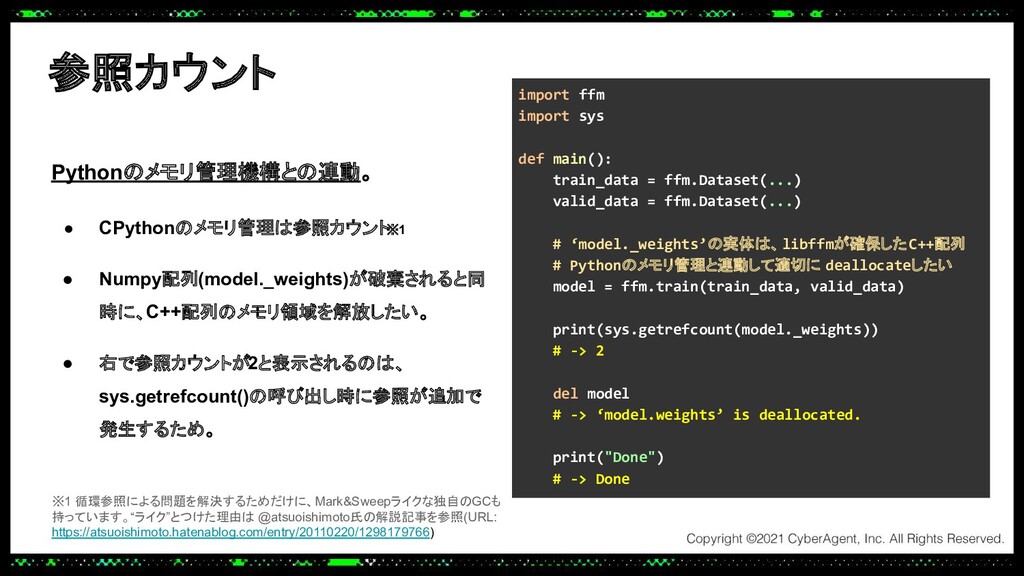
参照カウント • CPythonのメモリ管理は参照カウント ※1 • Numpy配列(model._weights)が破棄されると同 時に、C++配列のメモリ領域を解放したい。 • 右で参照カウントが2と表示されるのは、 sys.getrefcount()の呼び出し時に参照が追加で
発生するため。 import ffm import sys def main(): train_data = ffm.Dataset(...) valid_data = ffm.Dataset(...) # ‘model._weights’の実体は、libffmが確保したC++配列 # Pythonのメモリ管理と連動して適切に deallocateしたい model = ffm.train(train_data, valid_data) print(sys.getrefcount(model._weights)) # -> 2 del model # -> ‘model.weights’ is deallocated. print("Done") # -> Done ※1 循環参照による問題を解決するためだけに、Mark&Sweepライクな独自のGCも 持っています。“ライク”とつけた理由は @atsuoishimoto氏の解説記事を参照(URL: https://atsuoishimoto.hatenablog.com/entry/20110220/1298179766) Pythonのメモリ管理機構との連動。 -
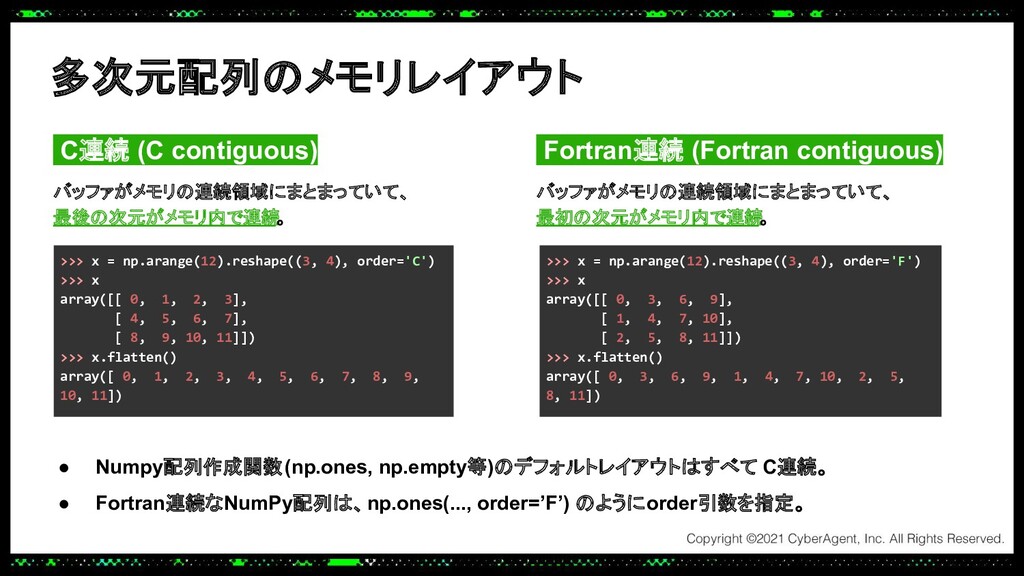
多次元配列のメモリレイアウト C連続 (C contiguous) バッファがメモリの連続領域にまとまっていて、 最後の次元がメモリ内で連続 。 Fortran連続 (Fortran contiguous)
バッファがメモリの連続領域にまとまっていて、 最初の次元がメモリ内で連続 。 >>> x = np.arange(12).reshape((3, 4), order='C') >>> x array([[ 0, 1, 2, 3], [ 4, 5, 6, 7], [ 8, 9, 10, 11]]) >>> x.flatten() array([ 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]) >>> x = np.arange(12).reshape((3, 4), order='F') >>> x array([[ 0, 3, 6, 9], [ 1, 4, 7, 10], [ 2, 5, 8, 11]]) >>> x.flatten() array([ 0, 3, 6, 9, 1, 4, 7, 10, 2, 5, 8, 11]) • Numpy配列作成関数(np.ones, np.empty等)のデフォルトレイアウトはすべて C連続。 • Fortran連続なNumPy配列は、np.ones(..., order=’F’) のようにorder引数を指定。 -
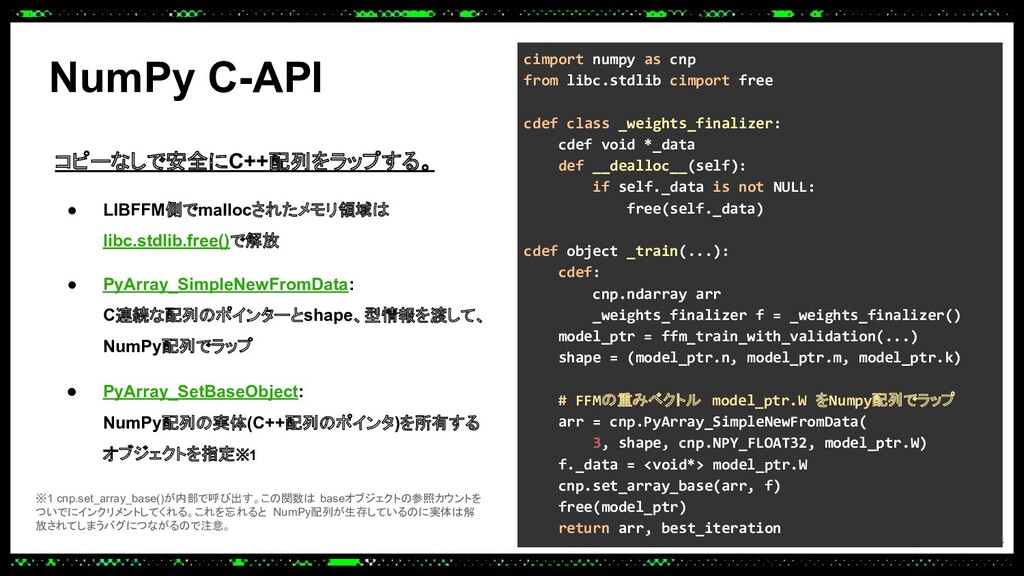
NumPy C-API • LIBFFM側でmallocされたメモリ領域は libc.stdlib.free()で解放 • PyArray_SimpleNewFromData: C連続な配列のポインターとshape、型情報を渡して、 NumPy配列でラップ •
PyArray_SetBaseObject: NumPy配列の実体(C++配列のポインタ)を所有する オブジェクトを指定※1 ※1 cnp.set_array_base()が内部で呼び出す。この関数は baseオブジェクトの参照カウントを ついでにインクリメントしてくれる。これを忘れると NumPy配列が生存しているのに実体は解 放されてしまうバグにつながるので注意。 cimport numpy as cnp from libc.stdlib cimport free cdef class _weights_finalizer: cdef void *_data def __dealloc__(self): if self._data is not NULL: free(self._data) cdef object _train(...): cdef: cnp.ndarray arr _weights_finalizer f = _weights_finalizer() model_ptr = ffm_train_with_validation(...) shape = (model_ptr.n, model_ptr.m, model_ptr.k) # FFMの重みベクトル model_ptr.W をNumpy配列でラップ arr = cnp.PyArray_SimpleNewFromData( 3, shape, cnp.NPY_FLOAT32, model_ptr.W) f._data = <void*> model_ptr.W cnp.set_array_base(arr, f) free(model_ptr) return arr, best_iteration コピーなしで安全にC++配列をラップする。 -
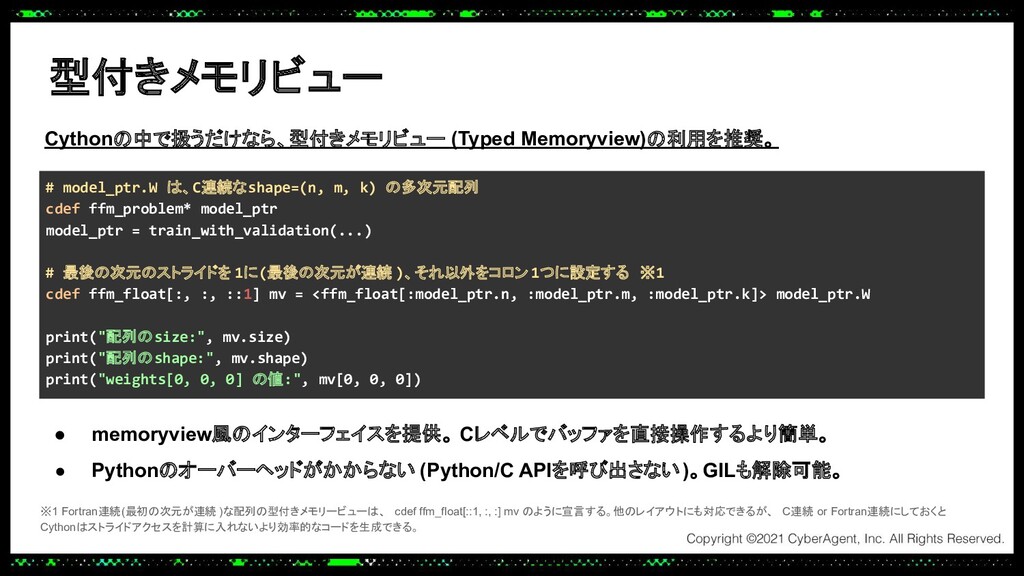
型付きメモリビュー Cythonの中で扱うだけなら、型付きメモリビュー (Typed Memoryview)の利用を推奨。 # model_ptr.W は、C連続なshape=(n, m, k) の多次元配列
cdef ffm_problem* model_ptr model_ptr = train_with_validation(...) # 最後の次元のストライドを 1に(最後の次元が連続 )、それ以外をコロン 1つに設定する ※1 cdef ffm_float[:, :, ::1] mv = <ffm_float[:model_ptr.n, :model_ptr.m, :model_ptr.k]> model_ptr.W print("配列のsize:", mv.size) print("配列のshape:", mv.shape) print("weights[0, 0, 0] の値:", mv[0, 0, 0]) ※1 Fortran連続(最初の次元が連続 )な配列の型付きメモリービューは、 cdef ffm_float[::1, :, :] mv のように宣言する。他のレイアウトにも対応できるが、 C連続 or Fortran連続にしておくと Cythonはストライドアクセスを計算に入れないより効率的なコードを生成できる。 • memoryview風のインターフェイスを提供。 Cレベルでバッファを直接操作するより簡単。 • Pythonのオーバーヘッドがかからない (Python/C APIを呼び出さない)。GILも解除可能。 -
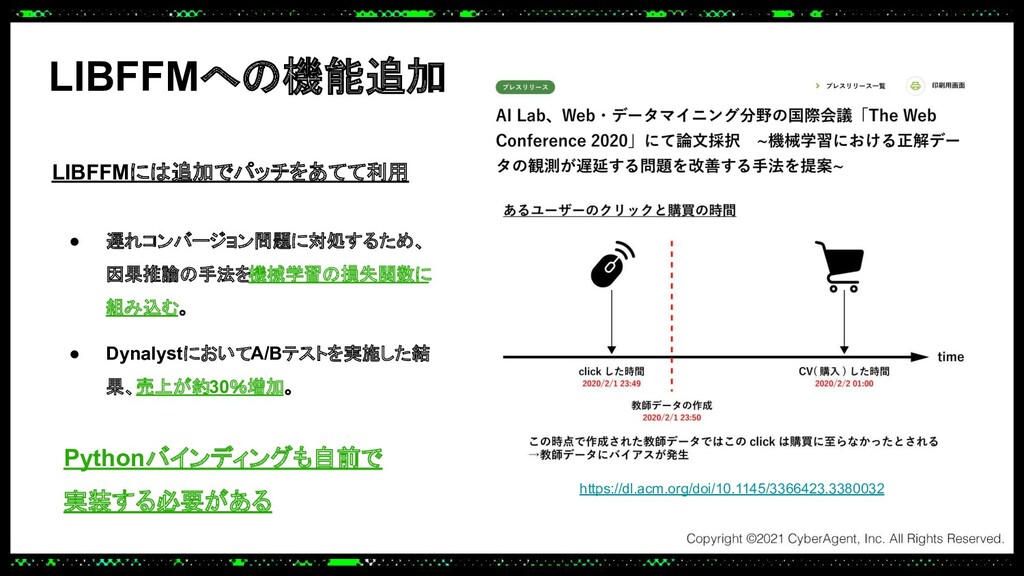
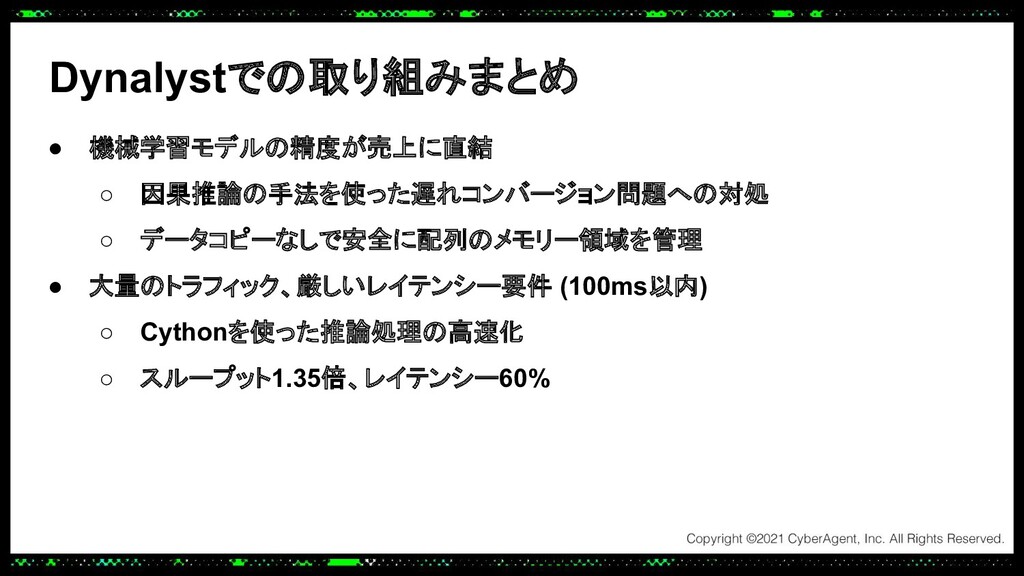
Dynalystでの取り組みまとめ • 機械学習モデルの精度が売上に直結 ◦ 因果推論の手法を使った遅れコンバージョン問題への対処 ◦ データコピーなしで安全に配列のメモリー領域を管理 • 大量のトラフィック、厳しいレイテンシー要件 (100ms以内)
◦ Cythonを使った推論処理の高速化 ◦ スループット1.35倍、レイテンシー60% -
学習パイプライン 学習パイプラインは、定期的に実行 。 新しいデータでモデルを再学習。 最適なハイパーパラメーターも Optunaで毎回探索する。 • AWS Step Functionsで構築
• 各種メトリクスの収集やモデルの管理 にはMLflowを利用 -
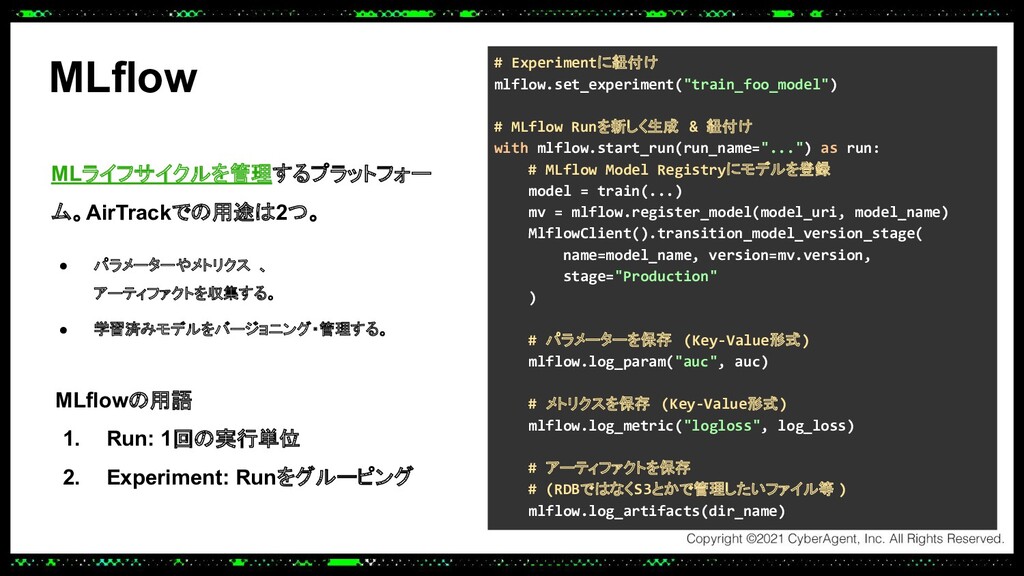
MLflow MLライフサイクルを管理するプラットフォー ム。AirTrackでの用途は2つ。 # Experimentに紐付け mlflow.set_experiment("train_foo_model") # MLflow Runを新しく生成 &
紐付け with mlflow.start_run(run_name="...") as run: # MLflow Model Registryにモデルを登録 model = train(...) mv = mlflow.register_model(model_uri, model_name) MlflowClient().transition_model_version_stage( name=model_name, version=mv.version, stage="Production" ) # パラメーターを保存 (Key-Value形式) mlflow.log_param("auc", auc) # メトリクスを保存 (Key-Value形式) mlflow.log_metric("logloss", log_loss) # アーティファクトを保存 # (RDBではなくS3とかで管理したいファイル等 ) mlflow.log_artifacts(dir_name) MLflowの用語 1. Run: 1回の実行単位 2. Experiment: Runをグルーピング • パラメーターやメトリクス 、 アーティファクトを収集する。 • 学習済みモデルをバージョニング・管理する。 -
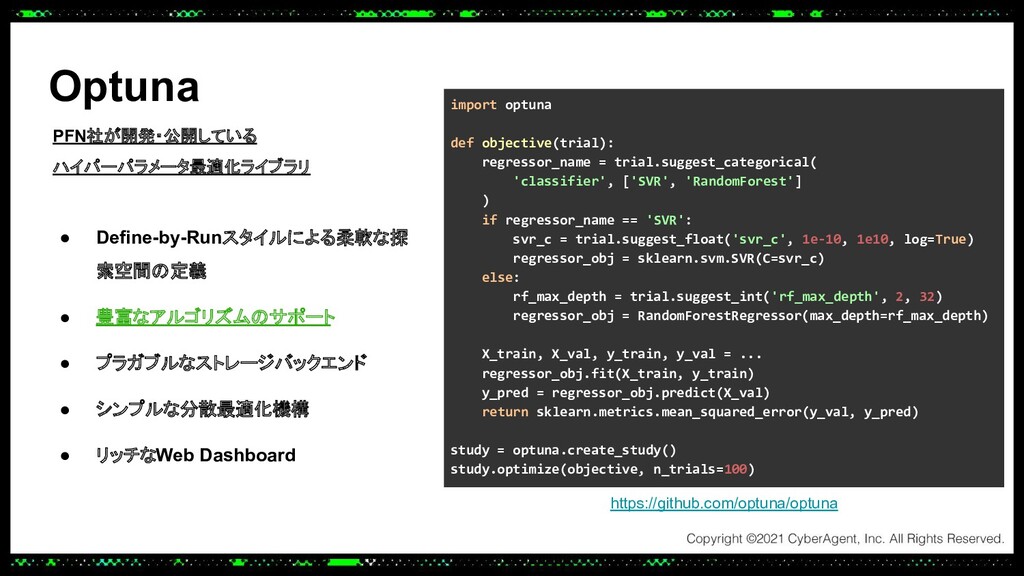
Optuna PFN社が開発・公開している ハイパーパラメータ最適化ライブラリ https://github.com/optuna/optuna import optuna def objective(trial): regressor_name =
trial.suggest_categorical( 'classifier', ['SVR', 'RandomForest'] ) if regressor_name == 'SVR': svr_c = trial.suggest_float('svr_c', 1e-10, 1e10, log=True) regressor_obj = sklearn.svm.SVR(C=svr_c) else: rf_max_depth = trial.suggest_int('rf_max_depth', 2, 32) regressor_obj = RandomForestRegressor(max_depth=rf_max_depth) X_train, X_val, y_train, y_val = ... regressor_obj.fit(X_train, y_train) y_pred = regressor_obj.predict(X_val) return sklearn.metrics.mean_squared_error(y_val, y_pred) study = optuna.create_study() study.optimize(objective, n_trials=100) • Define-by-Runスタイルによる柔軟な探 索空間の定義 • 豊富なアルゴリズムのサポート • プラガブルなストレージバックエンド • シンプルな分散最適化機構 • リッチなWeb Dashboard -
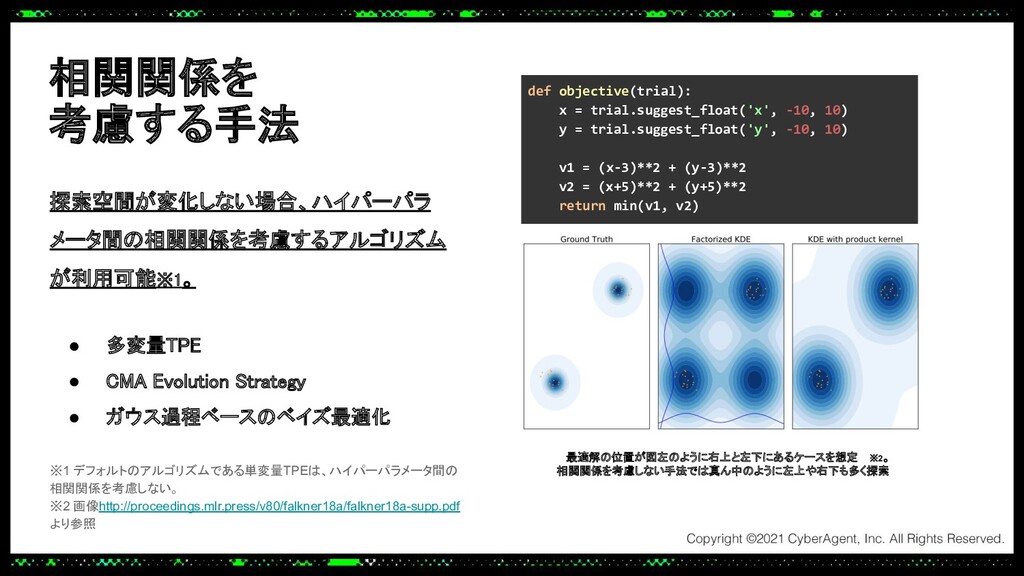
相関関係を 考慮する手法 探索空間が変化しない場合、ハイパーパラ メータ間の相関関係を考慮するアルゴリズム が利用可能※1。 ※1 デフォルトのアルゴリズムである単変量TPEは、ハイパーパラメータ間の 相関関係を考慮しない。 ※2 画像http://proceedings.mlr.press/v80/falkner18a/falkner18a-supp.pdf
より参照 最適解の位置が図左のように右上と左下にあるケースを想定 ※2。 相関関係を考慮しない手法では真ん中のように左上や右下も多く探索 def objective(trial): x = trial.suggest_float('x', -10, 10) y = trial.suggest_float('y', -10, 10) v1 = (x-3)**2 + (y-3)**2 v2 = (x+5)**2 + (y+5)**2 return min(v1, v2) • 多変量TPE • CMA Evolution Strategy • ガウス過程ベースのベイズ最適化 -
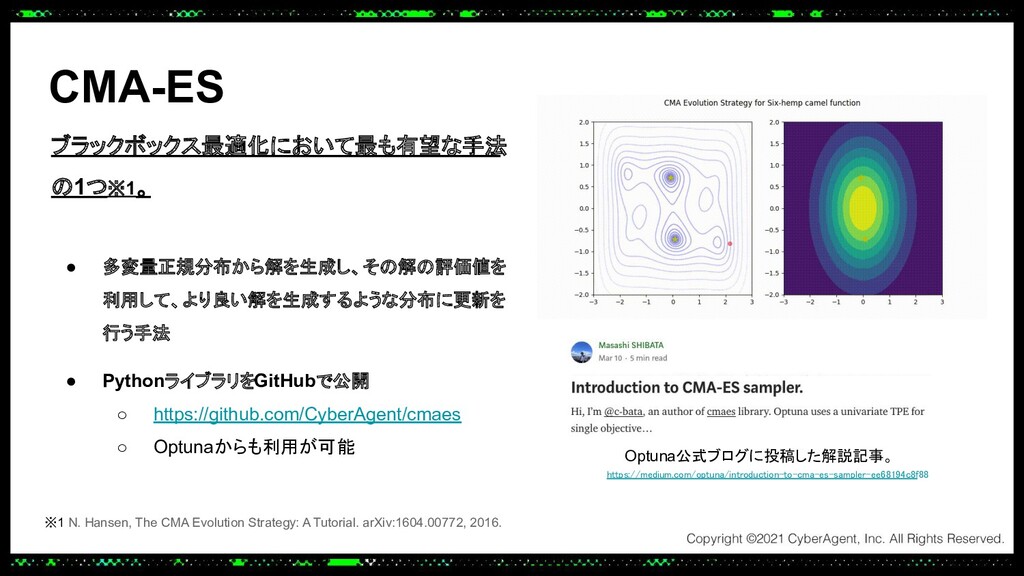
CMA-ES • 多変量正規分布から解を生成し、その解の評価値を 利用して、より良い解を生成するような分布に更新を 行う手法 • PythonライブラリをGitHubで公開 ◦ https://github.com/CyberAgent/cmaes ◦
Optunaからも利用が可能 Optuna公式ブログに投稿した解説記事。 https://medium.com/optuna/introduction-to-cma-es-sampler-ee68194c8f88 ※1 N. Hansen, The CMA Evolution Strategy: A Tutorial. arXiv:1604.00772, 2016. ブラックボックス最適化において最も有望な手法 の1つ※1。 -
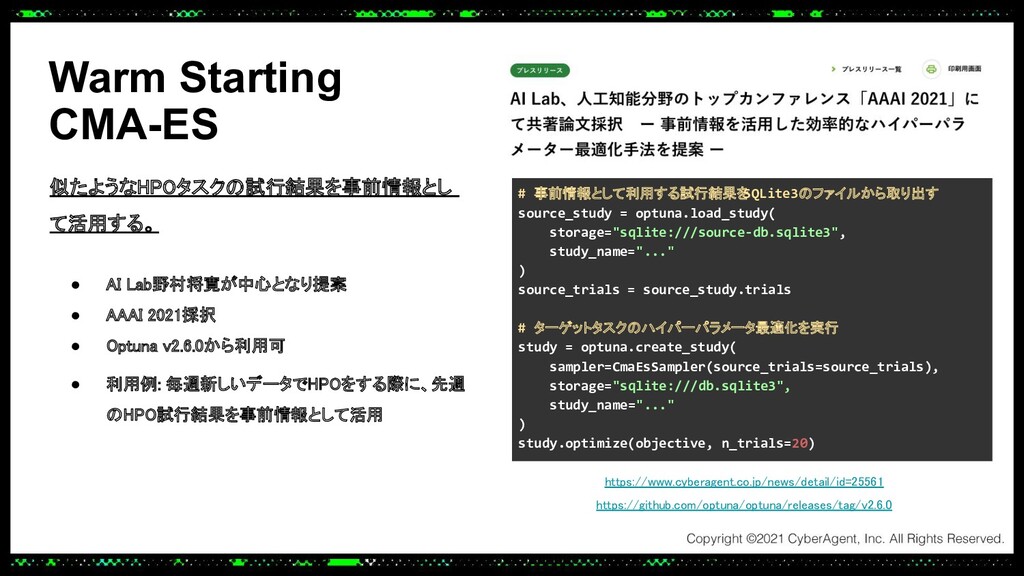
Warm Starting CMA-ES 似たようなHPOタスクの試行結果を事前情報とし て活用する。 # 事前情報として利用する試行結果を SQLite3のファイルから取り出す source_study =
optuna.load_study( storage="sqlite:///source-db.sqlite3", study_name="..." ) source_trials = source_study.trials # ターゲットタスクのハイパーパラメータ最適化を実行 study = optuna.create_study( sampler=CmaEsSampler(source_trials=source_trials), storage="sqlite:///db.sqlite3", study_name="..." ) study.optimize(objective, n_trials=20) https://www.cyberagent.co.jp/news/detail/id=25561 https://github.com/optuna/optuna/releases/tag/v2.6.0 • AI Lab野村将寛が中心となり提案 • AAAI 2021採択 • Optuna v2.6.0から利用可 • 利用例: 毎週新しいデータでHPOをする際に、先週 のHPO試行結果を事前情報として活用 -
先週のHPO試行結果の活用 最新のデータの取得 学習パイプライン Optunaの実行 試行結果を保存 MLflow Artifact 最新のデータの取得 学習パイプライン Optunaの実行
試行結果を保存 MLflow Artifact 1週間後 AirTrackの来訪予測モデル(XGBoost)で、 オフラインでの性能検証を行い、Optunaのデフォルト 最適化手法と比べて約2倍の高速化 を実現 -
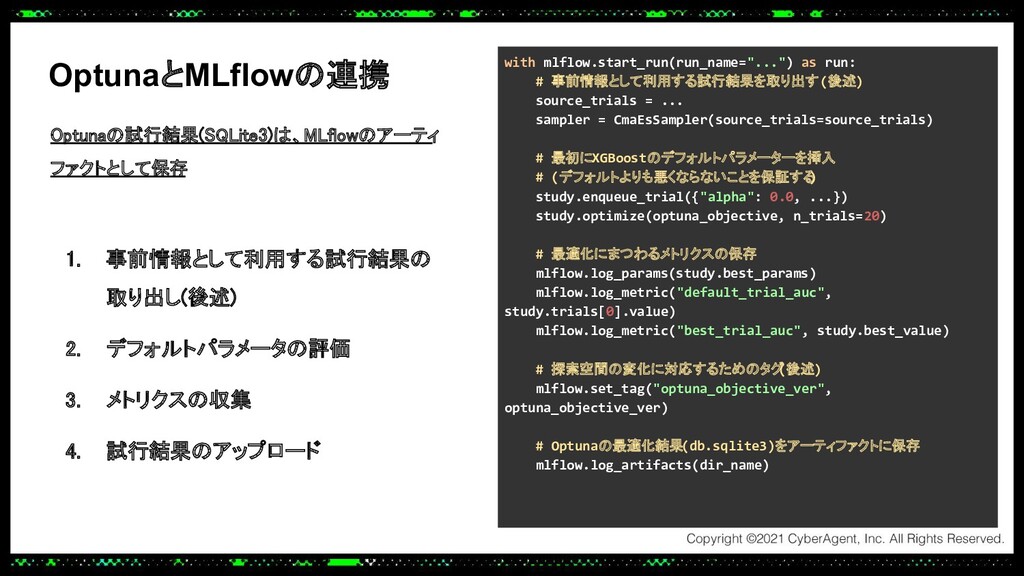
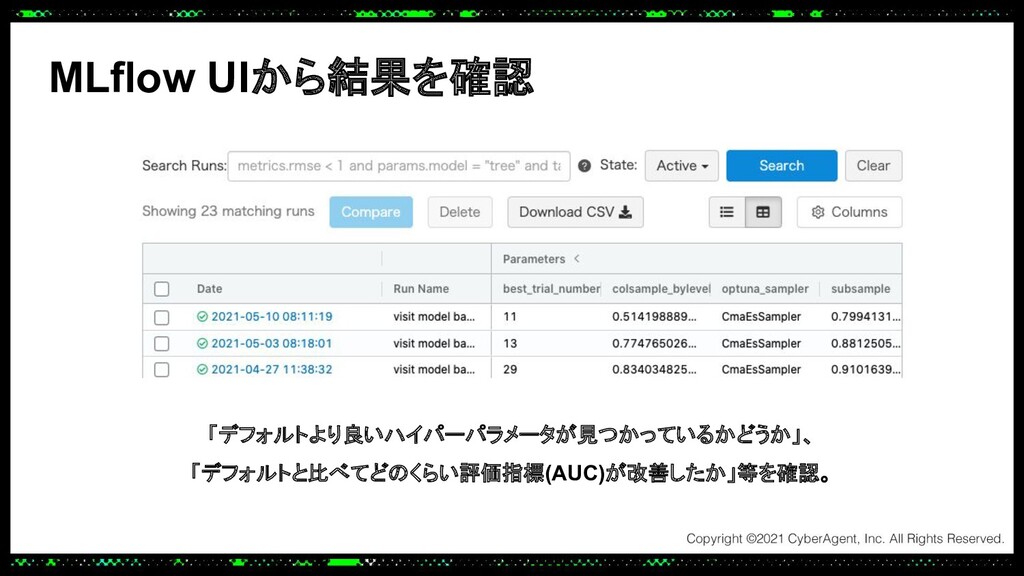
OptunaとMLflowの連携 1. 事前情報として利用する試行結果の 取り出し(後述) 2. デフォルトパラメータの評価 3. メトリクスの収集
4. 試行結果のアップロード with mlflow.start_run(run_name="...") as run: # 事前情報として利用する試行結果を取り出す (後述) source_trials = ... sampler = CmaEsSampler(source_trials=source_trials) # 最初にXGBoostのデフォルトパラメーターを挿入 # (デフォルトよりも悪くならないことを保証する ) study.enqueue_trial({"alpha": 0.0, ...}) study.optimize(optuna_objective, n_trials=20) # 最適化にまつわるメトリクスの保存 mlflow.log_params(study.best_params) mlflow.log_metric("default_trial_auc", study.trials[0].value) mlflow.log_metric("best_trial_auc", study.best_value) # 探索空間の変化に対応するためのタグ (後述) mlflow.set_tag("optuna_objective_ver", optuna_objective_ver) # Optunaの最適化結果(db.sqlite3)をアーティファクトに保存 mlflow.log_artifacts(dir_name) Optunaの試行結果(SQLite3)は、MLflowのアーティ ファクトとして保存 -
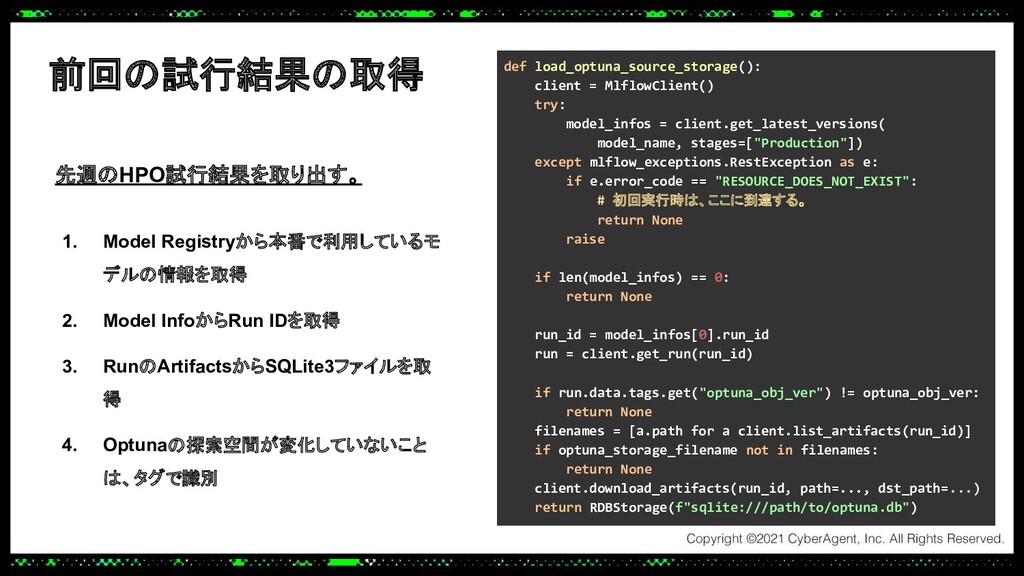
前回の試行結果の取得 1. Model Registryから本番で利用しているモ デルの情報を取得 2. Model InfoからRun IDを取得 3.
RunのArtifactsからSQLite3ファイルを取 得 4. Optunaの探索空間が変化していないこと は、タグで識別 def load_optuna_source_storage(): client = MlflowClient() try: model_infos = client.get_latest_versions( model_name, stages=["Production"]) except mlflow_exceptions.RestException as e: if e.error_code == "RESOURCE_DOES_NOT_EXIST": # 初回実行時は、ここに到達する。 return None raise if len(model_infos) == 0: return None run_id = model_infos[0].run_id run = client.get_run(run_id) if run.data.tags.get("optuna_obj_ver") != optuna_obj_ver: return None filenames = [a.path for a client.list_artifacts(run_id)] if optuna_storage_filename not in filenames: return None client.download_artifacts(run_id, path=..., dst_path=...) return RDBStorage(f"sqlite:///path/to/optuna.db") 先週のHPO試行結果を取り出す。 -
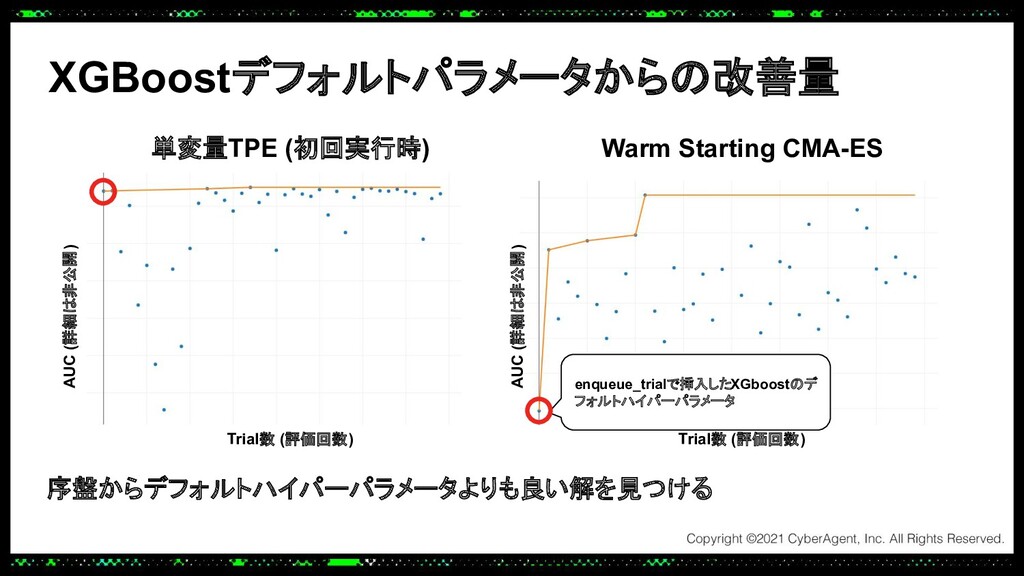
XGBoostデフォルトパラメータからの改善量 序盤からデフォルトハイパーパラメータよりも良い解を見つける 単変量TPE (初回実行時) Warm Starting CMA-ES AUC (詳細は非公開) AUC
(詳細は非公開) Trial数 (評価回数) Trial数 (評価回数) enqueue_trialで挿入したXGboostのデ フォルトハイパーパラメータ -
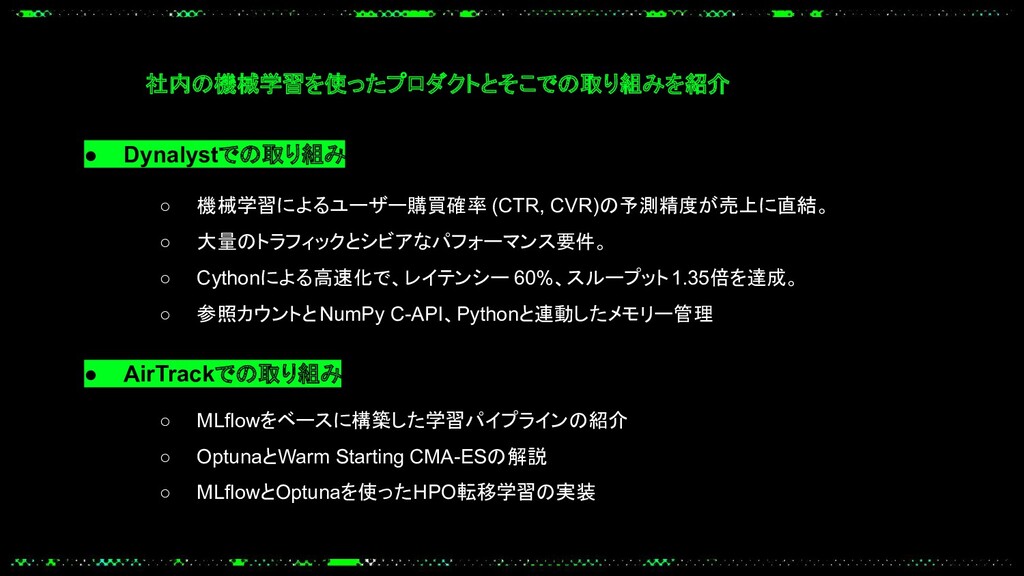
◦ 機械学習によるユーザー購買確率 (CTR, CVR)の予測精度が売上に直結。 ◦ 大量のトラフィックとシビアなパフォーマンス要件。 ◦ Cythonによる高速化で、レイテンシー 60%、スループット1.35倍を達成。 ◦
参照カウントとNumPy C-API、Pythonと連動したメモリー管理 社内の機械学習を使ったプロダクトとそこでの取り組みを紹介 ◦ MLflowをベースに構築した学習パイプラインの紹介 ◦ OptunaとWarm Starting CMA-ESの解説 ◦ MLflowとOptunaを使ったHPO転移学習の実装 • Dynalystでの取り組み • AirTrackでの取り組み