Share
Embed
[RSJ23] Everyday Object Search and Manipulation Based on Target Object Extraction Using Multimodal Foundation Models
Semantic Machine Intelligence Lab., Keio Univ. PRO
September 11, 2023
Transcript
27 slides
-
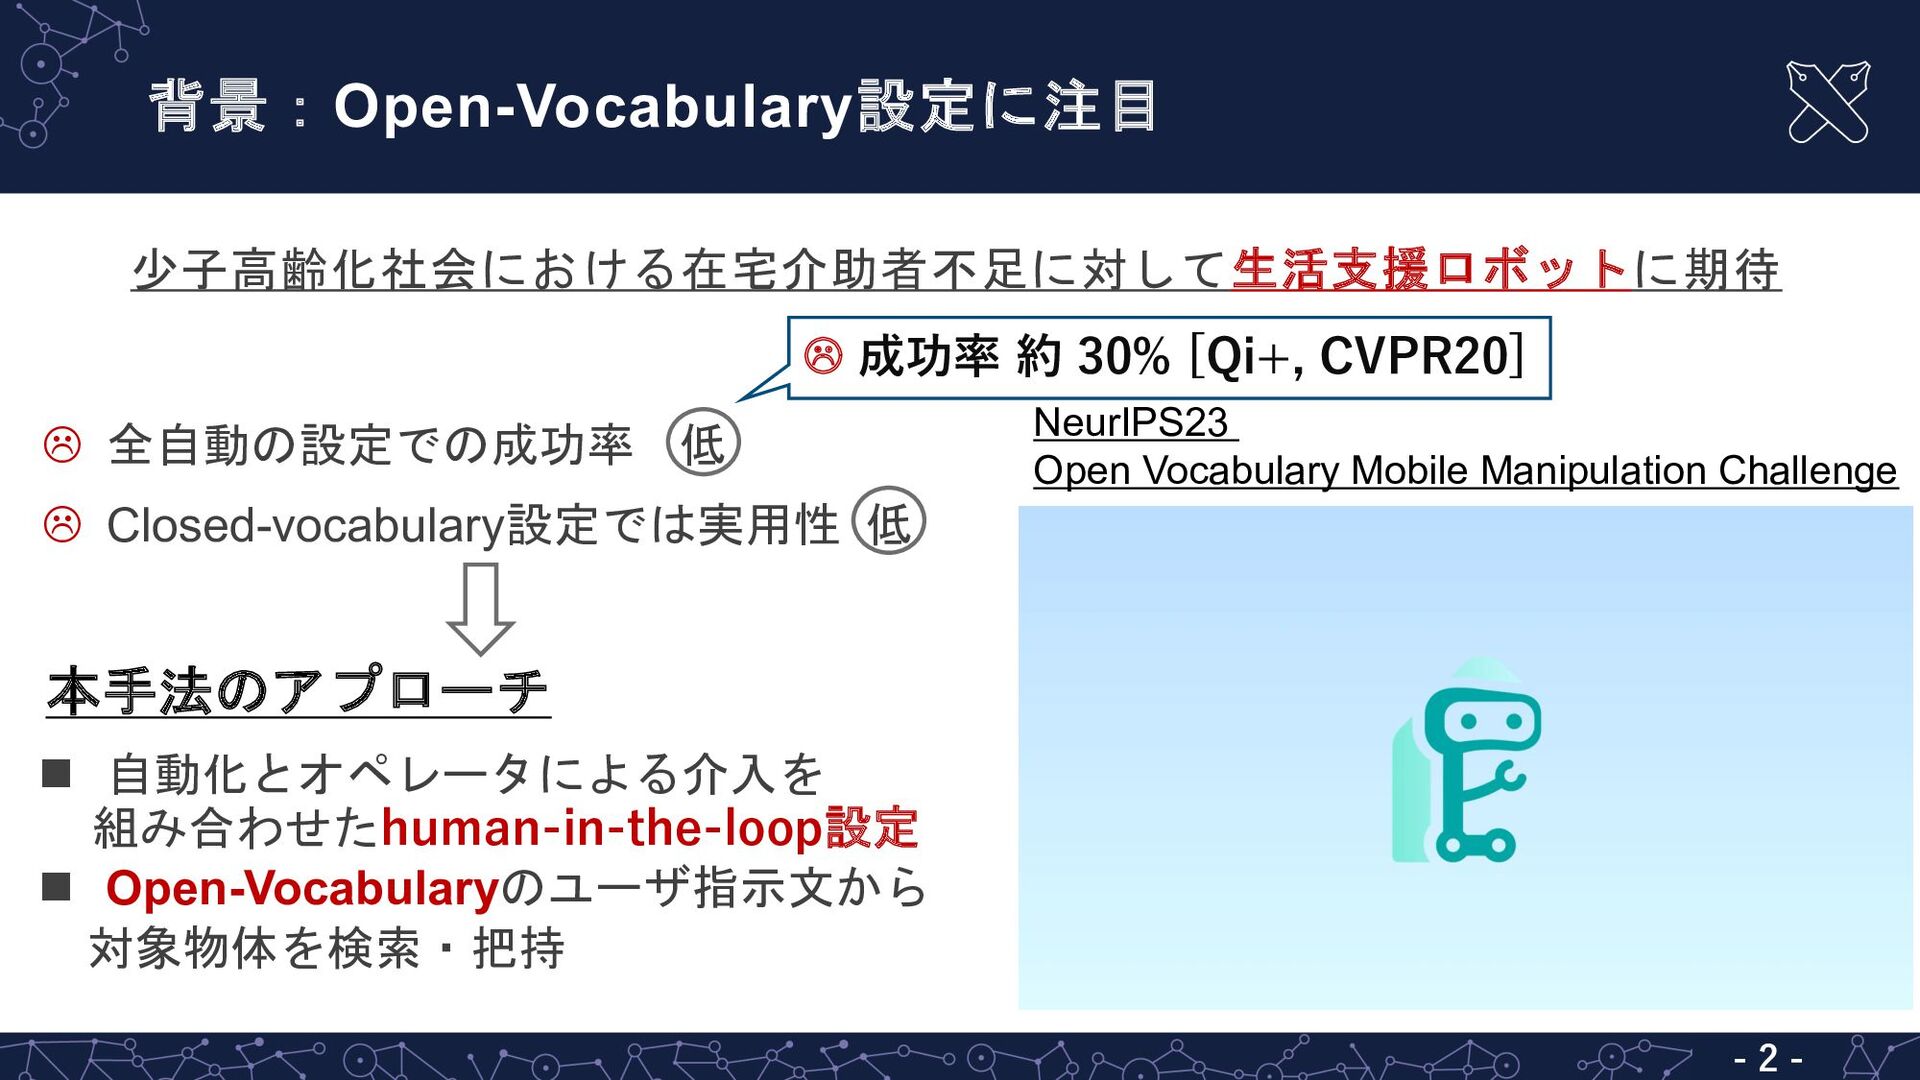
背景:Open-Vocabulary設定に注目 - 2 - 少子高齢化社会における在宅介助者不足に対して生活支援ロボットに期待 L 全自動の設定での成功率 低 NeurIPS23 Open
Vocabulary Mobile Manipulation Challenge n 自動化とオペレータによる介入を 組み合わせたhuman-in-the-loop設定 n Open-Vocabularyのユーザ指示文から 対象物体を検索・把持 L Closed-vocabulary設定では実用性 低 本手法のアプローチ L 成功率 約 30% [Qi+, CVPR20] -
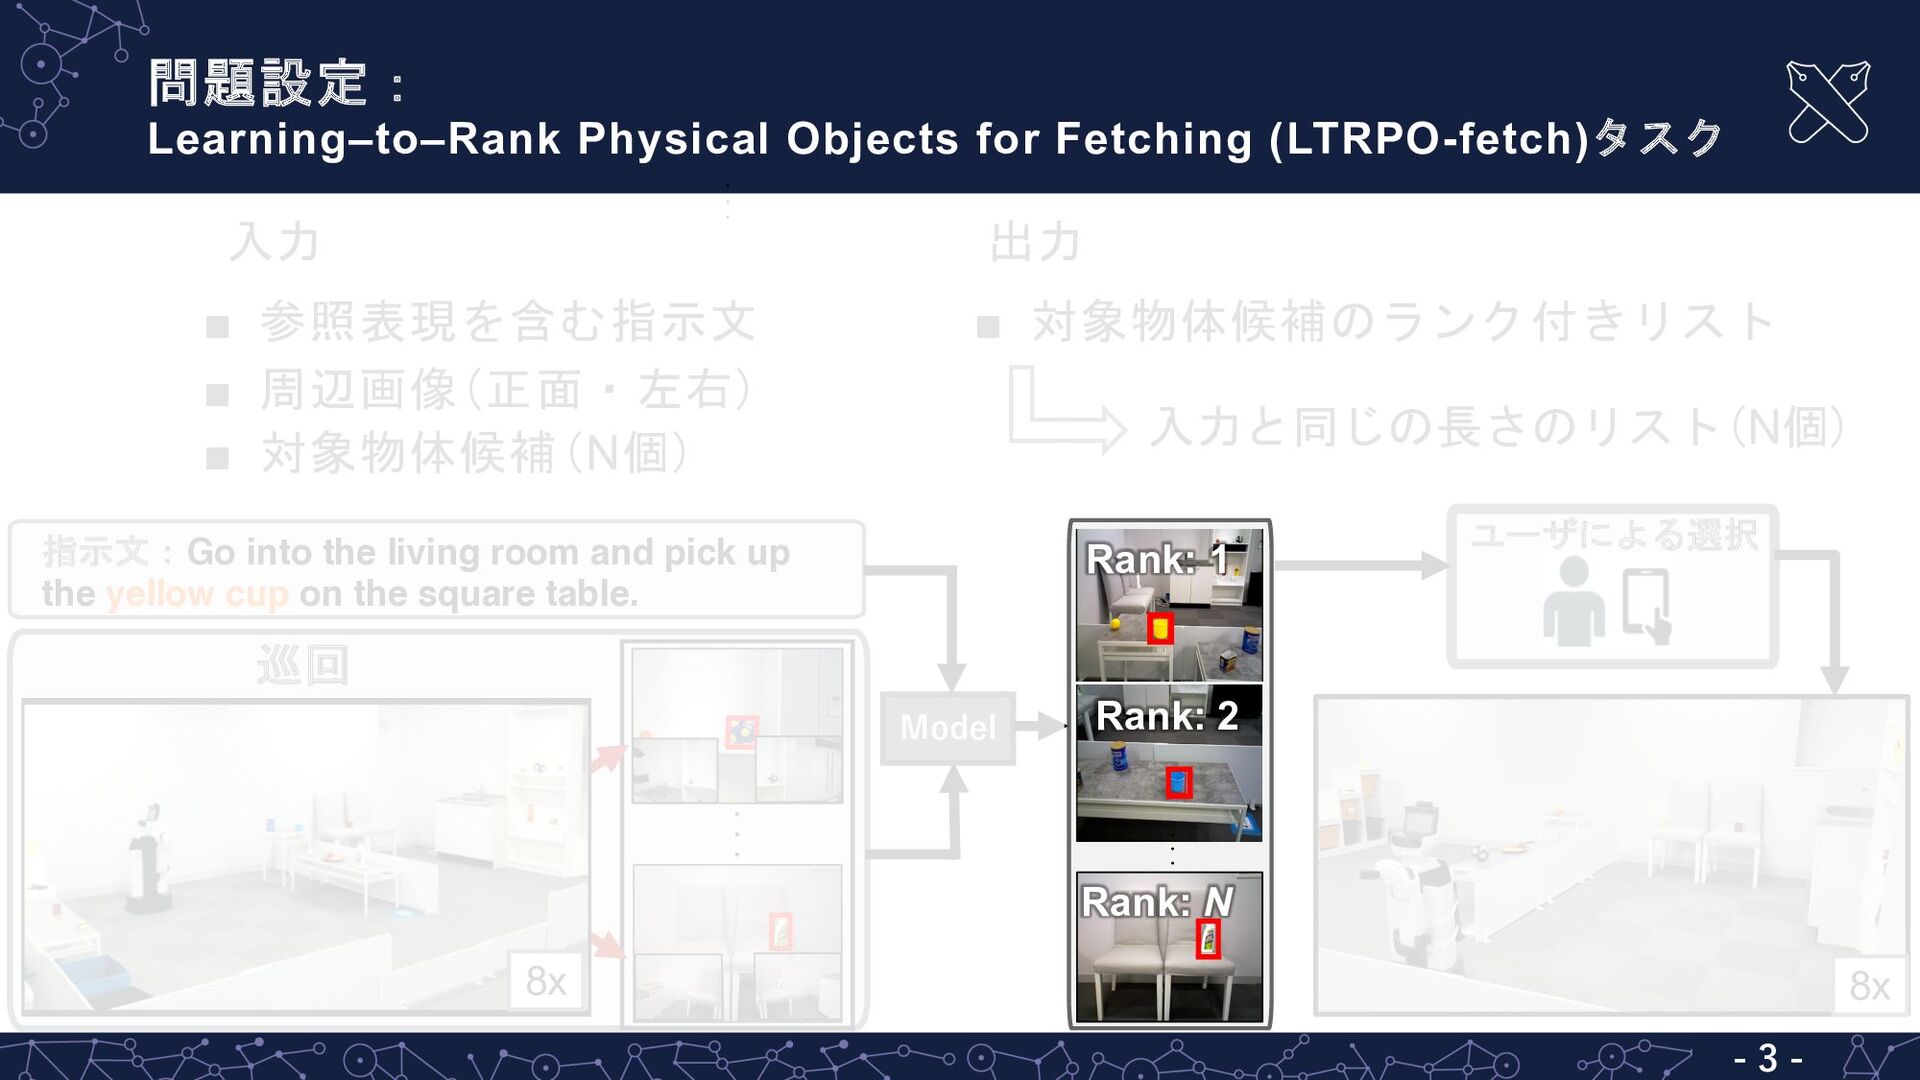
問題設定: Learning–to–Rank Physical Objects for Fetching (LTRPO-fetch)タスク - 3 -
▪ 参照表現を含む指示文 ▪ 周辺画像(正面・左右) ▪ 対象物体候補(N個) 入力 8x 指示文:Go into the living room and pick up the yellow cup on the square table. Model ・・・ 巡回 Rank: 1 Rank: 2 Rank: N ・・・ ユーザによる選択 ・・・ 8x 出力 ▪ 対象物体候補のランク付きリスト 入力と同じの長さのリスト(N個) -
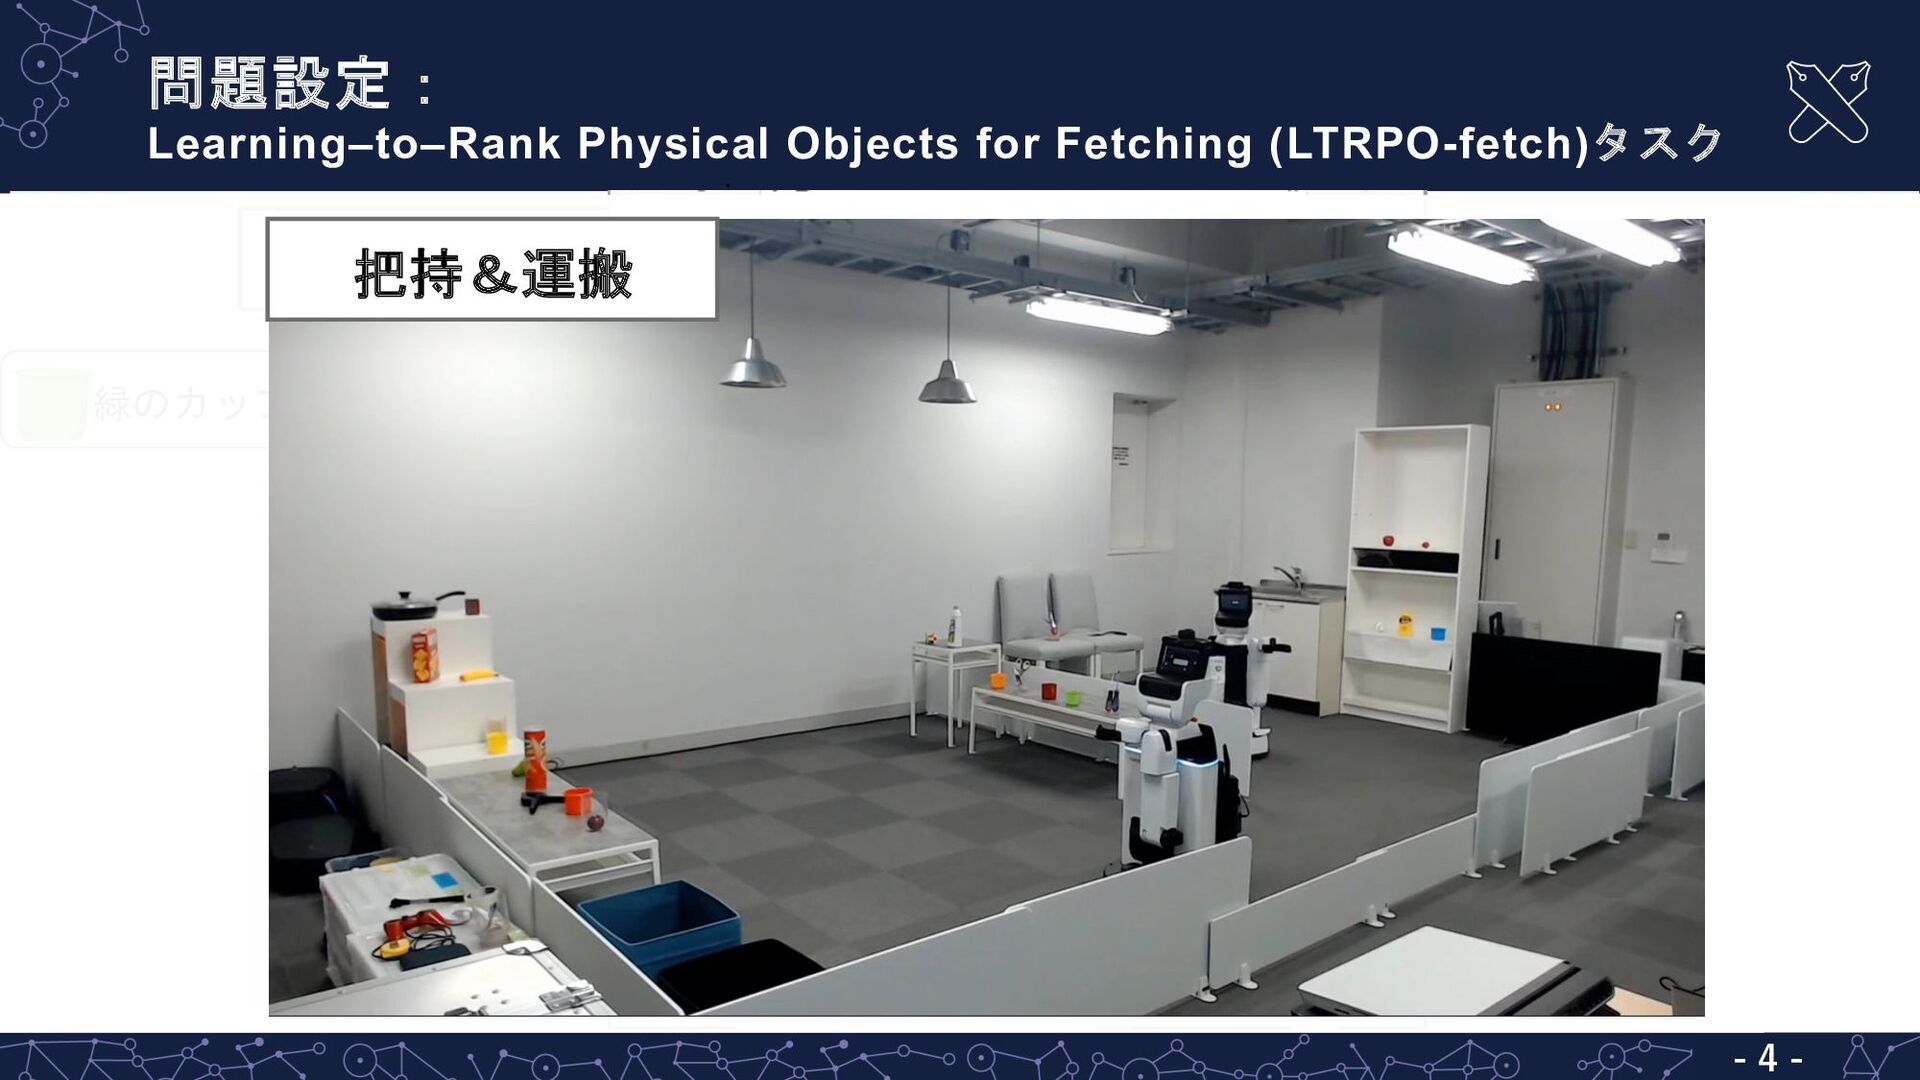
問題設定: Learning–to–Rank Physical Objects for Fetching (LTRPO-fetch)タスク - 4 -
・・・ 4~16x 巡回&画像収集 緑のカップを取ってください 16x 把持&運搬 -
関連研究:検索設定で実機評価を行う研究は少ない - 5 - 分野 手法 概要 クロスモーダ ル検索 DCNet
[Kim+, AAAI21] 参照画像とターゲット画像の差分を用いることで 頑健なマルチモーダル表現を学習 COTS [Lu+, CVPR22] トークン・タスクレベルの相互作用を取り入れた 2ストリームモデルを提案 MultiRankIt [兼田+, JSAI23] Human-in-the-loop設定において、ユーザの指示文から 対象物体を特定する新しいアプローチを提案 ロボティクス SHeFU [Korekata+, IROS23] 物体領域候補から対象物体、配置目標を単一モデルで特定 DCNet SHeFU -
既存⼿法の問題点:指⽰⽂からの対象物体表現の特定は困難 - 6 - MultiRankIt [兼田+, JSAI23] L 複数の候補を含む指示文からの対象物体表現の特定が困難 ▪
例) Go to the bathroom with two large paintings and a lot of red towels and clean the sink. L 指⽰⽂中の red towelsが上位に検索 指示文から正しく対象物体表現を抽出することができれば 性能向上が期待 -
提案⼿法の新規性: LLMとSAMの使⽤ - 7 - ▪ Target Phrase Extractor ▪
大規模言語モデル(LLM)を用いて複雑な指示文から対象物体表現を抽出 ▪ Object Segmentation Region Extractor ▪ SAM [Kirillov+, 23]を用いて物体の輪郭および形状に関する情報を処理 the towel -
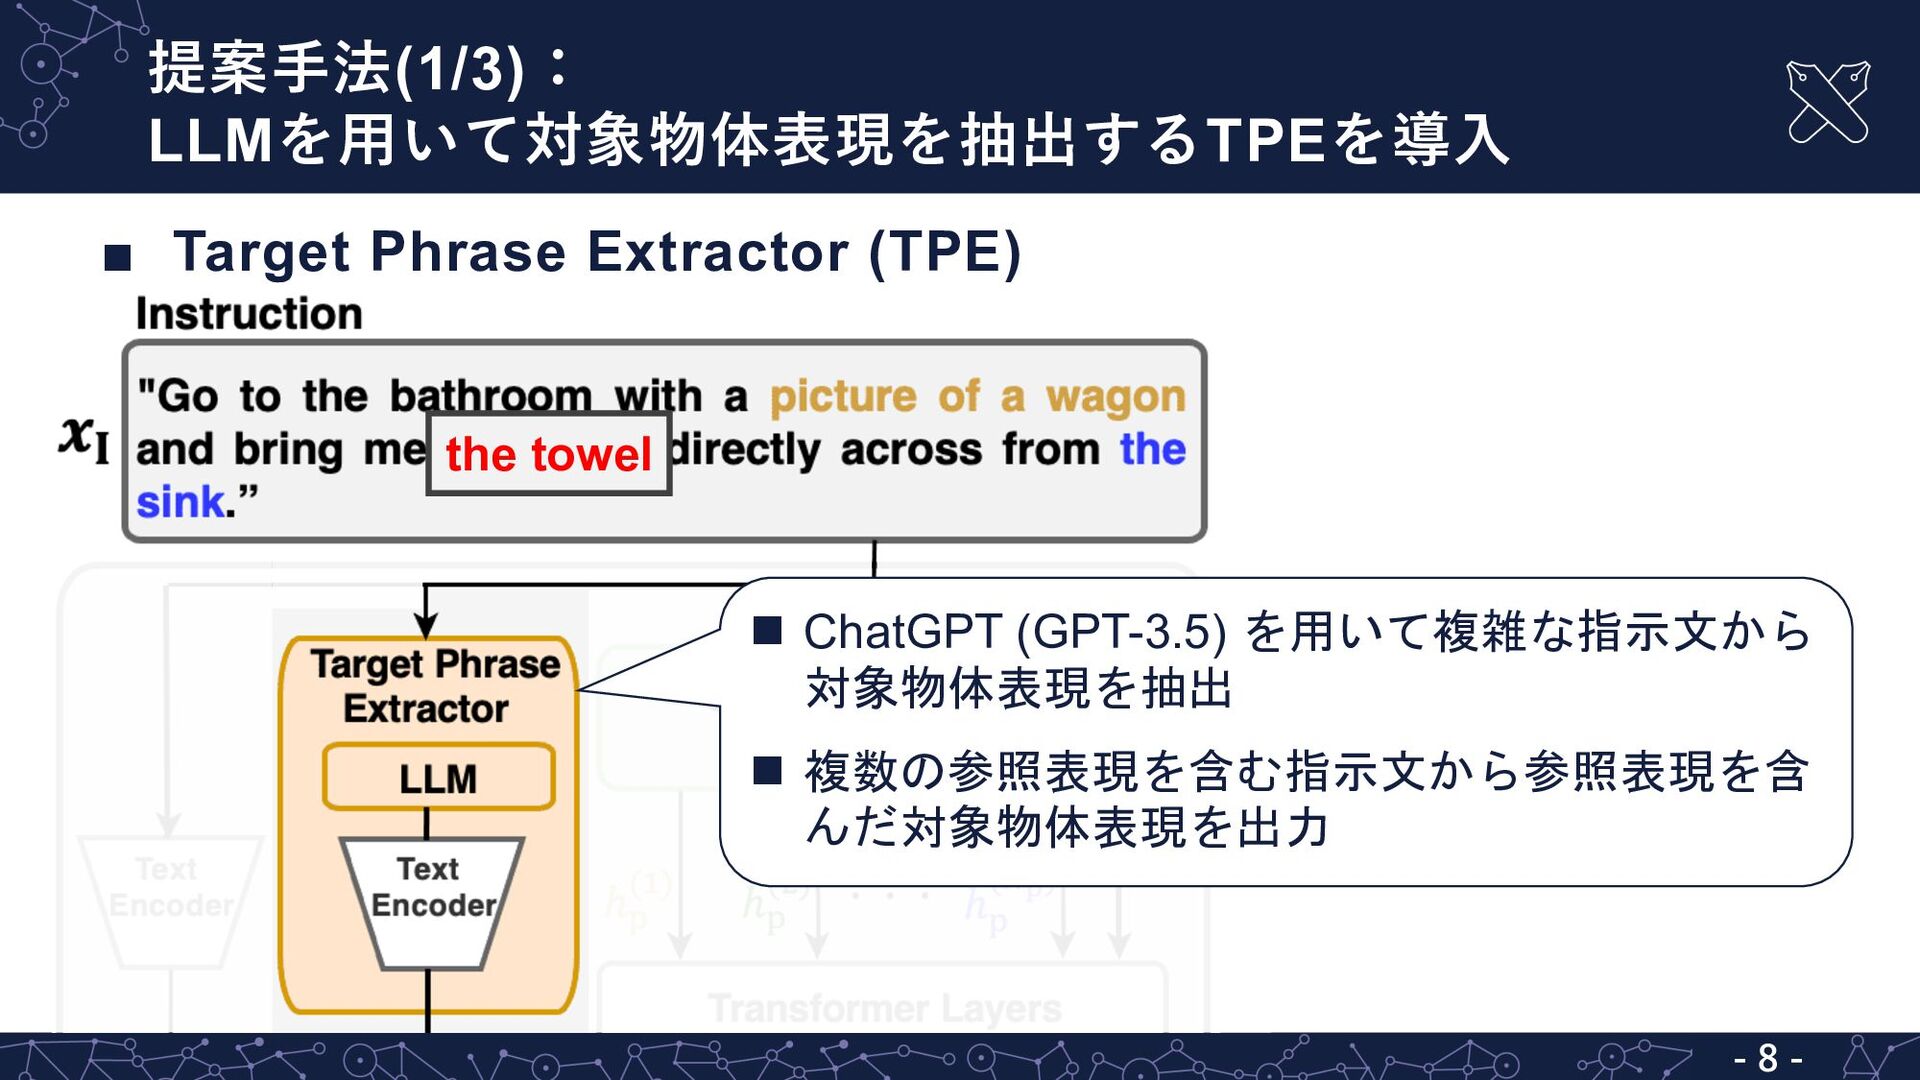
提案⼿法(1/3): LLMを⽤いて対象物体表現を抽出するTPEを導⼊ - 8 - ▪ Target Phrase Extractor (TPE)
the towel n ChatGPT (GPT-3.5) を用いて複雑な指示文から 対象物体表現を抽出 n 複数の参照表現を含む指示文から参照表現を含 んだ対象物体表現を出力 the towel the towel -
提案⼿法(1/3): LLMを⽤いて対象物体表現を抽出するTPEを導⼊ - 9 - ▪ Target Phrase Extractor (TPE)
the towel the towel the towel n ChatGPT (GPT-3.5) を用いて複雑な指示文から 対象物体表現を抽出 n 複数の参照表現を含む指示文から参照表現を含 んだ対象物体表現を出力 -
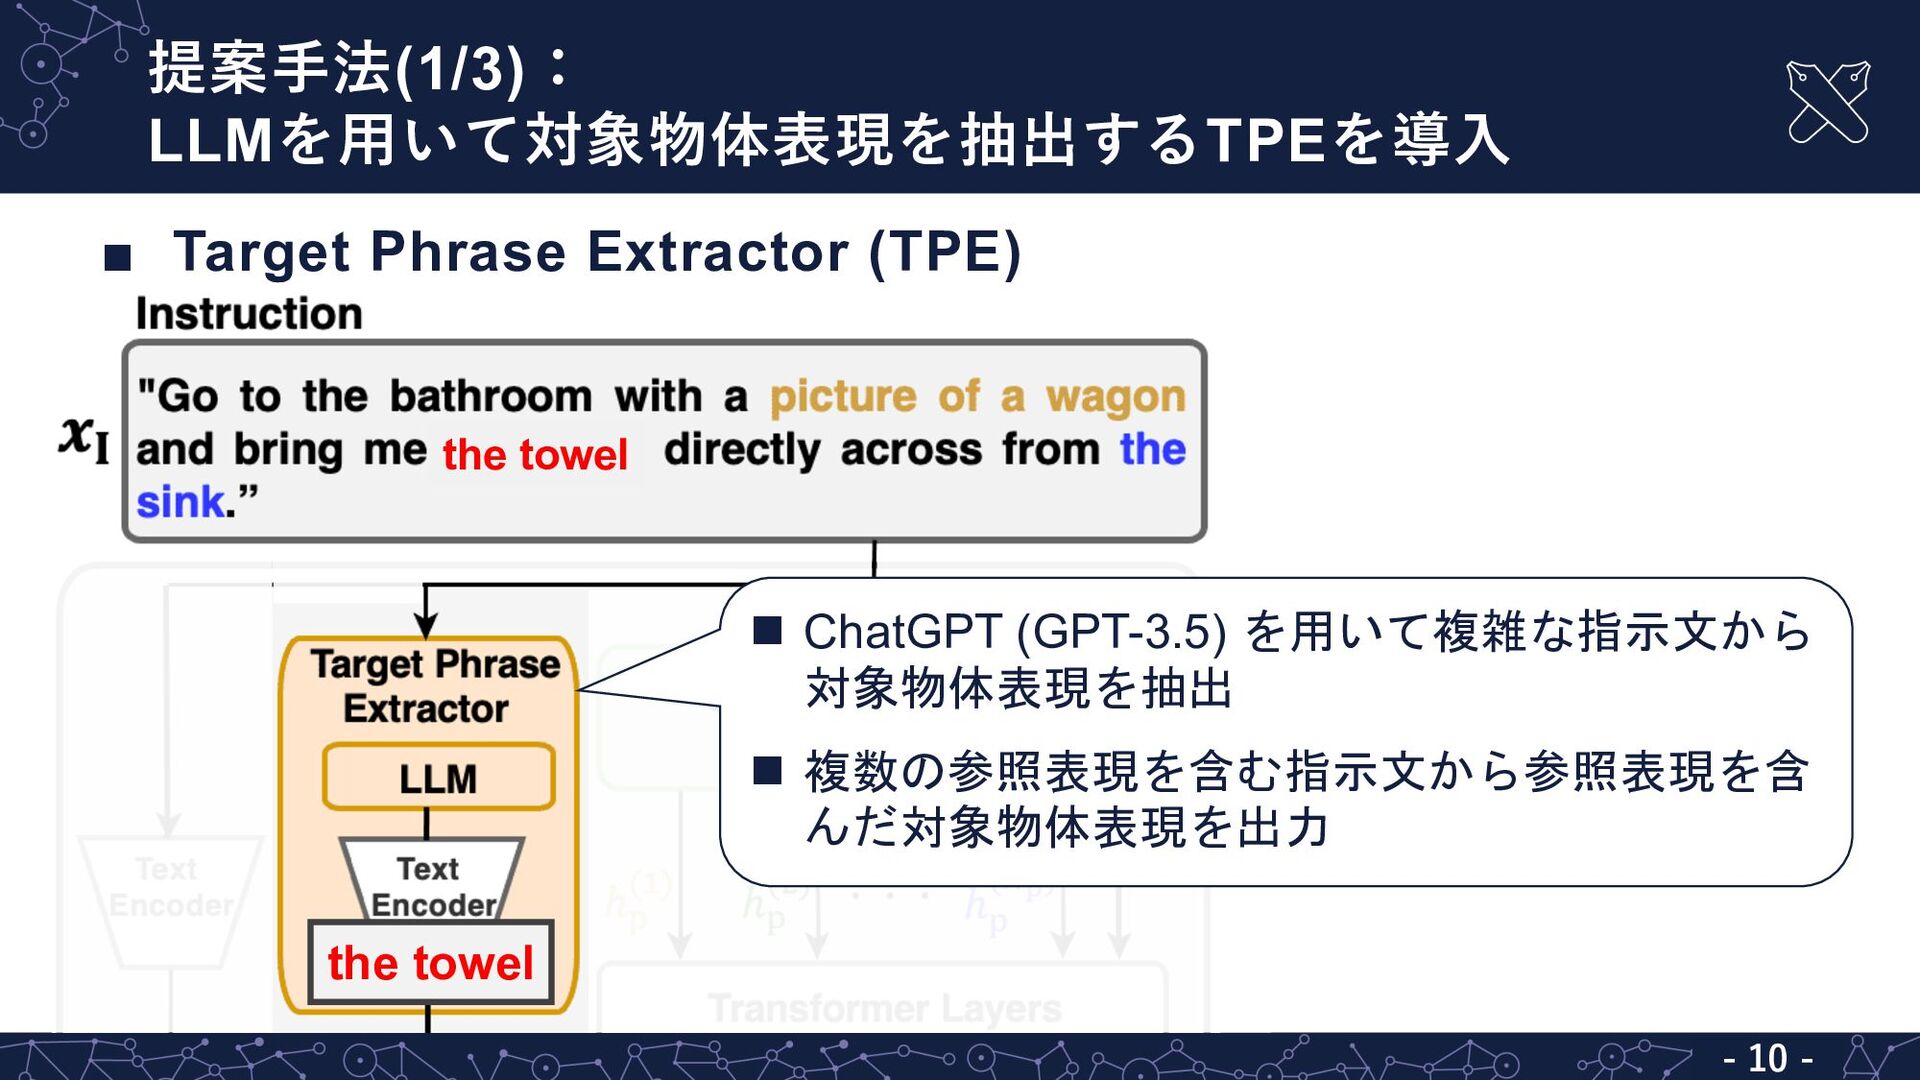
提案⼿法(1/3): LLMを⽤いて対象物体表現を抽出するTPEを導⼊ - 10 - ▪ Target Phrase Extractor (TPE)
the towel the towel the towel n ChatGPT (GPT-3.5) を用いて複雑な指示文から 対象物体表現を抽出 n 複数の参照表現を含む指示文から参照表現を含 んだ対象物体表現を出力 -
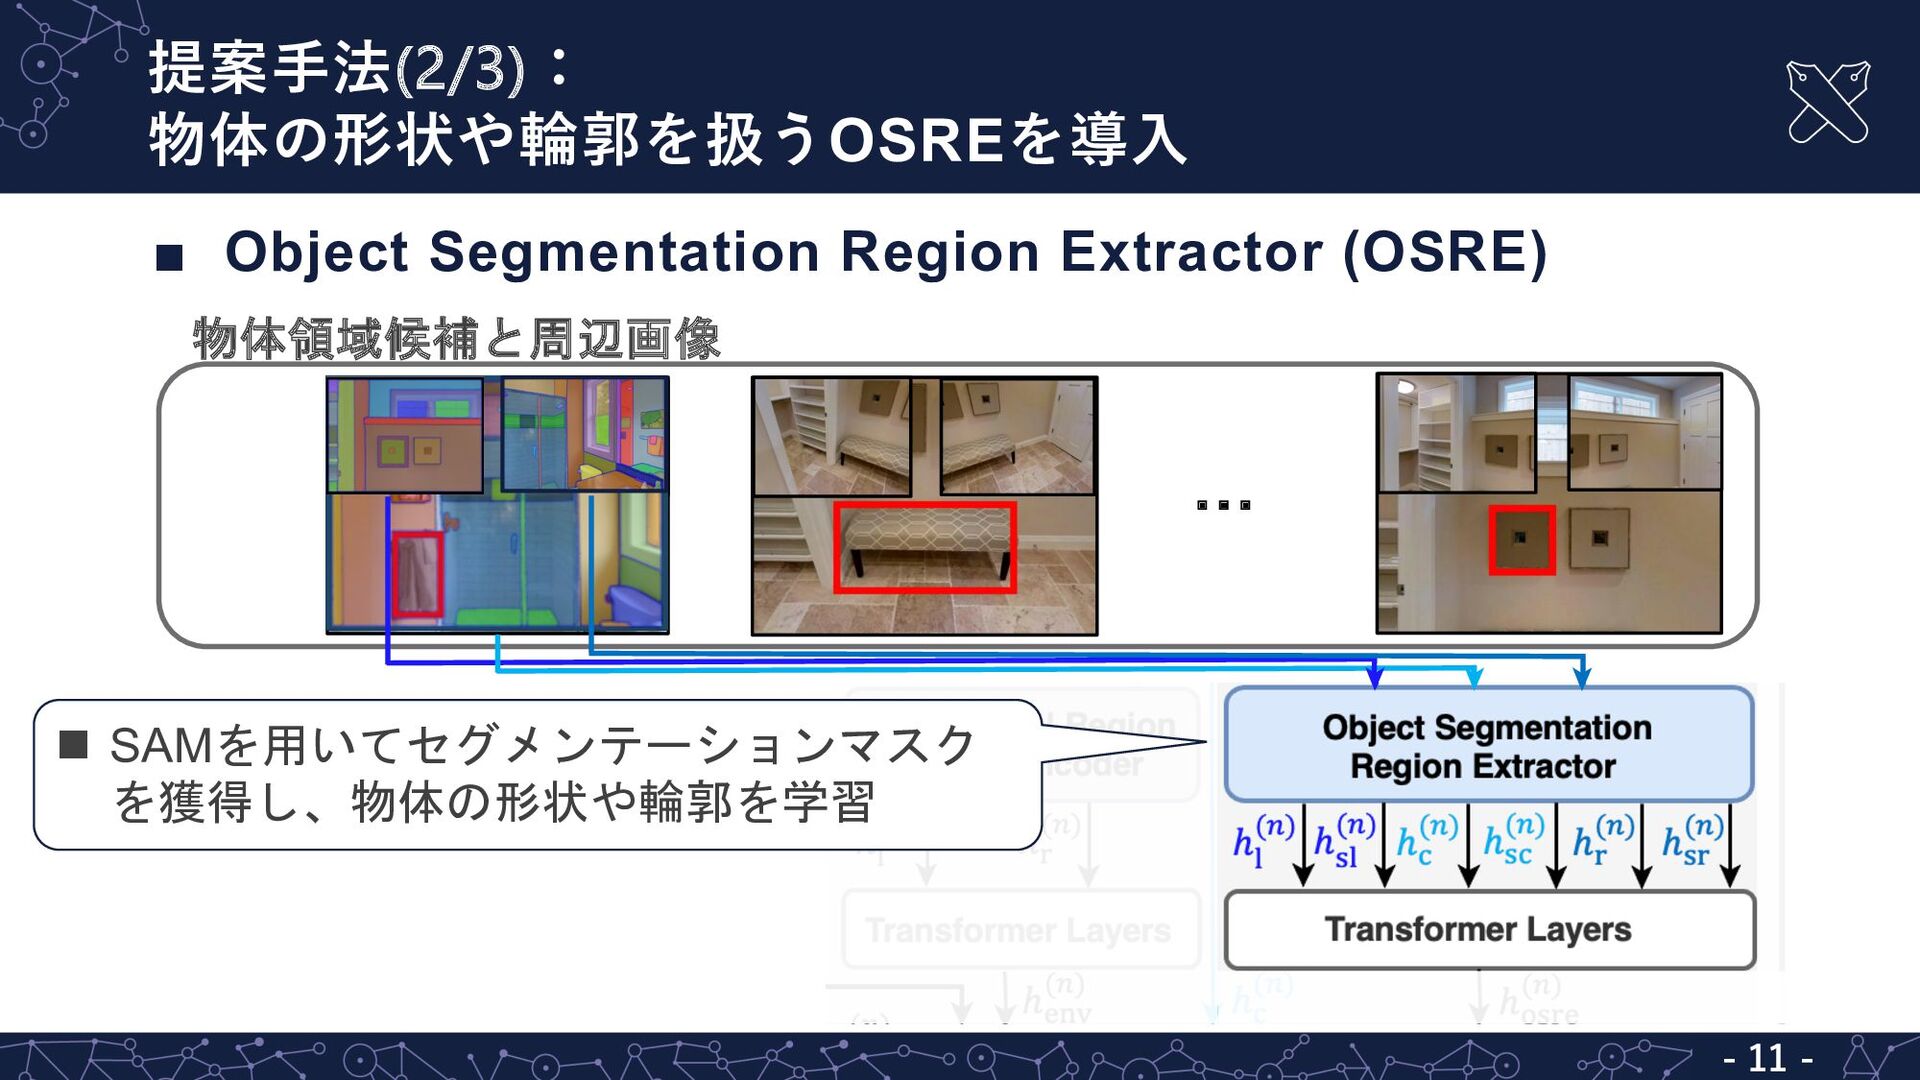
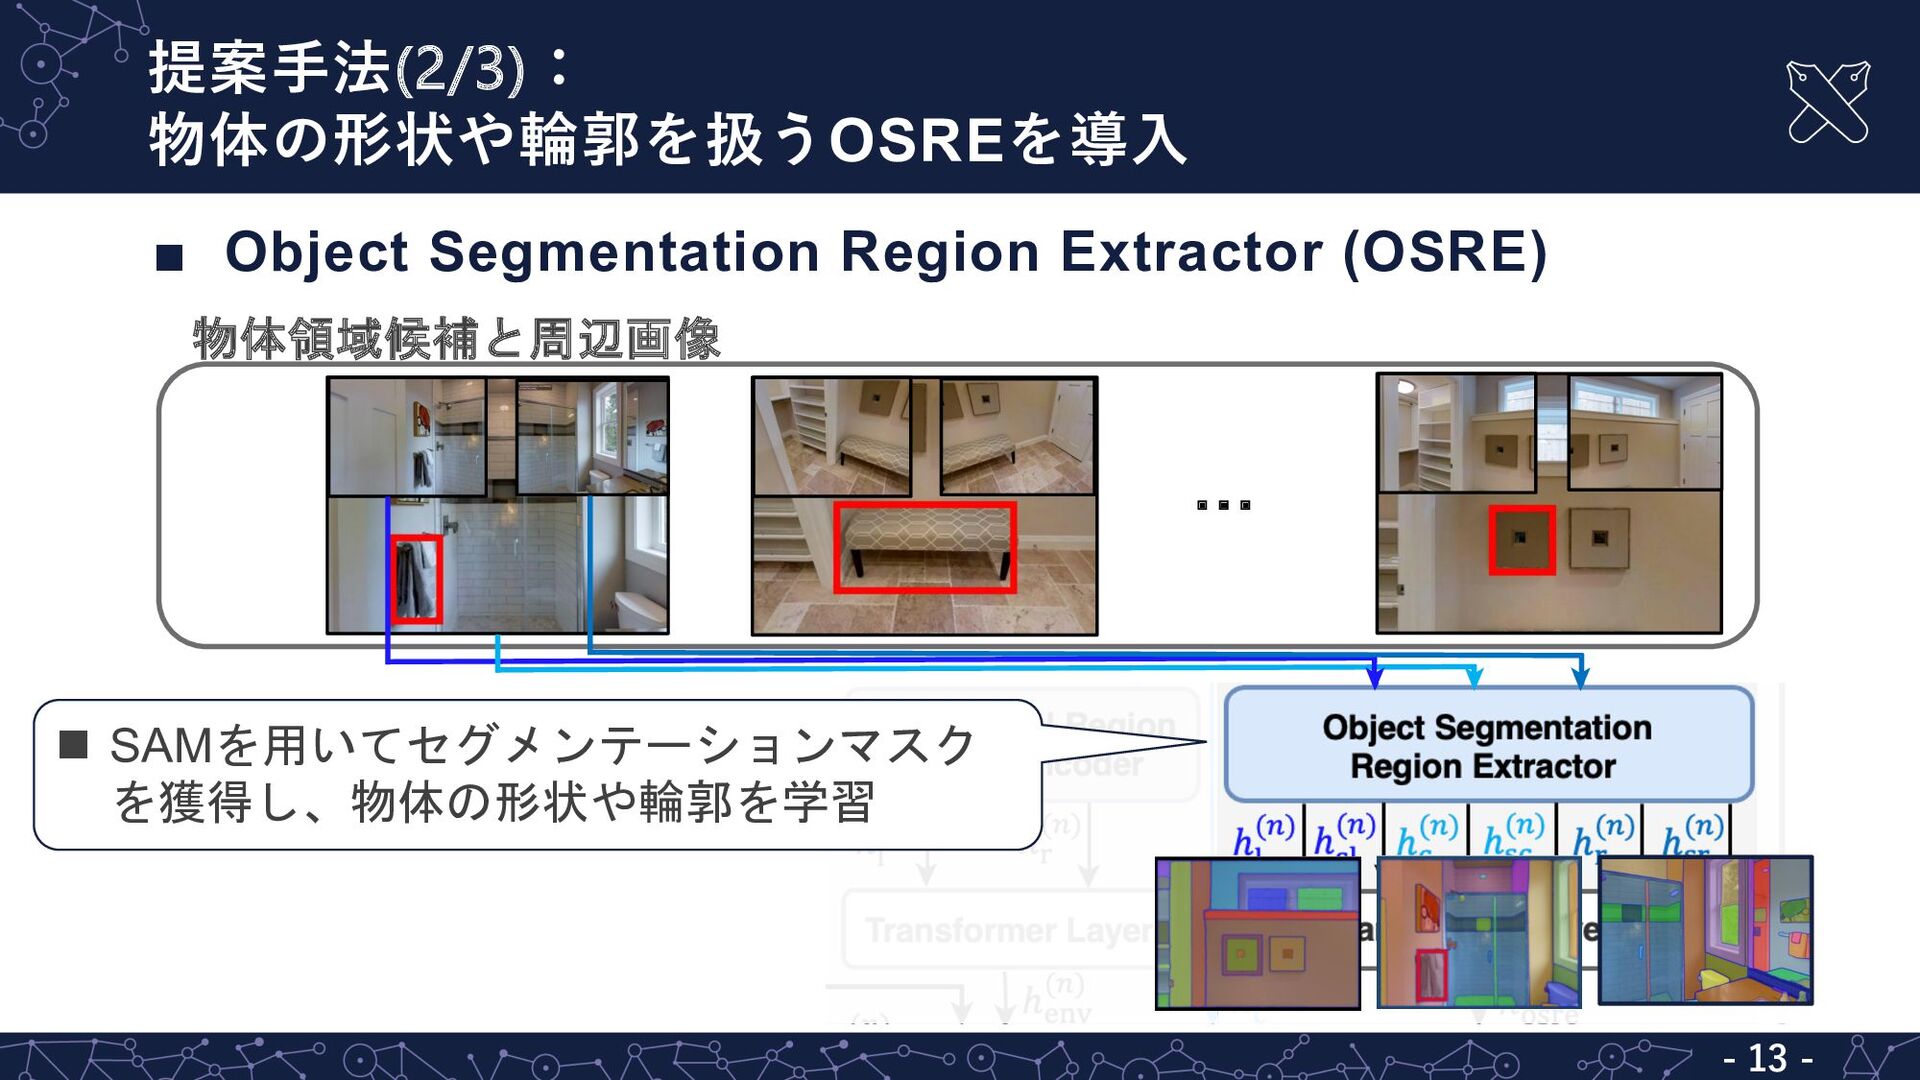
提案⼿法(2/3): 物体の形状や輪郭を扱うOSREを導⼊ - 11 - ▪ Object Segmentation Region Extractor
(OSRE) n SAMを用いてセグメンテーションマスク を獲得し、物体の形状や輪郭を学習 𝑥! (#) 𝑥% (#) … 物体領域候補と周辺画像 -
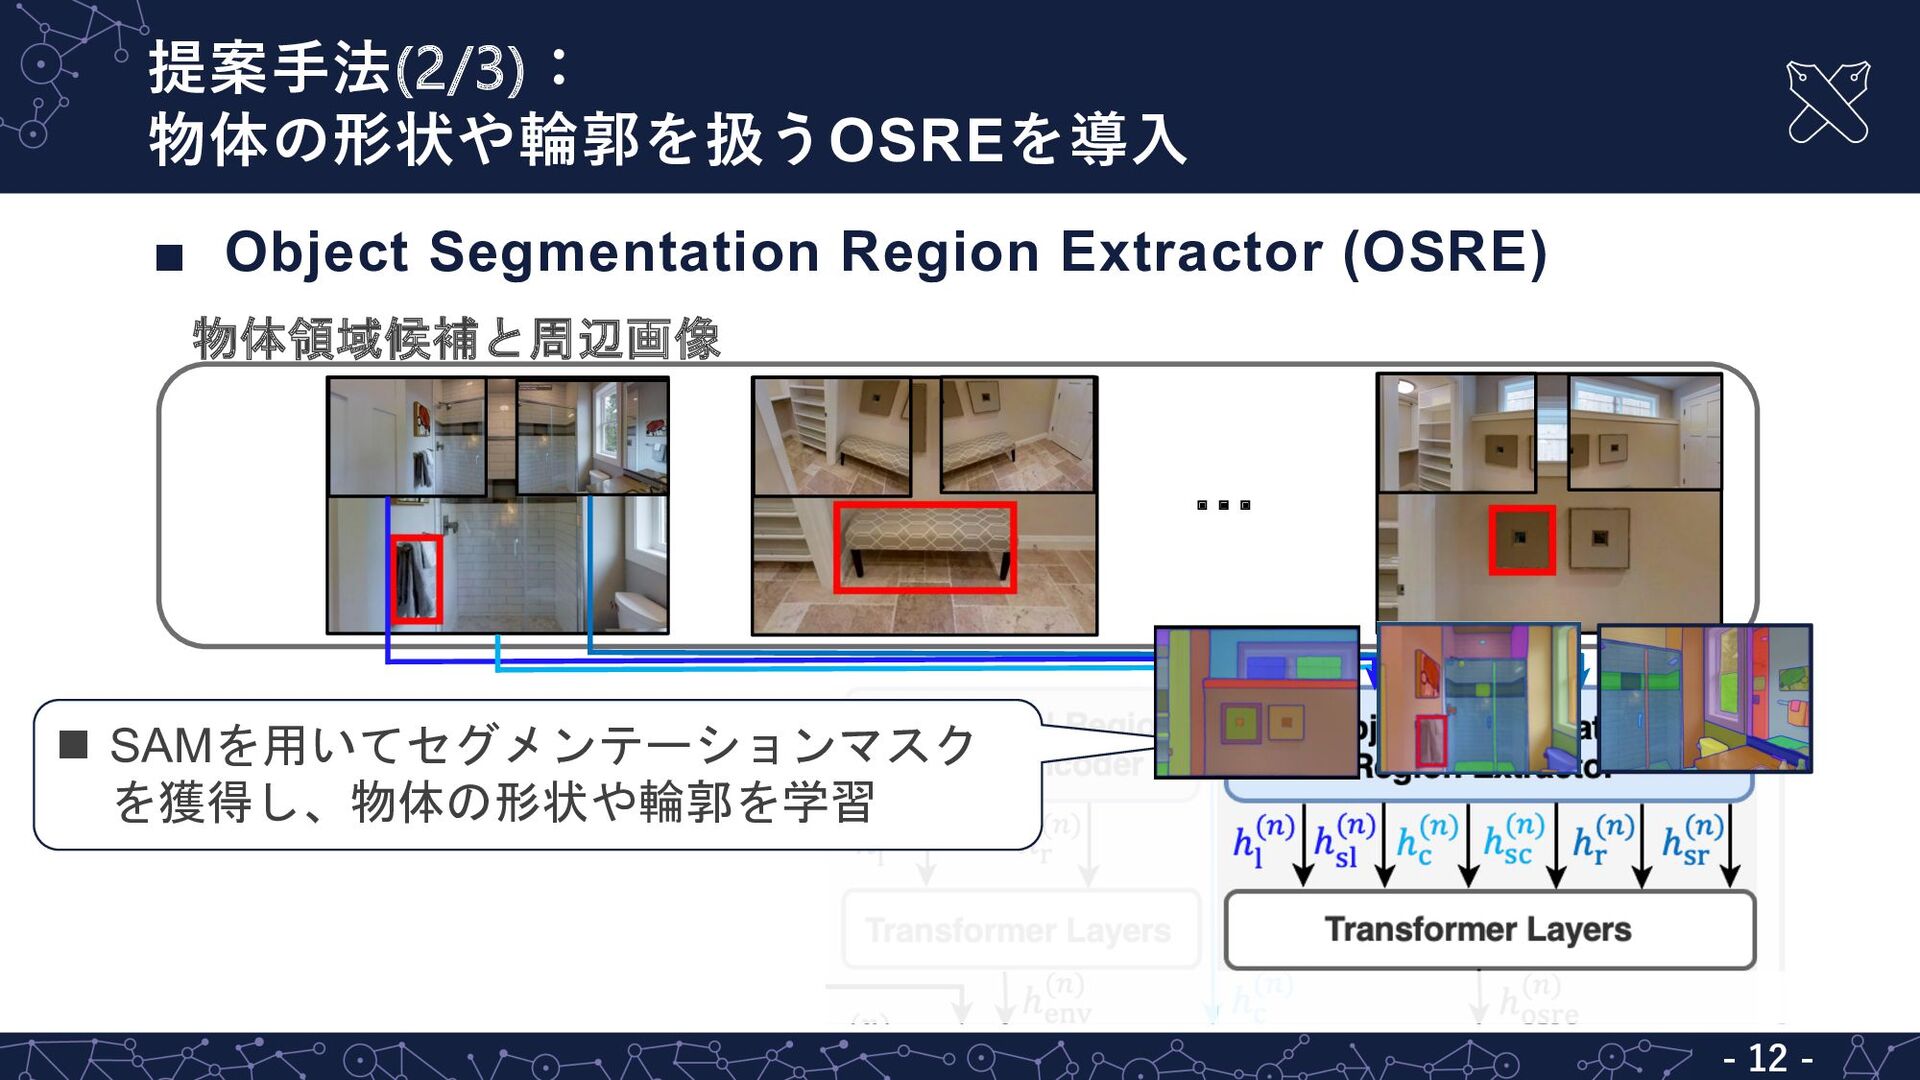
提案⼿法(2/3): 物体の形状や輪郭を扱うOSREを導⼊ - 12 - n SAMを用いてセグメンテーションマスク を獲得し、物体の形状や輪郭を学習 物体領域候補と周辺画像 𝑥!
(#) 𝑥% (#) … ▪ Object Segmentation Region Extractor (OSRE) -
提案⼿法(2/3): 物体の形状や輪郭を扱うOSREを導⼊ - 13 - n SAMを用いてセグメンテーションマスク を獲得し、物体の形状や輪郭を学習 𝑥! (#)
𝑥% (#) … 物体領域候補と周辺画像 ▪ Object Segmentation Region Extractor (OSRE) -
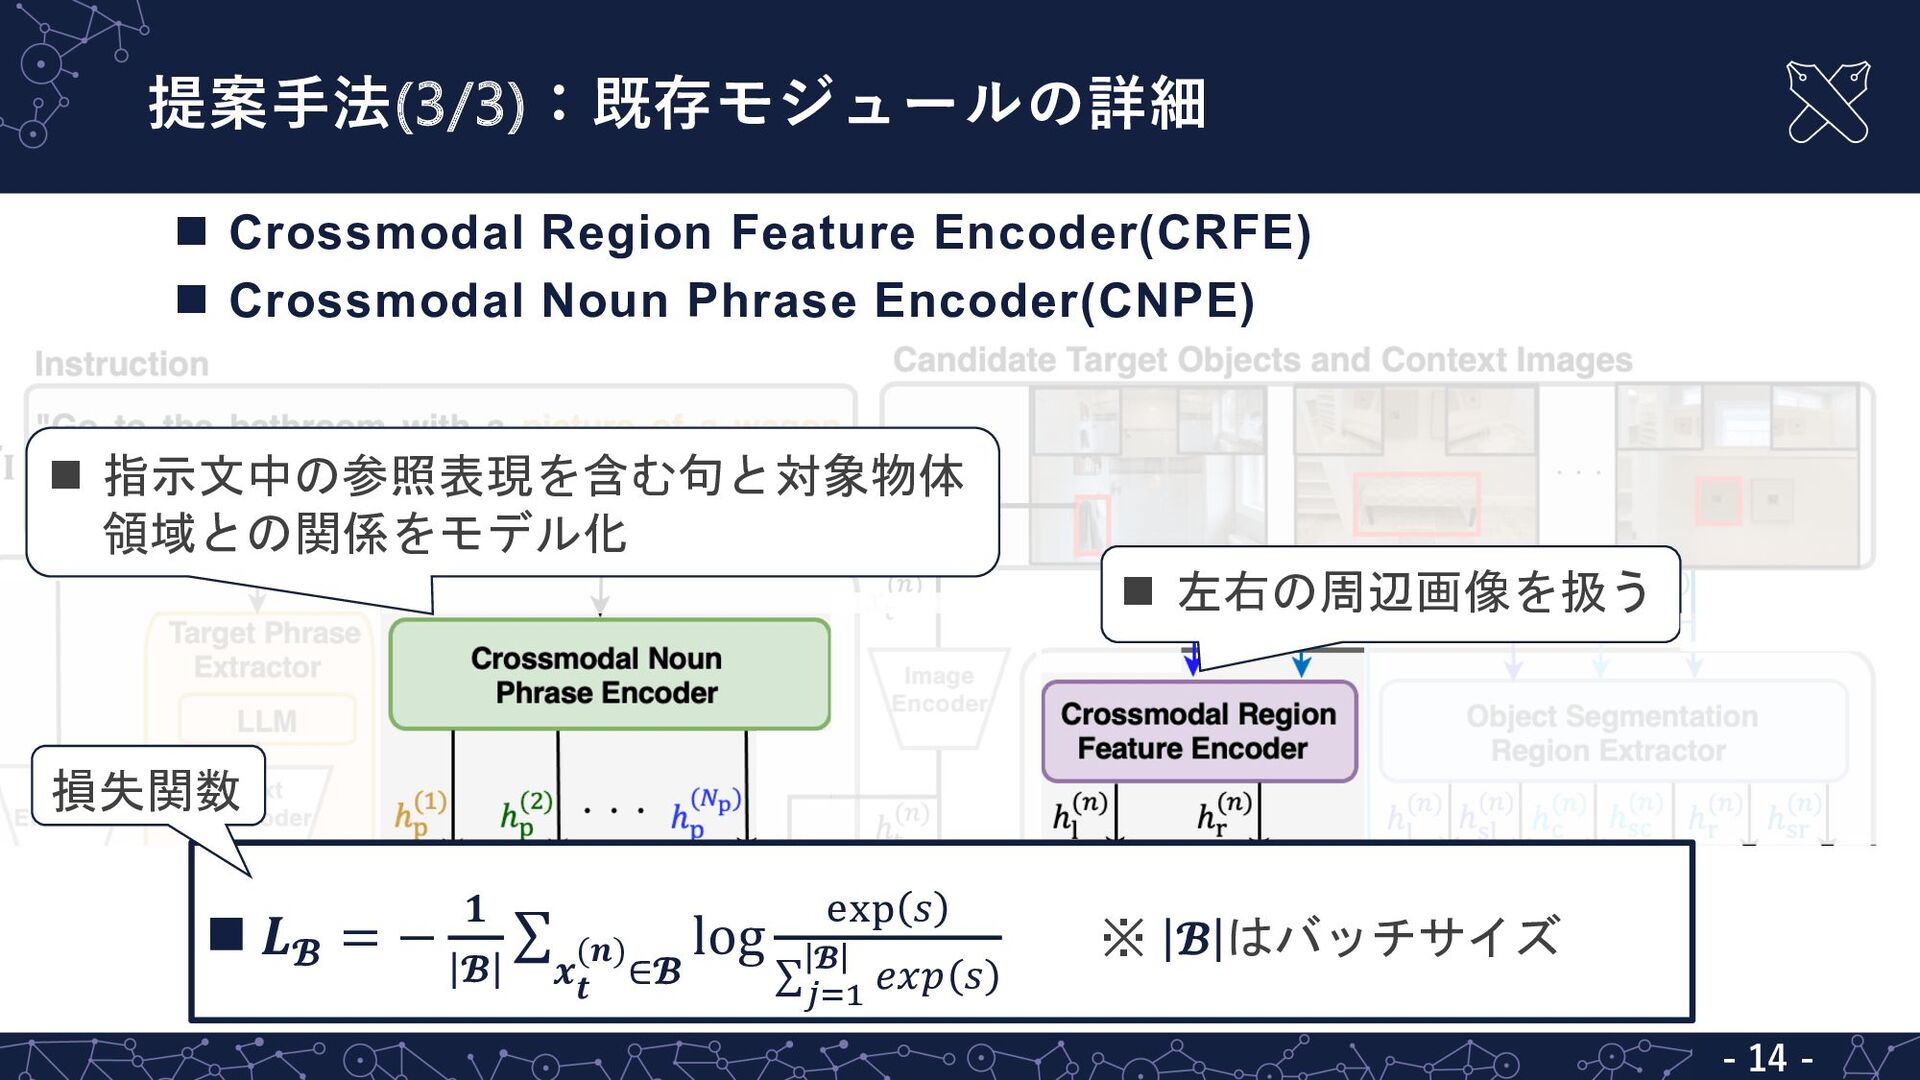
提案⼿法(3/3):既存モジュールの詳細 - 14 - n 左右の周辺画像を扱う n 指示文中の参照表現を含む句と対象物体 領域との関係をモデル化 n
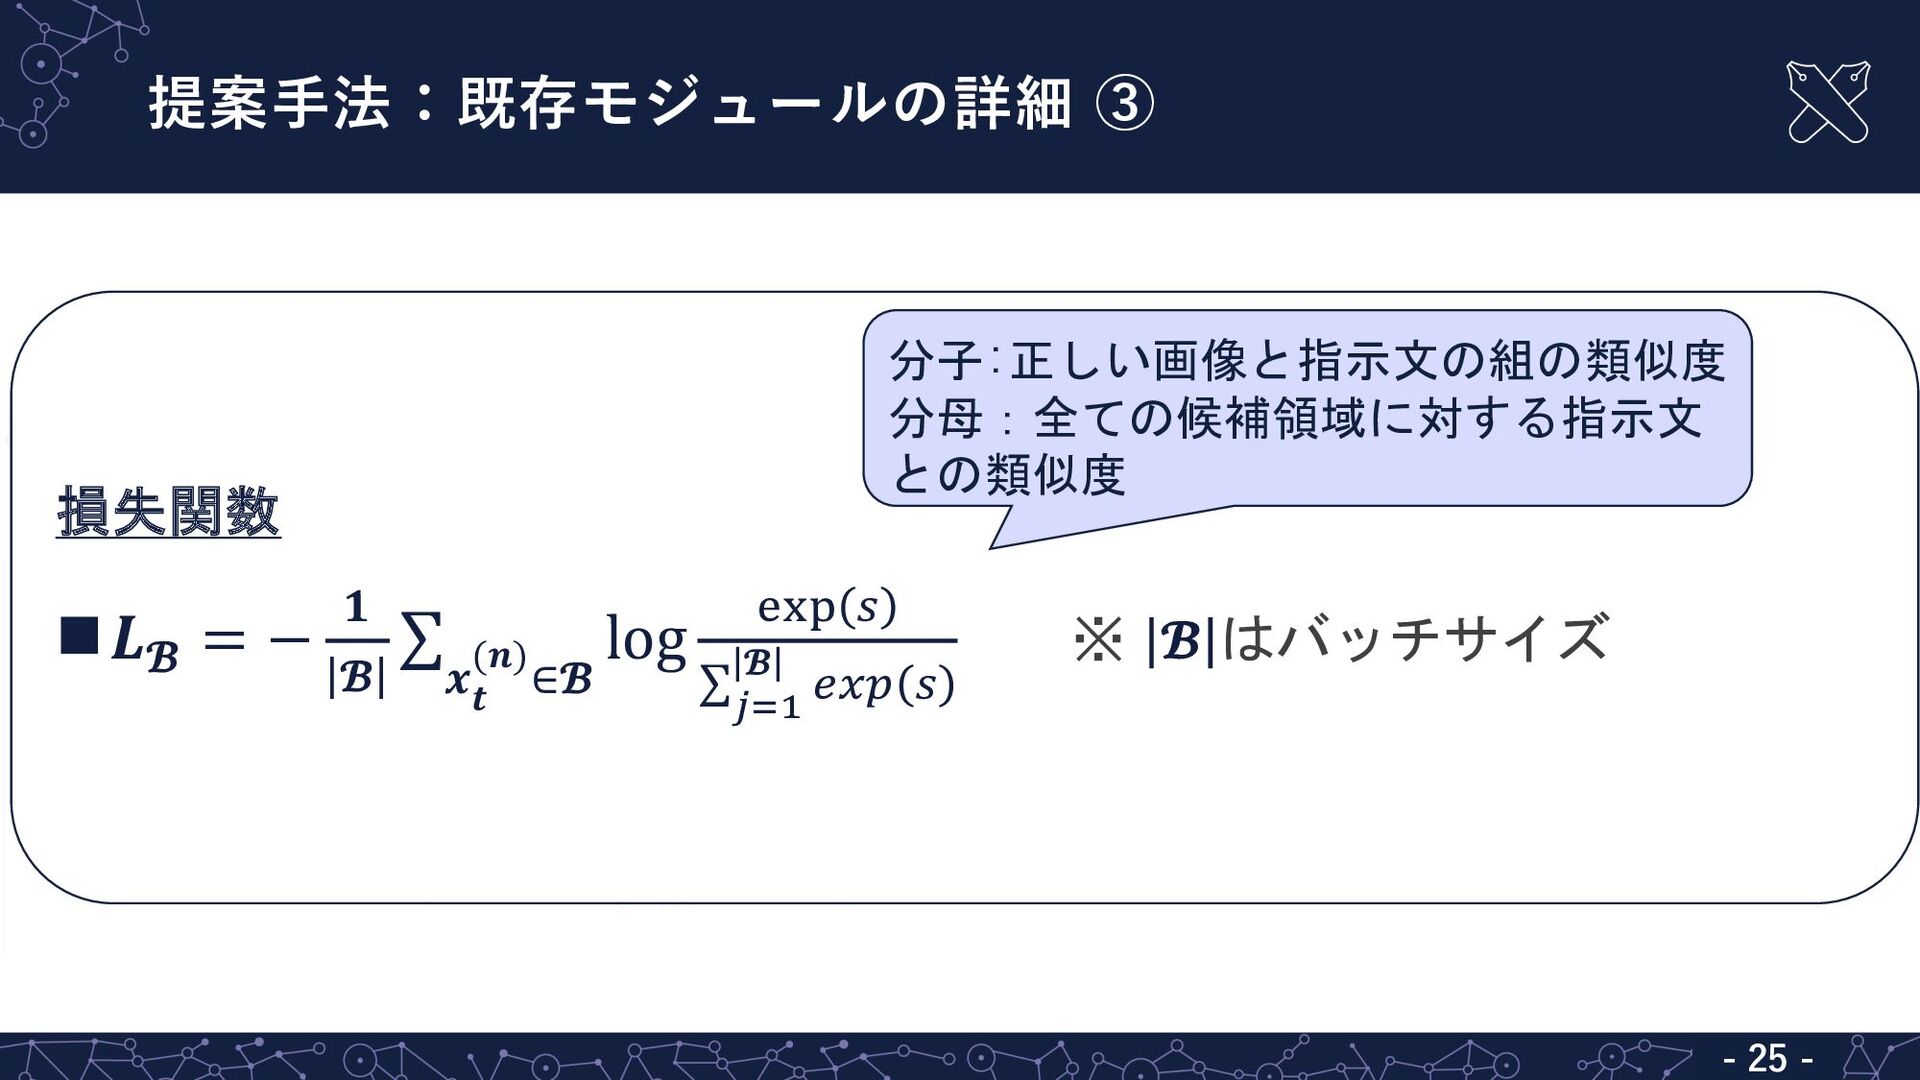
𝑳𝓑 = − 𝟏 𝓑 ∑ 𝒙𝒕 (𝒏) ∈𝓑 log %&' ( ∑ %&' 𝓑 *+, ( ※ 𝓑 はバッチサイズ 損失関数 n Crossmodal Region Feature Encoder(CRFE) n Crossmodal Noun Phrase Encoder(CNPE) -
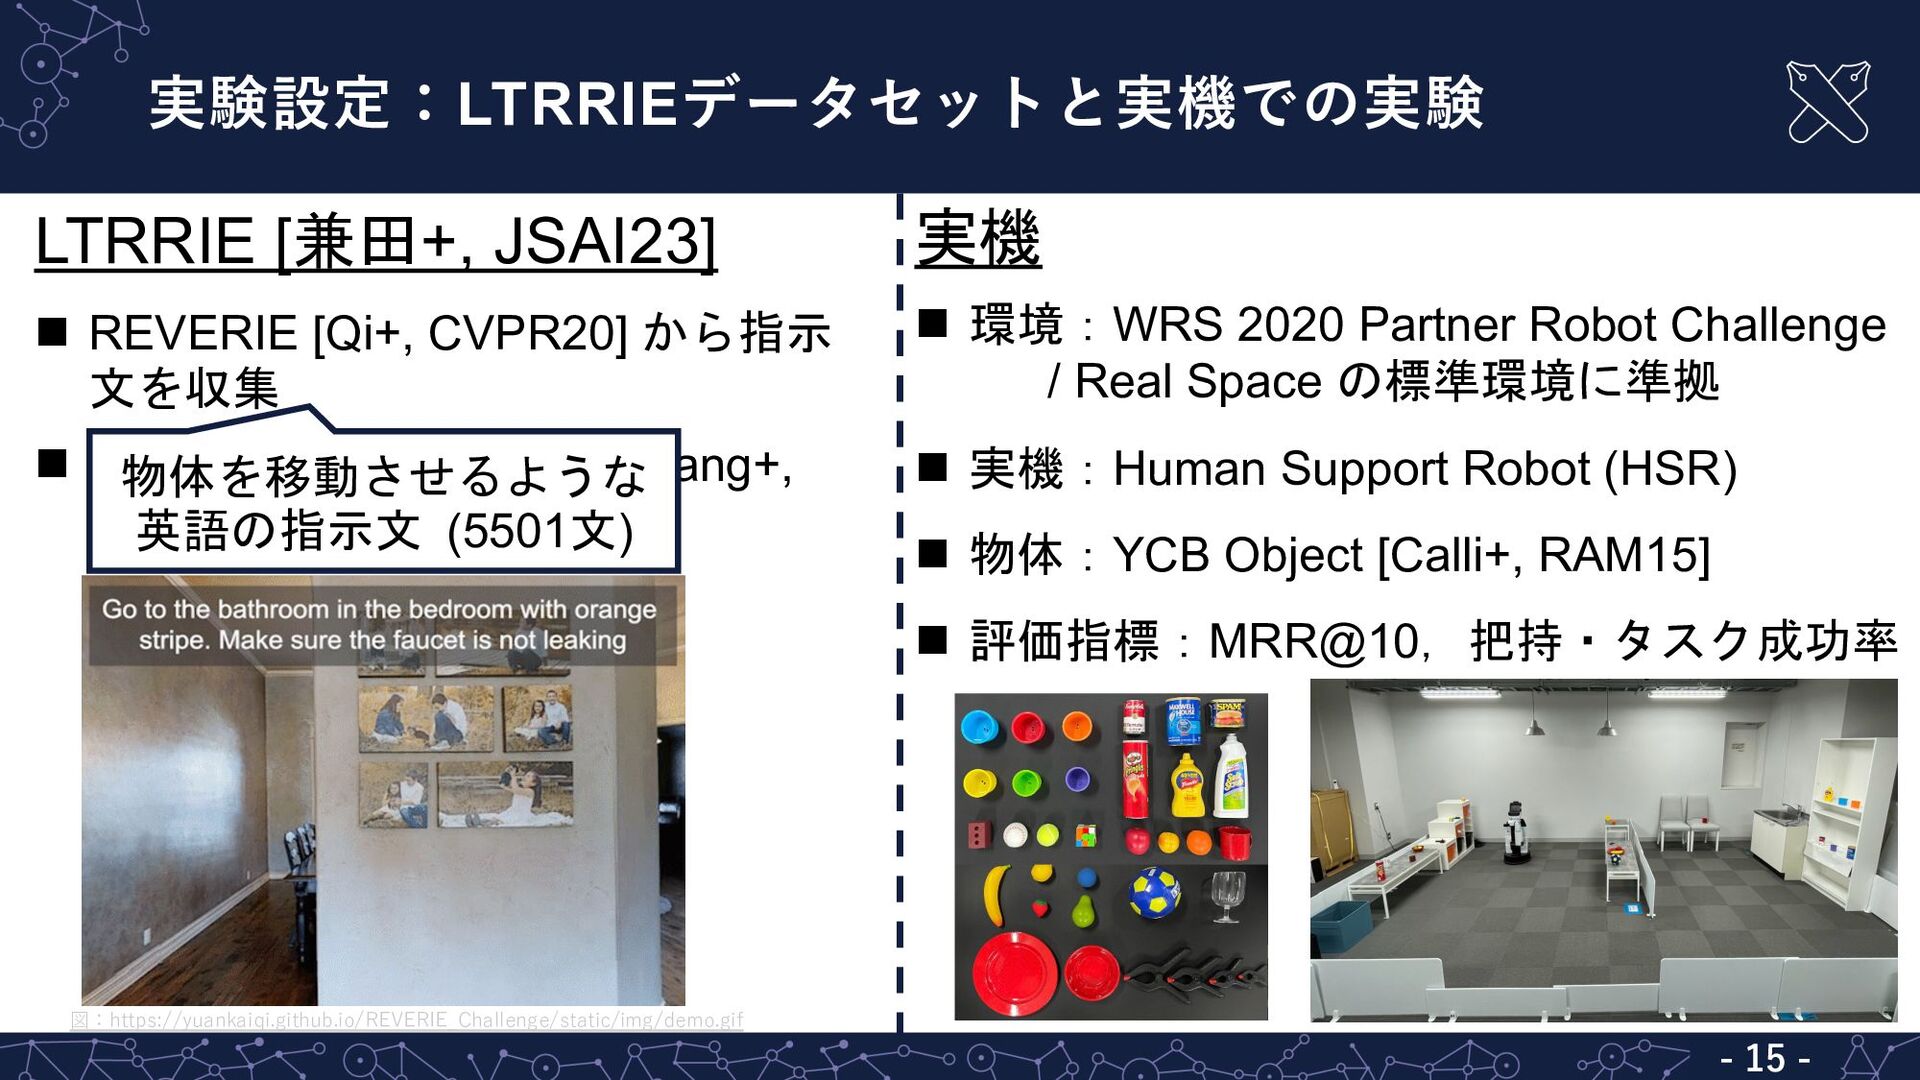
実験設定:LTRRIEデータセットと実機での実験 - 15 - 実機 n 環境:WRS 2020 Partner Robot
Challenge / Real Space の標準環境に準拠 n 実機:Human Support Robot (HSR) n 物体:YCB Object [Calli+, RAM15] n 評価指標:MRR@10, 把持・タスク成功率 LTRRIE [兼田+, JSAI23] n REVERIE [Qi+, CVPR20] から指示 文を収集 n Matterport3D Simulator [Chang+, 3DV17] から画像を収集 図:https://yuankaiqi.github.io/REVERIE_Challenge/static/img/demo.gif 物体を移動させるような 英語の指示文 (5501文) -
定量的結果: 全ての評価尺度においてベースライン手法を上回る - 16 - [%] MRR ↑ Recall@5 ↑
Recall@10 ↑ CLIP extended [Radford+, PMLR21] 41.5 ± 0.9 45.3 ± 1.7 63.8 ± 2.5 MultiRankIt [兼田+, JSAI23] 50.1 ± 0.8 52.2 ± 1.4 69.8 ± 1.5 提案手法 56.3 ± 1.3 58.7 ± 1.1 77.7 ± 1.1 +14.8 +13.4 +13.9 n 評価尺度 (2種類) n Mean Reciprocal Rank (MRR), Recall@K (K=1,5,10,20) -
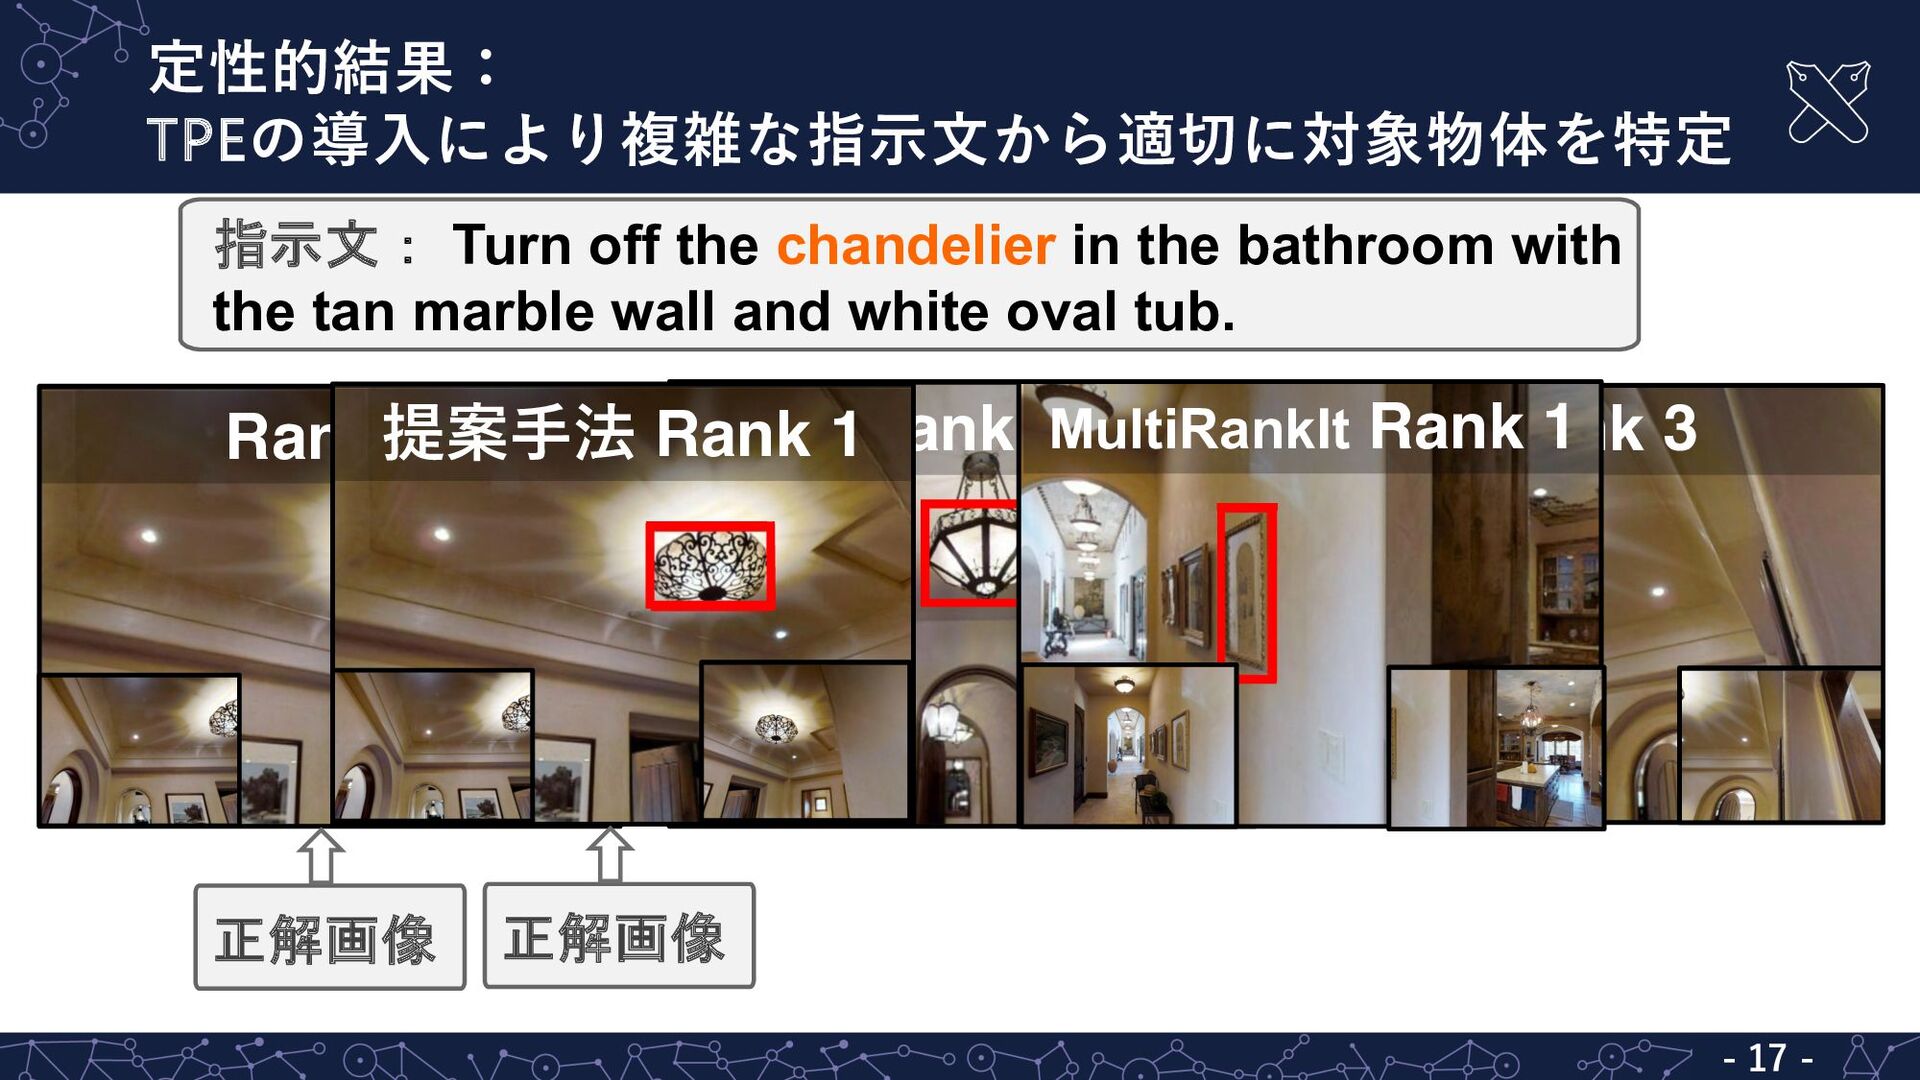
定性的結果: TPEの導⼊により複雑な指⽰⽂から適切に対象物体を特定 - 17 - 指示文: Turn off the chandelier
in the bathroom with the tan marble wall and white oval tub. Rank 1 Rank 2 Rank 3 MultiRankIt Rank 1 提案⼿法 Rank 1 正解画像 正解画像 -
Ablation Studies:TPEの導⼊が最も性能向上に寄与 - 18 - J 新規モジュールの有効性を確認 J 対象物体表現を抽出するTPEの導入が最も性能向上に寄与 [%]
MRR ↑ Recall@1 ↑ Recall@5 ↑ Recall@10 ↑ w/o TPE 52.6 ± 0.9 18.3 ± 0.6 55.1 ± 1.1 74.7 ± 1.0 w/o OSRE 55.7 ± 0.7 20.1 ± 0.4 60.1 ± 0.7 77.9 ± 0.9 提案手法 56.3 ± 1.3 20.7 ± 0.8 58.7 ± 1.1 77.7 ± 1.1 +3.7 +3.6 +2.4 +3.0 -
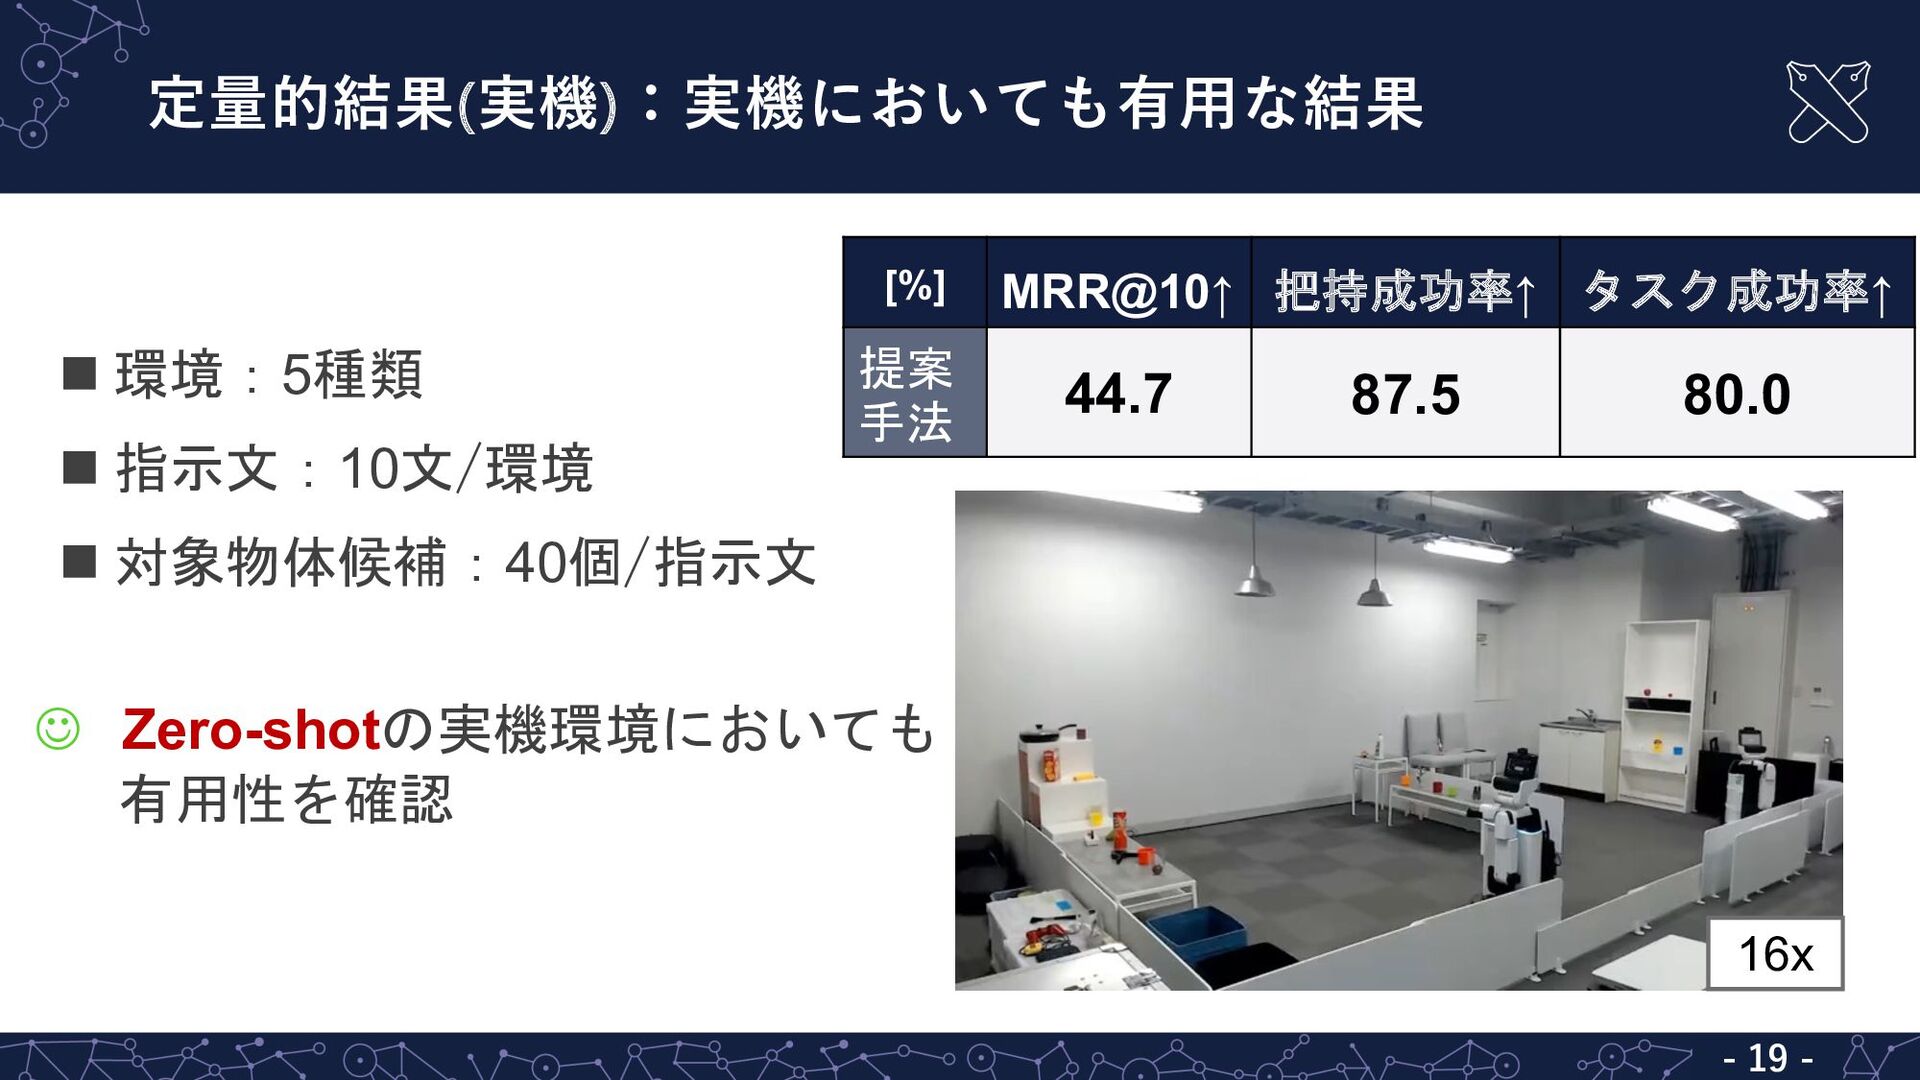
定量的結果(実機):実機においても有⽤な結果 - 19 - n 環境:5種類 n 指示文:10文/環境 n 対象物体候補:40個/指示文
[%] MRR@10↑ 把持成功率↑ タスク成功率↑ 提案 手法 44.7 87.5 80.0 J Zero-shotの実機環境においても 有用性を確認 16x -
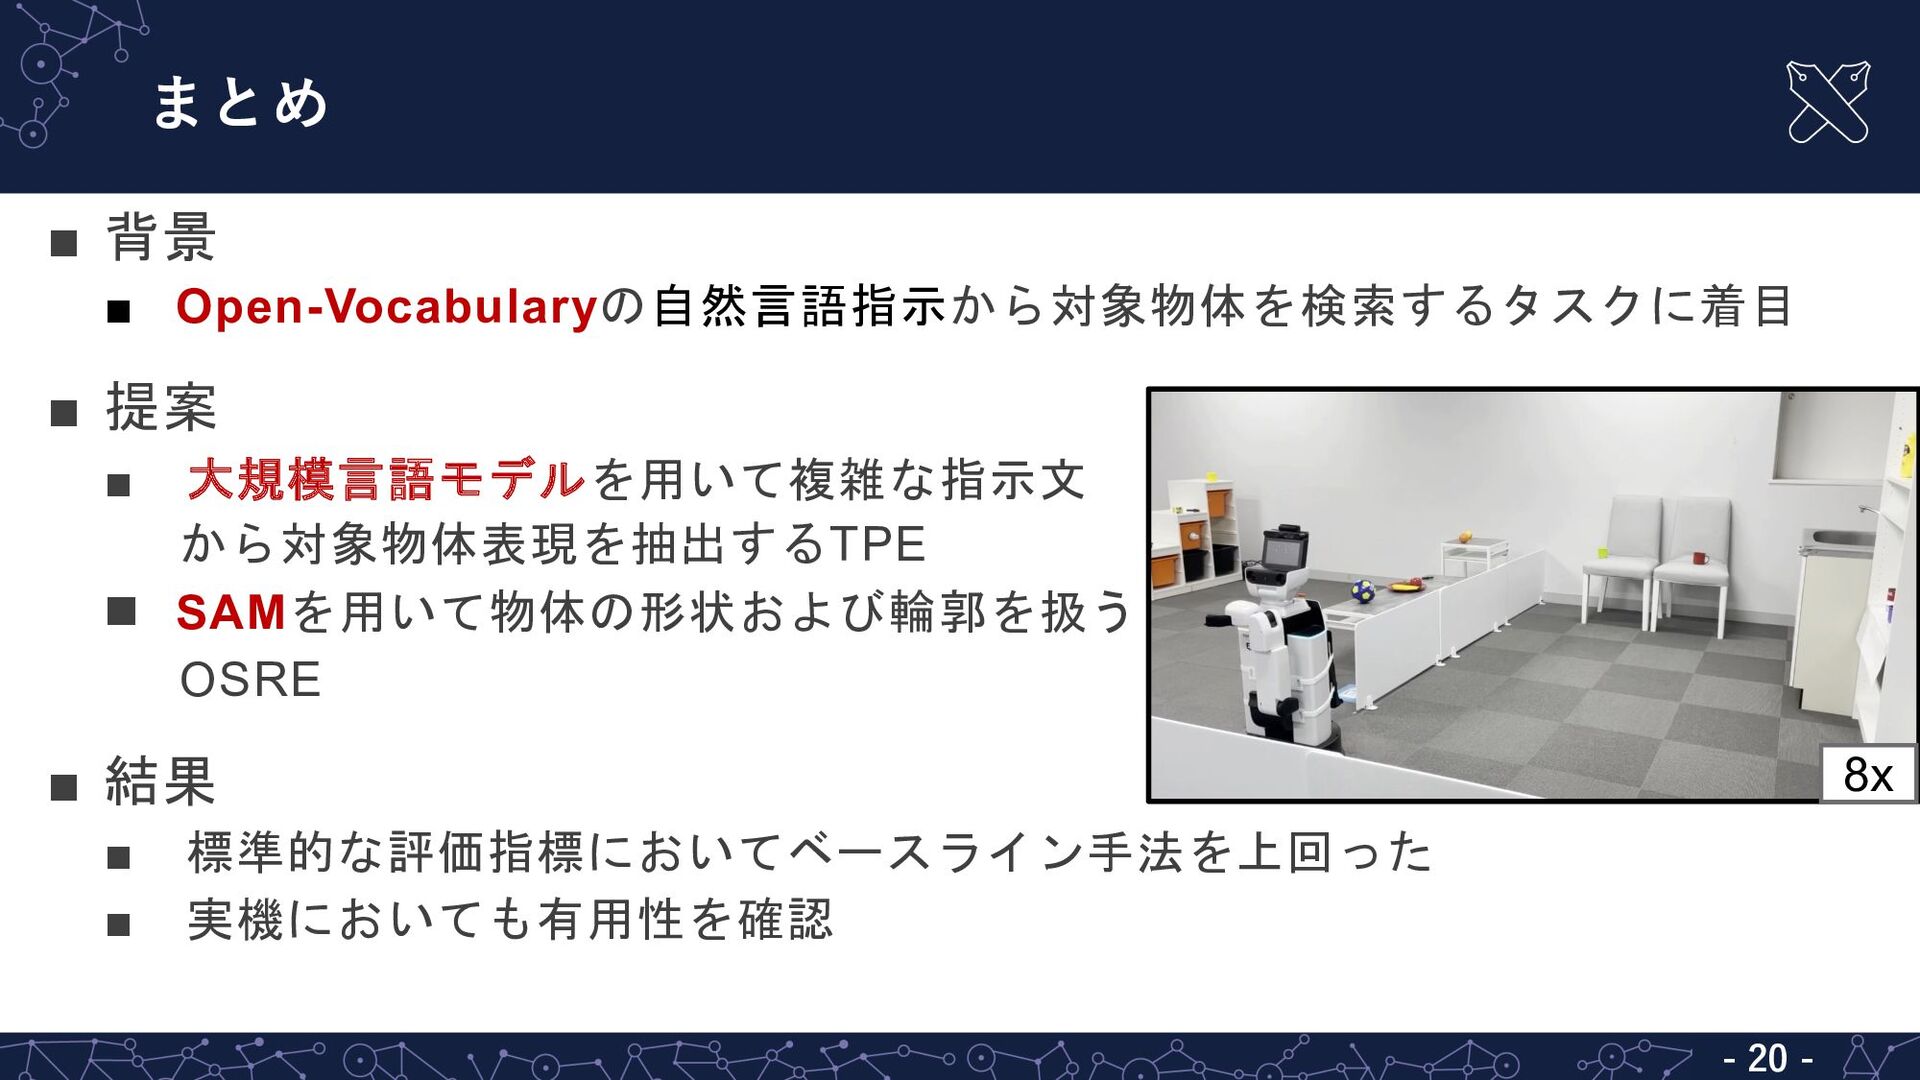
まとめ - 20 - ▪ 背景 ▪ Open-Vocabularyの自然言語指示から対象物体を検索するタスクに着目 ▪ 提案
▪ 大規模言語モデルを用いて複雑な指示文 から対象物体表現を抽出するTPE n SAMを用いて物体の形状および輪郭を扱う OSRE ▪ 結果 ▪ 標準的な評価指標においてベースライン手法を上回った ▪ 実機においても有用性を確認 8x -
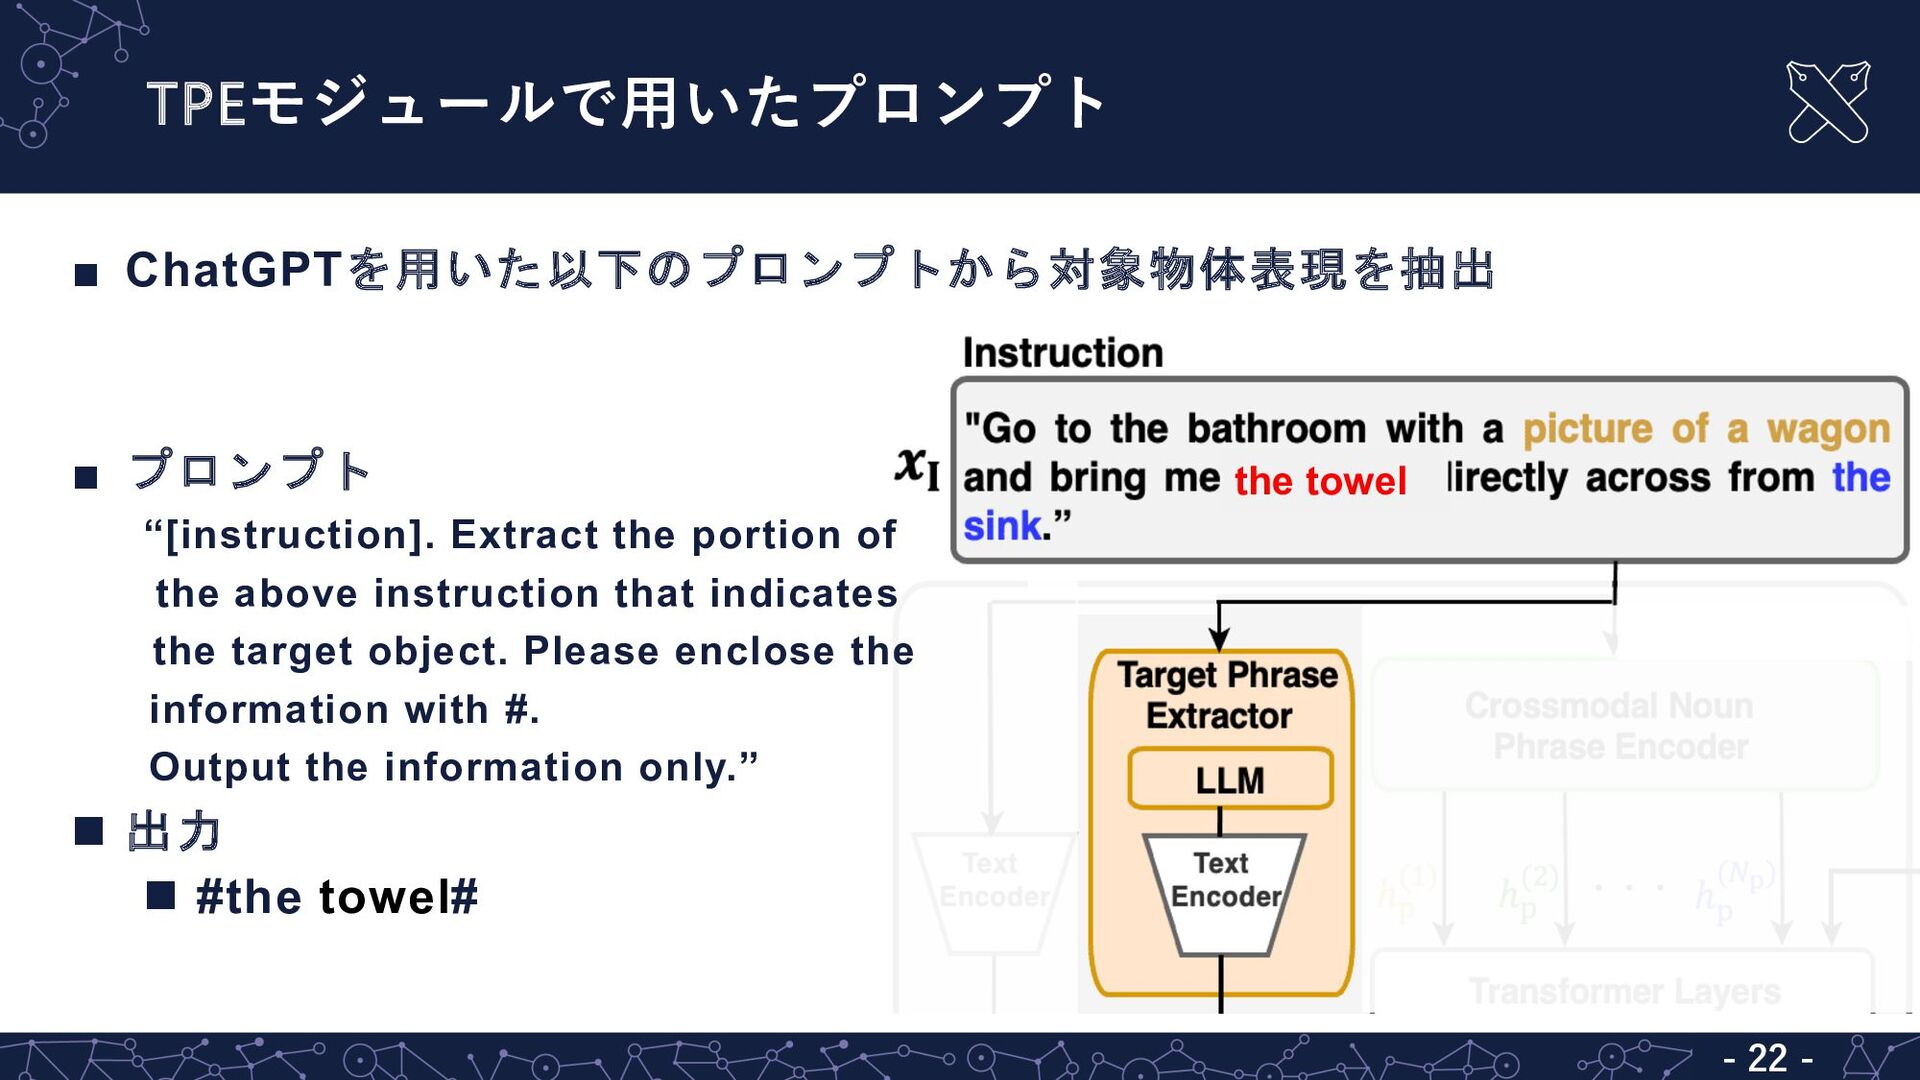
the towel TPEモジュールで⽤いたプロンプト - 22 - ▪ ChatGPTを用いた以下のプロンプトから対象物体表現を抽出 ▪ プロンプト
“[instruction]. Extract the portion of the above instruction that indicates the target object. Please enclose the information with #. Output the information only.” n 出力 n #the towel# -
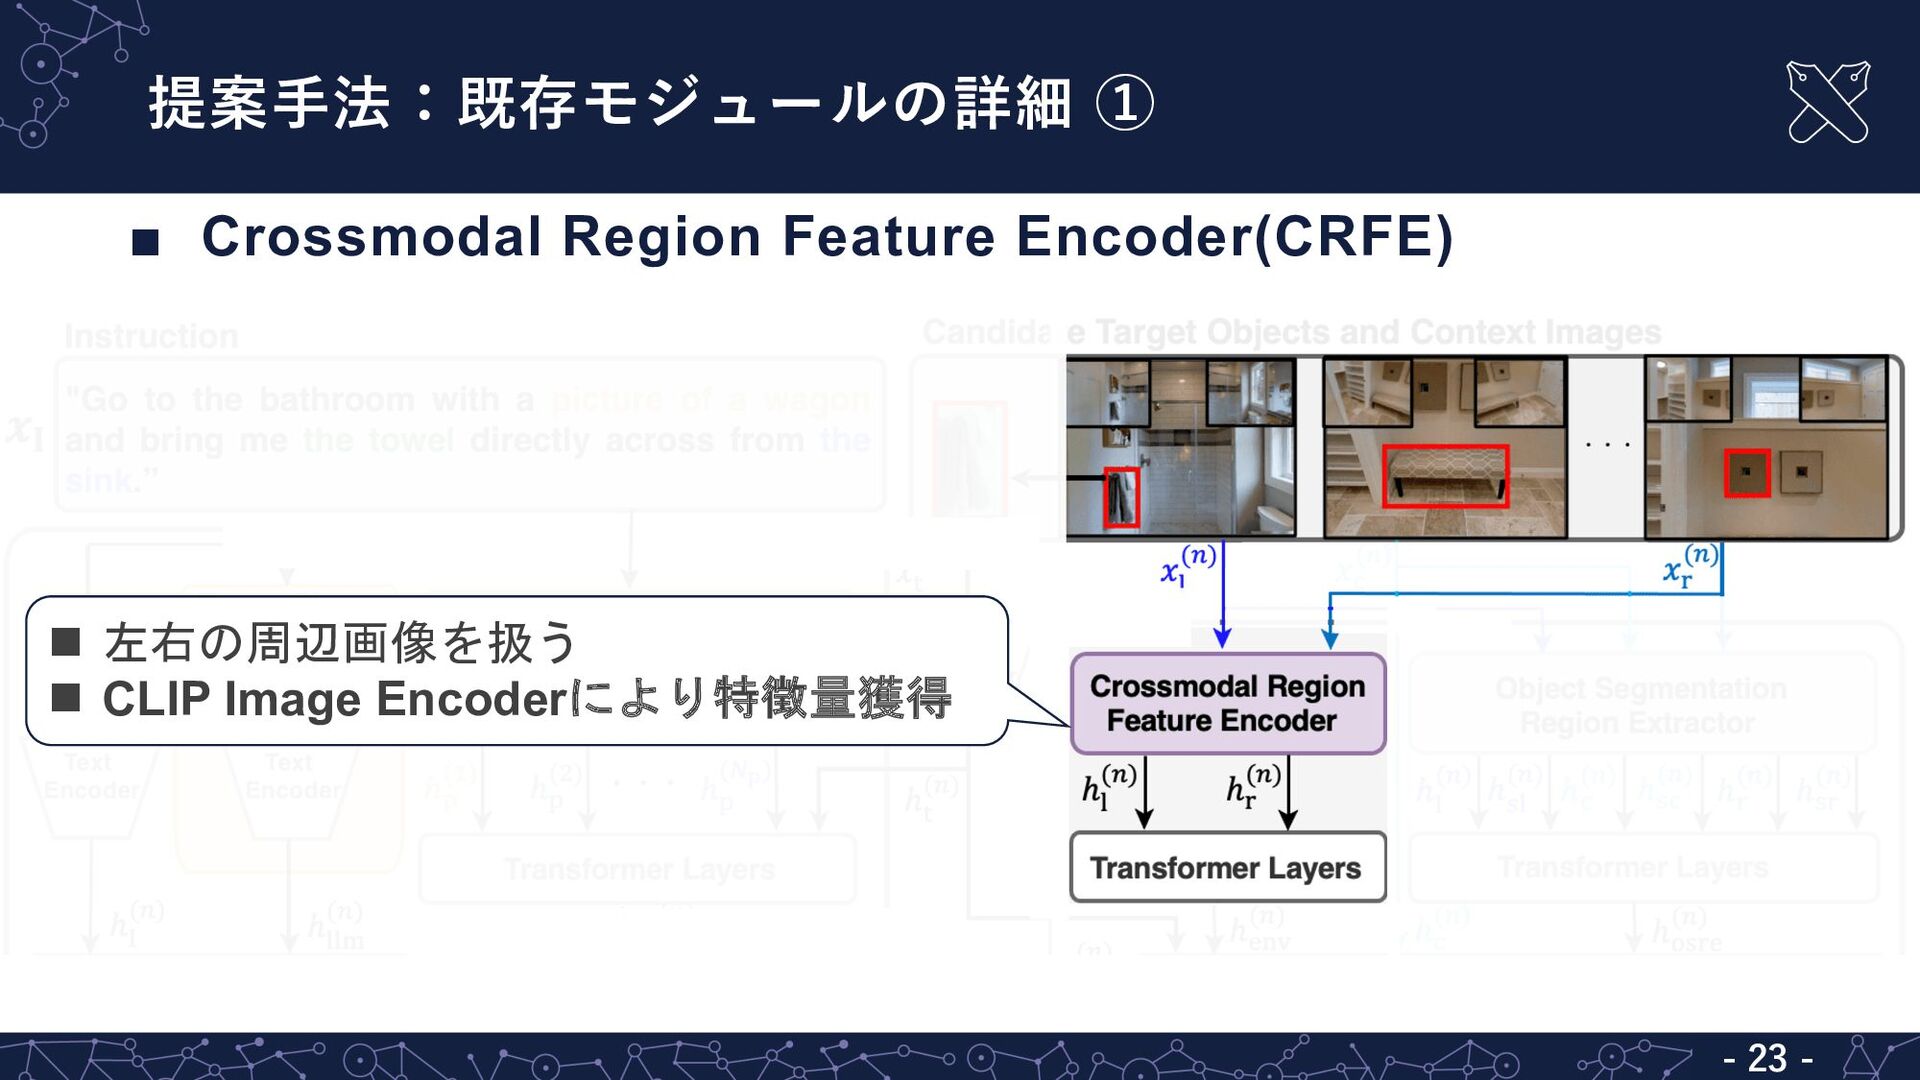
提案⼿法:既存モジュールの詳細 ① - 23 - n 左右の周辺画像を扱う n CLIP Image
Encoderにより特徴量獲得 ▪ Crossmodal Region Feature Encoder(CRFE) -
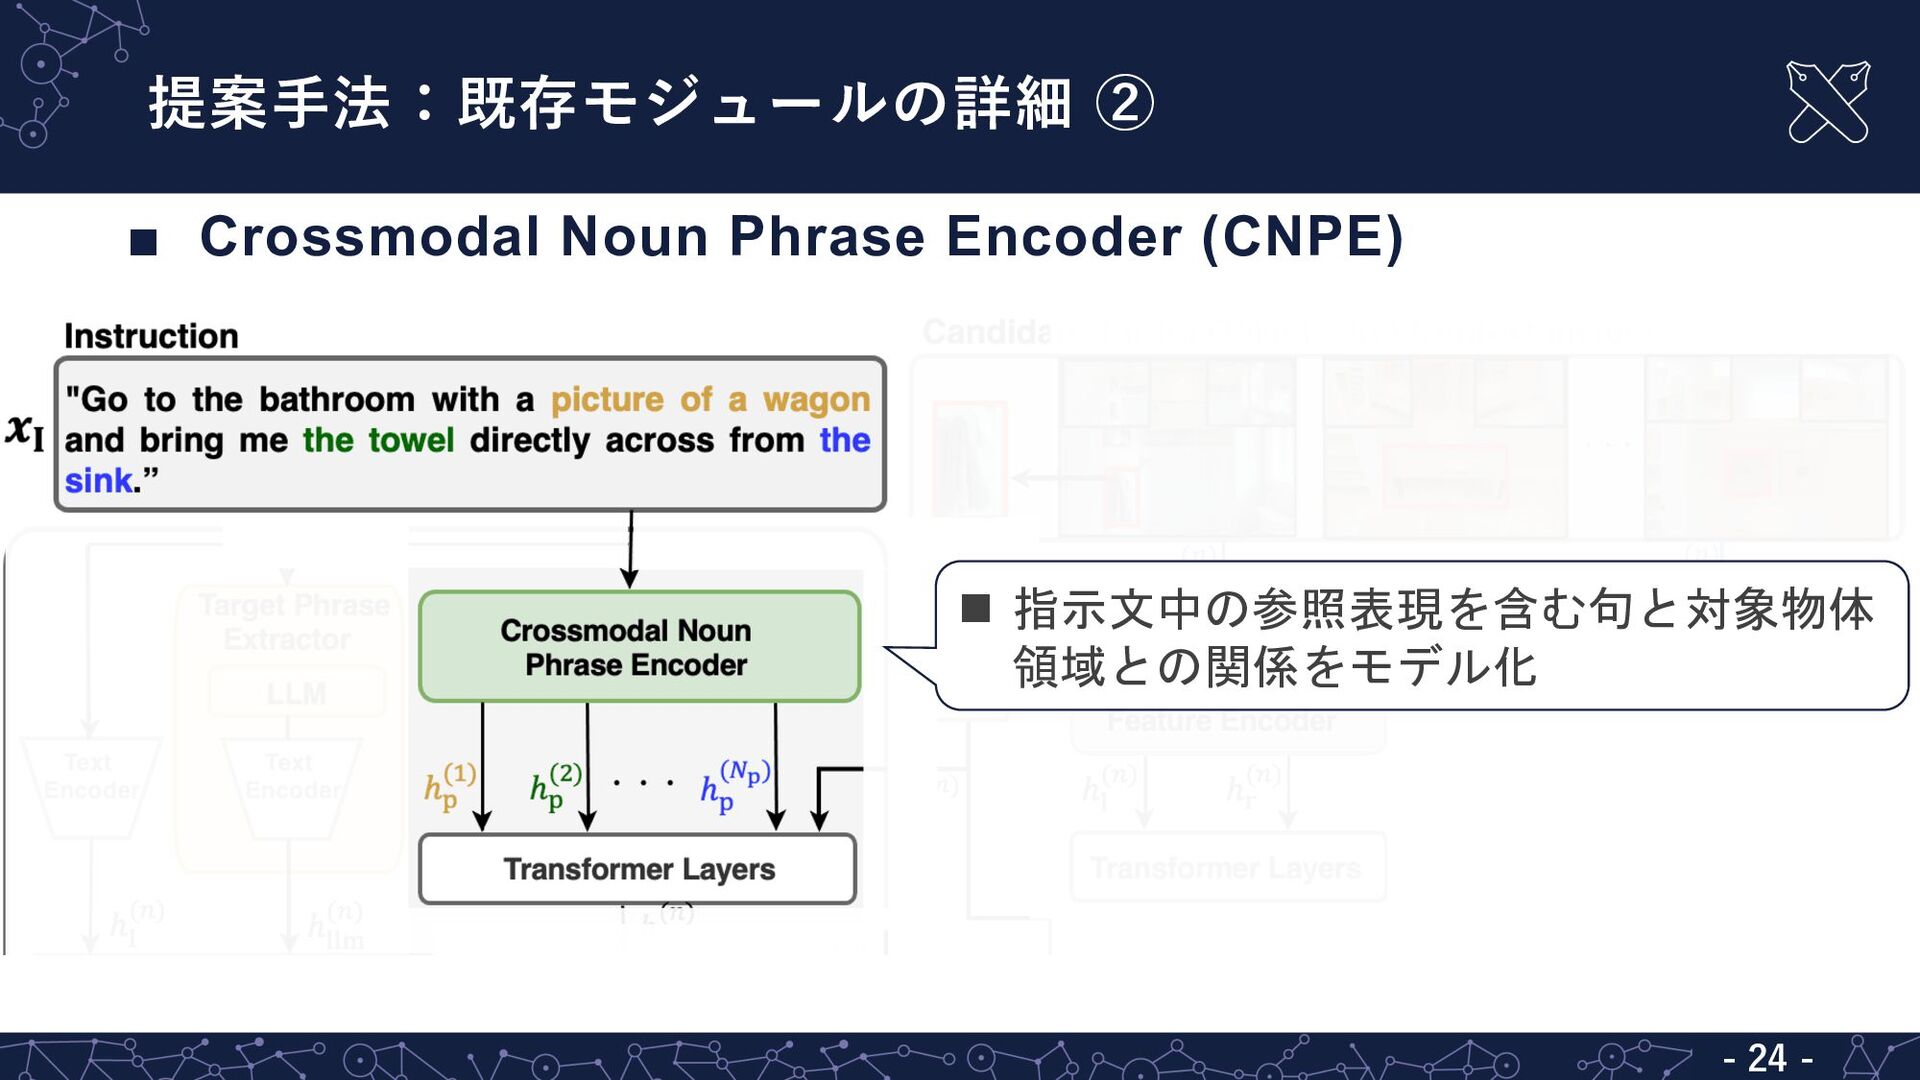
- 24 - ▪ Crossmodal Noun Phrase Encoder (CNPE) n
指示文中の参照表現を含む句と対象物体 領域との関係をモデル化 提案⼿法:既存モジュールの詳細 ② -
- 25 - n 左右の周辺画像を扱う n CLIP Image Encoderにより特徴量獲得 n
指示文中の参照表現を含む句と対象物体 領域との関係をモデル化 損失関数 n𝑳𝓑 = − 𝟏 𝓑 ∑ 𝒙𝒕 (𝒏) ∈𝓑 log %&' ( ∑ %&' 𝓑 *+, ( ※ 𝓑 はバッチサイズ 分子:正しい画像と指示文の組の類似度 分母:全ての候補領域に対する指示文 との類似度 提案⼿法:既存モジュールの詳細 ③ -
LTRRIE データセットの詳細 - 26 - LTRRIE データセット [兼田+, JSAI23] n
REVERIE [Qi+, CVPR20] から指示文を収集 n Matterport3D Simulator [Chang+, 3DV17] から画像を収集 複雑な参照表現を含む指示文と室内の実画像を含む LTRPO-fetch タスクのデータセット データセット分割 Train Validation Test 環境数 50 4 4 指示文数 4210 397 501 データセット概要 環境数 58 指示文数 5501 対象物体領域 4352 平均文長 18.78 語彙数 53118 -
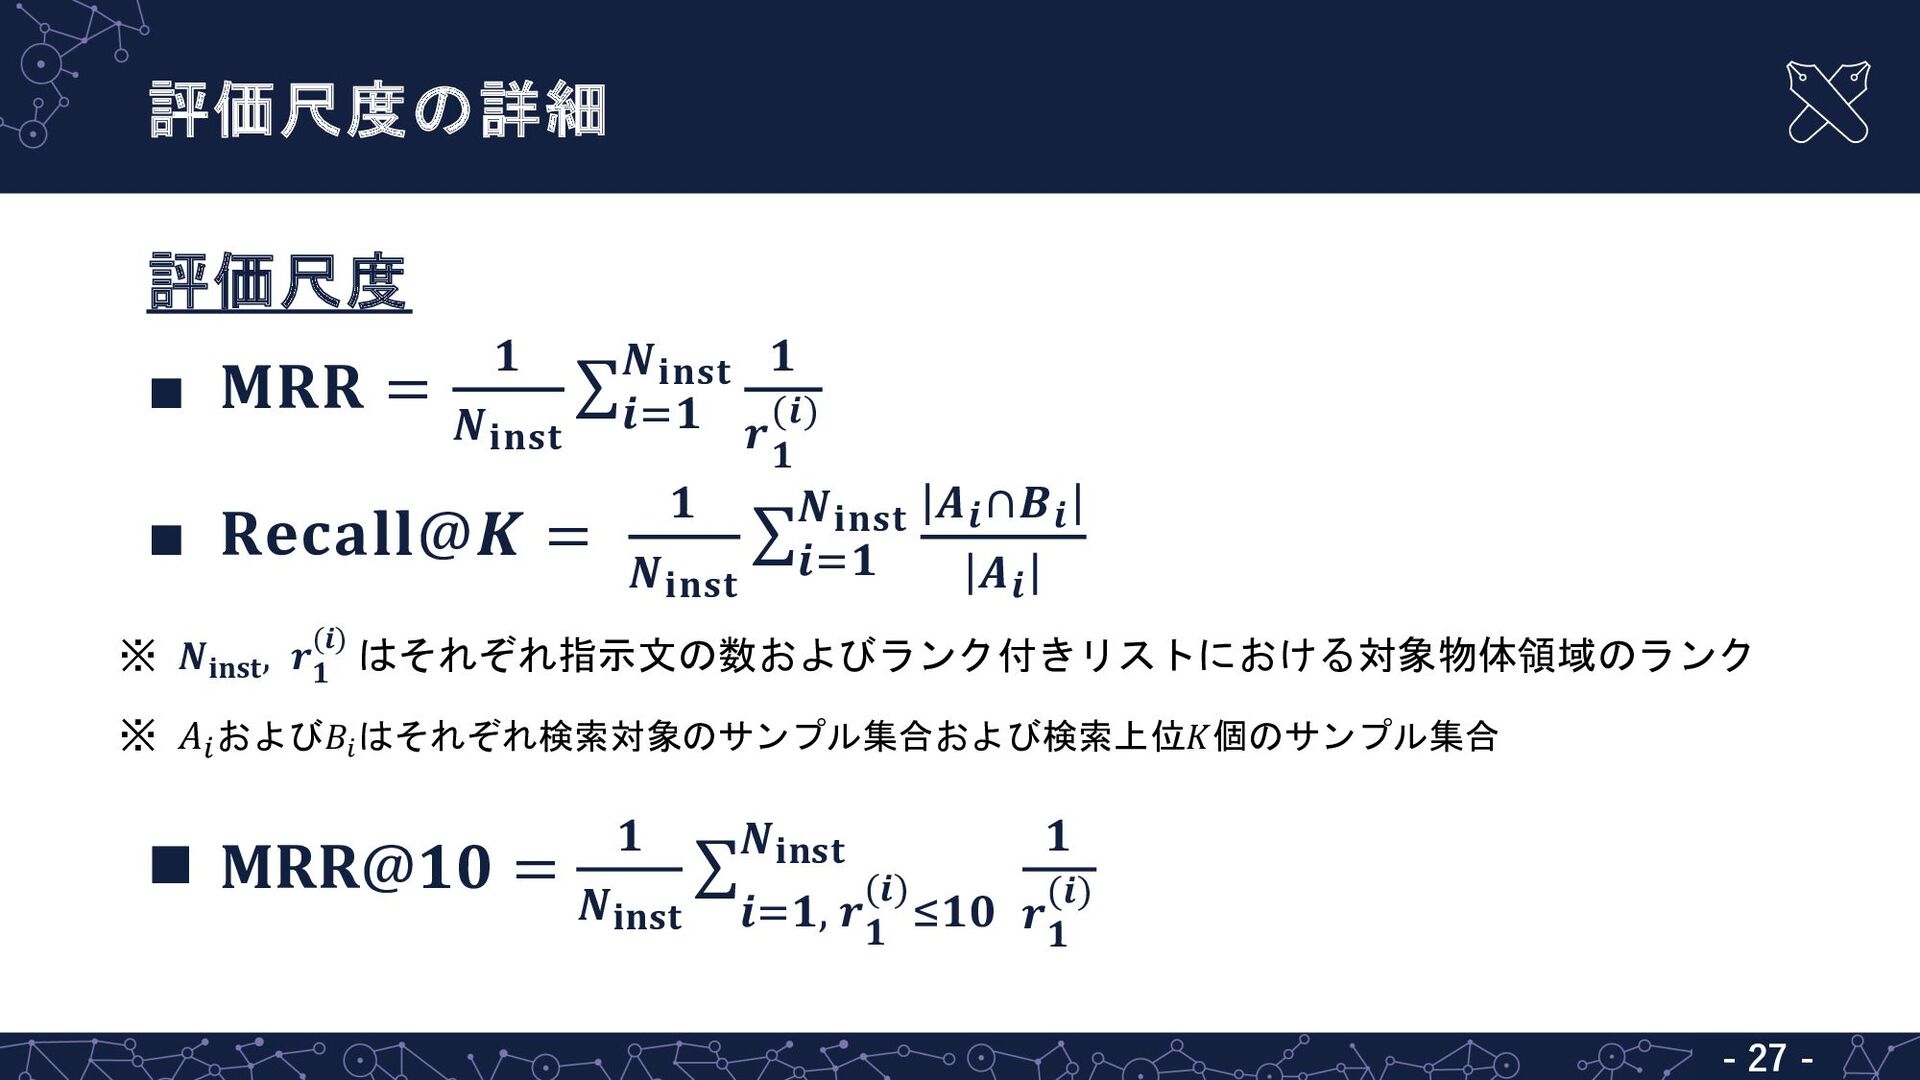
評価尺度の詳細 - 27 - 評価尺度 ▪ 𝐌𝐑𝐑 = 𝟏 𝑵𝐢𝐧𝐬𝐭
∑ 𝒊/𝟏 𝑵𝐢𝐧𝐬𝐭 𝟏 𝒓 𝟏 (𝒊) ※ 𝑵𝐢𝐧𝐬𝐭, 𝒓𝟏 (𝒊) はそれぞれ指示文の数およびランク付きリストにおける対象物体領域のランク ▪ 𝐑𝐞𝐜𝐚𝐥𝐥@𝑲 = 𝟏 𝑵𝐢𝐧𝐬𝐭 ∑ 𝒊/𝟏 𝑵𝐢𝐧𝐬𝐭 𝑨𝒊∩𝑩𝒊 𝑨𝒊 ※ 𝐴)および𝐵! はそれぞれ検索対象のサンプル集合および検索上位𝐾個のサンプル集合 n 𝐌𝐑𝐑@𝟏𝟎 = 𝟏 𝑵𝐢𝐧𝐬𝐭 ∑ 𝒊/𝟏, 𝒓 𝟏 (𝒊) 5𝟏𝟎 𝑵𝐢𝐧𝐬𝐭 𝟏 𝒓 𝟏 (𝒊)