ISR FOR MY THESIS DEFENSE
Sponsored
·
 Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→

Share
Embed

Transcript
62 slides
-
Meng Luo ( Yangzhou University) May 30, 2018 1/61 复杂性状遗传效应解析的新方法——重复筛选法
ISR for GWAS&E-GWAS&GS Meng Luo, Shiliang Gu Laboratory of Wheat Genetics, Molecular Breeding and Biostatistics Iterative screen regression ---- a new approach of dissecting genetic effects for complex traits -
优化全基因组关联分析的重复筛选法 重复筛选回归模型在数量性状上位性效应遗传作图中的应用 运用重复筛选回归模型进行全基因组预测 研究内容 Meng Luo (
Yangzhou University) May 30, 2018 2/61 ISR for GWAS&E-GWAS&GS -
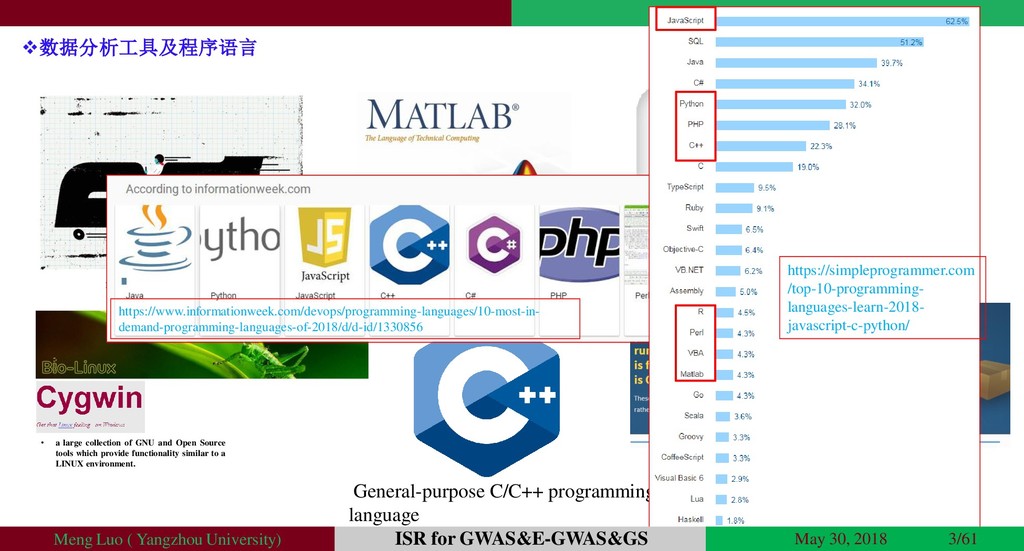
Nature Toolbox Adventures With R Data Analytics/Machine Learning • a
large collection of GNU and Open Source tools which provide functionality similar to a LINUX environment. Flexible & Powerful 数据分析工具及程序语言 General-purpose C/C++ programming language Python https://www.informationweek.com/devops/programming-languages/10-most-in- demand-programming-languages-of-2018/d/d-id/1330856 https://simpleprogrammer.com /top-10-programming- languages-learn-2018- javascript-c-python/ Meng Luo ( Yangzhou University) May 30, 2018 3/61 ISR for GWAS&E-GWAS&GS -
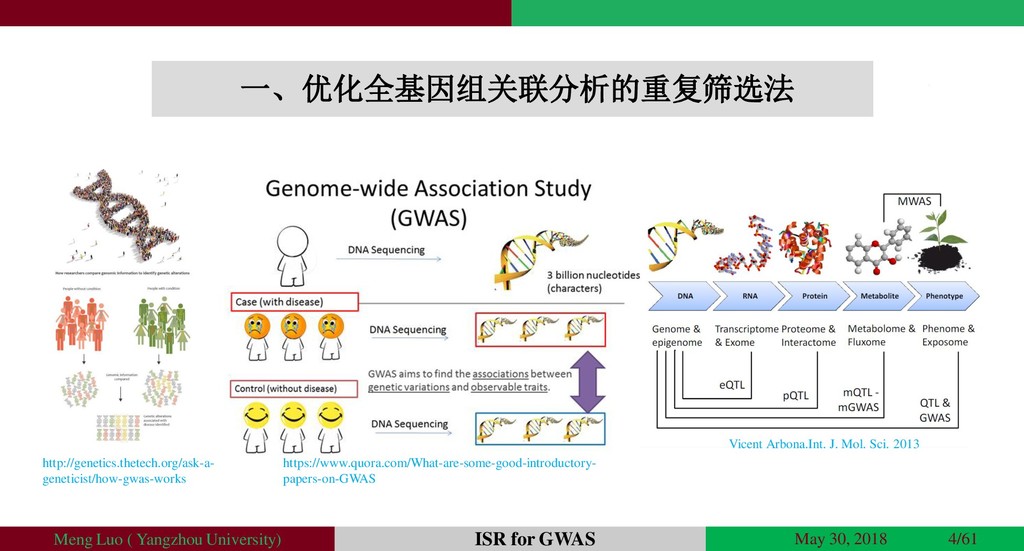
一、优化全基因组关联分析的重复筛选法 Meng Luo ( Yangzhou University) May 30, 2018 4/61
ISR for GWAS Vicent Arbona.Int. J. Mol. Sci. 2013 https://www.quora.com/What-are-some-good-introductory- papers-on-GWAS http://genetics.thetech.org/ask-a- geneticist/how-gwas-works -
背景 全基因组关联研究(GWASs)在检测与复杂性状和疾病相关的遗传变异方面越来越 突出,然而所鉴定的变异仅仅是解释了表型变异的一小部分,这就是所谓的“丢失遗 传力”,但也有些是能够表明生物学机制。 在GWAS中,研究的个体是彼此不相关,所以存在较为模糊的亲缘关系和群体分层 是不可避免的。同时,还存在另一个混杂因素,即遗传背景(非遗传因素),使得群 体结构控制在非常复杂的情况下表现不佳。 GWASs
进展及问题 Meng Luo ( Yangzhou University) May 30, 2018 5/61 ISR for GWAS -
在过去的20年里,研究员对于解决复杂性状中群体结构相关联的问题提出了很多方 案,比如,基因组控制(GC),结构化关联(SA),回归控制(RC),主成分调整 (PCA)和混合回归模型(MRM)。 在回归控制和主成分调整方法中,都是通过在回归模型中加入协变量来控制。在无 确定性偏差的情况下,RC与GC和SA方法类似,计算速度快,而且在向后(或逐步) 选择和收缩惩罚方法中回归分析更具有灵活性。 解决问题
Meng Luo ( Yangzhou University) May 30, 2018 6/61 ISR for GWAS 背景 -
混合线性模型 Adjustment on marker Prof.Zhizu Zhang Compressed MLM (CMLM)
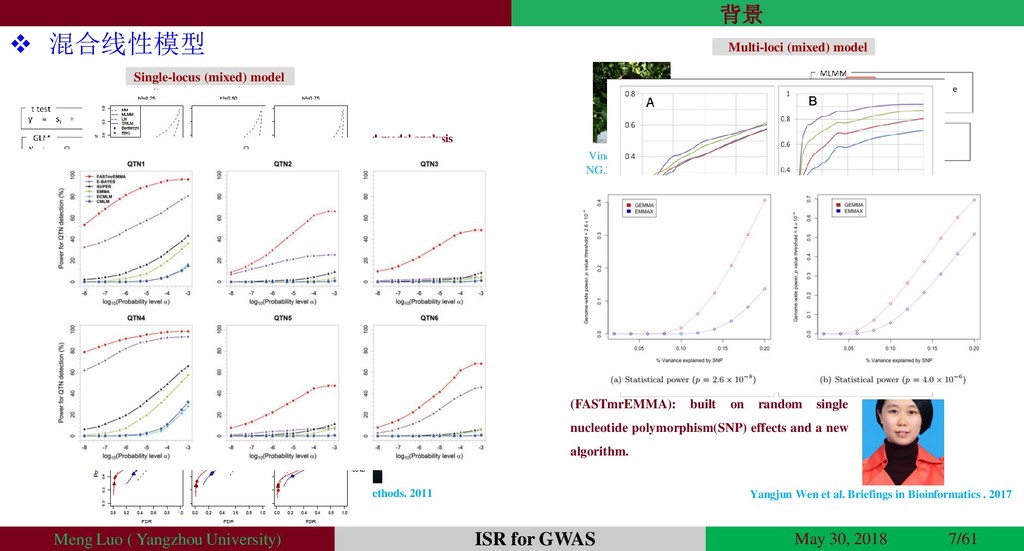
Genome-wide efficient mixed-model analysis (GEMMA) Prof.Xiang Zhou Brent‘s algorithm or Newton-Raphsons’ algorithm This method was called the approximate method by Zhiwu zhang (NG.2010). This method was called the exact method by Zhou and Stevens (NG.2012). Christoph Lippert. Microsoft research Christoph Lippert et al. Nature Methods. 2011 FaSTLMM Single-locus (mixed) model Vincent Segura et al. NG.2012 Xiaolei Liu et al. PLoS Genetics.2016 Yangjun Wen et al. Briefings in Bioinformatics . 2017 Fast multi-locus random-SNP-effect EMMA (FASTmrEMMA): built on random single nucleotide polymorphism(SNP) effects and a new algorithm. Multi-loci (mixed) model Meng Luo ( Yangzhou University) May 30, 2018 7/61 ISR for GWAS 背景 -
材料与方法 群体数据 Horton, .. et al. Nat Genet 2012
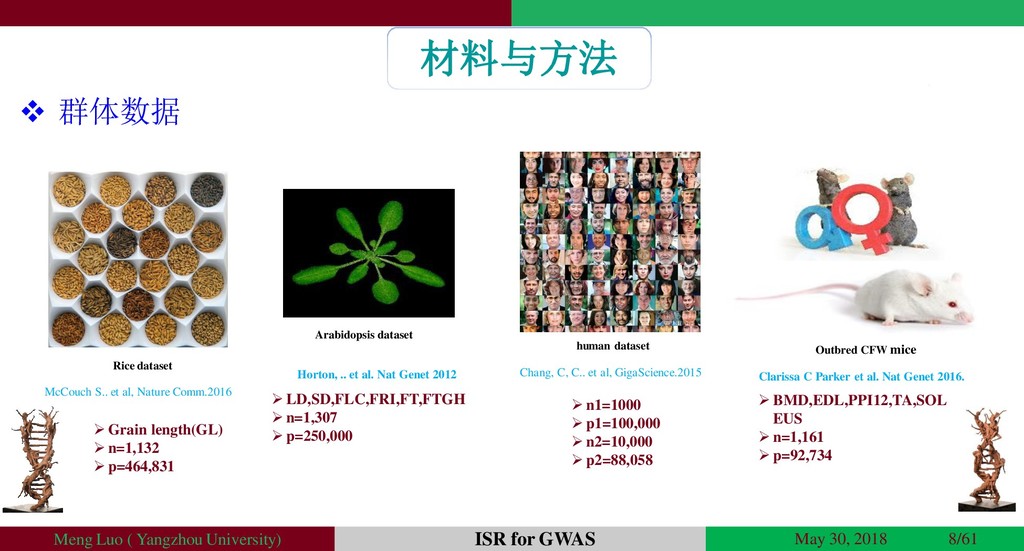
Arabidopsis dataset McCouch S.. et al, Nature Comm.2016 Rice dataset Chang, C, C.. et al, GigaScience.2015 human dataset Outbred CFW mice Clarissa C Parker et al. Nat Genet 2016. Meng Luo ( Yangzhou University) May 30, 2018 8/61 ISR for GWAS LD,SD,FLC,FRI,FT,FTGH n=1,307 p=250,000 Grain length(GL) n=1,132 p=464,831 n1=1000 p1=100,000 n2=10,000 p2=88,058 BMD,EDL,PPI12,TA,SOL EUS n=1,161 p=92,734 -
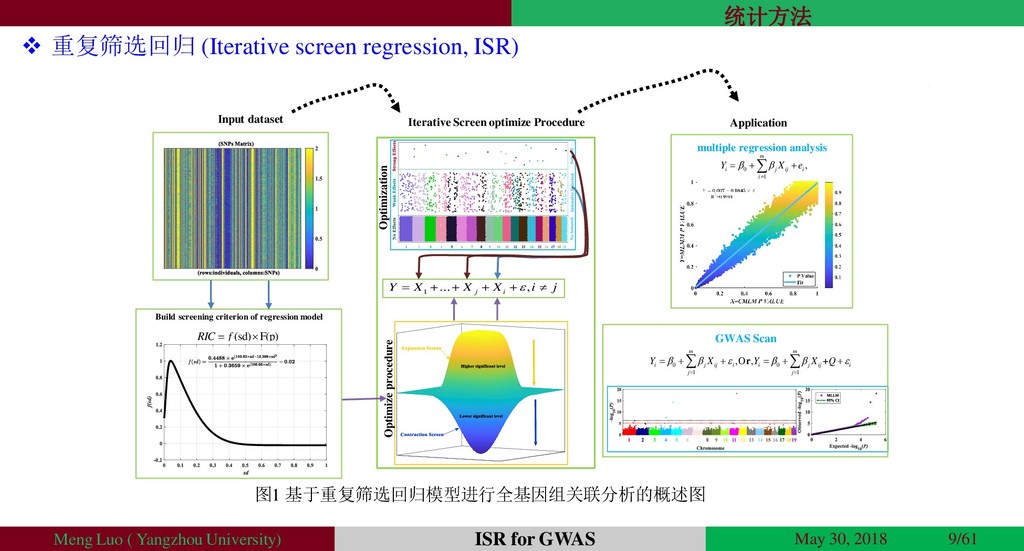
重复筛选回归 (Iterative screen regression, ISR) 图1 基于重复筛选回归模型进行全基因组关联分析的概述图 Meng Luo
( Yangzhou University) May 30, 2018 9/61 ISR for GWAS Build screening criterion of regression model Iterative Screen optimize Procedure Input dataset Application (sd) F(p) RIC f GWAS Scan 0 0 1 1 ,O , m m i j ij i i j ij i j j Y X Y X Q r + multiple regression analysis 0 1 , m i j ij i j Y X e 1 ... , j i Y X X X i j Optimization Optimize procedure 统计方法 -
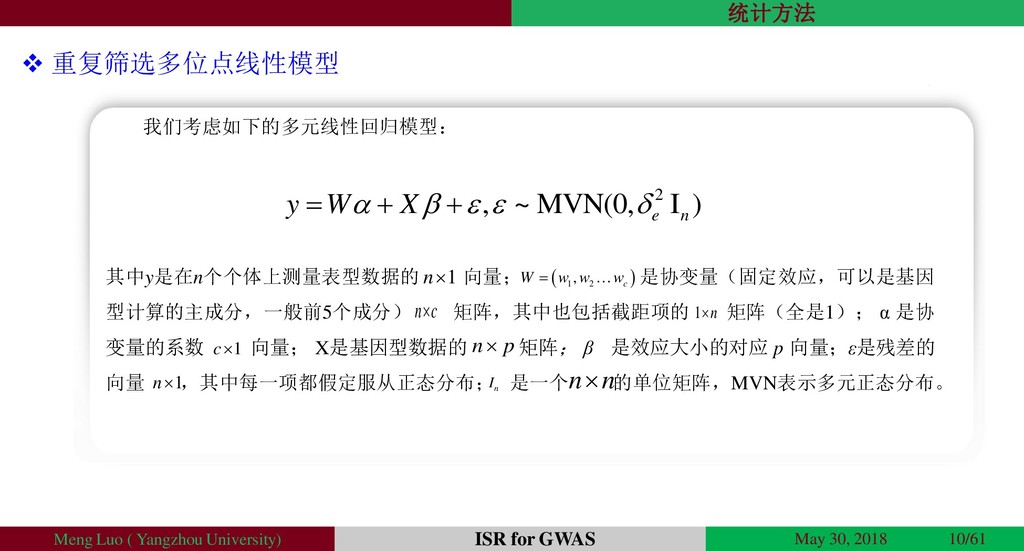
重复筛选多位点线性模型 我们考虑如下的多元线性回归模型: 2 , ~ MVN(0, I ) e
n y W X Meng Luo ( Yangzhou University) May 30, 2018 10/61 ISR for GWAS 其中y是在n个个体上测量表型数据的 向量; 是协变量(固定效应,可以是基因 型计算的主成分,一般前5个成分) 矩阵,其中也包括截距项的 矩阵(全是1); α 是协 变量的系数 向量; X是基因型数据的 矩阵; β 是效应大小的对应 p 向量;ε是残差的 向量 ,其中每一项都假定服从正态分布; 是一个 的单位矩阵,MVN表示多元正态分布。 1 n 1 2 , c W w w w 1 c n p n n n I n c 统计方法 1 n 1 n -
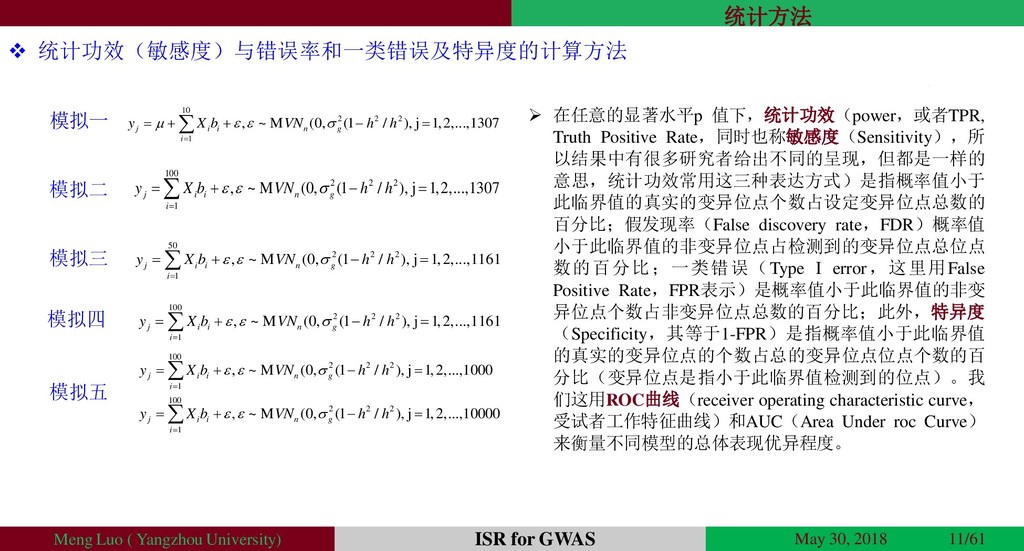
统计功效(敏感度)与错误率和一类错误及特异度的计算方法 10 2 2 2 1 , ~ M
(0, (1 / ), j 1,2,...,1307 j i i n g i y X b VN h h 模拟一 100 2 2 2 1 , ~ M (0, (1 / ), j 1,2,...,1307 j i i n g i y X b VN h h 50 2 2 2 1 , ~ M (0, (1 / ), j 1,2,...,1161 j i i n g i y X b VN h h 100 2 2 2 1 100 2 2 2 1 , ~ M (0, (1 / ), j 1,2,...,1000 , ~ M (0, (1 / ), j 1,2,...,10000 j i i n g i j i i n g i y X b VN h h y X b VN h h 100 2 2 2 1 , ~ M (0, (1 / ), j 1,2,...,1161 j i i n g i y X b VN h h 模拟二 模拟三 模拟四 模拟五 在任意的显著水平p 值下,统计功效(power,或者TPR, Truth Positive Rate,同时也称敏感度(Sensitivity),所 以结果中有很多研究者给出不同的呈现,但都是一样的 意思,统计功效常用这三种表达方式)是指概率值小于 此临界值的真实的变异位点个数占设定变异位点总数的 百分比;假发现率(False discovery rate,FDR)概率值 小于此临界值的非变异位点占检测到的变异位点总位点 数的百分比;一类错误(Type Ⅰ error,这里用False Positive Rate,FPR表示)是概率值小于此临界值的非变 异位点个数占非变异位点总数的百分比;此外,特异度 (Specificity,其等于1-FPR)是指概率值小于此临界值 的真实的变异位点的个数占总的变异位点位点个数的百 分比(变异位点是指小于此临界值检测到的位点)。我 们这用ROC曲线(receiver operating characteristic curve, 受试者工作特征曲线)和AUC(Area Under roc Curve) 来衡量不同模型的总体表现优异程度。 Meng Luo ( Yangzhou University) May 30, 2018 11/61 ISR for GWAS 统计方法 -
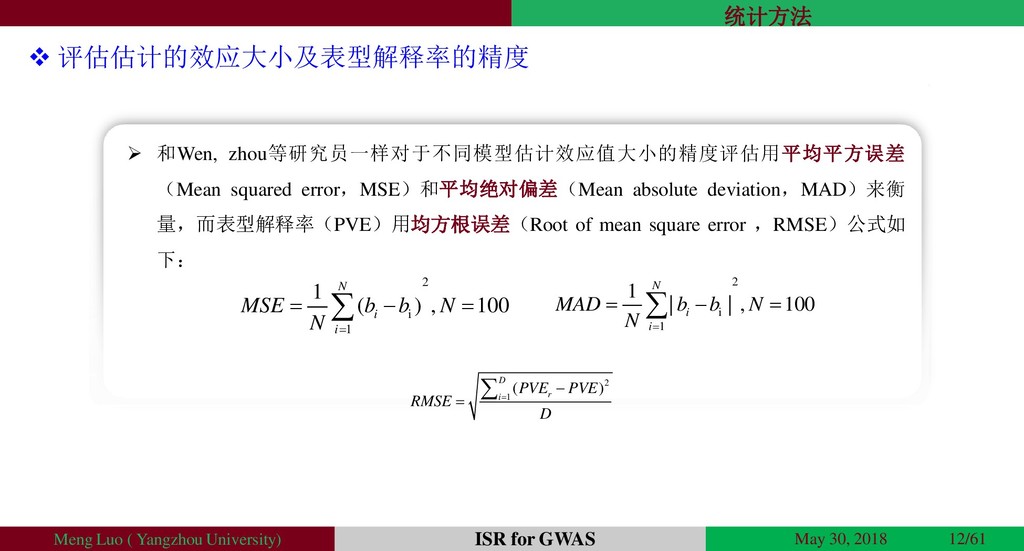
评估估计的效应大小及表型解释率的精度 和Wen, zhou等研究员一样对于不同模型估计效应值大小的精度评估用平均平方误差 (Mean squared error,MSE)和平均绝对偏差(Mean absolute deviation,MAD)来衡
量,而表型解释率(PVE)用均方根误差(Root of mean square error ,RMSE)公式如 下: 2 i 1 1 ( ) , 100 N i i MSE b b N N 2 i 1 1 | | , 100 N i i MAD b b N N 2 1 ( ) D r i PVE PVE RMSE D Meng Luo ( Yangzhou University) May 30, 2018 12/61 ISR for GWAS 统计方法 -
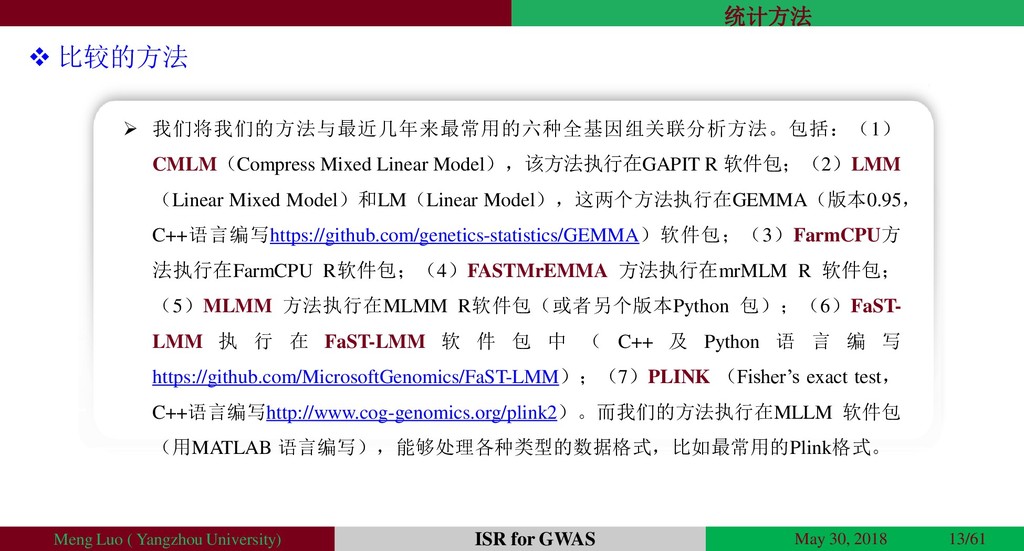
比较的方法 我们将我们的方法与最近几年来最常用的六种全基因组关联分析方法。包括:(1) CMLM(Compress Mixed Linear Model),该方法执行在GAPIT R 软件包;(2)LMM
(Linear Mixed Model)和LM(Linear Model),这两个方法执行在GEMMA(版本0.95, C++语言编写https://github.com/genetics-statistics/GEMMA)软件包;(3)FarmCPU方 法执行在FarmCPU R软件包;(4)FASTMrEMMA 方法执行在mrMLM R 软件包; (5)MLMM 方法执行在MLMM R软件包(或者另个版本Python 包);(6)FaST- LMM 执 行 在 FaST-LMM 软 件 包 中 ( C++ 及 Python 语 言 编 写 https://github.com/MicrosoftGenomics/FaST-LMM);(7)PLINK (Fisher’s exact test, C++语言编写http://www.cog-genomics.org/plink2)。而我们的方法执行在MLLM 软件包 (用MATLAB 语言编写),能够处理各种类型的数据格式,比如最常用的Plink格式。 Meng Luo ( Yangzhou University) May 30, 2018 13/61 ISR for GWAS 统计方法 -
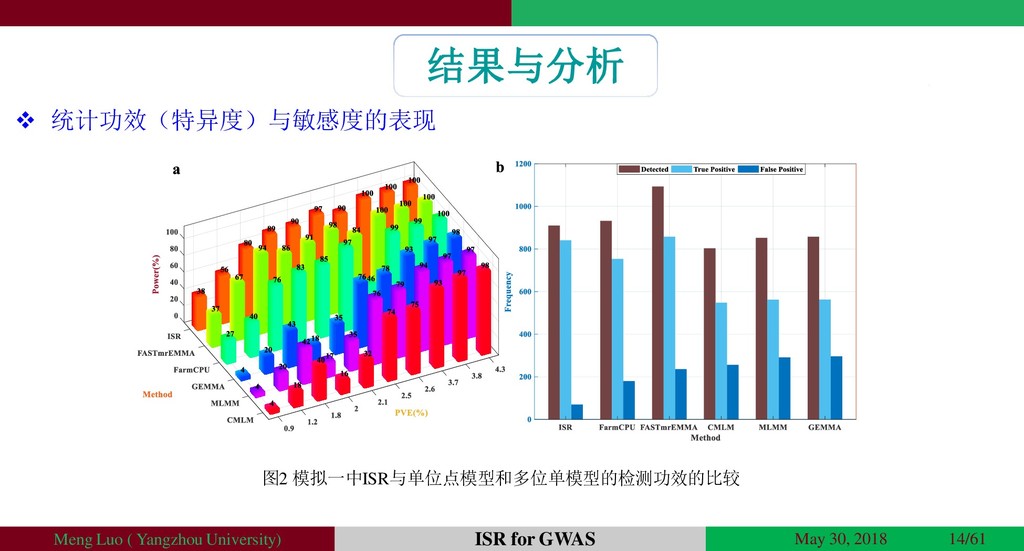
结果与分析 统计功效(特异度)与敏感度的表现 图2 模拟一中ISR与单位点模型和多位单模型的检测功效的比较 Meng Luo ( Yangzhou University)
May 30, 2018 14/61 ISR for GWAS -
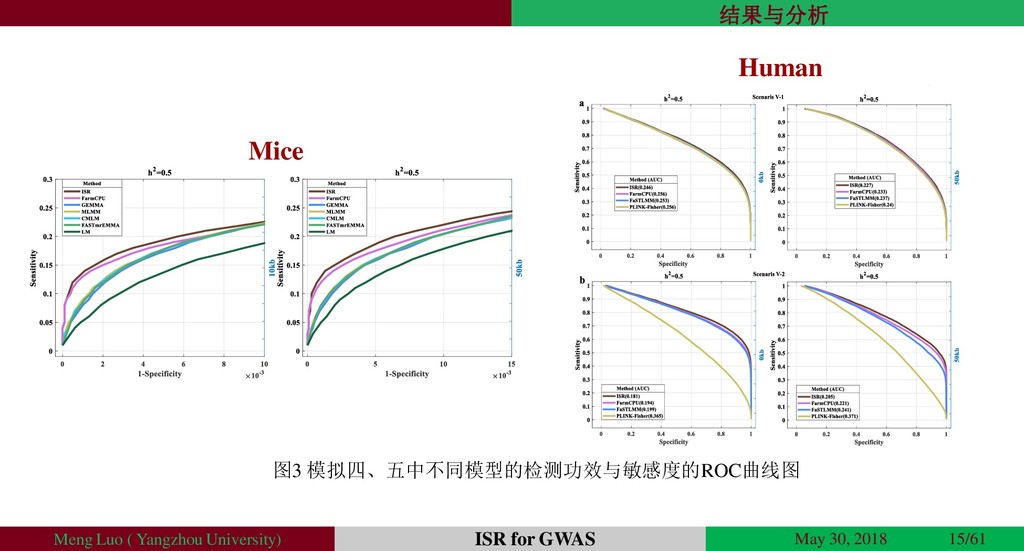
图3 模拟四、五中不同模型的检测功效与敏感度的ROC曲线图 Human Meng Luo ( Yangzhou University) May 30,
2018 15/61 ISR for GWAS Mice 结果与分析 -
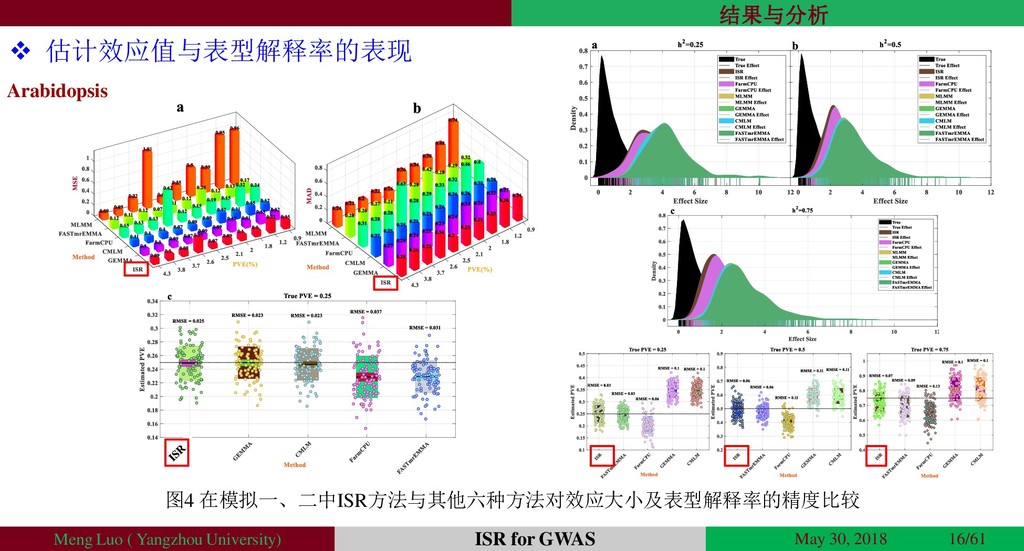
图4 在模拟一、二中ISR方法与其他六种方法对效应大小及表型解释率的精度比较 Meng Luo ( Yangzhou University) May 30, 2018
16/61 ISR for GWAS 估计效应值与表型解释率的表现 Arabidopsis 结果与分析 -
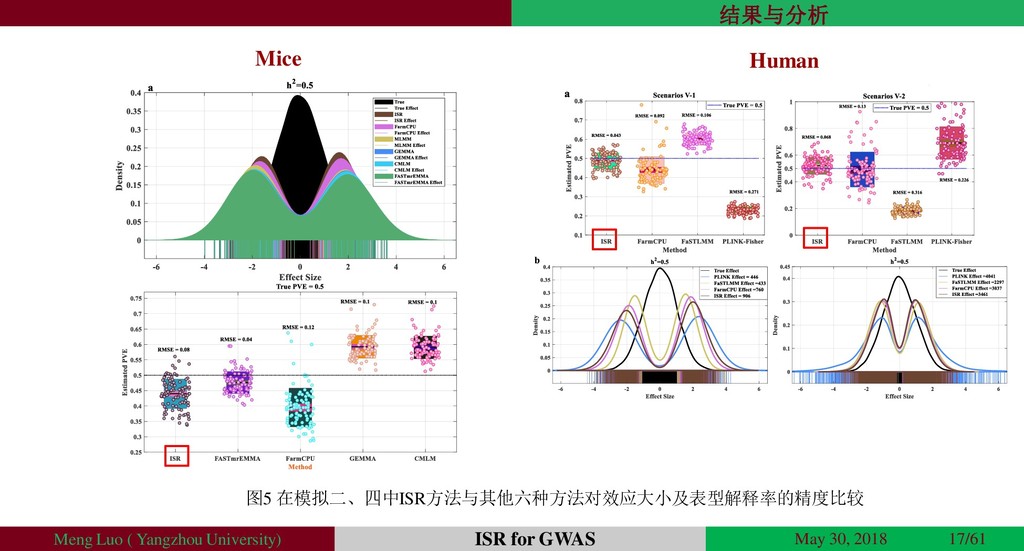
图5 在模拟二、四中ISR方法与其他六种方法对效应大小及表型解释率的精度比较 Human Meng Luo ( Yangzhou University) May 30,
2018 17/61 ISR for GWAS Mice 结果与分析 -
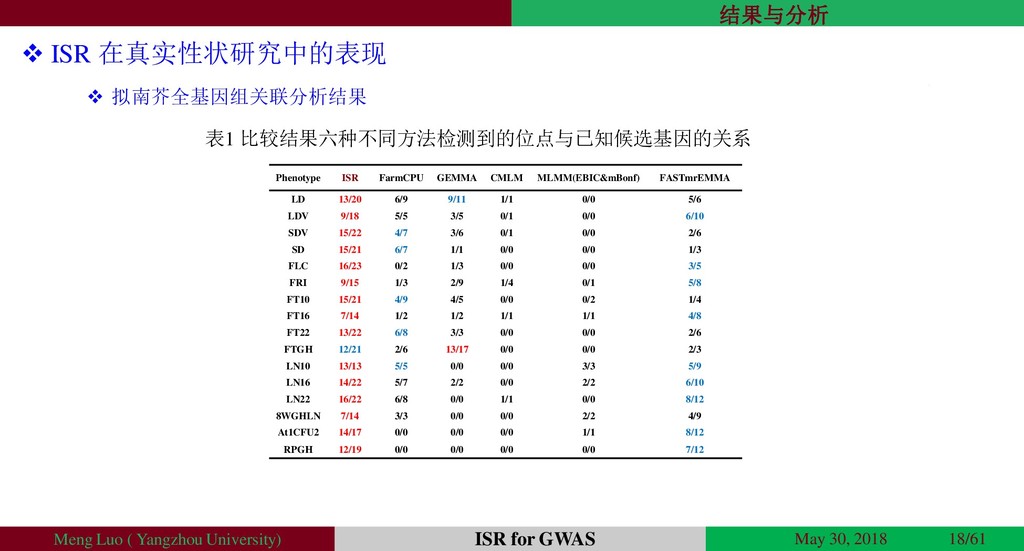
表1 比较结果六种不同方法检测到的位点与已知候选基因的关系 Phenotype ISR FarmCPU GEMMA CMLM MLMM(EBIC&mBonf) FASTmrEMMA LD
13/20 6/9 9/11 1/1 0/0 5/6 LDV 9/18 5/5 3/5 0/1 0/0 6/10 SDV 15/22 4/7 3/6 0/1 0/0 2/6 SD 15/21 6/7 1/1 0/0 0/0 1/3 FLC 16/23 0/2 1/3 0/0 0/0 3/5 FRI 9/15 1/3 2/9 1/4 0/1 5/8 FT10 15/21 4/9 4/5 0/0 0/2 1/4 FT16 7/14 1/2 1/2 1/1 1/1 4/8 FT22 13/22 6/8 3/3 0/0 0/0 2/6 FTGH 12/21 2/6 13/17 0/0 0/0 2/3 LN10 13/13 5/5 0/0 0/0 3/3 5/9 LN16 14/22 5/7 2/2 0/0 2/2 6/10 LN22 16/22 6/8 0/0 1/1 0/0 8/12 8WGHLN 7/14 3/3 0/0 0/0 2/2 4/9 At1CFU2 14/17 0/0 0/0 0/0 1/1 8/12 RPGH 12/19 0/0 0/0 0/0 0/0 7/12 ISR 在真实性状研究中的表现 拟南芥全基因组关联分析结果 Meng Luo ( Yangzhou University) May 30, 2018 18/61 ISR for GWAS 结果与分析 -
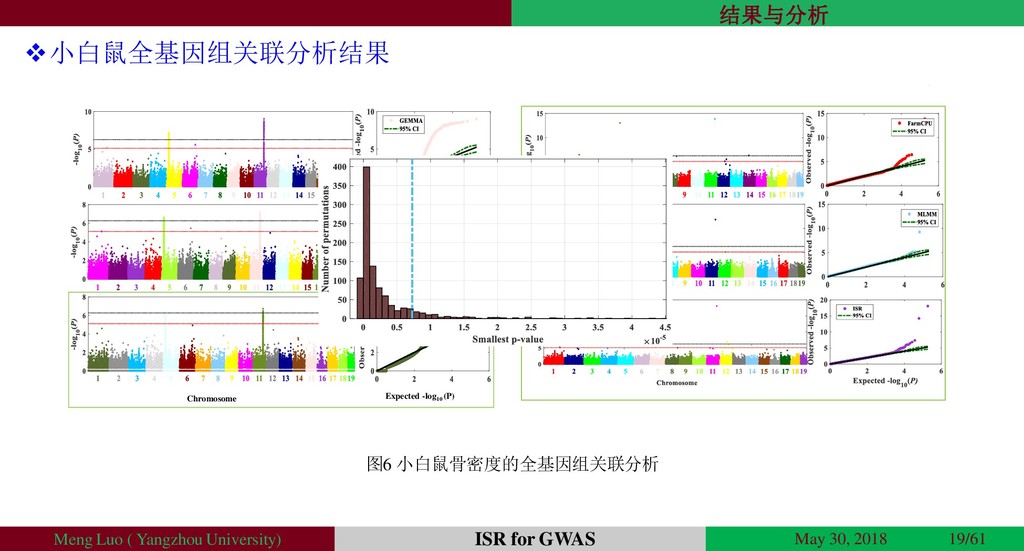
Chromosome Expected -log10 (P) 图6 小白鼠骨密度的全基因组关联分析 小白鼠全基因组关联分析结果 Meng Luo (
Yangzhou University) May 30, 2018 19/61 ISR for GWAS 结果与分析 -
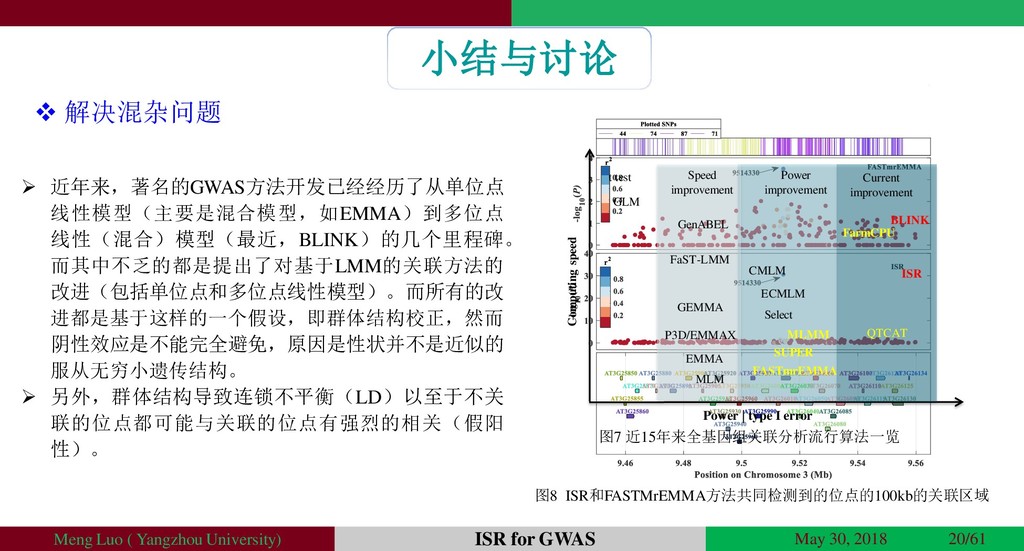
小结与讨论 解决混杂问题 近年来,著名的GWAS方法开发已经经历了从单位点 线性模型(主要是混合模型,如EMMA)到多位点 线性(混合)模型(最近,BLINK)的几个里程碑。 而其中不乏的都是提出了对基于LMM的关联方法的 改进(包括单位点和多位点线性模型)。而所有的改 进都是基于这样的一个假设,即群体结构校正,然而
阴性效应是不能完全避免,原因是性状并不是近似的 服从无穷小遗传结构。 另外,群体结构导致连锁不平衡(LD)以至于不关 联的位点都可能与关联的位点有强烈的相关(假阳 性)。 Meng Luo ( Yangzhou University) May 30, 2018 20/61 ISR for GWAS 图8 ISR和FASTMrEMMA方法共同检测到的位点的100kb的关联区域 Power | type I error Computing speed GLM t test MLM EMMA P3D/EMMAX GEMMA FaST-LMM GenABEL CMLM MLMM ECMLM Select SUPER Speed improvement Power improvement Current improvement FarmCPU ISR QTCAT FASTmrEMMA 图7 近15年来全基因组关联分析流行算法一览 BLINK -
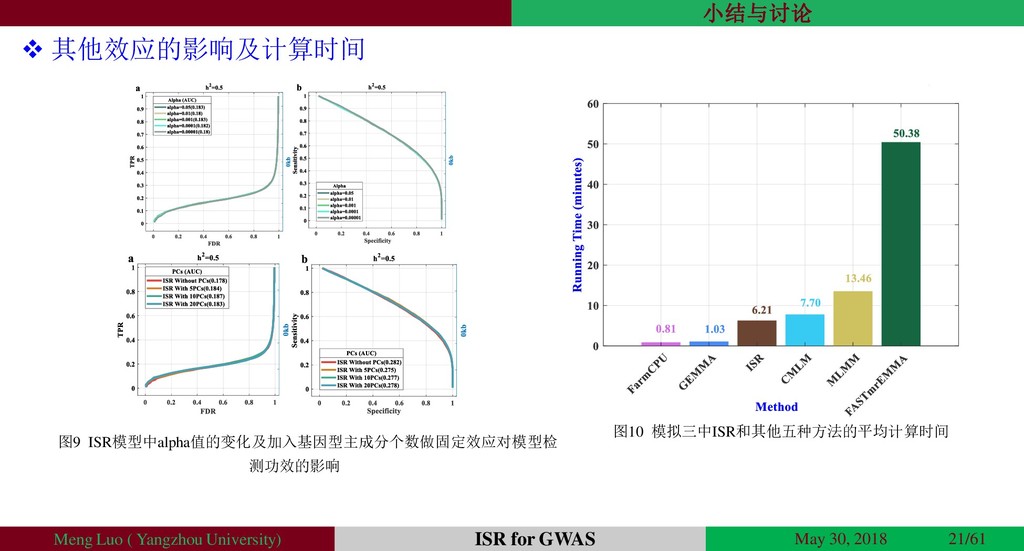
图10 模拟三中ISR和其他五种方法的平均计算时间 Meng Luo ( Yangzhou University) May 30, 2018
21/61 ISR for GWAS 图9 ISR模型中alpha值的变化及加入基因型主成分个数做固定效应对模型检 测功效的影响 其他效应的影响及计算时间 小结与讨论 -
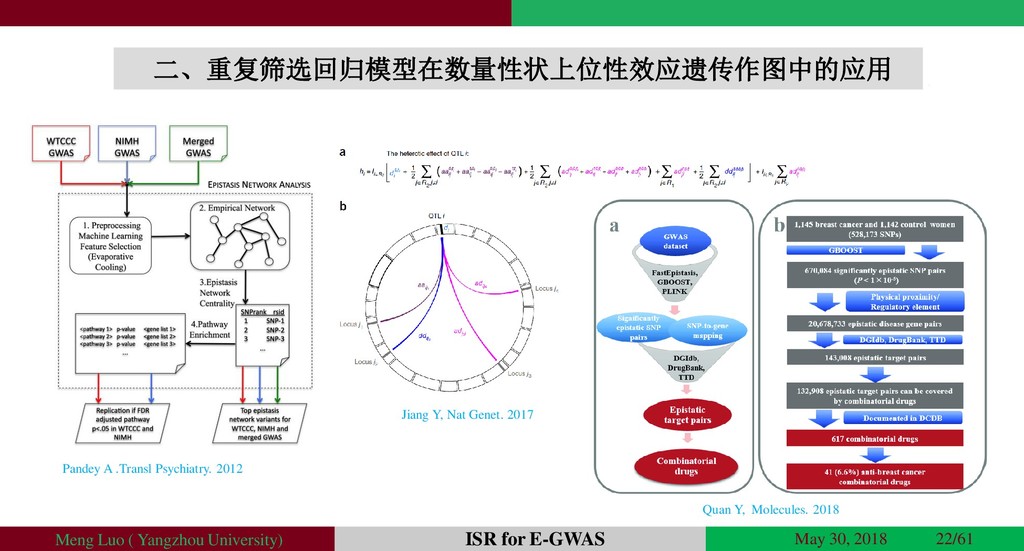
二、重复筛选回归模型在数量性状上位性效应遗传作图中的应用 Meng Luo ( Yangzhou University) May 30, 2018 22/61
ISR for E-GWAS Pandey A .Transl Psychiatry. 2012 Jiang Y, Nat Genet. 2017 Quan Y, Molecules. 2018 -
背景 遗传作图研究主要是以全基因组关联研究(GWASs)和QTL(quantitative trait loci)作 图两种方式,并且已经确定了数千个遗传基因位点与许多复杂性状和常见疾病相关联, 揭示表型变异的遗传基础。而大多数的这些遗传作图研究只是侧重于看单个位点的变异 主要包括加性效应及显性效应。然而很久以来就假设或许额外的其他效应可能会导致更 大的表型变异(解释较大的变形变异率)。 而上位性(基因位点之间的相互作用),被认为在研究复杂性状的遗传结构中起着关
键作用及构成了进化的遗传基础。 研究进展及问题 Meng Luo ( Yangzhou University) May 30, 2018 23/61 ISR for E-GWAS -
此外,基因组选择研究已被证明,模拟的模型加入上位性效应可提高一些模式生物的 表型预测准确性,并促进动物育种计划中的基因组选择,但这样的结论并不是指向所有 的假定。 最后,上位性已被提出作为解释丢失遗传率(表型的全基因组关联分析中,没有全部 被解释的部分遗传力)的一个主要因素。特别是研究假设了上位性的存在可能会影响在 系谱研究中的遗传力估计,其导致遗传力估计的高估,造成所谓的虚假遗传力 (phantom heritability)。 Meng
Luo ( Yangzhou University) May 30, 2018 24/61 ISR for E-GWAS 背景 -
Hua等使用水稻240 份RIL群体创造了360杂交种用以解剖上位性效应,并研究与水稻产 量构成性状的杂种优势遗传基础。同样jiang等研究了 135份父母本的生成的1604份杂交 种在11个环境中小麦的产量,并指出上位性效应相比显性效应在普通小麦的籽粒产量的 杂种优势扮演了重要角色。 然而正如我们知道的复杂性状一般都是有多基因控制的,所以单位点模型可能导致检 测功效低,估计的参数偏差大。为了克服这些问题,一些有效的多位点模型被提出然而 正如我们知道的复杂性状一般都是有多基因控制的,所以单位点模型可能导致检测功效
低,估计的参数偏差大。 Meng Luo ( Yangzhou University) May 30, 2018 25/61 ISR for E-GWAS 背景 -
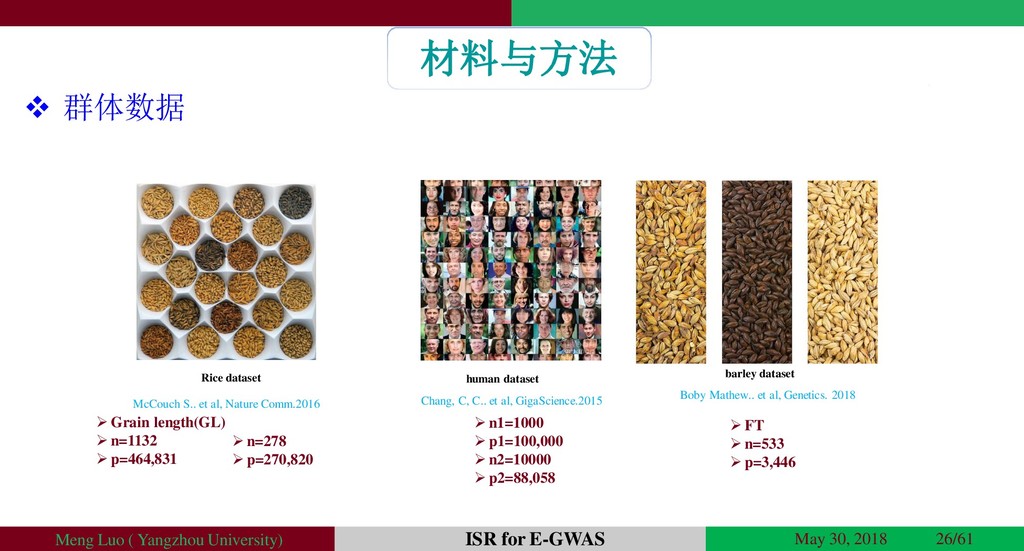
材料与方法 群体数据 McCouch S.. et al, Nature Comm.2016 Rice
dataset Chang, C, C.. et al, GigaScience.2015 human dataset Boby Mathew.. et al, Genetics. 2018 barley dataset Meng Luo ( Yangzhou University) May 30, 2018 26/61 ISR for E-GWAS Grain length(GL) n=1132 p=464,831 n1=1000 p1=100,000 n2=10000 p2=88,058 FT n=533 p=3,446 n=278 p=270,820 -
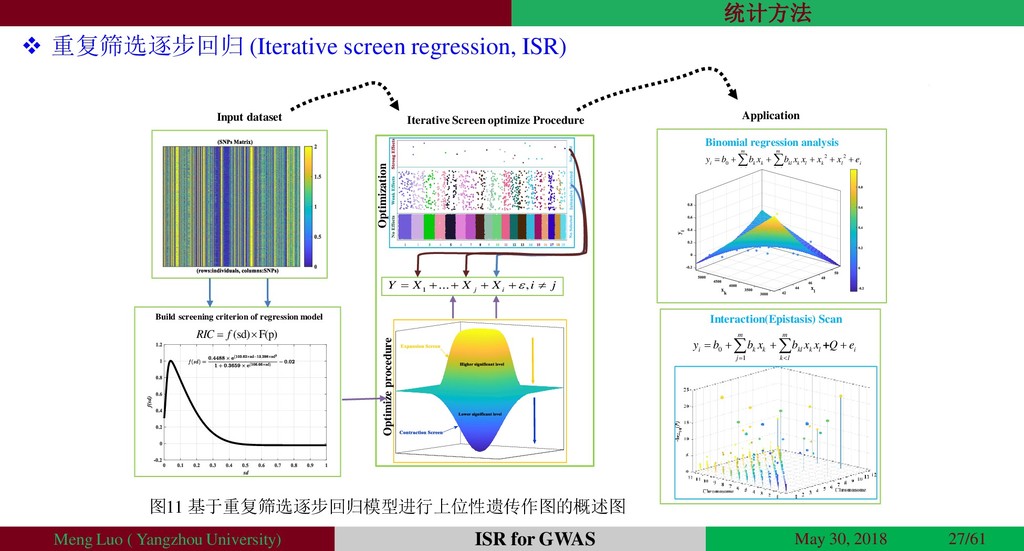
重复筛选逐步回归 (Iterative screen regression, ISR) 图11 基于重复筛选逐步回归模型进行上位性遗传作图的概述图 Meng Luo
( Yangzhou University) May 30, 2018 27/61 ISR for GWAS Build screening criterion of regression model Iterative Screen optimize Procedure Input dataset Application (sd) F(p) RIC f Binomial regression analysis 1 ... , j i Y X X X i j Optimization Optimize procedure 统计方法 Interaction(Epistasis) Scan 0 1 m m i k k kl k l i j k l y b b x b x x Q e + 2 2 0 1 m m i k k kl k l k l i j k l y b b x b x x x x e -
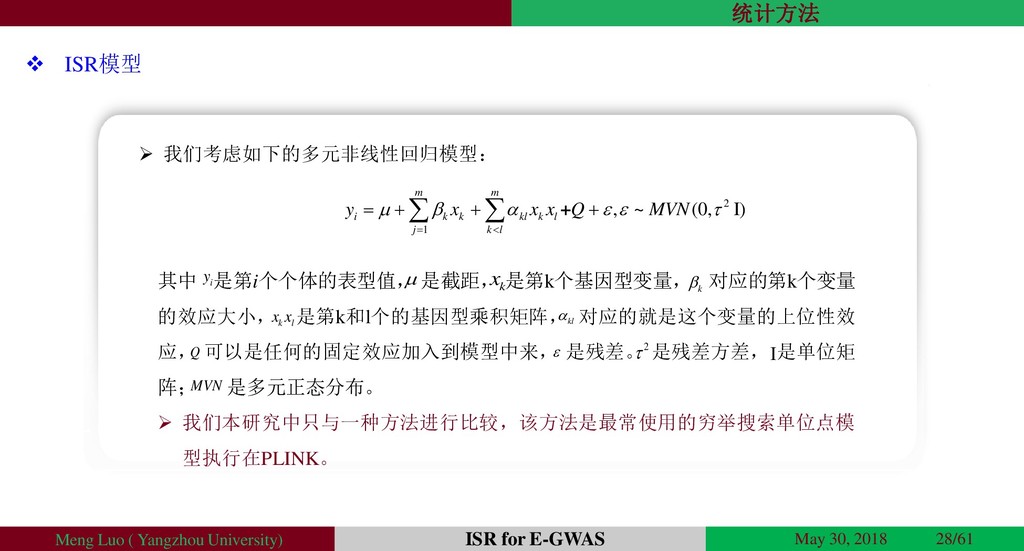
ISR模型 我们考虑如下的多元非线性回归模型: 2 1 , ~ (0, I)
m m i k k kl k l j k l y x x x Q MVN + Meng Luo ( Yangzhou University) May 30, 2018 28/61 ISR for E-GWAS 其中 是第i个个体的表型值, 是截距, 是第k个基因型变量, 对应的第k个变量 的效应大小, 是第k和l个的基因型乘积矩阵, 对应的就是这个变量的上位性效 应, 可以是任何的固定效应加入到模型中来, 是残差。 是残差方差, 是单位矩 阵; 是多元正态分布。 我们本研究中只与一种方法进行比较,该方法是最常使用的穷举搜索单位点模 型执行在PLINK。 i y k x k k l x x Q 2 I MVN kl 统计方法 -
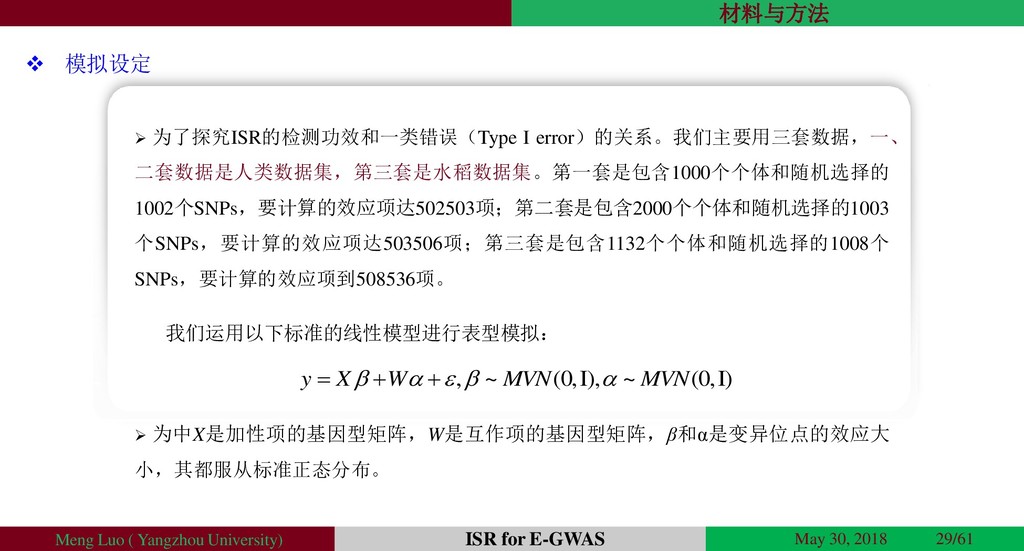
为了探究ISR的检测功效和一类错误(Type I error)的关系。我们主要用三套数据,一、 二套数据是人类数据集,第三套是水稻数据集。第一套是包含1000个个体和随机选择的 1002个SNPs,要计算的效应项达502503项;第二套是包含2000个个体和随机选择的1003 个SNPs,要计算的效应项达503506项;第三套是包含1132个个体和随机选择的1008个 SNPs,要计算的效应项到508536项。 为中X是加性项的基因型矩阵,W是互作项的基因型矩阵,β和α是变异位点的效应大
小,其都服从标准正态分布。 模拟设定 , ~ (0,I), ~ (0,I) y X W MVN MVN 我们运用以下标准的线性模型进行表型模拟: Meng Luo ( Yangzhou University) May 30, 2018 29/61 ISR for E-GWAS 材料与方法 -
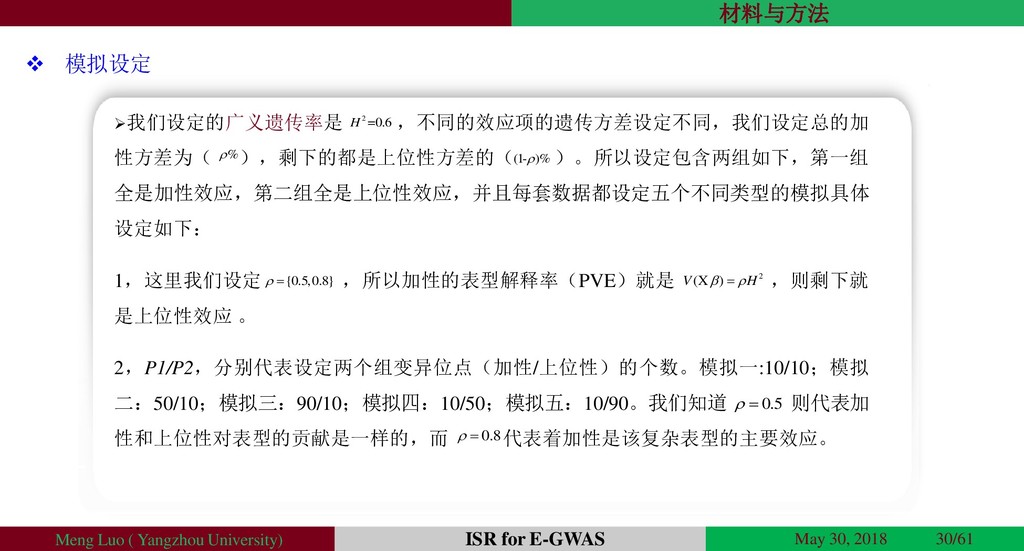
模拟设定 我们设定的广义遗传率是 ,不同的效应项的遗传方差设定不同,我们设定总的加 性方差为( ),剩下的都是上位性方差的( )。所以设定包含两组如下,第一组 全是加性效应,第二组全是上位性效应,并且每套数据都设定五个不同类型的模拟具体 设定如下: 1,这里我们设定
,所以加性的表型解释率(PVE)就是 ,则剩下就 是上位性效应 。 2,P1/P2,分别代表设定两个组变异位点(加性/上位性)的个数。模拟一:10/10;模拟 二:50/10;模拟三:90/10;模拟四:10/50;模拟五:10/90。我们知道 则代表加 性和上位性对表型的贡献是一样的,而 代表着加性是该复杂表型的主要效应。 % (1- )% {0.5,0.8} 2 (X ) V H Meng Luo ( Yangzhou University) May 30, 2018 30/61 ISR for E-GWAS 材料与方法 2 =0.6 H 0.5 0.8 -
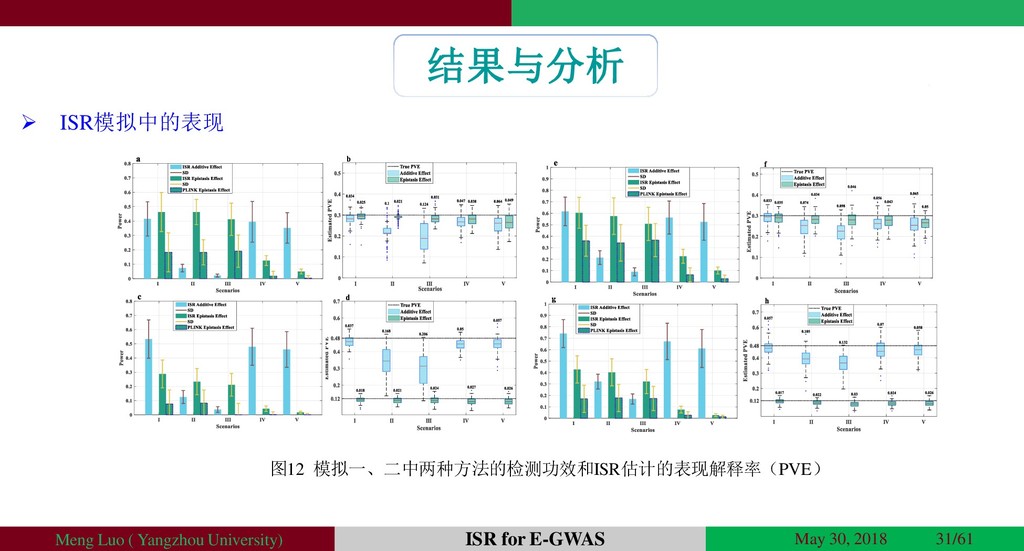
结果与分析 ISR模拟中的表现 图12 模拟一、二中两种方法的检测功效和ISR估计的表现解释率(PVE) Meng Luo ( Yangzhou University)
May 30, 2018 31/61 ISR for E-GWAS -
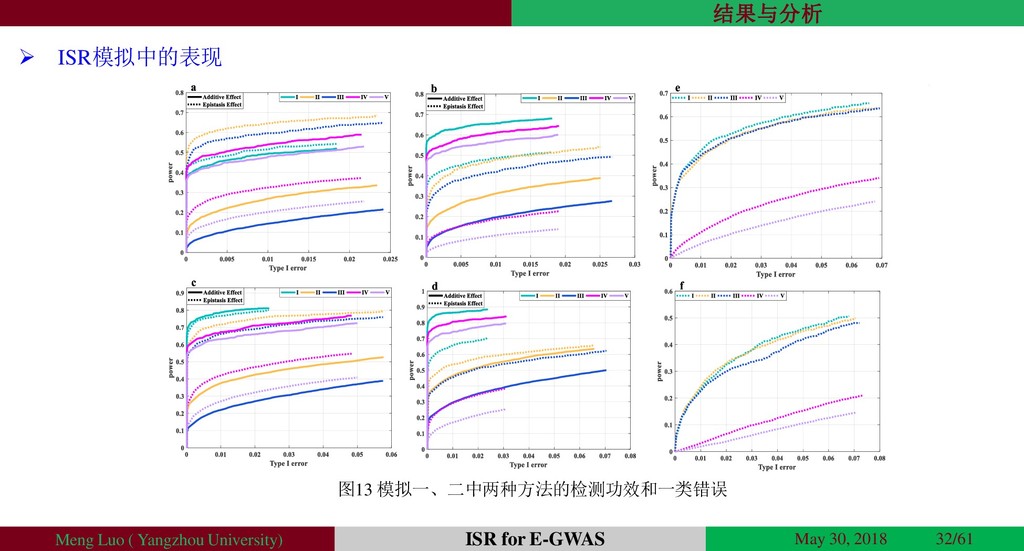
ISR模拟中的表现 图13 模拟一、二中两种方法的检测功效和一类错误 Meng Luo ( Yangzhou University) May
30, 2018 32/61 ISR for E-GWAS 结果与分析 -
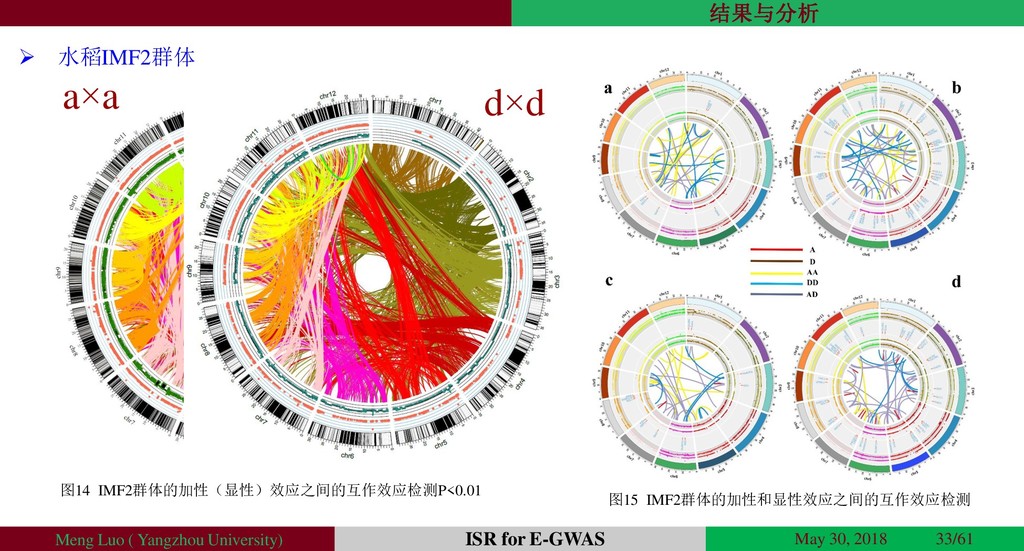
水稻IMF2群体 图15 IMF2群体的加性和显性效应之间的互作效应检测 a×a 图14 IMF2群体的加性(显性)效应之间的互作效应检测P<0.01 d×d Meng Luo
( Yangzhou University) May 30, 2018 33/61 ISR for E-GWAS 结果与分析 -
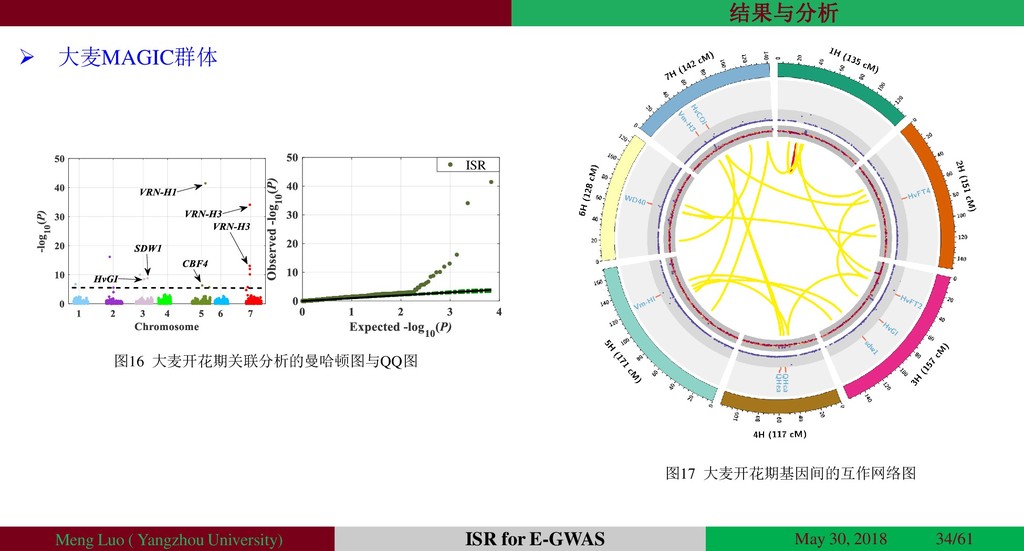
大麦MAGIC群体 结果与分析 Meng Luo ( Yangzhou University) May 30,
2018 34/61 ISR for E-GWAS 图16 大麦开花期关联分析的曼哈顿图与QQ图 图17 大麦开花期基因间的互作网络图 ISR -
小结与讨论 Meng Luo ( Yangzhou University) May 30, 2018 35/61
ISR for E-GWAS 模拟中的结果展示在 时加性与上位性相同的变异位点下,检测的上位性效应 的功效比设定的加性效应的功效高,这也说明了重复筛选回归方法更适合对于非线 模型的变量筛选。同样的,不管在不同的模拟研究下,不同类型的数据类型中ISR能 够精确地评估出PVE),与zhou和zhu等研究的结果是一致的(RMSE的变幅)。 在人类数据集模拟中,分别在0.05(ISR)和1(PLINK)的Bonfferroni多重矫正下 PLINK的检测功效显著低于ISR方法,而且在同种功效下,PLINK的一类型错误高。 =0.5 -
Meng Luo ( Yangzhou University) May 30, 2018 36/61 ISR
for E-GWAS 小结与讨论 上位性QTL(加性与上位性)关联作图结果鉴定了许多与四个性状相关的QTLs, 其中大多数是涉及基因间相互作用(杂种优势),而且互作效应项的贡献率都是最 高的。另外这些QTL中,在20cM距离内至少有一个是已经克隆的基因 。相比复合区 间作图法,我们检测到了其没能检测到的变异位点。 我们鉴定的基因互作结果与Mathew等研究员运用的贝叶斯多位点模型检测的结果 相对一致,此外我们还检测到了更多的基因互作的QTLs(用的是5% Bonfferroni阈值 进行矫正)。 -
Meng Luo ( Yangzhou University) May 30, 2018 37/61 ISR
for E-GWAS 小结与讨论 给出的真实表型的结果是相对保守的,因为我们都是以严格的显著值(0.05 bonferroni 矫正)来选择变异位点作为最终的结果。如果用相对较高的显著值来选出, 其结果可能会更佳。模型中同样也可以考虑加入环境或者其他的非遗传因素到模型 中进行模型矫正,一方面增加其检测的效率,另一方面降低一类错误的发生。其中 模拟的计算时间如下:平均时间(标准差),第一套数据模拟的平均时间1.34(0.2) 小时;第二套数据模拟的平均时间1.76(0.21)小时;第三套数据模拟的平均时间 1.44(0.16)小时;水稻真实表型的平均计算时间59.72(2.36)小时;大麦的计算时 间是74.38小时。所以可以看出ISR也是存在缺陷的。 -
三、 运用重复筛选回归模型进行全基因组预测 Meng Luo ( Yangzhou University) May 30, 2018
38/61 ISR for GS Genomic Selection/Prediction -
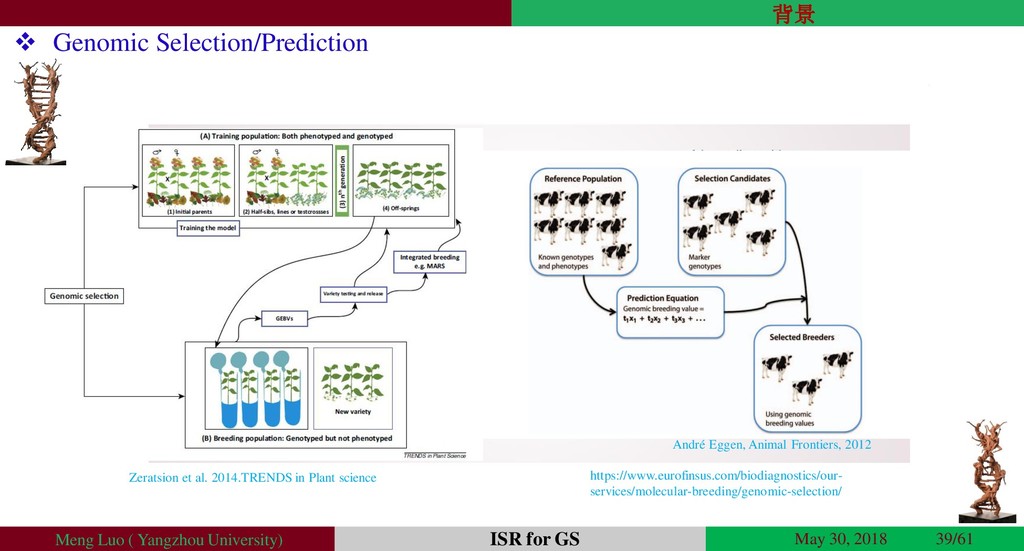
Meng Luo ( Yangzhou University) May 30, 2018 39/61 ISR
for GS 背景 Genomic Selection/Prediction Peter L. Morrell, Nature Reviews Genetics,2012 https://www.eurofinsus.com/biodiagnostics/our- services/molecular-breeding/genomic-selection/ Zeratsion et al. 2014.TRENDS in Plant science André Eggen, Animal Frontiers, 2012 -
来自现有的关联研究的遗传数据的不断积累,使得人们越来越关注使用遗传标记进行 预测复杂性状和疾病(除了使用传统环境或临床变量下)。在动物或植物中,用遗传标 记进行准确的表型预测可以协助选择出具有很满意育种值的个体,并且可以有效的改进 育种计划。在人类中,准确用遗传标记进行表型预测可以促进疾病预防和干预在早期阶 段的发病,并可以援助利用基因型信息开发个性化药物定制治疗,并预测结果。 准确的表型预测的需要开发能够同时模拟(建模)所有SNP的统计方法。 研究进展及问题 Meng
Luo ( Yangzhou University) May 30, 2018 40/61 ISR for GS 背景 -
先前的全基因组关联分析研究已经表明了,很多的复杂性状和常见疾病多是有多基因背 景并且每个都受到许多基因变异的影响都是具有很小的效应。例如,估计有数千个变异位 点影响人类的身高。同样,很多动物(牛)或植物(水稻、玉米)性状也是由数百个变异 位点所贡献而导致的变异。 大多数现有的,用于预测的多基因模型是对效应大小的分布做出假设,并且不同的方法 主要在于这种不同模型假设中的不同。例如,常用的线性混合模型(LMM),也称为最 佳线性无偏预测(BLUP),假设所有位点的效应大小都服从正态分布。 另外还有比如 Bayes
alphabetic(BayesA、BayesB)方法假设变异效应大小服从t分布或 其它的。Bayes LASSO 假定变异的效应大小服从双指数/拉普拉斯分布。 Meng Luo ( Yangzhou University) May 30, 2018 41/61 ISR for GS 背景 -
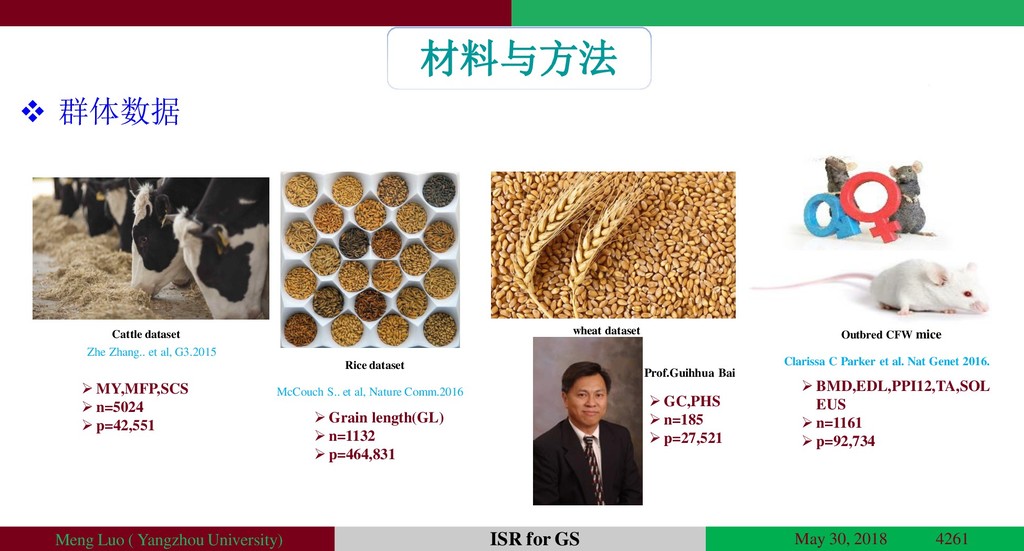
材料与方法 群体数据 Zhe Zhang.. et al, G3.2015 Cattle dataset
Outbred CFW mice Clarissa C Parker et al. Nat Genet 2016. wheat dataset Prof.Guihhua Bai Meng Luo ( Yangzhou University) May 30, 2018 4261 ISR for GS McCouch S.. et al, Nature Comm.2016 Rice dataset MY,MFP,SCS n=5024 p=42,551 Grain length(GL) n=1132 p=464,831 GC,PHS n=185 p=27,521 BMD,EDL,PPI12,TA,SOL EUS n=1161 p=92,734 -
Meng Luo ( Yangzhou University) May 30, 2018 43/61 ISR
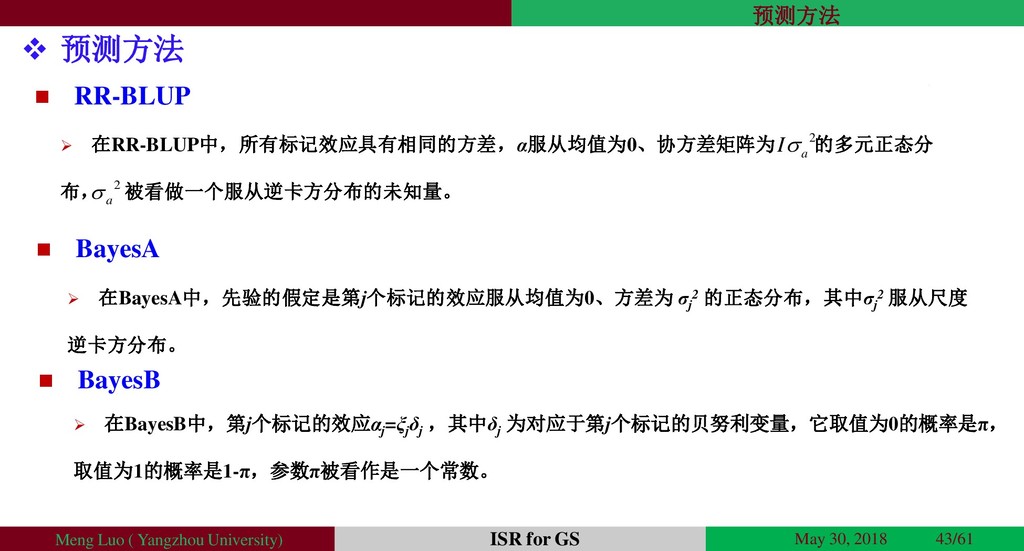
for GS 预测方法 RR-BLUP 在RR-BLUP中,所有标记效应具有相同的方差,α服从均值为0、协方差矩阵为 的多元正态分 布, 被看做一个服从逆卡方分布的未知量。 BayesA 在BayesA中,先验的假定是第j个标记的效应服从均值为0、方差为 σj 2 的正态分布,其中σj 2 服从尺度 逆卡方分布。 BayesB 在BayesB中,第j个标记的效应αj =ξj δj ,其中δj 为对应于第j个标记的贝努利变量,它取值为0的概率是π, 取值为1的概率是1-π,参数π被看作是一个常数。 预测方法 2 a I 2 a -
Meng Luo ( Yangzhou University) May 30, 2018 44/61 ISR
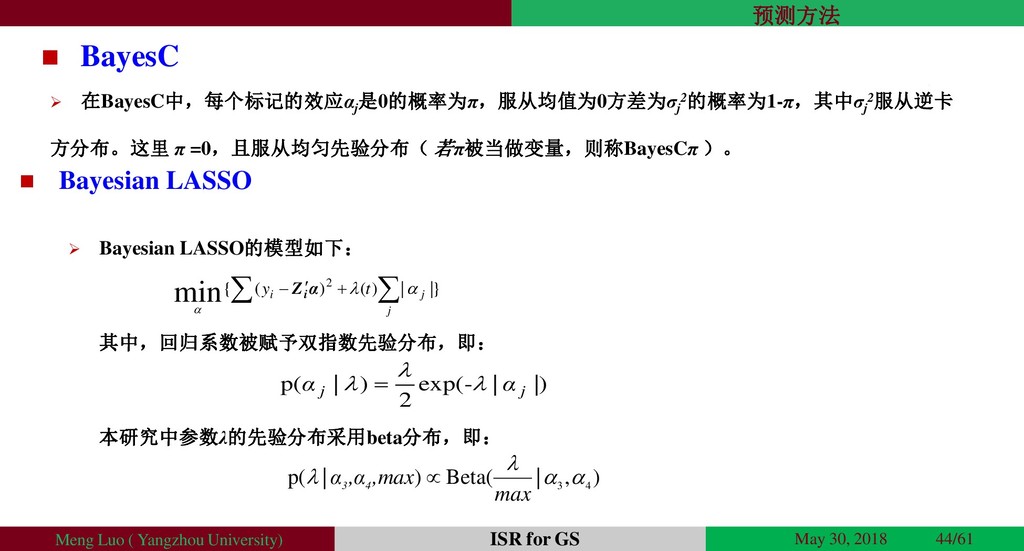
for GS BayesC 在BayesC中,每个标记的效应αj 是0的概率为π,服从均值为0方差为σj 2的概率为1-π,其中σj 2服从逆卡 方分布。这里 π =0,且服从均匀先验分布( 若π被当做变量,则称BayesCπ )。 Bayesian LASSO Bayesian LASSO的模型如下: 其中,回归系数被赋予双指数先验分布,即: 本研究中参数λ的先验分布采用beta分布,即: ) , | Beta( ) | p( 4 3 max ,max ,α α 4 3 } | | ) ( ) ( { 2 min j j i t y α Zi ) | | exp(- 2 ) | p( j j α α 预测方法 -
Meng Luo ( Yangzhou University) May 30, 2018 45/61 ISR
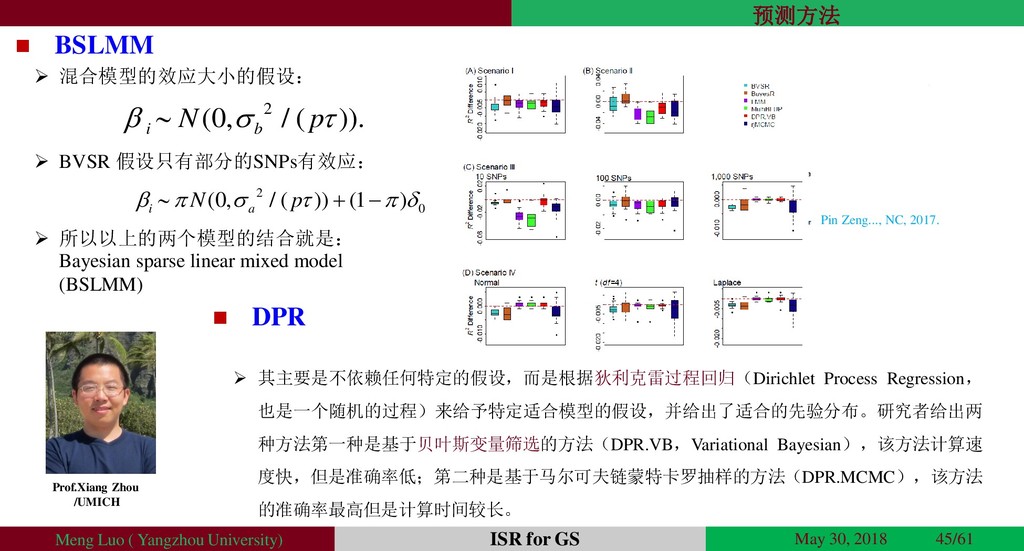
for GS 混合模型的效应大小的假设: 2 ( 0 ) , / . ( ) i b N p BVSR 假设只有部分的SNPs有效应: 2 0 ( ( 0, / )) ( ) 1 i a N p 所以以上的两个模型的结合就是: Bayesian sparse linear mixed model (BSLMM) Prof.Xiang Zhou /UMICH BSLMM 预测方法 Xiang zhou, Plos Genetics, 2013. 其主要是不依赖任何特定的假设,而是根据狄利克雷过程回归(Dirichlet Process Regression, 也是一个随机的过程)来给予特定适合模型的假设,并给出了适合的先验分布。研究者给出两 种方法第一种是基于贝叶斯变量筛选的方法(DPR.VB,Variational Bayesian),该方法计算速 度快,但是准确率低;第二种是基于马尔可夫链蒙特卡罗抽样的方法(DPR.MCMC),该方法 的准确率最高但是计算时间较长。 DPR Pin Zeng..., NC, 2017. -
Meng Luo ( Yangzhou University) May 30, 2018 46/61 ISR
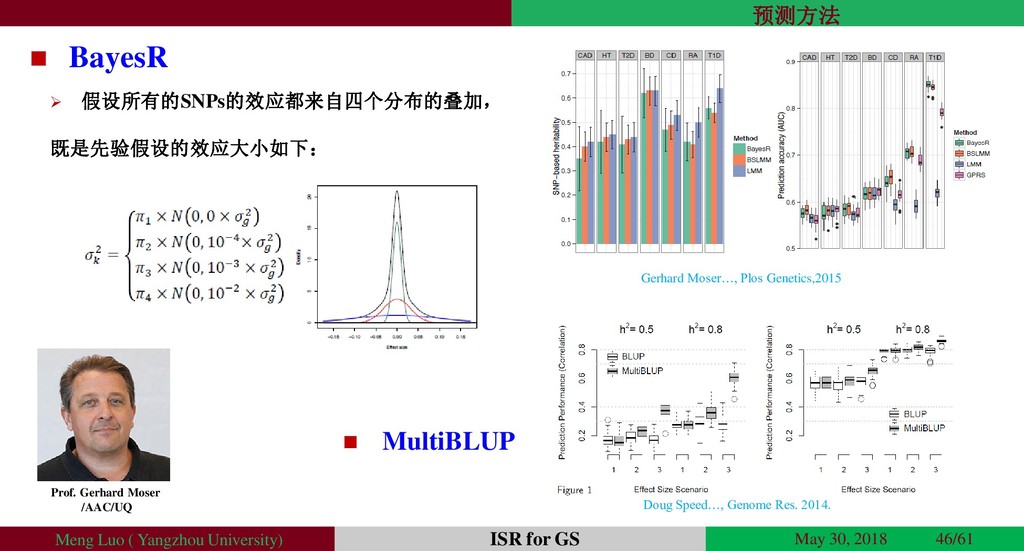
for GS 预测方法 Prof. Gerhard Moser /AAC/UQ BayesR Gerhard Moser…, Plos Genetics,2015 假设所有的SNPs的效应都来自四个分布的叠加, 既是先验假设的效应大小如下: MultiBLUP Doug Speed…, Genome Res. 2014. -
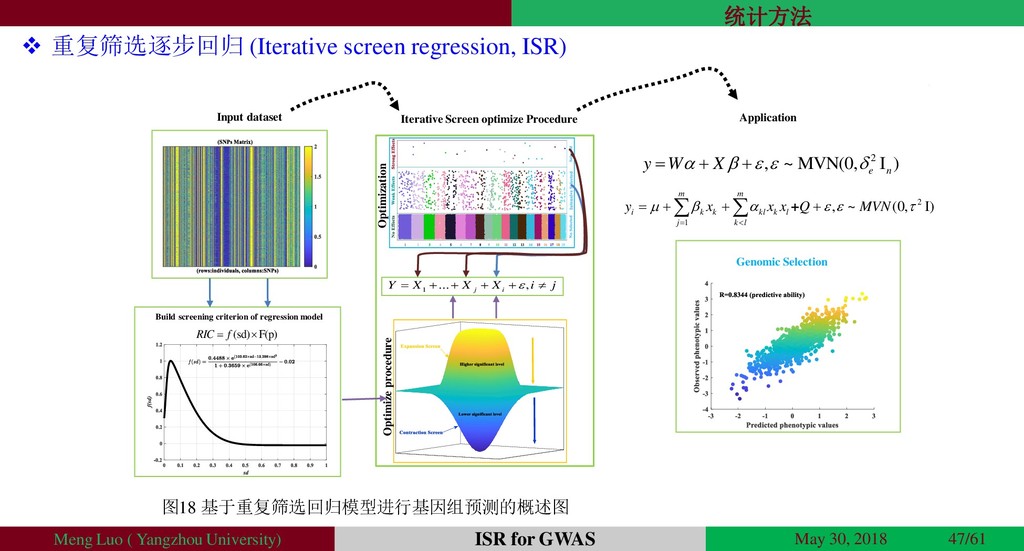
重复筛选逐步回归 (Iterative screen regression, ISR) 图18 基于重复筛选回归模型进行基因组预测的概述图 Meng Luo
( Yangzhou University) May 30, 2018 47/61 ISR for GWAS Build screening criterion of regression model Iterative Screen optimize Procedure Input dataset Application (sd) F(p) RIC f 1 ... , j i Y X X X i j Optimization Optimize procedure 统计方法 Genomic Selection 2 , ~ MVN(0, I ) e n y W X 2 1 , ~ (0, I) m m i k k kl k l j k l y x x x Q MVN + -
ISR方法 Meng Luo ( Yangzhou University) May 30, 2018
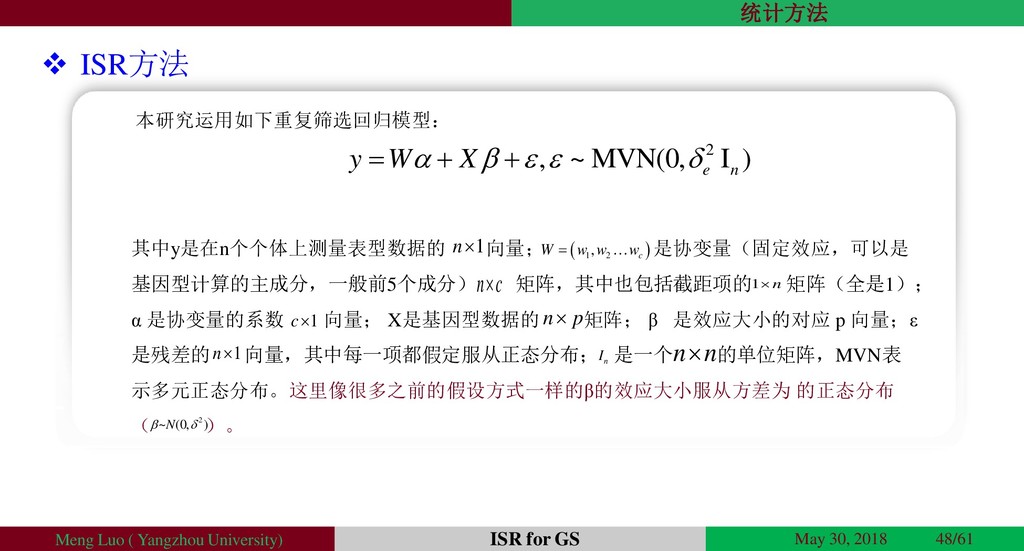
48/61 ISR for GS 本研究运用如下重复筛选回归模型: 2 , ~ MVN(0, I ) e n y W X 其中y是在n个个体上测量表型数据的 向量; 是协变量(固定效应,可以是 基因型计算的主成分,一般前5个成分) 矩阵,其中也包括截距项的 矩阵(全是1); α 是协变量的系数 向量; X是基因型数据的 矩阵; β 是效应大小的对应 p 向量;ε 是残差的 向量,其中每一项都假定服从正态分布; 是一个 的单位矩阵,MVN表 示多元正态分布。这里像很多之前的假设方式一样的β的效应大小服从方差为 的正态分布 ( )。 1 n 1 2 , c W w w w 1 c n p n n n I n c 1 n 2 ~ (0, ) N 1 n 统计方法 -
模拟设定 Meng Luo ( Yangzhou University) May 30, 2018
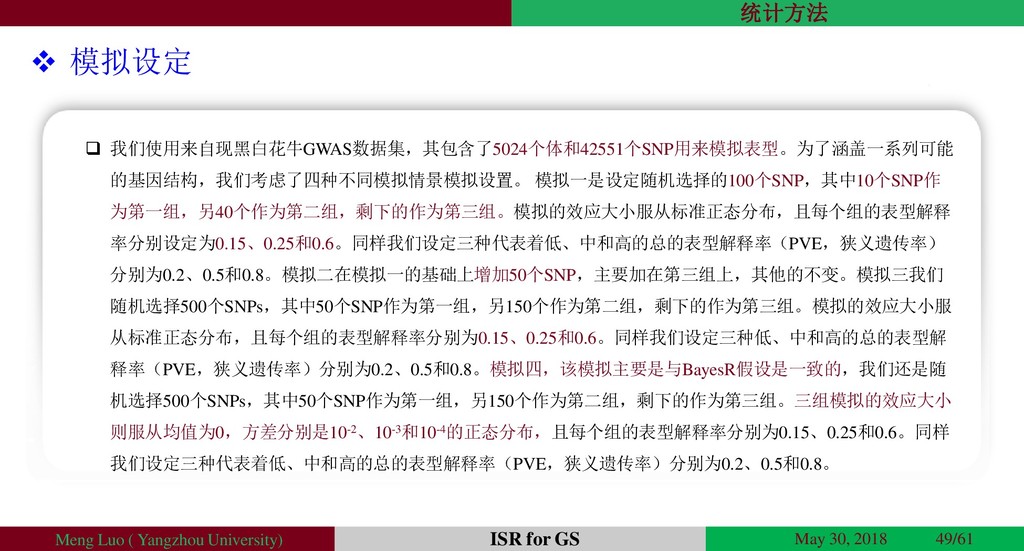
49/61 ISR for GS 我们使用来自现黑白花牛GWAS数据集,其包含了5024个体和42551个SNP用来模拟表型。为了涵盖一系列可能 的基因结构,我们考虑了四种不同模拟情景模拟设置。 模拟一是设定随机选择的100个SNP,其中10个SNP作 为第一组,另40个作为第二组,剩下的作为第三组。模拟的效应大小服从标准正态分布,且每个组的表型解释 率分别设定为0.15、0.25和0.6。同样我们设定三种代表着低、中和高的总的表型解释率(PVE,狭义遗传率) 分别为0.2、0.5和0.8。模拟二在模拟一的基础上增加50个SNP,主要加在第三组上,其他的不变。模拟三我们 随机选择500个SNPs,其中50个SNP作为第一组,另150个作为第二组,剩下的作为第三组。模拟的效应大小服 从标准正态分布,且每个组的表型解释率分别为0.15、0.25和0.6。同样我们设定三种低、中和高的总的表型解 释率(PVE,狭义遗传率)分别为0.2、0.5和0.8。模拟四,该模拟主要是与BayesR假设是一致的,我们还是随 机选择500个SNPs,其中50个SNP作为第一组,另150个作为第二组,剩下的作为第三组。三组模拟的效应大小 则服从均值为0,方差分别是10-2、10-3和10-4的正态分布,且每个组的表型解释率分别为0.15、0.25和0.6。同样 我们设定三种代表着低、中和高的总的表型解释率(PVE,狭义遗传率)分别为0.2、0.5和0.8。 统计方法 -
评估方法 Meng Luo ( Yangzhou University) May 30, 2018
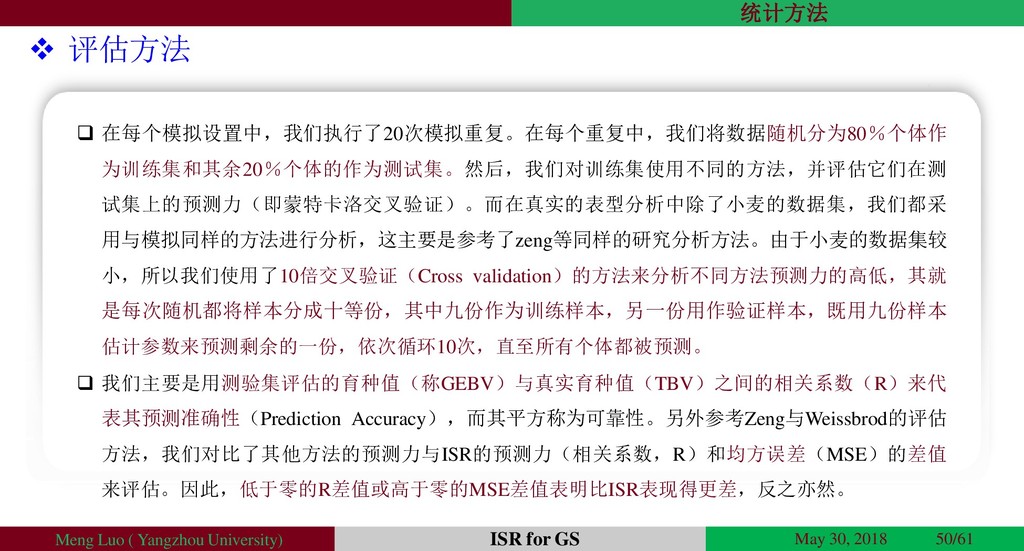
50/61 ISR for GS 我们主要是用测验集评估的育种值(称GEBV)与真实育种值(TBV)之间的相关系数(R)来代 表其预测准确性(Prediction Accuracy),而其平方称为可靠性。另外参考Zeng与Weissbrod的评估 方法,我们对比了其他方法的预测力与ISR的预测力(相关系数,R)和均方误差(MSE)的差值 来评估。因此,低于零的R差值或高于零的MSE差值表明比ISR表现得更差,反之亦然。 在每个模拟设置中,我们执行了20次模拟重复。在每个重复中,我们将数据随机分为80%个体作 为训练集和其余20%个体的作为测试集。然后,我们对训练集使用不同的方法,并评估它们在测 试集上的预测力(即蒙特卡洛交叉验证)。而在真实的表型分析中除了小麦的数据集,我们都采 用与模拟同样的方法进行分析,这主要是参考了zeng等同样的研究分析方法。由于小麦的数据集较 小,所以我们使用了10倍交叉验证(Cross validation)的方法来分析不同方法预测力的高低,其就 是每次随机都将样本分成十等份,其中九份作为训练样本,另一份用作验证样本,既用九份样本 估计参数来预测剩余的一份,依次循环10次,直至所有个体都被预测。 统计方法 -
结果与分析 ISR模拟中的表现 Meng Luo ( Yangzhou University) May 30,
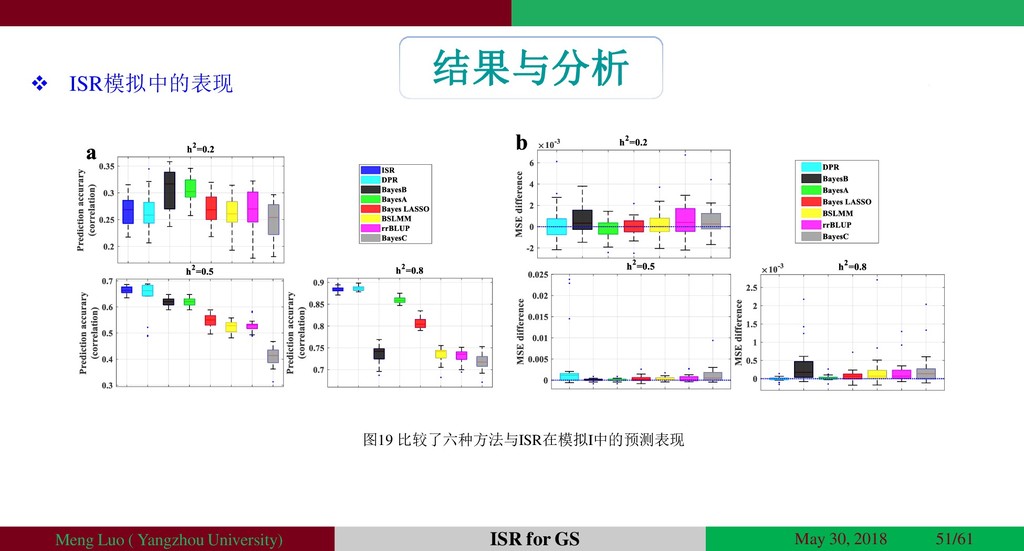
2018 51/61 ISR for GS 图19 比较了六种方法与ISR在模拟I中的预测表现 -
Meng Luo ( Yangzhou University) May 30, 2018 52/61 ISR
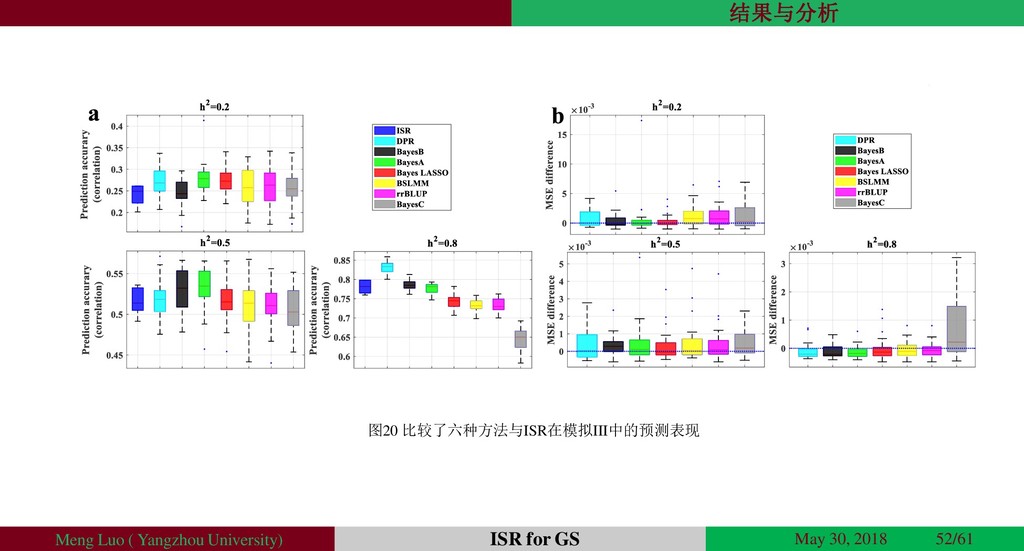
for GS 图20 比较了六种方法与ISR在模拟III中的预测表现 结果与分析 -
Meng Luo ( Yangzhou University) May 30, 2018 53/61 ISR
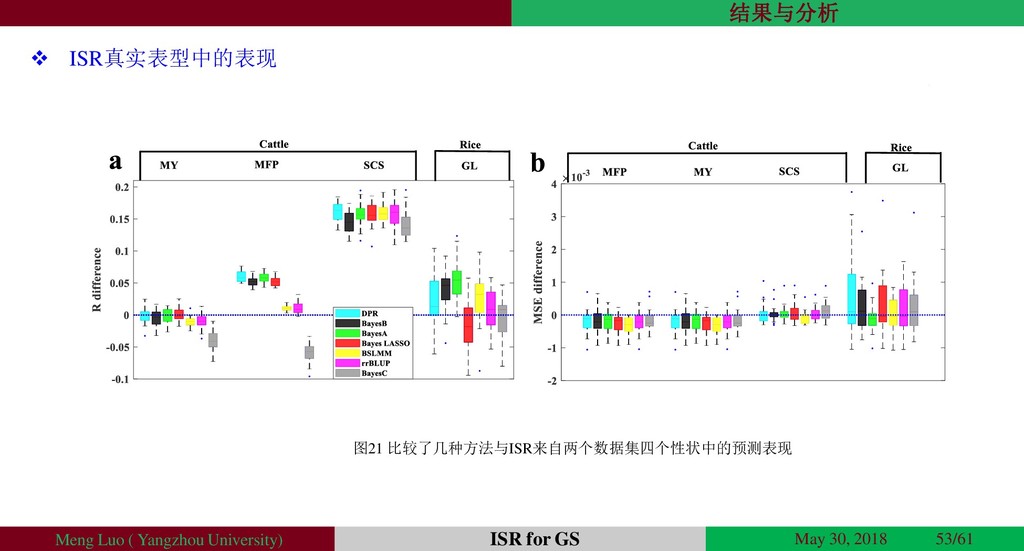
for GS 图21 比较了几种方法与ISR来自两个数据集四个性状中的预测表现 ISR真实表型中的表现 结果与分析 -
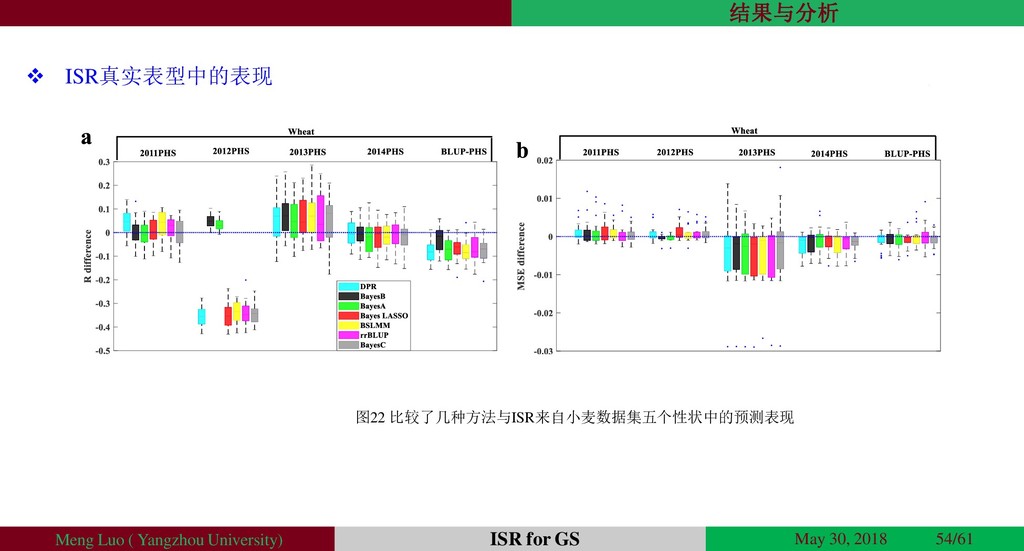
ISR真实表型中的表现 Meng Luo ( Yangzhou University) May 30, 2018
54/61 ISR for GS 图22 比较了几种方法与ISR来自小麦数据集五个性状中的预测表现 结果与分析 -
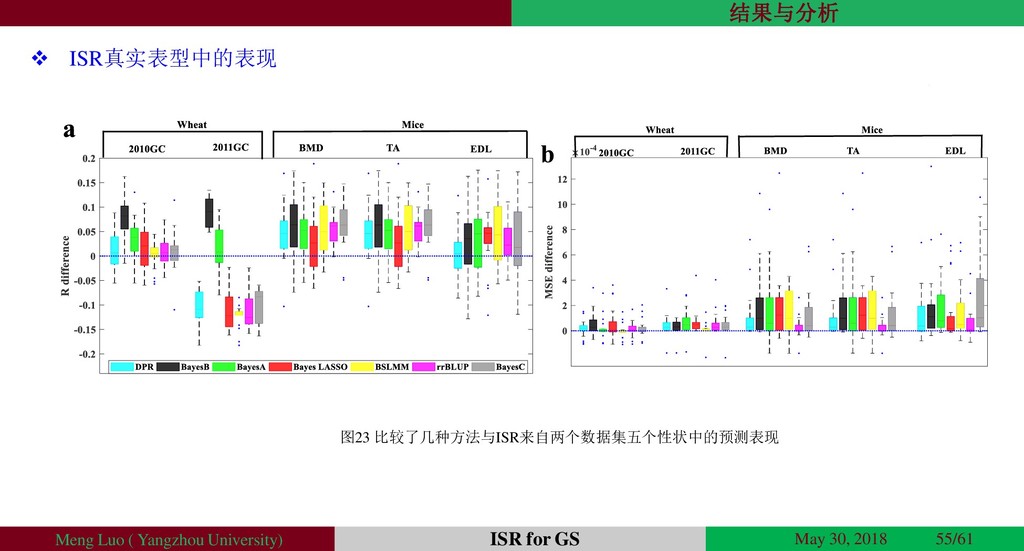
ISR真实表型中的表现 Meng Luo ( Yangzhou University) May 30, 2018
55/61 ISR for GS 图23 比较了几种方法与ISR来自两个数据集五个性状中的预测表现 结果与分析 -
小结与讨论 Meng Luo ( Yangzhou University) May 30, 2018 56/61
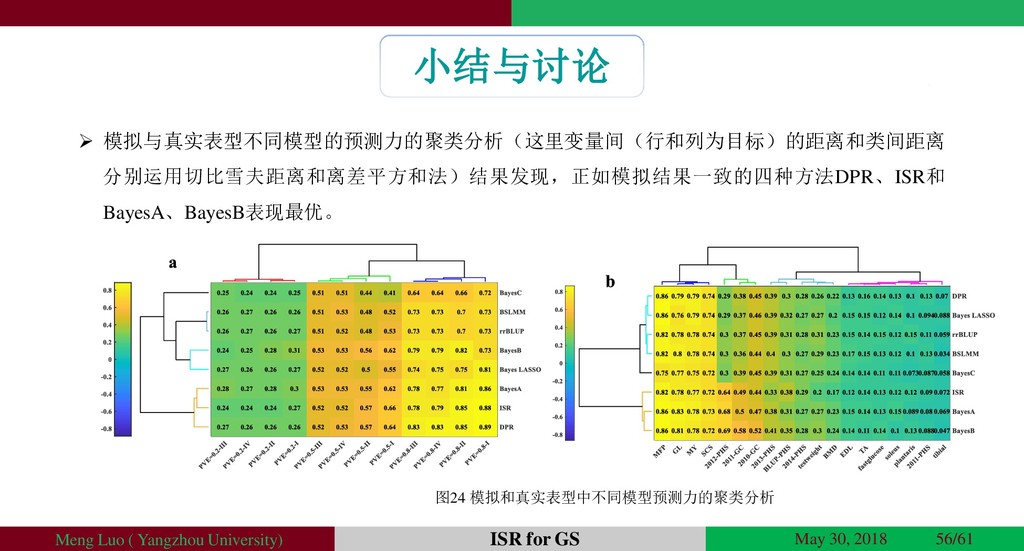
ISR for GS 图24 模拟和真实表型中不同模型预测力的聚类分析 模拟与真实表型不同模型的预测力的聚类分析(这里变量间(行和列为目标)的距离和类间距离 分别运用切比雪夫距离和离差平方和法)结果发现,正如模拟结果一致的四种方法DPR、ISR和 BayesA、BayesB表现最优。 -
March 18, 2017 Meng Luo ( Yangzhou University) May 30,
2018 57/61 ISR for GS TOPSIS综合评价:方法(综合得分(排名)):BayesB(0.60(1))、BayesA(0.59 (2))、ISR(0.57(3))、DPR(0.50(4))、BayesLASSO(0.48(5))、rrBLUP (0.47(6))、BSLMM(0.38(7))和BayesC(0.26(8))。 如果该性状是由很多基因及微效基因(所有的SNPs遗传标记都有较小的效应)控制的,则 会出现预测力较低的情况,比如花牛的三个性状的预测力就是相对其他的方法较低,与模 拟500SNPs时的结果是一样的(低中遗传率下)。但是如果结合基因间的互作考虑的话, 其预测力将会有所提高。 虽然,正如模拟与真实表型结果给出的ISR优于其他的模型,但该模型任有很多的改进空 间,比如算法的改进结合模型目标函数的优化都能够使得ISR表现更佳。而对于计算时间 的复杂程度也是有待优化的。 小结与讨论 -
March 18, 2017 Meng Luo ( Yangzhou University) May 30,
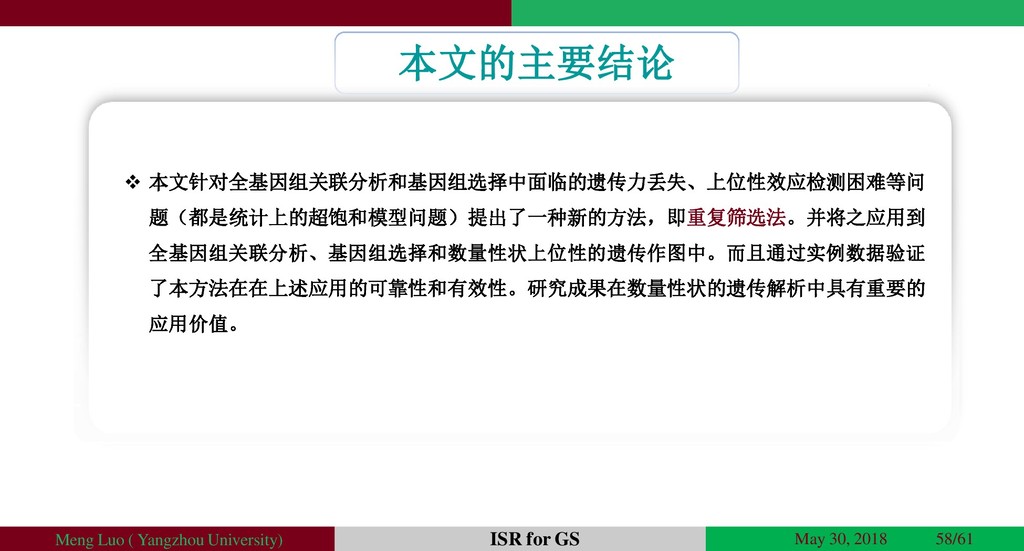
2018 58/61 ISR for GS 本文针对全基因组关联分析和基因组选择中面临的遗传力丢失、上位性效应检测困难等问 题(都是统计上的超饱和模型问题)提出了一种新的方法,即重复筛选法。并将之应用到 全基因组关联分析、基因组选择和数量性状上位性的遗传作图中。而且通过实例数据验证 了本方法在在上述应用的可靠性和有效性。研究成果在数量性状的遗传解析中具有重要的 应用价值。 本文的主要结论 -
感谢导师顾世梁教授在科研和生活上的悉心指导及帮助! 感谢李韬教授和李磊老师的帮助与关怀! 感谢我的家人和朋友! 感谢答辩委员会的各位专家! 感谢小麦育种组和数量遗传与分子进化课题组的各位同学! 感谢百忙之中参加毕业答辩的各位老师和同学! 致 谢 Meng Luo
( Yangzhou University) May 30, 2018 59/61 ISR for GWAS&E-GWAS&GS -
Meng Luo ( Yangzhou University) May 30, 2018 60/61 ISR
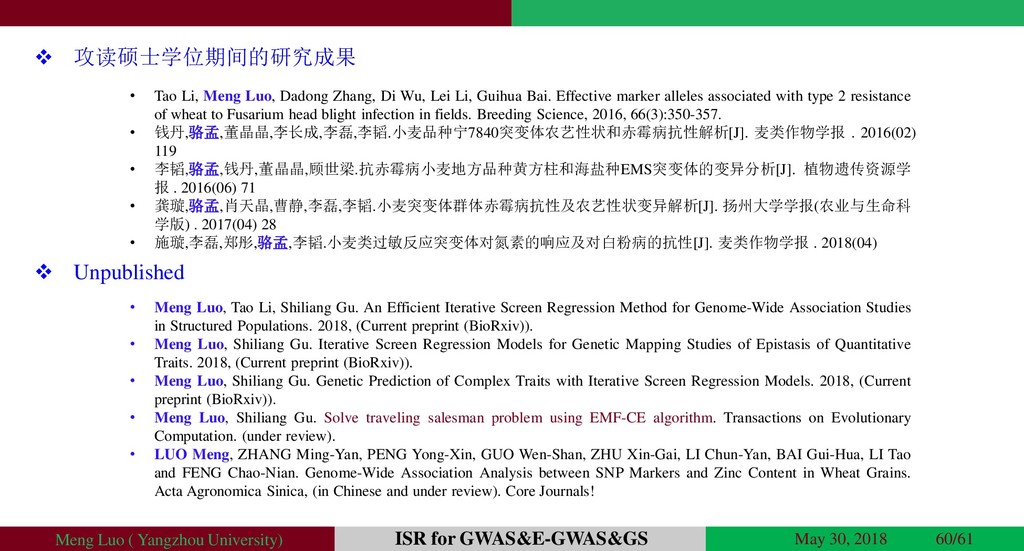
for GWAS&E-GWAS&GS 攻读硕士学位期间的研究成果 • Tao Li, Meng Luo, Dadong Zhang, Di Wu, Lei Li, Guihua Bai. Effective marker alleles associated with type 2 resistance of wheat to Fusarium head blight infection in fields. Breeding Science, 2016, 66(3):350-357. • 钱丹,骆孟,董晶晶,李长成,李磊,李韬.小麦品种宁7840突变体农艺性状和赤霉病抗性解析[J]. 麦类作物学报 . 2016(02) 119 • 李韬,骆孟,钱丹,董晶晶,顾世梁.抗赤霉病小麦地方品种黄方柱和海盐种EMS突变体的变异分析[J]. 植物遗传资源学 报 . 2016(06) 71 • 龚璇,骆孟,肖天晶,曹静,李磊,李韬.小麦突变体群体赤霉病抗性及农艺性状变异解析[J]. 扬州大学学报(农业与生命科 学版) . 2017(04) 28 • 施璇,李磊,郑彤,骆孟,李韬.小麦类过敏反应突变体对氮素的响应及对白粉病的抗性[J]. 麦类作物学报 . 2018(04) • Meng Luo, Tao Li, Shiliang Gu. An Efficient Iterative Screen Regression Method for Genome-Wide Association Studies in Structured Populations. 2018, (Current preprint (BioRxiv)). • Meng Luo, Shiliang Gu. Iterative Screen Regression Models for Genetic Mapping Studies of Epistasis of Quantitative Traits. 2018, (Current preprint (BioRxiv)). • Meng Luo, Shiliang Gu. Genetic Prediction of Complex Traits with Iterative Screen Regression Models. 2018, (Current preprint (BioRxiv)). • Meng Luo, Shiliang Gu. Solve traveling salesman problem using EMF-CE algorithm. Transactions on Evolutionary Computation. (under review). • LUO Meng, ZHANG Ming-Yan, PENG Yong-Xin, GUO Wen-Shan, ZHU Xin-Gai, LI Chun-Yan, BAI Gui-Hua, LI Tao and FENG Chao-Nian. Genome-Wide Association Analysis between SNP Markers and Zinc Content in Wheat Grains. Acta Agronomica Sinica, (in Chinese and under review). Core Journals! Unpublished -
Meng Luo ( Yangzhou University) May 30, 2018 61/61 ISR
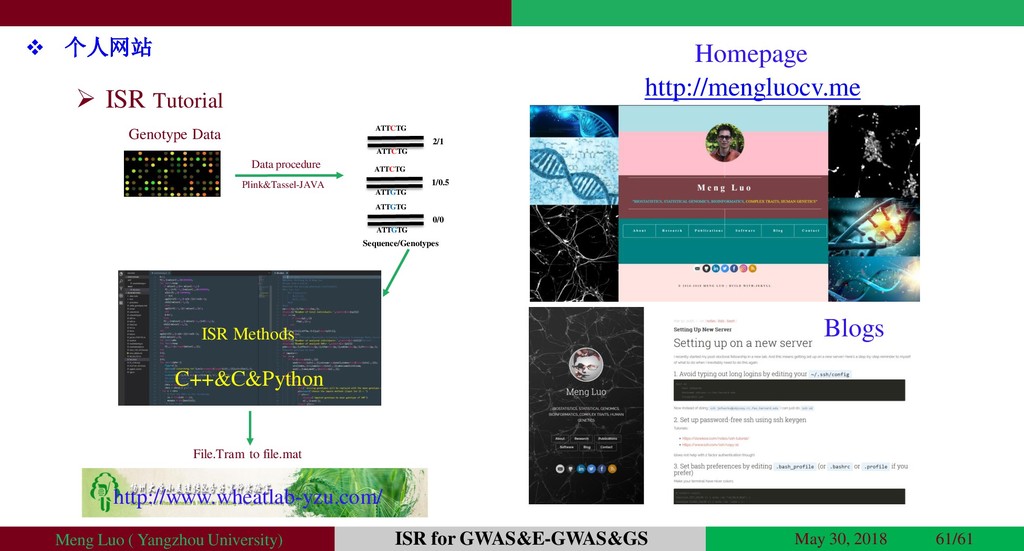
for GWAS&E-GWAS&GS 个人网站 Blogs ISR Tutorial http://mengluocv.me Homepage Genotype Data ATTCTG ATTCTG 2/1 ATTCTG ATTGTG 1/0.5 ATTGTG ATTGTG 0/0 Sequence/Genotypes Data procedure Plink&Tassel-JAVA File.Tram to file.mat ISR Methods http://www.wheatlab-yzu.com/ C++&C&Python -
Meng Luo ( Yangzhou University) May 30, 2018 ISR for
GWAS&E-GWAS&GS
 loyzhe
 ept
 institutdelelevage
 tkng
 sishi
 godel
 rikkabotan7
 kohlerjohannes
 enochan
 mikimhk
 smashingmag
 bkeepers
 tammyeverts
 rocio
 greggifford
 tenderlove
 honnibal
 yeseniaperezcruz
 aleyda
 matthewcrist
 asonas
 katarinadahlin