Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
偏りのある時系列データの分類について
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Masato MIWADA
October 19, 2024
Technology
90
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
偏りのある時系列データの分類について
Time series classification on imbalanced data
Masato MIWADA
October 19, 2024
More Decks by Masato MIWADA
See All by Masato MIWADA
画像による脳腫瘍の検出
masato_miwada
0
100
河川流計測における画像解析技術の実用化
masato_miwada
1
86
河川流計測における画像解析技術の実用化
masato_miwada
0
67
慣性センサログの効果的な可視化と分類手法について
masato_miwada
0
67
t-SNE(t分布型確率的近傍埋め込み法)による高次元データの可視化について
masato_miwada
0
120
畳み込みニューラルネットワークによる画像分類について
masato_miwada
0
89
Other Decks in Technology
See All in Technology
How to Design Configuration for Rails Applications
willnet
1
1.1k
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
1
1k
20年間 SNS サービス「GREE」 を支えた技術の刷新と、長期運用サービスの Kubernetes へのリアーキテクト
gree_tech
PRO
0
110
10年後、Engineering 行為を剥奪されるとして、わたしたちは、どう、何を創ればいいだろうか。 / If Engineering Is Taken Away in 10 Years, How and What Should We Create?
bitkey
PRO
1
220
導入から定着へ ~コーディングエージェントを日常業務に組み込む実践知~
yukisakai1225
0
170
Metadata - Section 2: Simple Metadata & Meta Tags
mohab1
0
100
CTO Night|NotionのAIエージェントとFDE
kzkhykw1991
0
300
Turning Repos into the Product Second Brain with an LLM Wiki
linedevth
0
130
JAWSUG TOHOKU 青森支部 「LoGoチャット」のAWS移行で 乗り越えたこと
taketakekaho
0
360
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
7
5.2k
顧客価値を追いかけたら、プライシングにたどり着いた
sansantech
PRO
2
370
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
220
Featured
See All Featured
Put a Button on it: Removing Barriers to Going Fast.
kastner
60
4.6k
How To Speak Unicorn (iThemes Webinar)
marktimemedia
1
610
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
How to build a perfect <img>
jonoalderson
1
6.1k
Paper Plane (Part 1)
katiecoart
PRO
2
12k
We Have a Design System, Now What?
morganepeng
55
8.4k
コードの90%をAIが書く世界で何が待っているのか / What awaits us in a world where 90% of the code is written by AI
rkaga
63
46k
Primal Persuasion: How to Engage the Brain for Learning That Lasts
tmiket
0
500
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
260
Design and Strategy: How to Deal with People Who Don’t "Get" Design
morganepeng
133
20k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
610
Typedesign – Prime Four
hannesfritz
42
3.2k
Transcript
偏りのある時系列データ の分類について (Time series classification on imbalanced data) (課題名:オゾンレベルの分類) (ミワダ
マサト) 三和田 将人
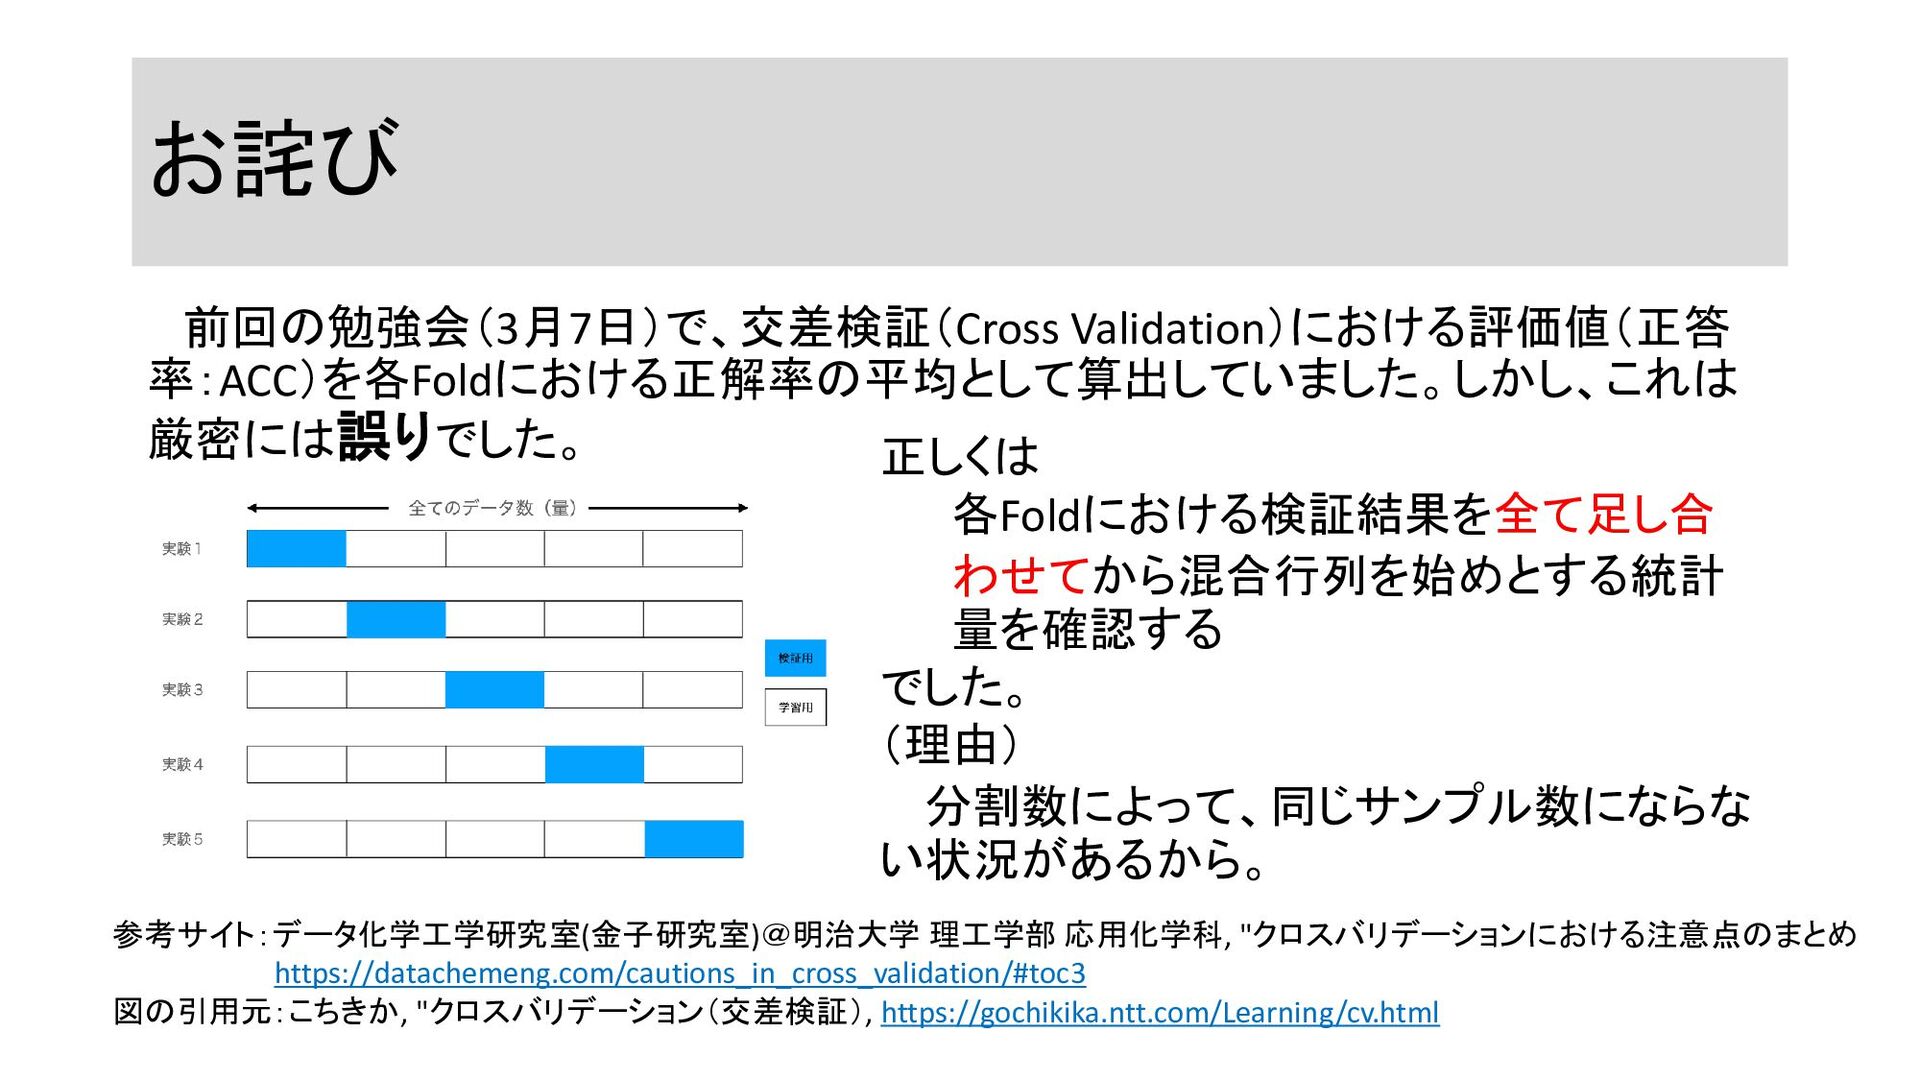
お詫び 前回の勉強会(3月7日)で、交差検証(Cross Validation)における評価値(正答 率:ACC)を各Foldにおける正解率の平均として算出していました。しかし、これは 厳密には誤りでした。 参考サイト:データ化学工学研究室(金子研究室)@明治大学 理工学部 応用化学科, "クロスバリデーションにおける注意点のまとめ https://datachemeng.com/cautions_in_cross_validation/#toc3
図の引用元:こちきか, "クロスバリデーション(交差検証), https://gochikika.ntt.com/Learning/cv.html 正しくは 各Foldにおける検証結果を全て足し合 わせてから混合行列を始めとする統計 量を確認する でした。 (理由) 分割数によって、同じサンプル数にならな い状況があるから。
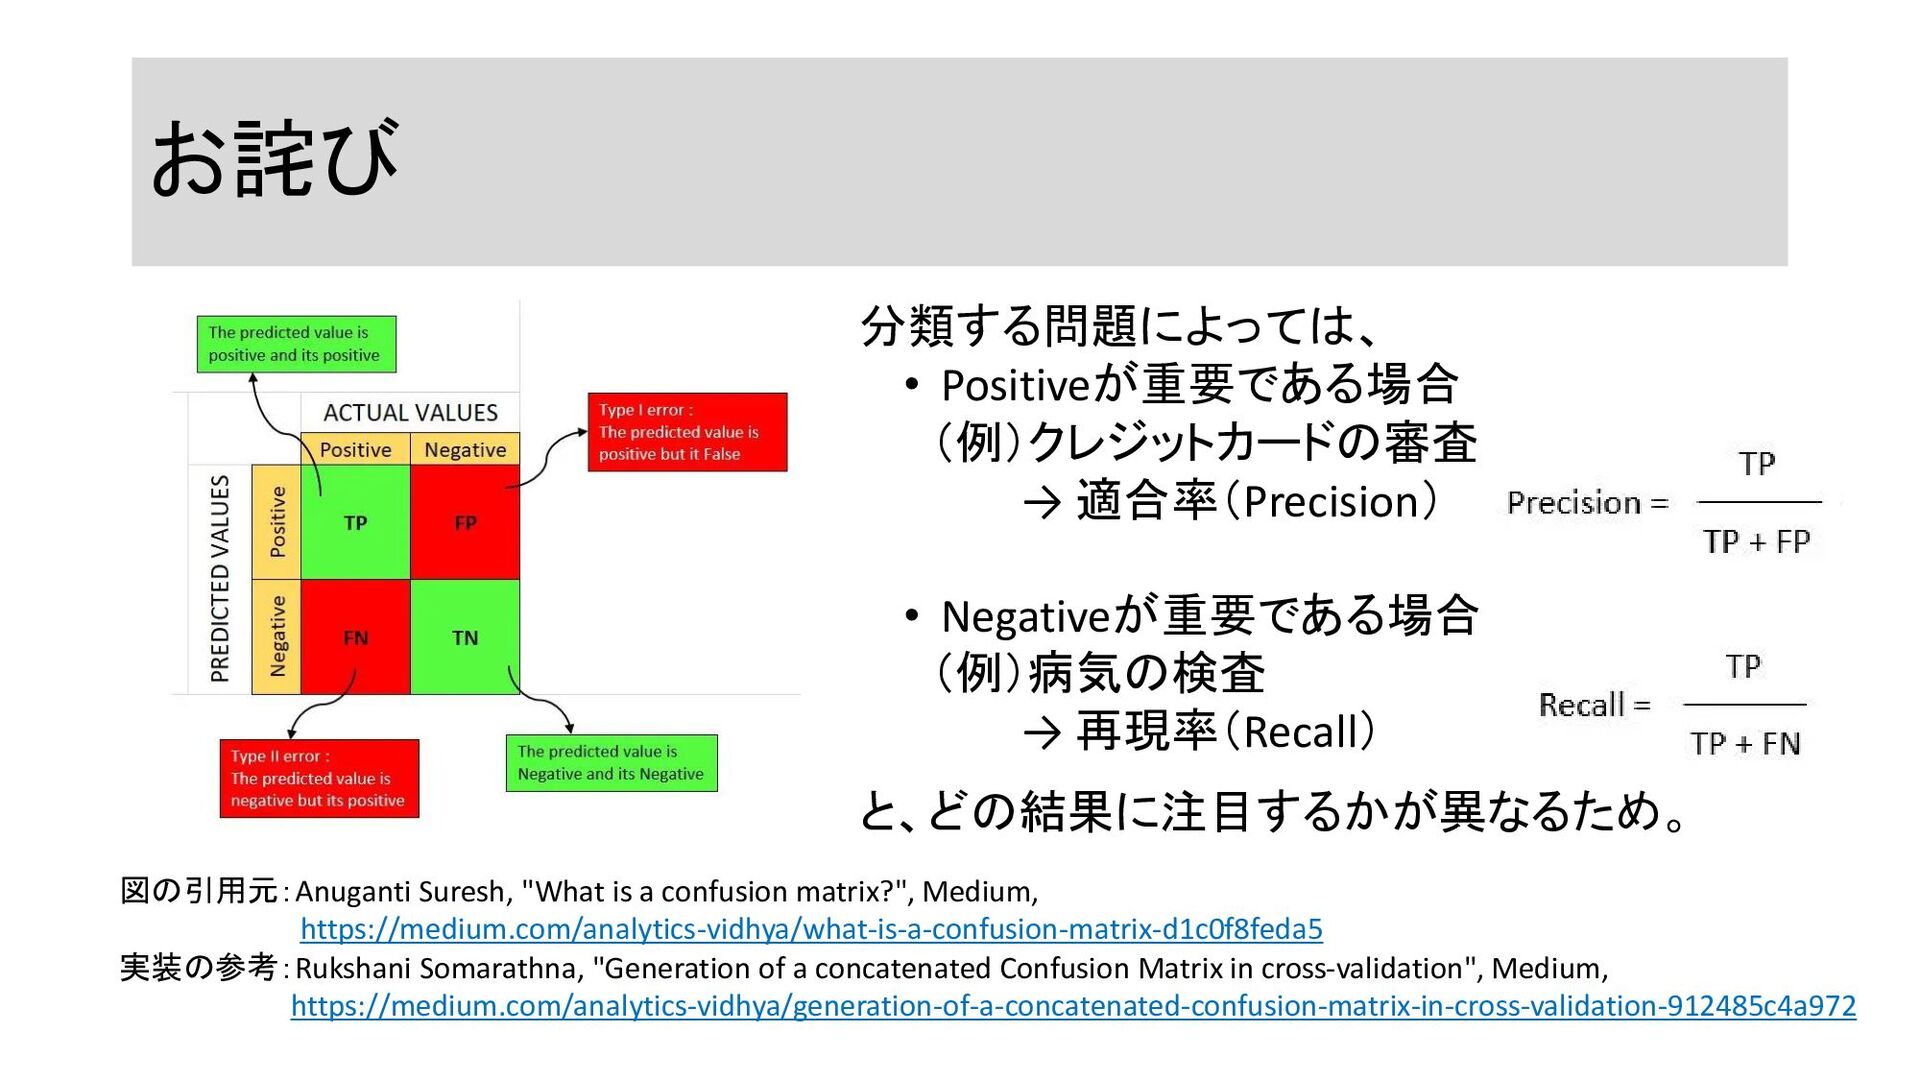
お詫び 図の引用元:Anuganti Suresh, "What is a confusion matrix?", Medium, https://medium.com/analytics-vidhya/what-is-a-confusion-matrix-d1c0f8feda5
実装の参考:Rukshani Somarathna, "Generation of a concatenated Confusion Matrix in cross-validation", Medium, https://medium.com/analytics-vidhya/generation-of-a-concatenated-confusion-matrix-in-cross-validation-912485c4a972 分類する問題によっては、 • Positiveが重要である場合 (例)クレジットカードの審査 → 適合率(Precision) • Negativeが重要である場合 (例)病気の検査 → 再現率(Recall) と、どの結果に注目するかが異なるため。
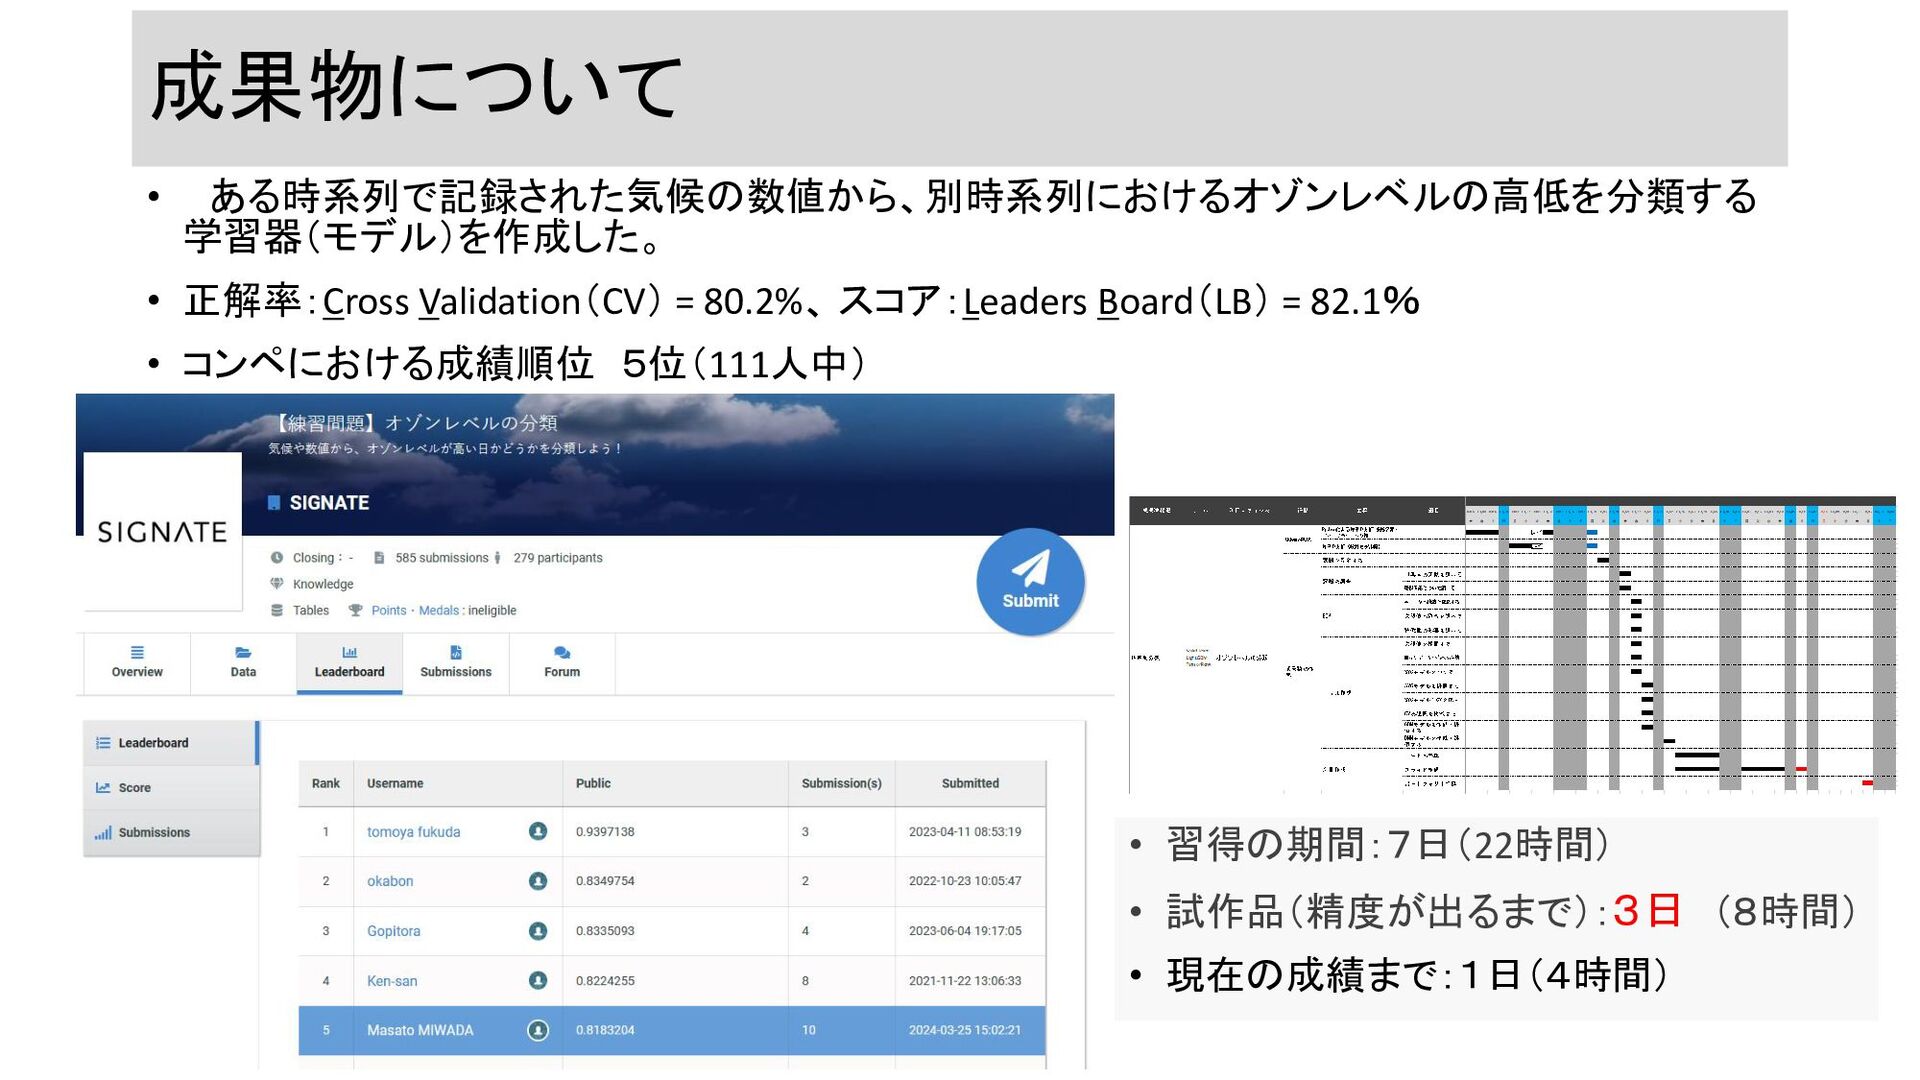
成果物について • ある時系列で記録された気候の数値から、別時系列におけるオゾンレベルの高低を分類する 学習器(モデル)を作成した。 • 正解率:Cross Validation(CV) = 80.2%、 スコア:Leaders
Board(LB) = 82.1% • コンペにおける成績順位 5位(111人中) • 習得の期間:7日(22時間) • 試作品(精度が出るまで):3日 (8時間) • 現在の成績まで:1日(4時間)
発表の流れについて 1. 時系列データについて 2. 今回の時系列データと問題点について 3. 作成スケジュール 4. 開発環境 5.
作製したモデルについて(モデルの種類、評価) 6. 苦労、実践したこと 7. 今回の振返りと今後について
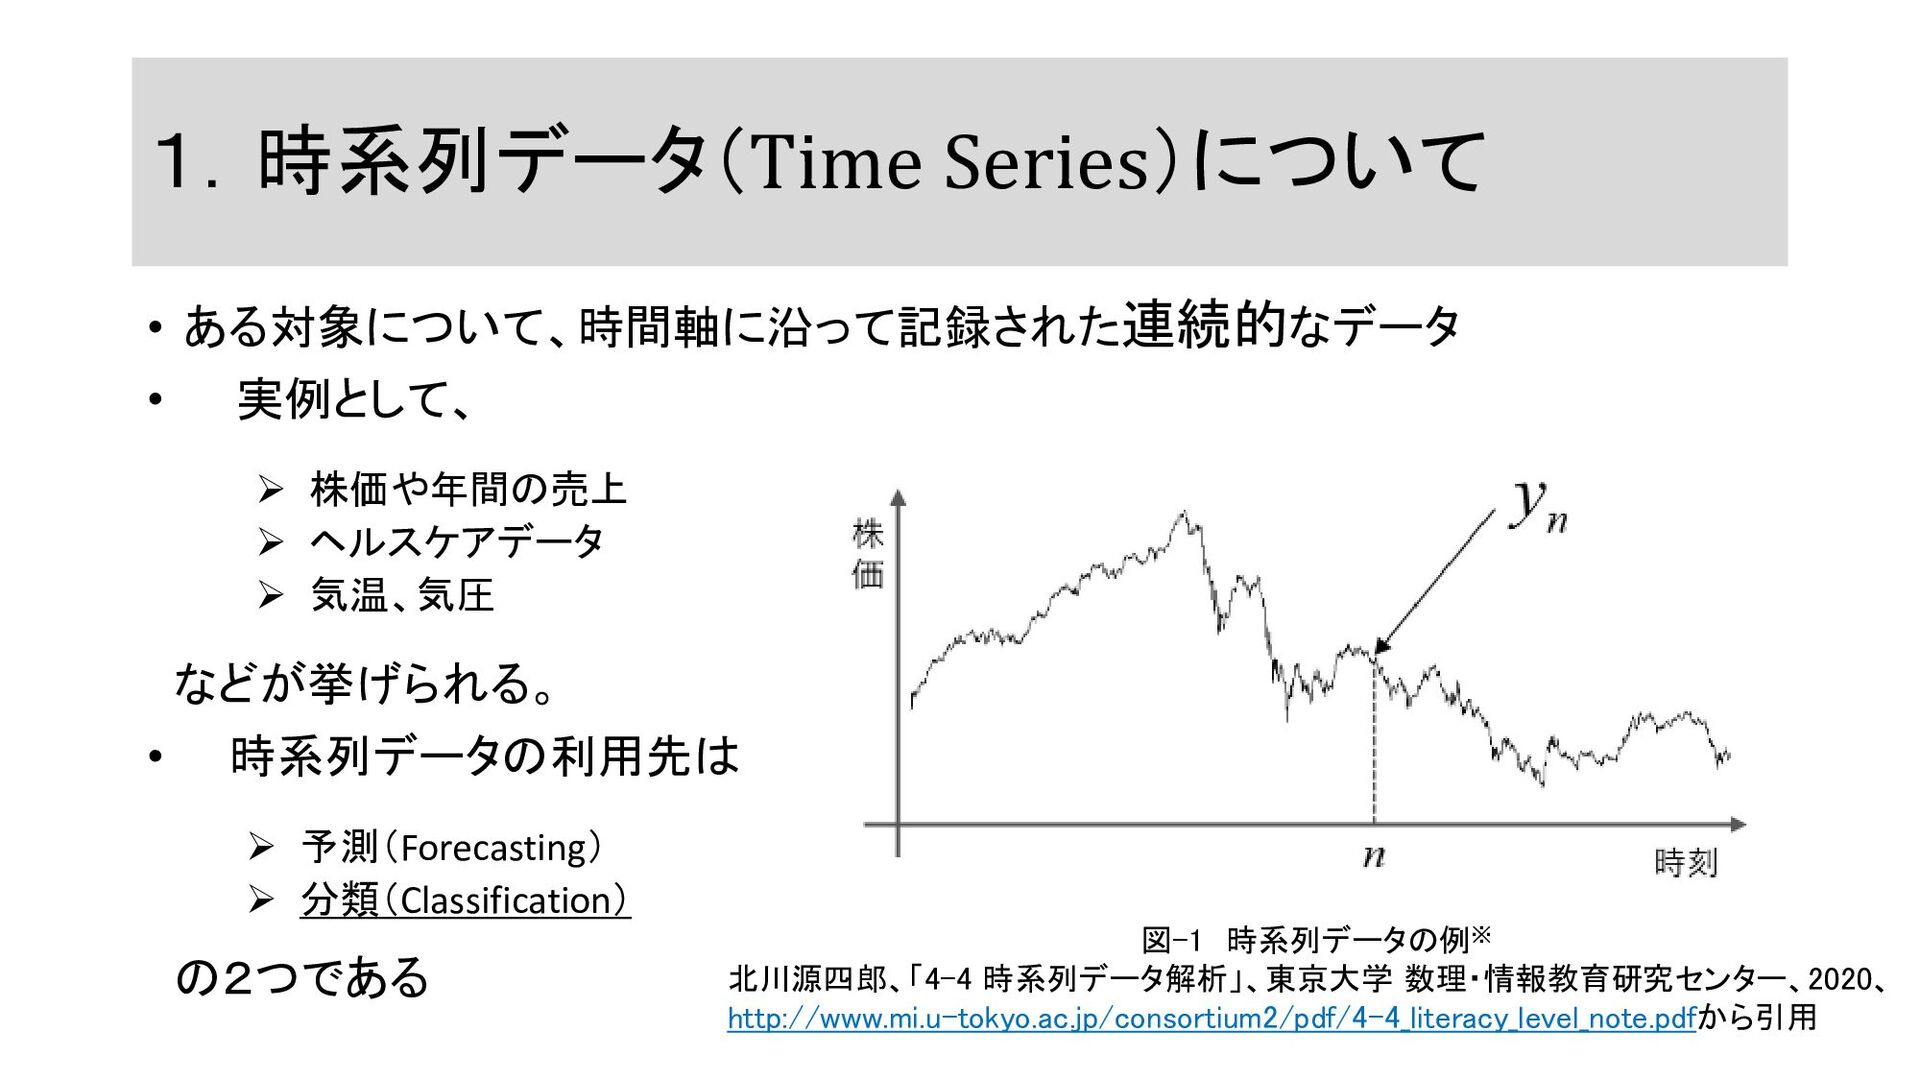
1.時系列データ(Time Series)について • ある対象について、時間軸に沿って記録された連続的なデータ • 実例として、 ➢ 株価や年間の売上 ➢ ヘルスケアデータ
➢ 気温、気圧 などが挙げられる。 • 時系列データの利用先は ➢ 予測(Forecasting) ➢ 分類(Classification) の2つである 図-1 時系列データの例※ 北川源四郎、「4-4 時系列データ解析」、東京大学 数理・情報教育研究センター、2020、 http://www.mi.u-tokyo.ac.jp/consortium2/pdf/4-4_literacy_level_note.pdfから引用
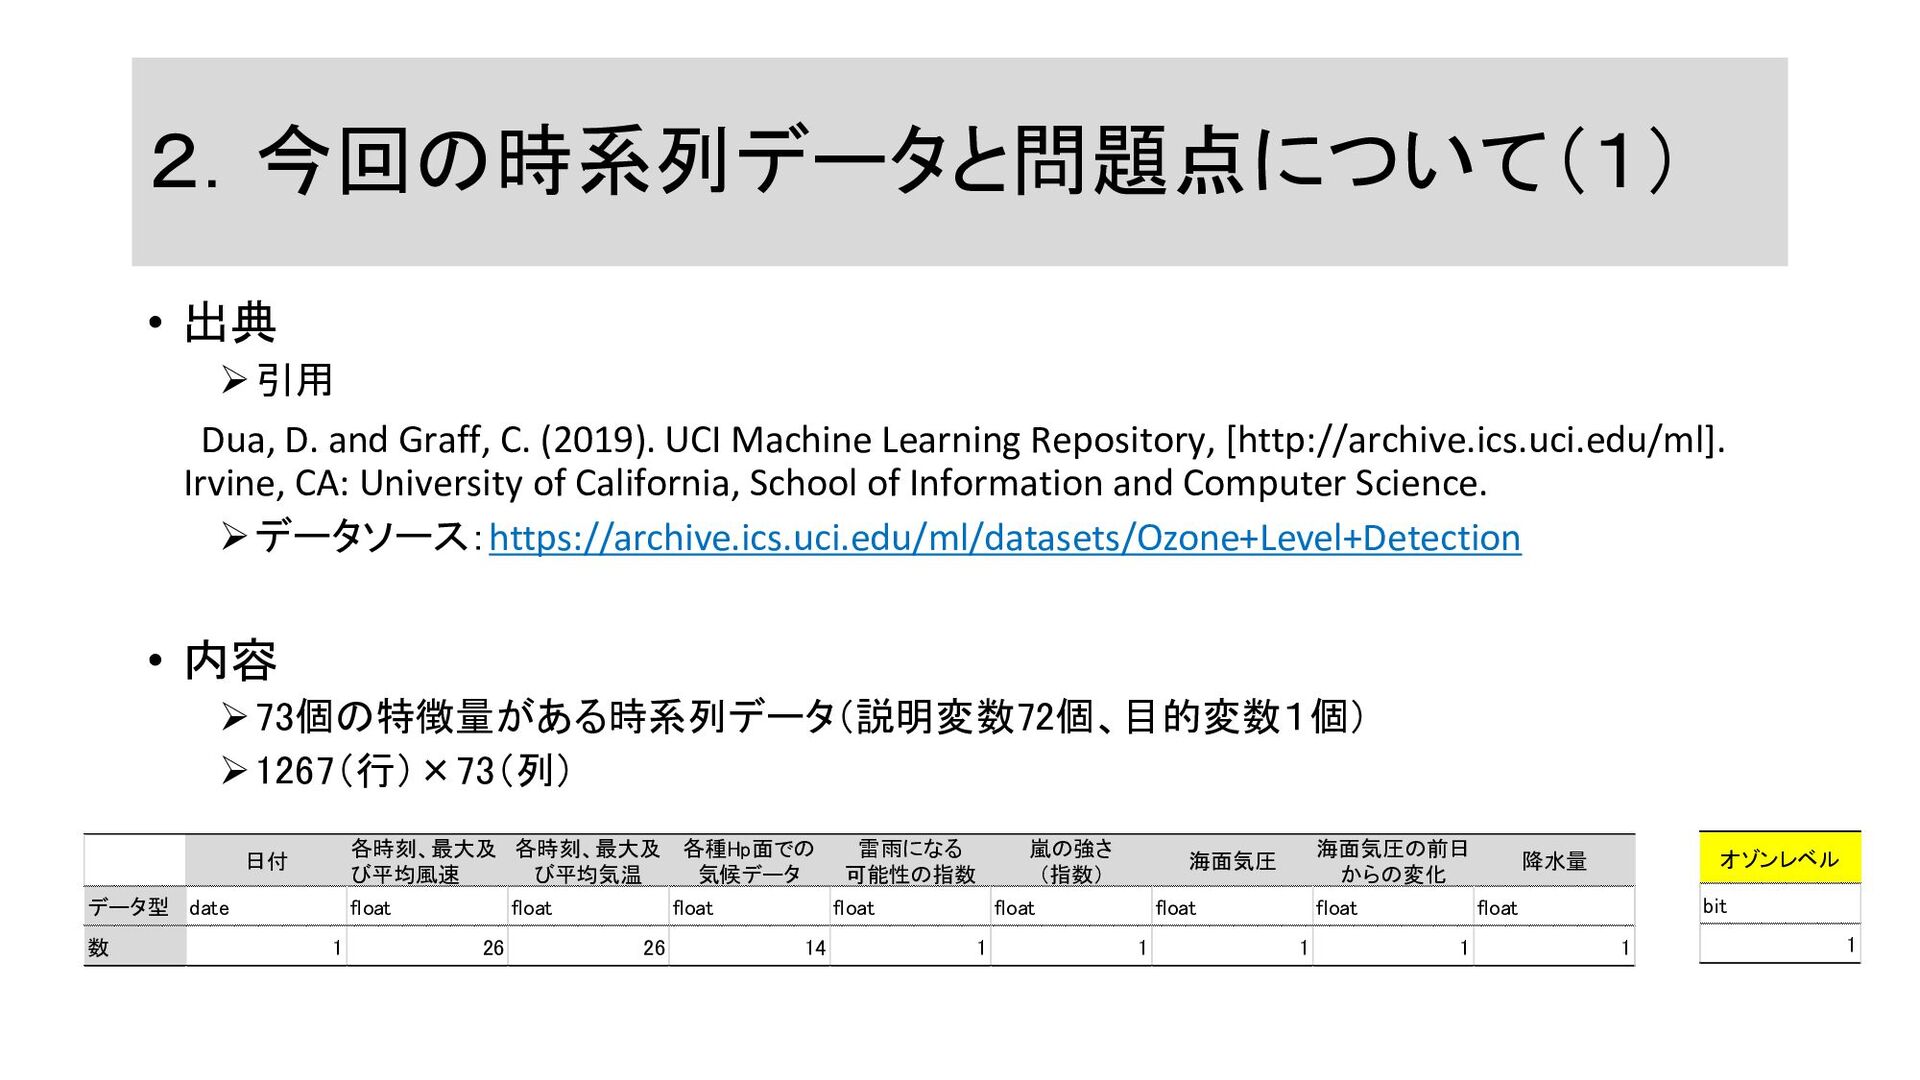
2.今回の時系列データと問題点について(1) • 出典 ➢引用 Dua, D. and Graff, C. (2019).
UCI Machine Learning Repository, [http://archive.ics.uci.edu/ml]. Irvine, CA: University of California, School of Information and Computer Science. ➢データソース:https://archive.ics.uci.edu/ml/datasets/Ozone+Level+Detection • 内容 ➢73個の特徴量がある時系列データ(説明変数72個、目的変数1個) ➢1267(行)×73(列) 日付 各時刻、最大及 び平均風速 各時刻、最大及 び平均気温 各種Hp面での 気候データ 雷雨になる 可能性の指数 嵐の強さ (指数) 海面気圧 海面気圧の前日 からの変化 降水量 データ型 date float float float float float float float float 数 1 26 26 14 1 1 1 1 1 オゾンレベル bit 1
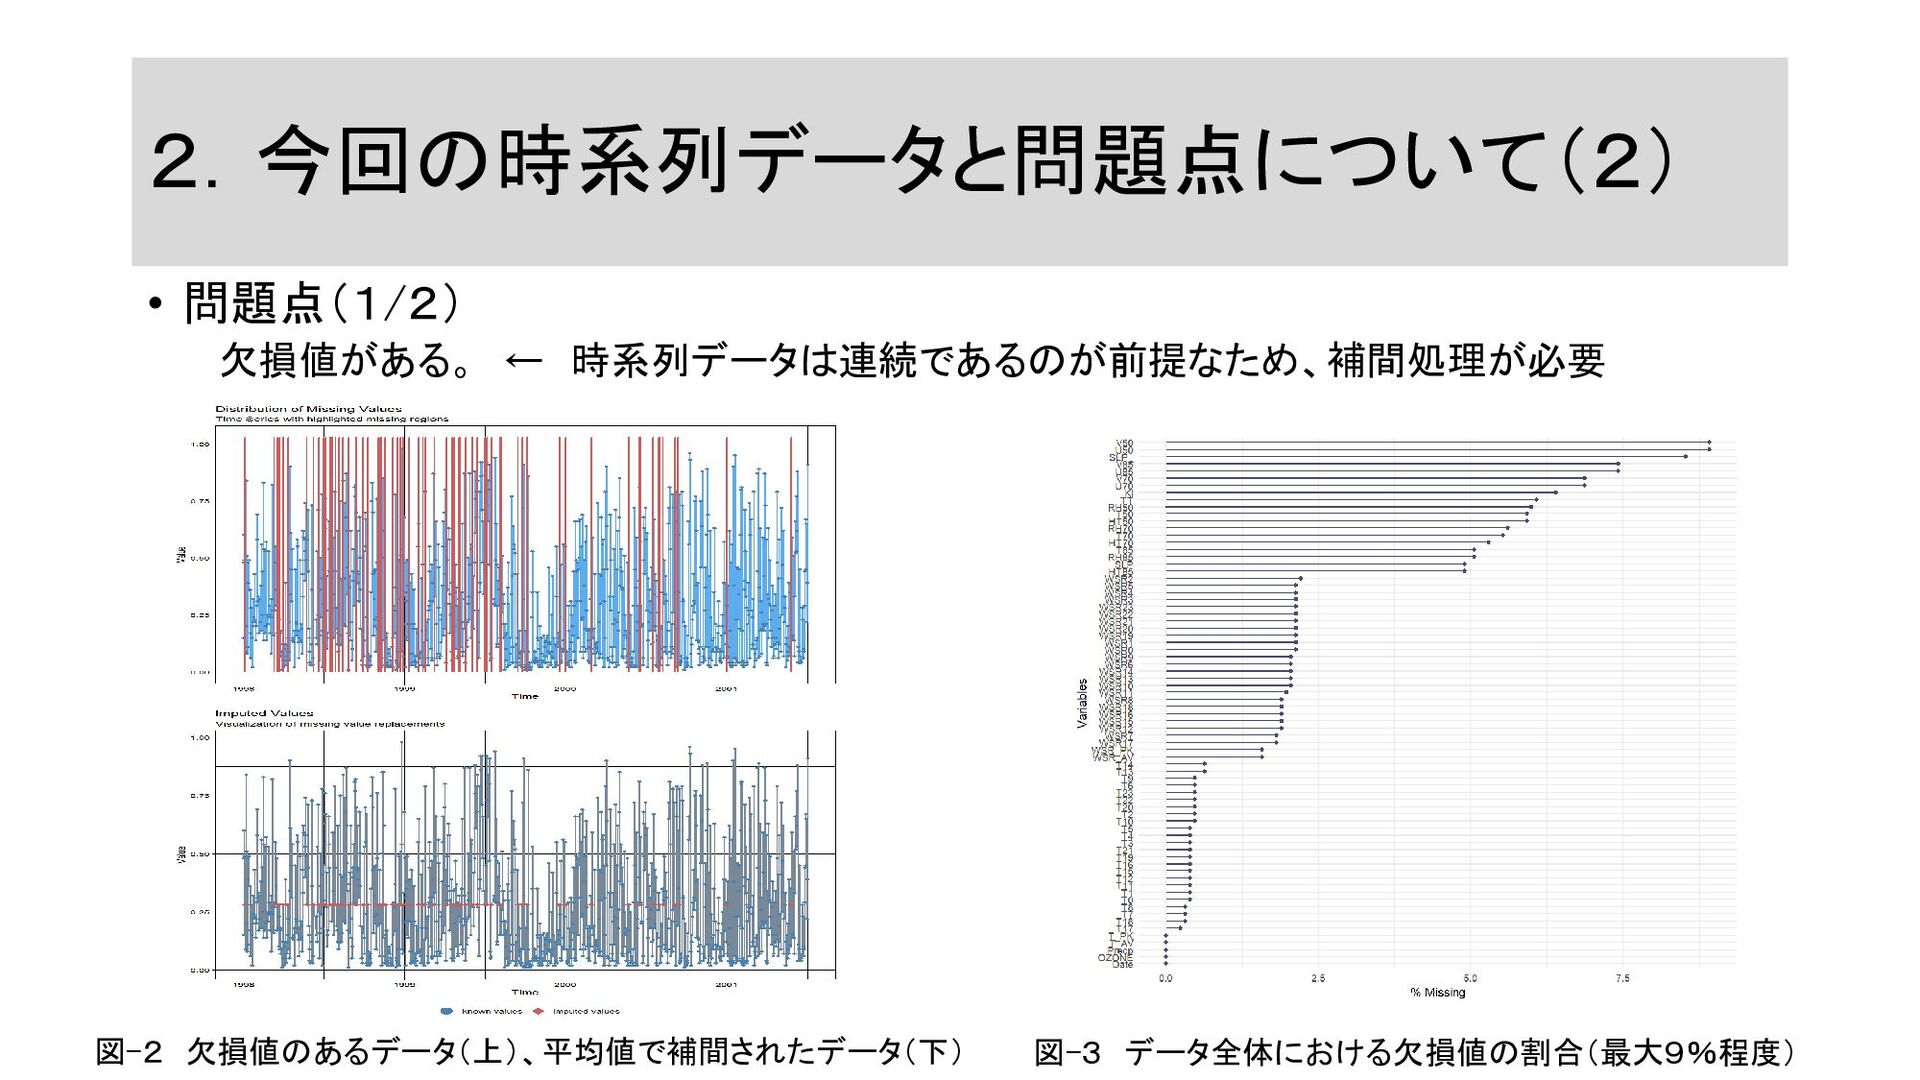
2.今回の時系列データと問題点について(2) • 問題点(1/2) 欠損値がある。 ← 時系列データは連続であるのが前提なため、補間処理が必要 図-2 欠損値のあるデータ(上)、平均値で補間されたデータ(下) 図-3 データ全体における欠損値の割合(最大9%程度)
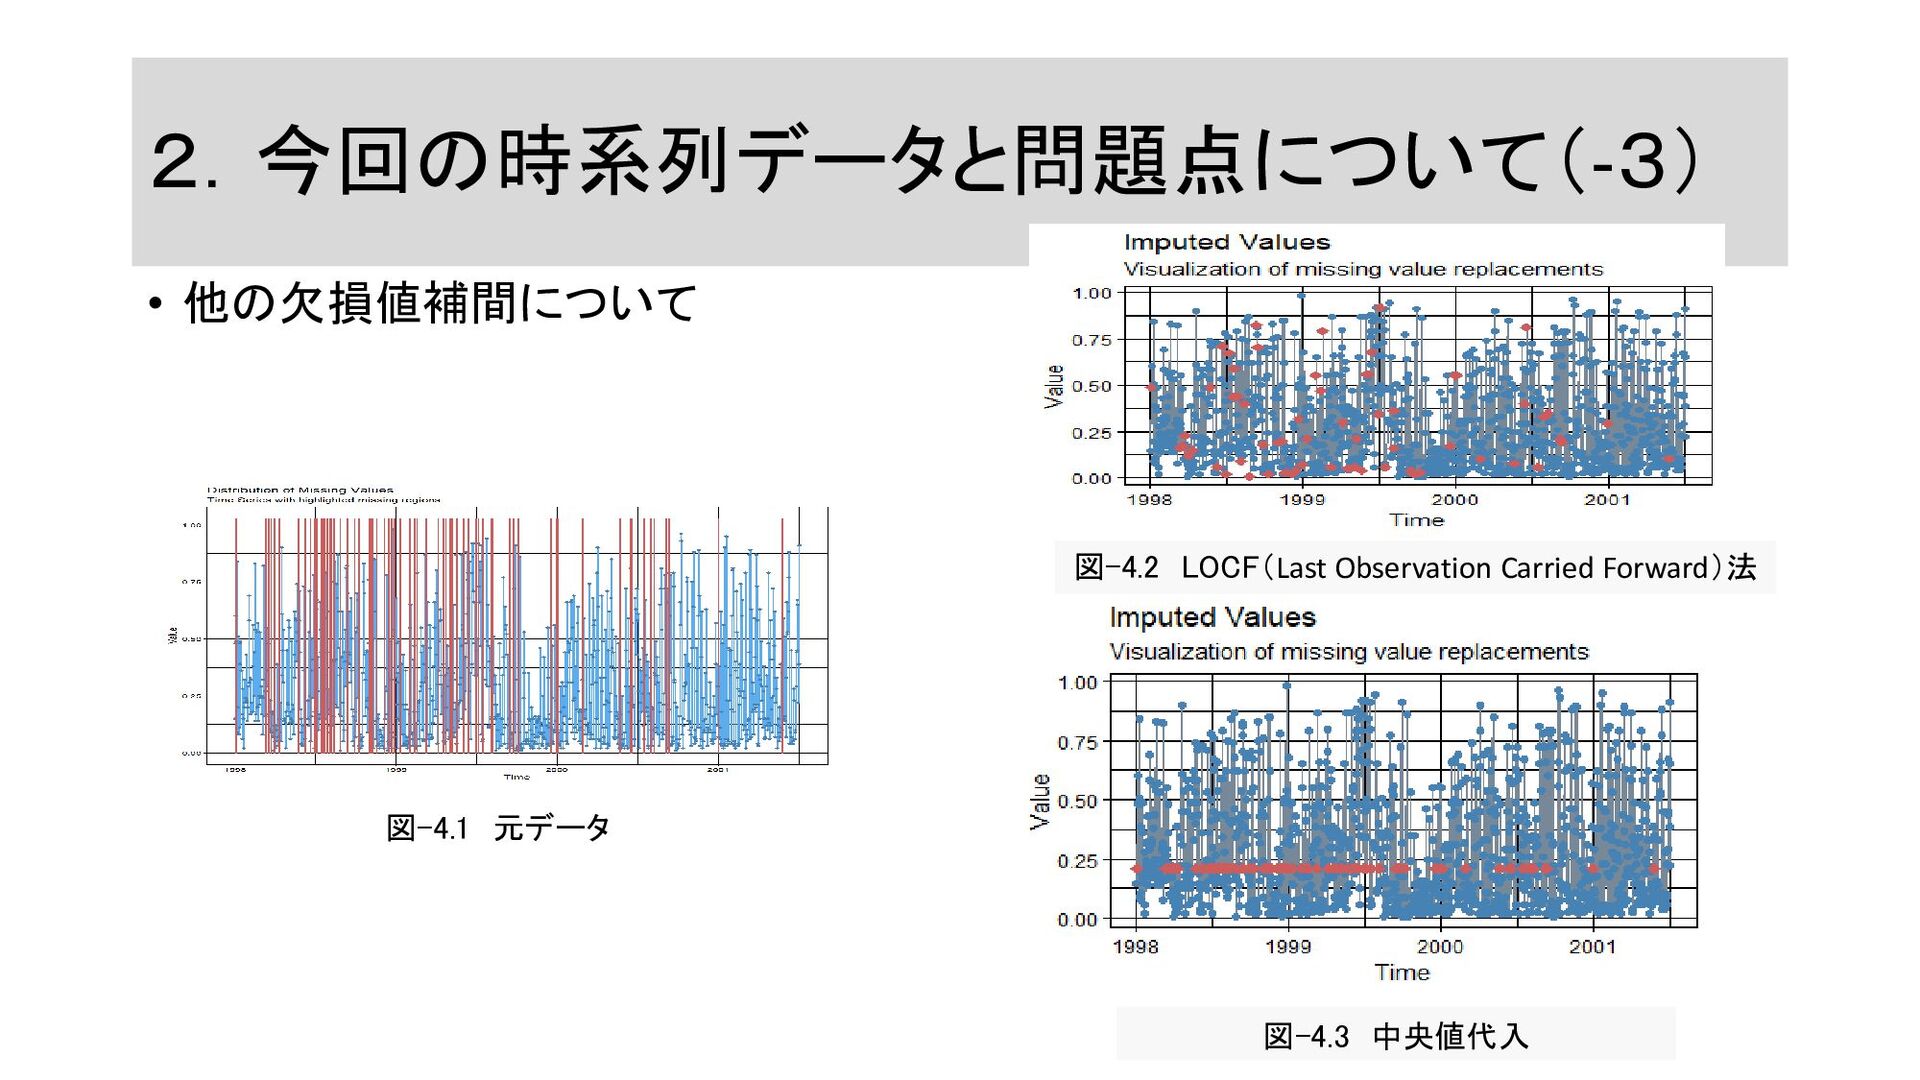
2.今回の時系列データと問題点について(-3) • 他の欠損値補間について 図-4.1 元データ 図-4.2 LOCF(Last Observation Carried Forward)法
図-4.3 中央値代入
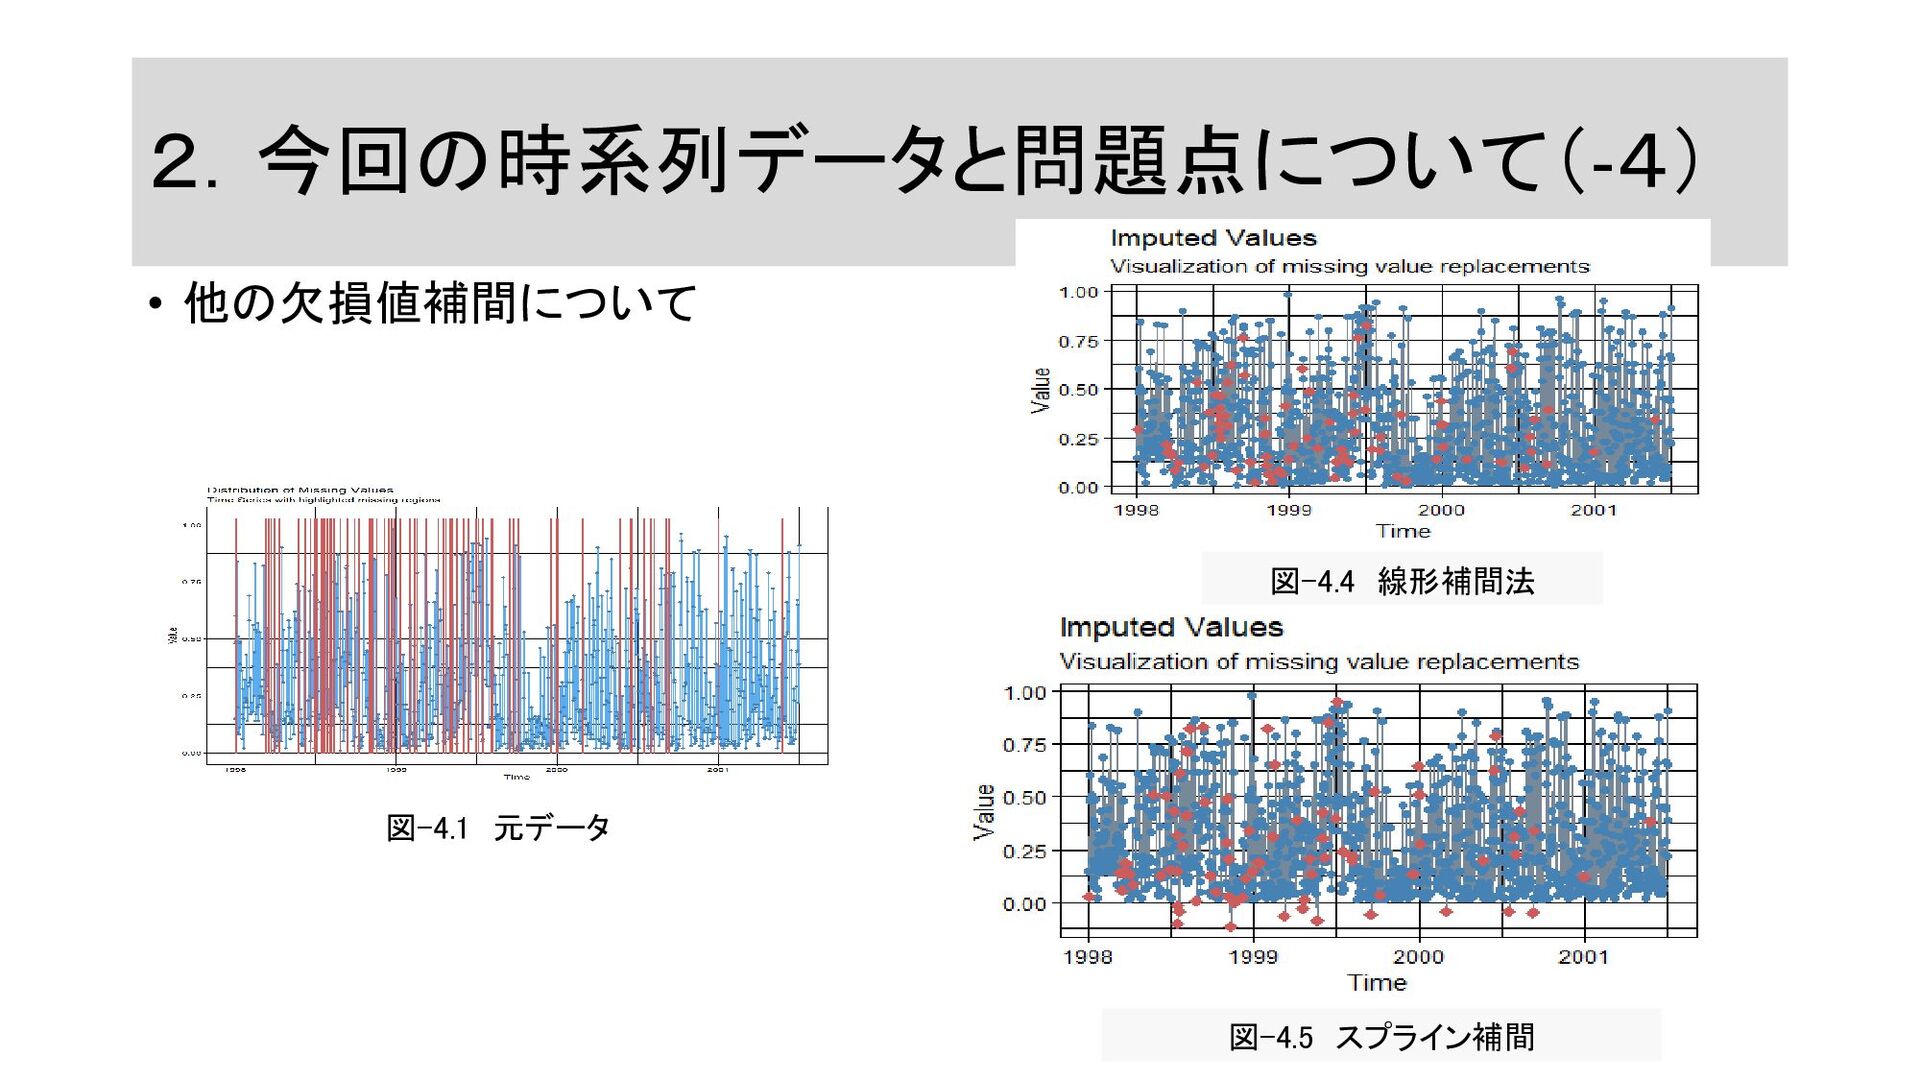
2.今回の時系列データと問題点について(-4) • 他の欠損値補間について 図-4.1 元データ 図-4.5 スプライン補間 図-4.4 線形補間法
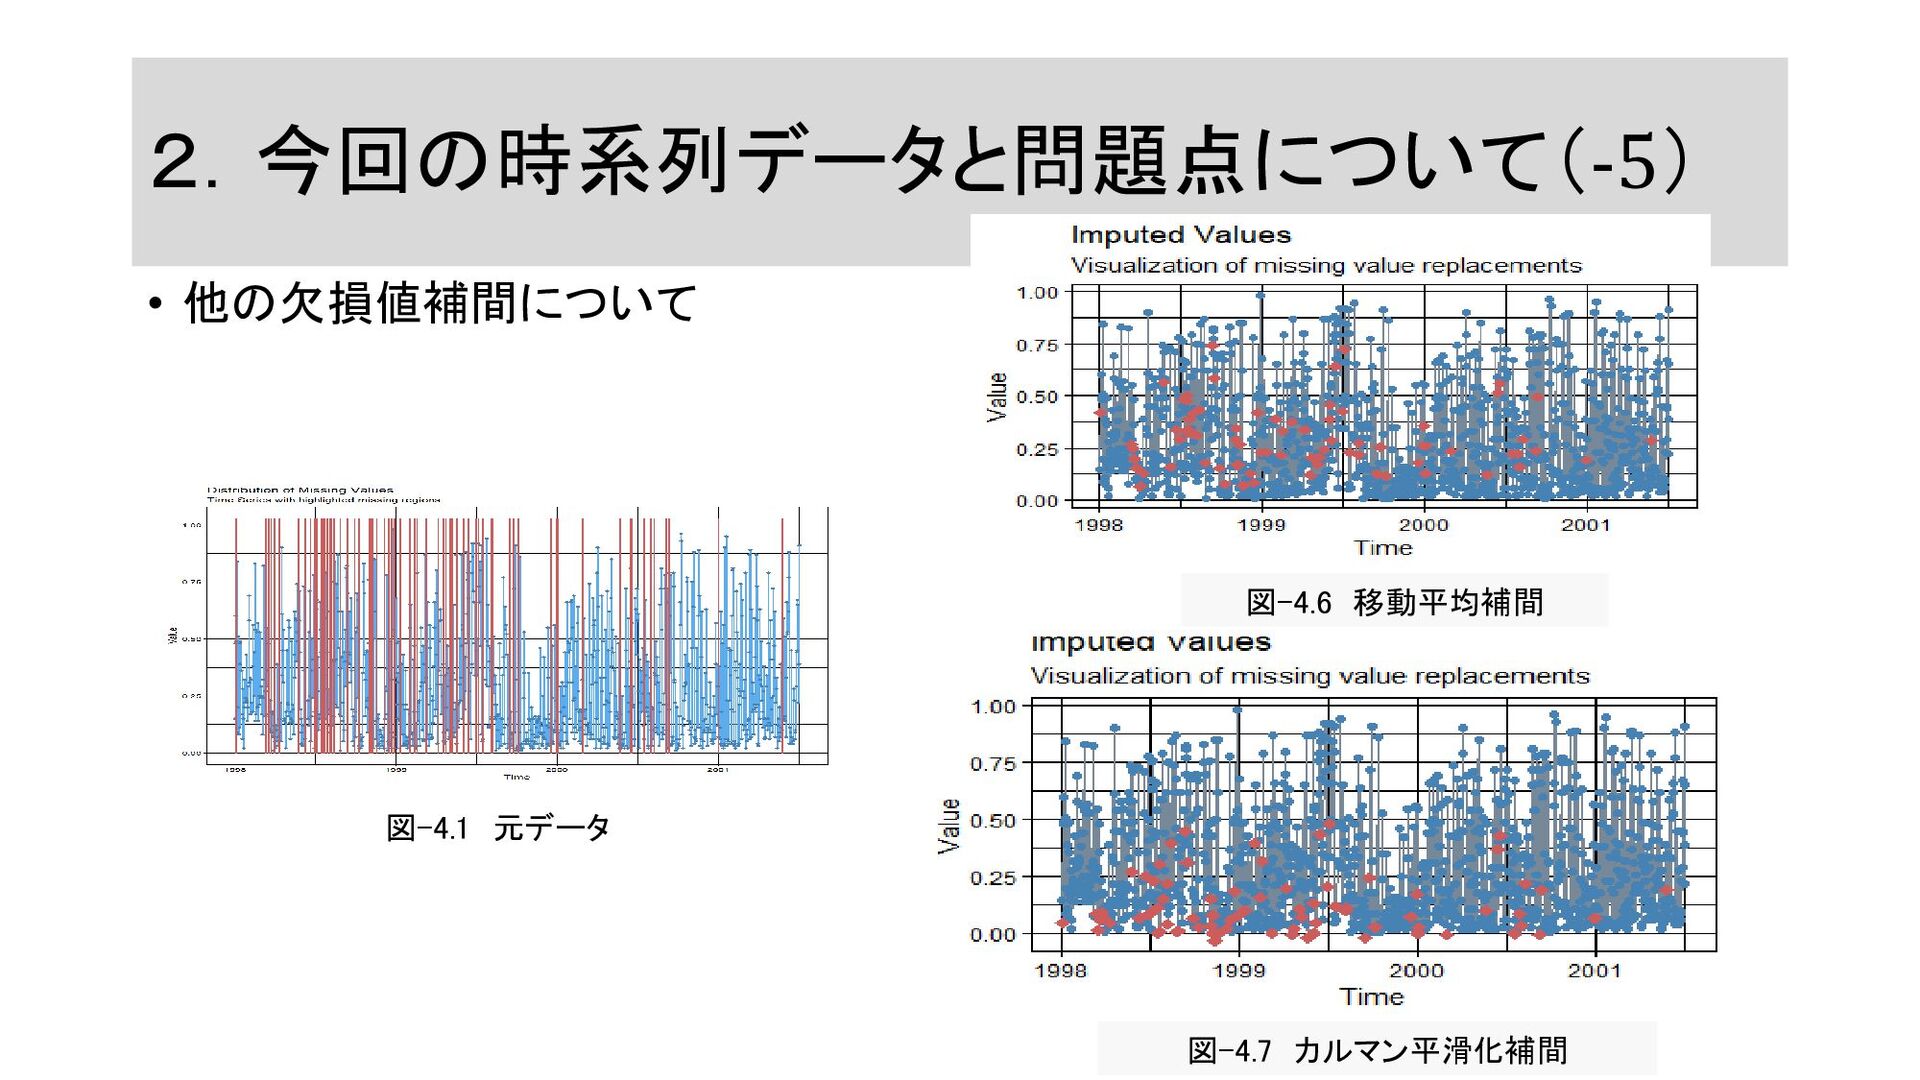
2.今回の時系列データと問題点について(-5) • 他の欠損値補間について 図-4.1 元データ 図-4.7 カルマン平滑化補間 図-4.6 移動平均補間
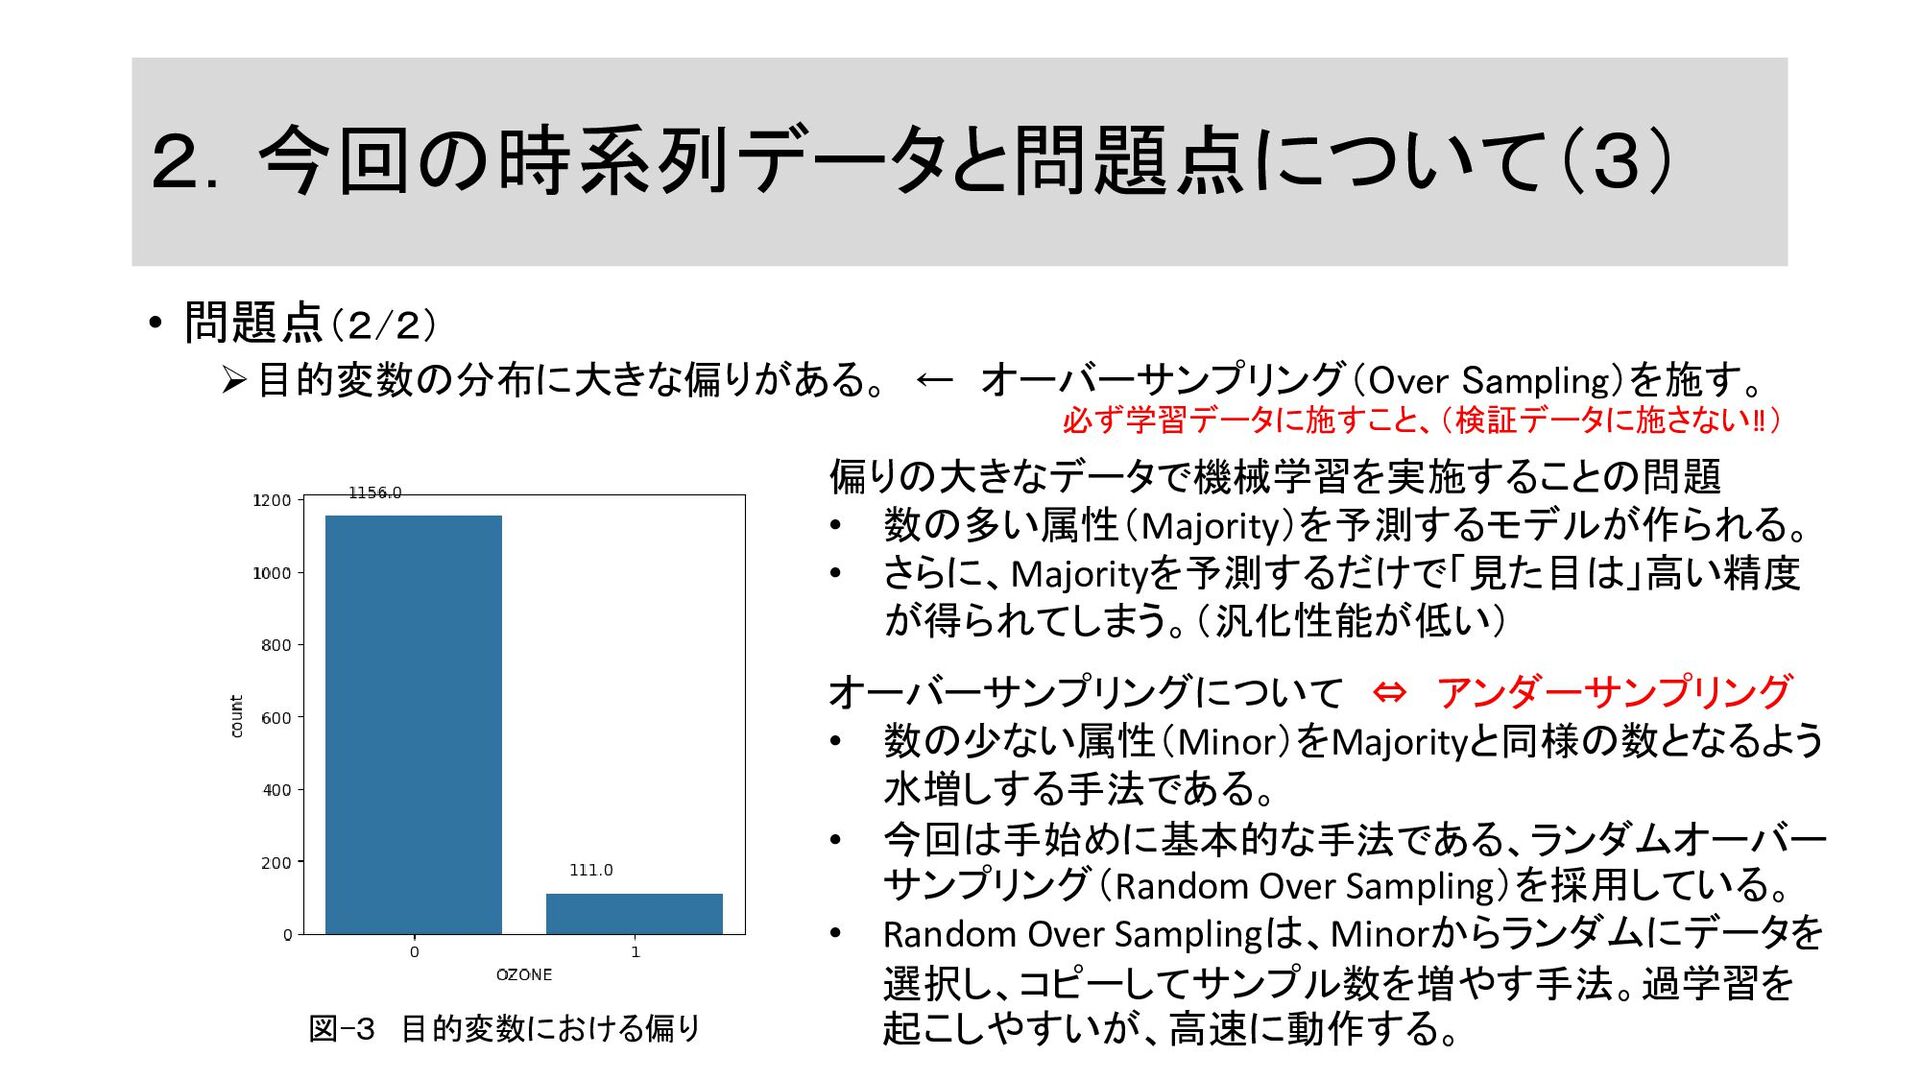
2.今回の時系列データと問題点について(3) • 問題点(2/2) ➢目的変数の分布に大きな偏りがある。 ← オーバーサンプリング(Over Sampling)を施す。 図-3 目的変数における偏り 偏りの大きなデータで機械学習を実施することの問題
• 数の多い属性(Majority)を予測するモデルが作られる。 • さらに、Majorityを予測するだけで「見た目は」高い精度 が得られてしまう。(汎化性能が低い) オーバーサンプリングについて ⇔ アンダーサンプリング • 数の少ない属性(Minor)をMajorityと同様の数となるよう 水増しする手法である。 • 今回は手始めに基本的な手法である、ランダムオーバー サンプリング(Random Over Sampling)を採用している。 • Random Over Samplingは、Minorからランダムにデータを 選択し、コピーしてサンプル数を増やす手法。過学習を 起こしやすいが、高速に動作する。 必ず学習データに施すこと、(検証データに施さない‼)
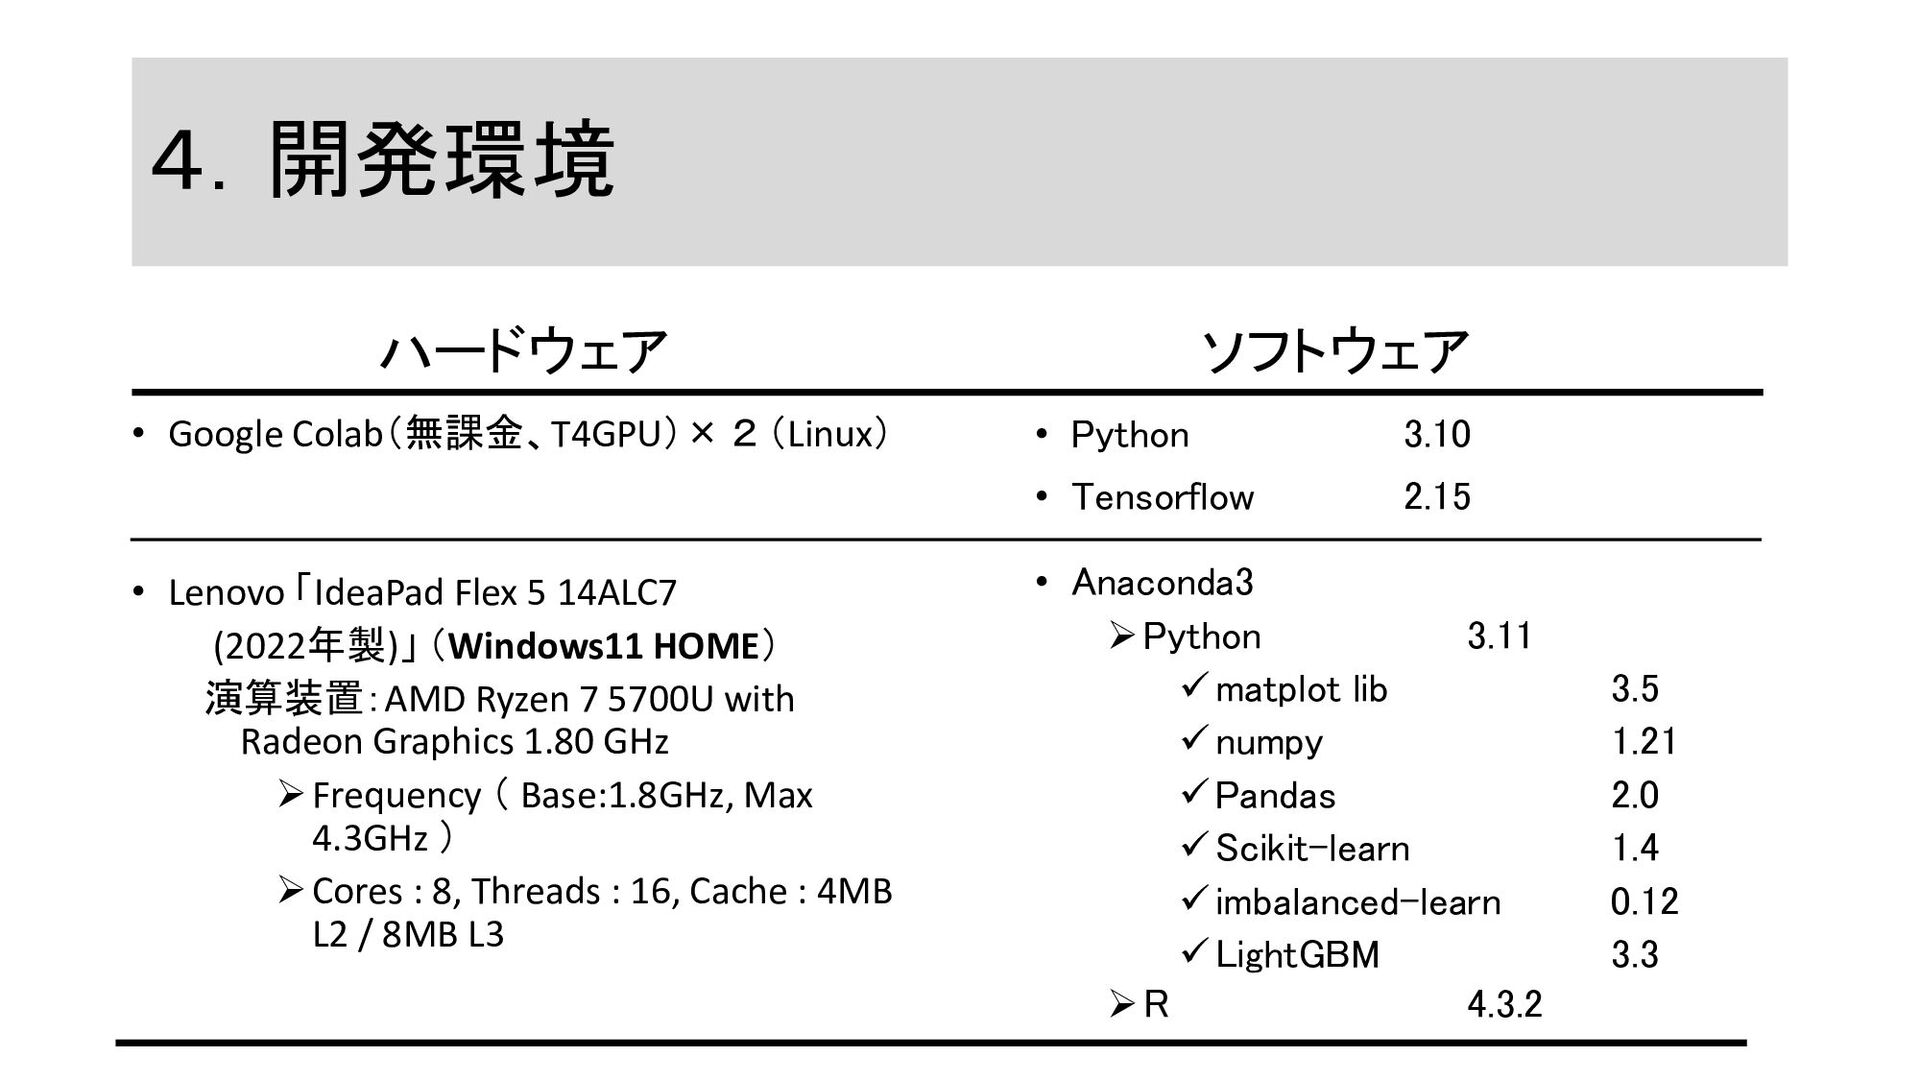
4.開発環境 • Python 3.10 • Tensorflow 2.15 • Anaconda3 ➢Python
3.11 ✓matplot lib 3.5 ✓numpy 1.21 ✓Pandas 2.0 ✓Scikit-learn 1.4 ✓imbalanced-learn 0.12 ✓LightGBM 3.3 ➢R 4.3.2 • Google Colab(無課金、T4GPU)× 2 (Linux) • Lenovo 「IdeaPad Flex 5 14ALC7 (2022年製)」 (Windows11 HOME) 演算装置:AMD Ryzen 7 5700U with Radeon Graphics 1.80 GHz ➢Frequency ( Base:1.8GHz, Max 4.3GHz ) ➢Cores : 8, Threads : 16, Cache : 4MB L2 / 8MB L3 ソフトウェア ハードウェア
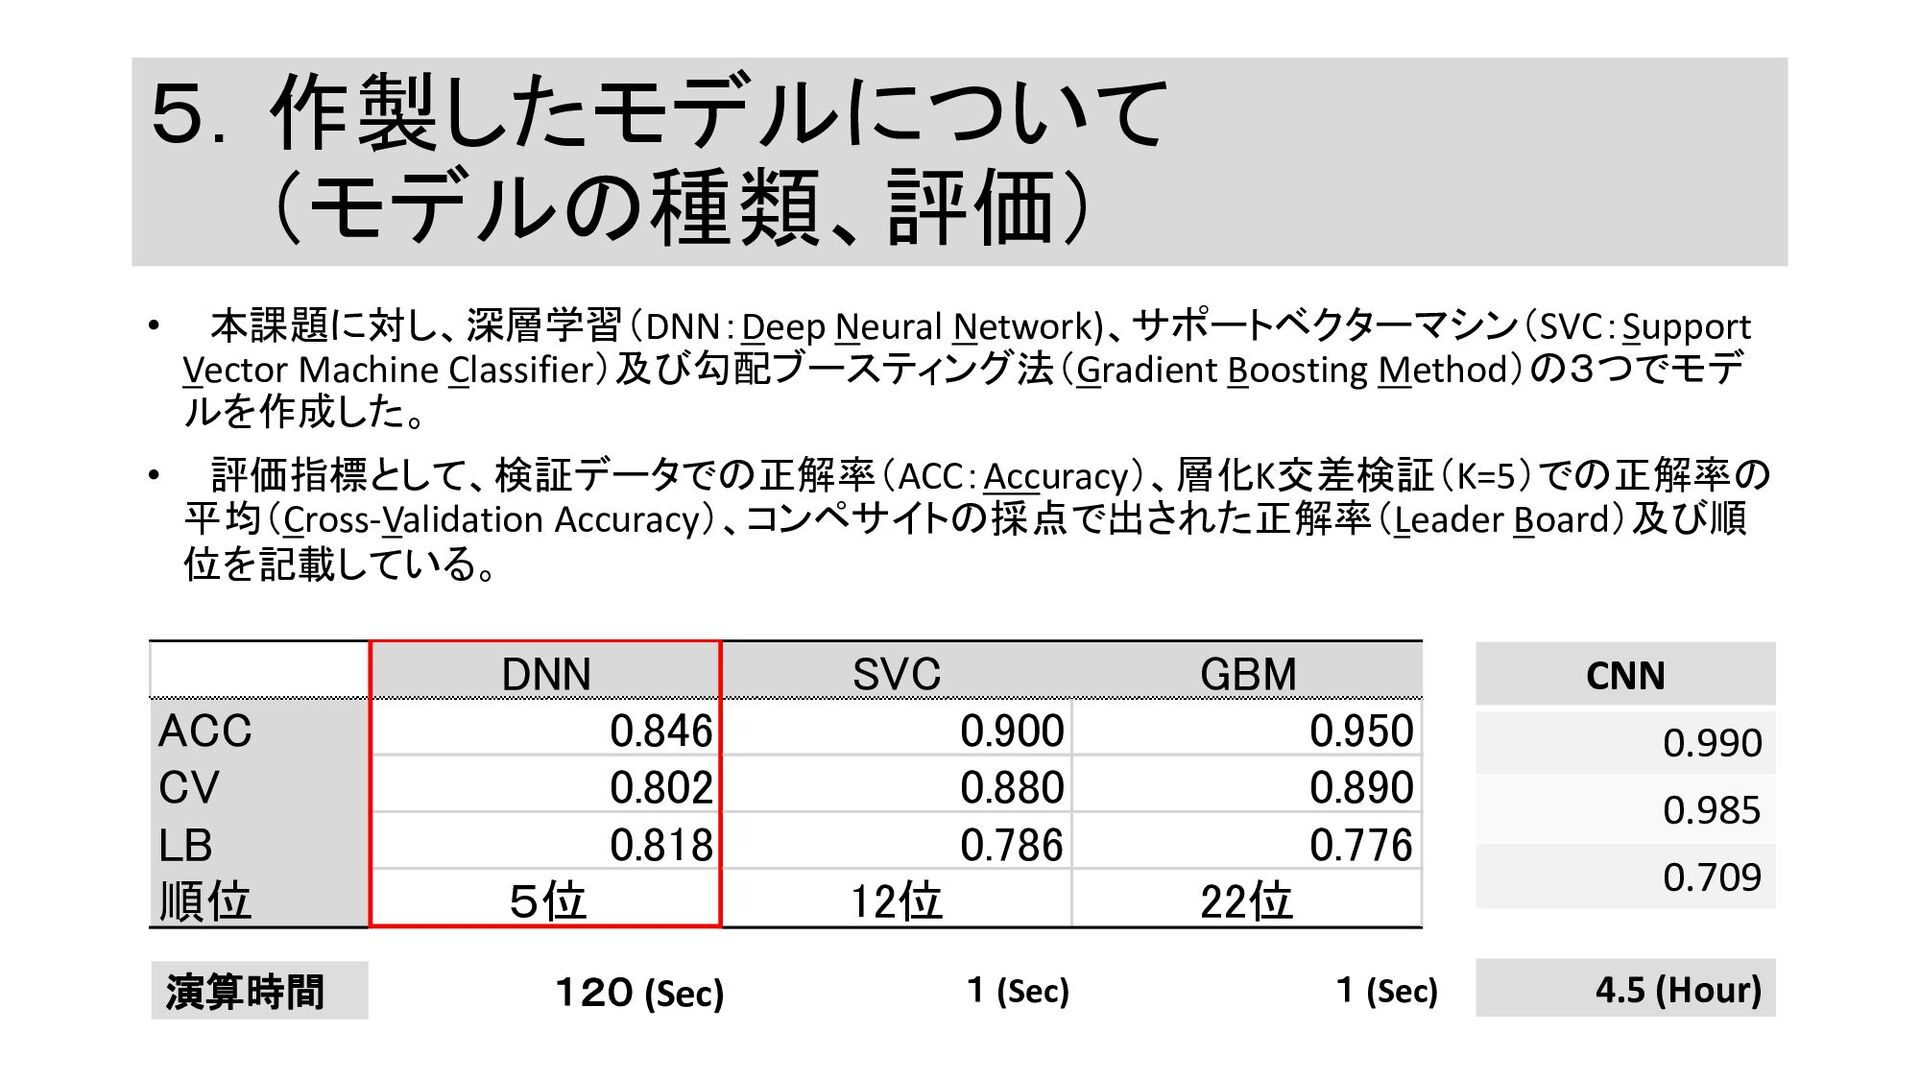
5.作製したモデルについて (モデルの種類、評価) • 本課題に対し、深層学習(DNN:Deep Neural Network)、サポートベクターマシン(SVC:Support Vector Machine Classifier)及び勾配ブースティング法(Gradient Boosting
Method)の3つでモデ ルを作成した。 • 評価指標として、検証データでの正解率(ACC:Accuracy)、層化K交差検証(K=5)での正解率の 平均(Cross-Validation Accuracy)、コンペサイトの採点で出された正解率(Leader Board)及び順 位を記載している。 CNN 0.990 0.985 0.709 演算時間 120 (Sec) 1 (Sec) 1 (Sec) 4.5 (Hour) DNN SVC GBM ACC 0.846 0.900 0.950 CV 0.802 0.880 0.890 LB 0.818 0.786 0.776 順位 5位 12位 22位
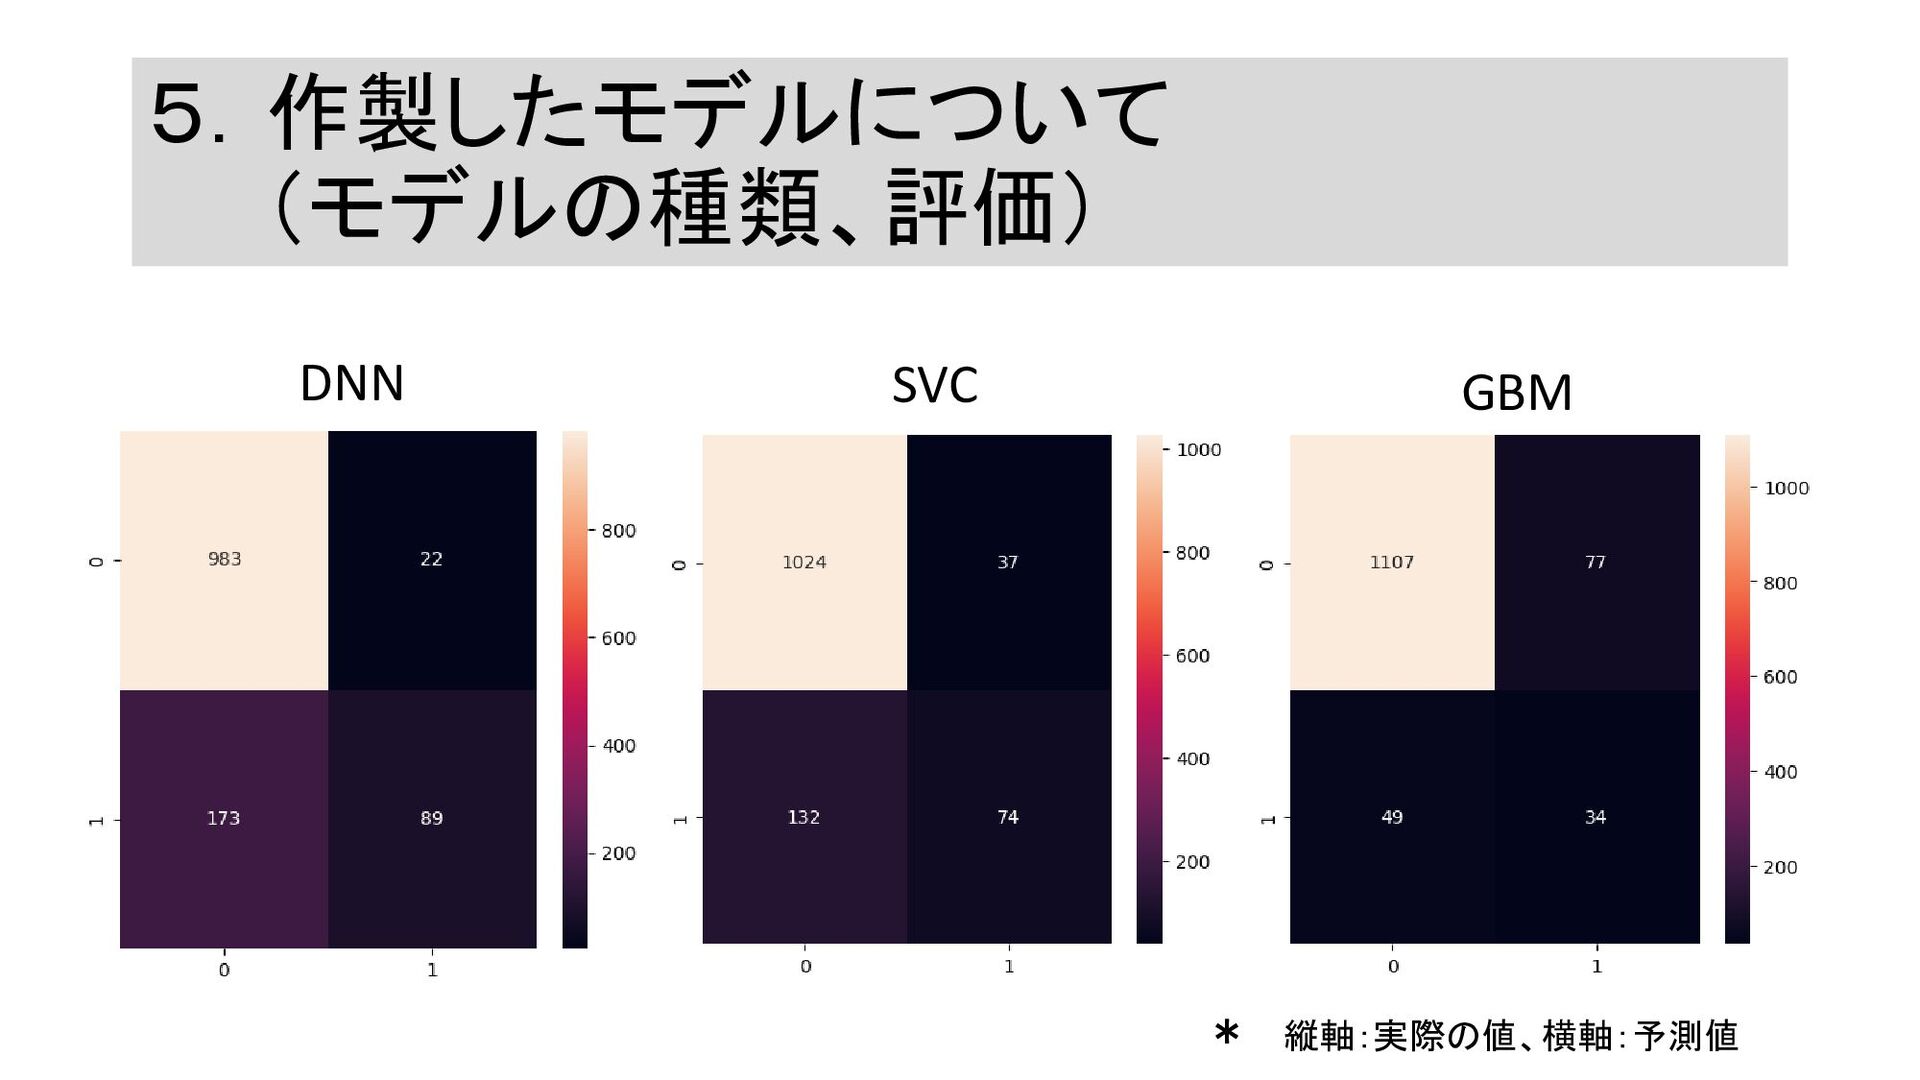
5.作製したモデルについて (モデルの種類、評価) SVC DNN GBM * 縦軸:実際の値、横軸:予測値
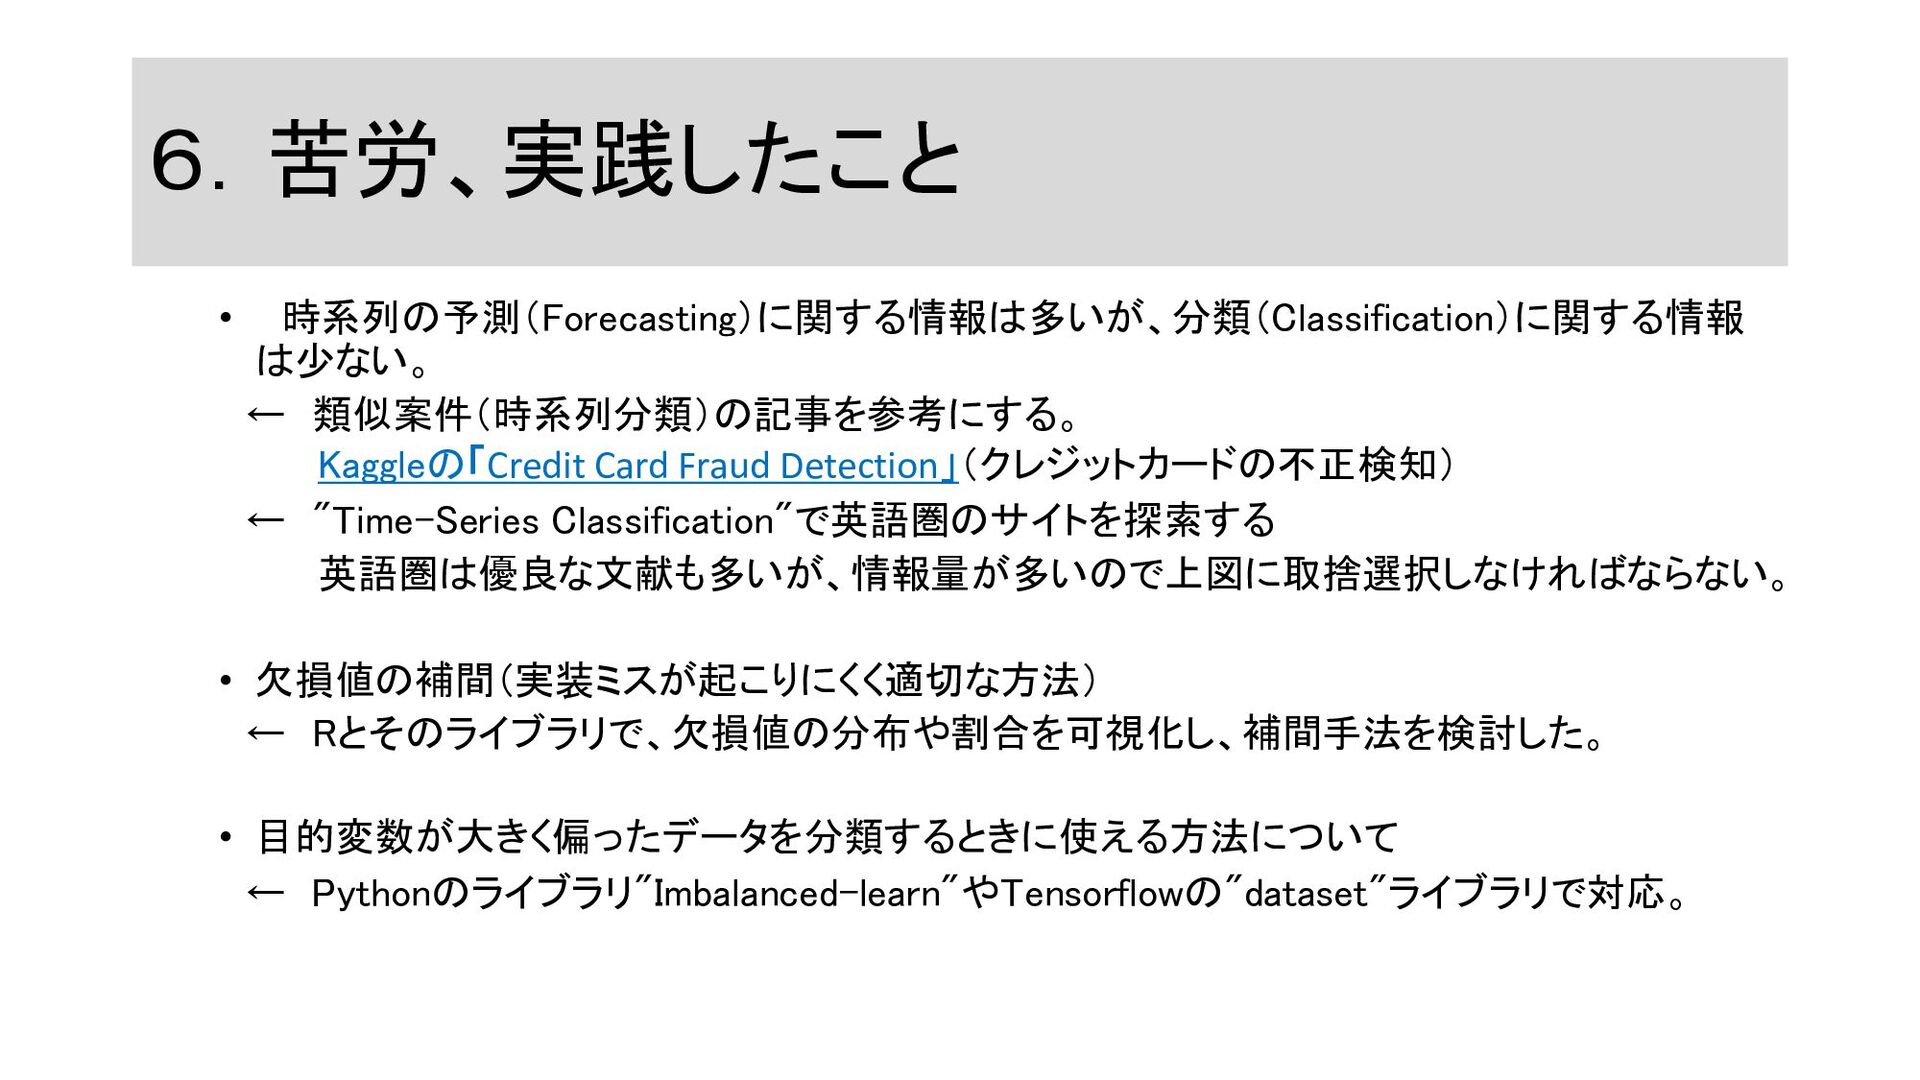
6.苦労、実践したこと • 時系列の予測(Forecasting)に関する情報は多いが、分類(Classification)に関する情報 は少ない。 ← 類似案件(時系列分類)の記事を参考にする。 Kaggleの「Credit Card Fraud Detection」(クレジットカードの不正検知)
← "Time-Series Classification"で英語圏のサイトを探索する 英語圏は優良な文献も多いが、情報量が多いので上図に取捨選択しなければならない。 • 欠損値の補間(実装ミスが起こりにくく適切な方法) ← Rとそのライブラリで、欠損値の分布や割合を可視化し、補間手法を検討した。 • 目的変数が大きく偏ったデータを分類するときに使える方法について ← Pythonのライブラリ"Imbalanced-learn"やTensorflowの"dataset"ライブラリで対応。
7.今後の施策(改良点) • 欠損値の補間について → 今回、補間の手法に平均値代入を使った。この方法は基本的なものだが、応用統計学の 分野からは、例えば多重代入法などの、より高精度な補間方法が考案及び実装されてい る。モデルが出来上がったら、こちらを導入して結果がどう変わっていくか検証していきたい。 • オーバーサンプリングの方法について →
今回のオーバーサンプリングはMinorに属するデータをコピーするという、一番単純な方 法だった。この方法は前述のとおり過学習しやすい欠点がある。そして、検証データでは高 い正解率であるモデルほど、反対にコンペでの正答率が低くなっていた。ここから考えられ るのは、与データに対して過学習をしており汎化性能が低くなっているということである。な ので、Minorからデータを合成するSMOTE(Synthetic Minority Over-sampling TEchnique)の 導入から考えている。 オーバーサンプリングの手法をランダムサンプリングからSMOTEに変えて分類(SVC)したが、結果はほぼ変わらず
ご清聴ありがとうございました
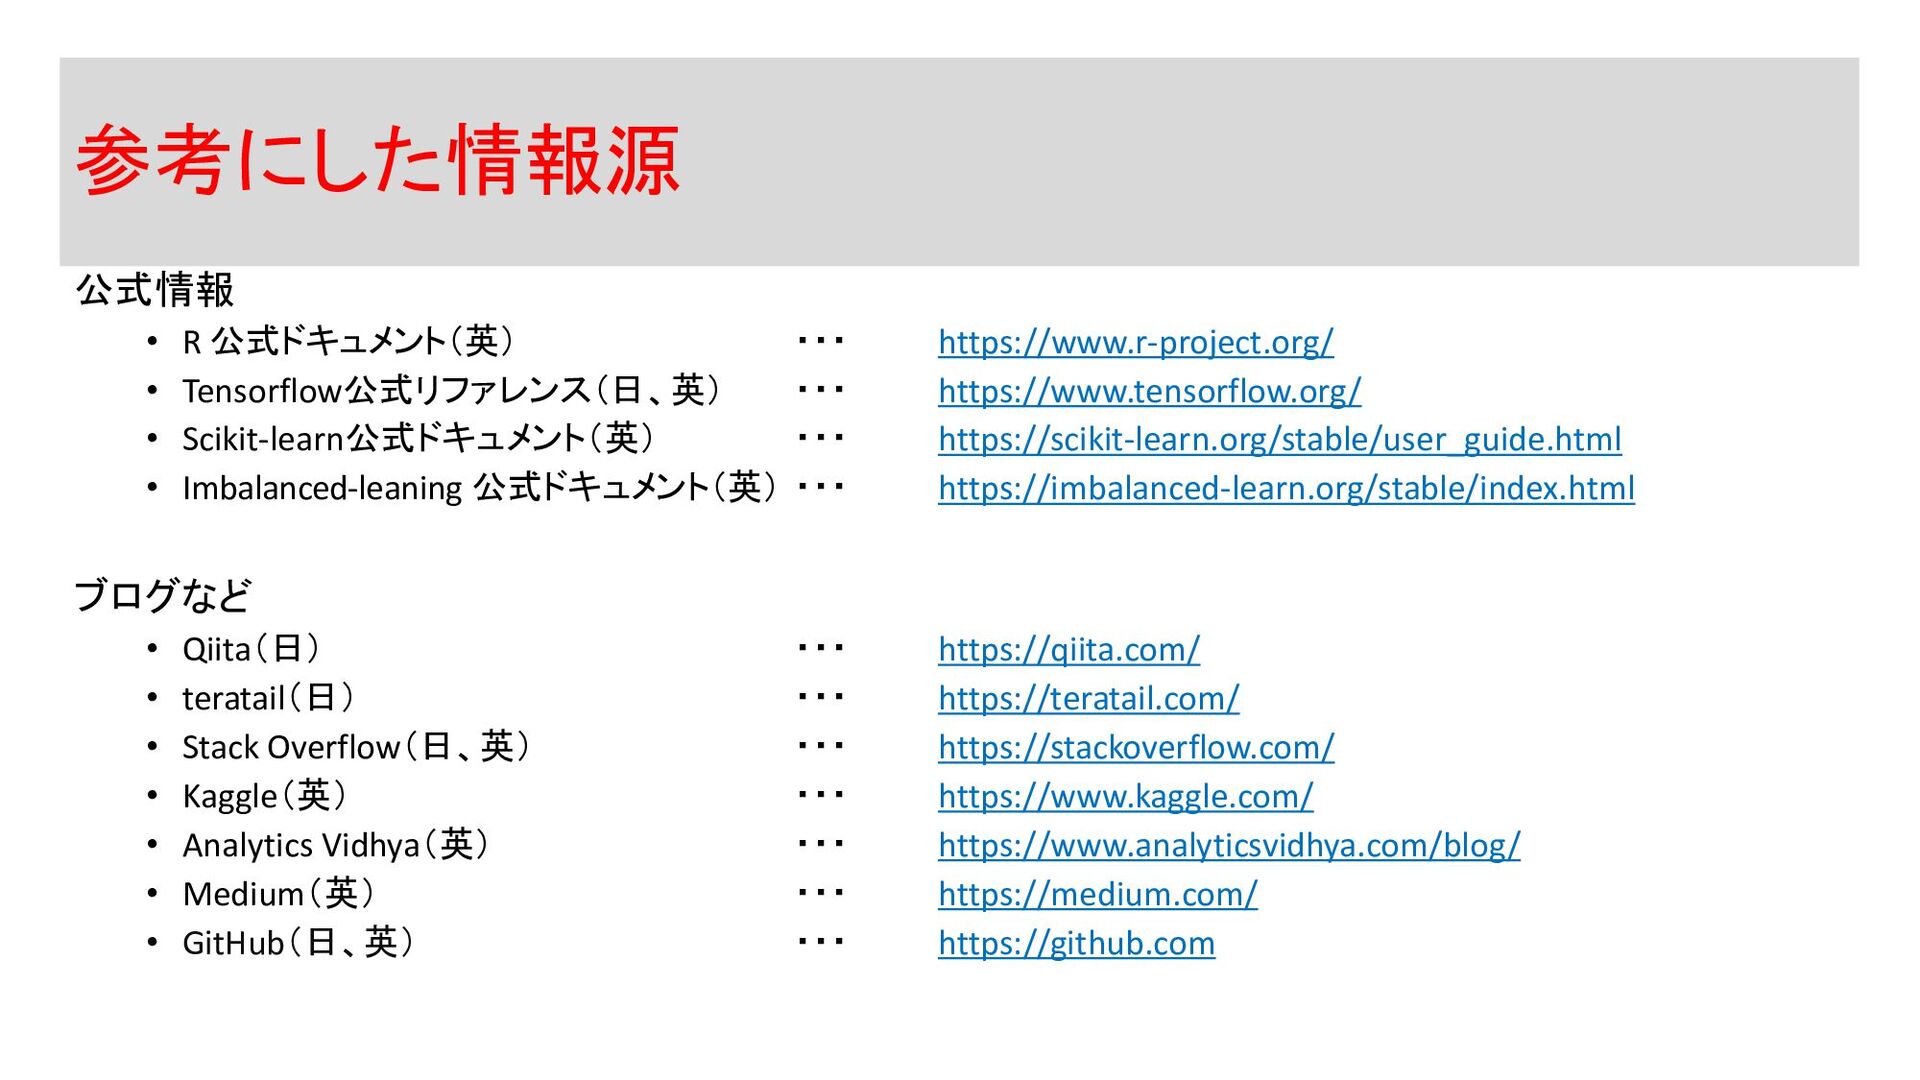
参考にした情報源 公式情報 • R 公式ドキュメント(英) ・・・ https://www.r-project.org/ • Tensorflow公式リファレンス(日、英) ・・・
https://www.tensorflow.org/ • Scikit-learn公式ドキュメント(英) ・・・ https://scikit-learn.org/stable/user_guide.html • Imbalanced-leaning 公式ドキュメント(英) ・・・ https://imbalanced-learn.org/stable/index.html ブログなど • Qiita(日) ・・・ https://qiita.com/ • teratail(日) ・・・ https://teratail.com/ • Stack Overflow(日、英) ・・・ https://stackoverflow.com/ • Kaggle(英) ・・・ https://www.kaggle.com/ • Analytics Vidhya(英) ・・・ https://www.analyticsvidhya.com/blog/ • Medium(英) ・・・ https://medium.com/ • GitHub(日、英) ・・・ https://github.com


 masato_miwada
 willnet
 occhi
 gree_tech
 bitkey
 yukisakai1225
 mohab1
 kzkhykw1991
 linedevth
 taketakekaho
 iktakahiro
 sansantech
 jtakeda
 kastner
 marktimemedia
 lindahogenes
 jonoalderson
 katiecoart
 morganepeng
 rkaga
 tmiket
 davidcarrasco
 reverentgeek
 hannesfritz