Share
Embed
Métodos Iterativos para sistemas lineares e matrizes esparsas
Paulo Bordoni
June 06, 2019
Transcript
107 slides
-
LNCC UFRJ Métodos iterativos para sistemas lineares e matrizes esparsas
Prof. Paulo Bordoni -
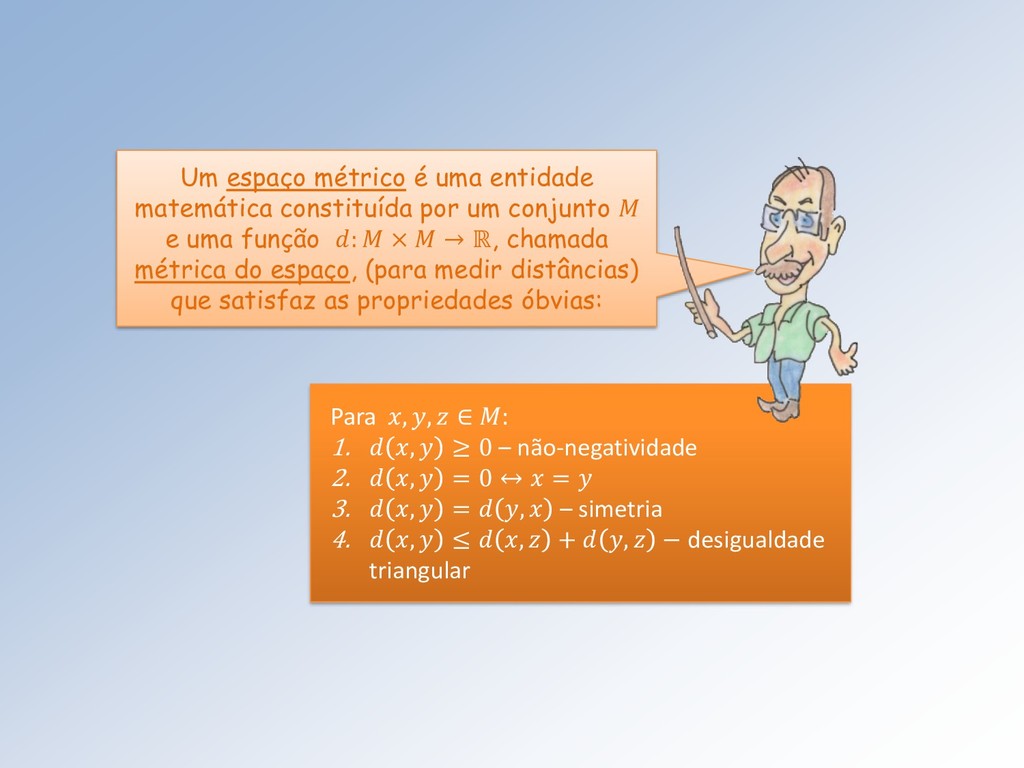
Para , , ∈ : 1. , ≥ 0 –
não-negatividade 2. , = 0 ↔ = 3. , = , – simetria 4. , ≤ , + , − desigualdade triangular Um espaço métrico é uma entidade matemática constituída por um conjunto M e uma função : × → ℝ, chamada métrica do espaço, (para medir distâncias) que satisfaz as propriedades óbvias: -
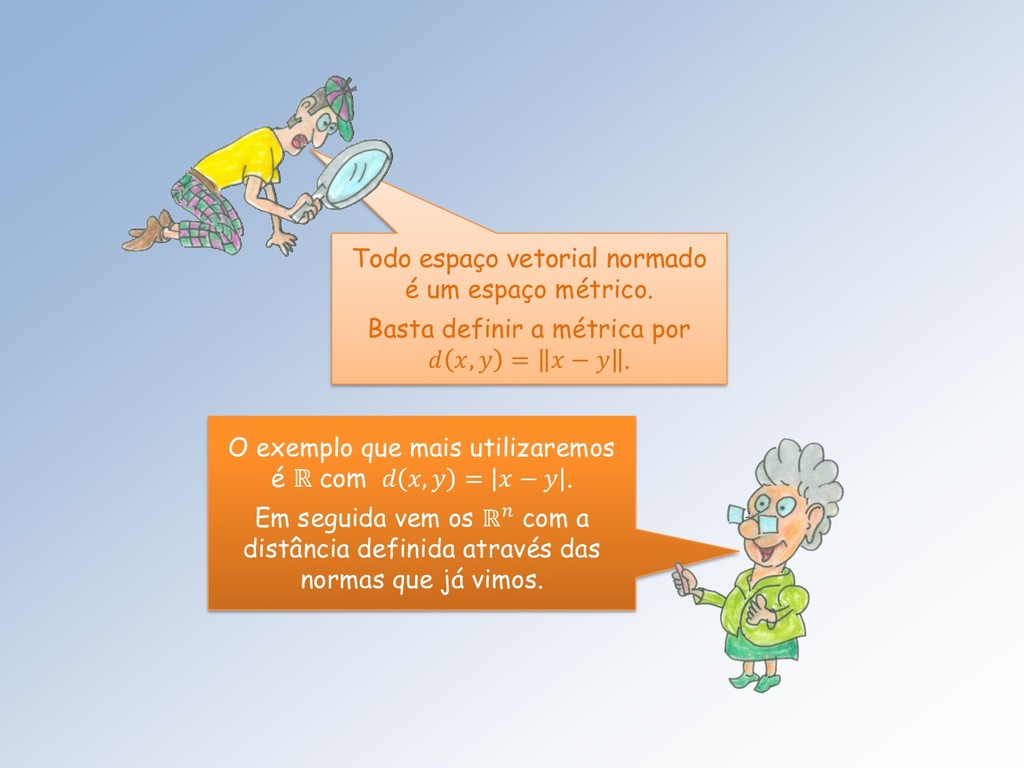
Todo espaço vetorial normado é um espaço métrico. Basta definir
a métrica por , = − . O exemplo que mais utilizaremos é ℝ com , = − . Em seguida vem os ℝ com a distância definida através das normas que já vimos. -
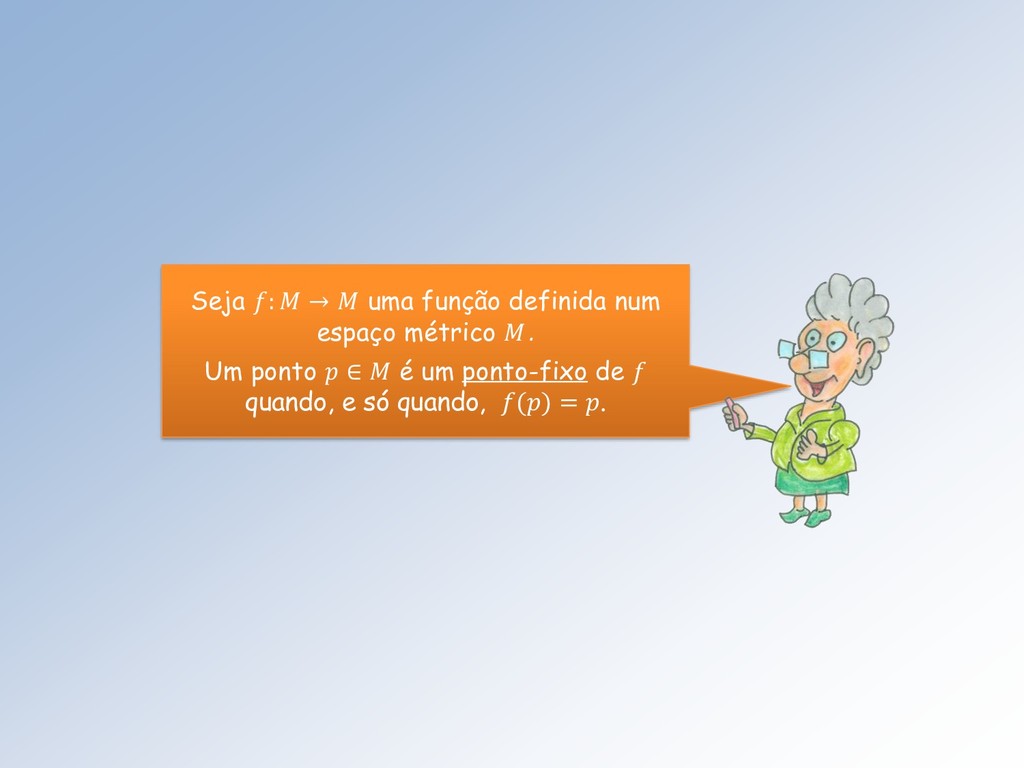
Seja : → uma função definida num espaço métrico M
. Um ponto ∈ é um ponto-fixo de quando, e só quando, () = . -
A função : ℝ → ℝ, é definida por =
3 possui três pontos-fixo. É verdade Mestra. Os pontos = 1, = 0 e = −1 são pontos-fixo. Todos satisfazem = . -
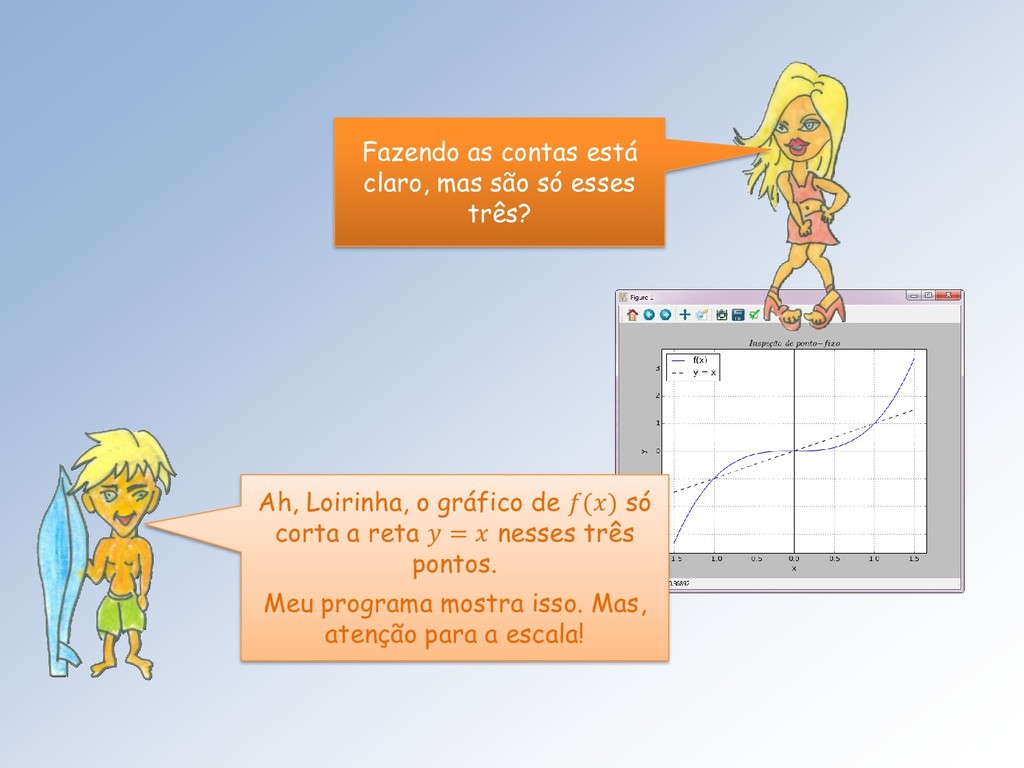
Ah, Loirinha, o gráfico de () só corta a reta
= nesses três pontos. Meu programa mostra isso. Mas, atenção para a escala! Fazendo as contas está claro, mas são só esses três? -
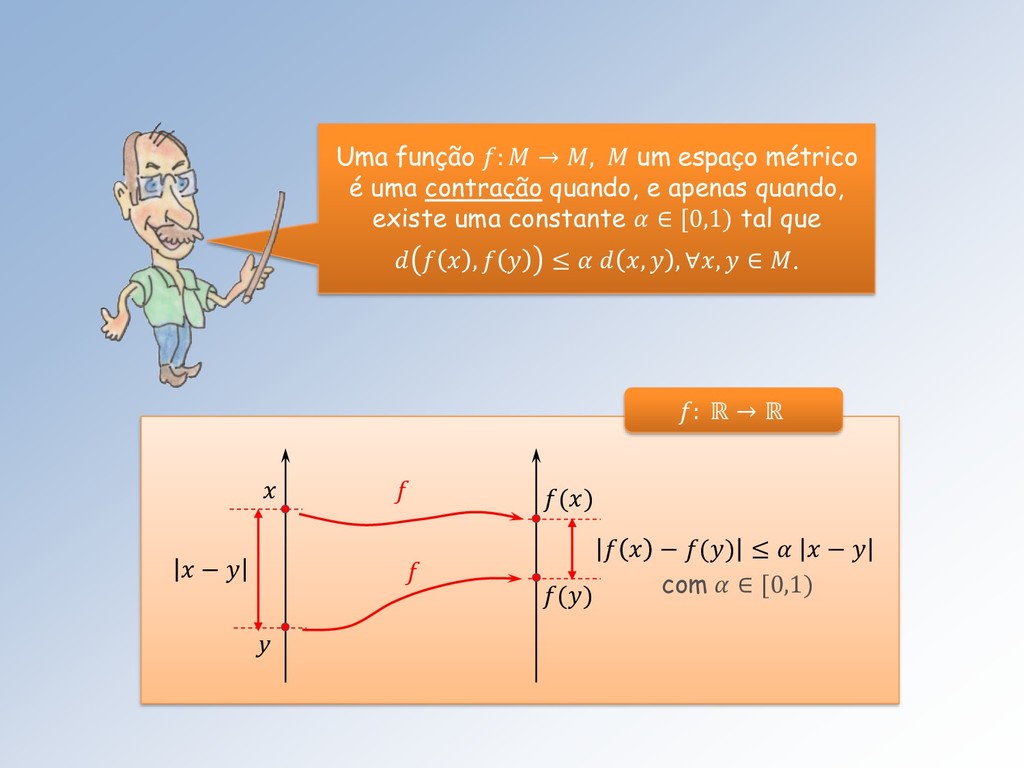
Uma função : → , um espaço métrico é uma
contração quando, e apenas quando, existe uma constante ∈ [0,1) tal que , ≤ , , ∀, ∈ . f () y f () − − () ≤ − com ∈ [0,1) : ℝ → ℝ -
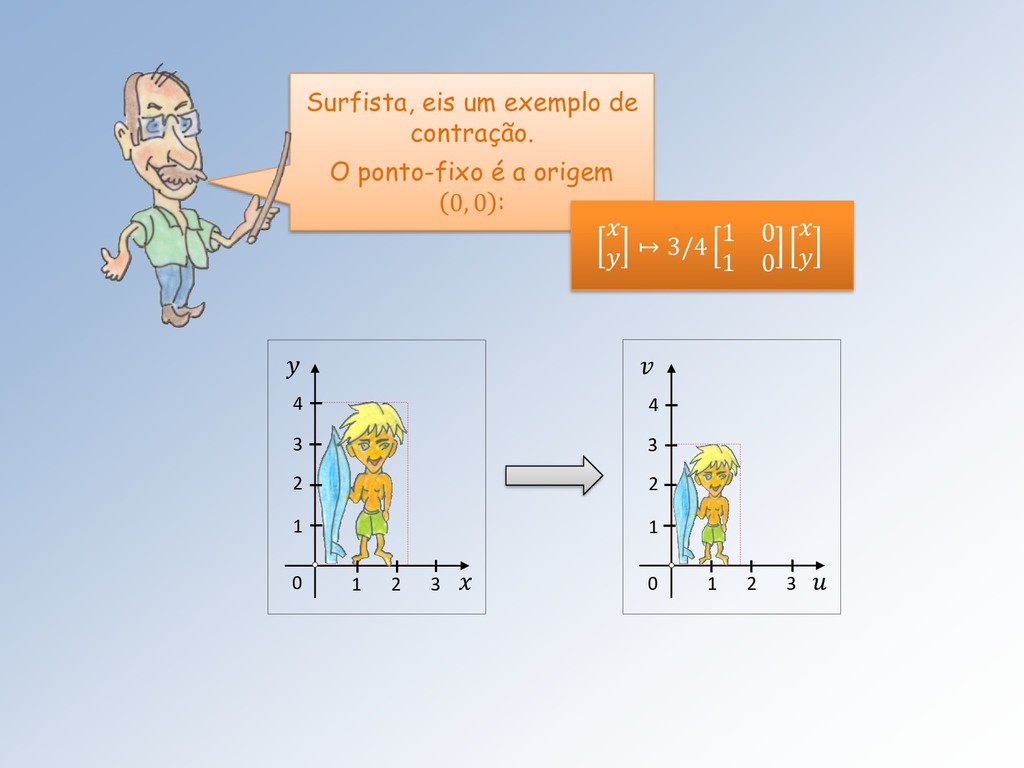
Surfista, eis um exemplo de contração. O ponto-fixo é a
origem 0, 0 : ↦ 3/4 1 0 1 0 3 2 1 0 4 1 2 3 3 2 1 0 1 2 3 4 -
Um dos resultados mais importantes de análise é o Teorema
do ponto-fixo de Banach: Num espaço métrico completo toda contração : → admite um único ponto-fixo ∈ , (isto é = ). -
Se : → é uma contração, podemos determinar seu ponto-fixo
p iterativamente, construindo uma sequência 0 , 1 , … , , … tal que lim →∞ = . Sim, basta definir +1 = ( ), com 0 ∈ . -
Uma das propriedade importantes é que (, ) ≤ 1
− (1 , 0 ) Que permite estimar a velocidade de convergência. -
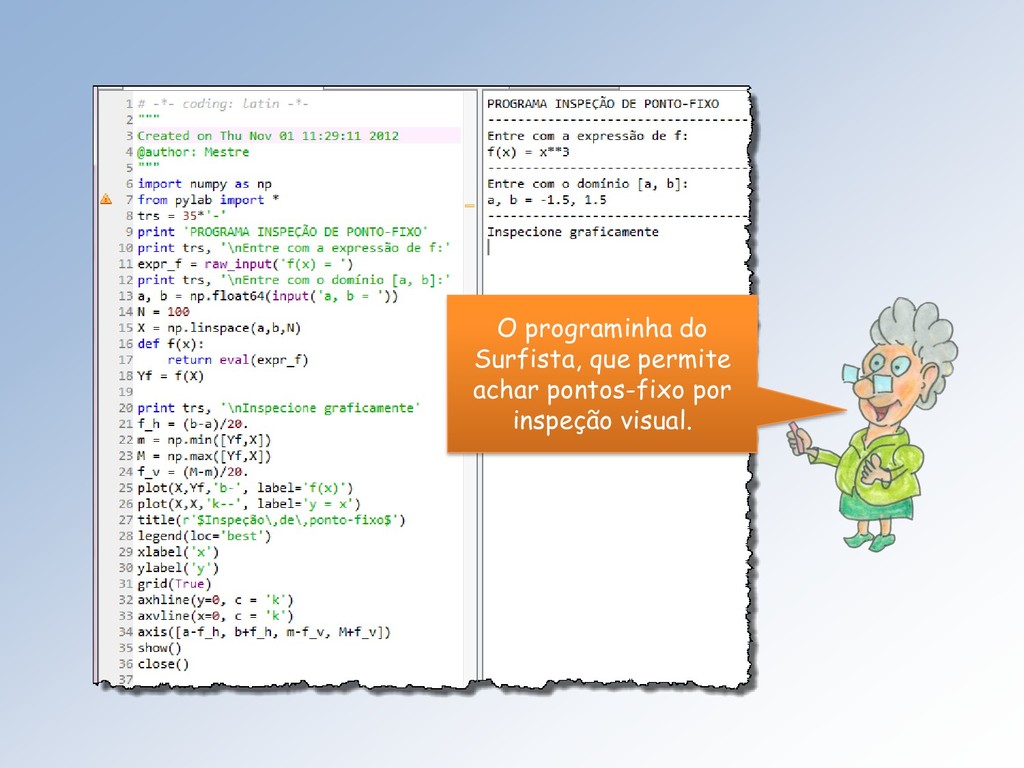
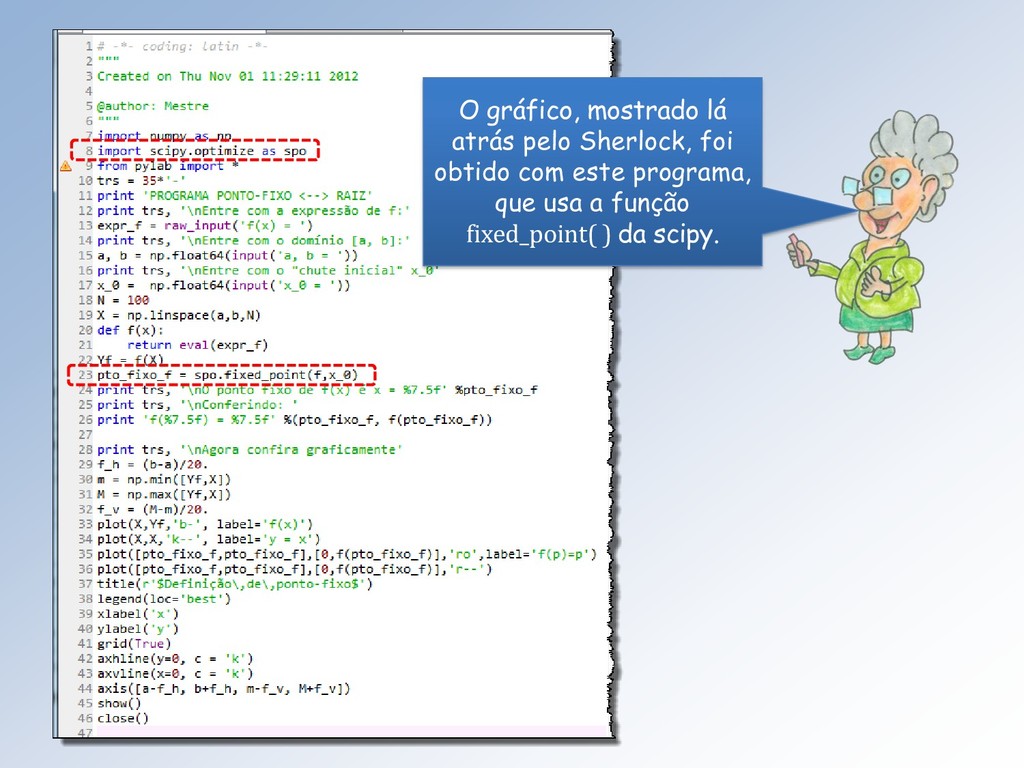
O gráfico, mostrado lá atrás pelo Sherlock, foi obtido com
este programa, que usa a função fixed_point( ) da scipy. -
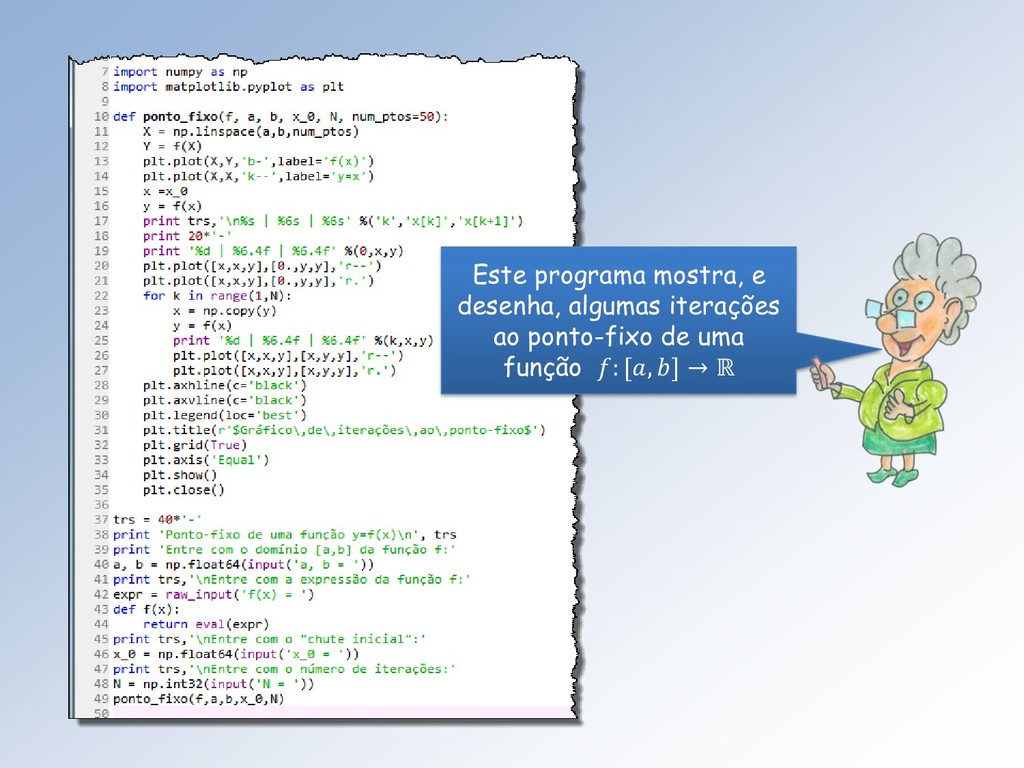
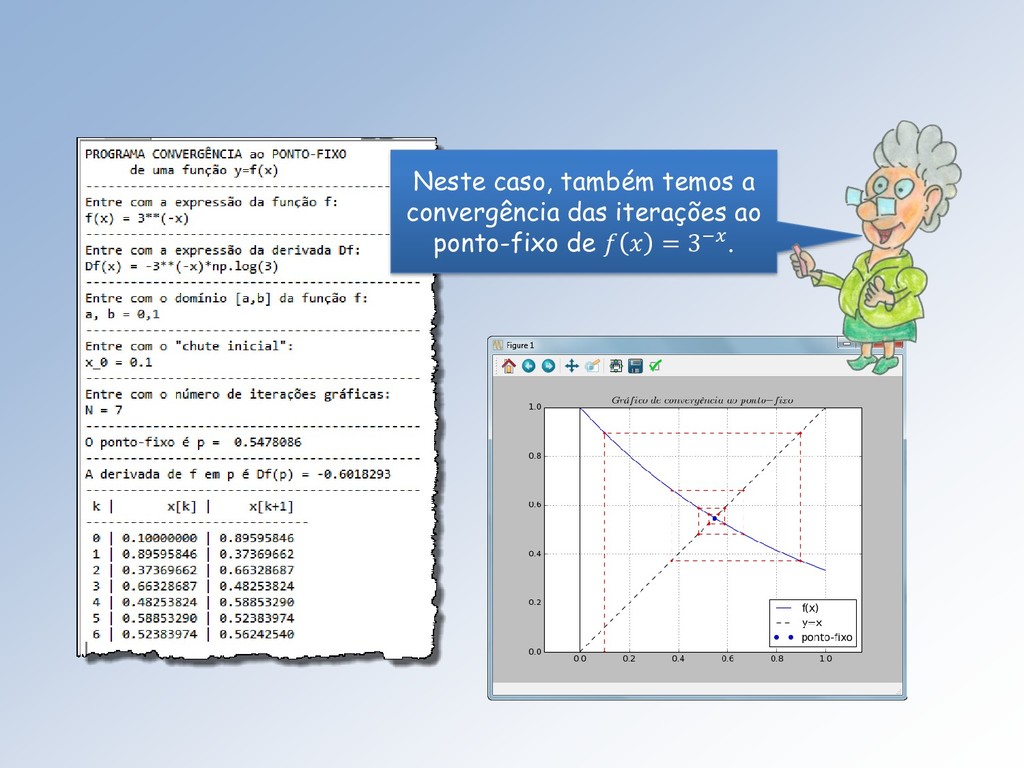
Este programa mostra, e desenha, algumas iterações ao ponto-fixo de
uma função : [, ] → ℝ -
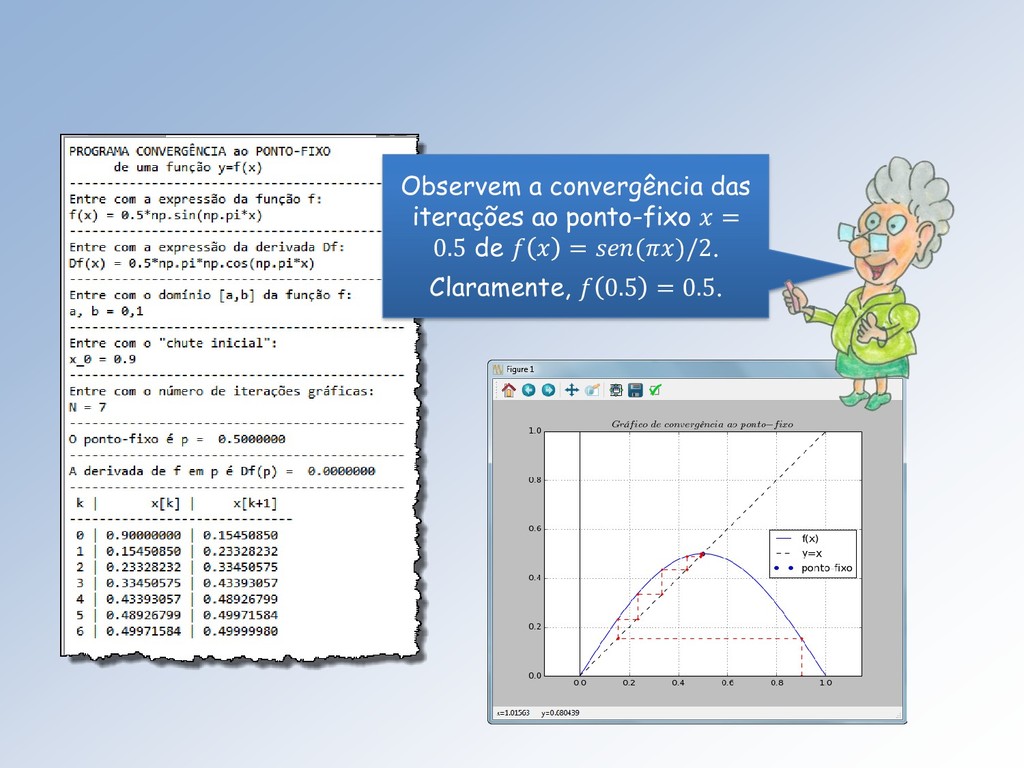
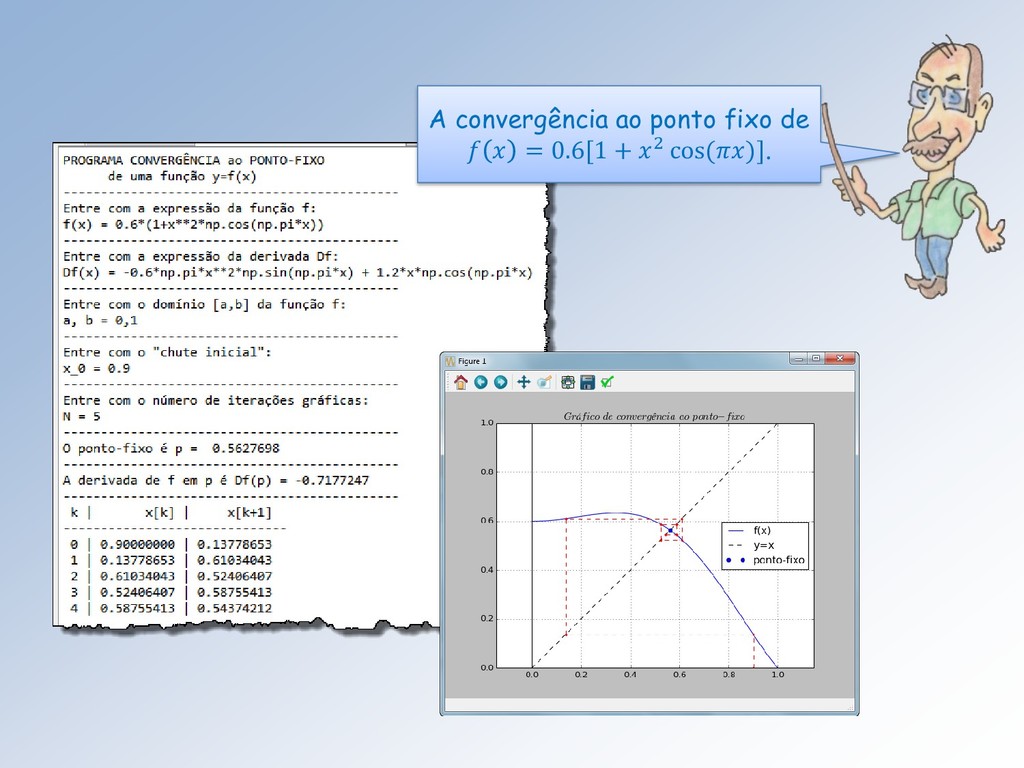
Observem a convergência das iterações ao ponto-fixo = 0.5 de
= ()/2. Claramente, 0.5 = 0.5. -
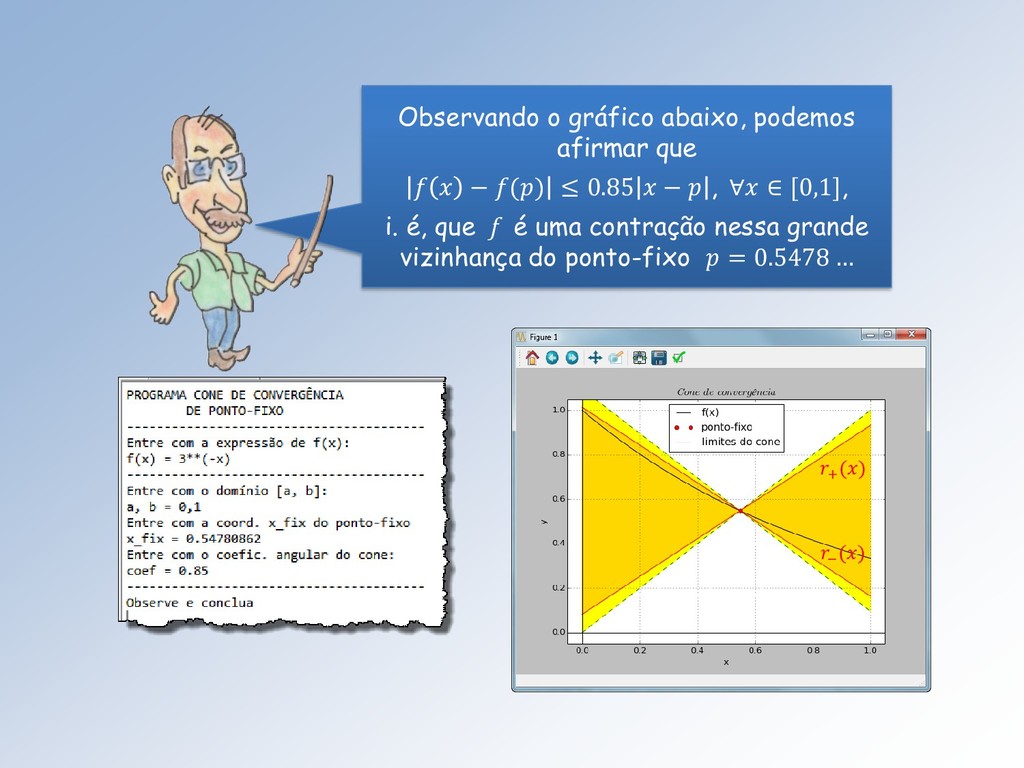
Observando o gráfico abaixo, podemos afirmar que − () ≤
0.85 − , ∀ ∈ [0,1], i. é, que f é uma contração nessa grande vizinhança do ponto-fixo = 0.5478 … − () + () -
Por quê, Mestre? Simplesmente porque o gráfico de f fica
inteiramente contido no cone de convergência. Acompanhe meu raciocínio: -
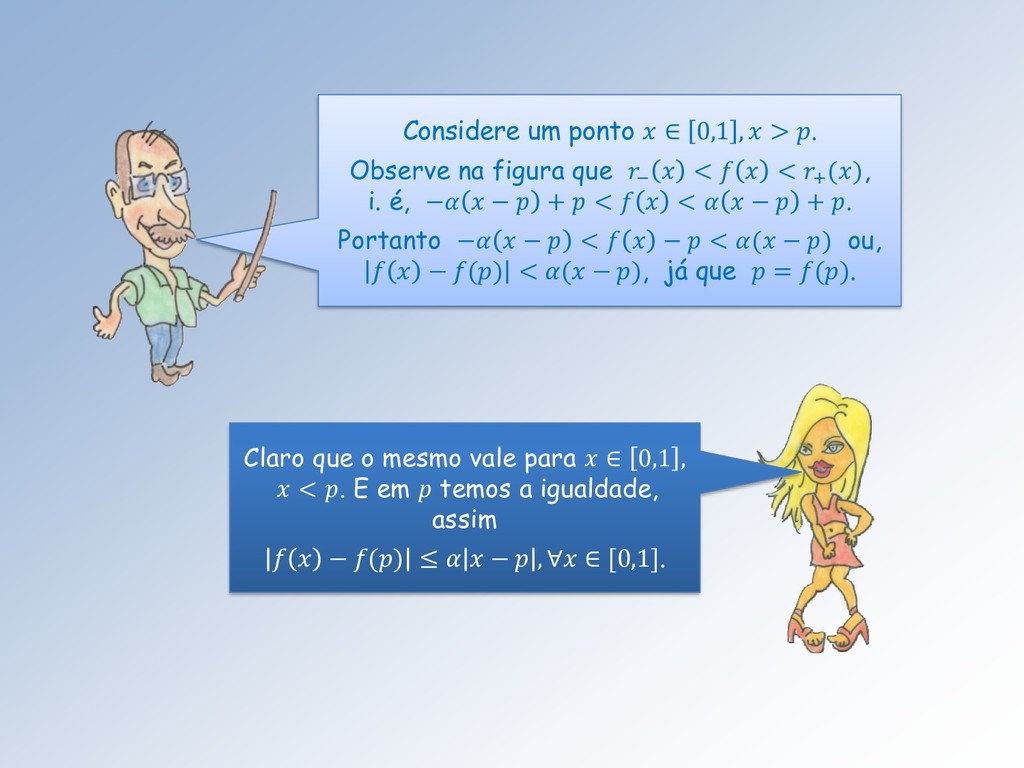
Considere um ponto ∈ 0,1 , > . Observe na
figura que − < < + (), i. é, − − + < < − + . Portanto − − < − < ( − ) ou, − () < ( − ), já que = (). Claro que o mesmo vale para ∈ 0,1 , < . E em p temos a igualdade, assim − () ≤ − , ∀ ∈ [0,1]. -
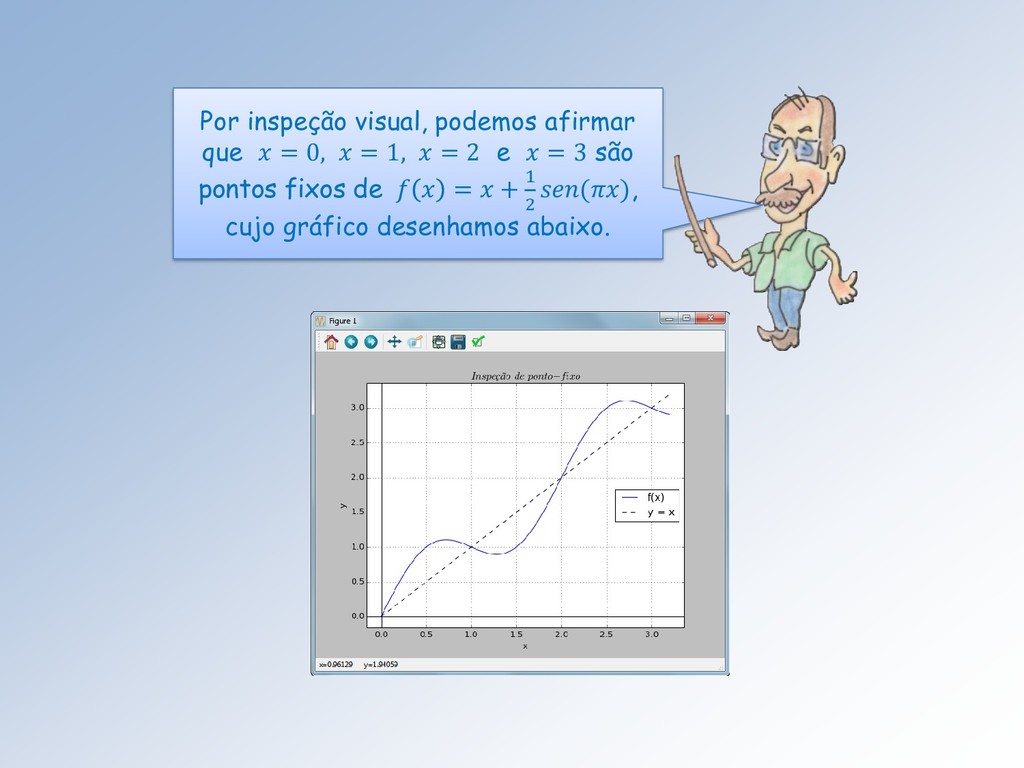
Por inspeção visual, podemos afirmar que = 0, = 1,
= 2 e = 3 são pontos fixos de = + 1 2 (), cujo gráfico desenhamos abaixo. -
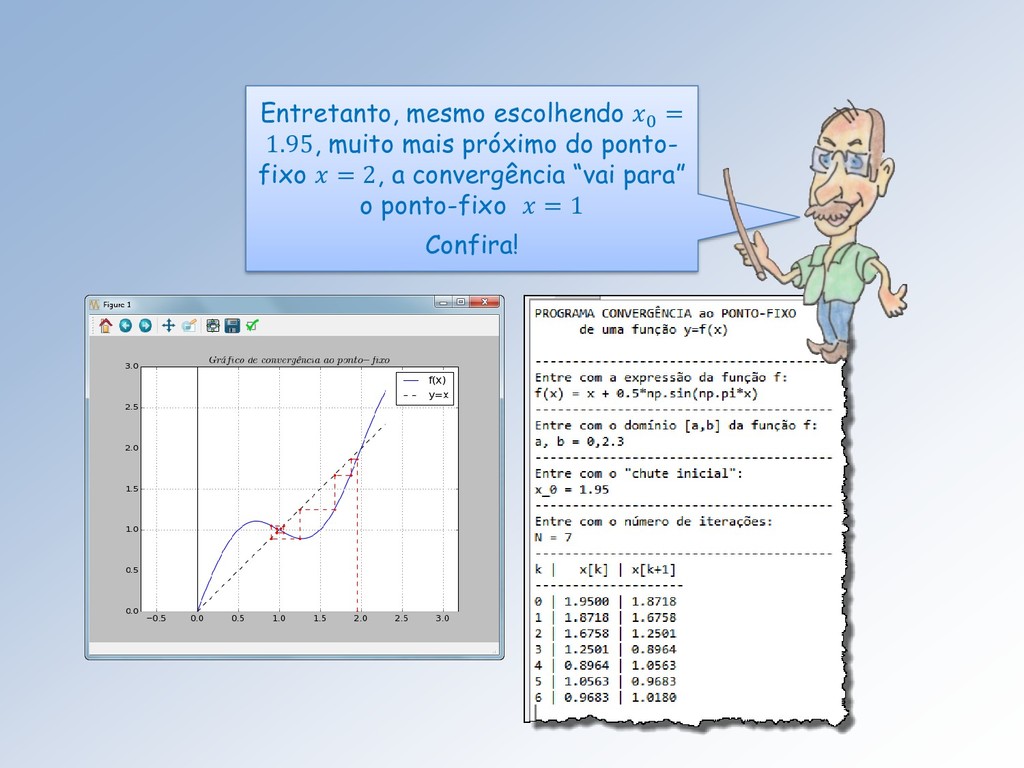
Entretanto, mesmo escolhendo 0 = 1.95, muito mais próximo do
ponto- fixo = 2, a convergência “vai para” o ponto-fixo = 1 Confira! -
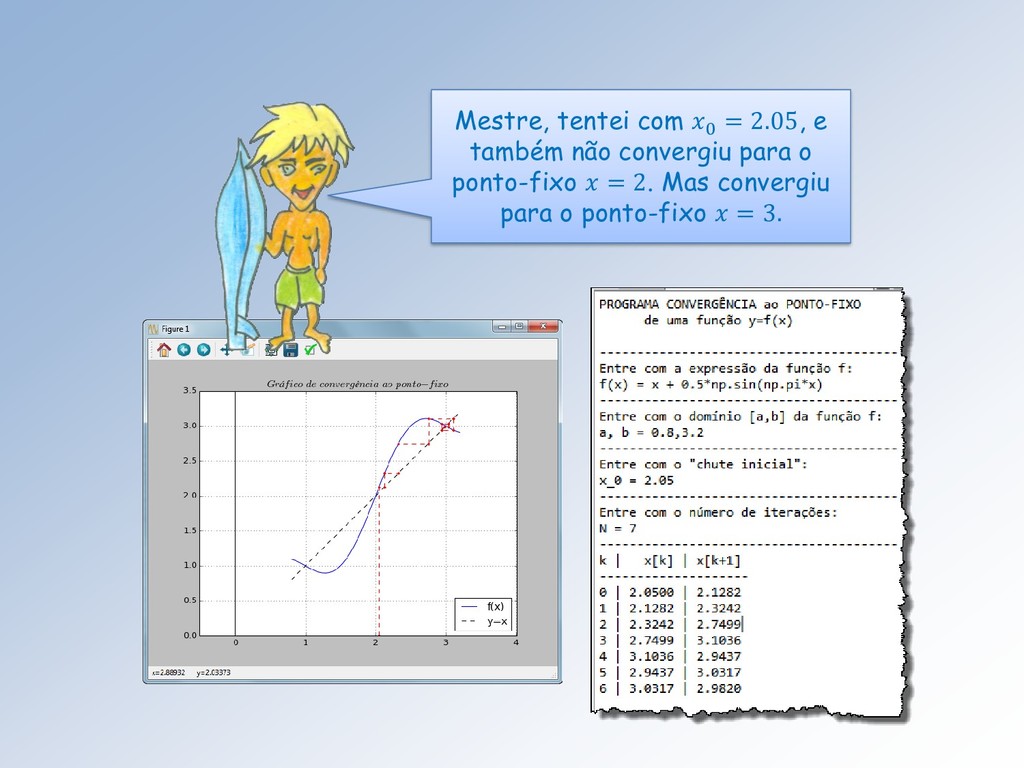
Mestre, tentei com 0 = 2.05, e também não convergiu
para o ponto-fixo = 2. Mas convergiu para o ponto-fixo = 3. -
O túnel é iluminado do início ao fim pelo teorema
do ponto-fixo de Banach. A condição para convergência é que f seja uma contração local entorno de p, i. é: para algum ∈ [0,1), − () ≤ − , para todo nas proximidades do ponto-fixo p. Mestres, há alguma luz no fim do túnel? -
Se: 1. ∈ [, ], 2. , ⊆ [, ],
3. f é derivável em (a, b) 4. ∃ ∈ 0, 1 tal que ′() ≤ , ∀ ∈ (, ) então, definindo uma sequência 0 , 1 , … , , … por +1 = ( ), com 0 ∈ [, ] poderemos afirmar que: a. lim →∞ = e p é o único ponto fixo de f em [, ] b. − ≤ 0 − , − 0 c. − ≤ Τ [ (1 − )] 1 − 0 , ∀ > 1. Às páginas 58,59 do Análise Numérica de Burden & Faires, 8ª ed. encontramos uma demonstração do Teorema: -
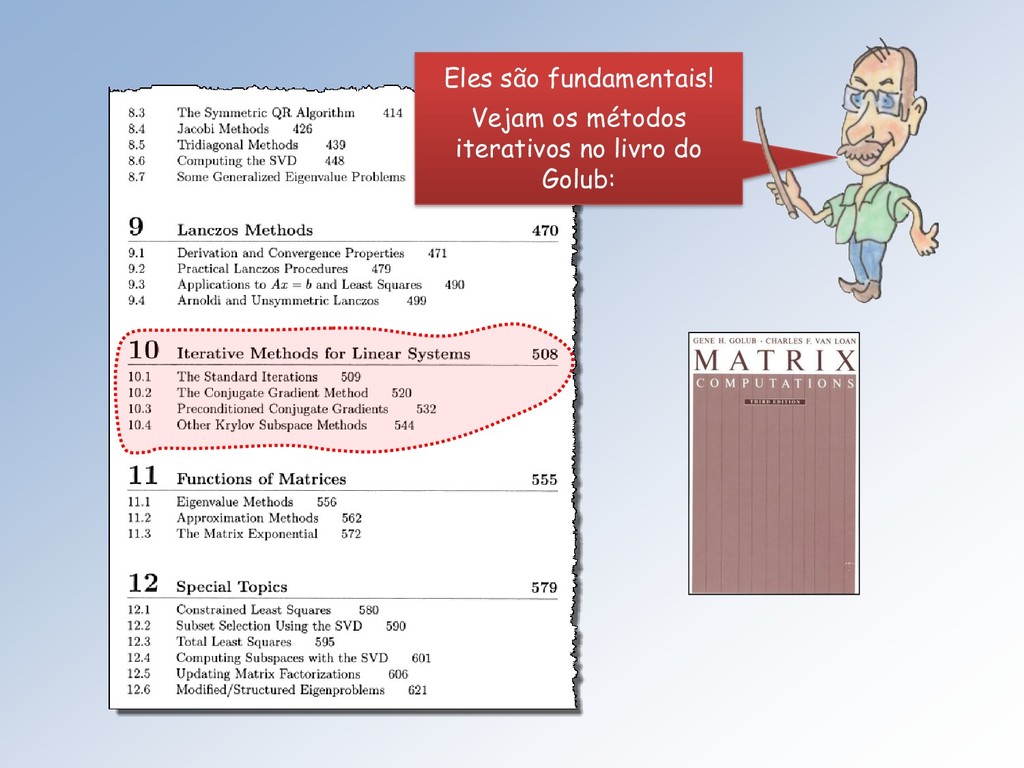
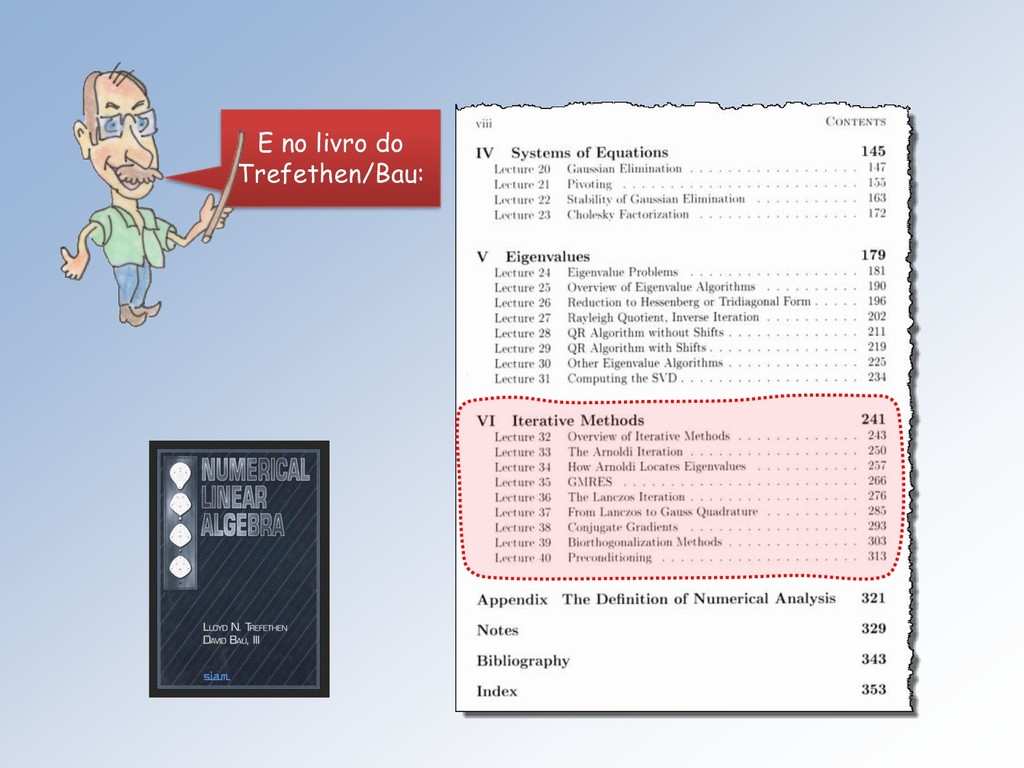
Além dos métodos diretos, métodos iterativos, constituem a outra vertente
para a resolução de sistemas lineares. Apresento uma visão geral dos especialistas: -
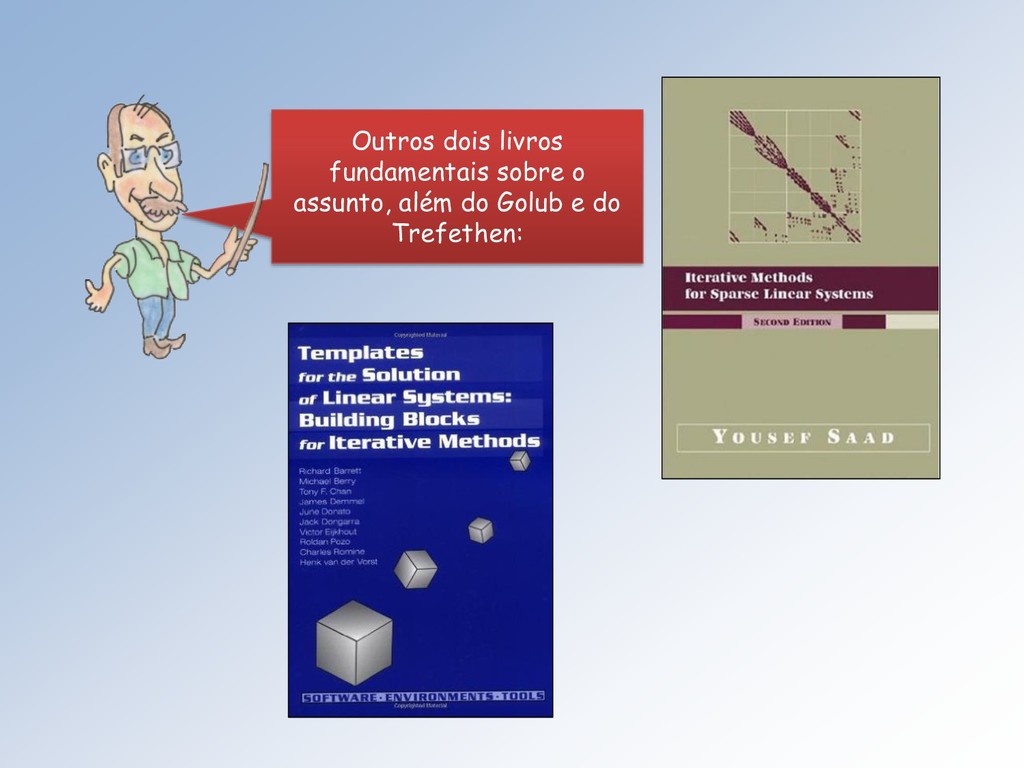
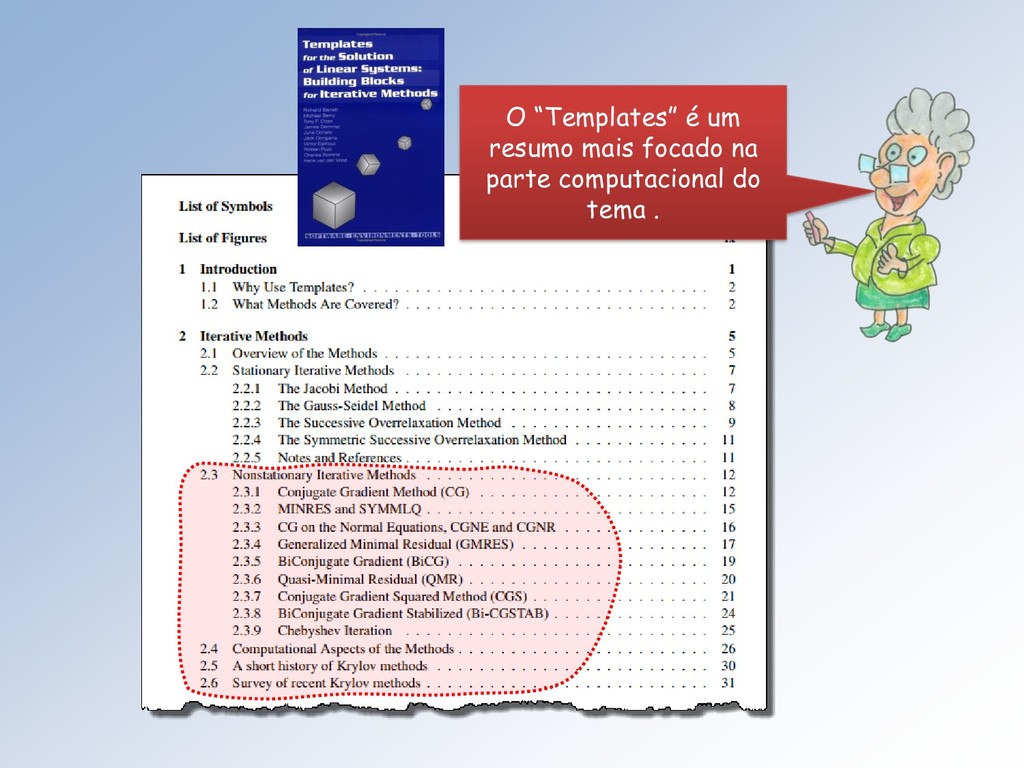
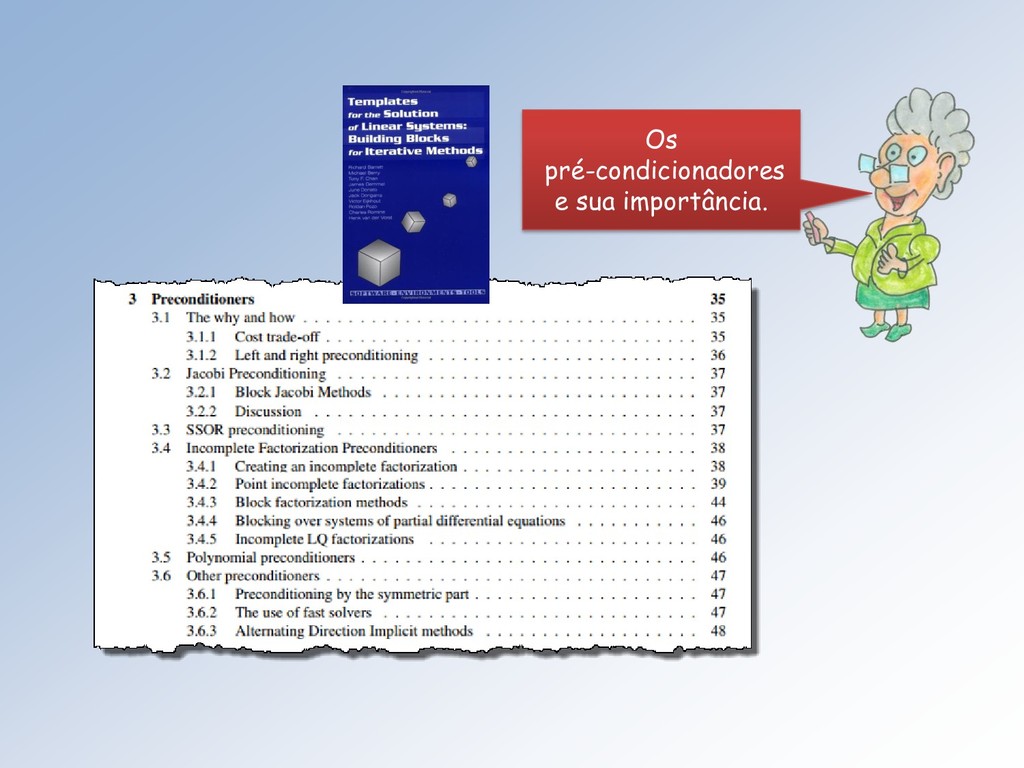
Outros dois livros fundamentais sobre o assunto, além do Golub
e do Trefethen: -
Agora, passaremos a examinar os métodos iterativos mais simples para
resolver sistemas lineares. -
Construiremos três métodos iterativos, de ponto-fixo, para resolver o sistema
linear = , conhecidos na literatura como métodos estacionários. Como desejamos achar uma “raiz” da equação vetorial () = 0, em que = − , procuraremos por pontos-fixo de alguma função linear = + onde a matriz é obtida através de manipulação algébrica de (). -
Para tudo funcionar, precisaremos garantir que a () seja uma
contração. E como podemos garantir que essa : ℝ → ℝ é uma contração, Mestra? -
Como antes, precisamos garantir que − () < − com
0 < < 1. Ora, se = + é linear, temos − = ( − ) e assim ( − ) ≤ ∙ − . Portanto se 0 < < 1 teremos que é uma contração. -
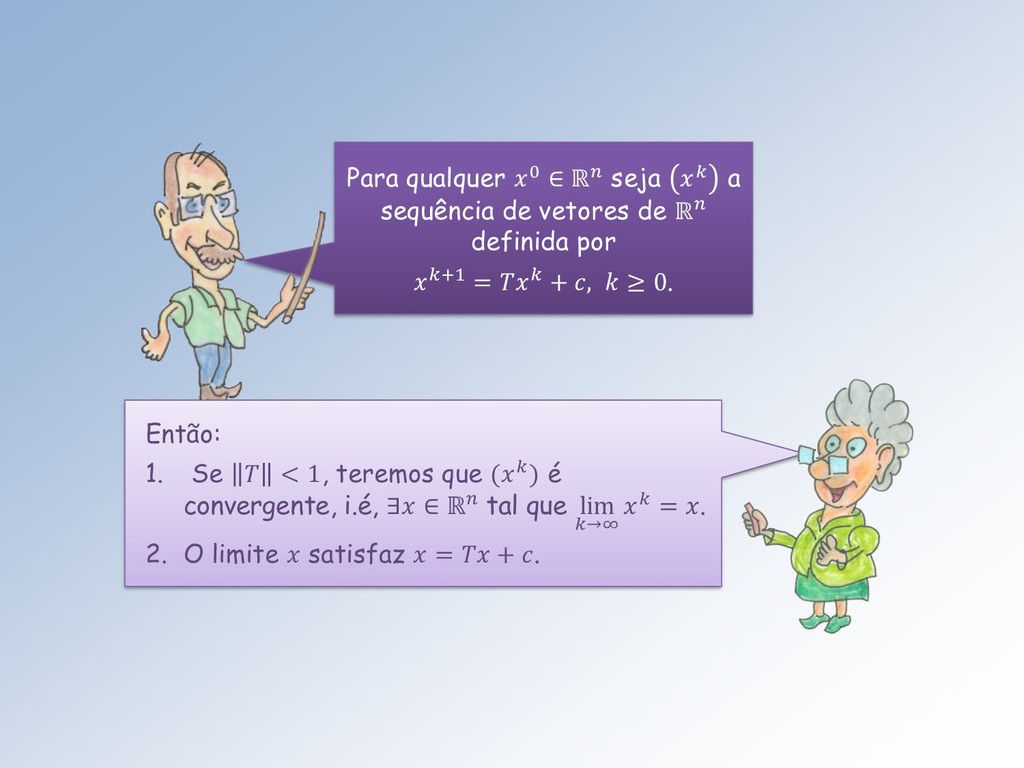
Para qualquer 0 ∈ ℝ seja a sequência de vetores
de ℝ definida por +1 = + , ≥ 0. Então: 1. Se < 1, teremos que () é convergente, i.é, ∃ ∈ ℝ tal que lim →∞ = . 2. O limite satisfaz = + . -
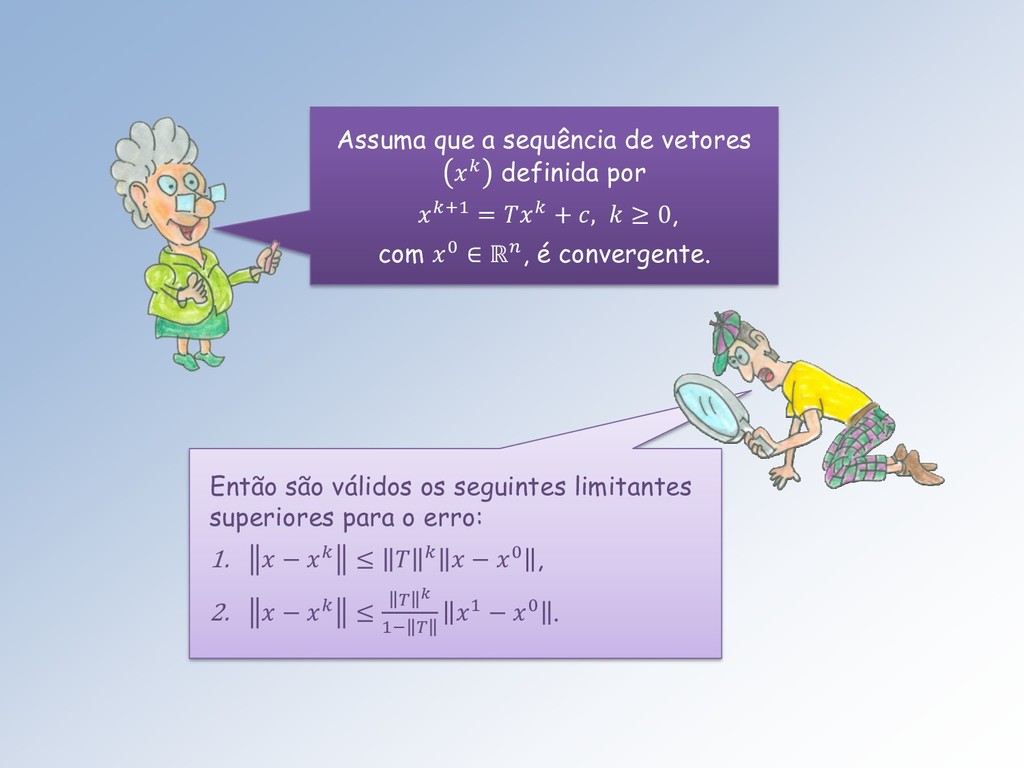
Então são válidos os seguintes limitantes superiores para o erro:
1. − ≤ − 0 , 2. − ≤ 1− 1 − 0 . Assuma que a sequência de vetores definida por +1 = + , ≥ 0, com 0 ∈ ℝ, é convergente. -
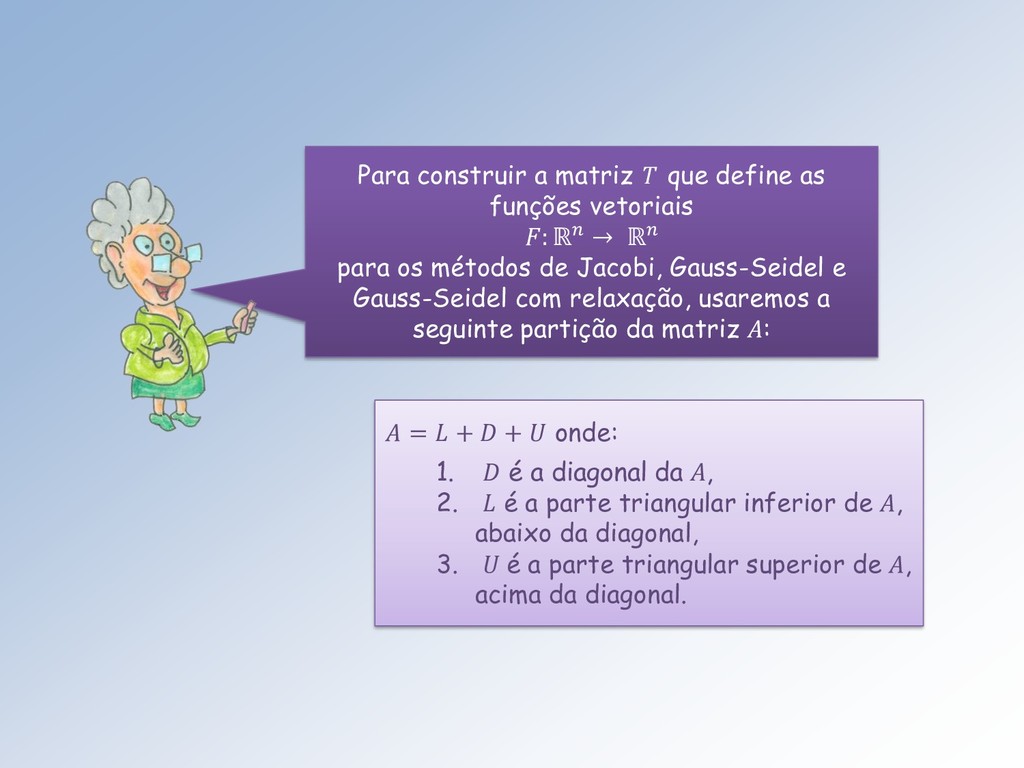
Para construir a matriz T que define as funções vetoriais
: ℝ → ℝ para os métodos de Jacobi, Gauss-Seidel e Gauss-Seidel com relaxação, usaremos a seguinte partição da matriz A: = + + onde: 1. é a diagonal da A, 2. L é a parte triangular inferior de A, abaixo da diagonal, 3. U é a parte triangular superior de A, acima da diagonal. -
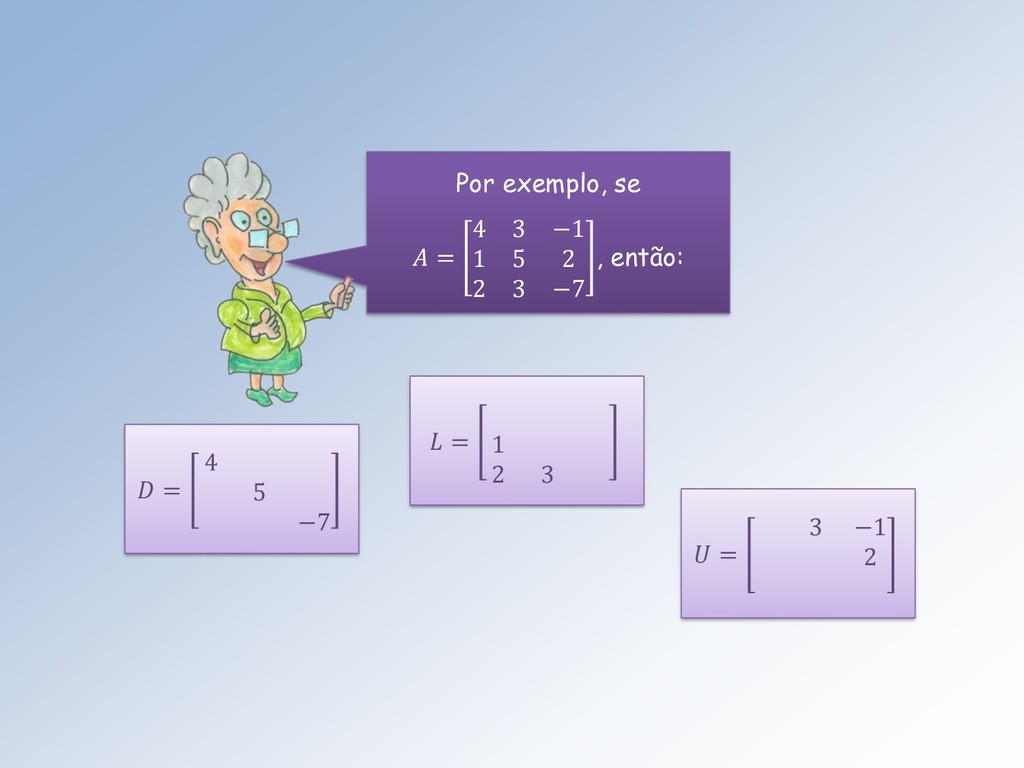
Por exemplo, se = 4 3 −1 1 5 2
2 3 −7 , então: = 4 5 −7 = 1 2 3 = 3 −1 2 -
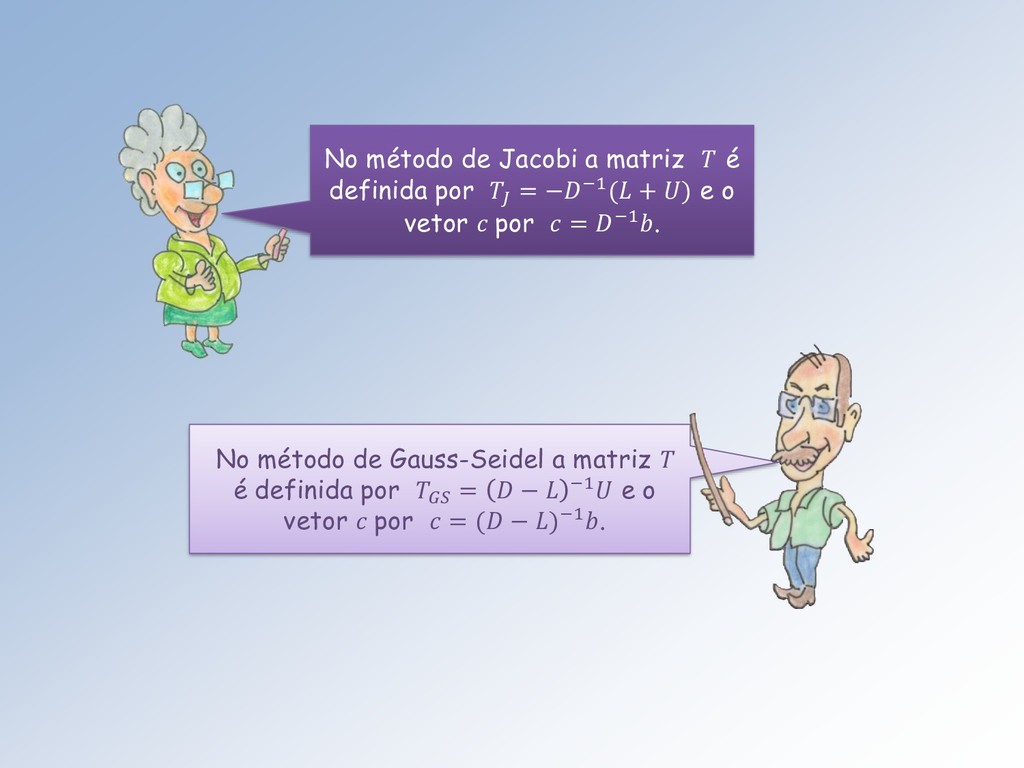
No método de Jacobi a matriz T é definida por
= −−1( + ) e o vetor c por = −1. No método de Gauss-Seidel a matriz T é definida por = − −1 e o vetor c por = ( − )−1. -
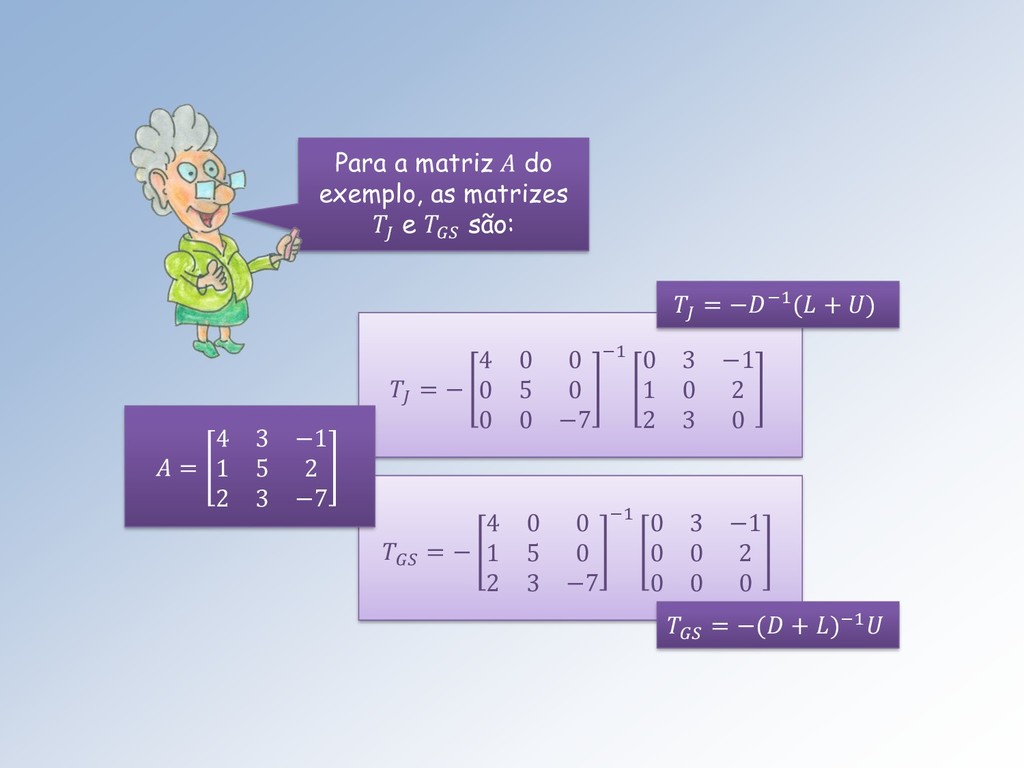
Para a matriz A do exemplo, as matrizes e são:
= − 4 0 0 0 5 0 0 0 −7 −1 0 3 −1 1 0 2 2 3 0 = − 4 0 0 1 5 0 2 3 −7 −1 0 3 −1 0 0 2 0 0 0 = 4 3 −1 1 5 2 2 3 −7 = −−1( + ) = −( + )−1 -
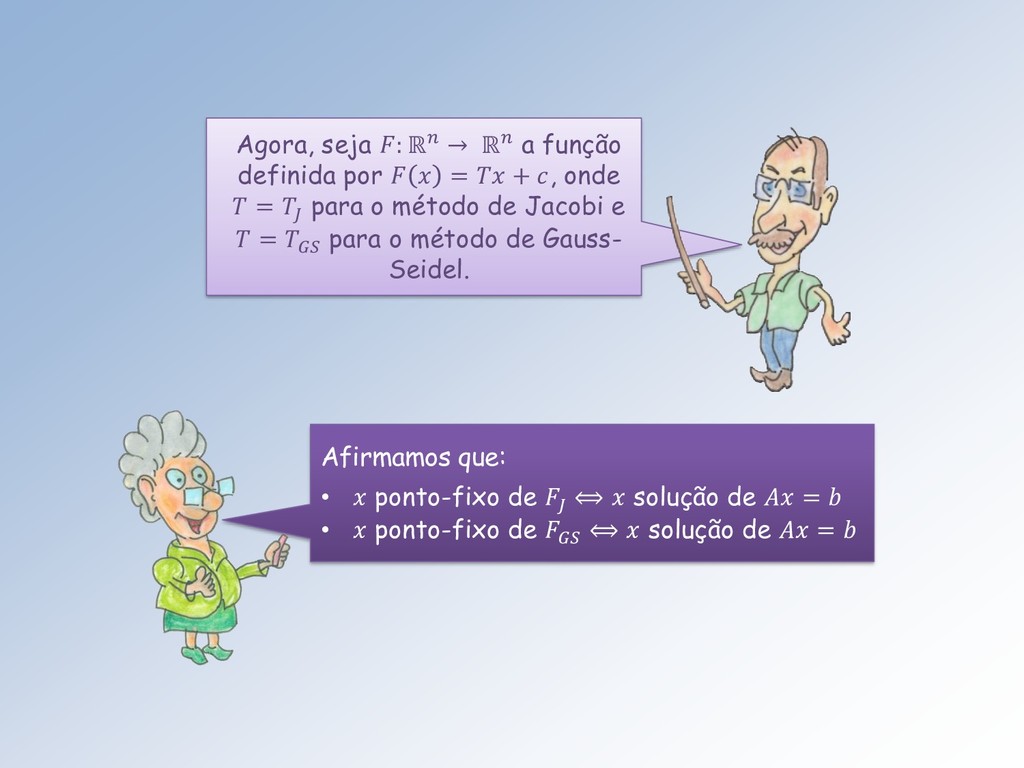
Afirmamos que: • ponto-fixo de ⟺ solução de = •
ponto-fixo de ⟺ solução de = Agora, seja : ℝ → ℝ a função definida por = + , onde = para o método de Jacobi e = para o método de Gauss- Seidel. -
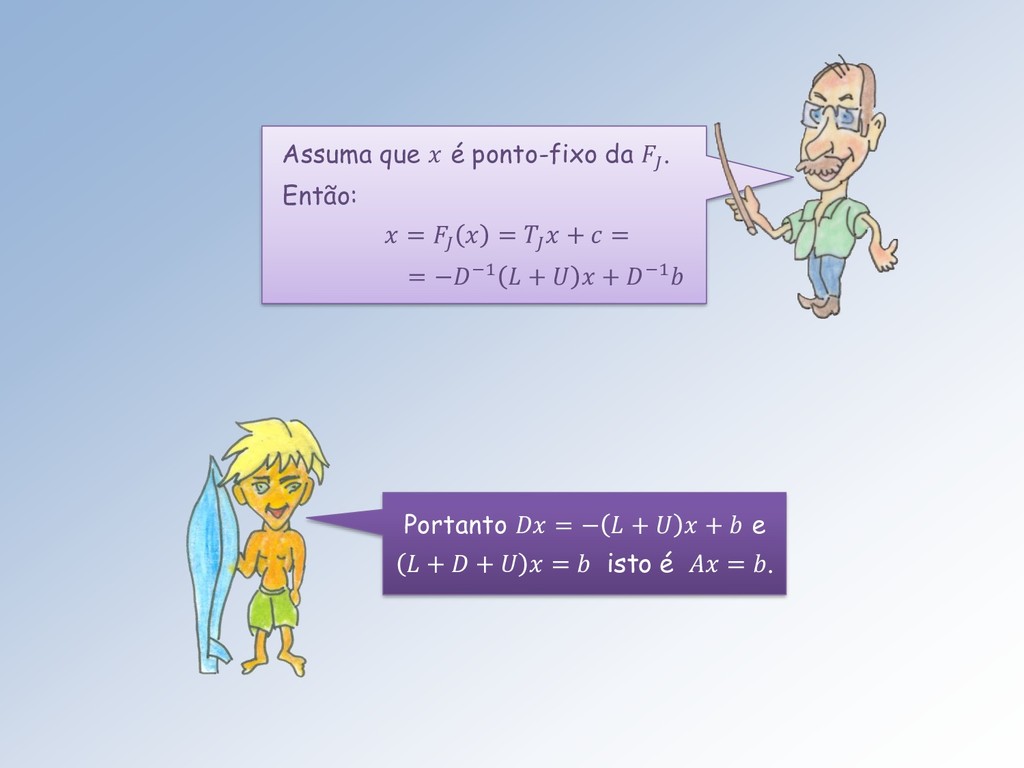
Assuma que é ponto-fixo da . Então: = = +
= = −−1 + + −1 Portanto = − + + e + + = isto é = . -
Para o método de Gauss-Seidel as contas são muito parecidas
e também vale a equivalência. Como esses passos podem ser revertidos, vale a volta. -
Agora, seja a sequência de vetores de ℝ definida por
+1 = () para = 0,1,2, … com 0 um vetor qualquer de ℝ. Tanto no caso de Jacobi como no de Gauss-Seidel. Se a : ℝ → ℝ for uma contração essa sequência convergirá. Então, sendo = lim →∞ , teremos que = . -
Sim Professor. Vou esclarecer as ideias na próxima transparência. O
método de Gauss-Seidel com fator de relaxação é uma combinação linear dos métodos de Jacobi e de Gauss-Seidel definida por: = + 1 − , para ≥ 0. -
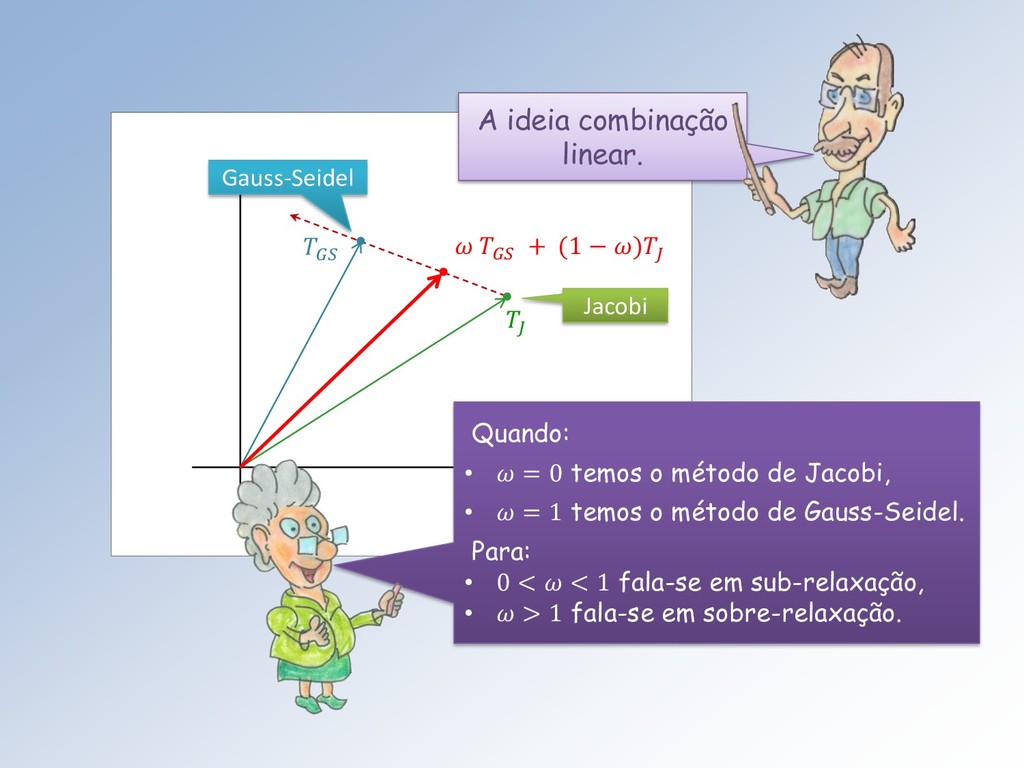
+ (1 − ) A ideia combinação linear. Quando: •
= 0 temos o método de Jacobi, • = 1 temos o método de Gauss-Seidel. Para: • 0 < < 1 fala-se em sub-relaxação, • > 1 fala-se em sobre-relaxação. Jacobi Gauss-Seidel -
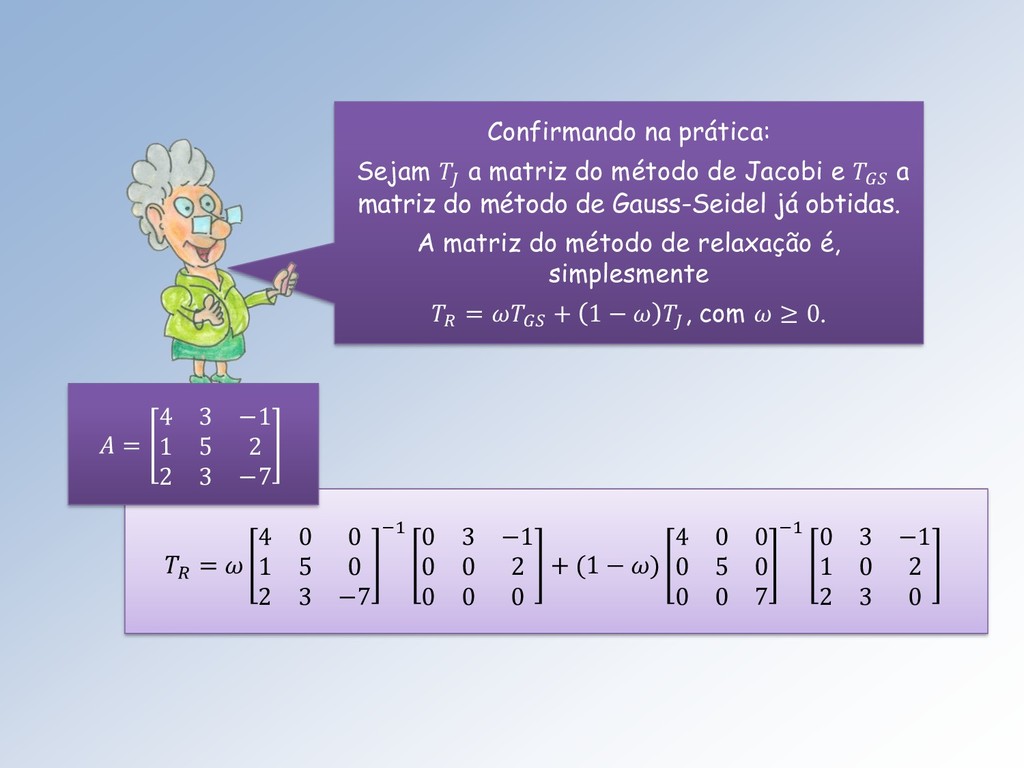
= 4 0 0 1 5 0 2 3 −7
−1 0 3 −1 0 0 2 0 0 0 + (1 − ) 4 0 0 0 5 0 0 0 7 −1 0 3 −1 1 0 2 2 3 0 Confirmando na prática: Sejam a matriz do método de Jacobi e a matriz do método de Gauss-Seidel já obtidas. A matriz do método de relaxação é, simplesmente = + 1 − , com ≥ 0. = 4 3 −1 1 5 2 2 3 −7 -
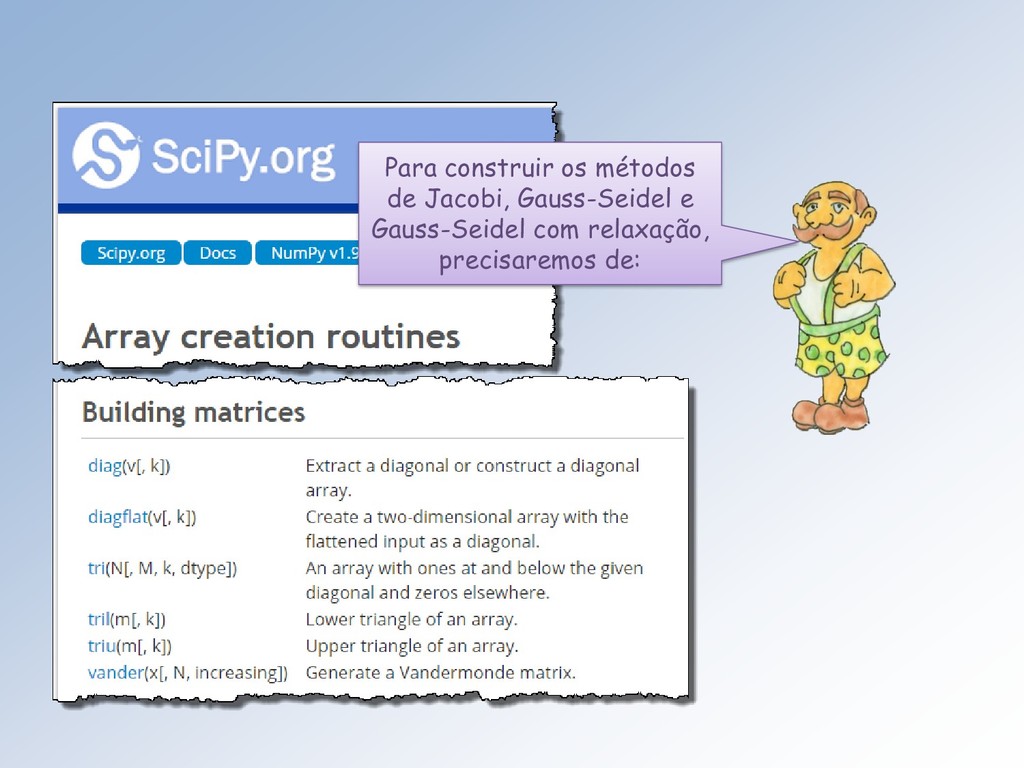
Para construir os métodos de Jacobi, Gauss-Seidel e Gauss-Seidel com
relaxação, precisaremos de: -
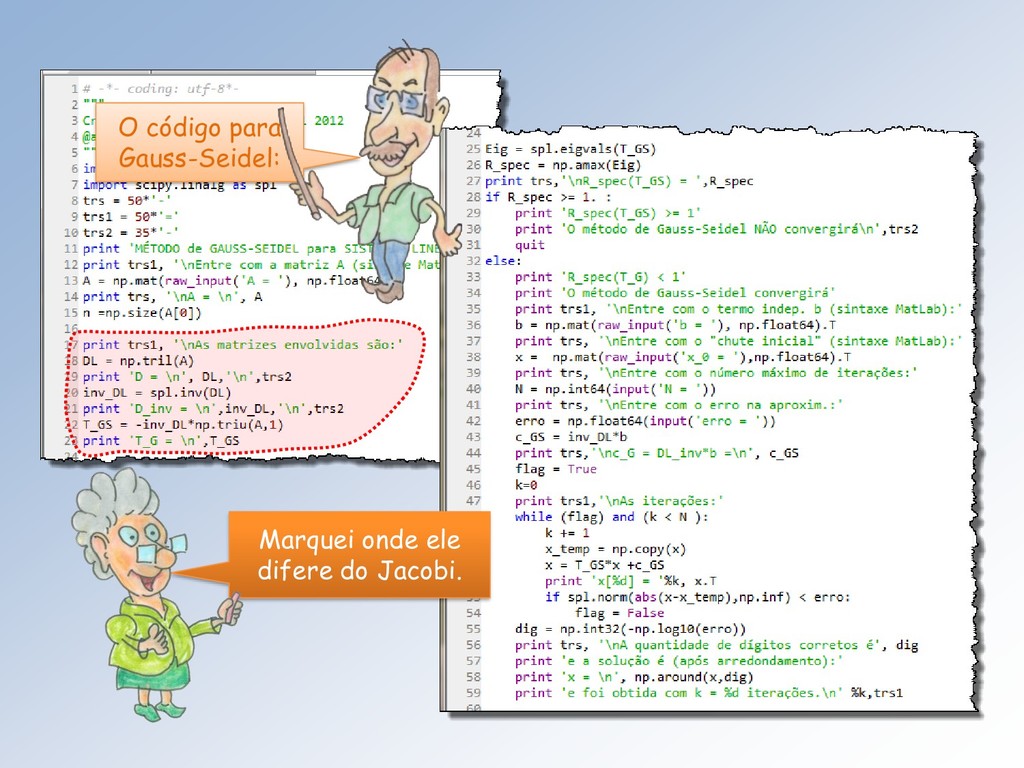
Apresentarei agora programas para os métodos de Jacobi, Gauss-Seidel e
relaxação e exemplos de execução. -
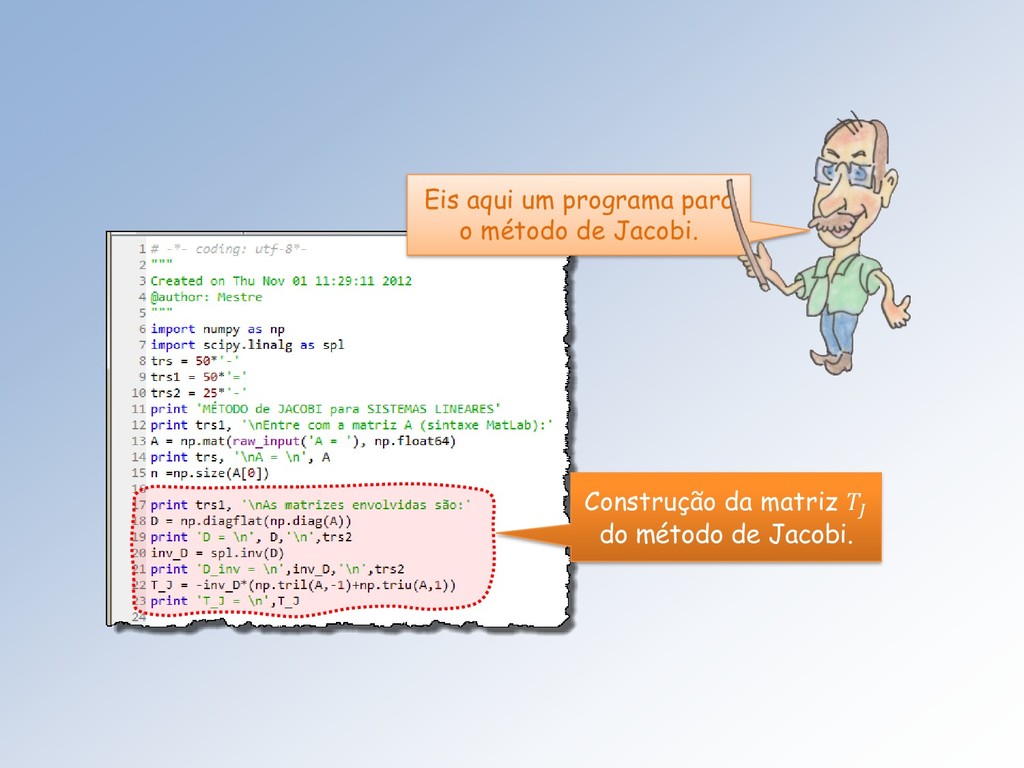
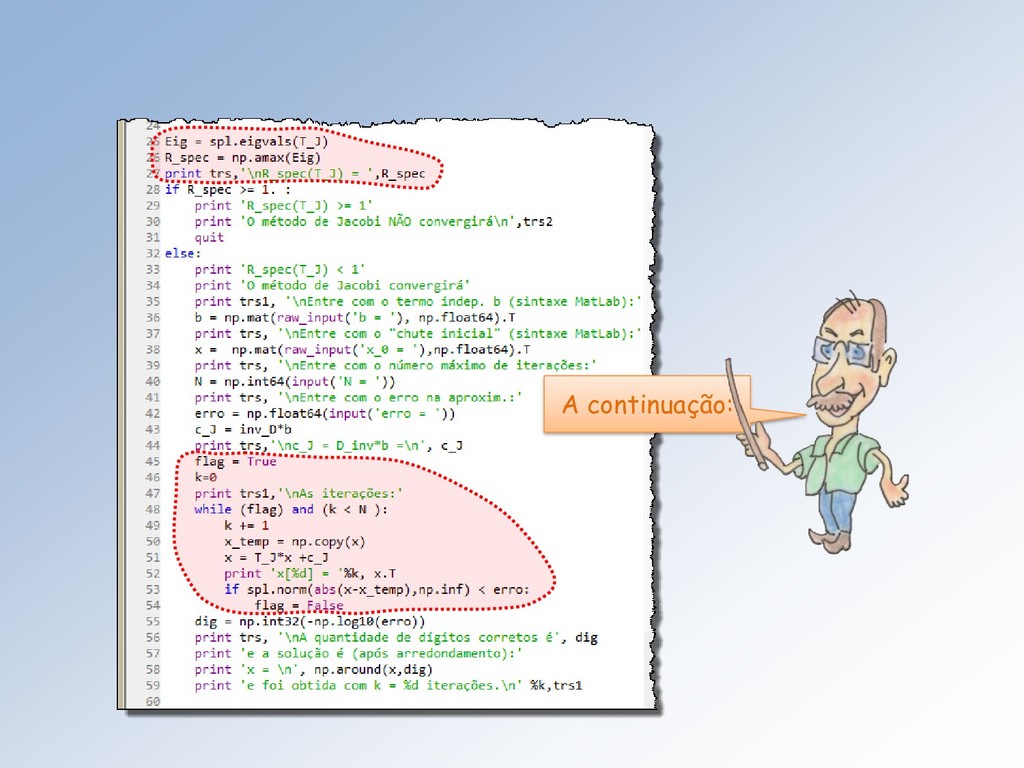
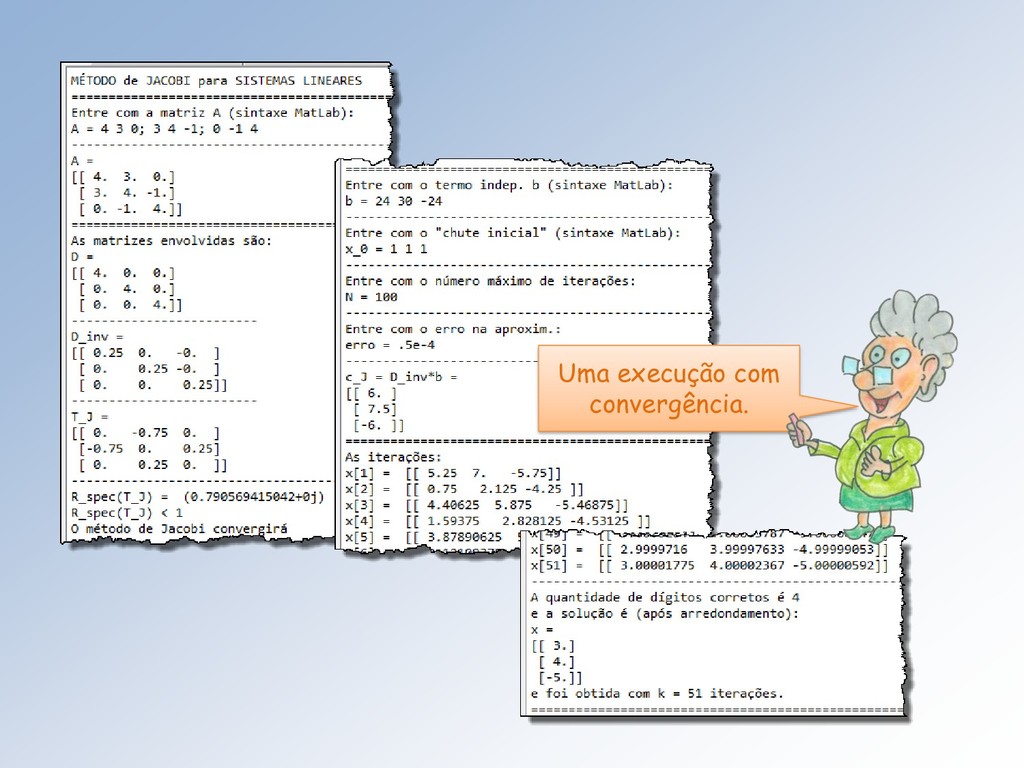
Eis aqui um programa para o método de Jacobi. Construção
da matriz do método de Jacobi. -
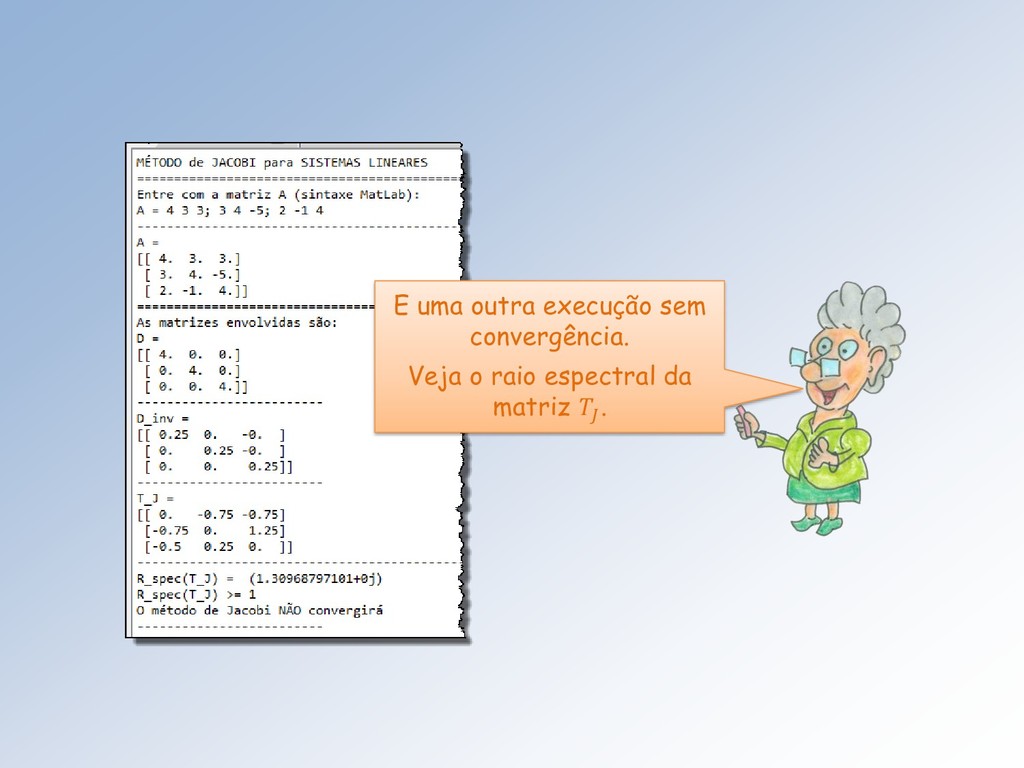
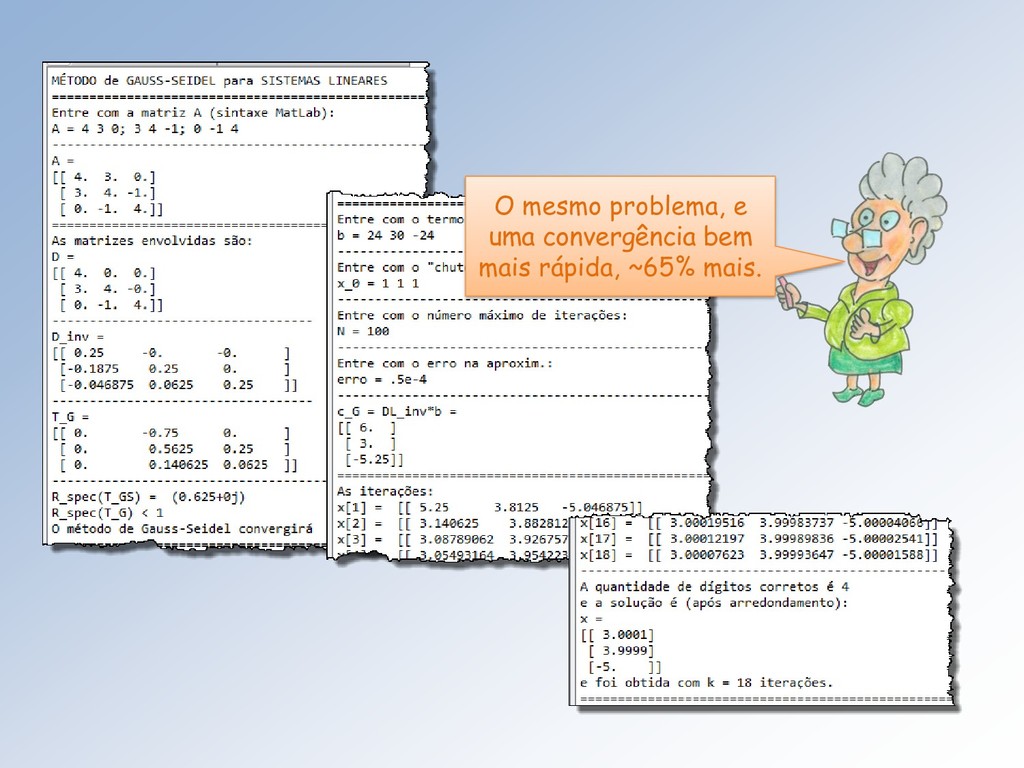
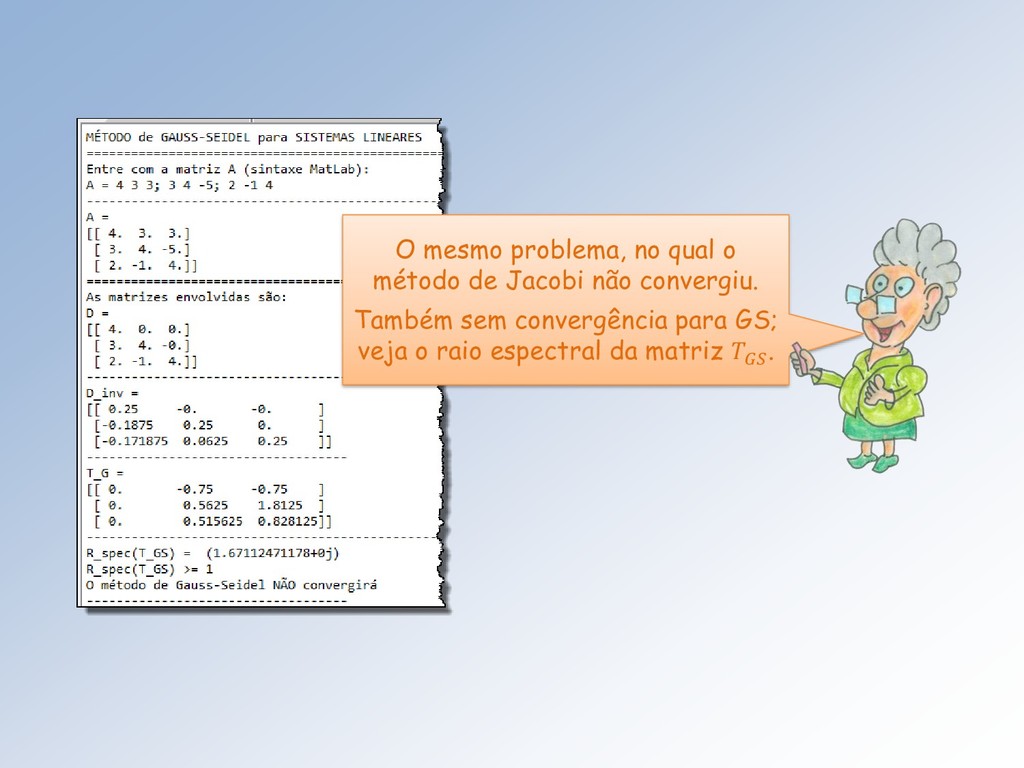
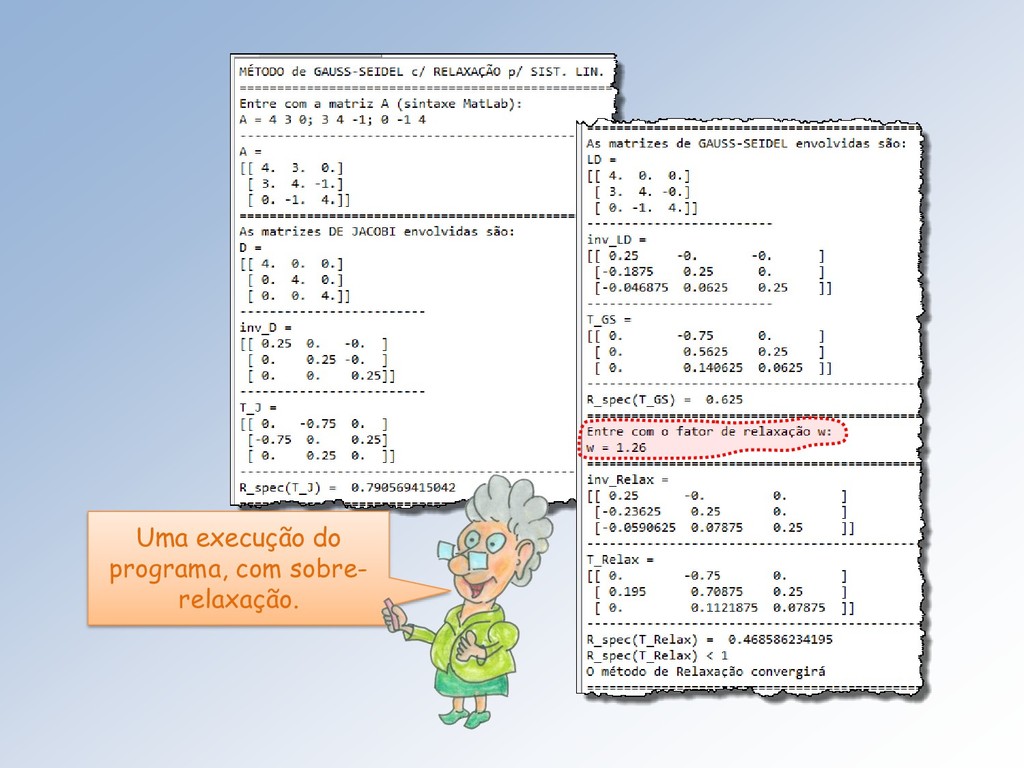
O mesmo problema, no qual o método de Jacobi não
convergiu. Também sem convergência para GS; veja o raio espectral da matriz . -
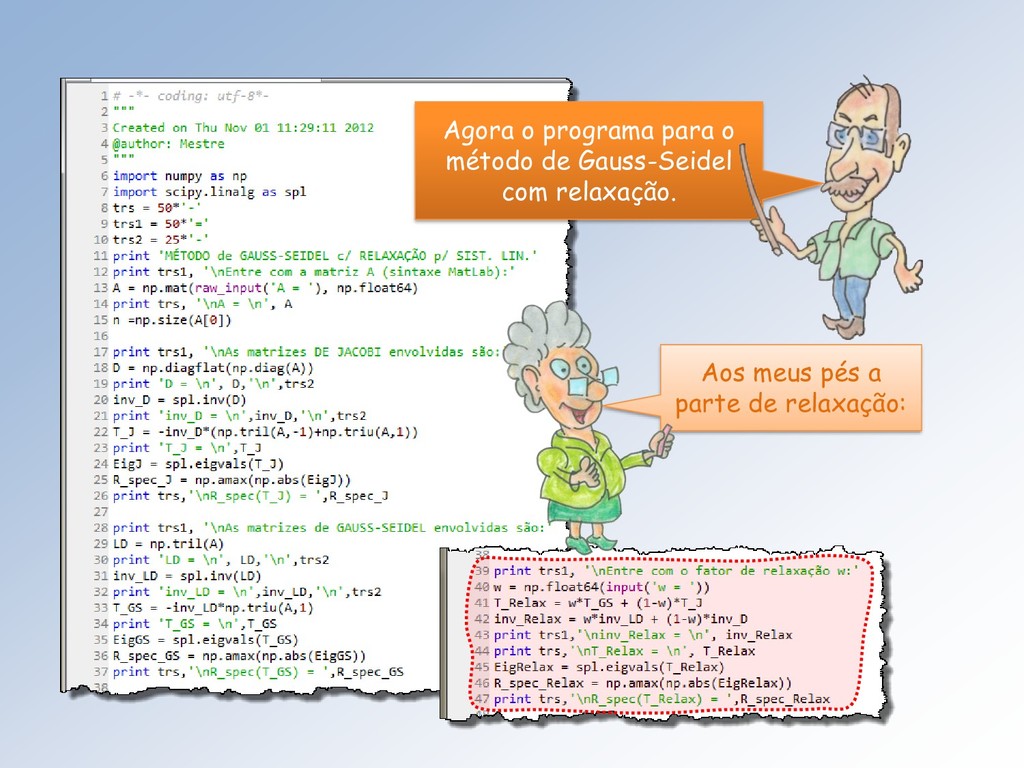
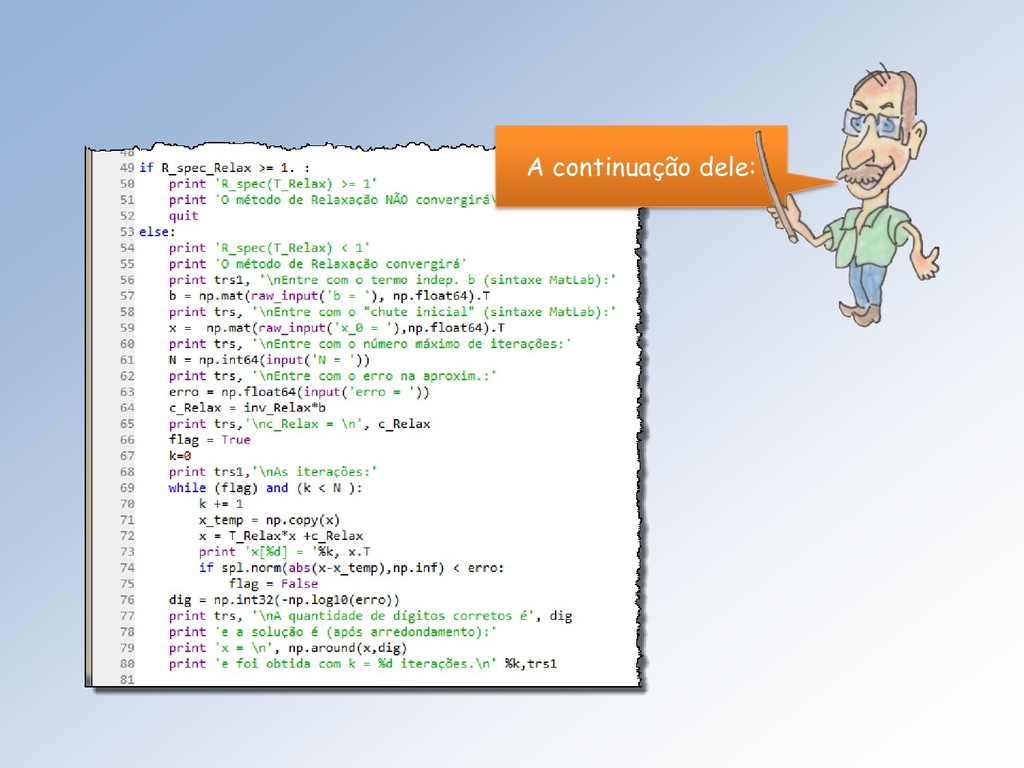
Agora o programa para o método de Gauss-Seidel com relaxação.
Aos meus pés a parte de relaxação: -
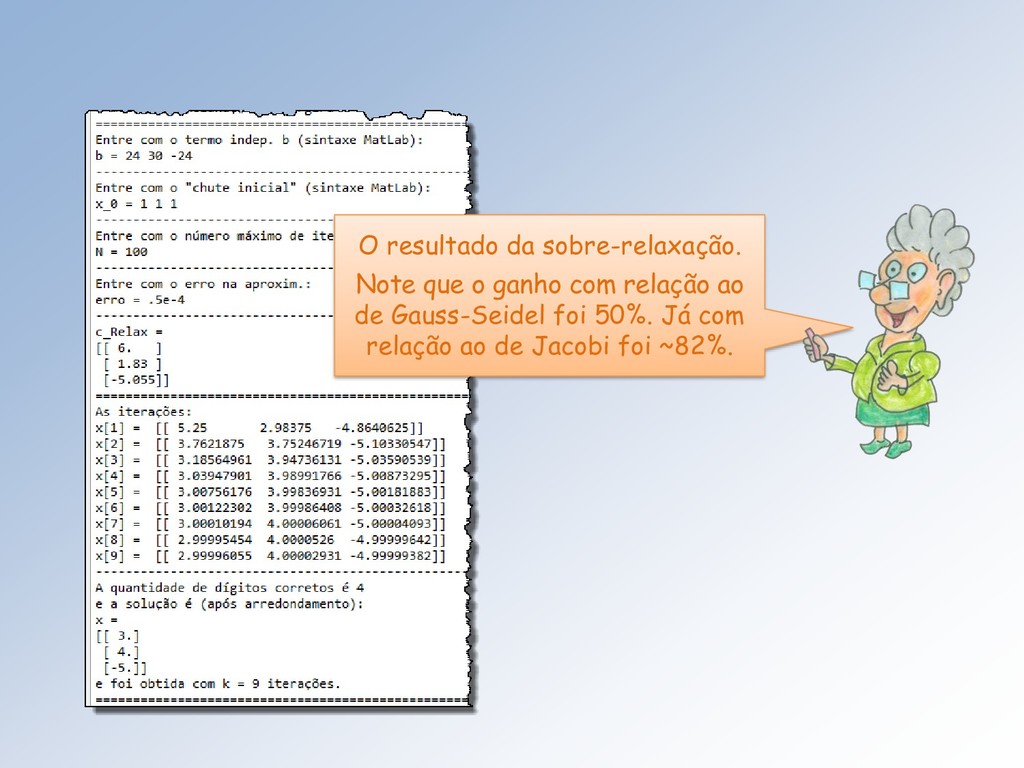
O resultado da sobre-relaxação. Note que o ganho com relação
ao de Gauss-Seidel foi 50%. Já com relação ao de Jacobi foi ~82%. -
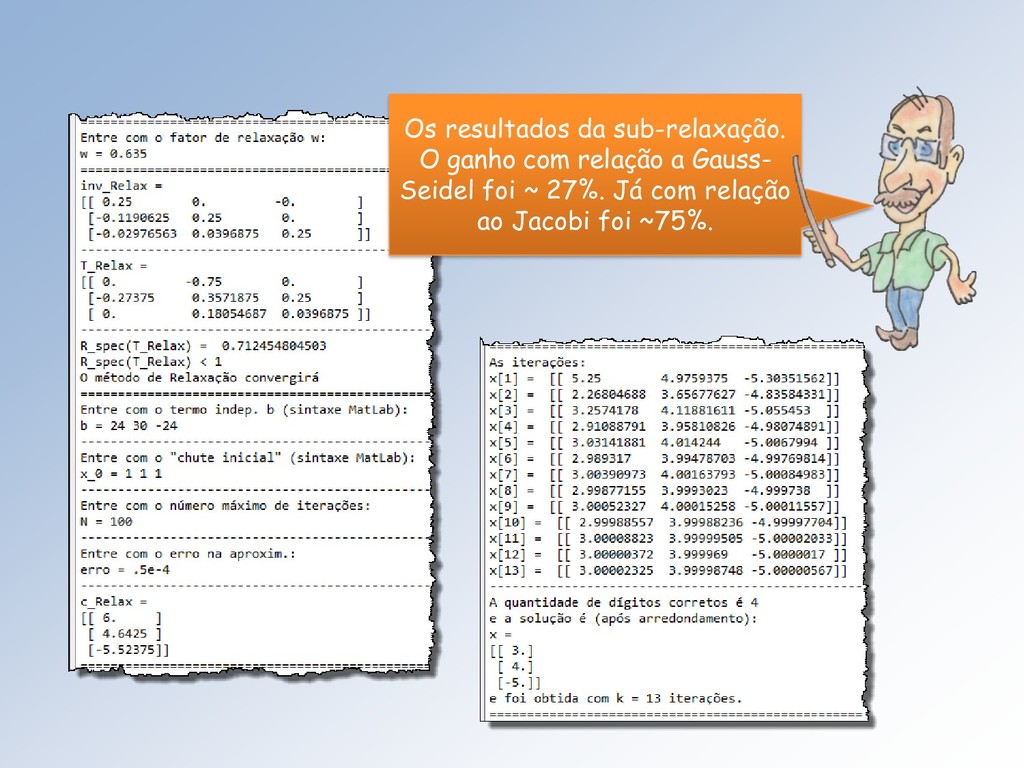
Os resultados da sub-relaxação. O ganho com relação a Gauss-
Seidel foi ~ 27%. Já com relação ao Jacobi foi ~75%. -
Mestre, e como você conseguiu esses valores de ? Ganhou
na loteria? Não Loirinha! Existem alguns resultados teóricos para ajudar na escolha de , mas na prática trabalhamos tentativa e erro. -
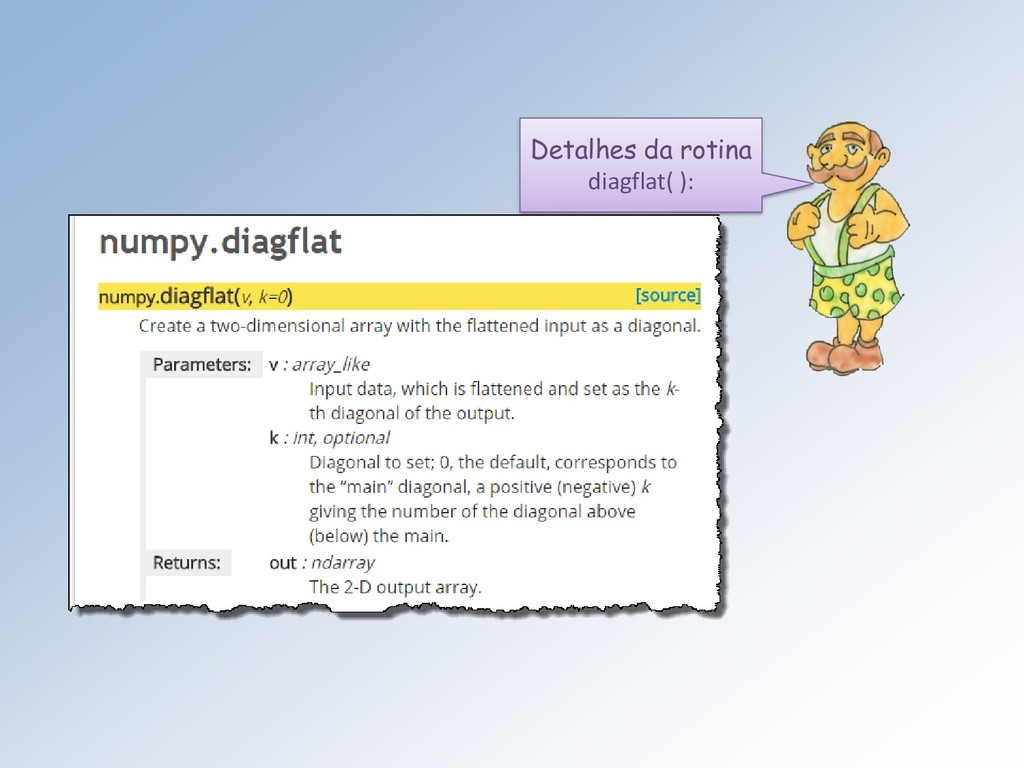
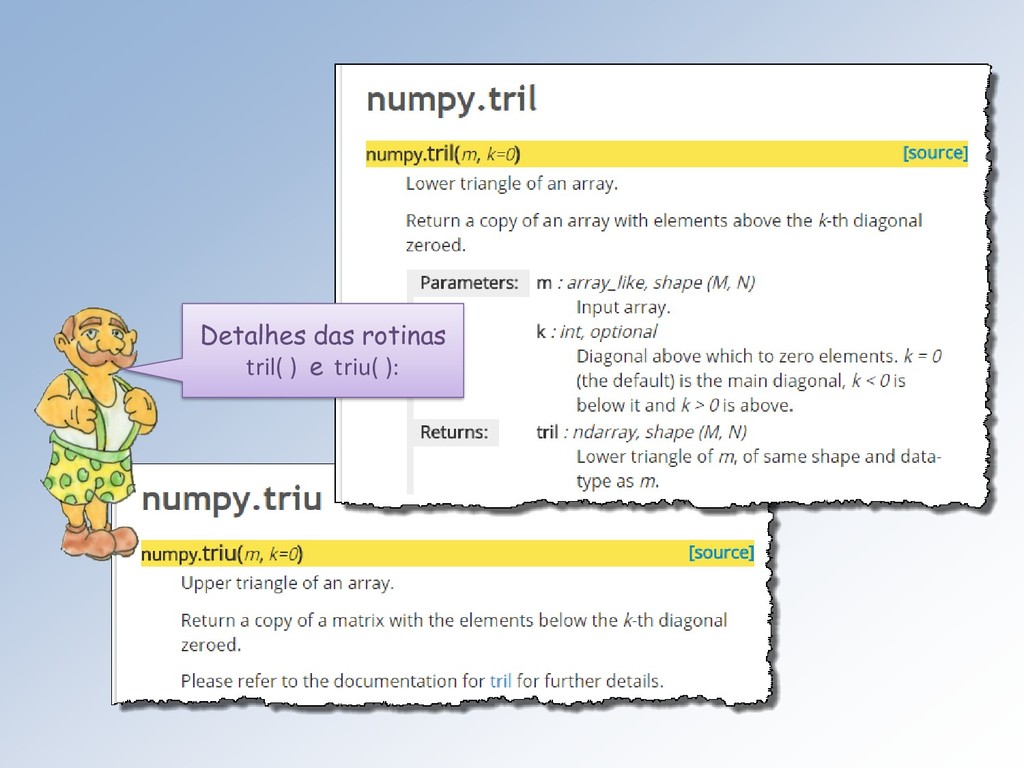
Agora vou apresentar a forma prática de implementar os três
métodos, trabalhando diretamente com as equações, sem usar as funções diag( ), tril( ), triu( ) da NumPy. -
Não entendo o motivo! Basta usar os programas mostrados pelo
Mestre. A importância dos métodos iterativos reside em utilizar apenas os coeficientes não-nulos da matriz A, o que não acontece com as diag( ), tril( ), triu( ). -
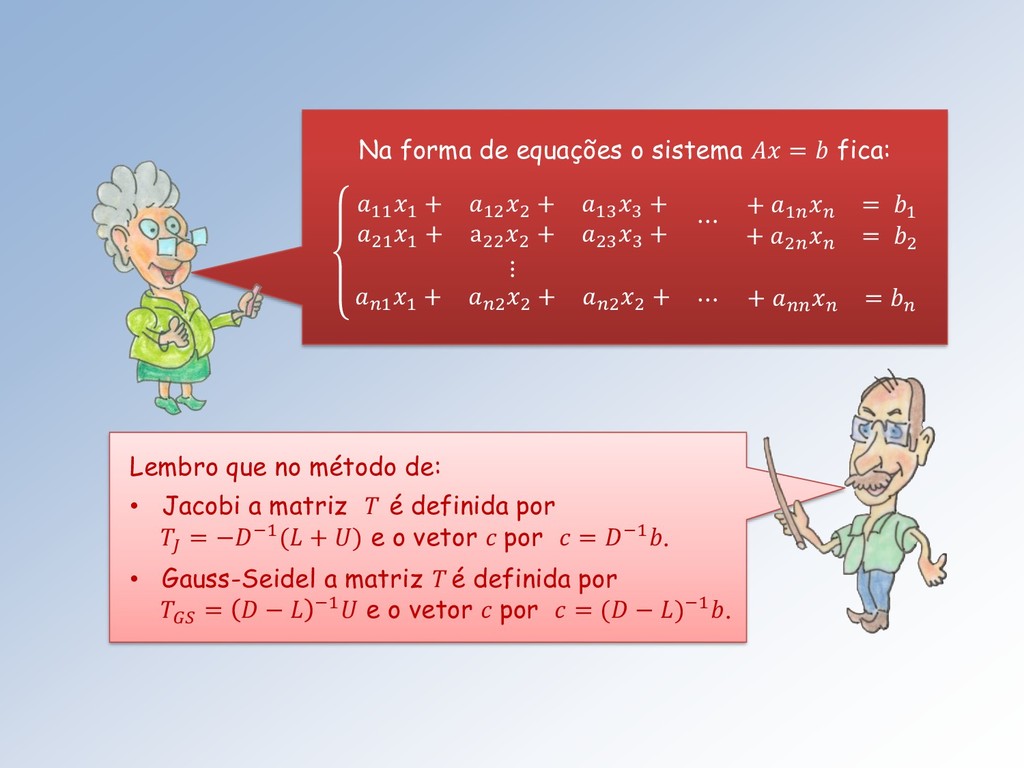
Na forma de equações o sistema = fica: 11 1
+ 21 1 + 12 2 + a22 2 + 13 3 + 23 3 + ⋯ + 1 = 1 + 2 = 2 ⋮ 1 1 + 2 2 + 2 2 + ⋯ + = Lembro que no método de: • Jacobi a matriz T é definida por = −−1( + ) e o vetor c por = −1. • Gauss-Seidel a matriz T é definida por = − −1 e o vetor c por = ( − )−1. -
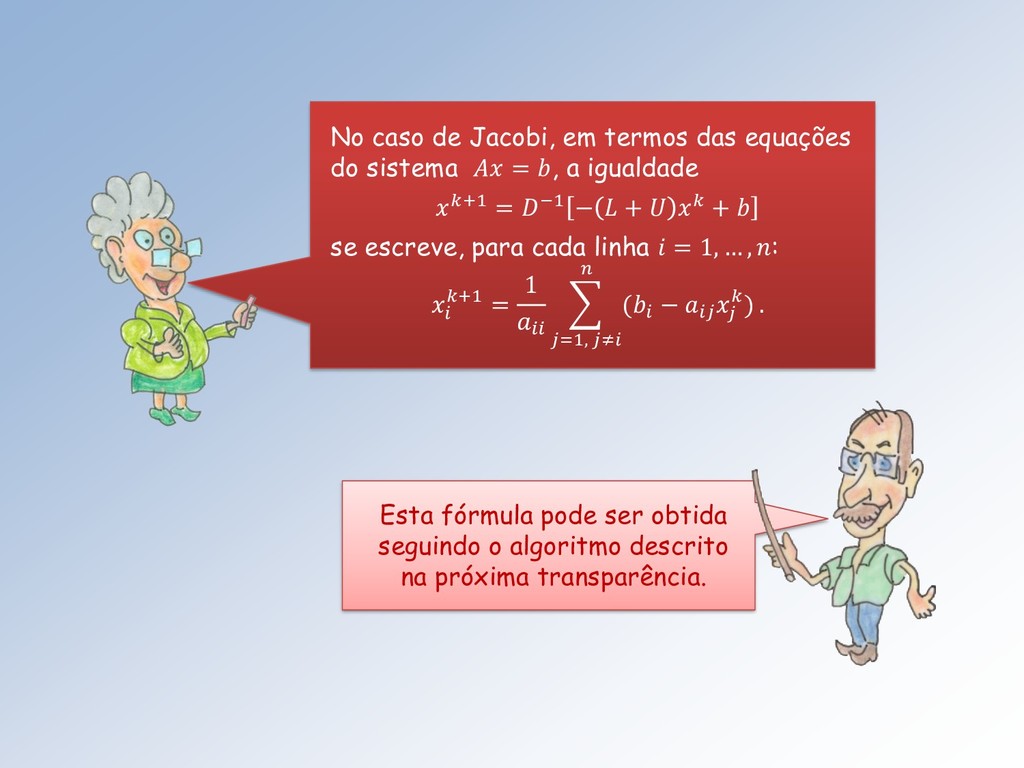
No caso de Jacobi, em termos das equações do sistema
= , a igualdade +1 = −1 − + + se escreve, para cada linha = 1, … , : +1 = 1 =1, ≠ ( − ) . Esta fórmula pode ser obtida seguindo o algoritmo descrito na próxima transparência. -
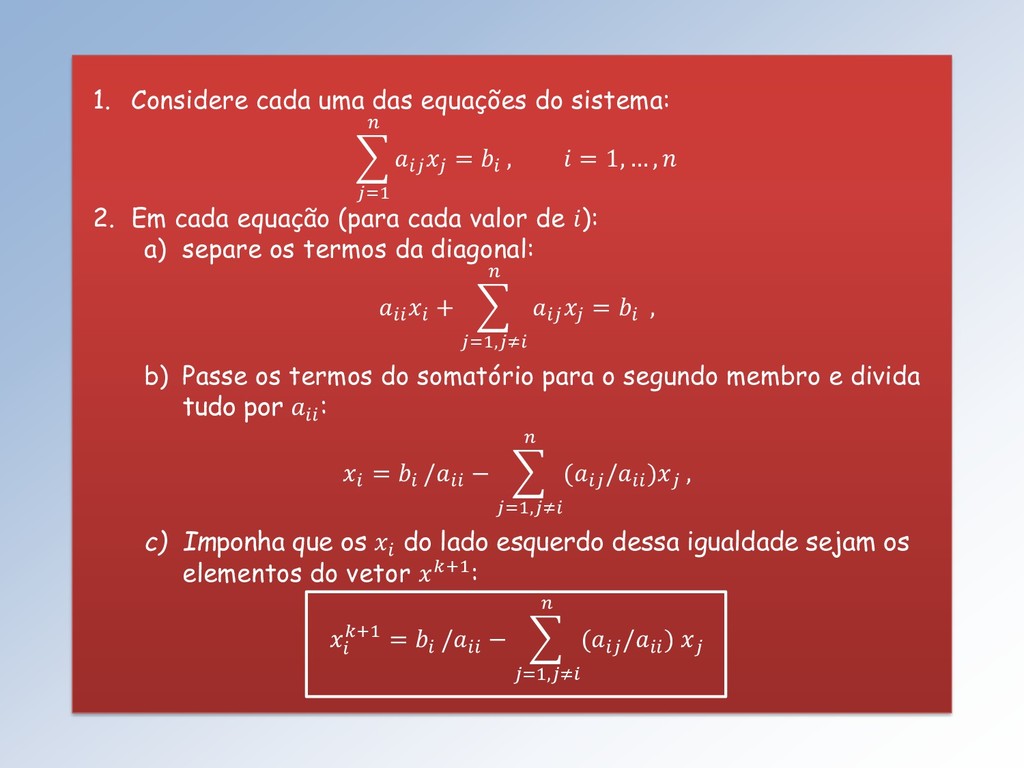
1. Considere cada uma das equações do sistema: =1
= , = 1, … , 2. Em cada equação (para cada valor de ): a) separe os termos da diagonal: + =1,≠ = , b) Passe os termos do somatório para o segundo membro e divida tudo por : = / − =1,≠ ( / ) , c) Imponha que os do lado esquerdo dessa igualdade sejam os elementos do vetor +1: +1 = / − =1,≠ ( / ) -
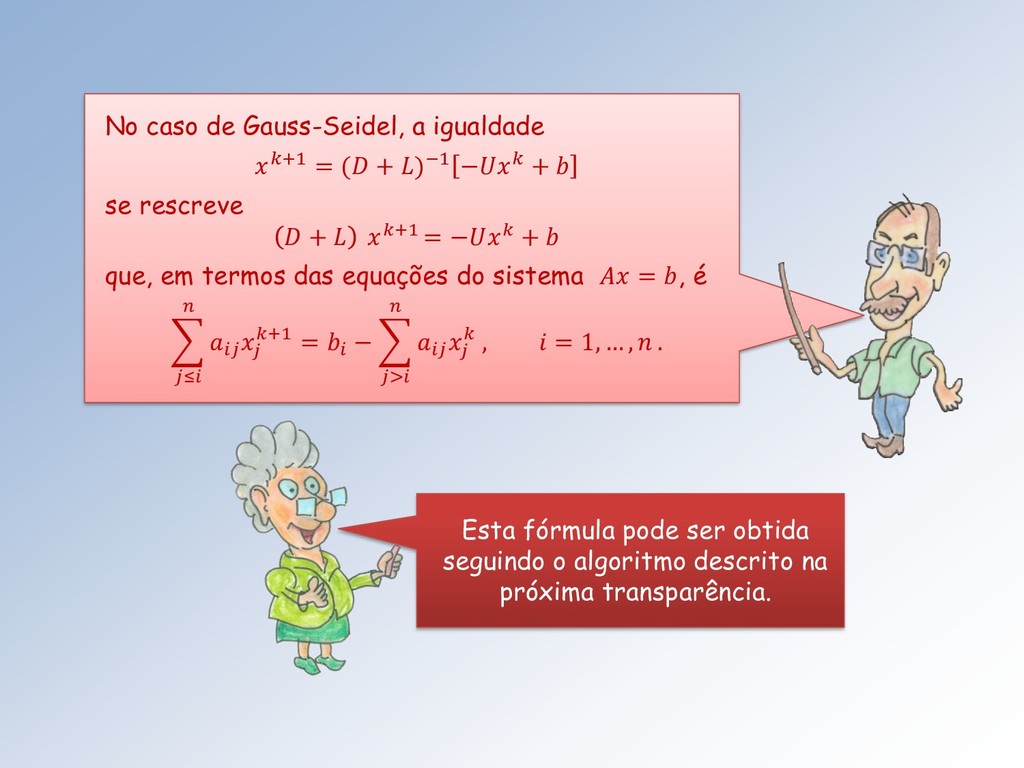
No caso de Gauss-Seidel, a igualdade +1 = ( +
)−1 − + se rescreve + +1 = − + que, em termos das equações do sistema = , é ≤ +1 = − > , = 1, … , . Esta fórmula pode ser obtida seguindo o algoritmo descrito na próxima transparência. -
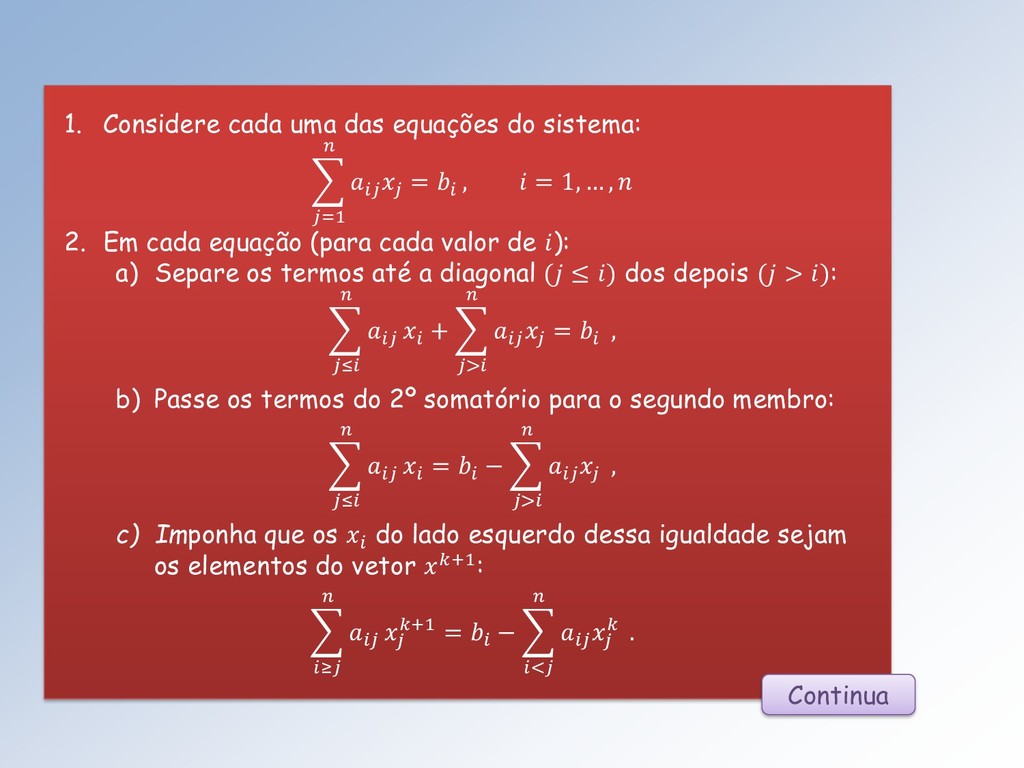
1. Considere cada uma das equações do sistema: =1
= , = 1, … , 2. Em cada equação (para cada valor de ): a) Separe os termos até a diagonal ( ≤ ) dos depois ( > ): ≤ + > = , b) Passe os termos do 2º somatório para o segundo membro: ≤ = − > , c) Imponha que os do lado esquerdo dessa igualdade sejam os elementos do vetor +1: ≥ +1 = − < . Continua -
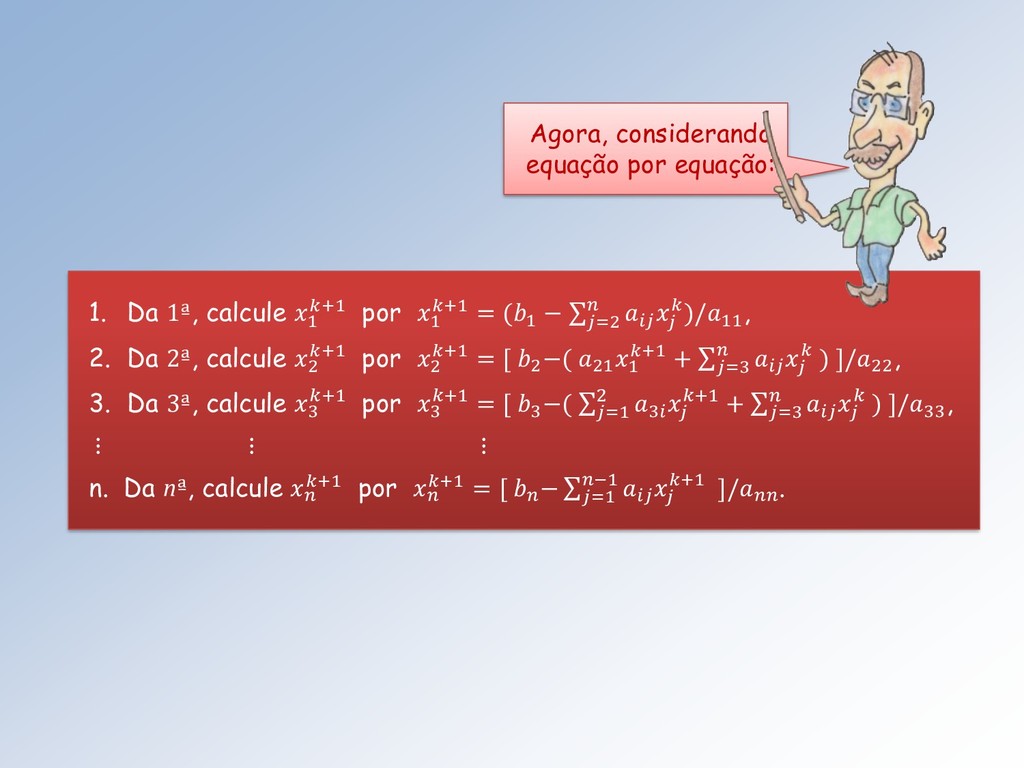
1. Da 1ª, calcule 1 +1 por 1 +1 =
(1 − σ =2 )/11 , 2. Da 2ª, calcule 2 +1 por 2 +1 = [ 2 −( 21 1 +1 + σ =3 ) ]/22 , 3. Da 3ª, calcule 3 +1 por 3 +1 = [ 3 −( σ=1 2 3 +1 + σ =3 ) ]/33 , ⋮ ⋮ ⋮ n. Da nª, calcule +1 por +1 = [ − σ =1 −1 +1 ]/ . Agora, considerando equação por equação: -
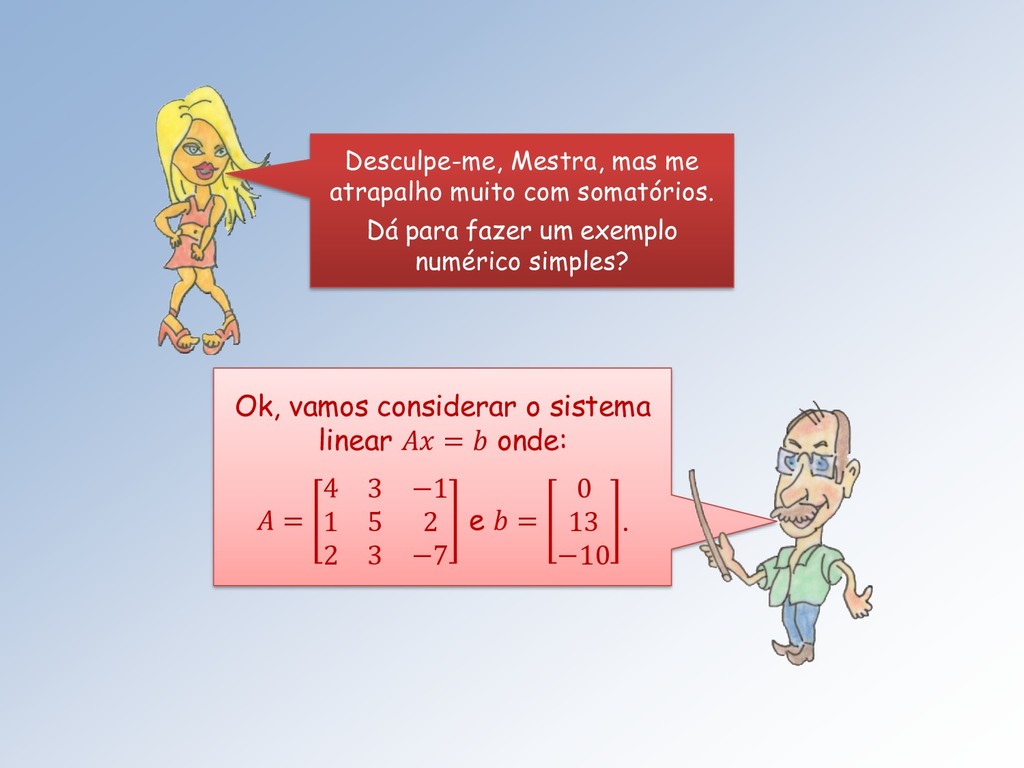
Desculpe-me, Mestra, mas me atrapalho muito com somatórios. Dá para
fazer um exemplo numérico simples? Ok, vamos considerar o sistema linear = onde: = 4 3 −1 1 5 2 2 3 −7 e = 0 13 −10 . -
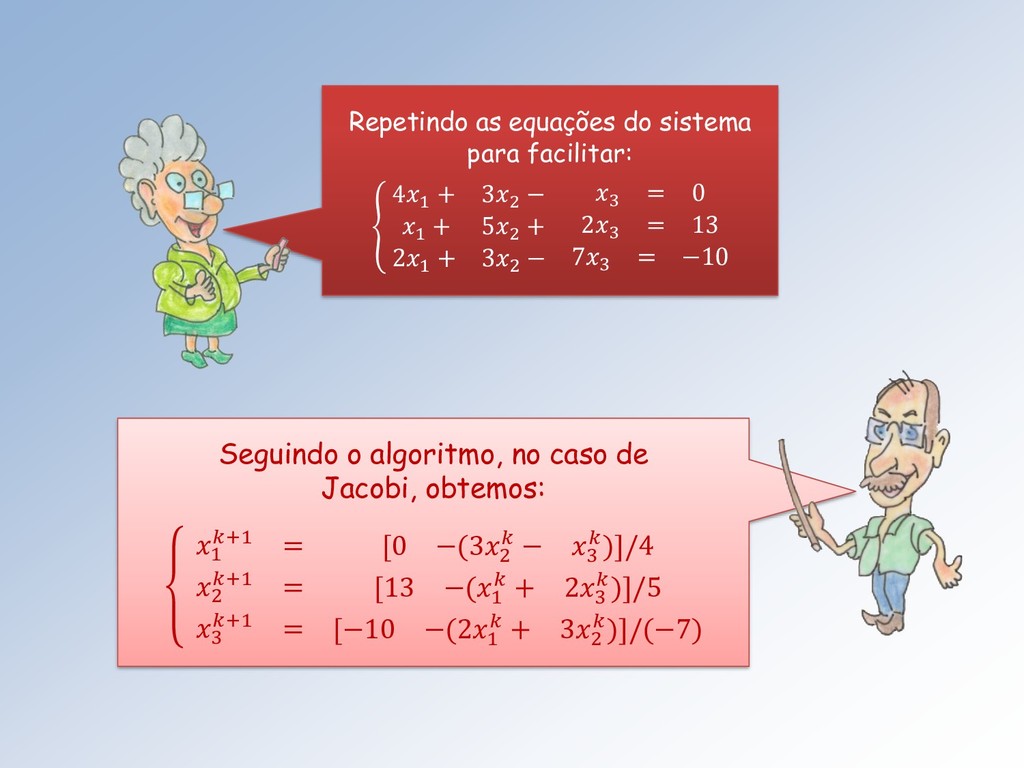
Repetindo as equações do sistema para facilitar: ቐ 41 +
32 − 3 = 0 1 + 52 + 23 = 13 21 + 32 − 73 = −10 Seguindo o algoritmo, no caso de Jacobi, obtemos: 1 +1 = [0 −(32 − 3 )]/4 2 +1 = [13 −(1 + 23 )]/5 3 +1 = [−10 −(21 + 32 )]/(−7) -
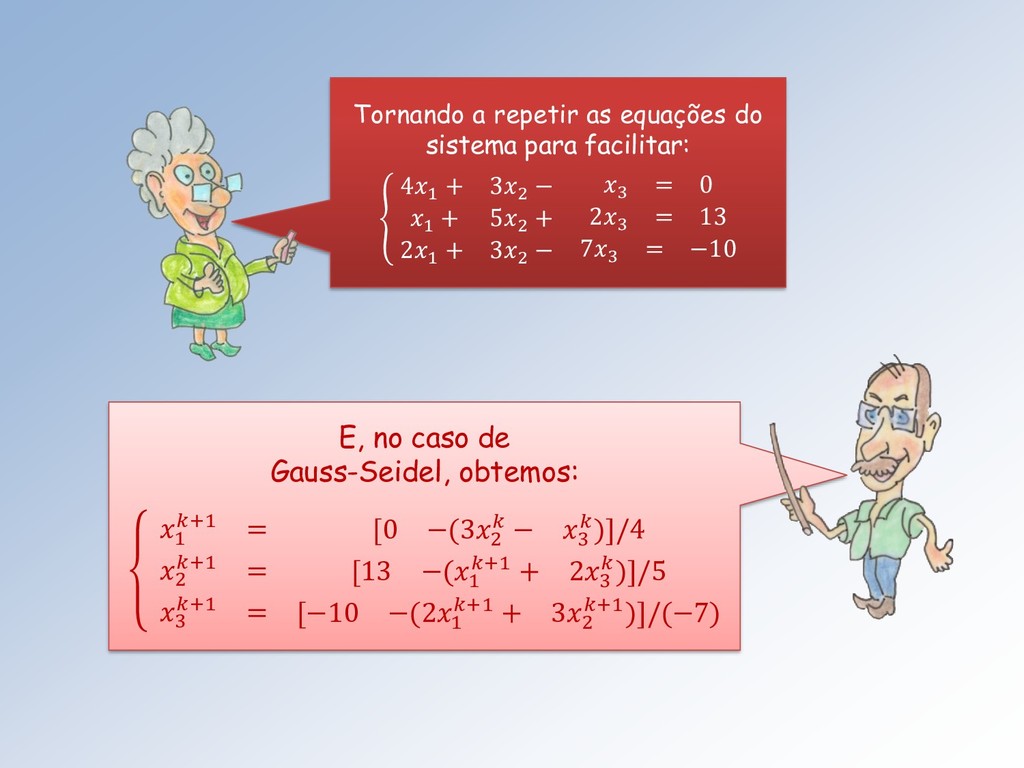
Tornando a repetir as equações do sistema para facilitar: ቐ
41 + 32 − 3 = 0 1 + 52 + 23 = 13 21 + 32 − 73 = −10 E, no caso de Gauss-Seidel, obtemos: 1 +1 = [0 −(32 − 3 )]/4 2 +1 = [13 −(1 +1 + 23 )]/5 3 +1 = [−10 −(21 +1 + 32 +1)]/(−7) -
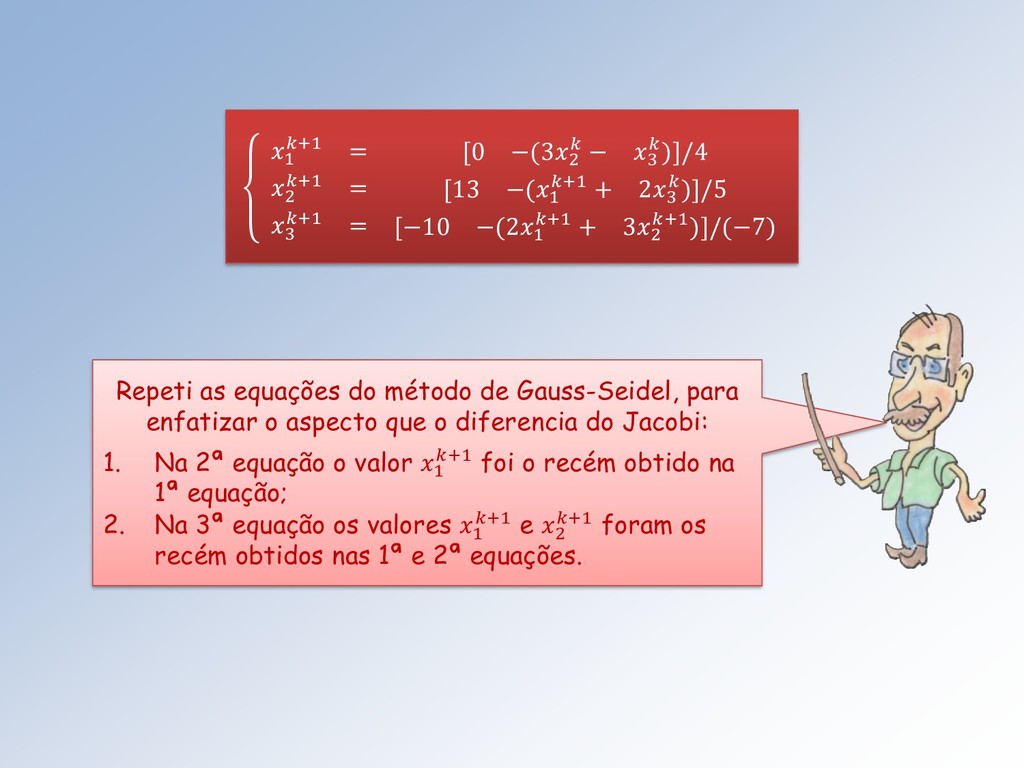
Repeti as equações do método de Gauss-Seidel, para enfatizar o
aspecto que o diferencia do Jacobi: 1. Na 2ª equação o valor 1 +1 foi o recém obtido na 1ª equação; 2. Na 3ª equação os valores 1 +1 e 2 +1 foram os recém obtidos nas 1ª e 2ª equações. 1 +1 = [0 −(32 − 3 )]/4 2 +1 = [13 −(1 +1 + 23 )]/5 3 +1 = [−10 −(21 +1 + 32 +1)]/(−7) -
Para implementar computacionalmente estes outros algoritmos precisaremos estudar métodos numéricos
para matrizes esparsas, nosso próximo tema. -
O que são matizes esparsas, Mestre? São matrizes com muitos
zeros. Tipicamente apenas 15% a 20% de seus elementos são não-nulos. -
Na solução de problemas envolvendo equações diferenciais, tanto pelo método
das diferenças finitas como dos elementos finitos. Como e onde elas aparecem? -
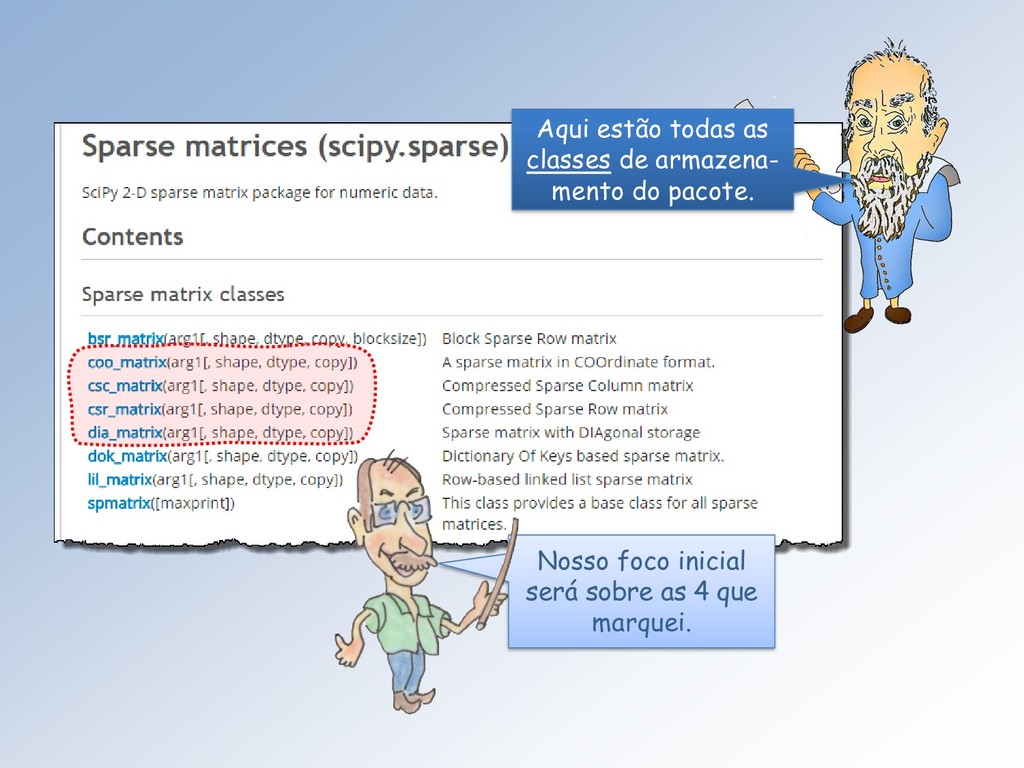
Na SciPy temos a scipy.sparse (armazenamento) e a scipy.sparse.linalg (álgebra
linear). A seguir a lista completa dos módulos. -
Aqui estão todas as classes de armazena- mento do pacote.
Nosso foco inicial será sobre as 4 que marquei. -
Algum motivo especial por essa opção Mestre? O armazenamento COO
é apropriado para o método dos elementos finitos e o DIA para o método das diferenças finitas. -
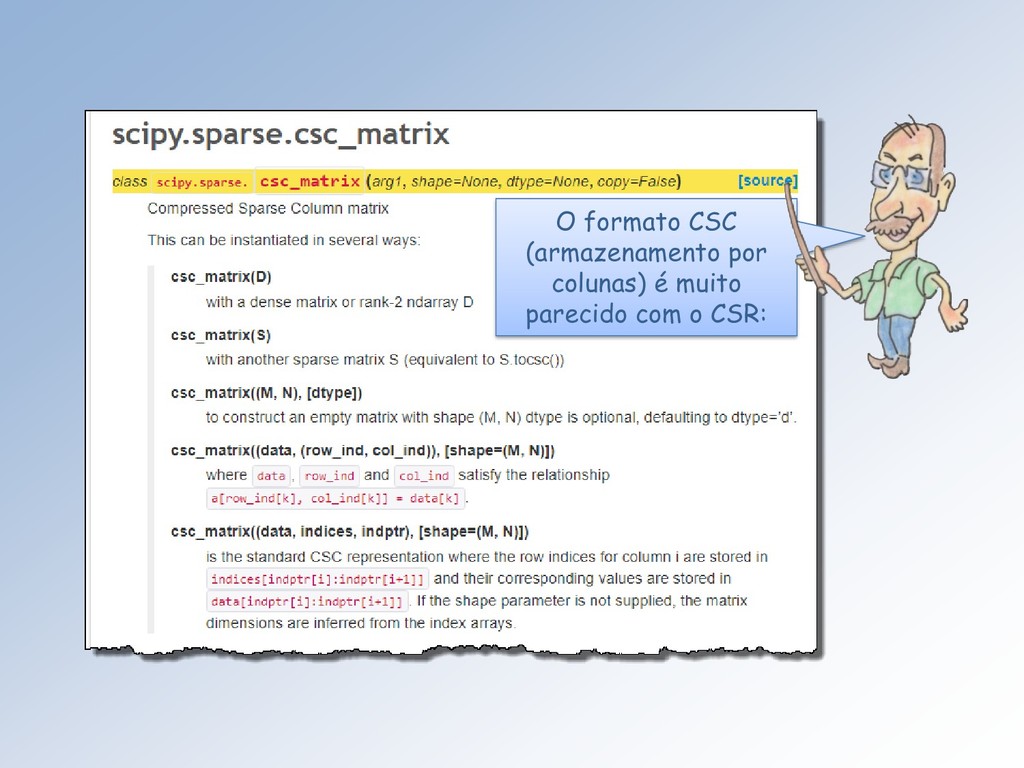
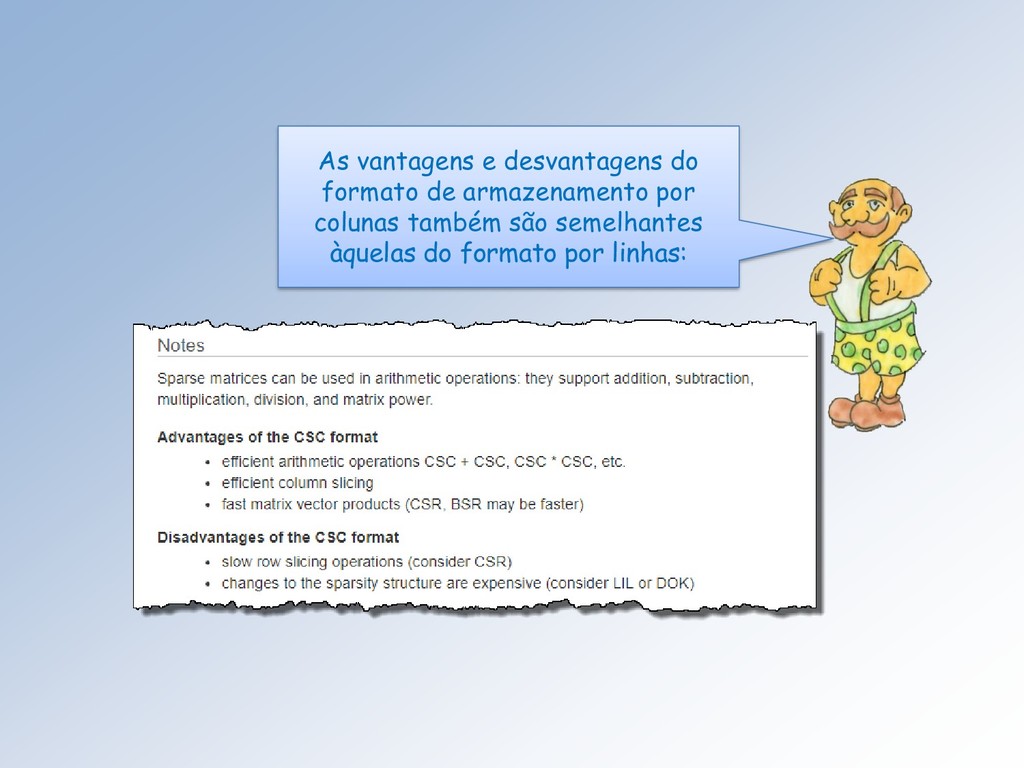
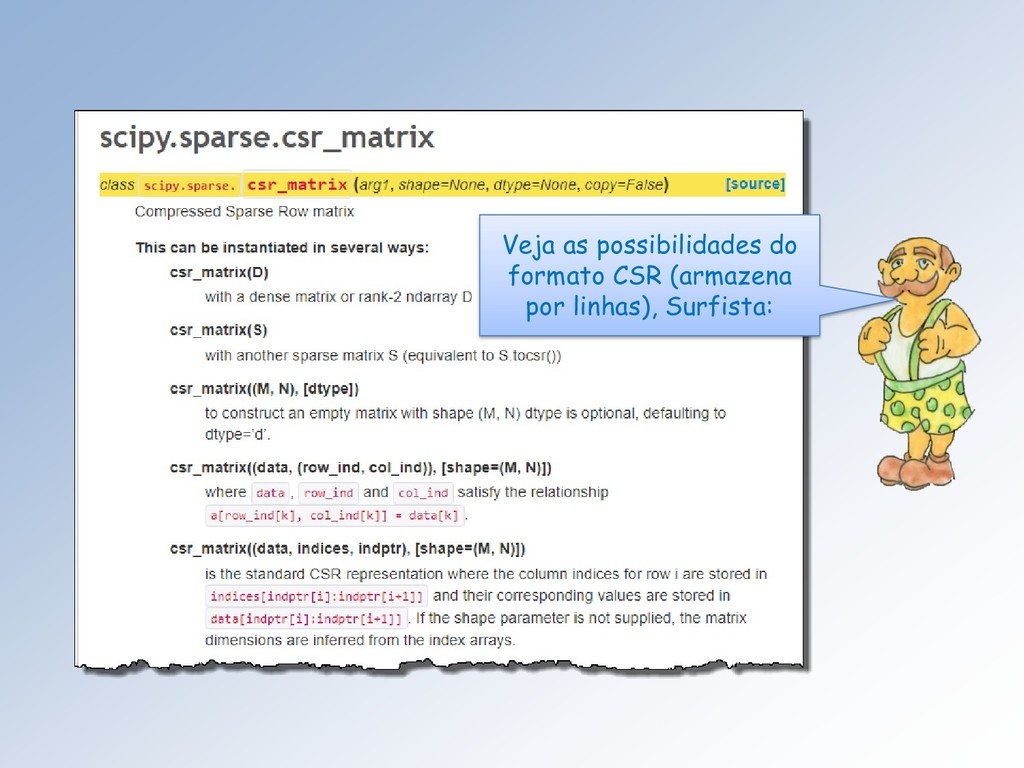
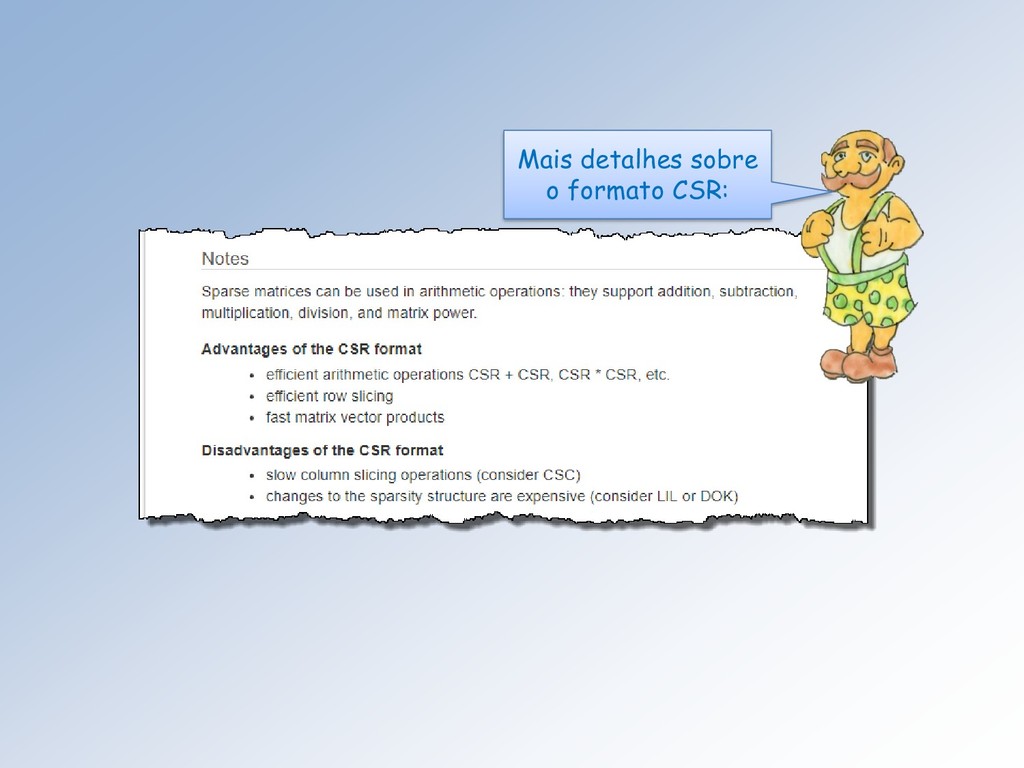
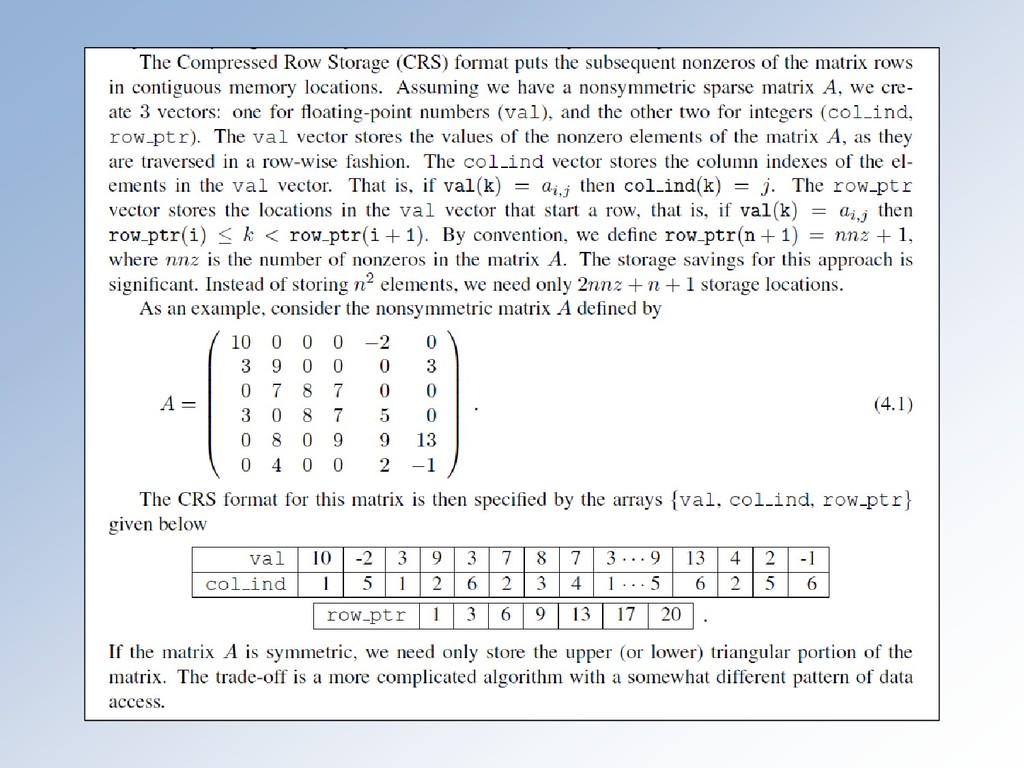
As vantagens e desvantagens do formato de armazenamento por colunas
também são semelhantes àquelas do formato por linhas: -
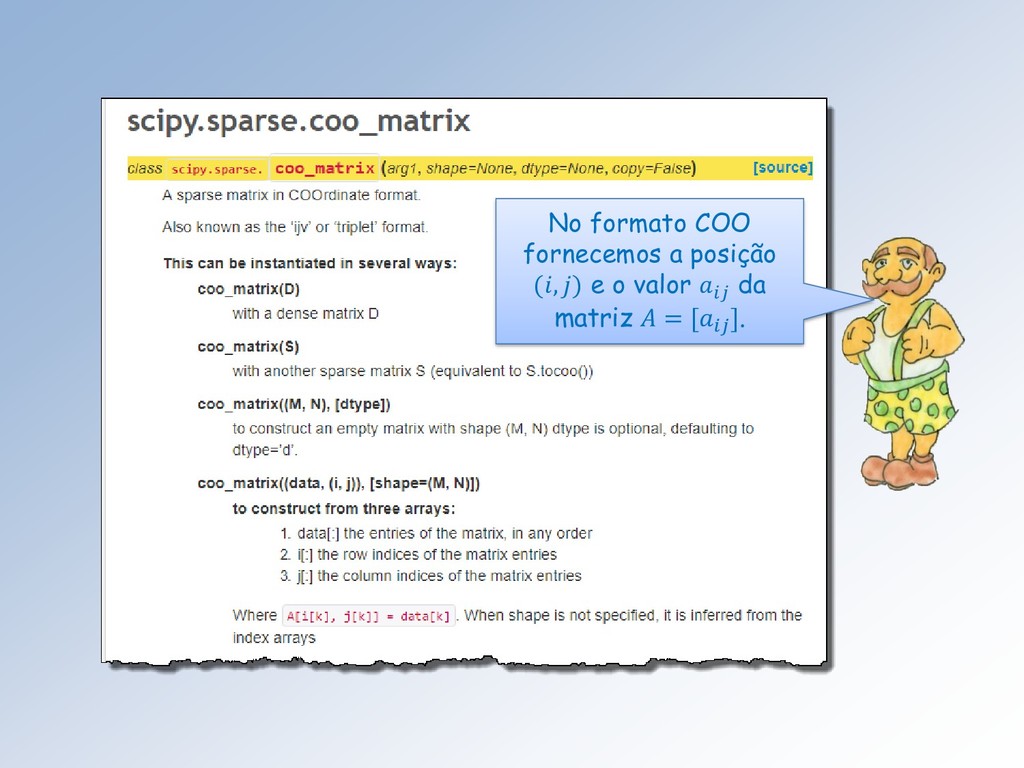
No formato COO fornecemos a posição (, ) e o
valor da matriz = [ ]. -
Mestre, apresente um programa envolvendo a criação de uma matriz
esparsa no formato COO. Sim! E como procedemos para passar do COO para outros formatos. -
É o que farei. Nele detalharei a conversão de tanto
para o formato tradicional como para o CSR, mais apropriado para operações algébricas. Sim Mestre, faça um programa envolvendo a criação de uma matriz já no formato COO. -
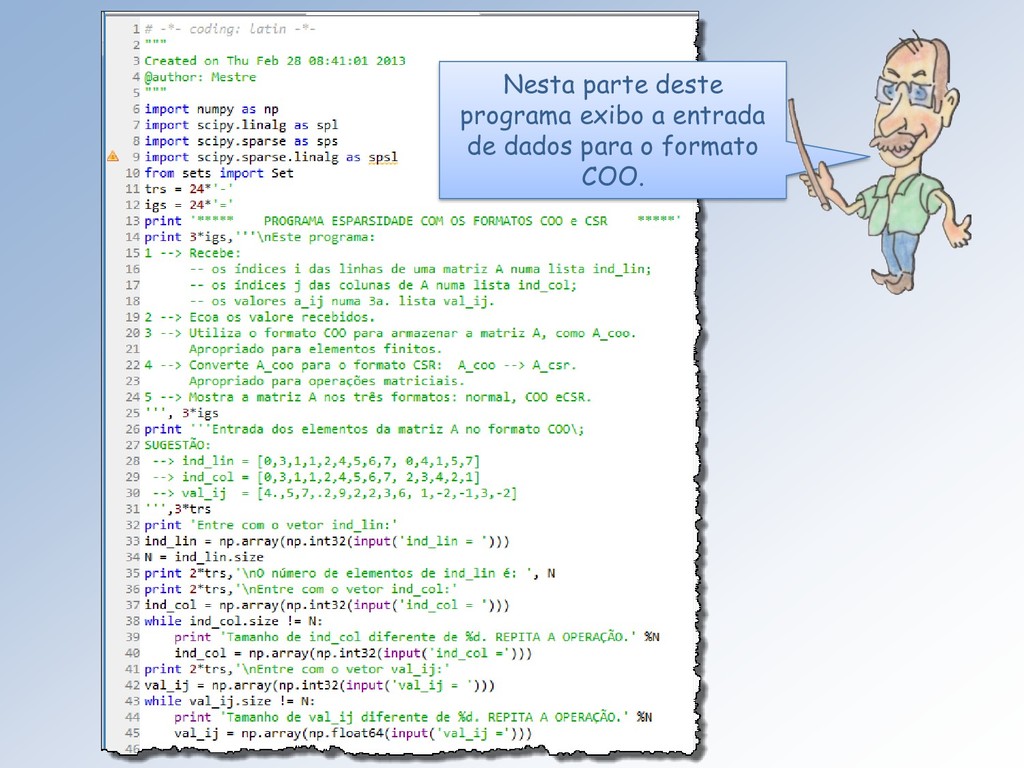
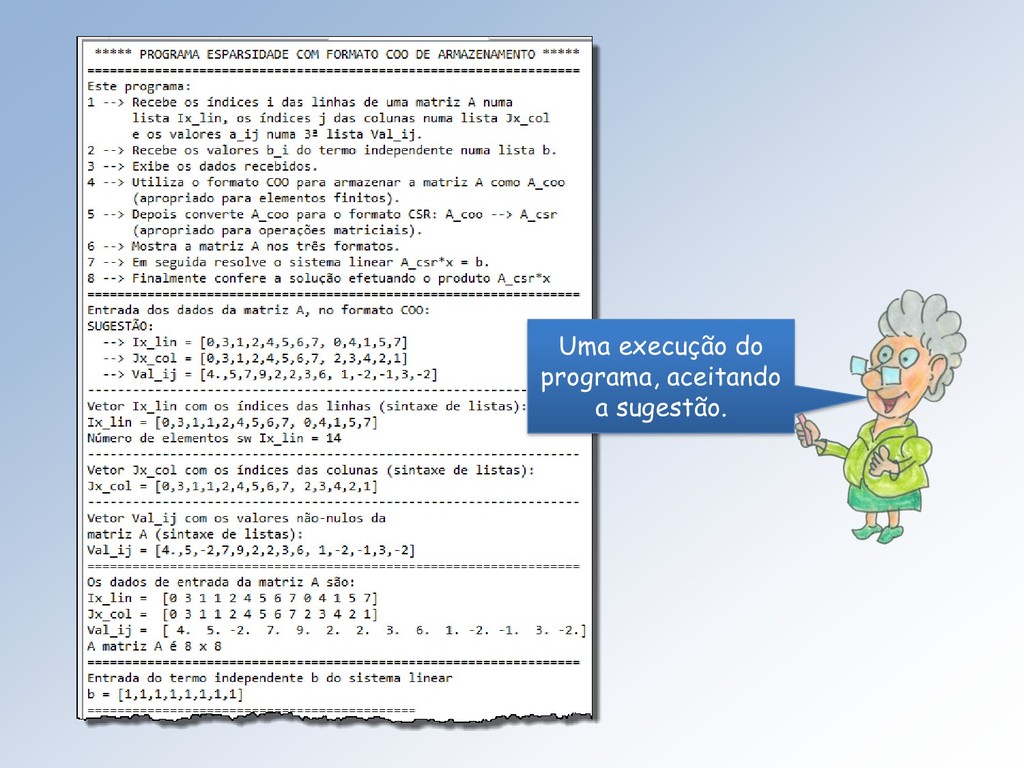
Nesta parte deste programa exibo a entrada de dados para
o formato COO. -
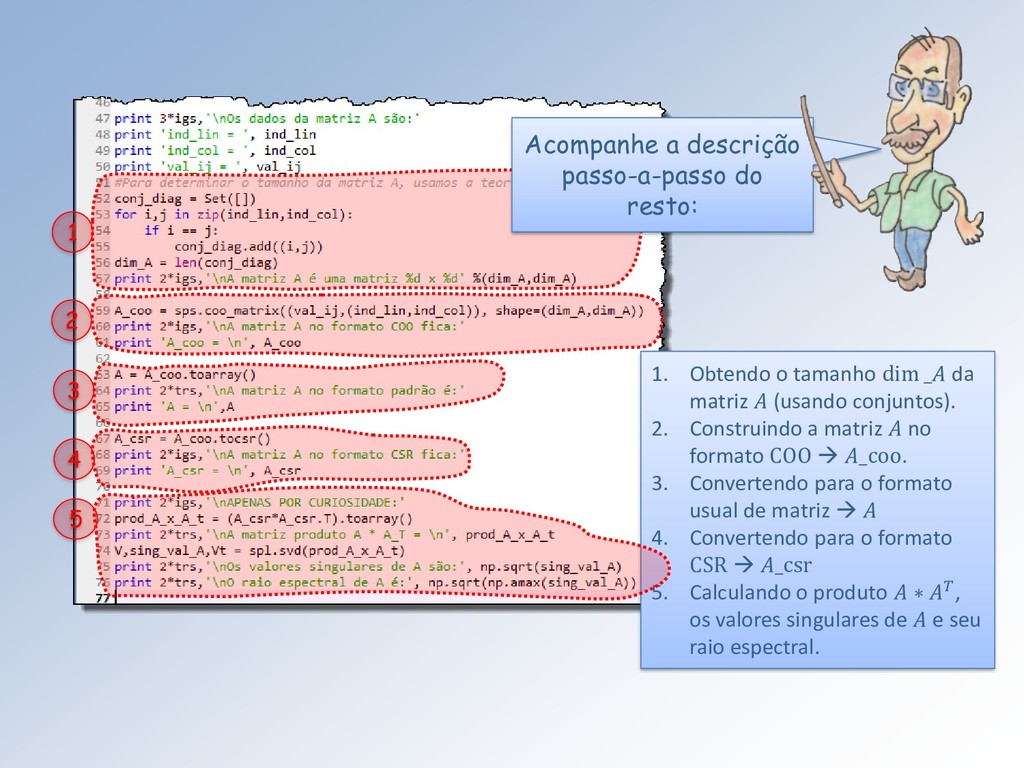
2 3 4 1. Obtendo o tamanho dim _ da
matriz (usando conjuntos). 2. Construindo a matriz no formato COO → _coo. 3. Convertendo para o formato usual de matriz → 4. Convertendo para o formato CSR → _csr 5. Calculando o produto ∗ , os valores singulares de e seu raio espectral. 1 5 Acompanhe a descrição passo-a-passo do resto: -
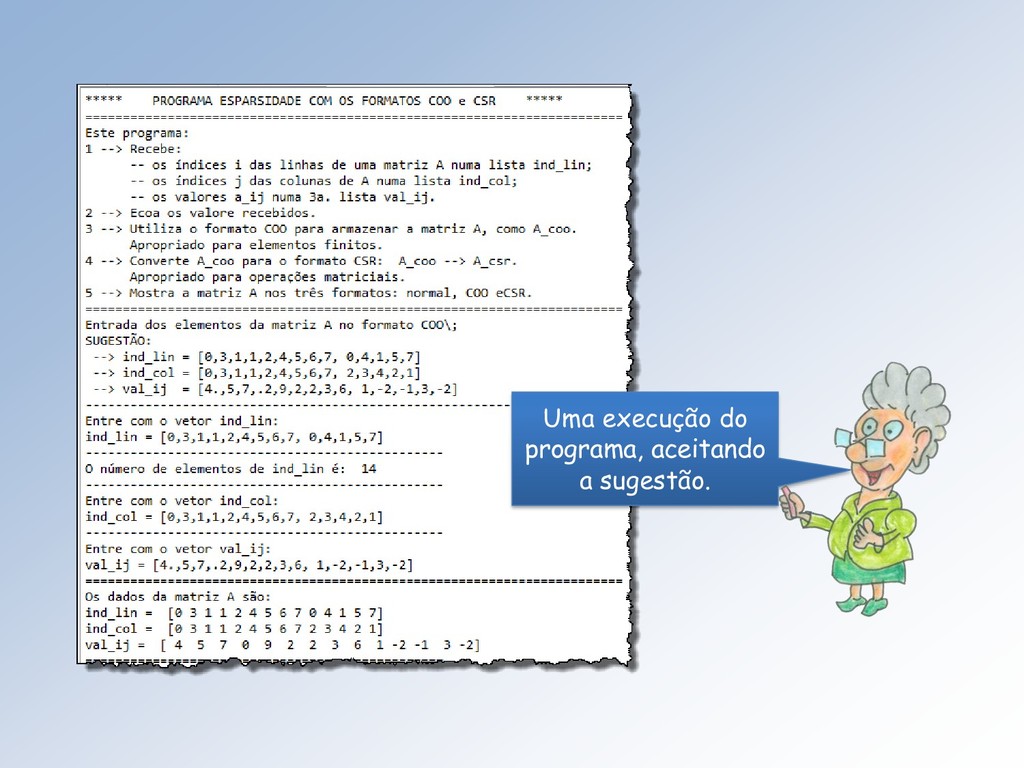
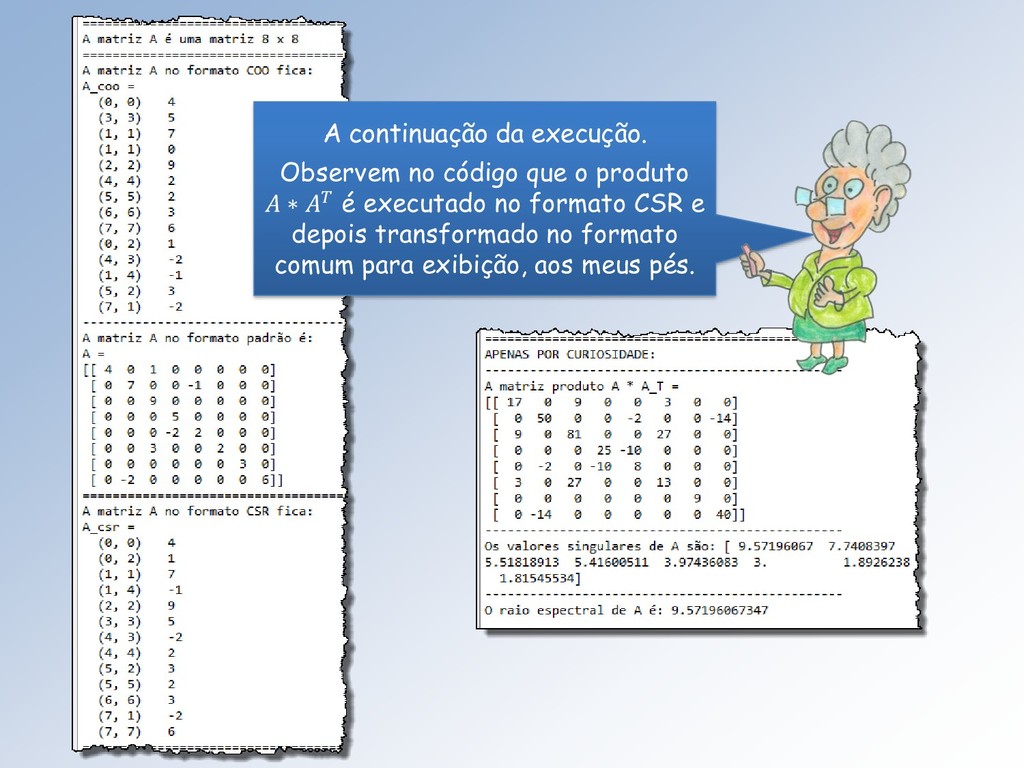
A continuação da execução. Observem no código que o produto
∗ é executado no formato CSR e depois transformado no formato comum para exibição, aos meus pés. -
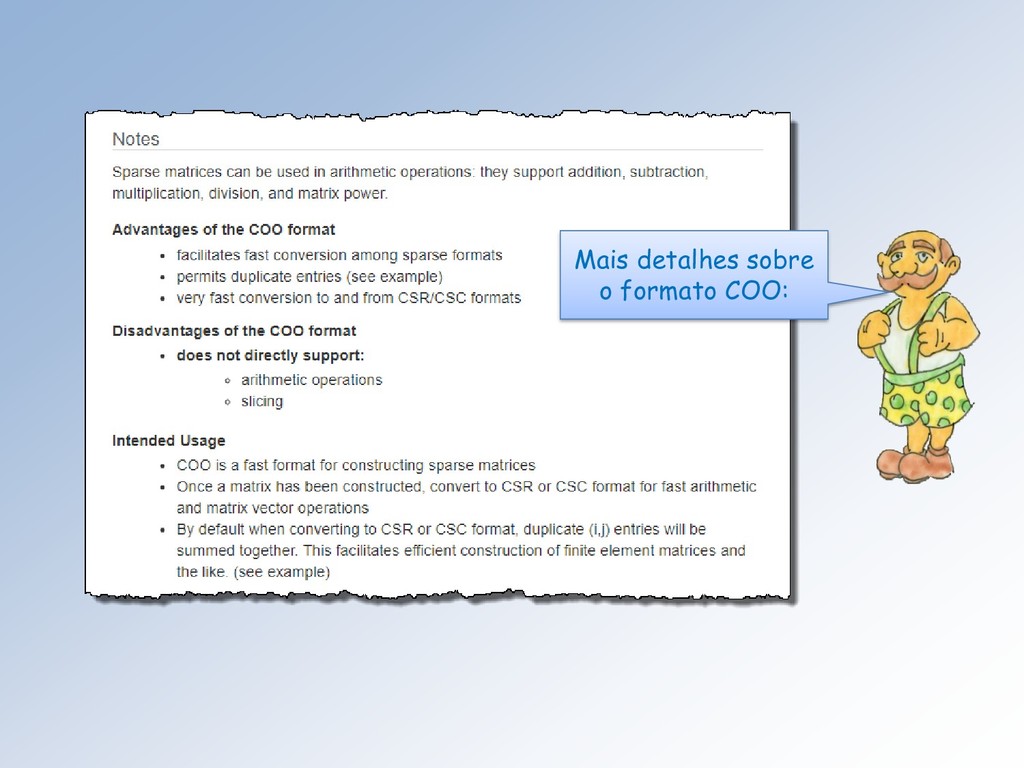
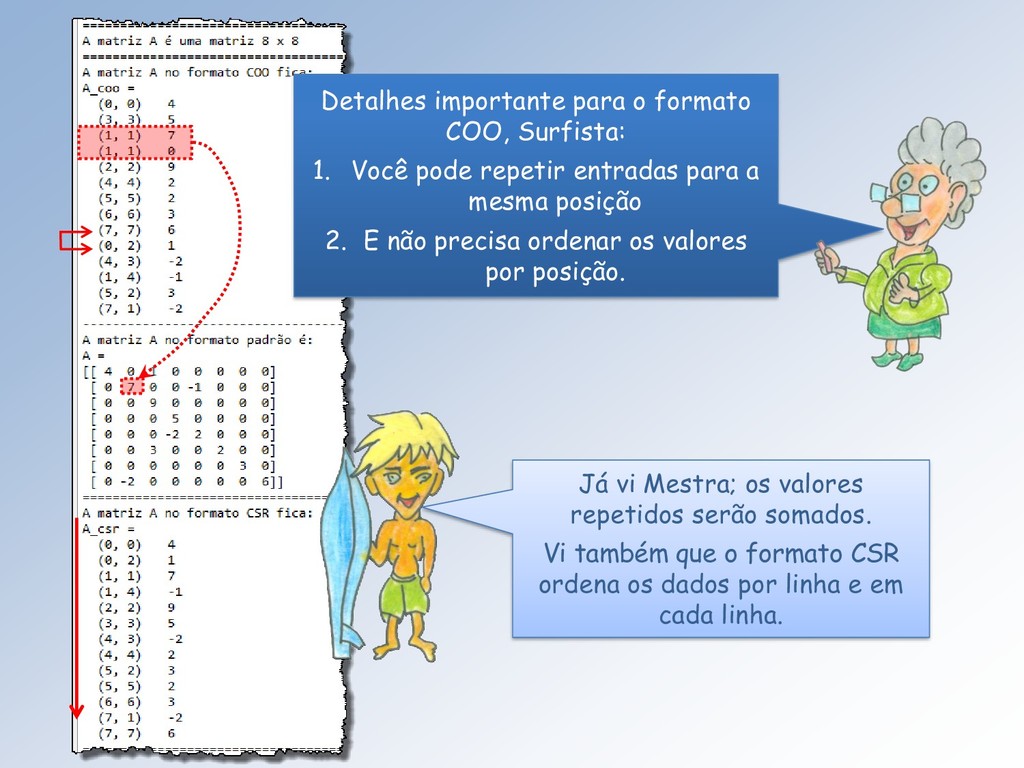
Detalhes importante para o formato COO, Surfista: 1. Você pode
repetir entradas para a mesma posição 2. E não precisa ordenar os valores por posição. Já vi Mestra; os valores repetidos serão somados. Vi também que o formato CSR ordena os dados por linha e em cada linha. -
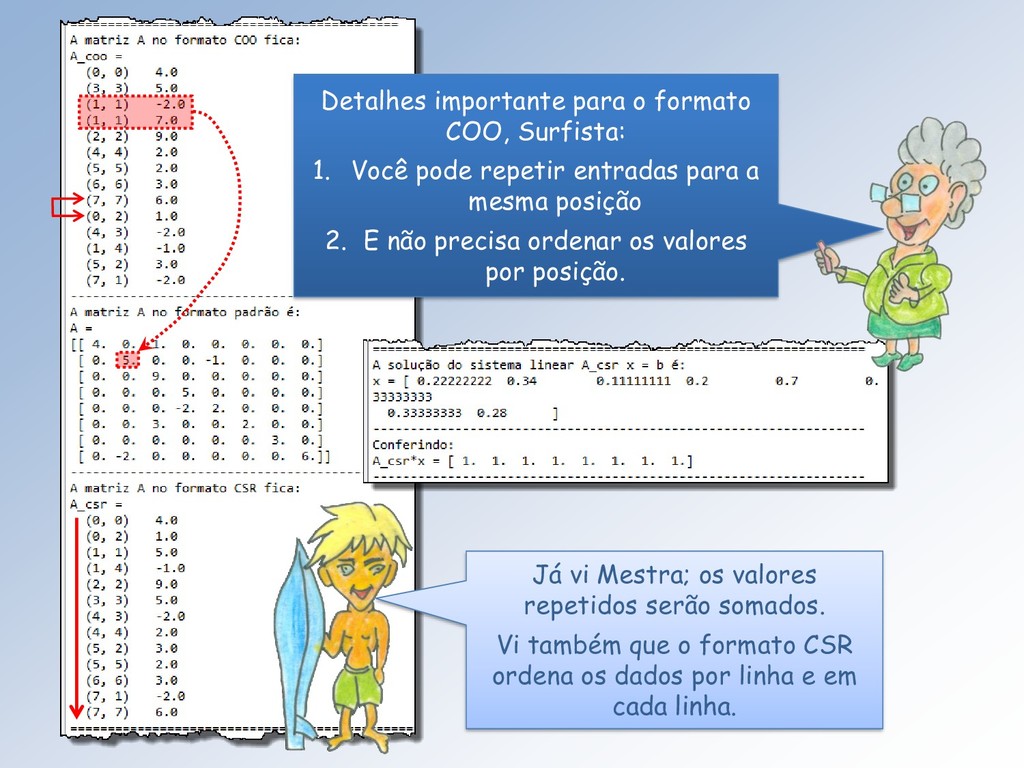
Detalhes importante para o formato COO, Surfista: 1. Você pode
repetir entradas para a mesma posição 2. E não precisa ordenar os valores por posição. Já vi Mestra; os valores repetidos serão somados. Vi também que o formato CSR ordena os dados por linha e em cada linha. -
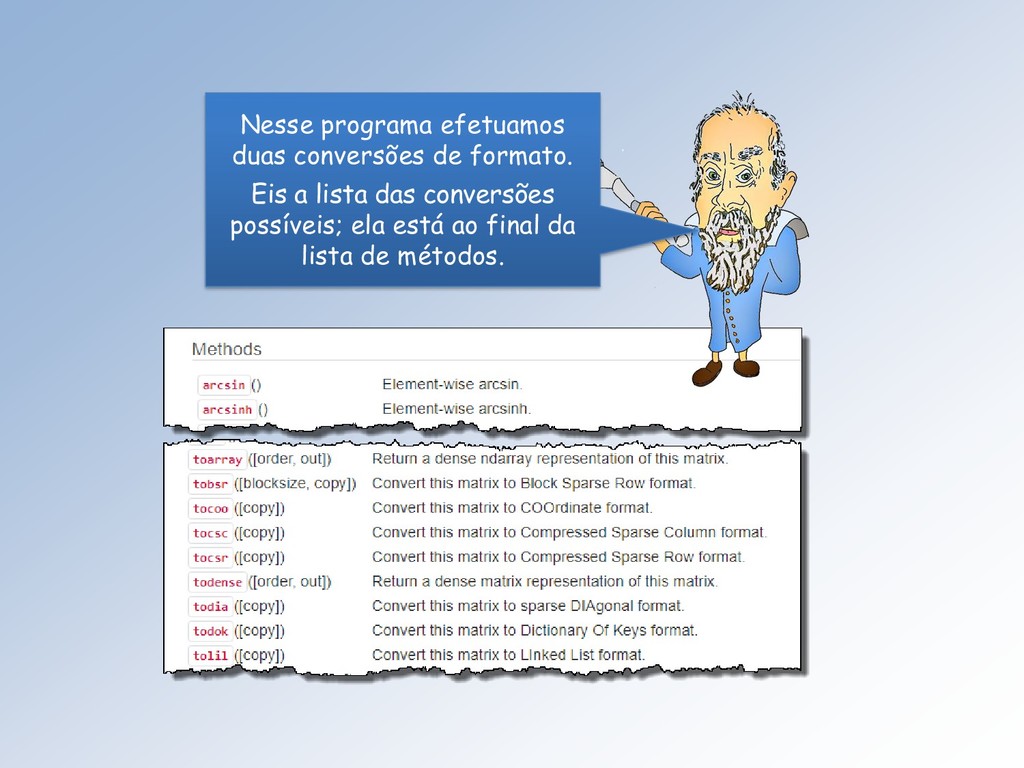
Nesse programa efetuamos duas conversões de formato. Eis a lista
das conversões possíveis; ela está ao final da lista de métodos.