Share
Embed
20250706_IPSJ-NL-264
「WRIME-MT:日英・日中ソーシャルメディア対訳データセットの構築」
第264回 情報処理学会 自然言語処理研究発表会,2025年7月.
論文URL https://researchmap.jp/shigashiyama/misc/50757515
shigashiyama
March 18, 2026
Transcript
21 slides
-
WRIME-MT: 日英・日中ソーシャルメディア 対訳データセットの構築 東山翔平1 梶原智之2 内山将夫1 1NICT 2愛媛大学/大阪大学 1 第264回
情報処理学会 自然言語処理研究発表会(2025/7/6) -
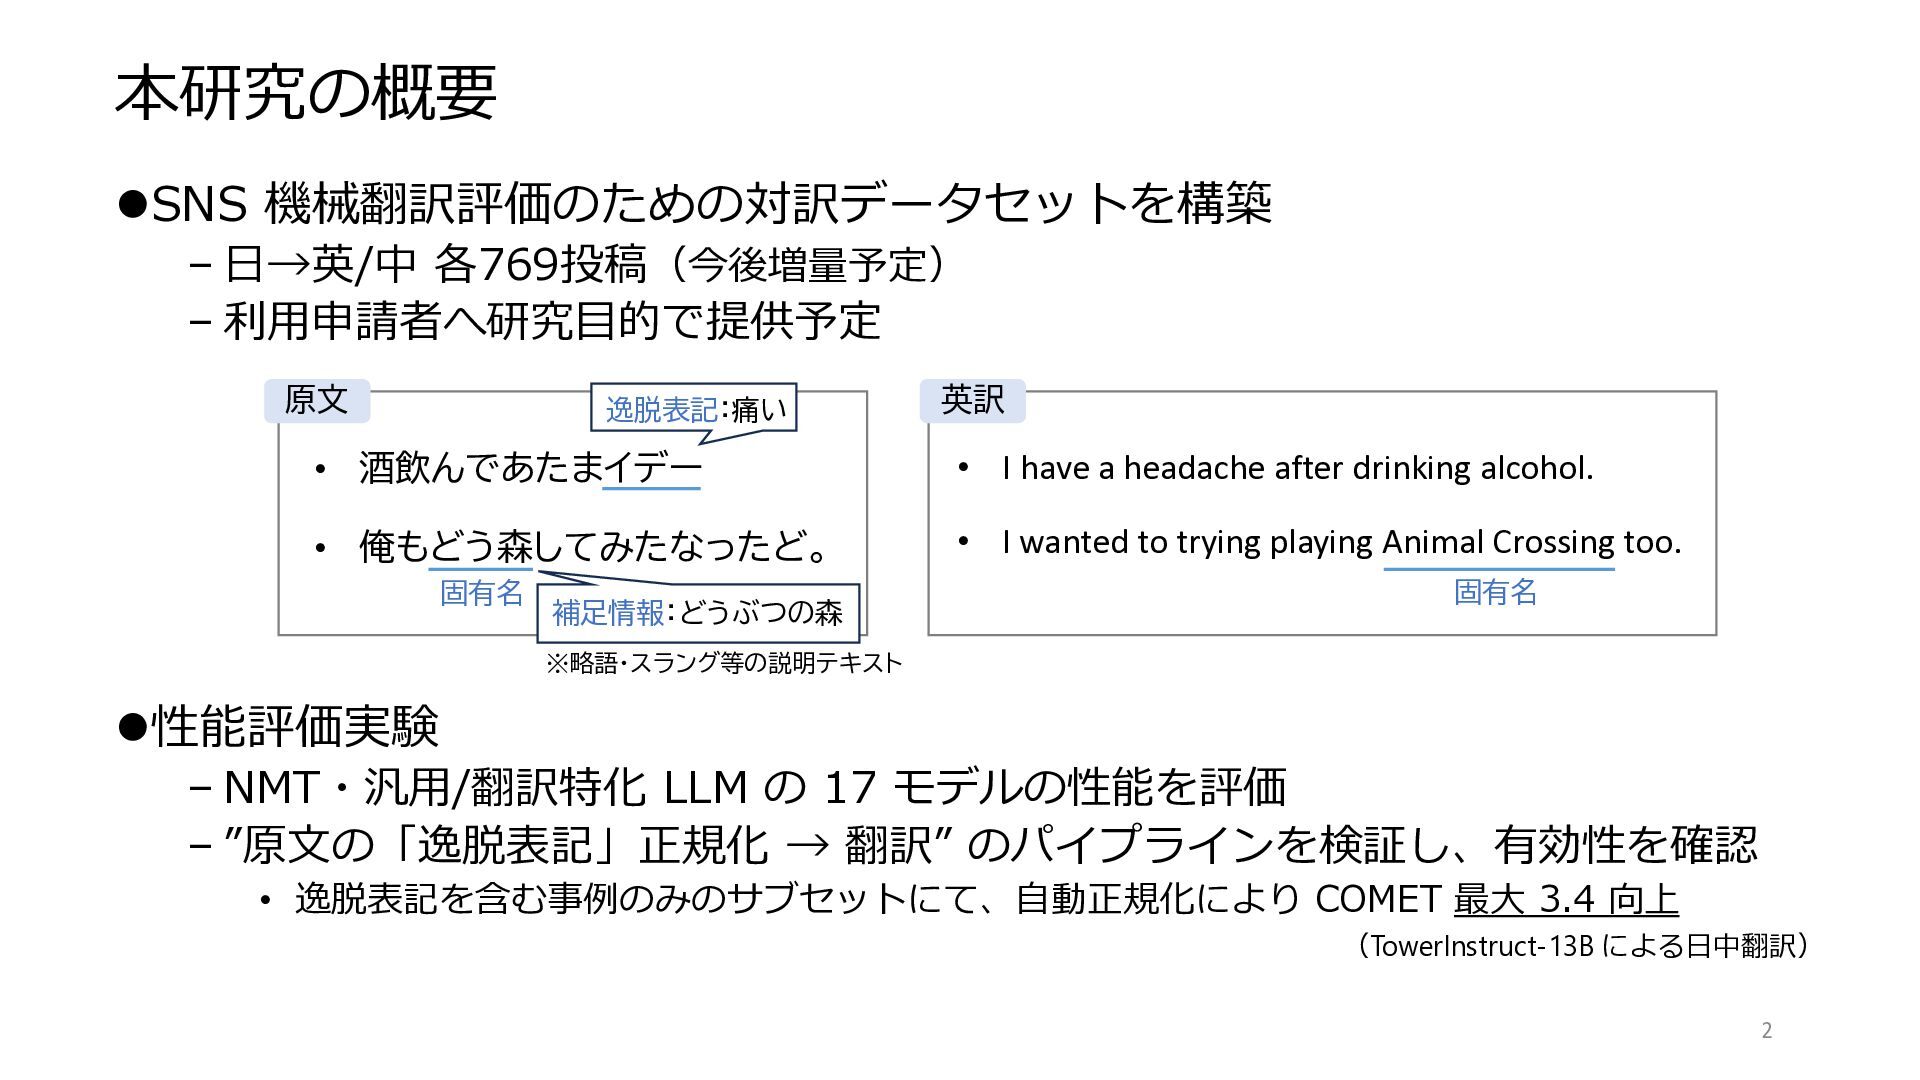
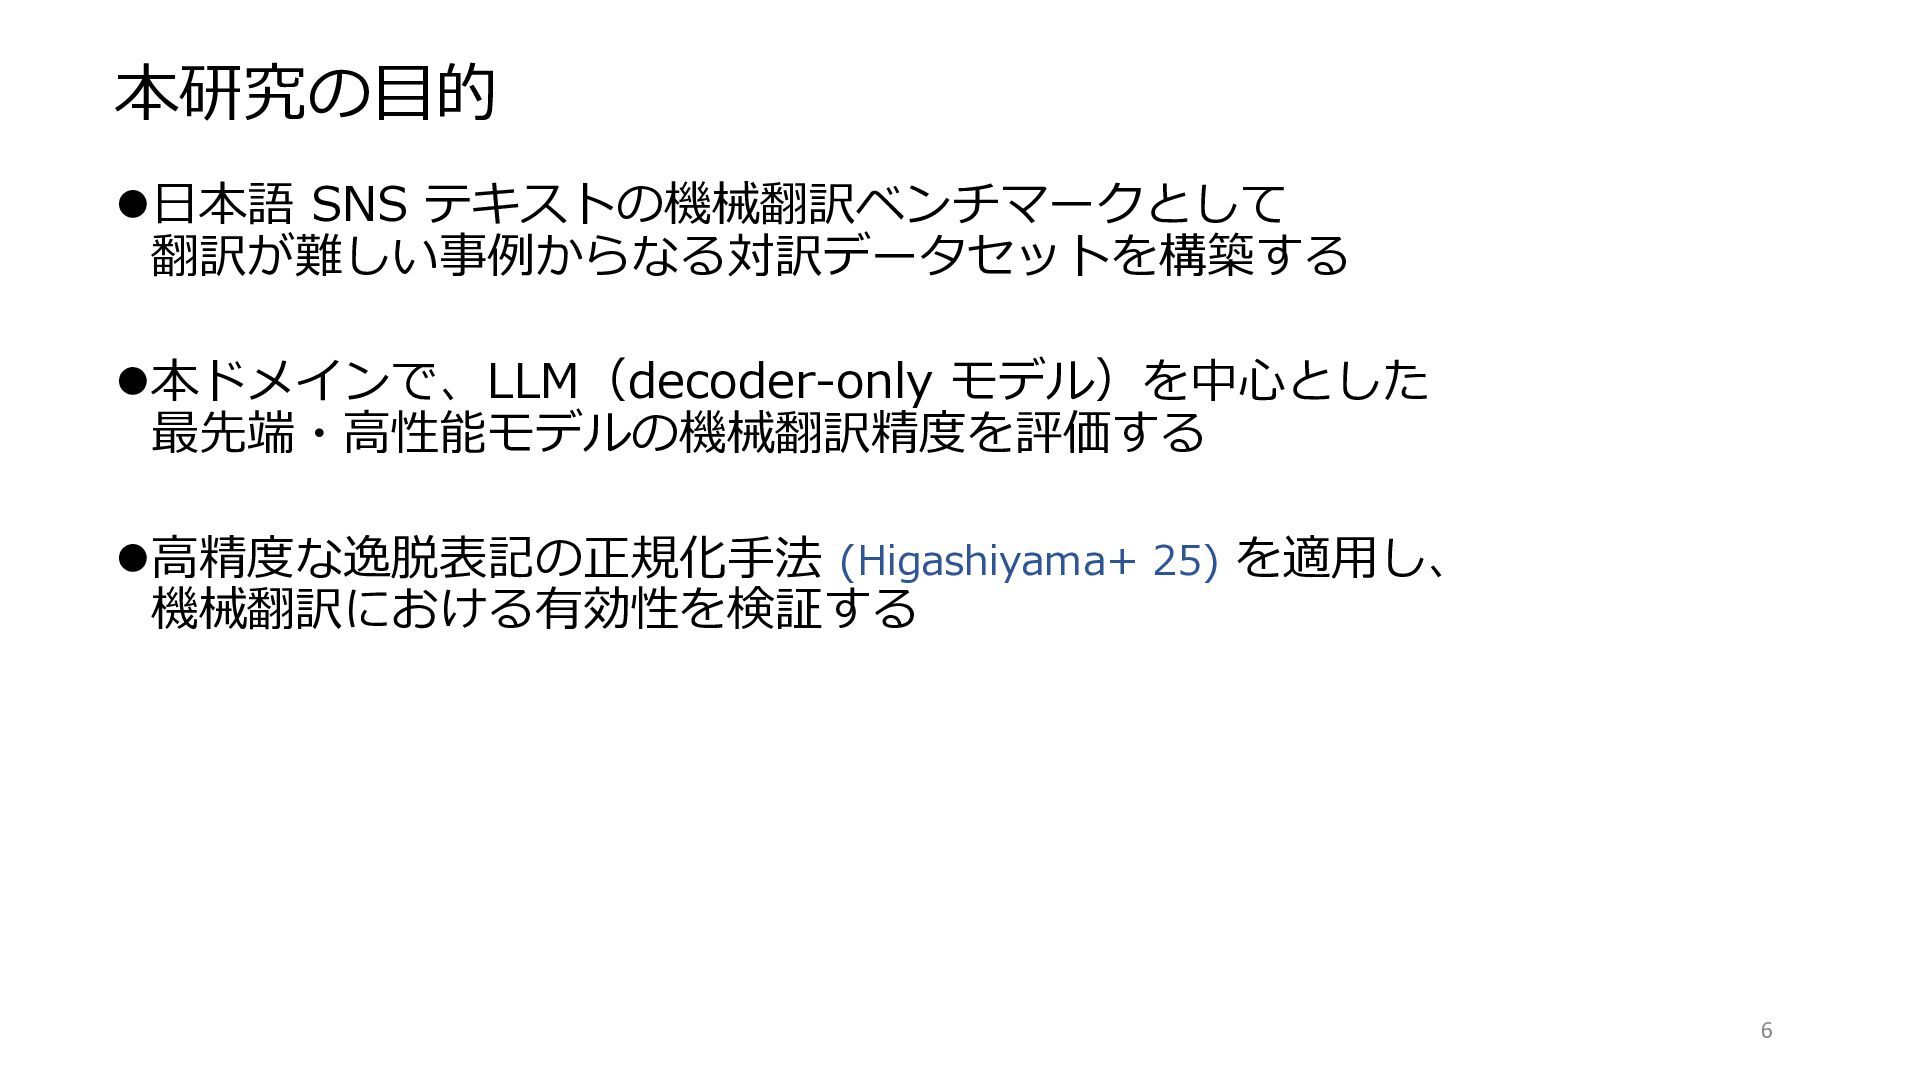
本研究の概要 ⚫SNS 機械翻訳評価のための対訳データセットを構築 – 日→英/中 各769投稿(今後増量予定) – 利用申請者へ研究目的で提供予定 ⚫性能評価実験 –
NMT・汎用/翻訳特化 LLM の 17 モデルの性能を評価 – ”原文の「逸脱表記」正規化 → 翻訳” のパイプラインを検証し、有効性を確認 • 逸脱表記を含む事例のみのサブセットにて、自動正規化により COMET 最大 3.4 向上 2 • 酒飲んであたまイデー • 俺もどう森してみたなったど。 固有名 • I have a headache after drinking alcohol. • I wanted to trying playing Animal Crossing too. 逸脱表記:痛い 補足情報:どうぶつの森 原文 英訳 固有名 ※略語・スラング等の説明テキスト (TowerInstruct-13B による日中翻訳) -
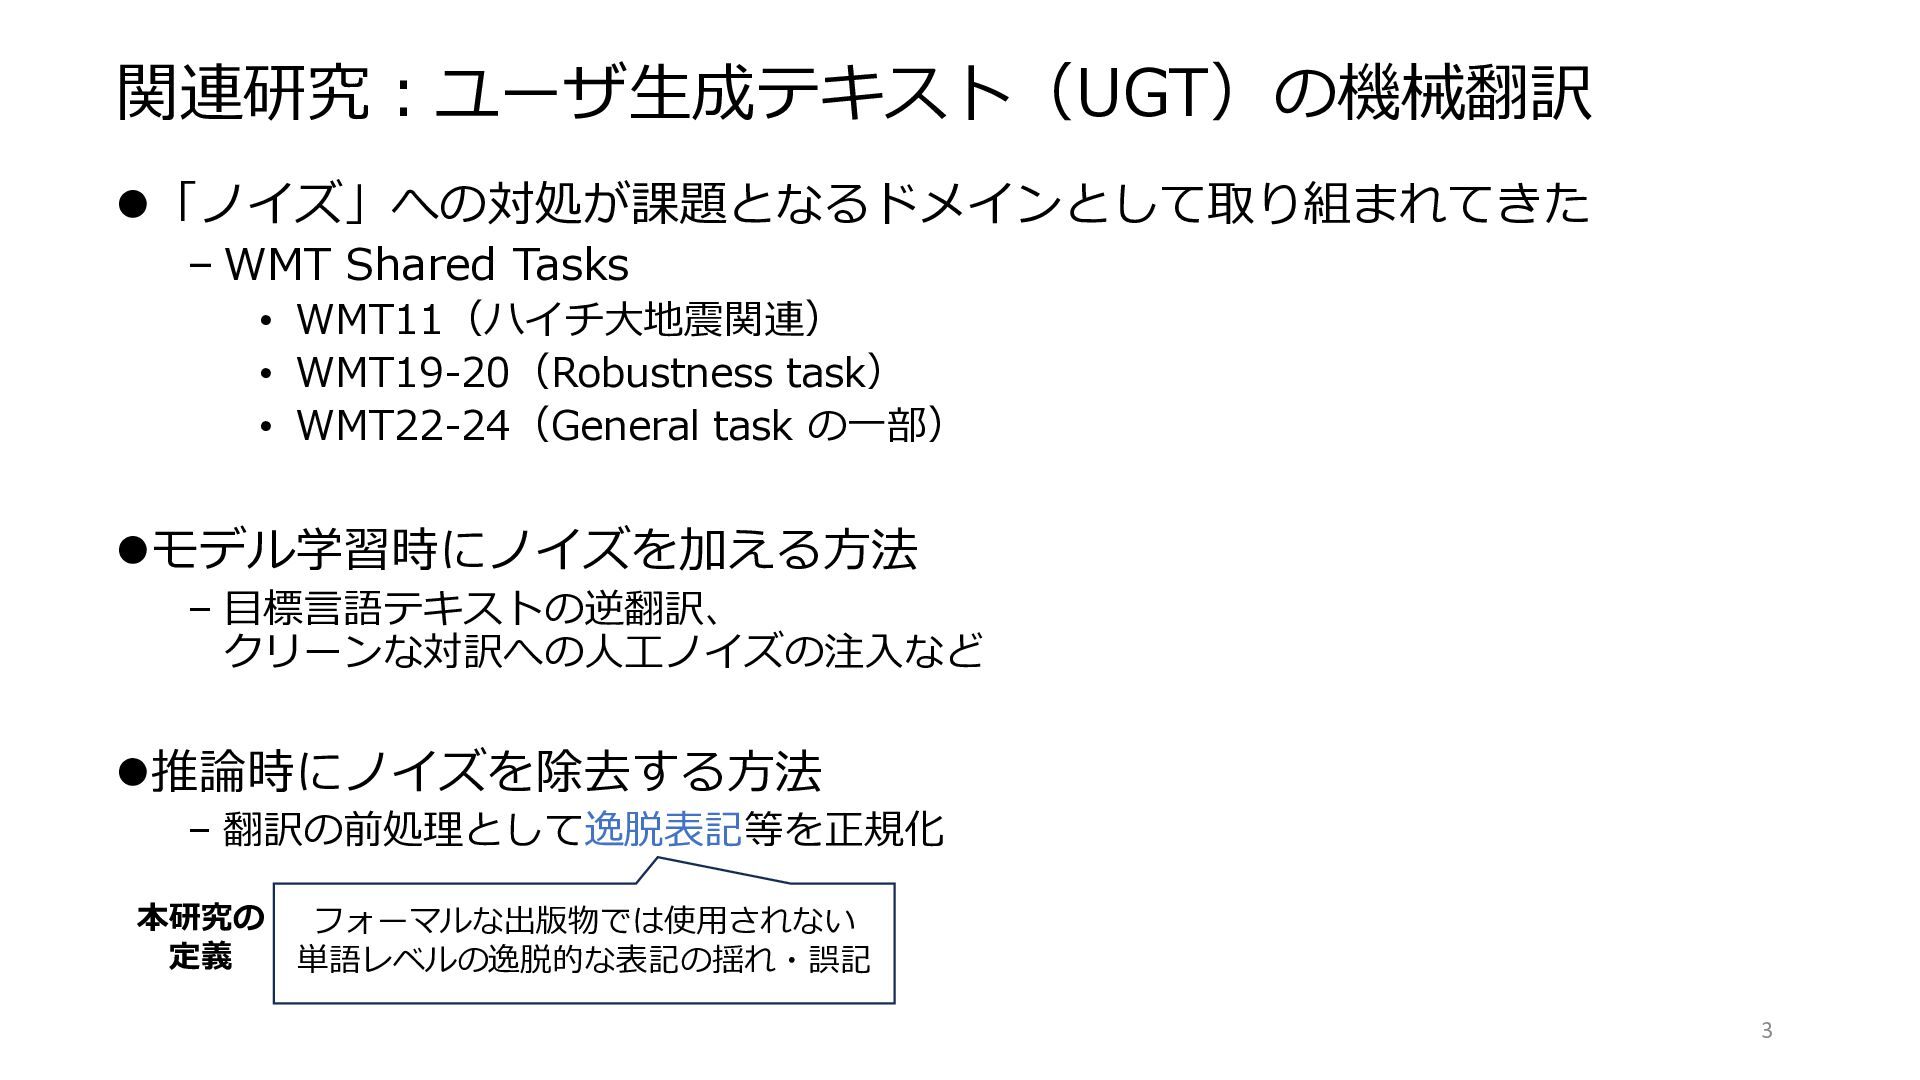
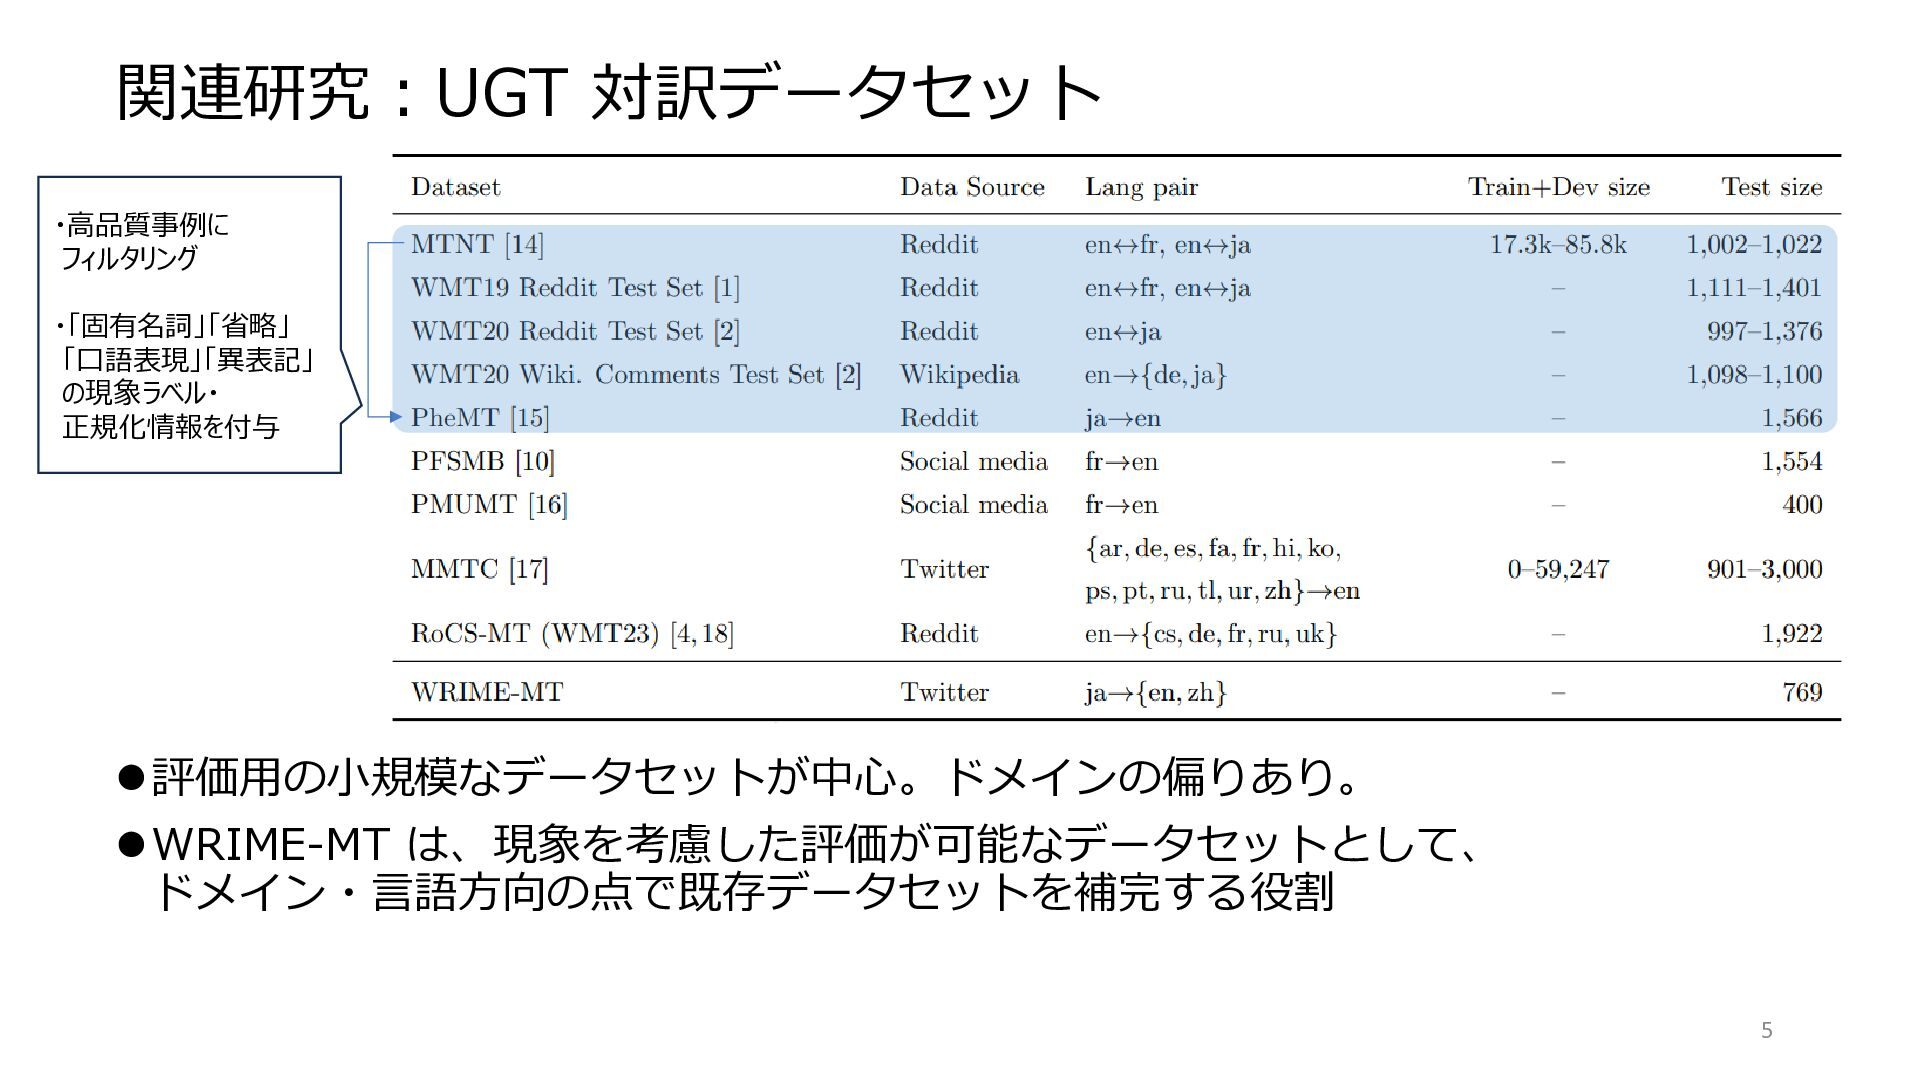
関連研究:ユーザ生成テキスト(UGT)の機械翻訳 ⚫「ノイズ」への対処が課題となるドメインとして取り組まれてきた – WMT Shared Tasks • WMT11(ハイチ大地震関連) • WMT19-20(Robustness
task) • WMT22-24(General task の一部) ⚫モデル学習時にノイズを加える方法 – 目標言語テキストの逆翻訳、 クリーンな対訳への人工ノイズの注入など ⚫推論時にノイズを除去する方法 – 翻訳の前処理として逸脱表記等を正規化 3 フォーマルな出版物では使用されない 単語レベルの逸脱的な表記の揺れ・誤記 本研究の 定義 -
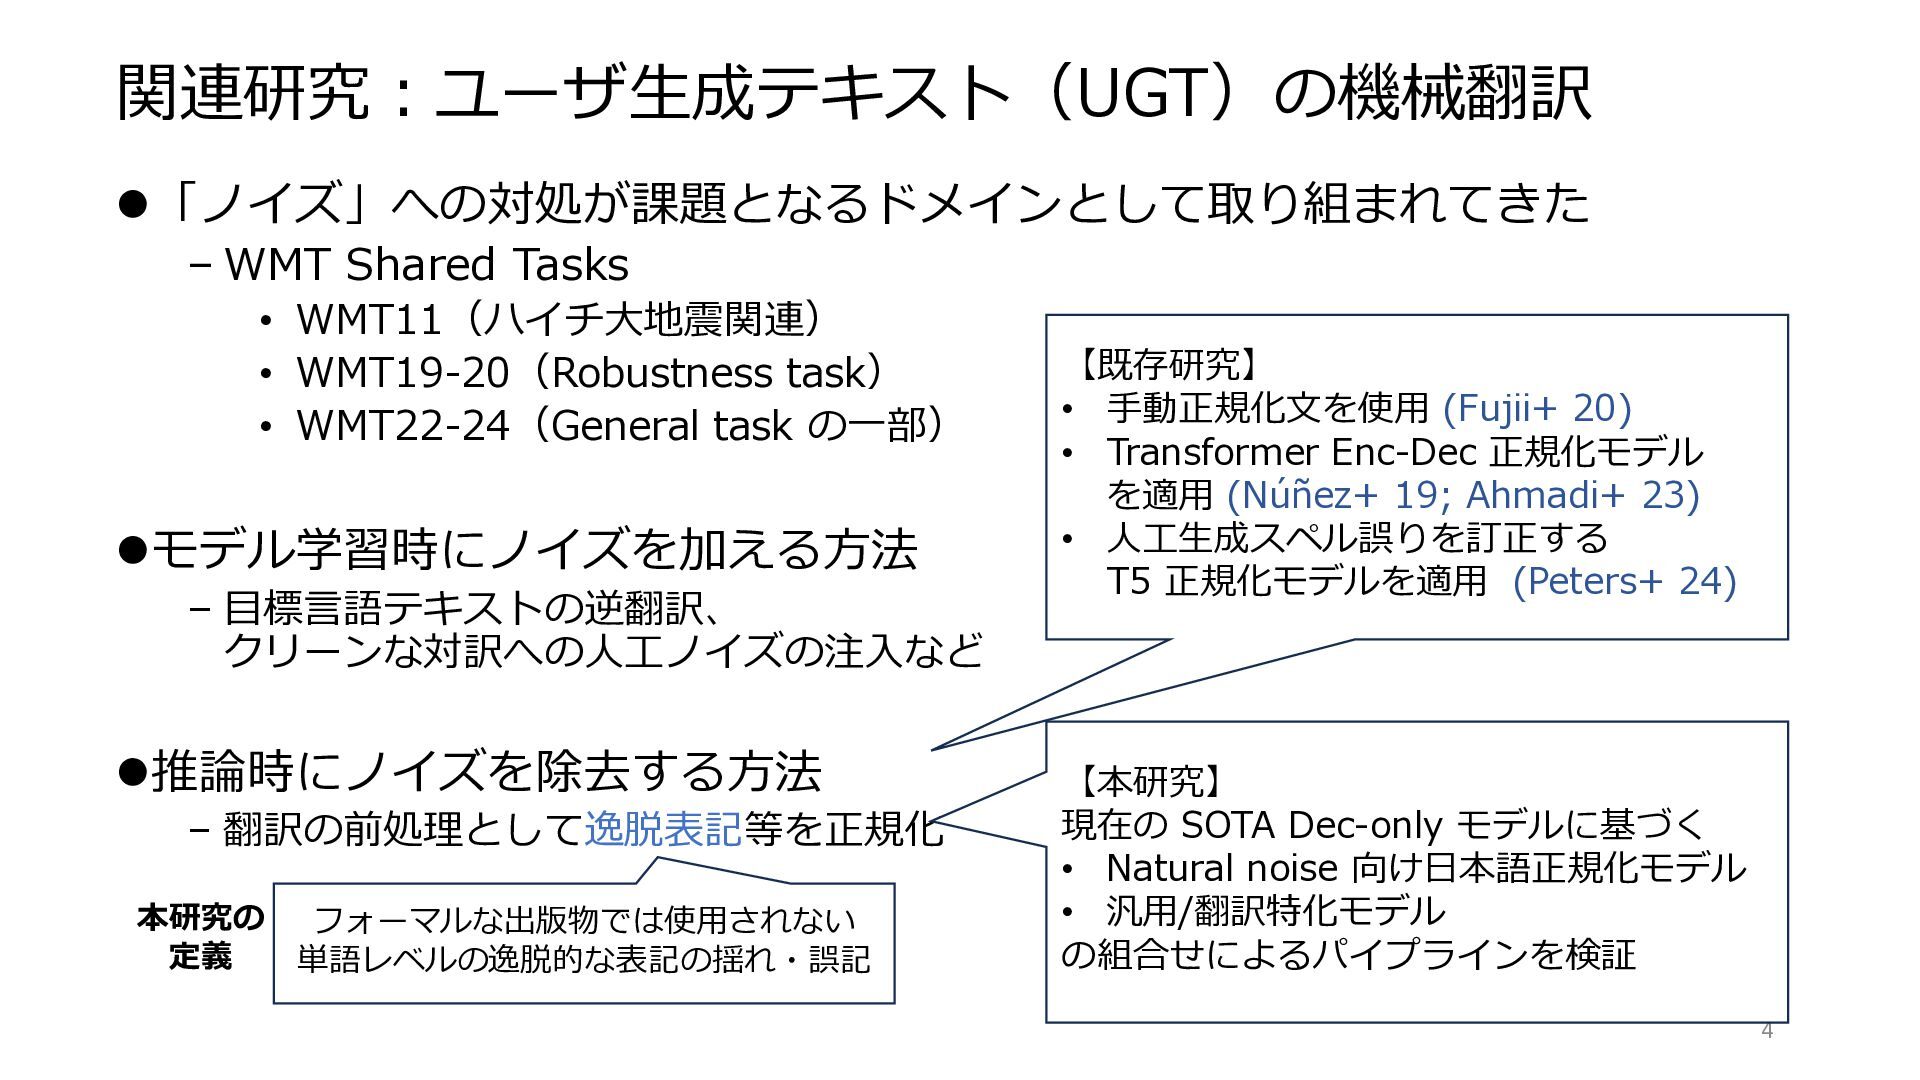
関連研究:ユーザ生成テキスト(UGT)の機械翻訳 ⚫「ノイズ」への対処が課題となるドメインとして取り組まれてきた – WMT Shared Tasks • WMT11(ハイチ大地震関連) • WMT19-20(Robustness
task) • WMT22-24(General task の一部) ⚫モデル学習時にノイズを加える方法 – 目標言語テキストの逆翻訳、 クリーンな対訳への人工ノイズの注入など ⚫推論時にノイズを除去する方法 – 翻訳の前処理として逸脱表記等を正規化 4 【既存研究】 • 手動正規化文を使用 (Fujii+ 20) • Transformer Enc-Dec 正規化モデル を適用 (Núñez+ 19; Ahmadi+ 23) • 人工生成スペル誤りを訂正する T5 正規化モデルを適用 (Peters+ 24) 【本研究】 現在の SOTA Dec-only モデルに基づく • Natural noise 向け日本語正規化モデル • 汎用/翻訳特化モデル の組合せによるパイプラインを検証 フォーマルな出版物では使用されない 単語レベルの逸脱的な表記の揺れ・誤記 本研究の 定義 -
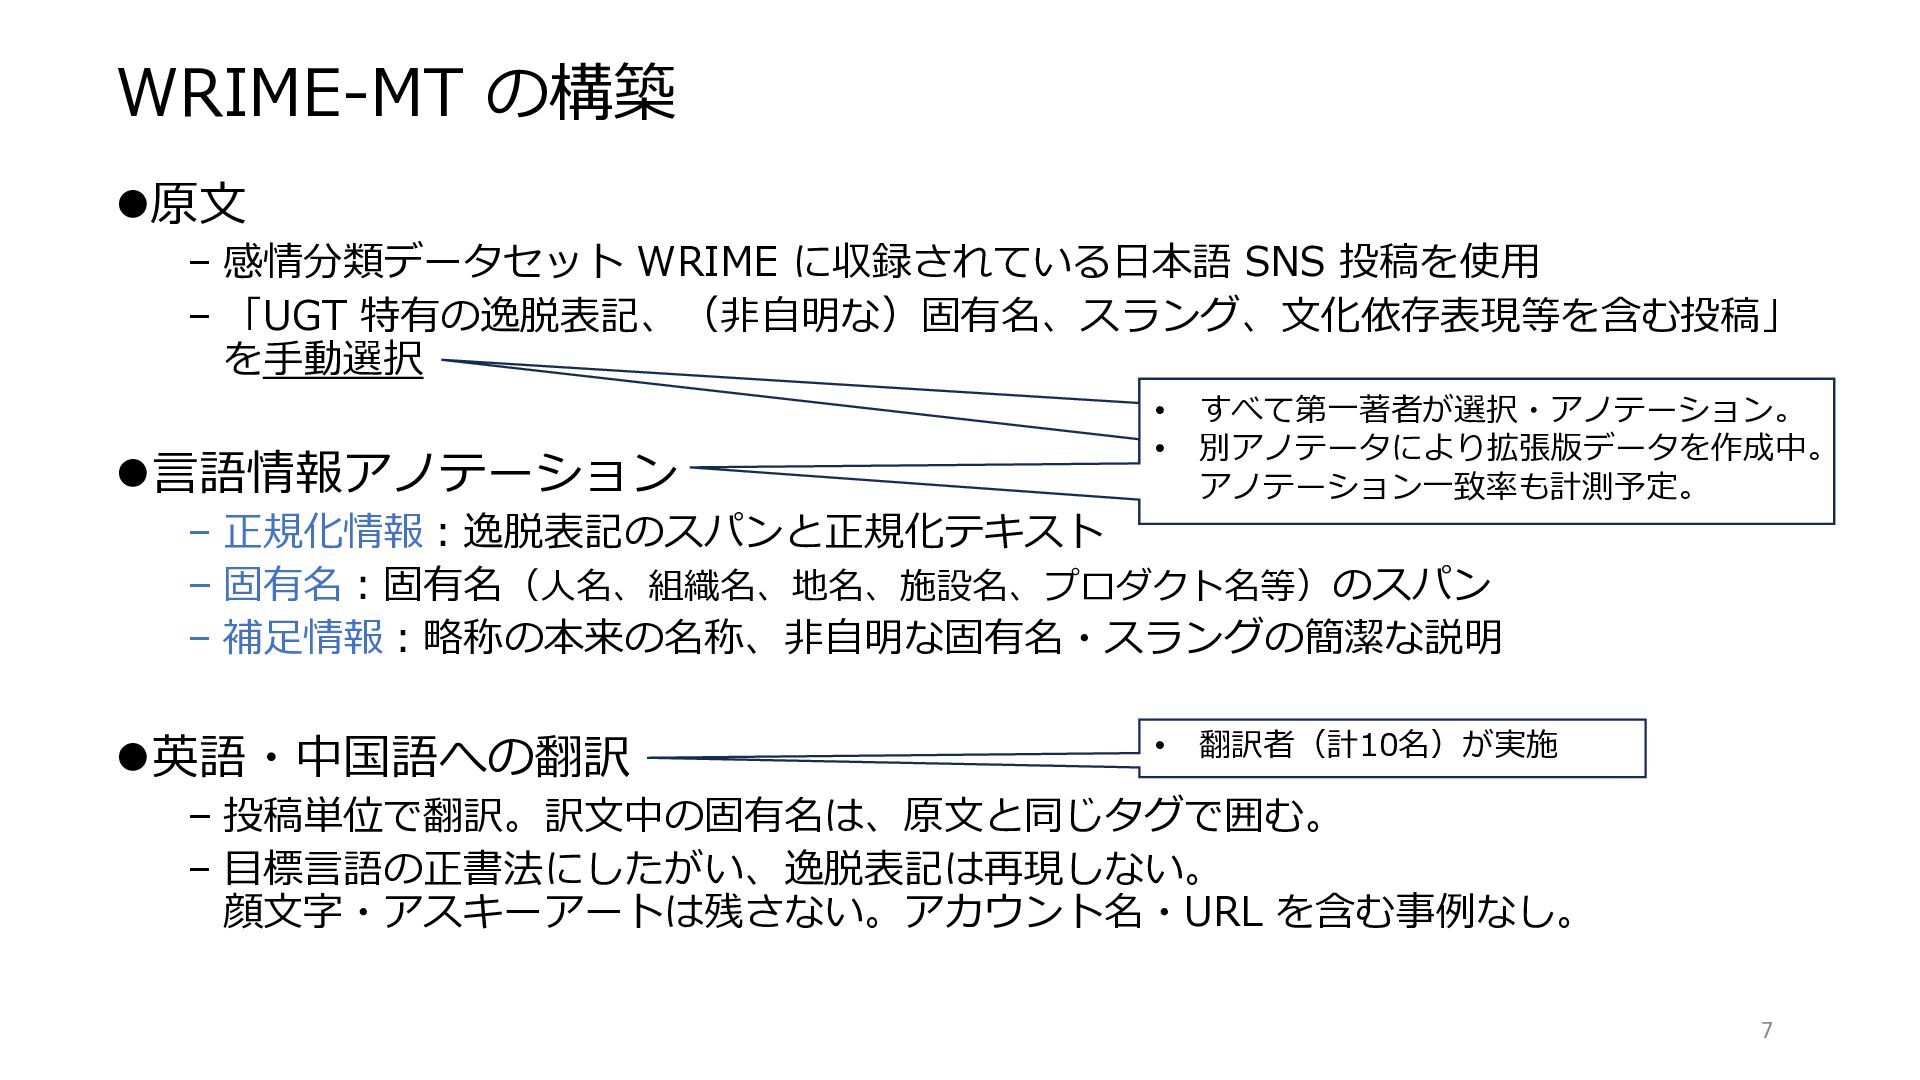
WRIME-MT の構築 ⚫原文 – 感情分類データセット WRIME に収録されている日本語 SNS 投稿を使用 –
「UGT 特有の逸脱表記、(非自明な)固有名、スラング、文化依存表現等を含む投稿」 を手動選択 ⚫言語情報アノテーション – 正規化情報:逸脱表記のスパンと正規化テキスト – 固有名:固有名(人名、組織名、地名、施設名、プロダクト名等)のスパン – 補足情報:略称の本来の名称、非自明な固有名・スラングの簡潔な説明 ⚫英語・中国語への翻訳 – 投稿単位で翻訳。訳文中の固有名は、原文と同じタグで囲む。 – 目標言語の正書法にしたがい、逸脱表記は再現しない。 顔文字・アスキーアートは残さない。アカウント名・URL を含む事例なし。 7 • すべて第一著者が選択・アノテーション。 • 別アノテータにより拡張版データを作成中。 アノテーション一致率も計測予定。 • 翻訳者(計10名)が実施 -
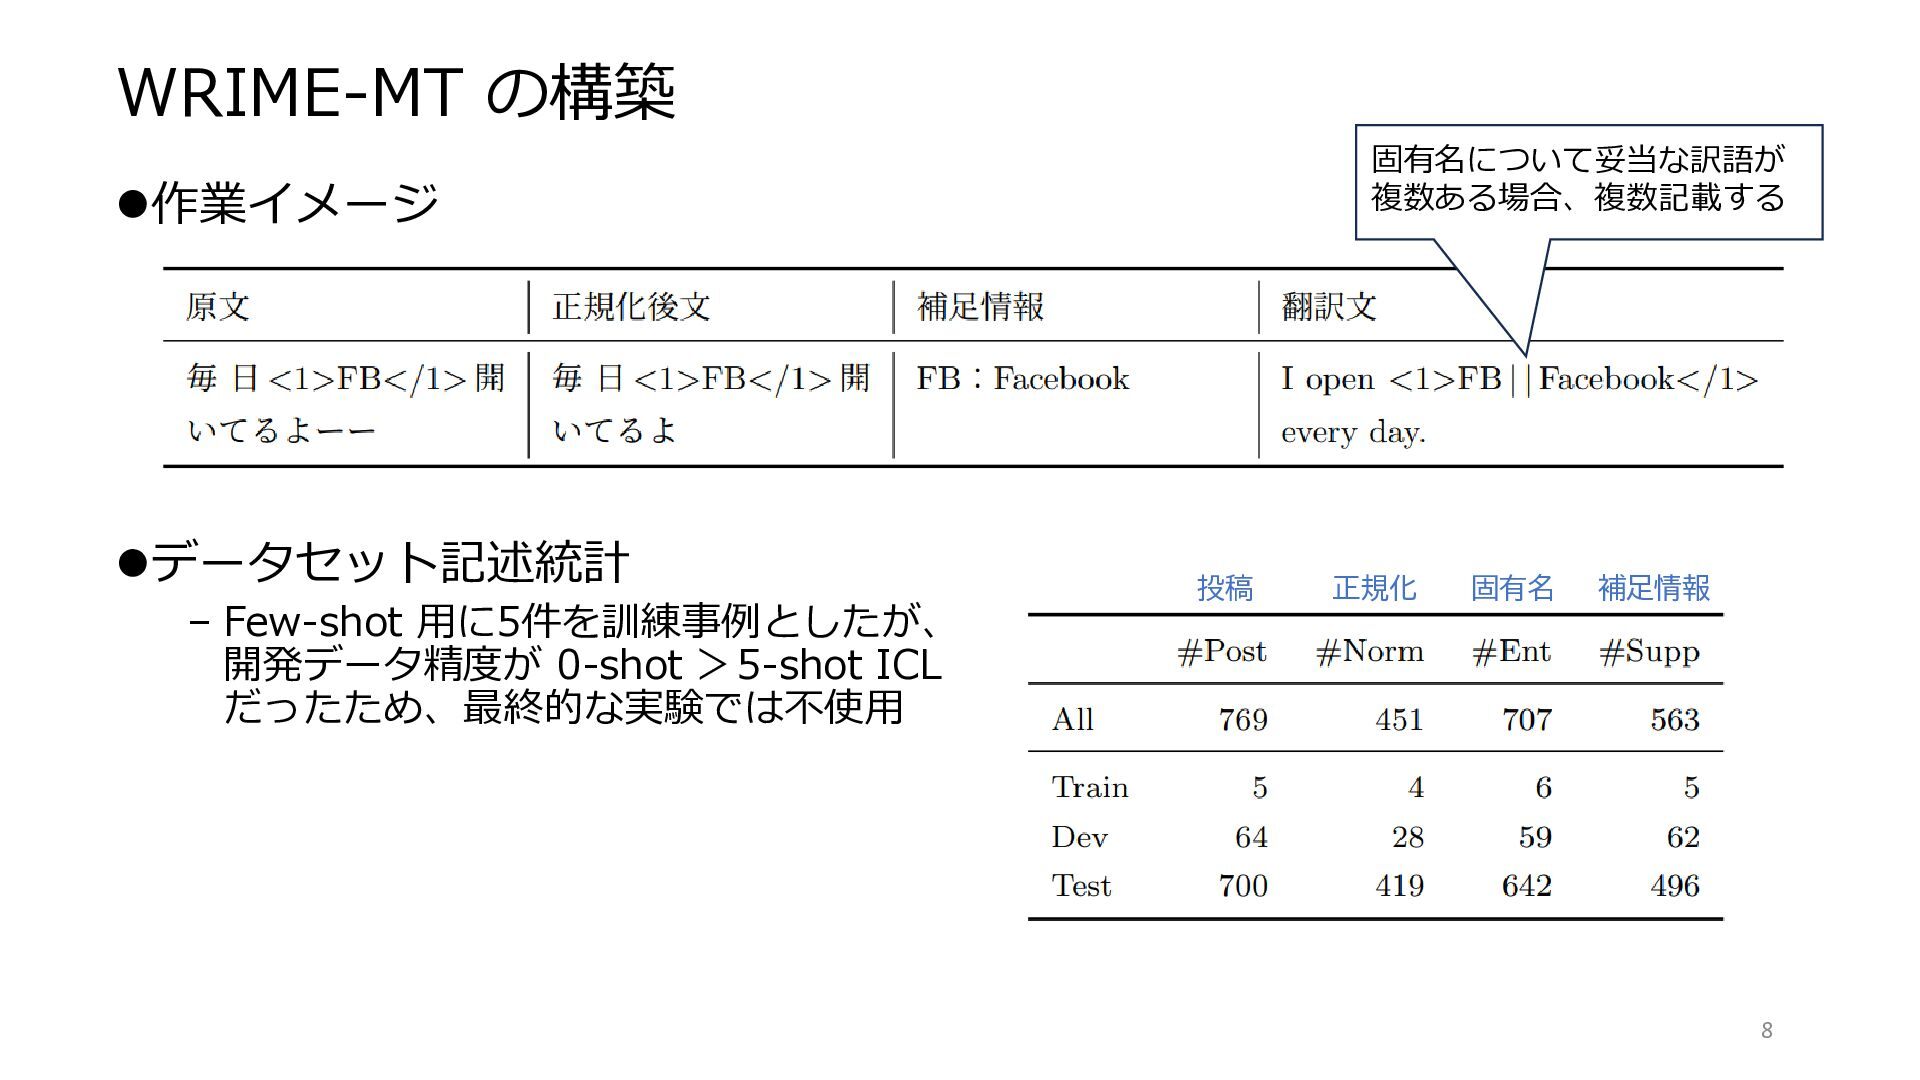
WRIME-MT の構築 ⚫作業イメージ ⚫データセット記述統計 – Few-shot 用に5件を訓練事例としたが、 開発データ精度が 0-shot >5-shot
ICL だったため、最終的な実験では不使用 8 固有名 補足情報 正規化 投稿 固有名について妥当な訳語が 複数ある場合、複数記載する -
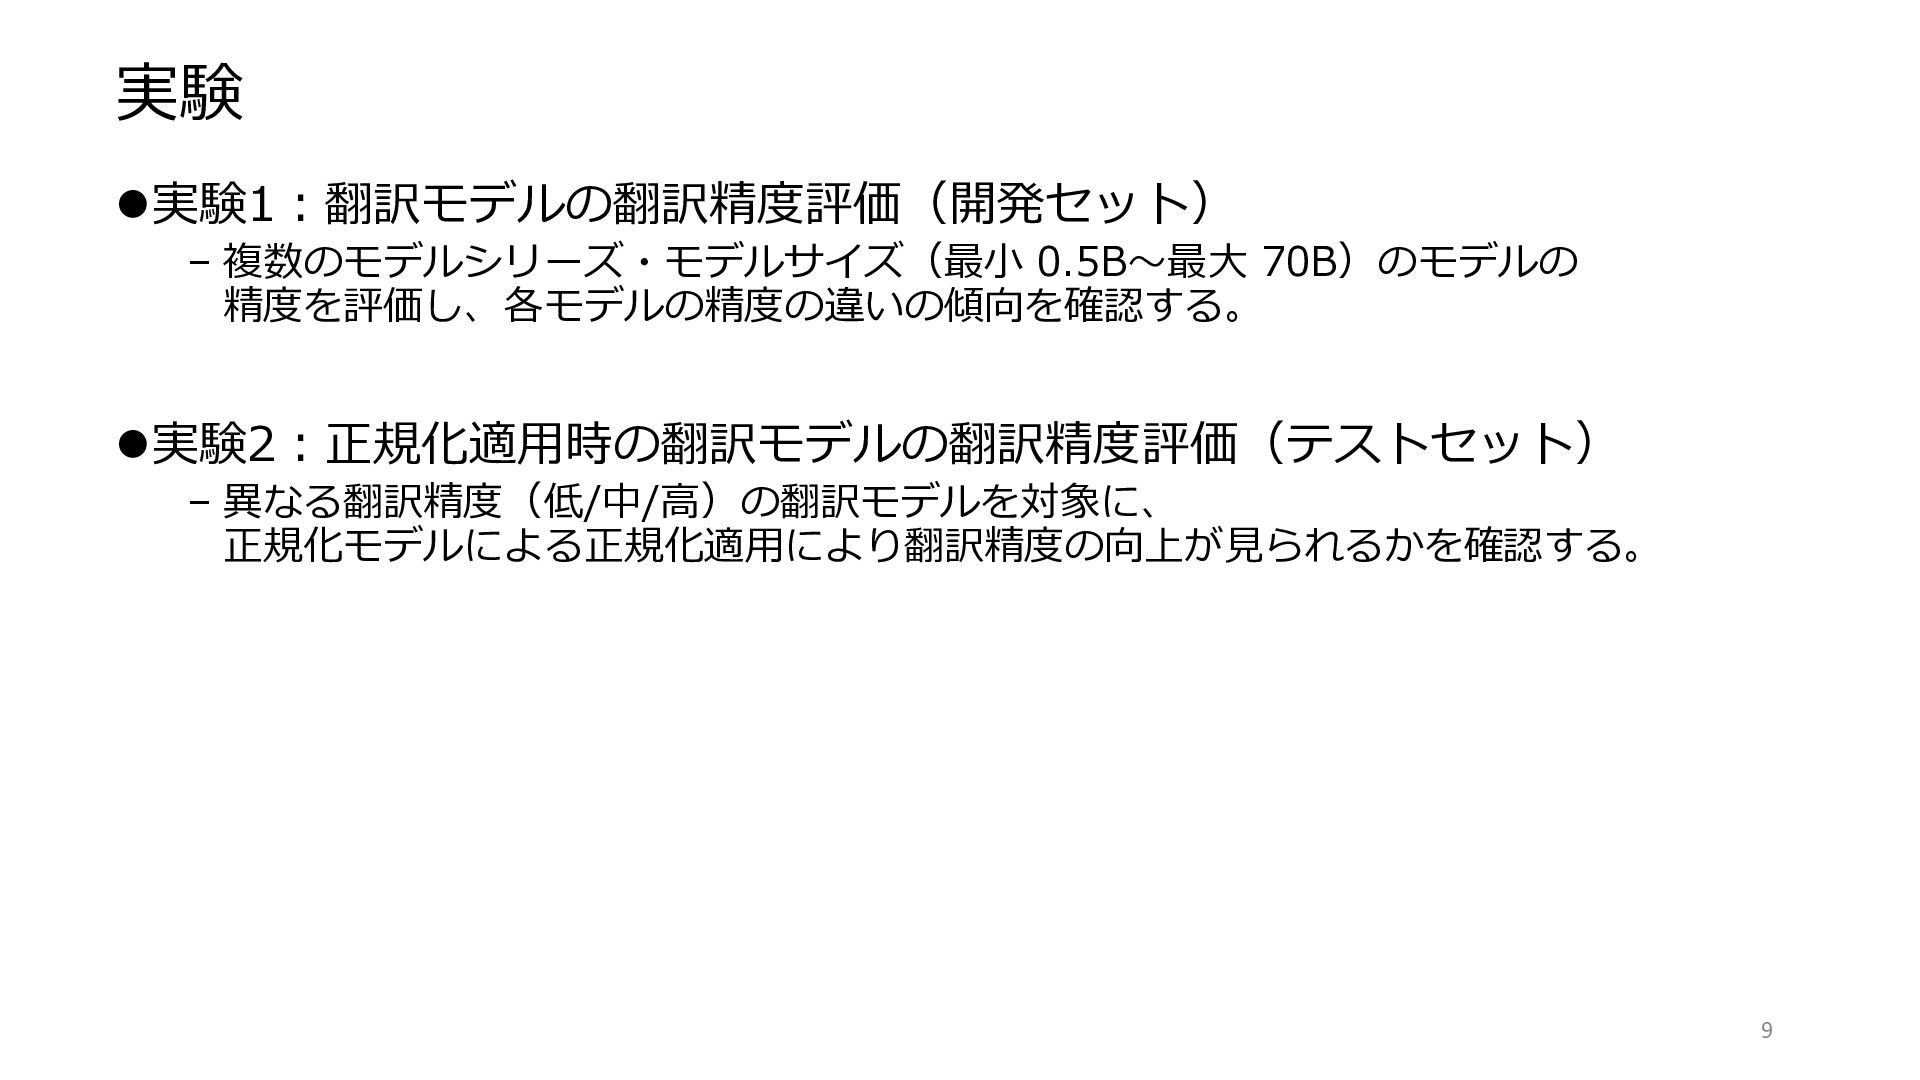
実験 ⚫実験1:翻訳モデルの翻訳精度評価(開発セット) – 複数のモデルシリーズ・モデルサイズ(最小 0.5B~最大 70B)のモデルの 精度を評価し、各モデルの精度の違いの傾向を確認する。 ⚫実験2:正規化適用時の翻訳モデルの翻訳精度評価(テストセット) – 異なる翻訳精度(低/中/高)の翻訳モデルを対象に、
正規化モデルによる正規化適用により翻訳精度の向上が見られるかを確認する。 9 -
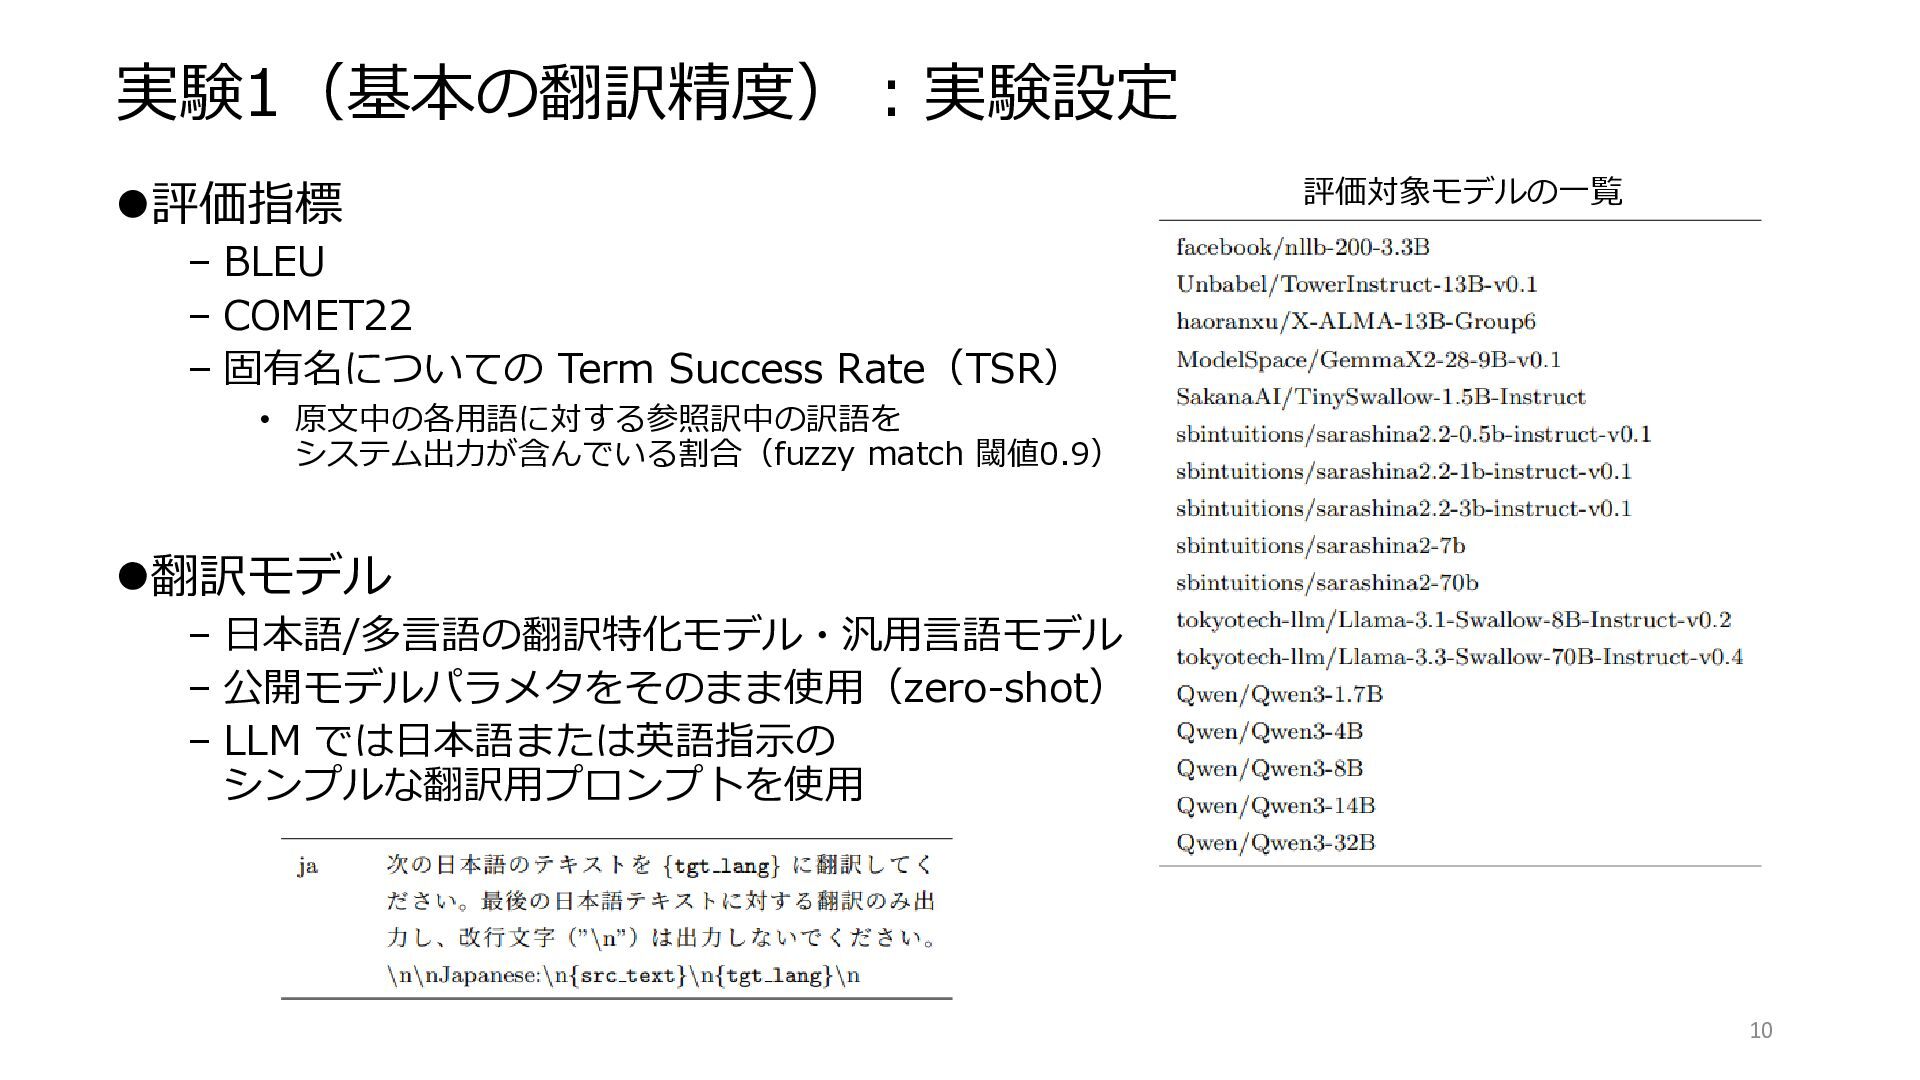
実験1(基本の翻訳精度):実験設定 ⚫評価指標 – BLEU – COMET22 – 固有名についての Term Success
Rate(TSR) • 原文中の各用語に対する参照訳中の訳語を システム出力が含んでいる割合(fuzzy match 閾値0.9) ⚫翻訳モデル – 日本語/多言語の翻訳特化モデル・汎用言語モデル – 公開モデルパラメタをそのまま使用(zero-shot) – LLM では日本語または英語指示の シンプルな翻訳用プロンプトを使用 10 評価対象モデルの一覧 -
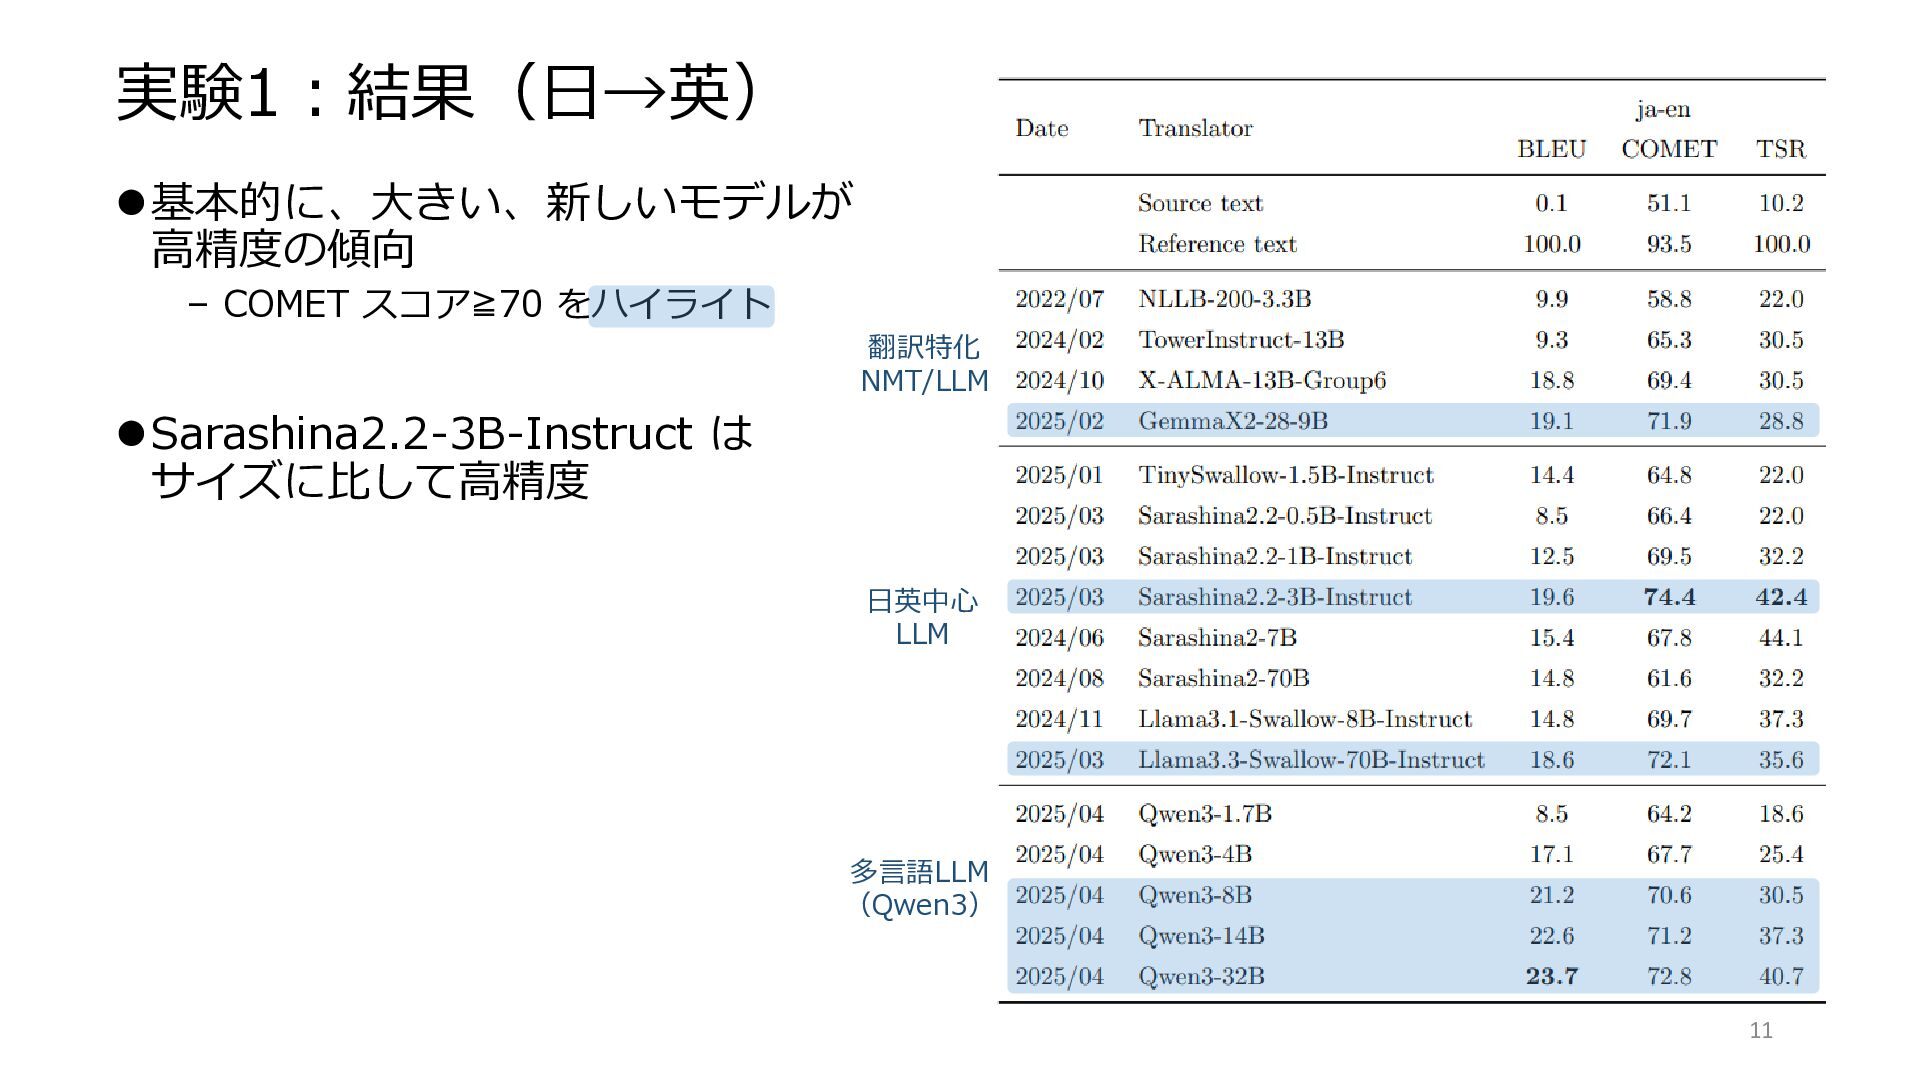
実験1:結果(日→英) ⚫基本的に、大きい、新しいモデルが 高精度の傾向 – COMET スコア≧70 をハイライト ⚫Sarashina2.2-3B-Instruct は サイズに比して高精度
11 翻訳特化 NMT/LLM 多言語LLM (Qwen3) 日英中心 LLM -
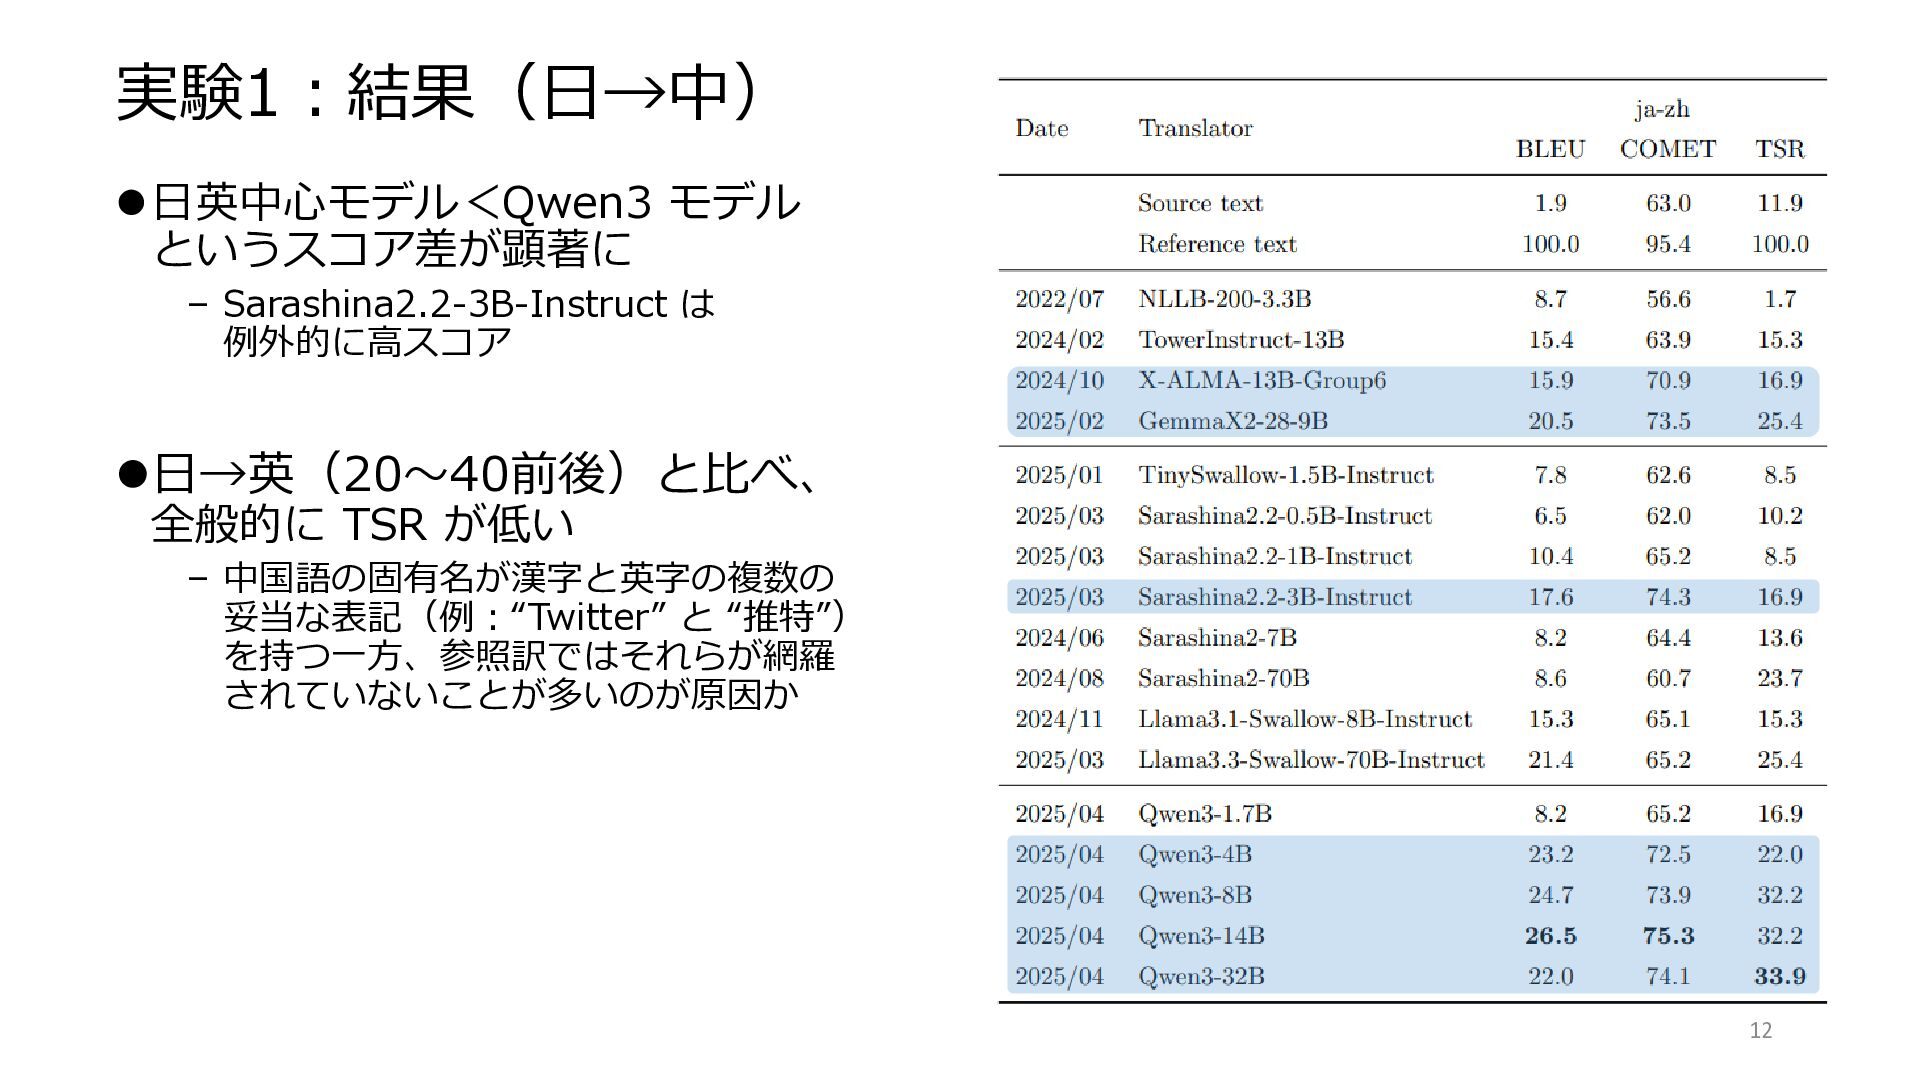
実験1:結果(日→中) ⚫日英中心モデル<Qwen3 モデル というスコア差が顕著に – Sarashina2.2-3B-Instruct は 例外的に高スコア ⚫日→英(20~40前後)と比べ、 全般的に
TSR が低い – 中国語の固有名が漢字と英字の複数の 妥当な表記(例:“Twitter” と “推特”) を持つ一方、参照訳ではそれらが網羅 されていないことが多いのが原因か 12 -
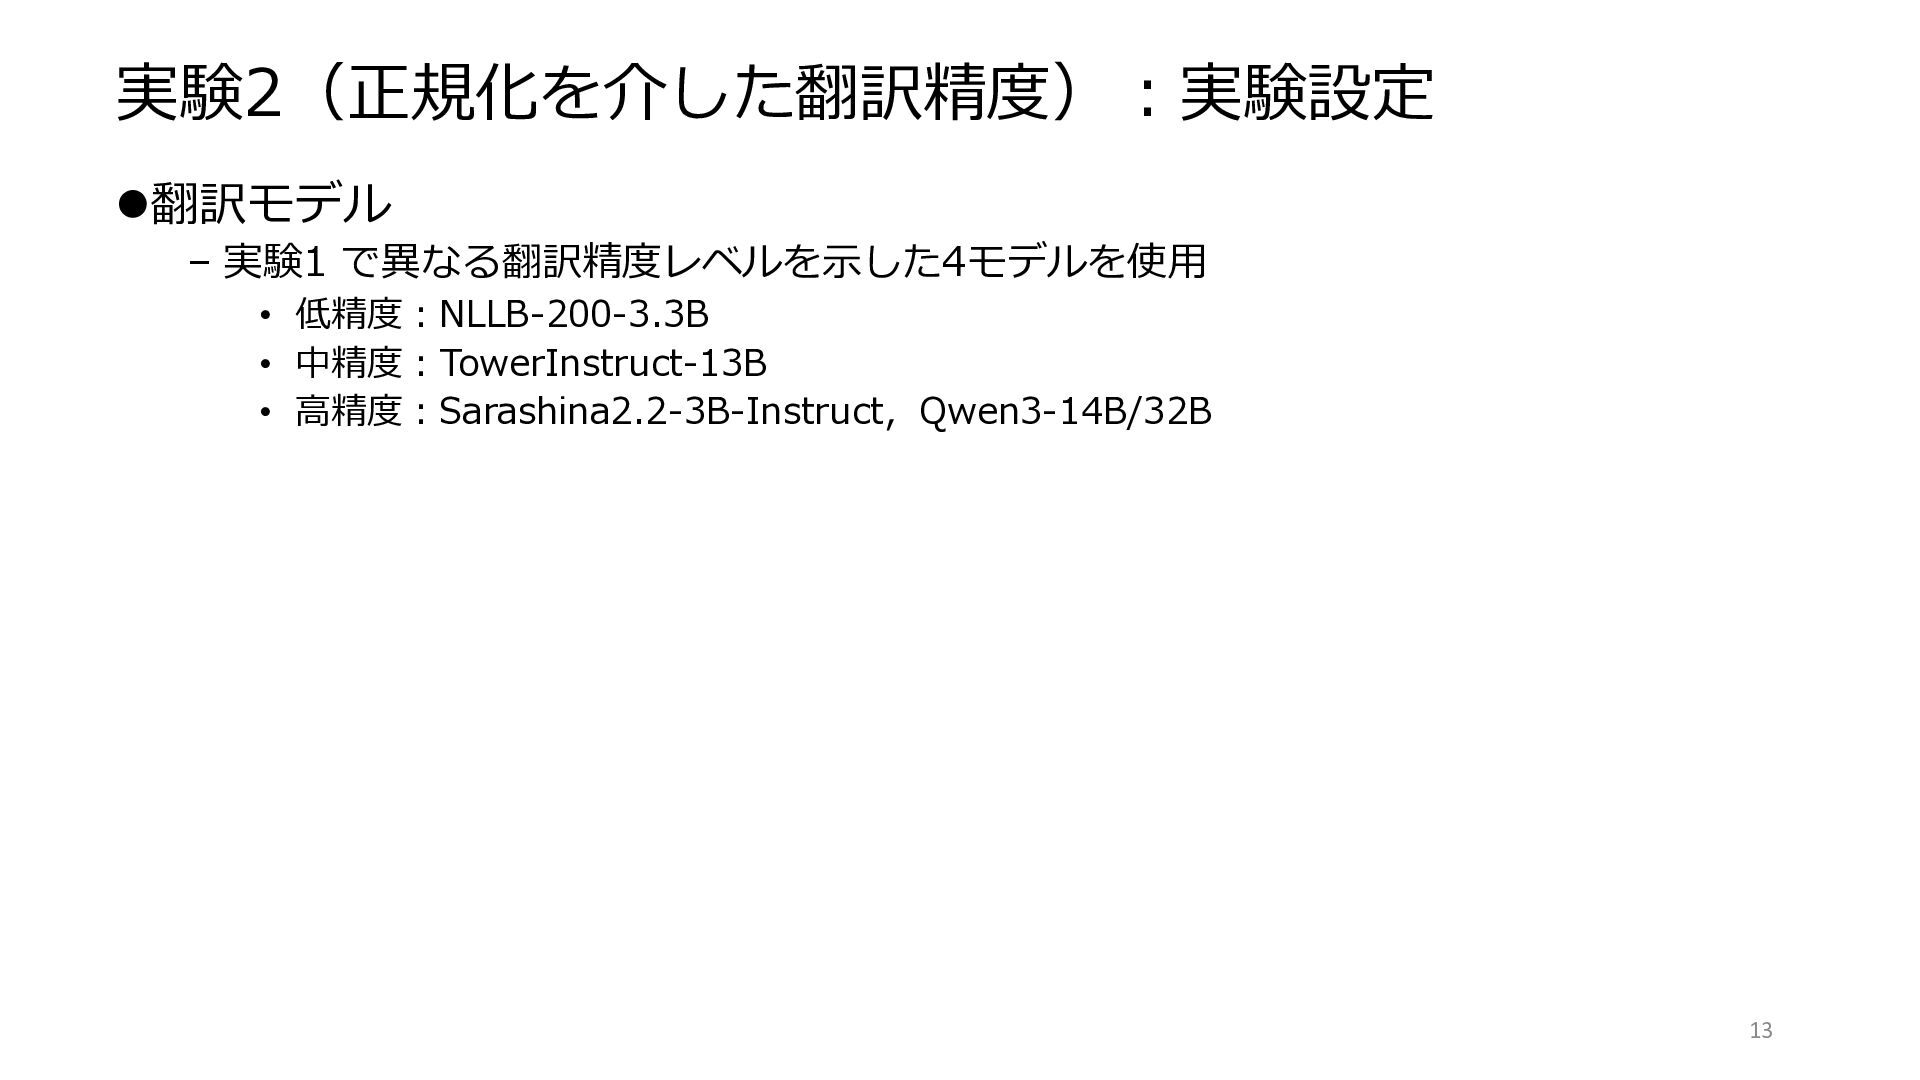
実験2(正規化を介した翻訳精度):実験設定 ⚫翻訳モデル – 実験1 で異なる翻訳精度レベルを示した4モデルを使用 • 低精度:NLLB-200-3.3B • 中精度:TowerInstruct-13B •
高精度:Sarashina2.2-3B-Instruct,Qwen3-14B/32B 13 -
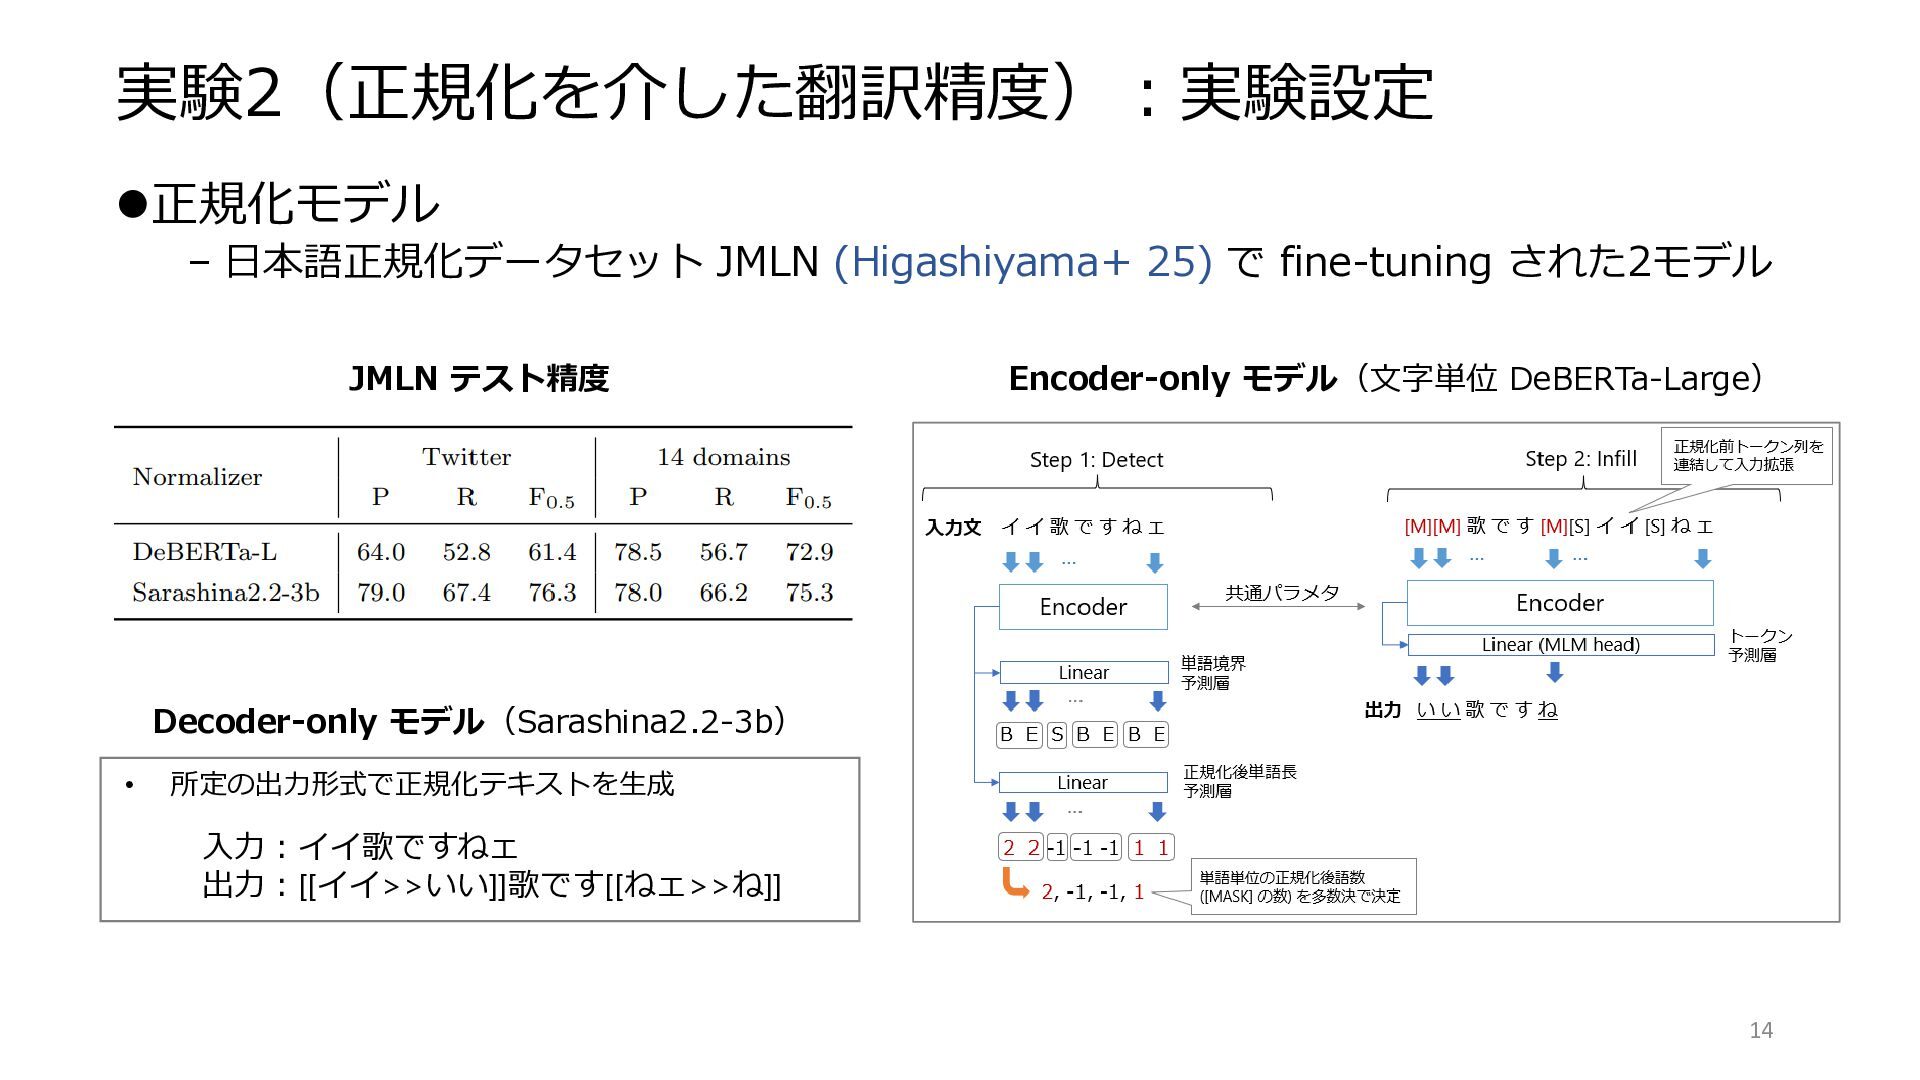
実験2(正規化を介した翻訳精度):実験設定 ⚫正規化モデル – 日本語正規化データセット JMLN (Higashiyama+ 25) で fine-tuning された2モデル
14 JMLN テスト精度 Encoder-only モデル(文字単位 DeBERTa-Large) Decoder-only モデル(Sarashina2.2-3b) 入力:イイ歌ですねェ 出力:[[イイ>>いい]]歌です[[ねェ>>ね]] • 所定の出力形式で正規化テキストを生成 -
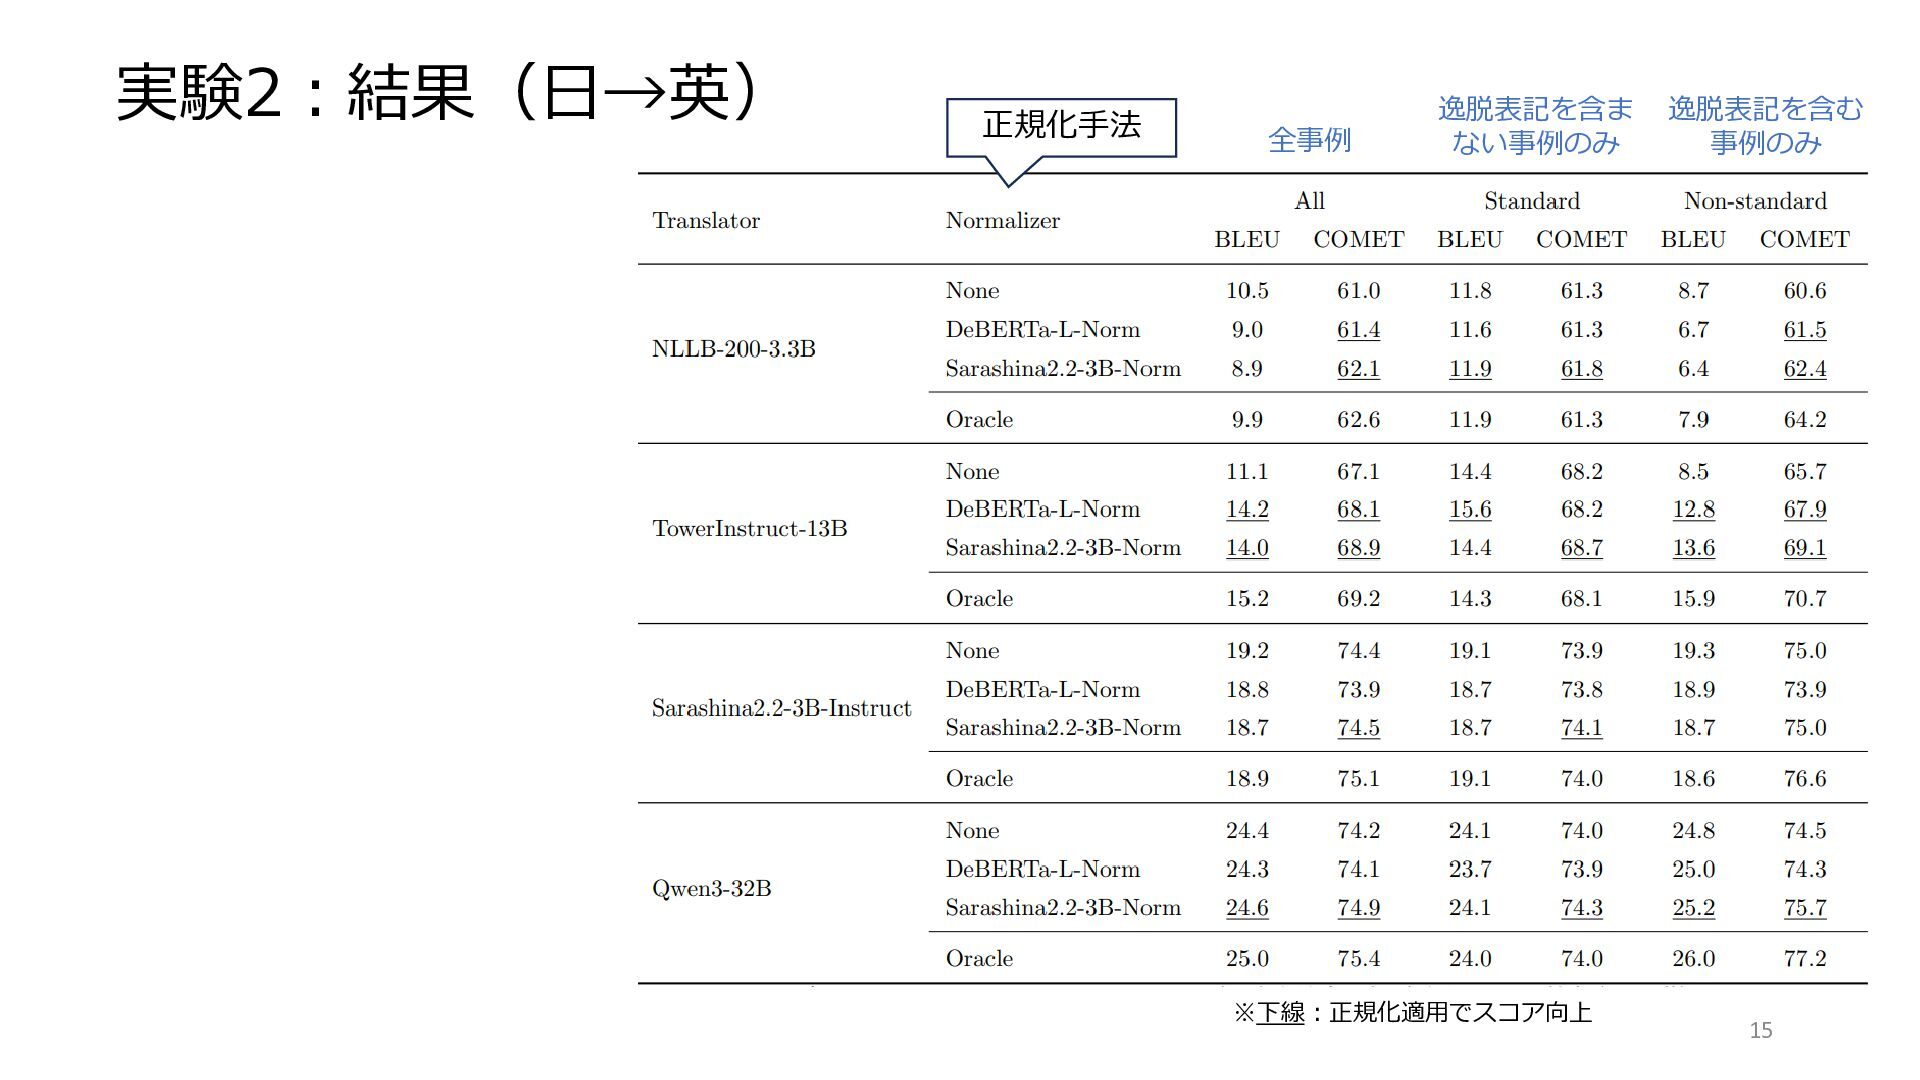
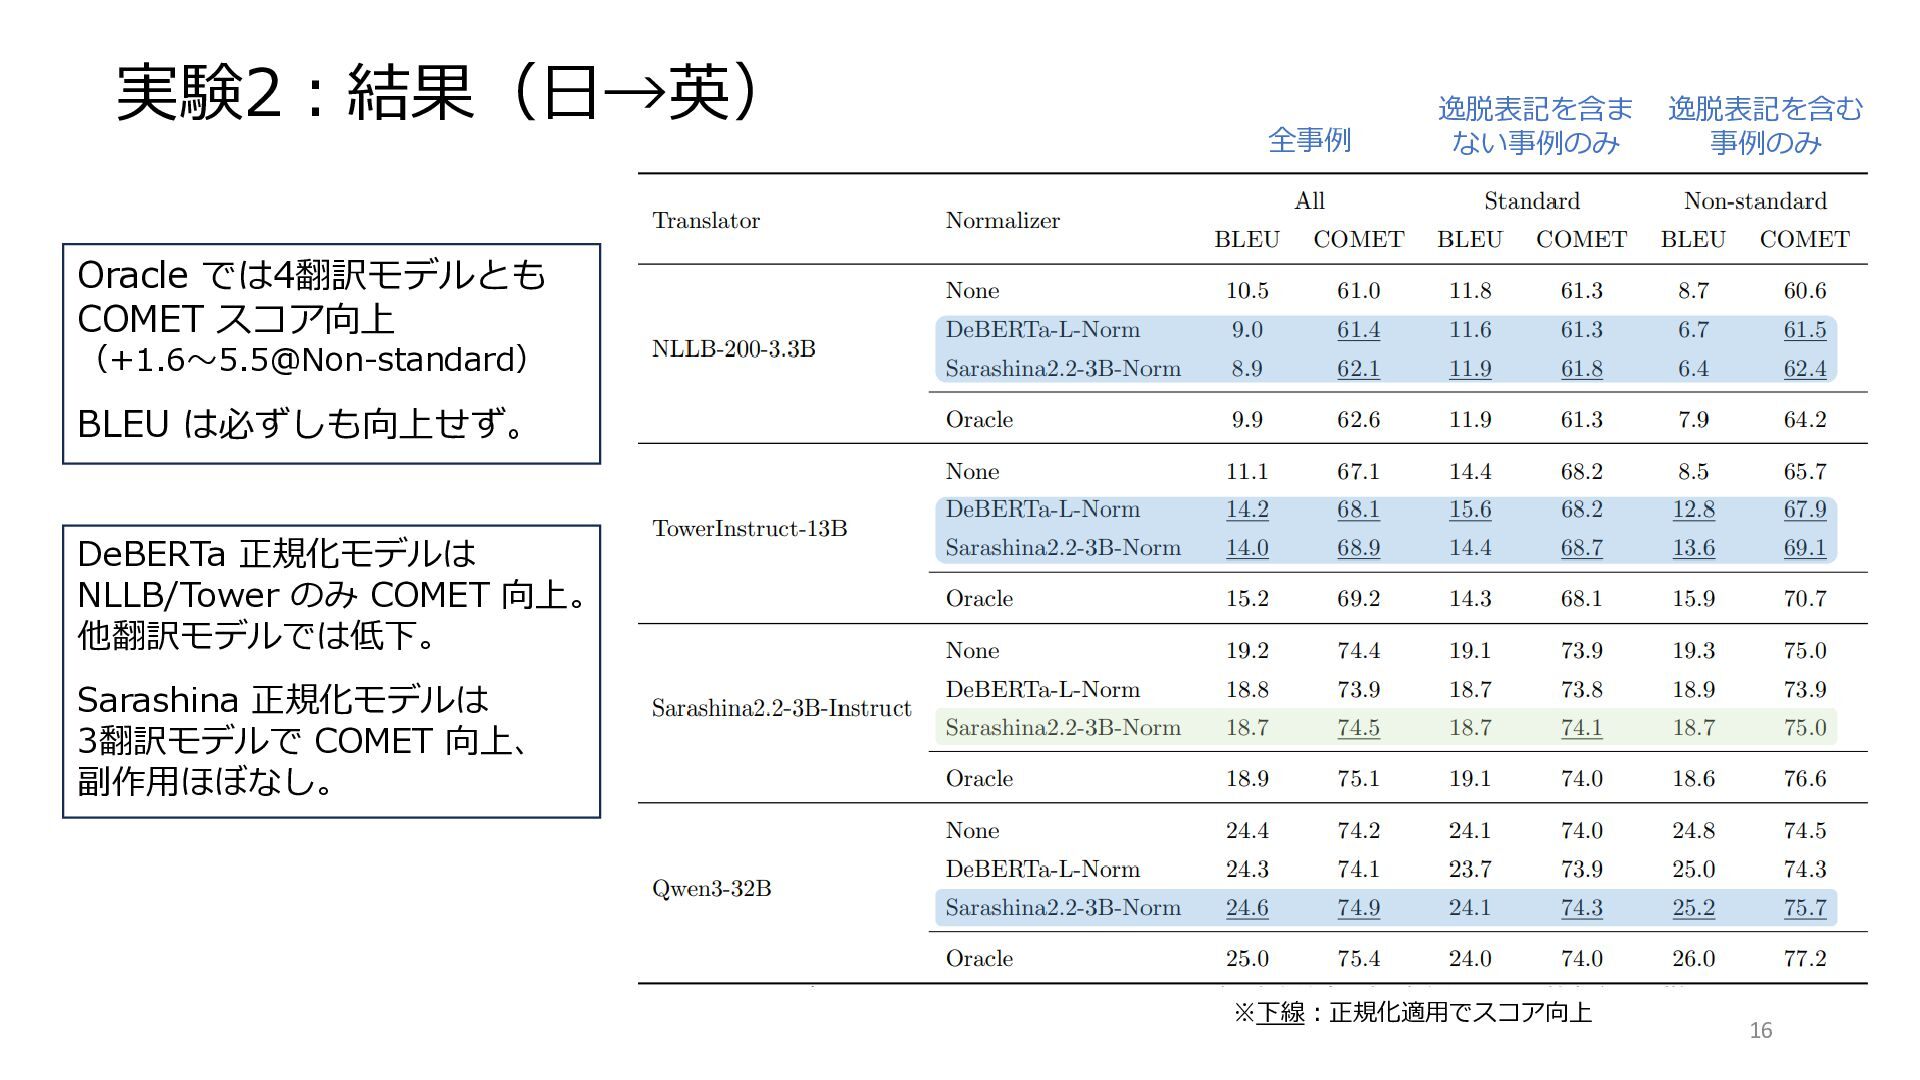
実験2:結果(日→英) 16 逸脱表記を含ま ない事例のみ 全事例 逸脱表記を含む 事例のみ ※下線:正規化適用でスコア向上 Oracle では4翻訳モデルとも
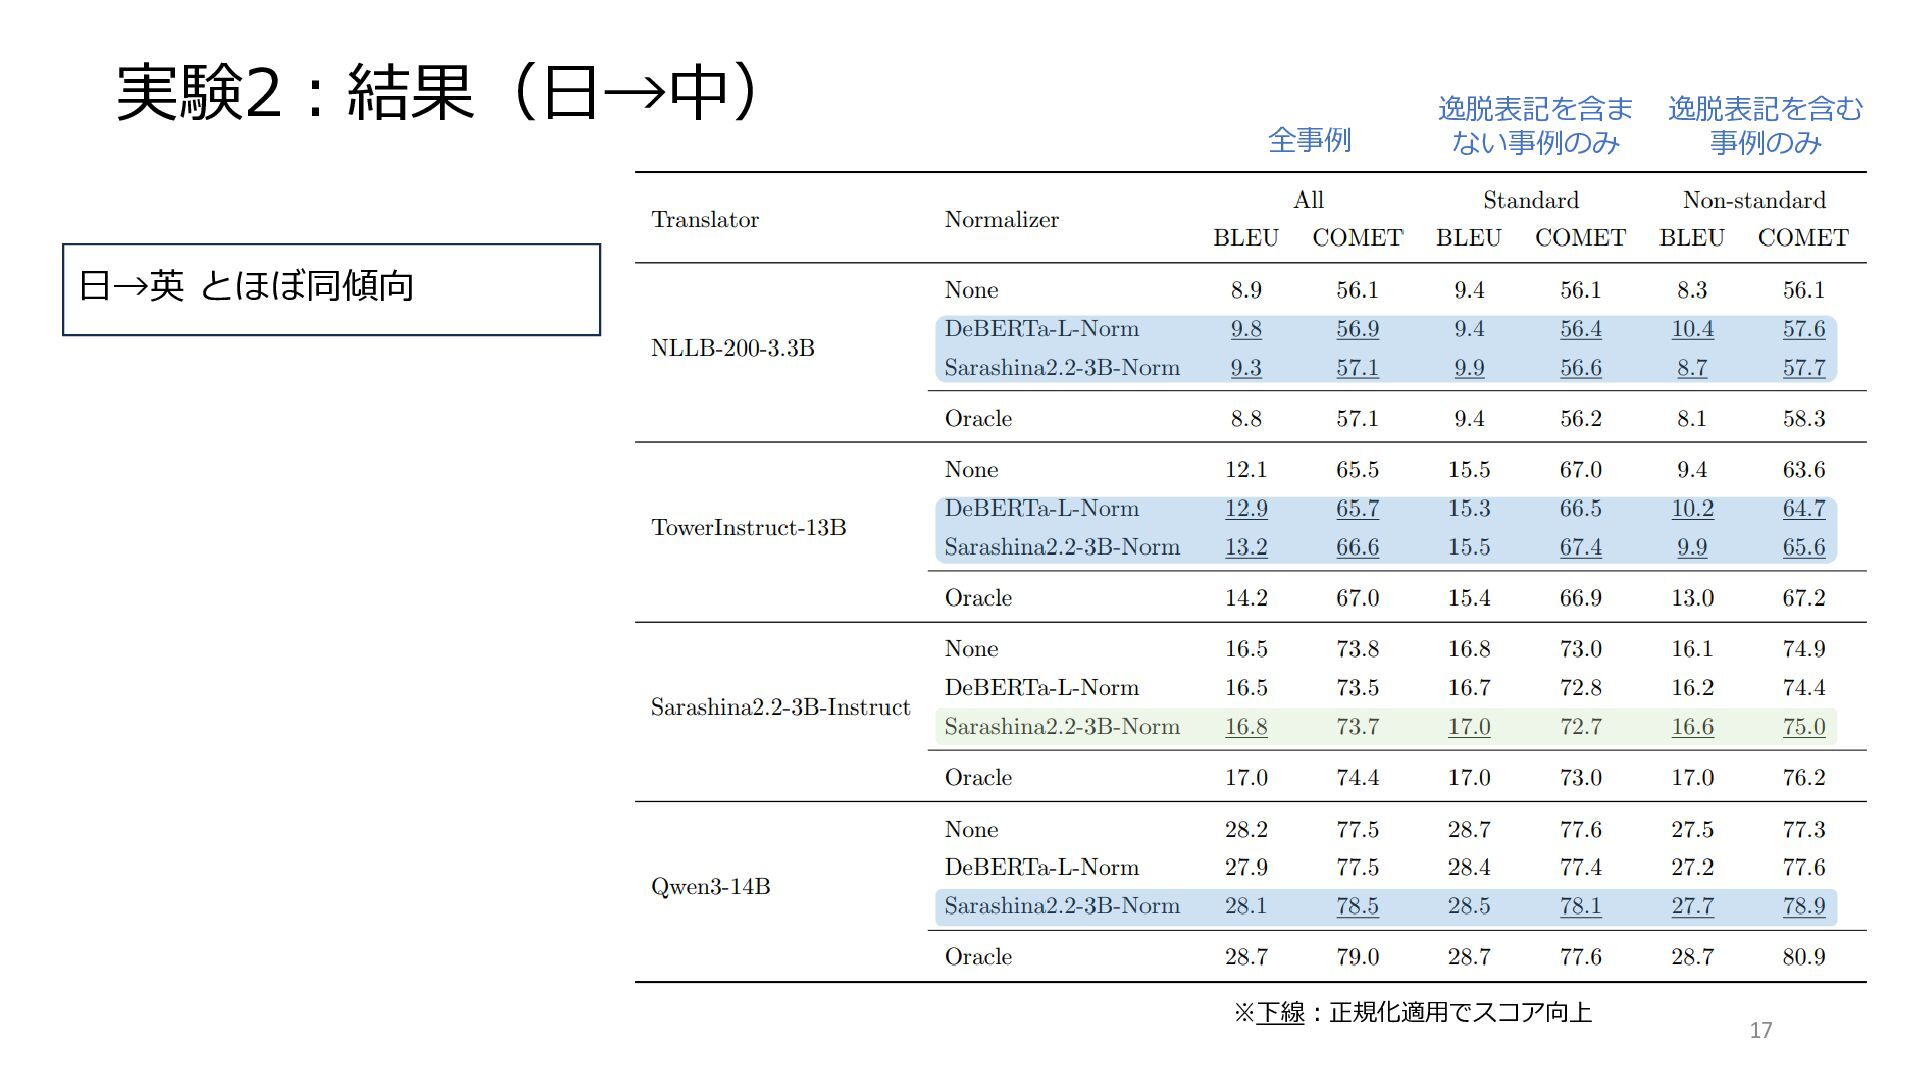
COMET スコア向上 (+1.6~5.5@Non-standard) BLEU は必ずしも向上せず。 DeBERTa 正規化モデルは NLLB/Tower のみ COMET 向上。 他翻訳モデルでは低下。 Sarashina 正規化モデルは 3翻訳モデルで COMET 向上、 副作用ほぼなし。 -
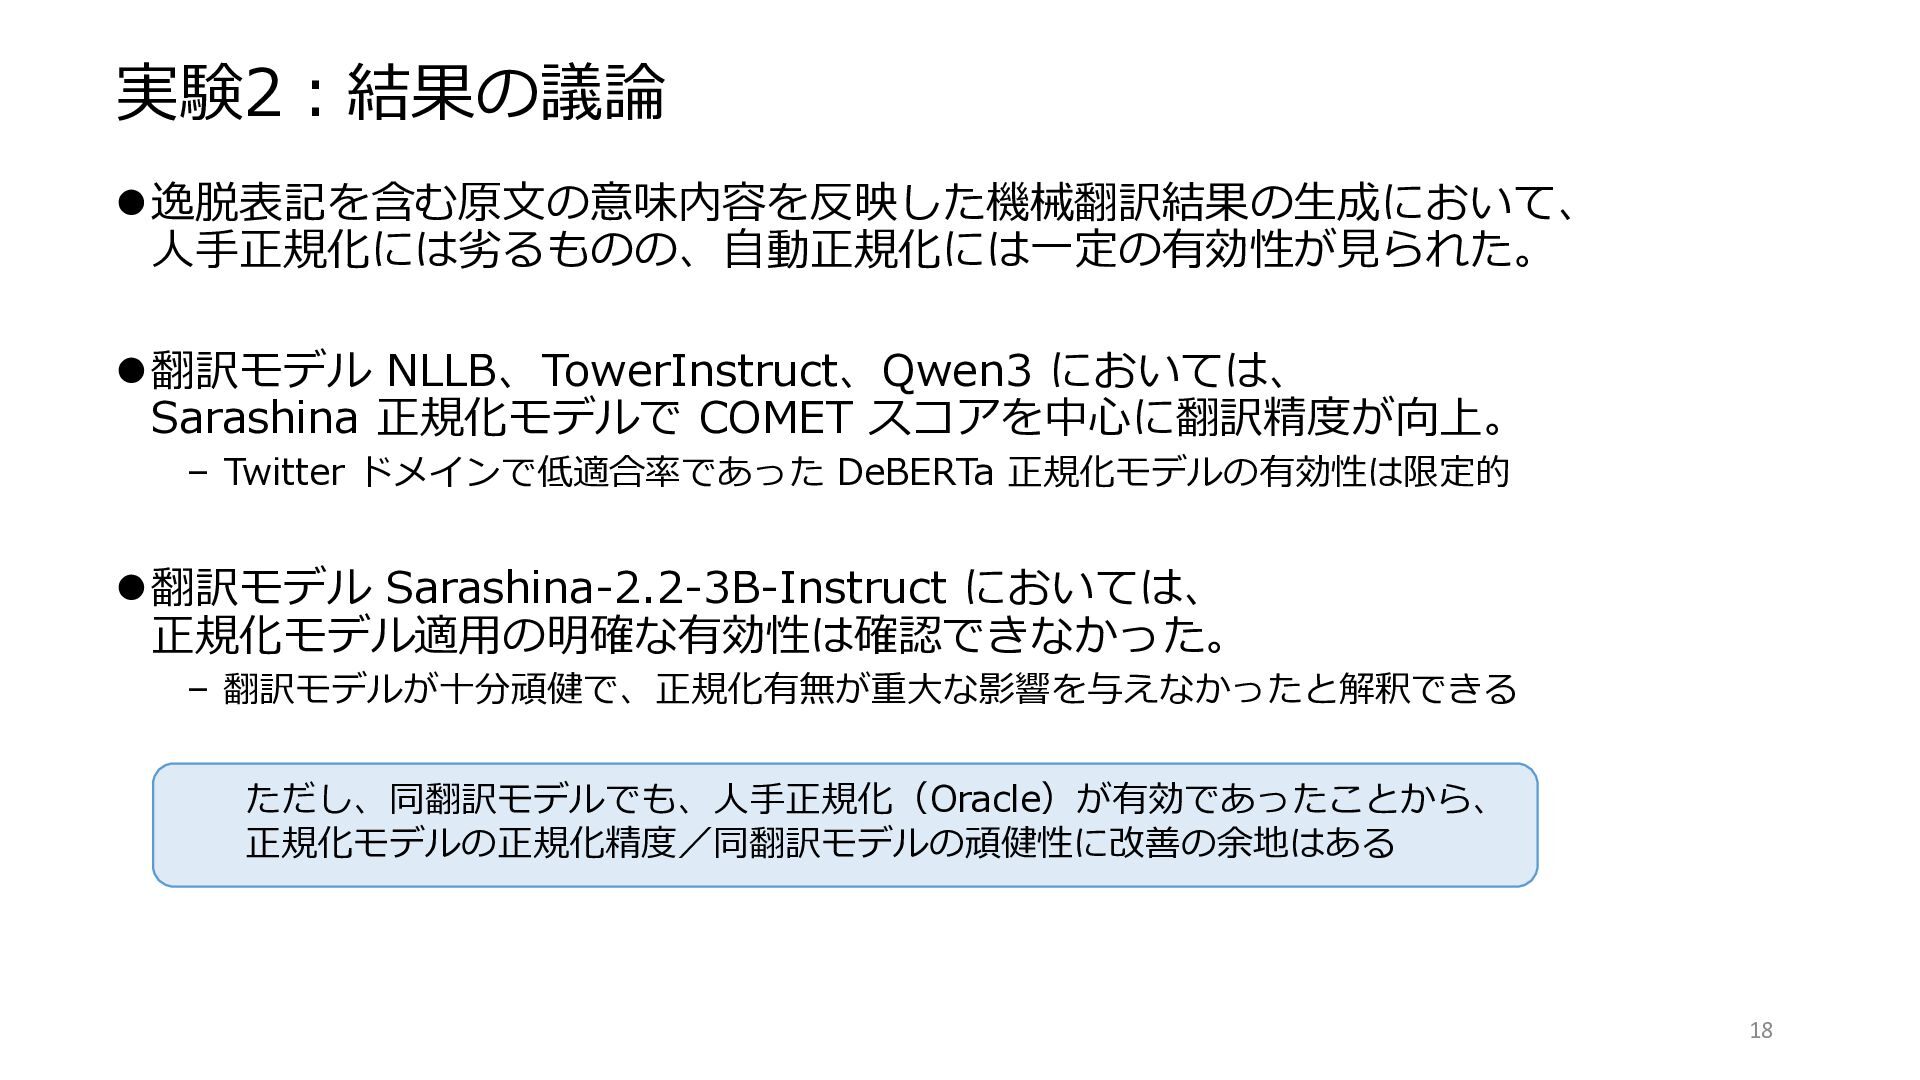
実験2:結果の議論 ⚫逸脱表記を含む原文の意味内容を反映した機械翻訳結果の生成において、 人手正規化には劣るものの、自動正規化には一定の有効性が見られた。 ⚫翻訳モデル NLLB、TowerInstruct、Qwen3 においては、 Sarashina 正規化モデルで COMET スコアを中心に翻訳精度が向上。
– Twitter ドメインで低適合率であった DeBERTa 正規化モデルの有効性は限定的 ⚫翻訳モデル Sarashina-2.2-3B-Instruct においては、 正規化モデル適用の明確な有効性は確認できなかった。 – 翻訳モデルが十分頑健で、正規化有無が重大な影響を与えなかったと解釈できる 18 ただし、同翻訳モデルでも、人手正規化(Oracle)が有効であったことから、 正規化モデルの正規化精度/同翻訳モデルの頑健性に改善の余地はある -
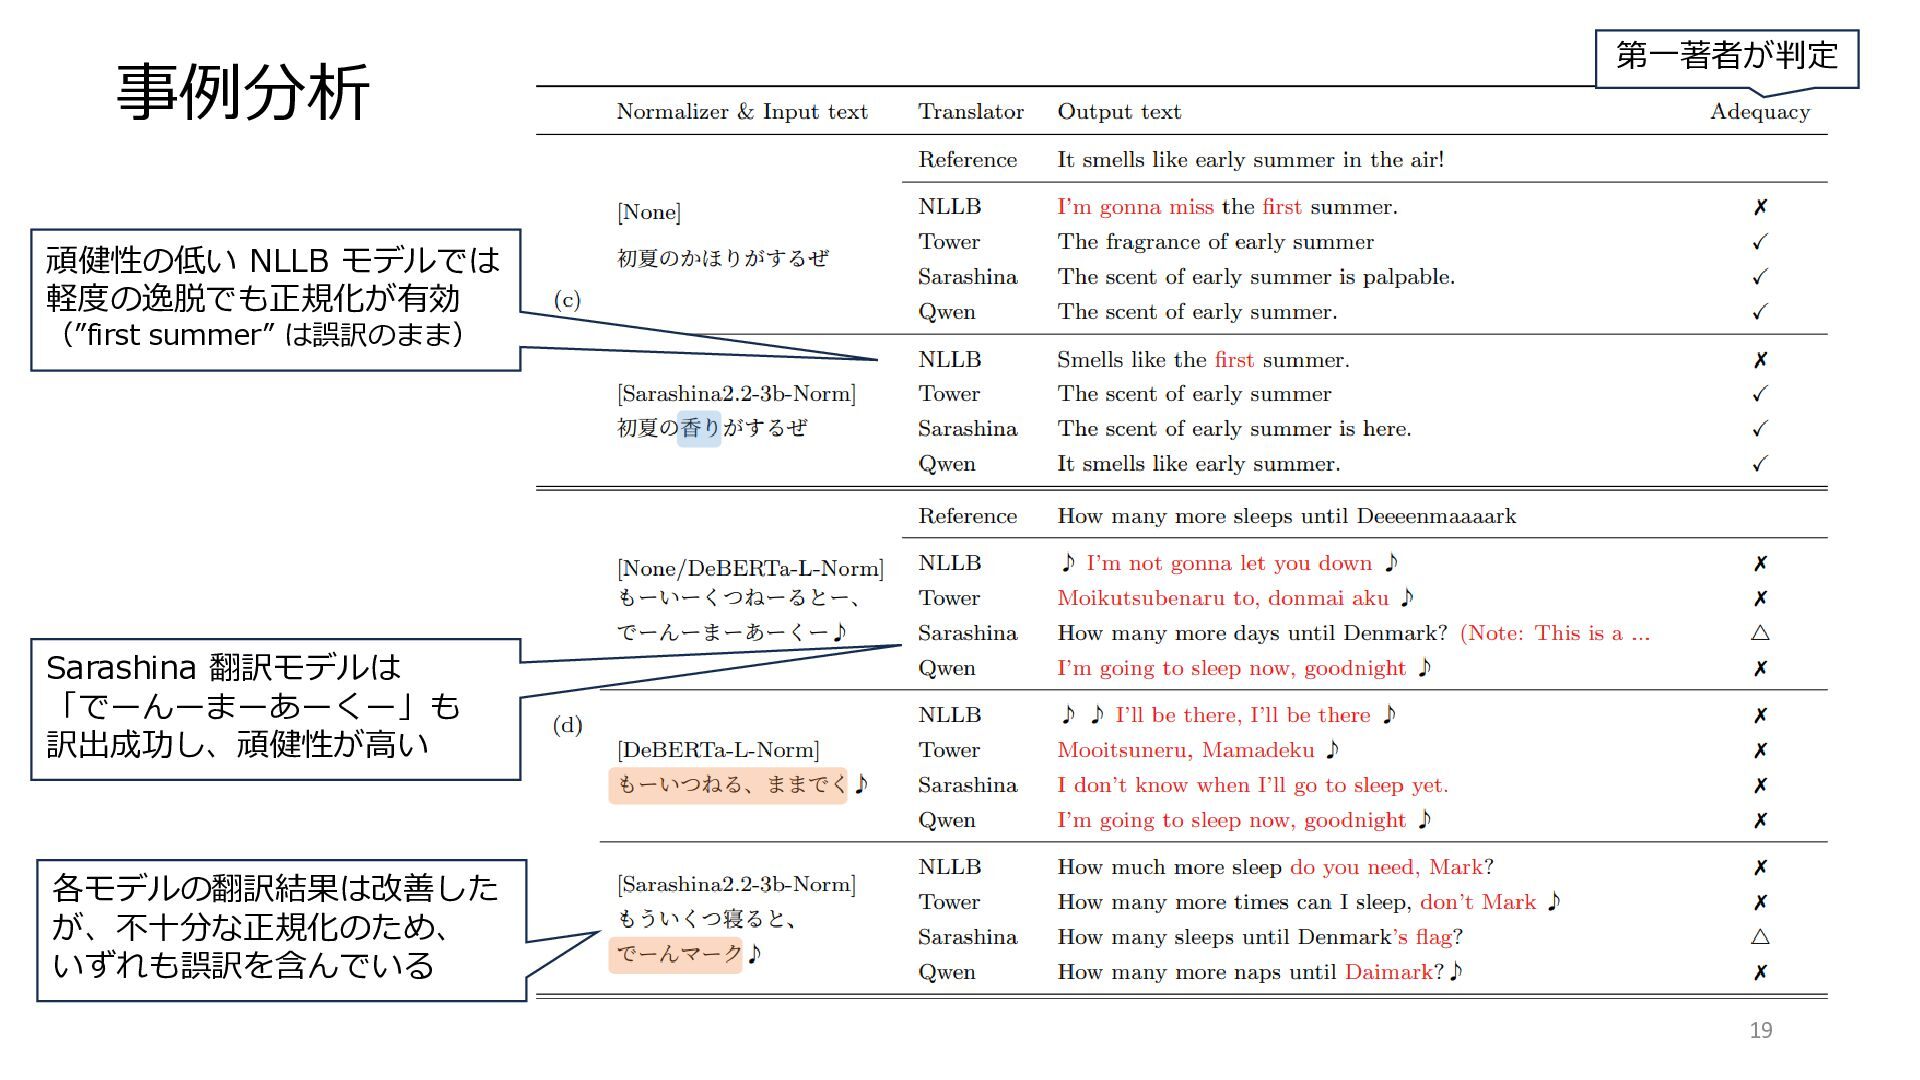
事例分析 19 第一著者が判定 頑健性の低い NLLB モデルでは 軽度の逸脱でも正規化が有効 (”first summer” は誤訳のまま)
Sarashina 翻訳モデルは 「でーんーまーあーくー」も 訳出成功し、頑健性が高い 各モデルの翻訳結果は改善した が、不十分な正規化のため、 いずれも誤訳を含んでいる -
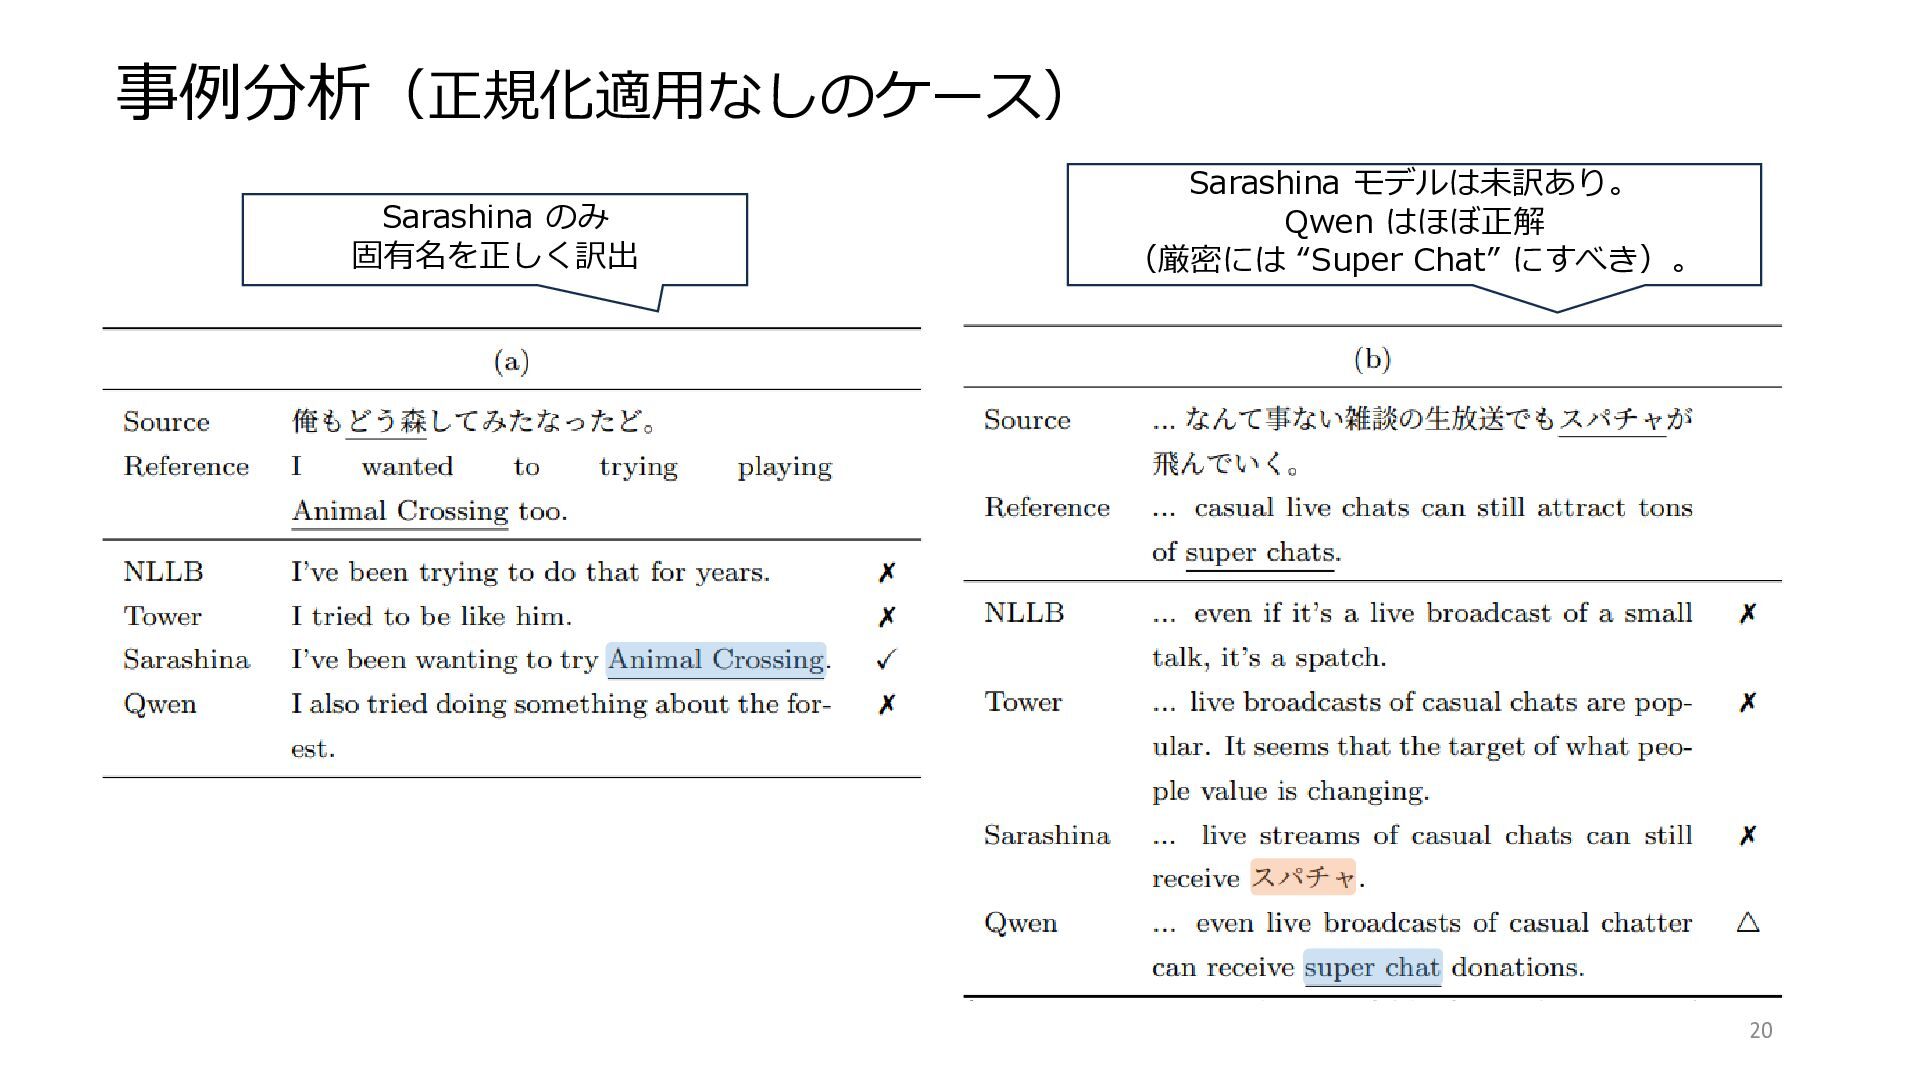
事例分析(正規化適用なしのケース) 20 Sarashina のみ 固有名を正しく訳出 Sarashina モデルは未訳あり。 Qwen はほぼ正解 (厳密には
“Super Chat” にすべき)。 -
まとめと展望 ⚫[目的1]難しい事例からなる日本語 SNS 機械翻訳ベンチマークを構築する – 評価結果のスコア・エラー事例から、難しいベンチマークであることを確認 ⚫[目的2]本ドメインで、最先端・高性能モデルの機械翻訳精度を評価する – Sarashina2.2-3B-Inst、Qwen3 シリーズ、GemmaX2-28-9B
の性能の高さを確認 ⚫[目的3]高精度な正規化手法を適用し、機械翻訳における有効性を検証する – 高精度な正規化により、翻訳精度が低/中/高程度の翻訳モデルでの精度向上を確認。 ただし、元から頑健性の高い Sarashina2.2-3B-Inst 翻訳モデルでは限定的な効果。 21 [展望] • データセットの拡張、アノテーション一貫性の評価 • RAG 等、固有名・略語の正確な翻訳方法の検討