Share
Embed
How to cluster-level logging aggregate on kubernates?
How to cluster-level logging aggregate on kubernates? / shinjuku-mokumoku vol.6
at 2018-07-14
threetreeslight
July 14, 2018
Transcript
31 slides
-
How to cluster-level logging aggregate on kubernates? shinjuku mokumoku programming
#6 @threetreeslight on 2018-07-14 1 / 31 -
今⽇やりたいこと ⾃分の運⽤するblog がGEK で動いている。このログ を分析に活かせるようなpipeline を作りたい 1. k8s( 主にGKE) でのlog
driver まわりやlog 集約の調査 2. ⽤意したほうが⾃由度⾼そうであれば⾃前のlog shipper を動作させるか考える 2 / 31 -
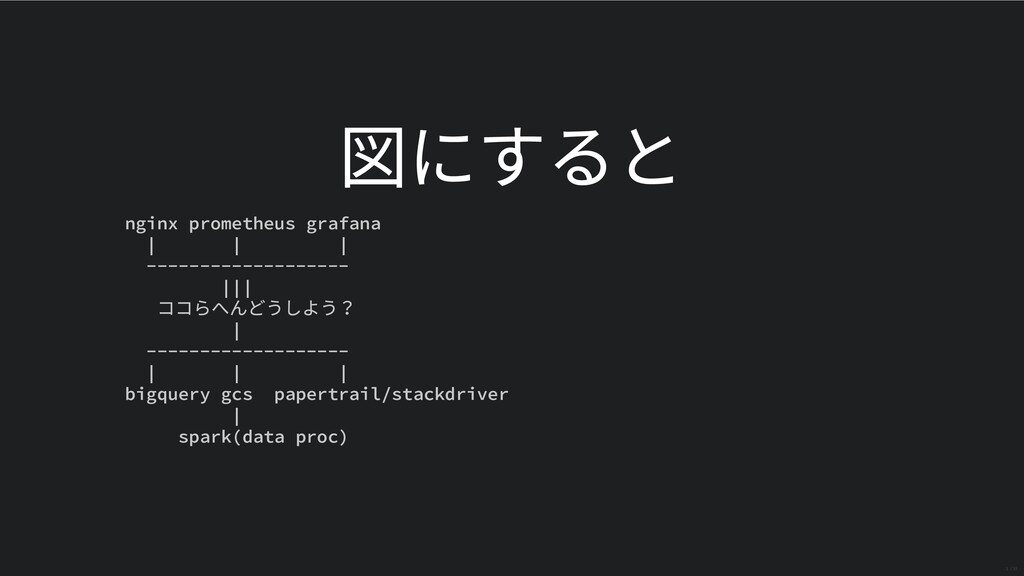
図にすると nginx prometheus grafana | | | ------------------- ||| ココらへんどうしよう?
| ------------------- | | | bigquery gcs papertrail/stackdriver | spark(data proc) 3 / 31 -
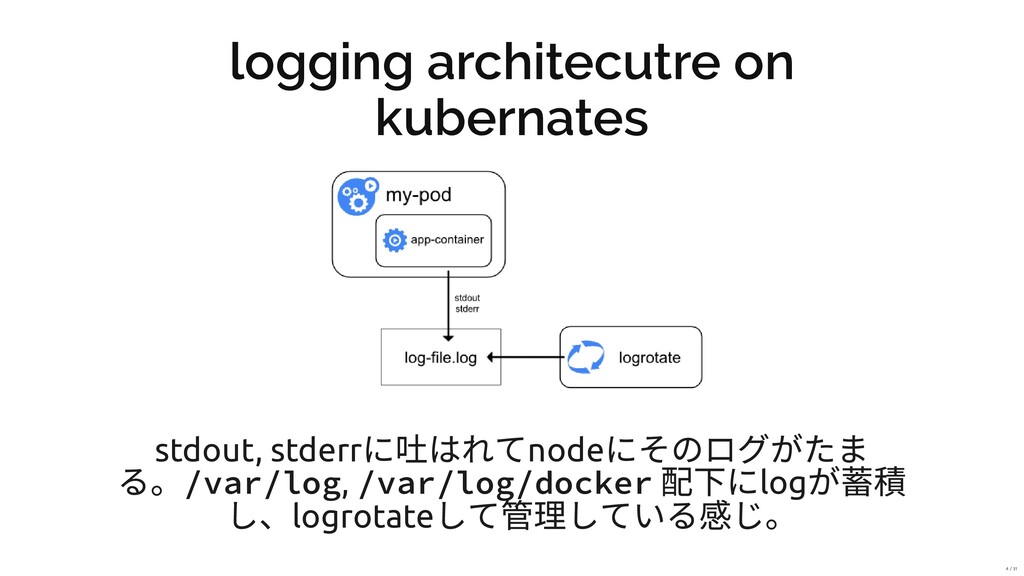
logging architecutre on kubernates stdout, stderr に吐はれてnode にそのログがたま る。/var/log, /var/log/docker
配下にlog が蓄積 し、logrotate して管理している感じ。 4 / 31 -
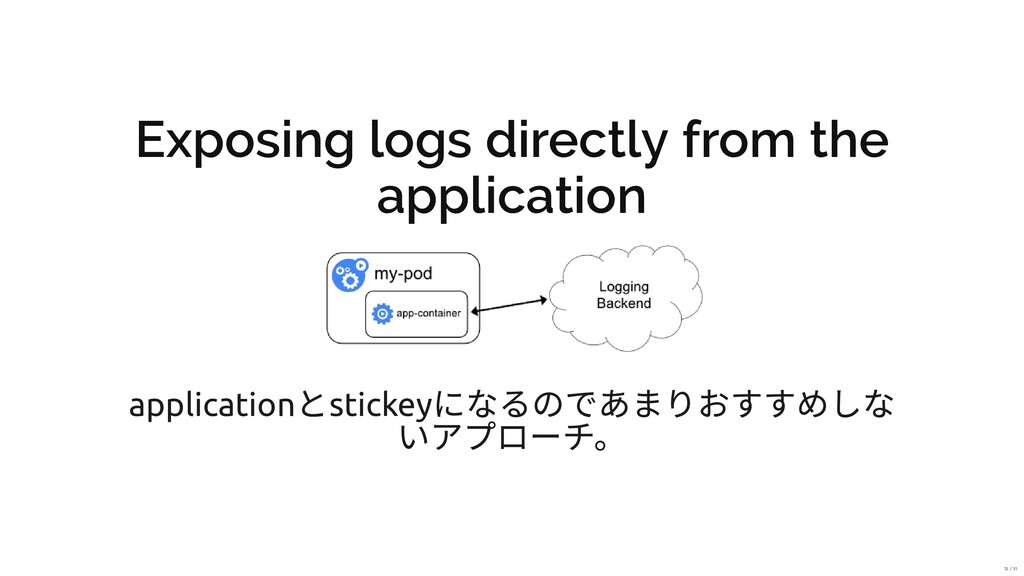
Approaches kubernates には、log 集約のapproach が綺麗にまとま っていたので良いですね! 1. 各node にagent いれて⾛らせる
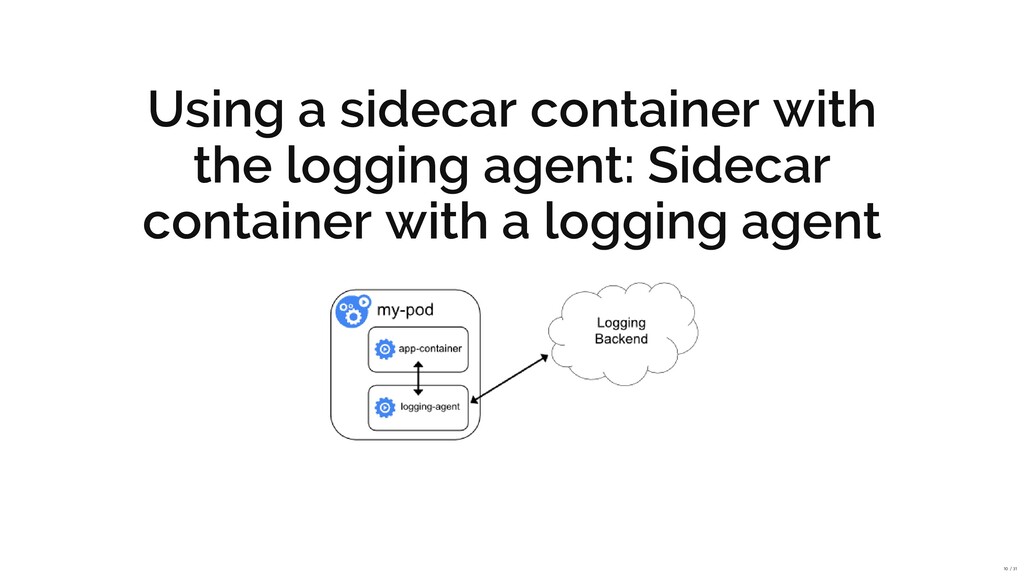
2. pod にlogging ⽤side car container をつけて集約 3. application からlog service に直接送る docker logdriver で直接送るようにすると接続先が down したときにどうにもならなくなるから推奨して いないのだろう :thinking_face: 6 / 31 -
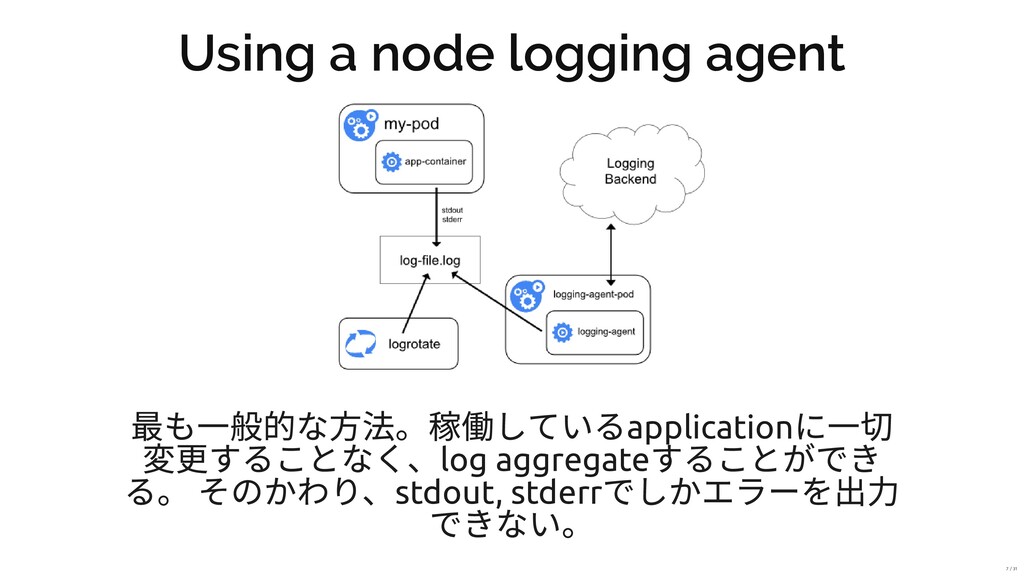
Using a node logging agent 最も⼀般的な⽅法。稼働しているapplication に⼀切 変更することなく、log aggregate することができ
る。 そのかわり、stdout, stderr でしかエラーを出⼒ できない。 7 / 31 -
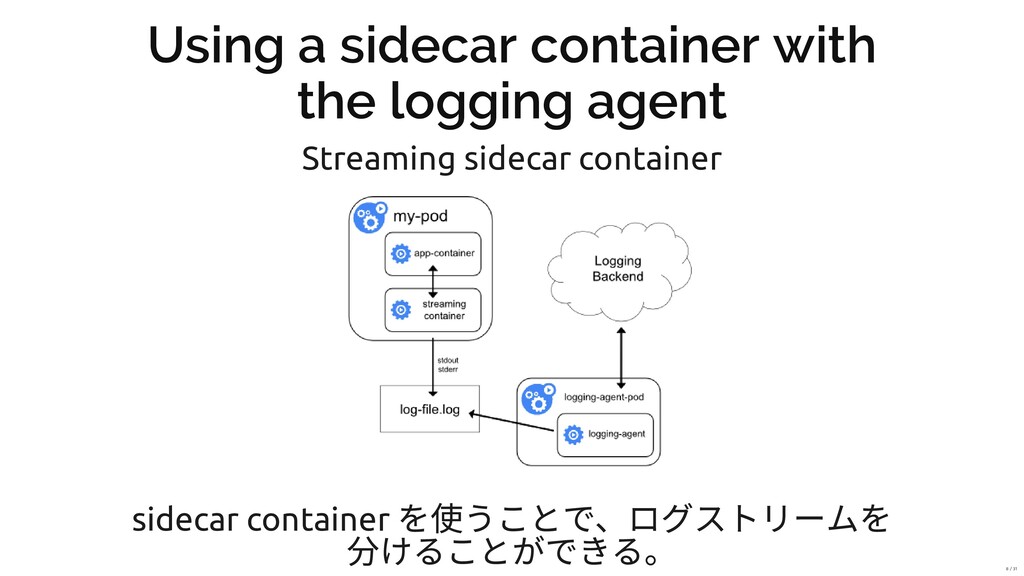
Using a sidecar container with the logging agent Streaming sidecar
container sidecar container を使うことで、ログストリームを 分けることができる。 8 / 31 -
Using a sidecar container with the logging agent: Sidecar container
with a logging agent 10 / 31 -
とはいえ、いくつかメリットもあ る? 1. node level のscalein/out に対して気遣いが不要となる 2. pod のscale
out/in に対して sidecar container の終了に係 る気遣いが不要となる リアルタイムにすべてのデータを受け付けられ、落 ちないlogging backend があるのであれば、この⽅法 もありだと思います。 13 / 31 -
12factor's app に従うと 1. Using a node logging agent アプローチを採⽤する
2. application からログのparse, buffering, retry 処理を切り 離したいのであれば、Streaming sidecar container を⼀ 緒に採⽤する 14 / 31 -
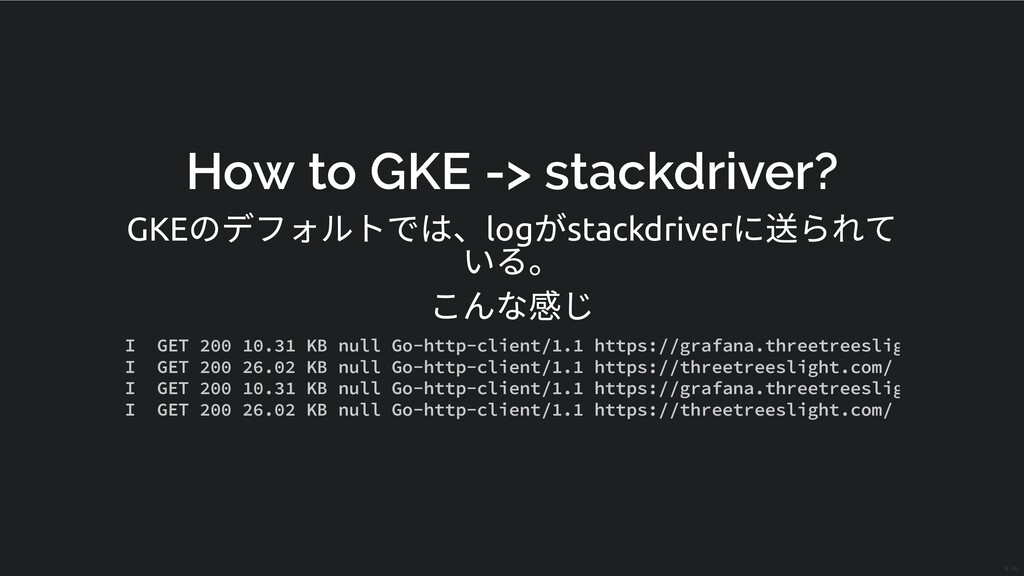
How to GKE -> stackdriver? GKE のデフォルトでは、log がstackdriver に送られて いる。
こんな感じ I GET 200 10.31 KB null Go-http-client/1.1 https://grafana.threetreeslig I GET 200 26.02 KB null Go-http-client/1.1 https://threetreeslight.com/ I GET 200 10.31 KB null Go-http-client/1.1 https://grafana.threetreeslig I GET 200 26.02 KB null Go-http-client/1.1 https://threetreeslight.com/ 15 / 31 -
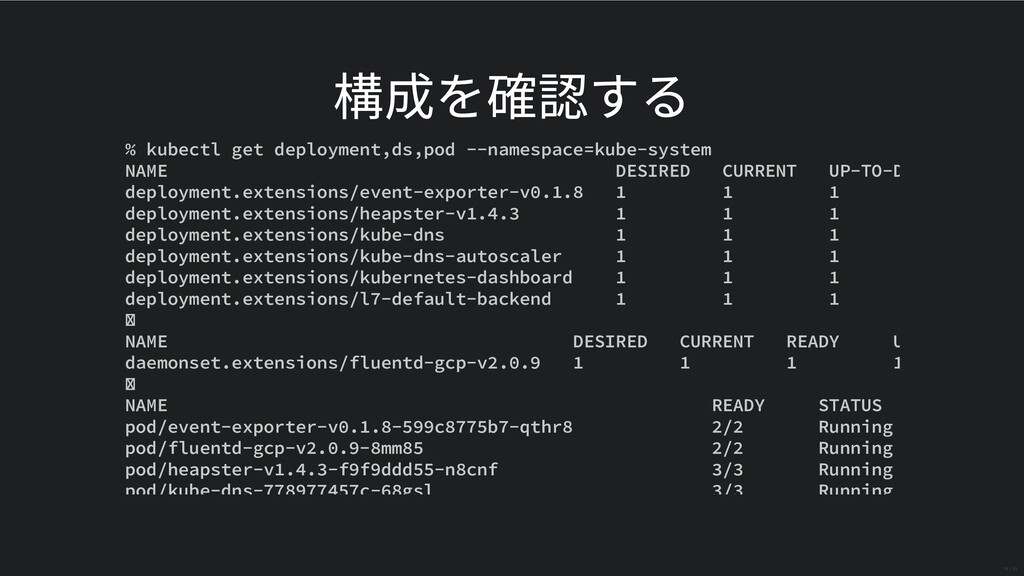
構成を確認する % kubectl get deployment,ds,pod --namespace=kube-system NAME DESIRED CURRENT UP-TO-D
deployment.extensions/event-exporter-v0.1.8 1 1 1 deployment.extensions/heapster-v1.4.3 1 1 1 deployment.extensions/kube-dns 1 1 1 deployment.extensions/kube-dns-autoscaler 1 1 1 deployment.extensions/kubernetes-dashboard 1 1 1 deployment.extensions/l7-default-backend 1 1 1 NAME DESIRED CURRENT READY U daemonset.extensions/fluentd-gcp-v2.0.9 1 1 1 1 NAME READY STATUS pod/event-exporter-v0.1.8-599c8775b7-qthr8 2/2 Running pod/fluentd-gcp-v2.0.9-8mm85 2/2 Running pod/heapster-v1.4.3-f9f9ddd55-n8cnf 3/3 Running pod/kube-dns-778977457c-68gsl 3/3 Running 16 / 31 -
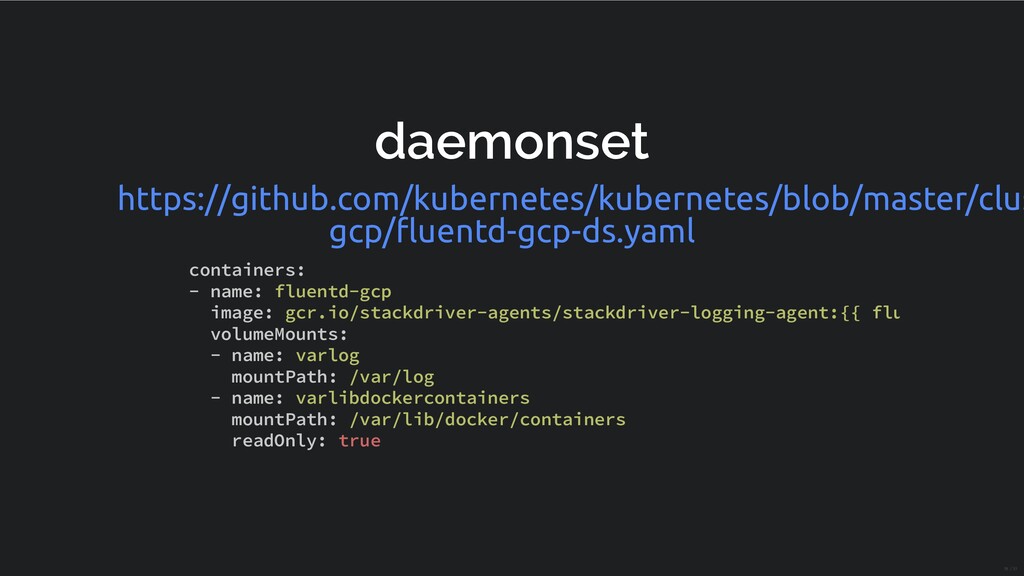
daemonset https://github.com/kubernetes/kubernetes/blob/master/clus gcp/fluentd-gcp-ds.yaml containers: - name: fluentd-gcp image: gcr.io/stackdriver-agents/stackdriver-logging-agent:{{ flu
volumeMounts: - name: varlog mountPath: /var/log - name: varlibdockercontainers mountPath: /var/lib/docker/containers readOnly: true 19 / 31 -
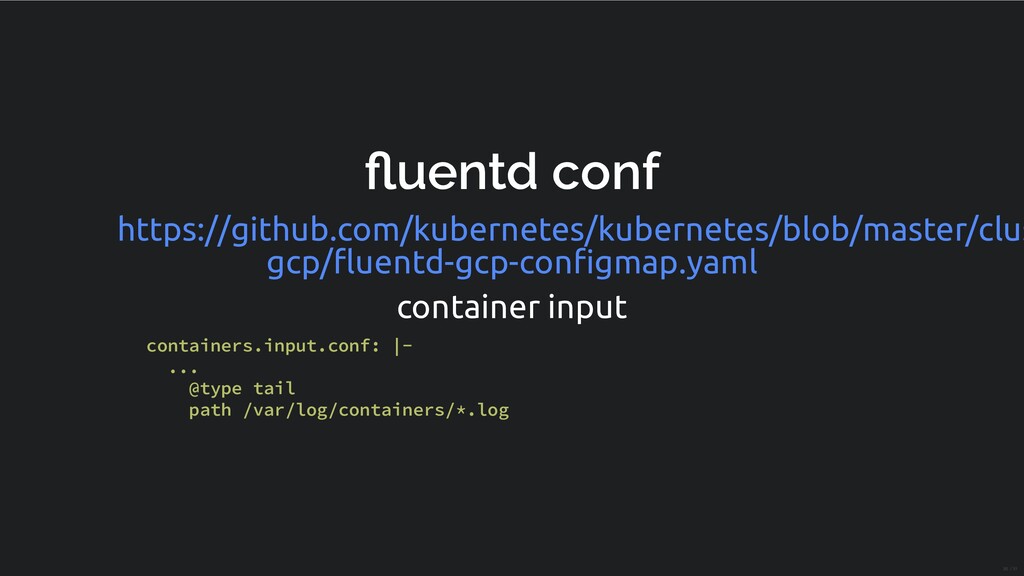
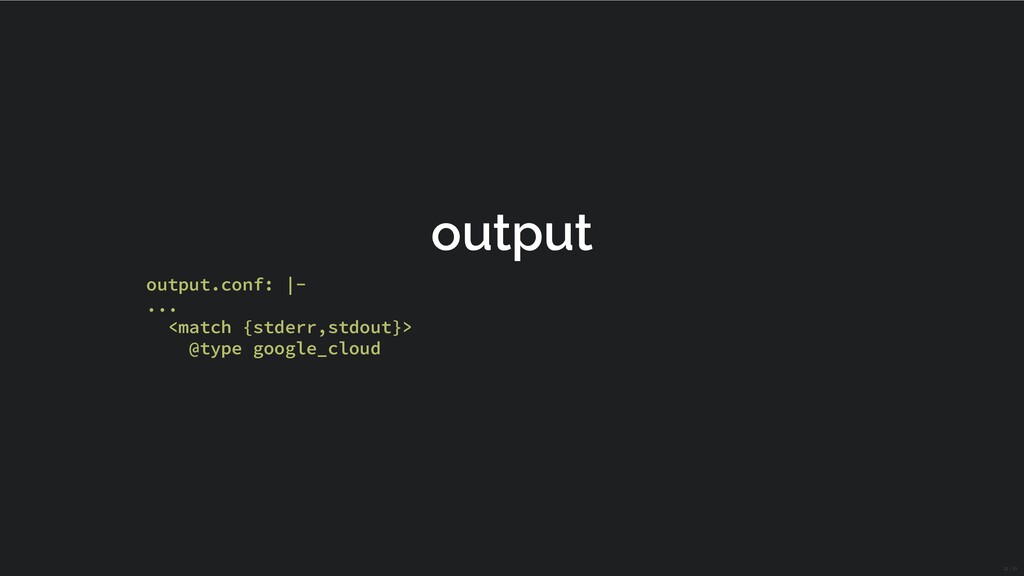
uentd conf container input https://github.com/kubernetes/kubernetes/blob/master/clus gcp/fluentd-gcp-configmap.yaml containers.input.conf: |- ... @type
tail path /var/log/containers/*.log 20 / 31 -
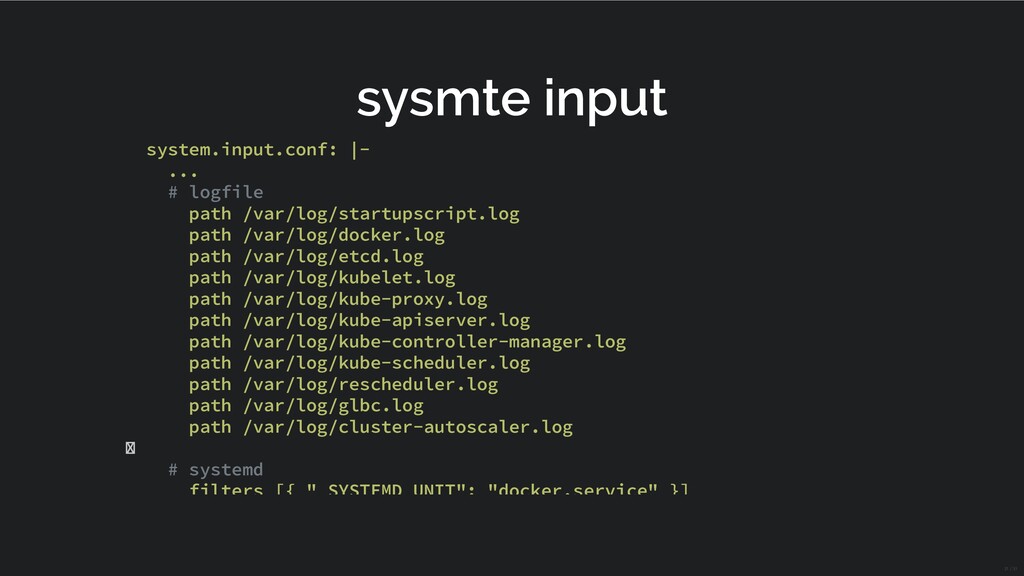
sysmte input system.input.conf: |- ... # logfile path /var/log/startupscript.log path
/var/log/docker.log path /var/log/etcd.log path /var/log/kubelet.log path /var/log/kube-proxy.log path /var/log/kube-apiserver.log path /var/log/kube-controller-manager.log path /var/log/kube-scheduler.log path /var/log/rescheduler.log path /var/log/glbc.log path /var/log/cluster-autoscaler.log # systemd filters [{ " SYSTEMD UNIT": "docker.service" }] 21 / 31 -
カスタマイズは? 設定変更やカスタマイズは、daemonset やconfig を いじれば良い GCP - Customizing Stackdriver Logs
for Kubernetes Engine with Fluentd kubernates - Logging Using Stackdriver 23 / 31 -
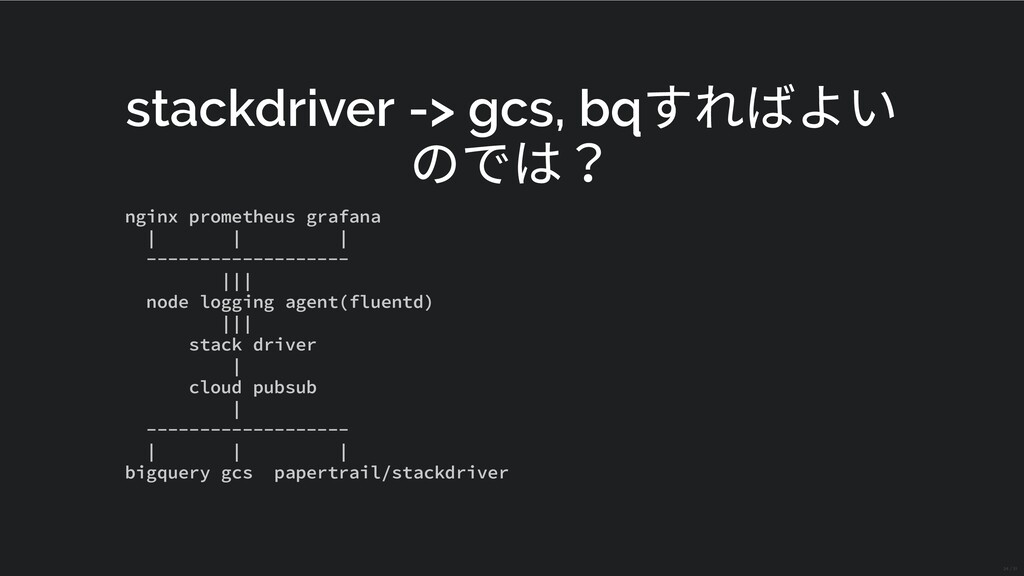
stackdriver -> gcs, bq すればよい のでは? nginx prometheus grafana |
| | ------------------- ||| node logging agent(fluentd) ||| stack driver | cloud pubsub | ------------------- | | | bigquery gcs papertrail/stackdriver 24 / 31 -
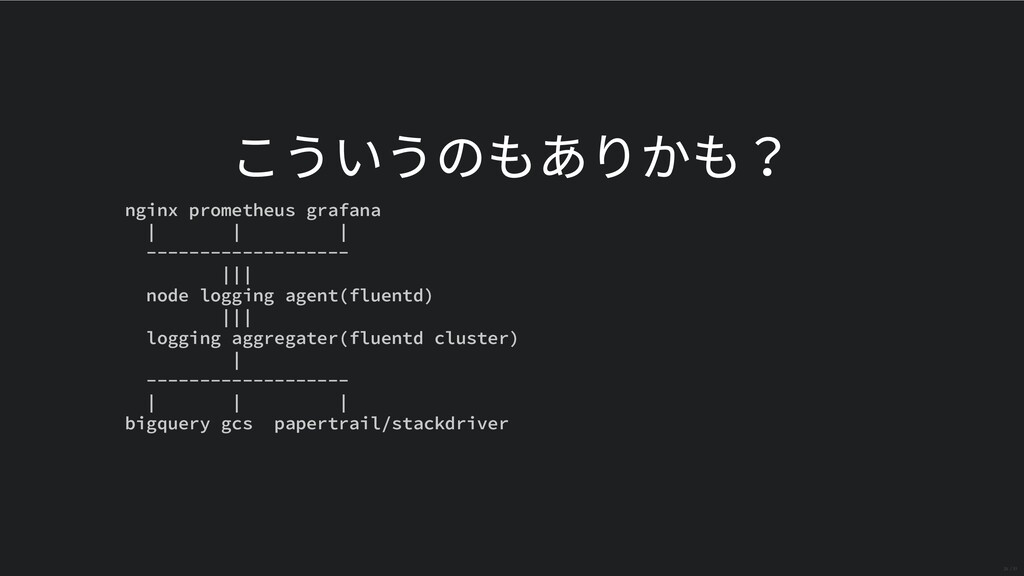
こういうのもありかも? nginx prometheus grafana | | | ------------------- ||| node
logging agent(fluentd) ||| logging aggregater(fluentd cluster) | ------------------- | | | bigquery gcs papertrail/stackdriver 25 / 31 -
そもそも node ごとにあるfleutnd 設定いじるのって正しいの? node にあるfluentd を触ると、配置されるpod によっ てnode ごとのfluentd
負荷が変わっちゃうだろうけ ど、致し⽅ないのだろうか? papertrail やdatadog logging あたりにつなぎこむん であればnode logging agent をカスタマイズするのあ りな認識。 26 / 31 -
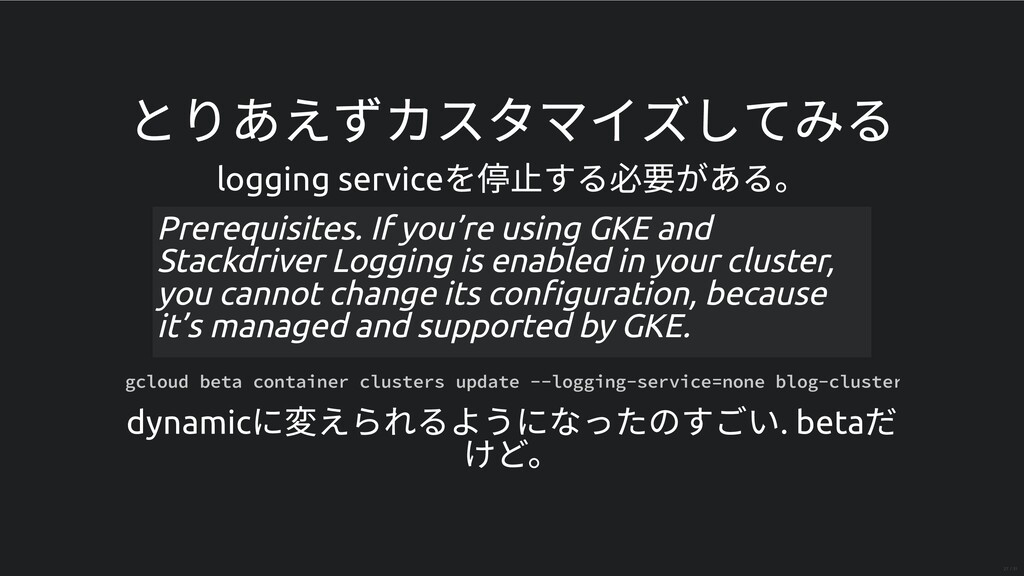
とりあえずカスタマイズしてみる logging service を停⽌する必要がある。 dynamic に変えられるようになったのすごい. beta だ けど。 Prerequisites.
If you’re using GKE and Stackdriver Logging is enabled in your cluster, you cannot change its configuration, because it’s managed and supported by GKE. gcloud beta container clusters update --logging-service=none blog-cluster 27 / 31 -
設定 は以下のrepo の内容を使うことも可能 すでにfluentd daemonset が動いているので、設定を 吐き出すことにする GoogleCloudPlatform/k8s-stackdriver GoogleCloudPlatform/container-engine-customize- fluentd
kubernetes/kubernetes - fluentd-gcp 28 / 31 -
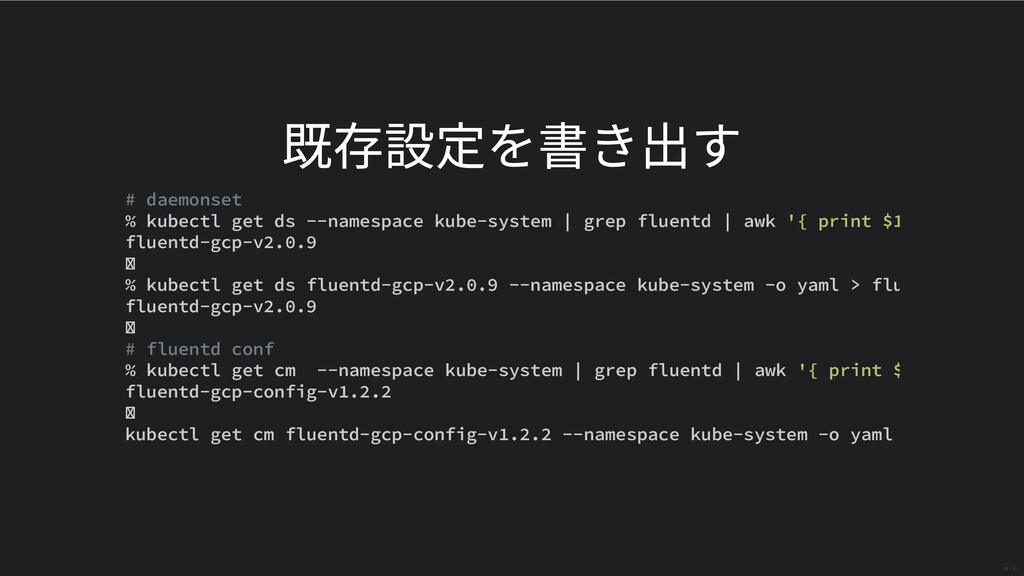
既存設定を書き出す # daemonset % kubectl get ds --namespace kube-system |
grep fluentd | awk '{ print $1 fluentd-gcp-v2.0.9 % kubectl get ds fluentd-gcp-v2.0.9 --namespace kube-system -o yaml > flu fluentd-gcp-v2.0.9 # fluentd conf % kubectl get cm --namespace kube-system | grep fluentd | awk '{ print $ fluentd-gcp-config-v1.2.2 kubectl get cm fluentd-gcp-config-v1.2.2 --namespace kube-system -o yaml 29 / 31 -
ここからがん ばること :innocent: 1. papertrail につなぎこむ設定を書いていく 2. GCS, BQ にはcloud
pubsub を使って吐き出していく 30 / 31 -
まとめ 1. Using a node logging agent アプローチを採⽤する 2. application
からログのparse, buffering, retry 処理を切り 離したいのであれば、Streaming sidecar container も採 ⽤する 3. gcp のstack に乗るんであればstackdriver export を使って データ加⼯することが望ましい 4. node logging agent の設定カスタマイズは趣味や papertrail やdatadog logging など別基盤に流すときぐら いにしかつかわない 31 / 31