Share
Embed
Transcript
103 slides
-
⾃自⼰己紹介 海野 裕也 l -2008 東⼤大情報理理⼯工修⼠士 l ⾃自然⾔言語処理理 l 2008-2011
⽇日本アイ・ビー・エム(株)東京基礎研 l テキストマイニング、⾃自然⾔言語処理理の研究開発 l 2011- (株)プリファードインフラストラクチャー l ⾃自然⾔言語処理理、情報検索索、機械学習、テキストマイニングなど の研究開発 l 研究開発系案件、コンサルティング l JubatusやChainerの開発 NLP若若⼿手の会共同委員⻑⾧長(2014-) 「オンライン機械学習」(2015, 講談社) 2 -
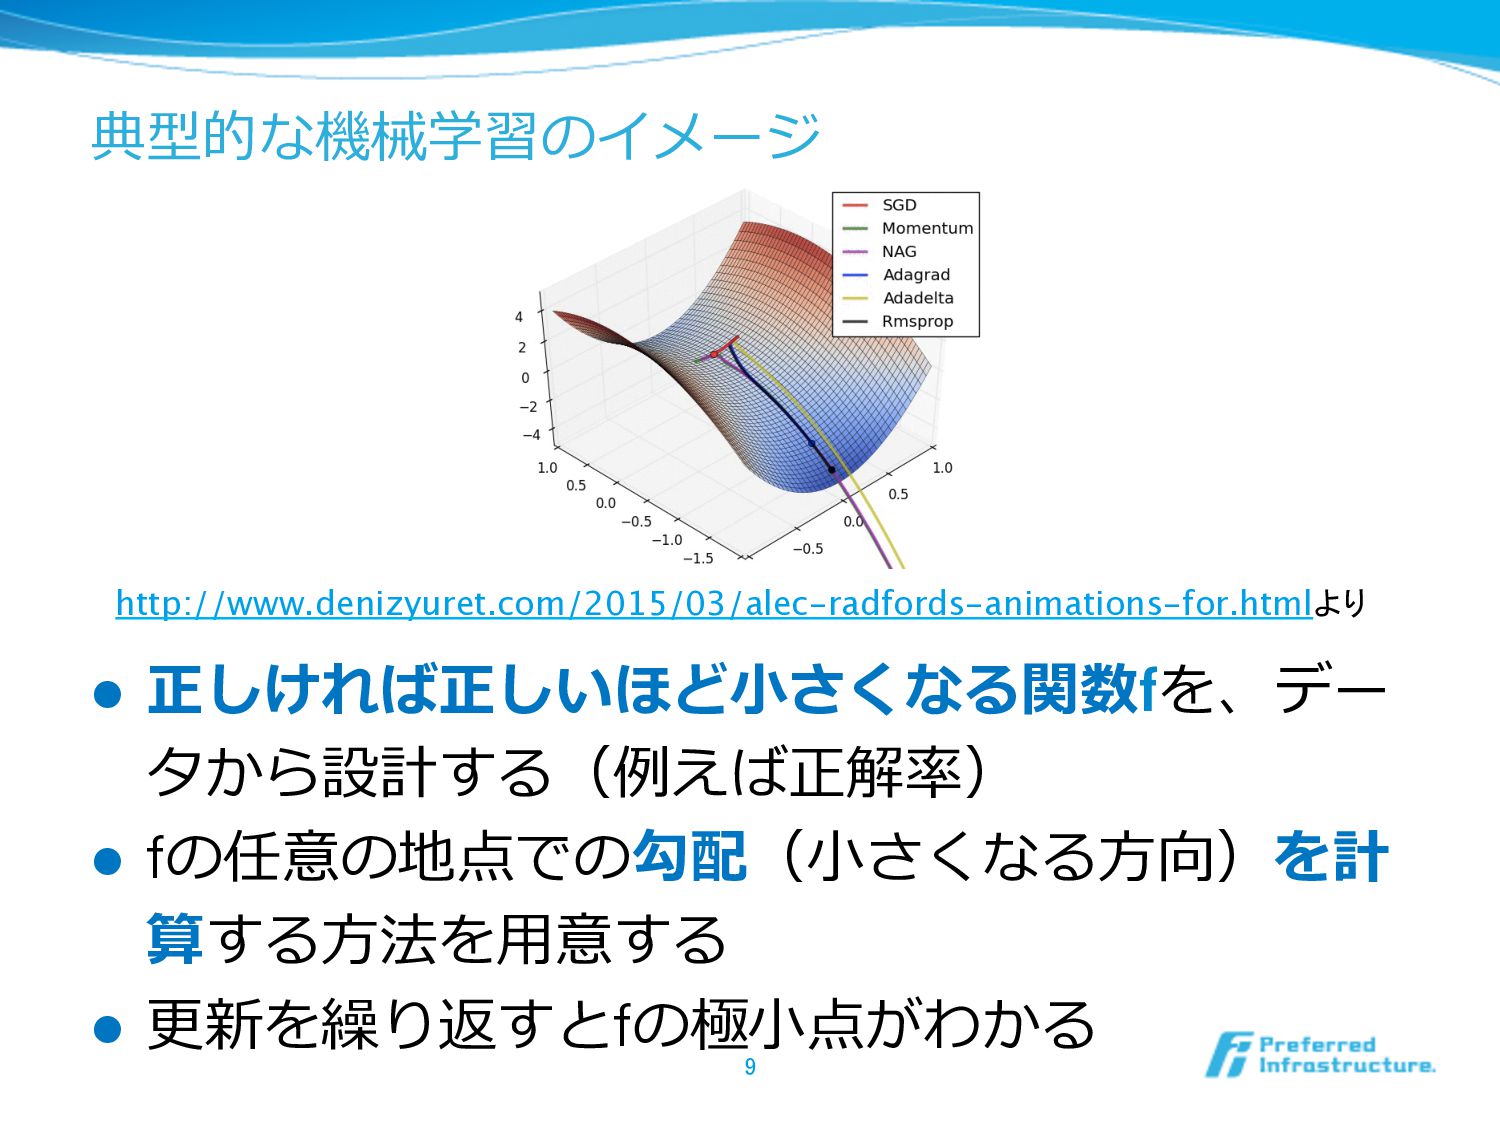
典型的な機械学習のイメージ l 正しければ正しいほど⼩小さくなる関数fを、デー タから設計する(例例えば正解率率率) l fの任意の地点での勾配(⼩小さくなる⽅方向)を計 算する⽅方法を⽤用意する l 更更新を繰り返すとfの極⼩小点がわかる 9
http://www.denizyuret.com/2015/03/alec-radfords-animations-for.htmlより -
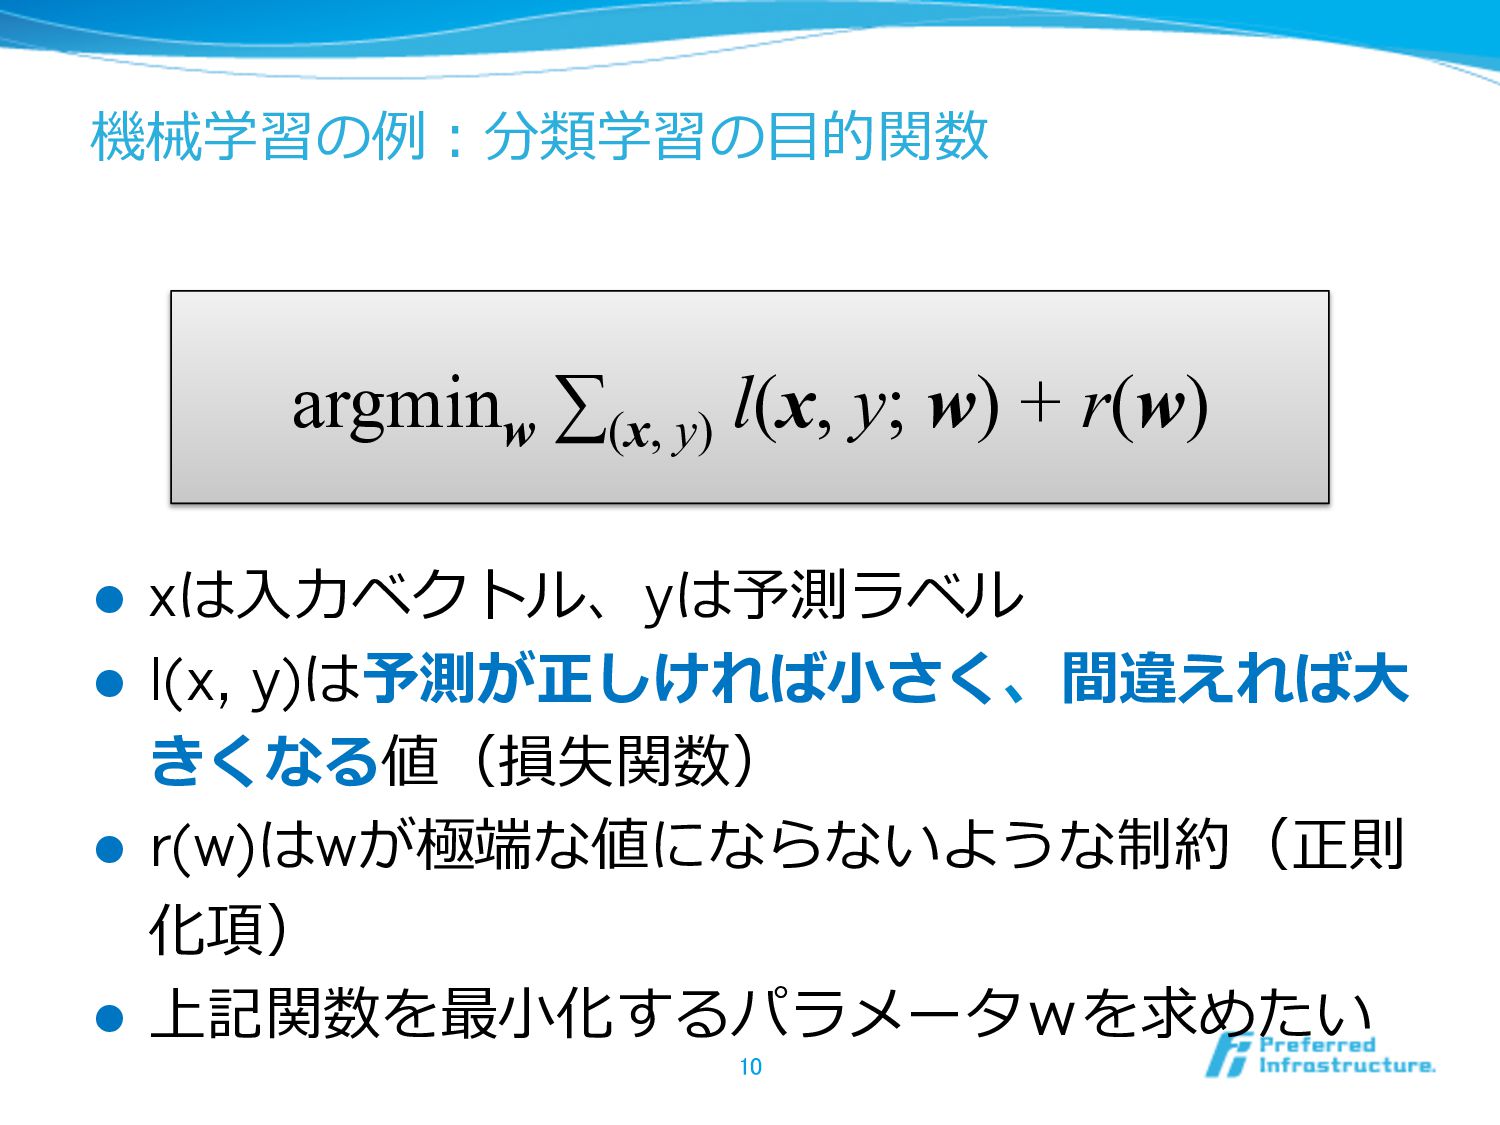
機械学習の例例:分類学習の⽬目的関数 10 argminw ∑(x, y) l(x, y; w) + r(w)
l xは⼊入⼒力力ベクトル、yは予測ラベル l l(x, y)は予測が正しければ⼩小さく、間違えれば⼤大 きくなる値(損失関数) l r(w)はwが極端な値にならないような制約(正則 化項) l 上記関数を最⼩小化するパラメータwを求めたい -
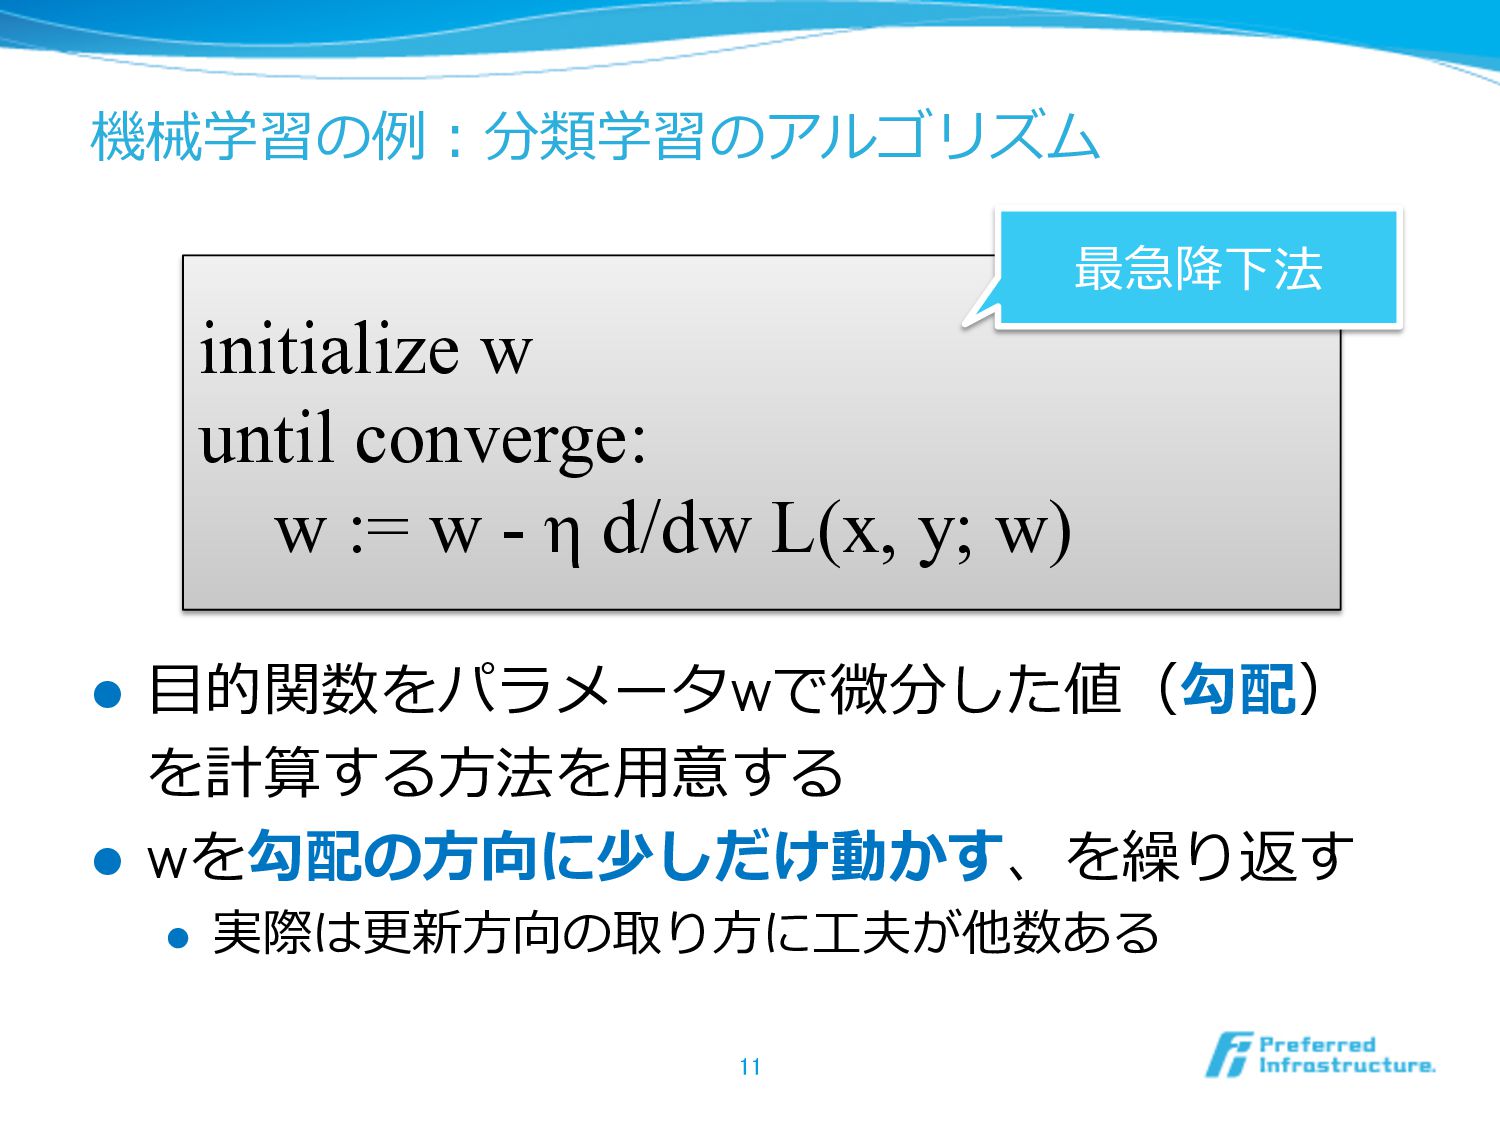
機械学習の例例:分類学習のアルゴリズム l ⽬目的関数をパラメータwで微分した値(勾配) を計算する⽅方法を⽤用意する l wを勾配の⽅方向に少しだけ動かす、を繰り返す l 実際は更更新⽅方向の取り⽅方に⼯工夫が他数ある 11 initialize
w until converge: w := w - η d/dw L(x, y; w) 最急降降下法 -
応⽤用タスクでは関数の設計が焦点 l 勾配の計算と、最⼩小化の反復復計算は、ほとんど ⾃自動化できるようになった l 重要な⼯工夫は他数あるが、今⽇日はしません(Dropout、 Batch normalization、ADAMなど) l 応⽤用系の深層学習研究では、問題に合った⽬目的
関数を設計するところが主な焦点 l RNN、CNN、skip-gramなど、全て⽬目的関数の形の ⼯工夫のはなし 12 -
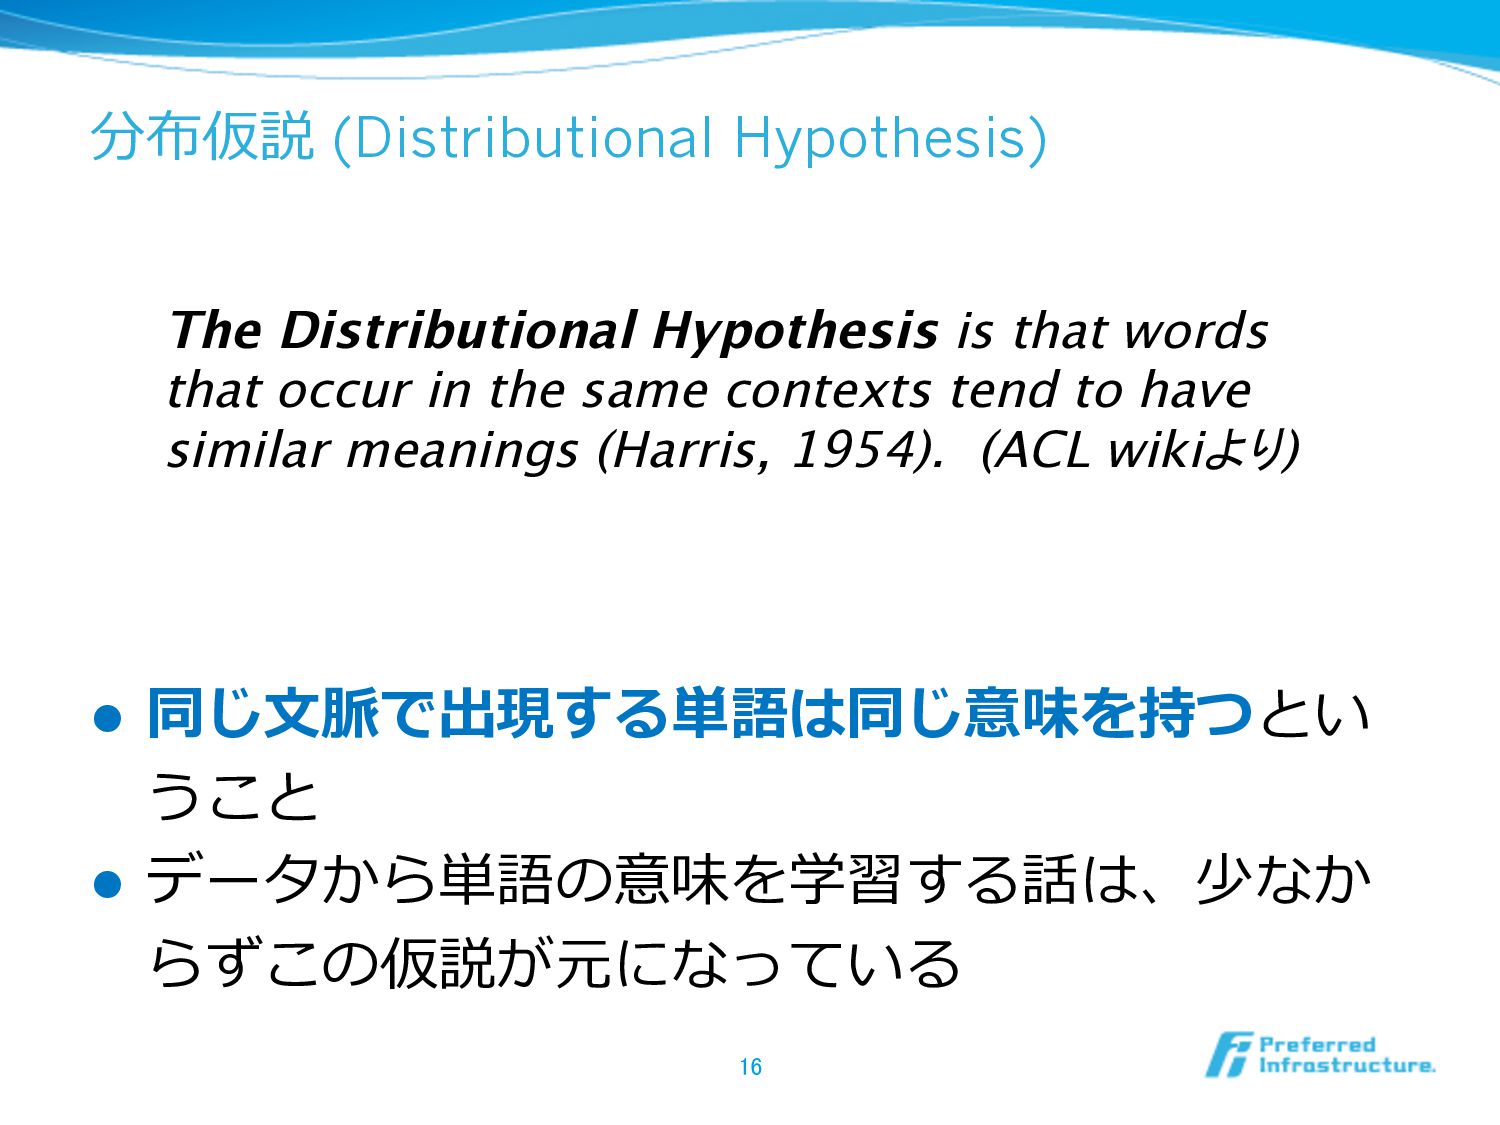
分布仮説 (Distributional Hypothesis) l 同じ⽂文脈で出現する単語は同じ意味を持つとい うこと l データから単語の意味を学習する話は、少なか らずこの仮説が元になっている 16
The Distributional Hypothesis is that words that occur in the same contexts tend to have similar meanings (Harris, 1954). (ACL wikiより) -
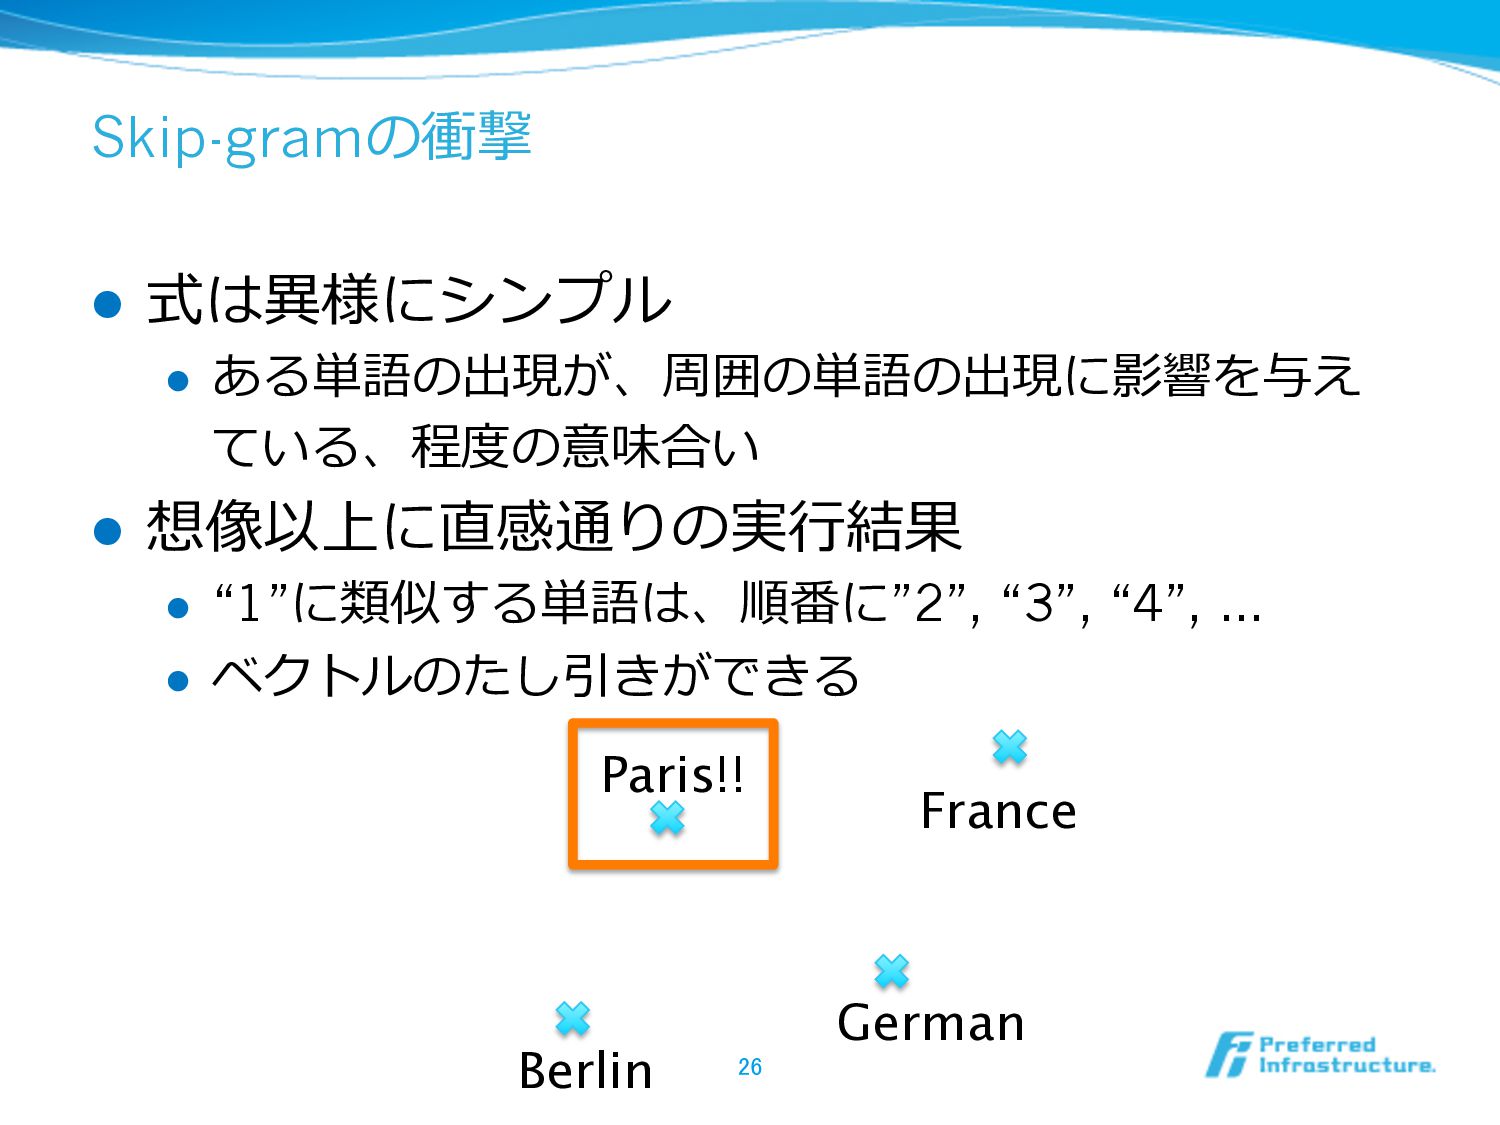
word2vec [Mikolov+13] l 各単語の「意味」を表現するベクトルを作るはなし l vec(Berlin) – vec(German) + vec(France)
と⼀一番近い単 語を探したら、vec(Paris)だった l ベクトルの作り⽅方は次のスライドで説明 20 Berlin German France Paris!! -
Skip-gramモデル (word2vec) [Mikolov+13a] l 周辺単語を予測するモデル l 周辺単語から予測するモデル (CBOW)も提案している l Analogical
reasoningの精 度度が劇的に向上 l ⾼高性能な実装が公開された ため、⼤大流流⾏行行した 21 [Mikolov+13a]より -
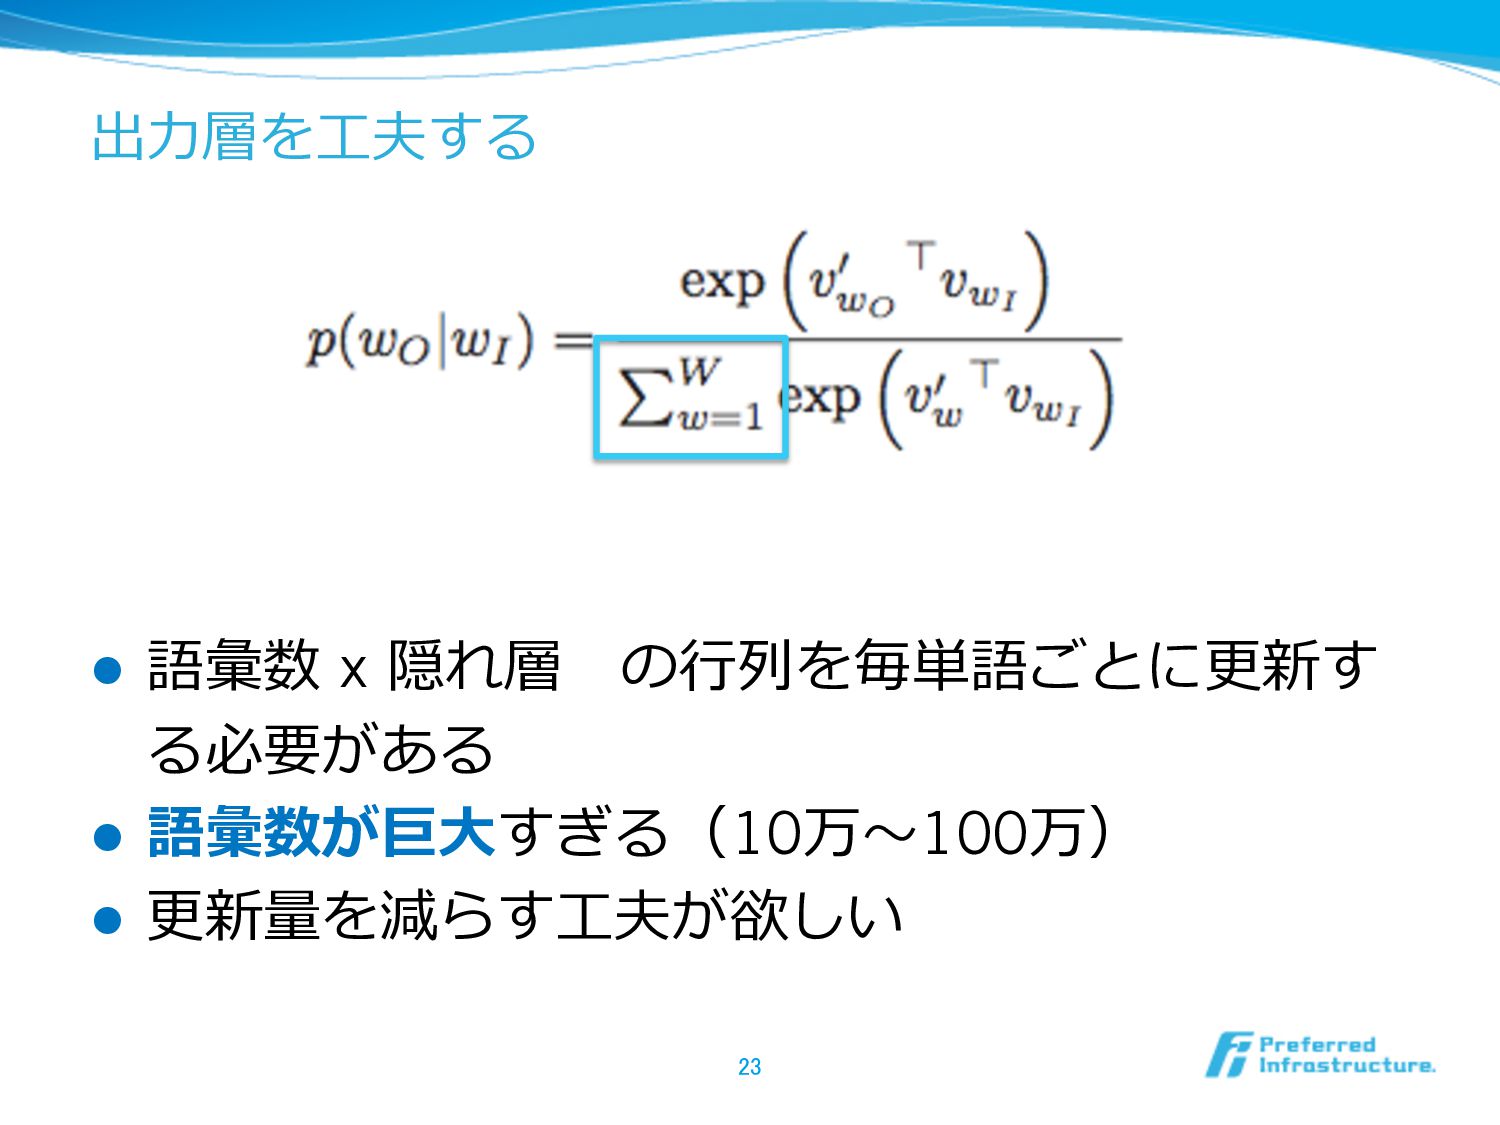
Skip-gramモデル[Mikolov+13a]の⽬目的関数 l ⼊入⼒力力コーパス: w 1 , w 2 , …,
w T (w i は単語) 22 これを最 ⼤大化 vw は単語wを表現するようなベクトル(適当な 次元)で、これらを推定したい cは文脈サイズで5くらい -
⼯工夫1: Hierarchical Softmax (HSM) [Morin+05] l 単語で⽊木を作り、ルートからその単語までの各ノードの ベクトルと内積をとり、そのシグモイドの積にする l 計算量量が語彙数の対数時間になる
l 学習時間が数⽇日から数分に 24 りんご みかん カレー ラーメン n1 n2 n3 各ノードのベ クトル ルートからw までの全ノー ドで積をとる σ(x)=1/(1 + exp(-x)) -
⼯工夫2: Negative Sampling [Mikolov+13b] l ∑の中の期待値計算は、k個のサンプルを取って 近似する l データが少ない時は5~20個、多ければ2~5個で充分 l
P(w)として、1-gram頻度度の3/4乗に⽐比例例させた ときが⼀一番良良かった 25 log P(wo |wI ) = -
Skip-gramの衝撃 l 式は異異様にシンプル l ある単語の出現が、周囲の単語の出現に影響を与え ている、程度度の意味合い l 想像以上に直感通りの実⾏行行結果 l “1”に類似する単語は、順番に”2”,
“3”, “4”, … l ベクトルのたし引きができる 26 Berlin German France Paris!! -
⽂文書のベクトル表現(Paragraph vector) [Le+14] l 周囲の単語に加えて、⽂文書固有のベクトル (Paragraph vector)も単語の予測に使う l このベクトルで⽂文書分類すると性能が向上する 31
Continuous BoW Paragraph vector [Le+14]より -
⾃自然⾔言語処理理の2⼤大構造 l 系列列構造 l そもそも⽂文が⽂文字列列なので、系列列を使うのは⾃自然 l cf. N-gram, HMM, linear-chain
CRF… l ⽊木構造 l 伝統的に⾃自然⾔言語処理理は⽊木構造を多⽤用してきた l cf. PCFG, 係り受け解析… 34 Recurrent Neural Network Recursive Neural Network -
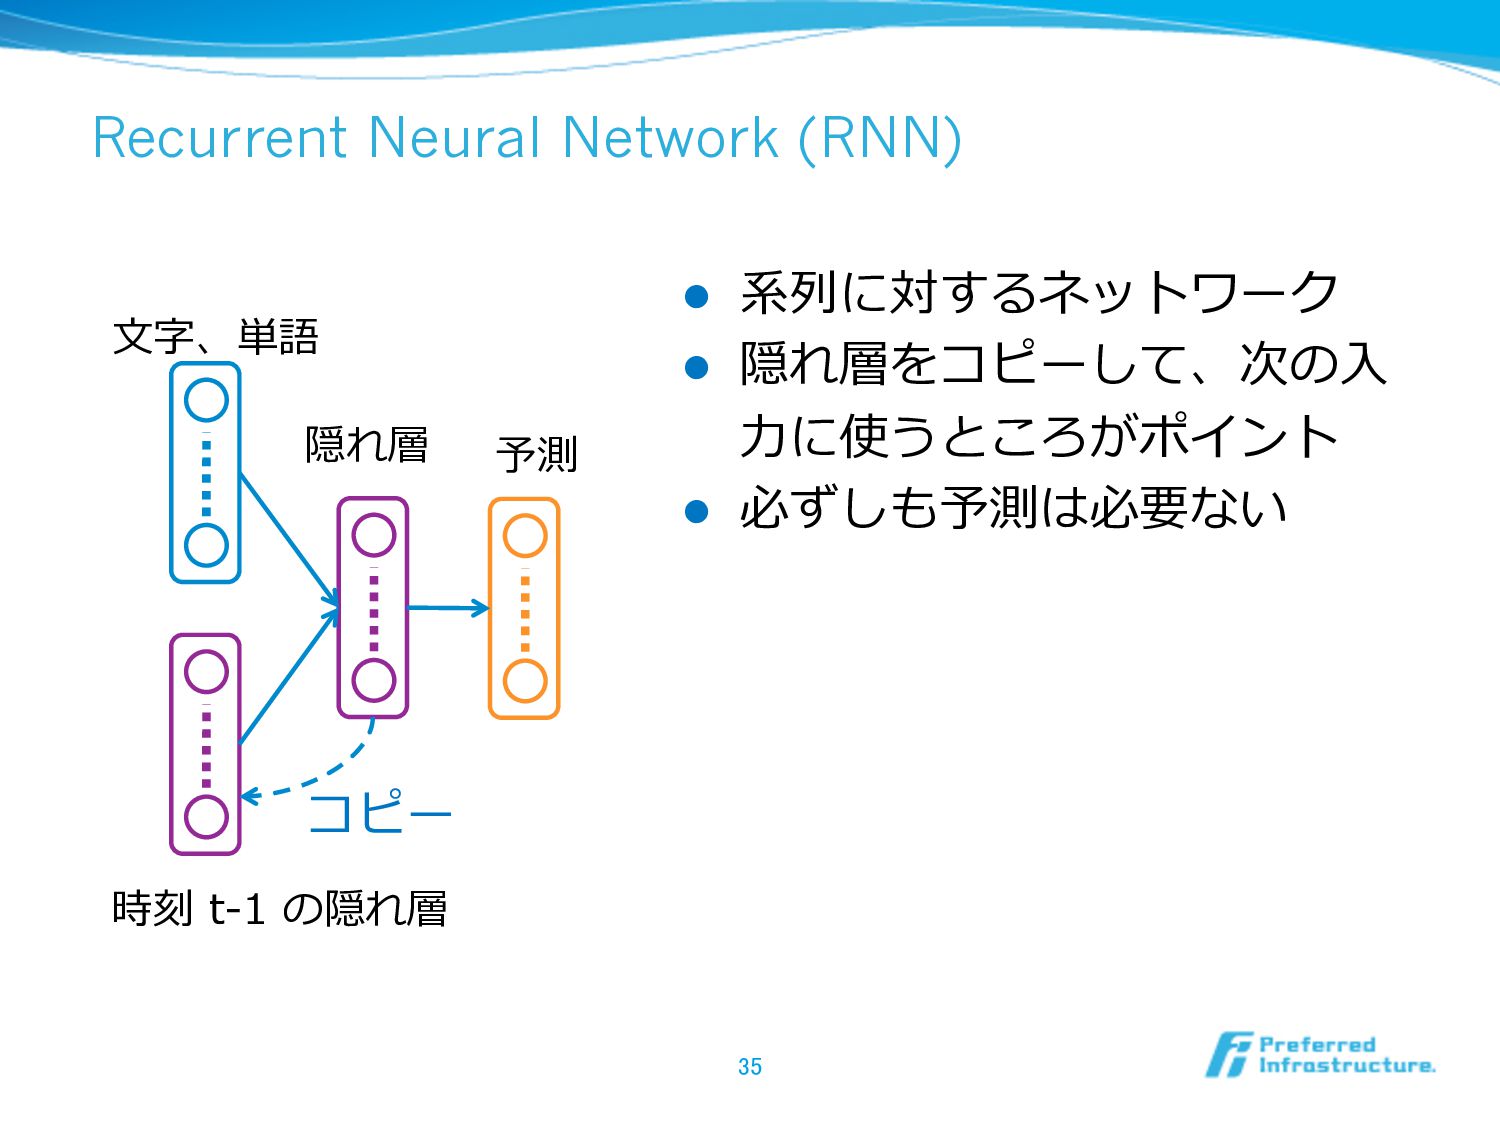
Recurrent Neural Network (RNN) l 系列列に対するネットワーク l 隠れ層をコピーして、次の⼊入 ⼒力力に使うところがポイント l
必ずしも予測は必要ない 35 ⽂文字、単語 時刻 t-‐‑‒1 の隠れ層 隠れ層 予測 コピー -
つなげて書くと・・・ 36 ⽂文字1 時刻 0 の隠れ層 隠れ層 時刻1の 予測 ⽂文字2
時刻2の 予測 ⽂文字3 時刻3の 予測 -
フィードフォワードニューラルネットとの関係 l 横⽅方向に並べて書くことが多い 37 ここだけみると、⽂文 ⻑⾧長と同じ⻑⾧長さのニュー ラルネットワーク yt = f(ht
) ht+1 = g(xt , ht ) x 1 x 2 x 3 x 4 h 1 h 2 h 3 h 4 y 1 y 2 y 3 y 4 入力データ 出力データ -
補⾜足:Skip-gramとRNNの違い l Skip-gramでは、各単語は独⽴立立に、周囲の単語 から予想していた l RNNでは隠れ状態の遷移が次の単語出⼒力力に影響 を与える 38 yt =
f(ht ), ht+1 = g(xt , ht ) yt = f(xt-2 , xt-1 , xt+1 , xt+2 ) -
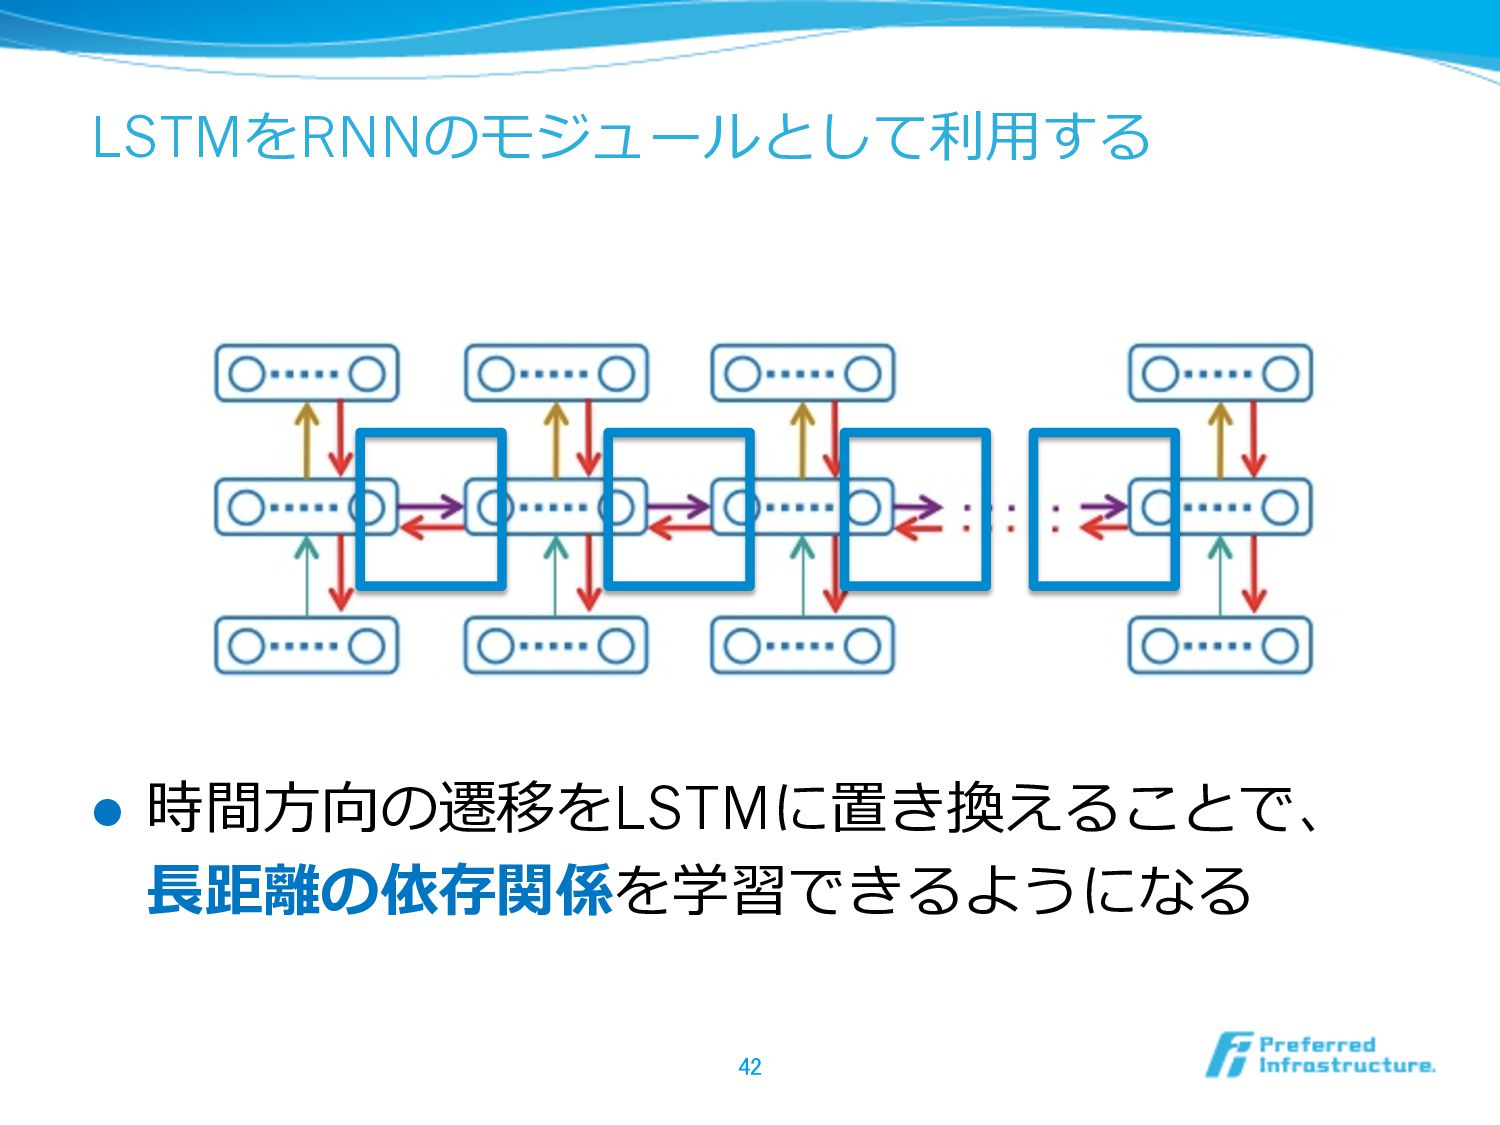
Long Short-Term Memory [Hochreiter+97] l 勾配が消えないようにエラーを内部に貯めこむ構造に なっている l ⼊入出⼒力力のゲートを作って、情報を選択的に流流すようにす る(流流すタイミングを学習するイメージ)
41 情報が貯まる 出⼒力力タイ ミング ⼊入⼒力力タイ ミング gateの出⼒力力が1に近い時だけ影響する -
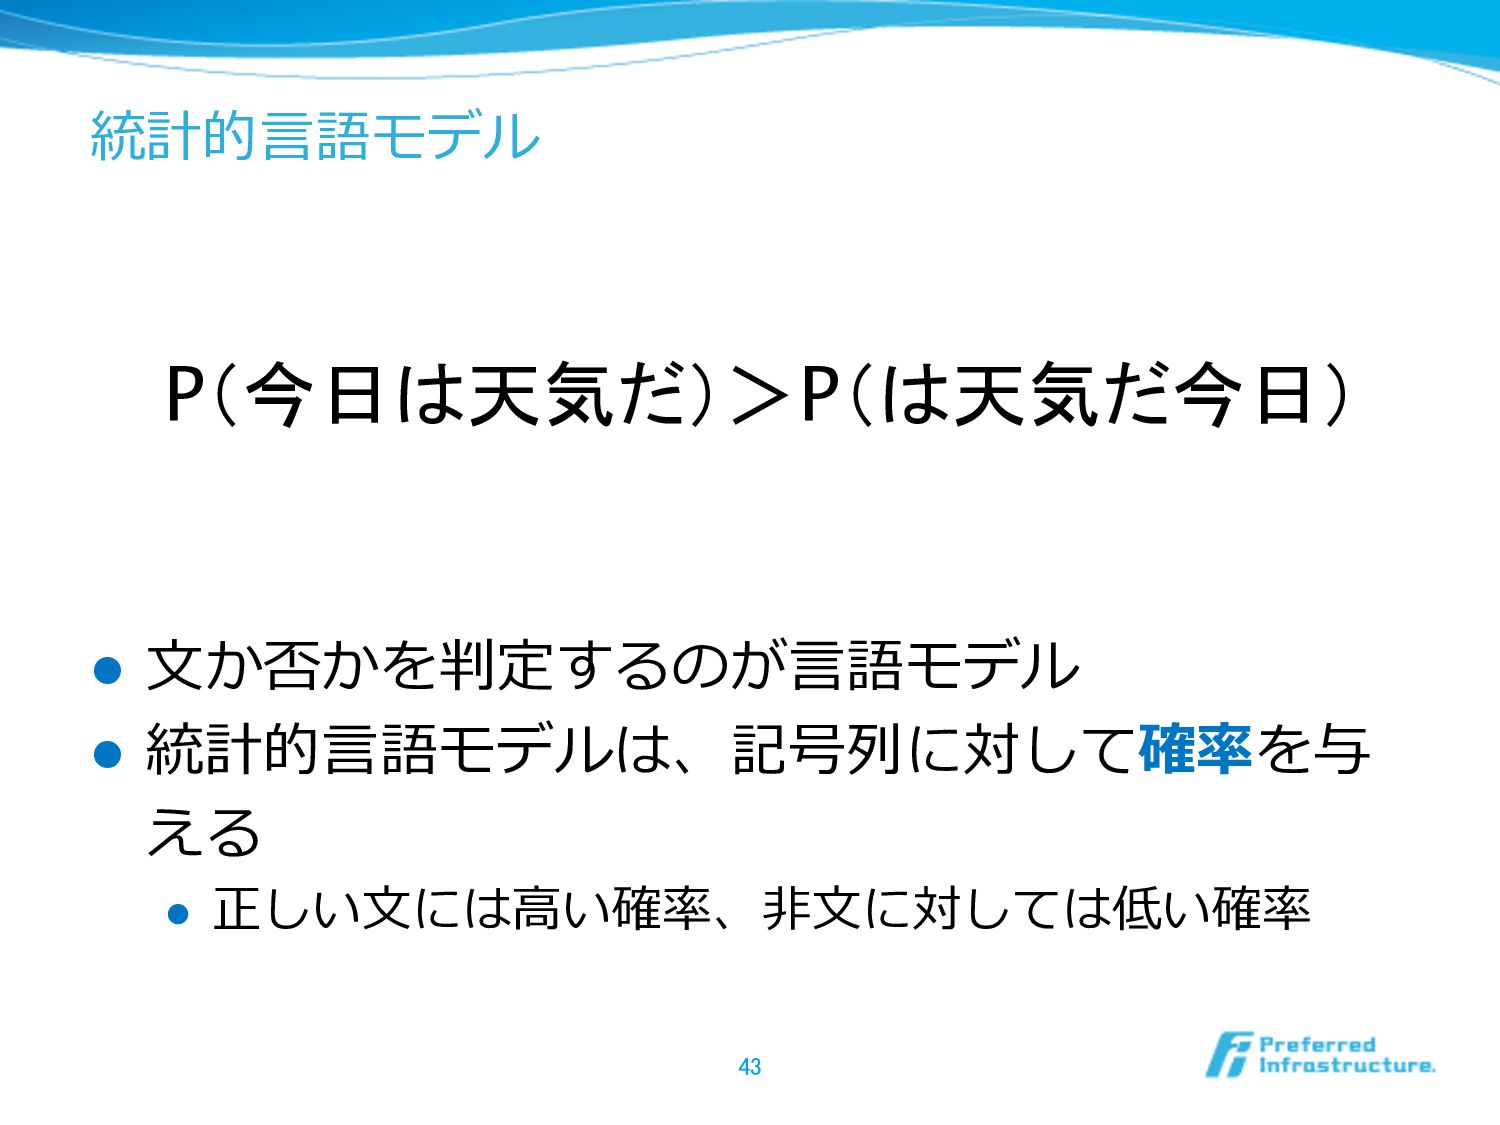
RNNの⾔言語モデルへの利利⽤用 [Mikolov+10] l ⼊入⼒力力は単語列列、出⼒力力は次の単語 l 副次的に単語毎にベクトルが学習される 44 今日 は 天気
だ は 天気 だ <eos> 単語毎に確率率率が出る -
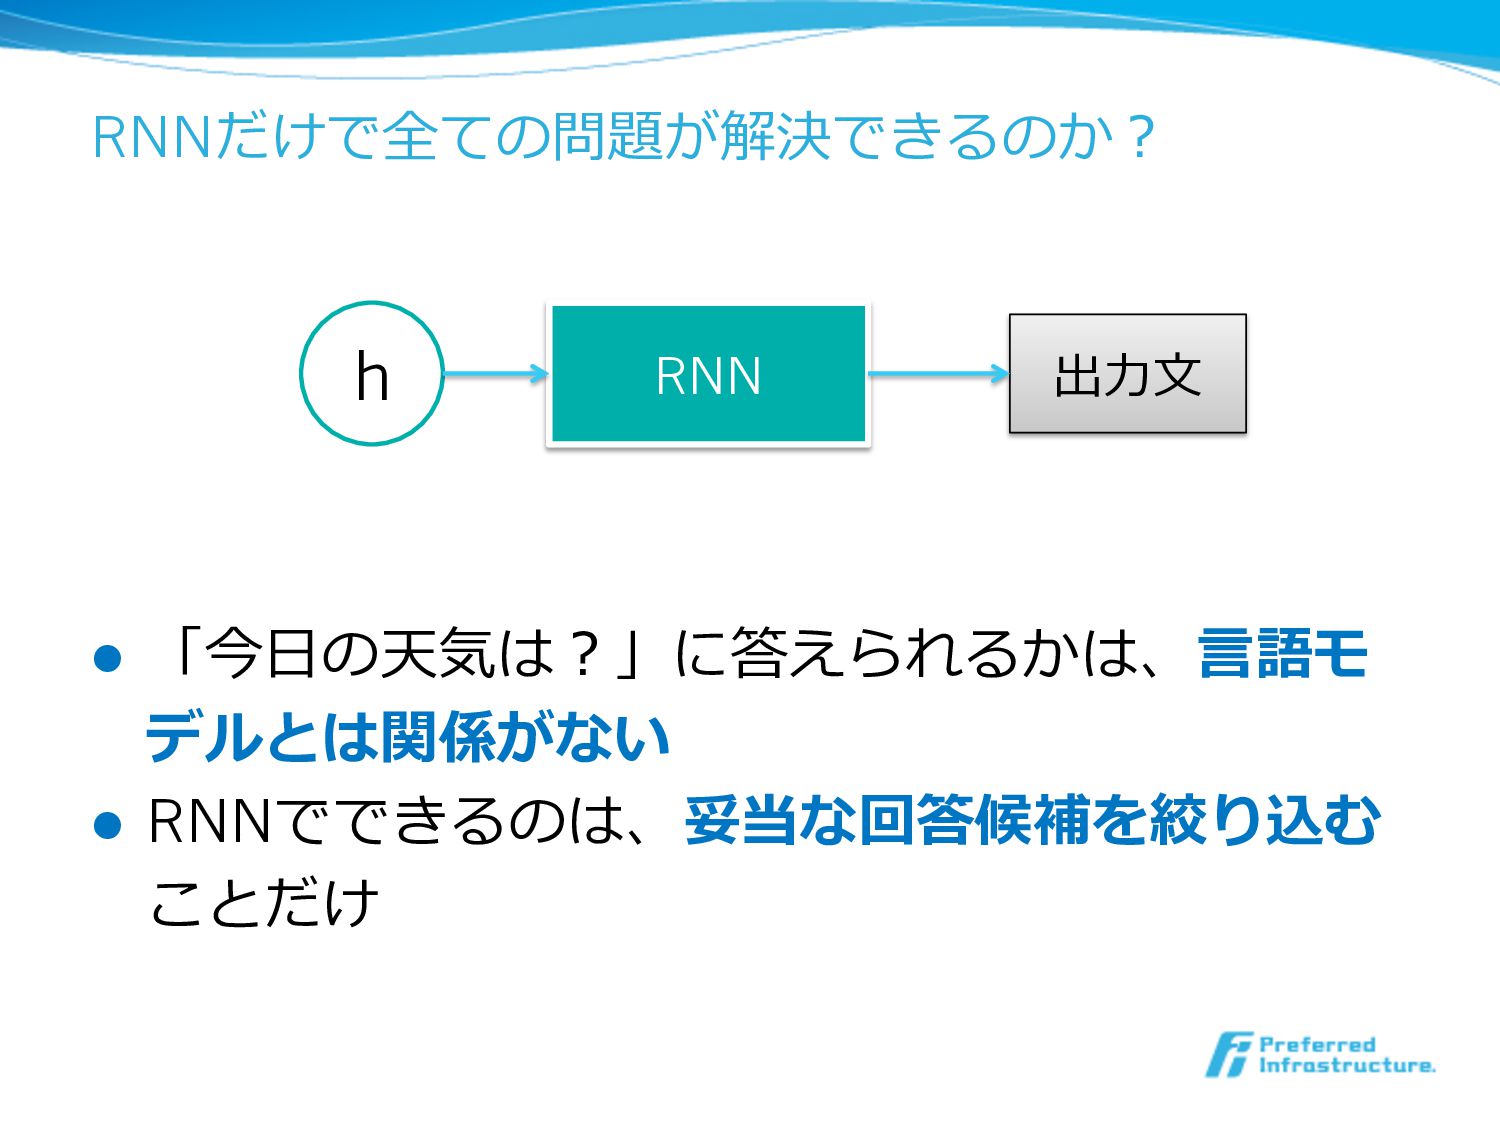
⾔言語モデルは何に使われるか? l ⽂文を⽣生成するあらゆるタスクに応⽤用できる l 翻訳 l ⽂文書要約 l ⾳音声認識識 l
対話 l 例例えば⾳音声認識識結果の候補がいくつかあったと きに、最も尤もらしい⽂文を選択するイメージ 45 -
従来の⾔言語モデルとRNN⾔言語モデルの⽐比較 l N-gram⾔言語モデル l 確率率率が直近N単語にのみ依存する l RNN⾔言語モデル l 隠れ状態に必要な情報がエンコードされる 46
P(xt | xt-1 , …) = f(xt , xt-1 , xt-2 ) P(xt | xt-1 , …) = f(xt , ht ) ht = g(ht-1 , xt-1 ) -
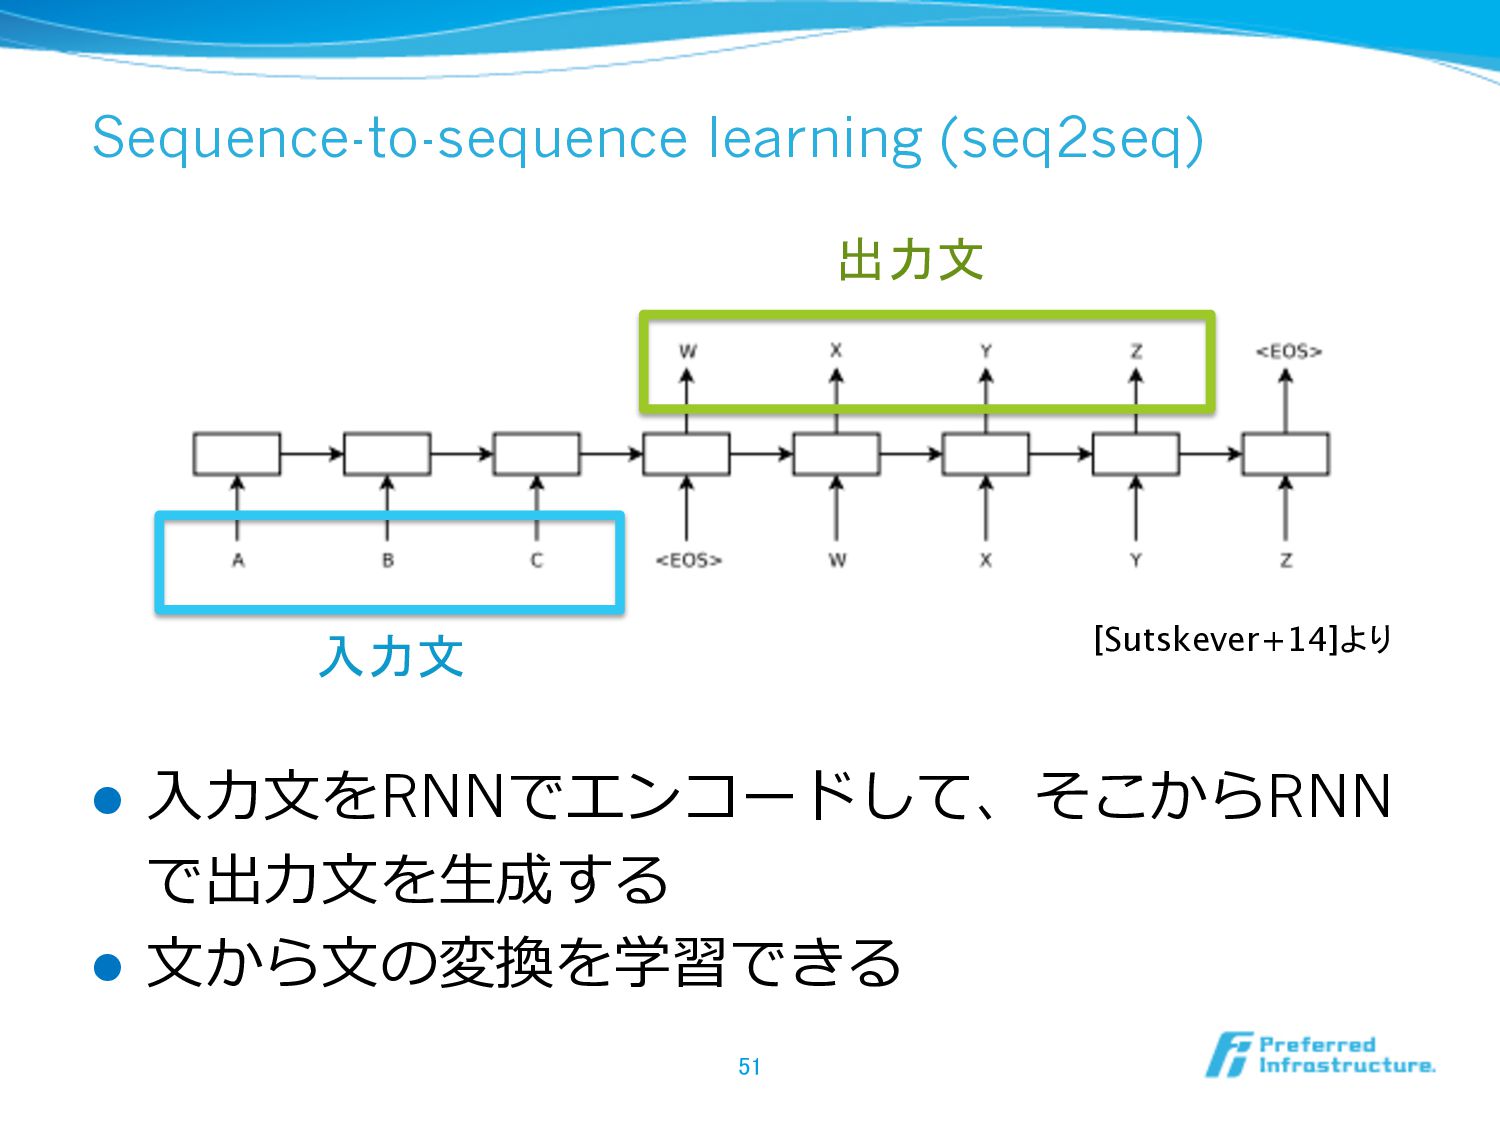
seq2seqが複数のタスクで成果を上げる l 機械翻訳 [Sutskever+14] l 原⽂文から翻訳⽂文へ l 構⽂文解析 [Vinyals+15b] l
⽂文から構⽂文⽊木(のS式表現)へ l 対話 [Vinyals+15c] l 相⼿手の発話から⾃自分の発話へ 52 WSJの記事になった -
従来の⾔言語モデルとの⽐比較 l 従来は⾔言語モデルとタスク固有のモデル(翻訳 モデルや⾳音響モデル)は式の上で分離離した l RNN的なアプローチでは全部くっつけ学習する 54 argmaxy P(y|x) =
argmaxy P(x|y) P(y) 翻訳モデル ⾔言語モデル -
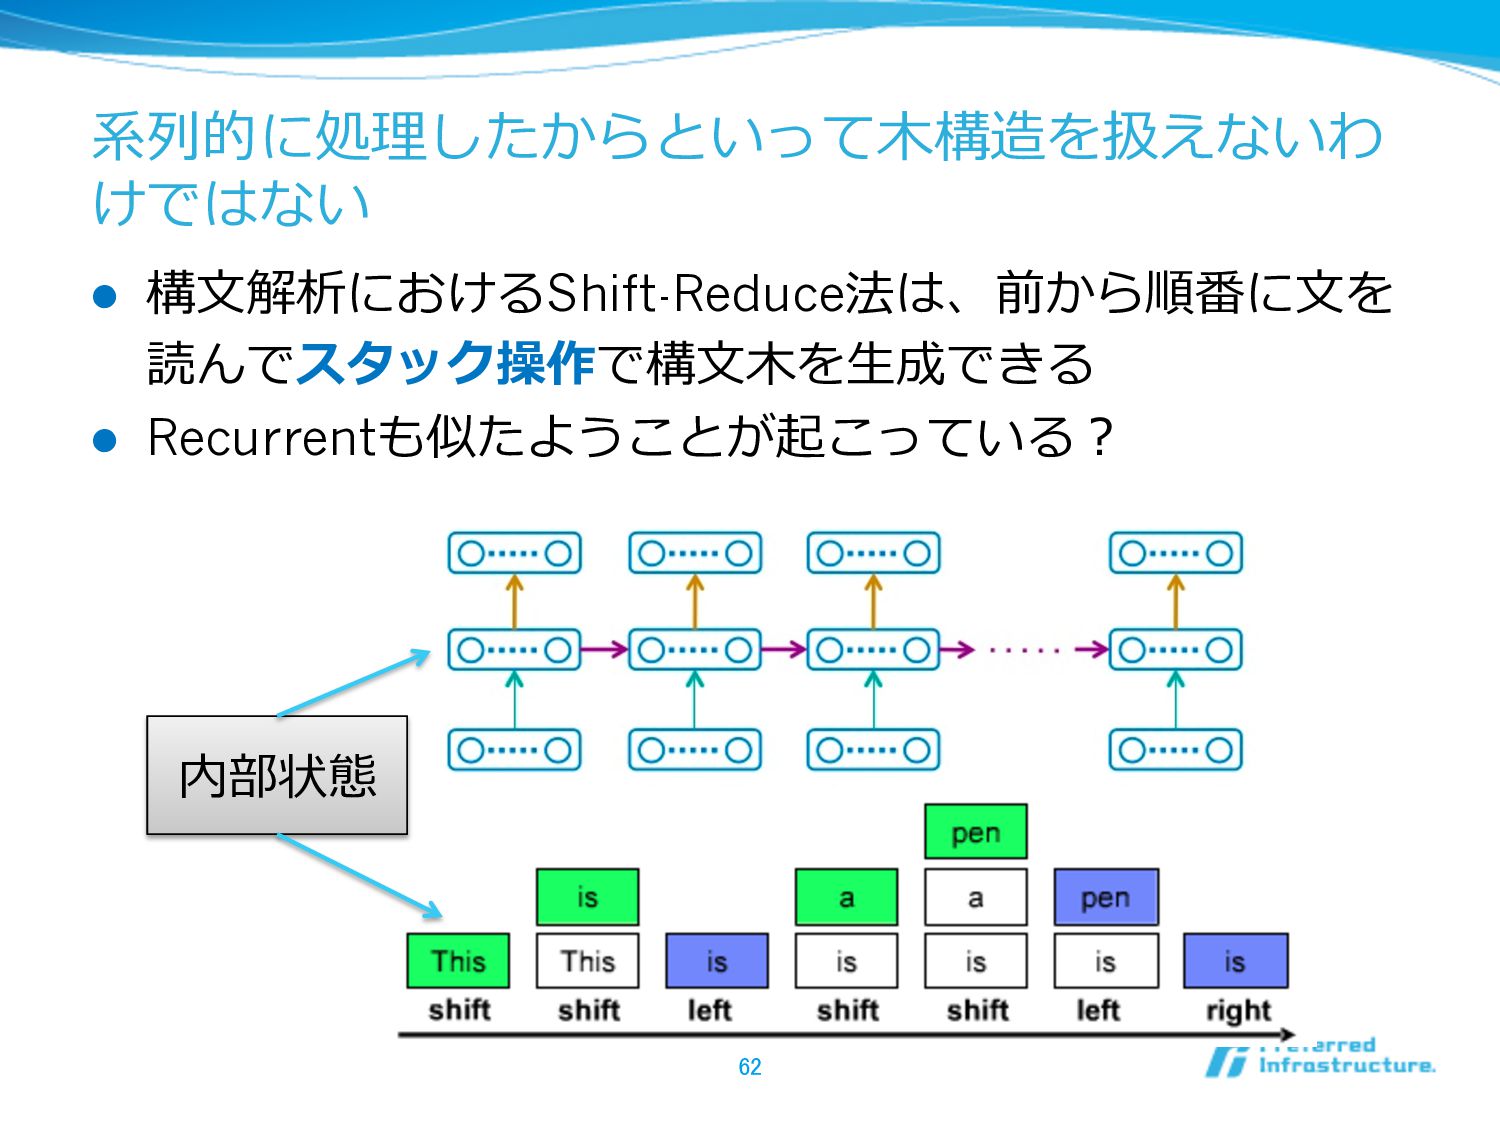
Recurrent vs Recursive l Recurrentは単純だが強⼒力力 l 実装は単純、構⽂文解析器が必要ない l ⽂文の⽣生成結果も良良好 l
GPUによる並列列化がし易易い l ⾔言語の複雑な現象を説明するのにRecursiveの⽅方 がよい? l 実際はRecurrentがかなり強いので⼀一概に⾔言いづらい 61 -
構造の深層学習まとめ l 構造は主に2種類の⼿手法がある l Recurrentは前から順番に単語を読む l LSTMが⾮非常に強⼒力力 l 翻訳や対話など、⽂文を⽣生成するタスクに期待 l
Recursiveは構⽂文⽊木に沿って処理理する l 複雑な⾔言語現象を捉えやすそう l 評判分析などに期待 l 両者は実は類似のことをしていないか? 63 -
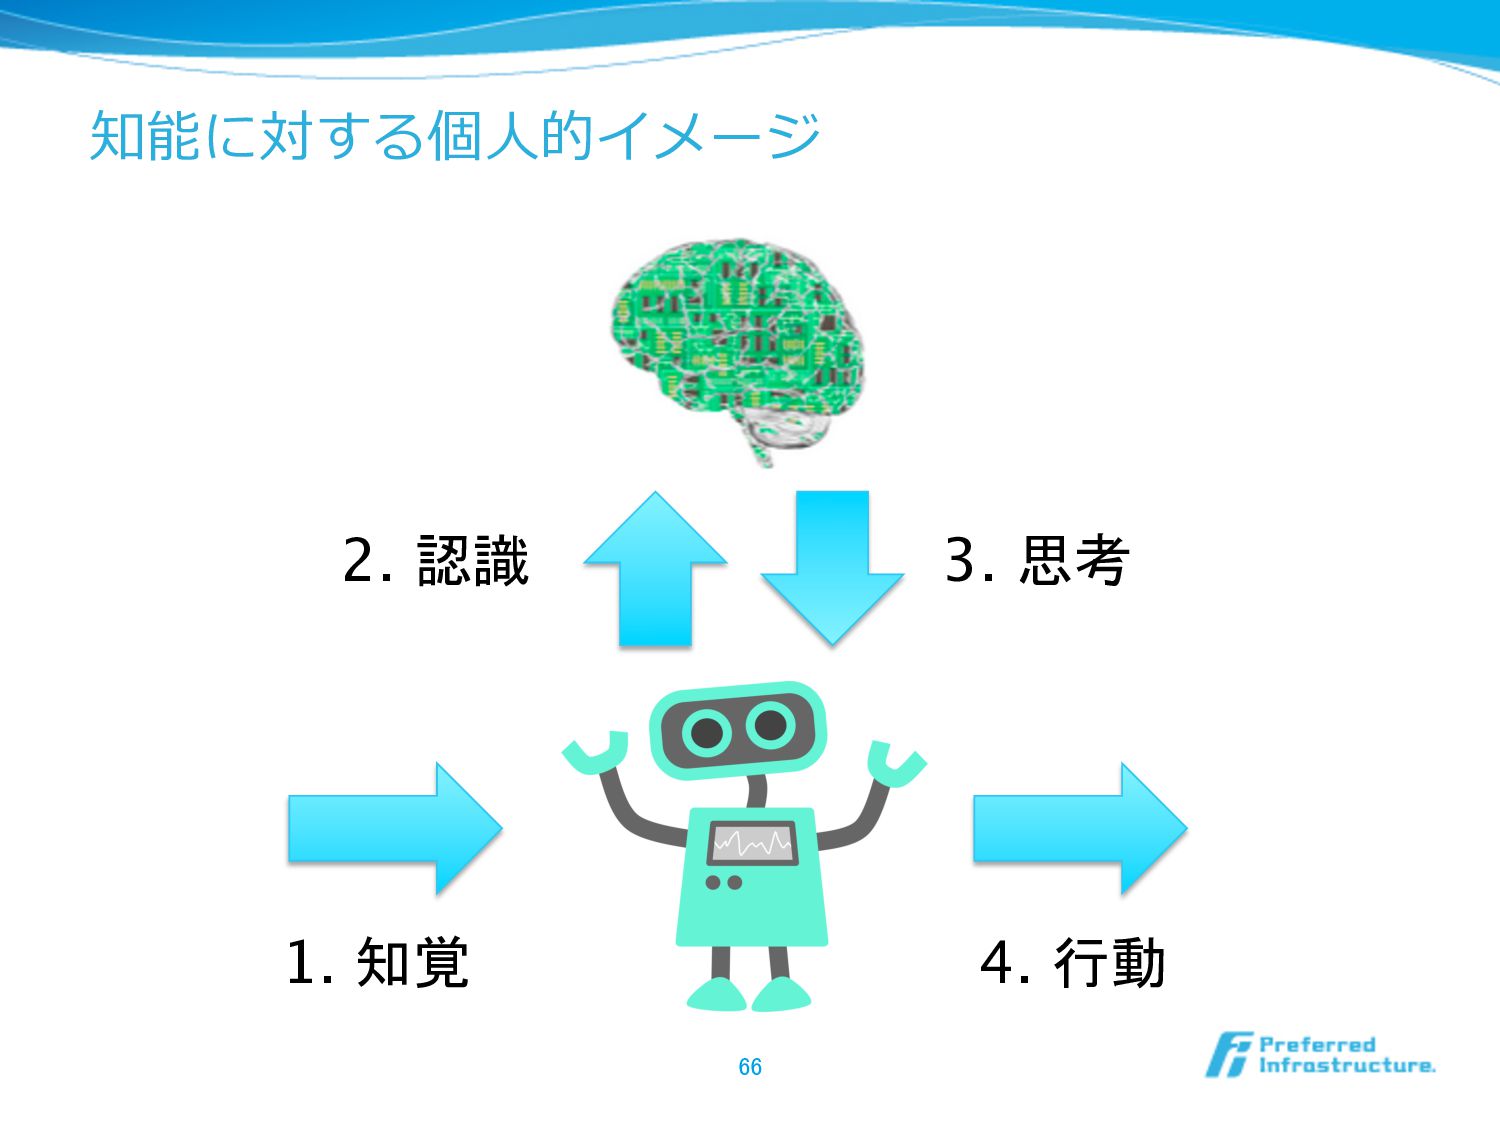
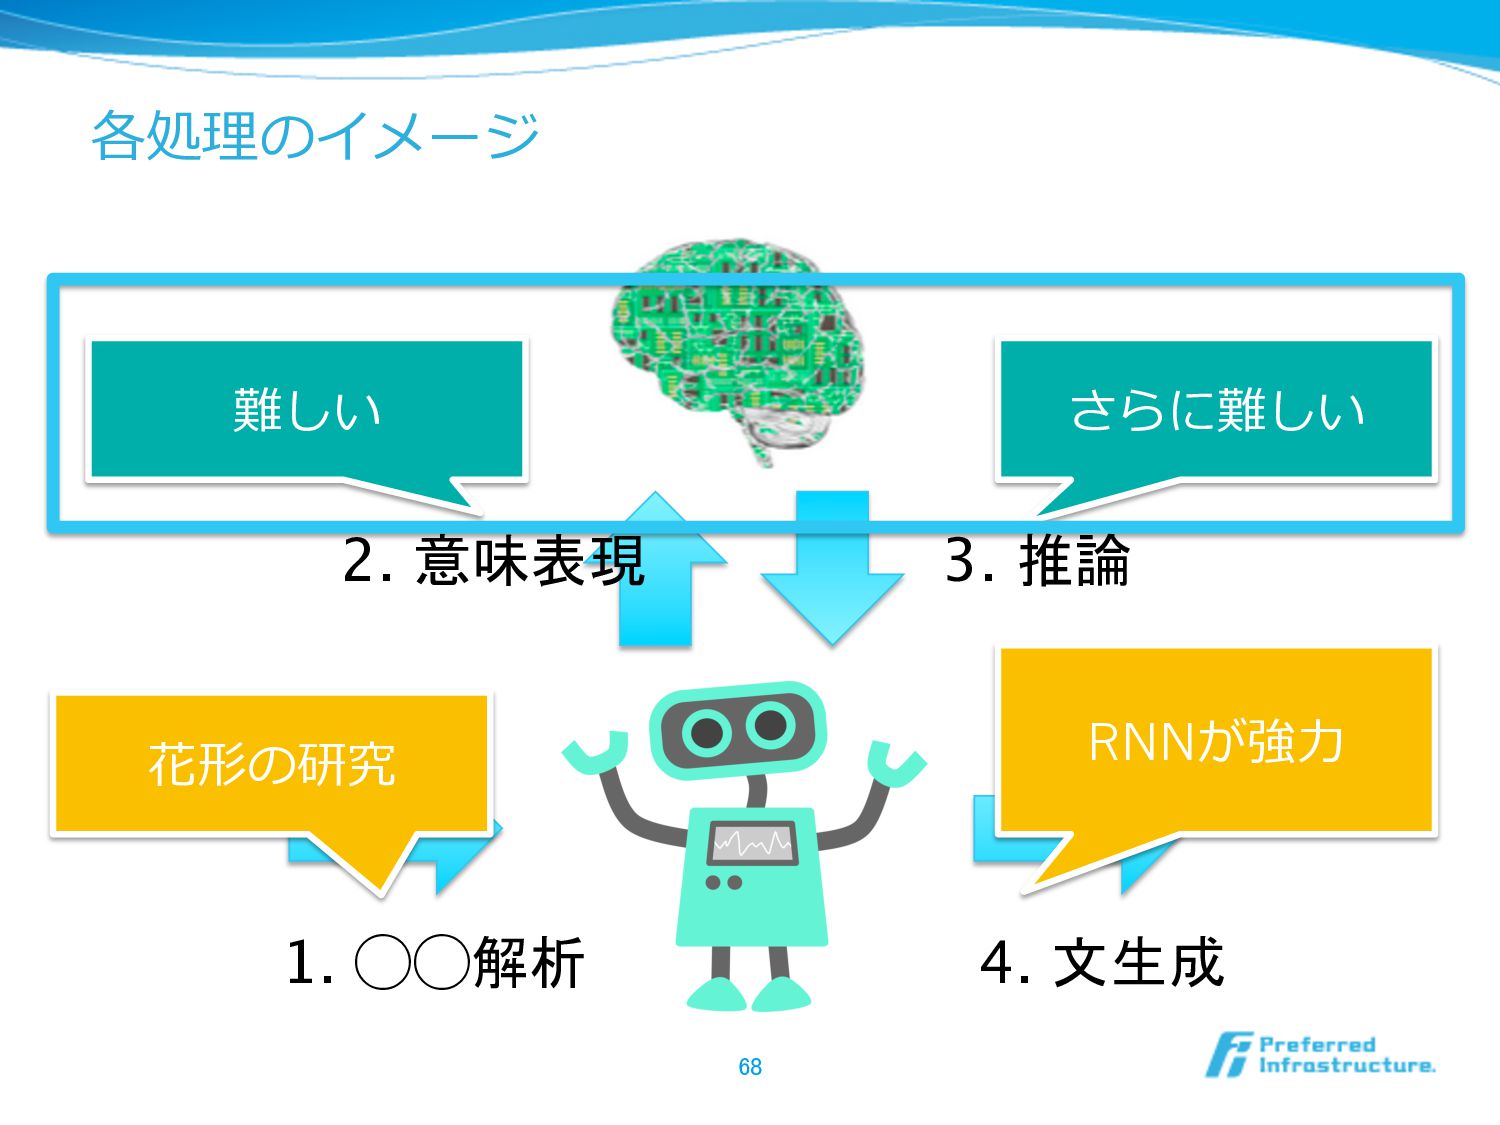
各処理理のイメージ 68 1. ◯◯解析 3. 推論 4. 文生成 2. 意味表現
花形の研究 難しい さらに難しい RNNが強⼒力力 -
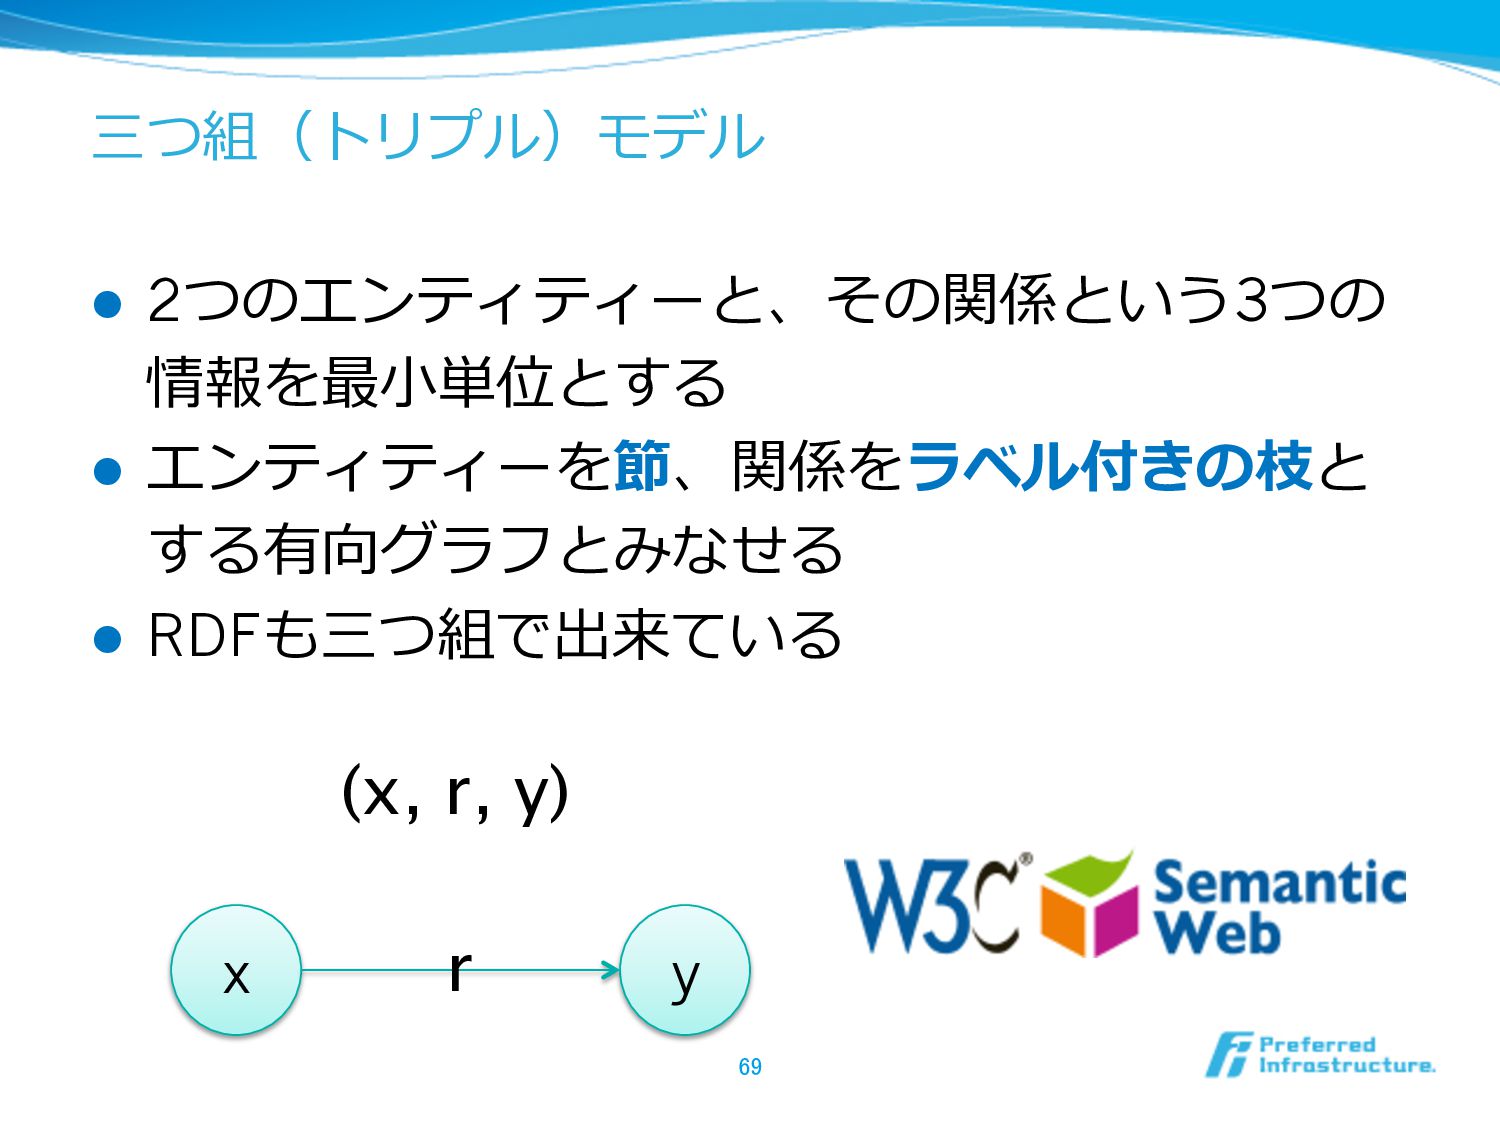
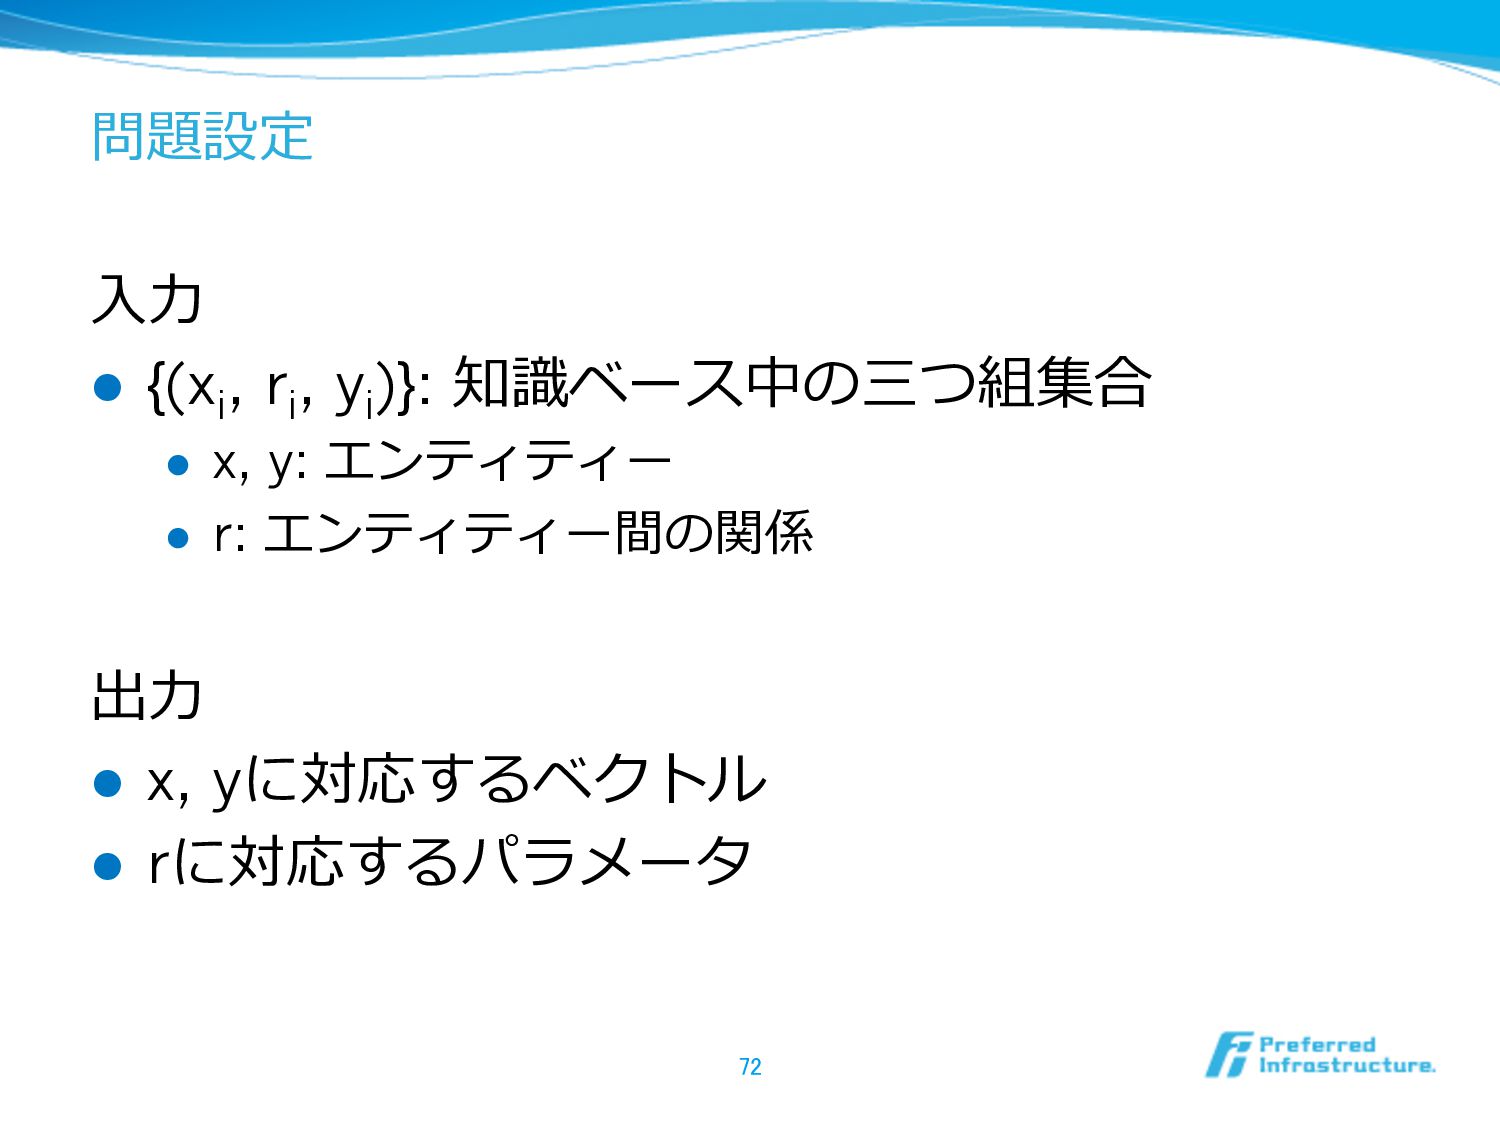
問題設定 ⼊入⼒力力 l {(x i , r i , y
i )}: 知識識ベース中の三つ組集合 l x, y: エンティティー l r: エンティティー間の関係 出⼒力力 l x, yに対応するベクトル l rに対応するパラメータ 72 -
Distance model (Structured Embedding) [Bordes +11] l e は、単語からベクトルへの関数 l
R left , R right は、関係から⾏行行列列への関数 l それぞれ別々の変換を⾏行行う l 学習データに対する f が⼩小さくなるように学習 74 f(x, r, y) = || Rleft (r) e(x) – Rright (r) e(y) ||1 -
TransE model [Brodes+13] l 関係 r は、ベクトル r を⾜足すだけというシンプ ルなモデル
l 良良好な結果で、ベースライン的扱い 75 f(x, r, y) = || e(x) + r – e(y) ||2 2 -
TransE modelの問題点 1対多関係、多対多関係の場合、TransEでは同じ 関係にある全ての埋め込みベクトルが同⼀一になる ように学習してしまう 拡張 l TransM: 広がりをもたせるように学習する l
TransH: 射影された超平⾯面上で同⼀一になるよう 学習する 76 -
TransM model [Fan+14] l r に応じて、重みをつける l w r は、r
の関係をもつ x, y の個数から決まる定数 77 f(x, r, y) = wr || e(x) + r – e(y) ||2 2 [Fan+14]より -
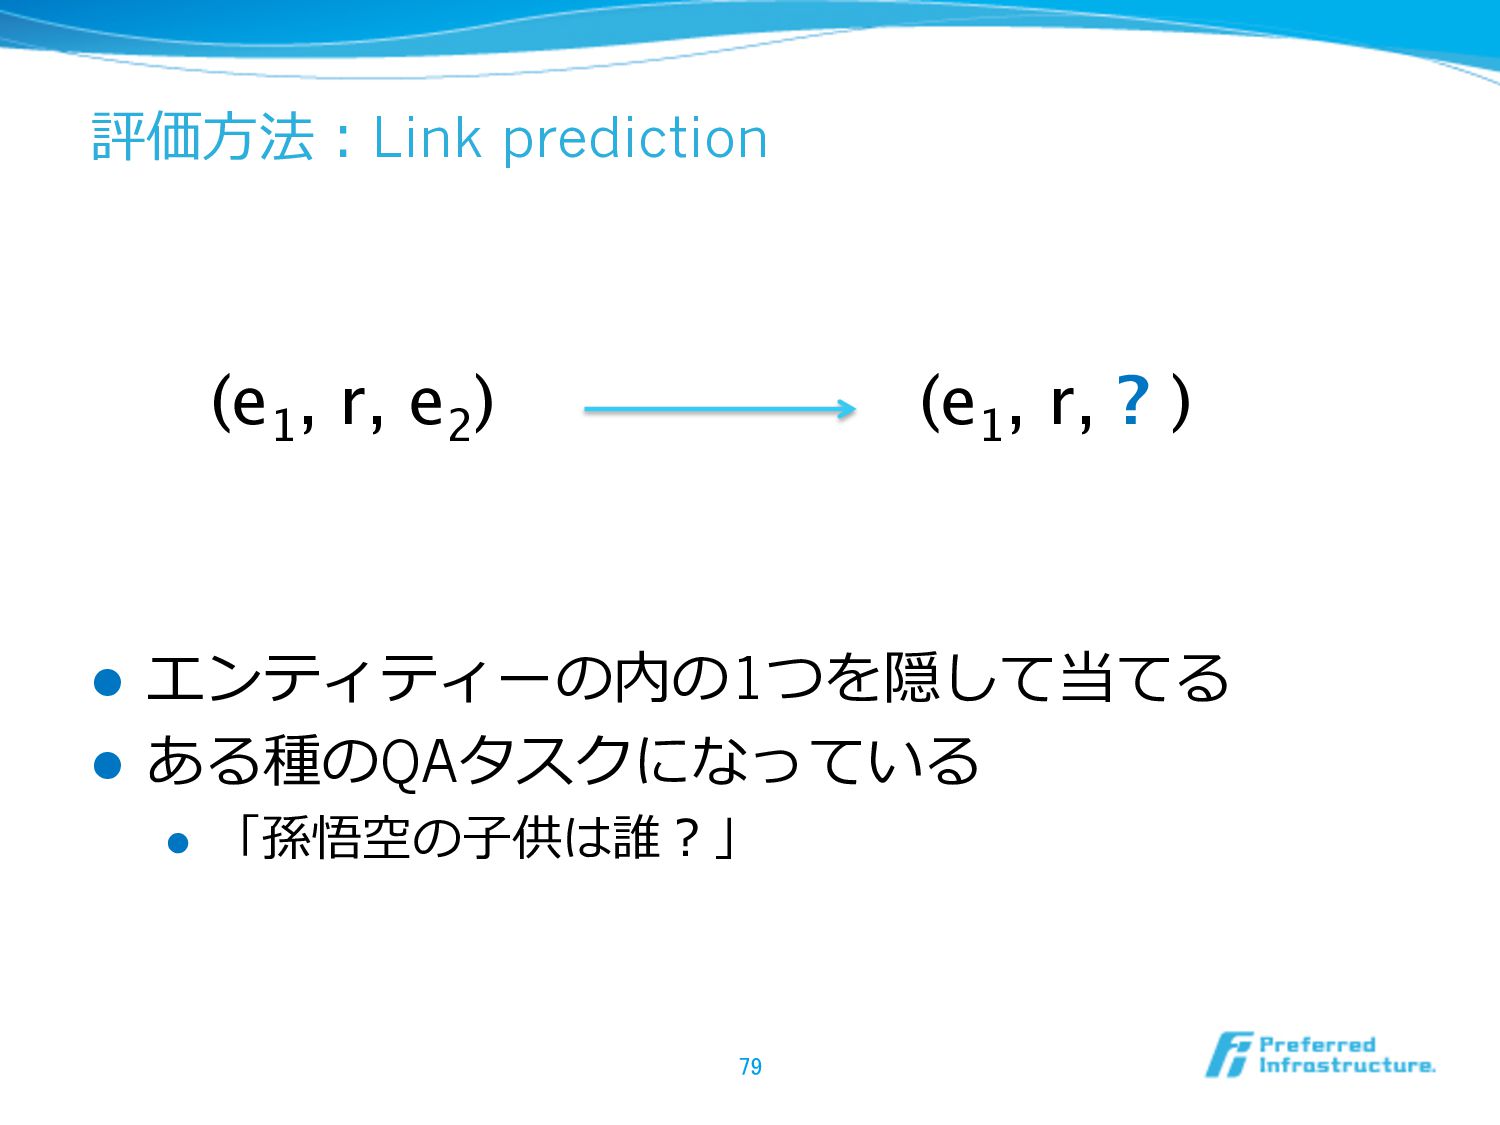
評価⽅方法:Link prediction l エンティティーの内の1つを隠して当てる l ある種のQAタスクになっている l 「孫悟空の⼦子供は誰?」 79 (e1
, r, e2 ) (e1 , r, ? ) -
記憶、知識識、推論論 l 記憶、知識識、推論論に関わりそうな研究が注⽬目さ れている l RNN-EM (Microsoft) l Memory Networks
(Facebook) l Neural Reasoner (Huawei) l 多くの研究が対話型質問応答システムを⽬目指し ているように⾒見見える 82 -
DL Workshop@ICML2015のパネル討論論より l ⾃自然⽂文対話とQ&Aシステムが重要になると、 FacebookとGoogle DeepMindが指摘 83 LeCun and Hassabis
both picked Q&A and natural language dialogue systems as next big things. https://sites.google.com/site/deepernn/home/blog/ briefsummaryofthepaneldiscussionatdlworkshopicml2015 -
RNN-EM [Peng+15a] l RNNに外部メモリ(External Memory)を追加 してより⻑⾧長い依存関係を学習 l 書き込み、読み込み操作も学習 84 ⼊入⼒力力単語
出⼒力力単語 隠れ状態 外部メモリ 書き込み 読み込み [Peng+15a]より -
Memory networks [Weston+15][Sukhbaatar+15] l ⾃自然⽂文の知識識をエンコードして、質問⽂文から答 えを探し答えるまでを1つのネットワークに 85 外部の⽂文献 知識識表現 質問⽂文
知識識の探索索 回答の⽣生成 [Sukhbaatar+15]より -
Neural Reasoner [Peng+15b] l 質問(q)と事実(f i )から、推論論を⾏行行うイメージ l この推論論を何回も⾏行行うと、結論論が得られる 86
質問と事実をRNNでエンコード 1段の推論論 最後に回答 推論論を何度度も [Peng+15b]より -
Deep Learningとは、「深い」ことだけではなく なってきている l 認識識系のDeep Learning l 段数の「深い」多層パーセプトロン l 段数の「深い」畳み込みニューラルネット
l 層の深さが重要だった l ⾔言語処理理のDeep Learning l 微分可能関数をうまく組み合わせる⼯工夫合戦 l 深さよりも構造の⼯工夫の⽅方が⽬目⽴立立つ 87 -
知識識の深層学習のまとめ l 知識識ベースの表現学習 l 三つ組による知識識ベースを、埋め込みベクトルで表 現する l 簡単な質問応答ができるようになった l より⾃自然な知識識や記憶の獲得が流流⾏行行中
l 対話型の質問応答システムに向かっている l 深さよりも問題特化した⼿手法が重要になってき ている 88 -
Skip-gramとseq2seqやSkip thought vectorの類似 性 l Skip-gram l 単語の意味(ベクトル)は、周囲に来やすい単語の 類似性によって決まる l
seq2seq l ⽂文の意味(ベクトル)は、変換後の⽂文の類似性に よって決まる l Skip thought vector l ⽂文の意味(ベクトル)は、周囲の⽂文の類似性によっ て決まる 92 -
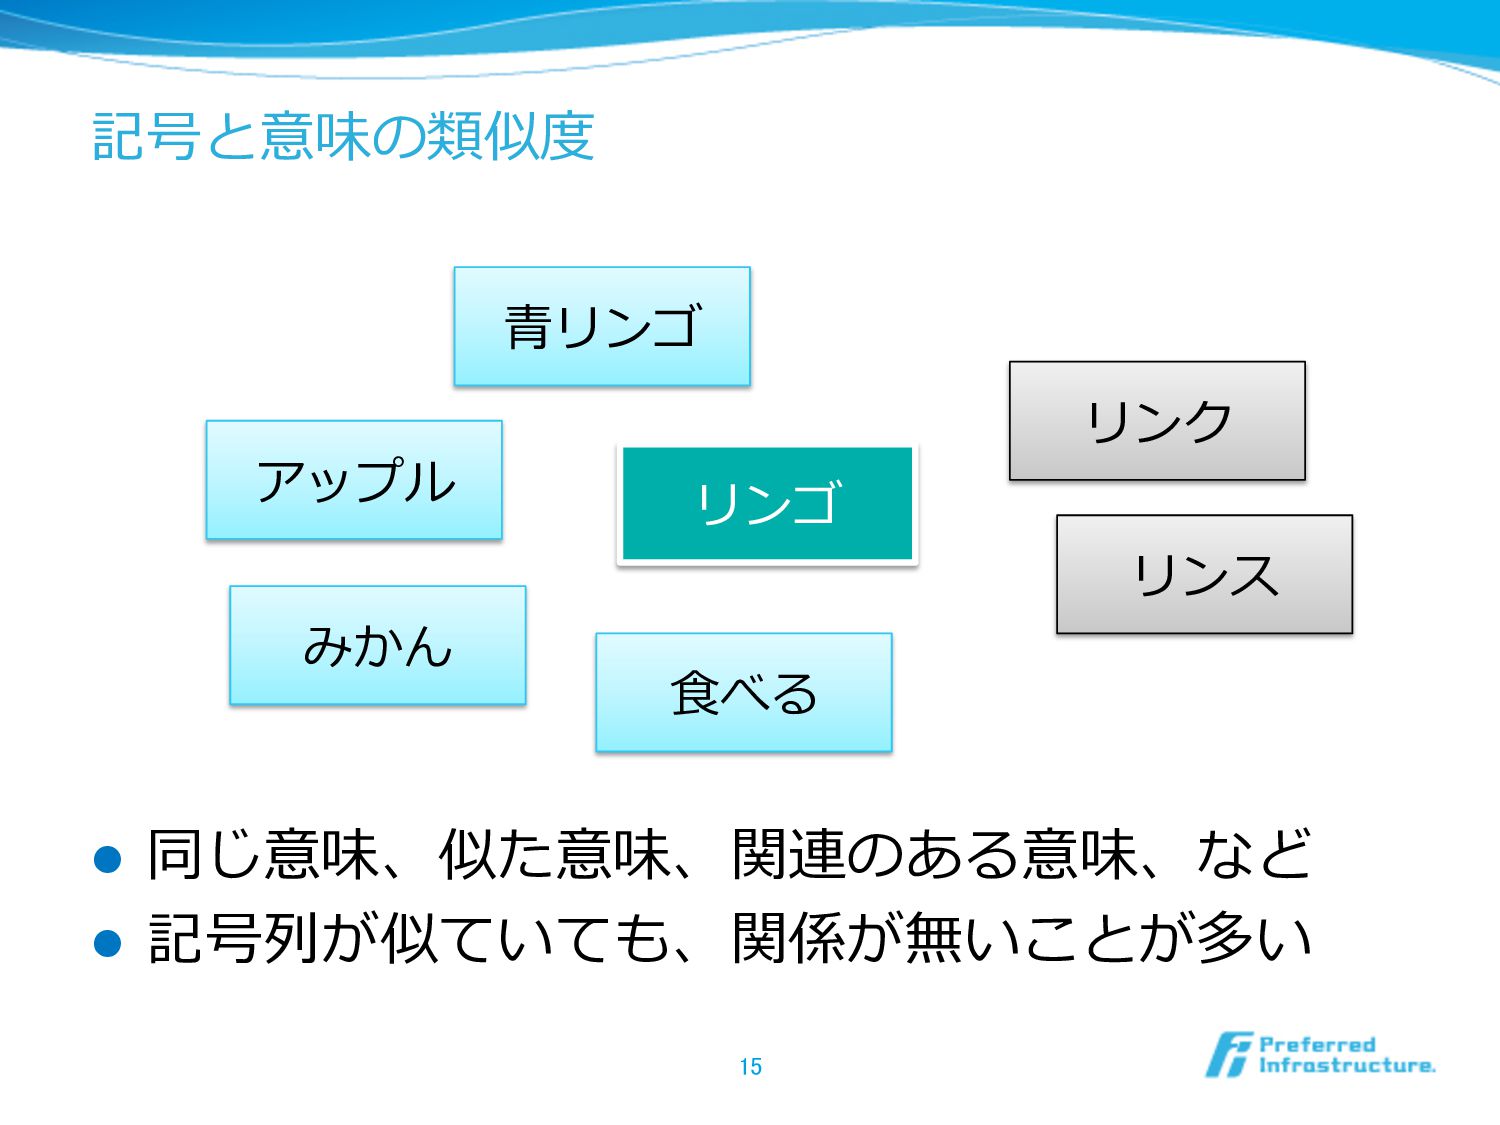
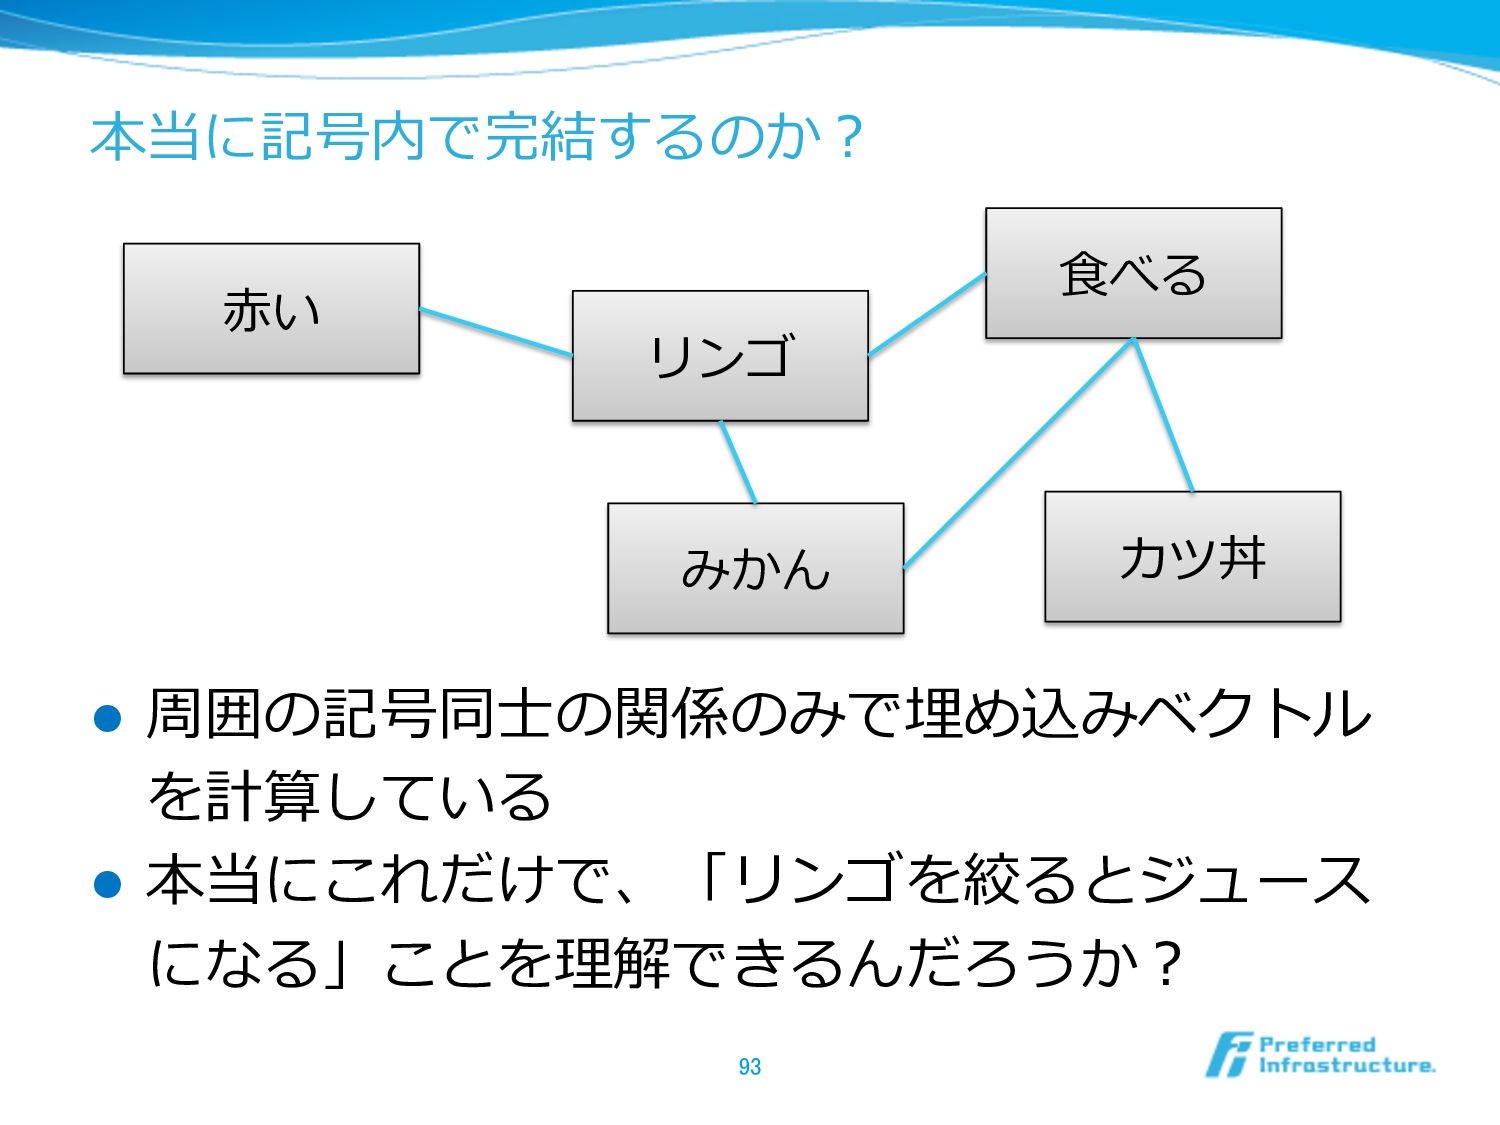
連続な表現とのマッピングが必要? l 記号の表現は不不連続 l 記号そのものは類似性を測れない l 現状は埋め込みベクトルの類似度度と、共起関係 から間接的に類似度度を測っている l もっと直接的にコトバを覚えられないか?
l コトバに対応した外部の刺刺激が必要? l ⾝身体性? 94 -
まとめ l 埋め込みの学習 l 周囲の単語との共起を使って学習 l Skip-gramが単純だが強⼒力力で、⼤大流流⾏行行している l 構造の学習 l
系列列を扱うのがRecurrentで、LSTMが⾮非常に強⼒力力 l ⽊木構造を扱うのがRecursive l 知識識や記憶の学習 l 知識識ベースの三つ組を埋め込みベクトルにエンコー ドする⼯工夫 l ⾃自然分を使った、より⾃自然なモデルへと研究のトレ ンドは移っている 95 -
参考⽂文献 l [Evert10] Stefan Evert. Distributional Semantic Models. NAACL 2010
Tutorial. l [Mikolov+13a] Tomas Mikolov, Kai Chen, Greg Corrado, Jeffrey Dean. Efficient Estimation of Word Representations in Vector Space. CoRR, 2013. l [Morin+05] Frederic Morin, Yoshua Bengio. Hierarchical Probabilistic Neural Network Language Model. AISTATS, 2005. l [Mikolov+13c] Tomas Mikolov, Ilya Sutskever, Kai Chen, Gregory S. Corrado, Jeffrey Dean. Distributed Representations of Words and Phrases and their Compositionality. NIPS, 2013. 97 -
参考⽂文献 l [Kim+13] Joo-Kyung Kim, Marie-Catherine de Marneffe. Deriving adjectival
scales from continuous space word representations. EMNLP , 2013. l [Mikolov+13d] Tomas Mikolov, Quoc V. Le, Ilya Sutskever. Exploiting Similarities among Languages for Machine Translation. CoRR, 2013. l [Neelakantan+14] Arvind Neelakantan, Jeevan Shankar, Alexandre Passos, Andrew McCallum. Efficient Non-parametric Estimation of Multiple Embeddings per Word in Vector Space. EMNLP , 2014. l [Le+14] Quoc Le, Tomas Mikolov. Distributed Representations of Sentences and Documents. ICML, 2014. 98 -
参考⽂文献 l [Hochreiter+97] Sepp Hochreiter, Jurgen Schmidhunber. Long Short-Term Memory.
Neural Computation 9(8), 1997. l [Mikolov+10] Tomas Mikolov, Martin Karafiat, Lukas Burget, Jan Honza Cernocky, Sanjeev Khudanpur. Recurrent neural network based language model. Interspeech, 2010. l [Graves13] Alex Graves. Generating Sequences With Recurrent Neural Networks. arXiv: 1308.0850, 2013. l [Vinyal+15a] Oriol Vinyals, Alexander Toshev, Samy Bengio, Dumitru Erhan. Show and tell: A neural image caption generator. CVPR, 2015. 99 -
参考⽂文献 l [Sutskever+14] Ilya Sutskever, Oriol Vinyals, Quoc V. Le.
Sequence to Sequence Learning with Neural Networks. NIPS 2014. l [Vinyals+15b] Oriol Vinyals, Lukasz Kaiser, Terry Koo, Slav Petrov, Ilya Sutskever, Geoffrey Hinton. Grammar as a foreign language. ICLR 2015. l [Vinyals+15c] Oriol Vinyals, Quoc Le. A Neural Conversational Model. ICML 2015. 100 -
参考⽂文献 l [Socher+11] Richard Socher, Cliff Lin, Andrew Y. Ng,
Christopher D. Manning. Parsing Natural Scenes and Natural Language with Recursive Neural Networks. ICML 2011 l [Socher+12] Richard Socher, Brody Huval, Christopher D. Manning, Andrew Y. Ng. Semantic Compositionality through Recursive Matrix-Vector Spaces. EMNLP2012. l [Socher+13] Richard Socher, Alex Perelygin, Jean Wu, Jason Chuang, Chris Manning, Andrew Ng, Chris Potts. Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank. EMNLP 2013. l [Tai+15] Kai Sheng Tai, Richard Socher, Christopher D. Manning. Improved Semantic Representations From Tree-Structured Long Short-Term Memory Networks. ACL 2015. 101 -
参考⽂文献 l [Bordes+11] A. Bordes, J. Weston, R. Collobert, Y.
Bengio. Learning structured embeddings of knowledge bases. AAAI2011. l [Bordes+13] A. Bordes, N. Usunier, A. Garcia-Duran, J. Weston, O. Yakhnenko. Translating Embeddings for Modeling Multi-relational Data. NIPS 2013. l [Fan+14] M. Fan, Q. Shou, E. Chang, T. F . Zheng. Transition-based Knowledge Graph Embedding with Relational Mapping Properties. PACLIC 2014. l [Wang+14] Z. Wang, J. Zhang, J. Feng, Z. Chen. Knowledge Graph Embedding by Translating on Hyperplanes. AAAI 2014. l [Bordes&Weston14] A. Bordes, J. Weston. Embedding Methods for Natural Language Processing. EMNLP2014 tutorial. 102 -
参考⽂文献 l [Peng+15a] Baolin Peng, Kaisheng Yao. Recurrent Neural Networks
with External Memory for Language Understanding. arXiv:1506.00195, 2015. l [Weston+15] J. Weston, S. Chopra, A. Bordes. Memory Networks. ICLR 2015. l [Sukhbaatar+15] Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston, Rob Fergus. End-To-End Memory Networks. arXiv:1503.08895, 2015. l [Kumar+15] Ankit Kumar, Ozan Irsoy, Jonathan Su, James Bradbury, Robert English, Brian Pierce, Peter Ondruska, Ishaan Gulrajani, Richard Socher. Ask Me Anything: Dynamic Memory Networks for Natural Language Processing. arXiv:1506.07285, 2015. l [Peng+15b] Baolin Peng, Zhengdong Lu, Hang Li, Kam-Fai Wong. Towards Neural Network-based Reasoning. arXiv:1508.05508, 2015. l [Kiros+15] Ryan Kiros, Yukun Zhu, Ruslan Salakhutdinov, Richard S. Zemel, Antonio Torralba, Raquel Urtasun, Sanja Fidler. Skip-Thought Vectors. arXiv:1506.06726, 2015. 103