Share
Embed
Transcript
34 slides
-
初めまして、吉原浩之(よしはら ひろし)です。 • 東大薬科学修士 / 京大SPH健康情報学博士課程(満期退学) • 東大 医療政策・公衆衛生学 ◦ 医療ビッグデータ(レセプト、カルテなど)の解析
◦ 生成AIを活用したエビデンス基盤の構築 • アイリス株式会社 ◦ 医療機器nodoca ™の開発 ◦ 生成AIなどの新技術を活用したプロトタイピング • RoboTech(ロボコン)、iGEM(合成生物学) • Kaggle Grandmaster / Google Developer Expert • 登山・トレラン 2 -
AIMO2 (AI Mathematical Olympiad Progress Prize 2) • 目的: AIの数学的推論能力の評価
• 問題の難易度: AIMO1 < AIME (国内大会) < AIMO2 < IMO (国際大会) • 答えは 0から999の非負整数 • 答えの数値の正誤のみで評価 5 -
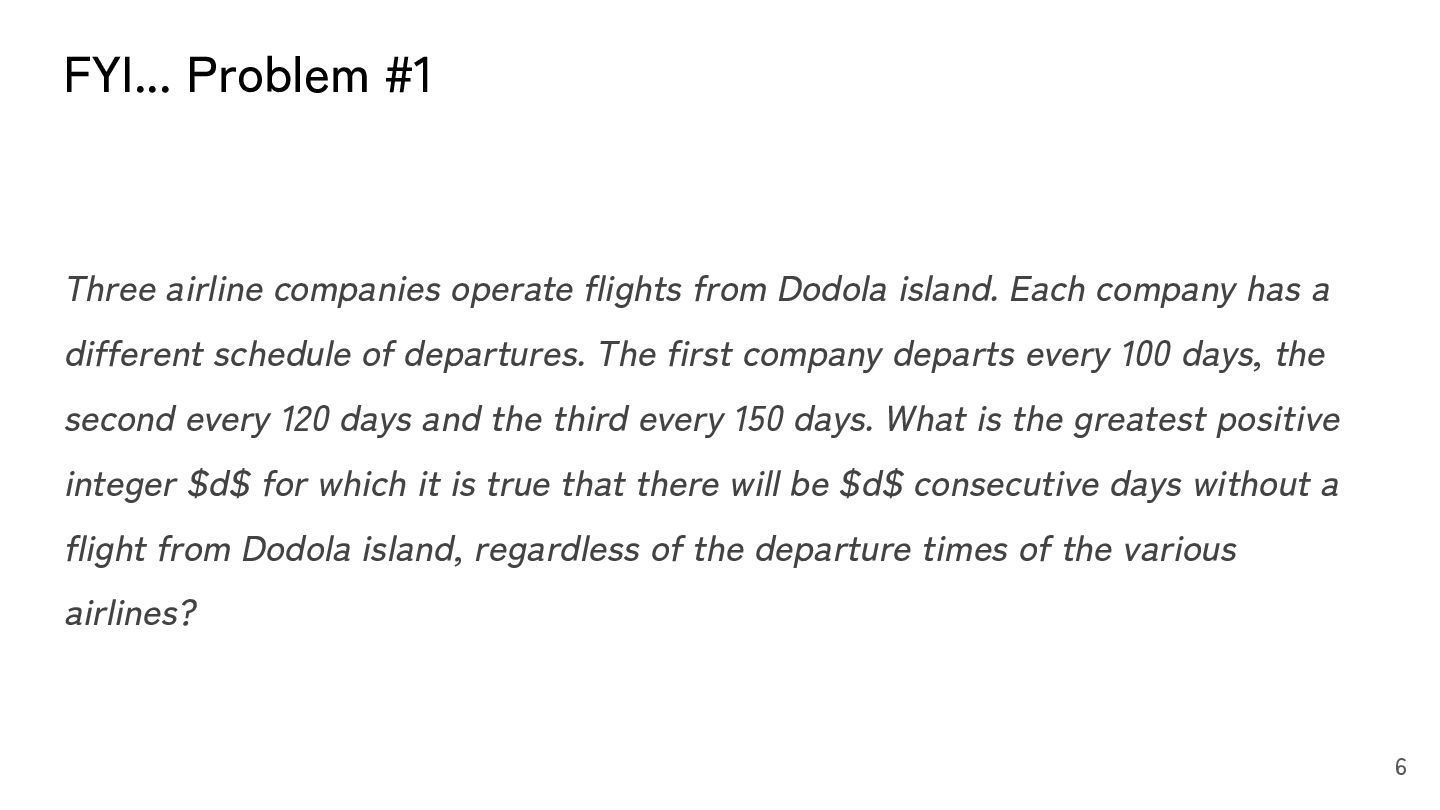
FYI... Problem #1 Three airline companies operate flights from Dodola
island. Each company has a different schedule of departures. The first company departs every 100 days, the second every 120 days and the third every 150 days. What is the greatest positive integer $d$ for which it is true that there will be $d$ consecutive days without a flight from Dodola island, regardless of the departure times of the various airlines? 6 -
コンペのセッティング • 問題: 10 examples + 50 public LB +
50 private LB • L4 x 4 インスタンス / 5時間の制限 • 公式の学習データはなし • 提出は1日1回まで • アルゴリズムが同時解答できる問題は1問のみ ◦ 複数の問題を同時に解くことはできない ◦ 前の問題に戻ることはできない • 出題順序はランダム(public LBのみ) 7 -
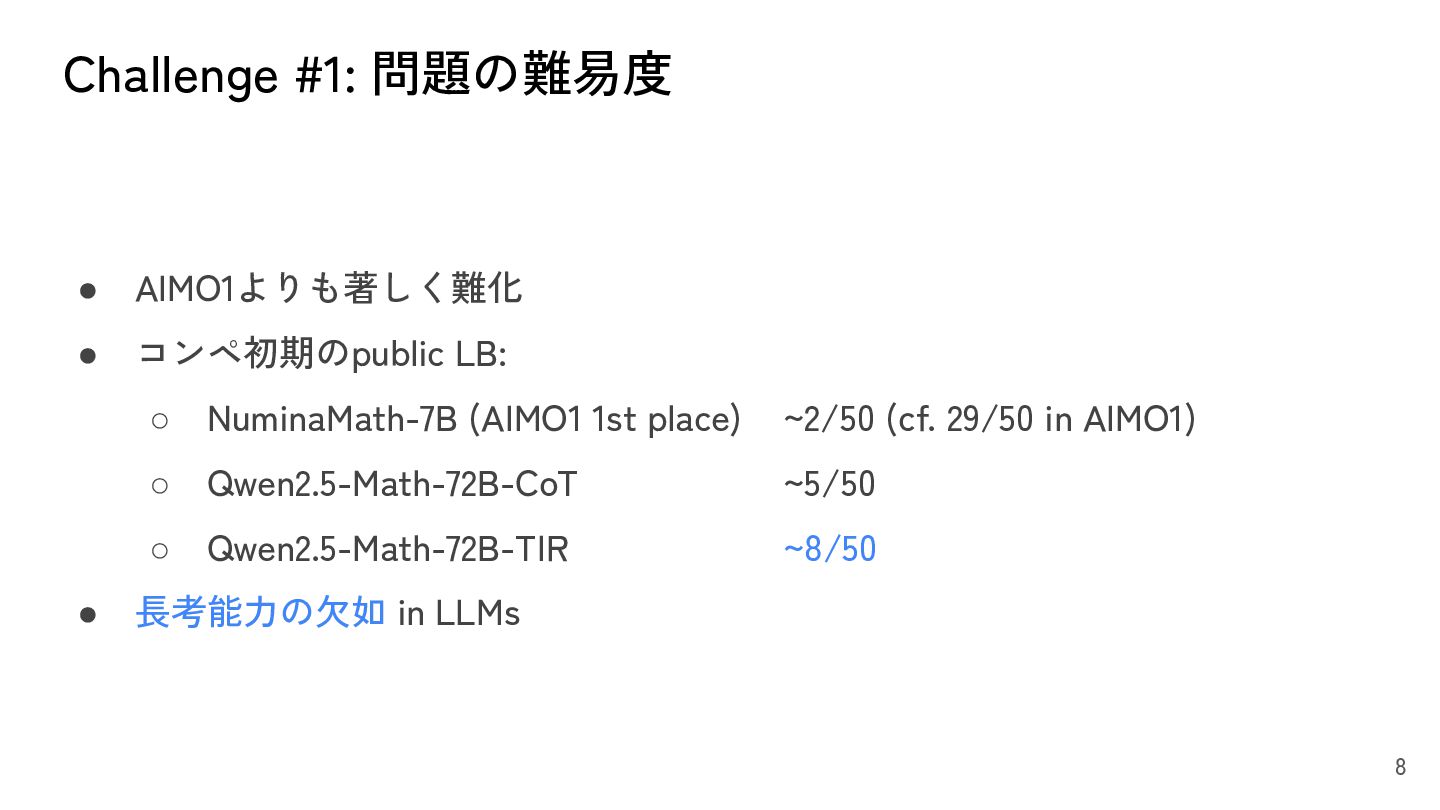
Challenge #1: 問題の難易度 • AIMO1よりも著しく難化 • コンペ初期のpublic LB: ◦ NuminaMath-7B
(AIMO1 1st place) ~2/50 (cf. 29/50 in AIMO1) ◦ Qwen2.5-Math-72B-CoT ~5/50 ◦ Qwen2.5-Math-72B-TIR ~8/50 • 長考能力の欠如 in LLMs 8 -
長考モデルの登場 • コンペ期間中に複数のオープンソースの長考モデルが公開された ◦ 11.2024 Alibaba - QwQ-32B-Preview ◦ 01.2025
DeepSeek - DeepSeek-R1 and distilled models • 長考モデル(追加学習なし) on public LB: ◦ QwQ-32B-Preview ~18/50 ◦ R1-Distilled-Qwen-14B ~27/50 • 長考モデルの登場でコンペのベースラインが大きく向上 9 -
How does long reasoning model works • Reasoning model is
trained to output a chain of thought (CoT) enclosed in <think> tags at the beginning of its response. ◦ <think> CoT... </think> response… • For math problems, the model is trained to output the final answer in LaTeX format using \boxed{}. • The answer is often also output right before the closing </think> tag. ◦ <think> CoT...\boxed{answer} </think> response…\boxed{answer} 10 -
公開ノートブック • https://www.kaggle.com/code/octaviograu/lb-27-aimo-2-deepseek-r1-distill- qwen-7b-awq • R1-Distilled-Qwen-7B-AWQ served on vLLM •
種類のプロンプト • トークン予算は12000 or 8000 (残り時間に応じて調整) • 後処理: </think> でのearly-stop, majority voting @ 32 • Public LB: 27/50 (不安定: スコアのばらつき ~4) 11 -
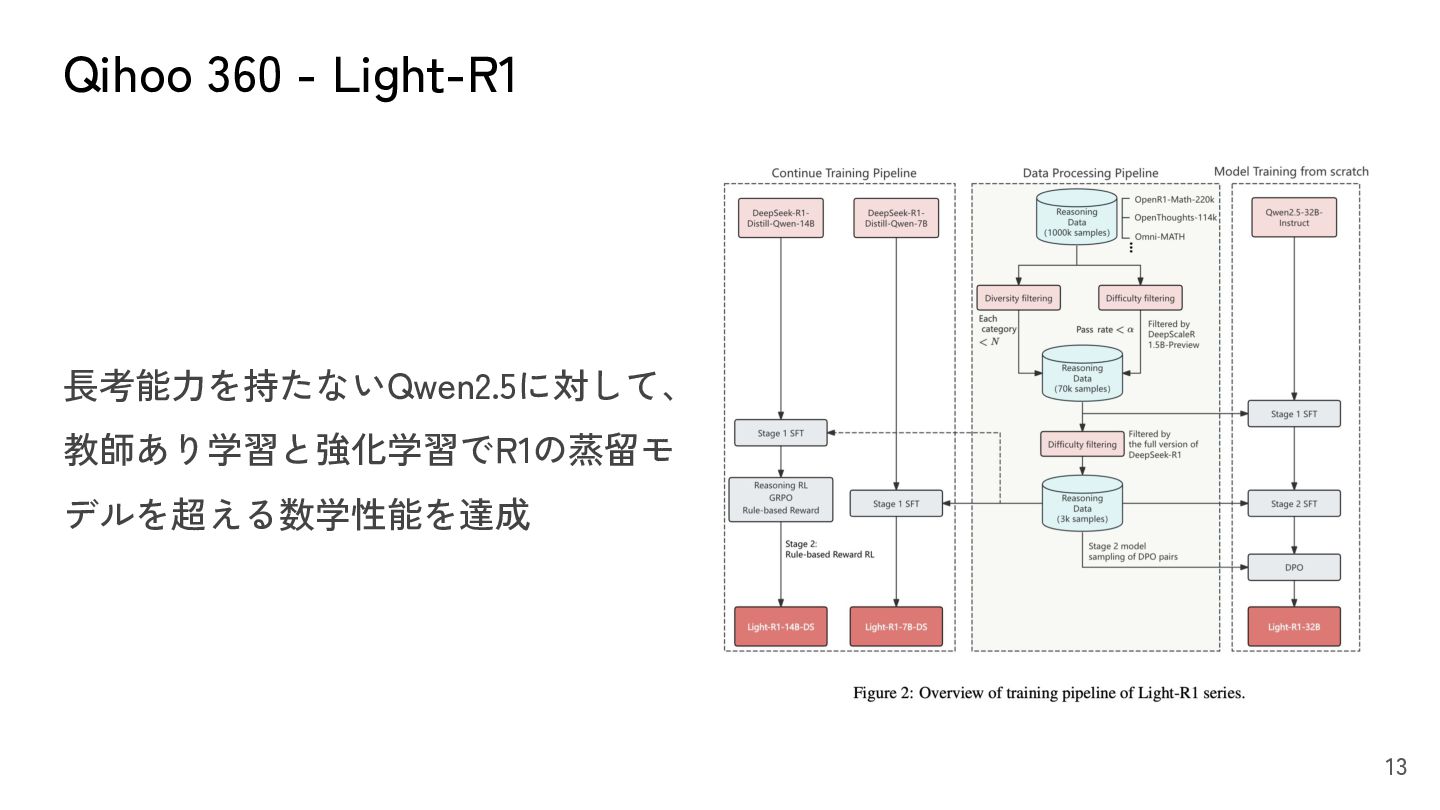
Challenge #2: 推論能力の向上 • Strategy #1: CoT(Chain of Thoughts)能力 ◦
e.g., Qihoo 360 - Light-R1 https://github.com/Qihoo360/Light-R1 • Strategy #2: TIR(Tool-Integrated Reasoning)能力 ◦ TIR: 外部ツール(Pythonインタプリタなど)を利用して問題を解く ◦ TIRによって主に探索によって解ける問題の正答率は大きく向上する 12 -
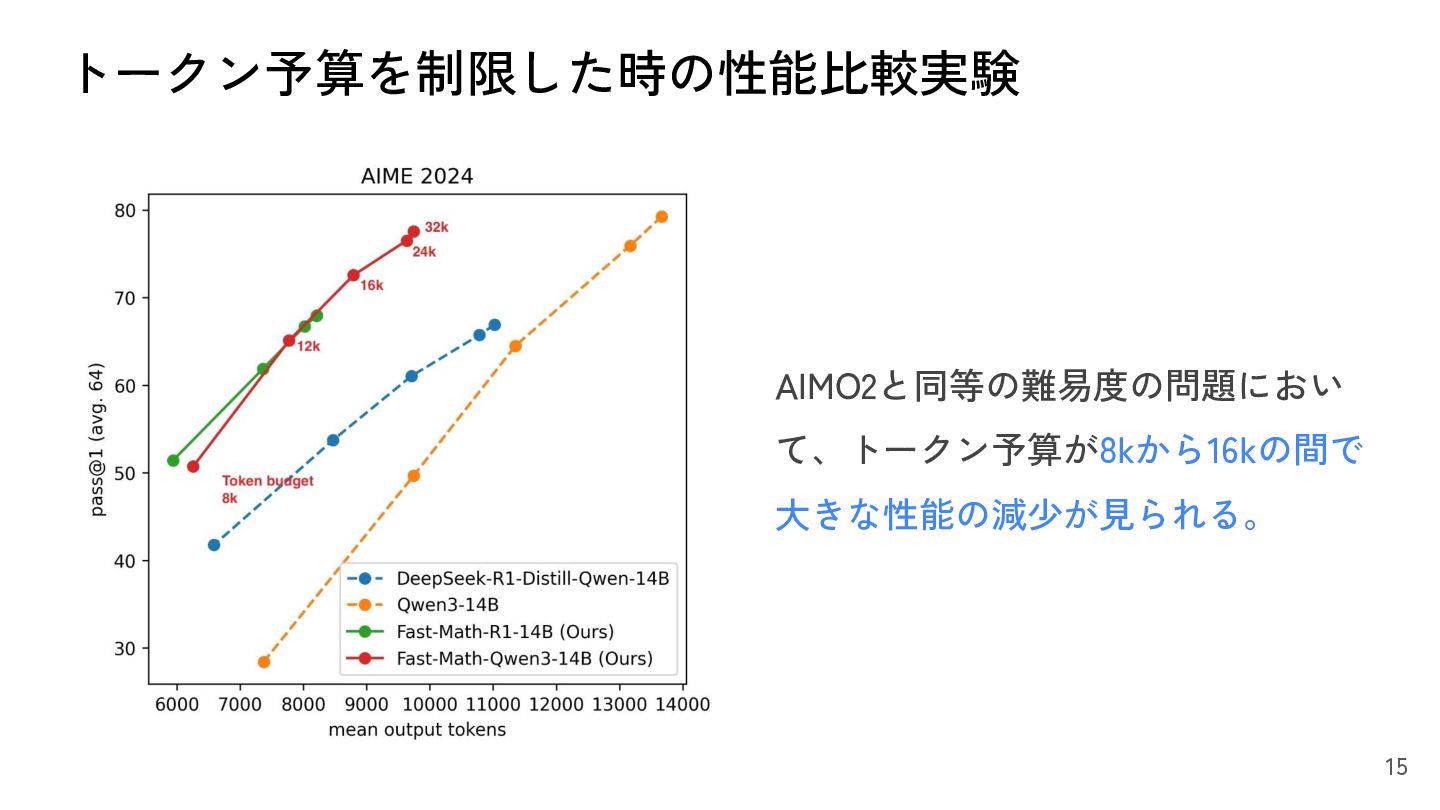
Challenge #3: 推論効率の向上 • 一般的に推論時間を伸ばすほどに推論能力は向上する ◦ 推論効率: 答えに達するまでに生成したトークン数 • 各種モデルの公式レポート記載のメトリックは一般的に大きなトークン予算
を用いている(e.g., 32kトークン) • AIMO2コンペの環境では, 実質的なトークン予算は8k–16kに限定される 14 -
Team Fast-Math-R1-14B (天才受験生と呼ばれたものたち) • Details: https://www.kaggle.com/competitions/ai-mathematical-olympiad-progress- prize-2/discussion/571252 • Members: ◦
Hiroshi Yoshihara: Aillis Inc., The University of Tokyo ◦ Yuichi Inoue: Sakana AI Co, Ltd. ◦ Taiki Yamaguchi: Rist Inc. • Public LB 29/50 (7th) - Private LB 28/50 (9th) 17 -
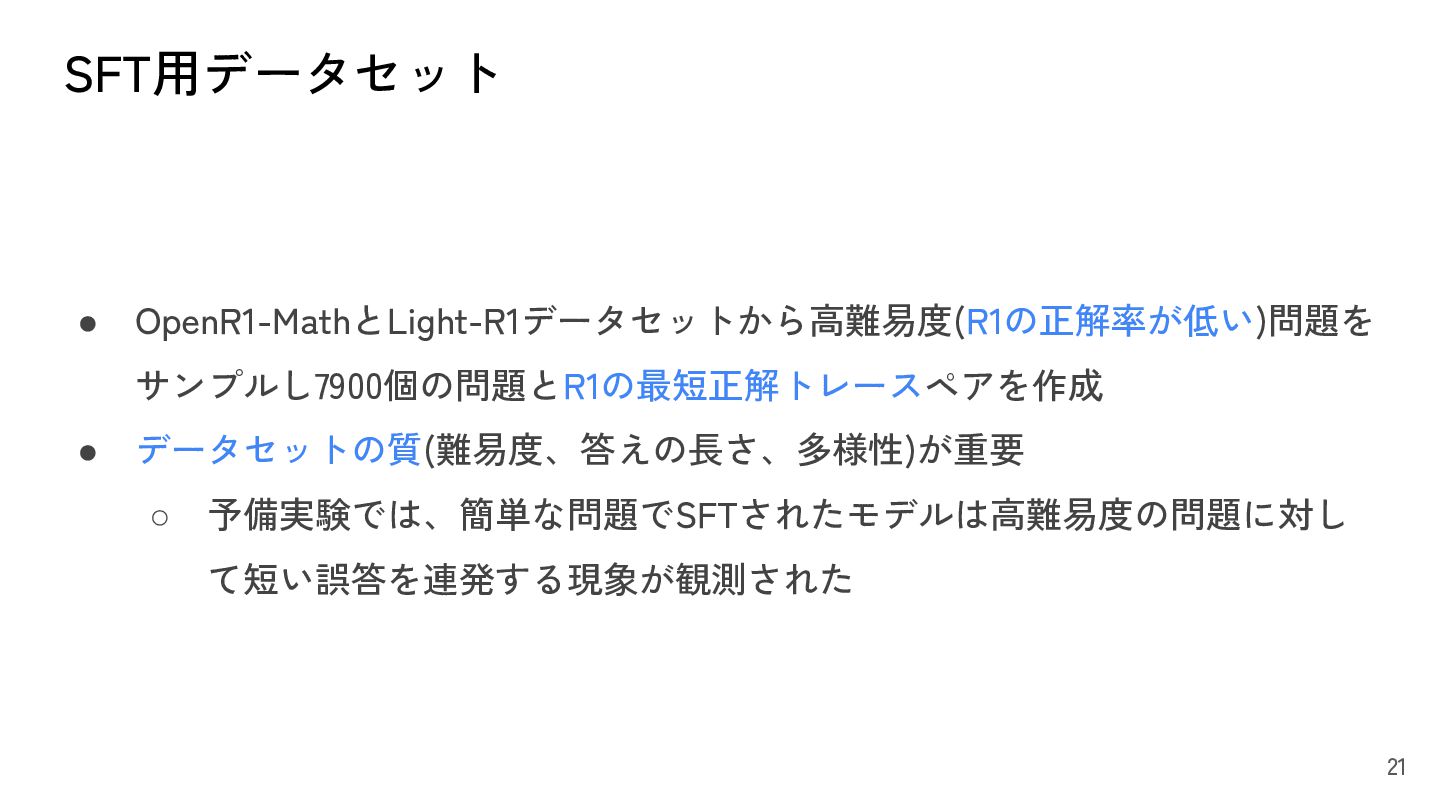
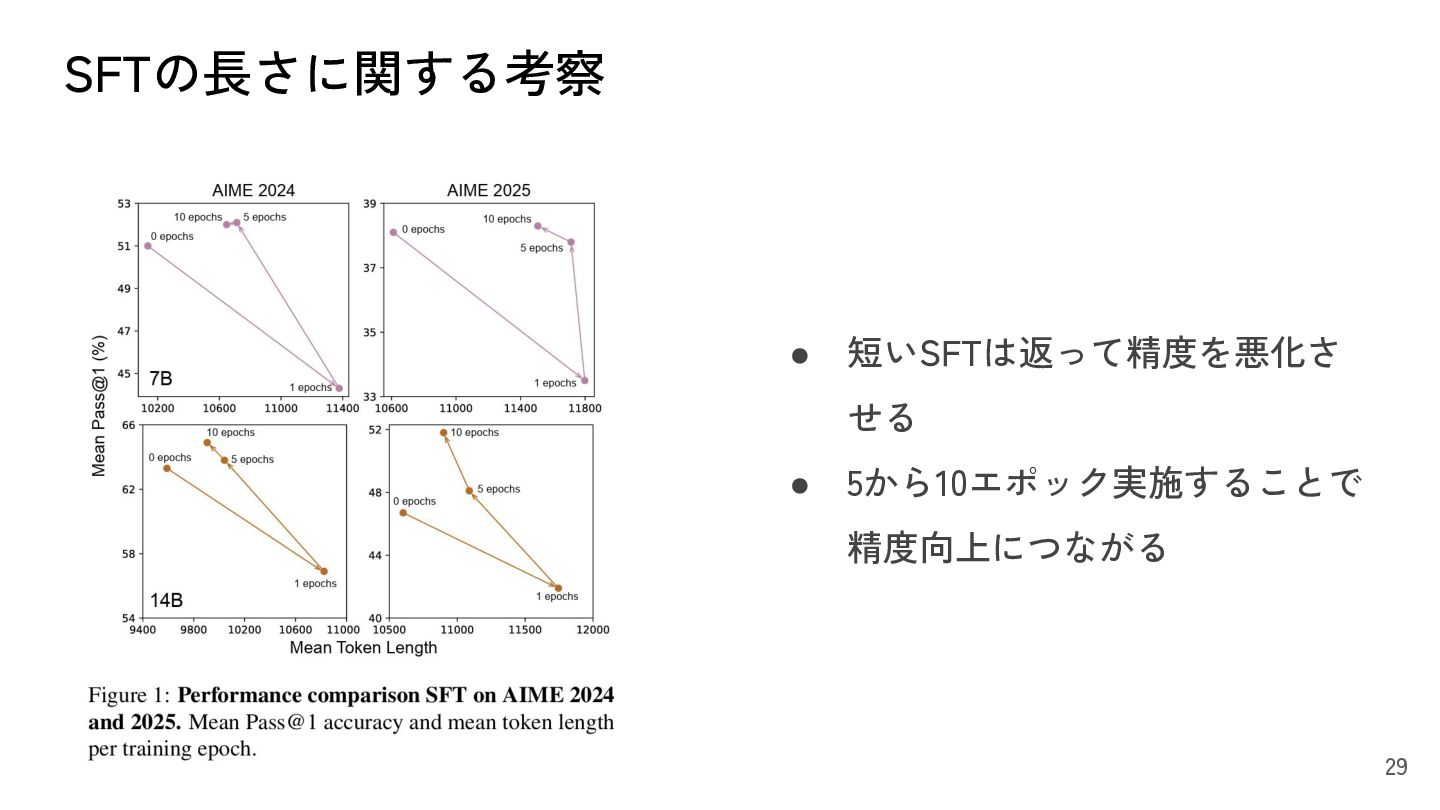
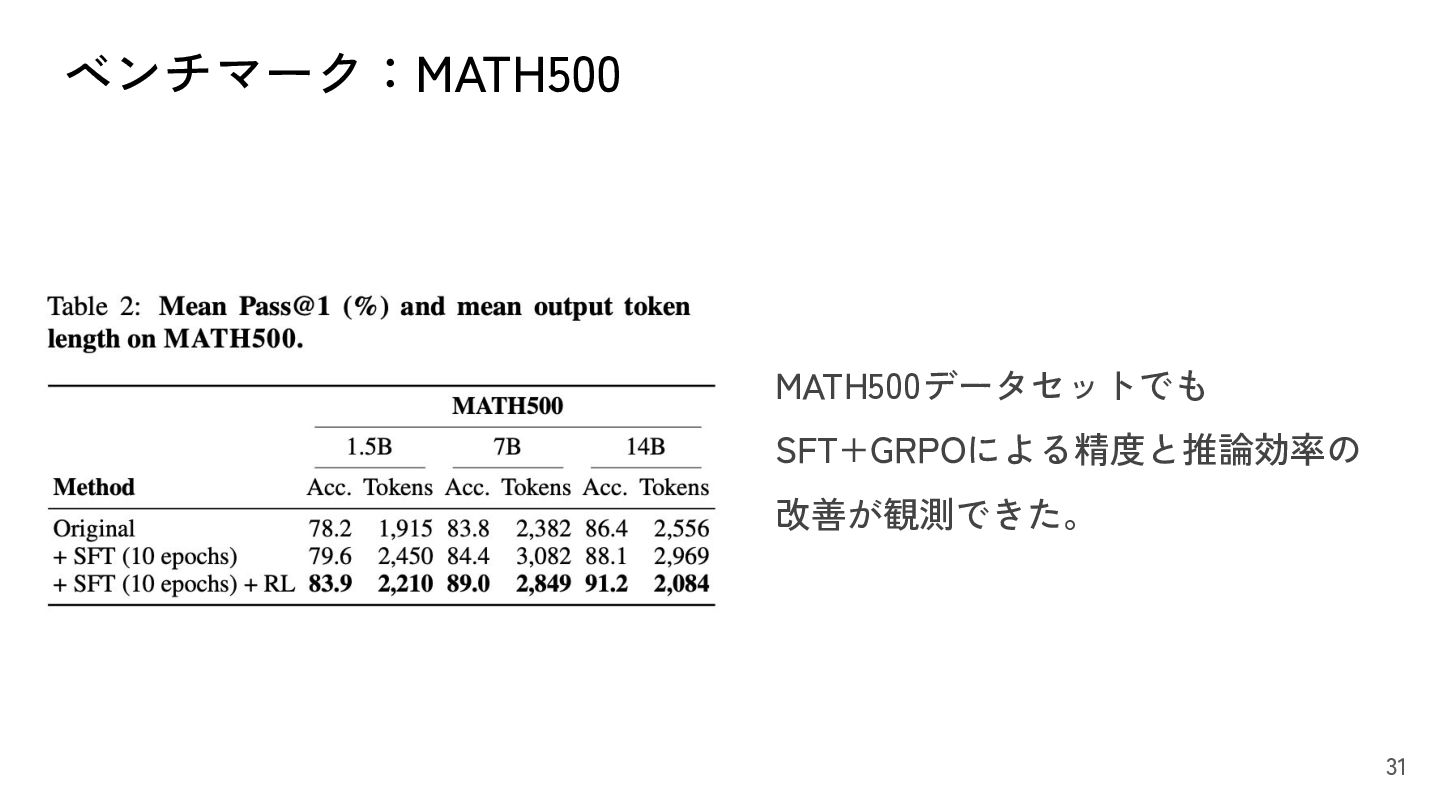
解法の概要: Fast-Math-R1-14B • ステージ1: 高難易度データセットを使用した教師あり学習(SFT) ◦ CoT能力の強化 • ステージ2: 高品質データによるGRPO
◦ CoT能力と推論効率の強化 • 問題難易度に応じたトークン予算のスケーリング 19 -
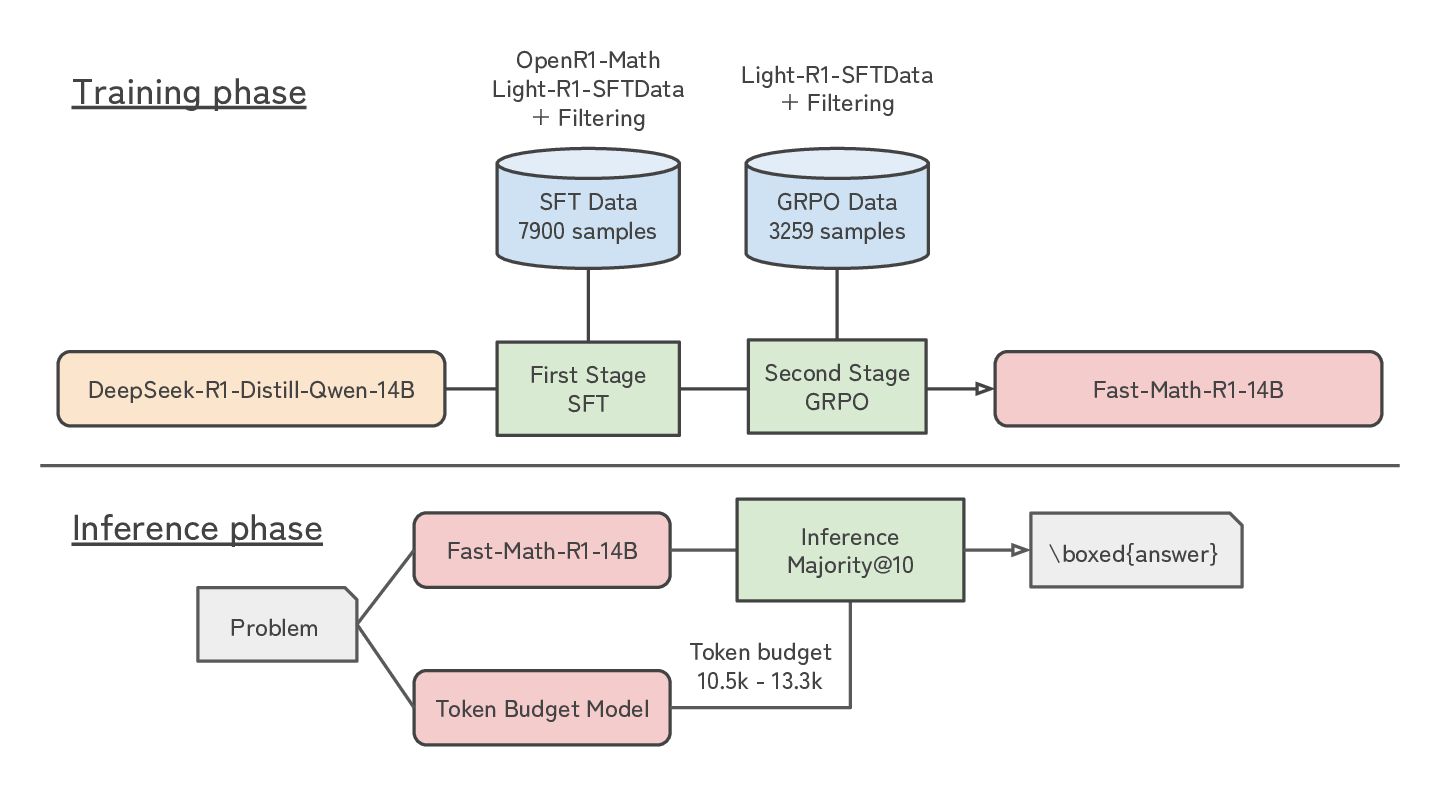
DeepSeek-R1-Distill-Qwen-14B SFT Data 7900 samples GRPO Data 3259 samples First
Stage SFT OpenR1-Math Light-R1-SFTData + Filtering Light-R1-SFTData + Filtering Second Stage GRPO Fast-Math-R1-14B Fast-Math-R1-14B Problem Token Budget Model \boxed{answer} Inference Majority@10 Token budget 10.5k - 13.3k Training phase Inference phase -
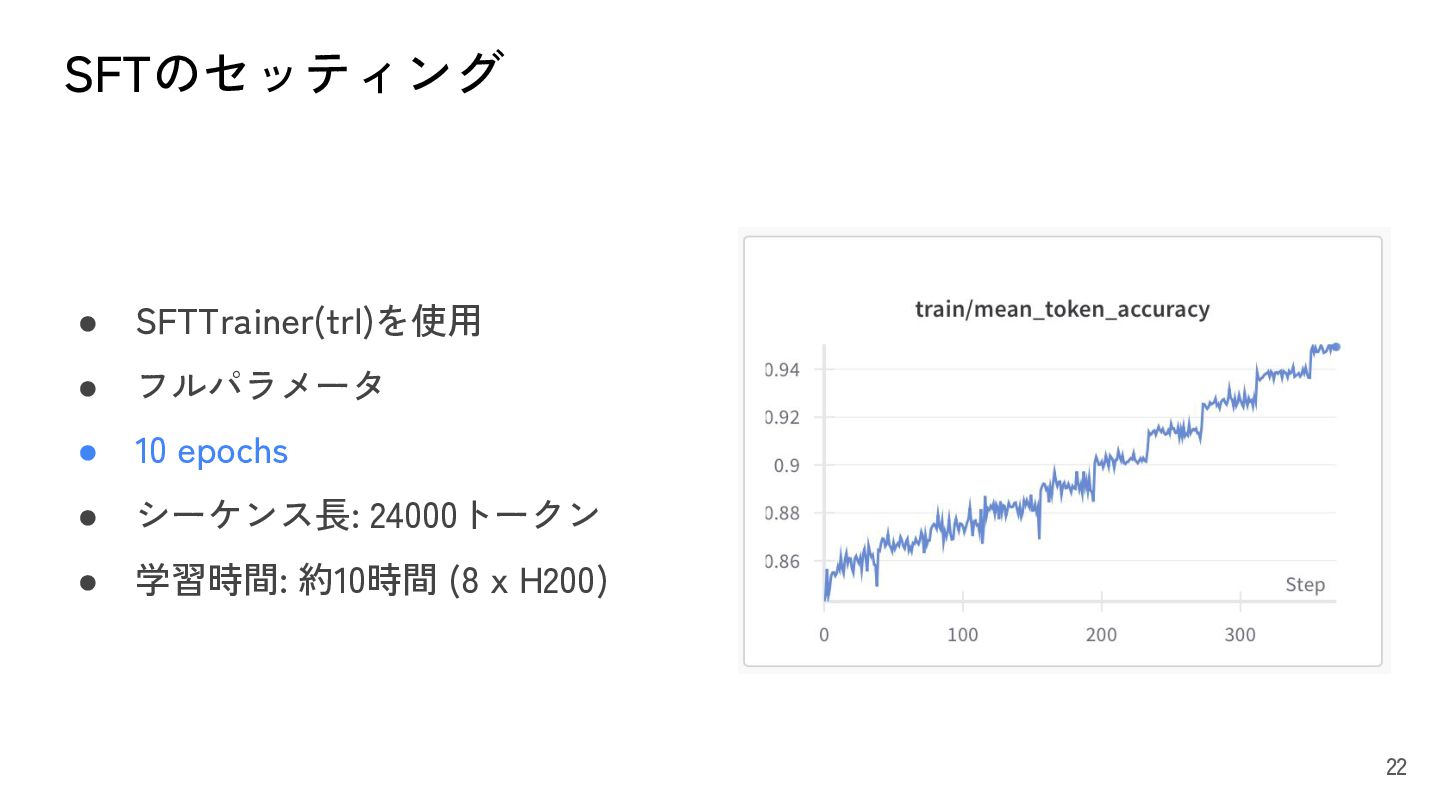
SFTのセッティング • SFTTrainer(trl)を使用 • フルパラメータ • 10 epochs • シーケンス長:
24000トークン • 学習時間: 約10時間 (8 x H200) 22 -
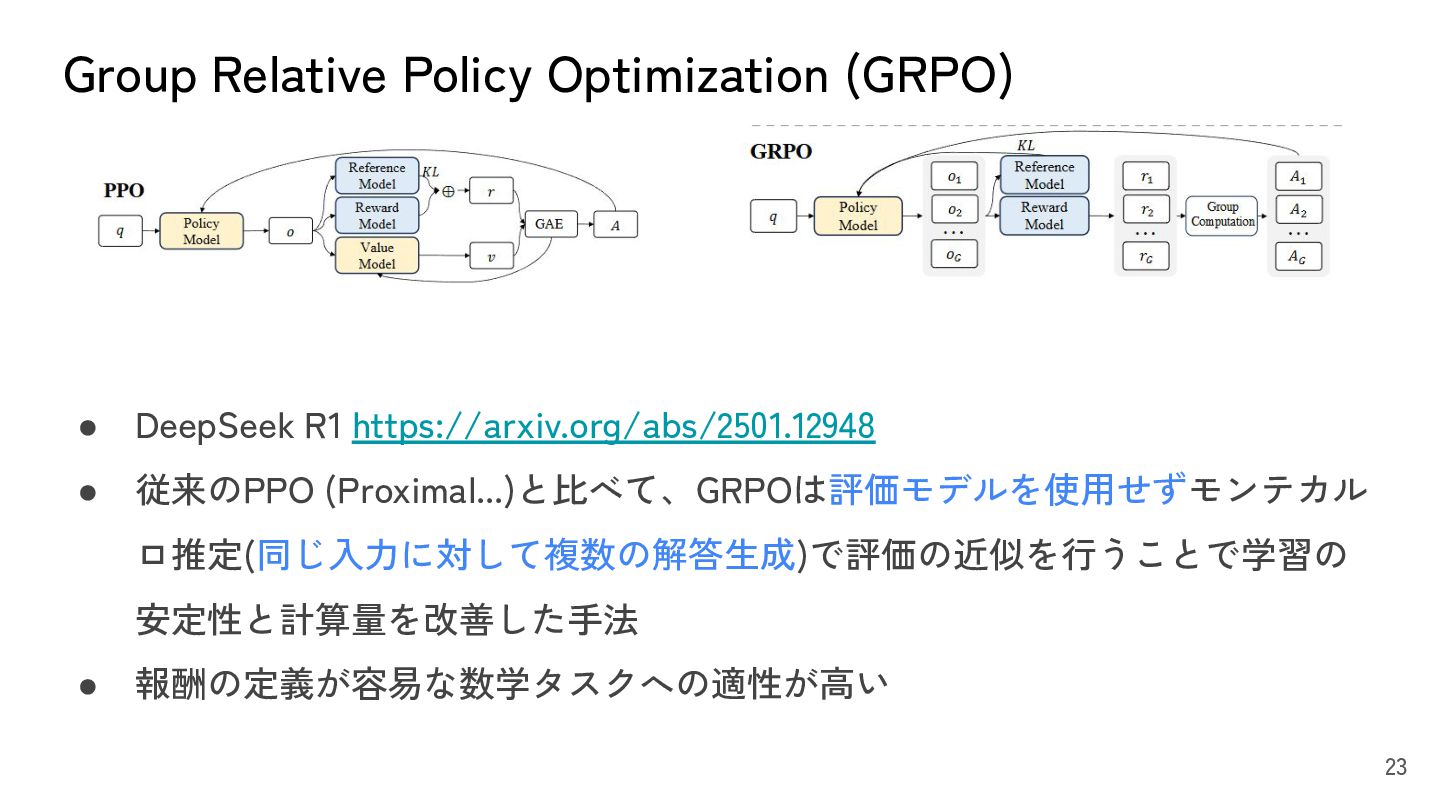
Group Relative Policy Optimization (GRPO) • DeepSeek R1 https://arxiv.org/abs/2501.12948 •
従来のPPO (Proximal...)と比べて、GRPOは評価モデルを使用せずモンテカル ロ推定(同じ入力に対して複数の解答生成)で評価の近似を行うことで学習の 安定性と計算量を改善した手法 • 報酬の定義が容易な数学タスクへの適性が高い 23 -
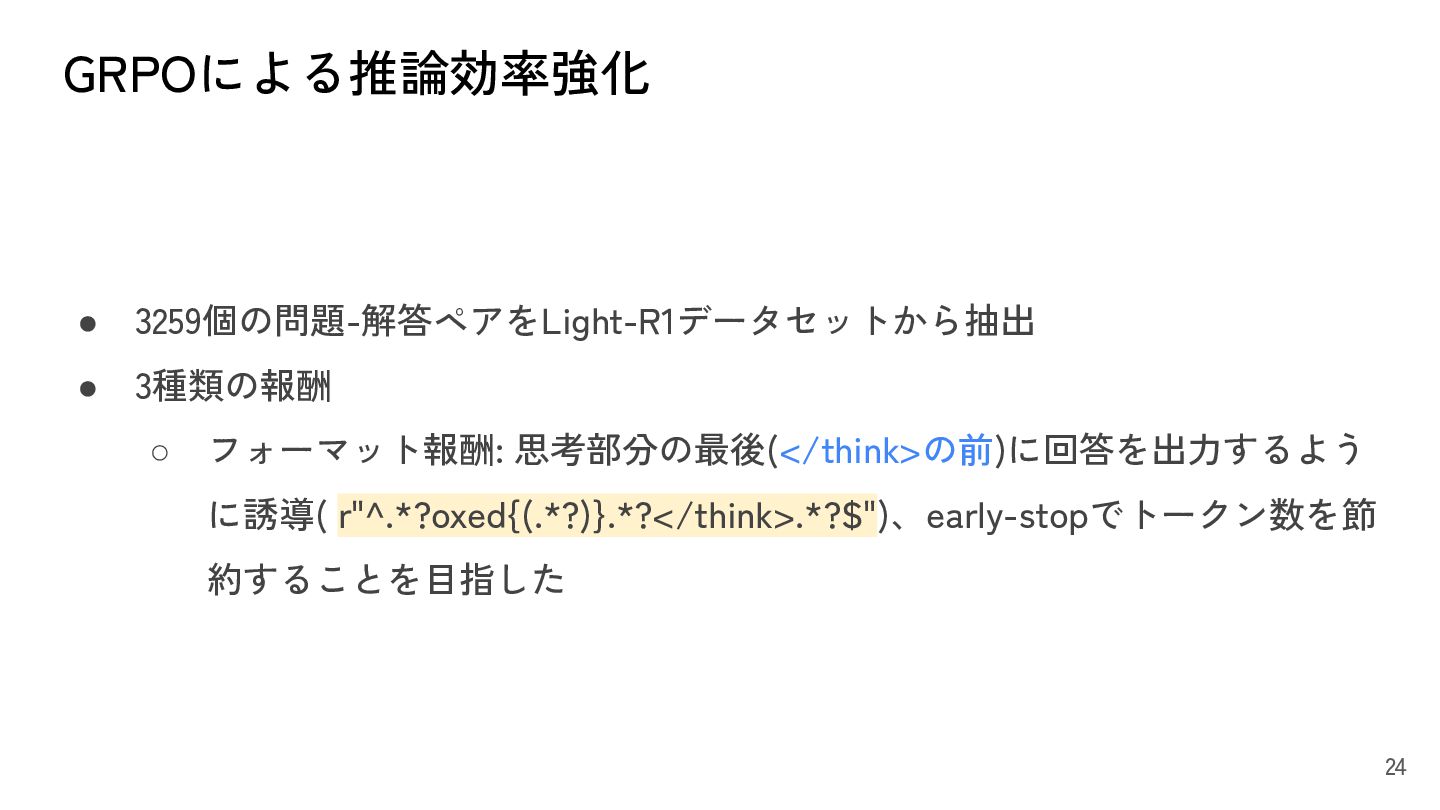
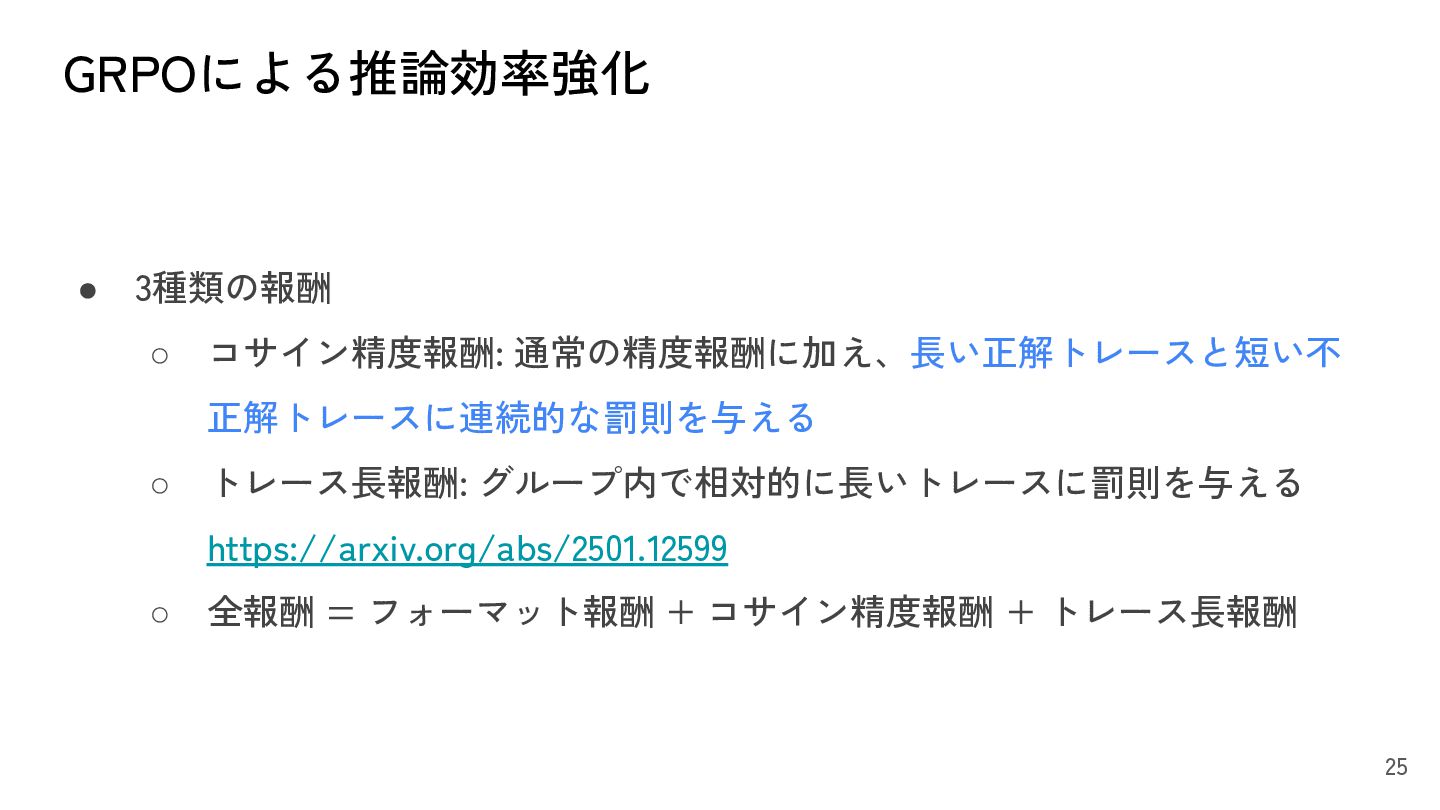
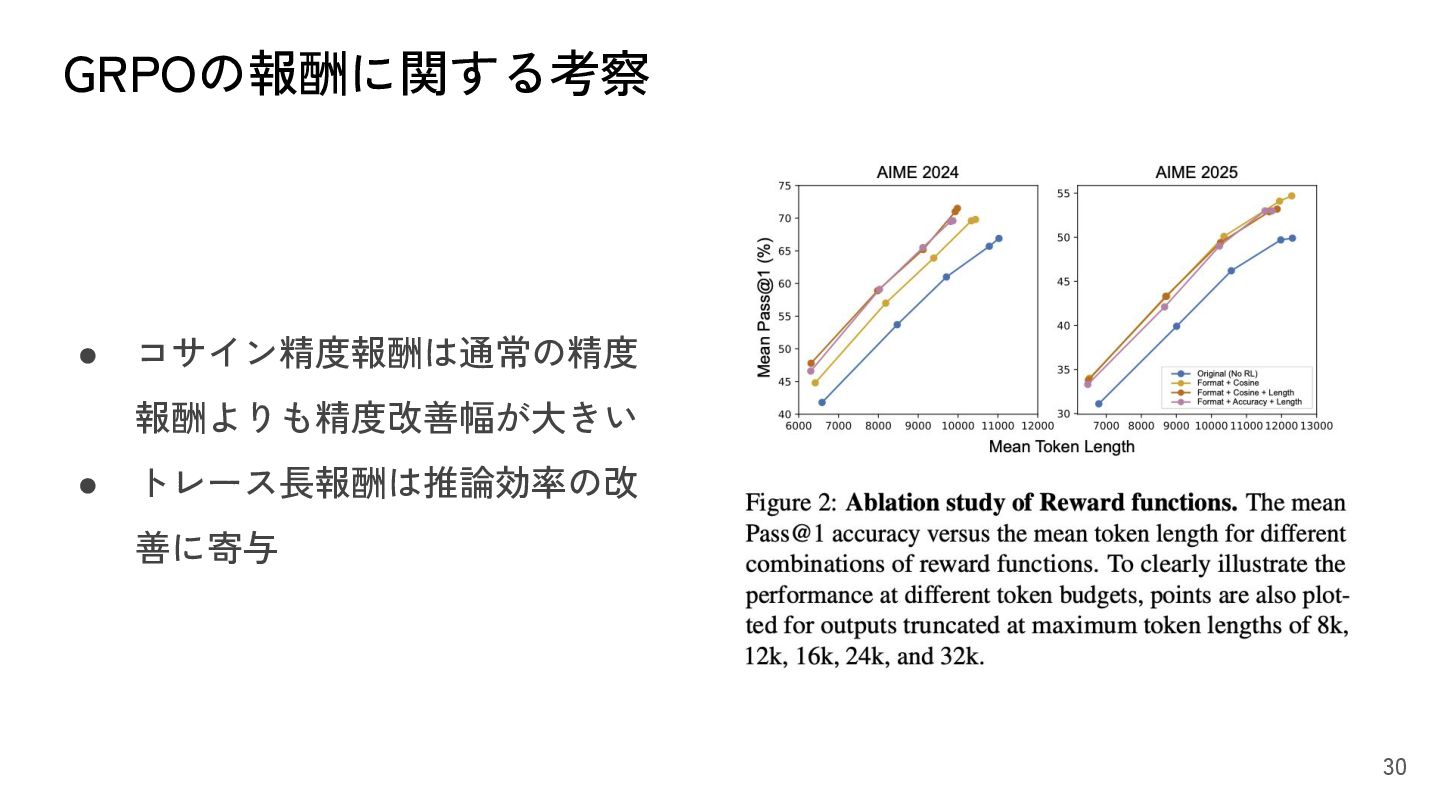
GRPOによる推論効率強化 • 3種類の報酬 ◦ コサイン精度報酬: 通常の精度報酬に加え、長い正解トレースと短い不 正解トレースに連続的な罰則を与える ◦ トレース長報酬: グループ内で相対的に長いトレースに罰則を与える
https://arxiv.org/abs/2501.12599 ◦ 全報酬 = フォーマット報酬 + コサイン精度報酬 + トレース長報酬 25 -
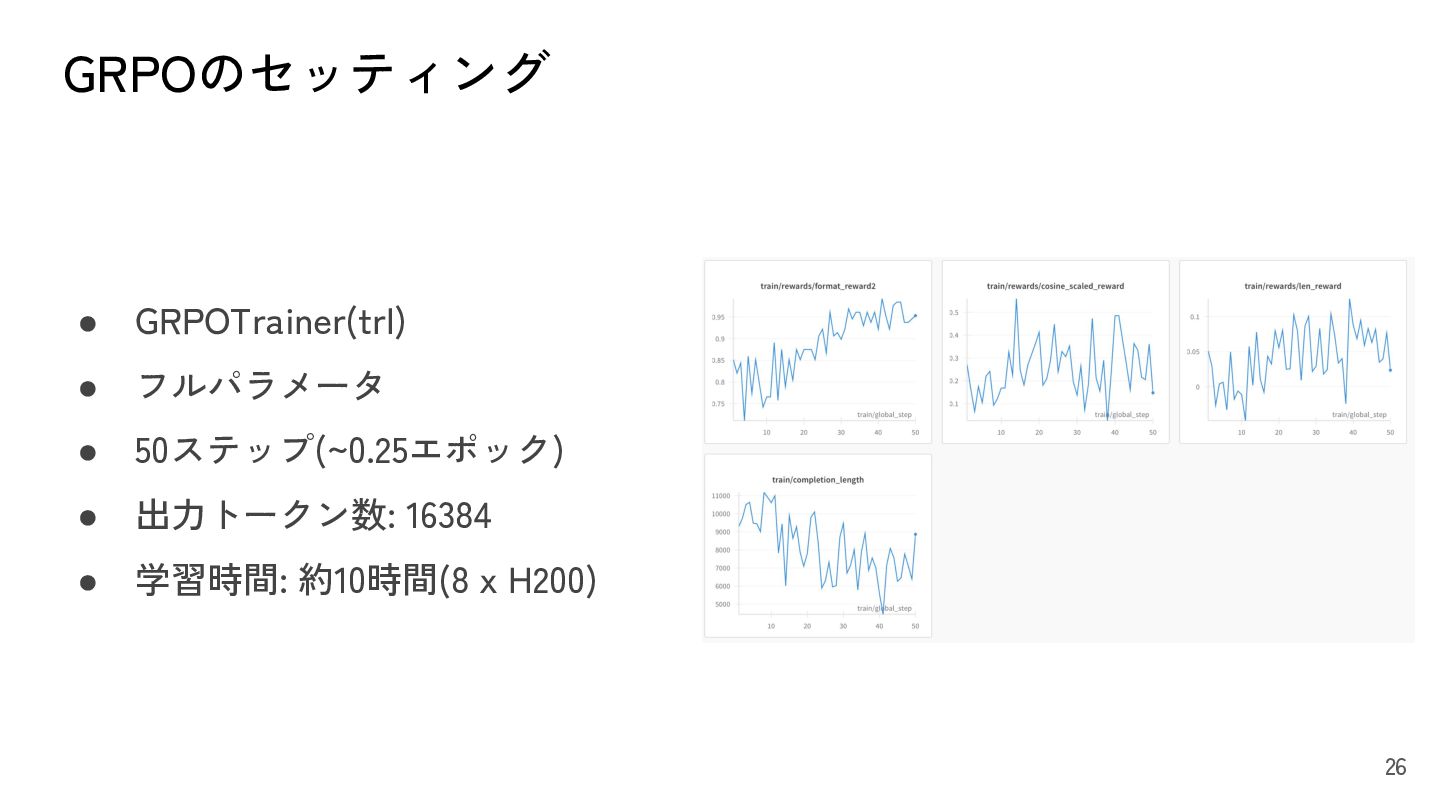
GRPOのセッティング • GRPOTrainer(trl) • フルパラメータ • 50ステップ(~0.25エポック) • 出力トークン数: 16384
• 学習時間: 約10時間(8 x H200) 26 -
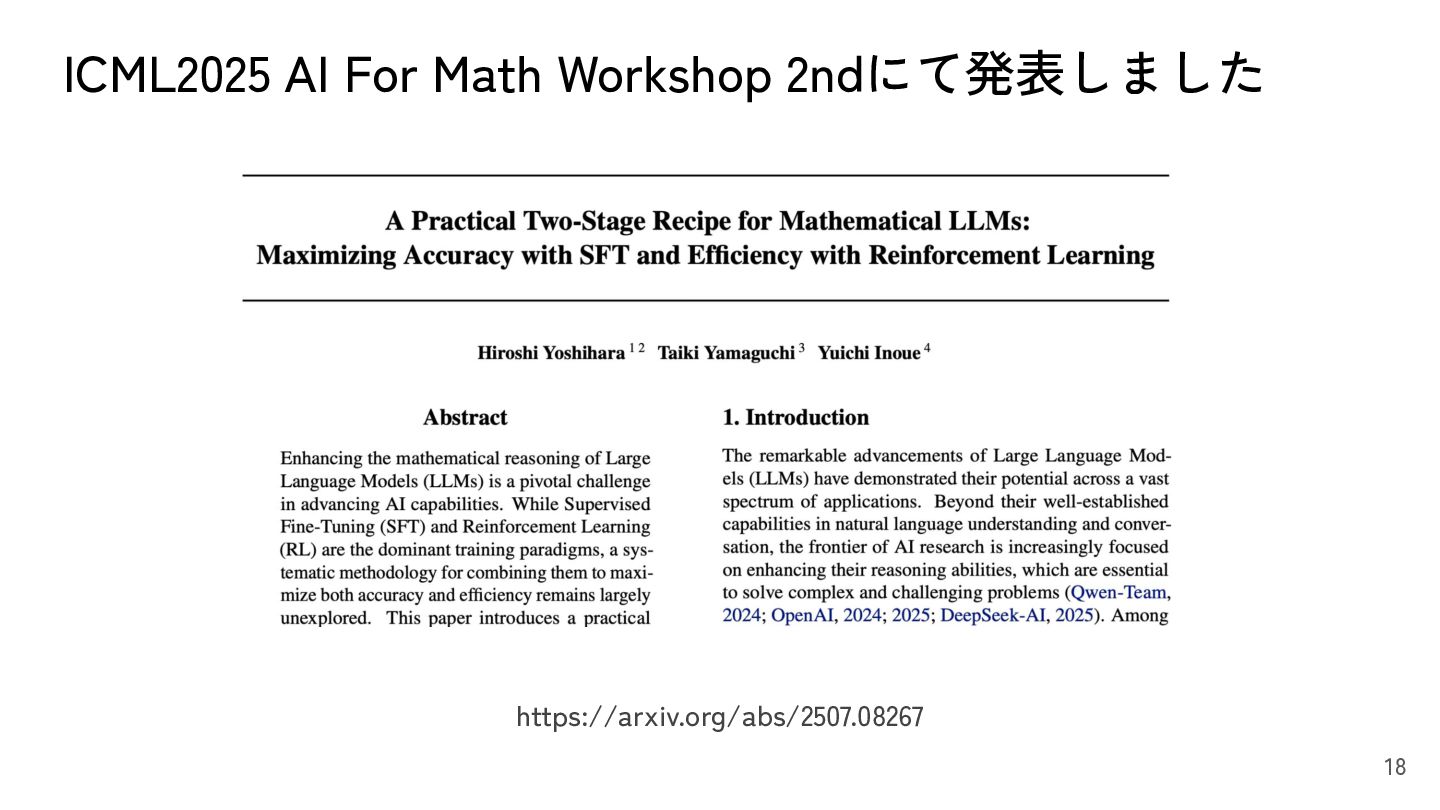
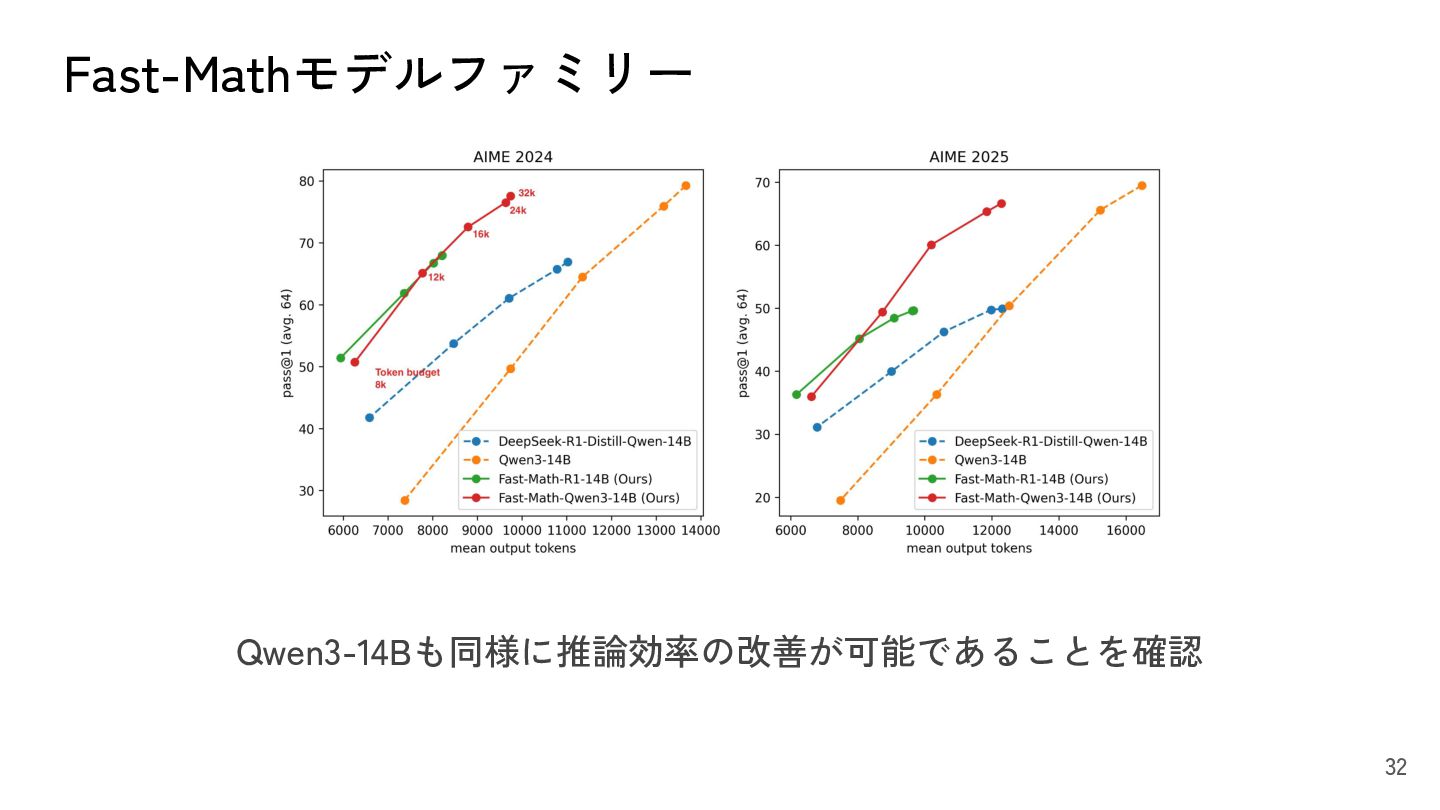
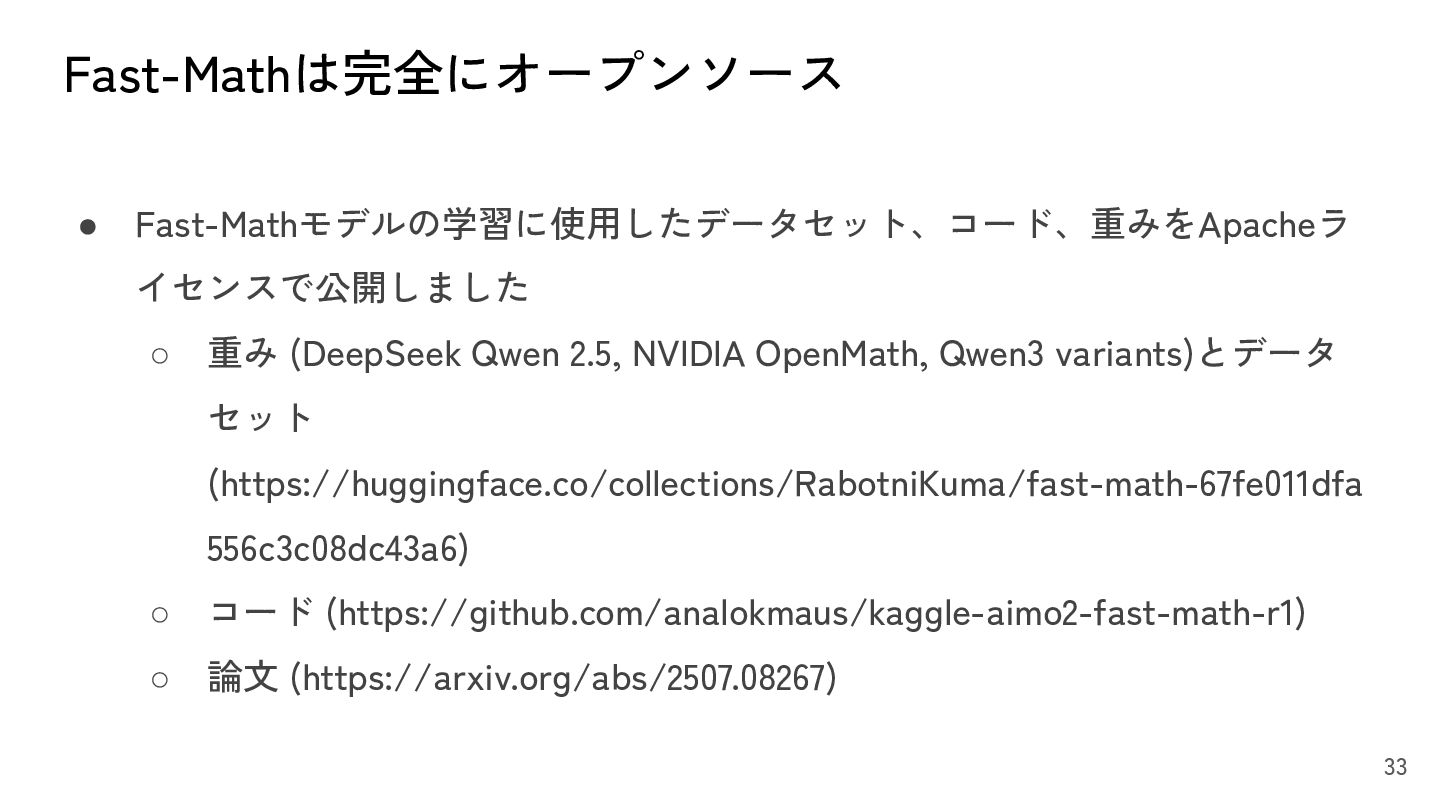
Fast-Mathは完全にオープンソース • Fast-Mathモデルの学習に使用したデータセット、コード、重みをApacheラ イセンスで公開しました ◦ 重み (DeepSeek Qwen 2.5, NVIDIA
OpenMath, Qwen3 variants)とデータ セット (https://huggingface.co/collections/RabotniKuma/fast-math-67fe011dfa 556c3c08dc43a6) ◦ コード (https://github.com/analokmaus/kaggle-aimo2-fast-math-r1) ◦ 論文 (https://arxiv.org/abs/2507.08267) 33