Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
評価駆動開発で不確実性を制御する - MLflow 3が支えるエージェント開発
Search
Databricks Japan
PRO
December 10, 2025
Technology
610
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
評価駆動開発で不確実性を制御する - MLflow 3が支えるエージェント開発
Databricks Japan
PRO
December 10, 2025
More Decks by Databricks Japan
See All by Databricks Japan
MLOps実践ワークショップ:Unity CatalogとMLflowで学ぶ特徴量・モデル管理
databricksjapan
PRO
0
170
Genie Code ワークショップ 応用編 / Genie-Code-Workshop-advanced
databricksjapan
PRO
0
580
データエンジニアリングワークショップ:Auto LoaderとSparkで学ぶデータパイプライン構築
databricksjapan
PRO
0
460
Lakebase ワークショップ / Lakebase-workshop
databricksjapan
PRO
0
260
はじめてのDatabricks:技術者向けワークショップ / beginner-workshop
databricksjapan
PRO
0
600
GenieAgents 品質向上ワークショップ / Genie-Tuning-Workshop
databricksjapan
PRO
0
200
Genie Code ワークショップ 基礎編 / Genie-Code-Workshop-fundamental
databricksjapan
PRO
0
590
生成AIワークショップ / Custom-AI-Agents-workshop
databricksjapan
PRO
0
510
Lakeflow Designer ワークショップ / lakeflow-designer-workshop
databricksjapan
PRO
0
590
Other Decks in Technology
See All in Technology
Google Cloud Next Tokyo 26登壇時のスクリプト
recruitengineers
PRO
0
200
自分で立ててみるLLMサービス
y_sera15
0
140
形式手法を使って仕様をコーディングしよう
mikanichinose
0
180
今こそ知りたいAmplifyGen2
mkdev10
2
150
AI時代だからこそ推したい!Gitコマンド再入門
munakata
0
150
AI Made Us Faster at Solving the Wrong Problems
marceloancelmo
0
180
3つのアプローチで目指す チームを強くするAI駆動開発
thkt
0
120
予測不能な実行エージェントを安全にサクッと試せるサンドボックス環境の話
sansantech
PRO
0
130
AIは爆速なのに、私が詰まっていた話 ― 音声入力と鳴くマスコットでボトルネックを削る
yama3133
0
530
カンファレンスに参加した後の浮遊感とセルフケア
pauli
0
310
Kernel testing frameworks
ennael
PRO
0
110
Futexes the good, the bad, the ugly
ennael
PRO
0
130
Featured
See All Featured
Building Adaptive Systems
keathley
44
3.2k
Deep Space Network (abreviated)
tonyrice
0
360
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.4k
Designing Powerful Visuals for Engaging Learning
tmiket
1
600
Practical Orchestrator
shlominoach
192
12k
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
620
Amusing Abliteration
ianozsvald
1
330
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Navigating the moral maze — ethical principles for Al-driven product design
skipperchong
2
600
The Straight Up "How To Draw Better" Workshop
denniskardys
239
140k
The Curious Case for Waylosing
cassininazir
1
560
How to Align SEO within the Product Triangle To Get Buy-In & Support - #RIMC
aleyda
2
1.8k
Transcript
評価駆動開発で不確実性を制御する MLflow 3 が⽀えるエージェント開発 渡辺祐貴 SWE / テックリード @ Databricks
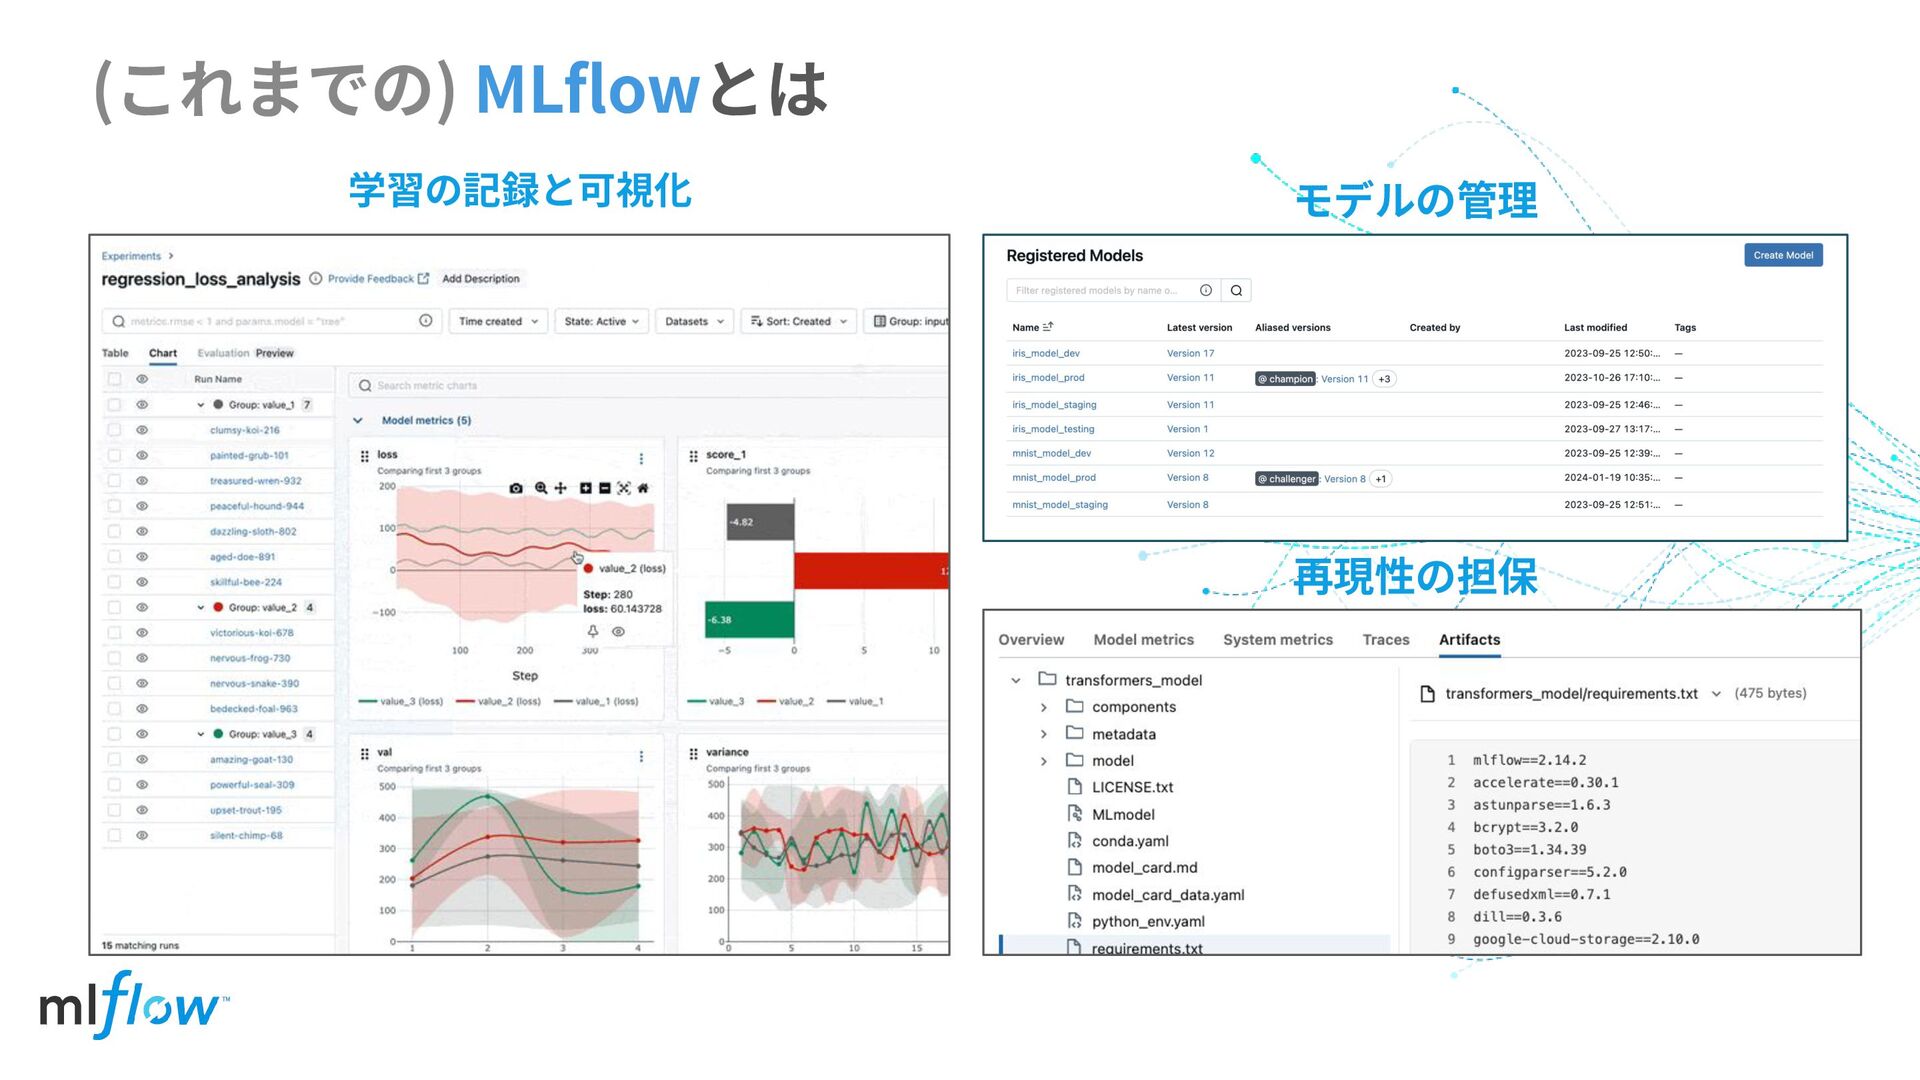
(これまでの) MLflowとは 学習の記録と可視化 再現性の担保 モデルの管理
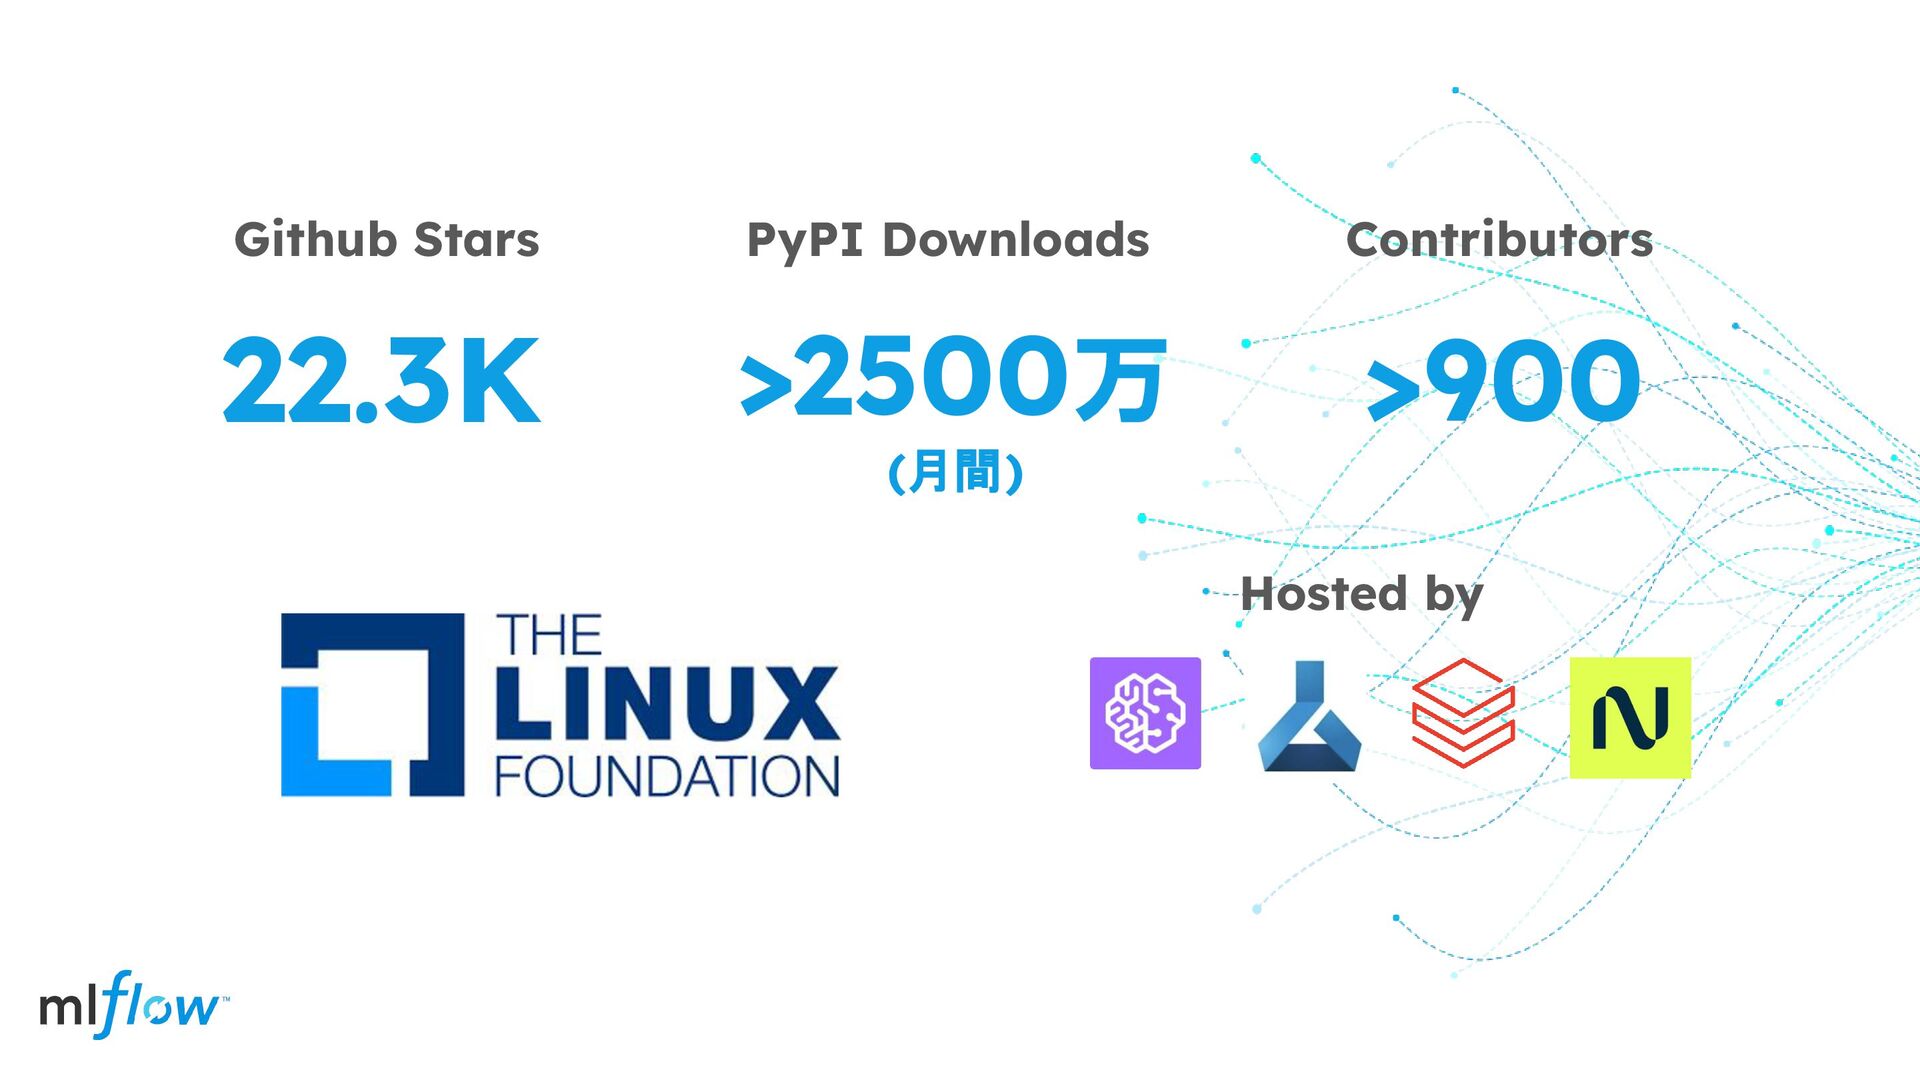
Github Stars 22.3K PyPI Downloads >2500万 (月間) Contributors >900 Hosted
by
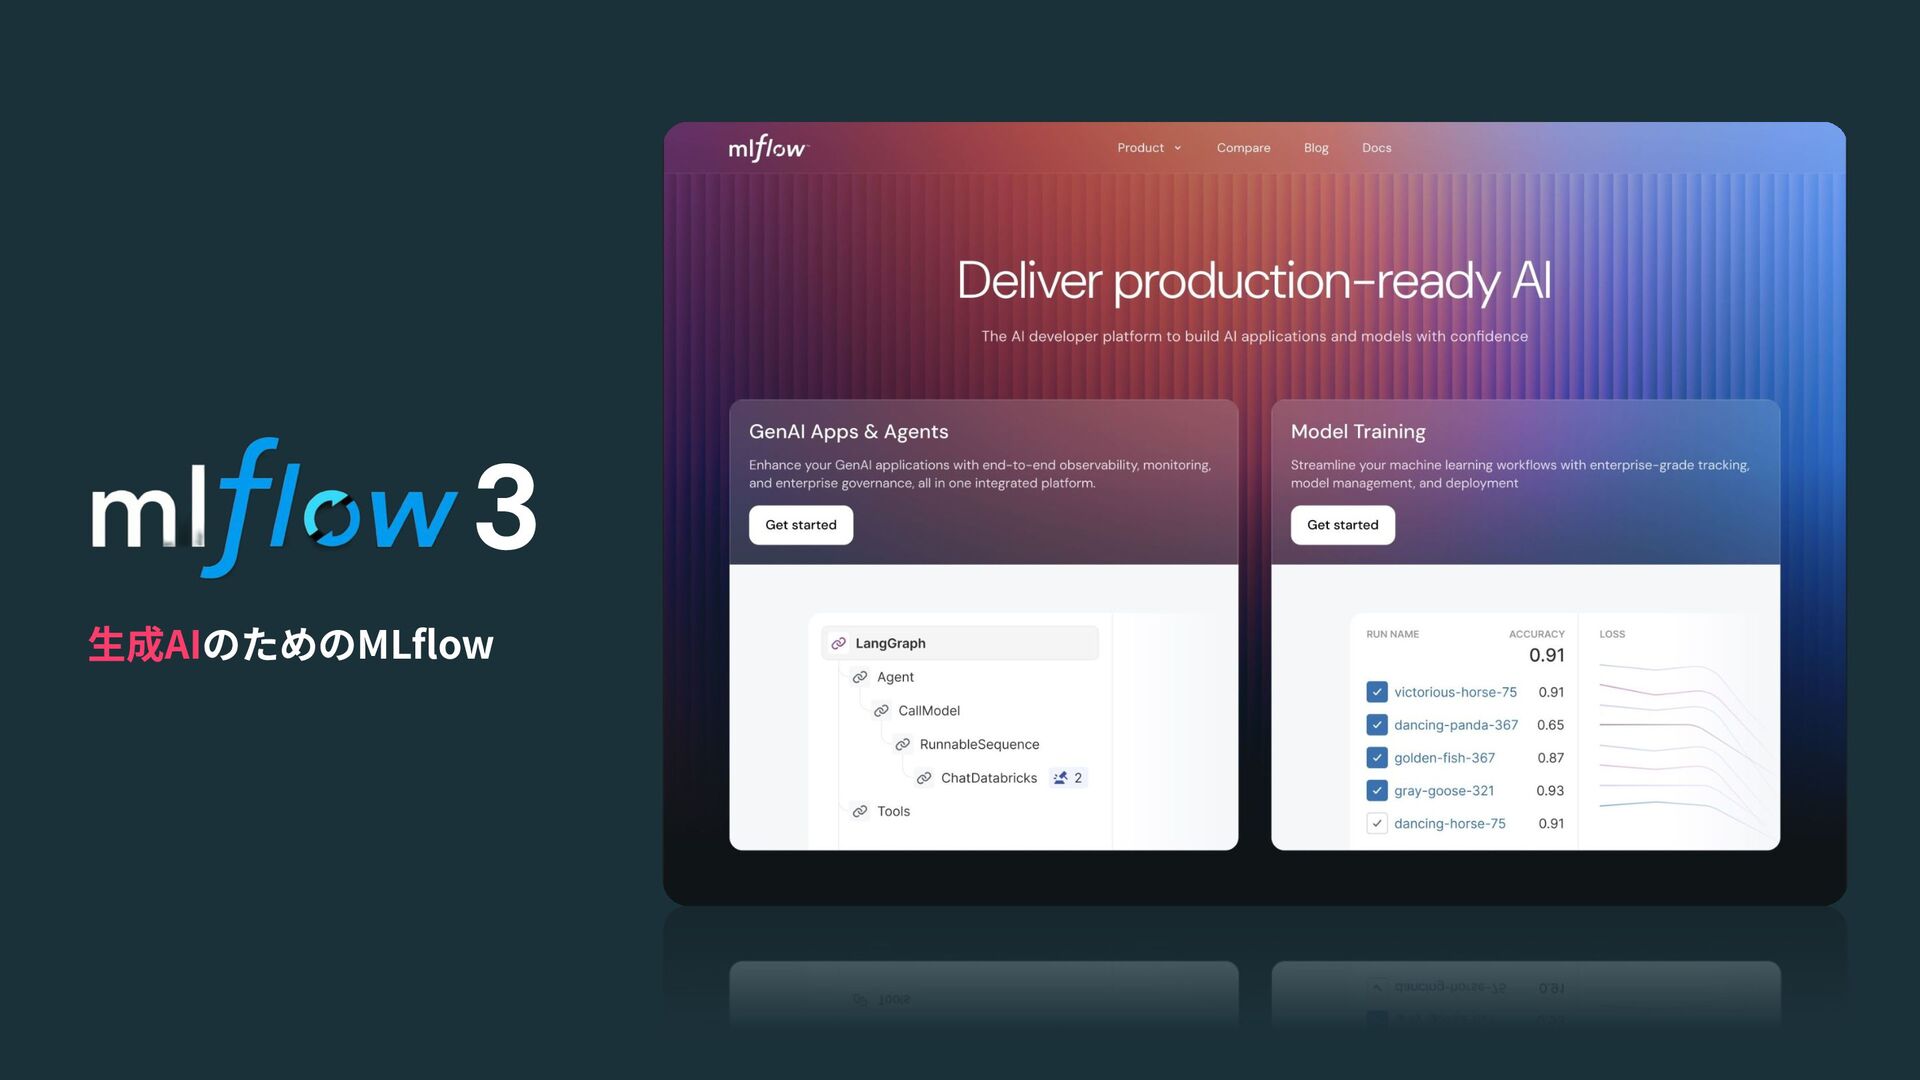
⽣成AIのためのMLflow 3
AIエージェント開発で最⼤の課題とは?
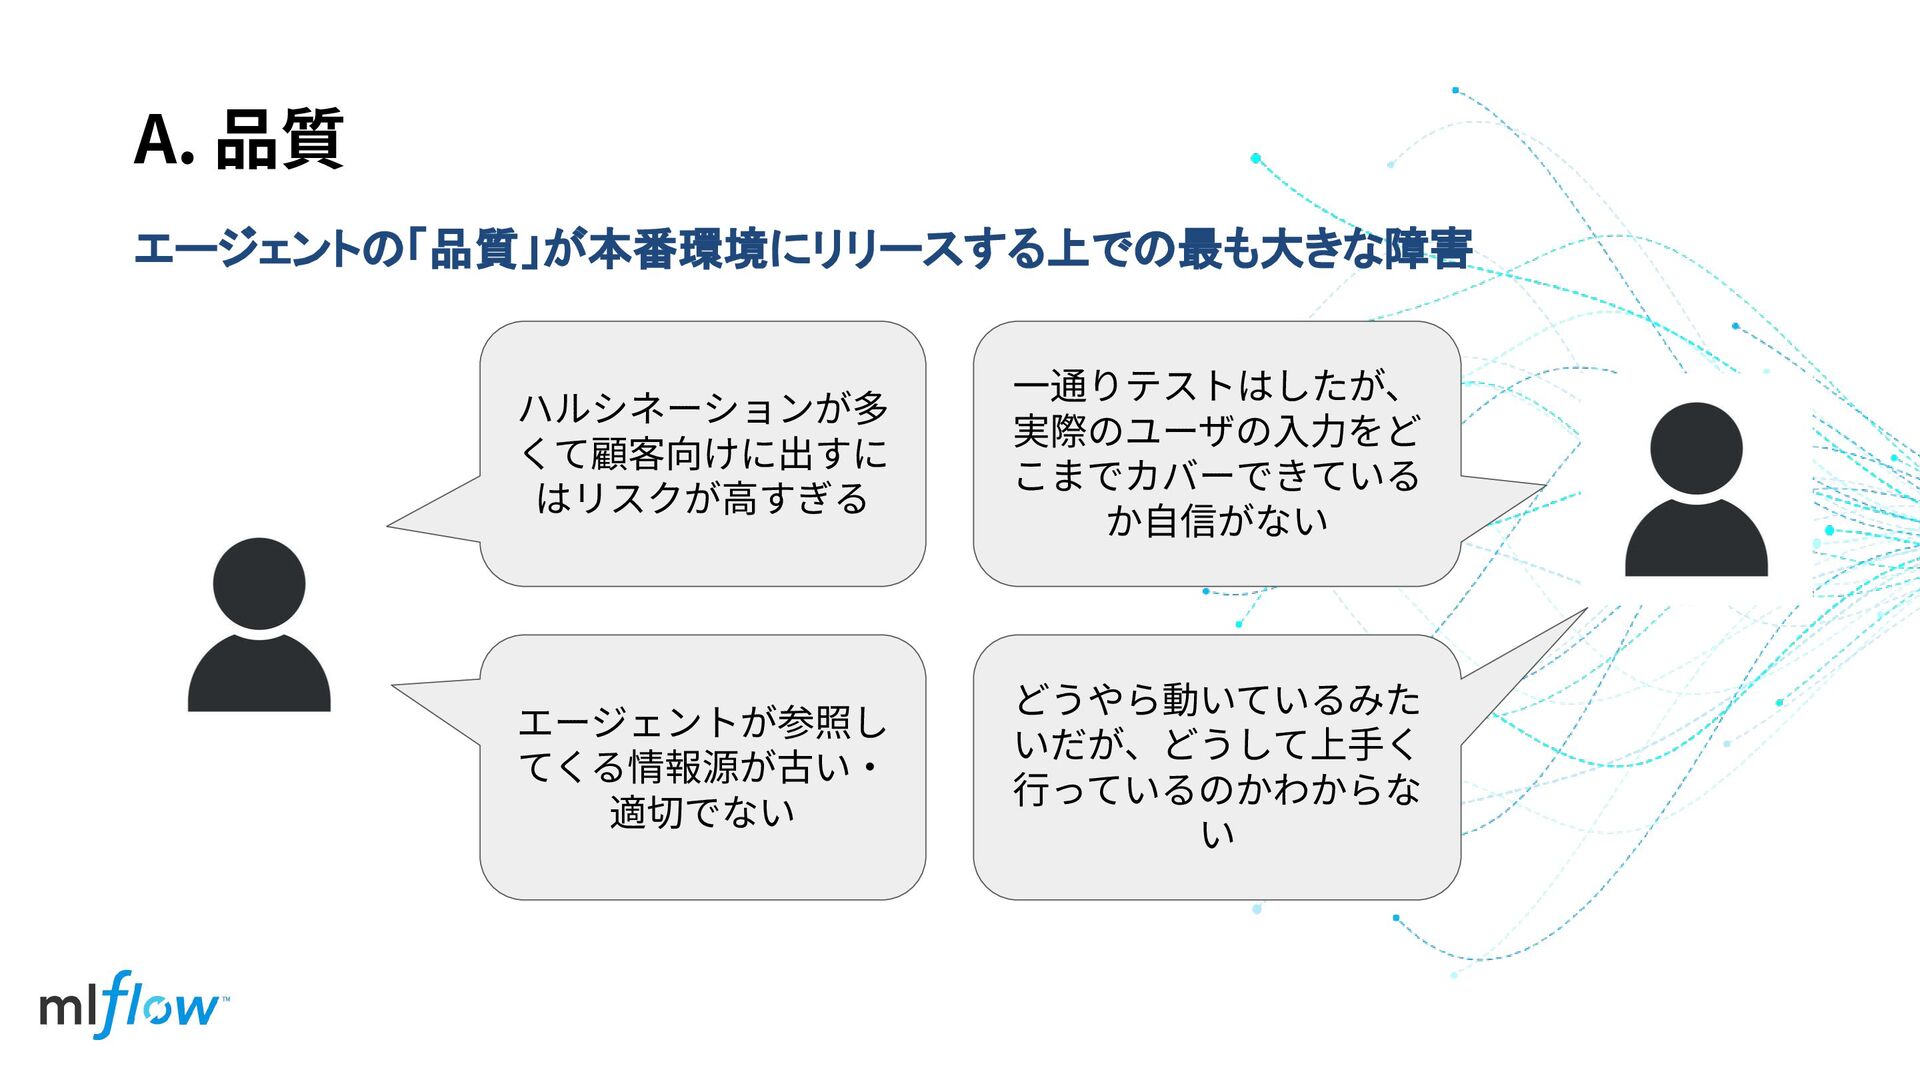
エージェントの「品質」が本番環境にリリースする上での最も大きな障害 A. 品質 ハルシネーションが多 くて顧客向けに出すに はリスクが⾼すぎる ⼀通りテストはしたが、 実際のユーザの⼊⼒をど こまでカバーできている か⾃信がない
エージェントが参照し てくる情報源が古い‧ 適切でない どうやら動いているみた いだが、どうして上⼿く ⾏っているのかわからな い
どうやって品質を上げるか • プロンプトの改善、ドキュメントの前後処理、クエリ⽅法、ツールの選定、コ ンテキストの圧縮. • 毎⽉のように新しいLLMが現れてベンチマークを更新していく.ただし実際の タスクで使えるかどうかは試してみないと分からない. • LLMは極めて不確実で、⼩さな変更が別の場所に及ぼす影響は未知. •
試せる⽅法は無数にあるが、全てを検証する時間はない. 品質を改善するものを選んで取り⼊れる必要がある
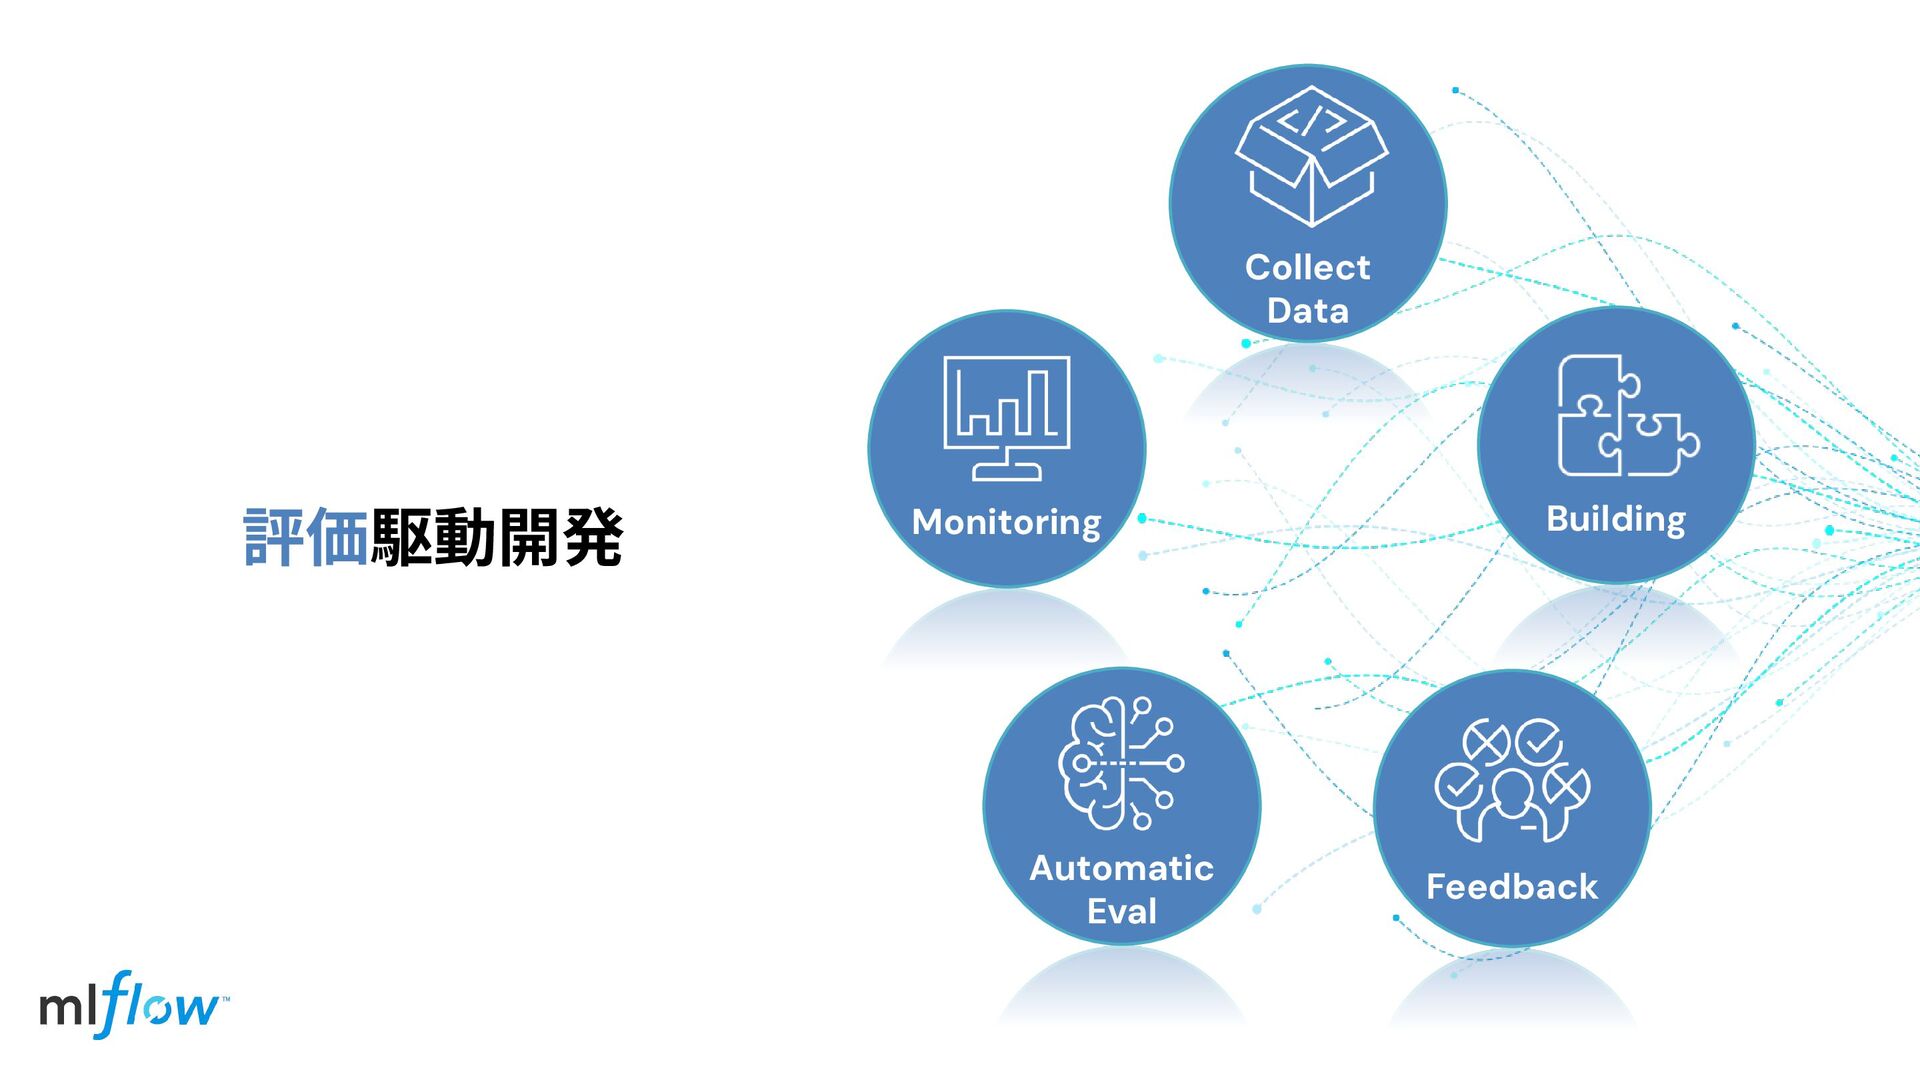
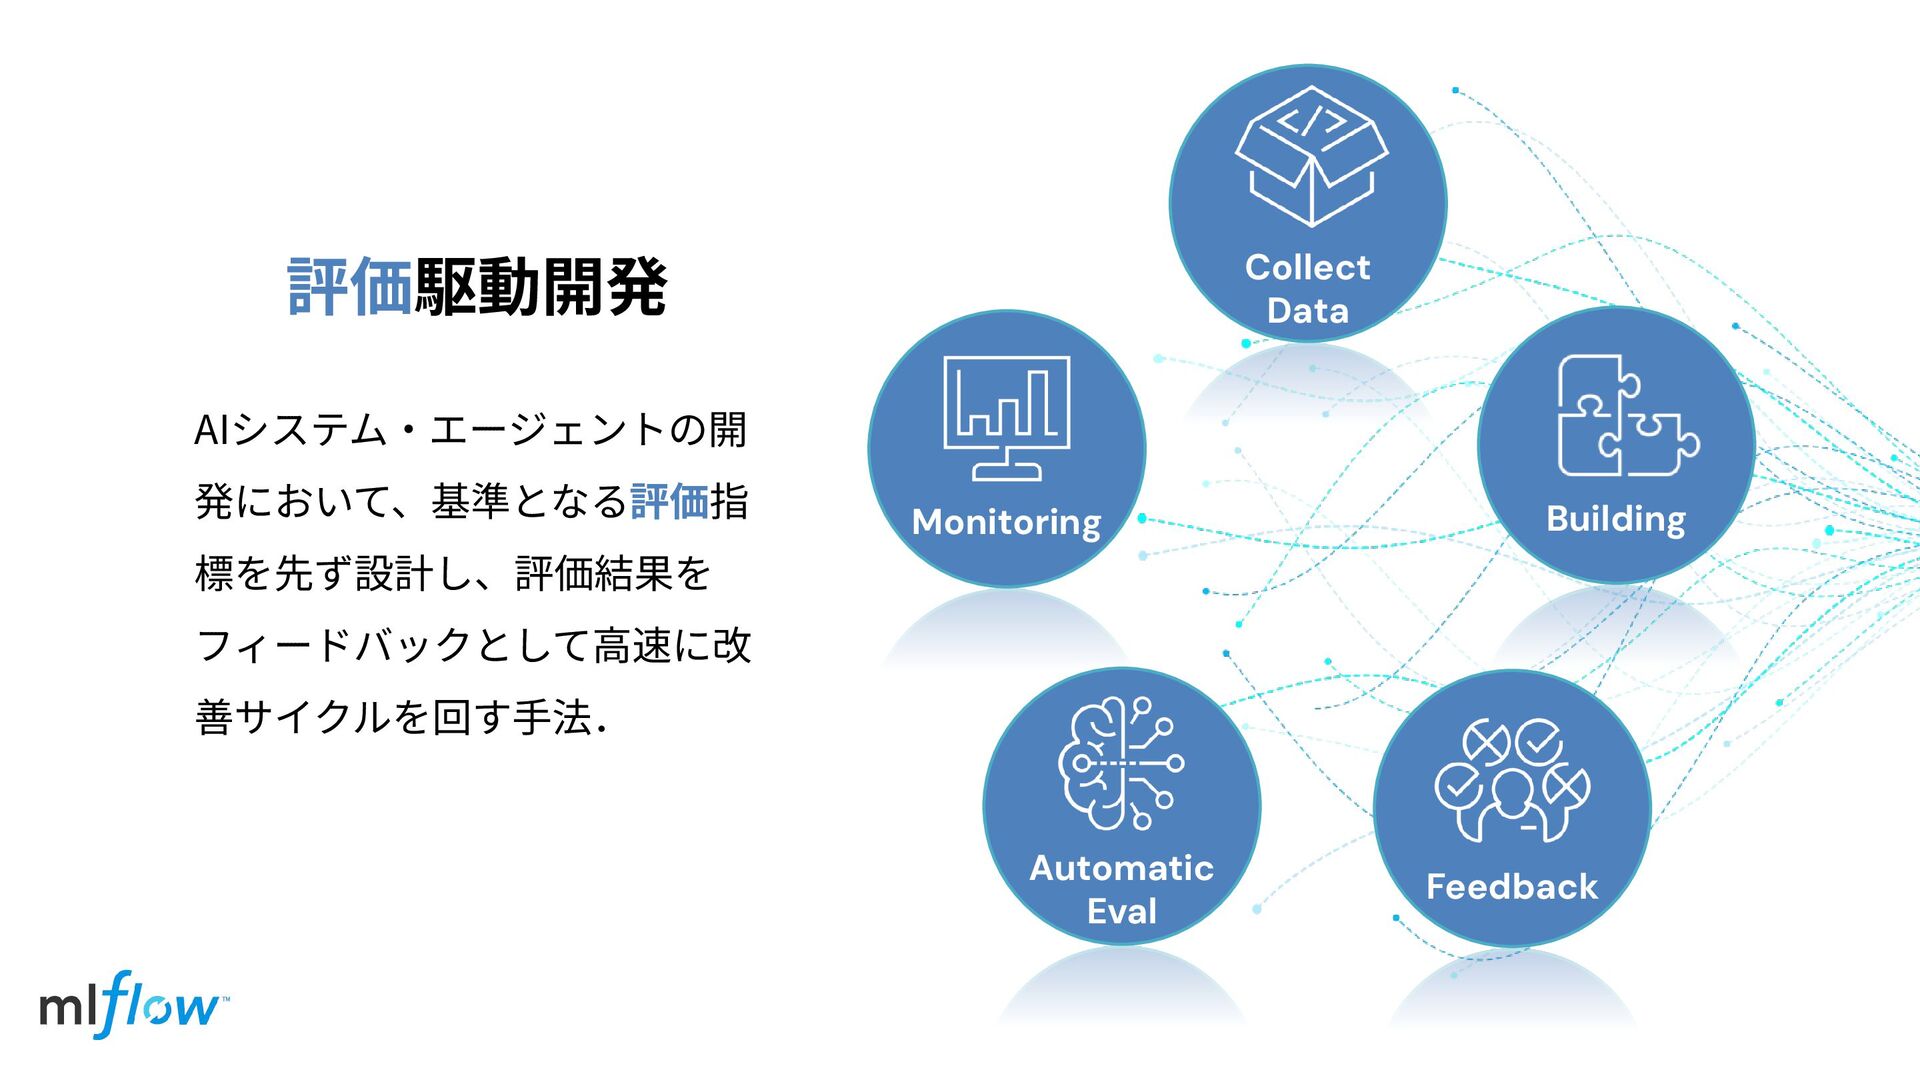
評価駆動開発 Collect Data Building Feedback Automatic Eval Monitoring
Collect Data Building Feedback Automatic Eval Monitoring 評価駆動開発 AIシステム‧エージェントの開 発において、基準となる評価指
標を先ず設計し、評価結果を フィードバックとして⾼速に改 善サイクルを回す⼿法.
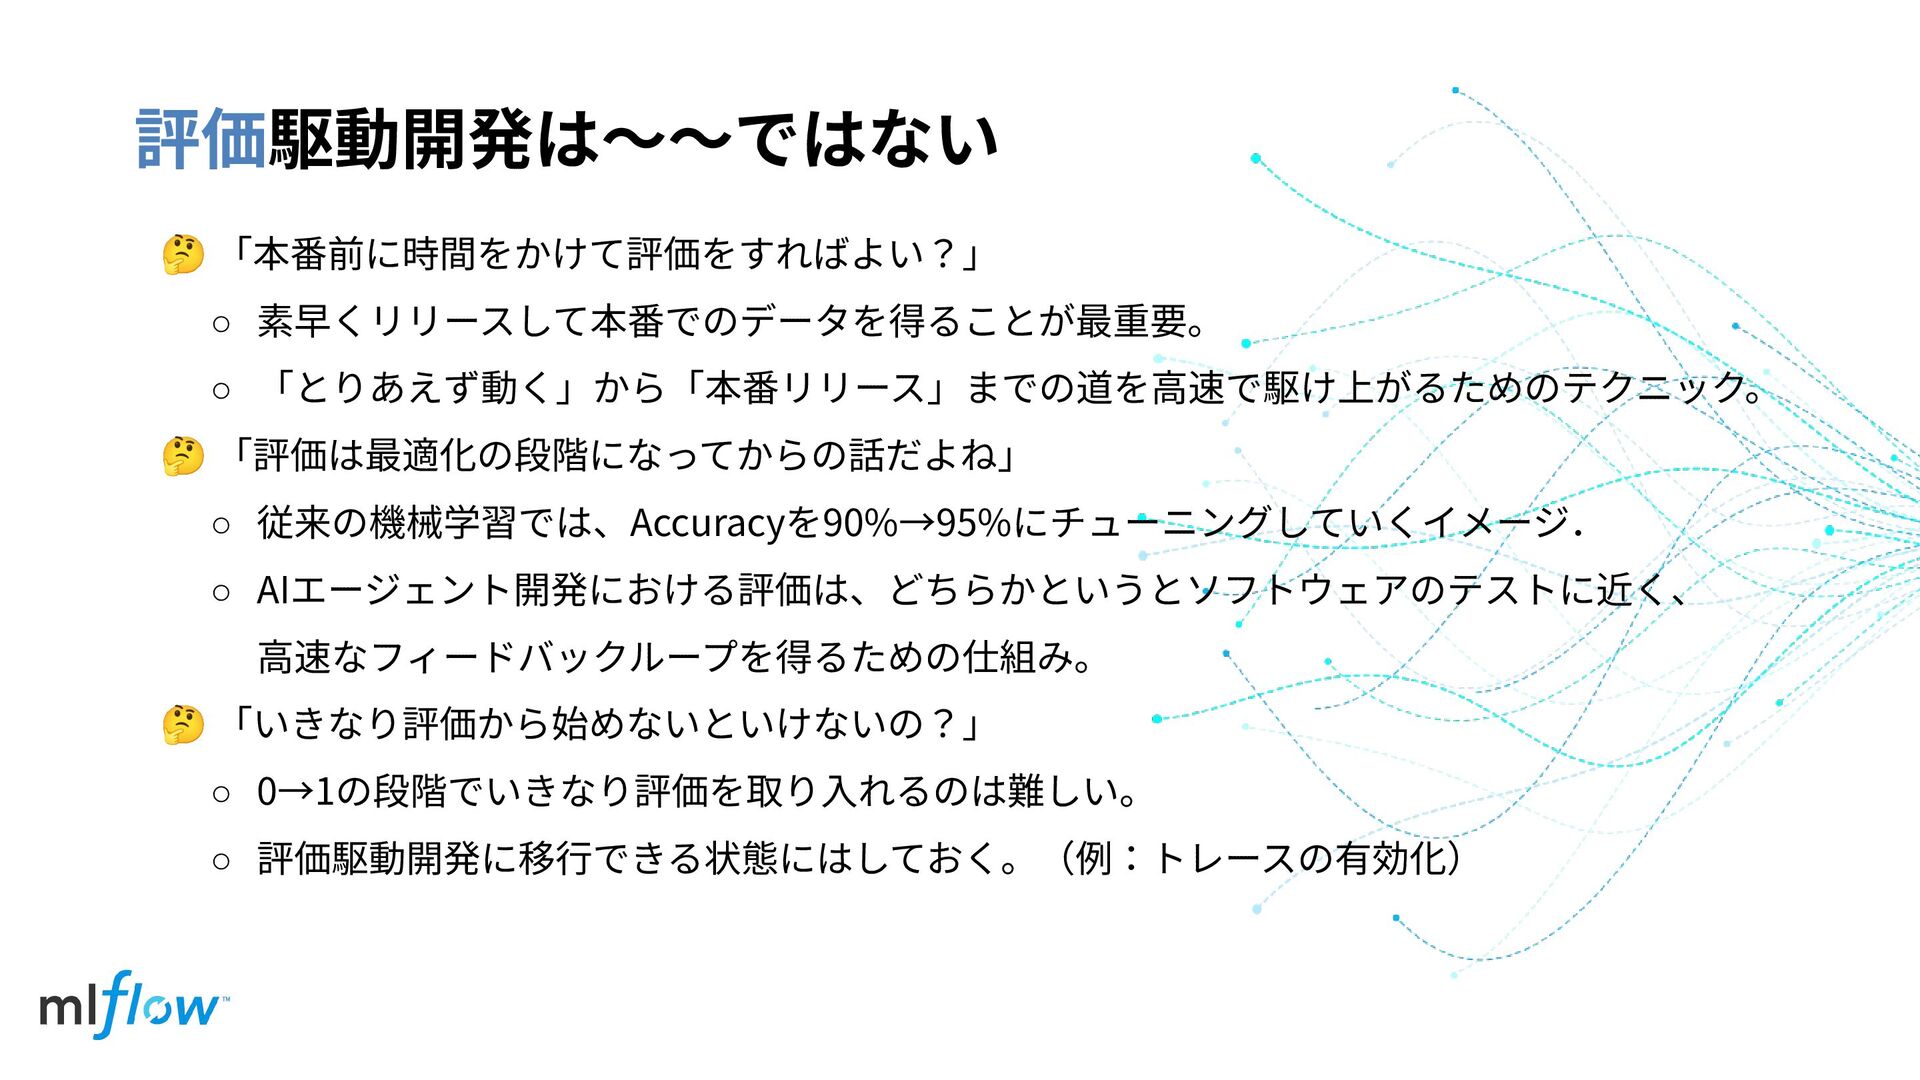
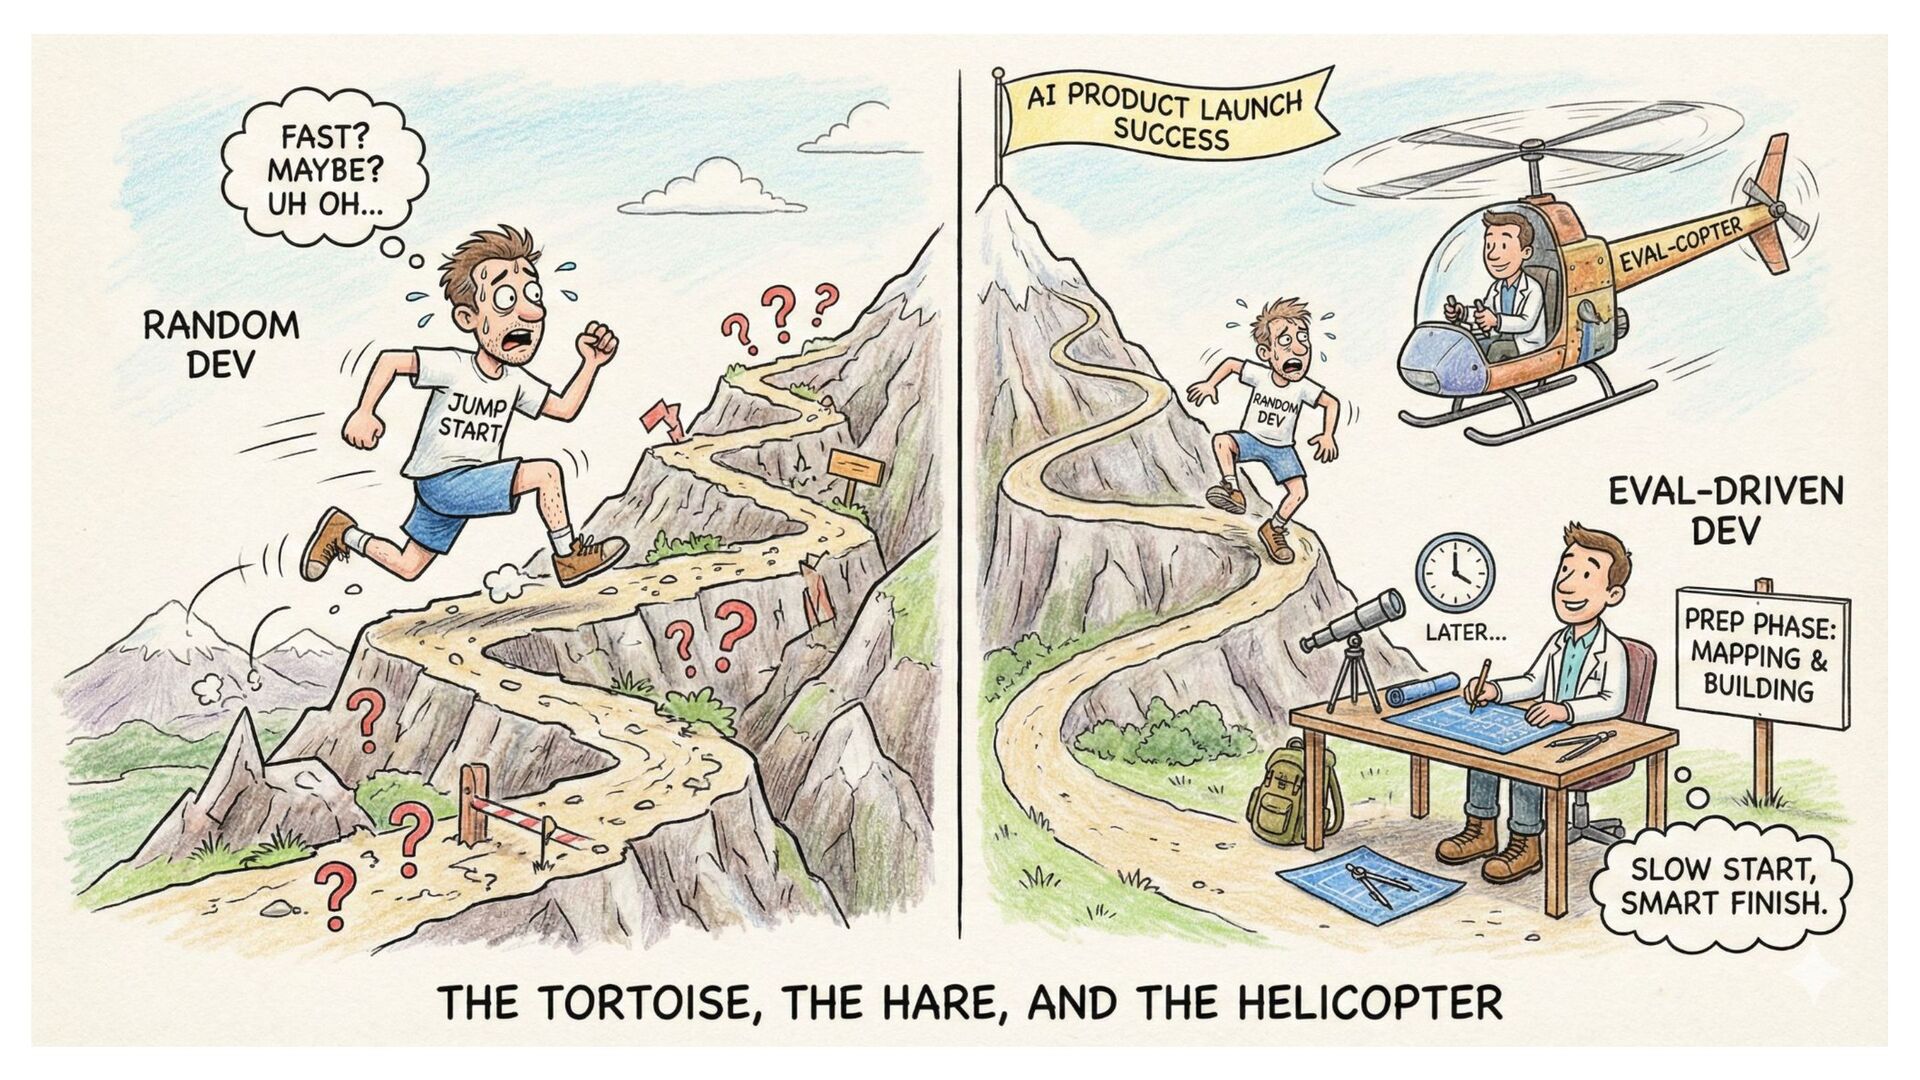
評価駆動開発は〜〜ではない 🤔 「本番前に時間をかけて評価をすればよい?」 ◦ 素早くリリースして本番でのデータを得ることが最重要。 ◦ 「とりあえず動く」から「本番リリース」までの道を⾼速で駆け上がるためのテクニック。 🤔 「評価は最適化の段階になってからの話だよね」 ◦
従来の機械学習では、Accuracyを90%→95%にチューニングしていくイメージ. ◦ AIエージェント開発における評価は、どちらかというとソフトウェアのテストに近く、 ⾼速なフィードバックループを得るための仕組み。 🤔 「いきなり評価から始めないといけないの?」 ◦ 0→1の段階でいきなり評価を取り⼊れるのは難しい。 ◦ 評価駆動開発に移⾏できる状態にはしておく。(例:トレースの有効化)
None
基盤: トレース‧可観測性
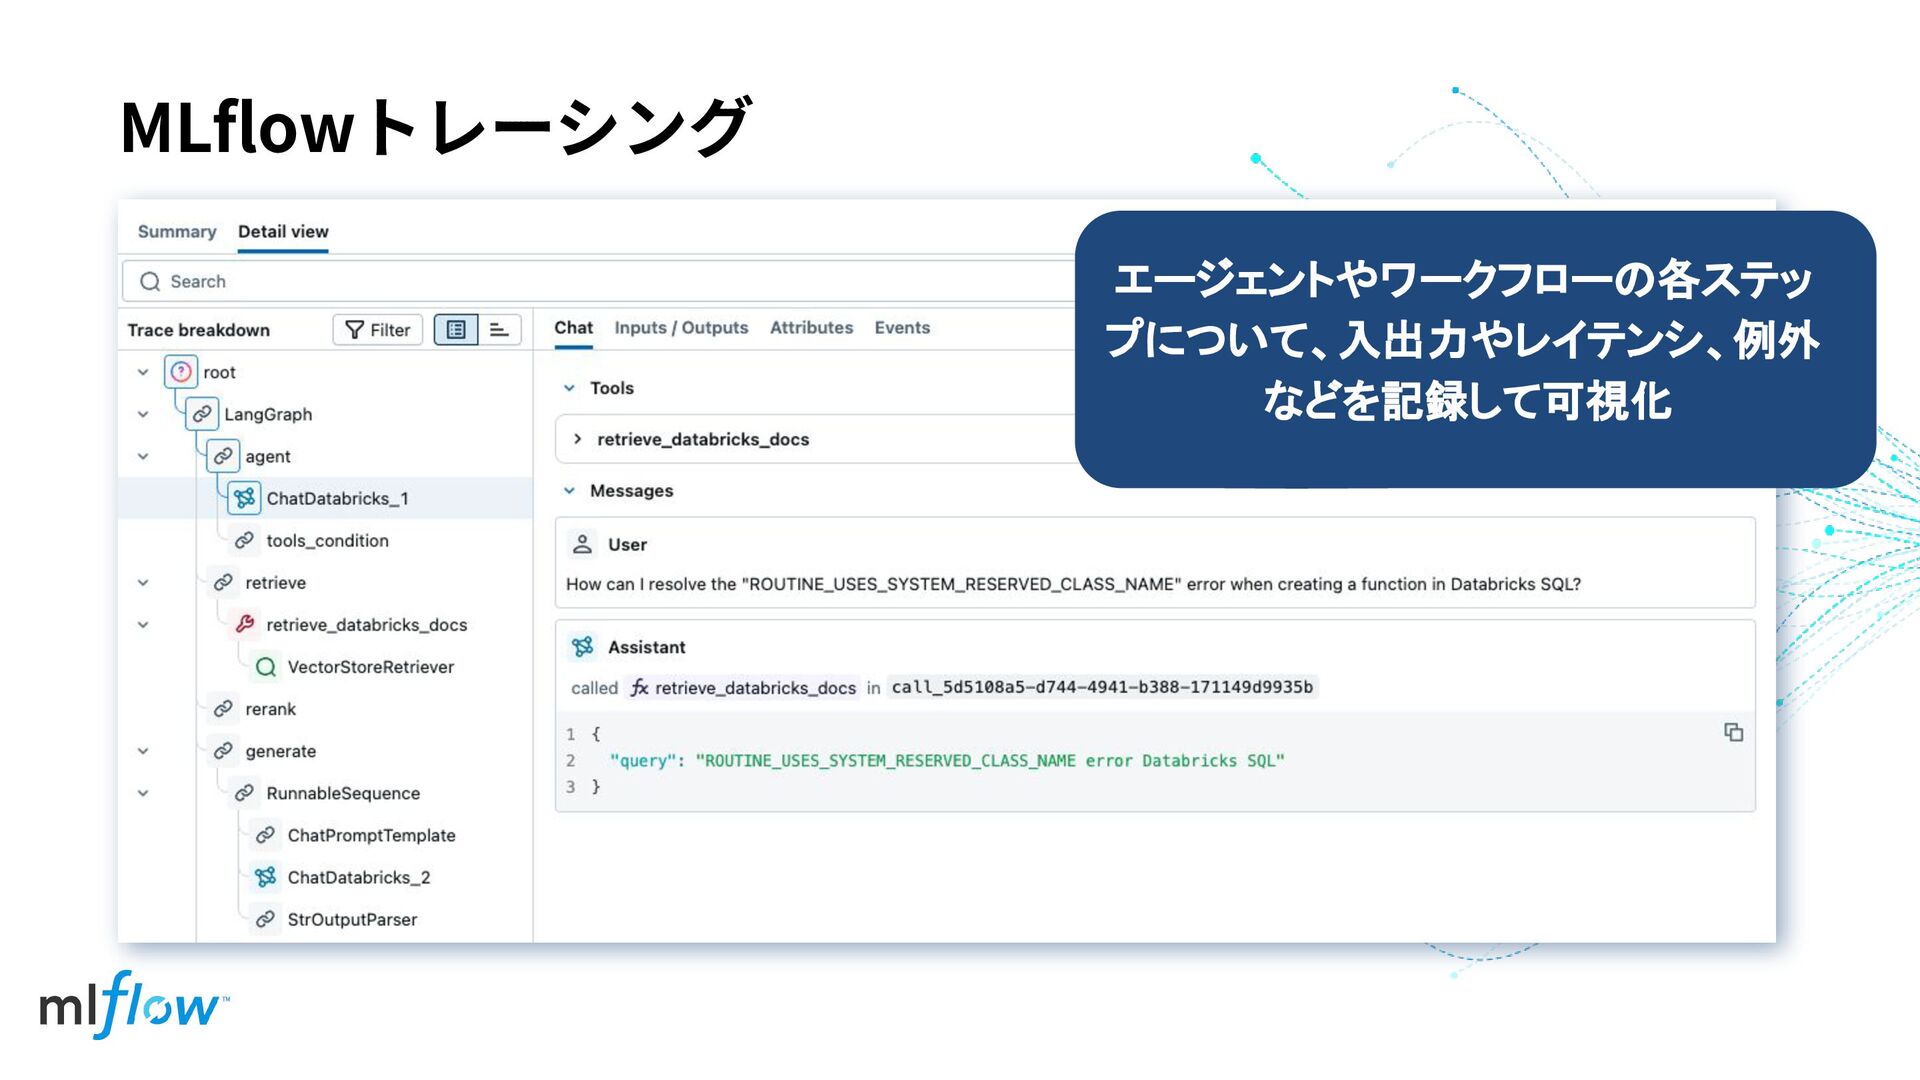
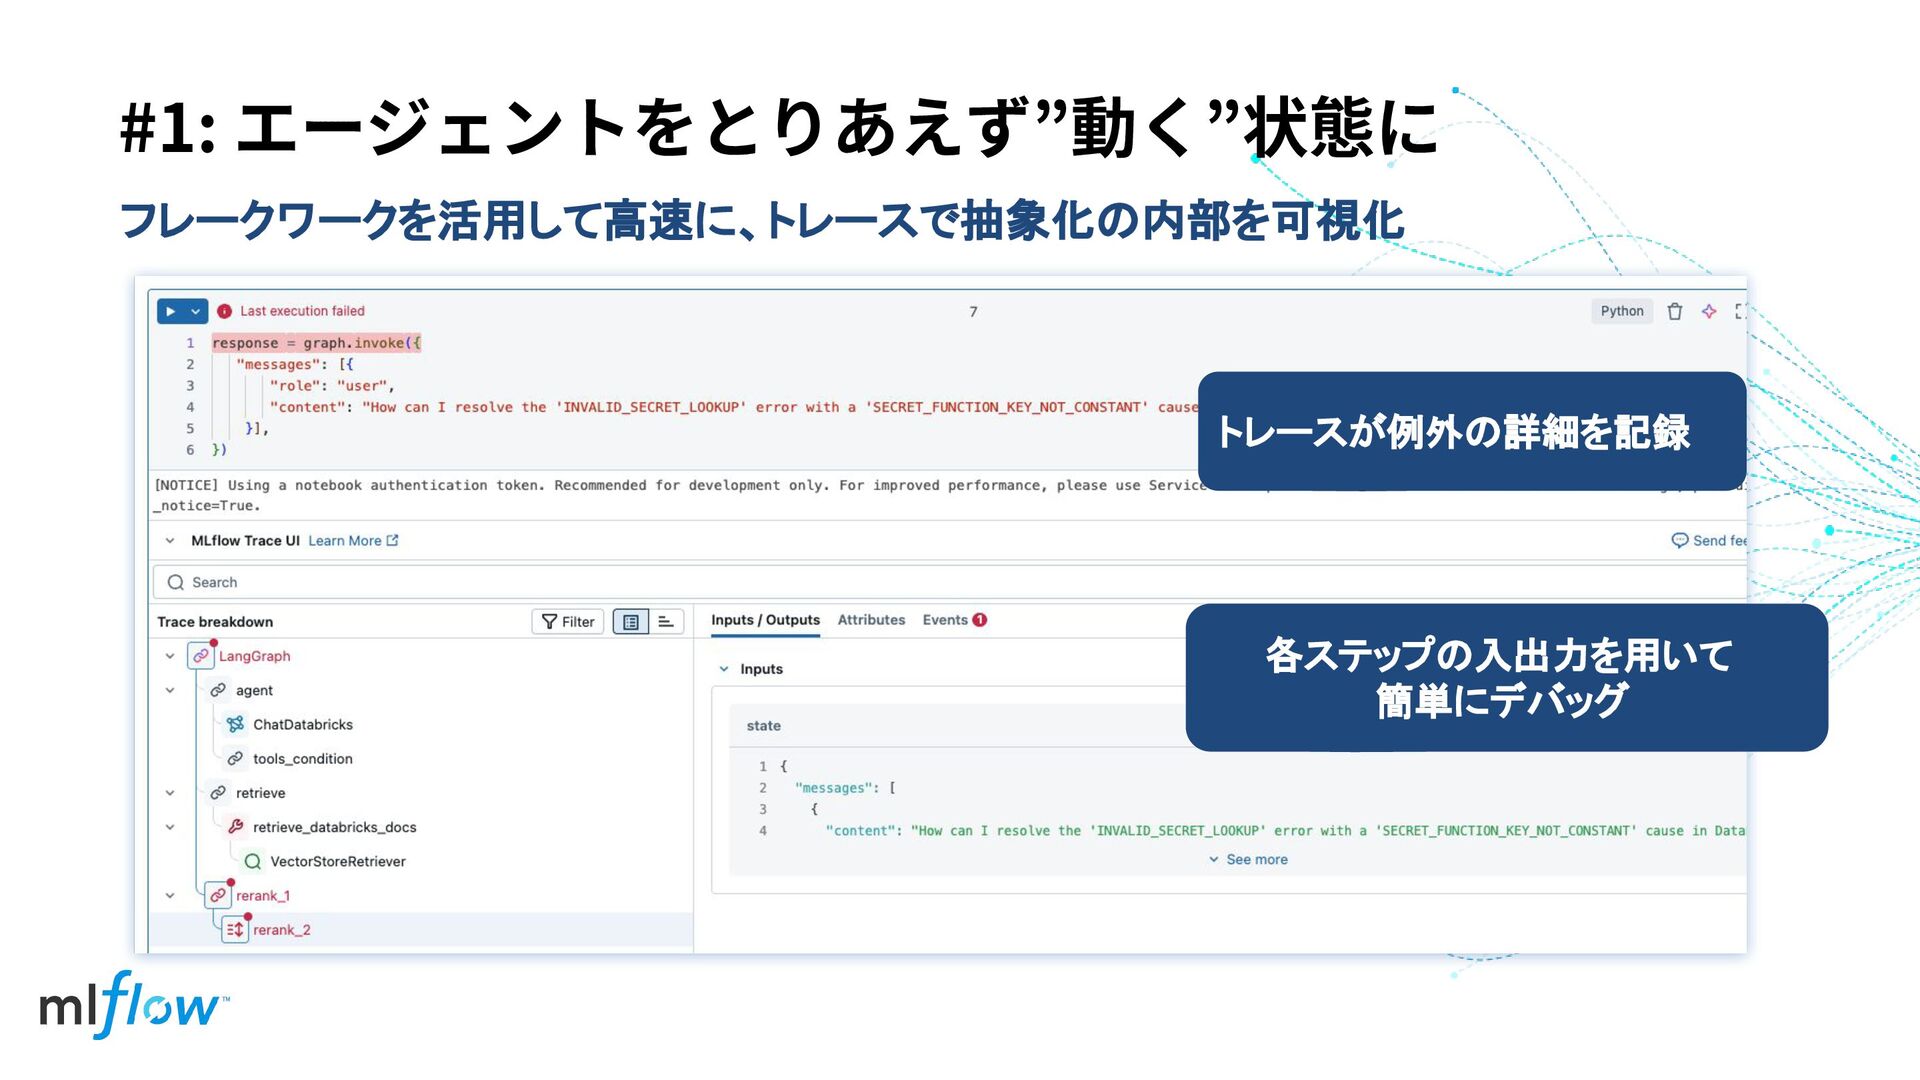
MLflowトレーシング エージェントやワークフローの各ステッ プについて、入出力やレイテンシ、例外 などを記録して可視化
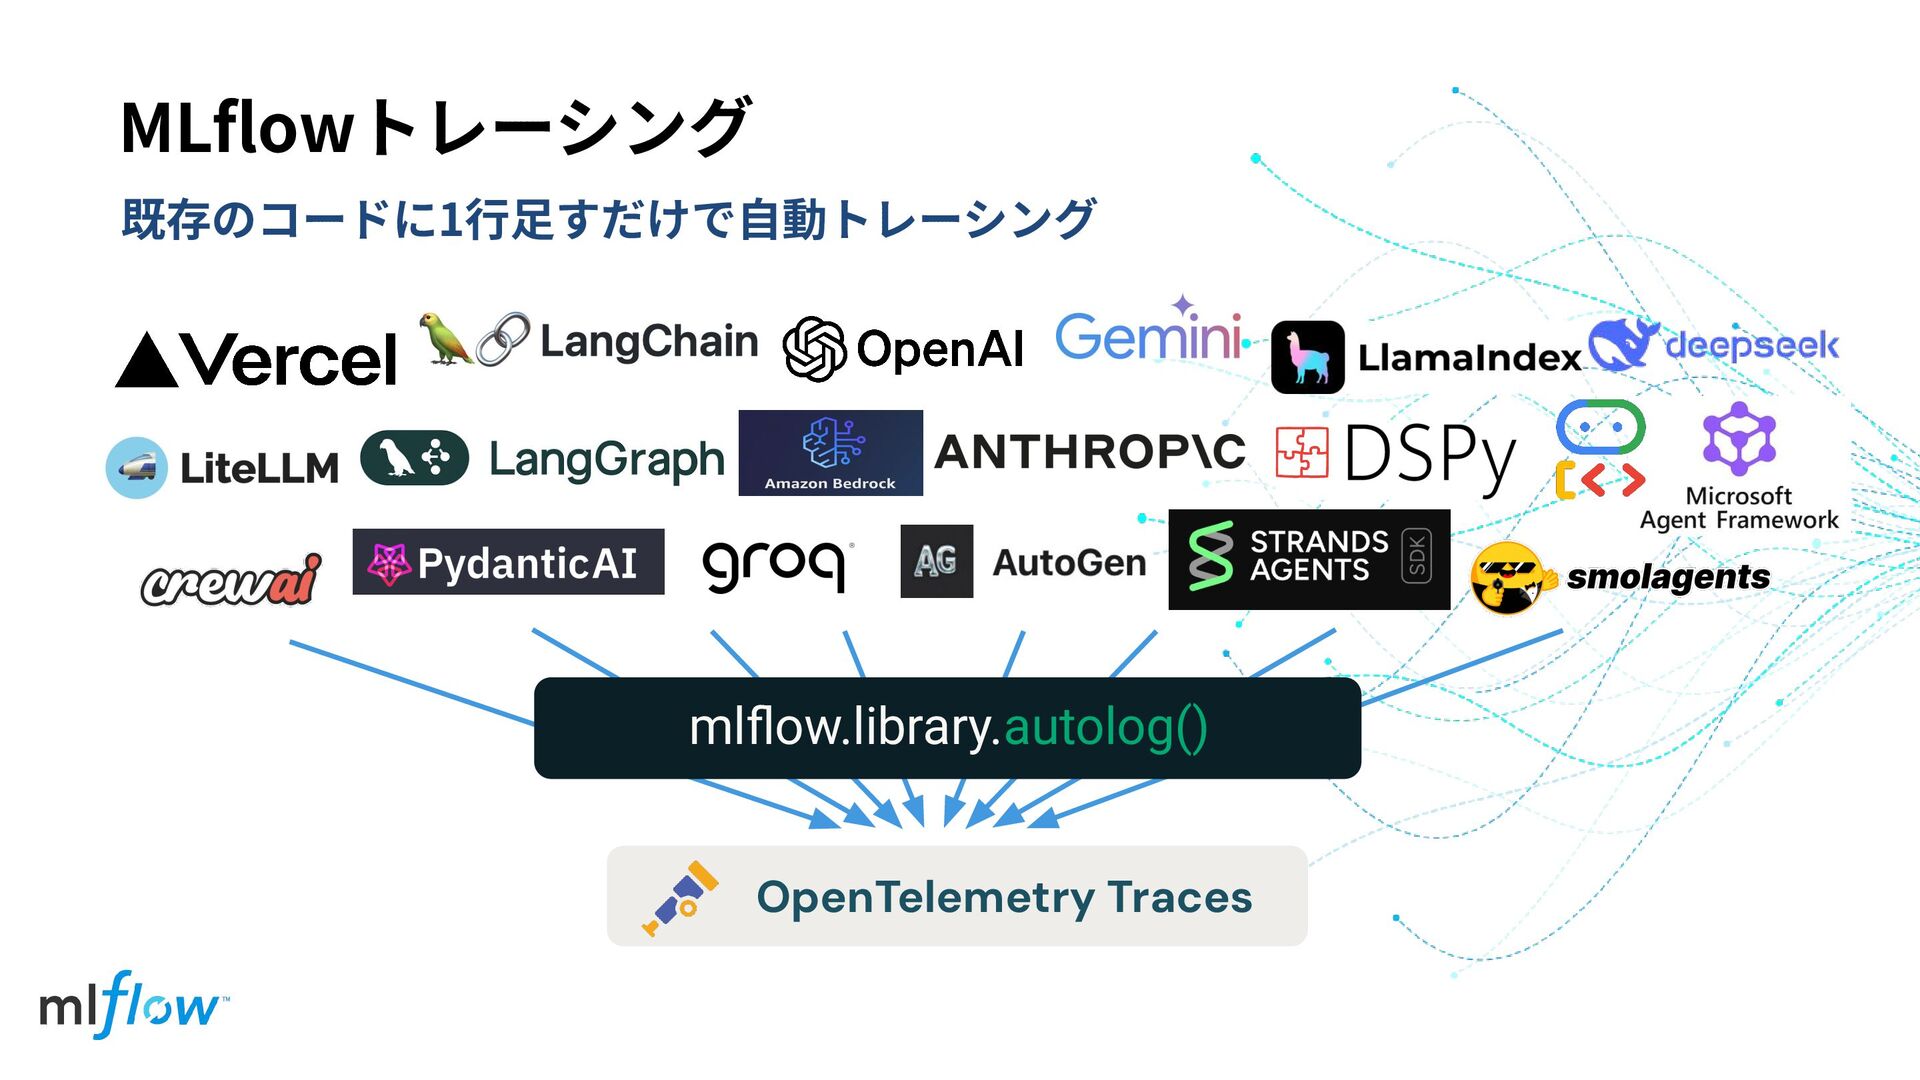
mlflow.library.autolog() OpenTelemetry Traces MLflowトレーシング 既存のコードに1⾏⾜すだけで⾃動トレーシング
• ソフトウェアの可観測性における業界標準の仕様とSDK • MLflowのトレースはOpenTelemetry SDK上に構築されており、 データも仕様に準拠しているため、ベンダーや⾔語に⾮依存。 • 例えばMLflowのトレースをGrafanaやNew Relicに送ったり、 OpenTelemetryをサポートしているあらゆる⾔語(Java,
Go, Rust, …)のサービスから直接MLflowにトレースを記録できる。 OpenTelemetry準拠
評価駆動開発の流れ
#1: エージェントをとりあえず”動く”状態に トレースが例外の詳細を記録 各ステップの入出力を用いて 簡単にデバッグ フレークワークを活用して高速に、トレースで抽象化の内部を可視化
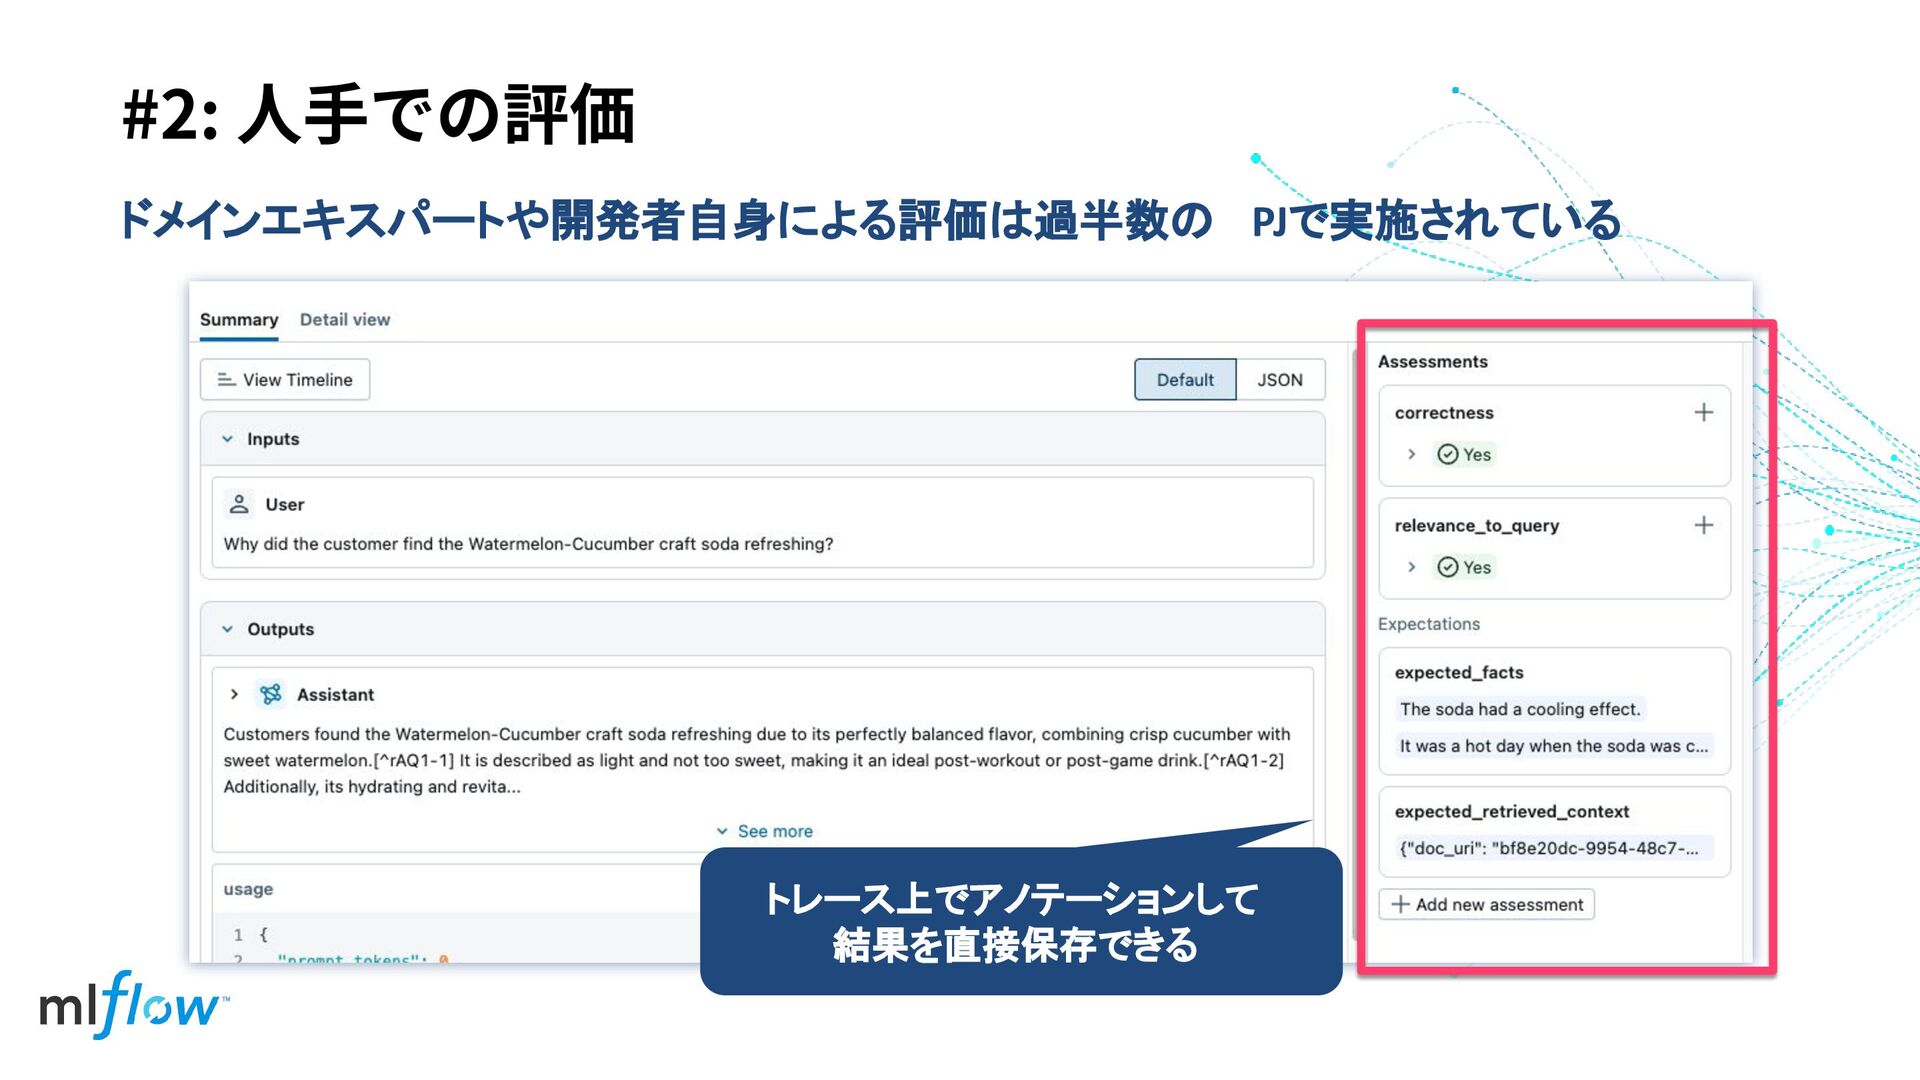
#2: ⼈⼿での評価 ドメインエキスパートや開発者自身による評価は過半数の PJで実施されている トレース上でアノテーションして 結果を直接保存できる
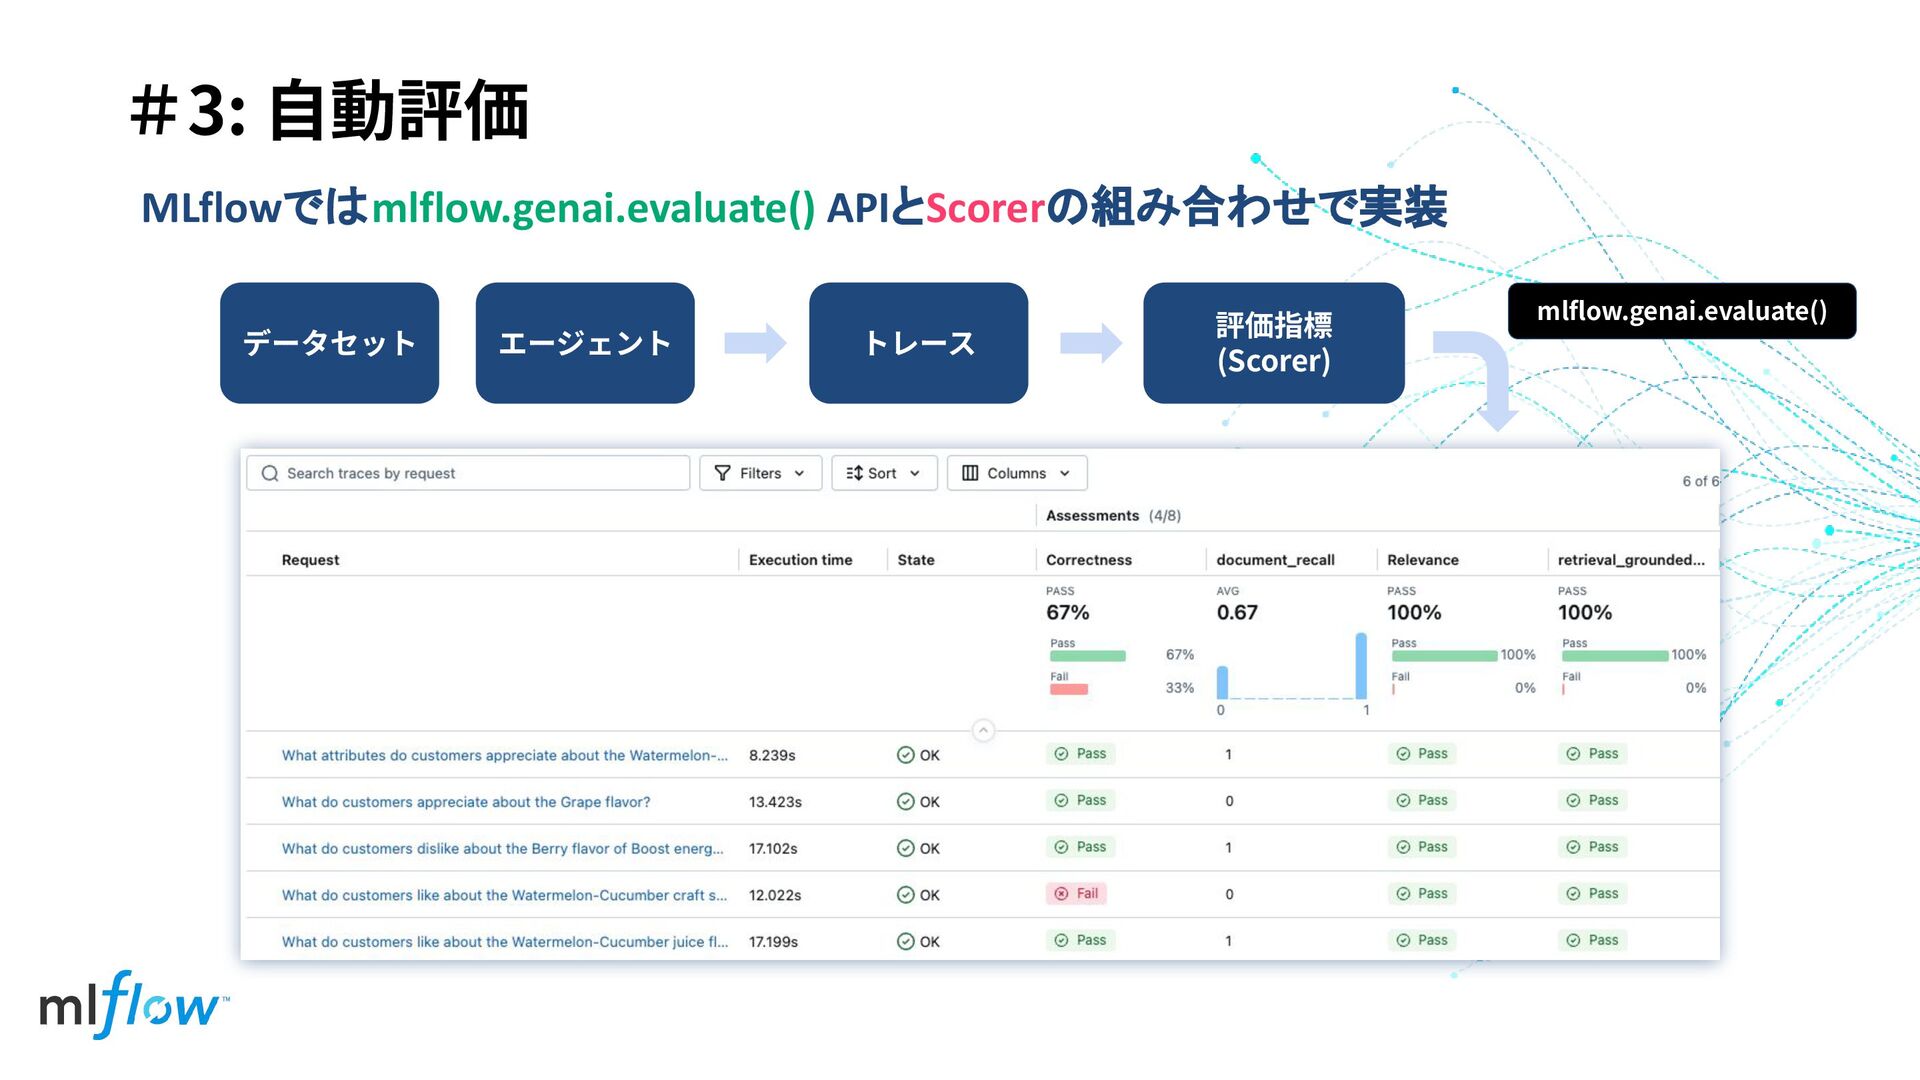
#3: ⾃動評価 評価指標 (Scorer) mlflow.genai.evaluate() MLflowではmlflow.genai.evaluate() APIとScorerの組み合わせで実装 データセット エージェント トレース
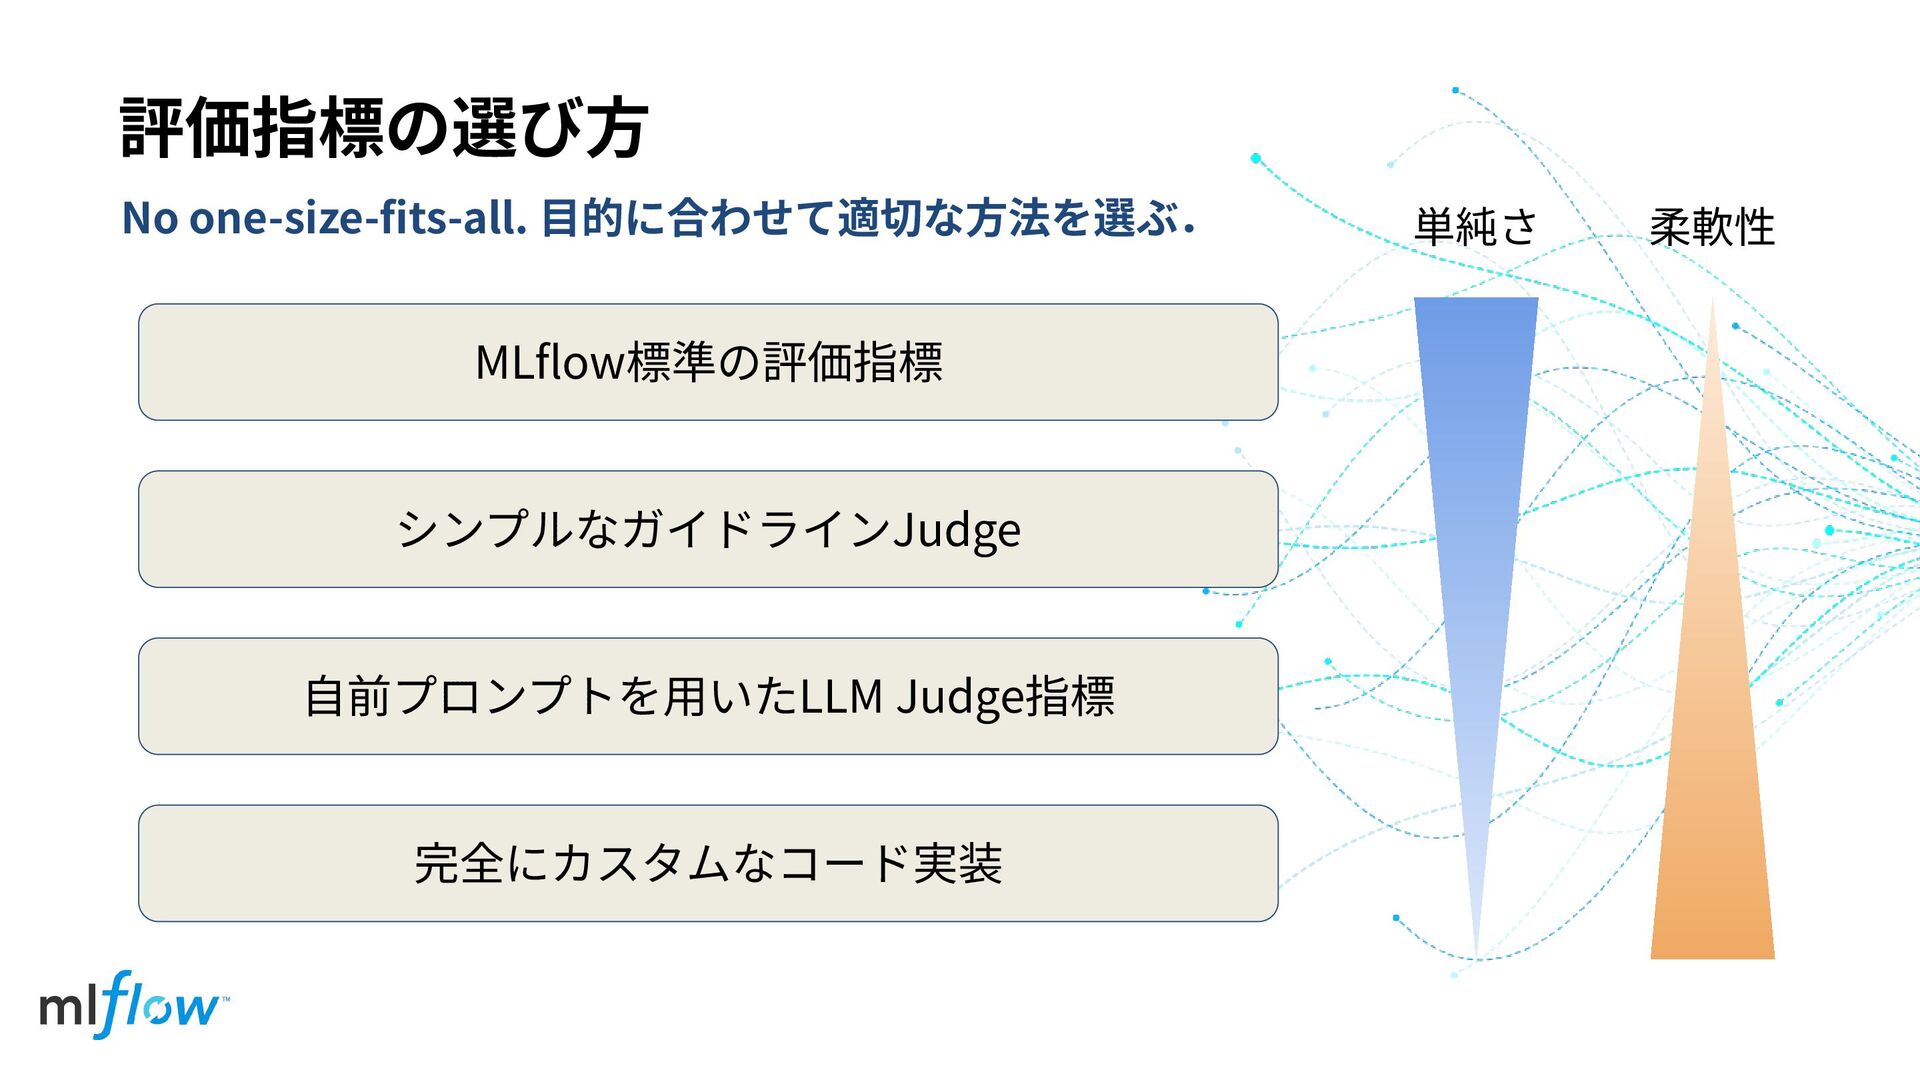
評価指標の選び⽅ No one-size-fits-all. ⽬的に合わせて適切な⽅法を選ぶ. MLflow標準の評価指標 シンプルなガイドラインJudge ⾃前プロンプトを⽤いたLLM Judge指標 完全にカスタムなコード実装 単純さ
柔軟性
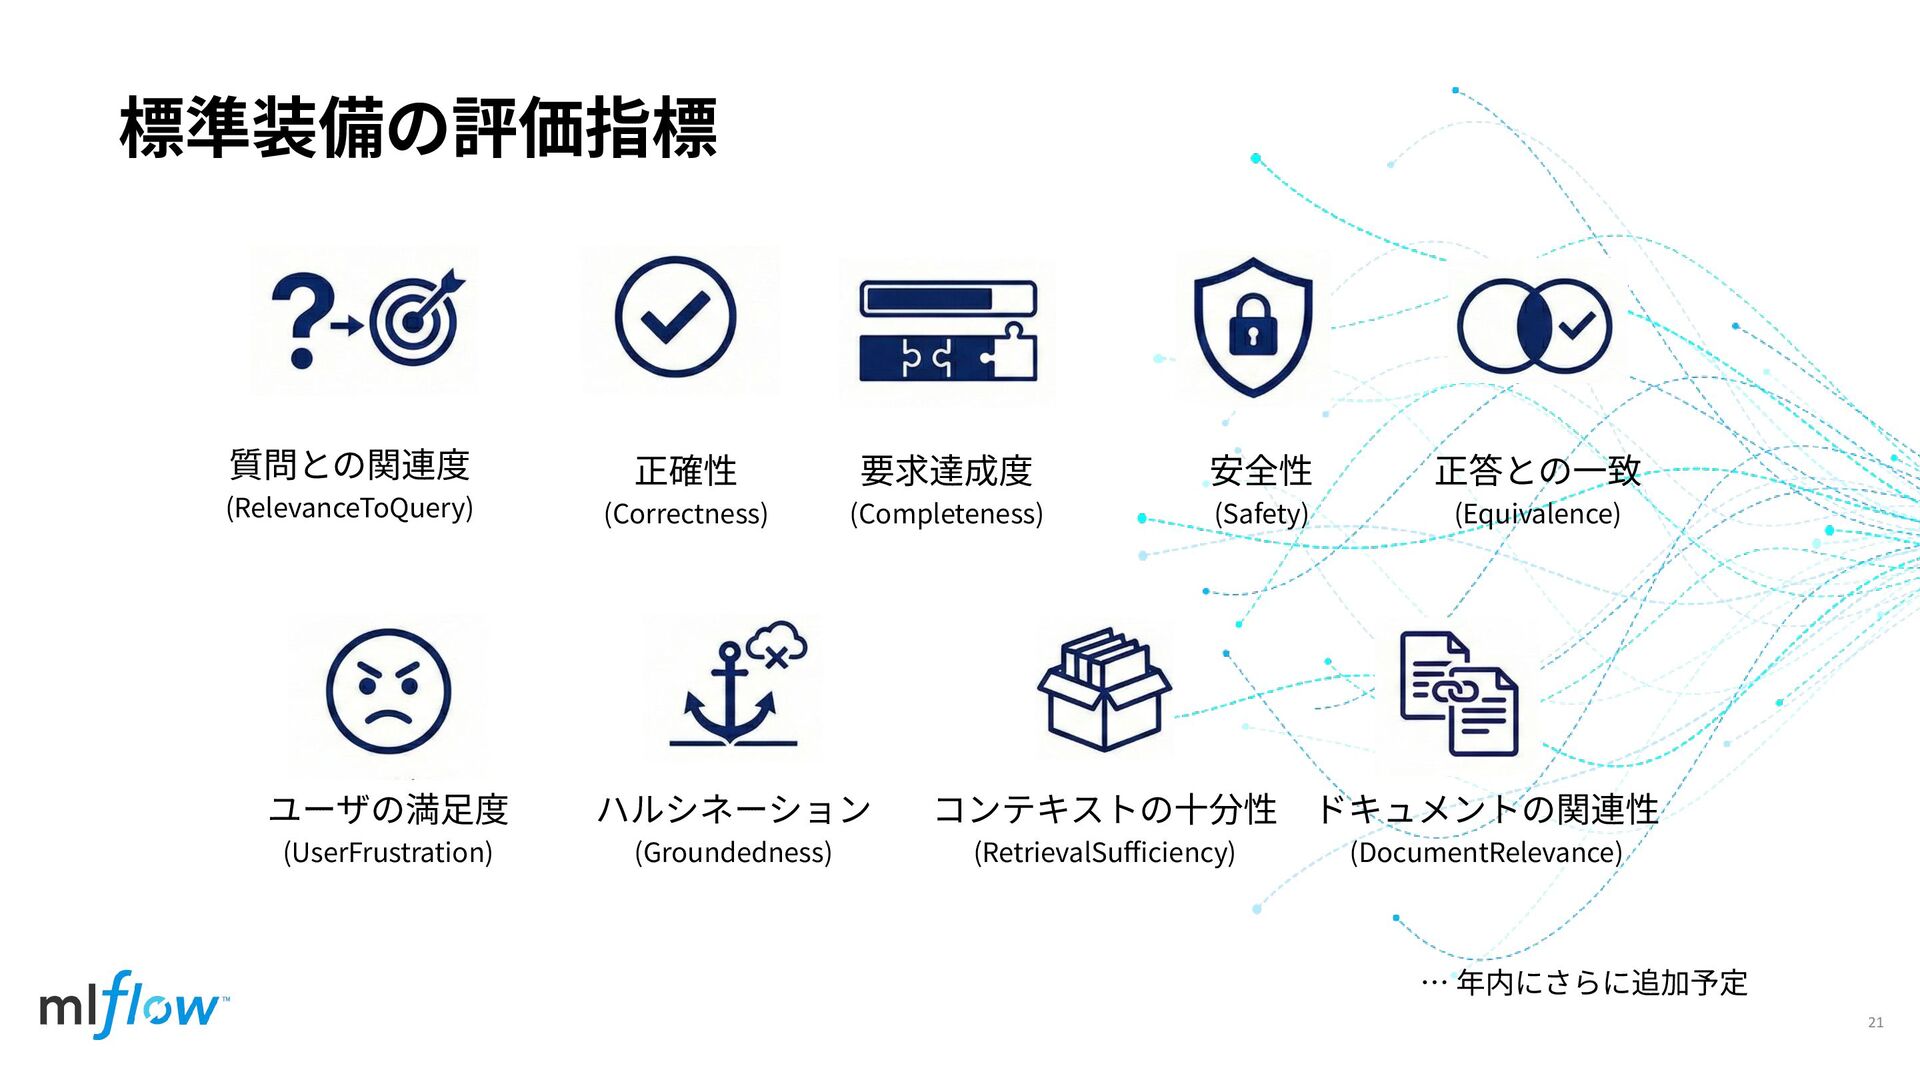
標準装備の評価指標 21 質問との関連度 (RelevanceToQuery) 正確性 (Correctness) 要求達成度 (Completeness) 安全性 (Safety)
正答との⼀致 (Equivalence) ユーザの満⾜度 (UserFrustration) ハルシネーション (Groundedness) コンテキストの⼗分性 (RetrievalSufficiency) ドキュメントの関連性 (DocumentRelevance) … 年内にさらに追加予定
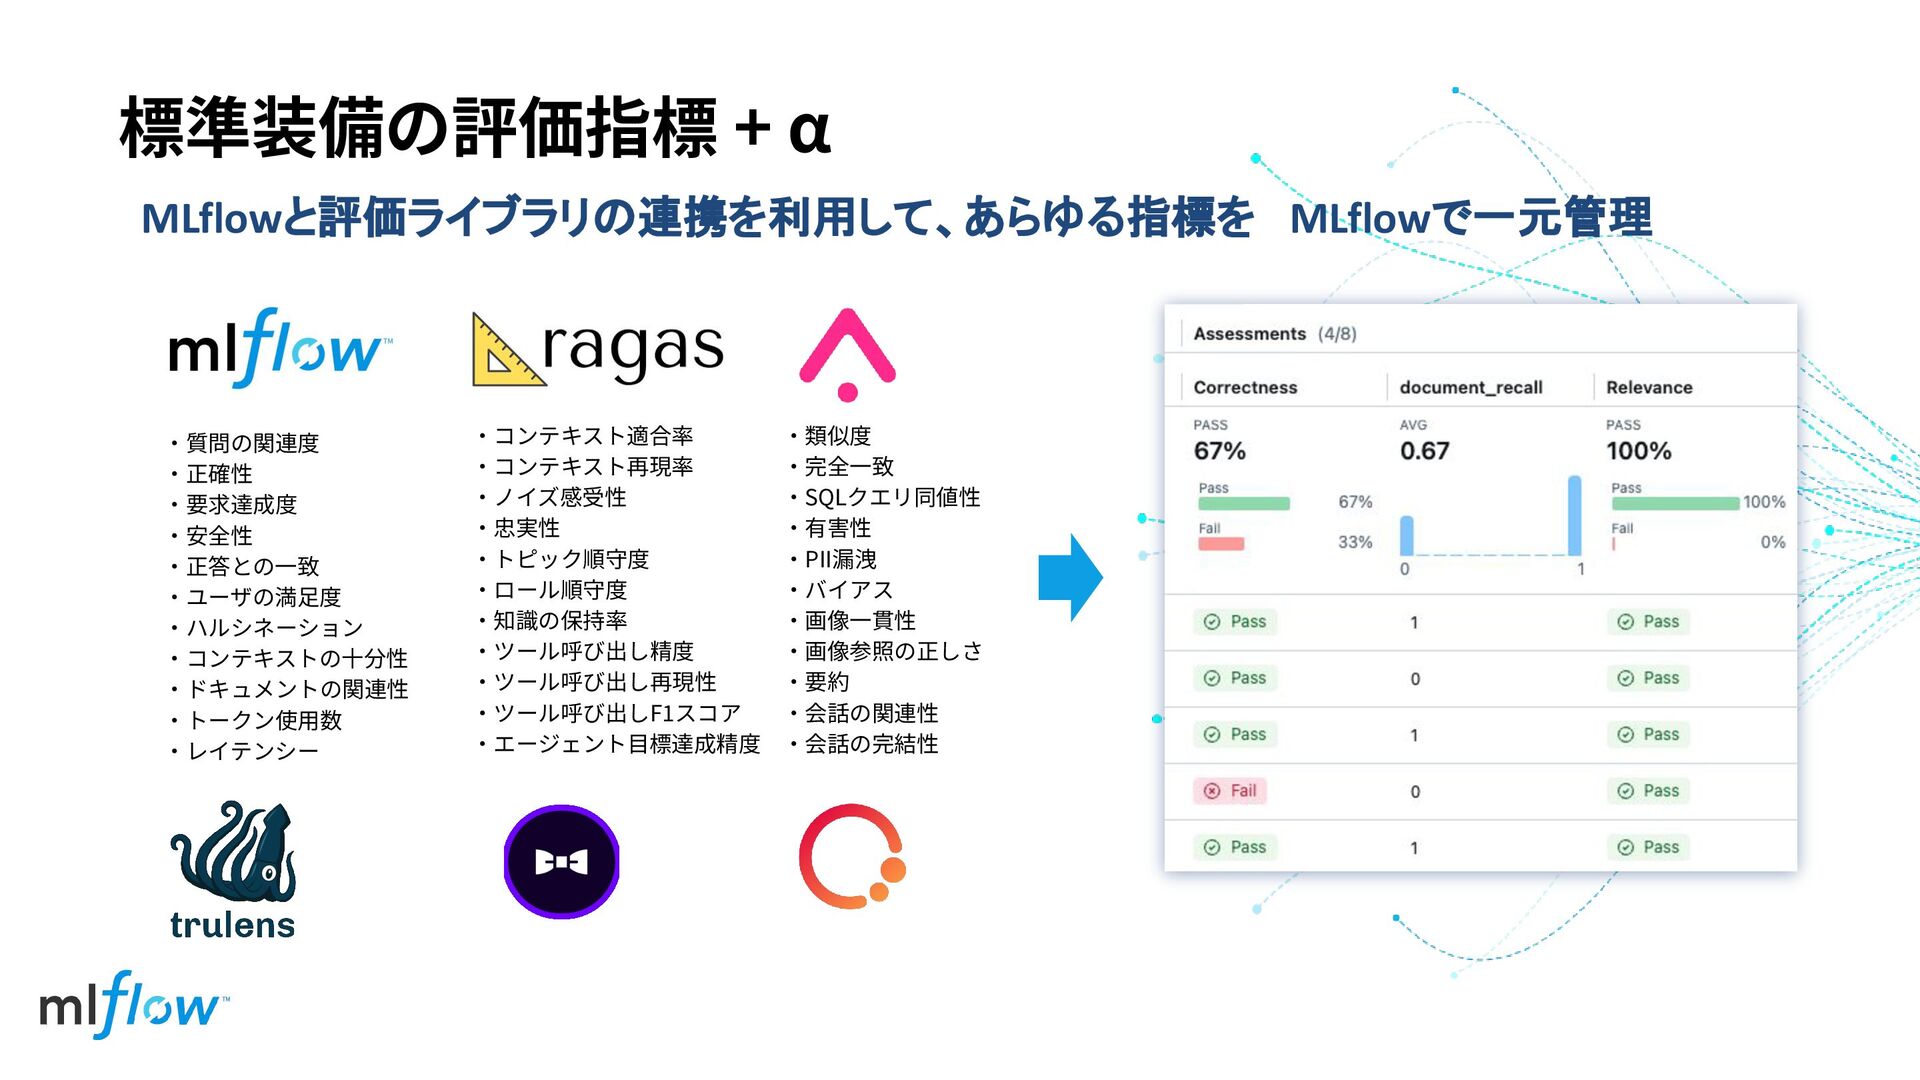
‧類似度 ‧完全⼀致 ‧SQLクエリ同値性 ‧有害性 ‧PII漏洩 ‧バイアス ‧画像⼀貫性 ‧画像参照の正しさ ‧要約 ‧会話の関連性
‧会話の完結性 標準装備の評価指標 + α MLflowと評価ライブラリの連携を利用して、あらゆる指標を MLflowで一元管理 ‧コンテキスト適合率 ‧コンテキスト再現率 ‧ノイズ感受性 ‧忠実性 ‧トピック順守度 ‧ロール順守度 ‧知識の保持率 ‧ツール呼び出し精度 ‧ツール呼び出し再現性 ‧ツール呼び出しF1スコア ‧エージェント⽬標達成精度 ‧質問の関連度 ‧正確性 ‧要求達成度 ‧安全性 ‧正答との⼀致 ‧ユーザの満⾜度 ‧ハルシネーション ‧コンテキストの⼗分性 ‧ドキュメントの関連性 ‧トークン使⽤数 ‧レイテンシー
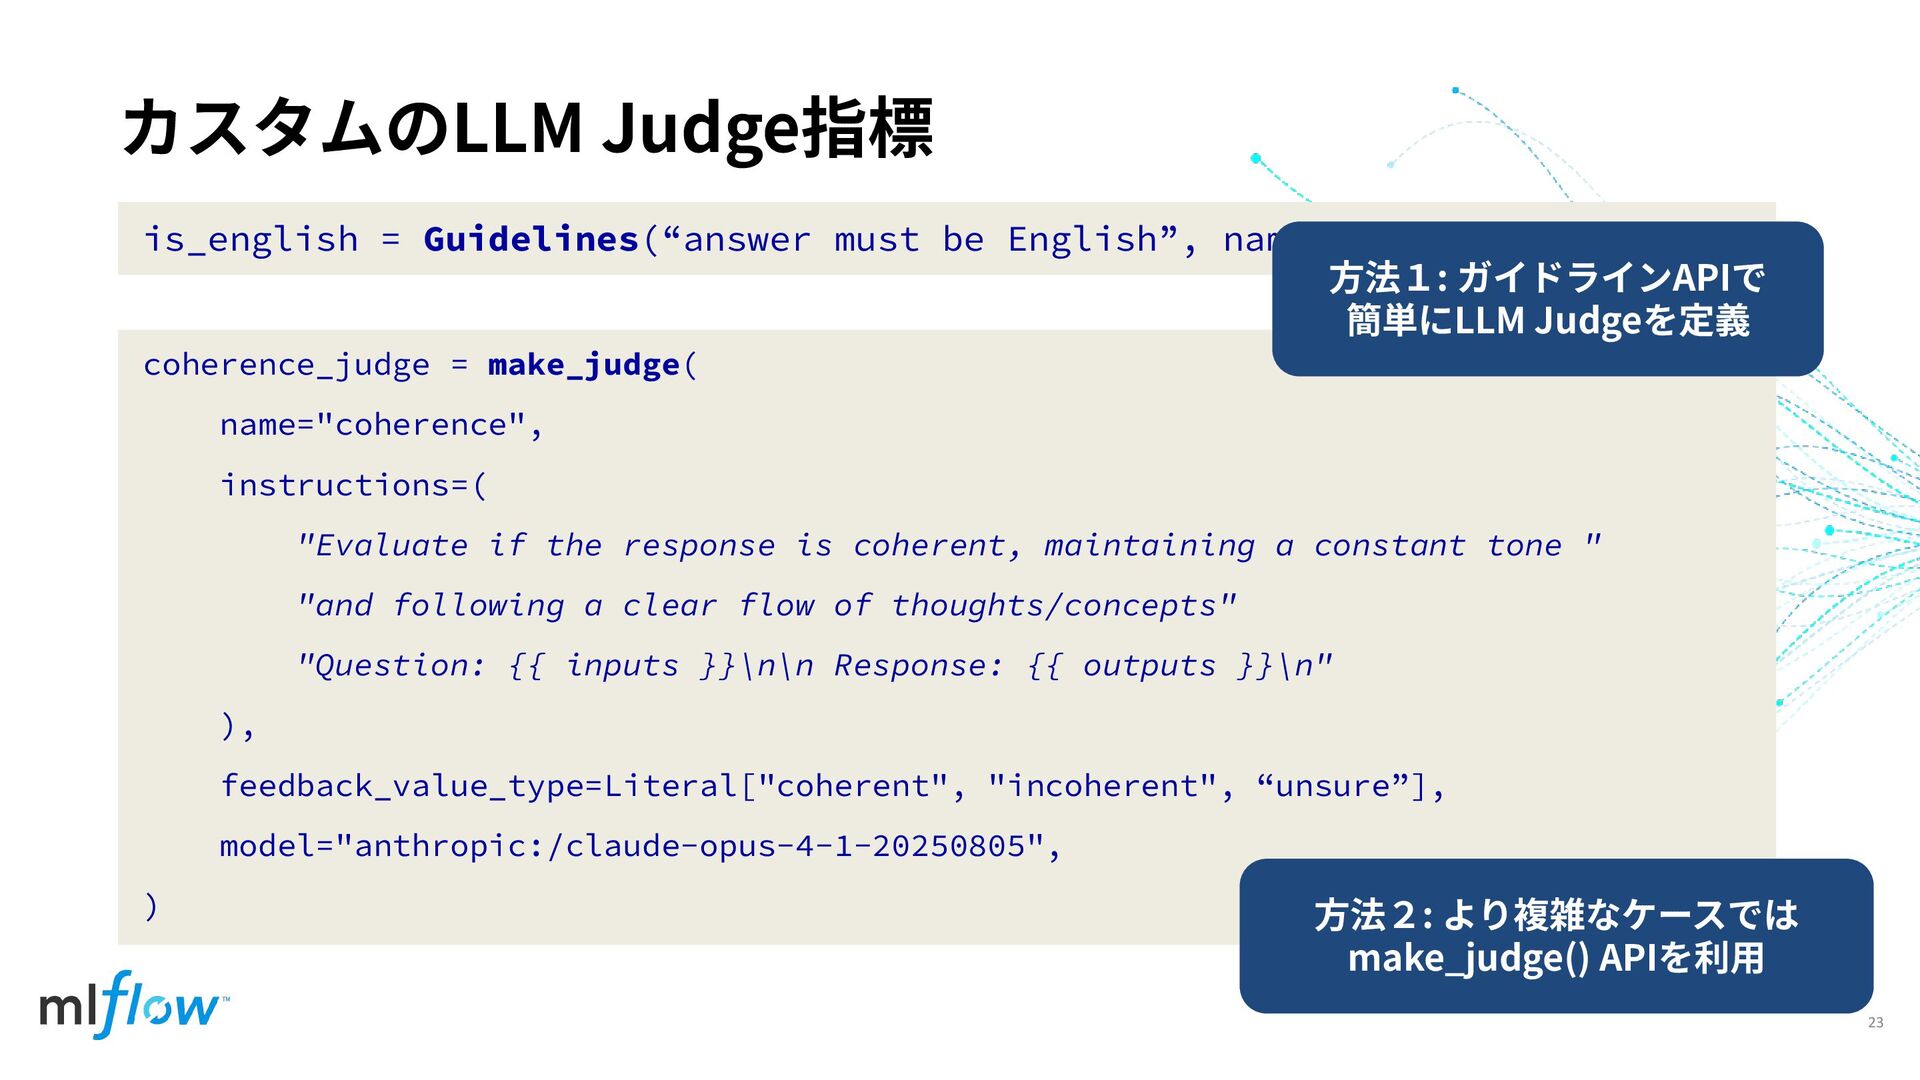
coherence_judge = make_judge( name="coherence", instructions=( "Evaluate if the response is
coherent, maintaining a constant tone " "and following a clear flow of thoughts/concepts" "Question: {{ inputs }}\n\n Response: {{ outputs }}\n" ), feedback_value_type=Literal["coherent", "incoherent", “unsure”], model="anthropic:/claude-opus-4-1-20250805", ) カスタムのLLM Judge指標 23 is_english = Guidelines(“answer must be English”, name=) ⽅法1: ガイドラインAPIで 簡単にLLM Judgeを定義 ⽅法2: より複雑なケースでは make_judge() APIを利⽤
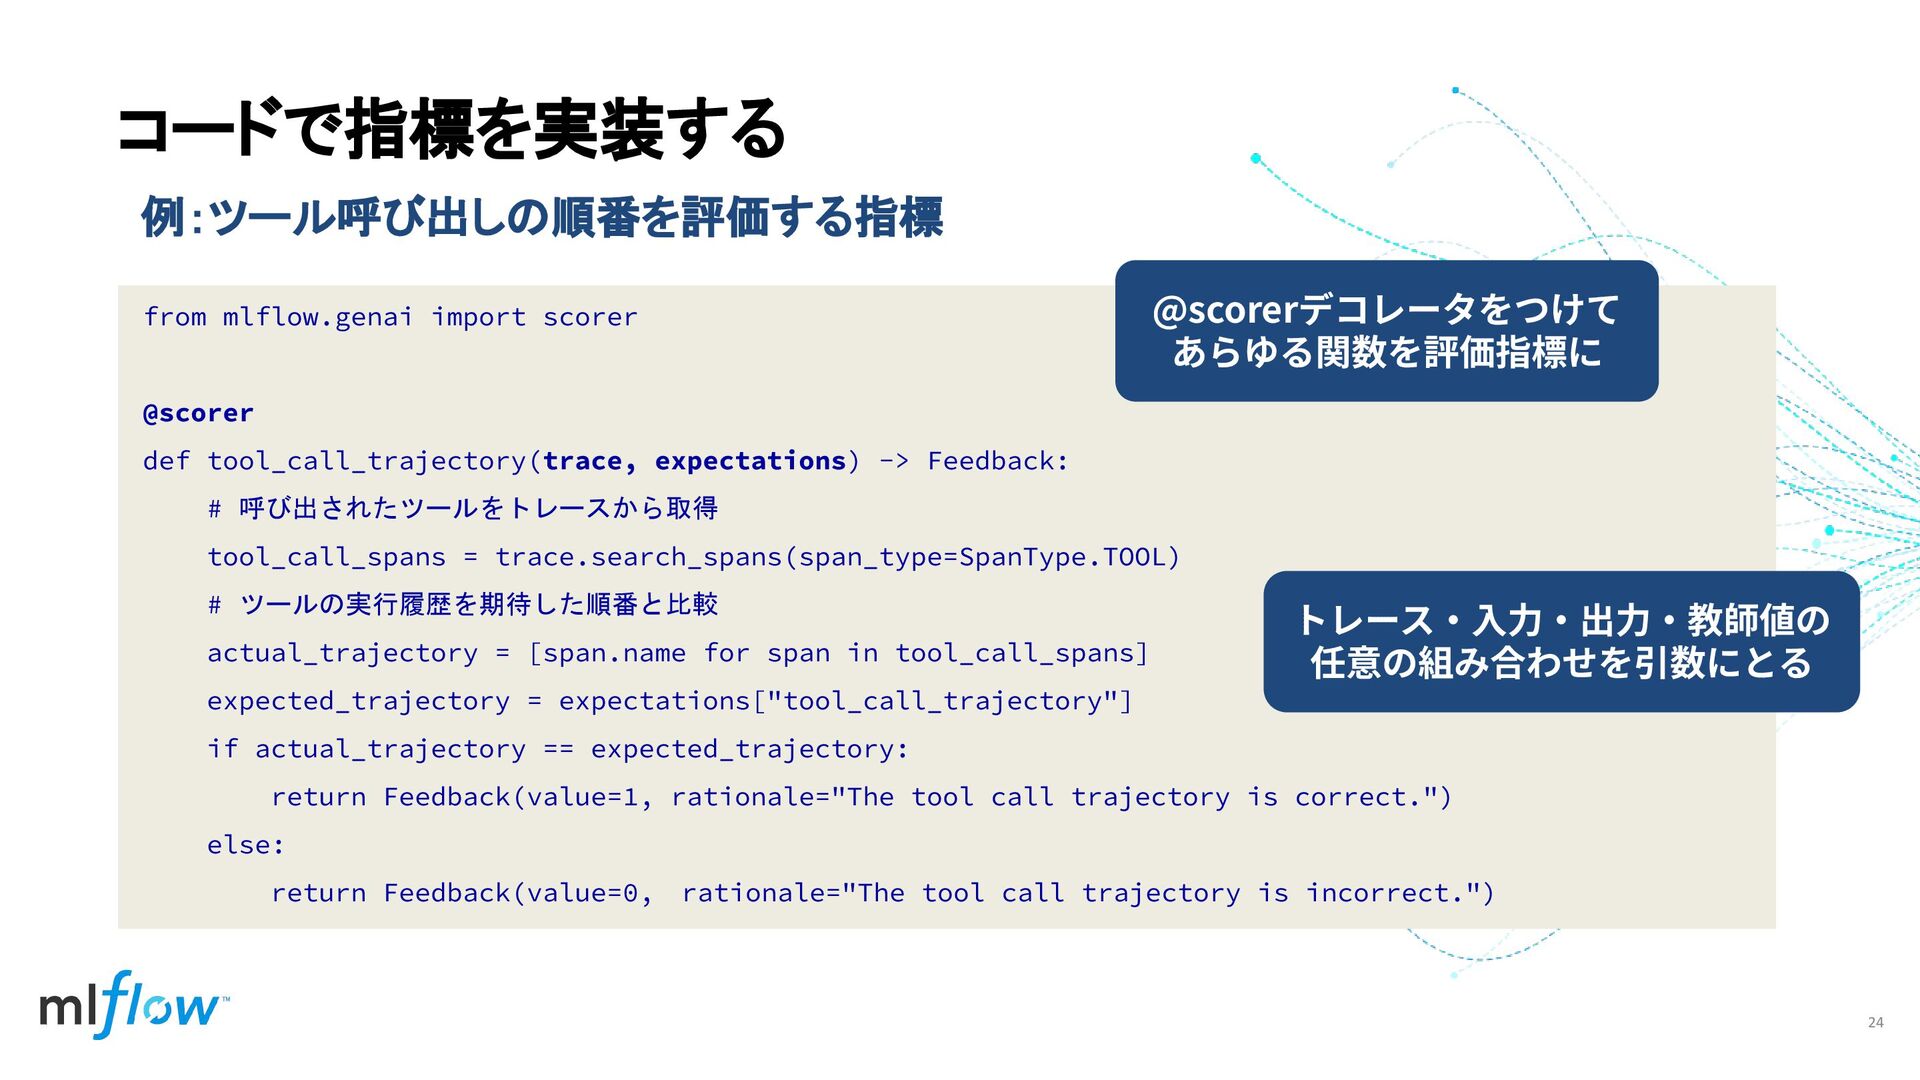
from mlflow.genai import scorer @scorer def tool_call_trajectory(trace, expectations) -> Feedback:
# 呼び出されたツールをトレースから取得 tool_call_spans = trace.search_spans(span_type=SpanType.TOOL) # ツールの実行履歴を期待した順番と比較 actual_trajectory = [span.name for span in tool_call_spans] expected_trajectory = expectations["tool_call_trajectory"] if actual_trajectory == expected_trajectory: return Feedback(value=1, rationale="The tool call trajectory is correct.") else: return Feedback(value=0, rationale="The tool call trajectory is incorrect.") コードで指標を実装する 24 例:ツール呼び出しの順番を評価する指標 トレース‧⼊⼒‧出⼒‧教師値の 任意の組み合わせを引数にとる @scorerデコレータをつけて あらゆる関数を評価指標に
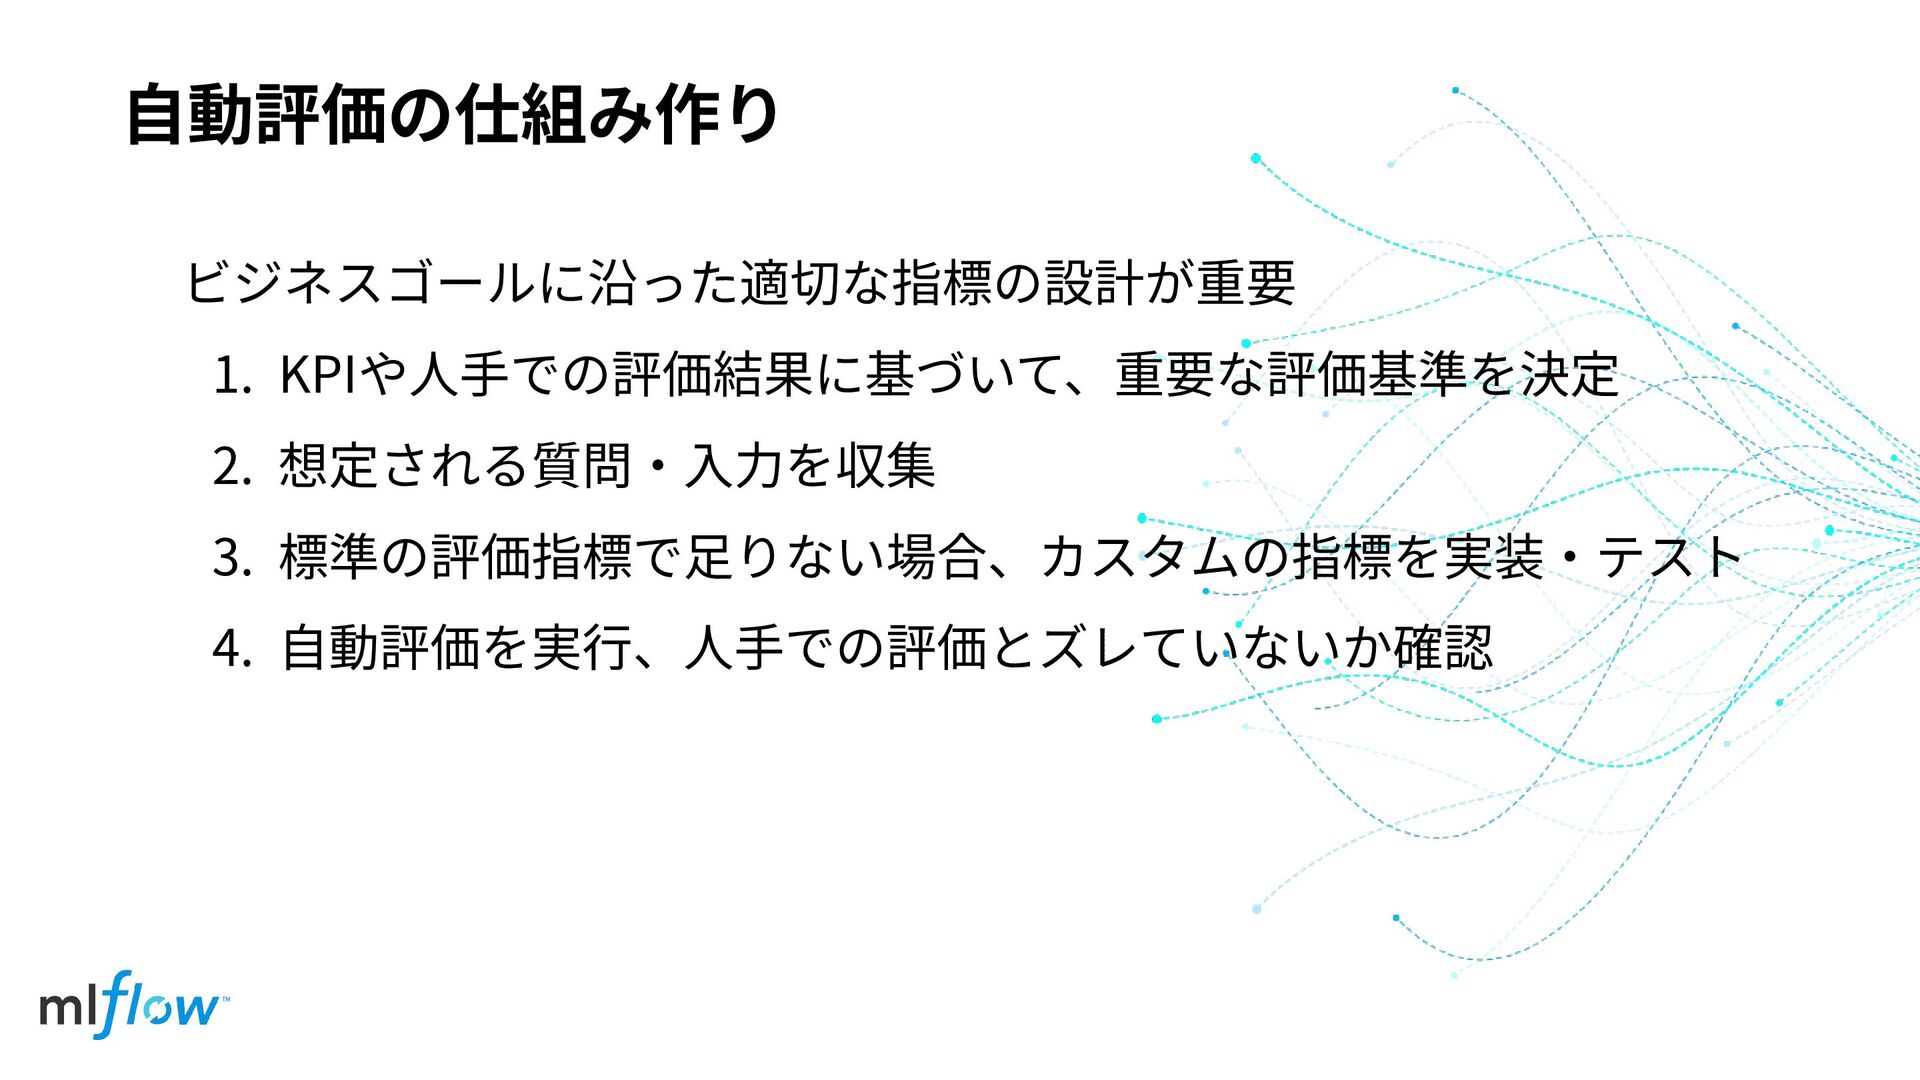
⾃動評価の仕組み作り ビジネスゴールに沿った適切な指標の設計が重要 1. KPIや⼈⼿での評価結果に基づいて、重要な評価基準を決定 2. 想定される質問‧⼊⼒を収集 3. 標準の評価指標で⾜りない場合、カスタムの指標を実装‧テスト 4. ⾃動評価を実⾏、⼈⼿での評価とズレていないか確認
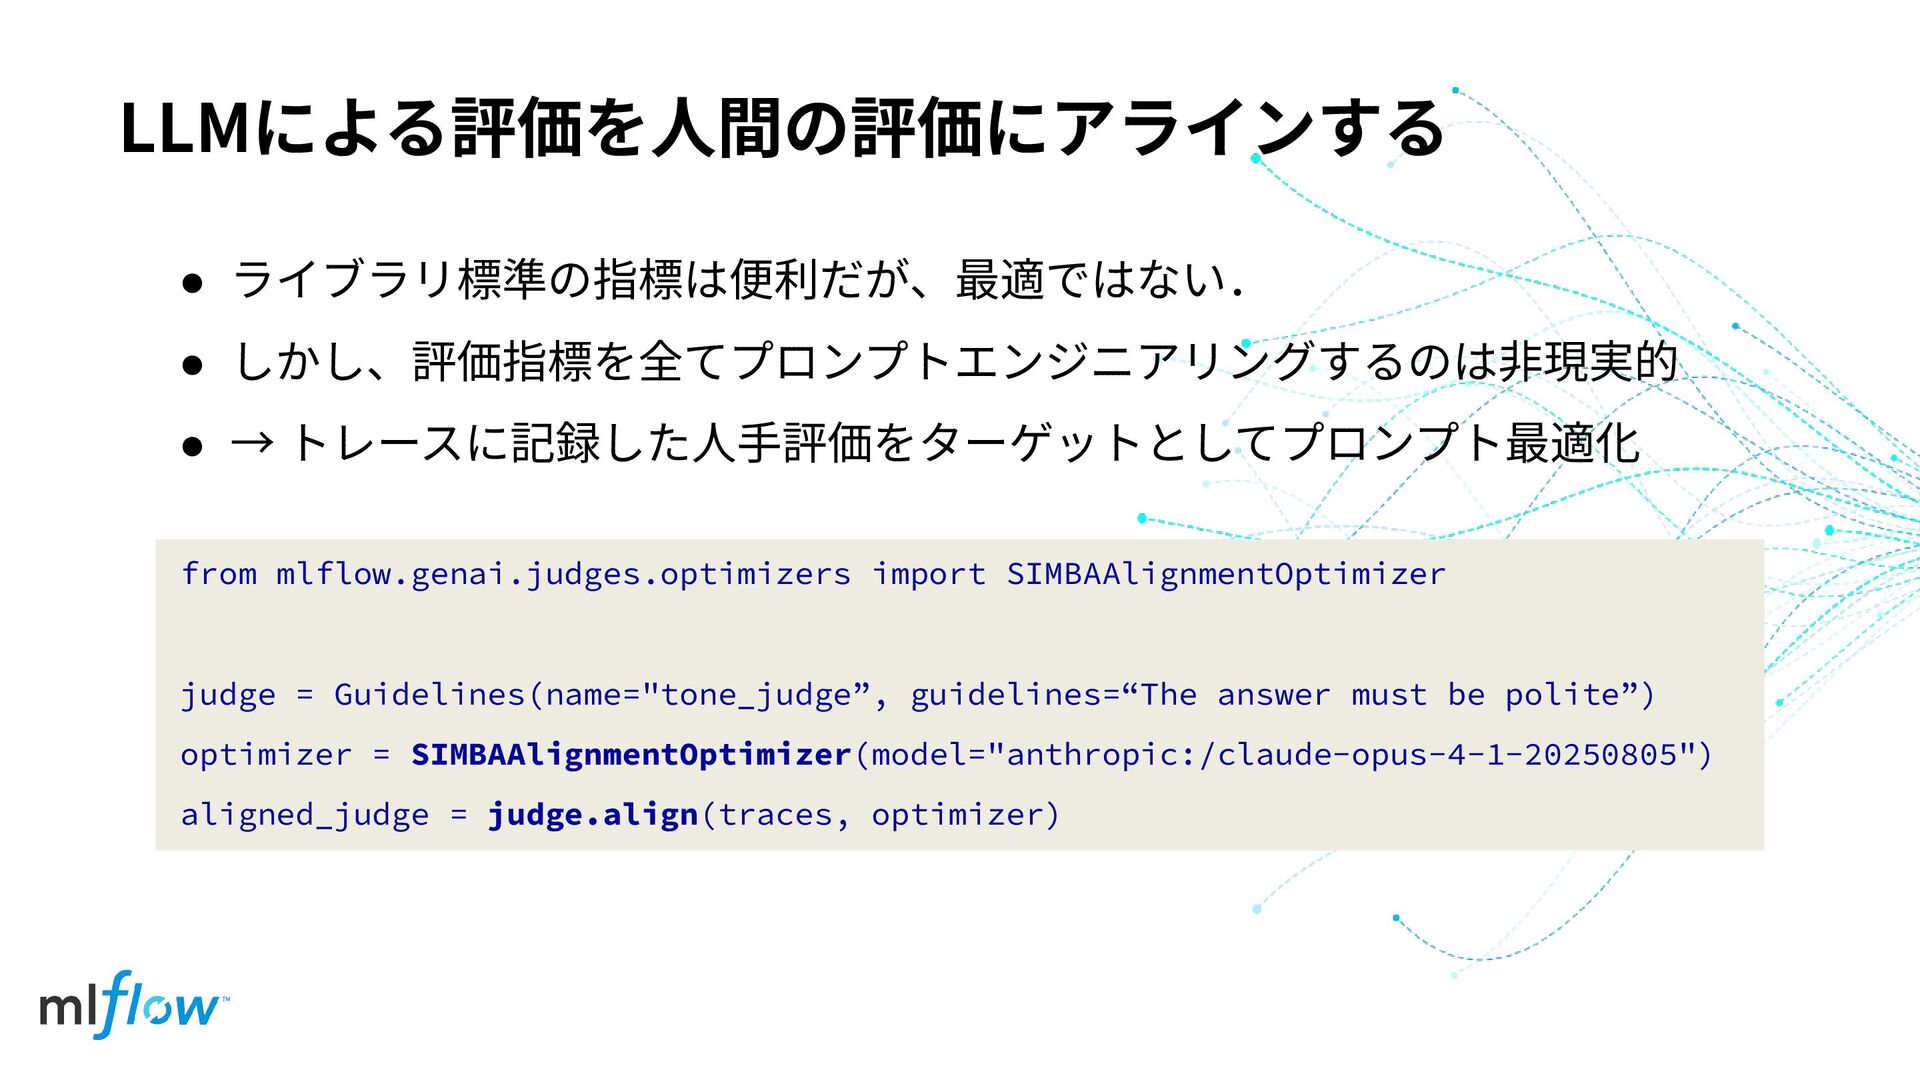
LLMによる評価を⼈間の評価にアラインする • ライブラリ標準の指標は便利だが、最適ではない. • しかし、評価指標を全てプロンプトエンジニアリングするのは⾮現実的 • → トレースに記録した⼈⼿評価をターゲットとしてプロンプト最適化 from mlflow.genai.judges.optimizers
import SIMBAAlignmentOptimizer judge = Guidelines(name="tone_judge”, guidelines=“The answer must be polite”) optimizer = SIMBAAlignmentOptimizer(model="anthropic:/claude-opus-4-1-20250805") aligned_judge = judge.align(traces, optimizer)
Agent-as-a-Judge 評価⽤のAgentがトレースを⾃ら⾛査して評価
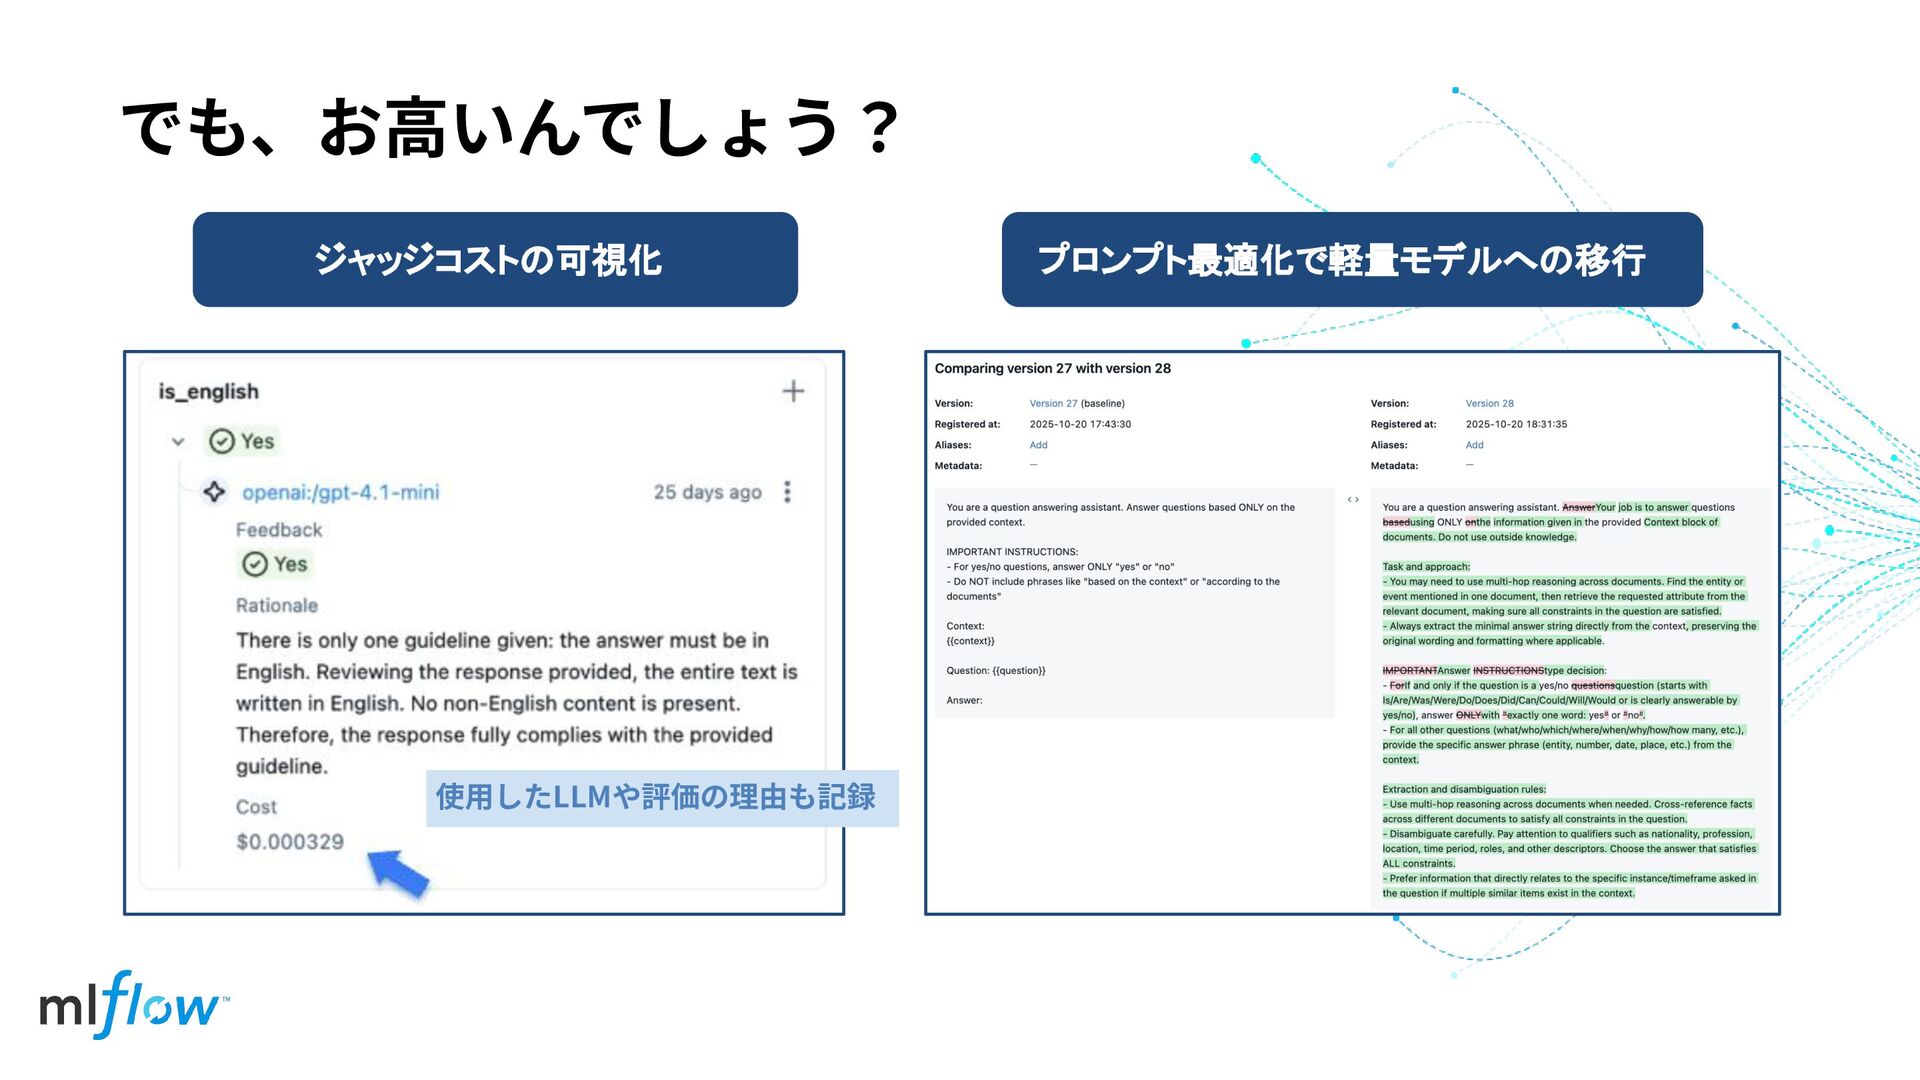
ジャッジコストの可視化 プロンプト最適化で軽量モデルへの移行 でも、お⾼いんでしょう? 使⽤したLLMや評価の理由も記録
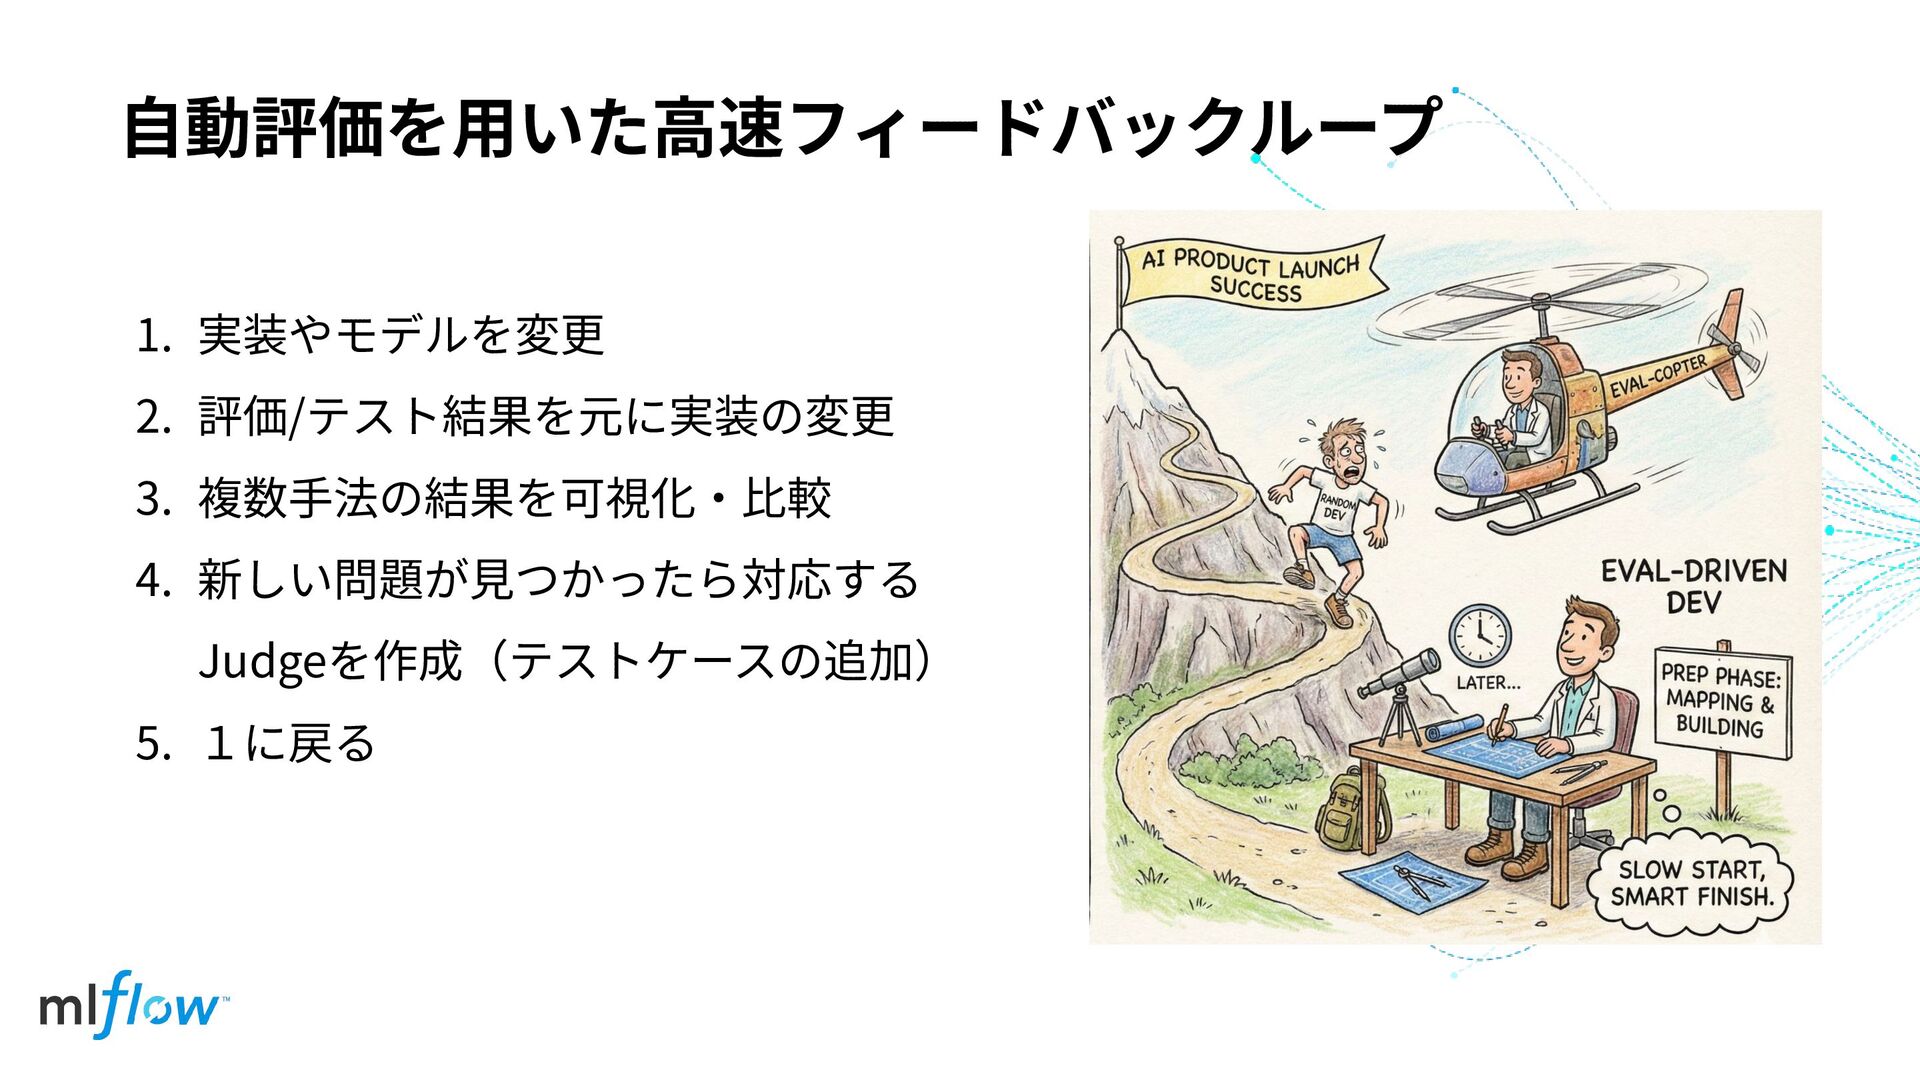
⾃動評価を⽤いた⾼速フィードバックループ 1. 実装やモデルを変更 2. 評価/テスト結果を元に実装の変更 3. 複数⼿法の結果を可視化‧⽐較 4. 新しい問題が⾒つかったら対応する Judgeを作成(テストケースの追加)
5. 1に戻る
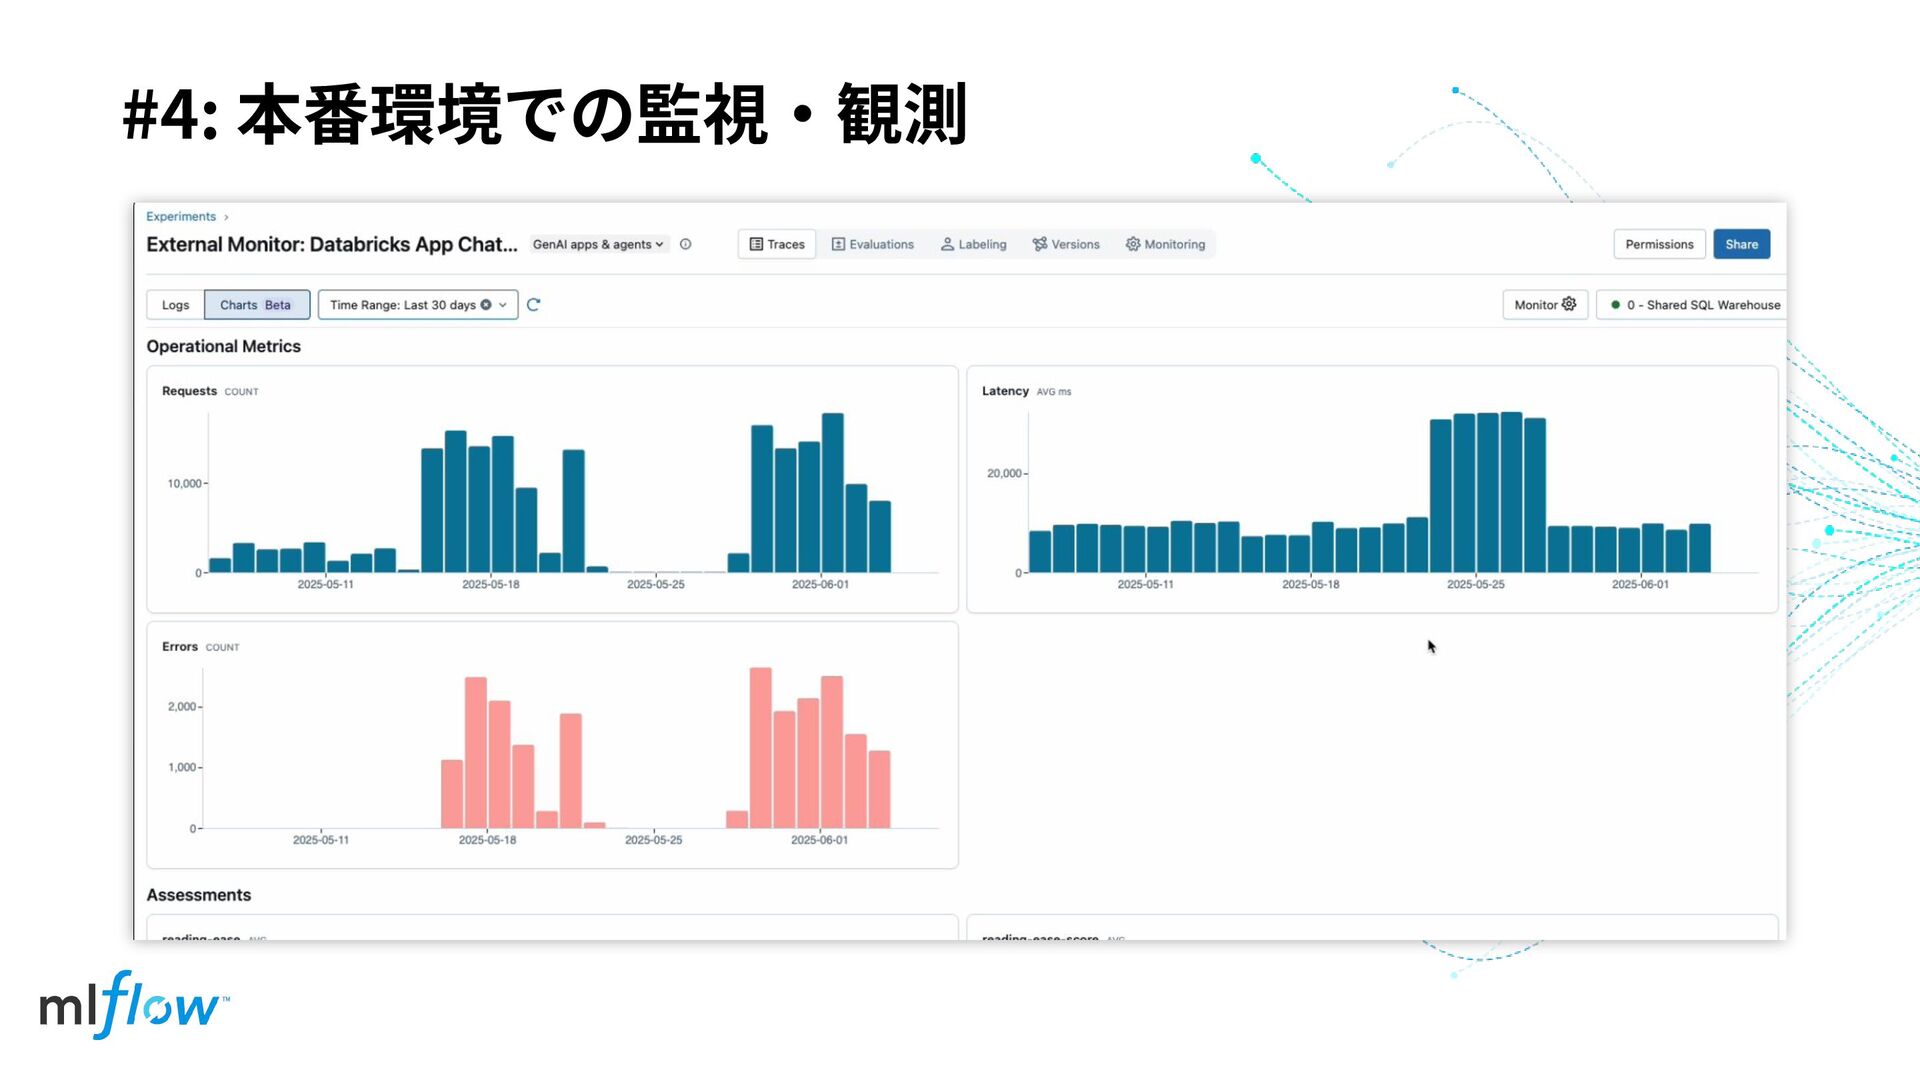
#4: 本番環境での監視‧観測
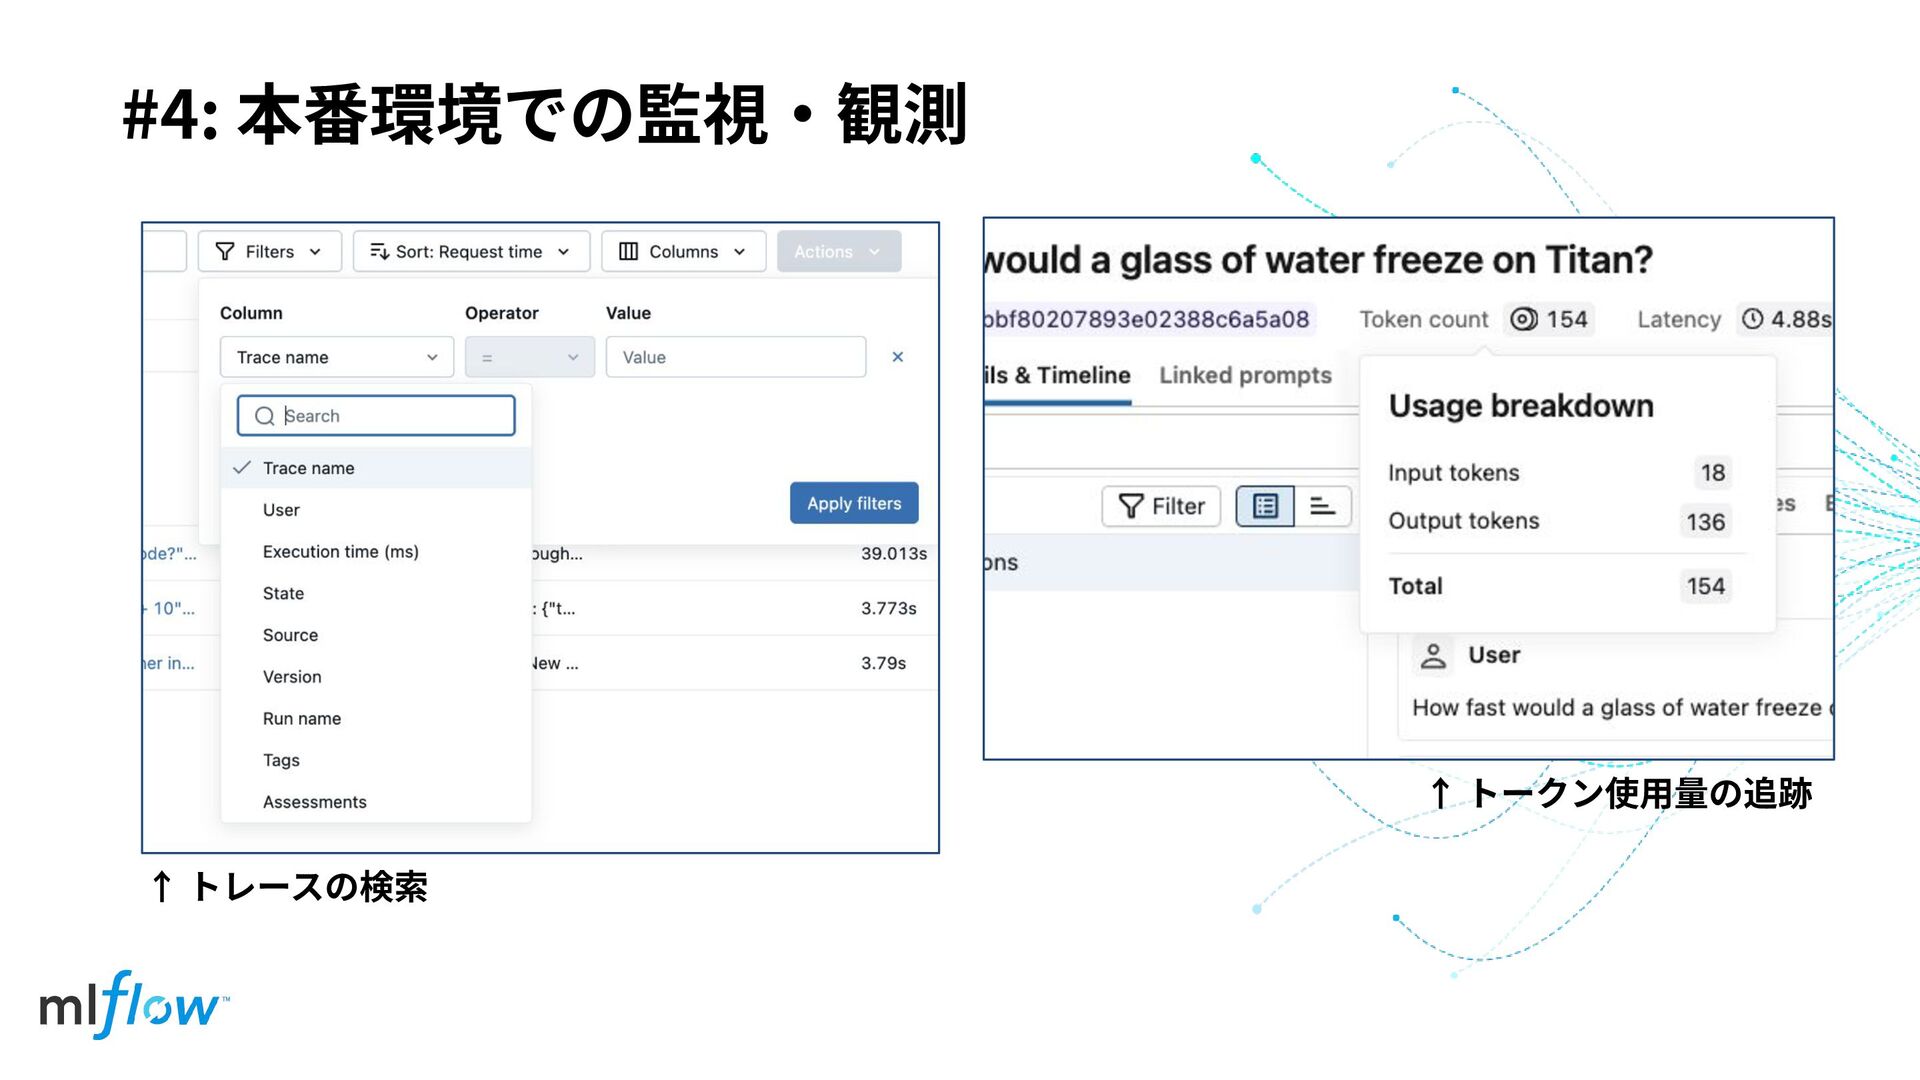
#4: 本番環境での監視‧観測 ↑ トレースの検索 ↑ トークン使⽤量の追跡
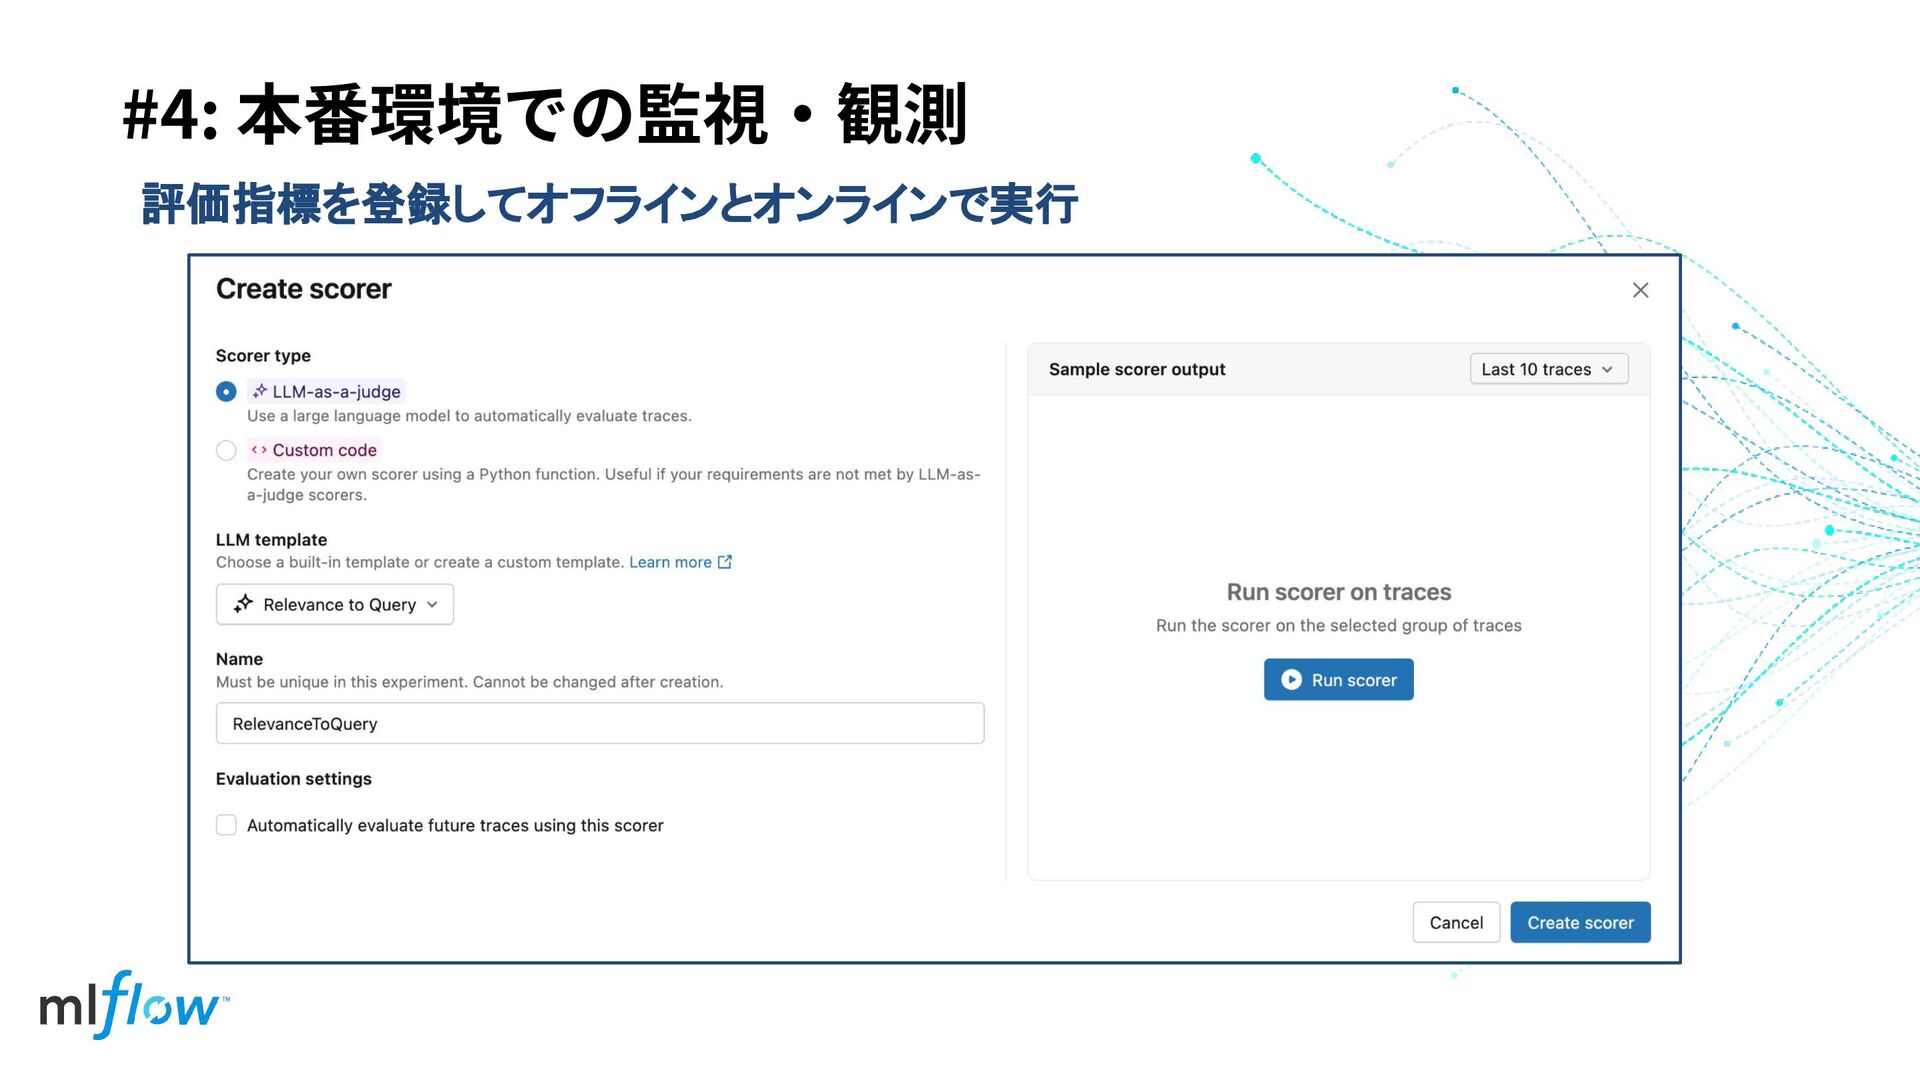
#4: 本番環境での監視‧観測 評価指標を登録してオフラインとオンラインで実行
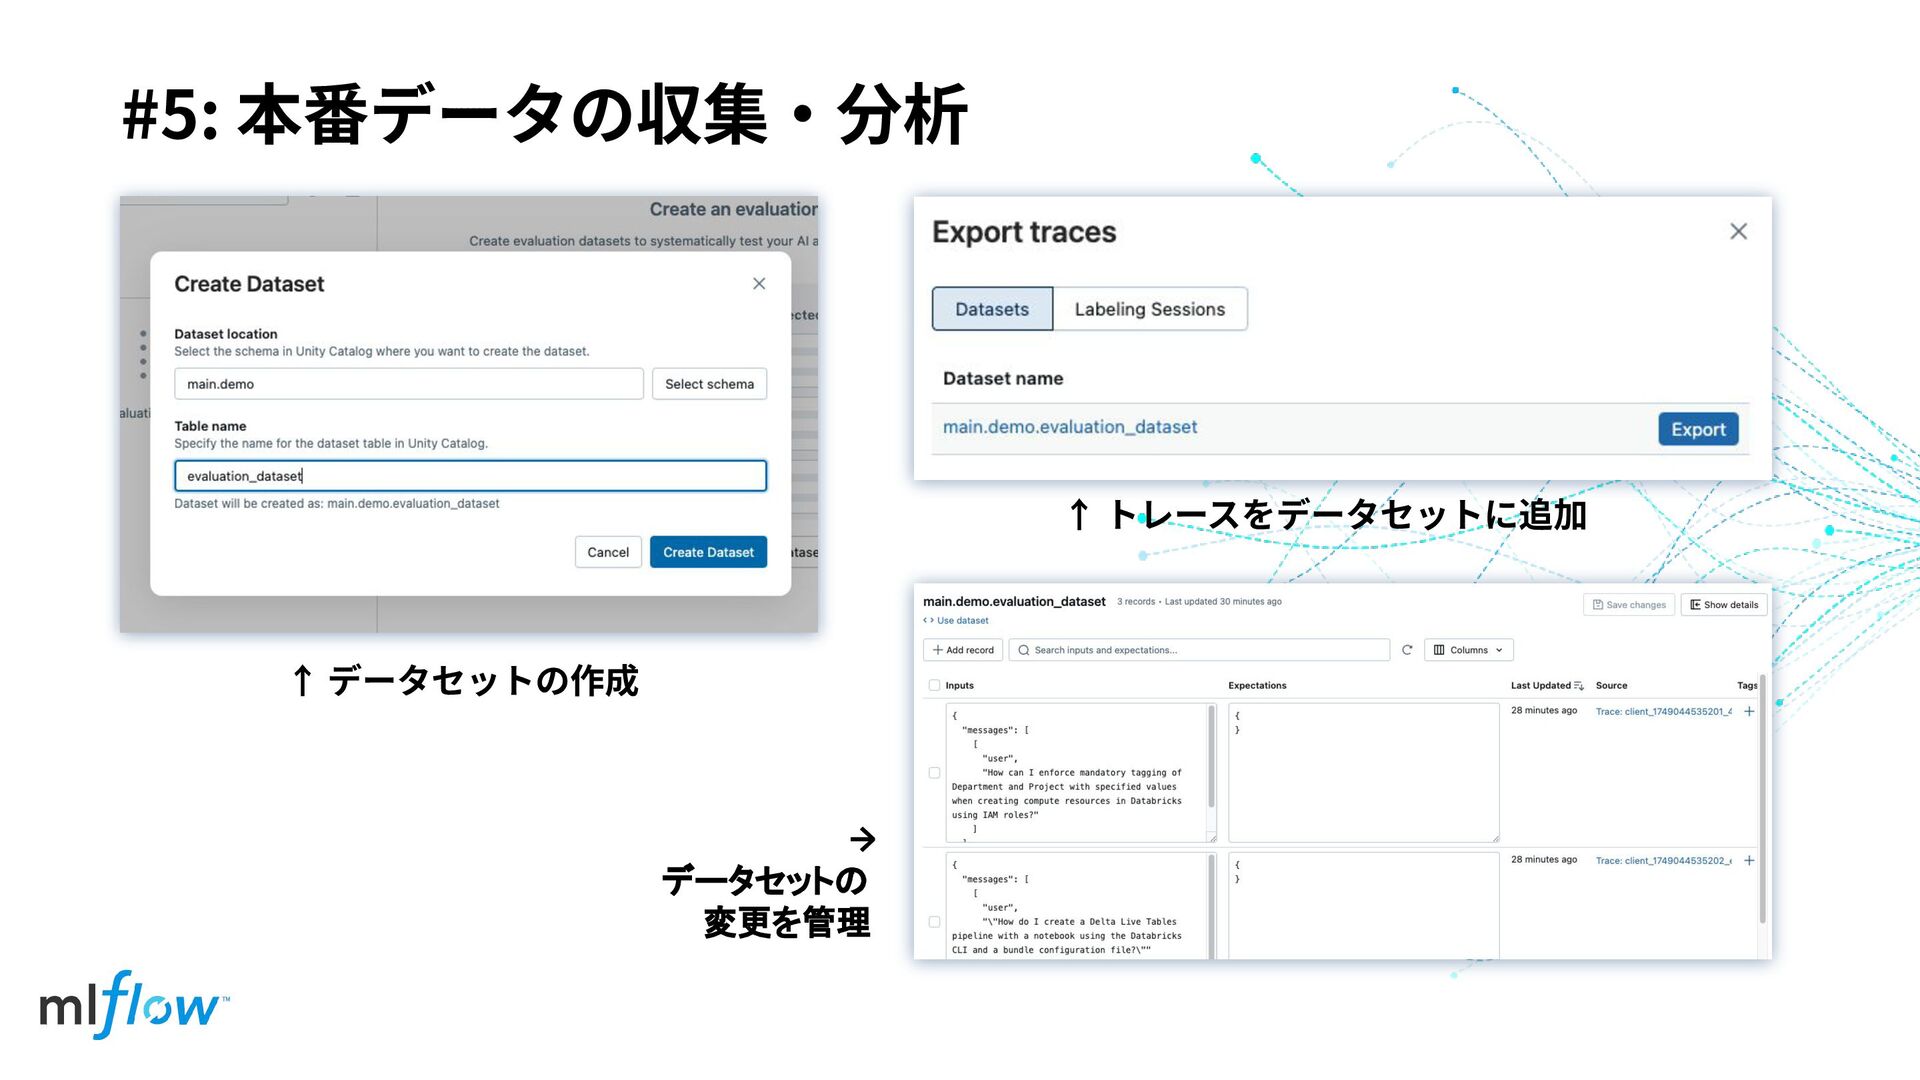
#5: 本番データの収集‧分析 ↑ データセットの作成 ↑ トレースをデータセットに追加 → データセットの 変更を管理
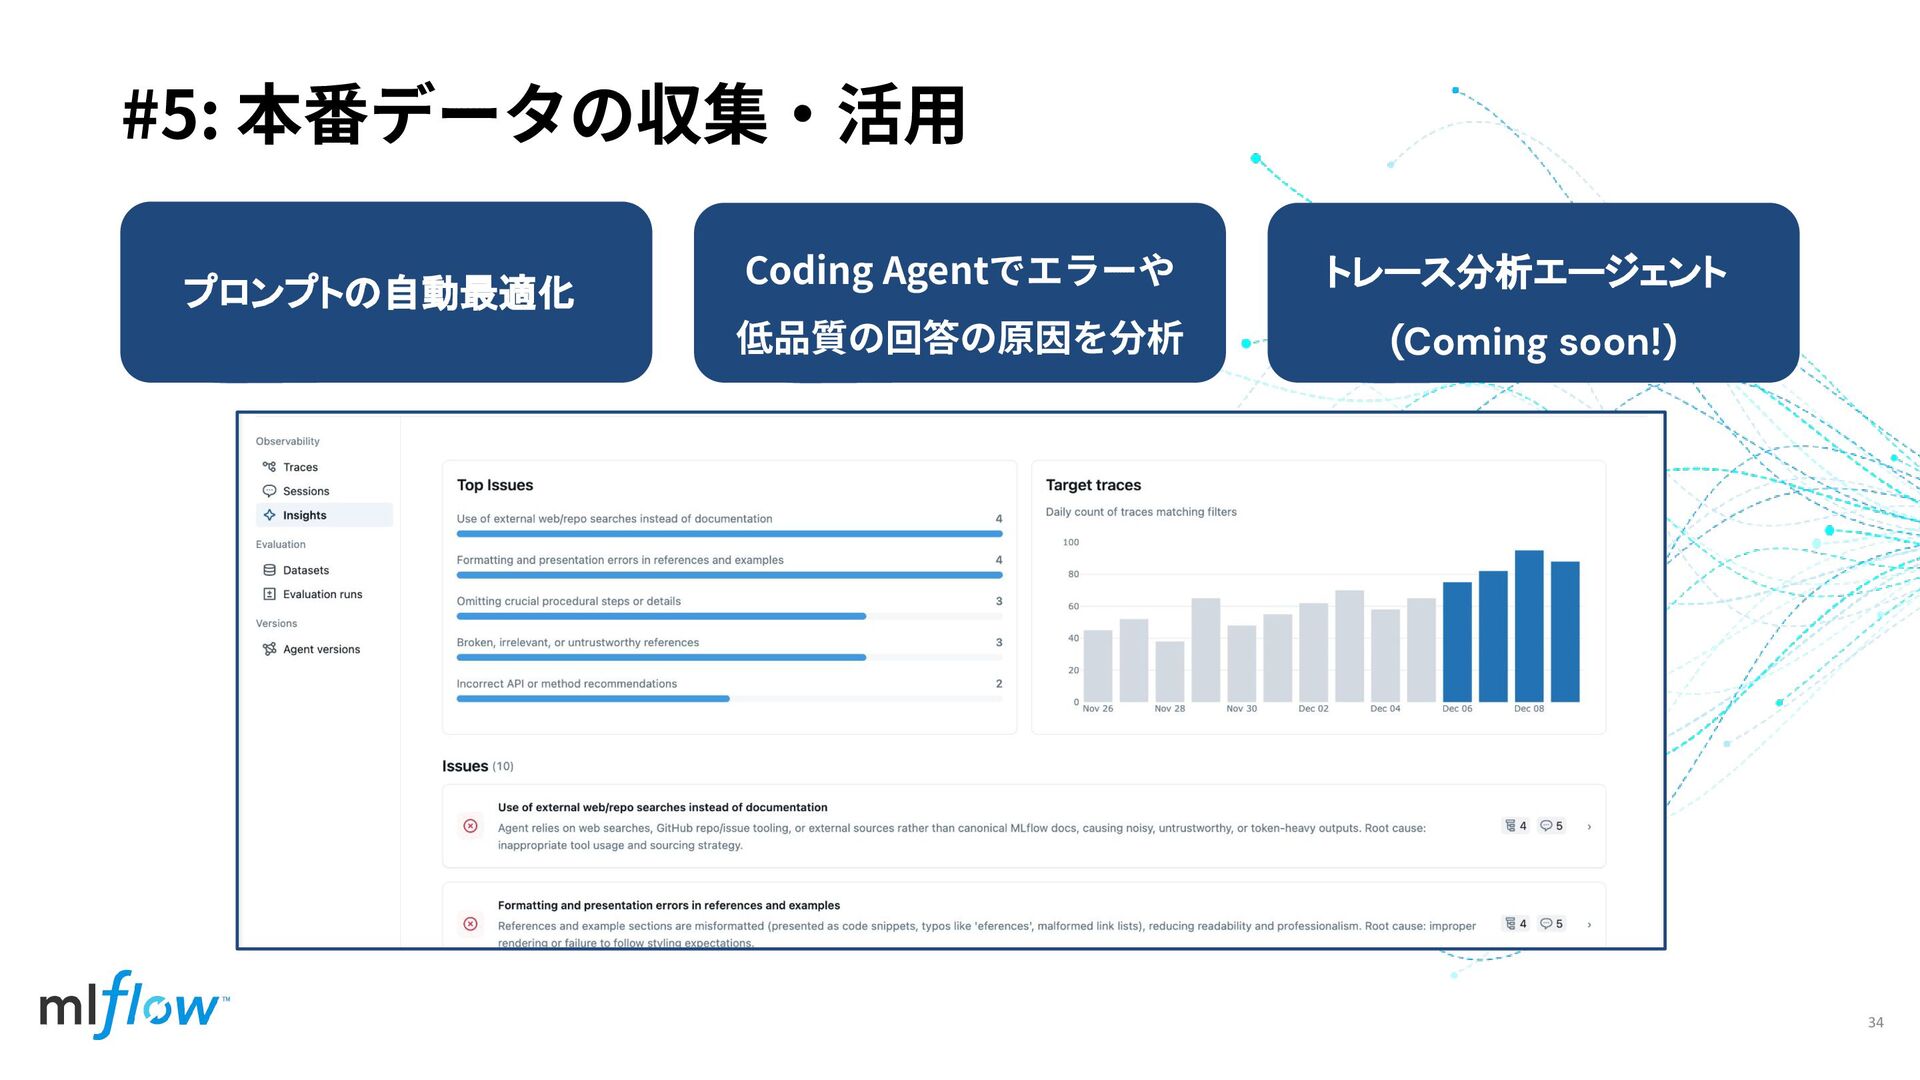
34 #5: 本番データの収集‧活⽤ Coding Agentでエラーや 低品質の回答の原因を分析 トレース分析エージェント (Coming soon!) プロンプトの自動最適化
MLflow 3をはじめる
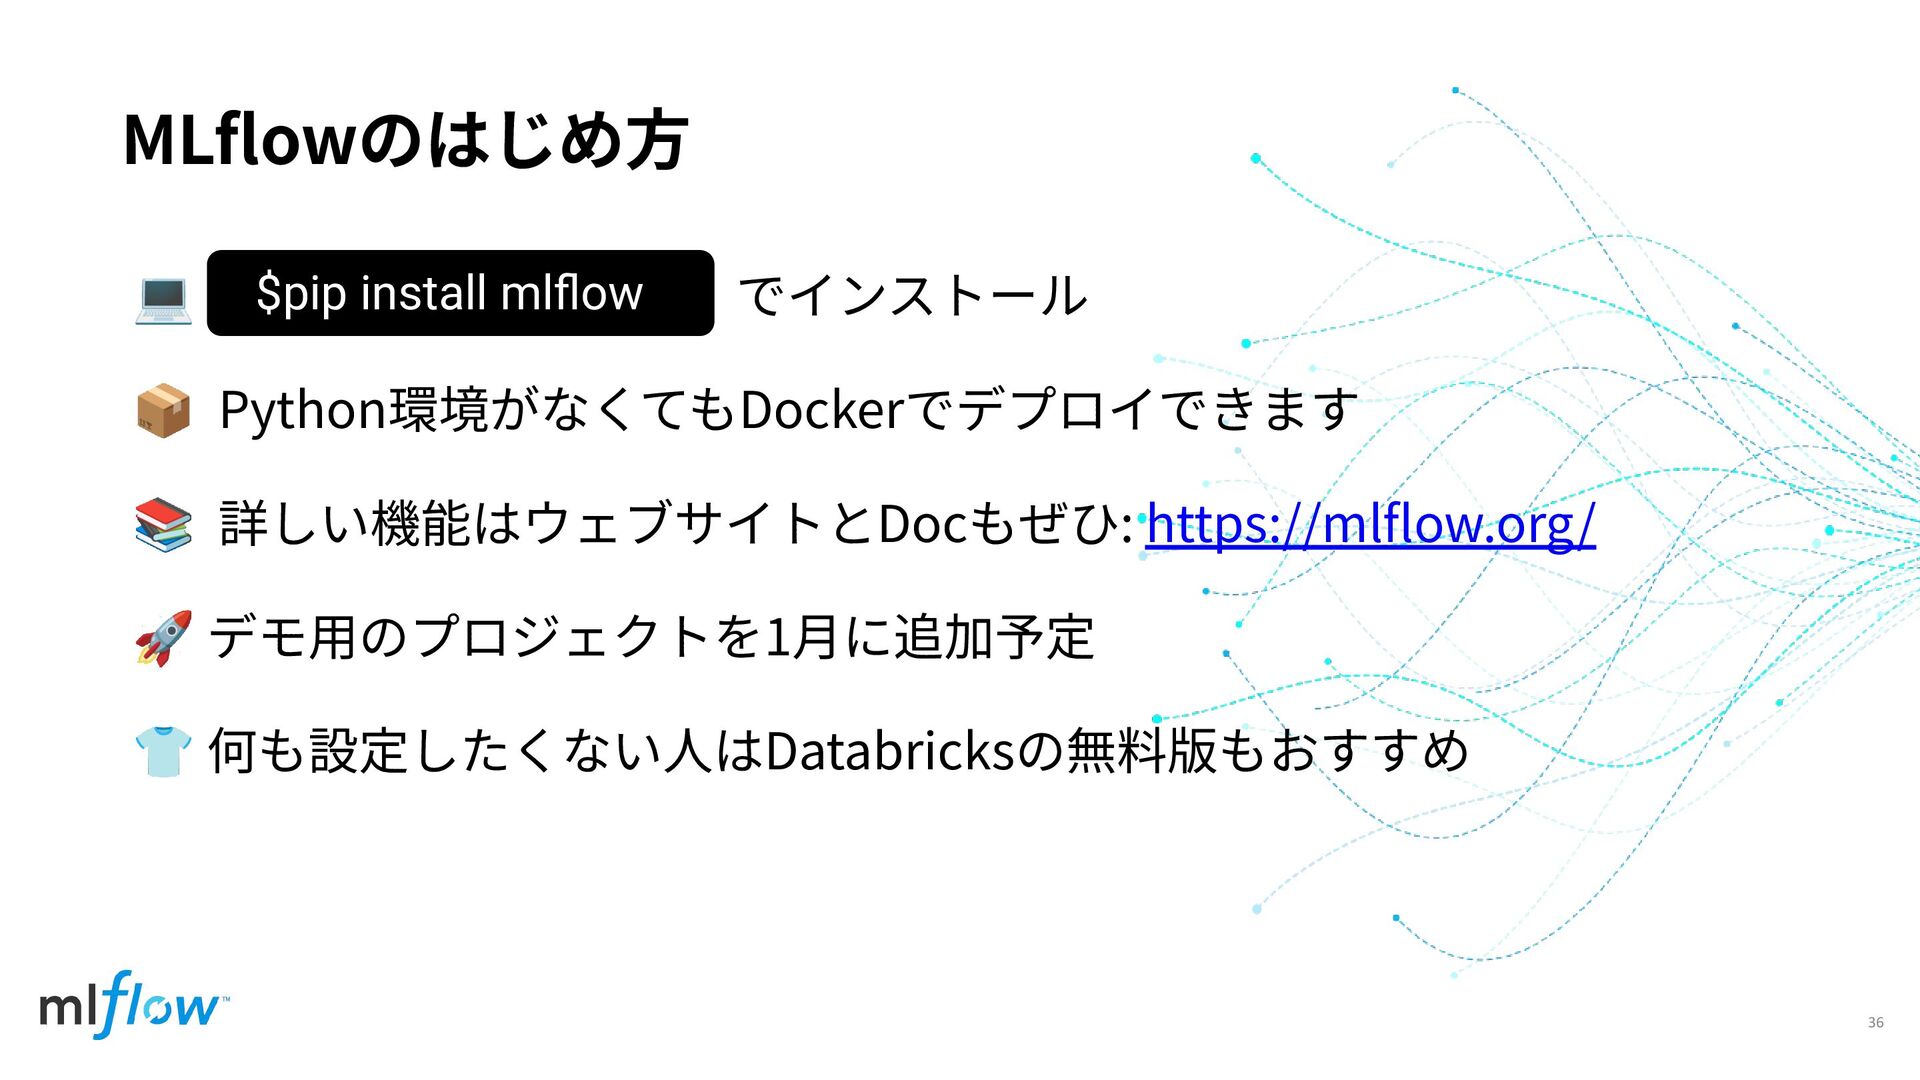
36 💻 でインストール 📦 Python環境がなくてもDockerでデプロイできます 📚 詳しい機能はウェブサイトとDocもぜひ: https://mlflow.org/ 🚀
デモ⽤のプロジェクトを1⽉に追加予定 👕 何も設定したくない⼈はDatabricksの無料版もおすすめ MLflowのはじめ⽅ $pip install mlflow


 databricksjapan
 recruitengineers
 y_sera15
 mikanichinose
 mkdev10
 munakata
 marceloancelmo
 thkt
 sansantech
 yama3133
 pauli
 ennael
 keathley
 tonyrice
 eileencodes
 tmiket
 shlominoach
 reverentgeek
 ianozsvald
 codingconduct
 skipperchong
 denniskardys
 cassininazir
 aleyda