Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
共起要素のクラスタリングを用いた分布類似度計算
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
自然言語処理研究室
March 31, 2011
Research
160
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
共起要素のクラスタリングを用いた分布類似度計算
大平 真一, 山本 和英. 共起要素のクラスタリングを用いた分布類似度計算. 言語処理学会第17回年次大会, pp.292-295 (2011.3)
自然言語処理研究室
March 31, 2011
More Decks by 自然言語処理研究室
See All by 自然言語処理研究室
データサイエンス14_システム.pdf
jnlp
0
430
データサイエンス13_解析.pdf
jnlp
0
550
データサイエンス12_分類.pdf
jnlp
0
380
データサイエンス11_前処理.pdf
jnlp
0
510
Recurrent neural network based language model
jnlp
0
190
自然言語処理研究室 研究概要(2012年)
jnlp
0
170
自然言語処理研究室 研究概要(2013年)
jnlp
0
130
自然言語処理研究室 研究概要(2014年)
jnlp
0
160
自然言語処理研究室 研究概要(2015年)
jnlp
0
240
Other Decks in Research
See All in Research
2025年度秋葉原ウォーカブルプロジェクト調査報告 「アキバらしいウォーカブル」とは何か
izumiyama_lab
1
240
[IR Reading 2026春 論文紹介] LLM-based Listwise Reranking under the Effect of Positional Bias (ECIR 2026) /IR-Reading-2026-Spring
koheishinden
PRO
0
460
MIRU2026 チュートリアル講演2:三次元データ処理の動向
nnchiba
8
5.2k
CVPR2026論文紹介_VLMにとって良いvision encoderとは何か?Rethinking Model Selection in VLM Through the Lens of Gromov-Wasserstein Distance
kobayashi31
1
260
【中間報告】国会議員の立法・政策実務を支える環境を巡る現状と課題
polipoli
0
690
人間中心の意思決定支援AI
yukinobaba
PRO
7
4.2k
SLAMはどこまで解決されたのか?
tomonom
0
1.4k
某助成金プロジェクト採択に向けて企業研究所のアウトリーチ専任者がやったこと
afroscript
0
190
SAM3を用いたコマ・吹き出しの 領域検出と分割構造からの読み順推定
kzmssk
0
170
NLP colloquium: AI Safety Survey
kanekomasahiro
2
1.1k
Source Code Diff Revolution
tsantalis
0
180
Développer des solutions de réduction des émissions de méthane entérique : 1ers résultats Méthane 2030
institutdelelevage
PRO
0
230
Featured
See All Featured
Agile Leadership in an Agile Organization
kimpetersen
PRO
0
270
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
<Decoding/> the Language of Devs - We Love SEO 2024
nikkihalliwell
1
350
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
58k
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
760
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
1
350
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
450
Into the Great Unknown - MozCon
thekraken
41
2.8k
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
570
Skip the Path - Find Your Career Trail
mkilby
1
240
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
Transcript
共起要素の クラスタリングを用いた 分布類似度計算 長岡技術科学大学 電気系 山本研究室 大平 真一,山本 和英
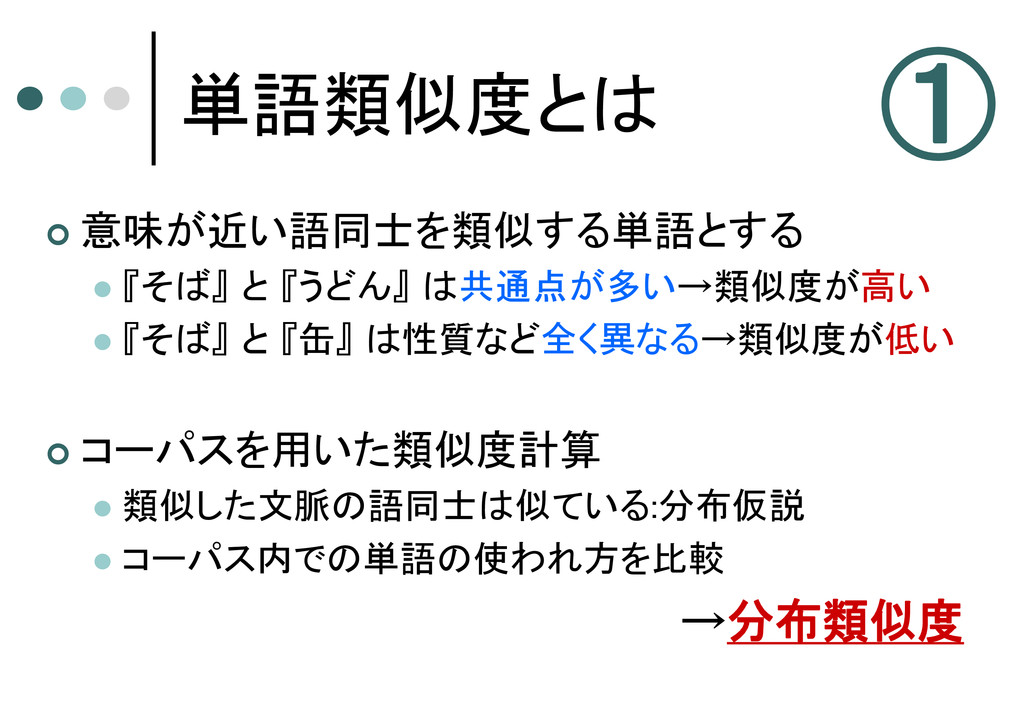
単語類似度とは 意味が近い語同士を類似する単語とする 『そば』 と 『うどん』 は共通点が多い→類似度が高い 『そば』
と 『缶』 は性質など全く異なる→類似度が低い コーパスを用いた類似度計算 類似した文脈の語同士は似ている:分布仮説 コーパス内での単語の使われ方を比較 →分布類似度 ①
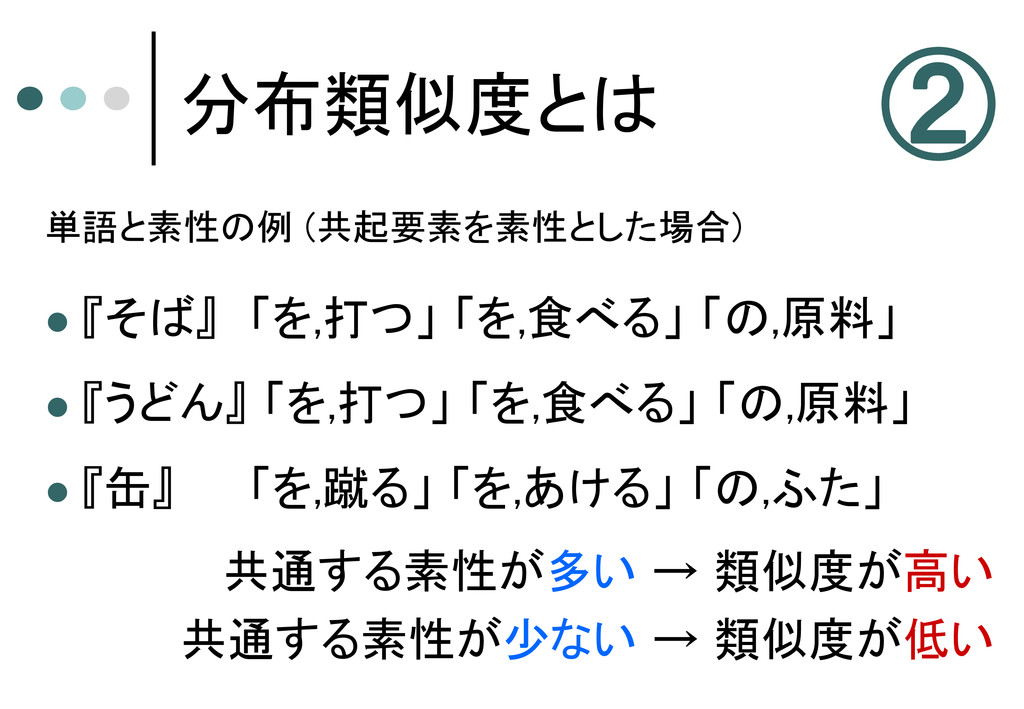
分布類似度とは 単語と素性の例 (共起要素を素性とした場合) 『そば』 「を,打つ」 「を,食べる」 「の,原料」 『うどん』
「を,打つ」 「を,食べる」 「の,原料」 『缶』 「を,蹴る」 「を,あける」 「の,ふた」 共通する素性が多い → 類似度が高い 共通する素性が少ない → 類似度が低い ②
既存研究 [相澤, 08] - 特徴を強く表す素性のみを使用 [柴田ら, 09] -
類似度計算に用いる式の検討 [Maayan Zhitomirsky-Geffet and Dagan, 09] - ブートストラップ法を用いての素性選択 [朝倉ら, 10] - 重みの相対性を用いた素性選択 ③
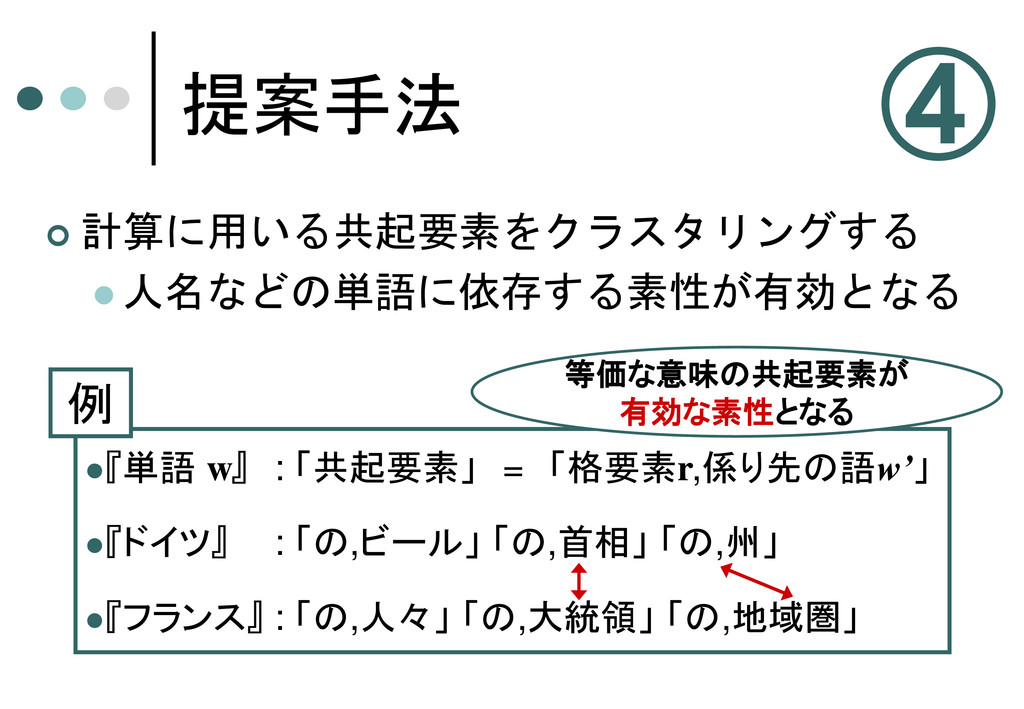
提案手法 計算に用いる共起要素をクラスタリングする 人名などの単語に依存する素性が有効となる 『単語 w』 : 「共起要素」 =
「格要素r,係り先の語w’」 『ドイツ』 : 「の,ビール」 「の,首相」 「の,州」 『フランス』 : 「の,人々」 「の,大統領」 「の,地域圏」 等価な意味の共起要素が 有効な素性となる 例 ④
システム全体の流れ 1. 共起要素の自動獲得 単語と共起要素の対を獲得[Lin, 98] 2. 共起要素のクラスタリング クラスタリングツールbayonを用いる
3. 関数を用いた類似度計算 Weight 関数によるノイズ低減と Measure 関数による類似度計算 [柴田ら, 09] ⑤
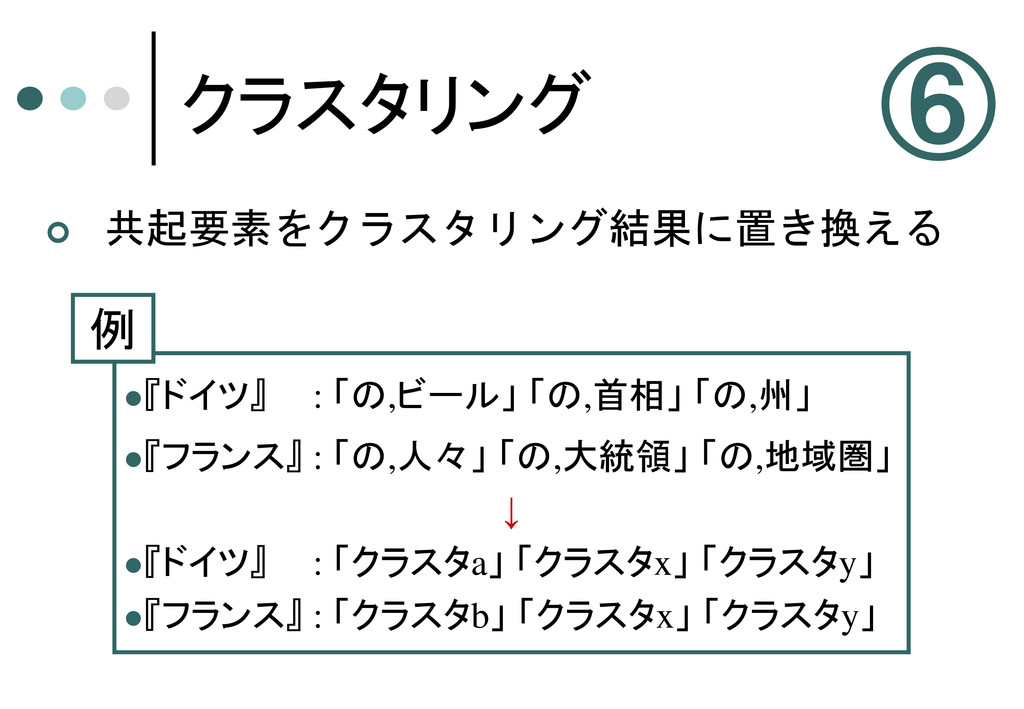
クラスタリング 『ドイツ』 : 「の,ビール」 「の,首相」 「の,州」 『フランス』 : 「の,人々」 「の,大統領」
「の,地域圏」 ↓ 『ドイツ』 : 「クラスタa」 「クラスタx」 「クラスタy」 『フランス』 : 「クラスタb」 「クラスタx」 「クラスタy」 例 共起要素をクラスタリング結果に置き換える ⑥
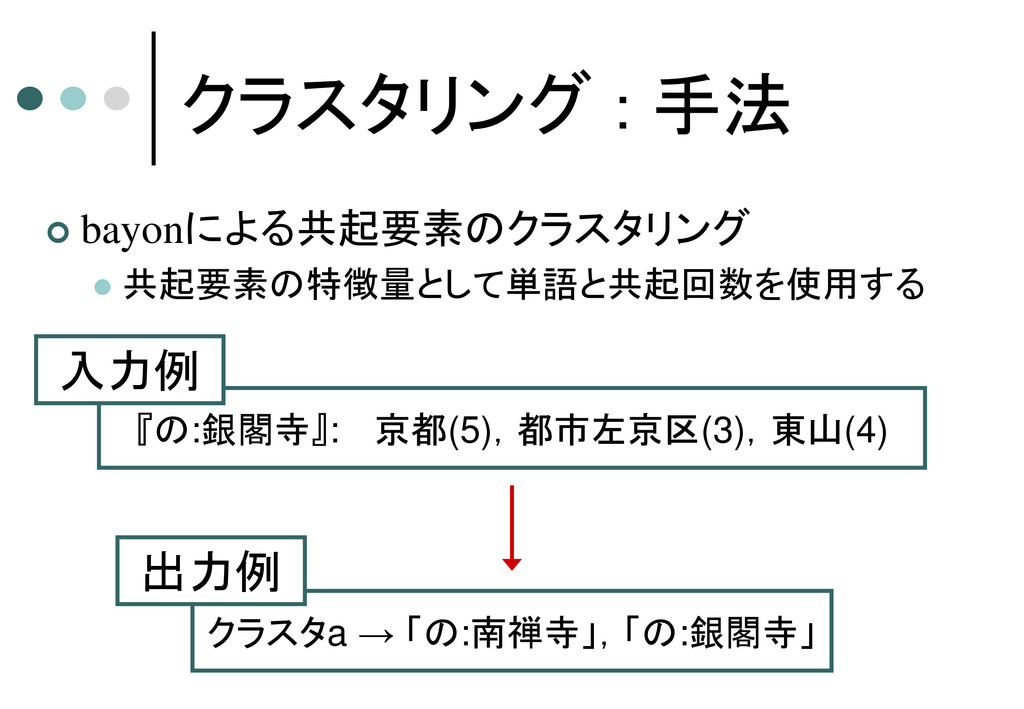
クラスタリング : 手法 bayonによる共起要素のクラスタリング 共起要素の特徴量として単語と共起回数を使用する 『の:銀閣寺』: 京都(5),都市左京区(3),東山(4) クラスタa
→ 「の:南禅寺」,「の:銀閣寺」 出力例 入力例
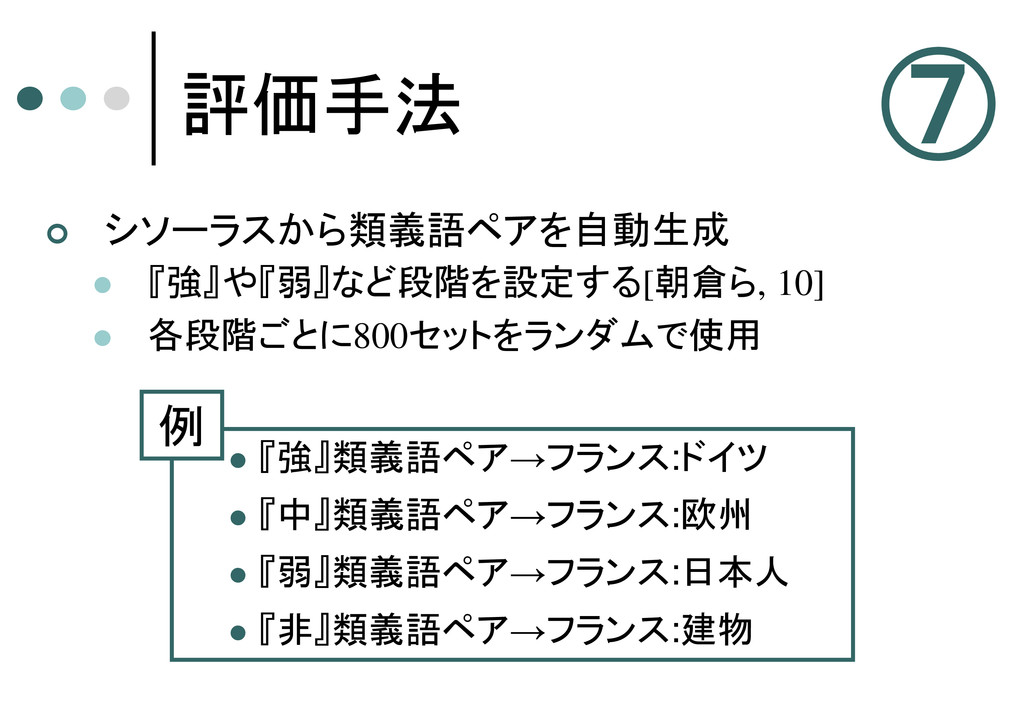
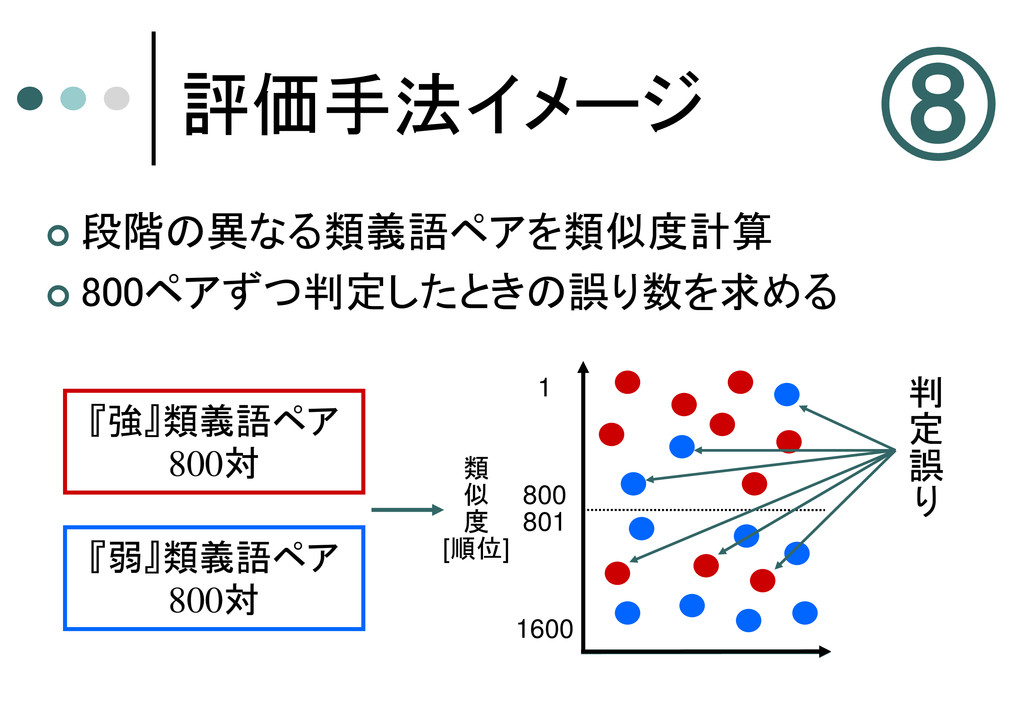
『強』類義語ペア→フランス:ドイツ 『中』類義語ペア→フランス:欧州 『弱』類義語ペア→フランス:日本人 『非』類義語ペア→フランス:建物 評価手法
シソーラスから類義語ペアを自動生成 『強』や『弱』など段階を設定する[朝倉ら, 10] 各段階ごとに800セットをランダムで使用 例 ⑦
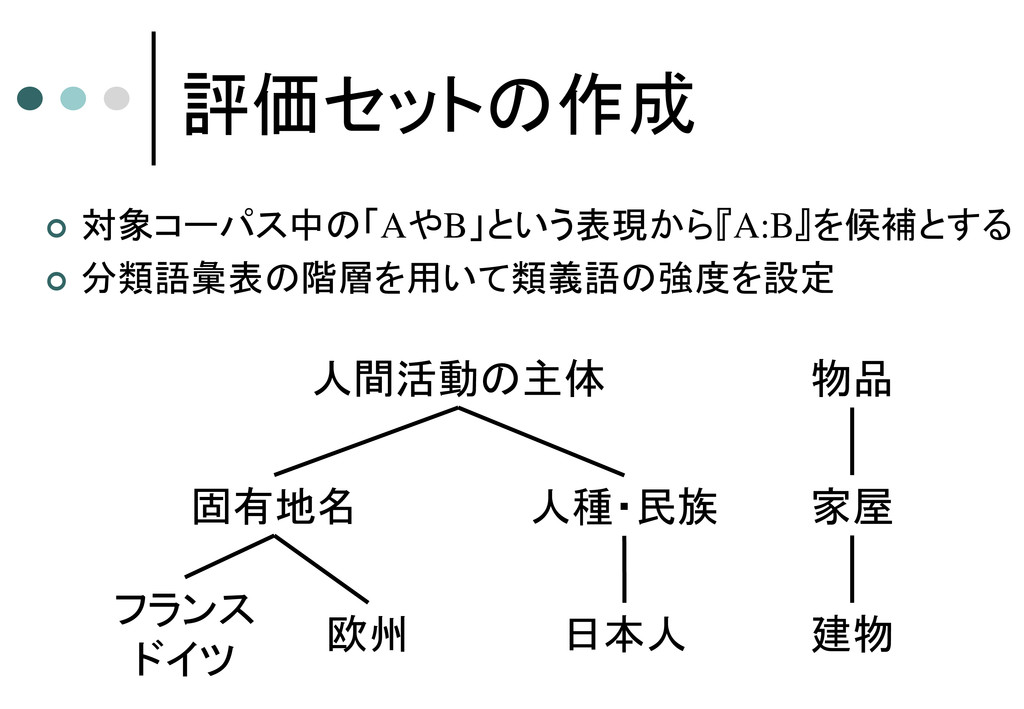
対象コーパス中の「AやB」という表現から『A:B』を候補とする 分類語彙表の階層を用いて類義語の強度を設定 物品 人間活動の主体 家屋 建物 固有地名 人種・民族
フランス ドイツ 欧州 日本人 評価セットの作成
評価手法イメージ 段階の異なる類義語ペアを類似度計算 800ペアずつ判定したときの誤り数を求める 『強』類義語ペア 800対 『弱』類義語ペア 800対 1
800 801 1600 類 似 度 [順位] 判 定 誤 り ⑧
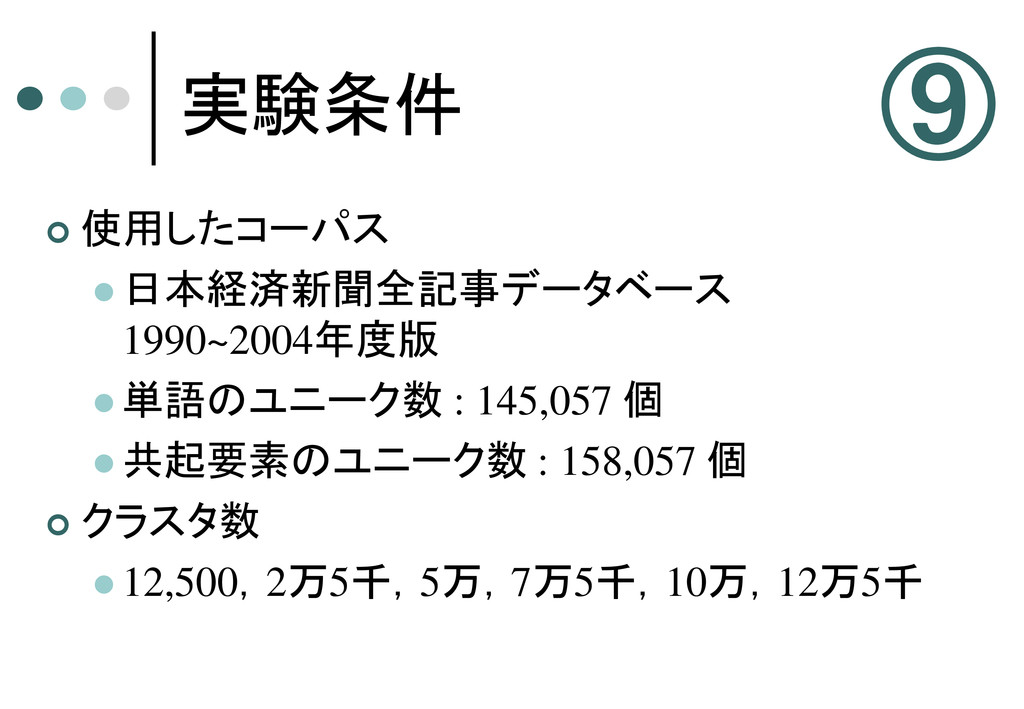
実験条件 使用したコーパス 日本経済新聞全記事データベース 1990~2004年度版 単語のユニーク数 : 145,057
個 共起要素のユニーク数 : 158,057 個 クラスタ数 12,500,2万5千,5万,7万5千,10万,12万5千 ⑨
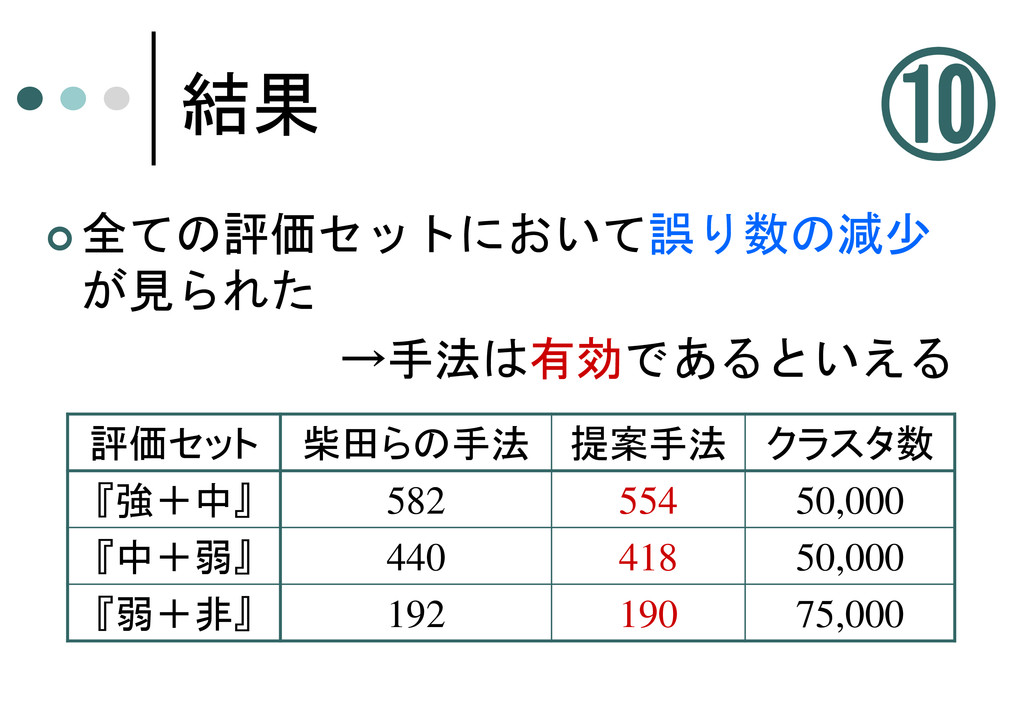
結果 全ての評価セットにおいて誤り数の減少 が見られた →手法は有効であるといえる 評価セット 柴田らの手法 提案手法 クラスタ数 『強+中』
582 554 50,000 『中+弱』 440 418 50,000 『弱+非』 192 190 75,000 ⑩
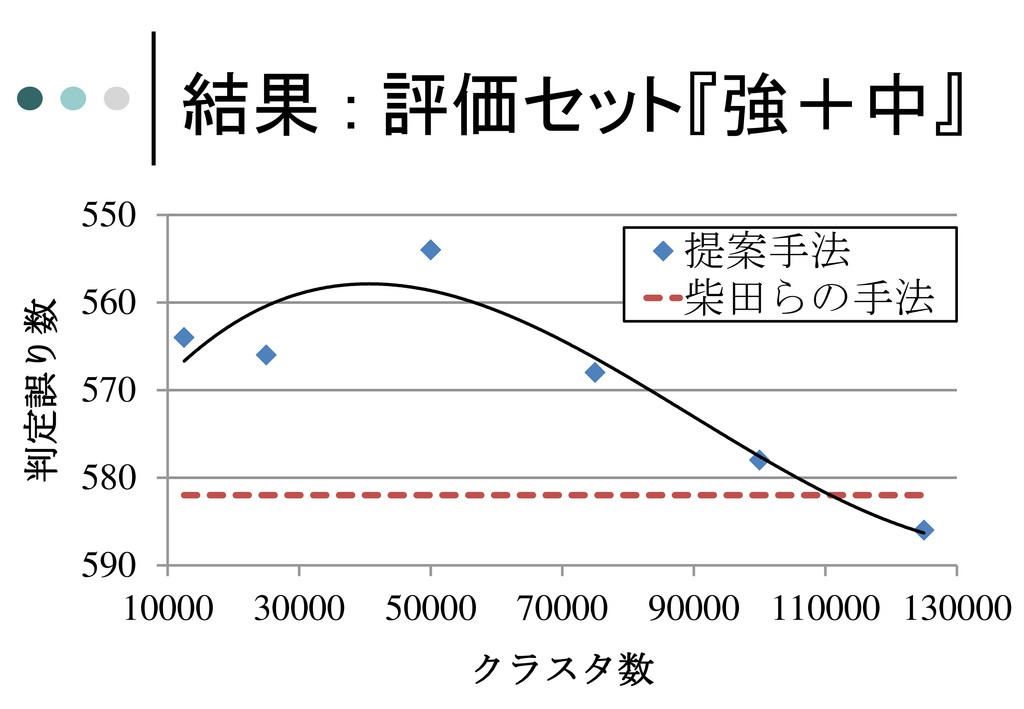
結果 : 評価セット『強+中』 550 560 570 580 590 10000 30000
50000 70000 90000 110000 130000 判定誤り数 クラスタ数 提案手法 柴田らの手法
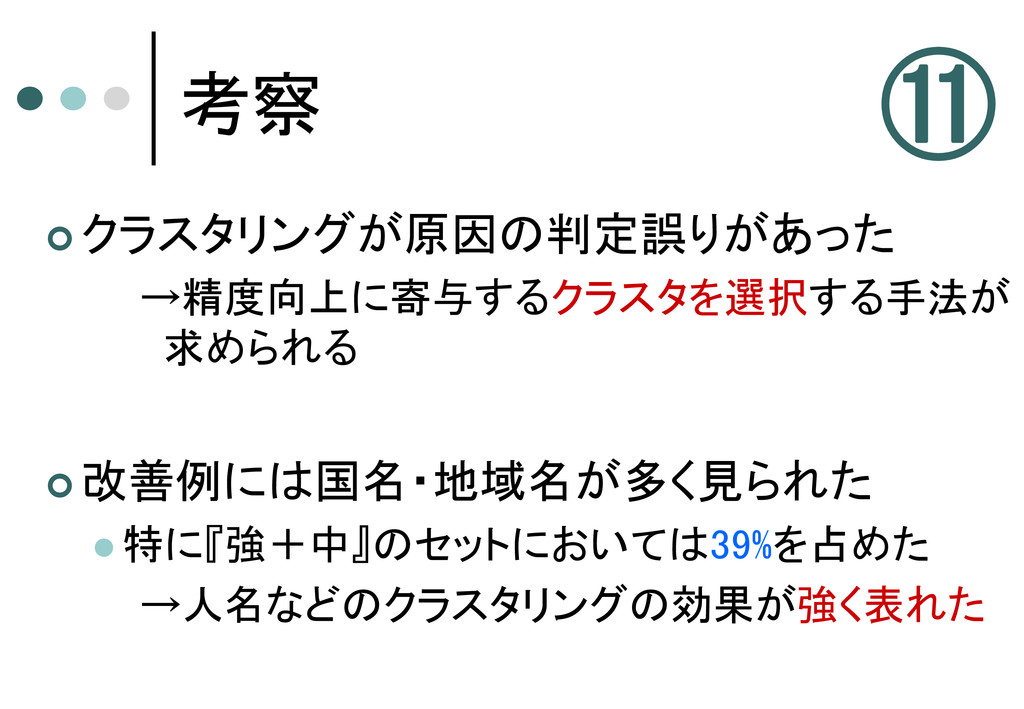
考察 クラスタリングが原因の判定誤りがあった →精度向上に寄与するクラスタを選択する手法が 求められる 改善例には国名・地域名が多く見られた 特に『強+中』のセットにおいては39%を占めた →人名などのクラスタリングの効果が強く表れた
⑪
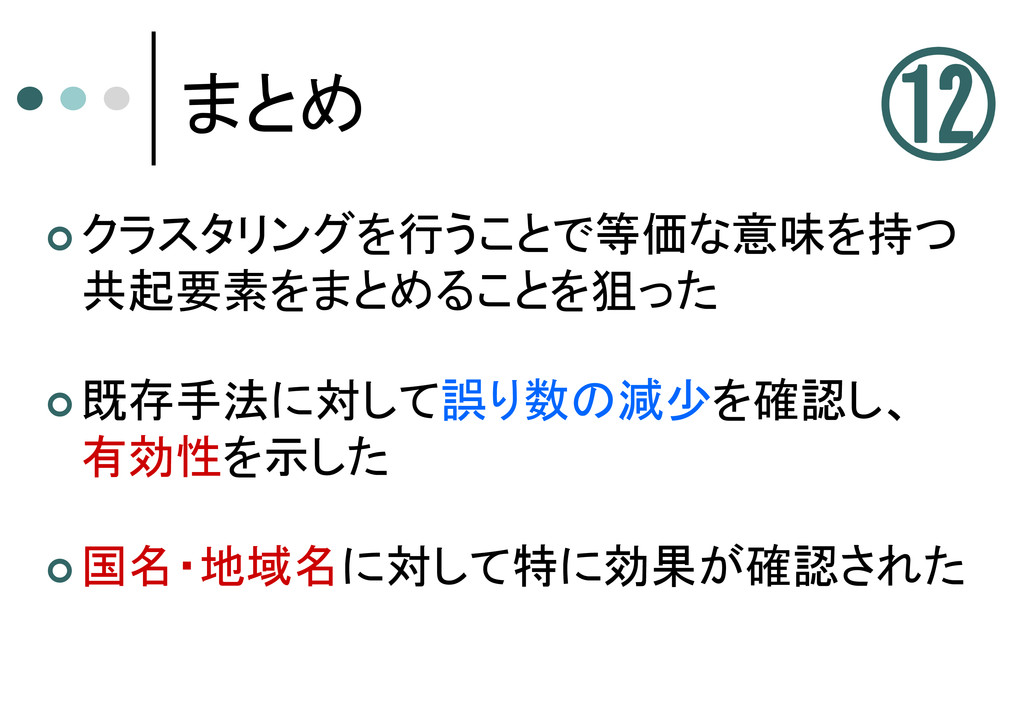
まとめ クラスタリングを行うことで等価な意味を持つ 共起要素をまとめることを狙った 既存手法に対して誤り数の減少を確認し、 有効性を示した 国名・地域名に対して特に効果が確認された ⑫

 Your Podcast. Everywhere. Effortlessly.


 jnlp
 izumiyama_lab
 koheishinden
 nnchiba
 kobayashi31
 polipoli
 yukinobaba
 tomonom
 afroscript
 kzmssk
 kanekomasahiro
 tsantalis
 institutdelelevage
 kimpetersen
 soudai
 nikkihalliwell
 portentint
 helenjbeal
 reverentgeek
 axbom
 thekraken
 samtorres
 mkilby
 mongodb