Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Journal club] Pay Attention to MLPs
Search
Semantic Machine Intelligence Lab., Keio Univ.
PRO
July 19, 2021
Technology
1.7k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Journal club] Pay Attention to MLPs
Semantic Machine Intelligence Lab., Keio Univ.
PRO
July 19, 2021
Transcript
16 slides
Hanxiao Liu, Zihang Dai, David R. So, Quoc V. Le
(Google Research, Brain Team) Pay Attention to MLPs Liu, Hanxiao, et al. "Pay Attention to MLPs." arXiv preprint arXiv:2105.08050 (2021). 慶應義塾大学 杉浦孔明研究室 畑中駿平
2 • Attention-free transformer の一種である「gMLP」の提案 • Transformer の構造を変更した gate 付き
Multi Layer Perceptron ( MLP ) のみで設計 概要 ✓ gMLP が現在の Transformer よりも優れた性能、または同等の性能を発揮 ✓ self-attention がさほど重要な要素ではない
3 • Transformer [Vaswani+, NIPS2017] の出現 − Natural Language Processing
( NLP ) … LSTM・RNN → BERT [Devlin+, NAACL2018] − Computer Vision ( CV ) … CNN → ViT [Dosovitskiy+, ICLR2020] • self-attention の特徴 1. 再帰的ではない ( = 並列処理 ) 2. token 間の空間情報を取得 背景:Transformer の出現による NLP, CV の発展
• Attention 機構のメリット [Bahdanau+, ICLR2015] − 入力データの表現に基づいた動的なパラメータの 決定により、より有効な帰納バイアスを導入可能 − 帰納バイアスが顕著に有効かどうか未解決
• MLP のメリット[Hornik+, 1989] − 静的なパラメータで任意の関数を近似可能 問題提起:MLP での代替案・Attention の必要性 • MLP で self-attention の特徴を表現可能か • self-attention を用いる必要性の是非 4
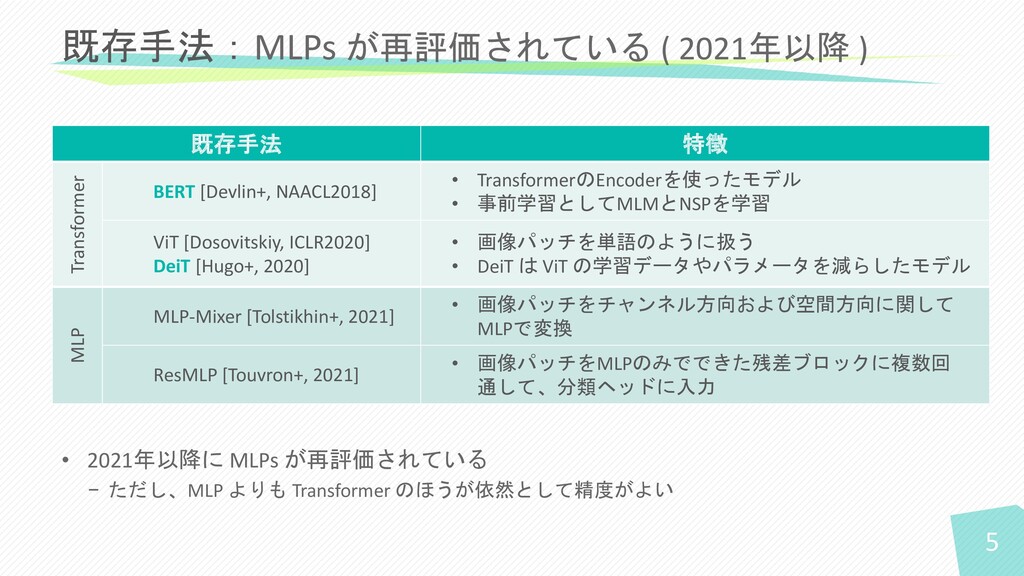
5 • 2021年以降に MLPs が再評価されている − ただし、MLP よりも Transformer のほうが依然として精度がよい
既存手法:MLPs が再評価されている ( 2021年以降 ) 既存手法 特徴 Transformer BERT [Devlin+, NAACL2018] • TransformerのEncoderを使ったモデル • 事前学習としてMLMとNSPを学習 ViT [Dosovitskiy, ICLR2020] DeiT [Hugo+, 2020] • 画像パッチを単語のように扱う • DeiT は ViT の学習データやパラメータを減らしたモデル MLP MLP-Mixer [Tolstikhin+, 2021] • 画像パッチをチャンネル方向および空間方向に関して MLPで変換 ResMLP [Touvron+, 2021] • 画像パッチをMLPのみでできた残差ブロックに複数回 通して、分類ヘッドに入力
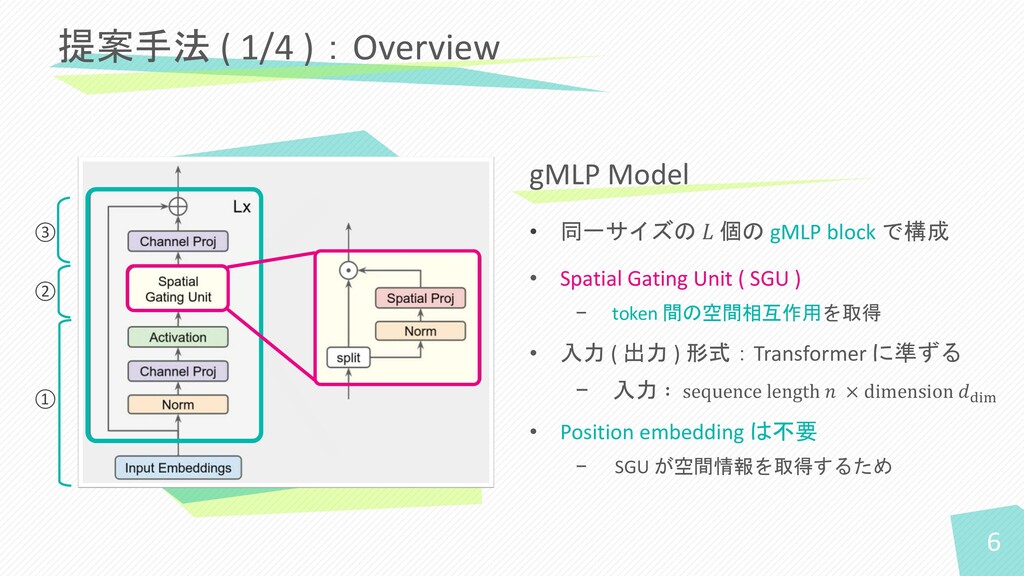
• 同一サイズの 𝐿 個の gMLP block で構成 • Spatial Gating
Unit ( SGU ) − token 間の空間相互作用を取得 • 入力 ( 出力 ) 形式:Transformer に準ずる − 入力 ∶ sequence length 𝑛 × dimension 𝑑dim • Position embedding は不要 − SGU が空間情報を取得するため 提案手法 ( 1/4 ):Overview gMLP Model 6 ① ② ③
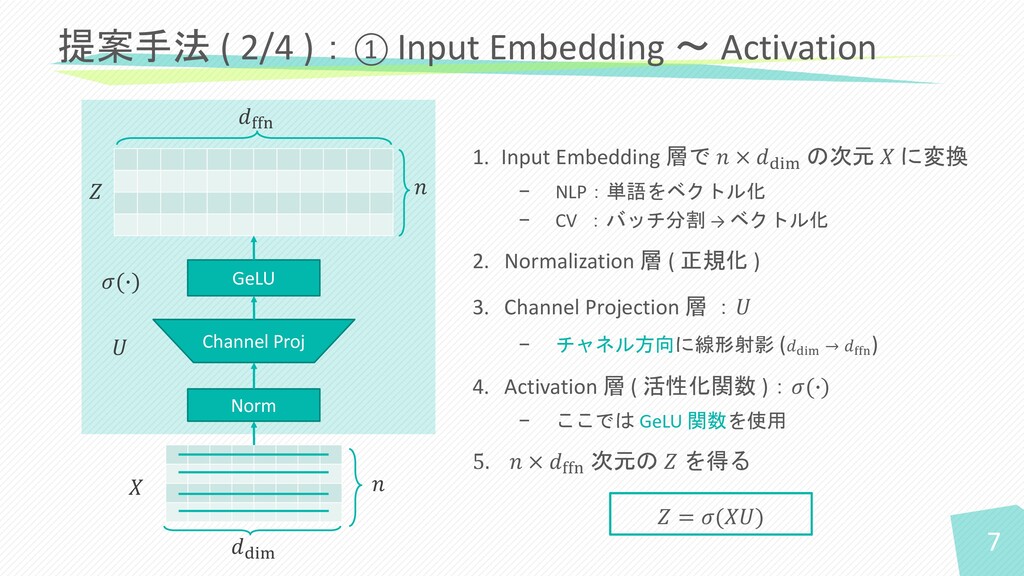
1. Input Embedding 層で 𝑛 × 𝑑dim の次元 𝑋 に変換
− NLP:単語をベクトル化 − CV :バッチ分割 → ベクトル化 2. Normalization 層 ( 正規化 ) 3. Channel Projection 層 :𝑈 − チャネル方向に線形射影 (𝑑dim → 𝑑ffn ) 4. Activation 層 ( 活性化関数 ):𝜎(∙) − ここでは GeLU 関数を使用 5. 𝑛 × 𝑑ffn 次元の 𝑍 を得る 提案手法 ( 2/4 ):① Input Embedding ~ Activation Norm Channel Proj GeLU 𝑛 𝑑dim 𝑑ffn 𝑈 𝜎(∙) 𝑍 𝑍 = 𝜎(𝑋𝑈) 𝑋 𝑛 7
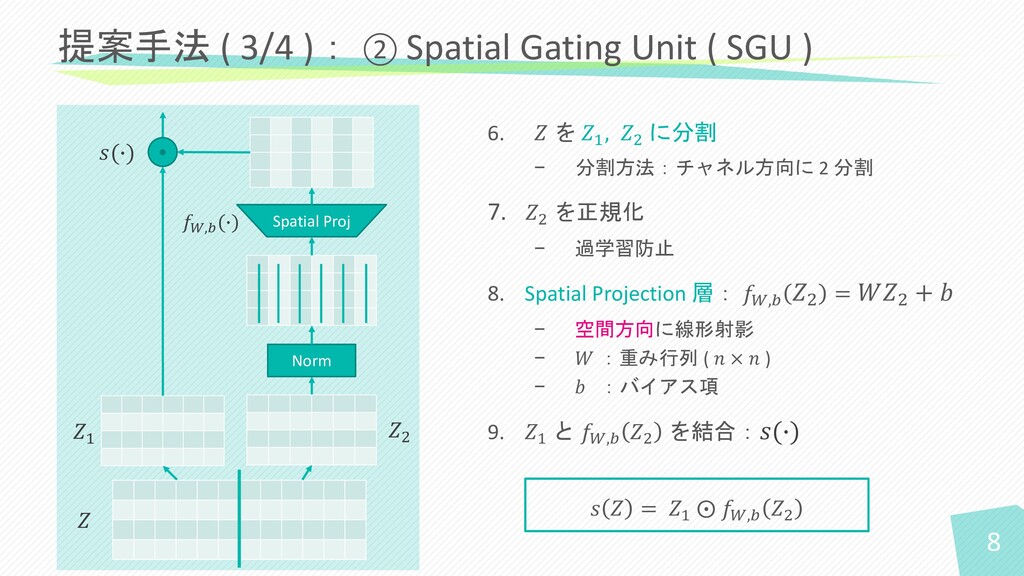
6. 𝑍 を 𝑍1 , 𝑍2 に分割 − 分割方法:チャネル方向に 2
分割 7. 𝑍2 を正規化 − 過学習防止 8. Spatial Projection 層: 𝑓𝑊,𝑏 𝑍2 = 𝑊𝑍2 + 𝑏 − 空間方向に線形射影 − 𝑊 :重み行列 ( 𝑛 × 𝑛 ) − 𝑏 :バイアス項 9. 𝑍1 と 𝑓𝑊,𝑏 𝑍2 を結合:𝑠(∙) 提案手法 ( 3/4 ): ② Spatial Gating Unit ( SGU ) 𝑠 𝑍 = 𝑍1 ⨀ 𝑓𝑊,𝑏 𝑍2 8 𝑍 Norm Spatial Proj 𝑍1 𝑍2 𝑓𝑊,𝑏 (∙) 𝑠(∙)
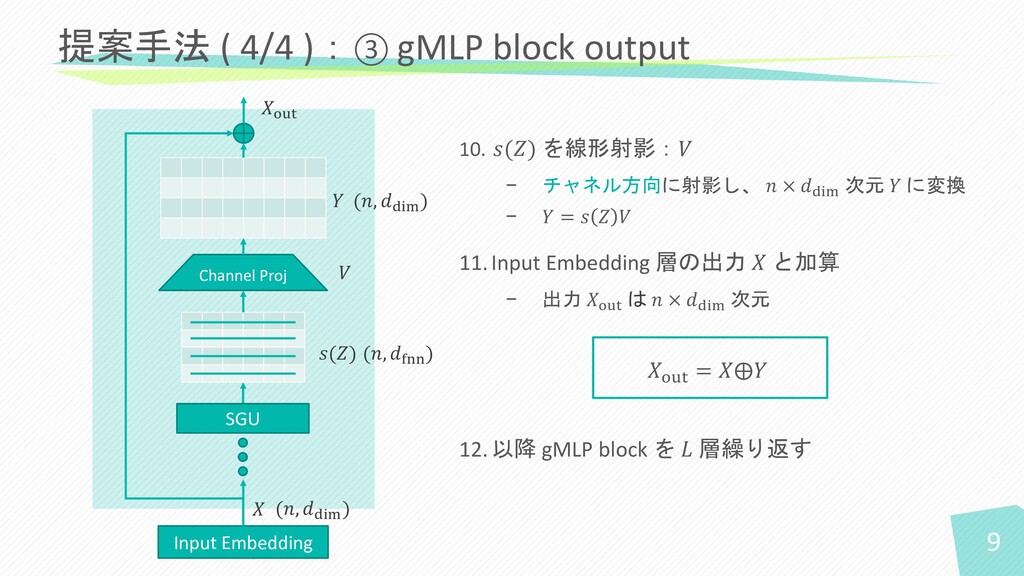
10. 𝑠(𝑍) を線形射影:𝑉 − チャネル方向に射影し、 𝑛 × 𝑑dim 次元 𝑌
に変換 − 𝑌 = 𝑠 𝑍 𝑉 11.Input Embedding 層の出力 𝑋 と加算 − 出力 𝑋out は 𝑛 × 𝑑dim 次元 12.以降 gMLP block を 𝐿 層繰り返す 提案手法 ( 4/4 ):③ gMLP block output 𝑠(𝑍) 𝑋out = 𝑋⨁𝑌 Channel Proj SGU Input Embedding 𝑉 (𝑛, 𝑑dim ) (𝑛, 𝑑dim ) 𝑋out 𝑌 𝑋 (𝑛, 𝑑fnn ) 9
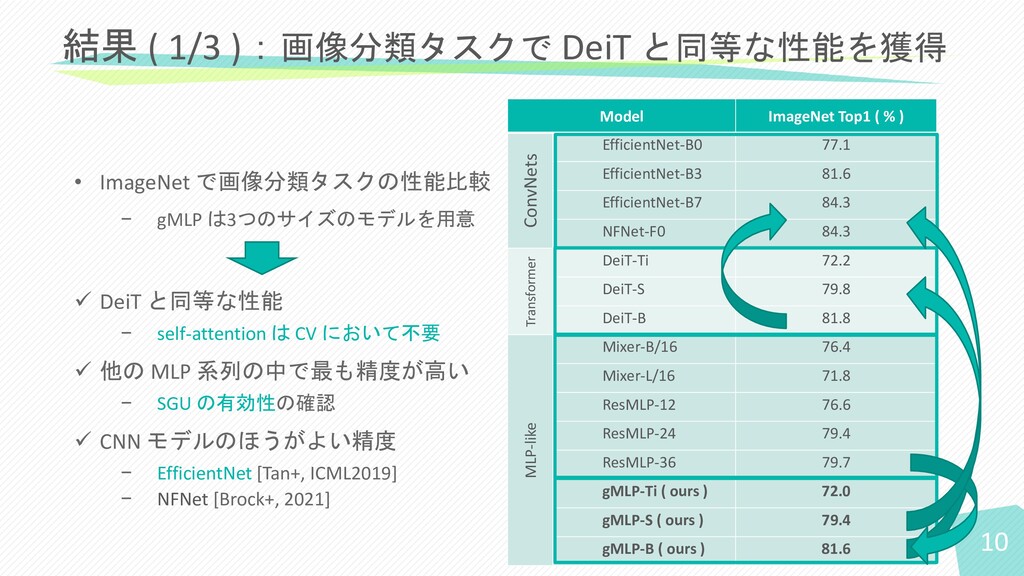
• ImageNet で画像分類タスクの性能比較 − gMLP は3つのサイズのモデルを用意 ✓ DeiT と同等な性能 −
self-attention は CV において不要 ✓ 他の MLP 系列の中で最も精度が高い − SGU の有効性の確認 ✓ CNN モデルのほうがよい精度 − EfficientNet [Tan+, ICML2019] − NFNet [Brock+, 2021] 結果 ( 1/3 ):画像分類タスクで DeiT と同等な性能を獲得 10 Model ImageNet Top1 ( % ) ConvNets EfficientNet-B0 77.1 EfficientNet-B3 81.6 EfficientNet-B7 84.3 NFNet-F0 84.3 Transformer DeiT-Ti 72.2 DeiT-S 79.8 DeiT-B 81.8 MLP-like Mixer-B/16 76.4 Mixer-L/16 71.8 ResMLP-12 76.6 ResMLP-24 79.4 ResMLP-36 79.7 gMLP-Ti ( ours ) 72.0 gMLP-S ( ours ) 79.4 gMLP-B ( ours ) 81.6
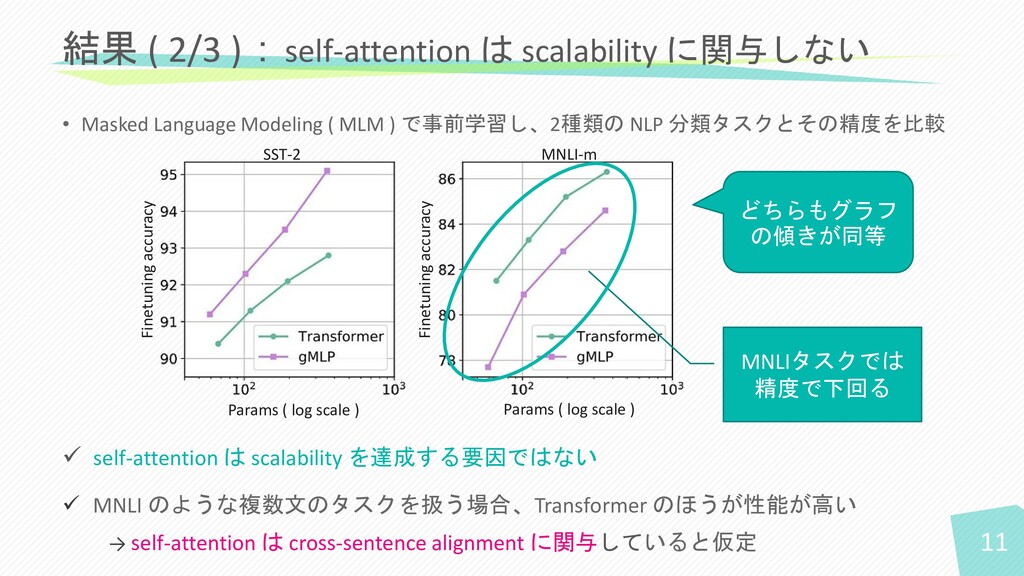
• Masked Language Modeling ( MLM ) で事前学習し、2種類の NLP 分類タスクとその精度を比較
MNLI-m ✓ self-attention は scalability を達成する要因ではない ✓ MNLI のような複数文のタスクを扱う場合、Transformer のほうが性能が高い → self-attention は cross-sentence alignment に関与していると仮定 結果 ( 2/3 ):self-attention は scalability に関与しない どちらもグラフ の傾きが同等 11 MNLIタスクでは 精度で下回る SST-2 Finetuning accuracy Finetuning accuracy Params ( log scale ) Params ( log scale )
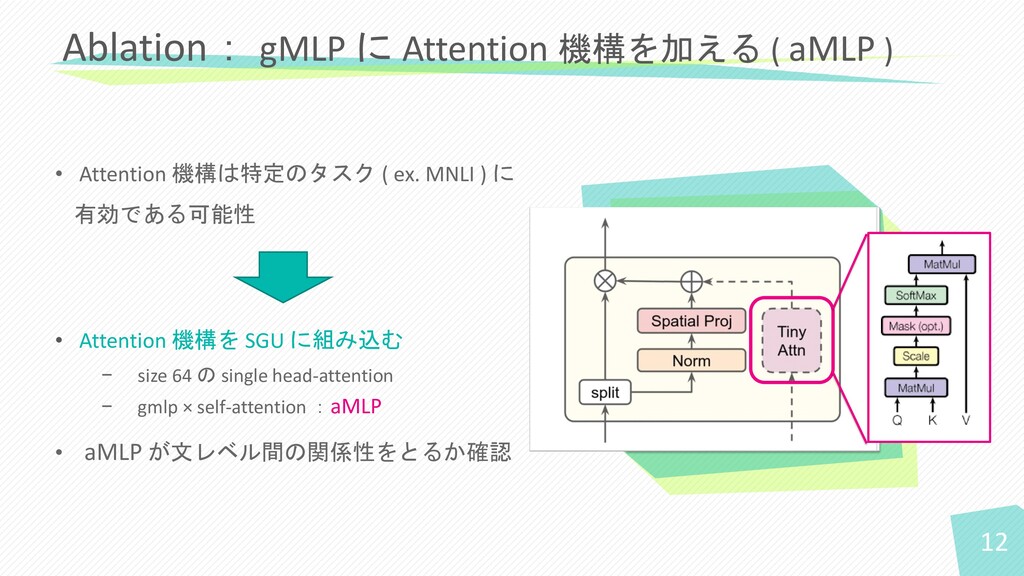
• Attention 機構は特定のタスク ( ex. MNLI ) に 有効である可能性 •
Attention 機構を SGU に組み込む − size 64 の single head-attention − gmlp × self-attention :aMLP • aMLP が文レベル間の関係性をとるか確認 Ablation: gMLP に Attention 機構を加える ( aMLP ) 12
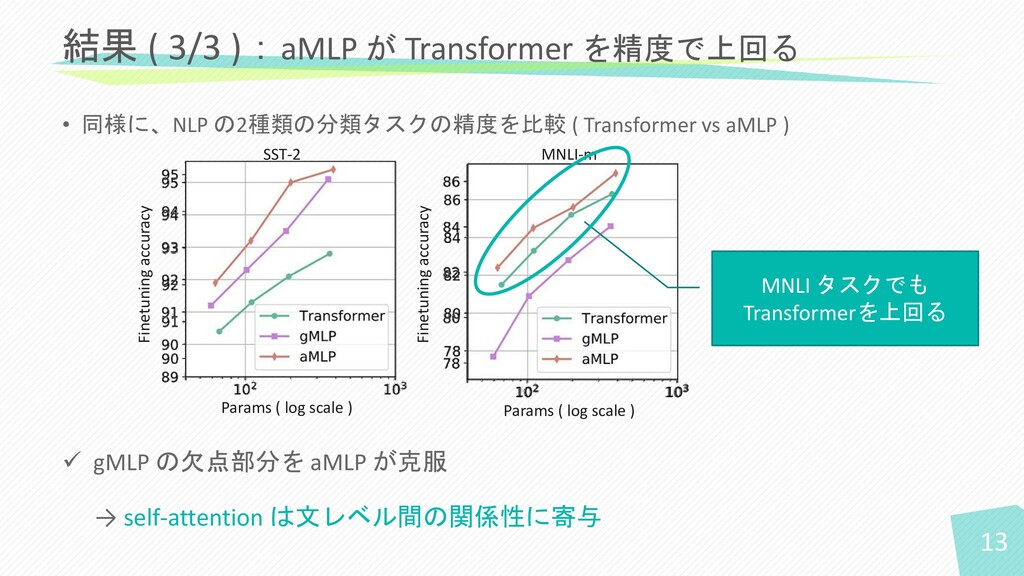
• 同様に、NLP の2種類の分類タスクの精度を比較 ( Transformer vs aMLP ) MNLI-m SST-2
✓ gMLP の欠点部分を aMLP が克服 → self-attention は文レベル間の関係性に寄与 結果 ( 3/3 ):aMLP が Transformer を精度で上回る 13 MNLI タスクでも Transformerを上回る Finetuning accuracy Finetuning accuracy Params ( log scale ) Params ( log scale )
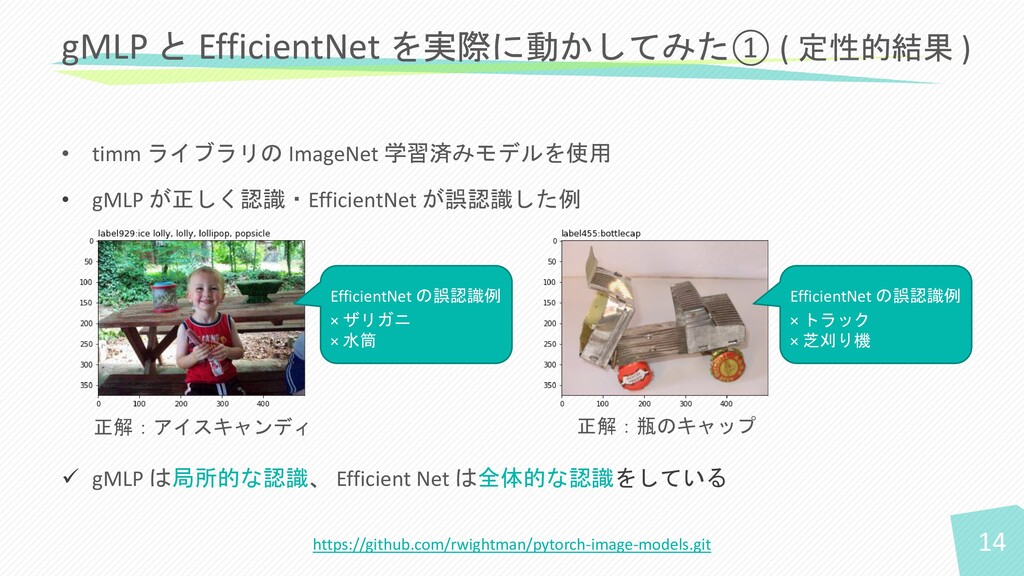
14 • timm ライブラリの ImageNet 学習済みモデルを使用 • gMLP が正しく認識・EfficientNet が誤認識した例
✓ gMLP は局所的な認識、 Efficient Net は全体的な認識をしている gMLP と EfficientNet を実際に動かしてみた① ( 定性的結果 ) https://github.com/rwightman/pytorch-image-models.git 正解:アイスキャンディ 正解:瓶のキャップ EfficientNet の誤認識例 × ザリガニ × 水筒 EfficientNet の誤認識例 × トラック × 芝刈り機
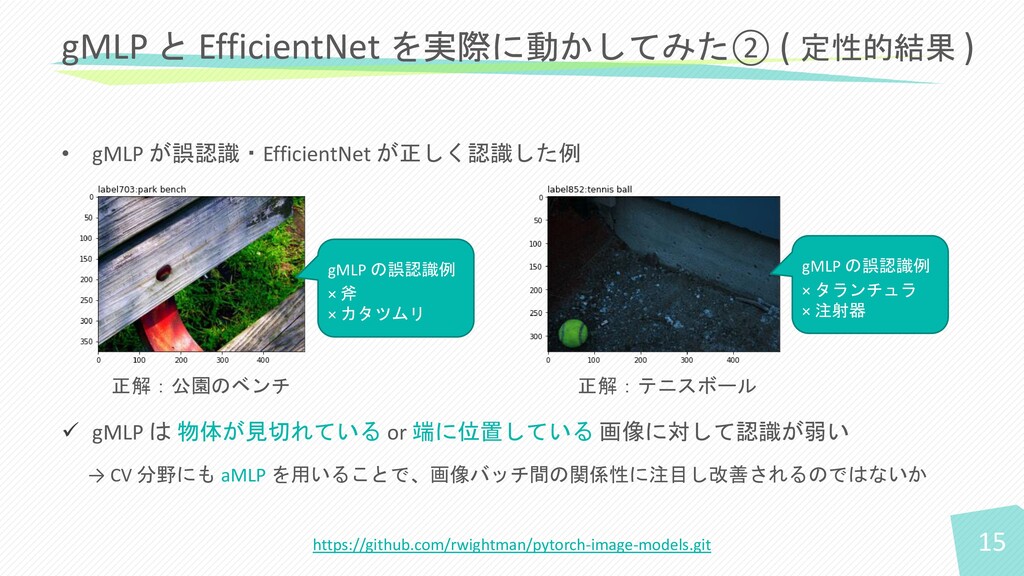
15 • gMLP が誤認識・EfficientNet が正しく認識した例 ✓ gMLP は 物体が見切れている or
端に位置している 画像に対して認識が弱い → CV 分野にも aMLP を用いることで、画像バッチ間の関係性に注目し改善されるのではないか gMLP と EfficientNet を実際に動かしてみた② ( 定性的結果 ) https://github.com/rwightman/pytorch-image-models.git 正解:公園のベンチ 正解:テニスボール gMLP の誤認識例 × 斧 × カタツムリ gMLP の誤認識例 × タランチュラ × 注射器
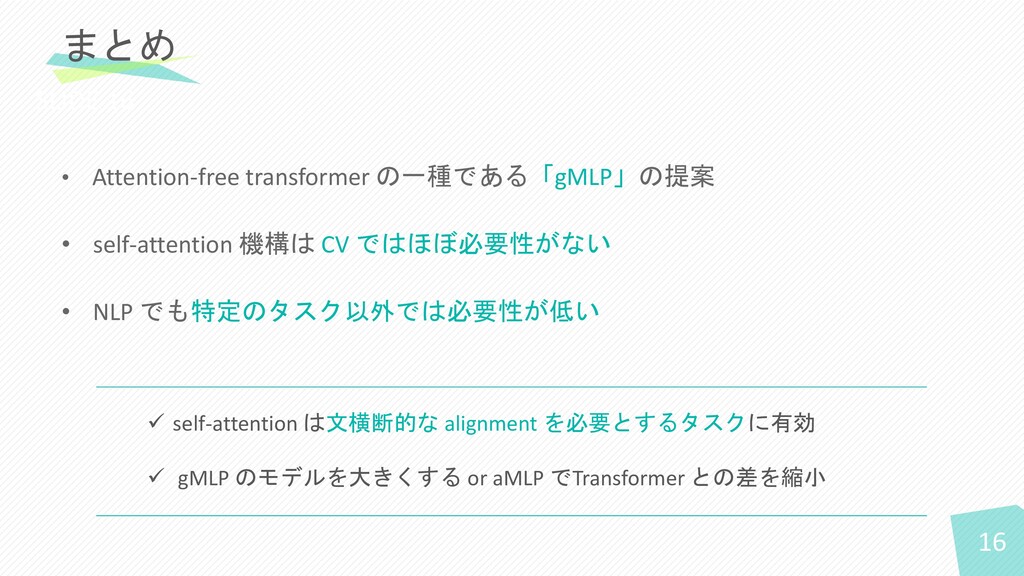
16 • Attention-free transformer の一種である「gMLP」の提案 • self-attention 機構は CV ではほぼ必要性がない
• NLP でも特定のタスク以外では必要性が低い まとめ SLIDE 16 ✓ self-attention は文横断的な alignment を必要とするタスクに有効 ✓ gMLP のモデルを大きくする or aMLP でTransformer との差を縮小
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
慶應義塾大学 AI実践05 論文執筆の仕組み化
keio_smilab
PRO
7
3.9k
[EMNLP26] RIGEL: Self-Distilled Score Adaptation for Image and Video Captioning Evaluation
keio_smilab
PRO
0
170
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
230
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
200
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
270
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
300
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
210
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
260
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
79
Other Decks in Technology
See All in Technology
農夫は秘伝のタレを知らない - NOBODY KNOWS THE HIDDEN SOURCE - Kaggriculture 3rd Place Solution
masspeaks
0
300
Bots in Kiro Crew (One point of contact for ongoing work) | Kiro: Zero to Hero 12
inariku
PRO
1
130
Claude Codeで新規事業を伸ばせるか? Zennの試行錯誤の記録
wadayusuke
2
170
速くなるほど、深く考える AI時代のQAに学ぶ
kobayashiyorimitsu
0
180
人間+AIを「チーム」としてプロセスを再設計する
littlehands
1
1.5k
「AIチャットからもできないの?」と言われたら ~業務アプリをMCP対応するときの認証・認可の勘所
oidfj
0
320
Claude Securityを使ってみた / claude-security-claude-code-meetup-nagoya
tnir
0
110
Kiro IDE 入門 (画面の各部から、頼み方、任せ方、戻し方まで) | 目指せ Kiro マスター 02
inariku
PRO
4
230
Context Ontology Accelerator 入門 (業務データの意味を、AI エージェントに渡す)
inariku
PRO
3
670
仕様と現実の間で落とし所を探るリモートMCPの認証・認可 — Sansanの認証基盤における課題と実践
sansantech
PRO
2
290
AWSを利用する上で知っておきたい名前解決の話 2026
nagisa53
5
3.6k
Steering と Hook (チームの決まりを守らせる) | 目指せ Kiro マスター 06
inariku
PRO
2
120
Featured
See All Featured
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
1
300
Primal Persuasion: How to Engage the Brain for Learning That Lasts
tmiket
0
520
Technical Leadership for Architectural Decision Making
baasie
4
640
Design and Strategy: How to Deal with People Who Don’t "Get" Design
morganepeng
133
20k
Automating Front-end Workflow
addyosmani
1370
210k
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
590
Cheating the UX When There Is Nothing More to Optimize - PixelPioneers
stephaniewalter
287
14k
Designing Powerful Visuals for Engaging Learning
tmiket
1
650
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
Fireside Chat
paigeccino
43
4.1k
Bridging the Design Gap: How Collaborative Modelling removes blockers to flow between stakeholders and teams @FastFlow conf
baasie
0
760


 keio_smilab
 masspeaks
 inariku
 wadayusuke
 kobayashiyorimitsu
 littlehands
 oidfj
 tnir
 sansantech
 nagisa53
 davidcarrasco
 tmiket
 baasie
 morganepeng
 addyosmani
 pwiseman
 stephaniewalter
 axbom
 reverentgeek
 paigeccino