Share
Embed
[Journal club] Transformers Learn In-Context by Gradient Descent
Semantic Machine Intelligence Lab., Keio Univ. PRO
July 22, 2023
Transcript
35 slides
-
Johannes von Oswald1,2 Eyvind Niklasson2 Ettore Randazzo2 Joao Sacramento1 Alexander
Mordvintsev2 Andrey Zhmoginov2 Max Vladymyrov2 1. ETH Zurich, 2. Google Research 杉浦孔明研究室 小槻誠太郎 ICML23 OralPoster J. von Oswald, E. Niklasson, E. Randazzo, J. Sacramento, A. Mordvintsev, A. Zhmoginov, and M. Vladymyrov, “Transformers Learn In-Context by Gradient Descent,” in ICML, 2023, pp. 35151–35174. -
多様な分野でtransformer architectureが採用されている 3 背景 – Transformerがデファクトに ViT [Dosovitskiy+, ICLR21] Graphormer
[Ying+, NeurIPS21] BERT [Devlin+,NAACL19] -
Induction heads [Olsson+, 22]: Input: [A], [B], …, [A] →
Output: [B] のようにtoken列を完成させる単純なアルゴリズムを実現するattention head - In-context learningの仕組みの大半はinduction headによって構成されるという仮説, - その間接的な証拠を提示 5 関連研究 – In-context learningの説明を試みた研究 -
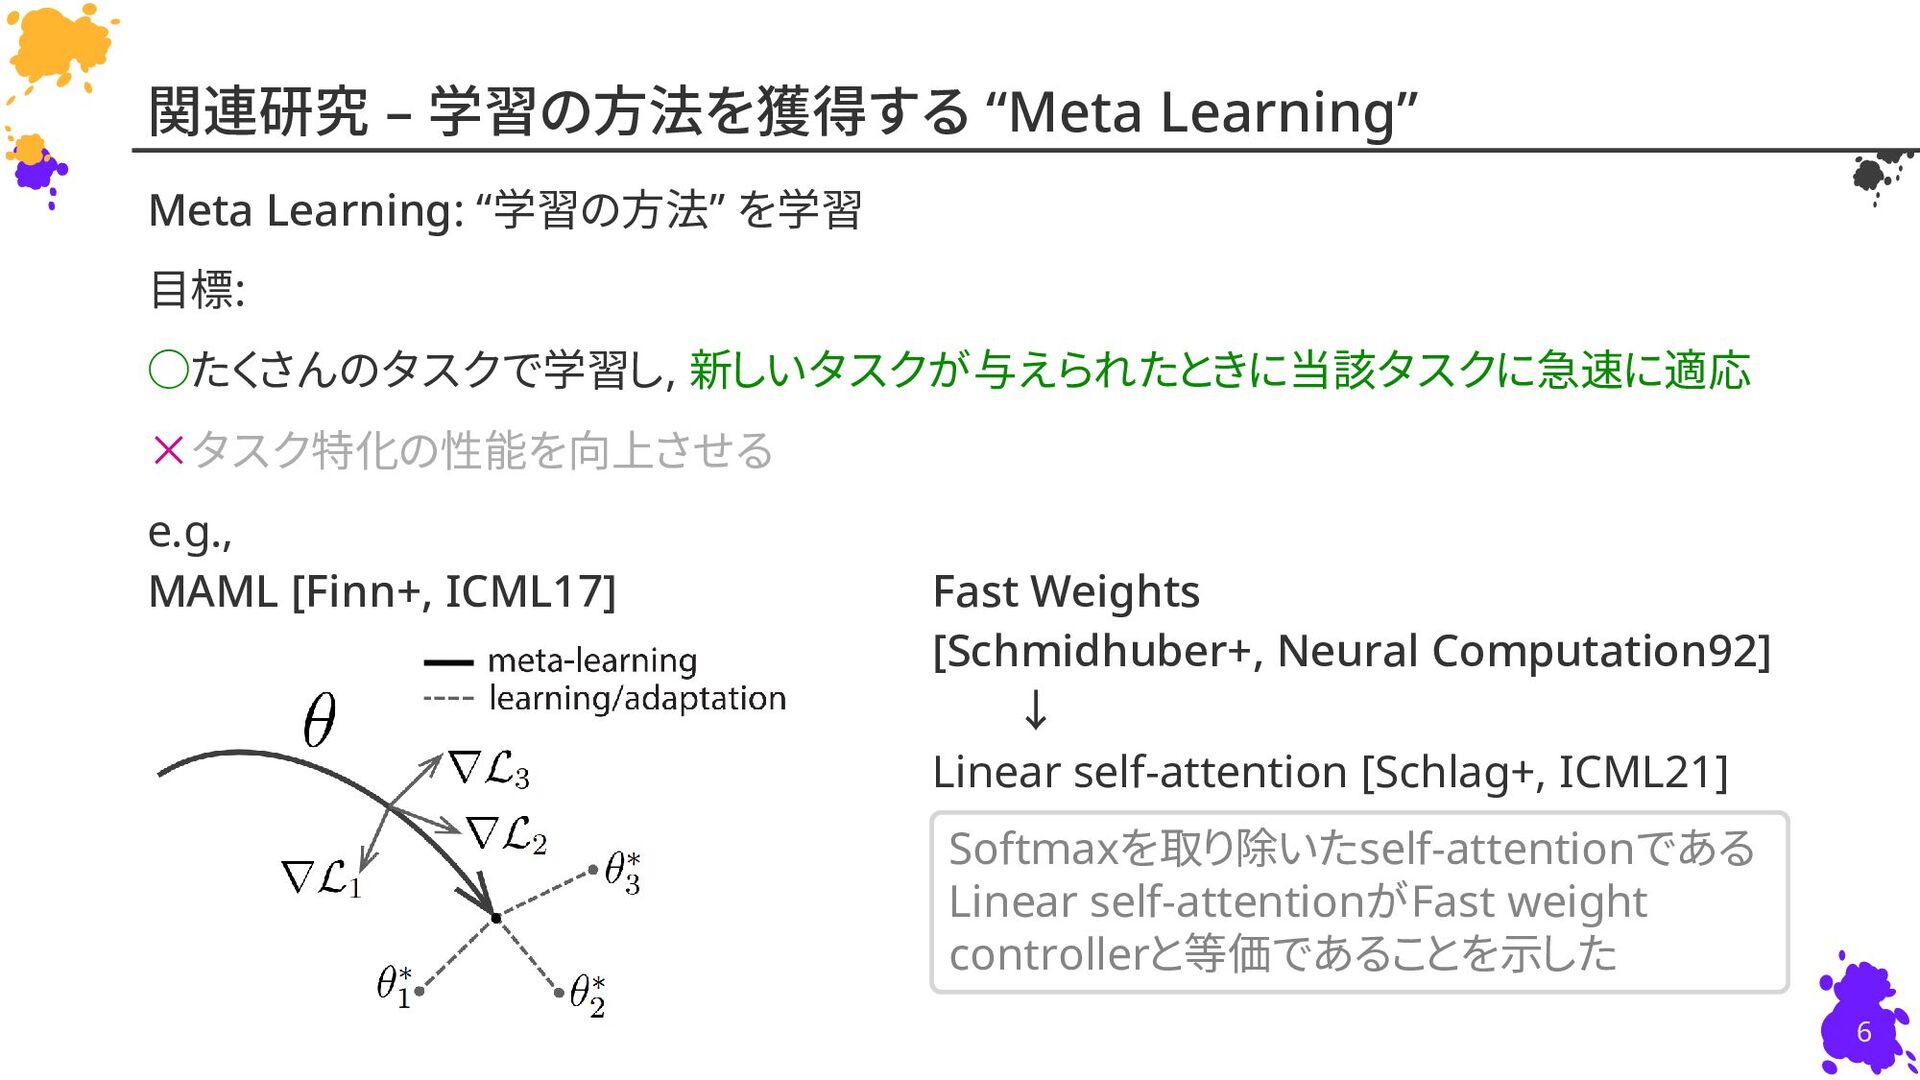
Meta Learning: “学習の方法” を学習 目標: ◦たくさんのタスクで学習し, 新しいタスクが与えられたときに当該タスクに急速に適応 ×タスク特化の性能を向上させる e.g., MAML
[Finn+, ICML17] Fast Weights [Schmidhuber+, Neural Computation92] ↓ Linear self-attention [Schlag+, ICML21] 6 関連研究 – 学習の方法を獲得する “Meta Learning” Softmaxを取り除いたself-attentionである Linear self-attentionがFast weight controllerと等価であることを示した -
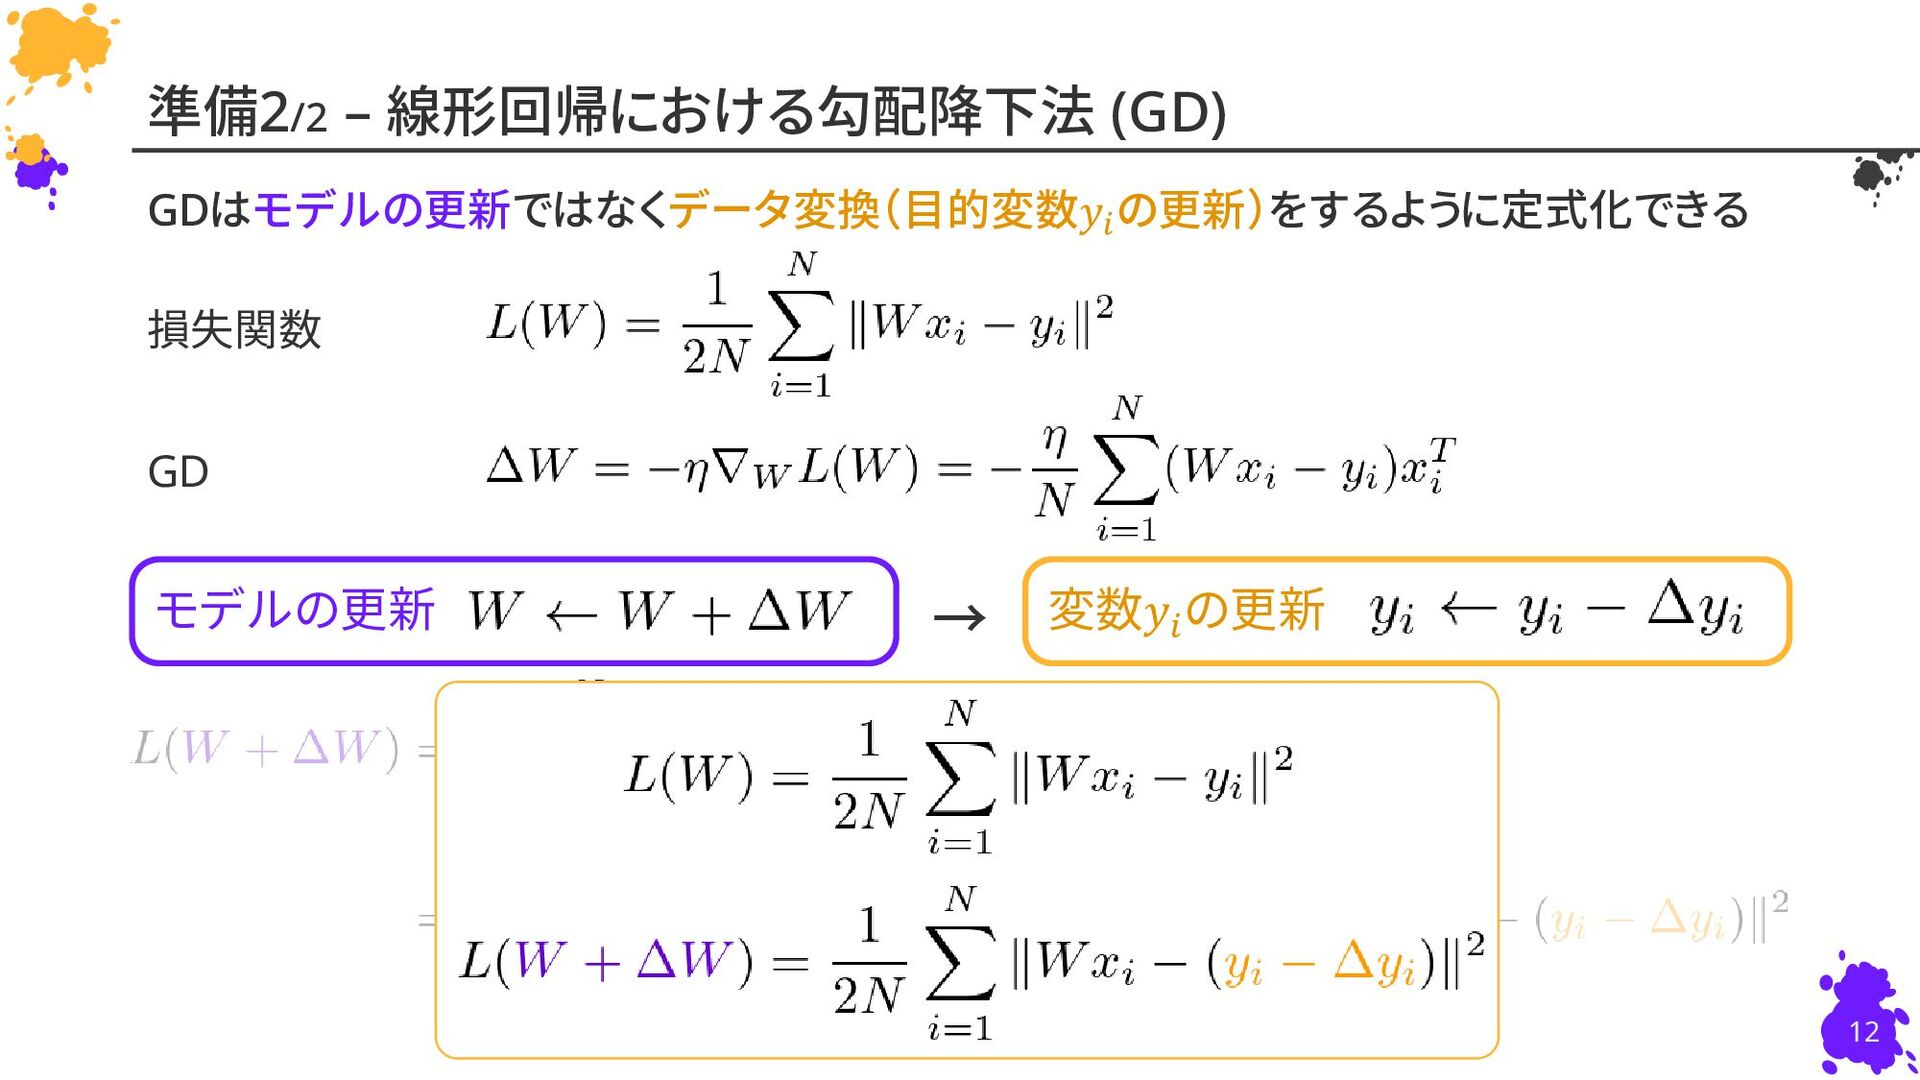
Recap: Self-attention ↓ Linear self-attention [Schlag+, ICML21] 8 準備1/2 –
Linear self-attention (LSA) の導入 Simplify (Softmax → 恒等写像) -
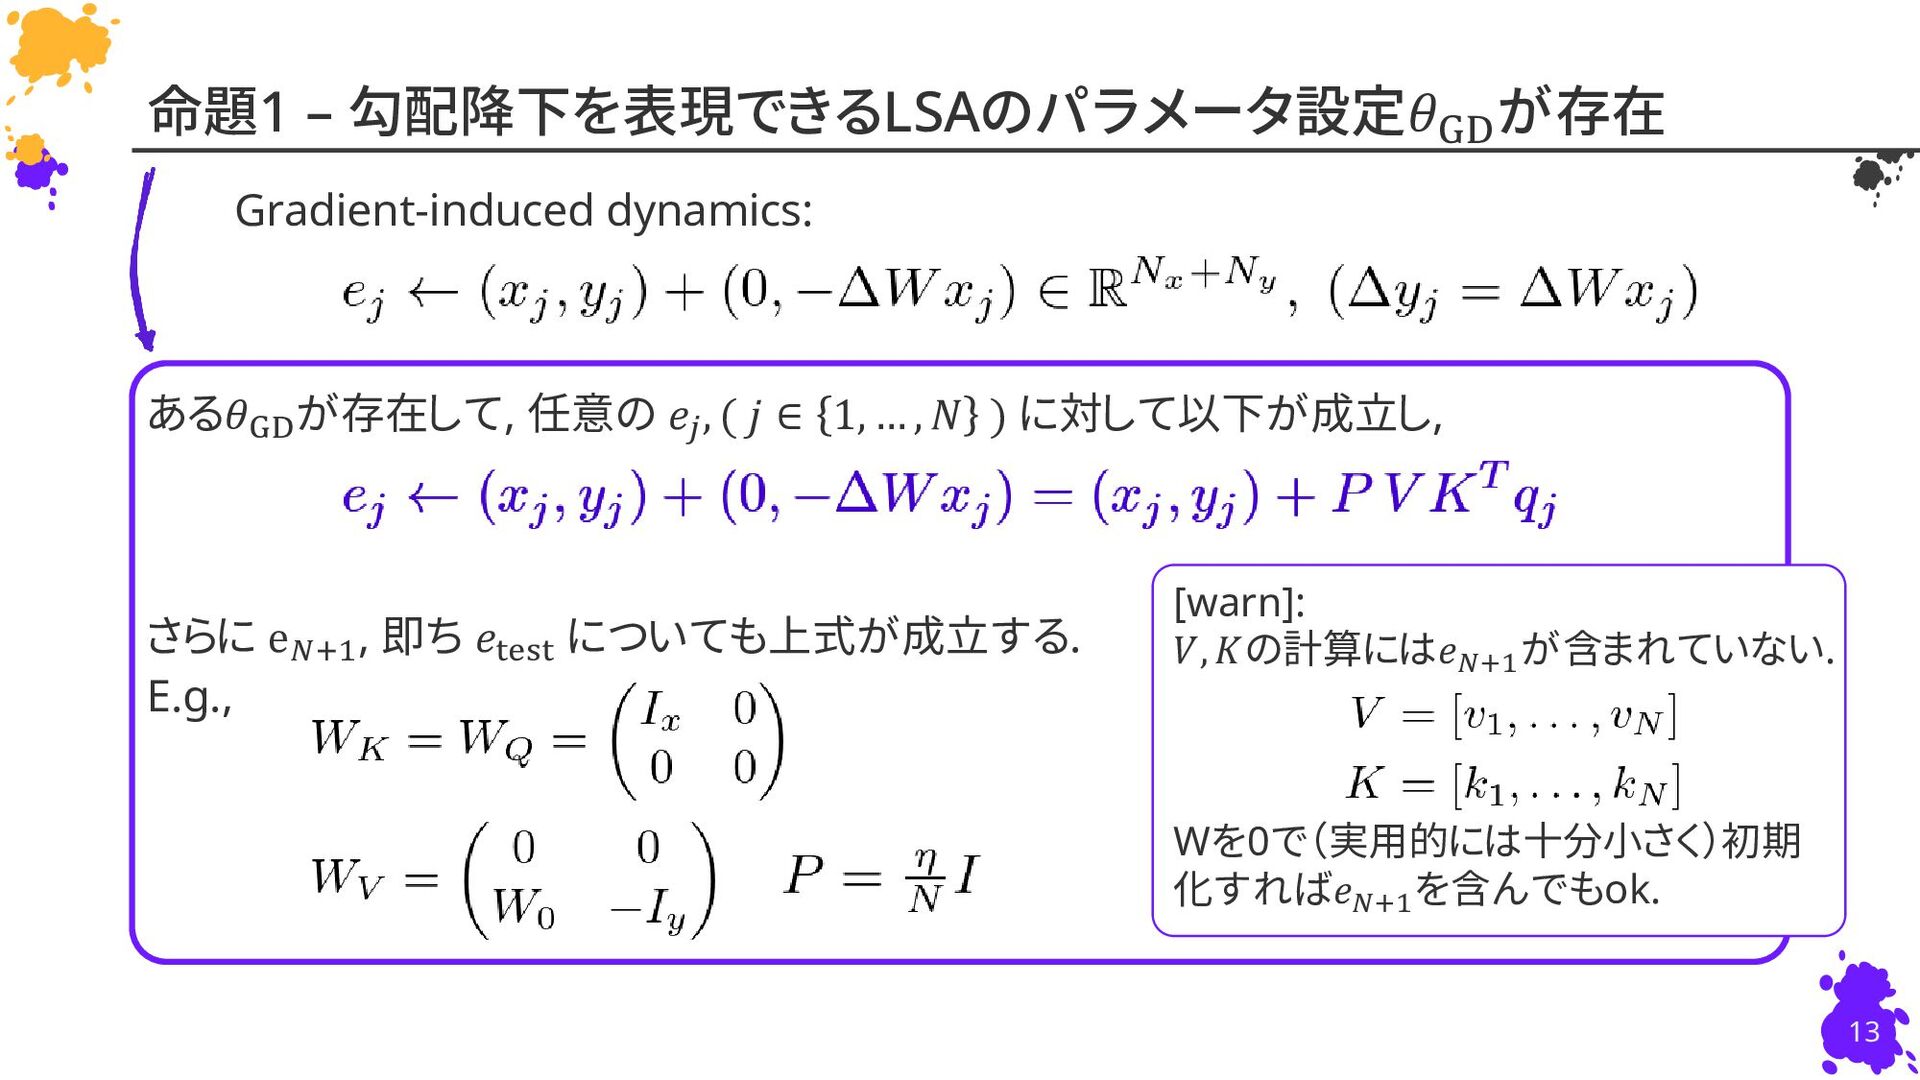
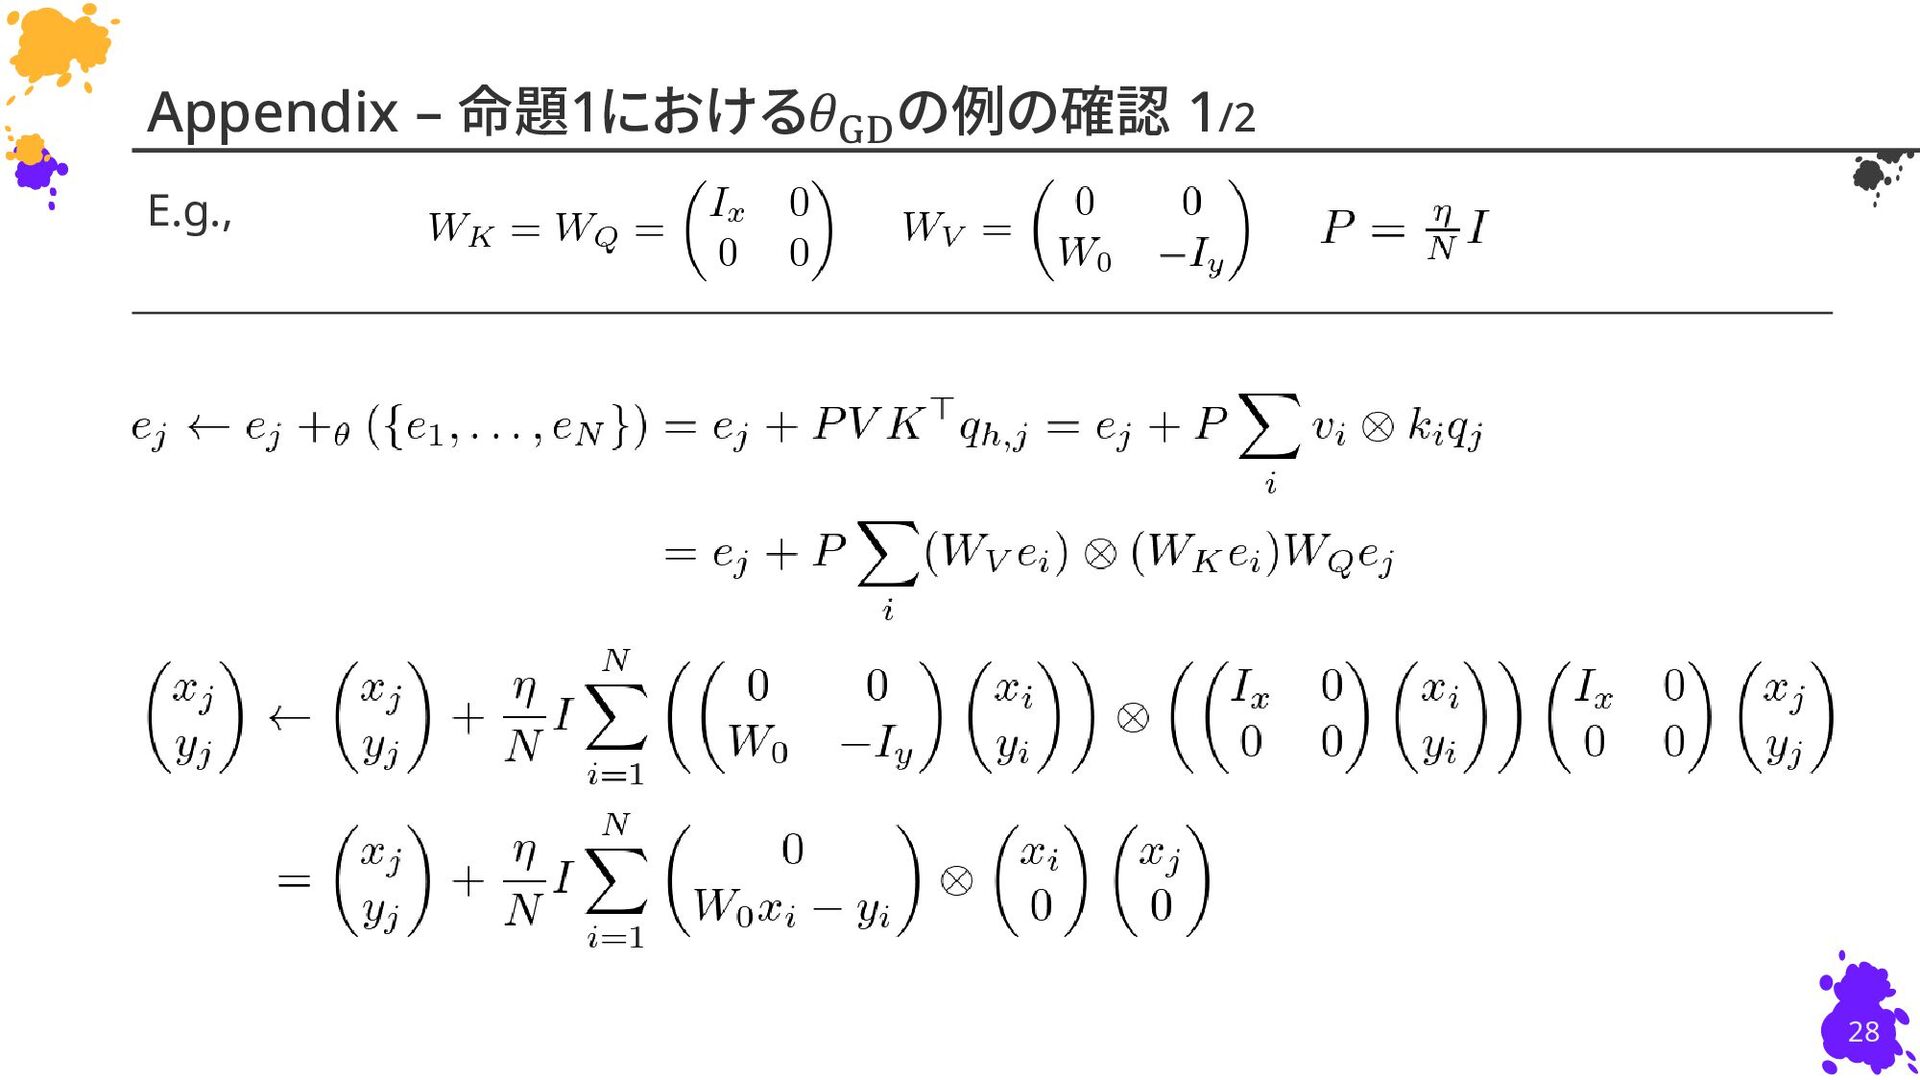
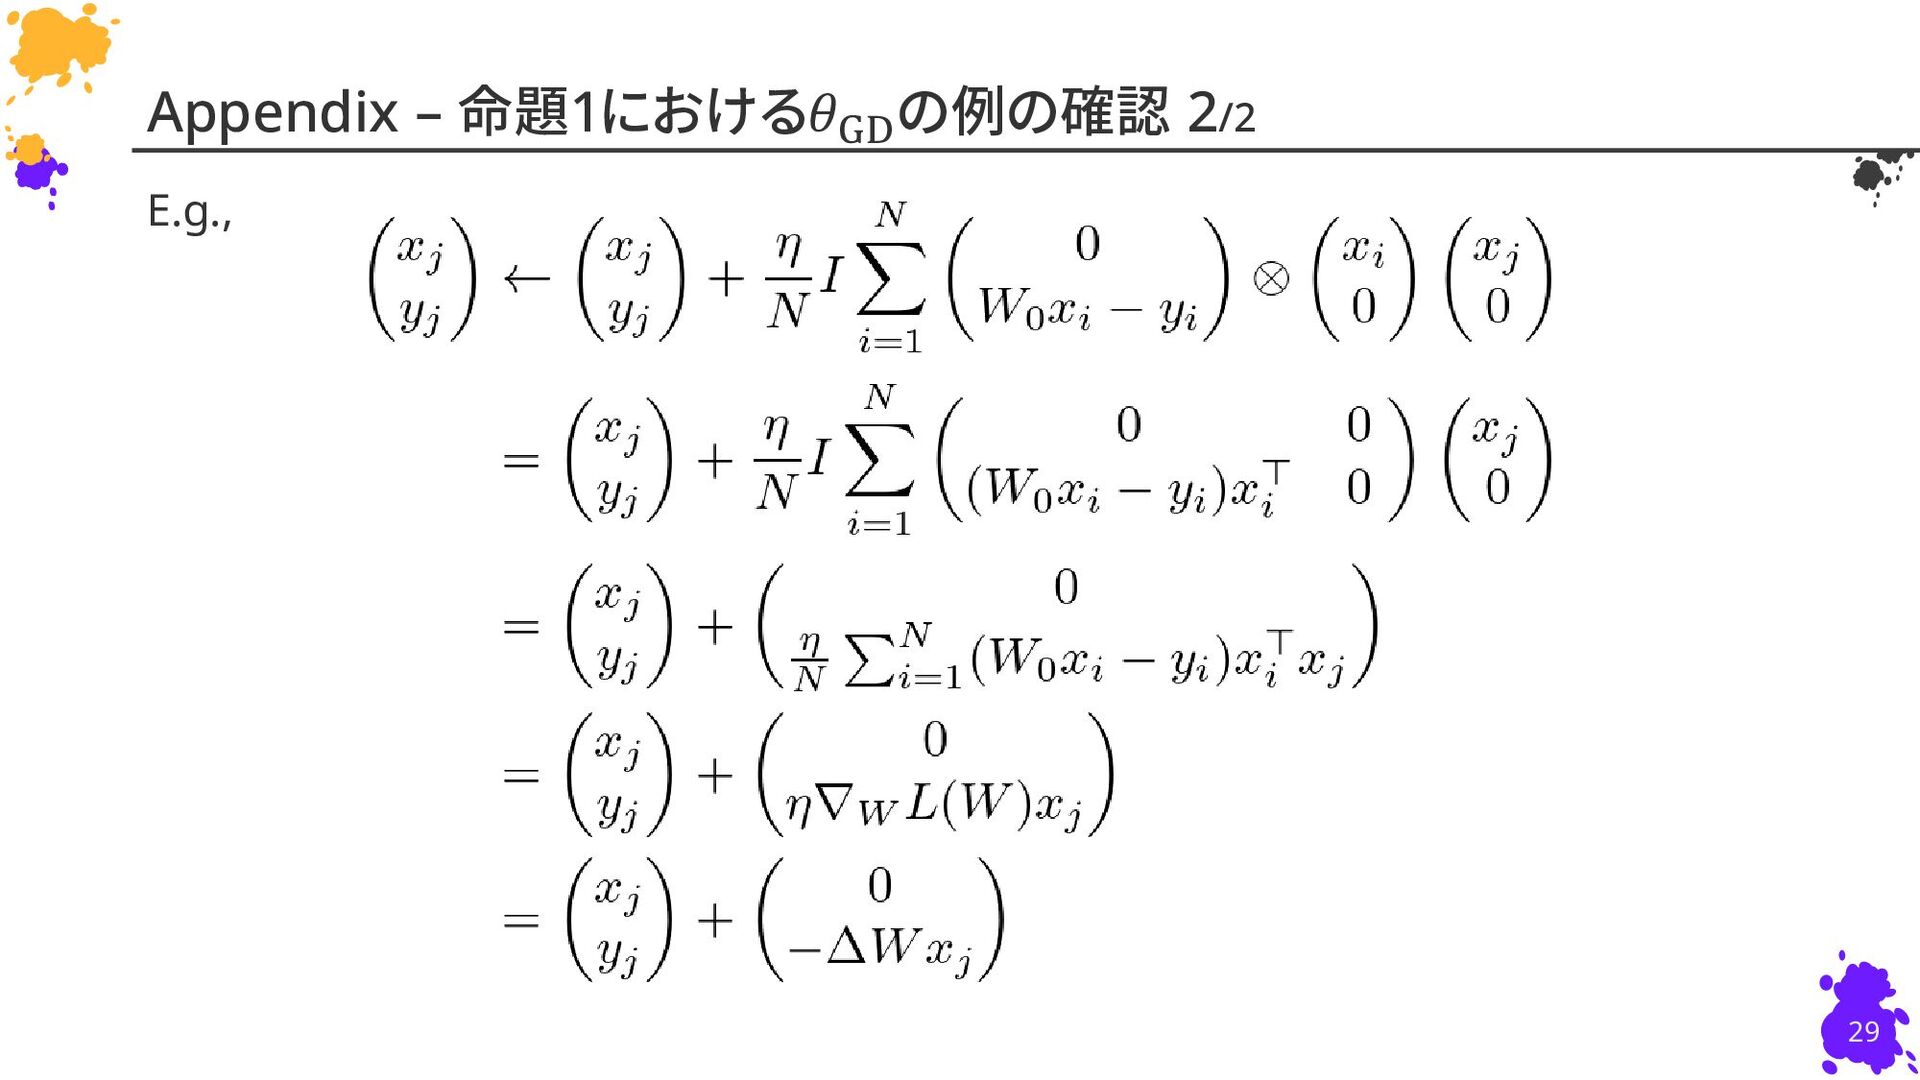
Gradient-induced dynamics: ある𝜃GD が存在して, 任意の 𝑒𝑗 , ( 𝑗 ∈
1, … , 𝑁 ) に対して以下が成立し, さらに e𝑁+1 , 即ち 𝑒test についても上式が成立する. E.g., 13 命題1 – 勾配降下を表現できるLSAのパラメータ設定𝜃GD が存在 [warn]: 𝑉, 𝐾の計算には𝑒𝑁+1 が含まれていない. Wを0で(実用的には十分小さく)初期 化すれば𝑒𝑁+1 を含んでもok. -
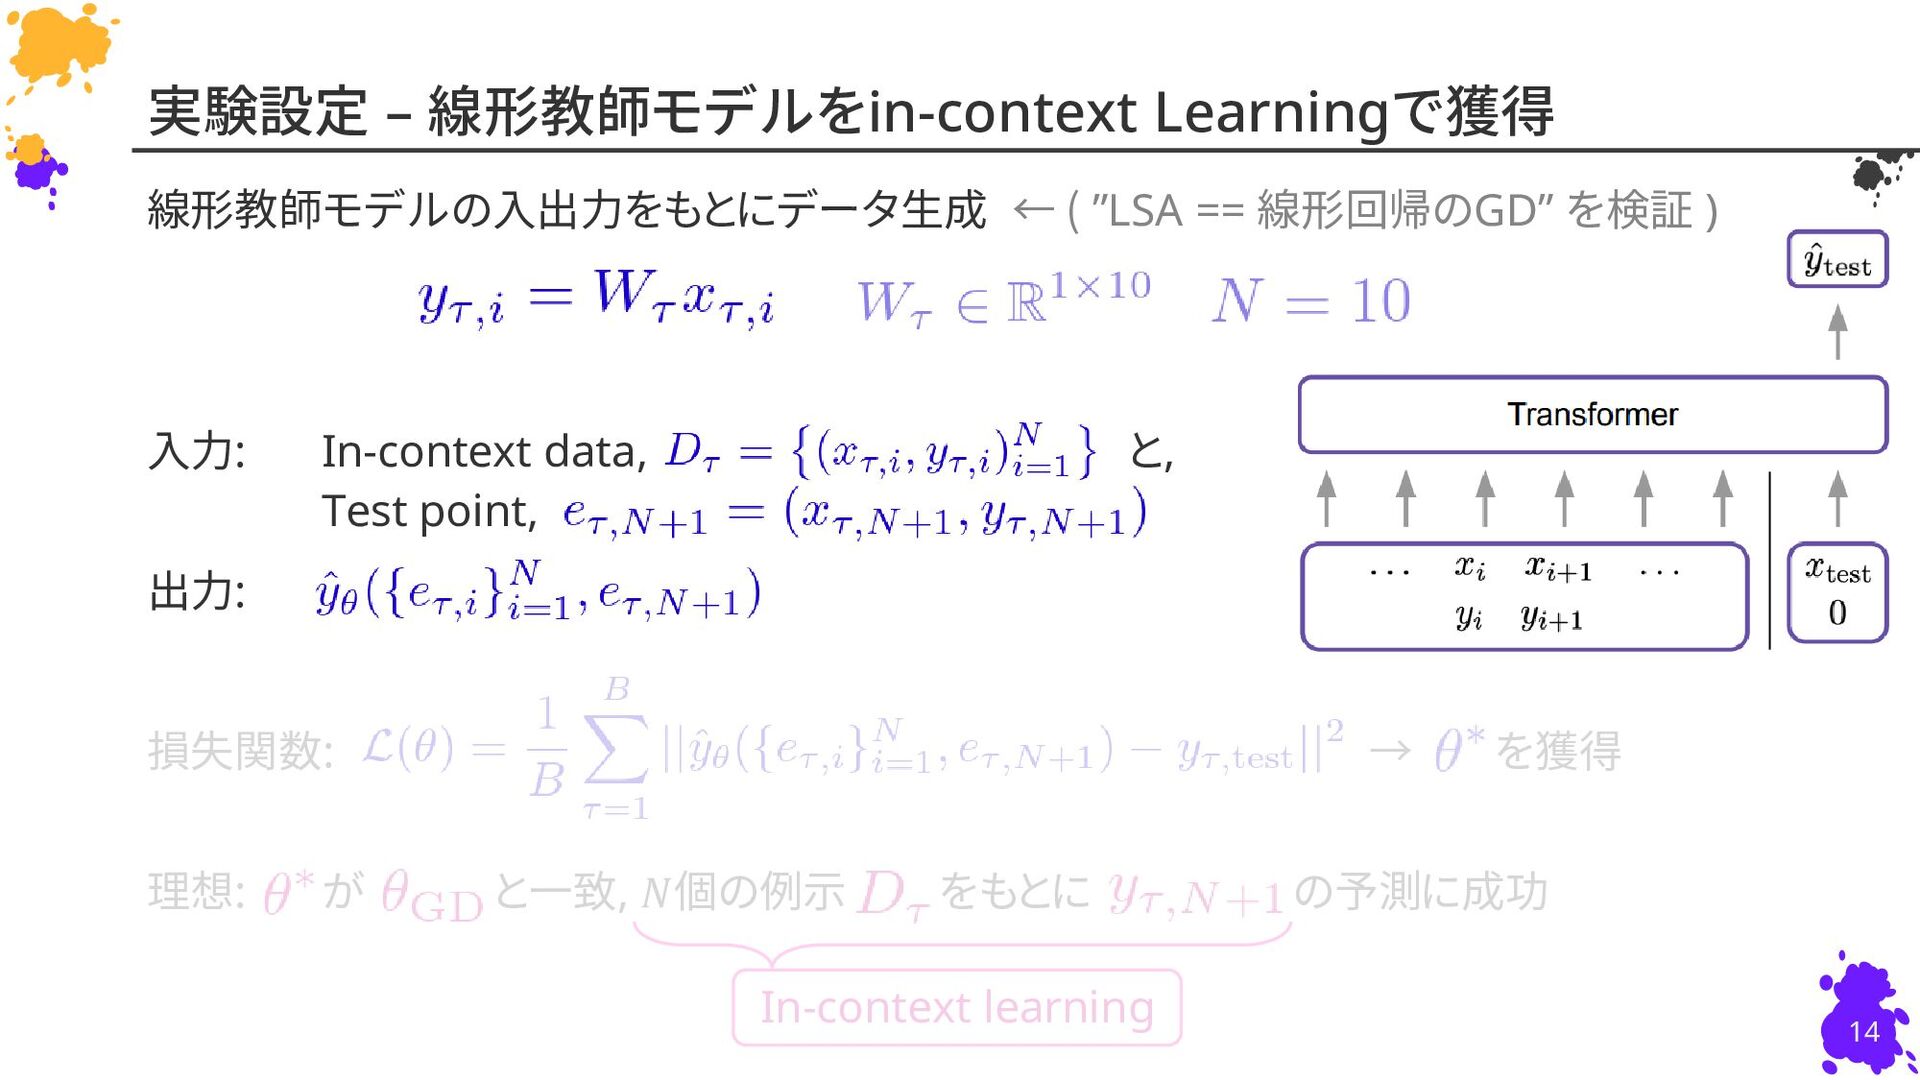
線形教師モデルの入出力をもとにデータ生成 ← ( ”LSA == 線形回帰のGD” を検証 ) 入力: In-context
data, と, Test point, 出力: 損失関数: → を獲得 理想: が と一致, 𝑁個の例示 をもとに の予測に成功 14 実験設定 – 線形教師モデルをin-context Learningで獲得 In-context learning -
線形教師モデルの入出力をもとにデータ生成 ← ( ”LSA == 線形回帰のGD” を検証 ) 入力: In-context
data, と, Test point, 出力: 損失関数: → を獲得 理想: が と一致, 𝑁個の例示 をもとに の予測に成功 15 実験設定 – 線形教師モデルをin-context Learningで獲得 In-context learning -
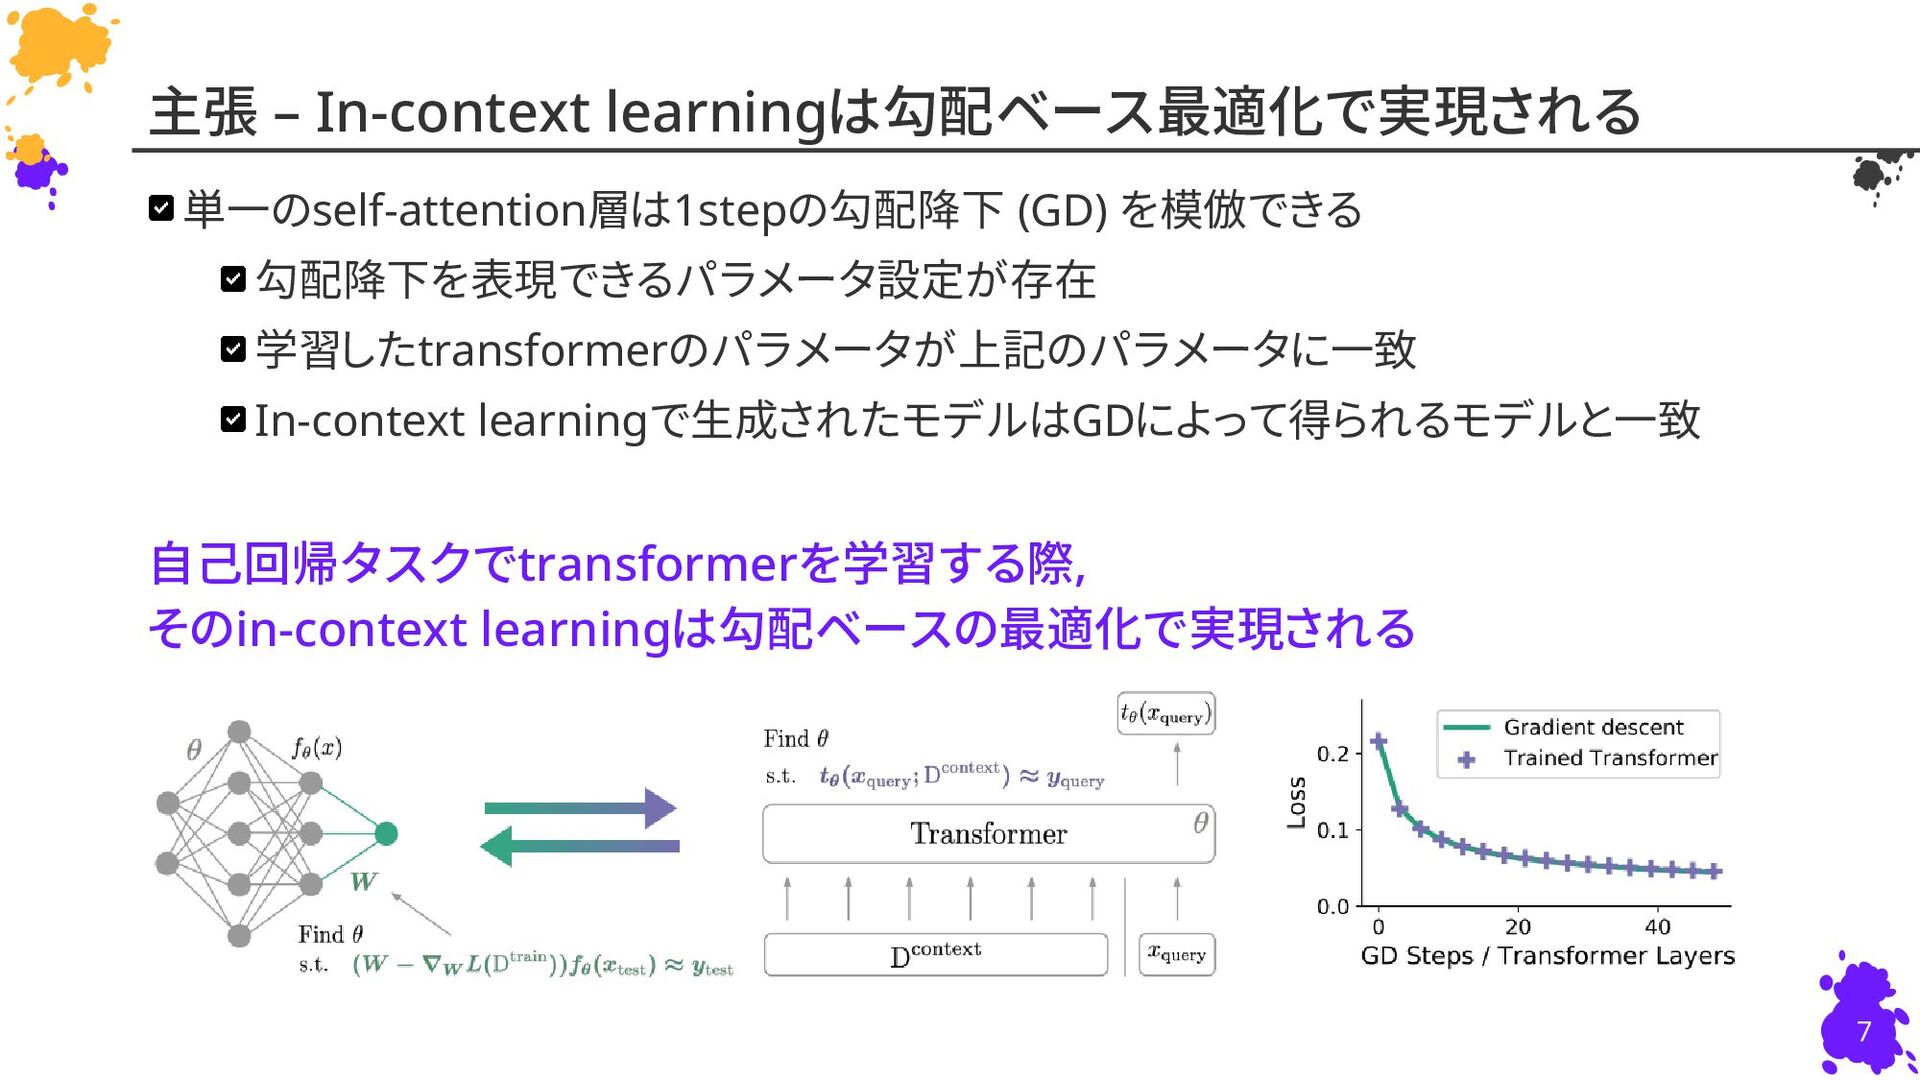
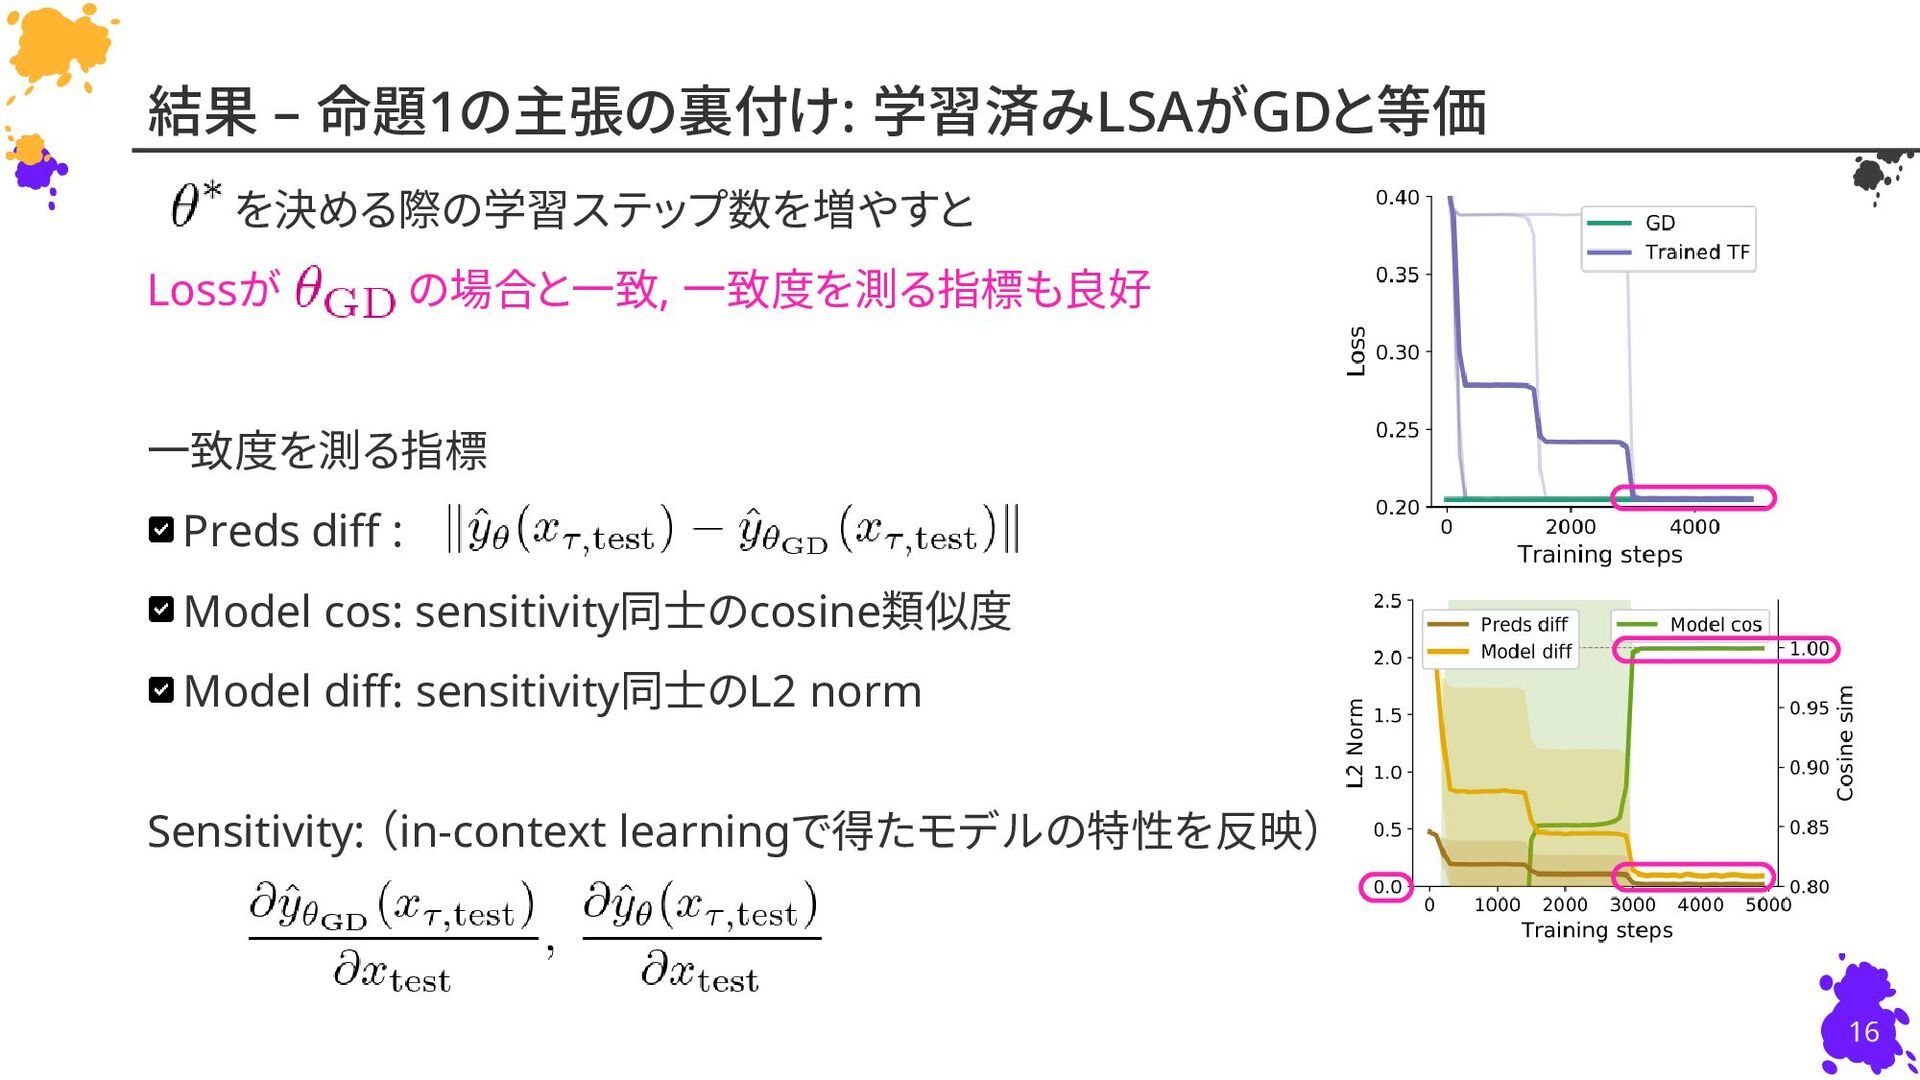
を決める際の学習ステップ数を増やすと Lossが の場合と一致, 一致度を測る指標も良好 一致度を測る指標 Preds diff : Model cos:
sensitivity同士のcosine類似度 Model diff: sensitivity同士のL2 norm Sensitivity: (in-context learningで得たモデルの特性を反映) 16 結果 – 命題1の主張の裏付け: 学習済みLSAがGDと等価 -
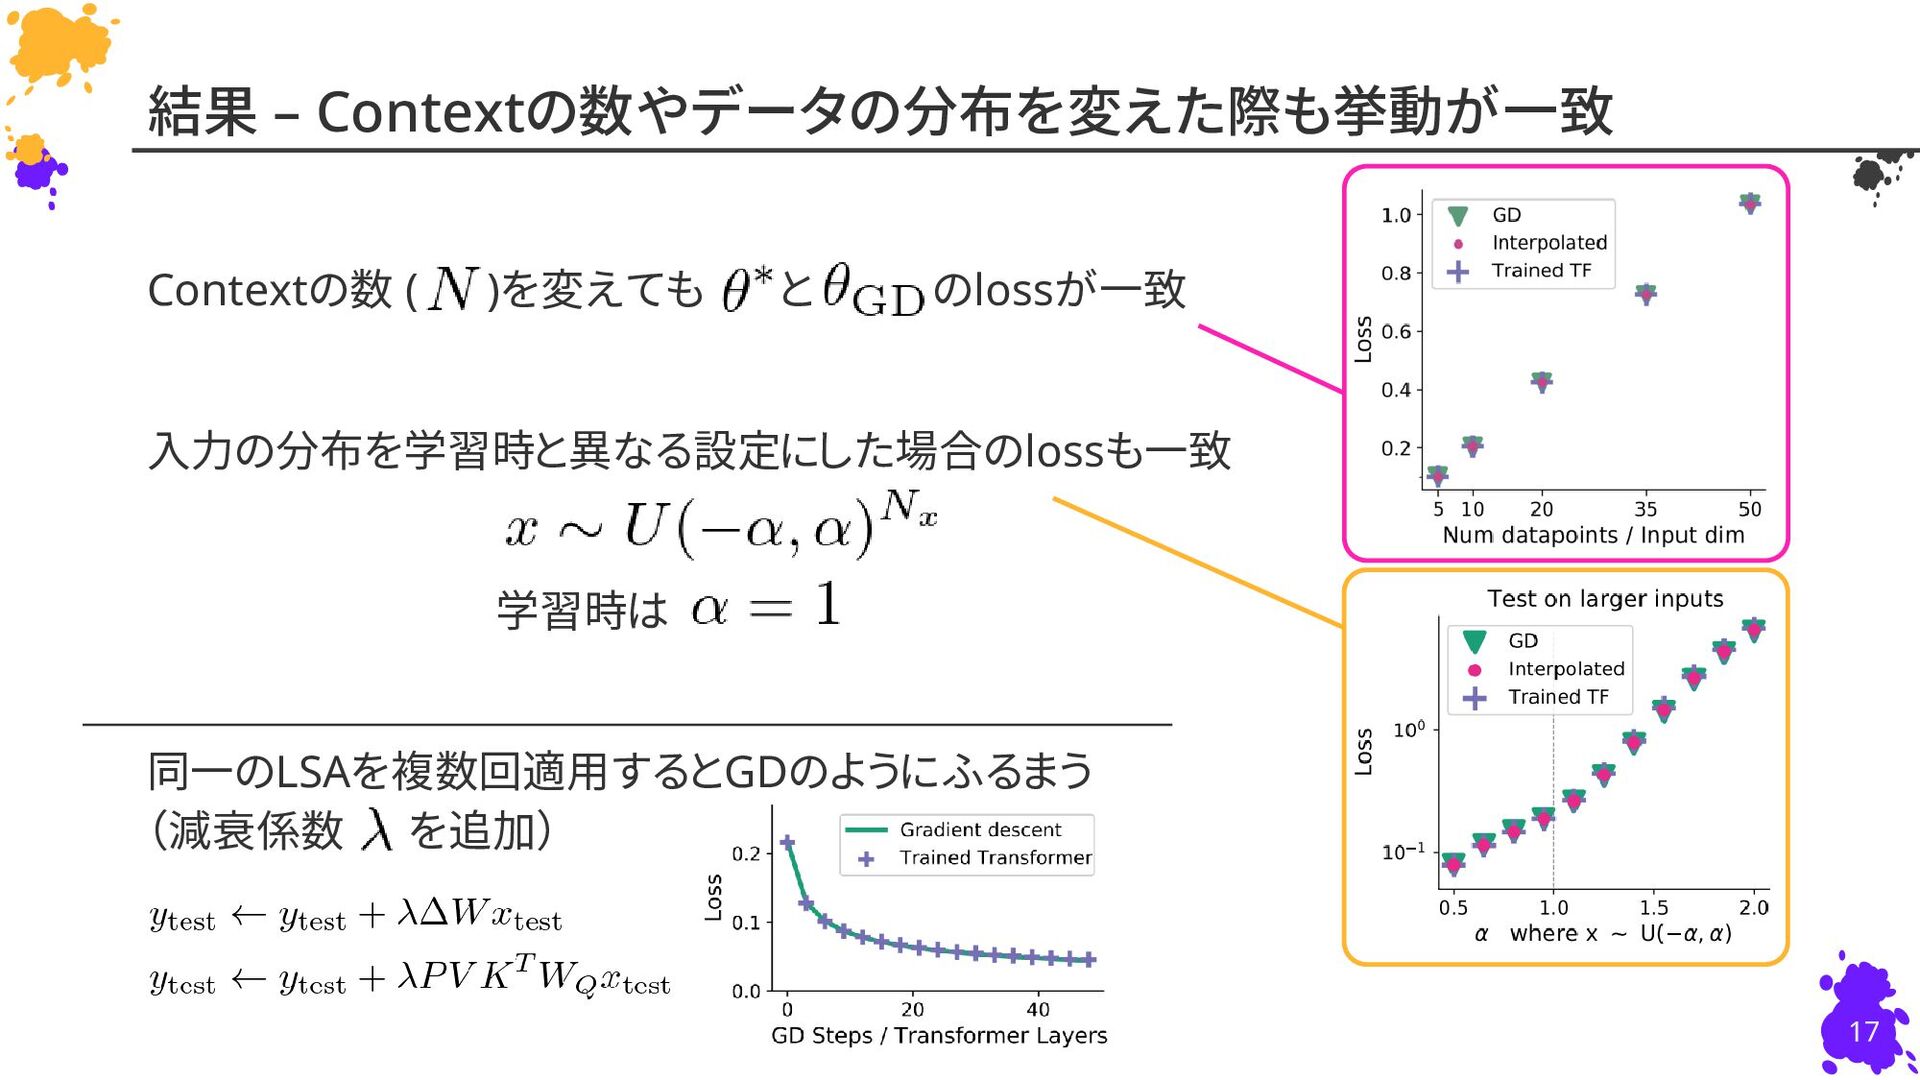
Contextの数 ( )を変えても と のlossが一致 入力の分布を学習時と異なる設定にした場合のlossも一致 学習時は 同一のLSAを複数回適用するとGDのようにふるまう (減衰係数 を追加)
17 結果 – Contextの数やデータの分布を変えた際も挙動が一致 -
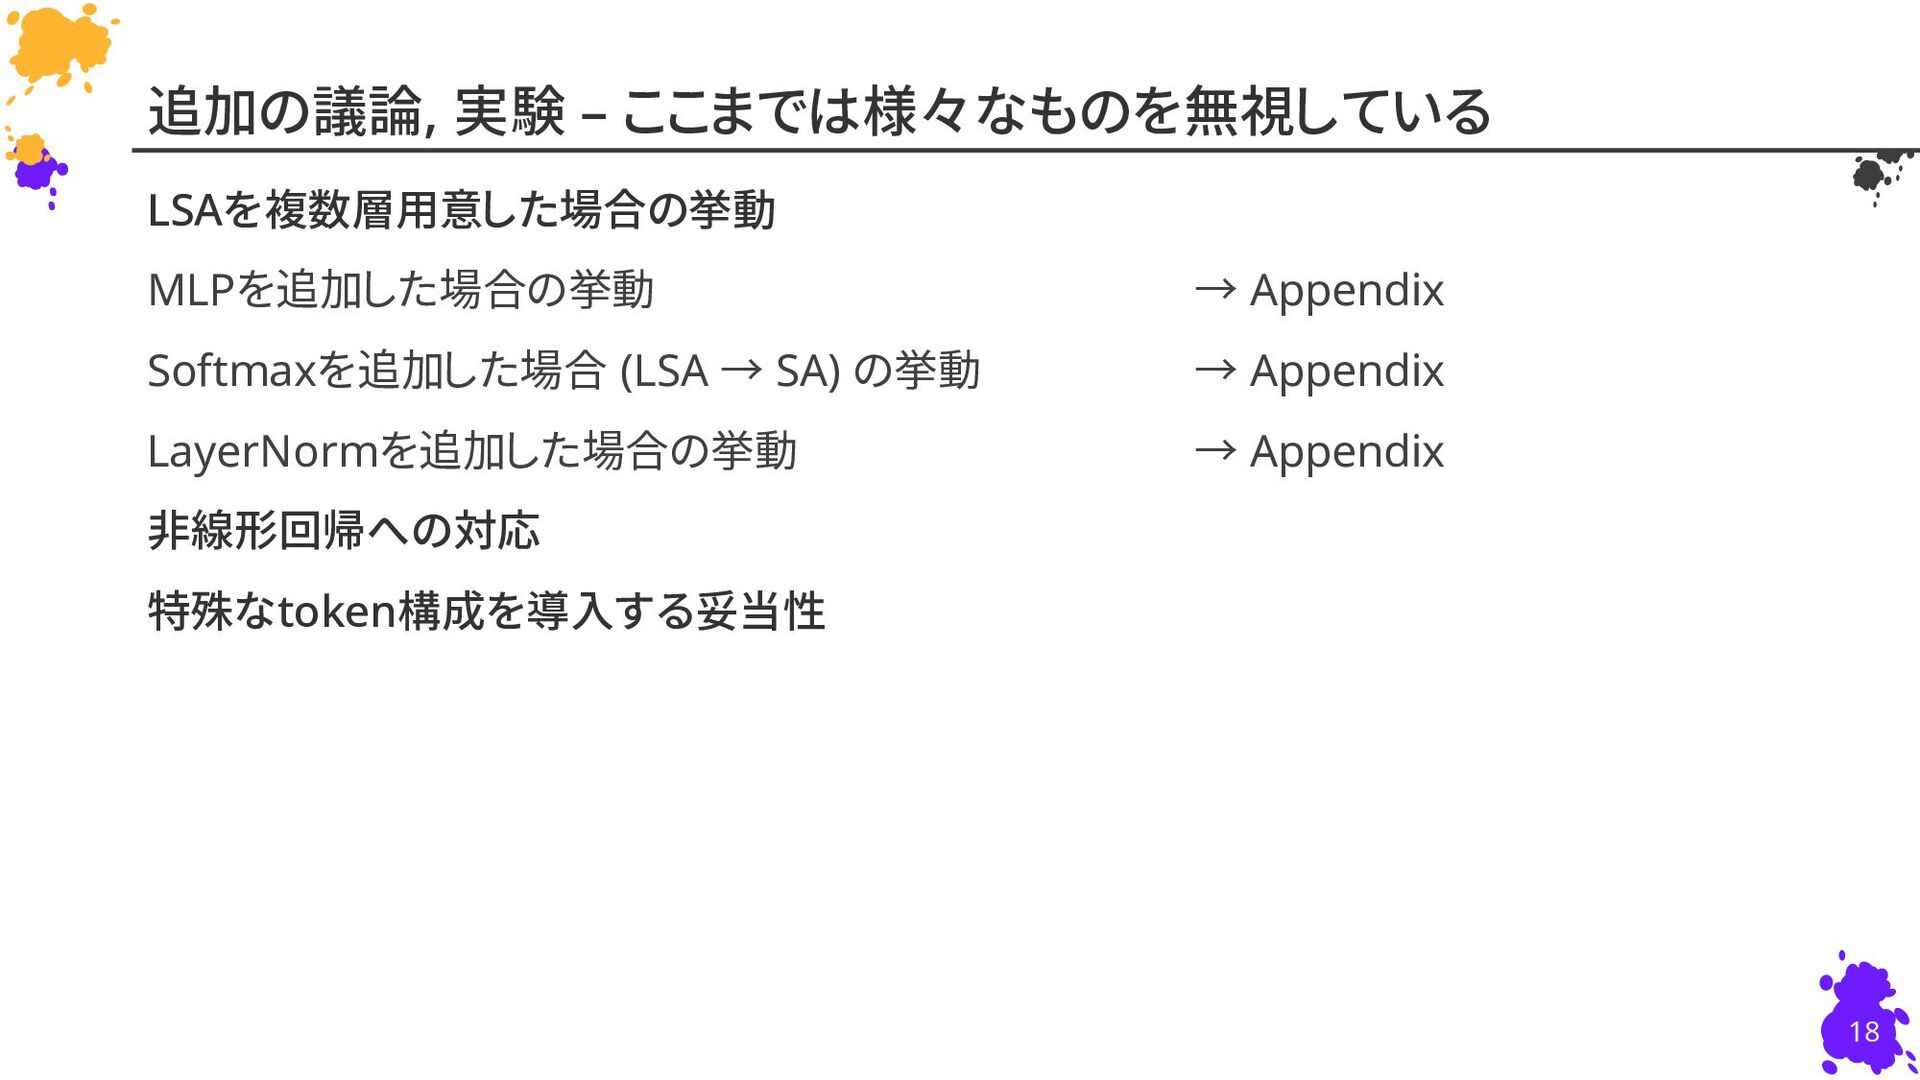
LSAを複数層用意した場合の挙動 MLPを追加した場合の挙動 → Appendix Softmaxを追加した場合 (LSA → SA) の挙動 →
Appendix LayerNormを追加した場合の挙動 → Appendix 非線形回帰への対応 特殊なtoken構成を導入する妥当性 18 追加の議論, 実験 – ここまでは様々なものを無視している -
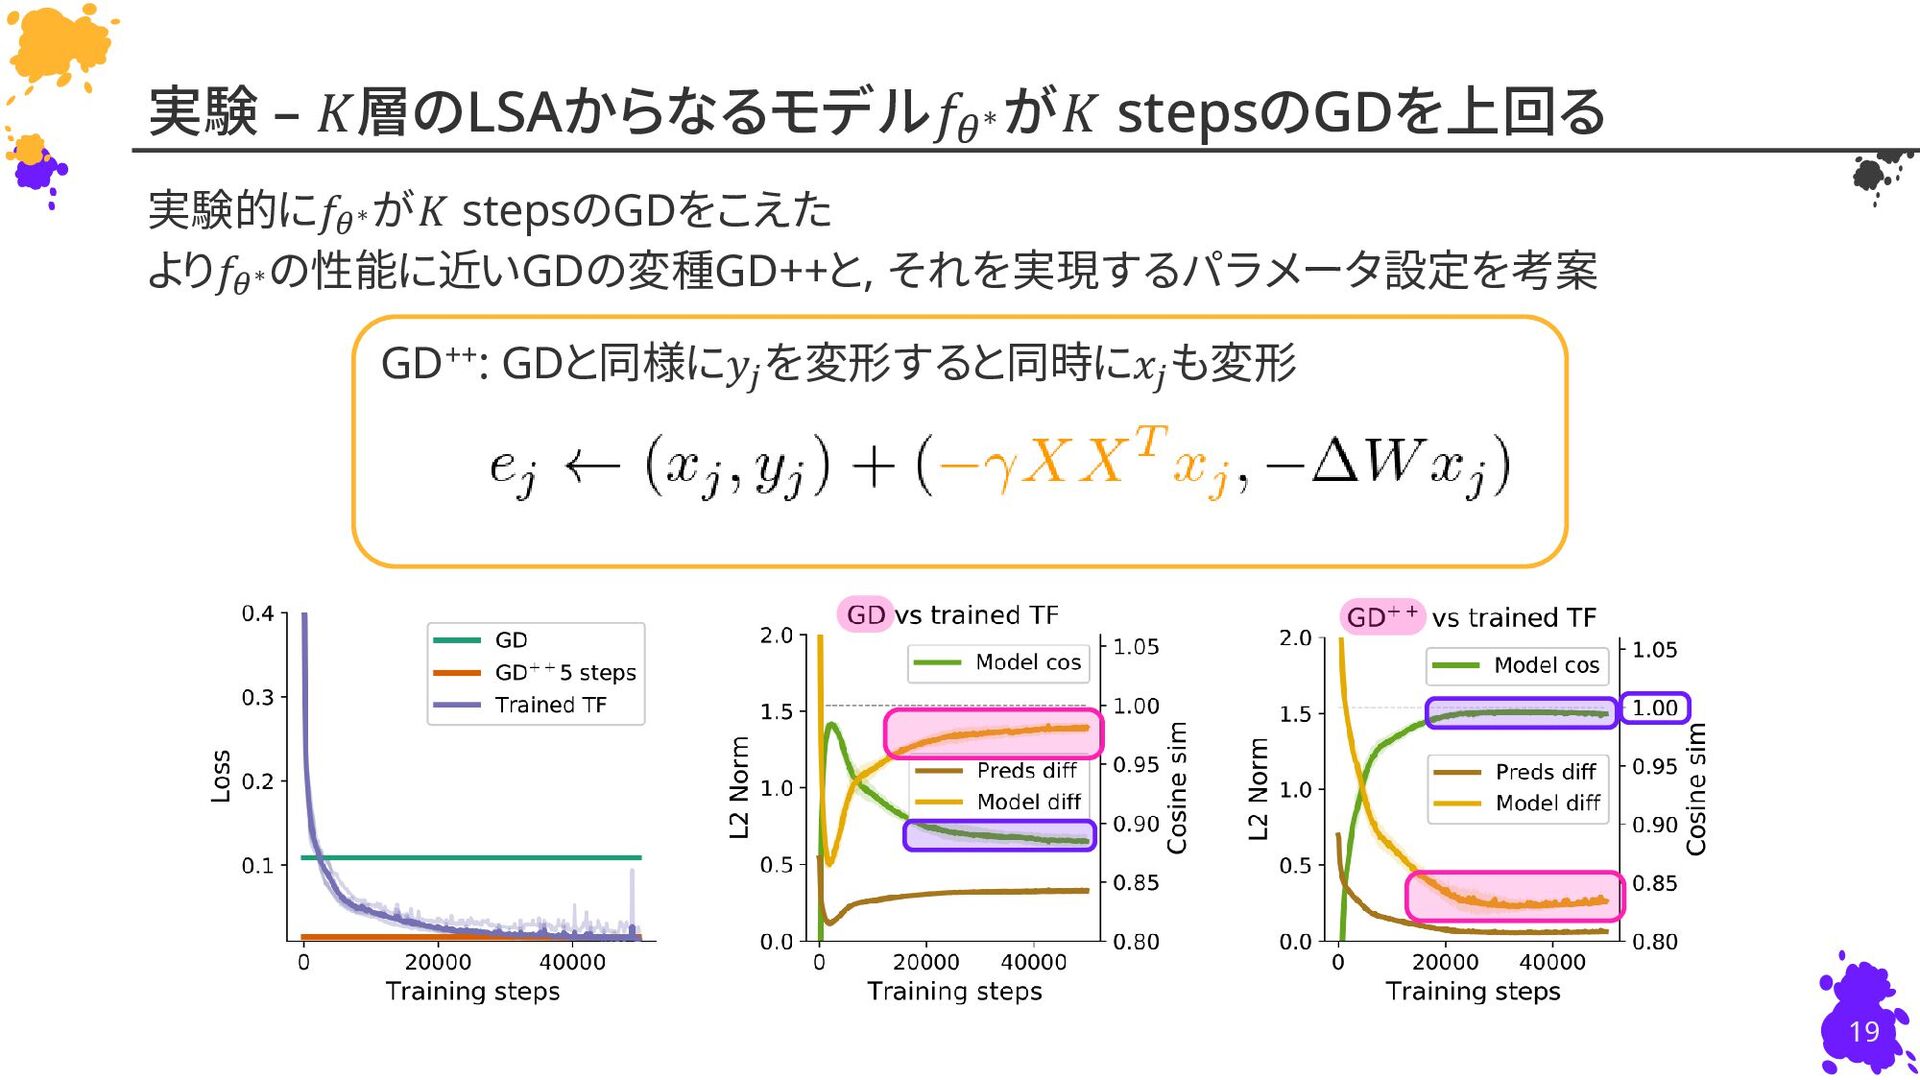
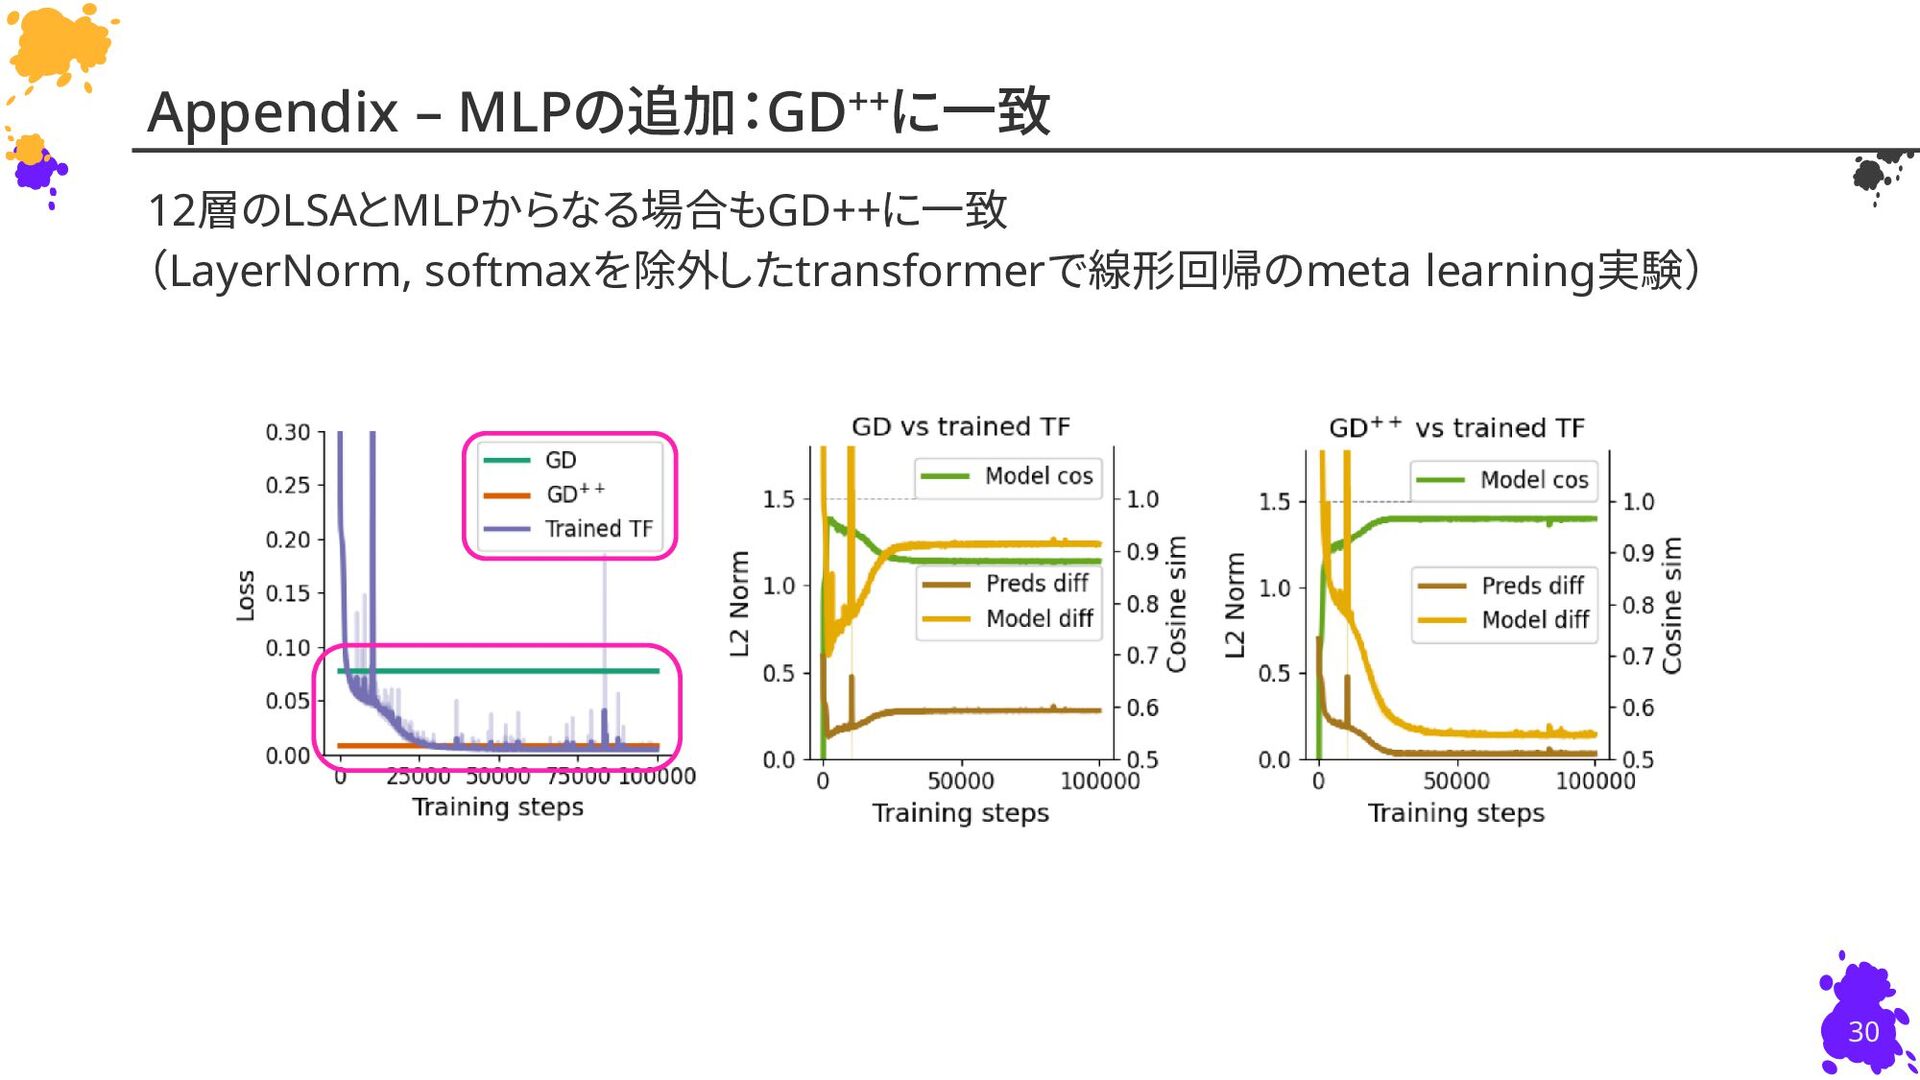
実験的に𝑓𝜃∗ が𝐾 stepsのGDをこえた より𝑓𝜃∗ の性能に近いGDの変種GD++と, それを実現するパラメータ設定を考案 19 実験 – 𝐾層のLSAからなるモデル𝑓𝜃∗
が𝐾 stepsのGDを上回る GD++: GDと同様に𝑦𝑗 を変形すると同時に𝑥𝑗 も変形 -
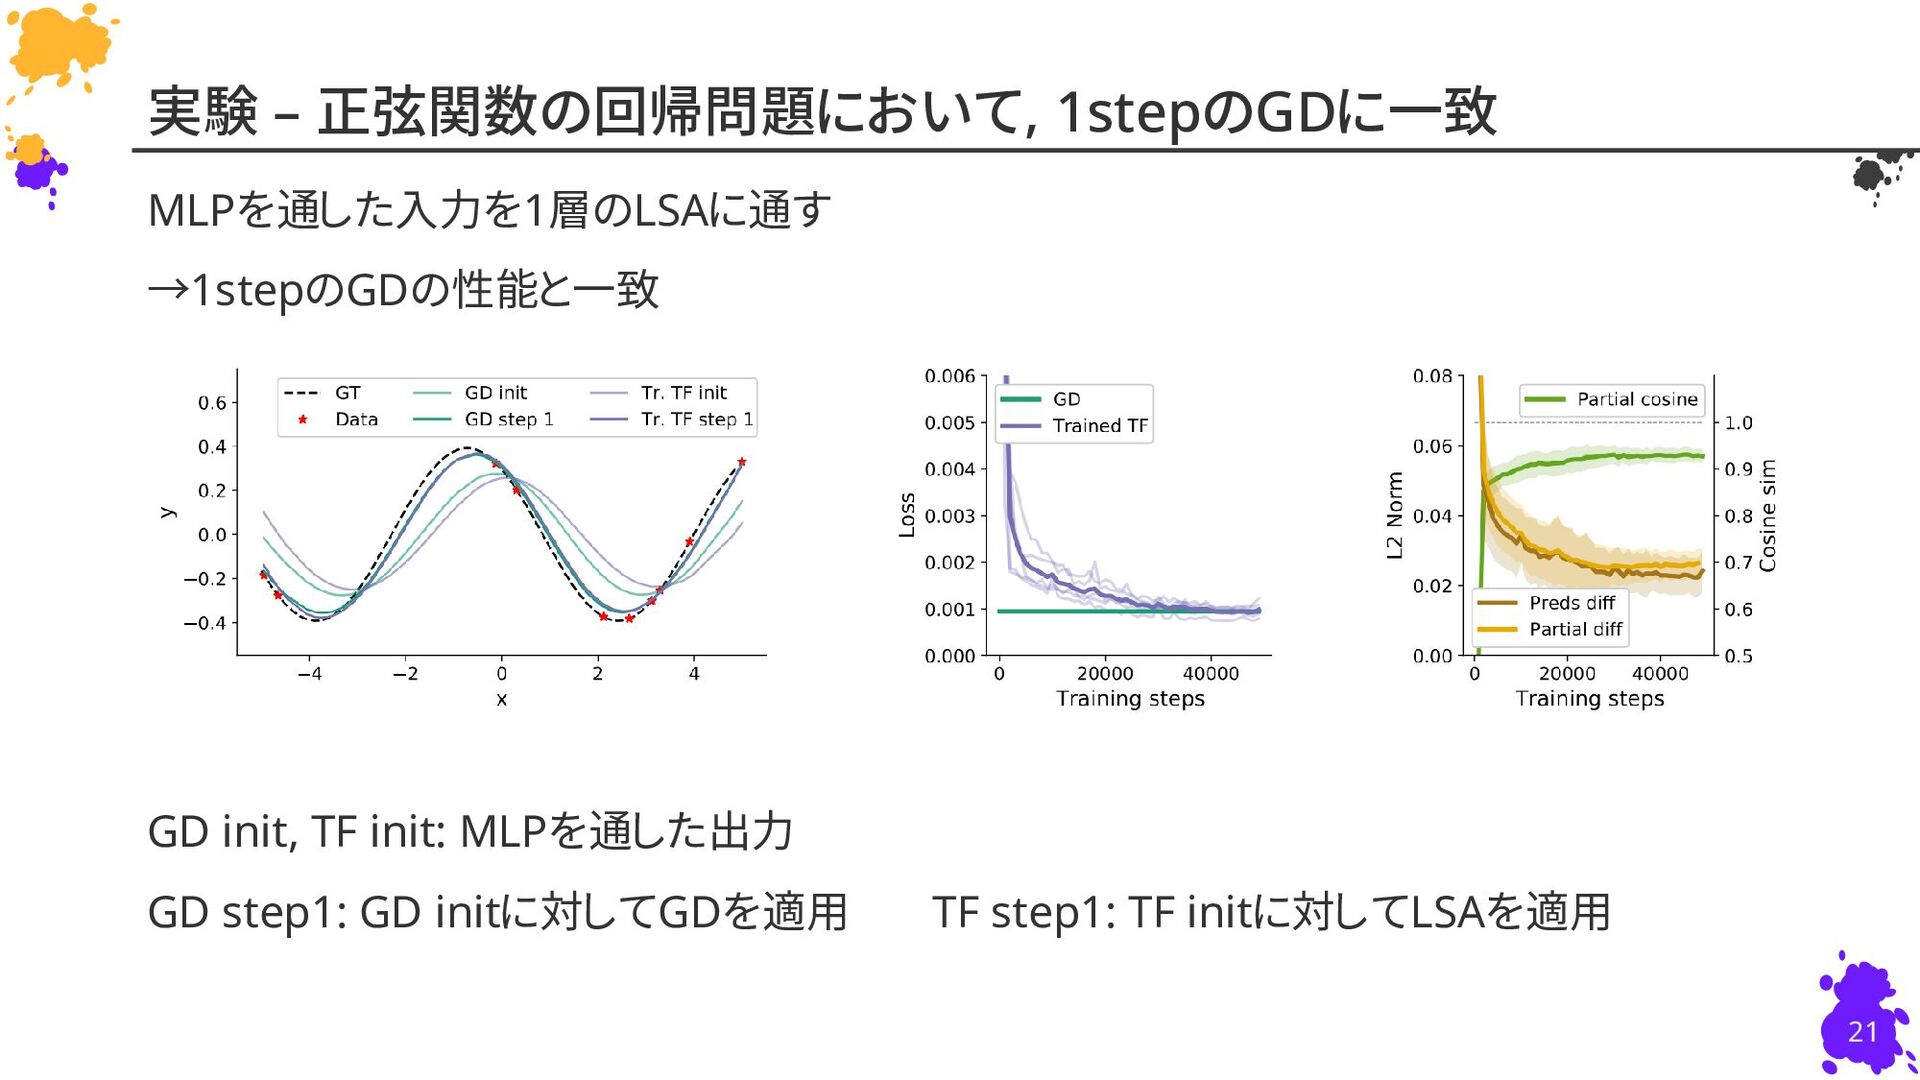
MLPを通した入力を1層のLSAに通す →1stepのGDの性能と一致 GD init, TF init: MLPを通した出力 GD step1: GD
initに対してGDを適用 TF step1: TF initに対してLSAを適用 21 実験 – 正弦関数の回帰問題において, 1stepのGDに一致 -
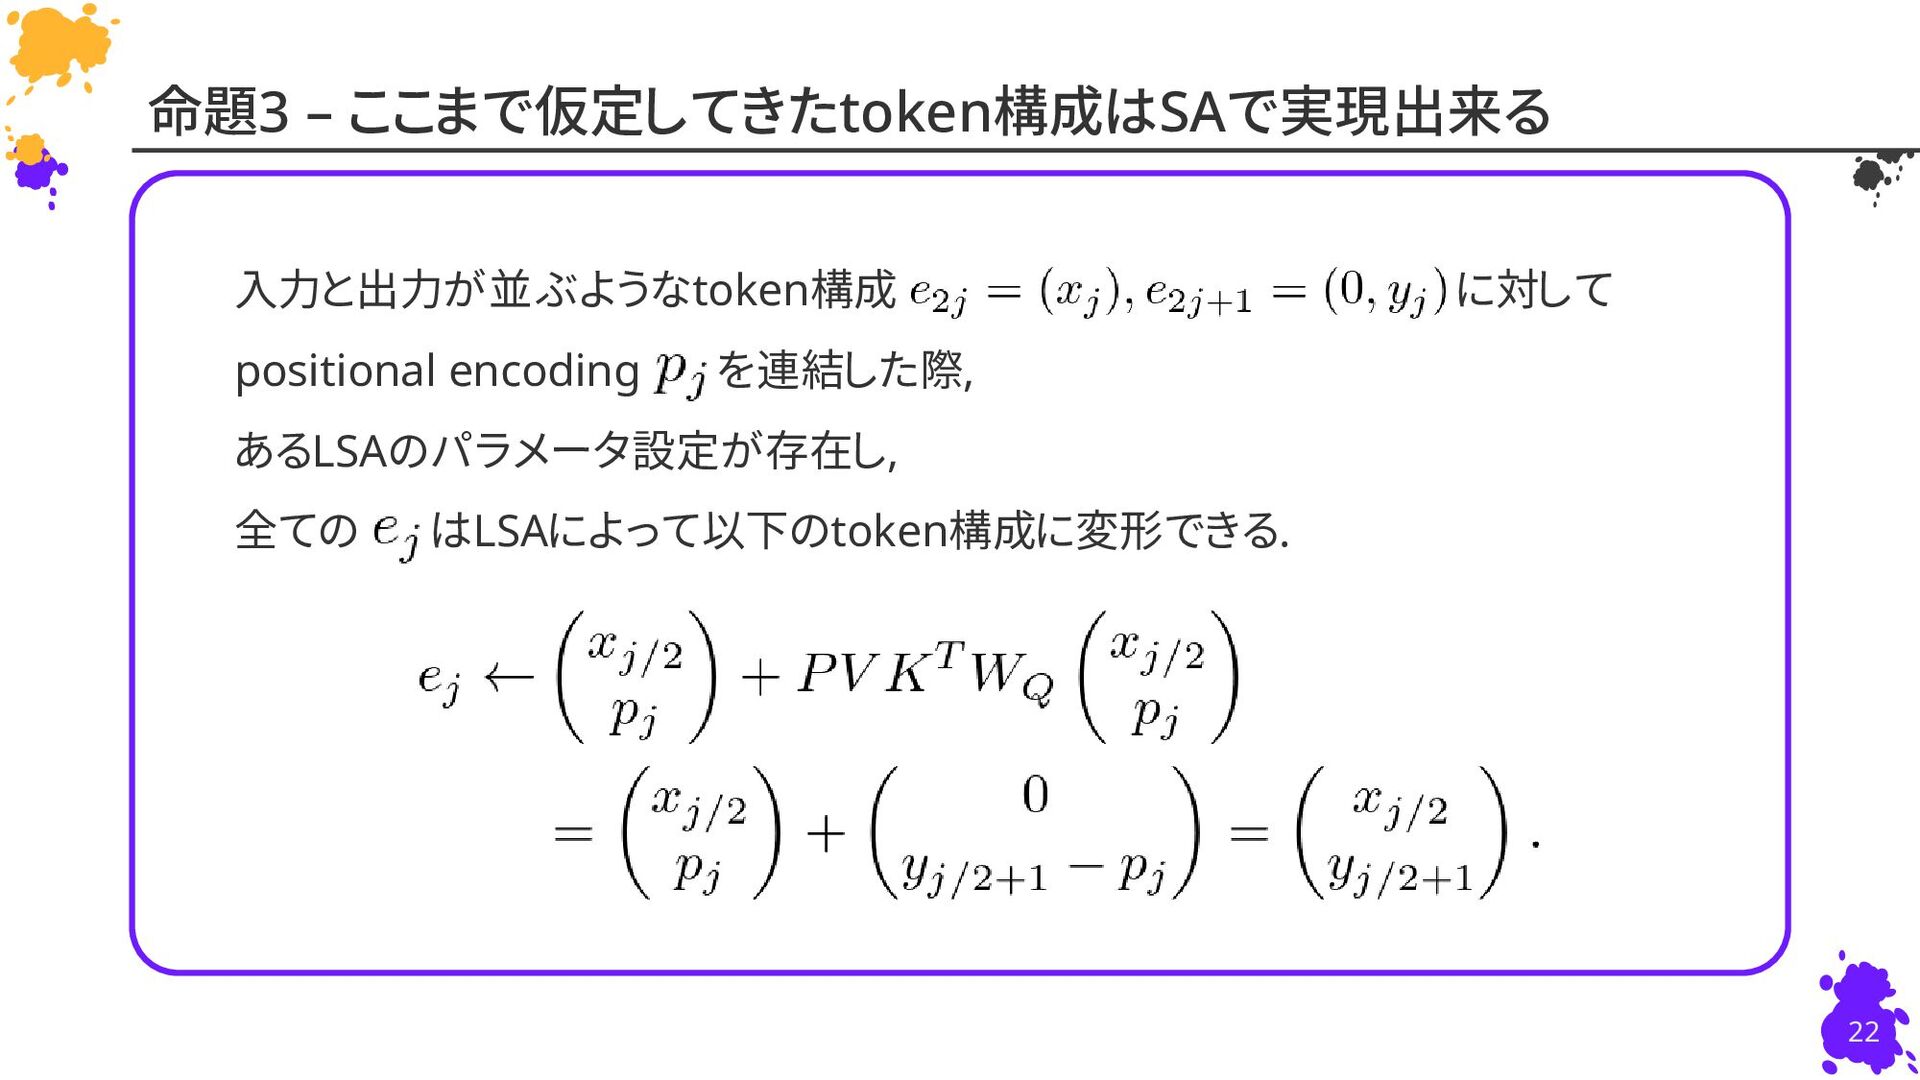
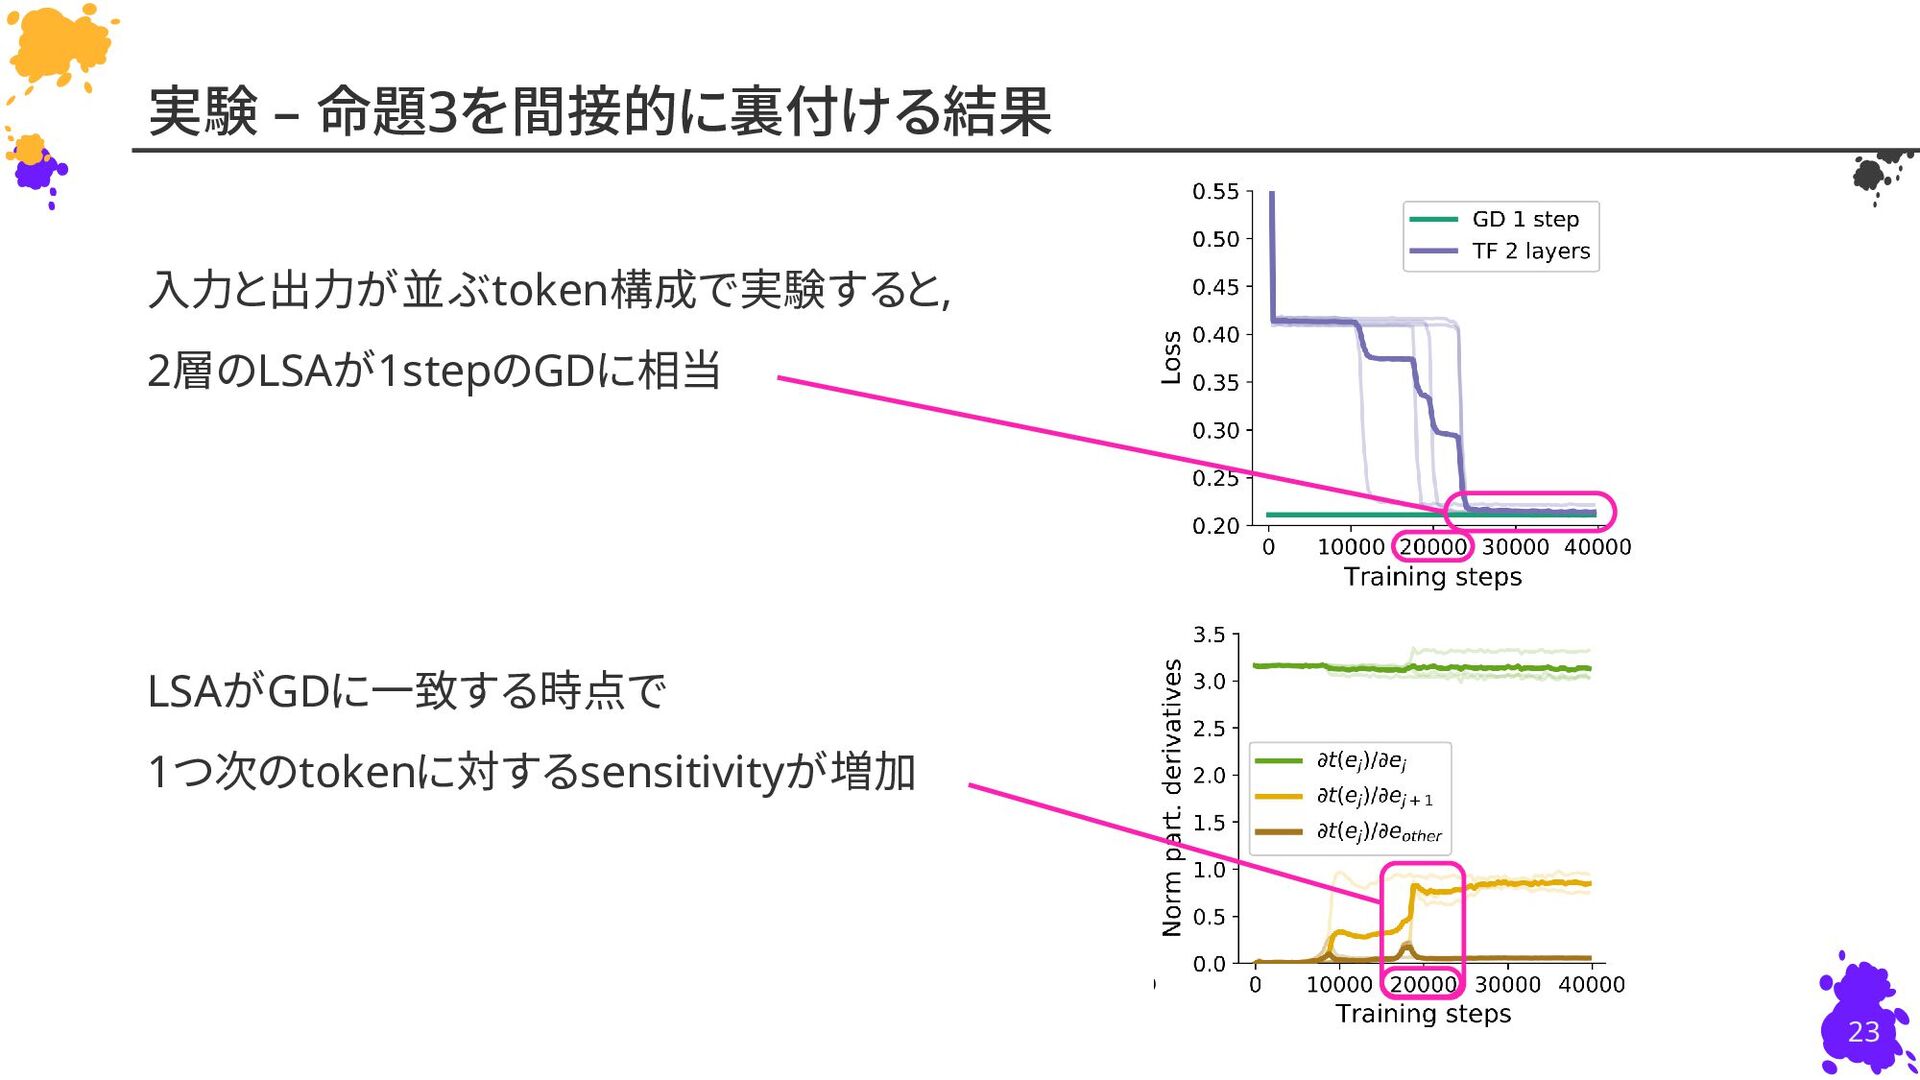
入力と出力が並ぶようなtoken構成 に対して positional encoding を連結した際, あるLSAのパラメータ設定が存在し, 全ての はLSAによって以下のtoken構成に変形できる. 22 命題3
– ここまで仮定してきたtoken構成はSAで実現出来る -
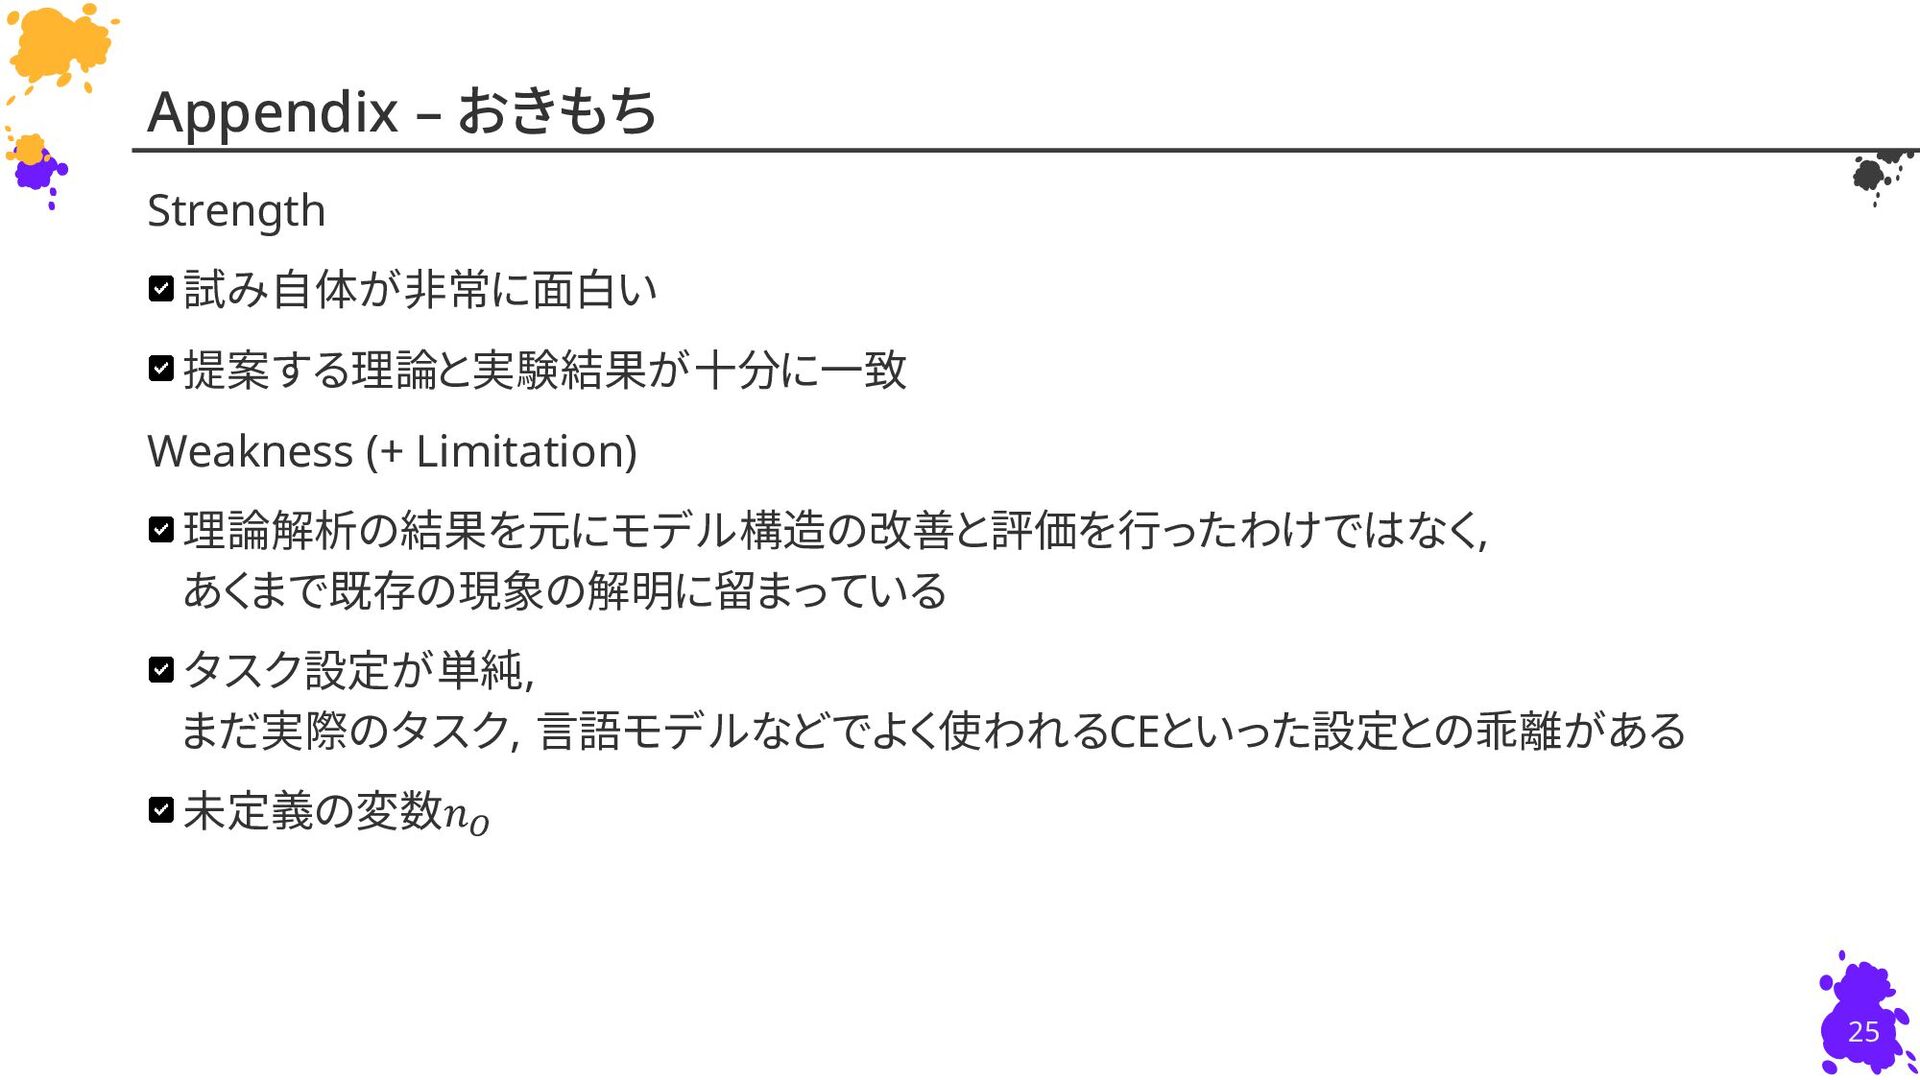
Strength 試み自体が非常に面白い 提案する理論と実験結果が十分に一致 Weakness (+ Limitation) 理論解析の結果を元にモデル構造の改善と評価を行ったわけではなく, あくまで既存の現象の解明に留まっている タスク設定が単純, まだ実際のタスク,
言語モデルなどでよく使われるCEといった設定との乖離がある 未定義の変数𝑛𝑂 25 Appendix – おきもち -
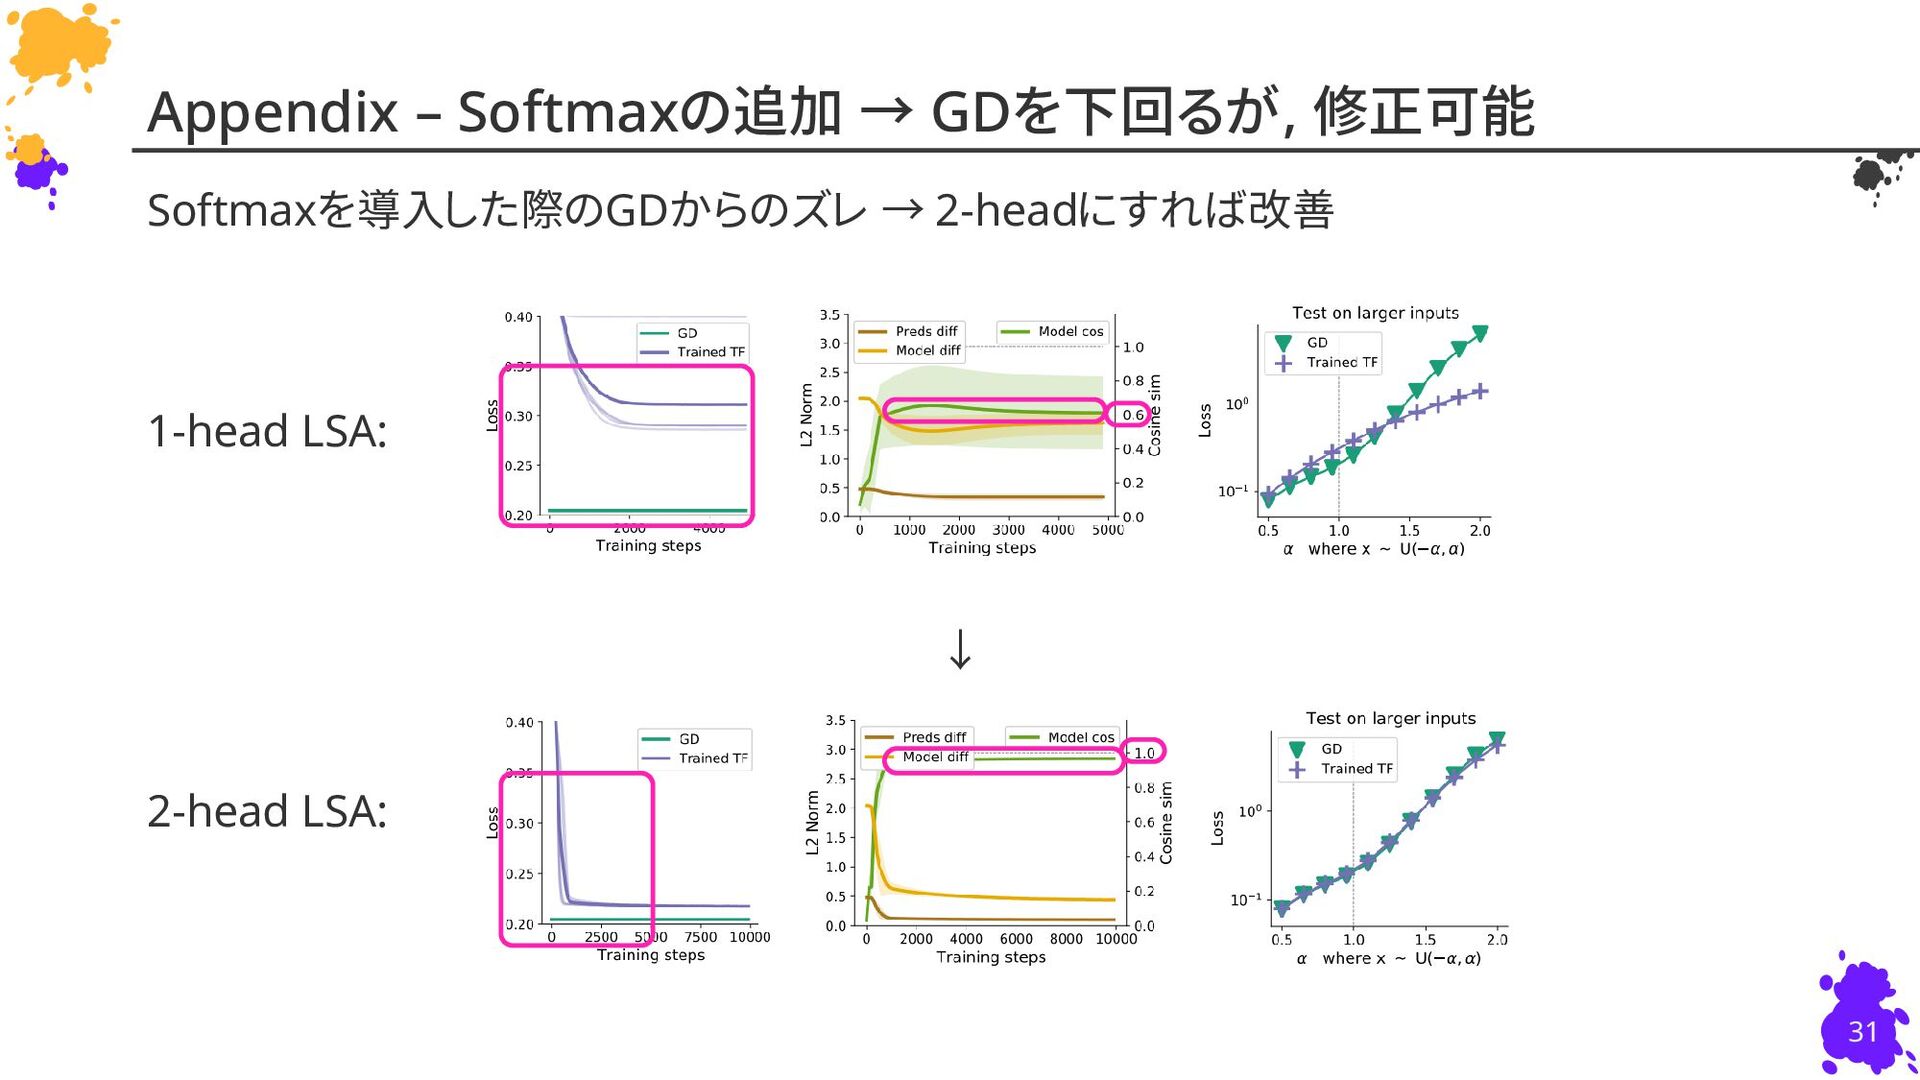
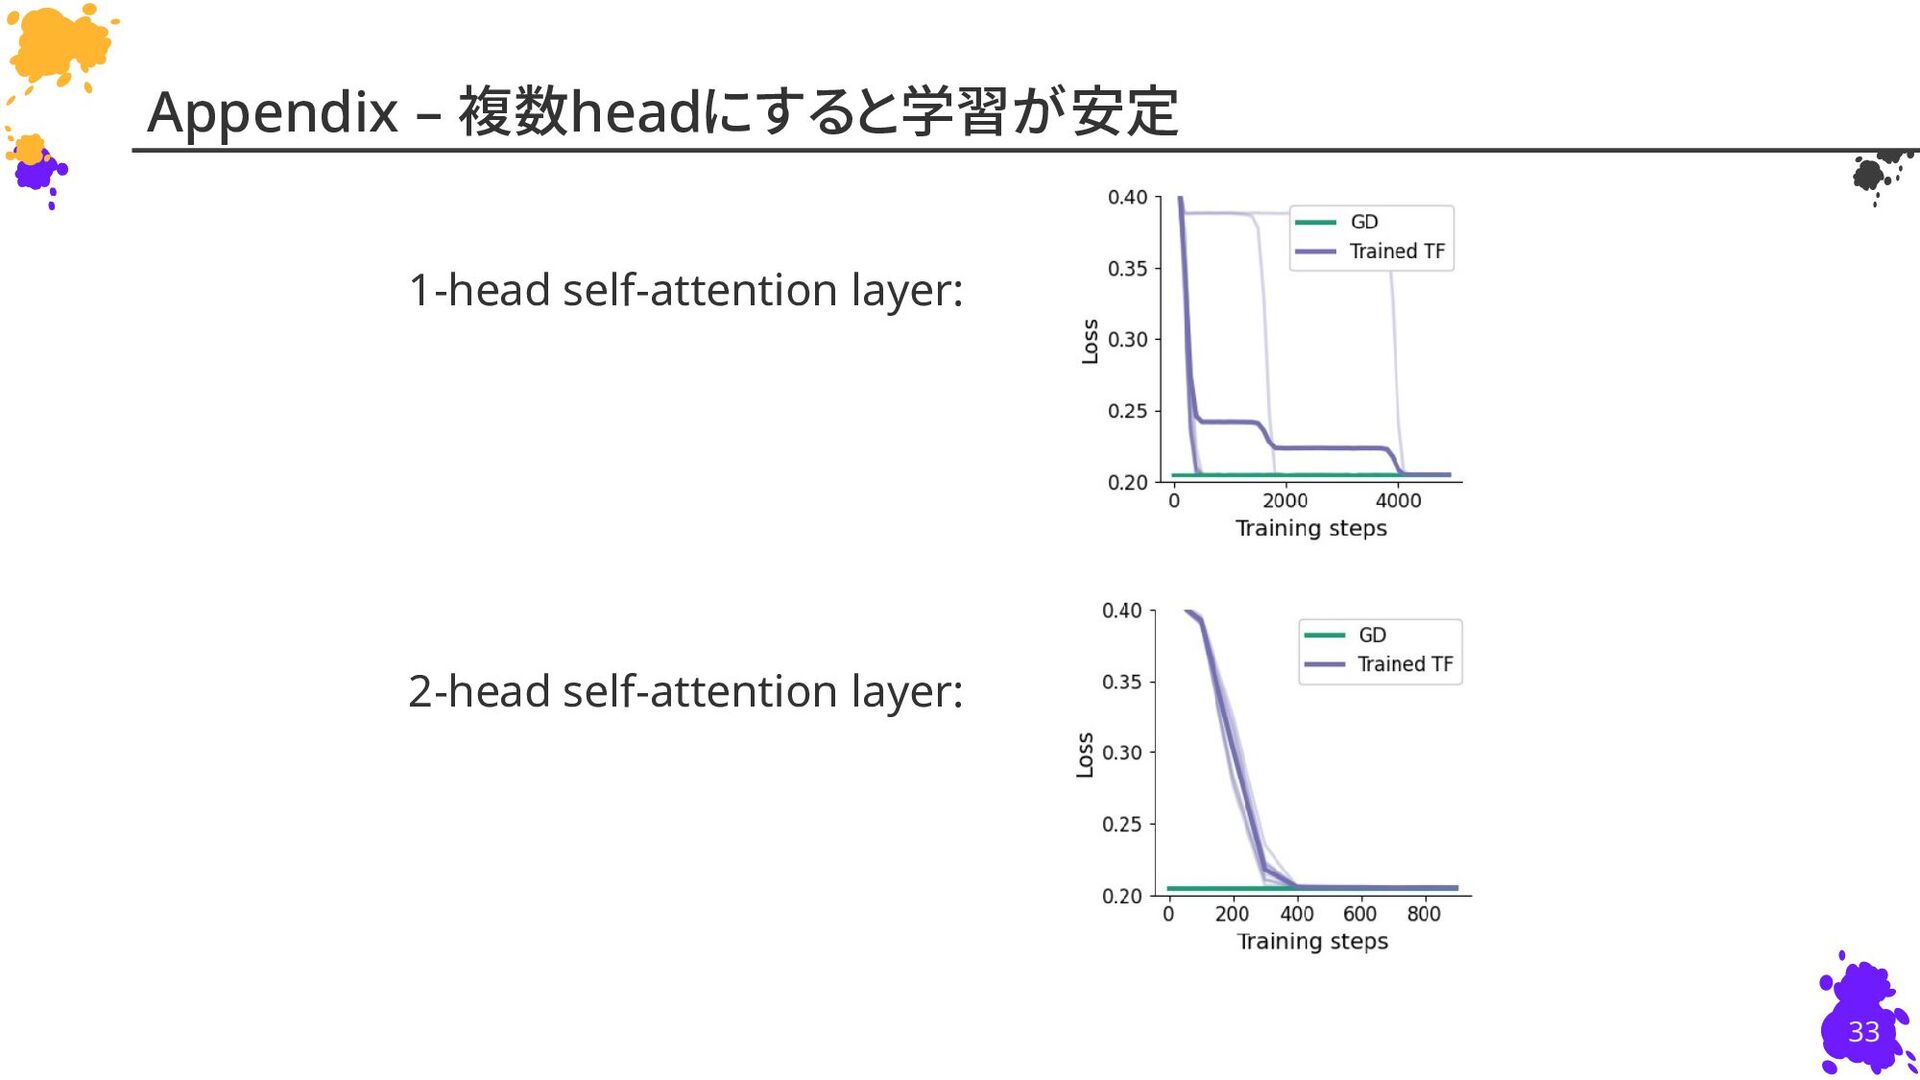
Softmaxを導入した際のGDからのズレ → 2-headにすれば改善 1-head LSA: ↓ 2-head LSA: 31 Appendix
– Softmaxの追加 → GDを下回るが, 修正可能 -
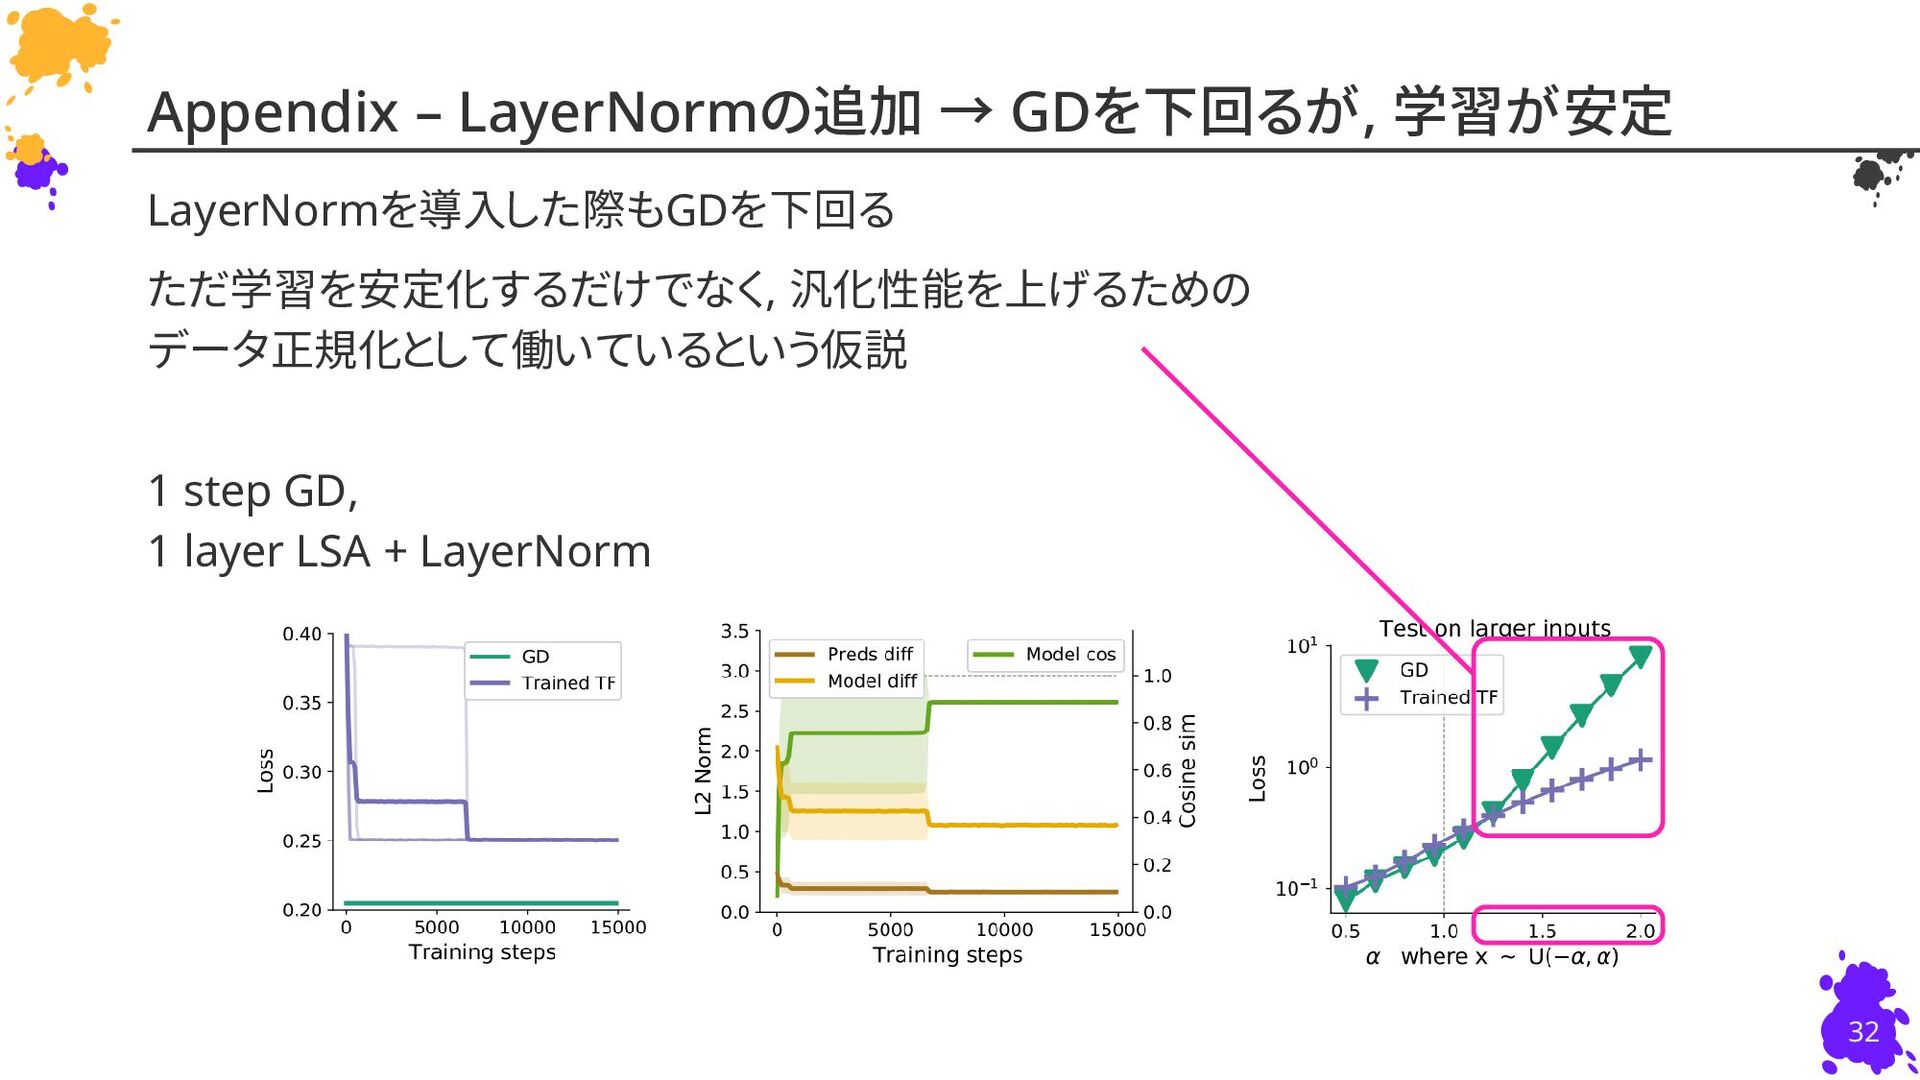
LayerNormを導入した際もGDを下回る ただ学習を安定化するだけでなく, 汎化性能を上げるための データ正規化として働いているという仮説 1 step GD, 1 layer LSA
+ LayerNorm 32 Appendix – LayerNormの追加 → GDを下回るが, 学習が安定 -
Paper (arXiv / OpenReview): https://arxiv.org/pdf/2212.07677.pdf https://openreview.net/pdf?id=tHvXrFQma5 Source Code: https://github.com/google-research/self-organising- systems/tree/master/transformers_learn_icl_by_gd
Slide: https://www.sscardapane.it/assets/files/nnds2022/Transformers %20learn%20in-context%20by%20gradient%20descent.pdf 35 Appendix – Link