Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Learning to Ask Good Questions: Ranking Clarifi...

Learning to Ask Good Questions: Ranking Clarification Questions using Neural Expected Value of Perfect Information

研究室の論文紹介での発表資料です。

ryoma yoshimura

December 19, 2018

Transcript

20 slides
  1. Learning to Ask Good Questions: Ranking Clarification Questions using Neural

    Expected Value of Perfect Information Sudha Rao, Hal Daume Ⅲ ACL2018 best paper 研究室論文読み会 紹介者: 吉村
  2. 概要 • 新しいタスクの提案(Ranking clarification questions) ◦ 有用な質問をランキングする • タスクを解くための新しいモデルを提案 ◦

    ニューラルネットワークを使用したマルチタスク学習 • タスクのためのデータセットを作成して公開 ◦ StackExchangeというQAサイトの投稿から作成 ◦ https://github.com/raosudha89/ ranking_clarification_questions
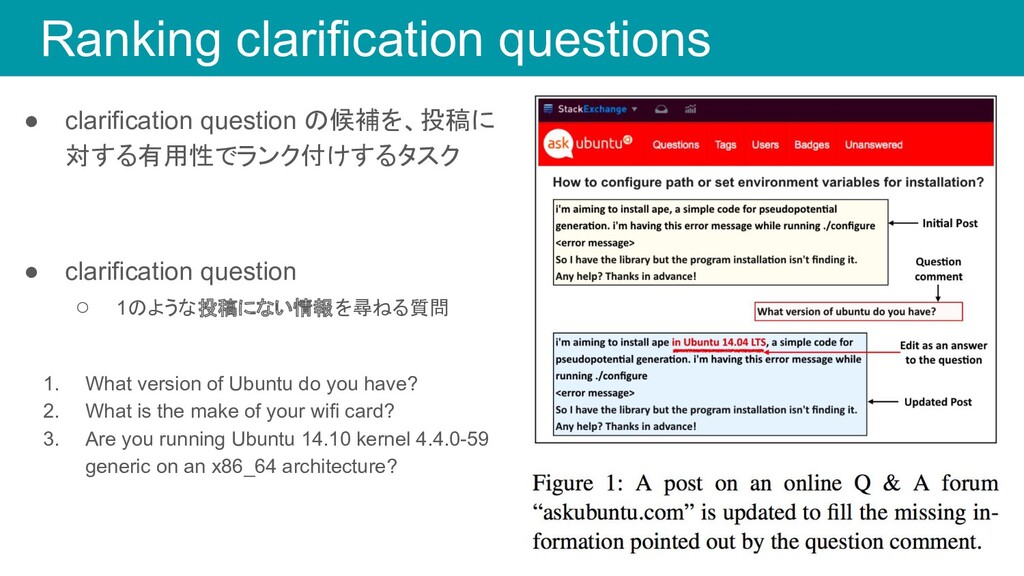
  3. Ranking clarification questions • clarification question の候補を、投稿に 対する有用性でランク付けするタスク • clarification

    question ◦ 1のような投稿にない情報を尋ねる質問 1. What version of Ubuntu do you have? 2. What is the make of your wifi card? 3. Are you running Ubuntu 14.10 kernel 4.4.0-59 generic on an x86_64 architecture?
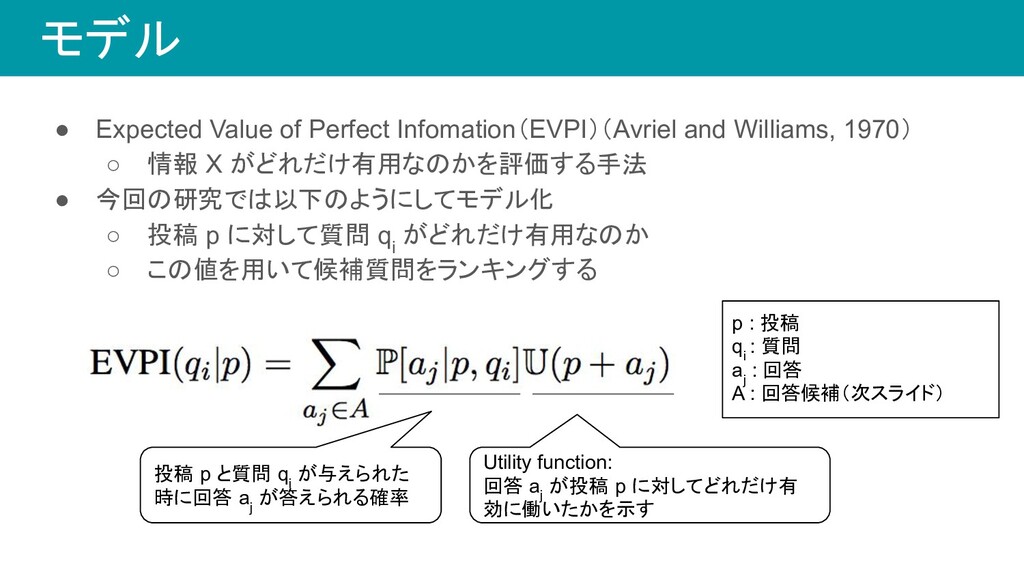
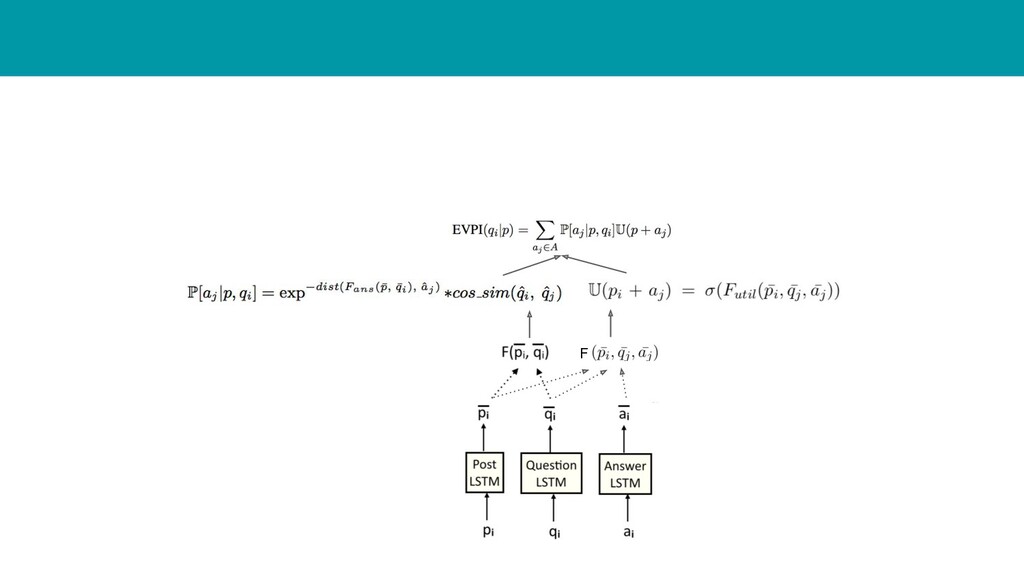
  4. モデル • Expected Value of Perfect Infomation(EVPI)(Avriel and Williams, 1970)

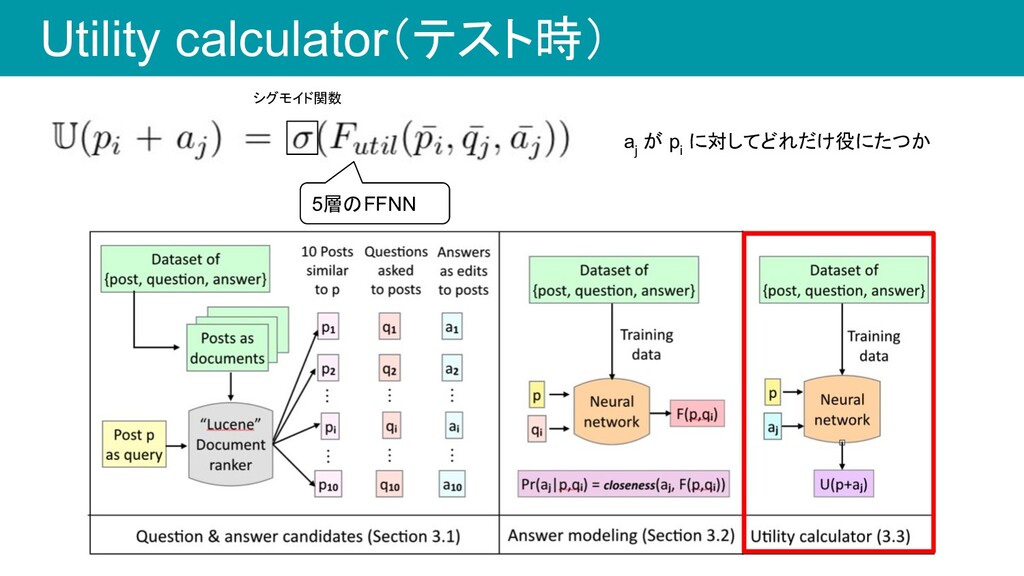
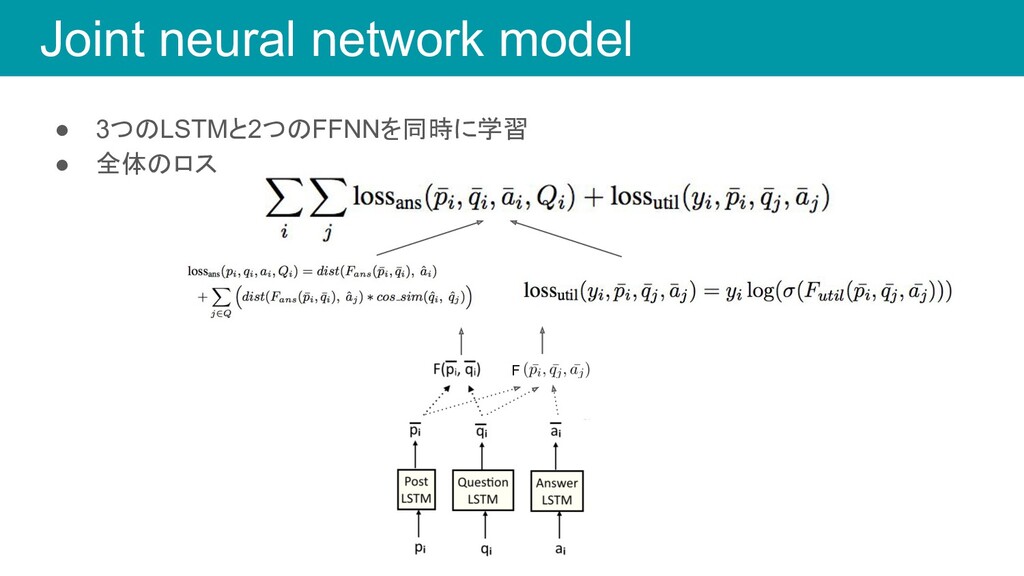
    ◦ 情報 X がどれだけ有用なのかを評価する手法 • 今回の研究では以下のようにしてモデル化 ◦ 投稿 p に対して質問 q i がどれだけ有用なのか ◦ この値を用いて候補質問をランキングする p : 投稿 q i : 質問 a j : 回答 A : 回答候補(次スライド) 投稿 p と質問 q i が与えられた 時に回答 a j が答えられる確率 Utility function: 回答 a j が投稿 p に対してどれだけ有 効に働いたかを示す
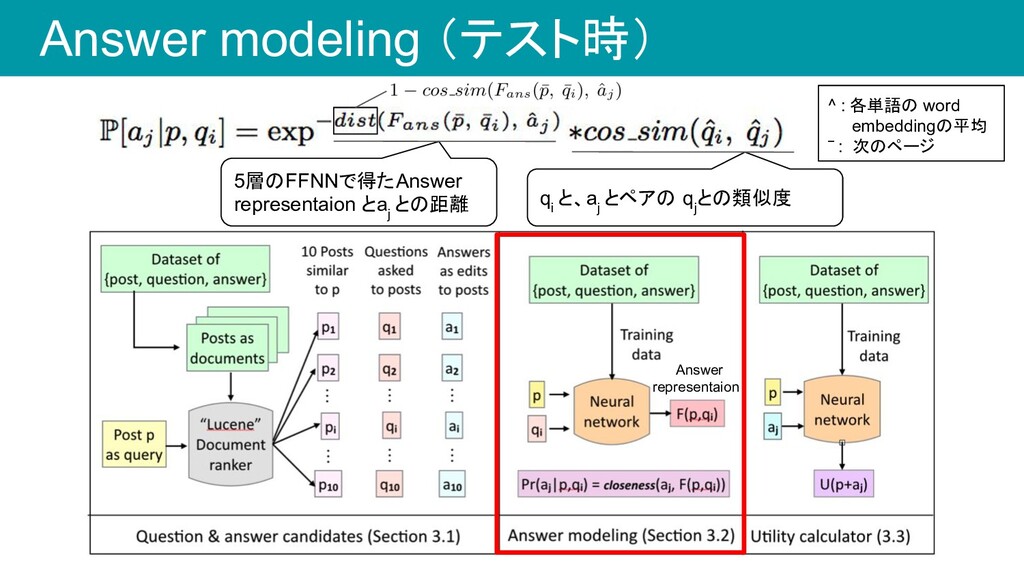
  5. Answer modeling (テスト時) Answer representaion 5層のFFNNで得たAnswer representaion とa j との距離

    q i と、a j とペアの q j との類似度 ^ : 各単語の word embeddingの平均 ‾ : 次のページ
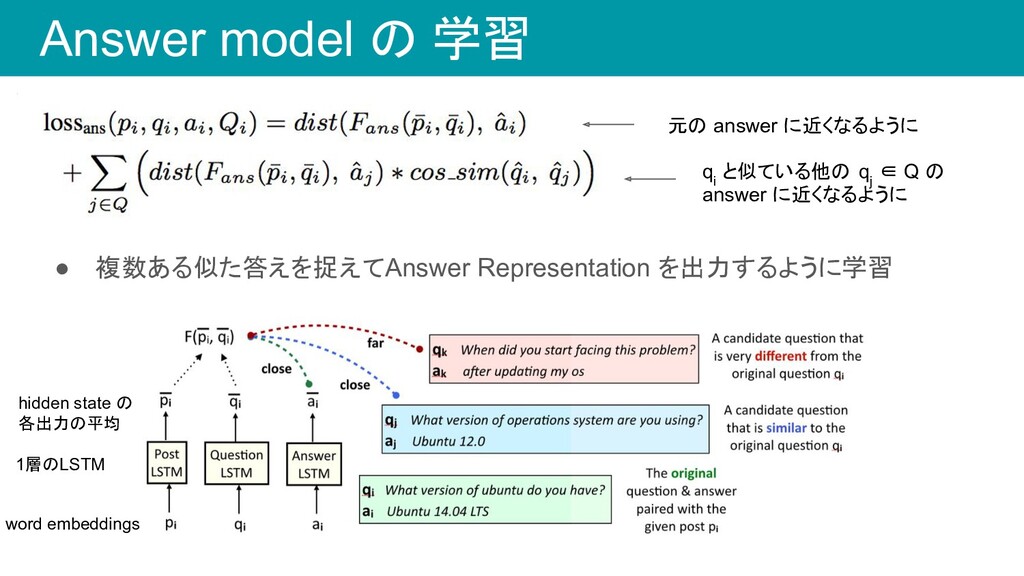
  6. Answer model の 学習 • 複数ある似た答えを捉えてAnswer Representation を出力するように学習 元の answer

    に近くなるように q i と似ている他の q j ∈ Q の answer に近くなるように 1層のLSTM hidden state の 各出力の平均 word embeddings
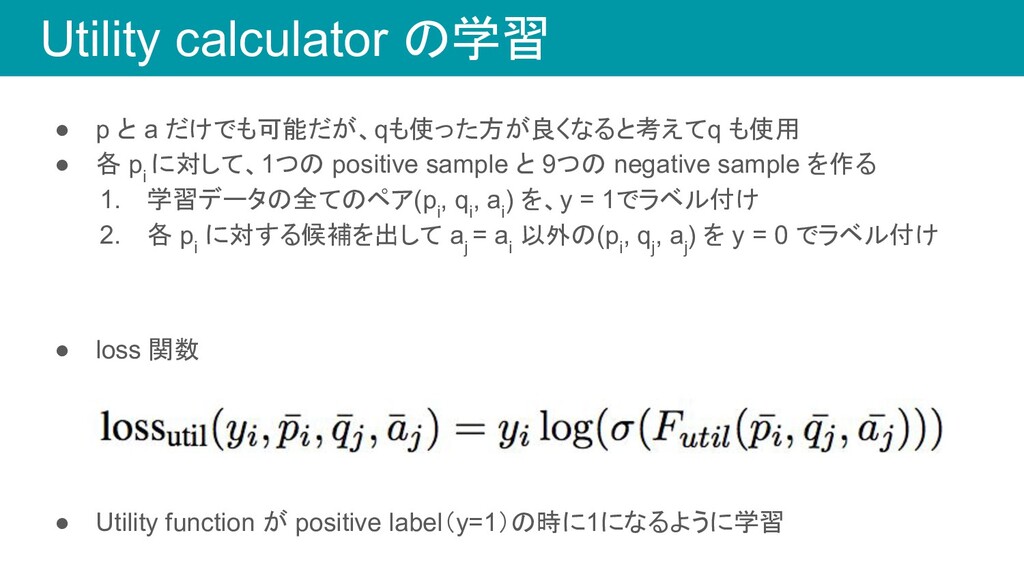
  7. Utility calculator の学習 • p と a だけでも可能だが、qも使った方が良くなると考えてq も使用 •

    各 p i に対して、1つの positive sample と 9つの negative sample を作る 1. 学習データの全てのペア(p i , q i , a i ) を、y = 1でラベル付け 2. 各 p i に対する候補を出して a j = a i 以外の(p i , q j , a j ) を y = 0 でラベル付け • loss 関数 • Utility function が positive label(y=1)の時に1になるように学習
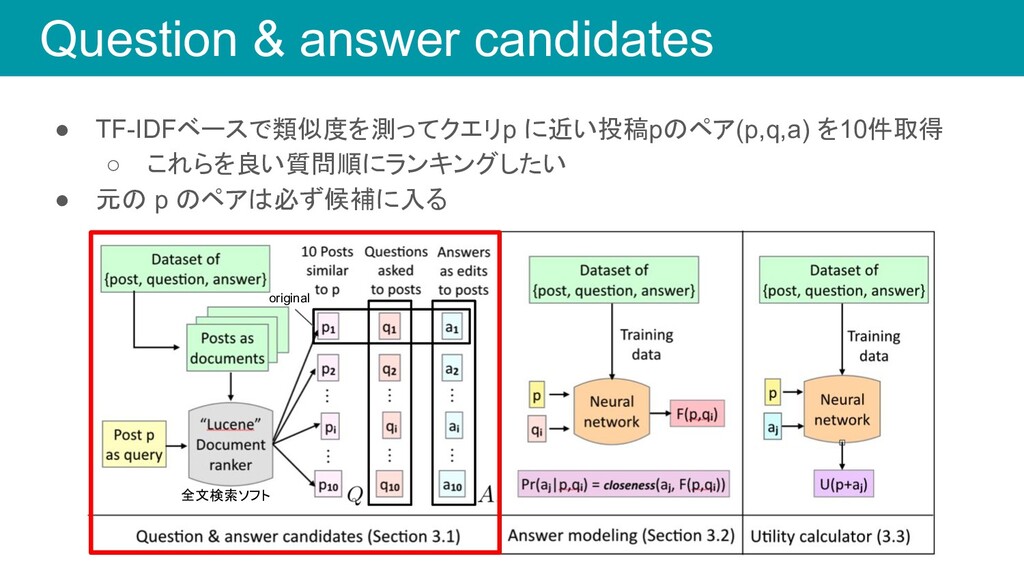
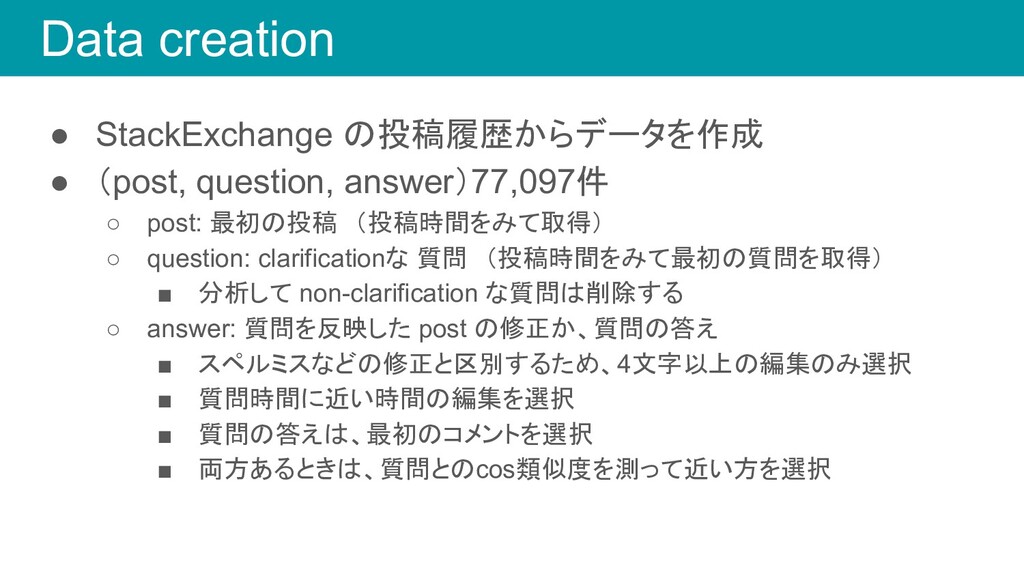
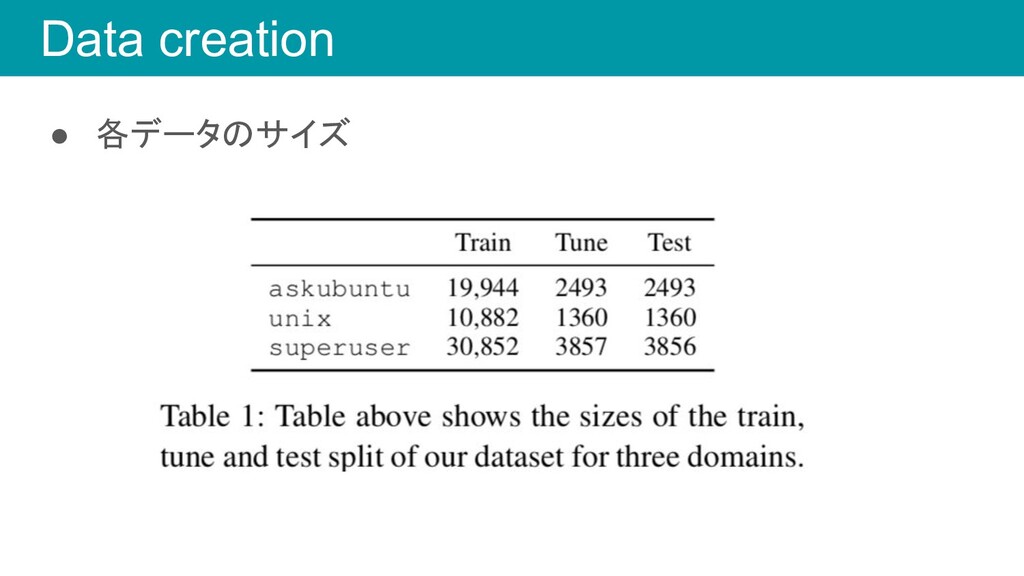
  8. Data creation • StackExchange の投稿履歴からデータを作成 • (post, question, answer)77,097件 ◦

    post: 最初の投稿 (投稿時間をみて取得) ◦ question: clarificationな 質問 (投稿時間をみて最初の質問を取得) ▪ 分析して non-clarification な質問は削除する ◦ answer: 質問を反映した post の修正か、質問の答え ▪ スペルミスなどの修正と区別するため、4文字以上の編集のみ選択 ▪ 質問時間に近い時間の編集を選択 ▪ 質問の答えは、最初のコメントを選択 ▪ 両方あるときは、質問とのcos類似度を測って近い方を選択
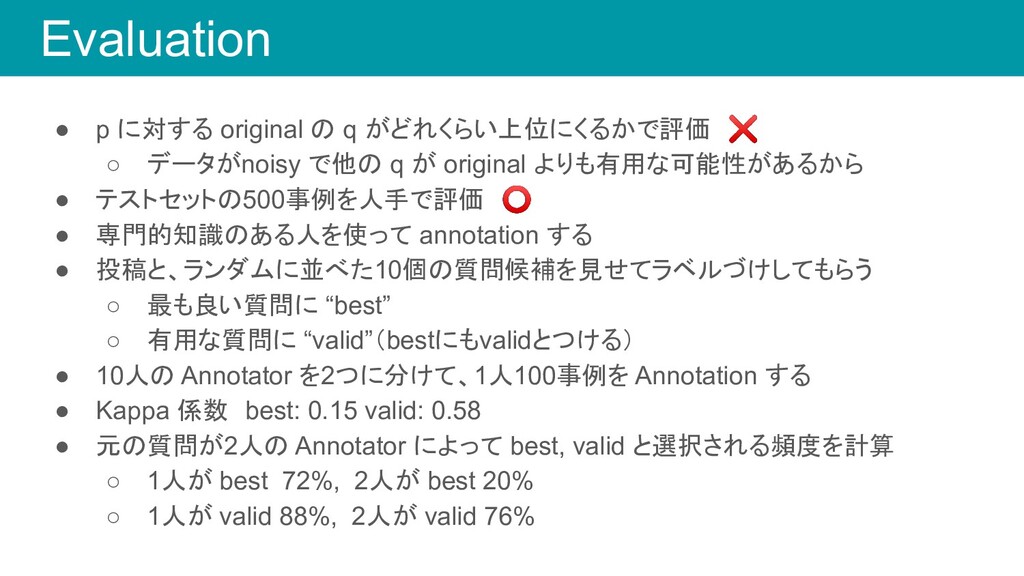
  9. Evaluation • p に対する original の q がどれくらい上位にくるかで評価 ❌ ◦ データがnoisy

    で他の q が original よりも有用な可能性があるから • テストセットの500事例を人手で評価 ⭕ • 専門的知識のある人を使って annotation する • 投稿と、ランダムに並べた10個の質問候補を見せてラベルづけしてもらう ◦ 最も良い質問に “best” ◦ 有用な質問に “valid”(bestにもvalidとつける) • 10人の Annotator を2つに分けて、1人100事例を Annotation する • Kappa 係数 best: 0.15 valid: 0.58 • 元の質問が2人の Annotator によって best, valid と選択される頻度を計算 ◦ 1人が best 72%, 2人が best 20% ◦ 1人が valid 88%, 2人が valid 76%
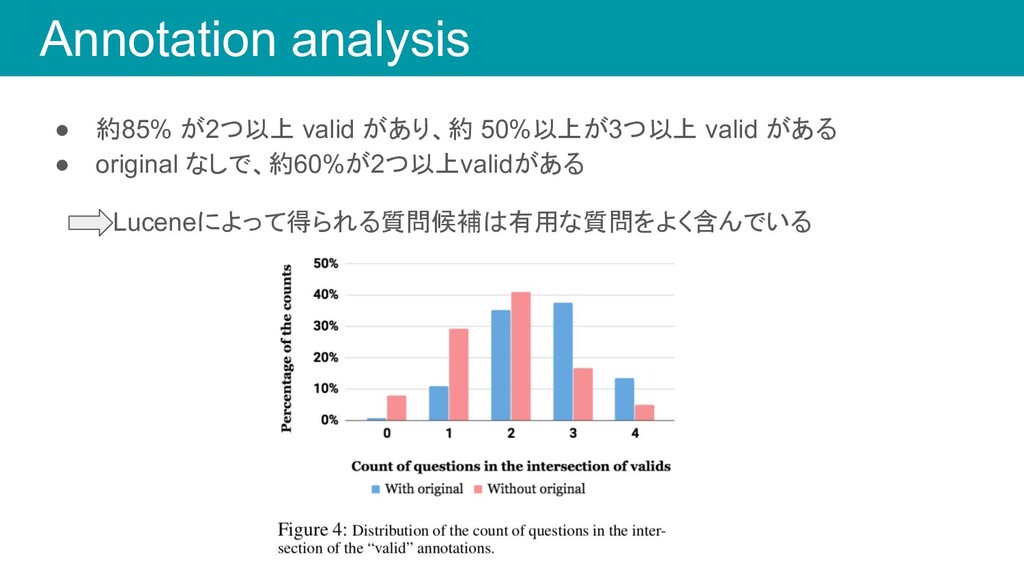
  10. Annotation analysis • 約85% が2つ以上 valid があり、約 50%以上が3つ以上 valid がある

    • original なしで、約60%が2つ以上validがある     Luceneによって得られる質問候補は有用な質問をよく含んでいる
  11. Baseline • Random ◦ 10個の質問候補をランダムに入れ替える • Bag-of-ngrams ◦ 投稿、質問、答えそれぞれのbag-of-ngramsをとって, Uのみ使って学習

    ◦ n=3で評価 • Community QA ◦ 投稿に関連する質問順にランク付するsubtaskで優勝したモデル ◦ ロジスティック回帰 • Neural baselines ◦ Uだけで、F(p,q), F(p,a), F(p,q,a)のlossを直接最小にするようにそれぞれ学 習
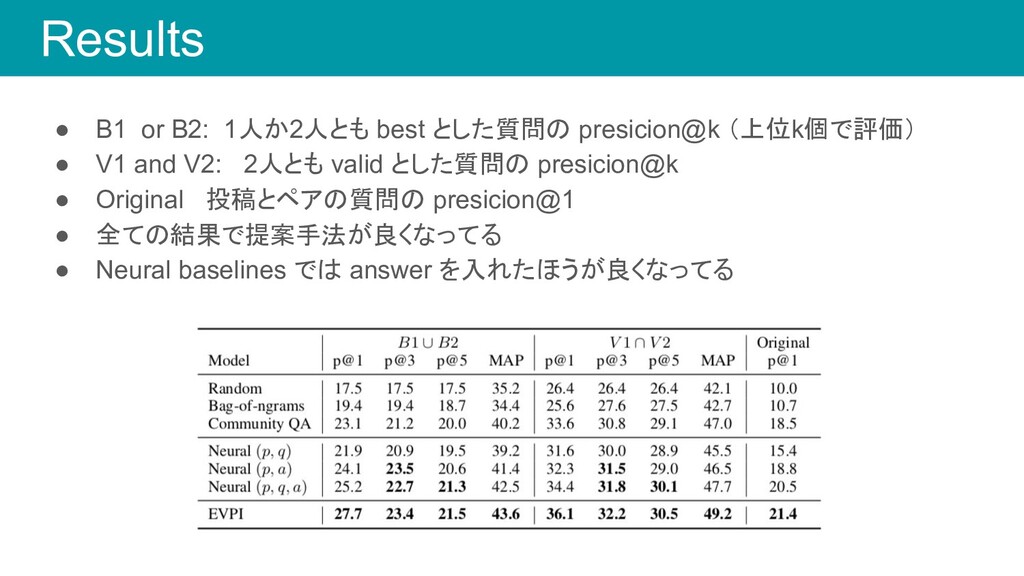
  12. Results • B1 or B2: 1人か2人とも best とした質問の presicion@k (上位k個で評価)

    • V1 and V2: 2人とも valid とした質問の presicion@k • Original 投稿とペアの質問の presicion@1 • 全ての結果で提案手法が良くなってる • Neural baselines では answer を入れたほうが良くなってる
  13. Conclusion • 新しい Ranking clarificaiton quesions task を定義 • タスクを解くためのEVPIを基にした新しいニューラルモデルを提案

    • タスクためのデータセットを作成、公開 future work • 一般化できるように ◦ “Which version of X are you running?” のようなテンプレートを作成 • ランキングから質問文生成へ  • 自動評価
  14. F

More Decks by ryoma yoshimura

Other Decks in Research