Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
20211118_GKEにおける高負荷時のPodとWorker_Nodeの挙動について.pdf
Search
nezumisannn
November 18, 2021
Technology
190
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
20211118_GKEにおける高負荷時のPodとWorker_Nodeの挙動について.pdf
nezumisannn
November 18, 2021
More Decks by nezumisannn
See All by nezumisannn
20250930_Conohaウェビナー_生成AI_Terraform_ConoHa_VPSサーバー_セットアップ入門編
nezumisannn
1
44
20250723_Conohaウェビナー_高騰する海外クラウド費用を劇的カット_サーバーコスト最適化のポイント解説と成功事例のご紹介.pdf
nezumisannn
0
66
20241204_ビヨンド勉強会_44_AWS_Service_Catalogを利用したIaCのテンプレート化とTerraformによるデプロイ.pdf
nezumisannn
0
430
20240828_ビヨンド勉強会_42_EKS_on_FargateでWebサービスを公開するために覚えておきたいこと.pdf
nezumisannn
0
120
20240530_ビヨンド勉強会#41_ビヨンドのエンジニア新卒研修における取り組み
nezumisannn
0
140
20230511_AWSにおけるコンテナサービスの選択とIaC実装例.pdf
nezumisannn
0
1.5k
リーダーになって1年経過して_取り組んできたことと大事にしている考え方_の裏側_.pdf
nezumisannn
0
96
20211014_Alibaba_Cloud_Container_Service_for_KubernetesにおけるServerless_Kubernetesの概要とManaged_Kubernetesとの違い.pdf
nezumisannn
0
120
20211008_ApsaraDB_for_PolarDBとAWS_Auroraの機能比較.pdf
nezumisannn
1
190
Other Decks in Technology
See All in Technology
AI時代のエンジニアの情報発信〜個人の発信を組織の力に変える〜
ryo_kawamata
0
4.1k
[General] 개발자로 해외 기업에서 일하기
skydoves
1
110
クラウドエージェントの先駆け Devin。今も最先端を走る、他との違い
kinopeee
1
520
アクセラレーターで実現するServiceNow活用の高速化 / ServiceNow World Forum 2026
visional_engineering_and_design
0
100
ドメインエキスパートは いかにして AI を使って プロダクト開発をするか
tatsuyashiraishi
1
240
構造で守らせる データ・法務・セキュリティ・開発チームとつくる AI時代のデータガバナンスとデータ基盤のリアル
legalontechnologies
PRO
2
690
SLOを阻む不安
sraku2159
0
150
AI時代の開発はウォーターフォールに回帰する? / development-with-ai-back-to-wf
okamototakuyasr2
0
160
AIに任せられるFlutterコードベースを作る 〜仕様をコードで表し、ハーネスで守る〜
myohei
1
570
E2Eってつらくないですか?E2Eの管理コストを下げる手段とその実践
akaboshinit
6
2.8k
Maestro MCPとClaude Code Skillsによる自律的なE2Eテスト支援
asmz
0
380
仕様駆動開発の、その先へ。決める力と確かめる仕組み
inariku
1
140
Featured
See All Featured
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
30 Presentation Tips
portentint
PRO
1
450
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
320
The Illustrated Guide to Node.js - THAT Conference 2024
reverentgeek
1
590
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
440
WCS-LA-2024
lcolladotor
0
940
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
68
59k
Building an army of robots
kneath
307
47k
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
660
Building Adaptive Systems
keathley
44
3.3k
Become a Pro
speakerdeck
PRO
31
6.3k
From π to Pie charts
rasagy
1
420
Transcript
GKEにおける高負荷時の PodとWorker Nodeの挙動について MixLeap Study #68 - 各社事例に学ぶKubernetes運用 2021/11/18 株式会社ビヨンド
寺岡 佑樹
自己紹介 resource “my_profile” “nezumisannn” { name = “Yuki.Teraoka” nickname =
“ねずみさん家。” company = “beyond Co., Ltd.” job = “Infra Engineer” twitter = “@yktr_sre” skills = [“Terraform”,”Packer”] }
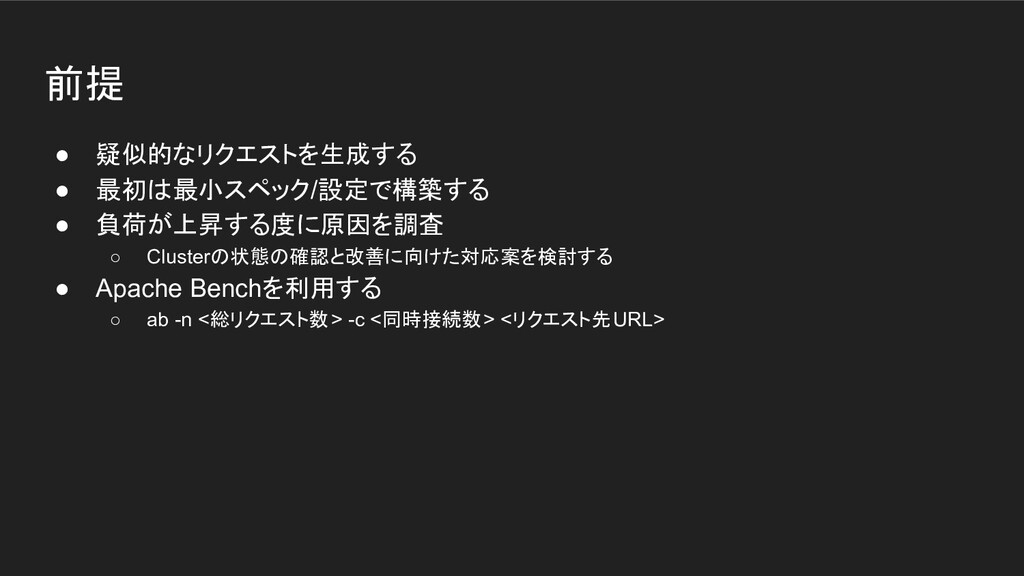
前提 • 疑似的なリクエストを生成する • 最初は最小スペック/設定で構築する • 負荷が上昇する度に原因を調査 ◦ Clusterの状態の確認と改善に向けた対応案を検討する •
Apache Benchを利用する ◦ ab -n <総リクエスト数> -c <同時接続数> <リクエスト先URL>
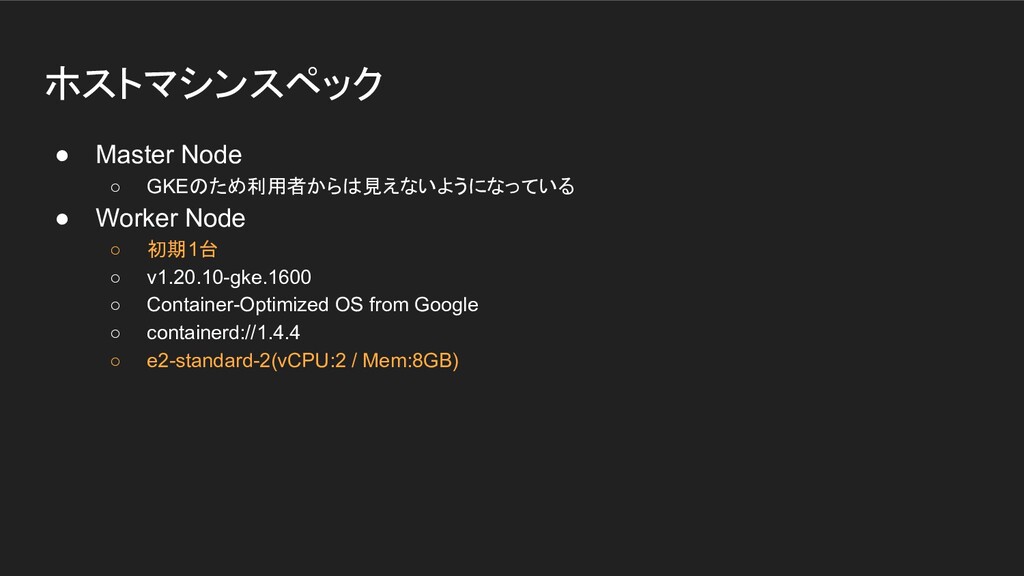
ホストマシンスペック • Master Node ◦ GKEのため利用者からは見えないようになっている • Worker Node ◦
初期1台 ◦ v1.20.10-gke.1600 ◦ Container-Optimized OS from Google ◦ containerd://1.4.4 ◦ e2-standard-2(vCPU:2 / Mem:8GB)
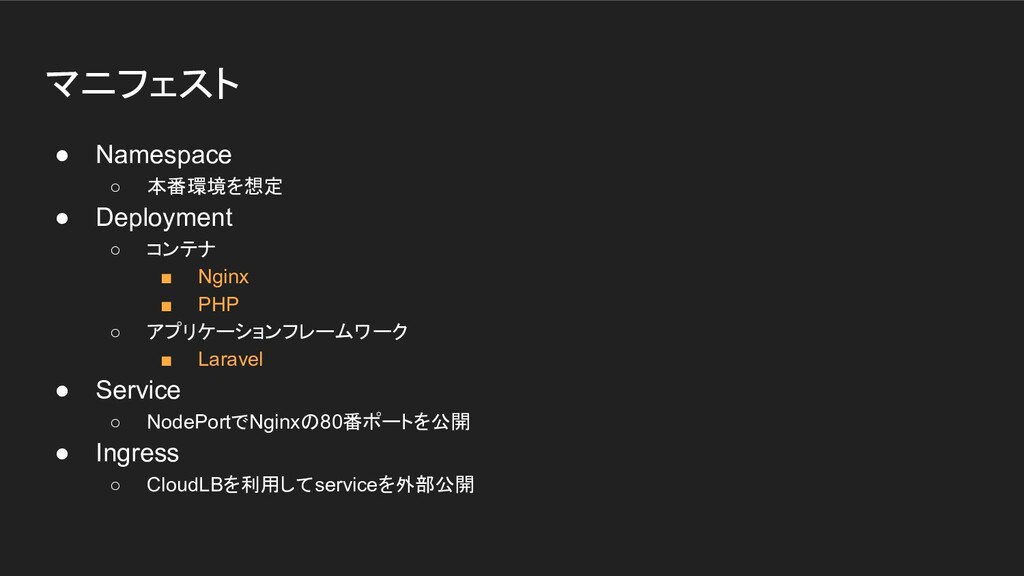
マニフェスト • Namespace ◦ 本番環境を想定 • Deployment ◦ コンテナ ▪
Nginx ▪ PHP ◦ アプリケーションフレームワーク ▪ Laravel • Service ◦ NodePortでNginxの80番ポートを公開 • Ingress ◦ CloudLBを利用してserviceを外部公開
平常時 Worker Node ``` $ kubectl top node NAME CPU(cores)
CPU% MEMORY(bytes) MEMORY% gke-gke-cluster-default-pool-a063d899-58t9 149m 15% 799Mi 28% ``` Pod(Production) ``` $ kubectl top pod -n production NAME CPU(cores) MEMORY(bytes) laravel-6dbd68b4f9-7pnln 16m 64Mi ```
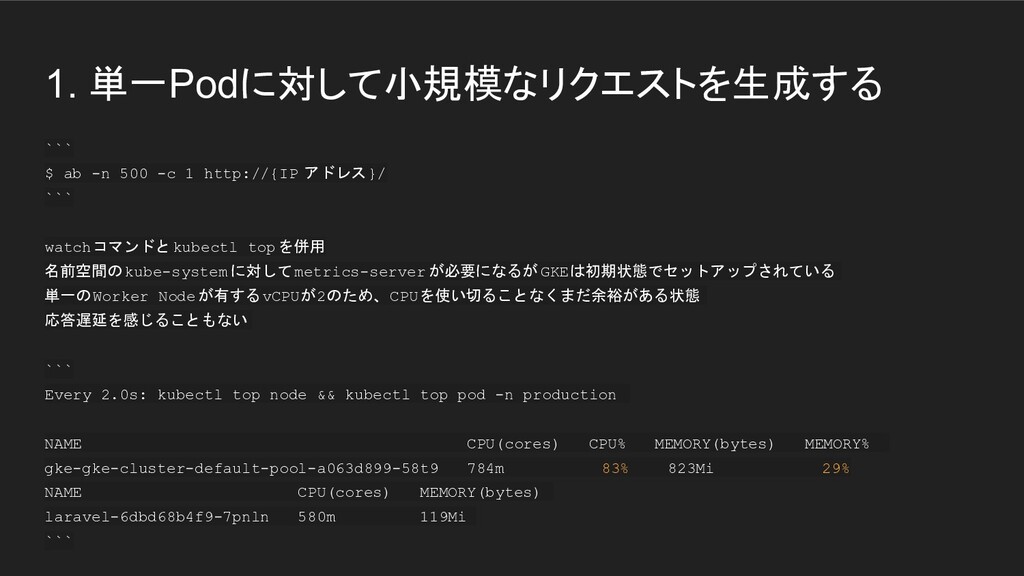
1. 単一Podに対して小規模なリクエストを生成する ``` $ ab -n 500 -c 1 http://{IP
アドレス}/ ``` watchコマンドとkubectl top を併用 名前空間のkube-system に対してmetrics-server が必要になるが GKEは初期状態でセットアップされている 単一のWorker Node が有するvCPUが2のため、CPUを使い切ることなくまだ余裕がある状態 応答遅延を感じることもない ``` Every 2.0s: kubectl top node && kubectl top pod -n production NAME CPU(cores) CPU% MEMORY(bytes) MEMORY% gke-gke-cluster-default-pool-a063d899-58t9 784m 83% 823Mi 29% NAME CPU(cores) MEMORY(bytes) laravel-6dbd68b4f9-7pnln 580m 119Mi ```
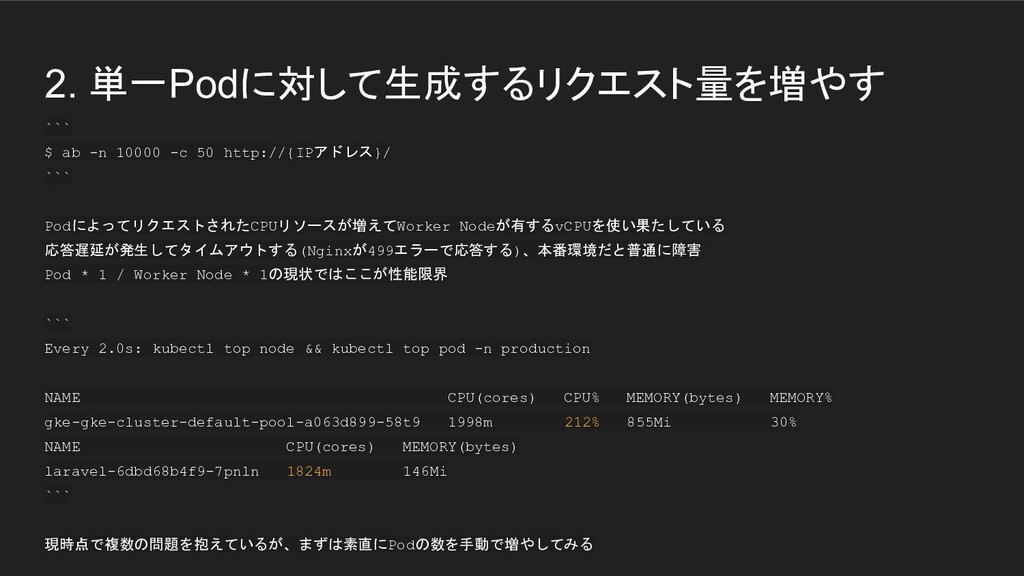
2. 単一Podに対して生成するリクエスト量を増やす ``` $ ab -n 10000 -c 50 http://{IPアドレス}/
``` PodによってリクエストされたCPUリソースが増えてWorker Nodeが有するvCPUを使い果たしている 応答遅延が発生してタイムアウトする(Nginxが499エラーで応答する)、本番環境だと普通に障害 Pod * 1 / Worker Node * 1の現状ではここが性能限界 ``` Every 2.0s: kubectl top node && kubectl top pod -n production NAME CPU(cores) CPU% MEMORY(bytes) MEMORY% gke-gke-cluster-default-pool-a063d899-58t9 1998m 212% 855Mi 30% NAME CPU(cores) MEMORY(bytes) laravel-6dbd68b4f9-7pnln 1824m 146Mi ``` 現時点で複数の問題を抱えているが、まずは素直にPodの数を手動で増やしてみる
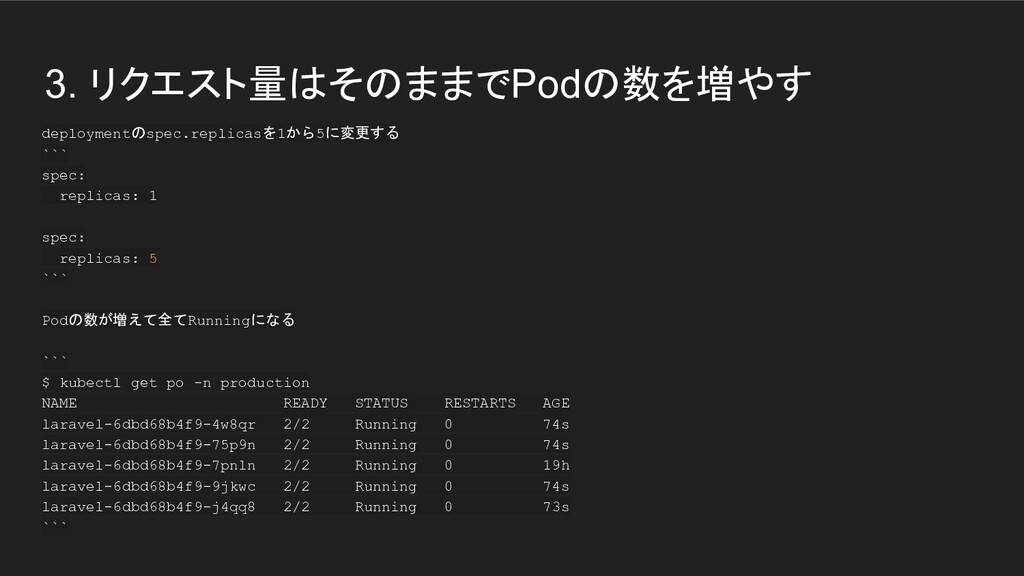
3. リクエスト量はそのままでPodの数を増やす deploymentのspec.replicasを1から5に変更する ``` spec: replicas: 1 spec: replicas: 5
``` Podの数が増えて全てRunningになる ``` $ kubectl get po -n production NAME READY STATUS RESTARTS AGE laravel-6dbd68b4f9-4w8qr 2/2 Running 0 74s laravel-6dbd68b4f9-75p9n 2/2 Running 0 74s laravel-6dbd68b4f9-7pnln 2/2 Running 0 19h laravel-6dbd68b4f9-9jkwc 2/2 Running 0 74s laravel-6dbd68b4f9-j4qq8 2/2 Running 0 73s ```
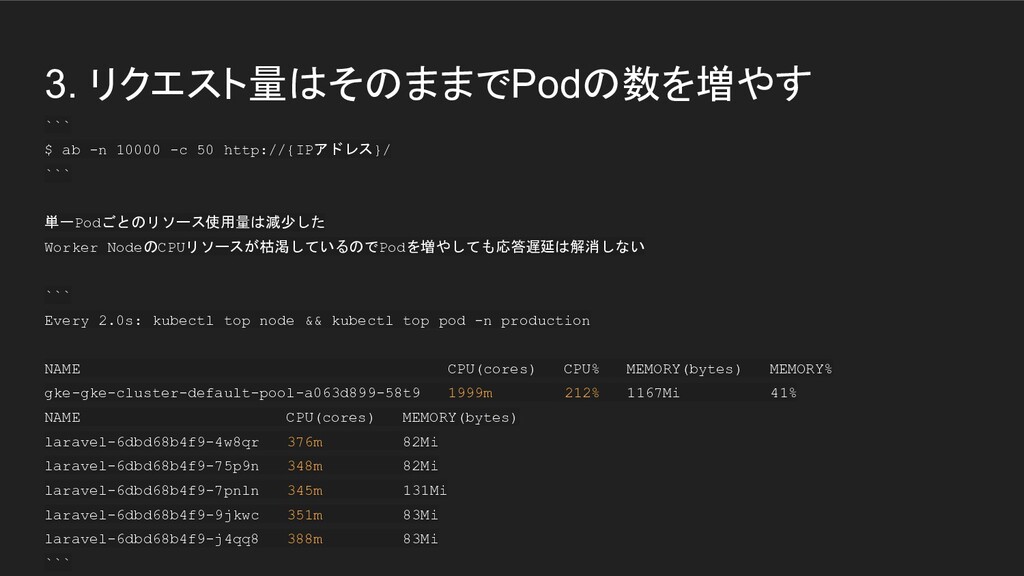
3. リクエスト量はそのままでPodの数を増やす ``` $ ab -n 10000 -c 50 http://{IPアドレス}/
``` 単一Podごとのリソース使用量は減少した Worker NodeのCPUリソースが枯渇しているのでPodを増やしても応答遅延は解消しない ``` Every 2.0s: kubectl top node && kubectl top pod -n production NAME CPU(cores) CPU% MEMORY(bytes) MEMORY% gke-gke-cluster-default-pool-a063d899-58t9 1999m 212% 1167Mi 41% NAME CPU(cores) MEMORY(bytes) laravel-6dbd68b4f9-4w8qr 376m 82Mi laravel-6dbd68b4f9-75p9n 348m 82Mi laravel-6dbd68b4f9-7pnln 345m 131Mi laravel-6dbd68b4f9-9jkwc 351m 83Mi laravel-6dbd68b4f9-j4qq8 388m 83Mi ```
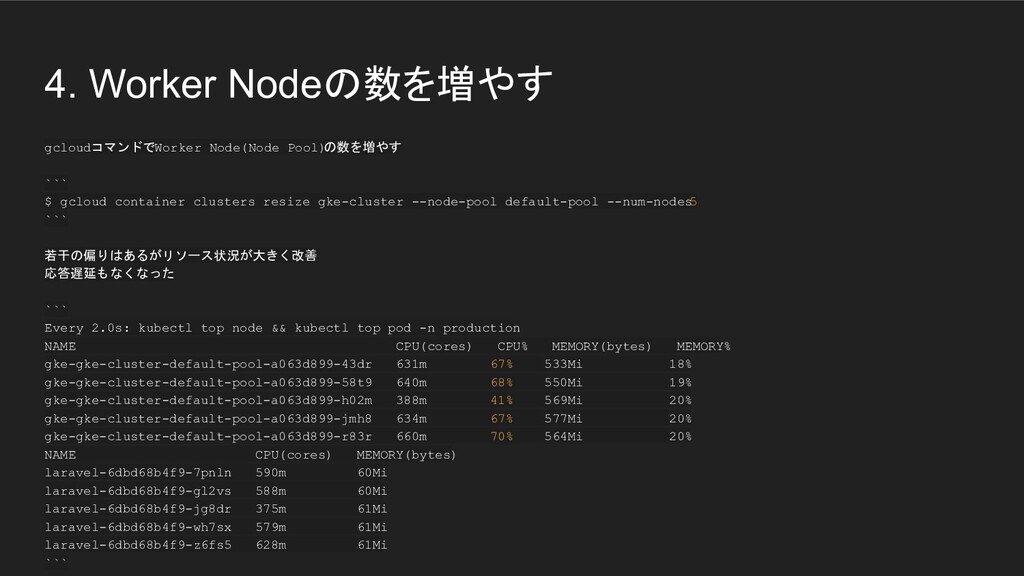
4. Worker Nodeの数を増やす gcloudコマンドでWorker Node(Node Pool) の数を増やす ``` $ gcloud
container clusters resize gke-cluster --node-pool default-pool --num-nodes 5 ``` 若干の偏りはあるがリソース状況が大きく改善 応答遅延もなくなった ``` Every 2.0s: kubectl top node && kubectl top pod -n production NAME CPU(cores) CPU% MEMORY(bytes) MEMORY% gke-gke-cluster-default-pool-a063d899-43dr 631m 67% 533Mi 18% gke-gke-cluster-default-pool-a063d899-58t9 640m 68% 550Mi 19% gke-gke-cluster-default-pool-a063d899-h02m 388m 41% 569Mi 20% gke-gke-cluster-default-pool-a063d899-jmh8 634m 67% 577Mi 20% gke-gke-cluster-default-pool-a063d899-r83r 660m 70% 564Mi 20% NAME CPU(cores) MEMORY(bytes) laravel-6dbd68b4f9-7pnln 590m 60Mi laravel-6dbd68b4f9-gl2vs 588m 60Mi laravel-6dbd68b4f9-jg8dr 375m 61Mi laravel-6dbd68b4f9-wh7sx 579m 61Mi laravel-6dbd68b4f9-z6fs5 628m 61Mi ```
ここまでの整理 • 単一PodでもWorker Nodeのリソースが枯渇しない限りは応答遅延が出なかった • Worker Nodeのリソースが枯渇すると当然ながら Podが起動していても障害状態になる • この状態でPodの数を増やすとRunningにはなるが状況は改善しない
• Worker Nodeを増やしてPodを再配置すると、利用できるリソース量が増えて改善した
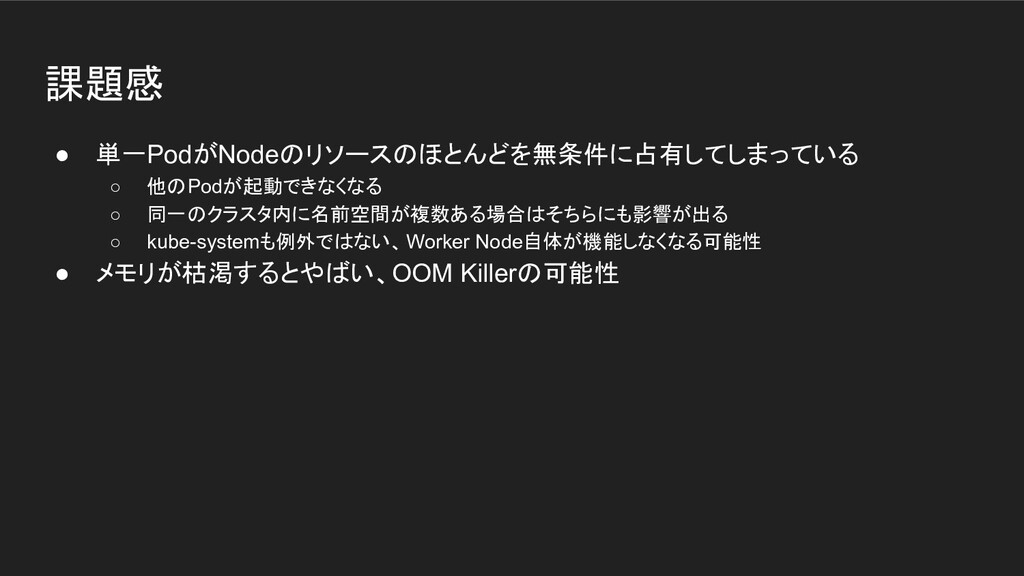
課題感 • 単一PodがNodeのリソースのほとんどを無条件に占有してしまっている ◦ 他のPodが起動できなくなる ◦ 同一のクラスタ内に名前空間が複数ある場合はそちらにも影響が出る ◦ kube-systemも例外ではない、Worker Node自体が機能しなくなる可能性
• メモリが枯渇するとやばい、OOM Killerの可能性
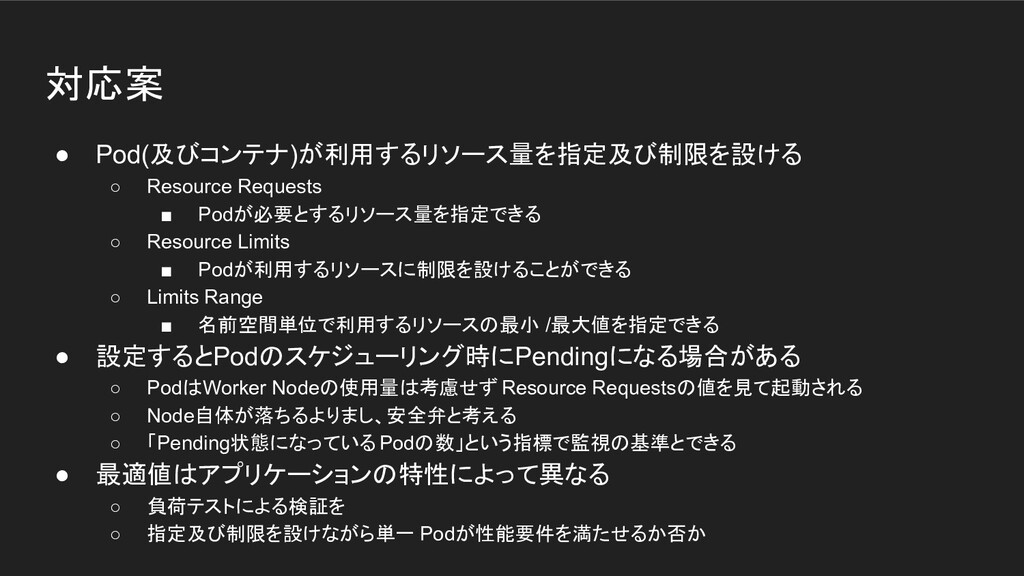
対応案 • Pod(及びコンテナ)が利用するリソース量を指定及び制限を設ける ◦ Resource Requests ▪ Podが必要とするリソース量を指定できる ◦ Resource
Limits ▪ Podが利用するリソースに制限を設けることができる ◦ Limits Range ▪ 名前空間単位で利用するリソースの最小 /最大値を指定できる • 設定するとPodのスケジューリング時にPendingになる場合がある ◦ PodはWorker Nodeの使用量は考慮せず Resource Requestsの値を見て起動される ◦ Node自体が落ちるよりまし、安全弁と考える ◦ 「Pending状態になっているPodの数」という指標で監視の基準とできる • 最適値はアプリケーションの特性によって異なる ◦ 負荷テストによる検証を ◦ 指定及び制限を設けながら単一 Podが性能要件を満たせるか否か
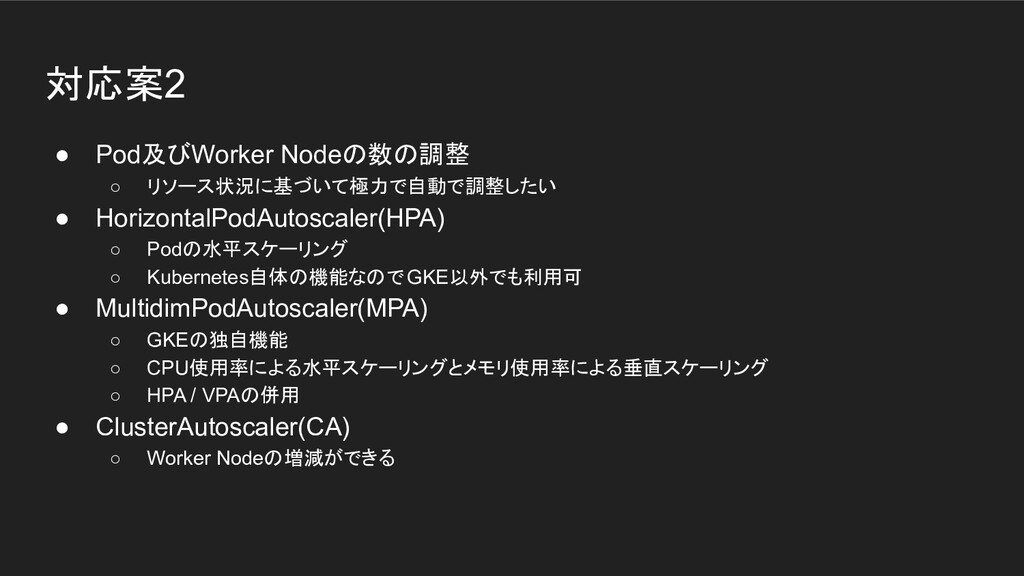
対応案2 • Pod及びWorker Nodeの数の調整 ◦ リソース状況に基づいて極力で自動で調整したい • HorizontalPodAutoscaler(HPA) ◦ Podの水平スケーリング
◦ Kubernetes自体の機能なのでGKE以外でも利用可 • MultidimPodAutoscaler(MPA) ◦ GKEの独自機能 ◦ CPU使用率による水平スケーリングとメモリ使用率による垂直スケーリング ◦ HPA / VPAの併用 • ClusterAutoscaler(CA) ◦ Worker Nodeの増減ができる
まとめ • 運用していると様々なトラブルシューティングをすることになる • 今回のその中の一部分を疑似的に再現してみた • 以下のサイトが非常に参考になる ◦ https://learnk8s.io/troubleshooting-deployments
終わり


 nezumisannn
 ryo_kawamata
 skydoves
 kinopeee
 visional_engineering_and_design
 tatsuyashiraishi
 legalontechnologies
 sraku2159
 okamototakuyasr2
 myohei
 akaboshinit
 asmz
 inariku
 chrisshort
 portentint
 stephenakadiri
 reverentgeek
 marketingsoph
 lcolladotor
 nwiizo
 kneath
 keathley
 speakerdeck
 rasagy