Share
Embed
ログ収集入門Elastic_Searchの機能と活用事例
ログ収集の入門者、初心者向けの資料です。
Elasticsearch について知りたい方にも。
概要
・ログ収集について
・Elasticsearch の仕組み
・Elasticsearch のオススメ機能
・ログ収集の業務での活用事例
All Japanese

osamu hasegawa
November 28, 2022
Transcript
94 slides
-
初めに:お断り この発表で扱う内容は、以下の通りです。 • ログ収集の概念 • Elasticsearch や Kibana の基礎的な説明、 および一部機能の概要
• 活用事例 あくまで基礎的な概念や活用事例がメインとなりますので、 インフラ面、他のサービスとの連動、 クエリや各機能の具体的な構築方法などは 本発表の対象外となります。 2 -
初めに:お断り 本資料における、 Elasticsearch や Kibana のスクリーンショット、 および製品のロゴの権利は、Elastic 社に帰属します。 資料の流用などは行わないでください。 Elasticsearch
is a trademark of Elasticsearch BV, registered in the U.S. and in other countries. Kibana is a trademark of Elasticsearch BV, registered in the U.S. and in other countries. Logstash is a trademark of Elasticsearch BV, registered in the U.S. and in other countries ※文章や製品以外のアイコンについては、 弊社、および作成者(長谷川)に帰属します。 3 -
初めに:タイムスケジュール • ログ収集についての説明 ◦ ログ収集とは何か? • Elastic 製品についての説明 • 少し難しい仕組みの説明
• 秀逸な機能(個人的オススメ機能!) ◦ 最近追加された機能など ◦ 有償機能のお話 • 活用事例 ◦ 業務でどんな風に使っているのか、どんな役に立つのか 4 -
初めに:講師の自己紹介 長谷川 脩 Hasegawa Osamu 2014年入社。昭和生まれ。 前職の運用・保守を経て、開発に転向。 Web 開発をメインに、Elasticsearch や
Ansible など 色々やっています。 ❏ 絵を描くのが好きです この資料の製品アイコン以外のイラストは自作 ❏ 歴史と世界遺産が好きです ❏ TRPG やってます ❏ 妻は中国出身&息子が 2人います なので、ほんの少しだけ中国語が分かります 5 -
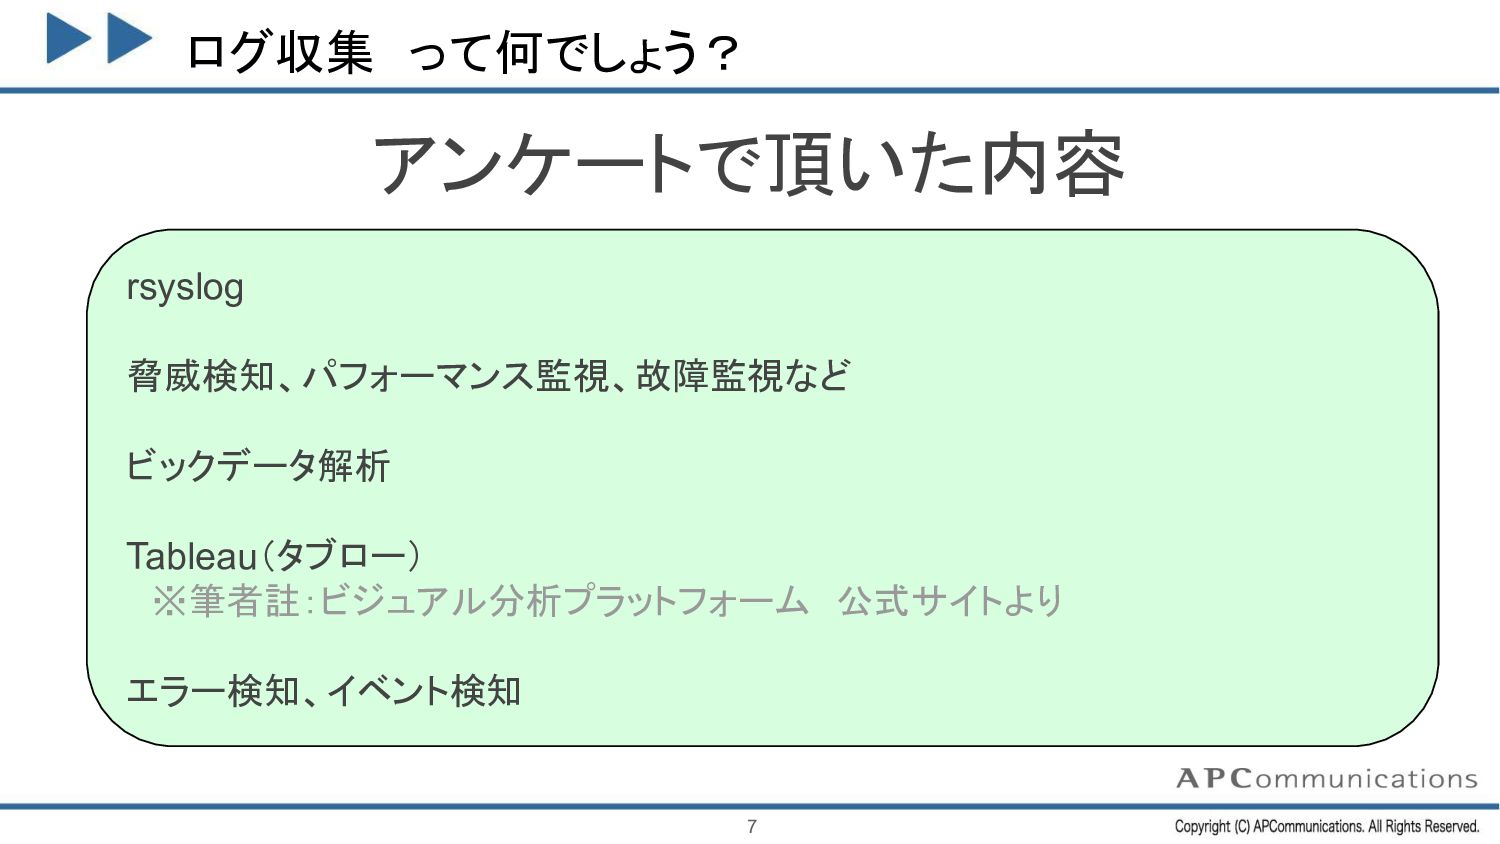
ログ収集とはなにか? ログ収集、およびログの可視化とは… サーバの操作ログ! だけでなく、 SNSの投稿や、IoTの情報(温度や消費電力) そして電車やトイレの混み具合 etc... などなど、 ありとあらゆる 大量のデータを集め、 グラフなどで
データを見やすくしたり、 特定のデータを検索・分析できるようにする プロセスです。 9 -
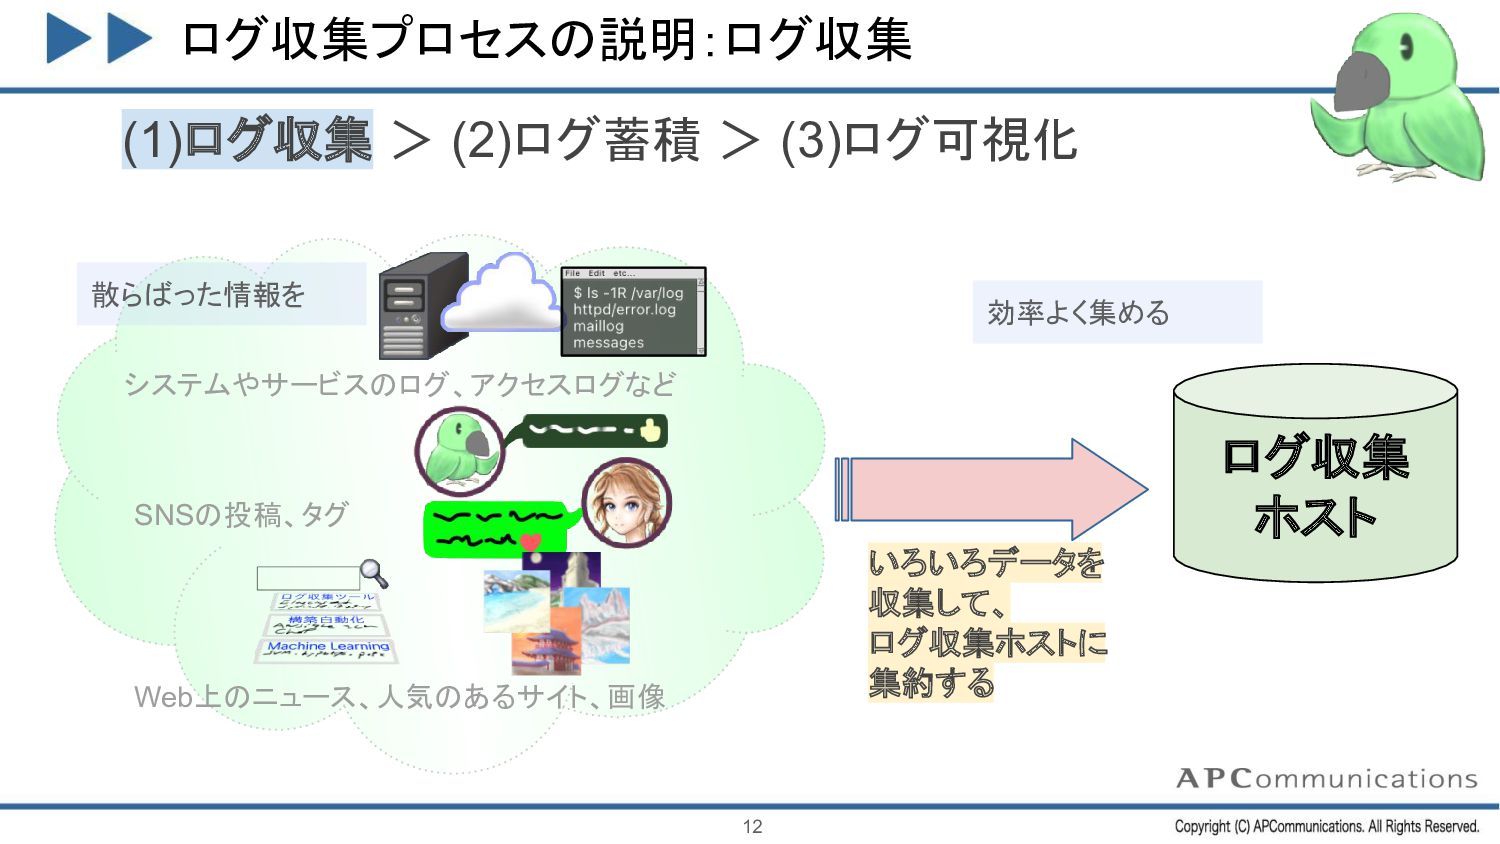
ログ収集プロセスの説明:ログ収集 (1)ログ収集 > (2)ログ蓄積 > (3)ログ可視化 ログ収集 ホスト 12 いろいろデータを
収集して、 ログ収集ホストに 集約する システムやサービスのログ、アクセスログなど SNSの投稿、タグ Web上のニュース、人気のあるサイト、画像 散らばった情報を 効率よく集める -
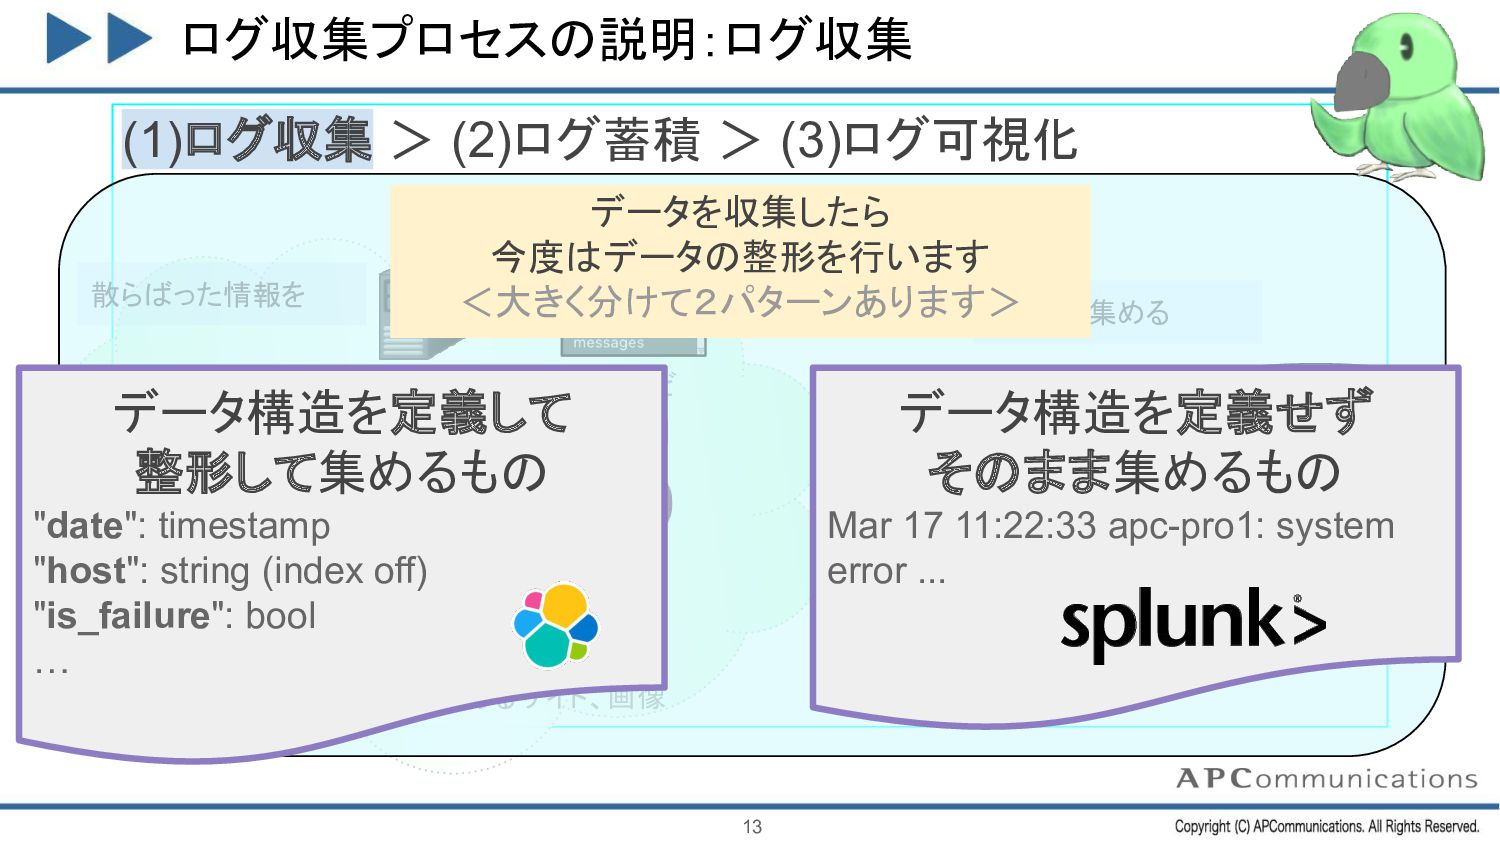
ログ収集プロセスの説明:ログ収集 (1)ログ収集 > (2)ログ蓄積 > (3)ログ可視化 13 ログ収集 ホスト いろいろデータを
収集して、 ログ収集ホストに 集約する システムやサービスのログ、アクセスログなど SNSの投稿、タグ Web上のニュース、人気のあるサイト、画像 散らばった情報を 効率よく集める データ構造を定義して 整形して集めるもの "date": timestamp "host": string (index off) "is_failure": bool … データ構造を定義せず そのまま集めるもの Mar 17 11:22:33 apc-pro1: system error ... データを収集したら 今度はデータの整形を行います <大きく分けて2パターンあります> -
ログ収集プロセスの説明:ログ蓄積 (1)ログ収集 > (2)ログ蓄積 > (3)ログ可視化 ログ収集 ホスト ログ蓄積 ホスト
収集したログを、蓄積用ホストに格納します。 ・データベースみたいなものです ・同じホストに保存しても OKです ・格納処理は ログ収集ツールが行います 収集したホストにそのまま保 存してもOK! ただし、それなりのマシンス ペックが必要 データベース みたいなものです 14 CUI から API 経由で の検索も可能! $ curl xxx.jp:9200/test_ index/_search -
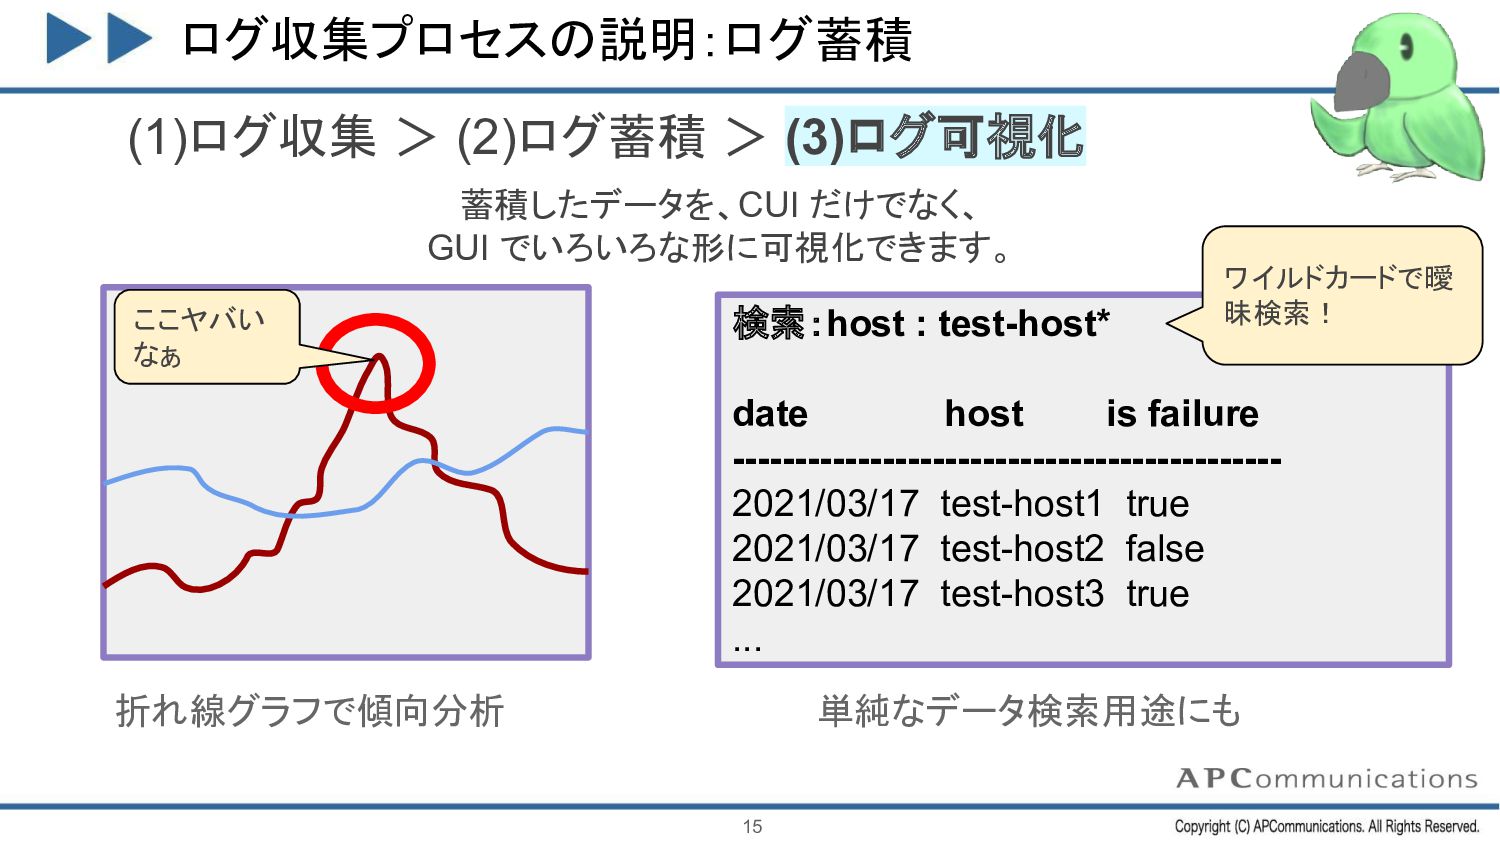
ログ収集プロセスの説明:ログ蓄積 (1)ログ収集 > (2)ログ蓄積 > (3)ログ可視化 折れ線グラフで傾向分析 検索:host : test-host*
date host is failure -------------------------------------------- 2021/03/17 test-host1 true 2021/03/17 test-host2 false 2021/03/17 test-host3 true ... 単純なデータ検索用途にも ここヤバい なぁ ワイルドカードで曖 昧検索! 蓄積したデータを、CUI だけでなく、 GUI でいろいろな形に可視化できます。 15 -
Elasticsearch とは? Elasticsearch とは? 公式の TOP ページによると、 無料かつオープン、Elastic Stackの心臓部 だそうです。
Elastic Stack って、何でしょうね。 まずはそこから見ていきましょう。 18 -
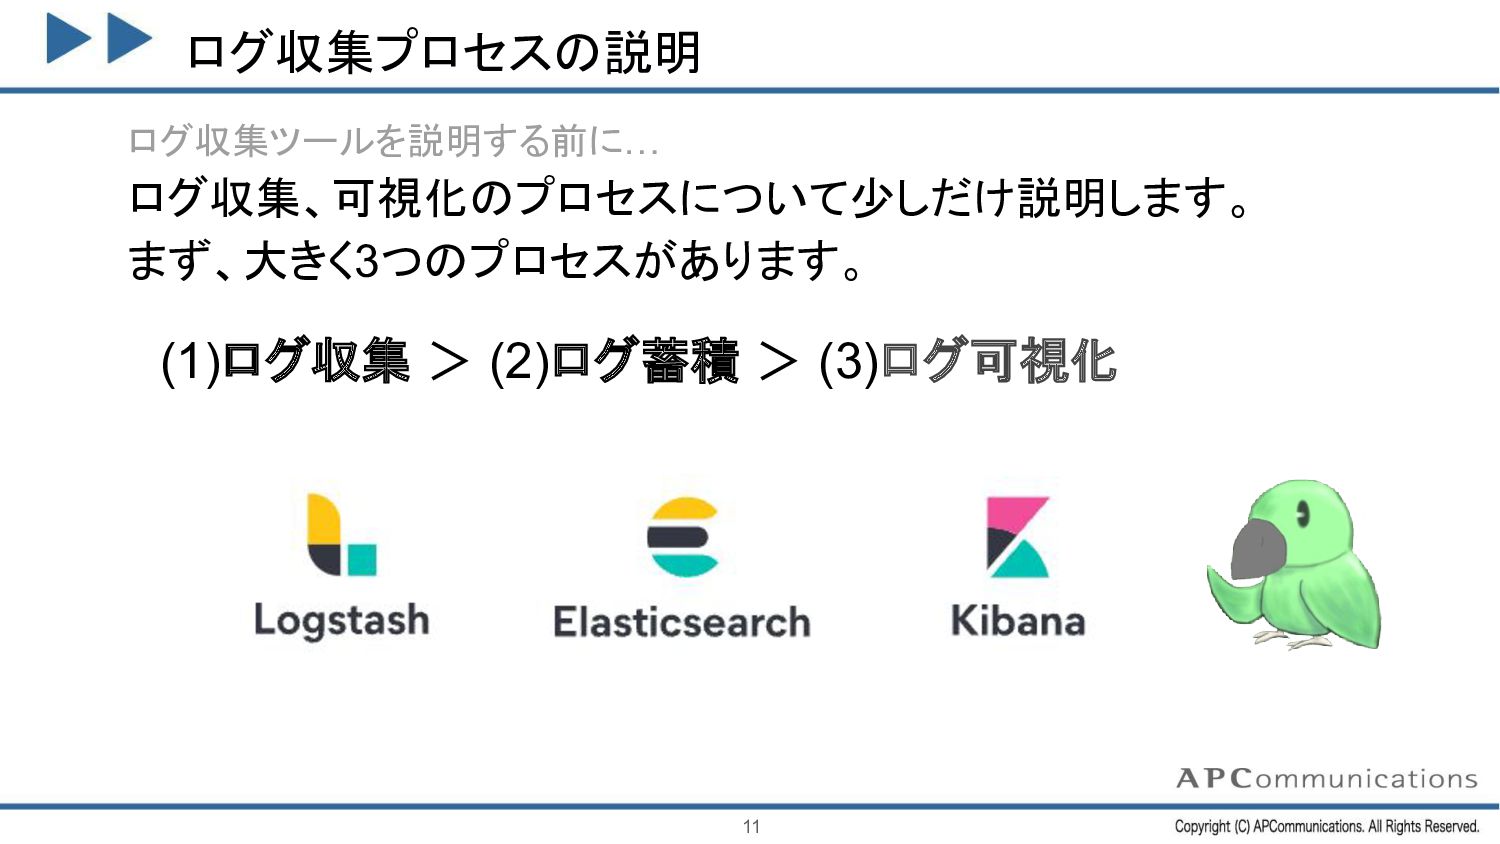
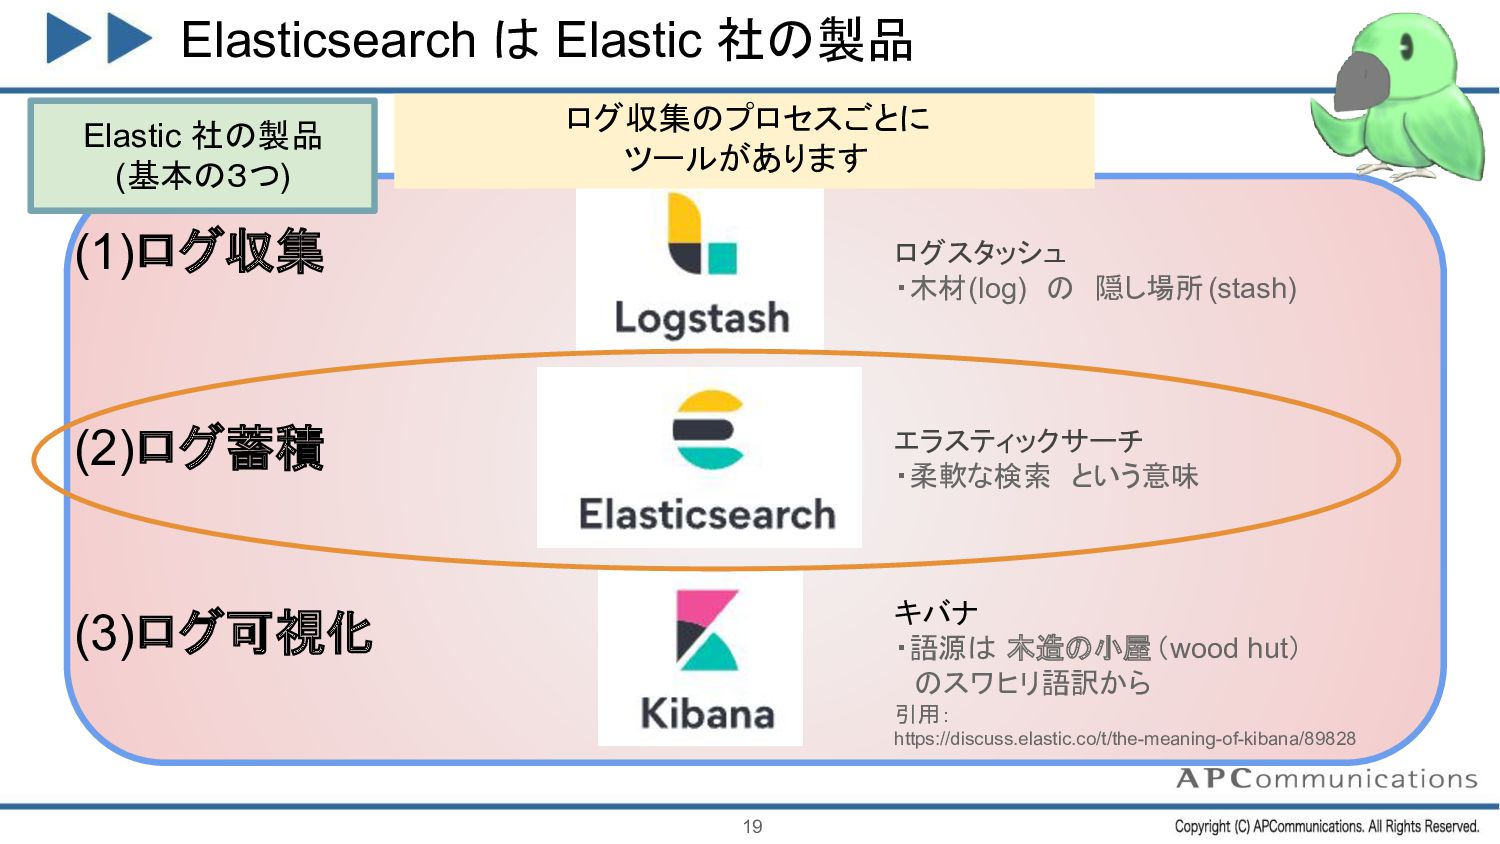
Elasticsearch は Elastic 社の製品 (1)ログ収集 (2)ログ蓄積 (3)ログ可視化 エラスティックサーチ ・柔軟な検索 という意味 ログスタッシュ
・木材(log) の 隠し場所(stash) キバナ ・語源は 木造の小屋(wood hut) のスワヒリ語訳から 引用: https://discuss.elastic.co/t/the-meaning-of-kibana/89828 Elastic 社の製品 (基本の3つ) ログ収集のプロセスごとに ツールがあります 19 -
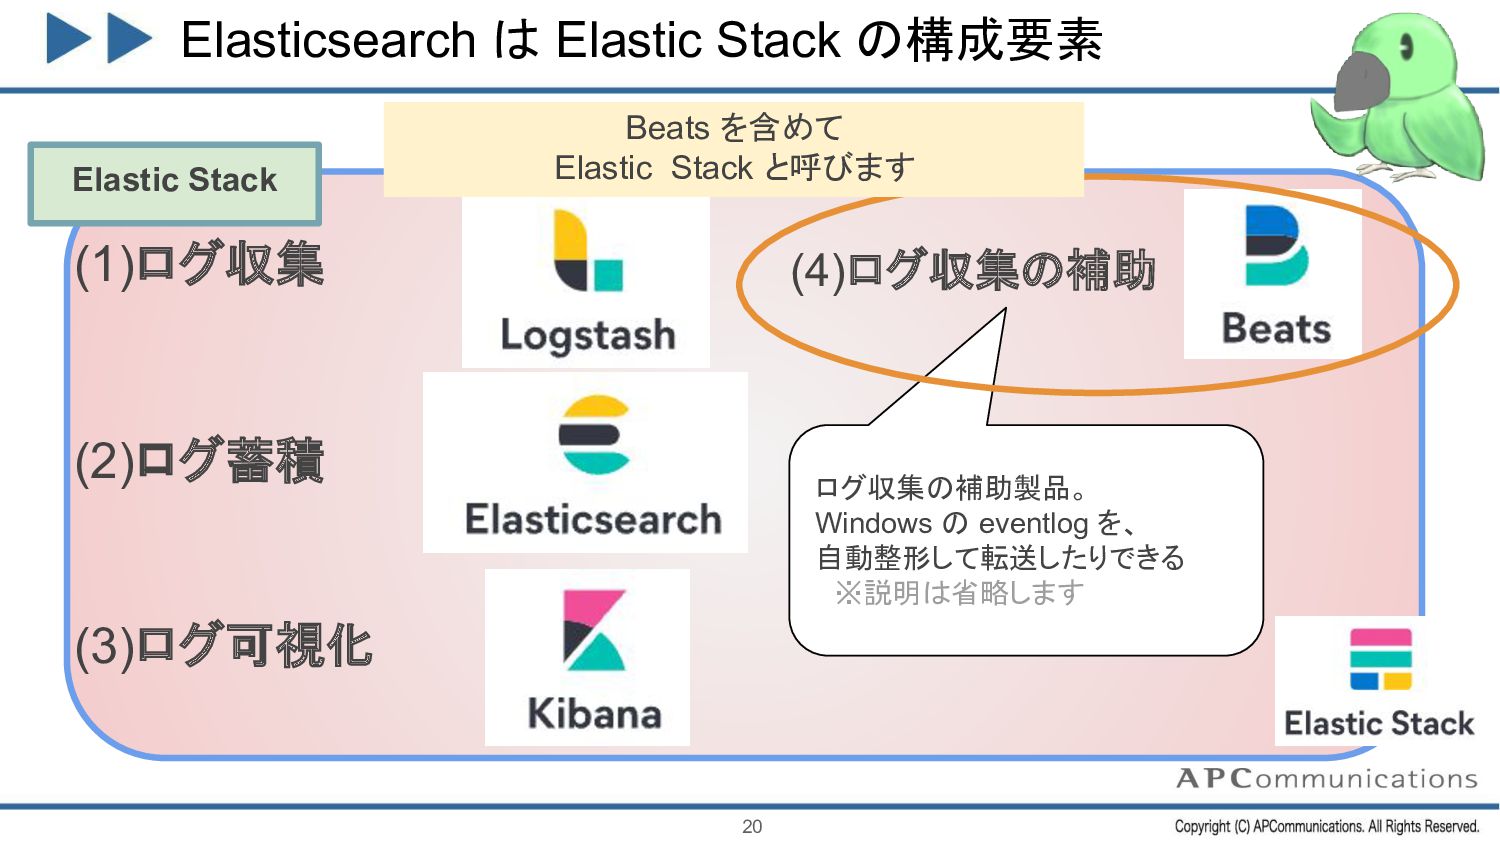
Elasticsearch は Elastic Stack の構成要素 (1)ログ収集 (2)ログ蓄積 (3)ログ可視化 Elastic Stack
(4)ログ収集の補助 ログ収集の補助製品。 Windows の eventlog を、 自動整形して転送したりできる ※説明は省略します Beats を含めて Elastic Stack と呼びます 20 -
Elasticsearch とは? まとめ Elasticsearch は Elastic 社の製品の1つで、 ログの蓄積処理を担当する機能です。 また、Elastic Stack という
パッケージの1つでもあります。 データを蓄えておく役割なので、 まさしく心臓部といえますね。 21 -
Elastic Stack の機能を見ていこう ではここで、 先ほど一覧で紹介した、 Elastic Stack の一部を見ていきましょう。 Logstash >
Elasticsearch > Kibana 22 -
Elastic 製品とは何か:Logstash Postgre SQL データベース ログ蓄積基盤 キャッシュ (1) いろいろなログ を収集して
(2) いろいろな形に 整形して (3) いろいろな場所に 蓄積する (1) いろいろなログを収集して、 (2) いろいろな形に整形して、 (3) いろいろな場所に蓄積する 23 ログ蓄積 ホスト JSON {}, CSV "","" -
Elastic 製品とは何か:Elasticsearch ブラウザから参照 ・ログ可視化ツール、サービス API で参照 24 データ構造の定義が必要な データ蓄積ツール "date":
timestamp "host": string (index off) "is_failure": bool … ログ蓄積 ホスト $ curl xxx.jp:9200/test_index/ _search -
Elastic 製品とは何か:Kibana 検索:host : test-host* date host is failure --------------------------------------------
2022/03/17 test-host1 true 2022/03/17 test-host2 false 2022/03/17 test-host3 true ... グラフで可視化したり DBのように検索クエリでデー タの検索ができる 25 Elasticsearch の情報可視化に 特化したツール -
Elastic 製品とは何か: 分析ツール Elastic 製品本体にも分析ツールはあります。 ※今回の資料では詳細な解説は省略します ・可視化の Kibana ・Elasticsearch の
Aggregation(集計)クエリ ・有償機能の機械学習 などなど 26 -
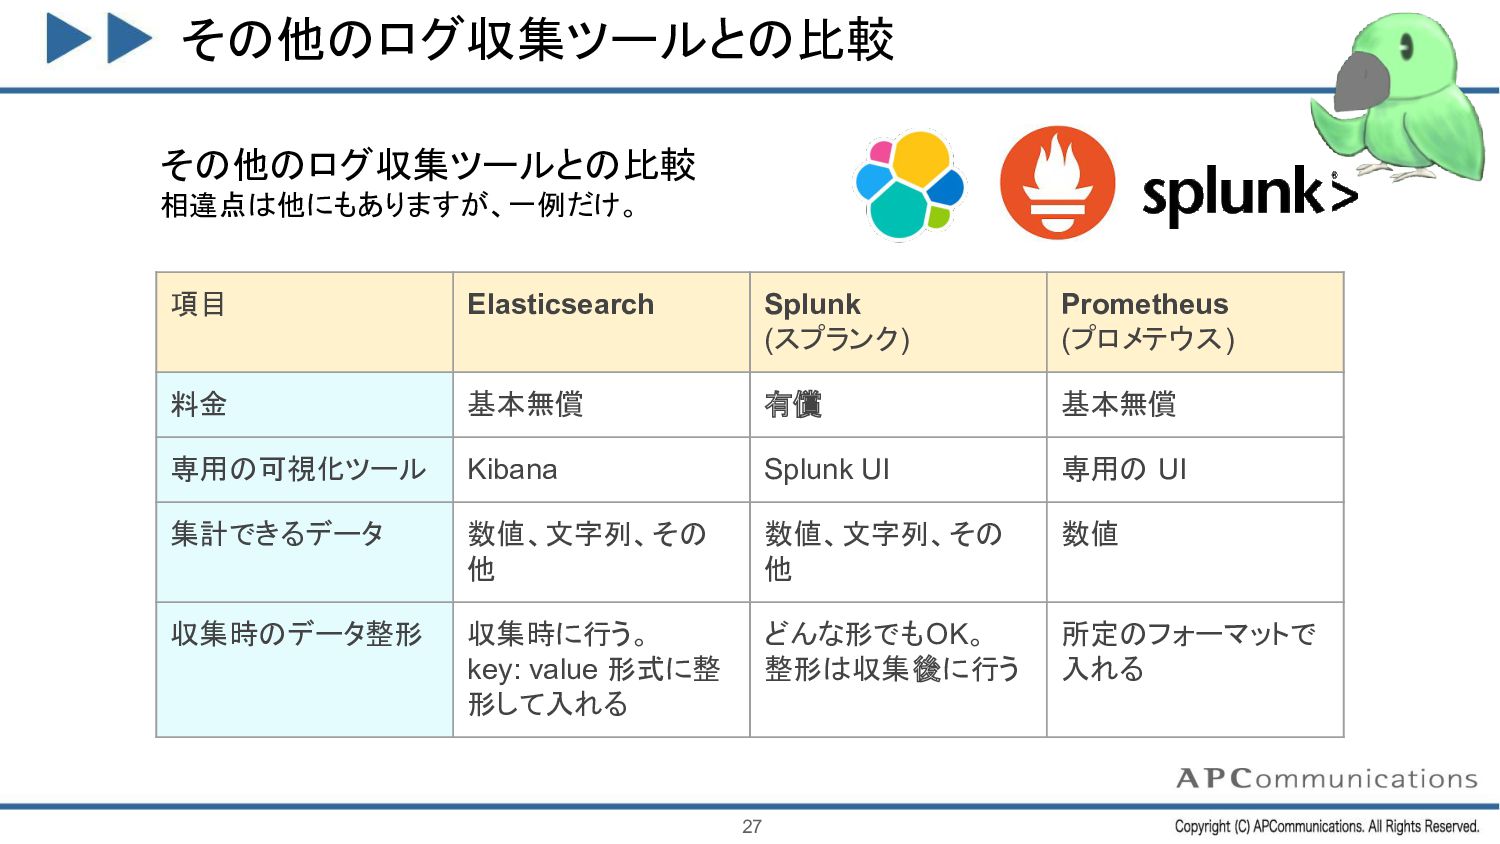
その他のログ収集ツールとの比較 27 項目 Elasticsearch Splunk (スプランク) Prometheus (プロメテウス) 料金 基本無償
有償 基本無償 専用の可視化ツール Kibana Splunk UI 専用の UI 集計できるデータ 数値、文字列、その 他 数値、文字列、その 他 数値 収集時のデータ整形 収集時に行う。 key: value 形式に整 形して入れる どんな形でもOK。 整形は収集後に行う 所定のフォーマットで 入れる その他のログ収集ツールとの比較 相違点は他にもありますが、一例だけ。 -
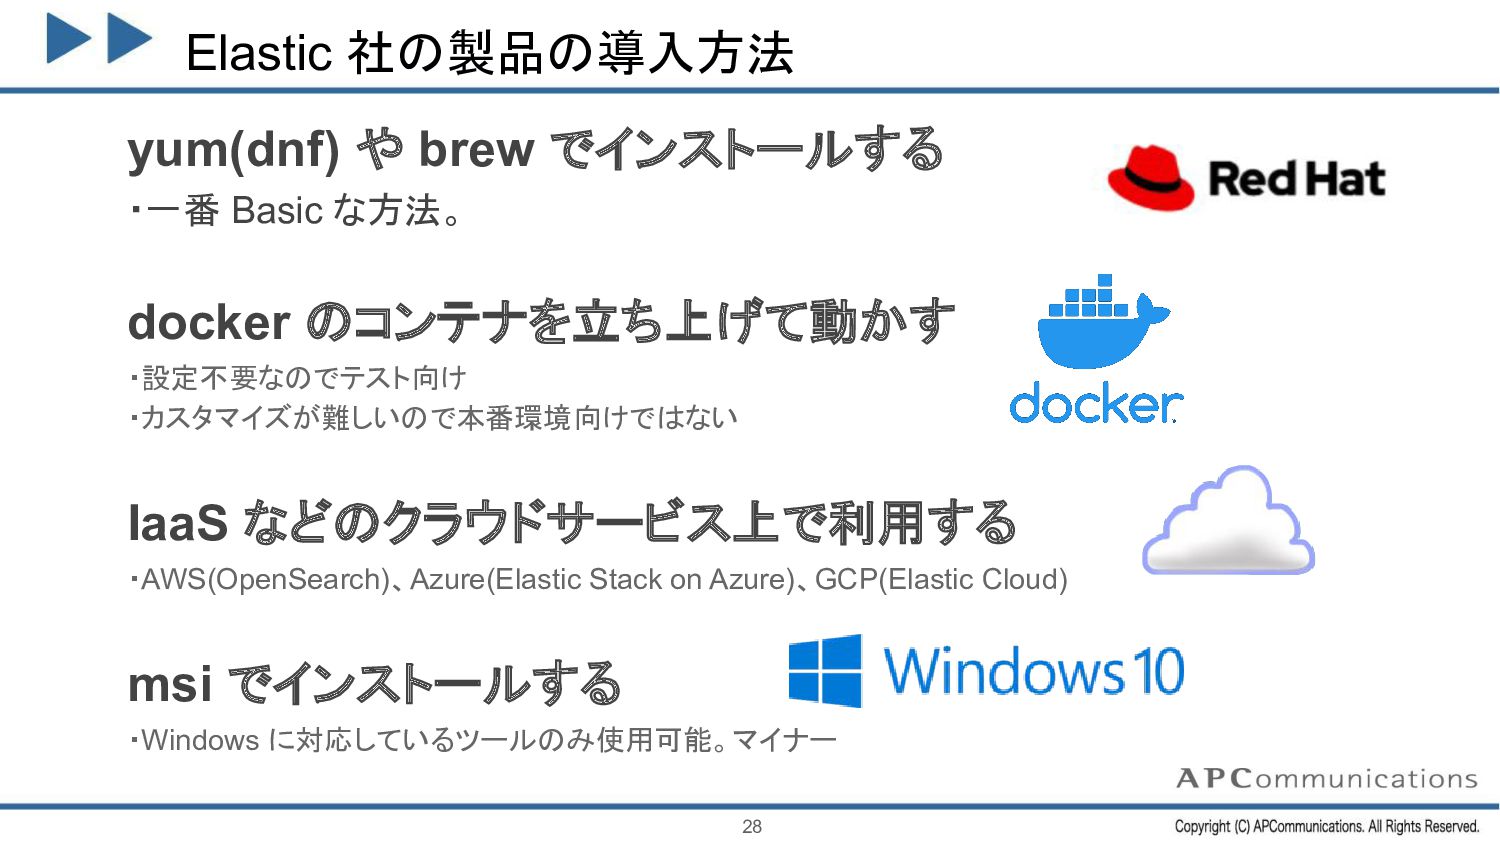
Elastic 社の製品の導入方法 yum(dnf) や brew でインストールする ・一番 Basic な方法。 docker
のコンテナを立ち上げて動かす ・設定不要なのでテスト向け ・カスタマイズが難しいので本番環境向けではない IaaS などのクラウドサービス上で利用する ・AWS(OpenSearch)、Azure(Elastic Stack on Azure)、GCP(Elastic Cloud) msi でインストールする ・Windows に対応しているツールのみ使用可能。マイナー 28 -
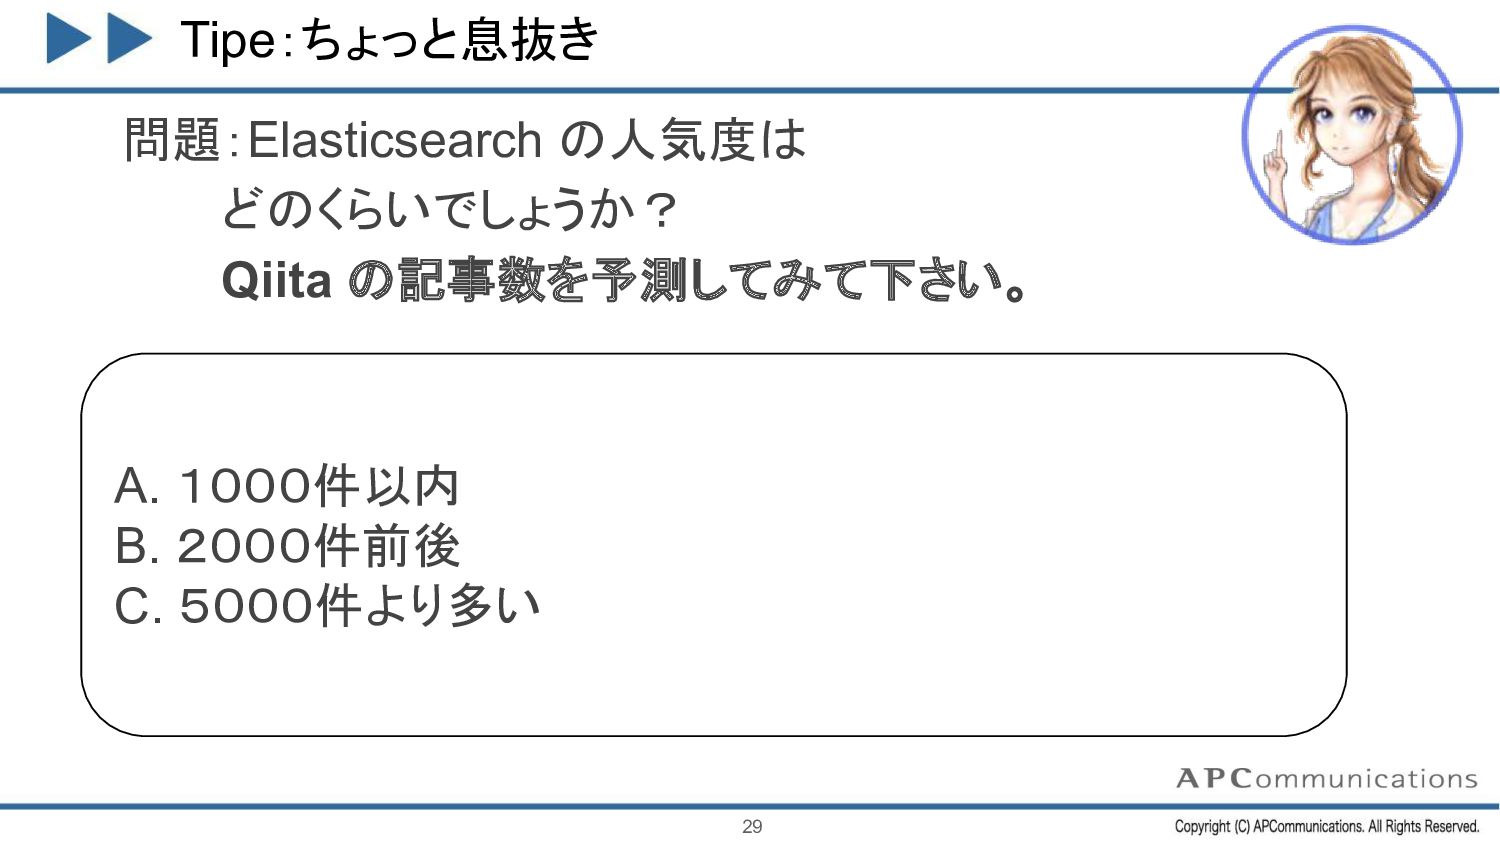
Tipe:ちょっと息抜き 問題:Elasticsearch の人気度は どのくらいでしょうか? Qiita の記事数を予測してみて下さい。 Elasticsearch:2,014 圧倒的! (さらに Kibana:682、Logstash:269) Splunk :452
BigQuery :1,191 2021/10/10 現在 A. 1000件以内 B. 2000件前後 C. 5000件より多い 29 -
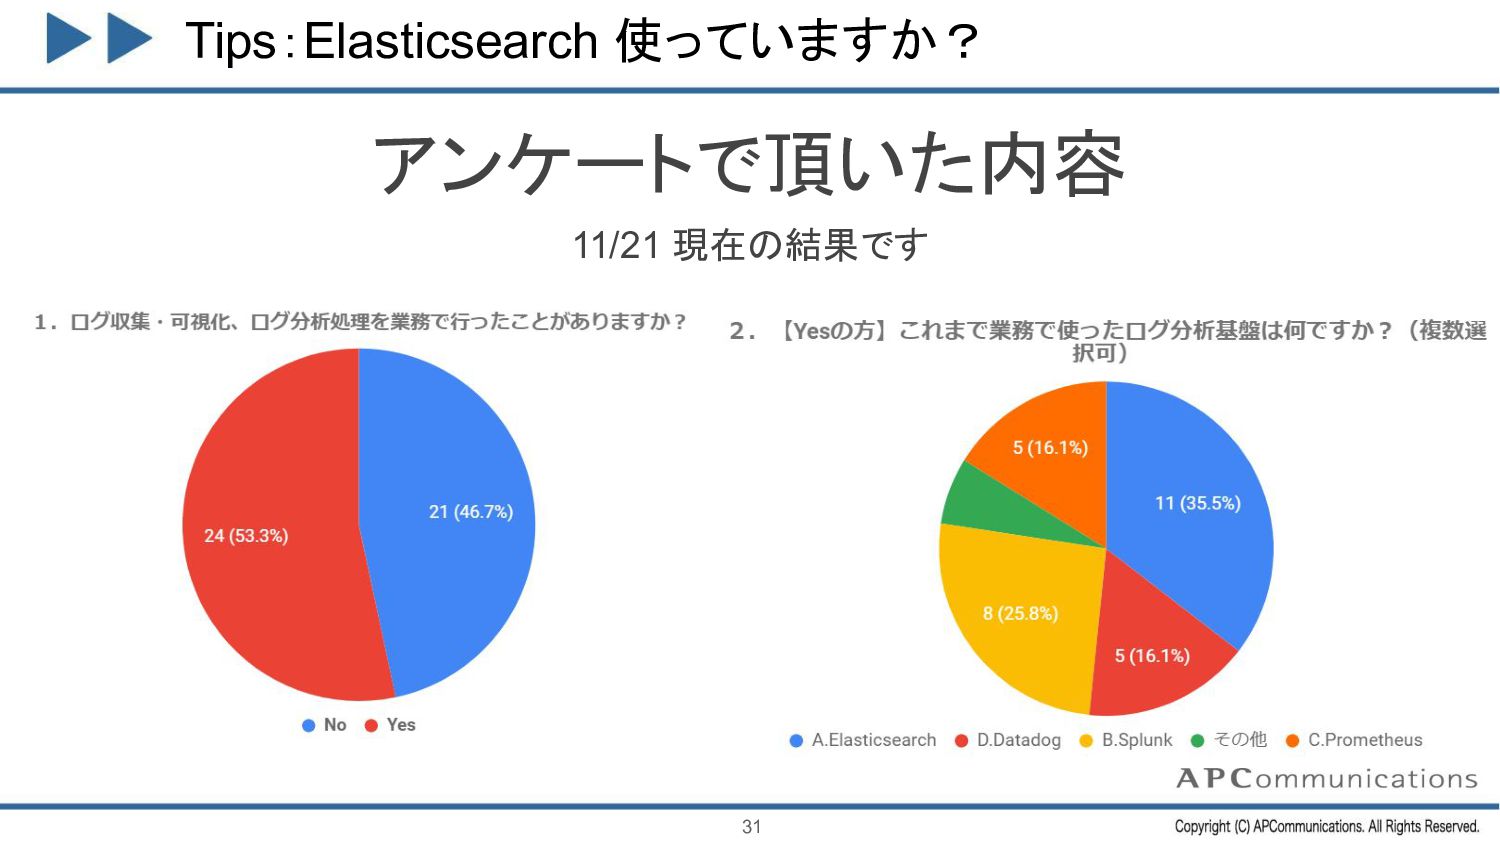
Tipe:ちょっと息抜き 答え 問題:Elasticsearch の人気度は・・・ 30 答え B. 2000件前後 2022/11/07 現在の Qiita での検索結果です。
参考までに、他のログ収集ツールではこんな感じです。 -
用語:index (インデックス) 1/2 index (インデックス) とは、 Elasticsearch に作成した、データ格納領域のことです。 役割としてはデータベースのテーブルに近いです。 ※公式的には別物です
34 例:access log の index index に投入された access log • Tips: 6系(バージョン6)以前は type という項目がテーブルの代わりでしたが、 7系からは非推奨となり、更に 8系からは廃止になるため、 実質インデックスがテーブル相当と言えるでしょう。 -
用語:index (インデックス) 2/2 index (インデックス) は通常、 日次や月次でローテーションされます。 例えば日次の場合。 毎日0時になると、 index
のローテーションが行われ、 自動的に新 index が作成されます。 ※index 名は日付や通番で一意に識別されます 35 index 名: test-20220407 index 名: test-20220408 ローテーション -
用語:document (ドキュメント) document (ドキュメント) とは、 Elasticsearch に格納したデータ1つずつを指します。 役割としてはデータベースのレコード(行)に近いです。 ※公式的には別物です 36
2021/12/14 10:00 GET https://xxxx 例: index に格納した access.log の一行 一行 を ドキュメント と呼ぶ 例:access log の index 2021/12/14 11:00 POST http://xxxx 2021/12/14 12:00 PUT http://xxxx -
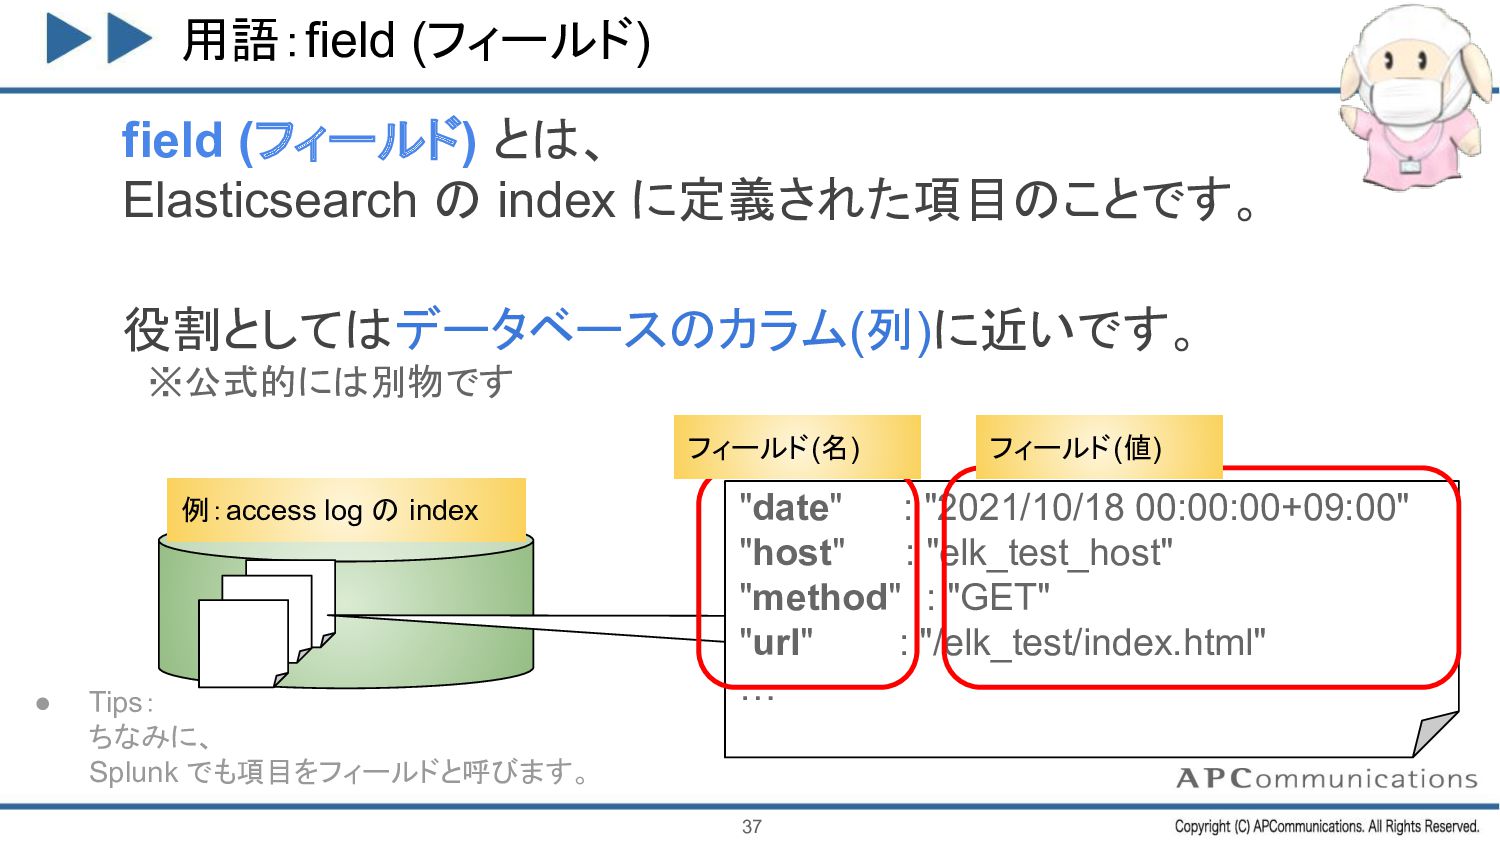
用語:field (フィールド) field (フィールド) とは、 Elasticsearch の index に定義された項目のことです。 役割としてはデータベースのカラム(列)に近いです。
※公式的には別物です 37 例:access log の index "date" : "2021/10/18 00:00:00+09:00" "host" : "elk_test_host" "method" : "GET" "url" : "/elk_test/index.html" … フィールド(名) フィールド(値) • Tips: ちなみに、 Splunk でも項目をフィールドと呼びます。 -
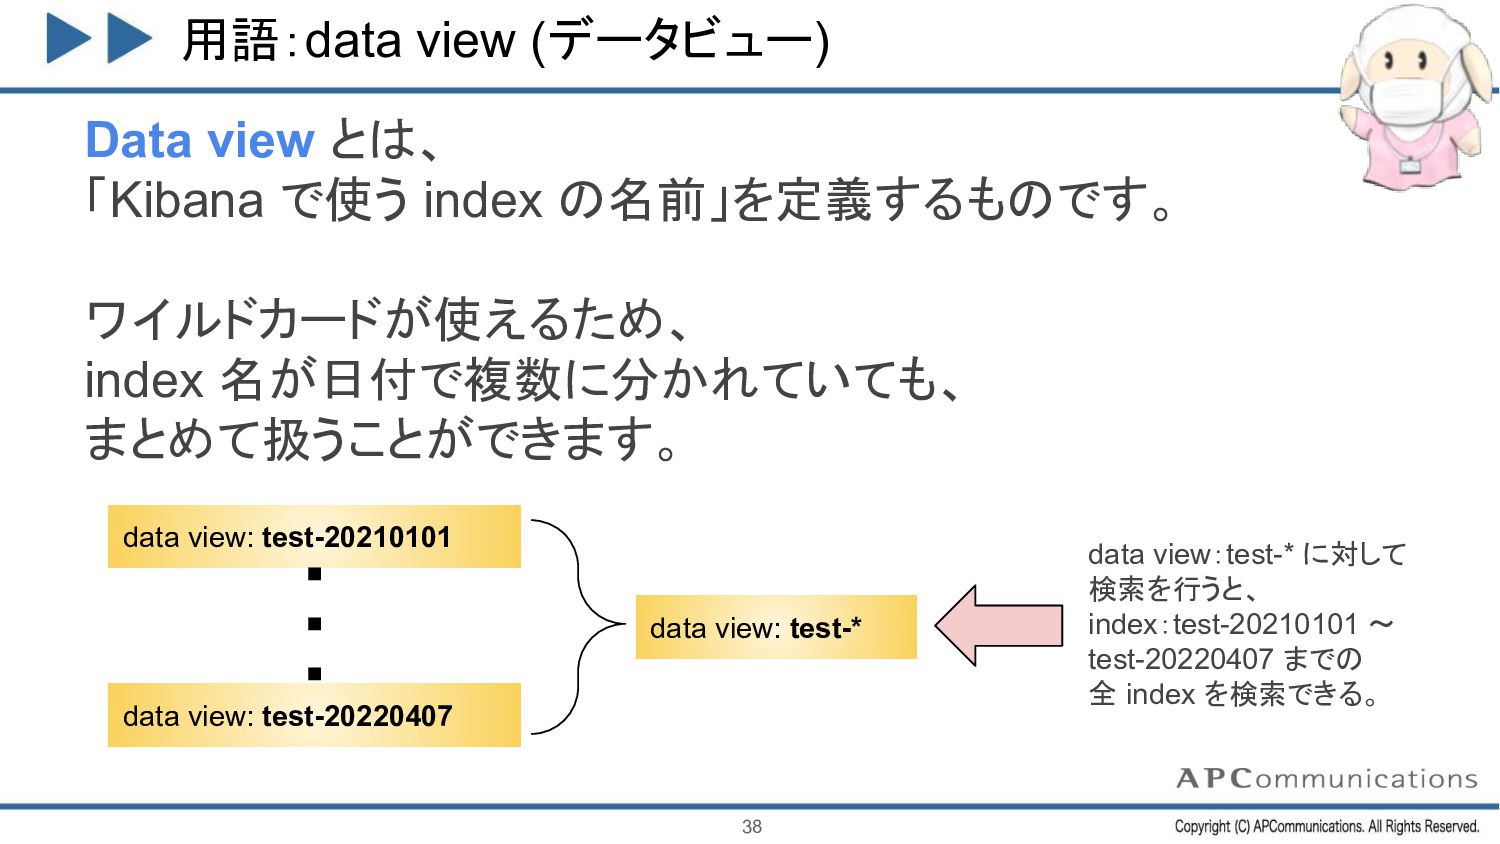
用語:data view (データビュー) Data view とは、 「Kibana で使う index の名前」を定義するものです。
ワイルドカードが使えるため、 index 名が日付で複数に分かれていても、 まとめて扱うことができます。 38 data view: test-* data view: test-20210101 data view: test-20220407 data view:test-* に対して 検索を行うと、 index:test-20210101 ~ test-20220407 までの 全 index を検索できる。 -
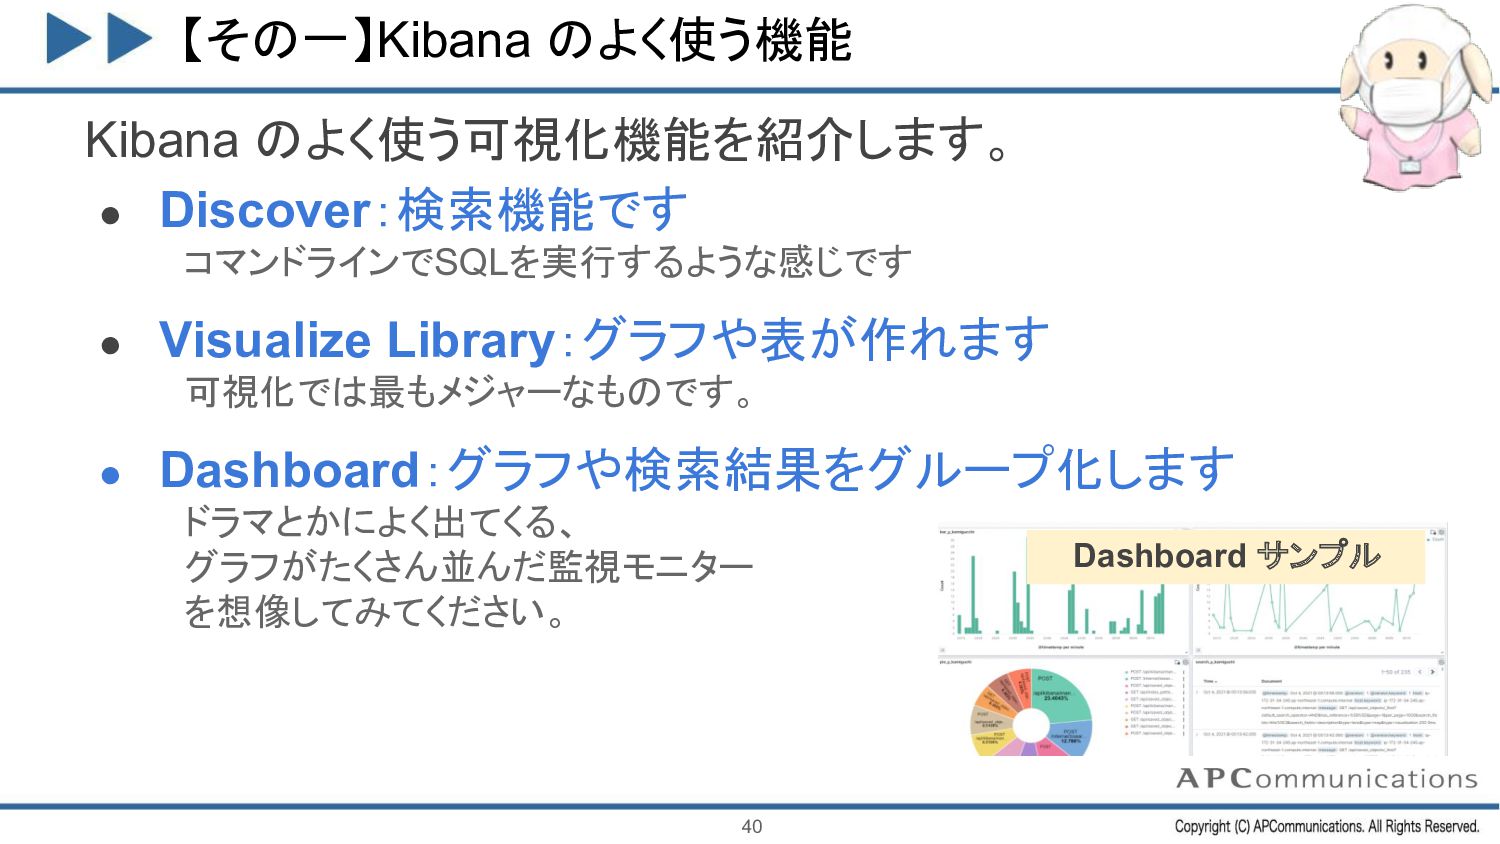
【その一】Kibana のよく使う機能 Kibana のよく使う可視化機能を紹介します。 • Discover:検索機能です コマンドラインでSQLを実行するような感じです • Visualize Library:グラフや表が作れます
可視化では最もメジャーなものです。 • Dashboard:グラフや検索結果をグループ化します ドラマとかによく出てくる、 グラフがたくさん並んだ監視モニター を想像してみてください。 40 Dashboard サンプル -
【その二】データの投入方法 Logstash 以外の方法でもデータを投入できます。 41 Fluentd ・メジャーなログ収集ツール。 ・考え方は Logstash と同じ、でも書き方が違う。 ・ログの退避など、様々な用途で使われているため、
既に業務で使っているのなら、導入のハードルも下がる。 Kibana ・UI からそのままログを投入できる。 ・ただし、カンマ区切りにするなど、ある程度の整形が必要。 -
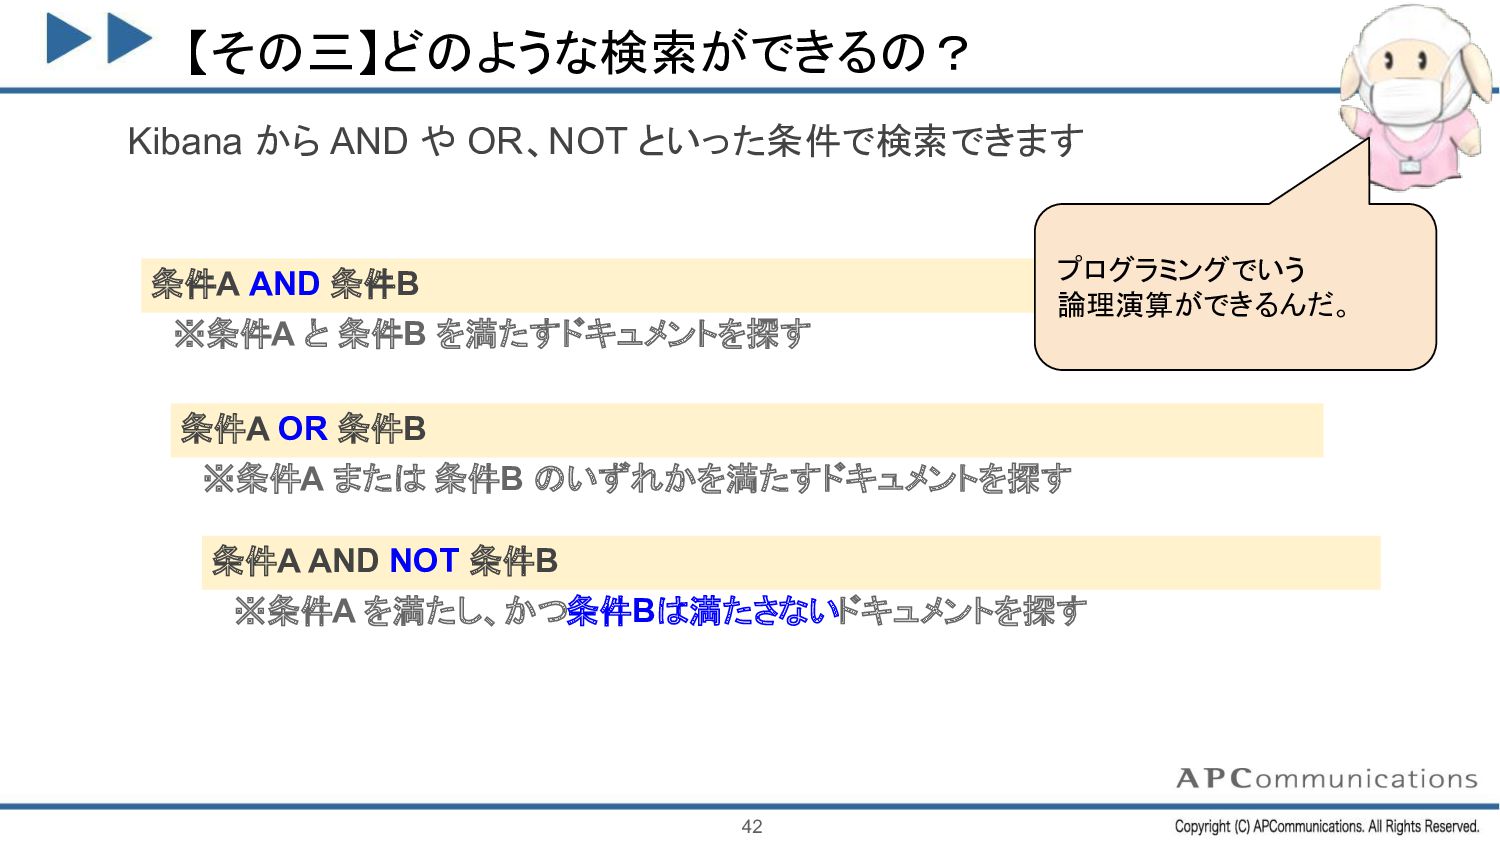
【その三】どのような検索ができるの? Kibana から AND や OR、NOT といった条件で検索できます 42 条件A AND
条件B ※条件A と 条件B を満たすドキュメントを探す 条件A OR 条件B ※条件A または 条件B のいずれかを満たすドキュメントを探す 条件A AND NOT 条件B ※条件A を満たし、かつ条件Bは満たさないドキュメントを探す プログラミングでいう 論理演算ができるんだ。 -
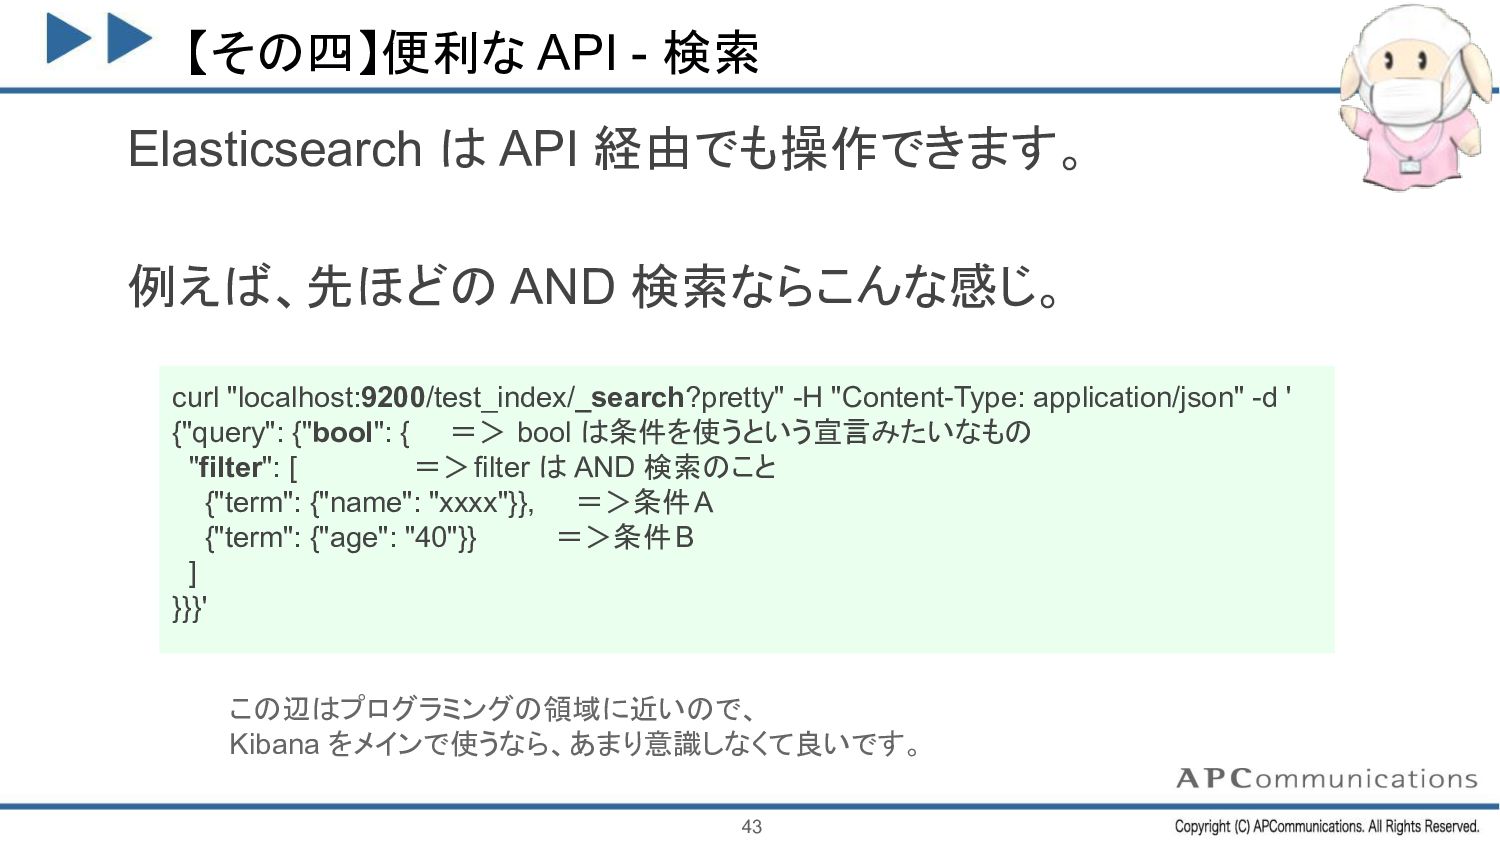
【その四】便利な API - 検索 Elasticsearch は API 経由でも操作できます。 例えば、先ほどの AND
検索ならこんな感じ。 43 curl "localhost:9200/test_index/_search?pretty" -H "Content-Type: application/json" -d ' {"query": {"bool": { => bool は条件を使うという宣言みたいなもの "filter": [ =>filter は AND 検索のこと {"term": {"name": "xxxx"}}, =>条件A {"term": {"age": "40"}} =>条件B ] }}}' この辺はプログラミングの領域に近いので、 Kibana をメインで使うなら、あまり意識しなくて良いです。 -
【その四】便利な API - ドキュメント操作、管理 データの登録、更新、削除も API 経由でできます。 ただ、運用で使う事は少なく、 アプリケーションと連携して使われることが多いでしょう。 管理
API もあります。 インデックスやドキュメントの数を把握したり、 次ページで説明するノードやシャードの状態を確認する API もあります。 こちらは運用作業の確認や障害調査などで使われることがあります。 _cat/indices =>インデックスの確認 _cat/nodes =>ノードの確認 _cat/shards =>シャードの確認 44 -
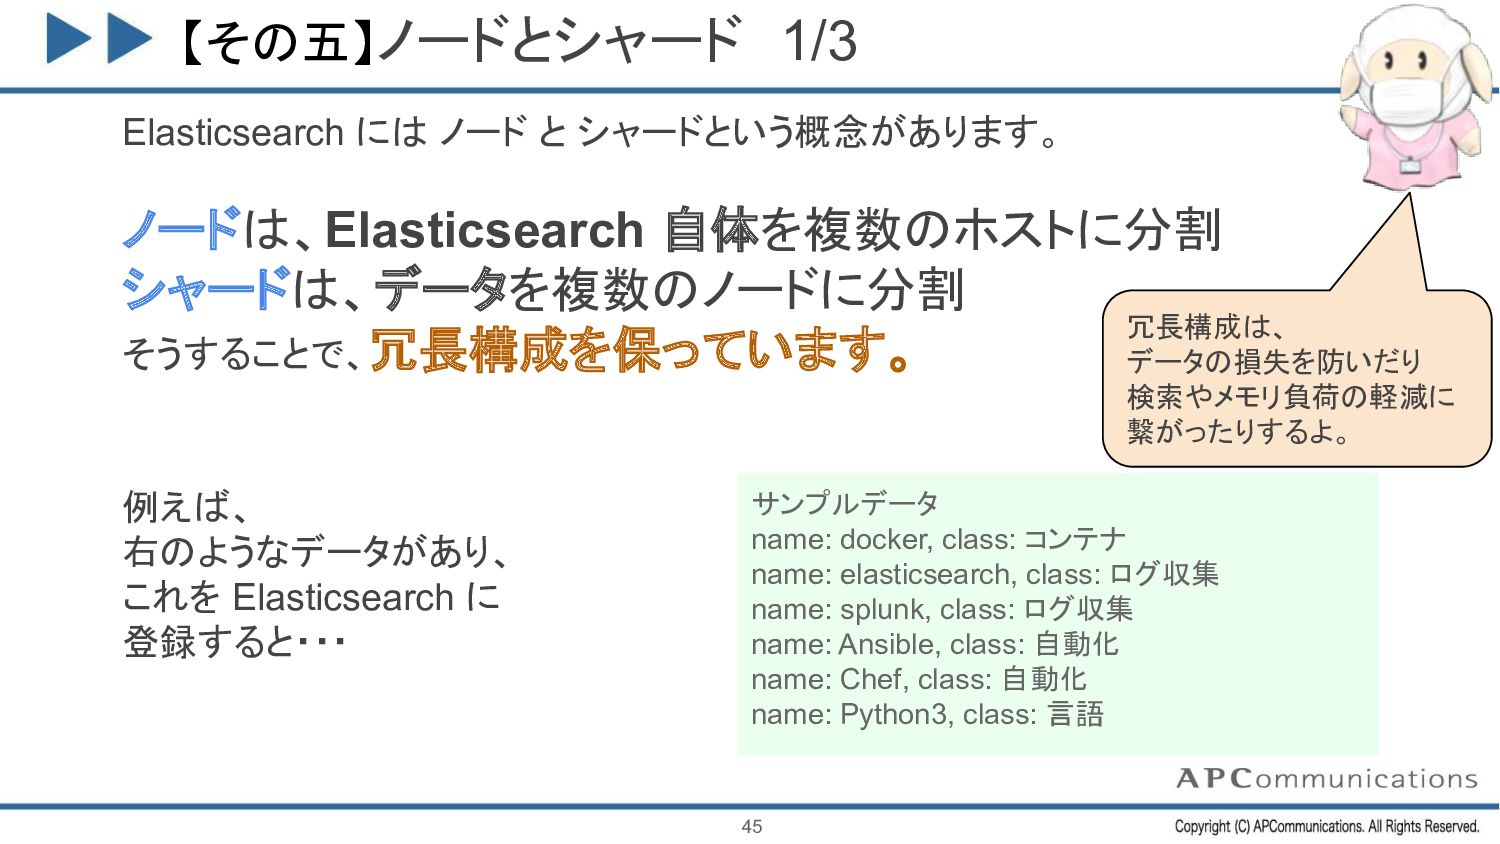
【その五】ノードとシャード 1/3 Elasticsearch には ノード と シャードという概念があります。 ノードは、Elasticsearch 自体を複数のホストに分割 シャードは、データを複数のノードに分割 そうすることで、冗長構成を保っています。
例えば、 右のようなデータがあり、 これを Elasticsearch に 登録すると・・・ 45 サンプルデータ name: docker, class: コンテナ name: elasticsearch, class: ログ収集 name: splunk, class: ログ収集 name: Ansible, class: 自動化 name: Chef, class: 自動化 name: Python3, class: 言語 冗長構成は、 データの損失を防いだり 検索やメモリ負荷の軽減に 繋がったりするよ。 -
図解してみましょう。 ノードとシャード 2/3 46 シャード1 name: docker, class: コンテナ name: elasticsearch,
class: ログ収集 シャード2 name: splunk, class: ログ収集 name: Ansible, class: 自動化 シャード3のレプリカ name: Chef, class: 自動化 name: Python3, class: 言語 シャード2のレプリカ name: splunk, class: ログ収集 name: Ansible, class: 自動化 シャード3 name: Chef, class: 自動化 name: Python3, class: 言語 シャード1のレプリカ name: docker, class: コンテナ name: elasticsearch, class: ログ収集 ノード1 ノード2 ノード3 レプリカ(レプリカシャード)は メインのデータ(プライマリシャード) のコピーだよ。 -
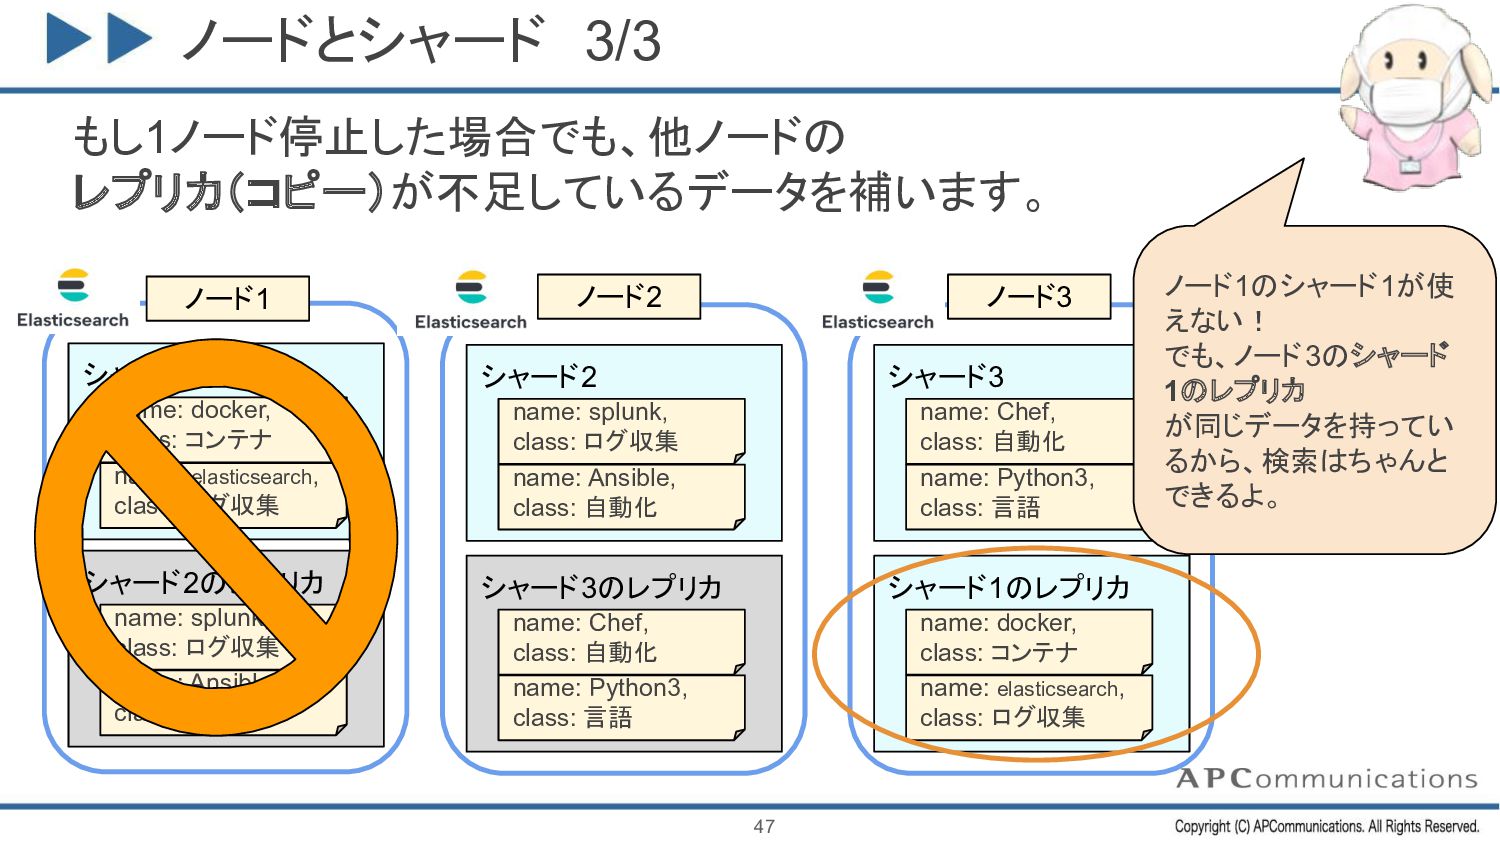
もし1ノード停止した場合でも、他ノードの レプリカ(コピー)が不足しているデータを補います。 ノードとシャード 3/3 47 シャード1 name: docker, class: コンテナ name:
elasticsearch, class: ログ収集 シャード2 name: splunk, class: ログ収集 name: Ansible, class: 自動化 シャード3のレプリカ name: Chef, class: 自動化 name: Python3, class: 言語 シャード2のレプリカ name: splunk, class: ログ収集 name: Ansible, class: 自動化 シャード3 name: Chef, class: 自動化 name: Python3, class: 言語 シャード1のレプリカ name: docker, class: コンテナ name: elasticsearch, class: ログ収集 ノード1 ノード2 ノード3 ノード1のシャード1が使 えない! でも、ノード3のシャード 1のレプリカ が同じデータを持ってい るから、検索はちゃんと できるよ。 -
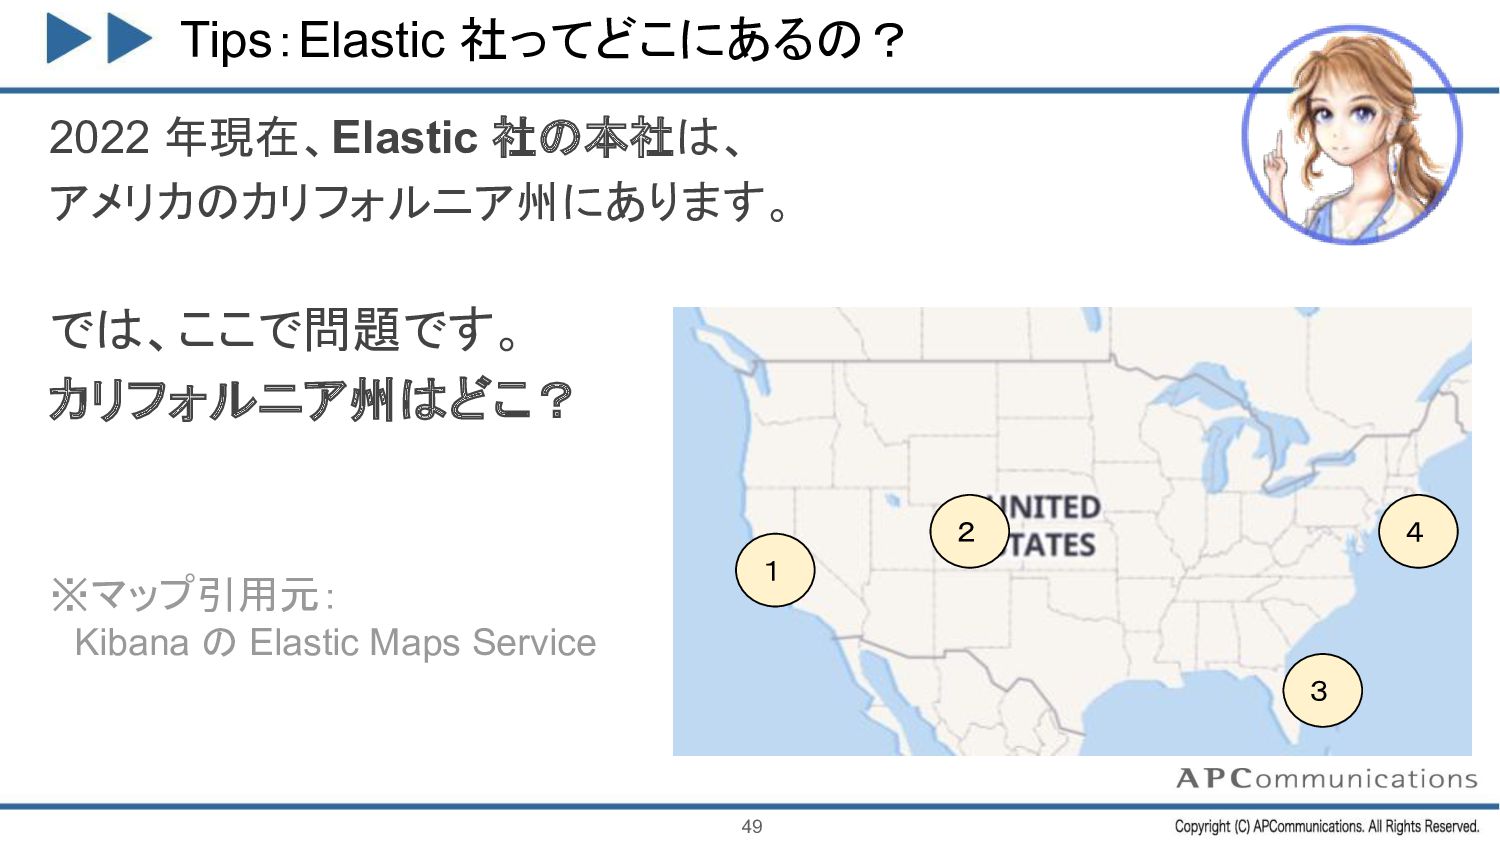
Tips:Elastic 社ってどこにあるの? 2022 年現在、Elastic 社の本社は、 アメリカのカリフォルニア州にあります。 では、ここで問題です。 カリフォルニア州はどこ? ※マップ引用元: Kibana
の Elastic Maps Service 1 2 3 4 49 -
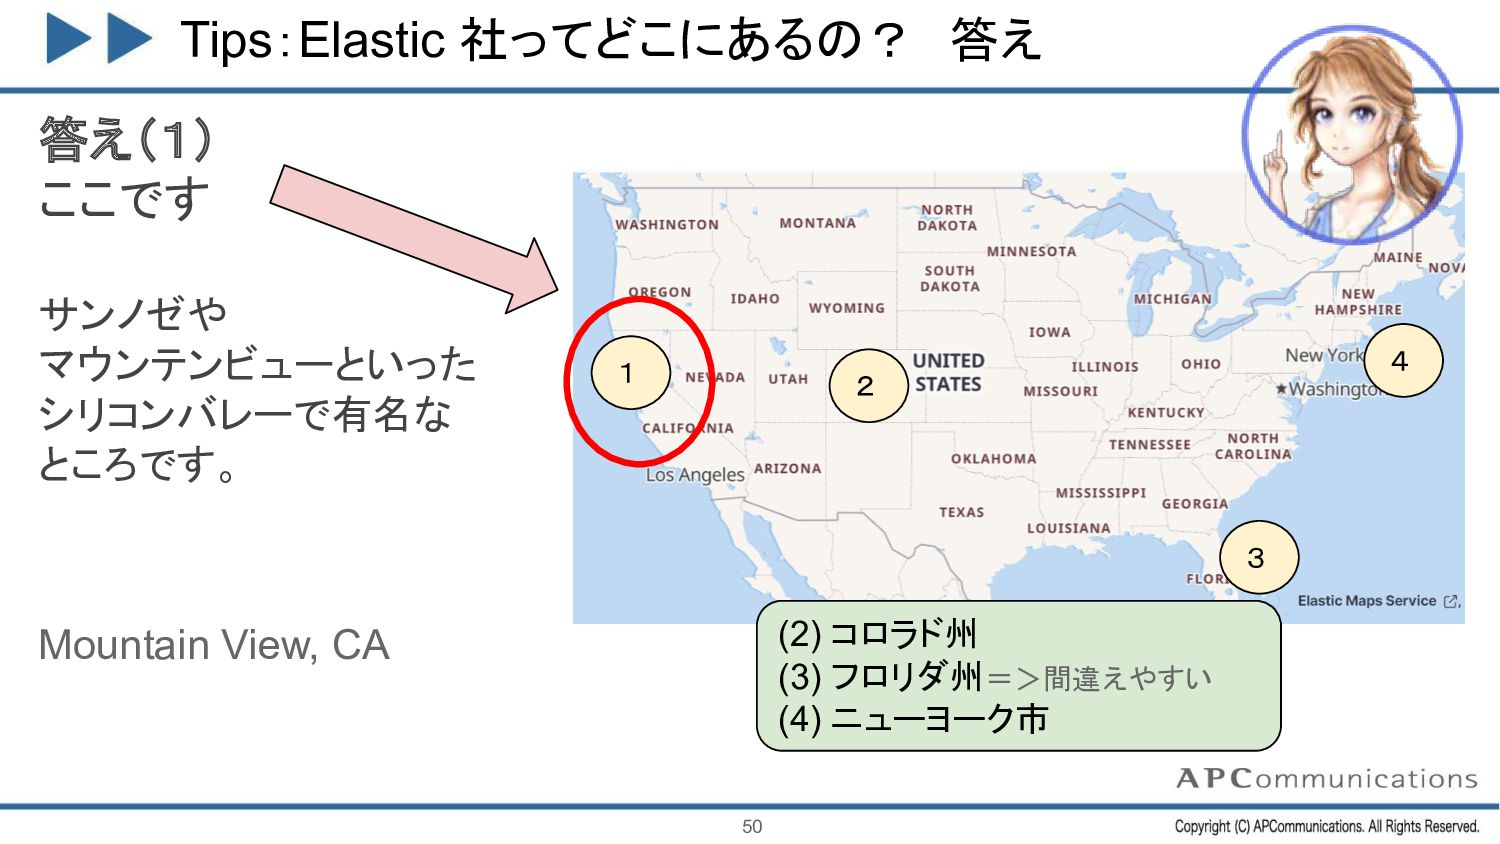
Tips:Elastic 社ってどこにあるの? 答え 答え(1) ここです サンノゼや マウンテンビューといった シリコンバレーで有名な ところです。 Mountain View,
CA 50 (2) コロラド州 (3) フロリダ州=>間違えやすい (4) ニューヨーク市 1 2 3 4 -
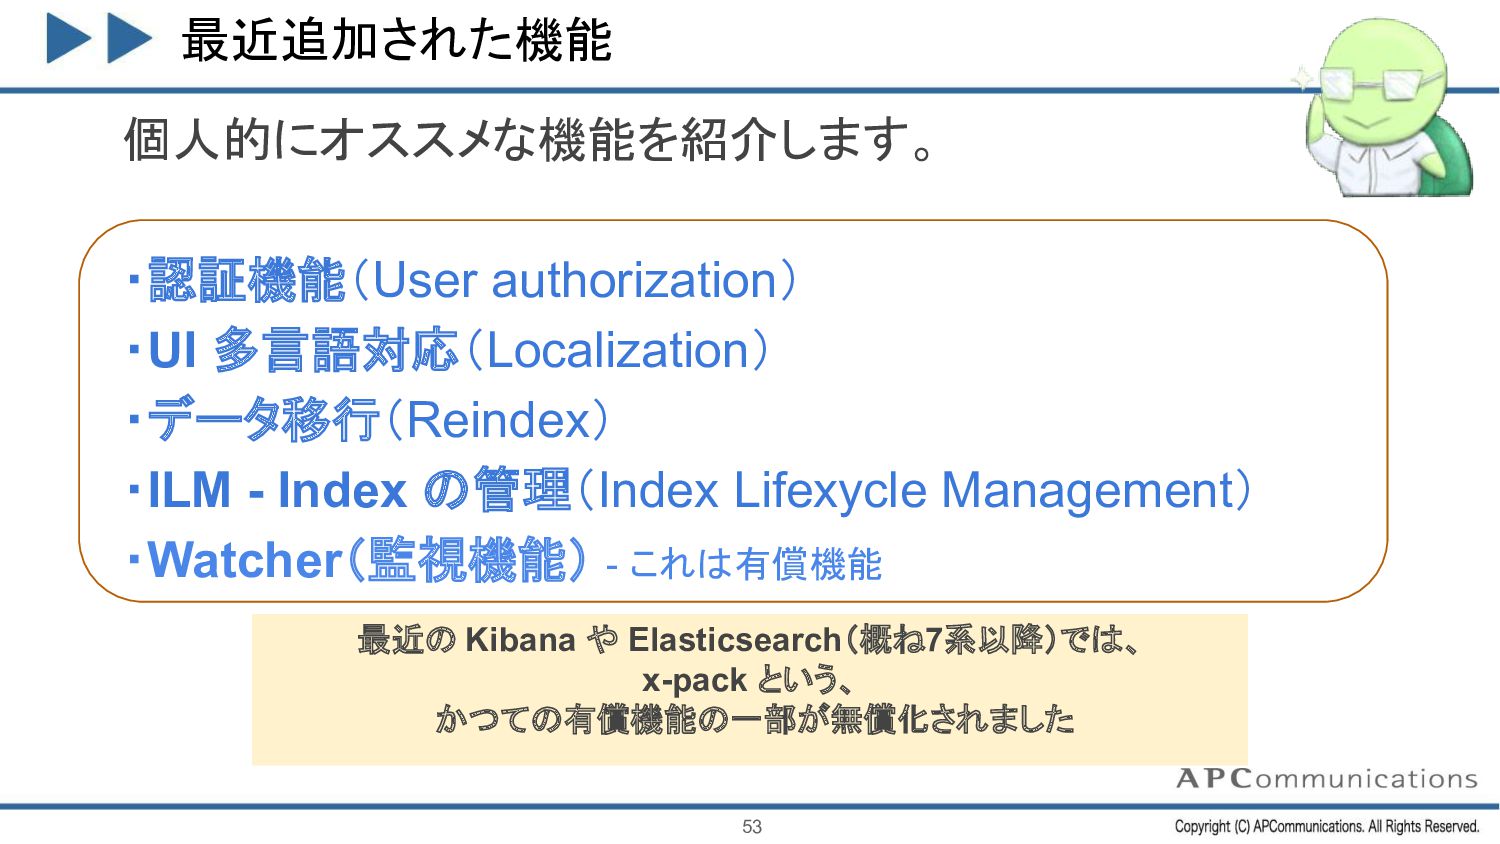
最近追加された機能 53 最近の Kibana や Elasticsearch(概ね7系以降)では、 x-pack という、 かつての有償機能の一部が無償化されました 個人的にオススメな機能を紹介します。
・認証機能(User authorization) ・UI 多言語対応(Localization) ・データ移行(Reindex) ・ILM - Index の管理(Index Lifexycle Management) ・Watcher(監視機能) - これは有償機能 -
オススメ機能1:認証機能 1/3 以前(6系) の Kibana では認証機能が有償なので、 無償版だと… 54 誰でも index
の削除が できてしまう! 怖い… 非公開の index が、 関係者以外にも見えてし まったり… -
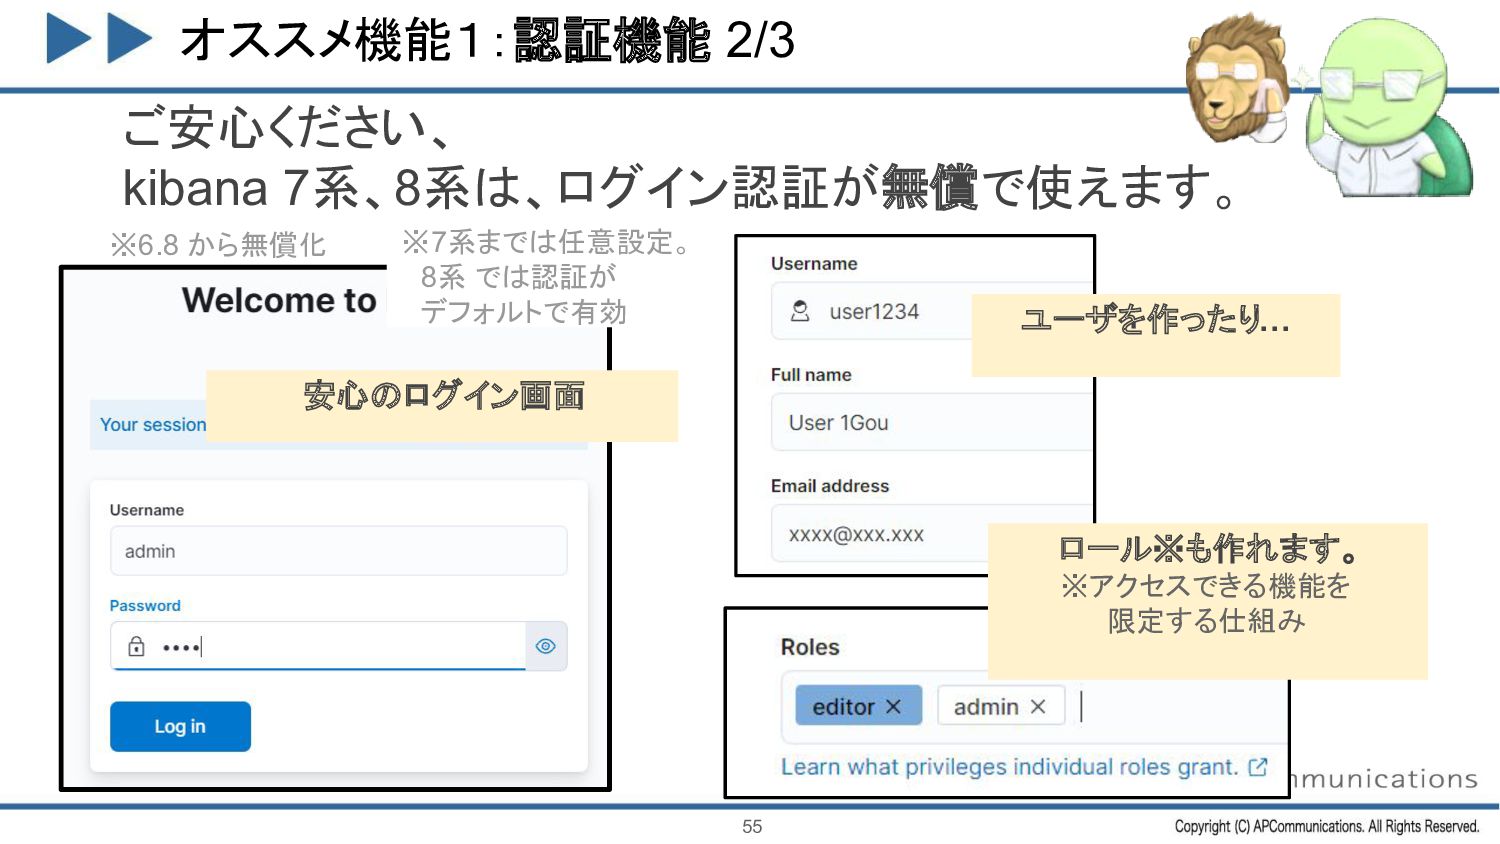
オススメ機能1:認証機能 2/3 ご安心ください、 kibana 7系、8系は、ログイン認証が無償で使えます。 55 ユーザを作ったり… ロール※も作れます。 ※アクセスできる機能を 限定する仕組み
安心のログイン画面 ※6.8 から無償化 ※7系までは任意設定。 8系 では認証が デフォルトで有効 -
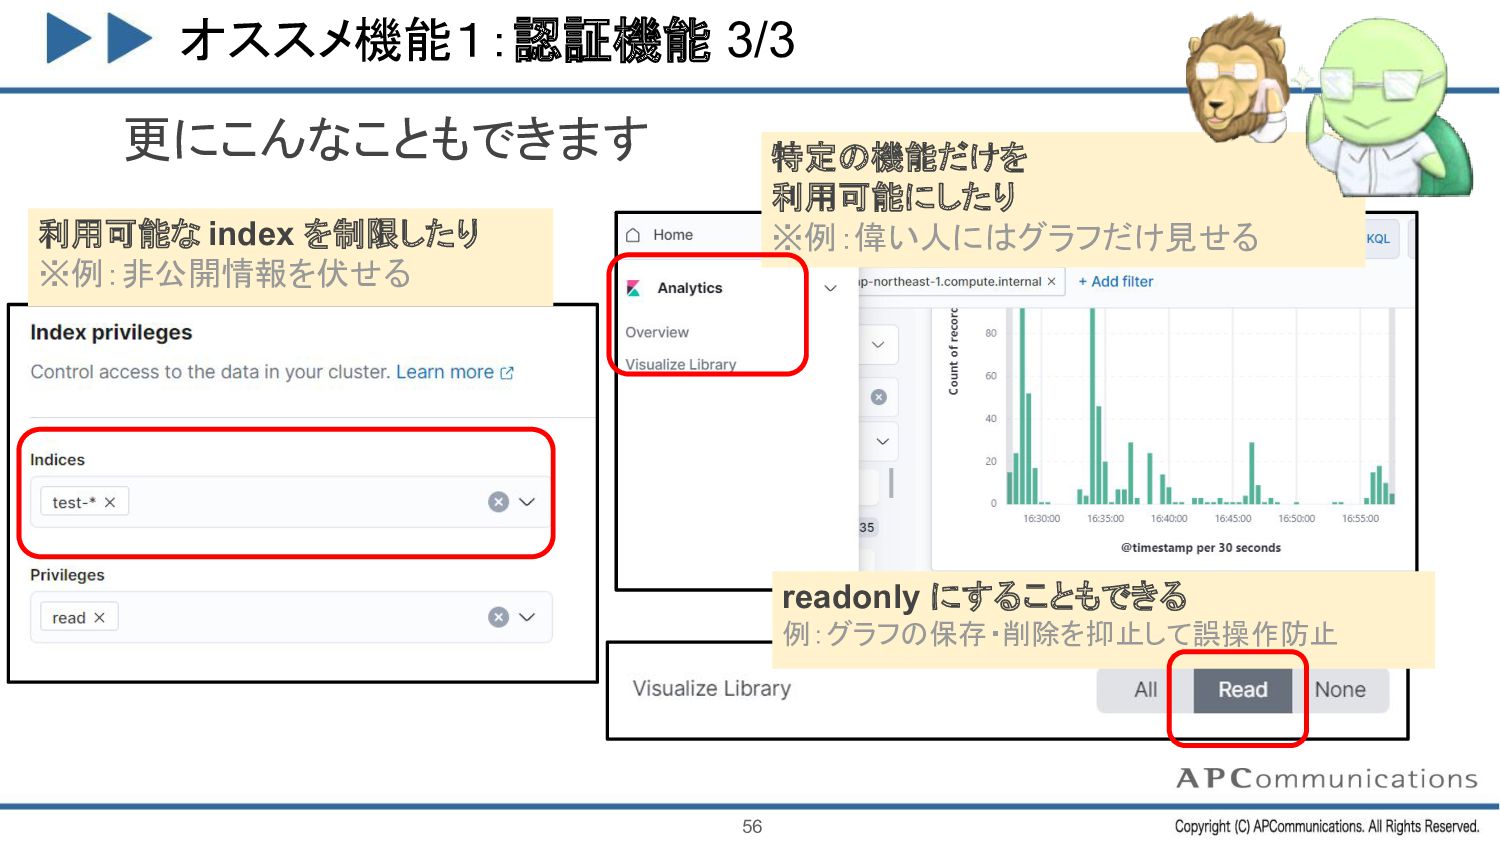
オススメ機能1:認証機能 3/3 更にこんなこともできます 56 利用可能な index を制限したり ※例:非公開情報を伏せる 特定の機能だけを 利用可能にしたり
※例:偉い人にはグラフだけ見せる readonly にすることもできる 例:グラフの保存・削除を抑止して誤操作防止 -
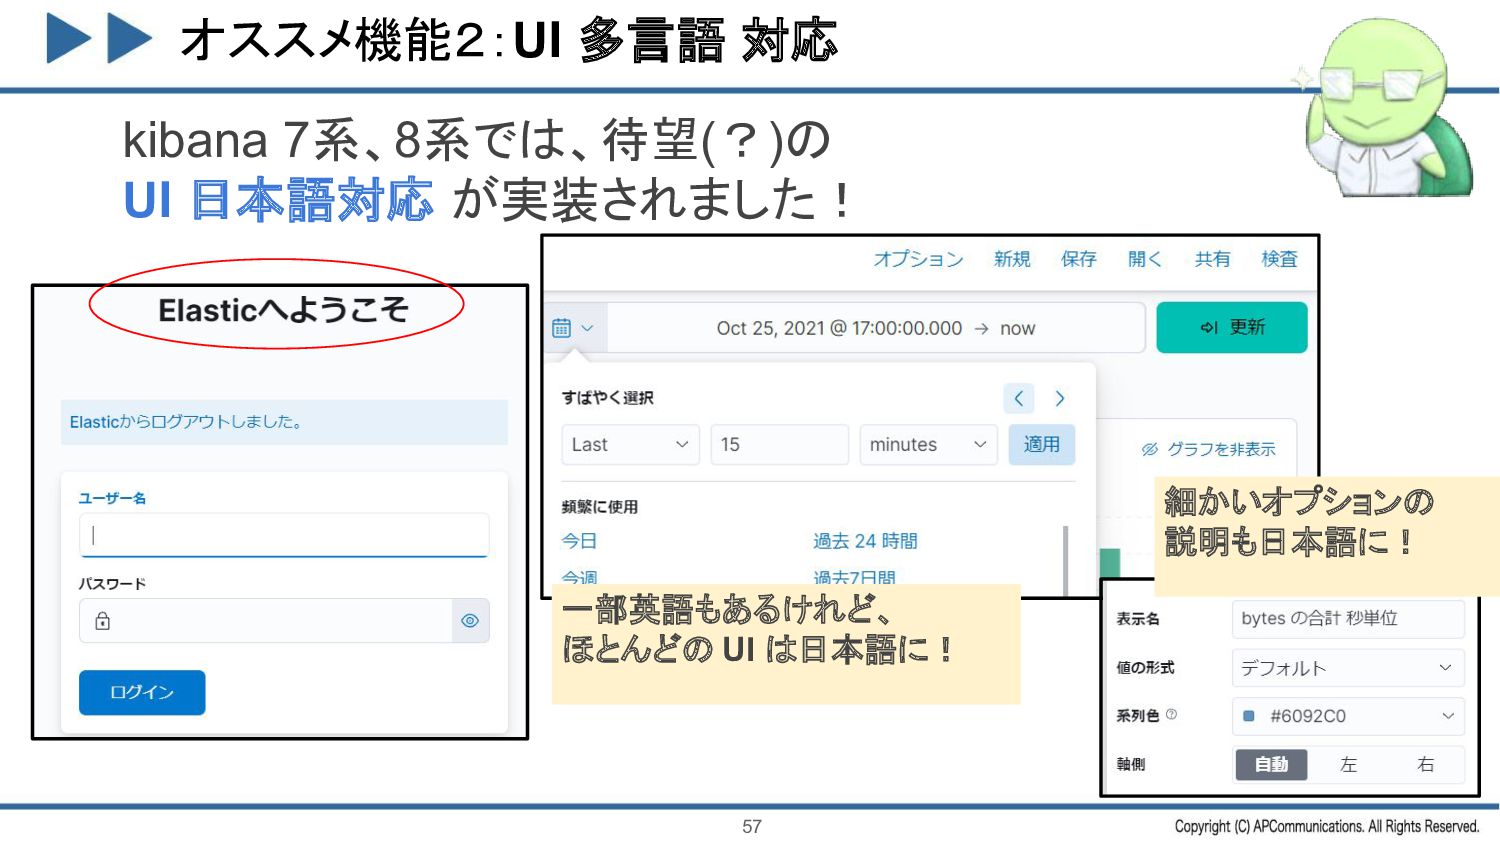
オススメ機能2:UI 多言語 対応 kibana 7系、8系では、待望(?)の UI 日本語対応 が実装されました! 57 一部英語もあるけれど、
ほとんどの UI は日本語に! 細かいオプションの 説明も日本語に! -
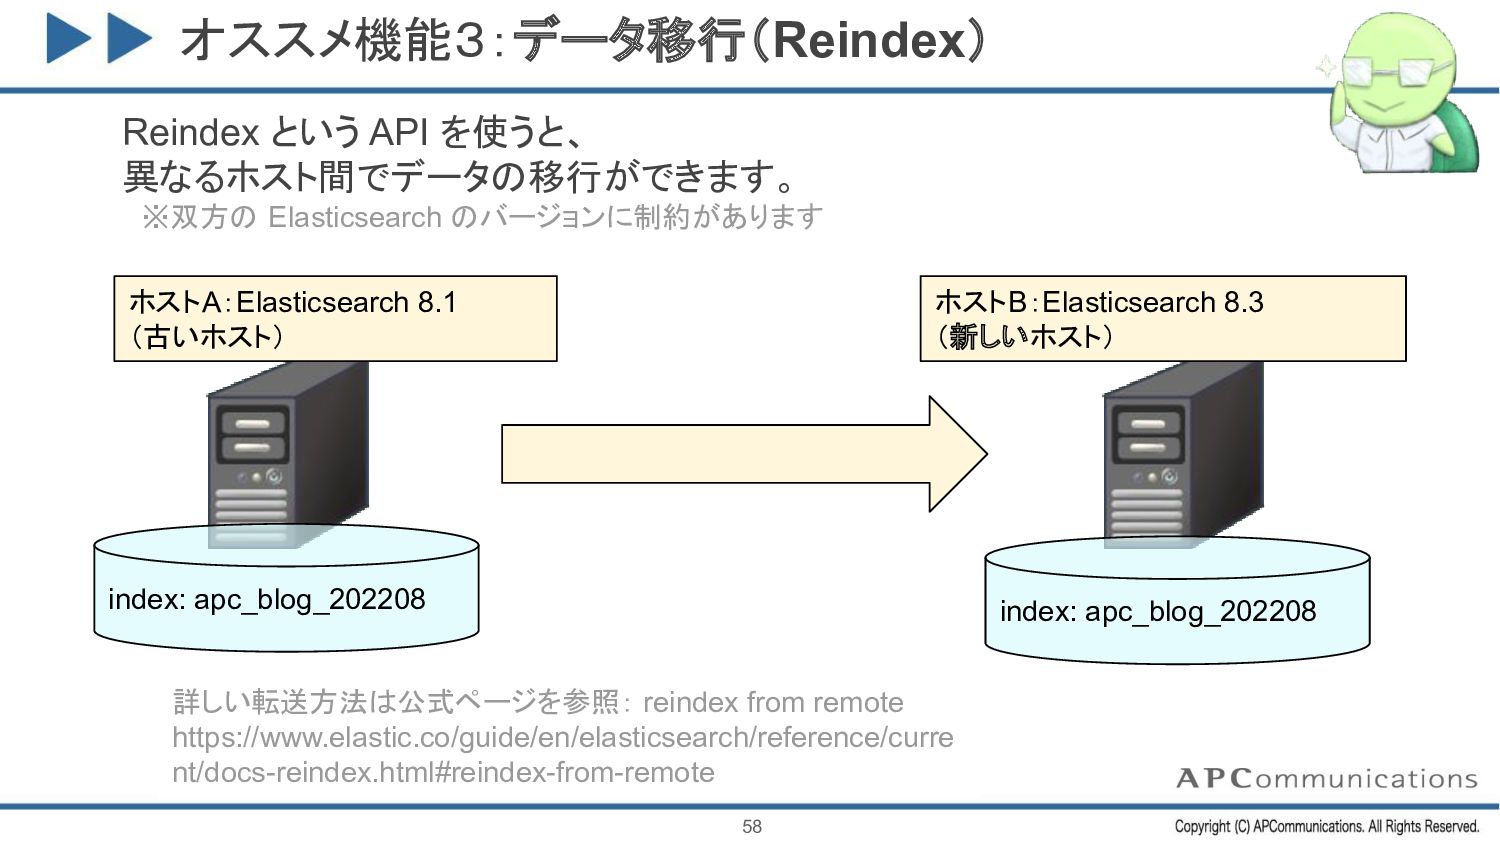
オススメ機能3:データ移行(Reindex) Reindex という API を使うと、 異なるホスト間でデータの移行ができます。 ※双方の Elasticsearch のバージョンに制約があります 58
index: apc_blog_202208 index: apc_blog_202208 ホストA:Elasticsearch 8.1 (古いホスト) ホストB:Elasticsearch 8.3 (新しいホスト) 詳しい転送方法は公式ページを参照: reindex from remote https://www.elastic.co/guide/en/elasticsearch/reference/curre nt/docs-reindex.html#reindex-from-remote -
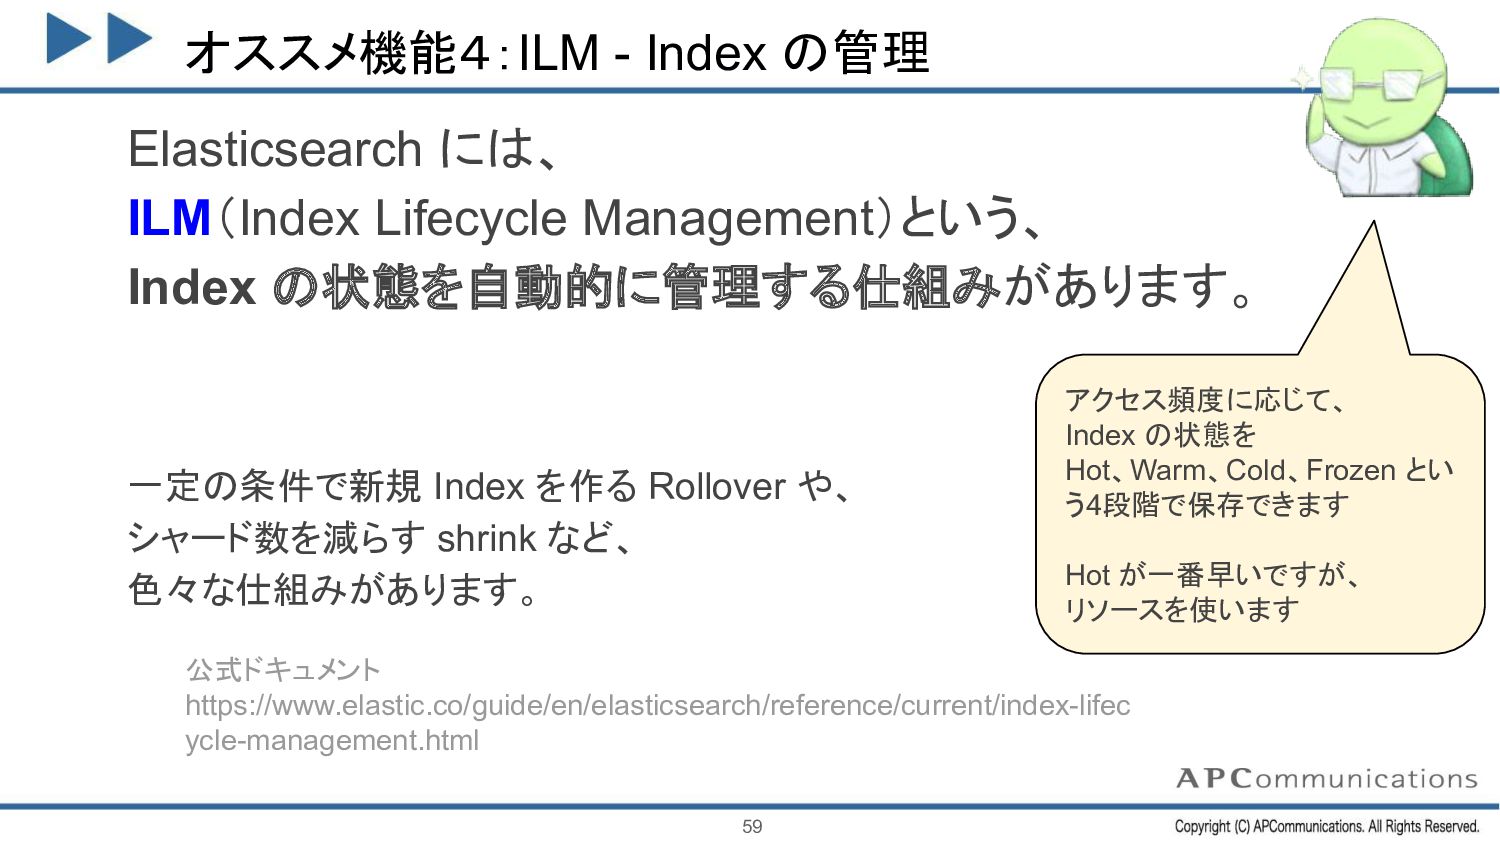
オススメ機能4:ILM - Index の管理 Elasticsearch には、 ILM(Index Lifecycle Management)という、 Index
の状態を自動的に管理する仕組みがあります。 一定の条件で新規 Index を作る Rollover や、 シャード数を減らす shrink など、 色々な仕組みがあります。 59 公式ドキュメント https://www.elastic.co/guide/en/elasticsearch/reference/current/index-lifec ycle-management.html アクセス頻度に応じて、 Index の状態を Hot、Warm、Cold、Frozen とい う4段階で保存できます Hot が一番早いですが、 リソースを使います -
オススメ機能4:ILM - Rollover の例 Rollover について図解してみます。例えば 50GB 以上で Index を切り替える場合
60 Index: apc_0001 データ 49GB データ エイリアス: apc Index: apc_0002 データ データ エイリアス: apc 0GB index のサイズが 50GBを超えたので Rollover 同じ mapping の 新 index が作成さ れ、エイリアスが 付け代わる 50GB 以上で Rolloverする設定 見るときはエイ リアスという別 名にアクセス 本当の名前は 連番になる Index: apc_0001 ータ データ 旧 index は参照さ れないが、 そのまま残る -
オススメ機能5:Watcher(監視機能) 有償の監視機能です。 特定の index の、特定のフィールドを監視し、 一定の数値以上 or 以下(未満 or 超過)でアクションを起こせます。
61 100 80 60 50 40 20 0 06:00 12:00 18:00 00:00 アクションには、 メールや Slack、 Webhook などがあり、 複数の手段で同時通知、 連続通知の抑止 なども可能です。 公式ドキュメント https://www.elastic.co/guide/en/kibana/current/watcher-ui.html -
Tips:有償機能はどれ? Elasticsearch と Kibana の有償機能について説明します。 その前に問題です。 次のうち、有償機能ではないもの はどれでしょうか? 63 A.
認証機能 B. 機械学習 C. web サポート ※今までのテキストの中に答えがあります -
料金と使える機能の比較 1/4 Elastic 製品の課金方法は、大きく分けて二種類あります ・クラウドサービスとして購入 AWS や Azure、GCP をベースとして提供されるサービス。 インフラ面も合わせて対応してくれるのが嬉しい
※ただし高い ・オンプレミス用※にライセンスを購入 インフラは自前で持つが、高度なサービスは使いたい! ※Elastic 用語では セルフマネジメント と呼ぶ 65 料金プラン ・Gold ・Platinum ・Enterprise ※料金は後述 -
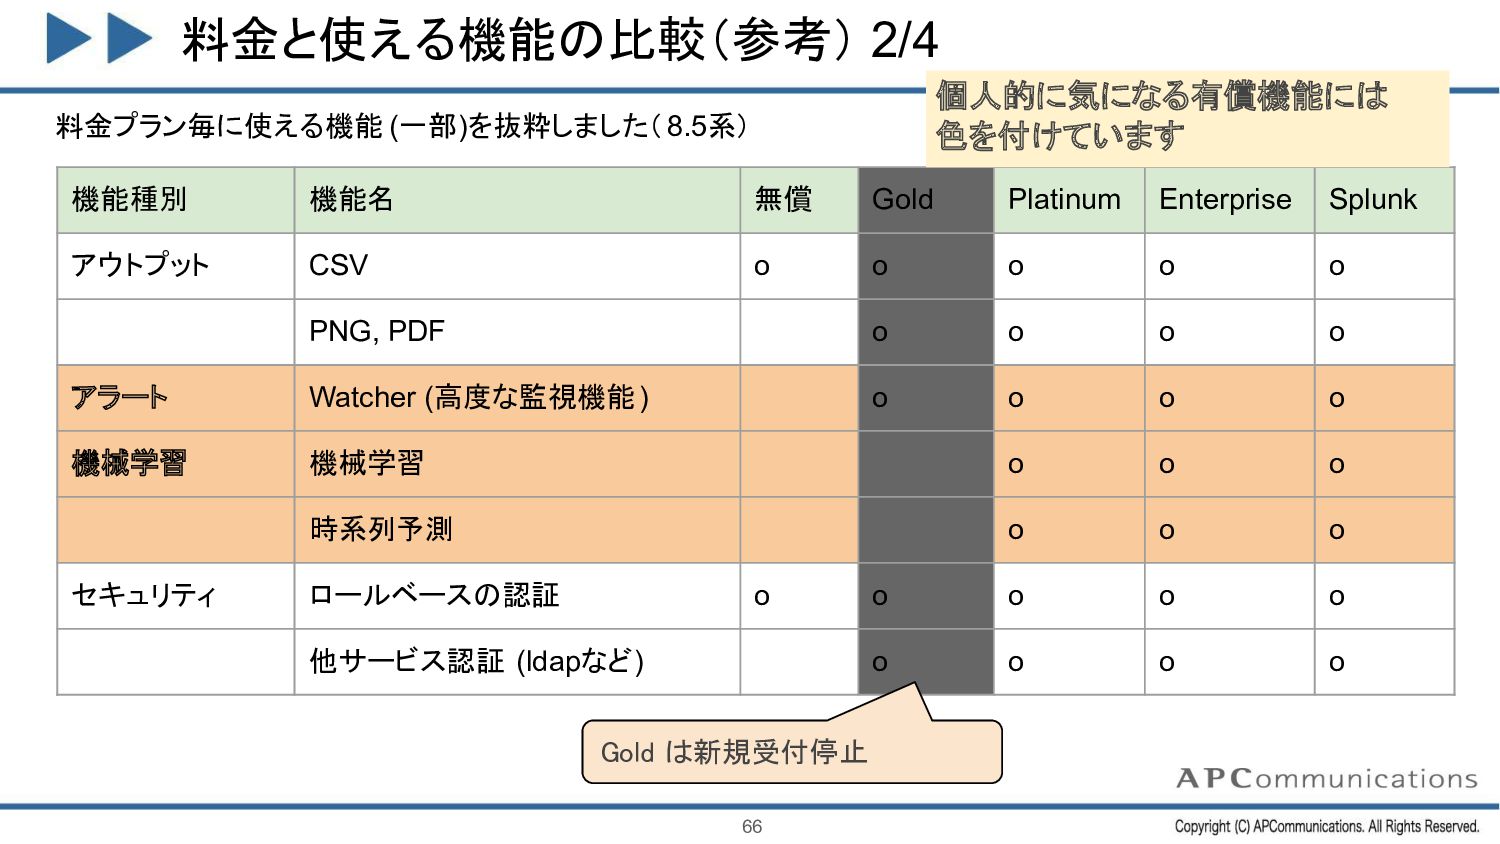
料金と使える機能の比較(参考) 2/4 66 機能種別 機能名 無償 Gold Platinum Enterprise Splunk
アウトプット CSV o o o o o PNG, PDF o o o o アラート Watcher (高度な監視機能) o o o o 機械学習 機械学習 o o o 時系列予測 o o o セキュリティ ロールベースの認証 o o o o o 他サービス認証 (ldapなど) o o o o 個人的に気になる有償機能には 色を付けています 料金プラン毎に使える機能 (一部)を抜粋しました(8.5系) Gold は新規受付停止 -
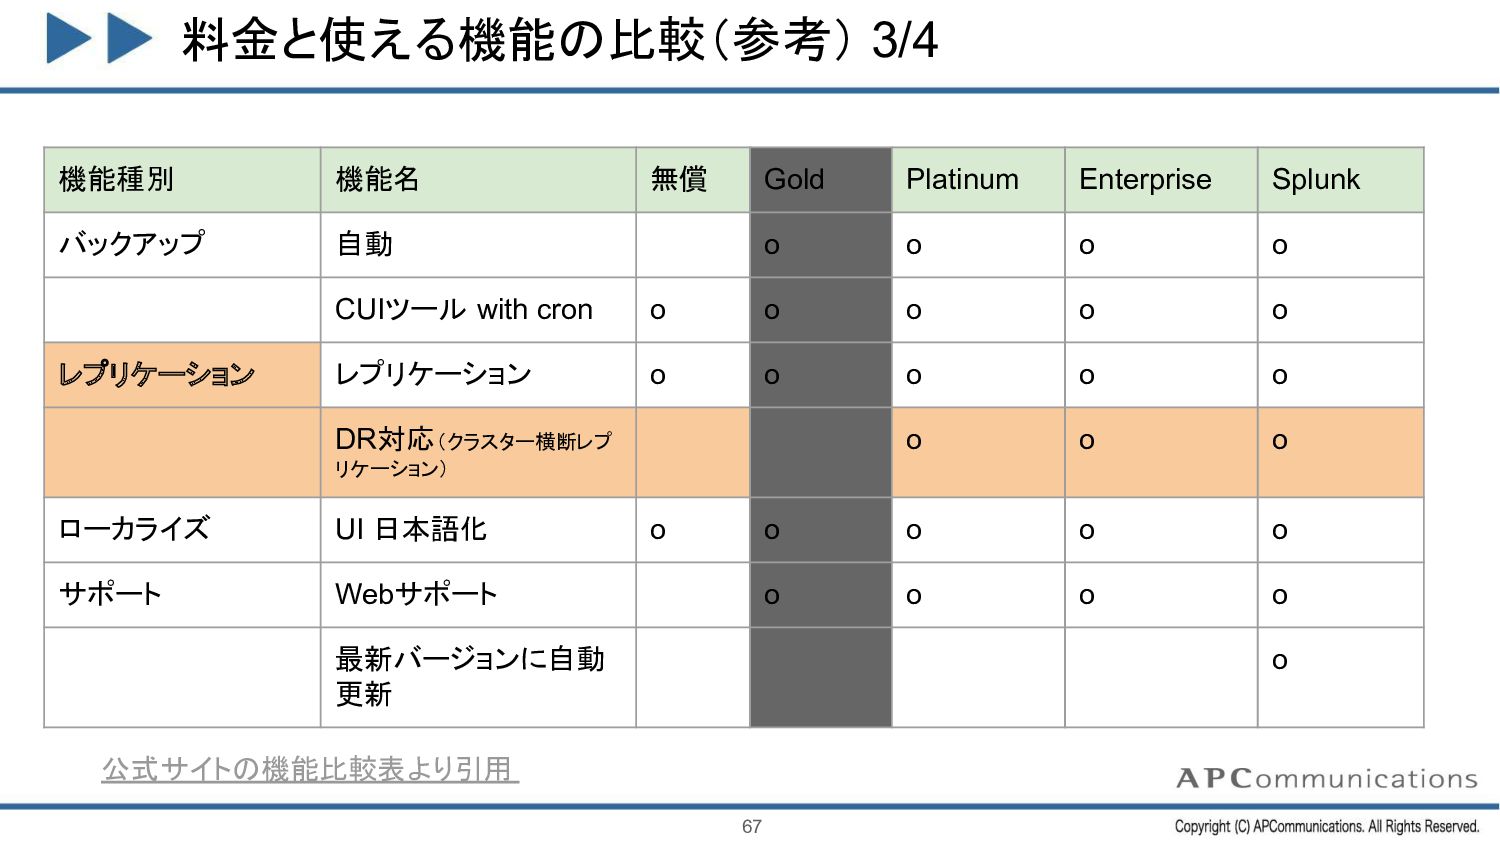
料金と使える機能の比較(参考) 3/4 67 機能種別 機能名 無償 Gold Platinum Enterprise Splunk
バックアップ 自動 o o o o CUIツール with cron o o o o o レプリケーション レプリケーション o o o o o DR対応(クラスター横断レプ リケーション) o o o ローカライズ UI 日本語化 o o o o o サポート Webサポート o o o o 最新バージョンに自動 更新 o 公式サイトの機能比較表より引用 -
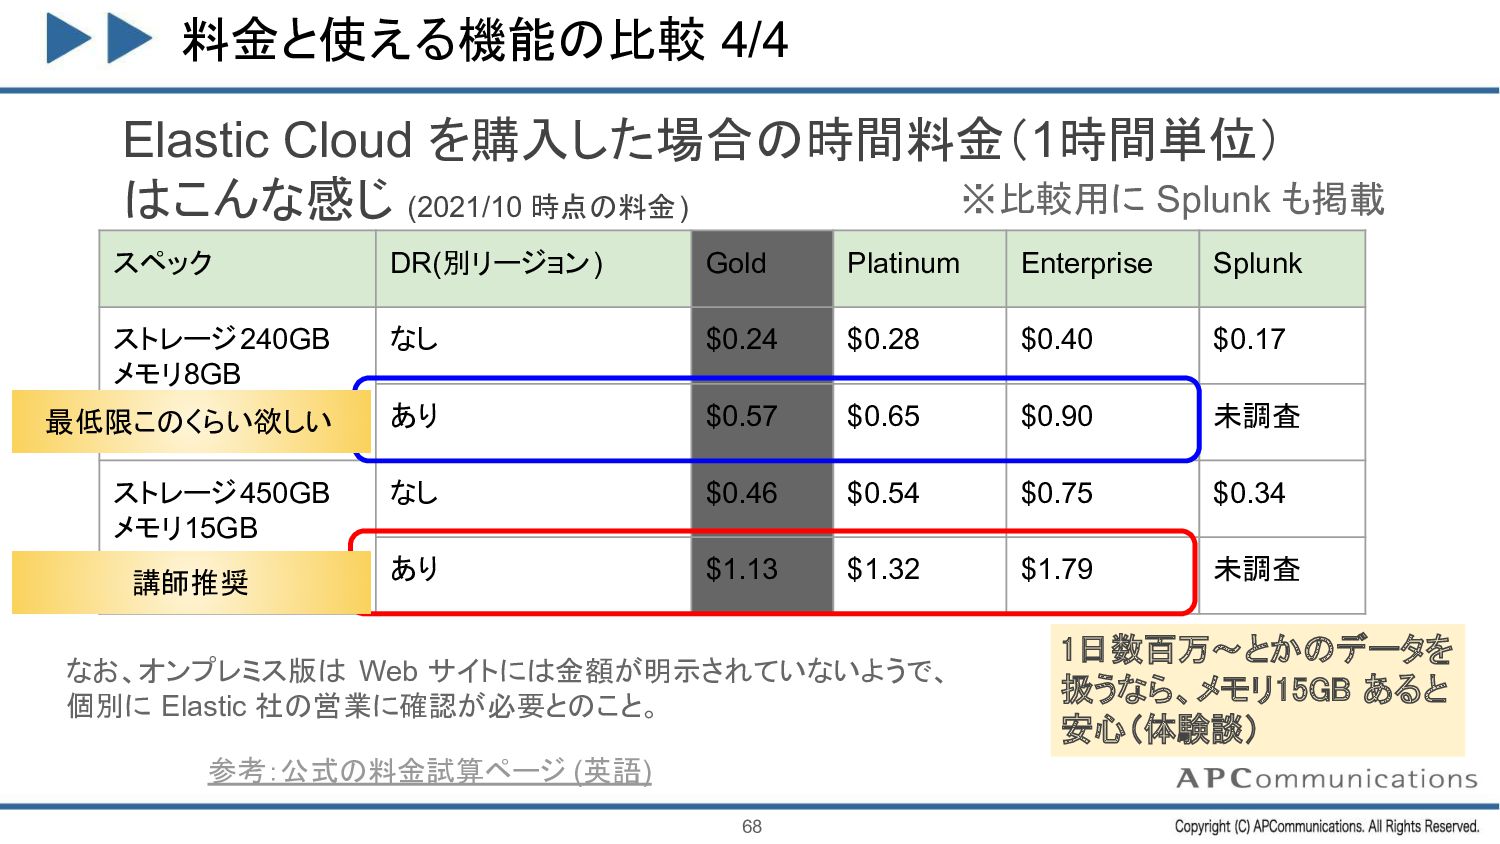
料金と使える機能の比較 4/4 Elastic Cloud を購入した場合の時間料金(1時間単位) はこんな感じ (2021/10 時点の料金) 68 スペック
DR(別リージョン) Gold Platinum Enterprise Splunk ストレージ240GB メモリ8GB なし $0.24 $0.28 $0.40 $0.17 あり $0.57 $0.65 $0.90 未調査 ストレージ450GB メモリ15GB なし $0.46 $0.54 $0.75 $0.34 あり $1.13 $1.32 $1.79 未調査 なお、オンプレミス版は Web サイトには金額が明示されていないようで、 個別に Elastic 社の営業に確認が必要とのこと。 最低限このくらい欲しい 講師推奨 1日数百万~とかのデータを 扱うなら、メモリ15GB あると 安心(体験談) ※比較用に Splunk も掲載 参考:公式の料金試算ページ (英語) -
課金すべきシチュエーション 1/2 課金すべきシチュエーションってどんなとき? ケース1:インフラ面の問題が出てきたとき • データ容量が増えてきて、 サーバのスケールアウト や index の削除に追われている •
検索時の高負荷で、よく Elasticsearch が停止する 課金による解決策: • Elastic Cloud を使えば、 ニーズに応じたスペックにインフラをスケールアウト(or アップ)できる (その分料金は増える) • Enterprise 版なら、クラウドオーケストレーション機能 を提供する Elastic Cloud Enterprise が使える。 69 -
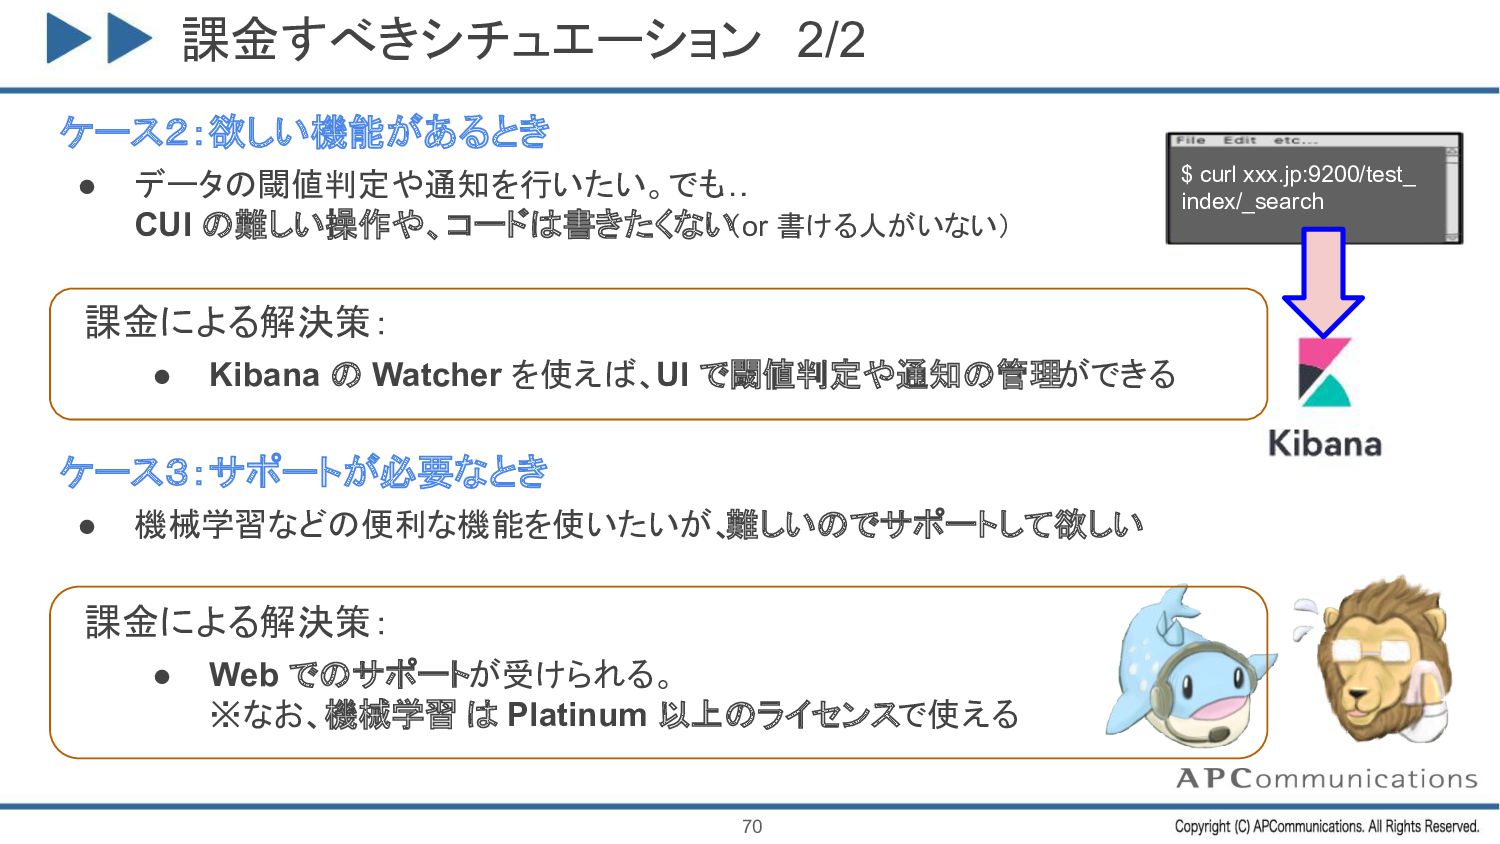
課金すべきシチュエーション 2/2 ケース2:欲しい機能があるとき • データの閾値判定や通知を行いたい。でも … CUI の難しい操作や、コードは書きたくない (or 書ける人がいない) 課金による解決策:
• Kibana の Watcher を使えば、UI で閾値判定や通知の管理ができる ケース3:サポートが必要なとき • 機械学習などの便利な機能を使いたいが、 難しいのでサポートして欲しい 課金による解決策: • Web でのサポートが受けられる。 ※なお、機械学習 は Platinum 以上のライセンスで使える 70 $ curl xxx.jp:9200/test_ index/_search -
Tips:なぜ私が Elastic 製品を選んだか? • 無償だから(一番重要) ◦ 無償でほとんどの機能が本番環境で使える • 業務で使っているから ◦
もう5年ほど使っています • 一番メジャーだから(Qiita 調べ) ◦ 使い方を検索して一番 HIT しやすい、というのも大事です • Python との親和性が高い(と思う)から ◦ 検索クエリが JSON 形式なので、Python でコードが書きやすい ◦ 個人的に Python が好きだから 71 -
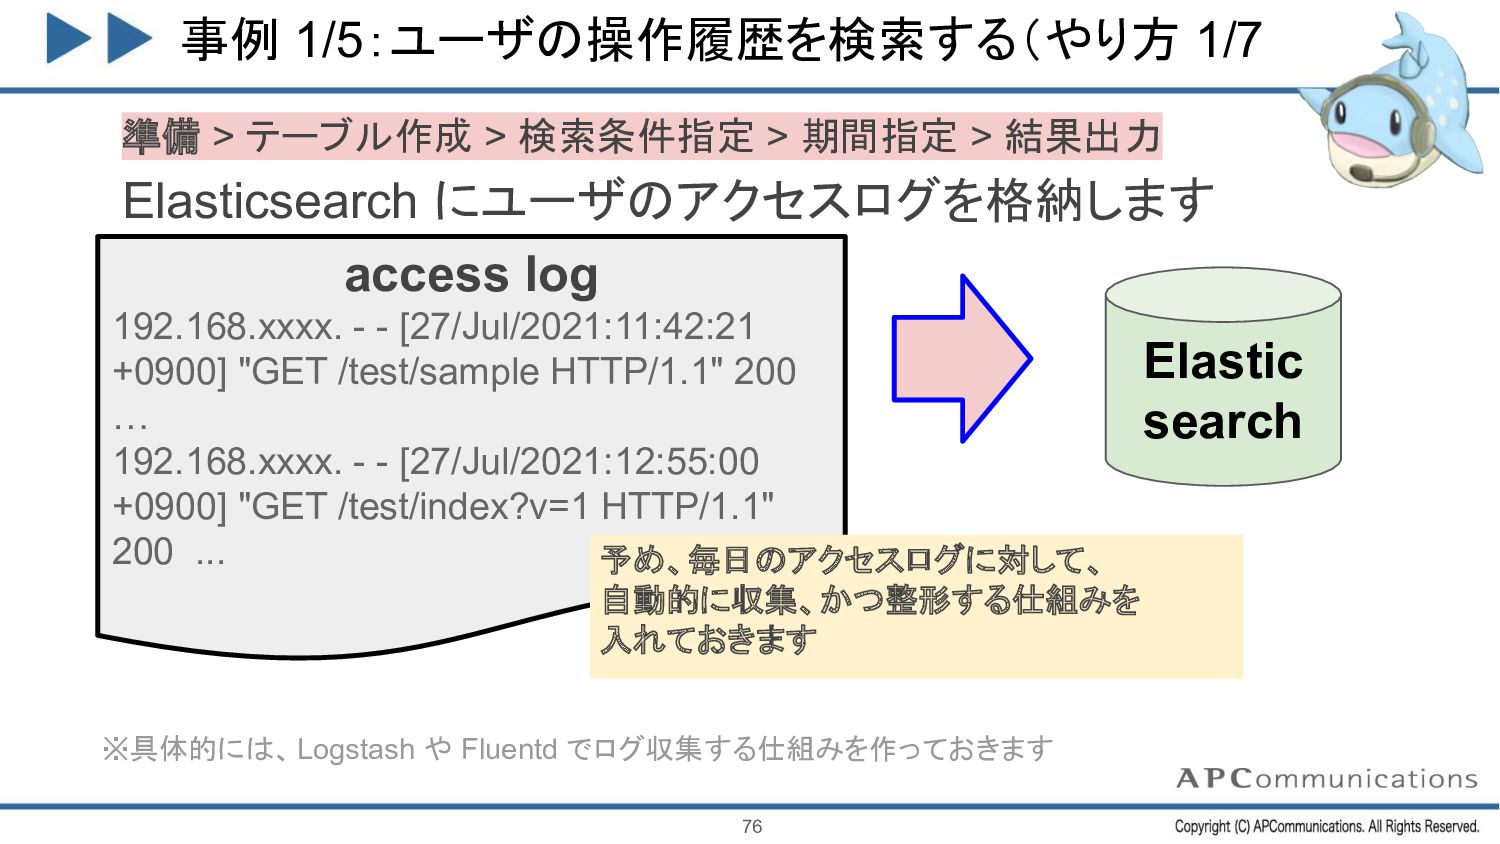
事例 1/5:ユーザの操作履歴を検索する(やり方 1/7 準備 > テーブル作成 > 検索条件指定 > 期間指定
> 結果出力 Elasticsearch にユーザのアクセスログを格納します access log 192.168.xxxx. - - [27/Jul/2021:11:42:21 +0900] "GET /test/sample HTTP/1.1" 200 … 192.168.xxxx. - - [27/Jul/2021:12:55:00 +0900] "GET /test/index?v=1 HTTP/1.1" 200 ... Elastic search 予め、毎日のアクセスログに対して、 自動的に収集、かつ整形する仕組みを 入れておきます ※具体的には、Logstash や Fluentd でログ収集する仕組みを作っておきます 76 -
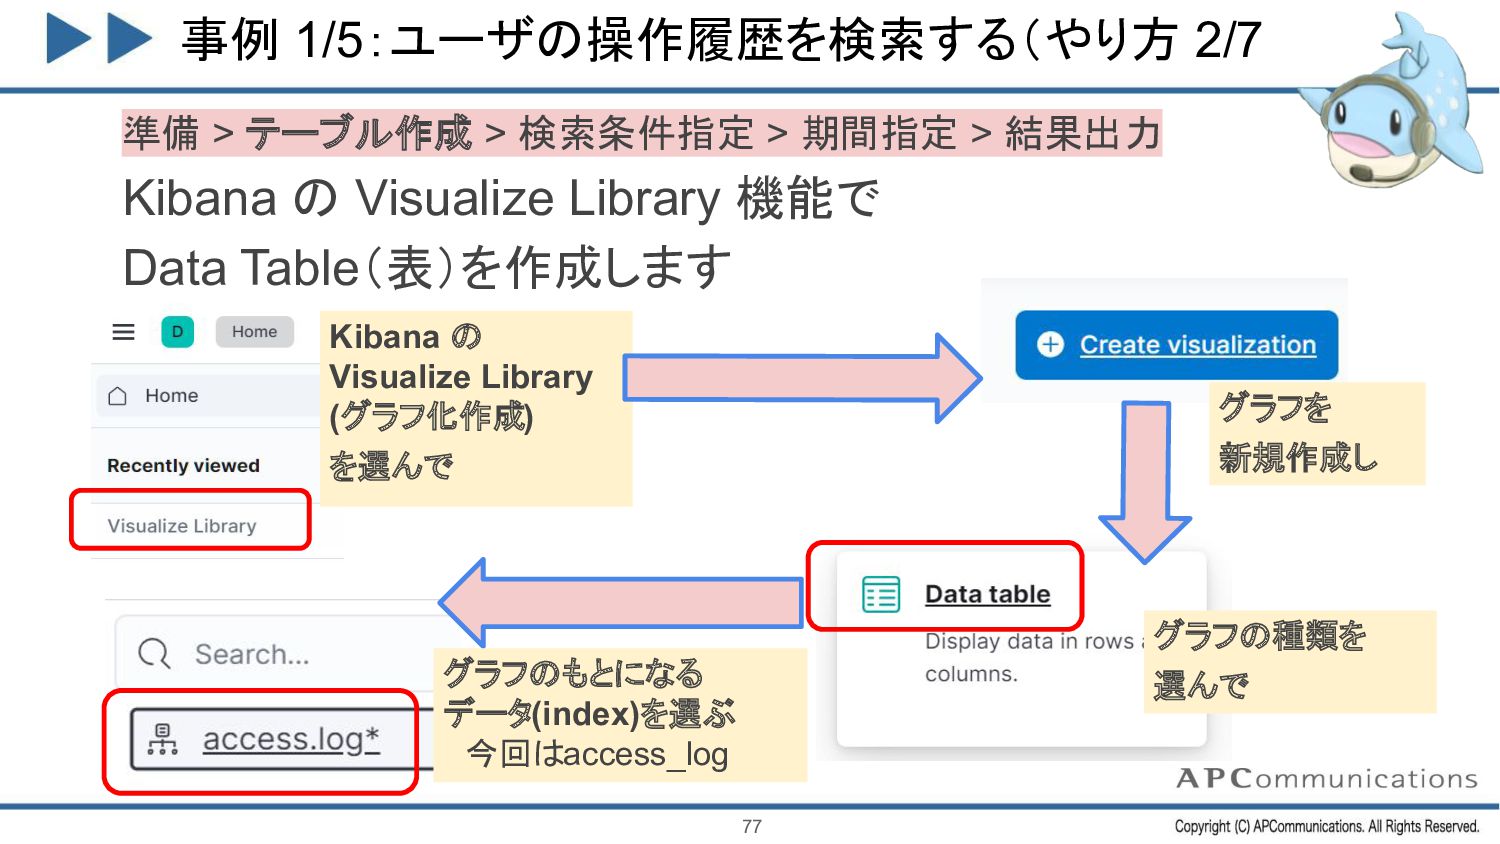
準備 > テーブル作成 > 検索条件指定 > 期間指定 > 結果出力 Kibana
の Visualize Library 機能で Data Table(表)を作成します 事例 1/5:ユーザの操作履歴を検索する(やり方 2/7 77 グラフを 新規作成し グラフの種類を 選んで グラフのもとになる データ(index)を選ぶ 今回はaccess_log Kibana の Visualize Library (グラフ化作成) を選んで -
事例 1/5:ユーザの操作履歴を検索する(やり方 3/7 準備 > テーブル作成 > 検索条件指定 > 期間指定
> 結果出力 Visualize 機能の設定で、 URLだけを表示(集計)します 78 集計条件を 適用する どの項目を表示するか 選ぶ ※今回はユーザが アクセスしたURL 表示件数を 入力する ※Aggregation=集計機能。 Terms は文字列の集計を行うもの ※Field に表示したい項目を指定する (今回は URL) ※Size=検索件数 は最大値(9999)にする -
準備 > テーブル作成 > 検索条件指定 > 期間指定 > 結果出力 顧客の
IPアドレス で絞り込みます ※検索条件を指定しないと、全顧客のログが出てしまいノイズになる 事例 1/5:ユーザの操作履歴を検索する(やり方 4/7 これで 該当顧客だけのデータが表示される でも、デフォルトだと 過去15分しか出ないので… 79 -
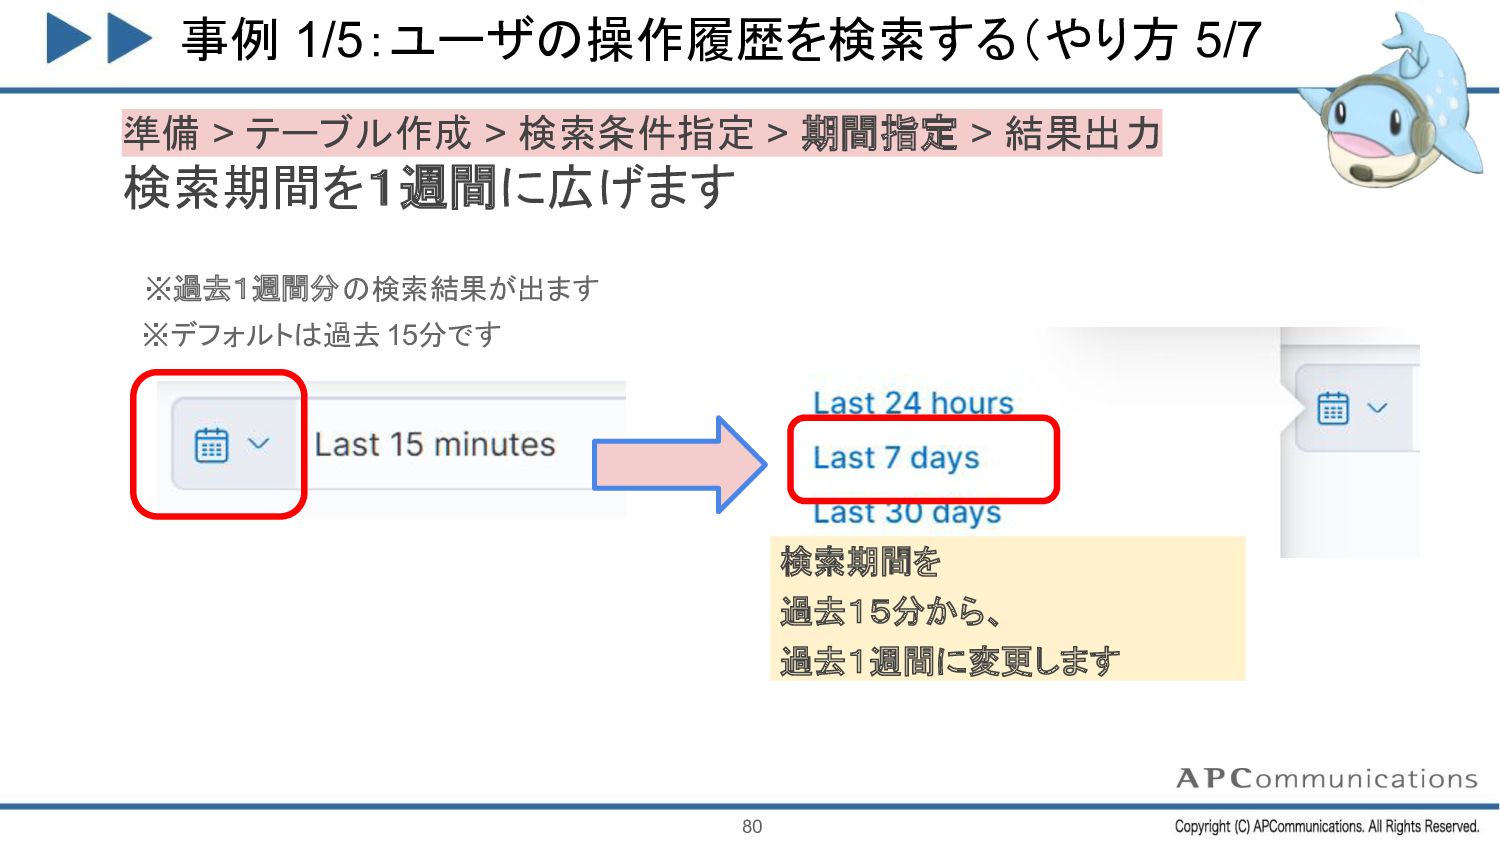
事例 1/5:ユーザの操作履歴を検索する(やり方 5/7 準備 > テーブル作成 > 検索条件指定 > 期間指定
> 結果出力 検索期間を1週間に広げます ※過去1週間分の検索結果が出ます ※デフォルトは過去 15分です 80 検索期間を 過去15分から、 過去1週間に変更します -
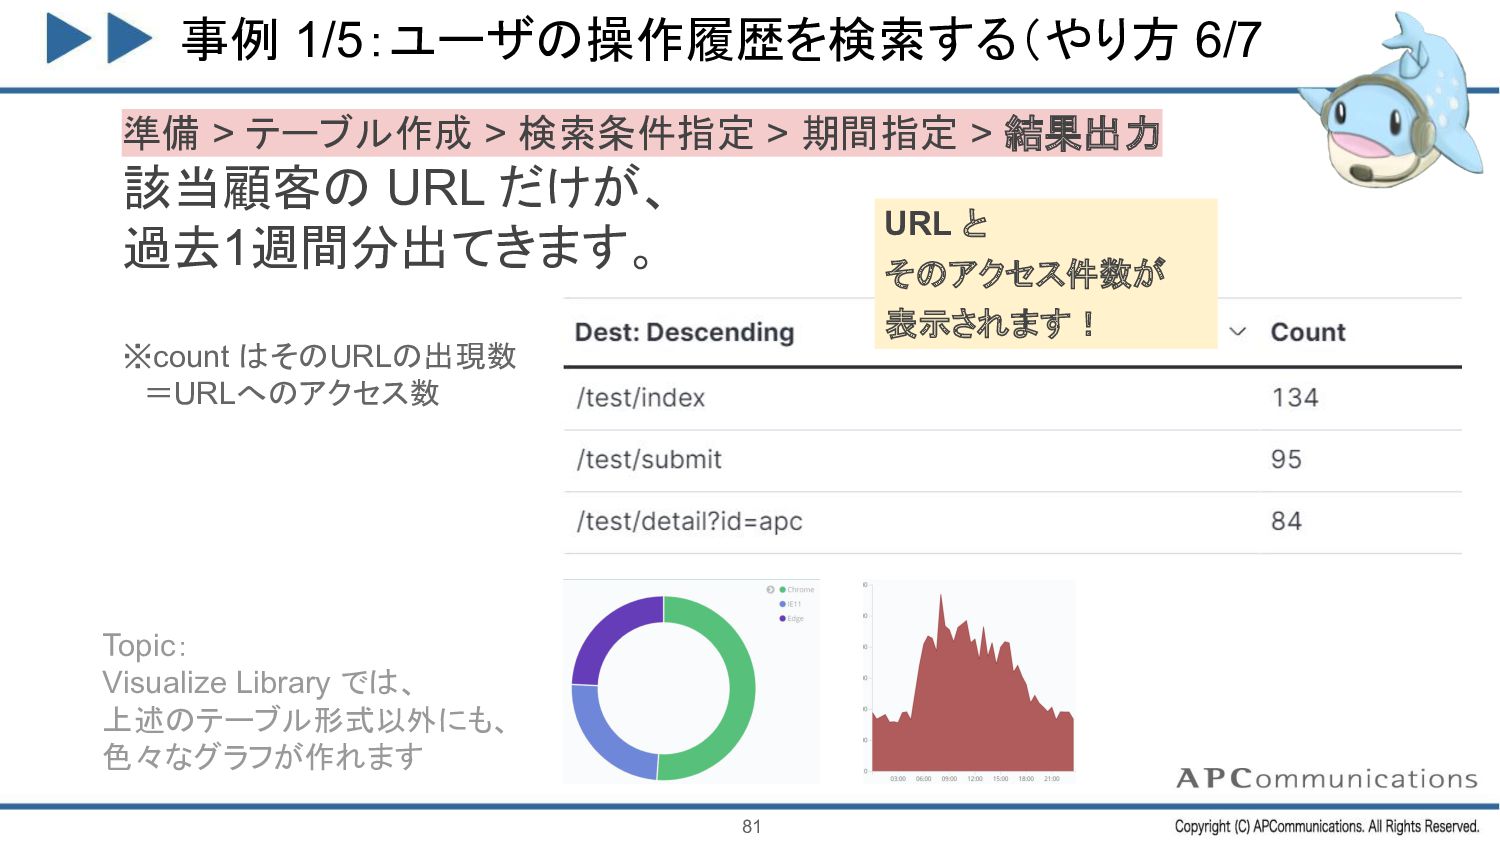
事例 1/5:ユーザの操作履歴を検索する(やり方 6/7 準備 > テーブル作成 > 検索条件指定 > 期間指定
> 結果出力 該当顧客の URL だけが、 過去1週間分出てきます。 ※count はそのURLの出現数 =URLへのアクセス数 Topic: Visualize Library では、 上述のテーブル形式以外にも、 色々なグラフが作れます 81 URL と そのアクセス件数が 表示されます! -
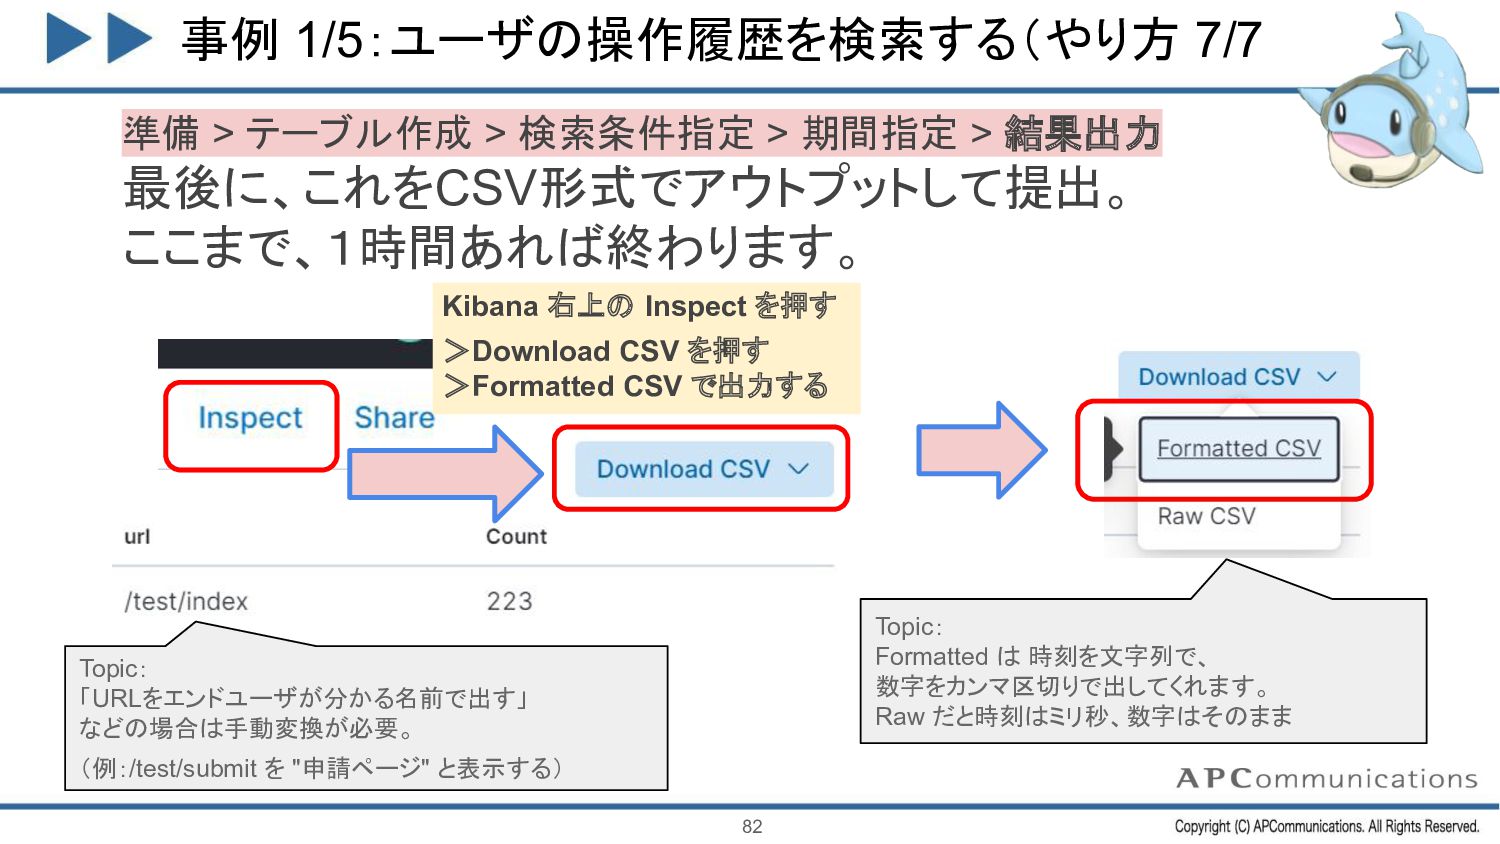
事例 1/5:ユーザの操作履歴を検索する(やり方 7/7 準備 > テーブル作成 > 検索条件指定 > 期間指定
> 結果出力 最後に、これをCSV形式でアウトプットして提出。 ここまで、1時間あれば終わります。 Topic: Formatted は 時刻を文字列で、 数字をカンマ区切りで出してくれます。 Raw だと時刻はミリ秒、数字はそのまま 82 Topic: 「URLをエンドユーザが分かる名前で出す」 などの場合は手動変換が必要。 (例:/test/submit を "申請ページ" と表示する) Kibana 右上の Inspect を押す >Download CSV を押す >Formatted CSV で出力する -
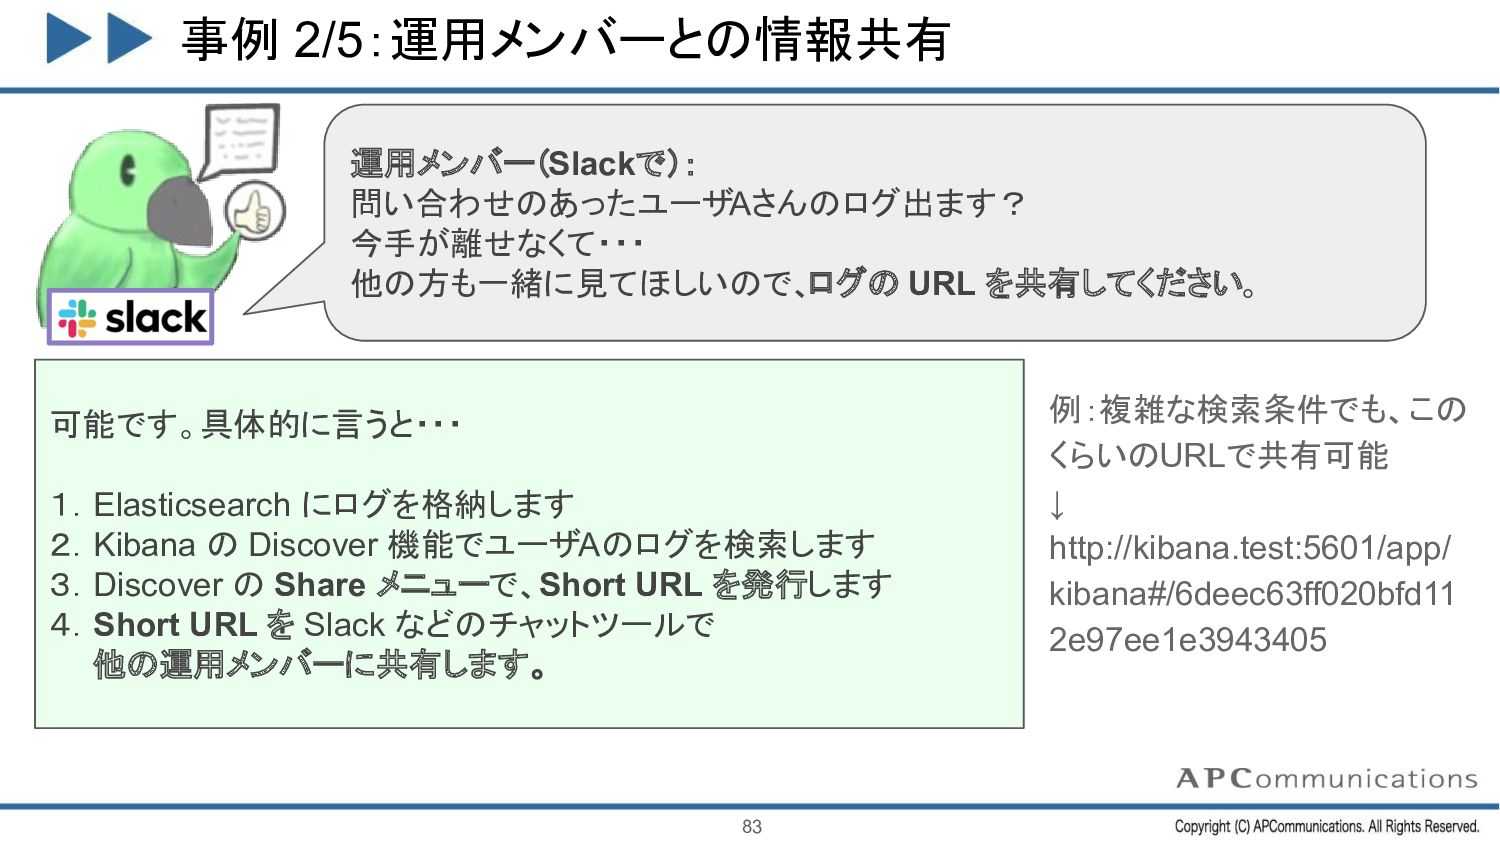
事例 2/5:運用メンバーとの情報共有 可能です。具体的に言うと・・・ 1.Elasticsearch にログを格納します 2.Kibana の Discover 機能でユーザAのログを検索します 3.Discover
の Share メニューで、Short URL を発行します 4.Short URL を Slack などのチャットツールで 他の運用メンバーに共有します。 運用メンバー(Slackで): 問い合わせのあったユーザAさんのログ出ます? 今手が離せなくて・・・ 他の方も一緒に見てほしいので、 ログの URL を共有してください。 例:複雑な検索条件でも、この くらいのURLで共有可能 ↓ http://kibana.test:5601/app/ kibana#/6deec63ff020bfd11 2e97ee1e3943405 83 -
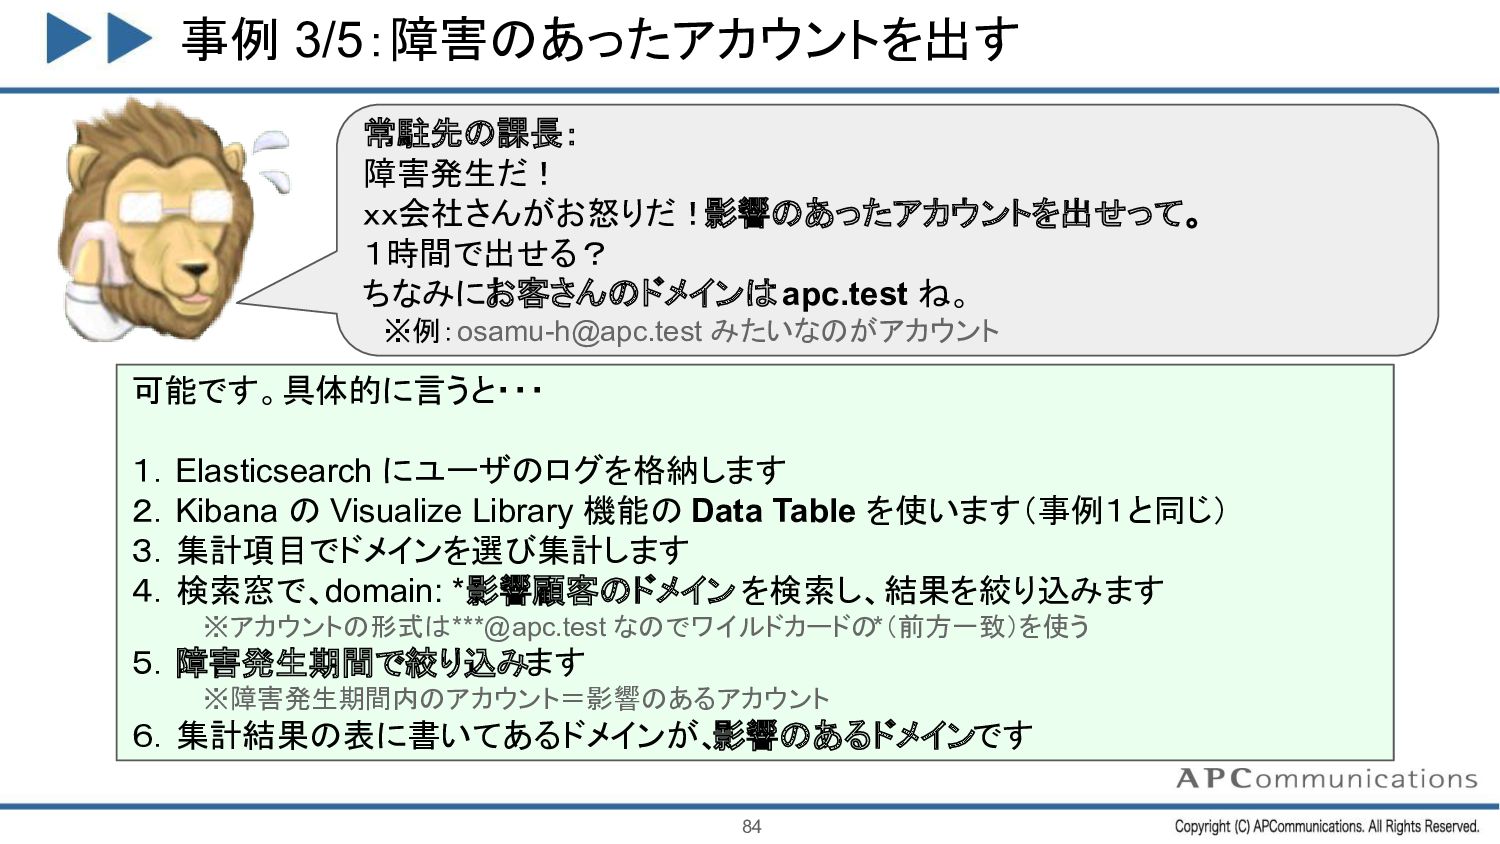
事例 3/5:障害のあったアカウントを出す 可能です。具体的に言うと・・・ 1.Elasticsearch にユーザのログを格納します 2.Kibana の Visualize Library 機能の
Data Table を使います(事例1と同じ) 3.集計項目でドメインを選び集計します 4.検索窓で、domain: *影響顧客のドメイン を検索し、結果を絞り込みます ※アカウントの形式は ***@apc.test なのでワイルドカードの*(前方一致)を使う 5.障害発生期間で絞り込みます ※障害発生期間内のアカウント=影響のあるアカウント 6.集計結果の表に書いてあるドメインが、 影響のあるドメインです 常駐先の課長: 障害発生だ! xx会社さんがお怒りだ!影響のあったアカウントを出せって。 1時間で出せる? ちなみにお客さんのドメインは apc.test ね。 ※例:[email protected] みたいなのがアカウント 84 -
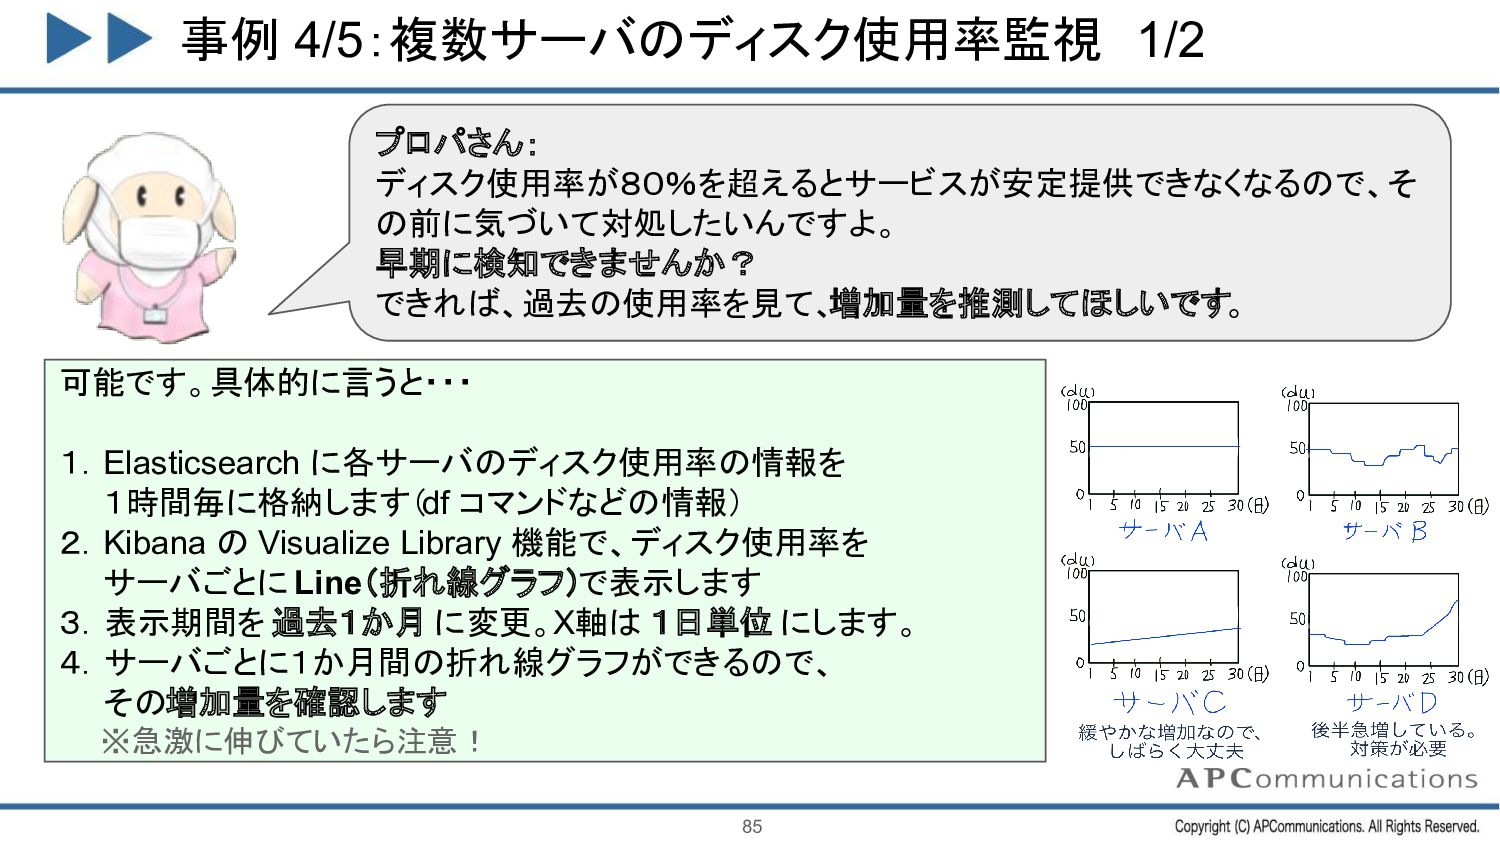
事例 4/5:複数サーバのディスク使用率監視 1/2 プロパさん: ディスク使用率が80%を超えるとサービスが安定提供できなくなるので、そ の前に気づいて対処したいんですよ。 早期に検知できませんか? できれば、過去の使用率を見て、 増加量を推測してほしいです。 可能です。具体的に言うと・・・ 1.Elasticsearch
に各サーバのディスク使用率の情報を 1時間毎に格納します(df コマンドなどの情報) 2.Kibana の Visualize Library 機能で、ディスク使用率を サーバごとに Line(折れ線グラフ)で表示します 3.表示期間を 過去1か月 に変更。X軸は 1日単位 にします。 4.サーバごとに1か月間の折れ線グラフができるので、 その増加量を確認します ※急激に伸びていたら注意! 85 -
事例 4/5:複数サーバのディスク使用率監視 2/2 プロパさん: ディスク使用率が80%を超えるとサービスが安定提供できなくなるので、そ の前に気づいて対処したいんですよ。 早期に検知できませんか? できれば、過去の使用率を見て、 増加量を推測してほしいです。 ただ、 これは
Prometheus の方に軍配が上がるかもしれません。 数値の監視に特化し、かつ無償で通知を飛ばせるためです。 ケースに応じて、ツールの使い分けが重要になってきます。 また、 増加量の予測 は 機械学習を使えば可能です。 ただし前述した通り、これは有償機能です。 86 -
事例 5/5:意思決定の材料に 偉い人: うちのサービスで、よく使われているオプションを知りたい ね。 広報で宣伝したり、そこに戦力を投入するとかしたいんだ。 いい材料ないかな? こういうときこそ可視化(見える化)、 Visualize の出番です!
1.Elasticsearch にオプションの使用数を溜めます。 >アプローチはサービスによって異なりますが、 例えば、Webページなら前述のアクセスログや DB の契約状況など 2.使用数を Kibana > Visualize の Table や Pie などで、 順位が分かるように可視化します。 3.そのページを偉い人に共有します。 >閲覧専用のロールを発行したり、偉い人閲覧用のスペースを作っておきましょう 87 -
本日のサマリ 1/2 • ログ収集とはなにか ◦ ログ収集 > ログ蓄積 > ログ可視化 からなる データの収集・可視化作業のこと
◦ 収集・可視化したデータを分析する • Elastic 製品とは何か ◦ Elasticsearch(蓄積)、Logstash(収集)、Kibana(可視化) ◦ ここに収集補助製品の Beats を加えて Elastic Stack と呼ぶ • 少し難しい仕組みの説明 ◦ Index(table)、Field(列)、Document(行) ◦ 投入・検索方法、API、ノードとシャード 89 本日学んだことを おさらいしましょう -
本日のサマリ 2/2 • 秀逸な機能 ◦ 認証機能、日本語UI、Reindex、ILM、Watcher • 業務での活用事例 ◦ 調査結果の出力と共有 ◦
障害影響調査 ◦ 負荷の監視や異常検知・通知 ◦ 意思決定の材料 90 本日学んだことを おさらいしましょう -
巻末付録:Q&A Q.エージェントへの移行や導入制約について、クラスタ管理 の大変さについて A.今回は対象外ですが、Elasticsearch はかなりメモリを消費します。 ザックリレベルですと、1台最低でもメモリ8GB は必要です。 この辺りはデータ量によって変わります。 自前で用意が難しい場合は有償の Elastic
Cloud を使うのも手ですが、 その場合は料金が制約になってきます。 クラスタ構築は DockerFile や Ansible で簡略化できます。 ただし、初期構築はそれなりに大変ですし、 クラスタ管理コマンドや yml ファイルの意味をちゃんと理解する必要があります。 93 -
巻末付録:Q&A Q.初心者がどうやって勉強していくのがもっとも効率的に習 熟できるかを聞いてみたいです。 A.まずは実際に Elasticsearch(Logstash と Kibana も) をインストールし、 使ってみることが早いと思います。
Docker などで入れることもできますが、 最初は yum(dnf)や brew でインストールした方が、 「Elasticsearch はこうやって動くんだ」ということが理解できるので、 お勧めです。 Logstash の難易度が少し高いので、 最初は Kibana のデモページで、データの可視化を体験してみるのもアリです。 https://www.elastic.co/jp/demos 94
 institutdelelevage
 rfujii
 auranightsky
 sishi
 tosseto
 hotchpotch
 beale
 kohlerjohannes
 satai
 hirachan
 takaomurakami
 chriscoyier
 hannesfritz
 sergeychernyshev
 bluesmoon
 csswizardry
 twada
 nmsamuel
 62gerente
 bryan
 yeseniaperezcruz
 konakalab
 aleyda