Share
Embed
ビジネスデータ分析

Tetsuro Shimada
March 14, 2023
Transcript
61 slides
-
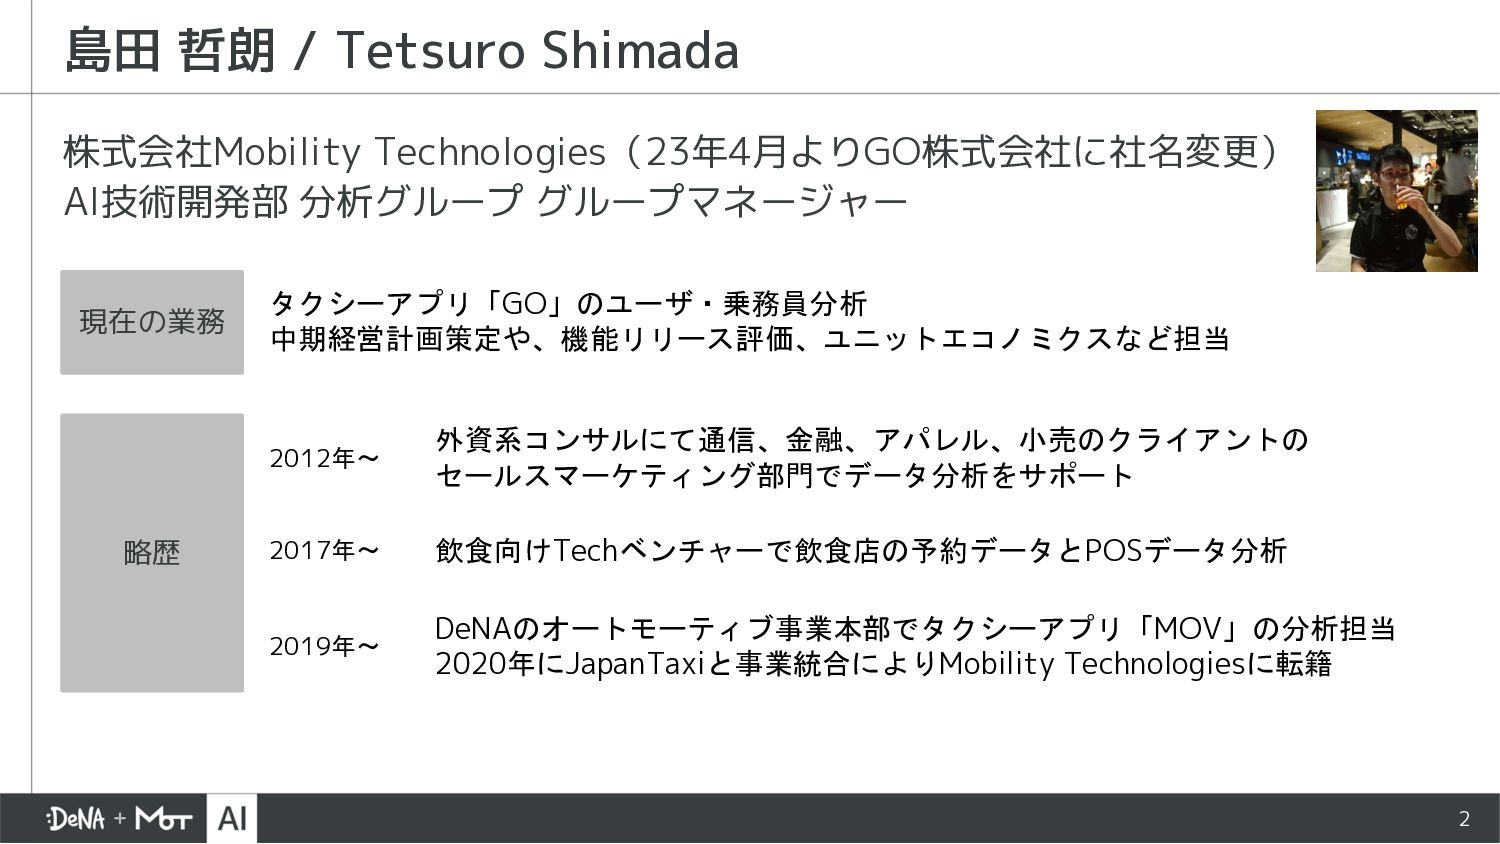
2 株式会社Mobility Technologies(23年4月よりGO株式会社に社名変更) AI技術開発部 分析グループ グループマネージャー 島田 哲朗 / Tetsuro
Shimada 現在の業務 タクシーアプリ「GO」のユーザ・乗務員分析 中期経営計画策定や、機能リリース評価、ユニットエコノミクスなど担当 略歴 2012年〜 外資系コンサルにて通信、金融、アパレル、小売のクライアントの セールスマーケティング部門でデータ分析をサポート 2017年〜 飲食向けTechベンチャーで飲食店の予約データとPOSデータ分析 2019年〜 DeNAのオートモーティブ事業本部でタクシーアプリ「MOV」の分析担当 2020年にJapanTaxiと事業統合によりMobility Technologiesに転籍 -
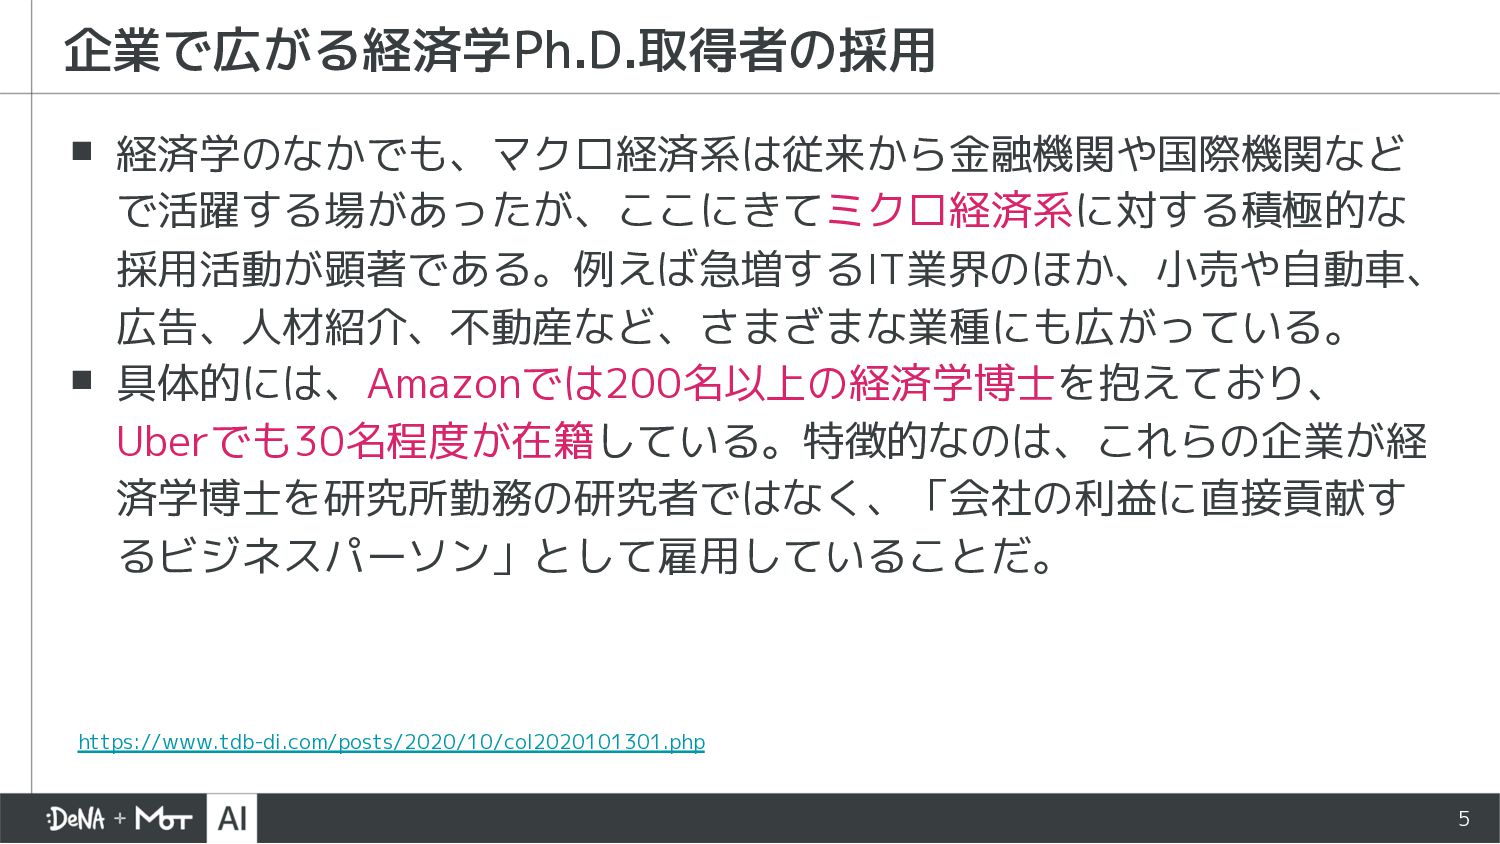
5 ▪ 経済学のなかでも、マクロ経済系は従来から金融機関や国際機関など で活躍する場があったが、ここにきてミクロ経済系に対する積極的な 採用活動が顕著である。例えば急増するIT業界のほか、小売や自動車、 広告、人材紹介、不動産など、さまざまな業種にも広がっている。 ▪ 具体的には、Amazonでは200名以上の経済学博士を抱えており、 Uberでも30名程度が在籍している。特徴的なのは、これらの企業が経 済学博士を研究所勤務の研究者ではなく、「会社の利益に直接貢献す
るビジネスパーソン」として雇用していることだ。 企業で広がる経済学Ph.D.取得者の採用 https://www.tdb-di.com/posts/2020/10/col2020101301.php -
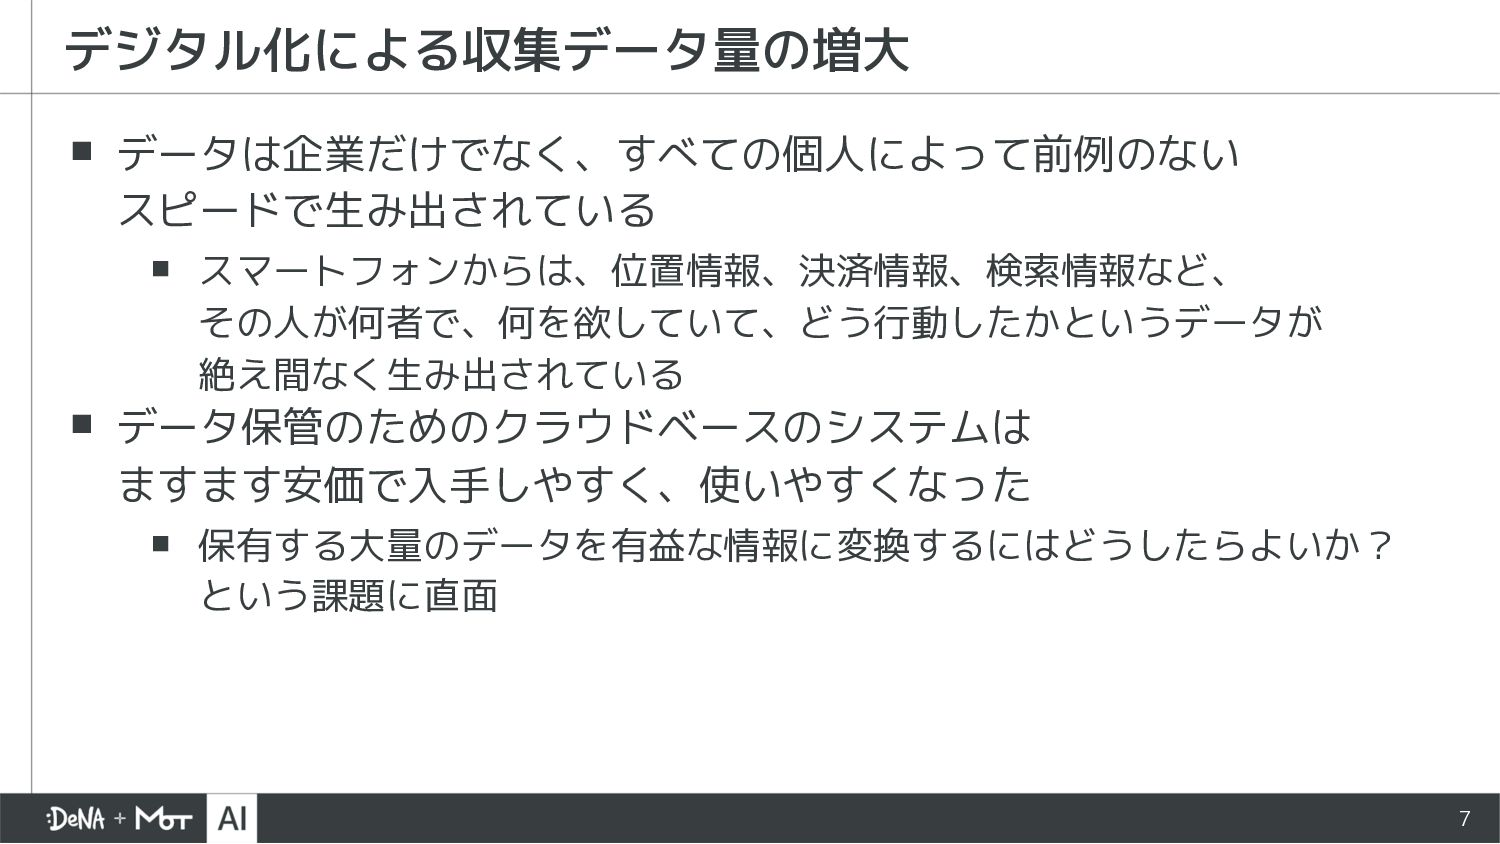
7 ▪ データは企業だけでなく、すべての個人によって前例のない スピードで生み出されている ▪ スマートフォンからは、位置情報、決済情報、検索情報など、 その人が何者で、何を欲していて、どう行動したかというデータが 絶え間なく生み出されている ▪ データ保管のためのクラウドベースのシステムは
ますます安価で入手しやすく、使いやすくなった ▪ 保有する大量のデータを有益な情報に変換するにはどうしたらよいか? という課題に直面 デジタル化による収集データ量の増大 -
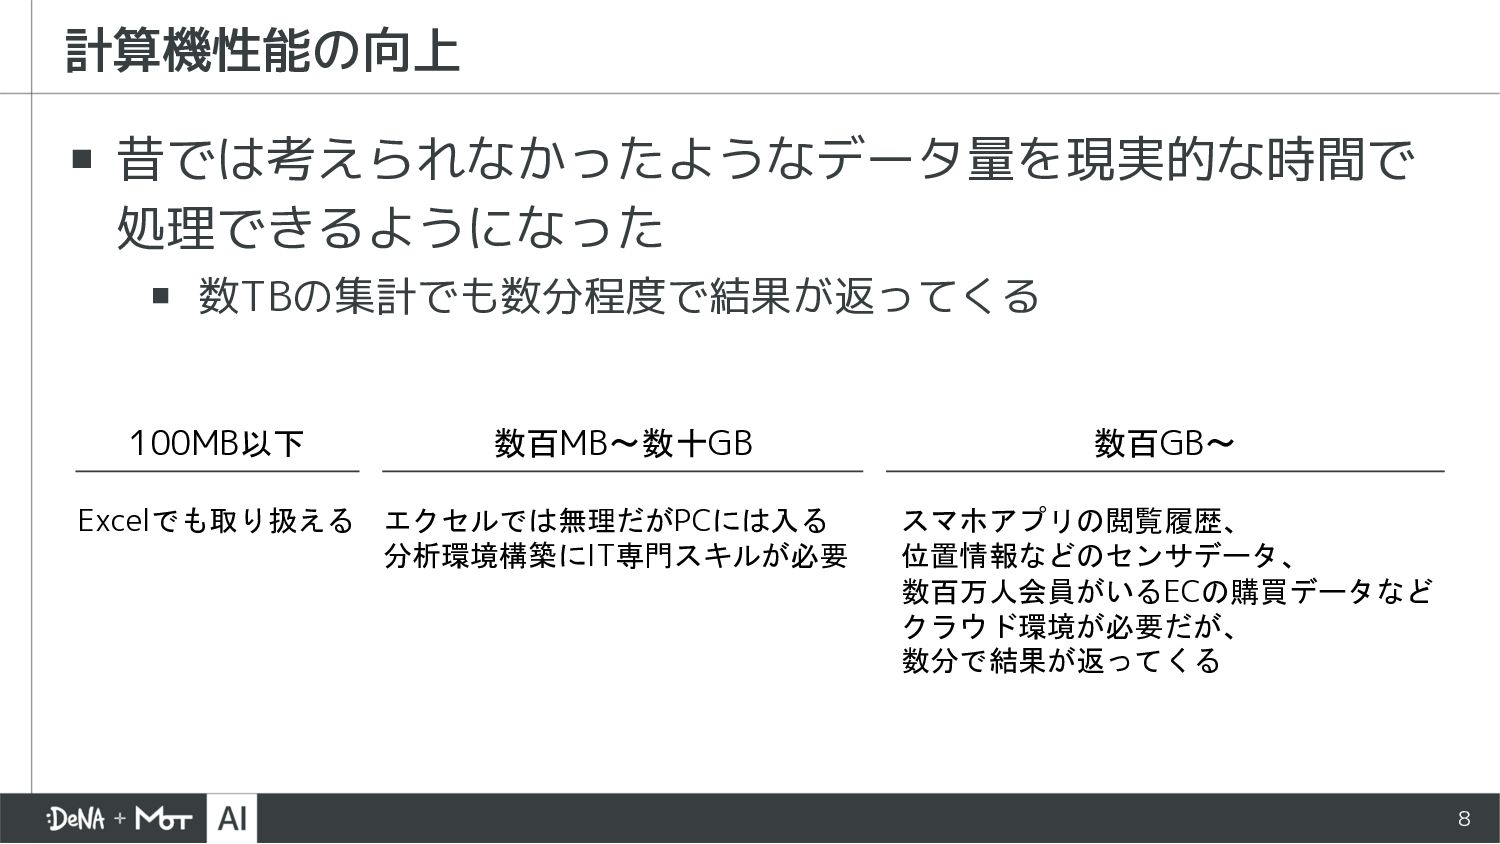
8 ▪ 昔では考えられなかったようなデータ量を現実的な時間で 処理できるようになった ▪ 数TBの集計でも数分程度で結果が返ってくる 計算機性能の向上 100MB以下 Excelでも取り扱える 数百MB〜数十GB
エクセルでは無理だがPCには入る 分析環境構築にIT専門スキルが必要 数百GB〜 スマホアプリの閲覧履歴、 位置情報などのセンサデータ、 数百万人会員がいるECの購買データなど クラウド環境が必要だが、 数分で結果が返ってくる -
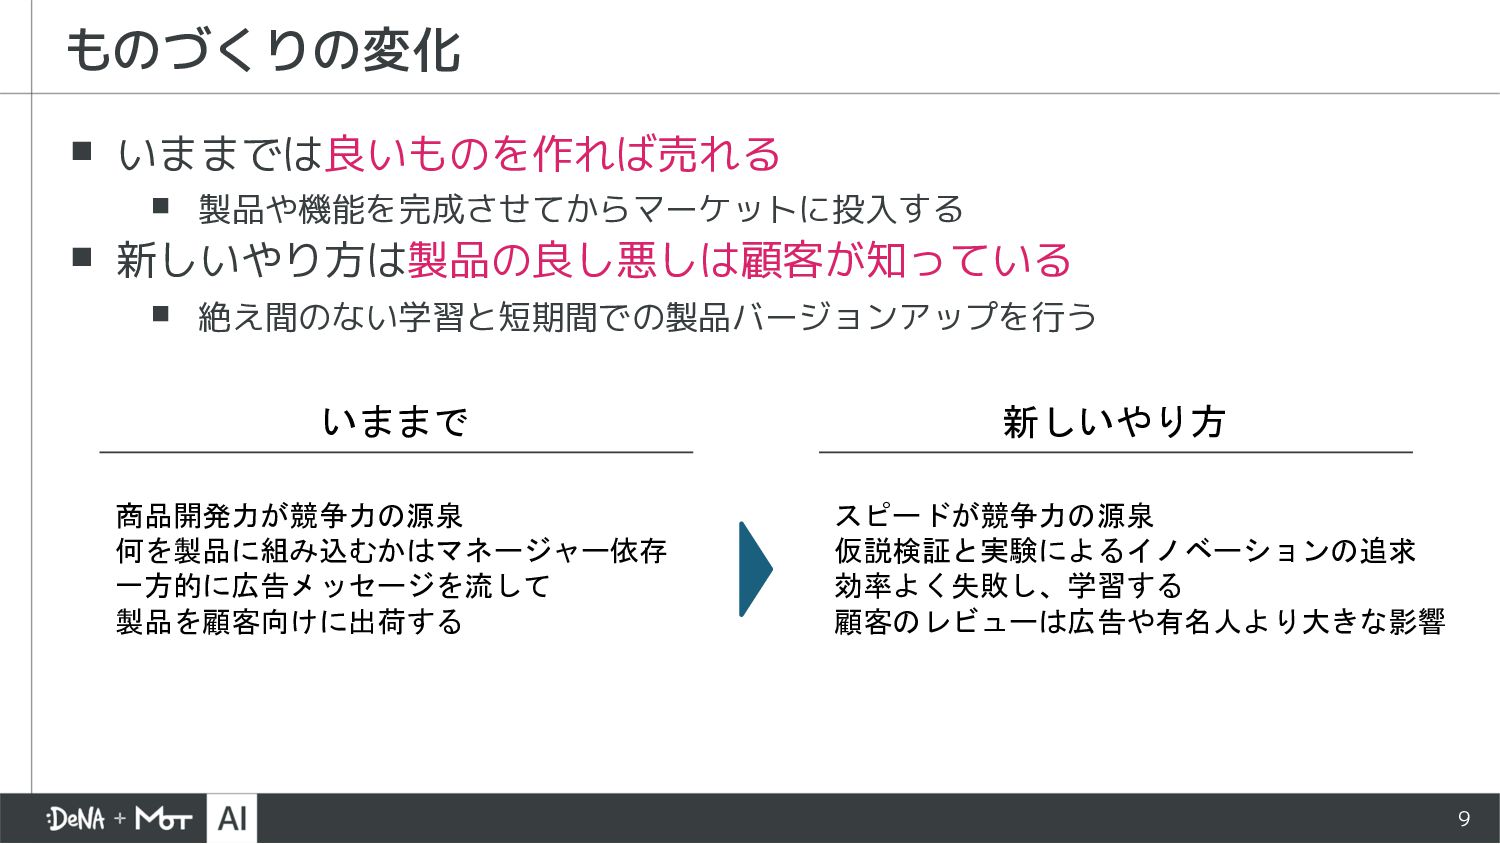
9 ▪ いままでは良いものを作れば売れる ▪ 製品や機能を完成させてからマーケットに投入する ▪ 新しいやり方は製品の良し悪しは顧客が知っている ▪ 絶え間のない学習と短期間での製品バージョンアップを行う ものづくりの変化
商品開発力が競争力の源泉 何を製品に組み込むかはマネージャー依存 一方的に広告メッセージを流して 製品を顧客向けに出荷する スピードが競争力の源泉 仮説検証と実験によるイノベーションの追求 効率よく失敗し、学習する 顧客のレビューは広告や有名人より大きな影響 いままで 新しいやり方 -
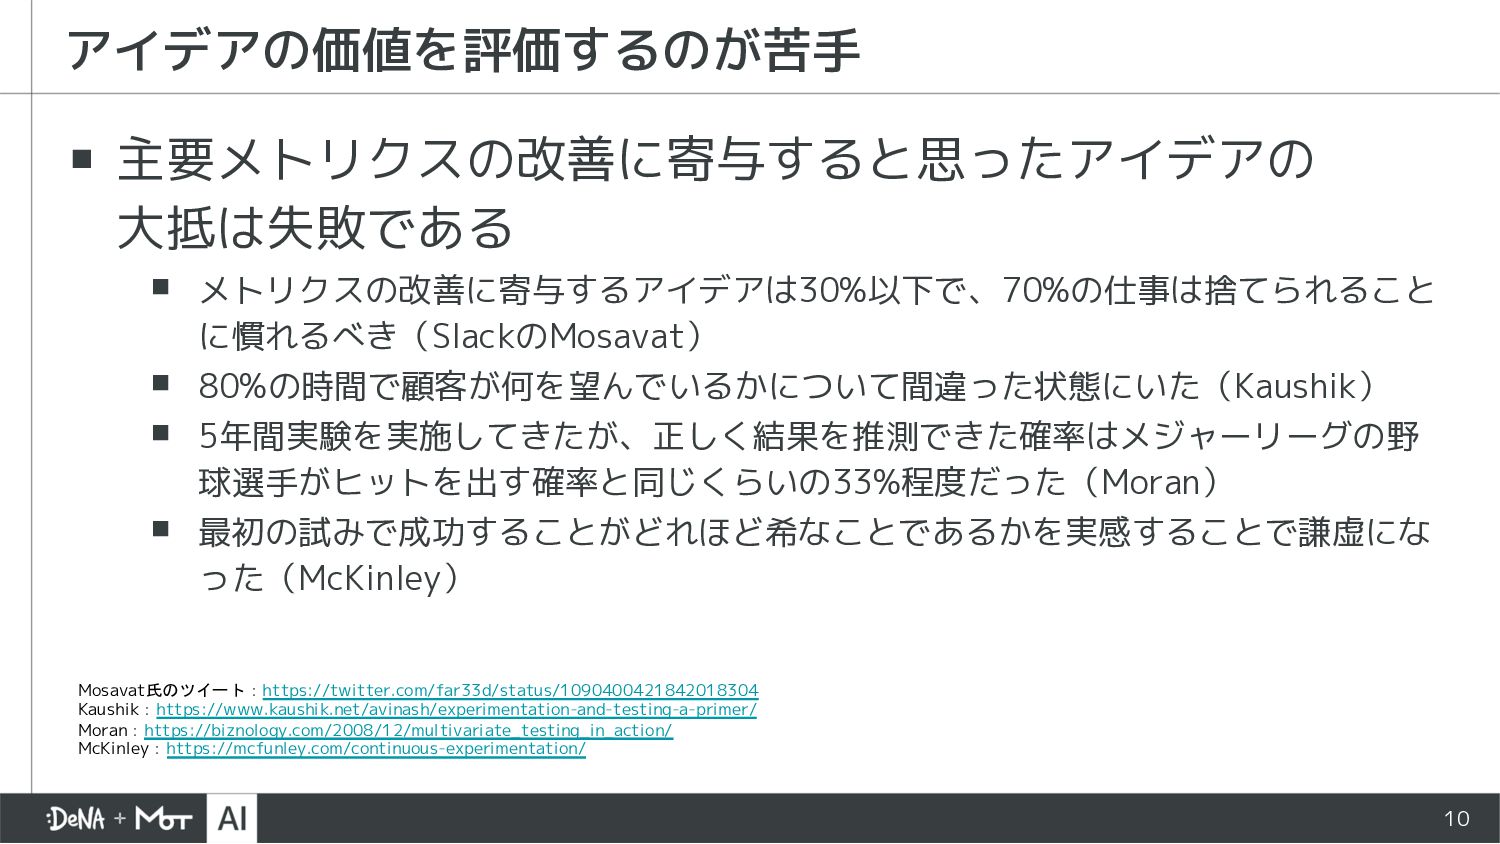
10 ▪ 主要メトリクスの改善に寄与すると思ったアイデアの 大抵は失敗である ▪ メトリクスの改善に寄与するアイデアは30%以下で、70%の仕事は捨てられること に慣れるべき(SlackのMosavat) ▪ 80%の時間で顧客が何を望んでいるかについて間違った状態にいた(Kaushik) ▪
5年間実験を実施してきたが、正しく結果を推測できた確率はメジャーリーグの野 球選手がヒットを出す確率と同じくらいの33%程度だった(Moran) ▪ 最初の試みで成功することがどれほど希なことであるかを実感することで謙虚にな った(McKinley) アイデアの価値を評価するのが苦手 Mosavat氏のツイート:https://twitter.com/far33d/status/1090400421842018304 Kaushik:https://www.kaushik.net/avinash/experimentation-and-testing-a-primer/ Moran:https://biznology.com/2008/12/multivariate_testing_in_action/ McKinley:https://mcfunley.com/continuous-experimentation/ -
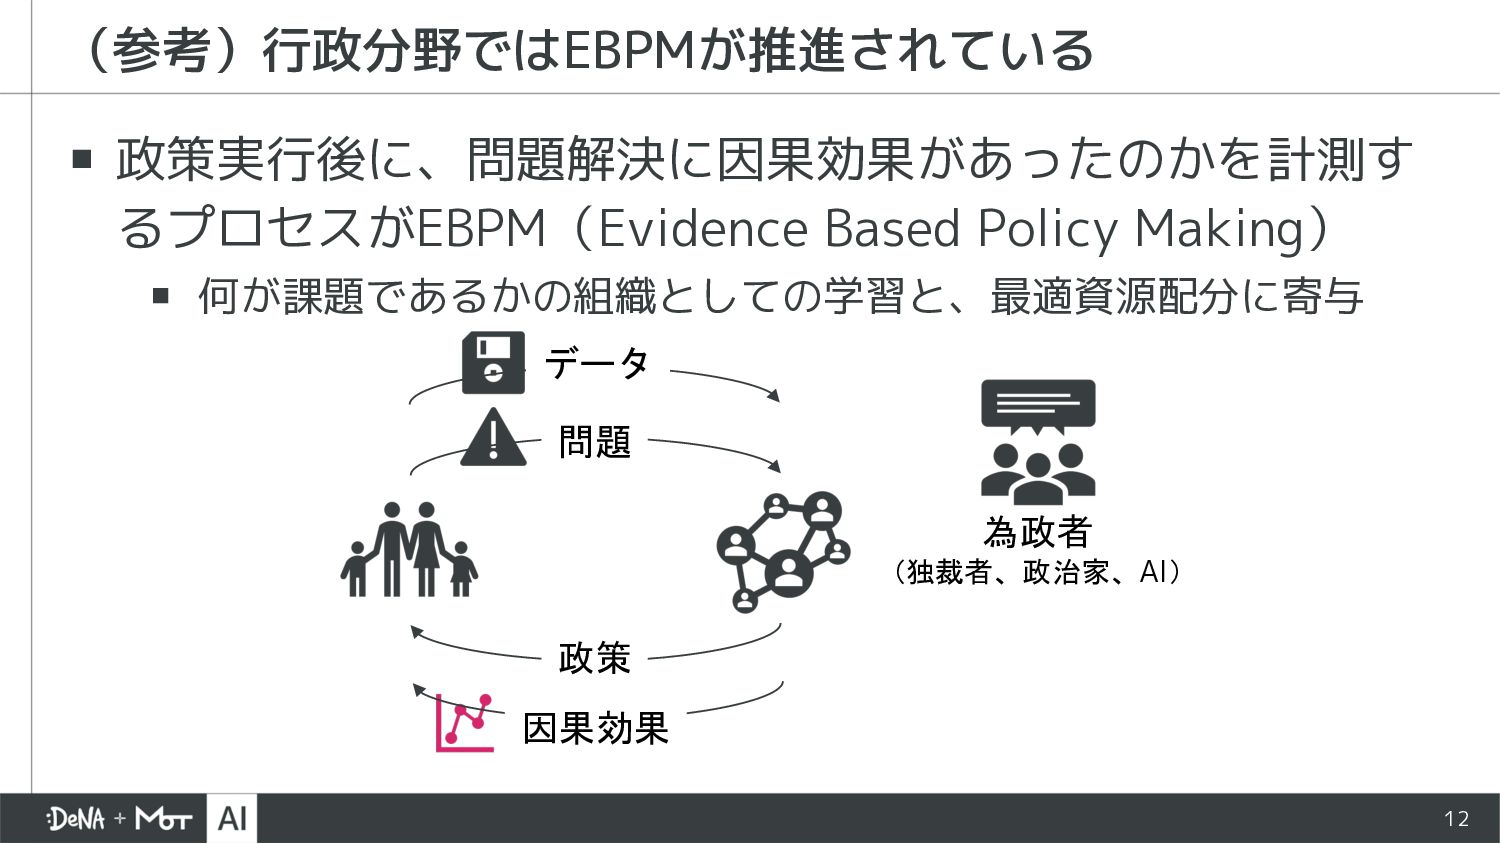
12 ▪ 政策実行後に、問題解決に因果効果があったのかを計測す るプロセスがEBPM(Evidence Based Policy Making) ▪ 何が課題であるかの組織としての学習と、最適資源配分に寄与 (参考)行政分野ではEBPMが推進されている
問題 政策 為政者 (独裁者、政治家、AI) データ 因果効果 -
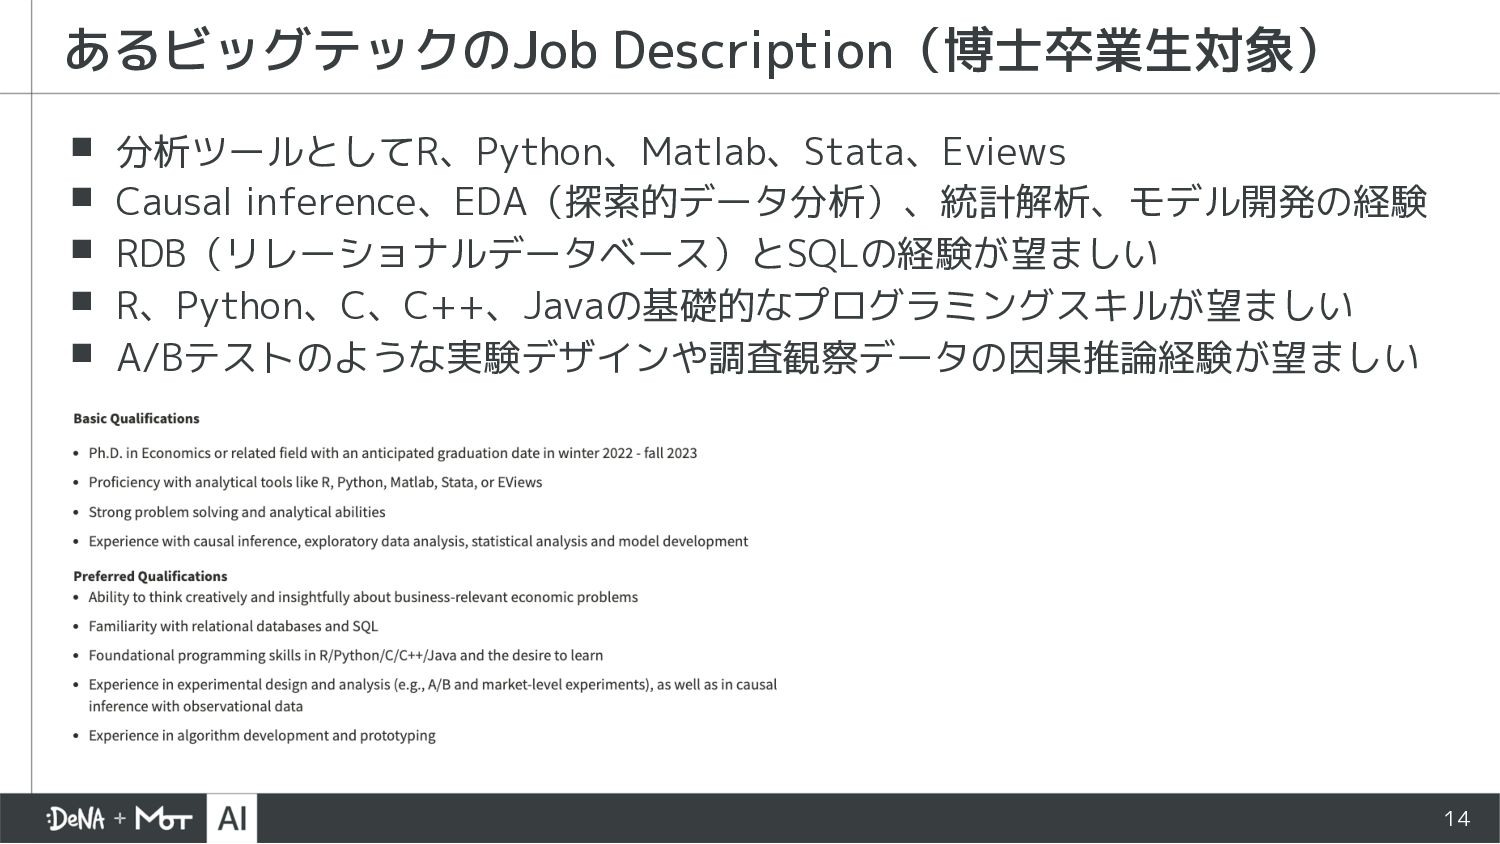
14 ▪ 分析ツールとしてR、Python、Matlab、Stata、Eviews ▪ Causal inference、EDA(探索的データ分析)、統計解析、モデル開発の経験 ▪ RDB(リレーショナルデータベース)とSQLの経験が望ましい ▪ R、Python、C、C++、Javaの基礎的なプログラミングスキルが望ましい
▪ A/Bテストのような実験デザインや調査観察データの因果推論経験が望ましい あるビッグテックのJob Description(博士卒業生対象) -
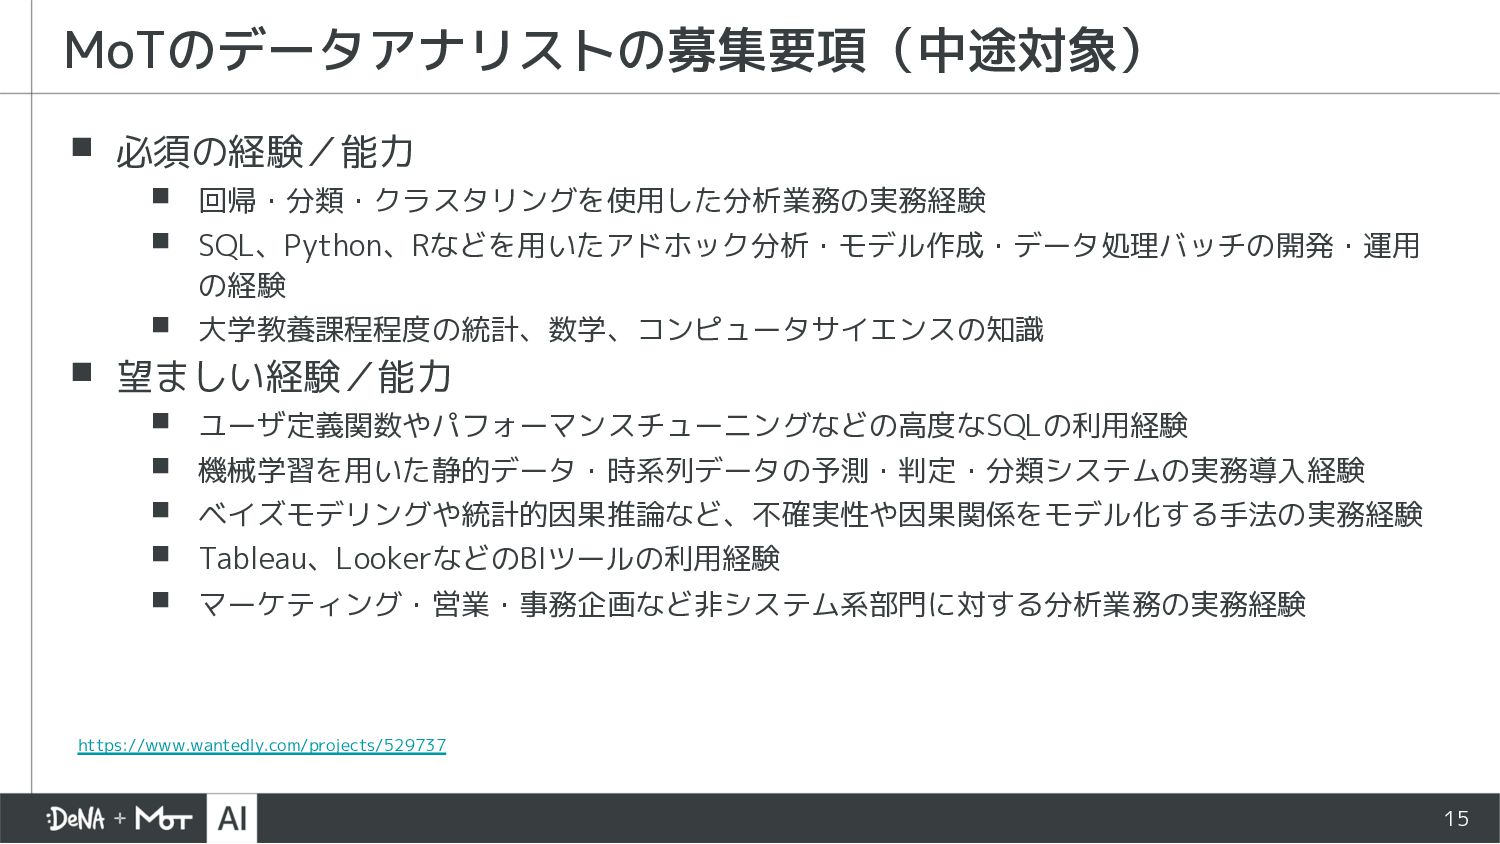
15 ▪ 必須の経験/能力 ▪ 回帰・分類・クラスタリングを使用した分析業務の実務経験 ▪ SQL、Python、Rなどを用いたアドホック分析・モデル作成・データ処理バッチの開発・運用 の経験 ▪ 大学教養課程程度の統計、数学、コンピュータサイエンスの知識
▪ 望ましい経験/能力 ▪ ユーザ定義関数やパフォーマンスチューニングなどの高度なSQLの利用経験 ▪ 機械学習を用いた静的データ・時系列データの予測・判定・分類システムの実務導入経験 ▪ ベイズモデリングや統計的因果推論など、不確実性や因果関係をモデル化する手法の実務経験 ▪ Tableau、LookerなどのBIツールの利用経験 ▪ マーケティング・営業・事務企画など非システム系部門に対する分析業務の実務経験 MoTのデータアナリストの募集要項(中途対象) https://www.wantedly.com/projects/529737 -
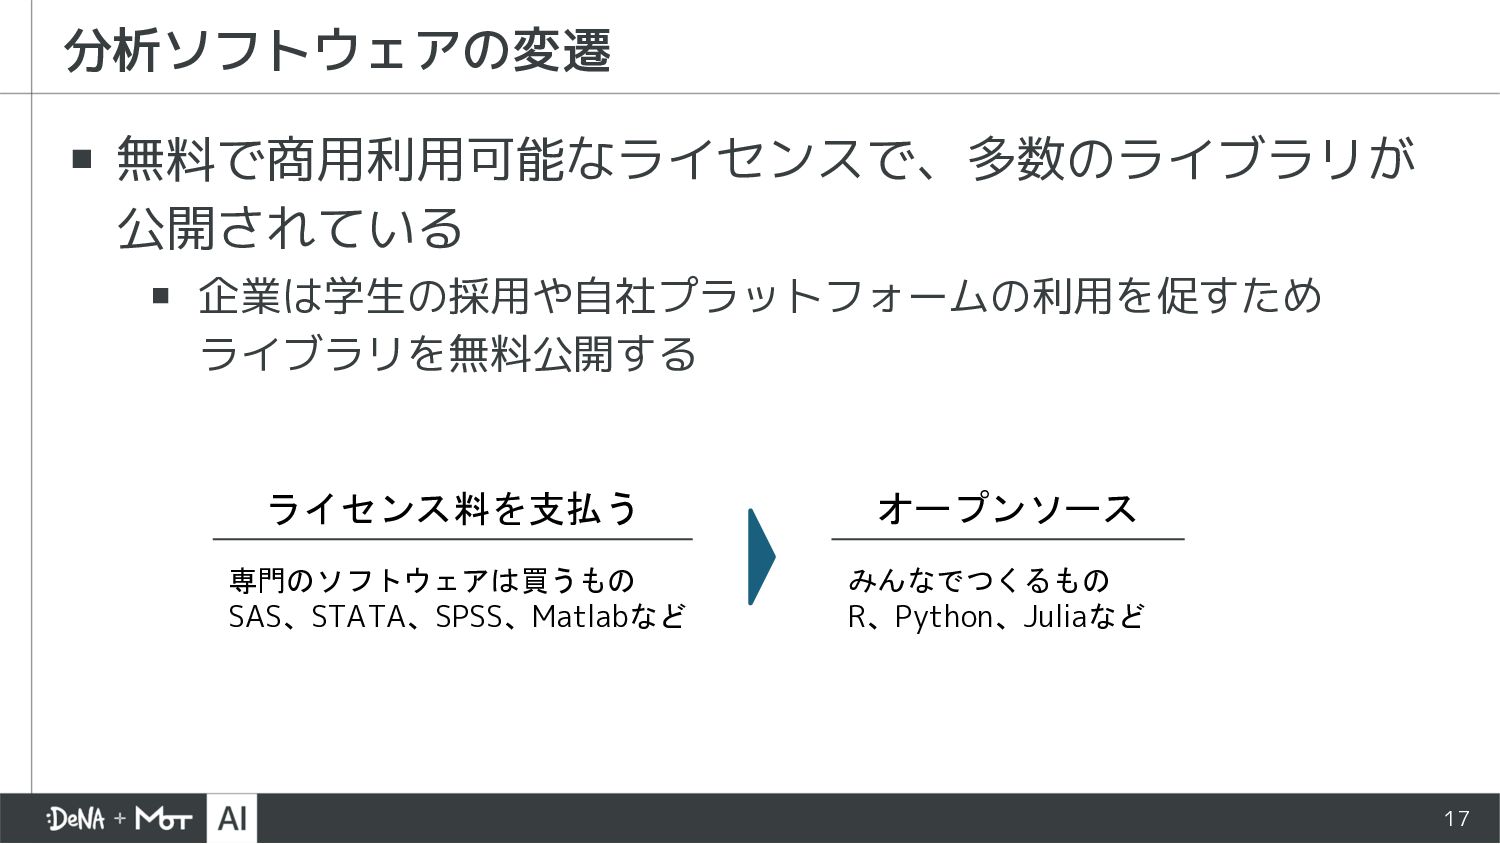
17 ▪ 無料で商用利用可能なライセンスで、多数のライブラリが 公開されている ▪ 企業は学生の採用や自社プラットフォームの利用を促すため ライブラリを無料公開する 分析ソフトウェアの変遷 ライセンス料を支払う オープンソース
専門のソフトウェアは買うもの SAS、STATA、SPSS、Matlabなど みんなでつくるもの R、Python、Juliaなど -
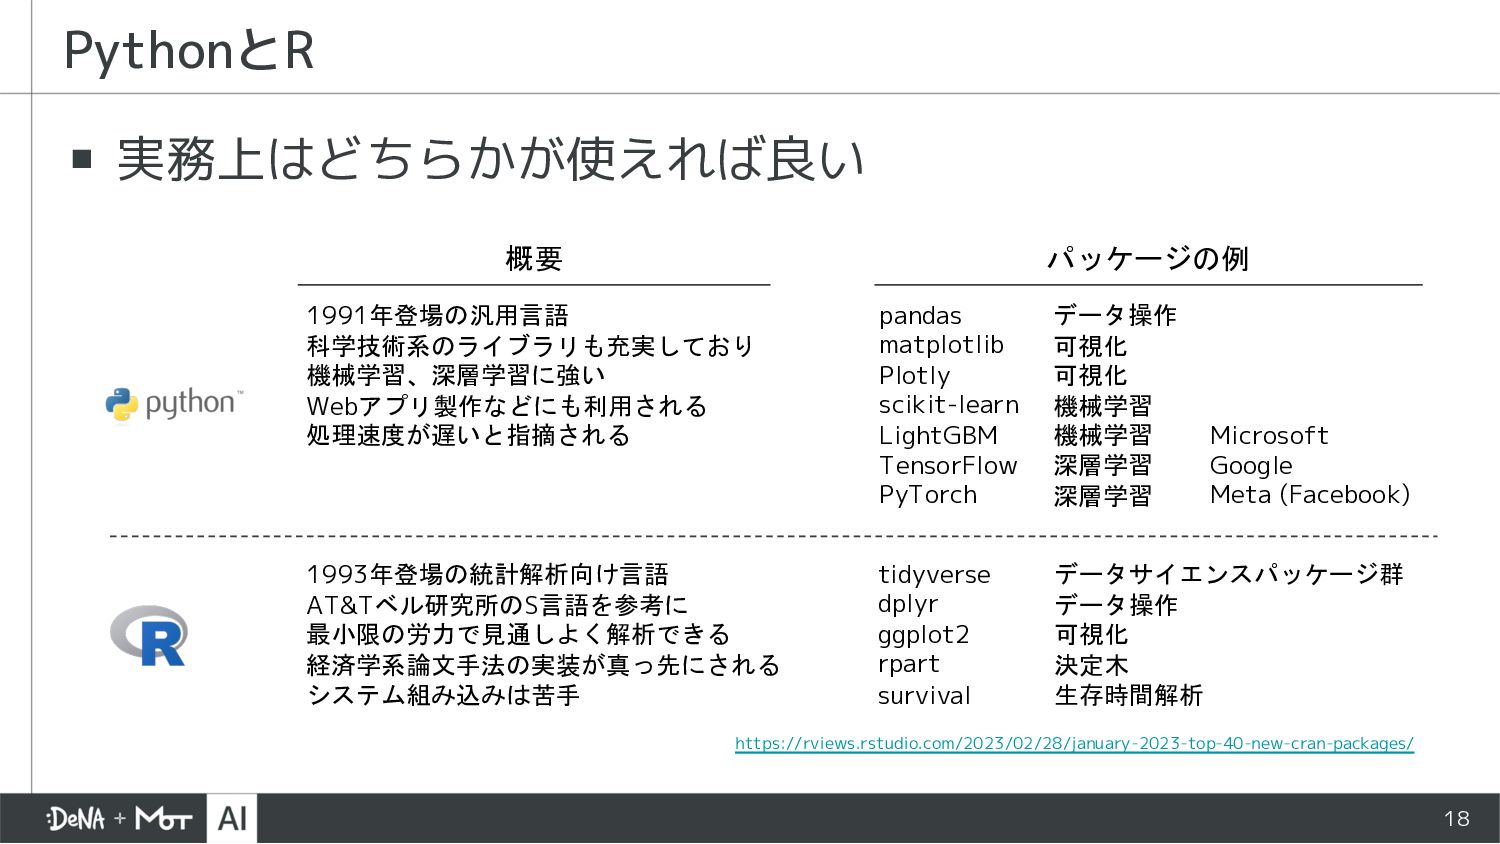
18 ▪ 実務上はどちらかが使えれば良い PythonとR 1991年登場の汎用言語 科学技術系のライブラリも充実しており 機械学習、深層学習に強い Webアプリ製作などにも利用される 処理速度が遅いと指摘される 1993年登場の統計解析向け言語
AT&Tベル研究所のS言語を参考に 最小限の労力で見通しよく解析できる 経済学系論文手法の実装が真っ先にされる システム組み込みは苦手 pandas matplotlib Plotly scikit-learn LightGBM TensorFlow PyTorch データ操作 可視化 可視化 機械学習 機械学習 深層学習 深層学習 Microsoft Google Meta (Facebook) tidyverse dplyr ggplot2 rpart survival https://rviews.rstudio.com/2023/02/28/january-2023-top-40-new-cran-packages/ データサイエンスパッケージ群 データ操作 可視化 決定木 生存時間解析 概要 パッケージの例 -
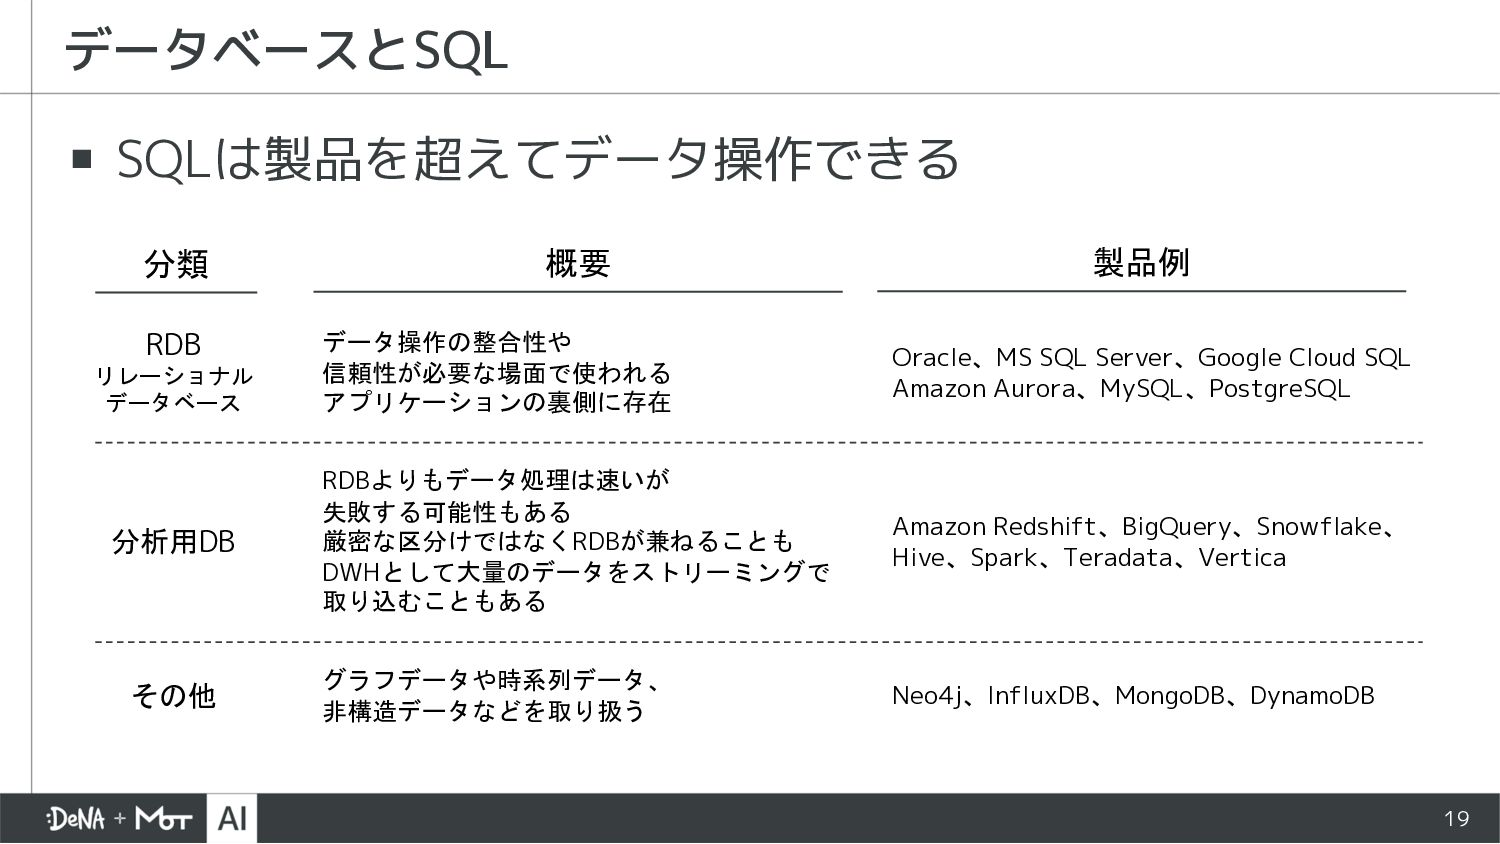
19 ▪ SQLは製品を超えてデータ操作できる データベースとSQL RDB リレーショナル データベース 分析用DB データ操作の整合性や 信頼性が必要な場面で使われる
アプリケーションの裏側に存在 RDBよりもデータ処理は速いが 失敗する可能性もある 厳密な区分けではなくRDBが兼ねることも DWHとして大量のデータをストリーミングで 取り込むこともある その他 グラフデータや時系列データ、 非構造データなどを取り扱う Oracle、MS SQL Server、Google Cloud SQL Amazon Aurora、MySQL、PostgreSQL Amazon Redshift、BigQuery、Snowflake、 Hive、Spark、Teradata、Vertica Neo4j、InfluxDB、MongoDB、DynamoDB 分類 概要 製品例 -
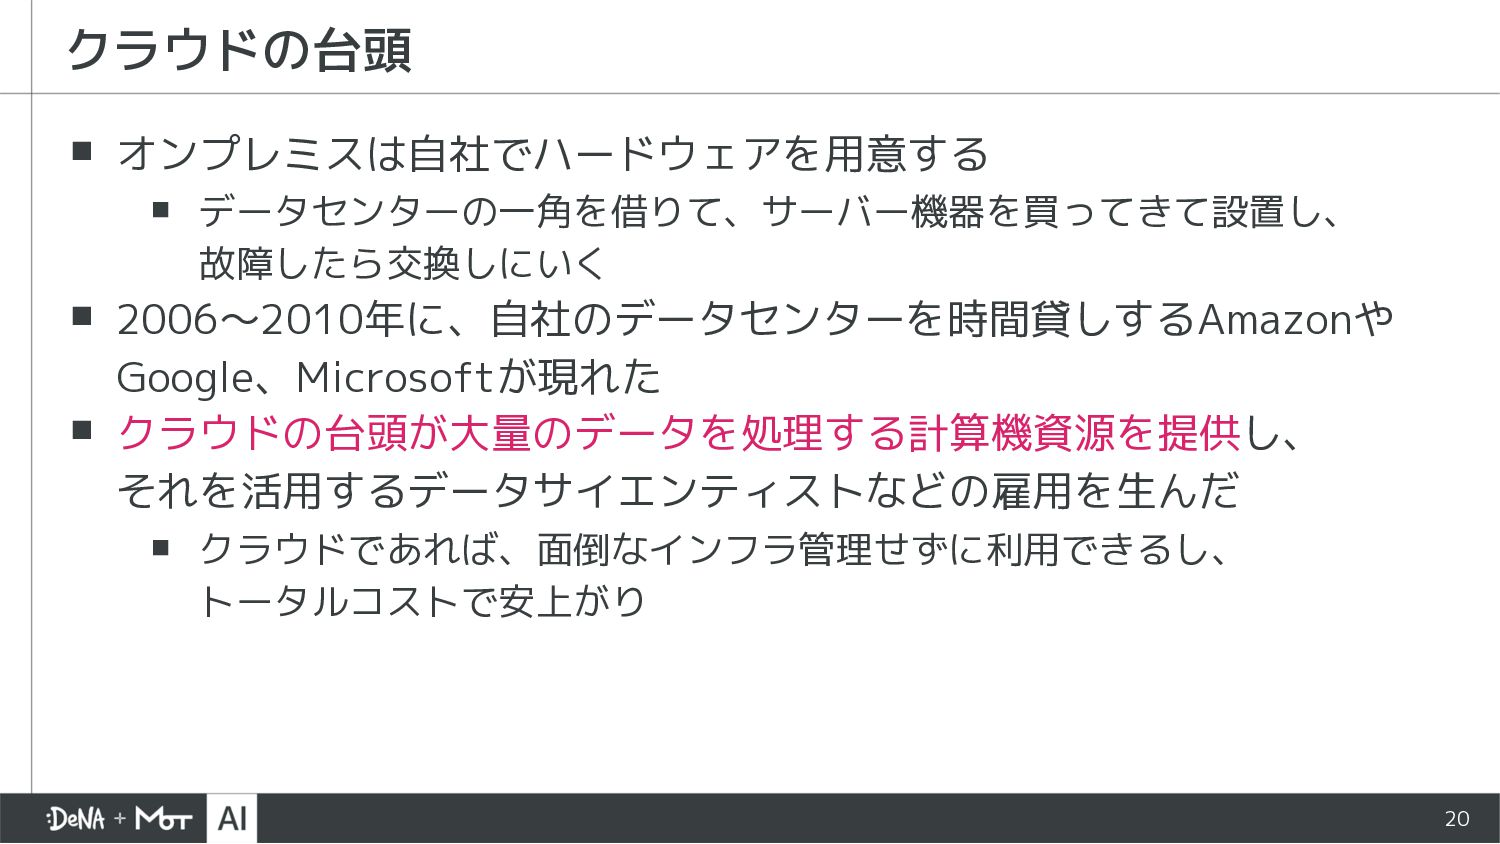
20 ▪ オンプレミスは自社でハードウェアを用意する ▪ データセンターの一角を借りて、サーバー機器を買ってきて設置し、 故障したら交換しにいく ▪ 2006〜2010年に、自社のデータセンターを時間貸しするAmazonや Google、Microsoftが現れた ▪
クラウドの台頭が大量のデータを処理する計算機資源を提供し、 それを活用するデータサイエンティストなどの雇用を生んだ ▪ クラウドであれば、面倒なインフラ管理せずに利用できるし、 トータルコストで安上がり クラウドの台頭 -
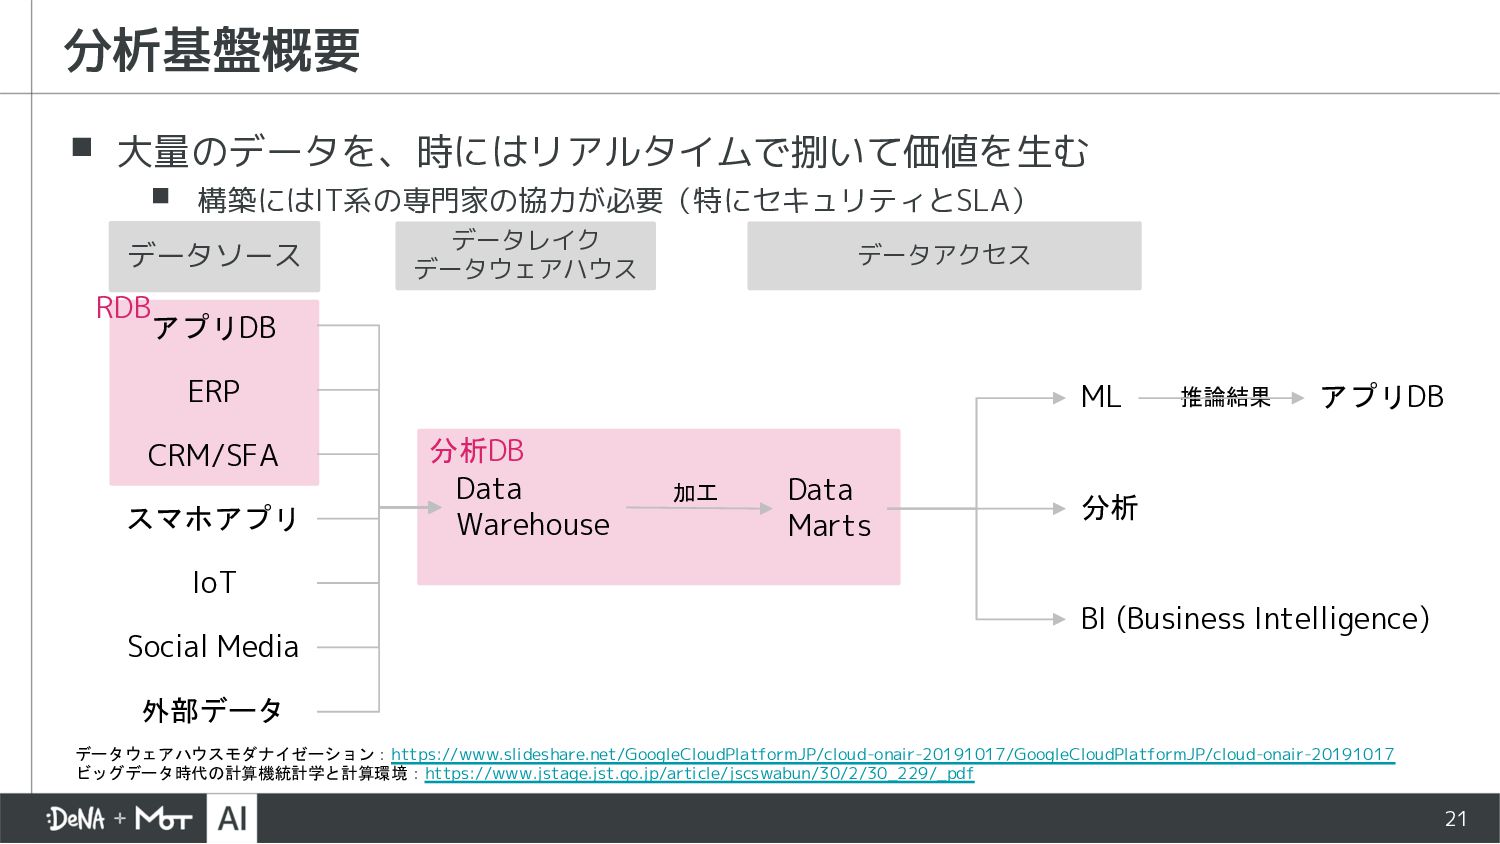
21 ▪ 大量のデータを、時にはリアルタイムで捌いて価値を生む ▪ 構築にはIT系の専門家の協力が必要(特にセキュリティとSLA) 分析基盤概要 ERP Social Media アプリDB
スマホアプリ IoT 外部データ Data Warehouse Data Marts BI (Business Intelligence) 分析 ML 推論結果 データソース データレイク データウェアハウス CRM/SFA データアクセス アプリDB 分析DB RDB データウェアハウスモダナイゼーション:https://www.slideshare.net/GoogleCloudPlatformJP/cloud-onair-20191017/GoogleCloudPlatformJP/cloud-onair-20191017 ビッグデータ時代の計算機統計学と計算環境:https://www.jstage.jst.go.jp/article/jscswabun/30/2/30_229/_pdf 加工 -
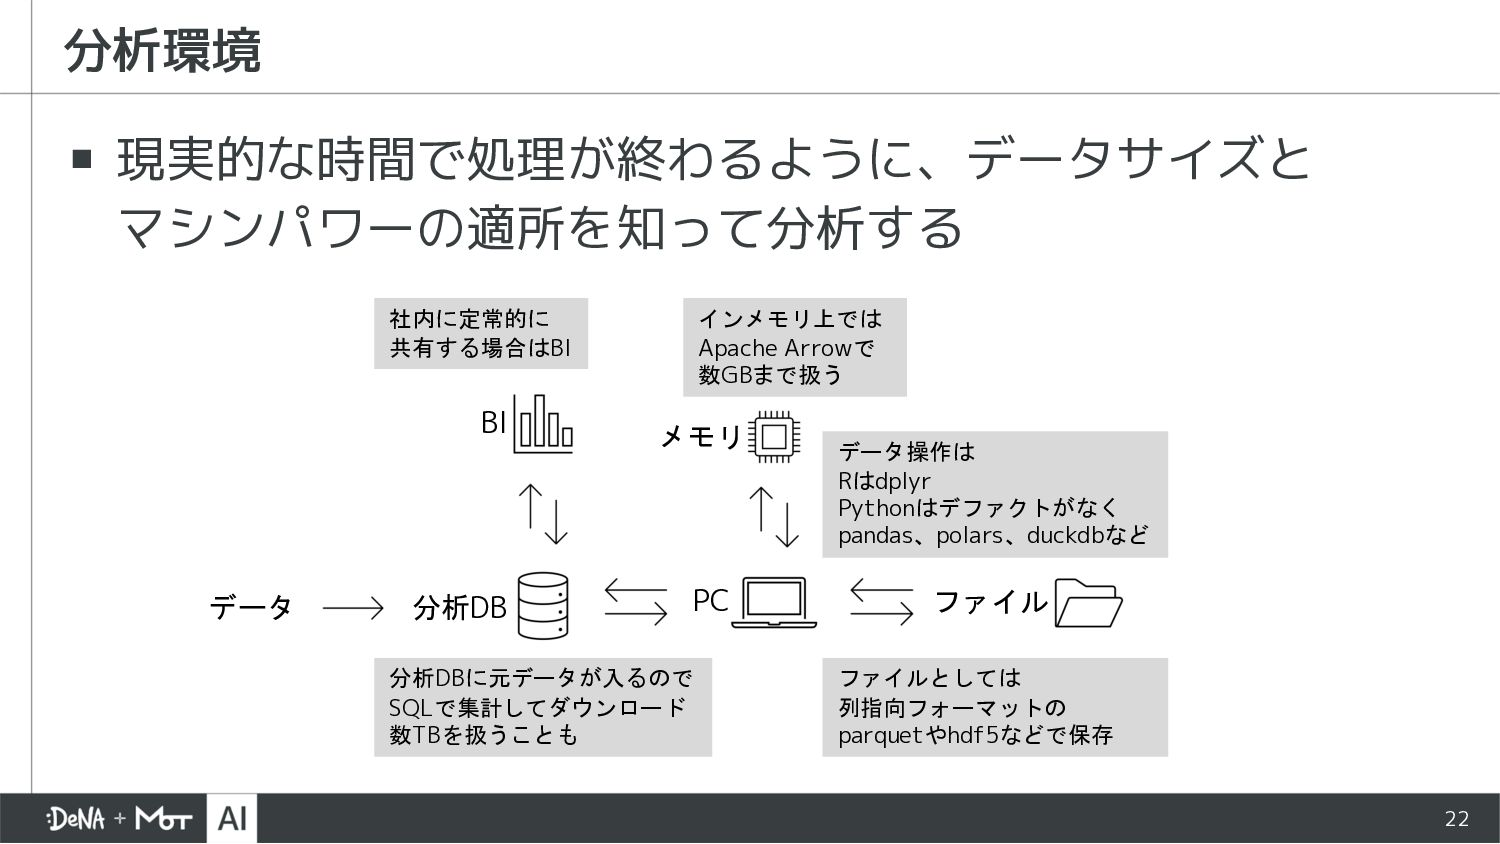
22 ▪ 現実的な時間で処理が終わるように、データサイズと マシンパワーの適所を知って分析する 分析環境 ファイルとしては 列指向フォーマットの parquetやhdf5などで保存 インメモリ上では Apache
Arrowで 数GBまで扱う データ操作は Rはdplyr Pythonはデファクトがなく pandas、polars、duckdbなど 分析DBに元データが入るので SQLで集計してダウンロード 数TBを扱うことも BI 分析DB PC メモリ ファイル 社内に定常的に 共有する場合はBI データ -
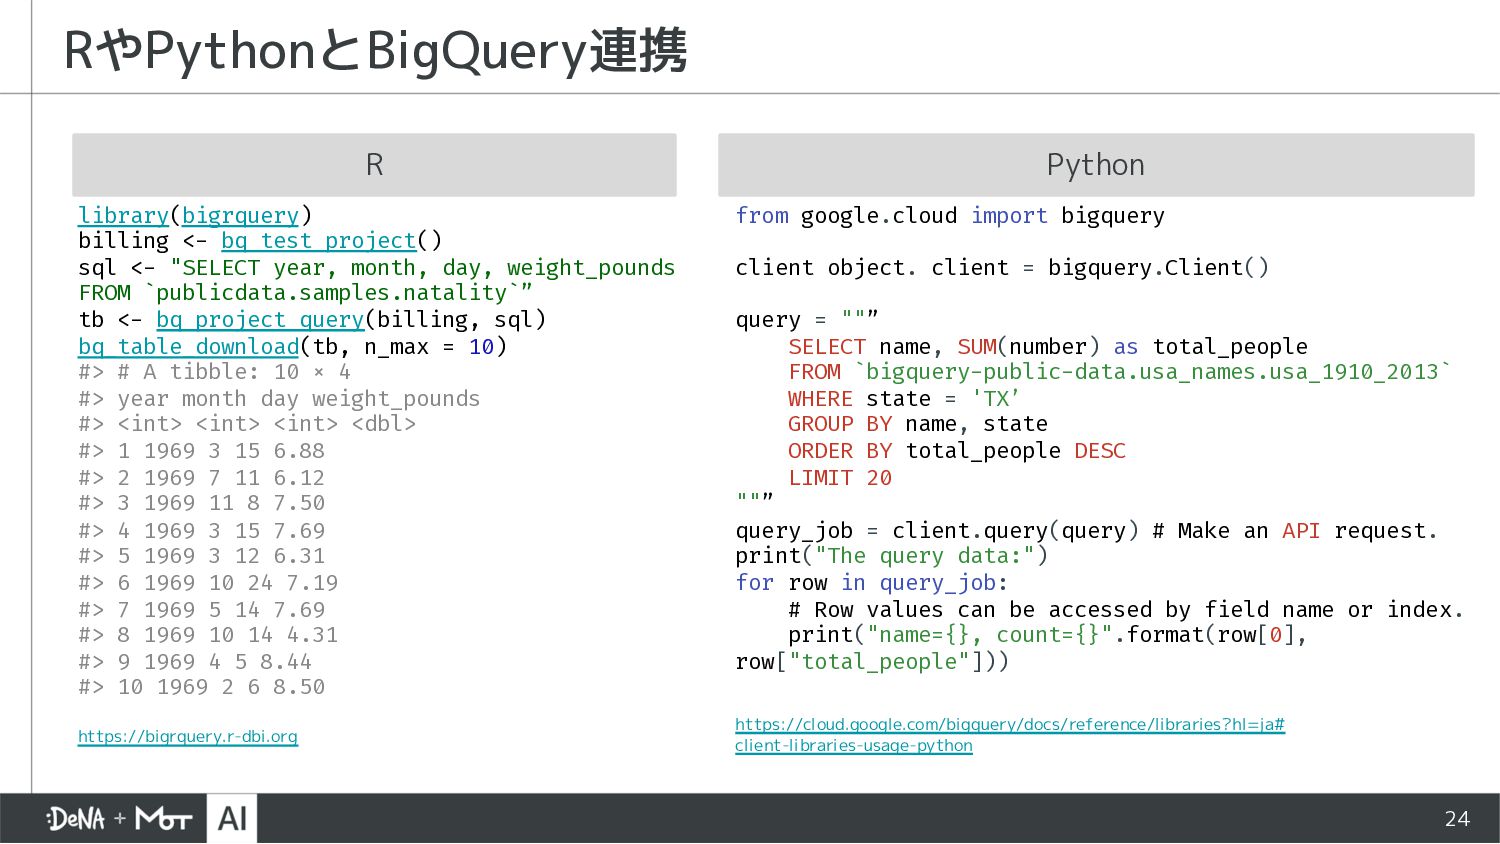
24 RやPythonとBigQuery連携 https://bigrquery.r-dbi.org library(bigrquery) billing <- bq_test_project() sql <- "SELECT
year, month, day, weight_pounds FROM `publicdata.samples.natality`” tb <- bq_project_query(billing, sql) bq_table_download(tb, n_max = 10) #> # A tibble: 10 × 4 #> year month day weight_pounds #> <int> <int> <int> <dbl> #> 1 1969 3 15 6.88 #> 2 1969 7 11 6.12 #> 3 1969 11 8 7.50 #> 4 1969 3 15 7.69 #> 5 1969 3 12 6.31 #> 6 1969 10 24 7.19 #> 7 1969 5 14 7.69 #> 8 1969 10 14 4.31 #> 9 1969 4 5 8.44 #> 10 1969 2 6 8.50 from google.cloud import bigquery client object. client = bigquery.Client() query = ""” SELECT name, SUM(number) as total_people FROM `bigquery-public-data.usa_names.usa_1910_2013` WHERE state = 'TX’ GROUP BY name, state ORDER BY total_people DESC LIMIT 20 ""” query_job = client.query(query) # Make an API request. print("The query data:") for row in query_job: # Row values can be accessed by field name or index. print("name={}, count={}".format(row[0], row["total_people"])) https://cloud.google.com/bigquery/docs/reference/libraries?hl=ja# client-libraries-usage-python R Python -
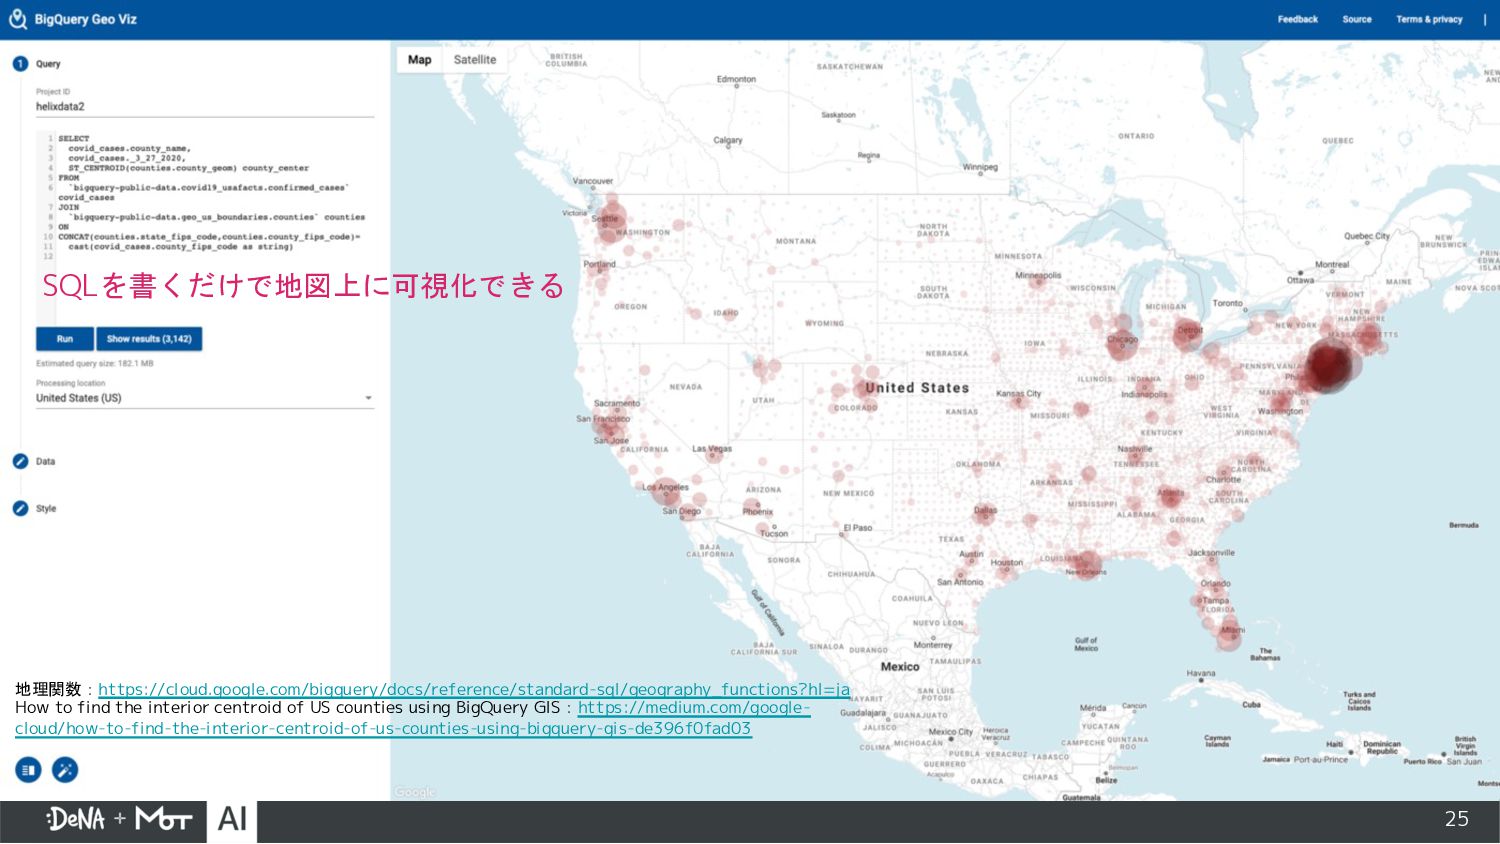
25 地理関数:https://cloud.google.com/bigquery/docs/reference/standard-sql/geography_functions?hl=ja How to find the interior centroid of US
counties using BigQuery GIS:https://medium.com/google- cloud/how-to-find-the-interior-centroid-of-us-counties-using-bigquery-gis-de396f0fad03 SQLを書くだけで地図上に可視化できる -
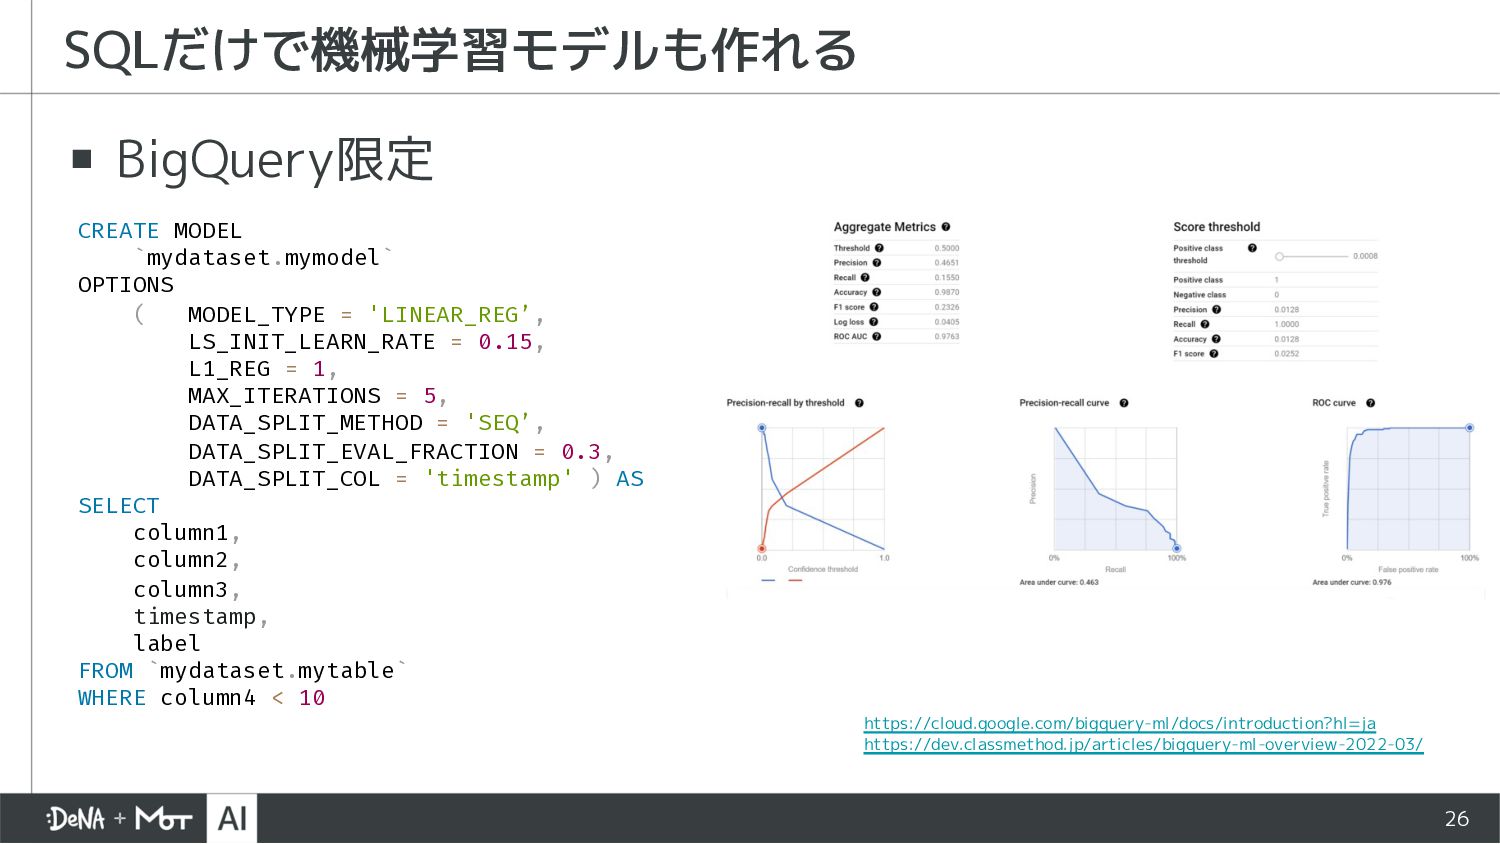
26 ▪ BigQuery限定 SQLだけで機械学習モデルも作れる CREATE MODEL `mydataset.mymodel` OPTIONS ( MODEL_TYPE
= 'LINEAR_REG’, LS_INIT_LEARN_RATE = 0.15, L1_REG = 1, MAX_ITERATIONS = 5, DATA_SPLIT_METHOD = 'SEQ’, DATA_SPLIT_EVAL_FRACTION = 0.3, DATA_SPLIT_COL = 'timestamp' ) AS SELECT column1, column2, column3, timestamp, label FROM `mydataset.mytable` WHERE column4 < 10 https://cloud.google.com/bigquery-ml/docs/introduction?hl=ja https://dev.classmethod.jp/articles/bigquery-ml-overview-2022-03/ -
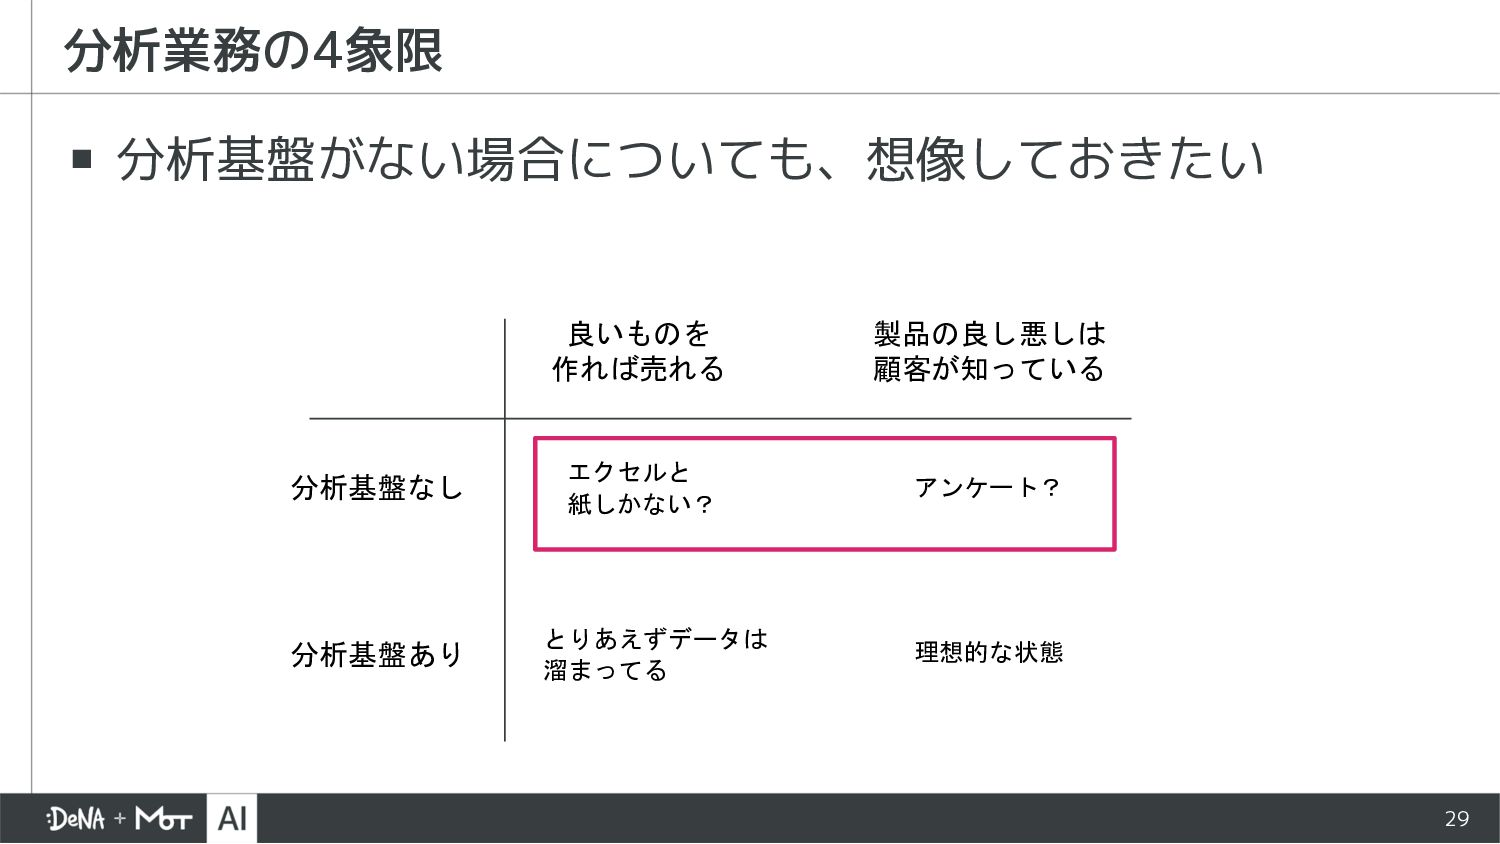
29 ▪ 分析基盤がない場合についても、想像しておきたい 分析業務の4象限 分析基盤なし 分析基盤あり 良いものを 作れば売れる 製品の良し悪しは 顧客が知っている
エクセルと 紙しかない? アンケート? とりあえずデータは 溜まってる 理想的な状態 -
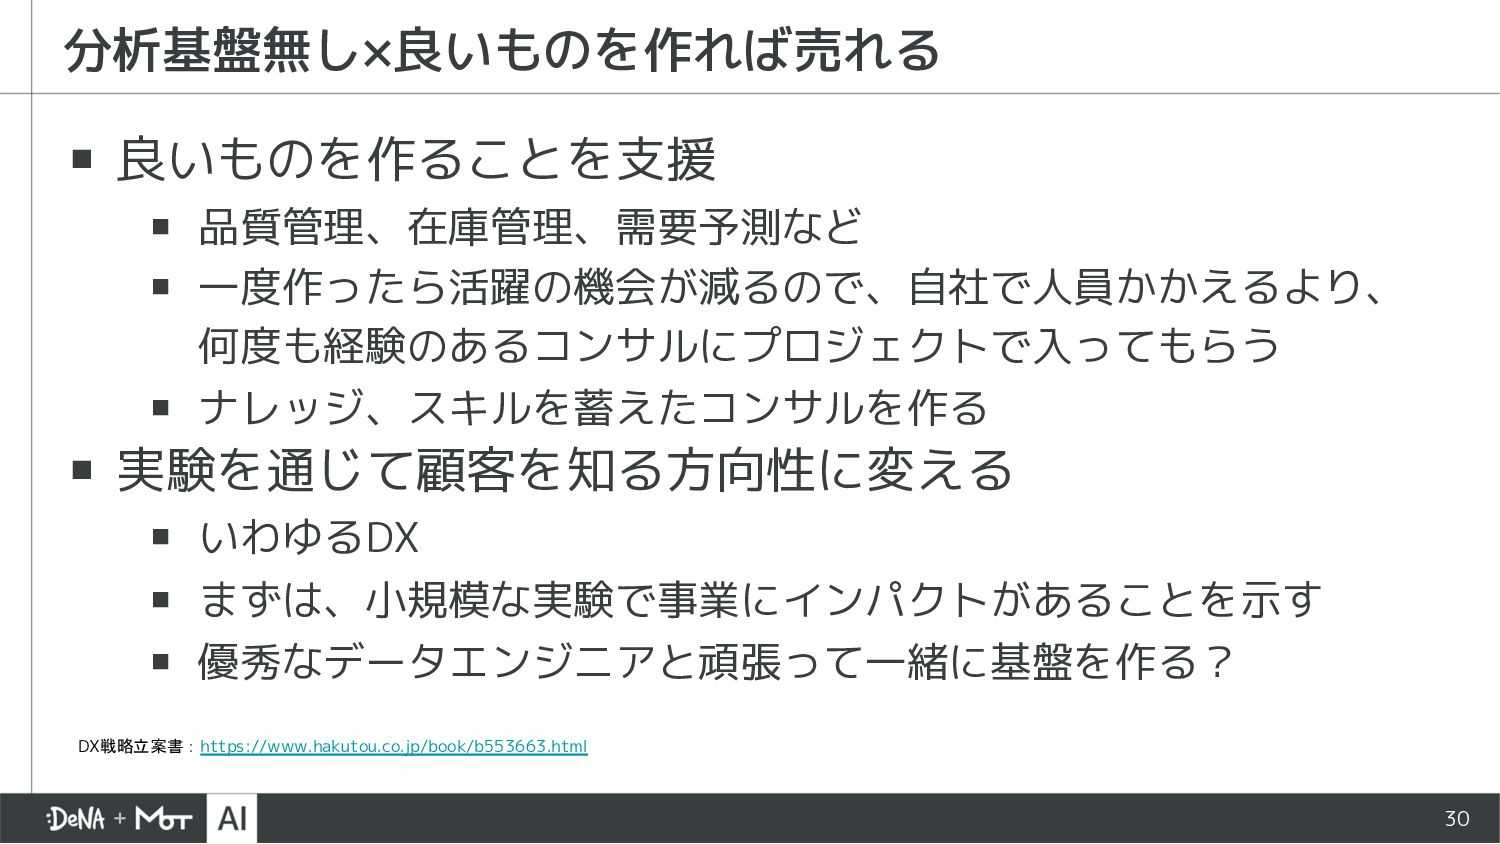
30 ▪ 良いものを作ることを支援 ▪ 品質管理、在庫管理、需要予測など ▪ 一度作ったら活躍の機会が減るので、自社で人員かかえるより、 何度も経験のあるコンサルにプロジェクトで入ってもらう ▪ ナレッジ、スキルを蓄えたコンサルを作る
▪ 実験を通じて顧客を知る方向性に変える ▪ いわゆるDX ▪ まずは、小規模な実験で事業にインパクトがあることを示す ▪ 優秀なデータエンジニアと頑張って一緒に基盤を作る? 分析基盤無し×良いものを作れば売れる DX戦略立案書:https://www.hakutou.co.jp/book/b553663.html -
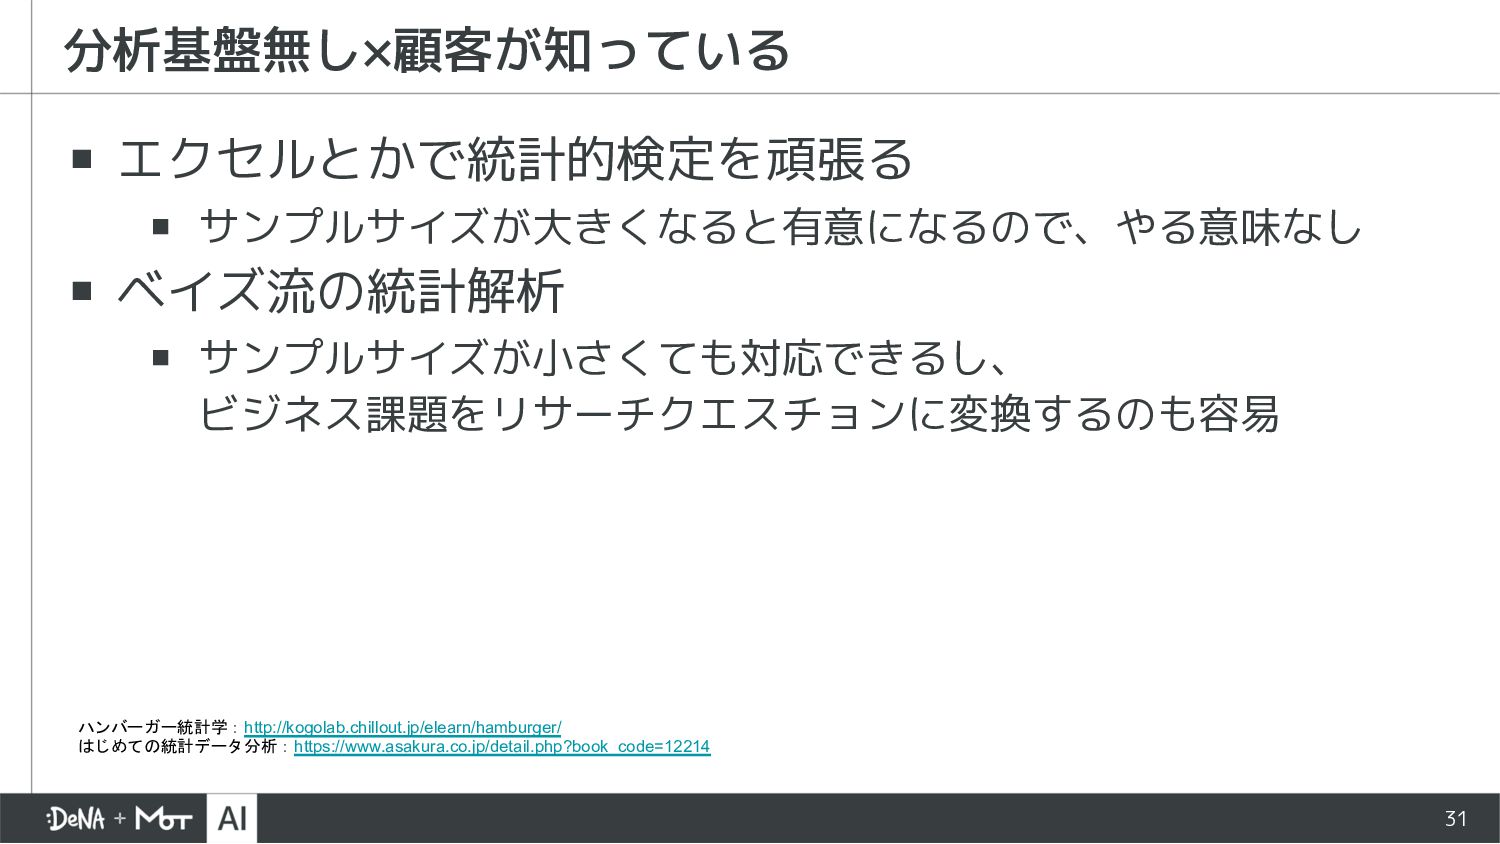
31 ▪ エクセルとかで統計的検定を頑張る ▪ サンプルサイズが大きくなると有意になるので、やる意味なし ▪ ベイズ流の統計解析 ▪ サンプルサイズが小さくても対応できるし、 ビジネス課題をリサーチクエスチョンに変換するのも容易
分析基盤無し×顧客が知っている ハンバーガー統計学:http://kogolab.chillout.jp/elearn/hamburger/ はじめての統計データ分析:https://www.asakura.co.jp/detail.php?book_code=12214 -
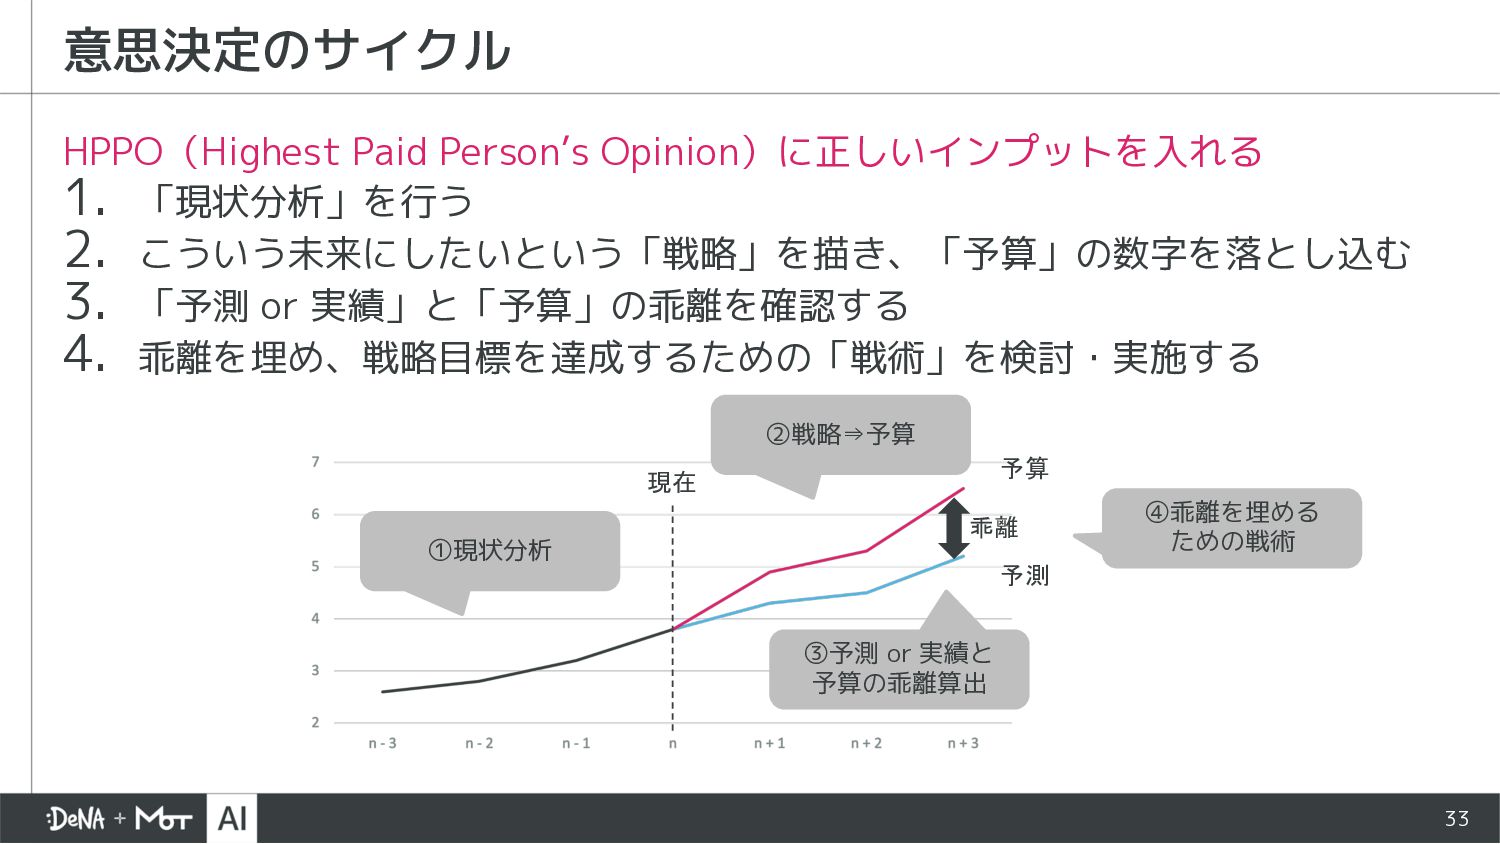
33 HPPO(Highest Paid Person’s Opinion)に正しいインプットを入れる 1. 「現状分析」を行う 2. こういう未来にしたいという「戦略」を描き、「予算」の数字を落とし込む 3.
「予測 or 実績」と「予算」の乖離を確認する 4. 乖離を埋め、戦略目標を達成するための「戦術」を検討・実施する 意思決定のサイクル ①現状分析 ②戦略⇒予算 ③予測 or 実績と 予算の乖離算出 ④乖離を埋める ための戦術 乖離 現在 予算 予測 -
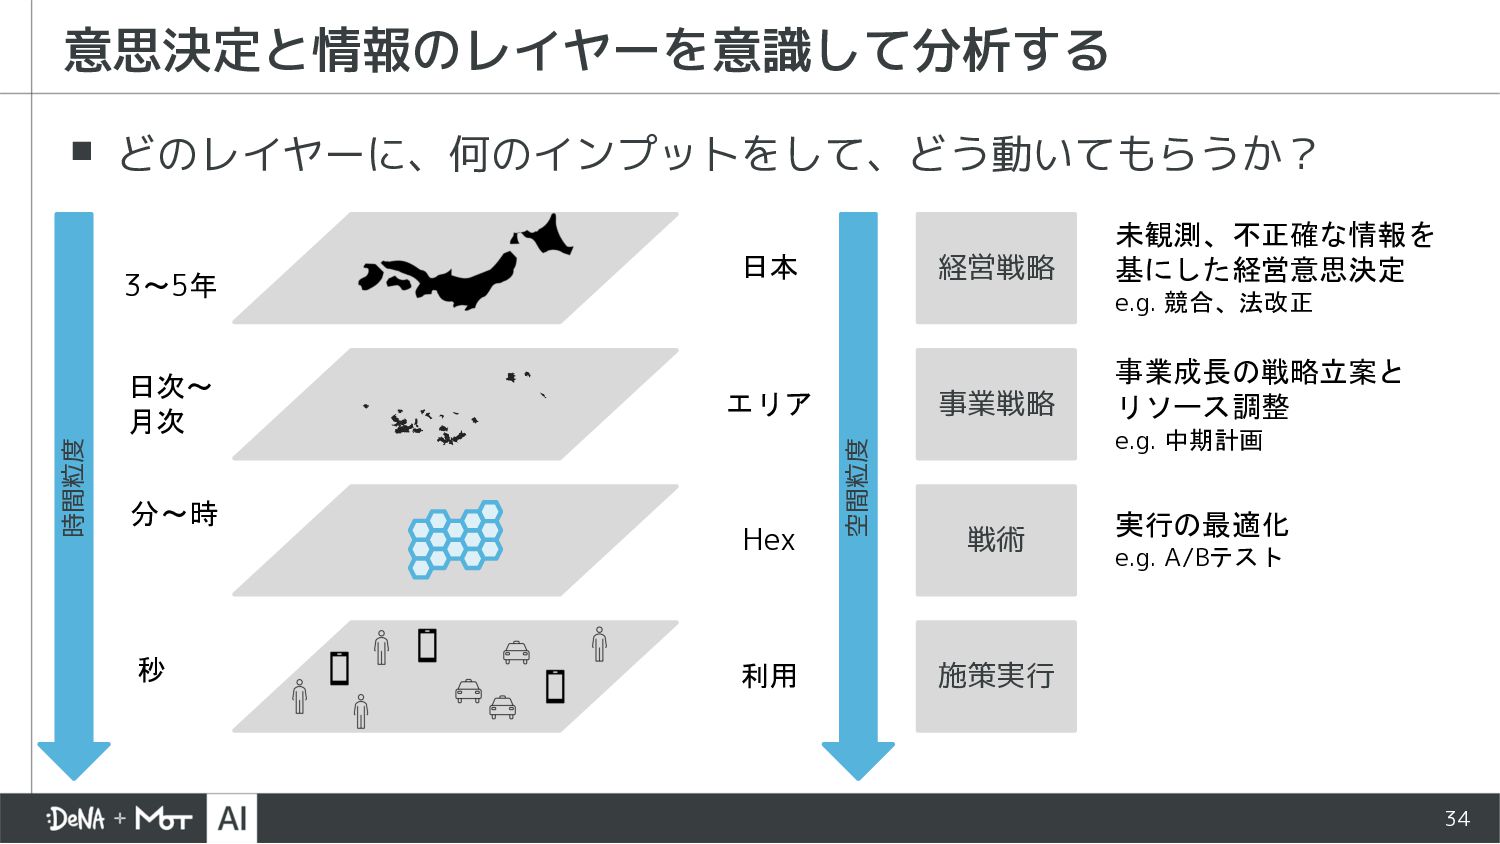
34 ▪ どのレイヤーに、何のインプットをして、どう動いてもらうか? 意思決定と情報のレイヤーを意識して分析する 時間粒度 3〜5年 日次〜 月次 分〜時 秒
空間粒度 経営戦略 未観測、不正確な情報を 基にした経営意思決定 e.g. 競合、法改正 事業成長の戦略立案と リソース調整 e.g. 中期計画 事業戦略 戦術 施策実行 実行の最適化 e.g. A/Bテスト 日本 エリア Hex 利用 -
35 ▪ 認知戦 ▪ 「タクシーに乗る」行為を「GO」から開始することが当たり前の認識を持たせる ▪ ユーザ・ドライバーの認知を変えることが目標だが、どうやって計測するのか? ▪ 異質性(heterogeneity) ▪
場所、時間帯、天候、タクシー利用意向によって異なる体験をどこまで分けて評価 すれば良いのか? ▪ 反実仮想 ▪ 単純集計ではバイアスが存在する状況で、どのようなデータ分析が妥当なのか? ▪ 純粋なA/Bテストを行えない ▪ 乖離を埋めるための戦術はまだ実施されておらずデータが無い 何が難しいのか? -
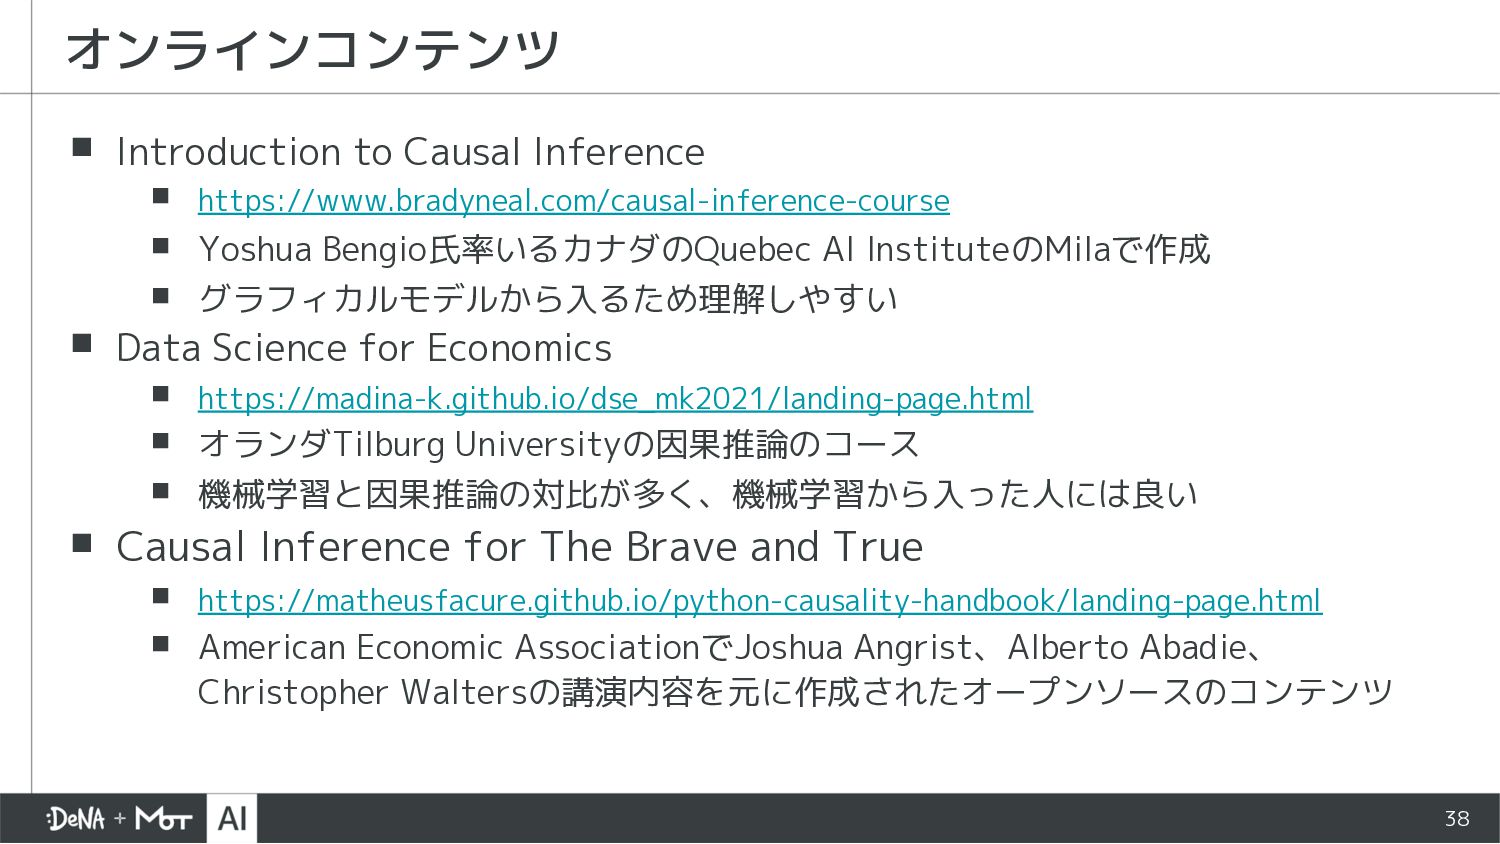
38 ▪ Introduction to Causal Inference ▪ https://www.bradyneal.com/causal-inference-course ▪ Yoshua
Bengio氏率いるカナダのQuebec AI InstituteのMilaで作成 ▪ グラフィカルモデルから入るため理解しやすい ▪ Data Science for Economics ▪ https://madina-k.github.io/dse_mk2021/landing-page.html ▪ オランダTilburg Universityの因果推論のコース ▪ 機械学習と因果推論の対比が多く、機械学習から入った人には良い ▪ Causal Inference for The Brave and True ▪ https://matheusfacure.github.io/python-causality-handbook/landing-page.html ▪ American Economic AssociationでJoshua Angrist、Alberto Abadie、 Christopher Waltersの講演内容を元に作成されたオープンソースのコンテンツ オンラインコンテンツ -
39 ▪ Machine Learning & Causal Inference: A Short Course
▪ https://www.gsb.stanford.edu/faculty-research/centers- initiatives/sil/research/methods/ai-machine-learning/short-course ▪ Stanford Graduate School of Businessで開催されたコース オンラインコンテンツ -
40 ▪ CFML勉強会 ▪ https://cfml.connpass.com ▪ Counterfactual Machine Learningについての勉強会 ▪
LINE Developer Meetup ▪ https://line.connpass.com ▪ NeurIPS、KDD、ICMLなどの論文読み会を開催 勉強会 -
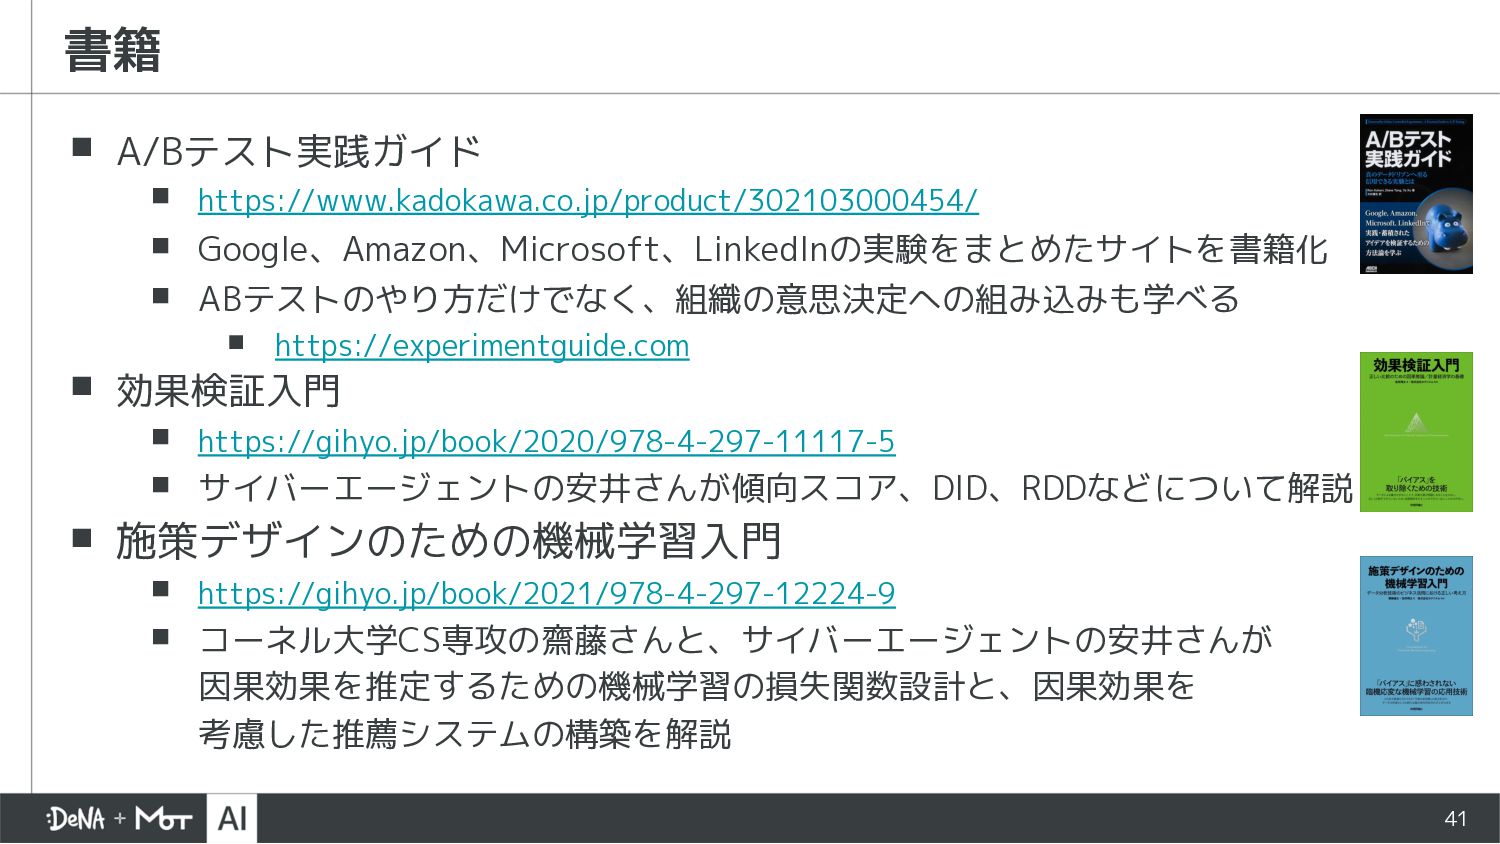
41 ▪ A/Bテスト実践ガイド ▪ https://www.kadokawa.co.jp/product/302103000454/ ▪ Google、Amazon、Microsoft、LinkedInの実験をまとめたサイトを書籍化 ▪ ABテストのやり方だけでなく、組織の意思決定への組み込みも学べる ▪
https://experimentguide.com ▪ 効果検証入門 ▪ https://gihyo.jp/book/2020/978-4-297-11117-5 ▪ サイバーエージェントの安井さんが傾向スコア、DID、RDDなどについて解説 ▪ 施策デザインのための機械学習入門 ▪ https://gihyo.jp/book/2021/978-4-297-12224-9 ▪ コーネル大学CS専攻の齋藤さんと、サイバーエージェントの安井さんが 因果効果を推定するための機械学習の損失関数設計と、因果効果を 考慮した推薦システムの構築を解説 書籍 -
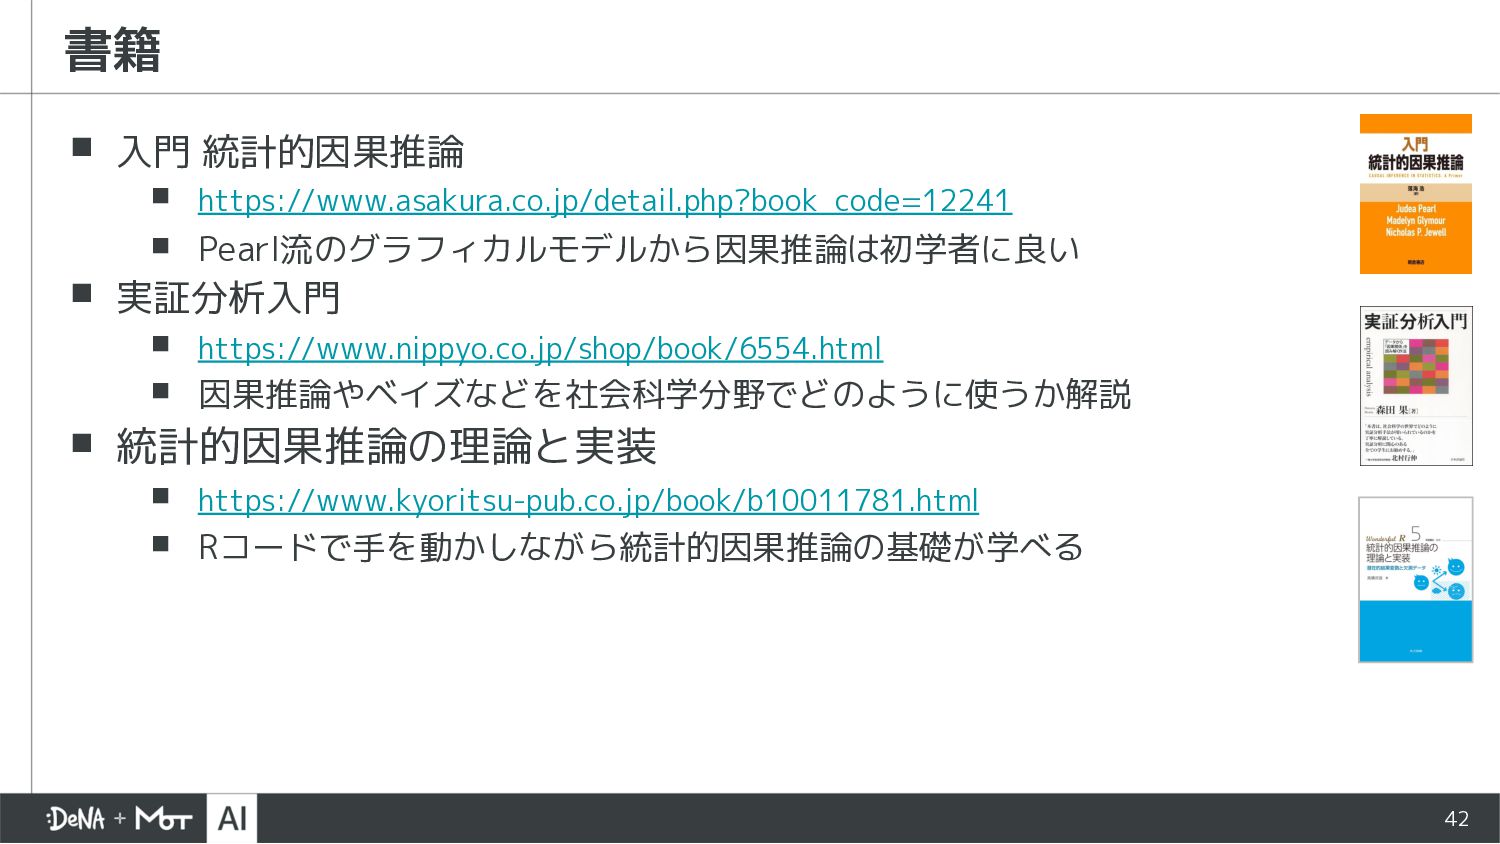
42 ▪ 入門 統計的因果推論 ▪ https://www.asakura.co.jp/detail.php?book_code=12241 ▪ Pearl流のグラフィカルモデルから因果推論は初学者に良い ▪ 実証分析入門
▪ https://www.nippyo.co.jp/shop/book/6554.html ▪ 因果推論やベイズなどを社会科学分野でどのように使うか解説 ▪ 統計的因果推論の理論と実装 ▪ https://www.kyoritsu-pub.co.jp/book/b10011781.html ▪ Rコードで手を動かしながら統計的因果推論の基礎が学べる 書籍 -
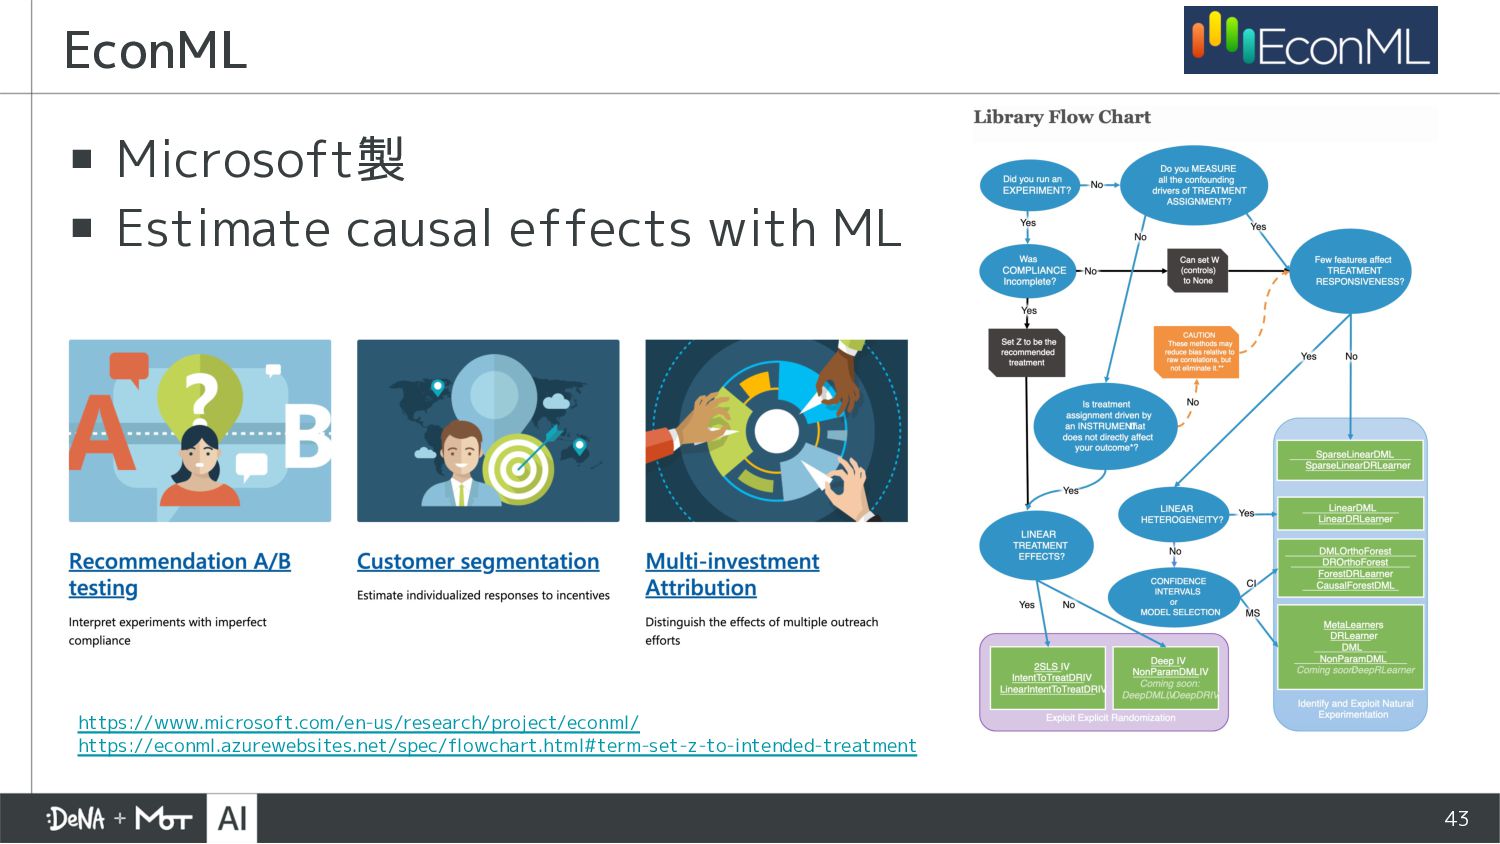
43 ▪ Microsoft製 ▪ Estimate causal effects with ML EconML
https://www.microsoft.com/en-us/research/project/econml/ https://econml.azurewebsites.net/spec/flowchart.html#term-set-z-to-intended-treatment -
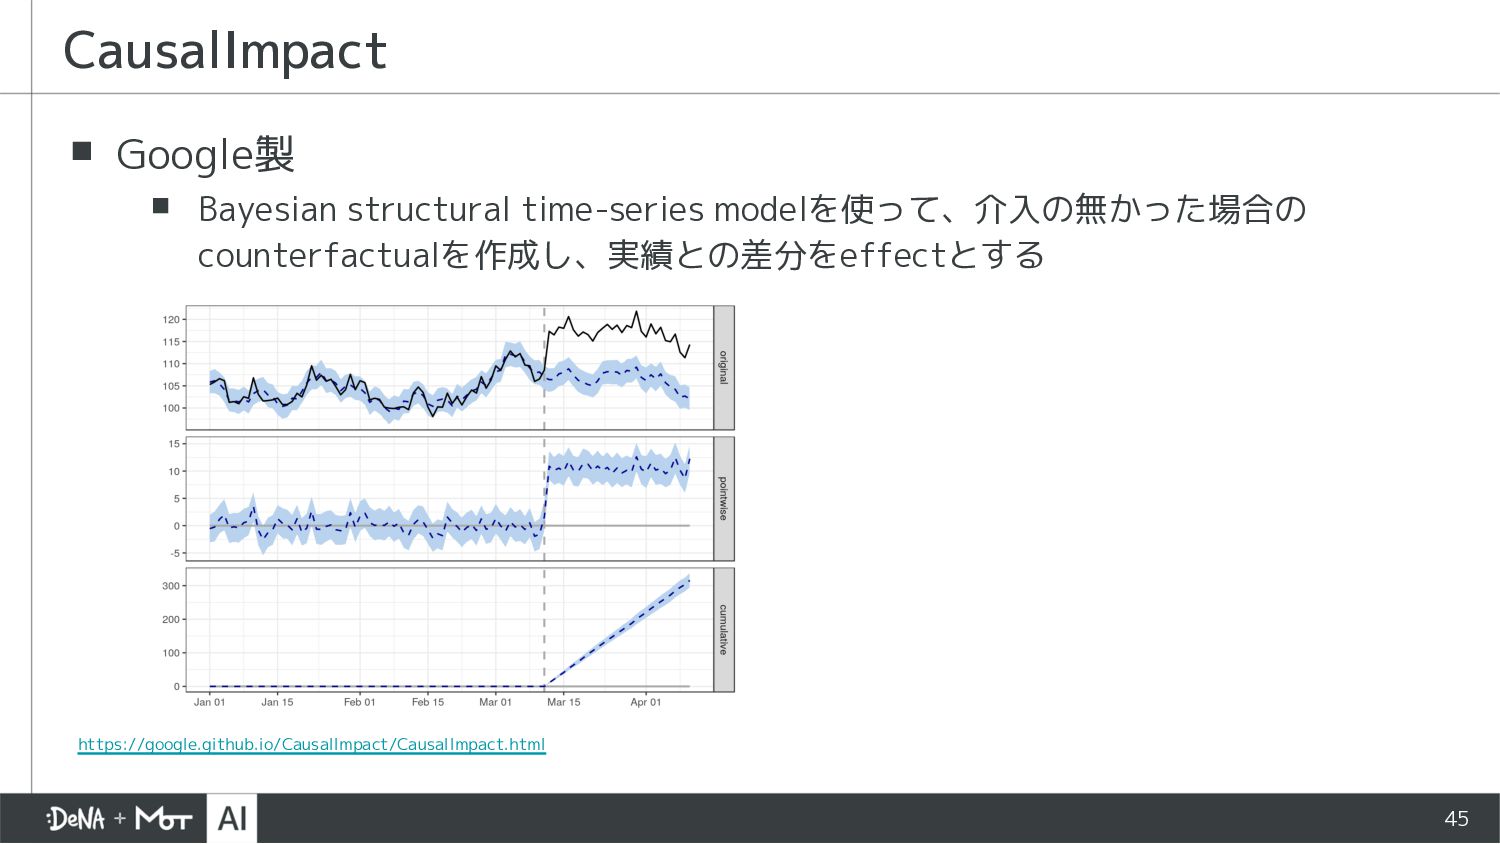
45 ▪ Google製 ▪ Bayesian structural time-series modelを使って、介入の無かった場合の counterfactualを作成し、実績との差分をeffectとする CausalImpact
https://google.github.io/CausalImpact/CausalImpact.html -
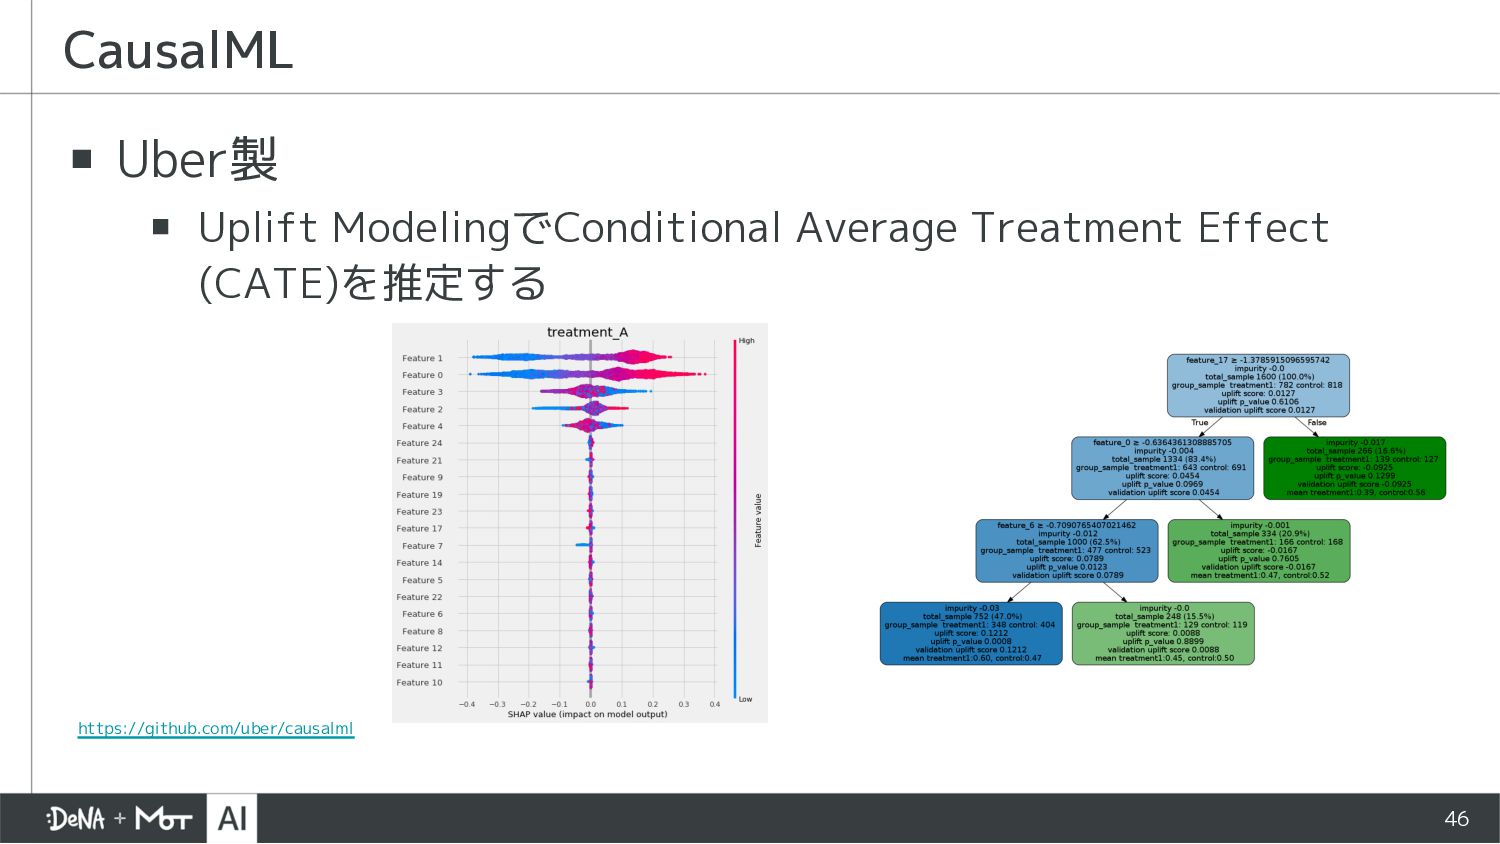
46 ▪ Uber製 ▪ Uplift ModelingでConditional Average Treatment Effect (CATE)を推定する
CausalML https://github.com/uber/causalml -
48 ▪ 介入した場合と介入しなかった場合の差分を (因果)効果量として知りたい ▪ コロナが収束したとして、今年の12月のタクシー実車数はどの程度になるだろうか? ▪ もしコロナが無かったとしたら、去年の12月のタクシー実車数はどの程度になるだろうか? ▪ アプリのUIを変更したが、ユーザのクリック率は向上しただろうか?
▪ サーバーのマッチングロジックを変更したが、ユーザのキャンセル率は減少しただろうか? ▪ クーポンを配ったが、ユーザの実車率は向上しただろうか? 因果推論のフレームワークはビジネスに役に立つ -
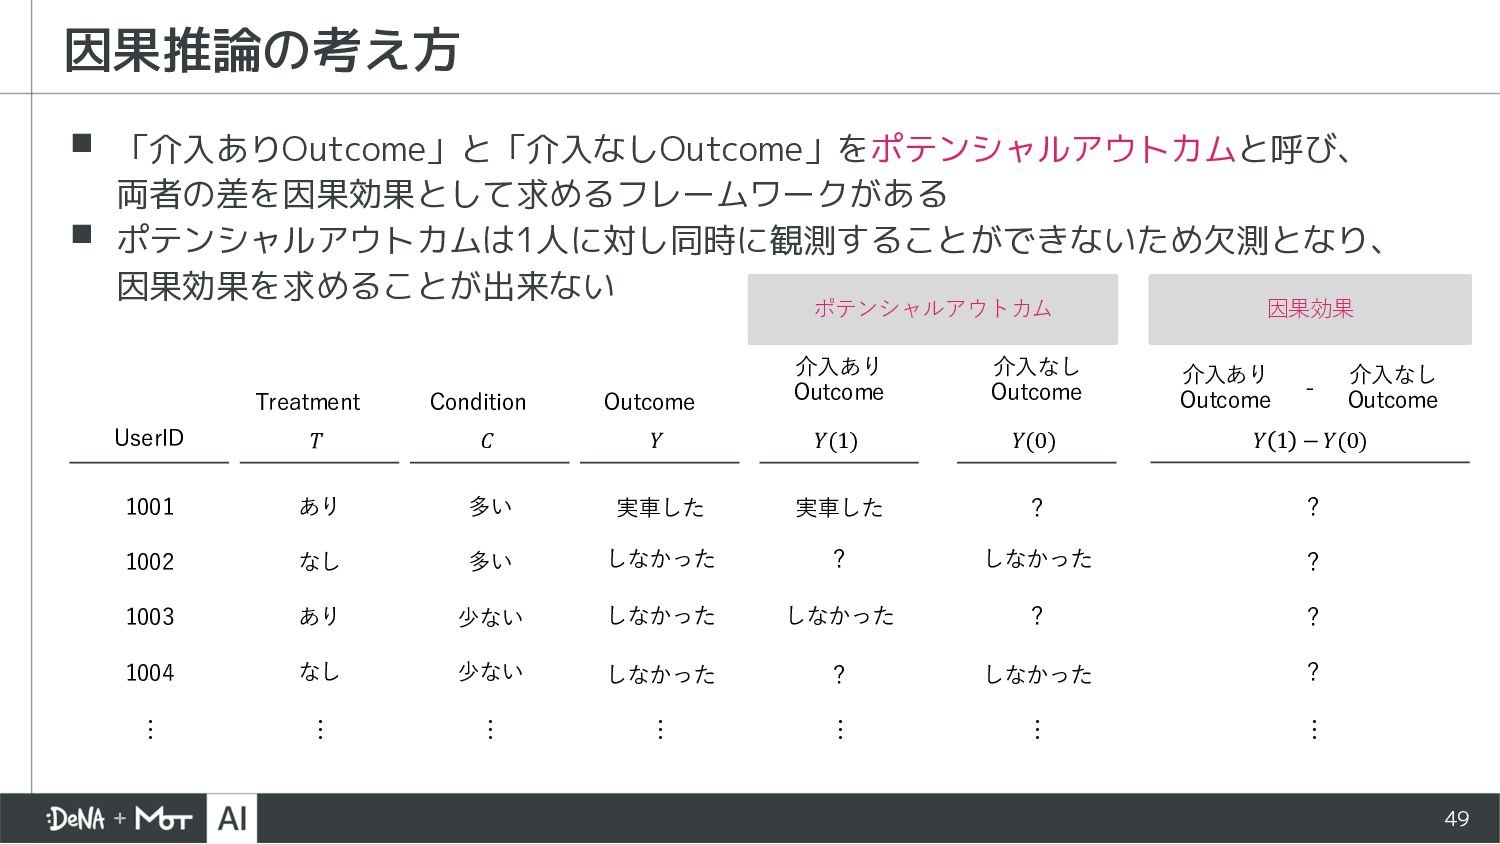
49 ▪ 「介入ありOutcome」と「介入なしOutcome」をポテンシャルアウトカムと呼び、 両者の差を因果効果として求めるフレームワークがある ▪ ポテンシャルアウトカムは1人に対し同時に観測することができないため欠測となり、 因果効果を求めることが出来ない 因果推論の考え方 UserID 1001
1002 1003 1004 … あり あり なし なし … 多い 多い 少ない 少ない 実⾞した しなかった しなかった しなかった … … 実⾞した ? しなかった ? … ? しなかった ? しなかった … ? ? ? ? … Treatment Condition Outcome 介⼊あり Outcome 介⼊なし Outcome 介⼊なし Outcome 介⼊あり Outcome - 𝑌(1) 𝑌(0) 𝑌 1 − 𝑌(0) 𝑇 𝐶 𝑌 ポテンシャルアウトカム 因果効果 -
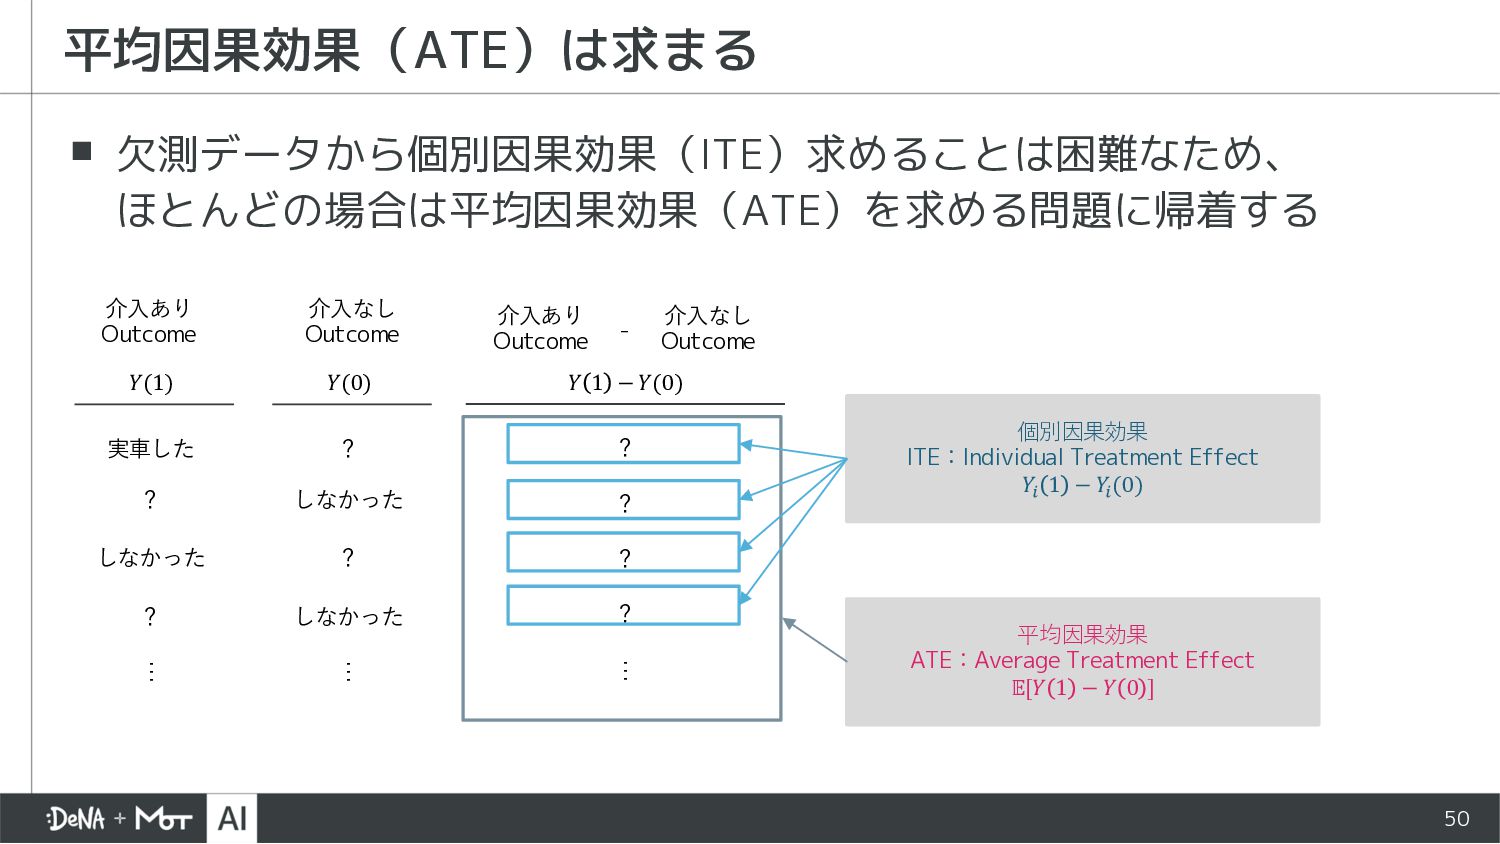
50 ▪ 欠測データから個別因果効果(ITE)求めることは困難なため、 ほとんどの場合は平均因果効果(ATE)を求める問題に帰着する 平均因果効果(ATE)は求まる 実⾞した ? しなかった ? …
? しなかった ? しなかった … ? ? ? ? … 個別因果効果 ITE:Individual Treatment Effect 𝑌! 1 − 𝑌! (0) 平均因果効果 ATE:Average Treatment Effect 𝔼[𝑌 1 − 𝑌 0 ] 介⼊あり Outcome 介⼊なし Outcome 介⼊なし Outcome 介⼊あり Outcome - 𝑌(1) 𝑌(0) 𝑌 1 − 𝑌(0) -
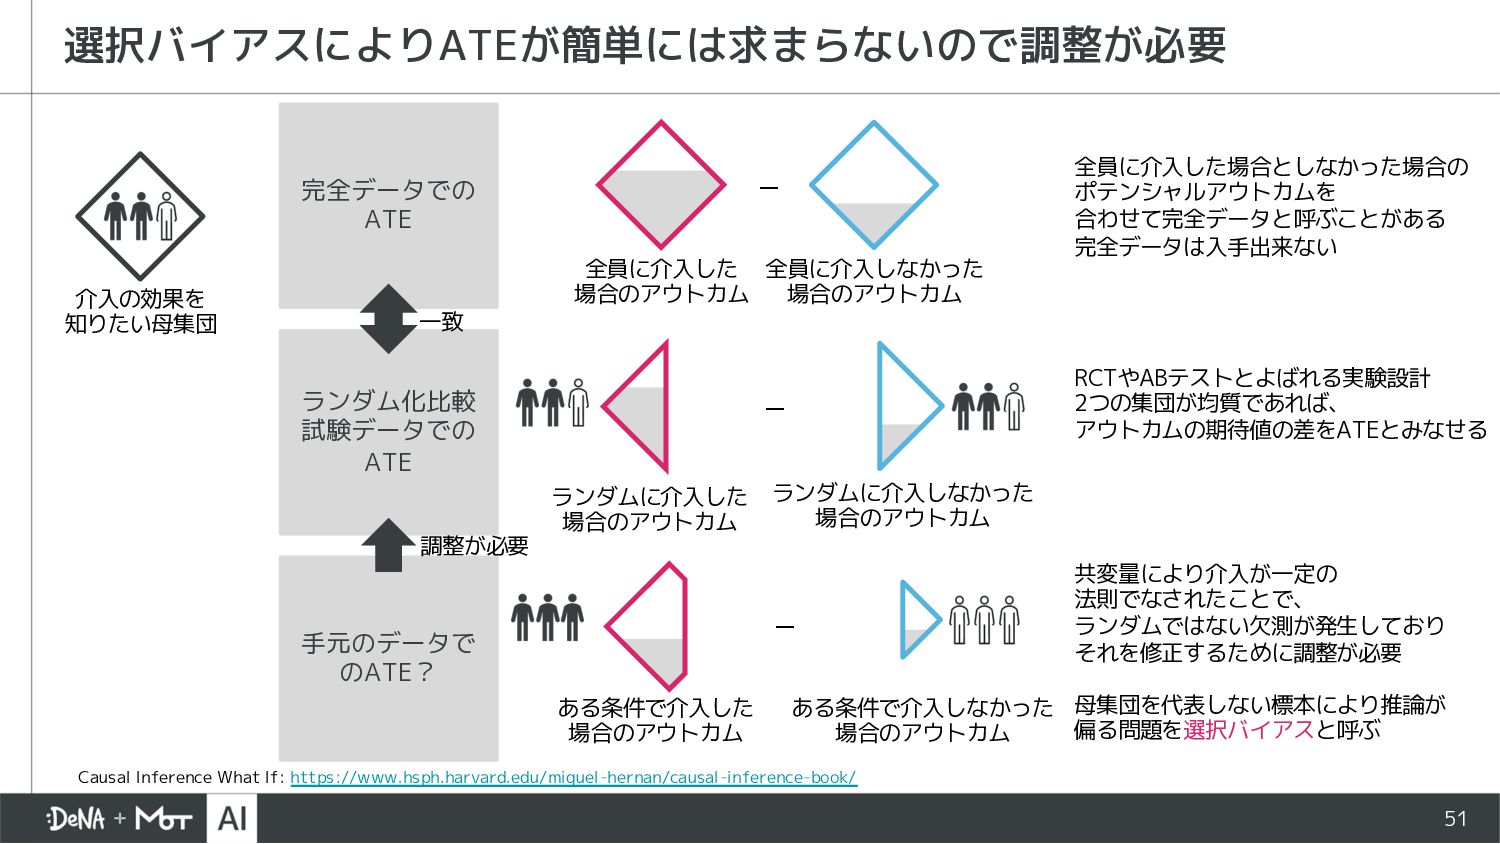
51 選択バイアスによりATEが簡単には求まらないので調整が必要 介入の効果を 知りたい母集団 全員に介入した 場合のアウトカム 全員に介入しなかった 場合のアウトカム − RCTやABテストとよばれる実験設計
2つの集団が均質であれば、 アウトカムの期待値の差をATEとみなせる − ランダムに介入した 場合のアウトカム ランダムに介入しなかった 場合のアウトカム − 完全データでの ATE ランダム化比較 試験データでの ATE 手元のデータで のATE? 一致 全員に介入した場合としなかった場合の ポテンシャルアウトカムを 合わせて完全データと呼ぶことがある 完全データは入手出来ない ある条件で介入した 場合のアウトカム ある条件で介入しなかった 場合のアウトカム 調整が必要 共変量により介入が一定の 法則でなされたことで、 ランダムではない欠測が発生しており それを修正するために調整が必要 母集団を代表しない標本により推論が 偏る問題を選択バイアスと呼ぶ Causal Inference What If: https://www.hsph.harvard.edu/miguel-hernan/causal-inference-book/ -
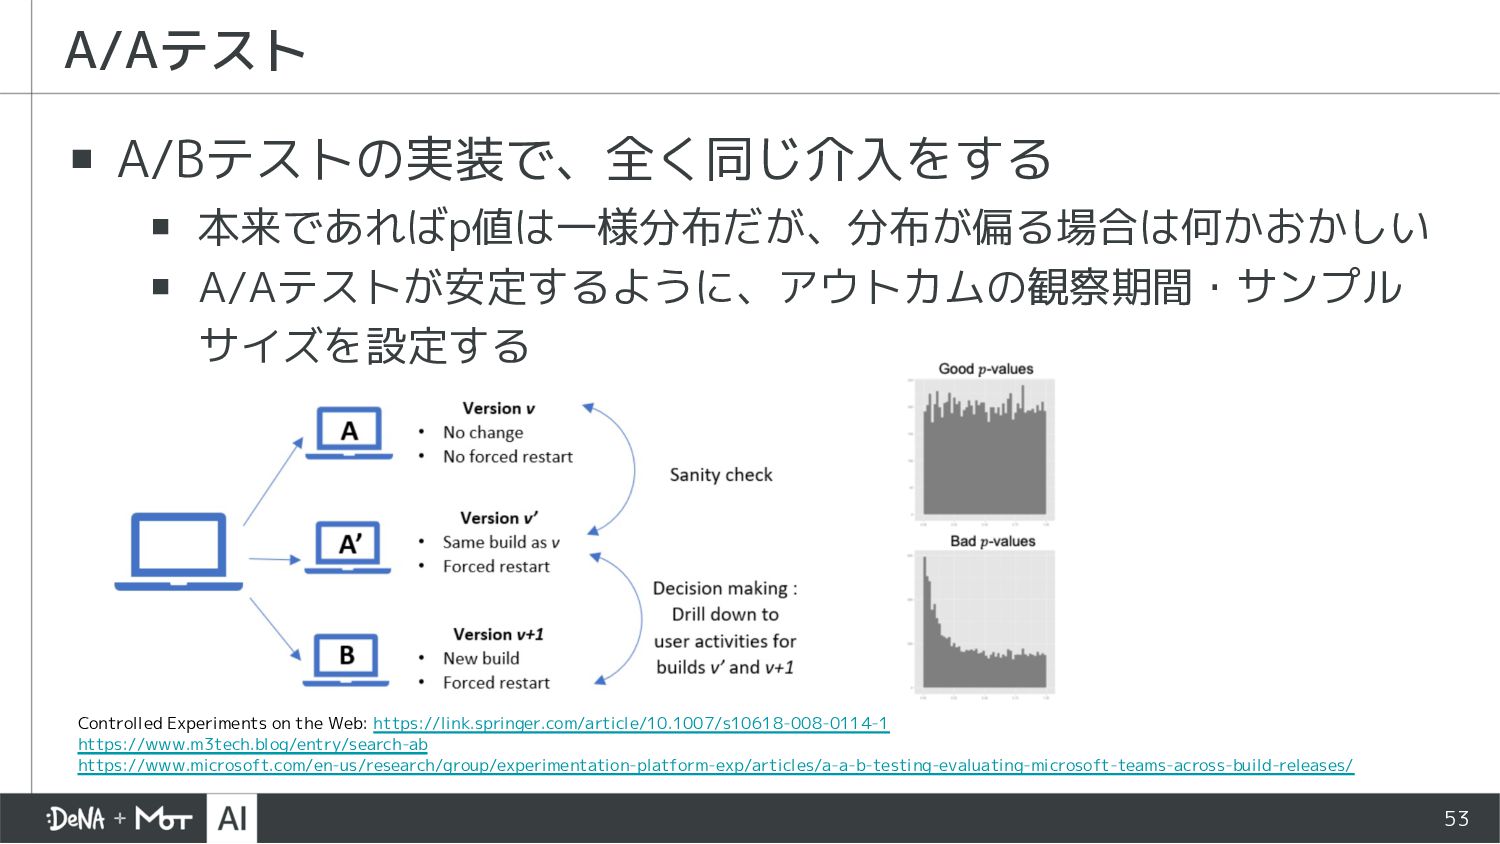
53 ▪ A/Bテストの実装で、全く同じ介入をする ▪ 本来であればp値は一様分布だが、分布が偏る場合は何かおかしい ▪ A/Aテストが安定するように、アウトカムの観察期間・サンプル サイズを設定する A/Aテスト Controlled
Experiments on the Web: https://link.springer.com/article/10.1007/s10618-008-0114-1 https://www.m3tech.blog/entry/search-ab https://www.microsoft.com/en-us/research/group/experimentation-platform-exp/articles/a-a-b-testing-evaluating-microsoft-teams-across-build-releases/ -
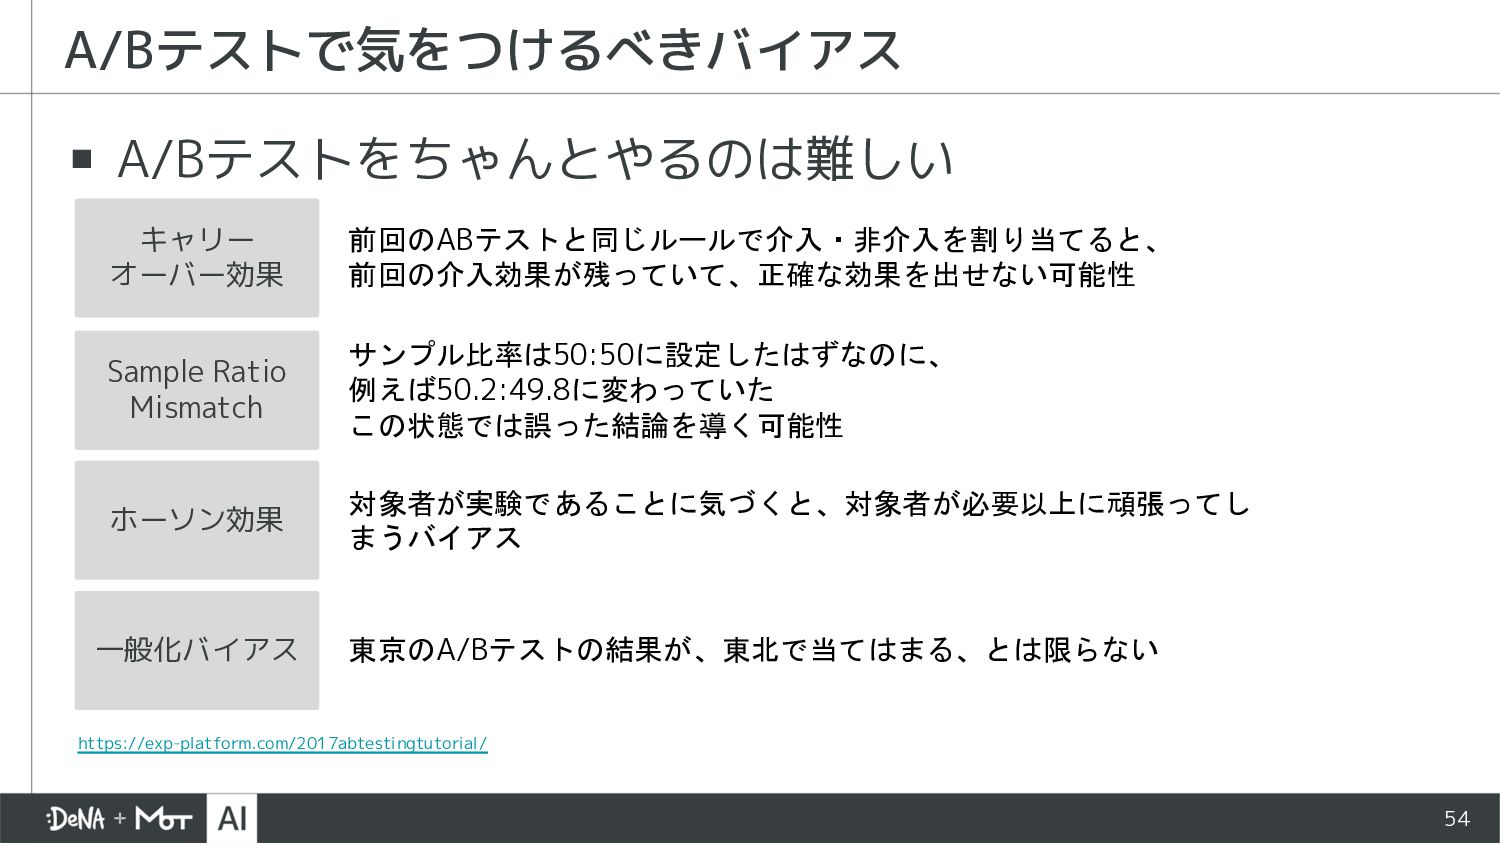
54 ▪ A/Bテストをちゃんとやるのは難しい A/Bテストで気をつけるべきバイアス https://exp-platform.com/2017abtestingtutorial/ Sample Ratio Mismatch サンプル比率は50:50に設定したはずなのに、 例えば50.2:49.8に変わっていた
この状態では誤った結論を導く可能性 ホーソン効果 対象者が実験であることに気づくと、対象者が必要以上に頑張ってし まうバイアス 一般化バイアス 東京のA/Bテストの結果が、東北で当てはまる、とは限らない キャリー オーバー効果 前回のABテストと同じルールで介入・非介入を割り当てると、 前回の介入効果が残っていて、正確な効果を出せない可能性 -
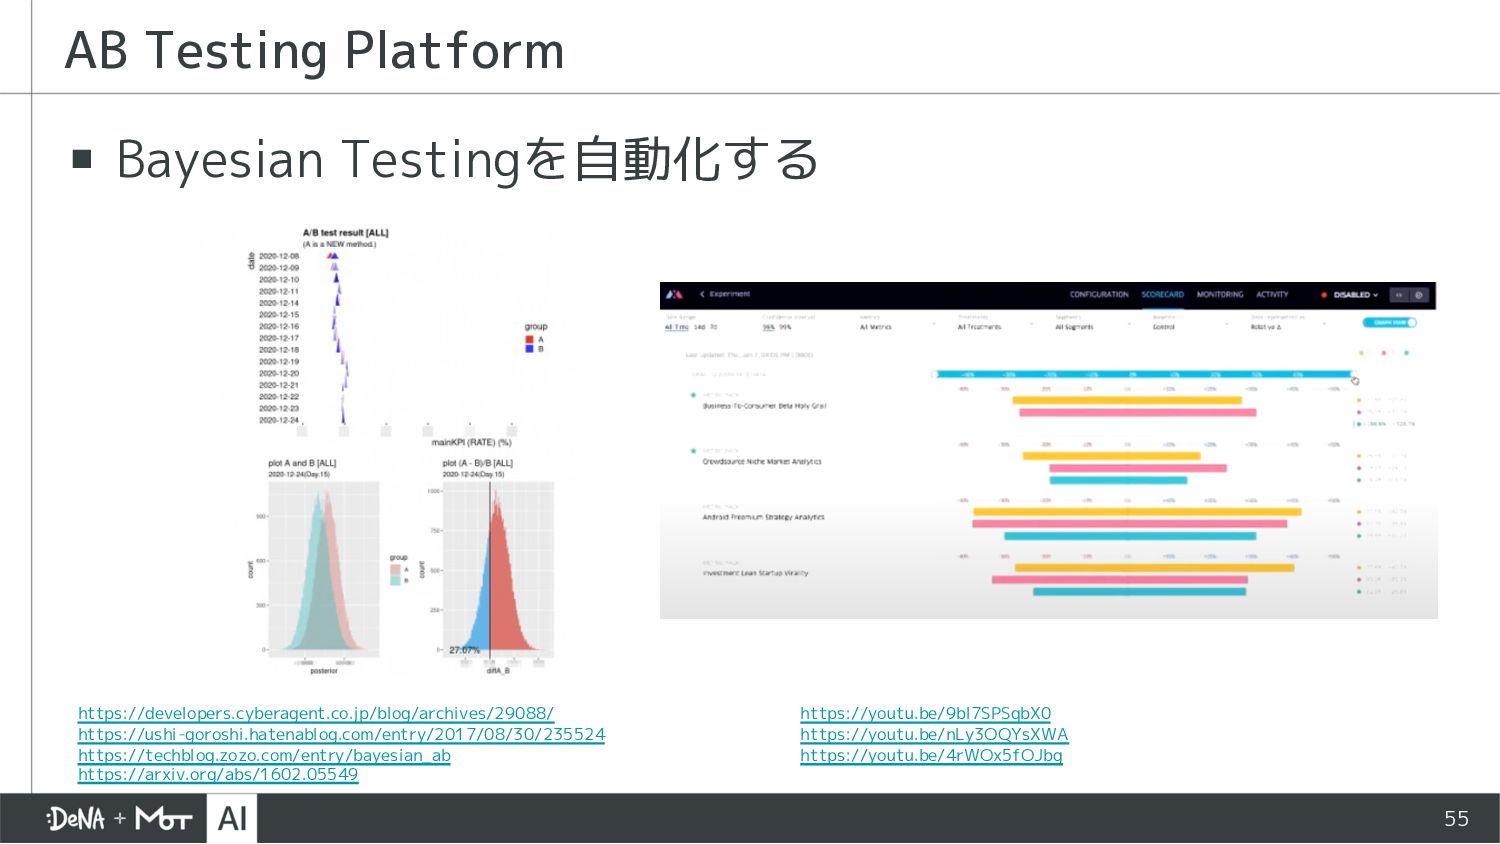
55 ▪ Bayesian Testingを自動化する AB Testing Platform https://youtu.be/9bl7SPSqbX0 https://youtu.be/nLy3OQYsXWA https://youtu.be/4rWOx5fOJbg
https://developers.cyberagent.co.jp/blog/archives/29088/ https://ushi-goroshi.hatenablog.com/entry/2017/08/30/235524 https://techblog.zozo.com/entry/bayesian_ab https://arxiv.org/abs/1602.05549 -
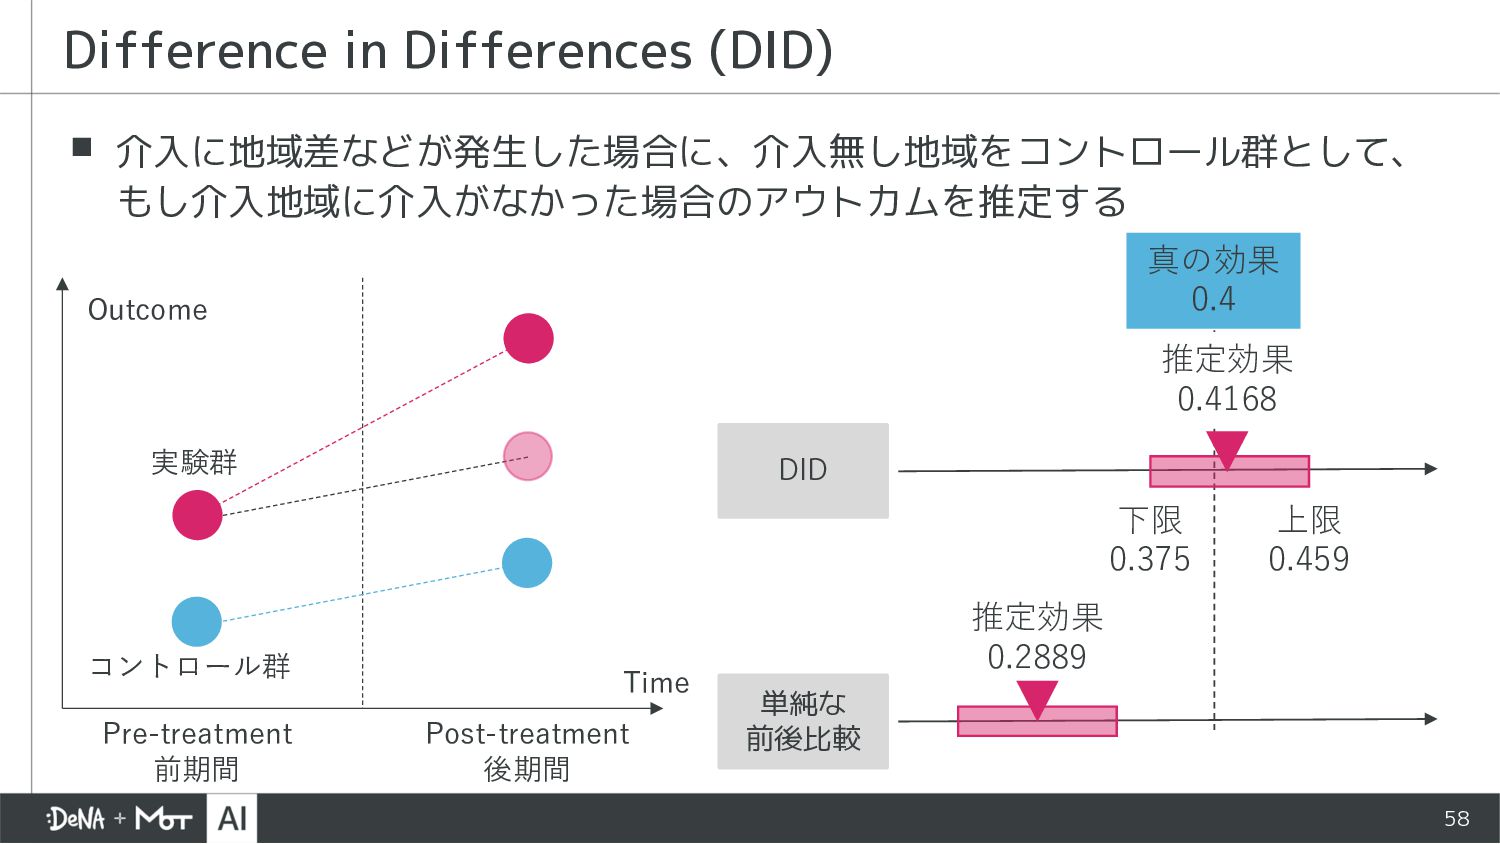
58 ▪ 介入に地域差などが発生した場合に、介入無し地域をコントロール群として、 もし介入地域に介入がなかった場合のアウトカムを推定する Difference in Differences (DID) 実験群 コントロール群
Time Outcome Pre-treatment 前期間 Post-treatment 後期間 真の効果 0.4 推定効果 0.4168 上限 0.459 下限 0.375 推定効果 0.2889 単純な 前後比較 DID
 tetchi
 progmat
 arm0020
 xinghr
 microbaseinc
 plainer
 kgnkhkr
 ediel
 smartgate
 nazoru
 chibanba1982
 takeuchigroup
 enechain
 jnunemaker
 garrettdimon
 mongodb
 holman
 stephenakadiri
 livdayseo
 sstephenson
 katarinadahlin
 inesmontani
 mkilby
 lindahogenes
 aarron