Share
Embed
BigQuery を利用した視聴データのリアルタイム ダッシュボード構築〜Google Cloud Next'19 in Tokyo〜 / TV Logs Realtime Dashboard with BigQuery and DataPortal
2019年7月29~31日に開かれた「Google Cloud Next Tokyo 2019」において登壇した資料。
@IT様のサイトで記事化していただいています。
番組視聴者数を秒単位で分析 テレビ東京のGCP活用事例
https://www.atmarkit.co.jp/ait/articles/1910/08/news005.html
動画はこちら
https://www.youtube.com/watch?v=JyMus-DtEYg
y-danno
July 30, 2019
Transcript
83 slides
-
段野 祐一郎 テレビ東京 テックリード Career 2007 年テレビ東京入社。 社内 SE 、カメラマン、動画配信 サービスのテックリードを経て
2019 年 4 月より動画配信技術を 軸に、配信サービスの企画開発や システム構築、技術戦略を担当 ydanno #GoogleNext19 #テレビ東京 -
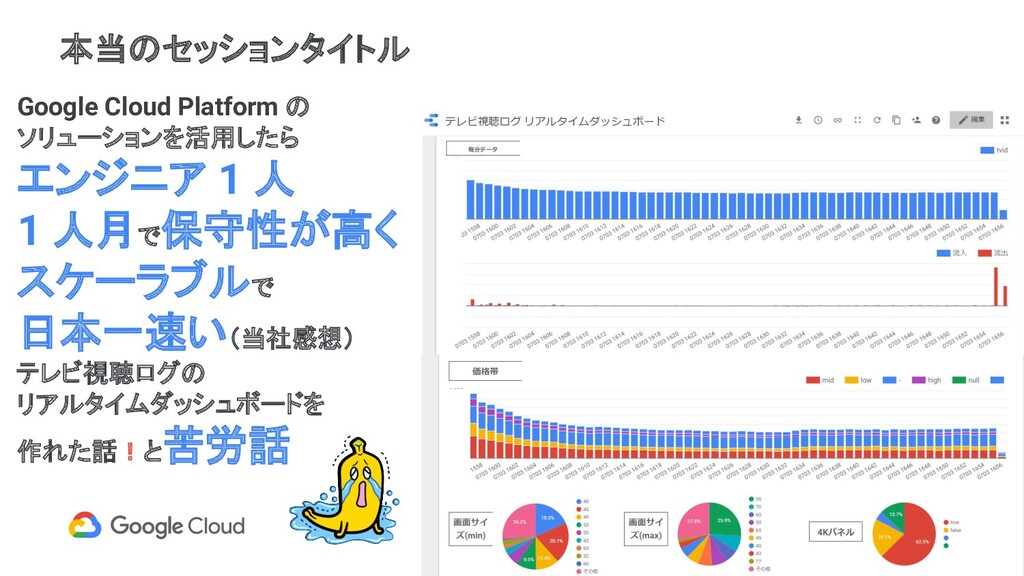
Google Cloud Platform の ソリューションを活用したら エンジニア 1 人 1 人月で保守性が高く
スケーラブルで 日本一速い(当社感想) テレビ視聴ログの リアルタイムダッシュボードを 作れた話!と苦労話 本当のセッションタイトル -
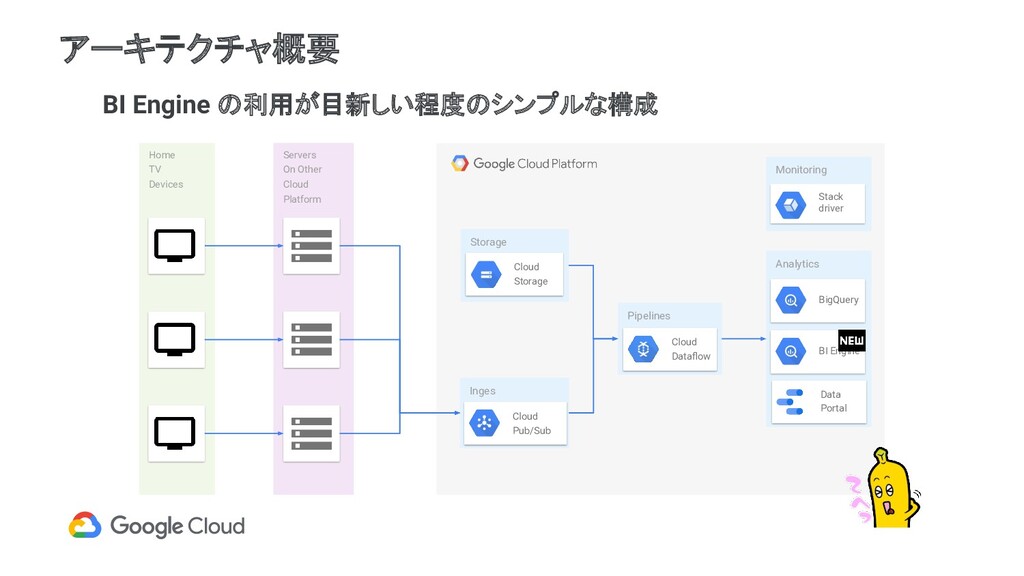
Home TV Devices Servers On Other Cloud Platform アーキテクチャ概要 Inges
t Storage Analytics Cloud Storage Cloud Pub/Sub Pipelines Cloud Dataflow BI Engine Data Portal BigQuery BI Engine の利用が目新しい程度のシンプルな構成 Monitoring Stack driver -
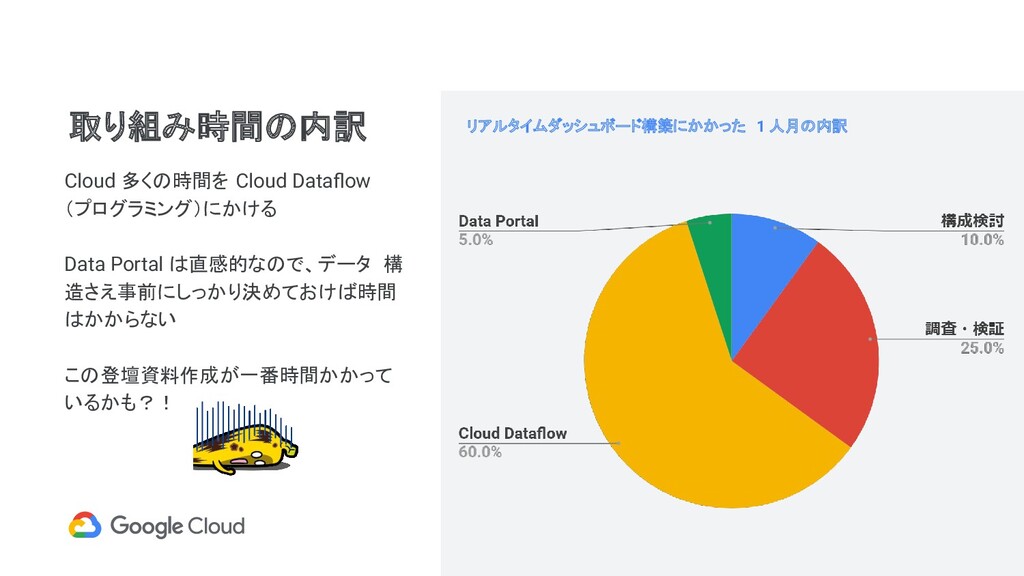
取り組み時間の内訳 Cloud 多くの時間を Cloud Dataflow (プログラミング)にかける Data Portal は直感的なので、データ 構 造さえ事前にしっかり決めておけば時間
はかからない この登壇資料作成が一番時間かかって いるかも?! リアルタイムダッシュボード構築にかかった 1 人月の内訳 -
既存のダッシュボードのリプレイス (高度な分析や連携ができない) 動くモノを見せながら、要件ヒアリング → 修正 のフローで精度を上げていきたい 他社クラウド・ BI ツールの組み合わせ事例が多いが G
Suite 利用社なら GCP 上で構築した方が データの利用やデータ民主化を浸透させやすい? 取り組みの背景 -
セッション対象者と伝えたいこと 対象者 これからリアルタイムダッシュボードやデータ分析基盤を 作りたいと思っている人 伝えたいこと ・GCP 上でのダッシュボード構築方法と勘所 ・BigQuery x AI
Ready なデータ の メリット ・GCP はやっぱり凄い、使わないと損! & -
FUN 開発、楽しい! reference to Developer Keynote: Get to the Fun
Part (Cloud Next '19) -
NOT FUN FUN (目的)を最短で達成するために NOT FUN なこと サーバー、ミドルウェア、データベース等の セットアップやチューニング 定期的なメンテナンス
セキュリティ対策 冗長性、可用性の担保 今回の GCP 構成を使えば、本質的ではないインフラの制約に 囚われることなくアプリケーション開発に専念できる -
1. 背景 テレビ東京がクラウド化を推進する理由/データ化に注力する理由/ GCP を選択した理由 2. BigQuery を利用したデータ基盤、ダッシュボードの構築 3. AI
ソリューションの活用例 4. 今後の展望とまとめ Agenda -
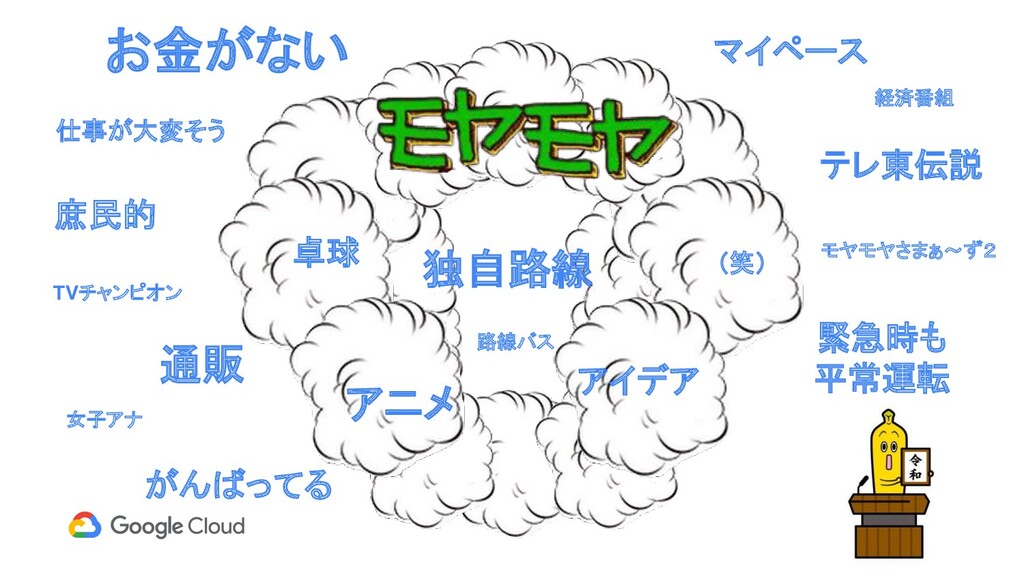
庶民的 マイペース 独自路線 お金がない 卓球 アニメ 通販 路線バス 仕事が大変そう 女子アナ
アイデア モヤモヤさまぁ~ず2 TVチャンピオン テレ東伝説 経済番組 緊急時も 平常運転 (笑) がんばってる -
庶民的 マイペース 独自路線 お金がない 卓球 アニメ 通販 路線バス 仕事が大変そう 女子アナ
アイデア モヤモヤさまぁ~ず2 TVチャンピオン テレ東伝説 経済番組 緊急時も 平常運転 (笑) がんばってる だいたいあってる -
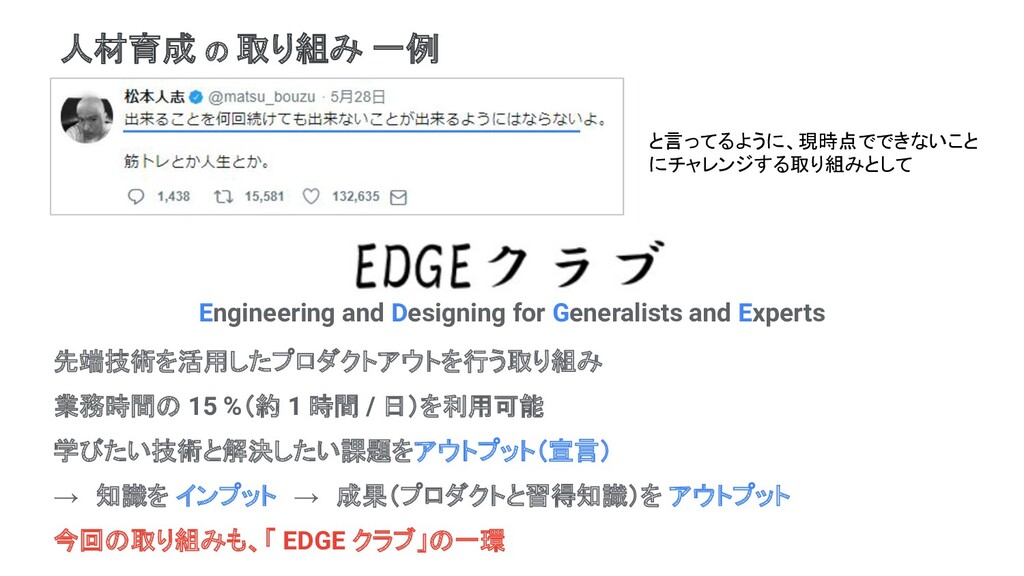
人材育成 の 取り組み 一例 先端技術を活用したプロダクトアウトを行う取り組み 業務時間の 15 %(約 1 時間
/ 日)を利用可能 学びたい技術と解決したい課題をアウトプット(宣言) → 知識を インプット → 成果(プロダクトと習得知識)を アウトプット 今回の取り組みも、「 EDGE クラブ」の一環 Engineering and Designing for Generalists and Experts と言ってるように、現時点でできないこと にチャレンジする取り組みとして -
テレビ東京のエンジニア組織 約 90 名! といっても内訳は下記 放送系 エンジニア : 約 70
名 情シス系 エンジニア : 約 20 名 システム保守は基本外注 グループ内 IT 戦略会社 TXCOM には WEB エンジニア 10 名在籍も 技術選定基準は、保守領域はなるべく少なく or 保守可能な技術選定。 → 保守観点でも、クラウド/マネージドが候補の筆頭 -
システム構築の3原則 クラウド・デフォルト クラウドサービスの利用を 最優先の候補とする パッケージ・ファースト 既存ソリューションの 活 用を第一に検討する 社内オープンデータ 様々なデータが社内で オープンに利活用できるこ
とを前提とする 今年新たに策定されたテレビ東京社内におけるシステム構築ポリシーに 前述までの戦略は反映されている -
とはいえ、クラウドベンダー選定は適材適所で 当面はマルチベンダー・適材適所に採用していく ・技術の移り変わりが激しい クラウドベンダーの勢力図の大きな差はない ・ベンダー依存リスク軽減 サービス的にも、自分のキャリア的にも ・一長一短 GCP は大規模トラフィック処理や DB
、AI が強い印象 ・各サービスの理解に役立つ 言葉と一緒。2カ国語話せる人は3ヶ国語目は簡単 (?) データと密接な領域! -
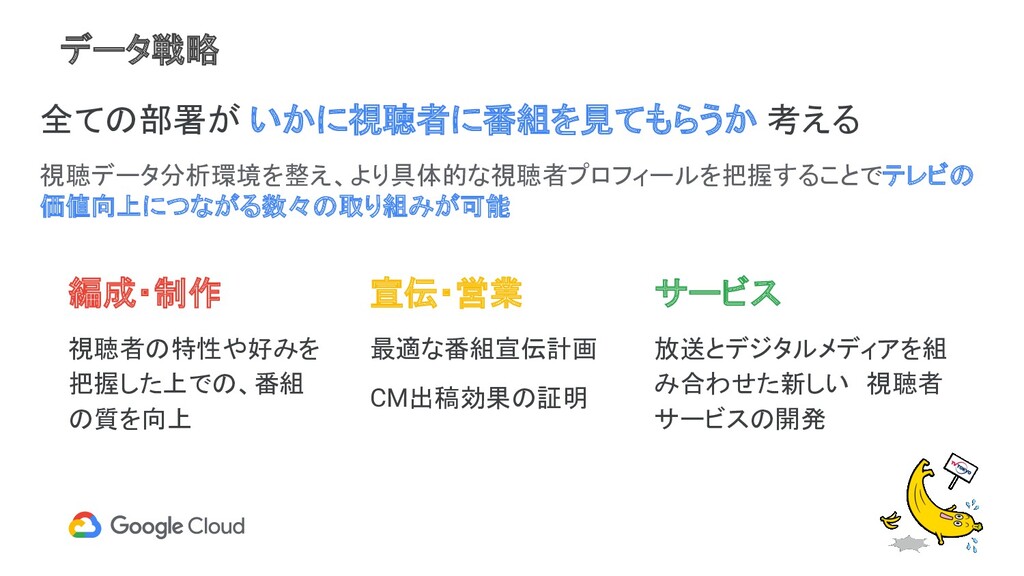
全ての部署が いかに視聴者に番組を見てもらうか 考える 視聴データ分析環境を整え、より具体的な視聴者プロフィールを把握することでテレビの 価値向上につながる数々の取り組みが可能 データ戦略 編成・制作 視聴者の特性や好みを 把握した上での、番組 の質を向上
宣伝・営業 最適な番組宣伝計画 CM出稿効果の証明 サービス 放送とデジタルメディアを組 み合わせた新しい 視聴者 サービスの開発 -
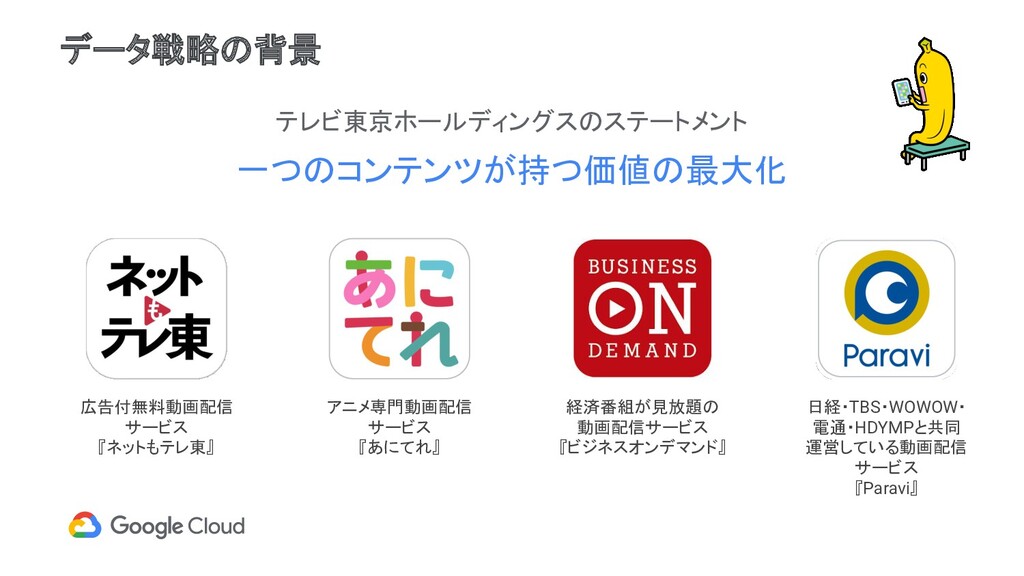
データ戦略の背景 広告付無料動画配信 サービス 『ネットもテレ東』 アニメ専門動画配信 サービス 『あにてれ』 経済番組が見放題の 動画配信サービス 『ビジネスオンデマンド』
日経・TBS・WOWOW・ 電通・HDYMPと共同 運営している動画配信 サービス 『Paravi』 テレビ東京ホールディングスのステートメント 一つのコンテンツが持つ価値の最大化 -
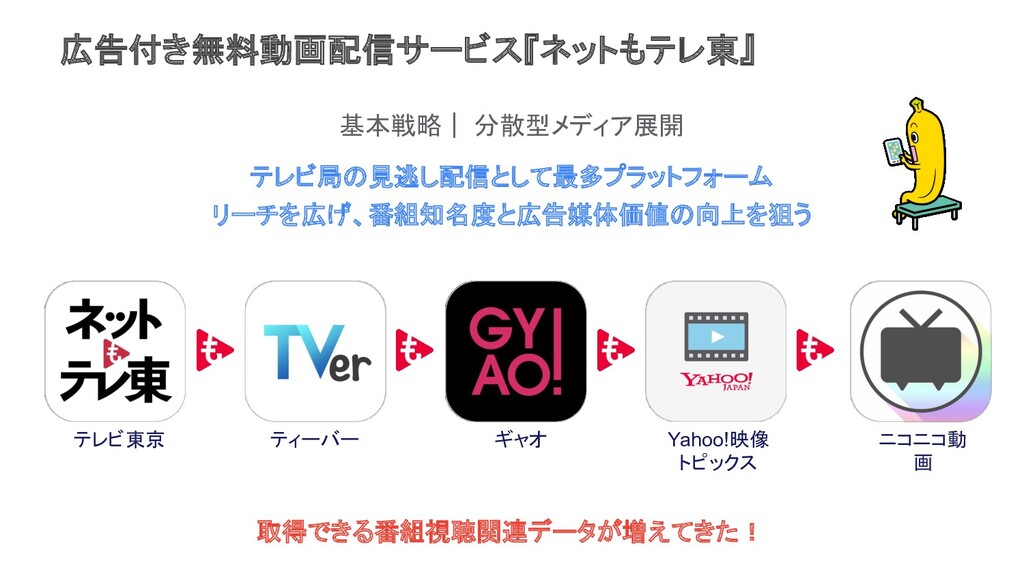
テレビ東京 ティーバー ギャオ Yahoo!映像 トピックス ニコニコ動 画 広告付き無料動画配信サービス『ネットもテレ東』 基本戦略| 分散型メディア展開
テレビ局の見逃し配信として最多プラットフォーム リーチを広げ、番組知名度と広告媒体価値の向上を狙う 取得できる番組視聴関連データが増えてきた! -
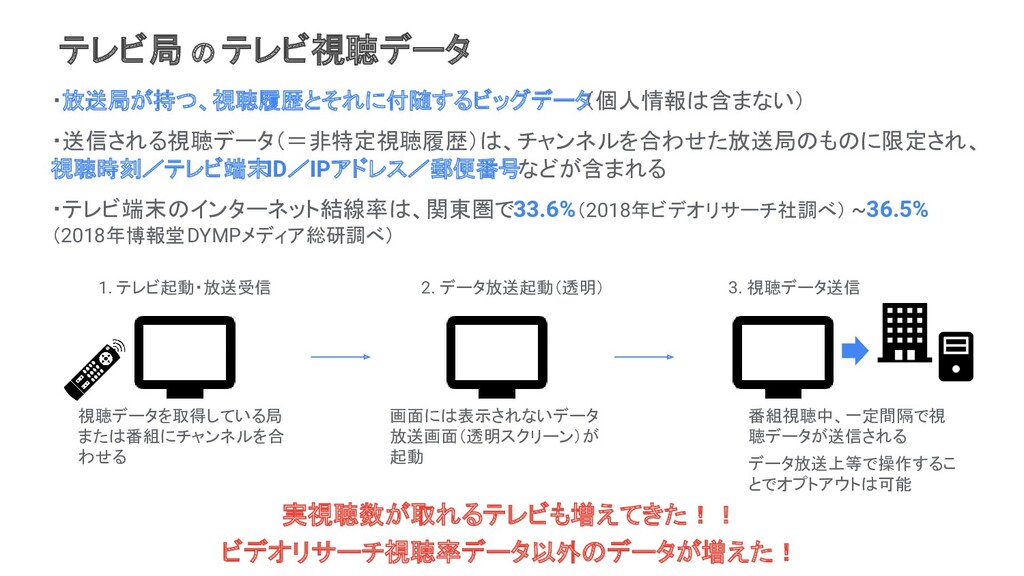
テレビ局 の テレビ視聴データ ・放送局が持つ、視聴履歴とそれに付随するビッグデータ (個人情報は含まない) ・送信される視聴データ(=非特定視聴履歴)は、チャンネルを合わせた放送局のものに限定され、 視聴時刻/テレビ端末ID/IPアドレス/郵便番号などが含まれる ・テレビ端末のインターネット結線率は、関東圏で 33.6%(2018年ビデオリサーチ社調べ) ~36.5%
(2018年博報堂DYMPメディア総研調べ) 1. テレビ起動・放送受信 2. データ放送起動(透明) 3. 視聴データ送信 視聴データを取得している局 または番組にチャンネルを合 わせる 画面には表示されないデータ 放送画面(透明スクリーン)が 起動 番組視聴中、一定間隔で視 聴データが送信される データ放送上等で操作するこ とでオプトアウトは可能 実視聴数が取れるテレビも増えてきた!! ビデオリサーチ視聴率データ以外のデータが増えた! -
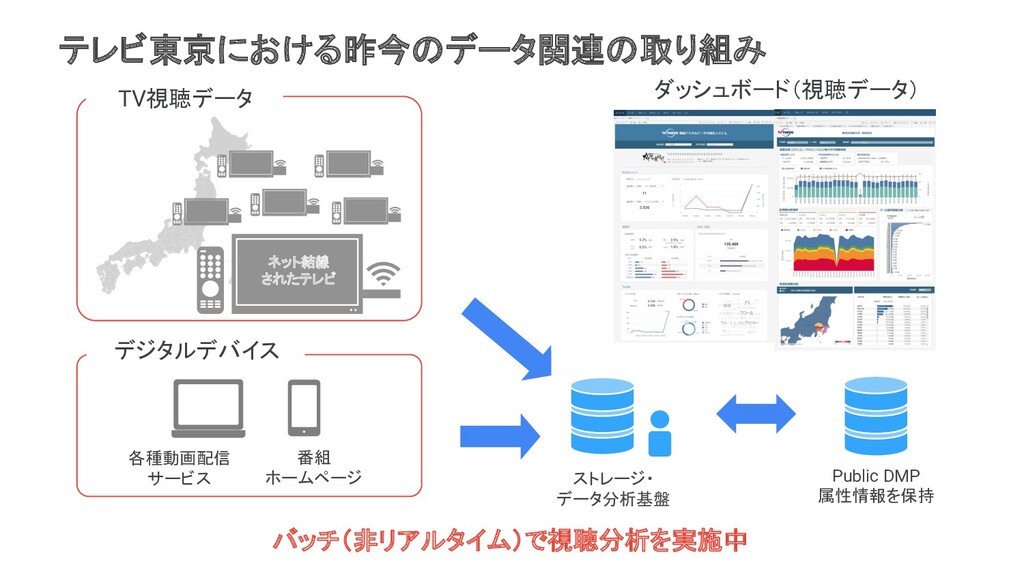
テレビ東京における昨今のデータ関連の取り組み ネット結線 されたテレビ ストレージ・ データ分析基盤 Public DMP 属性情報を保持 ダッシュボード(視聴データ) TV視聴データ
番組 ホームページ デジタルデバイス 各種動画配信 サービス バッチ(非リアルタイム)で視聴分析を実施中 -
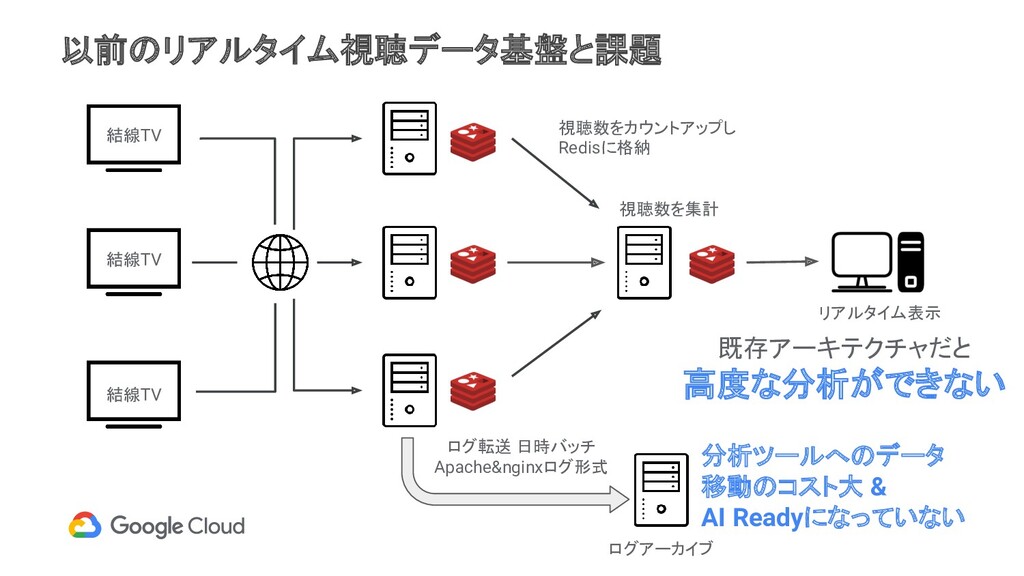
以前のリアルタイム視聴データ基盤と課題 既存アーキテクチャだと 高度な分析ができない 視聴数をカウントアップし Redisに格納 視聴数を集計 リアルタイム表示 ログ転送 日時バッチ Apache&nginxログ形式
分析ツールへのデータ 移動のコスト大 & AI Readyになっていない 結線TV 結線TV 結線TV ログアーカイブ -
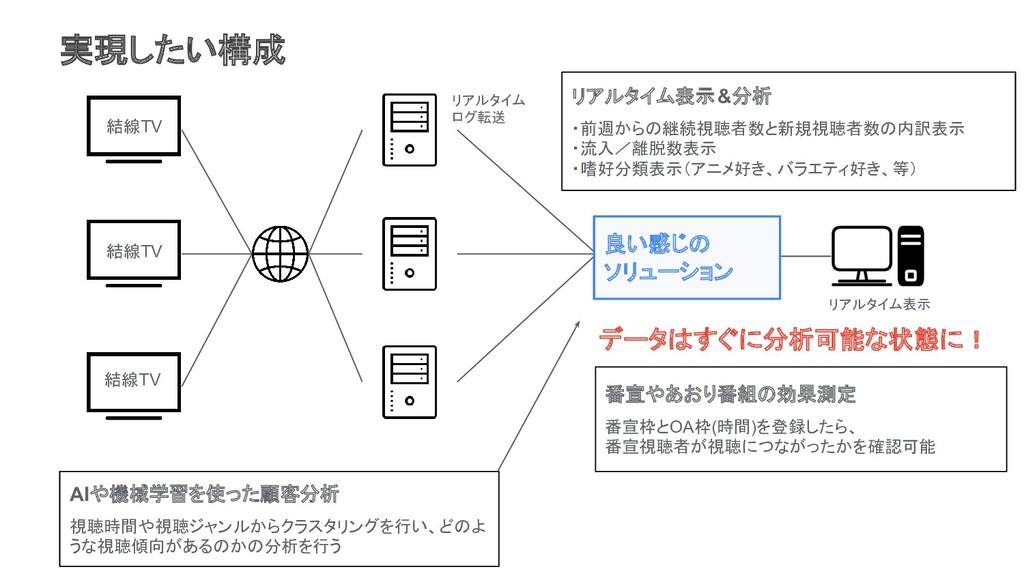
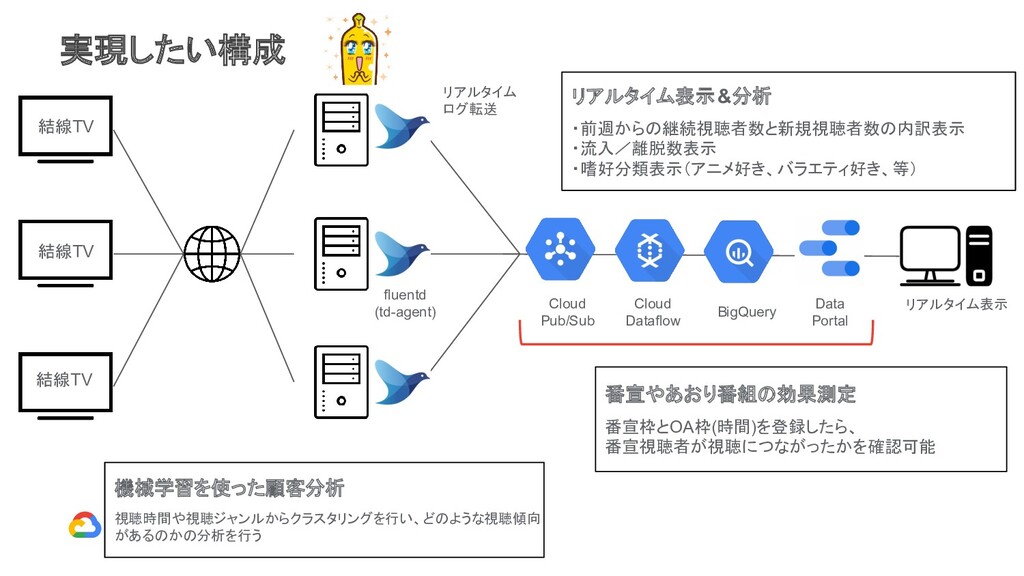
リアルタイム表示&分析 ・前週からの継続視聴者数と新規視聴者数の内訳表示 ・流入/離脱数表示 ・嗜好分類表示(アニメ好き、バラエティ好き、等) リアルタイム ログ転送 リアルタイム表示 結線TV 結線TV 結線TV
番宣やあおり番組の効果測定 番宣枠とOA枠(時間)を登録したら、 番宣視聴者が視聴につながったかを確認可能 AIや機械学習を使った顧客分析 視聴時間や視聴ジャンルからクラスタリングを行い、どのよ うな視聴傾向があるのかの分析を行う 実現したい構成 良い感じの ソリューション データはすぐに分析可能な状態に! -
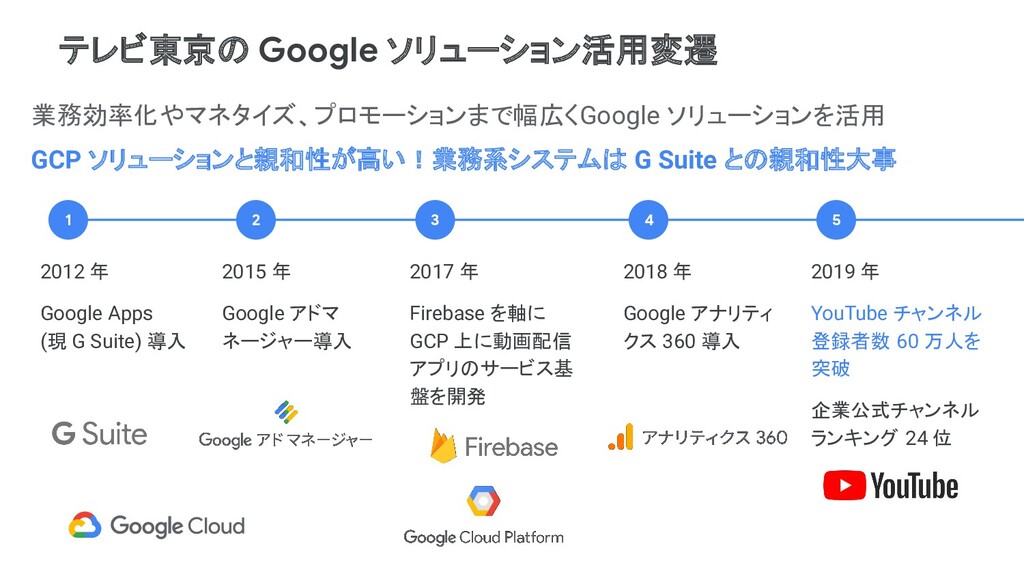
2012 年 Google Apps (現 G Suite) 導入 2015 年
Google アドマ ネージャー導入 2017 年 Firebase を軸に GCP 上に動画配信 アプリのサービス基 盤を開発 1 2 3 4 テレビ東京の Google ソリューション活用変遷 2018 年 Google アナリティ クス 360 導入 業務効率化やマネタイズ、プロモーションまで幅広くGoogle ソリューションを活用 GCP ソリューションと親和性が高い!業務系システムは G Suite との親和性大事 5 2019 年 YouTube チャンネル 登録者数 60 万人を 突破 企業公式チャンネル ランキング 24 位 -
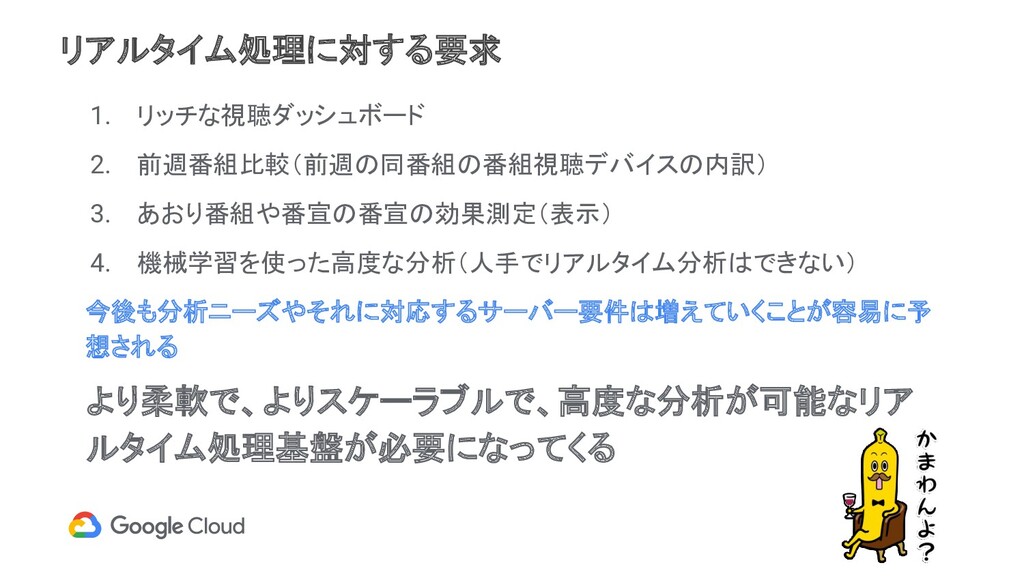
リアルタイム処理に対する要求 1. リッチな視聴ダッシュボード 2. 前週番組比較(前週の同番組の番組視聴デバイスの内訳) 3. あおり番組や番宣の番宣の効果測定(表示) 4. 機械学習を使った高度な分析(人手でリアルタイム分析はできない) 今後も分析ニーズやそれに対応するサーバー要件は増えていくことが容易に予
想される より柔軟で、よりスケーラブルで、高度な分析が可能なリア ルタイム処理基盤が必要になってくる -
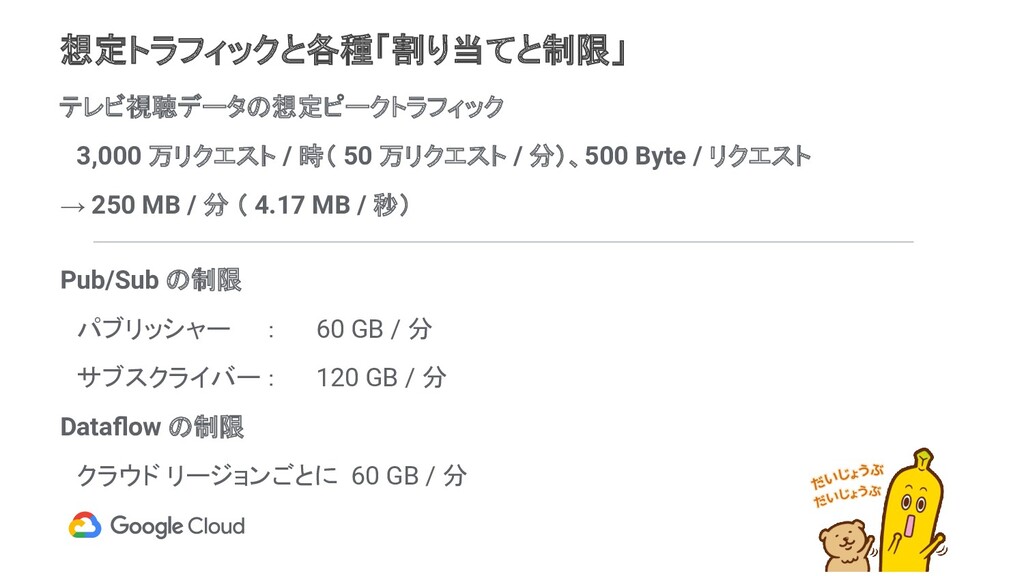
想定トラフィックと各種「割り当てと制限」 テレビ視聴データの想定ピークトラフィック 3,000 万リクエスト / 時( 50 万リクエスト / 分)、500
Byte / リクエスト → 250 MB / 分 ( 4.17 MB / 秒) Pub/Sub の制限 パブリッシャー : 60 GB / 分 サブスクライバー : 120 GB / 分 Dataflow の制限 クラウド リージョンごとに 60 GB / 分 -
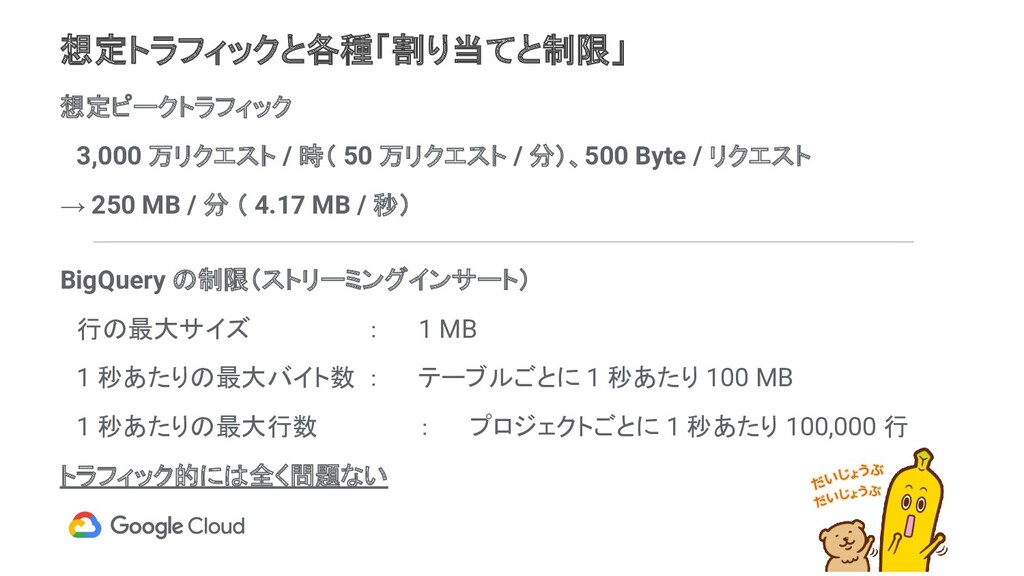
想定トラフィックと各種「割り当てと制限」 想定ピークトラフィック 3,000 万リクエスト / 時( 50 万リクエスト / 分)、500
Byte / リクエスト → 250 MB / 分 ( 4.17 MB / 秒) BigQuery の制限(ストリーミングインサート) 行の最大サイズ : 1 MB 1 秒あたりの最大バイト数 : テーブルごとに 1 秒あたり 100 MB 1 秒あたりの最大行数 : プロジェクトごとに 1 秒あたり 100,000 行 トラフィック的には全く問題ない -
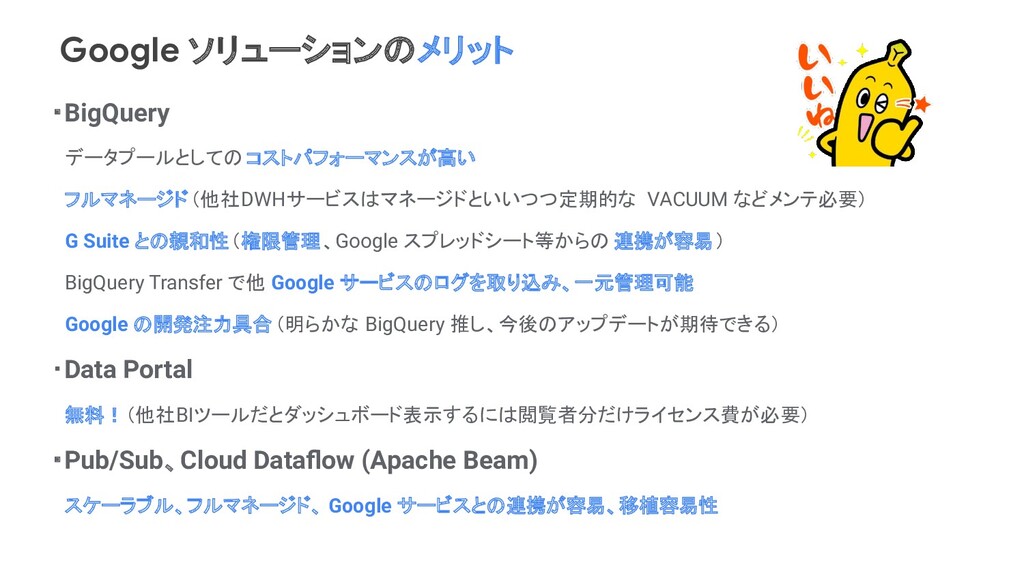
・BigQuery データプールとしての コストパフォーマンスが高い フルマネージド(他社DWHサービスはマネージドといいつつ定期的な VACUUM などメンテ必要) G Suite との親和性(権限管理、Google スプレッドシート等からの
連携が容易) BigQuery Transfer で他 Google サービスのログを取り込み、一元管理可能 Google の開発注力具合(明らかな BigQuery 推し、今後のアップデートが期待できる) ・Data Portal 無料!(他社BIツールだとダッシュボード表示するには閲覧者分だけライセンス費が必要) ・Pub/Sub、Cloud Dataflow (Apache Beam) スケーラブル、フルマネージド、 Google サービスとの連携が容易、移植容易性 Google ソリューションのメリット -
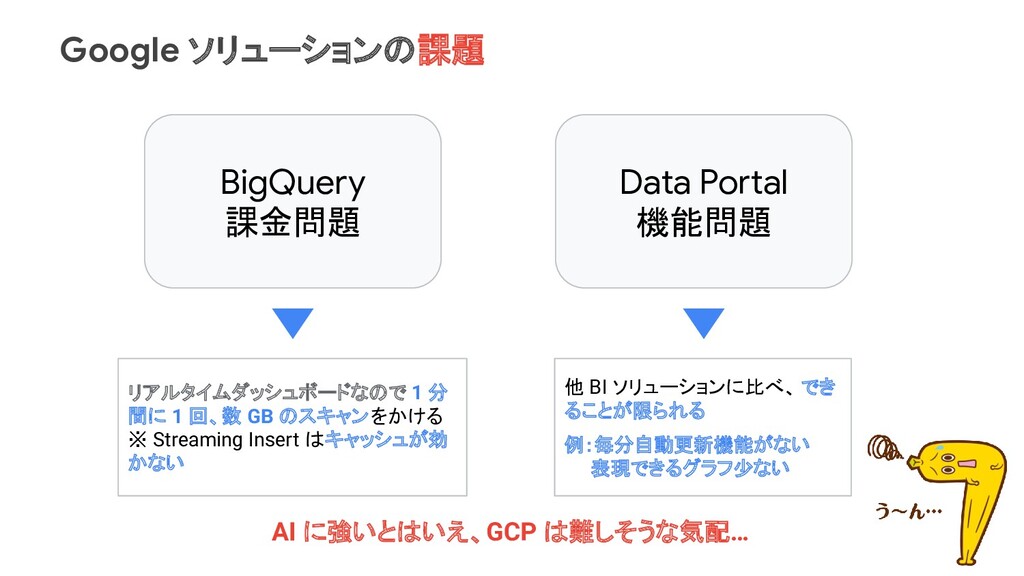
Google ソリューションの課題 BigQuery 課金問題 Data Portal 機能問題 リアルタイムダッシュボードなので 1 分
間に 1 回、数 GB のスキャンをかける ※ Streaming Insert はキャッシュが効 かない 他 BI ソリューションに比べ、 でき ることが限られる 例:毎分自動更新機能がない 表現できるグラフ少ない AI に強いとはいえ、GCP は難しそうな気配… -
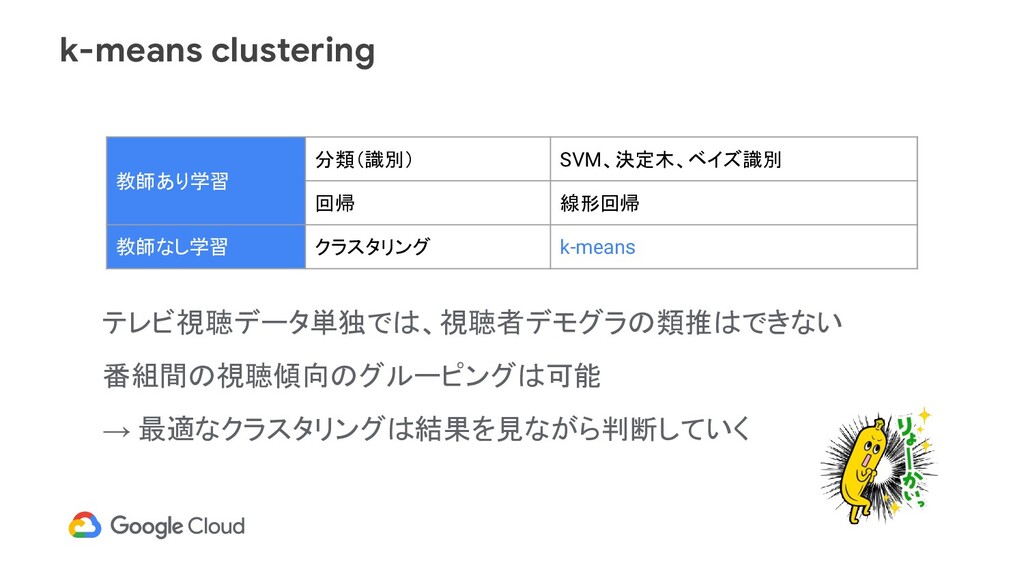
ドンピシャなアップデートたち BigQuery BI Engine(β版サービスのため、仕様が今後変更になる可能性あり) インメモリの分析サービスで、膨大かつ複雑なデータをほぼ瞬時に可視化、 分析、 操作を可能にする。現時点ではデータポータルからのみ利用可能。 BigQuery : k-means clustering
ML(β版提供) BigQuery 内 Standard SQL を通じ、指定する軸や属性に基づいてデータの クラ スタリングができる。専門的な知識がなくても機械学習を利用できる AutoML Tables(β版提供) 構造化データを基に AI を使って予測的なインサイトを導き出すことが可能。モデリ ング用データは BigQuery、Cloud Storage、その他ソースから取り込み可 -
ドンピシャなアップデートたち Connected sheets Google Spreadsheet から BigQuery に対してクエリを投げ、結果をグラフ化できる新 しい種類のスプレッドシート。数クリックするだけでデータをスプレッドシート上のダッ シュボードとして可視化し、セキュアに組織内で共有可能。
Cloud Dataflow SQL (パブリック アルファ提供) Cloud Pub/Sub に入っている Streaming データに対して adhoc にクエリを かけら れる。トラブル時に調査する際に便利 GCP で行けそうな気がしてきた! 特に BigQuery 周りのアップデートが多いので将来性高そう! -
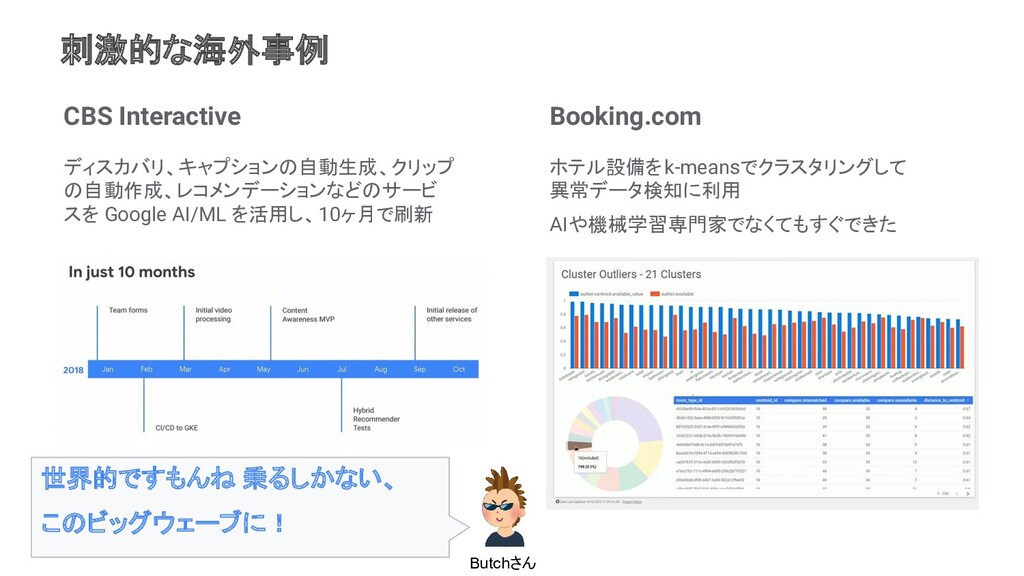
刺激的な海外事例 Booking.com ホテル設備をk-meansでクラスタリングして 異常データ検知に利用 AIや機械学習専門家でなくてもすぐできた CBS Interactive ディスカバリ、キャプションの自動生成、クリップ の自動作成、レコメンデーションなどのサービ スを
Google AI/ML を活用し、10ヶ月で刷新 世界的ですもんね 乗るしかない、 このビッグウェーブに! Butchさん -
リアルタイム表示&分析 ・前週からの継続視聴者数と新規視聴者数の内訳表示 ・流入/離脱数表示 ・嗜好分類表示(アニメ好き、バラエティ好き、等) リアルタイム ログ転送 リアルタイム表示 結線TV 結線TV 結線TV
BigQuery Data Portal 機械学習を使った顧客分析 視聴時間や視聴ジャンルからクラスタリングを行い、どのような視聴傾向 があるのかの分析を行う 実現したい構成 番宣やあおり番組の効果測定 番宣枠とOA枠(時間)を登録したら、 番宣視聴者が視聴につながったかを確認可能 Cloud Dataflow Cloud Pub/Sub fluentd (td-agent) -
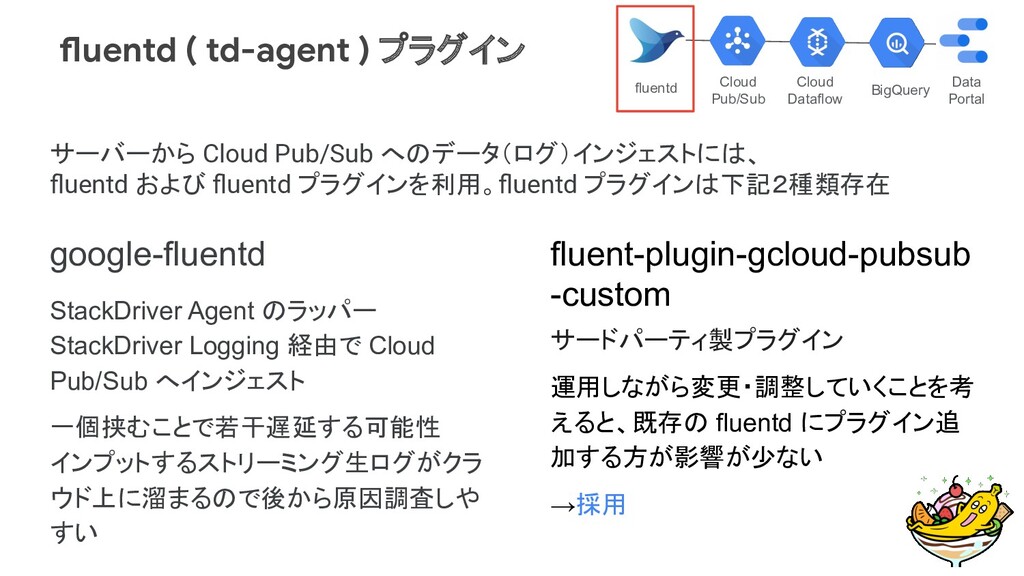
fluentd ( td-agent ) プラグイン fluent-plugin-gcloud-pubsub -custom サードパーティ製プラグイン 運用しながら変更・調整していくことを考 えると、既存の
fluentd にプラグイン追 加する方が影響が少ない →採用 BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd サーバーから Cloud Pub/Sub へのデータ(ログ)インジェストには、 fluentd および fluentd プラグインを利用。fluentd プラグインは下記2種類存在 google-fluentd StackDriver Agent のラッパー StackDriver Logging 経由で Cloud Pub/Sub へインジェスト 一個挟むことで若干遅延する可能性 インプットするストリーミング生ログがクラ ウド上に溜まるので後から原因調査しや すい -
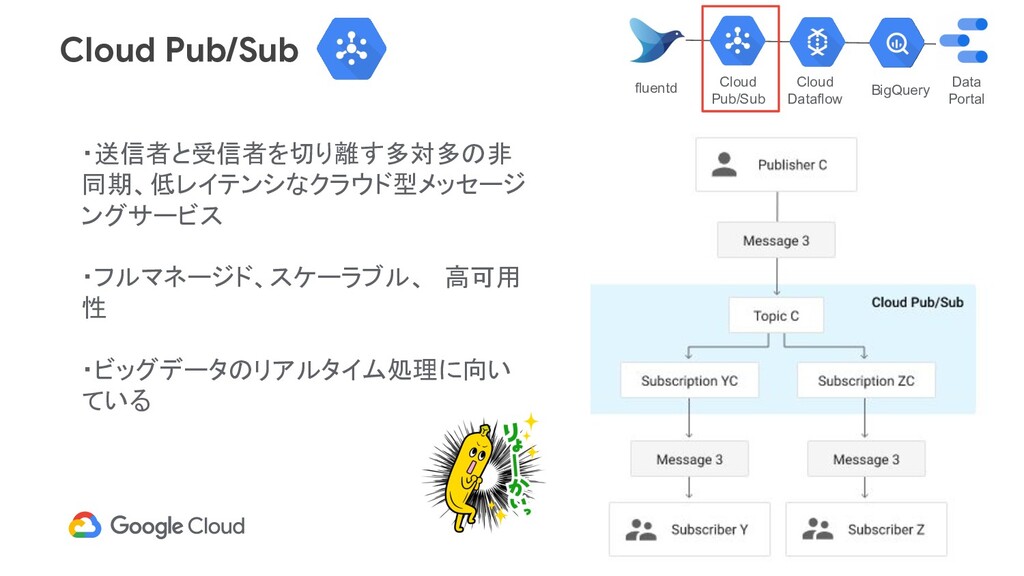
Cloud Pub/Sub ・送信者と受信者を切り離す多対多の非 同期、低レイテンシなクラウド型メッセージ ングサービス ・フルマネージド、スケーラブル、 高可用 性 ・ビッグデータのリアルタイム処理に向い ている BigQuery
Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
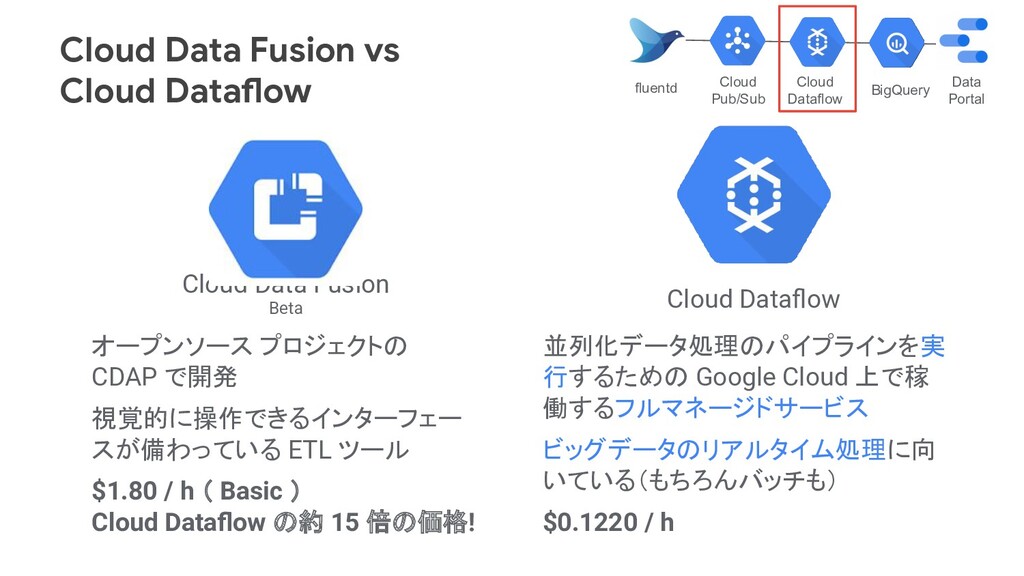
Cloud Data Fusion vs Cloud Dataflow Cloud Data Fusion Beta
Cloud Dataflow オープンソース プロジェクトの CDAP で開発 視覚的に操作できるインターフェー スが備わっている ETL ツール $1.80 / h ( Basic ) Cloud Dataflow の約 15 倍の価格! 並列化データ処理のパイプラインを実 行するための Google Cloud 上で稼 働するフルマネージドサービス ビッグデータのリアルタイム処理に向 いている(もちろんバッチも) $0.1220 / h BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
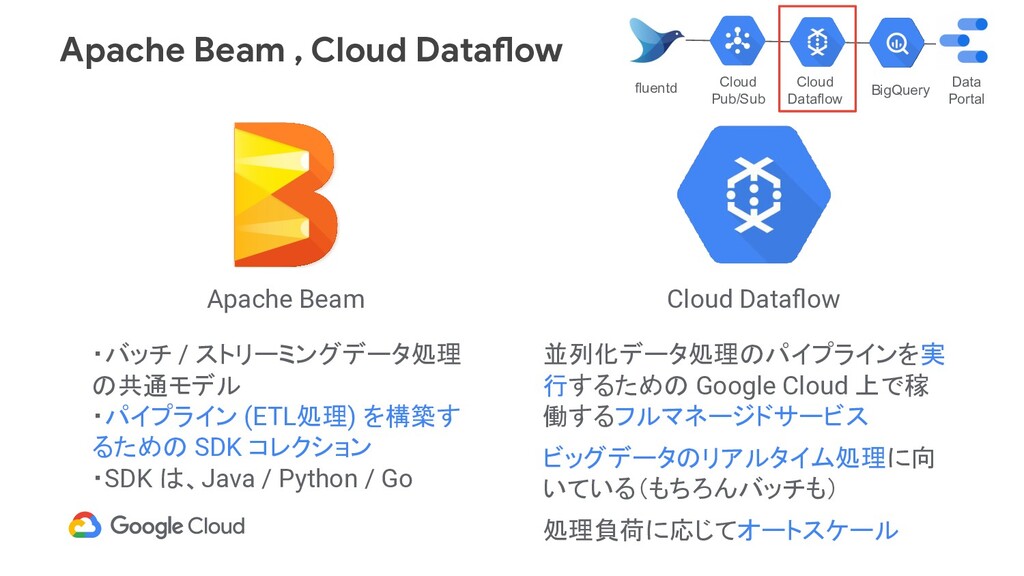
Apache Beam , Cloud Dataflow Apache Beam Cloud Dataflow ・バッチ
/ ストリーミングデータ処理 の共通モデル ・パイプライン (ETL処理) を構築す るための SDK コレクション ・SDK は、Java / Python / Go 並列化データ処理のパイプラインを実 行するための Google Cloud 上で稼 働するフルマネージドサービス ビッグデータのリアルタイム処理に向 いている(もちろんバッチも) 処理負荷に応じてオートスケール BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
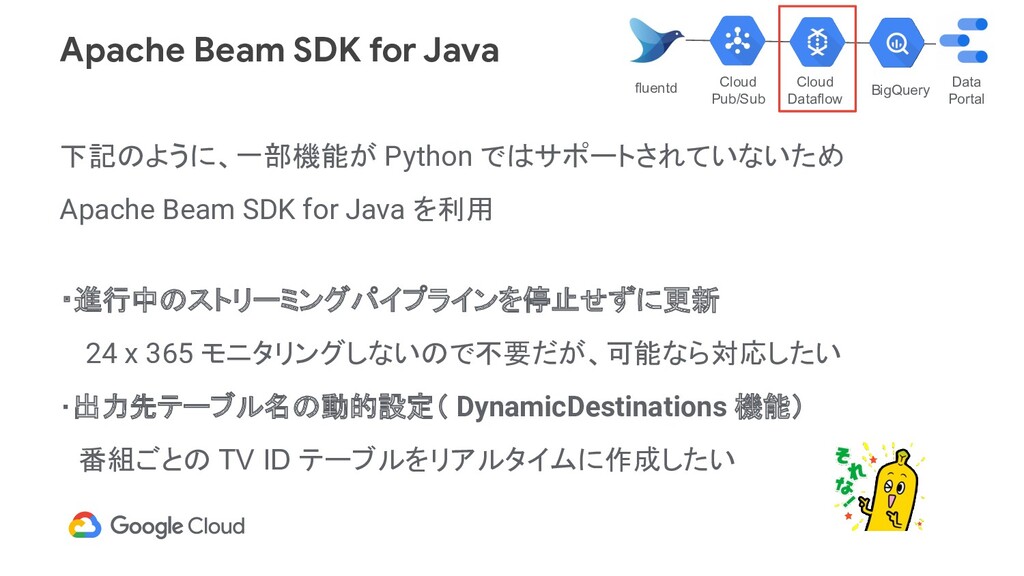
Apache Beam SDK for Java 下記のように、一部機能が Python ではサポートされていないため Apache Beam
SDK for Java を利用 ・進行中のストリーミングパイプラインを停止せずに更新 24 x 365 モニタリングしないので不要だが、可能なら対応したい ・出力先テーブル名の動的設定( DynamicDestinations 機能) 番組ごとの TV ID テーブルをリアルタイムに作成したい BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
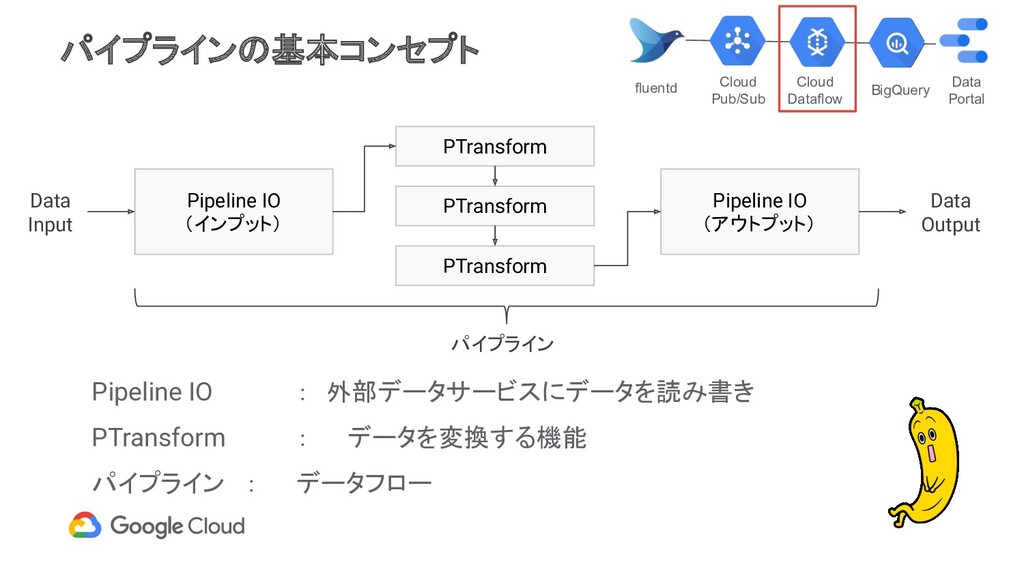
パイプラインの基本コンセプト Pipeline IO : 外部データサービスにデータを読み書き PTransform : データを変換する機能 パイプライン : データフロー
Pipeline IO (インプット) PTransform PTransform PTransform Pipeline IO (アウトプット) Data Input Data Output パイプライン BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
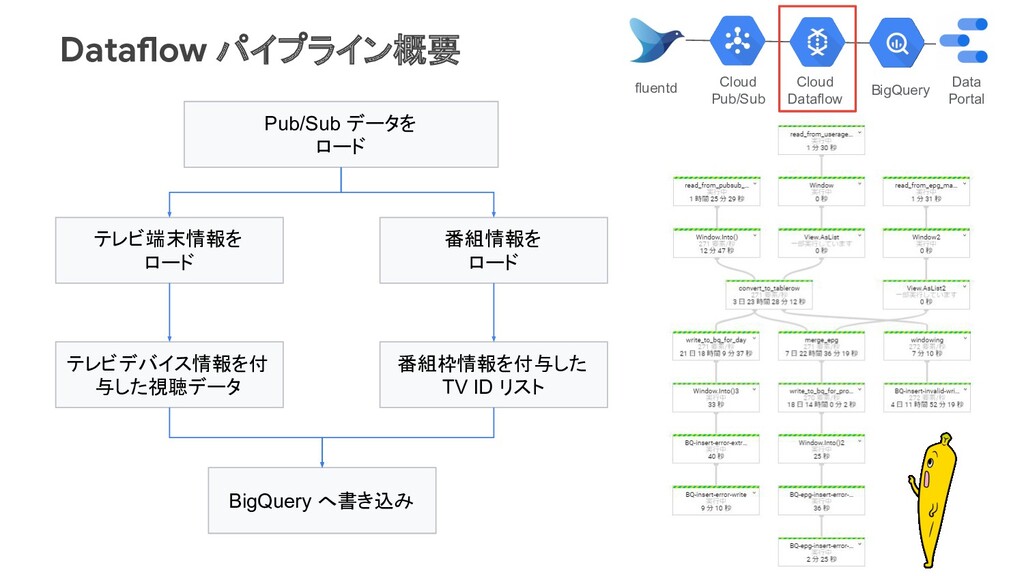
Dataflow パイプライン概要 Pub/Sub データを ロード BigQuery へ書き込み 番組枠情報を付与した TV ID
リスト テレビデバイス情報を付 与した視聴データ テレビ端末情報を ロード 番組情報を ロード BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
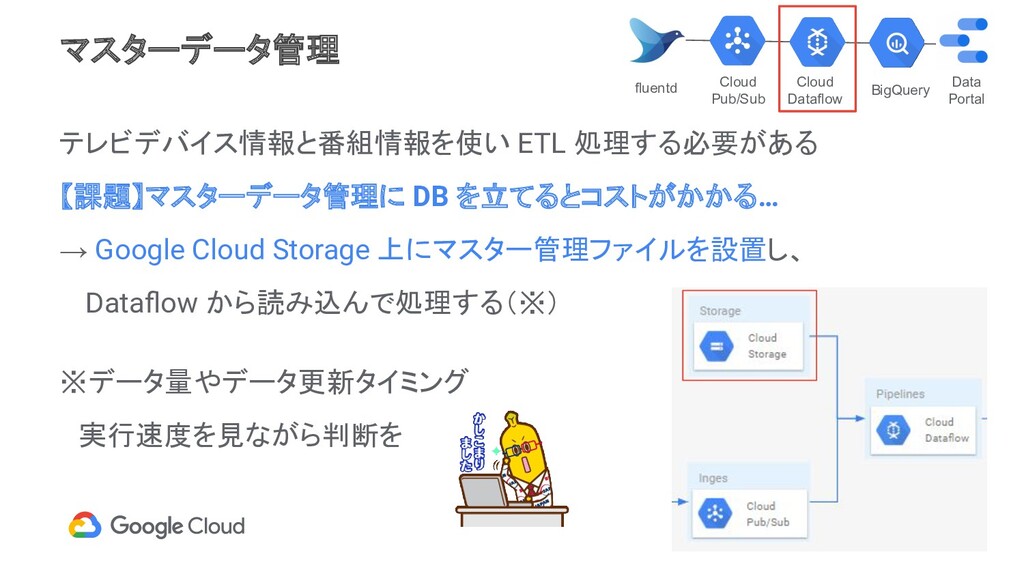
マスターデータ管理 テレビデバイス情報と番組情報を使い ETL 処理する必要がある 【課題】マスターデータ管理に DB を立てるとコストがかかる… → Google Cloud
Storage 上にマスター管理ファイルを設置し、 Dataflow から読み込んで処理する(※) ※データ量やデータ更新タイミング 実行速度を見ながら判断を BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
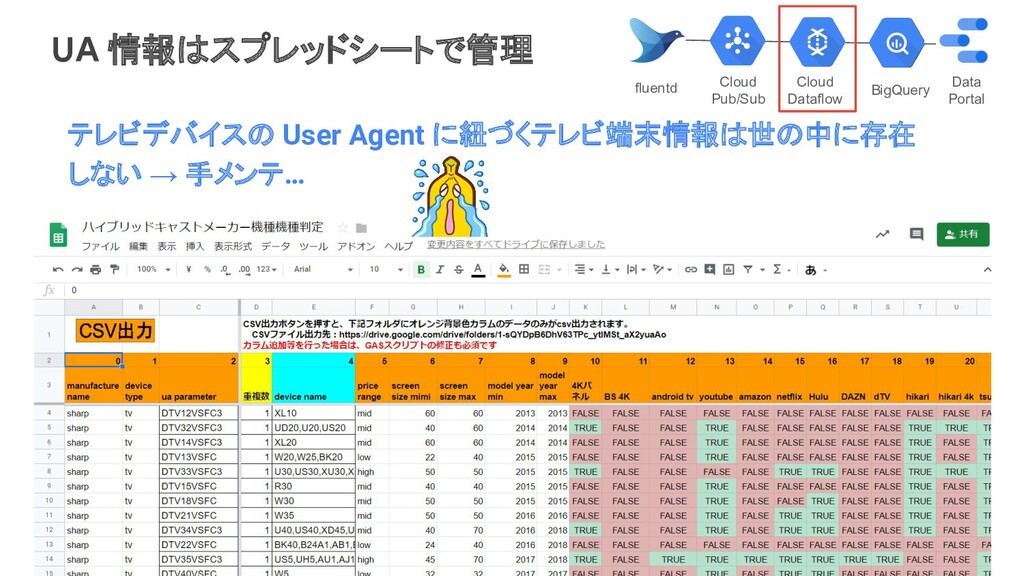
UA 情報はスプレッドシートで管理 テレビデバイスの User Agent に紐づくテレビ端末情報は世の中に存在 しない → 手メンテ… BigQuery
Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
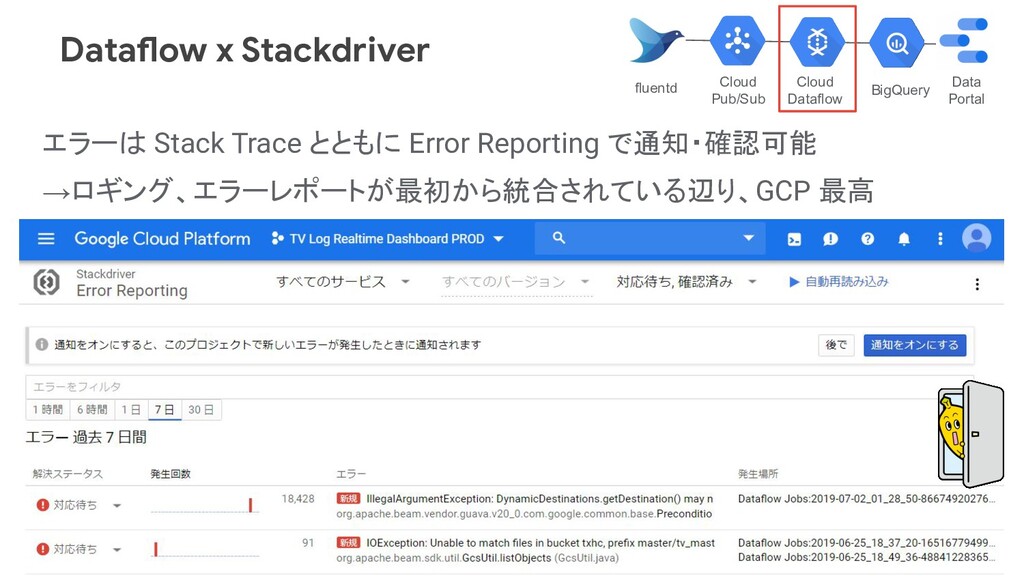
Dataflow x Stackdriver エラーは Stack Trace とともに Error Reporting で通知・確認可能
→ロギング、エラーレポートが最初から統合されている辺り、GCP 最高 BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
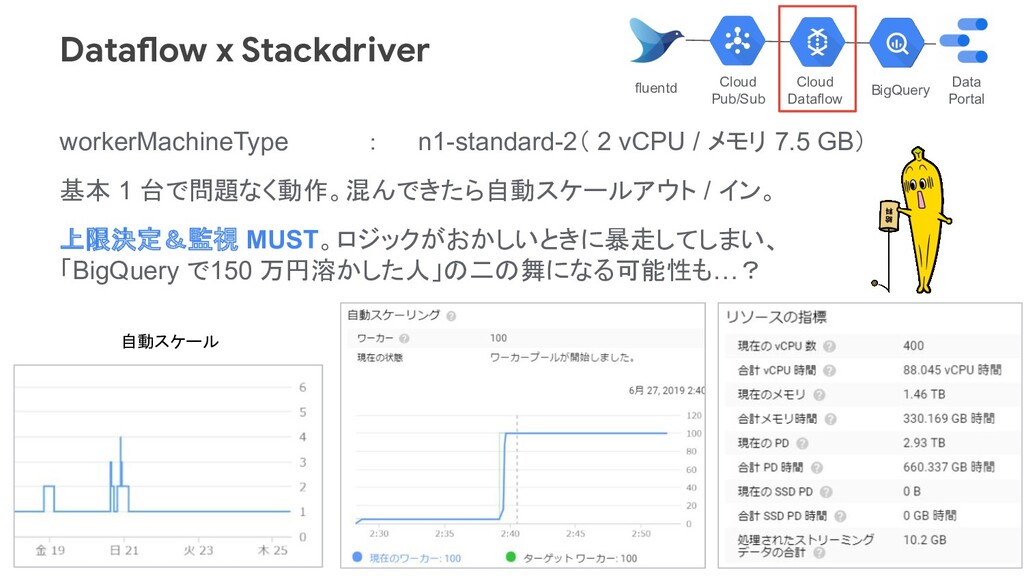
Dataflow x Stackdriver workerMachineType : n1-standard-2( 2 vCPU / メモリ
7.5 GB) 基本 1 台で問題なく動作。混んできたら自動スケールアウト / イン。 上限決定&監視 MUST。ロジックがおかしいときに暴走してしまい、 「BigQuery で150 万円溶かした人」の二の舞になる可能性も…? BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd 自動スケール -
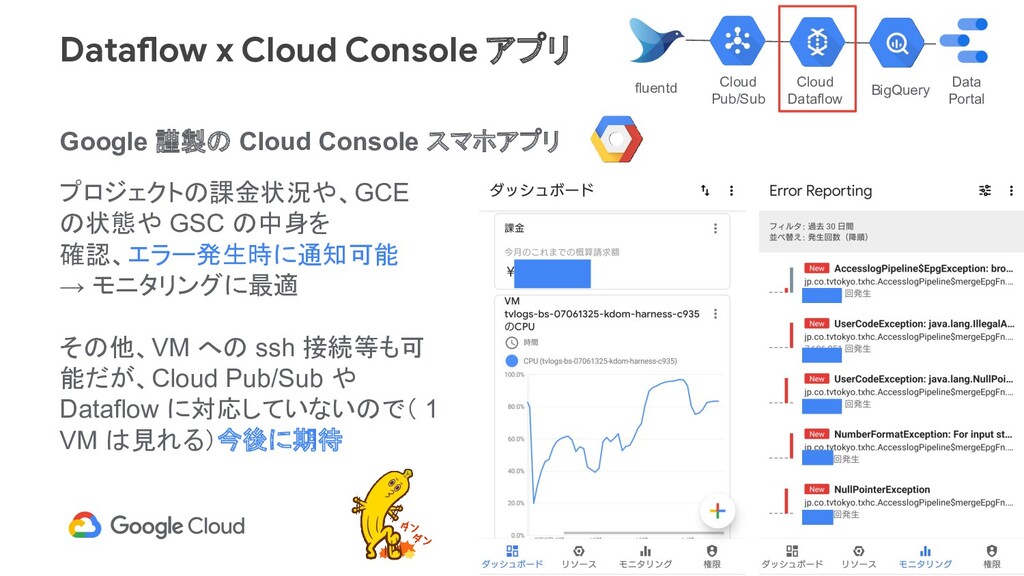
Dataflow x Cloud Console アプリ BigQuery Data Portal Cloud Dataflow
Cloud Pub/Sub fluentd Google 謹製の Cloud Console スマホアプリ プロジェクトの課金状況や、GCE の状態や GSC の中身を 確認、エラー発生時に通知可能 → モニタリングに最適 その他、VM への ssh 接続等も可 能だが、Cloud Pub/Sub や Dataflow に対応していないので( 1 VM は見れる)今後に期待 -
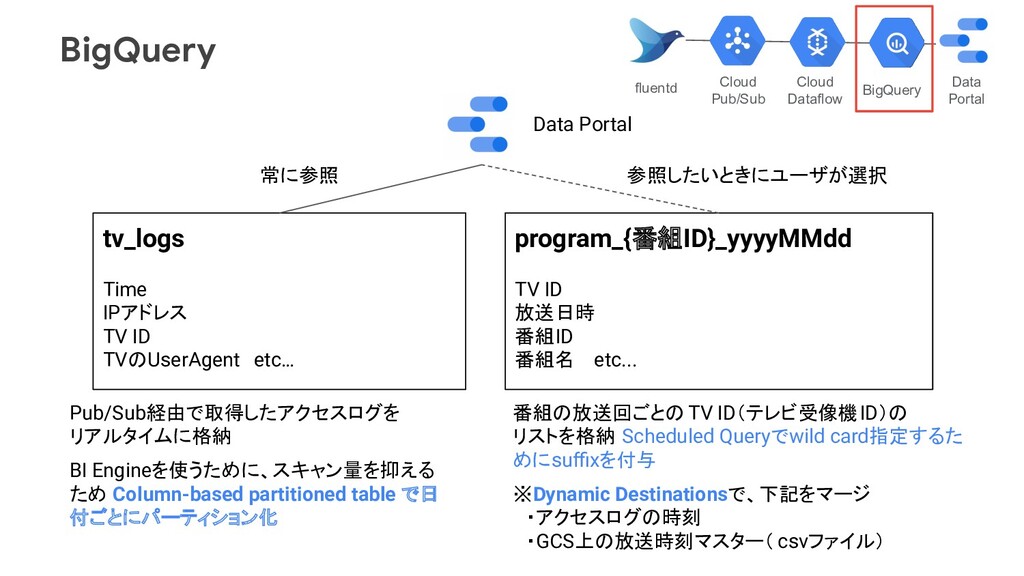
BigQuery Pub/Sub経由で取得したアクセスログを リアルタイムに格納 BI Engineを使うために、スキャン量を抑える ため Column-based partitioned table で日
付ごとにパーティション化 番組の放送回ごとの TV ID(テレビ受像機ID)の リストを格納 Scheduled Queryでwild card指定するた めにsuffixを付与 ※Dynamic Destinationsで、下記をマージ ・アクセスログの時刻 ・GCS上の放送時刻マスター( csvファイル) tv_logs Time IPアドレス TV ID TVのUserAgent etc… program_{番組ID}_yyyyMMdd TV ID 放送日時 番組ID 番組名 etc... 常に参照 参照したいときにユーザが選択 Data Portal BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
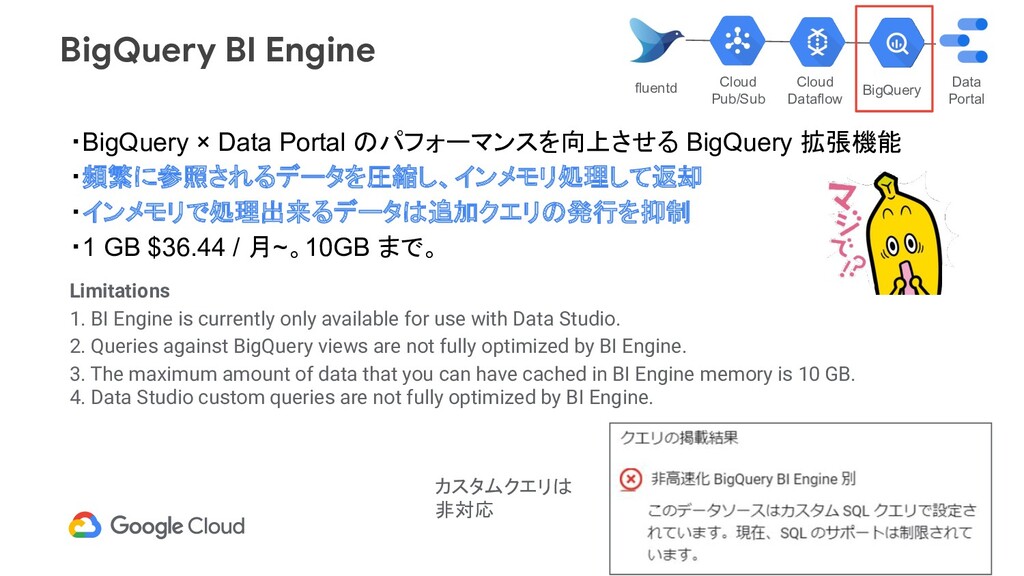
BigQuery BI Engine ・BigQuery × Data Portal のパフォーマンスを向上させる BigQuery 拡張機能
・頻繁に参照されるデータを圧縮し、インメモリ処理して返却 ・インメモリで処理出来るデータは追加クエリの発行を抑制 ・1 GB $36.44 / 月~。10GB まで。 Limitations 1. BI Engine is currently only available for use with Data Studio. 2. Queries against BigQuery views are not fully optimized by BI Engine. 3. The maximum amount of data that you can have cached in BI Engine memory is 10 GB. 4. Data Studio custom queries are not fully optimized by BI Engine. カスタムクエリは 非対応 BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
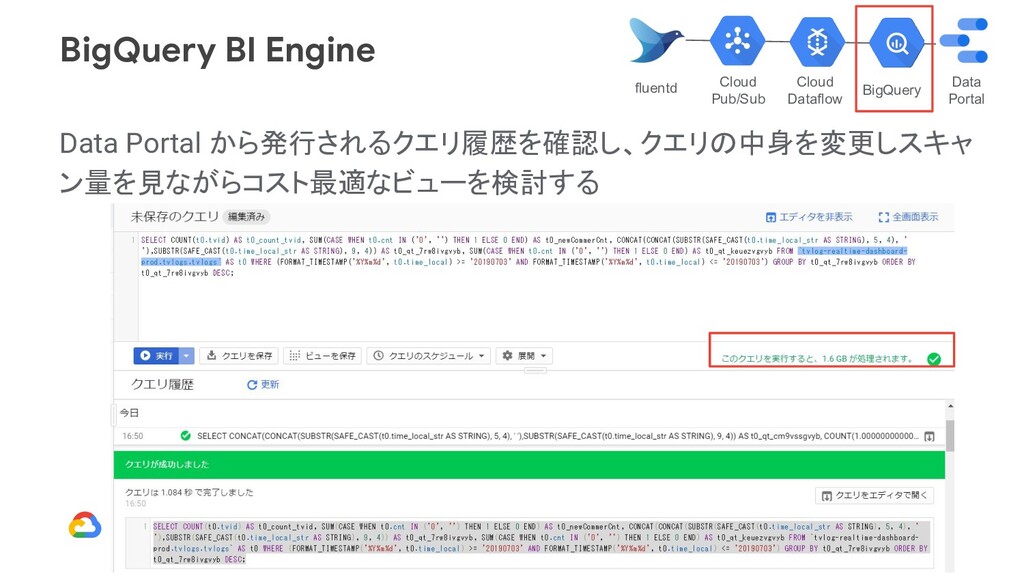
BigQuery BI Engine Data Portal から発行されるクエリ履歴を確認し、クエリの中身を変更しスキャ ン量を見ながらコスト最適なビューを検討する BigQuery Data Portal
Cloud Dataflow Cloud Pub/Sub fluentd -
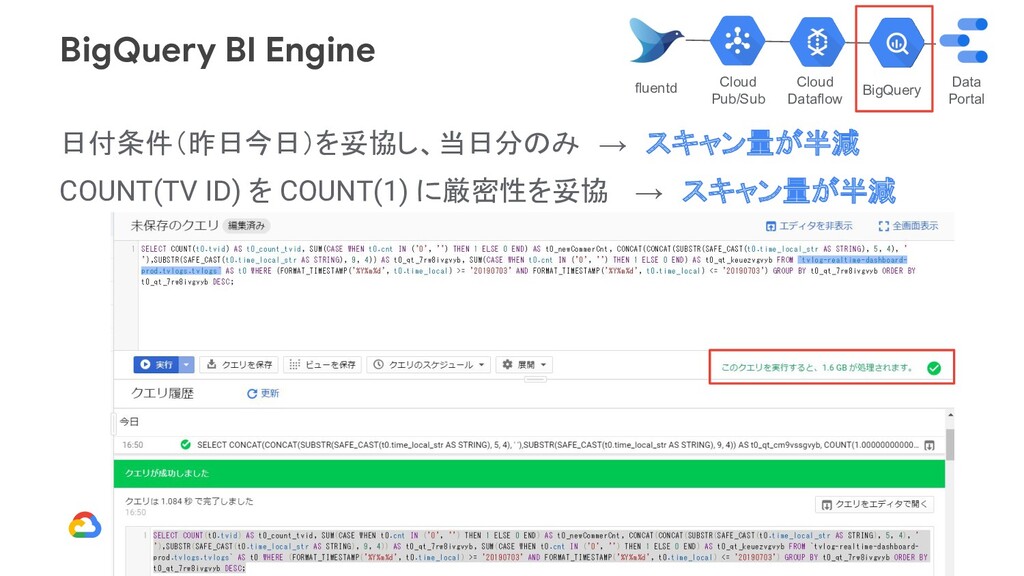
BigQuery BI Engine 日付条件(昨日今日)を妥協し、当日分のみ → スキャン量が半減 COUNT(TV ID) を COUNT(1) に厳密性を妥協 → スキャン量が半減
BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
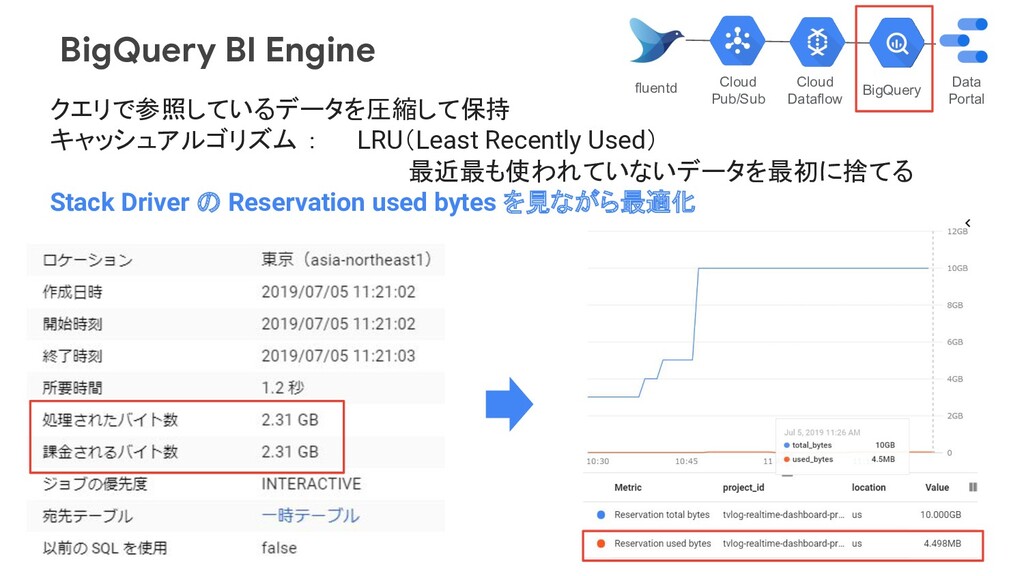
BigQuery BI Engine クエリで参照しているデータを圧縮して保持 キャッシュアルゴリズム : LRU(Least Recently Used) 最近最も使われていないデータを最初に捨てる
Stack Driver の Reservation used bytes を見ながら最適化 BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
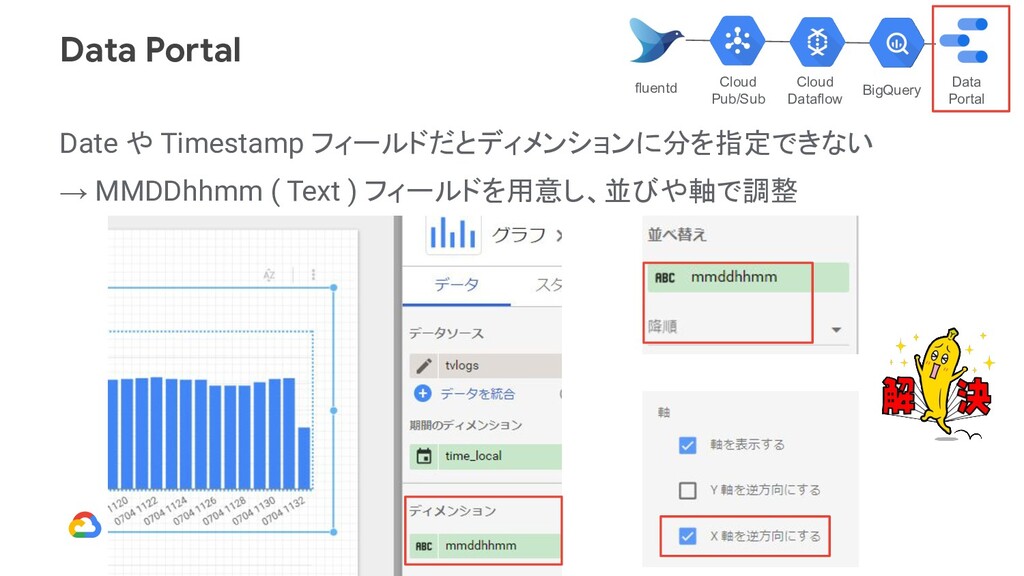
Data Portal Date や Timestamp フィールドだとディメンションに分を指定できない → MMDDhhmm ( Text
) フィールドを用意し、並びや軸で調整 BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
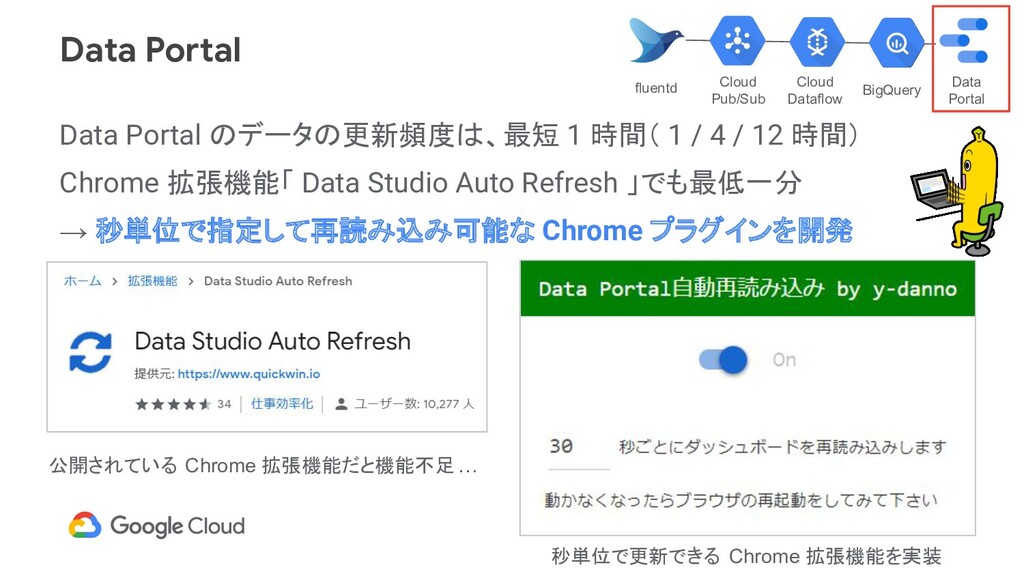
Data Portal Data Portal のデータの更新頻度は、最短 1 時間( 1 / 4
/ 12 時間) Chrome 拡張機能「 Data Studio Auto Refresh 」でも最低一分 → 秒単位で指定して再読み込み可能な Chrome プラグインを開発 公開されている Chrome 拡張機能だと機能不足 … 秒単位で更新できる Chrome 拡張機能を実装 BigQuery Data Portal Cloud Dataflow Cloud Pub/Sub fluentd -
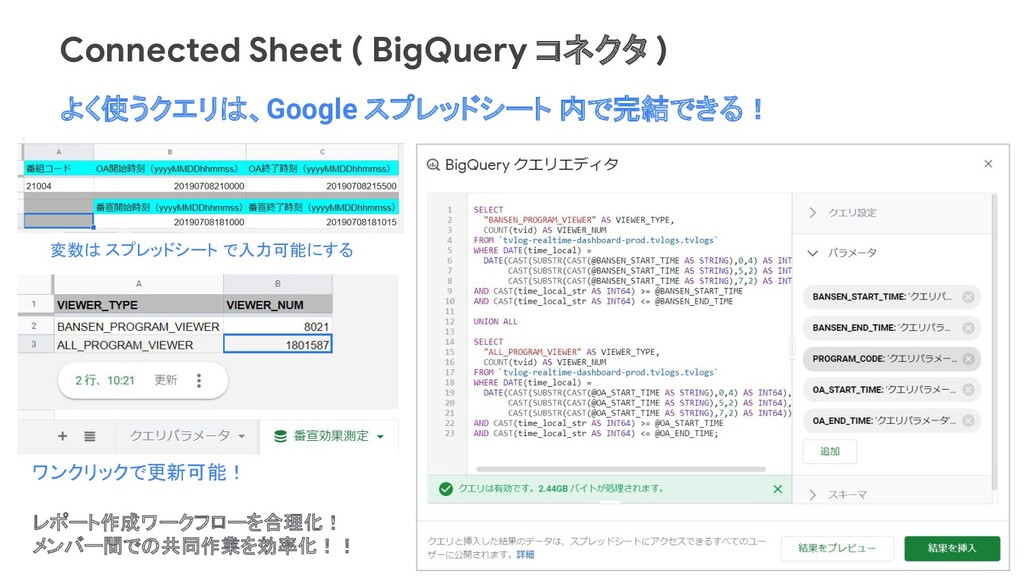
Connected Sheet ( BigQuery コネクタ ) レポート作成ワークフローを合理化! メンバー間での共同作業を効率化!! よく使うクエリは、Google スプレッドシート
内で完結できる! 変数は スプレッドシート で入力可能にする ワンクリックで更新可能! -
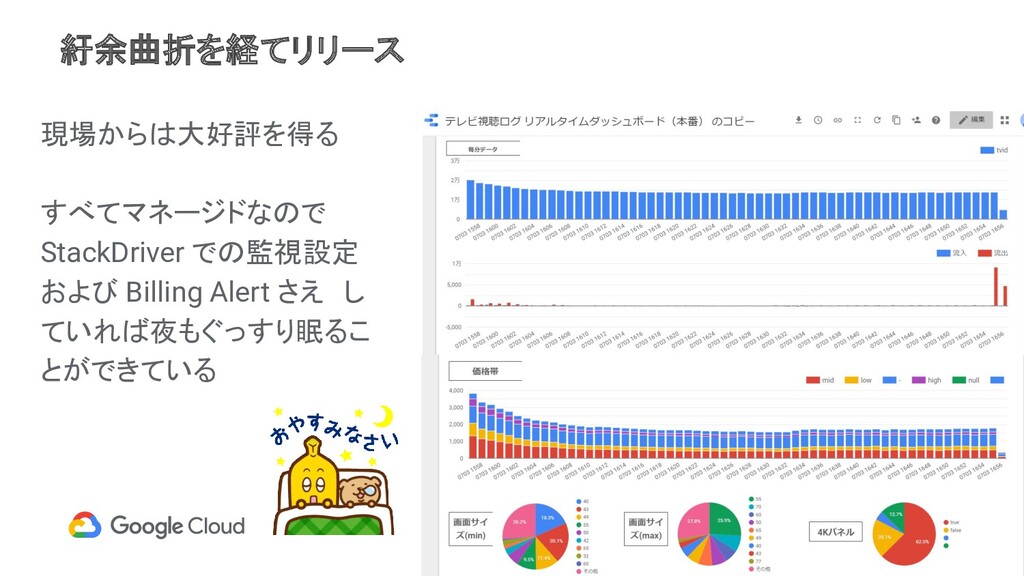
紆余曲折を経てリリース、その後 数字を見て思考する機会が増えた 動くものをユーザーに見せることで、新たな要望が出てくる ・データ更新は 1 分より短くしてほしい ・流入出は気になった時刻で、秒単位にドリルダウンしたい ・どのシーンで離脱したか、シーンごとのメタ情報も欲しい 荒削りでもいいので、迅速にプロダクト化し、フィードバック→改善のループを 素早く回していくことが大事。特にデータ系は!
Cloud Pub/Sub, Cloud Dataflow, BigQuery, データポータル 等の GCP 環境、G Suite は、そのために最適な環境! -
その他、感想 ・データ取得のワークロードを GCP 環境に統一化できたとはいえ、ETL 処理 部分の予期せぬ障害(ロジックのバグ)で取得できなくなる可能性はあるの で、既存のバッチ処理でのデータ取得経路はバックアップ経路として残して おいた方が良い ・Cloud Dataflow
はプログラムさえ組めばどんな処理も実現できるが保守 性の観点からは低いため、今後の Cloud Data Fusion の料金低下を期待 ・データポータル のアップデートは頻繁で今後も期待しているものの、 Looker がどうサービス提供されるかが一番の関心事 -
BigQuery ML 専門的な知識がなくても機械学習を利用できる! 2019 年 7 月 1 日現在で利用可能な機能 *
Linear regression - 線形回帰 * Binary logistic regression - 2値分類 * Multiclass logistic regression - 多値分類 * K-means clustering - K-means クラスタリング * BigQuery 上での予測用の TensorFlow モデルのインポート 今後利用可能になる予定の機能 * 協調フィルタリング (Matrix factorization) * TensorFlow を用いたディープニューラルネットワーク * Feature pre-processing functions -
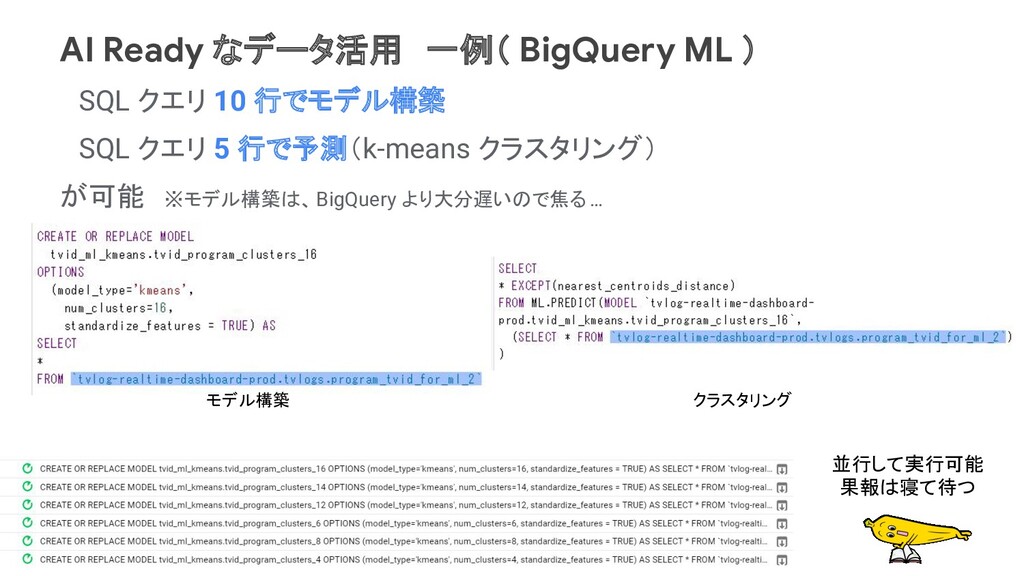
AI Ready なデータ活用 一例( BigQuery ML ) SQL クエリ 10 行でモデル構築
SQL クエリ 5 行で予測(k-means クラスタリング) が可能 ※モデル構築は、BigQuery より大分遅いので焦る … モデル構築 クラスタリング 並行して実行可能 果報は寝て待つ -
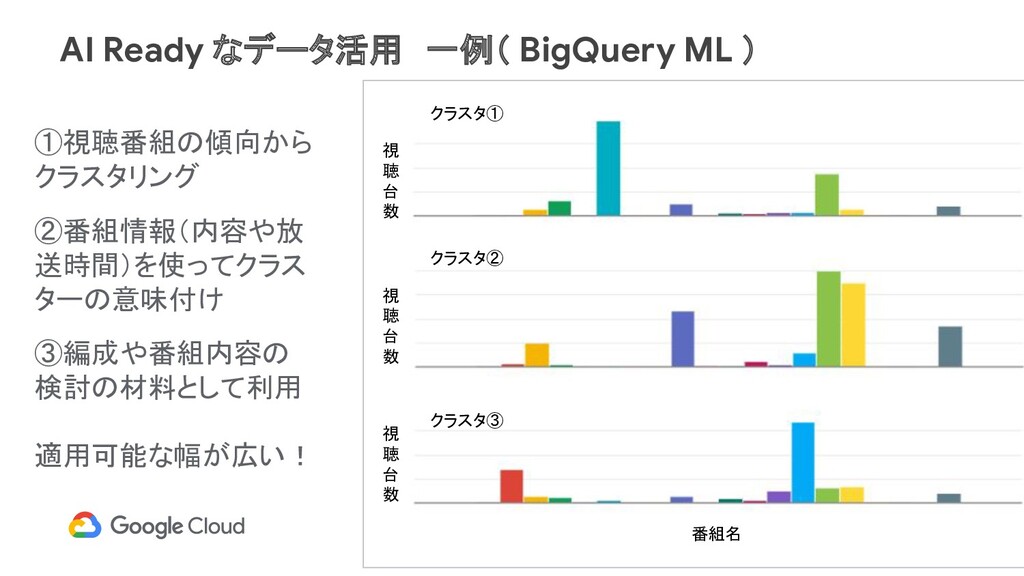
番組名 視 聴 台 数 視 聴 台 数 視
聴 台 数 クラスタ① クラスタ② クラスタ③ AI Ready なデータ活用 一例( BigQuery ML ) ①視聴番組の傾向から クラスタリング ②番組情報(内容や放 送時間)を使ってクラス ターの意味付け ③編成や番組内容の 検討の材料として利用 適用可能な幅が広い! -
まとめ ・BI Engine がリリースされ、BigQuery x データポータル ソリューションの活 用は、待ったなし! ・AI Ready
なデータを用意し、機械学習を使った分析、待ったなし! ・荒削りでもいいので、迅速にプロダクト化し、 フィードバック→改善のループを素早く回していくことが大事! ・データ活用の文化醸成にはユーザー自ら結果を出すことが大事! データポータル や Connected Sheet は非常に有用なツール & -
FUN Google Cloud で 開発、楽しい! Developer Keynote: Get to the
Fun Part (Cloud Next '19) -
今後の展望 より多くのデータを集める! Twitter のツイートやシーンメタなどテレビ視聴分析に有用そうな データも Dataflow でリアルタイム取得 → 可視化・分析へ より多くのデータを活用する!
BigQuery ML や 各種 AI ソリューションと活用し、 データを使って番組や編成改善、価値創出! そのための最適な環境を GCP が提供し続けて欲しい!