Share
Embed
[Journal club] ReMEmbR: Building and Reasoning Over Long-Horizon Spatio-Temporal Memory for Robot Navigation
Semantic Machine Intelligence Lab., Keio Univ. PRO
April 22, 2026
Transcript
16 slides
-
Abrar Anwar1, 2, John Welsh1, Joydeep Biswas1, 3, Soha Pouya1,
Yan Chang1 1NVIDIA, 2University of Southern California, 3University of Texas at Austin ICRA 2025 慶應義塾大学 杉浦孔明研究室 B4 高科明哲 ReMEmbR: Building and Reasoning Over Long-Horizon Spatio-Temporal Memory for Robot Navigation Abrar Anwar, et al. ReMEmbR: Building and Reasoning Over Long-Horizon Spatio-Temporal Memory for Robot Navigation. ICRA 2025. pp. 2838-2845. -
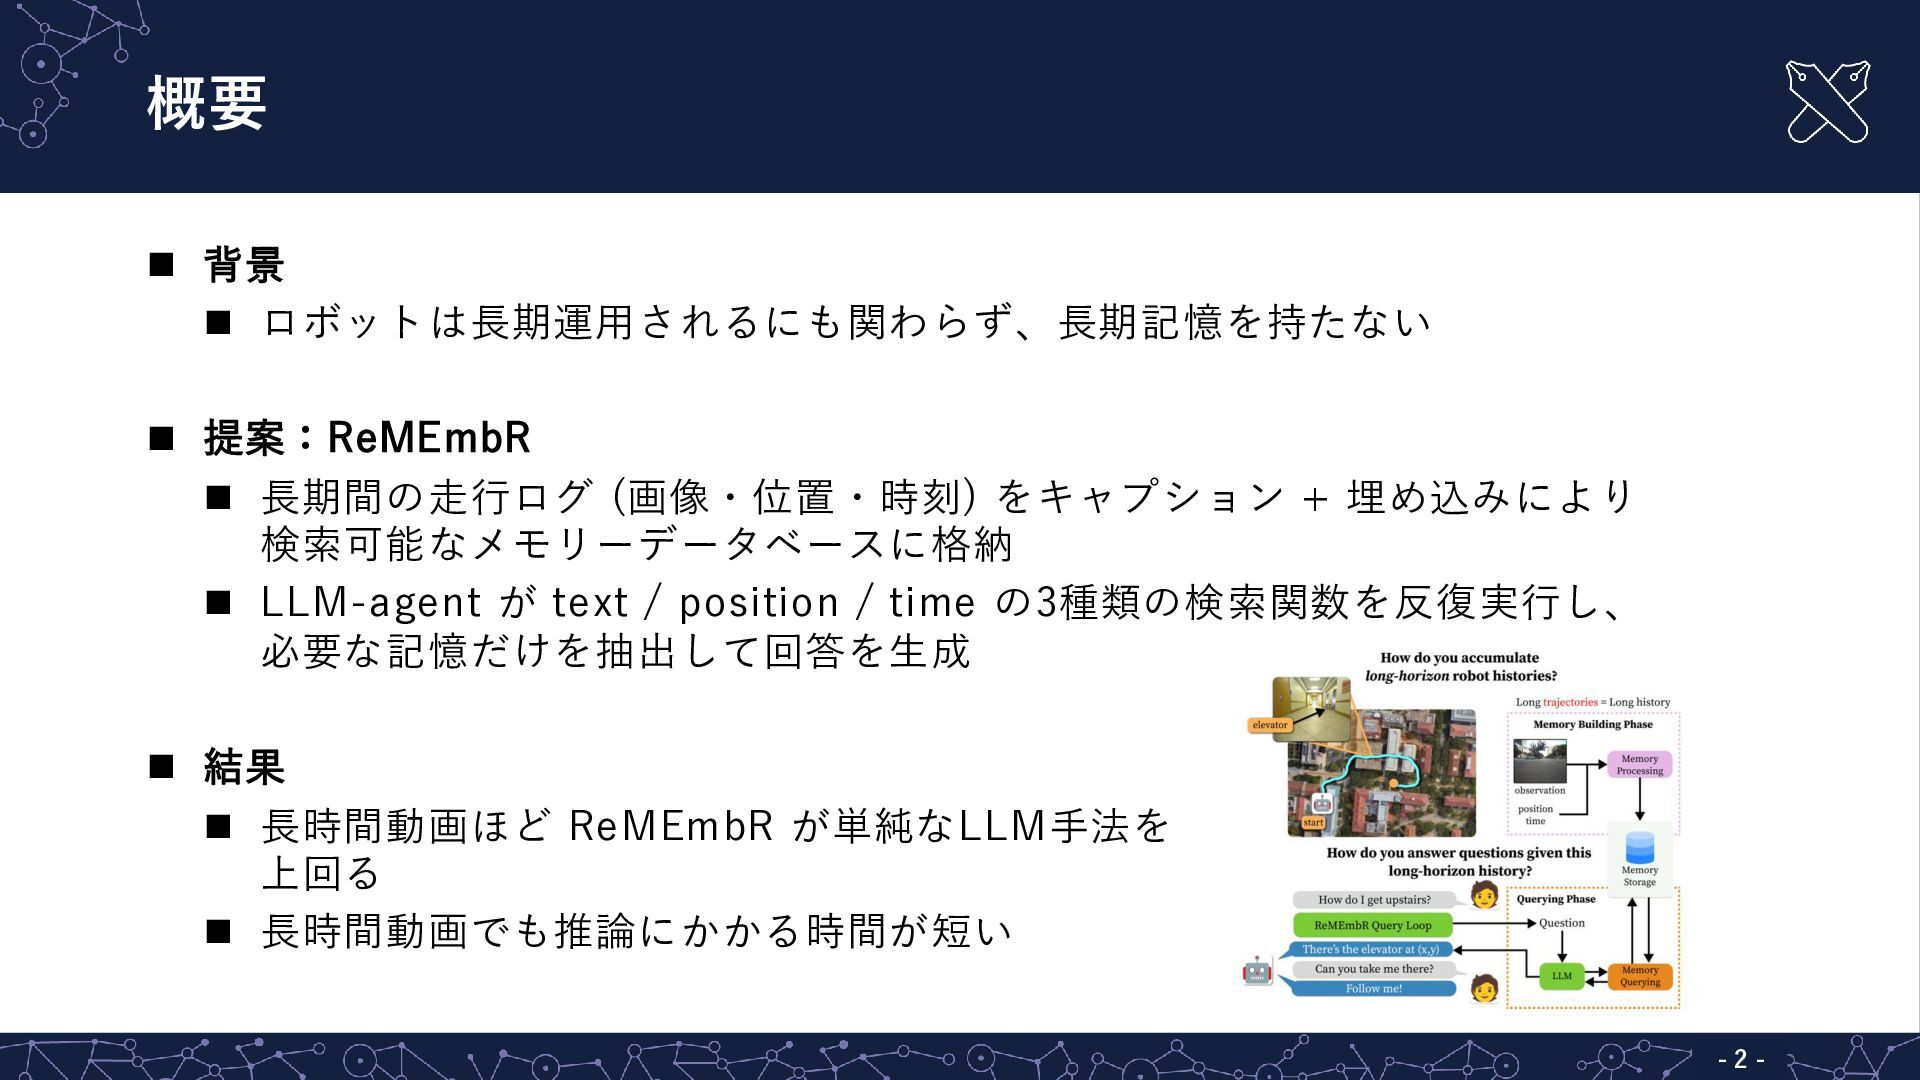
概要 - 2 - ◼ 提案:ReMEmbR ◼ 長期間の走行ログ (画像・位置・時刻) をキャプション
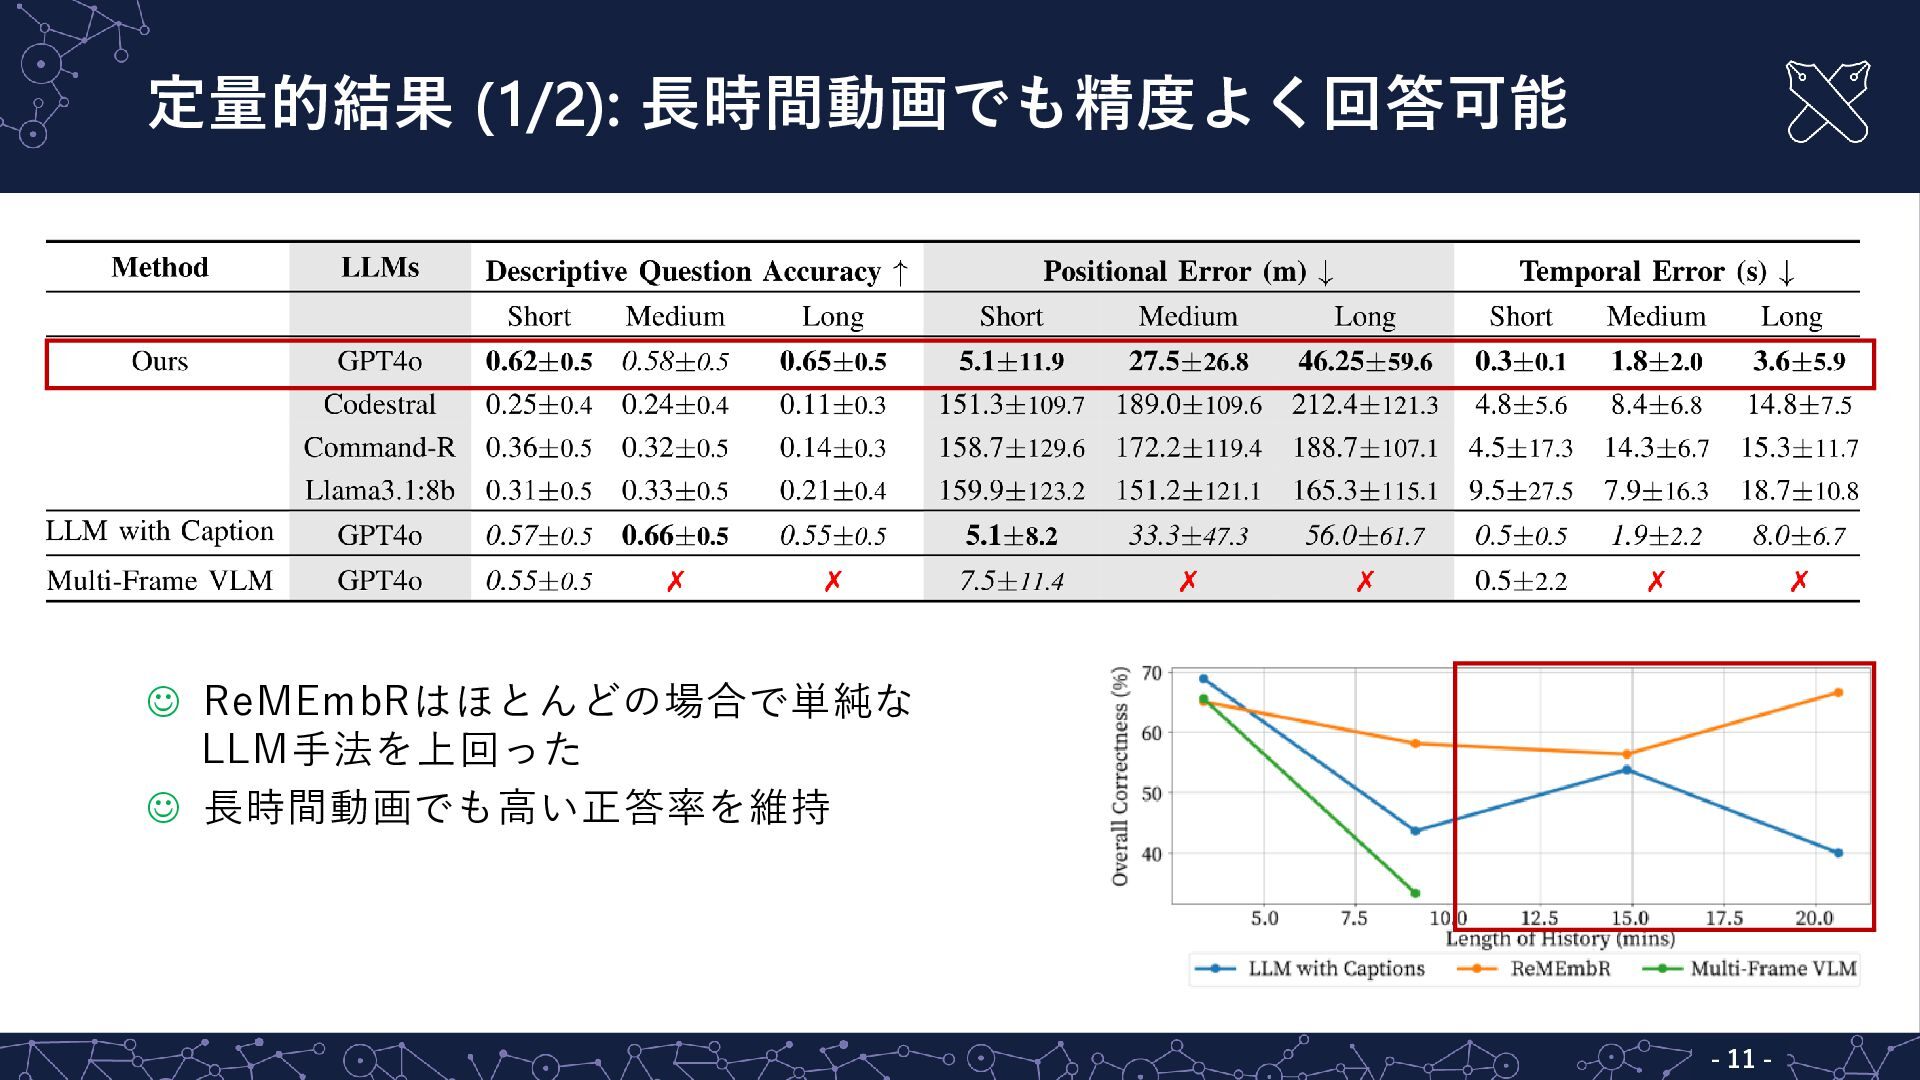
+ 埋め込みにより 検索可能なメモリーデータベースに格納 ◼ LLM-agent が text / position / time の3種類の検索関数を反復実行し、 必要な記憶だけを抽出して回答を生成 ◼ 結果 ◼ 長時間動画ほど ReMEmbR が単純なLLM手法を 上回る ◼ 長時間動画でも推論にかかる時間が短い -
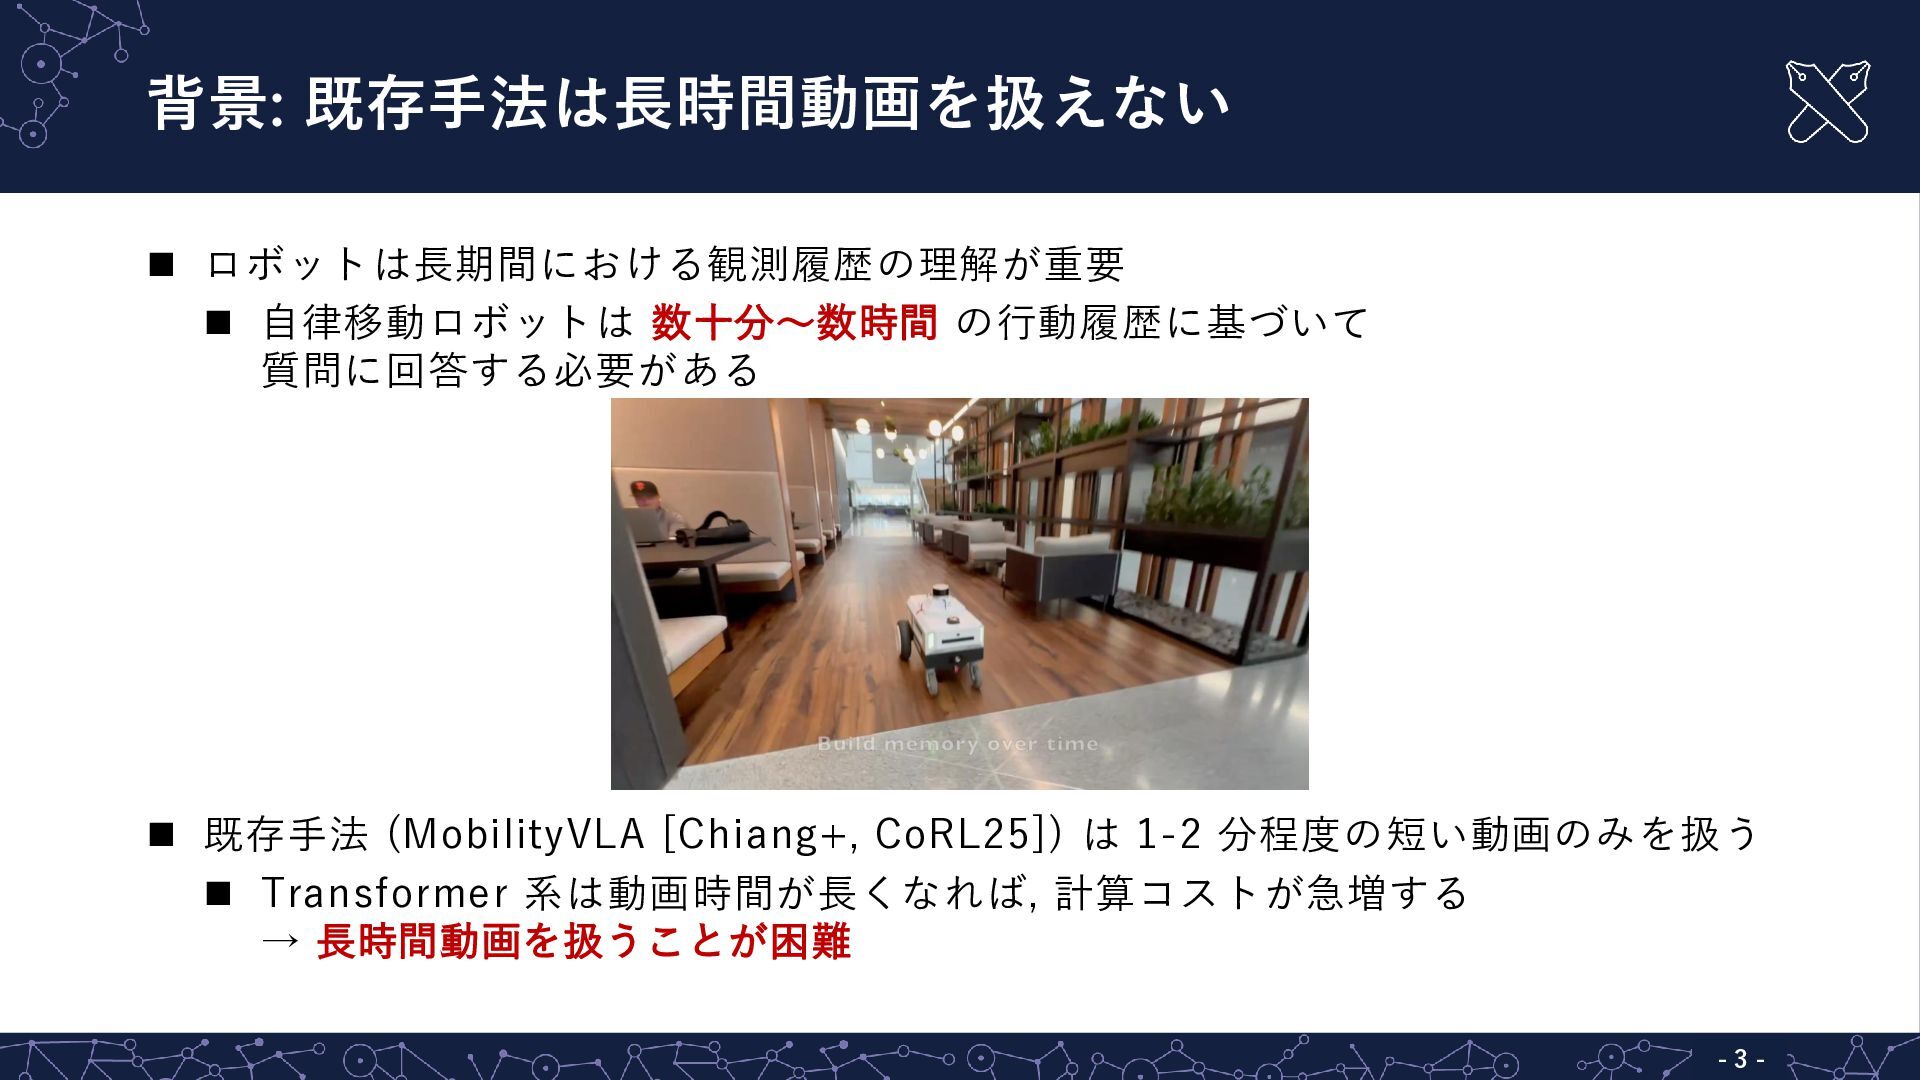
背景: 既存手法は長時間動画を扱えない - 3 - ◼ ロボットは長期間における観測履歴の理解が重要 ◼ 自律移動ロボットは 数十分〜数時間
の行動履歴に基づいて 質問に回答する必要がある ◼ 既存手法 (MobilityVLA [Chiang+, CoRL25]) は 1-2 分程度の短い動画のみを扱う ◼ Transformer 系は動画時間が長くなれば, 計算コストが急増する → 長時間動画を扱うことが困難 -
関連研究: 既存手法は長時間動画や時系列を扱えない - 4 - タスク・手法 特徴 OpenEQA [Majumdar+, CVPR24]
ロボットの視覚観測に基づく質問応答タスク 30秒程度の短いエピソードを対象 Vision-and-Language Navigation [Anderson+, CVPR18] 未知環境に対するナビゲーション ロボットは環境を事前に探索可能な場合が多い 3D Semantic Scene Graphs [Wald+, CVPR20] Topological Memory [Savinov, ICLR18] オブジェクト同士の意味的・空間的関係を捉える 時系列イベントや物体の動的な質問に対応できない MobilityVLA [Chiang+, CoRL25] long-context VLMを用いた目標地点へのナビゲーション 長時間動画に対してスケーラブルでない 3D Semantic Scene Graphs MobilityVLA -
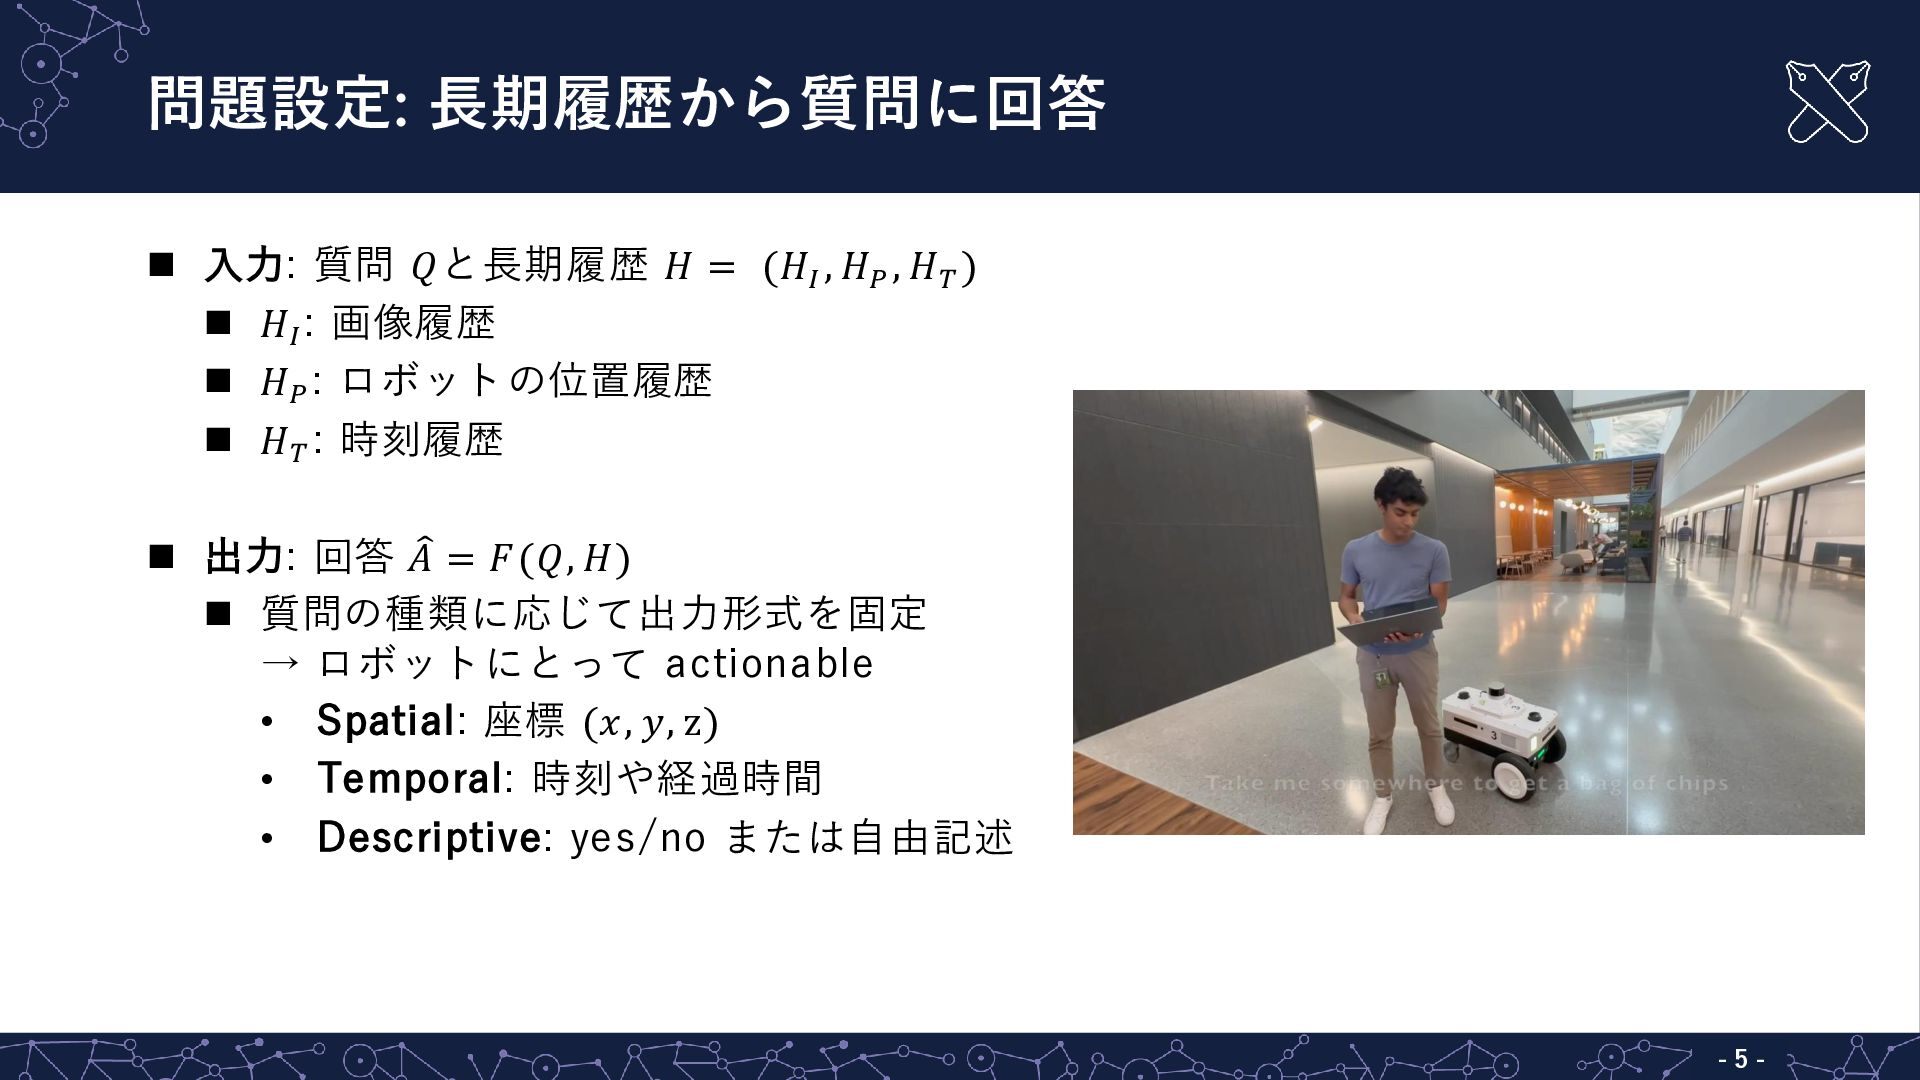
問題設定: 長期履歴から質問に回答 - 5 - ◼ 入力: 質問 𝑄と長期履歴 𝐻
= (𝐻𝐼 , 𝐻𝑃 , 𝐻𝑇 ) ◼ 𝐻𝐼 : 画像履歴 ◼ 𝐻𝑃 : ロボットの位置履歴 ◼ 𝐻𝑇 : 時刻履歴 ◼ 出力: 回答 𝐴 = 𝐹(𝑄, 𝐻) ◼ 質問の種類に応じて出力形式を固定 → ロボットにとって actionable • Spatial: 座標 (𝑥, 𝑦, z) • Temporal: 時刻や経過時間 • Descriptive: yes/no または自由記述 -
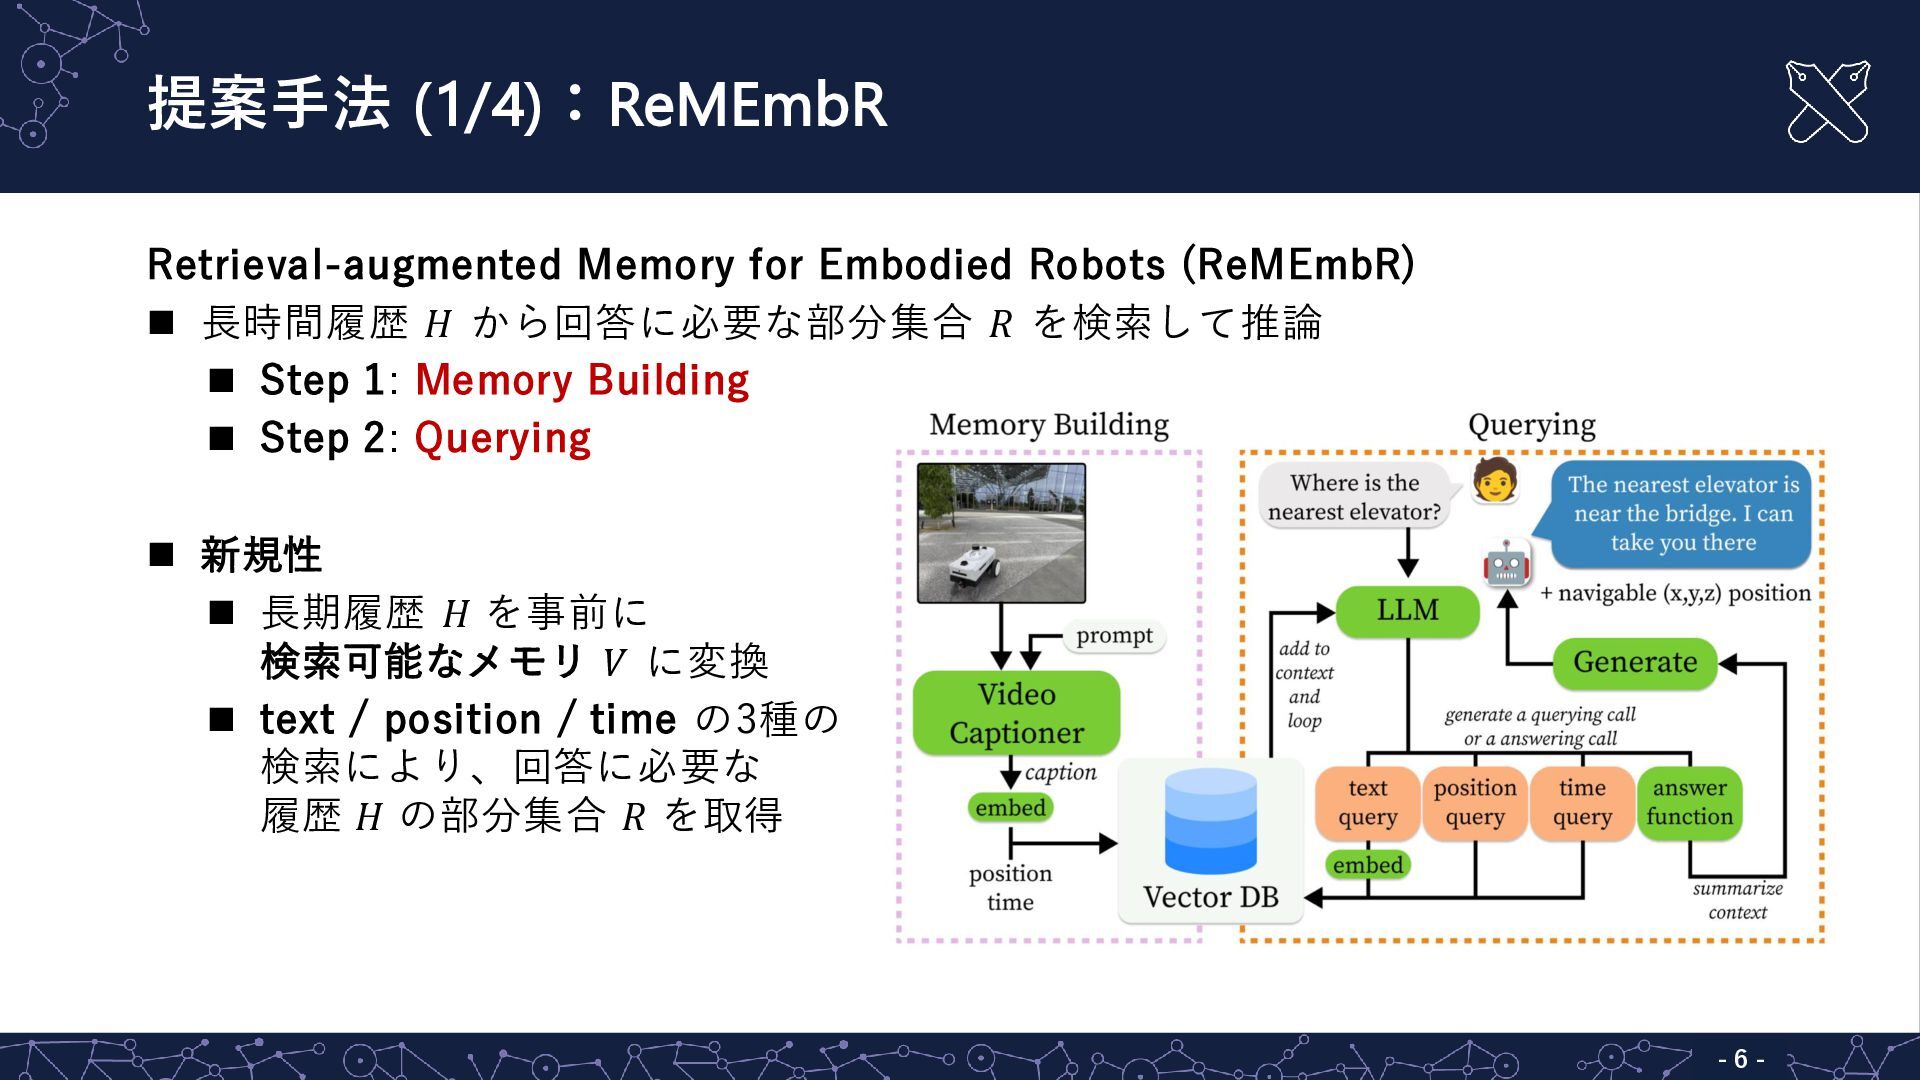
提案手法 (1/4):ReMEmbR - 6 - Retrieval-augmented Memory for Embodied Robots
(ReMEmbR) ◼ 長時間履歴 𝐻 から回答に必要な部分集合 𝑅 を検索して推論 ◼ Step 1: Memory Building ◼ Step 2: Querying ◼ 新規性 ◼ 長期履歴 𝐻 を事前に 検索可能なメモリ 𝑉 に変換 ◼ text / position / time の3種の 検索により、回答に必要な 履歴 𝐻 の部分集合 𝑅 を取得 -
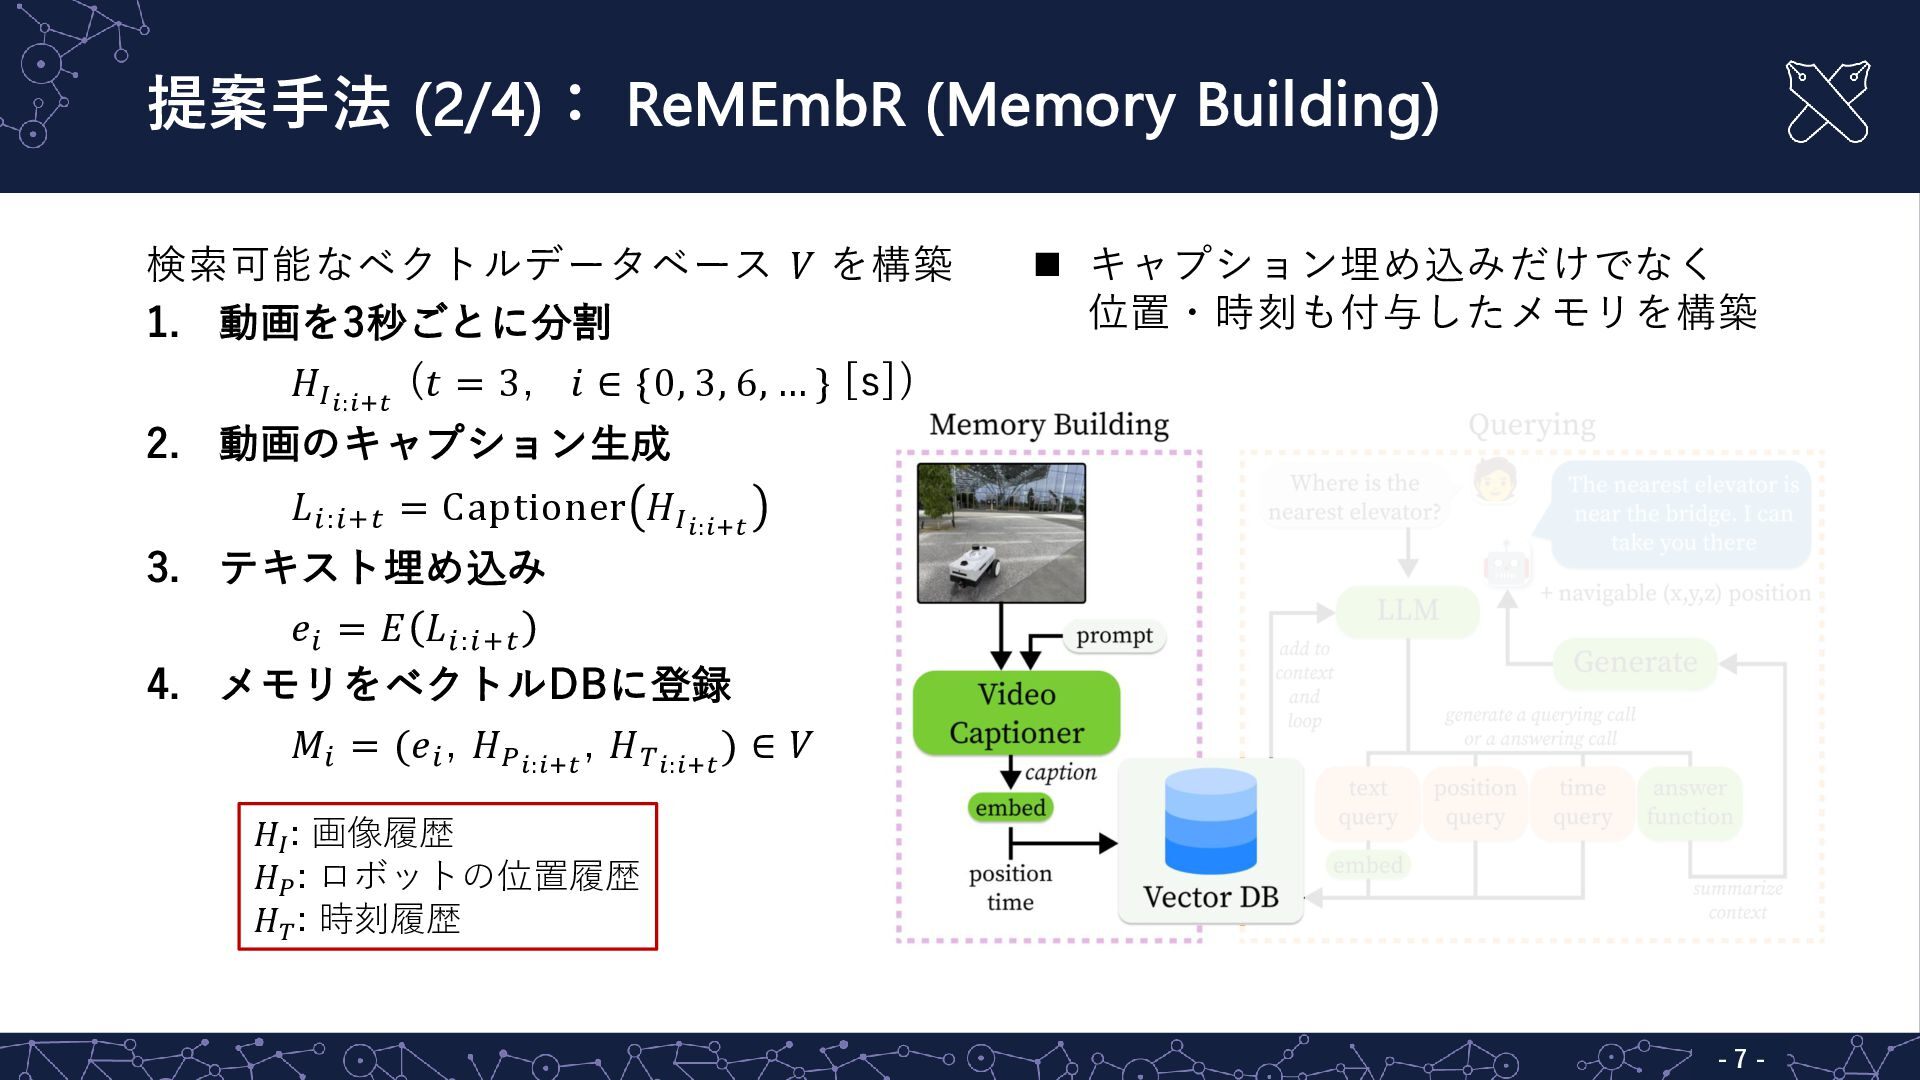
提案手法 (2/4): ReMEmbR (Memory Building) - 7 - 検索可能なベクトルデータベース 𝑉
を構築 1. 動画を3秒ごとに分割 𝐻𝐼𝑖:𝑖+𝑡 (𝑡 = 3, 𝑖 ∈ {0, 3, 6, … } [s]) 2. 動画のキャプション生成 𝐿𝑖:𝑖+𝑡 = Captioner 𝐻𝐼𝑖:𝑖+𝑡 3. テキスト埋め込み 𝑒𝑖 = 𝐸 𝐿𝑖:𝑖+𝑡 4. メモリをベクトルDBに登録 𝑀𝑖 = (𝑒𝑖 , 𝐻𝑃𝑖:𝑖+𝑡 , 𝐻𝑇𝑖:𝑖+𝑡 ) ∈ 𝑉 𝐻𝐼 : 画像履歴 𝐻𝑃 : ロボットの位置履歴 𝐻𝑇 : 時刻履歴 ◼ キャプション埋め込みだけでなく 位置・時刻も付与したメモリを構築 -
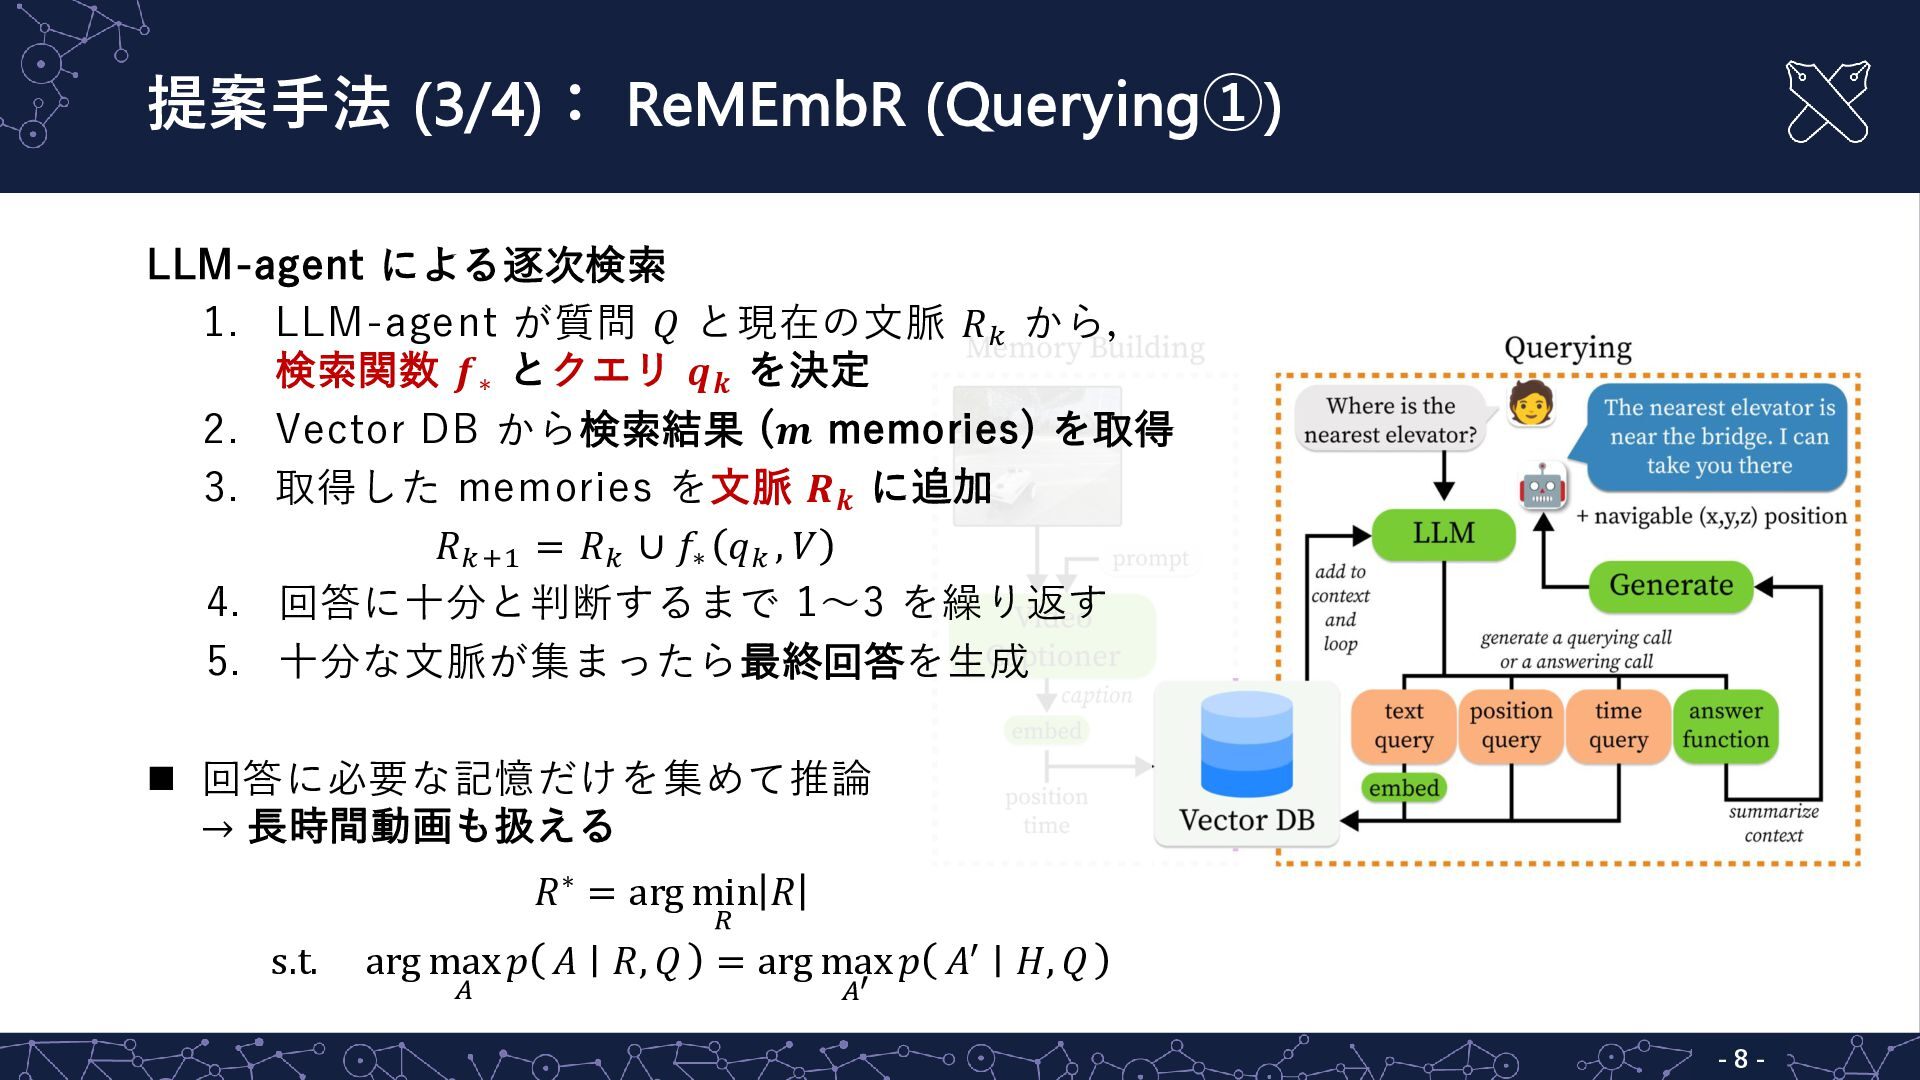
𝑅∗ = arg min 𝑅 𝑅 s.t. arg max 𝐴
𝑝 𝐴 𝑅, 𝑄 = arg max 𝐴′ 𝑝 𝐴′ 𝐻, 𝑄 LLM-agent による逐次検索 1. LLM-agent が質問 𝑄 と現在の文脈 𝑅𝑘 から, 検索関数 𝒇∗ とクエリ 𝒒𝒌 を決定 2. Vector DB から検索結果 (𝒎 memories) を取得 3. 取得した memories を文脈 𝑹𝒌 に追加 𝑅𝑘+1 = 𝑅𝑘 ∪ 𝑓∗ 𝑞𝑘 , 𝑉 4. 回答に十分と判断するまで 1〜3 を繰り返す 5. 十分な文脈が集まったら最終回答を生成 ◼ 回答に必要な記憶だけを集めて推論 → 長時間動画も扱える 提案手法 (3/4): ReMEmbR (Querying①) - 8 - -
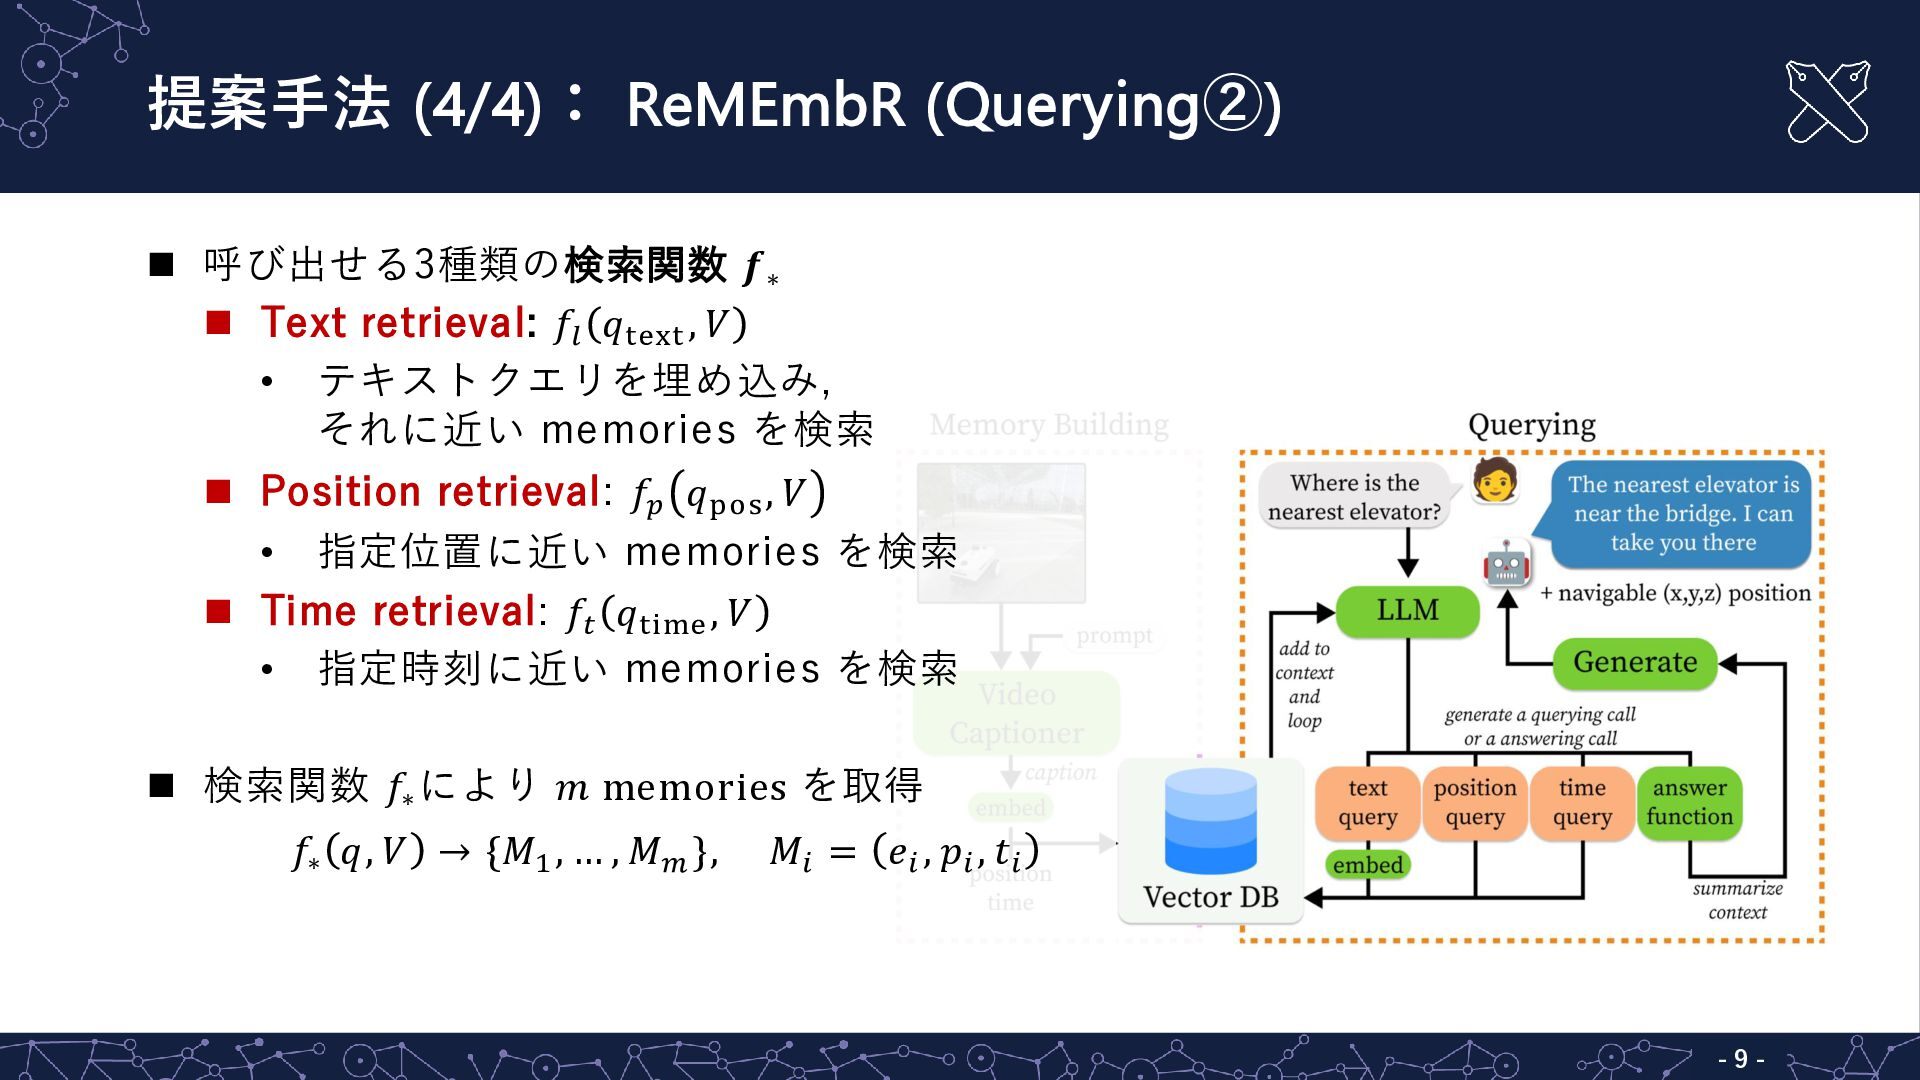
提案手法 (4/4): ReMEmbR (Querying②) - 9 - ◼ 呼び出せる3種類の検索関数 𝒇∗
◼ Text retrieval: 𝑓𝑙 𝑞text , 𝑉 • テキストクエリを埋め込み, それに近い memories を検索 ◼ Position retrieval: 𝑓𝑝 𝑞pos , 𝑉 • 指定位置に近い memories を検索 ◼ Time retrieval: 𝑓𝑡 𝑞time , 𝑉 • 指定時刻に近い memories を検索 ◼ 検索関数 𝑓∗ により 𝑚 memories を取得 𝑓∗ 𝑞, 𝑉 → {𝑀1 , … , 𝑀𝑚 }, 𝑀𝑖 = 𝑒𝑖 , 𝑝𝑖 , 𝑡𝑖 -
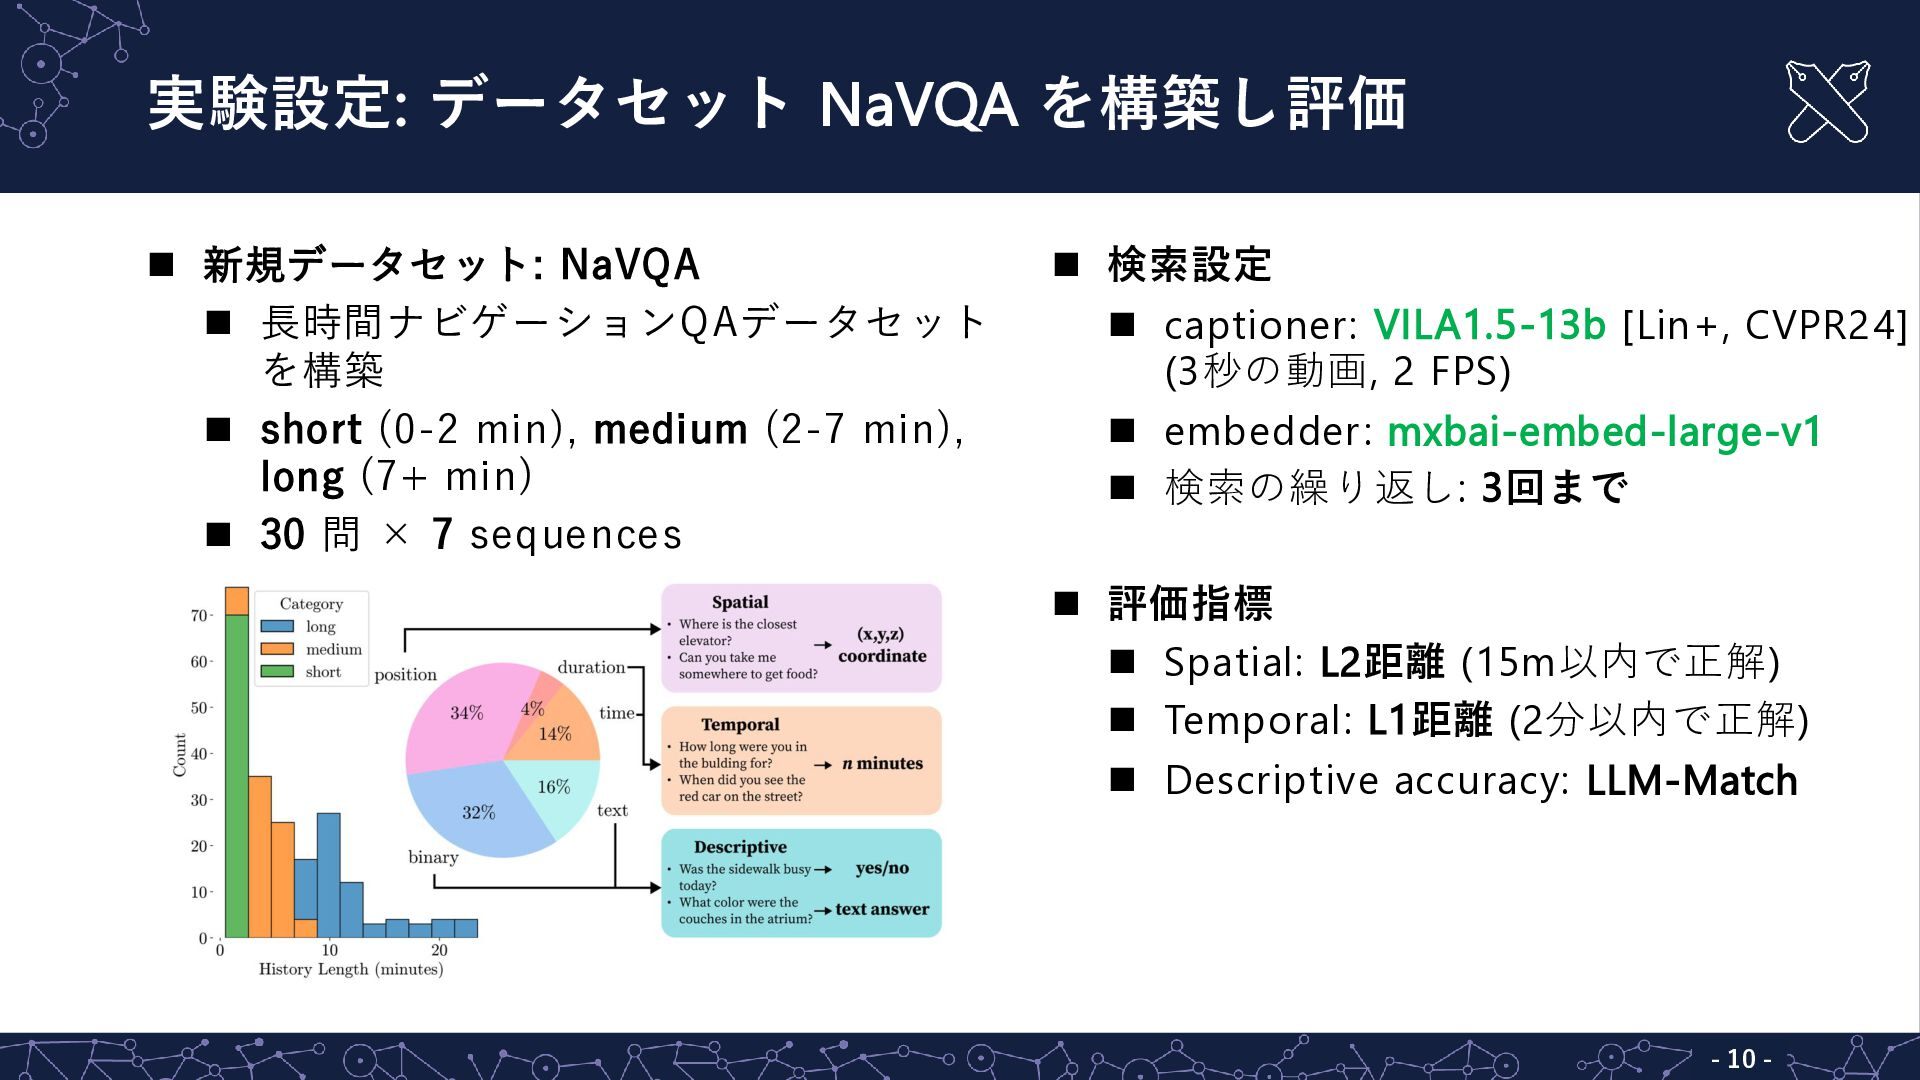
実験設定: データセット NaVQA を構築し評価 - 10 - ◼ 新規データセット: NaVQA
◼ 長時間ナビゲーションQAデータセット を構築 ◼ short (0-2 min), medium (2-7 min), long (7+ min) ◼ 30 問 × 7 sequences ◼ 検索設定 ◼ captioner: VILA1.5-13b [Lin+, CVPR24] (3秒の動画, 2 FPS) ◼ embedder: mxbai-embed-large-v1 ◼ 検索の繰り返し: 3回まで ◼ 評価指標 ◼ Spatial: L2距離 (15m以内で正解) ◼ Temporal: L1距離 (2分以内で正解) ◼ Descriptive accuracy: LLM-Match -
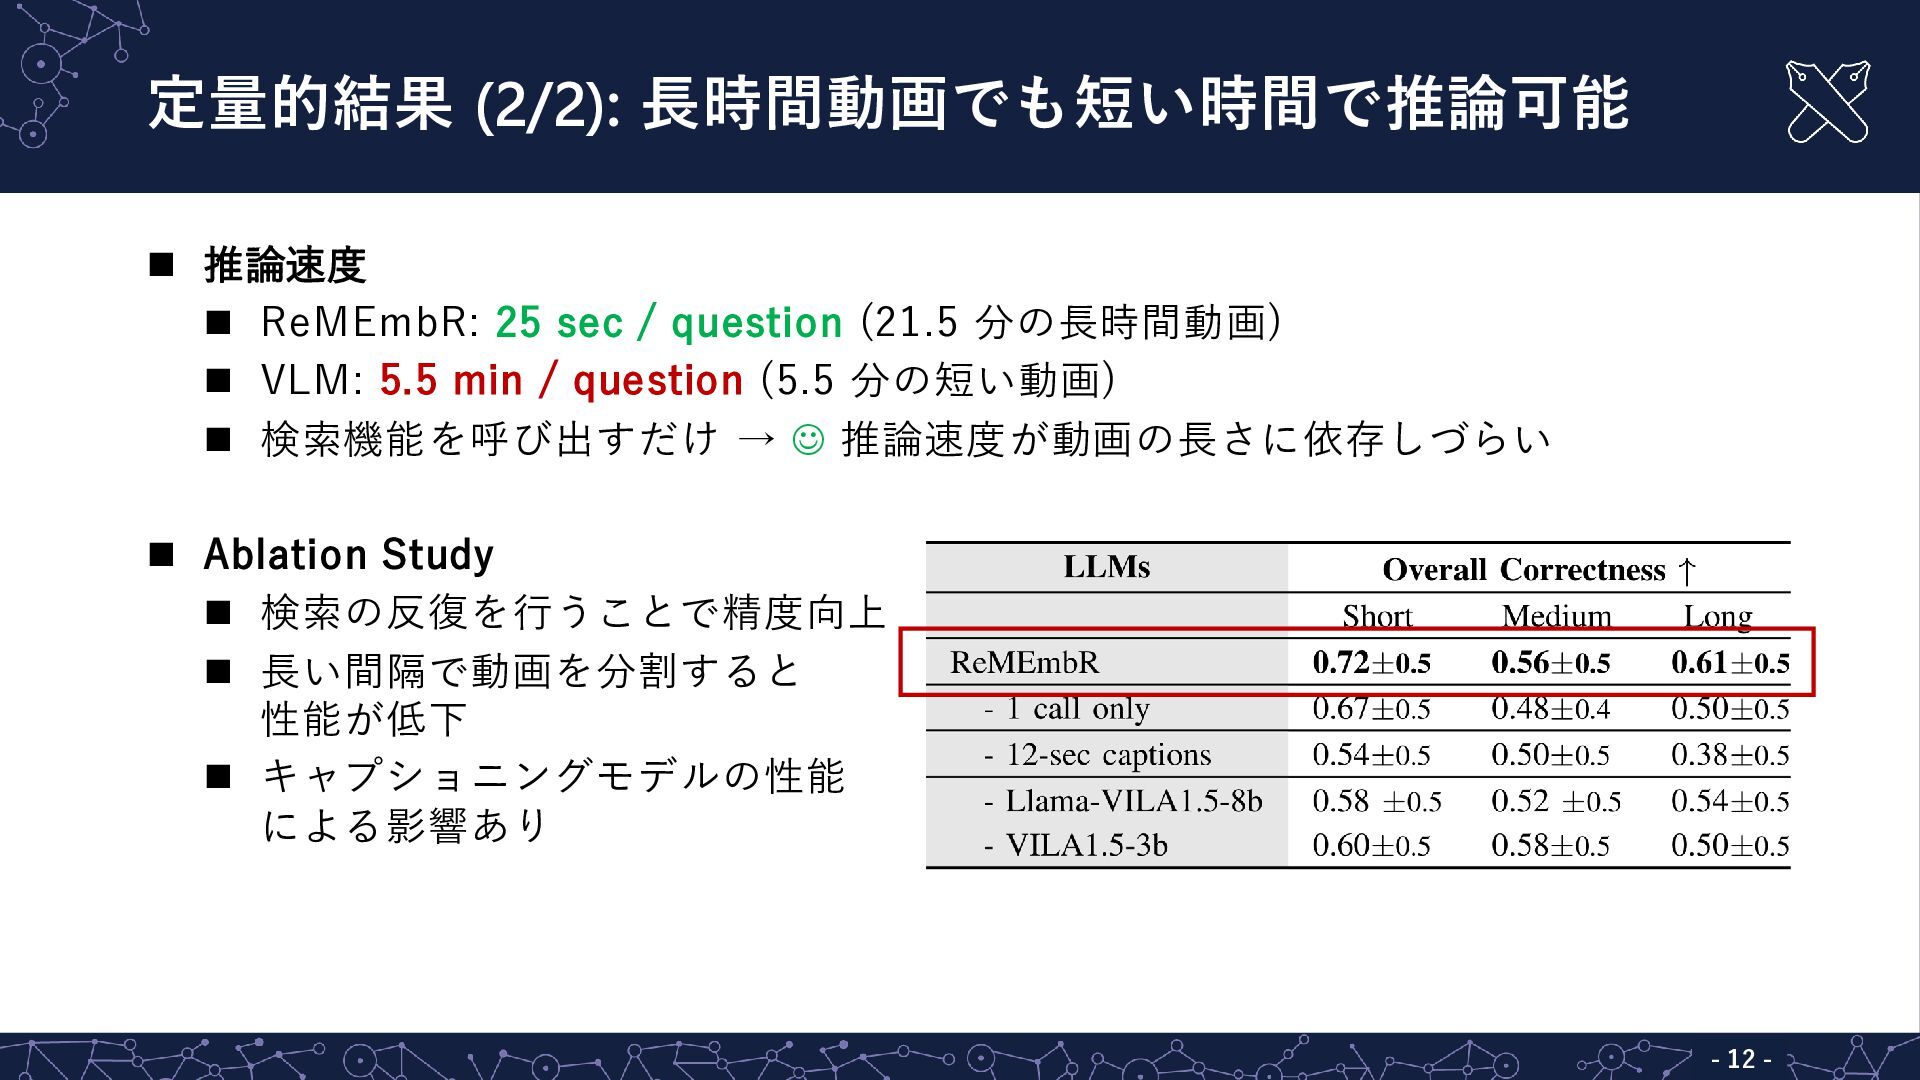
定量的結果 (2/2): 長時間動画でも短い時間で推論可能 - 12 - ◼ 推論速度 ◼ ReMEmbR:
25 sec / question (21.5 分の長時間動画) ◼ VLM: 5.5 min / question (5.5 分の短い動画) ◼ 検索機能を呼び出すだけ → ☺ 推論速度が動画の長さに依存しづらい ◼ Ablation Study ◼ 検索の反復を行うことで精度向上 ◼ 長い間隔で動画を分割すると 性能が低下 ◼ キャプショニングモデルの性能 による影響あり -
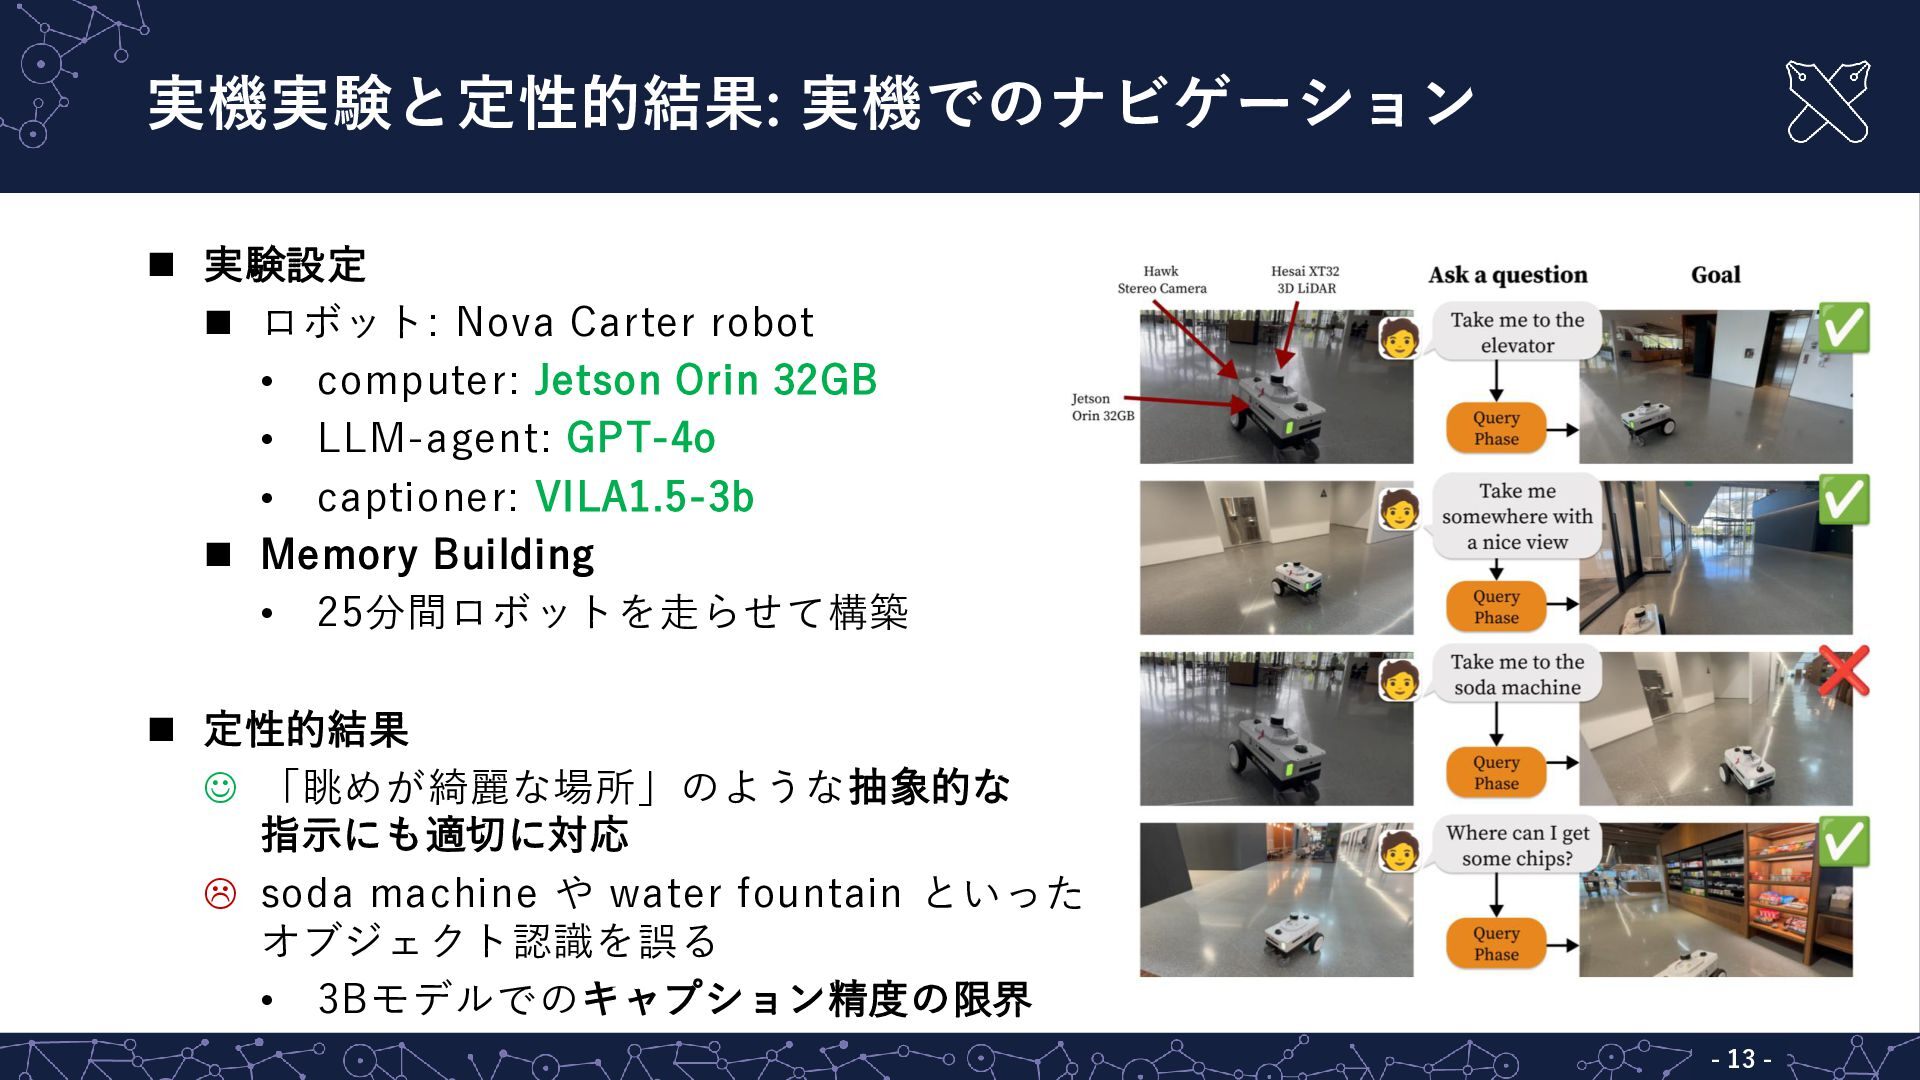
実機実験と定性的結果: 実機でのナビゲーション - 13 - ◼ 実験設定 ◼ ロボット: Nova
Carter robot • computer: Jetson Orin 32GB • LLM-agent: GPT-4o • captioner: VILA1.5-3b ◼ Memory Building • 25分間ロボットを走らせて構築 ◼ 定性的結果 ☺ 「眺めが綺麗な場所」のような抽象的な 指示にも適切に対応 soda machine や water fountain といった オブジェクト認識を誤る • 3Bモデルでのキャプション精度の限界 -
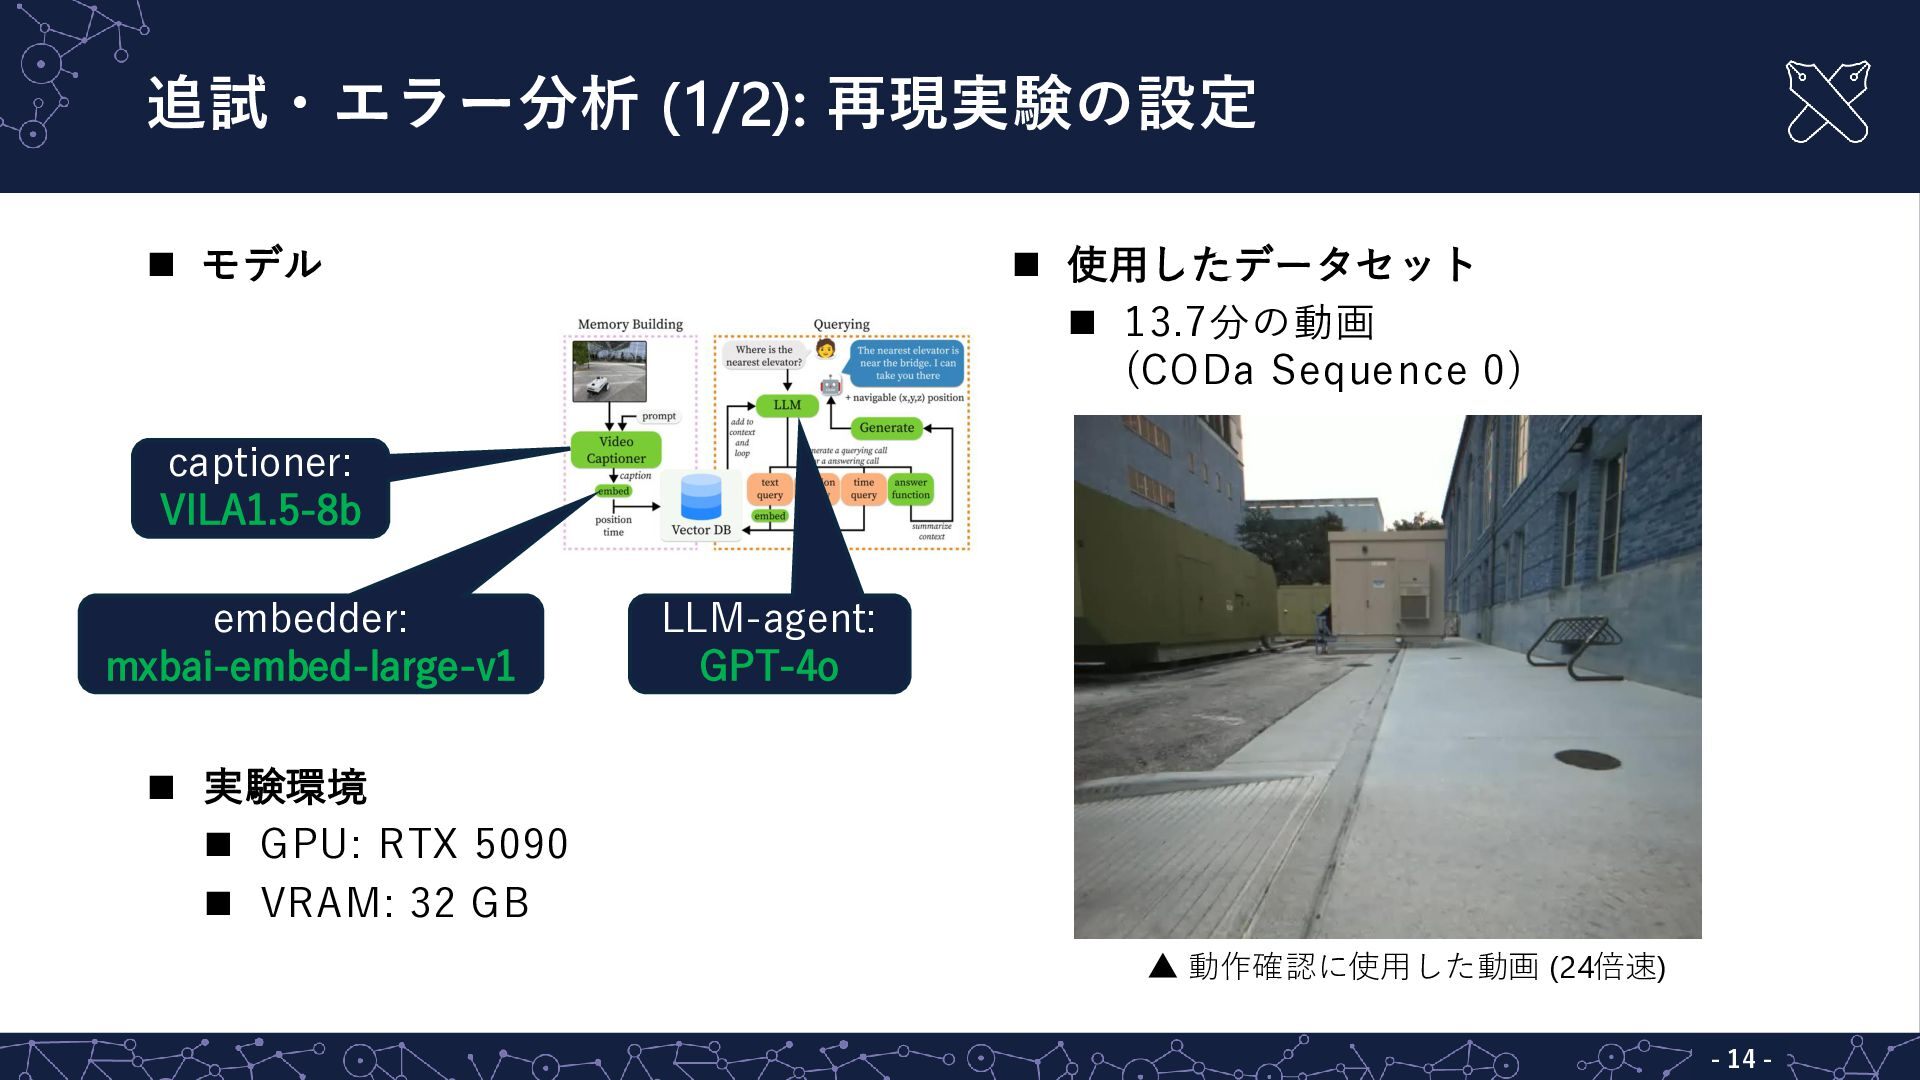
追試・エラー分析 (1/2): 再現実験の設定 - 14 - ◼ モデル ◼ 実験環境
◼ GPU: RTX 5090 ◼ VRAM: 32 GB ▲ 動作確認に使用した動画 (24倍速) captioner: VILA1.5-8b embedder: mxbai-embed-large-v1 LLM-agent: GPT-4o ◼ 使用したデータセット ◼ 13.7分の動画 (CODa Sequence 0) -
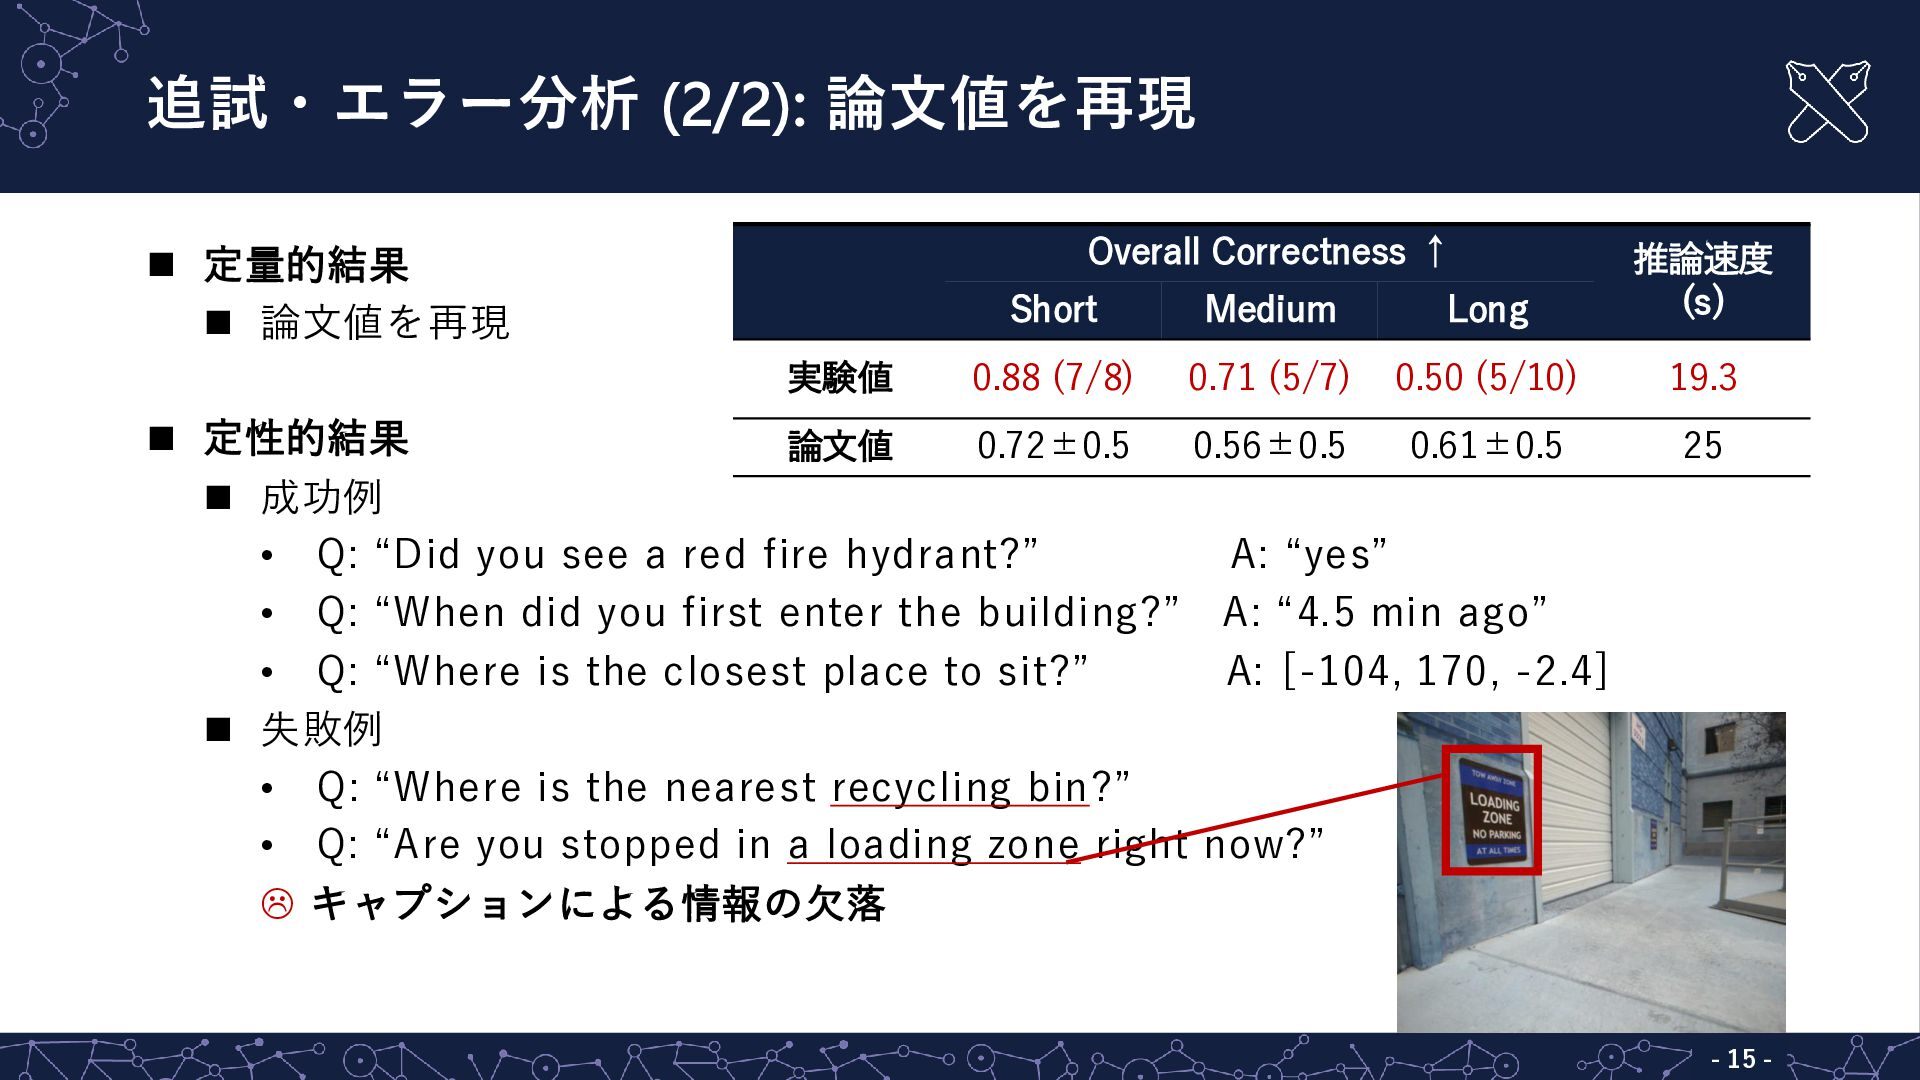
追試・エラー分析 (2/2): 論文値を再現 - 15 - ◼ 定量的結果 ◼ 論文値を再現
◼ 定性的結果 ◼ 成功例 • Q: “Did you see a red fire hydrant?” A: “yes” • Q: “When did you first enter the building?” A: “4.5 min ago” • Q: “Where is the closest place to sit?” A: [-104, 170, -2.4] ◼ 失敗例 • Q: “Where is the nearest recycling bin?” • Q: “Are you stopped in a loading zone right now?” キャプションによる情報の欠落 Overall Correctness ↑ 推論速度 (s) Short Medium Long 実験値 0.88 (7/8) 0.71 (5/7) 0.50 (5/10) 19.3 論文値 0.72±0.5 0.56±0.5 0.61±0.5 25 -
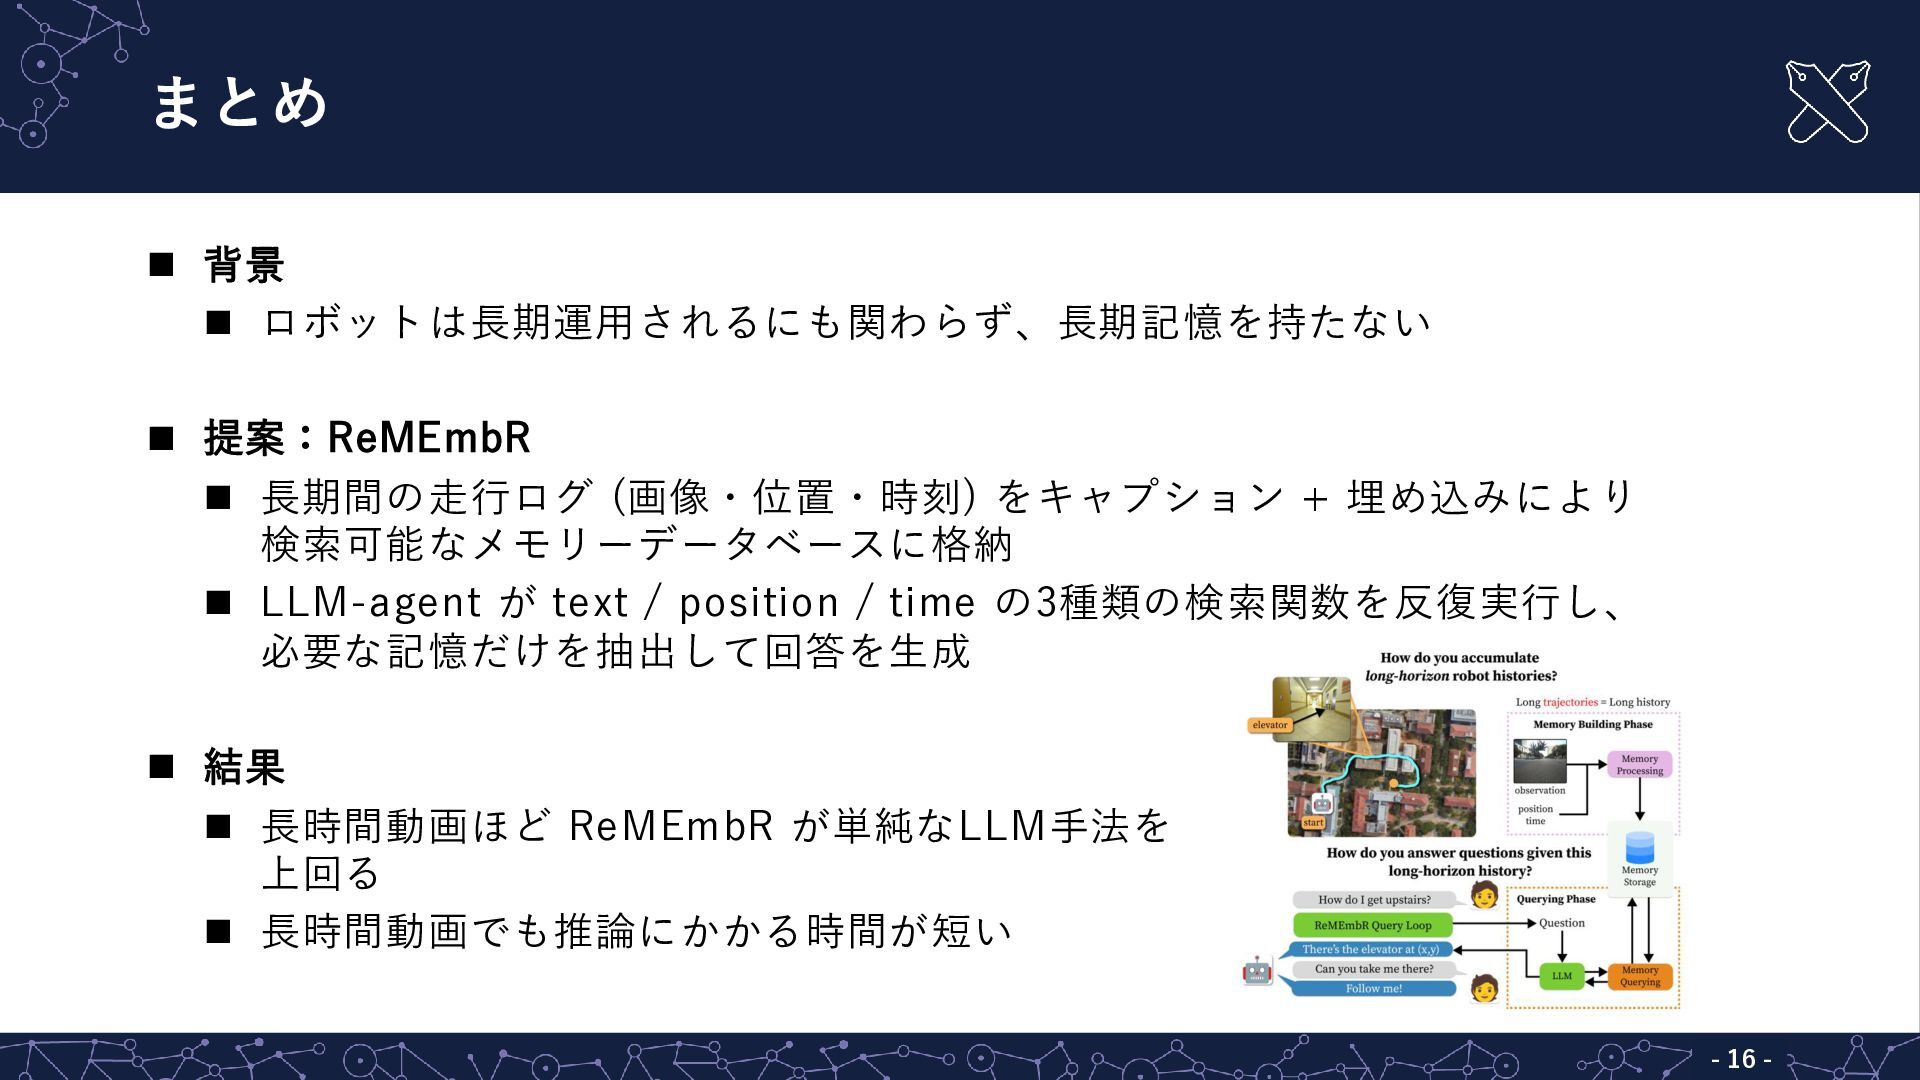
まとめ - 16 - ◼ 提案:ReMEmbR ◼ 長期間の走行ログ (画像・位置・時刻) をキャプション
+ 埋め込みにより 検索可能なメモリーデータベースに格納 ◼ LLM-agent が text / position / time の3種類の検索関数を反復実行し、 必要な記憶だけを抽出して回答を生成 ◼ 結果 ◼ 長時間動画ほど ReMEmbR が単純なLLM手法を 上回る ◼ 長時間動画でも推論にかかる時間が短い