Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[RSJ23]Trimodal Cross-Attentional Transformer f...
Search
Semantic Machine Intelligence Lab., Keio Univ.
PRO
September 09, 2023
Technology
1.3k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[RSJ23]Trimodal Cross-Attentional Transformer for Rearrangement Target Detection Using Visual Foundation Models
Semantic Machine Intelligence Lab., Keio Univ.
PRO
September 09, 2023
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
200
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
140
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
170
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
210
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
180
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
200
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
48
[MIRU26] To What Extent Does MLLM-as-a-Judge Exhibit Cross-Model Preference Bias?
keio_smilab
PRO
0
290
[Journal club] FlashVID: Efficient Video Large Language Models via Training-free Tree-based Spatiotemporal Token Merging
keio_smilab
PRO
0
37
Other Decks in Technology
See All in Technology
2026-09-09 【sigma_ucj#1】Sigma を IaC 管理したい! / IaC for Sigma
civitaspo
0
130
[2026-09-11]SREは誰のもの?運用エンジニアが始める 「SRE領域への越境」とチームの進化の軌跡 〜Road to NEXT CRE
tosite
0
190
AIを活用するために決めた "やらないこと" - 価値に注目する / Not betting on AI
soudai
PRO
1
470
DEFCON_CHV_CTF_Write-up.pdf
bata_24
0
150
データ界隈LT祭 第1回LT登壇
taromatsui_cccmkhd
1
1.1k
登壇の自信を奪う3匹のオバケ / 3 Ghosts That Rob You of Your Confidence in Public Speaking
pauli
8
760
技術的負債から考える、AI時代のエンジニアリング投資 — ビズリーチの技術的負債と向き合った経験から、変更し続けられるソフトウェアを考える/ technical-debt-con2026
visional_engineering_and_design
0
120
range over func 2年間の軌跡 Issue #56413 はGoのエコシステムをどう変えたか
ryujicre8ive
0
140
人間はどの意思決定を手放せるのか
kawasima
11
4.1k
2026_devsumi_ozono.pdf
o3
3
460
Microsoft 365 Copilot chat -tekoälypalvelun tietosuojaongelmat
hponka
0
840
多層防御と最⼩権限で実現する、安全なAIエージェント設計パターン
lycorptech_jp
PRO
1
280
Featured
See All Featured
How to build a perfect <img>
jonoalderson
1
6k
How to make the Groovebox
asonas
2
2.4k
Agile that works and the tools we love
rasmusluckow
331
22k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
560
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
0
520
Deep Space Network (abreviated)
tonyrice
0
300
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.5k
Become a Pro
speakerdeck
PRO
31
6.2k
Cheating the UX When There Is Nothing More to Optimize - PixelPioneers
stephaniewalter
287
14k
How GitHub (no longer) Works
holman
316
150k
The SEO Collaboration Effect
kristinabergwall1
1
560
Transcript
視覚的基盤モデルを用いた Trimodal Cross-Attentional Transformer に基づく再配置対象の検出 慶應義塾大学 西村喬行,松尾榛夏,杉浦孔明
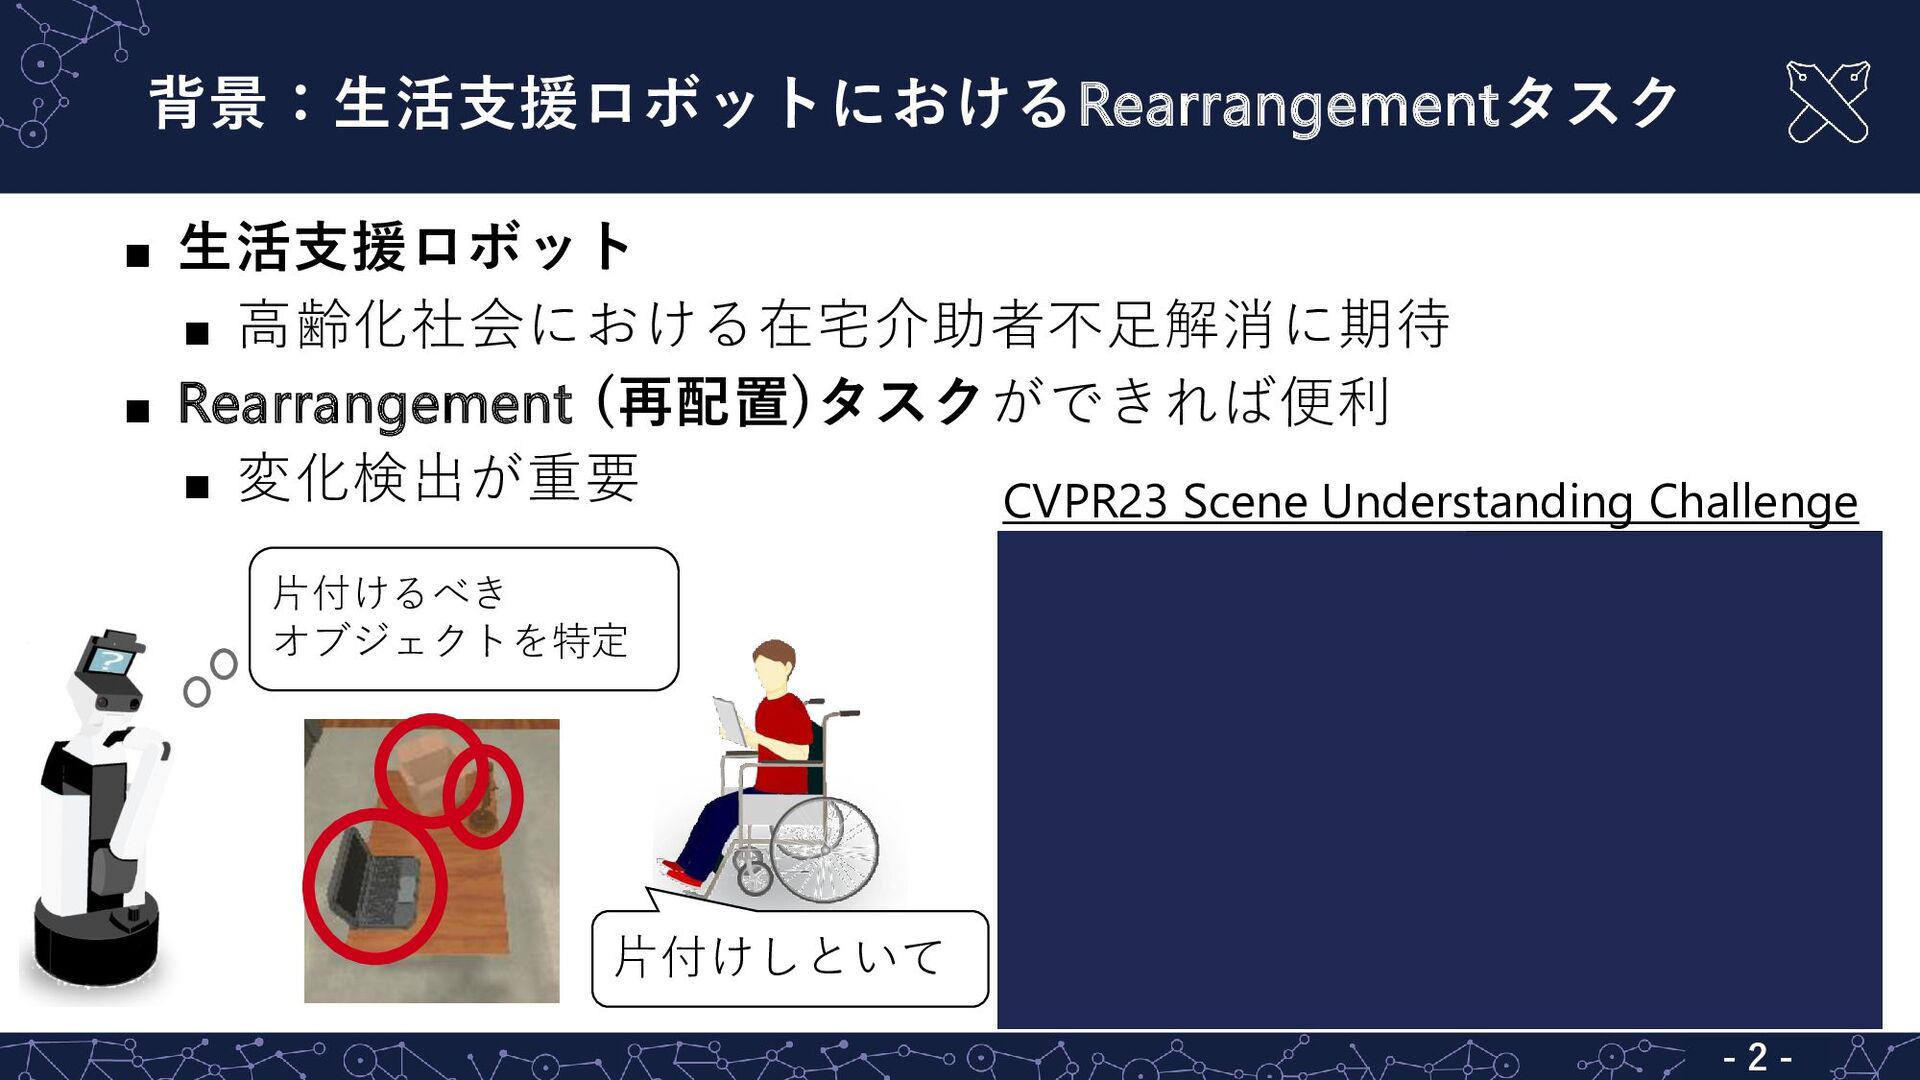
背景:生活支援ロボットにおけるRearrangementタスク ▪ 生活支援ロボット ▪ 高齢化社会における在宅介助者不足解消に期待 ▪ Rearrangement (再配置)タスクができれば便利 ▪ 変化検出が重要
- 2 - 片付けしといて 片付けるべき オブジェクトを特定 CVPR23 Scene Understanding Challenge
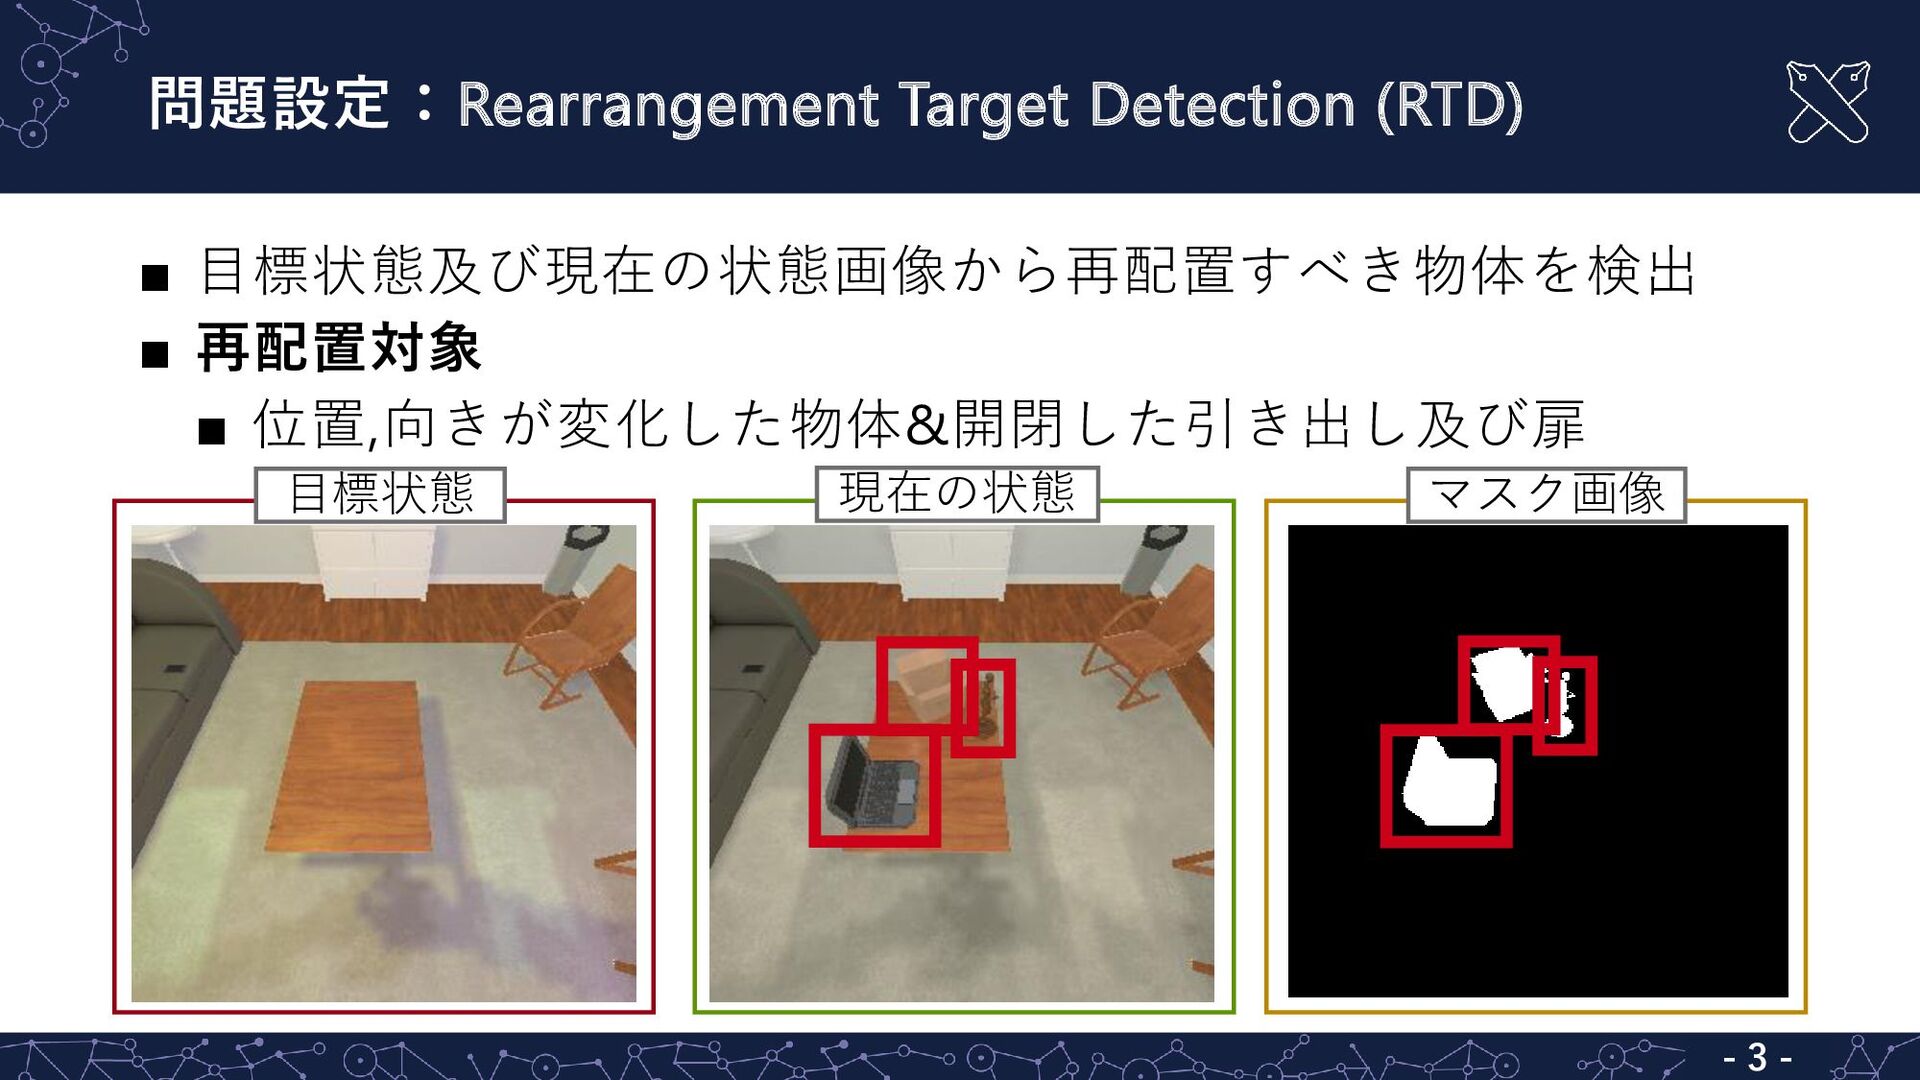
問題設定:Rearrangement Target Detection (RTD) - 3 - ▪ 目標状態及び現在の状態画像から再配置すべき物体を検出 ▪
再配置対象 ▪ 位置,向きが変化した物体&開閉した引き出し及び扉 目標状態 現在の状態 マスク画像
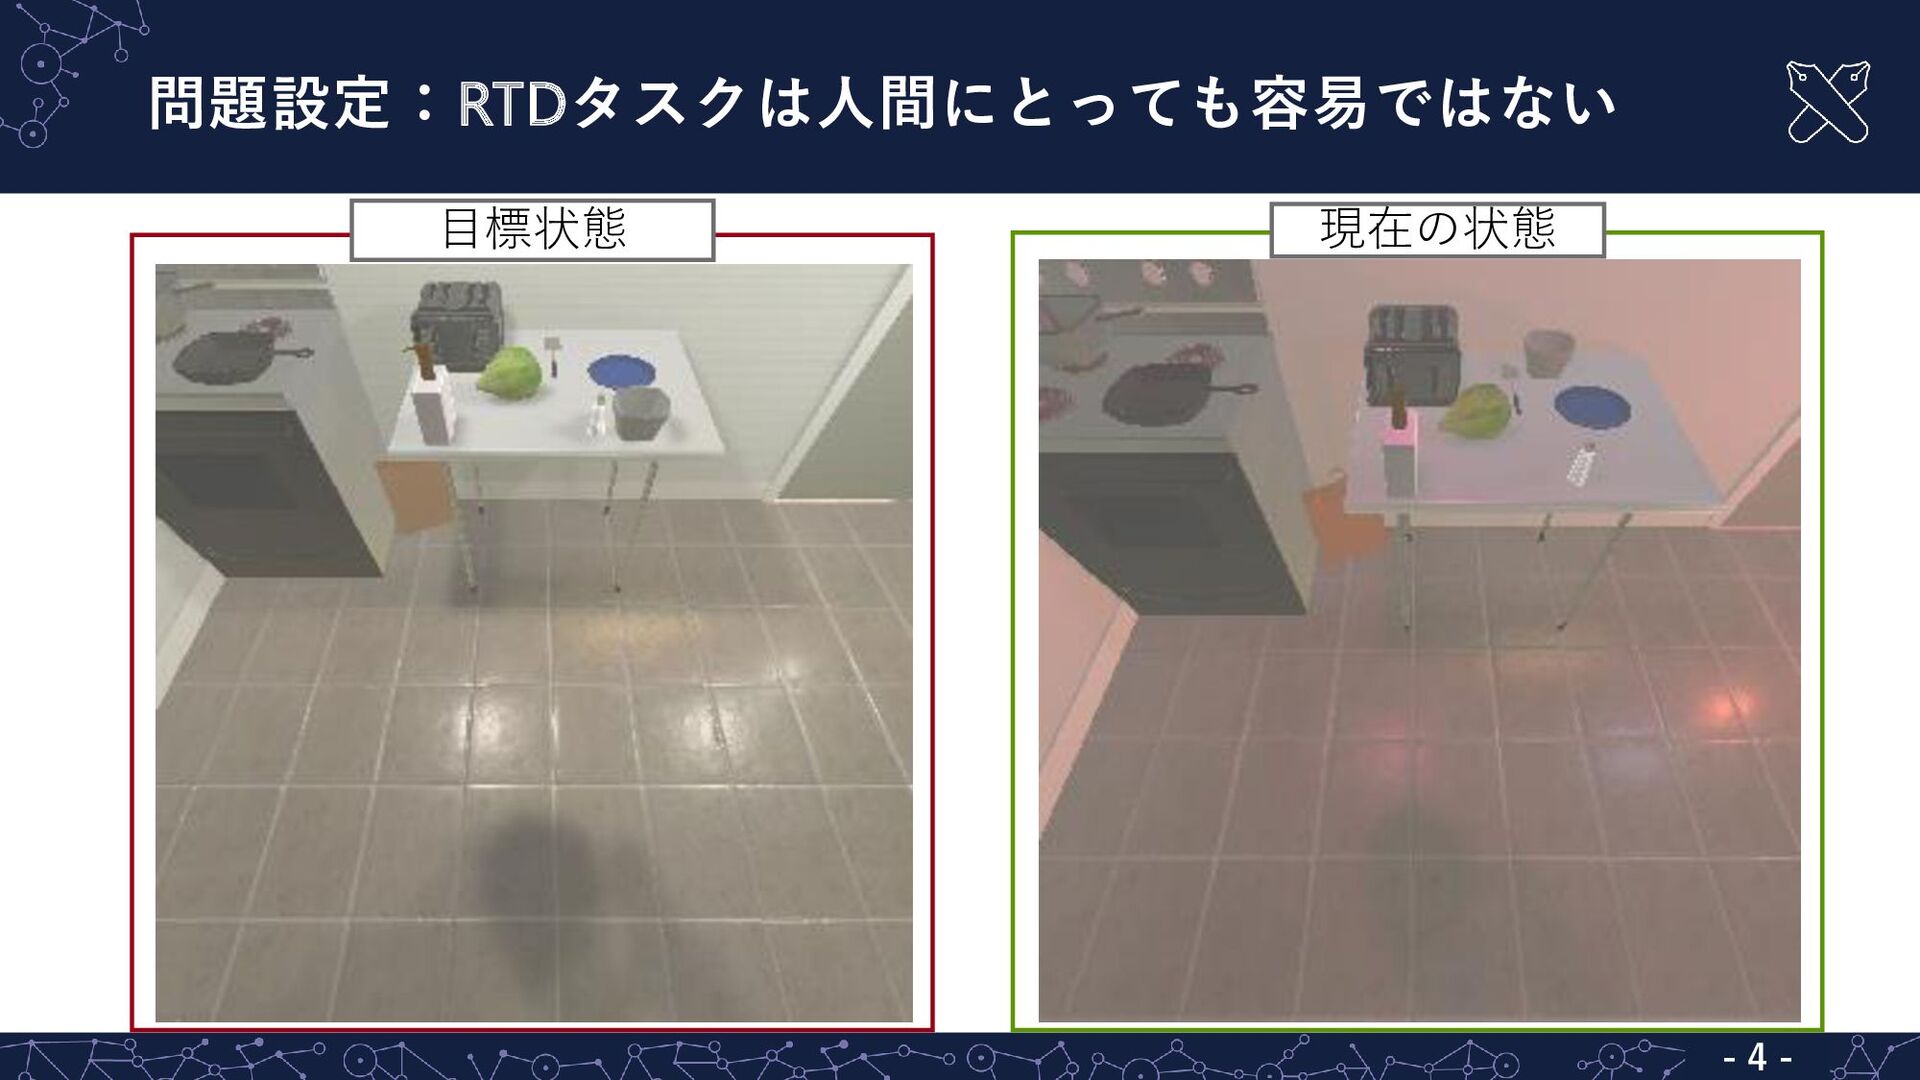
問題設定:RTDタスクは人間にとっても容易ではない - 4 - 現在の状態 目標状態
問題設定:RTDタスクは人間にとっても容易ではない - 5 - 目標状態 現在の状態 マスク画像
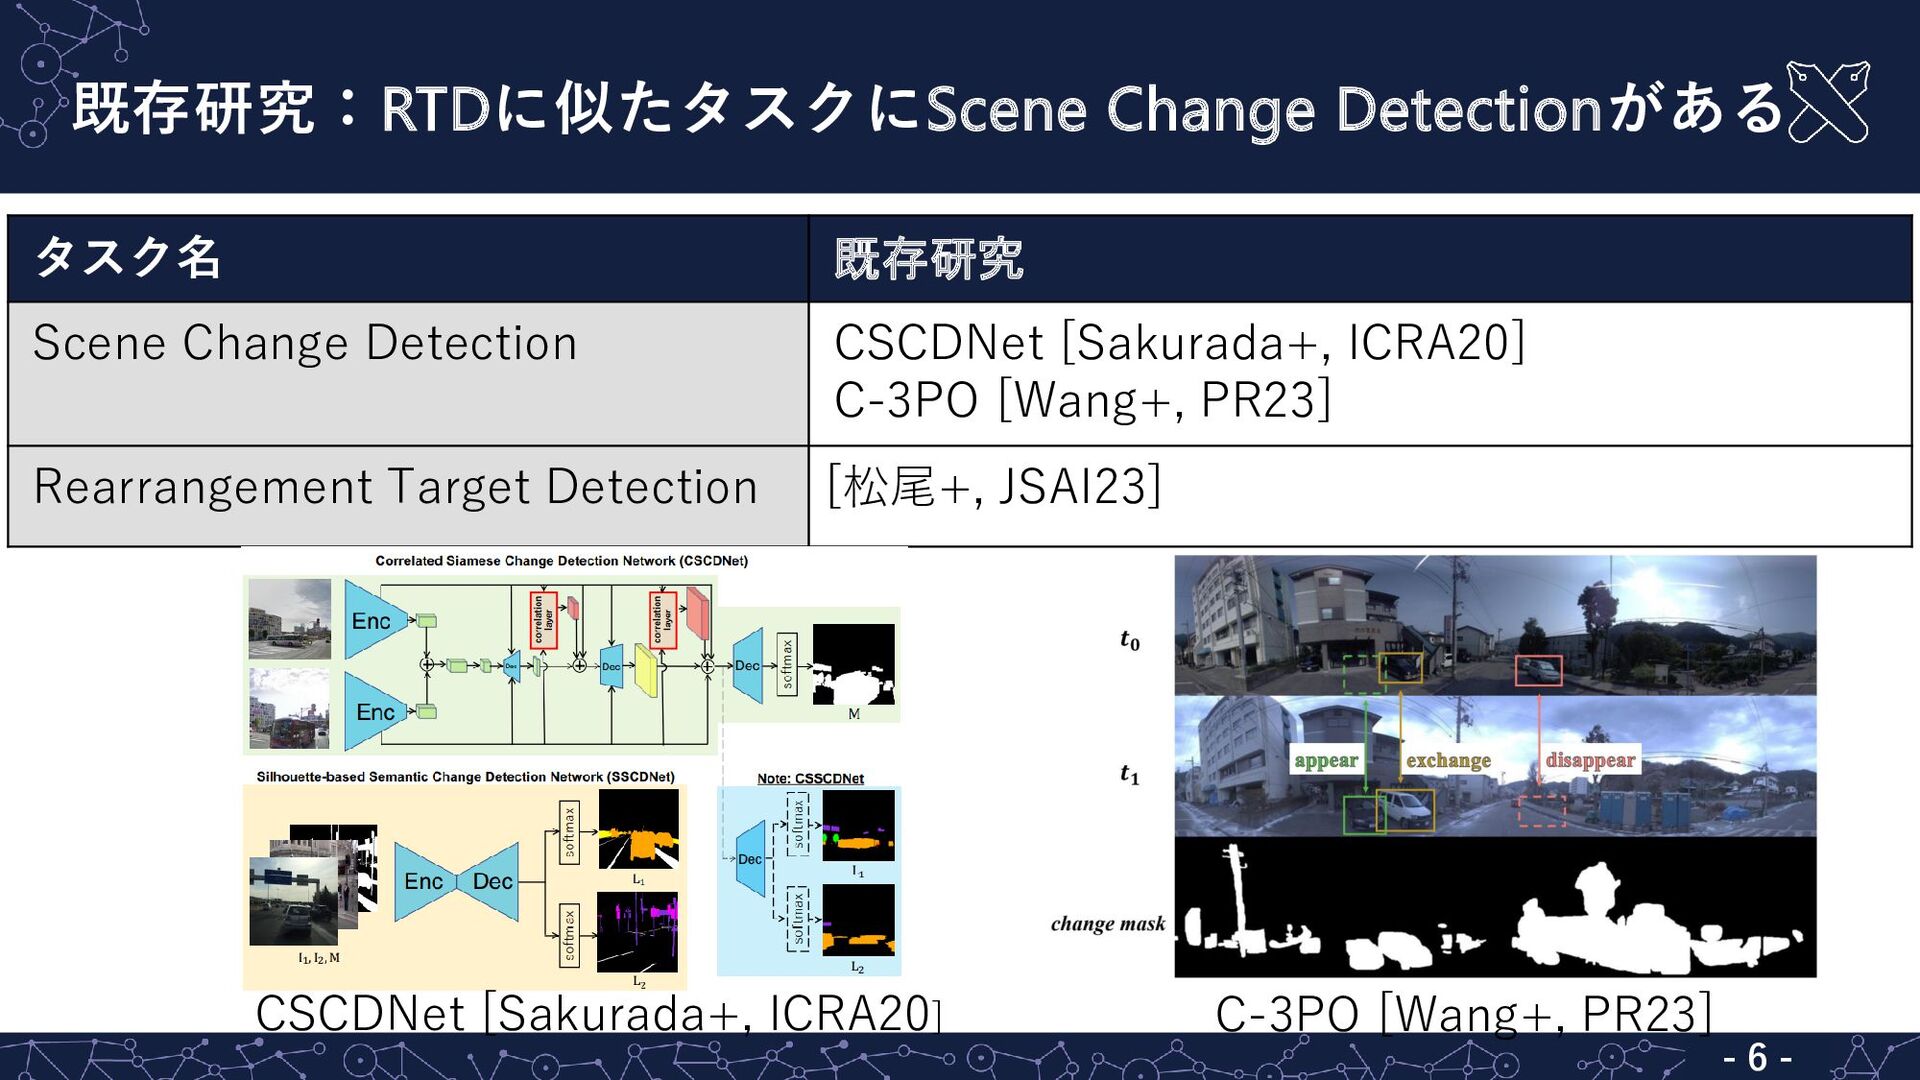
既存研究:RTDに似たタスクにScene Change Detectionがある - 6 - タスク名 既存研究 Scene Change
Detection CSCDNet [Sakurada+, ICRA20] C-3PO [Wang+, PR23] Rearrangement Target Detection [松尾+, JSAI23] CSCDNet [Sakurada+, ICRA20] C-3PO [Wang+, PR23]
既存研究:RTDに似たタスクにScene Change Detectionがある - 7 -
既存手法の問題点: RTDのためにはセグメンテーションの性能が不十分 - 8 - 画素値比較 [松尾, JSAI23] 画素値比較
影や明るさ変化に対応できない [松尾+, JSAI23] ドア開閉の深度変化や小物体に対する性能は不十分 影の変化をマスク 小物体を誤検出 ドアの開閉に課題
- 9 - 新規性: RGBD画像及びSAM [Kirillov+, 23]で 生成したセグメンテーション画像を扱う Trimodal Cross-Attentional
Encoder 提案手法: Trimodal Cross-Attentional Transformer及びSAMの導入 ☺深度とセグメント情報の統合及び (Trimodal) 目標、現在の状態関係性のモデル化 (Cross-Attentional Encoder)
▪ SAM [Kirillov+, 23] ☺ 各物体の領域情報を与えることができる →小物体や領域予測に役立つ Mask2Former [Cheng+, CVPR21]はSAMと比べ性能が劣る
- 10 - 対象画像 Mask2Former SAM 一部正確に領域予測 出来ていない ☺小物体も正確に予測
提案手法: モデル図の全体像 - 11 - Serial Encoder Serial Encoder Decoder
Trimodal Cross-Attentional Transformer
- 12 - ▪ 入力:RGBD画像の組 ▪ SAM [Kirillov+, 23] ▪
セグメンテーション画像 ▪ Serial Encoder ▪ Trimodal Cross-Attentional Encoder ▪ Decoder ▪ 出力:再配置物体のマスク画像 提案手法:主に3 つのモジュールをもつ
Serial Encoder:CoaT [Xu+, ICCV21] による視覚情報の強化 - 13 - RGBD画像を 結合
番目のserial block ➀パッチ埋め込み層でダウンサンプリング ②平坦化&CLSトークンを結合 ③Conv-Attention Module [Xu+, ICCV21]を 適用 ④画像トークンとCLSトークンを分離& 画像トークンを変形 ☺ Serial Encoder [Xu+, ICCV21]を用いて複数次元の画像特徴量を抽出
Conv-Attention Module [Xu+, ICCV21] 時間,空間計算量を削減したattention構造 - 14 - CoaT [Xu+,
ICCV21] -Convolutional Position Encoding 畳み込みをPosition embeddingとして利用 -Factorized Attention ☺計算量の削減
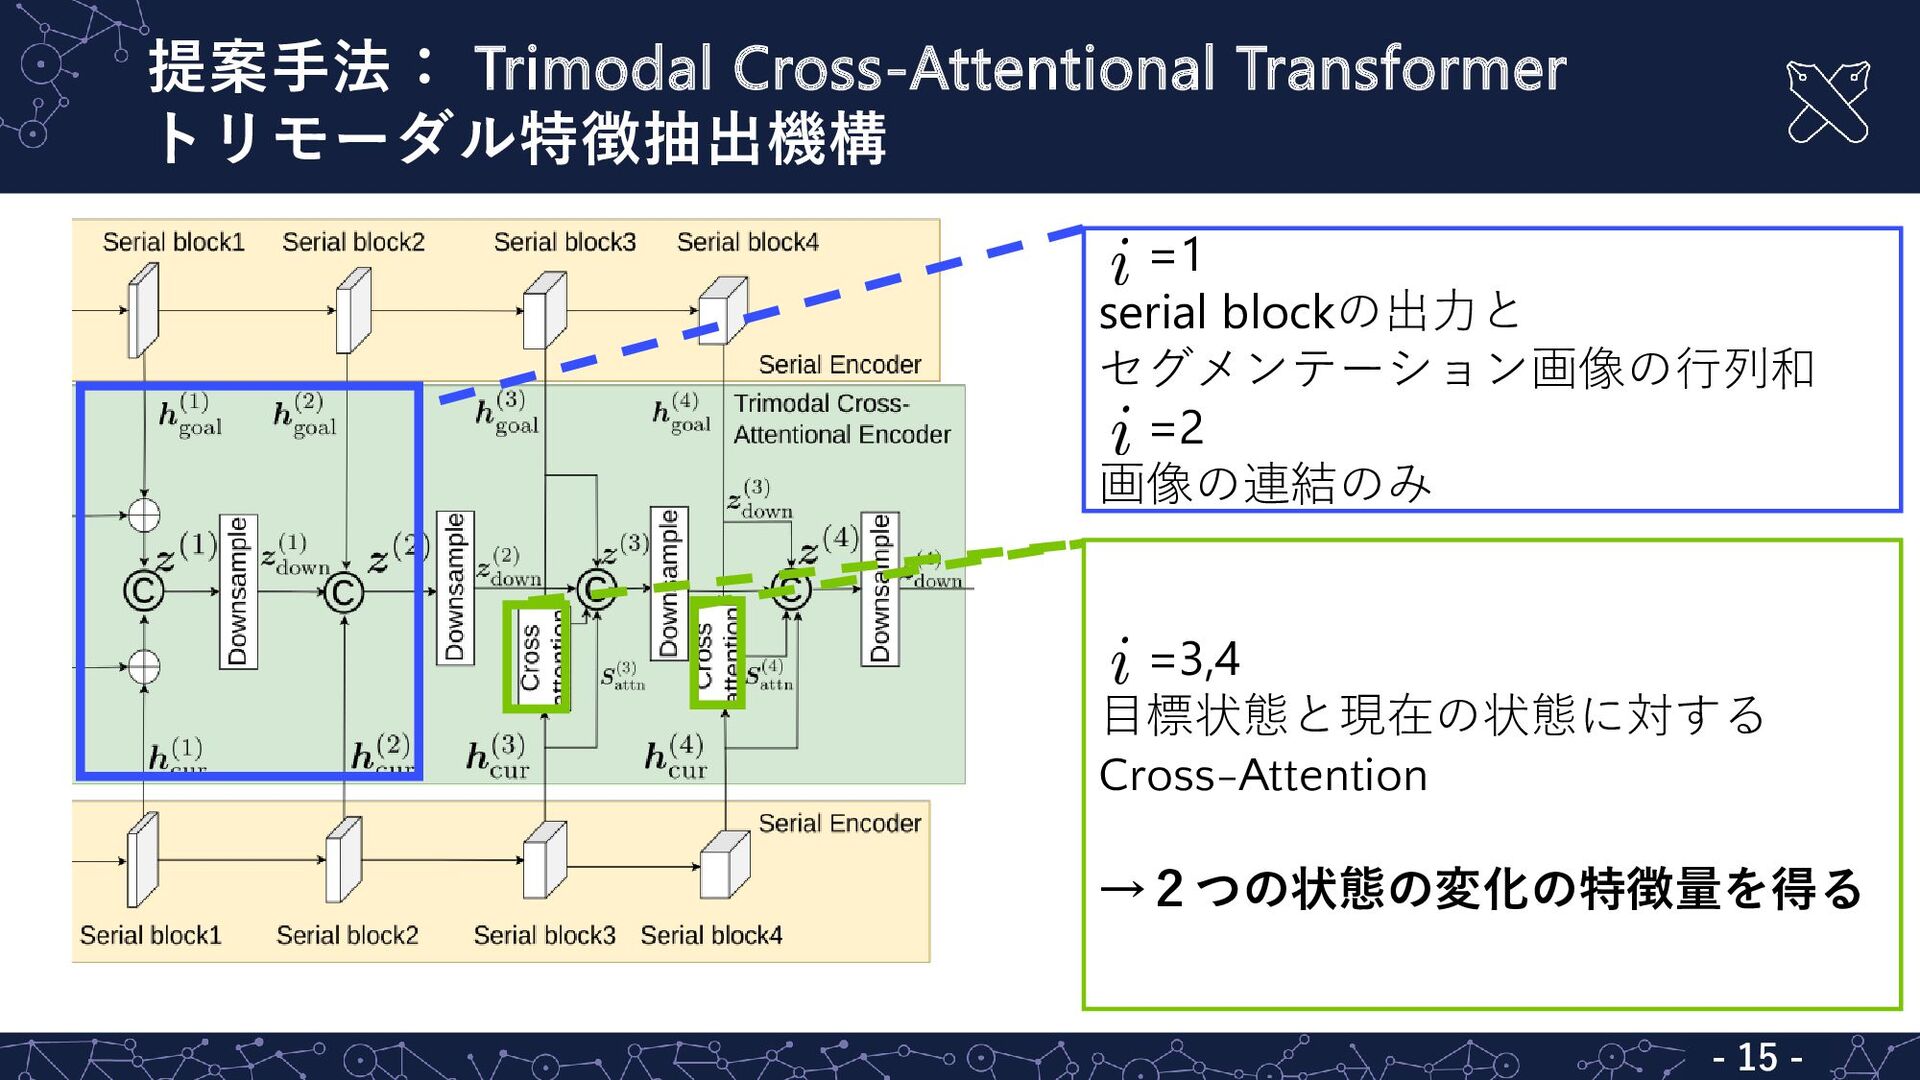
提案手法: Trimodal Cross-Attentional Transformer トリモーダル特徴抽出機構 - 15 - =1 serial
blockの出力と セグメンテーション画像の行列和 =2 画像の連結のみ =3,4 目標状態と現在の状態に対する Cross-Attention →2つの状態の変化の特徴量を得る
RTDDデータセットの構築:大規模な再配置検出データセット - 16 - ◼ AI2-THOR [Kolve+, 17]で作成 ◼ 目標,現在の状態のRGBD画像
◼ 正解マスク画像 ◼ 12000サンプル(10:1:1) ◼ ランダムに対象を配置 ◼ 30cm以上の移動 ◼ 60%以上の開閉
定量的結果:ベースライン手法をmIoU及びF1-scoreで上回る ▪ Trimodal Cross-Attentional Encoderを使用した手法の精度が最高 ▪ 深度画像の寄与が大きい ▪ ベースライン手法をmIoU及びF1 -score
で上回った (P<0.05) 手法 深度画像 mask mIoU [%] F1 -score [%] ベースライン手法 [松尾, JSAI23] - - 59.0±0.5 85.2±0.3 提案手法 ✓ 73.4±0.6 91.3±0.2 ✓ 58.3±0.7 84.9±0.3 ✓ ✓ 73.5±0.3 91.3±0.1 - 17 - +6.1 +14.5
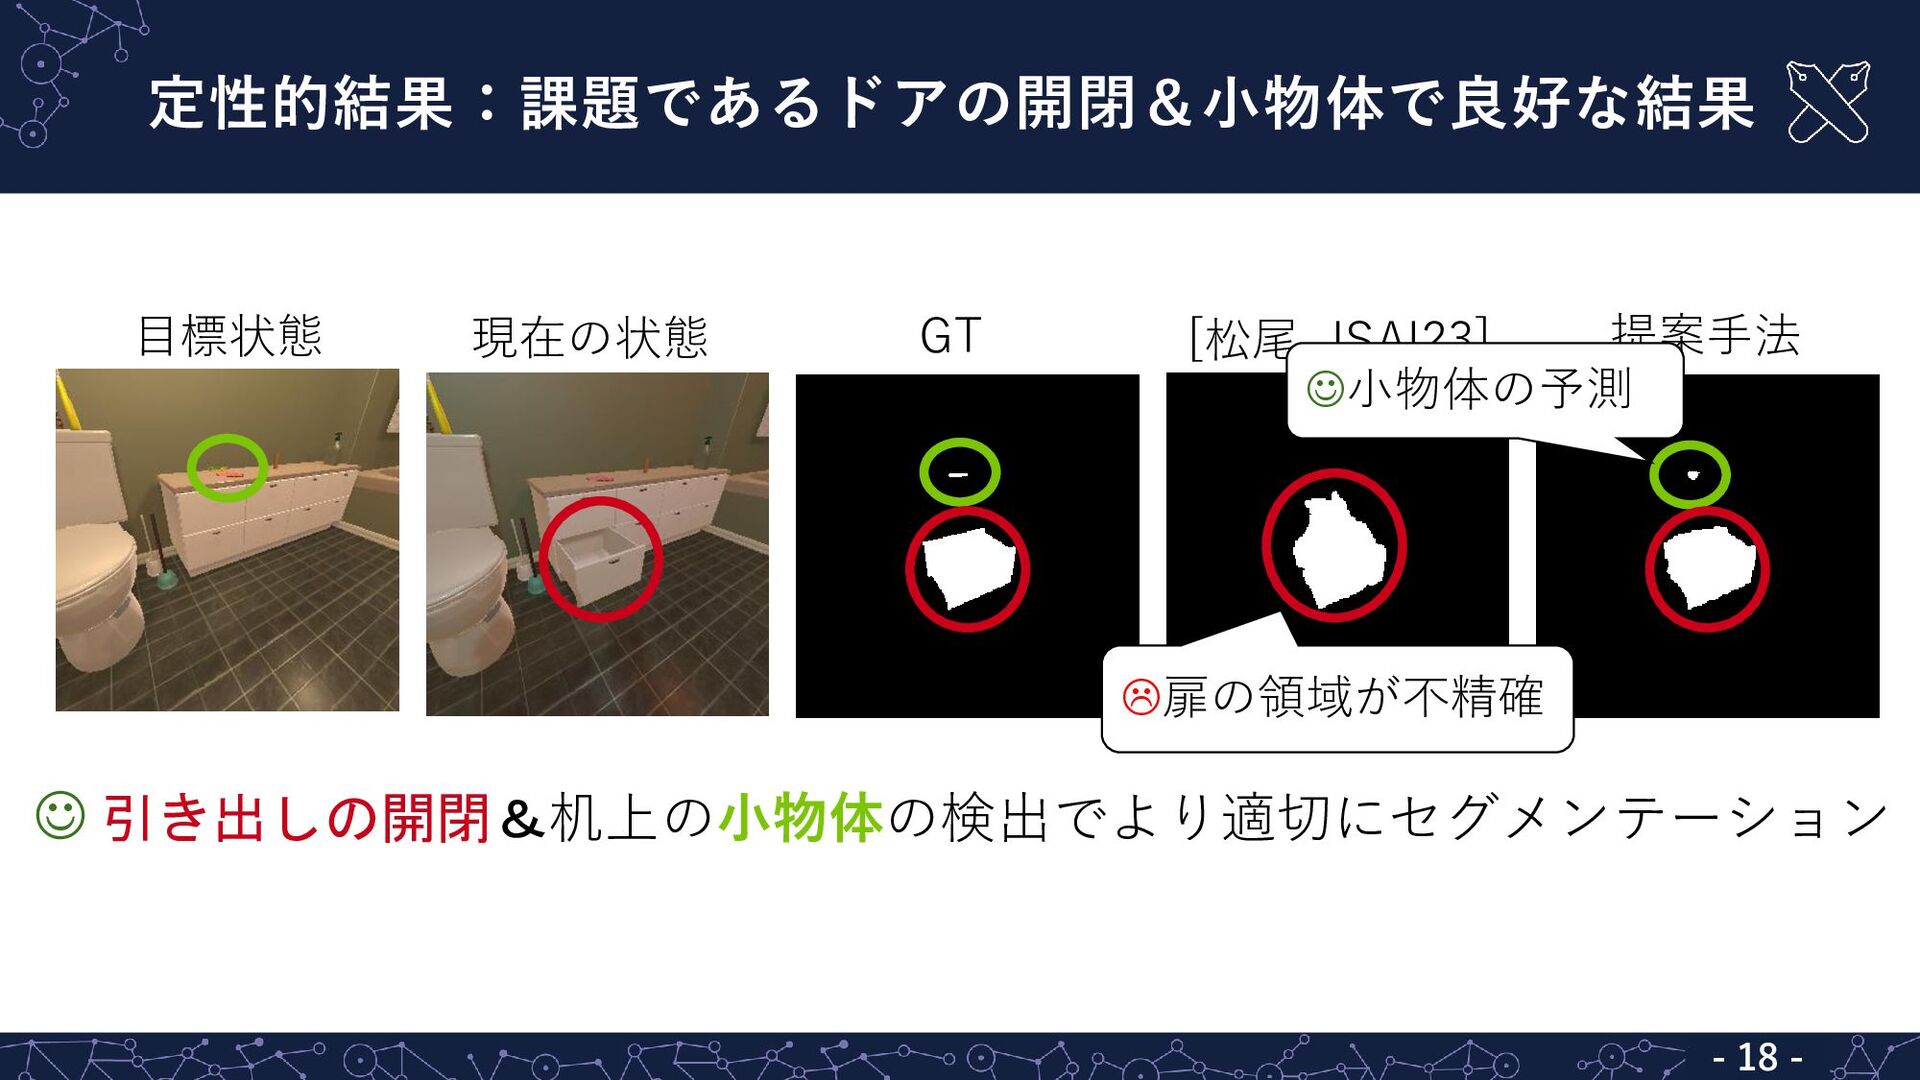
定性的結果:課題であるドアの開閉&小物体で良好な結果 ☺ 引き出しの開閉&机上の小物体の検出でより適切にセグメンテーション - 18 - 目標状態 現在の状態 GT [松尾,
JSAI23] 提案手法 扉の領域が不精確 ☺小物体の予測
定性的結果:物体内部をより適切にマスク - 19 - 目標状態 現在の状態 GT [松尾, JSAI23] 提案手法
☺ 大きな物体の内部をより適切にマスク 内部領域の 予測が不精確 ☺mIoU 4.5↑
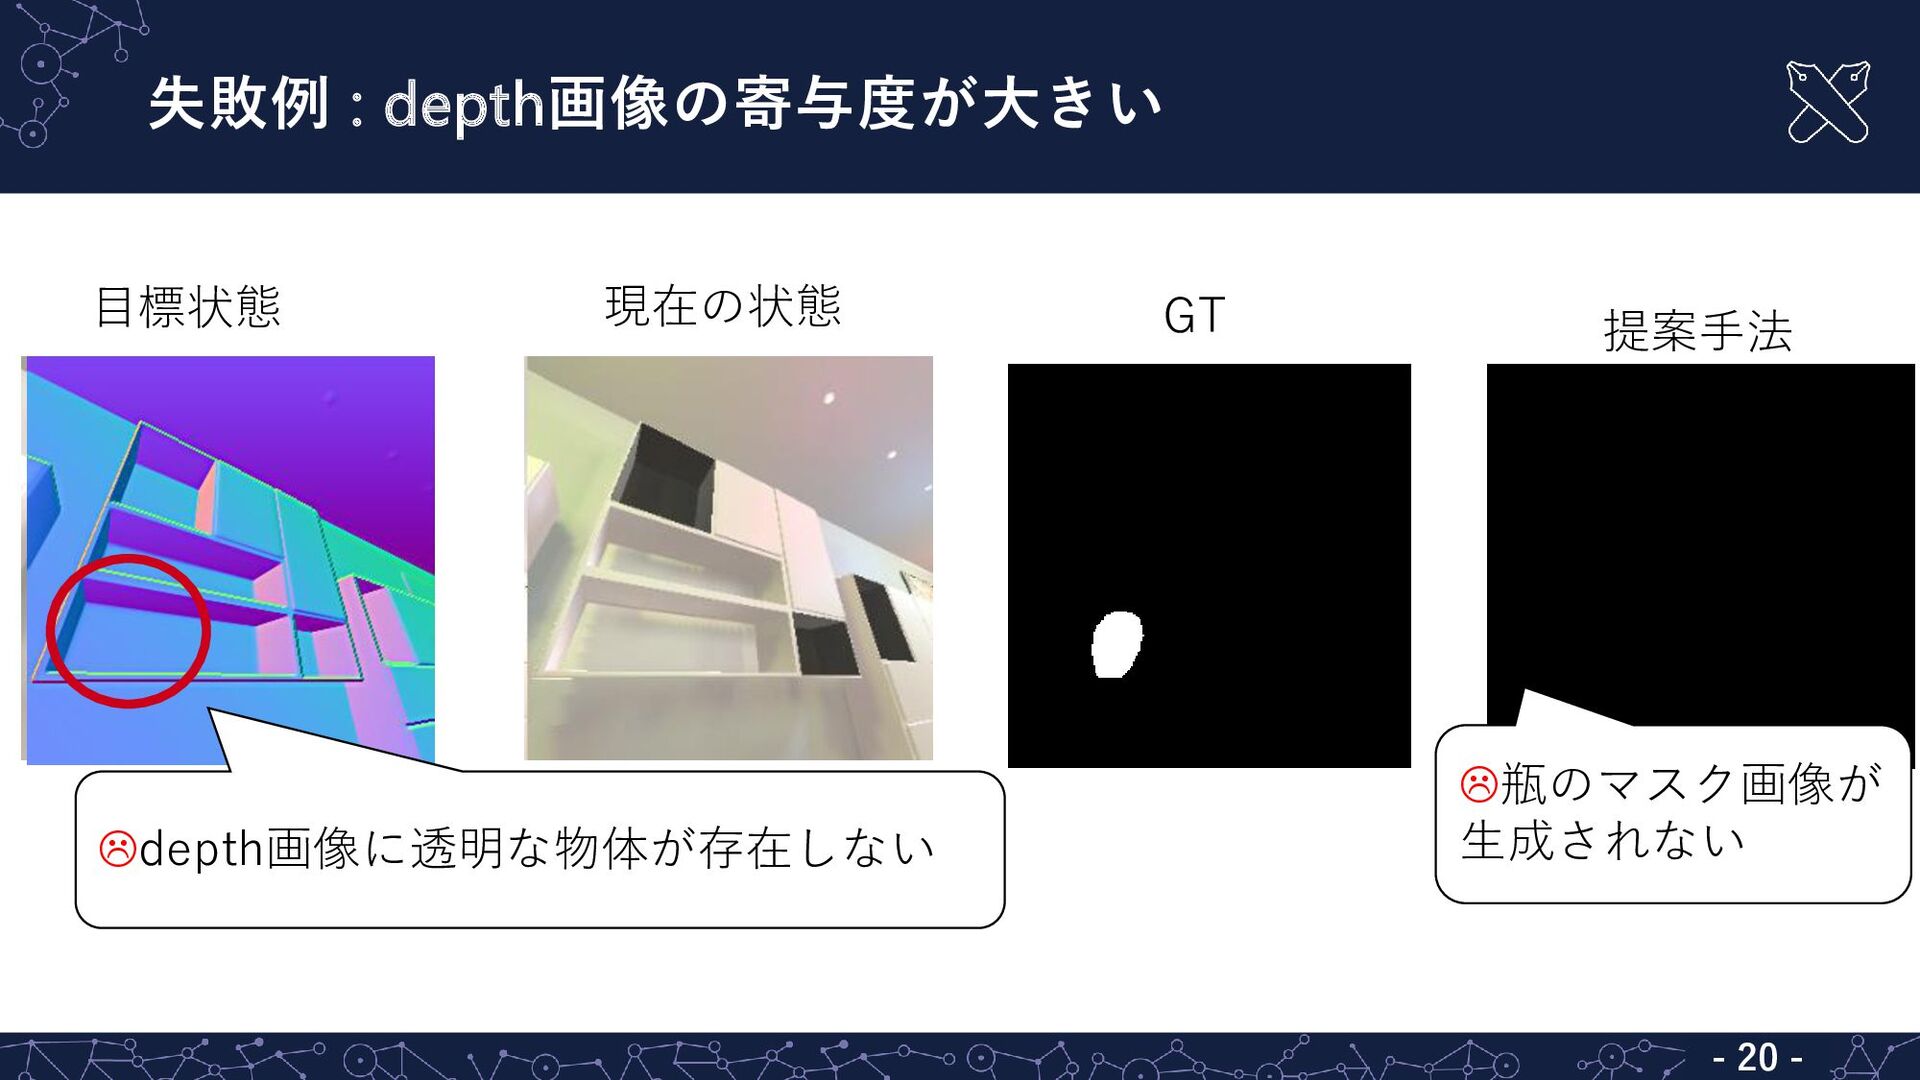
失敗例 : depth画像の寄与度が大きい - 20 - 目標状態 現在の状態 GT 提案手法
depth画像に透明な物体が存在しない 瓶のマスク画像が 生成されない
エラー分析 : depth画像に関連したエラーが多い - 21 - エラー種類 サンプル数 depthマップ上で違いが分かりにくい物体 41
変化距離が短い物体 32 過小または過大な領域予測 21 アノテーション誤り 20 ◼ depth画像の寄与度が高い ◼ 透明、薄い物体がdepth画像上に存在しない ◼ 変化距離の検出に課題
まとめ - 22 - ▪ 背景 ✓ 生活支援ロボットに変化検出は重要 ▪ 提案
✓ RGBD画像及びSAMで生成した セグメンテーション画像を扱う Trimodal Cross-Attentional Encoder ▪ 結果 ✓ ベースラインをmIoU及びF1 -scoreにおいて上回る ✓ドアの開閉&机上の小物体の検出で良好な結果
Appendix
Google Bard 2/2 : 存在しないものを参照 - 24 - Disappeared:
The computer mouse has disappeared. Added: There is a small plant on the table. ☺ Moved: The position of the keyboard has changed slightly.


 keio_smilab
 civitaspo
 tosite
 soudai
 bata_24
 taromatsui_cccmkhd
 pauli
 visional_engineering_and_design
 ryujicre8ive
 kawasima
 o3
 hponka
 lycorptech_jp
 jonoalderson
 asonas
 rasmusluckow
 reverentgeek
 aarron
 baasie
 tonyrice
 irinanazarova
 speakerdeck
 stephaniewalter
 holman
 kristinabergwall1