Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
OpenTalks.AI - Дмитрий Пагин, Ускорение сверточ...
Search
opentalks2
February 04, 2021
Business
430
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
OpenTalks.AI - Дмитрий Пагин, Ускорение сверточных сетей с помощью квантизации. Quantization aware training.
opentalks2
February 04, 2021
More Decks by opentalks2
See All by opentalks2
OpenTalks.AI - Сергей Терехов, Тензорная машина ассоциативного вывода
opentalks2
0
420
OpenTalks.AI - Максим Милков, Оптимизация бизнес-процессов и документооборота с использованием NLP технологий Бизнес-кейс: Цифровой аудитор
opentalks2
0
440
OpenTalks.AI - Анна Серебряникова, Влияние технологий ИИ на развитие машиночитаемого документооборота в России
opentalks2
0
350
OpenTalks.AI - Илья Жариков, Optimization of neural networks and their development
opentalks2
0
430
OpenTalks.AI - Никита Андриянов, Анализ эффективности распознавания образов на нестандартных типах изображений на примере радиолокационных изображений местности и рентгеновских снимков багажа и ручной клади
opentalks2
0
370
OpenTalks.AI - Сергей Алямкин, AutoDL или как сократить затраты на разработку и использование в проде нейронных сетей
opentalks2
0
510
Никитин.pdf
opentalks2
0
360
OpenTalks.AI - Александр Петюшко, Исследование устойчивости сверточных нейросетей на примере систем детекции и распознавания лиц
opentalks2
0
490
OpenTalks.AI - Сергей Лукашкин, Как ИИ повлиял на бизнес в 2020 году
opentalks2
0
400
Other Decks in Business
See All in Business
オープンワーク会社紹介資料 / company profile
openwork
4
610k
Crisp Code inc.|コーポレート・サービス紹介 - Corporate & Services Introduction
so_kotani
0
650
3ヶ月で月額300万円削減 ── AWSコスト削減プロジェクトのリアル
o2mami
0
580
データ基盤を Athena _ Glue から Databricks へ移行しました - 第4回 Youは何しにDatabricksへ!?
stanby_inc
0
250
【Progmat】Monthly-ST-Market-Report-2026-Sep.
progmat
0
380
㈱サンエー 会社 採用資料
uemura2024
0
5.5k
20261022_【DCC】トークン化国債・オンチェーンレポWG_中間整理_本紙
progmat
0
590
入社4ヶ月で 2つのプロダクトの撤退判断
tkt42u19421
3
4.8k
KEELLプロダクト紹介資料_202610
shunsuke_takeuchi
PRO
0
240
Crisp Code inc.|わたしたちの事例 / 実績 - Works
so_kotani
0
2.4k
新卒採用向け説明資料
kazumakitao
PRO
1
4.2k
Supermarket Floral Ad Roundup Week 43
karnelson84
0
130
Featured
See All Featured
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
Making the Leap to Tech Lead
cromwellryan
135
10k
The Power of CSS Pseudo Elements
geoffreycrofte
82
6.6k
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
410
Embracing the Ebb and Flow
colly
88
5.2k
<Decoding/> the Language of Devs - We Love SEO 2024
nikkihalliwell
1
360
Leveraging Curiosity to Care for An Aging Population
cassininazir
1
540
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
Making Projects Easy
brettharned
120
6.8k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
State of Search Keynote: SEO is Dead Long Live SEO
ryanjones
0
330
Transcript
Ускорение сверточных сетей с помощью квантизации. Quantization aware training. Dmitriy
Pagin, ML and CV developer
Задача
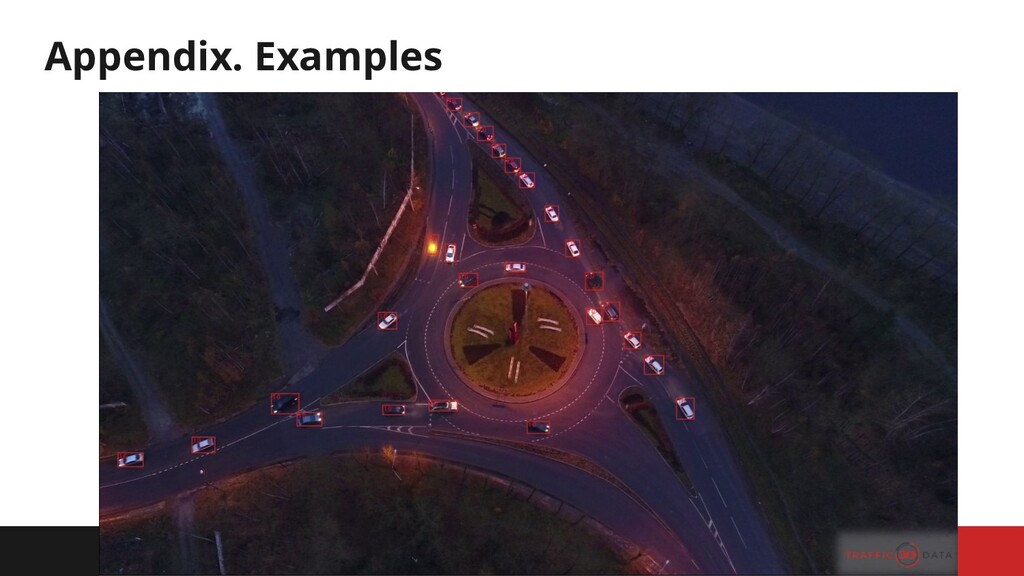
Задача • Детектировать и трекать автомобили с камер и дронов
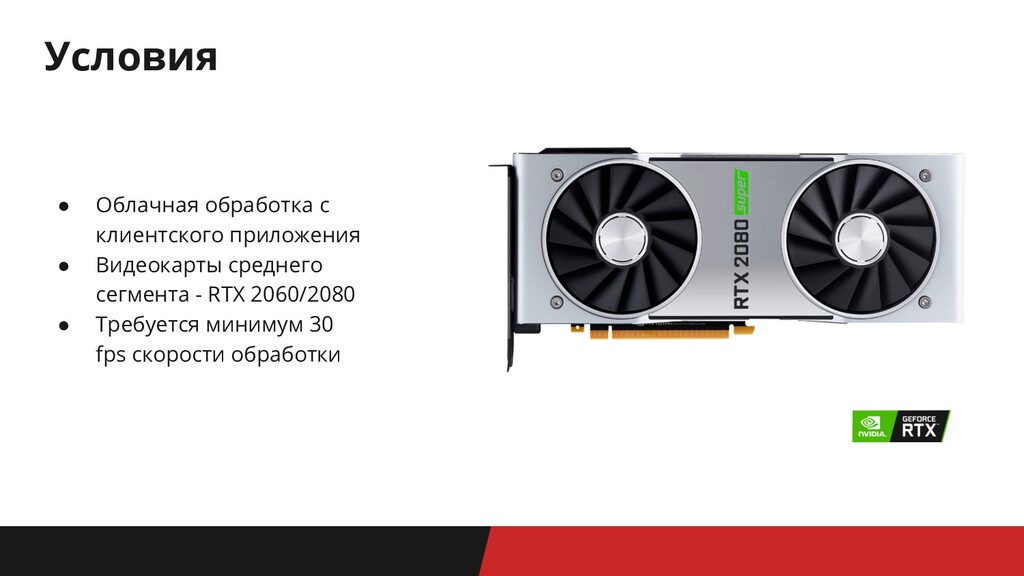
Условия • Облачная обработка с клиентского приложения • Видеокарты среднего
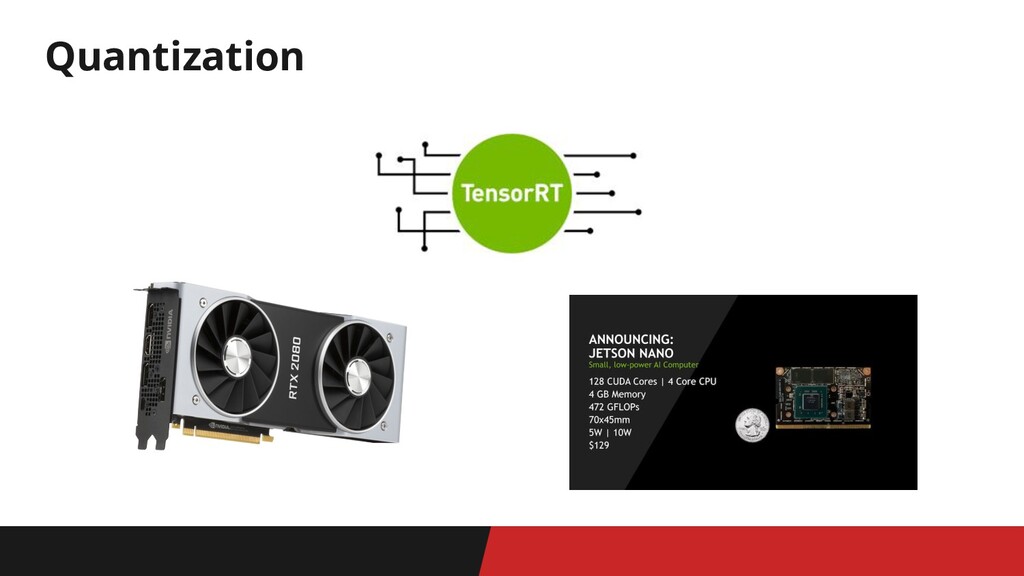
сегмента - RTX 2060/2080 • Требуется минимум 30 fps скорости обработки
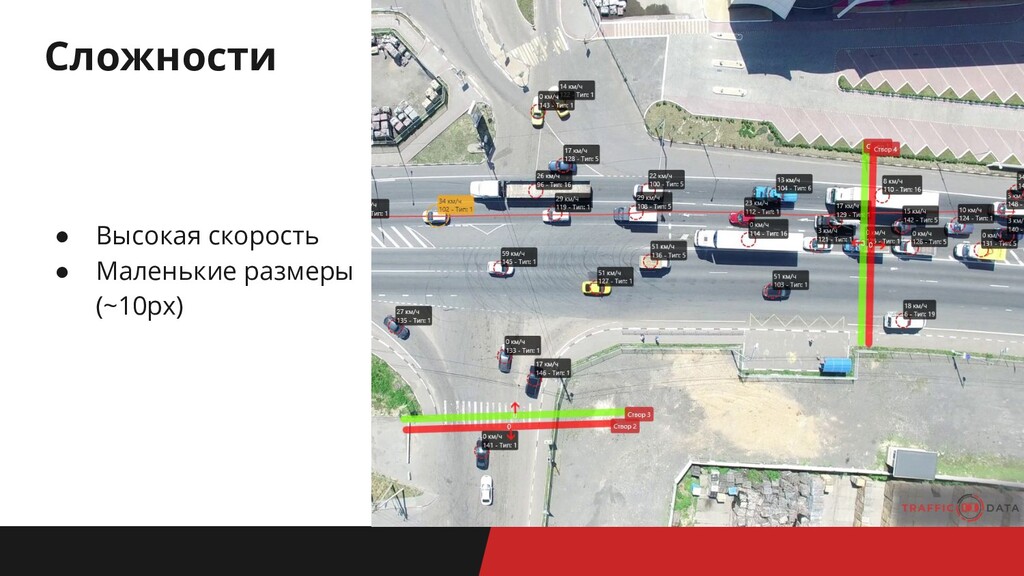
Сложности • Высокая скорость • Маленькие размеры (~10px)
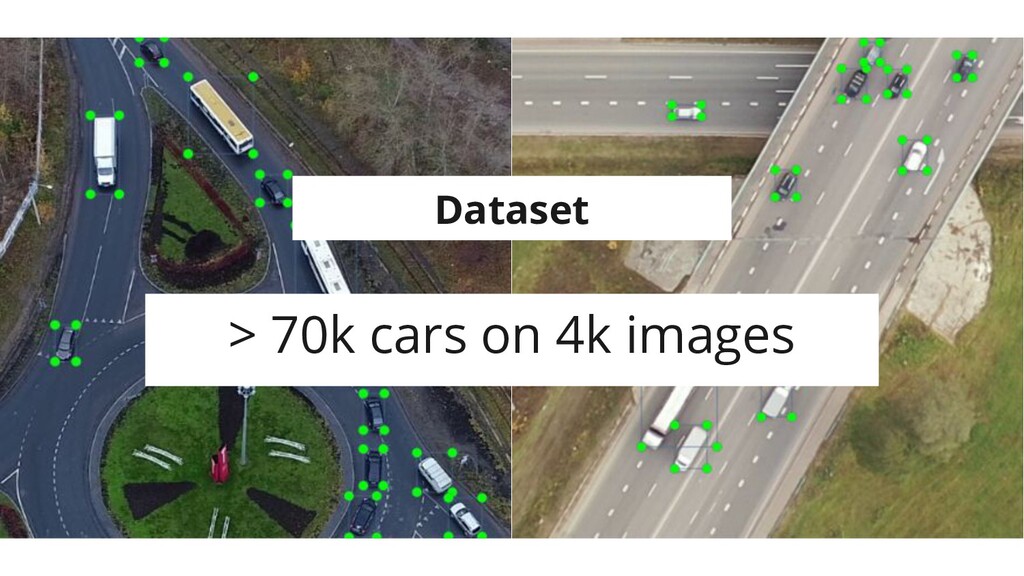
> 70k cars on 4k images Dataset
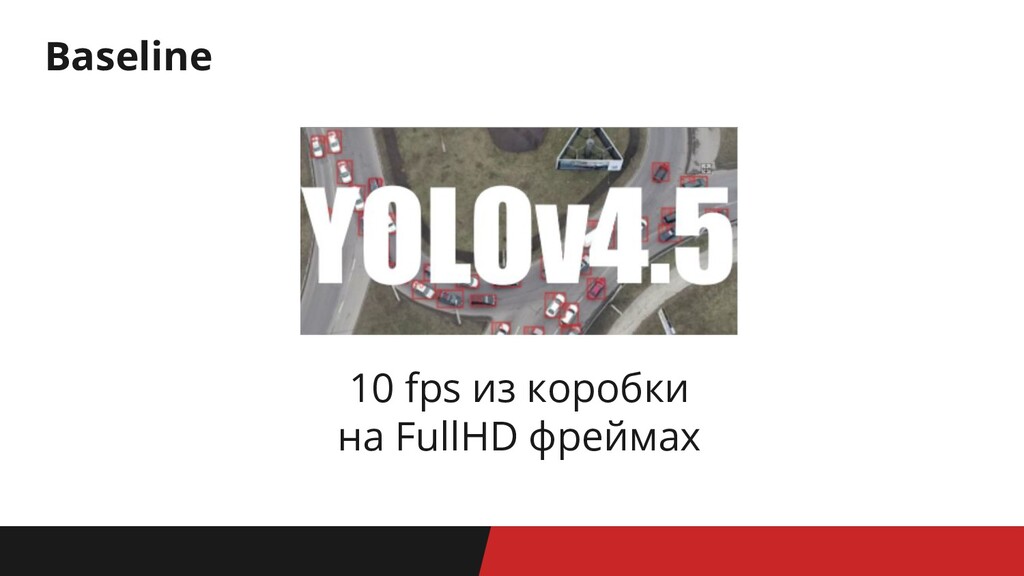
Baseline 10 fps из коробки на FullHD фреймах
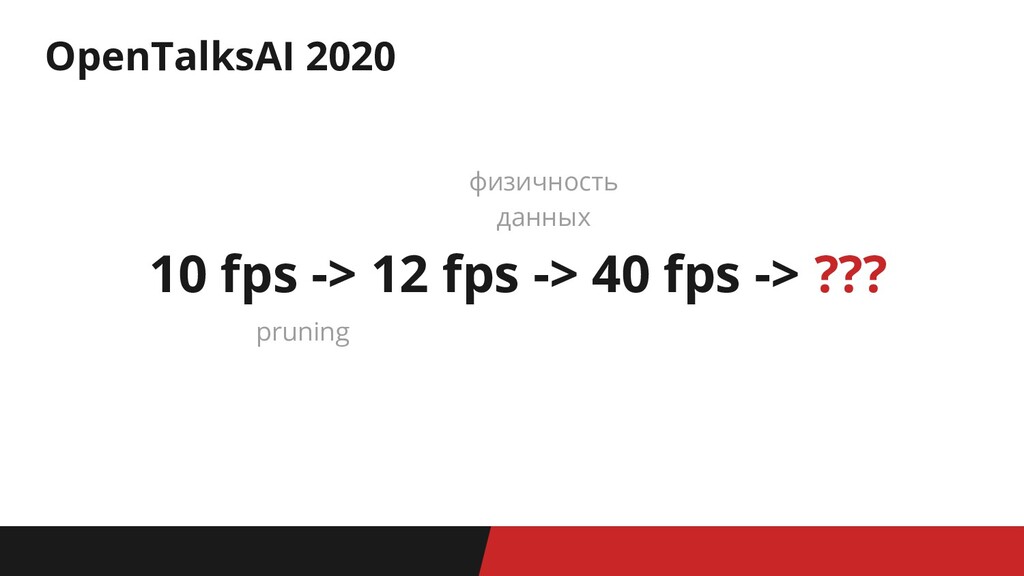
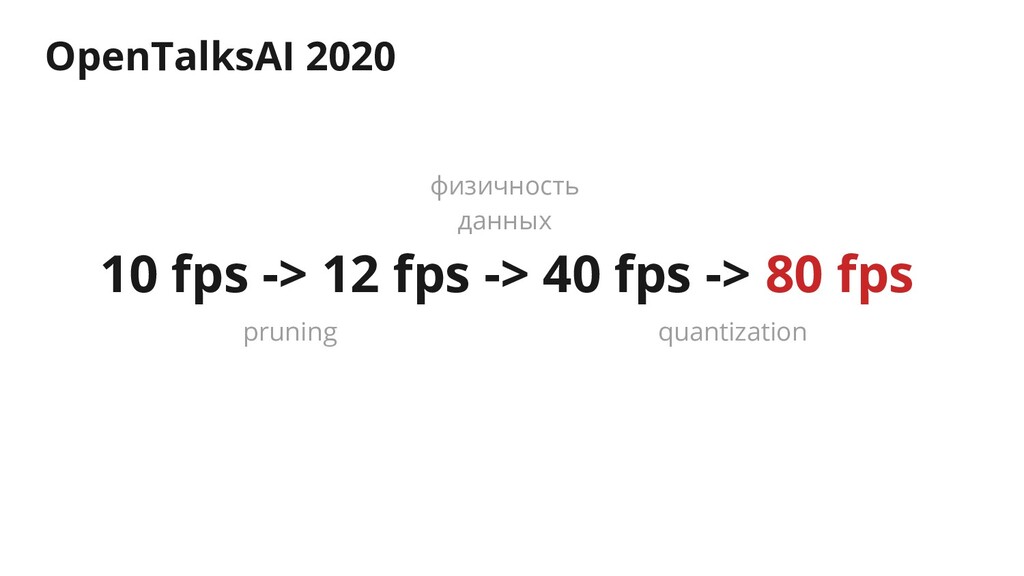
10 fps -> 12 fps -> 40 fps -> ???
OpenTalksAI 2020 pruning физичность данных
Как сделать быстрее?
Методы • Quantization • Quantization aware training
Quantization
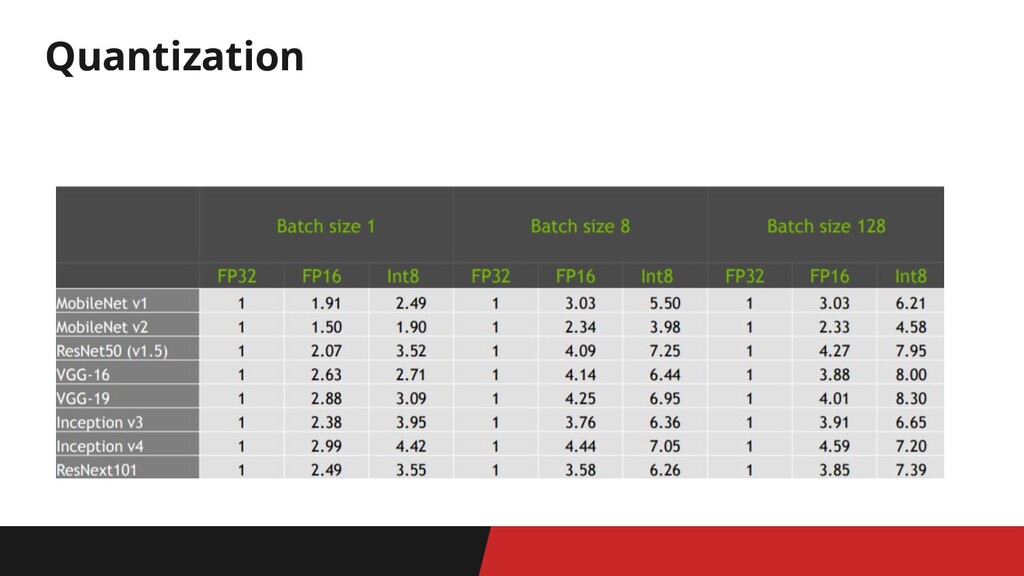
Quantization Quantization - приведение весов и вычислений к типам меньшей
точности с целью ускорения инференса и уменьшения размера сети
Quantization
Quantization По умолчанию - float32 • float16 - округление •
int8 - округление + нормирование (256! значений) • int4 … • binary ...
Quantization
Quantization. INT8 error increasing
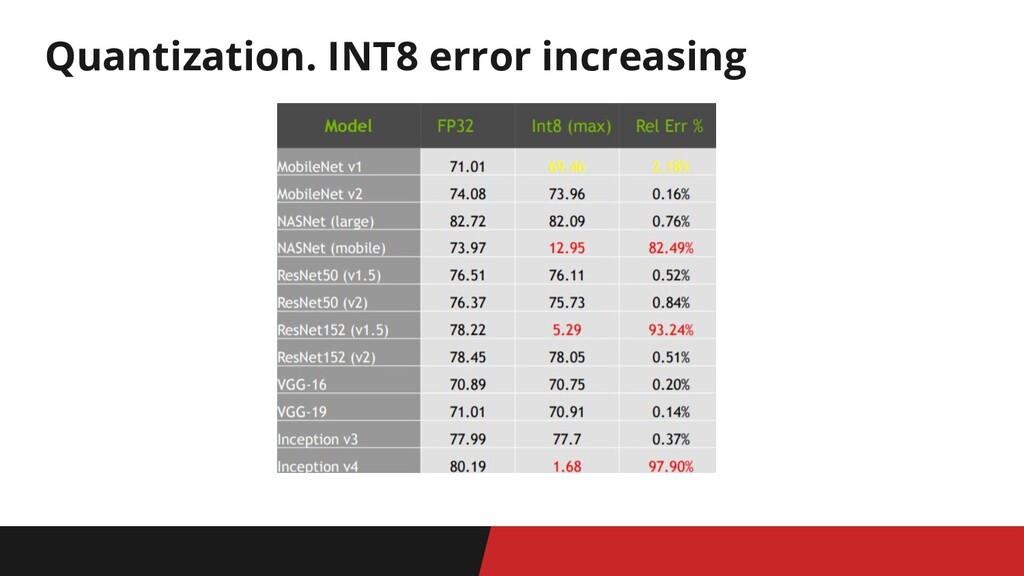
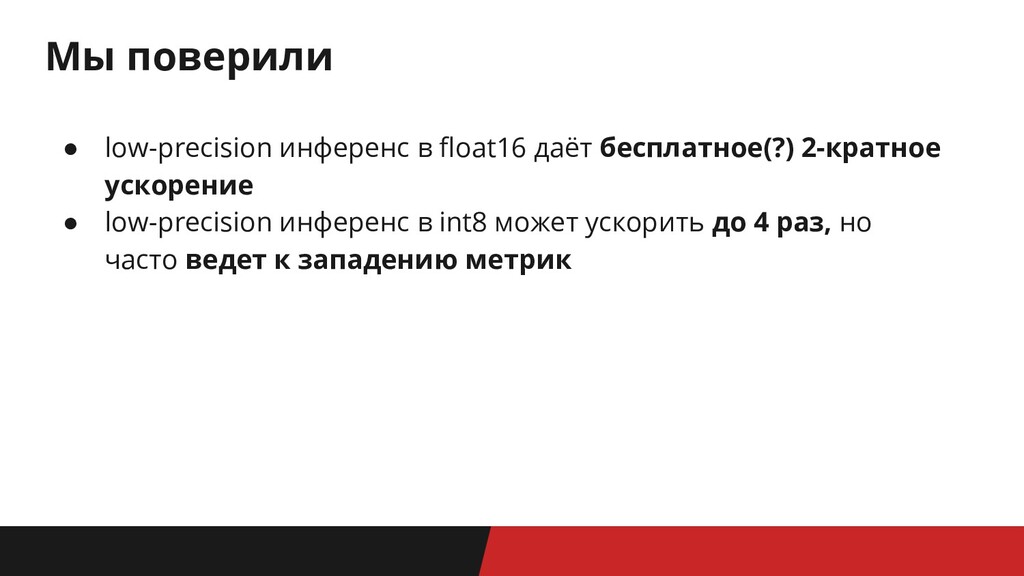
Мы поверили • low-precision инференс в float16 даёт бесплатное(?) 2-кратное
ускорение • low-precision инференс в int8 может ускорить до 4 раз, но часто ведет к западению метрик
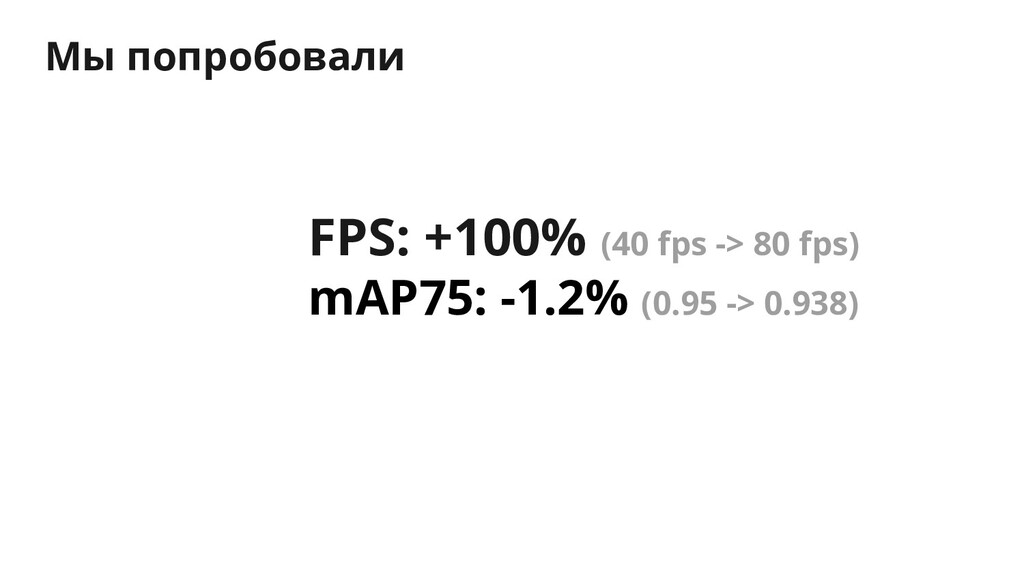
FPS: +100% (40 fps -> 80 fps) mAP75: -1.2% (0.95
-> 0.938) Мы попробовали
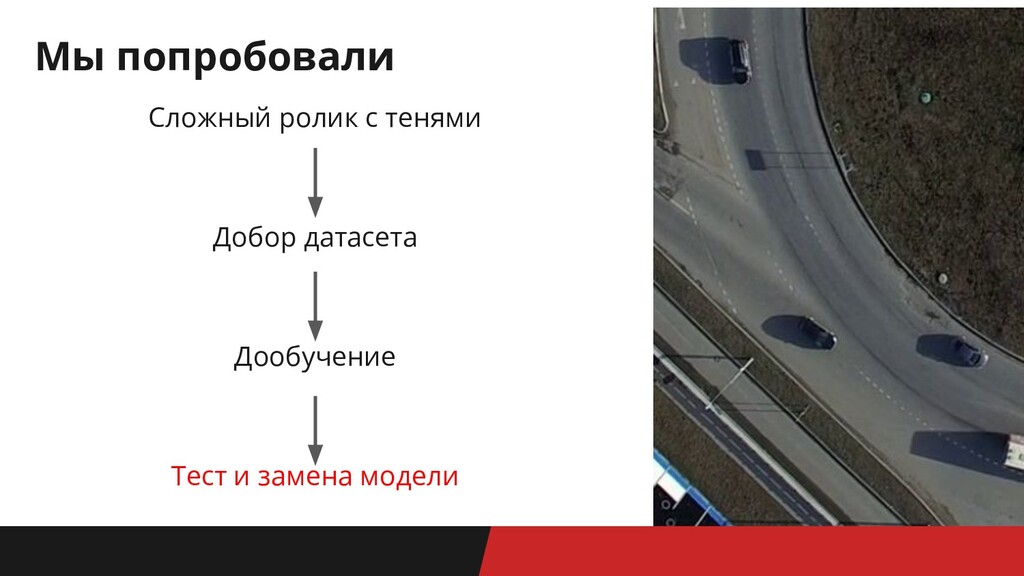
Мы попробовали Сложный ролик с тенями Добор датасета Дообучение Тест
и замена модели
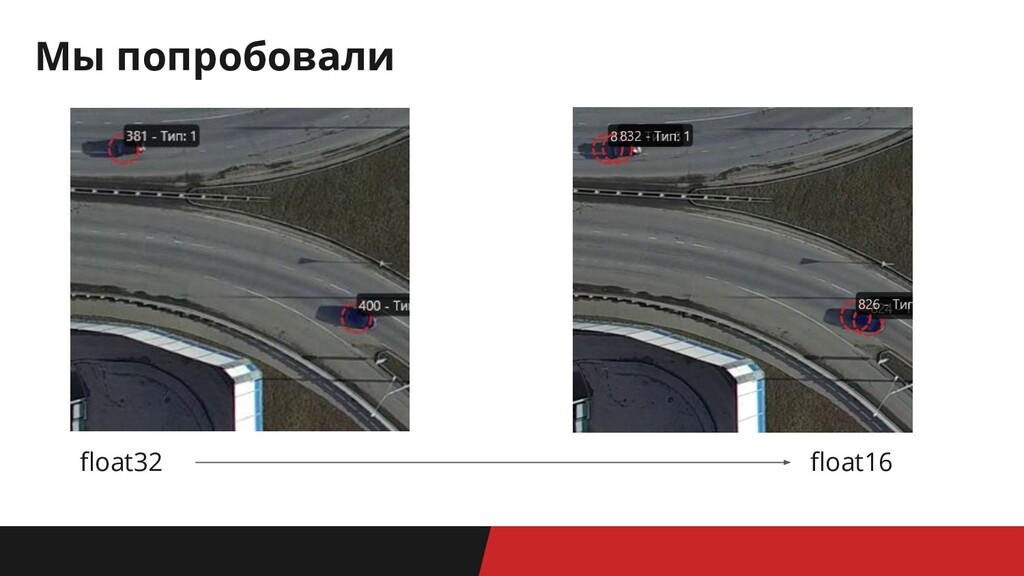
float32 float16 Мы попробовали
Quantization Aware Training
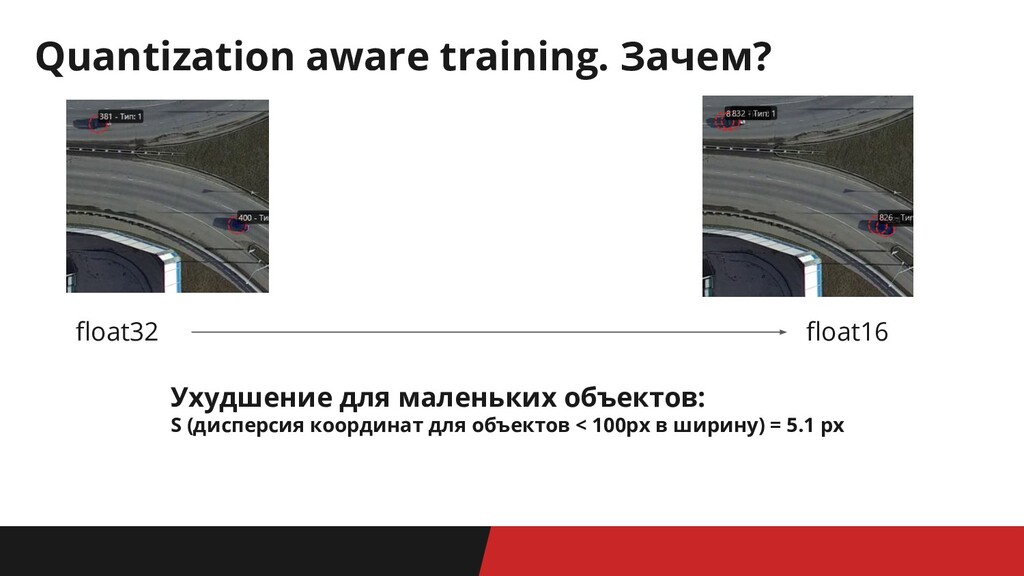
float32 float16 Потеря “нежных” фич: • тени • ночные ролики
• авто с прицепами Quantization aware training. Зачем?
float32 float16 Ухудшение для маленьких объектов: S (дисперсия координат для
объектов < 100px в ширину) = 5.1 px Quantization aware training. Зачем?
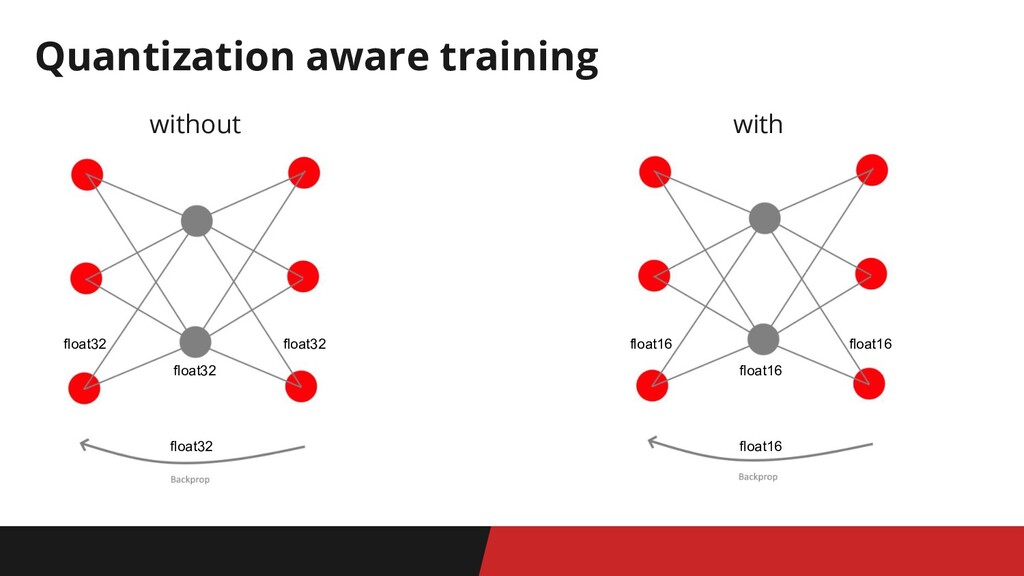
without Quantization aware training with float32 float32 float32 float32 float16
float16 float16 float16
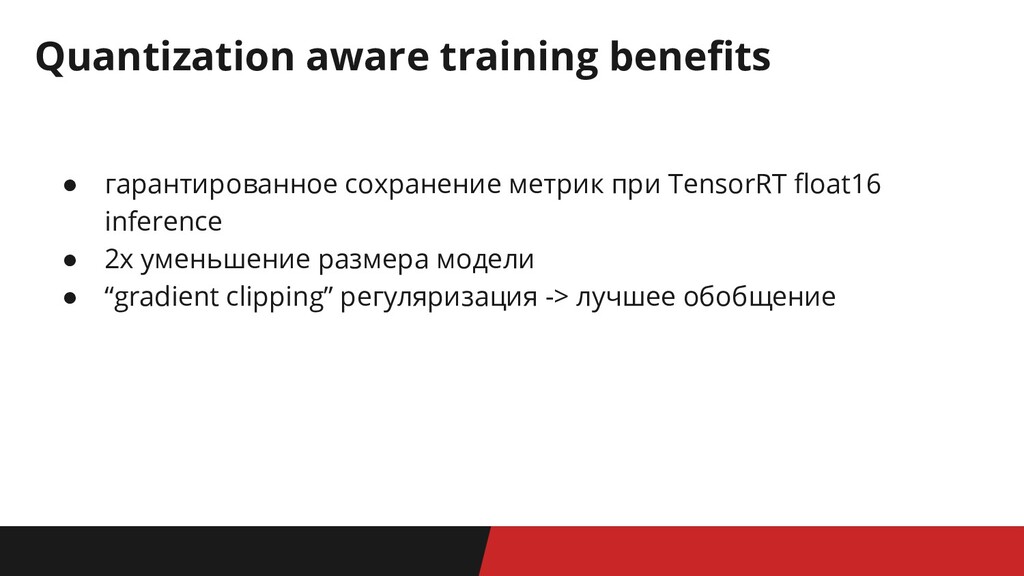
Quantization aware training benefits • гарантированное сохранение метрик при TensorRT
float16 inference • 2x уменьшение размера модели • “gradient clipping” регуляризация -> лучшее обобщение
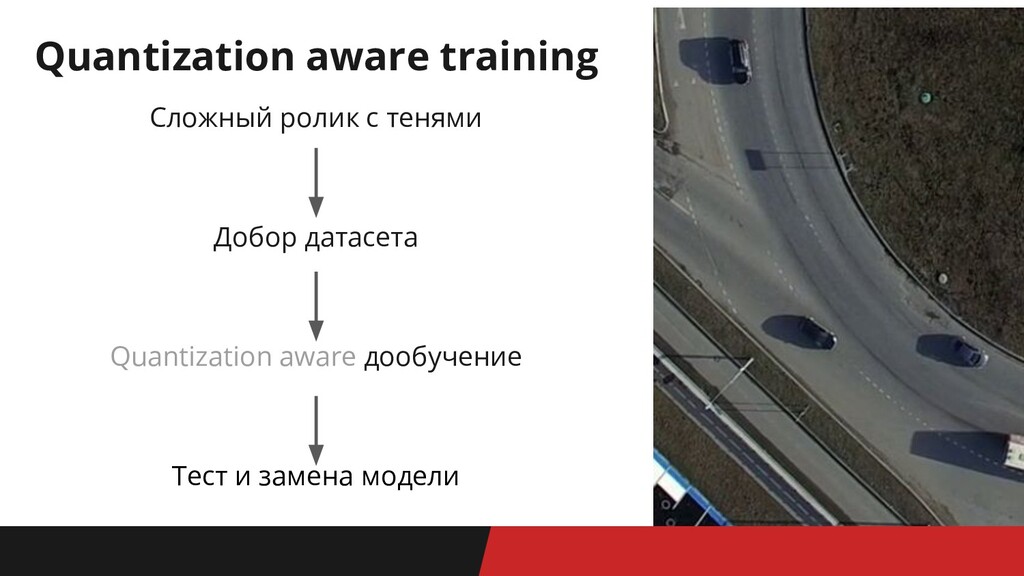
Quantization aware training Сложный ролик с тенями Добор датасета Quantization
aware дообучение Тест и замена модели
float32 float16 Quantization aware training
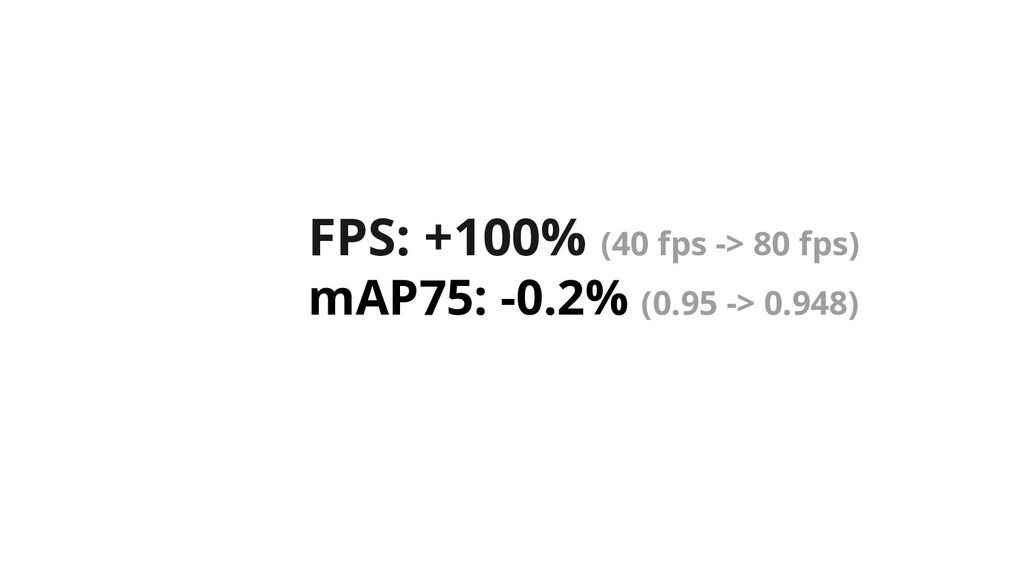
FPS: +100% (40 fps -> 80 fps) mAP75: -0.2% (0.95
-> 0.948)
Итоги • TensorRT low-precision must have -> 2x ускорение •
TensorRT low-precision лучше использовать после quantization aware training
10 fps -> 12 fps -> 40 fps -> 80
fps OpenTalksAI 2020 pruning физичность данных quantization
None
Thanks! Questions?
[email protected]
+7 952 335 65 70
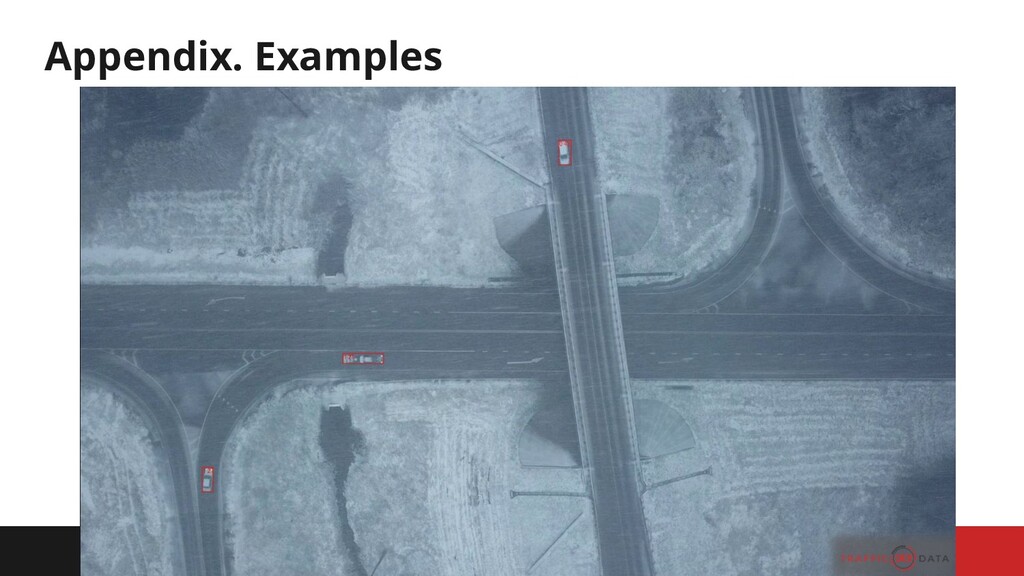
Appendix. Examples
Appendix. Examples
Appendix. Examples
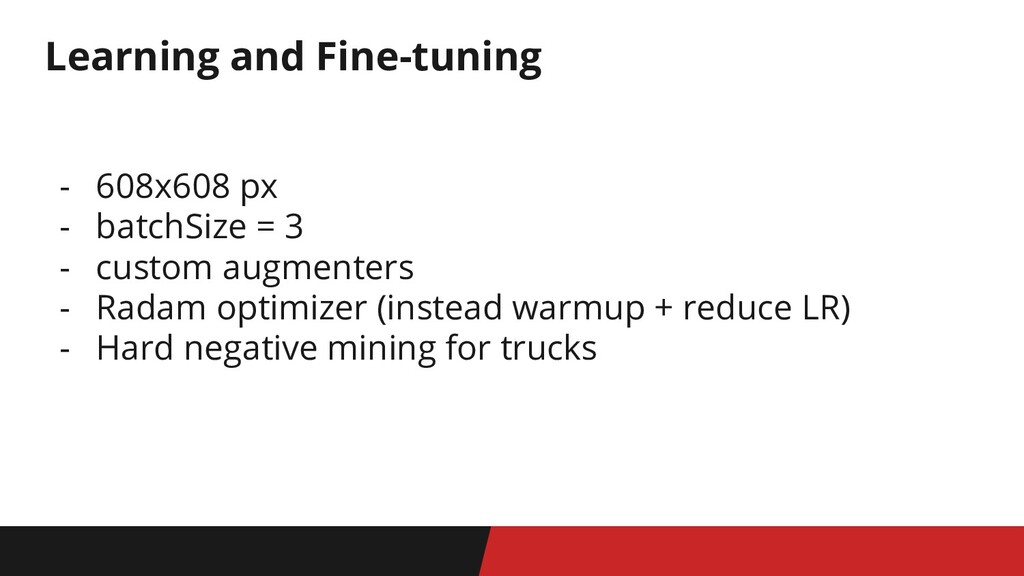
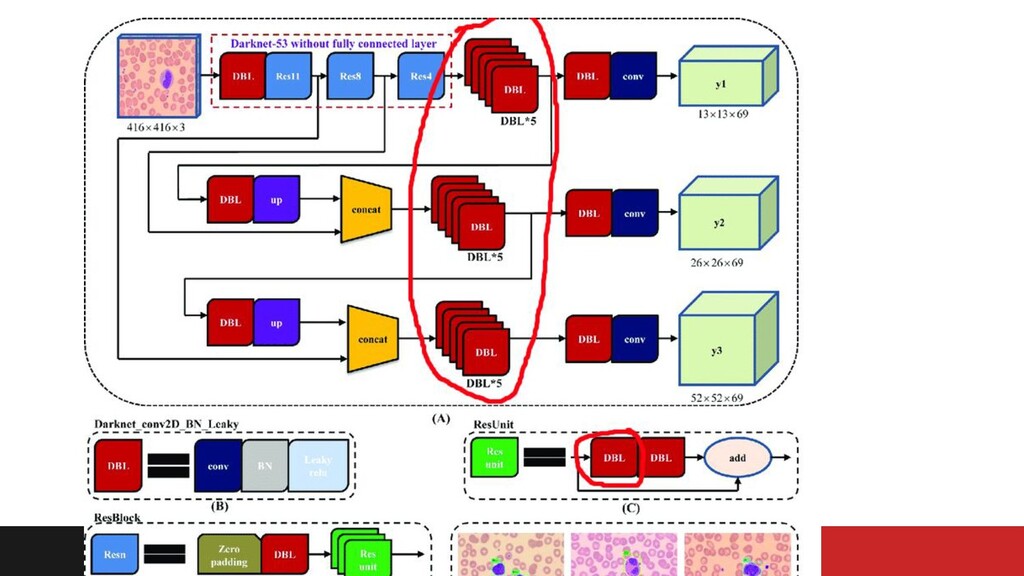
Learning and Fine-tuning - 608x608 px - batchSize = 3
- custom augmenters - Radam optimizer (instead warmup + reduce LR) - Hard negative mining for trucks
None
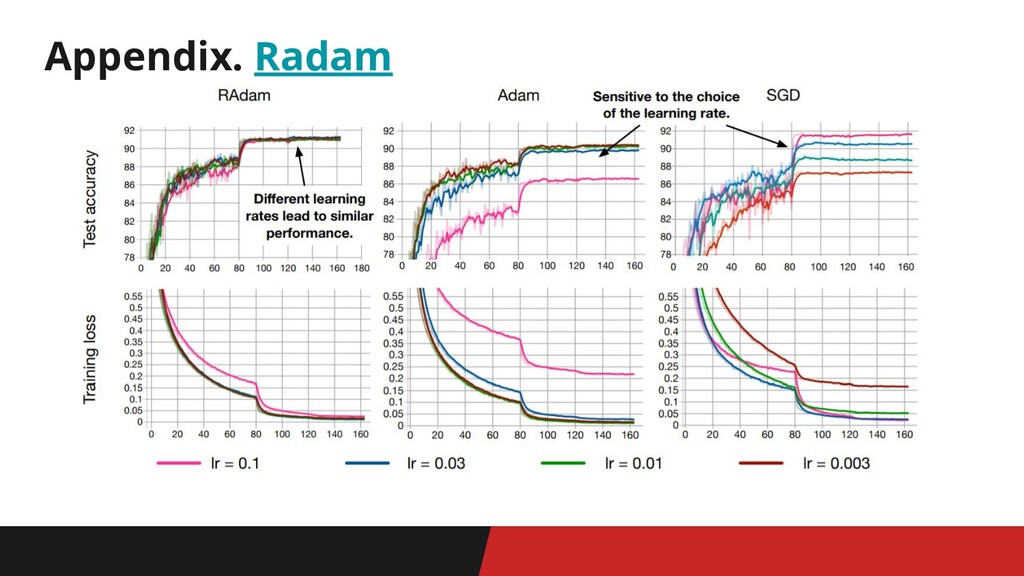
Appendix. Radam
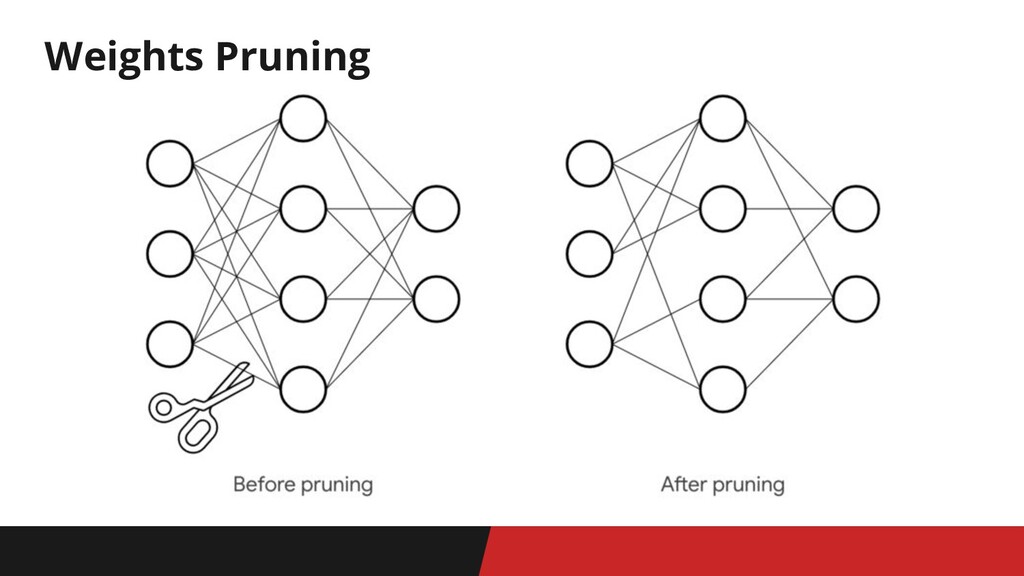
Weights Pruning Pruning - уменьшение размера обученной сети без потери
точности путем удаления слабых узлов
Weights Pruning
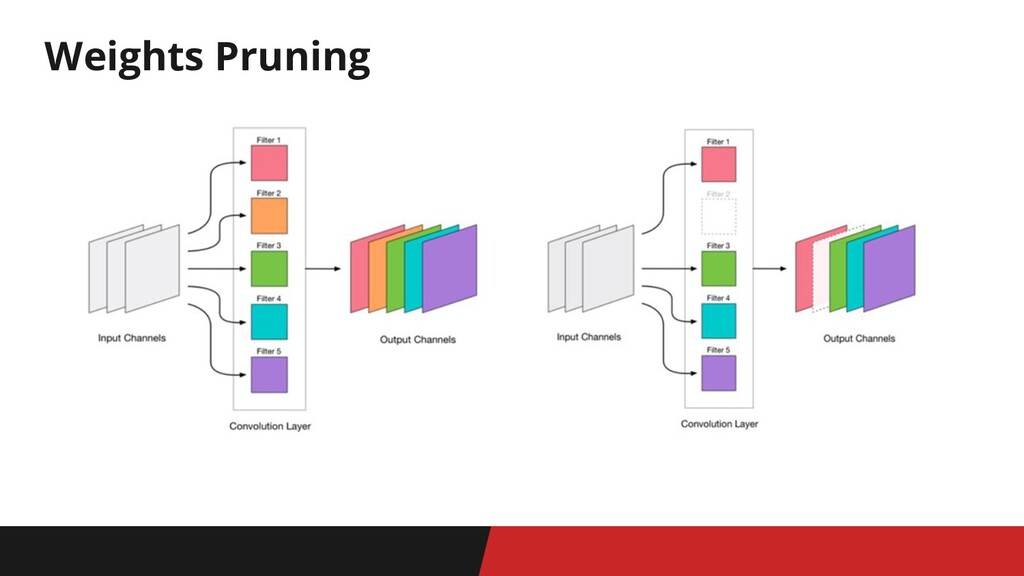
Weights Pruning
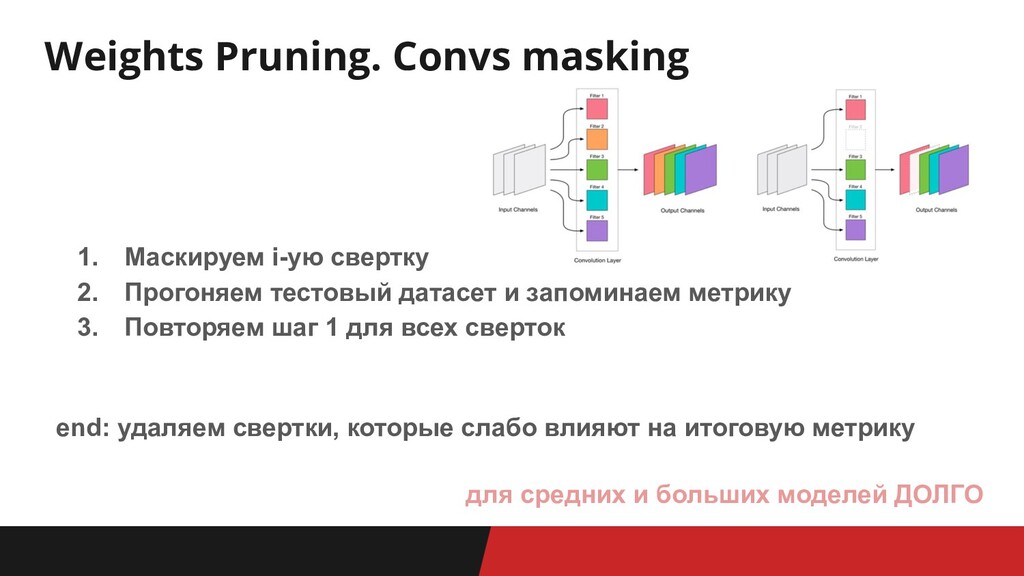
Weights Pruning. Convs masking 1. Маскируем i-ую свертку 2. Прогоняем
тестовый датасет и запоминаем метрику 3. Повторяем шаг 1 для всех сверток end: удаляем свертки, которые слабо влияют на итоговую метрику для средних и больших моделей ДОЛГО
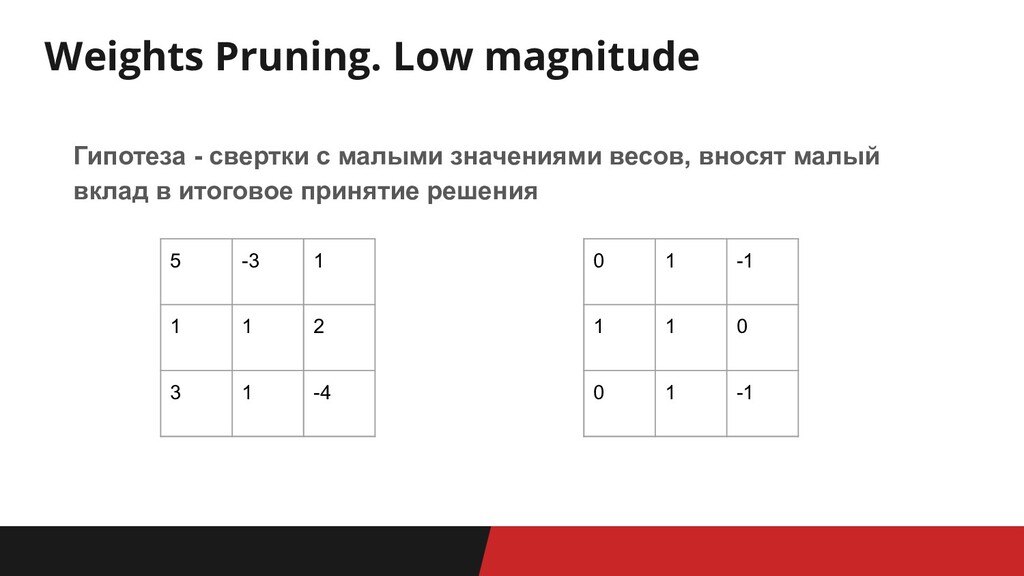
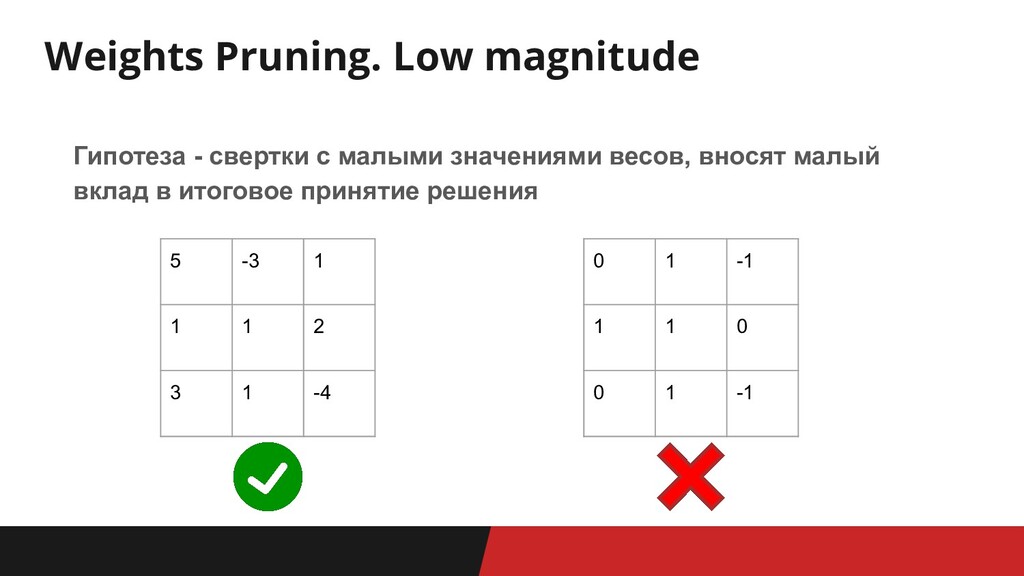
Weights Pruning. Low magnitude Гипотеза - свертки с малыми значениями
весов, вносят малый вклад в итоговое принятие решения 5 -3 1 1 1 2 3 1 -4 0 1 -1 1 1 0 0 1 -1
Weights Pruning. Low magnitude Гипотеза - свертки с малыми значениями
весов, вносят малый вклад в итоговое принятие решения 5 -3 1 1 1 2 3 1 -4 0 1 -1 1 1 0 0 1 -1
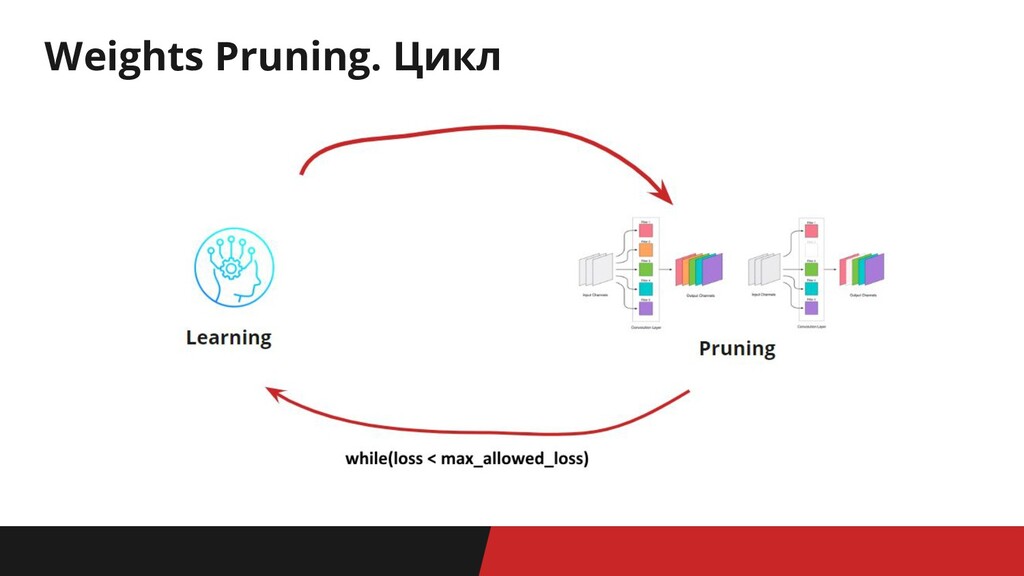
Weights Pruning. Цикл
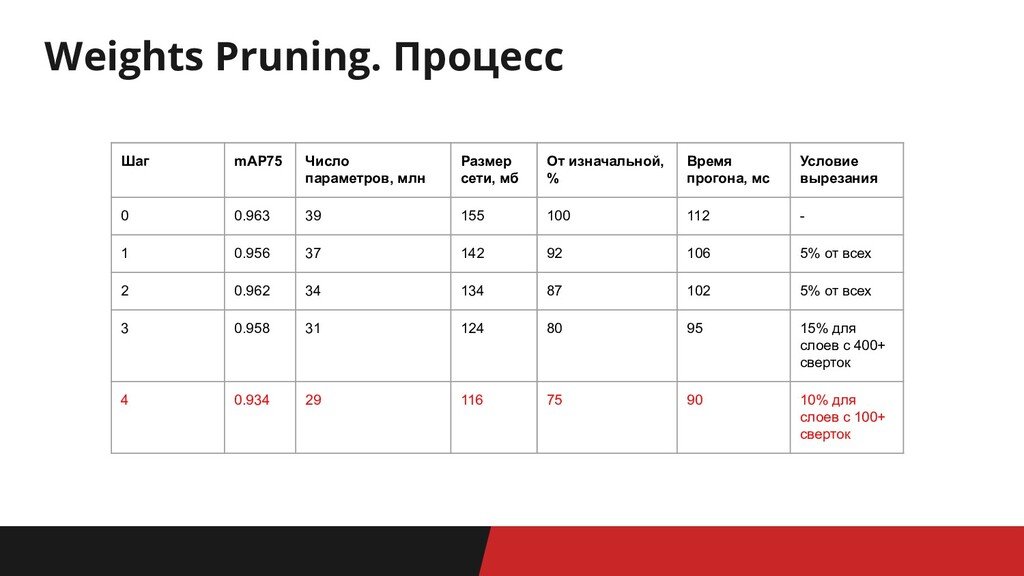
Weights Pruning. Процесс Шаг mAP75 Число параметров, млн Размер сети,
мб От изначальной, % Время прогона, мс Условие вырезания 0 0.963 39 155 100 112 - 1 0.956 37 142 92 106 5% от всех 2 0.962 34 134 87 102 5% от всех 3 0.958 31 124 80 95 15% для слоев с 400+ сверток 4 0.934 29 116 75 90 10% для слоев с 100+ сверток
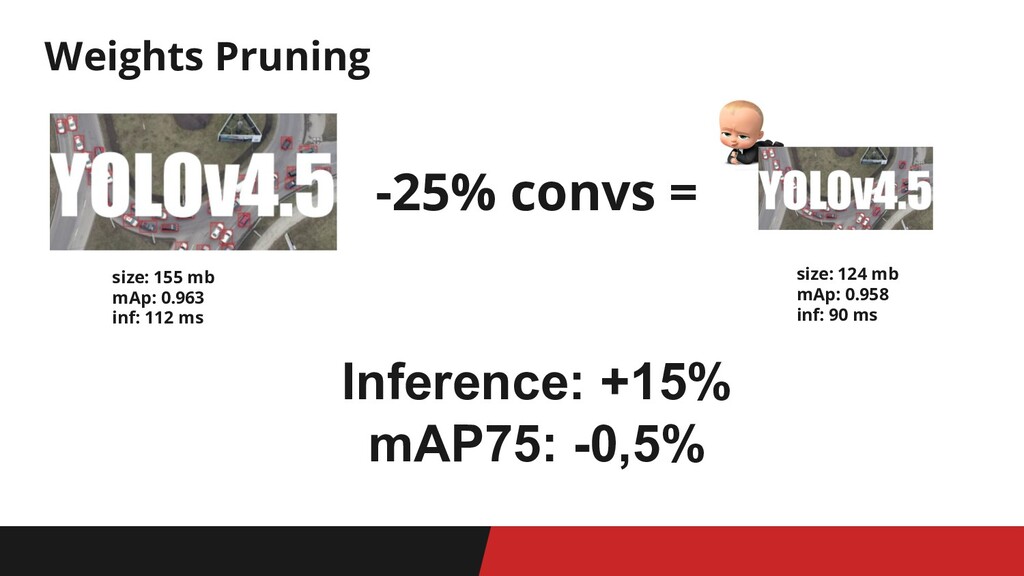
Weights Pruning -25% convs = size: 155 mb mAp: 0.963
inf: 112 ms size: 124 mb mAp: 0.958 inf: 90 ms Inference: +15% mAP75: -0,5%


 opentalks2
 openwork
 so_kotani
 o2mami
 stanby_inc
 progmat
 uemura2024
 tkt42u19421
 shunsuke_takeuchi
 kazumakitao
 karnelson84
 tammyeverts
 cromwellryan
 geoffreycrofte
 reverentgeek
 colly
 nikkihalliwell
 cassininazir
 philnash
 brettharned
 codingconduct
 chrisshort
 ryanjones