Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
言語処理学会2024-継続事前学習による日本語に強い大規模言語モデルの構築
Search
Kazuki Fujii
December 14, 2025
Research
100
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
言語処理学会2024-継続事前学習による日本語に強い大規模言語モデルの構築
Kazuki Fujii
December 14, 2025
More Decks by Kazuki Fujii
See All by Kazuki Fujii
IHPCSS2025-Kazuki-Fujii
fujiikazuki2000
0
50
2024-02-Tokyo-Tech-大規模言語モデルの事前学習知見
fujiikazuki2000
0
48
情報処理学会-全国大会2024-大規模言語モデルの分散並列学習
fujiikazuki2000
0
48
AWS Summit Japan 2025 Amazon SageMaker HyperPodを利用した日本語LLM(Swallow)の構築 (CUS-02)
fujiikazuki2000
0
72
合成データパイプラインを利用したSwallowProjectに おけるLLM性能向上
fujiikazuki2000
1
320
論文では語られないLLM開発において重要なこと Swallow Projectを通して
fujiikazuki2000
8
2.1k
大規模言語モデルの学習知見
fujiikazuki2000
0
240
自然言語処理のための分散並列学習
fujiikazuki2000
1
780
Other Decks in Research
See All in Research
某助成金プロジェクト採択に向けて企業研究所のアウトリーチ専任者がやったこと
afroscript
0
200
ハードウェア研究で国際トップ会議を目指す!IROS 2027での論文採択を目指して
ayatokanada
7
4k
VLMの推論を高速化する視覚トークン削減の仕組み
tattaka
2
370
論文紹介: Understanding Epistemic Language with a Language-augmented Bayesian Theory of Mind
hisaokatsumi
0
190
Easy to Guess, Hard to Verify: Lessons from AIMO 3 for Olympiad-Level AI Mathematics
corochann
0
130
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
390
Visual SLAM未来予測 / Future Prediction in Visual SLAM
koide3
1
1.2k
最先端NLP 2026 論文紹介: Wait, Wait, Wait... Why Do Reasoning Models Loop? / SNLP Paper Review: Wait, Wait, Wait... Why Do Reasoning Models Loop?
tkng
0
260
モデル評価を効率的にする方法
ftakahashi
0
220
MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing
satai
3
160
データサイエンティストの就労意識~2015 → 2026 一般(個人)会員アンケートより
datascientistsociety
PRO
0
1k
適応的スパムフィルタのための軽量な類似メッセージカウンタ / jsai2026-adaptive-spam-filter
monochromegane
0
5.9k
Featured
See All Featured
Statistics for Hackers
jakevdp
799
230k
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
370
Intergalactic Javascript Robots from Outer Space
tanoku
273
27k
Abbi's Birthday
coloredviolet
4
10k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
980
The Hidden Cost of Media on the Web [PixelPalooza 2025]
tammyeverts
2
520
Rails Girls Zürich Keynote
gr2m
96
14k
How Software Deployment tools have changed in the past 20 years
geshan
2
35k
Paper Plane
katiecoart
PRO
4
54k
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
3.4k
Marketing to machines
jonoalderson
1
5.9k
Transcript
継続事前学習による日本語に強い 大規模言語モデルの構築 東京工業大学 藤井一喜 中村泰士 Mengsay Loem 飯田大貴 大井聖也 服部翔 平井翔太 水木栄 横田理央 岡崎直観 A8-5
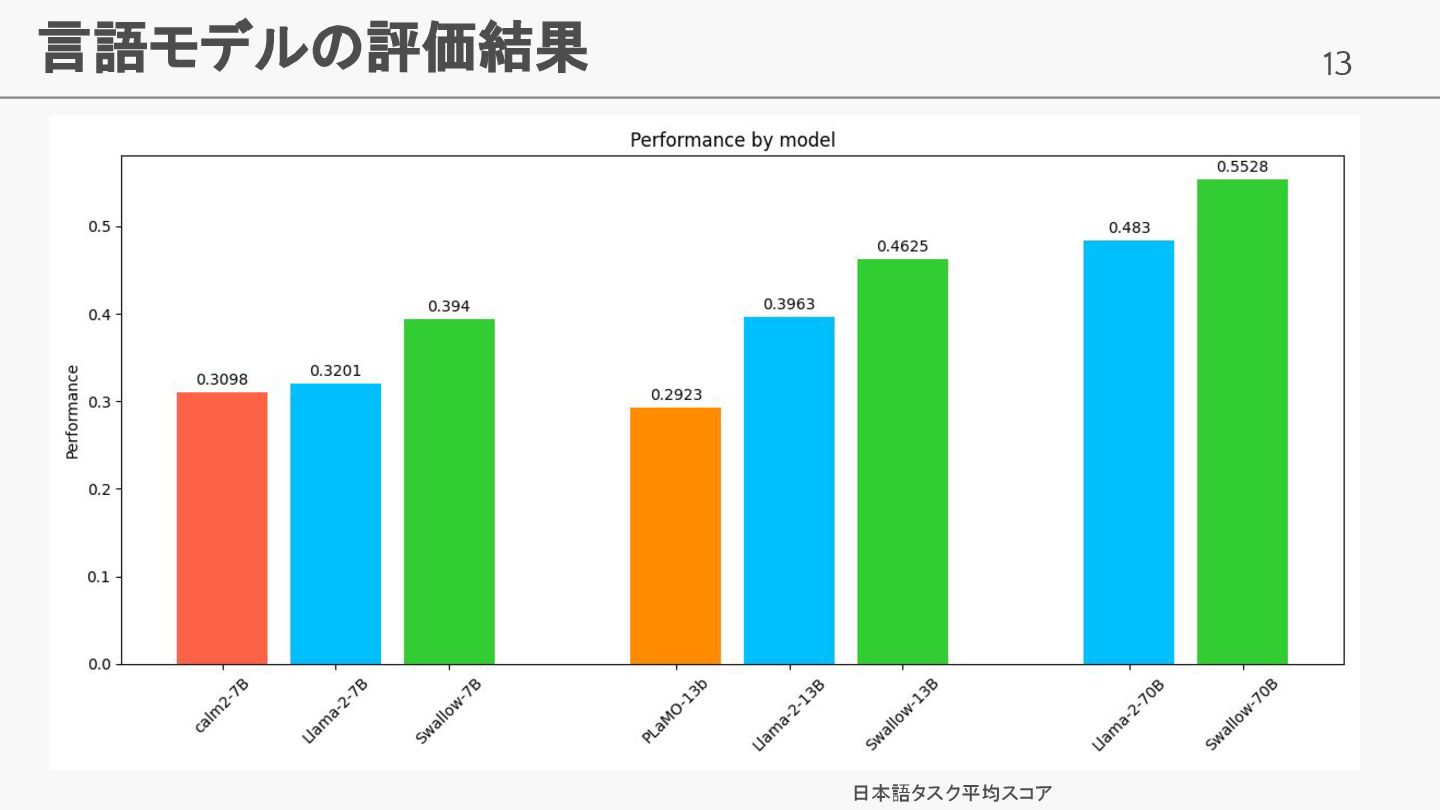
2 概要 • Llama 2をベースに日本語コーパスで継続事前学習 • 7B, 13B, 70B のモデル規模にて効果を確認
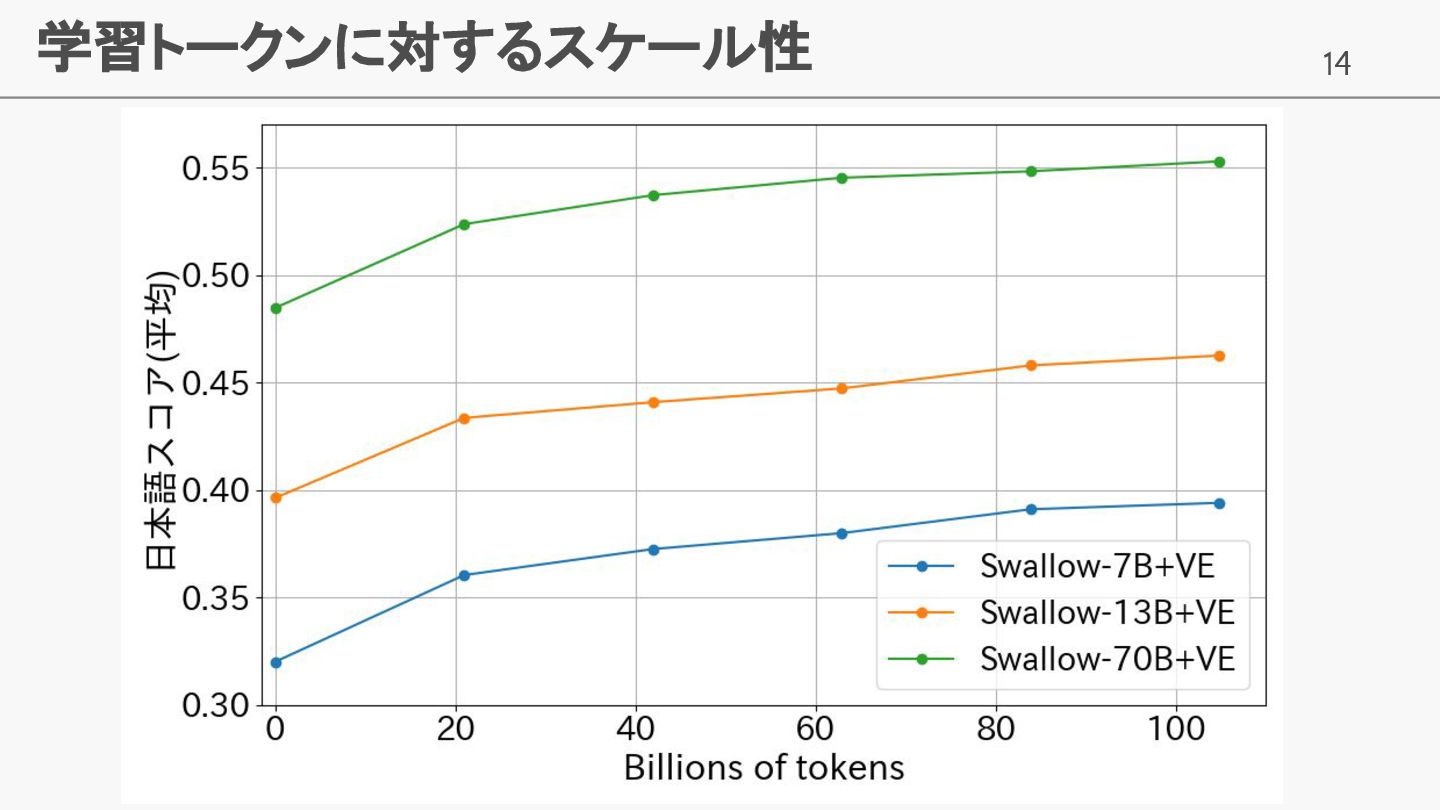
• 学習データ量の増加に伴い日本語性能が向上することを確 認
3 発表構成 • 背景、貢献 • モデルの学習 • モデルの評価
4 背景 • 英語言語資源 >> 日本語言語資源 • Common Crawlでは推定 英語:日本語
= 9:1 • from scratchからの事前学習には膨大な計算資源が必要 • 仮に本実験をfrom scratchから行うと約 20倍の計算資源が必要 → 英語LLM (Llama 2)から継続事前学習を行う 能力や知識を日本語に転移することを狙う
5 貢献 • 継続事前学習の有効性検証 • 7B, 13B, 70Bのモデルサイズ • フルスクラッチ日本語LLMとの比較
• 学習データ量のスケール性の確認 • 20B, 40B, 60B, 80B, 100B Token学習した際の日本語スコアにて検証 • Swallow 7B, 13B, 70Bを公開 • 語彙拡張版: Swallow 7B, 13B, 70B • 語彙拡張なし: Swallow 7B NVE, 13B NVE, 70B NVE
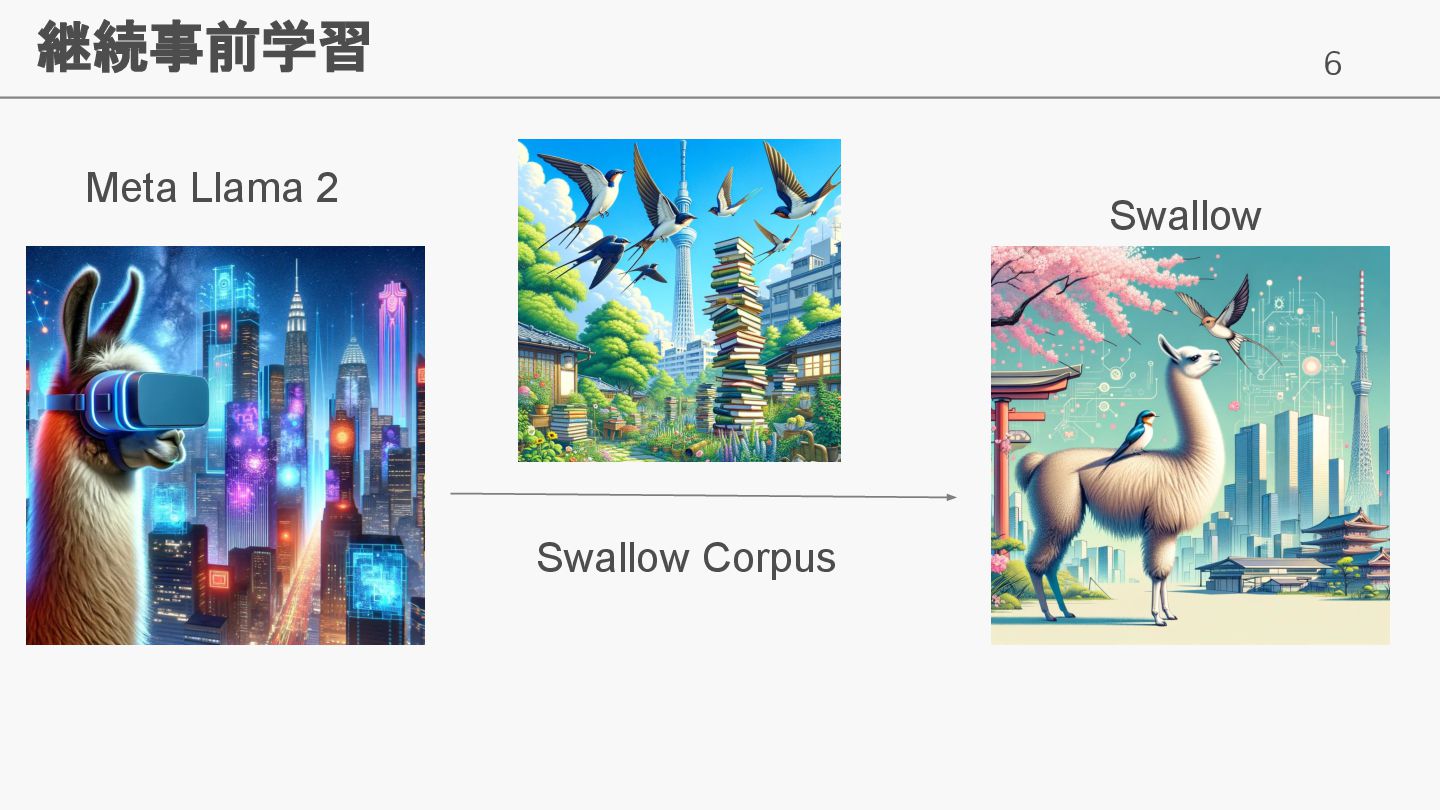
6 継続事前学習 Meta Llama 2 Swallow Swallow Corpus
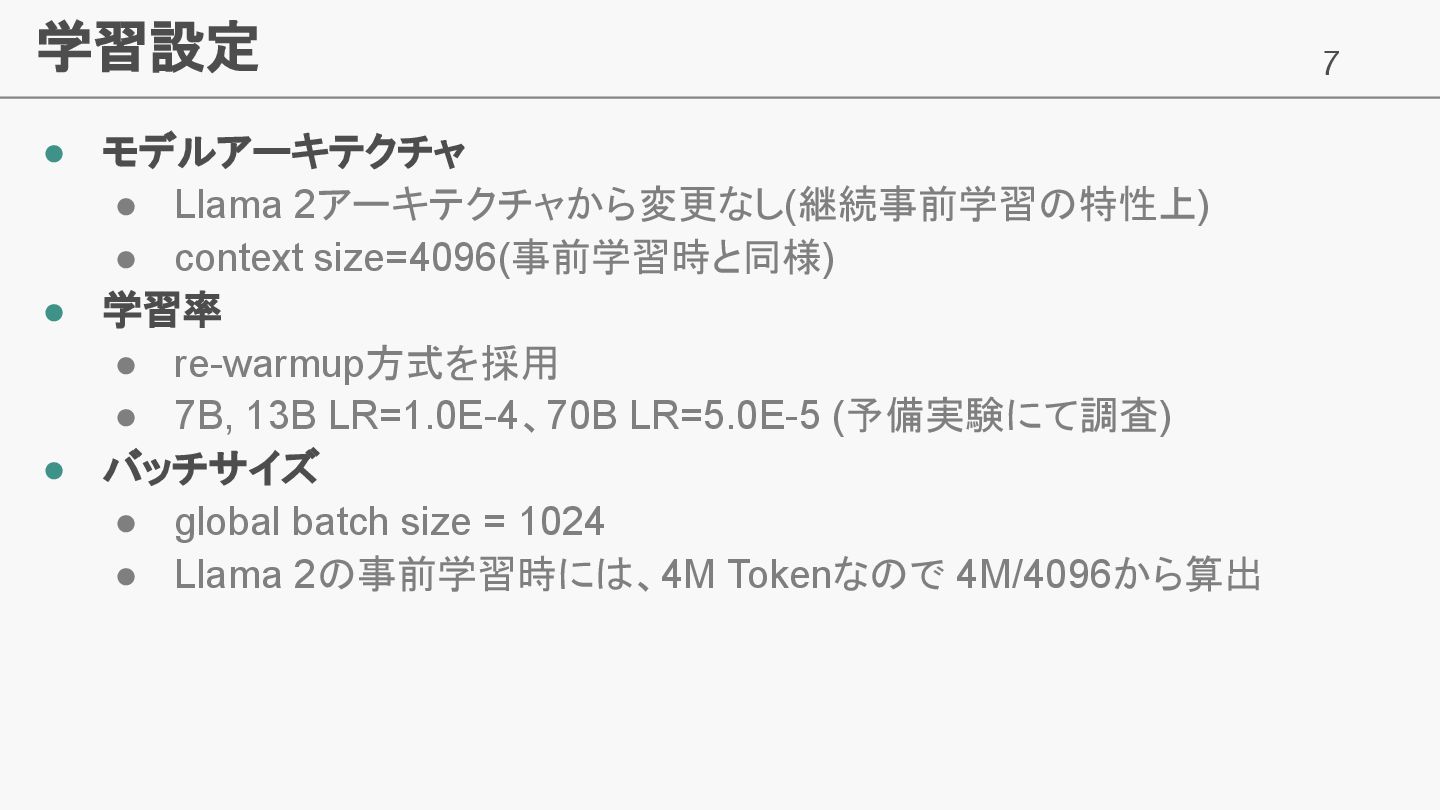
7 学習設定 • モデルアーキテクチャ • Llama 2アーキテクチャから変更なし(継続事前学習の特性上) • context size=4096(事前学習時と同様)
• 学習率 • re-warmup方式を採用 • 7B, 13B LR=1.0E-4、70B LR=5.0E-5 (予備実験にて調査) • バッチサイズ • global batch size = 1024 • Llama 2の事前学習時には、4M Tokenなので 4M/4096から算出
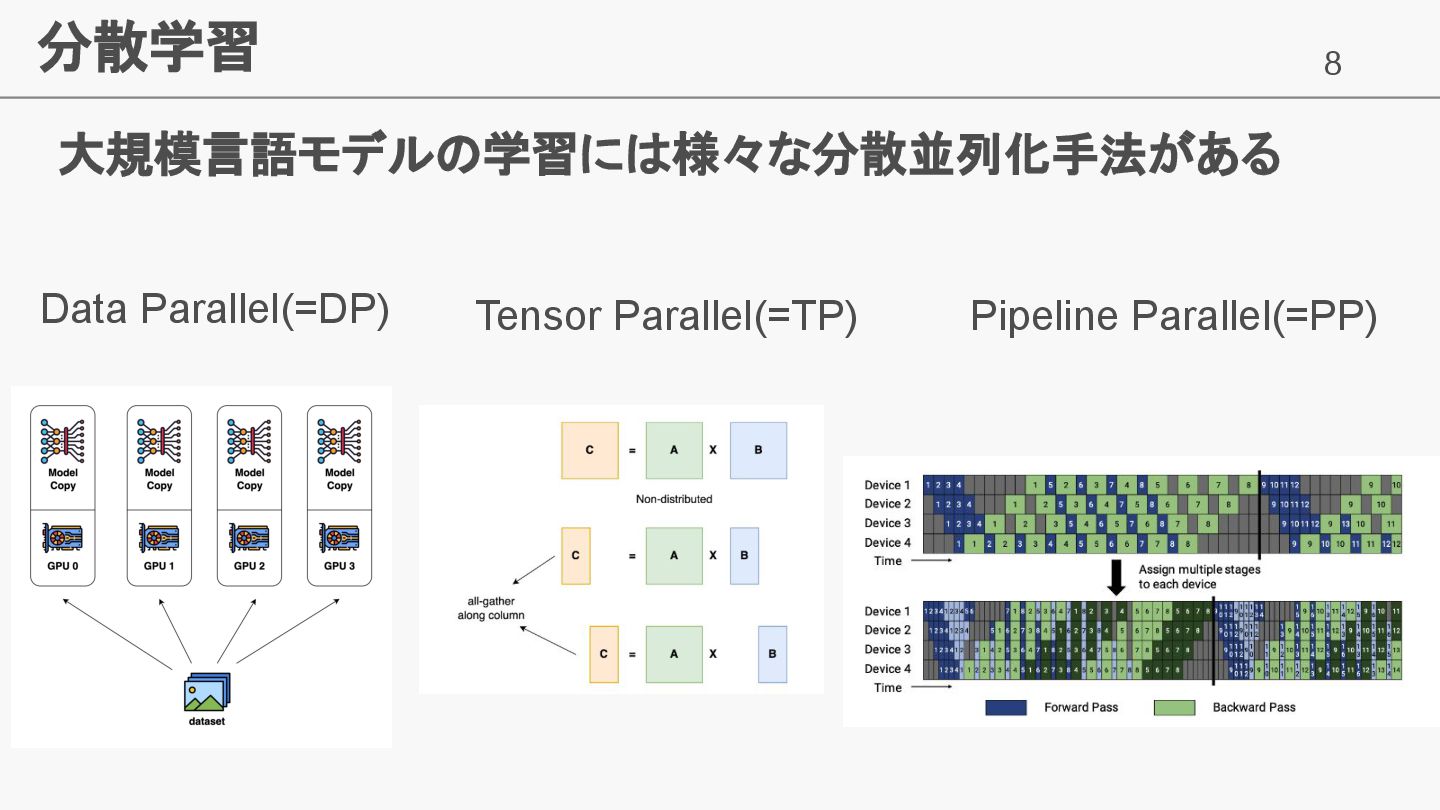
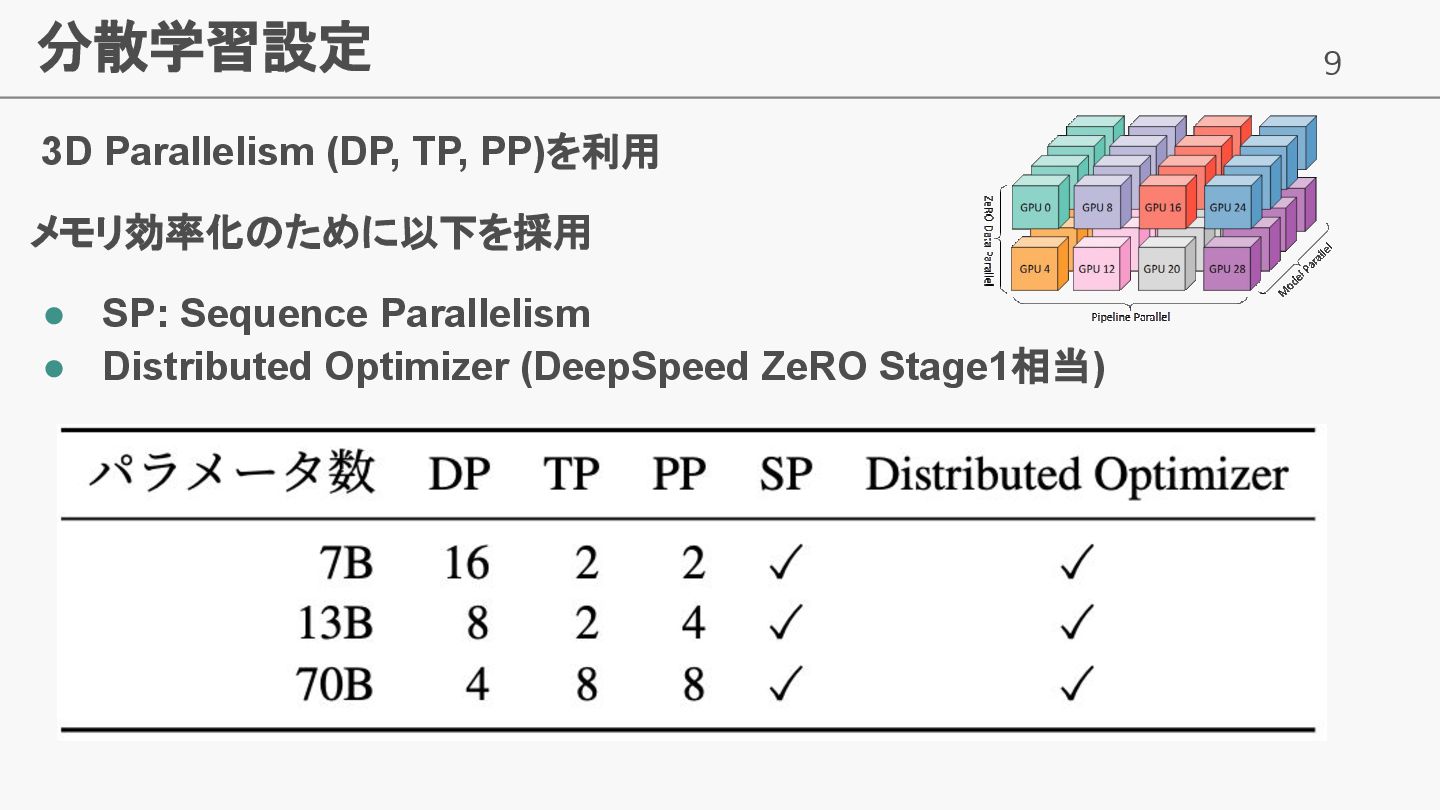
8 分散学習 大規模言語モデルの学習には様々な分散並列化手法がある Data Parallel(=DP) Tensor Parallel(=TP) Pipeline Parallel(=PP)
9 分散学習設定 3D Parallelism (DP, TP, PP)を利用 メモリ効率化のために以下を採用 • SP:
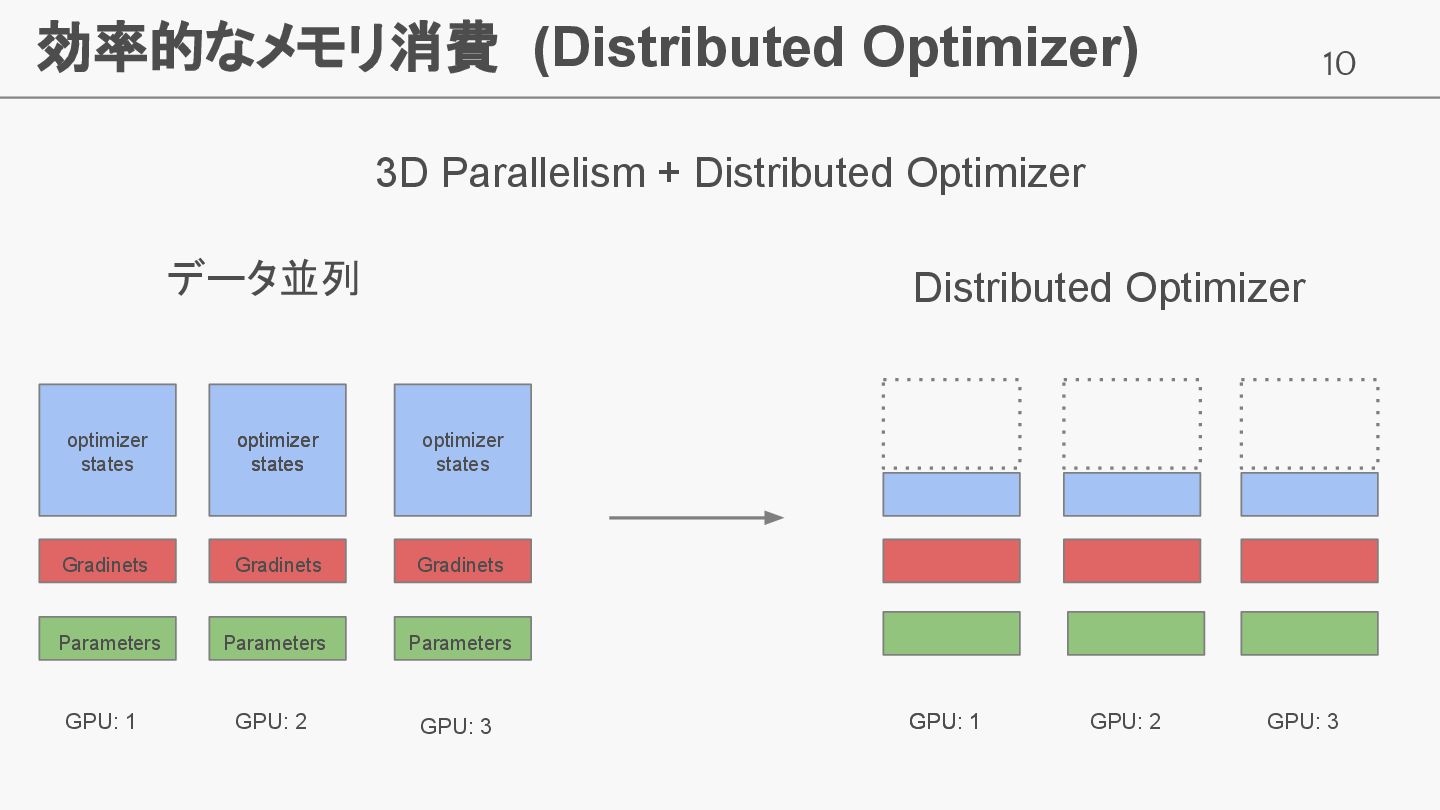
Sequence Parallelism • Distributed Optimizer (DeepSpeed ZeRO Stage1相当)
10 効率的なメモリ消費 (Distributed Optimizer) データ並列 Distributed Optimizer GPU: 1 GPU:
2 GPU: 3 GPU: 1 GPU: 1 GPU: 2 GPU: 3 3D Parallelism + Distributed Optimizer optimizer states optimizer states optimizer states Gradinets optimizer states Gradinets Gradinets Parameters Parameters Parameters
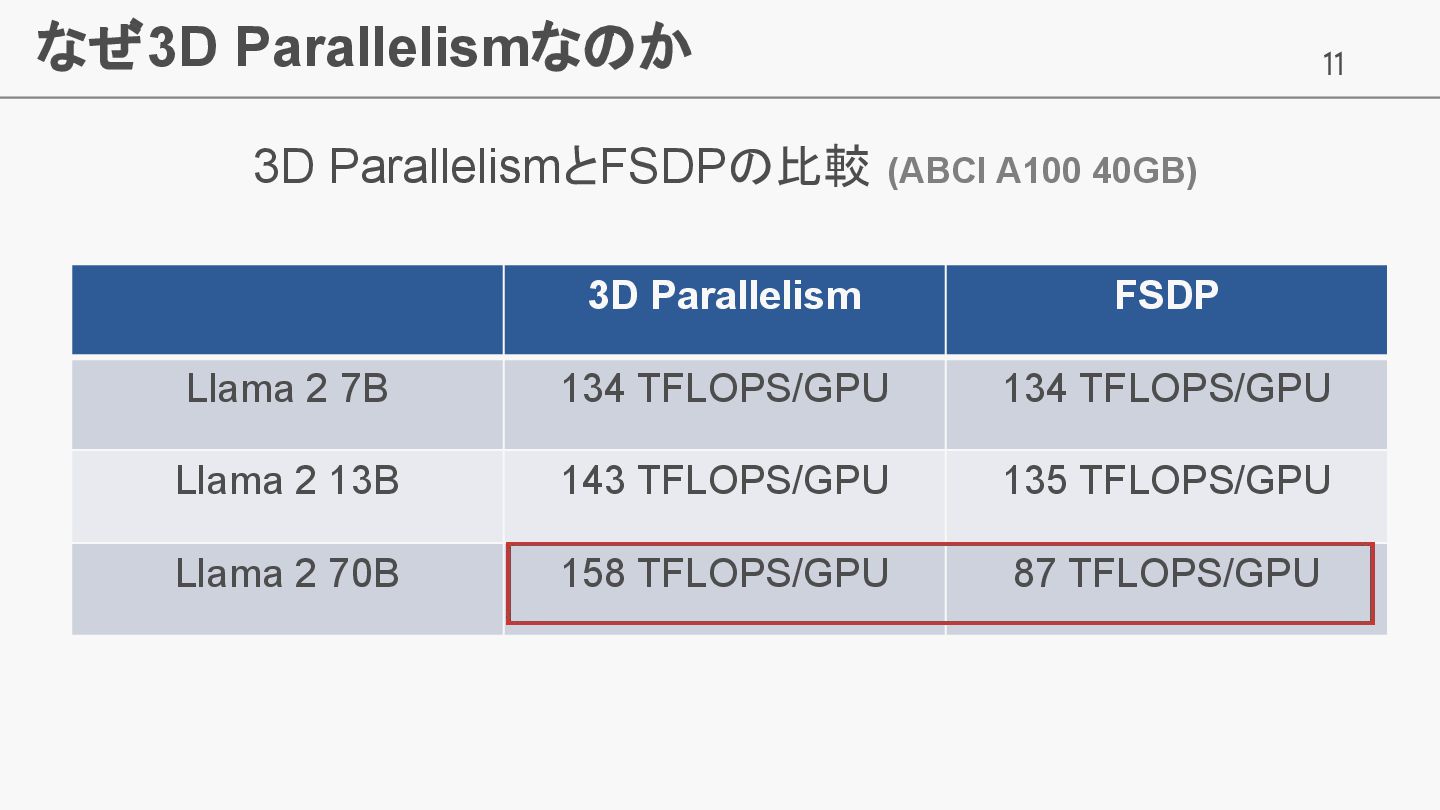
11 なぜ3D Parallelismなのか 3D ParallelismとFSDPの比較 (ABCI A100 40GB) 3D Parallelism
FSDP Llama 2 7B 134 TFLOPS/GPU 134 TFLOPS/GPU Llama 2 13B 143 TFLOPS/GPU 135 TFLOPS/GPU Llama 2 70B 158 TFLOPS/GPU 87 TFLOPS/GPU
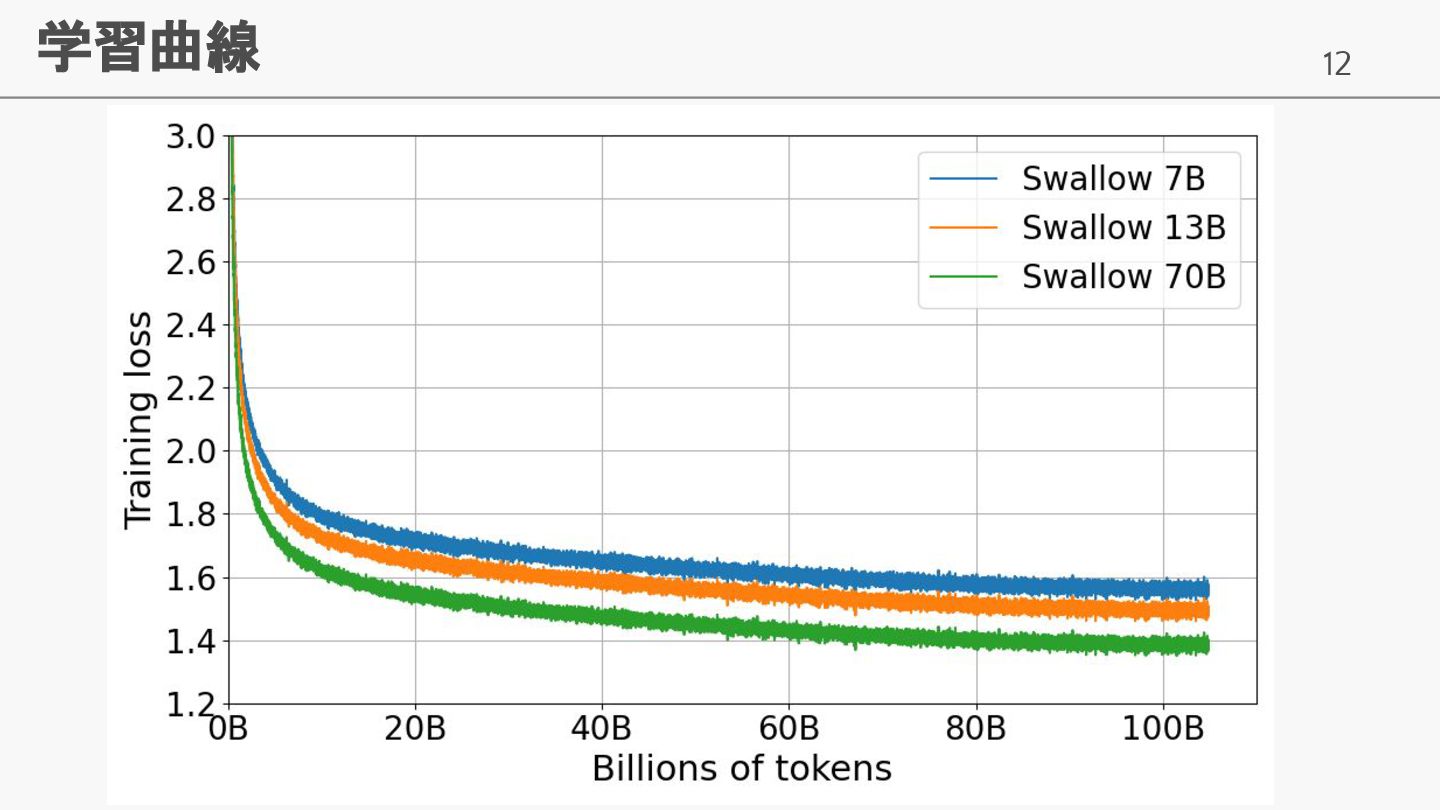
12 学習曲線
13 言語モデルの評価結果 日本語タスク平均スコア
14 学習トークンに対するスケール性
15 結論と今後の展望 • 結論 • 継続事前学習は有効 • 学習データ量に対するスケール性が存在 • 展望
• Llama 2以外のベースモデルからの継続事前学習 • 指示チューニングモデルの改善 • MoE(Mixture of Experts)モデルでの継続事前学習
補足資料
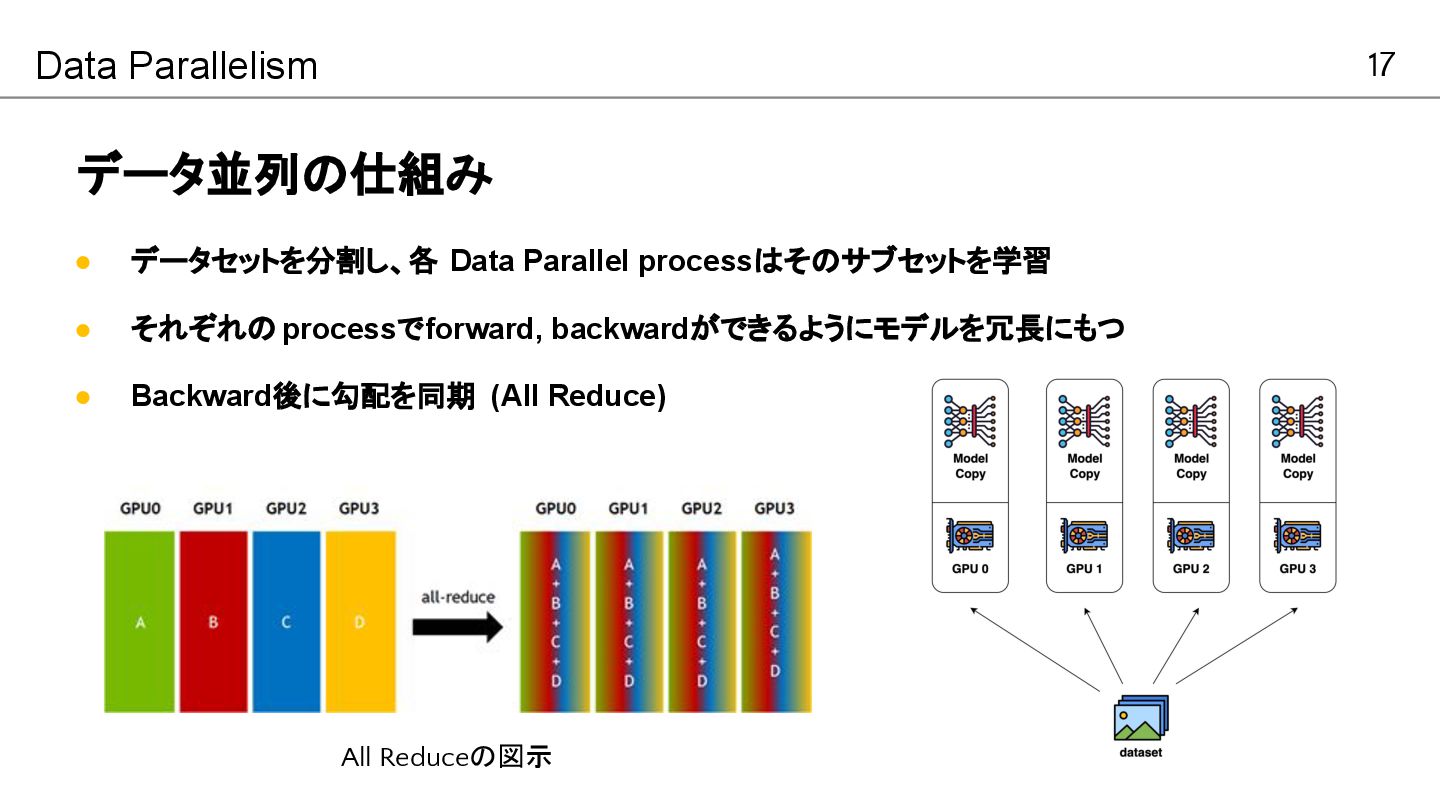
17 データ並列の仕組み Data Parallelism • データセットを分割し、各 Data Parallel processはそのサブセットを学習 •
それぞれの processでforward, backwardができるようにモデルを冗長にもつ • Backward後に勾配を同期 (All Reduce) All Reduceの図示
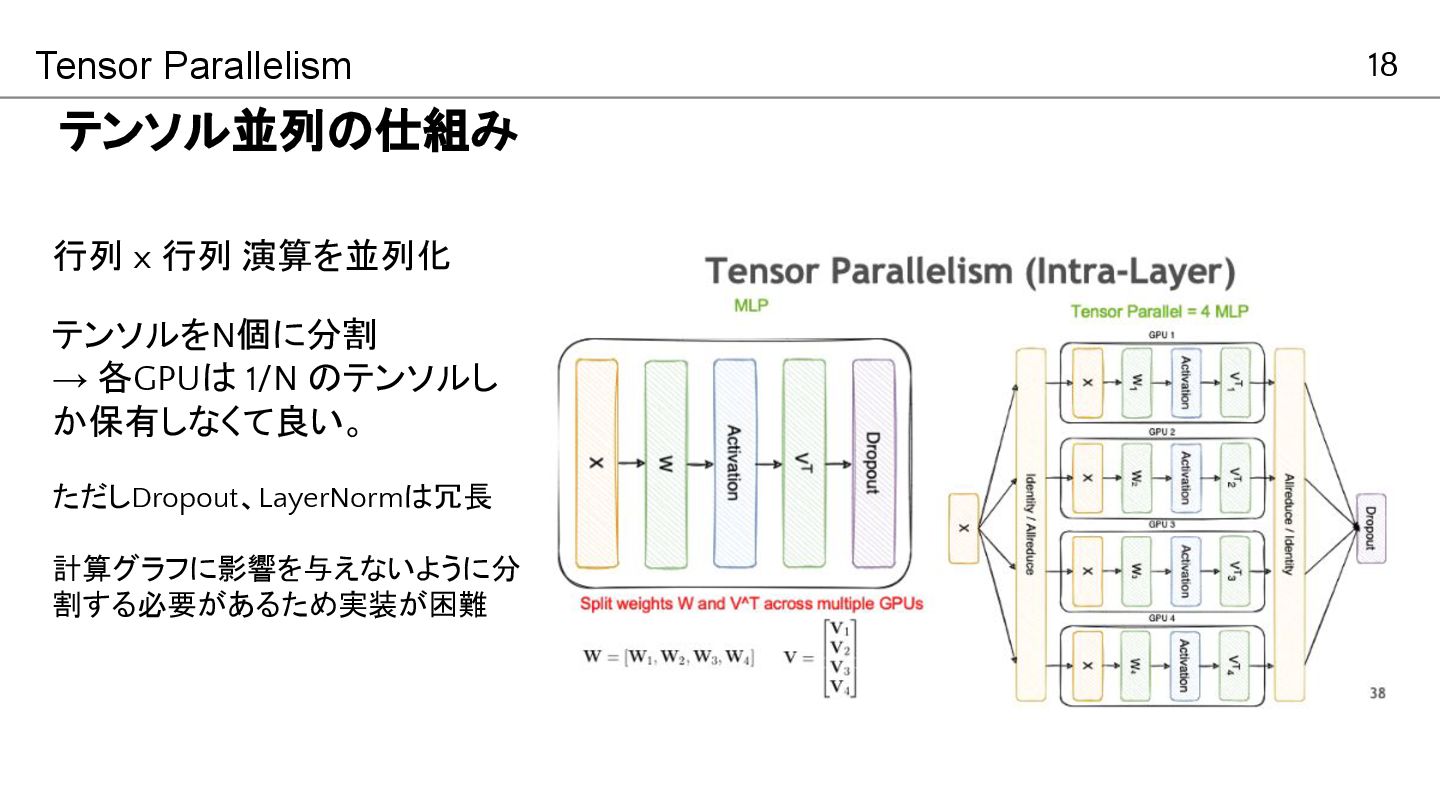
18 テンソル並列の仕組み Tensor Parallelism Dosovitskiy et al, ICLR2021, “An Image
is Worth 16x16 Words: Transformers for Image Recognition at Scale” 行列 x 行列 演算を並列化 テンソルをN個に分割 → 各GPUは 1/N のテンソルし か保有しなくて良い。 ただしDropout、LayerNormは冗長 計算グラフに影響を与えないように分 割する必要があるため実装が困難
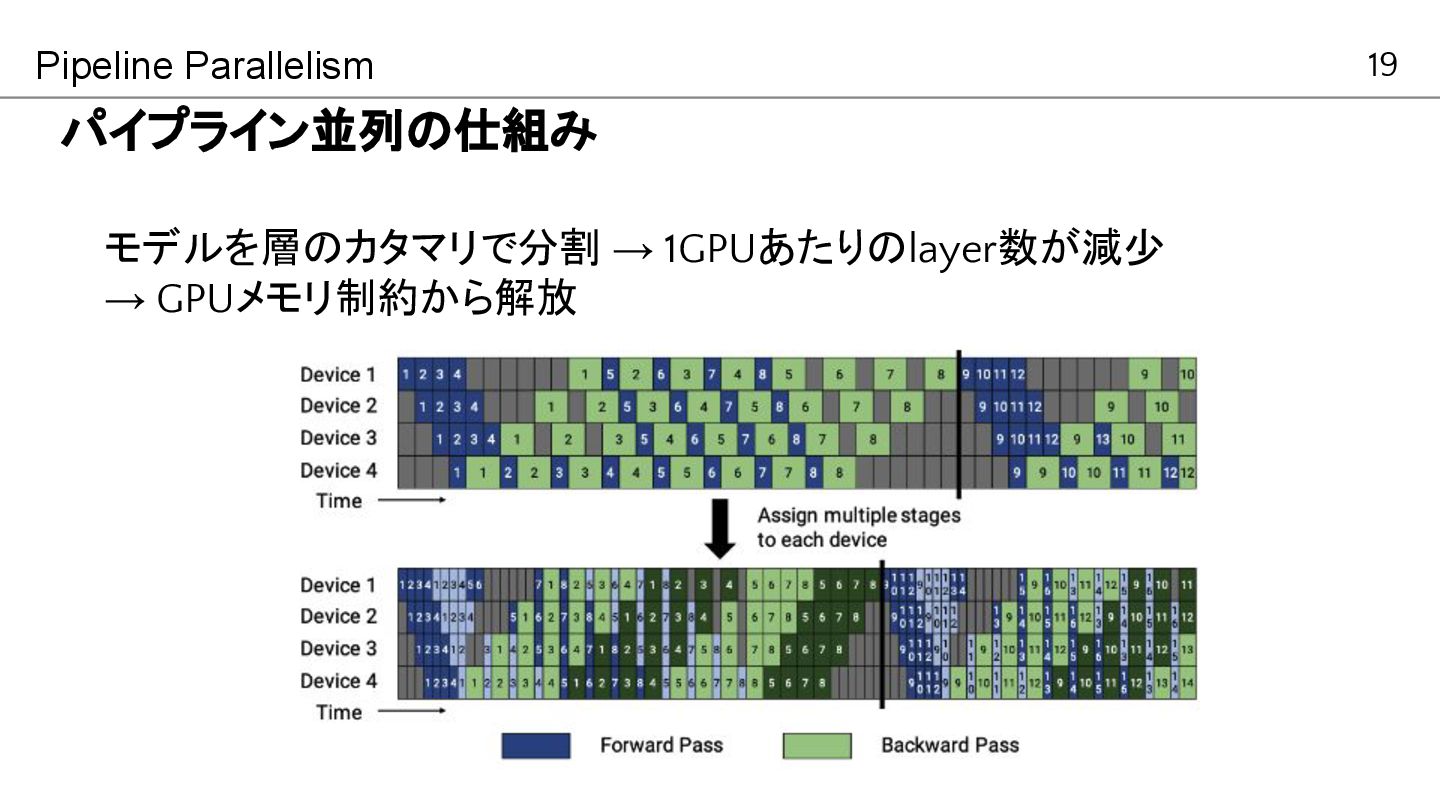
19 パイプライン並列の仕組み Pipeline Parallelism Dosovitskiy et al, ICLR2021, “An Image
is Worth 16x16 Words: Transformers for Image Recognition at Scale” モデルを層のカタマリで分割 → 1GPUあたりのlayer数が減少 → GPUメモリ制約から解放
20 学習コーパス Swallow Corpus 継続事前学習データ 日:英=9:1 日本語データ (90%) • Swallow
Corpus • 日本語Wikipedia 英語データ (10%) • RefinedWeb • The Pile arXiv Swallow Corpusについては、JNLP2024 「Swallow コーパス: 日本語大規模ウェブコーパス」 を参照のこと
21 学習ライブラリ 1. 3D Parallelism をサポート 2. Llamaアーキテクチャに対応 3. HF
→ Megatron 変換コードあり 詳細 ↓
22 評価タスク 言語モデルの日本語評価ベンチマーク • llm-jp eval (v1.0.0) • JP Language
Model Evaluation Harness • llm-jp eval • JCommonsenseQA、JEMHopQA、NIILC、JSQuAD • Evaluation Harness • XL-Sum, MGSM、WMT 2020 Japanese ↔ English
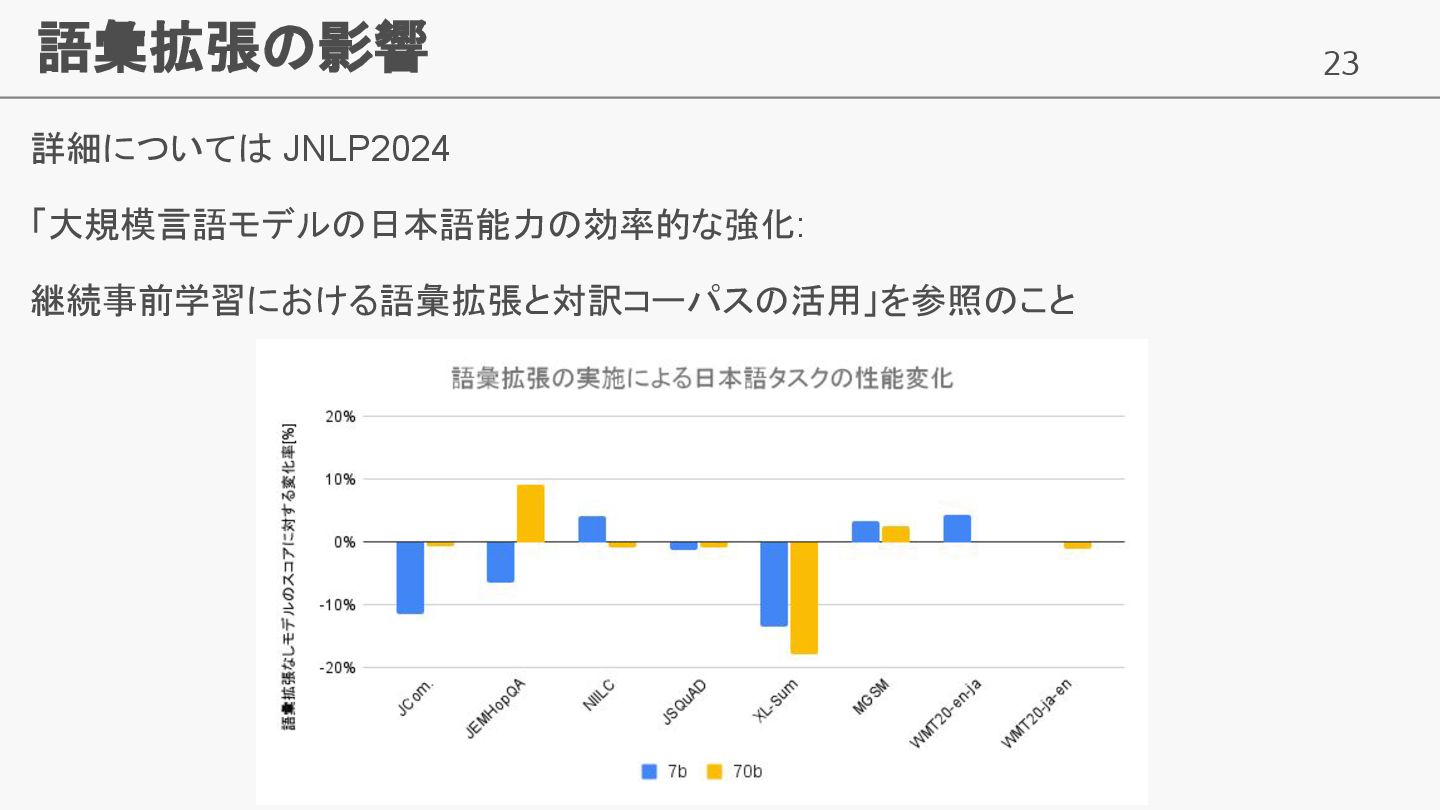
23 語彙拡張の影響 詳細については JNLP2024 「大規模言語モデルの日本語能力の効率的な強化: 継続事前学習における語彙拡張と対訳コーパスの活用」を参照のこと


 fujiikazuki2000
 afroscript
 ayatokanada
 tattaka
 hisaokatsumi
 corochann
 rfujii
 koide3
 tkng
 ftakahashi
 satai
 datascientistsociety
 monochromegane
 jakevdp
 jdejongh
 tanoku
 coloredviolet
 frankvandijk
 tammyeverts
 gr2m
 geshan
 katiecoart
 destraynor
 uxyall
 jonoalderson