Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Journal club] Mobile-Former: Bridging MobileNe...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Semantic Machine Intelligence Lab., Keio Univ.
PRO
July 27, 2022
Technology
1.4k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Journal club] Mobile-Former: Bridging MobileNet and Transformer
Semantic Machine Intelligence Lab., Keio Univ.
PRO
July 27, 2022
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
慶應義塾大学 AI実践05 論文執筆の仕組み化
keio_smilab
PRO
7
3.7k
[EMNLP26] RIGEL: Self-Distilled Score Adaptation for Image and Video Captioning Evaluation
keio_smilab
PRO
0
160
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
220
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
200
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
270
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
300
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
210
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
260
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
77
Other Decks in Technology
See All in Technology
Kiro 入門 (1 つのエージェントを、どの画面からでも) | 目指せ Kiro マスター 01
inariku
PRO
4
830
OneLakeをデータソースにした AI Search(Foundry IQ)の ライフサイクル管理
ryuseiiida
0
230
Copilot Coworkで「みのるん式」やってみた
minorun365
PRO
2
1.6k
攻撃 3 時間 vs 復旧 10 時間。アクセスキー流出の非対称性を体感するために CTF を作った話
kazzpapa3
1
150
試験勉強はGrokBotでやれ
maigo999
0
110
AI Agent 時代のデータ基盤: ClickHouse で実現する 超高速分析とコスト削減の両立
jozono
0
200
続・ソフトウェアアーキテクトのための意思決定術: Decision Readiness, Revisited — When AI Changes the Economics of Software Architecture
snoozer05
PRO
9
2.6k
生成AI時代のIAMのマニアックな話
takuros
6
2.6k
Gifu WordPress Meetup #200 に向けて、私たちには何ができるだろうか?/ 2026-11-07 Gifu WordPress Meetup
torounit
0
180
サボる子はいねぇがー!AgentCoreハーネスの脆弱性に学ぶ、エージェントの入力バリデーション
iwamot
PRO
4
290
バックオフィスに染み出すTypeScript ── clasp で安全に仕組みを作る
nealle
1
180
Oracle Database Security 詳細解説
oracle4engineer
PRO
2
270
Featured
See All Featured
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.4k
My Coaching Mixtape
mlcsv
0
380
The Straight Up "How To Draw Better" Workshop
denniskardys
239
140k
Code Review Best Practice
trishagee
74
20k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
510
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
68
60k
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.8k
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k
Writing Fast Ruby
sferik
630
63k
30 Presentation Tips
portentint
PRO
1
460
Raft: Consensus for Rubyists
vanstee
143
7.9k
Transcript
慶應義塾大学 杉浦孔明研究室 是方諒介 Mobile-Former: Bridging MobileNet and Transformer Yinpeng Chen1,
Xiyang Dai1, Dongdong Chen1, Mengchen Liu1, Xiaoyi Dong2, Lu Yuan1, Zicheng Liu1 (1Microsoft, 2University of Science and Technology of China) CVPR 2022 Yinpeng Chen, Xiyang Dai, Dongdong Chen, Mengchen Liu, Xiaoyi Dong, Lu Yuan, and Zicheng Liu. "Mobile-Former: Bridging MobileNet and Transformer." CVPR 2022.
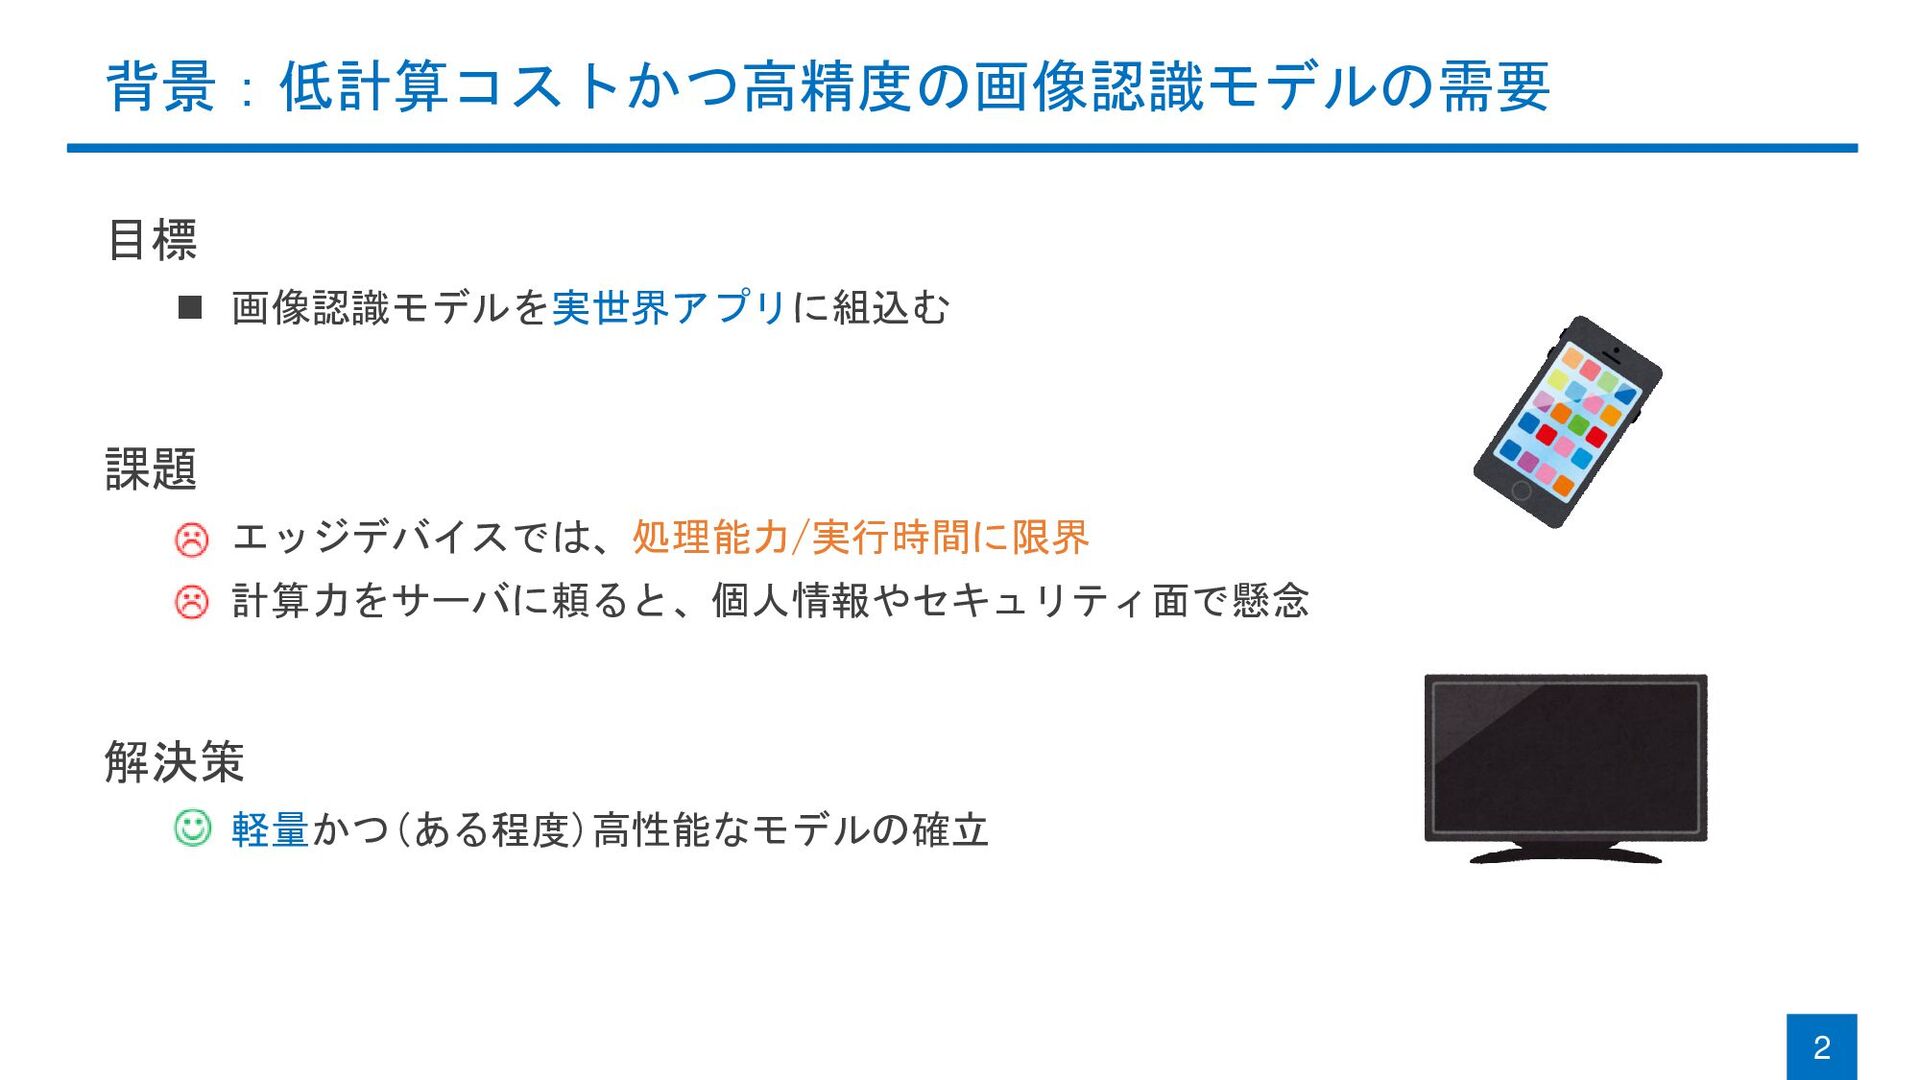
目標 ◼ 画像認識モデルを実世界アプリに組込む 課題 ◼ エッジデバイスでは、処理能力/実行時間に限界 ◼ 計算力をサーバに頼ると、個人情報やセキュリティ面で懸念 解決策 ◼
軽量かつ(ある程度)高性能なモデルの確立 背景:低計算コストかつ高精度の画像認識モデルの需要 2
関連研究:計算量/性能面で改善の余地 3 Model Detail MobileNetV1, V2, V3 [Howard+ 17], [Sandler+
18], [Howard+ ICCV19] ・携帯電話での利用を想定した軽量CNNモデル ・convolutionをdepthwiseとpointwiseに分割 ViT [Dosovitskiy+ ICLR21] ・transformer [Vaswani+ NeurIPS17] を画像分類に応用 CvT [Wu+ ICCV21] ・multi-head attentionの前にconvolutionを導入 CvT ① CNN ② transformer ③ CNN & transformer ViT
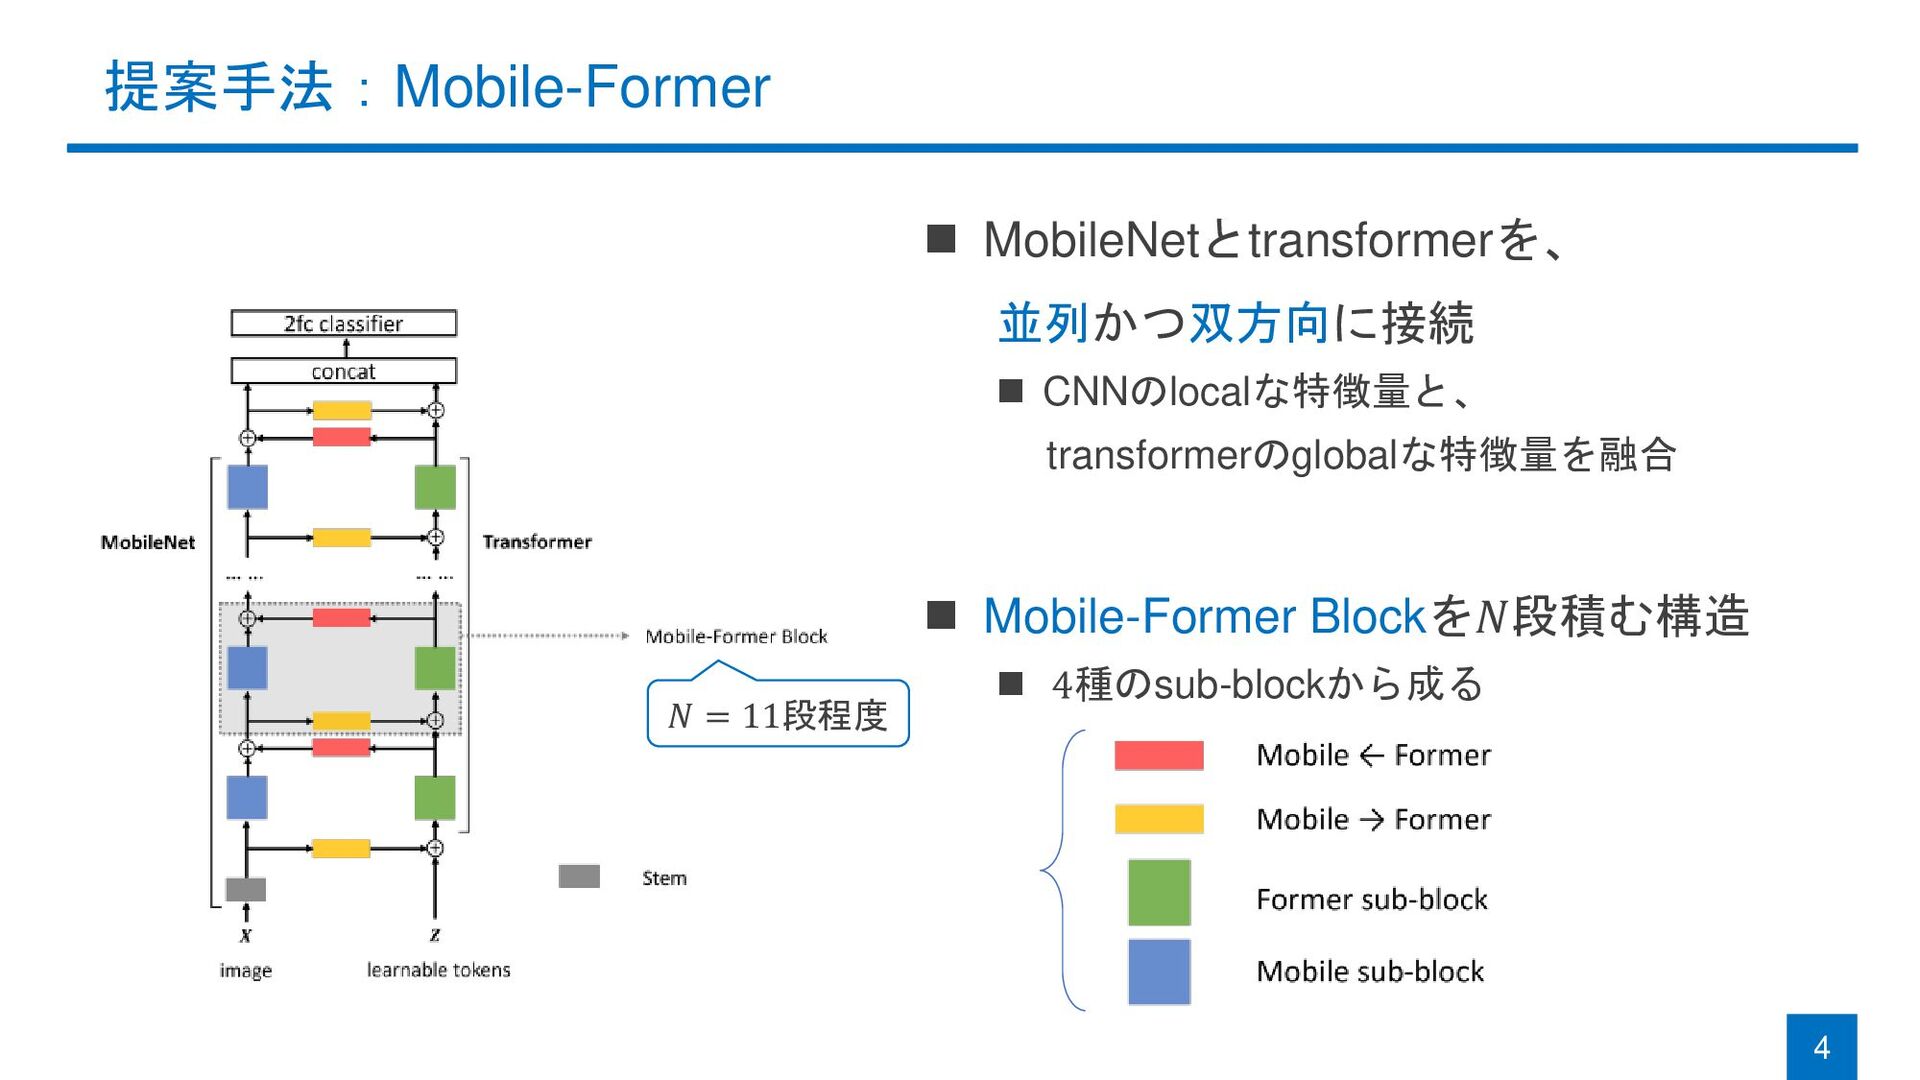
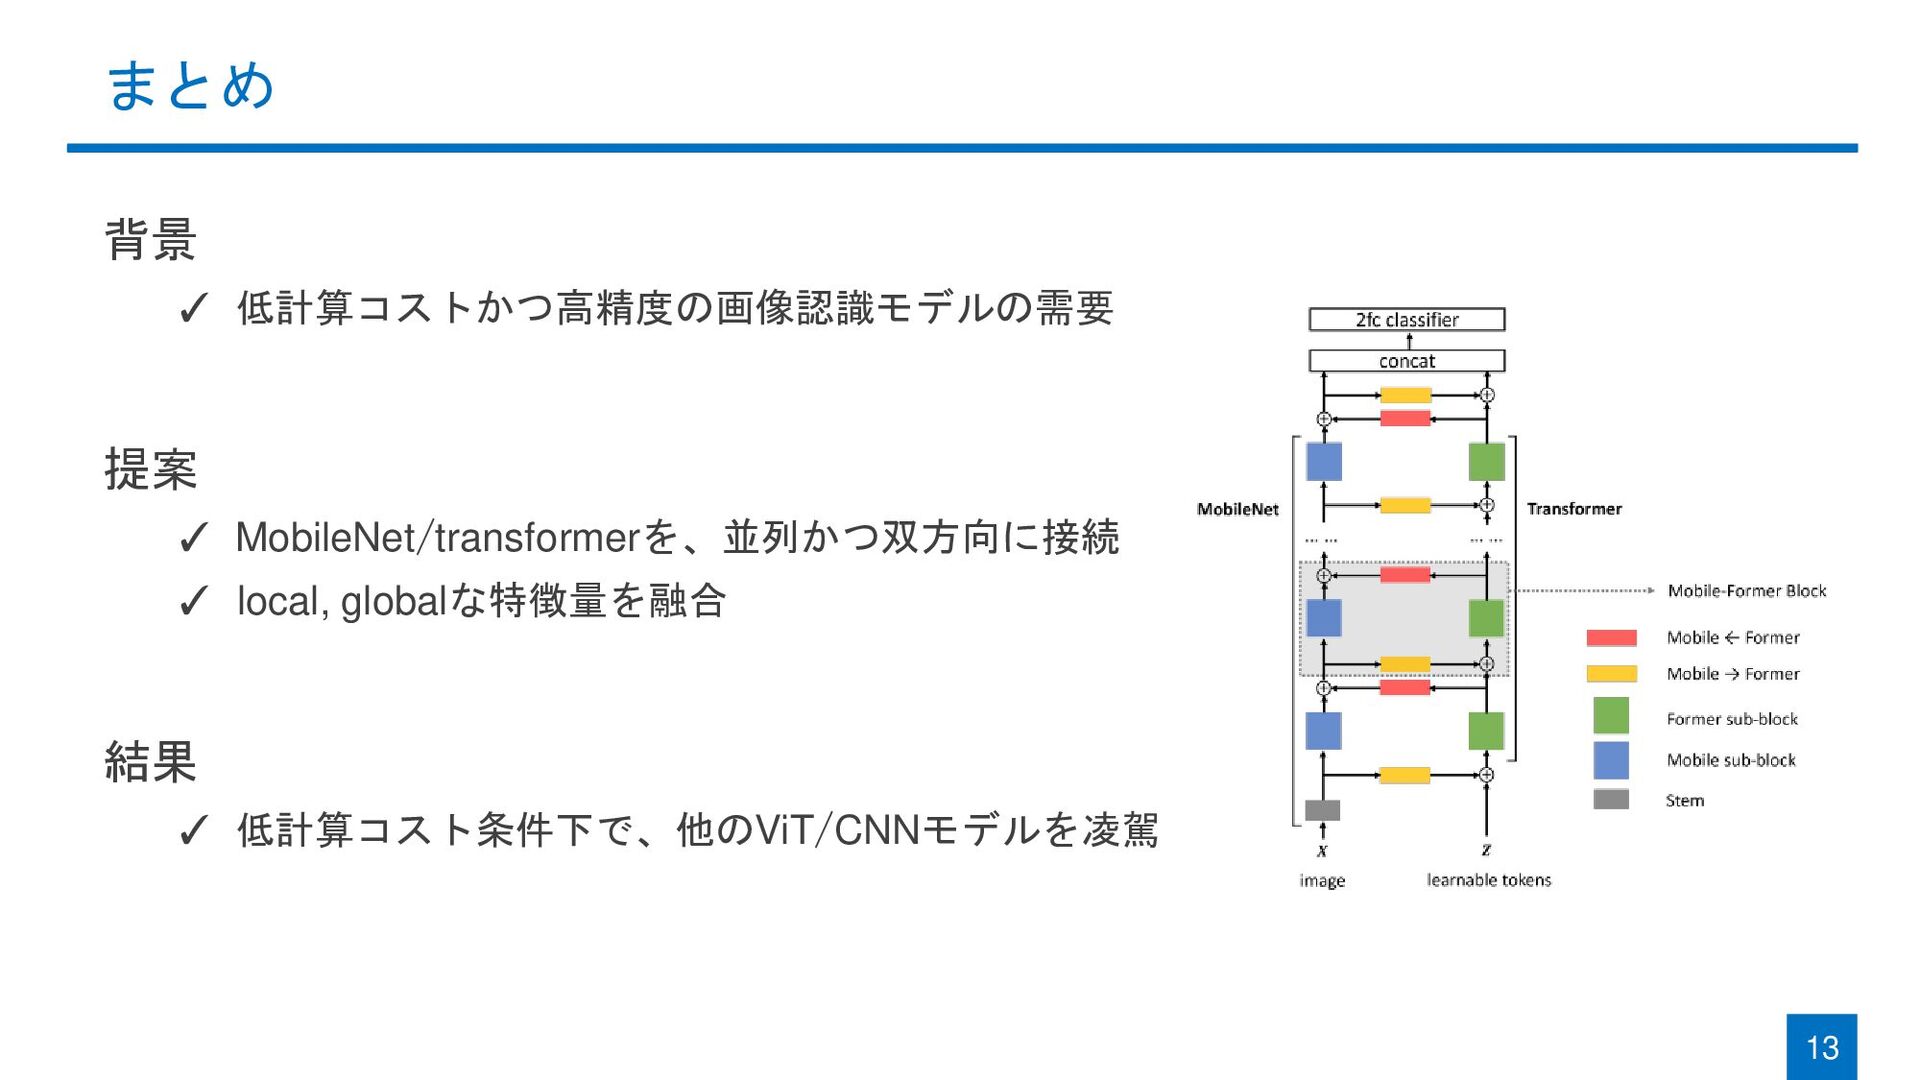
提案手法:Mobile-Former ◼ MobileNetとtransformerを、 並列かつ双方向に接続 ◼ CNNのlocalな特徴量と、 transformerのglobalな特徴量を融合 ◼ Mobile-Former Blockを𝑁段積む構造
◼ 4種のsub-blockから成る 4 𝑁 = 11段程度
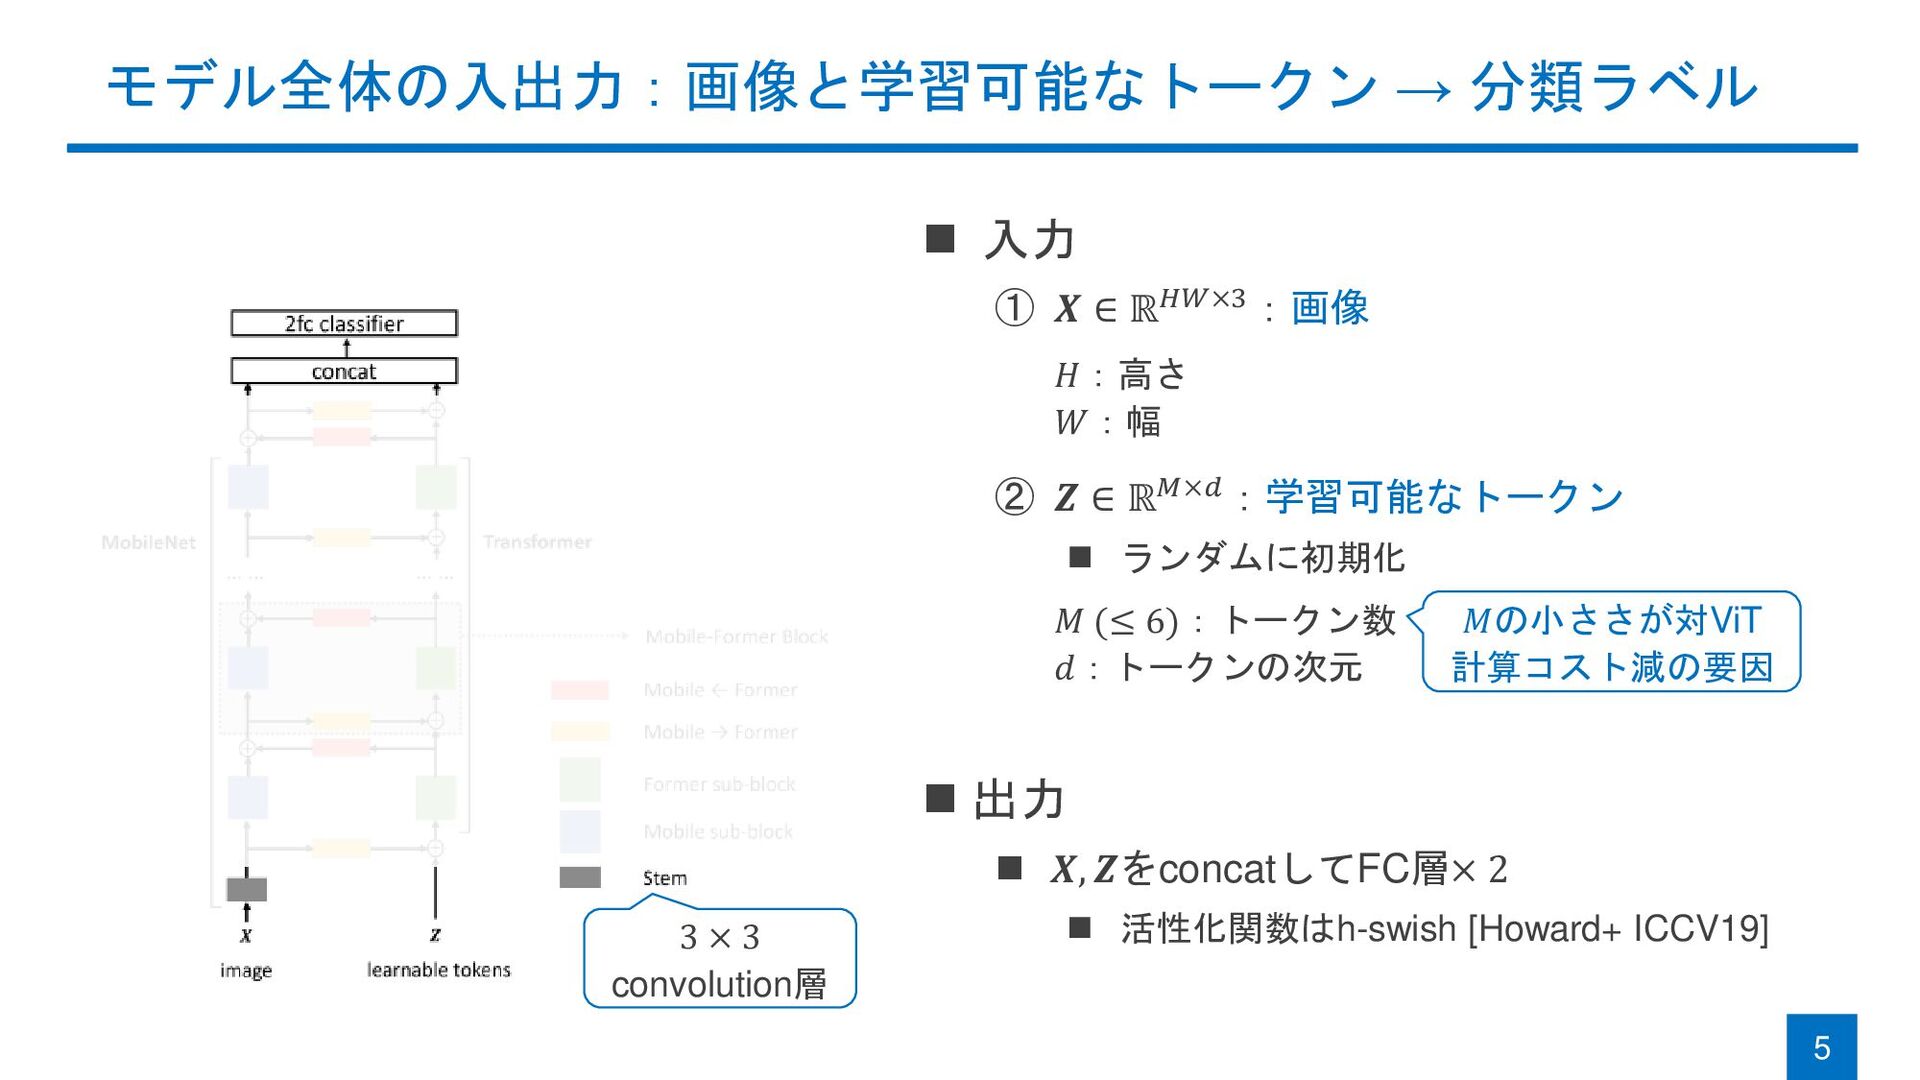
モデル全体の入出力:画像と学習可能なトークン → 分類ラベル ◼ 入力 ① 𝑿 ∈ ℝ𝐻𝑊×3:画像 ②
𝒁 ∈ ℝ𝑀×𝑑:学習可能なトークン ◼ ランダムに初期化 ◼ 出力 ◼ 𝑿, 𝒁をconcatしてFC層× 2 ◼ 活性化関数はh-swish [Howard+ ICCV19] 5 𝐻:高さ 𝑊:幅 𝑀 (≤ 6):トークン数 𝑑:トークンの次元 𝑀の小ささが対ViT 計算コスト減の要因 3 × 3 convolution層
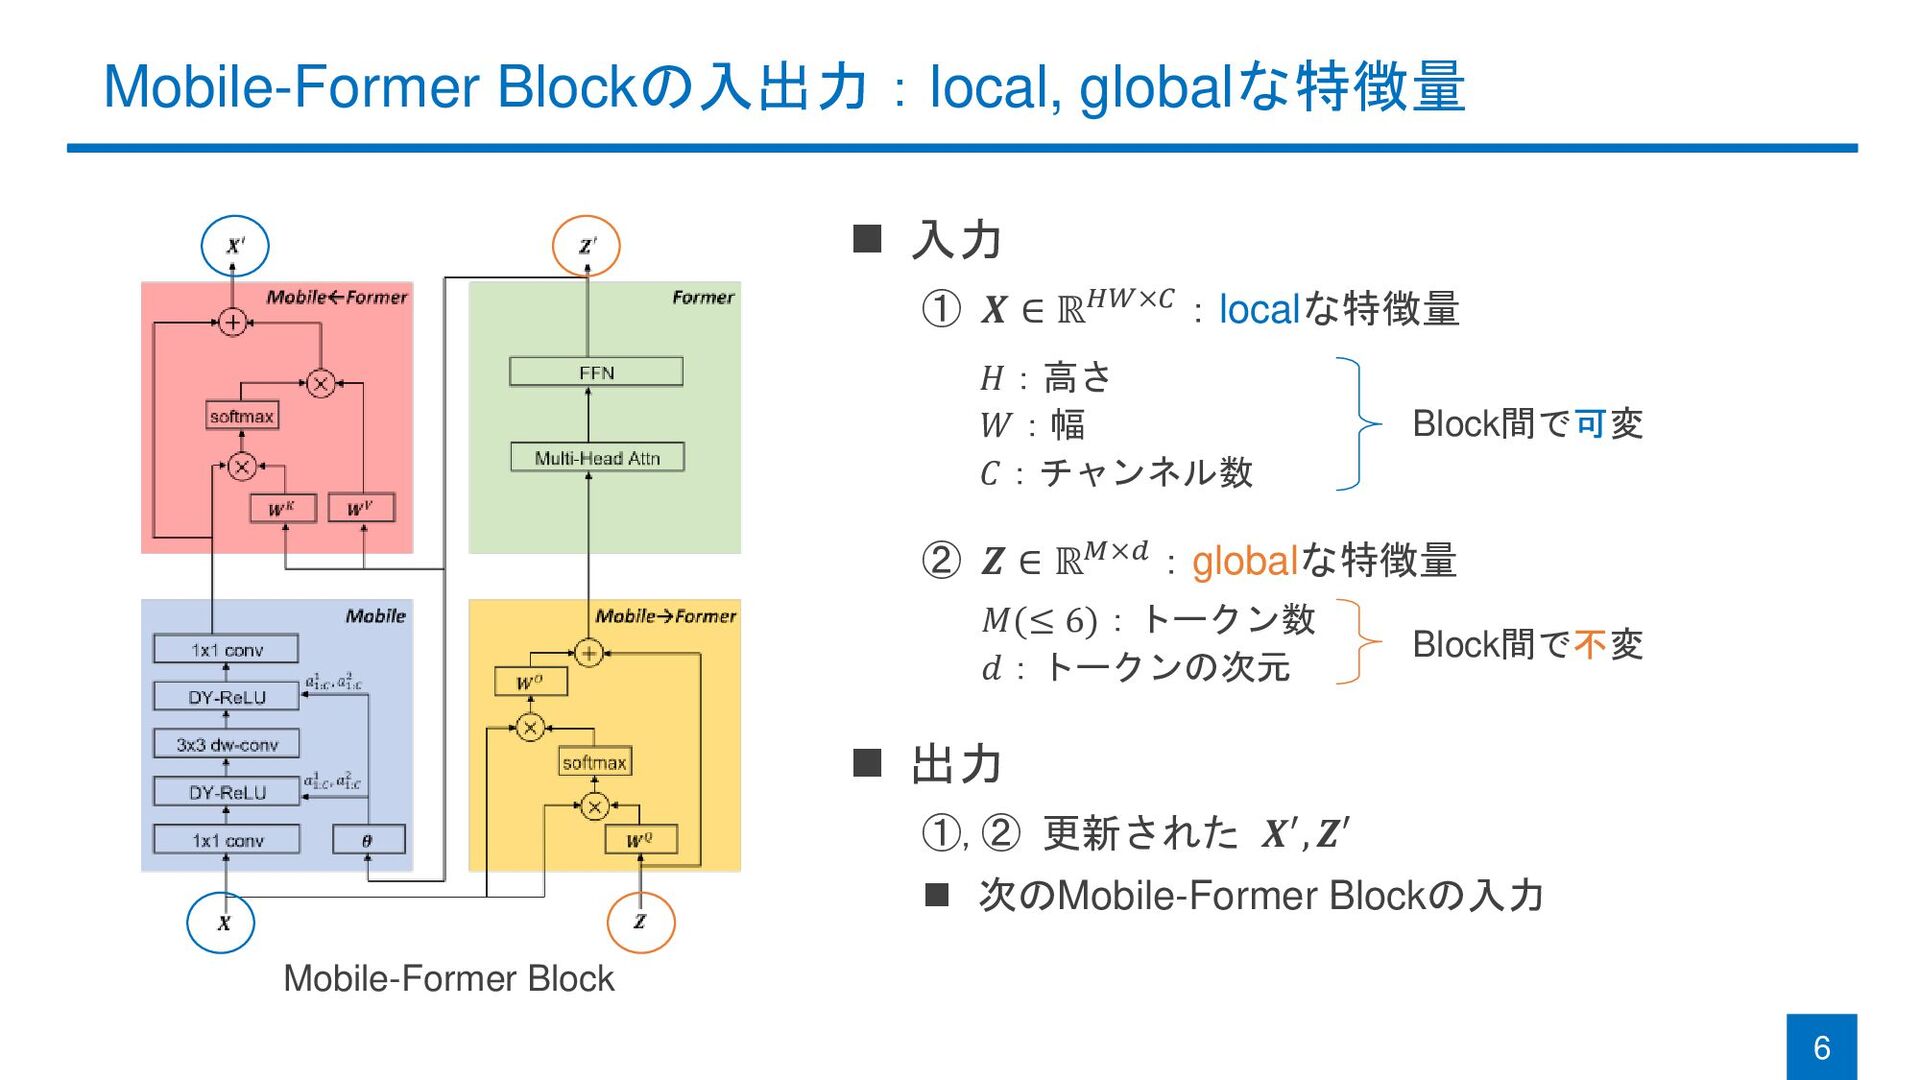
Mobile-Former Blockの入出力:local, globalな特徴量 6 Mobile-Former Block ◼ 入力 ① 𝑿
∈ ℝ𝐻𝑊×𝐶:localな特徴量 ② 𝒁 ∈ ℝ𝑀×𝑑:globalな特徴量 ◼ 出力 ①,② 更新された 𝑿′, 𝒁′ ◼ 次のMobile-Former Blockの入力 𝑀(≤ 6):トークン数 𝑑:トークンの次元 Block間で可変 Block間で不変 𝐻:高さ 𝑊:幅 𝐶:チャンネル数
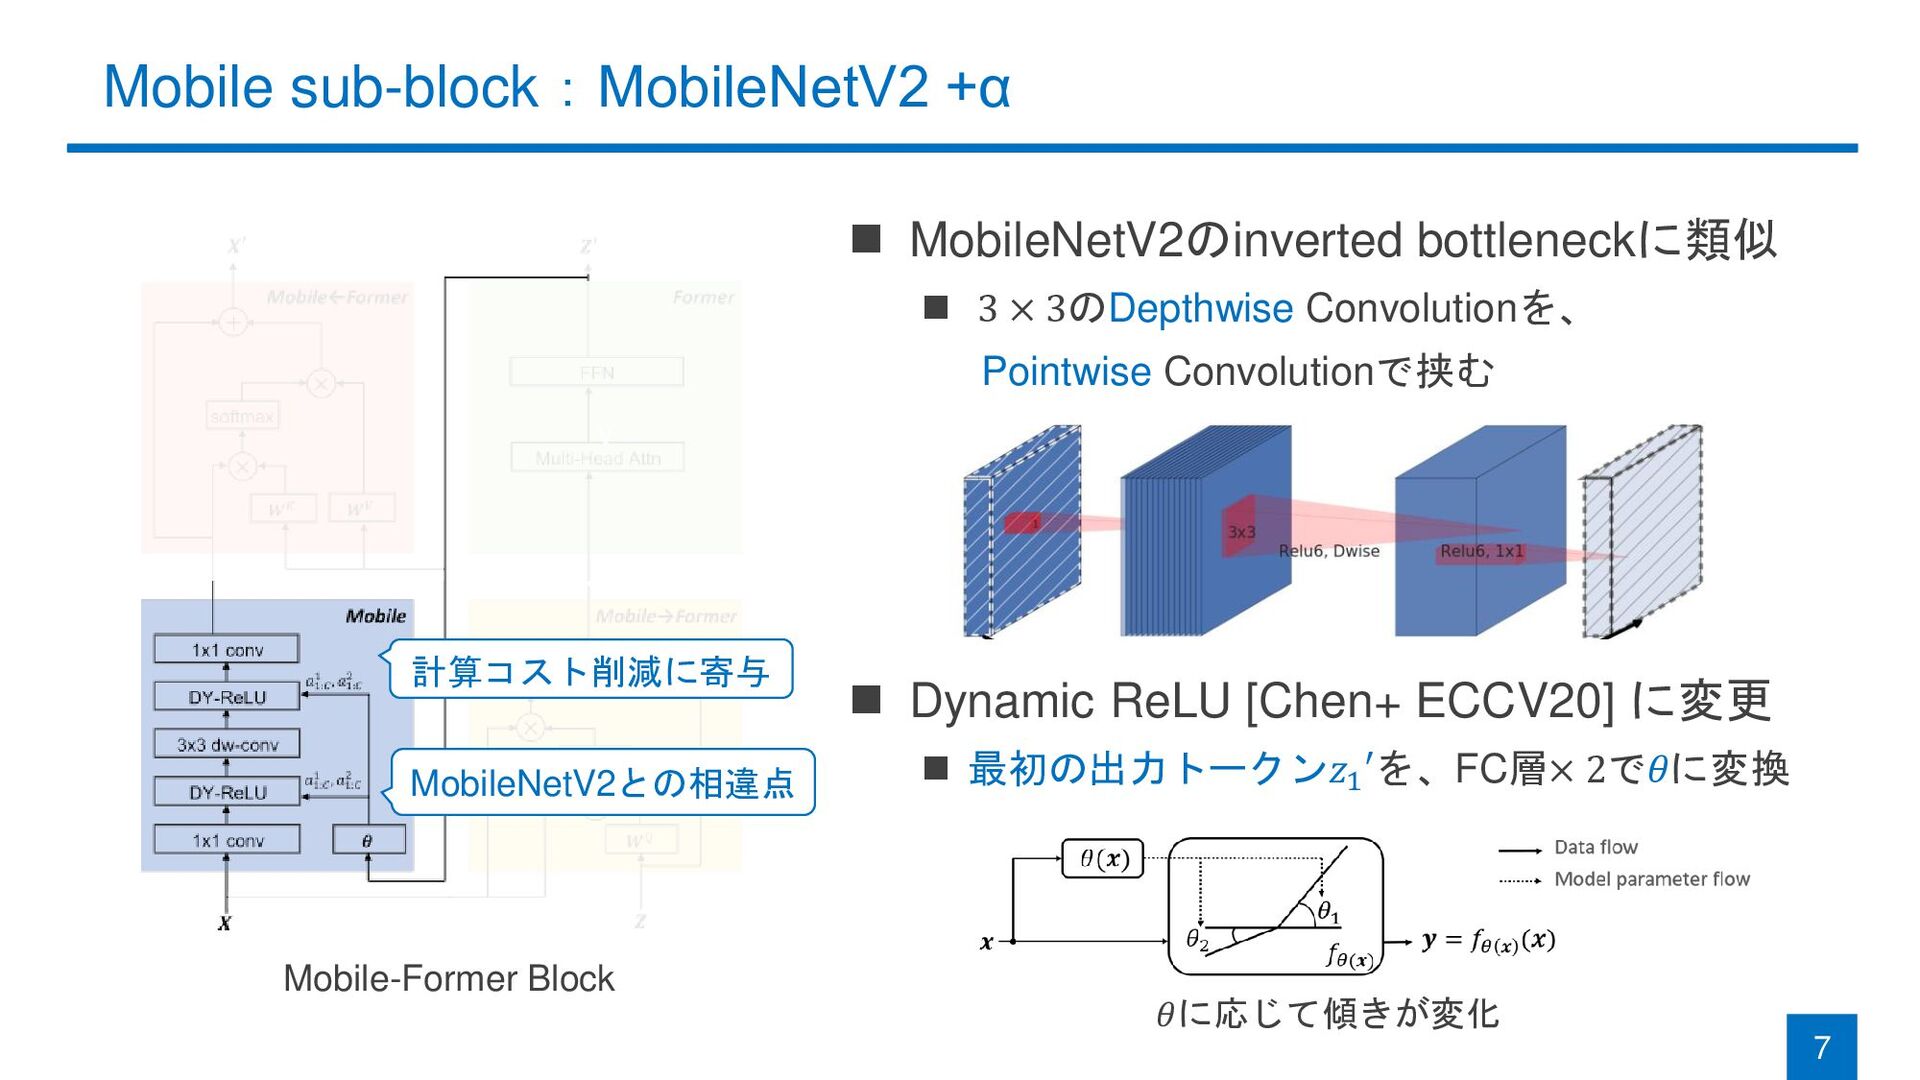
Mobile sub-block:MobileNetV2 +α 7 Mobile-Former Block ◼ MobileNetV2のinverted bottleneckに類似 ◼
3 × 3のDepthwise Convolutionを、 Pointwise Convolutionで挟む ◼ Dynamic ReLU [Chen+ ECCV20] に変更 ◼ 最初の出力トークン𝑧1 ′を、FC層× 2で𝜃に変換 v 計算コスト削減に寄与 MobileNetV2との相違点 𝜃に応じて傾きが変化
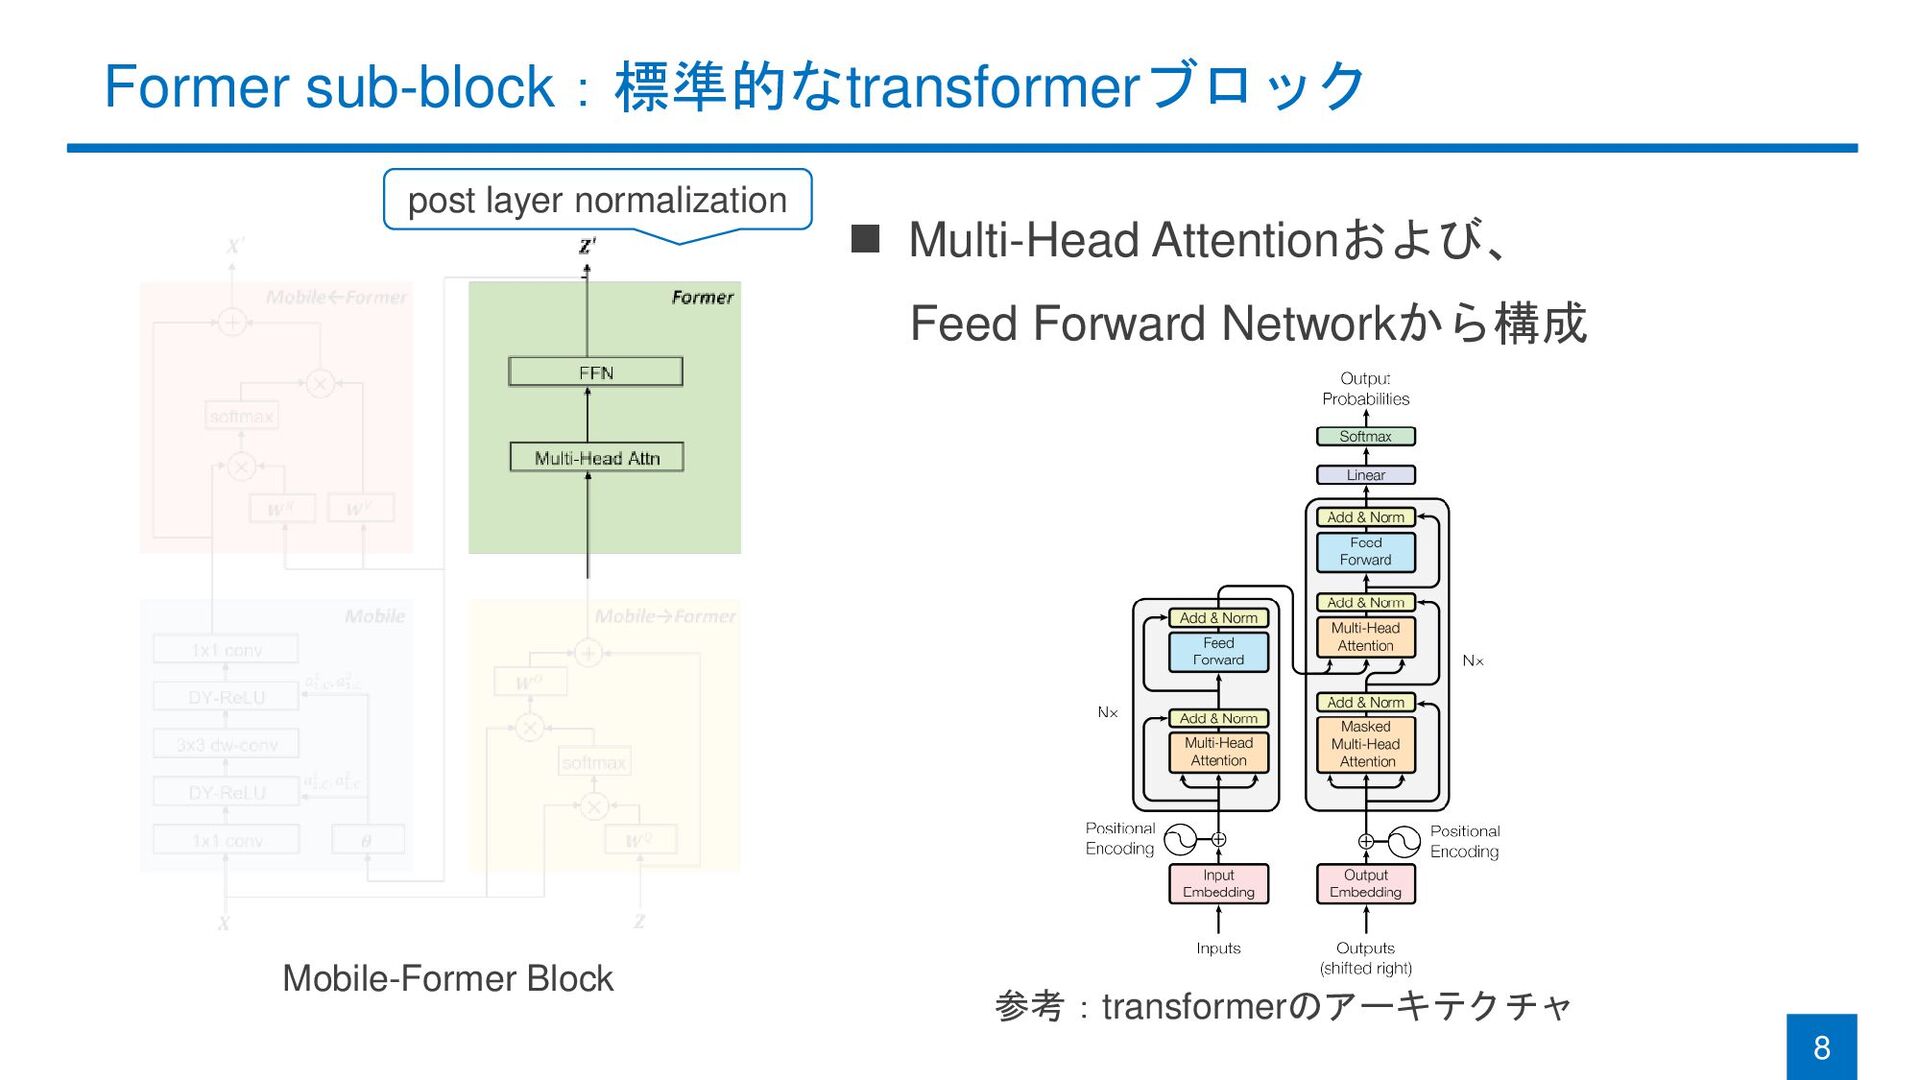
Former sub-block:標準的なtransformerブロック 8 Mobile-Former Block ◼ Multi-Head Attentionおよび、 Feed Forward
Networkから構成 参考:transformerのアーキテクチャ post layer normalization
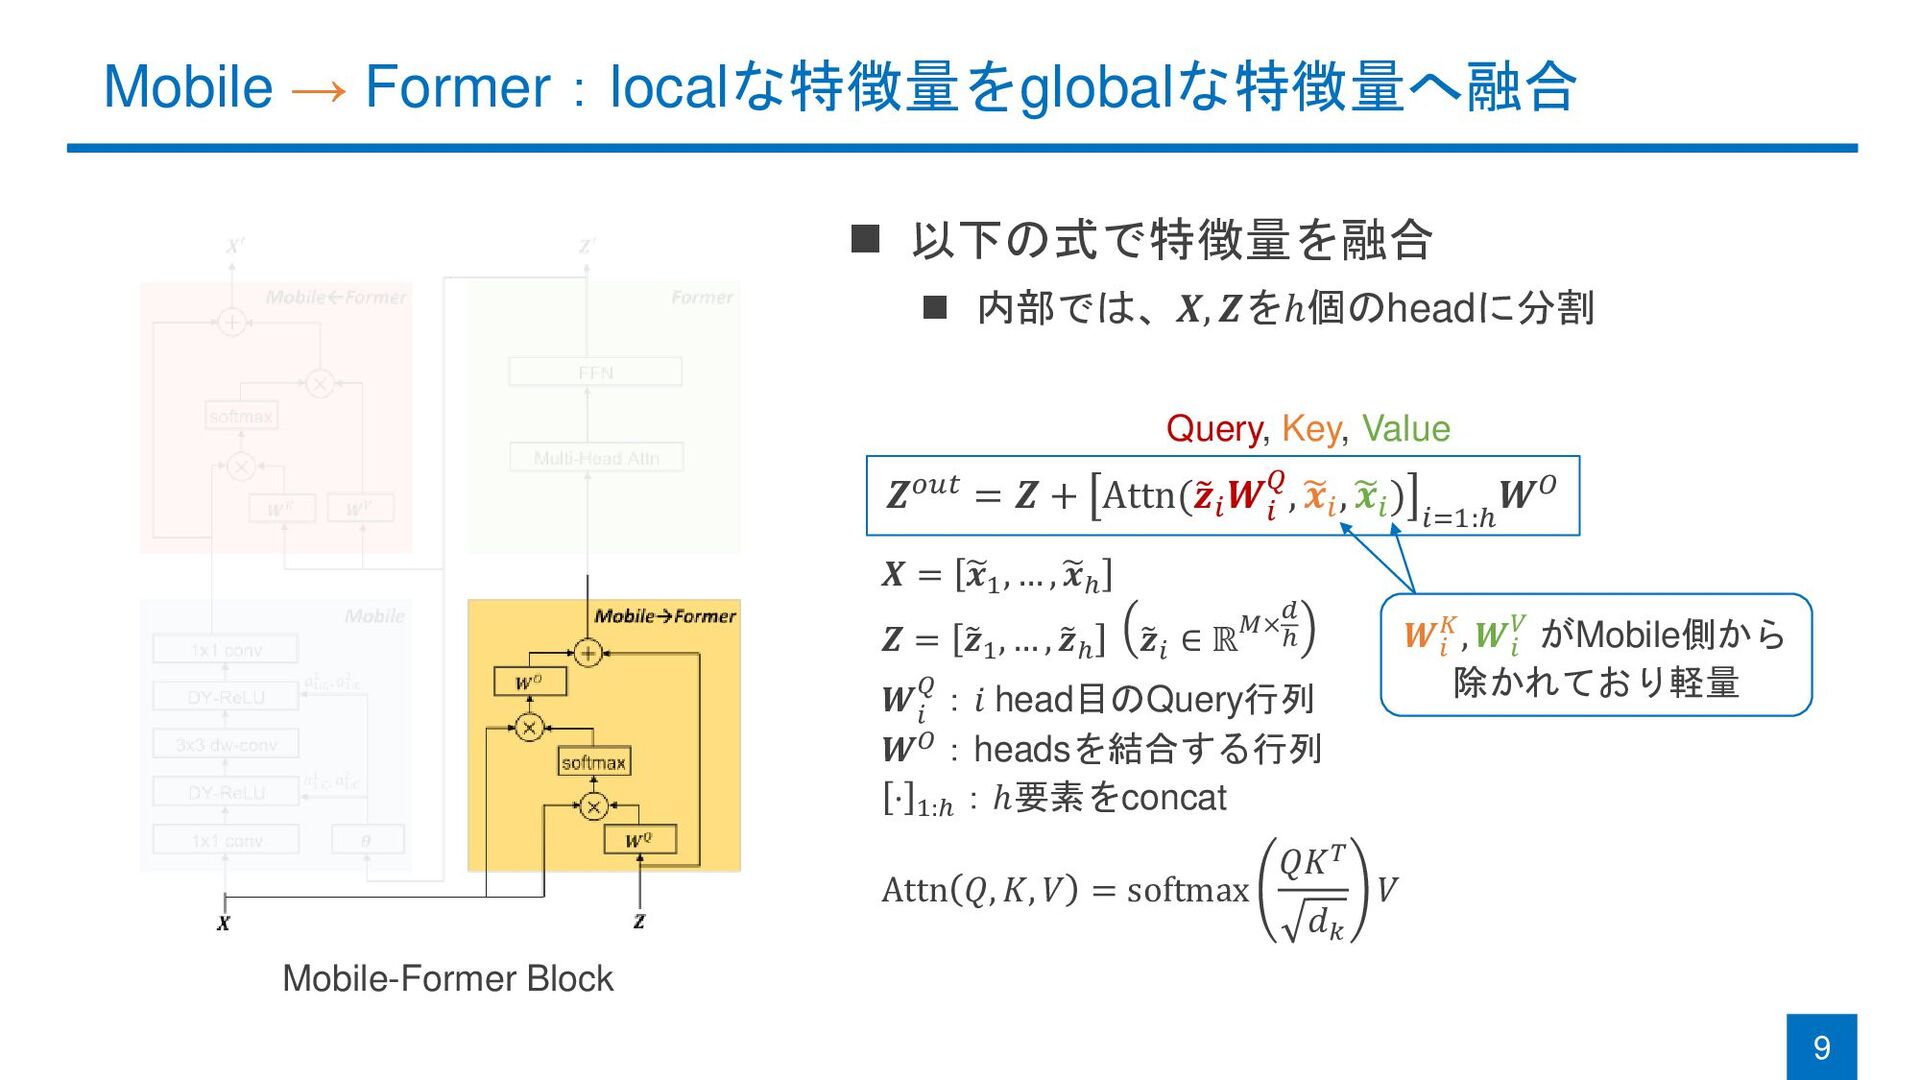
Mobile → Former:localな特徴量をglobalな特徴量へ融合 9 Mobile-Former Block ◼ 以下の式で特徴量を融合 ◼ 内部では、𝑿,
𝒁をℎ個のheadに分割 𝒁𝑜𝑢𝑡 = 𝒁 + Attn( 𝒛𝑖 𝑾 𝑖 𝑄, 𝒙𝑖 , 𝒙𝑖 ) 𝑖=1:ℎ 𝑾𝑂 𝑿 = 𝒙1 , … , 𝒙ℎ 𝒁 = 𝒛1 , … , 𝒛ℎ 𝒛𝑖 ∈ ℝ𝑀× 𝑑 ℎ 𝑾 𝑖 𝑄:𝑖 head目のQuery行列 𝑾𝑂:headsを結合する行列 ⋅ 1:ℎ :ℎ要素をconcat Attn 𝑄, 𝐾, 𝑉 = softmax 𝑄𝐾𝑇 𝑑𝑘 𝑉 Query, Key, Value 𝑾𝑖 𝐾, 𝑾𝑖 𝑉 がMobile側から 除かれており軽量
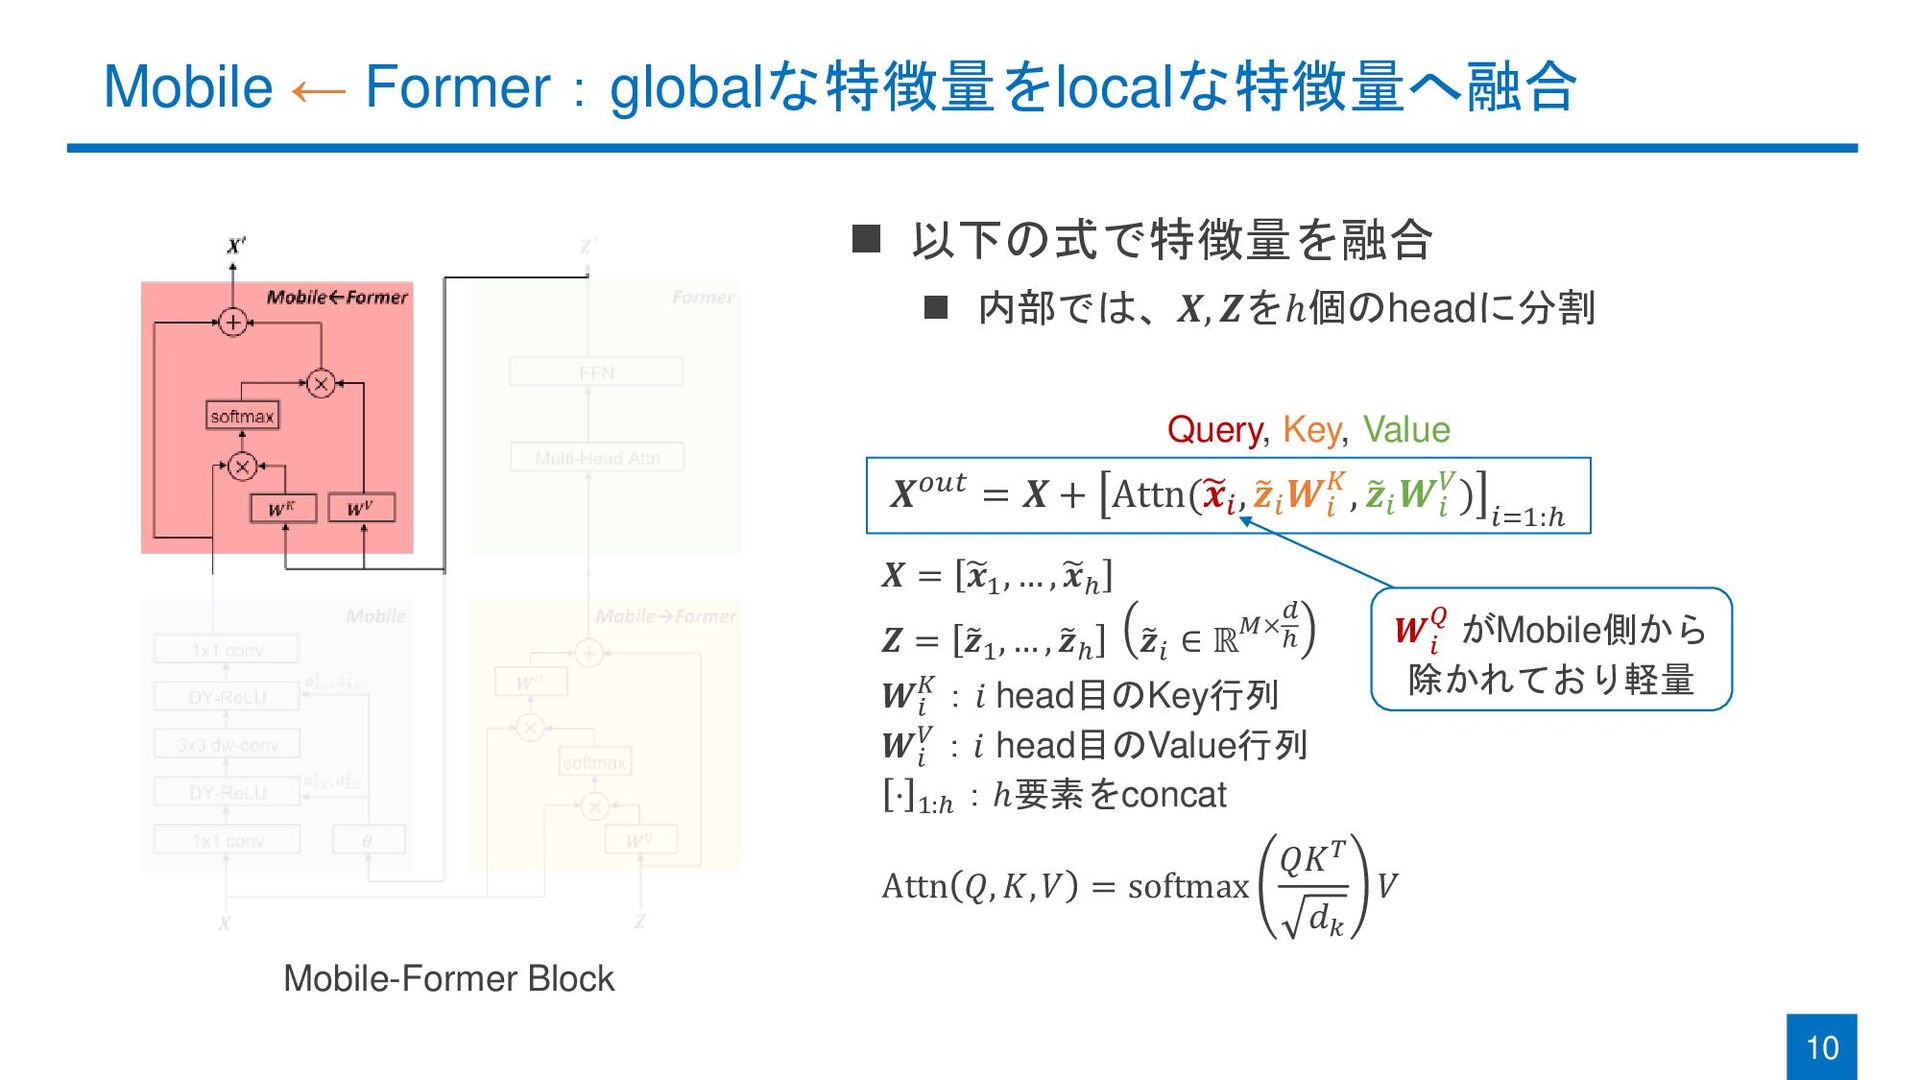
◼ 以下の式で特徴量を融合 ◼ 内部では、𝑿, 𝒁をℎ個のheadに分割 Mobile ← Former:globalな特徴量をlocalな特徴量へ融合 10 Mobile-Former
Block 𝑿𝑜𝑢𝑡 = 𝑿 + Attn( 𝒙𝑖 , 𝒛𝑖 𝑾𝑖 𝐾, 𝒛𝑖 𝑾𝑖 𝑉) 𝑖=1:ℎ 𝑿 = 𝒙1 , … , 𝒙ℎ 𝒁 = 𝒛1 , … , 𝒛ℎ 𝒛𝑖 ∈ ℝ𝑀× 𝑑 ℎ 𝑾𝑖 𝐾:𝑖 head目のKey行列 𝑾𝑖 𝑉:𝑖 head目のValue行列 ⋅ 1:ℎ :ℎ要素をconcat Attn 𝑄, 𝐾, 𝑉 = softmax 𝑄𝐾𝑇 𝑑𝑘 𝑉 Query, Key, Value 𝑾 𝑖 𝑄 がMobile側から 除かれており軽量
◼ 実験:ImageNet [Deng+ CVPR09] における画像分類 ◼ 計算コストが近いモデル同士で比較 定量的結果:対CNN/ViTともに計算コスト/性能で優位 11 Multiply-Adds:計算コストの指標
Model #Params↓ MAdds↓ Top-1↑ ShuffleNetV2 1.5× [Ma+ ECCV18] 3.5M 299M 72.6 MobileNetV3 1.25× [Howard+ ICCV19] 7.5M 356M 76.6 ViTC [Xiao+ NeurIPS21] 4.6M 1.1G 75.3 ConT-S [Yan+ CoRR21] 10.1M 1.5G 76.5 Mobile-Former-294M 11.4M 294M 77.9 CNN ViT
追試およびエラー分析(定性的結果):小さな類似物体の認識が課題 12 ◼ 類似の発展手法:MobileViT [Mehta+ ICLR22] ◼ データセット:花の5クラス画像分類(tf_flowers) ◼ 改善案:localな特徴量をより重視するため、CNNの寄与を向上
https://huggingface.co/spaces/keras-io/Flowers-Classification-MobileViT 予測:“sunflower” 正解:“dandelion” “rose” “tulip”
まとめ 背景 ✓ 低計算コストかつ高精度の画像認識モデルの需要 提案 ✓ MobileNet/transformerを、並列かつ双方向に接続 ✓ local, globalな特徴量を融合
結果 ✓ 低計算コスト条件下で、他のViT/CNNモデルを凌駕 13
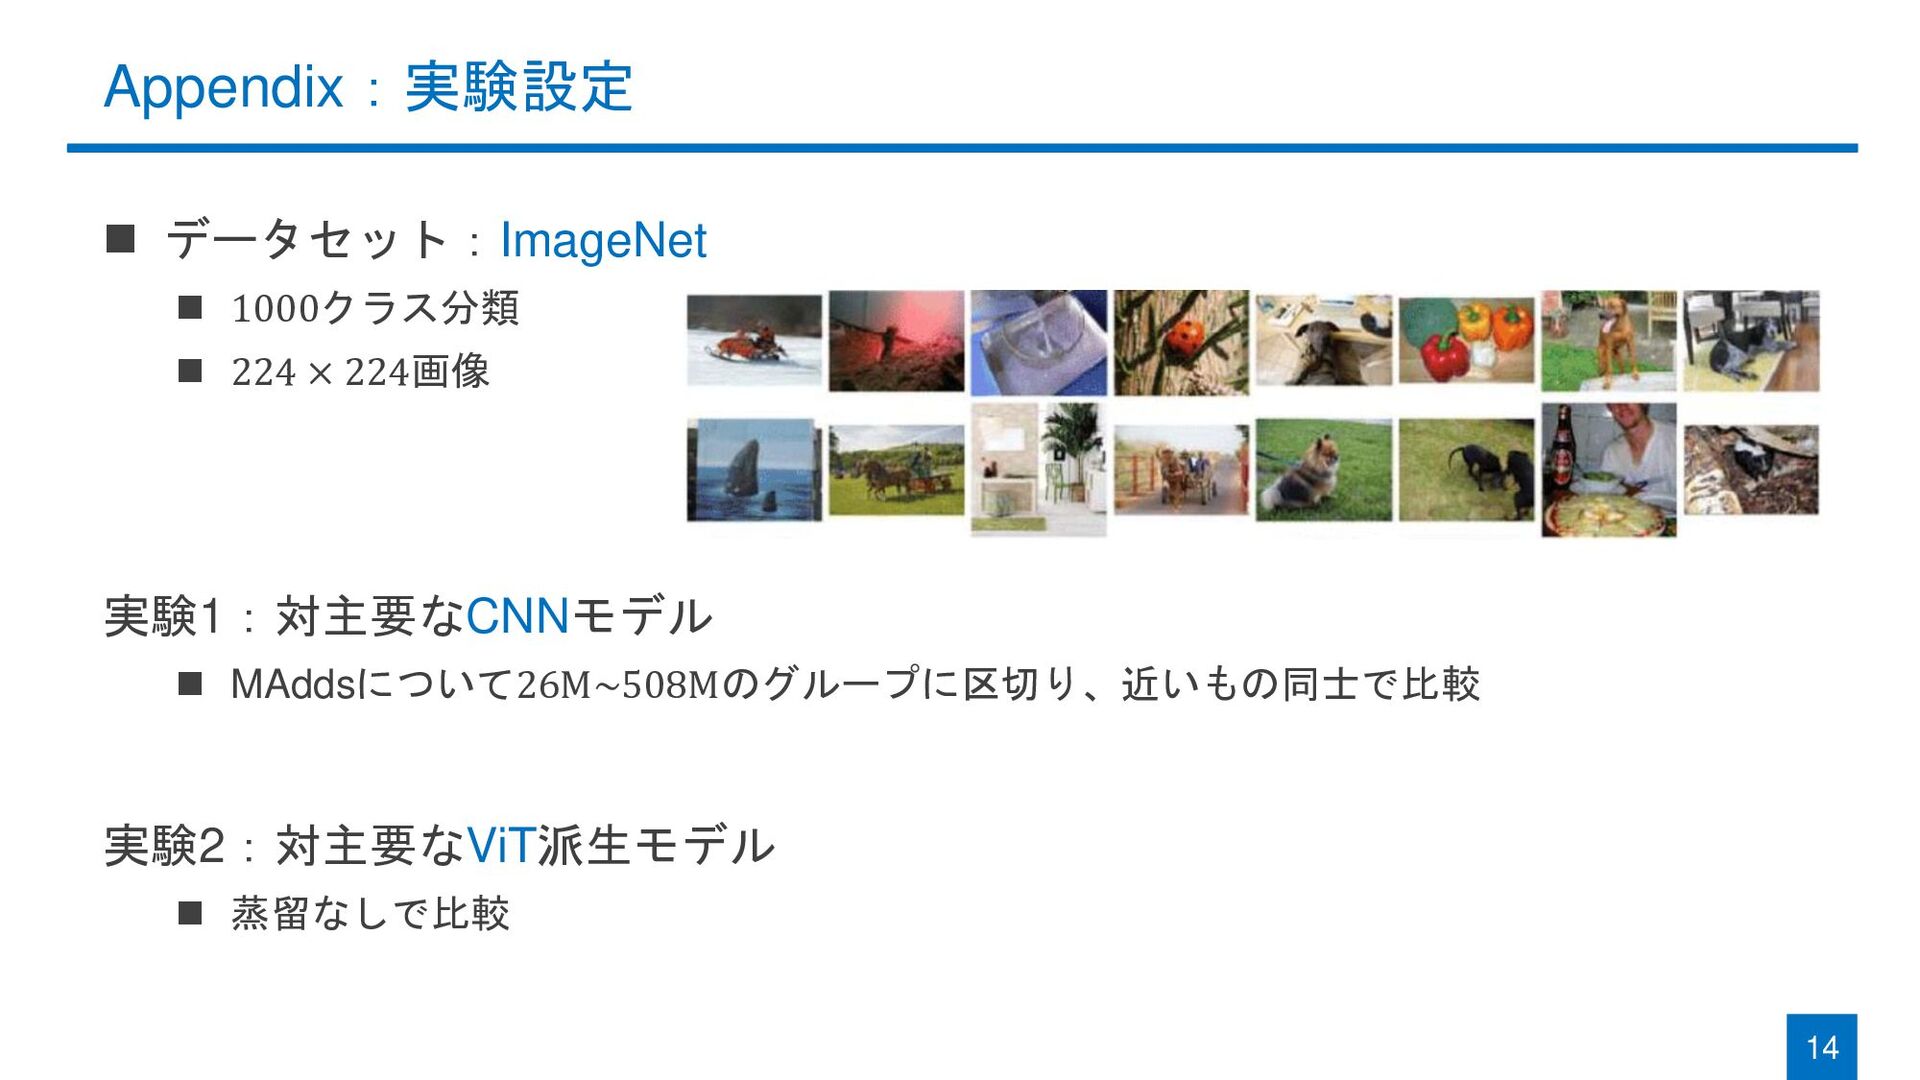
Appendix:実験設定 ◼ データセット:ImageNet ◼ 1000クラス分類 ◼ 224 × 224画像 実験1:対主要なCNNモデル
◼ MAddsについて26M~508Mのグループに区切り、近いもの同士で比較 実験2:対主要なViT派生モデル ◼ 蒸留なしで比較 14
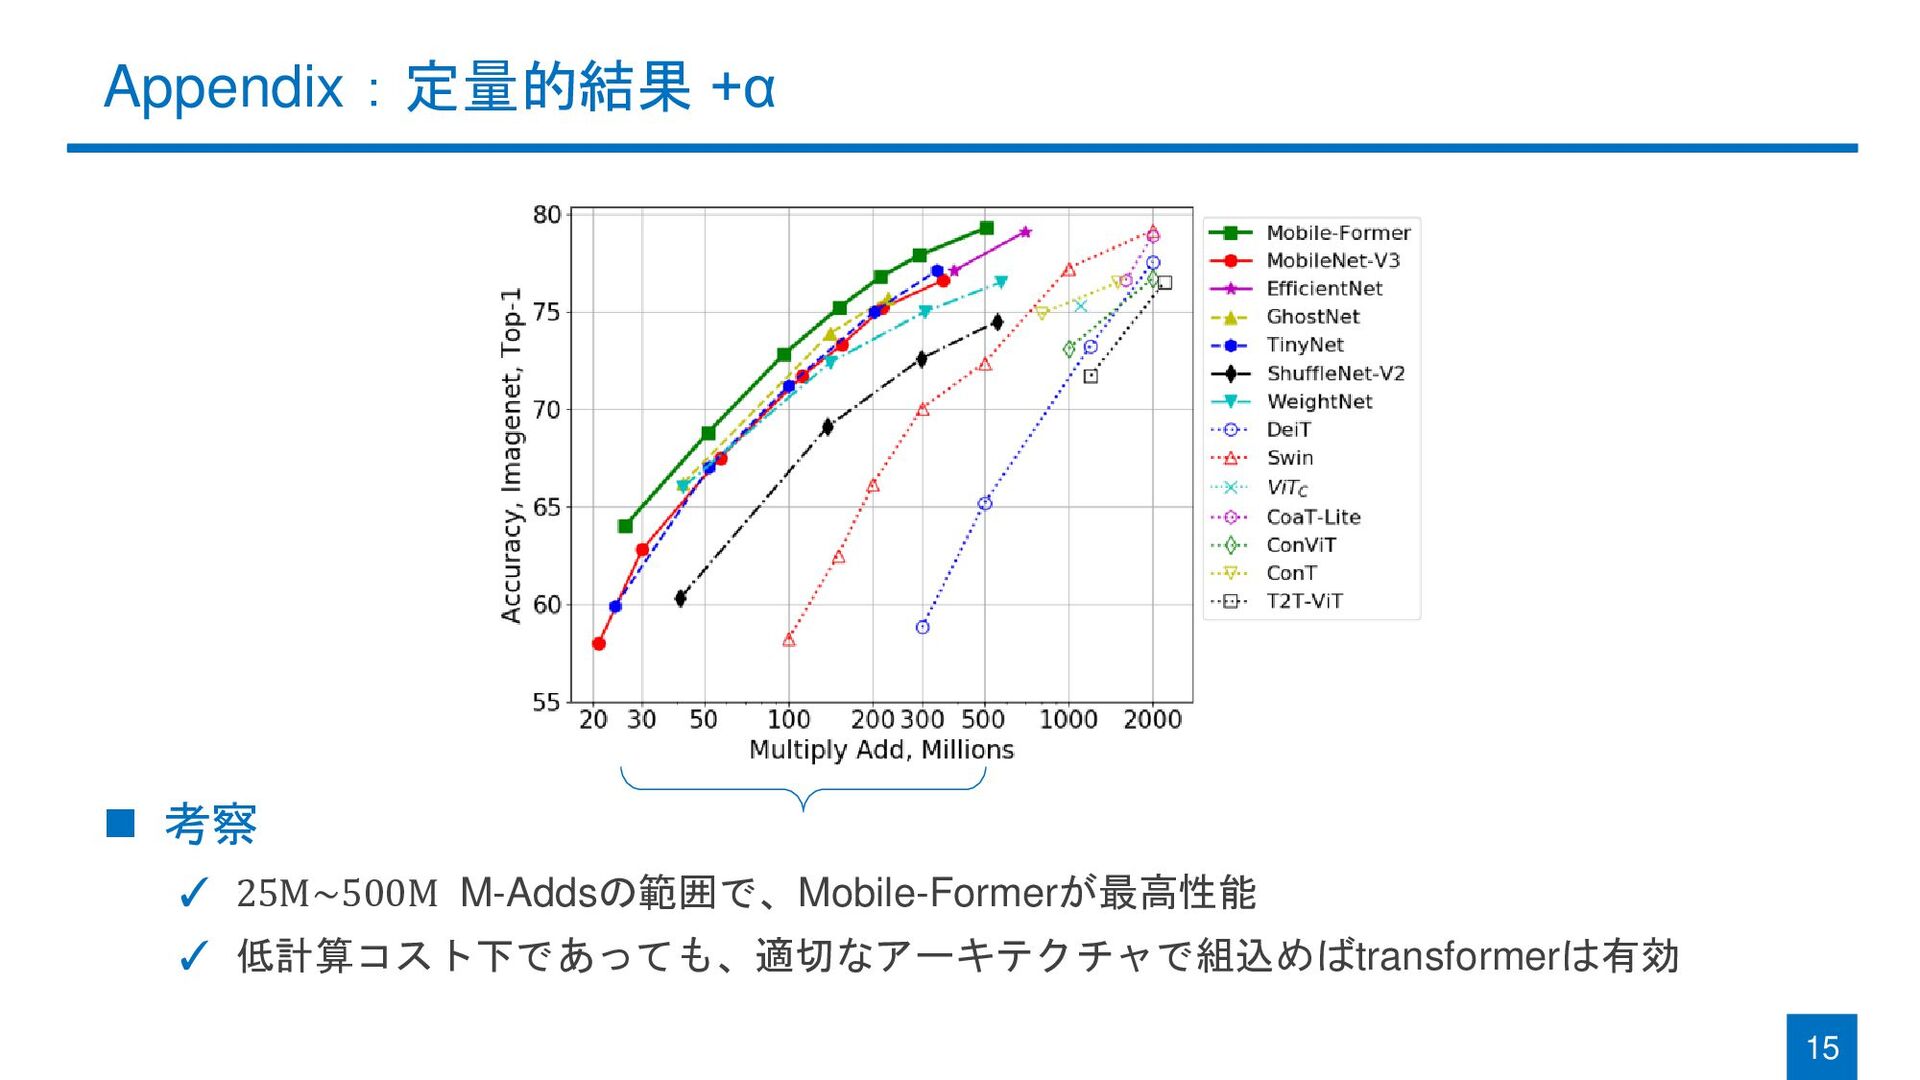
Appendix:定量的結果 +α ◼ 考察 ✓ 25M~500M M-Addsの範囲で、Mobile-Formerが最高性能 ✓ 低計算コスト下であっても、適切なアーキテクチャで組込めばtransformerは有効 15
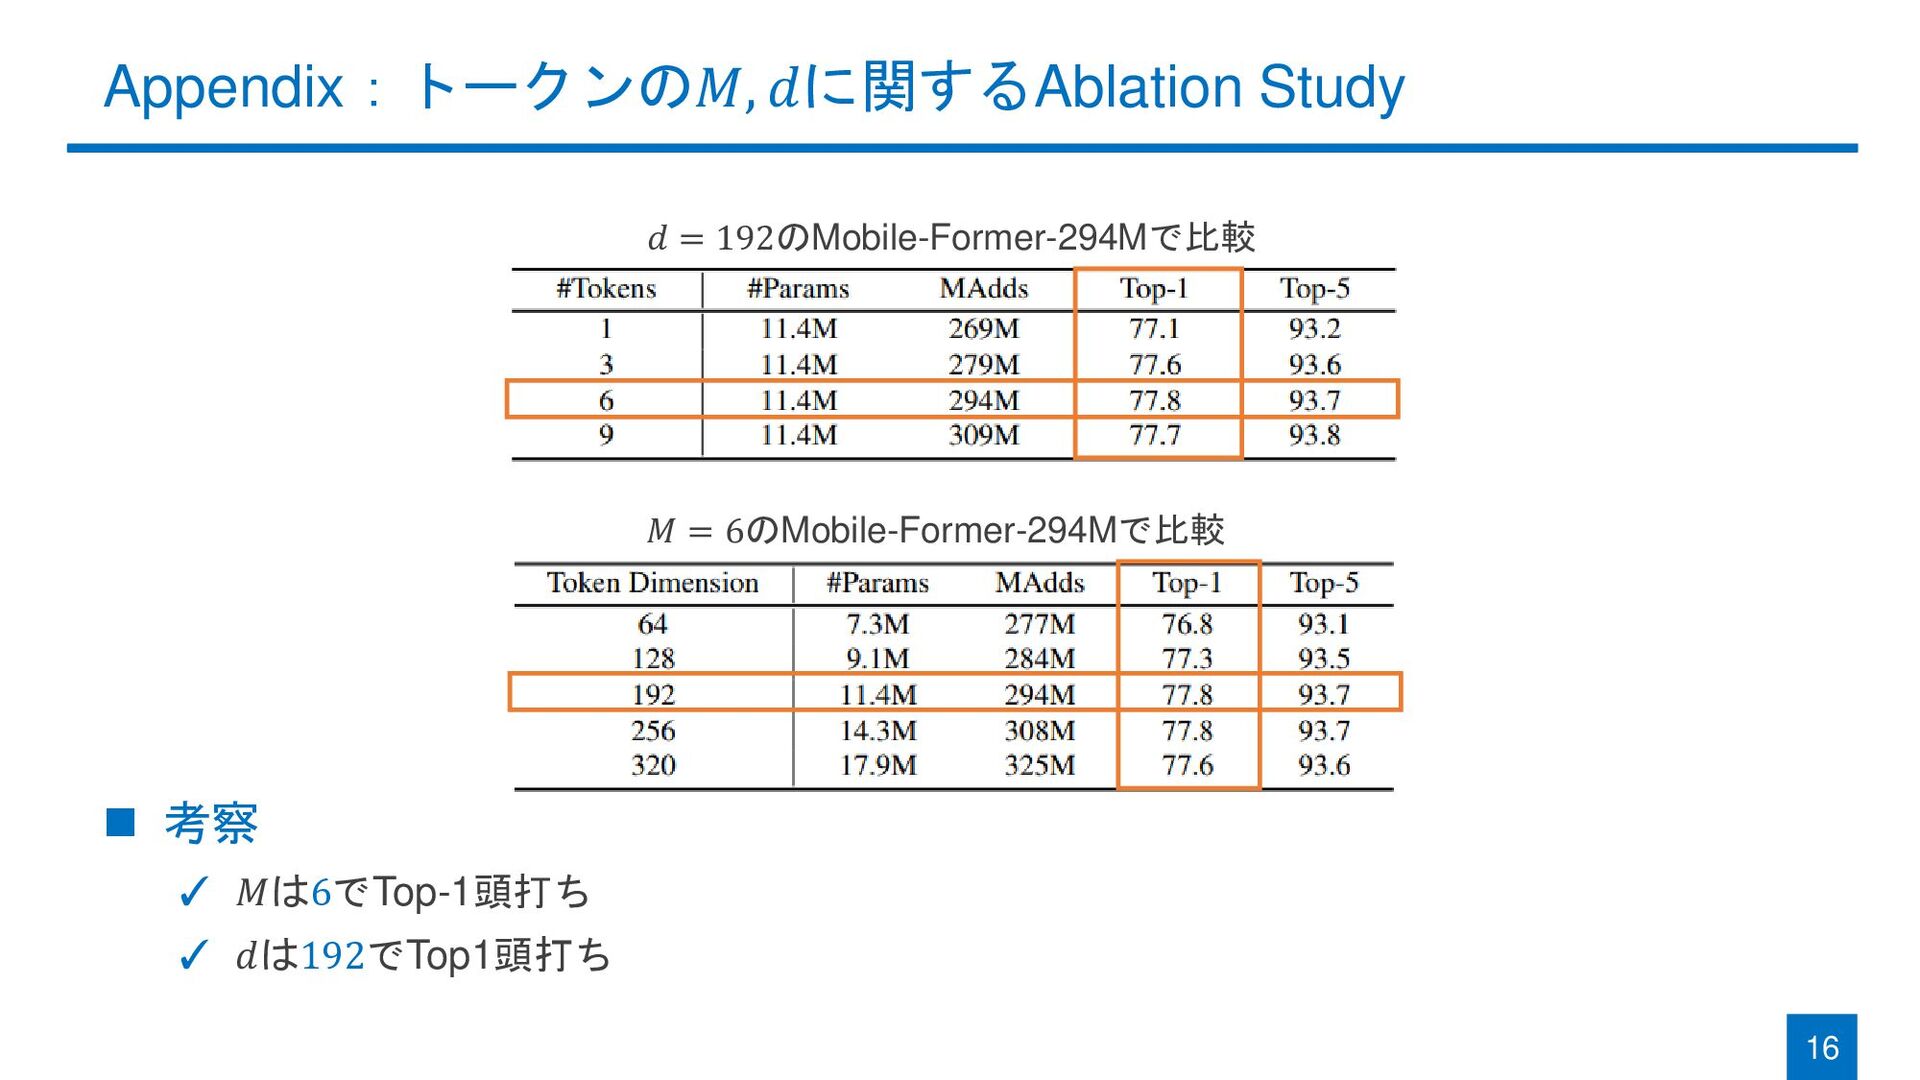
Appendix:トークンの𝑀, 𝑑に関するAblation Study ◼ 考察 ✓ 𝑀は6でTop-1頭打ち ✓ 𝑑は192でTop1頭打ち 16
𝑑 = 192のMobile-Former-294Mで比較 𝑀 = 6のMobile-Former-294Mで比較
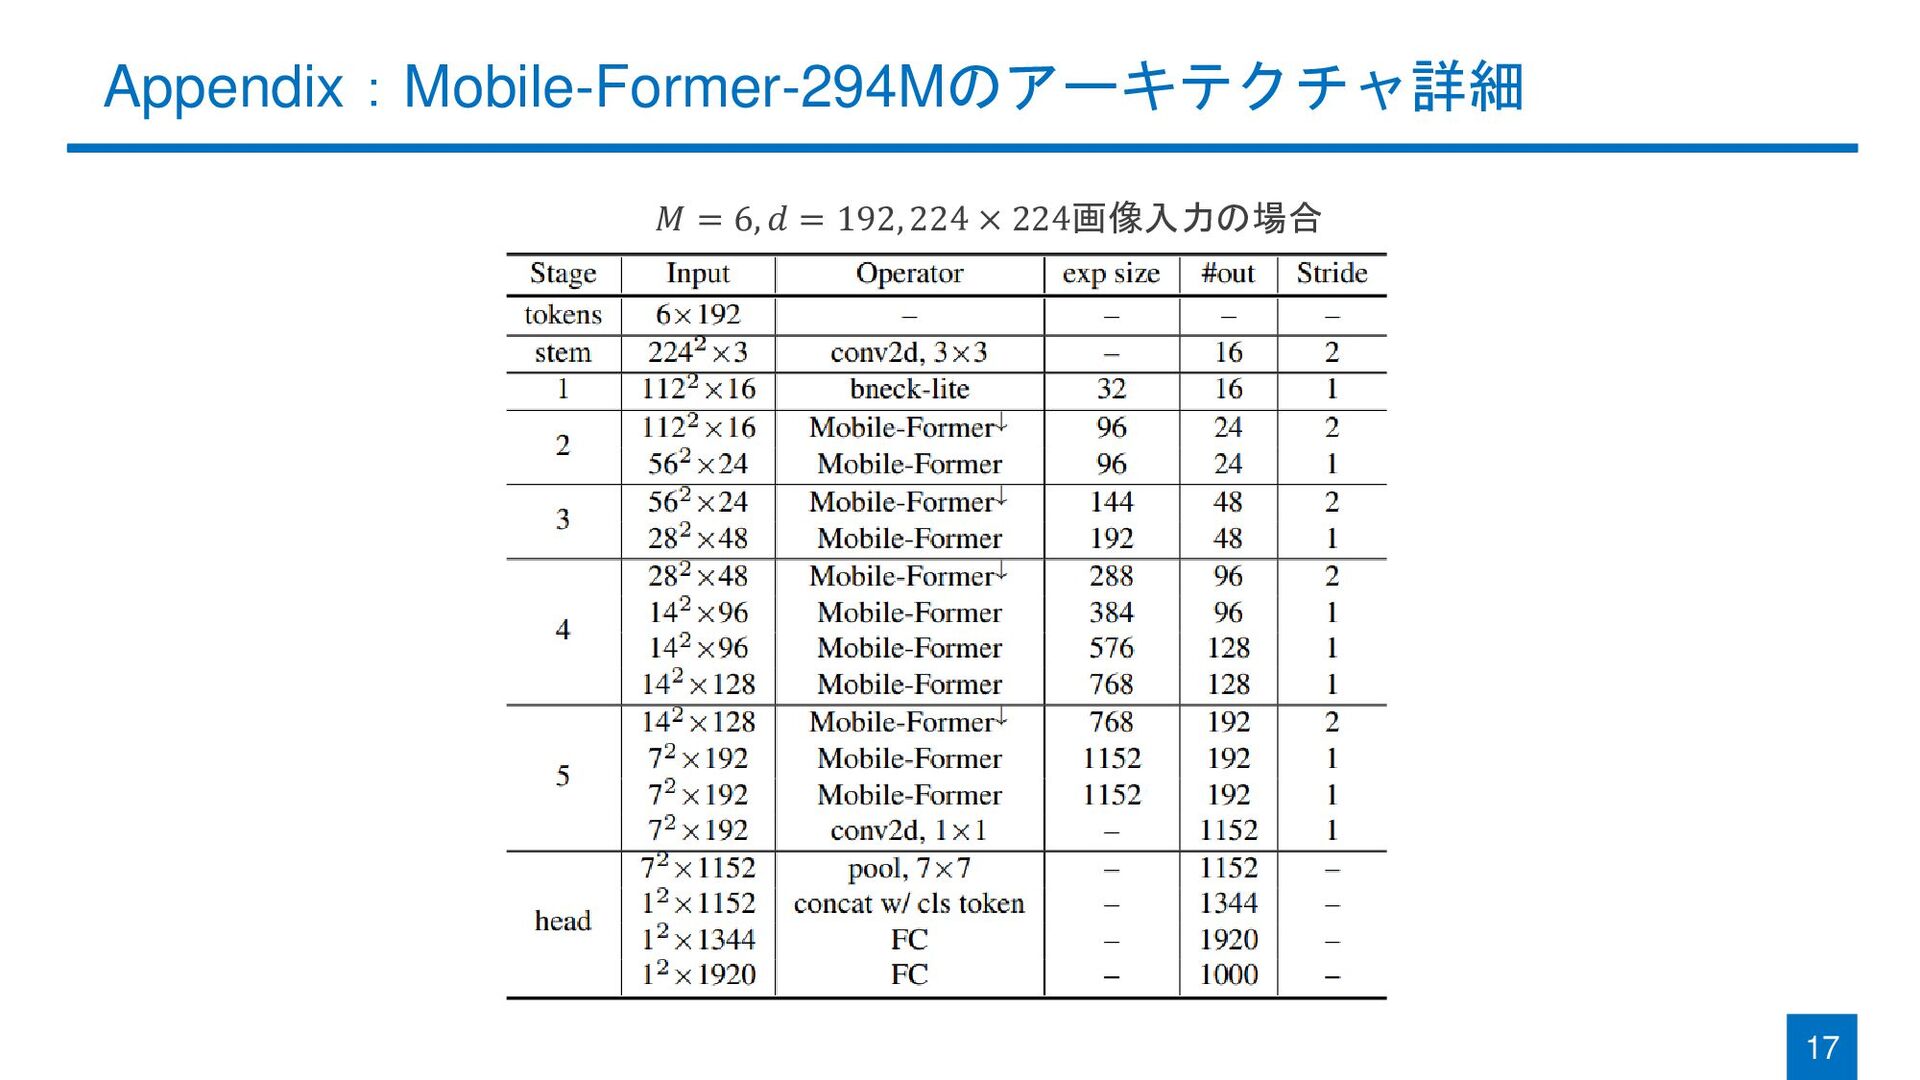
Appendix:Mobile-Former-294Mのアーキテクチャ詳細 17 𝑀 = 6, 𝑑 = 192, 224 ×
224画像入力の場合
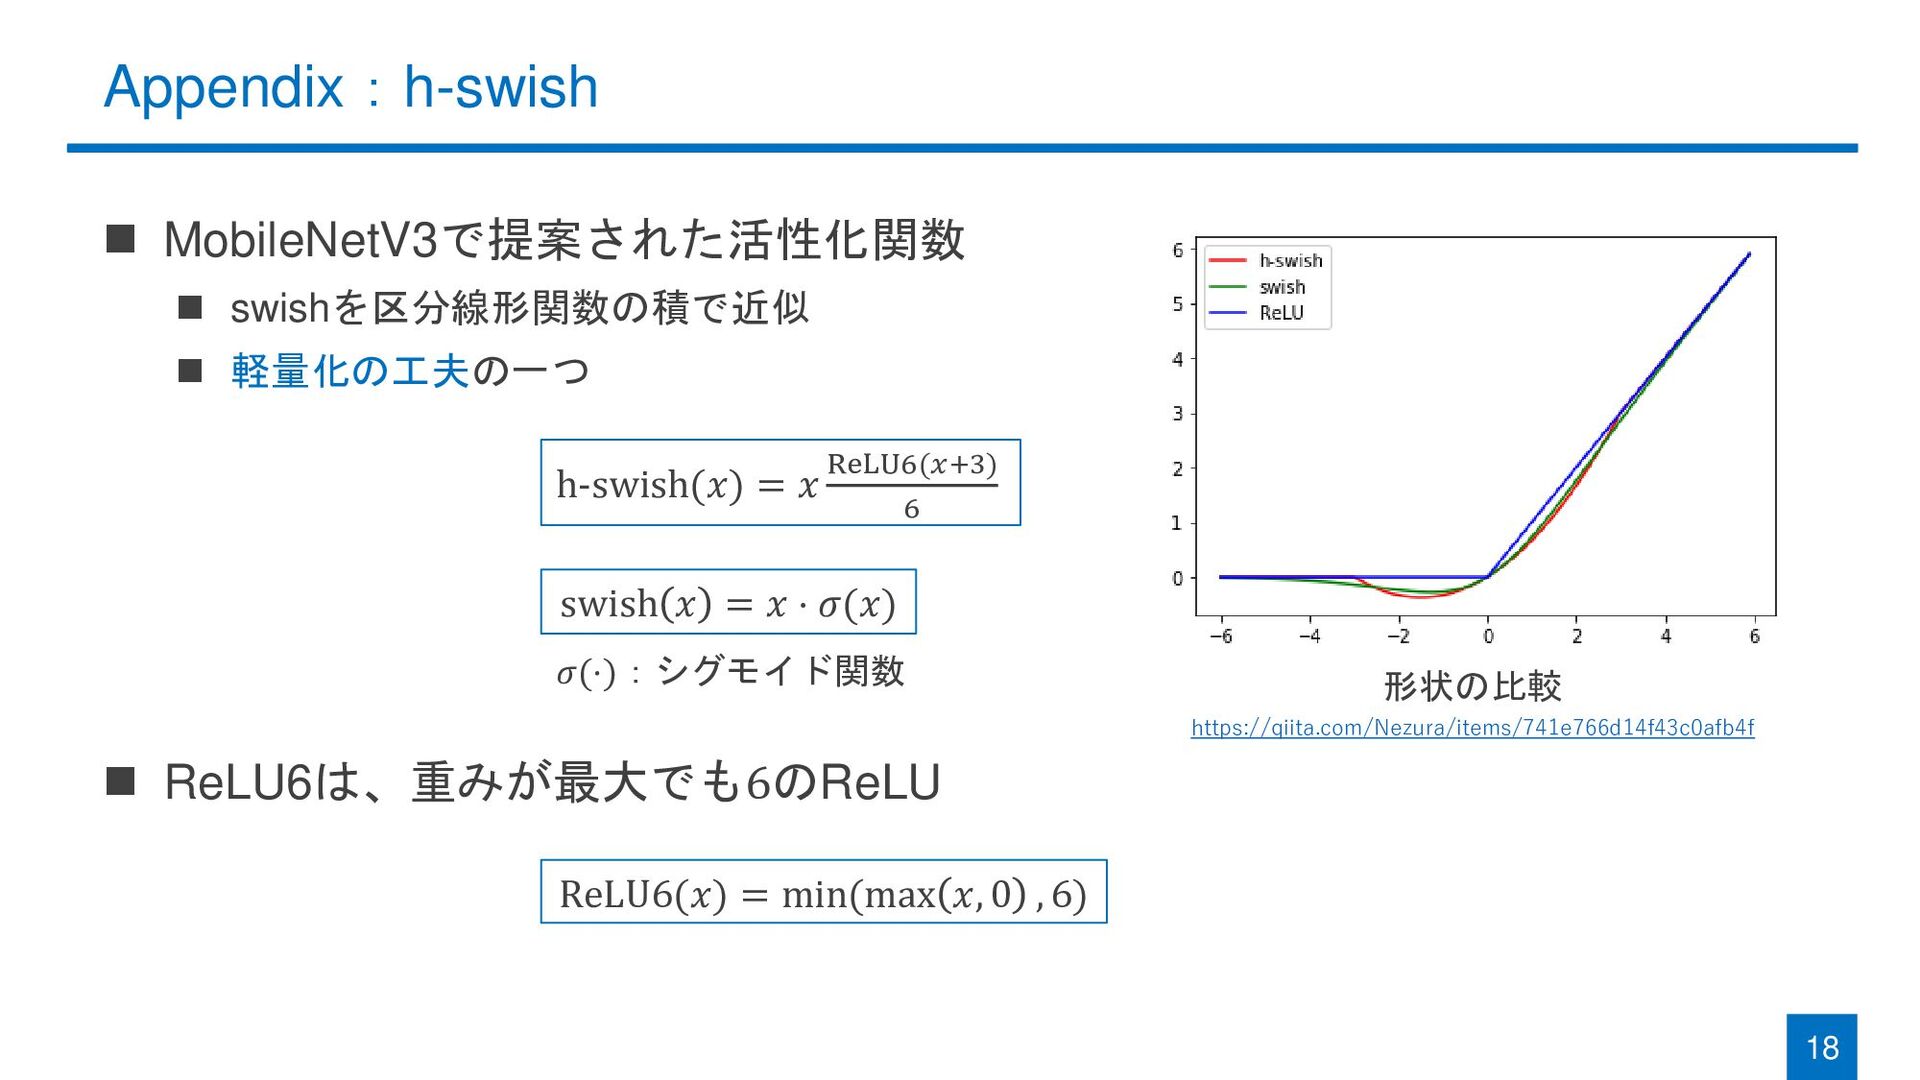
Appendix:h-swish ◼ MobileNetV3で提案された活性化関数 ◼ swishを区分線形関数の積で近似 ◼ 軽量化の工夫の一つ ◼ ReLU6は、重みが最大でも6のReLU 18
h-swish(𝑥) = 𝑥 ReLU6(𝑥+3) 6 ReLU6(𝑥) = min(max 𝑥, 0 , 6) https://qiita.com/Nezura/items/741e766d14f43c0afb4f swish 𝑥 = 𝑥 ⋅ 𝜎(𝑥) 𝜎(⋅):シグモイド関数 形状の比較
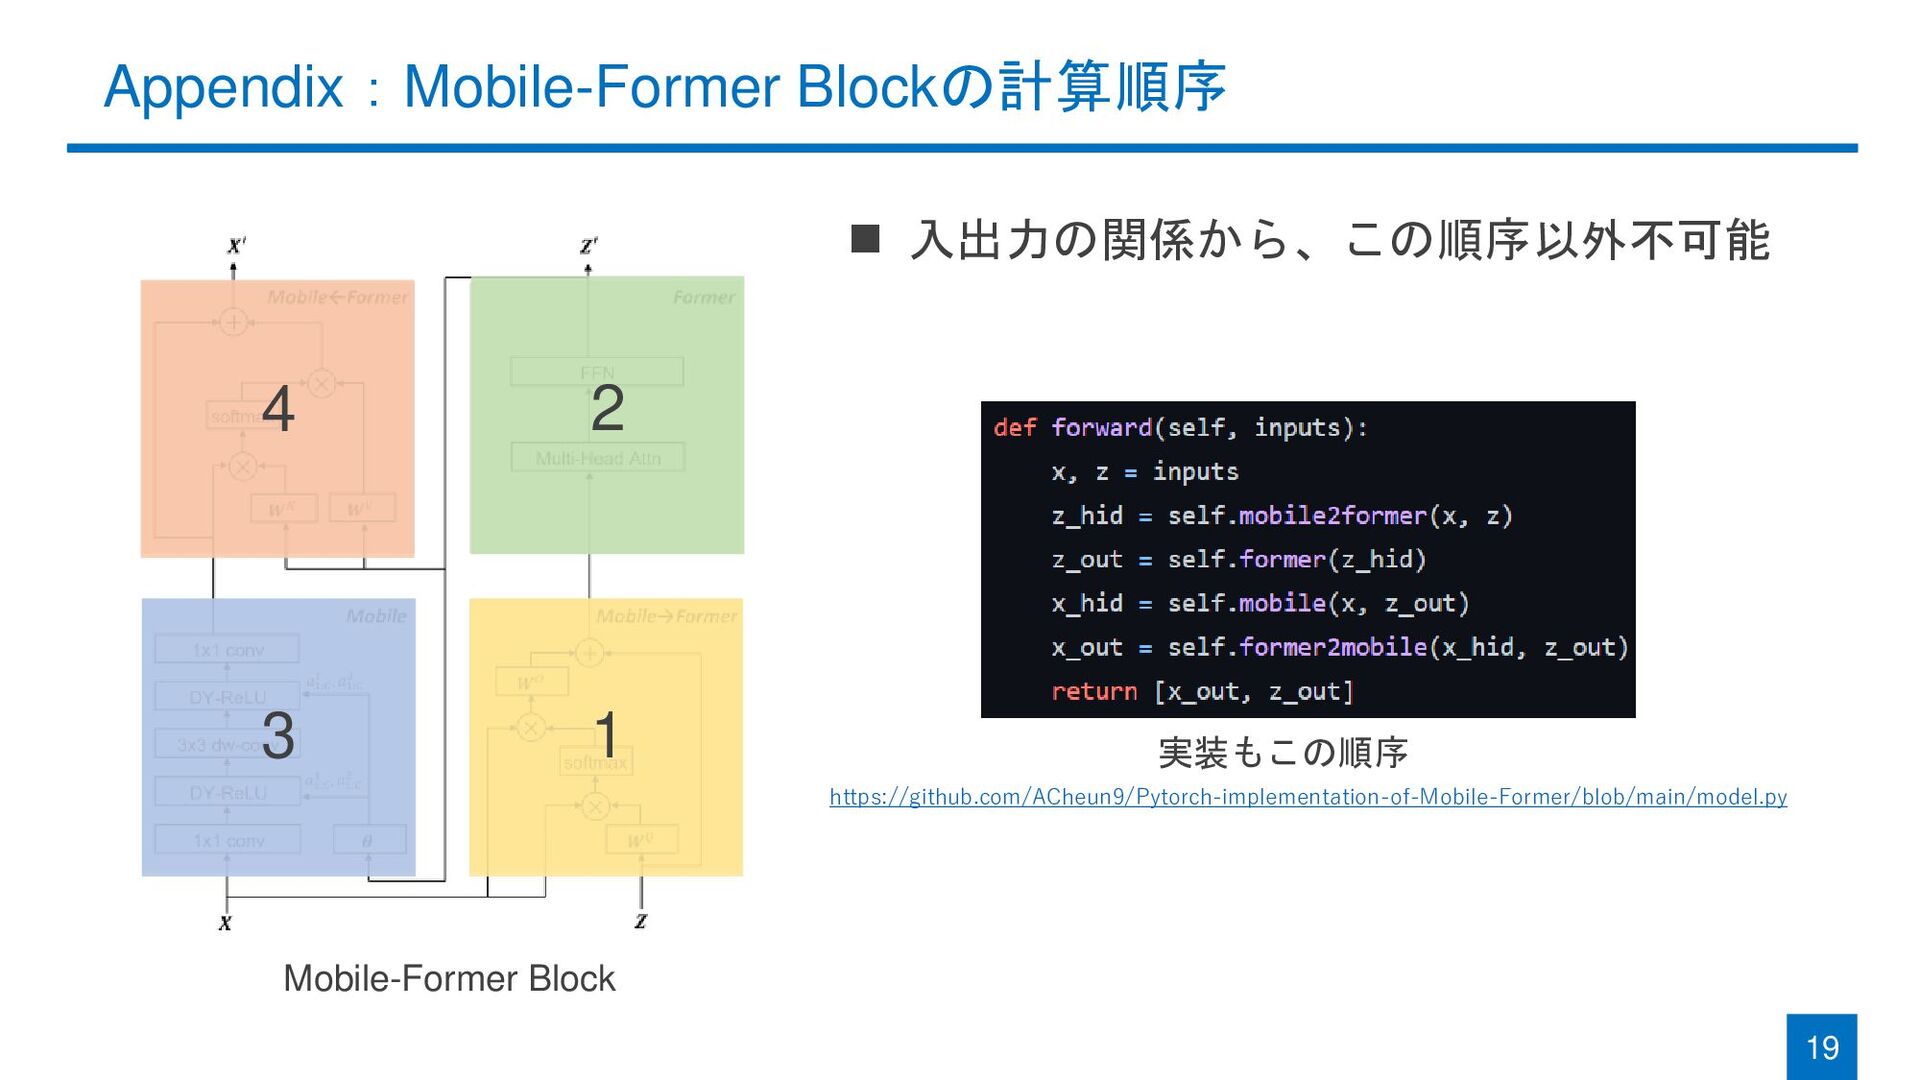
Appendix:Mobile-Former Blockの計算順序 19 Mobile-Former Block ◼ 入出力の関係から、この順序以外不可能 1 2 3
4 実装もこの順序 https://github.com/ACheun9/Pytorch-implementation-of-Mobile-Former/blob/main/model.py
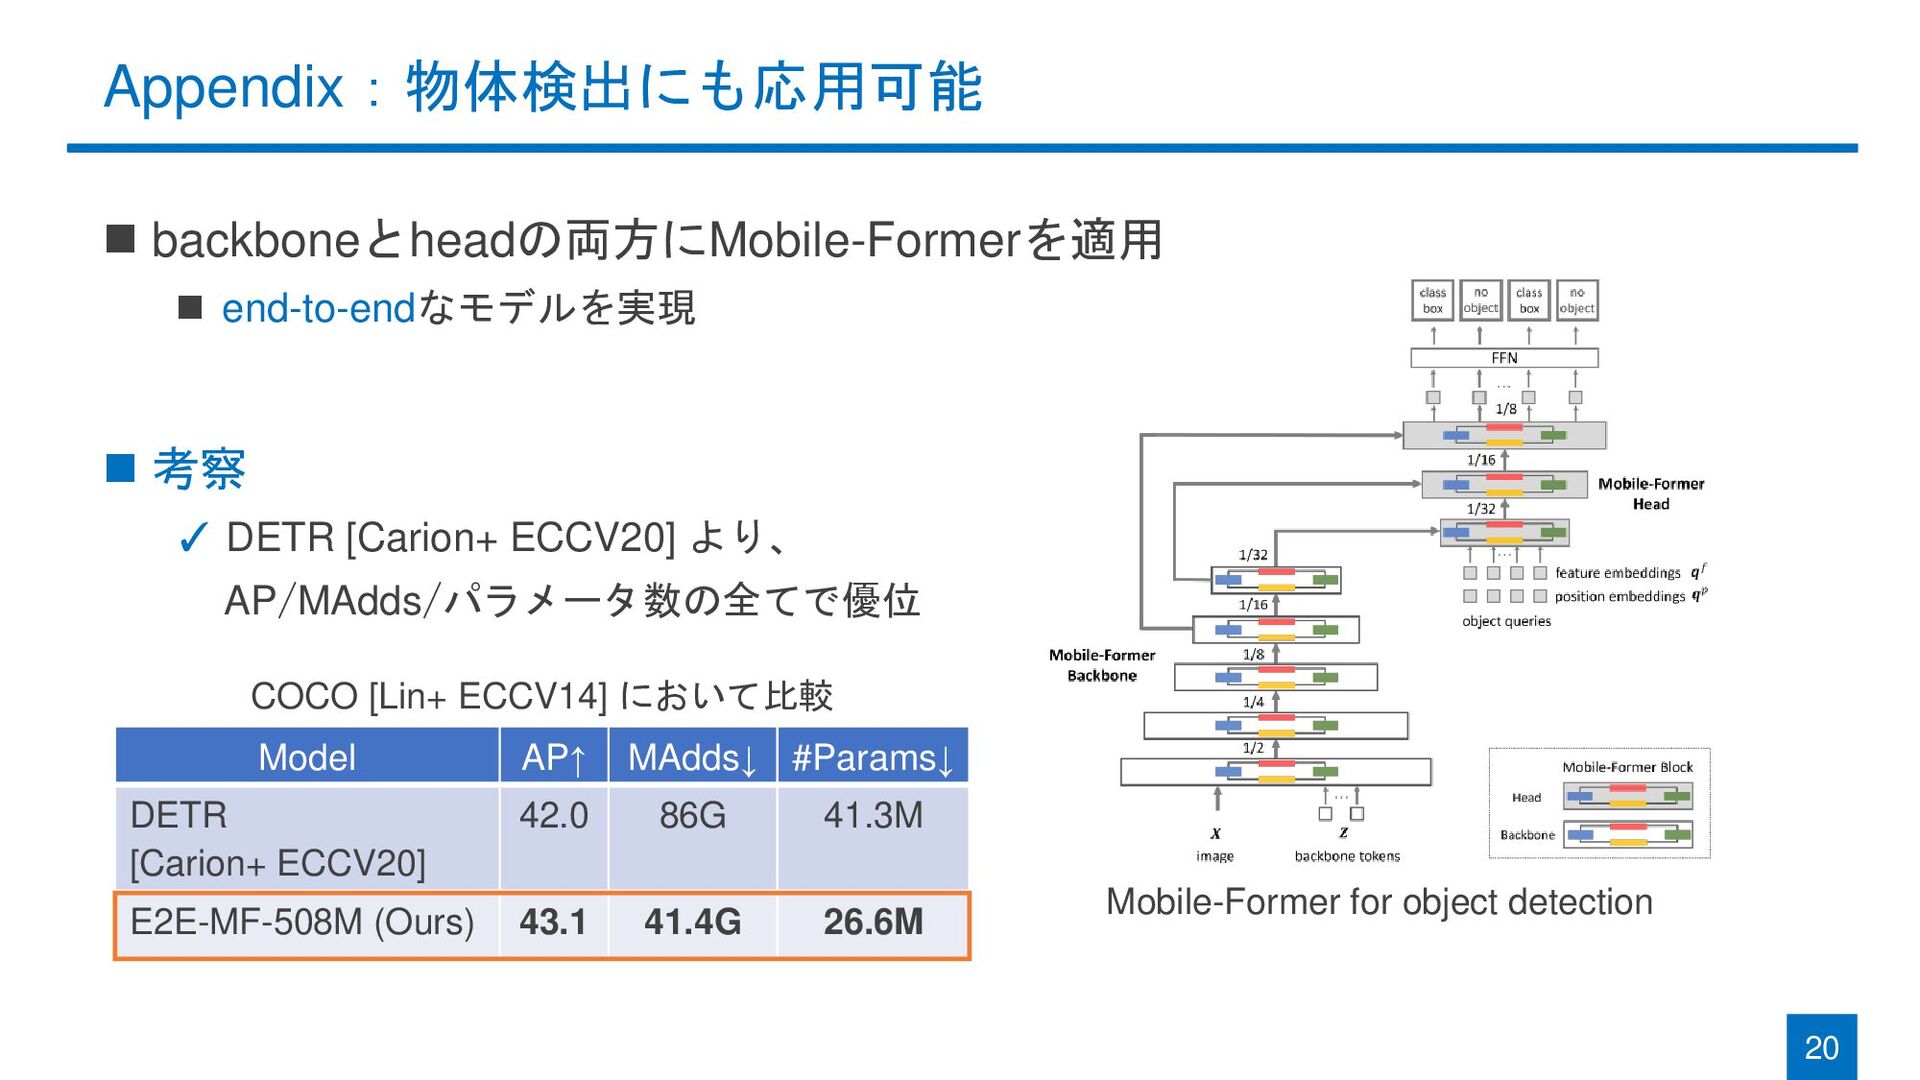
Appendix:物体検出にも応用可能 ◼ backboneとheadの両方にMobile-Formerを適用 ◼ end-to-endなモデルを実現 ◼ 考察 ✓ DETR [Carion+
ECCV20] より、 AP/MAdds/パラメータ数の全てで優位 20 Mobile-Former for object detection COCO [Lin+ ECCV14] において比較 Model AP↑ MAdds↓ #Params↓ DETR [Carion+ ECCV20] 42.0 86G 41.3M E2E-MF-508M (Ours) 43.1 41.4G 26.6M
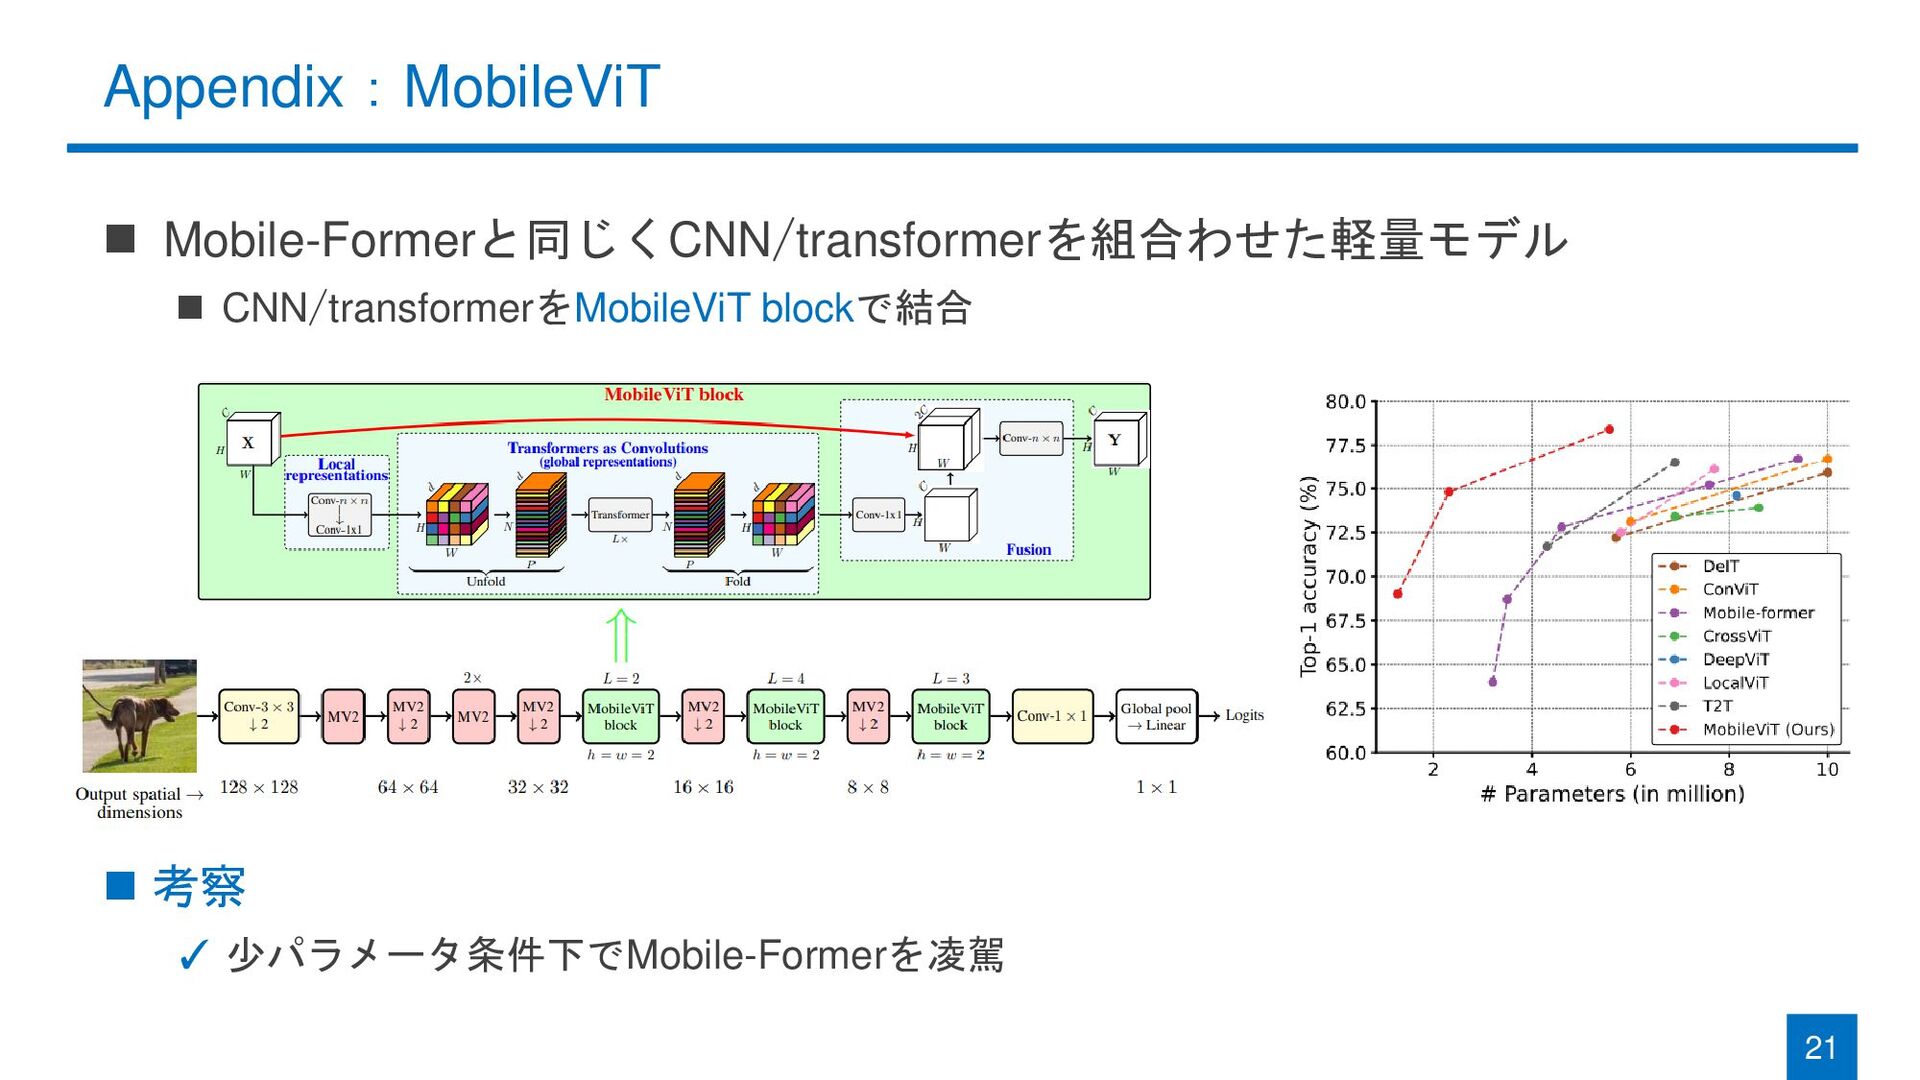
Appendix:MobileViT ◼ Mobile-Formerと同じくCNN/transformerを組合わせた軽量モデル ◼ CNN/transformerをMobileViT blockで結合 ◼ 考察 ✓ 少パラメータ条件下でMobile-Formerを凌駕
21


 keio_smilab
 inariku
 ryuseiiida
 minorun365
 kazzpapa3
 maigo999
 jozono
 snoozer05
 takuros
 torounit
 iwamot
 nealle
 oracle4engineer
 eileencodes
 mlcsv
 denniskardys
 trishagee
 axbom
 nwiizo
 addyosmani
 aleyda
 soudai
 sferik
 portentint
 vanstee