Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
文献紹介「二値符号予測と誤り訂正を用いたニューラル翻訳モデル」
Search
Ayumu
March 05, 2019
Technology
220
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
文献紹介「二値符号予測と誤り訂正を用いたニューラル翻訳モデル」
2019/03/05
長岡技術科学大学 自然言語処理研究室
学部4年 守谷 歩
Ayumu
March 05, 2019
More Decks by Ayumu
See All by Ayumu
B3ゼミ_03_28_マルチモーダル学習_.pdf
ayumum
0
200
マルチモーダル学習
ayumum
0
190
B3ゼミ 自然言語処理におけるCNN
ayumum
0
150
言語処理年次大会報告
ayumum
0
140
ニューラルネット4
ayumum
0
140
ニューラルネット3 誤差伝搬法,CNN,word2vec
ayumum
0
220
ニューラルネット実践
ayumum
0
150
文献紹介[Zero-Shot Dialog Generation with Cross-Domain Latent Action]
ayumum
0
230
パーセプトロンとニューラルネット1
ayumum
0
130
Other Decks in Technology
See All in Technology
AI Native Platform Engineering 〜PlatformとAgileで“作る速さ”を“価値”へ〜
uya116
0
140
【技術的負債conf】事業成長に伴う技術的負債の説明責任とAIによるモニタリング、認知的負債について
i35_267
4
2.2k
Claude Codeを「使うほど育つ」AI秘書にするノウハウ
minorun365
PRO
33
32k
Goodbye ShellScript, Hello File-based App
shunsock
0
1.1k
GitHub Agentic Workflows を触ってみる
htkym
2
600
.NET WebAssemblyで実現するクライアントサイドAI推論:NuGetからViteまで、2つのエコシステムを繋ぐビルド戦略
yamachu
1
860
AIに任せた品質は、誰が見立てるのか - AI時代のテストマネジメント
nakanao
3
3.1k
作って終わりじゃないサーバーレス 〜9年運用する大規模EC物流API基盤の設計・運用のリアル〜
zozotech
PRO
0
530
C#未経験の僕がAIに読めるコードを書かせるまで
maguroalternative
0
300
Oracle Base Database Service 技術詳細
oracle4engineer
PRO
16
120k
リアーキテクチャ後の障害ゼロを目指したShadow Testingの取り組み
nihonbuson
PRO
1
180
AIに書かせて、プラットフォームで縛る ― EKSプラットフォームで実践した責任境界と権限設計
elmodev09
0
550
Featured
See All Featured
How to audit for AI Accessibility on your Front & Back End
davetheseo
0
550
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
370
4 Signs Your Business is Dying
shpigford
187
23k
Documentation Writing (for coders)
carmenintech
77
5.5k
How To Speak Unicorn (iThemes Webinar)
marktimemedia
1
590
Design in an AI World
tapps
1
330
How STYLIGHT went responsive
nonsquared
100
6.3k
Writing Fast Ruby
sferik
630
63k
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
470
Deep Space Network (abreviated)
tonyrice
0
320
Transcript
二値符号予測と誤り訂正を 用いたニューラル翻訳モデル 2019/03/05 長岡技術科学大学 自然言語処理研究室 学部4年 守谷 歩 1
文献 ⚫「二値符号予測と誤り訂正を用いたニューラル翻訳モデル」 ⚫小田 悠介, Philip Arthur, Graham Neubig, 吉野 幸一郎,
中村 哲 ⚫二値符号予測と誤り訂正を用いたニューラル翻訳モデル, 自然言 語処理, 2018, 25 巻, 2 号, p. 167-199, 公開日 2018/06/15, Online ISSN 2185-8314, Print ISSN 1340- 7619, https://doi.org/10.5715/jnlp.25.167, https://www.jstage.jst.go .jp/article/jnlp/25/2/25_167/_article/-char/ja, 抄録: 2
概要 ⚫近年の機械翻訳ではエンコーダ、デコーダ、注釈機構からなる ニューラル翻訳モデルが研究されている。 ⚫既存の方法で表現力の高いニューラル翻訳モデルの出力層では ソフトマックス演算を行っており、これは、語彙に含まれる全単語の スコアを隠れ層の一次結合として計算するため、計算量が語彙サ イズに比例するため軽量化したい。 ⚫また、単純に二値符号のみを用いる方法だと翻訳精度が従来の 手法と比べて大幅に低下してしまう。 3
概要 ⚫従来の方法でも以下の4つの観点が計算量を軽量化するために 需要だと考えられる。 ⚫翻訳精度 ⚫空間効率(使用メモリ量) ⚫時間効率(実行速度) ⚫並列計算との親和性 ⚫軽量化をするために従来のソフトマックスモデルを部分的に導入 し、高頻度語と低頻度語を分離し、学習させる手法を提案。また、 二値符号の頑健性を向上させるため、誤り訂正符号、畳み込み符
号による冗長化を施す。 4
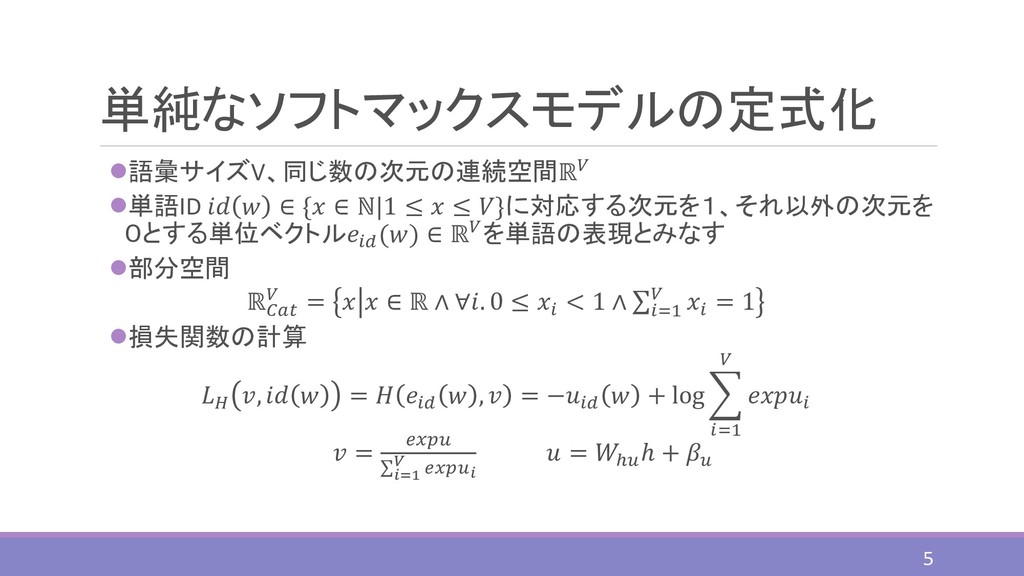
単純なソフトマックスモデルの定式化 ⚫語彙サイズV、同じ数の次元の連続空間ℝ ⚫単語ID ∈ { ∈ ℕ|1 ≤ ≤ }に対応する次元を1、それ以外の次元を
0とする単位ベクトル () ∈ ℝを単語の表現とみなす ⚫部分空間 ℝ = ∈ ℝ ∧ ∀. 0 ≤ < 1 ∧ σ =1 = 1 ⚫損失関数の計算 , = , = − + log =1 = σ =1 = ℎ ℎ + 5
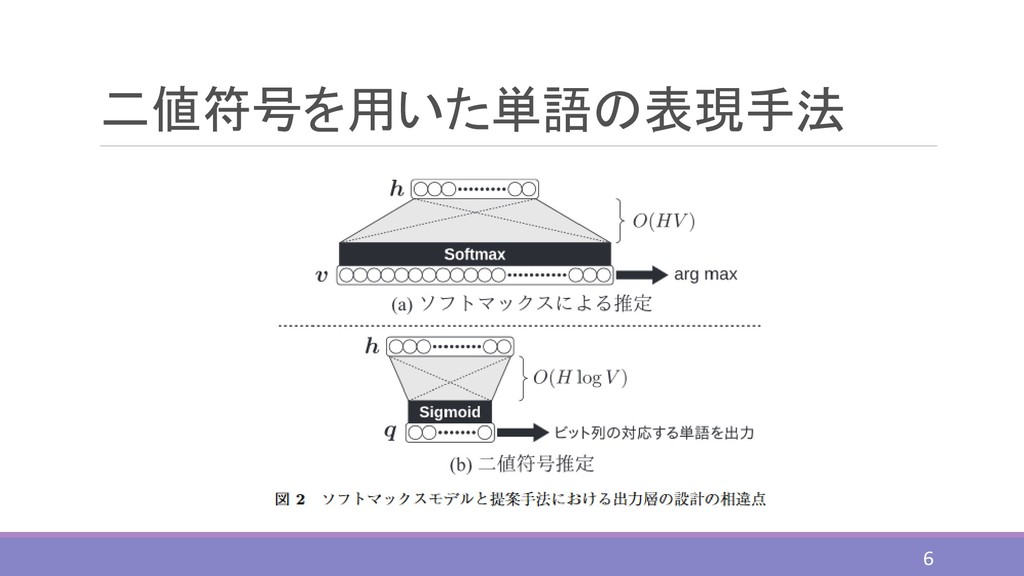
二値符号を用いた単語の表現手法 6
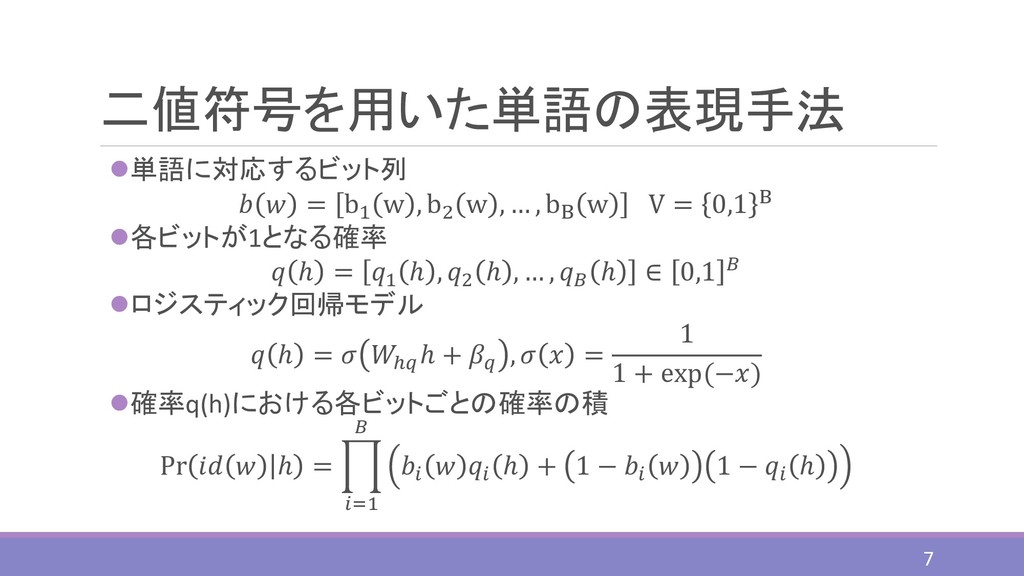
二値符号を用いた単語の表現手法 ⚫単語に対応するビット列 = b1 w , b2 w , …
, bB w V = 0,1 B ⚫各ビットが1となる確率 ℎ = 1 ℎ , 2 ℎ , … , ℎ ∈ 0,1 ⚫ロジスティック回帰モデル ℎ = ℎ ℎ + , = 1 1 + exp(−) ⚫確率q(h)における各ビットごとの確率の積 Pr ℎ = ෑ =1 ℎ + 1 − 1 − ℎ 7
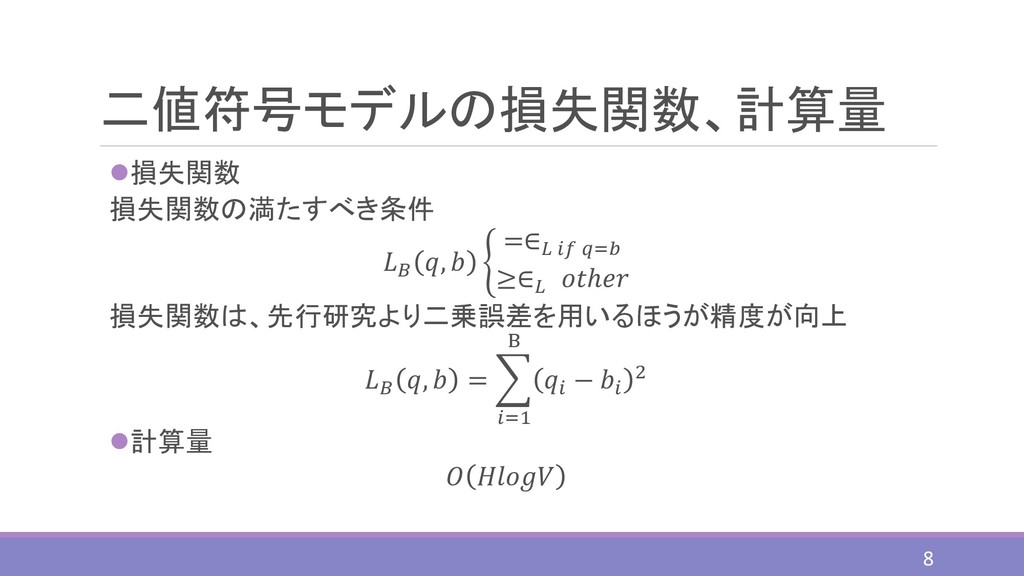
二値符号モデルの損失関数、計算量 ⚫損失関数 損失関数の満たすべき条件 , ቊ =∈ = ≥∈ ℎ 損失関数は、先行研究より二乗誤差を用いるほうが精度が向上
, = =1 B − 2 ⚫計算量 8
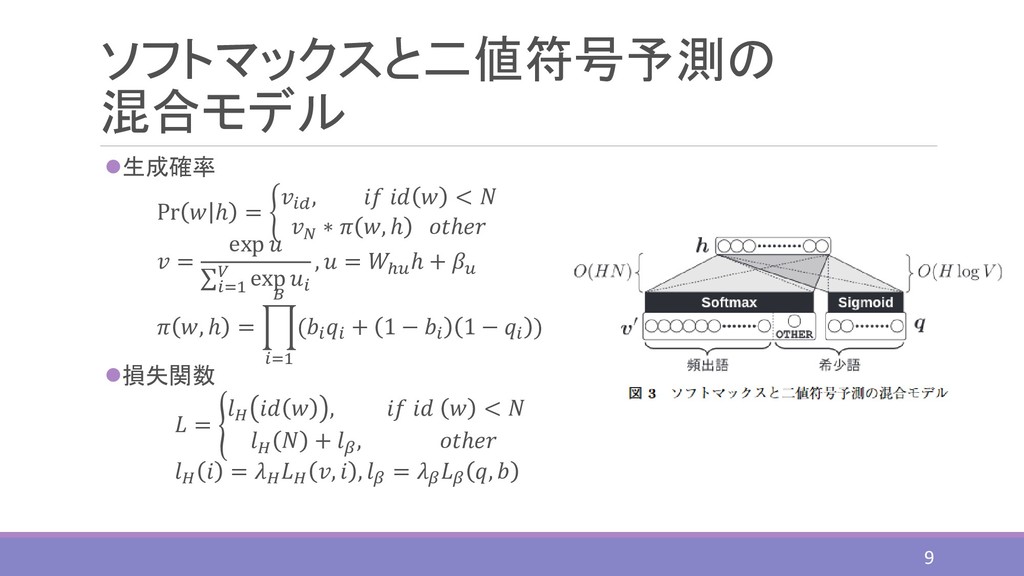
ソフトマックスと二値符号予測の 混合モデル ⚫生成確率 Pr ℎ = ቊ , < ∗
, ℎ ℎ = exp σ =1 exp , = ℎ ℎ + , ℎ = ෑ =1 ( + 1 − 1 − ) ⚫損失関数 = ൝ , < + , ℎ = , , = , 9
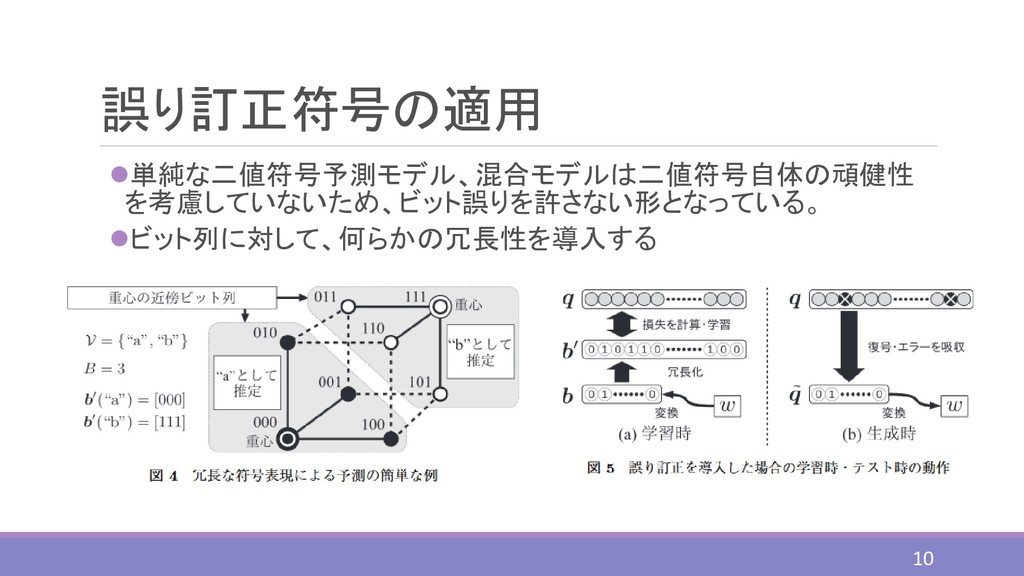
誤り訂正符号の適用 ⚫単純な二値符号予測モデル、混合モデルは二値符号自体の頑健性 を考慮していないため、ビット誤りを許さない形となっている。 ⚫ビット列に対して、何らかの冗長性を導入する 10
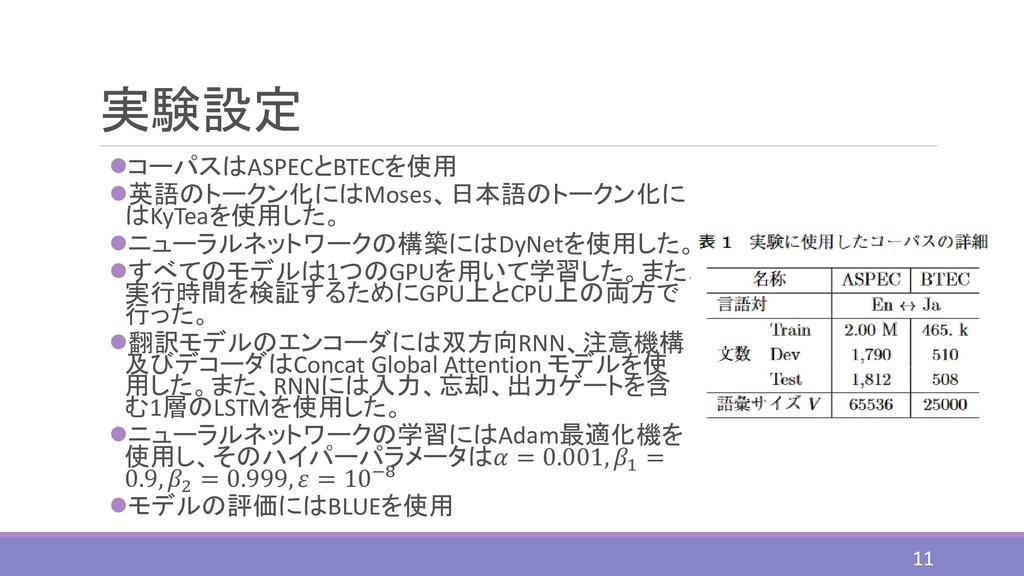
実験設定 ⚫コーパスはASPECとBTECを使用 ⚫英語のトークン化にはMoses、日本語のトークン化に はKyTeaを使用した。 ⚫ニューラルネットワークの構築にはDyNetを使用した。 ⚫すべてのモデルは1つのGPUを用いて学習した。また、 実行時間を検証するためにGPU上とCPU上の両方で 行った。 ⚫翻訳モデルのエンコーダには双方向RNN、注意機構 及びデコーダはConcat
Global Attention モデルを使 用した。また、RNNには入力、忘却、出力ゲートを含 む1層のLSTMを使用した。 ⚫ニューラルネットワークの学習にはAdam最適化機を 使用し、そのハイパーパラメータは = 0.001, 1 = 0.9, 2 = 0.999, = 10−8 ⚫モデルの評価にはBLUEを使用 11
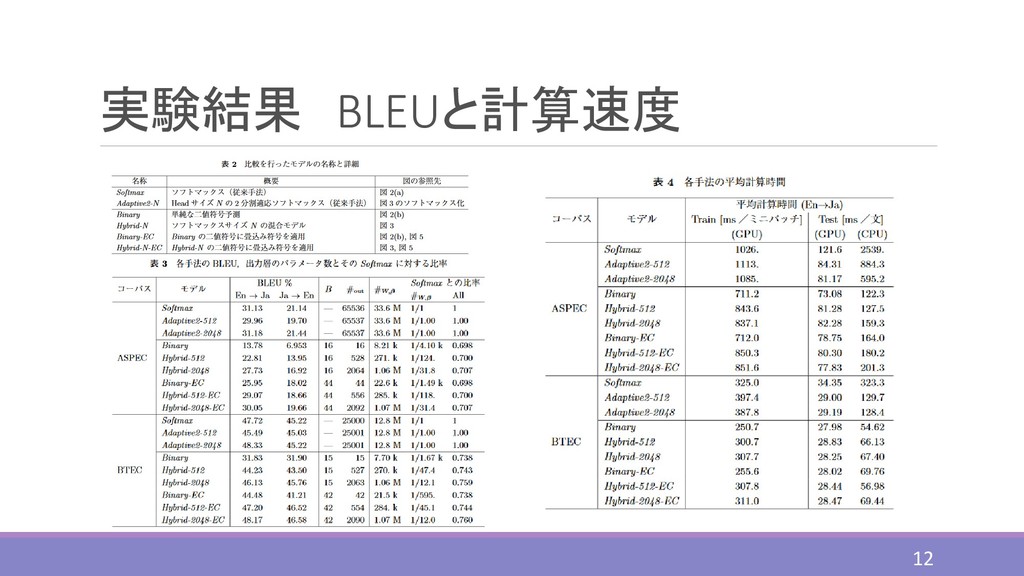
実験結果 BLEUと計算速度 12
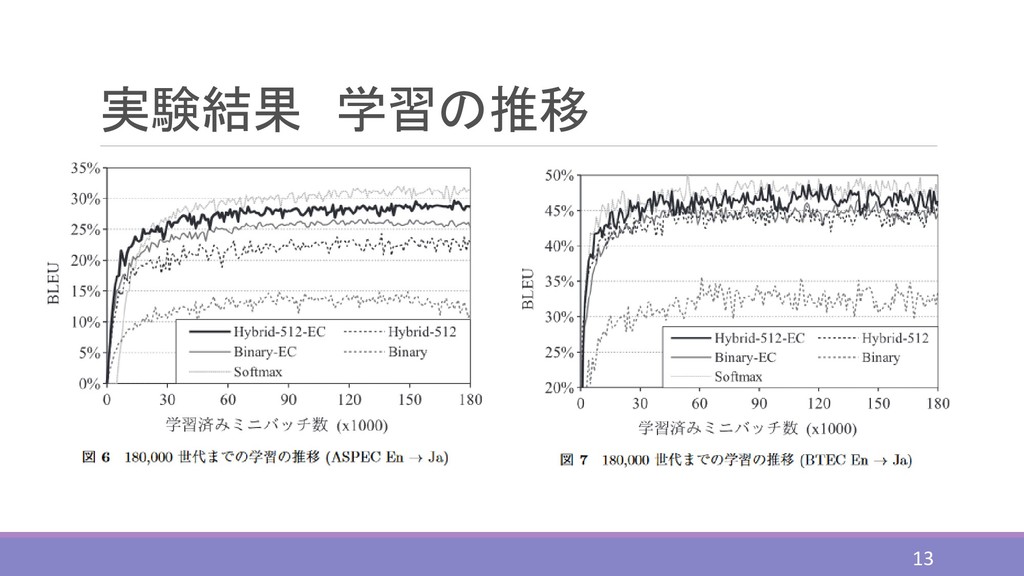
実験結果 学習の推移 13
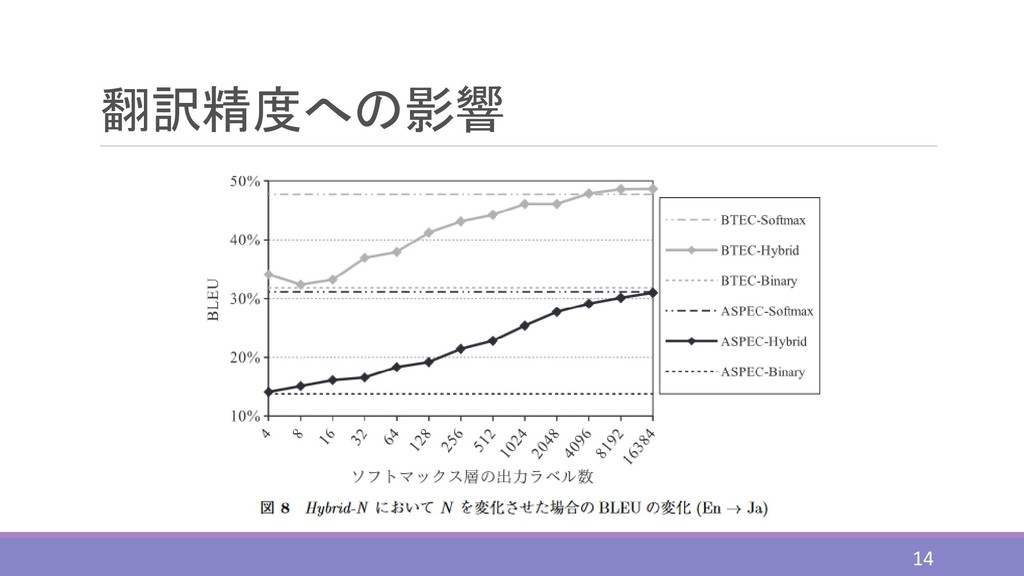
翻訳精度への影響 14
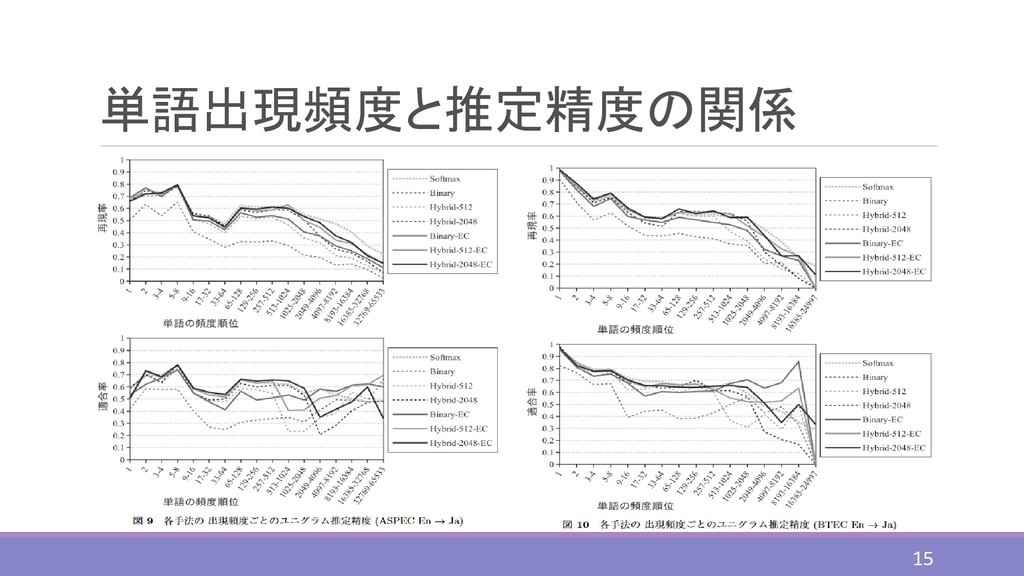
単語出現頻度と推定精度の関係 15
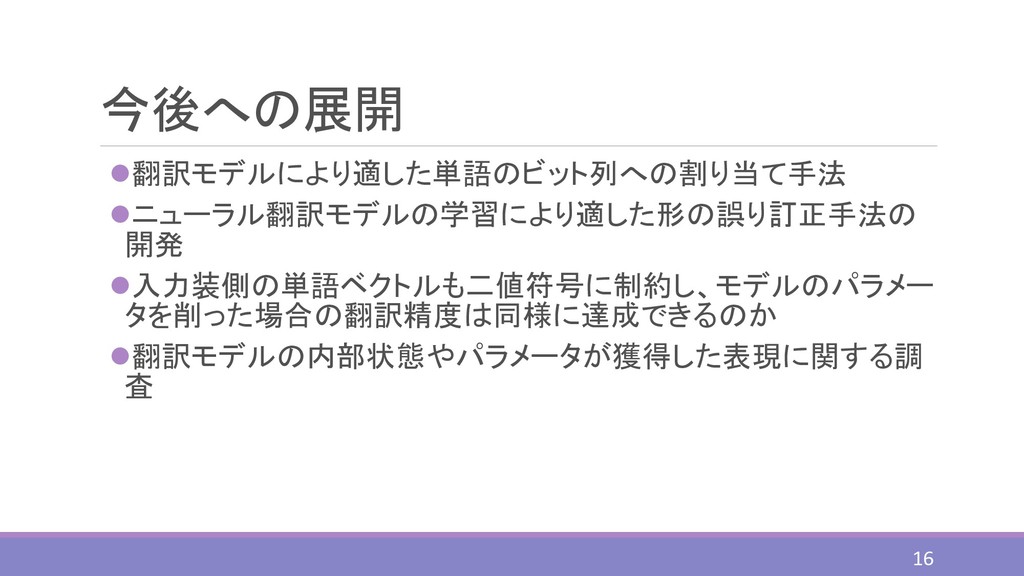
今後への展開 ⚫翻訳モデルにより適した単語のビット列への割り当て手法 ⚫ニューラル翻訳モデルの学習により適した形の誤り訂正手法の 開発 ⚫入力装側の単語ベクトルも二値符号に制約し、モデルのパラメー タを削った場合の翻訳精度は同様に達成できるのか ⚫翻訳モデルの内部状態やパラメータが獲得した表現に関する調 査 16


 ayumum
 uya116
 i35_267
 minorun365
 shunsock
 htkym
 yamachu
 nakanao
 zozotech
 maguroalternative
 oracle4engineer
 nihonbuson
 elmodev09
 davetheseo
 soudai
 reverentgeek
 shpigford
 carmenintech
 marktimemedia
 tapps
 nonsquared
 sferik
 kimpetersen
 tonyrice