Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Journal club] COMET: A Neural Framework for MT...
Search
Semantic Machine Intelligence Lab., Keio Univ.
PRO
July 28, 2023
Technology
710
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Journal club] COMET: A Neural Framework for MT Evaluation
Semantic Machine Intelligence Lab., Keio Univ.
PRO
July 28, 2023
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
200
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
keio_smilab
PRO
0
150
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
170
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
220
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
190
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
210
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
50
[MIRU26] To What Extent Does MLLM-as-a-Judge Exhibit Cross-Model Preference Bias?
keio_smilab
PRO
0
300
[Journal club] FlashVID: Efficient Video Large Language Models via Training-free Tree-based Spatiotemporal Token Merging
keio_smilab
PRO
0
39
Other Decks in Technology
See All in Technology
C#コードの結合を可視化する Roslyn解析による設計改善と リファクタリング判断
dora56
0
200
C#未経験の僕がAIに読めるコードを書かせるまで
maguroalternative
0
100
AI coding 整合正規方法
philipz
0
340
サーバーレスをどこまで使う? WebRTC対戦ゲームで選んだVPSとの共存設計
kaidouji85
0
180
AIに任せた品質は、誰が見立てるのか - AI時代のテストマネジメント
nakanao
3
2.4k
Reactの設計論
uhyo
24
14k
すぐできる衛星通信対応 あとは山奥に行くだけ
tatetate55
0
140
AIエージェントの自己改善をどう設計するか / How to Design Self-Improvement for AI Agents
22mi
25
16k
「守り」で活用するオンデバイスLLM 〜写ってはいけないを総力戦で防ぐ〜 / iOSDC Japan 2026
nakamuuu
0
180
AIエージェントの一手は 誰も見ていない - Falco拡張OSS「Prempti」とeBPFで サーバーレス実行基盤を二層防御する
keitah
0
310
アプリをもっと"iOSアプリっぽく"する小さな工夫 / Small Touches That Make Your App Feel More Like an iOS App
matsuji
2
960
なぜ「決定性」が 決定的に重要なのか? Durable Execution 基盤の数理的理解 #serverlessjp / ServerlessDays Tokyo 2026
ytaka23
3
900
Featured
See All Featured
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
2.9k
Typedesign – Prime Four
hannesfritz
42
3.2k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
510
Optimizing for Happiness
mojombo
378
71k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Neural Spatial Audio Processing for Sound Field Analysis and Control
skoyamalab
0
510
Why Our Code Smells
bkeepers
PRO
340
58k
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
530
Primal Persuasion: How to Engage the Brain for Learning That Lasts
tmiket
0
460
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
Bioeconomy Workshop: Dr. Julius Ecuru, Opportunities for a Bioeconomy in West Africa
akademiya2063
PRO
1
360
The untapped power of vector embeddings
frankvandijk
2
1.9k
Transcript
慶應義塾⼤学 杉浦孔明研究室 B4 齋藤⼤地 COMET: A Neural Framework for MT
Evaluation Ricardo Rei, Craig Stewart, Ana C Farinha, Alon Lavie (Unbabel AI) EMNLP 2020 COMET: A Neural Framework for MT Evaluation (Rei et al., EMNLP 2020)
背景:Rule-basedの評価指標は⼈間による評価との相関が低い - 3 - ▪ Rule-basedの評価指標 • BLEU [Papineni+, ACL02]やMETEOR
[Lavie+, ACL05] • !-gramの⼀致率に基づいて評価 ü シンプルで⾼速 ü 機械翻訳において主流 Ø ⼈間による評価との相関が低い BLEU = BP× exp + !"# $ ,! log 0! = 短い翻訳へのPenalty × 5 − gram精度の幾何平均 METEOR = Fmean ∗ 1 − #chunks #unigrams_matched
既存研究:学習可能な既存尺度は改善が必要 - 4 - ▪ RUSE [Shimanaka+, WMT18] • MLPにより⼈間による評価を回帰
▪ BLEURT [Sellam+, ACL20] • Wikipediaから取得した⼤量のテキストデータを 使⽤し,BERT [Devlin+, NAACL19]で事前学習 • ⼈間による評価でFine-tuning Ø 未だ性能に改善の余地あり RUSE [Shimanaka+, WMT18] BERT [Devlin+, NAACL19]
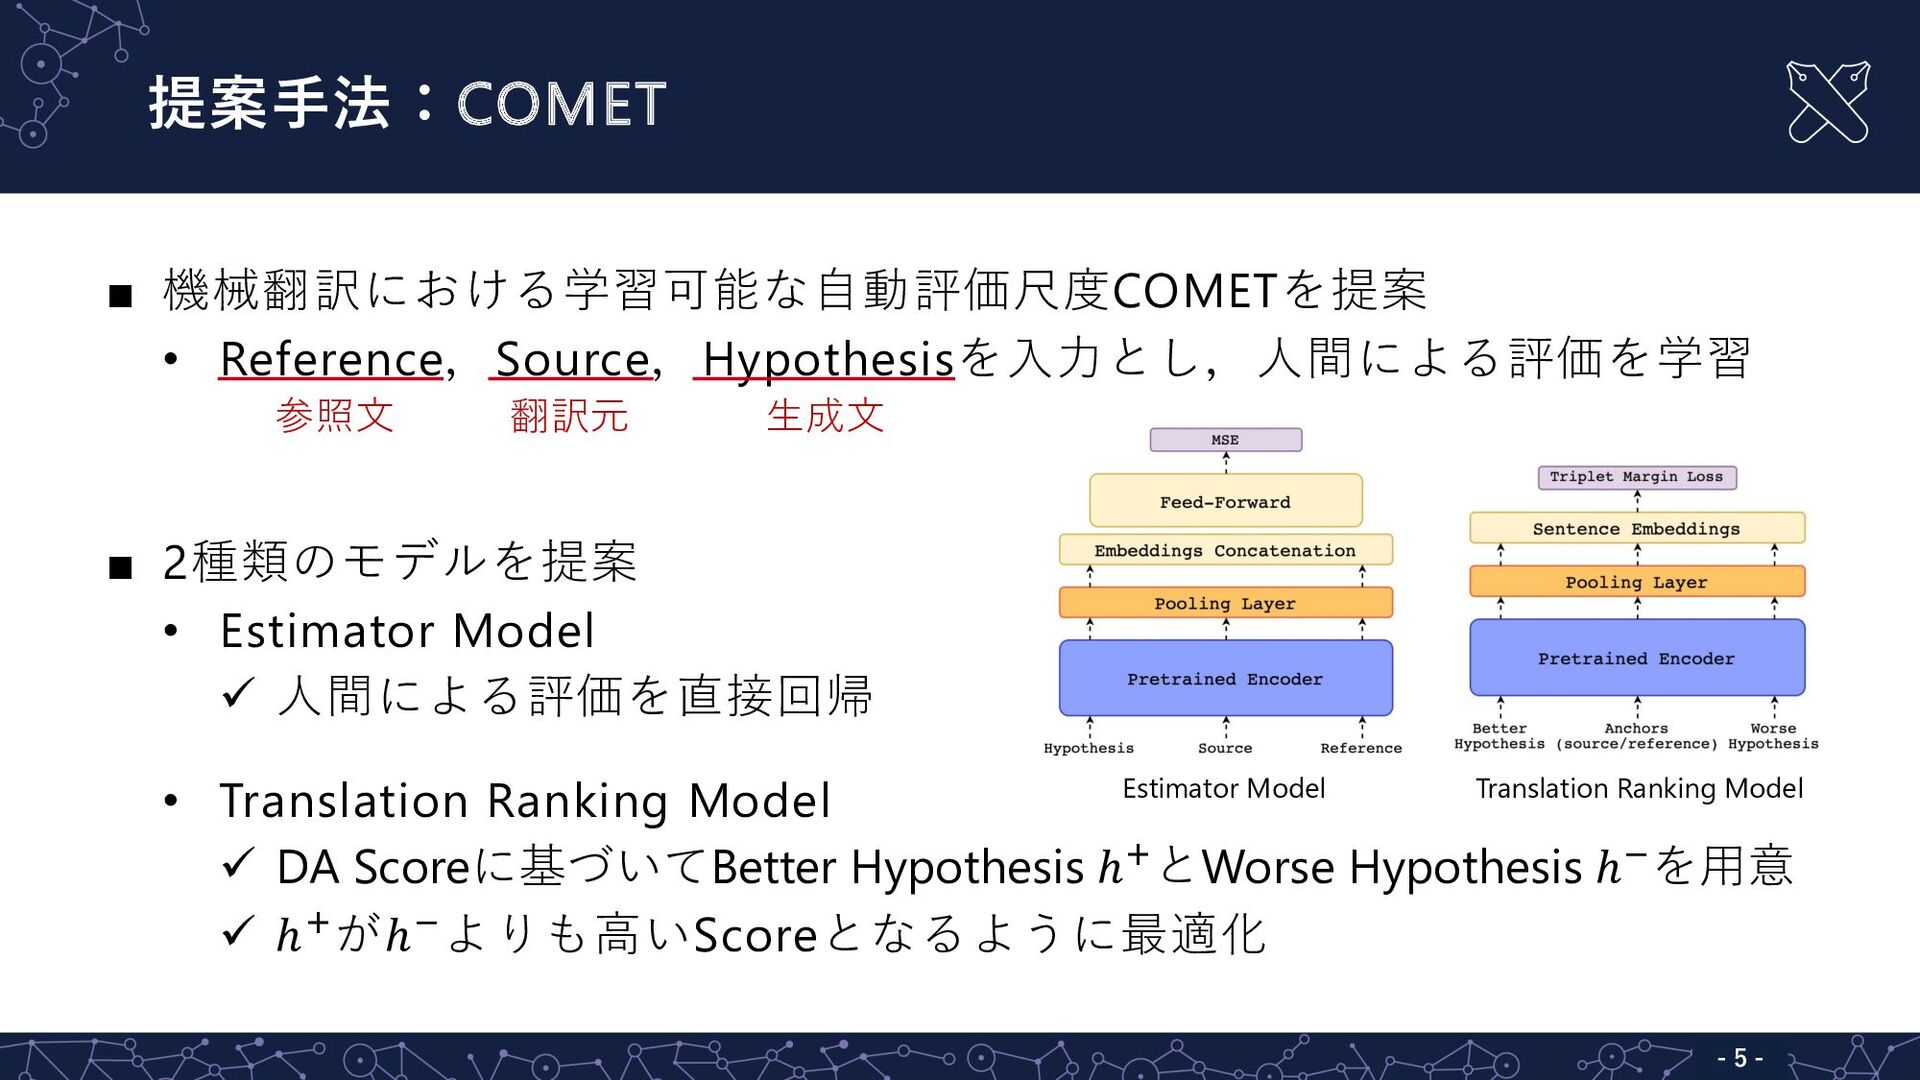
提案⼿法:COMET - 5 - ▪ 機械翻訳における学習可能な⾃動評価尺度COMETを提案 • Reference,Source,Hypothesisを⼊⼒とし,⼈間による評価を学習 ▪ 2種類のモデルを提案
• Estimator Model ü ⼈間による評価を直接回帰 • Translation Ranking Model ü DA Scoreに基づいてBetter Hypothesis ℎIとWorse Hypothesis ℎJを⽤意 ü ℎIがℎJよりも⾼いScoreとなるように最適化 参照⽂ 翻訳元 ⽣成⽂ Estimator Model Translation Ranking Model
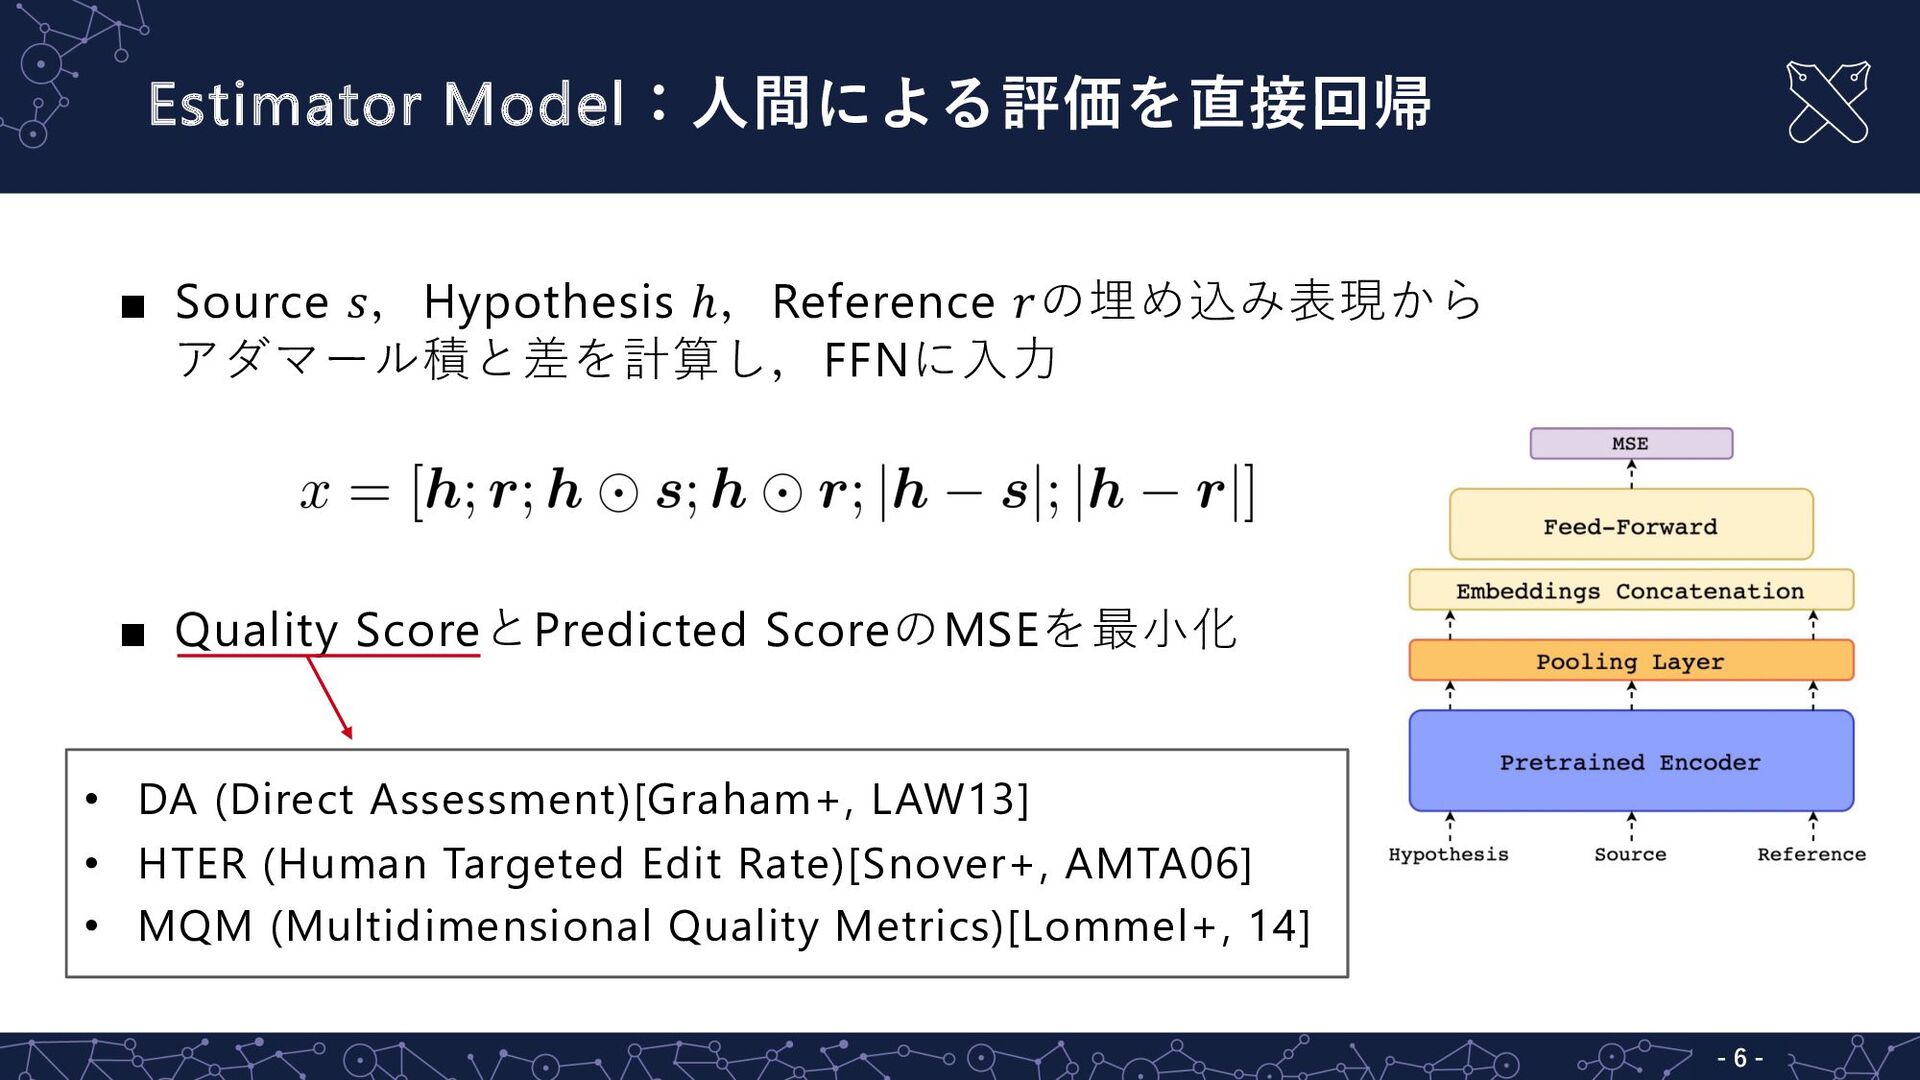
Estimator Model:⼈間による評価を直接回帰 - 6 - ▪ Source #,Hypothesis ℎ,Reference $の埋め込み表現から
アダマール積と差を計算し,FFNに⼊⼒ ▪ Quality ScoreとPredicted ScoreのMSEを最⼩化 • DA (Direct Assessment)[Graham+, LAW13] • HTER (Human Targeted Edit Rate)[Snover+, AMTA06] • MQM (Multidimensional Quality Metrics)[Lommel+, 14]
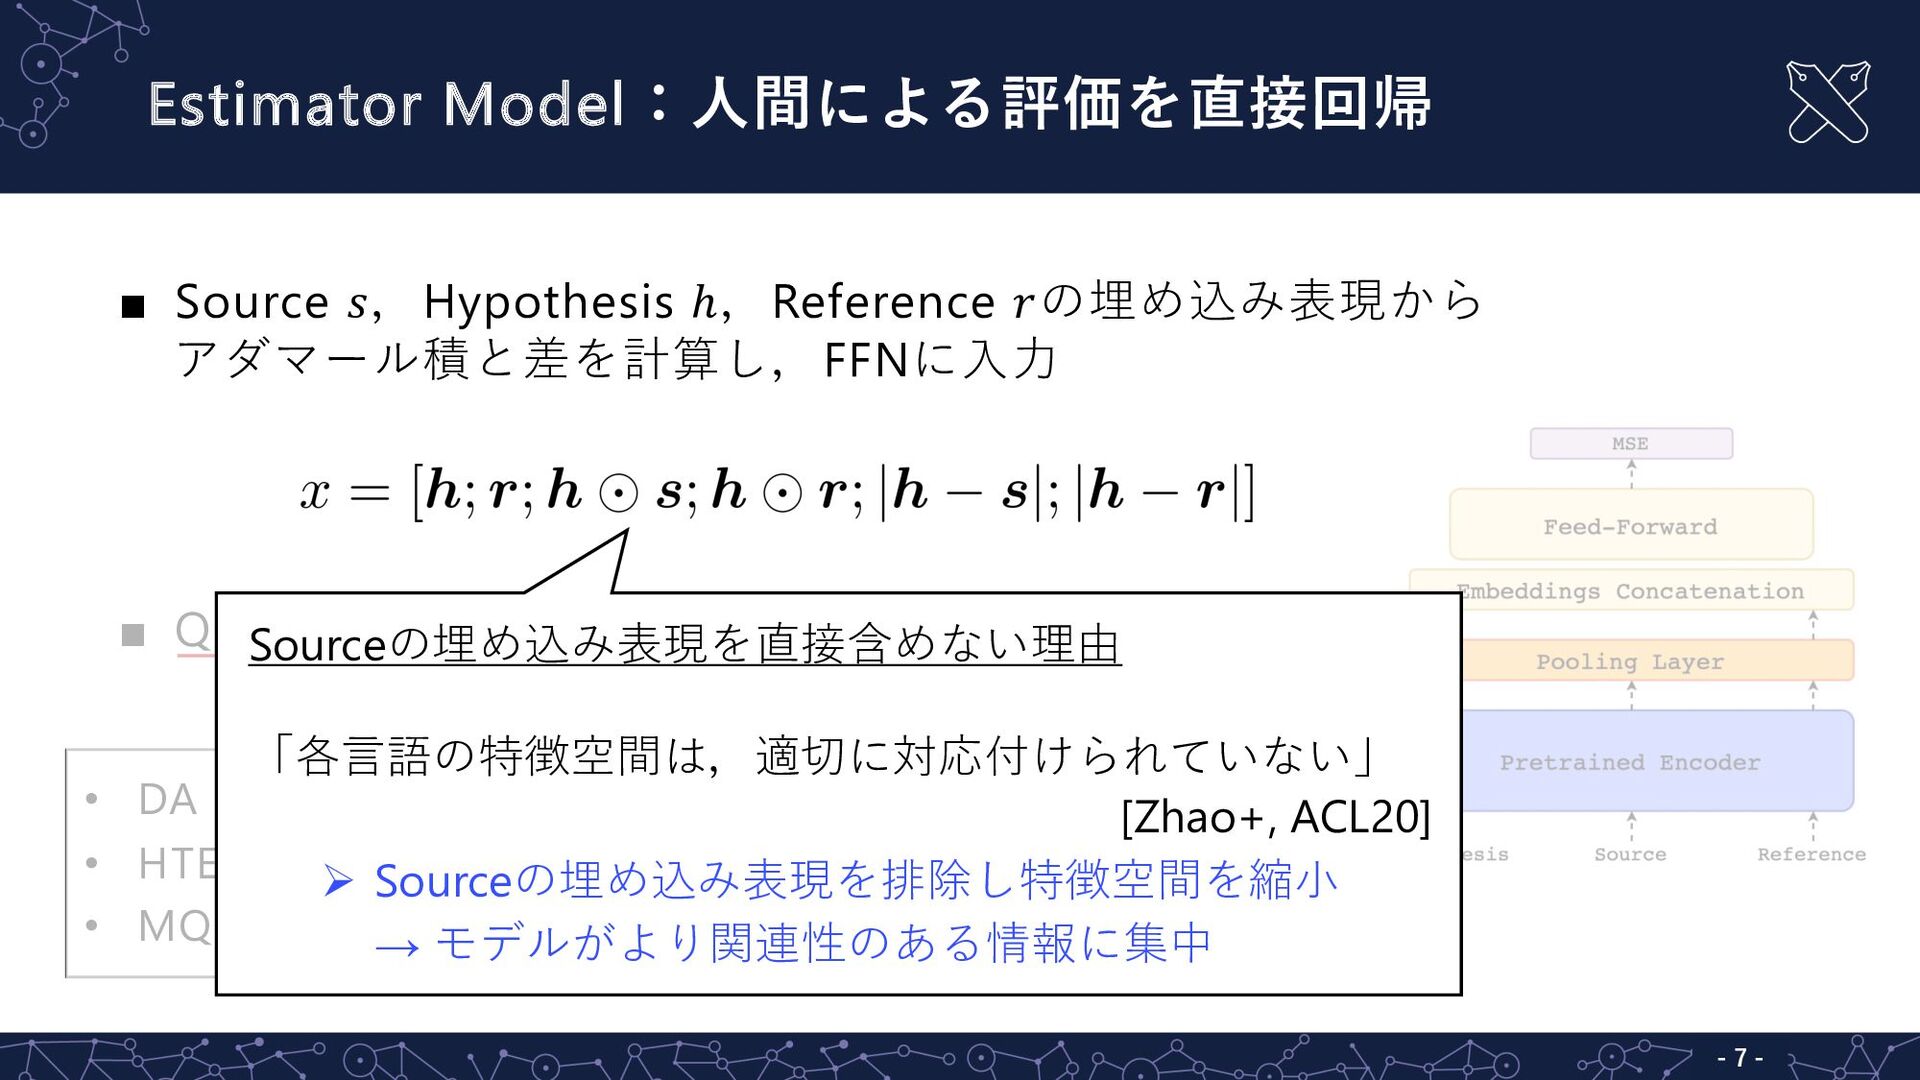
Estimator Model:⼈間による評価を直接回帰 - 7 - ▪ Source #,Hypothesis ℎ,Reference $の埋め込み表現から
アダマール積と差を計算し,FFNに⼊⼒ ▪ Quality ScoreとPredicted ScoreのMSEを最⼩化 • DA (Direct Assessment)[Graham+, LAW13] • HTER (Human Targeted Edit Rate)[Snover+, AMTA06] • MQM (Multidimensional Quality Metrics)[Lommel+, 14] Sourceの埋め込み表現を直接含めない理由 「各⾔語の特徴空間は,適切に対応付けられていない」 [Zhao+, ACL20] Ø Sourceの埋め込み表現を排除し特徴空間を縮⼩ → モデルがより関連性のある情報に集中
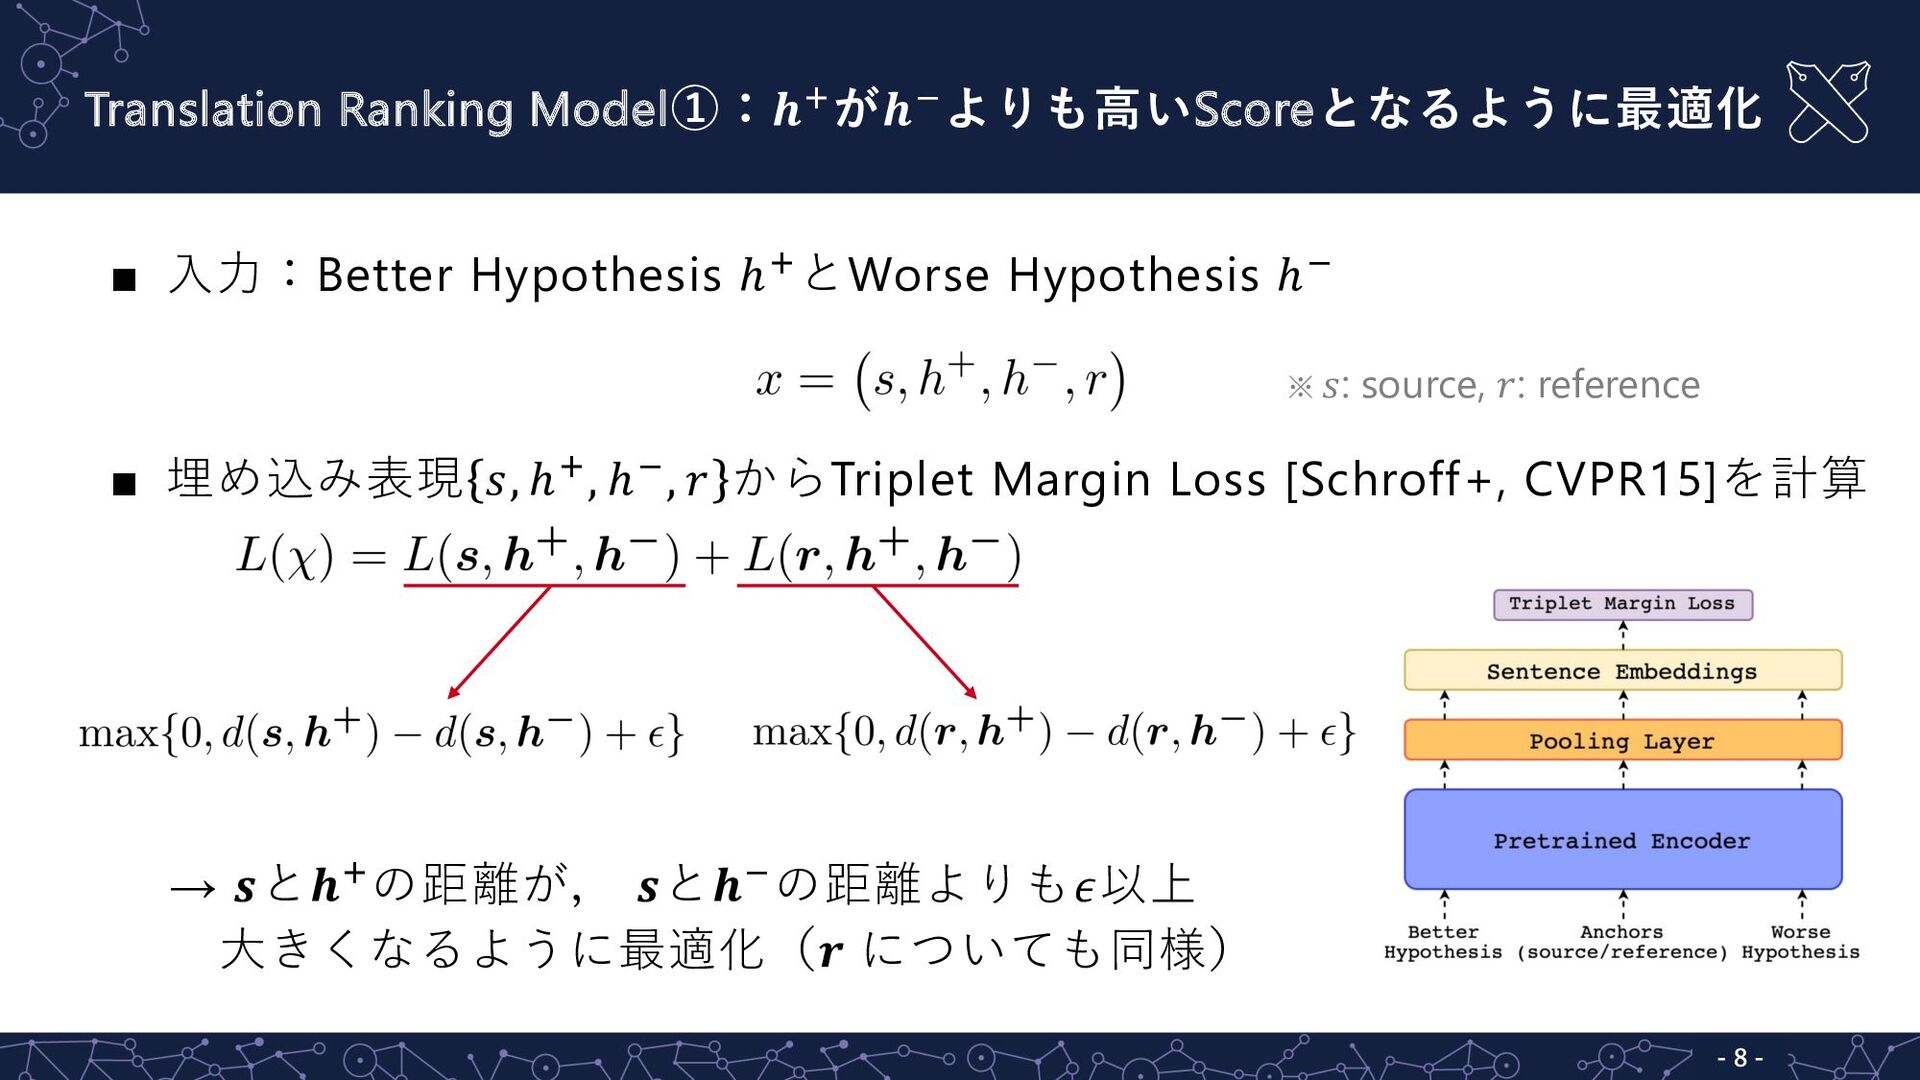
Translation Ranking Model①:%Iが%Jよりも⾼いScoreとなるように最適化 - 8 - ▪ ⼊⼒:Better Hypothesis ℎIとWorse
Hypothesis ℎJ ▪ 埋め込み表現 #, ℎI, ℎJ, $ からTriplet Margin Loss [Schroff+, CVPR15]を計算 → 'と%Iの距離が, 'と%Jの距離よりも(以上 ⼤きくなるように最適化() についても同様) ※ !: source, ": reference
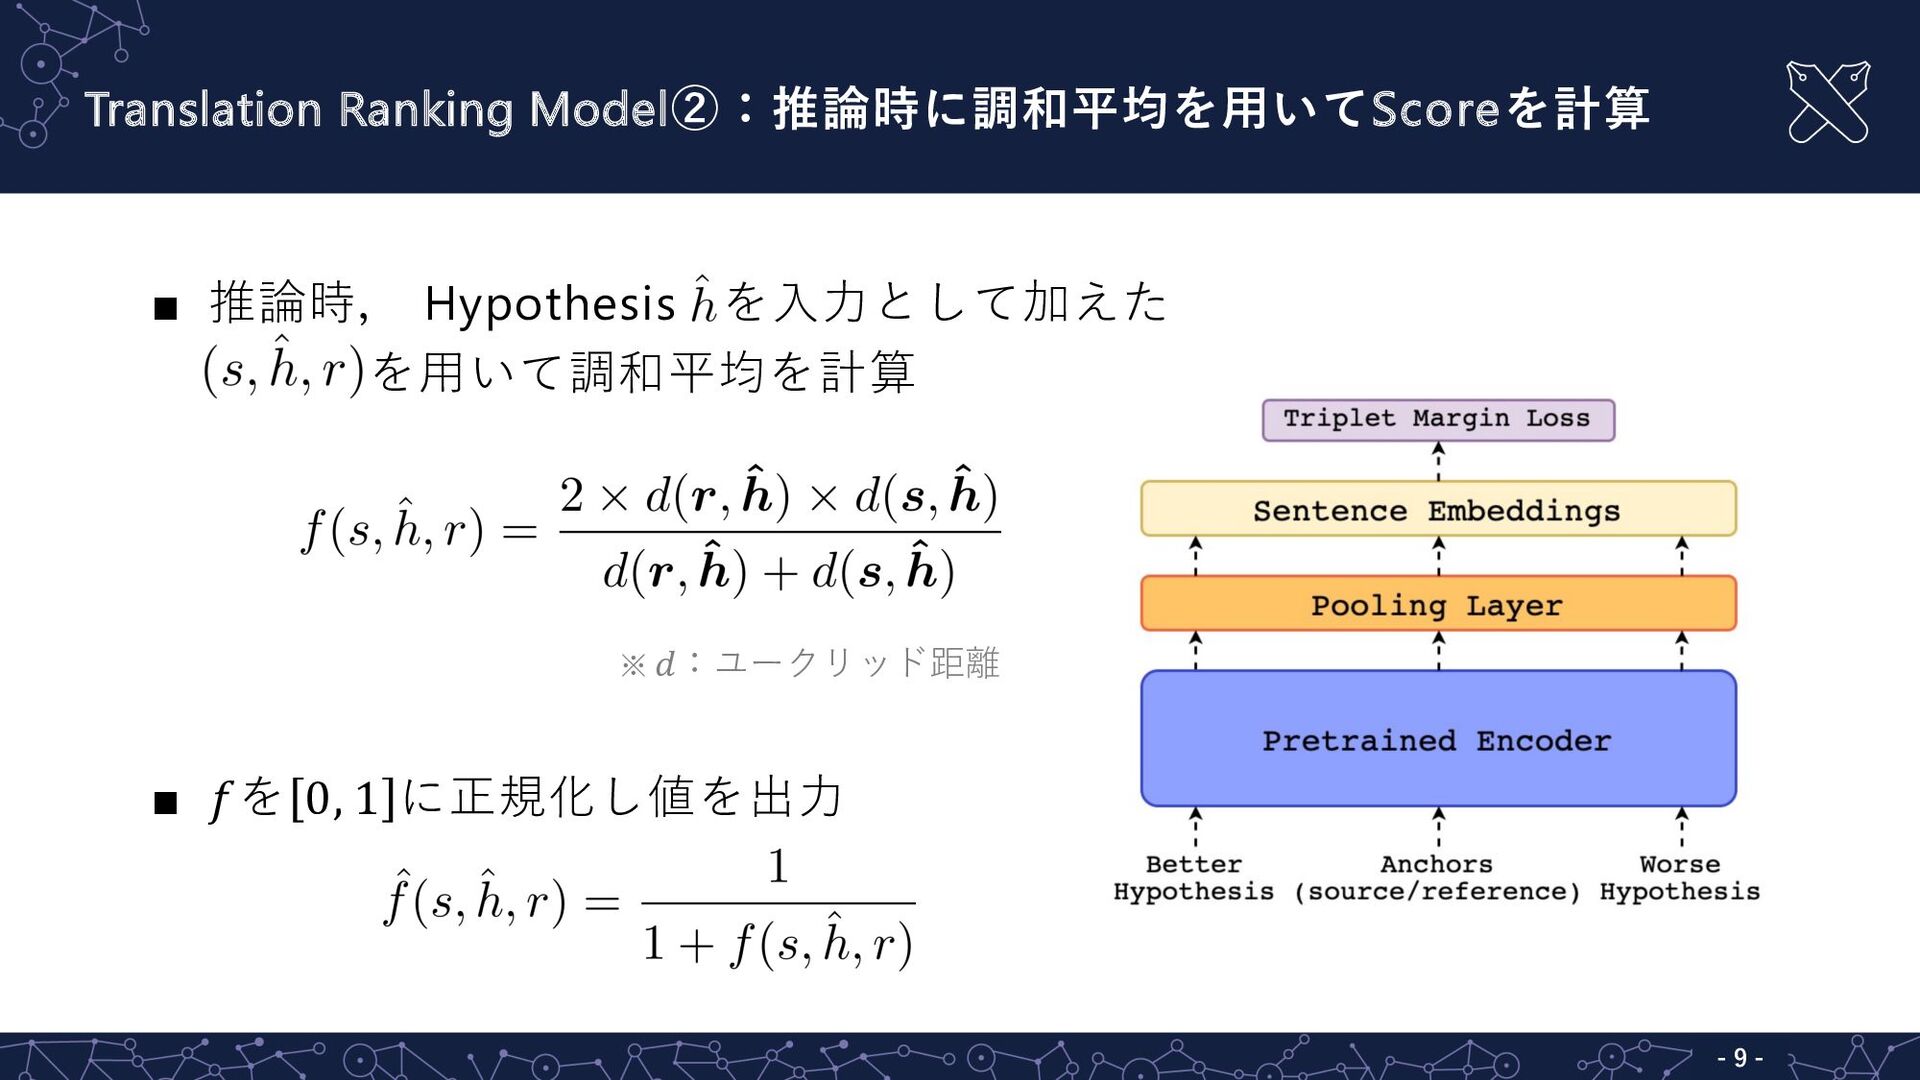
- 9 - ▪ 推論時, Hypothesis hを⼊⼒として加えた #, * ℎ,
$ を⽤いて調和平均を計算 ▪ +を 0, 1 に正規化し値を出⼒ ※ K:ユークリッド距離 Translation Ranking Model②:推論時に調和平均を⽤いてScoreを計算
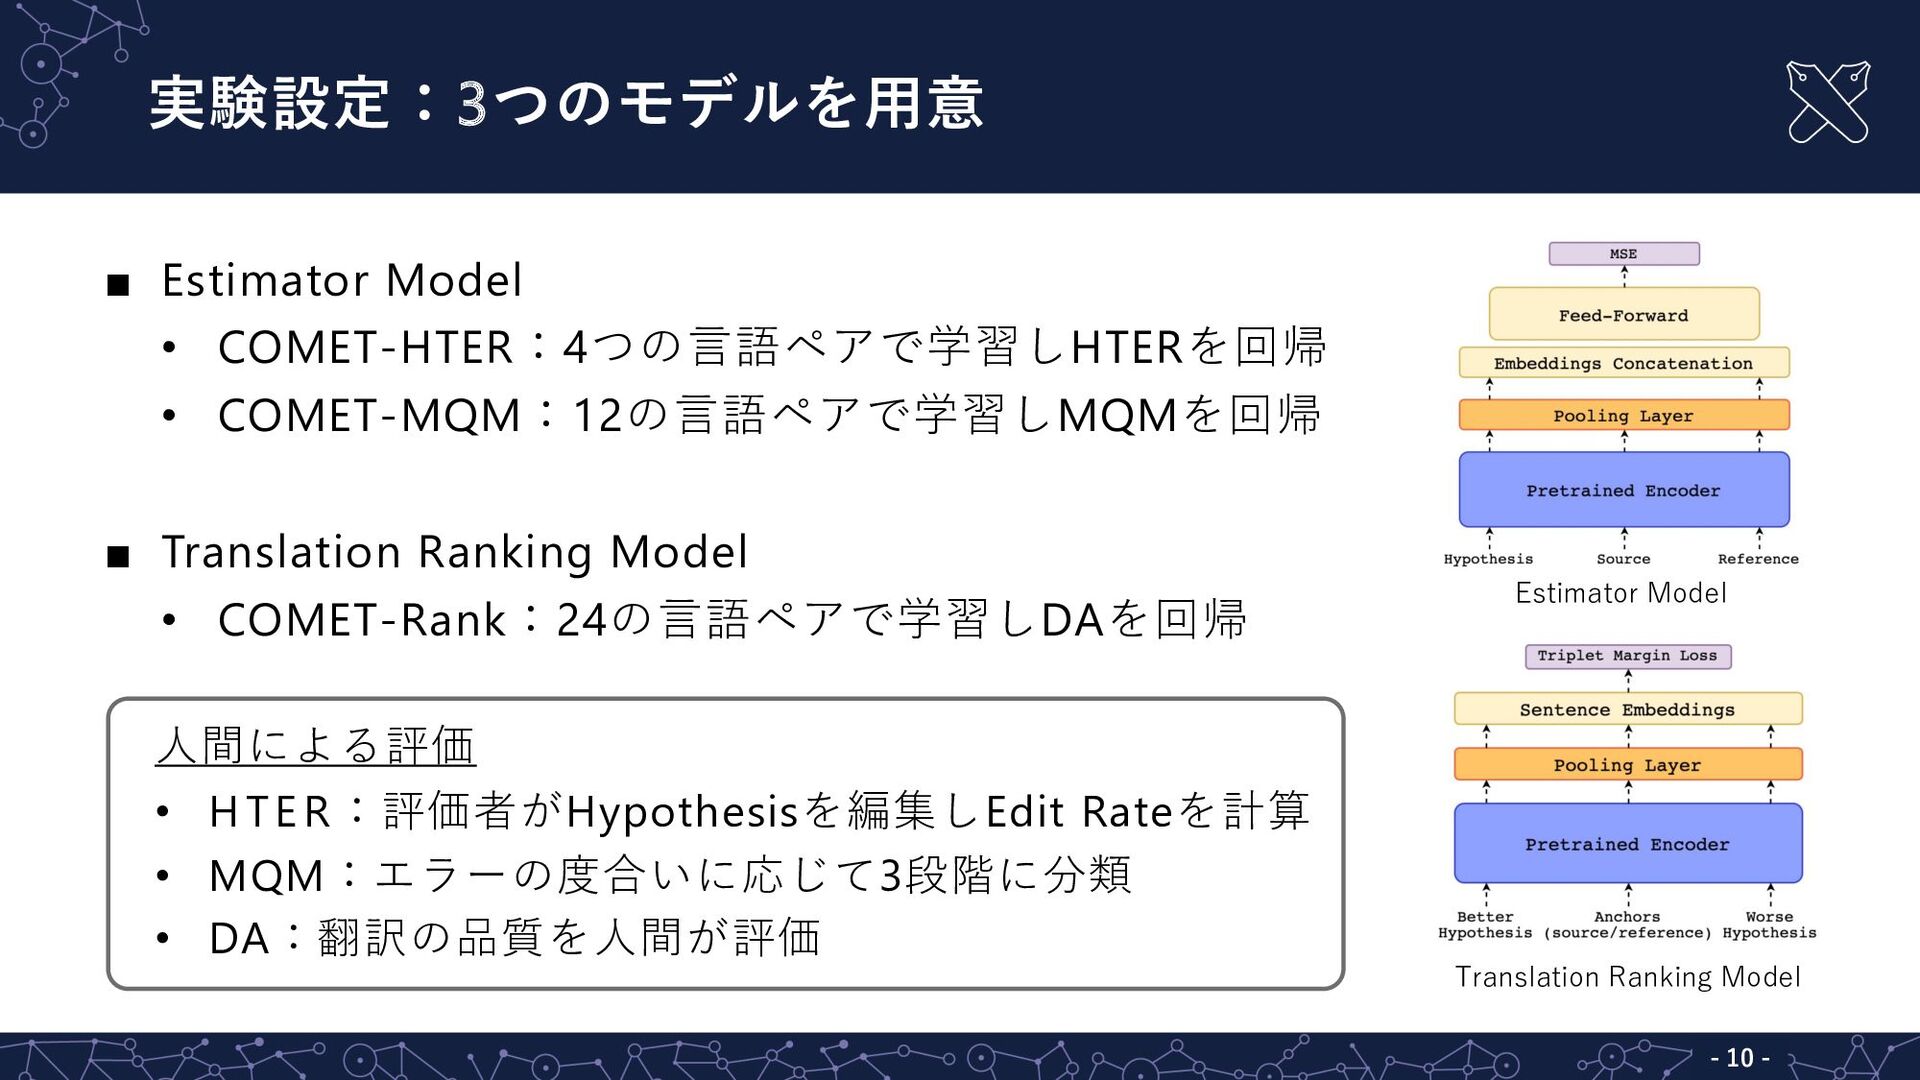
実験設定:3つのモデルを⽤意 - 10 - ▪ Estimator Model • COMET-HTER:4つの⾔語ペアで学習しHTERを回帰 •
COMET-MQM:12の⾔語ペアで学習しMQMを回帰 ▪ Translation Ranking Model • COMET-Rank:24の⾔語ペアで学習しDAを回帰 ⼈間による評価 • HTER:評価者がHypothesisを編集しEdit Rateを計算 • MQM:エラーの度合いに応じて3段階に分類 • DA:翻訳の品質を⼈間が評価 Estimator Model Translation Ranking Model
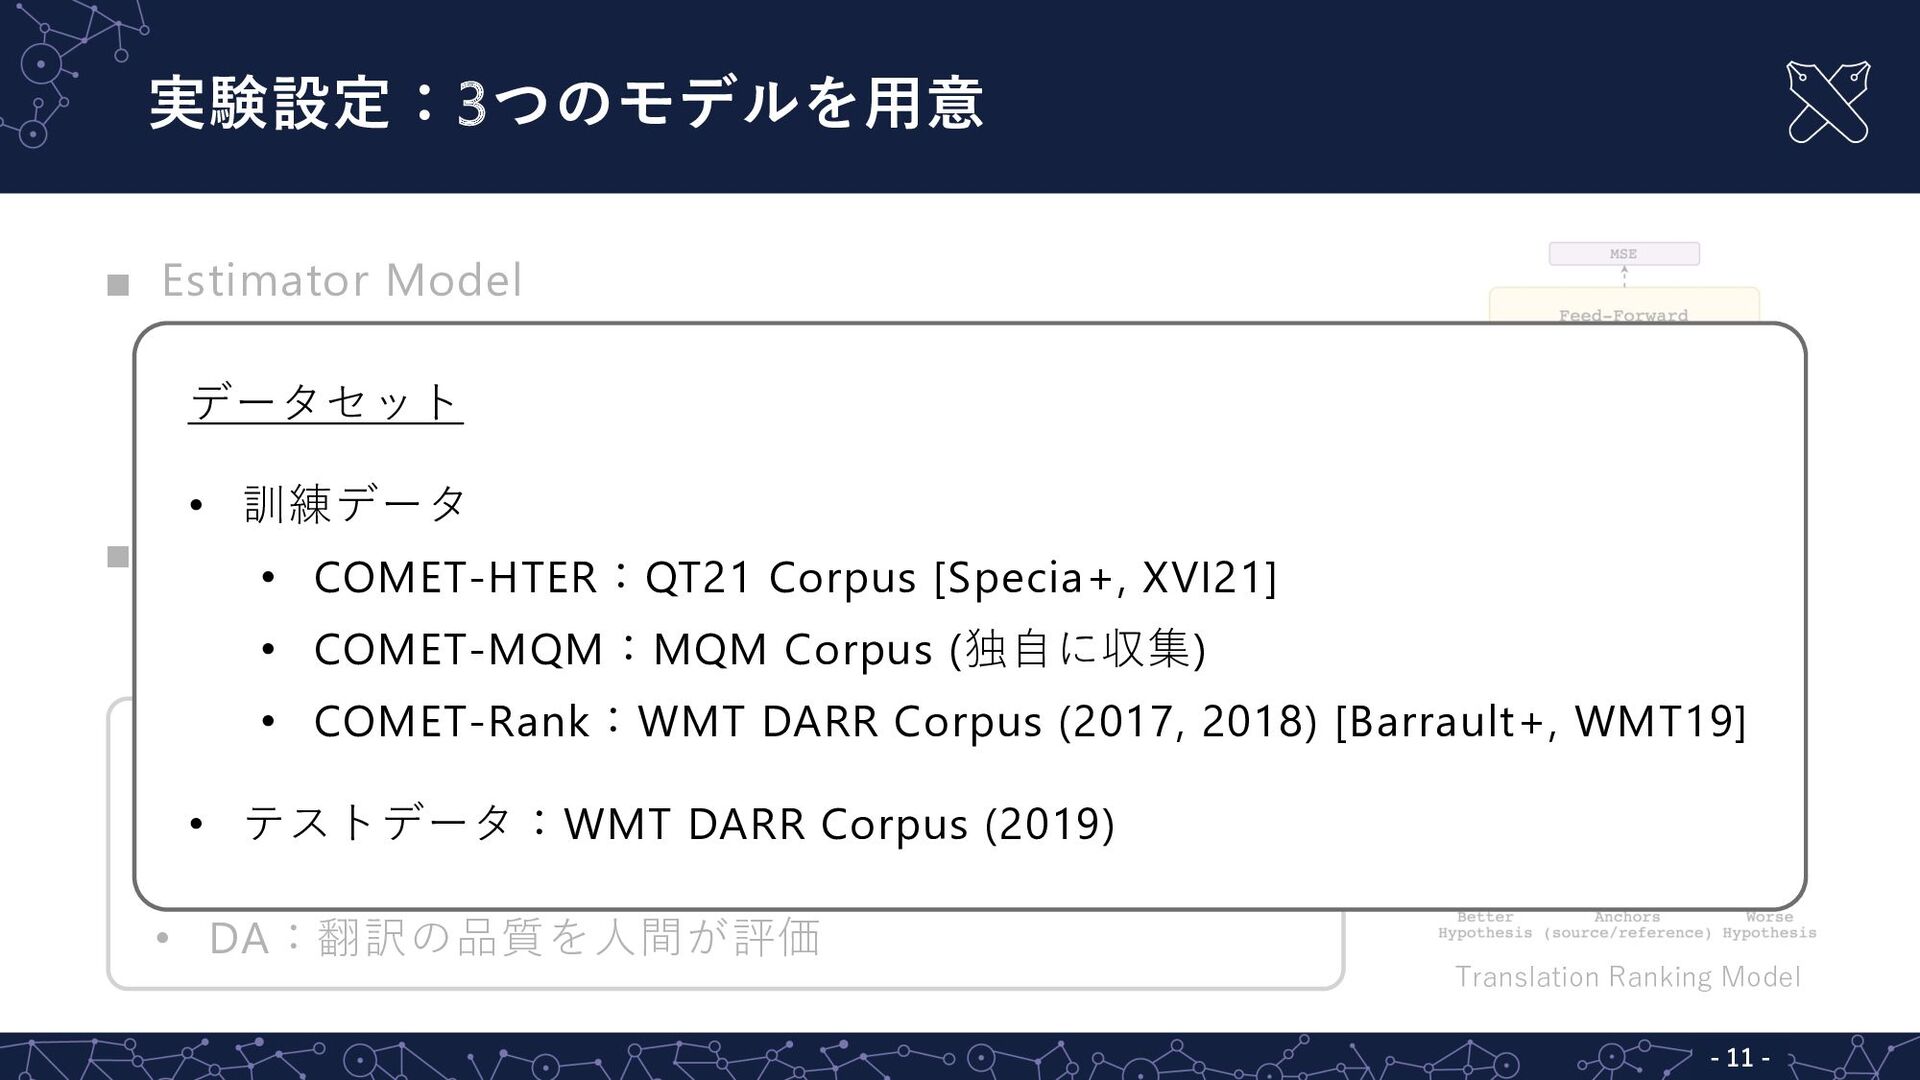
実験設定:3つのモデルを⽤意 - 11 - ▪ Estimator Model • COMET-HTER:4つの⾔語ペアで学習しHTERを回帰 •
COMET-MQM:12の⾔語ペアで学習しMQMを回帰 ▪ Translation Ranking Model • COMET-Rank:24の⾔語ペアで学習しDAを回帰 ⼈間による評価 • HTER:評価者がHypothesisを編集しEdit Rateを計算 • MQM:エラーの度合いに応じて3段階に分類 • DA:翻訳の品質を⼈間が評価 Estimator Model Translation Ranking Model データセット • 訓練データ • COMET-HTER:QT21 Corpus [Specia+, XVI21] • COMET-MQM:MQM Corpus (独⾃に収集) • COMET-Rank:WMT DARR Corpus (2017, 2018) [Barrault+, WMT19] • テストデータ:WMT DARR Corpus (2019)
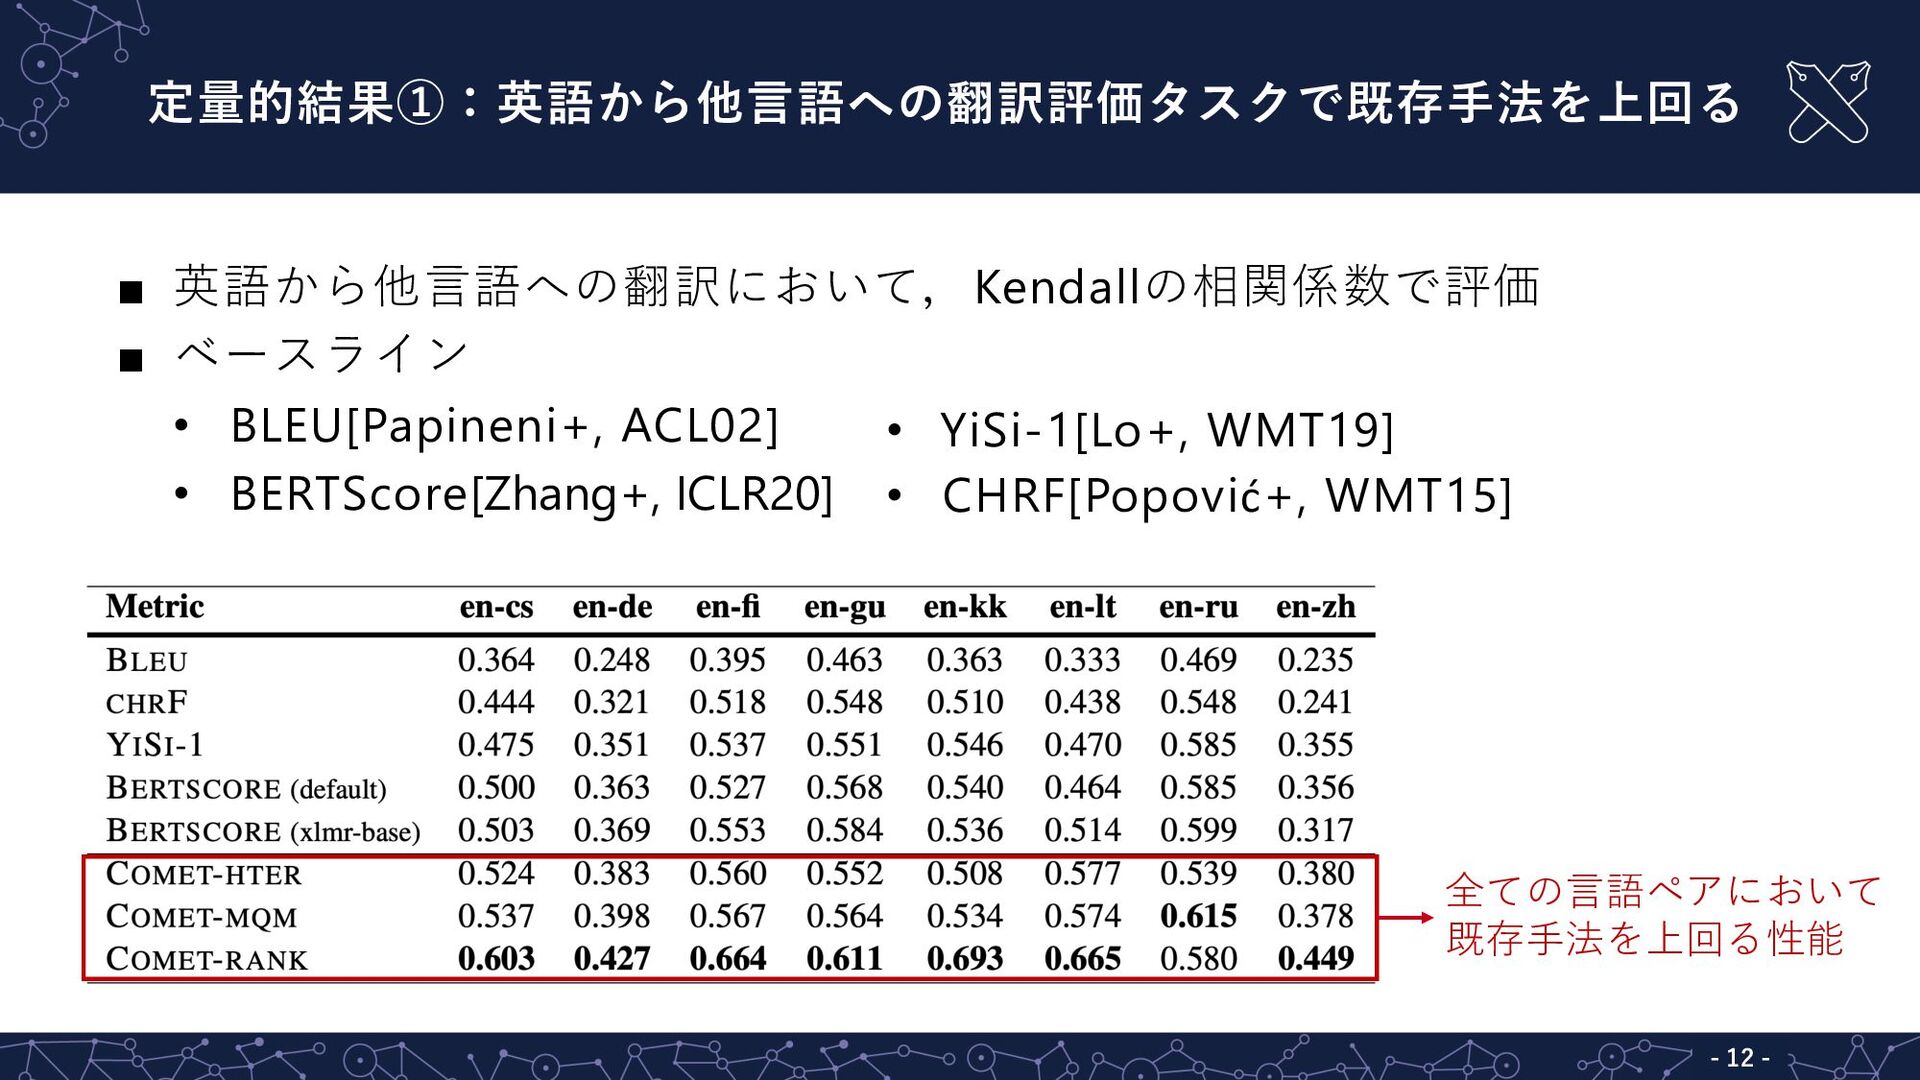
定量的結果①:英語から他⾔語への翻訳評価タスクで既存⼿法を上回る - 12 - ▪ 英語から他⾔語への翻訳において,Kendallの相関係数で評価 ▪ ベースライン • BLEU[Papineni+,
ACL02] • BERTScore[Zhang+, ICLR20] 全ての⾔語ペアにおいて 既存⼿法を上回る性能 • YiSi-1[Lo+, WMT19] • CHRF[Popović+, WMT15]
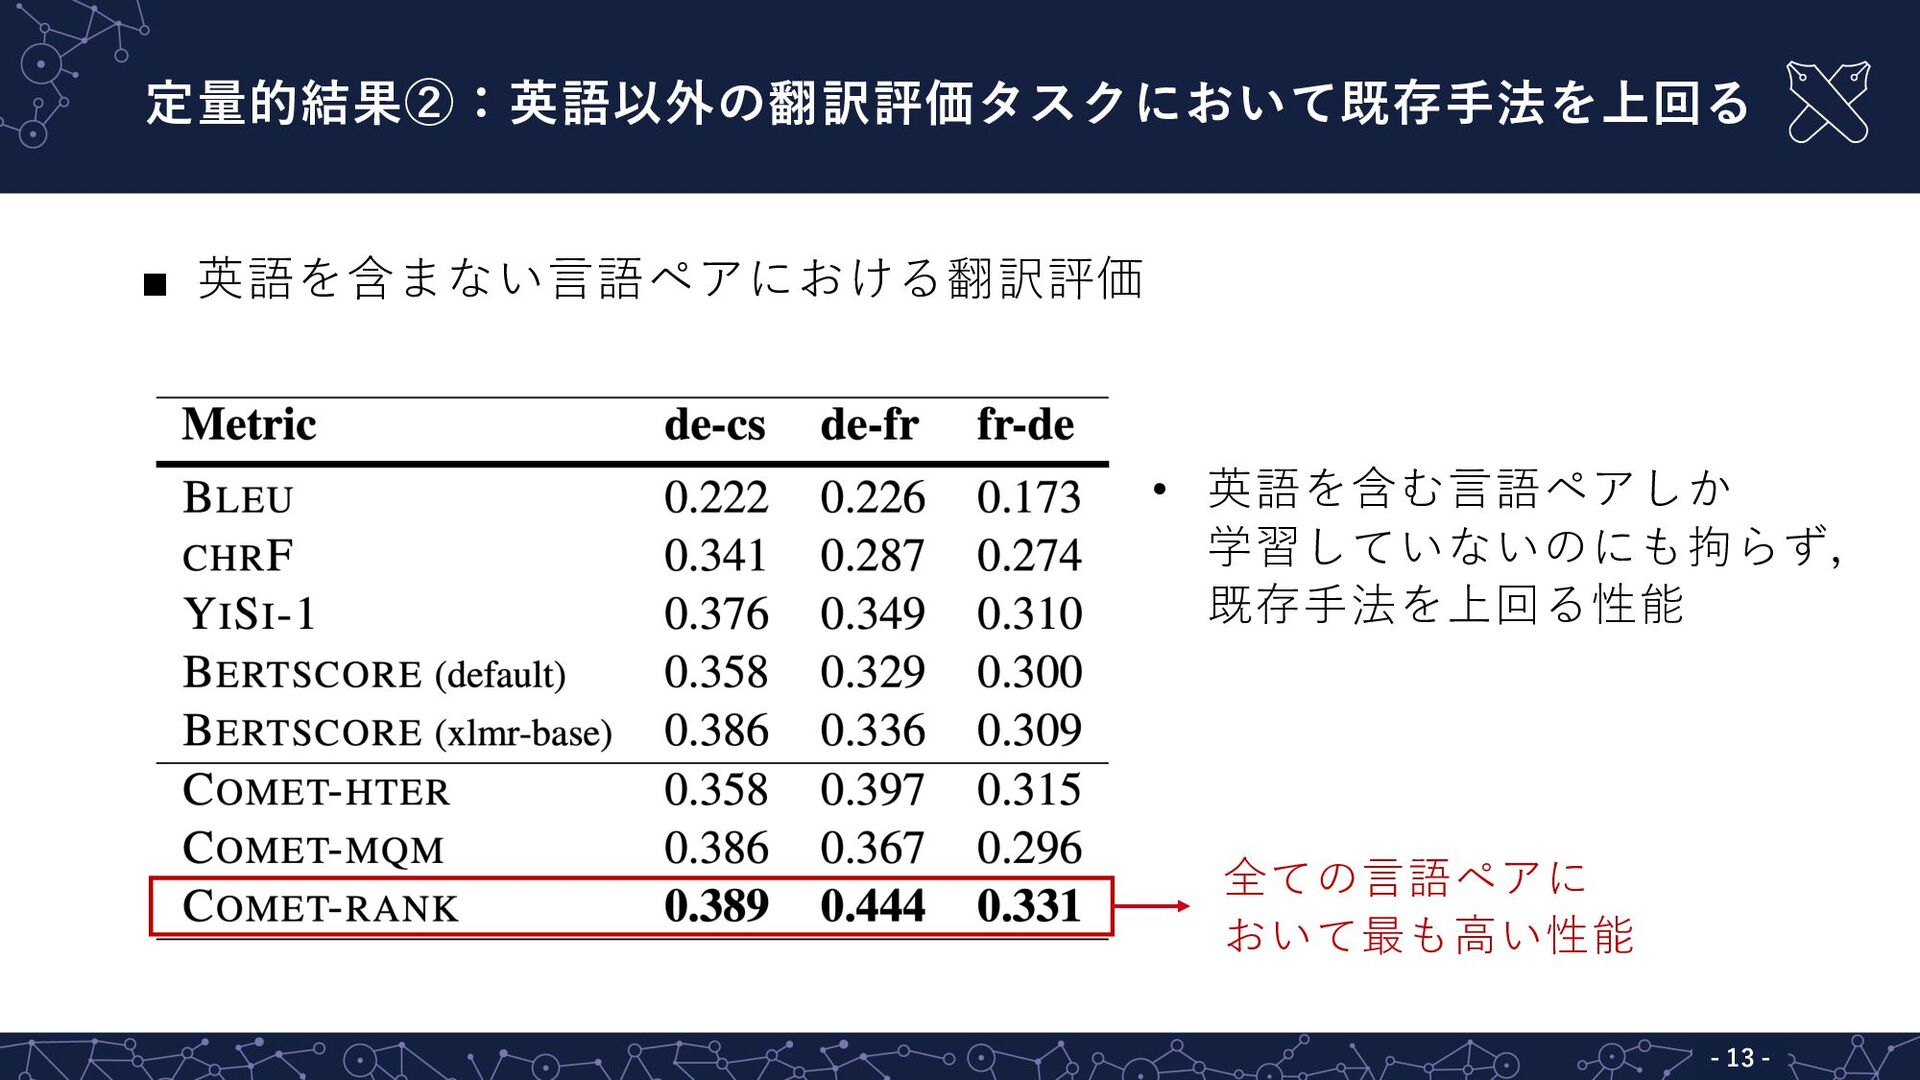
定量的結果②:英語以外の翻訳評価タスクにおいて既存⼿法を上回る - 13 - ▪ 英語を含まない⾔語ペアにおける翻訳評価 • 英語を含む⾔語ペアしか 学習していないのにも拘らず, 既存⼿法を上回る性能
全ての⾔語ペアに おいて最も⾼い性能
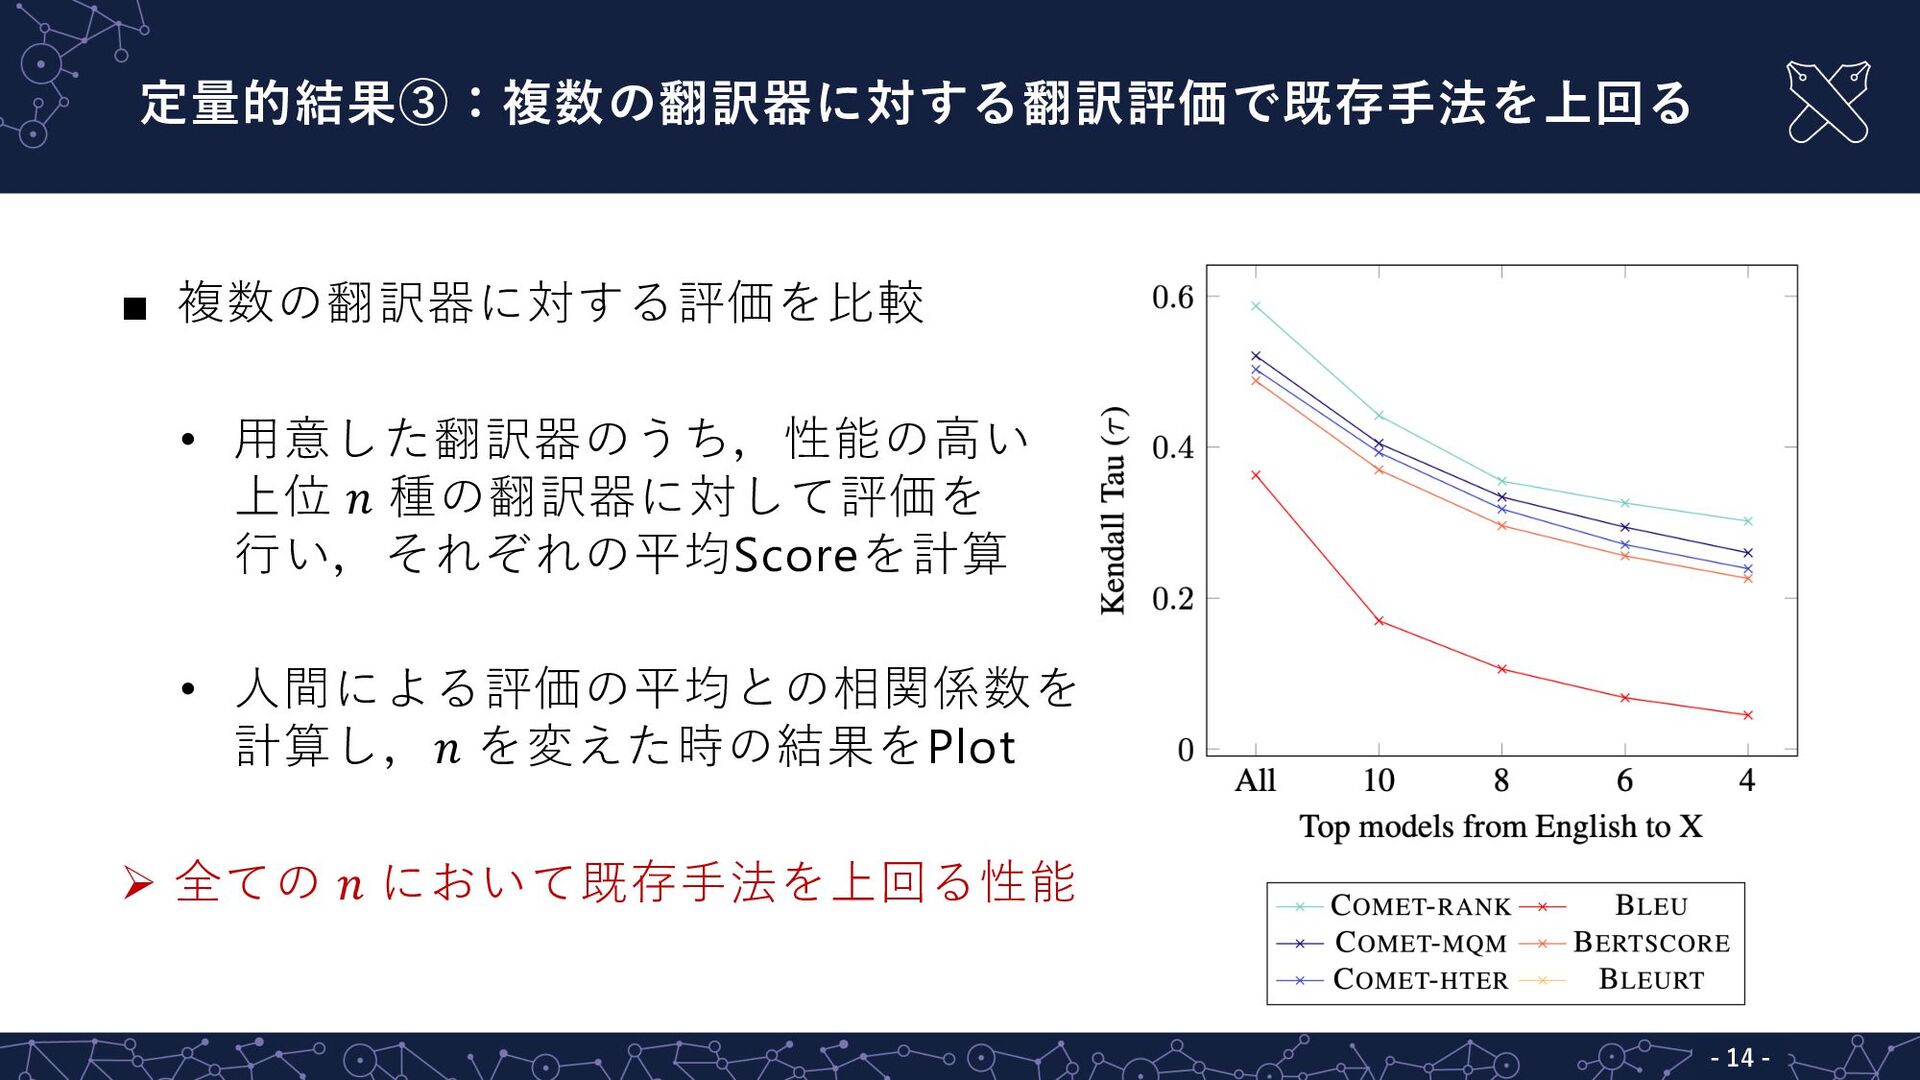
定量的結果③:複数の翻訳器に対する翻訳評価で既存⼿法を上回る - 14 - ▪ 複数の翻訳器に対する評価を⽐較 • ⽤意した翻訳器のうち,性能の⾼い 上位 !
種の翻訳器に対して評価を ⾏い,それぞれの平均Scoreを計算 • ⼈間による評価の平均との相関係数を 計算し,! を変えた時の結果をPlot Ø 全ての ! において既存⼿法を上回る性能
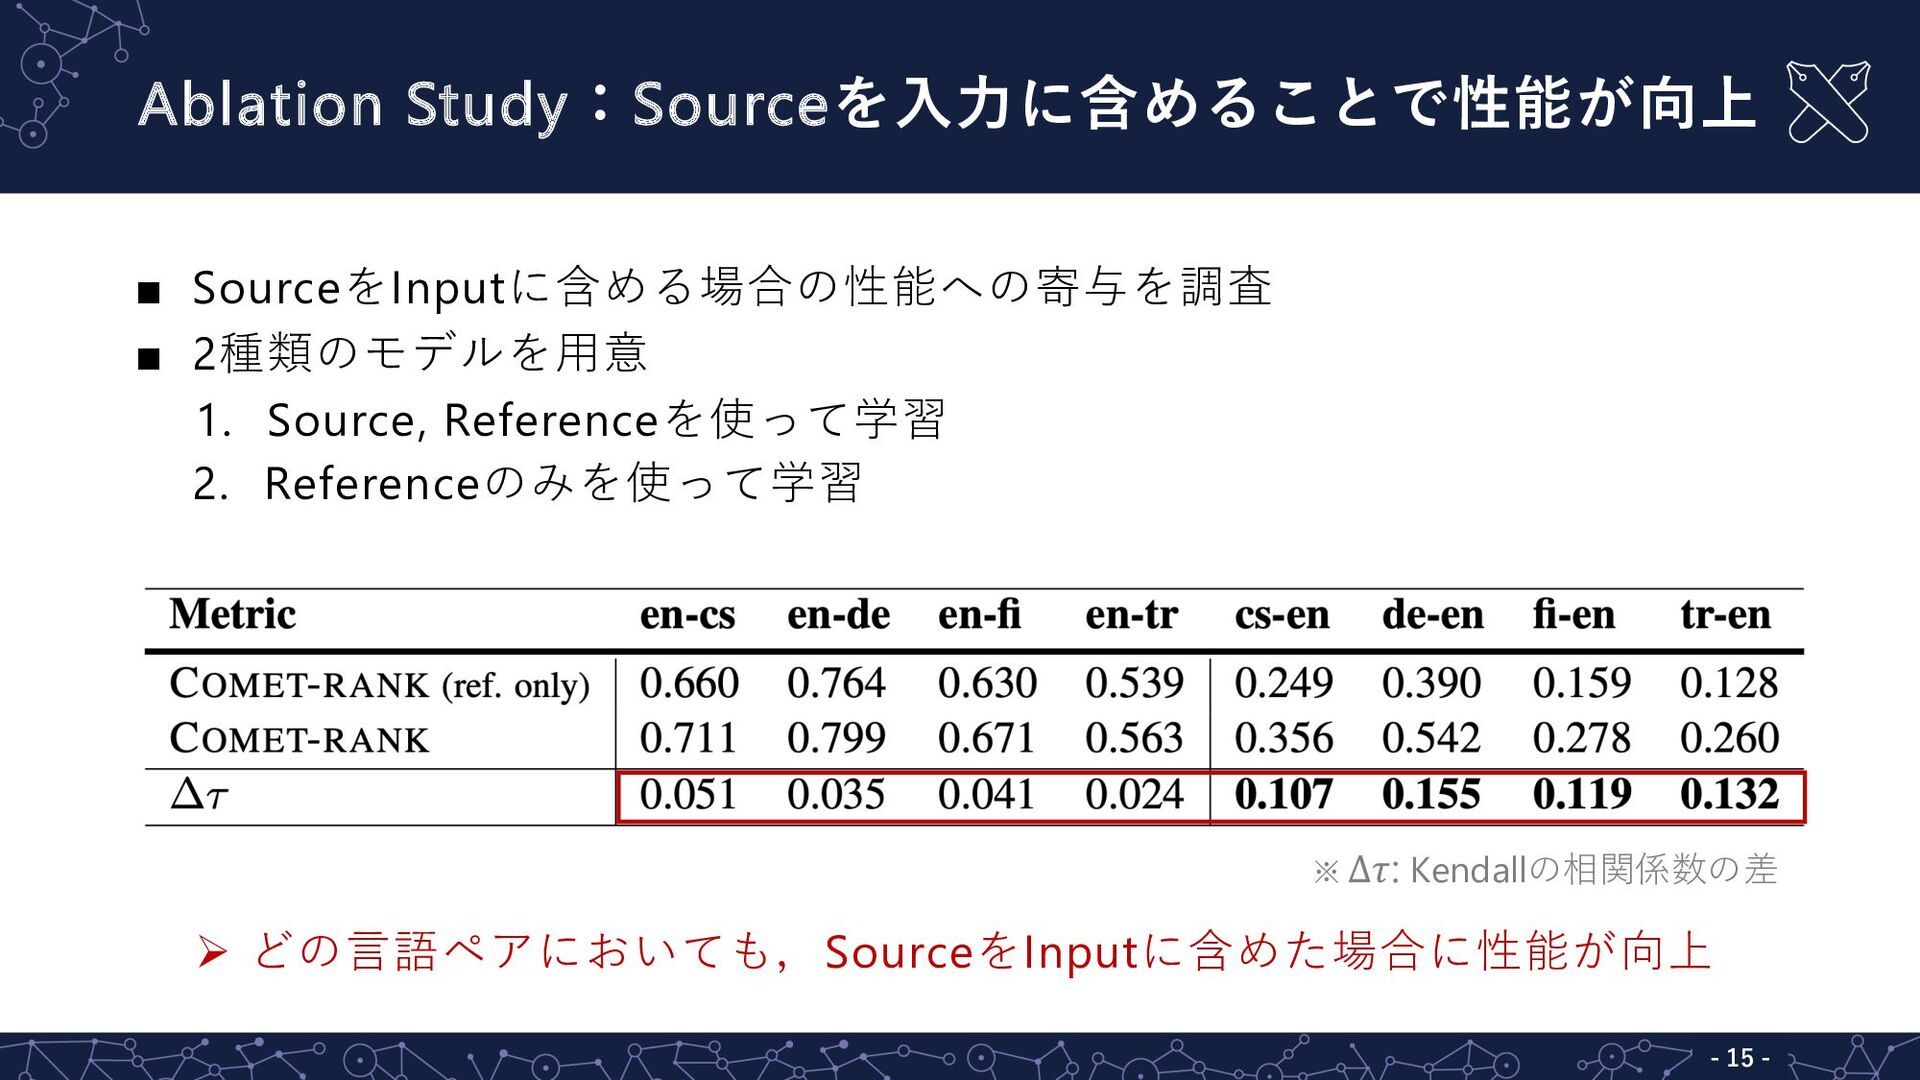
Ablation Study:Sourceを⼊⼒に含めることで性能が向上 - 15 - ▪ SourceをInputに含める場合の性能への寄与を調査 ▪ 2種類のモデルを⽤意 1.
Source, Referenceを使って学習 2. Referenceのみを使って学習 Ø どの⾔語ペアにおいても,SourceをInputに含めた場合に性能が向上 ※ ∆$: Kendallの相関係数の差
結論 - 18 - ▪ 問題点 • 機械翻訳の評価において,BLEUやMETEORといった Rule-basedの⼿法は,⼈間による評価との相関が低い ▪
提案⼿法 • 機械翻訳における学習可能な⾃動評価尺度COMETを提案 • Reference,Source,Hypothesisを⼊⼒とし,⼈間による評価を学習 ▪ 様々な機械翻訳評価タスクにおいて既存⼿法を上回る性能
Appendix:DA - 20 - ▪ DA (Direct Assessment)[Graham+, LAW13]:連続的な評価スケール Continuous
Measurement Scales [Graham+, LAW13] Continuous rating scale Likert-type scale
Appendix:TER, HTER - 21 - ▪ TER [Snover+, AMTA06]:事前に作成されたReferenceを⽤いて評価 ▪
HTER [Snover+, AMTA06] • 以下の処理により動的に新たなReferenceを⽣成して評価 • Step1:作業者にHypothesisとReferenceを提⽰ • Step2:作業者はReferenceをもとにHypothesisを編集し, 新たにTargeted Referenceを作成 • Step3:Targeted Referenceを⽤いてTERと同様にScoreを計算 ※S:ReferenceとHypothesisを⽐較した時の置換語数, I:ReferenceとHypothesisを⽐較した時の挿⼊語数 D:ReferenceとHypothesisを⽐較した時の脱落語数, M : 単語もしくは単語列のシフト回数 T:Referenceの単語数
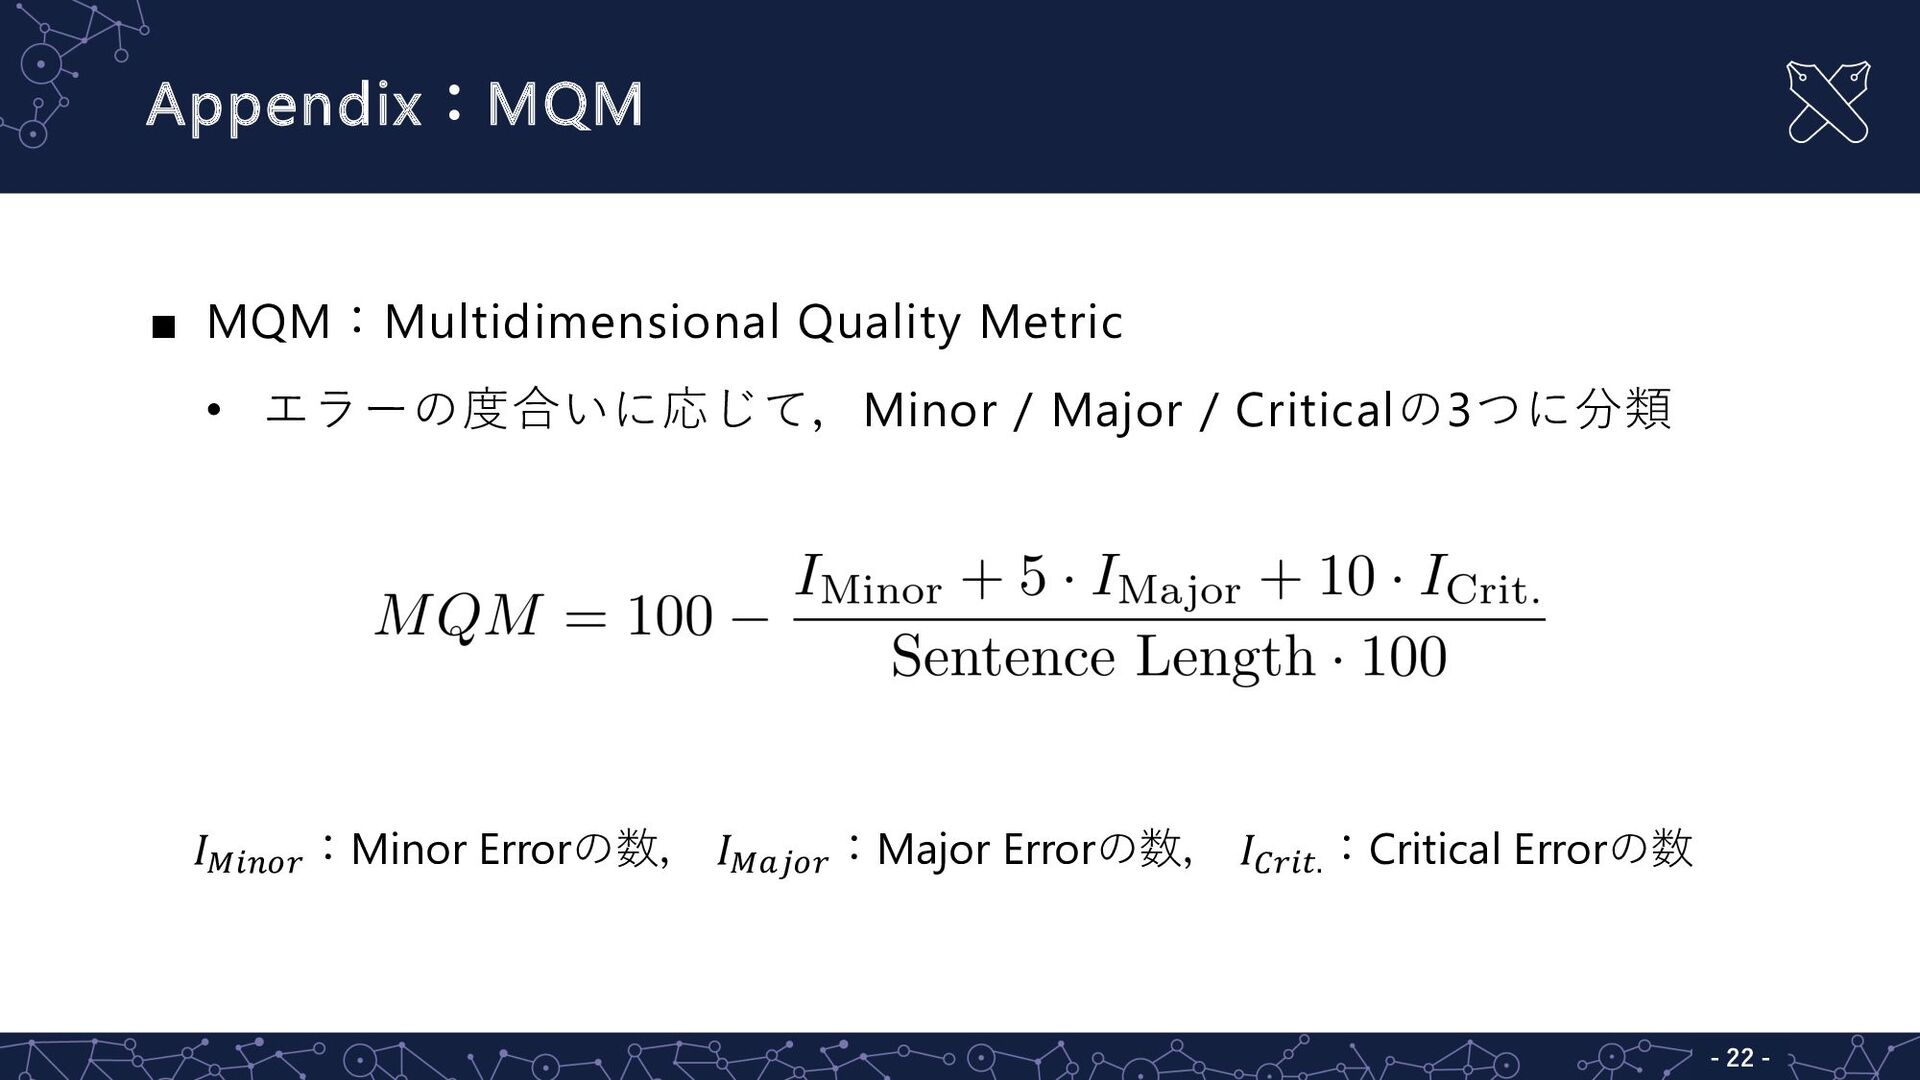
Appendix:MQM - 22 - ▪ MQM:Multidimensional Quality Metric • エラーの度合いに応じて,Minor
/ Major / Criticalの3つに分類 !!"#$% :Minor Errorの数, !!&'$% :Major Errorの数, !(%"). :Critical Errorの数
Appendix:BERT Score - 23 - ▪ BERT Score [Zhang+, ICLR20]
• 事前学習されたBERT [Devlin+, NAACL19]から得られる ベクトル表現を利⽤して,トークン間のcos類似度を計算 • 最後にPrecision, Recall, F値を計算
Appendix:BLEU - 24 - ▪ BLEU [Papineni+, ACL02] • !-gramのうち,どの程度が正解テキストに含まれているかを評価
• 出⼒テキストの⻑さに対する制約であるBP (Brevity Penalty)を導⼊ BLEU = BP× exp / !"# $ 0! log 4! = 短い翻訳へのPenalty × 9 − gram精度の幾何平均 ただし, LM = N 1 if P ≥ R S(#&'/)) if P ≤ R , 0! = ∑+ 5−gramの⼀致数 ∑+ 全5−gram数 P : 翻訳⽂の⻑さ R : referenceの⻑さ ,! : 重み (Baselineでは,! = 1/N)
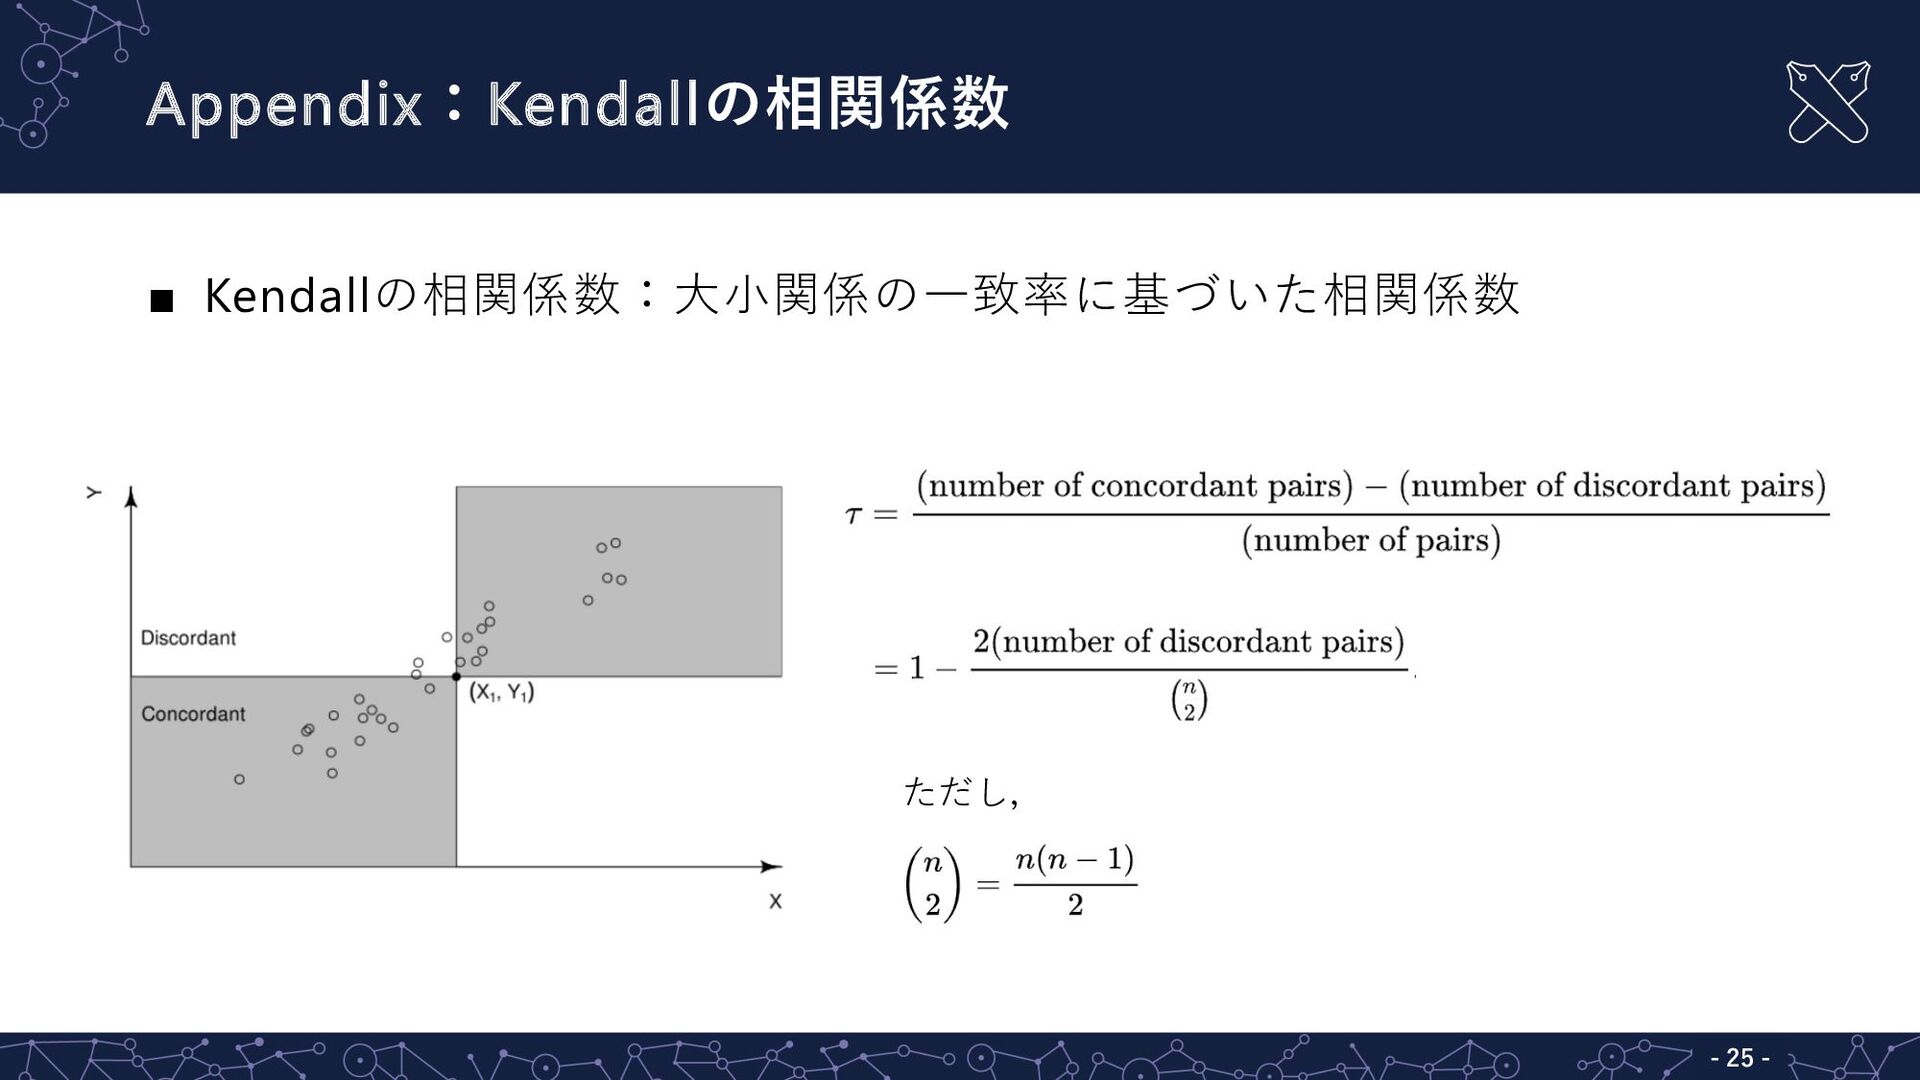
Appendix:Kendallの相関係数 - 25 - ▪ Kendallの相関係数:⼤⼩関係の⼀致率に基づいた相関係数 ただし,


 keio_smilab
 dora56
 maguroalternative
 philipz
 kaidouji85
 nakanao
 uhyo
 tatetate55
 22mi
 nakamuuu
 keitah
 matsuji
 ytaka23
 uxyall
 hannesfritz
 jct
 mojombo
 honnibal
 skoyamalab
 bkeepers
 katarinadahlin
 tmiket
 samlambert
 akademiya2063
 frankvandijk