Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Kubernetes実践トラブルシューティング
Search
Satoru Takeuchi
PRO
August 26, 2021
Technology
10k
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Kubernetes実践トラブルシューティング
以下イベントの発表資料です。
https://k8sjp.connpass.com/event/218143/
Satoru Takeuchi
PRO
August 26, 2021
More Decks by Satoru Takeuchi
See All by Satoru Takeuchi
119-多機能ファイルシステムBtrfs_のコピー.pdf
sat
PRO
1
67
Linuxカーネルの インタフェースは変わりうる?
sat
PRO
1
92
あなたの知らないバージョン命名規則
sat
PRO
3
890
Rook: Intro and Deep Dive with Ceph
sat
PRO
1
64
Machine Check Exception
sat
PRO
2
66
バイナリダンプの模様を読む
sat
PRO
0
89
cpコマンドはディスク上でデータを コピーしないことがある
sat
PRO
3
87
114-ファイルのshallow_copy.pdf
sat
PRO
2
57
113-Btrfsのスナップショット.pdf
sat
PRO
0
40
Other Decks in Technology
See All in Technology
家のリアーキテクト・リファクタリング
suguruooki
0
130
[2026-09-11]SREは誰のもの?運用エンジニアが始める 「SRE領域への越境」とチームの進化の軌跡 〜Road to NEXT CRE
tosite
0
170
20260906 「AWS運用入門」著者が教える、運用業務への生成AI活用入門
masaruogura
0
260
Snowflakeのコスト最適化を支えるアーキテクチャ設計
ktatsuya
1
1.5k
GoCon2026 - Open Source, Open World
sanposhiho
4
3.4k
Multica × 長期記憶:40個のミニプロジェクト管理
eiei114
1
260
フルカイテン株式会社 エンジニア向け採用資料
fullkaiten
0
12k
プロダクト思考 × 基盤思考を AIで実現する Compound Engineering
tkc66buzz
1
330
synctest時代のhttptest Go 1.27で変わるHTTPサーバテストの裏側 / go conference2026 synctest and httptest
budougumi0617
1
2.7k
全員がプロダクトへ向き合う組織を持続成長させるために——組織づくりのフライホイールと4象限 / The Flywheel Model and Four Quadrants for Organizational Design
hiro_torii
4
990
登壇の自信を奪う3匹のオバケ / 3 Ghosts That Rob You of Your Confidence in Public Speaking
pauli
3
310
日経電子版を支えていく Kasane Design System/fec_fukuoka
nikkei_engineer_recruiting
0
990
Featured
See All Featured
Build your cross-platform service in a week with App Engine
jlugia
234
19k
Become a Pro
speakerdeck
PRO
31
6.2k
Being A Developer After 40
akosma
91
590k
Evolving SEO for Evolving Search Engines
ryanjones
0
280
How to make the Groovebox
asonas
2
2.4k
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
430
Raft: Consensus for Rubyists
vanstee
141
7.7k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Designing Experiences People Love
moore
143
24k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
500
Have SEOs Ruined the Internet? - User Awareness of SEO in 2025
akashhashmi
0
500
Six Lessons from altMBA
skipperchong
29
4.5k
Transcript
Kubernetes 実践トラブルシューティング Aug. 26th, 2021 sat@サイボウズ ストレージチーム 1
はじめに ▌サイボウズのインフラ基盤はKubernetesクラスタ ▌ストレージもK8sクラスタ上に構築 ⚫Rook/Ceph(後述)によって分散ストレージを提供 ▌ストレージ開発中に発生した問題を例にトラブル シューティングのノウハウを共有 ⚫ストレージ、Rook/Cephについての前提知識は不要 2
このセッションで学べること ▌実際に起きた問題のトラブルシューティングの流れ ▌なぜその調査をしたのか、という思考プロセス ▌ログやメトリクスの重要性 3
もくじ ▌Rook/Ceph概要 ▌サイボウズのRook/Cephクラスタと監視/ログ基盤 ▌トラブル解析事例 ▌まとめ 4
Rook/Ceph概要 5
Cephとは ▌OSSのスケーラブルな分散ストレージ ⚫多くの種類のストレージを提供可能(後述) ⚫ペタバイトスケールのデータを扱える ▌20年以上にわたって幅広く使われてきた ⚫CERN, NASA ▌主な開発元はRed Hat ⚫Red
Hat Ceph Storageなどの製品を提供 6
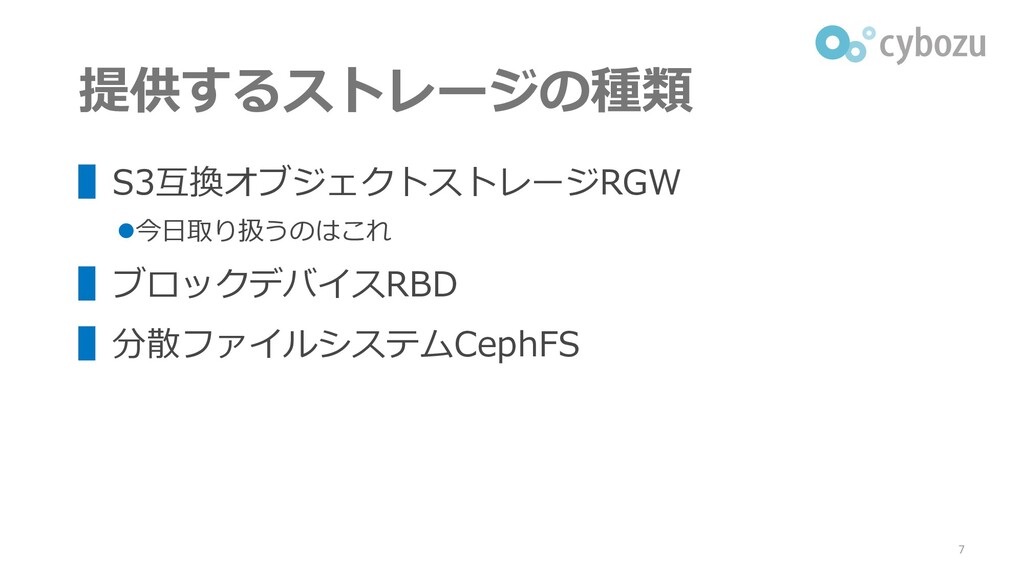
提供するストレージの種類 ▌S3互換オブジェクトストレージRGW ⚫今日取り扱うのはこれ ▌ブロックデバイスRBD ▌分散ファイルシステムCephFS 7
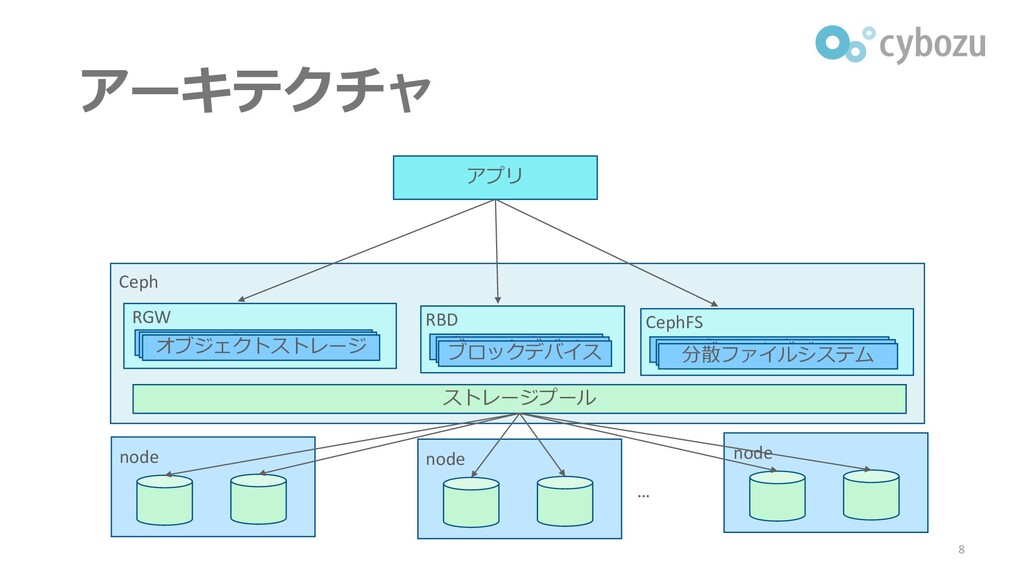
アーキテクチャ 8 アプリ ストレージプール Ceph node node node … RBD
RGW ブロックデバイス オブジェクト ブロックデバイス ブロックデバイス オブジェクト オブジェクトストレージ CephFS ブロックデバイス ブロックデバイス 分散ファイルシステム
▌RGWが提供するendpointにアプリがアクセス オブジェクトストレージの使い方 9 Rook/Cephクラスタ アプリ RGW daemon
Rookとは ▌Kubernetes上で動作するCephのオーケストレータ ⚫CNCFのgraduated Project ▌主な開発元 ⚫Red Hat, サイボウズ ▌製品 ⚫Red
Hat OpenShift Container Storage 10
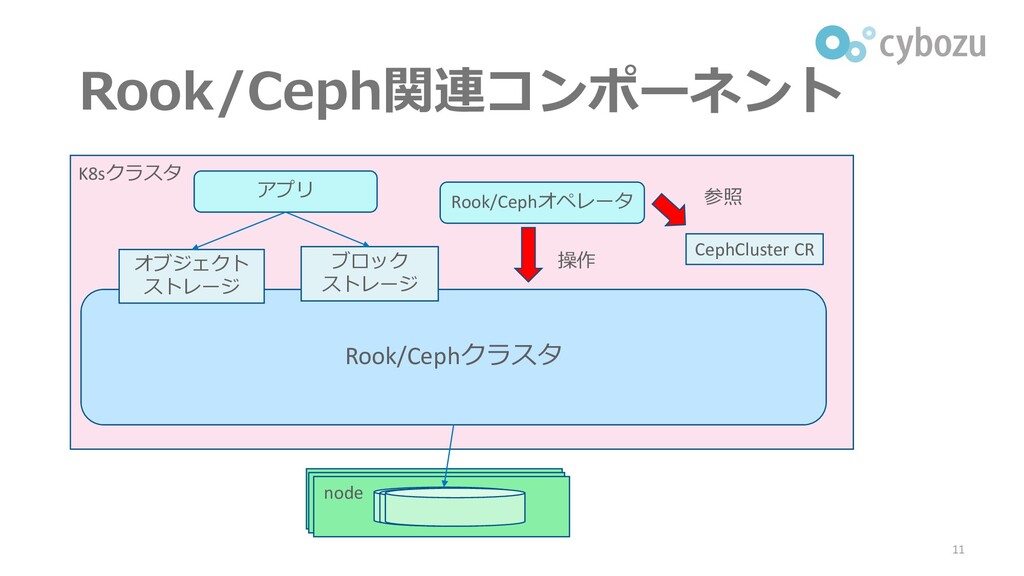
Rook/Ceph関連コンポーネント 11 K8sクラスタ Rook/Cephクラスタ オブジェクト ストレージ ブロック ストレージ HDD node
HDD アプリ Rook/Cephオペレータ CephCluster CR 操作 参照
オブジェクトストレージの使い方 12 K8sクラスタ Rook/Cephクラスタ アプリのPod RGW Pod
サイボウズの Rook/Cephクラスタと監視/ログ基盤 13
なぜRook/Cephなのか ▌商用製品はできれば避けたい ⚫ユーザデータは極めて重要 ⚫データ消失するとお客様もサイボウズも大ダメージ ⚫無いものは無い。取り返しがつかない ⚫商用製品には勝手に手を入れられない ⚫トラブル発生時にとれる手段が減る ▌OSSの自前運用が有力な選択肢 ⚫Rook/Cephが要件を満たしていた 14
サイボウズのRook/Cephクラスタ 15 K8sクラスタ Rook/Cephクラスタ (HDD) オブジェクト ストレージ ブロック ストレージ HDD
node node SSD HDD HDD SSD NVMe SSD アプリ Rook/Cephクラスタ (NVMe SSD) ブロック ストレージ
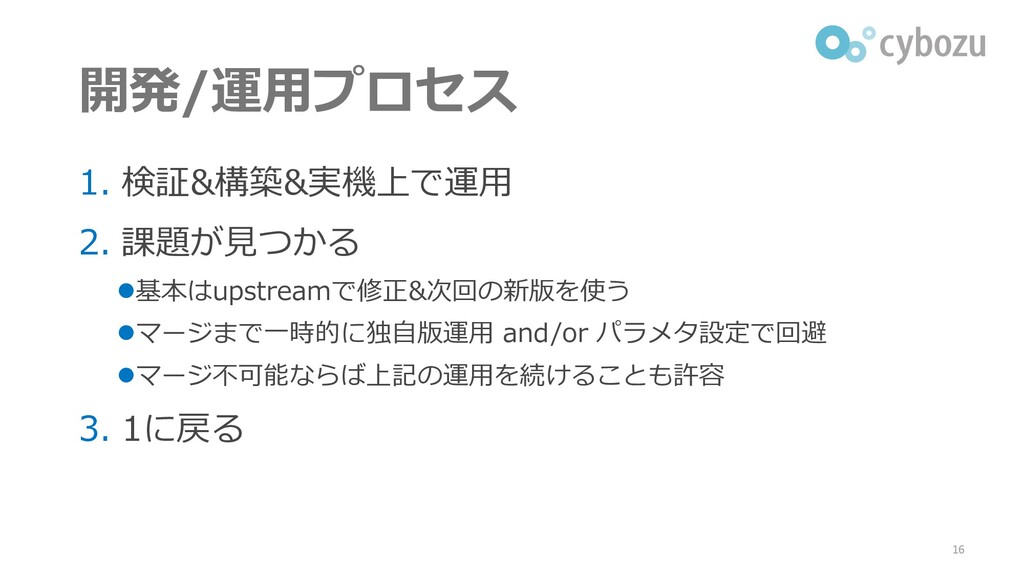
開発/運用プロセス 1. 検証&構築&実機上で運用 2. 課題が見つかる ⚫基本はupstreamで修正&次回の新版を使う ⚫マージまで一時的に独自版運用 and/or パラメタ設定で回避 ⚫マージ不可能ならば上記の運用を続けることも許容
3. 1に戻る 16
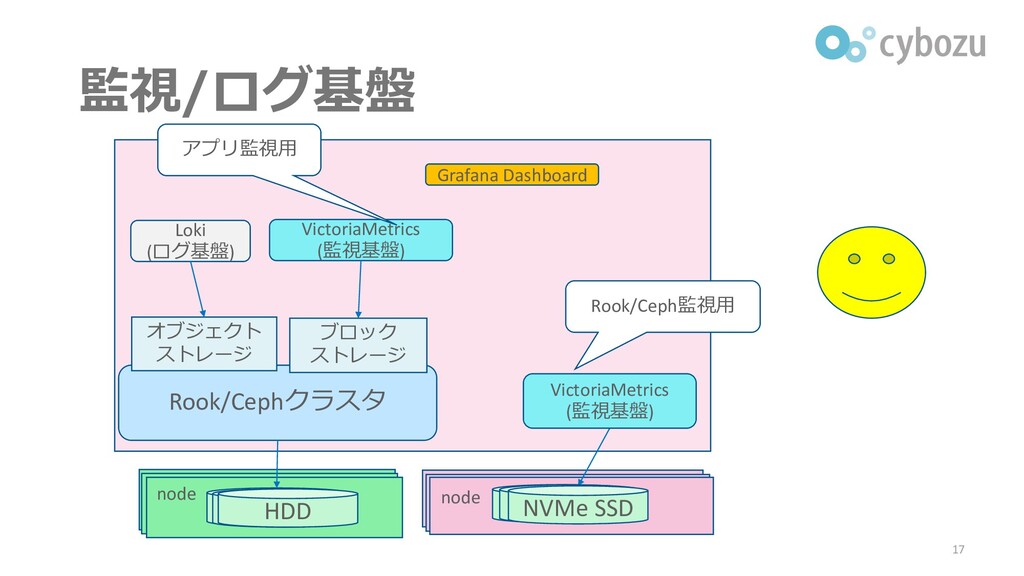
監視/ログ基盤 17 Rook/Cephクラスタ Loki (ログ基盤) VictoriaMetrics (監視基盤) オブジェクト ストレージ ブロック
ストレージ HDD node node SSD HDD HDD SSD NVMe SSD VictoriaMetrics (監視基盤) Grafana Dashboard アプリ監視用 Rook/Ceph監視用
監視/ログ基盤の使い方(1/4) 18 Rook/Cephクラスタ Loki (ログ基盤) オブジェクト ストレージ HDD node node
SSD HDD HDD SSD NVMe SSD VictoriaMetrics (監視基盤) Grafana Dashboard ①メトリクス収集 ①ログ収集
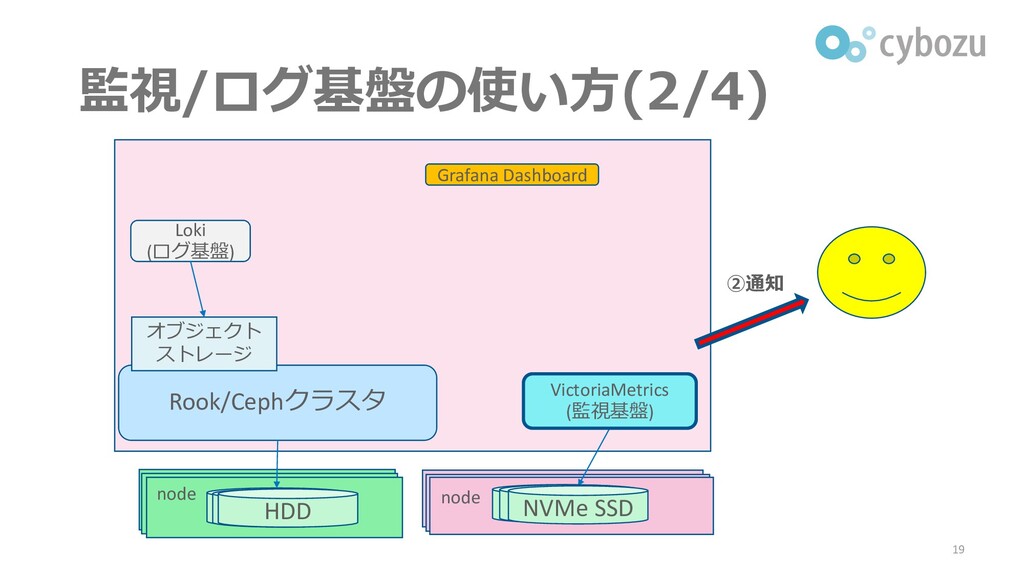
監視/ログ基盤の使い方(2/4) 19 Rook/Cephクラスタ Loki (ログ基盤) オブジェクト ストレージ HDD node node
SSD HDD HDD SSD NVMe SSD VictoriaMetrics (監視基盤) Grafana Dashboard ②通知
監視/ログ基盤の使い方(3/4) 20 Rook/Cephクラスタ Loki (ログ基盤) オブジェクト ストレージ HDD node node
SSD HDD HDD SSD NVMe SSD VictoriaMetrics (監視基盤) Grafana Dashboard ③操作
監視/ログ基盤の使い方(4/4) 21 Rook/Cephクラスタ Loki (ログ基盤) オブジェクト ストレージ HDD node node
SSD HDD HDD SSD NVMe SSD VictoriaMetrics (監視基盤) Grafana Dashboard ④クエリ発行
監視/ログ基盤の嬉しさ ▌システムのログやメトリクスを一か所に保存できる ▌システム全体の長期的な挙動がわかる ⚫ 「正常なときと異常なときと何が違うか」など ⚫ クエリ言語(PromQL, LogQL)により一括して情報を取得可能 ▌システムにおかしなことがあれば技術者に通知できる ⚫
技術者が常にダッシュボードを監視していなくてよい 22
トラブル解析事例 23
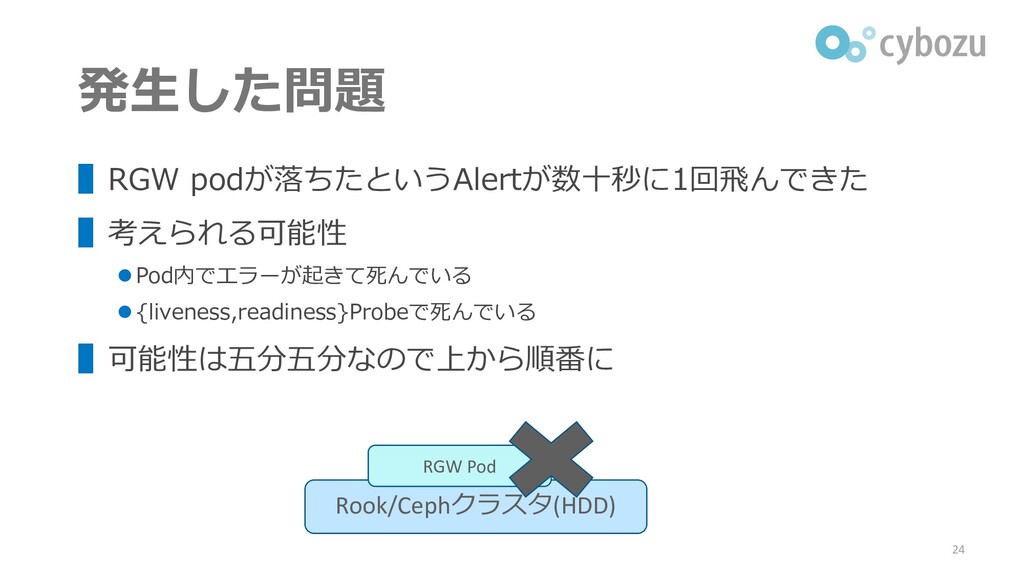
発生した問題 ▌RGW podが落ちたというAlertが数十秒に1回飛んできた ▌考えられる可能性 ⚫ Pod内でエラーが起きて死んでいる ⚫ {liveness,readiness}Probeで死んでいる ▌可能性は五分五分なので上から順番に 24
Rook/Cephクラスタ(HDD) RGW Pod
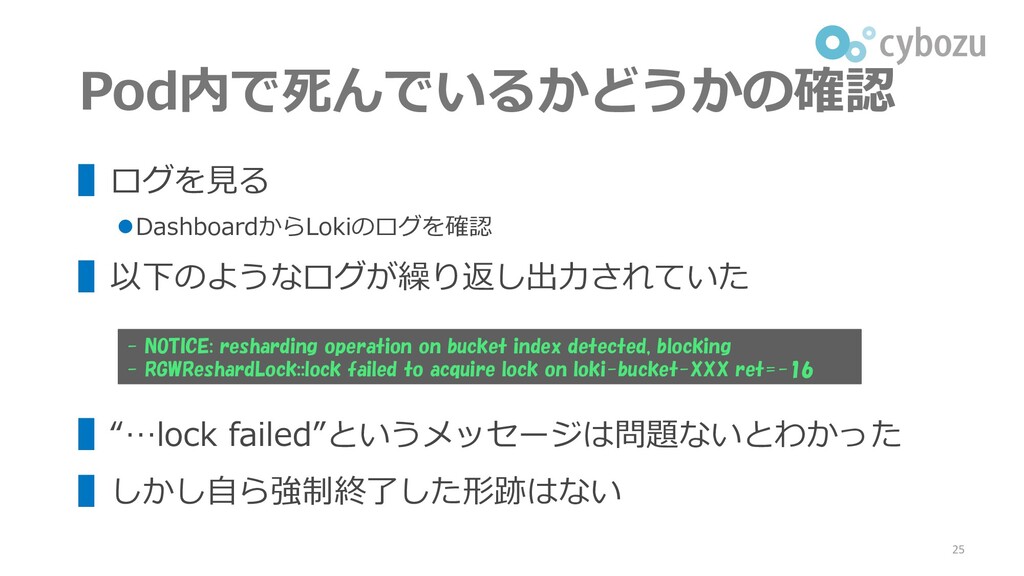
Pod内で死んでいるかどうかの確認 ▌ログを見る ⚫DashboardからLokiのログを確認 ▌以下のようなログが繰り返し出力されていた ▌“…lock failed”というメッセージは問題ないとわかった ▌しかし自ら強制終了した形跡はない - NOTICE: resharding
operation on bucket index detected, blocking - RGWReshardLock::lock failed to acquire lock on loki-bucket-XXX ret=-16 25
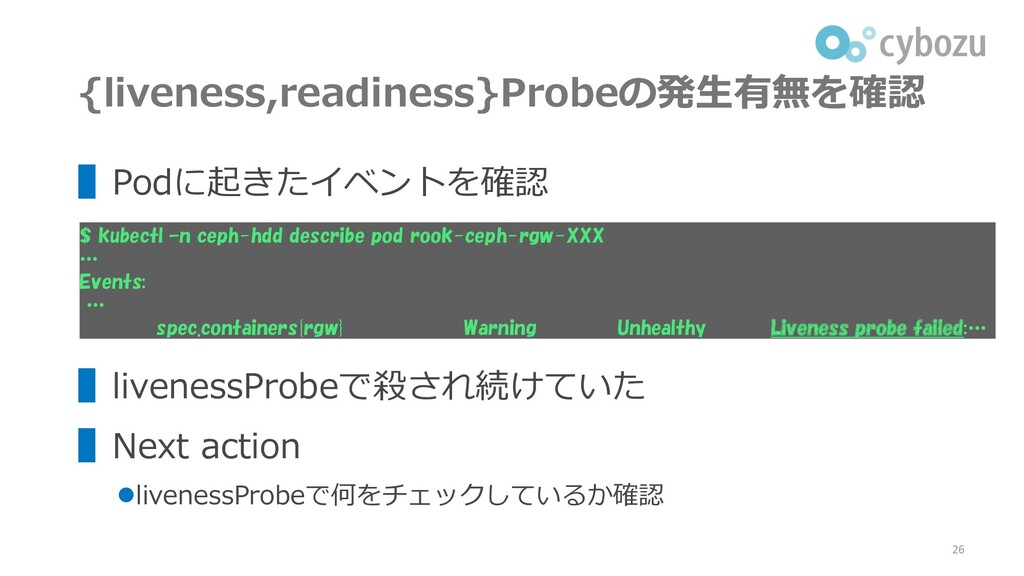
{liveness,readiness}Probeの発生有無を確認 ▌Podに起きたイベントを確認 ▌livenessProbeで殺され続けていた ▌Next action ⚫livenessProbeで何をチェックしているか確認 $ kubectl –n ceph-hdd
describe pod rook-ceph-rgw-XXX … Events: … spec.containers{rgw} Warning Unhealthy Liveness probe failed:… 26
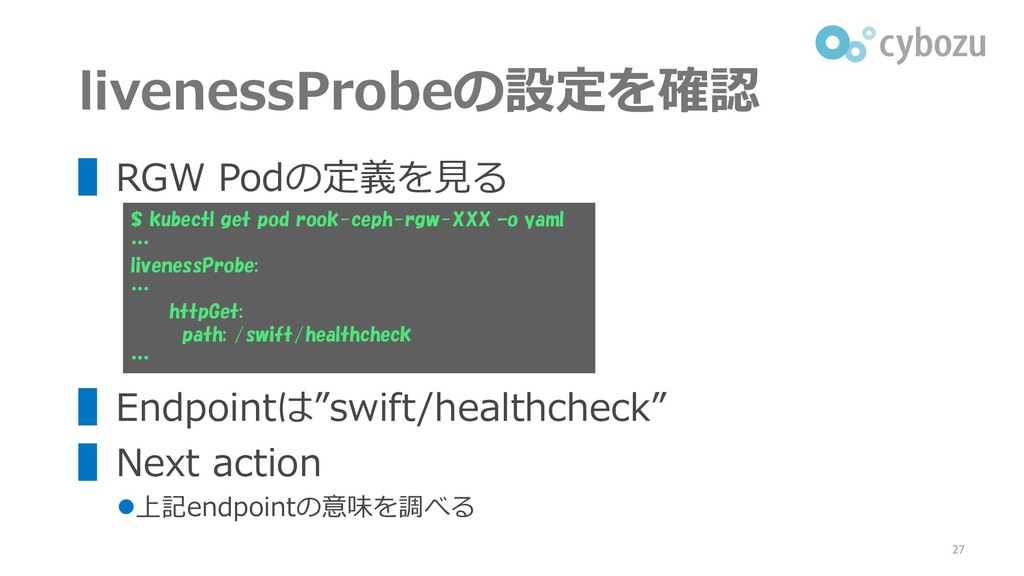
livenessProbeの設定を確認 ▌RGW Podの定義を見る ▌Endpointは”swift/healthcheck” ▌Next action ⚫上記endpointの意味を調べる $ kubectl get
pod rook-ceph-rgw-XXX –o yaml … livenessProbe: … httpGet: path: /swift/healthcheck … 27
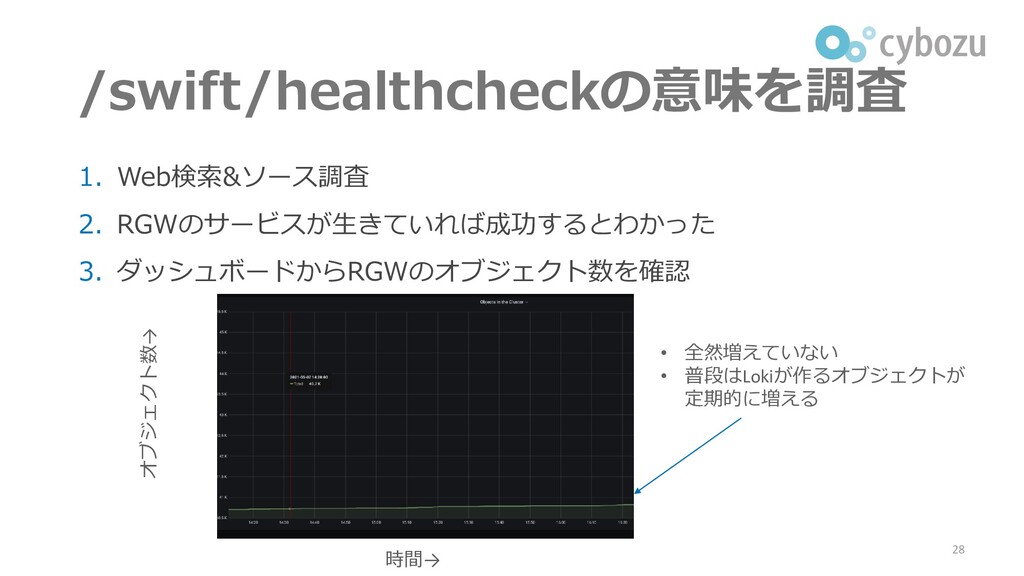
/swift/healthcheckの意味を調査 1. Web検索&ソース調査 2. RGWのサービスが生きていれば成功するとわかった 3. ダッシュボードからRGWのオブジェクト数を確認 28 オブジェクト数→ 時間→
• 全然増えていない • 普段はLokiが作るオブジェクトが 定期的に増える
状況の整理 ▌明らかになったこと 1. RGWのサービスが停止している 2. livenessProbeの使い方を間違えている ⚫ livenessProbe: Podの正常動作可否を確認 ⚫
readinessProbe: サービス提供可否を確認 ▌Next action ⚫重要度が高い①を先に調査 29
なぜサービスが停止するのかを調査 ▌RGW podのログを再び確認 ▌Dynamic resharding(後述)という処理が繰り返し動いている 0 block_while_resharding ERROR: bucket is
still resharding, please retry 0 check_bucket_shards: resharding needed: … 0 check_bucket_shards: resharding needed: … … 0 NOTICE: resharding operation on bucket index detected, blocking 0 RGWReshardLock::lock failed to acquire lock on reshard.0000000009 ret=-16 1 RGWRados::check_bucket_shards bucket loki-bucket-XXX needs resharding; … 30
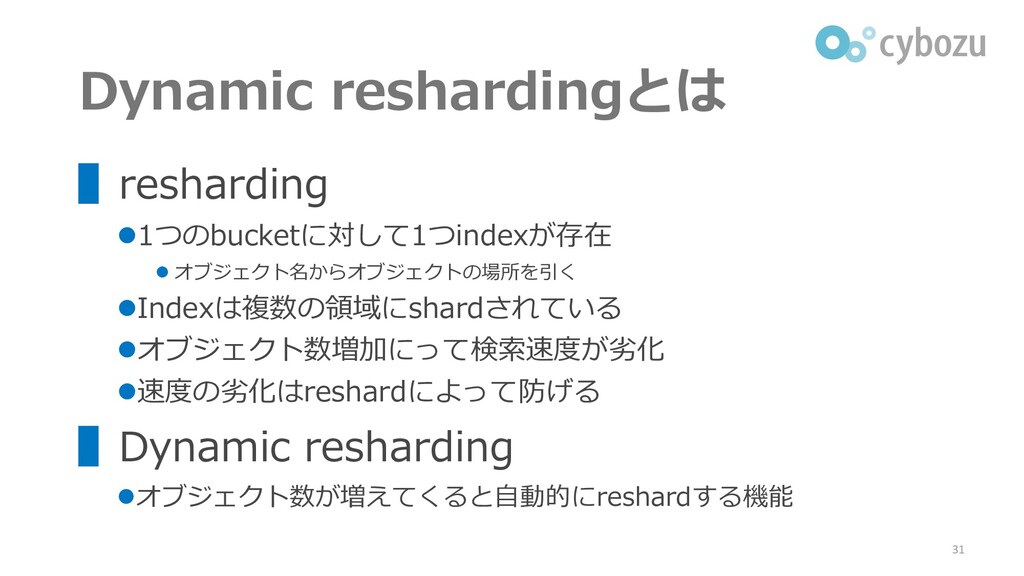
Dynamic reshardingとは ▌resharding ⚫1つのbucketに対して1つindexが存在 ⚫ オブジェクト名からオブジェクトの場所を引く ⚫Indexは複数の領域にshardされている ⚫オブジェクト数増加にって検索速度が劣化 ⚫速度の劣化はreshardによって防げる ▌Dynamic
resharding ⚫オブジェクト数が増えてくると自動的にreshardする機能 31
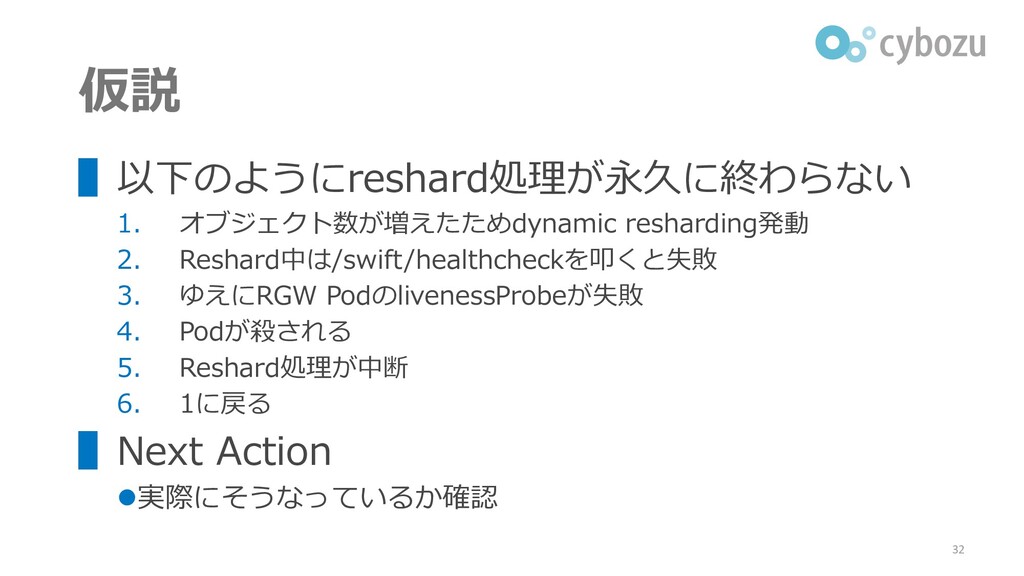
仮説 ▌以下のようにreshard処理が永久に終わらない 1. オブジェクト数が増えたためdynamic resharding発動 2. Reshard中は/swift/healthcheckを叩くと失敗 3. ゆえにRGW PodのlivenessProbeが失敗
4. Podが殺される 5. Reshard処理が中断 6. 1に戻る ▌Next Action ⚫実際にそうなっているか確認 32
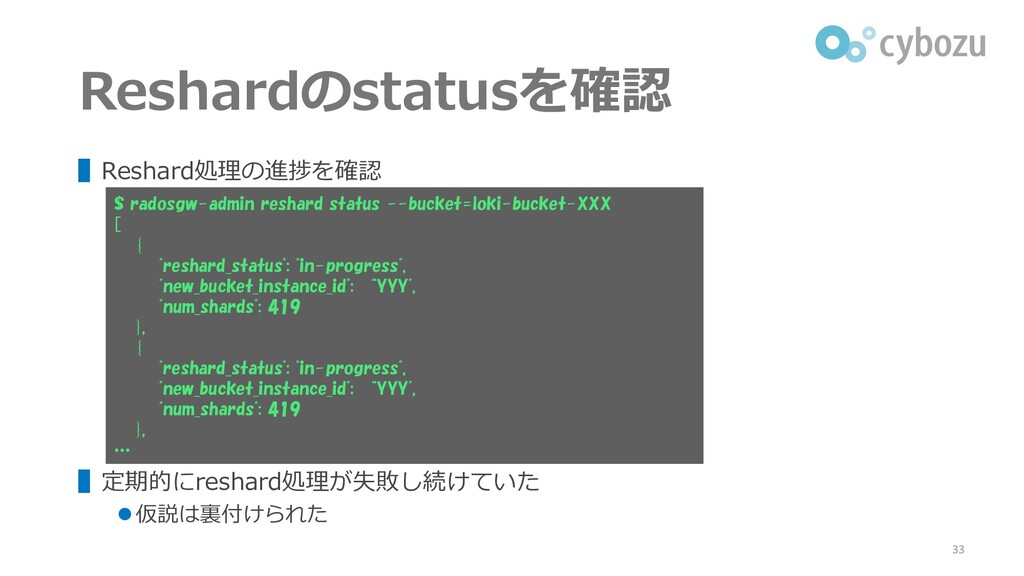
Reshardのstatusを確認 ▌Reshard処理の進捗を確認 ▌定期的にreshard処理が失敗し続けていた ⚫ 仮説は裏付けられた $ radosgw-admin reshard status --bucket=loki-bucket-XXX
[ { "reshard_status": "in-progress", "new_bucket_instance_id": “YYY", "num_shards": 419 }, { "reshard_status": "in-progress", "new_bucket_instance_id": “YYY", "num_shards": 419 }, … 33
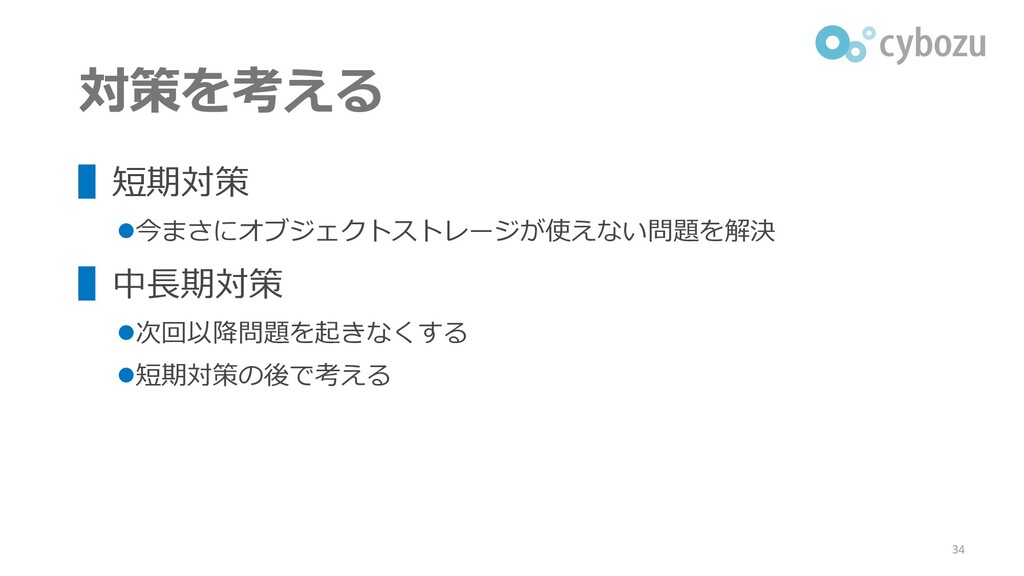
対策を考える ▌短期対策 ⚫今まさにオブジェクトストレージが使えない問題を解決 ▌中長期対策 ⚫次回以降問題を起きなくする ⚫短期対策の後で考える 34
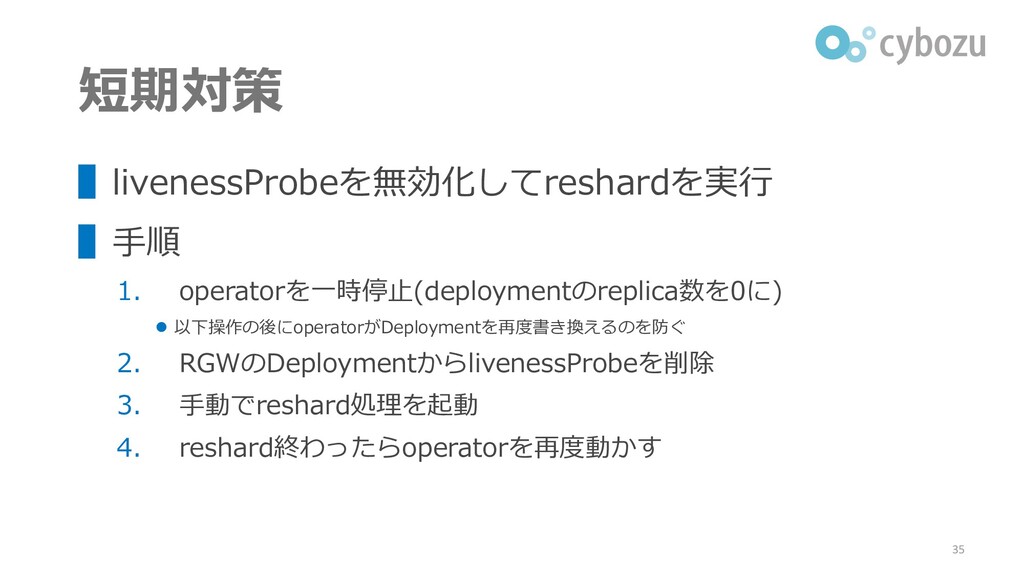
短期対策 ▌livenessProbeを無効化してreshardを実行 ▌手順 1. operatorを一時停止(deploymentのreplica数を0に) ⚫ 以下操作の後にoperatorがDeploymentを再度書き換えるのを防ぐ 2. RGWのDeploymentからlivenessProbeを削除 3.
手動でreshard処理を起動 4. reshard終わったらoperatorを再度動かす 35
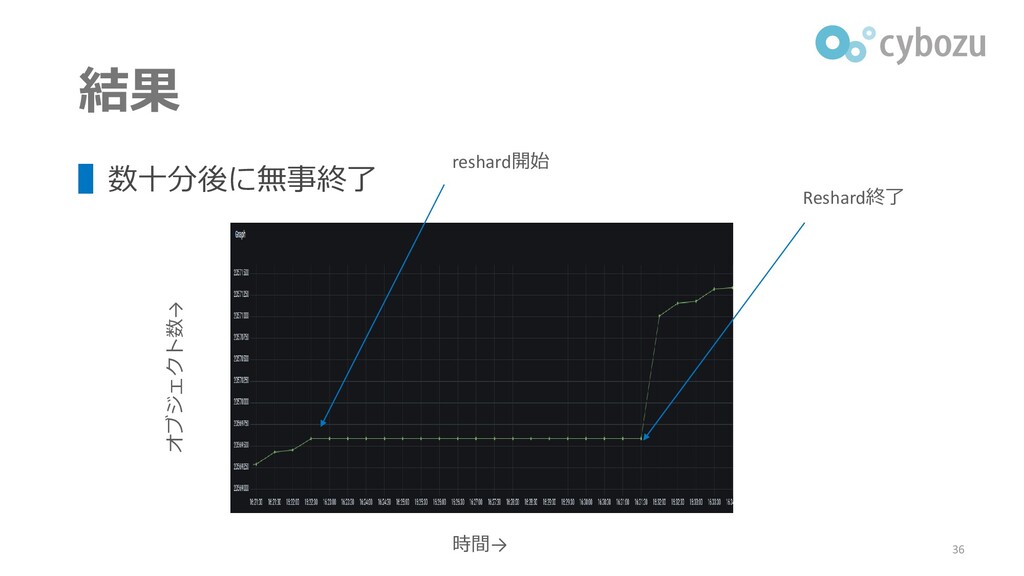
結果 ▌数十分後に無事終了 36 オブジェクト数→ 時間→ reshard開始 Reshard終了
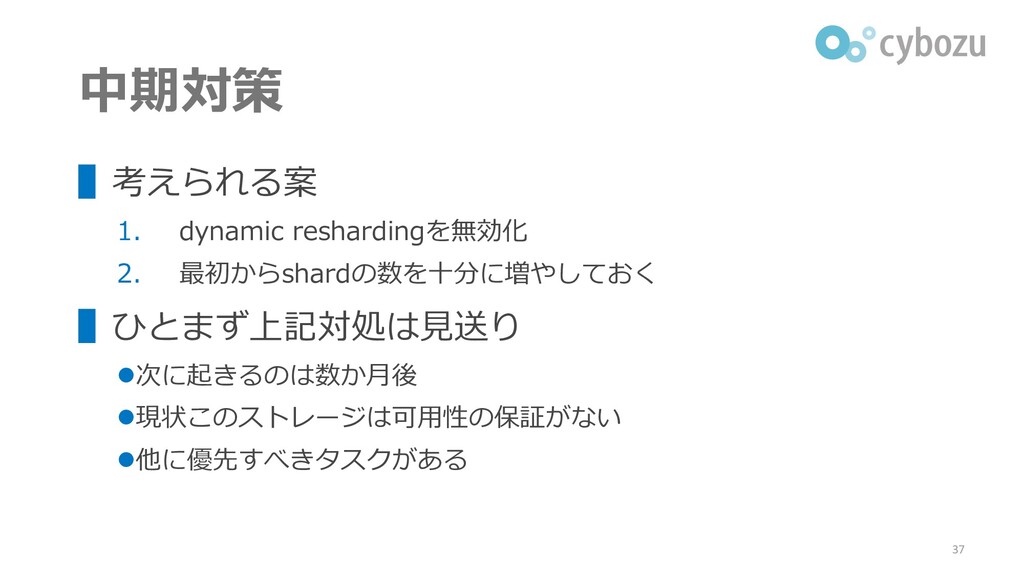
中期対策 ▌考えられる案 1. dynamic reshardingを無効化 2. 最初からshardの数を十分に増やしておく ▌ひとまず上記対処は見送り ⚫次に起きるのは数か月後 ⚫現状このストレージは可用性の保証がない
⚫他に優先すべきタスクがある 37
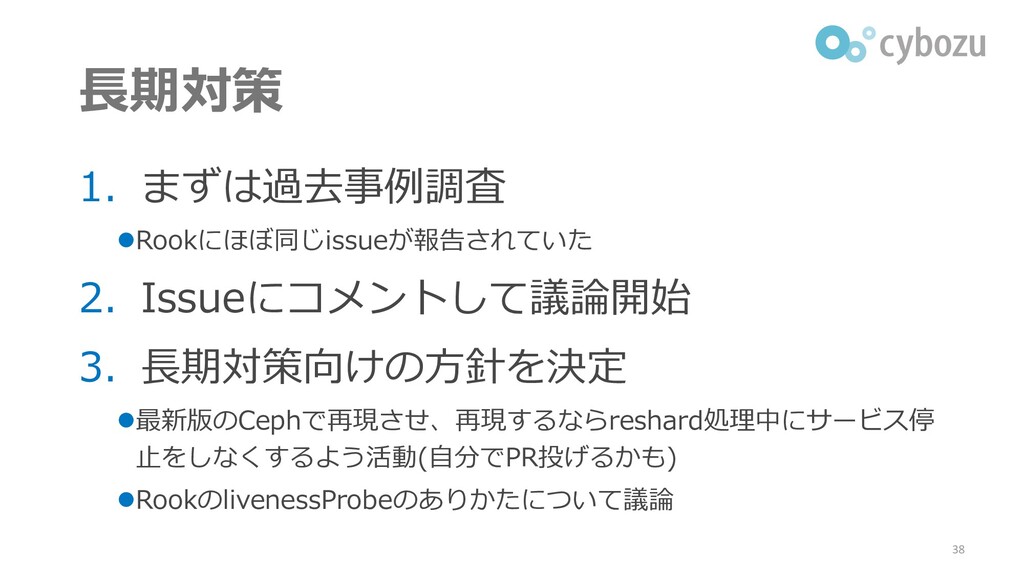
長期対策 1. まずは過去事例調査 ⚫Rookにほぼ同じissueが報告されていた 2. Issueにコメントして議論開始 3. 長期対策向けの方針を決定 ⚫最新版のCephで再現させ、再現するならreshard処理中にサービス停 止をしなくするよう活動(自分でPR投げるかも)
⚫RookのlivenessProbeのありかたについて議論 38
得られたもの ▌今後同じ問題を回避できるようになった ▌技術者の経験値が上がった ⚫今後の類似トラブル調査に当たりがつくようになった 39
その他トラシュー用のTIPS ▌システムに対して「いつ」「何をしたか」を常に記録 ⚫何か起きたときに発生契機を突き止めるためのヒントになる ▌調査中のログも可能な限り残す ⚫今後の調査に役立つ ▌最後にwikiなどにまとめる ⚫色々なところに情報が散らばっていると後から追いにくい ⚫そのうち記憶が無くなる 40
まとめ 41
学んだこと ▌実際に起きた問題のトラブルシューティングの流れ ▌なぜその調査をしたのか、という思考プロセス ▌ログやメトリクスの重要性 42
今後について ▌やること ⚫性能チューニング&可用性を高める ⚫技術者を育てる ⚫機能追加 ⚫ リモートレプリケーション ⚫ バックアップ/リストア ⚫既存データの移行
▌一緒に働いてくれるかたを募集中! 43
44 おわり


 sat
 suguruooki
 tosite
 masaruogura
 ktatsuya
 sanposhiho
 eiei114
 fullkaiten
 tkc66buzz
 budougumi0617
 hiro_torii
 pauli
 nikkei_engineer_recruiting
 jlugia
 speakerdeck
 akosma
 ryanjones
 asonas
 apolaine
 vanstee
 honnibal
 moore
 jct
 akashhashmi
 skipperchong